
Arquitecto de automatización con IA: Día 1
 Jeshua Romero Guadarrama
- 55 Min para leer
- 01 Feb, 2026
Índice de contenido
Resumen:
Automatizar no empieza en una plataforma, sino en un proceso medido. En esta primera entrada de la serie conocerá Trigo Lento, una panadería de masa madre que recibe 468 encargos al mes por cuatro canales y los apunta a mano, y a Valeria, Don Ernesto y Marisol, que la acompañarán durante 89 días con un presupuesto de 45 USD al mes. Verá qué es la automatización de procesos de negocio y en qué se distingue de la digitalización, de la RPA y de la BPM; medirá con Python cuánto cuesta el proceso de encargos (46.8 horas al mes y 54 minutos de espera en la hora pico) y terminará con una matriz que dice qué automatizar primero y con las cinco preguntas que un arquitecto se hace antes de construir.
¿Cómo citar el presente artículo?
Romero, J. (1 de febrero de 2026). Arquitecto de automatización con IA: Día 1. python-data-engineer. https://www.python-data-engineer.com/post/aai/dia_1/.
Arquitecto de automatización con IA: Día 1 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/aai/dia_1/.
Precios, límites y políticas de Make, n8n, Zapier, WhatsApp (Meta, Twilio, Wati) y de la API de Claude revisados en octubre de 2026. En este primer día no se llama a ningún servicio: todos los bloques de código se ejecutan sin red y sus salidas son las reales.
Día 1. Qué es la automatización de procesos y cómo piensa un arquitecto
Introducción
Esta serie tiene una promesa sencilla de enunciar y exigente de cumplir: aprenderá a diseñar, construir y gobernar automatizaciones con IA para un negocio real, desde el primer disparador hasta un ecosistema de agentes autónomos. Durante 89 días, del 1 de febrero al 30 de abril de 2026, seguirá a una panadería de la Ciudad de México mientras pasa de la libreta a un sistema de flujos que reciben pedidos, confirman entregas, facturan y redactan con ayuda de un modelo de lenguaje, siempre con una persona al mando.
Es sábado, son las 10:30 de la mañana y en el mostrador de Trigo Lento huele a hogaza recién salida del horno. Valeria, que lleva la administración, tiene el teléfono en una mano y la libreta de encargos en la otra. En la pantalla hay 14 mensajes sin leer: una clienta quiere “un pastel de chocolate para el sábado” sin decir de qué tamaño ni a qué hora; alguien pregunta por Instagram cuánto cuesta el pay de queso; la Cafetería Brújula pide que le confirmen las 40 baguettes del lunes; el formulario de la página web trae un pedido de bollos para hamburguesa con la dirección incompleta. Mientras contesta el primero, el teléfono fijo suena. Cada mensaje acaba en la libreta, después en una hoja de cálculo, después en un papel que alguien lleva al obrador.
Valeria lleva semanas pensando que esto se puede hacer mejor. Su padre, Don Ernesto, maestro panadero y dueño, la escucha con los brazos cruzados y la masa todavía en las uñas: “Valeria, aquí el pan se hace con las manos, no con botones. ¿Usted de verdad cree que una máquina va a saber atender a nuestros clientes?” Es una objeción razonable, y esta serie no la va a despachar con entusiasmo. La va a responder con números, y en algunos puntos le va a dar la razón.
En la presente entrada, descubrirá qué es la automatización de procesos de negocio y en qué se distingue de digitalizar, de la automatización robótica de procesos y de la gestión de procesos. Conocerá Trigo Lento, su catálogo, su gente y su presupuesto de 45 USD al mes, y verá el mapa de los 8 módulos de la serie. Después medirá con Python el proceso de encargos paso a paso: cuántos minutos cuesta cada pedido, cuántas horas y cuántos pesos se van al mes, cuánto espera un cliente en la hora pico según la teoría de colas y según una simulación, y por qué canales llegan los encargos. Al final construirá una matriz de priorización que dice qué proceso automatizar primero y aplicará las cinco preguntas que distinguen a un arquitecto de automatización de alguien que solo conecta aplicaciones.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Definir la automatización de procesos de negocio (BPA, por sus siglas en inglés: “Business Process Automation”) y distinguirla de la digitalización, de la automatización robótica de procesos (RPA) y de la gestión de procesos (BPM).
- Describir un proceso real con sus pasos, tiempos, dueños y puntos de error.
- Cuantificar el tiempo y el dinero que cuesta un proceso manual y la cola que genera en la hora pico.
- Priorizar qué automatizar primero con una matriz de frecuencia, tiempo, error y riesgo.
Trigo Lento: el negocio que se va a automatizar
Antes de hablar de automatización conviene conocer el negocio, porque todas las cifras de la serie salen de él y se reutilizan día tras día para que sean coherentes. Trigo Lento es una panadería artesanal de masa madre en la colonia Narvarte, en la Ciudad de México. Trabajan seis personas: Don Ernesto, dos panaderos, dos personas de mostrador y Valeria. Vende en mostrador y, sobre todo, por encargo: pasteles para cumpleaños, cajas de pan dulce para oficinas, hogazas apartadas para el fin de semana y el pedido diario de una cafetería. Los encargos llegan por cuatro canales (WhatsApp, mensajes directos de Instagram, un formulario web y el teléfono) y hoy se apuntan en una libreta y en una hoja de cálculo.
Los volúmenes del negocio son fijos en toda la serie. Llegan, en promedio, 18 encargos al día de lunes a sábado, es decir, $18 \cdot 26 = 468$ encargos al mes, con un ticket medio de 380 MXN. Además de los encargos, el número de WhatsApp recibe 60 mensajes al día (pedidos, preguntas por horarios y precios, alguna queja), unos 1 560 al mes. Entre las 10:00 y las 12:00 se concentra la hora pico: 9 mensajes por hora que Valeria atiende sola. Atender un encargo completo le lleva 6 minutos, y el objetivo de la serie es dejar esa atención humana en 1.5 minutos sin perder el trato.
Las personas
Tres personajes acompañarán cada entrada. Todos son ficticios, igual que la panadería, la cafetería y los clientes de los ejemplos:
- Valeria Ortiz es la administradora de Trigo Lento. Es contadora de formación y no ha programado nunca. Durante la serie aprenderá a ser arquitecta de automatización: medirá, decidirá, construirá en Python, en Make y en n8n, y lo documentará todo. Es la protagonista, y sus decisiones son las del lector.
- Don Ernesto Ortiz es su padre, maestro panadero y dueño. Es escéptico, y sus objeciones son concretas: el oficio, el coste, el trato con los clientes, las recetas que no deben salir del obrador. Representa la mirada del riesgo, y sus preguntas se responderán con números, no con promesas.
- Marisol Peña es la dueña de la Cafetería Brújula, el cliente mayorista: 40 baguettes diarias de lunes a sábado con factura semanal. Es exigente con las confirmaciones a tiempo y con las facturas sin errores, y será la voz del cliente cuando se hable de niveles de servicio.
Marisol, de hecho, ya dejó claro su requisito la semana pasada, cuando la confirmación de las baguettes llegó a las 11 de la mañana en lugar de a primera hora: “Valeria, yo no necesito que me escriban bonito. Necesito saber antes de las 8 si el pan del día siguiente está confirmado, y que la factura del viernes cuadre con lo que recibí.” Fíjese en que su queja no menciona ninguna tecnología. Habla de un plazo y de una exactitud. Así suelen llegar los requisitos reales.
El catálogo
El catálogo tiene 12 productos y es el mismo durante los 89 días. Se recoge en la Tabla 1, que el resto de la serie citará como “la Tabla 1 del Día 1”, y se guardará en el archivo catalogo.json.
Tabla 1. Catálogo de Trigo Lento (precios en pesos mexicanos).
| Clave | Producto | Precio MXN |
|---|---|---|
| P01 | Hogaza de masa madre (800 g) | 95 |
| P02 | Baguette tradicional | 38 |
| P03 | Pan de caja integral | 72 |
| P04 | Concha de vainilla | 22 |
| P05 | Croissant de mantequilla | 34 |
| P06 | Rol de canela | 38 |
| P07 | Galletas de avena (paquete de 6) | 60 |
| P08 | Pastel de zanahoria entero | 420 |
| P09 | Pastel de chocolate entero | 460 |
| P10 | Caja de 12 panes dulces surtidos | 240 |
| P11 | Bollos para hamburguesa (paquete de 6) | 66 |
| P12 | Pay de queso entero | 380 |
Todo el trabajo de la serie vive en una carpeta de proyecto llamada trigo_lento/, que irá acumulando archivos: el catálogo, los pedidos, una base de datos local, los consentimientos de los clientes, los flujos exportados de Make y de n8n, los prompts y un registro de ejecuciones. Comencemos por preparar el entorno con las importaciones base, la semilla global de la serie, $2026$, y la carpeta del proyecto. Este bloque abre todos los días de la serie:
# Importaciones base, semilla de la serie y carpeta del proyecto en Python:
import warnings
warnings.filterwarnings('ignore')
import json
from pathlib import Path
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 120)
pd.set_option('display.max_columns', 12)
carpeta = Path('trigo_lento')
carpeta.mkdir(exist_ok = True)
print('numpy', np.__version__, '| pandas', pd.__version__)
print('Carpeta del proyecto:', carpeta.resolve().name)
numpy 2.4.6 | pandas 3.0.3
Carpeta del proyecto: trigo_lento
La salida confirma las versiones de numpy y pandas con las que se calcularon todas las cifras de esta entrada y que la carpeta trigo_lento existe. La semilla fija hace que cualquier lector obtenga exactamente los mismos números aleatorios en las simulaciones de más abajo.
Ahora el catálogo. El siguiente código crea un DataFrame con las claves, los nombres y los precios de la Tabla 1 y lo escribe en trigo_lento/catalogo.json, el primer archivo del proyecto:
# Catálogo de Trigo Lento y archivo catalogo.json en Python:
catalogo = pd.DataFrame({
    'clave': [f'P{i:02d}' for i in range(1, 13)],
    'producto': ['Hogaza de masa madre (800 g)', 'Baguette tradicional', 'Pan de caja integral',
                 'Concha de vainilla', 'Croissant de mantequilla', 'Rol de canela',
                 'Galletas de avena (paquete de 6)', 'Pastel de zanahoria entero',
                 'Pastel de chocolate entero', 'Caja de 12 panes dulces surtidos',
                 'Bollos para hamburguesa (paquete de 6)', 'Pay de queso entero'],
    'precio_mxn': [95, 38, 72, 22, 34, 38, 60, 420, 460, 240, 66, 380]
})
(carpeta / 'catalogo.json').write_text(
    json.dumps(catalogo.to_dict(orient = 'records'), ensure_ascii = False, indent = 2), encoding = 'utf-8')
print(catalogo.to_string(index = False))
print('Productos:', len(catalogo), '| precio medio:', round(catalogo['precio_mxn'].mean(), 2), 'MXN',
      '| mediana:', catalogo['precio_mxn'].median(), 'MXN')
clave                               producto  precio_mxn
  P01           Hogaza de masa madre (800 g)          95
  P02                   Baguette tradicional          38
  P03                   Pan de caja integral          72
  P04                     Concha de vainilla          22
  P05               Croissant de mantequilla          34
  P06                          Rol de canela          38
  P07       Galletas de avena (paquete de 6)          60
  P08             Pastel de zanahoria entero         420
  P09             Pastel de chocolate entero         460
  P10       Caja de 12 panes dulces surtidos         240
  P11 Bollos para hamburguesa (paquete de 6)          66
  P12                    Pay de queso entero         380
Productos: 12 | precio medio: 160.42 MXN | mediana: 69.0 MXN
El catálogo queda guardado con sus $12$ productos. El precio medio es de $160.42$ MXN, pero la mediana es de solo $69$ MXN: tres productos caros (los dos pasteles enteros y el pay de queso, entre 380 y 460 MXN) tiran de la media hacia arriba. Esta asimetría tiene consecuencias de diseño que aparecerán más adelante. Un error en un pedido de conchas cuesta 22 pesos; un error en un pastel de chocolate cuesta 460 pesos y, probablemente, un cumpleaños arruinado. No todos los encargos pesan lo mismo, y un buen diseño trata con más cuidado los que más arriesgan.
El presupuesto de 45 USD
Trigo Lento no es una empresa de tecnología, y su automatización tiene un techo: 45 USD al mes para todo el ecosistema, que al tipo de cambio didáctico de la serie, $18.50$ MXN por dólar, son $832.50$ MXN. Ese tipo de cambio es un supuesto fijo para que las cuentas sean comparables entre días, no una cotización.
El reparto se calculará con detalle el Día 12, cuando se comparen los planes de las plataformas, pero el primer boceto ya permite ver dónde estará el dinero: unos 10.59 USD para el plan Core de Make, unos 6 USD para un servidor pequeño donde instalar n8n, 8 USD de tope para la API de Claude, unos 12 USD para los mensajes de WhatsApp por Twilio y el resto, 8.41 USD, como reserva. Cada cierre de módulo revisará ese reparto, y el Día 84 comparará el coste final con el techo.
Un presupuesto así cambia la forma de diseñar. Con 45 USD no se puede enviar cada mensaje al modelo más caro ni ejecutar flujos cada minuto “por si acaso”. Obliga a hacer lo que hace un arquitecto: decidir qué pasos merecen una plataforma, cuáles merecen un modelo de lenguaje y cuáles se resuelven con una regla de diez líneas que no cuesta nada.
Qué es la automatización de procesos de negocio
La automatización de procesos de negocio (o BPA, por sus siglas en inglés: “Business Process Automation”) es el uso de software para ejecutar, total o parcialmente, los pasos repetibles de un proceso, de modo que las personas intervengan solo donde aportan criterio. La definición tiene dos partes que conviene separar. La primera, “pasos repetibles de un proceso”, dice qué se automatiza: no una tarea aislada, sino una secuencia con un principio, un final y un resultado que alguien necesita. La segunda, “las personas intervienen donde aportan criterio”, dice para qué: el objetivo no es quitar a las personas, sino quitarles lo que no requiere su juicio.
Ejemplos cotidianos hay muchos. El banco que envía un aviso al teléfono cada vez que se usa la tarjeta automatiza un paso de su proceso de prevención de fraudes. La farmacia que manda un recordatorio cuando una receta está por vencer automatiza el seguimiento de sus clientes. El sistema que, al registrar una venta, descuenta el inventario y avisa cuando queda poca harina automatiza una parte del proceso de compras. En los tres casos hay un disparador (el uso de la tarjeta, la fecha, la venta), una o varias acciones y un resultado que alguien usa.
Tareas, procesos y flujos
Durante 89 días se usarán tres palabras con un significado preciso, y conviene fijarlo desde hoy:
- Una tarea es una unidad de trabajo que hace una persona o un programa de una sola vez: leer un mensaje, apuntar un pedido, enviar una confirmación. Se mide en minutos y tiene un responsable.
- Un proceso es una secuencia de tareas, decisiones y esperas que transforma unas entradas en un resultado con valor para alguien: el proceso de encargos convierte un mensaje de un cliente en un pedido apuntado, confirmado y avisado al obrador. Tiene un dueño, un inicio, un final y medidas de éxito (tiempo, errores, coste).
- Un flujo (o flujo de trabajo) es la implementación concreta de un proceso, o de una parte, en una herramienta: un escenario de Make, un workflow de n8n (así llama n8n a sus flujos) o un programa de Python. Empieza con un disparador, ejecuta pasos y termina con una salida.
La distinción importa porque los errores más caros nacen de confundir los niveles. Automatizar una tarea (por ejemplo, copiar automáticamente los mensajes de WhatsApp a una hoja) sin mirar el proceso completo puede dejar intacto el cuello de botella real, que en Trigo Lento, como verá enseguida, no es copiar sino preguntar los datos que faltan. Y construir un flujo sin haber dibujado antes el proceso produce lo que esta serie llamará “automatizaciones de cinta adhesiva”: funcionan el día que se hacen y nadie sabe por qué fallan un mes después.
BPA, RPA, BPM e IA
Alrededor de la automatización conviven varias siglas que se confunden con frecuencia. La automatización robótica de procesos (o RPA, por sus siglas en inglés: “Robotic Process Automation”) usa “robots” de software que imitan lo que una persona hace con el teclado y el ratón sobre las pantallas de otras aplicaciones. Van der Aalst y sus coautores la describen como una solución para tareas repetitivas sobre sistemas que no ofrecen otra forma de integración, con la advertencia de que es frágil: si la pantalla cambia, el robot se pierde. La gestión de procesos de negocio (o BPM, por sus siglas en inglés: “Business Process Management”) es la disciplina que descubre, modela, analiza, rediseña, ejecuta y supervisa los procesos de una organización; la automatización es solo una de sus herramientas. La digitalización es pasar información del papel a un formato electrónico. Y la IA generativa aporta modelos capaces de leer y redactar lenguaje natural, que permiten automatizar pasos que antes exigían a una persona, como entender “me aparta 2 conchitas pa mañana”.
La Tabla 2 compara las cinco ideas con un ejemplo de Trigo Lento y el límite de cada una.
Tabla 2. Digitalización, BPA, RPA, BPM e IA generativa: qué es, ejemplo en Trigo Lento y límite.
| Concepto | Qué es | Ejemplo en Trigo Lento | Límite |
|---|---|---|---|
| Digitalización | Pasar información del papel a un formato electrónico | Copiar la libreta de encargos a una hoja de cálculo | El trabajo sigue siendo manual: alguien teclea cada pedido |
| BPA | Software que ejecuta los pasos repetibles de un proceso | Al registrar un pedido completo, enviar la confirmación y avisar al obrador sin intervención | Solo funciona con datos estructurados y reglas claras |
| RPA | Robots que imitan clics y teclas sobre otras aplicaciones | Un robot que copia cada pedido de la hoja al portal del servicio de facturación | Frágil: se rompe cuando cambia la pantalla que imita |
| BPM | Disciplina para descubrir, rediseñar y supervisar procesos | Dibujar el proceso de encargos, medir sus tiempos y decidir qué cambiar | No ejecuta nada por sí misma: es método, no herramienta |
| IA generativa | Modelos que leen y redactan lenguaje natural | Extraer producto, cantidad y fecha de “un pastel de chocolate para el sábado” | Probabilística: puede equivocarse y necesita validación y supervisión |
Leída por columnas, la tabla muestra que las cinco ideas no compiten, se apilan. La BPM dice qué proceso conviene cambiar y cómo; la digitalización deja los datos en un formato que una máquina puede leer; la BPA ejecuta los pasos con reglas; la RPA es el último recurso cuando una aplicación no ofrece otra puerta; y la IA generativa cubre los pasos que necesitan entender lenguaje. Esta serie usará casi siempre BPA con plataformas de integración (Make y n8n), IA generativa en los pasos de lenguaje (con la API de Claude) y el método de la BPM para decidir. La RPA aparecerá poco, porque casi todas las aplicaciones que usa Trigo Lento tienen una interfaz de programación.
La escalera que muestra la Figura 1 resume estas ideas como peldaños de madurez, con un ejemplo de Trigo Lento en cada uno y el módulo de la serie en el que se construye.
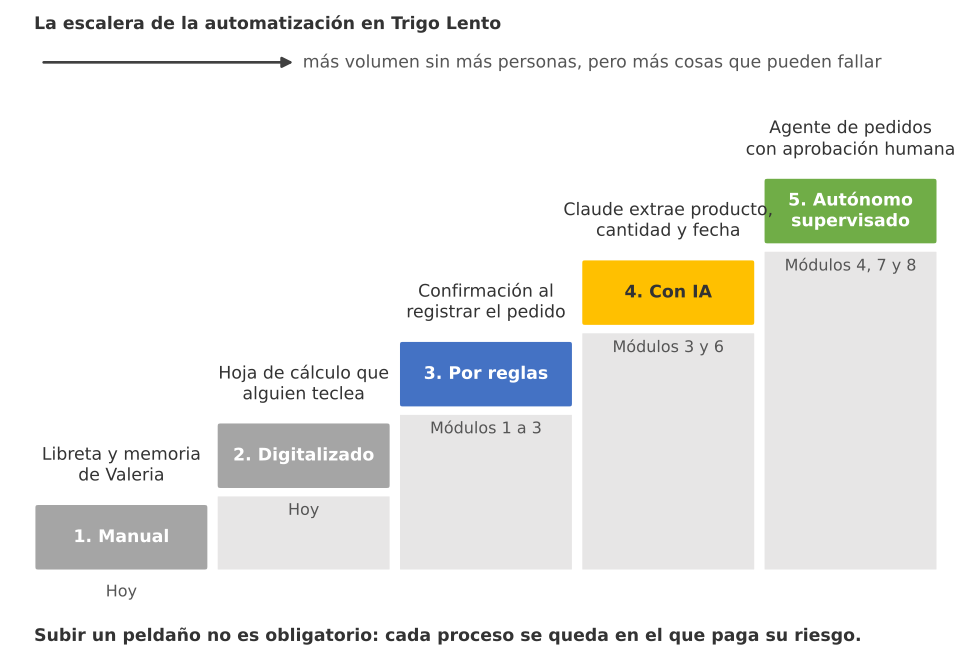
Figura 1. La escalera de la automatización: cinco peldaños, de la libreta de Valeria al agente autónomo supervisado, con un ejemplo de Trigo Lento en cada uno y el módulo de la serie que lo construye.
La escalera tiene una lectura que conviene subrayar desde el primer día: subir un peldaño no es obligatorio. El proceso de encargos de Trigo Lento llegará al peldaño 5, con un agente que atiende pedidos y pide aprobación a Valeria; la factura semanal de la Cafetería Brújula se quedará, a propósito, en el peldaño 3, porque un error fiscal no se compensa con la comodidad de que un modelo la redacte. Cada proceso se queda en el peldaño que paga su riesgo.
Automatizar no es digitalizar
En 1990, Michael Hammer publicó en la Harvard Business Review un artículo con un título provocador: “Reengineering Work: Don’t Automate, Obliterate”, que puede traducirse como “No automatice, elimine”. Su argumento era que muchas empresas habían gastado fortunas en informatizar procesos diseñados para el papel y que, al hacerlo, solo habían conseguido hacer más deprisa cosas que no deberían hacerse. El ejemplo clásico de su artículo es un departamento de cuentas por pagar que conciliaba facturas, órdenes de compra y recepciones; el rediseño eliminó la factura de la ecuación en lugar de automatizar la conciliación.
En Trigo Lento, la tentación equivalente es evidente. Si Valeria pasa la libreta a una hoja de cálculo compartida, el negocio estará digitalizado, pero no automatizado: cada pedido seguirá exigiendo que alguien lo lea, pregunte lo que falta, lo teclee, lo confirme y avise al obrador. Peor aún, si automatiza la copia de los mensajes de WhatsApp a esa hoja sin cambiar nada más, tendrá una hoja más llena y el mismo cuello de botella: las preguntas de ida y vuelta para completar los datos.
La lección de Hammer, adaptada a esta serie, es una regla de trabajo: primero se rediseña el proceso y después se automatiza el proceso rediseñado. Por ejemplo, si un formulario o un mensaje guiado pide sabor, tamaño, fecha y hora desde el principio, el paso más caro del encargo (preguntar lo que falta) desaparece antes de escribir una sola línea de automatización. Esa es la diferencia entre poner un motor a una carreta y diseñar un vehículo.
Trigo Lento hoy: el proceso de encargos
Para rediseñar un proceso hay que conocerlo tal como es, no como se cree que es. Durante una semana, Valeria cronometró cada encargo con el reloj del teléfono y anotó cuánto tardaba en cada paso. El resultado, redondeado a medios minutos, se recoge en la Tabla 3.
Tabla 3. Pasos del encargo manual con sus minutos.
| Orden | Paso | Minutos | Dueño | Qué puede fallar |
|---|---|---|---|---|
| 1 | Leer el mensaje | 0.5 | Valeria | Mensaje leído tarde o confundido con otro |
| 2 | Preguntar los datos faltantes | 2.0 | Valeria | El cliente no contesta o contesta a medias |
| 3 | Apuntar en la libreta | 1.0 | Valeria | Letra ilegible, fecha equivocada |
| 4 | Pasar a la hoja de cálculo | 1.0 | Valeria | Error al teclear la cantidad o el precio |
| 5 | Confirmar al cliente | 1.0 | Valeria | Confirmación olvidada o con el precio incorrecto |
| 6 | Avisar al obrador | 0.5 | Valeria y panadero | Aviso que no llega o llega sin fecha de entrega |
| Total | 6.0 |
Los seis pasos suman 6 minutos por encargo. La última columna es tan importante como la de los minutos: cada paso manual es un punto donde algo puede salir mal, y los errores de los pasos 3 y 4 (apuntar y teclear dos veces el mismo dato) existen solo porque el mismo pedido se escribe en dos sitios.
Esa misma anatomía, dibujada para el encargo de un pastel en la Figura 2, muestra las piezas que tiene cualquier proceso: una entrada, actividades con su duración, al menos una decisión, varias salidas y un dueño para cada paso.
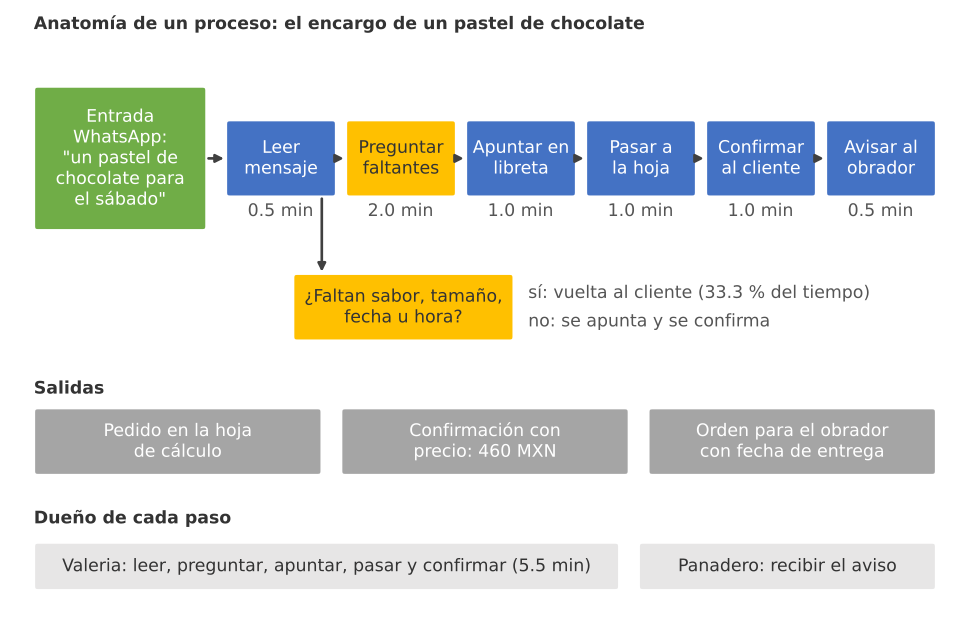
Figura 2. Anatomía de un proceso: el encargo de un pastel de chocolate con su entrada, las seis actividades con sus minutos, la decisión de si faltan datos, las tres salidas y el dueño de cada paso.
En la figura se ve algo que la tabla esconde: el proceso tiene un bucle. Cuando faltan datos (el sabor, el tamaño, la fecha o la hora), el encargo vuelve al cliente y se queda esperando su respuesta. Ese bucle es el paso amarillo, y no es casualidad que sea el más largo. Observe también la fila de dueños: cinco de los seis pasos dependen de una sola persona. Si Valeria está atendiendo el mostrador, el proceso entero se detiene.
Un diagrama de Pareto ordena los pasos de mayor a menor duración y añade una línea con el porcentaje acumulado; sirve para ver qué pocos pasos concentran la mayor parte del tiempo. El siguiente código construye la tabla de pasos con pandas, calcula los porcentajes y dibuja el Pareto:
# Pasos del encargo manual con sus minutos y diagrama de Pareto en Python:
pasos = pd.DataFrame({
    'paso': ['Preguntar datos faltantes', 'Apuntar en libreta', 'Pasar a hoja de cálculo',
             'Confirmar al cliente', 'Leer mensaje', 'Avisar al obrador'],
    'minutos': [2.0, 1.0, 1.0, 1.0, 0.5, 0.5]
}).sort_values('minutos', ascending = False, kind = 'stable').reset_index(drop = True)
pasos['pct'] = 100 * pasos['minutos'] / pasos['minutos'].sum()
pasos['pct_acumulado'] = pasos['pct'].cumsum()
print(pasos.round(1).to_string(index = False))
print('Total por encargo:', pasos['minutos'].sum(), 'minutos')

# Barras de minutos por paso y línea del porcentaje acumulado:
fig, ax = plt.subplots(figsize = (9, 4.8))
ax.bar(pasos['paso'], pasos['minutos'], color = '#2a78d6', width = 0.65)
ax.set_ylabel('Minutos por encargo')
ax.set_ylim(0, 2.4)
ax2 = ax.twinx()
ax2.plot(pasos['paso'], pasos['pct_acumulado'], color = '#eb6834', marker = 'o', linewidth = 2)
ax2.axhline(80, color = '#9a9994', linestyle = '--', linewidth = 1)
ax2.set_ylim(0, 115)
ax2.set_ylabel('Porcentaje acumulado del tiempo')
for x, y in zip(range(len(pasos)), pasos['pct_acumulado']):
    ax2.text(x, y + 5, f'{y:.1f} %', ha = 'center', fontsize = 9, color = '#52514e',
             bbox = dict(facecolor = 'white', edgecolor = 'none', pad = 1))
ax.set_title('Pareto de los 6 minutos de un encargo', fontsize = 16)
ax.set_xticks(range(len(pasos)))
ax.set_xticklabels(pasos['paso'], rotation = 20, ha = 'right')
ax.spines[['top']].set_visible(False)
ax2.spines[['top']].set_visible(False)
plt.tight_layout()
plt.show()
                     paso  minutos  pct  pct_acumulado
Preguntar datos faltantes      2.0 33.3           33.3
       Apuntar en libreta      1.0 16.7           50.0
  Pasar a hoja de cálculo      1.0 16.7           66.7
     Confirmar al cliente      1.0 16.7           83.3
             Leer mensaje      0.5  8.3           91.7
        Avisar al obrador      0.5  8.3          100.0
Total por encargo: 6.0 minutos
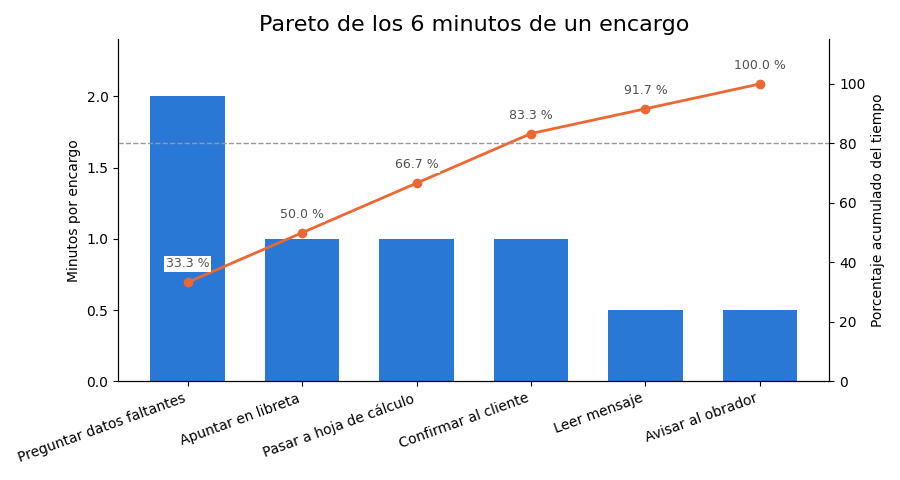
El paso de preguntar los datos faltantes se lleva por sí solo el $33.3%$ del tiempo de cada encargo, el doble que cualquier otro paso. Los cuatro primeros pasos del gráfico acumulan el $83.3%$ y cruzan la línea discontinua del $80%$, la referencia habitual del principio de Pareto. Pero la lectura útil no es la de la regla del 80 y el 20, sino la de las causas:
- Preguntar lo que falta ($2.0$ minutos) es un problema de diseño de la entrada: se resuelve pidiendo los datos completos desde el principio, con un mensaje guiado o un formulario, antes que con cualquier herramienta.
- Apuntar en la libreta y pasar a la hoja ($1.0 + 1.0$ minutos) son el mismo dato escrito dos veces. Es trabajo duplicado, y la digitalización bien hecha lo elimina: un solo registro, en un solo lugar.
- Confirmar al cliente y avisar al obrador ($1.0 + 0.5$ minutos) son pasos de comunicación perfectamente repetibles: con los datos completos, una regla los ejecuta sin intervención.
- En conclusión, de los 6 minutos, $4.5$ se pueden eliminar o automatizar, y el $1.5$ que queda (leer y revisar) es justamente el objetivo de atención humana de la serie.
Cuánto cuesta hacerlo a mano
Seis minutos parecen poco. La pregunta del arquitecto es cuánto suman. Si $n$ es el número de encargos al mes y $t$ el tiempo de atención por encargo en minutos, las horas de trabajo al mes son:
$$ H = \frac{n \cdot t}{60} $$
La lógica detrás de esta fórmula es múltiple:
- Multiplicar $n$ por $t$ da los minutos totales del mes; dividir entre $60$ los convierte en horas, la unidad en la que se paga y se planifica el trabajo.
- La fórmula es lineal en las dos variables: duplicar los encargos duplica las horas, y reducir el tiempo por encargo a la cuarta parte reduce las horas a la cuarta parte. Por eso un minuto ahorrado en un proceso frecuente vale mucho más que una hora ahorrada en uno raro.
- El valor de esas horas se obtiene multiplicando por el valor de la hora de quien hace el trabajo; en Trigo Lento, 75 MXN por hora para Valeria, un supuesto didáctico.
- En conclusión, el ahorro de automatizar es $(t_{\text{manual}} - t_{\text{objetivo}}), n / 60$ horas al mes, y se compara con lo que cuesta la automatización, que aquí son, como máximo, los 45 USD del presupuesto.
El siguiente código aplica la fórmula a los 468 encargos del mes con el tiempo manual de 6 minutos y el objetivo de 1.5 minutos, y compara el ahorro con el presupuesto:
# Horas y pesos al mes del proceso manual frente al objetivo en Python:
encargos_mes = 18 * 26          # 18 encargos al día, de lunes a sábado
minutos_manual, minutos_objetivo = 6.0, 1.5
valor_hora_mxn, mxn_por_usd, presupuesto_usd = 75, 18.50, 45

def horas_al_mes(n, t):
    # H = n * t / 60, con t en minutos por encargo:
    return n * t / 60

h_manual = horas_al_mes(encargos_mes, minutos_manual)
h_objetivo = horas_al_mes(encargos_mes, minutos_objetivo)
ahorro_h = h_manual - h_objetivo
ahorro_mxn = ahorro_h * valor_hora_mxn
print('Encargos al mes:', encargos_mes)
print(f'Horas a mano: {h_manual:.1f} | con el objetivo: {h_objetivo:.1f} | ahorro: {ahorro_h:.1f} h')
print(f'Coste a mano: {h_manual * valor_hora_mxn:,.2f} MXN | con el objetivo: {h_objetivo * valor_hora_mxn:,.2f} MXN')
print(f'Ahorro: {ahorro_mxn:,.2f} MXN = {ahorro_mxn / mxn_por_usd:.2f} USD al mes')
print(f'Presupuesto: {presupuesto_usd} USD = {presupuesto_usd * mxn_por_usd:,.2f} MXN al mes')
print(f'Ahorro por cada dólar de presupuesto: {ahorro_mxn / mxn_por_usd / presupuesto_usd:.2f} USD')
print(f'Jornadas de 8 horas recuperadas al mes: {ahorro_h / 8:.1f}')
Encargos al mes: 468
Horas a mano: 46.8 | con el objetivo: 11.7 | ahorro: 35.1 h
Coste a mano: 3,510.00 MXN | con el objetivo: 877.50 MXN
Ahorro: 2,632.50 MXN = 142.30 USD al mes
Presupuesto: 45 USD = 832.50 MXN al mes
Ahorro por cada dólar de presupuesto: 3.16 USD
Jornadas de 8 horas recuperadas al mes: 4.4
A mano, el proceso de encargos consume $46.8$ horas al mes, que al valor de la hora de Valeria cuestan $3,510$ MXN. Con el objetivo de 1.5 minutos bajaría a $11.7$ horas y $877.50$ MXN. El ahorro es de $35.1$ horas al mes, unas $4.4$ jornadas de ocho horas, que valen $2,632.50$ MXN, unos $142.30$ USD al tipo didáctico. Frente a un presupuesto de 45 USD, cada dólar gastado en automatización devuelve $3.16$ USD en horas de Valeria.
Tres advertencias para leer bien estas cifras:
- El ahorro está calculado solo con el proceso de encargos. No incluye los otros 1 560 mensajes al mes de WhatsApp ni la factura de Brújula; el cálculo es deliberadamente conservador.
- Las horas ahorradas no son dinero en el banco. Son tiempo que Valeria puede dedicar a otra cosa, y qué cosa sea es una decisión del negocio, no de la automatización. Se volverá sobre esto en las consideraciones finales.
- El objetivo de 1.5 minutos es una meta de diseño, no una medición. La serie la irá contrastando con datos: el Día 8 define las métricas y los primeros acuerdos de nivel de servicio, y el módulo 8 mide el resultado.
La cola de la hora pico
El coste en horas es el que ve el dueño. El cliente ve otra cosa: cuánto tarda en recibir respuesta. Entre las 10:00 y las 12:00 llegan 9 mensajes por hora y Valeria, sola, atiende a un ritmo de 10 por hora (6 minutos cada uno). A primera vista, 9 es menor que 10 y no debería haber problema. La teoría de colas dice lo contrario.
Una cola M/M/1 es el modelo más sencillo de una fila de espera: las llegadas siguen un proceso de Poisson con tasa $\lambda$ (mensajes por hora), los tiempos de atención son exponenciales con tasa $\mu$ (mensajes que se atienden por hora) y hay un solo servidor, en este caso Valeria. La primera M significa llegadas “sin memoria”, la segunda atención sin memoria y el 1 indica un único servidor. La utilización es $\rho = \lambda / \mu$, la fracción del tiempo en que el servidor está ocupado, y la cola solo es estable si $\rho < 1$. Cuando lo es, el tiempo medio que un mensaje pasa en el sistema (esperando más siendo atendido) y el tiempo medio de espera antes de ser atendido son:
$$ W = \frac{1}{\mu - \lambda}, \qquad W_q = \frac{\lambda}{\mu,(\mu - \lambda)} $$
La lógica detrás de estas fórmulas es múltiple:
- El denominador $\mu - \lambda$ es la holgura: cuántos mensajes por hora sobran de capacidad. Con $\lambda = 9$ y $\mu = 10$ la holgura es de un solo mensaje por hora, y $W = 1/1 = 1$ hora.
- Cuando $\lambda$ se acerca a $\mu$, la holgura tiende a cero y la espera crece sin límite. La espera no crece en proporción a la carga, sino de forma explosiva cerca del límite.
- $W_q$ es $W$ menos el tiempo de atención, $1/\mu$: con $\mu = 10$, $W_q = 1 - 0.1 = 0.9$ horas, es decir, 54 minutos de espera antes de que Valeria abra el mensaje.
- Con el objetivo de 1.5 minutos por mensaje, $\mu = 40$ y la holgura pasa a $31$: $W = 1/31$ horas, menos de 2 minutos.
La tercera pieza es la ley de Little, demostrada por John Little en 1961 y válida para casi cualquier sistema estable, no solo para las colas M/M/1:
$$ L = \lambda, W $$
donde $L$ es el número medio de mensajes en el sistema. La lógica detrás de esta fórmula es múltiple:
- Relaciona tres magnitudes que se miden de forma distinta: $\lambda$ se cuenta en el registro de llegadas, $W$ se cronometra y $L$ se observa contando los mensajes sin resolver en un momento dado. Conocidas dos, la tercera queda determinada.
- Con $\lambda = 9$ y $W = 1$ hora, $L = 9$: en promedio hay nueve mensajes sin resolver en la bandeja de Valeria durante la hora pico. Los 14 mensajes sin leer del sábado a las 10:30 no son mala suerte, son lo esperable en un mal momento.
- En conclusión, la ley de Little es una herramienta de diagnóstico que se usará toda la serie: si un flujo tiene muchos elementos pendientes, o llegan demasiados o tardan demasiado.
El siguiente código implementa las fórmulas en una función mm1(lam, mu), compara el escenario manual con el objetivo y añade un análisis de sensibilidad para ver qué pasa con la espera manual si llegan más o menos mensajes:
# Cola M/M/1 de la hora pico: fórmulas analíticas en Python:
def mm1(lam, mu):
    # Medidas de una cola M/M/1 estable (lam < mu), tiempos en horas:
    if lam >= mu:
        raise ValueError('La cola no es estable: lam debe ser menor que mu.')
    rho = lam / mu
    W = 1 / (mu - lam)              # tiempo medio en el sistema
    Wq = lam / (mu * (mu - lam))    # tiempo medio de espera antes de ser atendido
    return {'rho': rho, 'W_min': 60 * W, 'Wq_min': 60 * Wq, 'L': lam * W, 'Lq': lam * Wq}

lam = 9                              # mensajes por hora entre 10:00 y 12:00
escenarios_cola = {'Manual (6 min, mu = 10)': mm1(lam, 10),
                   'Objetivo (1.5 min, mu = 40)': mm1(lam, 40)}
tabla_cola = pd.DataFrame(escenarios_cola).T
print(tabla_cola.round(2))

# Sensibilidad: qué pasa con la espera manual si llegan más o menos mensajes:
for l in [5, 7, 8, 9, 9.5]:
    print(f'lam = {l:>4}: rho = {l / 10:.2f}, espera media Wq = {mm1(l, 10)["Wq_min"]:6.1f} min')
                              rho  W_min  Wq_min     L    Lq
Manual (6 min, mu = 10)      0.90  60.00   54.00  9.00  8.10
Objetivo (1.5 min, mu = 40)  0.22   1.94    0.44  0.29  0.07
lam =    5: rho = 0.50, espera media Wq =    6.0 min
lam =    7: rho = 0.70, espera media Wq =   14.0 min
lam =    8: rho = 0.80, espera media Wq =   24.0 min
lam =    9: rho = 0.90, espera media Wq =   54.0 min
lam =  9.5: rho = 0.95, espera media Wq =  114.0 min
La salida confirma las cuentas a mano. En el escenario manual, la utilización es $0.90$, un mensaje pasa en promedio $60$ minutos en el sistema y espera $54$ minutos antes de que alguien lo lea; hay $9$ mensajes en el sistema y $8.1$ en la cola. Con el objetivo de 1.5 minutos, la utilización baja a $0.22$, el tiempo en el sistema a $1.94$ minutos y la espera a menos de medio minuto.
Las cinco líneas de sensibilidad son la lección más valiosa de la sección. Con 5 mensajes por hora la espera media es de 6 minutos; con 8, de 24; con 9, de 54; y con 9.5, de $114$ minutos. Pasar de 9 a 9.5 mensajes por hora, un aumento del $5.6%$ en la carga, duplica la espera. Esa no linealidad explica por qué los negocios pequeños viven en dos estados, “todo tranquilo” y “todo se cae”, sin término medio.
Atención aquí: Un proceso con una utilización del 90 % no tiene margen. Cualquier imprevisto (una llamada larga, una clienta en el mostrador, un día con más pedidos de lo normal) dispara la espera. Cuando diseñe una automatización, no calcule la capacidad para el promedio: calcule la holgura en el pico, y recuerde que las fórmulas de la cola M/M/1 suponen estabilidad ($\lambda < \mu$). Si $\lambda \geq \mu$, la cola no tiene un tiempo medio de espera: crece sin parar hasta que alguien deja de atender o los clientes se van.
Simulación de la hora pico
Las fórmulas suponen que el sistema lleva mucho tiempo funcionando en el mismo régimen. Una simulación de eventos discretos permite comprobarlas y ver la distribución completa de las esperas, no solo la media. La idea es sencilla: se generan los instantes de llegada de cada mensaje con tiempos entre llegadas exponenciales de media $1/\lambda$, se genera un tiempo de atención para cada uno y se recorre la lista con la recursión de Lindley: cada mensaje empieza a atenderse cuando llega o cuando Valeria termina el anterior, lo que ocurra después.
El siguiente código simula 1 000 horas pico seguidas, con el mismo azar para los dos escenarios (así la diferencia se debe solo a la velocidad de atención), y además 500 ventanas reales de 2 horas que empiezan con la bandeja vacía, como ocurre cada mañana a las 10:00:
# Simulación de eventos discretos de 1 000 horas pico en Python:
def simular_cola(llegadas, servicios):
    # Recursión de Lindley: cada mensaje espera a que Valeria termine el anterior:
    espera = np.zeros(len(llegadas))
    fin_anterior = 0.0
    for i, (a, s) in enumerate(zip(llegadas, servicios)):
        inicio = max(a, fin_anterior)
        espera[i] = inicio - a
        fin_anterior = inicio + s
    return espera

horas = 1000
llegadas = np.cumsum(rng.exponential(1 / lam, size = int(lam * horas * 1.1)))
llegadas = llegadas[llegadas < horas]
base = rng.exponential(1.0, size = len(llegadas))          # mismo azar para los dos escenarios
espera_manual = 60 * simular_cola(llegadas, base / 10)
espera_auto = 60 * simular_cola(llegadas, base / 40)
print('Mensajes simulados:', len(llegadas))
for nombre, w in [('Manual', espera_manual), ('Objetivo', espera_auto)]:
    print(f'{nombre:>8}: espera media {w.mean():6.1f} min | mediana {np.median(w):6.1f} | '
          f'p90 {np.percentile(w, 90):6.1f} | sin espera {100 * (w == 0).mean():4.1f} %')

# Ventanas reales de 2 horas que empiezan con la bandeja vacía:
medias_ventana = []
for _ in range(500):
    lleg = np.cumsum(rng.exponential(1 / lam, size = 60))
    lleg = lleg[lleg < 2]
    medias_ventana.append(60 * simular_cola(lleg, rng.exponential(1 / 10, size = len(lleg))).mean())
print(f'Ventanas de 2 h que empiezan vacías: espera media {np.mean(medias_ventana):.1f} min')

# Histogramas de espera, manual frente a objetivo:
fig, (ax1, ax2) = plt.subplots(1, 2, figsize = (10, 4.6))
ax1.hist(espera_manual, bins = 40, color = '#eb6834', edgecolor = 'white')
ax1.axvline(espera_manual.mean(), color = '#0b0b0b', linestyle = '--', linewidth = 1.5)
ax1.text(espera_manual.mean() + 5, ax1.get_ylim()[1] * 0.9, f'media {espera_manual.mean():.1f} min', fontsize = 9)
ax1.set_title('Manual: 6 min por mensaje', fontsize = 12)
ax1.set_xlabel('Minutos de espera')
ax1.set_ylabel('Mensajes')
ax2.hist(espera_auto, bins = 40, color = '#2a78d6', edgecolor = 'white')
ax2.axvline(espera_auto.mean(), color = '#0b0b0b', linestyle = '--', linewidth = 1.5)
ax2.text(espera_auto.mean() + 0.3, ax2.get_ylim()[1] * 0.9, f'media {espera_auto.mean():.2f} min', fontsize = 9)
ax2.set_title('Objetivo: 1.5 min por mensaje', fontsize = 12)
ax2.set_xlabel('Minutos de espera')
for a in (ax1, ax2):
    a.spines[['top', 'right']].set_visible(False)
fig.suptitle('Espera en la hora pico: 1 000 horas simuladas', fontsize = 16)
plt.tight_layout()
plt.show()
Mensajes simulados: 8811
  Manual: espera media   47.4 min | mediana   25.5 | p90  131.7 | sin espera 12.7 %
Objetivo: espera media    0.4 min | mediana    0.0 | p90    1.5 | sin espera 78.4 %
Ventanas de 2 h que empiezan vacías: espera media 13.1 min
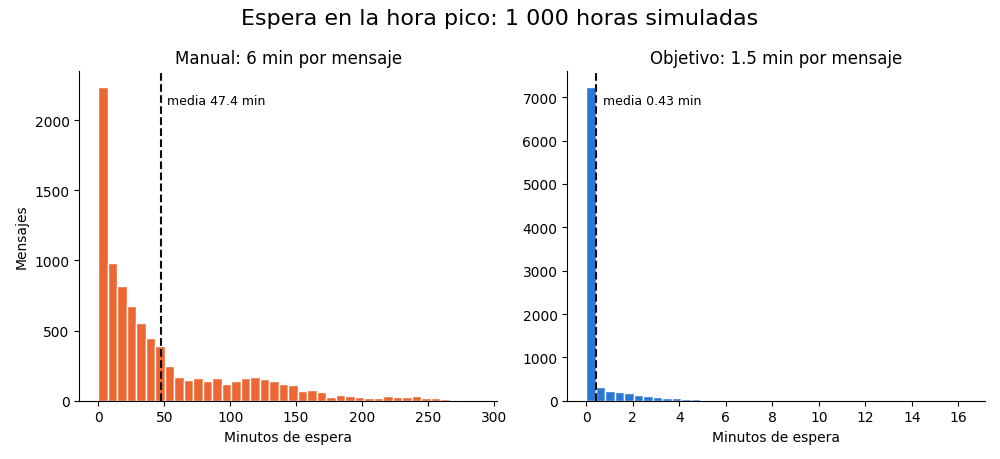
En 1 000 horas se simularon $8,811$ mensajes. En el escenario manual, la espera media es de $47.4$ minutos, cerca de los 54 de la fórmula; la diferencia se explica porque con $\rho = 0.9$ la cola tarda mucho en estabilizarse y la simulación empieza vacía. La mediana es de $25.5$ minutos y el percentil 90 de $131.7$ minutos: uno de cada diez clientes espera más de dos horas. Solo el $12.7%$ de los mensajes se atiende sin esperar, muy cerca del $1 - \rho = 10%$ que predice la teoría. En el escenario objetivo, la espera media es de $0.4$ minutos, el percentil 90 de $1.5$ minutos y el $78.4%$ de los mensajes no espera nada (la teoría da $1 - 0.225 = 77.5%$).
El histograma muestra la forma de esas esperas. A la izquierda, una cola larga hacia la derecha: la mayoría de los mensajes espera poco, pero hay una minoría que espera horas, y esa minoría es la que escribe la reseña de una estrella. A la derecha, casi todo se concentra en cero. Observe las escalas horizontales: el panel manual llega a 300 minutos y el automatizado a menos de 20.
La última línea de la salida corrige el modelo con la realidad del negocio. La hora pico de Trigo Lento dura dos horas y empieza cada día con la bandeja casi vacía, así que la espera media real es de $13.1$ minutos, bastante menos que los 54 del régimen estable. Las dos cifras son ciertas, pero responden a preguntas distintas: 54 minutos es lo que pasaría si la hora pico durara todo el día; 13 minutos es lo que vive un cliente promedio de Trigo Lento en una mañana normal. Un modelo es útil si usted sabe qué pregunta responde. Y aun así, 13 minutos de media con colas de horas en los días malos es exactamente lo que Marisol no está dispuesta a tolerar.
Qué automatizar primero
Ya se sabe cuánto cuesta el proceso de encargos y cuánto espera un cliente. Pero Trigo Lento tiene otros procesos, y el presupuesto, el tiempo de Valeria y su paciencia para aprender son limitados. ¿Por dónde empezar? La respuesta del arquitecto no es “por lo que más molesta”, sino por lo que una medición ordenada dice que rinde más con menos riesgo. Antes de construir la matriz, falta medir la frecuencia con más detalle.
Un mes de encargos por canal
Los 18 encargos diarios son un promedio. El número real varía de un día a otro y se reparte entre canales: según los registros de Valeria, el $55%$ llega por WhatsApp, el $20%$ por Instagram, el $15%$ por el formulario web y el $10%$ por teléfono. El siguiente código simula un mes de 26 días con llegadas de Poisson de media 18 al día y reparte cada día entre los canales con una distribución multinomial:
# Un mes de encargos simulados repartidos por canal en Python:
canales = ['WhatsApp', 'Instagram', 'Formulario web', 'Teléfono']
reparto = [0.55, 0.20, 0.15, 0.10]
por_dia = rng.poisson(18, size = 26)                        # 26 días de lunes a sábado
por_canal = np.array([rng.multinomial(n, reparto) for n in por_dia])
mes = pd.DataFrame(por_canal, columns = canales, index = range(1, 27))
resumen_canal = pd.DataFrame({'encargos': mes.sum(), 'pct': (100 * mes.sum() / mes.values.sum()).round(1)})
print(resumen_canal)
print('Total del mes:', mes.values.sum(), '| mínimo diario:', por_dia.min(), '| máximo diario:', por_dia.max())

# Barras por canal con el total del mes:
fig, ax = plt.subplots(figsize = (9, 4.8))
colores = ['#2a78d6', '#9ec5f4', '#c3c2b7', '#eb6834']
barras = ax.bar(canales, resumen_canal['encargos'], color = colores, width = 0.6)
for b, n, p in zip(barras, resumen_canal['encargos'], resumen_canal['pct']):
    ax.text(b.get_x() + b.get_width() / 2, n + 5, f'{n} ({p} %)', ha = 'center', fontsize = 10)
ax.set_title(f'Encargos de un mes simulado por canal (total: {mes.values.sum()})', fontsize = 16)
ax.set_ylabel('Encargos en 26 días')
ax.set_ylim(0, resumen_canal['encargos'].max() * 1.15)
ax.spines[['top', 'right']].set_visible(False)
plt.tight_layout()
plt.show()
                encargos   pct
WhatsApp             243  51.3
Instagram             91  19.2
Formulario web        82  17.3
Teléfono              58  12.2
Total del mes: 474 | mínimo diario: 11 | máximo diario: 29
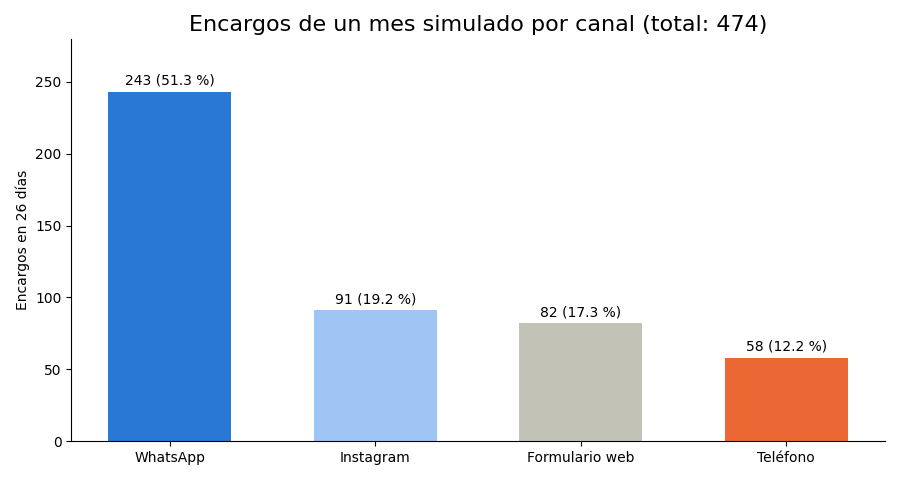
El mes simulado tuvo $474$ encargos, seis más que los 468 del promedio, con días de solo $11$ y días de hasta $29$ encargos. WhatsApp se llevó $243$ ($51.3%$), Instagram $91$, el formulario web $82$ y el teléfono $58$. Los porcentajes no coinciden exactamente con el reparto teórico porque un mes es una muestra pequeña, y esa es la primera lección del bloque: un mes concreto nunca es el promedio, y una automatización que solo funciona con 18 encargos se cae el día que llegan 29.
La segunda lección está en la gráfica: WhatsApp concentra más de la mitad de los encargos. Cualquier automatización que no empiece por WhatsApp atacará la parte pequeña del problema. Por eso el módulo 3 construye el escenario de pedidos de WhatsApp en Make y el módulo 5 dedica varios días a la mensajería. El teléfono, con el $12%$, seguirá siendo manual: una llamada no se automatiza sin cambiar la experiencia del cliente, y no hace falta.
La matriz de priorización
Valeria hizo una lista de cinco procesos candidatos y midió en cada uno cuatro cosas: cuántas veces ocurre al mes, cuántos minutos lleva cada vez, qué fracción de las veces sale con algún error y qué riesgo tiene, en una escala de 1 (bajo) a 5 (alto), que un error llegue al cliente o al negocio. Para combinar las cuatro medidas en un solo número, cada criterio se normaliza dividiéndolo entre su máximo, de modo que todos queden entre $0$ y $1$, y se pondera:
$$ P_i = w_f,\frac{f_i}{\max f} + w_t,\frac{t_i}{\max t} + w_e,\frac{e_i}{\max e} + w_r\left(1 - \frac{r_i - 1}{4}\right) $$
donde $f_i$ es la frecuencia mensual del proceso $i$, $t_i$ sus minutos por vez, $e_i$ su tasa de error, $r_i$ su riesgo y los pesos son $w_f = 0.35$, $w_t = 0.25$, $w_e = 0.20$ y $w_r = 0.20$.
La lógica detrás de esta fórmula es múltiple:
- La frecuencia pesa más que nada porque, como mostró la fórmula de las horas, el ahorro crece con $n$: un proceso diario rinde más que uno semanal aunque cada vez dure menos.
- El tiempo y el error suman prioridad: un proceso largo libera más horas y un proceso con muchos errores gana más calidad al automatizarse, porque una regla no se equivoca al teclear.
- El riesgo resta prioridad: el término $1 - (r_i - 1)/4$ vale $1$ con riesgo 1 y $0$ con riesgo 5. No significa que los procesos arriesgados no se automaticen, sino que no se empiezan por ellos: el primer flujo debe ser uno cuyo fallo se pueda corregir sin daño.
- Los pesos son una decisión del negocio, no una verdad matemática. Por eso conviene comprobar que el orden no cambia al moverlos, que es lo que hace la última línea del siguiente bloque.
El siguiente código construye la matriz con pandas, calcula las horas al mes y el puntaje de cada proceso y comprueba la robustez del orden con pesos iguales:
# Matriz de priorización de procesos candidatos con pandas en Python:
procesos = pd.DataFrame({
    'proceso': ['Encargos', 'Confirmaciones', 'Factura de Brújula', 'Inventario de harina', 'Respuesta a reseñas'],
    'frecuencia_mes': [468, 468, 4, 26, 30],
    'minutos': [6.0, 1.0, 25.0, 10.0, 4.0],
    'tasa_error': [0.08, 0.05, 0.10, 0.06, 0.03],
    'riesgo': [3, 2, 4, 2, 4]                      # de 1 (bajo) a 5 (alto)
}).set_index('proceso')
procesos['horas_mes'] = procesos['frecuencia_mes'] * procesos['minutos'] / 60
pesos = {'frecuencia': 0.35, 'tiempo': 0.25, 'error': 0.20, 'riesgo': 0.20}

def puntaje(df, w):
    # Cada criterio se normaliza entre 0 y 1; el riesgo resta prioridad:
    return (w['frecuencia'] * df['frecuencia_mes'] / df['frecuencia_mes'].max()
            + w['tiempo'] * df['minutos'] / df['minutos'].max()
            + w['error'] * df['tasa_error'] / df['tasa_error'].max()
            + w['riesgo'] * (1 - (df['riesgo'] - 1) / 4))

procesos['puntaje'] = puntaje(procesos, pesos)
procesos = procesos.sort_values('puntaje', ascending = False)
print(procesos.round(3))

# Robustez: el orden con pesos iguales:
iguales = puntaje(procesos, dict.fromkeys(pesos, 0.25)).sort_values(ascending = False)
print('Con pesos iguales:', ', '.join(f'{p} ({v:.3f})' for p, v in iguales.items()))
                      frecuencia_mes  minutos  tasa_error  riesgo  horas_mes  puntaje
proceso
Encargos                         468      6.0        0.08       3     46.800    0.670
Confirmaciones                   468      1.0        0.05       2      7.800    0.610
Factura de Brújula                 4     25.0        0.10       4      1.667    0.503
Inventario de harina              26     10.0        0.06       2      4.333    0.389
Respuesta a reseñas               30      4.0        0.03       4      2.000    0.172
Con pesos iguales: Encargos (0.635), Confirmaciones (0.573), Factura de Brújula (0.565), Inventario de harina (0.451), Respuesta a reseñas (0.194)
El orden se recoge en la Tabla 4.
Tabla 4. Procesos candidatos de Trigo Lento ordenados por puntaje de prioridad.
| Proceso | Veces al mes | Minutos cada vez | Horas al mes | Tasa de error | Riesgo (1 a 5) | Puntaje |
|---|---|---|---|---|---|---|
| Encargos | 468 | 6.0 | 46.8 | 0.08 | 3 | 0.670 |
| Confirmaciones | 468 | 1.0 | 7.8 | 0.05 | 2 | 0.610 |
| Factura de Brújula | 4 | 25.0 | 1.7 | 0.10 | 4 | 0.503 |
| Inventario de harina | 26 | 10.0 | 4.3 | 0.06 | 2 | 0.389 |
| Respuesta a reseñas | 30 | 4.0 | 2.0 | 0.03 | 4 | 0.172 |
El proceso de encargos queda primero con $0.670$: es el más frecuente, el que más horas consume ($46.8$ al mes, seis veces más que el siguiente) y tiene un riesgo medio. Las confirmaciones, que hoy son parte del encargo, quedan segundas con $0.610$: son igual de frecuentes, cortas y de riesgo bajo, el candidato ideal para una primera regla automática. La factura de Brújula queda tercera con $0.503$ a pesar de ocurrir solo cuatro veces al mes, porque es larga y tiene la tasa de error más alta; su riesgo fiscal, sin embargo, le resta puntos. Con pesos iguales el orden se mantiene (encargos $0.635$, confirmaciones $0.573$, factura $0.565$), aunque la factura se acerca mucho a las confirmaciones: si Marisol se quejara de una factura más, la decisión podría cambiar, y eso está bien. Una matriz de priorización no sustituye al criterio, lo hace explícito.
La respuesta a reseñas queda última con $0.172$, y hay una razón adicional que no aparece en los números: en esta serie no se automatiza nada que toque reseñas, seguidores ni comentarios públicos en nombre del negocio. Una respuesta automática a una reseña negativa es la forma más rápida de convertir un mal día en una crisis de reputación.
Para ver la matriz de un vistazo, el siguiente código dibuja cada proceso como una burbuja: la frecuencia en el eje horizontal (en escala logarítmica, porque va de 4 a 468), los minutos en el vertical y el tamaño según el riesgo:
# Burbujas de priorización: frecuencia frente a minutos, tamaño por riesgo en Python:
fig, ax = plt.subplots(figsize = (9, 5.2))
colores_p = ['#2a78d6', '#9ec5f4', '#eb6834', '#c3c2b7', '#f2a37f']
for (nombre, fila), color in zip(procesos.iterrows(), colores_p):
    ax.scatter(fila['frecuencia_mes'], fila['minutos'], s = 260 * fila['riesgo'], color = color,
               alpha = 0.85, edgecolor = '#52514e', linewidth = 1)
    ax.annotate(f"{nombre}\npuntaje {fila['puntaje']:.3f}", (fila['frecuencia_mes'], fila['minutos']),
                xytext = (14, 10), textcoords = 'offset points', fontsize = 9, color = '#0b0b0b')
ax.set_xscale('log')
ax.set_xlim(2, 2000)
ax.set_ylim(0, 30)
ax.set_title('Qué automatizar primero en Trigo Lento', fontsize = 16)
ax.set_xlabel('Veces al mes (escala logarítmica)')
ax.set_ylabel('Minutos cada vez')
ax.text(2.3, 1.2, 'Tamaño de la burbuja: riesgo de 1 a 5', fontsize = 9, color = '#52514e')
ax.spines[['top', 'right']].set_visible(False)
plt.tight_layout()
plt.show()
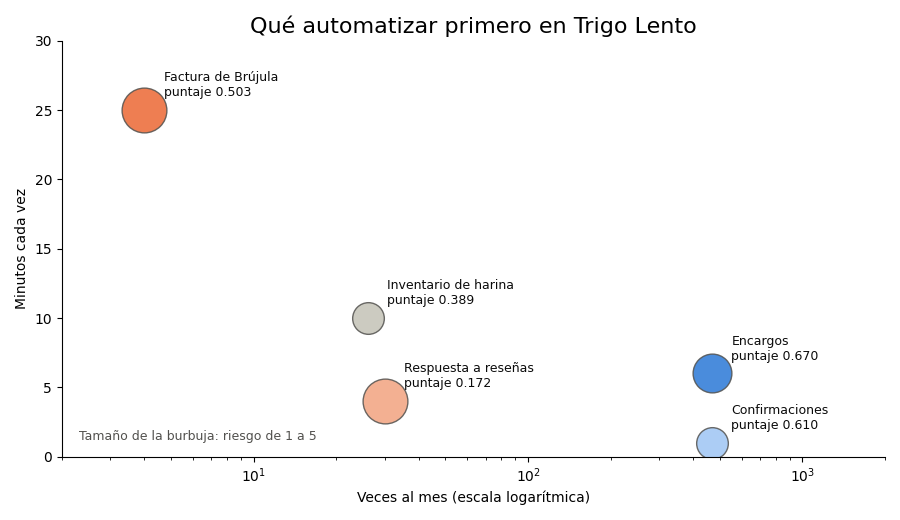
La gráfica separa los procesos en tres zonas. Abajo a la derecha están los frecuentes y cortos (encargos y confirmaciones): cada vez cuestan poco, pero suman mucho; son los que primero se automatizan. Arriba a la izquierda está la factura de Brújula, rara y larga, con una burbuja grande por su riesgo: merece una automatización cuidadosa, con revisión humana, más adelante. En el centro quedan el inventario de harina y las reseñas, que no justifican, por ahora, el esfuerzo. Esa es la hoja de ruta que seguirán los primeros módulos: primero lo frecuente y de bajo riesgo, después lo raro y delicado, y nunca lo que no se debe automatizar.
La mentalidad del arquitecto
Hasta aquí se ha medido. Ahora toca pensar como se piensa antes de construir. El primer gesto de un arquitecto de automatización no es abrir Make ni escribir un prompt, sino dibujar el sistema tal como está hoy, con todas sus piezas, incluidas las personas. El siguiente código dibuja el proceso actual de encargos con los parches de matplotlib, usando la paleta de formas que tendrá toda la serie: el cliente como óvalo verde (el disparador), los canales y los registros como rectángulos azules (acciones) y Valeria como hexágono gris (un paso humano):
# Diagrama del proceso actual de encargos dibujado con patches en Python:
from matplotlib.patches import FancyBboxPatch, FancyArrowPatch, Ellipse, RegularPolygon

fig, ax = plt.subplots(figsize = (11, 5.2))
ax.set_xlim(0, 11)
ax.set_ylim(-0.8, 5.4)
ax.axis('off')
ax.add_patch(Ellipse((0.9, 2.7), 1.4, 0.9, facecolor = '#d2f0e4', edgecolor = '#52514e'))
ax.text(0.9, 2.7, 'Cliente', ha = 'center', va = 'center', fontsize = 10)
for i, (canal, pct) in enumerate(zip(canales, reparto)):
    y = 4.4 - 1.15 * i
    ax.add_patch(FancyBboxPatch((2.3, y - 0.35), 1.8, 0.7, boxstyle = 'round,pad=0.04,rounding_size=0.1',
                                facecolor = '#cde2fb', edgecolor = '#52514e'))
    ax.text(3.2, y, f'{canal}\n{int(100 * pct)} %', ha = 'center', va = 'center', fontsize = 9)
    ax.add_patch(FancyArrowPatch((1.6, 2.7), (2.28, y), arrowstyle = '-|>', mutation_scale = 12, color = '#52514e'))
    ax.add_patch(FancyArrowPatch((4.12, y), (5.0, 2.75), arrowstyle = '-|>', mutation_scale = 12, color = '#52514e'))
ax.add_patch(RegularPolygon((5.6, 2.7), numVertices = 6, radius = 0.62, orientation = np.pi / 6,
                            facecolor = '#e6e5e1', edgecolor = '#52514e'))
ax.text(5.6, 2.7, 'Valeria', ha = 'center', va = 'center', fontsize = 10)
manuales = [(6.7, 3.6, 'Libreta\n1.0 min'), (8.5, 3.6, 'Hoja de cálculo\n1.0 min'), (8.5, 1.4, 'Obrador\naviso 0.5 min')]
for x, y, texto in manuales:
    ax.add_patch(FancyBboxPatch((x, y), 1.6, 0.8, boxstyle = 'round,pad=0.04,rounding_size=0.1',
                                facecolor = '#cde2fb', edgecolor = '#52514e'))
    ax.text(x + 0.8, y + 0.4, texto, ha = 'center', va = 'center', fontsize = 9)
flechas = [((6.1, 3.0), (6.7, 3.9)), ((8.3, 4.0), (8.5, 4.0)), ((9.3, 3.58), (9.3, 2.22))]
for inicio, fin in flechas:
    ax.add_patch(FancyArrowPatch(inicio, fin, arrowstyle = '-|>', mutation_scale = 12, color = '#52514e'))
ax.add_patch(FancyArrowPatch((5.6, 2.06), (0.9, 2.22), connectionstyle = 'arc3,rad=-0.75', arrowstyle = '-|>',
                             mutation_scale = 12, color = '#eb6834', linestyle = '--'))
ax.text(3.2, -0.6, 'Preguntar datos faltantes (2.0 min) y confirmar (1.0 min): ida y vuelta por el mismo canal',
        ha = 'center', fontsize = 9, color = '#eb6834')
ax.text(5.6, 1.7, 'Leer 0.5 min', ha = 'center', fontsize = 9, color = '#52514e')
ax.set_title('Proceso actual de encargos: 6 minutos y una sola persona', fontsize = 16)
plt.tight_layout()
plt.show()
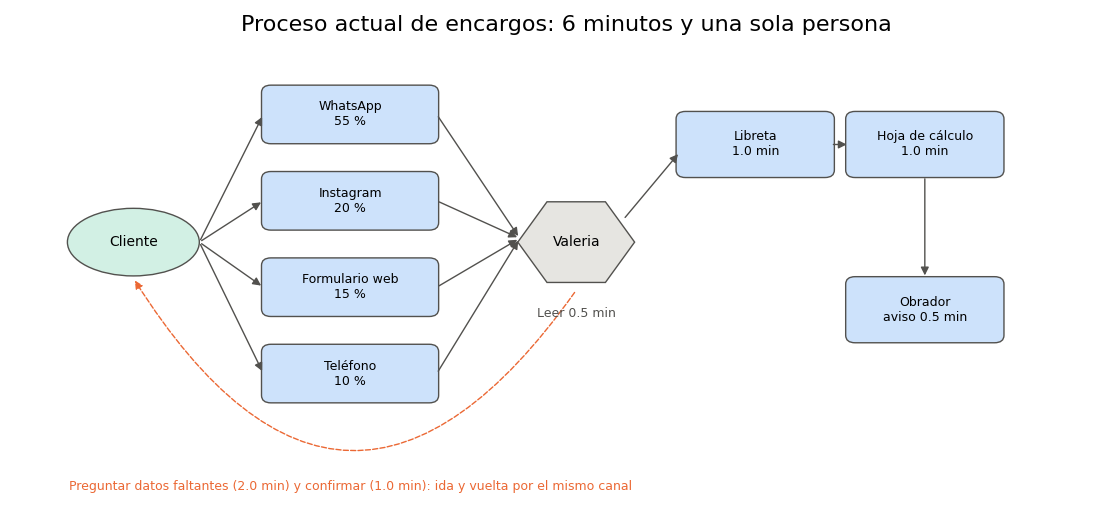
El diagrama hace visible lo que en la tabla eran solo minutos. Cuatro canales convergen en un único hexágono: Valeria es el embudo de todo el proceso. Desde ella salen la libreta, la hoja de cálculo y el aviso al obrador, y la flecha discontinua naranja que vuelve al cliente es el bucle de preguntar lo que falta y confirmar, el $50%$ del tiempo del encargo. Un arquitecto mira este dibujo y ve tres cosas antes de pensar en herramientas: un punto único de fallo (Valeria), un dato escrito dos veces (libreta y hoja) y un bucle que se puede acortar rediseñando la entrada.
Las cinco preguntas
Antes de construir cualquier flujo, el arquitecto responde cinco preguntas. No son originales ni secretas; su valor está en hacerlas siempre y en responderlas con datos:
- ¿Qué entra? Qué datos llegan, por qué canal, con qué frecuencia y en qué formato. Un flujo que no conoce sus entradas falla con la primera que no esperaba.
- ¿Qué sale? Qué resultado debe producir, para quién y en qué formato. Si la salida no está definida, no se puede comprobar si el flujo funciona.
- ¿Qué falla? Qué pasos fallan hoy, cuáles pueden fallar mañana y qué ocurre cuando fallan. Esta es la pregunta que distingue un sistema de un truco.
- ¿Cuánto cuesta? Cuánto cuesta hoy en horas y en espera, y cuánto costará automatizado en plataformas, mensajes y tokens, con el techo de 45 USD a la vista.
- ¿A quién afecta? Quién recibe el resultado, quién lo opera, quién lo arregla cuando se rompe y quién puede salir perjudicado.
El siguiente código responde las cinco preguntas para el proceso de encargos con las cifras calculadas en los bloques anteriores y las guarda en trigo_lento/ficha_encargos.json, una ficha que el Día 4 convertirá en un contrato de datos:
# Las cinco preguntas del arquitecto aplicadas al proceso de encargos en Python:
ficha = {
    'proceso': 'Encargos',
    'que_entra': f'{encargos_mes} encargos al mes por {len(canales)} canales, '
                 f"{resumen_canal.loc['WhatsApp', 'pct']} % por WhatsApp en el mes simulado",
    'que_sale': 'Pedido completo en la hoja, confirmación al cliente y aviso al obrador',
    'que_falla': f"Datos faltantes: {pasos.loc[pasos['paso'] == 'Preguntar datos faltantes', 'pct'].item():.1f} % "
                 f"del tiempo; error del {100 * procesos.loc['Encargos', 'tasa_error']:.0f} %",
    'cuanto_cuesta': f'{h_manual:.1f} h y {h_manual * valor_hora_mxn:,.0f} MXN al mes a mano; '
                     f"espera pico de {tabla_cola.iloc[0]['Wq_min']:.0f} min",
    'a_quien_afecta': ['Clientes', 'Valeria', 'Obrador', 'Cafetería Brújula', 'Don Ernesto'],
}
(carpeta / 'ficha_encargos.json').write_text(json.dumps(ficha, ensure_ascii = False, indent = 2), encoding = 'utf-8')
for clave, valor in ficha.items():
    print(f"{clave:>15}: {', '.join(valor) if isinstance(valor, list) else valor}")
        proceso: Encargos
      que_entra: 468 encargos al mes por 4 canales, 51.3 % por WhatsApp en el mes simulado
       que_sale: Pedido completo en la hoja, confirmación al cliente y aviso al obrador
      que_falla: Datos faltantes: 33.3 % del tiempo; error del 8 %
  cuanto_cuesta: 46.8 h y 3,510 MXN al mes a mano; espera pico de 54 min
 a_quien_afecta: Clientes, Valeria, Obrador, Cafetería Brújula, Don Ernesto
La ficha resume la entrada en seis líneas, y cada una sale de un bloque anterior: los $468$ encargos del Bloque 4, el $51.3%$ de WhatsApp del mes simulado del Bloque 7, el $33.3%$ del tiempo en datos faltantes del Pareto del Bloque 3, el $8%$ de error de la matriz del Bloque 8, las $46.8$ horas y los $3,510$ MXN del Bloque 4 y los $54$ minutos de espera de la cola M/M/1 del Bloque 5. Nada está escrito a mano: si cambia una medición, la ficha cambia con ella. Es un hábito pequeño con una consecuencia grande: las decisiones de diseño quedan atadas a los datos que las justifican.
Conectar aplicaciones frente a diseñar un sistema
Las plataformas de automatización han hecho muy fácil conectar aplicaciones: en diez minutos se puede lograr que cada mensaje de WhatsApp aparezca como fila en una hoja de cálculo. Esa facilidad es una bendición y una trampa. Quien solo conecta aplicaciones se pregunta “¿funciona?” y responde mirando el caso que acaba de probar. Quien diseña un sistema se pregunta qué pasa con el mensaje que llega a las 3 de la mañana, con el que trae una foto en lugar de texto, con el que se procesa dos veces porque la plataforma reintentó, con la hoja que se llena y con la persona que tiene que arreglarlo cuando Valeria está de vacaciones.
La diferencia entre las dos actitudes cabe en un dibujo, el de la Figura 3: a un lado, alguien que une piezas sueltas; al otro, alguien con un plano que anota entradas, salidas, fallos, costes y personas.
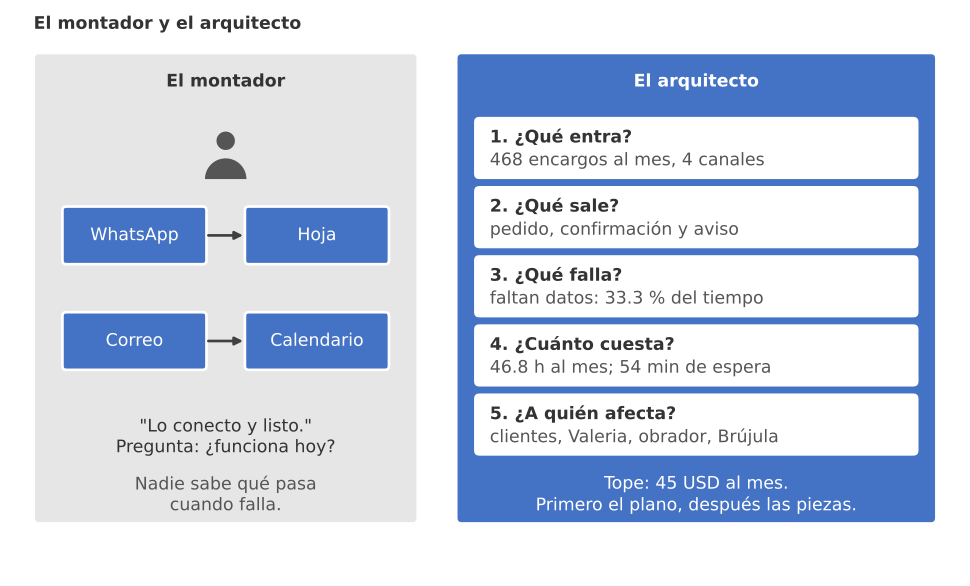
Figura 3. El montador y el arquitecto: a la izquierda, piezas unidas sin preguntar; a la derecha, el plano del proceso de encargos con las cinco preguntas respondidas con las cifras de esta entrada.
El plano de la derecha no es burocracia. Es lo que permite que un sistema de 45 USD al mes funcione durante años en una panadería sin un departamento de informática. A lo largo de la serie, esas cinco preguntas se convertirán en piezas concretas: el contrato de datos del Día 4 responde qué entra y qué sale; el manejo de errores del módulo 3 y las pruebas del módulo 4 responden qué falla; el control de costes de los días 12 y 84 responde cuánto cuesta; y el código de honor del Día 6, con la aprobación humana del módulo 4, responde a quién afecta.
Lo que dijo Don Ernesto
Al ver la matriz de priorización, Don Ernesto se sentó por primera vez en toda la mañana. No estaba convencido, pero tampoco cerrado. Hizo tres objeciones, y las tres son buenas:
- El oficio. “Mire, Valeria: el pan, las recetas y el trato con la gente son lo que somos. Si una computadora contesta por nosotros, ¿qué nos distingue de una cadena?” La objeción tiene razón en lo esencial, y la serie la respeta: nada de lo que se automatiza toca el obrador ni las recetas, que por decisión del Día 6 no saldrán nunca hacia un modelo de lenguaje. Se automatiza lo que rodea al pan (apuntar, confirmar, avisar, facturar), no el pan. El Día 6 escribe ese límite en un código de honor.
- El coste. "¿Y cuánto nos va a costar esto al mes? Porque las suscripciones se acumulan y yo no las veo." La respuesta de hoy es un techo de 45 USD y un ahorro estimado de 142.30 USD en horas solo en encargos; el Día 12 compara los planes reales de las plataformas y el Día 84 suma el coste final, que el plan de la serie estima en 36.35 USD al mes.
- El trato con los clientes. "¿Y si el robot le contesta mal a una clienta que nos compra desde hace veinte años?" Esta es la objeción más seria y la que más días ocupa. El Día 2 explica qué hace y qué no hace un modelo de lenguaje; el Día 38 construye un agente de pedidos que no confirma nada sin la aprobación de Valeria; y el Día 74 lleva esas aprobaciones a Slack y WhatsApp. Toda acción con efecto económico o reputacional pasa por una persona.
Valeria no ganó la discusión ese sábado, y no hacía falta. Don Ernesto aceptó una prueba con una condición: “Si en un mes un solo cliente se queja de que le contestó una máquina, usted lo apaga.” Es un criterio de aceptación perfectamente razonable, y un arquitecto debería agradecerlo: dice qué significa “funcionar” para quien paga.
El mapa de los 89 días
Las respuestas a Don Ernesto ya mencionan días concretos porque la serie tiene un recorrido planificado: 8 módulos contiguos, del 1 de febrero al 30 de abril de 2026, cada uno con una ganancia concreta para Trigo Lento. La Tabla 5 resume el mapa.
Tabla 5. Los 8 módulos de la serie, sus días y lo que gana Trigo Lento en cada uno.
| Módulo | Nombre | Días | Qué gana Trigo Lento |
|---|---|---|---|
| 1/8 | Fundamentos de IA y mentalidad de arquitecto de automatización | 1 a 10 | Proceso medido, contrato de datos, código de honor y primer flujo de juguete en Python |
| 2/8 | Ecosistema no-code y low-code | 11 a 21 | Elección razonada de plataformas con costes, conexiones seguras y mapa de automatización priorizado |
| 3/8 | Orquestación no-code con Make | 22 a 33 | Escenario de pedidos en Make con webhook, router, manejo de errores y clasificación con Claude |
| 4/8 | Automatización avanzada de agentes con n8n | 34 a 45 | n8n en servidor propio y un agente de pedidos con herramientas y aprobación humana |
| 5/8 | Ecosistema de comunicación: Gmail, Slack y WhatsApp API | 46 a 56 | WhatsApp dentro de presupuesto, borradores de Gmail y Slack como centro de operaciones |
| 6/8 | Inteligencia de negocio con la API de Claude (2026) | 57 a 67 | Lectura de facturas en PDF, lotes nocturnos, caché, conector del inventario e informe del lunes |
| 7/8 | Diseño de agentes y automatización de la creatividad | 68 a 77 | Base de conocimiento, agente con memoria, calendario editorial con aprobación y cuadro de mando |
| 8/8 | Proyecto integrador: el ecosistema de IA autónomo de Trigo Lento | 78 a 89 | Arquitectura documentada, manuales, pruebas de punta a punta y coste final frente a los 45 USD |
El orden de los módulos sigue la escalera de la Figura 1. Los diez primeros días no tocan ninguna plataforma: miden, definen contratos, fijan reglas éticas y terminan con un primer flujo de juguete en Python, porque un flujo construido sobre un proceso que no se entiende solo automatiza la confusión. El módulo 2 elige herramientas con números; los módulos 3 y 4 construyen en Make y en n8n; el 5 resuelve la mensajería; el 6 profundiza en la API de Claude; el 7 diseña agentes y contenido con una persona al mando; y el 8 lo integra, lo prueba y lo entrega. Los días 9, 32, 44, 66 y 87 son evaluaciones para que usted compruebe lo aprendido.
Fíjese también en lo que el mapa no promete. No promete que Trigo Lento funcione sola, ni que Valeria deje de trabajar, ni que la IA tome decisiones de negocio. Promete un ecosistema autónomo supervisado: flujos que hacen el trabajo repetible y personas que deciden lo que importa.
Consideraciones finales
Las cifras de hoy son modestas en apariencia: 6 minutos por encargo, 9 mensajes por hora, 45 USD al mes. Lo que las vuelve interesantes es que, puestas en relación, cuentan una historia que nadie en Trigo Lento había visto entera: casi 47 horas al mes en un solo proceso, una cola que en los días malos deja a un cliente de cada diez esperando más de dos horas, y un paso (preguntar lo que falta) que consume un tercio del tiempo y que no se arregla con tecnología, sino con un mejor diseño de la entrada.
Atención aquí: Esta serie automatiza para liberar horas, no para recortar personas. Las 35.1 horas que se ahorran en encargos se dedicarán a la atención en el mostrador y al obrador, y así se dirá en el negocio desde el principio, porque un equipo que teme por su trabajo sabotea, con razón, cualquier automatización. Además, los clientes tienen derecho a saber qué parte de la atención es automática: cuando un mensaje lo genere un sistema, se dirá. Los datos de esta entrada (clientes, mensajes, cifras de la panadería) son ficticios y de juguete; cuando la serie trate datos personales, lo hará con aviso de privacidad, finalidades declaradas y el mínimo de datos necesario.
Antes de pasar al Día 2, conviene que usted se haga algunas preguntas sobre su propio negocio o sobre el de alguien que conozca:
- ¿Cuál es el proceso más frecuente y cuántos minutos lleva cada vez? ¿Lo ha cronometrado o lo supone?
- ¿Qué paso concentra la mayor parte del tiempo, y se puede eliminar con un mejor diseño antes de automatizarlo?
- ¿Cuál es la utilización en la hora pico? Si está por encima de $0.8$, ¿qué pasaría con la espera si la carga creciera un $10%$?
- ¿Qué proceso no debería automatizarse nunca, y por qué?
Las limitaciones de las cifras también conviene decirlas. El modelo M/M/1 supone llegadas de Poisson y atención exponencial, una simplificación útil pero no exacta; los minutos por paso son mediciones de una semana redondeadas; la tasa de error y el riesgo de la matriz son estimaciones de Valeria, no registros auditados; y el valor de 75 MXN por hora es un supuesto didáctico. Ninguna de esas limitaciones invalida el método. Al contrario: el método está hecho para sustituir supuestos por mediciones a medida que el sistema funcione.
Un gran libro que habla de esto es Fundamentals of Business Process Management (o Fundamentos de la gestión de procesos de negocio), en el que Marlon Dumas, Marcello La Rosa, Jan Mendling y Hajo Reijers recorren el ciclo completo de un proceso: identificarlo, modelarlo, analizarlo con medidas cuantitativas (incluidas las colas), rediseñarlo y automatizarlo. Su lectura le dará un vocabulario común con cualquier equipo de procesos y le ayudará a no confundir nunca automatizar con rediseñar.
Un arquitecto de automatización no es quien sabe conectar más aplicaciones, es quien sabe qué conectar, por qué, cuánto cuesta y qué pasa cuando falla. Hoy Trigo Lento no tiene todavía ningún flujo, pero tiene algo más valioso para empezar: su proceso medido, su coste calculado, su cola explicada y una lista ordenada de qué hacer primero.
Conclusiones clave
Conceptos
- La automatización de procesos de negocio (BPA) ejecuta con software los pasos repetibles de un proceso para que las personas intervengan donde aportan criterio; no es lo mismo que digitalizar, ni que la RPA, ni que la BPM.
- Tarea, proceso y flujo son niveles distintos: automatizar una tarea sin mirar el proceso deja intacto el cuello de botella.
- Primero se rediseña y después se automatiza: en Trigo Lento, pedir los datos completos desde el principio elimina el paso más caro sin ninguna herramienta.
Medición
- El encargo manual dura 6 minutos y el paso de preguntar datos faltantes se lleva el 33.3 %; con $H = n \cdot t / 60$, los 468 encargos del mes cuestan 46.8 horas y 3 510 MXN.
- Con el objetivo de 1.5 minutos, el ahorro es de 35.1 horas y 2 632.50 MXN (142.30 USD) al mes, unas 3.16 veces el presupuesto de 45 USD.
- En la hora pico, con $\lambda = 9$ y $\mu = 10$, la cola M/M/1 da una espera de 54 minutos y 9 mensajes en el sistema por la ley de Little; con $\mu = 40$, menos de 2 minutos en el sistema.
- La simulación confirma la teoría (47.4 minutos de media, 131.7 en el percentil 90) y la corrige con la realidad: en ventanas de 2 horas que empiezan vacías, la espera media es de 13.1 minutos.
Prioridades
- La matriz de frecuencia, tiempo, error y riesgo ordena los procesos: encargos (0.670), confirmaciones (0.610), factura de Brújula (0.503), inventario de harina (0.389) y reseñas (0.172).
- Lo frecuente y de bajo riesgo se automatiza primero; lo raro y delicado, después y con revisión humana; las reseñas, nunca.
- Antes de construir, el arquitecto responde cinco preguntas con datos: qué entra, qué sale, qué falla, cuánto cuesta y a quién afecta.
Mañana, en el Día 2: La IA dentro de un flujo: qué hace un modelo de lenguaje y qué no. De los 60 mensajes diarios de WhatsApp no todos son pedidos, y Valeria comprobará qué parte de esa clasificación se resuelve con reglas y en qué parte compensa, con números, pagar una llamada a Claude.
Referencias
- Dumas, M., La Rosa, M., Mendling, J. y Reijers, H. A. (2018). Fundamentals of Business Process Management (2.ª ed.). Springer. https://doi.org/10.1007/978-3-662-56509-4
- Hammer, M. (1990). Reengineering Work: Don’t Automate, Obliterate. Harvard Business Review, 68(4), 104-112. https://hbr.org/1990/07/reengineering-work-dont-automate-obliterate
- van der Aalst, W. M. P., Bichler, M. y Heinzl, A. (2018). Robotic Process Automation. Business & Information Systems Engineering, 60(4), 269-272. https://doi.org/10.1007/s12599-018-0542-4
- Little, J. D. C. (1961). A Proof for the Queuing Formula: L = λW. Operations Research, 9(3), 383-387. https://doi.org/10.1287/opre.9.3.383
- Kleinrock, L. (1975). Queueing Systems, Volume 1: Theory. Wiley.