
Arquitecto de automatización con IA: Día 11
 Jeshua Romero Guadarrama
- 52 Min para leer
- 11 Feb, 2026
Índice de contenido
Resumen:
Elegir una plataforma de automatización por el anuncio que más se ve es la forma más rápida de pagar dos veces. En esta entrada, que abre el módulo 2, Valeria coloca Zapier, Power Automate, Make, n8n y Python en una regla graduada de control frente a velocidad, puntúa cuatro de ellas con una matriz ponderada (n8n 4.05, Make 3.80, Python 3.65 y Zapier 2.45), calcula el coste total a 12 meses de un mismo flujo (Make 191.94 USD frente a 201.73 de Python propio, con un cruce en el mes 14.1) y lee ese flujo escrito tres veces: en Python, en un blueprint de Make y en un workflow de n8n. Al terminar, usted sabrá construir una matriz de decisión explícita, estimar el coste de construir y de mantener, medir la dependencia del proveedor y dejar la decisión por escrito con sus condiciones de revisión.
¿Cómo citar el presente artículo?
Romero, J. (11 de febrero de 2026). Arquitecto de automatización con IA: Día 11. python-data-engineer. https://www.python-data-engineer.com/post/aai/dia_11/.
Arquitecto de automatización con IA: Día 11 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/aai/dia_11/.
Precios, límites y políticas de Make, n8n, Zapier, Power Automate, WhatsApp (Meta, Twilio, Wati) y de la API de Claude revisados en octubre de 2026; las fuentes secundarias consultadas discrepan en algunos valores y se indica cuáles. Este día no llama a ningún servicio: los bloques de Python se ejecutan sin red y sus salidas son las reales. Los dos archivos JSON de flujo (Bloques 6 y 7) tienen la estructura verificada contra la documentación de Make y de n8n, revisado en octubre de 2026; no son exportaciones de una cuenta real, y sus identificadores son valores de ejemplo.
Día 11. No-code, low-code y código: dónde está cada herramienta
Introducción
Ayer, en el Día 10 (Sesión práctica: el despertar del arquitecto), Valeria escribió en Python un motor de flujos de juguete con pasos, ejecución y registro, lo puso a trabajar con un día simulado de 60 mensajes y Trigo Lento ganó su primer flujo, el v0, que reduce de 60 a 15 las veces que una persona tiene que intervenir. Hoy comienza el módulo 2/8, Ecosistema no-code y low-code: once días para elegir herramientas con criterio y con números, entender los datos y las conexiones que todas comparten y usar la IA para acelerar el diseño sin perder el control.
Es miércoles 11 de febrero, pasadas las seis de la tarde. El obrador ya huele a la masa madre que reposa para mañana y Valeria tiene abiertas, en pestañas contiguas, las páginas de precios de cuatro plataformas. Las cuatro prometen lo mismo con palabras parecidas: “automatice sin escribir código”, “conecte miles de aplicaciones”, “agentes de IA en minutos”. Su motor de juguete del Día 10 funciona, pero vive en un cuaderno de Python que solo ella sabe ejecutar, no tiene un servidor donde quedarse encendido y no recibe los mensajes de WhatsApp de verdad. Hace falta pasar del laboratorio al mostrador, y para eso hay que elegir dónde van a vivir los flujos de Trigo Lento durante los próximos meses.
Don Ernesto, que ha seguido de lejos los diez primeros días, se asoma por encima del hombro de su hija, ve las cuatro páginas de precios y hace la pregunta que lleva rato pensando: “Valeria, ¿para qué vamos a pagar una suscripción si usted ya sabe Python? Usted misma hizo el robot de ayer. Escríbalo completo y nos ahorramos la cuota.” Es una pregunta mejor de lo que parece. Tiene razón en que la suscripción es un gasto que se repite cada mes; lo que todavía no ha puesto en la cuenta es lo que cuesta construir, lo que cuesta mantener y lo que cuesta depender de una sola persona. Al final de la entrada la responderemos con números, y no será un sí ni un no.
En la presente entrada, descubrirá que no-code, low-code y código no son tres cajas cerradas, sino un espectro continuo en el que cada herramienta ocupa una posición, y qué se gana y qué se pierde al moverse por él. Construirá una matriz de decisión ponderada con los pesos de Valeria, verá lo sensible que es su resultado a un solo peso y calculará el coste total a 12 meses de cuatro opciones con una fórmula que separa construir de mantener. Después estudiará la dependencia del proveedor y la portabilidad, leerá el mismo flujo, del formulario web a la hoja de pedidos, escrito en Python, en un blueprint de Make y en un workflow de n8n, y terminará respondiendo a Don Ernesto con una simulación de Monte Carlo y un registro de la decisión que dice cuándo hay que volver a tomarla.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Ubicar Zapier, Make, n8n y Python en un espectro de control frente a velocidad.
- Comparar herramientas con una matriz de decisión ponderada y explícita.
- Estimar el coste total de una automatización a 12 meses (construcción, suscripción y mantenimiento).
- Leer el mismo flujo expresado en Python, en un blueprint de Make y en un workflow de n8n.
Un espectro, no tres cajas
Las palabras no-code (sin código) y low-code (poco código) se usan a menudo como si nombraran categorías separadas, con una frontera nítida entre ellas y la programación. En la práctica funcionan mejor como marcas de una regla. En un extremo está la herramienta que se usa arrastrando bloques y rellenando formularios, sin ver nunca una línea de código; en el otro, el programa que se escribe entero a mano. Entre ambos hay posiciones intermedias: plataformas visuales que permiten expresiones, funciones y ramificaciones complejas; plataformas que añaden un nodo para escribir código cuando lo visual no alcanza, y que además se pueden instalar en un servidor propio.
Lo que cambia al recorrer la regla de izquierda a derecha no es una sola cosa, sino un paquete de propiedades que se mueven juntas. Hacia la izquierda se gana velocidad: el primer flujo funciona en una tarde, y lo puede construir una persona que nunca ha programado. Hacia la derecha se gana control: cada error se puede atrapar con precisión, cada dato se queda donde usted decide y nada depende del catálogo de conectores de un tercero. El precio de la velocidad es el control, y el precio del control es el tiempo. Un arquitecto de automatización no busca el extremo “correcto”, sino la posición que conviene a cada flujo.
Para que la idea no se quede en metáfora, Valeria escribe el espectro en una tabla. Como en todos los días de la serie, el primer bloque prepara las importaciones, la semilla global $2026$ y la carpeta del día. Añade dos supuestos que se usarán toda la entrada: el tipo de cambio didáctico de $18.50$ MXN por dólar y el valor de la hora de Valeria, $75$ MXN, que convertido a dólares será la $v$ de las fórmulas de coste:
# Importaciones base, semilla de la serie y carpeta del día en Python:
import warnings
warnings.filterwarnings('ignore')
import json
from pathlib import Path
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 120)
pd.set_option('display.max_columns', 12)
carpeta = Path('trigo_lento') / 'dia_11'
carpeta.mkdir(parents = True, exist_ok = True)

# Supuestos didácticos de la serie: tipo de cambio fijo y valor de la hora de Valeria:
TIPO_CAMBIO = 18.50                 # MXN por USD
V_HORA = 75 / TIPO_CAMBIO           # USD por hora
print('numpy', np.__version__, '| pandas', pd.__version__)
print(f'Hora de Valeria: 75 MXN = {V_HORA:.4f} USD')
numpy 2.4.6 | pandas 3.0.3
Hora de Valeria: 75 MXN = 4.0541 USD
La hora de Valeria vale $4.0541$ USD. Es un supuesto didáctico, declarado desde el Día 1, y no el sueldo de nadie: sirve para poner en la misma unidad las horas de trabajo y las cuotas de las plataformas, que es lo que hará la fórmula del coste total.
Ahora el espectro. Cada herramienta lleva su tipo, quién suele usarla, las horas de aprendizaje que necesita una persona como Valeria para tener su primer flujo funcionando (un supuesto razonado, no una medición), su límite principal y lo que permite exportar. La columna posicion coloca cada herramienta en una regla de $0$ a $100$ usando el logaritmo de las horas, porque la diferencia que se nota no es la de sumar horas, sino la de multiplicarlas: pasar de $2$ a $4$ horas se siente igual que pasar de $20$ a $40$. El siguiente bloque construye la tabla:
# El espectro de herramientas, de arrastrar y soltar a escribir código, como DataFrame en Python:
espectro = pd.DataFrame([
    ('Zapier', 'no-code', 'persona de negocio', 2, 'lógica ramificada cara; solo nube', 'limitada'),
    ('Power Automate', 'no-code corporativo', 'empresa con Microsoft 365', 4, 'pago por usuario', 'paquete .zip'),
    ('Make', 'visual con lógica', 'analista sin código', 6, 'créditos por módulo; solo nube', 'blueprint JSON'),
    ('n8n', 'low-code', 'analista técnico', 12, 'servidor propio que mantener', 'workflow JSON'),
    ('Python', 'código', 'programador', 40, 'todo se construye a mano', 'código fuente'),
], columns = ['herramienta', 'tipo', 'quien_la_usa', 'horas_curva', 'limite', 'exporta'])

# Posición en la regla graduada: logaritmo de las horas de aprendizaje, escalado de 0 a 100:
log_h = np.log(espectro['horas_curva'])
espectro['posicion'] = ((log_h - log_h.min()) / (log_h.max() - log_h.min()) * 100).round().astype(int)
print(espectro.to_string(index = False))
print('Razón de curvas Python / Zapier:', espectro['horas_curva'].iloc[-1] / espectro['horas_curva'].iloc[0])
   herramienta                tipo              quien_la_usa  horas_curva                            limite        exporta  posicion
        Zapier             no-code        persona de negocio            2 lógica ramificada cara; solo nube       limitada         0
Power Automate no-code corporativo empresa con Microsoft 365            4                  pago por usuario   paquete .zip        23
          Make   visual con lógica       analista sin código            6    créditos por módulo; solo nube blueprint JSON        37
           n8n            low-code          analista técnico           12      servidor propio que mantener  workflow JSON        60
        Python              código               programador           40          todo se construye a mano  código fuente       100
Razón de curvas Python / Zapier: 20.0
La salida reproduce la Tabla 1. La herramienta más rápida de aprender, Zapier, queda en la posición $0$; Python, en la $100$; y entre ambas aparecen Power Automate ($23$), Make ($37$) y n8n ($60$). La razón entre las curvas de aprendizaje de los dos extremos es de $20$ a $1$: la primera automatización en Python le costará a Valeria unas veinte veces más horas que en Zapier.
Tabla 1. El espectro de herramientas de automatización: tipo, usuario típico, curva de aprendizaje (supuesto), límite principal y lo que se puede exportar.
| Herramienta | Tipo | Quién la usa | Horas hasta el primer flujo | Límite principal | Exporta | Posición (0 a 100) |
|---|---|---|---|---|---|---|
| Zapier | No-code | Persona de negocio | 2 | Lógica ramificada cara; solo en la nube | Limitada | 0 |
| Power Automate | No-code corporativo | Empresa con Microsoft 365 | 4 | Pago por usuario | Paquete .zip | 23 |
| Make | Visual con lógica | Analista sin código | 6 | Créditos por módulo; solo en la nube | Blueprint JSON | 37 |
| n8n | Low-code | Analista técnico | 12 | Servidor propio que alguien mantiene | Workflow JSON | 60 |
| Python | Código | Programador | 40 | Todo se construye y se mantiene a mano | Código fuente | 100 |
Tres lecturas de la tabla merecen detenerse:
- Make no es “no-code puro”. Su editor es visual, pero un escenario serio usa routers, filtros, iteradores, agregadores y funciones en las expresiones de mapeo; el módulo 3 de la serie dedica doce días a esa lógica. Por eso ocupa una posición intermedia y no el extremo.
- n8n es low-code de verdad. Cada nodo se configura con formularios, pero el nodo Code admite JavaScript o Python, y la plataforma se puede instalar en un servidor propio (en inglés, self-hosted), lo que trae control sobre los datos y, a la vez, la obligación de mantener ese servidor.
- Power Automate juega en otra liga. Brilla cuando la empresa ya vive en Microsoft 365, con correo, hojas y archivos en ese ecosistema; Trigo Lento usa WhatsApp, una hoja de cálculo de Google y un formulario web, así que hoy queda como referencia. El Día 13 la pondrá a prueba junto con las demás con el mismo flujo.
La regla graduada que muestra la Figura 1 resume la tabla en una sola imagen: las cuatro herramientas que Valeria compara como marcas sobre la regla, y encima y debajo lo que se gana y lo que se pierde al desplazarse hacia la derecha.
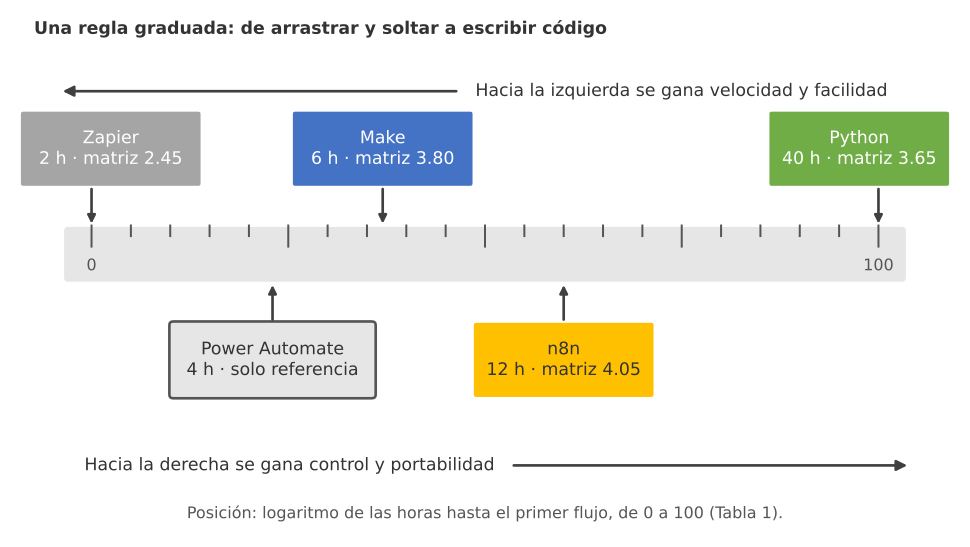
Figura 1. Una regla graduada: de arrastrar y soltar a escribir código, con Zapier, Power Automate, Make, n8n y Python como marcas, sus horas hasta el primer flujo, su puntuación en la matriz de Valeria y lo que se gana o se pierde al moverse.
Qué se gana y qué se pierde
Moverse por el espectro no es subir o bajar de categoría; es cambiar un conjunto de propiedades por otro. Conviene nombrarlas una por una, porque son las mismas que después se convertirán en criterios de la matriz de decisión.
Control. En Python, Valeria decide qué pasa en cada línea: si una petición devuelve un error 429 (demasiadas peticiones), espera lo que indique la cabecera Retry-After y reintenta; si devuelve un 400, no reintenta y aparta el pedido a revisión. En Make y en n8n ese control existe, pero se expresa con las piezas que ofrece la plataforma: manejadores de error (onerror en Make, la salida de error de un nodo y el Error Trigger en n8n), reintentos configurables y rutas alternativas. En Zapier el control de errores es más grueso: un paso falla, el Zap se detiene y llega un aviso. Ninguna de esas opciones es mala; lo que cambia es la granularidad.
Velocidad de construcción. Es la virtud de la izquierda del espectro. Un flujo de dos pasos se construye en minutos en Zapier o en Make, sin pensar en servidores, en credenciales cifradas ni en dónde se guarda el registro. En Python, el mismo flujo exige elegir una biblioteca para cada servicio, gestionar la autenticación OAuth de Google, decidir dónde se ejecuta y escribir los reintentos. El Bloque 5 lo mostrará con un flujo mínimo.
Mantenimiento. Es la cara oculta de la velocidad, y la que más se olvida al comparar. Una plataforma en la nube actualiza sus conectores cuando la API de un tercero cambia; un programa propio, no. Un servidor propio de n8n hay que actualizarlo, respaldarlo y vigilarlo. Una automatización que nadie mantiene no se queda igual: se degrada, porque el mundo alrededor cambia.
Portabilidad. Es la capacidad de llevarse los flujos y los datos a otro sitio. Un blueprint de Make es un archivo JSON que se puede guardar y volver a importar en Make, pero no en otra plataforma; un workflow de n8n es también un JSON, y como n8n se puede instalar en cualquier servidor, el flujo y la plataforma viajan juntos; el código de Python es lo más portable de todo, siempre que haya alguien que sepa leerlo.
Coste a escala. Las plataformas cobran con unidades distintas (créditos por módulo en Make, tareas por acción en Zapier, ejecuciones completas en n8n Cloud), y esas unidades crecen de forma distinta cuando crece el negocio. Python y n8n en un servidor propio cobran casi lo mismo por mil ejecuciones que por cien mil, hasta que el servidor se queda pequeño. El Día 12 traducirá el flujo de mensajes de Trigo Lento a cada unidad de cobro; hoy basta con saber que el coste a escala es un criterio con peso propio.
Hay una propiedad más, que en 2026 pesa más que hace dos años: la IA nativa. Make tiene módulos para llamar a modelos de lenguaje y n8n tiene una familia de nodos de IA (agente, memoria, herramientas, analizador de salida) que el módulo 4 usará a fondo; Zapier y Power Automate ofrecen pasos de IA integrados en sus planes. En Python, la IA llega por el SDK oficial del proveedor, con todo el control y sin ningún andamiaje ya hecho.
Ninguna herramienta gana en todas las propiedades a la vez, y por eso la decisión necesita un método. ¿Cómo se combinan cinco propiedades que se miden en unidades distintas en un solo número que permita comparar? Esa es la pregunta de la siguiente sección.
Criterios de elección
El método más sencillo que funciona es la matriz de decisión ponderada, una forma elemental del análisis de decisión multicriterio (o MCDA, por sus siglas en inglés: “Multi-Criteria Decision Analysis”). Se eligen los criterios, se asigna a cada uno un peso que refleja cuánto importa en este negocio, se puntúa cada opción en cada criterio con una escala común y se suman las puntuaciones multiplicadas por los pesos:
$$ S_j = \sum_{i=1}^{k} w_i , x_{ij}, \qquad \sum_{i=1}^{k} w_i = 1 $$
La lógica detrás de esta fórmula es múltiple:
- $x_{ij}$ es la puntuación de la herramienta $j$ en el criterio $i$, en una escala de $1$ (muy mal) a $5$ (muy bien). Usar la misma escala en todos los criterios es lo que permite sumarlos.
- $w_i$ es el peso del criterio $i$. Como los pesos suman $1$, la puntuación final $S_j$ queda también entre $1$ y $5$ y se lee como una nota media ponderada.
- Cada producto $w_i x_{ij}$ es el aporte de un criterio a la nota final. Mirar los aportes, y no solo la suma, dice por qué gana una opción.
- En conclusión, la matriz no descubre la verdad: hace explícitas las preferencias de quien decide. Dos personas con pesos distintos llegan a resultados distintos, y eso no es un defecto, es la información que la matriz pone sobre la mesa.
Valeria elige cinco criterios y les pone pesos pensando en Trigo Lento: la facilidad de uso ($0.20$), porque ella aprende sobre la marcha y no hay nadie más que construya; el coste a escala ($0.25$), el peso mayor, porque el presupuesto es de $45$ USD al mes para todo el ecosistema; el control de errores ($0.20$), porque un encargo perdido es un cliente perdido; la IA nativa ($0.15$), útil pero sustituible por una llamada HTTP; y la portabilidad y los datos propios ($0.20$), porque Don Ernesto no quiere que los teléfonos de sus clientes vivan donde nadie de la familia pueda sacarlos.
Las puntuaciones de la Tabla 2 van justificadas una por una, porque una puntuación sin razón es una opinión disfrazada de número:
Tabla 2. Matriz de decisión de Valeria: pesos, puntuaciones de 1 a 5 y su justificación.
| Criterio | Peso | Zapier | Make | n8n | Python | Justificación de las puntuaciones |
|---|---|---|---|---|---|---|
| Facilidad | 0.20 | 5 | 4 | 2 | 1 | Zapier se aprende en una tarde; Make pide entender routers y mapeos; n8n self-hosted exige además instalar y mantener un servidor; Python exige programar |
| Coste a escala | 0.25 | 1 | 4 | 5 | 4 | Zapier cobra cada acción y su plan de entrada incluye 750 tareas; Make cobra por módulo pero 10 000 créditos dan para mucho; n8n propio no cuenta ejecuciones; Python paga servidor y horas |
| Control de errores | 0.20 | 2 | 4 | 4 | 5 | Zapier detiene el Zap; Make y n8n tienen manejadores y rutas de error; Python controla cada excepción |
| IA nativa | 0.15 | 4 | 4 | 4 | 3 | Las tres plataformas traen pasos de IA; en Python hay que escribir el andamiaje alrededor del SDK |
| Portabilidad | 0.20 | 1 | 3 | 5 | 5 | Zapier no exporta a un formato que otra herramienta importe; el blueprint de Make solo se importa en Make; n8n y Python viajan con sus datos a cualquier servidor |
El siguiente bloque calcula $S_j$ como un producto punto, comprueba que los pesos suman $1$, prueba qué pasa si el peso de la facilidad cambia y dibuja los aportes de cada criterio como barras apiladas:
# Matriz de decisión ponderada: producto punto de pesos por puntuaciones en Python:
criterios = ['facilidad', 'coste_escala', 'control_errores', 'ia_nativa', 'portabilidad']
pesos = np.array([0.20, 0.25, 0.20, 0.15, 0.20])
puntuaciones = pd.DataFrame({
    'Zapier': [5, 1, 2, 4, 1],
    'Make':   [4, 4, 4, 4, 3],
    'n8n':    [2, 5, 4, 4, 5],
    'Python': [1, 4, 5, 3, 5]}, index = criterios)
assert np.isclose(pesos.sum(), 1.0), 'Los pesos deben sumar 1'

aportes = puntuaciones.mul(pesos, axis = 0)          # w_i * x_ij
total = aportes.sum().sort_values(ascending = False)  # S_j
print(puntuaciones.assign(peso = pesos).to_string())
print('Puntuación ponderada:', total.round(2).to_dict())

# Sensibilidad: el peso de la facilidad cambia y el resto se reparte en proporción:
for w_f in [0.10, 0.20, 0.30, 0.40]:
    w = np.r_[w_f, pesos[1:] / pesos[1:].sum() * (1 - w_f)]
    s = puntuaciones.T @ w
    print(f'peso facilidad {w_f:.2f}:', s.round(2).to_dict(), '-> gana', s.idxmax())

# Barras apiladas: cuánto aporta cada criterio a la puntuación de cada herramienta:
orden = total.index
colores = ['#2a78d6', '#3a9d5d', '#eb6834', '#7b5ea7', '#8a8986']
fig, ax = plt.subplots(figsize = (9, 4.8))
base = np.zeros(len(orden))
for criterio, color in zip(criterios, colores):
    valores = aportes.loc[criterio, orden].values
    ax.bar(orden, valores, bottom = base, color = color, edgecolor = 'white', label = criterio.replace('_', ' '))
    base += valores
for i, valor in enumerate(base):
    ax.text(i, valor + 0.05, f'{valor:.2f}', ha = 'center', fontsize = 11)
ax.set_ylim(0, 5)
ax.set_ylabel('Puntuación ponderada (de 1 a 5)')
ax.set_title('Matriz de decisión de Valeria: aporte de cada criterio', fontsize = 16)
ax.legend(loc = 'upper right', fontsize = 9, ncol = 2)
plt.tight_layout()
plt.show()
                 Zapier  Make  n8n  Python  peso
facilidad             5     4    2       1  0.20
coste_escala          1     4    5       4  0.25
control_errores       2     4    4       5  0.20
ia_nativa             4     4    4       3  0.15
portabilidad          1     3    5       5  0.20
Puntuación ponderada: {'n8n': 4.05, 'Make': 3.8, 'Python': 3.65, 'Zapier': 2.45}
peso facilidad 0.10: {'Zapier': 2.13, 'Make': 3.77, 'n8n': 4.31, 'Python': 3.98} -> gana n8n
peso facilidad 0.20: {'Zapier': 2.45, 'Make': 3.8, 'n8n': 4.05, 'Python': 3.65} -> gana n8n
peso facilidad 0.30: {'Zapier': 2.77, 'Make': 3.82, 'n8n': 3.79, 'Python': 3.32} -> gana Make
peso facilidad 0.40: {'Zapier': 3.09, 'Make': 3.85, 'n8n': 3.54, 'Python': 2.99} -> gana Make
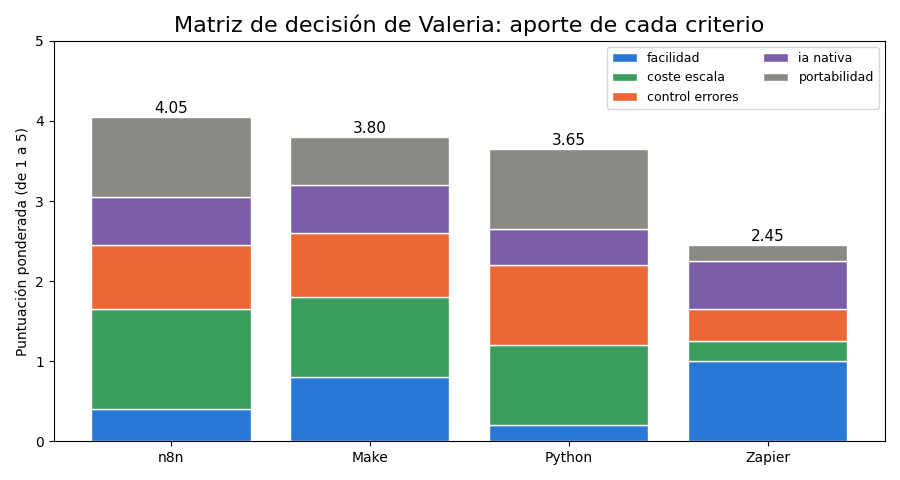
El resultado ordena las cuatro opciones así: n8n con $4.05$, Make con $3.80$, Python con $3.65$ y Zapier con $2.45$. Las barras apiladas cuentan la historia que hay detrás de cada número:
- En primer lugar, n8n gana por coste a escala y portabilidad: sus dos franjas más altas, verde y gris, suman $2.25$ de sus $4.05$ puntos. Pierde casi todo en facilidad, donde solo aporta $0.40$.
- En segundo lugar, Make es la opción más equilibrada: ninguna franja suya es la mayor, pero tampoco tiene ninguna hundida. Es el perfil de la herramienta que no destaca y no falla.
- En tercer lugar, Zapier pierde por las dos franjas con más peso: con un $1$ en coste a escala y otro en portabilidad, ni su $5$ en facilidad lo levanta.
Las líneas de sensibilidad son la parte más importante de la salida. Con el peso de la facilidad en $0.10$ o $0.20$, gana n8n; con $0.30$ o $0.40$, gana Make. Igualando las dos puntuaciones como funciones del peso $w_f$, con los demás pesos repartidos en proporción, el punto de cambio está en $w_f \approx 0.289$. Dicho en palabras: si a Valeria le importa la facilidad un poco más de lo que declaró, la recomendación cambia de herramienta. Una matriz cuyo ganador depende de una décima en un peso no está diciendo “elija n8n”; está diciendo “Make y n8n están empatados para usted, y la diferencia la decidirá otra cosa”. Esa otra cosa es el tiempo, y es el tema de la siguiente sección.
Atención aquí: una matriz ponderada se puede manipular sin darse cuenta. Si quien decide ya tiene una herramienta favorita, tenderá a subir el peso de los criterios en los que esa herramienta destaca o a redondear sus puntuaciones hacia arriba, y la matriz le devolverá la respuesta que quería oír con apariencia de rigor. Dos defensas sencillas: fijar los pesos antes de puntuar las opciones (Valeria los escribió en papel antes de abrir las páginas de precios) y publicar siempre el análisis de sensibilidad junto con el resultado. Un ganador que cambia con una décima en un peso no es un ganador, es un empate.
Construir frente a mantener
La matriz mide propiedades; el dinero se mide aparte. La pregunta de Don Ernesto, “¿para qué pagar si usted ya sabe Python?”, compara una cifra visible, la suscripción, con una invisible, las horas. El coste total de propiedad (o TCO, por sus siglas en inglés: “Total Cost of Ownership”) pone las dos en la misma cuenta. Para un flujo con un horizonte de $t$ meses:
$$ C_t = h_c \cdot v + t \cdot \left(s + h_m \cdot v\right), \qquad C_{12} = h_c \cdot v + 12 \cdot \left(s + h_m \cdot v\right) $$
La lógica detrás de esta fórmula es múltiple:
- $h_c \cdot v$ es el coste de construir: las horas de construcción $h_c$ por el valor de la hora $v$. Se paga una sola vez, al principio, y por eso no se multiplica por $t$.
- $s$ es la suscripción de la plataforma, o el servidor cuando la herramienta se aloja en casa. Se paga todos los meses.
- $h_m \cdot v$ es el coste de mantener: las horas al mes que se van en actualizar, corregir lo que se rompe y revisar el registro. También se paga todos los meses, aunque nadie reciba una factura por él.
- En conclusión, $C_t$ es una recta: arranca en el coste de construir y sube con una pendiente igual al coste mensual. Comparar dos opciones es comparar dos rectas, y la que empieza más abajo no siempre termina más abajo.
Antes de poner números conviene fijar los precios. La Tabla 3 reúne los planes que intervienen en la comparación, revisado en octubre de 2026, con sus páginas oficiales: Make, n8n, Zapier y Power Automate.
Tabla 3. Planes de las plataformas que compara este día (revisado en octubre de 2026).
| Plataforma | Plan | Pago mensual | Pago anual (por mes) | Unidad y volumen incluido | Nota de la revisión |
|---|---|---|---|---|---|
| Make | Free | 0 | 0 | 1 000 créditos al mes | 2 escenarios activos, intervalo mínimo de 15 minutos |
| Make | Core | 10.59 USD | 9 USD | 10 000 créditos | Un crédito por acción de módulo; una fuente cita 12 USD anuales por mes |
| Make | Pro | 18.82 USD | 16 USD | 10 000 créditos | Prioridad de ejecución |
| n8n Cloud | Starter | 24 EUR | 20 EUR | 2 500 ejecuciones | Una ejecución es una corrida completa, con los nodos que tenga |
| n8n Cloud | Pro | 60 EUR | 50 EUR | 10 000 ejecuciones | Más workflows activos |
| n8n | Community (self-hosted) | 0 más el servidor | 0 más el servidor | Sin límite de ejecuciones | Licencia Sustainable Use: uso interno permitido |
| Zapier | Free | 0 | 0 | 100 tareas | Solo flujos de dos pasos; el disparador no cuenta como tarea |
| Zapier | Professional | 29.99 USD | 19.99 USD | 750 tareas | Cada acción exitosa es una tarea; precios por volumen discrepantes entre fuentes |
| Power Automate | Premium | No se ofrece | 15 USD por usuario | Flujos en la nube y conectores premium | Pago anual; Process cuesta 150 USD por bot al mes |
En la página oficial de Make, consultada en octubre de 2026, los importes no aparecen en el texto descargable; las cifras de la tabla coinciden en dos fuentes secundarias y son las que usa la serie desde la Tabla B de su plan. La de Power Automate sí se contrastó en la página oficial de Microsoft.
Con los precios fijados, Valeria declara sus supuestos de horas para el flujo de hoy, el que lleva cada envío del formulario web a la hoja de pedidos, y para el ecosistema que lo rodea. Zapier se construye en $3$ horas y se mantiene con media hora al mes; Make, en $4$ horas y una hora al mes; n8n self-hosted, en $10$ horas (la instalación con Docker, el dominio, el certificado y el respaldo) y dos horas al mes de actualizaciones; Python propio, en $20$ horas y una hora al mes. Las suscripciones son las del plan que Trigo Lento necesitaría para todos sus flujos, no solo para este: Make Core a $10.59$ USD, un servidor pequeño de $6$ USD para n8n o para Python (el supuesto de la Tabla E del plan de la serie) y Zapier Professional a $29.99$ USD. El siguiente bloque aplica la fórmula, calcula los puntos de cruce y dibuja el coste acumulado durante dos años:
# Coste total a 12 meses: construcción, suscripción y mantenimiento en Python:
opciones = pd.DataFrame({
    'h_c': [3, 4, 10, 20],                  # horas de construcción (supuesto)
    's':   [29.99, 10.59, 6.00, 6.00],      # suscripción o servidor, USD al mes
    'h_m': [0.5, 1, 2, 1]},                 # horas de mantenimiento al mes (supuesto)
    index = ['Zapier Professional', 'Make Core', 'n8n self-hosted', 'Python propio'])

def coste_total(h_c, s, h_m, meses, v = V_HORA):
    # C_t = h_c * v + t * (s + h_m * v):
    return h_c * v + meses * (s + h_m * v)

tabla = opciones.assign(construccion = opciones['h_c'] * V_HORA,
                        mensual = opciones['s'] + opciones['h_m'] * V_HORA)
tabla['C12'] = coste_total(tabla['h_c'], tabla['s'], tabla['h_m'], 12)
tabla['C24'] = coste_total(tabla['h_c'], tabla['s'], tabla['h_m'], 24)
print(tabla.round(2).to_string())

def cruce(a, b):
    # Mes en que la opción b (más cara de construir) alcanza a la opción a:
    return (tabla.loc[b, 'construccion'] - tabla.loc[a, 'construccion']) / (tabla.loc[a, 'mensual'] - tabla.loc[b, 'mensual'])

t_mp = cruce('Make Core', 'Python propio')
print(f'Cruce Make frente a Python: mes {t_mp:.1f}')
print(f"Cruce Make frente a n8n: mes {cruce('Make Core', 'n8n self-hosted'):.1f}")
print(f"Cruce n8n frente a Python: mes {cruce('n8n self-hosted', 'Python propio'):.1f}")

# Coste acumulado mes a mes durante dos años:
meses = np.arange(0, 25)
fig, ax = plt.subplots(figsize = (9, 4.8))
for (opcion, fila), color in zip(tabla.iterrows(), ['#8a8986', '#2a78d6', '#eb6834', '#3a9d5d']):
    ax.plot(meses, coste_total(fila['h_c'], fila['s'], fila['h_m'], meses), color = color, lw = 2, label = opcion)
y_cruce = coste_total(*tabla.loc['Make Core', ['h_c', 's', 'h_m']], t_mp)
ax.scatter([t_mp], [y_cruce], s = 60, color = 'black', zorder = 3)
ax.annotate(f'Make = Python\nmes {t_mp:.1f}', (t_mp, y_cruce), xytext = (t_mp + 2, y_cruce - 130), fontsize = 10,
            arrowprops = dict(arrowstyle = '->', color = 'black'))
ax.axvline(12, color = '#52514e', ls = '--', lw = 1)
ax.set_xlabel('Meses desde la construcción')
ax.set_ylabel('Coste acumulado (USD)')
ax.set_title('Coste total acumulado del flujo por opción', fontsize = 16)
ax.legend(fontsize = 9)
plt.tight_layout()
plt.show()
                     h_c      s  h_m  construccion  mensual     C12     C24
Zapier Professional    3  29.99  0.5         12.16    32.02  396.37  780.57
Make Core              4  10.59  1.0         16.22    14.64  191.94  367.67
n8n self-hosted       10   6.00  2.0         40.54    14.11  209.84  379.14
Python propio         20   6.00  1.0         81.08    10.05  201.73  322.38
Cruce Make frente a Python: mes 14.1
Cruce Make frente a n8n: mes 45.4
Cruce n8n frente a Python: mes 10.0
La Tabla 4 resume la salida:
Tabla 4. Coste total por opción con los supuestos de Valeria (USD; horas de construcción y mantenimiento declaradas como supuestos).
| Opción | Horas de construcción | Suscripción al mes | Horas de mantenimiento al mes | Coste de construir | Coste mensual | Coste a 12 meses | Coste a 24 meses |
|---|---|---|---|---|---|---|---|
| Zapier Professional | 3 | 29.99 | 0.5 | 12.16 | 32.02 | 396.37 | 780.57 |
| Make Core | 4 | 10.59 | 1.0 | 16.22 | 14.64 | 191.94 | 367.67 |
| n8n self-hosted | 10 | 6.00 | 2.0 | 40.54 | 14.11 | 209.84 | 379.14 |
| Python propio | 20 | 6.00 | 1.0 | 81.08 | 10.05 | 201.73 | 322.38 |
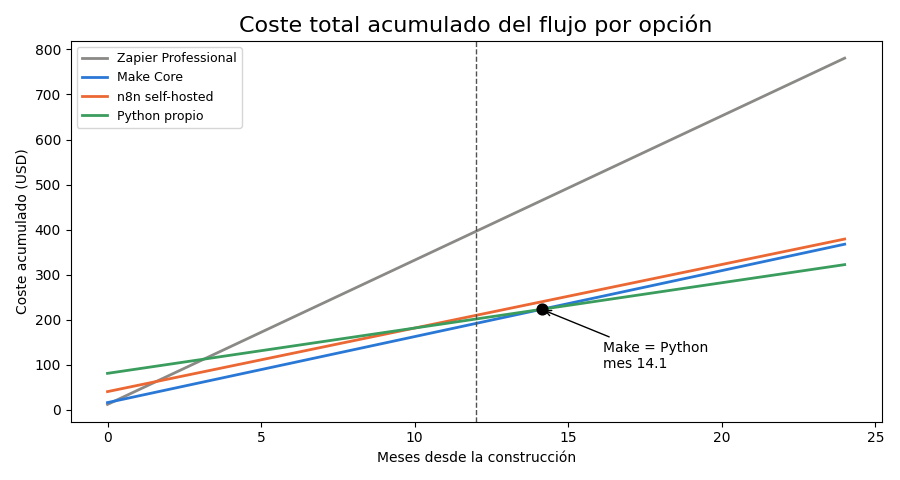
A 12 meses, Make Core es la opción más barata, con $191.94$ USD, seguida de Python propio ($201.73$), n8n self-hosted ($209.84$) y, muy lejos, Zapier Professional ($396.37$), que además se quedaría corto en volumen: sus $750$ tareas no alcanzan para los mensajes de Trigo Lento, como mostrará el Día 12. A 24 meses el orden cambia: Python propio pasa a ser el más barato, con $322.38$ USD, y Make sube a $367.67$.
El cambio de orden tiene un instante preciso. Dos rectas $C^A_t$ y $C^B_t$, donde $B$ cuesta más construir y menos mantener, se cruzan cuando sus costes acumulados se igualan:
$$ t^{*} = \frac{\left(h_c^{B} - h_c^{A}\right) v}{\left(s^{A} + h_m^{A} v\right) - \left(s^{B} + h_m^{B} v\right)} $$
La lógica detrás de esta fórmula es múltiple:
- El numerador es la ventaja inicial de $A$: cuánto menos cuesta construirla. Para Make frente a Python son $81.08 - 16.22 = 64.86$ USD.
- El denominador es la ventaja mensual de $B$: cuánto menos cuesta cada mes. Python ahorra $14.64 - 10.05 = 4.59$ USD al mes frente a Make.
- El cociente dice cuántos meses tarda $B$ en recuperar su desventaja inicial: $64.86 / 4.59 \approx 14.1$ meses.
- En conclusión, si el denominador es negativo, las rectas no se cruzan nunca hacia delante: la opción cara de construir también es cara de mantener y no hay horizonte que la justifique.
El bloque lo confirma: Make y Python se cruzan en el mes $14.1$, que es el punto negro de la figura. Make y n8n self-hosted se cruzan en el mes $45.4$, casi cuatro años, porque n8n solo ahorra unos centavos al mes frente a Make con dos horas de mantenimiento; y n8n y Python se cruzan en el mes $10.0$. La línea discontinua del mes $12$ separa lo que gana el primer año de lo que gana a largo plazo, y es la primera lección del día: el horizonte de la decisión importa tanto como los precios. Un flujo que se va a rehacer dentro de seis meses, porque el proceso todavía está cambiando, debe vivir donde construir es barato; un flujo estable que va a durar años puede justificar una construcción cara si su mantenimiento es barato.
Las cifras de la tabla, sin embargo, solo cuentan lo que se ve. El dibujo del iceberg de la Figura 2 muestra lo que queda por debajo de la línea de flotación en cualquiera de las cuatro opciones.
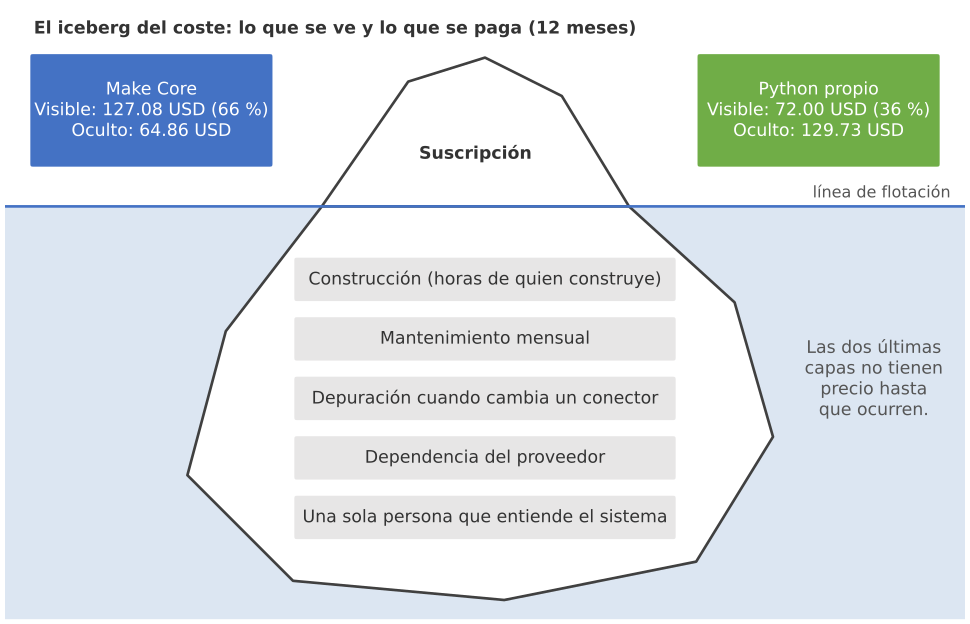
Figura 2. El iceberg del coste a 12 meses: la suscripción es lo que se ve; la construcción, el mantenimiento y los riesgos quedan bajo el agua. En Make la suscripción es el 66 % del total; en Python propio, el 36 %.
Lo que hay bajo el agua no está en la Tabla 4 porque es difícil de medir antes de que ocurra: horas de depuración cuando un conector cambia de versión, el día en que el servidor se queda sin disco, la migración forzosa cuando una plataforma cambia su modelo de precios, y el riesgo de que la única persona que entiende el sistema no esté disponible. Por eso las horas de mantenimiento de la tabla son la cifra más incierta del día, y la sección de Don Ernesto volverá sobre ellas con una simulación.
Dependencia del proveedor y portabilidad
Cuando un negocio construye sus procesos sobre una plataforma, empieza a depender de ella: de sus precios, de sus conectores, de su continuidad y de su política de datos. Esa dependencia (en inglés, vendor lock-in) no es mala en sí misma; es el precio de no tener que mantener la plataforma uno mismo. Se vuelve un problema cuando nadie sabe cuánto costaría salir. Un arquitecto la mide con una pregunta sencilla: si mañana esta plataforma duplicara su precio o cerrara, ¿qué me llevo y cuánto tardo en reconstruir lo que no me puedo llevar?
La respuesta tiene cuatro partes, porque un flujo no es solo su diseño. Están el diseño del flujo (qué pasos, en qué orden y con qué lógica), los datos que el flujo guarda en la plataforma (almacenes de datos, variables, tablas), las credenciales de las conexiones y el historial de ejecuciones. La Tabla 5 resume qué se puede exportar en cada herramienta, según su documentación consultada en octubre de 2026.
Tabla 5. Qué se puede llevar cada herramienta si hay que salir de ella (revisado en octubre de 2026; verifique en la documentación de cada plataforma).
| Elemento | Make | n8n | Zapier | Python |
|---|---|---|---|---|
| Diseño del flujo | Blueprint JSON, importable solo en Make | Workflow JSON, importable en cualquier instancia de n8n | Exportación limitada, sin formato que otra herramienta importe | Código fuente en un repositorio |
| Datos del flujo | Almacenes de datos, exportables con un escenario o a mano | En la base de datos de la propia instancia | Tablas propias de la plataforma | Donde el programa los escriba |
| Credenciales | No se exportan; se vuelven a conectar | Se exportan cifradas con la CLI; se recomienda volver a conectarlas | No se exportan | Variables de entorno o llavero del sistema |
| Historial de ejecuciones | Se consulta en la plataforma, con caducidad según el plan | En la base de datos propia, con la retención que se configure | Se consulta en la plataforma | En el registro que el programa escriba |
La fila de las credenciales es la más importante desde la ética del Día 6. Una exportación que llevara las claves de acceso sería un riesgo de seguridad cada vez que se comparte o se sube a un repositorio; por eso Make deja en el blueprint solo el identificador interno de la conexión (__IMTCONN__), y n8n solo el nombre y el identificador de la credencial, no su secreto. Aun así, la documentación de n8n advierte que esos nombres e identificadores pueden ser sensibles, y la serie los sustituye por valores de ejemplo antes de publicar o guardar cualquier flujo.
La fila de los datos es la que responde a Don Ernesto cuando dice que los teléfonos de sus clientes no pueden vivir donde la familia no pueda sacarlos. En una plataforma en la nube, los datos que un flujo guarda viven en los servidores del proveedor y se rigen por su política; con n8n self-hosted o con Python, viven en el servidor de Trigo Lento. Ninguna opción es gratuita: la primera traslada el riesgo al proveedor, la segunda lo deja en casa junto con la obligación de cuidarlo.
La consecuencia práctica para la serie es una regla que se aplicará en todos los módulos siguientes: cada flujo que se construya se exporta y se guarda, versionado, en la carpeta trigo_lento/flujos/, los de Make como <proceso>_v<n>.blueprint.json y los de n8n como <proceso>_v<n>.json. Así, la dependencia queda acotada al tiempo de reconstruir, y no al de redescubrir lo que hacía cada flujo.
El mismo flujo tres veces
Para ver el espectro con las manos, Valeria toma el flujo más sencillo de Trigo Lento y lo escribe tres veces. El formulario de la página web recibe el $15%$ de los encargos, unos $70$ al mes de los $468$, y cada envío debe acabar como una fila nueva en la hoja de cálculo de pedidos, con seis columnas: identificador del pedido, nombre, producto, cantidad, fecha de entrega y momento de recepción. Es un flujo de dos piezas: un disparador que recibe el envío y una acción que añade la fila.
En Python
La versión en código hace explícito todo lo que las plataformas esconden. Como en el Día 3, la llamada a la API de la hoja de cálculo se sustituye por simular_post, una función que devuelve un objeto con status_code, headers y json(), y que falla con probabilidades declaradas: un $3%$ de respuestas 429 y un $2%$ de respuestas 503 (servicio no disponible). La función formulario_a_hoja reintenta solo esos dos errores, que son pasajeros, hasta cuatro veces. El bloque simula los $70$ envíos de un mes con productos del catálogo de Trigo Lento y guarda la hoja resultante en trigo_lento/dia_11/pedidos_formulario.csv:
# Flujo mínimo en Python: del formulario web a la hoja de pedidos con simular_post:
class Respuesta:
    def __init__(self, status_code, headers, cuerpo):
        self.status_code, self.headers, self._cuerpo = status_code, headers, cuerpo
    def json(self):
        return self._cuerpo

HOJA = [['id_pedido', 'nombre', 'producto', 'cantidad', 'fecha_entrega', 'recibido']]
URL_HOJA = 'https://ejemplo.invalid/v4/spreadsheets/ID_DE_EJEMPLO/values/Pedidos!A1:append'

def simular_post(url, cuerpo, rng, p_429 = 0.03, p_503 = 0.02):
    # Falla con probabilidades declaradas: 3 % de límite de tasa y 2 % de servicio caído:
    u = rng.random()
    if u < p_429:
        return Respuesta(429, {'Retry-After': '2'}, {'error': 'demasiadas peticiones'})
    if u < p_429 + p_503:
        return Respuesta(503, {}, {'error': 'servicio no disponible'})
    HOJA.extend(cuerpo['values'])
    fila = len(HOJA)
    return Respuesta(200, {}, {'updates': {'updatedRange': f'Pedidos!A{fila}:F{fila}', 'updatedRows': 1}})

def formulario_a_hoja(envio, rng, max_intentos = 4):
    fila = [envio[c] for c in HOJA[0]]
    for intento in range(1, max_intentos + 1):
        r = simular_post(URL_HOJA, {'values': [fila]}, rng)
        if r.status_code not in (429, 503):    # éxito o error que no se arregla reintentando
            break
    return intento, r

# Un mes de envíos del formulario web: el 15 % de los 468 encargos:
catalogo = json.loads((Path('trigo_lento') / 'catalogo.json').read_text(encoding = 'utf-8'))
claves = [p['clave'] for p in catalogo]
n_envios = round(0.15 * 468)
resultados = []
for i in range(1, n_envios + 1):
    envio = {'id_pedido': f'TL-F{i:04d}', 'nombre': f'Cliente {i:03d}',
             'producto': str(rng.choice(claves)), 'cantidad': int(rng.integers(1, 4)),
             'fecha_entrega': str((pd.Timestamp('2026-02-12') + pd.Timedelta(days = int(rng.integers(0, 26)))).date()),
             'recibido': f'2026-02-11T{9 + i % 11:02d}:00:00-06:00'}
    intentos, r = formulario_a_hoja(envio, rng)
    resultados.append({'id_pedido': envio['id_pedido'], 'intentos': intentos, 'estado': r.status_code})

resultados = pd.DataFrame(resultados)
pd.DataFrame(HOJA[1:], columns = HOJA[0]).to_csv(carpeta / 'pedidos_formulario.csv', index = False)
print('Envíos del mes:', n_envios, '| filas en la hoja:', len(HOJA) - 1)
print('Primera fila añadida:', HOJA[1])
print('Intentos por envío:', resultados['intentos'].value_counts().sort_index().to_dict())
print('Estados finales:', resultados['estado'].value_counts().to_dict())
Envíos del mes: 70 | filas en la hoja: 70
Primera fila añadida: ['TL-F0001', 'Cliente 001', 'P11', 1, '2026-02-12', '2026-02-11T10:00:00-06:00']
Intentos por envío: {1: 68, 2: 2}
Estados finales: {200: 70}
Los $70$ envíos del mes acaban como $70$ filas en la hoja, la primera con el pedido TL-F0001 de un paquete de bollos para hamburguesa (P11). Del total, $68$ entraron al primer intento y $2$ necesitaron un segundo intento por un error pasajero; ninguno se perdió. Ese reintento es una decisión de diseño que en Python hay que escribir y que en Make o n8n se configura con una casilla.
Hay un detalle que el bloque no resuelve y que conviene nombrar: si el servicio hubiera añadido la fila y la respuesta se hubiera perdido por el camino, el reintento duplicaría el pedido. Es el problema de la idempotencia que vio el Día 3 con los webhooks, y en una hoja de cálculo se resuelve comprobando el id_pedido antes de escribir. Contar las líneas del bloque también es instructivo: unas $45$ líneas para un flujo de dos pasos, sin autenticación real, sin servidor y sin alertas. El código da control total, pero cada pieza de ese control hay que escribirla y mantenerla.
En un blueprint de Make
En Make, el mismo flujo es un escenario de dos módulos: un webhook personalizado (gateway:CustomWebHook) y la acción de añadir una fila de Google Sheets (google-sheets:addRow). Cuando se exporta, el escenario se convierte en un blueprint: un JSON con la lista flow de módulos, cada uno con su id, su module (aplicación y acción), su version, sus parameters (configuración estática, incluida la conexión), su mapper (los valores que se mapean desde módulos anteriores con la sintaxis {{id.campo}}) y su posición en el lienzo en metadata.designer. El bloque metadata final guarda la configuración del escenario. Este es el archivo trigo_lento/dia_11/flujos/make/formulario_hoja_v1.blueprint.json:
{
  "name": "TL Formulario a hoja v1",
  "flow": [
    {
      "id": 1,
      "module": "gateway:CustomWebHook",
      "version": 1,
      "parameters": {"hook": 0, "maxResults": 1},
      "mapper": {},
      "metadata": {"designer": {"x": 0, "y": 0}}
    },
    {
      "id": 2,
      "module": "google-sheets:addRow",
      "version": 2,
      "parameters": {"__IMTCONN__": 0},
      "mapper": {
        "mode": "select",
        "spreadsheetId": "/ID_DE_EJEMPLO",
        "sheetId": "Pedidos",
        "includesHeaders": true,
        "insertDataOption": "INSERT_ROWS",
        "valueInputOption": "USER_ENTERED",
        "insertUnformatted": false,
        "values": {
          "0": "{{1.id_pedido}}",
          "1": "{{1.nombre}}",
          "2": "{{1.producto}}",
          "3": "{{1.cantidad}}",
          "4": "{{1.fecha_entrega}}",
          "5": "{{now}}"
        }
      },
      "metadata": {"designer": {"x": 300, "y": 0}}
    }
  ],
  "metadata": {
    "instant": true,
    "version": 1,
    "scenario": {"roundtrips": 1, "maxErrors": 3, "autoCommit": true, "autoCommitTriggerLast": true, "sequential": false, "confidential": false, "dataloss": false, "dlq": false, "freshVariables": false},
    "designer": {"orphans": []}
  }
}
Lea el mapper del módulo $2$: la columna $0$ recibe {{1.id_pedido}}, es decir, el campo id_pedido de lo que entregó el módulo $1$, el webhook; la columna $5$ recibe {{now}}, la fecha y hora de la ejecución. La conexión con Google aparece solo como "__IMTCONN__": 0: en una exportación real sería el número interno de la conexión de la cuenta, y la serie lo sustituye siempre por $0$. El hook del webhook también es $0$, porque su número real permitiría reconstruir la URL a la que cualquiera podría enviar pedidos falsos. Los nombres de los módulos y los campos de metadata.scenario deben contrastarse exportando un escenario real antes de usarlos en producción, porque cambian con las versiones de las aplicaciones.
En un workflow de n8n
En n8n, el mismo flujo es un workflow de dos nodos: Webhook (tipo n8n-nodes-base.webhook) y Añadir fila (tipo n8n-nodes-base.googleSheets con la operación append). El JSON separa los nodos de las conexiones: la lista nodes describe cada nodo con su type, su typeVersion, su position y sus parameters, y el diccionario connections dice, indexado por el nombre del nodo de origen, a qué nodos va cada salida. Este es trigo_lento/dia_11/flujos/n8n/formulario_hoja_v1.json:
{
  "name": "TL Formulario a hoja v1",
  "nodes": [
    {
      "parameters": {"httpMethod": "POST", "path": "formulario-pedidos", "responseMode": "onReceived", "options": {}},
      "id": "0b1c0000-0000-4000-8000-000000000001",
      "name": "Webhook",
      "type": "n8n-nodes-base.webhook",
      "typeVersion": 2,
      "position": [0, 0],
      "webhookId": "00000000-0000-4000-8000-0000000000aa"
    },
    {
      "parameters": {
        "operation": "append",
        "documentId": {"__rl": true, "value": "ID_DE_EJEMPLO", "mode": "id"},
        "sheetName": {"__rl": true, "value": "Pedidos", "mode": "name"},
        "columns": {
          "mappingMode": "defineBelow",
          "value": {
            "id_pedido": "={{ $json.body.id_pedido }}",
            "nombre": "={{ $json.body.nombre }}",
            "producto": "={{ $json.body.producto }}",
            "cantidad": "={{ $json.body.cantidad }}",
            "fecha_entrega": "={{ $json.body.fecha_entrega }}",
            "recibido": "={{ $now.toISO() }}"
          }
        },
        "options": {}
      },
      "id": "7f3a0000-0000-4000-8000-000000000002",
      "name": "Añadir fila",
      "type": "n8n-nodes-base.googleSheets",
      "typeVersion": 4.5,
      "position": [220, 0],
      "credentials": {"googleSheetsOAuth2Api": {"id": "CREDENCIAL_DE_EJEMPLO", "name": "Hoja de Trigo Lento"}}
    }
  ],
  "connections": {
    "Webhook": {"main": [[{"node": "Añadir fila", "type": "main", "index": 0}]]}
  },
  "settings": {"executionOrder": "v1"},
  "pinData": {},
  "meta": {"templateCredsSetupCompleted": true}
}
Las expresiones de n8n empiezan por = y van entre dobles llaves: ={{ $json.body.id_pedido }} toma el campo id_pedido del cuerpo de la petición que recibió el webhook (en la versión 2 del nodo, el cuerpo llega dentro de body), y ={{ $now.toISO() }} escribe la fecha y hora en formato ISO 8601. La credencial de Google aparece con su tipo (googleSheetsOAuth2Api), un identificador y un nombre, ambos sustituidos por valores de ejemplo; el secreto nunca viaja en la exportación. Los id de los nodos y el webhookId son también valores de ejemplo, como manda la convención de la serie.
Leer las dos exportaciones con Python
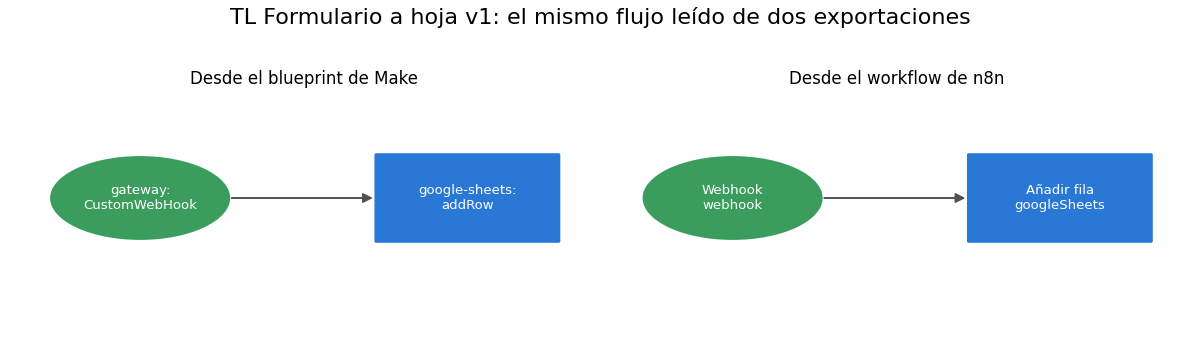
Los dos JSON describen el mismo flujo con gramáticas distintas: Make encadena los módulos por su orden en la lista flow (y por las rutas de los routers, cuando los hay), mientras que n8n declara cada conexión de forma explícita. Un arquitecto que sabe leer ambos formatos puede auditar, comparar y documentar flujos sin abrir las plataformas. El siguiente bloque los lee, los convierte al formato de nodos y aristas de la función dibujar_flujo del Día 2 (con un parámetro ax añadido para dibujar los dos lado a lado), cuenta nodos, aristas, claves y caracteres, y comprueba que ninguna exportación lleva identificadores reales:
# Lectura del blueprint de Make y del workflow de n8n, conteo de nodos y claves, y dibujo lado a lado en Python:
from matplotlib.patches import Ellipse, FancyBboxPatch, Polygon, RegularPolygon, FancyArrowPatch

FORMAS = {   # paleta de formas de la serie: tipo -> (forma, relleno)
    'disparador': ('ovalo', '#3a9d5d'), 'accion': ('rectangulo', '#2a78d6'),
    'decision': ('rombo', '#eb6834'), 'ia': ('rectangulo', '#7b5ea7'),
    'error': ('rectangulo', '#c8423b'), 'humano': ('hexagono', '#8a8986'),
}

def dibujar_flujo(nodos, aristas, titulo, ax = None, ancho = 1.9, alto = 0.9, recorte = 42):
    if ax is None:
        fig, ax = plt.subplots(figsize = (12, 5.6))
    for n in nodos:
        forma, color = FORMAS[n['tipo']]
        x, y = n['x'], n['y']
        if forma == 'ovalo':
            figura = Ellipse((x, y), ancho, alto)
        elif forma == 'rombo':
            figura = Polygon([(x - ancho / 2, y), (x, y + alto / 1.4), (x + ancho / 2, y), (x, y - alto / 1.4)])
        elif forma == 'hexagono':
            figura = RegularPolygon((x, y), 6, radius = ancho / 2, orientation = np.pi / 6)
        else:
            figura = FancyBboxPatch((x - ancho / 2, y - alto / 2), ancho, alto, boxstyle = 'round,pad=0.03')
        figura.set_facecolor(color)
        figura.set_edgecolor('white')
        figura.set_linewidth(2)
        ax.add_patch(figura)
        ax.text(x, y, n['texto'], ha = 'center', va = 'center', fontsize = 9.5, color = 'white')
    posicion = {n['id']: (n['x'], n['y']) for n in nodos}
    for origen, destino, etiqueta in aristas:
        (x1, y1), (x2, y2) = posicion[origen], posicion[destino]
        ax.add_patch(FancyArrowPatch((x1, y1), (x2, y2), arrowstyle = '-|>', mutation_scale = 14,
                                     shrinkA = recorte, shrinkB = recorte + 2, color = '#52514e', linewidth = 1.4))
        if etiqueta:
            ax.text((x1 + x2) / 2, (y1 + y2) / 2 + 0.18, etiqueta, ha = 'center', fontsize = 8.5,
                    color = '#52514e', bbox = dict(facecolor = 'white', edgecolor = 'none', pad = 1))
    xs, ys = [n['x'] for n in nodos], [n['y'] for n in nodos]
    ax.set_xlim(min(xs) - 1.3, max(xs) + 1.3)
    ax.set_ylim(min(ys) - 1.1, max(ys) + 1.1)
    ax.set_aspect('equal')
    ax.axis('off')
    ax.set_title(titulo, fontsize = 12)
    return ax

flujos = carpeta / 'flujos'
blueprint = json.loads((flujos / 'make' / 'formulario_hoja_v1.blueprint.json').read_text(encoding = 'utf-8'))
workflow = json.loads((flujos / 'n8n' / 'formulario_hoja_v1.json').read_text(encoding = 'utf-8'))

def tipo_de(nombre_tecnico):
    return 'disparador' if 'webhook' in nombre_tecnico.lower() else 'accion'

def nodos_desde_blueprint(bp, escala = 300 / 3.4):
    nodos = [{'id': str(m['id']), 'tipo': tipo_de(m['module']), 'texto': m['module'].replace(':', ':\n'),
              'x': m['metadata']['designer']['x'] / escala, 'y': -m['metadata']['designer']['y'] / escala}
             for m in bp['flow']]
    aristas = [(a['id'], b['id'], '') for a, b in zip(nodos, nodos[1:])]   # Make encadena en orden
    return nodos, aristas

def nodos_desde_n8n(wf, escala = 220 / 3.4):
    nodos = [{'id': n['name'], 'tipo': tipo_de(n['type']), 'texto': n['name'] + '\n' + n['type'].split('.')[-1],
              'x': n['position'][0] / escala, 'y': -n['position'][1] / escala} for n in wf['nodes']]
    aristas = [(origen, destino['node'], '') for origen, salidas in wf['connections'].items()
               for salida in salidas['main'] for destino in salida]
    return nodos, aristas

def contar_claves(objeto):
    if isinstance(objeto, dict):
        return len(objeto) + sum(contar_claves(v) for v in objeto.values())
    if isinstance(objeto, list):
        return sum(contar_claves(v) for v in objeto)
    return 0

def sin_secretos(bp, wf):
    conexiones_make = [m['parameters']['__IMTCONN__'] for m in bp['flow'] if '__IMTCONN__' in m['parameters']]
    credenciales_n8n = [c['id'] for n in wf['nodes'] for c in n.get('credentials', {}).values()]
    return all(c == 0 for c in conexiones_make) and all(c.endswith('DE_EJEMPLO') for c in credenciales_n8n)

n_make, a_make = nodos_desde_blueprint(blueprint)
n_n8n, a_n8n = nodos_desde_n8n(workflow)
comparacion = pd.DataFrame({
    'Make': [len(n_make), len(a_make), contar_claves(blueprint), len(json.dumps(blueprint, ensure_ascii = False))],
    'n8n': [len(n_n8n), len(a_n8n), contar_claves(workflow), len(json.dumps(workflow, ensure_ascii = False))]},
    index = ['nodos', 'aristas', 'claves', 'caracteres'])
print(comparacion.to_string())
print('Sin secretos ni identificadores reales:', sin_secretos(blueprint, workflow))
print('Campos que mapea Make:', len(blueprint['flow'][1]['mapper']['values']),
      '| campos que mapea n8n:', len(workflow['nodes'][1]['parameters']['columns']['value']))

fig, (ax1, ax2) = plt.subplots(1, 2, figsize = (12, 3.6))
dibujar_flujo(n_make, a_make, 'Desde el blueprint de Make', ax = ax1, recorte = 66)
dibujar_flujo(n_n8n, a_n8n, 'Desde el workflow de n8n', ax = ax2, recorte = 66)
fig.suptitle('TL Formulario a hoja v1: el mismo flujo leído de dos exportaciones', fontsize = 16)
plt.tight_layout()
plt.show()
            Make   n8n
nodos          2     2
aristas        1     1
claves        52    53
caracteres   978  1300
Sin secretos ni identificadores reales: True
Campos que mapea Make: 6 | campos que mapea n8n: 6
La Tabla 6 recoge la comparación de la salida junto con la versión en Python:
Tabla 6. El mismo flujo, del formulario a la hoja, en tres formatos.
| Medida | Python (Bloque 5) | Blueprint de Make | Workflow de n8n |
|---|---|---|---|
| Pasos o nodos | 2 funciones | 2 módulos | 2 nodos |
| Conexiones | Llamada directa | 1, implícita por el orden | 1, explícita en connections |
| Claves del JSON | No aplica | 52 | 53 |
| Caracteres | Unas 45 líneas de código | 978 | 1 300 |
| Campos mapeados | 6 | 6 | 6 |
| Reintentos ante 429 y 503 | Escritos a mano | Configurables en el escenario | Configurables en el nodo |
| Secretos en el archivo | Ninguno (variables de entorno) | Ninguno (__IMTCONN__ en 0) | Ninguno (credencial de ejemplo) |
Los dos dibujos son idénticos en forma, un óvalo verde de disparador y un rectángulo azul de acción, porque representan el mismo proceso. El blueprint ocupa $978$ caracteres y el workflow $1,300$, con $52$ y $53$ claves: tamaños casi iguales para el mismo contenido. Los seis campos se mapean en los dos, y la comprobación de secretos devuelve True. Lo que cambia entre formatos es la gramática, no la lógica, y por eso el Día 45, el de la migración de Make a n8n, podrá traducir un formato al otro con un programa.
Lo que dijo Don Ernesto
Con la tabla de costes impresa, Valeria vuelve a la pregunta de su padre: "¿Para qué pagar si usted ya sabe Python?". La respuesta tiene tres partes, y la primera es una corrección amable: Valeria no “sabe Python” en el sentido que haría falta. Escribió un motor de juguete con ayuda durante diez días; mantener un sistema en producción, con autenticación, servidor, registro y alertas, es otro oficio. Las puntuaciones de la Tabla 2 ya lo reflejaban: un $1$ en facilidad para Python.
La segunda parte es el perfil completo de cada herramienta, que el radar del siguiente bloque dibuja con los cinco criterios a la vez:
# Gráfico de radar de los cinco criterios por herramienta en Python:
angulos = np.linspace(0, 2 * np.pi, len(criterios), endpoint = False)
angulos_cerrados = np.r_[angulos, angulos[0]]
fig, ax = plt.subplots(figsize = (6.8, 6.4), subplot_kw = {'polar': True})
for herramienta, color in zip(['Zapier', 'Make', 'n8n', 'Python'], ['#8a8986', '#2a78d6', '#eb6834', '#3a9d5d']):
    valores = puntuaciones[herramienta].values
    valores_cerrados = np.r_[valores, valores[0]]
    ax.plot(angulos_cerrados, valores_cerrados, color = color, lw = 2, label = herramienta)
    ax.fill(angulos_cerrados, valores_cerrados, color = color, alpha = 0.08)
ax.set_xticks(angulos)
ax.set_xticklabels([c.replace('_', '\n') for c in criterios], fontsize = 10)
ax.set_ylim(0, 5)
ax.set_yticks([1, 2, 3, 4, 5])
ax.set_rlabel_position(54)
ax.set_title('Perfil de cada herramienta en los cinco criterios', fontsize = 16, pad = 28)
ax.legend(loc = 'upper center', bbox_to_anchor = (0.5, -0.06), ncol = 4, fontsize = 10)
areas = {h: 0.5 * np.sin(2 * np.pi / 5) * sum(puntuaciones[h].values * np.roll(puntuaciones[h].values, -1))
         for h in puntuaciones}
print('Área del polígono de cada herramienta:', {h: round(float(a), 2) for h, a in areas.items()})
plt.tight_layout()
plt.show()
Área del polígono de cada herramienta: {'Zapier': 11.41, 'Make': 34.24, 'n8n': 36.14, 'Python': 28.06}
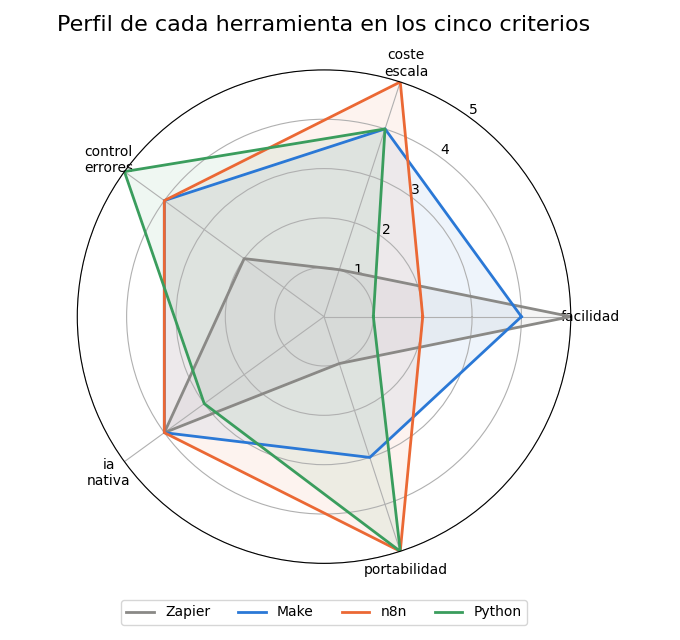
El radar hace visible lo que la suma de la matriz aplanaba. Python dibuja un polígono afilado: llega a $5$ en control de errores y en portabilidad, pero se hunde a $1$ en facilidad. Make dibuja el polígono más redondo, sin picos ni hundimientos. n8n se parece a Python con mejor IA nativa y coste a escala, y Zapier es un triángulo estrecho apoyado en la facilidad. El área de cada polígono, calculada con la fórmula del área de un pentágono irregular sobre ejes equiespaciados, es una medida aproximada del “tamaño” de cada herramienta: n8n $36.14$, Make $34.24$, Python $28.06$ y Zapier $11.41$. El área no sustituye a la matriz, porque ignora los pesos y depende del orden de los ejes, pero confirma la lectura: Make y n8n son las dos opciones fuertes para Trigo Lento, y Python es la más desigual.
La tercera parte de la respuesta es la incertidumbre. La Tabla 4 usó horas fijas, pero nadie sabe cuántas horas tardará Valeria en construir el flujo en Python, ni cuántas se irán cada mes en mantenerlo. Una forma honesta de responder es dejar que las horas varíen. El siguiente bloque modela cada cifra de horas con una distribución lognormal, la misma que el Día 8 usó para los tiempos de espera porque no admite valores negativos y tiene cola hacia la derecha, con la mediana en el supuesto de la Tabla 4. Simula $10,000$ escenarios y cuenta en qué proporción de ellos Python propio sale más barato que Make, a $12$, $24$ y $36$ meses, en dos casos: Valeria aprendiendo Python (mediana de $20$ horas de construcción) y una Valeria que ya supiera programar (mediana de $10$ horas):
# Monte Carlo de la objeción de Don Ernesto: Python propio frente a Make con horas inciertas en Python:
N = 10_000
def horas(mediana, sigma):
    return rng.lognormal(np.log(mediana), sigma, N)

escenarios = {'Valeria aprende Python': 20, 'Valeria ya sabe Python': 10}
for nombre, mediana_python in escenarios.items():
    make_c, make_m = horas(4, 0.4), horas(1, 0.6)
    py_c, py_m = horas(mediana_python, 0.5), horas(1, 0.6)
    fila = {}
    for t in (12, 24, 36):
        c_make = coste_total(make_c, 10.59, make_m, t)
        c_python = coste_total(py_c, 6.00, py_m, t)
        fila[f'{t} meses'] = f'{(c_python < c_make).mean():.1%}'
    print(f'{nombre:<24} P(Python más barato):', fila)
Valeria aprende Python   P(Python más barato): {'12 meses': '40.8%', '24 meses': '65.8%', '36 meses': '75.3%'}
Valeria ya sabe Python   P(Python más barato): {'12 meses': '71.1%', '24 meses': '81.8%', '36 meses': '84.6%'}
Las probabilidades responden a Don Ernesto con más matices que un sí o un no:
- En primer lugar, con la Valeria de hoy, Python es más barato que Make a 12 meses solo en el $40.8%$ de los escenarios. Es decir, lo más probable el primer año es que la suscripción de Make salga más barata que las horas de construir en Python.
- En segundo lugar, a 24 meses la balanza se inclina hacia Python ($65.8%$) y a 36 meses todavía más ($75.3%$). Don Ernesto tiene razón a largo plazo, siempre que el flujo dure ese tiempo sin rehacerse.
- En tercer lugar, si Valeria ya supiera programar, Python ganaría desde el primer año en el $71.1%$ de los escenarios. La objeción de Don Ernesto sería correcta para otra Valeria; para esta, todavía no.
Hay además un coste que ninguna simulación de horas recoge: el riesgo de que el sistema dependa de una sola persona. Si los flujos de Trigo Lento viven en un programa que solo Valeria entiende, el día que ella se enferme o se vaya de vacaciones nadie puede tocarlos. Un escenario de Make o un workflow de n8n, con su dibujo y sus nombres, lo puede leer otra persona con una tarde de formación. Las tres casas de la Figura 3 resumen la conversación con la metáfora que Don Ernesto, que algún día construyó su propio obrador, entendió a la primera.
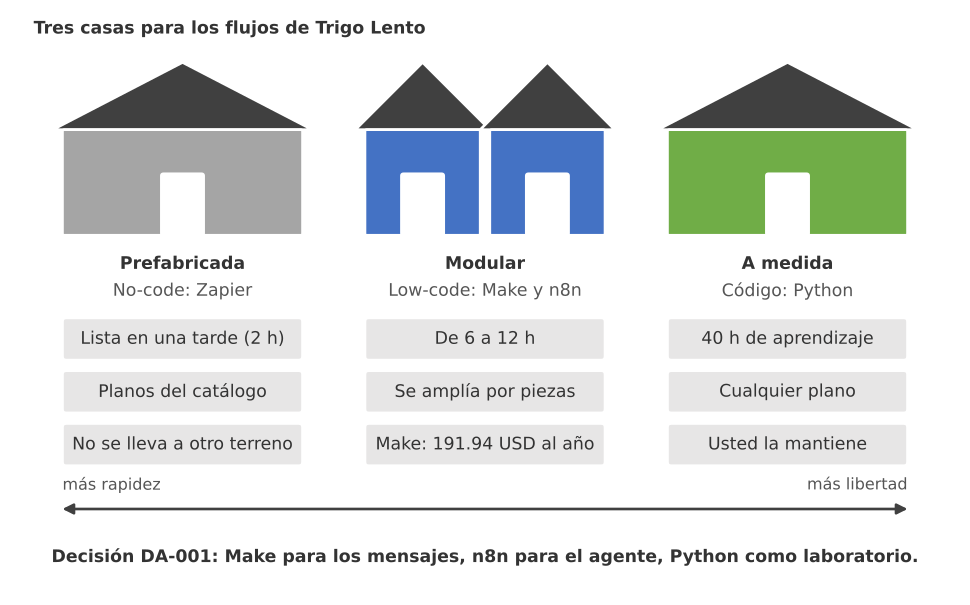
Figura 3. Tres casas: la prefabricada (no-code) se habita en una tarde, la modular (low-code) se amplía por piezas y la hecha a medida (código) admite cualquier plano, pero alguien tiene que mantenerla.
Don Ernesto mira la figura un rato y responde a su manera: “O sea, que pagamos la cuota mientras usted aprende, y cuando el pan esté saliendo solo, vemos si conviene hacer la casa a medida. Me parece bien. Pero apúntelo, porque dentro de un año ni usted ni yo nos vamos a acordar de por qué lo decidimos.” Es exactamente lo que hará la siguiente sección.
La decisión por escrito
Una decisión de arquitectura que no se escribe se pierde, y con ella las razones. El formato que se usa en ingeniería de software para guardarlas es el registro de decisión de arquitectura (o ADR, por sus siglas en inglés: “Architecture Decision Record”), un documento breve que dice qué se decidió, en qué contexto, qué alternativas se consideraron y qué consecuencias se aceptan. Valeria le añade un campo que suele faltar: las condiciones de revisión, es decir, qué tendría que pasar para volver a decidir. El siguiente bloque escribe el registro en trigo_lento/dia_11/decision_plataformas.json con las cifras de los bloques anteriores, no con cifras copiadas a mano:
# Registro de la decisión de arquitectura en un archivo JSON en Python:
decision = {
    'id': 'DA-001',
    'fecha': '2026-02-11',
    'titulo': 'Plataformas de automatización de Trigo Lento',
    'contexto': 'Presupuesto de 45 USD al mes; Valeria sin experiencia previa en programación',
    'opciones': {h: round(float(total[h]), 2) for h in total.index},
    'coste_12_meses_usd': tabla['C12'].round(2).to_dict(),
    'decision': 'Make para los flujos de mensajes (módulo 3); n8n self-hosted para el agente (módulo 4); '
                'Python como laboratorio y para lo que ninguna plataforma resuelva',
    'condiciones_de_revision': ['créditos de Make por encima del 80 % de la cuota dos meses seguidos',
                                'un flujo estable que vaya a durar más de 14 meses sin cambios',
                                'un cambio de precios de cualquier plataforma'],
    'portabilidad': 'cada flujo se exporta y se guarda en trigo_lento/flujos/ con su versión',
}
ruta = carpeta / 'decision_plataformas.json'
ruta.write_text(json.dumps(decision, ensure_ascii = False, indent = 2), encoding = 'utf-8')
print('Escrito:', ruta.as_posix(), '|', ruta.stat().st_size, 'bytes')
print('Mejor puntuación:', max(decision['opciones'], key = decision['opciones'].get),
      '| más barata a 12 meses:', min(decision['coste_12_meses_usd'], key = decision['coste_12_meses_usd'].get))
Escrito: trigo_lento/dia_11/decision_plataformas.json | 969 bytes
Mejor puntuación: n8n | más barata a 12 meses: Make Core
El archivo ocupa $969$ bytes y recoge la tensión del día en su última línea de salida: la mejor puntuación la tiene n8n, pero la opción más barata a 12 meses es Make Core. La decisión no elige una herramienta para todo, sino un reparto, que es lo que el resto de la serie construirá:
- Make para los flujos de mensajes: es la opción más barata el primer año, la más equilibrada en la matriz y la más fácil de aprender para Valeria. El módulo 3 (días 22 a 33) construye en Make el escenario de pedidos de WhatsApp.
- n8n self-hosted para el agente de pedidos con herramientas y aprobación humana: es donde su control, su IA nativa y la propiedad de los datos pesan más que la facilidad. El módulo 4 (días 34 a 45) lo instala y lo construye.
- Python como laboratorio para medir, simular y probar antes de construir, como en estos once días, y para lo que ninguna plataforma resuelva bien.
Las condiciones de revisión son tan importantes como la decisión: si los créditos de Make superan el $80%$ de la cuota dos meses seguidos, si un flujo estable va a durar más de $14$ meses sin cambios (el punto de cruce con Python) o si cualquier plataforma cambia sus precios, el registro dice que hay que volver a sentarse. Esa es la diferencia entre una decisión de arquitecto y una preferencia: la primera sabe cuándo deja de ser válida.
Consideraciones finales
El día empezó con cuatro páginas de precios abiertas y una pregunta de Don Ernesto, y termina con una regla graduada, una matriz con su sensibilidad, un coste total a 12 y a 24 meses, el mismo flujo leído en tres formatos y una decisión por escrito. Lo que llama la atención, al mirar todas las cifras juntas, es que ninguna herramienta ganó en todo: n8n ganó la matriz por $0.25$ puntos, Make ganó el coste del primer año por $9.79$ USD frente a Python y Python ganó el coste a dos años. Elegir una plataforma no es encontrar la mejor, sino decidir qué está dispuesto a pagar con dinero, qué con horas y qué con dependencia.
Antes de dar por buena una elección de herramientas, conviene hacerse algunas preguntas:
- ¿Cuánto tiempo va a vivir este flujo sin cambios? Si la respuesta es “no lo sé”, empiece donde construir es barato.
- ¿Qué peso de su matriz, al moverse una décima, cambia el ganador? Si alguno lo hace, tiene un empate, no una decisión.
- ¿Quién mantendrá el flujo si usted no está? Si la respuesta es “nadie”, el coste de mantener está mal calculado.
- ¿Qué se lleva si mañana la plataforma duplica su precio? Si no lo ha exportado, todavía no lo sabe.
Las cifras de hoy tienen límites claros. Las horas de construcción y de mantenimiento son supuestos razonados, no mediciones, y la simulación solo muestra cuánto pesa su incertidumbre; las puntuaciones de la matriz son el juicio de Valeria, justificado pero discutible; los precios son los revisados en octubre de 2026 y algunas fuentes secundarias no coinciden entre sí; y el valor de la hora de Valeria es un supuesto didáctico. Ninguno de esos límites cambia la estructura de la conclusión: el horizonte decide entre construir y suscribirse, y la portabilidad decide cuánto cuesta equivocarse.
Un gran libro que habla de esto es Fundamentals of Software Architecture (Richards y Ford), en el que los autores sostienen que en arquitectura no hay respuestas correctas, solo compromisos, y que el trabajo del arquitecto es hacerlos explícitos: qué característica se sacrifica por cuál, y por qué. Aunque está escrito para sistemas de software grandes, su idea central, que “todo en arquitectura es un compromiso”, es la que Valeria aplicó hoy con una hoja de cálculo y una panadería, y leerlo le ayudará a reconocer los compromisos que esconde cada página de precios.
Si quiere ir más lejos con las plataformas de bajo código como objeto de estudio, el trabajo de Sahay, Indamutsa, Di Ruscio y Pierantonio ($2020$) compara ocho plataformas low-code con una taxonomía de características (modelado, interoperabilidad, escalabilidad, seguridad) que se parece mucho a los criterios de la Tabla 2, y muestra que la comparación entre plataformas siempre depende del uso que se les vaya a dar.
Conclusiones clave
Espectro
- No-code, low-code y código son marcas de una regla continua: hacia la izquierda se gana velocidad y se pierde control; hacia la derecha, al revés. En la regla de Valeria, Zapier está en $0$, Power Automate en $23$, Make en $37$, n8n en $60$ y Python en $100$.
- Make es visual pero con lógica; n8n es low-code de verdad, con nodo de código y opción self-hosted; Power Automate conviene a empresas que ya viven en Microsoft 365.
Criterios
- La matriz ponderada $S_j = \sum w_i x_{ij}$ hace explícitas las preferencias: con los pesos de Valeria, n8n obtiene $4.05$, Make $3.80$, Python $3.65$ y Zapier $2.45$.
- El análisis de sensibilidad es obligatorio: con un peso de la facilidad superior a $0.289$, gana Make; un ganador que cambia con una décima es un empate.
- El coste total $C_t = h_c v + t (s + h_m v)$ separa construir de mantener: a 12 meses, Make Core cuesta $191.94$ USD y Python propio $201.73$; se cruzan en el mes $14.1$ y a 24 meses Python cuesta $322.38$ frente a $367.67$.
- Con horas inciertas, Python gana a Make el primer año solo en el $40.8%$ de $10,000$ escenarios, y en el $75.3%$ a 36 meses.
Portabilidad
- Un flujo tiene diseño, datos, credenciales e historial; solo el diseño se exporta en todas las plataformas, y las credenciales no deben viajar nunca.
- El mismo flujo ocupa $978$ caracteres como blueprint de Make y $1,300$ como workflow de n8n, con los mismos seis campos mapeados: cambia la gramática, no la lógica.
- La decisión queda en un registro con condiciones de revisión: Make para los mensajes, n8n self-hosted para el agente, Python como laboratorio, y cada flujo exportado y versionado en
trigo_lento/flujos/.
Mañana, en el Día 12: Costes y límites: créditos, tareas, ejecuciones y cuotas. Don Ernesto ya aceptó pagar una suscripción, pero quiere saber cuánto exactamente, sin un “depende”: Valeria traducirá el flujo de mensajes de Trigo Lento a créditos de Make, tareas de Zapier y ejecuciones de n8n, calculará la probabilidad de pasarse de la cuota en un mes cualquiera y repartirá el presupuesto de 45 USD.
Referencias
- Sahay, A., Indamutsa, A., Di Ruscio, D. y Pierantonio, A. (2020). Supporting the understanding and comparison of low-code development platforms. 46th Euromicro Conference on Software Engineering and Advanced Applications (SEAA), 171-178. https://ieeexplore.ieee.org/document/9226356
- Make (2026). Centro de ayuda: escenarios y blueprints. https://www.make.com/en/help
- n8n (2026). Documentación: exportar e importar workflows. https://docs.n8n.io/workflows/export-import/
- Make (2026). Precios y créditos. https://www.make.com/en/pricing
- n8n (2026). Precios. https://n8n.io/pricing
- Zapier (2026). Precios. https://zapier.com/pricing
- Microsoft (2026). Precios de Power Automate. https://www.microsoft.com/en-us/power-platform/products/power-automate/pricing
- Richards, M. y Ford, N. (2020). Fundamentals of Software Architecture: An Engineering Approach. O’Reilly Media.
- Nygard, M. (2011). Documenting Architecture Decisions. https://cognitect.com/blog/2011/11/15/documenting-architecture-decisions