
Arquitecto de automatización con IA: Día 14
 Jeshua Romero Guadarrama
- 54 Min para leer
- 14 Feb, 2026
Índice de contenido
Resumen:
Un teléfono que pierde su cero al pasar por una hoja de cálculo, un “False” que resulta verdadero y una hora de recogida sin zona horaria son el mismo problema visto tres veces: el flujo no sabía qué tipo de dato llevaba en la mano. En esta entrada, Valeria recorre los tipos primitivos y sus trampas (15 casos comprobados en Python), escribe el pedido de la Familia Herrera como un árbol JSON de 34 nodos, lo aplana en una tabla de 3 renglones con pandas.json_normalize, traduce las rutas a un dato entre Python, Make (índices desde 1) y n8n (índices desde 0), mide qué se pierde en una ida y vuelta por CSV (5 de 15 celdas) y compara cinco almacenes para el estado del negocio. Al terminar, usted sabrá reconocer el tipo de cada dato que viaja por un flujo, moverse con soltura entre árboles y tablas, escribir la misma ruta en tres dialectos y elegir dónde guardar lo que un flujo necesita recordar.
¿Cómo citar el presente artículo?
Romero, J. (14 de febrero de 2026). Arquitecto de automatización con IA: Día 14. python-data-engineer. https://www.python-data-engineer.com/post/aai/dia_14/.
Arquitecto de automatización con IA: Día 14 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/aai/dia_14/.
Precios, límites y políticas de Make, n8n, Zapier, WhatsApp (Meta, Twilio, Wati) y de la API de Claude revisados en octubre de 2026. Los límites de almacenamiento que usa este día (10 millones de celdas por hoja de cálculo de Google, 1 MB de almacén de datos de Make por cada 1 000 créditos del plan y 50 MB por omisión para todas las tablas de datos de una instancia de n8n) se contrastaron con la documentación oficial y con fuentes secundarias, revisado en octubre de 2026. Este día no llama a ningún servicio: los bloques de Python se ejecutan sin red y sus salidas son las reales; el Bloque 3 es un archivo JSON de ejemplo con datos ficticios.
Día 14. Estructuras de datos para automatizar: textos, listas, colecciones y tablas
Introducción
Ayer, en el Día 13 (Comparativa de herramientas I: Zapier, Make, n8n y Power Automate con el mismo flujo), Valeria escribió el recordatorio de recogida cuatro veces, una por plataforma, contó su consumo a 468 encargos al mes en créditos, tareas y ejecuciones, y Trigo Lento ganó una decisión en una sola hoja: Make para ese flujo en el módulo 3 y n8n cuando llegue el servidor propio.
Es sábado 14 de febrero, Día del Amor y la Amistad, y el obrador lleva despierto desde las cuatro de la mañana. Es el día del año con más pasteles por encargo: de chocolate, de zanahoria y pays de queso con dedicatoria. A las diez, Valeria revisa la hoja de cálculo donde caen los pedidos del formulario web y encuentra una fila que no cuadra. La Familia Herrera encargó un pastel de chocolate, seis conchas y cuatro croissants para recoger a las cinco y media, y escribió su teléfono como lo aprendió hace años, con el prefijo de larga distancia que ya no se usa: “0155 0000 0042”. La hoja lo recibió, decidió por su cuenta que aquello era un número, le quitó los espacios y el cero inicial, y ahora la celda dice 15500000042. La confirmación por WhatsApp que debía salir a las nueve no salió, porque ningún número de teléfono válido empieza así.
No es el único síntoma. En la misma hoja, una columna pagado tiene unas celdas con “FALSE”, otras con “no” y otras vacías; la hora de recogida aparece unas veces como “17:30” y otras como “5:30 p. m.”; y un pedido con tres productos ocupa tres filas en las que el nombre del cliente se repite tres veces, salvo en una, donde alguien lo corrigió a mano y ahora hay dos “clientes” distintos con el mismo teléfono. Ninguno de esos errores lo cometió una persona descuidada. Los cometió una estructura de datos que no era la adecuada para lo que guardaba.
Don Ernesto, que entra a la oficina con las manos todavía blancas de harina, mira la pantalla por encima del hombro de su hija y pone la objeción del día: “En mi libreta un pedido es una hoja: arriba el nombre y el teléfono, abajo lo que lleva. Nunca se me ha perdido un cero. ¿Por qué la computadora, que es tan lista, no puede hacer lo mismo?” La pregunta tiene más razón de la que parece. Su libreta guarda el pedido exactamente con la forma correcta: una cabecera y una lista de renglones. El problema empieza cuando ese pedido se copia a una cuadrícula que no sabe qué es un teléfono ni qué es una lista, y que trata todo lo que parece un número como un número.
En la presente entrada, descubrirá los cinco tipos primitivos con los que trabaja cualquier flujo (texto, número, booleano, fecha y nulo) y las trampas de cada uno, comprobadas en Python. Escribirá el pedido de la Familia Herrera como una colección anidada en JSON, la dibujará como un árbol y la aplanará en una tabla de renglones con pandas.json_normalize, entendiendo la relación de uno a muchos que hay entre un pedido y sus productos. Aprenderá a escribir la ruta hacia un dato en tres dialectos, Python, Make y n8n, con la diferencia que más errores causa: Make cuenta desde 1 y los otros dos desde 0. Después recorrerá los renglones para calcular un total y volverá a juntarlos, comparará JSON, CSV y el formato de los formularios web en una ida y vuelta, y terminará eligiendo, con números, dónde debe guardar Trigo Lento el estado de sus flujos.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Reconocer los tipos primitivos y sus trampas (texto que parece número, fechas con zona, nulos).
- Representar un pedido como colección con un arreglo de renglones y convertirlo en tabla.
- Acceder a campos anidados con rutas en Python, Make (índices desde 1) y n8n (índices desde 0).
- Elegir dónde guardar estado: hoja de cálculo, almacén de datos de la plataforma o base de datos.
Tipos primitivos y sus trampas
Todo dato que viaja por un flujo de automatización, por complicado que sea, está hecho de piezas pequeñas que no se pueden dividir más. Esas piezas son los tipos primitivos, y son casi los mismos en Python, en JSON, en Make y en n8n:
- Texto (cadena, en inglés string): una secuencia de caracteres, como
"Familia Herrera"o"P09". Un teléfono, un código postal, una clave de producto y un folio de factura son textos, aunque estén hechos de dígitos, porque nadie los suma. - Número: entero (
40baguettes) o decimal (0.0085dólares por mensaje). Se usa para lo que se cuenta, se suma o se compara por magnitud. - Booleano: verdadero o falso (
trueyfalseen JSON,TrueyFalseen Python). Responde a una pregunta de sí o no: ¿el pedido está pagado?, ¿el cliente aceptó recibir WhatsApp? - Fecha y hora: un instante o un día del calendario. JSON no tiene un tipo propio para fechas, así que viajan como texto en formato ISO 8601 (
"2026-02-14T17:30:00-06:00"), el mismo que fijó el contrato del Día 4. - Nulo: la ausencia de valor (
nullen JSON,Noneen Python). No es cero, ni falso, ni cadena vacía: es “no se sabe” o “no aplica”.
La regla que el arquitecto aplica a cada campo es sencilla de enunciar y difícil de cumplir: el tipo de un dato lo decide lo que se hace con él, no su aspecto. Un teléfono parece un número, pero si se le suma uno deja de ser el teléfono de alguien. Una clave como P10 parece texto y lo es; pero si se ordena como texto, queda antes que P9. Como en todos los días de la serie, el primer bloque prepara las importaciones, la semilla global $2026$ y la carpeta del día; añade la zona horaria fija de la Ciudad de México que usó el Día 4 y carga el catálogo de la Tabla 1 del Día 1 con los precios convertidos a centavos enteros, para que ningún cálculo de dinero pase por la coma flotante:
# Importaciones base, semilla de la serie, catálogo en centavos y carpeta del día en Python:
import warnings
warnings.filterwarnings('ignore')
import json
from pathlib import Path
from datetime import datetime, timedelta, timezone
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 120)
pd.set_option('display.max_columns', 12)
carpeta = Path('trigo_lento') / 'dia_14'
carpeta.mkdir(parents = True, exist_ok = True)
ZONA = timezone(timedelta(hours = -6), 'America/Mexico_City')   # la misma zona fija del Día 4

# Catálogo de la Tabla 1 del Día 1, con los precios convertidos a centavos enteros:
catalogo = json.loads((Path('trigo_lento') / 'catalogo.json').read_text(encoding = 'utf-8'))
precios = {p['clave']: p['precio_mxn'] * 100 for p in catalogo}
print('numpy', np.__version__, '| pandas', pd.__version__)
print('Productos en el catálogo:', len(catalogo), '| P02 en centavos:', precios['P02'])
numpy 2.4.6 | pandas 3.0.3
Productos en el catálogo: 12 | P02 en centavos: 3800
El catálogo tiene sus $12$ productos y la baguette, P02, vale $3,800$ centavos. Desde aquí, todo el dinero del día es un entero.
Con el entorno listo, el siguiente bloque pone a prueba quince expresiones, tres a cinco por tipo, y guarda el resultado de cada una tal como lo devuelve Python (con repr, para que se vea la diferencia entre '105' y 105). Ninguna es un ejemplo inventado para la ocasión: cada una corresponde a un error que se ha visto en flujos reales de negocios pequeños, y varias ya ocurrieron hoy en la hoja de Trigo Lento:
# Trampas de los tipos primitivos: texto, número, booleano, fecha y nulo en Python:
casos = []
def caso(tipo, expresion, valor):
    casos.append((tipo, expresion, repr(valor)))

caso('texto y número', '"05" == 5', "05" == 5)
caso('texto y número', 'int("05") == 5', int("05") == 5)
caso('texto y número', '"10" + "5"', "10" + "5")
caso('texto y número', 'sorted(["P10", "P9", "P1"])', sorted(["P10", "P9", "P1"]))
caso('texto y número', 'int("0155 0000 0042".replace(" ", ""))', int("0155 0000 0042".replace(" ", "")))
caso('booleano', 'bool("False")', bool("False"))
caso('booleano', 'bool("")', bool(""))
caso('booleano', '"False".strip().lower() == "true"', "False".strip().lower() == "true")

# Fechas: la misma hora de recogida sin zona (ingenua) y con la zona de la panadería:
ingenua = datetime(2026, 2, 14, 17, 30)
con_zona = datetime(2026, 2, 14, 17, 30, tzinfo = ZONA)
caso('fecha', 'ingenua.isoformat()', ingenua.isoformat())
caso('fecha', 'con_zona.isoformat()', con_zona.isoformat())
caso('fecha', 'con_zona en UTC', con_zona.astimezone(timezone.utc).isoformat())
try:
    con_zona - ingenua
except TypeError as error:
    caso('fecha', 'con_zona - ingenua', 'TypeError: ' + str(error))

# Nulos: None no es una cadena vacía, salvo cuando alguien los confunde al guardar:
caso('nulo', 'None == ""', None == "")
caso('nulo', 'json.dumps([None, ""])', json.dumps([None, ""]))
caso('nulo', 'pd.Series([None, ""]).isna().tolist()', pd.Series([None, ""]).isna().tolist())

trampas = pd.DataFrame(casos, columns = ['tipo', 'expresion', 'resultado'])
print(trampas.to_string(index = False))
print('Casos:', len(trampas))
          tipo                              expresion                                                           resultado
texto y número                              "05" == 5                                                               False
texto y número                         int("05") == 5                                                                True
texto y número                             "10" + "5"                                                               '105'
texto y número            sorted(["P10", "P9", "P1"])                                                 ['P1', 'P10', 'P9']
texto y número int("0155 0000 0042".replace(" ", ""))                                                         15500000042
      booleano                          bool("False")                                                                True
      booleano                               bool("")                                                               False
      booleano      "False".strip().lower() == "true"                                                               False
         fecha                    ingenua.isoformat()                                               '2026-02-14T17:30:00'
         fecha                   con_zona.isoformat()                                         '2026-02-14T17:30:00-06:00'
         fecha                        con_zona en UTC                                         '2026-02-14T23:30:00+00:00'
         fecha                     con_zona - ingenua "TypeError: can't subtract offset-naive and offset-aware datetimes"
          nulo                             None == ""                                                               False
          nulo                 json.dumps([None, ""])                                                        '[null, ""]'
          nulo  pd.Series([None, ""]).isna().tolist()                                                       [True, False]
Casos: 15
Los $15$ casos se leen de arriba abajo como una pequeña colección de accidentes:
- En primer lugar, el texto y el número no se mezclan solos.
"05" == 5esFalse, porque una cadena nunca es igual a un entero;"10" + "5"da'105', porque sumar textos es pegarlos; yint("0155 0000 0042".replace(" ", ""))da15500000042, exactamente lo que hizo la hoja de cálculo con el teléfono de la Familia Herrera. El cero inicial no tiene valor numérico, así que desaparece en cuanto alguien convierte el texto en número. - En segundo lugar, ordenar texto no es ordenar números:
sorted(["P10", "P9", "P1"])devuelve['P1', 'P10', 'P9'], porque compara carácter por carácter y"1"va antes que"9". Por eso el catálogo de Trigo Lento usa claves con dos dígitos (P01aP12): con un cero de relleno, el orden alfabético coincide con el numérico. - En tercer lugar,
bool("False")esTrue. En Python, cualquier cadena no vacía es verdadera, incluida la palabra “False”. Una columnapagadoque llega como texto desde un formulario o desde un CSV no se puede convertir conbool; hay que comparar el texto normalizado con una lista explícita, como hace la expresión"False".strip().lower() == "true". - En cuarto lugar, una fecha sin zona es ambigua. La hora ingenua
2026-02-14T17:30:00no dice de qué ciudad es; la que lleva zona,2026-02-14T17:30:00-06:00, sí, y por eso se puede convertir a tiempo universal coordinado:23:30en UTC. Python se niega a restar una de otra y lanza unTypeError, lo cual es una virtud: prefiere fallar a adivinar. - En quinto lugar, nulo y vacío son cosas distintas:
None == ""esFalse, JSON los escribe comonully"", y pandas solo considera ausente al primero. Un camponotasvacío significa “el cliente no dejó nota”; un camponotasnulo puede significar “este canal no tiene campo de notas”. Confundirlos borra esa diferencia.
La Tabla 1 reúne las trampas con un ejemplo de Trigo Lento y la solución que la serie aplicará en cada caso. Cada solución es una decisión de diseño que se toma una vez, en el contrato, y no cada vez que un dato pasa por el flujo.
Tabla 1. Trampas de tipos con ejemplo de Trigo Lento y solución.
| Tipo | Trampa | Ejemplo en Trigo Lento | Consecuencia | Solución |
|---|---|---|---|---|
| Texto que parece número | Conversión automática | Teléfono “0155 0000 0042” convertido en 15500000042 | La confirmación por WhatsApp no sale | Teléfono siempre como texto en E.164 (+525500000042) |
| Texto que parece número | Orden alfabético | P10 antes que P9 | Listas del obrador desordenadas | Claves de longitud fija con relleno (P09) |
| Número que parece texto | Suma que concatena | "10" + "5" da "105" piezas | Cantidades absurdas en el resumen | Convertir y validar cantidades como enteros en la frontera |
| Booleano como texto | Cualquier cadena no vacía es verdadera | bool("False") da True | Pedidos sin pagar marcados como pagados | Lista explícita de valores verdaderos; tipo booleano en el almacén |
| Fecha sin zona | Ambigüedad de la hora | “17:30” sin zona en un servidor en UTC | Recordatorio seis horas tarde | ISO 8601 con desfase -06:00 o en UTC |
| Nulo frente a vacío | Dos ausencias distintas mezcladas | notas nulo frente a notas vacío | Se pierde si el canal tenía el campo | null para “no aplica”; "" para “vacío a propósito” |
| Dinero decimal | Error de redondeo | $0.1 + 0.2 \neq 0.3$ | Totales con centavos fantasma | Centavos enteros (total_centavos) |
La última fila no es nueva: es la lección del Día 4, que hoy se ve como lo que es, otra trampa de tipos. El dinero no es un número decimal cualquiera; es una cantidad entera de centavos que se presenta con un punto.
Colecciones y arreglos
Los tipos primitivos son las piezas sueltas; los datos de un negocio necesitan además agruparlas. Hay solo dos formas de hacerlo, y todas las plataformas las usan, con nombres distintos:
- Una colección con nombre agrupa valores bajo claves: el cliente tiene un
nombrey untelefono. En Python se llama diccionario; en JSON, objeto; en Make, colección; en n8n, cada item lleva sus datos en un objeto llamadojson. El orden de las claves no importa: lo que importa es el nombre. - Una lista ordenada agrupa valores por posición: el primer renglón, el segundo, el tercero. En Python se llama lista; en JSON, arreglo; en Make, arreglo (array); en n8n, también arreglo, y además una lista de items es la forma en que los datos fluyen de un nodo a otro.
Lo interesante empieza cuando las dos formas se meten una dentro de otra. Un pedido de Trigo Lento es una colección (el pedido) que contiene otra colección (el cliente) y una lista (los renglones), y cada elemento de esa lista es a su vez una colección (un renglón) que contiene otra (el producto). Es la estructura de las muñecas rusas que muestra la Figura 1: cada muñeca abre otra más pequeña, y para llegar a la del fondo hay que abrirlas en orden.
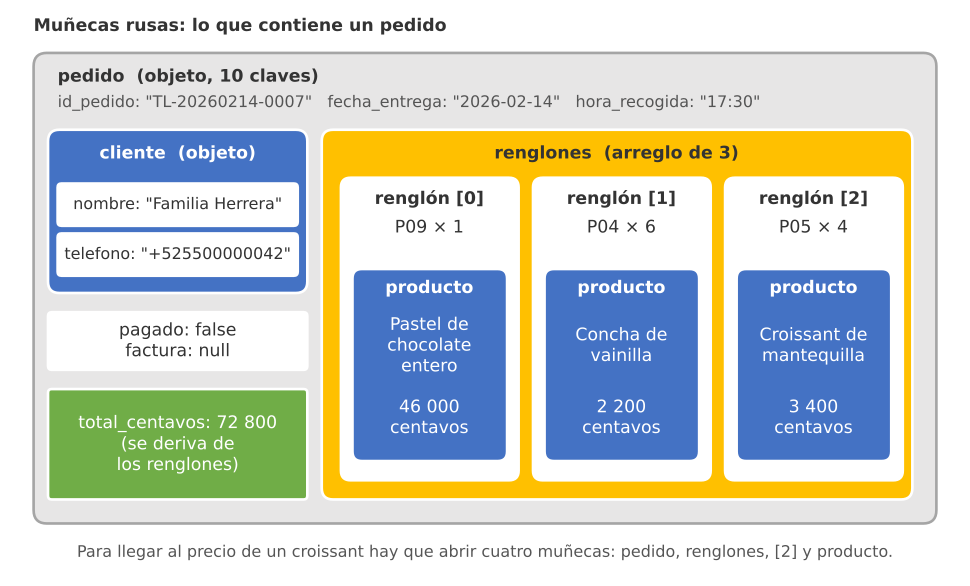
Figura 1. Muñecas rusas: el pedido TL-20260214-0007 contiene al cliente y a un arreglo de tres renglones; cada renglón contiene un producto, y el total de 72 800 centavos se deriva de los renglones.
Esa estructura no se inventó para las computadoras. Es la de la libreta de Don Ernesto: arriba, una vez, los datos del cliente y la fecha; abajo, tantos renglones como productos. Un pedido de un solo producto tiene un renglón; uno de siete productos, siete. La forma anidada es la forma natural del pedido, y la cuadrícula de una hoja de cálculo es la que lo deforma.
La Tabla 2 pone en una sola fila los nombres que recibe la misma idea en cada herramienta, porque buena parte de la confusión al pasar de una plataforma a otra es solo de vocabulario:
Tabla 2. Vocabulario: la misma estructura con cuatro nombres.
| Idea | Python | JSON | Make | n8n |
|---|---|---|---|---|
| Valores bajo claves con nombre | Diccionario (dict) | Objeto {...} | Colección | Item (su campo json) |
| Valores por posición | Lista (list) | Arreglo [...] | Arreglo (array) | Arreglo; y la lista de items entre nodos |
| Primer elemento de una lista | renglones[0] | Posición 0 | renglones[1] | renglones[0] |
| Dato que falta | None | null | Vacío (empty) | null o undefined |
| Recorrer una lista | Bucle for | No aplica (es solo formato) | Iterador (builtin:BasicFeeder) | Cada item se procesa solo; Split Out separa un arreglo |
| Volver a juntar | sum, Counter, append | No aplica | Agregador (builtin:BasicAggregator) | Nodo Aggregate o Code |
La Figura 2 dibuja la idea de la tabla: un solo dato, el cliente de la Familia Herrera, con cuatro etiquetas colgadas según quién lo mire.
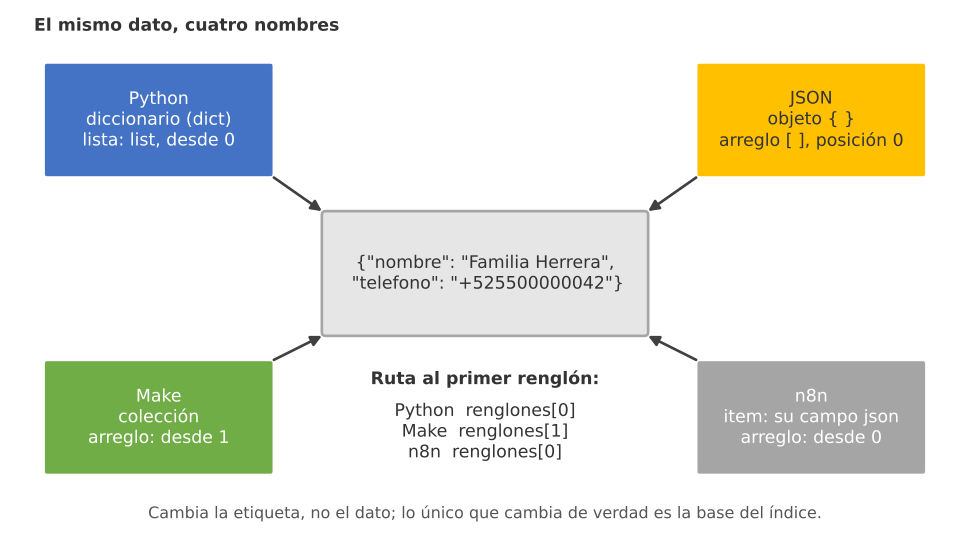
Figura 2. El mismo dato, cuatro nombres: el cliente de la Familia Herrera es un diccionario en Python, un objeto en JSON, una colección en Make y el campo json de un item en n8n; solo Make cuenta los elementos de un arreglo desde 1.
Veamos ahora el pedido completo de la Familia Herrera como documento JSON. No es el mensaje que llega por WhatsApp ni el que valida el contrato del Día 4 en la frontera, que solo exige clave y cantidad en cada renglón; es el pedido enriquecido que circula dentro del flujo una vez que el paso de validación lo cruzó con el catálogo y le añadió el nombre y el precio de cada producto. Lleva además dos campos internos, pagado y factura, para que aparezcan los cinco tipos primitivos. Guárdelo como trigo_lento/dia_14/pedido_familia.json:
{
  "id_pedido": "TL-20260214-0007",
  "canal": "whatsapp",
  "cliente": {
    "nombre": "Familia Herrera",
    "telefono": "+525500000042"
  },
  "fecha_entrega": "2026-02-14",
  "hora_recogida": "17:30",
  "notas": "Dedicatoria: Feliz 14",
  "renglones": [
    {
      "linea": 1,
      "clave": "P09",
      "cantidad": 1,
      "producto": {"nombre": "Pastel de chocolate entero", "precio_centavos": 46000}
    },
    {
      "linea": 2,
      "clave": "P04",
      "cantidad": 6,
      "producto": {"nombre": "Concha de vainilla", "precio_centavos": 2200}
    },
    {
      "linea": 3,
      "clave": "P05",
      "cantidad": 4,
      "producto": {"nombre": "Croissant de mantequilla", "precio_centavos": 3400}
    }
  ],
  "total_centavos": 72800,
  "pagado": false,
  "factura": null
}
Lea el documento de afuera hacia adentro. El pedido es un objeto con diez claves; cliente es un objeto de dos; renglones es un arreglo de tres objetos, y cada renglón lleva un objeto producto. Los tipos primitivos están todos: textos ("P09", "+525500000042"), números enteros (1, 46000, 72800), un booleano (false) y un nulo (null, porque la familia no pidió factura). La fecha y la hora van como texto en ISO 8601. El total, $72,800$ centavos, es la suma que el flujo calculó con el catálogo:
$$ T = \sum_{i=1}^{r} q_i , p_i = 1 \cdot 46,000 + 6 \cdot 2,200 + 4 \cdot 3,400 = 72,800 \text{ centavos} $$
La lógica detrás de esta fórmula es múltiple:
- $r$ es el número de renglones del pedido ($3$ en la Familia Herrera) y $i$ recorre cada uno; la suma tiene tantos términos como renglones, sean uno o doce.
- $q_i$ es la cantidad del renglón $i$ y $p_i$ su precio unitario en centavos, tomado del catálogo y nunca del mensaje del cliente.
- Cada producto $q_i p_i$ es el subtotal del renglón: $46,000$, $13,200$ y $13,600$ centavos.
- En conclusión, el total no es un dato que se guarde y se crea, sino un dato derivado de los renglones: si alguien cambia un renglón y no recalcula $T$, el pedido se contradice a sí mismo. Por eso los bloques de hoy siempre lo comprueban.
Antes de transformar el pedido conviene verlo. El siguiente bloque lee el archivo, lo recorre de forma recursiva (cada objeto y cada arreglo abren una rama; cada valor primitivo es una hoja) y lo dibuja como un árbol con rectángulos de matplotlib, coloreados por tipo. Las hojas se apilan de arriba abajo y cada nodo con hijos se coloca a la altura media de sus hijos, que es la forma más sencilla de dibujar un árbol sin cruces:
# El árbol del pedido anidado dibujado con patches de matplotlib en Python:
from matplotlib.patches import FancyBboxPatch

pedido = json.loads((carpeta / 'pedido_familia.json').read_text(encoding = 'utf-8'))

def recorrer(nombre, valor, profundidad, nodos, aristas, padre = None):
    # Cada nodo guarda su etiqueta, su tipo y su profundidad; las hojas reciben una fila propia:
    i = len(nodos)
    if isinstance(valor, dict):
        tipo, etiqueta = 'objeto', f'{nombre} {{{len(valor)}}}'
    elif isinstance(valor, list):
        tipo, etiqueta = 'arreglo', f'{nombre} [{len(valor)}]'
    else:
        tipo = {bool: 'booleano', int: 'número', float: 'número', str: 'texto'}.get(type(valor), 'nulo')
        etiqueta = f'{nombre}: {json.dumps(valor, ensure_ascii = False)}'
    nodos.append({'etiqueta': etiqueta, 'tipo': tipo, 'profundidad': profundidad})
    if padre is not None:
        aristas.append((padre, i))
    hijos = valor.items() if isinstance(valor, dict) else enumerate(valor) if isinstance(valor, list) else []
    for clave, hijo in hijos:
        recorrer(f'[{clave}]' if isinstance(valor, list) else clave, hijo, profundidad + 1, nodos, aristas, i)
    return nodos, aristas

nodos, aristas = recorrer('pedido', pedido, 0, [], [])
hijos_de = {i: [h for p, h in aristas if p == i] for i in range(len(nodos))}
fila = [0]
def ubicar(i):
    # Las hojas se apilan hacia abajo; un nodo con hijos queda a la altura media de sus hijos:
    if not hijos_de[i]:
        nodos[i]['y'] = -fila[0]
        fila[0] += 1
    else:
        nodos[i]['y'] = np.mean([ubicar(h) for h in hijos_de[i]])
    return nodos[i]['y']
ubicar(0)

COLORES = {'objeto': '#2a78d6', 'arreglo': '#eb6834', 'texto': '#3a9d5d',
           'número': '#7b5ea7', 'booleano': '#8a8986', 'nulo': '#8a8986'}
fig, ax = plt.subplots(figsize = (13, 9.5))
for n in nodos:
    n['ancho'] = max(2.4, 0.078 * len(n['etiqueta']))   # caja a la medida de su etiqueta
for p, h in aristas:
    ax.plot([nodos[p]['profundidad'] * 2.75 + nodos[p]['ancho'], nodos[h]['profundidad'] * 2.75],
            [nodos[p]['y'], nodos[h]['y']], color = '#52514e', lw = 1)
for n in nodos:
    x = n['profundidad'] * 2.75
    ax.add_patch(FancyBboxPatch((x, n['y'] - 0.35), n['ancho'], 0.7, boxstyle = 'round,pad=0.02',
                                fc = COLORES[n['tipo']], ec = 'white'))
    ax.text(x + 0.08, n['y'], n['etiqueta'], va = 'center', fontsize = 9, color = 'white')
for k, (tipo, color) in enumerate(list(COLORES.items())[:5]):
    ax.add_patch(FancyBboxPatch((11.2, -2 - k * 1.1), 0.5, 0.6, boxstyle = 'round,pad=0.02', fc = color))
    ax.text(11.85, -1.7 - k * 1.1, tipo if tipo != 'booleano' else 'booleano o nulo', va = 'center', fontsize = 10)
ax.set_xlim(-0.2, 14)
ax.set_ylim(-fila[0], 1)
ax.axis('off')
ax.set_title('El pedido TL-20260214-0007 como árbol: objetos, arreglos y hojas', fontsize = 16)
plt.tight_layout()
plt.show()

hojas = [n for i, n in enumerate(nodos) if not hijos_de[i]]
print('Nodos:', len(nodos), '| hojas:', len(hojas), '| profundidad máxima:', max(n['profundidad'] for n in nodos))
print('Nodos por tipo:', pd.Series([n['tipo'] for n in nodos]).value_counts().to_dict())
Nodos: 34 | hojas: 25 | profundidad máxima: 4
Nodos por tipo: {'texto': 13, 'número': 10, 'objeto': 8, 'arreglo': 1, 'booleano': 1, 'nulo': 1}
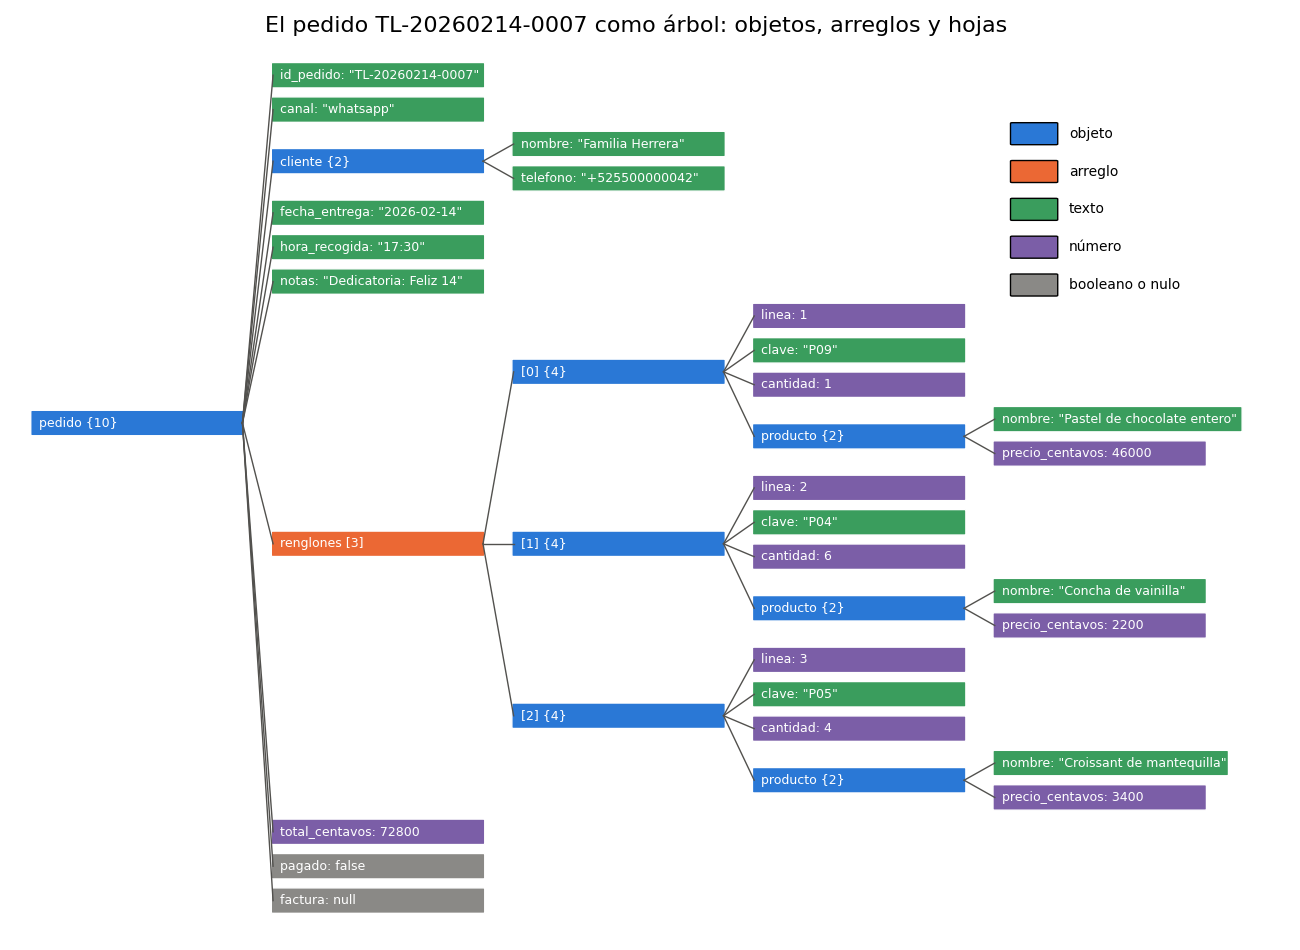
El pedido tiene $34$ nodos, de los cuales $25$ son hojas (los valores primitivos), y una profundidad máxima de $4$: para llegar al precio de un croissant hay que abrir el pedido, la lista de renglones, el tercer renglón y su producto. Por tipo hay $13$ textos, $10$ números, $8$ objetos, $1$ arreglo, $1$ booleano y $1$ nulo. El dibujo muestra también algo que la tabla de la hoja de cálculo escondía: la información del cliente aparece una sola vez, en la rama de arriba, y los renglones cuelgan todos de un mismo arreglo. En el árbol no hay manera de que el nombre del cliente se escriba distinto en dos renglones, porque solo está escrito en un sitio.
De árbol a tabla
El árbol es la forma natural del pedido, pero muchas herramientas solo saben trabajar con tablas: una hoja de cálculo, una tabla de base de datos, un CSV para el contador, una gráfica en pandas. Pasar de un árbol a una tabla se llama aplanar (en inglés, flatten), y es una de las operaciones que más se repiten en automatización: en Make, cada vez que un arreglo se escribe en Google Sheets; en n8n, cada vez que un nodo Split Out convierte un arreglo en items.
La pregunta clave al aplanar es ¿qué representa cada fila? Si cada fila es un pedido, la lista de renglones no cabe en una celda; si cada fila es un renglón, los datos del pedido se repiten en cada una. Es la relación de uno a muchos: un pedido tiene muchos renglones, y un renglón pertenece a un solo pedido. La Figura 3 muestra el despliegue: las tres ramas del arreglo se convierten en tres filas, y la cabecera del pedido se copia en las tres.
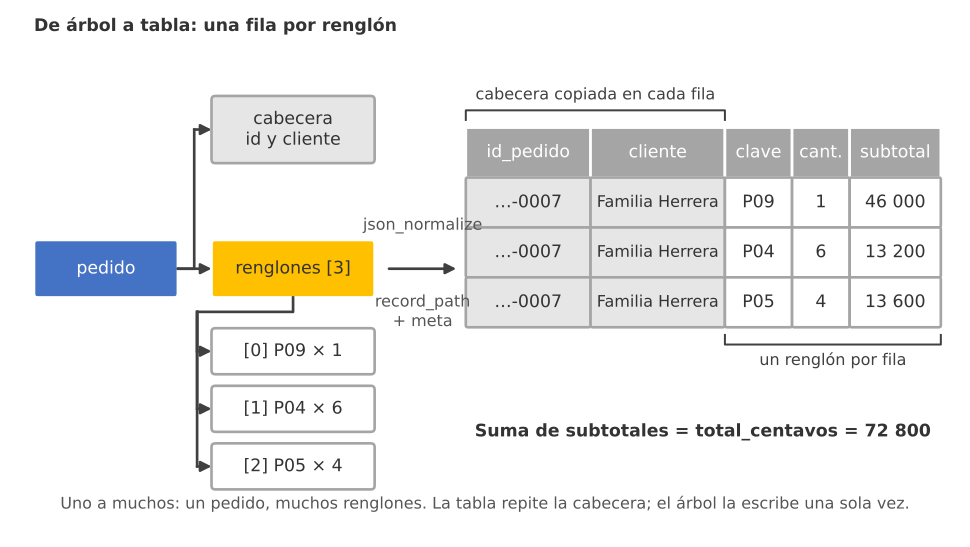
Figura 3. De árbol a tabla: json_normalize con record_path convierte los tres renglones del pedido en tres filas y copia en cada una la cabecera (identificador y cliente); la suma de subtotales sigue siendo 72 800 centavos.
La función pandas.json_normalize hace exactamente esa operación. Sin más argumentos, aplana los objetos anidados en columnas con nombres compuestos (cliente_nombre), pero deja los arreglos intactos dentro de una celda. Con record_path = 'renglones' le dice que cada elemento de ese arreglo es una fila, y con meta le indica qué datos del pedido copiar en cada una. El siguiente bloque prueba las dos versiones, comprueba que los subtotales suman el total y aplana también el pedido de Cafetería Brújula de un lunes, que es la colección más sencilla posible, con un arreglo de un solo renglón:
# De árbol a tabla: aplanado del pedido anidado con pandas.json_normalize en Python:
# Sin record_path, la lista de renglones se queda metida en una sola celda:
plano = pd.json_normalize(pedido, sep = '_')
print('Sin record_path:', plano.shape, '| la celda renglones es un', type(plano.loc[0, 'renglones']).__name__)

# Con record_path, cada renglón es una fila y meta repite en ella los datos del pedido:
renglones = pd.json_normalize(pedido, record_path = 'renglones',
                              meta = ['id_pedido', ['cliente', 'nombre'], 'fecha_entrega'], sep = '_')
renglones['subtotal_centavos'] = renglones['cantidad'] * renglones['producto_precio_centavos']
print(renglones[['id_pedido', 'cliente_nombre', 'linea', 'clave', 'cantidad',
                 'producto_precio_centavos', 'subtotal_centavos']].to_string(index = False))
print('Suma de subtotales:', renglones['subtotal_centavos'].sum(), '| total del JSON:', pedido['total_centavos'])

# El pedido de Cafetería Brújula de un lunes: una colección con un arreglo de un solo renglón:
brujula = {'id_pedido': 'TL-20260216-0001', 'canal': 'whatsapp',
           'cliente': {'nombre': 'Cafetería Brújula', 'telefono': '+525500000017'},
           'fecha_entrega': '2026-02-16',
           'renglones': [{'linea': 1, 'clave': 'P02', 'cantidad': 40,
                          'producto': {'nombre': 'Baguette tradicional', 'precio_centavos': precios['P02']}}]}
dos = pd.json_normalize([pedido, brujula], record_path = 'renglones', meta = ['id_pedido'], sep = '_')
print('Filas al aplanar los dos pedidos:', len(dos), '| por pedido:', dos['id_pedido'].value_counts(sort = False).to_dict())
print('Columnas:', list(dos.columns))
Sin record_path: (1, 11) | la celda renglones es un list
       id_pedido  cliente_nombre  linea clave  cantidad  producto_precio_centavos  subtotal_centavos
TL-20260214-0007 Familia Herrera      1   P09         1                     46000              46000
TL-20260214-0007 Familia Herrera      2   P04         6                      2200              13200
TL-20260214-0007 Familia Herrera      3   P05         4                      3400              13600
Suma de subtotales: 72800 | total del JSON: 72800
Filas al aplanar los dos pedidos: 4 | por pedido: {'TL-20260214-0007': 3, 'TL-20260216-0001': 1}
Columnas: ['linea', 'clave', 'cantidad', 'producto_nombre', 'producto_precio_centavos', 'id_pedido']
La primera línea de la salida muestra el problema: sin record_path, el pedido queda en una fila de $11$ columnas, y la celda renglones contiene una lista de Python, que ninguna hoja de cálculo sabe mostrar. Con record_path, el pedido de la Familia Herrera se convierte en $3$ filas, una por renglón, con el identificador del pedido y el nombre del cliente repetidos en cada una. La suma de los subtotales, $72,800$ centavos, coincide con el total_centavos del JSON: el aplanado no perdió nada.
Al aplanar los dos pedidos juntos salen $4$ filas: $3$ de la familia y $1$ de Cafetería Brújula. Fíjese en los nombres de las columnas: producto_nombre y producto_precio_centavos vienen del objeto producto de cada renglón, unidos con el separador _ que se pidió con sep. Es la misma convención que usará la base de datos al final del día.
El número de filas de la tabla aplanada no es el número de pedidos, sino la suma de sus renglones. Si $n$ pedidos tienen $r_1, r_2, \dots, r_n$ renglones, la tabla tiene
$$ F = \sum_{j=1}^{n} r_j, \qquad E[F] = n , (1 + \lambda) \quad \text{si} \quad r_j = 1 + \text{Poisson}(\lambda) $$
La lógica detrás de esta fórmula es múltiple:
- $F$ es el número de filas de la tabla de renglones; para los dos pedidos de arriba, $F = 3 + 1 = 4$.
- El supuesto $r_j = 1 + \text{Poisson}(\lambda)$ dice que todo pedido tiene al menos un renglón y que los adicionales siguen una distribución de Poisson de media $\lambda$; con $\lambda = 0.6$, un pedido tiene en promedio $1.6$ renglones, el supuesto que usará el Día 15 para proyectar volúmenes.
- $E[F]$ es el número esperado de filas: con $468$ encargos al mes, $468 \cdot 1.6 = 748.8$ filas de renglones al mes.
- En conclusión, la tabla de renglones crece más deprisa que la de pedidos, y es la que decide cuándo se llena un almacén. La sección de almacenes volverá a esta cuenta.
Rutas para llegar a un dato
En un árbol, cada hoja tiene una dirección: el camino de claves y posiciones que hay que seguir desde la raíz para llegar a ella. Esa dirección se llama ruta (en inglés, path), y escribirla bien es la mitad del trabajo de mapear datos en Make o en n8n. La clave del primer producto de la Familia Herrera está en la ruta “abra renglones, tome el primer elemento, lea clave”. El problema es que cada herramienta escribe esa frase de forma distinta, y que no todas están de acuerdo en cuál es el “primer” elemento:
- Python escribe
pedido["renglones"][0]["clave"]y cuenta desde $0$, como casi todos los lenguajes de programación. - Make escribe
{{1.renglones[1].clave}}en el panel de mapeo: el1.inicial es el número del módulo del que sale el dato, y el índice del arreglo empieza en $1$, como cuenta una persona. - n8n escribe
{{ $json.renglones[0].clave }}: sus expresiones son JavaScript,$jsones el objeto del item actual y el índice empieza en $0$, como en Python.
La conversión entre los dos convenios es una suma, pero una suma que se olvida con facilidad:
$$ i_{\text{Make}} = i_{\text{Python}} + 1 = i_{\text{n8n}} + 1 $$
La lógica detrás de esta fórmula es múltiple:
- $i_{\text{Python}}$ e $i_{\text{n8n}}$ cuentan los desplazamientos desde el inicio de la lista: el primer elemento está a $0$ pasos del inicio.
- $i_{\text{Make}}$ cuenta posiciones: el primer elemento ocupa la posición $1$.
- El tercer renglón es
renglones[2]en Python y en n8n, yrenglones[3]en Make. - En conclusión, un mapeo copiado de n8n a Make sin sumar $1$ no falla con un error: devuelve el renglón equivocado, que es mucho peor.
El siguiente bloque escribe una función, obtener_ruta, que recorre una ruta escrita con puntos ("renglones.0.clave", en base $0$) y devuelve un valor por defecto si algún tramo no existe, en lugar de lanzar una excepción. Añade dos traductores, a_make y a_n8n, que convierten la misma ruta a la sintaxis de cada plataforma, y los prueba con cinco rutas, dos de ellas a propósito inexistentes:
# Rutas para llegar a un dato: Python, Make (índices desde 1) y n8n (índices desde 0) en Python:
def obtener_ruta(dato, ruta, defecto = None):
    # Recorre "renglones.0.clave": los números son índices de lista (base 0); lo demás, claves:
    actual = dato
    for paso in ruta.split('.'):
        try:
            actual = actual[int(paso)] if isinstance(actual, list) else actual[paso]
        except (KeyError, IndexError, ValueError, TypeError):
            return defecto
    return actual

def partes_de(ruta, base):
    # Pega cada índice a la clave anterior, sumando la base del dialecto: 0 en n8n, 1 en Make:
    partes = []
    for paso in ruta.split('.'):
        if paso.isdigit():
            partes[-1] += f'[{int(paso) + base}]'
        else:
            partes.append(paso)
    return '.'.join(partes)

def a_make(ruta, modulo = 1):
    return '{{' + f'{modulo}.' + partes_de(ruta, base = 1) + '}}'

def a_n8n(ruta):
    return '{{ $json.' + partes_de(ruta, base = 0) + ' }}'

rutas = ['cliente.nombre', 'renglones.0.clave', 'renglones.2.producto.precio_centavos',
         'renglones.3.clave', 'factura.folio']
tabla_rutas = pd.DataFrame({
    'ruta': rutas,
    'valor': [obtener_ruta(pedido, r, defecto = '(sin dato)') for r in rutas],
    'make': [a_make(r) for r in rutas],
    'n8n': [a_n8n(r) for r in rutas]})
print(tabla_rutas.to_string(index = False))
print('Último renglón con índice negativo en Python:', obtener_ruta(pedido, 'renglones.-1.clave'))
                                ruta           valor                                        make                                               n8n
                      cliente.nombre Familia Herrera                        {{1.cliente.nombre}}                        {{ $json.cliente.nombre }}
                   renglones.0.clave             P09                    {{1.renglones[1].clave}}                    {{ $json.renglones[0].clave }}
renglones.2.producto.precio_centavos            3400 {{1.renglones[3].producto.precio_centavos}} {{ $json.renglones[2].producto.precio_centavos }}
                   renglones.3.clave      (sin dato)                    {{1.renglones[4].clave}}                    {{ $json.renglones[3].clave }}
                       factura.folio      (sin dato)                         {{1.factura.folio}}                         {{ $json.factura.folio }}
Último renglón con índice negativo en Python: P05
La salida es la Tabla 3 en bruto. El primer producto es P09 en las tres notaciones, pero la ruta de Make dice renglones[1] y las otras dos renglones[0]. La tercera fila llega dos niveles más abajo, al precio del croissant, $3,400$ centavos. Las dos últimas rutas no existen: el pedido tiene $3$ renglones, así que renglones.3 (el cuarto) no está, y factura es null, así que no tiene folio. En los dos casos obtener_ruta devuelve (sin dato) en lugar de romperse. La última línea muestra una comodidad de Python que no tienen las plataformas: el índice $-1$ da el último elemento, P05; en Make se usa la función last() y en n8n el método .last() de los arreglos o .at(-1).
Tabla 3. La misma ruta en tres dialectos, con su valor en el pedido de la Familia Herrera.
| Qué se busca | Python (base 0) | Make (base 1) | n8n (base 0) | Valor |
|---|---|---|---|---|
| Nombre del cliente | pedido["cliente"]["nombre"] | {{1.cliente.nombre}} | {{ $json.cliente.nombre }} | Familia Herrera |
| Clave del primer renglón | pedido["renglones"][0]["clave"] | {{1.renglones[1].clave}} | {{ $json.renglones[0].clave }} | P09 |
| Precio del tercer producto | pedido["renglones"][2]["producto"]["precio_centavos"] | {{1.renglones[3].producto.precio_centavos}} | {{ $json.renglones[2].producto.precio_centavos }} | 3400 |
| Clave del cuarto renglón | pedido["renglones"][3]["clave"] | {{1.renglones[4].clave}} | {{ $json.renglones[3].clave }} | No existe |
| Folio de la factura | pedido["factura"]["folio"] | {{1.factura.folio}} | {{ $json.factura.folio }} | No existe (factura es nulo) |
Las rutas que no existen se comportan distinto en cada sitio, y conviene saberlo antes de que ocurra. En Python, pedido["renglones"][3] lanza un IndexError y detiene el programa, salvo que se use una función como obtener_ruta. En Make, un mapeo a un elemento que no existe devuelve un valor vacío y el escenario sigue, de modo que el módulo siguiente recibe un campo en blanco. En n8n, la expresión sobre un índice inexistente da undefined, y leer .folio de un null produce un error de expresión que detiene el nodo, salvo que se escriba con el operador de encadenamiento opcional de JavaScript: {{ $json.factura?.folio }}.
Atención aquí: el error de índice entre Make y n8n es silencioso. Si un mapeo de n8n con renglones[0] se copia tal cual a Make, Make no avisa de nada: entrega el renglón que ocupa la posición $0$ en su convenio, que no existe, y el campo llega vacío; y si se copia renglones[1] de Make a n8n, n8n entrega el segundo renglón como si fuera el primero. En un pedido de un solo renglón, como el de Cafetería Brújula, el error ni siquiera se nota hasta el día en que llega un pedido con dos productos. La defensa es doble: al migrar un flujo, buscar todos los índices numéricos de las expresiones y revisarlos uno por uno (el Día 45 lo automatizará), y siempre que se pueda, recorrer el arreglo completo en lugar de pedir un elemento por su posición.
Iterar y agregar
Pedir un renglón por su posición sirve para inspeccionar un pedido, pero casi nunca para procesarlo: el flujo no sabe de antemano cuántos renglones trae cada pedido. Lo que hace en realidad es iterar, es decir, recorrer todos los elementos del arreglo uno por uno y aplicar a cada uno los mismos pasos, y después agregar, es decir, volver a juntar los resultados en uno solo: un total, una lista para el obrador, un mensaje de confirmación con todos los productos.
Las plataformas tienen piezas propias para cada mitad. En Make, el iterador recibe un arreglo y emite un paquete por elemento, y el agregador (de arreglo, de texto o numérico) recoge esos paquetes y devuelve uno solo; entre los dos, los módulos se ejecutan una vez por elemento. En n8n, cada item ya se procesa por separado de forma natural; un nodo Split Out convierte un arreglo en items y un nodo Aggregate los vuelve a juntar. El Día 25 dedicará una entrada completa a esas piezas en Make. Hoy basta con ver el patrón en Python, donde el iterador es un bucle for y el agregador una variable que acumula:
# Iterar los renglones y volver a juntar: total en centavos y piezas por producto en Python:
from collections import Counter

def total_centavos(p):
    total = 0
    for renglon in p['renglones']:                     # el iterador: un paquete por renglón
        total += renglon['cantidad'] * renglon['producto']['precio_centavos']
    return total                                        # el agregador: un solo número al final

for p in [pedido, brujula]:
    t = total_centavos(p)
    print(f"{p['id_pedido']}: {len(p['renglones'])} renglones, {t} centavos = {t / 100:,.2f} MXN")

# Piezas por clave para el obrador: agrupar renglones de varios pedidos:
piezas = Counter()
for p in [pedido, brujula]:
    for renglon in p['renglones']:
        piezas[renglon['clave']] += renglon['cantidad']
print('Piezas por clave para el obrador:', dict(sorted(piezas.items())))

# Créditos de Make con m módulos después del iterador: K = 2 + r * m (disparador e iterador):
for m in [1, 2, 3]:
    print(f"m = {m}: familia (r = 3) {2 + 3 * m} créditos | Brújula (r = 1) {2 + 1 * m} créditos")
TL-20260214-0007: 3 renglones, 72800 centavos = 728.00 MXN
TL-20260216-0001: 1 renglones, 152000 centavos = 1,520.00 MXN
Piezas por clave para el obrador: {'P02': 40, 'P04': 6, 'P05': 4, 'P09': 1}
m = 1: familia (r = 3) 5 créditos | Brújula (r = 1) 3 créditos
m = 2: familia (r = 3) 8 créditos | Brújula (r = 1) 4 créditos
m = 3: familia (r = 3) 11 créditos | Brújula (r = 1) 5 créditos
El pedido de la Familia Herrera suma $72,800$ centavos, $728.00$ MXN, y el de Cafetería Brújula, $40$ baguettes a $38$ pesos, $152,000$ centavos, $1,520.00$ MXN, la cuenta del ejemplo de juguete de la ficha: $40 \cdot 3,800 = 152,000$. La segunda agregación es la que de verdad le importa al obrador: no quiere leer pedidos, sino saber cuántas piezas de cada producto hornear. El Counter suma las cantidades por clave a través de los dos pedidos y devuelve $40$ baguettes (P02), $6$ conchas (P04), $4$ croissants (P05) y $1$ pastel de chocolate (P09). Es la lista de producción del día, y sale de iterar todos los renglones de todos los pedidos.
Iterar tiene un coste que el Día 12 (Costes y límites: créditos, tareas, ejecuciones y cuotas) ya enseñó a contar. En Make, cada módulo que se ejecuta consume un crédito, y los módulos que van después del iterador se ejecutan una vez por elemento. Para un pedido con $r$ renglones y $m$ módulos después del iterador, el escenario consume
$$ K = 2 + r \cdot m $$
La lógica detrás de esta fórmula es múltiple:
- El $2$ son el disparador y el iterador, que se ejecutan una vez por pedido, tenga los renglones que tenga.
- $r \cdot m$ son las ejecuciones de los módulos que hay dentro del recorrido: cada uno corre $r$ veces.
- Con $m = 2$ (por ejemplo, buscar el producto y escribir la fila), el pedido de la familia consume $2 + 3 \cdot 2 = 8$ créditos y el de Brújula, $4$.
- En conclusión, el coste en Make crece con los renglones, no con los pedidos, y por eso la distribución de renglones por pedido es un dato de negocio y no una curiosidad. En n8n, en cambio, una ejecución completa cuenta como una sola, recorra los items que recorra.
¿Cuántos renglones trae un pedido típico de Trigo Lento? Valeria no tiene todavía un historial limpio, así que simula $50$ pedidos con el supuesto $r = 1 + \text{Poisson}(0.6)$, elige para cada renglón un producto distinto del catálogo y una cantidad de $1$ a $6$, aplana los $50$ pedidos en una tabla y compara las frecuencias simuladas con las que predice el supuesto:
# 50 pedidos simulados y la distribución de sus renglones en Python:
n_pedidos = 50
claves = list(precios)
pedidos_sim = []
for j in range(n_pedidos):
    r = min(1 + int(rng.poisson(0.6)), 12)             # renglones por pedido: media 1.6 (supuesto)
    elegidas = rng.choice(claves, size = r, replace = False)
    pedidos_sim.append({'id_pedido': f'TL-20260214-{j + 1:04d}',
                        'renglones': [{'linea': k + 1, 'clave': str(c), 'cantidad': int(rng.integers(1, 7))}
                                      for k, c in enumerate(elegidas)]})
r_por_pedido = np.array([len(p['renglones']) for p in pedidos_sim])
tabla_sim = pd.json_normalize(pedidos_sim, record_path = 'renglones', meta = ['id_pedido'])
valores, cuentas = np.unique(r_por_pedido, return_counts = True)
print('Renglones por pedido:', {int(v): int(c) for v, c in zip(valores, cuentas)})
print('Media:', r_por_pedido.mean(), '| filas de la tabla aplanada:', len(tabla_sim),
      f'| pedidos de un solo renglón: {(r_por_pedido == 1).mean():.0%}')
print('Proyección a 468 encargos al mes:', round(468 * r_por_pedido.mean()), 'filas de renglones')

# Lo que espera el supuesto R = 1 + Poisson(0.6) en 50 pedidos, para comparar con lo simulado:
from math import exp, factorial
k = np.arange(1, 6)
esperados = n_pedidos * np.array([exp(-0.6) * 0.6 ** (x - 1) / factorial(x - 1) for x in k])
print('Esperados por el supuesto:', dict(zip(k.tolist(), esperados.round(1).tolist())))

fig, ax = plt.subplots(figsize = (9, 4.8))
ax.bar(valores, cuentas, color = '#2a78d6', edgecolor = 'white', width = 0.7)
for v, c in zip(valores, cuentas):
    ax.text(v, c + 0.4, str(c), ha = 'center', fontsize = 11)
ax.plot(k, esperados, 'o--', color = '#3a9d5d', label = 'esperado con 1 + Poisson(0.6)')
ax.axvline(r_por_pedido.mean(), color = '#eb6834', ls = '--', lw = 2, label = f'media = {r_por_pedido.mean():.2f}')
ax.set_xticks(k)
ax.set_ylim(0, cuentas.max() + 5)
ax.set_xlabel('Renglones por pedido')
ax.set_ylabel('Número de pedidos')
ax.set_title('Renglones por pedido en 50 pedidos simulados', fontsize = 16)
ax.legend()
plt.tight_layout()
plt.show()
Renglones por pedido: {1: 28, 2: 17, 3: 5}
Media: 1.54 | filas de la tabla aplanada: 77 | pedidos de un solo renglón: 56%
Proyección a 468 encargos al mes: 721 filas de renglones
Esperados por el supuesto: {1: 27.4, 2: 16.5, 3: 4.9, 4: 1.0, 5: 0.1}
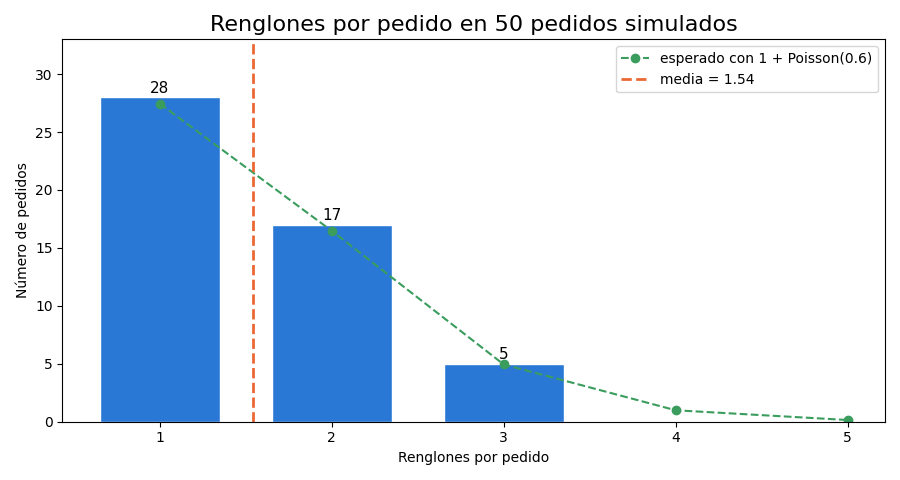
De los $50$ pedidos, $28$ tienen un renglón ($56%$), $17$ tienen dos y $5$ tienen tres; ninguno llega a cuatro. La media es $1.54$ renglones por pedido, cerca del $1.6$ del supuesto, y la tabla aplanada tiene $77$ filas, frente a las $80$ esperadas por la fórmula de $E[F]$. La línea verde de la gráfica, lo que predice la distribución ($27.4$, $16.5$ y $4.9$ pedidos), pasa casi por encima de las barras, como debe ocurrir con una muestra simulada con ese mismo supuesto. Llevado a un mes de $468$ encargos, la media simulada da unas $721$ filas de renglones.
Dos lecturas prácticas de la gráfica. La primera: más de la mitad de los pedidos tienen un solo renglón, así que un flujo que “funciona con los pedidos de prueba” puede no haber recorrido nunca un arreglo de verdad; los casos de prueba deben incluir pedidos de dos y tres renglones a propósito. La segunda: el día de hoy no es típico. El 14 de febrero los pedidos traen pastel y algo más, y la cola de la distribución engorda; un supuesto de volumen que se calcula con un mes normal se queda corto en los picos.
Formatos de intercambio
Un árbol o una tabla viven en la memoria de un programa; para viajar de una herramienta a otra se escriben en un formato de intercambio, un texto con reglas que el receptor sabe leer. Trigo Lento ya se cruza con tres a diario, y cada uno conserva cosas distintas:
- JSON (por sus siglas en inglés: “JavaScript Object Notation”), definido en el RFC 8259, conserva la anidación y distingue texto, número, booleano y nulo. Es el formato de las API, de los webhooks, de los blueprints de Make y de los workflows de n8n.
- CSV (por sus siglas en inglés: “Comma-Separated Values”), descrito en el RFC 4180, es una tabla en texto plano: filas separadas por saltos de línea y celdas separadas por comas. No tiene tipos (todo es texto hasta que alguien lo interpreta) ni anidación. Es el formato de las exportaciones de hojas de cálculo y de lo que se envía al contador.
application/x-www-form-urlencodedes el formato en el que un formulario web envía sus campos por defecto: paresclave=valorunidos con&, con los caracteres especiales codificados con%y el espacio como+. Todo es texto, y no hay listas ni objetos salvo por convenciones de cada servidor.
El riesgo está en la ida y vuelta. Un dato que sale de un formato tipado y vuelve a entrar por uno sin tipos llega reinterpretado por quien lo lee. El siguiente bloque escribe la misma pequeña lista de tres clientes en CSV y en JSON, la vuelve a leer con las opciones por defecto de cada lector y cuenta las celdas que cambiaron; después lee el CSV de forma defensiva y, al final, construye un cuerpo de formulario con el teléfono de la familia y una nota con un signo &:
# Ida y vuelta por CSV frente a JSON, y un cuerpo urlencoded, en Python:
from urllib.parse import urlencode, parse_qs
registros = [
    {'telefono': '015500000042', 'clave_favorita': 'P01', 'piezas': 3, 'acepta_whatsapp': True, 'notas': 'sin nuez'},
    {'telefono': '+525500000017', 'clave_favorita': 'P02', 'piezas': 40, 'acepta_whatsapp': False, 'notas': ''},
    {'telefono': '5500000023', 'clave_favorita': 'P10', 'piezas': 1, 'acepta_whatsapp': True, 'notas': None}]
pd.DataFrame(registros).to_csv(carpeta / 'clientes.csv', index = False)
(carpeta / 'clientes.json').write_text(json.dumps(registros, ensure_ascii = False), encoding = 'utf-8')

# Ida y vuelta: leer cada archivo con las opciones por defecto y comparar celda por celda:
desde_csv = pd.read_csv(carpeta / 'clientes.csv')
desde_json = json.loads((carpeta / 'clientes.json').read_text(encoding = 'utf-8'))
for col in ['telefono', 'notas']:
    print(f'{col} desde CSV:  {desde_csv[col].tolist()}')
    print(f'{col} desde JSON: {[r[col] for r in desde_json]}')
print('Tipos tras el CSV:', desde_csv.dtypes.astype(str).to_dict())
cambios_csv = [(col, r[col]) for i, r in enumerate(registros) for col in r
               if repr(r[col]) != repr(desde_csv[col].tolist()[i])]
cambios_json = [(col, r[col]) for i, r in enumerate(registros) for col in r if r[col] != desde_json[i][col]]
print('Celdas que cambiaron con el CSV:', len(cambios_csv), 'de', 5 * len(registros),
      '| con el JSON:', len(cambios_json))

# La lectura defensiva: todo como texto y sin convertir cadenas vacías en NaN:
seguro = pd.read_csv(carpeta / 'clientes.csv', dtype = str, keep_default_na = False)
print('CSV leído como texto:', seguro['telefono'].tolist(), seguro['notas'].tolist())

# application/x-www-form-urlencoded: todo viaja como texto y el signo + tiene doble sentido:
cuerpo = urlencode({'telefono': '+525500000042', 'piezas': 3, 'notas': 'sin nuez & sin pasas'})
print('Cuerpo:', cuerpo)
print('Leído:', parse_qs(cuerpo))
print('Con el + sin codificar:', parse_qs('telefono=+525500000042'))

# Tamaño del mismo pedido en cada formato:
compacto = json.dumps(pedido, ensure_ascii = False, separators = (',', ':')).encode('utf-8')
print('Bytes del pedido en JSON compacto:', len(compacto),
      '| en CSV de renglones:', len(renglones.to_csv(index = False).encode('utf-8')))
telefono desde CSV: [15500000042, 525500000017, 5500000023]
telefono desde JSON: ['015500000042', '+525500000017', '5500000023']
notas desde CSV: ['sin nuez', nan, nan]
notas desde JSON: ['sin nuez', '', None]
Tipos tras el CSV: {'telefono': 'int64', 'clave_favorita': 'str', 'piezas': 'int64', 'acepta_whatsapp': 'bool', 'notas': 'str'}
Celdas que cambiaron con el CSV: 5 de 15 | con el JSON: 0
CSV leído como texto: ['015500000042', '+525500000017', '5500000023'] ['sin nuez', '', '']
Cuerpo: telefono=%2B525500000042&piezas=3¬as=sin+nuez+%26+sin+pasas
Leído: {'telefono': ['+525500000042'], 'piezas': ['3'], 'notas': ['sin nuez & sin pasas']}
Con el + sin codificar: {'telefono': [' 525500000042']}
Bytes del pedido en JSON compacto: 599 | en CSV de renglones: 384
La ida y vuelta por CSV cambió $5$ de las $15$ celdas, y por JSON, $0$. Las cinco pérdidas son de dos tipos:
- En primer lugar, los teléfonos se volvieron números.
pandas.read_csvvio una columna de dígitos y la convirtió enint64: el015500000042perdió su cero, el+525500000017perdió su signo más y el5500000023, aunque se ve igual, ya no es texto, de modo que la próxima operación de texto sobre él fallará. Es, en tres líneas, el accidente de la Familia Herrera. - En segundo lugar, el vacío y el nulo se fundieron. La nota vacía del segundo cliente y la nota nula del tercero salieron del CSV las dos como
nan. El CSV no tiene forma de escribir la diferencia entre “no hay valor” y “el valor es una cadena vacía”: las dos se escriben como nada entre dos comas.
La lectura defensiva, con dtype = str y keep_default_na = False, recupera los teléfonos intactos, con su cero y su signo, porque le prohíbe al lector adivinar. No recupera la diferencia entre nulo y vacío (las dos notas salen como ''), porque esa información ya no estaba en el archivo. Lo que un formato no puede escribir, ninguna lectura cuidadosa lo puede recuperar.
El cuerpo de formulario muestra la tercera trampa. urlencode codifica el signo + del teléfono como %2B y el & de la nota como %26, y parse_qs los recupera bien, aunque devuelve todo como texto y cada valor dentro de una lista ('piezas': ['3']), porque un formulario puede repetir un campo. Pero si alguien escribe el cuerpo a mano sin codificar, el + se lee como un espacio: el teléfono llega como ' 525500000042'. Es un error clásico de los formularios web que mandan teléfonos internacionales a un webhook.
El mismo pedido de la familia ocupa $599$ bytes en JSON compacto y $384$ en el CSV de sus renglones. El CSV es más pequeño porque no repite los nombres de los campos en cada registro, pero ese ahorro se paga con todo lo que se acaba de perder. La Tabla 4 resume cuándo conviene cada formato:
Tabla 4. Formatos de intercambio: qué conserva cada uno y cuándo lo usa Trigo Lento.
| Formato | Tipos | Anidación | Nulo frente a vacío | Dónde aparece en Trigo Lento | Regla de la serie |
|---|---|---|---|---|---|
| JSON | Texto, número, booleano, nulo | Sí | Sí (null y "") | Webhooks, API de Claude, blueprints y workflows | Formato interno de todos los flujos |
| CSV | Ninguno: todo es texto | No | No | Exportaciones de la hoja y envío al contador | Leer siempre como texto y convertir columna a columna |
x-www-form-urlencoded | Ninguno: todo es texto | Solo por convención | No | Formulario web de pedidos | Convertir a JSON en el primer paso del flujo |
Dónde guardar el estado
Hasta aquí, los datos se movían: llegaban, se transformaban y salían. Pero un flujo de automatización también necesita recordar: qué pedidos ya procesó (la idempotencia del Día 3), qué cliente aceptó recibir WhatsApp (el consentimiento del Día 6), qué recordatorios ya envió hoy. Ese recuerdo se llama estado, y la decisión de dónde guardarlo es de arquitectura, porque cambia el coste, la fiabilidad y quién puede ver los datos.
Trigo Lento tiene cinco candidatos al alcance:
- Una hoja de cálculo de Google, la que ya usa. Todo el mundo sabe abrirla y editarla, y ese es a la vez su mayor virtud y su mayor riesgo: no impone tipos, no impide escribir un teléfono como número ni borrar una fila por accidente, y dos personas pueden editar la misma fila a la vez. El límite publicado es de $10$ millones de celdas por archivo, revisado en octubre de 2026.
- El almacén de datos de Make (data store): una tabla pequeña dentro de la plataforma, con una estructura de datos que declara el nombre y el tipo de cada columna. Su tamaño se reparte desde la cuota del plan: según la documentación de Make, $1$ MB por cada $1,000$ créditos, es decir, $1$ MB en el plan Free y $10$ MB en Core, revisado en octubre de 2026.
- Una tabla de datos de n8n (data tables), integrada en la instancia, o la base Postgres del propio servidor. La documentación de n8n fija, por omisión, $50$ MB para todas las tablas de datos de una instancia, ampliables en una instalación propia con la variable
N8N_DATA_TABLES_MAX_SIZE_BYTES, revisado en octubre de 2026. - SQLite local, la base
trigo_lento.sqliteque creó el Día 4: un archivo con tablas, tipos y restricciones, sin servidor, con un solo escritor a la vez. - Postgres, la base relacional de servidor que n8n puede usar como su propia base y que el módulo 4 instalará junto a n8n.
Para comparar capacidades en la misma unidad, Valeria traduce cada límite a pedidos que caben. En una hoja, un pedido ocupa sus columnas más las de sus renglones; en un almacén que guarda documentos, ocupa los bytes de su JSON. Con $n$ pedidos al año, $c_p$ columnas por pedido, $c_r$ por renglón y $F$ filas de renglones,
$$ C = n \cdot c_p + F \cdot c_r, \qquad A = \frac{\text{capacidad del almacén}}{\text{espacio por pedido} \cdot n} $$
La lógica detrás de esta fórmula es múltiple:
- $C$ es el número de celdas que ocupa un año de pedidos en una hoja: con $n = 5,616$ (468 al mes por 12), $c_p = 12$, $c_r = 6$ y $1.6$ renglones por pedido, cada pedido ocupa $12 + 1.6 \cdot 6 = 21.6$ celdas y el año, $121,305.6$.
- $A$ es el número de años que tarda el almacén en llenarse al ritmo actual; el espacio por pedido se mide en celdas para la hoja y en bytes para los almacenes de documentos.
- El pedido de la familia, $599$ bytes en JSON compacto, sirve de referencia para el tamaño de un registro; un almacén real añade su propia sobrecarga, así que la cifra es optimista.
- En conclusión, el resultado es orientativo: sirve para descartar lo que se llena demasiado pronto, no para predecir el día exacto.
El siguiente bloque hace la cuenta para los seis almacenes (el de Make en sus dos planes) y la dibuja junto a la facilidad de uso para Valeria, que es un juicio declarado en una escala de $1$ a $5$ y no una medición. Para SQLite y Postgres supone $10$ GB de disco libre:
# Comparación orientativa de almacenes para el estado de Trigo Lento en Python:
pedidos_anio = 468 * 12
celdas_pedido = 12 + 1.6 * 6                            # 12 columnas por pedido y 6 por renglón
bytes_pedido = len(compacto)                            # el pedido de la familia como referencia
MB = 1_000_000
almacenes = pd.DataFrame({
    'almacen': ['Hoja de cálculo', 'Data store de Make Free', 'Data store de Make Core',
                'Tabla de n8n', 'SQLite local', 'Postgres'],
    'capacidad': ['10 000 000 celdas', '1 MB', '10 MB', '50 MB por omisión', '10 GB de disco', '10 GB de disco'],
    'pedidos_que_caben': [10_000_000 / celdas_pedido, 1 * MB / bytes_pedido, 10 * MB / bytes_pedido,
                          50 * MB / bytes_pedido, 10_000 * MB / bytes_pedido, 10_000 * MB / bytes_pedido],
    'facilidad': [5, 4, 4, 3, 2, 1.5],
    'concurrencia': ['baja', 'media', 'media', 'alta', 'un escritor', 'alta']})
almacenes['anios_trigo_lento'] = almacenes['pedidos_que_caben'] / pedidos_anio
print(f'Pedidos al año: {pedidos_anio} | celdas por pedido: {celdas_pedido} | bytes por pedido: {bytes_pedido}')
print(almacenes.round(1).to_string(index = False))

fig, ax = plt.subplots(figsize = (9, 5.2))
colores = ['#3a9d5d', '#8a8986', '#2a78d6', '#eb6834', '#7b5ea7', '#52514e']
desplaza = [(8, 8), (-35, 12), (8, 8), (8, 8), (-75, 10), (-65, -20)]
for (_, fila_a), color, d in zip(almacenes.iterrows(), colores, desplaza):
    ax.scatter(fila_a['pedidos_que_caben'], fila_a['facilidad'], s = 140, color = color, zorder = 3)
    ax.annotate(fila_a['almacen'].replace(' de Make', '\nde Make'), (fila_a['pedidos_que_caben'], fila_a['facilidad']),
                xytext = d, textcoords = 'offset points', fontsize = 10)
ax.axvline(pedidos_anio, color = '#c0392b', ls = '--', lw = 1.5)
ax.text(pedidos_anio * 1.15, 1.2, f'un año de Trigo Lento\n({pedidos_anio} pedidos)', fontsize = 10, color = '#c0392b')
ax.set_xscale('log')
ax.set_xlim(500, 1e8)
ax.set_ylim(0.9, 5.5)
ax.set_xlabel('Pedidos que caben (escala logarítmica)')
ax.set_ylabel('Facilidad para Valeria (1 a 5, juicio)')
ax.set_title('Almacenes: capacidad frente a facilidad (orientativo)', fontsize = 16)
plt.tight_layout()
plt.show()
Pedidos al año: 5616 | celdas por pedido: 21.6 | bytes por pedido: 599
                almacen         capacidad  pedidos_que_caben  facilidad concurrencia  anios_trigo_lento
        Hoja de cálculo 10 000 000 celdas           462963.0        5.0         baja               82.4
Data store de Make Free              1 MB             1669.4        4.0        media                0.3
Data store de Make Core             10 MB            16694.5        4.0        media                3.0
           Tabla de n8n 50 MB por omisión            83472.5        3.0         alta               14.9
           SQLite local    10 GB de disco         16694490.8        2.0  un escritor             2972.7
               Postgres    10 GB de disco         16694490.8        1.5         alta             2972.7
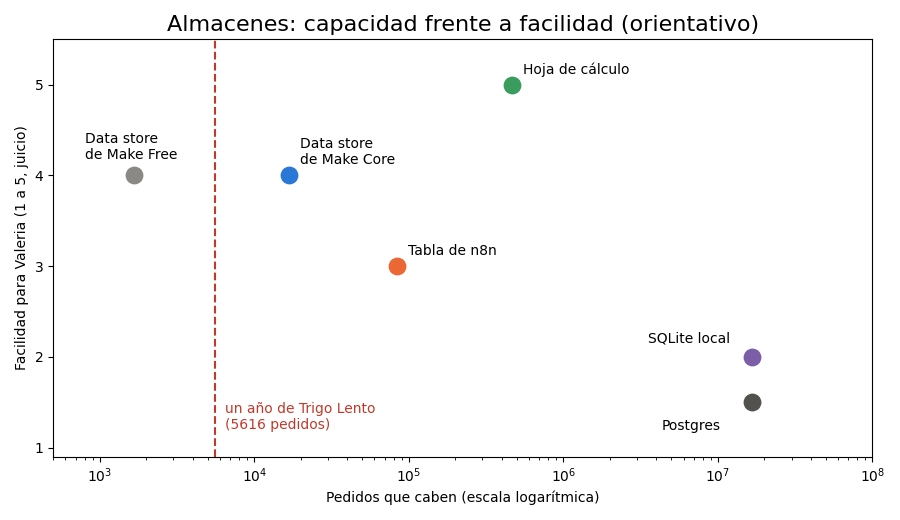
La cuenta separa los almacenes en tres grupos. El almacén de datos de Make Free guarda unos $1,669$ pedidos, menos de $0.3$ años de Trigo Lento: se llenaría antes de mayo. El de Make Core, unos $16,695$ pedidos, $3.0$ años; suficiente para el estado que un escenario necesita recordar (identificadores ya procesados, contadores), pero no para el historial de todos los pedidos. La tabla de n8n, con sus $50$ MB por omisión, aguanta $14.9$ años, y la hoja de cálculo, medida en celdas, $82.4$ años: el límite de la hoja no es el tamaño, sino todo lo demás. SQLite y Postgres, con $10$ GB, quedan tan lejos que el límite deja de ser la capacidad.
La gráfica muestra el compromiso de un vistazo: la hoja de cálculo está arriba a la derecha, fácil y espaciosa, lo cual explica por qué todos los negocios empiezan con una. Lo que la gráfica no puede dibujar es la columna de la concurrencia y de los tipos: la hoja es la única de las seis que deja que cualquiera escriba cualquier cosa en cualquier celda. La Tabla 5 pone las dimensiones juntas:
Tabla 5. Almacenes para el estado de Trigo Lento (capacidad revisada en octubre de 2026; años de uso orientativos).
| Almacén | Capacidad | Años de Trigo Lento | Tipos y restricciones | Concurrencia | Coste adicional | Cuándo usarlo |
|---|---|---|---|---|---|---|
| Hoja de cálculo | 10 millones de celdas | 82.4 | Ninguno por defecto; validación opcional | Baja: ediciones que se pisan | Ninguno | Vista para personas: el mostrador y Don Ernesto |
| Almacén de datos de Make Free | 1 MB | 0.3 | Estructura con tipos por columna | Media | Ninguno | Pruebas y estado mínimo |
| Almacén de datos de Make Core | 10 MB | 3.0 | Estructura con tipos por columna | Media | Incluido en los 10.59 USD del plan | Estado de un escenario: claves procesadas y contadores |
| Tabla de datos de n8n | 50 MB por omisión | 14.9 | Columnas con tipo | Alta | Ninguno en n8n propio | Estado de los workflows y del agente del módulo 4 |
| SQLite local | Disco (10 GB supuestos) | Miles | Tipos, CHECK, UNIQUE, claves foráneas | Un escritor a la vez | Ninguno | Fuente de verdad del laboratorio: trigo_lento.sqlite |
| Postgres | Disco (10 GB supuestos) | Miles | Tipos, restricciones y transacciones completas | Alta | El servidor de n8n (6 USD al mes, supuesto) | Fuente de verdad cuando los flujos vivan en el servidor |
Atención aquí: una hoja de cálculo compartida con datos de clientes es un riesgo, no solo un almacén incómodo. Contiene nombres y teléfonos, se comparte con un clic, se descarga entera con otro y guarda un historial de versiones en el que siguen visibles los datos que alguien borró. El código de honor del Día 6 (Ética y seguridad: el código de honor del arquitecto de automatización) exige minimización y mínimo privilegio: la hoja del mostrador debe tener solo las columnas que el mostrador necesita (nombre, productos, hora de recogida; no el teléfono completo ni el historial), debe compartirse con personas concretas y nunca con “cualquier persona con el enlace”, y la integración de Make o de n8n debe poder escribir solo en esa hoja. La LFPDPPP pide además que el aviso de privacidad diga dónde se guardan los datos de los clientes; si se guardan en la nube de un tercero, hay que decirlo.
La decisión de Valeria se escribe en una frase: SQLite (y después Postgres) es la fuente de verdad; la hoja es una vista; el almacén de la plataforma guarda solo el estado del propio flujo. Para comprobar que la fuente de verdad conserva todo lo que el árbol tenía, el último bloque guarda los dos pedidos en dos tablas relacionadas, pedidos y renglones, con los mismos nombres y restricciones que el Día 4; reconstruye el pedido de la familia como un objeto anidado a partir de las filas (de tabla a árbol, el camino inverso al de json_normalize) e intenta colar un renglón con cantidad cero:
# Guardar el estado en SQLite y reconstruir el árbol a partir de las tablas en Python:
import sqlite3
ruta_db = carpeta / 'estado_dia14.sqlite'
ruta_db.unlink(missing_ok = True)                      # base nueva para que el ejemplo sea reproducible
con = sqlite3.connect(ruta_db)
con.execute('PRAGMA foreign_keys = ON')
con.executescript('''
CREATE TABLE pedidos (
    id_pedido      TEXT PRIMARY KEY,
    nombre         TEXT NOT NULL,
    telefono       TEXT NOT NULL,
    fecha_entrega  TEXT NOT NULL,
    total_centavos INTEGER NOT NULL CHECK (total_centavos >= 0));
CREATE TABLE renglones (
    id_pedido       TEXT NOT NULL REFERENCES pedidos (id_pedido),
    linea           INTEGER NOT NULL,
    clave           TEXT NOT NULL,
    cantidad        INTEGER NOT NULL CHECK (cantidad > 0),
    precio_centavos INTEGER NOT NULL,
    PRIMARY KEY (id_pedido, linea));
''')
for p in [pedido, brujula]:
    with con:                                           # el pedido y sus renglones, juntos o nada
        con.execute('INSERT INTO pedidos VALUES (?, ?, ?, ?, ?)',
                    (p['id_pedido'], p['cliente']['nombre'], p['cliente']['telefono'],
                     p['fecha_entrega'], total_centavos(p)))
        con.executemany('INSERT INTO renglones VALUES (?, ?, ?, ?, ?)',
                        [(p['id_pedido'], r['linea'], r['clave'], r['cantidad'], r['producto']['precio_centavos'])
                         for r in p['renglones']])

def reconstruir(con, id_pedido):
    # De tabla a árbol: una fila del pedido más sus filas de renglones vuelven a ser un objeto:
    cab = con.execute('SELECT id_pedido, nombre, telefono, fecha_entrega, total_centavos '
                      'FROM pedidos WHERE id_pedido = ?', (id_pedido,)).fetchone()
    filas = con.execute('SELECT linea, clave, cantidad, precio_centavos FROM renglones '
                        'WHERE id_pedido = ? ORDER BY linea', (id_pedido,)).fetchall()
    return {'id_pedido': cab[0], 'cliente': {'nombre': cab[1], 'telefono': cab[2]},
            'fecha_entrega': cab[3], 'total_centavos': cab[4],
            'renglones': [{'linea': l, 'clave': c, 'cantidad': q, 'precio_centavos': pc}
                          for l, c, q, pc in filas]}

consulta = '''SELECT p.id_pedido, COUNT(*) AS renglones, SUM(r.cantidad * r.precio_centavos) AS suma,
                     p.total_centavos FROM pedidos p JOIN renglones r USING (id_pedido) GROUP BY p.id_pedido'''
print(pd.read_sql_query(consulta, con).to_string(index = False))
reconstruido = reconstruir(con, 'TL-20260214-0007')
print(json.dumps(reconstruido['renglones'][0], ensure_ascii = False))
print('Teléfono intacto:', reconstruido['cliente']['telefono'] == pedido['cliente']['telefono'],
      '| claves del renglón:', [r['clave'] for r in reconstruido['renglones']])
try:
    with con:
        con.execute("INSERT INTO renglones VALUES ('TL-20260214-0007', 4, 'P01', 0, 9500)")
except sqlite3.IntegrityError as error:
    print('Rechazado por la base:', error)
con.close()
       id_pedido  renglones   suma  total_centavos
TL-20260214-0007          3  72800           72800
TL-20260216-0001          1 152000          152000
{"linea": 1, "clave": "P09", "cantidad": 1, "precio_centavos": 46000}
Teléfono intacto: True | claves del renglón: ['P09', 'P04', 'P05']
Rechazado por la base: CHECK constraint failed: cantidad > 0
La consulta de comprobación devuelve, para cada pedido, el número de renglones y la suma de sus subtotales: $3$ renglones y $72,800$ centavos para la familia, $1$ renglón y $152,000$ para Cafetería Brújula, idénticos al total_centavos guardado. El pedido reconstruido tiene sus renglones en orden (P09, P04, P05), y el teléfono sale intacto, con su signo más, porque la columna es TEXT y nadie le permitió adivinar. Por último, la base rechaza el renglón de cantidad cero con CHECK constraint failed: cantidad > 0. Es la diferencia de fondo con la hoja de cálculo: la hoja guarda lo que le escriban; la base solo guarda lo que cumple el contrato.
Consideraciones finales
El día empezó con un cero perdido y termina con una idea que lo explica: los datos tienen forma y tienen tipo, y cada vez que pasan por una herramienta que no respeta ninguna de las dos, algo se pierde sin hacer ruido. El teléfono de la Familia Herrera no se perdió por un error humano, sino porque viajó como texto, llegó a una cuadrícula que lo reinterpretó como número y salió sin su cero. El pedido de tres productos no se duplicó por descuido, sino porque una tabla obliga a repetir la cabecera en cada renglón. Las dos cosas se previenen con el mismo gesto: decidir el tipo y la forma de cada dato en el contrato, y elegir para cada tarea la estructura que los conserva.
Antes de conectar una herramienta nueva a un flujo, conviene hacerse algunas preguntas:
- ¿Qué campos de este flujo parecen números pero no se suman? Esos van como texto, desde el primer paso.
- ¿Qué pasa si un arreglo trae un elemento más, o uno menos, de lo que esperan los casos de prueba?
- ¿Cada ruta de un mapeo está escrita en el convenio de índices de la plataforma donde vive?
- ¿Dónde está la fuente de verdad de este dato, y qué copias de él son solo vistas?
Las cifras de hoy tienen límites claros. Los $50$ pedidos son simulados con un supuesto de Poisson que todavía no se ha contrastado con el historial real de Trigo Lento; la comparación de almacenes usa el tamaño de un solo pedido como referencia y una escala de facilidad que es un juicio; y los límites de almacenamiento son los publicados en octubre de 2026, que las plataformas cambian con sus planes. Ninguno de esos límites cambia la conclusión: el árbol es la forma del pedido, la tabla es una vista útil de él y la fuente de verdad debe ser un almacén que haga cumplir los tipos.
Un gran libro que habla de esto es Python para el análisis de datos (o Python for Data Analysis, 3.ª edición), en el que Wes McKinney, el creador de pandas, dedica capítulos enteros a leer y escribir CSV y JSON, a los tipos de las columnas y a los valores ausentes, y a remodelar datos entre formatos anchos, largos y jerárquicos. Es el manual de referencia de las herramientas que se usaron hoy y la mejor forma de pasar de “funciona con este ejemplo” a “sé por qué funciona”.
Don Ernesto, al final de la mañana, resume la lección a su manera: “Entonces mi libreta no estaba mal; lo que estaba mal era copiarla en cuadritos sin decirle a los cuadritos qué era cada cosa.” Exactamente. La automatización no debe cambiar la forma de los pedidos para que quepan en la herramienta; debe elegir la herramienta que respeta la forma de los pedidos.
Conclusiones clave
Tipos
- Un flujo trabaja con cinco tipos primitivos (texto, número, booleano, fecha y nulo), y el tipo de un dato lo decide lo que se hace con él, no su aspecto: un teléfono es texto aunque solo tenga dígitos.
- Las trampas son reproducibles:
int("015500000042")pierde el cero,bool("False")esTrue,"P10"se ordena antes que"P9"y restar una fecha sin zona de una con zona es un error; las $15$ comprobaciones caben en un bloque. - Nulo y vacío no son lo mismo, y el dinero se guarda en centavos enteros: el pedido de la Familia Herrera vale $72,800$ centavos y el de Cafetería Brújula $152,000$.
Anidación y rutas
- Un pedido es una colección que contiene un arreglo de renglones: el de la familia es un árbol de $34$ nodos, $25$ hojas y profundidad $4$, y se aplana con
json_normalizeen $3$ filas sin perder un centavo. - La tabla de renglones crece con $F = \sum r_j$: en $50$ pedidos simulados, $56%$ tienen un solo renglón, la media es $1.54$ y salen $77$ filas, unas $721$ al mes con $468$ encargos.
- La misma ruta se escribe
pedido["renglones"][0]["clave"]en Python,{{1.renglones[1].clave}}en Make y{{ $json.renglones[0].clave }}en n8n: Make cuenta desde $1$, y el error de índice no avisa. - Iterar y agregar es el patrón de todo flujo con renglones; en Make cuesta $K = 2 + r \cdot m$ créditos por pedido, de modo que el coste crece con los renglones.
Almacenamiento
- Una ida y vuelta por CSV cambió $5$ de $15$ celdas (teléfonos convertidos en números, nulo y vacío fundidos) y por JSON, ninguna; un CSV se lee siempre como texto.
- El almacén de datos de Make Free guarda unos $1,669$ pedidos, $0.3$ años de Trigo Lento; el de Core, $3.0$ años; las tablas de n8n, $14.9$; la hoja, $82.4$, pero sin tipos ni control de ediciones.
- SQLite, y después Postgres, es la fuente de verdad: reconstruye el árbol desde las tablas con el teléfono intacto y rechaza un renglón de cantidad cero; la hoja es solo una vista con las columnas mínimas.
Mañana, en el Día 15: Comparativa de herramientas II: Airtable, Notion y Google Sheets con Apps Script como base operativa. Después del pico del 14, la hoja de pedidos amanecerá con un renglón que dice “P1” en lugar de P01, un pastel borrado por accidente y dos personas que editaron la misma fila; Valeria comparará tres bases operativas con números, límites y permisos para decidir qué mira el mostrador mientras SQLite sigue mandando.
Referencias
- McKinney, W. (2022). Python for Data Analysis: Data Wrangling with pandas, NumPy, and Jupyter (3.ª ed.). O’Reilly Media. https://wesmckinney.com/book/
- Bray, T. (Ed.) (2017). The JavaScript Object Notation (JSON) Data Interchange Format (RFC 8259). IETF. https://www.rfc-editor.org/rfc/rfc8259
- Shafranovich, Y. (2005). Common Format and MIME Type for Comma-Separated Values (CSV) Files (RFC 4180). IETF. https://www.rfc-editor.org/rfc/rfc4180
- pandas (2026). Documentación de
pandas.json_normalizey depandas.read_csv. https://pandas.pydata.org/docs/reference/api/pandas.json_normalize.html - WHATWG (2026). URL Standard: el formato
application/x-www-form-urlencoded. https://url.spec.whatwg.org/#application/x-www-form-urlencoded - Make (2026). Centro de ayuda: almacenes de datos (data stores) y estructuras de datos. https://help.make.com/l6du-data-stores
- n8n (2026). Documentación: tablas de datos (data tables). https://docs.n8n.io/data/data-tables/
- Google (2026). Archivos que puede guardar en Google Drive: límites de Hojas de cálculo. https://support.google.com/drive/answer/37603
- Organización Internacional de Normalización (2019). ISO 8601-1:2019. Date and time: Representations for information interchange. ISO.