
Arquitecto de automatización con IA: Día 15
 Jeshua Romero Guadarrama
- 61 Min para leer
- 15 Feb, 2026
Índice de contenido
Resumen:
La hoja de cálculo donde el mostrador apunta los encargos es, en la práctica, la base de datos de Trigo Lento, y nadie la eligió. En esta entrada Valeria compara Airtable, Notion y Google Sheets con Apps Script como base operativa: traduce el modelo de catálogo, clientes, pedidos y renglones a los tipos de cada herramienta, proyecta $14,601.6$ registros al año frente a los límites publicados (el plan gratuito de Airtable se agota en $0.82$ meses), simula la carga por API ($24.3$ segundos en Airtable frente a $405.6$ en Notion), escribe la matriz de permisos y un script que valida pedidos cada 10 minutos, y decide con una matriz ponderada (Sheets 3.90, Airtable 3.55, Notion 3.25) y su sensibilidad. Al terminar, usted sabrá separar la vista de trabajo de la fuente de verdad, medir una herramienta contra sus límites antes de adoptarla y calcular su coste por usuario con el presupuesto en la mano.
¿Cómo citar el presente artículo?
Romero, J. (15 de febrero de 2026). Arquitecto de automatización con IA: Día 15. python-data-engineer. https://www.python-data-engineer.com/post/aai/dia_15/.
Arquitecto de automatización con IA: Día 15 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/aai/dia_15/.
Precios, límites y políticas de Airtable, Notion, Google Sheets y Google Apps Script, de Make, n8n y de la API de Claude revisados en octubre de 2026. Los límites de tasa de Airtable y de Notion, las cuotas de Apps Script y de la API de Google Sheets se contrastaron en la documentación oficial; los registros por base de Airtable, el límite de celdas de Sheets y los precios por usuario de Notion y de Google Workspace proceden de fuentes secundarias que coinciden entre sí, y se indica en cada caso. Este día no llama a ningún servicio: los bloques de Python se ejecutan sin red y sus salidas son las reales; el JSON del Bloque 7 tiene la estructura verificada contra la documentación de Airtable y de Notion, revisado en octubre de 2026, con identificadores ficticios, y el Bloque 8 es código de Apps Script que se muestra y no se ejecuta.
Día 15. Comparativa de herramientas II: Airtable, Notion y Google Sheets con Apps Script como base operativa
Introducción
Ayer, en el Día 14 (Estructuras de datos para automatizar: textos, listas, colecciones y tablas), Valeria aprendió a reconocer las trampas de los tipos, a representar un pedido como una colección con un arreglo de renglones, a aplanarlo en una tabla y a llegar a cualquier dato con una ruta, y Trigo Lento ganó la tabla de almacenes que dice dónde guardar cada estado. Hoy esa pregunta se vuelve concreta: el lugar donde el mostrador apunta los pedidos todos los días ya es un almacén, y conviene elegirlo con la misma calma con la que el Día 13 (Comparativa de herramientas I: Zapier, Make, n8n y Power Automate con el mismo flujo) comparó las plataformas que mueven los datos.
Es domingo 15 de febrero, el único día en que el obrador descansa. El sábado fue el día más largo del año para Trigo Lento: el 14 de febrero se juntaron los pasteles de chocolate, las cajas de pan dulce para regalar y los pedidos de siempre, todos apuntados a toda prisa en la hoja de cálculo compartida. Esta mañana Valeria la abre con un café y encuentra tres cosas que no le gustan. Un renglón dice “P1” en lugar de P01, de modo que la fórmula que suma las hogazas no lo cuenta. Un pastel de zanahoria desapareció: alguien borró la fila sin querer al ordenar la columna de fechas, y solo el historial de versiones lo devolvió. Y dos personas del mostrador editaron la misma fila al mismo tiempo, una para cambiar la hora de recogida y la otra para marcar el pedido como pagado, y la segunda escritura se llevó por delante la primera.
Don Ernesto, que ha venido a revisar la masa madre, escucha el relato y lo resume a su manera: “La libreta nunca se cayó ni me cobró por usuario. Si la hoja da estos problemas, ¿por qué vamos a pagar otra cosa que seguramente da otros?” La objeción tiene dos partes y las dos son buenas. La primera es el coste: hay herramientas que cobran por cada persona que edita, y Trigo Lento tiene seis. La segunda es más sutil: cambiar de herramienta no arregla un problema de diseño si el diseño sigue igual. La libreta no se caía, pero tampoco sumaba sola, no avisaba de una clave mal escrita y no se podía consultar desde un flujo de Make.
En la presente entrada, descubrirá qué es una base operativa, en qué se distingue de la fuente de verdad y de la base de conocimiento, y qué le pide Trigo Lento a la suya. Llevará el modelo de catálogo, clientes, pedidos y renglones a los tipos de dato de Airtable, de Notion y de Google Sheets, y verá con 200 pedidos simulados qué pasa cuando una relación es una clave escrita a mano. Proyectará el volumen de registros y de celdas a 12 meses frente a los límites publicados, simulará cuánto tarda en cargarse un mes por API con los límites de tasa de cada servicio y escribirá la matriz de permisos de quién toca qué. Después leerá un script de Apps Script que valida los pedidos nuevos cada 10 minutos, reproducirá su lógica en Python, calculará el coste mensual en función del precio por usuario y terminará con una matriz ponderada, su sensibilidad y una decisión que deja a cada pieza en su papel.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Comparar Airtable, Notion y Google Sheets con Apps Script como base operativa del catálogo y los pedidos: tipos de dato, relaciones, límites, permisos, API y coste.
- Proyectar el volumen de registros y celdas de Trigo Lento a 12 meses frente a los límites publicados de cada herramienta.
- Leer un script de Apps Script que valida pedidos nuevos y reproducir su lógica en Python.
- Elegir con una matriz ponderada y decidir qué papel juega la base operativa frente a la fuente de verdad.
Qué es una base operativa
Una base operativa es el lugar donde las personas del negocio hacen su trabajo diario con los datos: el mostrador apunta un encargo, el obrador consulta qué hay que hornear mañana, Valeria marca un pedido como pagado. Es una vista de trabajo, pensada para que la usen personas que no programan, con filtros, colores y formularios. No es lo mismo que la fuente de verdad, el sistema que manda cuando dos copias de un dato no coinciden, ni que una base de conocimiento, donde se guardan políticas, fichas de producto y respuestas que un agente consultará.
En Trigo Lento las tres piezas ya tienen nombre, aunque dos todavía no existan del todo. La fuente de verdad es trigo_lento.sqlite, la base que el Día 4 creó con sus cinco tablas y sus restricciones CHECK, UNIQUE y de claves foráneas; el Día 16 la conectará con la vista del mostrador mediante una sincronización con marca de agua. La base de conocimiento será un espacio de Notion con las políticas y las fichas de producto, y llegará en el Día 68, cuando el módulo 7 construya la recuperación aumentada con fuentes citadas. Lo que falta decidir hoy es la vista: la superficie que el mostrador toca cincuenta veces al día.
La distinción importa porque cambia lo que se le exige a cada herramienta. A una fuente de verdad se le pide integridad: que no admita una clave inexistente, que no pierda una fila, que dos escrituras simultáneas no se pisen. A una vista de trabajo se le pide, sobre todo, que la gente la use bien y sin miedo. Una herramienta puede ser excelente vista y mala fuente de verdad, y es exactamente lo que le pasa a la hoja de cálculo de Trigo Lento: el mostrador la entiende, pero ayer dejó pasar una clave mal escrita, un borrado y una escritura pisada.
La separación entre las dos piezas cabe en el dibujo de la Figura 1: la base operativa como escaparate que el mostrador toca y trigo_lento.sqlite como bodega que manda, con la flecha de sincronización que llegará el Día 16.
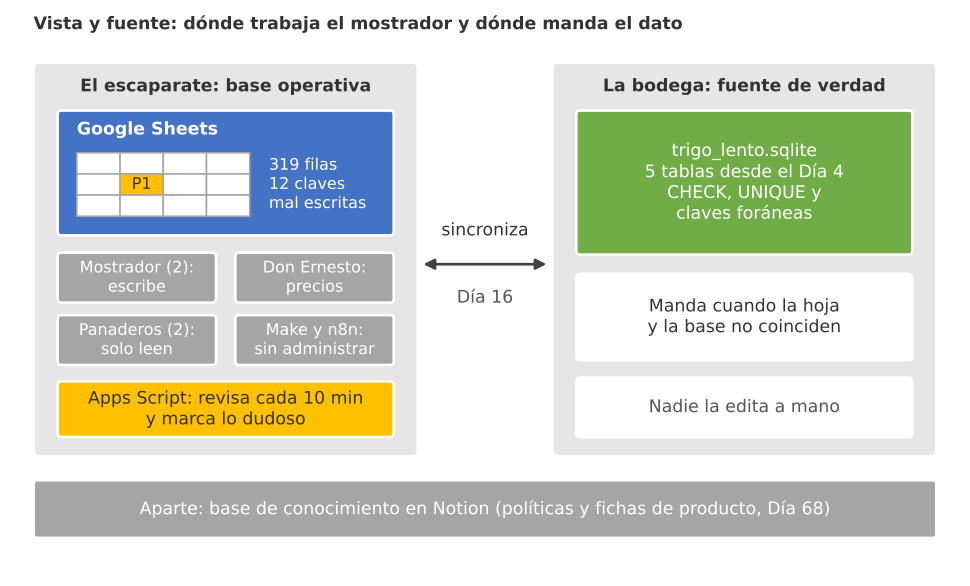
Figura 1. Vista y fuente: la hoja del mostrador, con Apps Script al lado, es el escaparate que tocan las personas; trigo_lento.sqlite es la bodega que manda cuando hay desacuerdo, y la flecha de sincronización llegará el Día 16. Notion queda aparte como base de conocimiento.
Valeria escribe los requisitos antes de mirar ninguna página de precios, la misma disciplina que el Día 11 recomendó para los pesos de una matriz. La Tabla 1 los reúne:
Tabla 1. Requisitos de la base operativa de Trigo Lento.
| Requisito | Valor para Trigo Lento | Por qué importa |
|---|---|---|
| Quién la usa | Valeria, Don Ernesto, 2 personas de mostrador, 2 panaderos y 2 integraciones (Make y n8n) | Define cuántos usuarios se pagan y cuántos permisos distintos hay que escribir |
| Qué edita cada quien | El mostrador crea pedidos y renglones; Don Ernesto ajusta precios; los panaderos solo leen | Los permisos por tabla deben poder expresarse en la herramienta |
| Volumen | 468 encargos al mes, 1.6 renglones por encargo (supuesto): 1 216.8 registros al mes | Decide qué límites de registros o de celdas se alcanzan y cuándo |
| Relaciones necesarias | Pedido con cliente, renglón con pedido, renglón con producto del catálogo | Sin relaciones reales, una clave mal escrita deja renglones huérfanos |
| Integración con Make y n8n | Crear y leer registros por API desde los flujos de los módulos 3 y 4 | Los límites de tasa fijan cuánto tarda una carga o una consulta masiva |
| Presupuesto | Lo que quede en la reserva de 8.41 USD al mes del presupuesto de 45 USD | Una herramienta que cobra por editor puede comerse la reserva entera |
Hay un requisito que no está en la tabla porque es una restricción y no una preferencia: los datos de los clientes (nombres y teléfonos) viven en la base operativa, y el Día 6 fijó que cada dato personal tiene una finalidad, un acceso mínimo y una persona responsable. Ninguna herramienta lo resuelve sola; lo resuelve el diseño de permisos que se verá más adelante.
Como en todos los días de la serie, el primer bloque prepara las importaciones, la semilla global $2026$, la carpeta del día y los datos fijos que se usarán toda la entrada: el catálogo de doce productos del Día 1, los $468$ encargos al mes, el supuesto de $1.6$ renglones por encargo y la fecha de hoy, el domingo 15 de febrero:
# Importaciones base, semilla de la serie, catálogo y carpeta del día en Python:
import warnings
warnings.filterwarnings('ignore')
import json
from pathlib import Path
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 120)
pd.set_option('display.max_columns', 12)
carpeta = Path('trigo_lento') / 'dia_15'
carpeta.mkdir(parents = True, exist_ok = True)

# Catálogo del Día 1 y datos fijos de la serie:
catalogo = json.loads((Path('trigo_lento') / 'catalogo.json').read_text(encoding = 'utf-8'))
CLAVES = {p['clave'] for p in catalogo}
ENCARGOS_MES = 468                  # 18 al día, 26 días al mes
RENGLONES_POR_ENCARGO = 1.6         # supuesto del día
HOY = pd.Timestamp('2026-02-15')    # domingo 15 de febrero de 2026
print('numpy', np.__version__, '| pandas', pd.__version__)
print('Productos en el catálogo:', len(CLAVES), '| encargos al mes:', ENCARGOS_MES)
numpy 2.4.6 | pandas 3.0.3
Productos en el catálogo: 12 | encargos al mes: 468
El catálogo tiene $12$ productos y Trigo Lento recibe $468$ encargos al mes. El supuesto de $1.6$ renglones por encargo es prudente: la base trigo_lento.sqlite del Día 4 tiene $176$ pedidos con $308$ renglones, una media de $1.75$, pero esos pedidos eran simulados y la mayoría de los encargos reales de Trigo Lento son de un solo producto.
Tipos de dato y relaciones
El Día 14 dejó el pedido de Trigo Lento descrito como un árbol: un pedido tiene un cliente y un arreglo de renglones, y cada renglón apunta a un producto del catálogo. Al aplanarlo, ese árbol se convierte en cuatro tablas, que son las que cualquier base operativa tiene que poder expresar: catálogo, clientes, pedidos y renglones. Lo que cambia de una herramienta a otra es cómo se escriben los tipos de cada campo y, sobre todo, cómo se escribe la flecha que une un renglón con su pedido y con su producto.
Edgar F. Codd lo formuló en 1970 con una idea que sigue vigente: los datos se organizan en relaciones (tablas) y los vínculos entre ellas se expresan con valores compartidos, de modo que la base pueda comprobar que cada referencia apunta a algo que existe. Esa comprobación se llama integridad referencial, y es la que ayer le faltó a la hoja: el renglón con “P1” apunta a un producto que no existe y nada lo impidió.
El siguiente bloque escribe el modelo común con un tipo lógico por campo y lo traduce al vocabulario de cada herramienta. La salida es la base de la Tabla 2:
# Modelo común de Trigo Lento y su traducción a los tipos de cada herramienta en Python:
modelo = {
    'catalogo':  {'clave': 'texto', 'producto': 'texto', 'precio_mxn': 'moneda', 'activo': 'casilla'},
    'clientes':  {'nombre': 'texto', 'telefono': 'texto', 'canal_preferido': 'seleccion'},
    'pedidos':   {'id_pedido': 'texto', 'cliente': 'relacion', 'canal': 'seleccion',
                  'entrega': 'fecha_hora', 'total_mxn': 'formula', 'comprobante': 'adjunto'},
    'renglones': {'pedido': 'relacion', 'producto': 'relacion', 'cantidad': 'numero',
                  'precio_unitario': 'busqueda', 'importe': 'formula'},
}
tipos = pd.DataFrame({
    'Airtable': ['Single line text', 'Number', 'Currency', 'Date (con hora)', 'Single select', 'Checkbox',
                 'Attachment', 'Link to another record', 'Lookup / Rollup', 'Formula'],
    'Notion':   ['Text / Title', 'Number', 'Number (moneda)', 'Date (con hora)', 'Select', 'Checkbox',
                 'Files & media', 'Relation', 'Rollup', 'Formula'],
    'Google Sheets': ['celda libre', 'celda + formato', 'formato de moneda', 'número de serie',
                      'lista desplegable', 'casilla', 'enlace a Drive',
                      'clave escrita a mano', 'BUSCARX', 'fórmula de celda'],
}, index = ['texto', 'numero', 'moneda', 'fecha_hora', 'seleccion', 'casilla',
            'adjunto', 'relacion', 'busqueda', 'formula'])
print(tipos.to_string())

# Campos del modelo y cuántos dependen de una relación real entre tablas:
campos = [(t, c, tp) for t, cs in modelo.items() for c, tp in cs.items()]
dependen = [f'{t}.{c}' for t, c, tp in campos if tp in ('relacion', 'busqueda')]
print('Campos del modelo:', len(campos), '| dependen de una relación:', len(dependen))
print(dependen)
tipo_impuesto = {'Airtable': 10, 'Notion': 10, 'Google Sheets': 0}   # tipos que la herramienta impone sin configurar nada
print('Tipos impuestos por la herramienta (de 10):', tipo_impuesto)
                          Airtable           Notion         Google Sheets
texto             Single line text     Text / Title           celda libre
numero                      Number           Number       celda + formato
moneda                    Currency  Number (moneda)     formato de moneda
fecha_hora         Date (con hora)  Date (con hora)       número de serie
seleccion            Single select           Select     lista desplegable
casilla                   Checkbox         Checkbox               casilla
adjunto                 Attachment    Files & media        enlace a Drive
relacion    Link to another record         Relation  clave escrita a mano
busqueda           Lookup / Rollup           Rollup               BUSCARX
formula                    Formula          Formula      fórmula de celda
Campos del modelo: 18 | dependen de una relación: 4
['pedidos.cliente', 'renglones.pedido', 'renglones.producto', 'renglones.precio_unitario']
Tipos impuestos por la herramienta (de 10): {'Airtable': 10, 'Notion': 10, 'Google Sheets': 0}
El modelo tiene $18$ campos y $4$ de ellos dependen de una relación real entre tablas: el cliente del pedido, el pedido y el producto de cada renglón y el precio unitario que el renglón toma del catálogo. Esos cuatro campos son los que separan a las herramientas, porque los otros catorce (texto, número, fecha, selección) se pueden representar en cualquiera de las tres con más o menos cuidado.
Tabla 2. Tipos de dato y relaciones del modelo de Trigo Lento en cada herramienta (revisado en octubre de 2026).
| Tipo lógico | Airtable | Notion | Google Sheets |
|---|---|---|---|
| Texto | Texto de una línea (Single line text) | Título o texto | Celda libre |
| Número | Número con precisión fija | Número | Celda con formato numérico |
| Moneda | Moneda con símbolo y decimales | Número con formato de moneda | Formato de moneda |
| Fecha con hora | Fecha con hora y zona | Fecha con hora | Número de serie con formato de fecha |
| Selección | Selección única o múltiple | Select y multi-select | Lista desplegable por validación de datos |
| Casilla | Casilla | Casilla | Casilla de verificación |
| Adjunto | Adjunto en el registro | Archivos y medios | Enlace a un archivo de Drive |
| Relación | Enlace a otro registro (Link to another record) | Relation | Clave escrita a mano |
| Búsqueda | Lookup y rollup | Rollup | BUSCARX o BUSCARV |
| Fórmula | Fórmula de campo | Fórmula de propiedad | Fórmula de celda |
La salida termina con un recuento que conviene leer despacio: Airtable y Notion imponen los $10$ tipos sin configurar nada, porque cada campo se crea con su tipo y la herramienta rechaza un valor que no encaja; Google Sheets impone $0$. En una hoja, una celda de la columna de cantidades admite “dos”, “2 piezas” o una fecha, salvo que alguien haya configurado una regla de validación y nadie la haya quitado. Las tres subsecciones siguientes explican qué significa eso en cada herramienta.
Airtable
Airtable organiza los datos en bases que contienen tablas, y cada tabla tiene campos con tipo. La pieza que la distingue es el campo enlace a otro registro: en la tabla de renglones, el campo producto no guarda el texto “P01”, sino una referencia al registro de la hogaza en la tabla catálogo. Quien captura un renglón no escribe la clave; la elige de una lista que solo contiene productos existentes. Si un producto se renombra, todos los renglones que lo enlazan muestran el nombre nuevo, porque nunca guardaron el viejo.
Sobre ese enlace se construyen los campos de búsqueda (lookup), que traen al renglón un valor del registro enlazado, como el precio unitario, y los de resumen (rollup), que agregan valores de todos los registros enlazados, como la suma de importes de los renglones de un pedido. Con esas dos piezas, el total del pedido se calcula solo y siempre cuadra con sus renglones. Es lo más parecido a una base de datos relacional que una persona sin formación técnica puede manejar, y por eso Airtable obtendrá la nota más alta en modelo de datos.
Notion
Notion organiza todo en páginas, y una base de datos de Notion es una colección de páginas que comparten un conjunto de propiedades. Cada pedido sería una página con propiedades de tipo título, fecha, select o número, y con una propiedad relation que la enlaza con la página del cliente y con las páginas de sus renglones. Los rollups agregan valores de las páginas relacionadas, igual que en Airtable.
La diferencia está en el uso cotidiano. Cada registro es una página que se puede abrir, comentar y llenar de texto libre, lo que es una virtud para una base de conocimiento y un pequeño estorbo para un mostrador que necesita capturar cuarenta renglones en una mañana. Notion también ha cambiado su modelo de datos recientemente: desde la versión 2025-09-03 de su API, una base de datos puede contener varias fuentes de datos (data sources), y las páginas nuevas se crean dentro de una fuente de datos y no directamente en la base. El Bloque 7 lo mostrará.
Google Sheets
Google Sheets es una hoja de cálculo: una cuadrícula de celdas sin tipo propio. El tipo de una celda lo decide su contenido y su formato, no la columna. La validación de datos permite restringir una columna a una lista desplegable, a números en un rango o a fechas, y es la herramienta correcta para que el mostrador elija P01 de una lista en lugar de escribirlo; pero la validación se puede desactivar, se pierde al pegar datos desde otro sitio y no impide borrar el producto de la hoja del catálogo mientras quedan renglones que lo usan.
Las búsquedas se hacen con fórmulas como BUSCARX o BUSCARV, que traen el precio desde la hoja del catálogo a partir de la clave escrita. Funcionan mientras la clave esté bien escrita; si no, devuelven un error que alguien tiene que ver. En una hoja de cálculo no hay integridad referencial: la relación existe solo en la cabeza de quien diseñó las fórmulas. A cambio, todo el mundo sabe usar una hoja, y eso pesa mucho en una panadería.
Las tres maneras de entender un mostrador caben en la Figura 2, que Valeria imprimió para explicarle a su padre por qué la respuesta no es “la libreta”, pero tampoco “la herramienta más cara”.
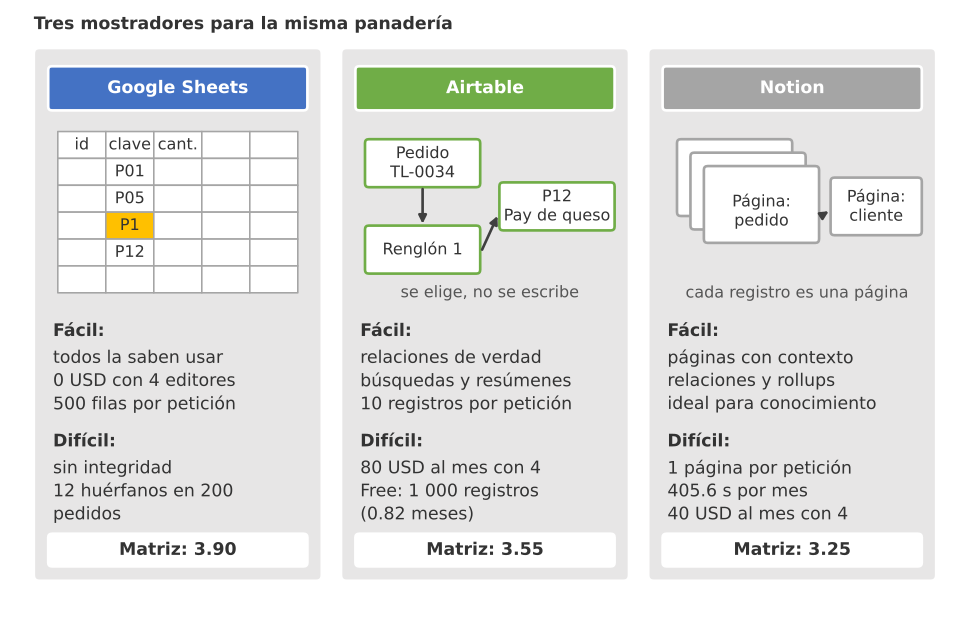
Figura 2. Tres mostradores: la hoja cuadriculada de Google Sheets, las fichas enlazadas por hilos de Airtable y el cuaderno de páginas que se citan de Notion, con lo que cada uno hace fácil, lo que hace difícil y sus cifras en esta entrada.
La diferencia entre “elegir de una lista” y “escribir una clave” parece pequeña hasta que se mide. El siguiente bloque simula $200$ pedidos capturados a mano en una hoja, con un número de renglones por pedido que sigue una distribución de Poisson desplazada (media $1.6$), y siembra doce errores de tecleo del tipo de los de ayer: cuatro “P1” con el cero perdido, tres “p01” en minúscula, tres “P13”, un producto que no existe, y dos " P05" con un espacio delante. Después cuenta los renglones huérfanos, los que apuntan a una clave que no está en el catálogo, y cuántos se podrían reparar normalizando la clave:
# 200 pedidos con claves escritas a mano en una hoja frente a registros enlazados en Python:
filas = []
for i in range(1, 201):
    n_renglones = 1 + rng.poisson(RENGLONES_POR_ENCARGO - 1)
    entrega = HOY + pd.Timedelta(days = int(rng.integers(-3, 14)))
    for linea in range(1, n_renglones + 1):
        filas.append({'id_pedido': f'TL-{i:04d}', 'linea': linea,
                      'clave': str(rng.choice(sorted(CLAVES))), 'cantidad': int(rng.integers(1, 5)),
                      'fecha_entrega': str(entrega.date()), 'estado': 'nuevo'})
hoja = pd.DataFrame(filas)

# Errores de tecleo sembrados: cero perdido, minúscula, clave inexistente y espacio de más:
sembrados = {'P1': 4, 'p01': 3, 'P13': 3, ' P05': 2}
posiciones = rng.choice(len(hoja), size = sum(sembrados.values()), replace = False)
inicio = 0
for clave_mala, veces in sembrados.items():
    hoja.loc[posiciones[inicio:inicio + veces], 'clave'] = clave_mala
    inicio += veces
hoja.to_csv(carpeta / 'hoja_pedidos.csv', index = False)

# En la hoja nada impide la clave mala; un registro enlazado solo admite claves del catálogo:
huerfanos = hoja[~hoja['clave'].isin(CLAVES)]
normalizada = huerfanos['clave'].str.strip().str.upper().str.replace(r'^P(\d)$', r'P0\1', regex = True)
reparables = normalizada.isin(CLAVES)
print('Pedidos:', hoja['id_pedido'].nunique(), '| renglones:', len(hoja),
      '| renglones por pedido:', round(len(hoja) / hoja['id_pedido'].nunique(), 2))
print('Renglones huérfanos en la hoja:', len(huerfanos), '| pedidos afectados:', huerfanos['id_pedido'].nunique())
print('Por clave escrita:', huerfanos['clave'].value_counts().to_dict())
print('Reparables normalizando:', int(reparables.sum()), '| imposibles de reparar:', int((~reparables).sum()))
print('Huérfanos que admitiría un campo enlazado: 0 (la clave se elige de la tabla catálogo)')
Pedidos: 200 | renglones: 319 | renglones por pedido: 1.59
Renglones huérfanos en la hoja: 12 | pedidos afectados: 12
Por clave escrita: {'P1': 4, 'P13': 3, 'p01': 3, ' P05': 2}
Reparables normalizando: 9 | imposibles de reparar: 3
Huérfanos que admitiría un campo enlazado: 0 (la clave se elige de la tabla catálogo)
La hoja tiene $319$ renglones en $200$ pedidos, una media de $1.59$, muy cerca del supuesto. Los $12$ errores sembrados producen $12$ renglones huérfanos en $12$ pedidos distintos: el $6%$ de los pedidos tiene al menos un renglón que ninguna fórmula sumará. De ellos, $9$ se pueden reparar con una normalización (quitar espacios, pasar a mayúsculas y reponer el cero), pero $3$ no, porque “P13” no se parece a ninguna clave del catálogo y nadie sabe si el cliente quería un pay de queso (P12) o un pan de caja (P03).
La última línea de la salida es la que justifica la sección: en un campo enlazado, el número de huérfanos posibles es $0$, porque la clave no se escribe, se elige. Eso no elimina el error humano (el mostrador puede elegir el producto equivocado), pero elimina una clase entera de errores, los de forma, que en esta simulación son el $3.8%$ de los renglones. Hay que recordar que los errores se sembraron a mano: la cifra describe el lote de prueba, no a las personas de Trigo Lento.
Límites y cuotas
Toda herramienta en la nube tiene límites, y la mayoría no se notan hasta el día en que se alcanzan. Para una base operativa interesan tres familias: cuántos registros o celdas caben, cuántas peticiones por segundo admite su API y, en el caso de Apps Script, cuánto tiempo de ejecución concede al día. Un arquitecto no espera a toparse con ellos; los proyecta con el volumen del negocio antes de elegir.
El volumen mensual de Trigo Lento en registros es la suma de pedidos y renglones:
$$ R_{mes} = E \cdot (1 + r), \qquad C_{mes} = E \cdot k_p + E \cdot r \cdot k_r $$
La lógica detrás de estas fórmulas es múltiple:
- $E$ son los encargos al mes ($468$) y $r$ los renglones por encargo ($1.6$, supuesto). Cada encargo produce un registro de pedido y, en media, $r$ registros de renglón, de modo que $R_{mes} = 468 \cdot 2.6 = 1,216.8$ registros.
- $C_{mes}$ cuenta celdas en lugar de registros, que es lo que limita a una hoja de cálculo: $k_p = 12$ columnas por pedido y $k_r = 6$ por renglón dan $468 \cdot 12 + 748.8 \cdot 6 = 10,108.8$ celdas al mes.
- El tiempo hasta agotar un límite $L$ es $L / R_{mes}$ meses (o $L / C_{mes}$ en una hoja), suponiendo que nada se archiva ni se borra.
- En conclusión, un límite de registros por base se mide contra $R_{mes}$ y un límite de celdas contra $C_{mes}$: comparar los dos números directamente no tiene sentido, porque miden cosas distintas.
La Tabla 3 reúne los límites que intervienen, revisado en octubre de 2026, con su fuente:
Tabla 3. Límites y cuotas de las tres herramientas (revisado en octubre de 2026; verifique en la documentación oficial antes de decidir).
| Herramienta | Límite | Valor | Fuente de la revisión |
|---|---|---|---|
| Airtable Free | Registros por base | 1 000 | Fuentes secundarias coincidentes; la página oficial de precios no lo muestra en texto |
| Airtable Free | Llamadas a la API por espacio de trabajo al mes | 1 000 | Fuentes secundarias coincidentes |
| Airtable Free | Editores por espacio de trabajo | 5 | Fuentes secundarias coincidentes |
| Airtable Team y Business | Registros por base | 50 000 y 125 000 | Fuentes secundarias coincidentes |
| Airtable (API) | Peticiones por segundo | 5 por base; 50 por usuario con tokens personales; 30 s de espera tras un 429 | Documentación oficial de la API |
| Airtable (API) | Registros por petición de creación | 10 | Documentación de la API y mensaje de error INVALID_RECORDS |
| Notion (API) | Peticiones por conexión | 180 por minuto (3 por segundo de media); 600 por minuto en Business y Enterprise | Documentación oficial de la API |
| Notion (API) | Tamaño de una petición | 1 000 bloques y 500 KB; 100 elementos por relación en cada petición | Documentación oficial de la API |
| Google Sheets | Celdas por archivo | 10 000 000 | Fuentes secundarias coincidentes desde 2022 |
| Google Sheets (API) | Peticiones de lectura y de escritura | 300 por minuto por proyecto; 60 por minuto por usuario | Documentación oficial de la API |
| Apps Script | Tiempo por ejecución | 6 minutos | Documentación oficial de cuotas |
| Apps Script | Tiempo total de disparadores al día | 90 minutos (cuenta personal); 6 horas (Google Workspace) | Documentación oficial de cuotas |
| Apps Script | Disparadores por usuario y script | 20 | Documentación oficial de cuotas |
La documentación de Apps Script advierte que todas sus cuotas pueden cambiar o eliminarse en cualquier momento sin aviso, y la de Notion menciona además un límite por espacio de trabajo, compartido entre todas las conexiones, cuya cifra no publica. Notion tampoco publica un límite de páginas por base de datos; su plan gratuito limita el número de bloques cuando el espacio tiene varios miembros, sin dar la cifra exacta. Con esas salvedades, el siguiente bloque proyecta el volumen de Trigo Lento a 12 meses y calcula en cuántos meses se agota cada límite:
# Proyección de registros y celdas de Trigo Lento a 12 meses frente a los límites publicados en Python:
meses = np.arange(1, 13)
registros_mes = ENCARGOS_MES * (1 + RENGLONES_POR_ENCARGO)                  # pedidos + renglones
celdas_mes = ENCARGOS_MES * 12 + ENCARGOS_MES * RENGLONES_POR_ENCARGO * 6   # 12 columnas por pedido, 6 por renglón
proyeccion = pd.DataFrame({'mes': meses,
                           'registros': registros_mes * meses,
                           'celdas': celdas_mes * meses})
print(proyeccion.iloc[[0, 2, 5, 11]].round(1).to_string(index = False))

# Límites revisados en octubre de 2026 y meses que tarda Trigo Lento en agotarlos:
limites = {'Airtable Free (registros por base)': (1_000, registros_mes),
           'Airtable Team (registros por base)': (50_000, registros_mes),
           'Airtable Business (registros por base)': (125_000, registros_mes),
           'Google Sheets (celdas por archivo)': (10_000_000, celdas_mes)}
for nombre, (limite, consumo) in limites.items():
    print(f'{nombre:<40} límite {limite:>10,} -> se agota en {limite / consumo:7.2f} meses')

fig, (ax1, ax2) = plt.subplots(1, 2, figsize = (11, 4.6))
ax1.plot(meses, proyeccion['registros'], marker = 'o', color = '#2a78d6', lw = 2, label = 'pedidos + renglones')
for limite, texto, color in [(1_000, 'Airtable Free: 1 000', '#c8423b'), (50_000, 'Airtable Team: 50 000', '#eb6834')]:
    ax1.axhline(limite, ls = '--', color = color, lw = 1.3)
    ax1.text(5, limite * 1.15, texto + ' (revisado oct. 2026)', fontsize = 9, color = color)
ax1.set_yscale('log')
ax1.set_ylim(500, 2e5)
ax1.set_xlabel('Mes')
ax1.set_ylabel('Registros acumulados (escala log)')
ax1.set_title('Registros frente a límites por base', fontsize = 13)
ax1.legend(loc = 'lower right', fontsize = 9)
ax2.plot(meses, proyeccion['celdas'], marker = 'o', color = '#3a9d5d', lw = 2, label = 'celdas ocupadas')
ax2.axhline(10_000_000, ls = '--', color = '#c8423b', lw = 1.3)
ax2.text(1, 1.15e7, 'Google Sheets: 10 000 000 (revisado oct. 2026)', fontsize = 9, color = '#c8423b')
ax2.set_yscale('log')
ax2.set_ylim(5e3, 4e7)
ax2.set_xlabel('Mes')
ax2.set_ylabel('Celdas acumuladas (escala log)')
ax2.set_title('Celdas frente al límite de un archivo', fontsize = 13)
ax2.legend(loc = 'lower right', fontsize = 9)
fig.suptitle('Trigo Lento a 12 meses: 1 216.8 registros y 10 108.8 celdas nuevas al mes', fontsize = 16)
plt.tight_layout()
plt.show()
 mes  registros   celdas
   1     1216.8  10108.8
   3     3650.4  30326.4
   6     7300.8  60652.8
  12    14601.6 121305.6
Airtable Free (registros por base)       límite      1,000 -> se agota en    0.82 meses
Airtable Team (registros por base)       límite     50,000 -> se agota en   41.09 meses
Airtable Business (registros por base)   límite    125,000 -> se agota en  102.73 meses
Google Sheets (celdas por archivo)       límite 10,000,000 -> se agota en  989.24 meses
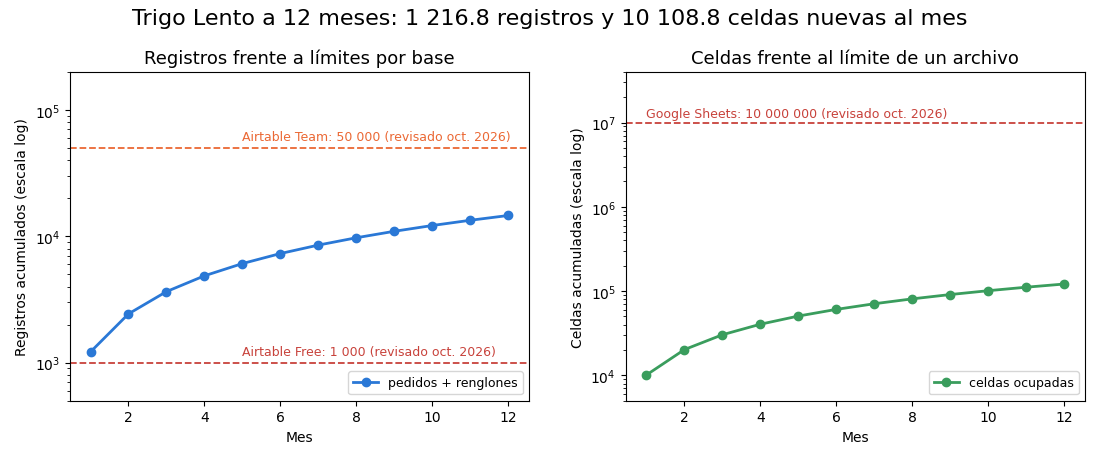
La cifra que más pesa en la salida es la primera de la lista: con el plan gratuito de Airtable, Trigo Lento agota los $1,000$ registros por base en $0.82$ meses, es decir, hacia el día 25 del primer mes. No es un límite que se pueda gestionar archivando de vez en cuando: el volumen de un solo mes ya lo supera. Con el plan Team, los $50,000$ registros duran $41.09$ meses, casi tres años y medio, y con Business, más de ocho años.
Google Sheets está en otra escala: los $10$ millones de celdas de un archivo durarían $989.24$ meses al ritmo actual, unos $82$ años. El límite real de una hoja no es el de celdas, sino el de la paciencia de quien la usa: mucho antes de llegar al millón de celdas, las fórmulas de búsqueda sobre miles de filas hacen que la hoja tarde en recalcular cada vez que alguien escribe, y el mostrador lo nota.
La figura de la izquierda, en escala logarítmica, muestra la línea de registros acumulados cruzando el límite gratuito de Airtable al principio del primer mes y quedándose lejos del de Team al final del año, con $14,601.6$ registros. La de la derecha muestra las celdas, que en un año llegan a $121,305.6$, dos órdenes de magnitud por debajo del límite de Sheets.
Permisos
La segunda pregunta después de “¿cabe?” es “¿quién puede tocar qué?”. Las tres herramientas responden con modelos distintos. En Airtable, los permisos se dan por espacio de trabajo y por base, con roles de propietario, creador, editor, comentarista y solo lectura; los planes de pago añaden permisos por campo y por tabla y vistas compartidas de solo lectura. En Notion, los permisos se dan por página y se heredan hacia abajo: una base de datos compartida con alguien comparte todas sus páginas, y las integraciones internas (las conexiones que usa un flujo de Make o de n8n) solo ven las páginas que alguien compartió explícitamente con ellas. En Google Sheets, el archivo se comparte con personas concretas como editoras, comentaristas o lectoras, y los rangos y hojas protegidos impiden que ciertas personas editen ciertas celdas, aunque no les impiden verlas.
Ese último detalle es importante para Trigo Lento. En una hoja de cálculo no se puede ocultar a una persona una hoja del mismo archivo que sí puede abrir: la protección evita la edición, no la lectura. Si los panaderos no deben ver los teléfonos de los clientes, los clientes tienen que vivir en otro archivo, o el obrador tiene que recibir una vista filtrada en un archivo aparte. En Airtable y en Notion, el mismo resultado se consigue con permisos sobre la tabla o sobre la base de datos.
Valeria escribe la matriz de permisos con cuatro niveles (sin acceso, leer, escribir y administrar) para las seis identidades que tocarán la base operativa, cuatro personas o grupos de personas y dos integraciones. La regla que guía la matriz es la del mínimo privilegio: cada identidad recibe el nivel más bajo que le permite hacer su trabajo, y ninguna integración administra nada. El siguiente bloque la escribe como DataFrame y la comprueba:
# Matriz de permisos de la base operativa y comprobaciones de mínimo privilegio en Python:
NIVEL = {'sin acceso': 0, 'leer': 1, 'escribir': 2, 'administrar': 3}
permisos = pd.DataFrame({
    'catalogo':  ['escribir', 'administrar', 'leer', 'leer', 'leer', 'leer'],
    'clientes':  ['leer', 'administrar', 'escribir', 'sin acceso', 'escribir', 'leer'],
    'pedidos':   ['leer', 'administrar', 'escribir', 'leer', 'escribir', 'escribir'],
    'renglones': ['leer', 'administrar', 'escribir', 'leer', 'escribir', 'leer']},
    index = ['Don Ernesto', 'Valeria', 'Mostrador (2)', 'Panaderos (2)', 'Integración Make', 'Integración n8n'])
print(permisos.to_string())

numerico = permisos.apply(lambda columna: columna.map(NIVEL))
integraciones = numerico.loc[['Integración Make', 'Integración n8n']]
personas = {'Don Ernesto': 1, 'Valeria': 1, 'Mostrador (2)': 2, 'Panaderos (2)': 2}
editores = sum(n for quien, n in personas.items() if numerico.loc[quien].max() >= 2)
print('¿Alguna integración administra?', bool((integraciones == 3).any().any()))
print('Administradores:', list(numerico.index[(numerico == 3).any(axis = 1)]))
print('¿Los panaderos ven clientes?', bool(numerico.loc['Panaderos (2)', 'clientes'] > 0))
print('Personas con permiso de escritura (editores que se cobran):', editores, 'de', sum(personas.values()))
                     catalogo     clientes      pedidos    renglones
Don Ernesto          escribir         leer         leer         leer
Valeria           administrar  administrar  administrar  administrar
Mostrador (2)            leer     escribir     escribir     escribir
Panaderos (2)            leer   sin acceso         leer         leer
Integración Make         leer     escribir     escribir     escribir
Integración n8n          leer         leer     escribir         leer
¿Alguna integración administra? False
Administradores: ['Valeria']
¿Los panaderos ven clientes? False
Personas con permiso de escritura (editores que se cobran): 4 de 6
La salida reproduce la Tabla 4:
Tabla 4. Matriz de permisos de la base operativa de Trigo Lento (sin acceso, leer, escribir, administrar).
| Identidad | Catálogo | Clientes | Pedidos | Renglones |
|---|---|---|---|---|
| Don Ernesto | Escribir | Leer | Leer | Leer |
| Valeria | Administrar | Administrar | Administrar | Administrar |
| Mostrador (2 personas) | Leer | Escribir | Escribir | Escribir |
| Panaderos (2 personas) | Leer | Sin acceso | Leer | Leer |
| Integración de Make | Leer | Escribir | Escribir | Escribir |
| Integración de n8n | Leer | Leer | Escribir | Leer |
Las comprobaciones del bloque dan tres resultados que se pueden auditar, y uno que tendrá consecuencias económicas:
- En primer lugar, ninguna integración administra: la de Make escribe clientes, pedidos y renglones porque el escenario de pedidos del módulo 3 los crea; la de n8n solo escribe en pedidos, para cambiar el estado cuando el agente del módulo 4 obtiene la aprobación de una persona. Si una de esas conexiones se filtrara, el daño posible quedaría acotado a lo que puede escribir.
- En segundo lugar, la única administradora es Valeria. Don Ernesto escribe en el catálogo porque los precios son suyos, pero no puede cambiar la estructura de las tablas ni los permisos de nadie.
- En tercer lugar, los panaderos no ven a los clientes: leen pedidos y renglones, que es lo que necesitan para hornear, pero no los nombres ni los teléfonos.
- En cuarto lugar, $4$ de las $6$ personas tienen permiso de escritura: Don Ernesto, Valeria y las dos personas del mostrador. Ese número es el que multiplican las herramientas que cobran por editor, y volverá en la sección de coste.
La matriz es también un anticipo del Día 17, que levantará el inventario de todas las credenciales de Trigo Lento con su dueño, su alcance y su caducidad. Hoy basta con fijar la regla: una integración recibe acceso a las tablas que usa y a nada más, y nunca con permisos de administración.
API e integración con Make y n8n
Una base operativa que no se puede leer ni escribir desde un flujo obliga a alguien a copiar datos a mano, que es justo lo que la serie intenta eliminar. Las tres herramientas tienen API, y las tres se conectan con Make y con n8n mediante módulos y nodos propios o, si hace falta, con una petición HTTP genérica. Lo que cambia es cómo se autentica la integración y cuánto se puede hacer por segundo.
Airtable usa tokens de acceso personal con alcances (scopes) explícitos, como data.records:read y data.records:write, limitados a las bases que se elijan al crear el token; la API de creación admite hasta $10$ registros por petición y un máximo de $5$ peticiones por segundo por base. Notion usa integraciones internas con un secreto propio, y la integración solo ve las páginas y bases de datos que una persona compartió con ella; la API crea una página por petición y admite, de media, $3$ peticiones por segundo por conexión en los planes que no son Business ni Enterprise. Google Sheets se conecta con OAuth 2.0 desde Make o n8n, y su API permite añadir muchas filas en una sola petición, con un máximo de $60$ peticiones por minuto por usuario. Apps Script no es una API para usar desde fuera, sino código que vive junto a la hoja y se ejecuta dentro de Google.
El Día 12 enseñó que los límites de tasa se traducen en tiempo. Si una petición crea $b$ registros y la herramienta admite $q$ peticiones por segundo, cargar $R$ registros tarda, en el mejor de los casos:
$$ T = \frac{R}{b \cdot q} $$
La lógica detrás de esta fórmula es múltiple:
- $b \cdot q$ es el caudal máximo en registros por segundo: $10 \cdot 5 = 50$ en Airtable, $1 \cdot 3 = 3$ en Notion y $500 \cdot 1 = 500$ en la API de Sheets con lotes de $500$ filas y una petición por segundo.
- Para un mes de Trigo Lento ($R = 1,216.8$), el tiempo ideal es $24.3$ segundos en Airtable, $405.6$ en Notion y $2.4$ en Sheets.
- La fórmula supone que el cliente aprovecha cada permiso de la cubeta y que la latencia de cada petición se solapa con la espera; si se envía una petición, se espera su respuesta y después se envía la siguiente, el tiempo crece.
- En conclusión, a igual volumen, lo que decide el tiempo de una carga es el tamaño del lote, más que la tasa: Notion admite pocas peticiones por segundo y además crea una página por petición.
Para ver la fórmula funcionando, el siguiente bloque simula la carga de un mes con una cubeta de tokens (token bucket), el mecanismo con el que se suelen describir los límites de tasa: la cubeta se llena a razón de $q$ tokens por segundo hasta una capacidad máxima, cada petición gasta un token y, si no hay tokens, el cliente espera. Cada petición tarda además una latencia aleatoria lognormal con mediana de $0.25$ segundos. La capacidad de cada cubeta es un supuesto (la de un segundo de tasa), porque ninguna de las tres documentaciones la publica:
# Carga simulada de un mes por API con una cubeta de tokens por herramienta en Python:
def cargar(n_registros, por_peticion, tasa, capacidad, rng, latencia = 0.25):
    # Envía cada petición en cuanto hay un token; devuelve el instante en que termina cada una:
    n_peticiones = int(np.ceil(n_registros / por_peticion))
    tokens, reloj, fines = capacidad, 0.0, []
    for _ in range(n_peticiones):
        if tokens < 1:                                   # espera a que la cubeta tenga un token
            espera = (1 - tokens) / tasa
            reloj += espera
            tokens += espera * tasa
        tokens -= 1
        fines.append(reloj + rng.lognormal(np.log(latencia), 0.3))
    return n_peticiones, np.sort(np.array(fines))

registros_carga = int(np.ceil(registros_mes))            # 1 217 registros de un mes
herramientas = {   # (registros por petición, peticiones por segundo, capacidad de la cubeta)
    'Airtable (lotes de 10, 5 por s)': (10, 5, 5),
    'Notion (1 página, 3 por s)': (1, 3, 3),
    'Google Sheets API (500 filas, 1 por s)': (500, 1, 1)}
fig, ax = plt.subplots(figsize = (9, 4.8))
for (nombre, (lote, tasa, cap)), color in zip(herramientas.items(), ['#2a78d6', '#7b5ea7', '#3a9d5d']):
    n_pet, fines = cargar(registros_carga, lote, tasa, cap, rng)
    teorico = registros_mes / (lote * tasa)
    cargados = np.minimum(np.arange(1, n_pet + 1) * lote, registros_carga)
    ax.step(np.r_[0, fines], np.r_[0, cargados], where = 'post', color = color, lw = 2, label = nombre)
    print(f'{nombre:<40} peticiones {n_pet:>5} | teórico {teorico:6.1f} s | simulado {fines[-1]:6.1f} s')
ax.set_xscale('symlog', linthresh = 10)
ax.set_xlabel('Segundos desde el inicio (escala logarítmica a partir de 10 s)')
ax.set_ylabel('Registros cargados')
ax.set_title('Cargar un mes de Trigo Lento por API', fontsize = 16)
ax.legend(fontsize = 9, loc = 'upper left')
plt.tight_layout()
plt.show()
print(f'Un año de registros en Notion (14 601.6): {14_601.6 / 3 / 60:.1f} minutos')
Airtable (lotes de 10, 5 por s)          peticiones   122 | teórico   24.3 s | simulado   23.6 s
Notion (1 página, 3 por s)               peticiones  1217 | teórico  405.6 s | simulado  404.9 s
Google Sheets API (500 filas, 1 por s)   peticiones     3 | teórico    2.4 s | simulado    2.3 s
Un año de registros en Notion (14 601.6): 81.1 minutos
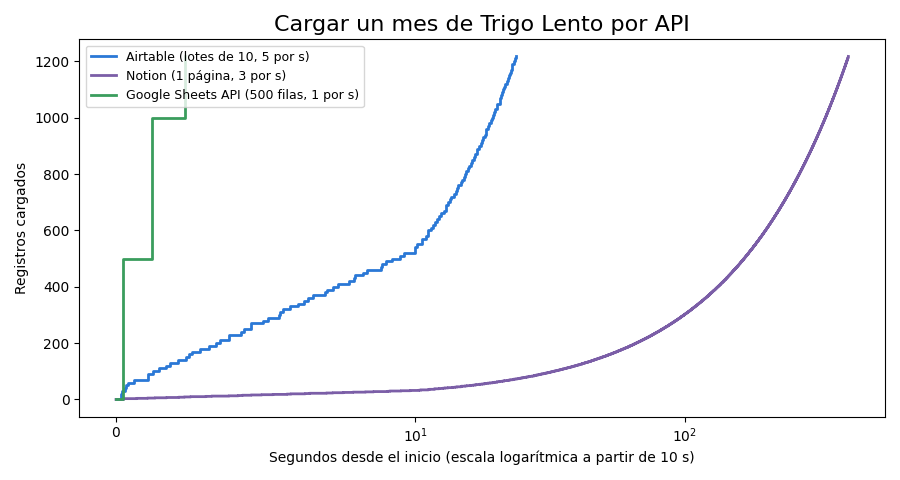
La simulación confirma el orden de magnitud de la fórmula: cargar un mes cuesta $122$ peticiones y unos $24$ segundos en Airtable, $1,217$ peticiones y casi $7$ minutos ($404.9$ segundos) en Notion, y $3$ peticiones y poco más de $2$ segundos en la API de Sheets. Los tiempos simulados quedan unas décimas por debajo de los teóricos porque la cubeta empieza llena y permite una pequeña ráfaga inicial. La figura, con el eje de tiempo en escala logarítmica a partir de $10$ segundos, muestra las tres escaleras: la de Sheets sube en tres peldaños de $500$ filas, la de Airtable en peldaños de $10$ y la de Notion en peldaños de uno, tan pequeños que parece una curva.
En el uso diario de Trigo Lento ninguno de esos tiempos es un problema: el escenario de pedidos crea un pedido cada pocos minutos, no mil doscientos de golpe. Los límites se notan en dos situaciones concretas. La primera es una migración: llevar un año de pedidos a Notion, $14,601.6$ registros, tardaría unos $81.1$ minutos, y cualquier error a la mitad obliga a saber exactamente qué se cargó. La segunda es un flujo mal diseñado que consulta la base en un bucle, registro por registro, en lugar de pedir una lista filtrada: con $3$ peticiones por segundo, un bucle de $500$ consultas tarda casi tres minutos y consume cuota que otros flujos necesitan.
Para que la integración sea concreta, el Bloque 7 muestra los cuerpos de petición con los que un flujo de Make o de n8n crearía un renglón en Airtable y un pedido en Notion. Son peticiones HTTP normales: en Airtable, POST a la tabla con una lista records de hasta diez objetos fields; en Notion, POST a /v1/pages con un parent que señala la fuente de datos y un objeto properties con un valor por propiedad, escrito según su tipo. Todos los identificadores son ficticios, y los secretos (el token de Airtable y el de la integración de Notion) viajan en la cabecera Authorization desde la conexión de la plataforma, nunca en el cuerpo. Este es el archivo trigo_lento/dia_15/cuerpos_peticion.json:
{
  "airtable_crear_renglones": {
    "metodo": "POST",
    "url": "https://api.airtable.com/v0/appEJEMPLO0000001/Renglones",
    "cabeceras": {"Authorization": "Bearer {{token desde la conexión}}", "Content-Type": "application/json"},
    "cuerpo": {
      "records": [
        {"fields": {"Pedido": ["recEJEMPLO0000034"], "Producto": ["recEJEMPLO0000P12"], "Cantidad": 1}},
        {"fields": {"Pedido": ["recEJEMPLO0000034"], "Producto": ["recEJEMPLO0000P05"], "Cantidad": 6}}
      ],
      "typecast": false
    }
  },
  "notion_crear_pedido": {
    "metodo": "POST",
    "url": "https://api.notion.com/v1/pages",
    "cabeceras": {"Authorization": "Bearer {{secreto desde la credencial}}", "Notion-Version": "2026-03-11",
                  "Content-Type": "application/json"},
    "cuerpo": {
      "parent": {"type": "data_source_id", "data_source_id": "00000000-0000-4000-8000-0000000000d5"},
      "properties": {
        "Pedido": {"title": [{"text": {"content": "TL-0034"}}]},
        "Cliente": {"relation": [{"id": "00000000-0000-4000-8000-0000000000c1"}]},
        "Canal": {"select": {"name": "whatsapp"}},
        "Entrega": {"date": {"start": "2026-02-16T10:00:00-06:00"}},
        "Estado": {"select": {"name": "nuevo"}}
      }
    }
  }
}
En el cuerpo de Airtable, los campos Pedido y Producto son enlaces a otros registros, y por eso reciben una lista de identificadores de registro (rec...) y no una clave escrita: es la integridad referencial del campo enlazado vista desde la API. El parámetro typecast en false hace que Airtable rechace un valor que no encaje con el tipo del campo en lugar de intentar convertirlo, que es lo que conviene cuando la fuente de verdad ya validó el dato. En el de Notion, cada propiedad declara su tipo en el propio JSON (title, relation, select, date), la fecha lleva la zona horaria de la Ciudad de México y el parent es una fuente de datos (data_source_id), como exige la API desde la versión 2025-09-03; la versión más reciente que lista la documentación oficial, revisado en octubre de 2026, es la 2026-03-11. Las cabeceras muestran dónde va cada secreto, con un marcador en lugar del valor.
Las dos peticiones crean lo mismo, un pedido con sus renglones, pero en Notion hacen falta tres peticiones (el pedido y dos renglones como páginas de otra base de datos relacionada) y en Airtable dos (el pedido y un lote con los dos renglones). Multiplicado por $468$ encargos al mes, esa diferencia es la que la simulación convirtió en segundos.
Atención aquí: la base operativa contiene nombres y teléfonos de clientes, y cada forma de compartirla es una forma de filtrarlos. Nunca comparta la hoja o la base con “cualquier persona que tenga el enlace”: ese enlace termina en un chat, en un correo reenviado o en el historial de un navegador ajeno. Dé acceso a personas con nombre, a las tablas que necesitan y con el nivel mínimo de la Tabla 4, y conceda a cada integración solo las bases o páginas que usa. Elegir una herramienta en la nube es también aceptar dónde se alojan los datos de los clientes de Trigo Lento: el aviso de privacidad debe decirlo, nombrando al proveedor, y Valeria debe poder exportar y borrar esos datos cuando un cliente ejerza sus derechos ARCO. Todos los nombres, teléfonos e identificadores de esta entrada son inventados.
Apps Script: lógica junto a la hoja
Google Sheets tiene una carta que las otras dos herramientas no juegan de la misma forma: Google Apps Script, un entorno de JavaScript que vive dentro de Google, que puede ir vinculado a una hoja concreta y que se ejecuta en los servidores de Google sin que nadie tenga que mantener una máquina. Con Apps Script, la hoja deja de ser solo una cuadrícula y gana un ayudante que puede revisar las filas nuevas, marcar las sospechosas, enviar un aviso o llamar a una API.
Valeria quiere un ayudante modesto: cada $10$ minutos, revisar las filas cuyo estado es “nuevo” y marcar con “revisar” las que tengan una clave que no está en el catálogo, una fecha de entrega pasada o una cantidad que no sea un entero positivo; las demás pasan a “validado”. El script no corrige nada: deja una nota en la columna de revisión para que una persona decida. Así lo exige el código de honor del Día 6, que reserva para una persona toda acción con efecto económico, y corregir el producto de un encargo lo tiene.
El script tiene dos funciones. validarPedidosNuevos() hace la revisión: pide un candado con LockService para que dos ejecuciones no escriban a la vez, lee todas las filas con una sola llamada a getValues(), decide el estado y el motivo de cada fila nueva en memoria y escribe el resultado con una sola llamada a setValues(). Leer y escribir en bloque, y no celda por celda, es la recomendación de rendimiento más repetida de la documentación de Apps Script, porque cada llamada a la hoja tarda. instalarDisparador() se ejecuta una sola vez, a mano, y crea un disparador por tiempo que llama a la primera función cada $10$ minutos, después de borrar cualquier disparador anterior para no duplicarlo. Este código se muestra y no se ejecuta en la entrada:
// Validación de pedidos nuevos de Trigo Lento con Google Apps Script (vinculado a la hoja):
const HOJA_RENGLONES = 'Renglones';   // columnas: id_pedido, linea, clave, cantidad, fecha_entrega, estado, revision
const HOJA_CATALOGO = 'Catalogo';     // columna A: clave del producto

function validarPedidosNuevos() {
  // Un candado evita que dos ejecuciones escriban a la vez:
  const candado = LockService.getScriptLock();
  if (!candado.tryLock(30000)) return;
  try {
    const libro = SpreadsheetApp.getActiveSpreadsheet();
    const claves = new Set(libro.getSheetByName(HOJA_CATALOGO).getRange('A2:A').getValues()
      .flat().filter(String));
    const hoja = libro.getSheetByName(HOJA_RENGLONES);
    const datos = hoja.getDataRange().getValues();          // una sola lectura
    const hoy = new Date();
    hoy.setHours(0, 0, 0, 0);
    const salida = datos.slice(1).map(function (fila) {
      const clave = fila[2], cantidad = fila[3], entrega = fila[4], estado = fila[5], revision = fila[6];
      if (estado !== 'nuevo') return [estado, revision];      // solo se revisan las filas nuevas
      const motivos = [];
      if (!claves.has(clave)) motivos.push('clave inexistente');
      if (!(entrega instanceof Date) || entrega < hoy) motivos.push('fecha pasada');
      if (!(Number(cantidad) >= 1)) motivos.push('cantidad inválida');
      return motivos.length ? ['revisar', motivos.join('; ')] : ['validado', ''];
    });
    if (salida.length) hoja.getRange(2, 6, salida.length, 2).setValues(salida);   // una sola escritura
  } finally {
    candado.releaseLock();
  }
}

function instalarDisparador() {
  // Disparador por tiempo cada 10 minutos; se ejecuta una sola vez, a mano:
  ScriptApp.getProjectTriggers()
    .filter(function (d) { return d.getHandlerFunction() === 'validarPedidosNuevos'; })
    .forEach(function (d) { ScriptApp.deleteTrigger(d); });
  ScriptApp.newTrigger('validarPedidosNuevos').timeBased().everyMinutes(10).create();
}
Tres detalles del script merecen una lectura atenta. El primero es el candado: tryLock(30000) espera hasta $30$ segundos a que termine otra ejecución y, si no lo consigue, la ejecución actual se retira sin tocar nada, porque la siguiente llegará en $10$ minutos. Ese candado protege al script de sí mismo, no de las personas: si alguien del mostrador edita una fila mientras el script escribe, la escritura en bloque puede devolver a la columna de estado un valor leído unos segundos antes. Por eso el script solo escribe en las columnas de estado y de revisión, que el mostrador no debería tocar, y la Tabla 4 se traduce en Sheets en un rango protegido sobre esas dos columnas.
El segundo detalle son las fechas: Apps Script devuelve las celdas con formato de fecha como objetos Date de JavaScript, y una fecha escrita como texto (“16/2”) no lo es, de modo que la condición !(entrega instanceof Date) la marca para revisión en lugar de interpretarla. Es la regla del Día 4, ahora en otro lenguaje: lo que no se puede normalizar sin adivinar se pregunta. El tercero son los alcances: al instalar el disparador, Google pide a quien lo instala que autorice el script a ver y editar la hoja y a gestionar disparadores. Se pueden restringir declarando en el manifiesto appsscript.json los alcances mínimos, https://www.googleapis.com/auth/spreadsheets.currentonly (solo la hoja a la que está vinculado) y https://www.googleapis.com/auth/script.scriptapp (para crear el disparador), en lugar del alcance amplio sobre todas las hojas de la cuenta. El Día 17 volverá sobre esa elección.
Como el código de Apps Script no se puede ejecutar dentro de la entrada, Valeria reproduce la misma lógica en Python sobre una copia local de la hoja: el archivo hoja_pedidos.csv que escribió el Bloque 3, leído con dtype = str para que pandas no adivine tipos, exactamente como llegaría una exportación de la hoja. Las tres reglas son las mismas y el resultado se escribe en las mismas dos columnas. Al final, el bloque calcula cuánto de la cuota diaria de Apps Script consumiría el disparador:
# La validación de Apps Script reproducida en Python sobre una copia local de la hoja:
copia = pd.read_csv(carpeta / 'hoja_pedidos.csv', dtype = str, keep_default_na = False)

def validar_pedidos_nuevos(hoja, claves, hoy):
    hoja = hoja.copy()
    hoja['revision'] = ''
    nuevas = hoja['estado'] == 'nuevo'
    clave_mala = ~hoja['clave'].isin(claves)
    fecha = pd.to_datetime(hoja['fecha_entrega'], errors = 'coerce')
    fecha_pasada = fecha.isna() | (fecha < hoy)
    cantidad = pd.to_numeric(hoja['cantidad'], errors = 'coerce')
    cantidad_mala = ~(cantidad >= 1)
    for mascara, motivo in [(clave_mala, 'clave inexistente'), (fecha_pasada, 'fecha pasada'),
                            (cantidad_mala, 'cantidad inválida')]:
        marcar = nuevas & mascara
        hoja.loc[marcar, 'revision'] = (hoja.loc[marcar, 'revision'] + '; ' + motivo).str.lstrip('; ')
    hoja.loc[nuevas & (hoja['revision'] == ''), 'estado'] = 'validado'
    hoja.loc[nuevas & (hoja['revision'] != ''), 'estado'] = 'revisar'
    return hoja

revisada = validar_pedidos_nuevos(copia, CLAVES, HOY)
marcadas = revisada[revisada['estado'] == 'revisar']
print('Filas revisadas:', len(revisada), '| validadas:', int((revisada['estado'] == 'validado').sum()),
      '| marcadas para revisar:', len(marcadas))
print('Motivos:', marcadas['revision'].value_counts().to_dict())
print(marcadas[marcadas['revision'].str.contains('clave')][['id_pedido', 'linea', 'clave', 'fecha_entrega', 'revision']]
      .head(5).to_string(index = False))

# Cuota diaria de disparadores de Apps Script con una ejecución cada 10 minutos:
ejecuciones_dia = 24 * 60 // 10
for segundos in (4, 20, 37.5):
    minutos = ejecuciones_dia * segundos / 60
    print(f'{ejecuciones_dia} ejecuciones de {segundos:>4} s = {minutos:5.1f} min al día '
          f'({minutos / 90:.0%} de 90 min, cuenta personal)')
Filas revisadas: 319 | validadas: 264 | marcadas para revisar: 55
Motivos: {'fecha pasada': 43, 'clave inexistente': 7, 'clave inexistente; fecha pasada': 5}
id_pedido linea clave fecha_entrega                        revision
  TL-0020     2    P1    2026-02-13 clave inexistente; fecha pasada
  TL-0032     2   P13    2026-02-13 clave inexistente; fecha pasada
  TL-0034     1   P13    2026-02-16               clave inexistente
  TL-0052     2    P1    2026-02-24               clave inexistente
  TL-0053     2    P1    2026-02-21               clave inexistente
144 ejecuciones de    4 s =   9.6 min al día (11% de 90 min, cuenta personal)
144 ejecuciones de   20 s =  48.0 min al día (53% de 90 min, cuenta personal)
144 ejecuciones de 37.5 s =  90.0 min al día (100% de 90 min, cuenta personal)
De $319$ filas nuevas, $264$ pasan a validadas y $55$ quedan marcadas para revisar. Los motivos cuentan dos historias distintas. Hay $12$ filas con clave inexistente ($7$ solo por la clave y $5$ por la clave y la fecha), que son exactamente los doce errores sembrados del Bloque 3: la validación los encuentra todos y no marca ninguna clave buena. Y hay $48$ filas con fecha pasada ($43$ solo por la fecha y las $5$ que coinciden con una clave mala), que en la simulación son pedidos con entrega del 12 al 14 de febrero que siguen en estado “nuevo”. En la vida real esas filas son pedidos ya entregados que nadie cerró, o pedidos con la fecha mal escrita; el script no sabe cuál de las dos cosas es y por eso no corrige, marca.
Las tres últimas líneas responden a una pregunta que la documentación de cuotas permite calcular antes de instalar nada. Un disparador cada $10$ minutos se ejecuta $144$ veces al día, y el tiempo total que consume es:
$$ T_{dia} = \frac{24 \cdot 60}{\Delta} \cdot t_{ej} \le T_{max} $$
La lógica detrás de esta fórmula es múltiple:
- $\Delta$ es el intervalo del disparador en minutos ($10$), de modo que $24 \cdot 60 / \Delta = 144$ ejecuciones al día.
- $t_{ej}$ es la duración de cada ejecución. Con una lectura y una escritura en bloque sobre unos cientos de filas, $4$ segundos es una estimación razonable; con lecturas celda por celda podría pasar de $20$.
- $T_{max}$ es la cuota diaria de tiempo de disparadores: $90$ minutos en una cuenta personal de Google y $6$ horas en una cuenta de Google Workspace.
- En conclusión, el disparador de Trigo Lento cabe con holgura: $144$ ejecuciones de $4$ segundos son $9.6$ minutos al día, el $11%$ de la cuota personal, y el techo está en $37.5$ segundos por ejecución. Un script que lea celda por celda y tarde $20$ segundos consumiría ya el $53%$.
La ilustración de la Figura 3 resume el papel del script: un ayudante sentado junto a la hoja, que pasa cada diez minutos, deja notas y lleva colgadas del cinturón solo las llaves que necesita.
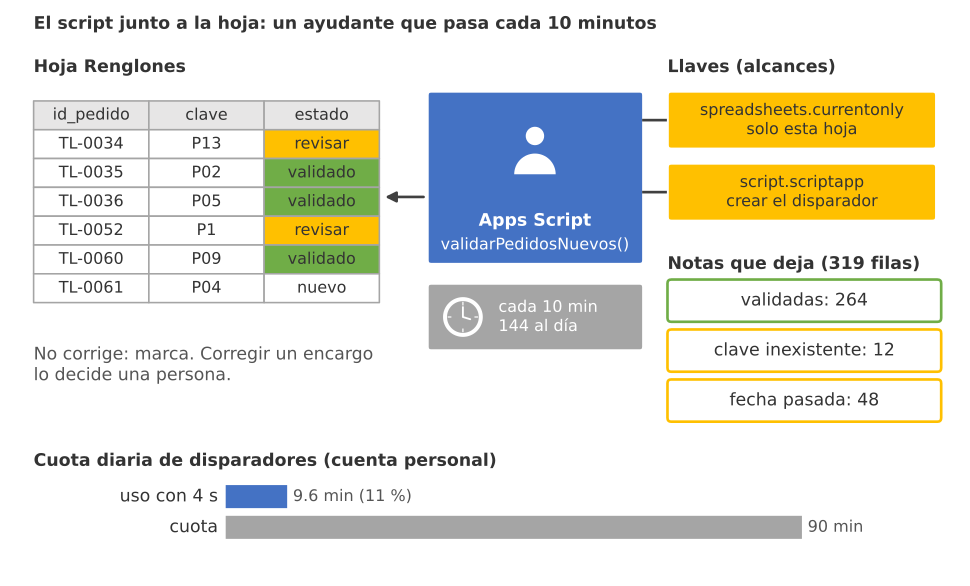
Figura 3. El script junto a la hoja: Apps Script revisa las filas nuevas cada 10 minutos, deja notas de revisión, lleva solo dos alcances como llaves y consume 9.6 de los 90 minutos diarios de cuota de una cuenta personal.
Coste y decisión
Con los límites y los permisos sobre la mesa, queda la pregunta de Don Ernesto: ¿cuánto cuesta? Las tres herramientas cobran de formas distintas, pero tienen algo en común: sus planes de pago cobran por usuario. Airtable cobra en Team y Business por cada persona con permiso de edición en al menos una base, y no cobra a los colaboradores de solo lectura ni a quien envía un formulario; Notion cobra por miembro del espacio de trabajo y deja entrar invitados sin coste con permisos limitados; Google Sheets es gratuito con cualquier cuenta de Google, y solo cuesta si el negocio decide pasar a Google Workspace, que también cobra por usuario. La Tabla 5 reúne los precios de referencia, revisado en octubre de 2026:
Tabla 5. Precios por usuario de las tres herramientas (USD al mes; revisado en octubre de 2026).
| Herramienta | Plan | Pago anual (por mes) | Pago mensual | A quién se cobra | Fuente de la revisión |
|---|---|---|---|---|---|
| Airtable | Free | 0 | 0 | Hasta 5 editores | Página oficial de precios y fuentes secundarias |
| Airtable | Team | 20 | No publicado en la página consultada | Personas con permiso de edición | Página oficial de precios |
| Airtable | Business | 45 | No publicado en la página consultada | Personas con permiso de edición | Página oficial de precios |
| Notion | Free | 0 | 0 | Miembros; bloques limitados con varios miembros | Página oficial de precios |
| Notion | Plus | 10 | 12 | Cada miembro; invitados aparte | Fuentes secundarias coincidentes |
| Notion | Business | 20 | 24 | Cada miembro | Fuentes secundarias; una de ellas da 18 y 22 |
| Google Sheets | Cuenta personal | 0 | 0 | Nadie | Sin plan de pago propio |
| Google Workspace | Business Starter | 7 | 8.40 | Cada cuenta de usuario | Fuentes secundarias coincidentes |
Como los precios cambian y las fuentes no siempre coinciden, la decisión no debe depender de una cifra exacta, sino de su forma. El coste mensual de una herramienta que cobra por usuario es una recta:
$$ C(n, p) = n \cdot p \le B_{reserva} $$
La lógica detrás de esta fórmula es múltiple:
- $n$ es el número de personas que la herramienta cobra: en Airtable, las que editan; en Notion y Workspace, todos los miembros. La matriz de permisos del Bloque 5 dio $n = 4$ editores.
- $p$ es el precio por usuario y mes. No hace falta fijarlo para razonar: la pregunta útil es cuál es el precio máximo que cabe, $p_{max} = B_{reserva} / n$.
- $B_{reserva}$ es la parte del presupuesto de $45$ USD que no está comprometida: los $8.41$ USD de reserva del reparto que calculó el Día 12.
- En conclusión, con $4$ editores y $8.41$ USD de reserva, el precio máximo por usuario que Trigo Lento puede pagar es de $2.10$ USD al mes, y ninguno de los planes de pago de la Tabla 5 se le acerca.
El siguiente bloque dibuja el coste en función del número de editores para una familia de precios por usuario, de $5$ en $5$ dólares, resalta los precios de referencia de la Tabla 5 y marca la reserva y los cuatro editores de Trigo Lento:
# Coste mensual en función del precio por usuario y del número de editores en Python:
RESERVA = 8.41                       # USD al mes, rubro libre del presupuesto de 45 USD
referencias = {'Airtable Team': 20, 'Notion Plus': 10, 'Google Workspace Business Starter': 7,
               'Google Sheets con cuentas existentes': 0}   # USD por usuario y mes, pago anual (revisado oct. 2026)
n_editores = np.arange(1, 7)
fig, ax = plt.subplots(figsize = (9, 4.8))
for p in range(5, 31, 5):
    ax.plot(n_editores, p * n_editores, color = '#d6d5d2', lw = 1)
    ax.text(6.08, p * 6, f'{p} USD', fontsize = 8, color = '#8a8986', va = 'center')
for (nombre, p), color in zip(referencias.items(), ['#eb6834', '#7b5ea7', '#2a78d6', '#3a9d5d']):
    ax.plot(n_editores, p * n_editores, marker = 'o', lw = 2, color = color, label = f'{nombre} ({p} USD)')
ax.axhline(RESERVA, ls = '--', color = '#c8423b', lw = 1.3)
ax.text(4.25, RESERVA + 2.5, f'Reserva del presupuesto: {RESERVA} USD', fontsize = 9, color = '#c8423b')
ax.axvline(editores, ls = ':', color = '#52514e')
ax.text(editores + 0.05, 140, f'{editores} editores (Bloque 5)', fontsize = 9, color = '#52514e')
ax.set_xlim(0.8, 6.6)
ax.set_xlabel('Personas que editan la base')
ax.set_ylabel('USD al mes')
ax.set_title('Coste mensual: precio por usuario por número de editores', fontsize = 15)
ax.legend(fontsize = 8.5, loc = 'upper left')
plt.tight_layout()
plt.show()
for nombre, p in referencias.items():
    coste = p * editores
    print(f'{nombre:<38} {coste:6.2f} USD al mes con {editores} editores | cabe en la reserva: {coste <= RESERVA}')
print(f'Precio máximo por usuario que cabe en la reserva con {editores} editores: {RESERVA / editores:.2f} USD')
Airtable Team                           80.00 USD al mes con 4 editores | cabe en la reserva: False
Notion Plus                             40.00 USD al mes con 4 editores | cabe en la reserva: False
Google Workspace Business Starter       28.00 USD al mes con 4 editores | cabe en la reserva: False
Google Sheets con cuentas existentes     0.00 USD al mes con 4 editores | cabe en la reserva: True
Precio máximo por usuario que cabe en la reserva con 4 editores: 2.10 USD
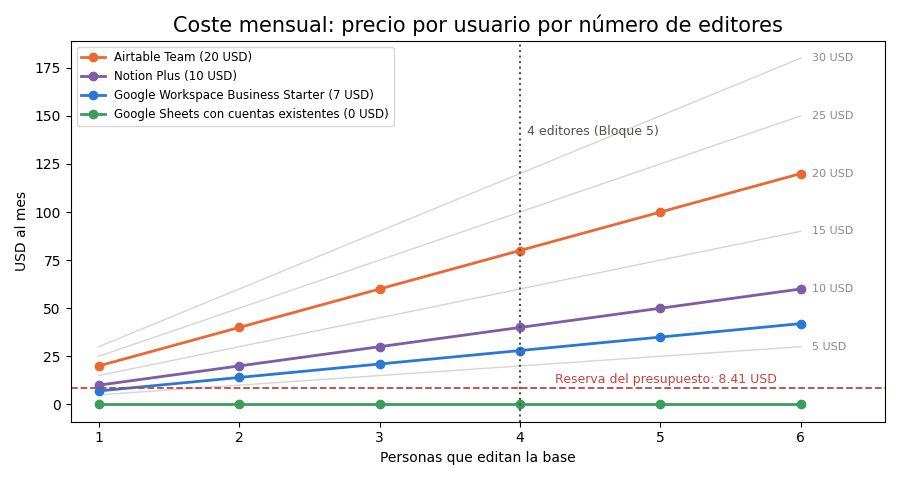
La figura hace visible lo que la fórmula anunciaba: todas las rectas de pago cruzan la línea de la reserva antes del segundo editor, salvo la de Google Workspace, que la cruza justo en el segundo. Con los $4$ editores de Trigo Lento, Airtable Team costaría $80$ USD al mes, casi el doble del presupuesto completo del ecosistema; Notion Plus, $40$ USD; Google Workspace Business Starter, $28$ USD. Solo Google Sheets con las cuentas que el negocio ya tiene cabe en la reserva, con $0$ USD.
Hay que leer esas cifras con justicia hacia las herramientas de pago. El plan gratuito de Airtable admite hasta $5$ editores, que bastarían para Trigo Lento, pero sus $1,000$ registros por base se agotan en menos de un mes, como mostró el Bloque 4. Notion gratuito funciona bien con una sola persona, pero limita los bloques cuando hay varios miembros. Y reducir los editores a uno, con el mostrador capturando por formularios (que Airtable no cobra), es una arquitectura posible, pero obliga a cambiar la forma de trabajar del mostrador justo cuando Valeria quiere cambiar lo menos posible.
La matriz ponderada
El coste no es el único criterio, y la matriz ponderada del Día 11 es la herramienta para combinarlo con los demás. Valeria fija los pesos antes de puntuar: modelo de datos y relaciones ($0.20$), límites y cuotas ($0.15$), permisos ($0.10$), API e integración ($0.15$), coste ($0.25$, el mayor, por la reserva de $8.41$ USD) y curva de aprendizaje del mostrador ($0.15$). La puntuación de cada herramienta es la suma de sus notas por los pesos:
$$ S_j = \sum_{i=1}^{6} w_i , x_{ij}, \qquad \sum_{i=1}^{6} w_i = 1 $$
Las notas, de $1$ a $5$, salen de lo medido en este día y van justificadas en la Tabla 6:
Tabla 6. Matriz ponderada de la base operativa: pesos de Valeria, pesos alternos y notas de 1 a 5 con su justificación.
| Criterio | Peso de Valeria | Peso alterno | Sheets + Apps Script | Airtable | Notion | Justificación |
|---|---|---|---|---|---|---|
| Modelo de datos y relaciones | 0.20 | 0.35 | 2 | 5 | 3 | Airtable tiene enlaces, búsquedas y resúmenes; Notion relaciones y rollups; Sheets no tiene integridad referencial (Bloque 3) |
| Límites y cuotas | 0.15 | 0.15 | 4 | 3 | 2 | Sheets tarda 82 años en llenarse y Apps Script cabe en la cuota; Airtable obliga a pagar desde el primer mes; Notion carga a 3 peticiones por segundo |
| Permisos | 0.10 | 0.10 | 3 | 4 | 3 | Sheets protege la edición pero no la lectura; Airtable da permisos por tabla en planes de pago; Notion hereda por página |
| API e integración | 0.15 | 0.15 | 4 | 5 | 3 | Airtable crea 10 registros por petición y tiene alcances por base; Sheets añade filas en lote; Notion crea una página por petición |
| Coste | 0.25 | 0.10 | 5 | 2 | 4 | Con 4 editores, Sheets cuesta 0 USD; Notion Plus 40; Airtable Team 80 (Bloque 10); los planes gratuitos de Notion y Airtable tienen límites que Trigo Lento roza |
| Curva del mostrador | 0.15 | 0.15 | 5 | 3 | 4 | El mostrador ya usa una hoja; Notion es familiar como documento; Airtable exige entender enlaces y vistas |
El siguiente bloque calcula $S_j$ con los pesos de Valeria y con un juego alterno, en el que el modelo de datos pesa $0.35$ y el coste $0.10$, que es como pesaría las cosas alguien que diera por resuelto el presupuesto. Después mueve el peso del modelo de datos de $0.20$ a $0.35$, quitándoselo al coste, para ver dónde cambia el ganador:
# Matriz ponderada de las tres bases operativas y su sensibilidad en Python:
criterios = ['modelo_datos', 'limites', 'permisos', 'api', 'coste', 'curva_mostrador']
pesos_valeria = np.array([0.20, 0.15, 0.10, 0.15, 0.25, 0.15])
pesos_alternos = np.array([0.35, 0.15, 0.10, 0.15, 0.10, 0.15])
notas = pd.DataFrame({'Sheets + Apps Script': [2, 4, 3, 4, 5, 5],
                      'Airtable': [5, 3, 4, 5, 2, 3],
                      'Notion': [3, 2, 3, 3, 4, 4]}, index = criterios)
assert np.isclose(pesos_valeria.sum(), 1) and np.isclose(pesos_alternos.sum(), 1)
s_valeria = notas.T @ pesos_valeria
s_alternos = notas.T @ pesos_alternos
print(notas.assign(peso = pesos_valeria, alterno = pesos_alternos).to_string())
print('Pesos de Valeria:', s_valeria.round(2).to_dict())
print('Pesos alternos:  ', s_alternos.round(2).to_dict())

# Sensibilidad: el modelo de datos gana peso a costa del coste:
for w in [0.20, 0.25, 0.30, 0.35]:
    p = pesos_valeria.copy()
    p[0], p[4] = w, 0.45 - w
    s = notas.T @ p
    print(f'modelo {w:.2f}, coste {0.45 - w:.2f}:', s.round(2).to_dict(), '-> gana', s.idxmax())
dif_modelo = notas.loc['modelo_datos', 'Airtable'] - notas.loc['modelo_datos', 'Sheets + Apps Script']
dif_coste = notas.loc['coste', 'Airtable'] - notas.loc['coste', 'Sheets + Apps Script']
w_cruce = 0.20 + (s_valeria['Sheets + Apps Script'] - s_valeria['Airtable']) / (dif_modelo - dif_coste)
print(f'Punto de cambio: peso del modelo de datos = {w_cruce:.3f}')

fig, ax = plt.subplots(figsize = (9, 4.8))
x = np.arange(len(notas.columns))
ax.bar(x - 0.2, s_valeria.values, width = 0.4, color = '#2a78d6', label = 'Pesos de Valeria (coste 0.25)')
ax.bar(x + 0.2, s_alternos.values, width = 0.4, color = '#eb6834', label = 'Pesos alternos (modelo 0.35)')
for i in range(len(x)):
    ax.text(i - 0.2, s_valeria.iloc[i] + 0.05, f'{s_valeria.iloc[i]:.2f}', ha = 'center', fontsize = 11)
    ax.text(i + 0.2, s_alternos.iloc[i] + 0.05, f'{s_alternos.iloc[i]:.2f}', ha = 'center', fontsize = 11)
ax.set_xticks(x)
ax.set_xticklabels(notas.columns)
ax.set_ylim(0, 5.4)
ax.set_ylabel('Puntuación ponderada (de 1 a 5)')
ax.set_title('Base operativa de Trigo Lento: dos juegos de pesos', fontsize = 16)
ax.legend(fontsize = 9, loc = 'upper right')
plt.tight_layout()
plt.show()
                 Sheets + Apps Script  Airtable  Notion  peso  alterno
modelo_datos                        2         5       3  0.20     0.35
limites                             4         3       2  0.15     0.15
permisos                            3         4       3  0.10     0.10
api                                 4         5       3  0.15     0.15
coste                               5         2       4  0.25     0.10
curva_mostrador                     5         3       4  0.15     0.15
Pesos de Valeria: {'Sheets + Apps Script': 3.9, 'Airtable': 3.55, 'Notion': 3.25}
Pesos alternos:   {'Sheets + Apps Script': 3.45, 'Airtable': 4.0, 'Notion': 3.1}
modelo 0.20, coste 0.25: {'Sheets + Apps Script': 3.9, 'Airtable': 3.55, 'Notion': 3.25} -> gana Sheets + Apps Script
modelo 0.25, coste 0.20: {'Sheets + Apps Script': 3.75, 'Airtable': 3.7, 'Notion': 3.2} -> gana Sheets + Apps Script
modelo 0.30, coste 0.15: {'Sheets + Apps Script': 3.6, 'Airtable': 3.85, 'Notion': 3.15} -> gana Airtable
modelo 0.35, coste 0.10: {'Sheets + Apps Script': 3.45, 'Airtable': 4.0, 'Notion': 3.1} -> gana Airtable
Punto de cambio: peso del modelo de datos = 0.258
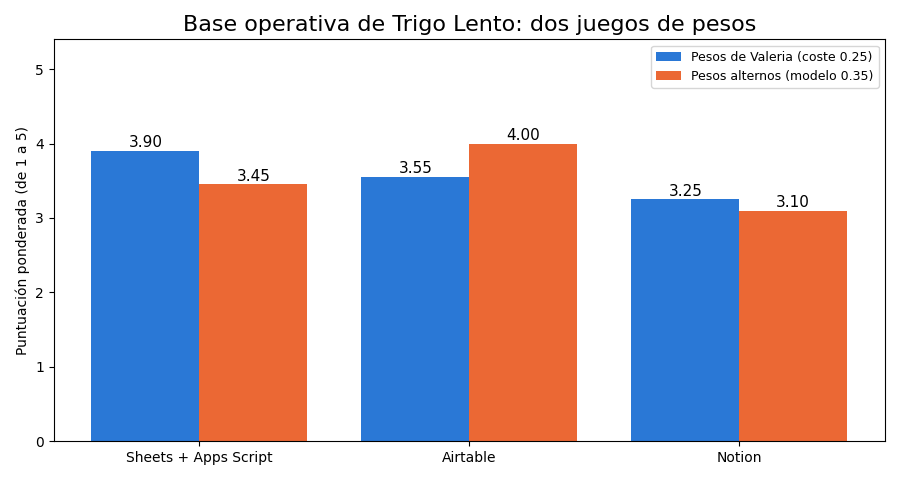
Con los pesos de Valeria, Google Sheets con Apps Script obtiene $3.90$, Airtable $3.55$ y Notion $3.25$. Con los pesos alternos, Airtable gana con $4.00$, Sheets baja a $3.45$ y Notion a $3.10$. La sensibilidad dice dónde está la frontera: con el modelo de datos en $0.25$ todavía gana Sheets, por apenas $0.05$ puntos; con $0.30$ ya gana Airtable. Igualando las dos puntuaciones como funciones del peso, el punto de cambio está en $w_{modelo} \approx 0.258$.
Las barras de la figura cuentan la misma historia con colores. La ventaja de Sheets viene casi entera del coste y de la curva del mostrador; la de Airtable, del modelo de datos y de la API. Notion no gana con ningún juego de pesos: es la herramienta del medio en casi todo, y para una base operativa con mucha captura no tiene un punto fuerte que la empuje. Eso no la descarta en Trigo Lento, solo la mueve de sitio: el Día 68 la usará como base de conocimiento, que es exactamente donde sus páginas, su texto libre y sus relaciones brillan.
Igual que en el Día 11, el resultado más útil no es el ganador, sino la condición: Sheets gana mientras el coste pese más que la integridad del modelo de datos, y la integridad se puede comprar de otra manera. Ahí está la decisión de Valeria:
- En primer lugar, Google Sheets con Apps Script será la vista del mostrador: cuesta $0$ USD, el mostrador ya la sabe usar y el script de validación compensa una parte de la integridad que le falta, marcando cada $10$ minutos lo que una relación habría impedido.
- En segundo lugar,
trigo_lento.sqliteserá la fuente de verdad: es la base que sí tiene claves foráneas, restricciones y transacciones, y es la que manda cuando la hoja y la base no coinciden. La flecha que las une, con su marca de agua y su regla de conflictos, es el tema del Día 16. - En tercer lugar, Airtable queda como opción con condiciones de revisión: si el presupuesto de Trigo Lento crece o el número de editores baja a uno o dos, si los renglones huérfanos superan el $2%$ de las filas durante dos semanas seguidas pese al script, o si un segundo negocio comparte el mismo sistema, la matriz se recalcula con pesos alternos.
Atención aquí: una hoja de cálculo como vista no es lo mismo que una hoja de cálculo como sistema. Si la hoja pasa a ser la única copia de los pedidos (porque la sincronización falla y nadie lo nota, o porque alguien empieza a corregir datos solo en la hoja), Trigo Lento vuelve a la situación de este domingo: claves mal escritas, filas borradas y escrituras pisadas sin una fuente que diga cuál es la versión buena. Active el historial de versiones, proteja las columnas que escriben los flujos y el script, y compruebe cada día que el número de pedidos de la hoja y el de trigo_lento.sqlite coinciden.
Lo que dijo Don Ernesto
Con la figura de los tres mostradores en la mano, Don Ernesto vuelve a su frase de la mañana: “La libreta nunca se cayó ni me cobró por usuario.” Valeria le da la razón en las dos cosas y le enseña lo que la libreta tampoco hacía. No sumaba sola; no avisaba de que alguien había escrito “P1”; no se podía consultar desde el flujo de pedidos de Make; y, sobre todo, no tenía una segunda copia. El pastel de zanahoria de esta mañana volvió gracias al historial de versiones de la hoja; en la libreta, una página arrancada se habría perdido para siempre.
La respuesta al coste es la más fácil, porque es una cifra: la base operativa elegida cuesta $0$ USD al mes con las cuentas de Google que Trigo Lento ya tiene, y la reserva de $8.41$ USD sigue intacta. La respuesta al riesgo es la más interesante. Don Ernesto teme que la herramienta nueva dé otros problemas, y tiene razón: la hoja no tiene integridad referencial, y por eso se le añade un script que vigila y una base que manda. El riesgo no se elimina eligiendo la herramienta perfecta, se reparte entre piezas que se vigilan unas a otras.
Don Ernesto pide una sola condición, que Valeria apunta en el registro de decisiones del Día 11 como la segunda entrada, DA-002: “Que el mostrador siga trabajando como hoy, y que si algo se marca para revisar, me entere yo también.” El script ya deja la nota; el Día 50, cuando Slack se convierta en el centro de operaciones, esa nota llegará también al canal del obrador.
Consideraciones finales
El día empezó con una hoja dañada por un sábado de mucho trabajo y termina con un modelo de cuatro tablas traducido a tres herramientas, un volumen proyectado de $14,601.6$ registros al año, una carga simulada que va de $2.3$ segundos a casi $7$ minutos según la herramienta, una matriz de permisos con $4$ editores y ninguna integración administradora, un script que encontró los $12$ errores sembrados sin una sola falsa alarma y una matriz ponderada cuyo ganador cambia si el modelo de datos pesa más de $0.258$. Lo que llama la atención al ponerlo todo junto es que la herramienta con mejor modelo de datos, Airtable, perdió por el precio de su modelo de cobro y no por ninguna carencia técnica. Una base operativa se elige por cómo la usarán las personas y cuánto cuesta cada una de ellas; la integridad que le falte se la presta la fuente de verdad.
Antes de dar por buena la elección de una base operativa, conviene hacerse algunas preguntas:
- ¿Cuántos registros genera su negocio al mes, y en cuántos meses agota el límite del plan que piensa contratar?
- ¿Cuántas personas editan, cuántas solo leen y cuánto cobra la herramienta por cada una?
- ¿Qué pasa en su herramienta cuando alguien escribe una clave que no existe? ¿Lo impide, lo marca o lo ignora?
- Si mañana la vista de trabajo y su fuente de verdad dicen cosas distintas, ¿cuál manda, y está escrito en algún sitio?
Las cifras de hoy tienen límites que conviene decir. Los $1.6$ renglones por encargo son un supuesto, y la base del Día 4 sugiere que podrían ser algo más; los errores de tecleo se sembraron a mano en un lote simulado y no describen al mostrador de Trigo Lento; la capacidad de las cubetas de tokens y la latencia de $0.25$ segundos son supuestos, porque ninguna documentación las publica; varios límites y precios proceden de fuentes secundarias que coinciden entre sí, pero no de la página oficial, y las cuotas de Google pueden cambiar sin aviso. Las notas de la matriz son el juicio de Valeria, justificado con las mediciones del día pero discutible. Ninguno de esos límites cambia la estructura de la conclusión: con cuatro editores y una reserva de $8.41$ USD, cualquier herramienta que cobre por usuario queda fuera, y la decisión se reabre si cambia uno de esos dos números.
Un gran libro que habla de esto es Designing Data-Intensive Applications (o Diseño de aplicaciones intensivas en datos), en el que Martin Kleppmann distingue entre los sistemas de registro, que guardan la versión autorizada de cada dato, y los datos derivados, como las cachés, los índices y las vistas, que se pueden reconstruir a partir de los primeros. La hoja del mostrador de Trigo Lento es un dato derivado con pretensiones de sistema de registro, y el libro explica con detalle qué pasa cuando esos dos papeles se confunden y cómo se mantienen sincronizados sin perder escrituras. Para la raíz de todo, el artículo de Codd de 1970 sigue siendo una lectura breve y sorprendentemente clara sobre por qué las relaciones se expresan con valores que la base puede comprobar.
Conclusiones clave
Modelo de datos
- Una base operativa es la vista donde trabajan las personas; la fuente de verdad (
trigo_lento.sqlite) es la que manda, y la base de conocimiento (Notion, Día 68) es otra pieza distinta. - El modelo de Trigo Lento tiene $18$ campos en cuatro tablas, y $4$ dependen de una relación real; Airtable y Notion imponen los $10$ tipos lógicos, Google Sheets ninguno.
- Con claves escritas a mano, $12$ errores de tecleo produjeron $12$ renglones huérfanos en $12$ de $200$ pedidos; $9$ se reparan normalizando y $3$ no; un campo enlazado admite $0$.
Límites y permisos
- Trigo Lento genera $R_{mes} = 468 \cdot 2.6 = 1,216.8$ registros al mes: el plan gratuito de Airtable ($1,000$ por base) se agota en $0.82$ meses, el Team ($50,000$) en $41.09$ y los $10$ millones de celdas de Sheets en $989.24$.
- Cargar un mes por API toma $24.3$ segundos en Airtable (lotes de $10$, $5$ por segundo), $405.6$ en Notion (una página, $3$ por segundo) y $2.4$ en la API de Sheets; un año en Notion, $81.1$ minutos.
- La matriz de permisos deja a Valeria como única administradora, a los panaderos sin acceso a clientes, a ninguna integración con permisos de administración y a $4$ de $6$ personas como editoras.
- El disparador de Apps Script cada $10$ minutos son $144$ ejecuciones al día: con $4$ segundos por ejecución, $9.6$ minutos, el $11%$ de la cuota de $90$ minutos de una cuenta personal.
Elegir la base operativa
- Con $4$ editores y $8.41$ USD de reserva, el precio máximo por usuario es de $2.10$ USD: Airtable Team costaría $80$ USD al mes, Notion Plus $40$ y Google Workspace $28$; Sheets con las cuentas existentes, $0$.
- Con los pesos de Valeria, Sheets con Apps Script obtiene $3.90$, Airtable $3.55$ y Notion $3.25$; con el modelo de datos en $0.35$ y el coste en $0.10$, Airtable gana con $4.00$, y el punto de cambio está en $w_{modelo} \approx 0.258$.
- Decisión: Sheets con Apps Script como vista del mostrador,
trigo_lento.sqlitecomo fuente de verdad y Airtable como alternativa con condiciones de revisión escritas.
Mañana, en el Día 16: Conexiones y sincronizaciones: claves, OAuth, webhooks y fuentes de verdad. La hoja del mostrador y trigo_lento.sqlite ya dicen cosas distintas sobre el mismo pastel de chocolate: Valeria aprenderá cómo se autentica cada conexión, diseñará una sincronización incremental con marca de agua entre la vista y la fuente de verdad y decidirá qué pasa cuando las dos cambian a la vez.
Referencias
- Airtable (2026). Web API: introducción, límites de tasa y tokens de acceso personal. https://airtable.com/developers/web/api/introduction
- Airtable (2026). Límites de tasa de la API. https://airtable.com/developers/web/api/rate-limits
- Airtable (2026). Precios. https://airtable.com/pricing
- Notion (2026). Límites de solicitudes de la API. https://developers.notion.com/reference/request-limits
- Notion (2026). Actualización a la versión 2025-09-03: fuentes de datos. https://developers.notion.com/docs/upgrade-guide-2025-09-03
- Notion (2026). Precios. https://www.notion.com/pricing
- Google (2026). Cuotas de los servicios de Google en Apps Script. https://developers.google.com/apps-script/guides/services/quotas
- Google (2026). Límites de uso de la API de Google Sheets. https://developers.google.com/sheets/api/limits
- Google (2026). Servicio de candados (LockService) y disparadores instalables de Apps Script. https://developers.google.com/apps-script/reference/lock/lock-service
- Codd, E. F. (1970). A Relational Model of Data for Large Shared Data Banks. Communications of the ACM, 13(6), 377-387. https://doi.org/10.1145/362384.362685
- Kleppmann, M. (2017). Designing Data-Intensive Applications: The Big Ideas Behind Reliable, Scalable, and Maintainable Systems. O’Reilly Media.