
Arquitecto de automatización con IA: Día 21
 Jeshua Romero Guadarrama
- 64 Min para leer
- 21 Feb, 2026
Índice de contenido
Resumen:
Una semana después del pico del 14 de febrero, Valeria reúne en un solo mapa lo que decidió durante el módulo 2: inventaria doce procesos de Trigo Lento, los ordena con un índice que pondera valor, esfuerzo y riesgo, asigna a cada uno una plataforma (Make, n8n, Python o una persona) con reglas escritas, revisa el presupuesto de 45 USD con consumos estimados y descubre que el recargo de Twilio sobre las conversaciones lo rompería por 0.27 USD. Después publica su primer flujo real, TL Formulario v1, lo ensaya sin red con seis casos de prueba y lo prueba contra su webhook. Al terminar, usted sabrá construir el mapa de automatización de un negocio pequeño, defender con números qué se automatiza primero y en qué herramienta, y dejar escrito qué se queda en manos de una persona.
¿Cómo citar el presente artículo?
Romero, J. (21 de febrero de 2026). Arquitecto de automatización con IA: Día 21. python-data-engineer. https://www.python-data-engineer.com/post/aai/dia_21/.
Arquitecto de automatización con IA: Día 21 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/aai/dia_21/.
Precios, límites y políticas de Make, n8n, Zapier, WhatsApp (Meta, Twilio, Wati) y de la API de Claude revisados en octubre de 2026. Los límites de los webhooks de Make (300 peticiones por intervalo de 10 segundos, una cola de 667 elementos por cada 10 000 créditos contratados al mes con un máximo de 10 000, desactivación a las 120 horas sin escenario y registros de 3 días) se contrastaron en su centro de ayuda en octubre de 2026. El precio de Make Core (10.59 USD al mes, 9 USD en pago anual) coincide en las fuentes secundarias consultadas, aunque alguna aún cita una cifra anterior; el del servidor pequeño (unos 5.49 EUR al mes más 0.50 EUR de IPv4, tras las subidas de abril y junio de 2026) sale de fuentes secundarias y debe verificarse en la página del proveedor. El blueprint del Bloque 7 tiene la estructura de exportación de Make verificada contra la documentación, revisado en octubre de 2026, y no es una exportación de una cuenta real; el Bloque 10 llama al webhook real y no se ejecutó para escribir la entrada: su salida es un ejemplo comentado.
Día 21. Sesión práctica: el mapa de automatización de Trigo Lento
Introducción
Ayer, en el Día 20 (Caso de otro negocio II: el mapa de automatización de una tienda en línea), Valeria ensayó con Café Altura el método del mapa (inventariar, medir, costear, valorar el riesgo y priorizar), comprobó que el proceso más rentable no siempre es por donde conviene empezar, y Trigo Lento ganó un método probado en un negocio ajeno antes de aplicarlo al propio. Hoy se cierra el módulo 2/8, Ecosistema no-code y low-code, y ese método se aplica por fin a la panadería, con todo lo que el módulo fue decidiendo día a día.
Es sábado 21 de febrero, a las seis de la tarde. La vitrina está casi vacía y el obrador huele a la masa que reposa para el domingo. Hace exactamente una semana, el 14 de febrero, Trigo Lento vivió el día más largo de su año: pasteles de chocolate, pays de queso con dedicatoria y cajas de pan dulce para regalar, todo pedido por WhatsApp, por Instagram, por el formulario web y por teléfono, y todo atendido a mano. Valeria contestó mensajes desde las siete de la mañana hasta las once de la noche; dos encargos se apuntaron dos veces, uno no se apuntó nunca y el teléfono de la Familia Herrera perdió su cero inicial en la hoja (el Día 14 lo convirtió en lección). Lo que el 14 de febrero dejó claro es que el problema no es un flujo concreto, sino la falta de un mapa: una visión de conjunto de todo lo que se hace a mano, de cuánto cuesta y de qué conviene automatizar primero.
Durante diez días, el módulo 2 fue tomando decisiones sueltas. El Día 11 colocó cada herramienta en el espectro que va del no-code al código; el Día 12 tradujo los flujos a créditos, tareas y ejecuciones y repartió los $45$ USD; el Día 13 escribió el mismo recordatorio en cuatro plataformas; el Día 14 aprendió que un teléfono es texto; los días 15 y 16 eligieron la hoja como vista y trigo_lento.sqlite como fuente de verdad, y diseñaron la sincronización entre las dos; el Día 17 (Seguridad I: OAuth, secretos y mínimo privilegio en las conexiones) sacó las llaves de los lugares donde no deben estar; el Día 18 enseñó a generar borradores de flujo con un validador; y el Día 19 (La creación democrática: desarrolladores ciudadanos y gobierno de las automatizaciones) levantó el inventario de los ocho flujos que ya existen o están planeados. Cada decisión era razonable por separado. La pregunta de hoy es si siguen siendo razonables juntas.
Don Ernesto se sienta frente a la pantalla con un café y una libreta de compras, la de la harina y la mantequilla, abierta en la página del mes. “Valeria, llevo diez días oyendo nombres de programas. Ahora dígame tres cosas, como se las diría al contador: qué va a automatizar primero, cuánto nos va a costar todo junto y qué no va a tocar nunca. Y si me dice que todo, no le creo.” La objeción es la de un dueño que ha visto proyectos crecer sin control, y tiene razón en desconfiar de la palabra “todo”. Un mapa de automatización sirve precisamente para decir que no con argumentos: qué procesos se quedan a mano, cuáles esperan y cuáles se descartan.
En la presente entrada, descubrirá cómo se construye el mapa de automatización de un negocio pequeño, con Trigo Lento como ejemplo completo. Inventariará doce procesos con su volumen, sus minutos, su riesgo y sus datos personales; calculará las horas que cada uno consume y las que se pueden ahorrar; los ordenará con un índice de prioridad que divide el valor entre el esfuerzo y el riesgo, y los colocará en una matriz de cuatro cuadrantes. Escribirá reglas explícitas para asignar cada proceso a Make, a n8n, a Python o a una persona; revisará el presupuesto con consumos estimados y verá qué rubro lo rompe; dibujará la hoja de ruta de los módulos 3 a 8 en un diagrama de Gantt; y publicará el primer flujo real de la serie, TL Formulario v1, con su blueprint, su dibujo, un ensayo sin red y la prueba de su webhook. Al final hará la retrospectiva del módulo 2 con sus decisiones y sus pendientes.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Inventariar los procesos de un negocio y priorizarlos por valor, esfuerzo y riesgo.
- Asignar cada proceso a una plataforma (Make, n8n, Python o persona) con razones explícitas.
- Revisar el presupuesto con consumos estimados por plataforma.
- Publicar el primer flujo real (
TL Formulario v1) y probar su webhook.
Inventario de procesos
Un mapa de automatización empieza por una lista honesta de todo lo que se hace a mano, no solo de lo que se quiere automatizar. Si el inventario incluye únicamente los procesos “interesantes”, la priorización ya está sesgada antes de empezar. Valeria recorre la panadería con su cuaderno durante la semana, del mostrador al obrador y del obrador a la oficina, y anota doce procesos que se repiten. Para cada uno mide o estima cinco datos:
- Casos al mes: cuántas veces ocurre, con los volúmenes fijos de la serie ($468$ encargos y $1,560$ mensajes al mes, $26$ días de trabajo).
- Minutos antes: cuánto tarda hoy una persona en cada caso.
- Minutos después: cuánto tardaría una persona si el proceso estuviera automatizado, porque casi ningún proceso baja a cero (alguien revisa, aprueba o corrige).
- Riesgo, de $1$ a $3$: qué pasa si el proceso automatizado se equivoca; $1$ es una molestia, $2$ es dinero o un cliente insatisfecho, $3$ es un daño fiscal, legal o reputacional difícil de revertir.
- Datos personales: si el proceso toca nombres, teléfonos, direcciones o datos de empleados, que la Ley Federal de Protección de Datos Personales en Posesión de los Particulares obliga a tratar con finalidad declarada y minimización.
Con los minutos, las horas que cada proceso consume y las que se pueden ahorrar se calculan con la misma fórmula que el Día 20 aplicó a Café Altura:
$$ V_i = \frac{n_i , (t_{a,i} - t_{d,i})}{60} $$
La lógica detrás de esta fórmula es múltiple:
- $n_i$ es el número de casos al mes del proceso $i$; $t_{a,i}$ y $t_{d,i}$ son los minutos por caso antes y después de automatizar.
- La diferencia $t_{a,i} - t_{d,i}$ son los minutos que se ahorran en cada caso; multiplicarla por $n_i$ da los minutos al mes, y dividir entre $60$ los convierte en horas.
- Usar $t_{d,i}$ en lugar de cero obliga a pensar en la persona que sigue en el proceso: el encargo automatizado todavía necesita $1.5$ minutos de atención humana, la meta que fijó el Día 1.
- En conclusión, $V_i$ mide el valor en la unidad que Don Ernesto entiende mejor, horas de Valeria, y deja fuera a propósito los beneficios difíciles de medir, que entrarán después como un peso.
El primer bloque prepara las importaciones, la semilla global $2026$, la carpeta del día y los supuestos fijos de la serie:
# Importaciones base, semilla de la serie y supuestos fijos de Trigo Lento en Python:
import warnings
warnings.filterwarnings('ignore')
import json
from pathlib import Path
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 130)
pd.set_option('display.max_columns', 14)
carpeta = Path('trigo_lento') / 'dia_21'
carpeta.mkdir(parents = True, exist_ok = True)

# Supuestos didácticos de la serie (A.5 y A.4.6 del plan):
ENCARGOS_MES, MENSAJES_MES = 468, 1_560
HORA_VALERIA_MXN, MXN_POR_USD, USD_POR_EUR = 75, 18.50, 1.08
PRESUPUESTO_USD = 45.00
print('numpy', np.__version__, '| pandas', pd.__version__)
print('Encargos al mes:', ENCARGOS_MES, '| mensajes al mes:', MENSAJES_MES,
      '| presupuesto:', PRESUPUESTO_USD, 'USD =', round(PRESUPUESTO_USD * MXN_POR_USD, 2), 'MXN')
numpy 2.4.6 | pandas 3.0.3
Encargos al mes: 468 | mensajes al mes: 1560 | presupuesto: 45.0 USD = 832.5 MXN
El presupuesto de $45$ USD equivale a $832.50$ MXN al tipo didáctico de $18.50$ pesos por dólar. Es la cifra contra la que se medirá todo lo que sigue.
El siguiente bloque guarda los doce procesos como un DataFrame, calcula las horas a mano y las horas ahorrables de cada uno y escribe el inventario en trigo_lento/dia_21/inventario_procesos.csv:
# Inventario de los doce procesos de Trigo Lento en Python:
procesos = pd.DataFrame([
    # proceso, casos al mes, minutos antes, minutos después, frecuencia, riesgo (1 a 3), datos personales
    ('Encargos',                 468, 6.0, 1.5, 'continua',  2, True),
    ('Confirmación de anticipos', 130, 3.0, 0.5, 'diaria',    2, True),
    ('Recordatorio de recogida', 468, 1.5, 0.1, 'diaria',    1, True),
    ('Pedido de Brújula',         26, 10.0, 2.0, 'diaria',   2, True),
    ('Factura semanal',            4, 35.0, 0.0, 'semanal',  3, True),
    ('Inventario de harina',      26, 15.0, 3.0, 'diaria',   1, False),
    ('Turnos',                     4, 60.0, 20.0, 'semanal', 2, True),
    ('Respuesta a reseñas',       30, 4.0, 0.5, 'diaria',    3, True),
    ('Publicaciones en redes',    12, 40.0, 15.0, 'semanal', 2, False),
    ('Quejas',                    15, 12.0, 9.0, 'eventual', 3, True),
    ('Cierre de caja',            26, 20.0, 8.0, 'diaria',   2, False),
    ('Pedidos a proveedores',      8, 25.0, 8.0, 'semanal',  2, False),
], columns = ['proceso', 'casos_mes', 'min_antes', 'min_despues', 'frecuencia', 'riesgo', 'datos_personales'])
procesos.index = range(1, len(procesos) + 1)

# Horas al mes antes y después, y horas ahorradas V = n (t_a - t_d) / 60:
procesos['horas_antes'] = (procesos.casos_mes * procesos.min_antes / 60).round(2)
procesos['horas_ahorradas'] = (procesos.casos_mes * (procesos.min_antes - procesos.min_despues) / 60).round(2)
print(procesos.drop(columns = ['min_antes', 'min_despues']).to_string())
print('Horas a mano al mes:', round(procesos.horas_antes.sum(), 2),
      '| ahorrables:', round(procesos.horas_ahorradas.sum(), 2),
      '| procesos con datos personales:', int(procesos.datos_personales.sum()))
procesos.to_csv(carpeta / 'inventario_procesos.csv', index_label = 'n')
                      proceso  casos_mes frecuencia  riesgo  datos_personales  horas_antes  horas_ahorradas
1                    Encargos        468   continua       2              True        46.80            35.10
2   Confirmación de anticipos        130     diaria       2              True         6.50             5.42
3    Recordatorio de recogida        468     diaria       1              True        11.70            10.92
4           Pedido de Brújula         26     diaria       2              True         4.33             3.47
5             Factura semanal          4    semanal       3              True         2.33             2.33
6        Inventario de harina         26     diaria       1             False         6.50             5.20
7                      Turnos          4    semanal       2              True         4.00             2.67
8         Respuesta a reseñas         30     diaria       3              True         2.00             1.75
9      Publicaciones en redes         12    semanal       2             False         8.00             5.00
10                     Quejas         15   eventual       3              True         3.00             0.75
11             Cierre de caja         26     diaria       2             False         8.67             5.20
12      Pedidos a proveedores          8    semanal       2             False         3.33             2.27
Horas a mano al mes: 107.16 | ahorrables: 80.08 | procesos con datos personales: 8
Trigo Lento dedica $107.16$ horas al mes a estos doce procesos, y $80.08$ horas se podrían ahorrar si todos se automatizaran tal como se describe. Ocho de los doce tocan datos personales. La Tabla 1 presenta el inventario completo, con los minutos de cada proceso.
Tabla 1. Inventario de los doce procesos de Trigo Lento (volúmenes y minutos de la serie; supuestos didácticos).
| N.º | Proceso | Casos al mes | Minutos antes | Minutos después | Horas a mano | Horas ahorrables | Frecuencia | Riesgo | Datos personales |
|---|---|---|---|---|---|---|---|---|---|
| 1 | Encargos | 468 | 6.0 | 1.5 | 46.80 | 35.10 | Continua | 2 | Sí |
| 2 | Confirmación de anticipos | 130 | 3.0 | 0.5 | 6.50 | 5.42 | Diaria | 2 | Sí |
| 3 | Recordatorio de recogida | 468 | 1.5 | 0.1 | 11.70 | 10.92 | Diaria | 1 | Sí |
| 4 | Pedido de Brújula | 26 | 10.0 | 2.0 | 4.33 | 3.47 | Diaria | 2 | Sí |
| 5 | Factura semanal | 4 | 35.0 | 0.0 | 2.33 | 2.33 | Semanal | 3 | Sí |
| 6 | Inventario de harina | 26 | 15.0 | 3.0 | 6.50 | 5.20 | Diaria | 1 | No |
| 7 | Turnos | 4 | 60.0 | 20.0 | 4.00 | 2.67 | Semanal | 2 | Sí |
| 8 | Respuesta a reseñas | 30 | 4.0 | 0.5 | 2.00 | 1.75 | Diaria | 3 | Sí |
| 9 | Publicaciones en redes | 12 | 40.0 | 15.0 | 8.00 | 5.00 | Semanal | 2 | No |
| 10 | Quejas | 15 | 12.0 | 9.0 | 3.00 | 0.75 | Eventual | 3 | Sí |
| 11 | Cierre de caja | 26 | 20.0 | 8.0 | 8.67 | 5.20 | Diaria | 2 | No |
| 12 | Pedidos a proveedores | 8 | 25.0 | 8.0 | 3.33 | 2.27 | Semanal | 2 | No |
Algunas filas merecen un comentario, porque cada cifra es una decisión:
- Encargos es el proceso del Día 1: $468$ encargos al mes a $6$ minutos son las $46.8$ horas que se midieron entonces, y la meta de $1.5$ minutos deja un ahorro de $35.1$ horas, el mayor de la tabla con mucha diferencia. Incluye los cuatro canales (WhatsApp, Instagram, formulario web y teléfono).
- Confirmación de anticipos son los $130$ pasteles y pays al mes que exigen un anticipo por transferencia; hoy Valeria revisa la banca en línea y confirma a mano. Toca dinero, y por eso su riesgo es $2$.
- Factura semanal es la de Cafetería Brújula: solo cuatro al mes, pero cada una lleva $35$ minutos y un error es fiscal; tiene el único riesgo $3$ que no es reputacional. Su “después” es cero minutos de captura, aunque, como verá en la sección de plataformas, alguien seguirá aprobándola.
- Quejas casi no ahorra: de $12$ minutos solo bajaría a $9$, porque lo que lleva tiempo es escuchar y decidir, no teclear. Esa fila ya anticipa lo que dirá la matriz.
- Respuesta a reseñas son unas $30$ reseñas al mes en mapas y redes. Responderlas automáticamente ahorraría $1.75$ horas, y su riesgo es $3$: un mensaje genérico o equivocado en público lo leen todos los clientes futuros.
La Figura 1 coloca los doce procesos donde ocurren, en el plano de la panadería, con el color de la plataforma que se les asignará más adelante. Un inventario en tabla dice cuánto; un plano dice dónde y quién, y deja ver que casi todo el valor está en el mostrador y en el teléfono de Valeria.
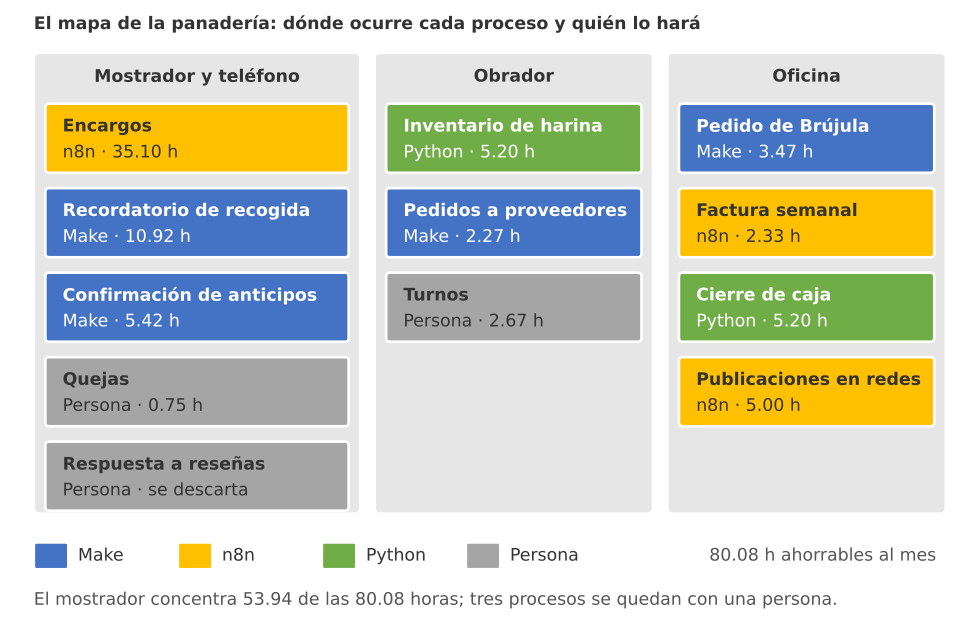
Figura 1. El mapa de la panadería: los doce procesos de Trigo Lento ubicados en el mostrador, el obrador y la oficina, con el color de su plataforma (Make, n8n, Python o una persona) y las horas que se pueden ahorrar al mes.
Un detalle de método: los minutos de la Tabla 1 son estimaciones de Valeria, cronometradas en algunos casos y recordadas en otros. Para un mapa basta con que el orden de magnitud sea correcto, porque el objetivo es decidir qué va primero, no presupuestar al minuto. Lo que no se puede hacer es dejar procesos fuera porque “no se van a automatizar”: turnos, quejas y reseñas están en la tabla precisamente para que la decisión de no automatizarlos quede escrita y justificada.
Priorizar
Con las horas en la mano, la tentación es ordenar los procesos por horas ahorradas y empezar por arriba. Es lo que haría una persona con prisa, y casi siempre se equivoca por dos razones. La primera es el esfuerzo: un proceso que ahorra cinco horas pero se construye en una tarde va antes que uno que ahorra siete y necesita un mes. La segunda es el riesgo: un proceso que ahorra mucho pero puede dañar la relación con un cliente o con el fisco exige controles, pruebas y aprobaciones que multiplican su coste real. La pregunta correcta no es ¿qué ahorra más?, sino ¿qué ahorra más por cada unidad de trabajo y de riesgo que nos cuesta?
El índice de prioridad
Valeria condensa esa pregunta en un índice:
$$ I_i = \frac{V_i \cdot w_{v,i}}{E_i \cdot R_i} $$
La lógica detrás de esta fórmula es múltiple:
- $V_i$ son las horas ahorradas al mes de la fórmula anterior; $w_{v,i}$ es un peso de valor que corrige lo que las horas no ven: $1.0$ si el proceso solo ahorra tiempo, $1.25$ si además protege ventas (un encargo que no se pierde, un pastel que sí se recoge), $1.5$ si sostiene un compromiso con un cliente mayorista, y menos de $1$ si el ahorro es interno y prescindible.
- $E_i$ es el esfuerzo de construcción en una escala de $1$ a $5$ (de una tarde a varias semanas), y $R_i$ el riesgo de la Tabla 1, de $1$ a $3$.
- El producto $E_i \cdot R_i$ es un coste ajustado por riesgo: construir con cuidado un proceso arriesgado cuesta más que construir uno inocuo, porque exige pruebas, aprobaciones humanas y vigilancia.
- Dividir el valor entre ese coste convierte la lista en una medida de eficiencia: el índice responde cuánto valor se obtiene por cada unidad de esfuerzo y de riesgo.
- En conclusión, un índice alto pide empezar pronto; uno bajo no prohíbe automatizar, pero exige una razón distinta del ahorro.
El índice tiene una debilidad que conviene nombrar desde el principio: los pesos y las escalas son juicios, no mediciones. Lo que el índice aporta no es objetividad, sino transparencia: cualquier persona puede ver qué peso se dio a cada proceso y discutirlo. Si Don Ernesto cree que la factura de Brújula merece un peso de $2$, se cambia una cifra y se vuelve a ordenar, en lugar de discutir impresiones.
La matriz de valor frente a esfuerzo
El índice se complementa con una representación clásica de la gestión de proyectos: la matriz de valor frente a esfuerzo, que divide los procesos en cuatro cuadrantes. Valeria la adapta con una modificación importante: en el eje horizontal no pone el esfuerzo a secas, sino el coste ajustado por riesgo $E_i \cdot R_i$, porque un proceso fácil de construir pero peligroso no es una victoria rápida. Los umbrales son $3$ horas equivalentes de valor y $4.5$ unidades de coste ajustado:
- Victorias rápidas: mucho valor y poco coste. Se hacen primero.
- Proyectos grandes: mucho valor y mucho coste. Se planifican y se trocean.
- Rellenos: poco valor y poco coste. Se hacen cuando sobra tiempo, o no se hacen.
- Trampas: poco valor y mucho coste. Se descartan o se dejan en manos de una persona.
El siguiente bloque asigna esfuerzo y peso a cada proceso, calcula el valor, el coste ajustado y el índice, clasifica cada proceso en su cuadrante y dibuja la matriz con el tamaño de cada punto proporcional a las horas ahorradas:
# Índice de prioridad I = V w_v / (E R) y matriz de valor frente a esfuerzo en Python:
procesos['esfuerzo'] = [3, 2, 2, 2, 4, 2, 2, 2, 4, 2, 3, 2]                         # E: 1 a 5
procesos['peso_valor'] = [1.25, 1.0, 1.25, 1.5, 1.5, 1.0, 0.75, 0.5, 1.0, 1.0, 1.0, 1.0]   # w_v
procesos['valor'] = (procesos.horas_ahorradas * procesos.peso_valor).round(2)
procesos['coste_ajustado'] = procesos.esfuerzo * procesos.riesgo               # E R
procesos['indice'] = (procesos.valor / procesos.coste_ajustado).round(3)

UMBRAL_VALOR, UMBRAL_COSTE = 3.0, 4.5
def cuadrante(fila):
    alto_valor = fila.valor >= UMBRAL_VALOR
    bajo_coste = fila.coste_ajustado <= UMBRAL_COSTE
    if alto_valor and bajo_coste:
        return 'victoria rápida'
    if alto_valor:
        return 'proyecto grande'
    return 'relleno' if bajo_coste else 'trampa'
procesos['cuadrante'] = procesos.apply(cuadrante, axis = 1)
orden = procesos.sort_values('indice', ascending = False)
print(orden[['proceso', 'horas_ahorradas', 'peso_valor', 'esfuerzo', 'riesgo', 'valor', 'indice', 'cuadrante']]
      .to_string())
print(procesos.cuadrante.value_counts().to_string())

colores_cuadrante = {'victoria rápida': '#3a9d5d', 'proyecto grande': '#2a78d6',
                     'relleno': '#8a8986', 'trampa': '#c8423b'}
fig, ax = plt.subplots(figsize = (8.4, 6.0))
ax.axvspan(0.5, UMBRAL_COSTE, ymin = 0, ymax = 1, color = '#f2f2f2', zorder = 0)
ax.axhline(UMBRAL_VALOR, color = '#52514e', linestyle = '--', linewidth = 1)
ax.axvline(UMBRAL_COSTE, color = '#52514e', linestyle = '--', linewidth = 1)
etiquetas = {'Recordatorio de recogida': (8, 6, 'left'), 'Inventario de harina': (0, -14, 'center'),
             'Pedidos a proveedores': (8, 4, 'left'), 'Confirmación de anticipos': (10, 10, 'left'),
             'Pedido de Brújula': (10, -10, 'left'), 'Turnos': (8, -6, 'left'), 'Cierre de caja': (10, -10, 'left'),
             'Encargos': (10, 0, 'left'), 'Respuesta a reseñas': (8, 4, 'left'), 'Quejas': (8, -8, 'left'),
             'Publicaciones en redes': (0, 13, 'center'), 'Factura semanal': (-10, 8, 'right')}
for _, f in procesos.iterrows():
    ax.scatter(f.coste_ajustado, f.valor, s = 60 + 12 * f.horas_ahorradas, color = colores_cuadrante[f.cuadrante],
               edgecolor = 'white', linewidth = 1.5, zorder = 3)
    dx, dy, alineacion = etiquetas[f.proceso]
    ax.annotate(f.proceso, (f.coste_ajustado, f.valor), xytext = (dx, dy), textcoords = 'offset points',
                fontsize = 9, ha = alineacion, va = 'center')
ax.set_yscale('log')
ax.set_xlim(0.5, 13)
ax.set_ylim(0.5, 80)
for texto, x, y in [('Victorias rápidas', 1.0, 60), ('Proyectos grandes', 12.6, 60),
                    ('Rellenos', 1.0, 0.6), ('Trampas', 12.6, 0.6)]:
    ax.text(x, y, texto, fontsize = 11, fontweight = 'bold', color = '#52514e',
            ha = 'left' if x < 5 else 'right')
ax.set_xlabel('Coste ajustado por riesgo (esfuerzo x riesgo)')
ax.set_ylabel('Valor: horas ahorradas x peso (escala log)')
ax.set_title('Matriz de valor frente a esfuerzo de Trigo Lento', fontsize = 16)
plt.tight_layout()
plt.show()
                      proceso  horas_ahorradas  peso_valor  esfuerzo  riesgo  valor  indice        cuadrante
1                    Encargos            35.10        1.25         3       2  43.88   7.313  proyecto grande
3    Recordatorio de recogida            10.92        1.25         2       1  13.65   6.825  victoria rápida
6        Inventario de harina             5.20        1.00         2       1   5.20   2.600  victoria rápida
2   Confirmación de anticipos             5.42        1.00         2       2   5.42   1.355  victoria rápida
4           Pedido de Brújula             3.47        1.50         2       2   5.20   1.300  victoria rápida
11             Cierre de caja             5.20        1.00         3       2   5.20   0.867  proyecto grande
9      Publicaciones en redes             5.00        1.00         4       2   5.00   0.625  proyecto grande
12      Pedidos a proveedores             2.27        1.00         2       2   2.27   0.568          relleno
7                      Turnos             2.67        0.75         2       2   2.00   0.500          relleno
5             Factura semanal             2.33        1.50         4       3   3.50   0.292  proyecto grande
8         Respuesta a reseñas             1.75        0.50         2       3   0.88   0.147           trampa
10                     Quejas             0.75        1.00         2       3   0.75   0.125           trampa
cuadrante
proyecto grande    4
victoria rápida    4
relleno            2
trampa             2
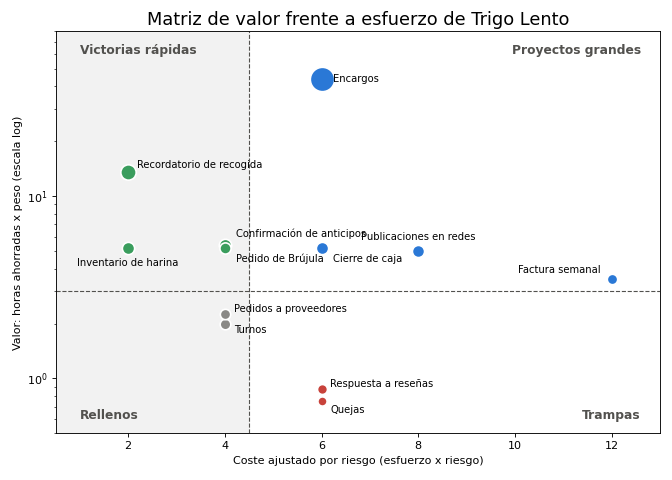
El ejemplo del plan se cumple tal como se esperaba: Encargos queda primero, con un índice de $7.313$, aunque cae en el cuadrante de proyectos grandes; el Recordatorio de recogida le sigue de cerca con $6.825$ y es la victoria rápida más clara; y la Respuesta a reseñas queda en las trampas, con $0.147$, junto con las Quejas ($0.125$). El reparto es simétrico: $4$ victorias rápidas, $4$ proyectos grandes, $2$ rellenos y $2$ trampas.
Hay tres lecturas de la matriz que no se ven en la tabla ordenada:
- El primero del índice es un proyecto grande. Encargos ahorra tanto ($43.88$ horas equivalentes con su peso) que su índice supera al de todas las victorias rápidas, pero no se puede construir en una tarde: tiene esfuerzo $3$, riesgo $2$ y cuatro canales. La respuesta del arquitecto es trocearlo: el canal del formulario web, el $15%$ de los encargos, es la rebanada más simple y la que hoy se publica como
TL Formulario v1; el escenario de WhatsApp llega en el módulo 3 y el agente en el 4. - La factura es grande por su riesgo, no por su volumen. Solo son cuatro al mes, pero el peso de $1.5$ (compromiso con Brújula) la sube a $3.5$ horas equivalentes, por encima del umbral de valor, y su coste ajustado de $12$ la coloca en el extremo derecho. Es un proyecto grande pequeño: poco trabajo repetido y mucho cuidado.
- Las trampas tienen algo en común. Reseñas y quejas son los dos procesos donde el cliente habla en público o está molesto. Automatizar la respuesta ahorra poco, porque el trabajo real es el juicio, y arriesga mucho, porque un error se ve. No es casualidad que el código de honor del Día 6 los reservara para una persona.
La Figura 2 resume los cuatro cuadrantes con un ejemplo de Trigo Lento en cada uno, para que el criterio se pueda explicar sin la gráfica.
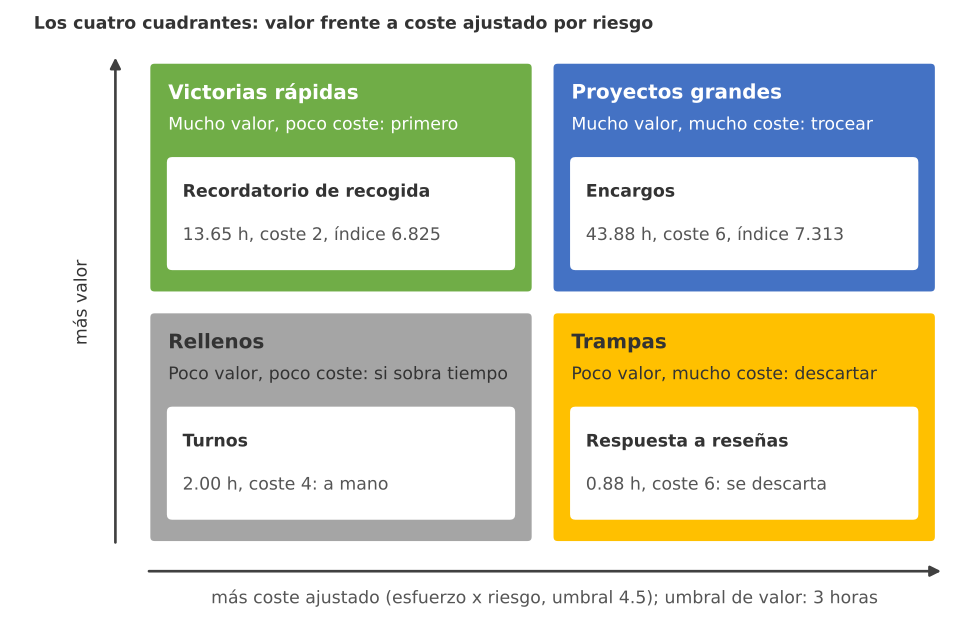
Figura 2. Los cuatro cuadrantes de la matriz de valor frente a coste ajustado por riesgo, con un ejemplo de Trigo Lento en cada uno: el recordatorio es una victoria rápida, los encargos un proyecto grande, los turnos un relleno y las reseñas una trampa.
La respuesta automática a reseñas no solo es una trampa por eficiencia: también lo es por ética. Una reseña respondida por una máquina como si la escribiera el dueño, o una política de responder solo a las positivas para empujarlas hacia arriba, roza el engaño a los consumidores que las leen para decidir. Por eso Trigo Lento descarta ese proceso en lugar de posponerlo: Don Ernesto seguirá contestando sus reseñas, con su nombre, cuando tenga un rato. Si algún día se quisiera ayuda, sería un borrador que él edita y firma, nunca una publicación automática.
Una plataforma para cada proceso
Priorizar dice el orden; no dice dónde vive cada proceso. Durante el módulo 2 la serie fue acumulando criterios para esa elección: el espectro del Día 11 (Make es visual y rápido, n8n admite código y servidor propio, Python da control total), los costes del Día 12 (Make cobra por módulo, n8n por ejecución o nada en un servidor propio), la comparativa del Día 13 y el gobierno del Día 19. Valeria los condensa en cuatro reglas que se aplican en orden; la primera que se cumple decide:
- Si hay juicio o riesgo reputacional, una persona. Lo que requiere escuchar, negociar o decidir sobre un caso único no se automatiza; como mucho, se asiste.
- Si hay un agente o volumen masivo, n8n. Los agentes con herramientas, memoria y aprobación humana, y los procesos que mueven cientos de elementos, salen más baratos por ejecución que por módulo, y n8n los ejecuta en el servidor propio.
- Si es cálculo o análisis, Python. Cuadrar la caja, proyectar la harina o redactar un informe con números son trabajos de datos, no de mover información entre aplicaciones.
- Si es una integración simple entre aplicaciones con conector, Make. Leer una hoja, enviar una plantilla, escribir una fila: Make lo resuelve con módulos ya hechos y sin servidor.
Y una regla de cierre: si nada de lo anterior se cumple, el proceso necesita una petición HTTP a un servicio sin conector, y va a n8n, que maneja mejor las credenciales genéricas y los reintentos de su nodo HTTP Request. Encima de la plataforma, una marca independiente: aprobación humana obligatoria cuando el riesgo es $3$ o el proceso mueve dinero.
El orden de las reglas importa. Si la regla de Make fuera la primera, las quejas (que tienen conector, porque llegan por WhatsApp) acabarían automatizadas; poner la regla del juicio delante es lo que garantiza que ningún proceso sensible se cuele por la puerta de la facilidad. El siguiente bloque describe cada proceso con seis rasgos (juicio, agente, masivo, cálculo, conector y dinero), aplica las reglas, marca la aprobación humana y anota el módulo de la serie en que se construye:
# Reglas de asignación de plataforma y módulo de construcción en Python:
rasgos = pd.DataFrame({
    'juicio':   [False, False, False, False, False, False, True, True, False, True, False, False],
    'agente':   [True, False, False, False, False, False, False, False, True, False, False, False],
    'masivo':   [True, False, False, False, False, False, False, False, False, False, False, False],
    'calculo':  [False, False, False, False, False, True, False, False, False, False, True, False],
    'conector': [True, True, True, True, False, True, True, True, True, True, False, True],
    'dinero':   [False, True, False, False, True, False, False, False, False, False, True, True],
}, index = procesos.index)

def asignar(fila):
    # Las reglas se aplican en orden; la primera que se cumple decide:
    if fila.juicio:
        return 'Persona', 'hay juicio o riesgo reputacional'
    if fila.agente or fila.masivo:
        return 'n8n', 'agente o volumen masivo'
    if fila.calculo:
        return 'Python', 'cálculo o análisis'
    if fila.conector:
        return 'Make', 'integración simple con conector'
    return 'n8n', 'sin conector: petición HTTP'

asignacion = procesos[['proceso', 'riesgo', 'cuadrante']].join(rasgos)
asignacion[['plataforma', 'razon']] = asignacion.apply(lambda f: pd.Series(asignar(f)), axis = 1)
asignacion['aprobacion_humana'] = (asignacion.riesgo == 3) | asignacion.dinero
asignacion['modulo'] = ['3 y 4 (Días 33 y 38)', '5 (Día 48)', '3 (Día 26)', '5 (Día 47)', '4 (Día 40)',
                        '6 (Día 62)', 'a mano', 'se descarta', '7 (Día 72)', 'a mano (triaje en el 5)',
                        '6 (Día 67)', '5 (Día 47)']
print(asignacion[['proceso', 'plataforma', 'razon', 'aprobacion_humana', 'modulo']].to_string())
print(asignacion.plataforma.value_counts().to_string())
horas_plataforma = (procesos.horas_ahorradas.groupby(asignacion.plataforma).sum().round(2))
print('Horas ahorradas por plataforma:', horas_plataforma.to_dict())
                      proceso plataforma                             razon  aprobacion_humana                   modulo
1                    Encargos        n8n           agente o volumen masivo              False     3 y 4 (Días 33 y 38)
2   Confirmación de anticipos       Make   integración simple con conector               True               5 (Día 48)
3    Recordatorio de recogida       Make   integración simple con conector              False               3 (Día 26)
4           Pedido de Brújula       Make   integración simple con conector              False               5 (Día 47)
5             Factura semanal        n8n       sin conector: petición HTTP               True               4 (Día 40)
6        Inventario de harina     Python                cálculo o análisis              False               6 (Día 62)
7                      Turnos    Persona  hay juicio o riesgo reputacional              False                   a mano
8         Respuesta a reseñas    Persona  hay juicio o riesgo reputacional               True              se descarta
9      Publicaciones en redes        n8n           agente o volumen masivo              False               7 (Día 72)
10                     Quejas    Persona  hay juicio o riesgo reputacional               True  a mano (triaje en el 5)
11             Cierre de caja     Python                cálculo o análisis               True               6 (Día 67)
12      Pedidos a proveedores       Make   integración simple con conector               True               5 (Día 47)
plataforma
Make       4
n8n        3
Persona    3
Python     2
Horas ahorradas por plataforma: {'Make': 22.08, 'Persona': 5.17, 'Python': 10.4, 'n8n': 42.43}
Las reglas dejan $4$ procesos en Make, $3$ en n8n, $2$ en Python y $3$ en manos de una persona. Por horas, el reparto es muy desigual: n8n se lleva $42.43$ horas de ahorro (casi todo por Encargos), Make $22.08$, Python $10.40$, y los procesos que se quedan con una persona suman $5.17$ horas que se renuncia a ahorrar a cambio de no correr sus riesgos. La Tabla 2 resume la asignación con su razón y su módulo.
Tabla 2. Asignación de plataforma por proceso, con la regla que decide y el módulo de la serie en que se construye.
| N.º | Proceso | Plataforma | Regla que decide | Aprobación humana | Módulo en que se construye |
|---|---|---|---|---|---|
| 1 | Encargos | n8n | Agente o volumen masivo | No (el agente escala las excepciones) | 3 y 4 (Días 33 y 38) |
| 2 | Confirmación de anticipos | Make | Integración simple con conector | Sí, mueve dinero | 5 (Día 48) |
| 3 | Recordatorio de recogida | Make | Integración simple con conector | No | 3 (Día 26) |
| 4 | Pedido de Brújula | Make | Integración simple con conector | No | 5 (Día 47) |
| 5 | Factura semanal | n8n | Sin conector: petición HTTP | Sí, riesgo fiscal | 4 (Día 40) |
| 6 | Inventario de harina | Python | Cálculo o análisis | No | 6 (Día 62) |
| 7 | Turnos | Persona | Hay juicio | No aplica | Se queda a mano |
| 8 | Respuesta a reseñas | Persona | Riesgo reputacional | Sí | Se descarta |
| 9 | Publicaciones en redes | n8n | Agente | No en la asignación; sí en el módulo 7 | 7 (Día 72) |
| 10 | Quejas | Persona | Hay juicio | Sí | A mano (triaje en el módulo 5) |
| 11 | Cierre de caja | Python | Cálculo o análisis | Sí, mueve dinero | 6 (Día 67) |
| 12 | Pedidos a proveedores | Make | Integración simple con conector | Sí, mueve dinero | 5 (Día 47) |
La tabla tiene dos matices que el código no capta y que una persona debe añadir:
- Encargos vive en dos plataformas, una después de otra. El escenario de pedidos se construye primero en Make en el módulo 3, porque Make no necesita servidor y el módulo 3 enseña a orquestar sin código; en el módulo 4 llega el agente en n8n, y el Día 45 migra el escenario completo. La regla dice dónde terminará el proceso; la hoja de ruta dice por dónde pasa.
- Las publicaciones en redes no salen como “aprobación humana” porque su riesgo es $2$, pero el módulo 7 las construye con aprobación obligatoria antes de publicar. Las reglas son un mínimo, no un techo: un proceso puede llevar más controles de los que exige la regla, nunca menos.
Observe también lo que la tabla dice de la promesa de Valeria a su padre. Tres procesos no se automatizan: los turnos, porque reparten la vida del equipo y eso se habla; las quejas, porque un cliente molesto merece una persona (el módulo 5 solo las detectará y las pondrá primero en la fila de Valeria); y las reseñas, que se descartan. Son exactamente las “cosas que no va a tocar nunca” que Don Ernesto pidió por escrito.
El presupuesto revisado
El Día 12 repartió los $45$ USD en rubros antes de saber qué flujos existirían. Hoy, con el mapa en la mano, se puede estimar el consumo real de cada plataforma y compararlo con aquel reparto. Hay dos unidades que cambian con el volumen y que conviene calcular con cuidado: los créditos de Make, porque el plan Core incluye $10,000$ al mes, y los mensajes de WhatsApp, porque Meta y Twilio cobran por mensaje.
Los créditos de Make se suman flujo por flujo:
$$ U_{Make} = \sum_{i} n_i \cdot k_i $$
La lógica detrás de esta fórmula es múltiple:
- $n_i$ es el número de ejecuciones al mes del flujo $i$ y $k_i$ los créditos que consume cada ejecución; en los flujos simples, $k_i$ es el número de módulos, porque Make cobra un crédito por cada operación de módulo.
- Para los flujos que el módulo 2 ya calculó se usa su cifra: $7,644$ créditos del flujo de mensajes (Día 12) y $962$ del recordatorio (Día 13), que incluye el iterador sobre los encargos del día.
- La suma tiene sentido solo dentro de un régimen: el conjunto de flujos que conviven en Make al mismo tiempo. El flujo de mensajes vive en Make durante el módulo 3 y se muda a n8n el Día 45; los flujos del módulo 5 todavía no existen en marzo.
- En conclusión, el consumo de Make no es una cifra sino dos: la de la transición (módulo 3) y la del régimen estable (desde el módulo 5).
Para WhatsApp, la cuenta usa la Tabla C del plan: $0.0085$ USD por plantilla de utilidad entregada en México (Meta) más $0.005$ USD de recargo de Twilio por cada mensaje enviado o recibido. Las respuestas dentro de la ventana de atención de $24$ horas no tienen tarifa de Meta, pero sí el recargo de Twilio. El servidor de n8n se actualiza con el precio de octubre de 2026 de un servidor pequeño de $2$ vCPU y $4$ GB ($5.49$ EUR más $0.50$ de IPv4, al tipo didáctico de $1.08$ USD por EUR), y la API de Claude suma las tareas del Día 12 ($4.03$ USD), unos cuatro borradores de flujo al mes con el generador del Día 18 ($0.40$), ocho fichas de flujo del Día 19 y dos mapeos del Día 16.
El siguiente bloque calcula los créditos de Make en los dos regímenes, el coste de WhatsApp con Twilio y con la Cloud API directa de Meta (la arquitectura que el Día 46 estudiará), y compara tres escenarios contra los $45$ USD:
# Gasto mensual estimado por plataforma frente a los 45 USD en Python:
# Créditos de Make por ejecución (un crédito por módulo) y ejecuciones al mes:
make = pd.DataFrame([
    ('Pedidos WhatsApp (Día 12)',  MENSAJES_MES, None, 7_644, 'transición'),
    ('TL Formulario v1',           70,  4, None, 'ambos'),
    ('Recordatorio (Día 13)',      None, None, 962, 'ambos'),
    ('Confirmación de anticipos',  130, 4, None, 'estable'),
    ('Pedido de Brújula',          26,  5, None, 'estable'),
    ('Pedidos a proveedores',      8,   4, None, 'estable'),
], columns = ['flujo', 'ejecuciones', 'creditos_por_ejecucion', 'creditos_fijos', 'regimen'])
make['creditos'] = make.creditos_fijos.fillna(make.ejecuciones * make.creditos_por_ejecucion).astype(int)
transicion = int(make.loc[make.regimen.isin(['transición', 'ambos']), 'creditos'].sum())
estable = int(make.loc[make.regimen.isin(['estable', 'ambos']), 'creditos'].sum())
CUOTA_CORE = 10_000
print(make[['flujo', 'creditos', 'regimen']].to_string(index = False))
print(f'Make Core en transición (módulo 3): {transicion} créditos = {transicion / CUOTA_CORE:.1%} | '
      f'estable (desde el Día 45): {estable} = {estable / CUOTA_CORE:.1%}')

# WhatsApp: Meta por plantilla de utilidad entregada; Twilio 0.005 por mensaje enviado o recibido:
META_UTILIDAD, RECARGO_TWILIO = 0.0085, 0.005
plantillas = 468 + 130                               # recordatorios y confirmaciones de anticipo
conversacion = 2 * MENSAJES_MES                      # mensajes recibidos y respuestas en la ventana de 24 h
wa_twilio = plantillas * (META_UTILIDAD + RECARGO_TWILIO) + conversacion * RECARGO_TWILIO
wa_directa = plantillas * META_UTILIDAD              # Cloud API de Meta directa (Día 46): sin recargo
servidor = round(5.99 * USD_POR_EUR, 2)              # VPS de 2 vCPU y 4 GB, 5.49 EUR más 0.50 de IPv4
claude = round(4.03 + 0.40 + 8 * 0.0077 + 2 * 0.024, 2)   # tareas del Día 12, borradores, fichas y mapeos
escenarios = pd.DataFrame({
    'Tabla E (Día 12)':        {'Make Core': 10.59, 'Servidor n8n': 6.00, 'API de Claude': 8.00, 'WhatsApp': 12.00},
    'Estimado con Twilio':     {'Make Core': 10.59, 'Servidor n8n': servidor, 'API de Claude': claude,
                                'WhatsApp': round(wa_twilio, 2)},
    'Estimado con Cloud API':  {'Make Core': 10.59, 'Servidor n8n': servidor, 'API de Claude': claude,
                                'WhatsApp': round(wa_directa, 2)},
})
escenarios.loc['Reserva'] = (PRESUPUESTO_USD - escenarios.sum()).round(2)
print(escenarios.to_string())
print('Recargo de Twilio sobre la conversación:', round(conversacion * RECARGO_TWILIO, 2), 'USD',
      '| holgura con Cloud API:', escenarios.loc['Reserva', 'Estimado con Cloud API'], 'USD')

colores_rubro = {'Make Core': '#2a78d6', 'Servidor n8n': '#eb6834', 'API de Claude': '#7b5ea7',
                 'WhatsApp': '#3a9d5d'}
fig, ax = plt.subplots(figsize = (8.0, 5.0))
base = np.zeros(3)
for rubro, color in colores_rubro.items():
    valores = escenarios.loc[rubro].values
    ax.bar(range(3), valores, bottom = base, color = color, width = 0.55, label = rubro, edgecolor = 'white')
    base += valores
for i, total in enumerate(base):
    ax.text(i, total + 0.8, f'{total:.2f} USD', ha = 'center', fontsize = 11)
ax.axhline(PRESUPUESTO_USD, color = '#c8423b', linestyle = '--', linewidth = 1.5)
ax.text(2.33, PRESUPUESTO_USD - 2.2, 'Tope: 45 USD', color = '#c8423b', fontsize = 10, ha = 'right')
ax.set_xticks(range(3), ['Tabla E\n(sin reserva)', 'Estimado\ncon Twilio', 'Estimado con\nCloud API (Día 46)'])
ax.set_ylim(0, 56)
ax.set_ylabel('USD al mes')
ax.set_title('Gasto mensual estimado por plataforma', fontsize = 16)
ax.legend(loc = 'upper left', fontsize = 9, ncol = 2)
plt.tight_layout()
plt.show()
                    flujo  creditos    regimen
Pedidos WhatsApp (Día 12)      7644 transición
         TL Formulario v1       280      ambos
    Recordatorio (Día 13)       962      ambos
Confirmación de anticipos       520    estable
        Pedido de Brújula       130    estable
    Pedidos a proveedores        32    estable
Make Core en transición (módulo 3): 8886 créditos = 88.9% | estable (desde el Día 45): 1924 = 19.2%
               Tabla E (Día 12)  Estimado con Twilio  Estimado con Cloud API
Make Core                 10.59                10.59                   10.59
Servidor n8n               6.00                 6.47                    6.47
API de Claude              8.00                 4.54                    4.54
WhatsApp                  12.00                23.67                    5.08
Reserva                    8.41                -0.27                   18.32
Recargo de Twilio sobre la conversación: 15.6 USD | holgura con Cloud API: 18.32 USD
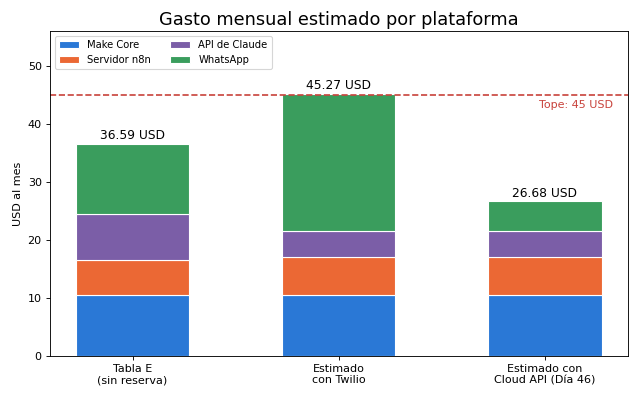
La salida tiene dos noticias, una buena y una mala, y las dos importan.
La buena es Make: en el régimen estable, desde que el flujo de mensajes se muda a n8n, los cinco flujos de Make consumen $1,924$ créditos, el $19.2%$ de Core. La mala también es Make, pero en la transición: durante el módulo 3, con el flujo de mensajes, el formulario y el recordatorio juntos, el consumo sube a $8,886$ créditos, el $88.9%$ de la cuota. Eso rebasa la alerta del $80%$ que el Día 12 configuró, y deja un margen de solo $1,114$ créditos. La consecuencia práctica es doble. Primero, la sincronización entre la hoja y la base que diseñó el Día 16 no cabe en Make durante marzo: con sus $1,560$ créditos al mes, el total llegaría a $10,446$, un $104.5%$. Correrá en Apps Script, donde ya vive el validador de la hoja (Día 15), hasta que el servidor de n8n esté encendido. Segundo, la migración del Día 45 no es un lujo técnico, sino una fecha límite: cada mes que el flujo de mensajes siga en Make, Trigo Lento vive al borde de su cuota.
La noticia más seria es WhatsApp. Con Twilio, el rubro sube de $12$ a $23.67$ USD, y el total del ecosistema llega a $45.27$ USD: la reserva queda en $-0.27$. El culpable no son las plantillas ($598$ al mes, $8.07$ USD con recargo), sino el recargo de Twilio sobre la conversación: $1,560$ mensajes recibidos y otras tantas respuestas a $0.005$ USD cada uno suman $15.60$ USD, más que cualquier otro rubro del ecosistema. Con la Cloud API de Meta directa, sin intermediario, WhatsApp cuesta $5.08$ USD y el ecosistema $26.68$, con una holgura de $18.32$ USD. La Tabla 3 reúne los tres escenarios.
Tabla 3. Presupuesto revisado por rubro frente a la Tabla E del Día 12 (USD al mes; precios revisados en octubre de 2026, volúmenes y tipo de cambio como supuestos didácticos).
| Rubro | Tabla E (Día 12) | Estimado con Twilio | Estimado con Cloud API directa | Cambio y causa |
|---|---|---|---|---|
| Make Core | 10.59 | 10.59 | 10.59 | Igual; 88.9 % de la cuota en marzo, 19.2 % después |
| Servidor de n8n | 6.00 | 6.47 | 6.47 | Sube por las tarifas de 2026 del servidor pequeño |
| API de Claude | 8.00 (tope) | 4.54 | 4.54 | El tope se mantiene; el consumo estimado es menor |
| 12.00 | 23.67 | 5.08 | El recargo de Twilio sobre 3 120 mensajes de conversación | |
| Reserva | 8.41 | -0.27 | 18.32 | Con Twilio no queda reserva |
| Total | 45.00 | 45.27 | 26.68 (más 18.32 de reserva) |
Dos advertencias sobre la columna de la Cloud API. La primera es que no es gratis en trabajo: exige la verificación del negocio ante Meta y alojar el webhook, lo que encaja con el servidor de n8n del módulo 4, pero añade una pieza que mantener. La segunda es que la regla de precios está cambiando: según Twilio y fuentes secundarias, desde el 1 de octubre de 2026 los mensajes de servicio dentro de la ventana empiezan a cobrarse con la tarifa de utilidad, con $1,000$ gratuitos al mes por número, mientras que la página de precios de Meta consultada en octubre de 2026 todavía los describe como gratuitos. Si la regla nueva se confirma, las $1,560$ respuestas de Trigo Lento pagarían $560 \cdot 0.0085 = 4.76$ USD más, y el ecosistema costaría $31.44$ USD: sigue cabiendo, pero la holgura baja a $13.56$. El Día 46 hará esa cuenta con calma.
La holgura del presupuesto se puede escribir como una fórmula sencilla, que conviene recalcular en cada cierre de módulo:
$$ H = 45 - \sum_{j} c_j $$
La lógica detrás de esta fórmula es múltiple:
- $c_j$ es el gasto mensual estimado del rubro $j$ (Make, servidor, Claude y WhatsApp), y $H$ lo que queda para imprevistos.
- Una $H$ negativa, como la de $-0.27$ con Twilio, no es un error de redondeo: significa que el diseño, tal como está, no cabe en el presupuesto, y que algo tiene que cambiar antes de construirlo.
- Una $H$ grande, como los $18.32$ de la Cloud API, no es dinero para gastar: es la protección frente a meses como el de San Valentín, a precios que cambian y a un bucle que se escape.
- En conclusión, el presupuesto no se revisa para confirmar el reparto del Día 12, sino para descubrir qué decisión de diseño lo rompe; hoy lo rompe el intermediario de WhatsApp.
La hoja de ruta
Con la prioridad, la plataforma y el coste de cada proceso, falta el orden en el tiempo. El índice dice qué conviene primero, pero el calendario tiene además dependencias: el agente de pedidos necesita el servidor de n8n, el inventario de harina necesita la base de datos y un servidor MCP, el cierre de caja necesita los datos de un mes completo. Por eso el Inventario de harina, tercero en el índice ($2.600$), no se construye hasta el módulo 6: su valor es alto, pero hacerlo antes obligaría a construirlo dos veces.
La Figura 3 dibuja esa hoja de ruta como un trayecto de seis paradas, una por módulo.
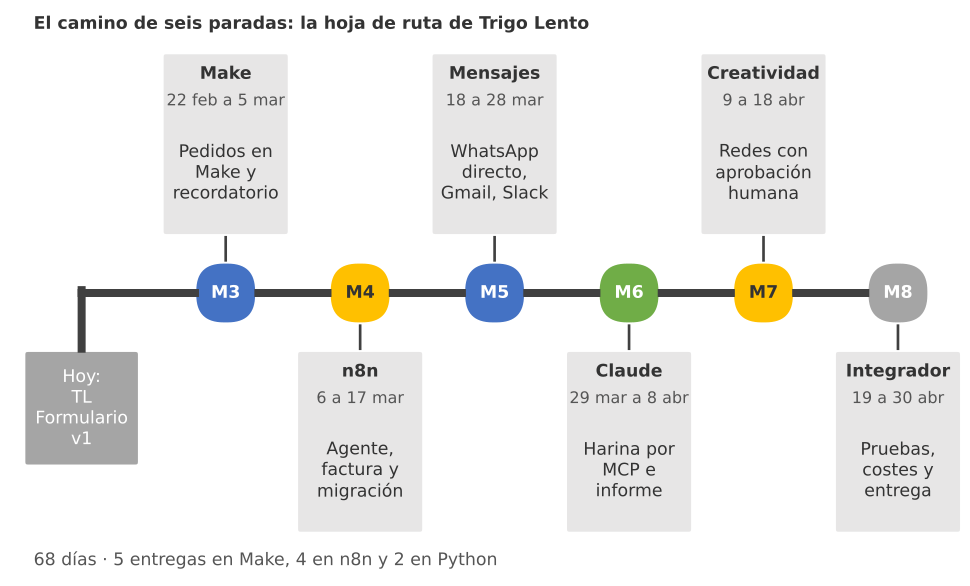
Figura 3. El camino de seis paradas: los módulos 3 a 8 como estaciones de un trayecto que empieza hoy con TL Formulario v1 y termina el 30 de abril con el ecosistema completo.
El siguiente bloque la convierte en un diagrama de Gantt con las fechas reales de la serie, los seis módulos como franjas y cada entrega coloreada según su plataforma:
# Gantt de la hoja de ruta: módulos 3 a 8 y procesos por módulo en Python:
import matplotlib.dates as mdates
modulos = pd.DataFrame([
    ('M3 Make', '2026-02-22', '2026-03-05'), ('M4 n8n', '2026-03-06', '2026-03-17'),
    ('M5 Comunicación', '2026-03-18', '2026-03-28'), ('M6 API de Claude', '2026-03-29', '2026-04-08'),
    ('M7 Agentes y creatividad', '2026-04-09', '2026-04-18'), ('M8 Proyecto integrador', '2026-04-19', '2026-04-30'),
], columns = ['modulo', 'inicio', 'fin'])
tareas = pd.DataFrame([
    ('TL Formulario v1 (hoy)',          'Make',   '2026-02-21', '2026-02-21'),
    ('Recordatorio de recogida',        'Make',   '2026-02-26', '2026-02-26'),
    ('Encargos: escenario de pedidos',  'Make',   '2026-02-22', '2026-03-05'),
    ('Encargos: agente de pedidos',     'n8n',    '2026-03-10', '2026-03-10'),
    ('Factura semanal por HTTP',        'n8n',    '2026-03-12', '2026-03-12'),
    ('Migración de Make a n8n',         'n8n',    '2026-03-17', '2026-03-17'),
    ('Pedido de Brújula y proveedores', 'Make',   '2026-03-19', '2026-03-19'),
    ('Confirmación de anticipos',       'Make',   '2026-03-20', '2026-03-20'),
    ('Inventario de harina (MCP)',      'Python', '2026-04-03', '2026-04-04'),
    ('Cierre de caja e informe',        'Python', '2026-04-08', '2026-04-08'),
    ('Publicaciones en redes',          'n8n',    '2026-04-12', '2026-04-13'),
    ('Pruebas, costes y entrega',       'Todos',  '2026-04-19', '2026-04-30'),
], columns = ['tarea', 'plataforma', 'inicio', 'fin'])
for df in (modulos, tareas):
    df['inicio'] = pd.to_datetime(df.inicio)
    df['fin'] = pd.to_datetime(df.fin) + pd.Timedelta(days = 1)
colores_plataforma = {'Make': '#2a78d6', 'n8n': '#eb6834', 'Python': '#7b5ea7', 'Todos': '#52514e'}
fig, ax = plt.subplots(figsize = (9.6, 6.0))
filas = list(tareas.tarea[::-1])
for i, f in enumerate(modulos.itertuples()):
    ax.axvspan(f.inicio, f.fin, color = '#f2f2f2' if i % 2 == 0 else 'white', zorder = 0)
    ax.text(f.inicio + (f.fin - f.inicio) / 2, len(filas) - 0.2, f.modulo.split(' ')[0], ha = 'center',
            fontsize = 10, fontweight = 'bold', color = '#52514e')
for f in tareas.itertuples():
    y = filas.index(f.tarea)
    ax.barh(y, (f.fin - f.inicio).days, left = f.inicio, height = 0.55, color = colores_plataforma[f.plataforma])
ax.set_yticks(range(len(filas)), filas, fontsize = 9)
ax.set_ylim(-0.7, len(filas) + 0.2)
ax.xaxis.set_major_locator(mdates.WeekdayLocator(byweekday = mdates.SU))
ax.xaxis.set_major_formatter(mdates.DateFormatter('%d/%m'))
from matplotlib.patches import Patch
ax.legend(handles = [Patch(color = c, label = p) for p, c in colores_plataforma.items()],
          loc = 'lower left', fontsize = 9, ncol = 4)
ax.set_title('Hoja de ruta de Trigo Lento: módulos 3 a 8', fontsize = 16)
plt.tight_layout()
plt.show()
duracion = (modulos.fin - modulos.inicio).dt.days
print('Días por módulo:', dict(zip(modulos.modulo.str.split(' ').str[0], duracion)), '| total:', duracion.sum())
print('Entregas por plataforma:', tareas.plataforma.value_counts().to_dict())
Días por módulo: {'M3': 12, 'M4': 12, 'M5': 11, 'M6': 11, 'M7': 10, 'M8': 12} | total: 68
Entregas por plataforma: {'Make': 5, 'n8n': 4, 'Python': 2, 'Todos': 1}
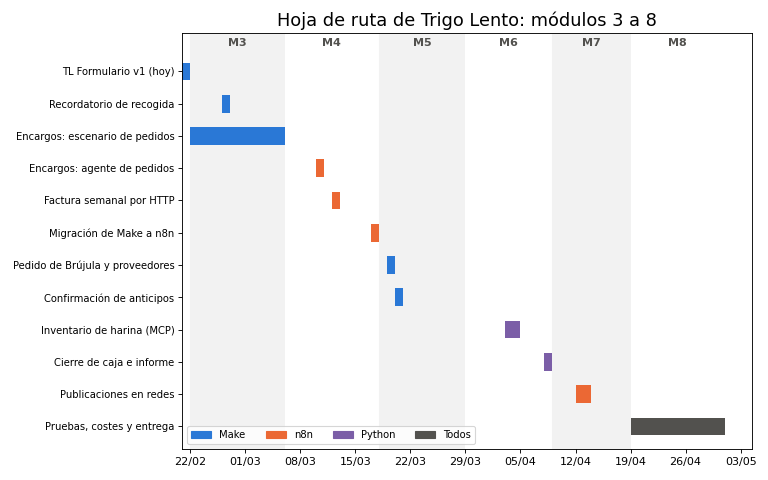
Los seis módulos restantes suman $68$ días, del 22 de febrero al 30 de abril, y producen $5$ entregas en Make, $4$ en n8n y $2$ en Python, más las pruebas, los costes y la entrega del módulo 8. El diagrama muestra un patrón que la tabla no deja ver: las entregas de Make se concentran al principio y las de Python al final. No es casualidad. Make permite poner en producción flujos simples sin servidor ni código, que es lo que Trigo Lento necesita mientras aprende; Python y el agente necesitan una base de datos fiable, un servidor encendido y semanas de registros, que solo existen después.
La barra más larga es la del escenario de pedidos en Make, que ocupa todo el módulo 3, y le sigue un trazo corto en n8n el 10 de marzo: el agente. Entre los dos, el 17 de marzo, la migración. Esa secuencia es la respuesta de arquitecto al proyecto grande de la matriz: un proceso de mucho valor y mucho coste no se ataca de una vez, sino en rebanadas que funcionan solas. Hoy, 21 de febrero, la primera rebanada es la barra azul del extremo izquierdo: TL Formulario v1.
Primer flujo real
El formulario web trae el $15%$ de los encargos, unos $70$ al mes. Es el canal más ordenado de todos: el cliente elige el producto de una lista, escribe la fecha en un selector y marca dos casillas, una obligatoria para aceptar el aviso de privacidad y otra, separada y opcional, para recibir avisos por WhatsApp. Hasta hoy, cada envío llegaba al correo de Valeria y ella lo copiaba a la hoja de pedidos, unos cuatro minutos por envío. El Día 11 dibujó una primera versión de dos módulos, TL Formulario a hoja v1, como ejemplo de portabilidad, y el Día 19 la registró en el inventario como prototipo. Hoy se publica la versión que entra en producción, TL Formulario v1, con cuatro cambios aprendidos durante el módulo:
- Un filtro de privacidad. El módulo 2 solo se ejecuta si el envío trae
acepta_privacidaden verdadero; sin aviso aceptado, no se guarda nada. - El teléfono como texto. El módulo de la hoja escribe con
valueInputOptionenRAW, no enUSER_ENTERED: así la hoja no interpreta “0155 0000 0073” como un número y no le quita el cero, la lección del Día 14. - El consentimiento de WhatsApp en su propia columna. La variable
whatsapp_okse guarda como “sí” o “no”, y el recordatorio del módulo 3 solo escribirá a quien tenga “sí” (A.9 del plan de la serie). - Una respuesta explícita. El último módulo responde al formulario con un código $200$ y un JSON con el
id_pedido, de modo que la página web puede mostrar “Recibimos su pedido TL-F0071” en lugar de un mensaje genérico.
El blueprint de TL Formulario v1
El escenario tiene cuatro módulos y un manejador de errores: un webhook personalizado (gateway:CustomWebHook), un módulo para establecer variables (util:SetVariables) con el filtro de privacidad, la acción de añadir una fila de Google Sheets (google-sheets:addRow) con un manejador builtin:Break que reintenta tres veces si la hoja falla, y la respuesta al webhook (gateway:WebhookRespond). La directiva Break con reintento necesita que el escenario permita guardar ejecuciones incompletas, por eso dlq está en verdadero en metadata.scenario. Como manda la serie, el número del webhook y la conexión de Google aparecen como $0$: los reales permitirían reconstruir la URL o identificar la cuenta. Este es el archivo trigo_lento/dia_21/flujos/make/formulario_v1.blueprint.json:
{
  "name": "TL Formulario v1",
  "flow": [
    {
      "id": 1,
      "module": "gateway:CustomWebHook",
      "version": 1,
      "parameters": {"hook": 0, "maxResults": 1},
      "mapper": {},
      "metadata": {"designer": {"x": 0, "y": 0}}
    },
    {
      "id": 2,
      "module": "util:SetVariables",
      "version": 1,
      "parameters": {},
      "filter": {
        "name": "Aviso de privacidad aceptado",
        "conditions": [[{"a": "{{1.acepta_privacidad}}", "b": "true", "o": "text:equal"}]]
      },
      "mapper": {
        "variables": [
          {"name": "id_pedido", "value": "{{1.id_pedido}}"},
          {"name": "telefono", "value": "{{replace(1.telefono; \"/[^0-9+]/g\"; emptystring)}}"},
          {"name": "whatsapp_ok", "value": "{{if(1.whatsapp_ok = \"true\"; \"sí\"; \"no\")}}"},
          {"name": "recibido", "value": "{{formatDate(now; \"YYYY-MM-DD HH:mm\"; \"America/Mexico_City\")}}"}
        ],
        "scope": "roundtrip"
      },
      "metadata": {"designer": {"x": 300, "y": 0}}
    },
    {
      "id": 3,
      "module": "google-sheets:addRow",
      "version": 2,
      "parameters": {"__IMTCONN__": 0},
      "mapper": {
        "mode": "select",
        "spreadsheetId": "/ID_DE_EJEMPLO",
        "sheetId": "Pedidos",
        "includesHeaders": true,
        "insertDataOption": "INSERT_ROWS",
        "valueInputOption": "RAW",
        "insertUnformatted": false,
        "values": {
          "0": "{{2.id_pedido}}",
          "1": "{{1.nombre}}",
          "2": "{{2.telefono}}",
          "3": "{{1.producto}}",
          "4": "{{1.cantidad}}",
          "5": "{{1.fecha_recogida}}",
          "6": "{{1.hora_recogida}}",
          "7": "{{2.whatsapp_ok}}",
          "8": "formulario",
          "9": "{{2.recibido}}"
        }
      },
      "metadata": {"designer": {"x": 600, "y": 0}},
      "onerror": [
        {
          "id": 5,
          "module": "builtin:Break",
          "version": 1,
          "parameters": {},
          "mapper": {"count": 3, "retry": true, "interval": 1},
          "metadata": {"designer": {"x": 600, "y": 250}}
        }
      ]
    },
    {
      "id": 4,
      "module": "gateway:WebhookRespond",
      "version": 1,
      "parameters": {},
      "mapper": {
        "status": "200",
        "body": "{\"estado\": \"recibido\", \"id_pedido\": \"{{2.id_pedido}}\"}",
        "headers": [{"key": "Content-Type", "value": "application/json"}]
      },
      "metadata": {"designer": {"x": 900, "y": 0}}
    }
  ],
  "metadata": {
    "instant": true,
    "version": 1,
    "scenario": {"roundtrips": 1, "maxErrors": 3, "autoCommit": true, "autoCommitTriggerLast": true, "sequential": false, "confidential": false, "dataloss": false, "dlq": true, "freshVariables": false},
    "designer": {"orphans": []}
  }
}
Lea el mapper de los módulos 2 y 3 juntos, porque ahí está el diseño. El módulo 2 transforma lo que llegó: limpia el teléfono con una expresión regular que deja solo dígitos y el signo más, traduce la casilla de WhatsApp a “sí” o “no” y fecha la recepción en la zona America/Mexico_City. El módulo 3 escribe diez columnas mezclando dos orígenes: lo que llegó sin transformar ({{1.nombre}}, {{1.producto}}) y lo que transformó el módulo 2 ({{2.telefono}}, {{2.whatsapp_ok}}). La columna $8$ es una constante, “formulario”, que deja escrito el canal de origen para que el mapa de canales del módulo 5 tenga datos reales. Fíjese, por último, en lo que no está: ni la URL del webhook, ni la clave de nada, ni un teléfono de cliente.
Ver el flujo
El siguiente bloque lee el blueprint con una versión sencilla de nodos_desde_blueprint, que recorre flow y los manejadores onerror, y lo dibuja con dibujar_flujo y la paleta de formas de la serie (disparador en óvalo verde, acciones en rectángulo azul, manejador de error en rectángulo rojo). Además comprueba lo que una persona revisaría antes de importar: cuántos módulos tiene, cuántas columnas escribe, si el teléfono se escribe como texto y si la conexión y el webhook están anonimizados:
# Lectura del blueprint TL Formulario v1 y dibujo con la paleta de la serie en Python:
import textwrap
from matplotlib.patches import Ellipse, FancyBboxPatch, Polygon, RegularPolygon, FancyArrowPatch

FORMAS = {   # paleta de formas de la serie: tipo -> (forma, relleno)
    'disparador': ('ovalo', '#3a9d5d'), 'accion': ('rectangulo', '#2a78d6'),
    'decision': ('rombo', '#eb6834'), 'ia': ('rectangulo', '#7b5ea7'),
    'error': ('rectangulo', '#c8423b'), 'humano': ('hexagono', '#8a8986'),
}

def dibujar_flujo(nodos, aristas, titulo, ax = None, ancho = 2.2, alto = 1.25, recorte = 30):
    if ax is None:
        fig, ax = plt.subplots(figsize = (12, 5.6))
    for n in nodos:
        forma, color = FORMAS[n['tipo']]
        x, y = n['x'], n['y']
        if forma == 'ovalo':
            figura = Ellipse((x, y), ancho, alto)
        elif forma == 'rombo':
            figura = Polygon([(x - ancho / 1.6, y), (x, y + alto / 1.4), (x + ancho / 1.6, y), (x, y - alto / 1.4)])
        elif forma == 'hexagono':
            figura = RegularPolygon((x, y), 6, radius = ancho / 2, orientation = np.pi / 6)
        else:
            figura = FancyBboxPatch((x - ancho / 2, y - alto / 2), ancho, alto, boxstyle = 'round,pad=0.03')
        figura.set_facecolor(color)
        figura.set_edgecolor('white')
        figura.set_linewidth(2)
        ax.add_patch(figura)
        ax.text(x, y, n['texto'], ha = 'center', va = 'center', fontsize = 8.5, color = 'white')
    posicion = {n['id']: (n['x'], n['y']) for n in nodos}
    for origen, destino, etiqueta in aristas:
        (x1, y1), (x2, y2) = posicion[origen], posicion[destino]
        ax.add_patch(FancyArrowPatch((x1, y1), (x2, y2), arrowstyle = '-|>', mutation_scale = 12,
                                     shrinkA = recorte, shrinkB = recorte + 2, linewidth = 1.3, color = '#52514e'))
        if etiqueta:
            ax.text((x1 + x2) / 2, (y1 + y2) / 2 + 0.75, etiqueta, ha = 'center', fontsize = 8, color = '#52514e')
    xs, ys = [n['x'] for n in nodos], [n['y'] for n in nodos]
    ax.set_xlim(min(xs) - 1.4, max(xs) + 1.4)
    ax.set_ylim(min(ys) - 1.3, max(ys) + 1.1)
    ax.set_aspect('equal')
    ax.axis('off')
    ax.set_title(titulo, fontsize = 12)
    return ax

def tipo_make(modulo):
    if modulo == 'gateway:CustomWebHook':
        return 'disparador'
    if modulo.startswith('builtin:') and modulo != 'builtin:BasicRouter':
        return 'error'
    return 'decision' if modulo == 'builtin:BasicRouter' else 'accion'

def nodos_desde_blueprint(blueprint):
    # Recorre flow (y los manejadores onerror) y devuelve nodos y aristas para dibujar_flujo:
    nodos, aristas, anterior = [], [], None
    for m in blueprint['flow']:
        x, y = m['metadata']['designer']['x'] / 300 * 3.6, -m['metadata']['designer']['y'] / 250 * 2.2
        nombre = m['module'].split(':')[1]
        nodos.append({'id': m['id'], 'x': x, 'y': y, 'tipo': tipo_make(m['module']),
                      'texto': '\n'.join(textwrap.wrap(nombre, 14)) + f'\n(módulo {m["id"]})'})
        if anterior is not None:
            aristas.append((anterior, m['id'], 'filtro: ' + m['filter']['name'].lower() if 'filter' in m else ''))
        for h in m.get('onerror', []):
            hx, hy = h['metadata']['designer']['x'] / 300 * 3.6, -h['metadata']['designer']['y'] / 250 * 2.2
            nodos.append({'id': h['id'], 'x': hx, 'y': hy, 'tipo': 'error',
                          'texto': h['module'].split(':')[1] + f'\n{h["mapper"]["count"]} reintentos\n(módulo {h["id"]})'})
            aristas.append((m['id'], h['id'], 'si falla'))
        anterior = m['id']
    return nodos, aristas

ruta_blueprint = carpeta / 'flujos' / 'make' / 'formulario_v1.blueprint.json'
blueprint = json.loads(ruta_blueprint.read_text(encoding = 'utf-8'))
nodos, aristas = nodos_desde_blueprint(blueprint)
modulos_flow = [m['module'] for m in blueprint['flow']]
print('Escenario:', blueprint['name'], '| módulos en flow:', len(modulos_flow), '| con manejador:', len(nodos))
print('Módulos:', modulos_flow)
print('Columnas que escribe la fila:', len(blueprint['flow'][2]['mapper']['values']),
      '| valueInputOption:', blueprint['flow'][2]['mapper']['valueInputOption'],
      '| créditos por ejecución:', len(modulos_flow))
print('Conexión y webhook anonimizados:', blueprint['flow'][2]['parameters']['__IMTCONN__'] == 0
      and blueprint['flow'][0]['parameters']['hook'] == 0)
fig, ax = plt.subplots(figsize = (12, 5.0))
dibujar_flujo(nodos, aristas, '', ax = ax, recorte = 36)
ax.set_title('TL Formulario v1 leído de su blueprint de Make', fontsize = 16)
plt.tight_layout()
plt.show()
Escenario: TL Formulario v1 | módulos en flow: 4 | con manejador: 5
Módulos: ['gateway:CustomWebHook', 'util:SetVariables', 'google-sheets:addRow', 'gateway:WebhookRespond']
Columnas que escribe la fila: 10 | valueInputOption: RAW | créditos por ejecución: 4
Conexión y webhook anonimizados: True
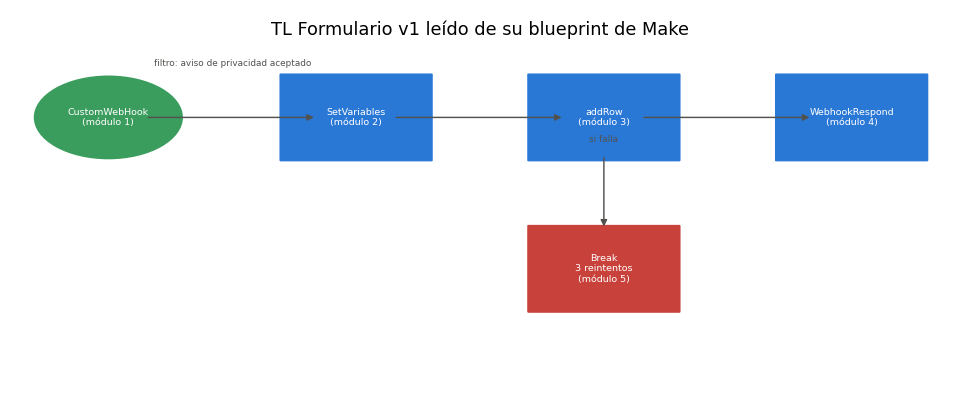
El escenario tiene $4$ módulos en flow y $5$ nodos con el manejador; escribe $10$ columnas con RAW; y la conexión y el webhook están anonimizados. La cifra que más importa para el presupuesto es la última de la tercera línea: $4$ créditos por ejecución, que con $70$ envíos al mes son los $280$ créditos que el Bloque 5 ya había contado. El dibujo deja ver la estructura de un vistazo: un camino recto de izquierda a derecha, con el filtro de privacidad en la primera flecha y el manejador rojo colgando de la escritura en la hoja, el único paso que depende de un servicio externo que puede fallar.
Ensayo sin red
Antes de gastar un solo crédito, Valeria ensaya el flujo en Python. La función simular_post(url, cuerpo, rng) de la serie (A.4.1 del plan) imita al webhook de Make con la misma lógica del blueprint (el filtro, la limpieza del teléfono, la fila y la respuesta) y devuelve un objeto con status_code, headers y json(), la misma interfaz que requests. Si el filtro no deja pasar el envío, devuelve lo que Make devuelve cuando ningún módulo de respuesta llega a ejecutarse: un $200$ con el texto “Accepted”. Y puede devolver un $429$, el código que Make usa cuando un webhook recibe más de $300$ peticiones en $10$ segundos.
Los seis casos de prueba están pensados para romper el flujo, no para confirmarlo:
- C1 es un pedido completo; C2, uno sin consentimiento de WhatsApp, que debe guardarse con “no”.
- C3 trae el teléfono con el antiguo prefijo “01 55”, el que el Día 14 vio perder su cero.
- C4 llega sin aviso de privacidad aceptado: no debe guardarse, y el formulario debería enterarse con un código de error.
- C5 es el reenvío exacto de C1, lo que ocurre cuando un cliente impaciente pulsa dos veces “Enviar”.
- C6 cae en una ráfaga y recibe un $429$ en el primer intento; el cliente del formulario debe reintentar con espera exponencial.
El siguiente bloque ejecuta los seis casos, cuenta las filas nuevas que deja cada uno en la hoja simulada y compara con lo esperado:
# Ensayo del webhook sin red: simular_post imita a Make con la lógica del blueprint en Python:
import re
import time
import uuid

class RespuestaSimulada:
    def __init__(self, status_code, cuerpo, headers = None):
        self.status_code, self._cuerpo = status_code, cuerpo
        self.headers = headers or {'Content-Type': 'application/json' if isinstance(cuerpo, dict) else 'text/plain'}
        self.text = json.dumps(cuerpo, ensure_ascii = False) if isinstance(cuerpo, dict) else cuerpo
    def json(self):
        return self._cuerpo if isinstance(self._cuerpo, dict) else json.loads(self._cuerpo)

hoja_pedidos = []   # la hoja Pedidos simulada

def simular_post(url, cuerpo, rng, prob_429 = 0.0):
    # 429 si se rebasan 300 peticiones en 10 s (aquí, con la probabilidad declarada):
    if rng.random() < prob_429:
        return RespuestaSimulada(429, 'Too many requests')
    # Módulo 2, filtro "Aviso de privacidad aceptado": si no pasa, Make responde su valor por omisión:
    if str(cuerpo.get('acepta_privacidad')).lower() != 'true':
        return RespuestaSimulada(200, 'Accepted')
    telefono = re.sub(r'[^0-9+]', '', cuerpo['telefono'])
    whatsapp = 'sí' if str(cuerpo.get('whatsapp_ok')).lower() == 'true' else 'no'
    # Módulo 3, añadir fila con RAW (el teléfono se queda como texto):
    hoja_pedidos.append({'id_pedido': cuerpo['id_pedido'], 'telefono': telefono, 'whatsapp_ok': whatsapp,
                         'producto': cuerpo['producto'], 'cantidad': cuerpo['cantidad']})
    # Módulo 4, responder al webhook:
    return RespuestaSimulada(200, {'estado': 'recibido', 'id_pedido': cuerpo['id_pedido']})

def enviar_con_reintentos(cuerpo, prob_429_inicial = 0.0, intentos = 3):
    for intento in range(1, intentos + 1):
        r = simular_post('https://hook.ejemplo.make.com/SIMULADO', cuerpo, rng,
                         prob_429 = prob_429_inicial if intento == 1 else 0.0)
        if r.status_code != 429:
            return r, intento
        time.sleep(0.01 * 2 ** intento)   # espera exponencial (acortada en el ensayo)
    return r, intentos

def pedido(id_pedido, telefono, whatsapp_ok = 'true', privacidad = 'true'):
    return {'id_pedido': id_pedido, 'nombre': 'Cliente de prueba', 'telefono': telefono, 'producto': 'P09',
            'cantidad': 1, 'fecha_recogida': '2026-02-28', 'hora_recogida': '13:00',
            'whatsapp_ok': whatsapp_ok, 'acepta_privacidad': privacidad}

casos = [  # (caso, cuerpo, 429 forzado en el primer intento, filas nuevas y código esperados)
    ('C1 pedido completo',             pedido('TL-F0071', '+52 55 0000 0071'), 0.0, 1, 200),
    ('C2 sin consentimiento WhatsApp', pedido('TL-F0072', '+52 55 0000 0072', whatsapp_ok = 'false'), 0.0, 1, 200),
    ('C3 teléfono con 01 55',          pedido('TL-F0073', '0155 0000 0073'), 0.0, 1, 200),
    ('C4 sin aviso de privacidad',     pedido('TL-F0074', '+52 55 0000 0074', privacidad = 'false'), 0.0, 0, 400),
    ('C5 reenvío de C1',               pedido('TL-F0071', '+52 55 0000 0071'), 0.0, 0, 200),
    ('C6 ráfaga con 429',              pedido('TL-F0076', '+52 55 0000 0076'), 1.0, 1, 200),
]
resultados = []
for nombre, cuerpo, p429, nuevas_esperadas, codigo_esperado in casos:
    antes = len(hoja_pedidos)
    r, intentos = enviar_con_reintentos(cuerpo, p429)
    nuevas = len(hoja_pedidos) - antes
    resultados.append({'caso': nombre, 'codigo': r.status_code, 'intentos': intentos,
                       'respuesta': r.text[:40], 'filas_nuevas': nuevas, 'esperado': f'{nuevas_esperadas} y {codigo_esperado}',
                       'pasa': nuevas == nuevas_esperadas and r.status_code == codigo_esperado})
ensayo = pd.DataFrame(resultados)
print(ensayo.to_string(index = False))
print('Casos que pasan:', int(ensayo.pasa.sum()), 'de', len(ensayo),
      '| teléfono de C3 en la hoja:', repr(hoja_pedidos[2]['telefono']),
      '| ids repetidos en la hoja:', len(hoja_pedidos) - len({f['id_pedido'] for f in hoja_pedidos}))
                          caso  codigo  intentos                                respuesta  filas_nuevas esperado  pasa
            C1 pedido completo     200         1 {"estado": "recibido", "id_pedido": "TL-             1  1 y 200  True
C2 sin consentimiento WhatsApp     200         1 {"estado": "recibido", "id_pedido": "TL-             1  1 y 200  True
         C3 teléfono con 01 55     200         1 {"estado": "recibido", "id_pedido": "TL-             1  1 y 200  True
    C4 sin aviso de privacidad     200         1                                 Accepted             0  0 y 400 False
              C5 reenvío de C1     200         1 {"estado": "recibido", "id_pedido": "TL-             1  0 y 200 False
             C6 ráfaga con 429     200         2 {"estado": "recibido", "id_pedido": "TL-             1  1 y 200  True
Casos que pasan: 4 de 6 | teléfono de C3 en la hoja: '015500000073' | ids repetidos en la hoja: 1
Pasan $4$ de los $6$ casos, y los dos que fallan son los más instructivos del día. El teléfono de C3 llega a la hoja como ‘015500000073’, texto con su cero, gracias a RAW; C6 recibe el $429$, espera y entra al segundo intento. Los fallos:
- C4 recibe un $200$ con “Accepted”. El flujo hizo lo correcto (no guardó nada), pero el formulario no se entera: para él, un envío rechazado y uno aceptado se parecen demasiado. La causa es de diseño: con un filtro, cuando el envío no pasa, ningún módulo de respuesta se ejecuta y Make contesta su valor por omisión. La corrección es sustituir el filtro por un router con dos rutas, una que guarda y responde $200$, y otra que responde $400$ con el motivo. Es exactamente lo que enseña el Día 24 con routers y filtros.
- C5 duplica el pedido. El reenvío de C1 añade una segunda fila con el mismo
id_pedido, y la hoja queda con $1$ identificador repetido. Es el problema de la idempotencia que el Día 3 presentó con los webhooks y que el Día 29 convertirá en el análisis de un fallo real, el webhook que duplicó $37$ pedidos. La corrección es buscar elid_pedidoen la hoja (o en un almacén de datos de Make) antes de añadir la fila.
La Tabla 4 deja los seis casos como registro de la prueba, con su resultado y lo que queda pendiente.
Tabla 4. Ensayo sin red de TL Formulario v1: seis casos, resultado y pendiente.
| Caso | Qué prueba | Código | Intentos | Filas nuevas (esperadas) | Resultado | Pendiente |
|---|---|---|---|---|---|---|
| C1 | Pedido completo | 200 | 1 | 1 (1) | Pasa | Ninguno |
| C2 | Sin consentimiento de WhatsApp | 200 | 1 | 1 (1) | Pasa | Ninguno |
| C3 | Teléfono con prefijo 01 55 | 200 | 1 | 1 (1) | Pasa | Ninguno |
| C4 | Sin aviso de privacidad | 200 “Accepted” (se esperaba 400) | 1 | 0 (0) | Falla | Router con respuesta 400 (Día 24) |
| C5 | Reenvío de C1 | 200 | 1 | 1 (0) | Falla | Idempotencia por id_pedido (Días 28 y 29) |
| C6 | Ráfaga con 429 | 200 | 2 | 1 (1) | Pasa | Ninguno |
¿Se publica un flujo que falla dos de seis casos? Valeria decide que sí, y escribe por qué en el registro: ninguno de los dos fallos pierde un pedido ni expone un dato. C4 no guarda lo que no debe guardar, aunque responda mal; C5 duplica una fila que se ve a simple vista en la hoja, en un canal de $70$ envíos al mes. Ambos quedan como pendientes con fecha, y el flujo entra en producción con una persona revisando la hoja cada mañana durante el módulo 3. Un flujo en producción con dos fallos conocidos y vigilados es más seguro que uno sin pruebas que parece perfecto.
Atención aquí: la URL de un webhook de Make es, en la práctica, una credencial: quien la conozca puede enviar pedidos falsos a la hoja de Trigo Lento, y Make no exige ninguna firma por omisión. No la escriba en el código, en un blueprint, en una captura de pantalla ni en un mensaje; guárdela en una variable de entorno o en el gestor de secretos del Día 17, y si se filtra, cree un webhook nuevo y borre el viejo. Para un formulario público, añada además una verificación en el propio formulario (un campo oculto o una firma) y vigile el volumen: un salto brusco de envíos es la primera señal de abuso.
La prueba real del webhook
Con el ensayo superado en lo esencial, Valeria importa el blueprint en Make, asigna a mano la conexión de Google (con el alcance mínimo a la hoja de pedidos, como pidió el Día 17), copia la URL del webhook a la variable de entorno TL_WEBHOOK_FORMULARIO de su equipo y activa el escenario. La prueba real usa exactamente la misma interfaz que el ensayo, porque simular_post imitaba a requests.post: cambiar el ensayo por la prueba real es cambiar una línea. El pedido de prueba lleva un identificador que empieza por TL-PRUEBA, para que se reconozca y se borre de la hoja, y un teléfono del formato de prueba de la serie.
Este bloque llama al webhook real y no se ejecutó para escribir la entrada; la salida es un ejemplo comentado:
# Prueba real del webhook de TL Formulario v1 con requests, archivo probar_formulario.py, en Python:
import os
import time

import requests

URL = os.environ['TL_WEBHOOK_FORMULARIO']          # la URL del webhook vive en el entorno, nunca en el código
prueba = {'id_pedido': 'TL-PRUEBA-0001', 'nombre': 'Cliente de prueba', 'telefono': '+52 55 0000 0099',
          'producto': 'P09', 'cantidad': 1, 'fecha_recogida': '2026-02-28', 'hora_recogida': '13:00',
          'whatsapp_ok': 'false', 'acepta_privacidad': 'true'}

for intento in range(1, 4):
    inicio = time.perf_counter()
    r = requests.post(URL, json = prueba, timeout = 30)
    segundos = time.perf_counter() - inicio
    if r.status_code != 429:                       # 429: más de 300 peticiones en 10 segundos
        break
    time.sleep(2 ** intento)
print('Código:', r.status_code, '| intentos:', intento, '| segundos:', round(segundos, 2))
print('Tipo de contenido:', r.headers.get('Content-Type'))
assert r.status_code == 200, f'El webhook respondió {r.status_code}: {r.text[:200]}'
assert r.json().get('id_pedido') == prueba['id_pedido'], 'La respuesta no confirma el pedido de prueba'
print('Respuesta:', r.json())

# Salida de ejemplo (puede variar):
# Código: 200 | intentos: 1 | segundos: 1.84
# Tipo de contenido: application/json
# Respuesta: {'estado': 'recibido', 'id_pedido': 'TL-PRUEBA-0001'}
En el ejemplo, el webhook responde $200$ en el primer intento, en $1.84$ segundos, con application/json y el id_pedido de la prueba. Las dos aserciones del bloque son la parte importante: no basta con un $200$, porque el caso C4 enseñó que Make también responde $200$ cuando no guardó nada; la prueba exige además que la respuesta confirme el pedido enviado. Con esa comprobación, TL Formulario v1 pasa de prototipo a producción en el inventario del Día 19, con Valeria como dueña, un suplente nombrado y una fecha de revisión al terminar el módulo 3.
Es el primer flujo de Trigo Lento que trabaja con datos reales. Ahorra unas $4$ horas al mes, poco frente a las $35.1$ del proceso completo de encargos, pero ya cumple su función de rebanada: demuestra que el canal más simple funciona de punta a punta, con privacidad, consentimiento, registro y una prueba repetible, antes de abordar el canal más difícil.
Retrospectiva del módulo 2
Once días después de abrir el módulo, Valeria hace lo que el Día 10 hizo con el módulo 1: poner en una tabla cada decisión, la cifra que la sostiene y lo que dejó pendiente. Una retrospectiva no sirve para celebrar, sino para descubrir lo que se decidió sin cerrar. El siguiente bloque guarda las once decisiones en trigo_lento/dia_21/retrospectiva_modulo_2.json, cuenta los pendientes y calcula el valor de las horas que el mapa permite automatizar:
# Retrospectiva del módulo 2: decisiones, cifras y pendientes de los días 11 a 21 en Python:
decisiones = pd.DataFrame([
    (11, 'Make para mensajes, n8n self-hosted para el agente, Python como laboratorio', 'n8n 4.05, Make 3.80', 'Revisar al llegar el servidor'),
    (12, 'Reparto de los 45 USD con alerta al 80 %', '7 644 créditos, 76.4 % de Core', 'Rubro de WhatsApp sin medir'),
    (13, 'Recordatorio de recogida en Make', '962 créditos al mes', 'Construirlo el Día 26'),
    (14, 'SQLite como fuente de verdad, teléfono como texto', '15 trampas de tipos', 'Ninguno'),
    (15, 'Google Sheets como vista del mostrador', '3.90 frente a 3.55 de Airtable', 'Condiciones de revisión'),
    (16, 'Sincronización incremental con cursor', '15.42 conflictos al mes cada 15 min', 'Elegir dónde corre'),
    (17, 'Plan de llaves con alcances mínimos y rotación', 'Ningún secreto en las exportaciones', 'Rotar la clave vencida'),
    (18, 'Generador de borradores con validador y firma', '0.0988 USD por flujo', 'Cerrar la lista blanca con enum'),
    (19, 'Inventario de flujos con dueño y suplente', '8 flujos, 0 aptos', 'Nombrar suplentes'),
    (20, 'Método del mapa ensayado en Café Altura', 'Empezar por lo seguro, no por lo más rentable', 'Ninguno'),
    (21, 'Mapa priorizado y TL Formulario v1', f'Make {transicion} créditos en el M3', 'Router con 400 e idempotencia'),
], columns = ['dia', 'decision', 'cifra', 'pendiente'])
pendientes = decisiones[decisiones.pendiente != 'Ninguno']
print(decisiones[['dia', 'decision', 'pendiente']].to_string(index = False))
automatizables = procesos.horas_ahorradas[asignacion.plataforma != 'Persona'].sum()
print('Decisiones:', len(decisiones), '| con pendiente:', len(pendientes),
      '| horas automatizables al mes:', round(automatizables, 2),
      '| valor:', round(automatizables * HORA_VALERIA_MXN, 2), 'MXN =',
      round(automatizables * HORA_VALERIA_MXN / MXN_POR_USD, 2), 'USD')
(carpeta / 'retrospectiva_modulo_2.json').write_text(
    decisiones.to_json(orient = 'records', force_ascii = False, indent = 2), encoding = 'utf-8')
 dia                                                                    decision                       pendiente
  11 Make para mensajes, n8n self-hosted para el agente, Python como laboratorio   Revisar al llegar el servidor
  12                                    Reparto de los 45 USD con alerta al 80 %     Rubro de WhatsApp sin medir
  13                                            Recordatorio de recogida en Make           Construirlo el Día 26
  14                           SQLite como fuente de verdad, teléfono como texto                         Ninguno
  15                                      Google Sheets como vista del mostrador         Condiciones de revisión
  16                                       Sincronización incremental con cursor              Elegir dónde corre
  17                              Plan de llaves con alcances mínimos y rotación          Rotar la clave vencida
  18                               Generador de borradores con validador y firma Cerrar la lista blanca con enum
  19                                   Inventario de flujos con dueño y suplente               Nombrar suplentes
  20                                     Método del mapa ensayado en Café Altura                         Ninguno
  21                                          Mapa priorizado y TL Formulario v1   Router con 400 e idempotencia
Decisiones: 11 | con pendiente: 9 | horas automatizables al mes: 74.91 | valor: 5618.25 MXN = 303.69 USD
El módulo deja $11$ decisiones, $9$ de ellas con un pendiente, y un mapa que permite automatizar $74.91$ horas al mes, que al valor de la hora de Valeria son $5,618.25$ MXN, unos $303.69$ USD. La Tabla 5 las resume con su cifra.
Tabla 5. Decisiones del módulo 2, cifra que las sostiene y pendiente que dejan.
| Día | Decisión | Cifra que la sostiene | Pendiente |
|---|---|---|---|
| 11 | Make para mensajes, n8n self-hosted para el agente, Python como laboratorio | n8n 4.05, Make 3.80 en la matriz ponderada | Revisar al llegar el servidor |
| 12 | Reparto de los 45 USD con alerta al 80 % | 7 644 créditos, 76.4 % de Core | Rubro de WhatsApp sin medir (medido hoy) |
| 13 | Recordatorio de recogida en Make | 962 créditos al mes | Construirlo el Día 26 |
| 14 | SQLite como fuente de verdad, teléfono como texto | 15 trampas de tipos | Ninguno |
| 15 | Google Sheets como vista del mostrador | 3.90 frente a 3.55 de Airtable | Condiciones de revisión |
| 16 | Sincronización incremental con cursor | 15.42 conflictos al mes cada 15 minutos | Elegir dónde corre (hoy: Apps Script en marzo) |
| 17 | Plan de llaves con alcances mínimos y rotación | Ningún secreto en las exportaciones | Rotar la clave vencida |
| 18 | Generador de borradores con validador y firma | 0.0988 USD por flujo | Cerrar la lista blanca con enum |
| 19 | Inventario de flujos con dueño y suplente | 8 flujos, 0 aptos para producción | Nombrar suplentes |
| 20 | Método del mapa ensayado en Café Altura | Empezar por lo seguro, no por lo más rentable | Ninguno |
| 21 | Mapa priorizado y TL Formulario v1 | 8 886 créditos de Make en el módulo 3 | Router con 400 e idempotencia |
Leída de arriba abajo, la tabla cuenta cómo una idea general se convierte en un plan. Los días 11 a 13 eligieron herramientas; los 14 a 17 se ocuparon de lo que todas comparten (datos, almacenes, conexiones y llaves); los 18 y 19 pusieron orden en quién construye y quién responde; y los 20 y 21 juntaron todo en un mapa. Leída como lista de pendientes, dice algo menos cómodo: nueve de once decisiones dejaron algo abierto. No es un fracaso; es la forma normal de un diseño, que se cierra construyendo. Lo que sería un fracaso es no saber cuáles son.
Lo que dijo Don Ernesto
Valeria imprime tres hojas: la matriz, la Tabla 2 y la Tabla 3. Don Ernesto las lee en silencio, con el lápiz detrás de la oreja, y se detiene en la última. “A ver si entendí. Si mandamos los mensajes por esa compañía, Twilio, nos pasamos veintisiete centavos de dólar. Y si los mandamos directo, nos sobran dieciocho dólares. O sea que los robots no son caros: lo caro es el intermediario.” Valeria asiente. “Igual que con la harina, papá: cuando la compró directo al molino, le salía un tercio más barata, pero tuvo que ir usted por ella.” La comparación es exacta, y el Día 46 la convertirá en una decisión con todas sus letras.
Después pasa a la Tabla 2 y pone el lápiz sobre la fila de las reseñas. “Esto me gusta. Las reseñas las contesto yo, con mi nombre, aunque sea tarde. Si una clienta escribe que el pan llegó duro, quiero que lea a un panadero, no a una máquina.” Y sobre la de los turnos: “Y los turnos también. Aquí la gente cambia de día porque tiene un hijo enfermo; eso no lo decide un programa.” Su última pregunta es la que más le importa: “Me dice que ahorra setenta y cinco horas al mes. ¿A dónde se van esas horas? Porque si se van a otra pantalla, no ganamos nada.” La respuesta de Valeria está en el mapa: la mayor parte del ahorro sale de los encargos y de la hora pico, y el destino que ella propone es el mostrador los sábados y la conversación con los clientes mayoristas, la parte del negocio que hoy no atiende por estar copiando mensajes. Don Ernesto no dice que sí, pero firma la hoja de la Tabla 2.
Consideraciones finales
El mapa de hoy no es un plan de automatizar todo: es un plan de decidir todo. Cada uno de los doce procesos tiene escrito qué se hará con él, en qué plataforma, en qué módulo y con qué controles, incluidos los tres que no se automatizarán. Ese es el entregable de un arquitecto de automatización en un negocio pequeño, más que cualquier flujo: una visión de conjunto que permite decir que no con argumentos y que se puede revisar cuando cambian los números.
Las cifras de hoy tienen límites que conviene repetir. Los minutos de la Tabla 1 son estimaciones de Valeria; los pesos y los esfuerzos del índice son juicios; los consumos del presupuesto usan volúmenes fijos de la serie y precios revisados en octubre de 2026 que cambiarán; y el ensayo del formulario es una simulación, no una medición de Make. Ninguno de esos límites invalida las tres conclusiones robustas del día: los encargos concentran casi la mitad del ahorro posible, el recargo de un intermediario puede pesar más que todas las plataformas juntas, y la suma de decisiones razonables por separado puede no caber en una cuota.
Antes de dar por terminado un mapa de automatización, conviene hacerse algunas preguntas:
- ¿Están en el inventario también los procesos que no se piensa automatizar, con su razón escrita?
- ¿El orden de las reglas de asignación impide que un proceso sensible se automatice solo porque es fácil?
- ¿Se sumaron los consumos de todos los flujos que convivirán en la misma plataforma al mismo tiempo, y no solo los de cada flujo por separado?
- ¿El primer flujo publicado tiene pruebas que intentan romperlo, y sus fallos conocidos tienen dueño y fecha?
Un gran libro que habla de esto es La meta (o The Goal), en el que Eliyahu M. Goldratt y Jeff Cox cuentan, en forma de novela, cómo el gerente de una fábrica descubre que mejorar cualquier máquina que no sea el cuello de botella no aumenta la producción. Es la misma lección del mapa de Trigo Lento: la restricción del negocio es la atención de Valeria en la hora pico, y por eso los encargos, que la consumen, van primero aunque sean un proyecto grande, mientras que automatizar a la perfección las publicaciones en redes no haría que la panadería vendiera un pan más. Léalo antes de su próximo mapa.
Un mapa de automatización no dice qué se puede automatizar; dice qué conviene automatizar, en qué orden, con qué herramienta y qué se queda, a propósito, en manos de una persona. Don Ernesto lo resume a su manera al apagar la luz de la oficina: “Que la máquina haga el reparto. El pan y la palabra siguen siendo nuestros.”
Conclusiones clave
Priorización
- El inventario de Trigo Lento tiene $12$ procesos que consumen $107.16$ horas al mes; con $V_i = n_i (t_{a,i} - t_{d,i})/60$ se podrían ahorrar $80.08$, y $35.1$ de ellas son de los encargos.
- El índice $I_i = V_i w_{v,i} / (E_i R_i)$ pone primero los encargos ($7.313$) y el recordatorio ($6.825$); la respuesta a reseñas ($0.147$) y las quejas ($0.125$) quedan en las trampas.
- La matriz usa el coste ajustado por riesgo en lugar del esfuerzo a secas: $4$ victorias rápidas, $4$ proyectos grandes, $2$ rellenos y $2$ trampas; un proyecto grande de mucho valor se trocea, y su primera rebanada es el formulario web.
Plataformas
- Cuatro reglas en orden (juicio a una persona, agente o volumen a n8n, cálculo a Python, conector a Make) dejan $4$ procesos en Make, $3$ en n8n, $2$ en Python y $3$ con una persona; la regla del juicio va primero para que la facilidad no decida.
- La respuesta automática a reseñas se descarta por riesgo de engaño a los consumidores; turnos y quejas se quedan a mano, y la aprobación humana es obligatoria con riesgo $3$ o dinero.
TL Formulario v1entra en producción con $4$ módulos, $4$ créditos por ejecución, teléfono como texto conRAW, consentimiento de WhatsApp separado y una prueba que exige elid_pedidoen la respuesta; el ensayo sin red pasó $4$ de $6$ casos y dejó dos pendientes con fecha (respuesta $400$ e idempotencia).
Presupuesto
- Make consume $8,886$ créditos en el módulo 3 ($88.9%$ de Core, por encima de la alerta) y $1,924$ desde la migración del Día 45 ($19.2%$); la sincronización del Día 16 correrá en Apps Script durante marzo.
- Con Twilio, WhatsApp cuesta $23.67$ USD, el ecosistema $45.27$ y la reserva queda en $-0.27$: el recargo sobre $3,120$ mensajes de conversación ($15.60$ USD) rompe el presupuesto.
- Con la Cloud API directa, el ecosistema cuesta $26.68$ USD y deja $18.32$ de holgura frente a un ahorro de $74.91$ horas al mes, unos $303.69$ USD de tiempo de Valeria.
Mañana, en el Día 22: Make por dentro: escenarios, módulos, paquetes y créditos. Hoy termina el módulo 2 con el mapa de Trigo Lento priorizado y su primer flujo real en producción, y mañana comienza el módulo 3/8, Orquestación no-code con Make, que construirá la rebanada más grande del mapa, el escenario de pedidos de WhatsApp: al terminarlo, Trigo Lento tendrá TL Pedidos WhatsApp v3 en producción, con webhook, router por tipo de mensaje, transformación de datos, manejo de errores y clasificación con Claude, y sabrá exactamente cuántos de sus $10,000$ créditos consume.
Referencias
- Dumas, M., La Rosa, M., Mendling, J. y Reijers, H. A. (2018). Fundamentals of Business Process Management (2.ª ed.). Springer. https://doi.org/10.1007/978-3-662-56509-4
- Goldratt, E. M. y Cox, J. (1984). The Goal: A Process of Ongoing Improvement. North River Press.
- Make (2026). Webhooks. Centro de ayuda de Make. https://help.make.com/webhooks
- Make (2026). Precios y planes. https://www.make.com/en/pricing
- n8n (2026). Precios de n8n. https://n8n.io/pricing/
- Twilio (2026). WhatsApp Business API pricing. https://www.twilio.com/en-us/whatsapp/pricing
- Meta (2026). Precios de la plataforma de WhatsApp Business. https://developers.facebook.com/docs/whatsapp/pricing/
- Cámara de Diputados del H. Congreso de la Unión (2025). Ley Federal de Protección de Datos Personales en Posesión de los Particulares. https://www.diputados.gob.mx/LeyesBiblio/