
Arquitecto de automatización con IA: Día 22
 Jeshua Romero Guadarrama
- 54 Min para leer
- 22 Feb, 2026
Índice de contenido
Resumen:
Un escenario de Make que funciona no es lo mismo que un escenario que se entiende. En esta entrada, que abre el módulo 3, Valeria abre por dentro el primer flujo real de Trigo Lento, TL Formulario v1: nombra cada pieza de Make (escenario, módulo, conexión, paquete, ciclo y programación), lee su blueprint exportado campo por campo, lo recorre con un lector recursivo que entra en routers y manejadores de error, y calcula sus créditos a partir de los paquetes que pasan por cada módulo: $4$ por envío, frente a $4 + n$ si cada renglón del pedido se guardara en su propia fila ($9$ con cinco renglones y $54$ con cincuenta). Al terminar, usted sabrá leer y validar un blueprint, estimar los créditos de un escenario antes de activarlo y elegir sus ajustes (secuencial, ejecuciones incompletas y datos confidenciales) con razones escritas.
¿Cómo citar el presente artículo?
Romero, J. (22 de febrero de 2026). Arquitecto de automatización con IA: Día 22. python-data-engineer. https://www.python-data-engineer.com/post/aai/dia_22/.
Arquitecto de automatización con IA: Día 22 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/aai/dia_22/.
Precios, límites y políticas de Make, n8n, Zapier, WhatsApp (Meta, Twilio, Wati) y de la API de Claude revisados en octubre de 2026. El blueprint del Bloque 2 tiene la estructura verificada contra la documentación de Make (formato de exportación con flow y metadata, identificadores como gateway:CustomWebHook y google-sheets:addRow), revisado en octubre de 2026; no es la exportación de una cuenta real y sus identificadores son valores de ejemplo. Las reglas de consumo de créditos y los ajustes del escenario se contrastaron con el centro de ayuda y la academia de Make en la misma fecha.
Día 22. Make por dentro: escenarios, módulos, paquetes y créditos
Introducción
Ayer, en el Día 21 (Sesión práctica: el mapa de automatización de Trigo Lento), Valeria inventarió y priorizó los procesos de la panadería, asignó cada uno a una plataforma con razones explícitas y revisó el presupuesto, y Trigo Lento ganó su mapa de automatización y su primer flujo real, TL Formulario v1, con un webhook que ya recibe envíos de prueba. Hoy comienza el módulo 3/8, Orquestación no-code con Make: doce días para construir en Make el escenario de pedidos de Trigo Lento con criterio profesional, desde el disparador hasta el manejo de errores y la clasificación con un modelo de lenguaje, hasta dejar TL Pedidos WhatsApp v3 en producción. Make se llamó Integromat hasta febrero de 2022, cuando la empresa checa que lo creó, adquirida por Celonis en 2020, cambió el nombre del producto; si encuentra tutoriales antiguos con “Integromat” en el título, hablan de la misma plataforma.
Es domingo 22 de febrero, a media tarde. La panadería cerró a las dos, el obrador está limpio y la masa madre descansa para el lunes. Valeria aprovecha la calma para mirar con atención lo que construyó ayer. El escenario funciona: cada vez que alguien llena el formulario de la página web, aparece una fila en la hoja de pedidos y el navegador del cliente recibe un “recibido”. Pero cuando intenta explicárselo a su padre, se da cuenta de que no sabe responder preguntas sencillas: qué pasa si dos clientes envían el formulario en el mismo segundo, dónde queda guardado el nombre de cada cliente después de cada ejecución, o cuántos créditos de Make gasta un pedido de cinco panes distintos. Hizo funcionar el escenario siguiendo las pantallas; ahora quiere entenderlo.
Don Ernesto, que ha estado revisando la libreta de compras en la mesa de al lado, levanta la vista cuando oye la palabra “créditos”: “Valeria, explíqueme una cosa. Si un cliente pide cinco panes distintos en el formulario, ¿Make me cobra cinco veces? Porque con el proveedor de harina pago por bulto, no por puñado.” La pregunta es mejor de lo que parece. La respuesta corta es “depende de cómo esté construido el escenario”, y Don Ernesto ya dejó claro en el Día 12 que “depende” no es una respuesta. La respuesta larga, con números, ocupa buena parte de esta entrada.
En la presente entrada, descubrirá cómo está hecho Make por dentro: qué son un escenario, un módulo, una conexión, un paquete y un ciclo, y cómo se ve la interfaz sin necesidad de capturas de pantalla. Leerá el blueprint de TL Formulario v1 campo por campo, lo recorrerá con una función de Python que entra en routers anidados y en manejadores de error, y lo dibujará con la paleta de formas de la serie. Después calculará los créditos de una ejecución a partir de los paquetes que pasan por cada módulo, verá por qué un iterador multiplica el consumo, simulará $10,000$ meses de envíos, escribirá un validador que detiene blueprints con secretos o conexiones reales y elegirá los ajustes del escenario con un historial simulado de $30$ días. Al final, TL Formulario v1 quedará documentado como TL Formulario v2, con su ficha y sus razones por escrito.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Describir los elementos de Make: escenario, módulo, conexión, paquete (bundle), ciclo y programación.
- Leer un blueprint exportado campo por campo y recorrerlo con Python, incluidos los routers anidados.
- Calcular créditos a partir de paquetes y módulos.
- Configurar un escenario: ejecución secuencial, errores consecutivos máximos, ejecuciones incompletas y datos confidenciales.
Qué es Make
Make es una plataforma en la nube para construir automatizaciones uniendo piezas visuales. Su unidad de trabajo es el escenario: un flujo con un disparador y una serie de pasos que se ejecutan cada vez que el disparador lo indica. En el vocabulario que la serie usa desde el Día 3, un escenario es un flujo; Make le da ese nombre porque en su editor el flujo se ve como una escena, con piezas redondas unidas por líneas, que se representa de izquierda a derecha.
Cada pieza del escenario es un módulo. Un módulo es una operación concreta de una aplicación concreta: “recibir un webhook personalizado”, “añadir una fila a una hoja de Google”, “establecer variables”, “responder al webhook”. Make agrupa los módulos por aplicación (Google Sheets, Gmail, Slack, HTTP, sus propias herramientas internas) y, dentro de cada aplicación, por el papel que cumplen: disparadores, que inician el escenario; acciones, que hacen algo; búsquedas, que devuelven resultados; y, entre las herramientas internas, iteradores, agregadores y routers, que no hablan con ninguna aplicación externa, sino que dan forma a los datos que circulan. El Día 23 dedicará una entrada entera a los tipos de módulo; hoy basta con saber que cada uno tiene un identificador interno con la forma aplicación:módulo, como google-sheets:addRow, y que ese identificador es el que aparece en el blueprint.
Para hablar con una aplicación externa, un módulo necesita una conexión: la autorización que Valeria dio, una sola vez, para que Make actúe en su nombre en Google Sheets. La conexión guarda el token de OAuth o la clave de API; el módulo solo guarda una referencia a ella. Esa separación es la que el Día 16 y el Día 17 (Seguridad I: OAuth, secretos y mínimo privilegio en las conexiones) convirtieron en regla: el secreto vive en la conexión, nunca en el escenario, y cada conexión pide el alcance mínimo que necesita.
Lo que viaja entre módulos son paquetes (en la documentación en inglés, bundles). Un paquete es un conjunto de datos con estructura, parecido a un diccionario de Python o a una fila con encabezados: el webhook de TL Formulario v1 produce un paquete con los campos nombre, telefono, fecha_entrega, renglones y consentimiento_whatsapp. La regla que más importa de toda la entrada cabe en una frase: cada módulo se ejecuta una vez por cada paquete que recibe. Si un módulo recibe un paquete, trabaja una vez; si recibe cinco, trabaja cinco veces. Es la regla que responderá a Don Ernesto.
Una ejecución completa del escenario se llama ejecución (run) y, por dentro, puede tener uno o varios ciclos. En un escenario con disparador instantáneo, como un webhook, cada envío produce normalmente una ejecución de un ciclo. En uno con disparador de sondeo, que pregunta cada cierto tiempo si hay datos nuevos, una ejecución puede repetir el ciclo varias veces para procesar lo pendiente, hasta el máximo de ciclos configurado. Cada ciclo pasa por cuatro fases que conviene conocer porque explican los ajustes de la sección de configuración: inicialización (se abren las conexiones), operación (los módulos trabajan), confirmación o reversión (los cambios se dan por buenos o se deshacen, en los módulos que lo permiten) y finalización (se cierran las conexiones).
Por último, la programación dice cuándo se ejecuta el escenario: de inmediato cuando llega un dato (disparadores instantáneos), a intervalos regulares (cada $15$ minutos como mínimo en el plan gratuito, según la Tabla B de la serie), a horas o días fijos, o solo a demanda. Un escenario programado, además, tiene que estar activo: un interruptor lo enciende o lo apaga sin borrar nada.
La Tabla 1 reúne los seis conceptos con su equivalente en el escenario de Valeria:
Tabla 1. Conceptos de Make y su equivalente en TL Formulario v1.
| Concepto | Qué es | En TL Formulario v1 |
|---|---|---|
| Escenario | El flujo completo, con disparador, pasos y ajustes | TL Formulario v1, cuatro módulos |
| Módulo | Una operación de una aplicación (aplicación:módulo) | Webhook, variables, añadir fila, responder |
| Conexión | La autorización guardada para hablar con una aplicación | La cuenta de Google de Trigo Lento, solo hojas |
| Paquete | Un conjunto de datos que viaja entre módulos | Un envío del formulario, con sus renglones |
| Ciclo | Una pasada de los datos por el escenario dentro de una ejecución | Un ciclo por envío |
| Programación | Cuándo se ejecuta el escenario | Inmediata: cada envío dispara una ejecución |
La interfaz, descrita
La serie no usa capturas de pantalla de Make, por dos razones: no se pueden generar con código y caducan en cuanto la plataforma rediseña un botón. En su lugar, la Figura 1 describe la interfaz en esquema, con los nombres en español y sin logotipos; sirve para orientarse en cualquier versión del editor, porque las piezas cambian de sitio pero no de función.
El centro del editor es el lienzo: una superficie en blanco donde cada módulo aparece como una burbuja redonda con el icono de su aplicación. Las burbujas se unen con líneas que indican el orden: el paquete que sale de una entra en la siguiente. Si se hace clic sobre una línea, se puede poner un filtro, una condición que deja pasar o detiene cada paquete; si se añade un router, el lienzo se ramifica en varias rutas, cada una con su propia fila de burbujas.
Al abrir un módulo aparece su formulario de configuración. En los campos que reciben datos de módulos anteriores se abre el panel de mapeo, una ventana con los campos que entregaron los módulos previos (se arrastran al campo) y con pestañas de funciones de texto, números, fechas y listas. Lo que en el panel se ve como una píldora de color con la etiqueta “nombre” del módulo 1, en el blueprint se escribe {{1.nombre}}: esa es la sintaxis de mapeo que leerá el Bloque 3.
En la parte inferior del editor hay una barra con los controles del escenario: el botón de ejecutar una vez, para probar sin activar; el reloj de programación, que abre los ajustes de cuándo se ejecuta; el engranaje de ajustes del escenario, que la sección de configuración recorrerá uno por uno; y el interruptor de activación. Fuera del editor, la página del escenario tiene un historial con una fila por ejecución (fecha, duración, créditos y estado) y una pestaña de ejecuciones incompletas para las que se detuvieron por un error y esperan una decisión. Después de una ejecución de prueba, cada burbuja muestra un pequeño contador; al hacer clic en él se ven los paquetes que entraron y salieron de ese módulo, que es la mejor forma de comprobar a mano la regla de los paquetes.
La Figura 1 reúne esas piezas en un único esquema:
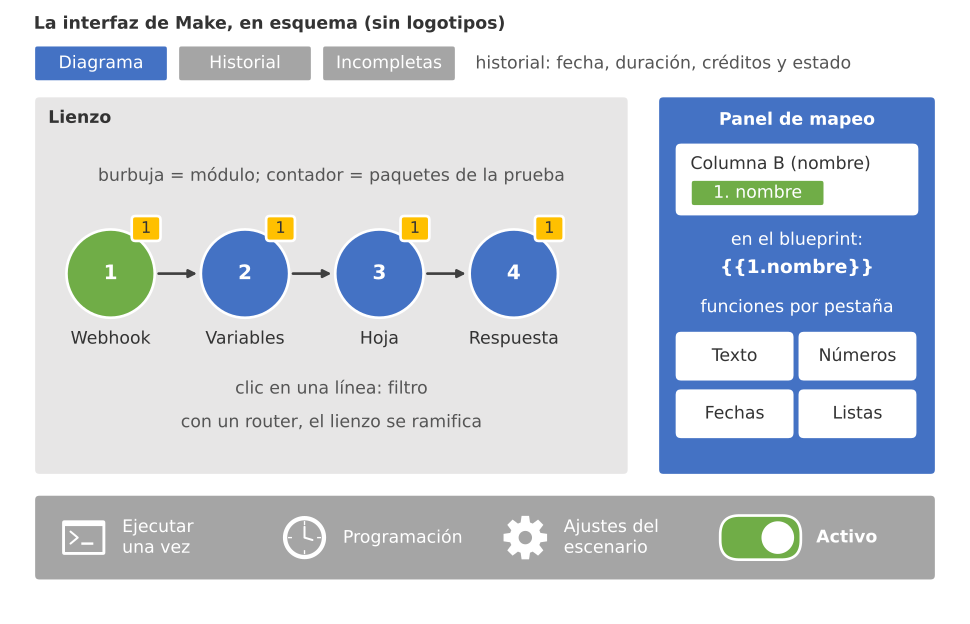
Figura 1. La interfaz de Make, en esquema: lienzo con las burbujas de TL Formulario v1, panel de mapeo con la sintaxis {{1.nombre}}, barra con ejecutar una vez, reloj de programación, engranaje de ajustes e interruptor de activación, e historial con ejecuciones incompletas.
Anatomía de un blueprint
Lo que el lienzo muestra con burbujas, Make lo guarda como un documento JSON llamado blueprint. Se obtiene desde el menú del escenario, con la opción de exportar el blueprint, y se puede volver a importar en otra cuenta o en otro equipo de Make; la API de Make lo devuelve en el punto de acceso GET /scenarios/{scenarioId}/blueprint y, en las peticiones de creación y actualización, lo recibe como una cadena de texto con el JSON dentro, no como un objeto. El Día 11 ya mostró un blueprint de dos módulos; el de hoy es el de TL Formulario v1, con los cuatro módulos que Valeria montó ayer: el webhook personalizado, el módulo de establecer variables (que calcula el identificador del pedido, la lista de productos y el número de renglones), el de añadir una fila a la hoja Pedidos y el de responder al webhook.
Antes de mostrarlo, el bloque de importaciones de siempre, con la semilla global $2026$, la carpeta del día y dos supuestos que se usarán toda la entrada: la cuota de $10,000$ créditos de Make Core y los envíos del formulario al mes, el $15%$ de los $468$ encargos:
# Importaciones base, semilla de la serie y carpeta del día en Python:
import warnings
warnings.filterwarnings('ignore')
import copy
import json
import re
from pathlib import Path
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 120)
carpeta = Path('trigo_lento') / 'dia_22'
flujos = carpeta / 'flujos' / 'make'
flujos.mkdir(parents = True, exist_ok = True)

# Supuestos del día: cuota de Make Core y envíos del formulario web al mes:
CUOTA_CORE = 10_000                     # créditos al mes (revisado en octubre de 2026)
FORMULARIOS_MES = round(0.15 * 468)     # el 15 % de los 468 encargos llega por el formulario
print('numpy', np.__version__, '| pandas', pd.__version__)
print('Cuota de Make Core:', CUOTA_CORE, 'créditos | envíos del formulario al mes:', FORMULARIOS_MES)
numpy 2.4.6 | pandas 3.0.3
Cuota de Make Core: 10000 créditos | envíos del formulario al mes: 70
Los envíos del formulario son $70$ al mes, la misma cifra que el Día 11 usó para el flujo del formulario a la hoja. Ahora sí, el blueprint, guardado en trigo_lento/dia_22/flujos/make/formulario_v1.blueprint.json:
{
  "name": "TL Formulario v1",
  "flow": [
    {
      "id": 1,
      "module": "gateway:CustomWebHook",
      "version": 1,
      "parameters": {"hook": 0, "maxResults": 1},
      "mapper": {},
      "metadata": {"designer": {"x": 0, "y": 0}}
    },
    {
      "id": 2,
      "module": "util:SetVariables",
      "version": 1,
      "parameters": {},
      "mapper": {
        "variables": [
          {"name": "id_pedido", "value": "TL-F{{formatDate(now; \"YYMMDDHHmmss\")}}"},
          {"name": "productos", "value": "{{join(map(1.renglones; \"producto\"); \", \")}}"},
          {"name": "n_renglones", "value": "{{length(1.renglones)}}"}
        ],
        "scope": "roundtrip"
      },
      "metadata": {"designer": {"x": 300, "y": 0}}
    },
    {
      "id": 3,
      "module": "google-sheets:addRow",
      "version": 2,
      "parameters": {"__IMTCONN__": 0},
      "mapper": {
        "mode": "select",
        "spreadsheetId": "/ID_DE_EJEMPLO",
        "sheetId": "Pedidos",
        "includesHeaders": true,
        "insertDataOption": "INSERT_ROWS",
        "valueInputOption": "USER_ENTERED",
        "insertUnformatted": false,
        "values": {
          "0": "{{2.id_pedido}}",
          "1": "{{1.nombre}}",
          "2": "{{1.telefono}}",
          "3": "{{2.productos}}",
          "4": "{{2.n_renglones}}",
          "5": "{{1.fecha_entrega}}",
          "6": "{{1.consentimiento_whatsapp}}",
          "7": "{{now}}"
        }
      },
      "metadata": {"designer": {"x": 600, "y": 0}}
    },
    {
      "id": 4,
      "module": "gateway:WebhookRespond",
      "version": 1,
      "parameters": {},
      "mapper": {
        "status": "200",
        "body": "{\"recibido\": true, \"id_pedido\": \"{{2.id_pedido}}\"}",
        "headers": [{"key": "Content-Type", "value": "application/json"}]
      },
      "metadata": {"designer": {"x": 900, "y": 0}}
    }
  ],
  "metadata": {
    "instant": true,
    "version": 1,
    "scenario": {"roundtrips": 1, "maxErrors": 3, "autoCommit": true, "autoCommitTriggerLast": true, "sequential": false, "confidential": false, "dataloss": false, "dlq": false, "freshVariables": false},
    "designer": {"orphans": []}
  }
}
El archivo tiene dos partes de primer nivel, además del nombre: la lista flow, con los módulos en el orden en que se ejecutan, y el objeto metadata, con los ajustes del escenario y del editor. La Tabla 2 explica cada campo, incluidos tres que este blueprint no usa pero que aparecerán en los próximos días: filter, routes y onerror.
Tabla 2. Campos del blueprint de Make y su papel (estructura verificada contra la documentación, revisado en octubre de 2026).
| Campo | Nivel | Qué guarda | Ejemplo en TL Formulario v1 |
|---|---|---|---|
name | Escenario | Nombre visible del escenario | TL Formulario v1 |
flow[] | Escenario | Lista ordenada de módulos | Cuatro módulos, del 1 al 4 |
id | Módulo | Número entero único; es el n de {{n.campo}} | 3 para añadir fila |
module | Módulo | Aplicación y operación, aplicación:módulo | google-sheets:addRow |
version | Módulo | Versión de la implementación del módulo | 2 en la hoja, 1 en el resto |
parameters | Módulo | Configuración estática, incluida la conexión __IMTCONN__ | {"__IMTCONN__": 0} |
mapper | Módulo | Valores mapeados desde módulos anteriores | "5": "{{1.fecha_entrega}}" |
metadata.designer | Módulo | Posición de la burbuja en el lienzo, x e y enteros | {"x": 600, "y": 0} |
filter | Módulo | Condición que deben cumplir los paquetes para llegar a él | No se usa hoy |
routes | Router | Lista de rutas, cada una con su propio flow | No se usa hoy |
onerror | Módulo | Manejadores de error (builtin:Break, builtin:Resume, …) | No se usa hoy |
metadata.scenario | Escenario | Ajustes: ciclos, errores, secuencial, confidencial, incompletas | Valores por omisión |
Tres detalles del archivo merecen una lectura atenta:
- Las referencias cruzan módulos por número. En el módulo $3$, la columna $0$ recibe
{{2.id_pedido}}(la variable que calculó el módulo $2$) y la columna $1$ recibe{{1.nombre}}(el campo que entregó el webhook). Si un día Valeria borra el módulo $2$ y lo vuelve a crear, recibirá otro número, y todas las referencias{{2.algo}}quedarán rotas. Es una de las razones por las que conviene leer los blueprints con código. - Las funciones de Make viven dentro de las cadenas.
{{join(map(1.renglones; "producto"); ", ")}}toma la lista de renglones, extrae el campoproductode cada uno conmapy los une con comas conjoin;{{length(1.renglones)}}cuenta los renglones. Make separa los argumentos con punto y coma, no con coma. - No hay secretos. La conexión con Google aparece como
"__IMTCONN__": 0y el número del webhook como"hook": 0: en una exportación real serían los identificadores internos de la cuenta, y la serie los sustituye siempre por $0$, porque el número del webhook permitiría reconstruir la URL a la que cualquiera podría enviar pedidos falsos.
La Figura 2 muestra la misma estructura como un árbol, con las ramas que hoy están vacías (routes y onerror) dibujadas para que se vea dónde crecerá el escenario en los días siguientes.
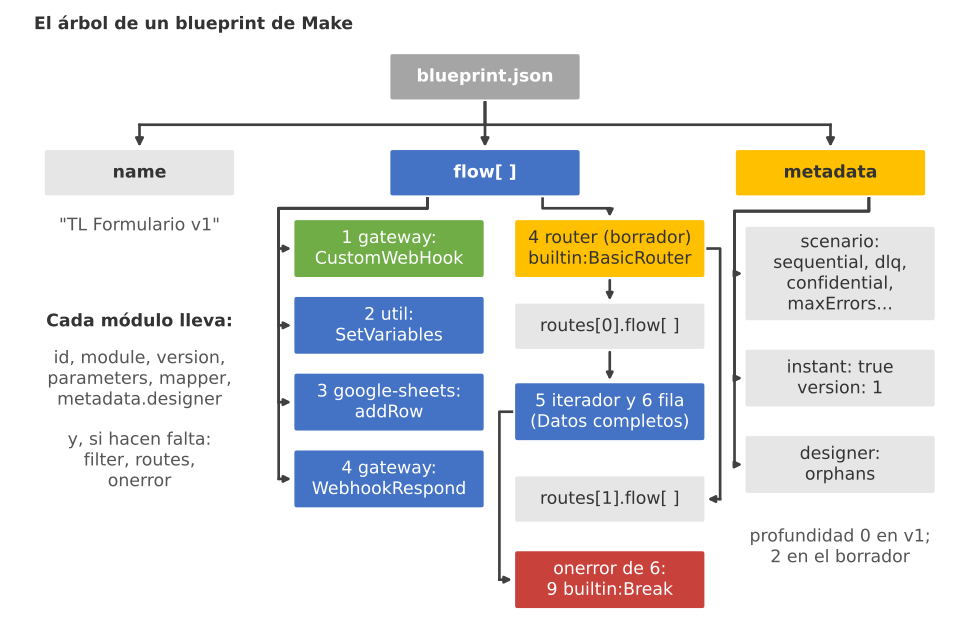
Figura 2. El árbol de un blueprint: el nombre, la lista flow con los cuatro módulos de TL Formulario v1, el router del borrador con sus routes y su flow anidado, el manejador onerror y los ajustes de metadata.scenario.
Leer un blueprint con Python
Un blueprint de cuatro módulos se lee a ojo. Uno de veinte, con dos routers y manejadores de error, no. La razón para leerlo con código es la misma que la del Día 11: un arquitecto audita, compara y documenta flujos sin abrir la plataforma, y lo hace igual para el primer escenario que para el último.
El primer paso es cargar el archivo y recorrer sus módulos. El siguiente bloque usa json.loads sobre el archivo del Bloque 2, separa cada identificador en aplicación y operación, asigna a cada módulo su tipo en la paleta de formas de la serie (disparador, acción, decisión, error) y busca, con una expresión regular, de qué módulos lee cada mapper: cada {{n.campo}} es una dependencia del módulo n:
# Carga del blueprint y recorrido de sus módulos con su tipo en Python:
blueprint = json.loads((flujos / 'formulario_v1.blueprint.json').read_text(encoding = 'utf-8'))

TIPOS = {   # identificador de módulo -> tipo de la paleta de formas de la serie
    'gateway:CustomWebHook': 'disparador', 'gateway:WebhookRespond': 'accion',
    'util:SetVariables': 'accion', 'google-sheets:addRow': 'accion',
    'builtin:BasicFeeder': 'accion', 'builtin:BasicAggregator': 'accion',
    'builtin:BasicRouter': 'decision', 'builtin:Break': 'error', 'builtin:Resume': 'error',
    'builtin:Ignore': 'error', 'builtin:Rollback': 'error', 'builtin:Commit': 'error',
}

def referencias(mapper):
    # Módulos de los que lee un mapper: cada {{n.campo}} apunta al módulo n:
    return sorted({int(n) for n in re.findall(r'\{\{[^}]*?\b(\d+)\.\w+', json.dumps(mapper, ensure_ascii = False))})

filas = []
for m in blueprint['flow']:
    app, accion = m['module'].split(':')
    filas.append({'id': m['id'], 'app': app, 'accion': accion, 'version': m['version'],
                  'tipo': TIPOS[m['module']], 'lee_de': referencias(m['mapper']) or '-',
                  'x': m['metadata']['designer']['x']})
print('Escenario:', blueprint['name'], '| instantáneo:', blueprint['metadata']['instant'],
      '| módulos:', len(blueprint['flow']))
print(pd.DataFrame(filas).to_string(index = False))
print('Ajustes:', blueprint['metadata']['scenario'])
Escenario: TL Formulario v1 | instantáneo: True | módulos: 4
 id           app         accion  version       tipo lee_de   x
  1       gateway  CustomWebHook        1 disparador      -   0
  2          util   SetVariables        1     accion    [1] 300
  3 google-sheets         addRow        2     accion [1, 2] 600
  4       gateway WebhookRespond        1     accion    [2] 900
Ajustes: {'roundtrips': 1, 'maxErrors': 3, 'autoCommit': True, 'autoCommitTriggerLast': True, 'sequential': False, 'confidential': False, 'dataloss': False, 'dlq': False, 'freshVariables': False}
La salida confirma que el escenario es instantáneo (instant: True, el webhook lo dispara al momento) y tiene cuatro módulos. La columna lee_de es la que más información da: el módulo $2$ lee solo del webhook; el módulo $3$, la hoja, lee del webhook y de las variables; y el módulo $4$, la respuesta, lee solo de las variables, porque devuelve al cliente el identificador del pedido. Con esa columna se puede dibujar el grafo de dependencias de datos, que no siempre coincide con el orden de ejecución: la respuesta va después de la hoja, pero no necesita nada de ella.
Esa observación tiene una consecuencia práctica. Hoy la respuesta al cliente espera a que la hoja de Google confirme la fila. Si la hoja tardara, el formulario de la página web se quedaría esperando; si la hoja fallara, el cliente vería un error aunque su pedido ya estuviera en las variables. El Día 23, el de los webhooks y sus respuestas, discutirá dónde conviene colocar el módulo de respuesta; hoy basta con que el blueprint lo deje a la vista.
El lector recursivo
Para dibujar el escenario hace falta convertirlo al formato de nodos y aristas de la función dibujar_flujo del Día 2. El lector del Día 11 bastaba para una lista plana de módulos, que Make encadena por su orden en flow. Pero un blueprint real no es plano: un router (builtin:BasicRouter) tiene una lista routes, y cada ruta tiene su propio flow, que puede contener otro router, con más rutas y más flow. Además, cualquier módulo puede llevar una lista onerror con manejadores. Es una estructura recursiva, un árbol, y la forma natural de recorrerla es una función que se llama a sí misma.
La función nodos_desde_blueprint del siguiente bloque hace exactamente eso. Recorre una lista de módulos; para cada uno crea un nodo con su tipo y su posición en el lienzo (metadata.designer, escalada a las unidades del dibujo y con el eje vertical invertido, porque en el lienzo de Make la y crece hacia abajo); une cada módulo con el anterior de su misma lista y pone como etiqueta de la flecha el nombre del filtro, si lo hay; y después se llama a sí misma sobre la lista onerror y sobre el flow de cada ruta, pasando como “anterior” el módulo actual. Cada llamada anota además la profundidad, para saber cuántos niveles de anidamiento tiene el escenario.
Para comprobar que el lector entra en las ramas, el bloque construye también un borrador que Valeria está considerando: después de responder al cliente, un router separa los envíos completos de los que llegan sin fecha de entrega; los completos pasan por un iterador (builtin:BasicFeeder) que parte la lista de renglones en paquetes, uno por producto, y guarda cada renglón en su propia fila; si la hoja falla, un manejador builtin:Break guarda la ejecución como incompleta y la reintenta tres veces cada $15$ minutos. Los envíos sin fecha van a una hoja de revisión. El borrador se escribe como un diccionario de Python con la misma estructura que un blueprint:
# Lector recursivo nodos_desde_blueprint y dibujo de dos escenarios en Python:
from matplotlib.patches import Ellipse, FancyBboxPatch, Polygon, RegularPolygon, FancyArrowPatch

FORMAS = {   # paleta de formas de la serie: tipo -> (forma, relleno)
    'disparador': ('ovalo', '#3a9d5d'), 'accion': ('rectangulo', '#2a78d6'),
    'decision': ('rombo', '#eb6834'), 'ia': ('rectangulo', '#7b5ea7'),
    'error': ('rectangulo', '#c8423b'), 'humano': ('hexagono', '#8a8986'),
}

def dibujar_flujo(nodos, aristas, titulo, ax = None, ancho = 2.0, alto = 0.95, recorte = 40):
    if ax is None:
        fig, ax = plt.subplots(figsize = (12, 5.6))
    for n in nodos:
        forma, color = FORMAS[n['tipo']]
        x, y = n['x'], n['y']
        if forma == 'ovalo':
            figura = Ellipse((x, y), ancho, alto)
        elif forma == 'rombo':
            figura = Polygon([(x - ancho / 2, y), (x, y + alto / 1.3), (x + ancho / 2, y), (x, y - alto / 1.3)])
        elif forma == 'hexagono':
            figura = RegularPolygon((x, y), 6, radius = ancho / 2, orientation = np.pi / 6)
        else:
            figura = FancyBboxPatch((x - ancho / 2, y - alto / 2), ancho, alto, boxstyle = 'round,pad=0.03')
        figura.set_facecolor(color)
        figura.set_edgecolor('white')
        figura.set_linewidth(2)
        ax.add_patch(figura)
        ax.text(x, y, n['texto'], ha = 'center', va = 'center', fontsize = 8.5, color = 'white')
    posicion = {n['id']: (n['x'], n['y']) for n in nodos}
    for origen, destino, etiqueta in aristas:
        (x1, y1), (x2, y2) = posicion[origen], posicion[destino]
        ax.add_patch(FancyArrowPatch((x1, y1), (x2, y2), arrowstyle = '-|>', mutation_scale = 14,
                                     shrinkA = recorte, shrinkB = recorte + 2, color = '#52514e', linewidth = 1.4))
        if etiqueta:
            ax.text((x1 + x2) / 2, (y1 + y2) / 2 + 0.22, etiqueta, ha = 'center', fontsize = 8.5,
                    color = '#52514e', bbox = dict(facecolor = 'white', edgecolor = 'none', pad = 1))
    xs, ys = [n['x'] for n in nodos], [n['y'] for n in nodos]
    ax.set_xlim(min(xs) - 1.3, max(xs) + 1.3)
    ax.set_ylim(min(ys) - 1.0, max(ys) + 1.0)
    ax.set_aspect('equal')
    ax.axis('off')
    ax.set_title(titulo, fontsize = 12)
    return ax

def nodos_desde_blueprint(bp, escala = 300 / 2.7):
    nodos, aristas = [], []
    def recorrer(flujo, previo, etiqueta, profundidad):
        for m in flujo:
            d = m['metadata']['designer']
            app, accion = m['module'].split(':')
            nodos.append({'id': m['id'], 'tipo': TIPOS.get(m['module'], 'accion'),
                          'texto': f"{m['id']} {app}\n{accion}", 'x': d['x'] / escala, 'y': -d['y'] / escala,
                          'profundidad': profundidad})
            if previo is not None:
                aristas.append((previo, m['id'], m.get('filter', {}).get('name', etiqueta)))
            recorrer(m.get('onerror', []), m['id'], 'si falla', profundidad + 1)     # manejadores
            for ruta in m.get('routes', []):                                         # rutas del router
                recorrer(ruta['flow'], m['id'], '', profundidad + 1)
            previo, etiqueta = m['id'], ''
    recorrer(bp['flow'], None, '', 0)
    return nodos, aristas

def modulo(id_, nombre, x, y, mapper = None, **extra):
    m = {'id': id_, 'module': nombre, 'version': 1, 'parameters': {}, 'mapper': mapper or {},
         'metadata': {'designer': {'x': x, 'y': y}}}
    m.update(extra)
    return m

# Borrador con router, iterador y manejador de error, escrito como diccionario:
uno, variables, fila, respuesta = copy.deepcopy(blueprint['flow'])
respuesta['id'], respuesta['metadata']['designer']['x'] = 3, 600
renglones = {'flow': [
    modulo(5, 'builtin:BasicFeeder', 1200, -150, {'array': '{{1.renglones}}'},
           filter = {'name': 'Datos completos', 'conditions': [[{'a': '{{1.fecha_entrega}}', 'o': 'exist'}]]}),
    modulo(6, 'google-sheets:addRow', 1500, -150, {'values': {'0': '{{2.id_pedido}}', '1': '{{5.producto}}',
                                                              '2': '{{5.cantidad}}'}},
           parameters = {'__IMTCONN__': 0},
           onerror = [modulo(9, 'builtin:Break', 1500, -400, {'retry': True, 'count': 3, 'interval': 15})])]}
revision = {'flow': [
    modulo(7, 'google-sheets:addRow', 1200, 150, {'values': {'0': '{{2.id_pedido}}', '1': '{{1.nombre}}'}},
           parameters = {'__IMTCONN__': 0},
           filter = {'name': 'Faltan datos', 'conditions': [[{'a': '{{1.fecha_entrega}}', 'o': 'notexist'}]]})]}
borrador = {'name': 'TL Formulario por renglones (borrador)',
            'flow': [uno, variables, respuesta,
                     modulo(4, 'builtin:BasicRouter', 900, 0, None, routes = [renglones, revision])],
            'metadata': copy.deepcopy(blueprint['metadata'])}
borrador['flow'][3]['mapper'] = None

fig, (ax1, ax2) = plt.subplots(2, 1, figsize = (12, 7.4), gridspec_kw = {'height_ratios': [1, 2.1]})
for bp, ax in [(blueprint, ax1), (borrador, ax2)]:
    nodos, aristas = nodos_desde_blueprint(bp)
    dibujar_flujo(nodos, aristas, bp['name'], ax = ax)
    print(f"{bp['name']}: {len(nodos)} nodos, {len(aristas)} aristas, "
          f"profundidad máxima {max(n['profundidad'] for n in nodos)}")
print('Aristas del borrador:', aristas)
fig.suptitle('Escenarios de Make dibujados desde su blueprint', fontsize = 16)
plt.tight_layout()
plt.show()
TL Formulario v1: 4 nodos, 3 aristas, profundidad máxima 0
TL Formulario por renglones (borrador): 8 nodos, 7 aristas, profundidad máxima 2
Aristas del borrador: [(1, 2, ''), (2, 3, ''), (3, 4, ''), (4, 5, 'Datos completos'), (5, 6, ''), (6, 9, 'si falla'), (4, 7, 'Faltan datos')]
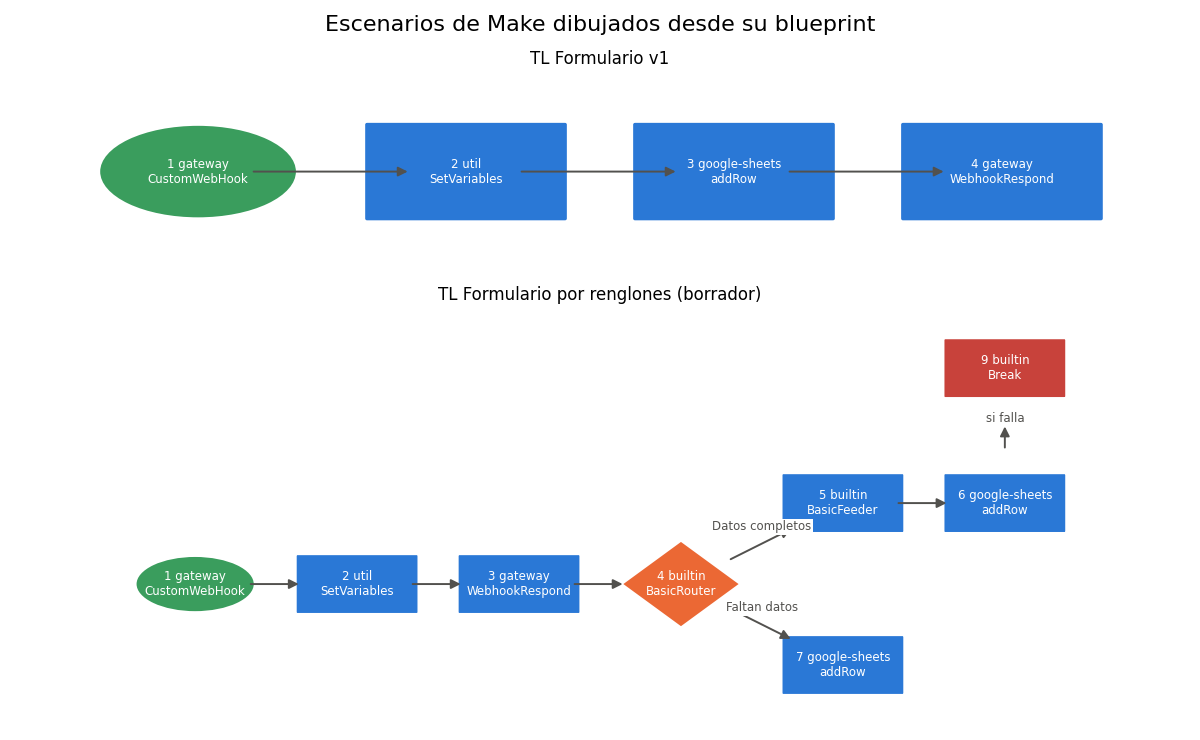
El lector produce $4$ nodos y $3$ aristas para TL Formulario v1, con profundidad máxima $0$ (no hay nada anidado), y $8$ nodos y $7$ aristas para el borrador, con profundidad máxima $2$: el router abre un nivel y el manejador de error, que cuelga de un módulo que ya está dentro de una ruta, abre el segundo. La lista de aristas del borrador muestra que las etiquetas salieron de los filtros: (4, 5, 'Datos completos') y (4, 7, 'Faltan datos'), y la arista hacia el manejador lleva la etiqueta 'si falla'.
En el dibujo, el escenario de ayer es una línea recta: un óvalo verde, el disparador, y tres rectángulos azules. El borrador ya parece un árbol: el rombo naranja del router abre dos ramas, la de arriba con el iterador y la fila por renglón, la de abajo con la hoja de revisión, y el rectángulo rojo del manejador de error queda encima de la fila que protege. Ninguna de esas formas se dibujó a mano; todas salen del JSON. Si Valeria cambia el borrador en Make, lo exporta y vuelve a ejecutar el bloque, el dibujo cambia con él.
Atención aquí: un blueprint exportado de una cuenta real puede llevar más de lo que parece. El identificador del webhook (hook) y el de cada conexión (__IMTCONN__) no son secretos por sí mismos, pero apuntan a recursos de la cuenta, y un mapper puede llevar escrita a mano una clave de API en una cabecera HTTP, una URL de webhook completa o el teléfono de un cliente de prueba que en realidad era de un cliente. Antes de guardar un blueprint en trigo_lento/flujos/, compartirlo con alguien o pegarlo en una conversación con un modelo de lenguaje, páselo por un validador como el del Bloque 7 y sustituya esos valores. Un blueprint publicado con la URL real del webhook es una invitación a que cualquiera envíe pedidos falsos que el escenario procesará, y pagará en créditos.
Paquetes y créditos
Con el escenario leído, la pregunta de Don Ernesto ya tiene dónde apoyarse. Make cobra en créditos, y según su documentación, revisada en octubre de 2026, la regla general es que cada operación de un módulo consume un crédito. Un disparador consume una operación cada vez que se ejecuta, devuelva un paquete o cincuenta; una acción consume una operación por cada paquete que procesa; los routers y los filtros no consumen ninguna. Los módulos de IA de la propia plataforma son la excepción: consumen una cantidad variable según los tokens que usan, y la serie los evitará en favor de llamadas HTTP a la API de Claude con coste conocido (Día 30).
Con esas reglas, los créditos de una ejecución son una suma:
$$ C = \sum_{m \in M} p_m $$
La lógica detrás de esta fórmula es múltiple:
- $M$ es el conjunto de módulos que consumen créditos: todos menos los routers. Los filtros no aparecen porque no son módulos, sino condiciones sobre las líneas.
- $p_m$ es el número de paquetes que entran en el módulo $m$ durante la ejecución, que es el número de veces que el módulo trabaja.
- Un módulo al que no llega ningún paquete, porque un filtro lo detuvo o porque su ruta no se tomó, tiene $p_m = 0$ y no cuesta nada.
- En conclusión, el coste de un escenario no depende de cuántos módulos tiene, sino de cuántos paquetes pasan por cada uno. Un escenario de veinte módulos puede costar menos que uno de cinco si sus filtros detienen pronto lo que no interesa.
El único problema práctico es calcular $p_m$. En TL Formulario v1 es trivial: el webhook produce un paquete, y ese paquete pasa por los cuatro módulos, así que $C = 1 + 1 + 1 + 1 = 4$, tenga el pedido un renglón o cinco, porque los cinco renglones viajan juntos dentro del mismo paquete, como una lista. El borrador es distinto. El iterador recibe un paquete con una lista de $n$ renglones y emite $n$ paquetes, uno por renglón, de modo que el módulo que lo sigue trabaja $n$ veces. Un agregador hace lo contrario: recibe $n$ paquetes y emite uno. Por eso $p_m$ se calcula propagando paquetes por el árbol, desde el disparador hasta las hojas:
$$ p_{m+1} = p_m \cdot k_m, \qquad k_m = \begin{cases} n & \text{si } m \text{ es un iterador} \ 1/p_m & \text{si } m \text{ es un agregador} \ 1 & \text{en otro caso} \end{cases} $$
La lógica detrás de esta fórmula es múltiple:
- Cada módulo pasa al siguiente tantos paquetes como recibió, salvo los dos que cambian la cuenta: el iterador la multiplica por el tamaño de la lista y el agregador la reduce a uno.
- En un router, cada ruta recibe los paquetes del router, pero solo los que pasan el filtro de su primer módulo; si el filtro no se cumple, la rama entera tiene $p_m = 0$.
- El disparador empieza la cuenta: en un webhook, un envío es un paquete, $p_1 = 1$.
- En conclusión, un iterador seguido de una acción convierte el coste de esa acción de constante en proporcional al tamaño de la lista: es el punto del escenario donde hay que mirar primero.
El siguiente bloque implementa la propagación en paquetes_por_modulo(bp, renglones, filtros_que_pasan), que devuelve, para cada módulo, cuántos paquetes recibe, y creditos(bp, paquetes), que aplica la suma excluyendo los routers. Calcula cinco casos: TL Formulario v1 con $1$ y con $5$ renglones, el borrador con $1$ y con $5$ renglones cuando el envío está completo, y el borrador con $5$ renglones cuando falta la fecha:
# Créditos de una ejecución a partir de los paquetes que pasan por cada módulo en Python:
SIN_COSTE = {'builtin:BasicRouter'}     # routers y filtros no consumen créditos

def paquetes_por_modulo(bp, renglones, filtros_que_pasan = ('Datos completos',)):
    conteo = {}
    def recorrer(flujo, p):
        for m in flujo:
            if 'filter' in m and m['filter']['name'] not in filtros_que_pasan:
                return                                 # el filtro detiene los paquetes de esta ruta
            conteo[m['id']] = (m['module'], p)         # el módulo se ejecuta una vez por paquete
            if m['module'] == 'builtin:BasicFeeder':
                p = p * renglones                      # el iterador parte el arreglo en paquetes
            elif m['module'] == 'builtin:BasicAggregator':
                p = 1                                  # el agregador los vuelve a juntar
            for ruta in m.get('routes', []):
                recorrer(ruta['flow'], p)
    recorrer(bp['flow'], 1)                            # un envío del formulario = 1 paquete
    return conteo

def creditos(bp, paquetes):
    return sum(p for modulo, p in paquetes.values() if modulo not in SIN_COSTE)

casos = [('v1, una fila por pedido', blueprint, 1, ('Datos completos',)),
         ('v1, una fila por pedido', blueprint, 5, ('Datos completos',)),
         ('borrador, una fila por renglón', borrador, 1, ('Datos completos',)),
         ('borrador, una fila por renglón', borrador, 5, ('Datos completos',)),
         ('borrador, faltan datos', borrador, 5, ('Faltan datos',))]
tabla = pd.DataFrame([{'escenario': nombre, 'renglones': n,
                       'creditos': creditos(bp, paquetes_por_modulo(bp, n, filtros))}
                      for nombre, bp, n, filtros in casos])
print(tabla.to_string(index = False))
detalle = paquetes_por_modulo(borrador, 5)
print('Paquetes por módulo (borrador, 5 renglones):',
      {i: f"{mod.split(':')[1]}={p}" for i, (mod, p) in detalle.items()})
a = creditos(borrador, paquetes_por_modulo(borrador, 0))
b = creditos(borrador, paquetes_por_modulo(borrador, 1)) - a
print(f'Borrador: créditos = {a} + {b} x renglones | v1: créditos = 4 sin importar los renglones')
                     escenario  renglones  creditos
       v1, una fila por pedido          1         4
       v1, una fila por pedido          5         4
borrador, una fila por renglón          1         5
borrador, una fila por renglón          5         9
        borrador, faltan datos          5         4
Paquetes por módulo (borrador, 5 renglones): {1: 'CustomWebHook=1', 2: 'SetVariables=1', 3: 'WebhookRespond=1', 4: 'BasicRouter=1', 5: 'BasicFeeder=1', 6: 'addRow=5'}
Borrador: créditos = 4 + 1 x renglones | v1: créditos = 4 sin importar los renglones
Ya se puede responder a Don Ernesto. Con el escenario de ayer, un pedido de cinco panes distintos cuesta $4$ créditos, igual que uno de un solo pan: Make no cobra por puñado, cobra por paquete, y el pedido entero viaja en un solo paquete. Con el borrador, el mismo pedido costaría $9$ créditos, porque el iterador convierte los cinco renglones en cinco paquetes y la hoja trabaja cinco veces. El detalle por módulo lo muestra: todos los módulos reciben $1$ paquete salvo el addRow de la rama de renglones, que recibe $5$. El router recibe $1$ paquete, pero no cuesta nada.
La última línea de la salida resume el borrador en una recta: $4 + 1 \cdot n$ créditos, con $n$ el número de renglones, frente a los $4$ fijos de la versión de ayer. En la práctica, eso significa que la diferencia de coste entre guardar el pedido en una fila y guardar cada renglón en la suya es exactamente un crédito por renglón. Cuando el envío llega sin fecha, el borrador cuesta $4$, porque la rama del iterador no se toma y la de revisión solo añade una fila.
La Figura 3 traduce la regla a la metáfora que Don Ernesto entendió a la primera: una cinta de panadería por la que avanzan cajas (los paquetes) que pasan por estaciones (los módulos), con un contador de créditos al final.
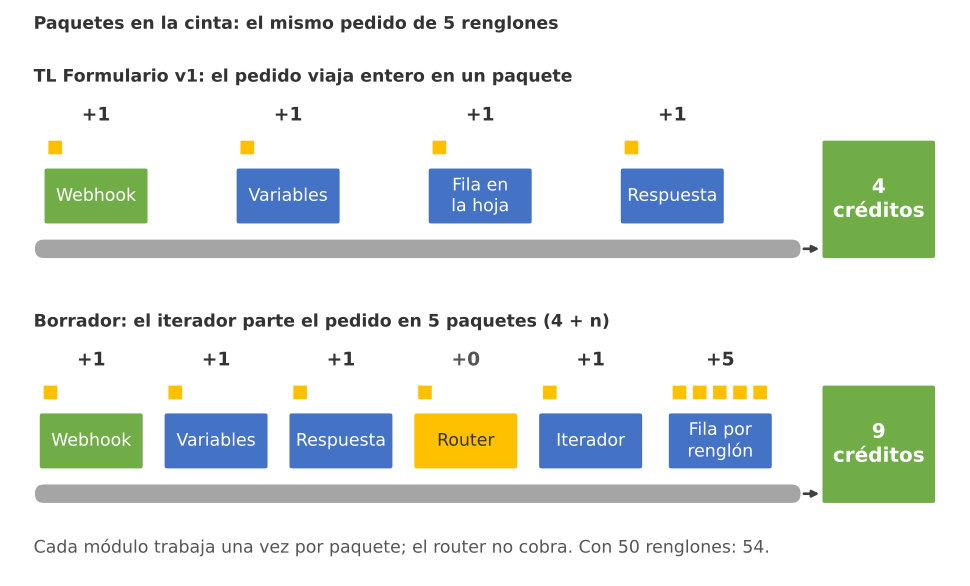
Figura 3. Paquetes en la cinta: el pedido de cinco renglones viaja en un solo paquete y cuesta 4 créditos en TL Formulario v1; con un iterador se parte en cinco paquetes y cuesta 9 (4 + n).
Créditos frente a paquetes
La regla de la recta se ve mejor dibujada, y conviene llevarla a un mes entero, porque la cuota de Make se mide por mes. El siguiente bloque hace dos cosas. Primero calcula los créditos de una ejecución de cada versión para pedidos de $1$ a $50$ renglones. Después simula $10,000$ meses con supuestos de juguete declarados: el número de envíos del mes sigue una distribución de Poisson con media $70$; cada pedido tiene $1$ renglón más un número de renglones extra que sigue una Poisson de media $1.4$ (en promedio, $2.4$ renglones por pedido); y el $88%$ de los envíos llega completo. Con esos supuestos, el consumo mensual esperado tiene una expresión cerrada:
$$ E[C_{mes}] = \lambda ,\big(a + b, q, E[n]\big) $$
La lógica detrás de esta fórmula es múltiple:
- $\lambda = 70$ es el número medio de envíos al mes; por la linealidad de la esperanza, el consumo medio del mes es $\lambda$ veces el consumo medio de un envío.
- $a = 4$ es la parte fija de cada ejecución (webhook, variables, respuesta e iterador o fila de revisión) y $b = 1$ el crédito que añade cada renglón cuando se toma la rama del iterador.
- $q = 0.88$ es la probabilidad de que el envío esté completo y $E[n] = 2.4$ los renglones medios; solo los envíos completos pagan la parte variable.
- En conclusión, para
TL Formulario v1($b = 0$) el consumo es $70 \cdot 4 = 280$ créditos; para el borrador, $70 \cdot (4 + 0.88 \cdot 2.4) = 427.8$.
# Créditos por ejecución frente a paquetes y simulación de 10 000 meses en Python:
n = np.arange(1, 51)
por_fila = np.array([creditos(blueprint, paquetes_por_modulo(blueprint, k)) for k in n])
por_renglon = np.array([creditos(borrador, paquetes_por_modulo(borrador, k)) for k in n])

# Supuestos de juguete: 1 + Poisson(1.4) renglones por pedido y 88 % de envíos completos:
MESES, Q_COMPLETO, LAMBDA_EXTRA = 10_000, 0.88, 1.4
envios = rng.poisson(FORMULARIOS_MES, MESES)
mes_v1 = 4 * envios
mes_borrador = np.array([4 * e + (rng.binomial(1, Q_COMPLETO, e) * (1 + rng.poisson(LAMBDA_EXTRA, e))).sum()
                         for e in envios])
for nombre, mes in [('v1', mes_v1), ('borrador', mes_borrador)]:
    print(f'{nombre:<9} media {mes.mean():7.1f} | p95 {np.percentile(mes, 95):6.0f} | '
          f'máx {mes.max():4d} créditos | {mes.mean() / CUOTA_CORE:.2%} de Core')
print(f'Teórico: v1 = {4 * FORMULARIOS_MES} | borrador = {FORMULARIOS_MES * (4 + Q_COMPLETO * (1 + LAMBDA_EXTRA)):.1f}')

fig, (ax1, ax2) = plt.subplots(1, 2, figsize = (12, 4.6))
ax1.plot(n, por_renglon, color = '#eb6834', lw = 2, label = 'Con iterador: una fila por renglón')
ax1.plot(n, por_fila, color = '#2a78d6', lw = 2, label = 'Sin iterador: una fila por pedido')
for k, dx, dy in [(5, 5, 9), (50, -16, 2)]:
    ax1.annotate(f'{por_renglon[k - 1]} créditos', (k, por_renglon[k - 1]), xytext = (k + dx, por_renglon[k - 1] + dy),
                 fontsize = 9, arrowprops = dict(arrowstyle = '->', color = '#52514e'))
ax1.set_xlabel('Renglones del pedido (paquetes que salen del iterador)')
ax1.set_ylabel('Créditos por ejecución')
ax1.set_ylim(0, 62)
ax1.set_title('Créditos de un envío', fontsize = 12)
ax1.legend(fontsize = 9, loc = 'upper left')
ax1.grid(color = '#e6e5e1')
ax2.hist(mes_v1, bins = np.arange(150, 650, 8), color = '#2a78d6', alpha = 0.8, label = 'v1')
ax2.hist(mes_borrador, bins = np.arange(150, 650, 8), color = '#eb6834', alpha = 0.8, label = 'Borrador por renglones')
ax2.set_xlabel('Créditos del formulario en un mes')
ax2.set_ylabel('Meses simulados')
ax2.set_title('10 000 meses de 70 envíos en promedio', fontsize = 12)
ax2.legend(fontsize = 9)
fig.suptitle('Paquetes y créditos en el formulario de Trigo Lento', fontsize = 16)
plt.tight_layout()
plt.show()
v1        media   280.1 | p95    336 | máx  412 créditos | 2.80% de Core
borrador  media   428.0 | p95    517 | máx  622 créditos | 4.28% de Core
Teórico: v1 = 280 | borrador = 427.8
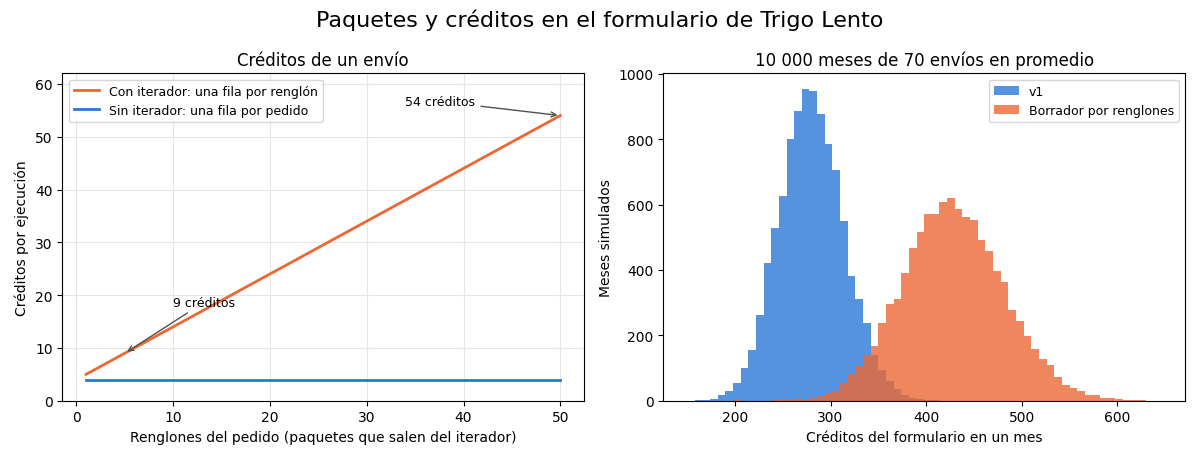
La simulación coincide con la fórmula: $280.1$ créditos al mes de media para la versión de ayer y $428.0$ para el borrador, frente a los $280$ y $427.8$ teóricos. Son el $2.80%$ y el $4.28%$ de la cuota de Make Core. En el peor de los $10,000$ meses, la versión de ayer llegó a $412$ créditos y el borrador a $622$; el percentil $95$, que es la cifra que conviene usar para planificar, es de $336$ y $517$.
El panel izquierdo de la figura es el que hay que recordar. La línea azul, una fila por pedido, es plana: $4$ créditos tenga el pedido los renglones que tenga. La naranja, una fila por renglón, sube un crédito por renglón: $9$ créditos con $5$ renglones y $54$ con $50$. Un pedido de $50$ renglones no es raro en el mundo de Trigo Lento: la Cafetería Brújula pide $40$ baguettes diarias, y si un día Marisol enviara su pedido semanal desglosado por día y producto por el formulario, el iterador lo convertiría en decenas de paquetes. Un iterador de $50$ elementos multiplica por $50$ el coste de todo lo que viene detrás, que es la nota que la Tabla B del plan de la serie dejó escrita junto al plan Core.
¿Y en el presupuesto de Trigo Lento? El Día 12 estimó que el flujo de mensajes de WhatsApp consumiría $7,644$ créditos al mes y el Día 13 que el recordatorio de recogida sumaría $962$, un total de $8,606$. Con el formulario, la suma de los consumos esperados se puede leer como una fracción de la cuota:
$$ u = \frac{1}{Q}\sum_{f} E[C_f] = \frac{7,644 + 962 + 280}{10,000} = 0.8886 $$
La lógica detrás de esta cuenta es sencilla:
- $Q = 10,000$ es la cuota mensual de créditos de Make Core y $E[C_f]$ el consumo esperado de cada escenario $f$.
- Los créditos de todos los escenarios de la cuenta salen de la misma cuota, así que se suman.
- Con la versión de ayer, el formulario lleva el uso al $88.86%$; con el borrador, a $(8,606 + 427.8) / 10,000 = 90.34%$.
- En conclusión, el formulario es barato por sí mismo, pero la cuota ya va cargada, y cada decisión de diseño que añade paquetes se paga con el margen de todos los demás escenarios.
Valeria toma nota: el borrador con iterador queda en borrador. Tener cada renglón en su propia fila sería útil para contar cuántas conchas se piden por semana, pero ese recuento se puede hacer en Python o en la propia hoja a partir de la lista de productos, sin gastar créditos. Guardar los datos juntos y separarlos donde separar es gratis es una regla que el módulo 3 aplicará más de una vez.
Validar un blueprint
Leer un blueprint con código abre una segunda posibilidad: comprobarlo antes de guardarlo, compartirlo o importarlo. El validador del siguiente bloque hace cinco comprobaciones sobre todos los módulos, incluidos los que están dentro de rutas y manejadores de error (para eso usa todos_los_modulos, un generador recursivo con la misma forma que el lector del Bloque 4):
- Identificadores únicos. Dos módulos con el mismo
idromperían las referencias{{n.campo}}: no se sabría de cuál leer. - Posiciones enteras. La referencia de la API de Make documenta
xeycomo enteros; un decimal suele delatar un blueprint editado a mano o generado por un programa sin cuidado. - Sin conexiones ni webhooks reales.
__IMTCONN__yhookdeben valer $0$ en cualquier blueprint que salga de la cuenta. - Sin secretos en el
mapper. Busca con expresiones regulares claves de Claude (sk-ant-), cabeceras con “api key”, tokensBearer, URLs de webhook de Make y teléfonos con formato mexicano real (los de prueba de la serie,+52 55 0000 00XX, no coinciden porque su bloque central empieza por cero). - Ajustes completos. Las nueve claves de
metadata.scenariodeben estar presentes, para que nadie importe un escenario con un ajuste que cambió sin darse cuenta.
Para comprobar que el validador detiene lo que debe, el bloque prepara una copia contaminada a propósito de TL Formulario v1: un webhook con número real, una conexión real, una posición decimal, un identificador repetido, una cabecera x-api-key con una clave de ejemplo y la clave dlq borrada de los ajustes:
# Validador de blueprint: ids únicos, posiciones enteras, conexiones y secretos en Python:
CLAVES_ESCENARIO = ['roundtrips', 'maxErrors', 'autoCommit', 'autoCommitTriggerLast', 'sequential',
                    'confidential', 'dataloss', 'dlq', 'freshVariables']
PATRONES_SECRETO = {'clave de Claude': r'sk-ant-[\w-]+', 'cabecera de clave': r'(?i)api[_-]?key',
                    'token Bearer': r'(?i)bearer\s+\w+', 'URL de webhook': r'https://hook\.[\w.]*make\.com/\w+',
                    'teléfono real': r'\+52\s?\d{2}\s?[1-9]\d{3}\s?\d{4}'}

def todos_los_modulos(flujo):
    for m in flujo:
        yield m
        yield from todos_los_modulos(m.get('onerror', []))
        for ruta in m.get('routes', []):
            yield from todos_los_modulos(ruta['flow'])

def validar_blueprint(bp):
    hallazgos, modulos = [], list(todos_los_modulos(bp['flow']))
    ids = [m['id'] for m in modulos]
    repetidos = sorted({i for i in ids if ids.count(i) > 1})
    if repetidos:
        hallazgos.append(f'ids repetidos: {repetidos}')
    for m in modulos:
        d = m['metadata']['designer']
        if not all(type(d.get(c)) is int for c in ('x', 'y')):
            hallazgos.append(f"módulo {m['id']}: posición no entera {d}")
        conexion = (m.get('parameters') or {}).get('__IMTCONN__')
        if conexion not in (None, 0):
            hallazgos.append(f"módulo {m['id']}: conexión real {conexion}")
        if m['module'] == 'gateway:CustomWebHook' and m['parameters'].get('hook') != 0:
            hallazgos.append(f"módulo {m['id']}: webhook real {m['parameters'].get('hook')}")
        texto = json.dumps(m.get('mapper') or {}, ensure_ascii = False)
        for nombre, patron in PATRONES_SECRETO.items():
            if re.search(patron, texto):
                hallazgos.append(f"módulo {m['id']}: {nombre} en el mapper")
    faltan = [c for c in CLAVES_ESCENARIO if c not in bp['metadata']['scenario']]
    if faltan:
        hallazgos.append(f'metadata.scenario sin {faltan}')
    return len(modulos), hallazgos

# Copia contaminada a propósito para ver que el validador la detiene:
contaminado = copy.deepcopy(blueprint)
contaminado['flow'][0]['parameters']['hook'] = 734512
contaminado['flow'][2]['parameters']['__IMTCONN__'] = 381022
contaminado['flow'][1]['metadata']['designer']['x'] = 300.5
contaminado['flow'][3]['id'] = 3
contaminado['flow'][3]['mapper']['headers'].append({'key': 'x-api-key', 'value': 'sk-ant-api03-EJEMPLO'})
del contaminado['metadata']['scenario']['dlq']
for bp in [blueprint, borrador, contaminado]:
    total, hallazgos = validar_blueprint(bp)
    print(f"{bp['name'][:38]:<38} módulos {total} | {'APTO' if not hallazgos else 'RECHAZADO'}")
    for h in hallazgos:
        print('   -', h)
TL Formulario v1                       módulos 4 | APTO
TL Formulario por renglones (borrador) módulos 8 | APTO
TL Formulario v1                       módulos 4 | RECHAZADO
   - ids repetidos: [3]
   - módulo 1: webhook real 734512
   - módulo 2: posición no entera {'x': 300.5, 'y': 0}
   - módulo 3: conexión real 381022
   - módulo 3: clave de Claude en el mapper
   - módulo 3: cabecera de clave en el mapper
   - metadata.scenario sin ['dlq']
TL Formulario v1 y el borrador salen APTOS, con $4$ y $8$ módulos revisados; que el borrador cuente $8$ confirma que el generador entró en las dos rutas y en el manejador de error. La copia contaminada sale RECHAZADA con siete hallazgos, uno por cada contaminación, más uno de propina: como el módulo de respuesta recibió el identificador $3$, el mismo que la hoja, los dos hallazgos de la cabecera aparecen atribuidos al “módulo 3”, y el primer hallazgo de la lista avisa precisamente de que hay dos. Es un buen ejemplo de por qué los identificadores repetidos se revisan primero: mientras no se corrigen, todos los demás mensajes son ambiguos.
El validador no sustituye a la revisión humana, pero la hace más barata. El Día 17 enseñó a buscar secretos que se cuelan en las exportaciones; desde hoy, esa búsqueda es una función que se ejecuta cada vez que un blueprint entra en la carpeta trigo_lento/flujos/make/, y que el Día 42 convertirá en una comprobación automática antes de cada versión.
Con el blueprint validado, Valeria hace la prueba que cierra el circuito: envía un formulario de prueba al webhook desde Python, como lo haría la página web, y comprueba la respuesta. La URL del webhook vive en una variable de entorno, TL_WEBHOOK_FORMULARIO, y no aparece ni en el código ni en el blueprint. El envío usa un teléfono con el formato de prueba de la serie y la marca prueba, para que la fila se pueda descartar. El bloque distingue tres respuestas: un 200 con el JSON que construye el módulo de respuesta (todo bien), el texto Accepted que Make devuelve cuando el escenario no tiene módulo de respuesta o no respondió a tiempo (el envío entró en la cola, pero algo no está como se esperaba) y cualquier otra cosa, ante la que no se reenvía a ciegas, porque el pedido podría estar ya en la hoja. Este bloque llama al webhook real y no se ejecutó para escribir la entrada; la salida es un ejemplo comentado:
# Envío de un formulario de prueba al webhook de TL Formulario v1 con requests en Python:
import os
import requests

# La URL real del webhook vive en una variable de entorno, nunca en el código ni en el blueprint:
URL = os.environ['TL_WEBHOOK_FORMULARIO']
prueba = {
    'nombre': 'Cliente de prueba 001',
    'telefono': '+52 55 0000 0001',                  # formato de prueba de la serie
    'correo': 'cliente@ejemplo.com',
    'fecha_entrega': '2026-02-25',
    'renglones': [{'producto': 'P08', 'cantidad': 1}, {'producto': 'P05', 'cantidad': 6}],
    'consentimiento_whatsapp': True,
    'prueba': True,                                   # la hoja marca y descarta las filas de prueba
}
respuesta = requests.post(URL, json = prueba, timeout = 30)
print('Estado:', respuesta.status_code, '| tipo:', respuesta.headers.get('Content-Type'))
print('Cuerpo:', respuesta.text[:120])
if respuesta.status_code == 200 and respuesta.headers.get('Content-Type', '').startswith('application/json'):
    print('Pedido registrado:', respuesta.json()['id_pedido'])
elif respuesta.text == 'Accepted':
    print('Make aceptó el envío en la cola, pero el escenario no respondió: revise que esté activo.')
else:
    print('Fallo: revise el historial del escenario antes de reenviar (podría duplicar el pedido).')

# Salida de ejemplo (puede variar):
# Estado: 200 | tipo: application/json
# Cuerpo: {"recibido": true, "id_pedido": "TL-F260222183015"}
# Pedido registrado: TL-F260222183015
La respuesta de ejemplo devuelve el identificador TL-F260222183015, construido por el módulo de variables con la fecha y la hora del envío. Según la documentación de Make revisada en octubre de 2026, si el escenario tiene un módulo de respuesta y no responde en $180$ segundos, Make contesta 200 Accepted por su cuenta; si el escenario falla, contesta 500 con el texto “Scenario failed to complete”; y el cuerpo de un webhook no puede pasar de $5$ MB. Ninguno de esos límites preocupa a un formulario de pedidos, pero los tres reaparecerán mañana, cuando los mensajes de WhatsApp entren por un webhook con prisa.
Configuración del escenario
La parte de metadata que todavía no se ha leído es metadata.scenario, con los ajustes que en el editor se cambian desde el engranaje. En TL Formulario v1 están todos en su valor por omisión, porque Valeria no los tocó al construirlo. La Tabla 3 traduce cada clave del blueprint al ajuste del editor, según el centro de ayuda de Make revisado en octubre de 2026, y dice cuándo conviene activarlo.
Tabla 3. Ajustes del escenario en metadata.scenario, su efecto y cuándo activarlos (revisado en octubre de 2026).
| Clave | Ajuste en el editor | Qué hace | Por omisión | En Trigo Lento |
|---|---|---|---|---|
sequential | Procesar en orden | Cada ejecución termina antes de que empiece la siguiente | false | Activar: dos envíos simultáneos no deben pisarse ni duplicar pedidos |
dlq | Guardar ejecuciones incompletas | Una ejecución que falla se guarda para corregirla y reanudarla | false | Activar: un error 429 de la hoja no debe perder un pedido |
confidential | Datos confidenciales | El historial registra que hubo ejecución, pero no los datos que procesó | false | Activar: el historial no debe guardar nombres ni teléfonos |
maxErrors | Errores antes de desactivar | Errores consecutivos permitidos antes de apagar el escenario | 3 | Mantener; ojo con los disparadores instantáneos |
roundtrips | Ciclos por ejecución | Máximo de ciclos en una ejecución | 1 | Mantener: un envío, un ciclo |
autoCommit | Confirmar tras cada módulo | Los cambios se confirman módulo a módulo y no se pueden revertir | true | Mantener: la hoja no admite reversión |
autoCommitTriggerLast | Confirmar el disparador al final | El disparador se confirma el último en la fase de confirmación | true | Mantener |
dataloss | Descartar datos si el almacén está lleno | Si la carpeta de incompletas se llena, se descartan | false | Mantener desactivado: nunca perder pedidos en silencio |
freshVariables | Usar valores actualizados de variables | Al reanudar una incompleta, usa los valores actuales de las variables de equipo | false | Mantener |
Tres ajustes cambian, y cada uno responde a una pregunta que Valeria no supo contestar al principio del día:
- ¿Qué pasa si dos clientes envían el formulario en el mismo segundo? Sin procesamiento en orden, Make puede ejecutar las dos ejecuciones en paralelo. Para un escenario que solo añade una fila es casi inofensivo, pero el módulo 3 añadirá pasos que buscan un cliente y lo crean si no existe, y dos ejecuciones paralelas del mismo cliente pueden crear dos clientes. Activar
sequentialcuesta algo de latencia en las ráfagas (el Día 23 la medirá con una cola) y evita esa clase de duplicados. - ¿Qué pasa si la hoja falla? Sin ejecuciones incompletas, la ejecución se detiene y el pedido solo queda en el historial. Con
dlqactivado, queda guardado como incompleto y se puede reanudar desde el módulo que falló, a mano o con un manejador de error que reintente. - ¿Dónde queda el nombre de cada cliente? Por omisión, el historial de Make guarda los datos de entrada y salida de cada módulo, que es justo lo que permite depurar. Con
confidentialactivado, el historial solo registra que hubo una ejecución. Es la consideración ética del día: Trigo Lento trata nombres, teléfonos y consentimientos, y el aviso de privacidad del Día 6 no dice en ningún lugar que esos datos se guardarán en el historial de una plataforma de terceros.
El ajuste de datos confidenciales tiene un precio, y la documentación de Make lo dice sin rodeos: con él activado, las opciones para resolver errores quedan muy limitadas, porque no se puede ver qué paquete provocó el fallo. Por eso Valeria lo acompaña de dos prácticas: probar cada cambio con datos de prueba antes de activar el ajuste y guardar en la hoja el identificador del pedido (TL-F...), que permite encontrar el envío sin que el historial tenga que guardarlo.
Sobre maxErrors, la documentación de Make añade un matiz que conviene subrayar: en los escenarios con disparador instantáneo, como un webhook, el escenario se desactiva tras el primer error, sin esperar al número configurado. Para TL Formulario v1, eso significa que un solo error 429 de la hoja, con los ajustes por omisión, puede apagar el formulario hasta que alguien lo vuelva a encender. Guardar las ejecuciones incompletas es la forma de que un error pasajero quede guardado en lugar de detenerlo todo.
Un historial de 30 días
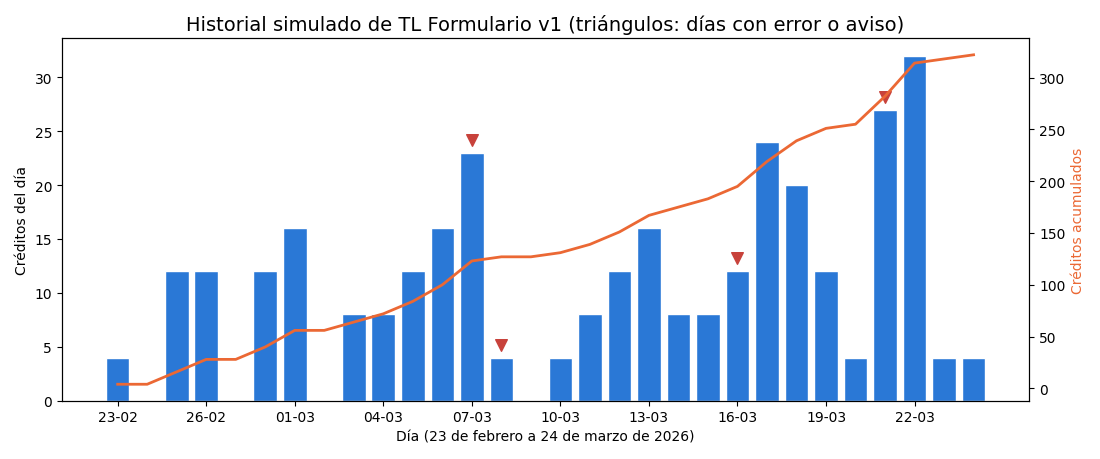
Los ajustes se entienden mejor con un mes de ejecuciones delante. Make no permite simular un historial, pero Python sí. El siguiente bloque genera $30$ días, del $23$ de febrero al $24$ de marzo, con un número de envíos diario de Poisson de media $70/30$, y asigna a cada ejecución unos renglones, una duración lognormal con mediana de $1.6$ segundos y un estado, con dos supuestos de juguete declarados: un $3%$ de errores 429 de la hoja (límite de peticiones) y un $2%$ de envíos sin fecha de entrega, que TL Formulario v1 no valida y guarda igual. Cuando la hoja falla, la ejecución consume $3$ créditos: los dos módulos que terminaron y el intento de la hoja, que se cuenta como supuesto conservador. Compara además qué pasa con esos errores con los ajustes por omisión y con las ejecuciones incompletas activadas, donde la reanudación vuelve a ejecutar la hoja y la respuesta, $2$ créditos más:
# Historial simulado de 30 días del escenario con ajustes por omisión y documentados en Python:
dias = pd.date_range('2026-02-23', periods = 30, freq = 'D')
P_429, P_DATOS = 0.03, 0.02             # supuestos: límite de la hoja y envío sin fecha
registros = []
for dia in dias:
    for k in range(rng.poisson(FORMULARIOS_MES / 30)):
        r = rng.random()
        estado = 'error 429' if r < P_429 else ('sin fecha' if r < P_429 + P_DATOS else 'éxito')
        registros.append({'dia': dia.date(), 'renglones': 1 + int(rng.poisson(LAMBDA_EXTRA)),
                          'duracion_s': round(float(rng.lognormal(np.log(1.6), 0.35)), 2), 'estado': estado,
                          'creditos': 3 if estado == 'error 429' else 4})
historial = pd.DataFrame(registros)
print(historial.head(8).to_string(index = False))
resumen = historial.groupby('estado').agg(ejecuciones = ('estado', 'size'), creditos = ('creditos', 'sum'),
                                          duracion_media = ('duracion_s', 'mean')).round(2)
print(resumen.to_string())
fallidas = (historial['estado'] == 'error 429').sum()
# Con "almacenar ejecuciones incompletas" el error 429 se reanuda desde la hoja: 2 créditos más por cada una:
print(f'Ejecuciones: {len(historial)} | créditos: {historial.creditos.sum()} | '
      f'pedidos perdidos con ajustes por omisión: {fallidas} | con incompletas: 0 '
      f'(+{2 * fallidas} créditos de reintento)')
print(f"Filas con fecha vacía que llegan a la hoja: {(historial['estado'] == 'sin fecha').sum()}")

diario = historial.groupby('dia')['creditos'].sum().reindex(dias.date, fill_value = 0)
errores = historial[historial['estado'] != 'éxito'].groupby('dia').size()
fig, ax = plt.subplots(figsize = (11, 4.6))
ax.bar(range(len(diario)), diario.values, color = '#2a78d6', edgecolor = 'white')
for i, d in enumerate(diario.index):
    if d in errores.index:
        ax.scatter(i, diario.values[i] + 1.2, marker = 'v', s = 70, color = '#c8423b', zorder = 3)
ax2 = ax.twinx()
ax2.plot(range(len(diario)), diario.cumsum().values, color = '#eb6834', lw = 2)
ax2.set_ylabel('Créditos acumulados', color = '#eb6834')
ax.set_xticks(range(0, 30, 3))
ax.set_xticklabels([d.strftime('%d-%m') for d in diario.index[::3]])
ax.set_xlabel('Día (23 de febrero a 24 de marzo de 2026)')
ax.set_ylabel('Créditos del día')
ax.set_title('Historial simulado de TL Formulario v1 (triángulos: días con error o aviso)', fontsize = 14)
plt.tight_layout()
plt.show()
       dia  renglones  duracion_s estado  creditos
2026-02-23          1        2.54  éxito         4
2026-02-25          4        2.11  éxito         4
2026-02-25          1        1.72  éxito         4
2026-02-25          2        1.75  éxito         4
2026-02-26          3        1.41  éxito         4
2026-02-26          3        1.07  éxito         4
2026-02-26          4        3.55  éxito         4
2026-02-28          1        0.81  éxito         4
           ejecuciones  creditos  duracion_media
estado
error 429            2         6            1.84
sin fecha            3        12            2.09
éxito               76       304            1.78
Ejecuciones: 81 | créditos: 322 | pedidos perdidos con ajustes por omisión: 2 | con incompletas: 0 (+4 créditos de reintento)
Filas con fecha vacía que llegan a la hoja: 3
La Tabla 4 resume el historial:
Tabla 4. Historial simulado de TL Formulario v1 en 30 días: ejecuciones, créditos y duración media por estado (supuestos de juguete declarados).
| Estado | Ejecuciones | Créditos | Duración media (s) | Qué significa |
|---|---|---|---|---|
| Éxito | 76 | 304 | 1.78 | Fila en la hoja y respuesta al cliente |
| Sin fecha | 3 | 12 | 2.09 | Fila incompleta en la hoja: nadie se entera |
| Error 429 | 2 | 6 | 1.84 | Pedido sin fila; perdido con los ajustes por omisión |
| Total | 81 | 322 | $3.22%$ de la cuota de Core |
En $30$ días hubo $81$ ejecuciones y $322$ créditos, algo más que los $280$ esperados porque este mes simulado tuvo $81$ envíos en lugar de $70$; es la variabilidad que el Bloque 6 midió con el percentil $95$. Las cifras que importan son las pequeñas:
- En primer lugar, $2$ pedidos se perdieron por errores 429 con los ajustes por omisión. Con las ejecuciones incompletas activadas, los dos se habrían reanudado por solo $4$ créditos más. Perder un pedido de pastel cuesta $420$ MXN y un cliente; reanudarlo cuesta dos créditos.
- En segundo lugar, $3$ filas llegaron a la hoja sin fecha de entrega, y el escenario las dio por buenas. Ningún ajuste lo arregla: hace falta un filtro o una validación, que es el tema del Día 24 (routers y filtros) y del contrato de datos del Día 4.
- En tercer lugar, la duración media ronda los $1.8$ segundos, lo que importa para la respuesta al cliente: el formulario espera ese tiempo por el “recibido”.
En la figura, cada barra es el consumo de un día, la línea naranja el acumulado y los triángulos rojos marcan los días con error o aviso. Los días sin barra son días sin envíos, algo normal con una media de poco más de dos envíos al día. El acumulado termina en $322$, muy lejos de los $10,000$ créditos de la cuota: el problema del formulario no es el coste, sino lo que pasa cuando algo falla.
Primer escenario: TL Formulario v1
Ayer, TL Formulario v1 nació como un escenario que funciona. Hoy termina como un escenario que se entiende, y la diferencia se puede dejar por escrito. El último bloque del día hace tres cosas: aplica a una copia del blueprint los tres ajustes de la sección anterior (procesar en orden, guardar ejecuciones incompletas y datos confidenciales) y la nombra TL Formulario v2, siguiendo la convención de la serie de que todo cambio de un escenario exportado es una versión nueva; la pasa por el validador del Bloque 7 y se niega a seguir si hay hallazgos (assert); y escribe el blueprint y una ficha del escenario, en la línea de las fichas de flujo del Día 19, con dueña, disparador, pasos, créditos, datos personales y ajustes:
# Versión documentada: ajustes del escenario, validación y ficha en Python:
documentado = copy.deepcopy(blueprint)
documentado['name'] = 'TL Formulario v2'
cambios = {'sequential': True, 'confidential': True, 'dlq': True}
antes = {c: documentado['metadata']['scenario'][c] for c in cambios}
documentado['metadata']['scenario'].update(cambios)
total, hallazgos = validar_blueprint(documentado)
assert not hallazgos, hallazgos

ruta_bp = flujos / 'formulario_v2.blueprint.json'
ruta_bp.write_text(json.dumps(documentado, ensure_ascii = False, indent = 2), encoding = 'utf-8')
ficha = [f"# {documentado['name']}",
         'Dueña: Valeria Ortiz | suplente: por nombrar | revisión: cada 3 meses',
         'Disparador: webhook del formulario web (instantáneo, 1 paquete por envío)',
         'Pasos: ' + ' -> '.join(m['module'] for m in documentado['flow']),
         f'Créditos por envío: {creditos(documentado, paquetes_por_modulo(documentado, 1))} '
         f'| al mes: {4 * FORMULARIOS_MES} de {CUOTA_CORE}',
         'Datos personales: nombre, teléfono y consentimiento de WhatsApp; historial confidencial',
         'Ajustes: ' + ', '.join(f'{c}={v}' for c, v in documentado['metadata']['scenario'].items())]
(carpeta / 'ficha_formulario_v2.md').write_text('\n'.join(ficha) + '\n', encoding = 'utf-8')
print('Cambios en metadata.scenario:', {c: f'{antes[c]} -> {v}' for c, v in cambios.items()})
print('Validación:', 'APTO' if not hallazgos else hallazgos, '| módulos:', total)
print('Escritos:', ruta_bp.as_posix(), f'({ruta_bp.stat().st_size} bytes) y ficha_formulario_v2.md')
print('\n'.join(ficha[3:5]))
Cambios en metadata.scenario: {'sequential': 'False -> True', 'confidential': 'False -> True', 'dlq': 'False -> True'}
Validación: APTO | módulos: 4
Escritos: trigo_lento/dia_22/flujos/make/formulario_v2.blueprint.json (2769 bytes) y ficha_formulario_v2.md
Pasos: gateway:CustomWebHook -> util:SetVariables -> google-sheets:addRow -> gateway:WebhookRespond
Créditos por envío: 4 | al mes: 280 de 10000
Los tres ajustes cambian de False a True, la validación sale APTA y el blueprint documentado ocupa $2,769$ bytes en trigo_lento/dia_22/flujos/make/formulario_v2.blueprint.json. La ficha resume en dos líneas lo que el día calculó: los cuatro pasos, de gateway:CustomWebHook a gateway:WebhookRespond, y $4$ créditos por envío, $280$ al mes de $10,000$.
Don Ernesto, que ha seguido la última media hora en silencio, mira la ficha impresa y resume el día a su manera: “O sea, que el pedido de cinco panes me cuesta lo mismo que el de uno, siempre que no le ponga usted esa máquina de separar renglones. Y que si la hoja se cae, el pedido se queda guardado en lugar de perderse. Eso último es lo que me importa.” Tiene razón en las dos cosas, y en el orden correcto.
Consideraciones finales
El día empezó con un escenario que funcionaba y una pregunta de Don Ernesto sobre si Make cobra por puñado, y termina con un vocabulario (escenario, módulo, conexión, paquete, ciclo y programación), un blueprint leído campo por campo, un lector recursivo que entra en routers y manejadores, una regla de créditos con su fórmula, un validador y un escenario documentado con sus ajustes elegidos por escrito. La cifra que lo resume es pequeña: $4$ créditos por envío, $280$ al mes. Lo que no es pequeño es la diferencia entre conocer esa cifra antes de activar un escenario y descubrirla en la factura. Un escenario que no se puede leer no se puede gobernar; uno que se lee con código se puede auditar, costear y documentar antes de que cueste nada.
Antes de dar por entendido un escenario de Make, conviene hacerse algunas preguntas:
- ¿Dónde está el iterador de su escenario y qué hay detrás de él? Todo lo que le sigue se paga tantas veces como elementos tenga la lista.
- ¿Qué módulo lee de cuál? Si borra un módulo y lo vuelve a crear, ¿sabe qué referencias
{{n.campo}}se rompen? - ¿Qué guarda el historial de su escenario? Si procesa datos de clientes y no es confidencial, la respuesta es “todo”.
- ¿Qué pasa con un pedido cuando el módulo más frágil falla? Si la respuesta es “se pierde”, falta activar las ejecuciones incompletas o un manejador de error.
Las cifras de hoy tienen límites claros. El blueprint tiene la estructura documentada, pero no es una exportación de una cuenta real, y los nombres internos de los módulos pueden cambiar con las versiones de las aplicaciones: antes de usarlo en producción hay que contrastarlo con una exportación propia. Las reglas de créditos son las generales de la documentación de Make; los módulos de IA y algunos módulos de tarifa fija consumen más de un crédito por operación, y el crédito de un módulo que falla se contó como supuesto conservador. Los renglones por pedido, la proporción de envíos completos, los errores 429 y las duraciones son supuestos de juguete. Ninguno de esos límites cambia la estructura de la conclusión: los créditos se calculan propagando paquetes, los iteradores son el punto caro de un escenario y los ajustes por omisión no protegen ni los pedidos ni los datos de los clientes.
Un gran libro que habla de esto es Enterprise Integration Patterns (Hohpe y Woolf), en el que los autores catalogan los patrones con los que se mueven mensajes entre sistemas: el Splitter, que parte un mensaje compuesto en varios (el iterador de Make), el Aggregator, que los vuelve a juntar, el Content-Based Router, que decide la ruta según el contenido (el router con filtros), y el Dead Letter Channel, donde van los mensajes que no se pudieron entregar (las ejecuciones incompletas). Aunque se escribió para sistemas empresariales de 2003, reconocer esos patrones en las burbujas de Make le permitirá leer cualquier plataforma de automatización con el mismo vocabulario.
Conclusiones clave
Conceptos de Make
- Un escenario es un flujo; sus piezas son módulos (
aplicación:módulo), que hablan con las aplicaciones a través de conexiones guardadas aparte, y entre ellos viajan paquetes. - Cada módulo se ejecuta una vez por paquete recibido; una ejecución tiene uno o varios ciclos, cada uno con sus fases de inicialización, operación, confirmación o reversión y finalización.
- La interfaz se resume en lienzo, burbujas, panel de mapeo, reloj de programación, engranaje de ajustes, interruptor de activación e historial; la serie la describe en esquema y no con capturas.
Blueprint
- Un blueprint tiene
name, una listaflowde módulos (id,module,version,parameters,mapper,metadata.designery, cuando hacen falta,filter,routesyonerror) y un objetometadatacon los ajustes; la API lo envía como cadena. - Un lector recursivo entra en
routesyonerror:TL Formulario v1tiene $4$ nodos y profundidad $0$; el borrador con router, iterador y manejador, $8$ nodos y profundidad $2$. - El validador revisa ids únicos, posiciones enteras,
hooky__IMTCONN__en $0$, secretos en elmappery las nueve claves demetadata.scenario; detuvo la copia contaminada con siete hallazgos. TL Formulario v2activa el procesamiento en orden, las ejecuciones incompletas y los datos confidenciales, y queda guardado con su ficha.
Créditos
- Los créditos de una ejecución son $C = \sum_m p_m$: cada operación cuesta un crédito, el disparador uno por ejecución, y routers y filtros nada.
- Un pedido de cinco panes cuesta $4$ créditos en
TL Formulario v1y $9$ con un iterador que guarda cada renglón en su fila ($4 + n$); con $50$ renglones, $54$. - Al mes, $280$ créditos frente a $427.8$ ($2.80%$ y $4.28%$ de Make Core); sumados a los $8,606$ de los días 12 y 13, el uso de la cuota llega al $88.86%$, y en un historial de $30$ días los ajustes por omisión perdieron $2$ pedidos que las incompletas habrían salvado por $4$ créditos.
Mañana, en el Día 23: Disparadores, acciones y módulos en Make. Los mensajes de WhatsApp entrarán a Make por primera vez: Valeria distinguirá los tipos de módulo, configurará un webhook personalizado con su respuesta explícita, verificará que cada mensaje viene de verdad de Twilio y medirá si la cola del webhook aguanta la hora pico con ejecución secuencial.
Referencias
- Make (2026). Centro de ayuda: escenarios, ajustes del escenario, paquetes y ejecuciones incompletas. https://help.make.com/scenario-settings
- Make (2026). Referencia de la API: escenarios y blueprints. https://developers.make.com/api-documentation
- Make (2026). Webhooks: Custom webhook y Webhook Response. https://apps.make.com/gateway
- Make Academy (2026). Make Foundation: Operations and Credits. https://academy-content.make.com/courses/make-foundation-operations-credits/02-credit-consumption-in-make
- Make (2026). Precios y créditos. https://www.make.com/en/pricing
- Hohpe, G. y Woolf, B. (2003). Enterprise Integration Patterns: Designing, Building, and Deploying Messaging Solutions. Addison-Wesley.