
Arquitecto de automatización con IA: Día 25
 Jeshua Romero Guadarrama
- 63 Min para leer
- 25 Feb, 2026
Índice de contenido
Resumen:
Un pedido que dice “pal sábado” no es una fecha hasta que alguien la calcula, y calcularla mal cuesta una semana de error. En esta entrada, Valeria aprende a transformar datos dentro de Make: compara doce funciones de texto, número, fecha y arreglo con su equivalente en Python (y encuentra cuatro que no se comportan igual), fija la zona America/Mexico_City en cada fecha, rebana el pedido con un iterador y lo vuelve a juntar con un agregador ($8 + n$ créditos por pedido), normaliza $200$ pedidos de juguete ($64.0%$ completos solo con reglas) y decide con números qué se resuelve con reglas, qué con código o con un modelo de lenguaje y qué con una persona. Al terminar, usted sabrá escribir transformaciones de Make que no dependan del reloj del servidor, contar lo que cuestan y dejar TL Pedidos WhatsApp v2.1 listo con su blueprint.
¿Cómo citar el presente artículo?
Romero, J. (25 de febrero de 2026). Arquitecto de automatización con IA: Día 25. python-data-engineer. https://www.python-data-engineer.com/post/aai/dia_25/.
Arquitecto de automatización con IA: Día 25 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/aai/dia_25/.
Precios, límites y políticas de Make, n8n, Zapier, WhatsApp (Meta, Twilio, Wati) y de la API de Claude revisados en octubre de 2026. Las firmas y los ejemplos de formatDate, parseDate, addDays, setDay, parseNumber, round, replace, get, map, length y join se contrastaron con el centro de ayuda de Make en octubre de 2026, igual que el cobro de la aplicación de código de Make (dos créditos por segundo de ejecución). El fragmento de blueprint del Bloque 6 y el blueprint completo del Bloque 9 tienen la estructura verificada contra la documentación, revisado en octubre de 2026; no son la exportación de una cuenta real, sus identificadores son valores de ejemplo y los nombres internos de los módulos (builtin:BasicFeeder, builtin:BasicAggregator) deben contrastarse con una exportación propia antes de usarlos.
Día 25. Transformar datos en Make: funciones, iteradores y agregadores
Introducción
Ayer, en el Día 24 (Routers y filtros: decidir sin código), Valeria ordenó las rutas del router de Make, escribió filtros con grupos de condiciones y los probó en Python con $200$ mensajes simulados hasta dejar sin huecos ni solapes el árbol de decisión, y Trigo Lento ganó TL Pedidos WhatsApp v2, con seis rutas y una de respaldo que termina en una persona. Hoy el router ya sabe qué es un pedido; lo que todavía no sabe es leerlo.
Es miércoles 25 de febrero, a media mañana, y Valeria revisa con calma lo que pasó la semana anterior. El viernes 20, a las once y media de la noche, una clienta escribió por WhatsApp: “hola, me aparta 2 hogazas y 1 pay de queso pal sábado, soy Lucía”. La versión 2 del escenario hizo lo que tenía que hacer: reconoció el pedido, lo mandó por la ruta correcta y guardó una fila en la hoja de pedidos. Pero la columna de la fecha de entrega se llenó con {{now}}, la fecha en que llegó el mensaje, porque nadie le había enseñado al escenario a convertir “pal sábado” en un día del calendario. El obrador planeó el sábado sin ese pay de queso. Lucía llegó a las diez, se llevó sus hogazas y una disculpa, y el pay salió el lunes.
El lunes, Valeria intentó arreglarlo con una fórmula rápida en el panel de mapeo: tomar la fecha actual, buscar el próximo sábado y formatearla. Probó con el mensaje de Lucía y la hoja devolvió 2026-02-28. Una semana tarde. La fórmula era correcta; el reloj con el que se calculaba, no. La organización de Make de Trigo Lento estaba configurada en UTC, y a las 23:30 del viernes en la Ciudad de México en UTC ya eran las 05:30 del sábado: para el servidor, “el próximo sábado que no sea hoy” era el 28.
Don Ernesto escucha la historia mientras amasa y no tarda en dar su veredicto: “Eso de las zonas horarias es cosa de aeropuertos, Valeria. Aquí todos vivimos en la misma hora. Y si la computadora no entiende ‘pal sábado’, póngale la inteligencia artificial esa, que dicen que entiende todo.” Tiene razón en una cosa: un modelo de lenguaje entiende “pal sábado” sin esfuerzo. Pero para convertirlo en una fecha también necesita saber qué día es hoy en el obrador, y si se lo dice un servidor en UTC se equivocará exactamente igual. Además, como verá hoy con números, la mayoría de los pedidos se resuelven con reglas que cuestan una fracción de centavo, no viajan a ningún proveedor externo y no se equivocan dos veces de la misma forma.
En la presente entrada, descubrirá las funciones de Make que transforman texto, números, fechas y arreglos, y comprobará en Python cuáles se comportan como uno espera y cuáles no (round, get, parseNumber y formatDate dan sorpresas). Fijará la zona America/Mexico_City en cada fecha y medirá a partir de qué hora un reloj en UTC ya vive el día siguiente. Rebanará un pedido con un iterador y lo volverá a juntar con un agregador, con la cuenta exacta de créditos de cada diseño, y leerá el fragmento de blueprint que lo hace. Después normalizará $200$ pedidos de juguete (teléfono, productos, fecha y total), comparará reglas, módulo de código y modelo de lenguaje por coste, latencia y cobertura, y terminará con TL Pedidos WhatsApp v2.1 ensamblado, validado y dibujado desde su blueprint.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Usar funciones de Make de texto, número, fecha y arreglo, y conocer su equivalente en Python.
- Manejar fechas con la zona
America/Mexico_City(sin horario de verano desde 2022). - Dividir un arreglo con un iterador y reconstruirlo con un agregador, contando los créditos.
- Decidir qué transformar con reglas y qué dejar a un modelo de lenguaje.
Funciones de Make
En Make, transformar datos no requiere un módulo especial: casi todo ocurre dentro de los campos, en el panel de mapeo, con funciones que se escriben entre dobles llaves. {{lower(1.Body)}} toma el texto del mensaje que entregó el módulo $1$ y lo pasa a minúsculas; {{formatDate(now; "YYYY-MM-DD")}} convierte la fecha actual en texto con el formato año, mes y día. Dos convenciones de sintaxis evitan la mitad de los errores: los argumentos se separan con punto y coma, no con coma, y los textos literales pueden ir sin comillas, aunque la serie las escribe siempre para que se lean igual que en Python.
Las funciones se agrupan en el panel por pestañas: texto, números, fechas, arreglos y generales. La Tabla 1 reúne las doce que usa la ruta de pedidos de Trigo Lento, con un ejemplo, el resultado en Make y la forma de obtener lo mismo en Python:
Tabla 1. Funciones de Make con ejemplo y equivalente en Python (firmas revisadas en octubre de 2026).
| Función | Ejemplo en Make | Resultado en Make | Equivalente en Python |
|---|---|---|---|
lower | lower("Pal SÁBADO") | pal sábado | texto.lower() |
trim | trim(" 2 hogazas ") | 2 hogazas | texto.strip() |
replace | replace("55-0000-0012"; /\D/g; "") | 5500000012 | re.sub(r'\D', '', texto) |
parseNumber | parseNumber("1 140,50"; ",") | 1140.5 | limpiar y float() |
round | round(2.5) | 3 | math.floor(x + 0.5), no round() |
formatDate | formatDate(t; "YYYY-MM-DD"; "America/Mexico_City") | 2026-02-20 | t.astimezone(zona).strftime('%Y-%m-%d') |
parseDate | parseDate("21/02/2026"; "DD/MM/YYYY") | 21 de febrero, 00:00 | datetime.strptime(texto, '%d/%m/%Y') |
addDays | addDays(fecha; 1) | el día siguiente | fecha + timedelta(days = 1) |
map | map(renglones; "clave") | [P01, P12] | [r['clave'] for r in renglones] |
get | get(claves; 1) | P01 (cuenta desde 1) | claves[0] |
length | length(claves) | 2 | len(claves) |
join | join(claves; ", ") | P01, P12 | ', '.join(claves) |
La columna que importa es la última, y no por su sintaxis, sino por las trampas que esconde. Para encontrarlas, el siguiente bloque escribe cada función de Make como una pequeña función de Python que imita su comportamiento documentado, la pone al lado de lo que escribiría alguien que traduce “a ojo” y compara los dos resultados. Antes, el bloque de importaciones de siempre, con la semilla global $2026$, las dos zonas horarias del día y dos supuestos que se usarán toda la entrada: el coste de un crédito de Make Core y los pedidos que llegan por WhatsApp al mes, el $55%$ de los $468$ encargos:
# Importaciones base, semilla de la serie, zonas horarias y supuestos del día en Python:
import warnings
warnings.filterwarnings('ignore')
import copy
import difflib
import json
import math
import re
from datetime import date, datetime, timedelta, timezone
from pathlib import Path
from zoneinfo import ZoneInfo
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 120)
carpeta = Path('trigo_lento') / 'dia_25'
flujos = carpeta / 'flujos' / 'make'
flujos.mkdir(parents = True, exist_ok = True)

# Las dos zonas del día y los supuestos de coste (revisado en octubre de 2026):
CDMX = ZoneInfo('America/Mexico_City')
UTC = timezone.utc
CUOTA_CORE = 10_000                         # créditos al mes de Make Core
USD_POR_CREDITO = 10.59 / CUOTA_CORE        # pago mensual de Core repartido entre sus créditos
PEDIDOS_WHATSAPP_MES = round(0.55 * 468)    # el 55 % de los 468 encargos llega por WhatsApp
print('numpy', np.__version__, '| pandas', pd.__version__)
print(f'Pedidos de WhatsApp al mes: {PEDIDOS_WHATSAPP_MES} | USD por crédito: {USD_POR_CREDITO:.6f}')
numpy 2.4.6 | pandas 3.0.3
Pedidos de WhatsApp al mes: 257 | USD por crédito: 0.001059
Un crédito de Make Core cuesta $0.001059$ USD (los $10.59$ USD del pago mensual repartidos entre $10,000$ créditos) y por WhatsApp llegan $257$ pedidos al mes. Ahora sí, la comparación de las doce funciones:
# Funciones de Make emuladas en Python frente a su equivalente ingenuo:
def make_round(x):                          # Make redondea las mitades hacia arriba
    return math.floor(x + 0.5)

def make_parse_number(texto, separador_decimal):
    limpio = re.sub(r'[^\d' + re.escape(separador_decimal) + '-]', '', texto)
    return float(limpio.replace(separador_decimal, '.'))

def make_get(arreglo, indice):              # Make cuenta desde 1
    return arreglo[indice - 1]

def intentar(funcion):
    try:
        return funcion()
    except Exception as error:
        return f'error ({type(error).__name__})'

renglones = [{'clave': 'P01', 'cantidad': 2}, {'clave': 'P12', 'cantidad': 1}]
claves = [r['clave'] for r in renglones]
instante = datetime(2026, 2, 21, 5, 30, tzinfo = UTC)   # 20 de febrero, 23:30 en la Ciudad de México
casos = [
    ('lower', 'lower("Pal SÁBADO")', lambda: 'Pal SÁBADO'.lower(), lambda: 'Pal SÁBADO'.lower()),
    ('trim', 'trim("  2 hogazas ")', lambda: '  2 hogazas '.strip(), lambda: '  2 hogazas '.strip()),
    ('replace', 'replace("55-0000-0012"; /\\D/g; "")', lambda: re.sub(r'\D', '', '55-0000-0012'),
     lambda: '55-0000-0012'.replace('-', '')),
    ('parseNumber', 'parseNumber("1 140,50"; ",")', lambda: make_parse_number('1 140,50', ','),
     lambda: float('1 140,50')),
    ('round', 'round(2.5)', lambda: make_round(2.5), lambda: round(2.5)),
    ('formatDate', 'formatDate(t; "YYYY-MM-DD"; zona)', lambda: instante.astimezone(CDMX).strftime('%Y-%m-%d'),
     lambda: instante.strftime('%Y-%m-%d')),
    ('parseDate', 'parseDate("21/02/2026"; "DD/MM/YYYY")',
     lambda: datetime.strptime('21/02/2026', '%d/%m/%Y').date().isoformat(),
     lambda: datetime.strptime('21/02/2026', '%d/%m/%Y').date().isoformat()),
    ('addDays', 'addDays(2026-02-20; 1)', lambda: (date(2026, 2, 20) + timedelta(days = 1)).isoformat(),
     lambda: (date(2026, 2, 20) + timedelta(days = 1)).isoformat()),
    ('map', 'map(renglones; "clave")', lambda: [r['clave'] for r in renglones],
     lambda: [r['clave'] for r in renglones]),
    ('get', 'get(claves; 1)', lambda: make_get(claves, 1), lambda: claves[1]),
    ('length', 'length(claves)', lambda: len(claves), lambda: len(claves)),
    ('join', 'join(claves; ", ")', lambda: ', '.join(claves), lambda: ', '.join(claves)),
]
tabla_funciones = pd.DataFrame([{'función': f, 'ejemplo en Make': ej, 'Make': str(intentar(m)),
                                 'Python ingenuo': str(intentar(p))} for f, ej, m, p in casos])
tabla_funciones['coinciden'] = np.where(tabla_funciones['Make'] == tabla_funciones['Python ingenuo'], 'sí', 'NO')
print(tabla_funciones.to_string(index = False))
print('Coinciden', (tabla_funciones['coinciden'] == 'sí').sum(), 'de', len(tabla_funciones))
    función                       ejemplo en Make           Make     Python ingenuo coinciden
      lower                   lower("Pal SÁBADO")     pal sábado         pal sábado        sí
       trim                  trim("  2 hogazas ")      2 hogazas          2 hogazas        sí
    replace    replace("55-0000-0012"; /\D/g; "")     5500000012         5500000012        sí
parseNumber          parseNumber("1 140,50"; ",")         1140.5 error (ValueError)        NO
      round                            round(2.5)              3                  2        NO
 formatDate     formatDate(t; "YYYY-MM-DD"; zona)     2026-02-20         2026-02-21        NO
  parseDate parseDate("21/02/2026"; "DD/MM/YYYY")     2026-02-21         2026-02-21        sí
    addDays                addDays(2026-02-20; 1)     2026-02-21         2026-02-21        sí
        map               map(renglones; "clave") ['P01', 'P12']     ['P01', 'P12']        sí
        get                        get(claves; 1)            P01                P12        NO
     length                        length(claves)              2                  2        sí
       join                    join(claves; ", ")       P01, P12           P01, P12        sí
Coinciden 8 de 12
Solo $8$ de las $12$ funciones coinciden con su traducción ingenua. Las cuatro que no coinciden merecen una explicación, porque cada una corresponde a un error real que se puede cometer en un escenario:
parseNumberrecibe el separador decimal como argumento y tolera espacios de miles:parseNumber("1 140,50"; ",")da $1140.5$. En Python,float("1 140,50")lanza un error, y quien traduce rápido tiende a “arreglarlo” quitando la coma, con lo que obtiene $114,050$.roundde Make redondea las mitades hacia arriba:round(2.5)es $3$. Elround()de Python usa el redondeo del banquero, que lleva las mitades al par más cercano, y da $2$. En dinero, una diferencia de un peso por cada mitad se acumula; por eso la serie guarda los importes en centavos enteros desde el Día 4 y casi nunca necesita redondear.formatDatecon la zonaAmerica/Mexico_Cityconvierte el instante de las 05:30 UTC del sábado en el texto2026-02-20, la fecha del obrador; elstrftimede Python sobre el mismo instante, sin convertirlo antes, da2026-02-21. Es el error de Lucía, y la sección siguiente lo estudia a fondo.getcuenta desde $1$:get(claves; 1)devuelve el primer elemento,P01. En Python,claves[1]devuelve el segundo,P12. El Día 14 ya advirtió que Make cuenta desde $1$ y n8n y Python desde $0$; aquí la consecuencia es que un pedido de hogazas se registraría como un pay de queso, sin que nada avise.
Una función que se traduce “a ojo” puede devolver un resultado plausible y equivocado, que es la peor clase de error: no detiene el escenario, no aparece en el historial como fallo y llega intacto a la hoja de pedidos.
Las funciones de fecha, contra su documentación
Las fechas merecen un bloque propio. La documentación de Make da las firmas formatDate(fecha; formato; [zona]), parseDate(texto; formato; [zona]), addDays(fecha; número) y setDay(fecha; día), y advierte que, si se omite la zona, Make usa la zona horaria de la organización. Los formatos usan fichas como YYYY (año), MM (mes), DD (día), HH (hora de 0 a 23), hh (hora de 1 a 12), mm (minutos) y A (AM o PM), y la ficha X lee segundos desde 1970. setDay cuenta los días de la semana del domingo ($1$) al sábado ($7$) dentro de la semana de domingo a sábado.
Para no depender de la memoria, el siguiente bloque escribe los equivalentes en Python (format_date, parse_date, add_days y set_day, con la zona de la organización como argumento) y los contrasta con los once ejemplos que publica la propia documentación de Make, incluidos dos que suponen una organización en la zona de Praga. Al final repite el experimento con la fecha “21/02/2026” que escribe un cliente, leída sin zona y con zona:
# Equivalentes de formatDate, parseDate, addDays y setDay contra los ejemplos de la documentación de Make:
FICHAS = {'YYYY': '%Y', 'MM': '%m', 'DD': '%d', 'HH': '%H', 'hh': '%I', 'mm': '%M', 'ss': '%S', 'A': '%p'}
PATRON_FICHAS = re.compile('|'.join(sorted(FICHAS, key = len, reverse = True)))
DIAS_INGLES = ['sunday', 'monday', 'tuesday', 'wednesday', 'thursday', 'friday', 'saturday']

def a_strftime(formato):
    return PATRON_FICHAS.sub(lambda m: FICHAS[m.group(0)], formato)

def format_date(t, formato, zona = None, zona_org = 'UTC'):
    # Sin zona explícita, Make usa la zona de la organización:
    return t.astimezone(ZoneInfo(zona or zona_org)).strftime(a_strftime(formato))

def parse_date(texto, formato, zona = None, zona_org = 'UTC'):
    if formato == 'X':                       # segundos desde 1970
        return datetime.fromtimestamp(int(texto), UTC)
    local = datetime.strptime(texto, a_strftime(formato)).replace(tzinfo = ZoneInfo(zona or zona_org))
    return local.astimezone(UTC)

def add_days(t, n):
    return t + timedelta(days = n)

def set_day(t, dia):                         # 1 = domingo ... 7 = sábado, semana de domingo a sábado
    if isinstance(dia, str):
        dia = DIAS_INGLES.index(dia.lower()) + 1
    actual = (t.weekday() + 1) % 7 + 1       # Python cuenta lunes = 0
    return t + timedelta(days = dia - actual)

def iso(t):
    return t.astimezone(UTC).strftime('%Y-%m-%dT%H:%M:%SZ')

t1 = datetime(2018, 10, 1, 7, 32, tzinfo = UTC)
t2 = datetime(2016, 12, 8, 15, 55, 57, tzinfo = UTC)
t3 = datetime(2018, 6, 27, 11, 36, 39, tzinfo = UTC)
pruebas = [
    ('parseDate(2016-12-28; YYYY-MM-DD)', iso(parse_date('2016-12-28', 'YYYY-MM-DD')), '2016-12-28T00:00:00Z'),
    ('parseDate(2016-12-28 16:03; YYYY-MM-DD HH:mm)', iso(parse_date('2016-12-28 16:03', 'YYYY-MM-DD HH:mm')),
     '2016-12-28T16:03:00Z'),
    ('parseDate(1482940986; X)', iso(parse_date('1482940986', 'X')), '2016-12-28T16:03:06Z'),
    ('formatDate(t; DD.MM.YYYY HH:mm; UTC)', format_date(t1, 'DD.MM.YYYY HH:mm', 'UTC'), '01.10.2018 07:32'),
    ('formatDate(t; YYYY-MM-DD hh:mm A), Praga', format_date(t1, 'YYYY-MM-DD hh:mm A', zona_org = 'Europe/Prague'),
     '2018-10-01 09:32 AM'),
    ('formatDate(t; MM/DD/YYYY), Praga', format_date(t1, 'MM/DD/YYYY', zona_org = 'Europe/Prague'), '10/01/2018'),
    ('addDays(2016-12-08T15:55:57Z; 2)', iso(add_days(t2, 2)), '2016-12-10T15:55:57Z'),
    ('addDays(2016-12-08T15:55:57Z; -2)', iso(add_days(t2, -2)), '2016-12-06T15:55:57Z'),
    ('setDay(2018-06-27T11:36:39Z; monday)', iso(set_day(t3, 'monday')), '2018-06-25T11:36:39Z'),
    ('setDay(2018-06-27T11:36:39Z; 1)', iso(set_day(t3, 1)), '2018-06-24T11:36:39Z'),
    ('setDay(2018-06-27T11:36:39Z; 7)', iso(set_day(t3, 7)), '2018-06-30T11:36:39Z'),
]
for nombre, obtenido, esperado in pruebas:
    print(f"{'ok ' if obtenido == esperado else 'MAL'} {nombre:<45} -> {obtenido}")
print('Casos que coinciden con la documentación:', sum(o == e for _, o, e in pruebas), 'de', len(pruebas))

# La fecha "21/02/2026" leída sin zona en una organización en UTC y mostrada en el obrador:
sin_zona = parse_date('21/02/2026', 'DD/MM/YYYY')
con_zona = parse_date('21/02/2026', 'DD/MM/YYYY', zona = 'America/Mexico_City')
print('Sin zona:', iso(sin_zona), '->', format_date(sin_zona, 'YYYY-MM-DD', 'America/Mexico_City'), 'en el obrador')
print('Con zona:', iso(con_zona), '->', format_date(con_zona, 'YYYY-MM-DD', 'America/Mexico_City'), 'en el obrador')
ok  parseDate(2016-12-28; YYYY-MM-DD)             -> 2016-12-28T00:00:00Z
ok  parseDate(2016-12-28 16:03; YYYY-MM-DD HH:mm) -> 2016-12-28T16:03:00Z
ok  parseDate(1482940986; X)                      -> 2016-12-28T16:03:06Z
ok  formatDate(t; DD.MM.YYYY HH:mm; UTC)          -> 01.10.2018 07:32
ok  formatDate(t; YYYY-MM-DD hh:mm A), Praga      -> 2018-10-01 09:32 AM
ok  formatDate(t; MM/DD/YYYY), Praga              -> 10/01/2018
ok  addDays(2016-12-08T15:55:57Z; 2)              -> 2016-12-10T15:55:57Z
ok  addDays(2016-12-08T15:55:57Z; -2)             -> 2016-12-06T15:55:57Z
ok  setDay(2018-06-27T11:36:39Z; monday)          -> 2018-06-25T11:36:39Z
ok  setDay(2018-06-27T11:36:39Z; 1)               -> 2018-06-24T11:36:39Z
ok  setDay(2018-06-27T11:36:39Z; 7)               -> 2018-06-30T11:36:39Z
Casos que coinciden con la documentación: 11 de 11
Sin zona: 2026-02-21T00:00:00Z -> 2026-02-20 en el obrador
Con zona: 2026-02-21T06:00:00Z -> 2026-02-21 en el obrador
Los equivalentes reproducen los $11$ ejemplos de la documentación, lo que permite usarlos como laboratorio: lo que pase con ellos en Python pasará en Make. Y el último experimento muestra el segundo error de fechas del día, más sutil que el de Lucía. Si parseDate("21/02/2026"; "DD/MM/YYYY") se escribe sin zona en una organización configurada en UTC, la fecha que guarda Make es la medianoche del 21 en UTC, 2026-02-21T00:00:00Z; cuando esa fecha se muestra en el obrador, son las 18:00 del día anterior, y el texto que llega a la hoja es 2026-02-20. Con la zona del obrador, la medianoche se guarda como las 06:00 UTC y se muestra como el 21, que es lo que pidió el cliente. Un pedido para el 21 que la hoja apunta para el 20 sale un día antes del horno: tal vez el cliente no se dé cuenta, pero las conchas del día siguiente ya no son “del día”.
Fechas y zonas horarias
Don Ernesto tiene razón en que en Trigo Lento todos viven en la misma hora. El problema es que Make no vive en Trigo Lento. Sus servidores guardan cada fecha como un instante, un punto de la línea del tiempo que no pertenece a ninguna zona, y lo escriben en la notación ISO 8601 con una Z al final, que significa UTC (el tiempo universal coordinado, el de la longitud cero). La zona aparece solo cuando ese instante se convierte en texto o cuando un texto se convierte en instante, y en ese momento Make usa la zona que usted le dé o, si no le da ninguna, la de la organización.
La Ciudad de México está seis horas detrás de UTC todo el año. No siempre fue así: hasta 2022 el país cambiaba la hora en verano y la diferencia era de cinco horas de abril a octubre. La Ley de los Husos Horarios publicada ese año eliminó el horario de verano en casi todo el país, y la base de datos de zonas de la IANA, que usan Python, los servidores y Make, refleja el cambio desde el 30 de octubre de 2022. Por eso la serie escribe siempre el nombre de la zona, America/Mexico_City, y nunca un desfase fijo como -06:00 en la lógica: si las reglas vuelven a cambiar, la base de datos se actualiza y el escenario no.
El siguiente bloque usa zoneinfo, el módulo de la biblioteca estándar que lee esa base de datos, para mirar la misma noche con los dos relojes. Interpreta seis mensajes con fechas relativas (“pal sábado”, “para mañana”, “para hoy”, “pal lunes”) primero con el “hoy” del obrador y después con el “hoy” de UTC, comprueba el desfase de la ciudad antes y después de octubre de 2022, y busca la hora local a partir de la cual la fecha de UTC ya es la del día siguiente:
# La misma hora en dos relojes: Ciudad de México y UTC con zoneinfo en Python:
DIAS = ['lunes', 'martes', 'miércoles', 'jueves', 'viernes', 'sábado', 'domingo']

def proximo(dia_semana, hoy):                # el próximo <día> que no sea hoy
    dias = (dia_semana - hoy.weekday()) % 7
    return hoy + timedelta(days = dias or 7)

def interpretar_relativa(expresion, recibido, zona):
    hoy = recibido.astimezone(zona).date()   # "hoy" depende del reloj que se consulte
    if expresion.endswith('hoy'):
        return hoy
    if expresion.endswith('mañana'):
        return hoy + timedelta(days = 1)
    return proximo(DIAS.index(expresion.split()[-1]), hoy)

mensajes = [(datetime(2026, 2, 20, 23, 30, tzinfo = CDMX), 'pal sábado'),
            (datetime(2026, 2, 20, 17, 59, tzinfo = CDMX), 'pal sábado'),
            (datetime(2026, 2, 20, 18, 0, tzinfo = CDMX), 'para mañana'),
            (datetime(2026, 2, 21, 9, 15, tzinfo = CDMX), 'para hoy'),
            (datetime(2026, 2, 21, 19, 40, tzinfo = CDMX), 'pal lunes'),
            (datetime(2026, 2, 25, 20, 10, tzinfo = CDMX), 'para mañana')]
filas = []
for recibido, expresion in mensajes:
    bien = interpretar_relativa(expresion, recibido, CDMX)
    mal = interpretar_relativa(expresion, recibido, UTC)
    en_utc = recibido.astimezone(UTC)
    filas.append({'recibido (CDMX)': f"{DIAS[recibido.weekday()][:3]} {recibido:%d %H:%M}",
                  'en UTC': f"{DIAS[en_utc.weekday()][:3]} {en_utc:%d %H:%M}", 'mensaje': expresion,
                  'entrega CDMX': bien.isoformat(), 'entrega UTC': mal.isoformat(), 'error (días)': (mal - bien).days})
print(pd.DataFrame(filas).to_string(index = False))

# Desfase de la Ciudad de México frente a UTC antes y después de octubre de 2022:
for f in [datetime(2021, 7, 1, 12), datetime(2022, 7, 1, 12), datetime(2022, 11, 1, 12),
          datetime(2026, 2, 20, 12), datetime(2026, 7, 1, 12)]:
    print(f.date(), 'UTC', f'{f.replace(tzinfo = CDMX).utcoffset().total_seconds() / 3600:+.0f} h')

# Desde qué hora local la fecha en UTC ya es la de mañana:
umbral = next(h for h in range(24) if datetime(2026, 2, 20, h, tzinfo = CDMX).astimezone(UTC).day == 21)
print(f'Desde las {umbral}:00 de la Ciudad de México, la fecha en UTC ya es la del día siguiente')
recibido (CDMX)       en UTC     mensaje entrega CDMX entrega UTC  error (días)
   vie 20 23:30 sáb 21 05:30  pal sábado   2026-02-21  2026-02-28             7
   vie 20 17:59 vie 20 23:59  pal sábado   2026-02-21  2026-02-21             0
   vie 20 18:00 sáb 21 00:00 para mañana   2026-02-21  2026-02-22             1
   sáb 21 09:15 sáb 21 15:15    para hoy   2026-02-21  2026-02-21             0
   sáb 21 19:40 dom 22 01:40   pal lunes   2026-02-23  2026-02-23             0
   mié 25 20:10 jue 26 02:10 para mañana   2026-02-26  2026-02-27             1
2021-07-01 UTC -5 h
2022-07-01 UTC -5 h
2022-11-01 UTC -6 h
2026-02-20 UTC -6 h
2026-07-01 UTC -6 h
Desde las 18:00 de la Ciudad de México, la fecha en UTC ya es la del día siguiente
La primera fila es el caso de Lucía, reproducido: a las 23:30 del viernes en el obrador, en UTC ya son las 05:30 del sábado, y la regla “el próximo sábado que no sea hoy” entrega el 28 en lugar del 21: siete días de error. La segunda fila es el mismo mensaje un minuto antes de las seis de la tarde, y ahí los dos relojes coinciden. La tercera muestra que no hace falta un día de la semana para equivocarse: “para mañana” a las 18:00 en punto da el domingo 22 en UTC, un día tarde y, además, un día en que Trigo Lento no abre. Las filas de la mañana y “pal lunes” del sábado por la noche no fallan, pero por suerte: el lunes siguiente es el mismo visto desde el sábado o desde el domingo.
El desfase confirma lo que dice la ley: $-5$ horas en julio de 2021 y de 2022, $-6$ horas desde noviembre de 2022 y en todas las fechas de la serie. La última línea da la regla general:
$$ \text{fecha}{UTC}(t) \neq \text{fecha}{local}(t) \iff h_{local}(t) \geq 24 + \Delta $$
La lógica detrás de esta fórmula es múltiple:
- $\Delta$ es el desfase de la zona local respecto de UTC, en horas: $\Delta = -6$ en la Ciudad de México desde octubre de 2022.
- $h_{local}(t)$ es la hora del reloj del obrador en el instante $t$. Cuando el reloj local marca $24 + \Delta = 18$ horas o más, en UTC ya pasó la medianoche.
- Entre las 18:00 y las 23:59 del obrador, una de cada cuatro horas del día, cualquier cálculo que use la fecha de UTC como “hoy” se adelanta un día: “hoy” se vuelve mañana, “mañana” pasado mañana y “el próximo sábado” puede saltar una semana.
- En conclusión, el riesgo no depende de la fórmula de fechas, sino de qué reloj se le pasa. Y las seis de la tarde no es una hora tranquila en Trigo Lento: es cuando los clientes salen del trabajo y encargan el pan del día siguiente.
La Figura 1 pone los dos relojes uno al lado del otro, con la franja de la tarde en la que sus fechas no coinciden.
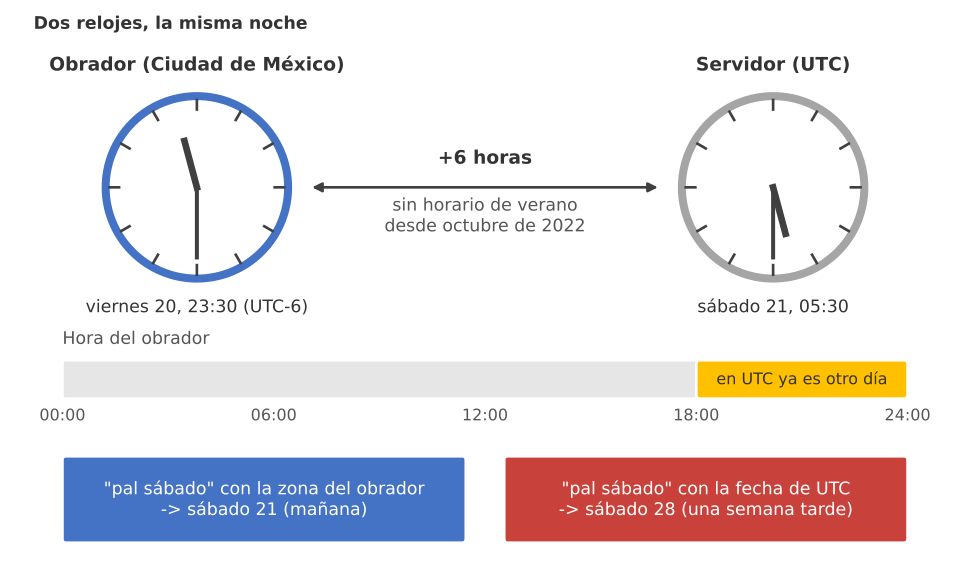
Figura 1. Dos relojes: a las 23:30 del viernes 20 en el obrador, el servidor en UTC ya vive el sábado 21 a las 05:30; entre las 18:00 y la medianoche las dos fechas no coinciden, y "pal sábado" se convierte en el 28 en lugar del 21.
Atención aquí: en Make, formatDate, parseDate y las comparaciones de fechas sin zona explícita usan la zona de la organización, y cada persona puede tener además su propia zona en el perfil, que solo cambia cómo ve las fechas en el editor. Revise la zona de la organización en sus ajustes, pero no confíe en ella: escriba "America/Mexico_City" como último argumento de cada formatDate y parseDate que produzca o lea una fecha del negocio, y guarde las fechas de entrega como texto AAAA-MM-DD ya convertido, no como un instante que otro módulo volverá a interpretar. Una organización que hoy está en la zona correcta puede cambiar mañana, y un escenario que se copia a otra cuenta se lleva sus fórmulas, pero no los ajustes de la cuenta.
El iterador
Con las fechas en su sitio, falta el otro problema del pedido de Lucía: tiene dos renglones, “2 hogazas” y “1 pay de queso”, escritos en una sola frase. El contrato del Día 4 pide un arreglo renglones con la clave del catálogo y la cantidad de cada uno, y el Día 14 mostró que un pedido es una cabecera con una lista de renglones, no una fila plana. Para pasar de la frase a la lista hay que recorrer sus partes una por una, y en Make eso lo hace el iterador (builtin:BasicFeeder).
El iterador recibe un paquete que contiene un arreglo y emite un paquete por cada elemento. Si el arreglo tiene tres partes, salen tres paquetes, y cada módulo que viene después trabaja tres veces, una por parte. Es la regla de los paquetes del Día 22 aplicada al caso que más la tensiona: los créditos de todo lo que sigue al iterador se multiplican por el tamaño del arreglo. En la ruta de pedidos de la versión 2.1, la secuencia es esta:
- El módulo $4$ (establecer variables) prepara el texto: lo pasa a minúsculas, le quita la cola de la fecha (“pal sábado, soy Lucía”) y lo parte por comas y por la palabra “y” con
split. “hola, me aparta 2 hogazas y 1 pay de queso” se convierte en["hola", " me aparta 2 hogazas", "1 pay de queso"]. - El módulo $5$, el iterador, emite tres paquetes, uno por parte.
- El módulo $6$ trabaja una vez por paquete: busca la cantidad (un número o una palabra como “una” o “media docena”), separa el producto y lo traduce a su clave del catálogo con
getsobre un objeto de alias.
La parte “hola” no tiene cantidad: no es un renglón, y un filtro la detendrá antes del siguiente paso. Pero el módulo $6$ ya trabajó con ella y ya cobró su crédito, porque el filtro está después. Es el precio de recorrer sin saber de antemano qué hay en cada parte.
La Figura 2 lo resume con la metáfora del obrador: el iterador es el cuchillo que rebana la hogaza, cada rebanada pasa por su propia estación, y al final hace falta una bolsa que las vuelva a juntar.
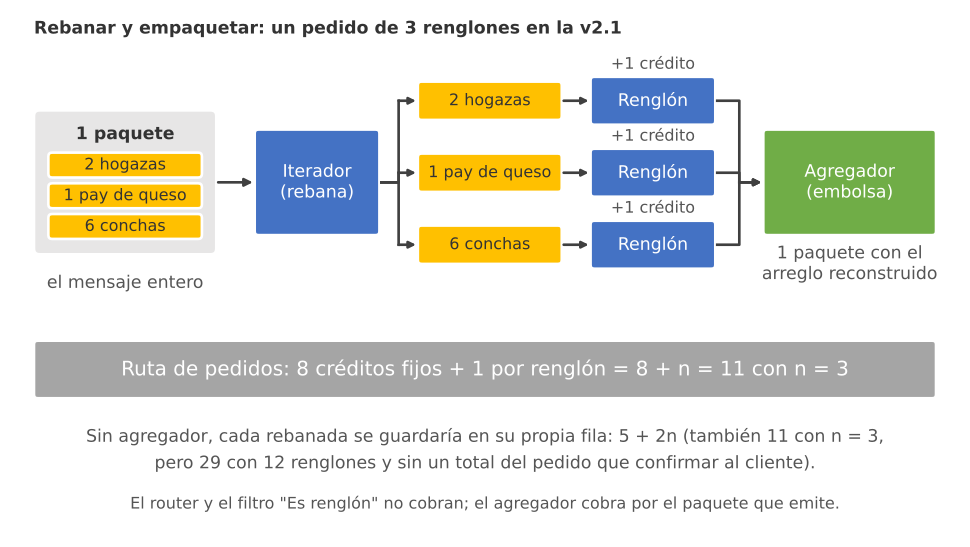
Figura 2. Rebanar y empaquetar: el pedido de tres renglones llega en un paquete, el iterador lo rebana en tres, cada rebanada pasa por el módulo de renglón y el agregador las vuelve a embolsar en un paquete; la ruta cuesta 8 + n = 11 créditos.
Los agregadores
Un iterador sin agregador deja el pedido en pedazos: tres paquetes sueltos que siguen el escenario por separado, cada uno sin saber de los otros. Si lo que sigue es “guardar una fila”, se guardan tres filas; si es “confirmar al cliente”, se le envían tres mensajes. Para volver a tener un pedido hace falta el movimiento contrario, y eso lo hacen los agregadores: reciben todos los paquetes que salieron de un mismo iterador (su módulo de origen) y emiten un solo paquete con el resultado. Make ofrece tres agregadores de uso diario:
- El agregador de arreglo (
builtin:BasicAggregator) junta los paquetes en un arreglo, con los campos que se elijan de cada uno. Es el que reconstruyerenglonescomo pide el contrato. - El agregador de texto (
util:TextAggregator) une los paquetes en una sola cadena con un separador; sirve para armar un resumen legible, como “2 hogazas, 1 pay de queso”, para la confirmación al cliente. - El agregador numérico suma, cuenta o promedia un campo de todos los paquetes; daría el total del pedido, aunque en la versión 2.1 el total se calcula después con
sum(map(7.array; "importe_centavos")), para tener el arreglo y el total en el mismo módulo.
¿Cuánto cuesta rebanar y volver a juntar? El Día 22 estableció que cada operación de un módulo cuesta un crédito, que el disparador cobra una vez por ejecución y que routers y filtros no cobran. Para el agregador, la serie adopta el supuesto de que cobra por el paquete que emite, uno por pedido, y el bloque calcula también qué pasaría si cobrara por cada paquete que recibe, para que el supuesto no quede escondido. Con esas reglas, los créditos de un pedido de $n$ renglones son una recta:
$$ C(n) = a + b,n, \qquad n^{*} = \frac{a_B - a_C}{b_C - b_B} $$
La lógica detrás de esta fórmula es múltiple:
- $a$ es la parte fija: los módulos que trabajan una vez por pedido, antes del iterador o después del agregador. $b$ es el número de módulos que trabajan una vez por renglón, entre el iterador y el agregador.
- El diseño B, el de la versión 2.1 (iterador y agregador), tiene $a_B = 8$ y $b_B = 1$: solo el módulo de renglón trabaja $n$ veces. El diseño C, un iterador sin agregador que guarda una fila por renglón, tiene $a_C = 5$ y $b_C = 2$: el módulo de renglón y la fila trabajan $n$ veces.
- $n^{}$ es el número de renglones en el que los dos diseños empatan: $n^{} = (8 - 5)/(2 - 1) = 3$. Con menos renglones, C es más barato; con más, B.
- En conclusión, el agregador no es gratis, pero convierte el coste por renglón en el de un solo módulo; cuanto más largo el pedido, más ahorra.
El siguiente bloque escribe los tres diseños como listas de módulos (el A es el formulario estructurado del Día 22, que no necesita iterador porque sus renglones llegan ya como arreglo), propaga los paquetes por cada uno y simula $2,000$ meses con $257$ pedidos en promedio y $1$ renglón más un número de renglones extra que sigue una distribución de Poisson de media $0.54$, la forma de los pedidos que midió el Día 14:
# Iterador y agregador simulados: créditos por pedido y por mes en Python:
DISENOS = {
    'A. Formulario estructurado, sin iterador': ['webhook', 'variables', 'fila', 'respuesta'],
    'B. Iterador y agregador (v2.1)': ['webhook', 'respuesta', 'router', 'catalogo', 'preparar', 'iterador',
                                       'renglon', 'agregador', 'normalizar', 'router', 'fila'],
    'C. Iterador sin agregador': ['webhook', 'respuesta', 'router', 'catalogo', 'preparar', 'iterador',
                                  'renglon', 'fila'],
}

def creditos_por_pedido(modulos, n, agregador_por_entrada = False):
    paquetes, creditos = 1, 0
    for m in modulos:
        if m == 'router':
            continue                                   # routers y filtros no cobran
        if m == 'agregador':
            creditos += paquetes if agregador_por_entrada else 1
            paquetes = 1                               # junta los n paquetes en uno
            continue
        creditos += paquetes                           # una operación por paquete recibido
        if m == 'iterador':
            paquetes *= n                              # parte el arreglo en n paquetes
    return creditos

n = np.arange(1, 13)
curvas = {d: np.array([creditos_por_pedido(m, k) for k in n]) for d, m in DISENOS.items()}
for d, c in curvas.items():
    print(f'{d:<42} n=1: {c[0]:>2} | n=3: {c[2]:>2} | n=12: {c[11]:>2}')
print('Si el agregador cobrara por paquete recibido, B con n=3:',
      creditos_por_pedido(DISENOS['B. Iterador y agregador (v2.1)'], 3, agregador_por_entrada = True))

# 2 000 meses simulados: Poisson(257) pedidos y 1 + Poisson(0.54) renglones por pedido:
MESES, EXTRA = 2_000, 0.54
mes_b, mes_c = np.zeros(MESES), np.zeros(MESES)
for i in range(MESES):
    r = 1 + rng.poisson(EXTRA, rng.poisson(PEDIDOS_WHATSAPP_MES))
    mes_b[i], mes_c[i] = (8 + r).sum(), (5 + 2 * r).sum()
for nombre, mes, teorico in [('B', mes_b, PEDIDOS_WHATSAPP_MES * (8 + 1 + EXTRA)),
                             ('C', mes_c, PEDIDOS_WHATSAPP_MES * (5 + 2 * (1 + EXTRA)))]:
    print(f'{nombre}: media {mes.mean():7.1f} (teórico {teorico:.1f}) | p95 {np.percentile(mes, 95):5.0f} | '
          f'{mes.mean() / CUOTA_CORE:.2%} de Core | {mes.mean() * USD_POR_CREDITO:.2f} USD')

fig, (ax1, ax2) = plt.subplots(1, 2, figsize = (12, 4.6))
colores = ['#8a8986', '#2a78d6', '#eb6834']
for (d, c), color in zip(curvas.items(), colores):
    ax1.plot(n, c, marker = 'o', ms = 4, lw = 2, color = color, label = d)
ax1.axvline(3, color = '#52514e', ls = ':', lw = 1)
ax1.text(3.25, 6.2, 'B y C empatan\ncon 3 renglones', fontsize = 9, color = '#52514e')
ax1.set_xlabel('Renglones del pedido')
ax1.set_ylabel('Créditos por pedido')
ax1.set_title('Créditos de un pedido', fontsize = 12)
ax1.legend(fontsize = 8.5, loc = 'upper left')
ax1.grid(color = '#e6e5e1')
bins = np.arange(1700, 2900, 20)
ax2.hist(mes_b, bins = bins, color = '#2a78d6', alpha = 0.8, label = 'B. Iterador y agregador')
ax2.hist(mes_c, bins = bins, color = '#eb6834', alpha = 0.8, label = 'C. Sin agregador')
ax2.set_xlabel('Créditos de la ruta de pedidos en un mes')
ax2.set_ylabel('Meses simulados')
ax2.set_title('2 000 meses de 257 pedidos en promedio', fontsize = 12)
ax2.legend(fontsize = 9)
fig.suptitle('Iterar y agregar: lo que cuesta cada renglón', fontsize = 16)
plt.tight_layout()
plt.show()
A. Formulario estructurado, sin iterador   n=1:  4 | n=3:  4 | n=12:  4
B. Iterador y agregador (v2.1)             n=1:  9 | n=3: 11 | n=12: 20
C. Iterador sin agregador                  n=1:  7 | n=3: 11 | n=12: 29
Si el agregador cobrara por paquete recibido, B con n=3: 13
B: media  2452.1 (teórico 2451.8) | p95  2698 | 24.52% de Core | 2.60 USD
C: media  2076.4 (teórico 2076.6) | p95  2285 | 20.76% de Core | 2.20 USD
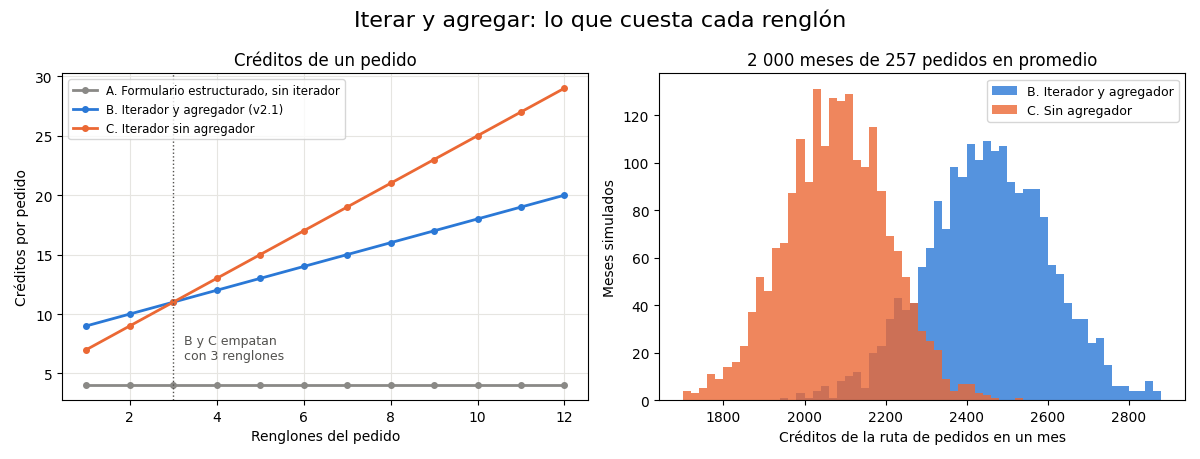
Las rectas salen como predice la fórmula: el diseño B cuesta $9$ créditos con un renglón, $11$ con tres y $20$ con doce; el C, $7$, $11$ y $29$. El empate en $n = 3$ es exacto, y con doce renglones (una caja de pan dulce para una fiesta, por ejemplo) el agregador ahorra $9$ créditos. El formulario del Día 22 se queda en $4$ créditos sin importar los renglones, porque sus datos llegan estructurados; ninguna transformación es tan barata como no tener que transformar. Si el agregador cobrara por cada paquete que recibe, el pedido de tres renglones costaría $13$ créditos en lugar de $11$: el supuesto importa, y conviene confirmarlo en el historial de la primera ejecución real.
Al mes, la ruta de pedidos de la versión 2.1 consume $2,452.1$ créditos de media (el teórico es $257 \cdot (8 + 1.54) = 2,451.8$), el $24.52%$ de Make Core, unos $2.60$ USD. El diseño C costaría $2,076.4$ créditos: $375$ menos, porque la mayoría de los pedidos tienen uno o dos renglones. Valeria elige B de todos modos, y la razón no está en la gráfica: con C no existe un pedido, sino filas sueltas, sin un total que confirmar al cliente ni una sola fila que el obrador pueda marcar como lista. El diseño más barato no siempre es el que conserva la forma del negocio.
El fragmento del blueprint que hace el trabajo son los módulos $5$, $6$ y $7$ de la ruta de pedidos, guardados en trigo_lento/dia_25/flujos/make/renglones_v2_1.fragmento.json:
{
  "name": "TL Pedidos WhatsApp v2.1 (fragmento: módulos 5 a 7 de la ruta de pedidos)",
  "flow": [
    {
      "id": 5,
      "module": "builtin:BasicFeeder",
      "version": 1,
      "parameters": {},
      "mapper": {"array": "{{4.partes}}"},
      "metadata": {"designer": {"x": 1500, "y": 150}}
    },
    {
      "id": 6,
      "module": "util:SetVariables",
      "version": 1,
      "parameters": {},
      "mapper": {
        "variables": [
          {"name": "cantidad", "value": "{{ifempty(parseNumber(replace(5.value; /^.*?\\b(\\d+)\\s.*$/; \"$1\"); \".\"); get(4.cantidades; replace(5.value; /^.*?\\b(media docena|una docena|una|un|dos|tres)\\s.*$/; \"$1\")))}}"},
          {"name": "producto", "value": "{{trim(replace(5.value; /^.*?\\b(\\d+|media docena|una docena|una|un|dos|tres)\\s+(de\\s+)?/; emptystring))}}"},
          {"name": "clave", "value": "{{get(4.alias; trim(replace(5.value; /^.*?\\b(\\d+|media docena|una docena|una|un|dos|tres)\\s+(de\\s+)?/; emptystring)))}}"},
          {"name": "importe_centavos", "value": "{{(ifempty(parseNumber(replace(5.value; /^.*?\\b(\\d+)\\s.*$/; \"$1\"); \".\"); get(4.cantidades; replace(5.value; /^.*?\\b(media docena|una docena|una|un|dos|tres)\\s.*$/; \"$1\")))) * get(4.precios_centavos; get(4.alias; trim(replace(5.value; /^.*?\\b(\\d+|media docena|una docena|una|un|dos|tres)\\s+(de\\s+)?/; emptystring))))}}"}
        ],
        "scope": "roundtrip"
      },
      "metadata": {"designer": {"x": 1800, "y": 150}}
    },
    {
      "id": 7,
      "module": "builtin:BasicAggregator",
      "version": 1,
      "parameters": {"feeder": 5},
      "filter": {
        "name": "Es renglón",
        "conditions": [[{"a": "{{6.cantidad}}", "o": "exist"}]]
      },
      "mapper": {
        "clave": "{{6.clave}}",
        "producto": "{{6.producto}}",
        "cantidad": "{{6.cantidad}}",
        "importe_centavos": "{{6.importe_centavos}}"
      },
      "metadata": {"designer": {"x": 2100, "y": 150}}
    }
  ]
}
Tres detalles del fragmento se leen con calma:
- El iterador solo dice qué arreglo recorrer:
"array": "{{4.partes}}". Cada paquete que emite expone el elemento comovalue, y por eso el módulo $6$ escribe5.valueen todas sus fórmulas. - El agregador lleva su módulo de origen en
parameters:"feeder": 5le dice que junte los paquetes que salieron del iterador $5$. Si alguien borra el iterador y lo vuelve a crear con otro número, el agregador queda huérfano, igual que las referencias{{n.campo}}del Día 22. - El filtro “Es renglón” está en la entrada del agregador: solo se agregan las partes con cantidad. “hola” y “soy Lucía” se quedan fuera sin coste adicional, porque los filtros no cobran. Las expresiones del módulo $6$ son largas porque una variable no puede leer otra del mismo módulo; la versión en Python del siguiente bloque es la especificación que esas expresiones deben cumplir.
Normalizar el pedido en Make
Con el pedido rebanado y vuelto a juntar, queda normalizar cada campo a la forma que exige el contrato del Día 4: el teléfono en E.164 (+52 y diez dígitos), la fecha de entrega en ISO 8601 con la zona del obrador, cada producto con su clave del catálogo y el total en centavos enteros. El módulo $8$ de la versión 2.1 hace esas cuatro cosas, y el router $9$ separa los pedidos completos de los que necesitan a una persona.
Normalizar no es adivinar. Las reglas de la versión 2.1 son deliberadamente estrictas, y lo que no pueden resolver sin inventar lo mandan a revisión:
- Teléfono: Twilio entrega el identificador de WhatsApp del cliente (
WaId) solo con dígitos. Los números de México pueden llegar como52más diez dígitos o con el antiguo521de los celulares; ambos se convierten en+52y los diez dígitos. Cualquier otra cosa (un número de otro país, por ejemplo) va a revisión, porque el contrato del Día 4 solo admite números mexicanos. - Productos: cada parte se busca en una tabla de alias del catálogo, con singulares y plurales (“hogaza”, “hogazas”). Una errata (“crosant”) no está en la tabla y va a revisión.
- Fecha: se reconocen fechas escritas (“21/02”), “hoy”, “mañana”, los días de la semana y “el 27”; todas se calculan desde el “hoy” del obrador. Una fecha pasada o un domingo, día en que Trigo Lento no abre, van a revisión, igual que las expresiones que no dicen un día (“la otra semana”, “cuando esté listo”).
- Total: la suma de cantidad por precio del catálogo, en centavos, solo si todos los productos se reconocieron.
Para saber qué tan lejos llegan esas reglas, el siguiente bloque genera $200$ pedidos de juguete con la forma de los mensajes reales (saludos, cantidades en número o en palabra, un $8%$ de erratas, siete formas de decir la fecha con proporciones declaradas, horas de llegada con el pico de la mañana y un repunte por la tarde, y un $5%$ de teléfonos extranjeros), los normaliza con las reglas y vuelve a calcular la fecha con el reloj en UTC para contar cuántos pedidos habría cambiado de día el error de Lucía:
# Normalización de 200 pedidos de WhatsApp con las reglas de la v2.1 en Python:
CATALOGO = {'P01': 95, 'P02': 38, 'P03': 72, 'P04': 22, 'P05': 34, 'P06': 38,
            'P07': 60, 'P08': 420, 'P09': 460, 'P10': 240, 'P11': 66, 'P12': 380}
ALIAS = {'hogaza': 'P01', 'hogazas': 'P01', 'baguette': 'P02', 'baguettes': 'P02', 'pan de caja': 'P03',
         'panes de caja': 'P03', 'concha': 'P04', 'conchas': 'P04', 'croissant': 'P05', 'croissants': 'P05',
         'cuernitos': 'P05', 'rol de canela': 'P06', 'roles de canela': 'P06', 'paquete de galletas': 'P07',
         'paquetes de galletas': 'P07', 'pastel de zanahoria': 'P08', 'pastel de chocolate': 'P09',
         'caja de pan dulce': 'P10', 'cajas de pan dulce': 'P10', 'paquete de bollos': 'P11',
         'paquetes de bollos': 'P11', 'pay de queso': 'P12', 'pays de queso': 'P12'}
ERRATAS = ['hogasa', 'crosant', 'baget', 'pay de keso', 'rol de canel', 'conhas']
CANTIDADES = {'un': 1, 'una': 1, 'dos': 2, 'tres': 3, 'media docena': 6, 'una docena': 12}
PATRON_CANTIDAD = re.compile(r'^.*?\b(\d+|media docena|una docena|una|un|dos|tres)\s+(?:de\s+)?')
COLA_FECHA = re.compile(r'\s+(?:pal|pa|para el|para|el|mañana|hoy|la otra semana|cuando|en la semana)\b.*$')

def normalizar_telefono(wa_id):
    m = re.fullmatch(r'52(1)?(\d{10})', re.sub(r'\D', '', wa_id))
    return '+52' + m.group(2) if m else None

def extraer_renglones(texto, alias = ALIAS):
    partes = re.split(r',|\s+y\s+', COLA_FECHA.sub('', texto.lower().strip()))
    salida = []
    for parte in partes:                               # el iterador: un paquete por parte
        m = PATRON_CANTIDAD.match(parte)
        if not m:
            continue                                   # filtro "Es renglón": sin cantidad no es renglón
        cantidad = int(m.group(1)) if m.group(1).isdigit() else CANTIDADES[m.group(1)]
        producto = parte[m.end():].strip()
        salida.append({'producto': producto, 'clave': alias.get(producto), 'cantidad': cantidad})
    return salida                                      # el agregador: el arreglo reconstruido

def interpretar_fecha(texto, recibido, zona):
    hoy, t = recibido.astimezone(zona).date(), texto.lower()
    if m := re.search(r'\b(\d{1,2})/(\d{1,2})(?:/(\d{4}))?\b', t):
        fecha = date(int(m.group(3) or hoy.year), int(m.group(2)), int(m.group(1)))
    elif re.search(r'\bmañana\b', t):
        fecha = hoy + timedelta(days = 1)
    elif re.search(r'\bhoy\b', t):
        fecha = hoy
    elif dia := next((d for d in DIAS if re.search(rf'\b{d}\b', t)), None):
        fecha = proximo(DIAS.index(dia), hoy)
    elif m := re.search(r'\bel (\d{1,2})\b', t):
        d = int(m.group(1))
        fecha = date(hoy.year, hoy.month, d) if d >= hoy.day else date(hoy.year, hoy.month + 1, d)
    else:
        return None, 'sin fecha reconocible'
    if fecha < hoy:
        return None, 'fecha pasada'
    if fecha.weekday() == 6:
        return None, 'domingo: cerrado'
    return fecha, 'ok'

# 200 pedidos de juguete con la forma de los mensajes reales (semilla 2026):
HORAS = np.arange(7, 24)
PESOS_HORA = np.array([2, 4, 6, 9, 9, 7, 5, 4, 4, 4, 4, 5, 6, 6, 4, 2, 1], dtype = float)
FORMAS_FECHA = ['semana', 'mañana', 'hoy', 'explicita', 'dia_mes', 'ambigua', 'sin']
PROB_FECHA = [0.28, 0.20, 0.05, 0.20, 0.10, 0.12, 0.05]
claves_alias = list(ALIAS)
pedidos = []
for i in range(200):
    recibido = datetime(2026, 2, 16 + int(rng.integers(0, 6)), int(rng.choice(HORAS, p = PESOS_HORA / PESOS_HORA.sum())),
                        int(rng.integers(0, 60)), tzinfo = CDMX)
    hoy = recibido.date()
    partes = []
    for _ in range(1 + min(rng.poisson(EXTRA), 3)):
        producto = str(rng.choice(ERRATAS)) if rng.random() < 0.08 else str(rng.choice(claves_alias))
        cantidad = str(rng.choice(['1', '2', '3', '4', 'una', 'dos', 'media docena de']))
        partes.append(f'{cantidad} {producto}')
    forma = rng.choice(FORMAS_FECHA, p = PROB_FECHA)
    if forma == 'semana':
        expresion = f"{rng.choice(['pal', 'para el', 'el'])} {rng.choice(DIAS, p = [.16, .16, .16, .16, .16, .16, .04])}"
    elif forma == 'mañana':
        expresion = str(rng.choice(['pa mañana', 'para mañana', 'mañana']))
    elif forma == 'hoy':
        expresion = 'para hoy'
    elif forma == 'explicita':
        f = hoy + timedelta(days = int(rng.integers(1, 9)))
        expresion = f'para el {f.day:02d}/{f.month:02d}'
    elif forma == 'dia_mes':
        expresion = f'el {(hoy + timedelta(days = int(rng.integers(1, 11)))).day}'
    elif forma == 'ambigua':
        expresion = str(rng.choice(['la otra semana', 'cuando esté listo', 'en la semana', 'para el cumple de mi mamá']))
    else:
        expresion = ''
    texto = (str(rng.choice(['hola, me aparta ', 'buenas tardes, quiero ', 'hola! me guarda ', 'quisiera ', '']))
             + ' y '.join(partes) + (' ' + expresion if expresion else '')
             + str(rng.choice(['', ', soy Lucía', ', gracias', ' porfa'])))
    sufijo = f'{i % 100:02d}'
    wa_id = rng.choice(['521550000' + '00' + sufijo, '52550000' + '00' + sufijo, '1555000' + '00' + sufijo],
                       p = [0.70, 0.25, 0.05])
    pedidos.append({'recibido': recibido, 'wa_id': str(wa_id), 'texto': texto, 'forma': forma})

def normalizar(p, alias = ALIAS, zona = CDMX):
    telefono = normalizar_telefono(p['wa_id'])
    renglones_p = extraer_renglones(p['texto'], alias)
    productos_ok = bool(renglones_p) and all(r['clave'] for r in renglones_p)
    fecha, motivo = interpretar_fecha(p['texto'], p['recibido'], zona)
    total = sum(r['cantidad'] * CATALOGO[r['clave']] * 100 for r in renglones_p) if productos_ok else None
    return {'telefono': telefono, 'productos': productos_ok, 'fecha_entrega': fecha, 'motivo_fecha': motivo,
            'total_centavos': total, 'renglones': len(renglones_p)}

resultados = pd.DataFrame([normalizar(p) for p in pedidos])
resultados['fecha_utc'] = [interpretar_fecha(p['texto'], p['recibido'], UTC)[0] for p in pedidos]
resultados['hora'] = [p['recibido'].hour for p in pedidos]
resultados['forma'] = [p['forma'] for p in pedidos]
campos = {'telefono': resultados['telefono'].notna(), 'productos': resultados['productos'],
          'fecha_entrega': resultados['fecha_entrega'].notna(), 'total_centavos': resultados['total_centavos'].notna()}
resultados['completo'] = np.logical_and.reduce(list(campos.values()))
tabla3 = pd.DataFrame([{'campo': c, 'normalizados': int(ok.sum()), 'a revisión': int((~ok).sum()),
                        'tasa': f'{ok.mean():.1%}'} for c, ok in campos.items()])
print(tabla3.to_string(index = False))
print('Pedidos completos:', int(resultados['completo'].sum()), 'de 200 | a revisión:', int((~resultados['completo']).sum()))
print('Motivos de fecha:', resultados['motivo_fecha'].value_counts().to_dict())
print('Renglones por pedido: media', round(resultados['renglones'].mean(), 2),
      '| con un solo renglón:', f"{(resultados['renglones'] == 1).mean():.0%}")
relativas = resultados['forma'].isin(['semana', 'mañana', 'hoy'])
error_utc = resultados['fecha_entrega'].notna() & (resultados['fecha_utc'] != resultados['fecha_entrega'])
print('Con el reloj en UTC cambiarían de fecha:', int(error_utc.sum()), 'pedidos; todos recibidos desde las',
      int(resultados.loc[error_utc, 'hora'].min()), 'h, de', int((relativas & (resultados['hora'] >= 18)).sum()),
      'relativos llegados desde las 18 h')
print('Ejemplo:', pedidos[0]['texto'], '->', normalizar(pedidos[0])['fecha_entrega'], normalizar(pedidos[0])['total_centavos'])

fig, (ax1, ax2) = plt.subplots(1, 2, figsize = (12, 4.6))
tasas = [ok.mean() * 100 for ok in campos.values()] + [resultados['completo'].mean() * 100]
etiquetas = list(campos) + ['pedido completo']
barras = ax1.barh(etiquetas[::-1], tasas[::-1], color = ['#3a9d5d'] + ['#2a78d6'] * 4)
for b, v in zip(barras, tasas[::-1]):
    ax1.text(v - 1, b.get_y() + b.get_height() / 2, f'{v:.1f} %', va = 'center', ha = 'right', color = 'white', fontsize = 10)
ax1.set_xlim(0, 100)
ax1.set_xlabel('% de los 200 pedidos normalizados sin intervención')
ax1.set_title('Tasa de normalización por campo', fontsize = 12)
horas = np.arange(7, 24)
rel_por_hora = [int((relativas & (resultados['hora'] == h)).sum()) for h in horas]
err_por_hora = [int((error_utc & (resultados['hora'] == h)).sum()) for h in horas]
ax2.bar(horas, rel_por_hora, color = '#2a78d6', label = 'Pedidos con fecha relativa')
ax2.bar(horas, err_por_hora, color = '#c8423b', label = 'Fecha distinta si el reloj está en UTC')
ax2.axvline(17.5, color = '#52514e', ls = ':', lw = 1)
ax2.text(17.7, max(rel_por_hora) * 0.92, '18:00 en la Ciudad de México\n= 00:00 en UTC', fontsize = 9, color = '#52514e')
ax2.set_xlabel('Hora de llegada (Ciudad de México)')
ax2.set_ylabel('Pedidos')
ax2.set_title('Dónde se equivoca un reloj en UTC', fontsize = 12)
ax2.legend(fontsize = 9, loc = 'upper left')
fig.suptitle('Normalizar 200 pedidos de WhatsApp con reglas', fontsize = 16)
plt.tight_layout()
plt.show()
         campo  normalizados  a revisión  tasa
      telefono           183          17 91.5%
     productos           178          22 89.0%
 fecha_entrega           157          43 78.5%
total_centavos           178          22 89.0%
Pedidos completos: 128 de 200 | a revisión: 72
Motivos de fecha: {'ok': 157, 'sin fecha reconocible': 31, 'domingo: cerrado': 12}
Renglones por pedido: media 1.5 | con un solo renglón: 60%
Con el reloj en UTC cambiarían de fecha: 12 pedidos; todos recibidos desde las 19 h, de 28 relativos llegados desde las 18 h
Ejemplo: dos pastel de zanahoria y 2 roles de canela para mañana -> 2026-02-21 91600
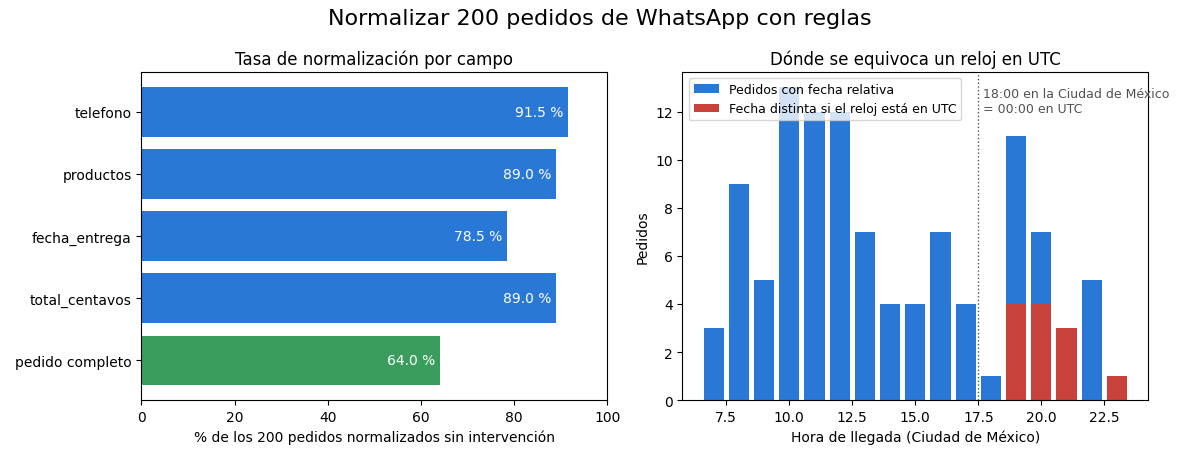
La Tabla 2 recoge el resultado por campo:
Tabla 2. Resultado de normalizar 200 pedidos de juguete con las reglas de la versión 2.1: éxito por campo y casos que van a revisión.
| Campo | Normalizados | A revisión | Tasa | Motivo principal de revisión |
|---|---|---|---|---|
| Teléfono | 183 | 17 | 91.5 % | Número de otro país |
| Productos | 178 | 22 | 89.0 % | Erratas y ruido (“conchas porfa”) |
| Fecha de entrega | 157 | 43 | 78.5 % | 31 sin fecha reconocible, 12 en domingo |
| Total en centavos | 178 | 22 | 89.0 % | Depende de que todos los productos se reconozcan |
| Pedido completo | 128 | 72 | 64.0 % | Al menos un campo a revisión |
Las reglas resuelven $128$ de los $200$ pedidos, el $64.0%$, sin intervención de nadie. El campo más difícil es la fecha ($78.5%$): de los $43$ casos que van a revisión, $31$ no dicen un día que se pueda calcular y $12$ piden un domingo. Ninguna regla, ningún código y ningún modelo de lenguaje pueden saber qué día es “cuando esté listo”; la respuesta correcta es preguntarle al cliente. Los teléfonos fallan en el $8.5%$, por encima del $5%$ que se sembró: la muestra es pequeña y la variación es la esperada en $200$ pedidos. Los pedidos tienen $1.5$ renglones de media y el $60%$ tiene uno solo, cerca de lo que midió el Día 14 ($1.54$ y $56%$). El ejemplo de la última línea muestra un pedido completo: “dos pastel de zanahoria y 2 roles de canela para mañana” se convierte en la fecha 2026-02-21 y un total de $91,600$ centavos ($2 \cdot 420 + 2 \cdot 38 = 916$ pesos).
La línea del reloj en UTC es la que Valeria imprime para Don Ernesto: $12$ de los $200$ pedidos habrían cambiado de fecha, todos llegados por la tarde, de los $28$ pedidos con fecha relativa que llegaron desde las seis. Es un $6%$ de los pedidos con el día de entrega equivocado y ningún error visible en el historial de Make. Los demás pedidos de la tarde no cambian por suerte, como “pal lunes” en la tabla anterior. En la figura, la izquierda muestra la tasa de cada campo y la del pedido completo, en verde; la derecha, los pedidos con fecha relativa por hora de llegada, con los que el reloj en UTC habría cambiado de día marcados en rojo, todos a la derecha de la línea de las 18:00.
Reglas, código o IA
Quedan $72$ pedidos que las reglas no resuelven. La pregunta de Don Ernesto (“póngale la inteligencia artificial esa”) merece una respuesta seria, y la respuesta seria es comparar opciones con los mismos criterios: cuánto cuesta cada pedido, cuánto tarda y qué parte de los pedidos resuelve. Hay cuatro herramientas disponibles:
- Reglas: las funciones de Make dentro de un módulo de establecer variables. Cuestan un crédito, tardan centésimas de segundo, son deterministas (el mismo mensaje da siempre el mismo resultado) y se pueden probar con un simulador como el del Bloque 7.
- Módulo de código: la aplicación de código de Make ejecuta JavaScript o Python en los planes de pago y cobra dos créditos por cada segundo de ejecución, con un límite de $30$ segundos en Core, según su centro de ayuda (revisado en octubre de 2026). La serie supone un segundo por pedido, dos créditos. Permite lo que las funciones no pueden, como comparar una errata con los alias del catálogo por parecido (
difflib). - Modelo de lenguaje: una llamada HTTP a la API de Claude con salida estructurada, un crédito del módulo HTTP más los tokens. Entiende el lenguaje libre, pero cuesta más, tarda más, envía el texto del cliente a un proveedor externo y puede equivocarse con seguridad.
- Persona: Valeria lee el pedido y, si hace falta, pregunta al cliente. Resuelve todo, pero cuesta $1.5$ minutos de su tiempo, unos $0.10$ USD a $75$ MXN la hora, y tarda lo que tarde en llegar a la pantalla.
La forma natural de combinarlas es una cascada: cada pedido pasa primero por la herramienta más barata y fiable, y baja al siguiente nivel solo si el anterior no lo resolvió. Su coste esperado por pedido es:
$$ E[c] = c_r + (1 - q_r),c_m + (1 - q_m),c_h $$
La lógica detrás de esta fórmula es múltiple:
- $c_r$ es el coste de las reglas, que se aplican a todos los pedidos; $q_r$ es la proporción que resuelven, $0.640$ en los $200$ pedidos de juguete.
- $c_m$ es el coste del segundo nivel (código o modelo), que solo pagan los pedidos que las reglas no resolvieron, la fracción $1 - q_r$.
- $q_m$ es la proporción de pedidos resueltos después del segundo nivel, y $c_h$ el coste de la persona, que solo pagan los que quedan, la fracción $1 - q_m$.
- En conclusión, el término que domina es el último: aunque $c_h$ solo lo pague una parte de los pedidos, es casi cien veces mayor que los demás. Reducir $1 - q_m$ ahorra más que abaratar $c_m$.
El siguiente bloque mide la cobertura del módulo de código con los mismos $200$ pedidos (las reglas más una búsqueda por parecido con difflib para las erratas), calcula la de un modelo de lenguaje con un supuesto declarado (resuelve lo que solo tiene problemas de forma, con una precisión supuesta del $97%$, y se abstiene ante una fecha que nadie puede saber), pone los costes con los precios de la Tabla A de la serie ($450$ tokens de entrada y $80$ de salida por pedido, una estimación) y compara cuatro estrategias para los $257$ pedidos del mes:
# Reglas, módulo de código o modelo de lenguaje: cobertura, coste y latencia en Python:
def alias_difuso(producto):
    parecido = difflib.get_close_matches(producto, claves_alias, n = 1, cutoff = 0.75)
    return ALIAS[parecido[0]] if parecido else None

class AliasConErratas(dict):                           # el "código": reglas más corrección de erratas
    def get(self, producto, defecto = None):
        return ALIAS.get(producto) or alias_difuso(producto)

con_codigo = pd.DataFrame([normalizar(p, alias = AliasConErratas()) for p in pedidos])
completo_codigo = (con_codigo['telefono'].notna() & con_codigo['productos'] & con_codigo['fecha_entrega'].notna())
q_reglas, q_codigo = resultados['completo'].mean(), completo_codigo.mean()

# Lo que un modelo podría resolver: solo productos dudosos; fecha ambigua, domingo o teléfono extranjero van a una persona:
resoluble_ia = (~resultados['completo']) & resultados['telefono'].notna() & resultados['fecha_entrega'].notna()
PRECISION_IA = 0.97                                    # supuesto declarado, no medido
q_ia = q_reglas + resoluble_ia.mean() * PRECISION_IA
tokens_entrada, tokens_salida = 450, 80
usd_haiku = tokens_entrada * 0.10 / 1e6 + tokens_salida * 0.50 / 1e6
usd_opus = tokens_entrada * 4.00 / 1e6 + tokens_salida * 20.00 / 1e6
USD_VALERIA = 1.5 / 60 * 75 / 18.50                    # 1.5 minutos a 75 MXN la hora
opciones = pd.DataFrame([
    {'opción': 'Reglas (funciones de Make)', 'créditos': 1, 'USD': USD_POR_CREDITO, 'latencia_s': 0.05, 'cobertura': q_reglas},
    {'opción': 'Módulo de código (Make Code)', 'créditos': 2, 'USD': 2 * USD_POR_CREDITO, 'latencia_s': 1.0, 'cobertura': q_codigo},
    {'opción': 'Claude Haiku 5.5 por HTTP', 'créditos': 1, 'USD': USD_POR_CREDITO + usd_haiku, 'latencia_s': 1.5, 'cobertura': q_ia},
    {'opción': 'Claude Opus 5.5 por HTTP', 'créditos': 1, 'USD': USD_POR_CREDITO + usd_opus, 'latencia_s': 6.0, 'cobertura': q_ia},
    {'opción': 'Persona (Valeria)', 'créditos': 0, 'USD': USD_VALERIA, 'latencia_s': 20 * 60, 'cobertura': 1.0},
])
print(opciones.to_string(index = False, formatters = {'USD': '{:.5f}'.format, 'cobertura': '{:.1%}'.format}))

# Cascada: reglas para todos, Haiku para lo dudoso, persona para lo demás, contra dos alternativas puras:
N = PEDIDOS_WHATSAPP_MES
c_r, c_ia = USD_POR_CREDITO, USD_POR_CREDITO + usd_haiku
cascada = N * (c_r + (1 - q_reglas) * c_ia + (1 - q_ia) * USD_VALERIA)
cascada_codigo = N * (c_r + (1 - q_reglas) * 2 * USD_POR_CREDITO + (1 - q_codigo) * USD_VALERIA)
todo_opus = N * ((USD_POR_CREDITO + usd_opus) + (1 - q_ia) * USD_VALERIA)
todo_persona = N * USD_VALERIA
print(f'Al mes ({N} pedidos): todo a mano {todo_persona:.2f} USD | todo con Opus {todo_opus:.2f} USD | '
      f'cascada con Haiku {cascada:.2f} USD | cascada con código {cascada_codigo:.2f} USD')
print('Teléfonos extranjeros:', int(resultados['telefono'].isna().sum()), '| fechas ambiguas o ausentes:',
      int((resultados['motivo_fecha'] == 'sin fecha reconocible').sum()), '| domingos:',
      int((resultados['motivo_fecha'] == 'domingo: cerrado').sum()))
print(f'Mensajes que viajan a un modelo: cascada {round(N * (1 - q_reglas))} de {N}; todo con Opus {N}')
print(f'Minutos de Valeria al mes: a mano {N * 1.5:.0f} | cascada {N * (1 - q_ia) * 1.5:.0f}')

fig, (ax1, ax2) = plt.subplots(1, 2, figsize = (12, 4.6))
nombres = ['Todo a mano', 'Todo con\nOpus 5.5', 'Cascada\ncon Haiku', 'Cascada\ncon código']
make_usd = [0, N * USD_POR_CREDITO, N * (c_r + (1 - q_reglas) * USD_POR_CREDITO),
            N * (c_r + (1 - q_reglas) * 2 * USD_POR_CREDITO)]
claude_usd = [0, N * usd_opus, N * (1 - q_reglas) * usd_haiku, 0]
persona_usd = [todo_persona, N * (1 - q_ia) * USD_VALERIA, N * (1 - q_ia) * USD_VALERIA, N * (1 - q_codigo) * USD_VALERIA]
ax1.bar(nombres, persona_usd, color = '#8a8986', label = 'Tiempo de Valeria')
ax1.bar(nombres, make_usd, bottom = persona_usd, color = '#2a78d6', label = 'Créditos de Make')
ax1.bar(nombres, claude_usd, bottom = np.add(persona_usd, make_usd), color = '#7b5ea7', label = 'API de Claude')
for k, total in enumerate([todo_persona, todo_opus, cascada, cascada_codigo]):
    ax1.text(k, total + 0.4, f'{total:.2f} USD', ha = 'center', fontsize = 10)
ax1.set_ylabel('USD al mes (ilustrativo)')
ax1.set_ylim(0, todo_persona * 1.18)
ax1.set_title(f'Normalizar {N} pedidos al mes', fontsize = 12)
ax1.legend(fontsize = 9)
ax2.barh(opciones['opción'][::-1], opciones['latencia_s'][::-1], color = ['#8a8986', '#7b5ea7', '#7b5ea7', '#2a78d6', '#2a78d6'])
ax2.set_xscale('log')
for y, v in enumerate(opciones['latencia_s'][::-1]):
    ax2.text(v * 1.15, y, f'{v:g} s', va = 'center', fontsize = 9)
ax2.set_xlim(0.02, 1e4)
ax2.set_xlabel('Latencia típica en segundos (escala logarítmica, ilustrativa)')
ax2.set_title('Cuánto espera el pedido', fontsize = 12)
fig.suptitle('Reglas, código o IA: coste y latencia', fontsize = 16)
plt.tight_layout()
plt.show()
                      opción  créditos     USD  latencia_s cobertura
  Reglas (funciones de Make)         1 0.00106        0.05     64.0%
Módulo de código (Make Code)         2 0.00212        1.00     72.0%
   Claude Haiku 5.5 por HTTP         1 0.00114        1.50     71.8%
    Claude Opus 5.5 por HTTP         1 0.00446        6.00     71.8%
           Persona (Valeria)         0 0.10135     1200.00    100.0%
Al mes (257 pedidos): todo a mano 26.05 USD | todo con Opus 8.50 USD | cascada con Haiku 7.73 USD | cascada con código 7.76 USD
Teléfonos extranjeros: 17 | fechas ambiguas o ausentes: 31 | domingos: 12
Mensajes que viajan a un modelo: cascada 93 de 257; todo con Opus 257
Minutos de Valeria al mes: a mano 386 | cascada 109
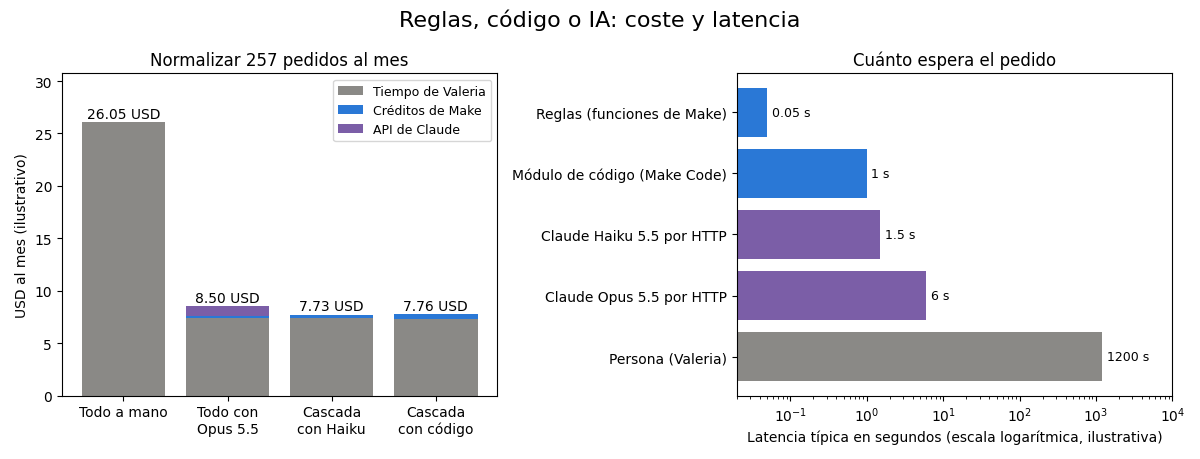
La Tabla 3 ordena las opciones con las cifras del bloque:
Tabla 3. Reglas, módulo de código o modelo de lenguaje: cuándo usar cada uno, coste por pedido y cobertura en los 200 pedidos de juguete (latencias ilustrativas).
| Opción | Cuándo usarla | Créditos | USD por pedido | Latencia típica | Cobertura |
|---|---|---|---|---|---|
| Reglas (funciones de Make) | Formatos conocidos y deterministas | 1 | 0.00106 | 0.05 s | 64.0 % |
| Módulo de código (Make Code) | Lógica que las funciones no expresan: parecido, bucles | 2 | 0.00212 | 1 s | 72.0 % |
| Claude Haiku 5.5 por HTTP | Lenguaje libre, volumen alto, coste mínimo | 1 | 0.00114 | 1.5 s | 71.8 % (supuesto) |
| Claude Opus 5.5 por HTTP | Lenguaje libre con matices o mucho contexto | 1 | 0.00446 | 6 s | 71.8 % (supuesto) |
| Persona (Valeria) | Lo ambiguo, lo delicado y lo que exige preguntar | 0 | 0.10135 | 20 min | 100 % |
Las cifras desmontan dos ideas a la vez. La primera, que el modelo de lenguaje resuelve “todo”: en estos pedidos, lo que queda después de las reglas son erratas, fechas que nadie puede calcular, domingos y teléfonos de otro país. Las erratas las resuelve igual un módulo de código ($72.0%$ frente a $71.8%$ con el supuesto de precisión); lo demás no lo resuelve nadie sin preguntar. La segunda idea, que el modelo es caro: con Haiku 5.5, una llamada cuesta $0.00114$ USD, menos que un segundo de módulo de código ($0.00212$). El coste de la API de Claude no es el argumento; los argumentos son la latencia, la imprevisibilidad y los datos que salen.
El mes lo resume: normalizar a mano los $257$ pedidos costaría $26.05$ USD de tiempo de Valeria ($386$ minutos); mandarlos todos a Opus 5.5, $8.50$ USD; la cascada con Haiku, $7.73$ USD, y la cascada con código, $7.76$ USD. Las tres opciones automáticas cuestan casi lo mismo, porque en todas lo que más pesa es el $28%$ que sigue llegando a Valeria ($109$ minutos al mes). Lo que sí cambia es cuántos mensajes de clientes viajan a un proveedor externo: $93$ de $257$ en la cascada frente a los $257$ si todo pasa por el modelo.
Valeria decide con esas cifras: reglas para todos, código para las erratas y una persona para lo demás, con la llamada a Claude reservada para el día en que lleguen mensajes que ni las reglas ni el código puedan leer (el Día 30 lo hará con la clasificación de mensajes). La Figura 3 resume la regla con la que Valeria explica la decisión a su padre: cada herramienta para el tipo de problema que resuelve mejor, en orden, y nada se descarta.
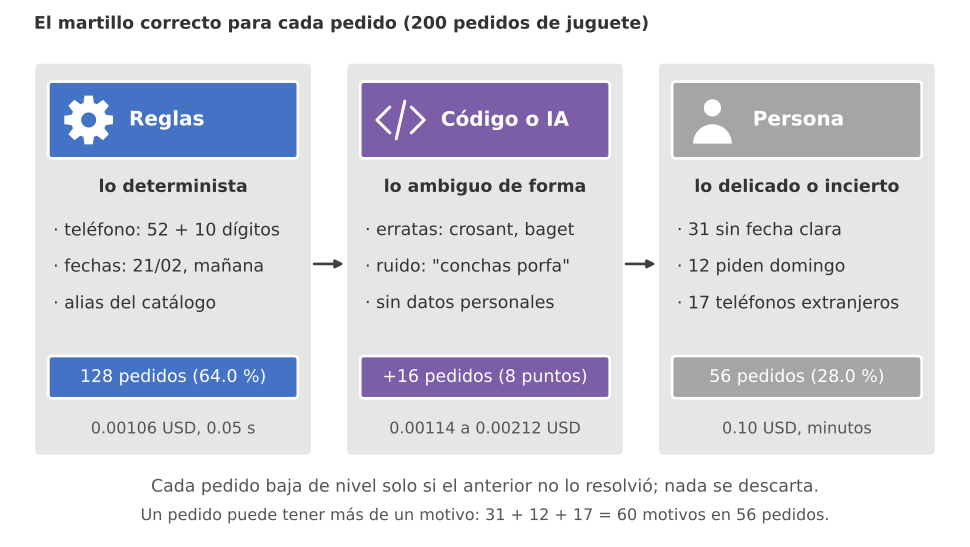
Figura 3. El martillo correcto: reglas para lo determinista (64.0 % de los pedidos), código o IA para lo ambiguo de forma (8 puntos más) y una persona para lo delicado o lo que nadie puede adivinar.
Atención aquí: mandar a un modelo de lenguaje lo que una regla resuelve no solo cuesta más: hace viajar a un proveedor externo el texto de un cliente que no lo necesitaba, con su nombre, su dirección o el motivo del pedido, y convierte un resultado determinista en uno que puede cambiar entre dos ejecuciones. El código de honor del Día 6 pide minimizar los datos personales que salen de Trigo Lento; la forma más sencilla de cumplirlo es que las reglas resuelvan primero y que lo que llegue al modelo vaya sin teléfono ni nombre. Si un modelo devuelve una fecha, compruébela con las mismas reglas (que no sea pasada ni domingo) antes de guardarla.
TL Pedidos WhatsApp v2.1
Con las funciones probadas, el iterador y el agregador contados y las reglas medidas, falta ensamblar el escenario. TL Pedidos WhatsApp v2.1 conserva la entrada de la versión 2 (el webhook de Twilio y la respuesta inmediata al emisor) y sustituye la ruta de pedidos por la secuencia del día: leer el catálogo del almacén de datos, preparar el texto, rebanar, normalizar cada renglón, agregar, normalizar el pedido y decidir entre la hoja de pedidos y la de revisión. Las otras rutas de la versión 2 (horario, precio, factura, queja y otro) no cambian hoy y aparecen resumidas en una sola, “No es pedido”, que termina en la hoja de revisión.
Dos decisiones del ensamblaje se ven en el código. La primera: el filtro “Es pedido” está en la entrada del módulo $13$, la lectura del catálogo, para que los mensajes que no son pedidos no paguen esa lectura. La segunda: el módulo $4$ calcula dia_semana_hoy con formatDate(now; "d"; "America/Mexico_City"), el día de la semana del obrador; la fórmula de la fecha de entrega del módulo $8$ lo usa en lugar del día de la semana del servidor. Esa es la corrección del error de Lucía, escrita en una línea.
El siguiente bloque copia las funciones dibujar_flujo (Día 2) y nodos_desde_blueprint (Día 22), porque cada entrada debe entenderse sola, y añade una regla para dibujar como paso humano (hexágono gris) las filas que van a la hoja de revisión. Después ensambla el blueprint con el fragmento del Bloque 6, lo valida (identificadores únicos, posiciones enteras, conexiones, webhooks y almacenes en $0$), lo guarda, cuenta los créditos de cada ruta propagando paquetes y lo dibuja:
# TL Pedidos WhatsApp v2.1: ensamblar el blueprint, validarlo, contar créditos y dibujarlo en Python:
from matplotlib.patches import Ellipse, FancyBboxPatch, Polygon, RegularPolygon, FancyArrowPatch

TIPOS = {'gateway:CustomWebHook': 'disparador', 'builtin:BasicRouter': 'decision'}
FORMAS = {'disparador': ('ovalo', '#3a9d5d'), 'accion': ('rectangulo', '#2a78d6'),
          'decision': ('rombo', '#eb6834'), 'ia': ('rectangulo', '#7b5ea7'),
          'error': ('rectangulo', '#c8423b'), 'humano': ('hexagono', '#8a8986')}

def tipo_de(m):
    if m['mapper'] and m['mapper'].get('sheetId') == 'Revisión':
        return 'humano'                                # la hoja de revisión la atiende una persona
    return TIPOS.get(m['module'], 'accion')

def dibujar_flujo(nodos, aristas, titulo, ax = None, ancho = 2.4, alto = 0.95, recorte = 34):
    if ax is None:
        fig, ax = plt.subplots(figsize = (12, 5.6))
    for nd in nodos:
        forma, color = FORMAS[nd['tipo']]
        x, y = nd['x'], nd['y']
        if forma == 'ovalo':
            figura = Ellipse((x, y), ancho, alto)
        elif forma == 'rombo':
            figura = Polygon([(x - ancho / 2, y), (x, y + alto / 1.3), (x + ancho / 2, y), (x, y - alto / 1.3)])
        elif forma == 'hexagono':
            figura = RegularPolygon((x, y), 6, radius = ancho / 2, orientation = np.pi / 6)
        else:
            figura = FancyBboxPatch((x - ancho / 2, y - alto / 2), ancho, alto, boxstyle = 'round,pad=0.03')
        figura.set_facecolor(color)
        figura.set_edgecolor('white')
        figura.set_linewidth(2)
        ax.add_patch(figura)
        ax.text(x, y, nd['texto'], ha = 'center', va = 'center', fontsize = 7.5, color = 'white')
    posicion = {nd['id']: (nd['x'], nd['y']) for nd in nodos}
    for origen, destino, etiqueta in aristas:
        (x1, y1), (x2, y2) = posicion[origen], posicion[destino]
        ax.add_patch(FancyArrowPatch((x1, y1), (x2, y2), arrowstyle = '-|>', mutation_scale = 14,
                                     shrinkA = recorte, shrinkB = recorte + 2, color = '#52514e', linewidth = 1.4))
        if etiqueta:
            ax.text((x1 + x2) / 2, (y1 + y2) / 2 + 0.3, etiqueta, ha = 'center', fontsize = 8,
                    color = '#52514e', bbox = dict(facecolor = 'white', edgecolor = 'none', pad = 1))
    xs, ys = [nd['x'] for nd in nodos], [nd['y'] for nd in nodos]
    ax.set_xlim(min(xs) - 1.3, max(xs) + 1.3)
    ax.set_ylim(min(ys) - 1.0, max(ys) + 1.0)
    ax.set_aspect('equal')
    ax.axis('off')
    ax.set_title(titulo, fontsize = 12)
    return ax

def nodos_desde_blueprint(bp, escala = 300 / 2.7):
    nodos, aristas = [], []
    def recorrer(flujo, previo, etiqueta, profundidad):
        for m in flujo:
            d = m['metadata']['designer']
            app, accion = m['module'].split(':')
            nodos.append({'id': m['id'], 'tipo': tipo_de(m), 'texto': f"{m['id']} {app}\n{accion}",
                          'x': d['x'] / escala, 'y': -d['y'] / escala, 'profundidad': profundidad})
            if previo is not None:
                aristas.append((previo, m['id'], m.get('filter', {}).get('name', etiqueta)))
            recorrer(m.get('onerror', []), m['id'], 'si falla', profundidad + 1)
            for ruta in m.get('routes', []):
                recorrer(ruta['flow'], m['id'], '', profundidad + 1)
            previo, etiqueta = m['id'], ''
    recorrer(bp['flow'], None, '', 0)
    return nodos, aristas

def modulo(id_, nombre, x, y, mapper = None, version = 1, **extra):
    m = {'id': id_, 'module': nombre, 'version': version, 'parameters': {}, 'mapper': mapper,
         'metadata': {'designer': {'x': x, 'y': y}}}
    m.update(extra)
    return m

def variables(**pares):
    return {'variables': [{'name': k, 'value': v} for k, v in pares.items()], 'scope': 'roundtrip'}

def hoja(id_, nombre_hoja, x, y, valores, **extra):
    mapper = {'mode': 'select', 'spreadsheetId': '/ID_DE_EJEMPLO', 'sheetId': nombre_hoja, 'includesHeaders': True,
              'valueInputOption': 'RAW', 'values': valores}
    return modulo(id_, 'google-sheets:addRow', x, y, mapper, version = 2, parameters = {'__IMTCONN__': 0}, **extra)

fragmento = json.loads((flujos / 'renglones_v2_1.fragmento.json').read_text(encoding = 'utf-8'))['flow']
SIN_FECHA = r'replace(lower(trim(1.Body)); /\s+(pal|pa|para el|para|el|mañana|hoy|la otra semana|cuando|en la semana)\b.*$/; emptystring)'
preparar = modulo(4, 'util:SetVariables', 1200, 150, variables(
    texto = '{{lower(trim(1.Body))}}',
    partes = '{{split(replace(' + SIN_FECHA + r'; /\s+y\s+/g; ","); ",")}}',
    dia_semana_hoy = '{{formatDate(now; "d"; "America/Mexico_City")}}',
    alias = '{{13.data.alias}}', cantidades = '{{13.data.cantidades}}', precios_centavos = '{{13.data.precios_centavos}}'))
normalizar_m = modulo(8, 'util:SetVariables', 2400, 150, variables(
    telefono = r'{{replace(1.WaId; /^52(1)?(\d{10})$/; "+52$2")}}',
    telefono_valido = r'{{length(replace(1.WaId; /^52(1)?(\d{10})$/; "+52$2")) = 13}}',
    fecha_entrega = '{{formatDate(if(contains(4.texto; "mañana"); addDays(now; 1); if(contains(4.texto; "sábado"); '
                    'addDays(now; if(4.dia_semana_hoy = 6; 7; 6 - 4.dia_semana_hoy)); emptystring)); '
                    '"YYYY-MM-DD"; "America/Mexico_City")}}',
    productos_reconocidos = '{{length(map(7.array; "clave")) = length(7.array)}}',
    total_centavos = '{{sum(map(7.array; "importe_centavos"))}}'))
completo = hoja(10, 'Pedidos', 3000, 0, {'0': '{{1.MessageSid}}', '1': '{{8.telefono}}', '2': '{{8.fecha_entrega}}',
                                         '3': '{{join(map(7.array; "clave"); ", ")}}', '4': '{{8.total_centavos}}'},
                filter = {'name': 'Completo', 'conditions': [[{'a': '{{8.fecha_entrega}}', 'o': 'exist'},
                          {'a': '{{8.telefono_valido}}', 'b': 'true', 'o': 'text:equal'},
                          {'a': '{{8.productos_reconocidos}}', 'b': 'true', 'o': 'text:equal'}]]})
revision = hoja(11, 'Revisión', 3000, 300, {'0': '{{1.MessageSid}}', '1': '{{4.texto}}', '2': 'normalización incompleta'},
                filter = {'name': 'Falta algo', 'conditions': [[{'a': '{{8.fecha_entrega}}', 'o': 'notexist'}],
                          [{'a': '{{8.telefono_valido}}', 'b': 'false', 'o': 'text:equal'}],
                          [{'a': '{{8.productos_reconocidos}}', 'b': 'false', 'o': 'text:equal'}]]})
ES_PEDIDO = [[{'a': '{{1.Body}}', 'b': p, 'o': 'text:contain:ci'}] for p in ('aparta', 'quiero', 'guarda', 'quisiera')]
ruta_pedido = {'flow': [modulo(13, 'datastore:GetRecord', 900, 150, {'key': 'catalogo'}, parameters = {'datastore': 0},
                               filter = {'name': 'Es pedido', 'conditions': ES_PEDIDO}),
                        preparar, *fragmento, normalizar_m,
                        modulo(9, 'builtin:BasicRouter', 2700, 150, routes = [{'flow': [completo]}, {'flow': [revision]}])]}
ruta_otros = {'flow': [hoja(12, 'Revisión', 900, -150, {'0': '{{1.MessageSid}}', '1': '{{1.Body}}', '2': 'rutas de la v2'},
                            filter = {'name': 'No es pedido', 'conditions': [[{'a': '{{1.Body}}', 'b': p, 'o': 'text:notcontain:ci'}
                                                               for p in ('aparta', 'quiero', 'guarda', 'quisiera')]]})]}
v21 = {'name': 'TL Pedidos WhatsApp v2.1',
       'flow': [modulo(1, 'gateway:CustomWebHook', 0, 0, {}, parameters = {'hook': 0, 'maxResults': 1}),
                modulo(2, 'gateway:WebhookRespond', 300, 0, {'status': '200', 'body': '<Response></Response>',
                       'headers': [{'key': 'Content-Type', 'value': 'text/xml'}]}),
                modulo(3, 'builtin:BasicRouter', 600, 0, routes = [ruta_pedido, ruta_otros])],
       'metadata': {'instant': True, 'version': 1,
                    'scenario': {'roundtrips': 1, 'maxErrors': 3, 'autoCommit': True, 'autoCommitTriggerLast': True,
                                 'sequential': True, 'confidential': True, 'dataloss': False, 'dlq': True,
                                 'freshVariables': False},
                    'designer': {'orphans': []}}}

# Validación mínima: ids únicos, posiciones enteras, sin conexiones ni webhooks reales:
def todos(flujo):
    for m in flujo:
        yield m
        for ruta in m.get('routes', []):
            yield from todos(ruta['flow'])
ids = [m['id'] for m in todos(v21['flow'])]
assert len(ids) == len(set(ids)), 'ids repetidos'
assert all(isinstance(v, int) for m in todos(v21['flow']) for v in m['metadata']['designer'].values())
assert all(m['parameters'].get(k, 0) == 0 for m in todos(v21['flow']) for k in ('__IMTCONN__', 'hook', 'datastore'))
ruta = flujos / 'pedidos_whatsapp_v2_1.blueprint.json'
ruta.write_text(json.dumps(v21, ensure_ascii = False, indent = 2), encoding = 'utf-8')

# Créditos por pedido propagando paquetes por la ruta tomada:
def creditos_ruta(flujo, n, rutas_tomadas, p = 1):
    total = 0
    for m in flujo:
        if 'filter' in m and m['filter']['name'] not in rutas_tomadas:
            return total
        if m['module'] == 'builtin:BasicRouter':
            total += sum(creditos_ruta(r['flow'], n, rutas_tomadas, p) for r in m['routes'])
            continue
        total += 1 if m['module'] == 'builtin:BasicAggregator' else p
        p = p * n if m['module'] == 'builtin:BasicFeeder' else (1 if m['module'] == 'builtin:BasicAggregator' else p)
    return total

print('Módulos:', len(ids), '| ids:', sorted(ids), '| escrito:', ruta.as_posix(), f'({ruta.stat().st_size} bytes)')
for k in (1, 3, 12):
    print(f'Pedido completo con {k:>2} renglones: {creditos_ruta(v21["flow"], k, {"Es pedido", "Es renglón", "Completo"})} créditos')
otros = creditos_ruta(v21['flow'], 1, {'No es pedido'})
print('Mensaje que no es pedido:', otros, 'créditos')
mes = mes_b.mean() + (1_560 - PEDIDOS_WHATSAPP_MES) * otros       # 1 560 mensajes de WhatsApp al mes
print(f'Escenario completo al mes: {mes:.0f} créditos ({mes / CUOTA_CORE:.1%} de Core)')

nodos, aristas = nodos_desde_blueprint(v21)
fig, ax = plt.subplots(figsize = (15, 4.6))
dibujar_flujo(nodos, aristas, '', ax = ax)
print(f'{len(nodos)} nodos, {len(aristas)} aristas, profundidad máxima {max(nd["profundidad"] for nd in nodos)}')
fig.suptitle('TL Pedidos WhatsApp v2.1 dibujado desde su blueprint', fontsize = 16)
plt.tight_layout()
plt.show()
Módulos: 13 | ids: [1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13] | escrito: trigo_lento/dia_25/flujos/make/pedidos_whatsapp_v2_1.blueprint.json (15201 bytes)
Pedido completo con  1 renglones: 9 créditos
Pedido completo con  3 renglones: 11 créditos
Pedido completo con 12 renglones: 20 créditos
Mensaje que no es pedido: 3 créditos
Escenario completo al mes: 6361 créditos (63.6% de Core)
13 nodos, 12 aristas, profundidad máxima 2
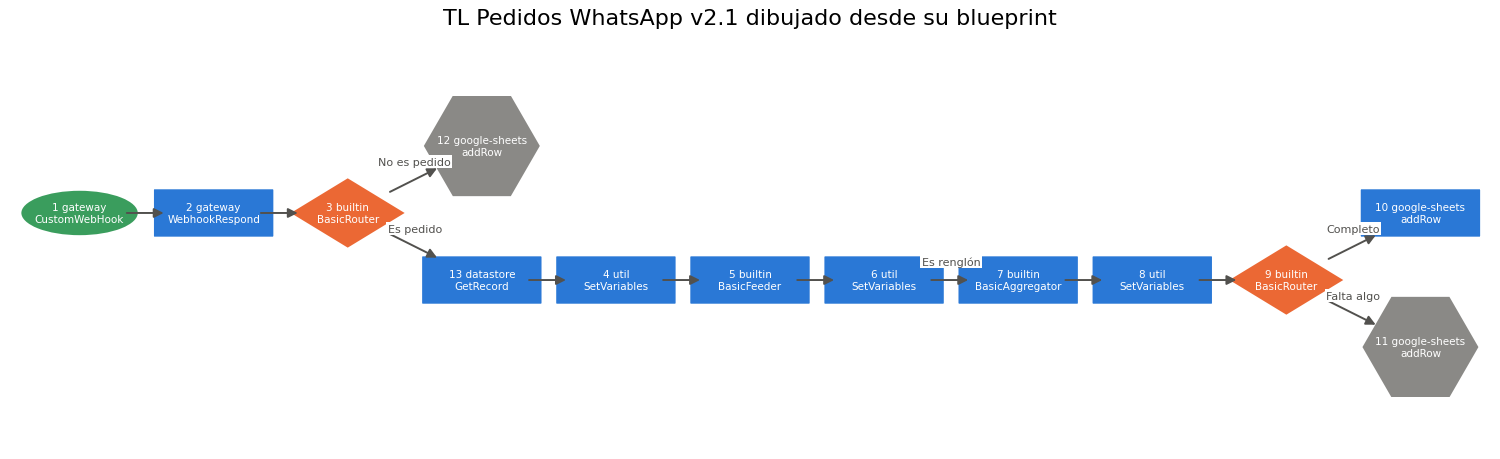
El escenario tiene $13$ módulos con identificadores únicos y pasa la validación; el blueprint ocupa $15,201$ bytes. Los créditos confirman la recta del Bloque 5 desde el blueprint, no desde una lista escrita a mano: $9$ créditos con un renglón, $11$ con tres y $20$ con doce. Un mensaje que no es pedido cuesta $3$ créditos (webhook, respuesta y fila de revisión). Con los $1,560$ mensajes de WhatsApp del mes, el escenario completo consume unos $6,361$ créditos, el $63.6%$ de Make Core: la ruta de pedidos aporta $2,452$ y los $1,303$ mensajes restantes, $3,909$. Es una cifra que el módulo debe vigilar, porque el Día 21 estimó $8,886$ créditos para todos los escenarios del módulo 3 y este todavía no maneja errores ni clasifica con un modelo; la evaluación del Día 32 cuadrará el total contra la cuota.
En el dibujo, la entrada es una línea corta (óvalo verde, respuesta y router), y la ruta de pedidos es la fila larga de abajo: catálogo, preparación, iterador, renglón, agregador y normalización, con el filtro “Es renglón” en la flecha que llega al agregador. El segundo router separa los pedidos completos, que van a la hoja Pedidos, de los que tienen algo pendiente, que van a la hoja Revisión, dibujada como paso humano. La profundidad máxima es $2$: el router de la entrada abre un nivel y el router de la ruta de pedidos, el segundo.
El segundo nivel, cuando haga falta
La cascada de Valeria no llama hoy a ningún modelo, pero conviene dejar escrita la llamada que se usará cuando lleguen mensajes que ni las reglas ni el código puedan leer. Tiene tres rasgos que la serie exige: modelo barato porque el volumen lo justifica (claude-haiku-5-5), salida estructurada con un esquema que admite null y una pregunta al cliente en lugar de una fecha inventada, y solo el texto del pedido, sin teléfono ni nombre. El siguiente bloque llama a la API de verdad, así que se muestra con su salida de ejemplo:
# Rescate de pedidos dudosos con Claude Haiku 5.5 y salida estructurada en Python:
import json
import anthropic

client = anthropic.Anthropic()                       # lee ANTHROPIC_API_KEY del entorno
ESQUEMA = {
    'type': 'object',
    'properties': {
        'renglones': {'type': 'array', 'items': {
            'type': 'object',
            'properties': {'clave': {'type': ['string', 'null']}, 'cantidad': {'type': 'integer'}},
            'required': ['clave', 'cantidad'], 'additionalProperties': False}},
        'fecha_entrega': {'type': ['string', 'null'], 'description': 'AAAA-MM-DD o null si no se puede saber'},
        'pregunta_al_cliente': {'type': ['string', 'null']},
    },
    'required': ['renglones', 'fecha_entrega', 'pregunta_al_cliente'],
    'additionalProperties': False,
}
SISTEMA = ('Normaliza encargos de una panadería. Usa solo las claves del catálogo. '
           'Si la fecha no se puede saber con certeza, devuelve null y redacta una pregunta breve, en usted. '
           'No adivines: un null con pregunta vale más que una fecha inventada.')

def rescatar(texto, recibido_local, catalogo):
    # Solo viaja el texto del pedido: sin teléfono ni nombre (seudonimización del Día 6):
    respuesta = client.messages.create(
        model = 'claude-haiku-5-5',
        max_tokens = 400,
        system = SISTEMA,
        messages = [{'role': 'user', 'content': f'Catálogo: {json.dumps(catalogo, ensure_ascii = False)}\n'
                                                f'Recibido (America/Mexico_City): {recibido_local}\n'
                                                f'Mensaje: {texto}'}],
        output_config = {'effort': 'low', 'format': {'type': 'json_schema', 'schema': ESQUEMA}},
    )
    if respuesta.stop_reason != 'end_turn':
        return None, respuesta.stop_reason                # refusal o max_tokens: a revisión humana
    texto_json = next(b.text for b in respuesta.content if b.type == 'text')
    return json.loads(texto_json), respuesta.usage

catalogo = {'hogaza': 'P01', 'croissant': 'P05', 'pay de queso': 'P12', 'rol de canela': 'P06'}
for mensaje in ['me guarda 3 crosant y 1 pay de keso pal sábado',
                'quiero 2 hogazas para el cumple de mi mamá']:
    datos, uso = rescatar(mensaje, '2026-02-20 23:30', catalogo)
    print(datos)
    print('Tokens:', uso.input_tokens, 'de entrada y', uso.output_tokens, 'de salida')

# Salida de ejemplo (puede variar):
# {'renglones': [{'clave': 'P05', 'cantidad': 3}, {'clave': 'P12', 'cantidad': 1}], 'fecha_entrega': '2026-02-21', 'pregunta_al_cliente': None}
# Tokens: 431 de entrada y 74 de salida
# {'renglones': [{'clave': 'P01', 'cantidad': 2}], 'fecha_entrega': None, 'pregunta_al_cliente': '¿Para qué día es el cumpleaños? Así le tenemos listas sus hogazas.'}
# Tokens: 428 de entrada y 69 de salida
En la salida de ejemplo, el modelo corrige las erratas (“crosant” y “pay de keso”), calcula el sábado 21 porque se le dio la fecha y la zona del obrador, y ante “para el cumple de mi mamá” devuelve null y una pregunta en usted, que es exactamente lo que haría Valeria. Las dos llamadas usan unos $430$ tokens de entrada y $70$ de salida, en la línea de la estimación del Bloque 8. Si stop_reason no es end_turn (un rechazo o una respuesta cortada), el pedido va a la hoja de revisión: el modelo es un nivel de la cascada, nunca el último.
Don Ernesto mira el dibujo impreso y la tabla de la cascada, y hace la pregunta que le importa: “Entonces, si Lucía escribe el viernes en la noche, ¿el pay sale el sábado?” Sale el sábado, porque la fecha se calcula con el reloj del obrador. "¿Y la máquina esa de la inteligencia?" Para los pedidos de esta semana, no hace falta; cuando haga falta, recibirá el pedido sin el teléfono de nadie. Don Ernesto asiente: “Mejor. Lo que se puede hacer con regla, se hace con regla. Así hacemos el pan.”
Consideraciones finales
El día empezó con un pay de queso que salió dos días tarde y una fórmula que calculaba bien con el reloj equivocado, y termina con doce funciones de Make probadas contra su documentación, una regla para saber cuándo un reloj en UTC ya vive el día siguiente, un iterador y un agregador con su coste exacto, $200$ pedidos normalizados con reglas y una decisión escrita sobre qué resuelve cada herramienta. La cifra que lo resume es pequeña: $64.0%$ de los pedidos completos sin intervención, con un crédito por pedido en las reglas. Lo que no es pequeño es lo que evita: $12$ pedidos de cada $200$ con el día de entrega equivocado y ningún aviso en el historial. Una transformación de datos que no declara su zona horaria, su base de conteo y su forma de redondear no es una regla: es una apuesta.
Antes de dar por buena una transformación en Make, conviene hacerse algunas preguntas:
- ¿Cada
formatDatey cadaparseDateque toca una fecha del negocio lleva la zona escrita como último argumento? - ¿Sabe qué función de su escenario cuenta desde $1$ y cuál redondea las mitades hacia arriba? ¿Lo probó con un caso en el que la diferencia se note?
- ¿Qué hay detrás de su iterador? Todo lo que esté entre el iterador y el agregador se paga una vez por elemento.
- ¿Qué parte de lo que envía a un modelo de lenguaje podría resolver una regla? ¿Y qué datos personales viajan con ese texto sin necesidad?
Las cifras de hoy tienen límites claros. Los $200$ pedidos son de juguete, con proporciones de erratas, fechas y teléfonos sembradas a mano: sirven para comparar opciones, no para predecir la tasa real de Trigo Lento, que solo dará el historial. Los blueprints tienen la estructura documentada pero no son exportaciones reales, y las expresiones de los módulos $6$ y $8$ son una traducción de las reglas de Python que debe comprobarse con pedidos de prueba en el escenario antes de activarlo. Las latencias son ilustrativas, el cobro del agregador es un supuesto con su sensibilidad calculada y la precisión del modelo de lenguaje es un supuesto, no una medición. Ninguno de esos límites cambia la estructura de la conclusión: el reloj se declara, los renglones se rebanan y se vuelven a juntar con su coste a la vista, y las reglas van antes que cualquier modelo.
Un gran libro que habla de esto es Diseño de aplicaciones intensivas en datos (o Designing Data-Intensive Applications), en el que Martin Kleppmann dedica páginas memorables a los relojes de los sistemas distribuidos: por qué dos máquinas nunca coinciden del todo, por qué una marca de tiempo sin zona es una fuente de errores silenciosos y por qué conviene separar el instante en que algo ocurrió de la forma en que se muestra. Leído junto a los patrones Splitter y Aggregator de Hohpe y Woolf, que el Día 22 recomendó, le dará el vocabulario para pensar cualquier transformación de datos, en Make o fuera de él.
Conclusiones clave
Funciones
- Las funciones de Make viven dentro de los campos, entre dobles llaves y con argumentos separados por punto y coma; doce de ellas cubren la ruta de pedidos de Trigo Lento.
- Solo $8$ de $12$ coinciden con una traducción ingenua a Python:
parseNumberadmite separador decimal,round(2.5)da $3$ en Make y $2$ en Python,getcuenta desde $1$ yformatDatedepende de la zona. - Los equivalentes en Python reproducen los $11$ ejemplos de la documentación de Make y sirven como laboratorio para probar fórmulas sin gastar créditos.
Fechas
- Make guarda instantes en UTC y usa la zona de la organización cuando no se le da otra; la Ciudad de México está a $-6$ horas todo el año desde octubre de 2022.
- Desde las $18{:}00$ del obrador, la fecha de UTC ya es la del día siguiente: “pal sábado” a las $23{:}30$ del viernes se vuelve el $28$ en lugar del $21$, y en $200$ pedidos el error habría cambiado $12$ fechas.
- La corrección cabe en una línea: escribir
"America/Mexico_City"en cadaformatDateyparseDate, y calcular el día de la semana del obrador conformatDate(now; "d"; "America/Mexico_City").
Iterar y agregar
- El iterador emite un paquete por elemento y multiplica el coste de lo que le sigue; el agregador de arreglo los vuelve a juntar en uno y reconstruye
renglones. - La ruta de pedidos de la versión 2.1 cuesta $8 + n$ créditos ($9$, $11$ y $20$ con $1$, $3$ y $12$ renglones), frente a $5 + 2n$ sin agregador; empatan en $n = 3$ y al mes suman $2,452$ créditos, el $24.5%$ de Core.
- El escenario completo, con $1,560$ mensajes al mes, consume unos $6,361$ créditos ($63.6%$ de Core), una cifra que la evaluación del Día 32 cuadrará con la estimación del módulo.
Reglas, código o IA
- Las reglas normalizan el $64.0%$ de los $200$ pedidos; el código con búsqueda por parecido llega al $72.0%$, y lo demás (fechas imposibles de calcular, domingos y teléfonos extranjeros) necesita a una persona que pregunte.
- Al mes, normalizar a mano cuesta $26.05$ USD de tiempo de Valeria y cualquier cascada automática unos $7.7$ USD; la cascada envía a un modelo $93$ mensajes de $257$ en lugar de todos.
- La llamada a Claude Haiku 5.5 queda escrita con salida estructurada,
nully una pregunta cuando la fecha no se puede saber, y sin teléfono ni nombre del cliente.
Mañana, en el Día 26: Laboratorio guiado en Make: el escenario de recordatorios de recogida, paso a paso. Dos clientes olvidaron recoger su pastel este miércoles y un tercero llegó un día antes; Valeria construirá módulo por módulo, con búsqueda, iterador, filtros de consentimiento y horario y un almacén de datos contra duplicados, el recordatorio que el Día 18 dejó especificado, y usará las fechas con zona de hoy para que nadie reciba el aviso a deshoras.
Referencias
- Make (2026). Date and time functions. Centro de ayuda de Make. https://help.make.com/date-and-time-functions
- Make (2026). Text and binary functions; Math functions; Array functions; General functions. Centro de ayuda de Make. https://help.make.com/text-and-binary-functions
- Make (2026). The Make Code app is available. Centro de ayuda de Make. https://help.make.com/the-make-code-app-is-available
- Make Academy (2026). Make Intermediate: Iterator and aggregator. https://academy-content.make.com/courses/make-intermediate-webhooks/05-iterator-and-aggregator/
- Make Academy (2026). Make Foundation: Credit consumption in Make. https://academy-content.make.com/courses/make-foundation-operations-credits/02-credit-consumption-in-make
- IANA (2026). Time Zone Database (zona
America/Mexico_City). https://www.iana.org/time-zones - Klyne, G. y Newman, C. (2002). Date and Time on the Internet: Timestamps (RFC 3339). IETF. https://www.rfc-editor.org/rfc/rfc3339
- Python Software Foundation (2026).
zoneinfo: IANA time zone support. https://docs.python.org/3/library/zoneinfo.html - Kleppmann, M. (2017). Designing Data-Intensive Applications. O’Reilly Media.
- Hohpe, G. y Woolf, B. (2003). Enterprise Integration Patterns: Designing, Building, and Deploying Messaging Solutions. Addison-Wesley.