
Arquitecto de automatización con IA: Día 28
 Jeshua Romero Guadarrama
- 61 Min para leer
- 28 Feb, 2026
Índice de contenido
Resumen:
Un martes a mediodía la hoja de cálculo de Trigo Lento dejó de responder durante 35 minutos y cuatro pedidos se quedaron guardados en una lista que nadie miraba; uno era el cambio de pedido de la Cafetería Brújula. En esta entrada, Valeria clasifica los errores de un flujo en reintentables y no reintentables, elige entre las cinco directivas de error de Make (Ignore, Resume, Commit, Rollback y Break), configura las ejecuciones incompletas y calcula con una fórmula por qué un escenario de $7$ módulos que fallan el $5%$ de las veces termina sin error solo el $69.8%$ de las ocasiones, y el $99.996%$ con tres reintentos por módulo. Después simula $10,000$ ejecuciones con tres políticas de reintento, elimina los pedidos duplicados con una clave SHA-256 del MessageSid, dibuja TL Pedidos WhatsApp v2.3 con sus manejadores en rojo, comprueba el nivel de servicio que pidió Marisol y monta una alerta que habría avisado del martes en $4$ minutos en lugar de $45$ horas. Al terminar, usted sabrá diseñar el manejo de errores de un escenario con números, no con esperanza.
¿Cómo citar el presente artículo?
Romero, J. (28 de febrero de 2026). Arquitecto de automatización con IA: Día 28. python-data-engineer. https://www.python-data-engineer.com/post/aai/dia_28/.
Arquitecto de automatización con IA: Día 28 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/aai/dia_28/.
Planes, precios y límites de Make, n8n, Zapier, WhatsApp (Meta, Twilio, Wati) y de la API de Claude revisados en octubre de 2026. El comportamiento de las cinco directivas de error, el estado final de cada una, el requisito de las ejecuciones incompletas, el calendario de reintentos automáticos (ocho intentos, de $1$ minuto a $7$ horas $51$ minutos), los valores por omisión del manejador de reintento ($3$ intentos cada $15$ minutos) y los endpoints de ejecuciones incompletas de la API se contrastaron con el centro de ayuda y la referencia de la API de Make en octubre de 2026. Desde el 26 de mayo de 2026, el editor de Make muestra Break con el nombre Retry e Ignore con el nombre Skip; la entrada conserva los nombres de los identificadores del blueprint (builtin:Break, builtin:Ignore). El blueprint del Bloque 7 tiene la estructura verificada contra la documentación, revisado en octubre de 2026; no es la exportación de una cuenta real, sus identificadores son valores de ejemplo y las claves de cada manejador (retry, count, interval y la salida sustituta de Resume) deben contrastarse con una exportación propia antes de usarlas.
Día 28. Flujos profesionales: manejo de errores, reintentos y ejecuciones incompletas
Introducción
Ayer, en el Día 27 (JSON y variables en Make: estructuras de datos, Parse JSON y almacenes), Valeria aprendió a leer y escribir JSON sin romperlo, a convertir texto en estructuras con Parse JSON y a guardar en variables y almacenes de datos lo que un escenario debe recordar entre una ejecución y la siguiente, y Trigo Lento ganó TL Pedidos WhatsApp v2.2, con un almacén de clientes y cuerpos de petición seguros. Hoy toca la pregunta que todo escenario termina por hacerse en producción: qué pasa cuando algo de lo que está fuera de Make no responde.
Es sábado 28 de febrero y Valeria repasa con calma una semana que terminó mejor de lo que empezó. El martes 24, entre las 13:05 y las 13:40, la API de la hoja de cálculo respondió con errores y tiempos agotados. El escenario de pedidos tenía activadas las ejecuciones incompletas desde el Día 22, así que cada ejecución que falló quedó guardada en lugar de perderse: once en total. Siete se resolvieron solas, porque eran errores de conexión y de tiempo agotado que Make reintenta por su cuenta. Las otras cuatro eran errores internos del servicio, de los que Make no reintenta de forma automática, y se quedaron en la pestaña de ejecuciones incompletas esperando a que alguien las reanudara. Nadie lo hizo. El jueves a las 10:30, una clienta llegó por dos hogazas que el obrador no tenía apuntadas, y al revisar, Valeria encontró los cuatro pedidos. Uno era de la Cafetería Brújula: Marisol había escrito el martes a las 13:22 para cambiar el pedido del miércoles de $40$ a $50$ baguettes, y el miércoles recibió $40$.
Marisol llamó el jueves por la tarde, amable y firme a la vez: “Valeria, no le pido que no fallen nunca; le pido saberlo. Si mando un cambio, quiero que me lo confirmen en cinco minutos, y si no se puede, que me lo digan. Con que eso pase noventa y cinco veces de cada cien, yo organizo mi cafetería.” Acababa de dictar, sin saberlo, un acuerdo de nivel de servicio con su métrica, su umbral y su porcentaje.
Don Ernesto escuchó la llamada en el altavoz y se tomó un momento antes de opinar: “Con la libreta, si se mojaba una hoja, yo me daba cuenta esa misma tarde. Su máquina guardó los cuatro pedidos con mucho cuidado, en una lista que no lee nadie. Eso no es guardar: es esconder. Y no me diga que la solución es que lo intente otra vez, porque si lo intenta dos veces me va a hacer hornear dos pasteles.” Las dos objeciones son correctas, y las dos tienen respuesta técnica. La primera pide alertas: un error que nadie ve es peor que un error que detiene todo. La segunda pide idempotencia: un reintento solo es seguro si repetir la operación no repite su efecto.
En la presente entrada, descubrirá por qué fallan los flujos y cómo distinguir los errores que merecen un reintento de los que no, con la clasificación de tipos de error de Make. Conocerá las cinco directivas de error (Ignore, Resume, Commit, Rollback y Break) con lo que cada una hace con el paquete que falla y con el resto del escenario, y configurará las ejecuciones incompletas. Calculará la fiabilidad de un escenario con y sin reintentos, escribirá una función de reintento con espera exponencial y fluctuación aleatoria, y simulará $10,000$ ejecuciones para comparar tres políticas por éxito, latencia y créditos. Después garantizará con una clave SHA-256 del MessageSid que un pedido entregado dos veces se guarda una sola vez, leerá y dibujará TL Pedidos WhatsApp v2.3 con sus manejadores de error, medirá si cumple lo que pidió Marisol y montará el registro de errores y la alerta que el martes faltó.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Clasificar los errores de un flujo en reintentables y no reintentables.
- Elegir la directiva de error de Make adecuada (Ignore, Resume, Commit, Rollback, Break) y configurar ejecuciones incompletas.
- Calcular la fiabilidad de un escenario con y sin reintentos, y diseñar reintentos con espera exponencial y fluctuación aleatoria.
- Garantizar idempotencia para no duplicar pedidos y medir el nivel de servicio prometido a la Cafetería Brújula.
Por qué fallan los flujos
Un escenario de Make es una cadena de llamadas a servicios que no son de Make: la API de Twilio que entrega el mensaje, la de Google Sheets que guarda la fila, el almacén de datos, el webhook del obrador. Cada eslabón puede fallar por razones que no tienen nada que ver con la lógica del escenario. Conviene agruparlas en tres familias, porque cada familia pide un tratamiento distinto:
- Fallos pasajeros: la red se corta un instante, el servicio está saturado y devuelve un $429$ (demasiadas peticiones) o un $503$ (no disponible), o tarda más de lo que el módulo está dispuesto a esperar. Si se repite la misma petición un poco más tarde, lo normal es que salga bien.
- Fallos de los datos: el paquete trae algo que el servicio no acepta, como una fecha con un formato que la hoja no entiende o un campo obligatorio vacío. Repetir la misma petición produce el mismo error, siempre.
- Fallos de configuración: la conexión caducó, alguien revocó un permiso o el proveedor cambió su API. Tampoco se arreglan repitiendo; se arreglan cambiando algo en el escenario o en la cuenta.
La pregunta que decide todo el diseño es, entonces, ¿repetir la petición puede cambiar el resultado? Si la respuesta es sí, el error es reintentable; si es no, reintentarlo solo gasta créditos y retrasa el momento en que una persona se entera. Make ayuda a responderla porque clasifica cada error con un tipo. Según su centro de ayuda (revisado en octubre de 2026), ConnectionError y RateLimitError son los más frecuentes y son temporales; junto con ModuleTimeoutError, son los tres que Make reintenta de forma automática cuando las ejecuciones incompletas están activadas. Errores como DataError, InvalidAccessTokenError o InconsistencyError piden un tratamiento propio, y otros, como OperationsLimitExceededError, desactivan la programación del escenario de inmediato.
El primer bloque del día prepara las importaciones, la semilla global $2026$ y los cinco supuestos que se usarán en toda la entrada: la probabilidad de fallo por módulo, que el plan fija en $p = 0.05$ como cifra de juguete deliberadamente pesimista; los $7$ módulos de la ruta de pedidos que hablan con un servicio; los $1,560$ mensajes y los $257$ pedidos de WhatsApp al mes, y los $5$ minutos de Marisol:
# Importaciones base, semilla de la serie, carpeta del día y supuestos en Python:
import warnings
warnings.filterwarnings('ignore')
import hashlib
import json
import sqlite3
from datetime import datetime, timedelta
from pathlib import Path
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 120)
pd.set_option('display.max_columns', 12)
carpeta = Path('trigo_lento') / 'dia_28'
(carpeta / 'flujos' / 'make').mkdir(parents = True, exist_ok = True)

# Supuestos del día (de juguete, declarados):
P_FALLO = 0.05                # probabilidad de que un módulo falle en un intento
MODULOS = 7                   # módulos de la ruta de pedidos que hablan con un servicio
MENSAJES_MES = 1_560          # mensajes de WhatsApp al mes (Día 1)
PEDIDOS_WA_MES = 257          # el 55 % de los 468 encargos llega por WhatsApp (Día 25)
SLA_MIN = 5                   # Marisol: confirmación en menos de 5 minutos
print('numpy', np.__version__, '| pandas', pd.__version__)
print('Carpeta del día:', carpeta.as_posix())
numpy 2.4.6 | pandas 3.0.3
Carpeta del día: trigo_lento/dia_28
Con la carpeta lista, el segundo bloque escribe dos tablas de referencia y reconstruye lo que pasó el martes. La primera tabla clasifica los errores típicos de Trigo Lento; la segunda resume las directivas de Make, que la sección siguiente explica una por una. Al final, el bloque toma las once ejecuciones fallidas del martes con su hora y su tipo de error, y separa las que Make reintentó solo de las que se quedaron esperando a una persona:
# Tipos de error, directivas de Make y el registro del martes 24 de febrero en Python:
errores = pd.DataFrame([
    ('Red cortada', 'ConnectionError', 'sí', 'sí', 'Retry (Break)'),
    ('429 límite de peticiones', 'RateLimitError', 'sí', 'sí', 'Retry (Break)'),
    ('Tiempo agotado', 'ModuleTimeoutError', 'sí', 'sí', 'Retry (Break)'),
    ('5xx del servicio', 'RuntimeError', 'sí', 'no', 'Retry (Break)'),
    ('Datos inválidos', 'DataError', 'no', 'no', 'Resume o revisión humana'),
    ('Clave o permiso inválido', 'InvalidAccessTokenError', 'no', 'no', 'Alerta y corrección'),
    ('Cambio de API', 'InvalidConfigurationError', 'no', 'no', 'Alerta y corrección'),
], columns = ['error', 'tipo en Make', 'reintentable', 'Make reintenta solo', 'directiva sugerida'])
print(errores.to_string(index = False))

directivas = pd.DataFrame([
    ('Ignore (Skip)', 'lo descarta', 'sigue', 'no', 'éxito'),
    ('Resume', 'usa un valor sustituto', 'sigue', 'no', 'éxito'),
    ('Commit', 'se detiene', 'se detiene; confirma lo hecho', 'sí', 'aviso'),
    ('Rollback', 'se detiene', 'se detiene; revierte lo transaccional', 'sí', 'error'),
    ('Break (Retry)', 'lo guarda como incompleto', 'sigue', 'no', 'aviso'),
], columns = ['directiva', 'el paquete que falló', 'los demás paquetes', 'detiene', 'estado'])
print(directivas.to_string(index = False))

# Registro de la tarde del martes 24: once ejecuciones fallidas mientras la hoja no respondía:
martes = pd.DataFrame({
    'hora': ['13:05', '13:07', '13:09', '13:12', '13:15', '13:18', '13:22', '13:26', '13:31', '13:35', '13:40'],
    'tipo': ['ModuleTimeoutError', 'RuntimeError', 'ConnectionError', 'RuntimeError', 'ConnectionError',
             'ModuleTimeoutError', 'RuntimeError', 'ConnectionError', 'ConnectionError', 'RuntimeError',
             'ConnectionError'],
})
automaticos = {'ConnectionError', 'RateLimitError', 'ModuleTimeoutError'}
martes['destino'] = np.where(martes['tipo'].isin(automaticos), 'reintento automático', 'incompleta sin resolver')
print(martes['destino'].value_counts().to_string())
print('Pedidos que nadie reanudó:', martes.loc[martes['destino'] == 'incompleta sin resolver', 'hora'].tolist())
                   error              tipo en Make reintentable Make reintenta solo       directiva sugerida
             Red cortada           ConnectionError           sí                  sí            Retry (Break)
429 límite de peticiones            RateLimitError           sí                  sí            Retry (Break)
          Tiempo agotado        ModuleTimeoutError           sí                  sí            Retry (Break)
        5xx del servicio              RuntimeError           sí                  no            Retry (Break)
         Datos inválidos                 DataError           no                  no Resume o revisión humana
Clave o permiso inválido   InvalidAccessTokenError           no                  no      Alerta y corrección
           Cambio de API InvalidConfigurationError           no                  no      Alerta y corrección
    directiva      el paquete que falló                    los demás paquetes detiene estado
Ignore (Skip)               lo descarta                                 sigue      no  éxito
       Resume    usa un valor sustituto                                 sigue      no  éxito
       Commit                se detiene         se detiene; confirma lo hecho      sí  aviso
     Rollback                se detiene se detiene; revierte lo transaccional      sí  error
Break (Retry) lo guarda como incompleto                                 sigue      no  aviso
destino
reintento automático       7
incompleta sin resolver    4
Pedidos que nadie reanudó: ['13:07', '13:12', '13:22', '13:35']
De las $11$ ejecuciones fallidas del martes, $7$ se resolvieron solas (cinco errores de conexión y dos de tiempo agotado) y $4$ se quedaron como incompletas sin resolver: las de las 13:07, 13:12, 13:22 y 13:35, todas con un error interno del servicio. La de las 13:22 es el cambio de Marisol. Ese reparto es la anatomía del problema: las ejecuciones incompletas hicieron su trabajo (no se perdió ningún dato), el calendario automático hizo el suyo con los errores que conoce, y lo que falló fue el último eslabón, el que dependía de que alguien abriera una pestaña.
La Tabla 1 recoge la clasificación con la que Valeria diseñará la versión $2.3$:
Tabla 1. Errores típicos de un escenario de Trigo Lento: tipo en Make, si son reintentables, si Make los reintenta solo y directiva sugerida (revisado en octubre de 2026).
| Error | Ejemplo en Trigo Lento | Tipo en Make | ¿Reintentable? | ¿Make lo reintenta solo? | Directiva sugerida |
|---|---|---|---|---|---|
| Red cortada | La conexión con la hoja se interrumpe | ConnectionError | Sí | Sí | Break (Retry) |
| 429 | La hoja recibe demasiadas peticiones en un minuto | RateLimitError | Sí | Sí | Break (Retry) |
| Tiempo agotado | El almacén tarda más de lo que el módulo espera | ModuleTimeoutError | Sí | Sí | Break (Retry) |
| 5xx | El servicio devuelve un error interno, como el martes | Error de ejecución | Sí | No | Break (Retry) con intentos explícitos |
| Datos inválidos | Una fecha que la hoja no acepta | DataError | No | No | Resume o revisión humana |
| Clave o permiso inválido | La conexión de Google caducó | InvalidAccessTokenError | No | No | Alerta y corrección |
| Cambio de API | El proveedor retiró un campo | Error de configuración | No | No | Alerta y corrección |
Tres lecturas de la tabla merecen quedarse:
- Los errores 5xx son reintentables, pero Make no los reintenta solo. Un error interno del servidor suele ser pasajero, y por eso un cliente bien escrito lo repite; pero como su tipo no está entre los tres del calendario automático, en Make hay que pedirlo de forma explícita con un manejador. El martes faltaba ese manejador.
- Los errores de datos no se reintentan: se rodean. Repetir una fila con una fecha inválida produce la misma fila inválida. Lo que sí se puede hacer es seguir con un valor sustituto razonable (Resume) o mandar el caso a una persona.
- Los errores de configuración no se reintentan ni se rodean: se avisan. Una conexión caducada falla en todas las ejecuciones hasta que alguien la renueva. Reintentarla es la forma más cara de esperar.
Las cinco directivas de error de Make
Cuando un módulo de Make falla, el escenario hace lo que diga su manejador de errores: una ruta especial que sale del módulo, dibujada en el editor con una línea de puntos, y que termina en una directiva. Sin manejador, Make aplica el comportamiento por omisión: si las ejecuciones incompletas están desactivadas, detiene la ejecución, revierte lo que se pueda revertir y la marca como error; y en un escenario instantáneo, como uno con webhook, lo desactiva al primer error sin esperar al número de errores consecutivos configurado. Con las ejecuciones incompletas activadas, guarda el estado para resolverlo después.
Las directivas son cinco, y la Tabla 2 las resume con la documentación de Make revisada en octubre de 2026:
Tabla 2. Las cinco directivas de error de Make: qué hacen con el paquete que falla, con el resto del escenario, estado final y un caso de Trigo Lento.
| Directiva (nombre en el editor desde mayo de 2026) | Paquete que falló | Resto del escenario | Estado final | Caso de Trigo Lento |
|---|---|---|---|---|
| Ignore (Skip) | Se descarta | Sigue con los demás paquetes | Éxito | El aviso interno al obrador falla: el pedido ya está en la hoja |
| Resume | Sigue con un valor sustituto | Sigue | Éxito | La búsqueda del cliente falla: se sigue como “cliente nuevo” |
| Commit | Se detiene | Se detiene y confirma lo hecho en módulos transaccionales | Aviso | Poco útil: la hoja no admite transacciones |
| Rollback | Se detiene | Se detiene y revierte lo hecho en módulos transaccionales | Error | Solo revierte almacenes de datos u otros módulos con la marca ACID |
| Break (Retry) | Se guarda como ejecución incompleta | Sigue con los demás paquetes | Aviso | La fila en la hoja falla: se reintenta $3$ veces, cada minuto |
La forma más fácil de recordarlas es pensar en un repartidor que encuentra un obstáculo en la calle:
- Ignore es seguir de largo: el paquete que falló no llega, pero el repartidor no se detiene y el día se da por bueno. Úsela solo donde perder ese paquete no le importe a nadie.
- Resume es tomar un desvío con un valor sustituto: el módulo que falló “devuelve” lo que usted le diga, y el paquete sigue su camino. Es útil cuando existe un valor por omisión honesto, y peligrosa cuando el sustituto disfraza un dato que falta.
- Commit es estacionarse guardando lo hecho: la ejecución se detiene, y lo que los módulos transaccionales ya hicieron queda confirmado.
- Rollback es dar reversa: la ejecución se detiene y se deshace lo que se pueda deshacer. La documentación de Make subraya que solo los módulos con transacciones (marcados como ACID, como el almacén de datos o MySQL) pueden revertir; una fila de Google Sheets o un mensaje enviado no se pueden deshacer.
- Break es llevar el paquete al taller: se aparta, se guarda con su error, sus datos y el resto del recorrido como ejecución incompleta, y se reintenta más tarde, de forma automática o a mano, mientras los demás paquetes siguen.
Dos detalles de la documentación cambian decisiones. El primero: las rutas de manejo de errores no consumen créditos por sí mismas, así que un Break o un Resume no encarecen el escenario; lo que cuesta es volver a ejecutar el módulo que falló. El segundo: Commit y Rollback dependen del ajuste de confirmación automática (autoCommit). Con ese ajuste activado, que es el valor por omisión, cada módulo confirma sus cambios al terminar y Rollback solo puede revertir el módulo que falló, no los anteriores.
La Figura 1 recoge la metáfora del tráfico, con sus cinco señales, tal como Valeria la dibujó en el pizarrón del obrador para explicársela a su padre:
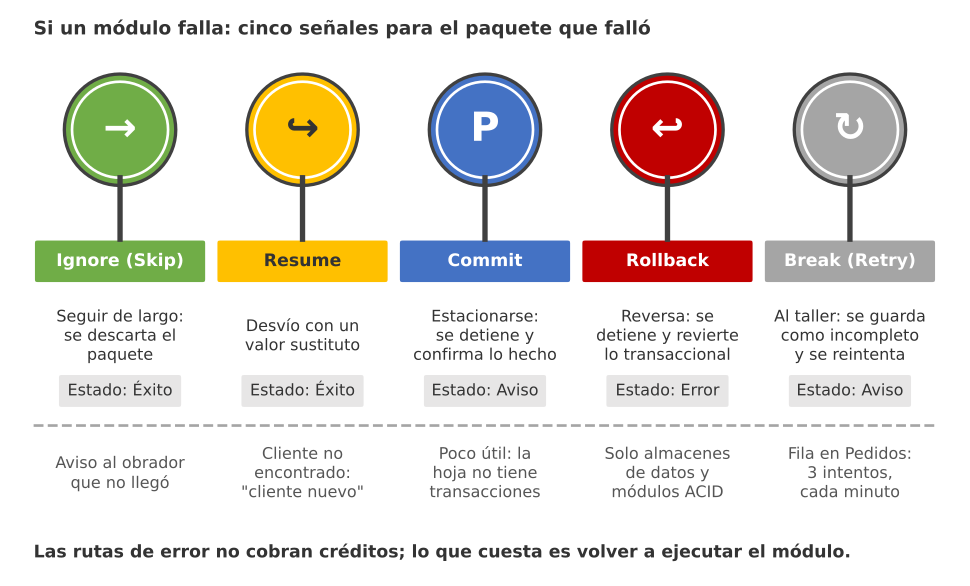
Figura 1. Las cinco directivas de error de Make como señales de tránsito: seguir (Ignore), desvío con valor sustituto (Resume), estacionarse guardando lo hecho (Commit), reversa (Rollback) y al taller a reintentar (Break), con su estado final y su caso en Trigo Lento.
Para Don Ernesto, la tabla se resume en una pregunta por módulo: si este paso falla, ¿qué es peor, perder el paquete, seguir con un dato inventado, detenerlo todo o esperar y volver a intentar? En Trigo Lento, para la fila de la hoja la respuesta es siempre la última, porque un pedido perdido es un cliente sin pan.
Ejecuciones incompletas y reintentos
Break solo funciona si el escenario tiene a dónde mandar el paquete. Ese lugar es la lista de ejecuciones incompletas, que se activa en los ajustes del escenario (“Store incomplete executions”, dlq: true en el blueprint) y que la serie activó por primera vez en TL Formulario v2 el Día 22. Cuando un módulo falla y la opción está activada, Make guarda el mensaje de error, los datos que lo provocaron, los mapeos y el resto del recorrido. La documentación añade tres reglas que conviene conocer antes de confiar en ella:
- El error del primer módulo no se guarda, salvo que ese módulo tenga su propio manejador de reintento. Si el webhook falla al recibir, no hay nada que reanudar.
- Si la lista se llena, el ajuste de pérdida de datos decide: desactivado (
dataloss: false, el de Trigo Lento), el escenario se desactiva antes que tirar paquetes; activado, se descarta lo que no cabe y el escenario sigue. - Con el procesamiento en orden activado, la documentación indica que la siguiente ejecución espera a que las incompletas se resuelvan o se reintenten de forma automática. En un escenario de pedidos, un reintento largo detiene la cola de todos los mensajes que vienen detrás.
Una ejecución incompleta puede terminar de tres maneras. Si su error es de conexión, de límite de peticiones o de tiempo agotado, Make la reintenta según un calendario fijo de ocho intentos que el Día 26 ya usó: a $1$, $11$, $21$ y $51$ minutos, a $1$ hora $21$ minutos y $1$ hora $51$ minutos, y a $4$ horas $51$ minutos y $7$ horas $51$ minutos del fallo, con un máximo de tres reintentos en paralelo por escenario. Si fue apartada por un Break con la finalización automática activada, se reintenta con el número de intentos y el intervalo del manejador, que por omisión son $3$ intentos cada $15$ minutos. Y si no ocurre ninguna de las dos cosas, espera a que alguien la abra, corrija lo que haga falta y la reanude, una por una o en lote.
El calendario automático es una espera creciente: empieza con un minuto y llega a tres horas. Es una buena política para no saturar un servicio caído, pero tiene un coste en latencia que el martes habría sido inaceptable: un pedido que agota los seis primeros reintentos se registra casi cinco horas después. Para la fila de pedidos, Valeria quiere otra cosa: pocos reintentos, cercanos y acotados, y una persona avisada si no bastan. Eso se configura en el Break de cada módulo con dos números, intentos e intervalo, y la pregunta es cuáles. Para elegirlos con números, primero hay que saber cuánto mejora la fiabilidad cada reintento.
Atención aquí: un Break o un reintento automático reanuda la ejecución en el módulo que falló, no desde el principio, y lo hace con los datos que tenía en el momento del error. Eso tiene dos consecuencias. La buena: si la fila se guardó y falló el aviso posterior, el reintento no vuelve a guardar la fila. La delicada: los filtros anteriores al módulo que falló no se vuelven a evaluar, y si usted reanuda “desde el principio” a mano, o el emisor del webhook reenvía el mensaje, el escenario sí repetirá todo. Además, un usuario del foro de la comunidad de Make informó de un intervalo configurado en $1$ minuto que se programó a los $5$; antes de prometer un tiempo a un cliente, provoque un fallo a propósito y mire en el historial a qué hora se reintenta de verdad.
La matemática de la fiabilidad
Un escenario termina sin error solo si todos sus módulos terminan sin error. Si cada módulo $m$ falla en un intento con probabilidad $p_m$, sus fallos son independientes y cada módulo se reintenta hasta $k$ veces, la probabilidad de que el escenario complete la ejecución es:
$$ P = \prod_{m=1}^{M} \left(1 - p_m^{,k+1}\right) $$
La lógica detrás de esta fórmula es múltiple:
- Un módulo con $k$ reintentos solo falla del todo si fallan sus $k + 1$ intentos: el original y los $k$ reintentos. Con fallos independientes, eso ocurre con probabilidad $p_m^{,k+1}$, y el módulo termina bien con $1 - p_m^{,k+1}$.
- El escenario necesita que terminen bien los $M$ módulos, así que se multiplican sus probabilidades. Por eso la fiabilidad cae con cada módulo que se añade: es una cadena, y una cadena es tan fuerte como el producto de sus eslabones.
- Con todos los módulos iguales, $P = (1 - p^{,k+1})^{M}$. Con $p = 0.05$, $M = 7$ y sin reintentos, $P = 0.95^7 = 0.698$; con $k = 3$, cada módulo falla con $0.05^4 = 6.25 \cdot 10^{-6}$ y $P = 0.99996$.
- En conclusión, el reintento ataca el exponente, no el factor: pasar de $k = 0$ a $k = 1$ convierte un $5%$ de fallo por módulo en un $0.25%$. Por eso un solo reintento rinde tanto, y por eso el supuesto de independencia es el que hay que vigilar.
Cada reintento, además, cuesta: vuelve a ejecutar el módulo y cobra un crédito. El número esperado de intentos de un módulo con hasta $k$ reintentos es:
$$ E[I] = \sum_{j=0}^{k} p^{,j} = 1 + p + p^2 + \cdots + p^{,k} $$
La lógica detrás de esta fórmula es múltiple:
- El primer intento ocurre siempre; el segundo, solo si el primero falló (probabilidad $p$); el tercero, solo si fallaron los dos primeros ($p^2$), y así hasta el intento $k + 1$.
- Los créditos extra de una ejecución son $M,(E[I] - 1)$: con $p = 0.05$ y $M = 7$, unos $0.35$ créditos con un reintento y $0.368$ con tres. Casi todo el coste lo pone el primer reintento.
- En conclusión, con fallos independientes y raros, los reintentos son casi gratis: $0.368$ créditos por ejecución frente a los $9$ o $10$ que cuesta la ruta de pedidos.
El siguiente bloque calcula las dos fórmulas para $0$, $1$, $2$ y $3$ reintentos, traduce los fallos a pedidos de un mes y dibuja la fiabilidad frente al número de módulos:
# Fiabilidad analítica de un escenario con M módulos y k reintentos por módulo en Python:
def fiabilidad(M, k, p = P_FALLO):
    return (1 - p ** (k + 1)) ** M

def intentos_esperados(k, p = P_FALLO):
    # 1 + p + p^2 + ... + p^k intentos por módulo:
    return sum(p ** j for j in range(k + 1))

for k in range(4):
    print(f'k = {k}: P(7 módulos) = {fiabilidad(MODULOS, k):.5f} | fallo de un módulo = {P_FALLO ** (k + 1):.2e} '
          f'| créditos extra por ejecución = {MODULOS * (intentos_esperados(k) - 1):.3f}')
fallos_mes = {k: PEDIDOS_WA_MES * (1 - fiabilidad(MODULOS, k)) for k in range(4)}
print('Pedidos al mes que no terminan en una sola ejecución:', {k: round(v, 2) for k, v in fallos_mes.items()})
print('Módulos para bajar del 50 % sin reintentos:', next(M for M in range(1, 40) if fiabilidad(M, 0) < 0.5))

M = np.arange(1, 21)
fig, ax = plt.subplots(figsize = (8.5, 4.8))
colores = ['#c8423b', '#eb6834', '#2a78d6', '#3a9d5d']
for k, color in zip(range(4), colores):
    ax.plot(M, fiabilidad(M, k), marker = 'o', ms = 4, lw = 2, color = color, label = f'{k} reintento{"" if k == 1 else "s"} por módulo')
ax.axvline(MODULOS, color = '#52514e', ls = ':', lw = 1)
ax.annotate(f'7 módulos sin reintentos: {fiabilidad(MODULOS, 0):.3f}', (MODULOS, fiabilidad(MODULOS, 0)),
            xytext = (10.5, 0.78), fontsize = 9, arrowprops = dict(arrowstyle = '->', color = '#52514e'))
ax.set_xlabel('Módulos del escenario (M)')
ax.set_ylabel('Probabilidad de terminar sin error')
ax.set_ylim(0.3, 1.02)
ax.set_xticks([1, 5, 7, 10, 15, 20])
ax.grid(color = '#e6e5e1')
ax.legend(fontsize = 9, loc = 'lower left')
ax.set_title('Fiabilidad del escenario con p = 0.05 por módulo', fontsize = 16)
plt.tight_layout()
plt.show()
k = 0: P(7 módulos) = 0.69834 | fallo de un módulo = 5.00e-02 | créditos extra por ejecución = 0.000
k = 1: P(7 módulos) = 0.98263 | fallo de un módulo = 2.50e-03 | créditos extra por ejecución = 0.350
k = 2: P(7 módulos) = 0.99913 | fallo de un módulo = 1.25e-04 | créditos extra por ejecución = 0.367
k = 3: P(7 módulos) = 0.99996 | fallo de un módulo = 6.25e-06 | créditos extra por ejecución = 0.368
Pedidos al mes que no terminan en una sola ejecución: {0: 77.53, 1: 4.46, 2: 0.22, 3: 0.01}
Módulos para bajar del 50 % sin reintentos: 14
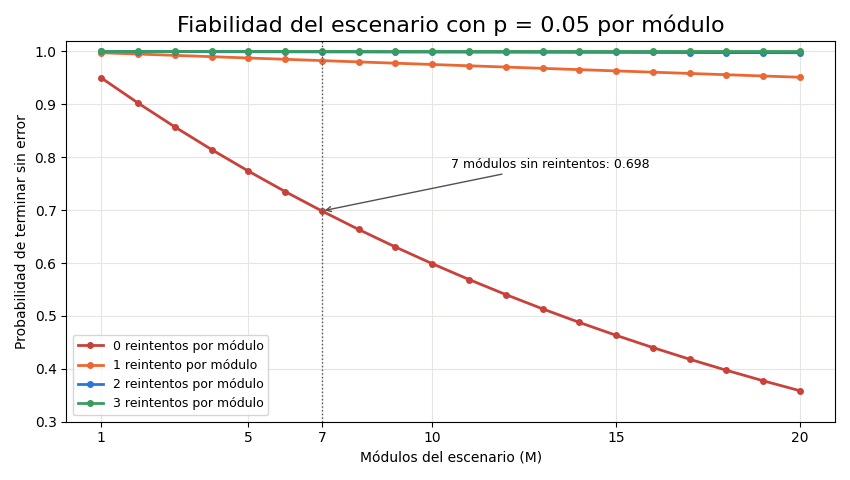
Las cifras confirman la fórmula y le ponen escala. Sin reintentos, el escenario de $7$ módulos termina sin error el $69.834%$ de las veces: con $257$ pedidos al mes, $77.5$ pedidos acabarían como ejecución incompleta. Un solo reintento por módulo sube la fiabilidad al $98.263%$ ($4.5$ pedidos al mes), dos al $99.913%$ y tres al $99.996%$, con $0.01$ pedidos al mes: uno cada ocho años. El coste extra es de $0.368$ créditos por ejecución con tres reintentos, unos $95$ créditos al mes para los $257$ pedidos, menos del $1%$ de Make Core.
En la gráfica, la curva roja muestra lo que pasa sin reintentos cuando el escenario crece: con $14$ módulos, ya termina mal más de la mitad de las veces. Las otras tres curvas casi no se mueven. Sin reintentos, cada módulo nuevo es un riesgo nuevo; con reintentos, la longitud del escenario casi deja de importar, siempre que los fallos sean independientes. El martes demostró que no siempre lo son: once fallos en $35$ minutos no son once monedas al aire, son una sola caída de la hoja. La siguiente sección se ocupa de eso.
Esperar antes de reintentar
Si un servicio falla porque está saturado, reintentar de inmediato es pedirle más trabajo justo cuando no puede hacerlo. Y si muchos clientes fallan a la vez, como los mensajes de un pico de la mañana cuando la hoja se cae, y todos reintentan al mismo ritmo, sus reintentos llegan juntos y vuelven a chocar: es el efecto que la literatura de sistemas distribuidos llama una manada que reintenta en sincronía. La respuesta clásica, que el Día 22 de la serie IAG ya aplicó a las llamadas a la API de Claude, es esperar cada vez más y no exactamente lo mismo que los demás:
$$ t_k = \min\left(t_{\max},; t_0 \cdot 2^{k}\right) \cdot U(0.5,, 1) $$
La lógica detrás de esta fórmula es múltiple:
- $t_k$ es la espera antes del reintento número $k + 1$, contando $k$ desde $0$. El factor $2^k$ la duplica en cada intento: $1$, $2$, $4$ y $8$ unidades con $t_0 = 1$. Si el servicio necesita tiempo para recuperarse, se lo da.
- $t_{\max}$ es el techo: con $t_{\max} = 8$, la espera nunca pasa de ocho unidades por muchos intentos que se acumulen.
- $U(0.5, 1)$ es la fluctuación aleatoria (en inglés, jitter): un número uniforme entre la mitad y el total de la espera. Hace que dos clientes que fallaron en el mismo instante no vuelvan a llamar en el mismo instante.
- En conclusión, la espera crece rápido, tiene techo y nunca coincide entre clientes. Marc Brooker la popularizó en 2015 con simulaciones que mostraban que la fluctuación reduce el trabajo total del servidor más que la propia espera exponencial.
El siguiente bloque escribe con_reintentos(funcion, max_intentos = 4, t0 = 1, tmax = 8), que reintenta solo los códigos reintentables y deja pasar sin repetir un $400$. Lo prueba con una hoja simulada que falla tres veces con $503$ y responde a la cuarta, y después hace fallar a $20$ clientes a la vez para contar cuántos reintentos caen en la misma ventana de un cuarto de segundo con y sin fluctuación:
# Reintentos con espera exponencial y fluctuación aleatoria en Python:
class ErrorServicio(Exception):
    def __init__(self, codigo):
        super().__init__(f'error {codigo}')
        self.codigo = codigo

REINTENTABLES = {429, 500, 502, 503, 504, 'red', 'tiempo'}

def espera(k, t0 = 1, tmax = 8, rng = rng):
    return min(tmax, t0 * 2 ** k) * rng.uniform(0.5, 1.0)

def con_reintentos(funcion, max_intentos = 4, t0 = 1, tmax = 8, dormir = None, rng = rng):
    esperas = []
    for k in range(max_intentos):
        try:
            return funcion(), esperas
        except ErrorServicio as error:
            if error.codigo not in REINTENTABLES or k == max_intentos - 1:
                raise                                   # un 400 no mejora repitiéndolo
            t = espera(k, t0, tmax, rng)
            esperas.append(round(t, 2))
            if dormir:
                dormir(t)

# Un servicio que falla tres veces con 503 y responde a la cuarta:
respuestas = iter([503, 503, 503, 200])
def hoja():
    codigo = next(respuestas)
    if codigo != 200:
        raise ErrorServicio(codigo)
    return 'fila guardada'
resultado, esperas = con_reintentos(hoja)
print('Resultado:', resultado, '| esperas (s):', esperas, '| total:', round(sum(esperas), 2))
def peticion_mal_formada():
    raise ErrorServicio(400)
try:
    con_reintentos(peticion_mal_formada)
except ErrorServicio as error:
    print('Un 400 no se reintenta:', error)

# Veinte clientes fallan a la vez: reintentos sincronizados frente a reintentos con fluctuación:
def choque_maximo(con_fluctuacion, clientes = 20, ventana = 0.25):
    instantes = []
    for _ in range(clientes):
        t = 0.0
        for k in range(3):
            t += min(8, 2 ** k) * (rng.uniform(0.5, 1.0) if con_fluctuacion else 1.0)
            instantes.append(t)
    conteo = np.histogram(instantes, bins = np.arange(0, 8, ventana))[0]
    return conteo.max()
print('Máximo de reintentos en la misma ventana de 0.25 s: sin fluctuación', choque_maximo(False),
      '| con fluctuación', choque_maximo(True))
Resultado: fila guardada | esperas (s): [0.59, 1.64, 2.93] | total: 5.16
Un 400 no se reintenta: error 400
Máximo de reintentos en la misma ventana de 0.25 s: sin fluctuación 20 | con fluctuación 12
La hoja responde al cuarto intento después de esperar $0.59$, $1.64$ y $2.93$ segundos, $5.16$ en total: cada espera cae dentro de su banda ($0.5$ a $1$, $1$ a $2$ y $2$ a $4$), en un punto distinto de cada banda. El $400$ sale al primer intento, como debe: una petición mal formada no mejora con paciencia. Y la última línea muestra para qué sirve la fluctuación: sin ella, los $20$ clientes reintentan en la misma ventana de un cuarto de segundo; con ella, el peor momento reúne a $12$. La carga se reparte en el tiempo justo cuando el servicio más lo necesita.
La Figura 2 dibuja la escalera de espera con sus bandas:
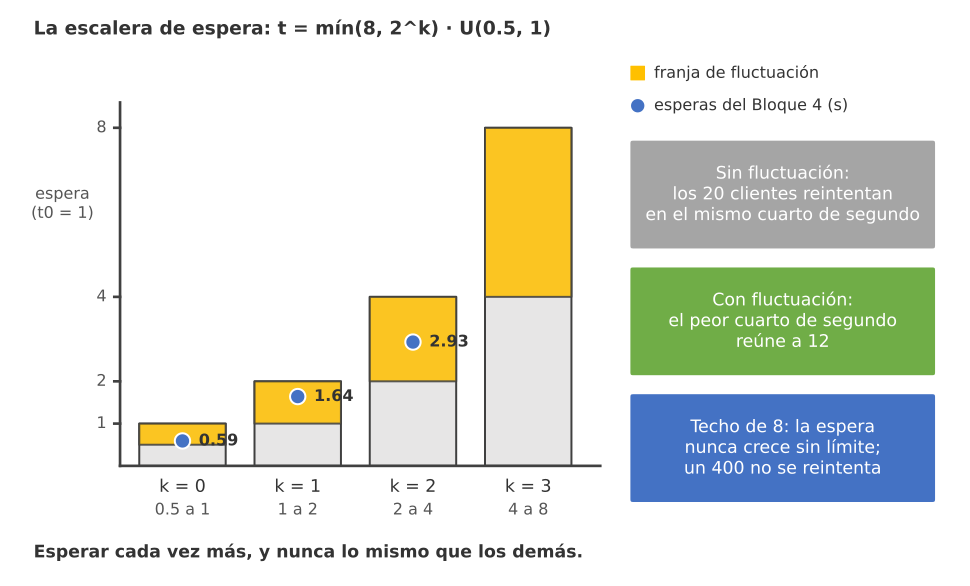
Figura 2. La escalera de espera: cada escalón duplica la espera (1, 2, 4 y 8) y la fluctuación la sortea entre la mitad y el total; las esperas del Bloque 4 fueron 0.59, 1.64 y 2.93 segundos, y con 20 clientes el peor momento baja de 20 reintentos a 12.
En Make, esta política tiene dos traducciones parciales, y conviene decirlo con claridad. El calendario automático de ocho intentos es una espera creciente, pero sin fluctuación y con escalones de minutos y horas. El Break, en cambio, usa un intervalo fijo: tantos intentos, cada tantos minutos. La función con_reintentos es la que usará la serie cuando el código sea propio: el Día 30 la necesitará para las llamadas a la API de Claude desde Python y el módulo 4 la reproducirá en n8n. Para la fila de pedidos de Make, la pregunta práctica es otra: ¿intervalo fijo y corto, o espera creciente? Para contestarla hace falta simular fallos que no sean independientes.
Diez mil ejecuciones con fallos
La fórmula de la fiabilidad supone que cada intento falla con la misma probabilidad, sin memoria. El martes no fue así: cuando la hoja falló, siguió fallando durante minutos. El siguiente bloque modela esa memoria con un supuesto declarado. Cada módulo llama a un servicio con simular_post, que falla con $p = 0.05$; cuando falla, abre un episodio de fallo cuya duración sigue una distribución lognormal con mediana de $30$ segundos y $\sigma = 1$, durante el cual todas las llamadas fallan. El escenario trabaja unos $6$ segundos en condiciones normales, y un mensaje llega a cualquier hora entre las 8:00 y las 20:00.
Se comparan tres políticas, aplicadas módulo por módulo:
- Sin reintentos: el primer fallo deja la ejecución incompleta, como los cuatro errores internos del martes, y Valeria la resuelve en su siguiente revisión de la pestaña, a las 10, 12, 14, 16, 18 o 20 horas, cinco minutos después.
- Tres reintentos inmediatos: el Break con $3$ intentos y un intervalo de $1$ minuto, el más corto que se puede configurar.
- Tres reintentos con espera exponencial: esperas de $t_k = \min(8, 2^k) \cdot U(0.5, 1)$ minutos, la política del bloque anterior en la escala de Make.
Si una política agota sus reintentos, la ejecución queda incompleta y espera a la revisión humana, igual que en la primera. Cada reintento cobra un crédito. El bloque ejecuta $10,000$ veces cada política y dibuja las tres distribuciones de latencia, con su percentil $95$ (p95) en línea discontinua:
# Monte Carlo de 10 000 ejecuciones con simular_post y tres políticas de reintento en Python:
class Respuesta:
    def __init__(self, status_code, cuerpo):
        self.status_code, self.headers, self._cuerpo = status_code, {'Content-Type': 'application/json'}, cuerpo
    def json(self):
        return self._cuerpo

def simular_post(url, cuerpo, rng, caido_hasta = 0.0, ahora = 0.0, p_fallo = P_FALLO):
    # Un servicio que falla con p_fallo y, al fallar, queda caído un episodio de duración aleatoria:
    if ahora < caido_hasta or rng.random() < p_fallo:
        return Respuesta(503, {'error': 'servicio no disponible'})
    return Respuesta(200, {'ok': True, 'url': url})

POLITICAS = {
    'Sin reintentos': lambda k: None,
    '3 reintentos inmediatos': lambda k: 1.0 if k < 3 else None,                  # Break: 3 cada minuto
    '3 reintentos con espera exponencial': lambda k: espera(k, t0 = 1, tmax = 8) if k < 3 else None,
}
EPISODIO_MEDIANA, EPISODIO_SIGMA = 0.5, 1.0     # minutos que dura un episodio de fallo (lognormal)

def revision_humana(minuto_del_dia):
    # Valeria revisa las ejecuciones incompletas a las 10, 12, 14, 16, 18 y 20 h:
    revisiones = np.arange(10, 21, 2) * 60
    siguiente = revisiones[revisiones >= minuto_del_dia]
    return (siguiente[0] if len(siguiente) else 24 * 60 + 10 * 60) - minuto_del_dia + 5

def ejecutar(politica, rng):
    t = rng.lognormal(np.log(0.1), 0.4)          # minutos de trabajo normal del escenario
    llegada = rng.uniform(8 * 60, 20 * 60)        # minuto del día en que llega el mensaje
    reintentos = 0
    for m in range(MODULOS):
        caido_hasta, k = 0.0, 0
        inicio = t
        while True:
            r = simular_post(f'https://servicio.ejemplo.invalid/modulo/{m}', {}, rng, caido_hasta, t - inicio)
            if r.status_code == 200:
                break
            if caido_hasta == 0.0:
                caido_hasta = (t - inicio) + rng.lognormal(np.log(EPISODIO_MEDIANA), EPISODIO_SIGMA)
            pausa = POLITICAS[politica](k)
            if pausa is None:                         # se agotan los reintentos: ejecución incompleta
                return t + revision_humana(llegada + t), reintentos, True
            t, k, reintentos = t + pausa, k + 1, reintentos + 1   # cada reintento cobra un crédito
    return t, reintentos, False

N = 10_000
filas = []
latencias = {}
for nombre in POLITICAS:
    datos = np.array([ejecutar(nombre, rng) for _ in range(N)], dtype = float)
    latencias[nombre] = datos[:, 0]
    filas.append({'política': nombre, 'completas': int((datos[:, 2] == 0).sum()),
                  'incompletas': int(datos[:, 2].sum()),
                  'p50 (min)': round(float(np.percentile(datos[:, 0], 50)), 2),
                  'p95 (min)': round(float(np.percentile(datos[:, 0], 95)), 2),
                  'créditos extra': round(float(datos[:, 1].mean()), 3)})
tabla3 = pd.DataFrame(filas)
print(tabla3.to_string(index = False))
print(f'Teoría sin reintentos: {fiabilidad(MODULOS, 0) * N:.0f} completas de {N}')

fig, ax = plt.subplots(figsize = (9, 4.8))
bins = np.logspace(np.log10(0.03), np.log10(1500), 60)
for (nombre, lat), color in zip(latencias.items(), ['#c8423b', '#2a78d6', '#3a9d5d']):
    ax.hist(lat, bins = bins, histtype = 'step', lw = 2, color = color, label = nombre)
    p50, p95 = np.percentile(lat, [50, 95])
    ax.axvline(p95, color = color, ls = '--', lw = 1.2)
ax.axvline(SLA_MIN, color = '#52514e', ls = ':', lw = 1.5)
ax.text(SLA_MIN * 1.1, 1.5, '5 minutos', fontsize = 9, color = '#52514e')
ax.set_xscale('log')
ax.set_yscale('log')
ax.set_xlabel('Latencia hasta terminar el pedido (minutos, escala logarítmica)')
ax.set_ylabel('Ejecuciones')
ax.legend(fontsize = 9, loc = 'upper right')
ax.grid(color = '#e6e5e1')
ax.set_title('10 000 ejecuciones con fallos: latencia y p95 (discontinua)', fontsize = 16)
plt.tight_layout()
plt.show()
                           política  completas  incompletas  p50 (min)  p95 (min)  créditos extra
                     Sin reintentos       6952         3048       0.13     105.80           0.000
            3 reintentos inmediatos       9881          119       0.13       2.19           0.489
3 reintentos con espera exponencial       9959           41       0.13       2.82           0.507
Teoría sin reintentos: 6983 completas de 10000
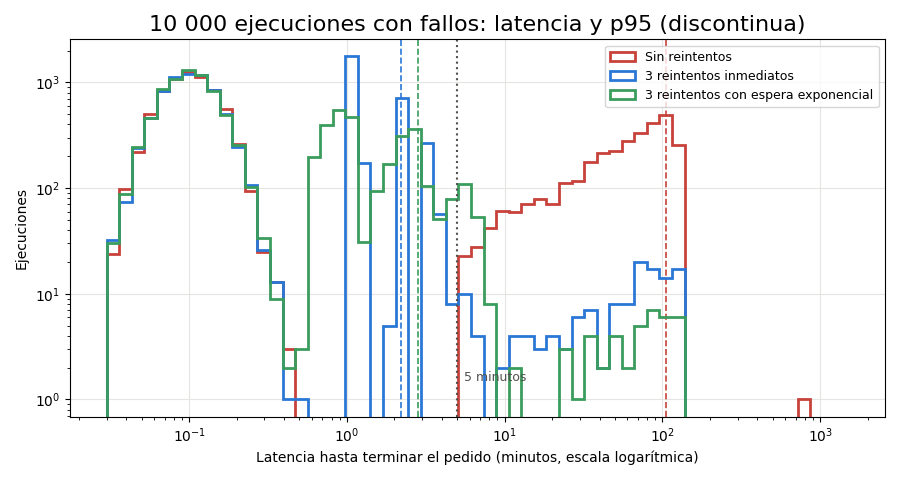
Primero, la comprobación: sin reintentos se completan $6,952$ de $10,000$ ejecuciones, frente a las $6,983$ que predice $0.95^7$; la diferencia está dentro de lo esperable en diez mil repeticiones. La Tabla 3 resume el resto:
Tabla 3. Monte Carlo de 10 000 ejecuciones de la ruta de pedidos (7 módulos, p = 0.05, episodios de fallo con mediana de 30 segundos) por política de reintento.
| Política | Completas | Incompletas | p50 (min) | p95 (min) | Créditos extra por ejecución |
|---|---|---|---|---|---|
| Sin reintentos | 6 952 | 3 048 | 0.13 | 105.80 | 0.000 |
| 3 reintentos inmediatos (1 por minuto) | 9 881 | 119 | 0.13 | 2.19 | 0.489 |
| 3 reintentos con espera exponencial | 9 959 | 41 | 0.13 | 2.82 | 0.507 |
La tabla desmiente dos intuiciones a la vez:
- La mediana no ve nada. Las tres políticas tienen la misma mediana, $0.13$ minutos (unos $8$ segundos), porque siete de cada diez ejecuciones no fallan nunca. Si Valeria midiera solo el tiempo típico, concluiría que los reintentos no importan. La diferencia está en la cola: el p95 es de $105.8$ minutos sin reintentos frente a $2.19$ y $2.82$ con ellos. Sin reintentos, una de cada veinte confirmaciones tarda casi dos horas.
- Con fallos que duran, los reintentos cuestan más de lo que dice la fórmula. La fórmula predecía $0.368$ créditos extra con tres reintentos; la simulación da $0.489$ y $0.507$. La diferencia es la memoria de los episodios: cuando un intento falla, el siguiente tiene más probabilidad de fallar también, así que se gastan más reintentos. Son unos $126$ créditos al mes para los $257$ pedidos ($257 \cdot 0.489 = 125.7$), el $1.26%$ de Make Core: barato, pero no gratis.
- La espera exponencial deja menos incompletas; los reintentos inmediatos terminan antes. Con episodios de fallo que a veces duran varios minutos, tres reintentos en tres minutos se quedan cortos en $119$ ejecuciones y la espera creciente solo en $41$, casi tres veces menos. Pero la espera creciente llega más tarde cuando sí funciona: su p95 es $0.63$ minutos mayor.
En la figura, en escala logarítmica para que se vean las colas, la curva roja tiene una segunda joroba entre las decenas de minutos y las dos horas: son las ejecuciones incompletas que esperan a la siguiente revisión de Valeria. Las curvas azul y verde la reducen a una cola delgada, y sus jorobas intermedias (al minuto, a los dos y a los tres minutos en la azul; repartidas en la verde, por la fluctuación) son los reintentos que sí funcionaron. Qué política conviene depende de qué se le promete a quién, y eso lo decide Marisol más adelante.
Idempotencia y la versión 2.3
La segunda objeción de Don Ernesto sigue en pie: si el escenario reintenta, ¿no hornearán dos pasteles? Con un Break, la respuesta corta es no, porque la reanudación empieza en el módulo que falló: si falló la fila, se reintenta la fila; si la fila se guardó y falló el aviso al obrador, se reintenta el aviso, no la fila. Pero hay otras dos fuentes de repeticiones que el Break no controla, y las dos son comunes:
- El emisor reenvía. Un servicio que entrega webhooks y no recibe respuesta a tiempo puede volver a enviar el mismo mensaje. Para Make es un paquete nuevo, con los mismos datos, que recorre el escenario desde el principio.
- Una persona reanuda desde el principio. Ante una ejecución incompleta dudosa, la tentación es volver a ejecutar todo con “Run once” o reenviar el mensaje de prueba. Si la fila ya estaba guardada, ahora hay dos.
Una operación es idempotente si ejecutarla una vez o varias produce el mismo efecto. Leer una fila lo es; añadirla, no. Las plataformas de mensajería suelen prometer entrega “al menos una vez”, no “exactamente una vez”, y el patrón para convivir con esa promesa es una clave de idempotencia: un identificador que depende solo de qué se pide, se consulta antes de actuar y se registra después.
La clave del mensaje
En el escenario de pedidos, la clave natural es el MessageSid que Twilio asigna a cada mensaje, el mismo que el Día 23 eligió como identificador del borrador: dos entregas del mismo mensaje traen el mismo MessageSid; dos mensajes distintos, nunca. Valeria no lo guarda tal cual, sino su resumen SHA-256, por la misma razón por la que el Día 23 usó el SHA-256 del WaId como clave del cliente: una clave de longitud fija ($64$ caracteres hexadecimales) que no depende del formato de ningún proveedor y que no revela nada por sí misma.
El patrón tiene tres pasos en el escenario: consultar el almacén con la clave antes de procesar (datastore:GetRecord), dejar pasar solo si no existe (filtro notexist) y registrar la clave después de guardar la fila (datastore:AddRecord sin sobrescribir). El orden importa: si la clave se registrara antes y la fila fallara, el reintento encontraría la clave y daría el pedido por hecho sin estar hecho. El siguiente bloque lo pone a prueba con $1,000$ mensajes, un $2%$ de reentregas del emisor y un $1.5%$ de reanudaciones desde el principio, que llegan mezcladas con los mensajes originales:
# Idempotencia: clave SHA-256 del MessageSid frente a reentregas simuladas en Python:
def clave_idempotencia(message_sid):
    return hashlib.sha256(message_sid.encode('utf-8')).hexdigest()

mensajes = [f'SM{i:032x}' for i in range(1, 1_001)]                # 1 000 mensajes con MessageSid de prueba
entregas = []
for sid in mensajes:
    entregas.append(sid)
    if rng.random() < 0.02:                                       # el emisor reenvía porque no vio respuesta
        entregas.append(sid)
    if rng.random() < 0.015:                                      # alguien reanuda desde el principio
        entregas.append(sid)
orden_llegada = rng.permutation(len(entregas))
entregas = [entregas[i] for i in orden_llegada]

def procesar(entregas, con_clave):
    almacen, filas = set(), 0
    for sid in entregas:
        if con_clave:
            k = clave_idempotencia(sid)
            if k in almacen:                                     # GetRecord encontró la clave: no se procesa
                continue
            almacen.add(k)                                       # AddRecord después de crear la fila
        filas += 1
    return filas

sin = procesar(entregas, con_clave = False)
con = procesar(entregas, con_clave = True)
print('Mensajes:', len(mensajes), '| entregas:', len(entregas), '| reentregas:', len(entregas) - len(mensajes))
print('Filas sin clave:', sin, '| duplicadas:', sin - len(mensajes))
print('Filas con clave:', con, '| duplicadas:', con - len(mensajes))
print('Clave del primer mensaje:', clave_idempotencia(mensajes[0])[:16] + '...', '| longitud:',
      len(clave_idempotencia(mensajes[0])))

# Ejecución paralela: dos entregas del mismo mensaje con 2 s de diferencia y 6 s de proceso:
def duplicados_en_paralelo(separacion_s, proceso_s = 6.0):
    # La segunda consulta llega antes de que la primera registre la clave: las dos ven "no existe":
    return 1 if separacion_s < proceso_s else 0
print('Con clave y ejecución paralela, reentrega a 2 s:', duplicados_en_paralelo(2.0),
      'duplicado | a 15 s:', duplicados_en_paralelo(15.0), '| con ejecución secuencial: 0')
Mensajes: 1000 | entregas: 1029 | reentregas: 29
Filas sin clave: 1029 | duplicadas: 29
Filas con clave: 1000 | duplicadas: 0
Clave del primer mensaje: f2caa3dbcd858f43... | longitud: 64
Con clave y ejecución paralela, reentrega a 2 s: 1 duplicado | a 15 s: 0 | con ejecución secuencial: 0
Los $1,000$ mensajes llegan como $1,029$ entregas: $29$ repeticiones. Sin clave, el escenario guarda $1,029$ filas, $29$ de ellas duplicadas, casi tres pedidos de cada cien que el obrador prepararía dos veces. Con la clave, $1,000$ filas y $0$ duplicados. Al mes, con $257$ pedidos y la misma proporción, la diferencia son unos $7$ pedidos duplicados: dos pasteles de zanahoria y cinco hogazas de más, o la confianza de una clienta que recibe dos confirmaciones.
La última línea del bloque recuerda el límite del patrón. Si el escenario procesa los mensajes en paralelo y la segunda entrega llega mientras la primera todavía se procesa (a $2$ segundos, con $6$ de trabajo), las dos consultas encuentran el almacén vacío, las dos pasan el filtro y aparece un duplicado. La clave por sí sola protege de las repeticiones separadas en el tiempo; contra las simultáneas hace falta, además, el procesamiento en orden que el escenario de pedidos tiene activado desde el Día 23, o una restricción de unicidad en el destino que rechace la segunda escritura. Trigo Lento tiene las dos defensas: procesamiento en orden en Make y la clave primaria de trigo_lento.sqlite desde el Día 4.
La Figura 3 resume la idea en una ecuación de palabras:
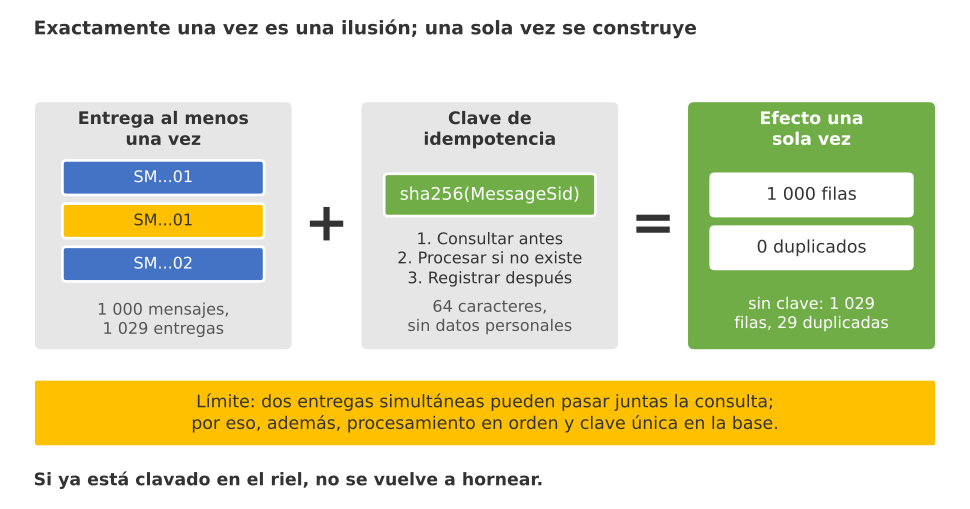
Figura 3. Exactamente una vez es una ilusión: una entrega al menos una vez (1 029 entregas de 1 000 mensajes) más una clave de idempotencia SHA-256 del MessageSid, consultada antes y registrada después, da un efecto una sola vez (1 000 filas y 0 duplicados).
Exactamente una vez no es algo que la red pueda prometer; es algo que el escenario construye con una entrega que puede repetirse y una clave que impide que se repita su efecto. Don Ernesto lo traduce a su oficio: “Como el ticket de la comanda. Si ya está clavado en el riel, no se vuelve a hornear aunque la mesera lo cante dos veces.”
TL Pedidos WhatsApp v2.3
Con las directivas elegidas, el intervalo decidido y la clave probada, la versión $2.3$ junta todo en la ruta de pedidos. La normalización de las versiones $2.1$ y $2.2$ (iterador, agregador y almacén de clientes) aparece condensada en los módulos $5$ y $6$ para que el blueprint se lea en una pantalla; lo nuevo de hoy está en los manejadores y en la clave. El blueprint se guarda en trigo_lento/dia_28/flujos/make/pedidos_whatsapp_v2_3.blueprint.json:
{
  "name": "TL Pedidos WhatsApp v2.3",
  "flow": [
    {
      "id": 1,
      "module": "gateway:CustomWebHook",
      "version": 1,
      "parameters": {"hook": 0, "maxResults": 1},
      "mapper": {},
      "metadata": {"designer": {"x": 0, "y": 0}}
    },
    {
      "id": 2,
      "module": "gateway:WebhookRespond",
      "version": 1,
      "parameters": {},
      "mapper": {"status": "200", "body": "<Response></Response>", "headers": [{"key": "Content-Type", "value": "text/xml"}]},
      "metadata": {"designer": {"x": 300, "y": 0}}
    },
    {
      "id": 3,
      "module": "builtin:BasicRouter",
      "version": 1,
      "mapper": null,
      "metadata": {"designer": {"x": 600, "y": 0}},
      "routes": [
        {
          "flow": [
            {
              "id": 4,
              "module": "datastore:GetRecord",
              "version": 1,
              "parameters": {"datastore": 0},
              "filter": {"name": "Es pedido", "conditions": [[{"a": "{{1.Body}}", "b": "aparta|quiero|guarda|quisiera", "o": "text:pattern:ci"}]]},
              "mapper": {"key": "{{sha256(1.MessageSid)}}"},
              "metadata": {"designer": {"x": 900, "y": 150}}
            },
            {
              "id": 5,
              "module": "util:SetVariables",
              "version": 1,
              "parameters": {},
              "filter": {"name": "Mensaje nuevo", "conditions": [[{"a": "{{4.key}}", "o": "notexist"}]]},
              "mapper": {
                "variables": [
                  {"name": "telefono", "value": "{{replace(1.WaId; /^52(1)?(\\d{10})$/; \"+52$2\")}}"},
                  {"name": "fecha_entrega", "value": "{{formatDate(addDays(now; 1); \"YYYY-MM-DD\"; \"America/Mexico_City\")}}"},
                  {"name": "renglones_json", "value": "[{\"clave\": \"P01\", \"cantidad\": 2}]"}
                ],
                "scope": "roundtrip"
              },
              "metadata": {"designer": {"x": 1200, "y": 150}}
            },
            {
              "id": 6,
              "module": "json:ParseJSON",
              "version": 1,
              "parameters": {"type": 0},
              "mapper": {"json": "{{5.renglones_json}}"},
              "metadata": {"designer": {"x": 1500, "y": 150}}
            },
            {
              "id": 7,
              "module": "datastore:GetRecord",
              "version": 1,
              "parameters": {"datastore": 0},
              "mapper": {"key": "{{sha256(1.WaId)}}", "almacen": "clientes"},
              "metadata": {"designer": {"x": 1800, "y": 150}},
              "onerror": [
                {
                  "id": 12,
                  "module": "builtin:Resume",
                  "version": 1,
                  "parameters": {},
                  "mapper": {"key": "", "data": {"nombre_pila": "cliente", "pedidos": 0, "consentimiento": "no"}},
                  "metadata": {"designer": {"x": 1800, "y": 450}}
                }
              ]
            },
            {
              "id": 8,
              "module": "google-sheets:addRow",
              "version": 2,
              "parameters": {"__IMTCONN__": 0},
              "mapper": {
                "mode": "select",
                "spreadsheetId": "/ID_DE_EJEMPLO",
                "sheetId": "Pedidos",
                "includesHeaders": true,
                "valueInputOption": "RAW",
                "values": {"0": "{{sha256(1.MessageSid)}}", "1": "{{5.telefono}}", "2": "{{5.fecha_entrega}}", "3": "{{join(map(6.array; \"clave\"); \", \")}}", "4": "{{7.data.nombre_pila}}"}
              },
              "metadata": {"designer": {"x": 2100, "y": 150}},
              "onerror": [
                {
                  "id": 13,
                  "module": "builtin:Break",
                  "version": 1,
                  "parameters": {},
                  "mapper": {"retry": true, "count": 3, "interval": 1},
                  "metadata": {"designer": {"x": 2100, "y": 450}}
                }
              ]
            },
            {
              "id": 9,
              "module": "datastore:AddRecord",
              "version": 1,
              "parameters": {"datastore": 0},
              "mapper": {"key": "{{sha256(1.MessageSid)}}", "overwrite": false, "data": {"registrado_en": "{{formatDate(now; \"YYYY-MM-DD HH:mm\"; \"America/Mexico_City\")}}"}},
              "metadata": {"designer": {"x": 2400, "y": 150}},
              "onerror": [
                {
                  "id": 14,
                  "module": "builtin:Break",
                  "version": 1,
                  "parameters": {},
                  "mapper": {"retry": true, "count": 3, "interval": 1},
                  "metadata": {"designer": {"x": 2400, "y": 450}}
                }
              ]
            },
            {
              "id": 10,
              "module": "http:ActionSendData",
              "version": 3,
              "parameters": {"handleErrors": true},
              "mapper": {
                "url": "https://webhook.ejemplo.invalid/trigo-lento/obrador",
                "method": "post",
                "bodyType": "raw",
                "contentType": "application/json",
                "data": "{\"pedido\": \"{{substring(sha256(1.MessageSid); 0; 8)}}\", \"entrega\": \"{{5.fecha_entrega}}\"}",
                "timeout": 10
              },
              "metadata": {"designer": {"x": 2700, "y": 150}},
              "onerror": [
                {
                  "id": 15,
                  "module": "builtin:Ignore",
                  "version": 1,
                  "parameters": {},
                  "mapper": {},
                  "metadata": {"designer": {"x": 2700, "y": 450}}
                }
              ]
            }
          ]
        },
        {
          "flow": [
            {
              "id": 11,
              "module": "google-sheets:addRow",
              "version": 2,
              "parameters": {"__IMTCONN__": 0},
              "filter": {"name": "No es pedido", "conditions": [[{"a": "{{1.Body}}", "b": "aparta|quiero|guarda|quisiera", "o": "text:notpattern:ci"}]]},
              "mapper": {"mode": "select", "spreadsheetId": "/ID_DE_EJEMPLO", "sheetId": "Revisión", "includesHeaders": true, "valueInputOption": "RAW", "values": {"0": "{{sha256(1.MessageSid)}}", "1": "rutas de la v2"}},
              "metadata": {"designer": {"x": 900, "y": -300}}
            }
          ]
        }
      ]
    }
  ],
  "metadata": {
    "instant": true,
    "version": 1,
    "scenario": {"roundtrips": 1, "maxErrors": 3, "autoCommit": true, "autoCommitTriggerLast": true, "sequential": true, "confidential": true, "dataloss": false, "dlq": true, "freshVariables": false},
    "designer": {"orphans": []}
  }
}
Cada manejador responde a una decisión de la Tabla 2, y conviene leerlos uno por uno:
- Módulo 4, consultar la clave.
datastore:GetRecordcon{{sha256(1.MessageSid)}}, y en el módulo 5 el filtro “Mensaje nuevo” con el operadornotexist. Si el mensaje ya se procesó, el paquete se detiene ahí, sin coste en los módulos siguientes. - Módulo 7, buscar al cliente, con Resume (12). Si el almacén de clientes del Día 27 falla, el pedido no debe esperar: sigue con un sustituto explícito,
nombre_pilaigual a “cliente”,pedidosigual a $0$ yconsentimientoigual a “no”. El sustituto es conservador a propósito: un cliente desconocido no recibe mensajes que requieran consentimiento. - Módulo 8, la fila en
Pedidos, con Break (13). El paso que no se puede perder: $3$ intentos, cada minuto, con la finalización automática activada (retry: true). Es la política de los reintentos inmediatos de la Tabla 3, y la sección de Marisol explica por qué. - Módulo 9, registrar la clave, con Break (14). Si la fila se guardó pero el registro falló, el reintento empieza en el registro y no repite la fila.
overwrite: falsehace que una clave repetida produzca un error en lugar de sobrescribir en silencio. - Módulo 10, avisar al obrador, con Ignore (15). El aviso es una cortesía: el obrador también ve la hoja. Si falla, se descarta y la ejecución termina bien. El cuerpo del aviso lleva solo un fragmento de la clave y la fecha de entrega, sin teléfono ni nombre.
- Los ajustes.
dlq: true(sin él, los Break no tienen a dónde mandar nada),sequential: true(procesamiento en orden contra las entregas simultáneas),confidential: true(el historial no guarda datos personales) ydataloss: false.
El siguiente bloque lee el blueprint, comprueba que todas las directivas son válidas, que ningún Break existe sin ejecuciones incompletas y que ningún Rollback cuelga de un módulo sin transacciones, y lo dibuja con la paleta de la serie, con los manejadores en rojo debajo del módulo al que protegen:
# Lectura, validación y dibujo de TL Pedidos WhatsApp v2.3 con sus manejadores de error en Python:
import textwrap
from matplotlib.patches import Ellipse, FancyBboxPatch, Polygon, RegularPolygon, FancyArrowPatch

with open(carpeta / 'flujos' / 'make' / 'pedidos_whatsapp_v2_3.blueprint.json', encoding = 'utf-8') as f:
    blueprint = json.load(f)

DIRECTIVAS = {'builtin:Break', 'builtin:Resume', 'builtin:Ignore', 'builtin:Rollback', 'builtin:Commit'}
ACID = ('datastore:',)                          # módulos con transacciones: solo ahí revierte Rollback

def todos_los_modulos(flujo):
    for m in flujo:
        yield m
        yield from todos_los_modulos(m.get('onerror', []))
        for ruta in m.get('routes', []):
            yield from todos_los_modulos(ruta['flow'])

def validar_errores(bp):
    hallazgos, modulos = [], list(todos_los_modulos(bp['flow']))
    ids = [m['id'] for m in modulos]
    if len(ids) != len(set(ids)):
        hallazgos.append('ids repetidos')
    for m in modulos:
        if (m.get('parameters') or {}).get('__IMTCONN__', 0) != 0:
            hallazgos.append(f"módulo {m['id']}: conexión real")
        for e in m.get('onerror', []):
            if e['module'] not in DIRECTIVAS:
                hallazgos.append(f"módulo {m['id']}: directiva desconocida {e['module']}")
            if e['module'] == 'builtin:Break' and not bp['metadata']['scenario']['dlq']:
                hallazgos.append(f"módulo {m['id']}: Break sin ejecuciones incompletas")
            if e['module'] == 'builtin:Rollback' and not m['module'].startswith(ACID):
                hallazgos.append(f"módulo {m['id']}: Rollback en un módulo sin transacciones")
    return modulos, hallazgos

FORMAS = {'disparador': ('ovalo', '#3a9d5d'), 'accion': ('rectangulo', '#2a78d6'),
          'decision': ('rombo', '#eb6834'), 'ia': ('rectangulo', '#7b5ea7'),
          'error': ('rectangulo', '#c8423b'), 'humano': ('hexagono', '#8a8986')}
NOMBRES = {'gateway:CustomWebHook': 'Webhook\nde Twilio', 'gateway:WebhookRespond': 'Responder\n200',
           'datastore:GetRecord': 'Consultar\nalmacén', 'json:ParseJSON': 'Parse\nJSON',
           'util:SetVariables': 'Normalizar\npedido', 'google-sheets:addRow': 'Fila en\nPedidos',
           'datastore:AddRecord': 'Registrar\nclave', 'http:ActionSendData': 'Avisar al\nobrador',
           'builtin:Break': 'Break:\n3 cada 1 min', 'builtin:Resume': 'Resume:\ncliente nuevo',
           'builtin:Ignore': 'Ignore', 'builtin:BasicRouter': 'Router'}

def tipo_de(m, primero):
    if primero:
        return 'disparador'
    if m['module'] in DIRECTIVAS:
        return 'error'
    if m['module'] == 'builtin:BasicRouter':
        return 'decision'
    if (m.get('mapper') or {}).get('sheetId') == 'Revisión':
        return 'humano'
    return 'accion'

def nodos_desde_blueprint(flujo, x0 = 0.0, y0 = 0.0, previo = None, nodos = None, aristas = None):
    nodos = [] if nodos is None else nodos
    aristas = [] if aristas is None else aristas
    x = x0
    for m in flujo:
        texto = NOMBRES.get(m['module'], m['module'])
        if m['module'] == 'datastore:GetRecord' and 'clientes' in json.dumps(m['mapper']):
            texto = 'Buscar\ncliente'
        if (m.get('mapper') or {}).get('sheetId') == 'Revisión':
            texto = 'Fila en\nRevisión'
        nodos.append({'id': m['id'], 'tipo': tipo_de(m, previo is None), 'texto': f"{m['id']}. {texto}",
                      'x': x, 'y': y0})
        if previo is not None:
            etiqueta = m['filter']['name'] if 'filter' in m else ''
            aristas.append((previo, m['id'], textwrap.fill(etiqueta, 12)))
        for e in m.get('onerror', []):
            nodos.append({'id': e['id'], 'tipo': 'error', 'texto': f"{e['id']}. {NOMBRES[e['module']]}",
                          'x': x, 'y': y0 - 1.9})
            aristas.append((m['id'], e['id'], ''))
        for i, ruta in enumerate(m.get('routes', [])):
            nodos_desde_blueprint(ruta['flow'], x + 2.5, y0 + (0 if i == 0 else 3.8), m['id'], nodos, aristas)
        previo, x = m['id'], x + 2.5
    return nodos, aristas

def dibujar_flujo(nodos, aristas, titulo, ax = None, ancho = 2.1, alto = 1.25, recorte = 30):
    if ax is None:
        fig, ax = plt.subplots(figsize = (15, 5.4))
    for n in nodos:
        forma, color = FORMAS[n['tipo']]
        x, y = n['x'], n['y']
        if forma == 'ovalo':
            figura = Ellipse((x, y), ancho * 1.05, alto * 1.1)
        elif forma == 'rombo':
            figura = Polygon([(x - ancho / 1.6, y), (x, y + alto / 1.15), (x + ancho / 1.6, y), (x, y - alto / 1.15)])
        elif forma == 'hexagono':
            figura = RegularPolygon((x, y), 6, radius = ancho / 2, orientation = np.pi / 6)
        else:
            figura = FancyBboxPatch((x - ancho / 2, y - alto / 2), ancho, alto, boxstyle = 'round,pad=0.03')
        figura.set_facecolor(color)
        figura.set_edgecolor('white')
        figura.set_linewidth(2)
        ax.add_patch(figura)
        ax.text(x, y, n['texto'], ha = 'center', va = 'center', fontsize = 8.5, color = 'white')
    posicion = {n['id']: (n['x'], n['y']) for n in nodos}
    for origen, destino, etiqueta in aristas:
        (x1, y1), (x2, y2) = posicion[origen], posicion[destino]
        ax.add_patch(FancyArrowPatch((x1, y1), (x2, y2), arrowstyle = '-|>', mutation_scale = 12,
                                     shrinkA = recorte, shrinkB = recorte + 2, color = '#52514e', linewidth = 1.3))
        if etiqueta:
            ax.text((x1 + x2) / 2, (y1 + y2) / 2 + 0.75, etiqueta, ha = 'center', fontsize = 8, color = '#eb6834')
    xs, ys = [n['x'] for n in nodos], [n['y'] for n in nodos]
    ax.set_xlim(min(xs) - 1.4, max(xs) + 1.4)
    ax.set_ylim(min(ys) - 1.0, max(ys) + 1.25)
    ax.set_aspect('equal')
    ax.axis('off')
    ax.set_title(titulo, fontsize = 16)
    return ax

modulos, hallazgos = validar_errores(blueprint)
for m in modulos:
    if m.get('onerror'):
        print(f"{m['id']:>2} {m['module']:<22} -> {[e['module'] for e in m['onerror']]}")
manejadores = [m for m in modulos if m['module'] in DIRECTIVAS]
print('Módulos:', len(modulos), '| manejadores:', len(manejadores), '| hallazgos:', hallazgos or 'ninguno')
print('Ajustes:', {k: blueprint['metadata']['scenario'][k] for k in ('sequential', 'dlq', 'confidential', 'maxErrors')})
nodos, aristas = nodos_desde_blueprint(blueprint['flow'])
print('Nodos dibujados:', len(nodos), '| aristas:', len(aristas))
dibujar_flujo(nodos, aristas, blueprint['name'] + ': manejadores de error en rojo')
plt.tight_layout()
plt.show()
 7 datastore:GetRecord    -> ['builtin:Resume']
 8 google-sheets:addRow   -> ['builtin:Break']
 9 datastore:AddRecord    -> ['builtin:Break']
10 http:ActionSendData    -> ['builtin:Ignore']
Módulos: 15 | manejadores: 4 | hallazgos: ninguno
Ajustes: {'sequential': True, 'dlq': True, 'confidential': True, 'maxErrors': 3}
Nodos dibujados: 15 | aristas: 14
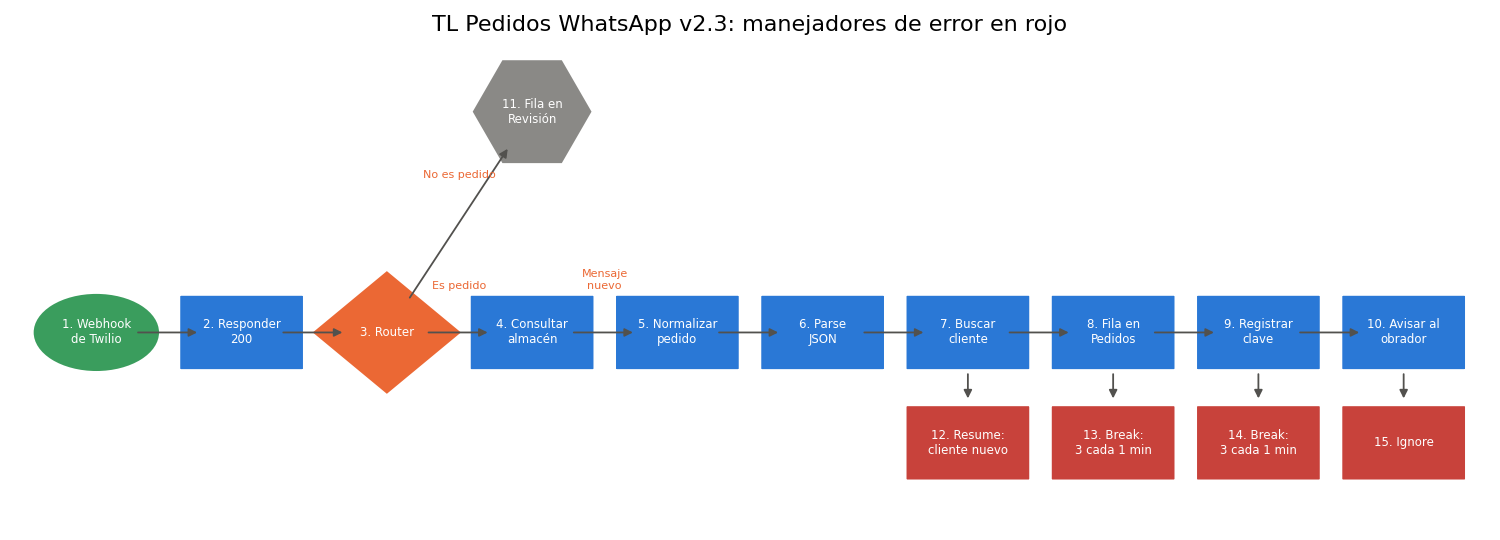
El validador recorre $15$ módulos, incluidos los $4$ manejadores, que encuentra porque entra en routes y en onerror, y no encuentra ningún hallazgo. Los ajustes confirman el procesamiento en orden, las ejecuciones incompletas y los datos confidenciales. En el dibujo, la fila del centro es la ruta de pedidos, con los filtros “Es pedido” y “Mensaje nuevo” en las flechas; arriba, el hexágono gris de la ruta de revisión, que atiende una persona; abajo, en rojo, los cuatro manejadores. La regla visual que Valeria aplica al revisar cualquier escenario es sencilla: todo módulo que escribe en un servicio externo tiene un rectángulo rojo debajo, y el color del rectángulo dice qué pasa con el pedido si ese módulo falla.
Lo que pidió Marisol
Marisol no pidió fiabilidad en abstracto: pidió que el $95%$ de sus cambios queden confirmados en menos de $5$ minutos. Es un acuerdo de nivel de servicio (o SLA, por sus siglas en inglés: “Service Level Agreement”) con sus tres piezas: una métrica (minutos hasta que el pedido está en la hoja y en el obrador), un umbral ($5$ minutos) y un objetivo ($95%$). El Día 8 enseñó a medirlos; hoy toca comprobar si las políticas de reintento lo cumplen.
La proporción que se mide es la fracción de ejecuciones con latencia menor que el umbral, y como sale de una simulación, conviene acompañarla de su margen de error:
$$ \hat{q} = \frac{1}{n} \sum_{i=1}^{n} \mathbb{1}\left[L_i < 5\right], \qquad \hat{q} \pm 1.96 \sqrt{\frac{\hat{q},(1 - \hat{q})}{n}} $$
La lógica detrás de esta fórmula es múltiple:
- $L_i$ es la latencia de la ejecución $i$ y $\mathbb{1}[L_i < 5]$ vale $1$ si terminó en menos de $5$ minutos y $0$ si no; su media $\hat{q}$ es la proporción que cumple.
- El término con la raíz es el margen de error del $95%$ de una proporción estimada con $n$ observaciones: con $n = 10,000$ y $\hat{q}$ cerca de $0.98$, unos $0.3$ puntos porcentuales.
- Una política cumple el SLA con holgura estadística si el extremo inferior del intervalo, $\hat{q} - 1.96\sqrt{\cdot}$, queda por encima de $0.95$.
- En conclusión, comparar dos políticas que difieren en menos que su margen de error es comparar ruido; aquí la diferencia entre ellas es mayor que el margen, pero no mucho.
El siguiente bloque calcula la proporción para las tres políticas del Monte Carlo y, como el supuesto más débil es la duración de los episodios de fallo, repite la simulación con medianas de $15$ segundos a $4$ minutos:
# Nivel de servicio de Marisol: confirmaciones en menos de 5 minutos por política en Python:
def proporcion_sla(lat, limite = SLA_MIN):
    return float((lat < limite).mean())

for nombre, lat in latencias.items():
    q = proporcion_sla(lat)
    error_est = 1.96 * np.sqrt(q * (1 - q) / len(lat))
    print(f'{nombre:<38} {q:.2%} (± {error_est:.2%}) | cumple el 95 %: {"sí" if q - error_est >= 0.95 else "no"}')

# Sensibilidad: qué pasa si los episodios de fallo duran más:
medianas = [0.25, 0.5, 1.0, 2.0, 4.0]
sensibilidad = {nombre: [] for nombre in POLITICAS}
for mediana in medianas:
    EPISODIO_MEDIANA = mediana
    for nombre in POLITICAS:
        lat = np.array([ejecutar(nombre, rng)[0] for _ in range(4_000)])
        sensibilidad[nombre].append(proporcion_sla(lat))
EPISODIO_MEDIANA = 0.5
print(pd.DataFrame(sensibilidad, index = [f'{m} min' for m in medianas]).map(lambda v: f'{v:.1%}').to_string())

fig, (ax1, ax2) = plt.subplots(1, 2, figsize = (12, 4.6))
nombres = list(POLITICAS)
valores = [proporcion_sla(latencias[n]) * 100 for n in nombres]
barras = ax1.bar(['Sin\nreintentos', '3 inmediatos', '3 con espera\nexponencial'], valores,
                 color = ['#c8423b', '#2a78d6', '#3a9d5d'])
for b, v in zip(barras, valores):
    ax1.text(b.get_x() + b.get_width() / 2, v + 0.6, f'{v:.1f} %', ha = 'center', fontsize = 10)
ax1.axhline(95, color = '#52514e', ls = '--', lw = 1.5)
ax1.text(-0.4, 95.8, 'meta: 95 %', fontsize = 9, color = '#52514e', ha = 'left')
ax1.set_ylim(60, 102)
ax1.set_ylabel('% confirmado en menos de 5 min')
ax1.set_title('Episodios de 30 s de mediana', fontsize = 12)
for nombre, color in zip(nombres, ['#c8423b', '#2a78d6', '#3a9d5d']):
    ax2.plot(medianas, np.array(sensibilidad[nombre]) * 100, marker = 'o', lw = 2, color = color, label = nombre)
ax2.axhline(95, color = '#52514e', ls = '--', lw = 1.5)
ax2.set_xscale('log')
ax2.set_xticks(medianas)
ax2.set_xticklabels([f'{m:g}' for m in medianas])
ax2.set_xlabel('Mediana del episodio de fallo (minutos)')
ax2.set_ylabel('% confirmado en menos de 5 min')
ax2.set_title('Si los fallos duran más', fontsize = 12)
ax2.legend(fontsize = 8.5, loc = 'center left')
ax2.grid(color = '#e6e5e1')
fig.suptitle('Lo que pidió Marisol: 95 % de confirmaciones en menos de 5 minutos', fontsize = 16)
plt.tight_layout()
plt.show()
Sin reintentos                         69.52% (± 0.90%) | cumple el 95 %: no
3 reintentos inmediatos                98.59% (± 0.23%) | cumple el 95 %: sí
3 reintentos con espera exponencial    97.76% (± 0.29%) | cumple el 95 %: sí
         Sin reintentos 3 reintentos inmediatos 3 reintentos con espera exponencial
0.25 min          69.3%                   99.6%                               99.2%
0.5 min           69.4%                   98.5%                               98.0%
1.0 min           69.1%                   94.8%                               93.6%
2.0 min           69.9%                   87.5%                               87.3%
4.0 min           71.3%                   80.6%                               79.6%
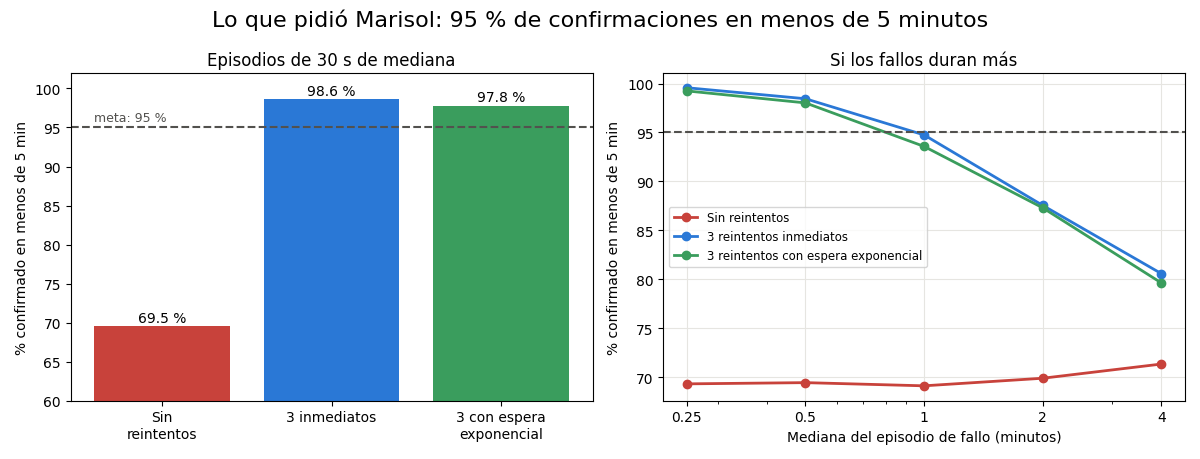
Con episodios de $30$ segundos de mediana, el resultado es claro: sin reintentos, $69.52%$, lejísimos del $95%$; reintentos inmediatos, $98.59%$ ($\pm 0.23$), y espera exponencial, $97.76%$ ($\pm 0.29$). Las dos políticas con reintentos cumplen con holgura, y la inmediata cumple mejor: sus tres intentos caen a $1$, $2$ y $3$ minutos, todos dentro del umbral, mientras que el tercer reintento de la espera exponencial cae, de media, pasados los $5$ minutos. La Tabla 4 recoge la sensibilidad:
Tabla 4. Proporción de pedidos confirmados en menos de 5 minutos según la duración mediana de los episodios de fallo (4 000 ejecuciones por celda).
| Mediana del episodio | Sin reintentos | 3 reintentos inmediatos | 3 con espera exponencial |
|---|---|---|---|
| 15 segundos | 69.3 % | 99.6 % | 99.2 % |
| 30 segundos | 69.4 % | 98.5 % | 98.0 % |
| 1 minuto | 69.1 % | 94.8 % | 93.6 % |
| 2 minutos | 69.9 % | 87.5 % | 87.3 % |
| 4 minutos | 71.3 % | 80.6 % | 79.6 % |
La tabla tiene una lectura incómoda que Valeria no esconde: el SLA de Marisol depende más de cuánto duran las caídas que de la política. Con episodios de un minuto de mediana, ninguna política llega al $95%$; con caídas de cuatro minutos, ninguna pasa del $81%$. Ninguna configuración de reintentos puede confirmar en $5$ minutos un pedido cuando el servicio está caído durante $10$. Lo que sí puede hacer el escenario es lo que Marisol pidió en segundo lugar: “si no se puede, que me lo digan”. Por eso la decisión de Valeria tiene dos partes:
- Break con $3$ intentos cada minuto en la fila de pedidos, porque es la política que mejor cumple el umbral mientras las caídas sean cortas, y porque, con el procesamiento en orden activado, un reintento largo detendría la cola de todos los mensajes que vienen detrás. Tres minutos de espera en el peor caso, en una hora pico de $9$ mensajes, retrasan como mucho a uno.
- Alerta en cuanto un pedido agota sus reintentos, para que una persona llame a Marisol antes de que pasen los $5$ minutos de margen que ella necesita para reorganizarse. Es la sección siguiente.
Una última cuenta, para que el porcentaje no engañe: Marisol escribe unos $26$ cambios o confirmaciones al mes. Con $98.59%$ por pedido, la probabilidad de que todos los del mes lleguen a tiempo es $0.9859^{26} \approx 0.69$. Dicho de otro modo, uno de cada tres meses tendrá al menos un retraso. Un SLA del $95%$ promete exactamente eso, y conviene que Marisol lo sepa también.
Alertas
El martes no faltaron datos: faltó que alguien se enterara. Las cuatro ejecuciones incompletas estuvieron en la pestaña de Make durante $45$ horas, perfectamente guardadas. La pieza que falta es una alerta: una regla que convierte una condición del registro en un aviso a una persona. Valeria la diseña con tres decisiones:
- Qué se registra. Cada ejecución deja una fila en la tabla
ejecucionesdetrigo_lento.sqlite, la del Día 4, ampliada hoy con dos columnas:estado(correcta o incompleta) ytipo_error. No se guarda el texto del mensaje ni el teléfono: el registro sirve para operar, no para tener otra copia de los datos personales. - Cuándo se avisa. Tras $3$ errores seguidos, la misma cifra que Make usa por omisión para desactivar un escenario programado. Un error aislado lo resuelve el Break; tres seguidos indican que algo de fuera está caído.
- A quién y por dónde. A Valeria, por un canal que ella mira: hoy, un escenario de notificación aparte que le escribe por correo; en el módulo 5, Slack como centro de operaciones. La alerta va en un escenario distinto para que, si el escenario de pedidos está roto, la alerta no se rompa con él.
El siguiente bloque crea la tabla ampliada, reconstruye la tarde del martes con las ejecuciones correctas y las once fallidas del Bloque 2, y aplica la regla de los tres errores seguidos:
# Registro de errores en la tabla ejecuciones y alerta tras 3 errores seguidos en Python:
ruta_bd = carpeta / 'ejecuciones_dia_28.sqlite'
ruta_bd.unlink(missing_ok = True)
con = sqlite3.connect(ruta_bd)
con.execute('CREATE TABLE ejecuciones (id_ejecucion INTEGER PRIMARY KEY, flujo TEXT NOT NULL, '
            'inicio TEXT NOT NULL, leidos INTEGER NOT NULL, guardados INTEGER NOT NULL, '
            'duplicados INTEGER NOT NULL, rechazados INTEGER NOT NULL)')
con.execute('ALTER TABLE ejecuciones ADD COLUMN estado TEXT NOT NULL DEFAULT "correcta"')
con.execute('ALTER TABLE ejecuciones ADD COLUMN tipo_error TEXT')

# La tarde del martes 24 reconstruida: ejecuciones correctas y las once fallidas del Bloque 2:
inicio = datetime(2026, 2, 24, 12, 0)
fallidas = dict(zip(martes['hora'], martes['tipo']))
registro = []
minuto = 0
while minuto < 180:
    hora = (inicio + timedelta(minutes = minuto)).strftime('%H:%M')
    if hora in fallidas:
        registro.append((hora, 'incompleta', fallidas[hora]))
    elif minuto % 7 == 0 and not ('13:05' <= hora <= '13:40'):
        registro.append((hora, 'correcta', None))
    minuto += 1
for hora, estado, tipo in registro:
    con.execute('INSERT INTO ejecuciones (flujo, inicio, leidos, guardados, duplicados, rechazados, estado, tipo_error) '
                'VALUES (?, ?, 1, ?, 0, 0, ?, ?)', ('TL Pedidos WhatsApp v2.3', f'2026-02-24 {hora}',
                                                    1 if estado == 'correcta' else 0, estado, tipo))
con.commit()

def alertas(con, umbral = 3):
    seguidos, salida = 0, []
    for inicio_ej, estado, tipo in con.execute('SELECT inicio, estado, tipo_error FROM ejecuciones ORDER BY inicio'):
        seguidos = seguidos + 1 if estado != 'correcta' else 0
        if seguidos == umbral:
            salida.append((inicio_ej, tipo))
    return salida

print(con.execute('SELECT estado, COUNT(*) FROM ejecuciones GROUP BY estado').fetchall())
print(con.execute('SELECT tipo_error, COUNT(*) FROM ejecuciones WHERE tipo_error IS NOT NULL '
                  'GROUP BY tipo_error ORDER BY 2 DESC').fetchall())
avisos = alertas(con)
print('Alertas:', avisos)
primera = datetime.strptime(avisos[0][0], '%Y-%m-%d %H:%M')
print('Minutos desde el primer error hasta la alerta:', int((primera - datetime(2026, 2, 24, 13, 5)).total_seconds() / 60),
      '| sin alerta, el martes se supo el jueves a las 10:30:',
      int((datetime(2026, 2, 26, 10, 30) - datetime(2026, 2, 24, 13, 5)).total_seconds() / 3600), 'horas después')
con.close()
[('correcta', 21), ('incompleta', 11)]
[('ConnectionError', 5), ('RuntimeError', 4), ('ModuleTimeoutError', 2)]
Alertas: [('2026-02-24 13:09', 'ConnectionError')]
Minutos desde el primer error hasta la alerta: 4 | sin alerta, el martes se supo el jueves a las 10:30: 45 horas después
La tarde del martes queda en $21$ ejecuciones correctas y $11$ incompletas, con el mismo reparto de tipos del Bloque 2. La regla dispara una sola alerta, a las 13:09, con el tercer error seguido: $4$ minutos después del primer fallo. Sin ella, el problema se descubrió el jueves a las 10:30, $45$ horas después. Con la alerta, Valeria habría sabido a las 13:09 que la hoja estaba fallando, habría revisado a las 13:45 la pestaña de incompletas, habría reanudado los cuatro pedidos esa misma tarde y Marisol habría recibido sus $50$ baguettes.
La regla es deliberadamente simple, y tiene dos límites que conviene conocer. No avisa de un error aislado que se queda sin resolver, como habría sido el de las 13:22 si hubiera llegado solo; para eso hace falta la segunda mitad de la vigilancia: revisar cada mañana la lista de incompletas sin resolver. Y no sabe nada de los errores que ocurren dentro de Make sin pasar por el registro. Ambas cosas se resuelven consultando a Make directamente.
La API de Make expone las ejecuciones incompletas de un escenario en el endpoint GET /api/v2/dlqs, con el identificador del escenario y un filtro de estado (resolved, scheduled, inprogress o unresolved), y exige un token con el permiso dlqs:read. El siguiente bloque es la revisión matutina que Valeria programa a las 9:00: pide solo las incompletas sin resolver y avisa si hay alguna. El token vive en una variable de entorno con ese único permiso, siguiendo el mínimo privilegio del Día 17 (Seguridad I: OAuth, secretos y mínimo privilegio en las conexiones). Este bloque llama a la API de Make y no se ejecutó para escribir la entrada; la salida es un ejemplo comentado:
# Revisión matutina de ejecuciones incompletas por la API de Make en Python:
import os
import requests

# Zona, token e identificador del escenario en variables de entorno, nunca en el código:
ZONA = os.environ.get('MAKE_ZONA', 'us1.make.com')        # la zona de su organización (eu1, eu2, us1, us2...)
ESCENARIO = os.environ['MAKE_ESCENARIO_PEDIDOS']
TOKEN = os.environ['MAKE_API_TOKEN']                      # token con el permiso dlqs:read y nada más

respuesta = requests.get(f'https://{ZONA}/api/v2/dlqs', timeout = 30,
                         params = {'scenarioId': ESCENARIO, 'status': 'unresolved'},
                         headers = {'Authorization': f'Token {TOKEN}'})
respuesta.raise_for_status()
pendientes = respuesta.json()['dlqs']
print('Ejecuciones incompletas sin resolver:', len(pendientes))
for d in pendientes:
    print(f"{d['created']} | intentos: {d['attempts']} | motivo: {d['reason'][:60]}")
if pendientes:
    print('ALERTA: revisar antes de las 10:00; no reanudar sin mirar el motivo.')

# Salida de ejemplo (puede variar):
# Ejecuciones incompletas sin resolver: 2
# 2026-03-02T19:07:12Z | intentos: 3 | motivo: The service is temporarily unavailable.
# 2026-03-02T19:31:40Z | intentos: 0 | motivo: Validation failed for 1 parameter(s).
# ALERTA: revisar antes de las 10:00; no reanudar sin mirar el motivo.
La salida de ejemplo muestra los dos casos que la revisión debe separar. La primera incompleta agotó sus $3$ intentos con un error del servicio: probablemente se resuelve reanudándola. La segunda tiene $0$ intentos y un error de validación: un dato inválido que ningún reintento arreglará y que hay que corregir antes de reanudar. La última línea es la regla que Valeria escribió en la ficha del escenario: no reanudar sin leer el motivo. Reanudar a ciegas una incompleta con un dato inválido solo produce otra incompleta; reanudar desde el principio un pedido que ya tenía fila produce un duplicado, salvo que exista la clave del Bloque 6.
Don Ernesto lee la ficha impresa, con la alerta y la revisión de las nueve, y la dobla en cuatro para guardarla en el bolsillo del mandil: “Esto sí. La máquina puede fallar, como falla el horno. Lo que no puede es fallar callada.”
Consideraciones finales
El día empezó con cuatro pedidos guardados en una pestaña que nadie miró y $50$ baguettes que se quedaron en $40$, y termina con una clasificación de errores, cinco directivas con su caso de uso, una fórmula que explica por qué un escenario de siete módulos sin reintentos falla casi una de cada tres veces, una simulación de diez mil ejecuciones que muestra dónde se esconde el coste de los fallos (en la cola, no en la mediana), una clave de idempotencia que reduce a cero los duplicados y una alerta que habría convertido $45$ horas de silencio en $4$ minutos. Un flujo profesional no es el que nunca falla: es el que falla de forma prevista, sin duplicar nada y avisando a tiempo a una persona.
Antes de activar un escenario con manejo de errores, conviene hacerse algunas preguntas:
- ¿Qué tipo de error puede devolver cada módulo que escribe fuera de Make? ¿Cuáles reintenta Make solo y cuáles necesitan un manejador explícito?
- ¿Qué pasa con el pedido si cada módulo falla: se pierde, sigue con un sustituto, se detiene todo o se reintenta? ¿Hay un rectángulo rojo debajo de cada módulo que escribe?
- Si este mensaje llega dos veces, ¿se guarda dos veces? ¿Dónde está la clave que lo impide y cuándo se registra?
- ¿Quién se entera, y en cuántos minutos, cuando un pedido agota sus reintentos?
Las cifras de hoy tienen límites claros. La probabilidad de fallo del $5%$ por módulo es de juguete y pesimista a propósito; la de un servicio real se mide en el historial. Los episodios de fallo lognormales con mediana de $30$ segundos son un supuesto, y la Tabla 4 muestra que la conclusión sobre el SLA depende de él. El blueprint tiene la estructura documentada, pero no es una exportación real, y las claves de los manejadores deben contrastarse; el intervalo mínimo real del Break también. Y la simulación trata cada ejecución por separado, cuando con el procesamiento en orden un reintento retrasa a los mensajes que esperan detrás. Ninguno de esos límites cambia la estructura del diseño: clasificar antes de reintentar, reintentar poco y cerca lo que es pasajero, no repetir efectos y avisar siempre.
Un gran libro que habla de esto es Release It! Design and Deploy Production-Ready Software, en el que Michael Nygard cuenta, con incidentes reales, cómo un sistema que funciona en pruebas cae en producción por un tiempo de espera mal puesto o un reintento sin límite, y propone patrones (tiempos de espera, disyuntores, compartimentos) para que los fallos se queden pequeños. Leído junto al capítulo de alertas de Site Reliability Engineering, el libro de Google editado por Beyer, Jones, Petoff y Murphy, le dará el vocabulario para decidir qué merece despertar a una persona y qué no.
Conclusiones clave
Tipos de error
- Los fallos de un flujo son pasajeros (red, $429$, $5$xx, tiempo agotado), de datos o de configuración; solo los pasajeros mejoran al repetir la petición.
- Make reintenta solo
ConnectionError,RateLimitErroryModuleTimeoutErrorcon un calendario de ocho intentos de $1$ minuto a $7$ horas $51$ minutos; un $5$xx es reintentable, pero necesita un manejador explícito. - El martes, $7$ de $11$ ejecuciones fallidas se resolvieron solas y $4$ esperaron $45$ horas en la pestaña de incompletas: no se perdió ningún dato, se perdió el aviso.
Directivas
- Ignore descarta el paquete y sigue, Resume sigue con un sustituto, Commit y Rollback detienen la ejecución (y solo revierten módulos transaccionales), y Break guarda el paquete como incompleto y lo reintenta; desde mayo de 2026, el editor llama Retry a Break y Skip a Ignore.
- Break necesita las ejecuciones incompletas activadas, reanuda en el módulo que falló y, como las demás rutas de error, no cobra créditos por sí mismo.
TL Pedidos WhatsApp v2.3usa Resume en la búsqueda del cliente, Break con $3$ intentos cada minuto en la fila y en el registro de la clave, e Ignore en el aviso al obrador; el validador revisa $15$ módulos y no encuentra hallazgos.
Fiabilidad y SLA
- Con $P = \prod (1 - p_m^{,k+1})$, un escenario de $7$ módulos con $p = 0.05$ completa el $69.8%$ de las ejecuciones sin reintentos y el $99.996%$ con tres; el coste teórico es de $0.368$ créditos por ejecución.
- En $10,000$ ejecuciones con fallos que duran, la mediana no cambia ($0.13$ minutos) y el p95 baja de $105.8$ minutos a $2.19$ con reintentos inmediatos y $2.82$ con espera exponencial, que deja menos incompletas ($41$ frente a $119$).
- La clave SHA-256 del
MessageSid, consultada antes y registrada después, redujo de $29$ a $0$ los duplicados en $1,029$ entregas; con ejecución paralela, además, hace falta el procesamiento en orden. - El SLA de Marisol se cumple con reintentos ($98.59%$ y $97.76%$ en menos de $5$ minutos) mientras las caídas sean cortas; la alerta de tres errores seguidos habría avisado del martes en $4$ minutos.
Mañana, en el Día 29: Anatomía de un fallo real I: el webhook que duplicó 37 pedidos. Valeria reconstruirá con evidencias y sin buscar culpables un incidente en el que un webhook lento y una respuesta tardía multiplicaron los pedidos de un sábado, y comprobará con una simulación por qué la clave de idempotencia de hoy no era un detalle opcional.
Referencias
- Nygard, M. T. (2018). Release It! Design and Deploy Production-Ready Software (2.ª ed.). Pragmatic Bookshelf.
- Brooker, M. (2015). Exponential Backoff And Jitter. AWS Architecture Blog. https://aws.amazon.com/blogs/architecture/exponential-backoff-and-jitter/
- Make (2026). Overview of error handling; Error handlers; Retry error handler; Rollback error handler. Centro de ayuda de Make. https://help.make.com/error-handlers
- Make (2026). Automatic retry of incomplete executions. Centro de ayuda de Make. https://help.make.com/automatic-retry-of-incomplete-executions
- Make (2026). Incomplete executions: List incomplete executions (
GET /dlqs). Referencia de la API de Make. https://developers.make.com/api-documentation/api-reference/incomplete-executions - Make Community (2026). Error handlers update (Break pasa a llamarse Retry e Ignore pasa a llamarse Skip). https://community.make.com/t/error-handlers-update/109506
- Beyer, B., Jones, C., Petoff, J. y Murphy, N. R. (Eds.) (2016). Site Reliability Engineering: How Google Runs Production Systems. O’Reilly Media.
- Kleppmann, M. (2017). Designing Data-Intensive Applications. O’Reilly Media.