
Arquitecto de automatización con IA: Día 29
 Jeshua Romero Guadarrama
- 60 Min para leer
- 01 Mar, 2026
Índice de contenido
Resumen:
Un sábado de hora pico, el escenario de pedidos de Trigo Lento convirtió 14 pedidos en 51 filas y el obrador horneó dos veces un pastel de zanahoria. En esta entrada, Valeria reconstruye el incidente (ficticio e ilustrativo) con sus evidencias: la línea de tiempo, los tiempos hasta detectar y resolver, el mecanismo de los reintentos simulado 10 000 veces, los cinco porqués, el diagrama de Ishikawa y la corrección con respuesta inmediata y clave de idempotencia. Al terminar, usted sabrá separar el síntoma, las causas contribuyentes y la causa raíz de un fallo de automatización, comprobar con simulación que una corrección funciona y redactar un análisis posterior sin culpables con acciones, dueños y fechas.
¿Cómo citar el presente artículo?
Romero, J. (1 de marzo de 2026). Arquitecto de automatización con IA: Día 29. python-data-engineer. https://www.python-data-engineer.com/post/aai/dia_29/.
Arquitecto de automatización con IA: Día 29 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/aai/dia_29/.
Planes, precios y límites de Make, n8n, Zapier, WhatsApp (Meta, Twilio, Wati) y de la API de Claude revisados en octubre de 2026. Las políticas de reintento citadas en la Tabla 3 se tomaron de la documentación oficial en octubre de 2026: Twilio (parámetros de conexión ct, rt, tt, rc y rp, con un tiempo total máximo de 15 segundos que incluye los reintentos), Meta (reintentos con frecuencia decreciente durante un máximo de 7 días) y Make (reintento automático de ejecuciones incompletas y manejador de reintento, antes llamado Break). Los dos fragmentos de blueprint tienen la estructura de exportación documentada por Make (estructura verificada contra la documentación, revisado en octubre de 2026); el operador notexist del filtro y la opción overwrite del almacén deben contrastarse con un escenario exportado antes de activarlos.
Día 29. Anatomía de un fallo real I: el webhook que duplicó 37 pedidos
Introducción
Ayer, en el Día 28 (Flujos profesionales: manejo de errores, reintentos y ejecuciones incompletas), Valeria clasificó los errores de un flujo en reintentables y no reintentables, eligió una directiva de Make para cada módulo, calculó cuánto sube la fiabilidad con reintentos espaciados y dejó escrita una clave de idempotencia derivada de MessageSid, y Trigo Lento ganó el diseño de TL Pedidos WhatsApp v2.3. Ese diseño, sin embargo, todavía estaba en el cuaderno de Valeria cuando ocurrió lo que hoy se analiza: el escenario activo era la versión anterior, la v2.2, que llevaba tres días en piloto.
Una aclaración antes de empezar: el incidente de hoy es ficticio e ilustrativo. Trigo Lento, sus clientes y sus cifras son inventados, como en toda la serie; el registro de la hoja que verá en los bloques de código se reconstruyó con datos de juguete, sin teléfonos ni mensajes reales. Lo que no es inventado es el mecanismo. Los webhooks que se repiten, los escenarios que no comprueban si ya procesaron un mensaje y las hojas de cálculo que se vuelven lentas en el peor momento son la causa de una buena parte de los incidentes de automatización en negocios pequeños, y conviene haberlos visto de cerca antes de vivirlos.
Es sábado 28 de febrero, a las 10:41. El obrador trabaja a pleno, porque el sábado es el día de más encargos. Don Ernesto toma de la impresora la comanda de un pastel de zanahoria para las cinco de la tarde y se detiene: es la tercera comanda idéntica que ve en media hora, con el mismo nombre de clienta, la misma hora de recogida y la misma dedicatoria. Uno de los panaderos ya había metido al horno el primero y había empezado a rallar zanahoria para el segundo. Casi al mismo tiempo, la clienta escribe por WhatsApp: “Me llegaron tres confirmaciones del pastel, ¿me van a cobrar tres?”. Valeria abre la hoja de pedidos y cuenta. A las 10:55 pausa el escenario. Al final de la mañana, la hoja tiene $51$ filas para $14$ pedidos.
El domingo por la mañana, con el obrador cerrado, Valeria y Don Ernesto se sientan a revisar lo que pasó. Don Ernesto abre la conversación con una frase que resume el espíritu del día: “Yo no busco culpables, Valeria, busco que no vuelva a pasar. Pero el pastel de más alguien lo horneó, y la caja de pan dulce también. Quiero saber por qué la máquina pidió cuatro veces lo mismo, y quiero saber por qué nos enteramos por una comanda y no por la propia máquina.” Son dos preguntas distintas y las dos son justas. La primera es de mecanismo: qué cadena de hechos convirtió un pedido en cuatro filas. La segunda es de detección: por qué pasaron $38$ minutos sin que nadie lo supiera.
En la presente entrada, descubrirá cómo se analiza un fallo de automatización con método, sin adivinar y sin buscar a quién señalar. Reconstruirá la línea de tiempo a partir de las evidencias (el historial de ejecuciones de Make, las marcas de tiempo de la hoja, las comandas del obrador y los mensajes a clientes) y medirá el tiempo hasta detectar, hasta mitigar y hasta resolver. Simulará $10,000$ veces el mecanismo de los reintentos para comprobar que explica los $37$ duplicados observados, y verá qué dicen de verdad las políticas de reintento de Twilio, de Meta y de Make. Aplicará los cinco porqués y el diagrama de Ishikawa hasta separar el síntoma, las causas contribuyentes y la causa raíz. Leerá el fragmento del blueprint tal como estaba y el fragmento corregido, comparará los tres diseños posibles frente a la latencia de la hoja, construirá un detector de duplicados en SQLite y, al final, generará un análisis posterior sin culpables con acciones, dueños y fechas.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Reconstruir la línea de tiempo de un incidente a partir de sus evidencias y medir el tiempo hasta detectar, mitigar y resolver.
- Diagnosticar con cinco porqués y un diagrama de Ishikawa hasta separar el síntoma, las causas contribuyentes y la causa raíz.
- Corregir con respuesta inmediata al webhook, clave de idempotencia y almacén de claves, y comprobar con simulación que los duplicados desaparecen.
- Redactar un análisis posterior sin culpables con acciones, dueños y fechas.
Qué pasó: la línea de tiempo
Un análisis de incidente empieza siempre por lo mismo: los hechos, en orden, cada uno con su evidencia. No empieza por la causa, porque quien empieza por la causa tiende a buscar solo los hechos que la confirman. Valeria reúne cuatro fuentes antes de opinar nada:
- El historial de ejecuciones de Make, que guarda para cada ejecución su hora de inicio, su duración, los paquetes que pasaron por cada módulo y el resultado.
- La hoja de pedidos, con la marca de tiempo de cada fila y el
MessageSidque el escenario copiaba en la primera columna. - Las comandas impresas del obrador, que Don Ernesto guardó en un sobre en lugar de tirarlas: un gesto de oficio que resultó ser evidencia.
- Los mensajes y llamadas a clientes, con su hora, para saber cuándo terminó de verdad el incidente.
Con esas fuentes se reconstruye la historia. Conviene recordar, antes, cómo estaba el escenario. El martes 24, la hoja de cálculo dejó de responder durante unos minutos y se perdieron cuatro pedidos, el episodio con el que abre el Día 28. La reacción, razonable y rápida, llegó en la v2.2 del Día 27 (JSON y variables en Make: estructuras de datos, Parse JSON y almacenes), que se activó en piloto el miércoles: la respuesta al emisor (gateway:WebhookRespond) pasó del principio del escenario al final, con la idea de que el emisor solo recibiera su $200$ cuando el pedido estuviera de verdad guardado en la hoja, y de que, si la hoja fallaba, el emisor volviera a intentarlo y el pedido no se perdiera. Retenga esa decisión, porque es una buena intención que, combinada con otras dos piezas, produjo el incidente.
El primer bloque fija las importaciones, la semilla de la serie y los supuestos del incidente: los $6$ créditos por ejecución de la ruta de pedidos de la v2.2 y el comportamiento del emisor que se usará en todo el análisis (espera $10$ segundos una respuesta y reintenta hasta tres veces):
# Importaciones base, semilla de la serie y carpeta del día en Python:
import warnings
warnings.filterwarnings('ignore')
import hashlib
import json
import math
import sqlite3
from collections import Counter
from datetime import datetime, timedelta
from pathlib import Path
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 120)
carpeta = Path('trigo_lento') / 'dia_29'
carpeta.mkdir(parents = True, exist_ok = True)

# Supuestos fijos de la serie (A.5) y del incidente ficticio:
HORA_VALERIA = 75             # MXN por hora (supuesto didáctico)
CREDITOS_V22 = 6              # módulos de la ruta de pedidos de TL Pedidos WhatsApp v2.2
ESPERA_EMISOR = 10            # segundos que el emisor simplificado espera la respuesta
MAX_REINTENTOS = 3            # reintentos del emisor simplificado
print('numpy', np.__version__, '| pandas', pd.__version__)
print('Créditos por ejecución de la v2.2:', CREDITOS_V22, '| espera del emisor:', ESPERA_EMISOR,
      's | reintentos:', MAX_REINTENTOS)
numpy 2.4.6 | pandas 3.0.3
Créditos por ejecución de la v2.2: 6 | espera del emisor: 10 s | reintentos: 3
El segundo bloque reconstruye la hoja del sábado. Los datos son inventados, pero respetan lo que dicen las evidencias: $14$ pedidos que llegaron entre las 10:02 y las 10:48, cada uno con su MessageSid de juguete, su producto del catálogo y un teléfono con el formato de prueba de la serie. Para cada pedido se generan tantas filas como entregas recibió el escenario: la entrega original más las que provocó cada reintento. Las entregas que vencieron tardaron más de $10$ segundos en la hoja; la última, lo que la hoja tardara. Al final, el bloque agrupa las filas por MessageSid, que es la clave natural del mensaje, y calcula el impacto:
# Registro reconstruido de la hoja del sábado 28 de febrero (datos inventados) en Python:
catalogo = {'P01': ('Hogaza de masa madre', 95), 'P02': ('Baguette tradicional', 38),
            'P04': ('Concha de vainilla', 22), 'P05': ('Croissant de mantequilla', 34),
            'P06': ('Rol de canela', 38), 'P08': ('Pastel de zanahoria entero', 420),
            'P09': ('Pastel de chocolate entero', 460), 'P10': ('Caja de 12 panes dulces surtidos', 240),
            'P12': ('Pay de queso entero', 380)}
dia = datetime(2026, 2, 28)
# Catorce pedidos: llegada (hh:mm:ss), producto, cantidad y copias de más que dejó el incidente:
pedidos_reales = [('10:02:50', 'P09', 1, 3), ('10:06:15', 'P01', 2, 3), ('10:09:40', 'P05', 6, 3),
                  ('10:13:05', 'P10', 1, 3), ('10:16:30', 'P02', 4, 2), ('10:19:55', 'P06', 6, 3),
                  ('10:23:20', 'P12', 1, 3), ('10:26:45', 'P04', 10, 3), ('10:30:10', 'P01', 1, 3),
                  ('10:33:35', 'P09', 1, 3), ('10:37:00', 'P08', 1, 2), ('10:40:25', 'P05', 4, 3),
                  ('10:43:50', 'P02', 2, 3), ('10:48:10', 'P06', 3, 0)]
filas = []
for i, (hora, clave, cantidad, copias) in enumerate(pedidos_reales, start = 1):
    llegada = datetime.combine(dia.date(), datetime.strptime(hora, '%H:%M:%S').time())
    sid = 'SM' + hashlib.sha256(f'pedido-{i}'.encode()).hexdigest()[:32]   # MessageSid de juguete
    for intento in range(copias + 1):
        # Los intentos que vencieron tardaron más de 10 s; el último, lo que tardara la hoja:
        latencia = rng.lognormal(math.log(20), 0.5)
        latencia = max(latencia, 10.5) if intento < copias else latencia
        entrega = llegada + timedelta(seconds = ESPERA_EMISOR * intento)
        filas.append({'message_sid': sid, 'intento': intento, 'llegada_pedido': llegada,
                      'escrita': entrega + timedelta(seconds = float(latencia)),
                      'producto': clave, 'cantidad': cantidad,
                      'telefono': f'+52 55 0000 00{i:02d}'})
hoja = pd.DataFrame(filas).sort_values('escrita', ignore_index = True)
hoja.to_csv(carpeta / 'hoja_reconstruida_2026-02-28.csv', index = False)

# Agrupación por clave: cuántas filas dejó cada MessageSid:
por_clave = hoja.groupby('message_sid').size()
duplicados = int((por_clave - 1).sum())
print('Filas en la hoja:', len(hoja), '| pedidos únicos:', por_clave.size, '| duplicados:', duplicados)
print('Pedidos por número de copias de más:', dict(sorted(Counter(por_clave - 1).items())))

# Impacto (Tabla 4): créditos, minutos y producto horneado de más:
clientes_afectados = int((por_clave > 1).sum())
minutos = duplicados * 2 + clientes_afectados * 4      # 2 min por fila borrada, 4 por llamada
impacto = pd.DataFrame([
    ('Pedidos afectados', por_clave.size), ('Filas en la hoja', len(hoja)),
    ('Filas duplicadas', duplicados), ('Clientes con confirmaciones repetidas', clientes_afectados),
    ('Créditos de Make desperdiciados', duplicados * CREDITOS_V22),
    ('Minutos de limpieza y llamadas', minutos),
    ('Coste de esos minutos (MXN)', round(minutos / 60 * HORA_VALERIA, 2)),
    ('Producto horneado de más (MXN)', catalogo['P10'][1] + catalogo['P08'][1])],
    columns = ['concepto', 'valor'])
for concepto, valor in impacto.itertuples(index = False):
    print(f'{concepto:<40} {valor:>8g}')
Filas en la hoja: 51 | pedidos únicos: 14 | duplicados: 37
Pedidos por número de copias de más: {0: 1, 2: 2, 3: 11}
Pedidos afectados                              14
Filas en la hoja                               51
Filas duplicadas                               37
Clientes con confirmaciones repetidas          13
Créditos de Make desperdiciados               222
Minutos de limpieza y llamadas                126
Coste de esos minutos (MXN)                 157.5
Producto horneado de más (MXN)                660
La agrupación confirma lo que Valeria contó a mano el sábado: $51$ filas, $14$ pedidos únicos y $37$ duplicados. El reparto también es informativo: $11$ pedidos tienen tres copias de más (cuatro filas cada uno), $2$ tienen dos copias de más y solo $1$ quedó sin duplicar, el último de la mañana. Es decir, $11 \cdot 3 + 2 \cdot 2 = 37$. Uno de los dos pedidos con dos copias es el pastel de zanahoria: por eso Don Ernesto vio tres comandas y no cuatro.
Observe una decisión del bloque que no es un detalle: la agrupación se hace por MessageSid y no por teléfono ni por producto. Dos filas con el mismo teléfono y el mismo producto pueden ser dos pedidos legítimos (una clienta que pide el mismo pan para el sábado y para el domingo); dos filas con el mismo MessageSid son, sin discusión, el mismo mensaje procesado dos veces. Una clave de deduplicación debe identificar el mensaje, no parecerse a él.
El tercer bloque ordena los eventos del sábado con su evidencia, calcula los tiempos del incidente y dibuja las filas acumuladas en la hoja frente a los pedidos reales, con las horas clave marcadas:
# Línea de tiempo del incidente, tiempos de detección, mitigación y resolución en Python:
import matplotlib.dates as mdates
def hora(texto, base = dia):
    return datetime.combine(base.date(), datetime.strptime(texto, '%H:%M').time())

eventos = pd.DataFrame([
    ('09:52', 'La hoja de cálculo empieza a tardar de 15 a 30 s por escritura', 'Historial de ejecuciones de Make'),
    ('10:03', 'Primer reintento del emisor: el pedido de las 10:02 entra dos veces', 'Filas de la hoja con su marca de tiempo'),
    ('10:41', 'Don Ernesto ve la tercera comanda del mismo pastel de zanahoria', 'Comandas impresas en el obrador'),
    ('10:55', 'Valeria pausa el escenario TL Pedidos WhatsApp v2.2', 'Registro de cambios del escenario'),
    ('11:30', 'Limpieza: se marcan y borran las filas repetidas', 'Versión de la hoja antes y después'),
    ('12:40', 'Último cliente avisado por teléfono', 'Mensajes y llamadas a clientes')],
    columns = ['hora', 'evento', 'evidencia'])
eventos['momento'] = eventos['hora'].map(hora)
inicio, deteccion, mitigacion, resolucion = (eventos['momento'][i] for i in (1, 2, 3, 5))
minutos_entre = lambda a, b: int((b - a).total_seconds() // 60)
print(eventos[['hora', 'evento']].to_string(index = False))
print('Tiempo hasta detectar (TTD):', minutos_entre(inicio, deteccion), 'min')
print('Tiempo hasta mitigar desde la detección:', minutos_entre(deteccion, mitigacion), 'min')
print('Tiempo hasta resolver (TTR):', minutos_entre(inicio, resolucion), 'min')
filas_antes = int((hoja['escrita'] <= deteccion).sum())
pedidos_antes = int(hoja.loc[hoja['escrita'] <= deteccion, 'message_sid'].nunique())
print('Al detectarlo había', filas_antes, 'filas para', pedidos_antes, 'pedidos')

# Filas acumuladas en la hoja frente a pedidos reales:
fig, ax = plt.subplots(figsize = (10, 5))
t_filas = hoja['escrita'].sort_values()
primeras = hoja.groupby('message_sid')['escrita'].min().sort_values()
ax.step(t_filas, np.arange(1, len(t_filas) + 1), where = 'post', color = '#c8423b', lw = 2,
        label = 'Filas en la hoja')
ax.step(primeras, np.arange(1, len(primeras) + 1), where = 'post', color = '#2a78d6', lw = 2,
        label = 'Pedidos reales')
for _, ev in eventos.iloc[:4].iterrows():
    ax.axvline(ev['momento'], color = '#8a8986', ls = '--', lw = 1)
    ax.text(ev['momento'], 53, ev['hora'], rotation = 90, va = 'top', ha = 'right', fontsize = 9,
            color = '#52514e')
ax.set_xlim(hora('09:45'), hora('11:05'))
ax.set_ylim(0, 55)
ax.xaxis.set_major_formatter(mdates.DateFormatter('%H:%M'))
ax.set_title('Sábado 28 de febrero: filas en la hoja frente a pedidos reales', fontsize = 16)
ax.set_xlabel('Hora')
ax.set_ylabel('Acumulado')
ax.spines[['top', 'right']].set_visible(False)
ax.legend(loc = 'lower right', frameon = False)
plt.tight_layout()
plt.show()
 hora                                                              evento
09:52      La hoja de cálculo empieza a tardar de 15 a 30 s por escritura
10:03 Primer reintento del emisor: el pedido de las 10:02 entra dos veces
10:41     Don Ernesto ve la tercera comanda del mismo pastel de zanahoria
10:55                 Valeria pausa el escenario TL Pedidos WhatsApp v2.2
11:30                    Limpieza: se marcan y borran las filas repetidas
12:40                                 Último cliente avisado por teléfono
Tiempo hasta detectar (TTD): 38 min
Tiempo hasta mitigar desde la detección: 14 min
Tiempo hasta resolver (TTR): 157 min
Al detectarlo había 43 filas para 12 pedidos
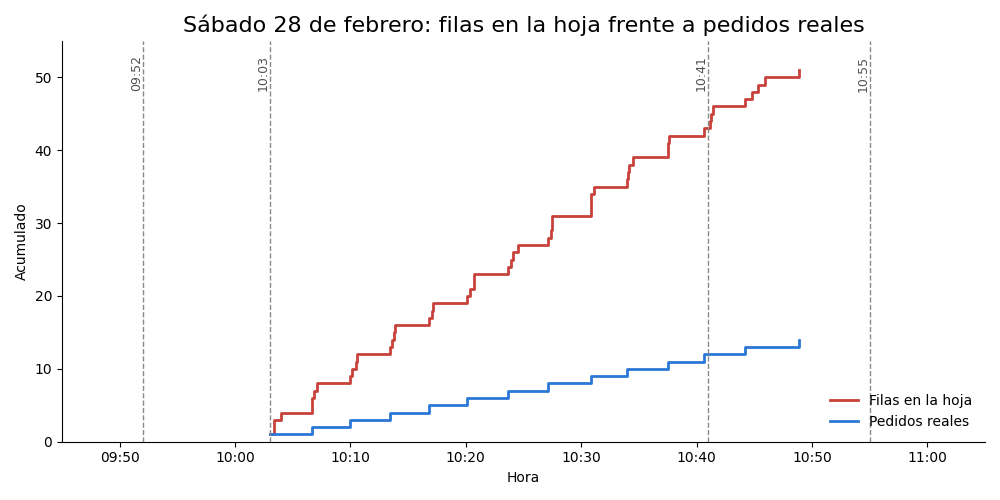
La Tabla 1 recoge la línea de tiempo completa con la evidencia de cada hecho. La columna de evidencia es la que convierte una historia en un análisis: si un evento no tiene evidencia, se marca como supuesto y se busca la forma de comprobarlo.
Tabla 1. Línea de tiempo del incidente del sábado 28 de febrero de 2026, con su evidencia.
| Hora | Evento | Evidencia |
|---|---|---|
| 09:52 | La hoja de cálculo empieza a tardar de 15 a 30 segundos por escritura | Historial de ejecuciones de Make: duraciones de la ruta de pedidos |
| 10:03 | Primer reintento del emisor: el pedido de las 10:02 entra dos veces | Filas de la hoja con el mismo MessageSid y su marca de tiempo |
| 10:41 | Don Ernesto ve la tercera comanda del mismo pastel de zanahoria | Comandas impresas guardadas en el obrador |
| 10:55 | Valeria pausa el escenario TL Pedidos WhatsApp v2.2 | Registro de cambios del escenario en Make |
| 11:30 | Limpieza: se marcan y borran las filas repetidas | Versión de la hoja antes y después de la limpieza |
| 12:40 | Último cliente avisado por teléfono | Registro de mensajes y llamadas a clientes |
| Domingo 1 de marzo | Análisis posterior con Don Ernesto | Este documento y el archivo analisis_posterior_2026-02-28.md |
La gráfica cuenta la misma historia de un vistazo. La línea azul, los pedidos reales, sube un escalón cada tres o cuatro minutos, al ritmo normal de un sábado. La línea roja, las filas de la hoja, sube cuatro escalones casi juntos por cada escalón azul: cada pedido llega, la hoja tarda, el emisor reintenta, y la fila se repite. La distancia entre las dos líneas es el incidente, y crece sin freno desde las 10:03 hasta que el escenario se pausa. Cuando Don Ernesto lo detectó, a las 10:41, la hoja tenía ya $43$ filas para $12$ pedidos. Fíjese también en el hueco entre las 09:52 y las 10:03: la hoja ya estaba lenta, pero ningún pedido llegó en esos once minutos, así que la lentitud no hizo daño hasta que hubo tráfico.
Detección y tiempos
Un incidente se mide con tres relojes. El tiempo hasta detectar (TTD, por sus siglas en inglés: “Time To Detect”) va desde que empieza el daño hasta que alguien lo sabe; el tiempo hasta mitigar (TTM, “Time To Mitigate”) va desde la detección hasta que el daño deja de crecer; el tiempo hasta resolver (TTR, “Time To Resolve”) va desde el inicio hasta que el último efecto se ha corregido. En fórmulas:
$$ TTD = t_{det} - t_{ini}, \qquad TTM = t_{mit} - t_{det}, \qquad TTR = t_{res} - t_{ini} $$
La lógica de cada término es la siguiente:
- $t_{ini}$ es el momento en que empieza el daño, no el momento en que empieza la causa. La hoja se volvió lenta a las 09:52, pero el primer duplicado se creó a las 10:03; el daño empieza a las 10:03.
- $t_{det}$ es el momento en que una persona o un sistema sabe que algo va mal: las 10:41, con la tercera comanda.
- $t_{mit}$ es el momento en que el daño deja de crecer: las 10:55, con el escenario pausado. Después de esa hora no se crea ninguna fila nueva.
- $t_{res}$ es el momento en que el último efecto está corregido: las 12:40, cuando el último cliente afectado recibe la explicación.
Con las horas de la Tabla 1, el Bloque 3 dio un TTD de $38$ minutos, una mitigación $14$ minutos después de la detección y un TTR de $157$ minutos. De los tres números, el que más le interesa a un arquitecto es el primero. Los $14$ minutos de mitigación son razonables para un negocio de seis personas un sábado a media mañana: Valeria tuvo que dejar el mostrador, abrir Make y entender qué estaba viendo. Los $38$ minutos de detección, en cambio, no dependen de la rapidez de nadie: dependen de que no había nada mirando. El incidente lo detectó una persona en el obrador, por casualidad y por oficio, no una alerta. Si la comanda repetida hubiera sido de pan de caja, que se hornea en tandas grandes y no llama la atención, el escenario habría seguido duplicando hasta el cierre.
Hay una relación simple entre la detección y el daño que conviene tener presente. Si el daño crece a un ritmo aproximadamente constante, las filas de más que deja un incidente son, como mucho:
$$ D \approx r \cdot (TTD + TTM) $$
donde $r$ es el ritmo de duplicados por minuto. El sábado, $r \approx 37 / 52 \approx 0.71$ filas de más por minuto. Reducir el TTD de $38$ a $5$ minutos, con todo lo demás igual, habría dejado unas $0.71 \cdot (5 + 14) \approx 13.5$ filas de más en lugar de $37$. El tiempo hasta detectar es la palanca más barata de un incidente, y es la que una automatización pequeña suele olvidar.
La Tabla 2 recoge el impacto completo, con las cifras que calculó el Bloque 2.
Tabla 2. Impacto del incidente (cifras del registro reconstruido y supuestos de la serie).
| Concepto | Valor | Cómo se calcula |
|---|---|---|
| Pedidos afectados | 14 | MessageSid distintos en la hoja entre las 10:02 y las 10:55 |
| Filas en la hoja | 51 | Filas de la mañana con marca de tiempo en esa ventana |
| Filas duplicadas | 37 | $51 - 14$ |
| Clientes con confirmaciones repetidas | 13 | Pedidos con al menos una copia de más |
| Créditos de Make desperdiciados | 222 | $37 \cdot 6$ créditos por ejecución de la v2.2 |
| Minutos de limpieza y llamadas | 126 | $37 \cdot 2$ minutos por fila más $13 \cdot 4$ minutos por llamada |
| Coste de esos minutos | 157.50 MXN | $126 / 60 \cdot 75$ MXN por hora de Valeria |
| Producto horneado de más | 660 MXN | Una caja de 12 panes dulces (240) y un pastel de zanahoria (420), a precio de venta |
Tres comentarios sobre la tabla. El primero: el coste en créditos ($222$, el $2.2%$ de los $10,000$ del plan Core) es el menos importante de todos, aunque sea el más fácil de medir. El segundo: el coste en producto ($660$ MXN) pudo ser mucho mayor; se horneó de más solo lo que entró al horno antes de las 10:41, y el resto de las comandas repetidas se apartaron a tiempo gracias a que Don Ernesto avisó en voz alta. El tercero, y el más serio, no cabe en la tabla: $13$ clientes recibieron confirmaciones repetidas y una de ellas preguntó si le iban a cobrar tres veces. En Trigo Lento el pago es al recoger, así que nadie pagó de más, y Valeria lo explicó a cada cliente con honestidad, uno por uno. En un negocio que cobra al confirmar, el mismo incidente habría sido un cobro triple.
El mecanismo
La línea de tiempo dice qué pasó; el mecanismo dice cómo. El mecanismo se entiende mejor dibujado, como en la Figura 1, y después se comprueba con números.
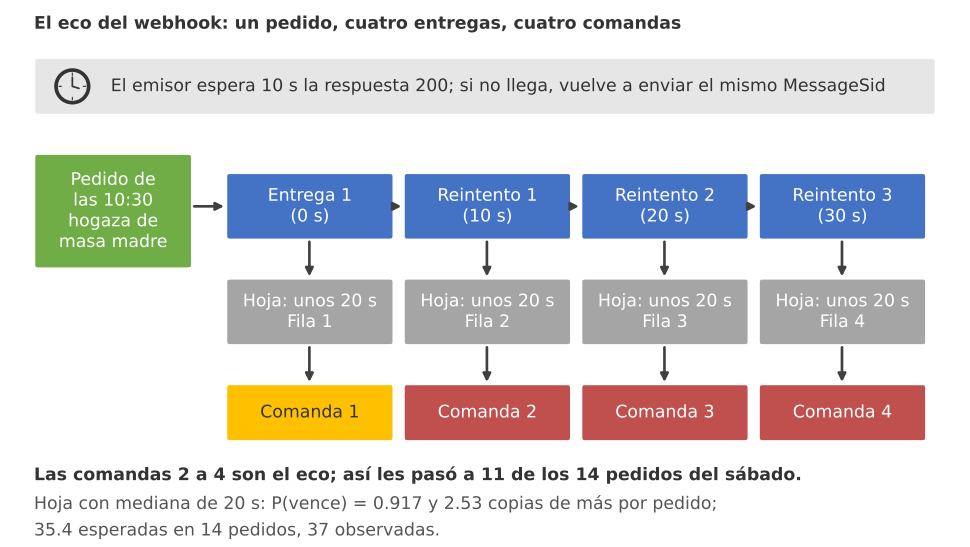
Figura 1. El eco del webhook: el pedido de las 10:30 espera ante un reloj de 10 segundos, no recibe la respuesta 200 porque la hoja tarda unos 20 y vuelve a entrar; cada vuelta deja una fila y una comanda.
Tres piezas tuvieron que coincidir. La primera es el emisor que reintenta. Para este análisis se modela de forma simplificada: espera $10$ segundos una respuesta $200$ y, si no llega, vuelve a enviar el mismo mensaje, hasta tres veces. Es un supuesto didáctico del incidente ficticio, no la política de ningún proveedor concreto; la Tabla 3, más abajo, resume lo que hacen de verdad Twilio, Meta y Make. La segunda pieza es la respuesta al final: en la v2.2, gateway:WebhookRespond es el último módulo, después de escribir en la hoja y de enviar la confirmación. La respuesta tarda, por tanto, al menos lo que tarde la hoja. La tercera pieza es la hoja lenta: desde las 09:52, cada escritura tardaba de $15$ a $30$ segundos.
Con esas tres piezas, el mecanismo es inevitable. El mensaje entra; la hoja tarda $20$ segundos; a los $10$, el emisor deja de esperar y lo envía de nuevo. Make no sabe que es el mismo mensaje: para el webhook es un paquete nuevo, entra a la cola, recorre el escenario y crea otra fila y otra confirmación. Y como la hoja sigue lenta, el reintento también vence, y el emisor vuelve a enviar. Cada vuelta deja una fila y una comanda.
Ahora los números. Si la latencia $L$ de la hoja sigue una distribución lognormal de mediana $m$ y dispersión $\sigma$ (la forma habitual de los tiempos de respuesta, con una cola larga hacia la derecha), la probabilidad de que una entrega venza la espera $T$ del emisor es:
$$ p = P(L > T) = 1 - \Phi\left(\frac{\ln(T/m)}{\sigma}\right) $$
y, si cada intento vence de forma independiente con esa probabilidad y el emisor reintenta hasta $R$ veces, el número esperado de copias de más por pedido es:
$$ E[D] = \sum_{k=1}^{R} p^{k} = p + p^{2} + \cdots + p^{R} $$
La lógica de las dos fórmulas:
- $\Phi$ es la función de distribución de la normal estándar. Como $\ln L$ es normal con media $\ln m$ y desviación $\sigma$, la probabilidad de que $L$ supere $T$ es la de que una normal estándar supere $\ln(T/m)/\sigma$.
- Con $m = 20$ segundos, $\sigma = 0.5$ y $T = 10$: $\ln(10/20)/0.5 = -1.386$ y $p = 1 - \Phi(-1.386) = 0.917$. Más de nueve de cada diez entregas vencen.
- Hay un primer reintento si vence la entrega original (probabilidad $p$); hay un segundo si vencen la original y el primer reintento ($p^2$); y un tercero si vencen tres seguidas ($p^3$). La esperanza de una suma de indicadores es la suma de sus probabilidades.
- Con $p = 0.917$ y $R = 3$, $E[D] = 0.917 + 0.841 + 0.771 = 2.53$ copias de más por pedido; para $14$ pedidos, $14 \cdot 2.53 = 35.4$.
El cuarto bloque calcula lo mismo y lo contrasta con una simulación de Monte Carlo de $10,000$ réplicas del sábado, cada una con $14$ pedidos. La función simular_duplicados sortea la latencia de cada intento y cuenta los intentos que vencen de forma consecutiva, porque el emisor deja de reintentar en cuanto una respuesta llega a tiempo. Al final prueba dos variantes: una hoja menos lenta (mediana de $12$ segundos) y un emisor que espera $5$ segundos y reintenta dos veces, de modo que sus tres intentos caben en $15$ segundos:
# Simulación del mecanismo: hoja lenta, espera de 10 s y hasta tres reintentos en Python:
def phi(z):
    return 0.5 * (1 + math.erf(z / math.sqrt(2)))

def prob_vence(mediana, sigma = 0.5, espera = ESPERA_EMISOR):
    # P(L > espera) con L lognormal de mediana dada:
    return 1 - phi(math.log(espera / mediana) / sigma)

def duplicados_esperados(p, reintentos = MAX_REINTENTOS):
    return sum(p ** k for k in range(1, reintentos + 1))

def simular_duplicados(n_pedidos, mediana, rng, sigma = 0.5, espera = ESPERA_EMISOR,
                       reintentos = MAX_REINTENTOS, replicas = 10_000):
    # Cada intento tarda lo que tarde la hoja; si vence, el emisor reintenta y se crea otra fila:
    latencias = rng.lognormal(math.log(mediana), sigma, size = (replicas, n_pedidos, reintentos))
    vencidos = np.cumprod(latencias > espera, axis = 2)     # sigue reintentando mientras venza
    return vencidos.sum(axis = (1, 2))

p = prob_vence(20)
print(f'P(la respuesta tarda más de 10 s) = {p:.3f}')
print(f'Duplicados esperados por pedido = {duplicados_esperados(p):.2f} | para 14 pedidos = '
      f'{14 * duplicados_esperados(p):.1f}')
sim = simular_duplicados(14, 20, rng)
banda = np.percentile(sim, [5, 95])
print(f'Monte Carlo (10 000 réplicas): media {sim.mean():.1f} | banda del 90 %: {banda[0]:.0f} a {banda[1]:.0f}'
      f' | P(37 o más) = {(sim >= 37).mean():.3f}')
print(f'Con mediana de 12 s: {14 * duplicados_esperados(prob_vence(12)):.1f} duplicados esperados')
p_tw = prob_vence(20, espera = 5)
print(f'Emisor con espera de 5 s y 2 reintentos (cabe en 15 s): {14 * duplicados_esperados(p_tw, 2):.1f}')

# Histograma de duplicados con la marca de los 37 observados:
fig, ax = plt.subplots(figsize = (9, 4.8))
valores, cuentas = np.unique(sim, return_counts = True)
ax.bar(valores, cuentas / len(sim), color = '#2a78d6', width = 0.85, label = 'Réplicas simuladas')
ax.axvline(37, color = '#c8423b', lw = 2.5, label = 'Observados: 37')
ax.axvspan(banda[0], banda[1], color = '#8a8986', alpha = 0.15, label = 'Banda del 90 %')
ax.set_title('Duplicados en 10 000 réplicas del mecanismo (14 pedidos)', fontsize = 16)
ax.set_xlabel('Filas duplicadas')
ax.set_ylabel('Proporción de réplicas')
ax.spines[['top', 'right']].set_visible(False)
ax.legend(loc = 'upper left', frameon = False)
plt.tight_layout()
plt.show()
P(la respuesta tarda más de 10 s) = 0.917
Duplicados esperados por pedido = 2.53 | para 14 pedidos = 35.4
Monte Carlo (10 000 réplicas): media 35.4 | banda del 90 %: 29 a 41 | P(37 o más) = 0.410
Con mediana de 12 s: 18.5 duplicados esperados
Emisor con espera de 5 s y 2 reintentos (cabe en 15 s): 27.9
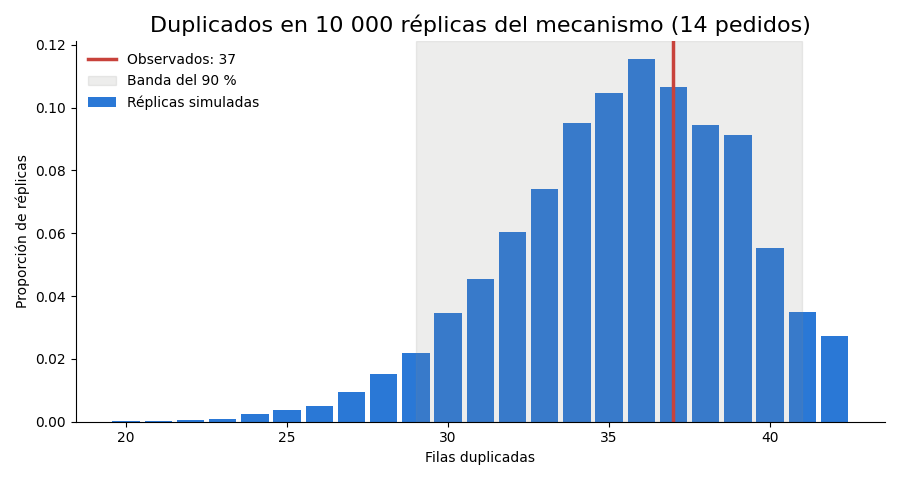
La simulación coincide con la fórmula: $35.4$ duplicados de media, con una banda del $90%$ que va de $29$ a $41$. Los $37$ observados están dentro de la banda, y el $41%$ de las réplicas da $37$ o más. Esto es lo que un análisis debe buscar: un mecanismo que explique la magnitud observada, no solo su existencia. Si el Monte Carlo hubiera dado $5$ duplicados de media, el mecanismo de los reintentos sería cierto pero insuficiente, y habría que buscar otra causa (un segundo escenario escribiendo en la misma hoja, por ejemplo). Como da $35.4$, el mecanismo basta.
Las dos variantes enseñan algo más. Con una hoja de mediana $12$ segundos, los duplicados esperados bajan a $18.5$: la lentitud de la hoja modula el daño, pero no lo elimina, porque cualquier latencia por encima de la espera del emisor lo produce. Y con un emisor que espera solo $5$ segundos y reintenta dos veces, el resultado es casi igual de malo, $27.9$: el problema no depende de los números concretos de la política de reintentos. Cualquier emisor que reintente ante la falta de respuesta, combinado con un escenario que responde tarde y no se protege de las copias, duplica.
Una simplificación del modelo merece decirse en voz alta. El simulador trata cada intento como independiente y no modela la cola del webhook. En la v2.2 el procesamiento era secuencial ("sequential": true), así que los reintentos esperaban su turno detrás de los demás paquetes, lo que alarga aún más la respuesta y empuja $p$ hacia $1$. Con $51$ ejecuciones de unos $20$ segundos en $52$ minutos, el escenario estuvo ocupado alrededor de un tercio del tiempo, así que la cola fue moderada y el modelo simple basta; con más tráfico, el modelo se quedaría corto, nunca largo.
“Al menos una vez” exige idempotencia
El Día 3 lo anticipó y el Día 28 lo convirtió en diseño: la entrega de un webhook se repite por diseño. Los emisores serios prefieren entregar dos veces a no entregar nunca, porque un mensaje perdido no se recupera y un mensaje repetido se puede detectar. A esa garantía se le llama entrega al menos una vez (at least once). La entrega exactamente una vez no existe como propiedad de la red; lo que sí puede existir es el efecto exactamente una vez, y lo construye el receptor: si recibe dos veces el mismo mensaje, debe producir el mismo resultado que si lo hubiera recibido una sola vez. Esa propiedad es la idempotencia.
La Tabla 3 resume lo que hacen de verdad los tres sistemas que intervienen en el escenario de Trigo Lento, según su documentación oficial consultada en octubre de 2026.
Tabla 3. Políticas reales de reintento de los sistemas del escenario (revisado en octubre de 2026).
| Sistema | Cuándo reintenta | Cuánto espera y cuántas veces | Consecuencia para Trigo Lento |
|---|---|---|---|
| Twilio (webhook entrante) | Por omisión, solo si falla la conexión TCP o TLS (rp=ct); se puede ampliar a tiempo de lectura agotado (rt), 4xx, 5xx o all | Lectura hasta 15 s (rt), tiempo total hasta 15 s incluidos los reintentos (tt), 1 reintento por omisión y 5 como máximo (rc); los parámetros van en el fragmento de la URL, tras # | Con rp=rt, una respuesta lenta produce copias; la documentación menciona la cabecera I-Twilio-Idempotency-Token para distinguir reintentos |
| Meta (Cloud API de WhatsApp) | Si la respuesta no es un código 200 | Con frecuencia decreciente hasta que tiene éxito, durante un máximo de 7 días | La propia documentación advierte que los reintentos pueden generar notificaciones duplicadas |
| Make (ejecuciones incompletas) | Errores RateLimitError, ConnectionError y ModuleTimeoutError, y los del manejador de reintento (antes Break) con finalización automática | 8 reintentos con espera exponencial, del minuto 1 a 7 h 51 min después; el manejador permite fijar intentos e intervalo | Un ModuleTimeoutError en la hoja puede repetir una escritura que sí se hizo: otra fuente de duplicados |
La tabla deja dos lecciones. La primera: con la configuración por omisión, Twilio no habría reintentado ante una respuesta lenta, sino que habría registrado un error y abandonado el mensaje; es la razón por la que el Día 23 advirtió que la política rt convierte la lentitud en duplicados. Meta, en cambio, reintenta durante días cualquier respuesta que no sea un $200$. La segunda lección es más importante: el escenario no controla la política de reintentos de quien le envía mensajes, y esa política puede cambiar con un ajuste de configuración, con un cambio de proveedor (el Día 46 evaluará la Cloud API directa) o con una actualización del propio proveedor. Lo único que el escenario controla es su propio comportamiento ante una copia. Por eso la defensa no es “configurar bien el emisor”, sino ser idempotente.
El blueprint tal como estaba
Para cerrar el mecanismo falta la evidencia más directa: el blueprint de la v2.2. El siguiente fragmento muestra la ruta de pedidos tal como estaba activa el sábado. Para que quepa en pantalla, la extracción de renglones de la v2.1 (Día 25) se resume en el campo borrador_json, que el módulo $2$ convierte en estructura con json:ParseJSON. La conexión de Google y la de Twilio aparecen como __IMTCONN__ con valor $0$, la hoja con un identificador de ejemplo y el webhook sin dirección real:
{
  "name": "TL Pedidos WhatsApp v2.2 (fragmento: ruta de pedidos tal como estaba el 28 de febrero)",
  "flow": [
    {
      "id": 1,
      "module": "gateway:CustomWebHook",
      "version": 1,
      "parameters": {"hook": 0, "maxResults": 1},
      "mapper": {},
      "metadata": {"designer": {"x": 0, "y": 0}}
    },
    {
      "id": 2,
      "module": "json:ParseJSON",
      "version": 1,
      "parameters": {"type": 0},
      "mapper": {"json": "{{1.borrador_json}}"},
      "metadata": {"designer": {"x": 300, "y": 0}}
    },
    {
      "id": 3,
      "module": "datastore:GetRecord",
      "version": 1,
      "parameters": {"datastore": 0},
      "mapper": {"key": "{{sha256(1.WaId)}}"},
      "metadata": {"designer": {"x": 600, "y": 0}}
    },
    {
      "id": 4,
      "module": "google-sheets:addRow",
      "version": 2,
      "parameters": {"__IMTCONN__": 0},
      "mapper": {"mode": "select", "spreadsheetId": "/ID_DE_EJEMPLO", "sheetId": "Pedidos", "includesHeaders": true, "valueInputOption": "USER_ENTERED", "values": {"0": "{{1.MessageSid}}", "1": "{{ifempty(3.data.nombre; 1.ProfileName)}}", "2": "{{2.producto}}", "3": "{{2.cantidad}}", "4": "{{2.fecha_entrega}}", "5": "{{now}}"}},
      "metadata": {"designer": {"x": 900, "y": 0}}
    },
    {
      "id": 5,
      "module": "http:ActionSendData",
      "version": 3,
      "parameters": {"handleErrors": true, "__IMTCONN__": 0},
      "mapper": {"url": "https://api.twilio.com/2010-04-01/Accounts/{{1.AccountSid}}/Messages.json", "method": "post", "bodyType": "x_www_form_urlencoded", "data": [{"key": "From", "value": "{{1.To}}"}, {"key": "To", "value": "{{1.From}}"}, {"key": "Body", "value": "Mensaje automático de Trigo Lento: recibimos su pedido {{4.rowNumber}}. Le confirmamos el total al recoger."}]},
      "metadata": {"designer": {"x": 1200, "y": 0}}
    },
    {
      "id": 6,
      "module": "gateway:WebhookRespond",
      "version": 1,
      "parameters": {},
      "mapper": {"status": "200", "body": "<Response></Response>", "headers": [{"key": "Content-Type", "value": "text/xml"}]},
      "metadata": {"designer": {"x": 1500, "y": 0}}
    }
  ],
  "metadata": {
    "instant": true,
    "version": 1,
    "scenario": {"roundtrips": 1, "maxErrors": 3, "autoCommit": true, "autoCommitTriggerLast": true, "sequential": true, "confidential": true, "dataloss": false, "dlq": true, "freshVariables": false},
    "designer": {"orphans": []}
  }
}
Tres detalles del fragmento son, vistos ahora, las huellas del incidente:
gateway:WebhookRespondes el módulo $6$, el último. Entre el webhook y la respuesta están la búsqueda del cliente, la fila en la hoja (google-sheets:addRow) y la confirmación por la API de Twilio (http:ActionSendData). La respuesta llega cuando todo eso ha terminado.- Ningún módulo busca el
MessageSidantes de escribir. El módulo $3$ busca al cliente por el SHA-256 de suWaId, que sirve para saludarlo por su nombre, pero no para saber si su mensaje ya se procesó: un mismo cliente puede enviar varios pedidos legítimos. - El
MessageSidse escribe en la columna $0$ de la hoja, así que la evidencia para deduplicar existía; lo que faltaba era usarla antes de escribir y no solo después, para limpiar.
Los $6$ módulos explican también los $6$ créditos por ejecución de la Tabla 2: el webhook y los cinco módulos que siguen procesan cada uno un paquete por entrega, y cada copia los vuelve a cobrar todos.
Cinco porqués
Con el mecanismo comprobado, toca preguntarse por qué existía. La técnica de los cinco porqués viene del sistema de producción de Toyota: Taiichi Ohno la describe como la costumbre de preguntar “¿por qué?” cinco veces ante cada problema, hasta que la respuesta deja de ser un hecho técnico y se convierte en una decisión que se puede cambiar. Cinco no es un número mágico; es una advertencia contra parar demasiado pronto. La primera respuesta casi siempre es el síntoma; la segunda, el disparador; solo las últimas llegan a algo que, corregido, impide que el problema vuelva.
Dos reglas hacen que la técnica funcione en lugar de convertirse en un juego de palabras. La primera: cada respuesta lleva su evidencia, igual que cada evento de la línea de tiempo. La segunda: las respuestas hablan de sistemas y decisiones, no de personas. “Porque Valeria movió la respuesta al final” es verdad, pero no sirve: la siguiente persona que diseñe el escenario puede cometer el mismo error. “Porque el piloto se activó sin preguntar qué pasa si un mensaje llega dos veces” sirve, porque esa pregunta se puede añadir a una lista de revisión.
El sexto bloque escribe los cinco porqués como una lista de diccionarios con pregunta, respuesta y evidencia, para que el análisis se pueda guardar, revisar y comparar con el del siguiente incidente:
# Cinco porqués del incidente, cada respuesta con su evidencia, en Python:
porques = [
    {'pregunta': '¿Por qué hay 37 filas de más en la hoja?',
     'respuesta': 'Porque cada reintento del emisor creó una fila nueva del mismo pedido.',
     'evidencia': '51 filas con solo 14 MessageSid distintos'},
    {'pregunta': '¿Por qué reintentó el emisor?',
     'respuesta': 'Porque no recibió la respuesta 200 dentro de su espera de 10 s.',
     'evidencia': 'Ejecuciones de 15 a 30 s en el historial de Make'},
    {'pregunta': '¿Por qué no llegó la respuesta a tiempo?',
     'respuesta': 'Porque el módulo de respuesta estaba al final, después de escribir en una hoja lenta.',
     'evidencia': 'Blueprint de la v2.2: gateway:WebhookRespond es el módulo 6'},
    {'pregunta': '¿Por qué cada reintento creó otra fila?',
     'respuesta': 'Porque el escenario no comprobaba si el MessageSid ya estaba registrado.',
     'evidencia': 'Ningún módulo busca la clave; la hoja no tiene columna única'},
    {'pregunta': '¿Por qué se activó así el piloto?',
     'respuesta': 'Porque nadie preguntó antes: ¿qué pasa si este mensaje llega dos veces?',
     'evidencia': 'Caso C5 del Día 21 pendiente; lista de revisión sin esa pregunta'},
]
for n, fila in enumerate(porques, start = 1):
    print(f"{n}. {fila['pregunta']}\n   {fila['respuesta']}\n   Evidencia: {fila['evidencia']}")
cadena = ' -> '.join(f"P{n}" for n in range(1, len(porques) + 1))
print('Cadena:', cadena, '| raíz:', porques[-1]['respuesta'][7:])
1. ¿Por qué hay 37 filas de más en la hoja?
   Porque cada reintento del emisor creó una fila nueva del mismo pedido.
   Evidencia: 51 filas con solo 14 MessageSid distintos
2. ¿Por qué reintentó el emisor?
   Porque no recibió la respuesta 200 dentro de su espera de 10 s.
   Evidencia: Ejecuciones de 15 a 30 s en el historial de Make
3. ¿Por qué no llegó la respuesta a tiempo?
   Porque el módulo de respuesta estaba al final, después de escribir en una hoja lenta.
   Evidencia: Blueprint de la v2.2: gateway:WebhookRespond es el módulo 6
4. ¿Por qué cada reintento creó otra fila?
   Porque el escenario no comprobaba si el MessageSid ya estaba registrado.
   Evidencia: Ningún módulo busca la clave; la hoja no tiene columna única
5. ¿Por qué se activó así el piloto?
   Porque nadie preguntó antes: ¿qué pasa si este mensaje llega dos veces?
   Evidencia: Caso C5 del Día 21 pendiente; lista de revisión sin esa pregunta
Cadena: P1 -> P2 -> P3 -> P4 -> P5 | raíz: nadie preguntó antes: ¿qué pasa si este mensaje llega dos veces?
La Tabla 4 recoge la cadena completa.
Tabla 4. Cinco porqués del incidente, cada respuesta con su evidencia.
| # | Pregunta | Respuesta | Evidencia |
|---|---|---|---|
| 1 | ¿Por qué hay 37 filas de más en la hoja? | Porque cada reintento del emisor creó una fila nueva del mismo pedido | 51 filas con solo 14 MessageSid distintos |
| 2 | ¿Por qué reintentó el emisor? | Porque no recibió la respuesta 200 dentro de su espera de 10 s | Ejecuciones de 15 a 30 s en el historial de Make |
| 3 | ¿Por qué no llegó la respuesta a tiempo? | Porque el módulo de respuesta estaba al final, después de escribir en una hoja lenta | Blueprint de la v2.2: gateway:WebhookRespond es el módulo 6 |
| 4 | ¿Por qué cada reintento creó otra fila? | Porque el escenario no comprobaba si el MessageSid ya estaba registrado | Ningún módulo busca la clave; la hoja no tiene columna única |
| 5 | ¿Por qué se activó así el piloto? | Porque nadie preguntó antes: ¿qué pasa si este mensaje llega dos veces? | Caso C5 del Día 21 pendiente; lista de revisión sin esa pregunta |
Lea la cadena de abajo arriba y verá la historia completa en sentido causal. El piloto se activó sin una pregunta concreta (5); por eso el escenario no se protegía de las copias (4) y respondía al final (3); cuando la hoja se volvió lenta, el emisor reintentó (2); y cada reintento dejó una fila (1). Fíjese en el quinto porqué: la evidencia remite al Día 21, en el que el ensayo sin red de TL Formulario v1 falló el caso C5, el reenvío de un pedido, y Valeria lo dejó como pendiente con fecha. La pregunta existía; lo que faltó fue convertirla en una condición para activar cualquier escenario nuevo, y no solo una nota sobre el formulario.
Don Ernesto lee la tabla con el ceño fruncido y pone el dedo en el segundo porqué: "¿Y por qué no le cortamos los reintentos a quien nos manda los mensajes? Si no reintenta, no duplica." La objeción es buena y la respuesta tiene dos partes. La primera está en la Tabla 3: el escenario no controla esa política, y en el caso de Meta los reintentos no se pueden desactivar. La segunda es más profunda: sin reintentos, el martes 24 se habrían perdido los cuatro pedidos igual que se perdieron, y cada caída de la hoja volvería a costar pedidos. Los reintentos no son el problema; son la mitad de una solución que solo funciona con la otra mitad, la idempotencia.
Diagrama de Ishikawa
Los cinco porqués siguen una sola cadena, y su debilidad es justamente esa: un incidente rara vez tiene una sola cadena. El diagrama de Ishikawa, también llamado diagrama de causa y efecto o de espina de pescado, lo propuso Kaoru Ishikawa para el control de calidad industrial: el efecto va en la cabeza del pescado y las causas posibles se agrupan en espinas por familias. Las familias clásicas de la industria son las “seis emes” (método, máquina, materiales, mano de obra, medición y medio ambiente); en una automatización se adaptan sin esfuerzo: método (el diseño del flujo), máquina (las plataformas y servicios), datos (en lugar de materiales), personas, medición (lo que se vigila) y entorno.
El valor del diagrama no está en dibujarlo, sino en obligar a recorrer cada familia y preguntarse si aportó algo. El séptimo bloque lo dibuja con matplotlib.patches, con las seis espinas y dos causas en cada una:
# Diagrama de Ishikawa del incidente con matplotlib.patches en Python:
from matplotlib.patches import FancyBboxPatch

espinas = {
    'Método': ['Respuesta 200\nal final', 'Sin clave de\nidempotencia'],
    'Máquina': ['Hoja con 15 a 30 s\npor escritura', 'Emisor que reintenta\na los 10 s'],
    'Datos': ['Sin columna única\nen la hoja', 'MessageSid\nno se guardaba'],
    'Personas': ['Piloto activado\nsin revisión', 'Prueba C5\npendiente'],
    'Medición': ['Sin alerta de\nduplicados', 'Lo detectó\nel obrador'],
    'Entorno': ['Sábado de\nhora pico', 'v2.3 aún\nno activa'],
}
fig, ax = plt.subplots(figsize = (13, 6))
ax.set_xlim(0, 14)
ax.set_ylim(0, 6)
ax.axis('off')
ax.annotate('', xy = (11.3, 3), xytext = (0.4, 3),
            arrowprops = dict(arrowstyle = '-|>', lw = 2.5, color = '#52514e', mutation_scale = 22))
ax.add_patch(FancyBboxPatch((11.4, 2.35), 2.3, 1.3, boxstyle = 'round,pad=0.05', facecolor = '#c8423b',
                            edgecolor = 'white'))
ax.text(12.55, 3, '37 pedidos\nduplicados', ha = 'center', va = 'center', fontsize = 12, color = 'white',
        weight = 'bold')
for k, (nombre, causas) in enumerate(espinas.items()):
    x = 2.6 + 3.6 * (k % 3)
    arriba = k < 3
    y_fin = 5.4 if arriba else 0.6
    ax.plot([x, x + 1.4], [y_fin, 3], color = '#52514e', lw = 1.8)
    ax.text(x, y_fin + (0.2 if arriba else -0.2), nombre, ha = 'center', fontsize = 12, weight = 'bold',
            color = '#2a78d6', va = 'bottom' if arriba else 'top')
    for j, causa in enumerate(causas):
        t = 0.25 + 0.4 * j
        yc = y_fin + t * (3 - y_fin)
        xc = x + t * 1.4
        ax.plot([xc - 0.3, xc], [yc, yc], color = '#8a8986', lw = 1)
        ax.text(xc - 0.35, yc, causa, ha = 'right', va = 'center', fontsize = 9.5, color = '#0b0b0b')
ax.set_title('Diagrama de Ishikawa: seis familias de causas del incidente', fontsize = 16)
plt.tight_layout()
plt.show()
print('Espinas:', len(espinas), '| causas:', sum(len(c) for c in espinas.values()))
Espinas: 6 | causas: 12
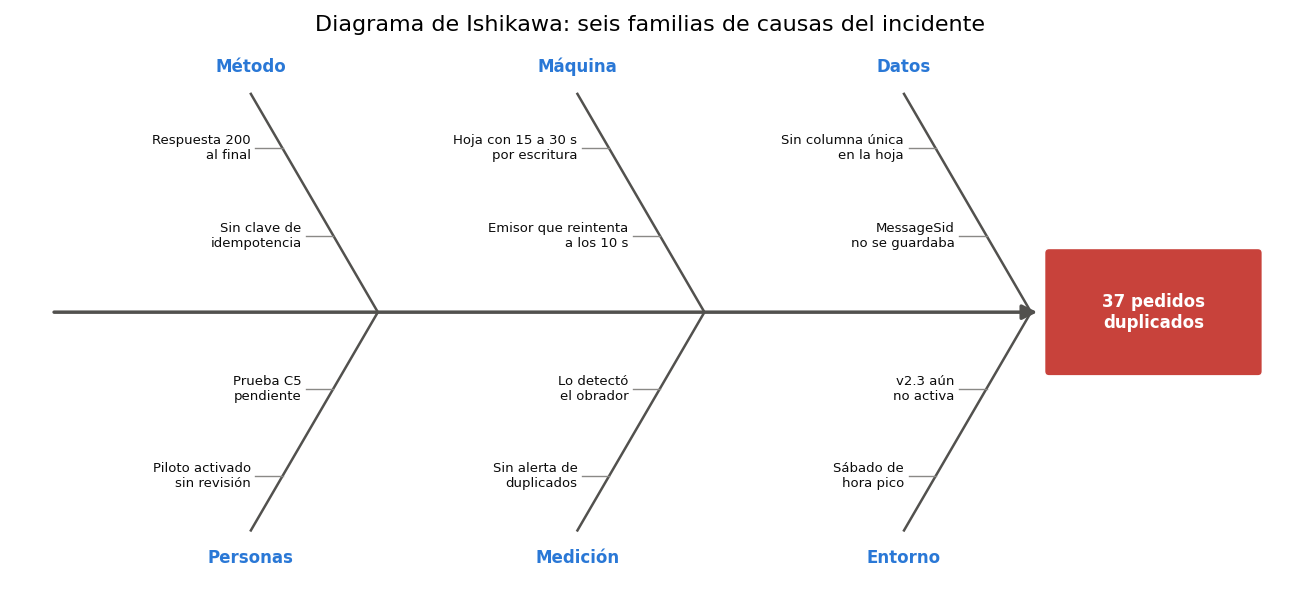
El diagrama reúne $12$ causas en $6$ familias. Recórralas con la pregunta “¿qué habría pasado sin esta causa?”, que es la forma de distinguir las que importan de las que solo acompañan:
- Método: respuesta $200$ al final y ninguna clave de idempotencia. Sin cualquiera de las dos, el incidente no habría ocurrido: con la respuesta al principio, el emisor no habría reintentado; con la clave, los reintentos no habrían creado filas.
- Máquina: la hoja lenta y el emisor que reintenta a los $10$ segundos. Son el disparador: sin ellas, el sábado habría sido normal. Pero una hoja lenta en hora pico es un hecho de la vida, no una anomalía, y volverá a ocurrir.
- Datos: sin columna de clave única en la hoja y sin un registro del
MessageSidconsultable antes de escribir. Es la versión en datos de la falta de idempotencia del método. - Personas: el piloto se activó sin revisión y la prueba C5 seguía pendiente. Observe la redacción: no dice quién, dice qué faltó en el proceso.
- Medición: ninguna alerta de duplicados; lo detectó el obrador. Es la causa del TTD de $38$ minutos y, por tanto, del tamaño del daño.
- Entorno: sábado de hora pico, con la v2.3 todavía en el cuaderno. Aumentó el tráfico y, con él, el número de pedidos expuestos.
El ejercicio separa tres tipos de causa con naturalidad. Las de método y datos son necesarias: quitar una impide el incidente. Las de máquina y entorno son disparadoras: lo hicieron ocurrir ese día y no otro. Las de medición y personas son amplificadoras o habilitadoras: no causan el fallo, pero deciden cuánto dura y si se pudo prevenir. Esa clasificación es exactamente la que necesita la siguiente sección.
Causa raíz y causas contribuyentes
La metáfora del iceberg ordena lo que se ha visto hasta ahora, como muestra la Figura 2.
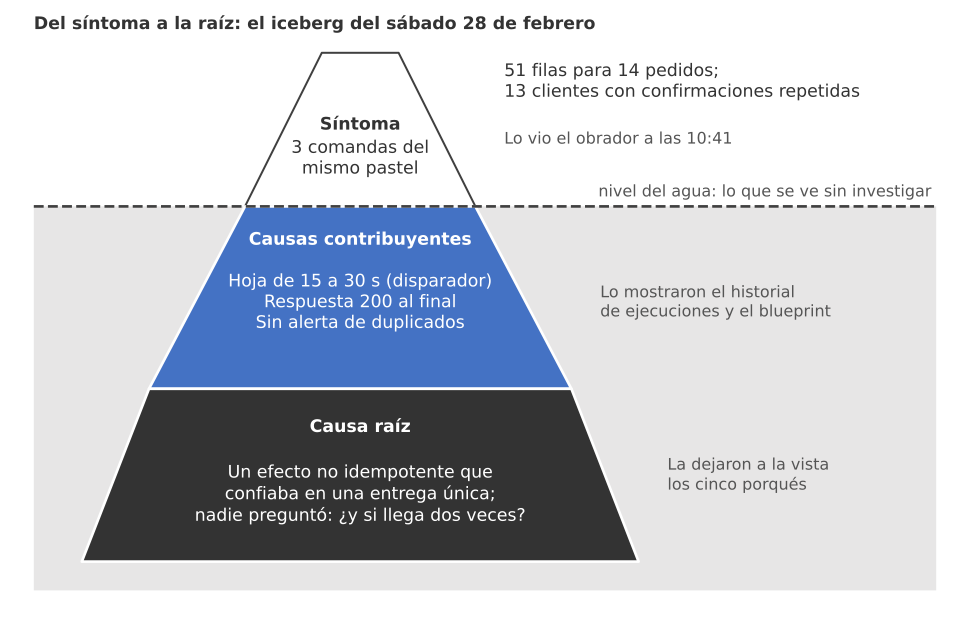
Figura 2. Del síntoma a la raíz: arriba, lo que vio el obrador; bajo el agua, las causas contribuyentes que mostró el historial; en el fondo, la causa raíz que dejaron los cinco porqués.
Arriba del agua está el síntoma, lo que cualquiera ve sin investigar: tres comandas del mismo pastel, $51$ filas para $14$ pedidos, $13$ clientes con confirmaciones repetidas. El error más común de un análisis apresurado es corregir el síntoma (borrar las filas, disculparse) y dar el incidente por cerrado. El sábado a las 11:30 el síntoma estaba corregido, y el escenario seguía igual de expuesto que a las 10:02.
Justo bajo el agua están las causas contribuyentes: la hoja de $15$ a $30$ segundos, la respuesta $200$ al final y la falta de alerta de duplicados. Son reales y conviene corregirlas, pero ninguna, por sí sola, explica el incidente ni lo impide. La lentitud de la hoja merece una mención especial, porque es la explicación que todo el mundo da primero: “la hoja se puso lenta”. La latencia de la hoja fue el disparador, no la causa. Si mañana la hoja vuelve a ser rápida, el escenario de la v2.2 sigue duplicando a la primera lentitud de la red, del proveedor o de la propia Make; y una hoja de cálculo compartida en la nube no ofrece ninguna garantía de latencia que permita confiar en lo contrario.
En el fondo está la causa raíz: un escenario no idempotente que confiaba en una entrega única. Es la causa que cumple las dos condiciones que la definen: explica todo el incidente (el mecanismo de la Figura 1 y la magnitud del Monte Carlo) y, si se corrige, el incidente no puede repetirse por ningún disparador, ni la hoja lenta, ni Meta reintentando durante días, ni un reintento de Make por tiempo agotado. Y bajo la causa raíz técnica está su origen organizativo, el quinto porqué: el escenario se activó sin que nadie preguntara qué pasa si un mensaje llega dos veces.
Conviene distinguir con precisión, porque cada nivel pide una acción distinta:
- El síntoma pide limpieza: borrar duplicados, avisar a clientes, apartar comandas. Es urgente y no previene nada.
- Las causas contribuyentes piden mitigación: responder antes, vigilar los duplicados. Reducen la probabilidad o el tamaño del daño.
- La causa raíz pide corrección: hacer el efecto idempotente. Elimina la clase entera de incidentes, no solo este.
- El origen organizativo pide prevención: una pregunta fija en la lista de revisión, para que el próximo escenario nazca idempotente.
La corrección
La corrección tiene dos movimientos y una red de seguridad. El primer movimiento es aceptar y encolar: responder al emisor en cuanto el mensaje llega y procesarlo después. Es el patrón que el Día 3 llamó acusar recibo, y el que ya tenía la v2 del Día 24 antes de que la v2.2 lo deshiciera con buena intención. La intención de la v2.2, que el emisor reintente si la hoja falla, se conserva de otra forma: si la escritura falla después de responder, el error lo maneja Make, con el manejador de reintento sobre el módulo de la hoja y las ejecuciones incompletas activadas, como diseñó el Día 28. Así, ni se pierde el pedido ni se depende del emisor para recuperarlo.
El segundo movimiento es la clave de idempotencia. Antes de crear la fila, el escenario calcula sha256(MessageSid) y lo busca en un almacén de datos de Make; si la clave existe, el mensaje ya se procesó y la ruta se detiene; si no existe, se crea la fila y, a continuación, se guarda la clave. El SHA-256 no es para esconder un secreto (el MessageSid no lo es), sino para tener una clave de longitud fija y sin datos del mensaje que se pueda guardar en un almacén y en los registros sin pensarlo dos veces.
La red de seguridad son una columna de clave única en la hoja, con formato condicional que pinte de rojo las claves repetidas, y una alerta si una clave aparece dos veces, que se construye en el Bloque 10. El fragmento corregido, que se incorpora a TL Pedidos WhatsApp v2.3, es este:
{
  "name": "TL Pedidos WhatsApp v2.3 (fragmento: ruta de pedidos corregida tras el incidente)",
  "flow": [
    {
      "id": 1,
      "module": "gateway:CustomWebHook",
      "version": 1,
      "parameters": {"hook": 0, "maxResults": 1},
      "mapper": {},
      "metadata": {"designer": {"x": 0, "y": 0}}
    },
    {
      "id": 2,
      "module": "gateway:WebhookRespond",
      "version": 1,
      "parameters": {},
      "mapper": {"status": "200", "body": "<Response></Response>", "headers": [{"key": "Content-Type", "value": "text/xml"}]},
      "metadata": {"designer": {"x": 300, "y": 0}}
    },
    {
      "id": 3,
      "module": "datastore:GetRecord",
      "version": 1,
      "parameters": {"datastore": 0},
      "mapper": {"key": "{{sha256(1.MessageSid)}}"},
      "metadata": {"designer": {"x": 600, "y": 0}}
    },
    {
      "id": 4,
      "module": "json:ParseJSON",
      "version": 1,
      "parameters": {"type": 0},
      "filter": {
        "name": "Clave nueva",
        "conditions": [[
          {"a": "{{3.key}}", "o": "notexist"}
        ]]
      },
      "mapper": {"json": "{{1.borrador_json}}"},
      "metadata": {"designer": {"x": 900, "y": 0}}
    },
    {
      "id": 5,
      "module": "google-sheets:addRow",
      "version": 2,
      "parameters": {"__IMTCONN__": 0},
      "mapper": {"mode": "select", "spreadsheetId": "/ID_DE_EJEMPLO", "sheetId": "Pedidos", "includesHeaders": true, "valueInputOption": "USER_ENTERED", "values": {"0": "{{sha256(1.MessageSid)}}", "1": "{{1.MessageSid}}", "2": "{{2.producto}}", "3": "{{4.cantidad}}", "4": "{{4.fecha_entrega}}", "5": "{{now}}"}},
      "metadata": {"designer": {"x": 1200, "y": 0}},
      "onerror": [
        {
          "id": 8,
          "module": "builtin:Break",
          "version": 1,
          "parameters": {},
          "mapper": {"retry": true, "count": 3, "interval": 15},
          "metadata": {"designer": {"x": 1200, "y": 300}}
        }
      ]
    },
    {
      "id": 6,
      "module": "datastore:AddRecord",
      "version": 1,
      "parameters": {"datastore": 0},
      "mapper": {"key": "{{sha256(1.MessageSid)}}", "overwrite": false, "data": {"fila": "{{5.rowNumber}}", "registrada": "{{now}}"}},
      "metadata": {"designer": {"x": 1500, "y": 0}}
    },
    {
      "id": 7,
      "module": "http:ActionSendData",
      "version": 3,
      "parameters": {"handleErrors": true, "__IMTCONN__": 0},
      "mapper": {"url": "https://api.twilio.com/2010-04-01/Accounts/{{1.AccountSid}}/Messages.json", "method": "post", "bodyType": "x_www_form_urlencoded", "data": [{"key": "From", "value": "{{1.To}}"}, {"key": "To", "value": "{{1.From}}"}, {"key": "Body", "value": "Mensaje automático de Trigo Lento: recibimos su pedido {{5.rowNumber}}. Le confirmamos el total al recoger."}]},
      "metadata": {"designer": {"x": 1800, "y": 0}}
    }
  ],
  "metadata": {
    "instant": true,
    "version": 1,
    "scenario": {"roundtrips": 1, "maxErrors": 3, "autoCommit": true, "autoCommitTriggerLast": true, "sequential": true, "confidential": true, "dataloss": false, "dlq": true, "freshVariables": false},
    "designer": {"orphans": []}
  }
}
La lectura del fragmento, módulo a módulo:
- El webhook (1) y la respuesta (2) van juntos al principio. El emisor recibe su $200$ en lo que tarda Make en llegar al segundo módulo, menos de un segundo en condiciones normales, sea cual sea la latencia de la hoja.
datastore:GetRecord(3) busca la clave{{sha256(1.MessageSid)}}en el almacén. Si la encuentra, devuelve el registro; si no, devuelve un paquete vacío.- El filtro “Clave nueva” del módulo 4 deja pasar el paquete solo si la clave no existe (
notexist). Las copias se detienen aquí, después de haber consumido solo los créditos del webhook, la respuesta y la búsqueda: $3$ en lugar de $6$. - La fila (5) lleva la clave en la columna $0$ y el
MessageSiden la $1$, y tiene un manejador de reintento (builtin:Break, módulo 8) para que una hoja caída produzca una ejecución incompleta que Make reintenta, no un pedido perdido. datastore:AddRecord(6) guarda la clave con"overwrite": false, de modo que intentar guardar dos veces la misma clave produce un error en lugar de sobrescribir en silencio; y solo después se envía la confirmación (7).
Atención aquí: Buscar la clave y guardarla en dos módulos separados deja una ventana entre los dos. Si dos copias del mismo mensaje se procesaran a la vez, ambas podrían encontrar el almacén vacío y crear dos filas. La v2.3 cierra esa ventana con el procesamiento secuencial ("sequential": true), que obliga a cada paquete a esperar a que termine el anterior; si algún día se activa el procesamiento en paralelo para ganar velocidad, la idempotencia de este fragmento deja de estar garantizada. Además, responder primero sin clave de idempotencia no basta: reduce los reintentos por lentitud, pero no los de Meta ante una respuesta perdida en la red ni los de Make ante un tiempo agotado.
Falta comprobar que la corrección funciona, y comprobarlo antes de activarla, no después. El noveno bloque usa el simulador del Bloque 4 para comparar tres diseños frente a la latencia mediana de la hoja, de $2$ a $40$ segundos: el original (respuesta al final), la respuesta inmediata sola y la respuesta inmediata con idempotencia. En los dos diseños con respuesta inmediata, Make contesta en una mediana de $0.8$ segundos y, para no hacer trampa a favor de la corrección, el $1%$ de las respuestas se pierde en la red y provoca un reintento igualmente:
# Duplicados esperados frente a la latencia de la hoja para tres diseños en Python:
def duplicados_diseno(diseno, mediana, n_pedidos = 14, replicas = 2_000, p_red = 0.01):
    if diseno == 'original':          # respuesta al final: espera lo que tarde la hoja
        return simular_duplicados(n_pedidos, mediana, rng, replicas = replicas).mean()
    # Respuesta inmediata: Make contesta en ~0.8 s; solo se reintenta si la respuesta se pierde en la red:
    rapida = rng.lognormal(math.log(0.8), 0.5, size = (replicas, n_pedidos, MAX_REINTENTOS))
    perdida = rng.random((replicas, n_pedidos, MAX_REINTENTOS)) < p_red
    reintentos = np.cumprod((rapida > ESPERA_EMISOR) | perdida, axis = 2).sum(axis = (1, 2))
    # Con idempotencia el reintento llega y cobra, pero no crea fila:
    return reintentos.mean() if diseno == 'inmediata' else 0.0

medianas = np.arange(2, 41, 2)
disenos = {'original': 'Respuesta al final (v2.2)', 'inmediata': 'Respuesta inmediata',
           'idempotente': 'Respuesta inmediata e idempotencia (v2.3)'}
curvas = {d: [duplicados_diseno(d, m) for m in medianas] for d in disenos}
tabla = pd.DataFrame(curvas, index = medianas).loc[[4, 10, 12, 20, 30, 40]].round(2)
tabla.index.name = 'mediana_s'
print(tabla.to_string())

fig, ax = plt.subplots(figsize = (9.5, 5))
colores = {'original': '#c8423b', 'inmediata': '#eb6834', 'idempotente': '#3a9d5d'}
for d, etiqueta in disenos.items():
    ax.plot(medianas, curvas[d], marker = 'o', ms = 4, lw = 2, color = colores[d], label = etiqueta)
ax.axvline(20, color = '#8a8986', ls = '--', lw = 1)
ax.text(20.5, 20, 'sábado 28: mediana de 20 s', fontsize = 9, color = '#52514e')
ax.text(2, 38, '37 observados', fontsize = 9, color = '#52514e')
ax.axhline(37, color = '#8a8986', ls = ':', lw = 1)
ax.set_title('Duplicados esperados según la latencia de la hoja (14 pedidos)', fontsize = 16)
ax.set_xlabel('Latencia mediana de la hoja (s)')
ax.set_ylabel('Filas duplicadas esperadas')
ax.spines[['top', 'right']].set_visible(False)
ax.legend(loc = 'center right', frameon = False)
plt.tight_layout()
plt.show()
           original  inmediata  idempotente
mediana_s
4              0.48       0.14          0.0
10            12.11       0.14          0.0
12            18.41       0.15          0.0
20            35.41       0.14          0.0
30            40.81       0.15          0.0
40            41.77       0.15          0.0
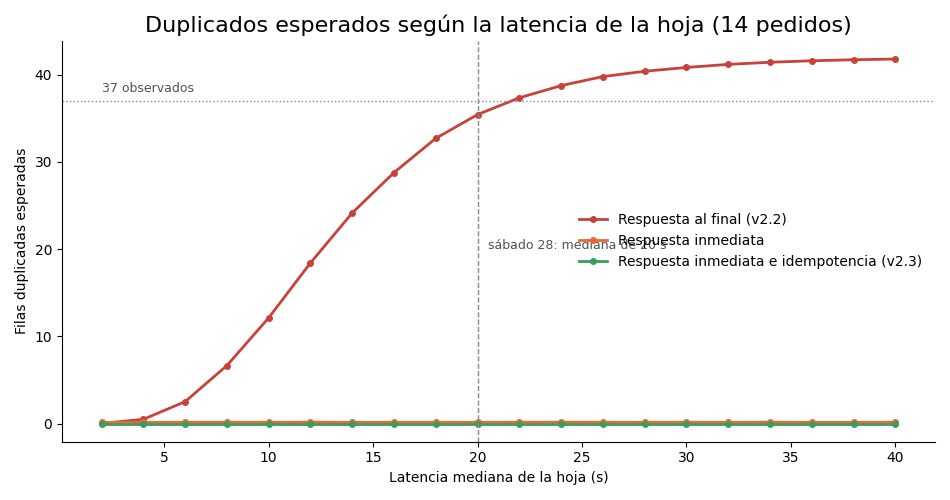
La tabla y la figura muestran tres comportamientos distintos:
- Respuesta al final (v2.2): los duplicados dependen por completo de la hoja. Con una mediana de $4$ segundos apenas aparecen ($0.48$ esperados en $14$ pedidos), con $10$ segundos son $12.11$, con $20$ son $35.41$ y a partir de ahí se acercan al máximo de $42$ ($14 \cdot 3$). El diseño funciona solo mientras la hoja sea rápida, que es como decir que funciona hasta el día en que más se necesita.
- Respuesta inmediata: los duplicados ya no dependen de la hoja y se quedan en torno a $0.14$ por cada $14$ pedidos, los que provoca la pérdida de respuestas en la red. Es una mejora de dos órdenes de magnitud, pero no es cero: unos $468 \cdot 0.01 \approx 4.7$ pedidos duplicados al mes con el volumen de Trigo Lento.
- Respuesta inmediata con idempotencia (v2.3): cero duplicados con cualquier latencia. El emisor sigue reintentando cuando pierde una respuesta, y el reintento sigue entrando al escenario y cobrando sus $3$ créditos, pero no crea ninguna fila.
La idempotencia no evita que el mensaje llegue dos veces; evita que importe. Esa es la diferencia entre las dos líneas de abajo de la figura, y la razón por la que la respuesta inmediata, aunque necesaria, no es la corrección de la causa raíz.
La diferencia entre las dos versiones cabe en dos carriles, como en la Figura 3.
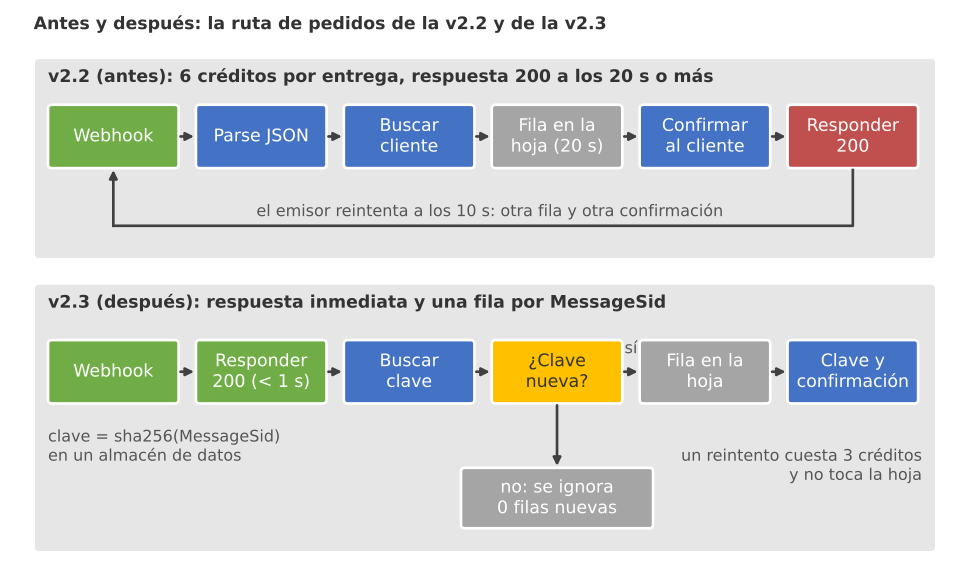
Figura 3. Antes y después: en la v2.2 la respuesta 200 llega después de la hoja y cada reintento crea otra fila; en la v2.3 la respuesta sale de inmediato y el filtro Clave nueva deja pasar una sola vez cada MessageSid.
Detectar en minutos, no en comandas
La corrección elimina los duplicados del mecanismo conocido, pero un buen análisis no confía en haber previsto todos los mecanismos. La causa de medición del Ishikawa pide algo independiente del diseño: un detector que avise si una clave aparece dos veces, venga de donde venga la copia. El décimo bloque lo construye sobre una copia del registro del sábado en SQLite: una tabla pedidos_hoja con la clave (el SHA-256 del MessageSid, nunca el teléfono ni el texto), una tabla ejecuciones para las alertas y una consulta que agrupa por clave y se queda con las que tienen más de una fila. Después lo hace correr cada $5$ minutos desde las 10:00 para responder a la pregunta que importa: ¿cuándo habría avisado?
# Detector de duplicados en SQLite y alerta en la tabla ejecuciones en Python:
ruta_bd = carpeta / 'incidente_2026-02-28.sqlite'
ruta_bd.unlink(missing_ok = True)
con = sqlite3.connect(ruta_bd)
con.execute('CREATE TABLE pedidos_hoja (clave TEXT, producto TEXT, cantidad INTEGER, escrita TEXT)')
con.execute('CREATE TABLE ejecuciones (momento TEXT, escenario TEXT, nivel TEXT, detalle TEXT)')
# La clave es el SHA-256 del MessageSid: el registro no guarda teléfonos ni mensajes:
con.executemany('INSERT INTO pedidos_hoja VALUES (?, ?, ?, ?)',
                [(hashlib.sha256(r.message_sid.encode()).hexdigest(), r.producto, int(r.cantidad),
                  r.escrita.strftime('%Y-%m-%d %H:%M:%S')) for r in hoja.itertuples()])

CONSULTA = '''SELECT clave, COUNT(*) AS filas, MIN(escrita) AS primera
              FROM pedidos_hoja WHERE escrita <= ?
              GROUP BY clave HAVING COUNT(*) > 1 ORDER BY primera'''

def revisar(con, corte):
    repetidas = con.execute(CONSULTA, (corte.strftime('%Y-%m-%d %H:%M:%S'),)).fetchall()
    if repetidas:
        detalle = f'{len(repetidas)} claves repetidas, {sum(f - 1 for _, f, _ in repetidas)} filas de más'
        con.execute('INSERT INTO ejecuciones VALUES (?, ?, ?, ?)',
                    (corte.strftime('%H:%M'), 'TL Pedidos WhatsApp v2.2', 'alerta', detalle))
    return repetidas

# El detector corre cada 5 minutos desde las 10:00; ¿cuándo habría avisado?
corte = hora('10:00')
while not revisar(con, corte):
    corte += timedelta(minutes = 5)
print('Primera alerta:', corte.strftime('%H:%M'), '| frente a la detección humana de las 10:41:',
      minutos_entre(corte, deteccion), 'min antes')
finales = revisar(con, hora('10:55'))
print('Al pausar (10:55):', len(finales), 'claves repetidas,', sum(f - 1 for _, f, _ in finales), 'filas de más')
for clave, n, primera in finales[:3]:
    print(f'  {clave[:12]}...  filas: {n}  primera: {primera[11:]}')
print(pd.read_sql('SELECT * FROM ejecuciones', con).to_string(index = False))
con.commit()
con.close()
Primera alerta: 10:05 | frente a la detección humana de las 10:41: 36 min antes
Al pausar (10:55): 13 claves repetidas, 37 filas de más
  0e243c8a4d17...  filas: 4  primera: 10:03:03
  fdc748ca8c23...  filas: 4  primera: 10:06:42
  ef8493844b1d...  filas: 4  primera: 10:09:57
momento                escenario  nivel                              detalle
  10:05 TL Pedidos WhatsApp v2.2 alerta   1 claves repetidas, 3 filas de más
  10:55 TL Pedidos WhatsApp v2.2 alerta 13 claves repetidas, 37 filas de más
El detector habría avisado a las 10:05, $36$ minutos antes que la comanda del obrador, con una sola clave repetida y tres filas de más. Con un TTD de unos $2$ minutos en lugar de $38$, y con la misma mitigación de $14$ minutos, la fórmula de la sección de detección da unas $0.71 \cdot (2 + 14) \approx 11$ filas de más en lugar de $37$, y probablemente ningún pastel horneado de más. La segunda revisión, la de las 10:55, encuentra las $13$ claves repetidas y las $37$ filas de más, que es exactamente el inventario que Valeria necesitaba para la limpieza de las 11:30 y que tuvo que hacer a mano.
La consulta es deliberadamente sencilla: un GROUP BY con HAVING COUNT(*) > 1. En producción, la misma lógica cabe en un escenario programado de Make que lea la columna de claves de la hoja cada $5$ minutos, o en el sondeo de rescate del Día 3; el coste es de unos pocos créditos por revisión. Lo importante no es la herramienta, sino la propiedad: el detector no sabe por qué se duplica un pedido, solo que se duplicó, y por eso sirve también para los mecanismos que nadie ha imaginado todavía.
Análisis posterior sin culpables
El último paso del día es el documento que queda. Un análisis posterior (en inglés, postmortem) es el registro escrito de un incidente: qué pasó, cuánto dañó, por qué ocurrió, qué salió bien y qué se va a cambiar, con dueños y fechas. El capítulo de cultura de análisis posteriores del libro de SRE de Google y el texto de John Allspaw sobre análisis sin culpables en Etsy coinciden en el punto central: el documento habla de decisiones y sistemas, no de personas. No porque las personas no importen, sino porque un análisis que busca culpables produce dos efectos perversos: la gente deja de contar lo que de verdad pasó, y las acciones se convierten en “tener más cuidado”, que no cambia nada.
La estructura que usa Trigo Lento tiene seis partes:
- Resumen: tres frases que alguien que no estuvo pueda entender.
- Impacto: las cifras de la Tabla 2, con su forma de cálculo.
- Línea de tiempo: la Tabla 1, con evidencia.
- Causas: la causa raíz, las contribuyentes y el origen organizativo.
- Lo que salió bien: tan importante como lo que salió mal, porque es lo que hay que conservar.
- Acciones: qué, de qué tipo (corrige, previene o detecta), quién es su dueña o dueño, para cuándo y en qué estado está.
El último bloque genera el documento en Markdown a partir de un diccionario, lo guarda en trigo_lento/dia_29/analisis_posterior_2026-02-28.md y comprueba que no contiene teléfonos ni palabras de culpa:
# Análisis posterior sin culpables generado en Markdown desde un diccionario en Python:
analisis = {
    'titulo': 'Análisis posterior: pedidos duplicados del sábado 28 de febrero de 2026',
    'resumen': ('Entre las 10:03 y las 10:55, TL Pedidos WhatsApp v2.2 convirtió 14 pedidos en 51 filas. '
                'La hoja tardó de 15 a 30 s por escritura, la respuesta al emisor llegaba al final y cada '
                'reintento creó una fila nueva. Ningún cliente pagó de más; el pago es al recoger.'),
    'impacto': dict(zip(impacto['concepto'], impacto['valor'])),
    'linea_de_tiempo': list(zip(eventos['hora'], eventos['evento'])),
    'causa_raiz': 'Un escenario no idempotente que confiaba en que cada mensaje llegaría una sola vez.',
    'contribuyentes': ['Respuesta 200 después de escribir en la hoja', 'Hoja lenta en hora pico',
                       'Sin detección automática de duplicados'],
    'salio_bien': ['Don Ernesto detuvo el horneado de los duplicados restantes',
                   'Valeria pausó el escenario 14 min después de la detección',
                   'Los 13 clientes recibieron una explicación honesta el mismo día'],
    'acciones': [
        ('Mover la respuesta 200 justo después del webhook', 'corrige', 'Valeria', '2026-03-02', 'En v2.3'),
        ('Clave sha256(MessageSid) en un almacén antes de crear la fila', 'corrige', 'Valeria', '2026-03-02', 'En v2.3'),
        ('Columna de clave única en la hoja con formato de duplicados', 'previene', 'Valeria', '2026-03-03', 'Pendiente'),
        ('Prueba de reenvío (caso C5) en cada versión antes de activar', 'previene', 'Valeria', '2026-03-03', 'Pendiente'),
        ('Pregunta "¿y si llega dos veces?" en la lista de revisión de pilotos', 'previene', 'Valeria y Don Ernesto', '2026-03-06', 'Pendiente'),
        ('Detector de duplicados cada 5 min con alerta a Valeria', 'detecta', 'Valeria', '2026-03-04', 'Pendiente'),
        ('Comanda con folio: dos comandas con el mismo folio no se hornean', 'detecta', 'Don Ernesto', '2026-03-02', 'Hecho'),
    ],
}
lineas = [f"# {analisis['titulo']}", '', '## Resumen', analisis['resumen'], '', '## Impacto']
lineas += [f'- {k}: {v}' for k, v in analisis['impacto'].items()]
lineas += ['', '## Línea de tiempo'] + [f'- {h} {e}' for h, e in analisis['linea_de_tiempo']]
lineas += ['', '## Causas', f"- Raíz: {analisis['causa_raiz']}"]
lineas += [f'- Contribuyente: {c}' for c in analisis['contribuyentes']]
lineas += ['', '## Lo que salió bien'] + [f'- {s}' for s in analisis['salio_bien']]
lineas += ['', '## Acciones', '|Acción|Tipo|Dueña o dueño|Fecha|Estado|', '|:---|:---:|:---:|:---:|:---:|']
lineas += [f'|{a}|{t}|{d}|{f}|{s}|' for a, t, d, f, s in analisis['acciones']]
documento = '\n'.join(lineas)
(carpeta / 'analisis_posterior_2026-02-28.md').write_text(documento, encoding = 'utf-8')

acciones = pd.DataFrame(analisis['acciones'], columns = ['accion', 'tipo', 'duenio', 'fecha', 'estado'])
print(acciones[['tipo', 'duenio', 'fecha', 'estado']].to_string())
print('Acciones por tipo:', dict(Counter(acciones['tipo'])))
prohibidas = ['+52', 'culpa', 'error de Valeria']
print('Líneas del documento:', len(lineas), '| palabras prohibidas encontradas:',
      [p for p in prohibidas if p in documento])
       tipo                 duenio       fecha     estado
0   corrige                Valeria  2026-03-02    En v2.3
1   corrige                Valeria  2026-03-02    En v2.3
2  previene                Valeria  2026-03-03  Pendiente
3  previene                Valeria  2026-03-03  Pendiente
4  previene  Valeria y Don Ernesto  2026-03-06  Pendiente
5   detecta                Valeria  2026-03-04  Pendiente
6   detecta            Don Ernesto  2026-03-02      Hecho
Acciones por tipo: {'corrige': 2, 'previene': 3, 'detecta': 2}
Líneas del documento: 44 | palabras prohibidas encontradas: []
El documento tiene $44$ líneas y la comprobación final no encontró ningún teléfono ni ninguna de las expresiones prohibidas. La Tabla 5 recoge las siete acciones con su texto completo.
Tabla 5. Acciones del análisis posterior: qué, tipo, dueña o dueño, fecha y estado.
| Acción | Tipo | Dueña o dueño | Fecha | Estado |
|---|---|---|---|---|
| Mover la respuesta 200 justo después del webhook | Corrige | Valeria | 2026-03-02 | En v2.3 |
Clave sha256(MessageSid) en un almacén antes de crear la fila | Corrige | Valeria | 2026-03-02 | En v2.3 |
| Columna de clave única en la hoja con formato de duplicados | Previene | Valeria | 2026-03-03 | Pendiente |
| Prueba de reenvío (caso C5) en cada versión antes de activar | Previene | Valeria | 2026-03-03 | Pendiente |
| Pregunta “¿y si llega dos veces?” en la lista de revisión de pilotos | Previene | Valeria y Don Ernesto | 2026-03-06 | Pendiente |
| Detector de duplicados cada 5 minutos con alerta a Valeria | Detecta | Valeria | 2026-03-04 | Pendiente |
| Comanda con folio: dos comandas con el mismo folio no se hornean | Detecta | Don Ernesto | 2026-03-02 | Hecho |
Hay $2$ acciones que corrigen, $3$ que previenen y $2$ que detectan, y la proporción no es casual. Un análisis con solo acciones correctivas arregla este incidente y deja intacta la puerta al siguiente; uno con solo acciones preventivas confía demasiado en haber previsto todo. Observe además la última fila: la única acción que ya está hecha es de Don Ernesto, y no tiene nada de digital. Desde el domingo, cada comanda lleva impreso el número de fila de la hoja como folio, y el obrador tiene una regla: si llegan dos comandas con el mismo folio, la segunda no se hornea hasta preguntar. La mejor alerta del sábado fue un panadero atento; la acción la convierte en un procedimiento.
La sección “Lo que salió bien” merece la misma atención. Don Ernesto detuvo el horneado de los duplicados restantes; Valeria pausó el escenario $14$ minutos después de la detección, en lugar de intentar arreglarlo en caliente; y los $13$ clientes recibieron el mismo día una explicación honesta: hubo un fallo del sistema de pedidos, su pedido es uno solo, no habrá cobros dobles porque el pago es al recoger. Ninguna de esas tres cosas estaba escrita en un manual, y las tres conviene escribirlas, porque la próxima vez quizá no esté la misma persona.
Para terminar, Valeria hace la prueba que exige su propio análisis: activa la v2.3 en un escenario de prueba, reenvía tres veces el mismo mensaje con el mismo MessageSid y comprueba que la hoja tiene una sola fila, que el almacén tiene una sola clave y que el historial muestra dos ejecuciones detenidas en el filtro “Clave nueva”. Es el caso C5 del Día 21, por fin con resultado “pasa”.
Consideraciones finales
El incidente del sábado tiene una forma que se repite en casi todos los fallos de automatización: una decisión razonable (responder solo cuando el pedido está guardado, para no perder pedidos como el martes), un supuesto implícito (cada mensaje llega una sola vez) y un disparador banal (una hoja lenta en hora pico). Ninguna de las tres cosas, por separado, era un error grave. Juntas, convirtieron $14$ pedidos en $51$ filas en $52$ minutos. Lo que distingue a un arquitecto de automatización no es no tener incidentes, sino tener el método para entenderlos y cerrarlos de forma que no vuelvan.
Antes de dar por cerrado cualquier análisis, conviene hacerse algunas preguntas:
- ¿El mecanismo explica la magnitud observada, o solo su existencia? Si no la explica, falta una causa.
- ¿La causa raíz, corregida, impide el incidente con cualquier disparador, o solo con el de ese día?
- ¿Hay al menos una acción que detecte el problema aunque su mecanismo sea otro?
- ¿Alguna acción dice “tener más cuidado”? Si la hay, todavía no es una acción.
- ¿Se podría leer el documento en voz alta delante de todo el equipo sin que nadie se sienta acusado?
Las cifras de hoy tienen límites claros. El incidente es ficticio, el registro está reconstruido con datos de juguete, el emisor se modeló de forma simplificada (espera de $10$ segundos y tres reintentos) y la latencia de la hoja se supuso lognormal e independiente entre intentos, sin cola. Ninguno de esos límites cambia las conclusiones: el Monte Carlo muestra que cualquier emisor que reintente, con cualquier espera por debajo de la latencia de la hoja, duplica; y que la idempotencia lleva los duplicados a cero con cualquier latencia.
Un gran libro que habla de esto es The Field Guide to Understanding ‘Human Error’, en el que Sidney Dekker explica por qué “error humano” es el principio de una investigación y no su conclusión, y cómo reconstruir lo que una decisión parecía razonable en el momento en que se tomó. Leerlo después de esta entrada le ayudará a escribir análisis posteriores que mejoren los sistemas en lugar de señalar a las personas, que es lo único que de verdad impide el siguiente incidente.
Un mensaje puede llegar dos veces; un pedido no debe existir dos veces. Con la respuesta al principio, la clave sha256(MessageSid), el filtro “Clave nueva”, un detector que habría avisado $36$ minutos antes y siete acciones con dueño y fecha, Trigo Lento sale del primer incidente serio de su automatización con un escenario más robusto y, sobre todo, con un método para el siguiente.
Conclusiones clave
El incidente
- Entre las 10:03 y las 10:55,
TL Pedidos WhatsApp v2.2convirtió $14$ pedidos en $51$ filas: $37$ duplicados, $13$ clientes con confirmaciones repetidas, $222$ créditos, $126$ minutos ($157.50$ MXN) y $660$ MXN de producto horneado de más. - El TTD fue de $38$ minutos, la mitigación llegó $14$ minutos después y el TTR fue de $157$; lo detectó una persona en el obrador, no una alerta.
- Con una hoja de mediana $20$ segundos, $p = 1 - \Phi(\ln(10/20)/0.5) = 0.917$ y $E[D] = p + p^2 + p^3 = 2.53$ copias por pedido: $35.4$ esperadas, con banda del $90%$ de $29$ a $41$, que contiene las $37$ observadas.
El diagnóstico
- Los cinco porqués llevan del síntoma ($37$ filas de más) a una decisión que se puede cambiar: el piloto se activó sin preguntar qué pasa si un mensaje llega dos veces.
- El Ishikawa recorre seis familias (método, máquina, datos, personas, medición y entorno) y separa causas necesarias, disparadoras y amplificadoras.
- La latencia de la hoja fue el disparador, no la causa; la causa raíz es un efecto no idempotente que confiaba en una entrega única.
La prevención
- La v2.3 responde de inmediato, busca
sha256(MessageSid)en un almacén, filtra con “Clave nueva” y guarda la clave sin sobrescribir; con procesamiento secuencial, los duplicados son cero con cualquier latencia. - Responder primero sin idempotencia deja unos $0.14$ duplicados por cada $14$ pedidos por respuestas perdidas en la red; ni Twilio, ni Meta, ni Make garantizan una entrega única.
- Un detector con
GROUP BY ... HAVING COUNT(*) > 1cada $5$ minutos habría avisado a las 10:05, $36$ minutos antes que la comanda. - El análisis posterior sin culpables deja $7$ acciones ($2$ corrigen, $3$ previenen y $2$ detectan) con dueña o dueño, fecha y estado, y ningún dato personal.
Mañana, en el Día 30: IA dentro de Make: llamar a la API de Claude con el módulo HTTP. Con el escenario ya a salvo de las copias, Valeria se enfrenta a los mensajes que las reglas de palabras clave no entienden, como “me aparta lo de siempre para el sábado”, y pondrá a Claude a clasificar y extraer los pedidos dentro de Make, con su coste contado y sin que una respuesta generada salga al cliente sin revisión cuando no debe.
Referencias
- Ohno, T. (1988). Toyota Production System: Beyond Large-Scale Production. Productivity Press.
- Ishikawa, K. (1986). Guide to Quality Control (2.ª ed. revisada). Asian Productivity Organization.
- Beyer, B., Jones, C., Petoff, J. y Murphy, N. R. (Eds.) (2016). Site Reliability Engineering (cap. 15, Postmortem Culture: Learning from Failure). O’Reilly Media. https://sre.google/sre-book/postmortem-culture/
- Allspaw, J. (2012). Blameless PostMortems and a Just Culture. Code as Craft (blog de ingeniería de Etsy). https://www.etsy.com/codeascraft/blameless-postmortems
- Kleppmann, M. (2017). Designing Data-Intensive Applications. O’Reilly Media.
- Dekker, S. (2014). The Field Guide to Understanding ‘Human Error’ (3.ª ed.). Ashgate.
- Twilio (2026). Webhooks (HTTP callbacks): Connection Overrides. Documentación de Twilio. https://www.twilio.com/docs/usage/webhooks/webhooks-connection-overrides
- Meta (2026). WhatsApp Cloud API: configurar webhooks. Documentación para desarrolladores. https://developers.facebook.com/docs/whatsapp/cloud-api/guides/set-up-webhooks
- Make (2026). Reintento automático de ejecuciones incompletas. Centro de ayuda de Make. https://help.make.com/automatic-retry-of-incomplete-executions
- Make (2026). Manejador de reintento (Retry error handler). Centro de ayuda de Make. https://help.make.com/retry-error-handler