
Arquitecto de automatización con IA: Día 3
 Jeshua Romero Guadarrama
- 58 Min para leer
- 03 Feb, 2026
Índice de contenido
Resumen:
Un flujo no empieza solo: algo tiene que ponerlo en marcha. En esta entrada, Valeria revisa los disparadores que activarán las automatizaciones de Trigo Lento y mide con Python lo que cuesta cada uno: sondear cada 15 minutos son 2 880 comprobaciones al mes con 7.5 minutos de espera media, frente a 1 560 avisos por webhook que llegan en segundos. Al terminar, usted sabrá clasificar los disparadores, escribir expresiones cron, firmar y verificar un webhook con HMAC-SHA256 y marca de tiempo, deduplicar entregas repetidas y decidir qué hacer cuando el receptor se cae a las once de la mañana.
¿Cómo citar el presente artículo?
Romero, J. (3 de febrero de 2026). Arquitecto de automatización con IA: Día 3. python-data-engineer. https://www.python-data-engineer.com/post/aai/dia_3/.
Arquitecto de automatización con IA: Día 3 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/aai/dia_3/.
Precios, límites y políticas de Make, n8n, Zapier, WhatsApp (Meta, Twilio, Wati) y de la API de Claude revisados en octubre de 2026. La firma de webhooks de esta entrada sigue la especificación Standard Webhooks; cada proveedor usa sus propios nombres de cabecera y su propio esquema de firma, que se contrastan el día en que se conecta cada uno. En este día no se llama a ningún servicio: todos los bloques de Python se ejecutan sin red y sus salidas son las reales.
Día 3. Arquitectura de flujos I: disparadores
Introducción
Ayer, en el Día 2 (La IA dentro de un flujo: qué hace un modelo de lenguaje y qué no), Valeria comprobó que un modelo de lenguaje es una función de texto a texto, probabilística y con coste por token, que conviene reservar para los pasos que de verdad necesitan entender lenguaje, y Trigo Lento ganó su primer flujo con un único paso de IA para clasificar los mensajes de WhatsApp. Ese flujo tiene, sin embargo, una pregunta pendiente que ayer no se respondió: ¿quién lo pone en marcha?
Es martes, son las 10:40 y Valeria tiene abierto en la laptop el dibujo del flujo de ayer: un óvalo verde que dice “Mensaje de WhatsApp”, una caja morada que clasifica, un rombo que reparte. El óvalo parece la parte más sencilla, y es la que más preguntas esconde. ¿El flujo se entera del mensaje en cuanto llega o lo descubre cuando alguien va a mirar? ¿Cada cuánto se mira? ¿Qué pasa si el mismo mensaje se avisa dos veces? ¿Y si alguien que no es WhatsApp envía un “mensaje” inventado a la misma dirección? En la libreta de Trigo Lento el disparador siempre fue Valeria: el teléfono vibra, ella lo mira, y el proceso empieza. Automatizar obliga a sustituir ese gesto por algo que no se cansa, pero que tampoco piensa.
Don Ernesto, que ha escuchado la explicación mientras forma hogazas, tiene una objeción muy concreta: “Muy bonito todo, Valeria, pero a las once, cuando más pedidos entran, a veces se va el internet. ¿Y si se va el internet a las once? ¿Se pierden los pedidos? ¿Llegan dos veces? ¿Quién se entera?” Es una gran pregunta, y no es retórica. Las caídas de red, los reintentos y las entregas repetidas son la vida normal de un disparador, y un diseño que no los contempla falla precisamente en la hora pico, cuando más duele.
En la presente entrada, descubrirá qué piezas tiene un flujo y por qué el disparador es la que decide cuándo y cuántas veces se ejecuta todo lo demás. Conocerá los cinco tipos de disparadores (manual, programado, sondeo, webhook y evento nativo), calculará con Python la latencia y el consumo de un sondeo frente a un webhook con los 60 mensajes diarios de Trigo Lento y escribirá un intérprete mínimo de expresiones cron. Después verá por qué los webhooks entregan “al menos una vez”, cómo se deduplican las entregas repetidas, cómo se firma y se verifica un webhook con HMAC-SHA256 y una marca de tiempo, y cómo se combina todo en un receptor que rechaza pedidos falsos. Al final dibujará el mapa de disparadores de Trigo Lento y responderá con números a la pregunta de Don Ernesto.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Clasificar los disparadores (manual, programado, sondeo, webhook, evento nativo) y elegir el adecuado para cada proceso.
- Calcular la latencia media y el consumo de un disparador por sondeo frente a uno por webhook.
- Proteger un webhook con firma HMAC y marca de tiempo, y deduplicar entregas repetidas.
- Escribir expresiones cron para tareas programadas.
Anatomía de un flujo
El Día 1 definió un flujo como la implementación concreta de un proceso, o de una parte, en una herramienta: un escenario de Make, un workflow de n8n o un programa de Python. Hoy toca abrirlo y nombrar sus piezas, porque toda la serie hablará de ellas con el mismo vocabulario:
- El disparador (en inglés, trigger) es el suceso que pone el flujo en marcha: un mensaje que llega, una hora del reloj, un botón que alguien pulsa. Cada vez que se dispara, el flujo se ejecuta una vez; por eso el disparador decide cuántas ejecuciones habrá al mes y, en muchas plataformas, cuánto se paga.
- Las entradas son los datos que el disparador entrega al flujo: el texto del mensaje, el teléfono de quien escribe, la hora de llegada. El Día 4 las convertirá en un contrato de datos con campos, tipos y reglas.
- Los pasos son las acciones que el flujo ejecuta en orden: validar, clasificar, consultar el catálogo, decidir por qué rama seguir. Algunos son deterministas (una regla, una suma) y otros probabilísticos (una llamada a un modelo, como vio ayer).
- Las salidas son lo que el flujo deja hecho en el mundo: una fila en la hoja de pedidos, una confirmación al cliente, un aviso al obrador. Una salida que modifica algo fuera del flujo se llama efecto, y es la razón por la que importa tanto que el flujo no se ejecute dos veces por el mismo suceso.
Un disparador mal elegido no se nota en el diagrama, pero se nota en todo lo demás. Si el flujo de pedidos se dispara cada hora, el cliente espera en promedio media hora antes de que alguien lea su mensaje; si se dispara dos veces por el mismo mensaje, el obrador hornea dos pasteles; si cualquiera puede dispararlo desde internet, cualquiera puede hacer un pedido falso. Por eso este día y el siguiente forman una pareja: hoy, cuándo y cuántas veces se ejecuta un flujo; mañana, qué entra y qué sale.
Los eventos que ponen en marcha el flujo
Antes de comparar disparadores conviene saber qué eventos tendrán que detectar. En Trigo Lento llegan, en promedio, 60 mensajes de WhatsApp al día, pero no de forma uniforme: entre las 10:00 y las 12:00 se concentran 9 por hora, y a primera y última hora apenas llegan 2. Ese patrón se modela como un proceso de Poisson no homogéneo: en cada hora $h$ los mensajes llegan al azar con una tasa $\lambda_h$ propia, de modo que el número de mensajes de esa hora sigue una distribución de Poisson y el total esperado del día es la suma de las tasas:
$$ P(N_h = k) = \frac{e^{-\lambda_h},\lambda_h^{k}}{k!}, \qquad \Lambda = \sum_{h=7}^{19} \lambda_h = 60 $$
La lógica detrás de estas fórmulas es múltiple:
- Dentro de cada hora, los mensajes no se ponen de acuerdo para llegar: cada cliente escribe cuando quiere. Esa independencia es lo que hace razonable el modelo de Poisson, el mismo que el Día 1 usó para las llegadas de la hora pico.
- La tasa $\lambda_h$ cambia de una hora a otra; por eso el proceso es “no homogéneo”. Con $\lambda_{10} = \lambda_{11} = 9$ se reproduce la hora pico del Día 1, y con tasas más bajas el resto del día.
- El total esperado del día, $\Lambda$, es la suma de las tasas. El total observado varía alrededor de $\Lambda$ con una desviación típica de $\sqrt{60} \approx 7.7$ mensajes, así que un día con 52 o con 68 mensajes es perfectamente normal.
- En conclusión, un disparador no se diseña para el promedio, sino para la forma del día: lo que importa es qué pasa a las 10:30, no a las 15:00.
Comencemos por preparar el entorno con las importaciones base, la semilla global de la serie, $2026$, y la carpeta del proyecto, como todos los días. Esta vez se añaden hmac, hashlib y base64, que servirán para firmar webhooks, y se comprueba que la ficha de encargos que el Día 1 dejó en trigo_lento/ficha_encargos.json sigue en su sitio:
# Importaciones base, semilla de la serie y carpeta del proyecto en Python:
import warnings
warnings.filterwarnings('ignore')
import json
import hmac
import hashlib
import base64
from datetime import datetime, timedelta, timezone
from pathlib import Path
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 120)
carpeta = Path('trigo_lento')
carpeta.mkdir(exist_ok = True)
print('numpy', np.__version__, '| pandas', pd.__version__)
print('Ficha de encargos del Día 1 disponible:', (carpeta / 'ficha_encargos.json').exists())
numpy 2.4.6 | pandas 3.0.3
Ficha de encargos del Día 1 disponible: True
La ficha del Día 1 está disponible, y al final de la entrada se le añadirá una sección de disparadores en un archivo nuevo. Ahora, el día de mensajes. El siguiente código define las tasas por hora de 07:00 a 19:59, simula las llegadas de un día con la función llegadas_del_dia y, con la misma función, un mes de 30 días que empieza el lunes 2 de febrero y tiene 26 días de lunes a sábado. Ese mes simulado será la materia prima de los bloques siguientes:
# Llegadas de mensajes por hora con un proceso de Poisson no homogéneo en Python:
horas = np.arange(7, 20)                                     # de 07:00 a 19:59
tasa = np.array([2, 4, 6, 9, 9, 6, 5, 4, 4, 4, 3, 2, 2])     # mensajes por hora; pico de 10:00 a 12:00
print('Mensajes esperados al día:', tasa.sum())

def llegadas_del_dia(rng):
    # Tasa constante dentro de cada hora: n ~ Poisson(tasa) e instantes uniformes en esa hora:
    instantes = [h + rng.uniform(0, 1, rng.poisson(l)) for h, l in zip(horas, tasa)]
    return np.sort(np.concatenate(instantes))                 # hora del día con decimales

dia = llegadas_del_dia(rng)
conteo = pd.Series(np.floor(dia).astype(int)).value_counts().reindex(horas, fill_value = 0)
print('Mensajes del día simulado:', len(dia), '| de 10:00 a 12:00:', conteo.loc[[10, 11]].sum())
print(f'Hora con más mensajes: {conteo.idxmax()}:00 ({conteo.max()} mensajes)')

# Un mes de 30 días que empieza el lunes 2 de febrero de 2026 (26 días de lunes a sábado):
inicio_mes = datetime(2026, 2, 2)
mes = []
for d in range(30):
    if (inicio_mes + timedelta(days = d)).weekday() < 6:       # de lunes (0) a sábado (5)
        mes.extend(24 * d + llegadas_del_dia(rng))              # horas desde el inicio del mes
mes = np.array(mes)
print('Mensajes del mes simulado:', len(mes), '| media por día hábil:', round(len(mes) / 26, 1))

# Mensajes por hora del día simulado frente a la tasa esperada:
fig, ax = plt.subplots(figsize = (9, 4.6))
ax.axvspan(9.5, 11.5, color = '#fde3d6', label = 'Hora pico (10:00 a 12:00)')
ax.bar(horas, conteo.values, width = 0.7, color = '#2a78d6', label = 'Día simulado')
ax.plot(horas, tasa, color = '#eb6834', marker = 'o', linewidth = 2, label = 'Tasa esperada por hora')
ax.set_xticks(horas)
ax.set_xticklabels([f'{h}:00' for h in horas], rotation = 45, ha = 'right')
ax.set_ylabel('Mensajes de WhatsApp')
ax.set_title(f'Llegadas de un día simulado: {len(dia)} mensajes', fontsize = 16)
ax.legend(frameon = False)
ax.spines[['top', 'right']].set_visible(False)
plt.tight_layout()
plt.show()
Mensajes esperados al día: 60
Mensajes del día simulado: 57 | de 10:00 a 12:00: 18
Hora con más mensajes: 10:00 (13 mensajes)
Mensajes del mes simulado: 1647 | media por día hábil: 63.3
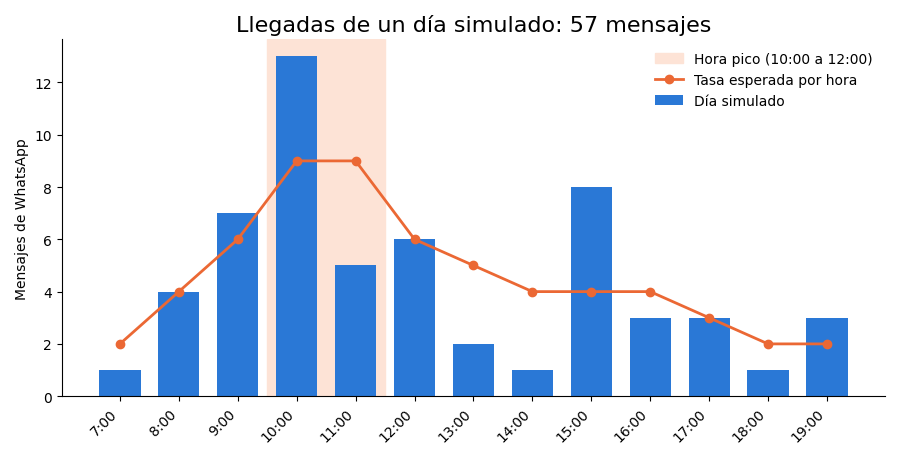
El día simulado tuvo $57$ mensajes, tres menos que los $60$ esperados, y la hora de las 10:00 recibió $13$, cuatro más que su tasa de $9$. Las dos horas del pico sumaron $18$, exactamente lo esperado ($9 + 9$), pero repartidos de forma muy desigual: $13$ en la primera y $5$ en la segunda. Así es el azar de Poisson, y es la primera lección del bloque: una hora pico concreta puede traer el 50 % más de mensajes de los que dice su tasa, y el disparador debe aguantarlo sin perder ninguno.
El mes simulado tuvo $1,647$ mensajes, una media de $63.3$ por día hábil, algo por encima de los $1,560$ nominales ($60 \cdot 26$). Es un mes cargado, a unas dos desviaciones típicas de la media, y viene bien que lo sea: las cifras de latencia y consumo que siguen se calculan sobre un mes exigente, no sobre uno cómodo. La gráfica muestra el día hora por hora: las barras azules son los mensajes simulados, la línea naranja la tasa esperada y la franja sombreada la hora pico. Observe las 15:00, con $8$ mensajes frente a una tasa de $4$: también fuera del pico hay ráfagas.
Tipos de disparadores
Con los eventos sobre la mesa, la pregunta es cómo se entera el flujo de que ocurrieron. Hay cinco respuestas posibles, y casi todas las plataformas de automatización las ofrecen con nombres parecidos. La Tabla 1 las resume con la latencia típica de cada una (el tiempo entre que ocurre el evento y que el flujo arranca), su consumo y un ejemplo en Trigo Lento.
Tabla 1. Tipos de disparador: cómo se activa, latencia típica, consumo y ejemplo en Trigo Lento.
| Tipo | Cómo se activa | Latencia típica | Consumo | Ejemplo en Trigo Lento |
|---|---|---|---|---|
| Manual | Una persona pulsa un botón o captura un dato | La de la persona | Una ejecución por cada vez que alguien lo lanza | Valeria captura un encargo que llegó por teléfono |
| Programado (cron) | El reloj, a horas fijas | Ninguna respecto al horario, pero no reacciona a eventos | Una ejecución por horario, haya o no trabajo | Resumen de encargos del día a las 07:00 |
| Sondeo | La plataforma pregunta cada $T$ minutos si hay novedades | Media de $T/2$ y máximo de $T$ | Una comprobación por intervalo, encuentre algo o no | Revisar cada 15 minutos una hoja de cálculo de pedidos |
| Webhook | El sistema de origen envía una petición HTTP en cuanto ocurre el evento | Segundos | Una llamada por evento | Mensaje entrante de WhatsApp |
| Evento nativo | La plataforma se suscribe por usted a un evento de la aplicación | Segundos si por debajo hay un webhook; la del sondeo si no | Depende de la implementación | Nueva respuesta del formulario web |
Cada fila merece una frase de explicación:
- Manual. Es el disparador más subestimado. No todo debe arrancar solo: un encargo telefónico lo escucha una persona y lo captura una persona, y es razonable que así sea. Un disparador manual bien diseñado (un formulario corto en el teléfono de Valeria) ya es una mejora enorme frente a la libreta, porque deja el dato en el mismo sitio que los demás canales.
- Programado. El flujo arranca a una hora fija, se describa como “todos los días a las 7” o con una expresión cron, que verá enseguida. Es perfecto para trabajos que dependen del calendario y no de un evento: el resumen de la mañana, el inventario del sábado, la factura del viernes.
- Sondeo (en inglés, polling). El flujo pregunta periódicamente “¿hay algo nuevo?” a la aplicación de origen. Funciona con cualquier sistema que tenga una forma de consultar sus datos, por eso es tan común, pero paga dos precios: la espera hasta la siguiente pregunta y el coste de todas las preguntas que no encuentran nada.
- Webhook. Se invierte la dirección: es el sistema de origen el que avisa, con una petición HTTP a una dirección (URL) que usted le dio, en el momento en que ocurre el evento. Hohpe y Woolf, en Enterprise Integration Patterns, llaman a las dos estrategias consumidor que sondea (Polling Consumer) y consumidor dirigido por eventos (Event-Driven Consumer).
- Evento nativo. Es la versión empaquetada de las anteriores: la plataforma ofrece un disparador del tipo “nueva fila en la hoja” o “nuevo correo” y se encarga de la suscripción. Por dentro puede ser un webhook que la plataforma registra por usted o un sondeo disfrazado. En Make, por ejemplo, los disparadores marcados como instantáneos se apoyan en webhooks, mientras que los demás se ejecutan según la programación del escenario, es decir, sondean.
La quinta fila es la que más confusiones provoca, y por eso conviene una regla práctica: cuando una plataforma le ofrezca un disparador nativo, averigüe si es instantáneo o programado antes de calcular su coste y su latencia. Un disparador “nuevo correo” que en realidad mira el buzón cada 15 minutos se comporta exactamente como el sondeo de la tercera fila, con todas sus consecuencias.
Sondeo frente a webhook
La decisión que más se repite al diseñar el disparador de un flujo es elegir entre preguntar y que le avisen. La diferencia entre las dos estrategias cabe en una imagen cotidiana: ir al buzón cada cierto tiempo o tener un timbre en la puerta.
Con el buzón, usted decide cada cuánto va a mirar. Si va cada $T$ minutos, una carta que llega justo después de su visita espera casi $T$ minutos, y una que llega justo antes espera casi nada. Como las cartas llegan al azar, la espera es uniforme entre $0$ y $T$, y su media es la mitad del intervalo. El número de visitas, en cambio, no depende de las cartas: se va al buzón aunque no haya nada. Con $1,440$ minutos al día y 30 días al mes, las dos magnitudes del sondeo son:
$$ \bar{\ell} = \frac{T}{2}, \qquad C = \frac{1440}{T} \cdot 30 $$
La lógica detrás de estas fórmulas es múltiple:
- $\bar{\ell}$ es la latencia media de detección: el tiempo promedio entre que llega un mensaje y que el flujo lo ve. Depende solo del intervalo $T$, no del número de mensajes. Con $T = 15$ minutos, $\bar{\ell} = 7.5$ minutos, y ningún mensaje espera más de $15$.
- $C$ es el número de comprobaciones al mes: $1440/T$ al día durante 30 días, porque un sondeo programado sin restricciones también trabaja de noche y en domingo. Con $T = 15$, $C = 96 \cdot 30 = 2,880$.
- Las dos fórmulas tiran en sentidos opuestos: reducir $T$ a la mitad divide la latencia entre dos y multiplica por dos las comprobaciones. No hay un intervalo que sea a la vez rápido y barato.
- En conclusión, un webhook rompe ese compromiso: su latencia es la de la red (segundos) y su consumo es exactamente el número de eventos, $1,560$ al mes en Trigo Lento, ni uno más.
El siguiente código comprueba la primera fórmula con el mes simulado del Bloque 2. Para cada intervalo, la comprobación que descubre un mensaje es el primer múltiplo de $T$ posterior a su llegada, así que la latencia es la distancia hasta ese múltiplo. Para el webhook se usa una latencia de red lognormal con mediana de $1.5$ segundos, un supuesto didáctico declarado como tal, no una medición de ningún proveedor:
# Latencia de detección con sondeo cada 1, 5, 15 y 60 minutos en Python:
minutos = mes * 60                                            # instantes de llegada en minutos del mes
intervalos = [1, 5, 15, 60]
latencias = {}
for T in intervalos:
    # La comprobación siguiente ocurre en el primer múltiplo de T posterior a la llegada:
    latencias[T] = T * np.ceil(minutos / T) - minutos
webhook = rng.lognormal(np.log(1.5), 0.5, size = len(minutos)) / 60   # supuesto: mediana de 1.5 s
resumen_lat = pd.DataFrame({f'Sondeo {T} min': [l.mean(), np.median(l), np.percentile(l, 95), l.max()]
                            for T, l in latencias.items()}, index = ['media', 'mediana', 'p95', 'máximo']).T
resumen_lat.loc['Webhook'] = [webhook.mean(), np.median(webhook), np.percentile(webhook, 95), webhook.max()]
print('Latencia de detección en minutos sobre', len(minutos), 'mensajes:')
print(resumen_lat.round(2))

# Distribución de la latencia por intervalo de sondeo:
fig, ax = plt.subplots(figsize = (9, 4.6))
datos_caja = [webhook] + [latencias[T] for T in intervalos]
ax.boxplot(datos_caja, vert = False, widths = 0.55, showfliers = False,
           medianprops = dict(color = '#eb6834', linewidth = 2))
ax.scatter([d.mean() for d in datos_caja], range(1, 6), color = '#0b0b0b', marker = 'D', s = 30,
           zorder = 3, label = 'Media')
ax.set_yticks(range(1, 6))
ax.set_yticklabels(['Webhook'] + [f'Sondeo {T} min' for T in intervalos])
ax.set_xlabel('Minutos desde que llega el mensaje hasta que el flujo lo ve')
ax.set_title('Latencia de detección: sondeo frente a webhook', fontsize = 16)
ax.legend(frameon = False, loc = 'lower right')
ax.grid(axis = 'x', color = '#e6e5e1')
ax.set_axisbelow(True)
plt.tight_layout()
plt.show()
Latencia de detección en minutos sobre 1647 mensajes:
               media  mediana    p95  máximo
Sondeo 1 min    0.50     0.50   0.94    1.00
Sondeo 5 min    2.48     2.50   4.73    5.00
Sondeo 15 min   7.45     7.40  14.22   15.00
Sondeo 60 min  30.58    30.68  56.71   59.89
Webhook         0.03     0.03   0.06    0.15
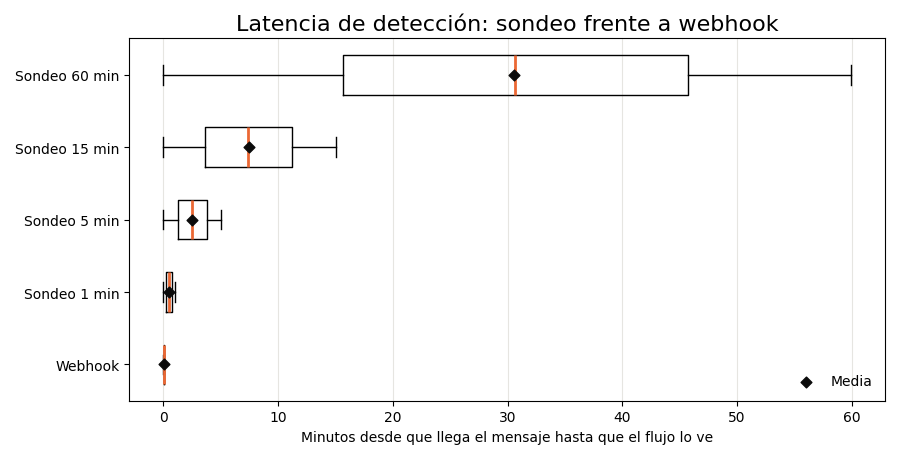
La simulación confirma la fórmula con una precisión notable: con sondeo cada $1$, $5$, $15$ y $60$ minutos, la latencia media es de $0.50$, $2.48$, $7.45$ y $30.58$ minutos, frente a los $0.5$, $2.5$, $7.5$ y $30$ de $T/2$. El percentil 95 se queda cerca de $0.95,T$ ($14.22$ minutos con $T = 15$) y el máximo toca $T$, como corresponde a una espera uniforme. El webhook, en cambio, tiene una latencia media de $0.03$ minutos, menos de dos segundos, y su peor caso simulado son $0.15$ minutos, unos $9$ segundos.
La gráfica pone las cinco distribuciones en el mismo eje. Las cajas del sondeo son anchas y simétricas porque la espera es uniforme: con $T = 60$, la mitad de los mensajes espera entre $15$ y $46$ minutos. La caja del webhook es una raya pegada al cero. Para un cliente que pregunta si le apartan dos conchas para mañana, la diferencia entre $7.5$ minutos de media y dos segundos puede no importar; para la confirmación que Marisol quiere antes de las 8, o para un pedido urgente en la hora pico, sí.
La segunda fórmula, la del consumo, es la que más sorpresas da. El siguiente código calcula las comprobaciones al mes de cada intervalo, cuántas de ellas encontraron al menos un mensaje nuevo en el mes simulado, el porcentaje de comprobaciones vacías y cuántas veces más llamadas hace el sondeo que el webhook; la gráfica compara además con los $1,000$ créditos mensuales del plan Free de Make (Tabla B del plan de la serie, revisada en octubre de 2026):
# Comprobaciones al mes por intervalo frente a los eventos de un webhook en Python:
eventos_webhook = 60 * 26                                     # 60 mensajes al día, 26 días hábiles
filas = []
for T in intervalos:
    comprobaciones = int(1440 / T * 30)                       # C = 1440 / T * 30
    con_novedad = len(np.unique(np.ceil(minutos / T)))        # comprobaciones que encontraron algo
    filas.append({'intervalo_min': T, 'latencia_media_min': T / 2, 'comprobaciones_mes': comprobaciones,
                  'con_novedad': con_novedad, 'vacias_pct': 100 * (1 - con_novedad / comprobaciones),
                  'veces_webhook': comprobaciones / eventos_webhook})
tabla3 = pd.DataFrame(filas)
print(tabla3.round(1).to_string(index = False))
print('Webhook:', eventos_webhook, 'llamadas al mes, una por evento, sin comprobaciones vacías;',
      f'latencia media de {60 * webhook.mean():.1f} s')
print('Plan Free de Make: 1 000 créditos al mes frente a', tabla3.loc[2, 'comprobaciones_mes'],
      'comprobaciones con sondeo cada 15 min')

# Comprobaciones al mes en escala logarítmica:
fig, ax = plt.subplots(figsize = (9, 4.6))
ax.plot(tabla3['intervalo_min'], tabla3['comprobaciones_mes'], color = '#2a78d6', marker = 'o',
        markersize = 8, linewidth = 2, label = 'Sondeo: comprobaciones al mes')
for x, y in zip(tabla3['intervalo_min'], tabla3['comprobaciones_mes']):
    ax.annotate(f'{y:,}'.replace(',', ' '), (x, y), textcoords = 'offset points', xytext = (8, 6), fontsize = 10)
ax.axhline(eventos_webhook, color = '#eb6834', linestyle = '--', linewidth = 2,
           label = f'Webhook: {eventos_webhook:,} eventos reales'.replace(',', ' '))
ax.axhline(1000, color = '#8a8986', linestyle = ':', linewidth = 2, label = 'Créditos del plan Free de Make')
ax.set_xscale('log')
ax.set_yscale('log')
ax.set_xticks(intervalos)
ax.set_xticklabels([f'{T} min' for T in intervalos])
ax.set_xlabel('Intervalo de sondeo')
ax.set_ylabel('Llamadas al mes (escala logarítmica)')
ax.set_title('Cuánto cuesta preguntar: sondeo frente a webhook', fontsize = 16)
ax.legend(frameon = False, loc = 'upper right')
ax.spines[['top', 'right']].set_visible(False)
plt.tight_layout()
plt.show()
 intervalo_min  latencia_media_min  comprobaciones_mes  con_novedad  vacias_pct  veces_webhook
             1                 0.5               43200         1571        96.4           27.7
             5                 2.5                8640         1306        84.9            5.5
            15                 7.5                2880          912        68.3            1.8
            60                30.0                 720          323        55.1            0.5
Webhook: 1560 llamadas al mes, una por evento, sin comprobaciones vacías; latencia media de 1.7 s
Plan Free de Make: 1 000 créditos al mes frente a 2880 comprobaciones con sondeo cada 15 min
Los resultados se recogen en la Tabla 3.
Tabla 3. Intervalo de sondeo frente a latencia media y comprobaciones al mes (mes simulado de 1 647 mensajes).
| Intervalo de sondeo | Latencia media teórica | Latencia media simulada | Comprobaciones al mes | Con algún mensaje nuevo | Comprobaciones vacías | Veces las llamadas del webhook |
|---|---|---|---|---|---|---|
| 1 minuto | 0.5 min | 0.50 min | 43 200 | 1 571 | 96.4 % | 27.7 |
| 5 minutos | 2.5 min | 2.48 min | 8 640 | 1 306 | 84.9 % | 5.5 |
| 15 minutos | 7.5 min | 7.45 min | 2 880 | 912 | 68.3 % | 1.8 |
| 60 minutos | 30 min | 30.58 min | 720 | 323 | 55.1 % | 0.5 |
| Webhook | segundos | 1.7 s | 1 560 | 1 560 | 0 % | 1.0 |
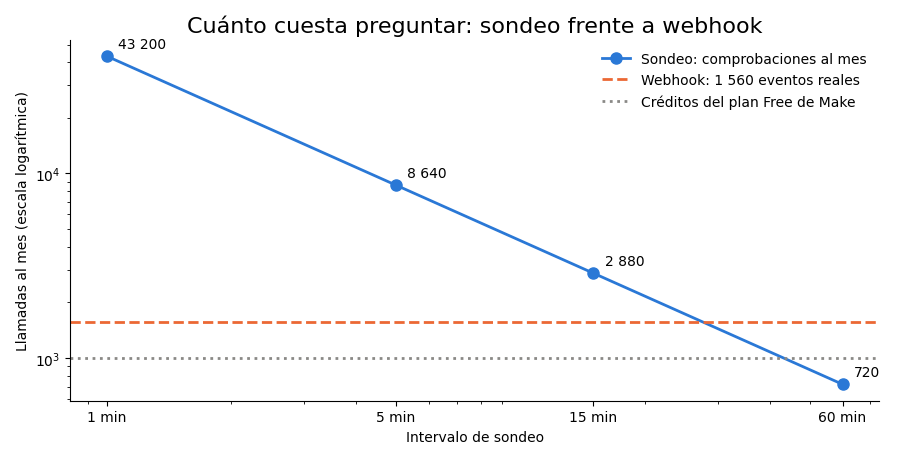
La tabla se lee en las dos direcciones. Hacia arriba, el sondeo se vuelve rápido y absurdamente caro: con $T = 1$ minuto, la latencia es de medio minuto, pero se hacen $43,200$ comprobaciones al mes y el $96.4%$ de ellas no encuentra nada; son $27.7$ veces las llamadas de un webhook. Hacia abajo, el sondeo se abarata y se vuelve lento: con $T = 60$ minutos se hacen solo $720$ comprobaciones, menos que los eventos del webhook, pero cada mensaje espera media hora y más de la mitad de las visitas sigue siendo en vano.
El punto intermedio, $T = 15$ minutos, es el mínimo del plan Free de Make, y la gráfica muestra el problema: sus $2,880$ comprobaciones quedan muy por encima de la línea punteada de los $1,000$ créditos del plan. Según la documentación de Make revisada en octubre de 2026, la comprobación de un disparador programado consume créditos aunque no encuentre datos, así que un solo escenario que sondee cada 15 minutos agotaría el plan gratuito en $1,000 / 96 \approx 10.4$ días. Por eso el webhook no es solo la opción rápida: en una cuenta con créditos contados, el webhook es también la opción barata, porque solo cobra cuando hay algo que hacer.
Todas las ideas de esta sección se resumen en la Figura 1.
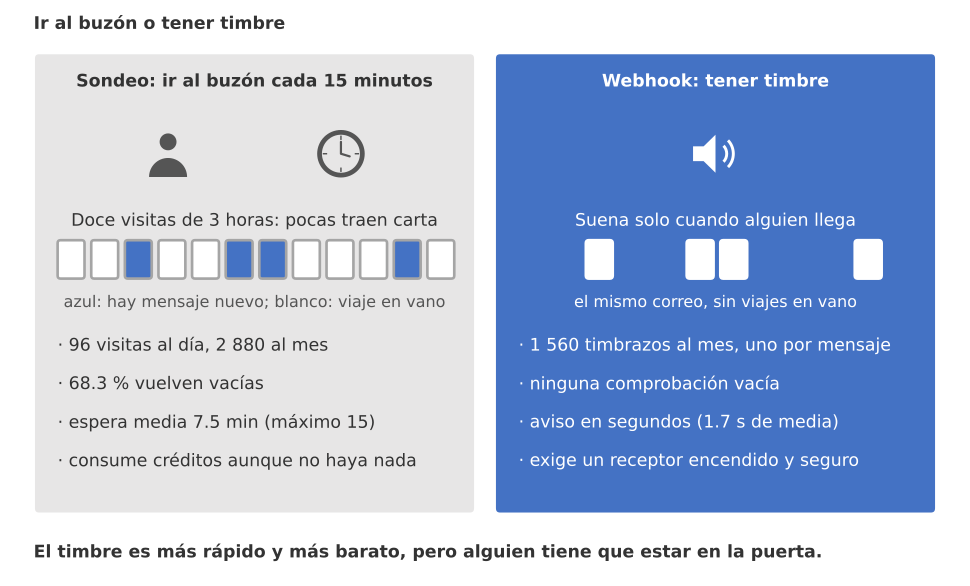
Figura 1. Ir al buzón o tener timbre: con sondeo cada 15 minutos se hacen 2 880 visitas al mes y el 68.3 % vuelve vacío; con un webhook suenan 1 560 timbrazos, uno por mensaje, y el aviso llega en segundos.
La frase del pie de la figura es la advertencia de toda la sección: el timbre es más rápido y más barato, pero alguien tiene que estar en la puerta. Un webhook exige un receptor encendido las 24 horas, accesible desde internet, que responda rápido y que verifique quién llama. Esas tres exigencias ocupan el resto del día. Y hay casos en que el sondeo sigue siendo la elección correcta: cuando el sistema de origen no ofrece webhooks (una hoja de cálculo compartida, un portal antiguo), cuando la latencia no importa (un informe semanal) o como red de seguridad de un webhook, como verá en la sección de Don Ernesto.
Expresiones cron
El disparador programado tiene su propio idioma. Una expresión cron (el nombre viene de cron, el programador de tareas de los sistemas Unix) describe un calendario con cinco campos separados por espacios: minuto ($0$ a $59$), hora ($0$ a $23$), día del mes ($1$ a $31$), mes ($1$ a $12$) y día de la semana ($0$ a $6$, donde $0$ es el domingo). Cada campo admite un asterisco (todos los valores), un número, un rango (1-6), una lista (0,30) o un paso (*/15, cada 15).
El resumen diario de Trigo Lento, que debe estar listo antes de que abra el obrador de lunes a sábado, se escribe así: 0 7 * * 1-6. Se lee de izquierda a derecha: en el minuto $0$, de la hora $7$, cualquier día del mes, cualquier mes, de lunes ($1$) a sábado ($6$). El inventario de harina, que Don Ernesto revisa al cerrar el sábado, es 0 18 * * 6. Y el sondeo cada 15 minutos de la sección anterior también es una expresión cron: */15 * * * *.
Las plataformas de automatización interpretan estas expresiones por usted, pero escribir un intérprete mínimo es la mejor forma de no equivocarse al leerlas. El siguiente código convierte cada campo en el conjunto de valores permitidos, comprueba si un instante coincide con la expresión y busca las próximas ejecuciones avanzando minuto a minuto desde el martes 3 de febrero a las 22:00, la hora de publicación de esta entrada. Al final cuenta las ejecuciones de dos expresiones de sondeo en el mes de 30 días:
# Intérprete mínimo de expresiones cron y próximas ejecuciones en Python:
DIAS = ['lunes', 'martes', 'miércoles', 'jueves', 'viernes', 'sábado', 'domingo']

def campo(texto, minimo, maximo):
    # Convierte '*', '*/15', '1-6', '0,30' o '7' en el conjunto de valores permitidos:
    valores = set()
    for parte in texto.split(','):
        rango, _, paso = parte.partition('/')
        if rango == '*':
            a, b = minimo, maximo
        elif '-' in rango:
            a, b = map(int, rango.split('-'))
        else:
            a = b = int(rango)
        valores.update(range(a, b + 1, int(paso or 1)))
    return valores

def coincide(expresion, t):
    minuto, hora, dia_mes, mes_cron, dia_semana = expresion.split()
    return (t.minute in campo(minuto, 0, 59) and t.hour in campo(hora, 0, 23)
            and t.day in campo(dia_mes, 1, 31) and t.month in campo(mes_cron, 1, 12)
            and (t.weekday() + 1) % 7 in campo(dia_semana, 0, 6))       # en cron, 0 es domingo

def proximas(expresion, desde, n = 5):
    t, resultado = desde.replace(second = 0, microsecond = 0), []
    while len(resultado) < n:
        t += timedelta(minutes = 1)
        if coincide(expresion, t):
            resultado.append(t)
    return resultado

def contar(expresion, desde, dias = 30):
    return sum(coincide(expresion, desde + timedelta(minutes = m)) for m in range(dias * 1440))

ahora = datetime(2026, 2, 3, 22, 0)                           # martes 3 de febrero, 22:00 (Ciudad de México)
for expresion, nombre in [('0 7 * * 1-6', 'Resumen diario'), ('0 18 * * 6', 'Inventario de harina')]:
    print(f'{nombre} ({expresion}):')
    for t in proximas(expresion, ahora, 5 if nombre == 'Resumen diario' else 3):
        print(f'   {DIAS[t.weekday()]:<9} {t:%Y-%m-%d %H:%M}')
for expresion in ['*/15 * * * *', '*/15 7-19 * * 1-6']:
    print(f'{expresion:<18} -> {contar(expresion, inicio_mes):>5} ejecuciones en 30 días')
Resumen diario (0 7 * * 1-6):
   miércoles 2026-02-04 07:00
   jueves    2026-02-05 07:00
   viernes   2026-02-06 07:00
   sábado    2026-02-07 07:00
   lunes     2026-02-09 07:00
Inventario de harina (0 18 * * 6):
   sábado    2026-02-07 18:00
   sábado    2026-02-14 18:00
   sábado    2026-02-21 18:00
*/15 * * * *       ->  2880 ejecuciones en 30 días
*/15 7-19 * * 1-6  ->  1352 ejecuciones en 30 días
Las cinco próximas ejecuciones del resumen son miércoles, jueves, viernes, sábado y lunes a las 07:00: el domingo 8 de febrero no aparece, porque el campo 1-6 lo excluye. El inventario cae los sábados 7, 14 y 21 a las 18:00. La comprobación más útil es la del final: */15 * * * * da $2,880$ ejecuciones en 30 días, la misma cifra que la fórmula $C$, y restringir el sondeo al horario de apertura con */15 7-19 * * 1-6 lo baja a $1,352$, un $53%$ menos. Un buen calendario ahorra más que un buen intervalo, pero ni así el sondeo cabe en los $1,000$ créditos del plan gratuito.
Tres advertencias sobre cron que cuestan caras cuando se olvidan:
- La zona horaria. Una expresión cron no dice en qué zona se interpreta; lo decide el servidor o la configuración de la plataforma. Si el servidor está en UTC,
0 7 * * 1-6se ejecuta a la 1 de la madrugada de Ciudad de México (UTC menos 6 horas, sin horario de verano desde 2022). Configure siempre la zona del escenario o del workflow. - El día del mes y el día de la semana a la vez. En el cron clásico, si se restringen los dos campos, basta con que se cumpla uno de los dos, no ambos. El intérprete de este bloque exige los dos, como hacen algunas plataformas y no otras; si necesita combinarlos, consulte la documentación de la suya.
- El domingo. Muchas implementaciones aceptan también $7$ como domingo; el intérprete mínimo de este bloque no, y responderá con un rango vacío.
Cuando el mismo evento llega dos veces
Un webhook parece una promesa sencilla: “cuando ocurra algo, le aviso”. Pero la red no es fiable. El emisor envía la petición, el receptor la procesa y responde 200 OK, y esa respuesta se pierde por el camino. Desde el punto de vista del emisor, el aviso no llegó, así que lo reenvía. El receptor recibe por segunda vez el mismo evento, y si no se da cuenta, el pedido se registra dos veces.
Por eso casi todos los proveedores de webhooks garantizan una entrega al menos una vez (at-least-once delivery): prometen que el evento llegará, no que llegará una sola vez. La alternativa, entregar “como mucho una vez”, significa aceptar que algunos eventos se pierdan, y para un pedido de pastel eso es peor. La entrega “exactamente una vez” no existe como propiedad de la red; se construye en el receptor, que debe reconocer las repeticiones. Martin Kleppmann lo explica con detalle en Designing Data-Intensive Applications: lo que se puede lograr es un efecto exactamente una vez, combinando reintentos con un receptor idempotente, es decir, uno que produce el mismo resultado si recibe el mismo evento una o diez veces.
La herramienta para lograrlo es el identificador de evento: un valor único que el emisor asigna a cada evento y repite, idéntico, en cada reintento. El receptor guarda los identificadores que ya procesó y, si uno se repite, responde 200 (para que el emisor deje de reintentar) sin volver a procesarlo. Si cada evento tiene una probabilidad $p$ de llegar repetido, con $n$ eventos al mes y $m$ al día:
$$ E[D] = n \cdot p, \qquad P(\text{al menos un duplicado en un día}) = 1 - (1 - p)^{m} $$
La lógica detrás de estas fórmulas es múltiple:
- Cada evento es un ensayo independiente que sale “duplicado” con probabilidad $p$; el número esperado de duplicados es la suma de esos ensayos, $n \cdot p$. Con $n = 1,560$ y $p = 0.03$, $E[D] = 46.8$ duplicados al mes.
- La probabilidad de que un día no haya ningún duplicado es $(1-p)^m$, la de que los $m$ eventos lleguen una sola vez; su complemento es la de que haya al menos uno.
- Con $m = 60$ y $p = 0.03$, $1 - 0.97^{60} \approx 0.84$: en la gran mayoría de los días hay algún duplicado. Un receptor sin deduplicación no falla de vez en cuando: falla casi todos los días.
- En conclusión, $p = 0.03$ parece una tasa pequeña hasta que se multiplica por el volumen; por eso la deduplicación no es una optimización, es parte del diseño mínimo.
El siguiente código simula las entregas de un mes con $1,560$ eventos de identificador único, en el que cada uno se reenvía con probabilidad $0.03$. Marca como encargo el $16.5%$ de los mensajes (los $468 \cdot 0.55 = 257.4$ encargos mensuales que llegan por WhatsApp, sobre $1,560$ mensajes), deduplica con un conjunto de identificadores y calcula lo que habría costado no hacerlo:
# Entregas al menos una vez y deduplicación por identificador de evento en Python:
p_dup = 0.03
ids = [f'evt_{i:05d}' for i in range(1, eventos_webhook + 1)]
es_pedido = dict(zip(ids, rng.random(len(ids)) < 468 * 0.55 / eventos_webhook))   # 16.5 % son encargos
entregas = []
for evento in ids:
    entregas.append(evento)
    if rng.random() < p_dup:                                  # el emisor no recibió el 200 y reenvía
        entregas.append(evento)

vistos, procesados, duplicados = set(), [], []
for evento in entregas:
    if evento in vistos:
        duplicados.append(evento)                             # se responde 200, pero no se procesa
        continue
    vistos.add(evento)
    procesados.append(evento)

pedidos_dobles = sum(es_pedido[e] for e in duplicados)
print('Eventos distintos:', len(ids), '| entregas recibidas:', len(entregas))
print('Duplicados detectados:', len(duplicados), f'| esperado n * p = {len(ids) * p_dup:.1f}')
print('Procesados una sola vez:', len(procesados))
print('Sin deduplicar habría', pedidos_dobles, 'encargos dobles al mes =',
      f'{pedidos_dobles * 380:,} MXN de pan hecho dos veces (ticket medio de 380 MXN)')
print(f'Probabilidad de al menos un duplicado en un día de 60 mensajes: {1 - (1 - p_dup) ** 60:.3f}')
Eventos distintos: 1560 | entregas recibidas: 1602
Duplicados detectados: 42 | esperado n * p = 46.8
Procesados una sola vez: 1560
Sin deduplicar habría 7 encargos dobles al mes = 2,660 MXN de pan hecho dos veces (ticket medio de 380 MXN)
Probabilidad de al menos un duplicado en un día de 60 mensajes: 0.839
De $1,560$ eventos distintos llegaron $1,602$ entregas: $42$ duplicados, cerca de los $46.8$ que predice $n \cdot p$. El conjunto vistos los detectó todos, y el receptor procesó cada evento exactamente una vez. Sin deduplicación, $7$ de esos duplicados habrían sido encargos, y al ticket medio de $380$ MXN eso son $2,660$ MXN al mes de pan hecho dos veces, más siete llamadas incómodas a clientes a los que se les cobró o se les entregó de más. La última línea confirma la fórmula: con 60 mensajes al día, la probabilidad de que un día tenga al menos un duplicado es de $0.839$.
Hay dos detalles de diseño que el bloque deja ver y que conviene subrayar:
- El duplicado se responde con 200, no con un error. Si el receptor respondiera
409o500, el emisor entendería que el evento no se procesó y seguiría reintentando, con lo que fabricaría más duplicados. Para el emisor, “ya lo tenía” es un éxito. - El conjunto de identificadores crece. Con $1,560$ identificadores al mes no hay problema, pero un receptor que funcione años debe olvidar los antiguos. Lo habitual es guardarlos con una caducidad algo mayor que el periodo de reintentos del emisor (por ejemplo, 7 días) en una tabla de la base de datos, que el Día 4 creará como
trigo_lento.sqlite.
Webhooks seguros
La deduplicación protege contra los errores del emisor legítimo. Falta protegerse de algo peor: de alguien que no es el emisor. La URL de un webhook es, al fin y al cabo, una dirección pública de internet. Si un tercero la descubre (porque se compartió en una captura de pantalla, porque quedó en un registro, porque se adivinó), puede enviar peticiones con la forma exacta de un pedido de WhatsApp. Un receptor que acepta todo lo que llega a su URL acepta también los pedidos falsos.
Atención aquí: Un webhook sin firma es una puerta sin cerradura. Cualquiera que conozca la URL puede inyectar pedidos falsos, cancelar encargos reales si el flujo lo permite o llenar la cola de basura en plena hora pico. La URL secreta no es una protección suficiente: se filtra en capturas, registros e historiales. Todo receptor de la serie verificará la firma del emisor antes de procesar nada, guardará el secreto de firma fuera del código (en una variable de entorno, en la conexión de Make o en las credenciales de n8n) y responderá 401 a cualquier petición que no la supere.
Firma HMAC
La defensa estándar es que emisor y receptor compartan un secreto que nadie más conoce y que el emisor firme cada petición con él. La firma se calcula con un código de autenticación de mensajes basado en hash (o HMAC, por sus siglas en inglés: “Hash-based Message Authentication Code”), definido por Krawczyk, Bellare y Canetti en el RFC 2104:
$$ \mathrm{HMAC}(K, m) = H\big((K’ \oplus \mathit{opad}) ,\Vert, H((K’ \oplus \mathit{ipad}) ,\Vert, m)\big) $$
La lógica detrás de esta fórmula es múltiple:
- $H$ es una función hash criptográfica, aquí SHA-256, que convierte cualquier texto en $32$ bytes que cambian por completo si cambia una sola letra. $m$ es el mensaje que se firma y $K’$ es el secreto ajustado al tamaño de bloque de $H$.
- $\mathit{ipad}$ y $\mathit{opad}$ son dos constantes fijas, y $\oplus$ es la operación XOR bit a bit; $\Vert$ significa concatenar. El hash se aplica dos veces, una con cada máscara, para que no se pueda extender una firma válida añadiendo texto al final, un ataque que sí funciona con un hash simple de “secreto más mensaje”.
- Sin conocer $K$, nadie puede calcular la firma correcta de un mensaje nuevo ni de uno alterado. Basta con que el receptor recalcule la firma con su copia del secreto y la compare con la que llegó.
- En conclusión, la firma demuestra dos cosas a la vez: que la petición la envió alguien que conoce el secreto (autenticidad) y que nadie la cambió por el camino (integridad).
La firma, sin embargo, no protege de un tercer ataque: la repetición. Quien capture una petición legítima, con su firma válida, puede reenviarla tal cual horas después, y la firma seguirá cuadrando. Por eso la especificación Standard Webhooks, que siguen cada vez más proveedores, firma no solo el cuerpo, sino la cadena id.marca.cuerpo, donde la marca es el instante del envío en segundos, y pide al receptor que rechace las marcas fuera de una tolerancia $\tau$:
$$ \lvert t_{\text{recepción}} - t_{\text{marca}} \rvert \leq \tau, \qquad \tau = 300 \text{ s} $$
Como la marca está dentro de lo firmado, el atacante no puede actualizarla sin invalidar la firma. Una repetición tardía queda fuera de la ventana de 5 minutos, y una repetición rápida, dentro de la ventana, choca con la deduplicación por identificador de la sección anterior. Las dos defensas se cubren mutuamente.
El siguiente código implementa la firma y la verificación al estilo de Standard Webhooks: la firma viaja en la cabecera webhook-signature con el prefijo de versión v1, y codificada en base64, y la comparación se hace con hmac.compare_digest, que tarda lo mismo acierte o falle en el primer carácter, para no dar pistas a quien intente adivinar la firma midiendo tiempos. Se prueban tres casos: una petición válida, una con el cuerpo alterado y una repetición diez minutos después:
# Firma y verificación HMAC-SHA256 con marca de tiempo y tolerancia de 5 minutos en Python:
SECRETO = b'clave-de-prueba-solo-para-este-ejemplo'          # en producción, desde una variable de entorno
TOLERANCIA = 300                                              # segundos (5 minutos)
CDMX = timezone(timedelta(hours = -6))

def firmar(id_evento, marca, cuerpo, secreto = SECRETO):
    # Se firma "id.marca.cuerpo", como propone la especificación Standard Webhooks:
    contenido = f'{id_evento}.{marca}.{cuerpo}'.encode('utf-8')
    return 'v1,' + base64.b64encode(hmac.new(secreto, contenido, hashlib.sha256).digest()).decode()

def verificar(cabeceras, cuerpo, ahora, secreto = SECRETO):
    esperada = firmar(cabeceras['webhook-id'], cabeceras['webhook-timestamp'], cuerpo, secreto)
    if not hmac.compare_digest(esperada, cabeceras['webhook-signature']):   # comparación en tiempo constante
        return 401, 'firma inválida'
    if abs(ahora - int(cabeceras['webhook-timestamp'])) > TOLERANCIA:
        return 401, 'marca de tiempo fuera de tolerancia'
    return 200, 'válido'

marca = int(datetime(2026, 2, 3, 10, 15, 42, tzinfo = CDMX).timestamp())
cuerpo = json.dumps({'id_evento': 'evt_00042', 'canal': 'whatsapp', 'texto': 'Me aparta 2 conchas para mañana'},
                    ensure_ascii = False)
cabeceras = {'webhook-id': 'evt_00042', 'webhook-timestamp': str(marca),
             'webhook-signature': firmar('evt_00042', marca, cuerpo)}
print('Marca de tiempo:', marca, '| firma:', cabeceras['webhook-signature'])
casos = [('Válido, llega 2 s después', cuerpo, marca + 2),
         ('Cuerpo alterado (2 -> 20 conchas)', cuerpo.replace('2 conchas', '20 conchas'), marca + 2),
         ('Repetición 10 min después', cuerpo, marca + 600)]
for nombre, cuerpo_recibido, instante in casos:
    estado, motivo = verificar(cabeceras, cuerpo_recibido, instante)
    print(f'{nombre:<34} -> {estado} {motivo}')
Marca de tiempo: 1770135342 | firma: v1,oobNn2ndrUfYd9lAQGmsAplt8/t3YrBaN8KjPbwa1ts=
Válido, llega 2 s después          -> 200 válido
Cuerpo alterado (2 -> 20 conchas)  -> 401 firma inválida
Repetición 10 min después          -> 401 marca de tiempo fuera de tolerancia
Los tres casos se comportan como deben. La petición válida, que llega dos segundos después de firmarse, obtiene 200 válido. La que cambió “2 conchas” por “20 conchas” obtiene 401 firma inválida: bastó un carácter para que el HMAC no se pareciera en nada al original. Y la repetición de la petición intacta diez minutos después, con su firma perfectamente correcta, obtiene 401 marca de tiempo fuera de tolerancia. La marca $1,770,135,342$ corresponde al 3 de febrero de 2026 a las 10:15:42 en Ciudad de México, en segundos desde el 1 de enero de 1970 en UTC, la convención habitual.
Dos precisiones sobre el secreto. En el bloque aparece escrito en el código solo porque es un ejemplo sin consecuencias; en un receptor real se lee de una variable de entorno o de la caja de credenciales de la plataforma, y nunca aparece en un blueprint exportado ni en un repositorio. Y cada proveedor tiene su esquema: Meta firma las notificaciones de WhatsApp con HMAC-SHA256 del cuerpo en la cabecera X-Hub-Signature-256, sin marca de tiempo, y Twilio usa la cabecera X-Twilio-Signature con su propio algoritmo. Cuando el proveedor no firma la marca, la deduplicación por identificador del mensaje pasa a ser la única defensa contra la repetición, y se vuelve todavía más importante.
El receptor completo
Falta juntar todo en un receptor. El orden de las comprobaciones importa: primero la firma (lo que no está firmado no merece ni leerse), después la marca de tiempo, después el identificador y, solo al final, el procesamiento. El siguiente código define simular_post, la función de la serie que imita una petición HTTP sin red: entrega la petición al receptor y, con una probabilidad declarada de $0.03$, pierde la respuesta por el camino y devuelve un 504 al emisor, aunque el receptor sí la haya procesado. El emisor reintenta hasta tres veces, cada vez con una marca de tiempo nueva y el mismo identificador.
Sobre ese canal se envían los $1,647$ mensajes legítimos del mes simulado y tres tipos de tráfico hostil: $25$ pedidos falsos firmados con una clave adivinada, $10$ capturas de peticiones legítimas repetidas diez minutos después y las mismas $10$ capturas repetidas solo 90 segundos después. El receptor escribe un registro en trigo_lento/registro_eventos_dia3.csv con el identificador, el canal, el instante, el resultado y un hash del remitente, sin el texto del mensaje:
# Receptor de webhook simulado con firma, marca de tiempo y deduplicación usando simular_post en Python:
class Respuesta:
    def __init__(self, status_code, cuerpo):
        self.status_code, self.headers, self._cuerpo = status_code, {'content-type': 'application/json'}, cuerpo
    def json(self):
        return self._cuerpo

registro, ya_procesados = [], set()
def receptor(cabeceras, cuerpo, ahora):
    estado, motivo = verificar(cabeceras, cuerpo, ahora)
    if estado == 200 and cabeceras['webhook-id'] in ya_procesados:
        motivo = 'duplicado'                                  # 200 para que el emisor deje de reintentar
    elif estado == 200:
        ya_procesados.add(cabeceras['webhook-id'])
        motivo = 'aceptado'
    evento = json.loads(cuerpo)
    registro.append({'id_evento': cabeceras['webhook-id'], 'canal': evento['canal'], 'recibido_en': ahora,
                     'remitente_hash': hashlib.sha256(evento['remitente'].encode()).hexdigest()[:12],
                     'resultado': motivo})                    # sin el texto del cliente
    return Respuesta(estado, {'resultado': motivo})

RECEPTORES = {'https://ejemplo.invalid/webhooks/pedidos': receptor}
URL = 'https://ejemplo.invalid/webhooks/pedidos'

def simular_post(url, cuerpo, rng, cabeceras = None, ahora = 0, p_perdida = 0.03):
    # Entrega la petición; con probabilidad p_perdida la respuesta no vuelve al emisor (504):
    respuesta = RECEPTORES[url](cabeceras, cuerpo, ahora)
    return Respuesta(504, {'error': 'sin respuesta a tiempo'}) if rng.random() < p_perdida else respuesta

def emitir(id_evento, cuerpo, instante, secreto = SECRETO, max_intentos = 3):
    # El emisor firma cada intento con su propia marca de tiempo y reintenta si no recibe 2xx:
    for intento in range(max_intentos):
        t = instante + 5 * intento
        cab = {'webhook-id': id_evento, 'webhook-timestamp': str(t),
               'webhook-signature': firmar(id_evento, t, cuerpo, secreto)}
        if simular_post(URL, cuerpo, rng, cab, ahora = t).status_code == 200:
            return intento + 1
    return max_intentos

origen = int(datetime(2026, 2, 2, tzinfo = CDMX).timestamp())
capturas, intentos = [], []
for i, h in enumerate(mes, start = 1):
    id_evento, instante = f'evt_{i:05d}', origen + int(h * 3600)
    cuerpo_i = json.dumps({'id_evento': id_evento, 'canal': 'whatsapp', 'remitente': f'+52 55 0000 {i % 100:04d}',
                           'texto': 'mensaje de juguete'}, ensure_ascii = False)
    intentos.append(emitir(id_evento, cuerpo_i, instante))
    if i % 150 == 0:
        capturas.append((id_evento, cuerpo_i, instante))      # lo que un atacante podría haber copiado
for k in range(25):                                           # pedidos falsos firmados con otra clave
    falso = json.dumps({'id_evento': f'evt_x{k}', 'canal': 'whatsapp', 'remitente': '+52 55 0000 9999',
                        'texto': 'pedido falso'}, ensure_ascii = False)
    emitir(f'evt_x{k}', falso, origen + 86400 + 60 * k, secreto = b'clave-adivinada', max_intentos = 1)
for id_evento, cuerpo_i, instante in capturas:                # repeticiones: tardías y casi inmediatas
    for retraso in (600, 90):
        cab = {'webhook-id': id_evento, 'webhook-timestamp': str(instante), 'webhook-signature': firmar(id_evento, instante, cuerpo_i)}
        receptor(cab, cuerpo_i, instante + retraso)

resultados = pd.DataFrame(registro)
print('Peticiones recibidas:', len(resultados), '| eventos legítimos:', len(mes),
      '| reintentos del emisor:', sum(intentos) - len(intentos))
print(resultados['resultado'].value_counts().to_string())
resultados.to_csv(carpeta / 'registro_eventos_dia3.csv', index = False)
print(resultados.head(3).to_string(index = False))
Peticiones recibidas: 1732 | eventos legítimos: 1647 | reintentos del emisor: 40
resultado
aceptado                               1647
duplicado                                50
firma inválida                           25
marca de tiempo fuera de tolerancia      10
id_evento    canal  recibido_en remitente_hash resultado
evt_00001 whatsapp   1770037976   2cbecc8e7960  aceptado
evt_00002 whatsapp   1770039540   062c93af663b  aceptado
evt_00003 whatsapp   1770039782   3419bb0054d1  aceptado
El receptor recibió $1,732$ peticiones y las clasificó como se resume en la Tabla 4.
Tabla 4. Peticiones recibidas por el webhook simulado en un mes y decisión del receptor.
| Resultado | Peticiones | De dónde vienen | Respuesta HTTP | ¿Se procesa? |
|---|---|---|---|---|
| Aceptado | 1 647 | Primer envío de cada mensaje legítimo | 200 | Sí, una vez |
| Duplicado | 50 | 40 reintentos del emisor y 10 repeticiones a los 90 s | 200 | No |
| Firma inválida | 25 | Pedidos falsos firmados con una clave adivinada | 401 | No |
| Marca fuera de tolerancia | 10 | Repeticiones de capturas legítimas a los 10 min | 401 | No |
| Total | 1 732 | 1 647 |
Los $1,647$ mensajes legítimos se procesaron exactamente una vez, a pesar de los $40$ reintentos que provocaron las respuestas perdidas. Ningún pedido falso pasó: los $25$ chocaron con la firma. Las repeticiones muestran las dos defensas trabajando en equipo: las $10$ tardías fueron rechazadas por la marca de tiempo y las $10$ rápidas, que llegaron dentro de la ventana de 5 minutos con firma y marca válidas, fueron detenidas por el identificador y contadas como duplicados. Si faltara cualquiera de las tres comprobaciones, alguna de esas filas se habría colado en la cola de encargos.
Las tres primeras filas del registro enseñan lo que se guarda: identificador, canal, instante y resultado, más remitente_hash, los primeros 12 caracteres del SHA-256 del teléfono. Es suficiente para auditar, contar mensajes por cliente o investigar un incidente, y no guarda lo que el cliente escribió. Conviene ser honestos con el hash: un teléfono mexicano tiene diez dígitos, y probar los $10^{10}$ posibles es trivial para un ordenador, así que un SHA-256 sin clave no anonimiza, solo evita que el número aparezca a simple vista. El Día 6 sustituirá ese hash por una seudonimización con clave, que no se puede revertir sin el secreto.
Todas las piezas de esta sección se reúnen en la Figura 2.
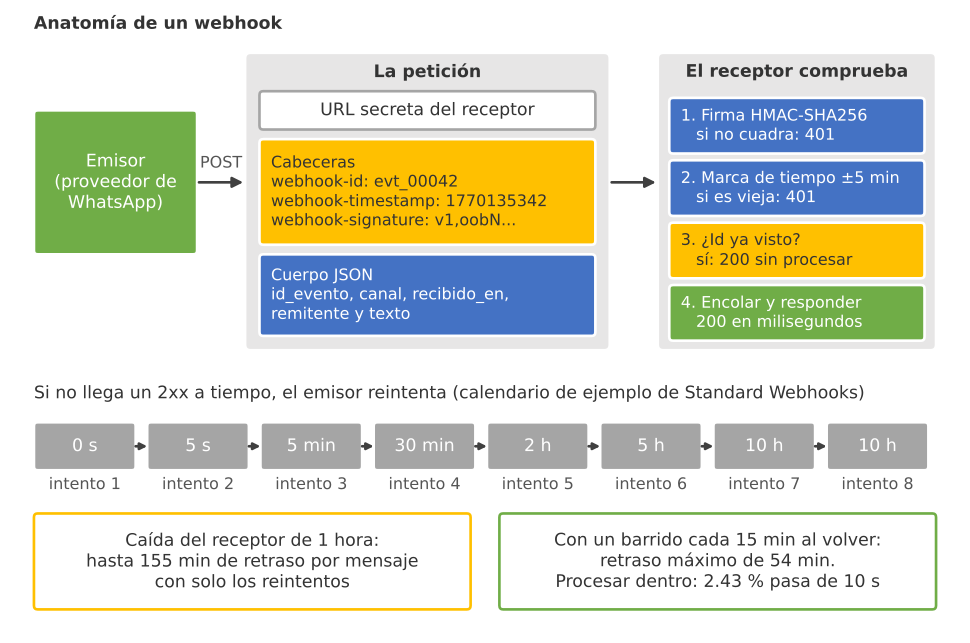
Figura 2. Anatomía de un webhook: el emisor envía un POST firmado con id, marca de tiempo y firma; el receptor comprueba firma, tolerancia de 5 minutos e identificador, responde 200 en milisegundos y, si no lo hace, el emisor reintenta según su calendario.
La figura se lee de izquierda a derecha y de arriba abajo. La petición tiene tres partes: la URL (que debe tratarse como secreta, aunque no sea una protección por sí sola), las cabeceras con el identificador, la marca y la firma, y el cuerpo JSON con los datos del evento. El receptor aplica las cuatro comprobaciones en orden y responde. La fila inferior es el calendario de reintentos del emisor, que se usará en la última sección, y las dos cajas del pie adelantan sus resultados.
Los disparadores de Trigo Lento
Con los tipos, sus costes y sus defensas claros, Valeria ya puede decidir qué disparador pone en marcha cada flujo de Trigo Lento. Antes, un vistazo a lo que entrará por el disparador principal. El siguiente bloque es el cuerpo de ejemplo de un webhook de pedido tal como lo recibirá el receptor, con los campos que se usaron en los bloques anteriores. Es el primer borrador de un contrato de datos, que el Día 4 formalizará con tipos, campos obligatorios y reglas de validación; los datos son inventados y el teléfono usa el formato de prueba de la serie:
{
  "id_evento": "evt_00042",
  "tipo": "mensaje.recibido",
  "canal": "whatsapp",
  "recibido_en": "2026-02-03T10:15:42-06:00",
  "remitente": "+52 55 0000 0042",
  "texto": "Buenos días, ¿me aparta 2 conchas de vainilla para mañana a las 9?",
  "adjuntos": []
}
Cada campo tiene una razón de ser. id_evento es la clave de la deduplicación y debe ser único y estable entre reintentos. tipo permite que el mismo receptor distinga en el futuro mensajes, confirmaciones de lectura o bajas, sin cambiar de URL. canal dice por dónde entró, porque el mismo receptor atenderá WhatsApp, Instagram y el formulario. recibido_en lleva la zona horaria explícita (-06:00), para que nadie tenga que adivinarla. remitente y texto son los únicos datos personales del cuerpo y, como se vio en el registro del Bloque 8, el texto se usa para procesar el pedido pero no se guarda en la bitácora. adjuntos queda vacío hoy, pero existe para que una foto de un pastel de referencia no rompa el flujo el día que llegue.
La Tabla 2 recoge la decisión de Valeria para cada flujo, con su frecuencia al mes: los $1,560$ mensajes de WhatsApp y, para los otros canales, los encargos que reciben según el reparto del Día 1 ($20%$, $15%$ y $10%$ de $468$).
Tabla 2. Disparadores de Trigo Lento: tipo, activación, frecuencia al mes y por qué.
| Flujo | Disparador | Activación | Veces al mes | Por qué este tipo |
|---|---|---|---|---|
| Mensajes de WhatsApp | Webhook del proveedor | Mensaje entrante | 1 560 | El canal con más volumen: latencia de segundos y ninguna comprobación vacía |
| Mensajes directos de Instagram | Webhook | Mensaje directo | 93.6 | Mismo receptor y mismas defensas que WhatsApp |
| Formulario web | Webhook | Envío del formulario | 70.2 | El formulario es propio: puede firmar sus envíos con el mismo esquema |
| Encargos por teléfono | Manual | Captura de Valeria en un formulario corto | 46.8 | Una llamada la atiende una persona; la persona es el control |
| Resumen diario | Programado | 0 7 * * 1-6 | 26 | Debe estar listo antes de las 8 de lunes a sábado |
| Inventario de harina | Programado (semanal) | 0 18 * * 6 | 4 | Depende del calendario, no de un evento |
El siguiente código construye la misma tabla con pandas, guarda la ficha del Día 1 ampliada con su sección de disparadores en un archivo nuevo, trigo_lento/ficha_encargos_dia3.json (el original del Día 1 no se toca), y dibuja el mapa de disparadores con la función dibujar_flujo que el Día 2 presentó. Como cada entrada debe entenderse sola, la función se copia completa con su paleta de formas: disparadores en óvalo verde, acciones en rectángulo azul, decisiones en rombo naranja, errores en rojo y pasos humanos en hexágono gris:
# Mapa de disparadores de Trigo Lento con dibujar_flujo en Python:
from matplotlib.patches import Ellipse, FancyBboxPatch, Polygon, RegularPolygon, FancyArrowPatch

FORMAS = {   # paleta de formas de la serie: tipo -> (forma, relleno)
    'disparador': ('ovalo', '#3a9d5d'), 'accion': ('rectangulo', '#2a78d6'),
    'decision': ('rombo', '#eb6834'), 'ia': ('rectangulo', '#7b5ea7'),
    'error': ('rectangulo', '#c8423b'), 'humano': ('hexagono', '#8a8986'),
}

def dibujar_flujo(nodos, aristas, titulo, ancho = 1.9, alto = 0.9):
    fig, ax = plt.subplots(figsize = (12, 5.6))
    for n in nodos:
        forma, color = FORMAS[n['tipo']]
        x, y = n['x'], n['y']
        if forma == 'ovalo':
            figura = Ellipse((x, y), ancho, alto)
        elif forma == 'rombo':
            figura = Polygon([(x - ancho / 2, y), (x, y + alto / 1.4), (x + ancho / 2, y), (x, y - alto / 1.4)])
        elif forma == 'hexagono':
            figura = RegularPolygon((x, y), 6, radius = ancho / 2, orientation = np.pi / 6)
        else:
            figura = FancyBboxPatch((x - ancho / 2, y - alto / 2), ancho, alto, boxstyle = 'round,pad=0.03')
        figura.set_facecolor(color)
        figura.set_edgecolor('white')
        figura.set_linewidth(2)
        ax.add_patch(figura)
        ax.text(x, y, n['texto'], ha = 'center', va = 'center', fontsize = 9.5, color = 'white')
    posicion = {n['id']: (n['x'], n['y']) for n in nodos}
    for origen, destino, etiqueta in aristas:
        (x1, y1), (x2, y2) = posicion[origen], posicion[destino]
        ax.add_patch(FancyArrowPatch((x1, y1), (x2, y2), arrowstyle = '-|>', mutation_scale = 14,
                                     shrinkA = 42, shrinkB = 44, color = '#52514e', linewidth = 1.4))
        if etiqueta:
            ax.text((x1 + x2) / 2, (y1 + y2) / 2 + 0.18, etiqueta, ha = 'center', fontsize = 8.5,
                    color = '#52514e', bbox = dict(facecolor = 'white', edgecolor = 'none', pad = 1))
    xs, ys = [n['x'] for n in nodos], [n['y'] for n in nodos]
    ax.set_xlim(min(xs) - 1.3, max(xs) + 1.3)
    ax.set_ylim(min(ys) - 1.1, max(ys) + 1.1)
    ax.set_aspect('equal')
    ax.axis('off')
    ax.set_title(titulo, fontsize = 16)
    return fig, ax

disparadores = pd.DataFrame({
    'disparador': ['WhatsApp', 'Instagram', 'Formulario web', 'Teléfono', 'Resumen diario', 'Inventario de harina'],
    'tipo': ['webhook', 'webhook', 'webhook', 'manual', 'programado', 'programado'],
    'activacion': ['mensaje entrante', 'mensaje directo', 'envío del formulario', 'captura de Valeria',
                   '0 7 * * 1-6', '0 18 * * 6'],
    'veces_mes': [eventos_webhook, round(468 * 0.20, 1), round(468 * 0.15, 1), round(468 * 0.10, 1),
                  contar('0 7 * * 1-6', inicio_mes), contar('0 18 * * 6', inicio_mes)]})
print(disparadores.to_string(index = False))
print('Disparos al mes:', disparadores['veces_mes'].sum())

# La ficha del Día 1 gana su sección de disparadores (archivo nuevo, con sufijo del día):
ficha = json.loads((carpeta / 'ficha_encargos.json').read_text(encoding = 'utf-8'))
ficha['disparadores'] = disparadores.to_dict(orient = 'records')
(carpeta / 'ficha_encargos_dia3.json').write_text(json.dumps(ficha, ensure_ascii = False, indent = 2),
                                                 encoding = 'utf-8')

nodos = [
    {'id': 'd1', 'tipo': 'disparador', 'texto': 'WhatsApp\n(webhook)', 'x': 0, 'y': 4.2},
    {'id': 'd2', 'tipo': 'disparador', 'texto': 'Instagram\n(webhook)', 'x': 0, 'y': 2.8},
    {'id': 'd3', 'tipo': 'disparador', 'texto': 'Formulario\n(webhook)', 'x': 0, 'y': 1.4},
    {'id': 'd4', 'tipo': 'humano', 'texto': 'Teléfono:\ncaptura', 'x': 0, 'y': -0.1},
    {'id': 'd5', 'tipo': 'disparador', 'texto': 'Cron 07:00\nlun a sáb', 'x': 0, 'y': -1.7},
    {'id': 'd6', 'tipo': 'disparador', 'texto': 'Cron sábado\n18:00', 'x': 0, 'y': -3.1},
    {'id': 'a1', 'tipo': 'accion', 'texto': 'Verificar\nfirma y hora', 'x': 3.2, 'y': 2.8},
    {'id': 'r1', 'tipo': 'decision', 'texto': '¿Válido\ny nuevo?', 'x': 6.0, 'y': 2.8},
    {'id': 'a2', 'tipo': 'accion', 'texto': 'Cola de\nencargos', 'x': 8.8, 'y': 1.4},
    {'id': 'e1', 'tipo': 'error', 'texto': 'Rechazo 401\no duplicado', 'x': 8.8, 'y': 4.2},
    {'id': 'a3', 'tipo': 'accion', 'texto': 'Resumen\ndel día', 'x': 3.2, 'y': -1.7},
    {'id': 'a4', 'tipo': 'accion', 'texto': 'Revisar\nharina', 'x': 3.2, 'y': -3.1},
]
aristas = [('d1', 'a1', ''), ('d2', 'a1', ''), ('d3', 'a1', ''), ('a1', 'r1', ''), ('r1', 'a2', 'sí'),
           ('r1', 'e1', 'no'), ('d4', 'a2', 'sin firma'),
           ('d5', 'a3', ''), ('d6', 'a4', '')]
fig, ax = dibujar_flujo(nodos, aristas, 'Mapa de disparadores de Trigo Lento')
print('Nodos por tipo:', pd.Series([n['tipo'] for n in nodos]).value_counts().to_dict())
plt.tight_layout()
plt.show()
          disparador       tipo           activacion  veces_mes
            WhatsApp    webhook     mensaje entrante     1560.0
           Instagram    webhook      mensaje directo       93.6
      Formulario web    webhook envío del formulario       70.2
            Teléfono     manual   captura de Valeria       46.8
      Resumen diario programado          0 7 * * 1-6       26.0
Inventario de harina programado           0 18 * * 6        4.0
Disparos al mes: 1800.6
Nodos por tipo: {'disparador': 5, 'accion': 4, 'humano': 1, 'decision': 1, 'error': 1}
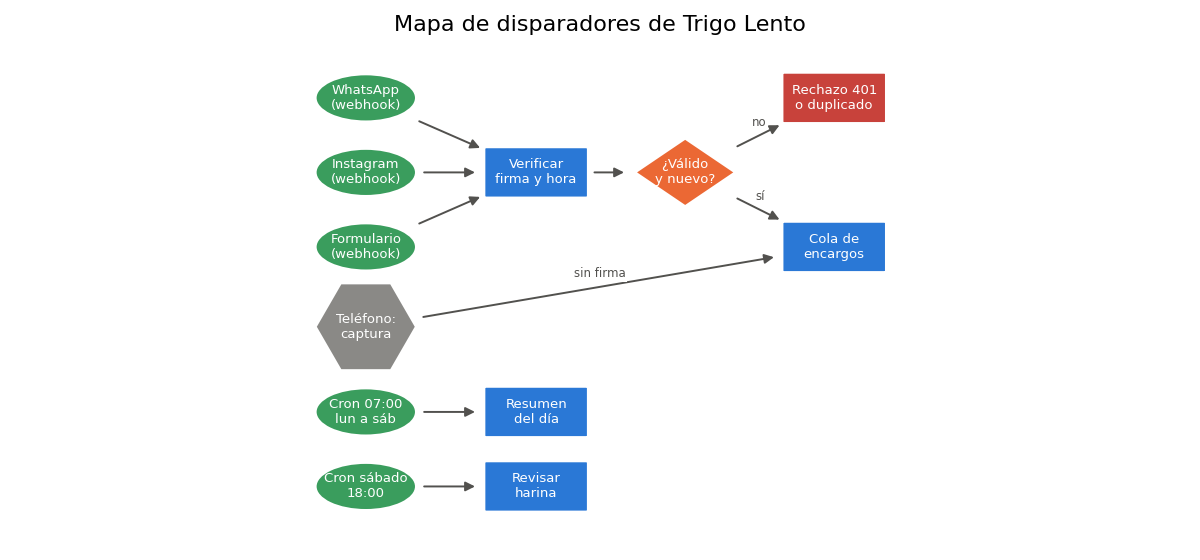
En un mes, los seis disparadores suman unos $1,800$ disparos, de los que $1,723.8$ (el $95.7%$) llegan por webhook. El mapa hace visible una decisión de arquitectura que la tabla no muestra: los tres webhooks convergen en un solo receptor que verifica la firma y la hora y decide, en el rombo, si el evento es válido y nuevo. Lo válido va a la cola de encargos; lo falso, lo tardío o lo repetido va a la caja roja, donde se responde 401 o se descarta el duplicado. Un único receptor significa un único sitio donde poner las defensas y un único registro que auditar.
El teléfono entra a la cola de encargos por otro camino, sin firma, y la etiqueta de la flecha lo dice: ahí la persona es el control. Y los dos cron viven aparte, porque no reaccionan a nada: el reloj los dispara aunque no haya llegado ni un mensaje. La Figura 3 pone esos disparadores sobre el reloj de un día cualquiera.
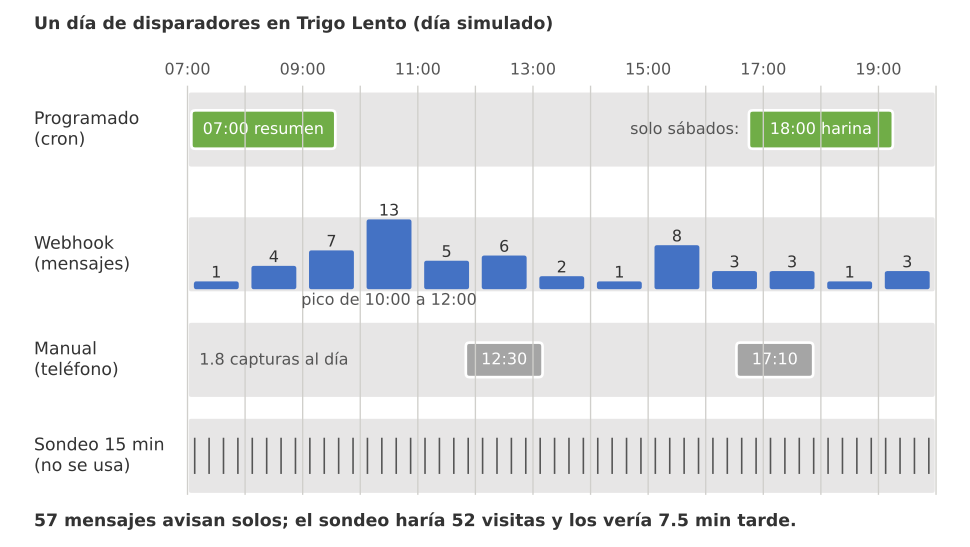
Figura 3. Un día de disparadores en Trigo Lento: el cron del resumen a las 07:00, los 57 mensajes del día simulado que llegan por webhook, las capturas manuales del teléfono y las 52 comprobaciones que haría un sondeo cada 15 minutos en horario de apertura.
La línea de tiempo resume el día en cuatro carriles. Arriba, el cron: una ejecución a las 07:00, y la del inventario solo si el día es sábado. Debajo, los $57$ mensajes del día simulado, con su pico de $13$ a las 10:00, cada uno de los cuales dispara el flujo por sí mismo. Más abajo, las capturas manuales, unas $1.8$ al día ($46.8$ al mes entre 26 días). Y en el último carril, gris, las $52$ visitas que haría un sondeo cada 15 minutos solo en horario de apertura: más visitas que mensajes, y cada mensaje visto, en promedio, $7.5$ minutos tarde.
El resumen de las 07:00 tiene, además, una destinataria indirecta. Marisol Peña dejó claro el Día 1 que necesita saber antes de las 8 si sus 40 baguettes del día siguiente están confirmadas. Un resumen programado a las 07:00 con los encargos confirmados, incluido el suyo, convierte su requisito en una hora de disparo. “No me importa cómo lo hagan”, le dijo a Valeria por teléfono, “pero si a las 8 no tengo la confirmación, para mí no existe.” Es un acuerdo de nivel de servicio en una frase, y el Día 8 lo medirá.
Lo que dijo Don Ernesto
Queda la pregunta de la introducción: ¿y si se va el internet a las once? Hay que empezar por precisarla, porque tiene dos versiones. Si se va el internet de la panadería, el receptor ni se entera: vive en la nube (en Make, en n8n Cloud o en el servidor que el módulo 4 alquilará fuera del local), y los mensajes de los clientes siguen llegando a él. Lo que se interrumpe es la vista de Valeria, que verá los encargos acumulados cuando vuelva la conexión. Por eso el receptor de un webhook nunca debe vivir en la computadora del mostrador.
La versión seria es la otra: que se caiga el receptor, por una actualización, un reinicio del servidor o un fallo de la plataforma. Entonces entra en juego el emisor, que no recibe su 200 y reintenta según su propio calendario. Un calendario habitual en la industria, el que documenta por ejemplo Svix (una de las empresas detrás de Standard Webhooks), espera $0$ segundos, $5$ segundos, $5$ minutos, $30$ minutos, $2$ horas, $5$ horas, $10$ horas y $10$ horas entre intentos. Es un calendario prudente para no saturar a un receptor caído, y tiene una consecuencia que pocos calculan: si los primeros intentos caen dentro de la caída, el siguiente puede llegar horas después de que el receptor ya se haya recuperado.
Hay una segunda forma, más silenciosa, de provocar reintentos: responder tarde. El emisor espera la respuesta un tiempo limitado; si el receptor procesa el pedido entero antes de responder (leerlo, llamar a un modelo para clasificarlo, escribir en la hoja), cualquier procesamiento lento supera ese plazo, el emisor da el envío por fallido y reintenta un evento que sí se procesó. El siguiente código simula las dos situaciones con el día del Bloque 2: una caída del receptor de 11:00 a 12:00, con y sin un barrido de rescate cada 15 minutos (un cron que, al volver el servicio, consulta al proveedor los eventos que no se pudieron entregar, si el proveedor lo permite), y un procesamiento dentro del webhook con tiempos lognormales de mediana $3$ segundos frente a un plazo del emisor de $10$ segundos, ambos supuestos declarados:
# Caída del receptor de 11:00 a 12:00, reintentos del emisor y tiempo de respuesta en Python:
CALENDARIO = [0, 5, 300, 1800, 7200, 18000, 36000, 36000]    # segundos antes de cada intento
caida = (11 * 3600, 12 * 3600)                               # receptor sin servicio, en segundos del día

def entregar(t0, barrido = None):
    # Devuelve el instante de entrega: el primer intento fuera de la caída o el barrido de rescate:
    t = t0
    for espera in CALENDARIO:
        t += espera
        if not caida[0] <= t < caida[1]:
            break
    if barrido:                                               # barrido de rescate cada 'barrido' segundos
        t = min(t, caida[1] + (-caida[1]) % barrido)
    return t

llegada = dia * 3600
afectados = llegada[(llegada >= caida[0]) & (llegada < caida[1])]
solo_webhook = np.array([entregar(t) for t in afectados]) - afectados
con_barrido = np.array([entregar(t, barrido = 900) for t in afectados]) - afectados
print('Mensajes que llegaron durante la caída:', len(afectados))
print(pd.DataFrame({'llegada': [f'{int(t // 3600)}:{int(t % 3600 // 60):02d}' for t in afectados],
                    'retraso_webhook_min': (solo_webhook / 60).round(1),
                    'retraso_con_barrido_min': (con_barrido / 60).round(1)}).to_string(index = False))

# Responder rápido: procesar dentro del webhook frente a acusar recibo y encolar:
plazo = 10                                                    # segundos que espera el emisor (supuesto)
sincrono = rng.lognormal(np.log(3), 0.6, size = 10000)        # leer, llamar a un modelo y escribir
print(f'Procesando dentro del webhook: {100 * (sincrono > plazo).mean():.2f} % supera {plazo} s y provoca reintento')
print('Acusando recibo y encolando: 0.00 % (se responde 200 en milisegundos)')

fig, (ax1, ax2) = plt.subplots(1, 2, figsize = (11, 4.6))
x = np.arange(len(afectados))
ax1.bar(x - 0.2, solo_webhook / 60, width = 0.4, color = '#eb6834', label = 'Solo reintentos del emisor')
ax1.bar(x + 0.2, con_barrido / 60, width = 0.4, color = '#2a78d6', label = 'Con barrido cada 15 min')
ax1.set_xticks(x)
ax1.set_xticklabels([f'{int(t // 3600)}:{int(t % 3600 // 60):02d}' for t in afectados])
ax1.set_xlabel('Hora de llegada del mensaje')
ax1.set_ylabel('Minutos de retraso en la entrega')
ax1.set_title('Caída del receptor de 11:00 a 12:00', fontsize = 12)
ax1.legend(frameon = False)
ax2.hist(sincrono, bins = np.arange(0, 20.5, 0.5), color = '#8a8986', edgecolor = 'white')
ax2.axvline(plazo, color = '#c8423b', linestyle = '--', linewidth = 2)
ax2.text(plazo + 0.4, ax2.get_ylim()[1] * 0.85, f'plazo del emisor: {plazo} s', color = '#c8423b', fontsize = 10)
ax2.set_xlabel('Segundos de procesamiento dentro del webhook')
ax2.set_ylabel('Peticiones')
ax2.set_title('Procesar antes de responder', fontsize = 12)
for a in (ax1, ax2):
    a.spines[['top', 'right']].set_visible(False)
fig.suptitle('Lo que dijo Don Ernesto: caídas y respuestas lentas', fontsize = 16)
plt.tight_layout()
plt.show()
Mensajes que llegaron durante la caída: 5
llegada  retraso_webhook_min  retraso_con_barrido_min
  11:05                155.1                     54.4
  11:19                155.1                     40.4
  11:29                 35.1                     30.0
  11:31                 35.1                     28.8
  11:54                 35.1                      5.7
Procesando dentro del webhook: 2.43 % supera 10 s y provoca reintento
Acusando recibo y encolando: 0.00 % (se responde 200 en milisegundos)
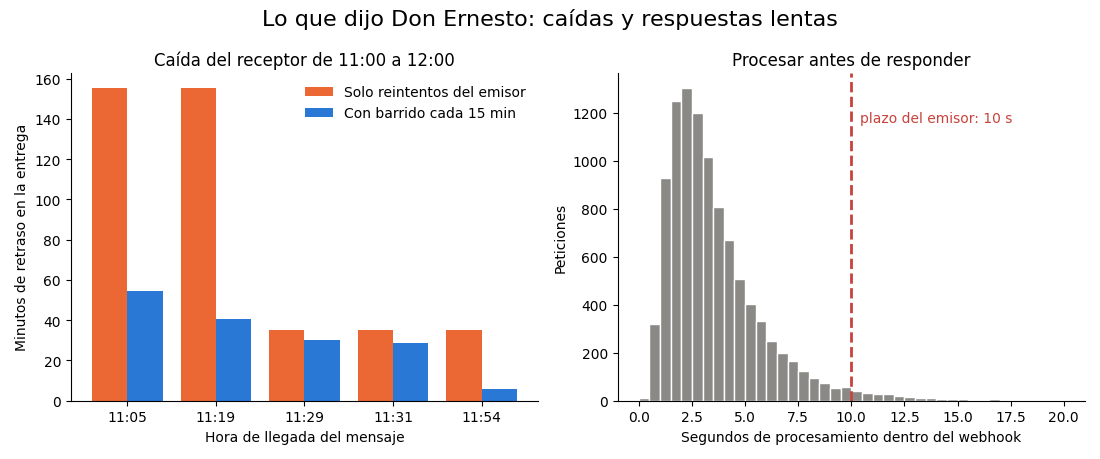
Durante la hora de caída llegaron $5$ mensajes, y sus retrasos cuentan la historia del calendario de reintentos. Los que llegaron a las 11:05 y a las 11:19 tuvieron su cuarto intento a los 35 minutos, todavía dentro de la caída, y el quinto llegó dos horas después: $155.1$ minutos de retraso, más de dos horas y media, aunque el receptor estuvo de vuelta a las 12:00. Los que llegaron a las 11:29, 11:31 y 11:54 tuvieron más suerte: su cuarto intento cayó ya con el receptor en pie y se retrasaron $35.1$ minutos. Una caída de una hora produce retrasos de más de dos horas, y los sufren justamente los primeros clientes de la caída.
Con el barrido de rescate cada 15 minutos, todos los mensajes pendientes se recuperan a las 12:00, en cuanto vuelve el servicio: el peor retraso baja a $54.4$ minutos (el del mensaje de las 11:05, que esperó toda la caída) y el del último mensaje, a $5.7$ minutos. La gráfica de la izquierda lo compara mensaje a mensaje. Esta es la respuesta de arquitectura a Don Ernesto: el webhook para la rapidez, un sondeo de rescate para la tranquilidad. El patrón combinado aprovecha lo mejor de cada uno: el webhook trae casi todos los mensajes en segundos, y el sondeo, que solo busca lo que se perdió, garantiza que una caída no se convierta en un pedido olvidado. No todos los proveedores permiten consultar los eventos no entregados; el módulo 5 resolverá ese detalle con el proveedor que se elija.
La gráfica de la derecha responde a la segunda mitad de la pregunta. Si el receptor procesa todo antes de contestar, el $2.43%$ de las peticiones supera el plazo de $10$ segundos, y cada una provoca un reintento de un evento ya procesado: con $1,560$ mensajes al mes, unos $38$ reintentos evitables. Si en cambio el receptor acusa recibo y encola (comprueba firma, marca e identificador, guarda el evento en una cola y responde 200 en milisegundos), ese porcentaje cae a cero, y el procesamiento lento ocurre después, sin nadie esperando al otro lado. Es la cuarta caja del receptor de la Figura 2, y será la regla de todos los receptores de la serie.
Don Ernesto escuchó los números con la misma cara con la que prueba una masa nueva. “O sea, que si se cae lo de usted una hora, hay clientes que se enteran a las dos horas y media.” Valeria asintió. “Si solo confiamos en los reintentos de ellos, sí. Con el barrido, como mucho una hora, y a la gente que escribió durante la caída le contestamos primero.” Don Ernesto lo pensó un momento. “Entonces apunte en algún sitio a quién hay que contestar primero cuando vuelva. Eso lo hacía yo con la libreta.” Tenía razón, y es exactamente lo que hace el registro del Bloque 8: la lista de lo que llegó, cuándo y qué se hizo con ello.
Consideraciones finales
El disparador es la pieza más pequeña de un diagrama de flujo y la que más decisiones esconde. Las cifras de hoy lo muestran: el mismo flujo de pedidos puede ejecutarse $43,200$ veces al mes o $1,560$, ver cada mensaje en dos segundos o en treinta minutos, procesar cada evento una vez o duplicar siete encargos al mes, aceptar pedidos falsos o rechazarlos todos, según cómo se dispare. Ninguna de esas diferencias se ve en el dibujo; todas se ven en la factura, en la espera del cliente y en el obrador.
Atención aquí: Registrar no es guardar todo. El registro de ejecuciones de un receptor sirve para auditar qué llegó, cuándo y qué se decidió, y para eso no necesita el texto que escribió el cliente. Guarde identificadores, instantes y resultados; deje fuera el contenido del mensaje cuando no haga falta para la tarea y tenga presente que un hash de un teléfono sin clave se puede revertir. Los mensajes, remitentes y teléfonos de esta entrada son inventados y usan los formatos de prueba de la serie.
Antes de pasar al Día 4, conviene que usted se haga algunas preguntas sobre los disparadores de su propio negocio:
- ¿Cuáles de sus flujos se disparan por sondeo, aunque la aplicación de origen ofrezca webhooks? ¿Cuántas de esas comprobaciones vuelven vacías?
- ¿En qué zona horaria se interpretan sus expresiones cron? ¿Lo ha comprobado con una ejecución real?
- Si su receptor recibe dos veces el mismo evento, ¿qué efecto se duplica: un cobro, un pedido, un correo?
- ¿Quién puede enviar una petición a la URL de su webhook, y qué pasaría si lo hiciera?
Las cifras de hoy tienen límites que conviene decir. Las llegadas siguen un modelo de Poisson con tasas por hora fijas, cuando en la realidad hay días de fiesta, lluvia y quincena; la latencia del webhook y los tiempos de procesamiento son supuestos lognormales, no mediciones de un proveedor; la probabilidad de duplicado de $0.03$ es un valor didáctico; y el calendario de reintentos cambia de un proveedor a otro. Ninguno de esos límites cambia las conclusiones: el sondeo paga en latencia y en comprobaciones vacías, los webhooks entregan al menos una vez, la firma y la marca de tiempo separan lo legítimo de lo falso, y una caída se paga en la cola de los retrasos.
Un gran libro que habla de esto es Patrones de integración empresarial (o Enterprise Integration Patterns), en el que Gregor Hohpe y Bobby Woolf catalogan las soluciones a los problemas de conectar sistemas que se envían mensajes. Varios de los patrones de hoy tienen allí su nombre y su discusión: el consumidor que sondea, el consumidor dirigido por eventos, el receptor idempotente y la entrega garantizada. Aunque se escribió antes de que existieran Make o n8n, es el mejor vocabulario para entender lo que esas plataformas hacen por debajo, y le ayudará a reconocer cada patrón cuando lo vea dibujado en un escenario.
Un disparador decide cuándo y cuántas veces se ejecuta todo lo demás; diséñelo para el día malo, no para el promedio. Trigo Lento termina el día con su mapa de disparadores, un receptor que verifica firma, marca e identificador antes de aceptar nada, un resumen programado que llega antes de las 8 y una respuesta con números para Don Ernesto.
Conclusiones clave
Tipos
- Un flujo tiene disparador, entradas, pasos y salidas; el disparador decide cuándo y cuántas veces se ejecuta todo lo demás.
- Los disparadores son manuales, programados (cron), de sondeo, webhooks o eventos nativos; un disparador nativo puede ser un webhook o un sondeo disfrazado, y conviene averiguarlo antes de calcular su coste.
0 7 * * 1-6dispara el resumen de lunes a sábado a las 07:00; la zona horaria de la plataforma y la regla del día del mes frente al día de la semana deben comprobarse siempre.
Latencia y coste
- El sondeo tiene una latencia media de $T/2$ y hace $1440/T \cdot 30$ comprobaciones al mes: con $T = 15$ minutos, $7.45$ minutos simulados de espera y $2,880$ comprobaciones, el $68.3%$ vacías.
- El webhook hace una llamada por evento ($1,560$ al mes) con latencia de segundos; con créditos contados, como los $1,000$ del plan Free de Make, es también la opción barata.
- Un sondeo de rescate cada 15 minutos complementa al webhook: tras una caída de una hora, el peor retraso baja de $155.1$ a $54.4$ minutos.
Seguridad
- Los webhooks entregan al menos una vez: con $p = 0.03$ hubo $42$ duplicados en $1,560$ eventos, y sin deduplicar habría $7$ encargos dobles al mes ($2,660$ MXN).
- La firma HMAC-SHA256 de
id.marca.cuerpo, comparada conhmac.compare_digest, rechaza pedidos falsos y cuerpos alterados; la tolerancia de 5 minutos rechaza las repeticiones tardías y el identificador, las rápidas. - El receptor acusa recibo y encola en milisegundos; procesar antes de responder hace que el $2.43%$ de las peticiones supere un plazo de 10 segundos y provoque reintentos.
Mañana, en el Día 4: Arquitectura de flujos II: entradas, salidas y contratos de datos. El cuerpo JSON de hoy es solo un borrador, y Valeria lo convertirá en un contrato con campos obligatorios, tipos y reglas, para que un pedido sin fecha de entrega se detenga en la puerta del flujo y no en el obrador.
Referencias
- Hohpe, G. y Woolf, B. (2003). Enterprise Integration Patterns: Designing, Building, and Deploying Messaging Solutions. Addison-Wesley. https://www.enterpriseintegrationpatterns.com
- Standard Webhooks (2024). Standard Webhooks: especificación abierta para el envío, la firma y la verificación de webhooks. https://www.standardwebhooks.com
- Krawczyk, H., Bellare, M. y Canetti, R. (1997). HMAC: Keyed-Hashing for Message Authentication (RFC 2104). IETF. https://www.rfc-editor.org/rfc/rfc2104
- Kleppmann, M. (2017). Designing Data-Intensive Applications. O’Reilly Media.