
Arquitecto de automatización con IA: Día 32
 Jeshua Romero Guadarrama
- 65 Min para leer
- 04 Mar, 2026
Índice de contenido
Resumen:
Mañana Valeria integrará el escenario de pedidos de Trigo Lento de punta a punta, y antes conviene medir qué domina de verdad del módulo de Make. Esta entrada es la evaluación intermedia de los días 22 a 31: quince preguntas de opción múltiple con retroalimentación por opción y un corrector en Python que diagnostica por partes, un caso práctico (el pedido diario de la Cafetería Brújula) que se valora con una rúbrica analítica ponderada, y un blueprint con siete errores sembrados que se depura primero a ojo y después con un validador. Al terminar, usted sabrá autoevaluarse con criterio, puntuar un diseño de escenario, encontrar los errores de un blueprint antes de importarlo y estimar sus créditos antes de construirlo.
¿Cómo citar el presente artículo?
Romero, J. (4 de marzo de 2026). Arquitecto de automatización con IA: Día 32. python-data-engineer. https://www.python-data-engineer.com/post/aai/dia_32/.
Arquitecto de automatización con IA: Día 32 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/aai/dia_32/.
Precios, límites y políticas revisados en octubre de 2026: planes, precios y límites de Make, n8n, Zapier, WhatsApp (Meta, Twilio, Wati) y de la API de Claude. Dos datos de Make que aparecen en las preguntas se contrastaron en octubre de 2026: los materiales oficiales de formación indican que routers y filtros no consumen créditos, y el editor de escenarios rebautizó dos manejadores de error (Break pasó a llamarse Retry e Ignore pasó a llamarse Skip). Los blueprints de esta entrada tienen la estructura verificada contra la documentación, revisado en octubre de 2026; los identificadores de los módulos de Gmail (google-email:ActionSearchEmails y google-email:ActionSendEmail) no están en la lista de la serie y deben contrastarse exportando un escenario real. Nueve de los once bloques se ejecutan sin red y sus salidas son las reales; los bloques 7 y 10 son blueprints exportados.
Día 32. Evaluación intermedia: Make en la práctica
Introducción
Ayer, en el Día 31 (Caso de otro negocio III: el despacho contable recibe y clasifica comprobantes con Make), Valeria llevó lo aprendido con el escenario de pedidos al buzón de comprobantes de su contador, leyó un CFDI 4.0 por dentro y clasificó con reglas primero y con Claude solo lo ambiguo, y el despacho Ledesma y Asociados ganó un escenario que ordena su buzón sin enviar datos fiscales de más. Hoy no hay pieza nueva de Make: es el segundo día de evaluación de la serie, y llega justo antes de la sesión práctica de mañana, en la que todo el módulo se integra en un solo escenario.
Es miércoles 4 de marzo, a media tarde. El obrador ya entregó el último encargo y Valeria tiene sobre la mesa su cuaderno de las dos últimas semanas: el blueprint de TL Formulario v1 con sus créditos contados (Día 22), el webhook de Twilio con su firma (Día 23), el router que contestó “gracias por su pedido” a una queja (Día 24), el sábado que se convirtió en el sábado equivocado por culpa de UTC (Día 25), el laboratorio de recordatorios (Día 26), las comillas de Ramiro que rompieron un cuerpo JSON (Día 27), las cinco directivas de error (Día 28), los $37$ pedidos duplicados del webhook lento (Día 29), la cascada de modelos con el módulo HTTP (Día 30) y los comprobantes del despacho contable (Día 31). Son diez días con diez lecciones distintas, y mañana tendrá que usarlas todas a la vez.
Don Ernesto se acerca con dos tazas de café y deja clara su condición antes de que ella abra la laptop: “Antes de dejar a Make solo con los pedidos, quiero ver que Valeria lo sabe arreglar cuando se rompa. No que lo sabe construir con las pantallas delante: que lo sabe arreglar un sábado a las diez, con el obrador lleno.” La exigencia es razonable y además precisa. Construir un escenario siguiendo un tutorial es una habilidad; diagnosticar por qué un escenario hace lo que no debe es otra, y es la que de verdad necesita un negocio que ya depende de él.
Por eso la evaluación de hoy tiene tres piezas y la tercera es nueva respecto del Día 9 (Evaluación de fundamentos: IA, prompts y flujos). La primera son quince preguntas que se corrigen solas. La segunda es un caso práctico de diseño, el pedido diario de la Cafetería Brújula, que se valora con una rúbrica. La tercera es un ejercicio de depuración: un blueprint con siete errores sembrados que usted debe encontrar primero a ojo y después con un validador escrito en Python. Como en el Día 9, el método se apoya en el efecto de la práctica de recuperación (Roediger y Karpicke, 2006): recordar sin consultar consolida lo aprendido más que volver a leerlo.
En la presente entrada, descubrirá cómo autoevaluarse con quince preguntas sobre los días 22 a 31, corregirlas con el mismo corrector del Día 9 y calcular la probabilidad de aprobar por suerte con la distribución binomial. Después diseñará en papel el escenario que registra cada noche el pedido de Brújula y lo valorará con una rúbrica de cinco criterios con pesos distintos, en la que los errores y la idempotencia pesan tanto como el diseño del flujo. Por último, depurará TL Brújula diario v0, un blueprint roto, con un validador que comprueba siete reglas del formato de Make, lo dibujará con los módulos defectuosos en rojo y, en la solución plegada, verá la versión corregida, TL Brújula diario v1, validada y con sus créditos contados.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Comprobar la comprensión de los días 22 a 31 con 15 preguntas autocorregibles con retroalimentación por opción.
- Diseñar un escenario de Make para un caso de Trigo Lento y valorarlo con una rúbrica analítica.
- Depurar un blueprint roto con siete errores sembrados usando un validador escrito en Python.
- Estimar créditos, fallos posibles y riesgos de un diseño antes de construirlo.
Cómo usar esta evaluación
La evaluación se hace en orden y por escrito. Primero las quince preguntas de las tres partes, cinco por parte: escenarios, módulos, routers y transformación (días 22 a 25); laboratorio, JSON, almacenes y errores (días 26 a 28); y causa raíz, Claude en Make y el caso contable (días 29 a 31). Después el caso práctico de Brújula, que usted diseña en papel antes de mirar la rúbrica aplicada. Por último, la depuración del blueprint roto, que conviene intentar a ojo antes de ejecutar el validador. La solución comentada va al final, plegada, para que no la lea por accidente.
Le propongo las reglas que Valeria se puso a sí misma:
- Tiempo sugerido: $90$ minutos en total, unos $30$ para las preguntas, $35$ para el caso y $25$ para la depuración.
- Sin consultar: ni las entradas anteriores, ni el código, ni la documentación de Make. Si consulta, está releyendo, y releer no es recuperar.
- Por escrito: la letra de cada respuesta y una línea con la razón; el diseño del caso como un diagrama de cajas; la lista de errores del blueprint con su ubicación.
- Umbral de dominio: el $80%$, es decir, $12$ de $15$ en total y $4$ de $5$ en cada parte. Una parte por debajo indica qué días repasar antes del Día 33.
- Solución al final: el caso y la depuración se resuelven antes de abrir la solución; abrirla antes convierte un ejercicio de diseño en uno de lectura.
Las preguntas no piden recordar definiciones sueltas. Siguiendo la taxonomía revisada de Bloom (Anderson y Krathwohl, 2001), la mayoría piden aplicar (contar créditos, despejar un empate, sumar un coste) o analizar (distinguir el disparador de la causa raíz, una directiva de otra). El caso pide crear un diseño y la depuración pide evaluar un artefacto ajeno contra reglas explícitas, que es exactamente lo que hará usted cada vez que alguien le pase un blueprint para revisar. Los distractores, las opciones incorrectas, están hechos con los errores reales que aparecieron en el módulo: la cifra del escenario sin iterador, la ruta que se detiene en la primera coincidencia, el reloj largo de Make frente al corto de Twilio.
La Figura 1 reúne en un mapa los conceptos del módulo 3 y cómo se relacionan, con el número de las preguntas que cubren cada uno: el escenario se compone de módulos por los que viajan paquetes, cada paquete procesado cuesta un crédito, el router y sus filtros deciden sin cobrar, el iterador y el agregador cambian cuántos paquetes hay, el almacén recuerda lo que pasó, la directiva de error decide qué se hace cuando algo falla, la idempotencia garantiza que repetir no duplica y la petición HTTP a Claude añade lenguaje donde las reglas no alcanzan.
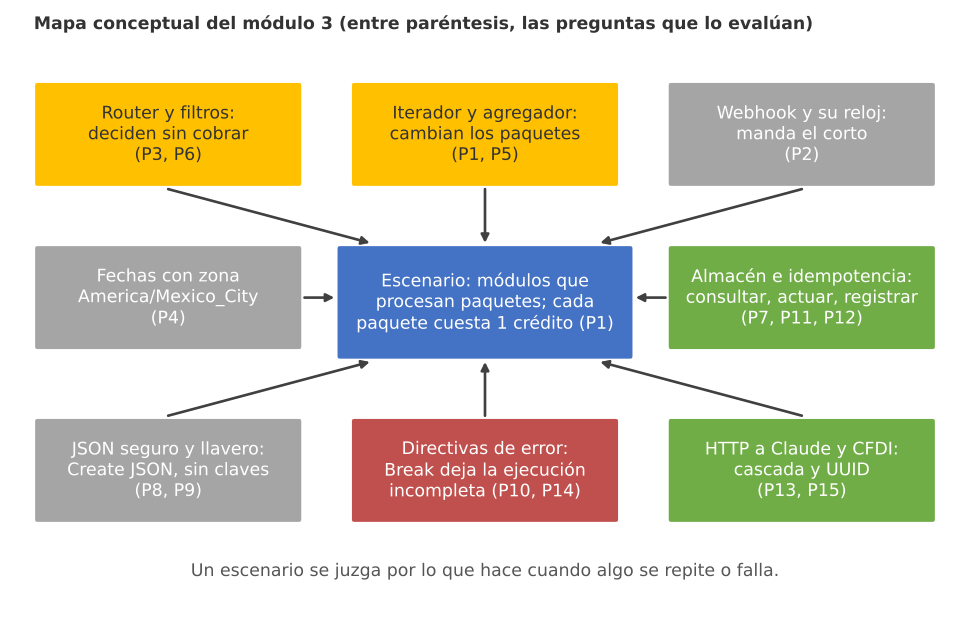
Figura 1. Mapa conceptual del módulo 3: el escenario, sus módulos, paquetes y créditos en el centro y, a su alrededor, las piezas que deciden, transforman, recuerdan, fallan y consultan a Claude, cada una con las preguntas de la evaluación que la cubren.
Todo lo que ocurre en esta entrada es personal y local. Las respuestas se escriben en su hoja y el corrector se ejecuta en su computadora; no se envía ni se recoge información del lector. El caso usa datos inventados de la Cafetería Brújula y el correo de prueba cliente@ejemplo.com; ningún blueprint contiene claves, conexiones ni direcciones reales.
Parte 1: escenarios, módulos, routers y transformación
La primera parte cubre los días 22 a 25: cómo se cuentan los créditos de una ejecución, qué reloj manda cuando un webhook espera respuesta, qué hace un router cuando un paquete cumple dos filtros, por qué una organización en UTC cambia la fecha de un pedido y cuándo empatan dos diseños con iterador. Las cinco preguntas están en la Tabla 1. Lea cada enunciado completo antes de mirar las opciones.
Tabla 1. Parte 1: escenarios, módulos, routers y transformación (preguntas 1 a 5).
| # | Pregunta | A | B | C | D | Día |
|---|---|---|---|---|---|---|
| 1 | TL Formulario v1 cuesta 4 créditos por ejecución. Si se añade un iterador que guarda cada renglón en su propia fila, ¿cuántos créditos consume un formulario de 5 renglones? | 4 | 5 | 9 | 20 | 22 |
| 2 | Twilio espera la respuesta del webhook 15 segundos y Make mantiene la petición hasta 180. Un escenario llega a su módulo de respuesta a los 60 segundos. ¿Qué ocurre? | Todo bien: Make espera 180 segundos | Twilio da la entrega por vencida a los 15 segundos | Make corta la ejecución a los 15 segundos | Make contesta “Accepted” y Twilio espera | 23 |
| 3 | Un mensaje cumple los filtros de dos rutas del router. ¿Qué ocurre? | Entra en las dos rutas, una detrás de otra | Solo entra en la primera ruta que cumple | Va a la ruta de respaldo | Make elige una ruta al azar | 24 |
| 4 | Una clienta escribe “pal sábado” a las 23:30 del viernes 20 y la organización de Make está en UTC. ¿Qué fecha calcula formatDate sin zona? | El sábado 21, sin problema | Un error de formato | Ninguna: hay que usar un modelo de lenguaje | El sábado 28; se corrige con "America/Mexico_City" en cada fecha | 25 |
| 5 | La ruta con agregador cuesta $8 + n$ créditos y la ruta sin agregador $5 + 2n$, con $n$ renglones. ¿Con cuántos renglones empatan? | 1 | 2 | 3 | 5 | 25 |
La pregunta 1 es la de Don Ernesto del Día 22, la de “¿Make me cobra cinco veces?”, con su respuesta en números. El consumo de una ejecución es la suma de los paquetes que procesa cada módulo, y un iterador multiplica lo que va después de él:
$$ C = \sum_{m} p_m, \qquad C_{\text{iterador}} = c_{\text{fijo}} + n $$
La lógica detrás de esta fórmula es múltiple:
- $p_m$ es el número de paquetes que procesa el módulo $m$ en una ejecución: el disparador procesa uno, y cada módulo que va detrás de un iterador procesa uno por elemento.
- Routers y filtros no aparecen en la suma, porque no cobran; por eso las decisiones se ponen lo antes posible, una idea que vuelve en la pregunta 6.
- En
TL Formulario v1, los $4$ créditos fijos se pagan una vez y la fila por renglón se paga $n$ veces: con $n = 5$, $C = 4 + 5 = 9$. - En conclusión, quien multiplica los $4$ módulos por $5$ renglones ($20$) supone que el iterador repite todo el escenario, y quien responde $5$ olvidó que los módulos fijos también cobran.
La pregunta 2 tiene una trampa conocida: el reloj que manda es el del emisor. Make puede esperar tres minutos, pero si Twilio dejó de esperar a los $15$ segundos, la entrega ya se dio por fallida y el reintento está en camino. La pregunta 5 es álgebra de una línea, $8 + n = 5 + 2n$, que da $n = 3$, con $11$ créditos para cada diseño; con más renglones gana el agregador. Fíjese en que todas las cifras de esta parte salen de los blueprints de Valeria y del plan Core de Make, que incluye $10,000$ créditos al mes por $10.59$ USD en pago mensual o $9$ USD al mes en pago anual (revisado en octubre de 2026).
Parte 2: laboratorio, JSON, almacenes y errores
La segunda parte cubre los días 26 a 28: dónde se colocan los filtros para no pagar de más, en qué orden se consulta y se escribe un almacén que evita duplicados, cómo se construye un cuerpo JSON que no se rompe con las comillas de un cliente, dónde vive una clave secreta y qué directiva deja una ejecución pendiente de reintento. La Tabla 2 recoge las preguntas 6 a 10.
Tabla 2. Parte 2: laboratorio, JSON, almacenes y errores (preguntas 6 a 10).
| # | Pregunta | A | B | C | D | Día |
|---|---|---|---|---|---|---|
| 6 | En el escenario de recordatorios, ¿por qué el filtro de consentimiento va antes de la consulta al almacén? | Porque el almacén no admite filtros | Porque los filtros no cobran y detienen al cliente sin consentimiento antes del primer módulo que cobra por paquete | Por el orden alfabético del editor | Para que la clave del almacén sea única | 26 |
| 7 | ¿Cuándo se escribe la clave en el almacén recordatorios_enviados? | Antes del envío, para bloquear duplicados | En una variable de escenario | Solo cuando el envío falla | Se consulta antes del envío y se escribe después | 26 |
| 8 | El mensaje Me aparta el de "siempre" rompió el cuerpo JSON de la petición a Claude. ¿Cómo se construye un cuerpo seguro en Make? | Pidiendo a los clientes que no usen comillas | Cambiando las comillas por apóstrofos con replace | Con Create JSON mapeado entero, o con escapeJSON en cada dato | Subiendo max_tokens | 27 |
| 9 | ¿Dónde debe vivir la clave de la API de Claude en Make? | En el llavero (keychain) o en la conexión | En una variable personalizada | En una cabecera escrita en el mapper | En un almacén de datos | 27 |
| 10 | ¿Qué directiva de error guarda el paquete como ejecución incompleta para reintentarlo? | Resume | Break (Retry en el editor actual) | Ignore | Rollback | 28 |
Las preguntas 6 y 7 son las dos mitades de una misma idea del laboratorio del Día 26: el orden de los módulos es una decisión de coste y de corrección, no de estética. El filtro de consentimiento antes de la consulta convierte $1 + n + 2k$ créditos por corrida en $1 + 3k$, porque los $n - k$ clientes sin consentimiento se detienen gratis; y la clave escrita después del envío garantiza que el almacén solo diga “avisado” cuando el aviso salió de verdad. Si la clave se escribiera antes y el envío fallara, el cliente nunca recibiría el recordatorio y el almacén afirmaría lo contrario.
La pregunta 9 mezcla dos días a propósito. El Día 27 enseñó que las variables personalizadas de Make se guardan en texto plano y no existen en el plan Core, y el Día 30 enseñó que la clave de Claude va en el llavero de Make, desde donde el módulo HTTP la toma sin que aparezca nunca en el mapper. Una clave escrita en una cabecera del mapper viaja en cada exportación del blueprint, y esa es precisamente una de las siete trampas del ejercicio de depuración de hoy.
La pregunta 10 tiene un matiz de vocabulario que conviene conocer. El editor actual de Make llama Retry al manejador que la documentación y los blueprints de la serie llaman Break, y Skip al que llamaban Ignore (revisado en octubre de 2026). El comportamiento no cambió: Break, o Retry, guarda el paquete que falla como ejecución incompleta y lo reanuda en el módulo que falló, siempre que las ejecuciones incompletas estén activadas. Si usted eligió Resume, recuerde que Resume no guarda nada: sigue con un sustituto, que es justo lo que se quiere en una búsqueda de cliente y lo que no se quiere en una fila de pedido.
Parte 3: causa raíz, Claude en Make y el caso contable
La tercera parte cubre los días 29 a 31: por qué responder rápido al webhook no evita los duplicados, qué papel tuvo la latencia de la hoja en el incidente de los $37$ pedidos, cuánto cuesta la cascada de modelos, qué se hace con un error $400$ de la API de Claude y qué campo identifica un comprobante fiscal. Son las preguntas que más le importan a Don Ernesto, porque un error aquí no cuesta créditos, sino pasteles horneados de más o una factura traspapelada. Están en la Tabla 3.
Tabla 3. Parte 3: causa raíz, Claude en Make y el caso contable (preguntas 11 a 15).
| # | Pregunta | A | B | C | D | Día |
|---|---|---|---|---|---|---|
| 11 | ¿Por qué responder al webhook antes de escribir en la hoja no basta sin clave de idempotencia? | Porque la respuesta se puede perder en la red y ni Twilio, ni Meta, ni Make garantizan una entrega única | Sí basta: si no hay demora, no hay reintentos | Porque Make no sabe responder antes de terminar | Porque la hoja tarda 20 segundos | 29 |
| 12 | En el incidente del Día 29, la latencia de la hoja de cálculo fue… | La causa raíz | Irrelevante | El disparador; la causa raíz es un efecto no idempotente | Culpa de quien activó el piloto | 29 |
| 13 | La cascada clasifica todo con Haiku 5.5 (0.21 USD al mes) y escala 234 mensajes a Opus 5.5 a 0.0054 USD cada uno. ¿Cuánto cuesta al mes? | 8.42 USD | 0.21 USD | 1.26 USD | 1.47 USD | 30 |
| 14 | El módulo HTTP recibe de la API de Claude un 400 invalid_request_error. ¿Qué política aplica? | Break con tres reintentos | No reintentar: registrar, avisar y corregir la petición | Escalar la petición a Opus 5.5 | Resume con una categoría inventada | 30 |
| 15 | ¿Qué campo del CFDI 4.0 identifica de forma única al comprobante? | El UUID del timbre fiscal digital | El RFC del emisor | El folio interno | El total y la fecha | 31 |
Las preguntas 11 y 12 separan dos ideas que el Día 29 se esforzó en distinguir. La latencia de la hoja disparó el incidente, porque convirtió respuestas puntuales en respuestas tardías y provocó los reintentos del emisor; pero la causa raíz fue que guardar un pedido no era una operación idempotente. Con la clave sha256(MessageSid) consultada antes y registrada después, la misma latencia no habría duplicado nada. Por eso responder primero ayuda pero no basta: una respuesta puntual también se puede perder en la red, y el Día 29 estimó que, sin clave, quedarían unos $0.14$ duplicados por cada $14$ pedidos.
La pregunta 13 se resuelve sumando, no recordando: $0.21 + 234 \cdot 0.0054 = 1.47$ USD al mes, muy lejos de los $8.42$ USD de mandar todo a Opus 5.5 y muy por debajo del rubro de $8$ USD de la API de Claude en el presupuesto de $45$ USD. La pregunta 14 es la versión de Claude de la clasificación de errores del Día 28: un $429$ o un $529$ son pasajeros y merecen reintento; un $400$ dice que la petición está mal formada, y reintentarla tres veces solo produce tres errores más. La pregunta 15 viene del despacho contable: el UUID de $36$ caracteres del timbre fiscal digital es lo único que identifica el comprobante, y por eso el escenario del Día 31 lo guardaba en un almacén para detectar repetidos.
Autocorrección en Python
Con las quince letras escritas en su hoja, toca corregir. El corrector es el del Día 9 sin cambios, y esa es la gracia: el Día 9 guardó el banco en un archivo JSON aparte para que el mismo código sirviera con otro banco. Comencemos con el bloque de preparación habitual: importaciones, la semilla global $2026$ y la carpeta del día, trigo_lento/dia_32/, donde se guardarán el banco de preguntas y los blueprints del ejercicio de depuración:
# Importaciones base, semilla de la serie y carpeta de la evaluación en Python:
import warnings
warnings.filterwarnings('ignore')
import copy
import json
import re
import textwrap
from math import comb
from pathlib import Path
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import scipy
from scipy import stats

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 120)
carpeta = Path('trigo_lento') / 'dia_32'
(carpeta / 'flujos' / 'make').mkdir(parents = True, exist_ok = True)
print('numpy', np.__version__, '| pandas', pd.__version__, '| scipy', scipy.__version__,
      '| carpeta:', carpeta.as_posix())
numpy 2.4.6 | pandas 3.0.3 | scipy 1.17.1 | carpeta: trigo_lento/dia_32
El entorno queda con numpy $2.4.6$, pandas $3.0.3$ y scipy $1.17.1$, las mismas versiones del Día 9, y la carpeta del día no toca ningún archivo de días anteriores.
El banco de preguntas
El banco tiene la misma forma que el del Día 9: una lista de diccionarios con el número, la parte, el día que evalúa, un enunciado abreviado (el completo está en las tablas), la letra correcta, las cuatro opciones y una retroalimentación por opción. Cada retroalimentación nombra el error concreto que lleva a elegir esa opción, de modo que quien falla sabe por qué falló y no solo que falló. El bloque guarda el banco en banco_preguntas.json y hace las dos comprobaciones de calidad del Día 9: que cada parte tenga el mismo número de preguntas y que las respuestas correctas estén repartidas entre las cuatro letras:
# Banco de 15 preguntas sobre los días 22 a 31 con retroalimentación por opción en Python:
def pregunta(n, parte, dia, enunciado, correcta, opciones):
    # opciones: cuatro pares (texto, retroalimentación) en el orden A, B, C, D:
    return {'n': n, 'parte': parte, 'dia': dia, 'enunciado': enunciado, 'correcta': correcta,
            'opciones': {l: t for l, (t, _) in zip('ABCD', opciones)},
            'retro': {l: r for l, (_, r) in zip('ABCD', opciones)}}

BANCO = [
    pregunta(1, 1, 22, 'Formulario de 5 renglones con iterador e inserción por renglón: ¿créditos?', 'C', [
        ('4', 'Es el escenario sin iterador; el iterador multiplica lo que le sigue.'),
        ('5', 'Contó un crédito por renglón y olvidó los módulos fijos.'),
        ('9', 'Correcto: C = 4 + n = 4 + 5 = 9 créditos por ejecución.'),
        ('20', 'Multiplicó los 4 módulos por 5; solo se repite lo que va tras el iterador.')]),
    pregunta(2, 1, 23, 'Twilio espera 15 s, Make 180 s y el escenario responde a los 60 s: ¿qué pasa?', 'B', [
        ('Todo bien: Make espera 180 s', 'El reloj de Make no sirve si el emisor ya se rindió.'),
        ('Twilio da la entrega por vencida a los 15 s', 'Correcto: manda el reloj corto, el del emisor.'),
        ('Make corta la ejecución a los 15 s', 'Make no conoce el plazo de Twilio; sigue trabajando.'),
        ('Make contesta Accepted y Twilio espera', 'Accepted solo sale sin módulo de respuesta.')]),
    pregunta(3, 1, 24, 'Un mensaje cumple los filtros de dos rutas del router: ¿qué ocurre?', 'A', [
        ('Entra en las dos rutas, en orden', 'Correcto: toma todas las rutas que cumple y paga sus módulos.'),
        ('Solo entra en la primera', 'El router no se detiene en la primera ruta que cumple.'),
        ('Va a la ruta de respaldo', 'El respaldo solo recibe lo que no cumple ninguna ruta.'),
        ('Make elige una al azar', 'El orden de las rutas es fijo y no hay azar.')]),
    pregunta(4, 1, 25, '"Pal sábado" a las 23:30 del viernes con la organización en UTC: ¿fecha?', 'D', [
        ('El sábado 21, sin problema', 'En UTC ya es sábado a las 05:30: el próximo sábado es el 28.'),
        ('Un error de formato', 'No hay error: hay una fecha válida y equivocada.'),
        ('Hay que usar un modelo de lenguaje', 'El modelo también necesita saber qué día es en el obrador.'),
        ('El 28; se corrige con la zona en formatDate', 'Correcto: "America/Mexico_City" en cada fecha.')]),
    pregunta(5, 1, 25, 'Con agregador 8 + n y sin agregador 5 + 2n: ¿con cuántos renglones empatan?', 'C', [
        ('1', 'Con 1 renglón, 9 frente a 7: gana el diseño sin agregador.'),
        ('2', 'Con 2 renglones, 10 frente a 9: todavía no empatan.'),
        ('3', 'Correcto: 8 + n = 5 + 2n da n = 3 (11 créditos cada uno).'),
        ('5', 'Con 5 renglones el agregador ya ahorra 2 créditos.')]),
    pregunta(6, 2, 26, '¿Por qué el filtro de consentimiento va antes de la consulta al almacén?', 'B', [
        ('El almacén no admite filtros', 'Sí los admite; la razón es de coste y de ética.'),
        ('Los filtros no cobran y detienen antes del módulo que cobra', 'Correcto: 1 + 3k frente a 1 + n + 2k.'),
        ('Por el orden alfabético del editor', 'El editor no ordena módulos por nombre.'),
        ('Para que la clave del almacén sea única', 'La unicidad la da la clave, no la posición del filtro.')]),
    pregunta(7, 2, 26, '¿Cuándo se escribe la clave en recordatorios_enviados?', 'D', [
        ('Antes del envío', 'Si el envío falla, la clave dice "avisado" y nadie avisa.'),
        ('En una variable de escenario', 'Dura una ejecución; mañana no recuerda nada.'),
        ('Solo cuando el envío falla', 'Al revés: se registra lo que sí salió.'),
        ('Se consulta antes y se escribe después', 'Correcto: consultar, enviar y registrar, en ese orden.')]),
    pregunta(8, 2, 27, 'El texto con comillas rompió el cuerpo JSON: ¿cómo se construye seguro?', 'C', [
        ('Pidiendo a los clientes que no usen comillas', 'El sistema se adapta al cliente, no al revés.'),
        ('Cambiando comillas por apóstrofos', 'Arregla un carácter; fallan barras y saltos de línea.'),
        ('Create JSON o escapeJSON en cada dato', 'Correcto: el cuerpo se mapea entero o se escapa.'),
        ('Subiendo max_tokens', 'El error es de formato de la petición, no de la respuesta.')]),
    pregunta(9, 2, 27, '¿Dónde vive la clave de la API de Claude en Make?', 'A', [
        ('En el llavero o en la conexión', 'Correcto: nunca en el mapper ni en el blueprint.'),
        ('En una variable personalizada', 'Se guarda en texto plano y no existe en Core.'),
        ('En una cabecera del mapper', 'Viaja en cada exportación del blueprint.'),
        ('En un almacén de datos', 'Cualquiera con acceso al almacén la leería.')]),
    pregunta(10, 2, 28, '¿Qué directiva deja la ejecución incompleta para reintentarla?', 'B', [
        ('Resume', 'Sigue con un sustituto; no guarda nada para reintentar.'),
        ('Break (Retry en el editor)', 'Correcto: guarda el paquete y reanuda en el módulo que falló.'),
        ('Ignore', 'Descarta el paquete y la ejecución termina bien.'),
        ('Rollback', 'Detiene y revierte, sin guardar la ejecución.')]),
    pregunta(11, 3, 29, '¿Por qué responder al webhook primero no basta sin clave?', 'A', [
        ('La respuesta se puede perder y nadie garantiza entrega única', 'Correcto: unos 0.14 duplicados por 14 pedidos.'),
        ('Sí basta: sin demora no hay reintentos', 'Una respuesta perdida en la red provoca el reintento.'),
        ('Porque Make no sabe responder antes', 'Sí sabe: el módulo de respuesta va donde se ponga.'),
        ('Porque la hoja tarda 20 s', 'La latencia dispara el fallo; la causa es otra.')]),
    pregunta(12, 3, 29, 'En el incidente del Día 29, la latencia de la hoja fue...', 'C', [
        ('La causa raíz', 'Con idempotencia, la misma latencia no duplica nada.'),
        ('Irrelevante', 'Sin ella no se habría disparado el reintento.'),
        ('El disparador; la raíz es un efecto no idempotente', 'Correcto: necesaria, disparadora y amplificadora.'),
        ('Culpa de quien activó el piloto', 'El análisis es sin culpables: se cambia el proceso.')]),
    pregunta(13, 3, 30, 'Cascada: Haiku 0.21 USD más 234 escalados a 0.0054 USD: ¿coste al mes?', 'D', [
        ('8.42 USD', 'Es el coste de mandar todo a Opus 5.5.'),
        ('0.21 USD', 'Es solo Haiku 5.5, sin escalados.'),
        ('1.26 USD', 'Son solo los escalados; falta la base de Haiku.'),
        ('1.47 USD', 'Correcto: 0.21 + 234 * 0.0054 = 1.47 USD.')]),
    pregunta(14, 3, 30, 'La API de Claude responde 400 invalid_request_error: ¿qué política?', 'B', [
        ('Break con tres reintentos', 'La misma petición mal formada fallará igual cuatro veces.'),
        ('No reintentar: registrar, avisar y corregir', 'Correcto: 400 es un error de datos o configuración.'),
        ('Escalar a Opus 5.5', 'El modelo no arregla una petición inválida.'),
        ('Resume con una categoría inventada', 'Un sustituto inventado esconde el fallo.')]),
    pregunta(15, 3, 31, '¿Qué campo del CFDI identifica de forma única al comprobante?', 'A', [
        ('El UUID del timbre fiscal digital', 'Correcto: 36 caracteres, en tfd:TimbreFiscalDigital.'),
        ('El RFC del emisor', 'El mismo emisor timbra muchos comprobantes.'),
        ('El folio interno', 'Es opcional y lo pone cada emisor a su manera.'),
        ('El total y la fecha', 'Dos comprobantes pueden coincidir en ambos.')]),
]
PARTES = {1: 'Escenarios y datos', 2: 'Laboratorio, JSON y errores', 3: 'Causa raíz, Claude y CFDI'}
(carpeta / 'banco_preguntas.json').write_text(json.dumps(BANCO, ensure_ascii = False, indent = 2),
                                              encoding = 'utf-8')
banco = pd.DataFrame(BANCO)
print('Preguntas por parte:', banco.groupby('parte').size().rename(PARTES).to_dict())
print('Respuestas correctas por letra:', banco['correcta'].value_counts().sort_index().to_dict())
print('Días evaluados:', sorted(banco['dia'].unique().tolist()))
Preguntas por parte: {'Escenarios y datos': 5, 'Laboratorio, JSON y errores': 5, 'Causa raíz, Claude y CFDI': 5}
Respuestas correctas por letra: {'A': 4, 'B': 4, 'C': 4, 'D': 3}
Días evaluados: [22, 23, 24, 25, 26, 27, 28, 29, 30, 31]
Las tres partes tienen $5$ preguntas cada una, las respuestas correctas se reparten en $4$ A, $4$ B, $4$ C y $3$ D y los días evaluados van del $22$ al $31$, sin hueco: los diez días del módulo anteriores a hoy tienen al menos una pregunta. Los días 25, 26, 27, 29 y 30 tienen dos, porque sus ideas son las que más se usarán mañana. Si usted quiere ampliar el banco con sus propias preguntas, basta con añadir llamadas a pregunta con el mismo formato; el corrector no cambia.
Corregir y diagnosticar
La función corregir recibe un diccionario con el número de cada pregunta y la letra elegida, y devuelve una fila por pregunta con el acierto y la retroalimentación de la opción elegida. Para la demostración se usan las respuestas de un lector de ejemplo, inventadas para que el diagnóstico tenga algo que decir. El bloque imprime sus aciertos, la retroalimentación de cada fallo y los días que conviene repasar:
# Corrección automática de las respuestas de un lector de ejemplo en Python:
def corregir(respuestas, banco = BANCO):
    # Devuelve una fila por pregunta con el acierto y la retroalimentación de la opción elegida:
    filas = []
    for p in banco:
        elegida = respuestas.get(p['n'], '-')
        filas.append({'n': p['n'], 'parte': p['parte'], 'dia': p['dia'], 'elegida': elegida,
                      'correcta': p['correcta'], 'acierto': elegida == p['correcta'],
                      'retro': p['retro'].get(elegida, 'Sin respuesta.')})
    return pd.DataFrame(filas)

# Respuestas de un lector de ejemplo (inventadas para la demostración):
lector = {1: 'C', 2: 'B', 3: 'B', 4: 'D', 5: 'C', 6: 'B', 7: 'D', 8: 'C',
          9: 'A', 10: 'A', 11: 'B', 12: 'C', 13: 'D', 14: 'A', 15: 'A'}
resultado = corregir(lector)
aciertos = int(resultado['acierto'].sum())
print(f'Aciertos: {aciertos} de {len(resultado)} ({aciertos / len(resultado):.0%})')
for _, f in resultado[~resultado['acierto']].iterrows():
    print(f'Pregunta {f.n} (Día {f.dia}): eligió {f.elegida}, era {f.correcta}. {f.retro}')
repasar = sorted(resultado.loc[~resultado['acierto'], 'dia'].unique().tolist())
print('Días que conviene repasar:', repasar)
Aciertos: 11 de 15 (73%)
Pregunta 3 (Día 24): eligió B, era A. El router no se detiene en la primera ruta que cumple.
Pregunta 10 (Día 28): eligió A, era B. Sigue con un sustituto; no guarda nada para reintentar.
Pregunta 11 (Día 29): eligió B, era A. Una respuesta perdida en la red provoca el reintento.
Pregunta 14 (Día 30): eligió A, era B. La misma petición mal formada fallará igual cuatro veces.
Días que conviene repasar: [24, 28, 29, 30]
El lector de ejemplo obtiene $11$ de $15$ aciertos, el $73%$: no alcanza el umbral. Lo interesante no es la cifra, sino el patrón de sus cuatro fallos. En la pregunta 3 creyó que el router se detiene en la primera ruta que cumple; en la 10 confundió Resume con Break; en la 11 creyó que responder rápido basta; y en la 14 reintentaría un error $400$. Los cuatro fallos hablan de lo mismo: qué pasa cuando algo se repite o falla. Es la lección central de los días 24, 28, 29 y 30, y es justo lo que Don Ernesto quería comprobar antes de dejar a Make solo con los pedidos.
Puntuación por parte
El total del $73%$ dice que el lector no aprueba, pero no dice qué hacer. El siguiente bloque agrupa los aciertos por parte, señala las que quedan por debajo del $80%$ y dibuja la puntuación en barras horizontales con la línea del umbral:
# Puntuación por parte con el umbral del 80 % en Python:
por_parte = resultado.groupby('parte')['acierto'].agg(['sum', 'count'])
por_parte['porcentaje'] = 100 * por_parte['sum'] / por_parte['count']
por_parte.index = [PARTES[i] for i in por_parte.index]
print(por_parte.to_string())
print('Partes bajo el umbral:', por_parte.index[por_parte['porcentaje'] < 80].tolist(),
      '| total:', f'{100 * aciertos / len(resultado):.1f} %')

fig, ax = plt.subplots(figsize = (8.4, 3.8))
colores = ['#3a9d5d' if v >= 80 else '#eb6834' for v in por_parte['porcentaje']]
ax.barh(por_parte.index[::-1], por_parte['porcentaje'][::-1], color = colores[::-1], height = 0.55)
for i, (v, s, c) in enumerate(zip(por_parte['porcentaje'][::-1], por_parte['sum'][::-1],
                                  por_parte['count'][::-1])):
    ax.text(v - 2, i, f'{v:.0f} % ({s} de {c})', ha = 'right', va = 'center', color = 'white', fontsize = 11)
ax.axvline(80, color = '#52514e', linestyle = '--', linewidth = 1.5)
ax.text(81, 2.5, 'umbral 80 %', fontsize = 10, color = '#52514e')
ax.set_xlim(0, 105)
ax.set_ylim(-0.5, 2.8)
ax.set_xlabel('Aciertos (%)')
ax.set_title('Lector de ejemplo: puntuación por parte', fontsize = 16)
ax.grid(axis = 'x', color = '#e6e5e1')
ax.set_axisbelow(True)
plt.tight_layout()
plt.show()
                             sum  count  porcentaje
Escenarios y datos             4      5        80.0
Laboratorio, JSON y errores    4      5        80.0
Causa raíz, Claude y CFDI      3      5        60.0
Partes bajo el umbral: ['Causa raíz, Claude y CFDI'] | total: 73.3 %
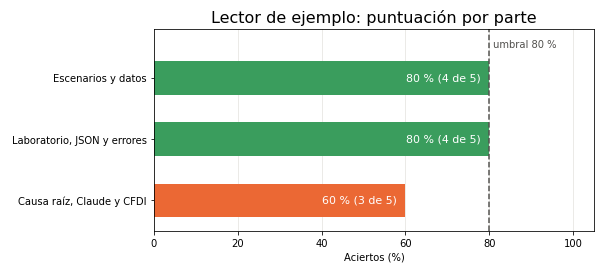
La gráfica separa lo que el total junta. Escenarios y datos y laboratorio, JSON y errores quedan justo en el $80%$, con $4$ de $5$ cada una; causa raíz, Claude y CFDI cae al $60%$, la única parte por debajo. Para este lector, el siguiente paso no es seguir al Día 33, sino repasar el Día 29 y la sección de errores de la API del Día 30, y volver a responder las preguntas de la tercera parte dentro de unos días. Estar justo en el umbral en las otras dos partes también es una señal: los fallos de las preguntas 3 y 10 están en el mismo tema, así que repasar la tercera parte reforzará también las otras.
La probabilidad de aprobar por suerte
Todo examen de opción múltiple debe responder una pregunta incómoda: ¿qué probabilidad hay de aprobar contestando al azar? Con cuatro opciones por pregunta, la probabilidad de acertar una al azar es $p = 1/4$, y el número de aciertos $X$ en $n = 15$ preguntas sigue una distribución binomial. La probabilidad de alcanzar el corte de $12$ es:
$$ P(X \geq 12) = \sum_{k=12}^{15} \binom{15}{k}, p^{k},(1-p)^{15-k}, \qquad E[X] = n,p = 15 \cdot 0.25 = 3.75 $$
La lógica detrás de esta fórmula es múltiple:
- $\binom{15}{k}$ cuenta de cuántas maneras se pueden repartir $k$ aciertos entre $15$ preguntas, y $p^{k}(1-p)^{15-k}$ es la probabilidad de cada una de esas maneras.
- La suma recorre los cuatro resultados que aprueban: $12$, $13$, $14$ y $15$ aciertos.
- La media $E[X] = 3.75$ dice dónde cae, en promedio, quien adivina: muy lejos del corte.
- En conclusión, si la probabilidad es diminuta, aprobar es una señal de conocimiento; si fuera grande, el examen tendría que ser más largo o tener más opciones.
El siguiente bloque calcula esa probabilidad con scipy.stats.binom y a mano con math.comb, la probabilidad de llegar al menos a $9$ aciertos y la de aprobar las tres partes por separado, y dibuja la distribución completa:
# Probabilidad de aprobar respondiendo al azar con la distribución binomial en Python:
n_preg, p_azar = 15, 0.25
k = np.arange(0, n_preg + 1)
masa = stats.binom.pmf(k, n_preg, p_azar)
media = stats.binom.mean(n_preg, p_azar)
p12 = stats.binom.sf(11, n_preg, p_azar)
p12_mano = sum(comb(15, j) * 0.25**j * 0.75**(15 - j) for j in range(12, 16))
p9 = stats.binom.sf(8, n_preg, p_azar)
print(f'Media de aciertos al azar: {media:.2f} | desviación: {stats.binom.std(n_preg, p_azar):.2f}')
print(f'P(X >= 12) = {p12:.3g} (a mano: {p12_mano:.3g}) | P(X >= 9) = {p9:.4f}')
print(f'Una vez en {1 / p12:,.0f} intentos | P(aprobar las tres partes al azar, 4 de 5 en cada una) = '
      f'{stats.binom.sf(3, 5, 0.25)**3:.2e}')

fig, ax = plt.subplots(figsize = (8.4, 4.2))
ax.bar(k, masa, color = ['#2a78d6' if j < 12 else '#3a9d5d' for j in k], width = 0.75)
ax.axvline(11.5, color = '#c8423b', linestyle = '--', linewidth = 1.5)
ax.text(11.7, 0.20, 'corte: 12 de 15', color = '#c8423b', fontsize = 10)
ax.annotate(f'P(X >= 12) = {p12:.2e}', (13, 0.004), xytext = (12.2, 0.12), fontsize = 10,
            arrowprops = dict(arrowstyle = '-', color = '#3a9d5d'), color = '#3a9d5d')
ax.axvline(media, color = '#52514e', linestyle = ':', linewidth = 1.2)
ax.text(media + 0.15, 0.245, f'media {media:.2f}', fontsize = 10, color = '#52514e')
ax.set_ylim(0, 0.27)
ax.set_xticks(k)
ax.set_xlabel('Aciertos respondiendo al azar (15 preguntas, p = 0.25)')
ax.set_ylabel('Probabilidad')
ax.set_title('Aprobar adivinando es prácticamente imposible', fontsize = 16)
ax.grid(axis = 'y', color = '#e6e5e1')
ax.set_axisbelow(True)
plt.tight_layout()
plt.show()
Media de aciertos al azar: 3.75 | desviación: 1.68
P(X >= 12) = 1.24e-05 (a mano: 1.24e-05) | P(X >= 9) = 0.0042
Una vez en 80,878 intentos | P(aprobar las tres partes al azar, 4 de 5 en cada una) = 3.81e-06
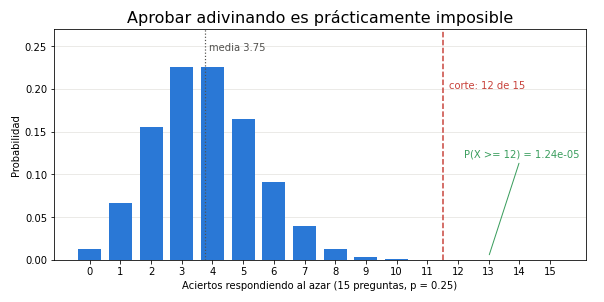
La media al azar es de $3.75$ aciertos, con una desviación de $1.68$. La probabilidad de llegar a $12$ es de $1.24 \times 10^{-5}$, más o menos una vez en $80,878$ intentos, y las dos formas de calcularla coinciden. Incluso llegar a $9$ aciertos, que no aprueba, tiene una probabilidad de solo $0.0042$. Y exigir $4$ de $5$ en cada parte por separado hace la suerte todavía más improbable: $3.81 \times 10^{-6}$. En la gráfica, toda la masa de probabilidad se concentra entre $1$ y $7$ aciertos; a la derecha de la línea roja, las barras son tan pequeñas que no se ven. Así pues, quien aprueba esta evaluación no lo hace por suerte, y quien no aprueba tiene en la retroalimentación un mapa preciso de lo que le falta.
Caso práctico: el pedido diario de la Cafetería Brújula
Las preguntas miden si usted reconoce la respuesta correcta entre cuatro. El caso mide algo más difícil: si sabe diseñar un escenario cuando nadie le ofrece opciones, con las piezas de Make que conoce y con un cliente real al otro lado.
Enunciado
Marisol Peña, la dueña de la Cafetería Brújula, recibe de Trigo Lento $40$ baguettes cada mañana de lunes a sábado. Hasta hoy, Valeria apunta el pedido a mano cada noche en la hoja de pedidos para que el obrador lo vea a primera hora. Cuando Marisol necesita otra cantidad, escribe un correo; el martes pasado escribió a las 19:40 para pedir $50$ baguettes el miércoles, el correo se quedó sin leer hasta las 22:00 y, por suerte, Valeria lo vio antes de dormir. Marisol lo dijo claro en el Día 28: no pide que nunca haya fallos, pide saber qué pasó con su pedido.
Diseñe en papel un escenario de Make que haga lo siguiente:
- Programación: cada noche a las 21:00 (hora de la Ciudad de México), de domingo a viernes, registrar el pedido del día siguiente.
- Cambio de Marisol: si Marisol envió antes de las 20:00 un correo con otra cantidad, registrar esa cantidad; si no, las $40$ de siempre.
- Confirmación: enviar a Marisol un correo que confirme la cantidad y la fecha, identificado como automático y con una forma de hablar con una persona.
- Sin duplicados: si el escenario se ejecuta dos veces la misma noche (una reejecución manual, una ejecución incompleta que se reanuda), no debe haber dos filas ni dos correos.
- Excepciones: qué pasa si la cantidad del correo no se entiende (“cincuenta”), si es absurda ($400$) o si la hoja de cálculo falla.
Tenga en cuenta lo que ya sabe: las baguettes son el producto P02 del catálogo, a $38$ MXN; el plan Core tiene $10,000$ créditos al mes y el escenario de pedidos ya consume la mayor parte; los datos de Marisol son de una persona y de una empresa cliente, y el correo de prueba de la serie es cliente@ejemplo.com. La Figura 2 resume la noche del caso en una línea de tiempo: el corte de las 20:00, la corrida de las 21:00 y la reejecución que no debe duplicar nada.
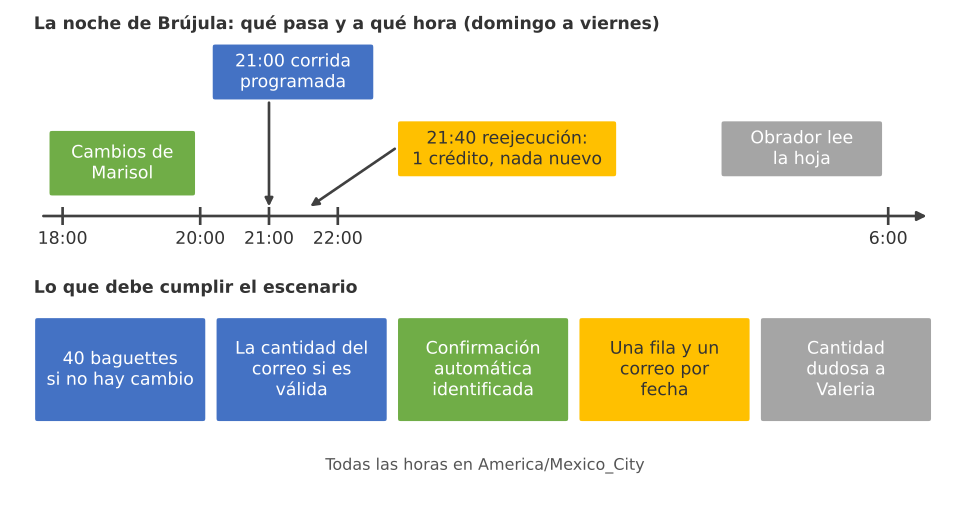
Figura 2. La noche de Brújula: Marisol puede pedir un cambio hasta las 20:00, el escenario corre a las 21:00 de domingo a viernes, una reejecución no debe duplicar nada y el obrador lee la hoja a las 6:00.
La rúbrica analítica
La rúbrica del Día 9 daba el mismo peso a sus cinco criterios. La de hoy no, y la diferencia es una decisión de diseño de la evaluación: errores e idempotencia pesa lo mismo que el diseño del flujo, un $25%$, porque el Día 29 demostró que un escenario que funciona pero duplica pedidos le falla al cliente tanto como uno que no funciona. El coste en créditos y la ética pesan menos, un $15%$ cada uno, no porque importen menos, sino porque en este caso concreto tienen menos maneras de salir mal. La rúbrica completa está en la Tabla 4.
Tabla 4. Rúbrica del caso Brújula: cinco criterios con su peso y cuatro niveles de desempeño.
| Criterio (peso) | 1. Inicial | 2. En desarrollo | 3. Competente | 4. Ejemplar |
|---|---|---|---|---|
| Diseño del flujo y programación (25 %) | Sin programación o con disparador instantáneo sin justificar | Programado a las 21:00, sin zona horaria explícita o sin días de la semana | Programado de domingo a viernes en America/Mexico_City, con módulos en un orden razonable | Todo lo anterior, con la búsqueda del cambio antes de decidir la cantidad y una ruta para cada desenlace |
| Filtros y datos (20 %) | La cantidad se escribe fija en la fila | Lee el correo, pero sin validar la cantidad | Valida que la cantidad sea un número en un rango razonable | Valida formato y rango, fija la fecha de entrega con zona y deja la cantidad dudosa a una persona |
| Errores e idempotencia (25 %) | Sin almacén ni directiva de error | Directiva de error en algún módulo, sin clave contra duplicados | Clave por fecha en un almacén, consultada antes; sin directiva en la fila o el registro | Clave brujula_<fecha> consultada al principio y registrada después de la fila, con Break en cada escritura y ejecuciones incompletas activadas |
| Coste en créditos (15 %) | No estima el consumo | Estima con una cifra sin desglose | Desglosa los créditos por corrida | Desglosa por corrida, con y sin cambio, la reejecución y el total del mes frente a Make Core |
| Ética y consentimiento (15 %) | Escribe a Marisol sin base o con datos de más | Confirma, pero sin identificar el mensaje como automático | Confirma con un mensaje automático identificado | Mensaje identificado, forma de hablar con una persona, secretos fuera del blueprint y datos mínimos en la hoja |
Los descriptores hablan de cosas que se ven en un diagrama o en un blueprint (“clave brujula_<fecha> consultada al principio”, “Break en cada escritura”) y no de impresiones (“buen manejo de errores”). Esa es la condición para que dos personas distintas lleguen al mismo nivel al leer el mismo diseño, y es la recomendación central de Brookhart (2013) para que una rúbrica sirva para aprender y no solo para calificar: los niveles describen la calidad del trabajo, no cuánto se esforzó quien lo hizo.
Puntuar un diseño
La puntuación global es la media de los niveles ponderada por el peso de cada criterio. Si $s_c$ es el nivel del criterio $c$, de $1$ a $4$, y $w_c$ su peso:
$$ S = \frac{\sum_{c} w_c, s_c}{\sum_{c} w_c}, \qquad \Delta S_c = \frac{w_c,(s_c^{\text{rev}} - s_c^{\text{bor}})}{\sum_{c} w_c} $$
La lógica detrás de esta fórmula es múltiple:
- Con pesos distintos, un nivel en “errores e idempotencia” vale $0.25$ puntos y un nivel en “ética”, $0.15$: el mismo salto de nivel no aporta lo mismo en todos los criterios.
- $S$ vive en la escala de $1$ a $4$; dividir entre $4$ la convierte en porcentaje.
- $\Delta S_c$ es el aporte del criterio $c$ a la mejora entre dos versiones, y la suma de todos los $\Delta S_c$ es la diferencia entre sus puntuaciones.
- En conclusión, la rúbrica devuelve tres cosas: una cifra para comparar diseños, la lista de criterios por debajo de $3$ y el criterio que más explica la mejora.
Valeria aplicó la rúbrica a dos versiones de su diseño. El borrador, hecho en veinte minutos, programaba el escenario a las 21:00 sin zona horaria, buscaba el correo de Marisol sin ventana de tiempo, escribía la fila sin comprobar si ya existía, no tenía ninguna directiva de error, no estimaba los créditos y enviaba la confirmación por HTTP con la clave del servicio de correo escrita en una cabecera. La versión revisada corrigió todo eso, salvo la validación de la cantidad, que se quedó en competente porque todavía no distinguía una cantidad escrita con letra. El siguiente bloque puntúa los dos diseños y calcula el aporte de cada criterio a la mejora:
# Rúbrica analítica del caso de Brújula y puntuación ponderada de dos diseños en Python:
rubrica = pd.DataFrame({
    'criterio': ['Flujo y programación', 'Filtros y datos', 'Errores e idempotencia',
                 'Coste en créditos', 'Ética y consentimiento'],
    'peso': [25, 20, 25, 15, 15],
    'borrador': [2, 3, 1, 2, 2],     # sin almacén ni directiva de error; correo con clave en el mapper
    'revisada': [4, 3, 4, 3, 4],     # almacén brujula_<fecha>, Break, ruta de revisión humana
})

def puntuar(niveles, pesos):
    # Media ponderada de los niveles 1 a 4 de cada criterio:
    return float(np.dot(pesos, niveles) / np.sum(pesos))

for diseno in ['borrador', 'revisada']:
    s = puntuar(rubrica[diseno], rubrica['peso'])
    print(f'{diseno:<9} {s:.2f} de 4 ({s / 4:.1%}) | criterios por debajo de 3:',
          rubrica.loc[rubrica[diseno] < 3, 'criterio'].tolist())
aporte = rubrica['peso'] * (rubrica['revisada'] - rubrica['borrador']) / 100
print('Aporte de cada criterio a la mejora:', dict(zip(rubrica['criterio'], aporte.round(2))))

fig, ax = plt.subplots(figsize = (9.2, 4.4))
x = np.arange(len(rubrica))
ax.bar(x - 0.2, rubrica['borrador'], width = 0.4, color = '#8a8986', label = 'Borrador (1.95)')
ax.bar(x + 0.2, rubrica['revisada'], width = 0.4, color = '#2a78d6', label = 'Versión revisada (3.65)')
ax.axhline(3, color = '#52514e', linestyle = '--', linewidth = 1.2)
ax.set_xlim(-0.6, 5.3)
ax.text(5.28, 3.06, 'competente', ha = 'right', fontsize = 9, color = '#52514e')
ax.set_xticks(x)
ax.set_xticklabels([f'{c}\n({p} %)' for c, p in zip(rubrica['criterio'], rubrica['peso'])], fontsize = 9)
ax.set_yticks([1, 2, 3, 4])
ax.set_ylim(0, 4.6)
ax.set_ylabel('Nivel de la rúbrica (1 a 4)')
ax.set_title('Rúbrica del caso Brújula aplicada a dos diseños', fontsize = 16)
ax.legend(loc = 'upper left', frameon = False, ncol = 2)
ax.grid(axis = 'y', color = '#e6e5e1')
ax.set_axisbelow(True)
plt.tight_layout()
plt.show()
borrador  1.95 de 4 (48.8%) | criterios por debajo de 3: ['Flujo y programación', 'Errores e idempotencia', 'Coste en créditos', 'Ética y consentimiento']
revisada  3.65 de 4 (91.2%) | criterios por debajo de 3: []
Aporte de cada criterio a la mejora: {'Flujo y programación': 0.5, 'Filtros y datos': 0.0, 'Errores e idempotencia': 0.75, 'Coste en créditos': 0.15, 'Ética y consentimiento': 0.3}
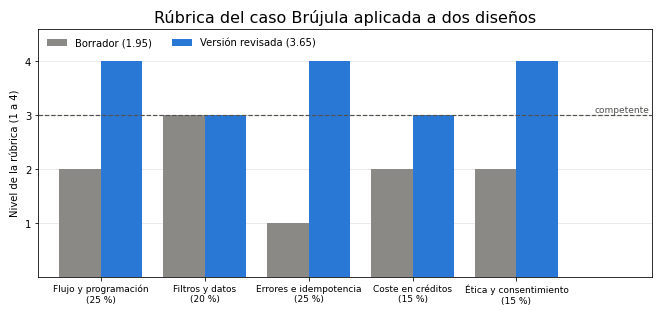
El borrador obtiene $1.95$ de $4$ ($48.8%$) y la versión revisada $3.65$ de $4$ ($91.2%$), una mejora de $1.70$ puntos. El borrador queda por debajo de competente en cuatro de los cinco criterios; la revisada, en ninguno. El desglose de la mejora es la parte más instructiva: errores e idempotencia aporta $0.75$ puntos, casi la mitad del total, porque subió de $1$ a $4$ en el criterio que más pesa. Le siguen el diseño del flujo ($0.50$), la ética ($0.30$) y el coste ($0.15$); los filtros no aportan nada porque se quedaron en $3$.
Es la lección del Día 29 convertida en cifra: lo que separa un borrador de un escenario confiable no es que haga más cosas, sino que sepa qué hacer cuando repite y cuando falla. Haga usted lo mismo con su diseño: puntúelo con la Tabla 4, pídale a otra persona que lo puntúe y discuta cualquier criterio en el que sus niveles difieran en más de un punto.
Depurar un blueprint roto
La tercera pieza de la evaluación es la que pidió Don Ernesto: arreglar lo que está roto. Valeria escribió TL Brújula diario v0 el lunes por la noche, con prisa, y Andrés, el panadero que la ayuda con la computadora, sembró a propósito siete errores mientras ella dormía, uno por cada regla del formato de blueprint que el módulo ha ido acumulando (A.4.2 del plan de la serie, días 22, 24, 26 y 28). El encargo para usted es el mismo que para Valeria: encuentre los siete errores a ojo, anote dónde están y qué síntoma producirían en Make, y solo después ejecute el validador.
La Figura 3 muestra la idea del ejercicio: el blueprint extendido sobre la mesa de trabajo, con siete etiquetas rojas, y al lado la lista de reglas que cada etiqueta incumple. Un blueprint es texto, y el texto se puede revisar con método antes de importarlo y activarlo.
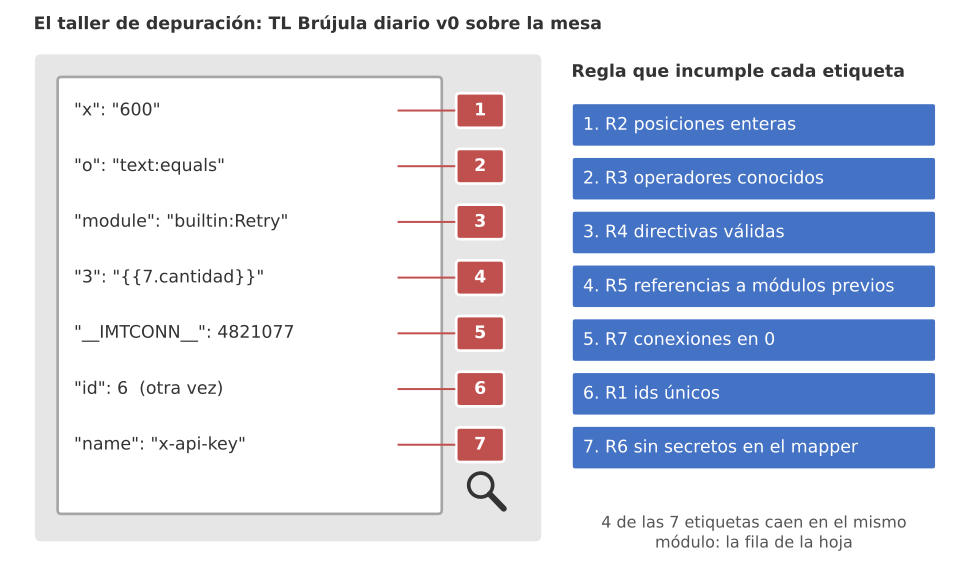
Figura 3. El taller de depuración: el blueprint TL Brújula diario v0 extendido sobre la mesa con siete etiquetas rojas, y al lado las siete reglas del validador que incumple cada una.
El blueprint TL Brújula diario v0
El escenario es programado ("instant": false), y su programación a las 21:00 de domingo a viernes se configura en la cuenta, no viaja en el blueprint, como se vio en el Día 26. Lea el blueprint completo antes de seguir. Fíjese en los identificadores, en las posiciones del diseñador, en los operadores de los filtros, en los manejadores de error, en las referencias {{n.campo}}, en los mapper y en los parameters:
{
  "name": "TL Brújula diario v0",
  "flow": [
    {
      "id": 1,
      "module": "datastore:GetRecord",
      "version": 1,
      "parameters": {"datastore": 0},
      "mapper": {"key": "brujula_{{formatDate(addDays(now; 1); \"YYYY-MM-DD\"; \"America/Mexico_City\")}}"},
      "metadata": {"designer": {"x": 0, "y": 0}}
    },
    {
      "id": 2,
      "module": "google-email:ActionSearchEmails",
      "version": 2,
      "parameters": {"__IMTCONN__": 0},
      "filter": {"name": "Aún no registrado", "conditions": [[{"a": "{{1.key}}", "o": "notexist"}]]},
      "mapper": {"from": "cliente@ejemplo.com", "subject": "Cambio Brújula", "limit": 1},
      "metadata": {"designer": {"x": 300, "y": 0}}
    },
    {
      "id": 3,
      "module": "builtin:BasicAggregator",
      "version": 1,
      "parameters": {"feeder": 2},
      "mapper": {"subject": "{{2.subject}}"},
      "metadata": {"designer": {"x": "600", "y": 0}}
    },
    {
      "id": 4,
      "module": "util:SetVariables",
      "version": 1,
      "parameters": {"scope": "roundtrip"},
      "mapper": {
        "variables": [
          {"name": "cantidad", "value": "{{if(length(3.array) > 0; trim(last(split(get(map(3.array; \"subject\"); 1); \":\"))); 40)}}"},
          {"name": "fecha_entrega", "value": "{{formatDate(addDays(now; 1); \"YYYY-MM-DD\"; \"America/Mexico_City\")}}"}
        ]
      },
      "metadata": {"designer": {"x": 900, "y": 0}}
    },
    {
      "id": 5,
      "module": "builtin:BasicRouter",
      "version": 1,
      "mapper": null,
      "metadata": {"designer": {"x": 1200, "y": 0}},
      "routes": [
        {
          "flow": [
            {
              "id": 6,
              "module": "google-sheets:addRow",
              "version": 2,
              "parameters": {"__IMTCONN__": 4821077},
              "filter": {"name": "Cantidad válida", "conditions": [[
                {"a": "{{4.cantidad}}", "b": "^[0-9]+$", "o": "text:equals"},
                {"a": "{{4.cantidad}}", "b": "80", "o": "number:lessorequal"}
              ]]},
              "mapper": {
                "mode": "select",
                "spreadsheetId": "/ID_DE_EJEMPLO",
                "sheetId": "Pedidos",
                "includesHeaders": true,
                "valueInputOption": "RAW",
                "values": {"0": "brujula_{{4.fecha_entrega}}", "1": "Cafetería Brújula", "2": "P02", "3": "{{7.cantidad}}", "4": "{{4.fecha_entrega}}"}
              },
              "metadata": {"designer": {"x": 1500, "y": 0}},
              "onerror": [
                {
                  "id": 9,
                  "module": "builtin:Retry",
                  "version": 1,
                  "parameters": {},
                  "mapper": {"retry": true, "count": 3, "interval": 5},
                  "metadata": {"designer": {"x": 1500, "y": 300}}
                }
              ]
            },
            {
              "id": 6,
              "module": "datastore:AddRecord",
              "version": 1,
              "parameters": {"datastore": 0},
              "mapper": {"key": "brujula_{{4.fecha_entrega}}", "overwrite": false, "data": {"cantidad": "{{4.cantidad}}"}},
              "metadata": {"designer": {"x": 1800, "y": 0}}
            },
            {
              "id": 8,
              "module": "http:ActionSendData",
              "version": 3,
              "parameters": {"handleErrors": true},
              "mapper": {
                "url": "https://correo.ejemplo.invalid/v1/enviar",
                "method": "post",
                "headers": [{"name": "x-api-key", "value": "clave-de-ejemplo-0000"}],
                "bodyType": "raw",
                "contentType": "application/json",
                "data": "{\"para\": \"cliente@ejemplo.com\", \"asunto\": \"Pedido del {{4.fecha_entrega}} registrado\"}"
              },
              "metadata": {"designer": {"x": 2100, "y": 0}}
            }
          ]
        },
        {
          "flow": [
            {
              "id": 12,
              "module": "google-sheets:addRow",
              "version": 2,
              "parameters": {"__IMTCONN__": 0},
              "filter": {"name": "Cantidad dudosa", "conditions": [
                [{"a": "{{4.cantidad}}", "b": "^[0-9]+$", "o": "text:notpattern"}],
                [{"a": "{{4.cantidad}}", "b": "80", "o": "number:greater"}]
              ]},
              "mapper": {"mode": "select", "spreadsheetId": "/ID_DE_EJEMPLO", "sheetId": "Revisión", "includesHeaders": true, "valueInputOption": "RAW", "values": {"0": "brujula_{{4.fecha_entrega}}", "1": "Cambio de Brújula por revisar", "2": "{{4.cantidad}}"}},
              "metadata": {"designer": {"x": 1500, "y": -300}}
            }
          ]
        }
      ]
    }
  ],
  "metadata": {
    "instant": false,
    "version": 1,
    "scenario": {"roundtrips": 1, "maxErrors": 3, "autoCommit": true, "autoCommitTriggerLast": true, "sequential": true, "confidential": true, "dataloss": false, "dlq": true, "freshVariables": false},
    "designer": {"orphans": []}
  }
}
Si ya tiene su lista, compárela con las reglas del validador. Si le faltan errores, no se preocupe: algunos son muy difíciles de ver a ojo en más de cien líneas de JSON, y esa es exactamente la razón para escribir un validador. Antes de ejecutarlo, conviene una advertencia sobre uno de los siete errores.
Atención aquí: el editor de Make llama hoy Retry al manejador que la serie escribe como builtin:Break (revisado en octubre de 2026). Esa coincidencia de nombres es una trampa fácil: quien escribe un blueprint a mano, o quien pide a un modelo de lenguaje que lo genere, puede poner builtin:Retry creyendo que es el nombre nuevo del identificador. El nombre visible en el editor y el identificador de la exportación no tienen por qué coincidir; la regla de la serie es usar siempre el identificador que aparece en una exportación real del escenario y contrastarlo de nuevo cada vez que Make cambie el editor. Un manejador con un identificador desconocido puede rechazarse al importar o, peor, dejar el módulo sin protección.
El validador ampliado
El validador del Día 22 revisaba identificadores, posiciones, conexiones y secretos, y el del Día 28 añadió las directivas de error. El de hoy reúne esas comprobaciones y añade dos nuevas, hasta siete reglas:
- R1, identificadores únicos: dos módulos con el mismo
idhacen ambiguas las referencias y los mensajes del historial (Día 22). - R2, posiciones enteras:
metadata.designer.xeyson enteros; un texto puede rechazarse al importar (Día 22). - R3, operadores conocidos: cada condición de filtro usa un operador de la lista de los días 24 y 26; un operador inexistente no filtra lo que se cree.
- R4, directivas válidas: cada manejador de
onerrores una de las cinco directivas documentadas (Día 28). - R5, referencias a módulos previos: cada
{{n.campo}}cita un módulo que existe y que se ejecuta antes en el mismo camino; una referencia a un módulo posterior o inexistente llega vacía. - R6, sin secretos en el
mapper: ninguna cabecera ni valor con forma de clave (días 17 y 22). - R7, conexiones en 0:
__IMTCONN__se sustituye por $0$ en todo blueprint publicado o compartido (A.4.2).
La regla nueva más interesante es la R5. Para comprobarla, el validador recorre el blueprint en el orden en que Make ejecuta los módulos, con una lista de los identificadores ya vistos en el camino: un módulo dentro de una ruta del router puede citar al router y a lo que va antes de él, pero no a un módulo de otra ruta ni a uno que viene después. El siguiente bloque escribe el validador y lo aplica al blueprint roto:
# Validador ampliado de blueprints de Make con siete reglas en Python:
OPERADORES = {'text:equal', 'text:equal:ci', 'text:notequal', 'text:contain', 'text:contain:ci',
              'text:notcontain', 'text:notcontain:ci', 'text:pattern', 'text:pattern:ci',
              'text:notpattern', 'text:notpattern:ci', 'number:equal', 'number:greater',
              'number:greaterorequal', 'number:less', 'number:lessorequal', 'date:greater',
              'date:less', 'exist', 'notexist'}                               # Día 24 y Día 26
DIRECTIVAS = {'builtin:Break', 'builtin:Resume', 'builtin:Ignore', 'builtin:Rollback', 'builtin:Commit'}
SECRETOS = r'(?i)(api[_-]?key|bearer\s+\w+|sk-ant-[\w-]+|authorization)'
REFERENCIA = re.compile(r'(?<![\w.])(\d+)\.[A-Za-z_]\w*')

def referencias(objeto):
    # Números de módulo citados como {{n.campo}} dentro de cualquier texto del objeto:
    texto = json.dumps(objeto, ensure_ascii = False)
    return {int(m) for bloque in re.findall(r'\{\{(.*?)\}\}', texto) for m in REFERENCIA.findall(bloque)}

def validar_blueprint_ampliado(bp):
    hallazgos, vistos = [], []
    def anotar(regla, m, detalle):
        hallazgos.append({'regla': regla, 'modulo': m['id'], 'tipo': m['module'], 'detalle': detalle})
    def recorrer(flujo, previos):
        previos = list(previos)
        for m in flujo:
            if m['id'] in vistos:
                anotar('R1 ids únicos', m, f"el id {m['id']} ya existe")
            vistos.append(m['id'])
            d = m['metadata']['designer']
            if not all(type(d.get(c)) is int for c in ('x', 'y')):
                anotar('R2 posiciones enteras', m, f'designer = {d}')
            for grupo in (m.get('filter') or {}).get('conditions', []):
                for c in grupo:
                    if c['o'] not in OPERADORES:
                        anotar('R3 operadores conocidos', m, f"operador {c['o']}")
            for e in m.get('onerror', []):
                if e['module'] not in DIRECTIVAS:
                    anotar('R4 directivas válidas', m, f"directiva {e['module']}")
                vistos.append(e['id'])
            for r in sorted(referencias({'mapper': m.get('mapper'), 'filter': m.get('filter')})):
                if r not in previos:
                    anotar('R5 referencias a módulos previos', m, f'{{{{{r}.…}}}} no es un módulo anterior')
            if re.search(SECRETOS, json.dumps(m.get('mapper') or {}, ensure_ascii = False)):
                anotar('R6 sin secretos en el mapper', m, 'cabecera o clave en el mapper')
            conexion = (m.get('parameters') or {}).get('__IMTCONN__', 0)
            if conexion != 0:
                anotar('R7 conexión en 0', m, f'__IMTCONN__ = {conexion}')
            previos.append(m['id'])
            for ruta in m.get('routes', []):
                recorrer(ruta['flow'], previos)
    recorrer(bp['flow'], [])
    return pd.DataFrame(hallazgos, columns = ['regla', 'modulo', 'tipo', 'detalle'])

ruta_v0 = carpeta / 'flujos' / 'make' / 'brujula_diario_v0.blueprint.json'
v0 = json.loads(ruta_v0.read_text(encoding = 'utf-8'))
hallazgos_v0 = validar_blueprint_ampliado(v0)
print(v0['name'], '|', len(hallazgos_v0), 'hallazgos')
print(hallazgos_v0.to_string(index = False))
print('Reglas incumplidas:', hallazgos_v0['regla'].nunique(), 'de 7')
TL Brújula diario v0 | 7 hallazgos
                           regla  modulo                    tipo                          detalle
           R2 posiciones enteras       3 builtin:BasicAggregator  designer = {'x': '600', 'y': 0}
         R3 operadores conocidos       6    google-sheets:addRow             operador text:equals
           R4 directivas válidas       6    google-sheets:addRow          directiva builtin:Retry
R5 referencias a módulos previos       6    google-sheets:addRow {{7.…}} no es un módulo anterior
                R7 conexión en 0       6    google-sheets:addRow            __IMTCONN__ = 4821077
                   R1 ids únicos       6     datastore:AddRecord                el id 6 ya existe
    R6 sin secretos en el mapper       8     http:ActionSendData    cabecera o clave en el mapper
Reglas incumplidas: 7 de 7
El validador encuentra $7$ hallazgos, uno por cada regla, y la Tabla 5 los ordena con el síntoma que producirían en Make y su corrección.
Tabla 5. Errores sembrados en TL Brújula diario v0: ubicación, síntoma en Make, regla que incumplen y corrección.
| # | Ubicación | Síntoma que produciría en Make | Regla | Corrección |
|---|---|---|---|---|
| 1 | Módulo 3 (agregador), designer.x | La importación puede rechazar el blueprint o colocar el módulo fuera del lienzo | R2 | "x": 600 como entero |
| 2 | Módulo 6 (fila), filtro “Cantidad válida” | text:equals no existe: la condición no se puede evaluar como se espera y la cantidad no se valida | R3 | text:pattern con ^[0-9]+$, más el rango de 1 a 80 |
| 3 | Módulo 6, manejador 9 | builtin:Retry no es un identificador de directiva: la fila queda sin protección ante un fallo de la hoja | R4 | builtin:Break con 3 intentos cada 5 minutos |
| 4 | Módulo 6, columna de la cantidad | {{7.cantidad}} cita un módulo que no existe: la fila llega con la cantidad vacía | R5 | {{4.cantidad}}, la variable fijada en el módulo 4 |
| 5 | Módulo 6, parameters | __IMTCONN__ con un número real: el blueprint publicado expone una conexión de la cuenta | R7 | "__IMTCONN__": 0 |
| 6 | Segundo módulo con id 6 (registrar clave) | Dos módulos 6: las referencias y los mensajes del historial se vuelven ambiguos | R1 | "id": 7 |
| 7 | Módulo 8, cabecera x-api-key | La clave del servicio de correo viaja en cada exportación del blueprint | R6 | Módulo de correo con su conexión, o clave en el llavero de Make |
Fíjese en que cuatro de los siete errores están en el mismo módulo, la fila de la hoja. No es casualidad: es el módulo más importante del escenario, el que más se toca y, por eso, el que más se rompe. Fíjese también en el hallazgo de la R1: el validador lo atribuye al segundo módulo con id 6, el de registrar la clave, porque es el que repite un identificador que ya existía. Mientras ese error no se corrige, todos los demás mensajes que dicen “módulo 6” son ambiguos, igual que ocurrió con la copia contaminada del Día 22. Por eso los identificadores repetidos se corrigen primero.
El blueprint roto, dibujado
Una lista de hallazgos se lee mejor junto a un dibujo. El siguiente bloque reutiliza nodos_desde_blueprint y dibujar_flujo, con un cambio importante respecto del Día 28: cada nodo recibe una clave propia, independiente de su id, porque un blueprint con identificadores repetidos rompería un dibujo que se apoya en ellos. Los módulos con algún hallazgo se pintan en rojo con borde oscuro:
# Dibujo del blueprint roto con los módulos defectuosos en rojo en Python:
from matplotlib.patches import Ellipse, FancyBboxPatch, Polygon, FancyArrowPatch

NOMBRES = {'datastore:GetRecord': 'Consultar\nclave', 'google-email:ActionSearchEmails': 'Buscar\ncorreo',
           'builtin:BasicAggregator': 'Agregar\nresultados', 'util:SetVariables': 'Fijar\ncantidad',
           'builtin:BasicRouter': 'Router', 'google-sheets:addRow': 'Fila en\nla hoja',
           'datastore:AddRecord': 'Registrar\nclave', 'http:ActionSendData': 'Correo\npor HTTP',
           'google-email:ActionSendEmail': 'Correo de\nconfirmación', 'builtin:Break': 'Break',
           'builtin:Retry': 'Retry (?)'}

def nodos_desde_blueprint(flujo, x0 = 0.0, y0 = 0.0, previo = None, nodos = None, aristas = None):
    # Cada nodo recibe una clave propia: los ids repetidos no deben romper el dibujo:
    nodos = [] if nodos is None else nodos
    aristas = [] if aristas is None else aristas
    x = x0
    for m in flujo:
        clave = len(nodos)
        tipo = 'disparador' if previo is None else ('decision' if 'Router' in m['module'] else 'accion')
        texto = NOMBRES.get(m['module'], m['module'])
        if m.get('mapper') and m['mapper'].get('sheetId') == 'Revisión':
            tipo, texto = 'humano', 'Fila en\nRevisión'
        nodos.append({'clave': clave, 'id': m['id'], 'modulo': m['module'], 'tipo': tipo,
                      'texto': f"{m['id']}. {texto}", 'x': x, 'y': y0})
        if previo is not None:
            aristas.append((previo, clave, textwrap.fill(m.get('filter', {}).get('name', ''), 12)))
        for e in m.get('onerror', []):
            nodos.append({'clave': len(nodos), 'id': e['id'], 'modulo': e['module'], 'tipo': 'error',
                          'texto': f"{e['id']}. {NOMBRES.get(e['module'], e['module'])}", 'x': x, 'y': y0 - 1.9})
            aristas.append((clave, len(nodos) - 1, ''))
        for i, ruta in enumerate(m.get('routes', [])):
            nodos_desde_blueprint(ruta['flow'], x + 2.5, y0 + (0 if i == 0 else 2.4), clave, nodos, aristas)
        previo, x = clave, x + 2.5
    return nodos, aristas

COLORES = {'disparador': '#3a9d5d', 'accion': '#2a78d6', 'decision': '#eb6834', 'error': '#8a8986',
           'humano': '#8a8986'}

def dibujar_flujo(nodos, aristas, titulo, defectuosos = (), ancho = 2.1, alto = 1.2):
    fig, ax = plt.subplots(figsize = (15, 5.6))
    for n in nodos:
        x, y = n['x'], n['y']
        color = '#c8423b' if n['clave'] in defectuosos else COLORES[n['tipo']]
        if n['tipo'] == 'disparador':
            figura = Ellipse((x, y), ancho * 1.05, alto * 1.1)
        elif n['tipo'] == 'decision':
            figura = Polygon([(x - ancho / 1.6, y), (x, y + alto / 1.15), (x + ancho / 1.6, y), (x, y - alto / 1.15)])
        else:
            figura = FancyBboxPatch((x - ancho / 2, y - alto / 2), ancho, alto, boxstyle = 'round,pad=0.03')
        figura.set_facecolor(color)
        figura.set_edgecolor('#1f1f1f' if n['clave'] in defectuosos else 'white')
        figura.set_linewidth(2.5 if n['clave'] in defectuosos else 2)
        ax.add_patch(figura)
        ax.text(x, y, n['texto'], ha = 'center', va = 'center', fontsize = 8.5, color = 'white')
    posicion = {n['clave']: (n['x'], n['y']) for n in nodos}
    for origen, destino, etiqueta in aristas:
        (x1, y1), (x2, y2) = posicion[origen], posicion[destino]
        ax.add_patch(FancyArrowPatch((x1, y1), (x2, y2), arrowstyle = '-|>', mutation_scale = 12,
                                     shrinkA = 30, shrinkB = 32, color = '#52514e', linewidth = 1.3))
        if etiqueta:
            ax.text((x1 + x2) / 2, (y1 + y2) / 2 + 0.7, etiqueta, ha = 'center', fontsize = 8, color = '#eb6834')
    xs, ys = [n['x'] for n in nodos], [n['y'] for n in nodos]
    ax.set_xlim(min(xs) - 1.4, max(xs) + 1.4)
    ax.set_ylim(min(ys) - 1.0, max(ys) + 1.3)
    ax.set_aspect('equal')
    ax.axis('off')
    ax.set_title(titulo, fontsize = 16)
    return ax

nodos, aristas = nodos_desde_blueprint(v0['flow'])
con_hallazgo = set(hallazgos_v0['modulo'])
# Un módulo es defectuoso si su id tiene un hallazgo (el id repetido marca a sus dos dueños)
# o si es un manejador con una directiva desconocida:
defectuosos = {n['clave'] for n in nodos if (n['tipo'] != 'error' and n['id'] in con_hallazgo)
               or (n['tipo'] == 'error' and n['modulo'] not in DIRECTIVAS)}
print('Nodos dibujados:', len(nodos), '| aristas:', len(aristas), '| defectuosos:',
      sorted(n['texto'].replace('\n', ' ') for n in nodos if n['clave'] in defectuosos))
dibujar_flujo(nodos, aristas, f"{v0['name']}: módulos con errores en rojo", defectuosos)
plt.tight_layout()
plt.show()
Nodos dibujados: 10 | aristas: 9 | defectuosos: ['3. Agregar resultados', '6. Fila en la hoja', '6. Registrar clave', '8. Correo por HTTP', '9. Retry (?)']
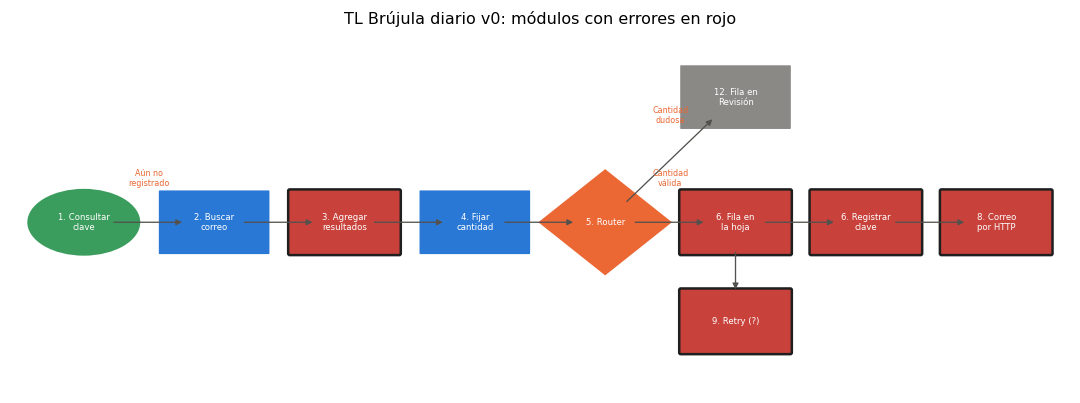
El dibujo tiene $10$ nodos y $9$ aristas, y $5$ módulos en rojo: el agregador con su posición en texto, los dos módulos con id 6, el correo por HTTP con la clave y el manejador Retry (?). En la fila de arriba, el hexágono gris de la ruta “Cantidad dudosa”, que atiende Valeria, no tiene ningún error de formato. Pero el dibujo enseña algo que el validador no ve: la ruta principal no tiene ningún manejador de error correcto, y la ruta de revisión no registra la clave, así que una reejecución mandaría dos veces el mismo cambio dudoso a Valeria.
Esa es la frontera de un validador de formato: comprueba que el blueprint está bien escrito, no que el escenario está bien pensado. Un blueprint con cero hallazgos puede seguir sin idempotencia, buscar el correo sin ventana de tiempo o confirmar a Marisol una cantidad que nadie revisó. Lo primero lo encuentra el código; lo segundo, la rúbrica y una persona que la aplique.
Solución comentada
La solución está plegada para que la abra solo después de haber escrito sus respuestas, su diseño y su lista de errores. Contiene la clave de las quince preguntas con la razón de cada respuesta, el diseño de referencia del caso Brújula, el blueprint corregido TL Brújula diario v1 y su validación con los créditos contados.
Ver solución
Tabla 6. Clave de respuestas con la razón y el día que conviene repasar si falló.
| # | Correcta | Por qué | Día |
|---|---|---|---|
| 1 | C | $C = 4 + n = 4 + 5 = 9$ créditos: solo se repite lo que va después del iterador. | 22 |
| 2 | B | Manda el reloj corto, el del emisor: a los 15 segundos Twilio da la entrega por fallida y reintenta. | 23 |
| 3 | A | El router recorre sus rutas en orden y el paquete entra en todas las que cumple; se pagan los módulos de ambas. | 24 |
| 4 | D | A las 23:30 del viernes en la Ciudad de México ya son las 05:30 del sábado en UTC; el “próximo sábado” es el 28. | 25 |
| 5 | C | $8 + n = 5 + 2n$ da $n = 3$, con 11 créditos cada uno. | 25 |
| 6 | B | Los filtros no cobran: $1 + 3k$ frente a $1 + n + 2k$ créditos por corrida. | 26 |
| 7 | D | Consultar, enviar y registrar, en ese orden: el almacén solo dice “avisado” si el aviso salió. | 26 |
| 8 | C | Create JSON mapeado entero ({{16.json}}) o escapeJSON en cada dato. | 27 |
| 9 | A | Llavero o conexión; las variables personalizadas están en texto plano y no existen en Core. | 27 |
| 10 | B | Break (Retry en el editor) guarda el paquete como incompleto y reanuda en el módulo que falló. | 28 |
| 11 | A | Una respuesta puntual también se pierde a veces; sin clave quedan unos 0.14 duplicados por cada 14 pedidos. | 29 |
| 12 | C | La latencia disparó el fallo; la causa raíz fue un efecto no idempotente. | 29 |
| 13 | D | $0.21 + 234 \cdot 0.0054 = 1.47$ USD al mes. | 30 |
| 14 | B | Un 400 es un error de la petición: reintentarlo no lo arregla. | 30 |
| 15 | A | El UUID del timbre fiscal digital, de 36 caracteres. | 31 |
El diseño de referencia del caso. Un diseño de nivel $4$ en los cinco criterios tiene estas piezas, en este orden:
- Consultar la clave
brujula_<fecha de mañana>en un almacén de datos, con la fecha calculada enAmerica/Mexico_City. Si ya existe, un filtro “Aún no registrado” detiene el paquete y la corrida cuesta un solo crédito. - Buscar el correo de Marisol con asunto “Cambio Brújula”, recibido hoy antes de las 20:00, con un límite de un resultado.
- Agregar los resultados con un agregador, para que el escenario siga aunque no haya ningún correo (el detalle técnico está en la advertencia de más abajo).
- Fijar la cantidad y la fecha en variables: la cantidad del asunto si hubo cambio, $40$ si no.
- Un router con dos rutas: “Cantidad válida” (un número entre $1$ y $80$) escribe la fila en
Pedidos, registra la clave y confirma a Marisol por correo; “Cantidad dudosa” escribe una fila enRevisiónpara Valeria y registra la clave, sin confirmar nada. - Break con tres intentos cada cinco minutos en la fila, en el registro de la clave y en el correo, con las ejecuciones incompletas, el procesamiento en orden y los datos confidenciales activados.
El correo de confirmación dice que es automático y cómo hablar con una persona, y la conexión de Gmail sustituye a la cabecera con la clave del borrador. La hoja guarda la clave, el cliente, el producto, la cantidad, la fecha y el origen del dato, y nada más.
Atención aquí: en Make, un módulo de búsqueda que no encuentra nada no emite ningún paquete, y la ruta que sigue no se ejecuta. Si el escenario de Brújula pusiera la fila justo después de buscar el correo, las noches sin cambio (casi todas) no se registraría ningún pedido y nadie se enteraría. El diseño de referencia pone un agregador detrás de la búsqueda para seguir con una lista vacía; antes de activarlo, compruebe en una ejecución de prueba con el buzón vacío que el agregador entrega su paquete y que la fila se escribe con las $40$ baguettes de siempre.
El blueprint corregido, TL Brújula diario v1, es el siguiente. Compárelo con el roto: además de corregir los siete errores de la Tabla 5, añade la variable hay_cambio, la ventana de tiempo de la búsqueda, el registro de la clave en la ruta de revisión y los manejadores Break del registro y del correo, que el validador no exigía pero la rúbrica sí:
{
  "name": "TL Brújula diario v1",
  "flow": [
    {
      "id": 1,
      "module": "datastore:GetRecord",
      "version": 1,
      "parameters": {"datastore": 0},
      "mapper": {"key": "brujula_{{formatDate(addDays(now; 1); \"YYYY-MM-DD\"; \"America/Mexico_City\")}}"},
      "metadata": {"designer": {"x": 0, "y": 0}}
    },
    {
      "id": 2,
      "module": "google-email:ActionSearchEmails",
      "version": 2,
      "parameters": {"__IMTCONN__": 0},
      "filter": {"name": "Aún no registrado", "conditions": [[{"a": "{{1.key}}", "o": "notexist"}]]},
      "mapper": {
        "from": "cliente@ejemplo.com",
        "subject": "Cambio Brújula",
        "after": "{{formatDate(now; \"YYYY-MM-DD\"; \"America/Mexico_City\")}}",
        "before": "{{formatDate(now; \"YYYY-MM-DD\"; \"America/Mexico_City\")}} 20:00",
        "limit": 1
      },
      "metadata": {"designer": {"x": 300, "y": 0}}
    },
    {
      "id": 3,
      "module": "builtin:BasicAggregator",
      "version": 1,
      "parameters": {"feeder": 2},
      "mapper": {"subject": "{{2.subject}}"},
      "metadata": {"designer": {"x": 600, "y": 0}}
    },
    {
      "id": 4,
      "module": "util:SetVariables",
      "version": 1,
      "parameters": {"scope": "roundtrip"},
      "mapper": {
        "variables": [
          {"name": "hay_cambio", "value": "{{length(3.array) > 0}}"},
          {"name": "cantidad", "value": "{{if(length(3.array) > 0; trim(last(split(get(map(3.array; \"subject\"); 1); \":\"))); 40)}}"},
          {"name": "fecha_entrega", "value": "{{formatDate(addDays(now; 1); \"YYYY-MM-DD\"; \"America/Mexico_City\")}}"}
        ]
      },
      "metadata": {"designer": {"x": 900, "y": 0}}
    },
    {
      "id": 5,
      "module": "builtin:BasicRouter",
      "version": 1,
      "mapper": null,
      "metadata": {"designer": {"x": 1200, "y": 0}},
      "routes": [
        {
          "flow": [
            {
              "id": 6,
              "module": "google-sheets:addRow",
              "version": 2,
              "parameters": {"__IMTCONN__": 0},
              "filter": {"name": "Cantidad válida", "conditions": [[
                {"a": "{{4.cantidad}}", "b": "^[0-9]+$", "o": "text:pattern"},
                {"a": "{{4.cantidad}}", "b": "0", "o": "number:greater"},
                {"a": "{{4.cantidad}}", "b": "80", "o": "number:lessorequal"}
              ]]},
              "mapper": {
                "mode": "select",
                "spreadsheetId": "/ID_DE_EJEMPLO",
                "sheetId": "Pedidos",
                "includesHeaders": true,
                "valueInputOption": "RAW",
                "values": {"0": "brujula_{{4.fecha_entrega}}", "1": "Cafetería Brújula", "2": "P02", "3": "{{4.cantidad}}", "4": "{{4.fecha_entrega}}", "5": "{{if(4.hay_cambio; \"cambio de Marisol\"; \"pedido diario\")}}"}
              },
              "metadata": {"designer": {"x": 1500, "y": 0}},
              "onerror": [
                {
                  "id": 9,
                  "module": "builtin:Break",
                  "version": 1,
                  "parameters": {},
                  "mapper": {"retry": true, "count": 3, "interval": 5},
                  "metadata": {"designer": {"x": 1500, "y": 300}}
                }
              ]
            },
            {
              "id": 7,
              "module": "datastore:AddRecord",
              "version": 1,
              "parameters": {"datastore": 0},
              "mapper": {"key": "brujula_{{4.fecha_entrega}}", "overwrite": false, "data": {"cantidad": "{{4.cantidad}}", "registrado_en": "{{formatDate(now; \"YYYY-MM-DD HH:mm\"; \"America/Mexico_City\")}}"}},
              "metadata": {"designer": {"x": 1800, "y": 0}},
              "onerror": [
                {
                  "id": 10,
                  "module": "builtin:Break",
                  "version": 1,
                  "parameters": {},
                  "mapper": {"retry": true, "count": 3, "interval": 5},
                  "metadata": {"designer": {"x": 1800, "y": 300}}
                }
              ]
            },
            {
              "id": 8,
              "module": "google-email:ActionSendEmail",
              "version": 2,
              "parameters": {"__IMTCONN__": 0},
              "mapper": {
                "to": ["cliente@ejemplo.com"],
                "subject": "Trigo Lento: pedido del {{4.fecha_entrega}} registrado",
                "content": "Buenas noches, Marisol: quedó registrado su pedido de {{4.cantidad}} baguettes para el {{4.fecha_entrega}}. Mensaje automático de Trigo Lento; para hablar con una persona responda a este correo."
              },
              "metadata": {"designer": {"x": 2100, "y": 0}},
              "onerror": [
                {
                  "id": 11,
                  "module": "builtin:Break",
                  "version": 1,
                  "parameters": {},
                  "mapper": {"retry": true, "count": 3, "interval": 5},
                  "metadata": {"designer": {"x": 2100, "y": 300}}
                }
              ]
            }
          ]
        },
        {
          "flow": [
            {
              "id": 12,
              "module": "google-sheets:addRow",
              "version": 2,
              "parameters": {"__IMTCONN__": 0},
              "filter": {"name": "Cantidad dudosa", "conditions": [
                [{"a": "{{4.cantidad}}", "b": "^[0-9]+$", "o": "text:notpattern"}],
                [{"a": "{{4.cantidad}}", "b": "80", "o": "number:greater"}]
              ]},
              "mapper": {"mode": "select", "spreadsheetId": "/ID_DE_EJEMPLO", "sheetId": "Revisión", "includesHeaders": true, "valueInputOption": "RAW", "values": {"0": "brujula_{{4.fecha_entrega}}", "1": "Cambio de Brújula por revisar", "2": "{{4.cantidad}}"}},
              "metadata": {"designer": {"x": 1500, "y": -300}}
            },
            {
              "id": 13,
              "module": "datastore:AddRecord",
              "version": 1,
              "parameters": {"datastore": 0},
              "mapper": {"key": "brujula_{{4.fecha_entrega}}", "overwrite": false, "data": {"cantidad": "revisión", "registrado_en": "{{formatDate(now; \"YYYY-MM-DD HH:mm\"; \"America/Mexico_City\")}}"}},
              "metadata": {"designer": {"x": 1800, "y": -300}}
            }
          ]
        }
      ]
    }
  ],
  "metadata": {
    "instant": false,
    "version": 1,
    "scenario": {"roundtrips": 1, "maxErrors": 3, "autoCommit": true, "autoCommitTriggerLast": true, "sequential": true, "confidential": true, "dataloss": false, "dlq": true, "freshVariables": false},
    "designer": {"orphans": []}
  }
}
El último bloque valida el blueprint corregido con las mismas siete reglas y simula sus corridas con una función que reproduce su lógica en Python, para contar los créditos sin gastar ninguno: una noche sin cambio, la reejecución de esa misma noche, un cambio a $50$, un cambio escrito con letra y uno fuera de rango, y un mes de $26$ corridas con supuestos declarados ($15%$ de noches con cambio y $10%$ con reejecución). Los créditos del mes salen de la fórmula:
$$ C_{\text{mes}} = N \cdot c_{\text{corrida}} + R \cdot c_{\text{reejecución}} $$
La lógica detrás de esta fórmula es múltiple:
- $N$ es el número de corridas programadas al mes, $26$ de domingo a viernes, y $c_{\text{corrida}}$ los créditos de una corrida completa: $7$ si la cantidad es válida y $6$ si va a revisión.
- $R$ es el número de reejecuciones y $c_{\text{reejecución}} = 1$, porque el filtro “Aún no registrado” detiene el paquete después de la primera consulta.
- Que haya o no correo de Marisol no cambia el coste: la búsqueda cobra un crédito encuentre algo o no.
- En conclusión, la idempotencia no solo evita filas repetidas; también hace barata la repetición.
# Validación del blueprint corregido y créditos por corrida y al mes en Python:
ruta_v1 = carpeta / 'flujos' / 'make' / 'brujula_diario_v1.blueprint.json'
v1 = json.loads(ruta_v1.read_text(encoding = 'utf-8'))
print(v1['name'], '|', len(validar_blueprint_ampliado(v1)), 'hallazgos | instant:',
      v1['metadata']['instant'], '| dlq:', v1['metadata']['scenario']['dlq'])

def corrida(fecha, correo, almacen):
    # Simula una corrida de TL Brújula diario v1 y devuelve los créditos y lo que hizo:
    creditos, clave = 1, f'brujula_{fecha}'                    # módulo 1: consultar la clave
    if clave in almacen:
        return creditos, 'ya registrado: no hace nada'         # filtro "Aún no registrado"
    creditos += 3                                              # buscar correo, agregar, fijar cantidad
    cantidad = correo.split(':')[-1].strip() if correo else '40'
    if re.fullmatch(r'[0-9]+', cantidad) and 0 < int(cantidad) <= 80:
        creditos += 3                                          # fila, registrar clave, correo
        almacen[clave] = int(cantidad)
        return creditos, f'{cantidad} baguettes y confirmación'
    creditos += 2                                              # fila en Revisión y registrar clave
    almacen[clave] = 'revisión'
    return creditos, f'"{cantidad}" a revisión de Valeria'

almacen = {}
casos = [('2026-03-05', None, 'sin cambio'), ('2026-03-05', None, 'reejecución de la misma noche'),
         ('2026-03-06', 'Cambio Brújula: 50', 'con cambio a 50'),
         ('2026-03-07', 'Cambio Brújula: cincuenta', 'cambio escrito con letra'),
         ('2026-03-09', 'Cambio Brújula: 400', 'cambio fuera de rango')]
for fecha, correo, nombre in casos:
    c, accion = corrida(fecha, correo, almacen)
    print(f'{nombre:<32} {c} créditos | {accion}')

# Un mes de 26 corridas: 15 % de noches con cambio y 10 % con reejecución (supuestos):
hay_cambio = rng.random(26) < 0.15
hay_reejecucion = rng.random(26) < 0.10
almacen, total = {}, 0
for dia in range(26):
    fecha = f'2026-03-{dia + 1:02d}'
    correo = 'Cambio Brújula: 50' if hay_cambio[dia] else None
    total += corrida(fecha, correo, almacen)[0]
    if hay_reejecucion[dia]:
        total += corrida(fecha, correo, almacen)[0]
print(f'Mes simulado: {total} créditos con {hay_cambio.sum()} cambios y {hay_reejecucion.sum()} '
      f'reejecuciones | {total / 10000:.2%} de Make Core | filas de Brújula: {len(almacen)}')
print(f'Cota con una reejecución cada noche: {26 * (7 + 1)} créditos ({26 * 8 / 10000:.2%} de Core)')
TL Brújula diario v1 | 0 hallazgos | instant: False | dlq: True
sin cambio                       7 créditos | 40 baguettes y confirmación
reejecución de la misma noche    1 créditos | ya registrado: no hace nada
con cambio a 50                  7 créditos | 50 baguettes y confirmación
cambio escrito con letra         6 créditos | "cincuenta" a revisión de Valeria
cambio fuera de rango            6 créditos | "400" a revisión de Valeria
Mes simulado: 182 créditos con 1 cambios y 0 reejecuciones | 1.82% de Make Core | filas de Brújula: 26
Cota con una reejecución cada noche: 208 créditos (2.08% de Core)
El blueprint corregido sale con $0$ hallazgos, programado (instant: False) y con las ejecuciones incompletas activadas. Una corrida cuesta $7$ créditos con o sin cambio de Marisol, y $6$ cuando la cantidad va a revisión; la reejecución de la misma noche cuesta $1$ crédito y no hace nada más. El cambio escrito con letra (“cincuenta”) y el absurdo ($400$) terminan en la hoja de revisión de Valeria, sin confirmación a Marisol. El mes simulado consume $182$ créditos, el $1.82%$ de Make Core, y la cota con una reejecución cada noche es de $208$: añadir Brújula al plan de Trigo Lento cuesta menos de dos puntos de la cuota.
Tabla 7. Créditos por corrida de TL Brújula diario v1 según el desenlace.
| Desenlace | Módulos que cobran | Créditos | Qué queda en la hoja | Correo a Marisol |
|---|---|---|---|---|
| Sin cambio | Clave, búsqueda, agregador, variables, fila, registro, correo | 7 | 40 baguettes | Sí |
| Con cambio válido | Los mismos siete | 7 | La cantidad pedida | Sí |
| Cantidad dudosa | Clave, búsqueda, agregador, variables, fila en Revisión, registro | 6 | Fila para Valeria | No |
| Reejecución de la misma noche | Solo la consulta de la clave | 1 | Nada nuevo | No |
Si su diseño difiere en la forma (otro orden, la confirmación antes del registro, un correo de aviso a Valeria en la ruta de revisión), no se preocupe: la rúbrica no premia un dibujo concreto, sino la presencia de cada pieza. Si le falta alguna, ya sabe qué criterio baja y a qué día volver.
Consideraciones finales
El día empezó con una condición de Don Ernesto y termina con tres mediciones. Las preguntas dicen qué domina Valeria del módulo y qué días debe repasar; la rúbrica dice qué tan bueno es un diseño y qué criterio explica su mejora; la depuración dice si sabe encontrar, con método y con herramientas, lo que está roto en un escenario ajeno. Las tres comparten una idea que el módulo 3 ha repetido de muchas formas: un escenario no se juzga por lo que hace cuando todo sale bien, sino por lo que hace cuando algo se repite o falla.
Antes de dar por cerrada esta evaluación, conviene hacerse algunas preguntas:
- ¿Revisé la puntuación de cada parte, y no solo el total?
- ¿Mis fallos tienen un tema común, como los del lector de ejemplo, o están dispersos?
- ¿Mi diseño del caso aguanta una reejecución, un buzón vacío y una cantidad escrita con letra?
- ¿Encontré a ojo los errores que el validador no ve, los de diseño, o solo los de formato?
Las cifras de hoy tienen límites claros. El lector de ejemplo y sus respuestas son inventados; los dos diseños de Valeria se puntuaron con una rúbrica que ella misma aplicó; los identificadores de los módulos de Gmail deben contrastarse con una exportación real; y el mes simulado de Brújula usa supuestos declarados, no mediciones de un escenario en producción. Nada de eso cambia las conclusiones de método: se evalúa por partes, se puntúa con descriptores observables, se valida el blueprint antes de importarlo y se cuentan los créditos antes de construir.
Un gran libro que habla de esto es El arte de probar software (o The Art of Software Testing, en su título original), en el que Glenford J. Myers, Corey Sandler y Tom Badgett defienden una idea que incomoda a cualquiera que construye: probar es intentar demostrar que el programa falla, no que funciona, y quien escribió el programa es la persona menos indicada para probarlo. Es exactamente lo que hizo Andrés al sembrar siete errores en el blueprint de Valeria, y es la actitud que necesitará mañana con los veinte casos de prueba del escenario completo.
Don Ernesto miró la gráfica de las partes, la rúbrica de las dos versiones y el dibujo con los cinco módulos en rojo. Preguntó solo una cosa: "¿Y cuánto tardó en encontrar los siete?" Valeria encontró cinco a ojo en veinte minutos; el validador, los siete en un segundo. No es una competencia: los cinco que encontró ella le dicen que entiende el formato, y los dos que no encontró, la referencia {{7.cantidad}} y el identificador repetido, le dicen por qué conviene ejecutar el validador cada vez que un blueprint cambia.
Conclusiones clave
Lo esencial de Make
- Las quince preguntas recorren los días 22 a 31: créditos como suma de paquetes ($4 + n = 9$ con cinco renglones), el reloj corto del emisor, las rutas que se toman todas, la zona horaria en cada fecha, el empate en $n = 3$, el filtro antes del módulo que cobra y Break como la directiva que deja la ejecución incompleta.
- Aprobar al azar es prácticamente imposible: la media es de $3.75$ aciertos y $P(X \geq 12) = 1.24 \times 10^{-5}$.
- El lector de ejemplo saca $11$ de $15$ ($73%$) y cae al $60%$ en la tercera parte: sus cuatro fallos tratan de qué pasa cuando algo se repite o falla.
Diseñar con criterio
- La rúbrica del caso Brújula pondera el diseño y los errores e idempotencia con un $25%$ cada uno; el borrador saca $1.95$ y la versión revisada $3.65$ de $4$.
- Errores e idempotencia explica $0.75$ de los $1.70$ puntos de mejora: lo que separa un borrador de un escenario confiable es cómo responde a la repetición y al fallo.
- Un escenario programado con clave
brujula_<fecha>cuesta $7$ créditos por corrida con o sin cambio, $1$ en la reejecución y $182$ al mes, el $1.82%$ de Make Core.
Depurar con método
- Un validador de siete reglas (ids únicos, posiciones enteras, operadores conocidos, directivas válidas, referencias a módulos previos, sin secretos en el
mappery conexiones en $0$) encuentra los siete errores sembrados enTL Brújula diario v0, cuatro de ellos en la fila de la hoja. - El nombre visible en el editor no es el identificador del blueprint: Retry en el editor sigue siendo
builtin:Breaken la exportación que usa la serie. - Un validador comprueba el formato, no el diseño: la falta de idempotencia o una búsqueda que no devuelve nada solo las ve la rúbrica o una persona.
Mañana, en el Día 33: Sesión práctica: el escenario de pedidos de Trigo Lento, de punta a punta. Con la evaluación hecha y los puntos débiles anotados, Valeria integrará en TL Pedidos WhatsApp v3 el webhook firmado, la cascada de Claude, el router, la transformación, el almacén, los errores y la idempotencia, lo probará con veinte casos en Python y simulará un mes de producción contra el presupuesto de $45$ USD.
Referencias
- Roediger, H. L. y Karpicke, J. D. (2006). Test-Enhanced Learning: Taking Memory Tests Improves Long-Term Retention. Psychological Science, 17(3), 249-255. https://doi.org/10.1111/j.1467-9280.2006.01693.x
- Brookhart, S. M. (2013). How to Create and Use Rubrics for Formative Assessment and Grading. ASCD.
- Make (2026). Referencia de la API: escenarios y blueprints. https://developers.make.com/api-documentation (revisado en octubre de 2026).
- Myers, G. J., Sandler, C. y Badgett, T. (2011). The Art of Software Testing (3.ª ed.). Wiley.
- Anderson, L. W. y Krathwohl, D. R. (Eds.) (2001). A Taxonomy for Learning, Teaching, and Assessing: A Revision of Bloom’s Taxonomy of Educational Objectives. Longman.
- Make (2026). Manejadores de error: Retry, Skip, Resume, Commit y Rollback. Centro de ayuda de Make. https://help.make.com/error-handlers (revisado en octubre de 2026).
- Make Academy (2026). Make Foundation: Operations and Credits; Routing and Filters. https://academy-content.make.com/ (revisado en octubre de 2026).
- Make (2026). Precios y planes de Make. https://www.make.com/en/pricing (revisado en octubre de 2026).