
Arquitecto de automatización con IA: Día 35
 Jeshua Romero Guadarrama
- 57 Min para leer
- 07 Mar, 2026
Índice de contenido
Resumen:
Una copia de seguridad que nunca se ha restaurado es una promesa, no un respaldo. En esta entrada, Valeria descubre que el servidor de n8n que instaló ayer tiene copias diarias, pero que la clave que cifra sus credenciales solo vive en ese mismo servidor. Inventaría qué hay que proteger, exporta workflows y credenciales con la CLI de n8n, respalda Postgres con pg_dump, reparte las copias según la regla 3-2-1, fija el RPO y el RTO con números y cronometra un simulacro de restauración en un servidor limpio. Al terminar, usted sabrá qué protege N8N_ENCRYPTION_KEY, cuándo es aceptable una exportación descifrada, cuánto pesa una copia con y sin poda de ejecuciones y cómo comprobar con huellas SHA-256 que lo restaurado es lo mismo que lo respaldado.
¿Cómo citar el presente artículo?
Romero, J. (7 de marzo de 2026). Arquitecto de automatización con IA: Día 35. python-data-engineer. https://www.python-data-engineer.com/post/aai/dia_35/.
Arquitecto de automatización con IA: Día 35 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/aai/dia_35/.
Precios, límites y políticas revisados en octubre de 2026: planes, precios y límites de Make, n8n, Zapier, WhatsApp (Meta, Twilio, Wati) y de la API de Claude. Los comandos n8n export:workflow, n8n export:credentials (con --backup, --separate y --decrypted), n8n import:workflow e import:credentials, las variables N8N_ENCRYPTION_KEY, EXECUTIONS_DATA_PRUNE, EXECUTIONS_DATA_MAX_AGE (336 horas por omisión) y EXECUTIONS_DATA_PRUNE_MAX_COUNT (10 000 por omisión), y la cabecera X-N8N-API-KEY de la API pública se contrastaron con la documentación oficial de n8n, revisado en octubre de 2026. No se pudo levantar un contenedor de n8n al escribir la entrada: el archivo de credencial exportada (Bloque 4) tiene la estructura verificada contra la documentación, revisado en octubre de 2026, con datos ficticios cifrados con una clave de ejemplo, y las salidas de los bloques de terminal son ejemplos comentados. Siete de los doce bloques son Python que se ejecuta sin red y sus salidas son las reales.
Día 35. Seguridad II: credenciales cifradas, respaldo y restauración de n8n
Introducción
Ayer, en el Día 34 (n8n: nube frente a instalación propia), Valeria comparó n8n Cloud con la instalación propia por coste, mantenimiento, datos y disponibilidad, levantó n8n con Docker Compose y Postgres detrás de Caddy, que pone el HTTPS, y Trigo Lento ganó un servidor propio de $6.47$ USD al mes con su clave de cifrado, su zona horaria de Ciudad de México y una política de copias de 7 diarias y 4 semanales. Hoy esa política se pone a prueba antes de que haga falta.
Es sábado 7 de marzo, a media mañana. El obrador ya despachó los encargos del día y Valeria revisa el correo del proveedor del servidor: “Mantenimiento programado del nodo de cómputo. Lunes 9 de marzo, de 02:00 a 04:00 (hora del centro de México). Los servidores alojados pueden reiniciarse; recomendamos verificar sus copias de seguridad”. Valeria abre la carpeta de copias y ve lo que esperaba: la copia de las 03:00 de hoy, la primera de su política, con su archivo de huella al lado. Lo que no esperaba es la pregunta que se le ocurre un segundo después: si el lunes el servidor no vuelve, ¿sabría yo rehacerlo con esa copia? No lo sabe. Nunca ha restaurado nada.
Don Ernesto la escucha mientras acomoda las charolas y responde con la lógica del obrador: “Si se me descompone el horno, horneo en el de mi compadre. Ya lo hice una vez, en el 2019, y sé cuánto tardo en llevar la masa y a qué temperatura lo pone. ¿Su servidor tiene compadre? Y no me diga que sí: dígame cuánto tarda en hornear allá.” Es la objeción correcta. Una copia de seguridad responde a “¿guardé los datos?”; lo que pregunta Don Ernesto es otra cosa: dónde se vuelve a levantar el servicio, con qué, y en cuánto tiempo. Esa pregunta solo se contesta restaurando de verdad, con un reloj en la mano.
Hay, además, un detalle que Valeria todavía no ha visto y que hoy va a costarle un primer intento fallido: n8n guarda las credenciales cifradas, y la clave que las abre está en el archivo .env del mismo servidor que el lunes puede no volver. Ayer la copió también al gestor de contraseñas, como pedía su lista de responsabilidades, pero nadie ha comprobado que la del gestor sea la misma que usa el servidor. Una copia de la base sin la clave correcta conserva los workflows, pero no los secretos que los hacen funcionar.
En la presente entrada, descubrirá qué hay que proteger en una instalación de n8n y dónde vive cada pieza, qué cifra N8N_ENCRYPTION_KEY y por qué perderla equivale a perder todas las credenciales. Exportará workflows y credenciales con la CLI de n8n y verá cuándo es aceptable, y cuándo es una imprudencia, la exportación descifrada. Respaldará Postgres con pg_dump, calculará cuánto pesa una copia con y sin poda de ejecuciones y repartirá las copias según la regla 3-2-1, con la probabilidad de perderlo todo calculada y simulada. Después fijará el RPO y el RTO con números, comparará con huellas SHA-256 lo respaldado con lo restaurado y cronometrará dos simulacros en un servidor limpio. Al final, todo quedará en una página: el manual de restauración de Trigo Lento.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Explicar qué protege
N8N_ENCRYPTION_KEYy por qué perderla equivale a perder todas las credenciales guardadas. - Exportar workflows y credenciales con la CLI de n8n, distinguir la exportación cifrada de la descifrada (
--decrypted) y gestionar su riesgo. - Respaldar Postgres con
pg_dump, aplicar la regla 3-2-1 y fijar RPO y RTO con números. - Ejecutar y cronometrar un simulacro de restauración en un servidor limpio, con verificaciones automáticas al terminar.
Qué hay que proteger
Antes de copiar nada conviene saber qué se copia. Una instalación de n8n con Docker Compose, como la del Día 34, no es “un programa con sus datos”, sino cinco o seis piezas que viven en lugares distintos y que se pierden de formas distintas. Si se respalda solo una, la restauración se queda a medias, y casi siempre se descubre en el peor momento.
Comencemos, como cada día, por las importaciones base, la semilla global de la serie y los supuestos del día. Las cifras de volumen salen de los datos fijos de Trigo Lento: cuando el agente de pedidos esté en marcha, cada uno de los $1,560$ mensajes de WhatsApp del mes será una ejecución de n8n. El tamaño medio de una ejecución guardada y las probabilidades de fallo son supuestos de juguete, declarados como tales:
# Importaciones base, semilla de la serie, carpeta del día y supuestos en Python:
import warnings
warnings.filterwarnings('ignore')
import base64
import copy
import hashlib
import json
from pathlib import Path
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 120)
carpeta = Path('trigo_lento') / 'dia_35'
carpeta.mkdir(parents = True, exist_ok = True)

# Supuestos del día (cifras de juguete, declaradas como tales):
EJECUCIONES_MES = 1560        # un mensaje de WhatsApp = una ejecución del agente (A.5)
KB_POR_EJECUCION = 20         # tamaño medio de una ejecución guardada (supuesto)
BASE_MB = 2.0                 # workflows, credenciales, usuarios y esquema (supuesto)
RETENCION_DIAS = 14           # EXECUTIONS_DATA_MAX_AGE = 336 horas, el valor por omisión
COPIAS = 7 + 4 - 1            # 7 diarias y 4 semanales; la del domingo cuenta en los dos grupos (Día 34)
P_SERVIDOR = 0.03             # probabilidad anual de perder el servidor (supuesto)
P_OTRA_COPIA = 0.05           # probabilidad anual de perder cada copia externa (supuesto)
RTO_MIN = 120                 # tiempo máximo para volver al servicio
print('numpy', np.__version__, '| pandas', pd.__version__)
print(f'Ejecuciones al mes: {EJECUCIONES_MES} | por día: {EJECUCIONES_MES / 30:.1f} | RTO: {RTO_MIN} min')
numpy 2.4.6 | pandas 3.0.3
Ejecuciones al mes: 1560 | por día: 52.0 | RTO: 120 min
La salida confirma las versiones con las que se calcularon todas las cifras de la entrada y el ritmo de trabajo: $52$ ejecuciones al día de media, con un RTO de $120$ minutos que se justificará más adelante. Hoy el servidor tiene solo tres workflows de prueba, pero las copias se diseñan para el tráfico que tendrá dentro de un mes, no para el de hoy.
El inventario de la Tabla 1 recoge cada activo de la instalación, dónde vive, si guarda secretos o datos personales y cómo se respalda. Fíjese en la columna “Dónde vive”: las tres primeras filas comparten un mismo lugar, la base de datos, y las dos siguientes viven fuera de ella.
Tabla 1. Activos de la instalación de n8n de Trigo Lento, dónde vive cada uno y cómo se respalda.
| Activo | Qué es | Dónde vive | Secretos | Datos personales | Cómo se respalda |
|---|---|---|---|---|---|
| Workflows (3) | Nodos, conexiones y ajustes de cada flujo | Postgres, volumen postgres_data | No (solo referencias a credenciales) | No | pg_dump diario y exportación tras cada cambio |
| Credenciales (2) | Claves de API y contraseñas que usan los nodos | Postgres, cifradas con la clave | Sí, cifrados | No | pg_dump diario y exportación cifrada |
| Historial de ejecuciones | Entrada y salida de cada nodo en cada ejecución | Postgres, volumen postgres_data | A veces (respuestas de servicios) | Sí: mensajes y teléfonos | pg_dump, con poda a 14 días |
Archivo .env | Variables de entorno de Docker Compose | /opt/trigo_lento/.env en el servidor | Sí (clave de cifrado, contraseña de Postgres) | No | Copia en el gestor de contraseñas |
N8N_ENCRYPTION_KEY | Clave que cifra y descifra las credenciales | .env y /home/node/.n8n/config | Sí | No | Gestor de contraseñas, fuera de las copias |
docker-compose.yml | Servicios, volúmenes y versiones | /opt/trigo_lento y repositorio privado | No (lee los valores del .env) | No | Repositorio de configuración |
El siguiente bloque convierte el inventario en un DataFrame, que es la forma de que la tabla no se quede en un documento que nadie actualiza: cuando Trigo Lento añada un activo (por ejemplo, la carpeta de datos binarios del Día 41), se añade una fila y los recuentos cambian solos:
# Inventario de activos de la instalación de n8n del Día 34 en Python:
activos = pd.DataFrame([
    ('Workflows (3)', 'Postgres, volumen postgres_data', 'no', 'no', 'pg_dump diario y exportación tras cada cambio'),
    ('Credenciales (2)', 'Postgres, cifradas con la clave', 'sí, cifrados', 'no', 'pg_dump diario y exportación cifrada'),
    ('Historial de ejecuciones', 'Postgres, volumen postgres_data', 'a veces', 'sí', 'pg_dump con poda a 14 días'),
    ('Archivo .env', '/opt/trigo_lento/.env en el servidor', 'sí', 'no', 'copia en el gestor de contraseñas'),
    ('N8N_ENCRYPTION_KEY', '.env y /home/node/.n8n/config', 'sí', 'no', 'gestor de contraseñas, fuera de las copias'),
    ('docker-compose.yml', '/opt/trigo_lento y repositorio privado', 'no', 'no', 'repositorio de configuración'),
], columns = ['activo', 'donde_vive', 'secretos', 'datos_personales', 'como_se_respalda'])
print(activos[['activo', 'secretos', 'datos_personales']].to_string(index = False))
con_secretos = activos['secretos'].str.startswith(('sí', 'a veces')).sum()
print(f'Activos con secretos: {con_secretos} de {len(activos)} | con datos personales: '
      f'{(activos["datos_personales"] == "sí").sum()}')
print('Viajan dentro del pg_dump:', ', '.join(activos.loc[activos['donde_vive'].str.startswith('Postgres'), 'activo']))
                  activo     secretos datos_personales
           Workflows (3)           no               no
        Credenciales (2) sí, cifrados               no
Historial de ejecuciones      a veces               sí
            Archivo .env           sí               no
      N8N_ENCRYPTION_KEY           sí               no
      docker-compose.yml           no               no
Activos con secretos: 4 de 6 | con datos personales: 1
Viajan dentro del pg_dump: Workflows (3), Credenciales (2), Historial de ejecuciones
El inventario deja tres conclusiones que guían el resto del día:
- En primer lugar, $4$ de los $6$ activos contienen secretos, y solo uno de ellos, el bloque de credenciales, está cifrado. Los otros tres (el
.env, la clave y, a veces, el historial) contienen secretos en claro, así que su copia necesita más cuidado que la de los workflows. - En segundo lugar, una sola copia, el
pg_dump, se lleva tres activos a la vez: workflows, credenciales e historial. Es una buena noticia (un solo archivo que mover) y una advertencia: ese archivo contiene los mensajes de los clientes y las credenciales cifradas juntos. - En tercer lugar, la clave de cifrado no viaja en el
pg_dump. Vive en el.envy en la carpeta de datos de n8n, fuera de la base. Si solo se copia la base, la restauración tendrá los cofres pero no la llave.
Esa tercera conclusión es el tema de la siguiente sección.
La clave de cifrado
Cuando usted guarda una credencial en n8n (la clave de la API de Claude, la contraseña del correo de avisos), n8n no la escribe tal cual en la base. La cifra con una clave propia de la instalación y guarda solo el resultado. Esa clave es N8N_ENCRYPTION_KEY. Según la documentación de n8n, si no se fija la variable, n8n genera una clave aleatoria en su primer arranque y la guarda en su carpeta de datos, ~/.n8n (en el contenedor de Docker, /home/node/.n8n); fuentes secundarias precisan que queda en el archivo config, con el nombre encryptionKey, un detalle que conviene comprobar en la versión instalada. En el Día 34, Valeria hizo lo recomendable: fijó la clave en el .env y la pasó al contenedor como variable de entorno, de modo que no depende de un archivo que se crea solo.
La consecuencia práctica se resume en una tabla de verdad muy corta:
- Base restaurada con la misma clave: n8n arranca, lee los workflows y descifra las credenciales. Todo funciona como antes.
- Base restaurada con otra clave, o sin clave: n8n arranca (si no encuentra la clave, genera una nueva), lee los workflows, pero no puede descifrar ninguna credencial. Los workflows aparecen intactos en el editor y fallan en cuanto un nodo intenta autenticarse. Los foros de n8n están llenos de la misma frase: “las credenciales no se pudieron descifrar”.
- Clave perdida para siempre: las credenciales cifradas son irrecuperables. No hay puerta trasera, y eso es exactamente lo que se le pide a un buen cifrado. La única salida es volver a crear cada credencial a mano, pidiendo de nuevo cada clave a cada servicio.
Para una panadería con dos credenciales, volver a crearlas es una tarde perdida. Para un negocio con cuarenta, con tokens de OAuth que exigen volver a autorizar cuentas de Google y de Meta (Día 17, Seguridad I: OAuth, secretos y mínimo privilegio en las conexiones), es una semana con la operación detenida. Perder la clave equivale a perder todas las credenciales, aunque la copia de la base esté perfecta.
Por eso la regla de la clave es la contraria de la regla de los datos. Los datos se copian muchas veces y en muchos lugares. La clave se guarda fuera del servidor, fuera de las copias y fuera del repositorio, en un gestor de contraseñas con acceso de emergencia para una segunda persona. Si la clave viajara dentro de la misma copia que la base, quien robara la copia tendría cofre y llave; si la clave viviera solo en el servidor, quien perdiera el servidor perdería la llave. Los dos caminos tienen que estar separados, como muestra la Figura 1.
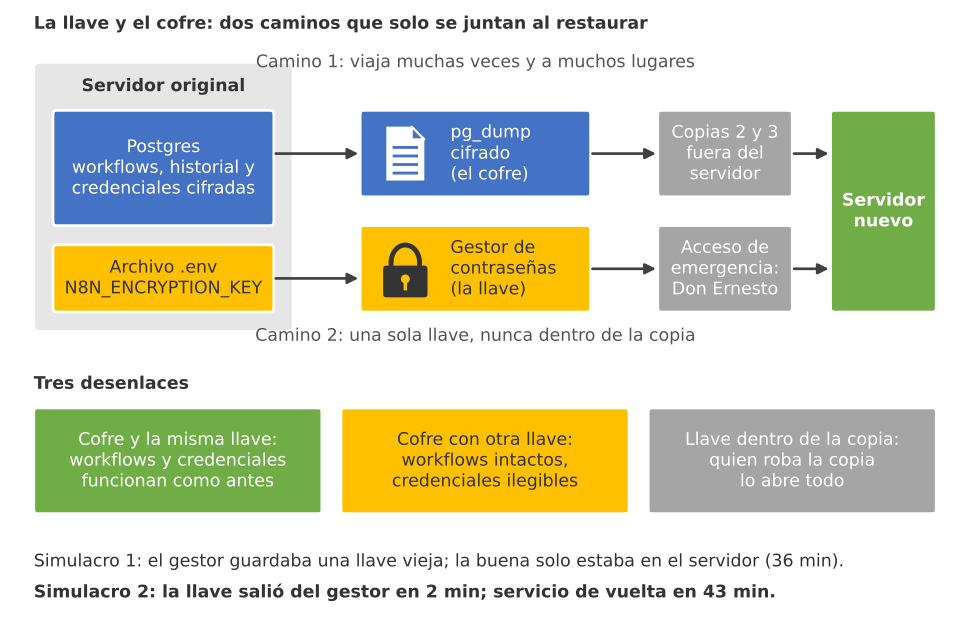
Figura 1. La llave y el cofre: las credenciales cifradas viajan dentro de la copia de Postgres, y la clave N8N_ENCRYPTION_KEY viaja por otro camino, hasta el gestor de contraseñas; solo juntos en el servidor nuevo vuelven a abrir las credenciales.
En Trigo Lento, la segunda persona con acceso de emergencia al gestor es Don Ernesto. No tiene que saber qué es Docker; tiene que saber que existe un sobre digital con la etiqueta “Clave de n8n” y que, si Valeria no está, se lo entrega a quien vaya a restaurar.
Guardar la clave en el gestor no basta: hay que guardar la clave que usa el servidor. Una forma barata de comprobarlo sin exponerla es anotar junto a ella su huella, los primeros caracteres de su SHA-256, y compararla con la del .env del servidor (grep '^N8N_ENCRYPTION_KEY=' .env | cut -d= -f2 | tr -d '\n' | sha256sum). Si las huellas no coinciden, el gestor guarda una clave que no abre nada. Valeria lo aprenderá esta tarde por las malas.
Exportar workflows y credenciales
La copia de la base (que se verá en la sección siguiente) es la forma más completa de respaldar n8n: se lleva todo de una vez, con el historial incluido. Pero tiene dos limitaciones. Es un archivo binario que solo entiende Postgres, y para restaurarla hay que restaurar la base entera, aunque solo se quiera recuperar un workflow que alguien borró por error. La CLI de n8n ofrece una segunda vía, más fina: exportar cada workflow y cada credencial a su propio archivo JSON.
Los comandos documentados son n8n export:workflow y n8n export:credentials. Las opciones que importan hoy son cuatro:
--allexporta todos los workflows o todas las credenciales;--idexporta solo uno.--separateescribe un archivo por workflow o por credencial, nombrado con su identificador, en la carpeta que indica--output. Es lo que conviene para comparar versiones y para restaurar uno solo.--prettyda formato legible al JSON, con sangrías y saltos de línea.--backupes un atajo que equivale a--all --pretty --separate: todo, legible y en archivos separados.
Como n8n corre dentro de un contenedor, los comandos se lanzan con docker compose exec desde la carpeta del docker-compose.yml, y la exportación se escribe dentro del volumen de n8n y después se copia al servidor. El siguiente bloque es el que Valeria añade a su rutina de cada sábado y a cada cambio importante en un workflow. Es un bloque de terminal y no se ejecutó para escribir la entrada; la salida es un ejemplo comentado:
# Exportación de workflows y credenciales con la CLI de n8n, dentro del contenedor, en Bash:
cd /opt/trigo_lento                       # carpeta del docker-compose.yml del Día 34
FECHA=$(date +%F)                         # 2026-03-07
DESTINO=/home/node/.n8n/respaldos/$FECHA

# Un archivo por workflow y por credencial (--backup equivale a --all --pretty --separate):
docker compose exec -u node n8n n8n export:workflow --backup --output=$DESTINO/workflows/
docker compose exec -u node n8n n8n export:credentials --backup --output=$DESTINO/credenciales/

# Los secretos siguen cifrados con N8N_ENCRYPTION_KEY: solo los abre una instancia con la misma clave.
# Variante descifrada, SOLO para migrar a otra clave, en una carpeta temporal y borrándola al terminar:
# docker compose exec -u node n8n n8n export:credentials --all --decrypted --output=/tmp/descifradas.json
# (deja tokens y contraseñas en texto plano: nunca en una carpeta sincronizada ni en un repositorio)

# Sacar la exportación del contenedor y comprobar qué salió:
docker compose cp n8n:$DESTINO ./exportaciones/
ls exportaciones/$FECHA/workflows exportaciones/$FECHA/credenciales

# Salida de ejemplo (puede variar):
# Successfully exported 3 workflows.
# Successfully exported 2 credentials.
# hT3qLs9WbE2nVx5K.json  Rz8mPc4JdN6wQa1F.json  Yb5vGk7TfS3mUe9C.json
# Kp7RmX2aQ9vLc3Nd.json  Wf4TsB8eH1yZj6Uq.json
La exportación produce cinco archivos: tres workflows (TL Prueba de salud, el webhook que responde “ok” y que servirá en el simulacro; TL Hola Claude, una prueba manual de la credencial de la API, y TL Recordatorio de simulacro, que avisará a Valeria cada tres meses) y dos credenciales (Anthropic TL y Correo de avisos TL). El siguiente bloque muestra el archivo exportado de la credencial Anthropic TL, con datos ficticios cifrados con una clave de ejemplo:
{
  "createdAt": "2026-03-06T23:18:42.511Z",
  "updatedAt": "2026-03-06T23:18:42.511Z",
  "id": "Kp7RmX2aQ9vLc3Nd",
  "name": "Anthropic TL",
  "data": "U2FsdGVkX19RZIHXWPD9XDgyVe7cKMIc0+zXJyYxTGDd5dLGfC32AhC4RQbM+A/UligZdEcGJaChFDkAXEmEVDm9r9M/lmNrfDrVoo8SYjK8Pcl5OtPb7MuJw/ys+lQK",
  "type": "httpHeaderAuth",
  "isManaged": false
}
Recorra el archivo campo a campo, porque cada uno dice algo sobre la seguridad del respaldo:
idynameson el identificador interno y el nombre visible. Los workflows guardan solo esto de sus credenciales (en el nodo HTTP Request deTL Hola Claudeaparece{"id": "Kp7RmX2aQ9vLc3Nd", "name": "Anthropic TL"}), y por eso un workflow exportado no contiene secretos, aunque sí revela qué servicios usa el negocio.typedice qué clase de credencial es:httpHeaderAuth, una cabecera de autenticación comox-api-key.dataes el cofre. No es JSON legible, sino una cadena en base64 que empieza porU2FsdGVkX1. Esa secuencia no es casual: es la palabraSalted__codificada en base64, la marca de un formato de cifrado simétrico con sal. Dentro va el nombre de la cabecera y su valor; fuera solo se ve ruido.
Cifradas frente a –decrypted
La exportación por omisión deja las credenciales cifradas con la clave de la instalación. Eso tiene una consecuencia que a veces se olvida: un archivo de credenciales exportado solo sirve en una instancia que tenga la misma clave. Si Valeria importa ese archivo en un n8n nuevo con otra clave, la importación termina sin errores, pero las credenciales no se pueden abrir, exactamente como en el caso de la base restaurada con otra clave.
Para el caso en que hay que cambiar de clave (por ejemplo, porque la anterior se filtró y hay que rotarla, o porque se migra a una instancia que ya tiene la suya), la CLI ofrece --decrypted. La documentación lo dice sin rodeos: con esa opción, toda la información sensible queda visible en los archivos. El archivo descifrado ya no lleva el cofre, sino su contenido: el nombre de la cabecera y la clave de la API en texto plano, y el servidor, el usuario y la contraseña del correo.
Atención aquí: una exportación con --decrypted es la copia más peligrosa que puede producir n8n, porque reúne en un solo archivo, legible por cualquiera, todos los secretos del negocio. Úsela solo para migrar de clave, en una carpeta temporal del servidor (no del contenedor de su laptop), fuera de cualquier carpeta sincronizada (Drive, OneDrive, Dropbox) y de cualquier repositorio, impórtela de inmediato en la instancia nueva y bórrela al terminar. Nunca la adjunte a un correo, nunca la suba a la copia externa y nunca la deje “para después”. Si sospecha que un archivo descifrado salió del servidor, trate todas sus credenciales como filtradas y rótelas en cada servicio.
En el bloque de exportación, la variante descifrada aparece solo como comentario, y no por pudor didáctico: Valeria no la necesita hoy. Mientras la clave sea la misma, la exportación cifrada basta para cualquier restauración, y es la única que puede viajar a otros lugares sin convertir cada copia en una lista de contraseñas.
Importar lo exportado
La operación inversa se hace con n8n import:workflow y n8n import:credentials. Con --separate y --input apuntando a la carpeta, importan todos los archivos JSON que encuentran. La documentación advierte de dos comportamientos que el manual de restauración debe tener en cuenta:
- Los identificadores existentes se sobrescriben. Si en la base ya hay un workflow o una credencial con el mismo
id, el archivo importado lo reemplaza. En un servidor limpio no importa; en un servidor con trabajo nuevo, puede borrar cambios sin avisar. - Los workflows llegan desactivados. Por omisión,
import:workflowdesactiva todos los workflows importados; la opción--activeState=fromJson, que respeta el campoactivede cada archivo, solo está disponible en los modos de varias instancias principales y de colas. En la instalación sencilla de Trigo Lento, después de importar hay que reactivar a mano los que estaban activos, y por eso el inventario guarda cuáles lo estaban.
Las dos vías se complementan. El pg_dump restaura todo tal cual estaba, con el historial y el estado activo de cada workflow; la exportación por archivos permite recuperar una pieza suelta, revisar los cambios con un comparador de texto (el control de versiones del Día 42 se apoyará en ella) y migrar a otra base de datos.
Respaldar Postgres
La copia principal es la de la base. Postgres incluye la herramienta estándar para ello, pg_dump, que produce una copia coherente de la base aunque n8n la esté usando en ese momento: lee todo como estaba en el instante en que empezó, sin bloquear las escrituras. El formato personalizado (-Fc) tiene tres ventajas sobre el volcado en texto SQL: va comprimido, se puede inspeccionar con pg_restore --list sin restaurarlo y permite restaurar con opciones como --clean --if-exists, que borra los objetos existentes antes de recrearlos.
El siguiente bloque es el guion que el cron del servidor ejecuta cada día a las 03:00, la hora del Día 34. Hace cuatro cosas en orden: el volcado desde el contenedor, una comprobación de que el archivo se puede leer, la rotación de 7 copias diarias y 4 semanales, y la salida de la copia cifrada hacia dos almacenamientos fuera del servidor. Es un bloque de terminal y no se ejecutó para escribir la entrada:
# Copia diaria de Postgres con rotación de 7 diarias y 4 semanales y copia externa en Bash:
set -euo pipefail
cd /opt/trigo_lento
DIR=/opt/respaldos/n8n                      # disco del servidor: copia 1 de 3
HOY=$(date +%F)                             # 2026-03-07
ARCHIVO=$DIR/diaria/n8n_$HOY.dump
mkdir -p $DIR/diaria $DIR/semanal

# Volcado en formato personalizado (-Fc, comprimido) desde el contenedor de Postgres:
docker compose exec -T postgres pg_dump -U n8n -Fc n8n > $ARCHIVO
docker compose exec -T postgres pg_restore --list < $ARCHIVO > /dev/null   # falla si está dañado
sha256sum $ARCHIVO > $ARCHIVO.sha256

# Los domingos, la copia del día también se guarda como semanal:
if [ "$(date +%u)" = "7" ]; then cp $ARCHIVO $DIR/semanal/; fi

# Rotación: quedan las 7 diarias y las 4 semanales más recientes:
ls -1t $DIR/diaria/*.dump | tail -n +8 | xargs -r rm -f
ls -1t $DIR/semanal/*.dump | tail -n +5 | xargs -r rm -f

# Copias 2 y 3: cifradas con una frase guardada en el gestor de contraseñas, y fuera del servidor:
gpg --batch --symmetric --cipher-algo AES256 --passphrase-file /root/.frase_respaldo \
    -o $ARCHIVO.gpg $ARCHIVO
rclone copy $ARCHIVO.gpg proveedor:tl-respaldos/diaria/     # almacenamiento de objetos del proveedor
rclone copy $ARCHIVO.gpg externo:tl-respaldos/diaria/       # otro proveedor, otra región
rm -f $ARCHIVO.gpg

# Salida de ejemplo (puede variar), con: ls -lh /opt/respaldos/n8n/diaria
# -rw-r--r-- 1 root root 412K Mar  7 03:00 n8n_2026-03-07.dump
# -rw-r--r-- 1 root root  103 Mar  7 03:00 n8n_2026-03-07.dump.sha256
Cuatro detalles del guion merecen atención:
set -euo pipefailhace que el guion se detenga ante el primer error. Sin esa línea, unpg_dumpfallido dejaría un archivo vacío que la rotación conservaría como si fuera una copia buena, y borraría la última copia buena para hacerle sitio.- La comprobación con
pg_restore --listno restaura nada: solo lee el índice del volcado. Si el archivo está truncado, falla, y el guion se detiene antes de rotar. Es la verificación más barata que existe, y la mayoría de las copias que “no sirvieron” la habrían reprobado. - La huella
.sha256acompaña a cada copia. En la restauración se recalcula y se compara: si no coincide, el archivo se corrompió por el camino. - La copia externa sale cifrada con una frase que vive en el gestor de contraseñas. Las credenciales ya iban cifradas con la clave de n8n, pero el historial de ejecuciones no: contiene mensajes y teléfonos de clientes en claro. Cifrar el volcado completo protege a esos clientes si alguien obtiene acceso al almacenamiento externo.
Cuánto pesa una copia
El tamaño de la copia importa por tres razones: lo que cuesta guardarla, lo que tarda en subir y bajar (que entra en el RTO) y, sobre todo, cuántos datos personales contiene. Casi todo su peso, cuando el agente esté en marcha, será el historial de ejecuciones, porque n8n guarda la entrada y la salida de cada nodo de cada ejecución.
n8n controla ese historial con la poda de ejecuciones. Según la documentación revisada en octubre de 2026, la poda está activada por omisión (EXECUTIONS_DATA_PRUNE), borra las ejecuciones terminadas con más de $336$ horas, es decir, $14$ días (EXECUTIONS_DATA_MAX_AGE), y además limita el total a $10,000$ ejecuciones (EXECUTIONS_DATA_PRUNE_MAX_COUNT). Con poda, el tamaño de la copia se estabiliza; sin ella, crece cada día. El modelo es sencillo:
$$ S(t) = B + \min(t, R) \cdot e \cdot s $$
La lógica detrás de esta fórmula es múltiple:
- $B$ es la parte fija de la base (workflows, credenciales, usuarios y la estructura de las tablas), unos $2$ MB de supuesto, que apenas cambia de un día a otro.
- $e$ son las ejecuciones por día ($1,560 / 30 = 52$) y $s$ el tamaño medio de cada una ($20$ KB de supuesto); su producto es lo que crece la base cada día.
- $R$ es la retención en días. Mientras $t < R$, la base crece; a partir de $R$, cada día entra lo mismo que la poda borra y el tamaño se queda plano. Sin poda, $R$ es infinita y el mínimo siempre vale $t$.
- En conclusión, con poda el tamaño de la copia depende de la retención y no de la antigüedad de la instalación: la copia del mes doce pesa lo mismo que la del mes uno.
El siguiente bloque calcula el tamaño de la copia día a día durante doce meses de $30$ días, con poda a $14$ días y sin poda, y el espacio que ocupan las copias de la política. Son $10$ copias distintas, no $11$: la copia del domingo es a la vez la diaria de ese día y la semanal de esa semana, así que cuenta en los dos grupos:
# Tamaño de la copia de Postgres a 12 meses con y sin poda de ejecuciones en Python:
dias = np.arange(0, 361)                                   # 12 meses de 30 días
por_dia = EJECUCIONES_MES / 30
mb_ejecucion = KB_POR_EJECUCION / 1024
con_poda = BASE_MB + np.minimum(dias, RETENCION_DIAS) * por_dia * mb_ejecucion
sin_poda = BASE_MB + dias * por_dia * mb_ejecucion
retenidas = por_dia * RETENCION_DIAS
print(f'Ejecuciones retenidas con poda: {retenidas:.0f} | {retenidas * mb_ejecucion:.1f} MB')
print(f'Ejecuciones a los 12 meses sin poda: {dias[-1] * por_dia:.0f} | {dias[-1] * por_dia * mb_ejecucion:.1f} MB')
print(f'Una copia con poda: {con_poda[-1]:.1f} MB | {COPIAS} copias: {COPIAS * con_poda[-1]:.1f} MB')
print(f'Una copia sin poda a los 12 meses: {sin_poda[-1]:.1f} MB | {COPIAS} copias: {COPIAS * sin_poda[-1] / 1024:.2f} GB')
print(f'Tope por número (EXECUTIONS_DATA_PRUNE_MAX_COUNT = 10000): {10000 * mb_ejecucion:.1f} MB; '
      f'se alcanzaría a los {10000 / por_dia:.0f} días')

fig, ax = plt.subplots(figsize = (8, 4.6))
meses = dias / 30
ax.plot(meses, sin_poda, color = '#eb6834', linewidth = 2.5, label = 'Sin poda (EXECUTIONS_DATA_PRUNE=false)')
ax.plot(meses, con_poda, color = '#2a78d6', linewidth = 2.5, label = 'Con poda a 14 días (valor por omisión)')
ax.annotate(f'{sin_poda[-1]:.1f} MB', (12, sin_poda[-1]), xytext = (-70, -4), textcoords = 'offset points', fontsize = 10)
ax.annotate(f'{con_poda[-1]:.1f} MB', (12, con_poda[-1]), xytext = (-60, 8), textcoords = 'offset points', fontsize = 10)
ax.set_xlim(0, 12.3)
ax.set_xticks(range(0, 13))
ax.set_xlabel('Meses de operación del agente de pedidos')
ax.set_ylabel('Tamaño de una copia (MB, sin comprimir)')
ax.set_title('Tamaño de la copia de Postgres con y sin poda', fontsize = 16)
ax.legend(loc = 'upper left', frameon = False)
ax.grid(color = '#e6e5e1')
ax.set_axisbelow(True)
plt.tight_layout()
plt.show()
Ejecuciones retenidas con poda: 728 | 14.2 MB
Ejecuciones a los 12 meses sin poda: 18720 | 365.6 MB
Una copia con poda: 16.2 MB | 10 copias: 162.2 MB
Una copia sin poda a los 12 meses: 367.6 MB | 10 copias: 3.59 GB
Tope por número (EXECUTIONS_DATA_PRUNE_MAX_COUNT = 10000): 195.3 MB; se alcanzaría a los 192 días
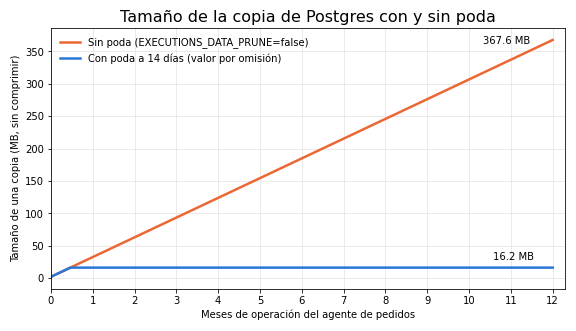
Con la poda por omisión, n8n retiene $728$ ejecuciones, unos $14.2$ MB, y la copia completa se queda en $16.2$ MB; las $10$ copias de la política ocupan $162.2$ MB. Sin poda, a los doce meses las ejecuciones suman $365.6$ MB y cada copia pesa $367.6$ MB; las $10$ copias, casi $3.59$ GB, veintidós veces más. Los tamaños son sin comprimir: el formato -Fc los reduce bastante, pero la proporción entre las dos curvas se mantiene.
La última línea de la salida explica por qué hay dos límites. Si alguien subiera la retención por edad a, digamos, un año, el tope de $10,000$ ejecuciones entraría en juego a los $192$ días y dejaría la copia en unos $195.3$ MB. Con la retención por omisión, ese tope nunca se alcanza: $728$ está muy lejos de $10,000$.
La figura muestra la diferencia: la línea azul sube durante dos semanas y se queda plana; la naranja no deja de subir. La poda no es una optimización de espacio: es una decisión sobre cuántos mensajes de clientes guarda el negocio. Con $14$ días, una copia contiene unas $728$ conversaciones; sin poda, a fin de año contendría $18,720$, con sus nombres, teléfonos y direcciones, repetidas diez veces en tres lugares. La ley mexicana de protección de datos personales (LFPDPPP) pide minimización y medidas de seguridad proporcionales; guardar menos es la medida más barata de todas.
Si su instalación usa SQLite
La instalación de Trigo Lento usa Postgres, pero si usted levantó n8n sin base de datos externa, n8n usa SQLite y toda la base es un único archivo, database.sqlite, dentro de /home/node/.n8n. Copiarlo con cp mientras n8n escribe en él puede dar una copia inconsistente; lo correcto es detener n8n durante la copia o usar la orden .backup de la herramienta sqlite3, que produce una copia coherente. La documentación de n8n añade un detalle propio de SQLite: el espacio de las ejecuciones podadas no se devuelve al disco, sino que se reutiliza; para liberarlo hay que ejecutar VACUUM o activar DB_SQLITE_VACUUM_ON_STARTUP. El resto de la entrada (la clave, la regla 3-2-1, el RPO, el RTO y el simulacro) se aplica igual.
La regla 3-2-1
La política de 7 diarias y 4 semanales del Día 34 resuelve una pregunta (¿cuántas copias guardo y durante cuánto tiempo?) y deja otra a medias: ¿dónde? La lista de responsabilidades del Día 34 pedía una copia fuera del servidor, pero esta mañana las copias solo existen en /opt/respaldos, en el mismo disco del mismo servidor que el lunes entra en mantenimiento.
La regla 3-2-1, popularizada por el fotógrafo Peter Krogh para proteger archivos digitales y adoptada después como norma básica de respaldo, dice:
- 3 copias de los datos: la original y dos copias.
- en 2 medios distintos (no dos carpetas del mismo disco);
- con 1 copia fuera del sitio, lejos del edificio, de la cuenta o del proveedor de las otras.
La clave de la regla es el modo común de fallo: un suceso que destruye varias copias a la vez. Siete copias en el mismo disco no son siete copias; frente a un disco que se quema, un servidor que se borra o una cuenta suspendida, cuentan como una. La probabilidad de perderlo todo depende de cuántos lugares independientes guardan una copia, no de cuántos archivos hay. Si $p_s$ es la probabilidad anual de perder el servidor y $q_i$ la de perder la copia del lugar $i$, con fallos independientes entre lugares:
$$ P_{\text{total}} = p_s \prod_{i=1}^{k} q_i $$
La lógica detrás de esta fórmula es múltiple:
- Para perderlo todo hay que perder el servidor y cada una de las $k$ copias externas; con sucesos independientes, la probabilidad de que ocurran todos es el producto.
- Las copias que viven en el servidor no aparecen en el producto: comparten su destino, así que su $q$ vale $1$ en cuanto el servidor se pierde. Por eso siete copias en el mismo disco dejan $P_{\text{total}} = p_s$.
- Con $p_s = 0.03$ y dos copias externas con $q = 0.05$ cada una, $P_{\text{total}} = 0.03 \cdot 0.05 \cdot 0.05 = 7.5 \cdot 10^{-5}$.
- En conclusión, cada lugar independiente multiplica el riesgo por su $q$; cada copia más en el mismo lugar lo multiplica por $1$.
El siguiente bloque calcula la probabilidad anual de pérdida total para cuatro esquemas y la contrasta con una simulación de $4$ millones de años de operación, con fallos independientes entre lugares:
# Probabilidad anual de perderlo todo por esquema de copias, con modo común, en Python:
esquemas = {
    'Una copia en el servidor': P_SERVIDOR,
    'Siete copias en el mismo disco': P_SERVIDOR,                 # mueren juntas: modo común
    'Servidor y almacenamiento del proveedor': P_SERVIDOR * P_OTRA_COPIA,
    'Regla 3-2-1': P_SERVIDOR * P_OTRA_COPIA ** 2,
}
# Simulación de 4 millones de años de operación con fallos independientes entre lugares:
N = 4_000_000
servidor = rng.random(N) < P_SERVIDOR
proveedor = rng.random(N) < P_OTRA_COPIA
externo = rng.random(N) < P_OTRA_COPIA
simulado = {
    'Una copia en el servidor': servidor.mean(),
    'Siete copias en el mismo disco': servidor.mean(),
    'Servidor y almacenamiento del proveedor': (servidor & proveedor).mean(),
    'Regla 3-2-1': (servidor & proveedor & externo).mean(),
}
for nombre, p in esquemas.items():
    print(f'{nombre:<40} teórica {p:.2e} | simulada {simulado[nombre]:.2e}')
print(f'Años con pérdida total en la simulación 3-2-1: {(servidor & proveedor & externo).sum()} de {N:,}'.replace(',', ' '))
print(f'Reducción del riesgo con 3-2-1: {esquemas["Una copia en el servidor"] / esquemas["Regla 3-2-1"]:.0f} veces')
print(f'Si las siete copias fueran independientes (no lo son): {P_SERVIDOR ** 7:.1e}')

fig, ax = plt.subplots(figsize = (8, 4.4))
nombres = list(esquemas)
colores = ['#eb6834', '#eb6834', '#f2a33a', '#2a78d6']
ax.barh(nombres, [esquemas[n] for n in nombres], color = colores, height = 0.55)
ax.scatter([simulado[n] for n in nombres], nombres, color = '#0b0b0b', zorder = 3, s = 30, label = 'Simulación')
for i, n in enumerate(nombres):
    ax.text(esquemas[n] * 1.6, i, f'{esquemas[n]:.1e}', va = 'center', fontsize = 10)
ax.set_xscale('log')
ax.set_xlim(1e-5, 1)
ax.invert_yaxis()
ax.set_xlabel('Probabilidad anual de perderlo todo (escala logarítmica)')
ax.set_title('Riesgo de pérdida total por esquema', fontsize = 16)
ax.legend(loc = 'lower right', frameon = False)
ax.grid(axis = 'x', color = '#e6e5e1')
ax.set_axisbelow(True)
plt.tight_layout()
plt.show()
Una copia en el servidor                 teórica 3.00e-02 | simulada 3.00e-02
Siete copias en el mismo disco           teórica 3.00e-02 | simulada 3.00e-02
Servidor y almacenamiento del proveedor  teórica 1.50e-03 | simulada 1.47e-03
Regla 3-2-1                              teórica 7.50e-05 | simulada 7.78e-05
Años con pérdida total en la simulación 3-2-1: 311 de 4 000 000
Reducción del riesgo con 3-2-1: 400 veces
Si las siete copias fueran independientes (no lo son): 2.2e-11
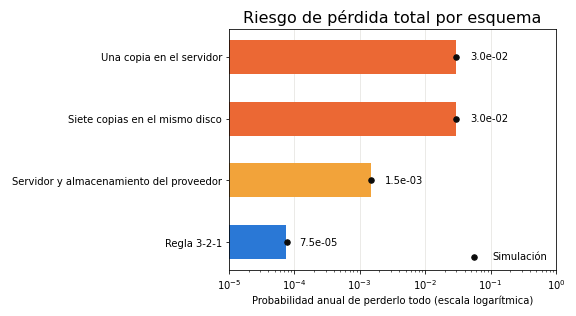
La simulación confirma la teoría. Con una copia en el servidor, o con siete, la probabilidad anual de perderlo todo es $0.03$: tres años de cada cien. Añadir el almacenamiento de objetos del proveedor la baja a $1.5 \cdot 10^{-3}$ (la simulación da $1.47 \cdot 10^{-3}$). Con la regla 3-2-1 completa, $7.5 \cdot 10^{-5}$: en $4$ millones de años simulados hubo $311$ años con pérdida total, una frecuencia de $7.78 \cdot 10^{-5}$, dentro de lo esperable con tan pocos sucesos. El riesgo baja $400$ veces.
La última línea es la trampa que la regla evita. Si las siete copias del mismo disco fueran independientes, la cuenta ingenua daría $0.03^7 = 2.2 \cdot 10^{-11}$, una cifra tranquilizadora y completamente falsa. En la gráfica, en escala logarítmica, las dos barras naranjas de arriba tienen exactamente la misma longitud: multiplicar las copias sin multiplicar los lugares no mueve la barra.
En Trigo Lento, los tres lugares quedan así, como muestra la Figura 2:
- Copia 1, en el servidor: las $7$ diarias y $4$ semanales ($10$ archivos distintos) en
/opt/respaldos. Sirven para lo más frecuente, que no es perder el servidor, sino borrar un workflow por error o necesitar la base de ayer. Restaurar desde aquí tarda segundos. - Copia 2, en el almacenamiento de objetos del proveedor: otro medio (no es el disco del servidor), cifrada, con la misma rotación. Sobrevive a un disco dañado o a un servidor borrado.
- Copia 3, en otro proveedor y otra región: cifrada, con la misma rotación. Sobrevive a lo que la copia 2 no: una cuenta suspendida por un problema de pago, un incidente del proveedor o un error que borre todo lo de esa cuenta.
Las $q$ de $0.05$ son supuestos, y el más discutible es el de la copia 2: el almacenamiento del mismo proveedor comparte con el servidor la cuenta, la tarjeta de pago y, en parte, la infraestructura, así que no es del todo independiente. Por eso la tercera copia va a otro proveedor. La regla 3-2-1 no es una superstición de tres números: es una forma de garantizar que existe al menos una copia sin modo común con el servidor.
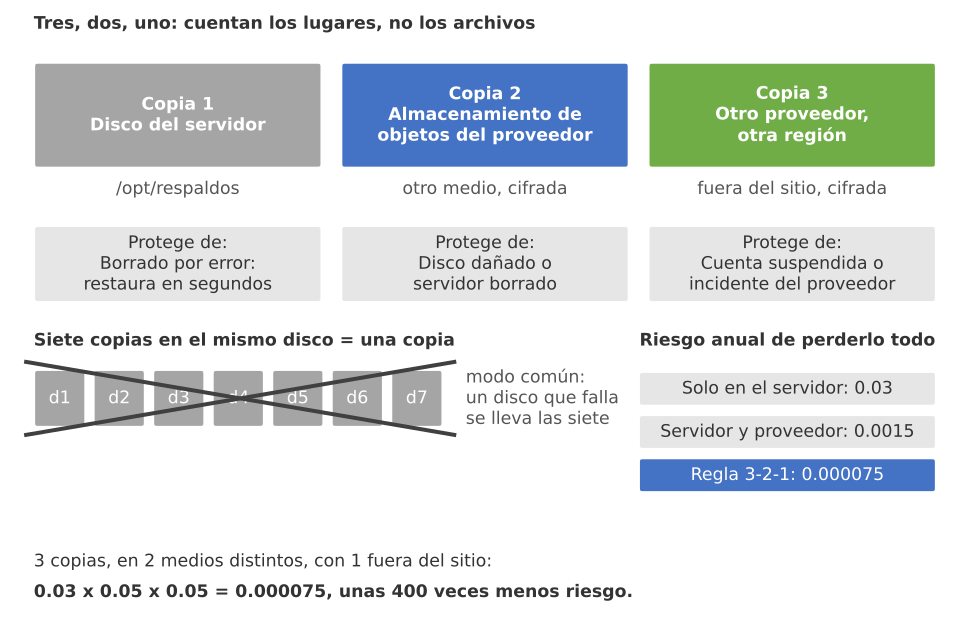
Figura 2. Tres, dos, uno: copias en el servidor, en el almacenamiento del proveedor y en otro proveedor; las siete copias del mismo disco mueren juntas (modo común) y el riesgo anual baja de 0.03 a 0.000075.
RPO y RTO
Tener la copia a salvo responde a “¿puedo recuperar los datos?”. Don Ernesto preguntó dos cosas más: cuántos datos se pierden y cuánto se tarda. Esas dos preguntas tienen nombre en la planificación de contingencias, y la guía del NIST para sistemas de información (SP 800-34) las define con precisión:
- El objetivo de punto de recuperación (o RPO, por sus siglas en inglés: “Recovery Point Objective”) es la cantidad máxima de datos, medida en tiempo, que el negocio acepta perder. Si la última copia es de las 03:00 y el servidor cae a las 18:00, se pierden $15$ horas de cambios. El RPO lo fija el intervalo entre copias.
- El objetivo de tiempo de recuperación (o RTO, por sus siglas en inglés: “Recovery Time Objective”) es el tiempo máximo que el servicio puede estar caído antes de que el daño sea inaceptable. Lo fija la duración de la restauración, desde que se declara el incidente hasta que el servicio responde.
Con una copia cada $T$ horas y una caída que puede ocurrir en cualquier instante con la misma probabilidad, los datos perdidos $P$ son el tiempo transcurrido desde la última copia:
$$ E[P] = \frac{T}{2}, \qquad P_{\max} = T $$
La lógica detrás de esta fórmula es múltiple:
- Si la caída ocurre en un instante uniforme dentro del intervalo entre dos copias, el tiempo desde la última copia es una variable uniforme entre $0$ y $T$.
- La media de una uniforme entre $0$ y $T$ es $T/2$: con una copia diaria, en promedio se pierden $12$ horas.
- El peor caso es caer justo antes de la copia siguiente: se pierde el intervalo entero, $T$. El RPO que se promete es este máximo, no la media.
- En conclusión, para reducir a la mitad la pérdida, hay que duplicar las copias; para hacerla nula, hay que replicar de forma continua, que es otra arquitectura y otro presupuesto.
El siguiente bloque simula $10,000$ caídas en instantes uniformes a lo largo de un año de $360$ días y mide los datos perdidos con copias cada $24$, $12$, $6$ y $1$ hora. La copia diaria corre a las 03:00, como la de Trigo Lento; la pérdida en horas se traduce también en ejecuciones del historial, con $1,560$ al mes:
# Datos perdidos en 10 000 fallos uniformes según el intervalo entre copias en Python:
horas_anio = 360 * 24
fallos = rng.uniform(0, horas_anio, 10_000)                    # instante de cada caída, en horas
ejecuciones_hora = EJECUCIONES_MES / (30 * 24)
perdidas, filas = {}, []
for T in [24, 12, 6, 1]:
    perdida = (fallos - 3) % T if T == 24 else fallos % T     # la diaria corre a las 03:00
    perdidas[T] = perdida
    filas.append({'intervalo_h': T, 'copias_dia': 24 // T, 'esperada_T/2': T / 2,
                  'media_sim': round(perdida.mean(), 2), 'p95': round(np.percentile(perdida, 95), 2),
                  'maxima_sim': round(perdida.max(), 2),
                  'ejecuciones_perdidas': round(perdida.mean() * ejecuciones_hora, 1)})
tabla2 = pd.DataFrame(filas)
print(tabla2.to_string(index = False))

fig, ax = plt.subplots(figsize = (8, 4.6))
ax.boxplot([perdidas[T] for T in [24, 12, 6, 1]], labels = ['Cada 24 h', 'Cada 12 h', 'Cada 6 h', 'Cada hora'],
           widths = 0.5, patch_artist = True, boxprops = dict(facecolor = '#e3eefb', color = '#2a78d6'),
           medianprops = dict(color = '#eb6834', linewidth = 2), whiskerprops = dict(color = '#2a78d6'),
           capprops = dict(color = '#2a78d6'))
for i, T in enumerate([24, 12, 6, 1], start = 1):
    ax.text(i + 0.3, T / 2, f'media {perdidas[T].mean():.1f} h', fontsize = 9, va = 'center')
ax.set_xlim(0.5, 4.95)
ax.set_ylabel('Horas de datos perdidos por caída')
ax.set_xlabel('Intervalo entre copias')
ax.set_title('Datos perdidos en 10 000 caídas simuladas', fontsize = 16)
ax.grid(axis = 'y', color = '#e6e5e1')
ax.set_axisbelow(True)
plt.tight_layout()
plt.show()
 intervalo_h  copias_dia  esperada_T/2  media_sim   p95  maxima_sim  ejecuciones_perdidas
          24           1          12.0      12.01 22.77        24.0                  26.0
          12           2           6.0       6.07 11.42        12.0                  13.2
           6           4           3.0       3.02  5.70         6.0                   6.5
           1          24           0.5       0.50  0.95         1.0                   1.1
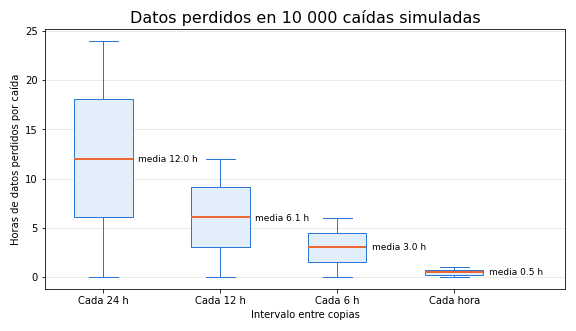
La simulación reproduce la fórmula al centésimo: con la copia diaria, la pérdida media es $12.01$ horas frente a las $12$ teóricas, el percentil $95$ es de $22.77$ horas y el máximo, $24$ horas. Cada vez que se duplican las copias, la media se divide entre dos: $6.07$ horas con dos al día, $3.02$ con cuatro y $0.50$ con una por hora. En el diagrama de cajas, la caja de la copia diaria ocupa casi todo el rango de $0$ a $24$, porque la pérdida es uniforme: tan probable es perder una hora como veinte.
¿Qué significan esas horas para Trigo Lento? Menos de lo que parece, y por eso la copia diaria basta. En n8n, lo que se pierde entre dos copias es de dos clases:
- Historial de ejecuciones: con la copia diaria, unas $26$ ejecuciones de media y $52$ como máximo. Es el registro de lo que hizo el agente, no los pedidos: los pedidos viven en
trigo_lento.sqlitey en la hoja del mostrador (Día 16), que tienen sus propias copias. Perder un día de historial es perder trazabilidad, no ventas. - Cambios en workflows y credenciales: si Valeria pasa una tarde ajustando un workflow y el servidor cae antes de las 03:00, se pierde la tarde. Para eso existe la exportación por CLI del Bloque 3: se lanza después de cada cambio importante, y el RPO de los workflows pasa de $24$ horas a cero en la práctica.
El RTO se elige mirando el negocio, no el servidor. Los mensajes de WhatsApp que llegan con n8n caído no se pierden: el Día 34 configuró en Twilio la URL de respaldo hacia el escenario TL Pedidos WhatsApp v3 de Make, que responde como respondía antes de n8n. Pero Make no tiene lo que se construirá en n8n (el agente, las herramientas, la aprobación humana), y lo que no aguanta Trigo Lento es una mañana entera en modo de respaldo, con Valeria resolviendo a mano lo que Make no sabe: en la hora pico, de 10:00 a 12:00, llegan $9$ mensajes por hora que Valeria atiende sola. Dos horas de caída son unos $18$ mensajes atendidos a mano, una molestia; una mañana son decenas y encargos que se escapan. El RTO se fija en $2$ horas. La Tabla 2 reúne los objetivos por activo.
Tabla 2. RPO y RTO por activo, frecuencia de copia y pérdida esperada y máxima.
| Activo | RPO | RTO | Frecuencia de copia | Pérdida esperada | Pérdida máxima |
|---|---|---|---|---|---|
| Workflows | 24 h (cero tras cada exportación) | 2 h | Diaria a las 03:00 y exportación tras cada cambio | 12 h | 24 h |
| Credenciales | 24 h (cero tras cada alta o rotación) | 2 h | Diaria y exportación cifrada tras cada cambio | 12 h | 24 h |
| Historial de ejecuciones | 24 h | No bloquea la vuelta al servicio | Diaria a las 03:00 | 12 h (unas 26 ejecuciones) | 24 h (52 ejecuciones) |
Archivo .env | Cero | 5 min | En el gestor, en el momento de cada cambio | Ninguna | Ninguna |
N8N_ENCRYPTION_KEY | Cero | 2 min | Una sola vez: no cambia | Ninguna | Ninguna |
docker-compose.yml | Cero | 5 min | En el repositorio, con cada cambio | Ninguna | Ninguna |
Las tres últimas filas tienen RPO cero porque no son datos que crecen, sino configuración que cambia pocas veces: se guarda en su lugar seguro en el momento de cambiarla, no en la copia nocturna. La clave tiene además el RTO más corto de la tabla, y es el que más fácilmente se incumple: si no está en el gestor, no hay RTO que valga.
La Figura 3 pone los dos objetivos en una sola línea de tiempo: a la izquierda de la caída, el RPO mide hacia atrás hasta la última copia; a la derecha, el RTO mide hacia delante hasta que el servicio responde.
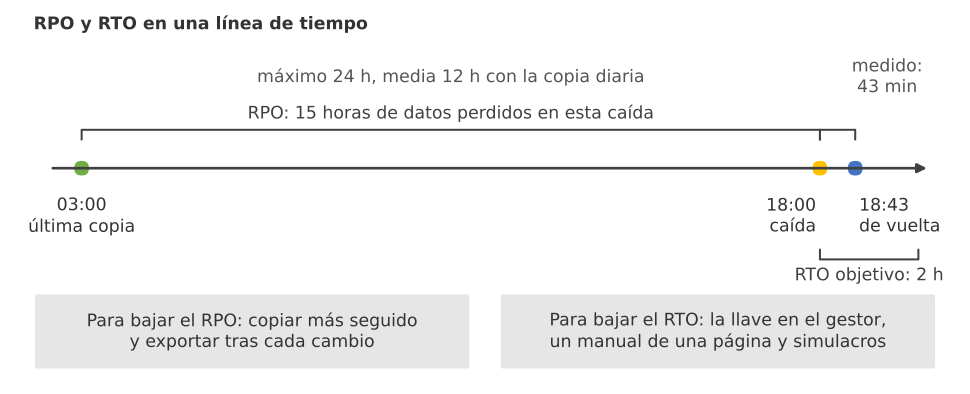
Figura 3. RPO y RTO en una línea de tiempo: la última copia de las 03:00, la caída de las 18:00 con 15 horas de datos perdidos (máximo 24) y una restauración de 43 minutos frente a un RTO de 2 horas.
Simulacro de restauración
Con la copia, la clave y los objetivos definidos, falta lo único que convierte todo lo anterior en un respaldo: restaurar de verdad. Valeria lo hace el mismo sábado por la tarde, con el servidor original todavía en marcha, en un servidor nuevo del mismo tamaño que contrata por horas. Las reglas del simulacro son tres: el servidor nuevo empieza vacío, solo se usa lo que estaría disponible si el original hubiera desaparecido (la copia externa, el repositorio de configuración y el gestor de contraseñas) y nadie escribe a ningún cliente: la prueba de vida es el webhook TL Prueba de salud.
Huellas para comparar antes y después
¿Cómo se sabe que lo restaurado es lo mismo que lo respaldado? Abrir los tres workflows y mirarlos “a ojo” no escala ni es fiable. Lo fiable es una huella: el resultado de aplicar una función resumen, SHA-256, al contenido de cada archivo. Si un solo carácter cambia, la huella cambia por completo; si la huella coincide, el contenido es idéntico con una probabilidad de error despreciable.
Hay una complicación. n8n reescribe algunos campos cada vez que guarda un workflow, aunque su lógica no cambie: updatedAt (la fecha de la última modificación) y versionId (un identificador de versión que cambia con cada guardado), y lleva la cuenta de disparadores en triggerCount. Si se calcula la huella del archivo tal cual, cualquier restauración que pase por un guardado parecerá un cambio. La solución es normalizar antes de calcular: quitar los campos volátiles, ordenar las claves y eliminar los espacios, de modo que dos archivos con el mismo contenido lógico produzcan siempre el mismo texto.
El siguiente bloque calcula las huellas de los tres workflows exportados antes del simulacro y de los que exporta el servidor restaurado. Para comprobar que la prueba sirve, a uno de ellos se le cambió a propósito la hora de su disparador, de las 9:00 a las 10:00. Al final revisa las dos credenciales exportadas: su data debe empezar por Salted__ y su huella debe ser la misma antes y después:
# Huellas SHA-256 de workflows y credenciales antes y después de restaurar en Python:
VOLATILES = {'updatedAt', 'versionId', 'triggerCount'}

def huella(objeto, ignorar = ()):
    # JSON canónico: sin campos volátiles, claves ordenadas y sin espacios:
    limpio = {k: v for k, v in objeto.items() if k not in ignorar}
    texto = json.dumps(limpio, sort_keys = True, ensure_ascii = False, separators = (',', ':'))
    return hashlib.sha256(texto.encode('utf-8')).hexdigest()

respaldo = carpeta / 'respaldo'
antes = {p.stem: json.loads(p.read_text(encoding = 'utf-8')) for p in sorted((respaldo / 'workflows').glob('*.json'))}

# Lo que exportaría el servidor restaurado: n8n reescribe updatedAt y versionId al guardar,
# y a uno de los workflows se le cambió la hora a propósito para comprobar que la prueba lo detecta:
despues = copy.deepcopy(antes)
for w in despues.values():
    w['updatedAt'], w['versionId'] = '2026-03-07T17:44:12.009Z', w['versionId'][:-4] + 'b' + w['versionId'][-3:]
regla = despues['Yb5vGk7TfS3mUe9C']['nodes'][0]['parameters']['rule']['interval'][0]
regla['triggerAtHour'] = 10

filas = []
for id_, w in antes.items():
    cruda = huella(w) == huella(despues[id_])
    a, d = huella(w, VOLATILES), huella(despues[id_], VOLATILES)
    filas.append({'workflow': w['name'], 'cruda_igual': cruda, 'antes': a[:12], 'despues': d[:12], 'coincide': a == d})
print(pd.DataFrame(filas).to_string(index = False))

# Las credenciales viajan cifradas: el "cofre" debe llegar idéntico y empezar por "Salted__":
for p in sorted((respaldo / 'credenciales').glob('*.json')):
    c = json.loads(p.read_text(encoding = 'utf-8'))
    cabecera = base64.b64decode(c['data'])[:8]
    print(f"{c['name']:<20} tipo {c['type']:<15} cabecera {cabecera} | {len(c['data'])} caracteres | "
          f"huella {hashlib.sha256(c['data'].encode()).hexdigest()[:12]}")
                    workflow  cruda_igual        antes      despues  coincide
          TL Prueba de salud        False f373d5274292 f373d5274292      True
              TL Hola Claude        False 7c1df79cc666 7c1df79cc666      True
TL Recordatorio de simulacro        False fed021810462 15f616604224     False
Anthropic TL         tipo httpHeaderAuth  cabecera b'Salted__' | 128 caracteres | huella 8e7272254ab0
Correo de avisos TL  tipo smtp            cabecera b'Salted__' | 192 caracteres | huella b5e0163dc618
La tabla de salida enseña por qué hace falta normalizar. La columna cruda_igual es falsa en los tres workflows: con las huellas del archivo tal cual, los tres parecerían cambiados, y una prueba que siempre falla es una prueba que se deja de mirar. Con la normalización, TL Prueba de salud y TL Hola Claude producen exactamente la misma huella antes y después (f373d5274292... y 7c1df79cc666...), y solo TL Recordatorio de simulacro no coincide: fed021810462... antes y 15f616604224... después. Es justo el que se alteró. La prueba detecta un cambio de un solo número en un archivo de casi dos mil caracteres.
Las dos credenciales cumplen las dos condiciones: su campo data empieza por b'Salted__', es decir, siguen cifradas, y tienen $128$ y $192$ caracteres. En el simulacro, la huella del cofre de Anthropic TL (8e7272254ab0...) es la misma en el servidor original y en el restaurado: el pg_restore copia la cadena cifrada sin tocarla. Que el cofre llegue intacto no basta, como se verá en el primer intento: también tiene que llegar la llave.
Restaurar en un servidor limpio
La restauración sigue un orden que importa. Primero se rehace el .env con la clave que sale del gestor; después se levanta solo Postgres y se carga la copia, para que n8n no escriba en una base a medio restaurar; al final se levanta n8n, que lee la misma clave y abre las credenciales. El siguiente bloque es la secuencia completa, con la alternativa de importar desde la exportación del Bloque 3 cuando no hay copia de la base. Es un bloque de terminal y no se ejecutó para escribir la entrada:
# Restauración en un servidor limpio con la misma clave de cifrado en Bash:
cd /opt/trigo_lento                      # docker-compose.yml copiado del repositorio de configuración
# 1. El .env se rehace con la clave que sale del gestor de contraseñas, no del servidor caído:
grep -c '^N8N_ENCRYPTION_KEY=' .env      # debe imprimir 1

# 2. Solo la base primero, para cargar la copia sin que n8n escriba en ella:
docker compose up -d postgres
rclone copy externo:tl-respaldos/diaria/n8n_2026-03-07.dump.gpg .
gpg --batch --passphrase-file /root/.frase_respaldo -d n8n_2026-03-07.dump.gpg > n8n.dump
docker compose exec -T postgres pg_restore -U n8n -d n8n --clean --if-exists --no-owner < n8n.dump

# 3. Ahora sí, n8n, que lee la misma clave y abre las credenciales:
docker compose up -d n8n
docker compose logs --tail=20 n8n

# Alternativa sin copia de la base: importar la exportación del Bloque 3.
# Los workflows llegan desactivados y se reactivan a mano después de revisarlos:
# docker compose exec -u node n8n n8n import:workflow --separate --input=/home/node/.n8n/respaldos/2026-03-07/workflows/
# docker compose exec -u node n8n n8n import:credentials --separate --input=/home/node/.n8n/respaldos/2026-03-07/credenciales/

# 4. Prueba de vida con el webhook de prueba (no escribe a ningún cliente):
curl -s https://n8n.trigolento.example/webhook/salud-tl

# Salida de ejemplo (puede variar):
# Editor is now accessible via:
# https://n8n.trigolento.example
# {"estado": "ok", "hora": "2026-03-07T17:46:03.218-06:00"}
Tres detalles del bloque vienen de errores habituales:
grep -c '^N8N_ENCRYPTION_KEY=' .envdebe imprimir $1$. Si imprime $0$, n8n arrancará, generará una clave nueva y las credenciales quedarán ilegibles; mejor detenerse aquí que descubrirlo veinte minutos después.--clean --if-existsborra antes de recrear cada objeto de la base, sin fallar si el objeto no existe. Sin--clean, una restauración sobre una base que n8n ya inicializó choca con las tablas existentes; con--no-owner, los objetos quedan a nombre del usuario que restaura.- La prueba de vida es un webhook propio, no un mensaje a un cliente.
TL Prueba de saludresponde{"estado": "ok"}con la hora del servidor: si responde por el dominio público, funcionan a la vez el proxy, el certificado HTTPS, n8n y la base.
Dos intentos cronometrados
Valeria cronometra cada paso con el reloj del teléfono y anota los minutos en una hoja. El primer intento avanza bien durante veinte minutos: el servidor nuevo, Docker y el repositorio de configuración están listos. En el tercer paso abre el gestor de contraseñas, encuentra la entrada “Clave de n8n” y la copia al .env en dos minutos. Descarga la copia, la restaura y arranca n8n sin errores. En la primera verificación, la credencial Anthropic TL no se descifra. A los $36$ minutos, el simulacro se detiene. La explicación aparece cuando compara huellas: el viernes, el primer docker compose up falló por un error en el Caddyfile, y al repetir la instalación desde el principio volvió a ejecutar el paso que genera el .env. La clave del gestor es la de la primera vuelta; la que cifra las credenciales es la de la segunda, y solo estaba en el .env del servidor original.
El hallazgo vale más que un simulacro limpio. Si el lunes el servidor no hubiera vuelto, la clave se habría perdido con él, y con ella las dos credenciales, aunque las diez copias estuvieran perfectas. Valeria sustituye en el gestor la clave vieja por la del servidor original, anota su huella al lado, con acceso de emergencia para Don Ernesto, y repite el simulacro desde cero.
El segundo intento termina. La duración total de la restauración es la suma de los pasos, y la comparación con el objetivo es directa:
$$ T_{\text{rest}} = \sum_{j=1}^{7} d_j \le \text{RTO} $$
La lógica detrás de esta fórmula es múltiple:
- Los pasos de la restauración son secuenciales: no se puede restaurar la base sin el servidor ni arrancar n8n sin la base, así que las duraciones $d_j$ se suman, como en una ruta crítica sin ramas.
- El RTO es un tope: si la suma lo supera, el plan no cumple, aunque cada paso parezca razonable por separado.
- El margen, $\text{RTO} - T_{\text{rest}}$, es el colchón para lo que el simulacro no tuvo: un domingo, un proveedor lento, una persona que no recuerda la contraseña del panel.
- En conclusión, un RTO solo es creíble si una suma medida, no estimada, cabe debajo de él.
El siguiente bloque recoge los tiempos de los dos intentos, los compara con el RTO de $120$ minutos, estima la variabilidad con $10,000$ simulacros en los que cada paso dura su tiempo medido multiplicado por un factor lognormal, y dibuja los dos intentos como un diagrama de Gantt:
# Tiempos del simulacro de restauración frente al RTO de 2 horas en Python:
pasos = ['Aprovisionar el servidor', 'Instalar Docker y la configuración', 'Recuperar la clave del gestor',
         'Descargar la copia externa', 'pg_restore', 'Arrancar n8n', 'Verificaciones']
intento_1 = [11, 9, 2, 3, 4, 2, 5]      # la clave del gestor no era la del servidor; se detuvo al verificar
intento_2 = [11, 9, 2, 3, 4, 2, 12]
tabla3 = pd.DataFrame({'paso': pasos, 'intento_1': intento_1, 'intento_2': intento_2})
tabla3['fin_intento_2'] = tabla3['intento_2'].cumsum()
print(tabla3.to_string(index = False))
print(f'Intento 1: detenido en el minuto {sum(intento_1)} (la credencial de prueba no se descifró)')
print(f'Intento 2: {sum(intento_2)} min | margen frente al RTO: {RTO_MIN - sum(intento_2)} min')

# Variabilidad: cada paso dura su tiempo medido por un factor lognormal (sigma 0.35):
factores = rng.lognormal(0, 0.35, size = (10_000, len(pasos)))
totales = (factores * np.array(intento_2)).sum(axis = 1)
print(f'10 000 simulacros: p50 = {np.percentile(totales, 50):.1f} min | p95 = {np.percentile(totales, 95):.1f} min | '
      f'P(> RTO) = {(totales > RTO_MIN).mean():.4f}')

fig, ax = plt.subplots(figsize = (9, 4.8))
colores = ['#9a9994', '#9a9994', '#7b5ea7', '#2a78d6', '#2a78d6', '#70ad47', '#f2a33a']
for fila, (nombre, tiempos) in enumerate([('Intento 1', intento_1), ('Intento 2', intento_2)]):
    inicio = 0
    for paso, t, c in zip(pasos, tiempos, colores):
        ax.barh(fila, t, left = inicio, color = c, edgecolor = 'white', linewidth = 2, height = 0.5,
                label = paso if fila == 1 else None)
        inicio += t
    ax.text(inicio + 1.5, fila, f'{inicio} min' + (' (detenido)' if fila == 0 else ''), va = 'center', fontsize = 10)
ax.axvline(RTO_MIN, color = '#eb6834', linestyle = '--', linewidth = 2)
ax.text(RTO_MIN - 2, -0.35, 'RTO: 120 min', color = '#eb6834', ha = 'right', fontsize = 10)
ax.set_yticks([0, 1])
ax.set_yticklabels(['Intento 1', 'Intento 2'])
ax.set_xlim(0, 130)
ax.set_ylim(1.7, -0.5)
ax.set_xlabel('Minutos desde el inicio del simulacro')
ax.set_title('Simulacro de restauración frente al RTO', fontsize = 16)
ax.legend(loc = 'lower right', fontsize = 8, frameon = False, ncol = 2, bbox_to_anchor = (0.92, 0))
plt.tight_layout()
plt.show()
                              paso  intento_1  intento_2  fin_intento_2
          Aprovisionar el servidor         11         11             11
Instalar Docker y la configuración          9          9             20
     Recuperar la clave del gestor          2          2             22
        Descargar la copia externa          3          3             25
                        pg_restore          4          4             29
                      Arrancar n8n          2          2             31
                    Verificaciones          5         12             43
Intento 1: detenido en el minuto 36 (la credencial de prueba no se descifró)
Intento 2: 43 min | margen frente al RTO: 77 min
10 000 simulacros: p50 = 45.2 min | p95 = 58.7 min | P(> RTO) = 0.0000
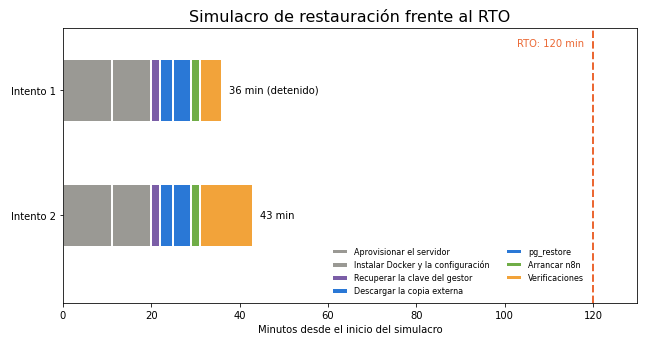
La Tabla 3 recoge los tiempos medidos.
Tabla 3. Tiempos del simulacro por paso, en minutos: intento 1 (detenido) e intento 2 (completo).
| Paso | Intento 1 | Intento 2 | Minuto en que termina (intento 2) |
|---|---|---|---|
| Aprovisionar el servidor | 11 | 11 | 11 |
| Instalar Docker y la configuración | 9 | 9 | 20 |
| Recuperar la clave del gestor | 2 (era una clave vieja) | 2 | 22 |
| Descargar la copia externa | 3 | 3 | 25 |
pg_restore | 4 | 4 | 29 |
| Arrancar n8n | 2 (con la clave equivocada) | 2 | 31 |
| Verificaciones | 5 (detenido: la credencial no se descifra) | 12 | 43 |
| Total | 36, sin servicio | 43 | Margen: 77 minutos |
El segundo intento termina en $43$ minutos: $11 + 9 + 2 + 3 + 4 + 2 + 12$, con un margen de $77$ minutos frente al RTO de $2$ horas. Las verificaciones son el paso más largo ($12$ minutos), y es correcto que lo sean: comparar huellas, abrir una credencial de prueba, llamar al webhook y consultar la API son la diferencia entre “n8n arrancó” y “n8n funciona”.
La simulación con variabilidad matiza la cifra. La mediana de los $10,000$ simulacros es de $45.2$ minutos, un poco más que los $43$ medidos, porque un factor lognormal con mediana $1$ tiene una media algo mayor que $1$ y los retrasos se suman más que los adelantos. El percentil $95$ es de $58.7$ minutos y ninguno de los $10,000$ superó el RTO. El plan cumple con holgura cuando la clave está en su sitio, y no cumple nunca cuando no lo está: el intento 1 no es una barra larga en el Gantt, es una barra que no termina.
La última verificación: la API
La comprobación final cierra el círculo con el inventario: ¿están activos en el servidor restaurado los mismos workflows que estaban activos antes? La API pública de n8n responde a esa pregunta con una petición GET a /api/v1/workflows?active=true, autenticada con la cabecera X-N8N-API-KEY. La API pagina sus resultados (por omisión $100$ por página, como máximo $250$) y devuelve un nextCursor cuando hay más páginas, así que el bloque recorre todas. La clave de la API se lee del entorno, como cualquier secreto de la serie. Este bloque llama a un servicio real y no se ejecutó para escribir la entrada; la salida es un ejemplo comentado:
# Verificación posterior por la API pública de n8n contra el inventario en Python:
import os
import requests

URL = os.environ['N8N_URL']                    # https://n8n.trigolento.example, del servidor restaurado
CABECERAS = {'accept': 'application/json',
             'X-N8N-API-KEY': os.environ['N8N_API_KEY']}   # la clave de la API nunca va en el código

def workflows_activos():
    # La API pagina: 100 resultados por omisión, 250 como máximo, y nextCursor para seguir:
    activos, cursor = [], None
    while True:
        params = {'active': 'true', 'limit': 250}
        if cursor:
            params['cursor'] = cursor
        r = requests.get(f'{URL}/api/v1/workflows', headers = CABECERAS, params = params, timeout = 30)
        r.raise_for_status()
        cuerpo = r.json()
        activos += [(w['id'], w['name']) for w in cuerpo['data']]
        cursor = cuerpo.get('nextCursor')
        if not cursor:
            return activos

# Inventario de antes de la caída: los workflows que debían estar activos:
esperados = {('hT3qLs9WbE2nVx5K', 'TL Prueba de salud'),
             ('Yb5vGk7TfS3mUe9C', 'TL Recordatorio de simulacro')}
encontrados = set(workflows_activos())
print('Activos en el servidor restaurado:', len(encontrados))
print('Faltan:', sorted(esperados - encontrados) or 'ninguno')
print('Sobran:', sorted(encontrados - esperados) or 'ninguno')

# Salida de ejemplo (puede variar):
# Activos en el servidor restaurado: 2
# Faltan: ninguno
# Sobran: ninguno
Con la restauración por pg_restore, el estado activo de cada workflow viaja en la base y la comparación sale limpia: dos activos esperados, dos encontrados, ninguno de más ni de menos. Con la alternativa de importar archivos, la misma comprobación habría devuelto “Faltan” con los dos workflows, porque import:workflow los deja desactivados: es el recordatorio automático de reactivarlos. Un workflow que sobra también es una señal: puede ser uno de prueba que alguien activó y olvidó, y en el servidor restaurado conviene revisarlo antes de dejarlo correr.
El manual de restauración
Todo lo anterior cabe en una página, y debe caber en una página: un manual de restauración se lee con prisa, de madrugada y, si las cosas van mal de verdad, por alguien que no es quien lo escribió. Valeria lo escribe con los tiempos del segundo intento y una dueña por paso, como en la lista de responsabilidades del Día 34. La Tabla 4 es el manual de Trigo Lento.
Tabla 4. Manual de restauración de n8n de Trigo Lento: paso, comando, comprobación y responsable.
| Paso | Comando o lugar | Comprobación | Responsable | Tiempo objetivo |
|---|---|---|---|---|
| 1. Declarar el incidente | Avisar al mostrador: pedidos por WhatsApp a mano | El mostrador confirma | Valeria | 2 min |
| 2. Aprovisionar el servidor | Panel del proveedor, mismo tamaño y región distinta si la caída es regional | Responde por SSH | Valeria | 11 min |
| 3. Instalar Docker y la configuración | Clonar el repositorio de configuración | docker compose version responde | Valeria | 9 min |
4. Recuperar la clave y el .env | Gestor de contraseñas, entrada “Clave de n8n” | grep -c imprime 1 y la huella coincide con la anotada | Valeria; Don Ernesto con acceso de emergencia | 2 min |
| 5. Descargar y descifrar la copia | rclone copy y gpg -d desde la copia externa | La huella .sha256 coincide | Valeria | 3 min |
| 6. Restaurar la base | pg_restore --clean --if-exists | Termina sin errores | Valeria | 4 min |
| 7. Arrancar n8n | docker compose up -d n8n | El editor abre por HTTPS | Valeria | 2 min |
| 8. Verificar | Huellas, credencial de prueba, webhook salud-tl, API | Las cuatro pruebas pasan | Valeria | 12 min |
| 9. Apuntar el dominio | DNS del dominio al servidor nuevo | El webhook responde por el dominio público | Valeria | Según el TTL del DNS |
| 10. Cerrar y anotar | Hoja del simulacro o del incidente | Tiempos y hallazgos anotados | Valeria y Don Ernesto | 5 min |
El manual tiene dos reglas que no son pasos:
- Simulacro trimestral. Una restauración que se practicó hace un año ya no es una restauración practicada: cambian las versiones, las contraseñas del panel y la memoria de quien la hizo. El workflow
TL Recordatorio de simulacroavisa a Valeria cada tres meses, el día $7$ a las 9:00, y cada simulacro actualiza los tiempos de la tabla. - El manual vive fuera del servidor. Una copia impresa en el cajón de la oficina y otra en el gestor de contraseñas. Un manual que solo existe en el servidor caído es el mismo problema que la clave del primer intento.
Hay un paso que el manual no puede acortar: el noveno. Si el dominio apunta al servidor viejo con un tiempo de vida (TTL) de DNS de varias horas, los webhooks de Twilio seguirán llamando a la dirección antigua aunque el servidor nuevo esté listo. Valeria baja el TTL del registro del dominio a $5$ minutos ese mismo sábado; así el paso nueve cabe en el margen de $77$ minutos.
El lunes 9 de marzo, a las 04:20, el servidor vuelve del mantenimiento sin incidentes. Valeria no tuvo que usar el manual. Pero ahora sabe, con un reloj y no con una esperanza, que si hubiera hecho falta, Trigo Lento habría vuelto a atender pedidos antes de las 05:00.
Consideraciones finales
El día empezó con una copia de seguridad que nadie había restaurado y termina con un respaldo en el sentido completo de la palabra: la clave de cifrado en un gestor con acceso de emergencia, una exportación cifrada de workflows y credenciales, un pg_dump diario de $16.2$ MB con la poda por omisión y diez copias distintas, tres copias en tres lugares que bajan $400$ veces el riesgo de perderlo todo, un RPO de $24$ horas para los datos y de cero para la configuración, y una restauración medida en $43$ minutos frente a un RTO de $2$ horas. La pieza decisiva no fue ninguna de las técnicas, sino el primer intento fallido: sin simulacro, la clave habría seguido viviendo solo en el servidor hasta el día en que el servidor no volviera.
Las cifras tienen límites que conviene decir. Las probabilidades de fallo ($0.03$ y $0.05$) son supuestos didácticos, no estadísticas de ningún proveedor; la independencia entre el servidor y el almacenamiento del mismo proveedor es optimista; el tamaño de $20$ KB por ejecución depende de cuántos nodos tenga el agente y de cuánto texto devuelva Claude, y los tiempos del simulacro se midieron una vez, en sábado y con el servidor original a mano para copiar la clave. Ninguno de esos límites cambia las conclusiones: los lugares independientes cuentan más que las copias, la poda decide cuántos datos personales se guardan, y la clave separada de la copia es la diferencia entre un respaldo y un archivo inútil.
Antes de dar por terminado el respaldo de cualquier sistema, conviene hacerse algunas preguntas:
- ¿Dónde está la clave que abre lo que usted respalda, y quién más que usted puede llegar a ella si usted no está?
- ¿Cuántas de sus copias morirían juntas si su proveedor le suspendiera la cuenta mañana?
- ¿Cuándo fue la última vez que restauró, no copió, y cuánto tardó?
- ¿Cuántos mensajes de clientes contiene su copia, y los necesita todos?
Un gran libro que habla de esto es Site Reliability Engineering: How Google Runs Production Systems, editado por Betsy Beyer, Chris Jones, Jennifer Petoff y Niall Richard Murphy. Su capítulo sobre integridad de los datos parte de una idea que resume este día: a nadie le interesan las copias de seguridad, lo que interesa son las restauraciones. Aunque describe sistemas de un tamaño muy distinto al de una panadería, sus principios (probar la recuperación de forma continua, desconfiar de las copias que nunca se leyeron, separar los modos de fallo) se aplican igual a un servidor de $6.47$ USD al mes.
Una copia que nunca se restauró es una promesa; un respaldo es una restauración cronometrada. El servidor de Trigo Lento ya tiene compadre, como pedía Don Ernesto: otro proveedor con la copia, un gestor con la llave, una hoja con los pasos y la certeza de que, en $43$ minutos, el horno de al lado ya está caliente.
Conclusiones clave
Clave y credenciales
- n8n cifra las credenciales con
N8N_ENCRYPTION_KEY; si no se fija, genera una al primer arranque en su carpeta de datos (/home/node/.n8nen Docker). - Guardar la clave en el gestor no basta: hay que comprobar con su huella que es la que usa el servidor.
- Una base restaurada con otra clave conserva los workflows y pierde todas las credenciales; la clave se guarda fuera del servidor, de las copias y del repositorio, en un gestor con acceso de emergencia.
- La exportación por omisión deja el campo
datacifrado (empieza porSalted__en base64) y solo sirve con la misma clave;--decryptedexpone todos los secretos y se usa solo para migrar de clave, en una carpeta temporal que se borra al terminar.
Copias
--backupequivale a--all --pretty --separate;import:workflowsobrescribe los identificadores existentes y deja los workflows desactivados.pg_dump -Fcse lleva workflows, credenciales cifradas e historial en un solo archivo; se comprueba conpg_restore --list, se firma con SHA-256 y sale del servidor cifrado.- Con la poda por omisión (14 días), la copia se estabiliza en $16.2$ MB y las $10$ copias distintas (la del domingo cuenta como diaria y semanal) ocupan $162.2$ MB; sin poda, a los doce meses cada copia pesa $367.6$ MB y guarda $18,720$ conversaciones.
- Siete copias en el mismo disco cuentan como una; con 3-2-1, $P_{\text{total}} = 0.03 \cdot 0.05^2 = 7.5 \cdot 10^{-5}$, $400$ veces menos que con las copias solo en el servidor.
Restaurar de verdad
- Con copias cada $T$ horas, la pérdida esperada es $T/2$ y la máxima $T$: $12.01$ y $24$ horas simuladas con la diaria; la exportación tras cada cambio deja en cero el RPO de los workflows.
- Las huellas SHA-256 se calculan sobre el JSON normalizado, sin
updatedAt,versionIdnitriggerCount; así detectaron el único workflow alterado. - El primer simulacro se detuvo a los $36$ minutos porque la clave buena solo estaba en el servidor y el gestor guardaba una vieja; el segundo terminó en $43$ minutos frente a un RTO de $120$, con un percentil $95$ simulado de $58.7$.
- El manual de restauración cabe en una página con diez pasos, un responsable por paso y un simulacro trimestral.
Mañana, en el Día 36: Primer workflow en n8n: nodos, items y expresiones. Con el servidor respaldado y la restauración probada, Valeria por fin arrastra su primer nodo en serio y descubre que n8n no piensa en paquetes, como Make, sino en listas de items que cada nodo recibe y entrega.
Referencias
- n8n (2026). CLI commands: export and import workflows and credentials. n8n Docs. https://docs.n8n.io/hosting/cli-commands/
- n8n (2026). Set a custom encryption key y Execution data (variables de entorno de poda). n8n Docs. https://docs.n8n.io/hosting/configuration/configuration-examples/encryption-key/ y https://docs.n8n.io/hosting/scaling/execution-data/
- n8n (2026). API authentication y Pagination. n8n Docs. https://docs.n8n.io/api/authentication/
- PostgreSQL Global Development Group (2026). Backup and Restore (pg_dump y pg_restore). PostgreSQL Documentation. https://www.postgresql.org/docs/current/backup.html
- Swanson, M., Bowen, P., Phillips, A. W., Gallup, D. y Lynes, D. (2010). Contingency Planning Guide for Federal Information Systems (NIST SP 800-34 Rev. 1). National Institute of Standards and Technology. https://csrc.nist.gov/pubs/sp/800/34/r1/upd1/final
- Krogh, P. (2009). The DAM Book: Digital Asset Management for Photographers (2.ª ed.). O’Reilly Media.
- Beyer, B., Jones, C., Petoff, J. y Murphy, N. R. (Eds.) (2016). Site Reliability Engineering: How Google Runs Production Systems. O’Reilly Media. https://sre.google/sre-book/data-integrity/