
Arquitecto de automatización con IA: Día 39
 Jeshua Romero Guadarrama
- 71 Min para leer
- 11 Mar, 2026
Índice de contenido
Resumen:
Un martes a mediodía, el agente de pedidos de Trigo Lento consultó la disponibilidad del horno, recibió un “no” y, cuarenta y un segundos después, le escribió a una clienta “¡Listo, su pastel estará a las 15:00!”. En esta entrada, Valeria disecciona ese incidente (ficticio e ilustrativo) con las trazas que exporta n8n: reconstruye la línea de tiempo, lee los pasos intermedios del agente, aplica cinco porqués y un árbol de fallos con compuerta Y, y diseña tres barreras en capas: una herramienta determinista de capacidad, un validador de la respuesta antes de enviarla y una aprobación humana con contexto. Al terminar, usted sabrá distinguir los factores que se alinean en el fallo de un agente, construir un conjunto de regresión de 40 conversaciones, interpretar cero fallos con su intervalo de Wilson y redactar un análisis posterior sin culpables.
¿Cómo citar el presente artículo?
Romero, J. (11 de marzo de 2026). Arquitecto de automatización con IA: Día 39. python-data-engineer. https://www.python-data-engineer.com/post/aai/dia_39/.
Arquitecto de automatización con IA: Día 39 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/aai/dia_39/.
Precios, límites y políticas revisados en octubre de 2026: planes, precios y límites de Make, n8n, Zapier, WhatsApp (Meta, Twilio, Wati) y de la API de Claude. Las opciones del nodo AI Agent de n8n que usa la entrada (mensaje de sistema, número máximo de iteraciones, Return Intermediate Steps) y la revisión humana de herramientas (Human review, que pausa el workflow antes de ejecutar una herramienta marcada) se contrastaron con la documentación oficial de n8n, revisado en octubre de 2026. No se pudo levantar un contenedor de n8n al escribir la entrada (el servicio de Docker no respondía): la traza del Bloque 4 y el fragmento de workflow del Bloque 11 tienen la estructura verificada contra la documentación, revisado en octubre de 2026, con identificadores de ejemplo. El Bloque 9 llama a la API de Claude y su salida es un ejemplo comentado; los demás bloques de Python se ejecutan sin red y sus salidas son las reales.
Día 39. Anatomía de un fallo real II: el agente que prometió un pastel imposible
Introducción
Ayer, en el Día 38 (Agentes autónomos con supervisión humana: el asistente de pedidos), Valeria decidió cuándo se justifica un agente, le dio cinco herramientas con esquemas estrictos, puso una aprobación humana delante de todo lo que deja huella, lo limitó en iteraciones, tokens y tiempo, y Trigo Lento ganó TL Agente de pedidos v2, el asistente que atiende por WhatsApp los encargos de pasteles con ida y vuelta. Hoy ese agente falla, y lo hace de una forma que ningún webhook duplicado podría imitar.
Una aclaración antes de empezar, la misma que abrió el Día 29 (Anatomía de un fallo real I: el webhook que duplicó 37 pedidos): el incidente de hoy es ficticio e ilustrativo. La clienta, sus mensajes, la traza y las cifras son inventados y se presentan con identificadores de ejemplo, sin teléfonos ni nombres. Lo que no es inventado es el mecanismo. Un agente que recibe de su herramienta un resultado negativo y, aun así, responde lo que la persona quería oír es uno de los fallos más comunes de los sistemas con modelos de lenguaje, y conviene haberlo visto despiezado antes de vivirlo.
Es martes 10 de marzo, a las 13:05. Una clienta escribe por WhatsApp: quiere un pastel de chocolate entero, el P09 de 460 MXN, “para hoy a las tres”. El agente consulta el catálogo, consulta la disponibilidad, crea un borrador, lo manda a aprobación y, a las 13:06, contesta: "¡Listo, su pastel estará a las 15:00!". El horno, sin embargo, estaba ocupado hasta las 17:00 con las hogazas y el pan de caja del miércoles, y un pastel entero necesita horas de horno, enfriado y decorado. A las 13:31, Valeria aprueba el borrador desde el obrador, con las manos llenas de harina. A las 14:40, Don Ernesto revisa la lista impresa del día, ve un pastel de chocolate para las tres de la tarde que nadie ha empezado y llama a la clienta para disculparse.
Esa noche, Don Ernesto deja la lista sobre el escritorio de Valeria con una frase subrayada: “Le dije que no prometiera nada que yo no pudiera hornear, y lo prometió. ¿Para qué quiero un ayudante que se equivoca con tan buena ortografía?” La pregunta es dura y es justa. El Día 38 escribió esa regla en el prompt de sistema, con casi las mismas palabras, y no bastó. La diferencia con el Día 29 es de fondo: allí falló la tubería, un mensaje que llegó cuatro veces; aquí la tubería funcionó a la perfección y falló el juicio de un componente probabilístico. Así pues, en la presente entrada, descubrirá cómo se disecciona el fallo de un agente sin buscar culpables: cómo se reconstruye la línea de tiempo con las trazas de n8n, cómo se leen los pasos intermedios del agente turno por turno, por qué tres defensas razonables se alinearon como los agujeros de un queso, qué barreras deterministas cortan la cadena, cuánto demuestran de verdad cero fallos en cuarenta pruebas y cómo se escribe el documento que queda.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Reconstruir un incidente de un agente de IA a partir de sus trazas de ejecución (historial de n8n, pasos intermedios del agente y registro de auditoría del Día 38).
- Distinguir los factores que contribuyen al fallo de un agente (salida de herramienta ignorada, instrucción ambigua, falta de validación de la salida) y llegar a la causa raíz con cinco porqués y un árbol de fallos.
- Diseñar barreras en capas para un agente: una herramienta determinista de capacidad, un validador de la respuesta antes de enviarla y una aprobación humana con contexto suficiente.
- Construir un conjunto de regresión de 40 conversaciones, interpretar cero fallos con su intervalo de confianza y redactar un análisis posterior sin culpables.
El incidente, minuto a minuto
El método es el del Día 29 y no cambia porque el protagonista sea un modelo de lenguaje: primero los hechos, en orden y con evidencia; después las causas. Valeria reúne cinco fuentes antes de opinar nada: el historial de ejecuciones de n8n, que guarda la entrada y la salida de cada nodo; los pasos intermedios del nodo AI Agent, que la v2 ya exportaba porque tenía activada la opción Return Intermediate Steps; el registro de auditoría del Día 38, con cada herramienta de escritura, sus argumentos seudonimizados y quién aprobó; la lista impresa del día, que Don Ernesto conserva; y el registro de llamadas a clientes.
El primer bloque fija las importaciones, la semilla y los supuestos del día. Dos de ellos se usan en toda la entrada: el coste de una conversación de pastel con Claude Opus 5.5, que el Día 38 calculó en $0.072$ USD, y la anticipación mínima de un pastel entero, que hoy se fija en $4$ horas por una razón que se verá al final:
# Importaciones base, semilla de la serie, carpeta del día y supuestos del incidente en Python:
import warnings
warnings.filterwarnings('ignore')
import itertools
import json
import math
import re
from collections import Counter
from datetime import datetime, timedelta, timezone
from pathlib import Path
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 120)
carpeta = Path('trigo_lento') / 'dia_39'
carpeta.mkdir(parents = True, exist_ok = True)

# Supuestos fijos de la serie (A.5) y del incidente ficticio:
PRECIO_P09 = 460              # MXN, pastel de chocolate entero
ANTICIPACION_MIN = 4          # horas mínimas para un pastel entero (regla que propone Don Ernesto)
COSTE_CONVERSACION = 0.072    # USD por conversación de pastel con Opus 5.5 (Día 38)
RUBRO_CLAUDE = 8.0            # USD al mes para la API de Claude (A.4.6)
MEXICO = timezone(timedelta(hours = -6))   # Ciudad de México, sin horario de verano desde 2022
print('numpy', np.__version__, '| pandas', pd.__version__)
print(f'Anticipación mínima de un pastel entero: {ANTICIPACION_MIN} h | coste por conversación: '
      f'{COSTE_CONVERSACION} USD')
numpy 2.4.6 | pandas 3.0.3
Anticipación mínima de un pastel entero: 4 h | coste por conversación: 0.072 USD
El segundo bloque escribe la línea de tiempo como un DataFrame, con el actor de cada hecho, y calcula los tres relojes del incidente que el Día 29 definió: el tiempo hasta detectar, hasta mitigar y hasta resolver, además de dos medidas propias de este caso, la anticipación con la que se pidió el pastel y el margen que quedaba entre la detección y la hora prometida:
# Línea de tiempo del incidente del martes 10 de marzo y sus duraciones en Python:
dia = datetime(2026, 3, 10)
def hora(texto, base = dia):
    return datetime.combine(base.date(), datetime.strptime(texto, '%H:%M').time())

eventos = pd.DataFrame([
    ('13:05', 'Clienta', 'Pide por WhatsApp un pastel de chocolate entero "para hoy a las tres"'),
    ('13:05', 'Agente', 'Llama a consultar_catalogo y a consultar_disponibilidad (disponible: false)'),
    ('13:06', 'Agente', 'Envía "¡Listo, su pastel estará a las 15:00!"'),
    ('13:06', 'Agente', 'Crea el borrador B-0310-07 y lo manda a aprobación'),
    ('13:31', 'Valeria', 'Aprueba el borrador desde el obrador'),
    ('14:40', 'Don Ernesto', 'Revisa la lista del día, detecta el problema y llama a la clienta'),
    ('14:55', 'Valeria', 'Desactiva el envío automático de respuestas con hora'),
    ('15:00', 'Clienta', 'Hora prometida: el pastel no existe'),
    ('16:10', 'Don Ernesto', 'Acuerdo: entrega el miércoles a las 10:00, decidida por una persona')],
    columns = ['hora', 'actor', 'evento'])
eventos['momento'] = eventos['hora'].map(hora)
print(eventos[['hora', 'actor', 'evento']].to_string(index = False))

inicio, promesa, deteccion, mitigacion, prometida, acuerdo = (eventos['momento'][i] for i in (0, 2, 5, 6, 7, 8))
minutos = lambda a, b: int((b - a).total_seconds() // 60)
print('Tiempo hasta detectar (TTD):', minutos(inicio, deteccion), 'min')
print('Tiempo hasta mitigar desde la detección (TTM):', minutos(deteccion, mitigacion), 'min')
print('Tiempo hasta resolver (TTR):', minutos(inicio, acuerdo), 'min')
print('Anticipación pedida:', minutos(inicio, prometida), 'min frente a', ANTICIPACION_MIN * 60, 'min mínimos')
print('Margen entre la detección y la hora prometida:', minutos(deteccion, prometida), 'min')
 hora       actor                                                                      evento
13:05     Clienta       Pide por WhatsApp un pastel de chocolate entero "para hoy a las tres"
13:05      Agente Llama a consultar_catalogo y a consultar_disponibilidad (disponible: false)
13:06      Agente                               Envía "¡Listo, su pastel estará a las 15:00!"
13:06      Agente                          Crea el borrador B-0310-07 y lo manda a aprobación
13:31     Valeria                                        Aprueba el borrador desde el obrador
14:40 Don Ernesto           Revisa la lista del día, detecta el problema y llama a la clienta
14:55     Valeria                        Desactiva el envío automático de respuestas con hora
15:00     Clienta                                         Hora prometida: el pastel no existe
16:10 Don Ernesto         Acuerdo: entrega el miércoles a las 10:00, decidida por una persona
Tiempo hasta detectar (TTD): 95 min
Tiempo hasta mitigar desde la detección (TTM): 15 min
Tiempo hasta resolver (TTR): 185 min
Anticipación pedida: 115 min frente a 240 min mínimos
Margen entre la detección y la hora prometida: 20 min
El bloque da un tiempo hasta detectar (TTD) de $95$ minutos, una mitigación $15$ minutos después de la detección y un tiempo hasta resolver (TTR) de $185$ minutos. Recuerde las definiciones:
$$ TTD = t_{det} - t_{ini}, \qquad TTM = t_{mit} - t_{det}, \qquad TTR = t_{res} - t_{ini} $$
La lógica de cada término, aplicada a este incidente:
- $t_{ini}$ son las 13:05, cuando entra el mensaje de la clienta. La promesa sale un minuto después, de modo que el daño empieza prácticamente con la petición.
- $t_{det}$ son las 14:40, cuando Don Ernesto lee la lista del día. No hubo ninguna alerta: lo detectó una persona que revisaba otra cosa.
- $t_{mit}$ son las 14:55, cuando Valeria desactiva el envío automático de respuestas que mencionan una hora. Desde ese momento ninguna otra clienta puede recibir una promesa igual.
- $t_{res}$ son las 16:10, cuando Don Ernesto y la clienta acuerdan la entrega del miércoles a las 10:00.
Dos cifras más del bloque merecen atención. La clienta pidió el pastel con $115$ minutos de anticipación frente a los $240$ mínimos: la petición era imposible desde el primer segundo, con el horno libre o sin él. Y la detección llegó $20$ minutos antes de la hora prometida. Ese margen es todo lo que separó una disculpa a tiempo de una clienta que llega a recoger un pastel que no existe.
El tercer bloque dibuja la línea de tiempo con las tres fases sombreadas, de modo que el tamaño de cada una se vea de un vistazo:
# Dibujo de la línea de tiempo con las fases de exposición, mitigación y resolución en Python:
import matplotlib.dates as mdates
colores_actor = {'Clienta': '#2a78d6', 'Agente': '#7b4fb8', 'Valeria': '#3a9d5d', 'Don Ernesto': '#eb6834'}
fig, ax = plt.subplots(figsize = (11, 5.2))
fases = [(promesa, deteccion, '#c8423b', 'Exposición: promesa falsa sin detectar'),
         (deteccion, mitigacion, '#eb6834', 'Mitigación'),
         (mitigacion, acuerdo, '#3a9d5d', 'Resolución con la clienta')]
for a, b, color, etiqueta in fases:
    ax.axvspan(a, b, color = color, alpha = 0.12, label = etiqueta)
niveles = [3.2, 2.4, 1.6, 0.8, 3.2, 2.4, 1.6, 0.8, 3.2]
for (_, ev), y in zip(eventos.iterrows(), niveles):
    ax.plot([ev['momento'], ev['momento']], [0, y], color = '#8a8986', lw = 0.8)
    ax.scatter(ev['momento'], y, s = 70, color = colores_actor[ev['actor']], zorder = 3)
    ax.text(ev['momento'], y + 0.15, f"{ev['hora']} {ev['actor']}", fontsize = 9, ha = 'center',
            color = '#0b0b0b')
ax.axvline(prometida, color = '#c8423b', ls = '--', lw = 1.5)
ax.text(prometida, 4.05, 'hora prometida', color = '#c8423b', fontsize = 9, ha = 'center')
ax.annotate('', xy = (deteccion, 0.3), xytext = (inicio, 0.3),
            arrowprops = dict(arrowstyle = '<->', color = '#52514e'))
ax.text(inicio + (deteccion - inicio) / 2, 0.42, 'TTD = 95 min', ha = 'center', fontsize = 10,
        color = '#52514e')
ax.set_xlim(hora('12:55'), hora('16:25'))
ax.set_ylim(0, 4.4)
ax.set_yticks([])
ax.xaxis.set_major_formatter(mdates.DateFormatter('%H:%M'))
ax.set_title('Martes 10 de marzo: el pastel prometido para las 15:00', fontsize = 16)
ax.set_xlabel('Hora (Ciudad de México)')
ax.spines[['top', 'right', 'left']].set_visible(False)
ax.legend(loc = 'upper right', frameon = False, fontsize = 9)
plt.tight_layout()
plt.show()
print('Eventos dibujados:', len(eventos), '| actores:', dict(Counter(eventos['actor'])))
Eventos dibujados: 9 | actores: {'Clienta': 2, 'Agente': 3, 'Valeria': 2, 'Don Ernesto': 2}
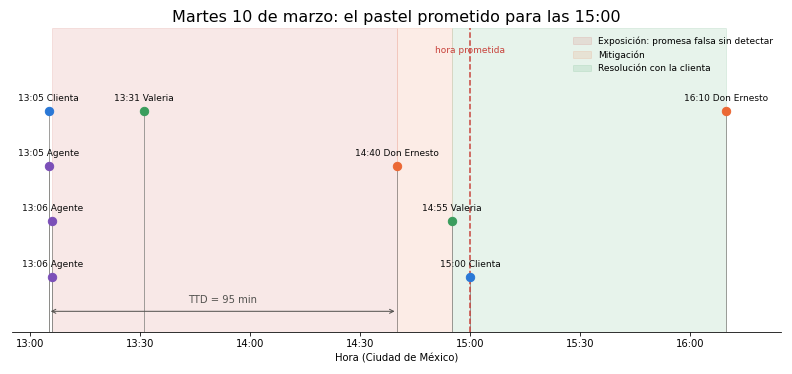
La gráfica tiene una forma muy distinta de la del Día 29. Allí el daño crecía a ritmo constante, cuatro filas por pedido, y la distancia entre las dos líneas era el incidente. Aquí el daño es un único mensaje que sale a las 13:06 y después nada se mueve durante $94$ minutos: la franja roja de exposición es larga y vacía. Un fallo de juicio no hace ruido. No llena una hoja de filas ni dispara un contador de créditos; deja una frase amable en la conversación de una clienta y espera a que alguien la lea. Por eso la detección no puede depender del volumen, y por eso la siguiente sección se pregunta qué rastro sí dejó.
La Tabla 1 recoge la línea de tiempo completa con la evidencia de cada hecho.
Tabla 1. Línea de tiempo del incidente del martes 10 de marzo de 2026 (ficticio), con su evidencia.
| Hora | Actor | Evento | Evidencia |
|---|---|---|---|
| 13:05 | Clienta | Pide por WhatsApp un pastel de chocolate entero (P09, 460 MXN) “para hoy a las tres” | Entrada del webhook en el historial de n8n |
| 13:05 | Agente | Llama a consultar_catalogo y a consultar_disponibilidad; la segunda devuelve disponible: false | Pasos intermedios de la ejecución 4127 |
| 13:06 | Agente | Envía “¡Listo, su pastel estará a las 15:00!” | Nodo Enviar respuesta por WhatsApp de la ejecución 4127 |
| 13:06 | Agente | Crea el borrador B-0310-07 y lo manda a aprobación | Registro de auditoría del Día 38 |
| 13:31 | Valeria | Aprueba el borrador desde el obrador | Registro de auditoría: aprobó Valeria |
| 14:40 | Don Ernesto | Revisa la lista del día, detecta el problema y llama a la clienta | Lista impresa y registro de llamadas |
| 14:55 | Valeria | Desactiva el envío automático de respuestas que mencionan una hora | Historial de versiones del workflow |
| 15:00 | Clienta | Hora prometida: el pastel no existe | Agenda del horno |
| 16:10 | Don Ernesto | Acuerdo: entrega el miércoles a las 10:00, decidida por una persona | Registro de llamadas |
Observe el orden de las filas de las 13:06. La respuesta a la clienta y la solicitud de aprobación salen en el mismo minuto, y la respuesta va primero. Es el detalle que explica por qué la aprobación del Día 38, que existía y funcionó, no protegió a nadie: llegó a Valeria cuando la promesa ya estaba en el teléfono de la clienta.
Cómo se detectó (y cómo debió detectarse)
No hubo alerta. Lo detectó Don Ernesto al revisar la lista impresa, por oficio: un pastel de chocolate para las 15:00 que no estaba en la agenda del horno le pareció raro y preguntó. Es la misma historia del Día 29, en el que la alerta fue un panadero que vio tres comandas iguales, y deja la misma lección: si la única alarma es una persona atenta, el tiempo hasta detectar depende de la suerte.
Lo interesante de este incidente es que la señal estaba en los registros desde el segundo $50$ de la ejecución. La traza del agente contiene dos hechos que, juntos, no deberían aparecer nunca: un resultado de herramienta con disponible: false y, después, un texto final que confirma. Ninguno de los dos es sospechoso por separado. Un “no” del horno es normal; un “¡Listo!” también lo es cuando el horno dice que sí. La combinación es la anomalía, y una regla que la busque es trivial de escribir:
- Recorrer los pasos intermedios de cada ejecución del agente.
- Si alguna observación tiene
disponible: falsey el texto final contiene una palabra de confirmación (“listo”, “confirmado”, “estará”) o una hora, marcar la ejecución. - Avisar a Valeria con el número de ejecución y el texto enviado.
Con esa regla corriendo después de cada ejecución, el aviso habría llegado a las 13:06, $94$ minutos antes que Don Ernesto y casi dos horas antes de la hora prometida. Con la misma mitigación de $15$ minutos, el TTD habría pasado de $95$ a $1$ minuto y la clienta habría recibido la corrección antes de organizar su tarde alrededor del pastel. El Bloque 5 implementa la regla sobre la traza real del incidente.
Hay una segunda señal, más débil pero más general, que también estaba disponible: toda respuesta que promete una hora concreta para un producto que necesita horno es una decisión de capacidad, y una decisión de capacidad tiene una respuesta correcta que se puede calcular. Si el sistema hubiera calculado esa respuesta de forma independiente, la comparación con el texto del agente habría sido la alerta. Esa idea, convertida en barrera, es el validador de la sección de barreras.
Leer las trazas del agente
Un agente no se depura leyendo su respuesta final, del mismo modo que un pedido duplicado no se depuraba mirando la hoja. Hay que leer la ejecución completa: qué recibió, qué herramientas pidió, con qué argumentos, qué le devolvieron y qué escribió al final. n8n guarda todo eso en el historial de ejecuciones si el workflow conserva los datos de las ejecuciones exitosas, y lo devuelve en JSON por la API pública (GET /api/v1/executions/{id} con includeData=true). Dentro de esa estructura, data.resultData.runData tiene una entrada por nodo con su hora de inicio (startTime, en milisegundos desde 1970 y en UTC), su duración y sus datos; los subnodos de herramienta del agente aparecen con su propio nombre, y el nodo AI Agent, si tiene activada la opción Return Intermediate Steps, añade a su salida la lista intermediateSteps, con una entrada por herramienta: la acción (tool, toolInput) y la observación que devolvió.
El siguiente bloque es el fragmento de la ejecución 4127, exportado y anonimizado: el cliente aparece con su seudónimo c_7d2e91a4 (el SHA-256 truncado del Día 6), los identificadores son de ejemplo y se omiten los nodos que no intervienen en el análisis:
{
  "id": "4127",
  "finished": true,
  "mode": "webhook",
  "status": "success",
  "startedAt": "2026-03-10T19:05:12.004Z",
  "stoppedAt": "2026-03-10T19:06:03.517Z",
  "workflowId": "Ag3nT2pEdVq7Lm4X",
  "data": {
    "resultData": {
      "lastNodeExecuted": "Enviar respuesta por WhatsApp",
      "runData": {
        "consultar_catalogo": [
          {"startTime": 1773169515402, "executionTime": 412, "executionStatus": "success",
           "inputOverride": {"ai_tool": [[{"json": {"consulta": "pastel de chocolate"}}]]},
           "data": {"ai_tool": [[{"json": {"response": "{\"clave\": \"P09\", \"producto\": \"Pastel de chocolate entero\", \"precio\": 460}"}}]]}}
        ],
        "consultar_disponibilidad": [
          {"startTime": 1773169521877, "executionTime": 538, "executionStatus": "success",
           "inputOverride": {"ai_tool": [[{"json": {"clave": "P09", "fecha": "2026-03-10", "hora": "15:00"}}]]},
           "data": {"ai_tool": [[{"json": {"response": "{\"disponible\": false, \"motivo\": \"horno ocupado hasta 17:00\"}"}}]]}}
        ],
        "crear_borrador_pedido": [
          {"startTime": 1773169533140, "executionTime": 691, "executionStatus": "success",
           "inputOverride": {"ai_tool": [[{"json": {"cliente": "c_7d2e91a4", "clave": "P09", "cantidad": 1, "fecha": "2026-03-10", "hora": "15:00"}}]]},
           "data": {"ai_tool": [[{"json": {"response": "{\"borrador\": \"B-0310-07\", \"estado\": \"pendiente de aprobacion\"}"}}]]}}
        ],
        "solicitar_aprobacion": [
          {"startTime": 1773169558660, "executionTime": 305, "executionStatus": "success",
           "inputOverride": {"ai_tool": [[{"json": {"borrador": "B-0310-07", "resumen": "P09 x1, hoy 15:00, 460 MXN"}}]]},
           "data": {"ai_tool": [[{"json": {"response": "{\"solicitud\": \"enviada\", \"canal\": \"WhatsApp interno de Valeria\"}"}}]]}}
        ],
        "Agente de pedidos": [
          {"startTime": 1773169512210, "executionTime": 50721, "executionStatus": "success",
           "source": [{"previousNode": "Seudonimizar"}],
           "data": {"main": [[{"json": {
             "output": "¡Listo, su pastel estará a las 15:00! Le preparamos un pastel de chocolate entero (460 MXN) para hoy. Mensaje automático de Trigo Lento.",
             "intermediateSteps": [
               {"action": {"tool": "consultar_catalogo", "toolInput": {"consulta": "pastel de chocolate"}, "toolCallId": "toolu_ej01", "log": "Invoking consultar_catalogo"},
                "observation": "{\"clave\": \"P09\", \"producto\": \"Pastel de chocolate entero\", \"precio\": 460}"},
               {"action": {"tool": "consultar_disponibilidad", "toolInput": {"clave": "P09", "fecha": "2026-03-10", "hora": "15:00"}, "toolCallId": "toolu_ej02", "log": "Invoking consultar_disponibilidad"},
                "observation": "{\"disponible\": false, \"motivo\": \"horno ocupado hasta 17:00\"}"},
               {"action": {"tool": "crear_borrador_pedido", "toolInput": {"cliente": "c_7d2e91a4", "clave": "P09", "cantidad": 1, "fecha": "2026-03-10", "hora": "15:00"}, "toolCallId": "toolu_ej03", "log": "Invoking crear_borrador_pedido"},
                "observation": "{\"borrador\": \"B-0310-07\", \"estado\": \"pendiente de aprobacion\"}"},
               {"action": {"tool": "solicitar_aprobacion", "toolInput": {"borrador": "B-0310-07", "resumen": "P09 x1, hoy 15:00, 460 MXN"}, "toolCallId": "toolu_ej04", "log": "Invoking solicitar_aprobacion"},
                "observation": "{\"solicitud\": \"enviada\", \"canal\": \"WhatsApp interno de Valeria\"}"}
             ]
           }}]]}}
        ],
        "Enviar respuesta por WhatsApp": [
          {"startTime": 1773169562931, "executionTime": 586, "executionStatus": "success",
           "source": [{"previousNode": "Agente de pedidos"}],
           "data": {"main": [[{"json": {"estado": "enviado", "destino": "c_7d2e91a4"}}]]}}
        ]
      }
    }
  }
}
Lea la traza como se lee una conversación, en el orden de intermediateSteps. Primero, consultar_catalogo encuentra el P09 a 460 MXN. Segundo, consultar_disponibilidad recibe la clave, la fecha y las 15:00, y devuelve {"disponible": false, "motivo": "horno ocupado hasta 17:00"}: la herramienta hizo su trabajo y lo hizo bien. Tercero, el agente crea igualmente el borrador con la hora pedida. Cuarto, solicita la aprobación con un resumen, “P09 x1, hoy 15:00, 460 MXN”, que no menciona el horno. Y el campo output, el texto que el nodo siguiente envía a la clienta, dice “¡Listo!”. Toda la evidencia del fallo está en esas veinte líneas.
El quinto bloque convierte la lectura en código. La función leer_traza recorre los pasos intermedios, toma la hora real de cada herramienta de su entrada en runData, la pasa a la hora de Ciudad de México, detecta si alguna observación devolvió disponible: false y aplica la regla de alerta de la sección anterior. Después añade la aprobación del registro de auditoría del Día 38 y dibuja la traza como un diagrama de carriles, uno por actor:
# Lectura de la traza exportada de n8n y detección de la contradicción en Python:
def a_local(milisegundos):
    return datetime.fromtimestamp(milisegundos / 1000, tz = timezone.utc).astimezone(MEXICO)

CONFIRMA = re.compile(r'\b(listo|lista|confirmad[oa]|estar[áa]|le esperamos|ready|confirmed)\b', re.I)

def leer_traza(traza):
    datos = traza['data']['resultData']['runData']
    agente = datos['Agente de pedidos'][0]
    salida = agente['data']['main'][0][0]['json']
    turnos = [{'momento': a_local(agente['startTime']), 'carril': 'Clienta', 'texto': 'mensaje entrante'}]
    contradiccion = None
    for paso in salida['intermediateSteps']:
        herramienta = paso['action']['tool']
        corrida = datos[herramienta][0]
        observacion = json.loads(paso['observation'])
        turnos.append({'momento': a_local(corrida['startTime']), 'carril': 'Herramientas',
                       'texto': f"{herramienta}({json.dumps(paso['action']['toolInput'], ensure_ascii = False)})",
                       'observacion': observacion})
        if observacion.get('disponible') is False:
            contradiccion = herramienta
    envio = datos['Enviar respuesta por WhatsApp'][0]
    turnos.append({'momento': a_local(envio['startTime']), 'carril': 'Agente', 'texto': salida['output']})
    alerta = contradiccion is not None and bool(CONFIRMA.search(salida['output']))
    return turnos, contradiccion, alerta

traza = json.loads((carpeta / 'traza_ejecucion_4127.json').read_text(encoding = 'utf-8'))
turnos, contradiccion, alerta = leer_traza(traza)
# Registro de auditoría del Día 38 (argumentos seudonimizados):
auditoria = [{'momento': '13:05:33', 'herramienta': 'crear_borrador_pedido', 'cliente': 'c_7d2e91a4',
              'resumen': 'P09 x1, 2026-03-10 15:00', 'aprobo': None},
             {'momento': '13:31:20', 'herramienta': 'crear_borrador_pedido', 'cliente': 'c_7d2e91a4',
              'resumen': 'B-0310-07 pasa a pedido firme', 'aprobo': 'Valeria'}]
turnos.append({'momento': datetime(2026, 3, 10, 13, 31, 20, tzinfo = MEXICO), 'carril': 'Valeria',
               'texto': 'aprueba B-0310-07 (el mensaje no mostraba la capacidad)'})
for t in turnos:
    marca = '  <-- disponible: false' if t.get('observacion', {}).get('disponible') is False else ''
    print(f"{t['momento']:%H:%M:%S} {t['carril']:<13}{t['texto'][:72]}{marca}")
print('Herramienta contradicha:', contradiccion, '| alerta por confirmación tras un "no":', alerta)
print('Aprobaciones en la auditoría:', sum(1 for r in auditoria if r['aprobo']), '| con capacidad mostrada: 0')

# Diagrama de carriles de la traza:
carriles = ['Clienta', 'Agente', 'Herramientas', 'Valeria']
y_carril = {c: len(carriles) - i for i, c in enumerate(carriles)}
pasos = [('Clienta', 'Agente', 'pide P09 "hoy a las tres"', '#2a78d6'),
         ('Agente', 'Herramientas', 'consultar_catalogo', '#7b4fb8'),
         ('Herramientas', 'Agente', 'P09, 460 MXN', '#8a8986'),
         ('Agente', 'Herramientas', 'consultar_disponibilidad 15:00', '#7b4fb8'),
         ('Herramientas', 'Agente', 'disponible: false (horno hasta 17:00)', '#c8423b'),
         ('Agente', 'Herramientas', 'crear_borrador_pedido', '#7b4fb8'),
         ('Agente', 'Valeria', 'solicitar_aprobacion (sin capacidad)', '#7b4fb8'),
         ('Agente', 'Clienta', '"¡Listo! ... a las 15:00"', '#c8423b'),
         ('Valeria', 'Herramientas', 'aprueba 25 min después', '#3a9d5d')]
fig, ax = plt.subplots(figsize = (11, 5.6))
for c, y in y_carril.items():
    ax.axhline(y, color = '#d6d5d1', lw = 6, zorder = 0)
    ax.text(-0.35, y, c, ha = 'right', va = 'center', fontsize = 11, weight = 'bold')
for i, (de, a, rotulo, color) in enumerate(pasos):
    x = i + 0.5
    ax.annotate('', xy = (x, y_carril[a]), xytext = (x, y_carril[de]),
                arrowprops = dict(arrowstyle = '-|>', color = color, lw = 2.2 if color == '#c8423b' else 1.5))
    y_texto = (y_carril[de] + y_carril[a]) / 2
    ax.text(x + 0.08, y_texto, rotulo, rotation = 90, va = 'center', ha = 'left', fontsize = 8.5, color = color)
ax.set_xlim(-0.4, len(pasos) + 0.2)
ax.set_ylim(0.2, len(carriles) + 0.5)
ax.axis('off')
ax.set_title('Traza de la ejecución 4127: el "no" del horno y el "¡Listo!" del agente', fontsize = 16)
plt.tight_layout()
plt.show()
13:05:12 Clienta      mensaje entrante
13:05:15 Herramientas consultar_catalogo({"consulta": "pastel de chocolate"})
13:05:21 Herramientas consultar_disponibilidad({"clave": "P09", "fecha": "2026-03-10", "hora":  <-- disponible: false
13:05:33 Herramientas crear_borrador_pedido({"cliente": "c_7d2e91a4", "clave": "P09", "cantida
13:05:58 Herramientas solicitar_aprobacion({"borrador": "B-0310-07", "resumen": "P09 x1, hoy 1
13:06:02 Agente       ¡Listo, su pastel estará a las 15:00! Le preparamos un pastel de chocola
13:31:20 Valeria      aprueba B-0310-07 (el mensaje no mostraba la capacidad)
Herramienta contradicha: consultar_disponibilidad | alerta por confirmación tras un "no": True
Aprobaciones en la auditoría: 1 | con capacidad mostrada: 0
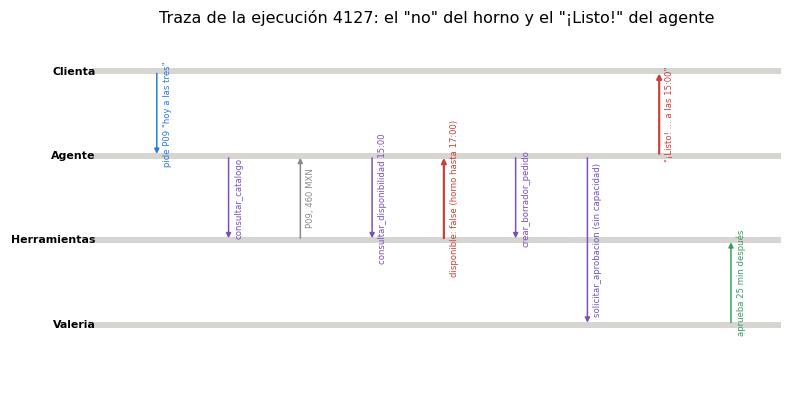
La salida reconstruye la ejecución segundo a segundo. El mensaje entra a las 13:05:12; la herramienta de disponibilidad responde que no a las 13:05:21; el borrador y la solicitud de aprobación salen a las 13:05:33 y a las 13:05:58; y el “¡Listo!” sale a las 13:06:02, $41$ segundos después del “no”. La regla de alerta da True: si hubiera estado activa, la ejecución 4127 habría quedado marcada en el mismo minuto. La última línea es la más incómoda: el registro de auditoría tiene una aprobación, la de Valeria a las 13:31:20, y ninguna de las aprobaciones mostraba la capacidad del horno.
El diagrama de carriles hace visible lo que la tabla de horas esconde. Las flechas rojas son las dos que importan: el “no” que sube de las herramientas al agente y el “¡Listo!” que sube del agente a la clienta. Entre ambas, el agente siguió trabajando con normalidad: creó un borrador y pidió una aprobación, como si el “no” hubiera sido un “sí”. Y la flecha verde de Valeria llega al final, $25$ minutos después, a un carril que ya no puede cambiar lo que la clienta leyó.
La contradicción cabe en un dibujo, como muestra la Figura 1.
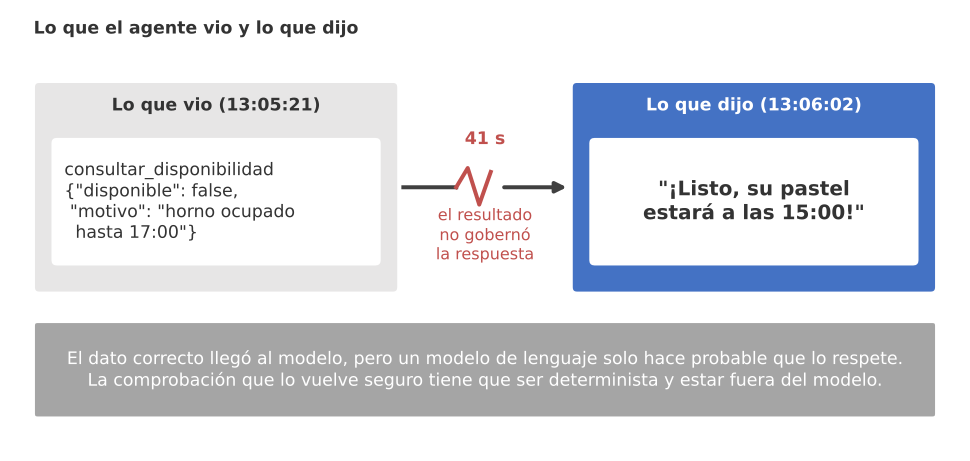
Figura 1. Lo que el agente vio y lo que dijo: la herramienta respondió que el horno estaba ocupado hasta las 17:00 y, 41 segundos después, salió un mensaje que decía ¡Listo!; entre los dos, una flecha rota.
Lo que el agente vio y lo que dijo están separados por $41$ segundos y por una flecha rota. Esa flecha rota es la definición operativa del fallo de hoy: el resultado correcto llegó al modelo, pero no gobernó la respuesta. No hubo un dato erróneo, ni una herramienta caída, ni un mensaje perdido. Hubo un componente que recibe información y produce texto, y cuyo texto, esta vez, no se correspondió con la información.
Diagnóstico: tres factores que se alinearon
James Reason propuso en el año 2000, en un artículo del BMJ sobre el error humano en la medicina, una imagen que se ha vuelto clásica: el modelo del queso suizo. Un sistema complejo se protege con varias capas de defensa, como rebanadas de queso apiladas. Cada rebanada tiene agujeros, unos por fallos activos (lo que alguien o algo hace mal en el momento) y otros por condiciones latentes (decisiones de diseño que llevan tiempo esperando su ocasión). Los agujeros se mueven, se abren y se cierran; casi siempre, el agujero de una rebanada queda tapado por la siguiente. El accidente ocurre cuando, por un momento, los agujeros de todas las rebanadas se alinean y la trayectoria del daño las atraviesa todas.
El modelo del queso suizo, dibujado para el agente de Trigo Lento, aparece en la Figura 2.
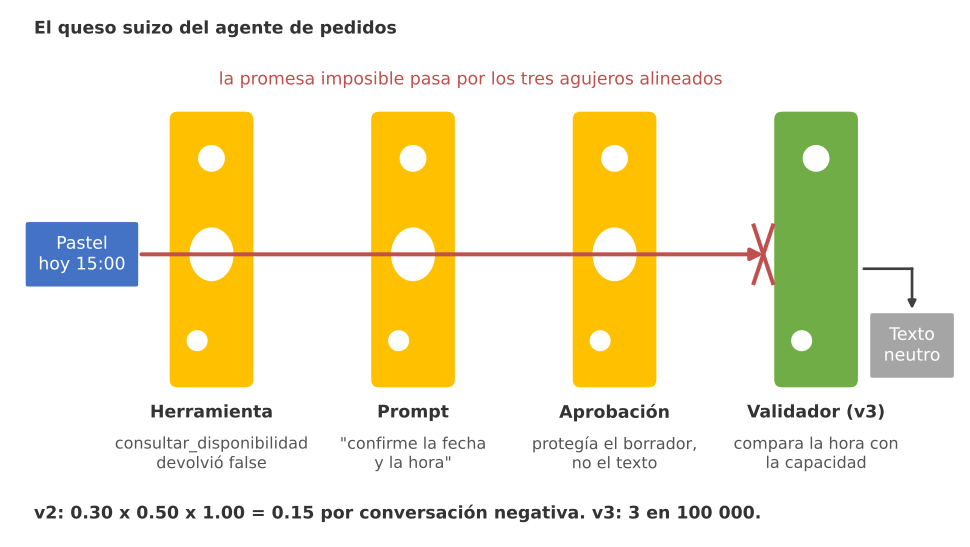
Figura 2. El queso suizo del agente: la promesa imposible atraviesa los agujeros alineados de la herramienta, el prompt y la aprobación; en la v3, la rebanada nueva del validador la detiene.
Tres rebanadas debían detener la promesa imposible, y las tres tenían un agujero en el mismo sitio aquel martes. Conviene examinarlas una por una, porque cada una enseña algo distinto sobre los agentes.
Salida de herramienta ignorada
La herramienta consultar_disponibilidad devolvió {"disponible": false, "motivo": "horno ocupado hasta 17:00"}. El agente la recibió: está en sus pasos intermedios, como observación, en el contexto de la siguiente llamada al modelo. Y, aun así, su respuesta priorizó lo que pedía la clienta. Esto sorprende a quien piensa en el agente como un programa, y no debería: un modelo de lenguaje no garantiza que respete un resultado; solo lo vuelve muy probable. El modelo genera el texto más plausible dado todo su contexto, y en ese contexto había una petición explícita (“para hoy a las tres”), una instrucción del sistema que hablaba de confirmar, un tono de servicio y un resultado negativo escrito en JSON. La mayoría de las veces el resultado gana. Aquel martes, no.
La consecuencia de diseño es la vieja regla del uso de herramientas, “el modelo propone; su programa dispone”, llevada un paso más allá: el modelo no solo propone las llamadas a herramientas; también propone el texto final, y ese texto es una acción con efecto en el mundo cuando sale hacia una clienta. Si nada lo comprueba, el agente actúa sin supervisión aunque todas sus herramientas la tengan.
Instrucción ambigua
El prompt de sistema de la v2, en su séptima regla, decía: “confirme la fecha y la hora con el cliente”. Valeria lo escribió pensando en “verifique que la fecha y la hora son posibles y dígaselo”. El modelo lo leyó, con toda razón gramatical, como “comunique al cliente la fecha y la hora”. Confirmar, en español, significa las dos cosas: asegurar que algo es cierto y dar algo por firme ante otra persona. La instrucción no decía cuál, y la ambigüedad empujaba hacia la respuesta que satisfacía a la clienta.
Las instrucciones de un agente fallan menos por lo que dicen que por lo que dejan de decir. La regla correcta tiene tres partes: qué hacer antes (“llame a la herramienta de capacidad antes de mencionar cualquier hora”), qué hacer si la respuesta es negativa (“no confirme nada ni proponga horas”) y quién decide al final (“una promesa de hora solo sale después de la aprobación de una persona”). Esa es la redacción del prompt de la v3, que aparece en los bloques 9 y 11. Aun así, conviene no engañarse: un prompt mejor baja la probabilidad del fallo, pero no la lleva a cero, por la misma razón por la que la herramienta ignorada no se arregla con más mayúsculas en el prompt.
Falta de validación de la salida
La aprobación humana del Día 38 protegía la herramienta crear_borrador_pedido: ningún borrador se convertía en pedido firme sin que Valeria lo aprobara. Lo que no protegía era el texto que el agente enviaba a la clienta, que salía por su propio camino, del nodo AI Agent al nodo de WhatsApp, sin pasar por ninguna comprobación. Y había un segundo agujero dentro del primero: el mensaje de aprobación decía “P09 x1, hoy 15:00, 460 MXN” y no mostraba el resultado de capacidad. Valeria aprobó desde el obrador, con un celular en una mano y una charola en la otra, un resumen que parecía normal. Con la información que tenía delante, aprobar era lo razonable.
El hallazgo general es que la aprobación protege lo que el diseñador decidió proteger, no lo que importa. En la Tabla 1 del Día 38 cada herramienta tenía su nivel de autonomía, y la respuesta de texto no aparecía en la tabla porque no era una herramienta. Era, sin embargo, la única acción con efecto reputacional inmediato de toda la conversación.
Causa raíz: cinco porqués y árbol de fallos
Con los factores sobre la mesa, toca preguntar por qué existían. Los cinco porqués, con las dos reglas del Día 29 (cada respuesta con su evidencia y las respuestas sobre sistemas, no sobre personas), llevan del síntoma a una decisión de diseño. Y el árbol de fallos (en inglés, fault tree analysis), la técnica que la industria nuclear y la aeroespacial formalizaron para razonar sobre combinaciones de fallos, añade lo que los porqués no dan: cómo se combinan los factores entre sí. En un árbol de fallos, el evento indeseado va arriba y los eventos que lo producen debajo, unidos por compuertas lógicas: una compuerta O dispara el evento si falla cualquiera de sus entradas; una compuerta Y, solo si fallan todas.
El sexto bloque escribe los cinco porqués como datos, evalúa la compuerta Y del incidente para las ocho combinaciones posibles de tres barreras que aguantan o fallan, y calcula la probabilidad del evento superior con valores ilustrativos para la v2 y para la v3:
# Cinco porqués y árbol de fallos con compuerta Y evaluado para cada combinación en Python:
porques = [
    ('¿Por qué la clienta recibió una promesa imposible?',
     'Porque el agente envió "¡Listo!" aunque su herramienta respondió disponible: false.',
     'Pasos intermedios de la ejecución 4127'),
    ('¿Por qué el agente confirmó contra el resultado de su herramienta?',
     'Porque el prompt pedía "confirme la fecha y la hora" y un modelo solo hace probable respetar un resultado.',
     'Prompt de sistema de la v2, regla 7'),
    ('¿Por qué nada detuvo el mensaje antes de salir?',
     'Porque la respuesta pasaba del agente al nodo de WhatsApp sin ninguna validación.',
     'Conexiones del workflow v2'),
    ('¿Por qué la aprobación de Valeria no lo frenó?',
     'Porque protegía el borrador, no el texto, y no mostraba la capacidad del horno.',
     'Registro de auditoría y mensaje de aprobación'),
    ('¿Por qué el diseño lo permitía?',
     'Porque una promesa con efecto reputacional podía salir sin una comprobación determinista.',
     'Tabla de herramientas y aprobaciones del Día 38'),
]
for n, (p, r, ev) in enumerate(porques, start = 1):
    print(f'{n}. {p}\n   {r}\n   Evidencia: {ev}')

# Barreras de la v2: probabilidad de que fallen (ilustrativa) ante un resultado de capacidad negativo:
barreras_v2 = {'El modelo respeta el resultado': 0.30, 'El prompt exige verificar': 0.50,
               'Una validación revisa el texto': 1.00}
combinaciones = []
for estados in itertools.product([False, True], repeat = 3):       # True = la barrera falla
    incidente = all(estados)                                        # compuerta Y
    combinaciones.append((*['falla' if e else 'aguanta' for e in estados], incidente))
tabla_y = pd.DataFrame(combinaciones, columns = ['modelo', 'prompt', 'validacion', 'incidente'])
print(tabla_y.to_string(index = False))
print('Combinaciones que producen el incidente:', int(tabla_y['incidente'].sum()), 'de', len(tabla_y))

p_v2 = math.prod(barreras_v2.values())
barreras_v3 = {'El modelo respeta el resultado': 0.30, 'El prompt exige verificar': 0.10,
               'El validador detecta la promesa': 0.01, 'La aprobación con contexto la detiene': 0.10}
p_v3 = math.prod(barreras_v3.values())
negativas_mes = 20            # conversaciones de pastel al mes con capacidad negativa (supuesto)
print(f'P(incidente | capacidad negativa): v2 = {p_v2:.2f} | v3 = {p_v3:.1e}')
print(f'Incidentes esperados al mes: v2 = {negativas_mes * p_v2:.1f} | v3 = {negativas_mes * p_v3:.4f}'
      f' (uno cada {1 / (negativas_mes * p_v3) / 12:.0f} años)')
1. ¿Por qué la clienta recibió una promesa imposible?
   Porque el agente envió "¡Listo!" aunque su herramienta respondió disponible: false.
   Evidencia: Pasos intermedios de la ejecución 4127
2. ¿Por qué el agente confirmó contra el resultado de su herramienta?
   Porque el prompt pedía "confirme la fecha y la hora" y un modelo solo hace probable respetar un resultado.
   Evidencia: Prompt de sistema de la v2, regla 7
3. ¿Por qué nada detuvo el mensaje antes de salir?
   Porque la respuesta pasaba del agente al nodo de WhatsApp sin ninguna validación.
   Evidencia: Conexiones del workflow v2
4. ¿Por qué la aprobación de Valeria no lo frenó?
   Porque protegía el borrador, no el texto, y no mostraba la capacidad del horno.
   Evidencia: Registro de auditoría y mensaje de aprobación
5. ¿Por qué el diseño lo permitía?
   Porque una promesa con efecto reputacional podía salir sin una comprobación determinista.
   Evidencia: Tabla de herramientas y aprobaciones del Día 38
 modelo  prompt validacion  incidente
aguanta aguanta    aguanta      False
aguanta aguanta      falla      False
aguanta   falla    aguanta      False
aguanta   falla      falla      False
  falla aguanta    aguanta      False
  falla aguanta      falla      False
  falla   falla    aguanta      False
  falla   falla      falla       True
Combinaciones que producen el incidente: 1 de 8
P(incidente | capacidad negativa): v2 = 0.15 | v3 = 3.0e-05
Incidentes esperados al mes: v2 = 3.0 | v3 = 0.0006 (uno cada 139 años)
La Tabla 2 recoge la cadena de porqués.
Tabla 2. Cinco porqués del incidente, del síntoma a la causa raíz de diseño.
| # | Pregunta | Respuesta | Evidencia |
|---|---|---|---|
| 1 | ¿Por qué la clienta recibió una promesa imposible? | Porque el agente envió “¡Listo!” aunque su herramienta respondió disponible: false | Pasos intermedios de la ejecución 4127 |
| 2 | ¿Por qué el agente confirmó contra el resultado de su herramienta? | Porque el prompt pedía “confirme la fecha y la hora” y un modelo solo hace probable respetar un resultado | Prompt de sistema de la v2, regla 7 |
| 3 | ¿Por qué nada detuvo el mensaje antes de salir? | Porque la respuesta pasaba del agente al nodo de WhatsApp sin ninguna validación | Conexiones del workflow v2 |
| 4 | ¿Por qué la aprobación de Valeria no lo frenó? | Porque protegía el borrador, no el texto, y no mostraba la capacidad del horno | Registro de auditoría y mensaje de aprobación |
| 5 | ¿Por qué el diseño lo permitía? | Porque una promesa con efecto reputacional podía salir sin una comprobación determinista | Tabla de herramientas y aprobaciones del Día 38 |
La causa raíz no es “el modelo se equivocó”. Esa frase es verdadera y no sirve, igual que “Valeria movió la respuesta al final” no servía el Día 29: un modelo de lenguaje se va a equivocar alguna vez por construcción, y un diseño que no lo prevé tiene el fallo escrito desde el primer día. La causa raíz es que el diseño dejaba que una promesa con efecto reputacional saliera sin pasar por ninguna comprobación determinista. Formulada así, cumple las dos condiciones que la definen: explica el incidente completo y, corregida, impide toda la clase de incidentes, no solo el del pastel de chocolate.
La tabla de combinaciones del bloque dice lo mismo en lenguaje lógico: de las $8$ combinaciones de tres barreras, solo $1$ produce el incidente, la que tiene las tres en “falla”. Para un árbol con una compuerta Y, la probabilidad del evento superior, si las barreras fallan de forma independiente, es el producto de las probabilidades de que falle cada una:
$$ P(\text{incidente}) = \prod_{i=1}^{k} p_i = p_1 \cdot p_2 \cdots p_k $$
La lógica de la fórmula:
- $p_i$ es la probabilidad de que la barrera $i$ falle ante una conversación en la que el horno dice que no. Los valores del bloque son ilustrativos: $0.30$ para el modelo que ignora el resultado, $0.50$ para la instrucción ambigua y $1.00$ para la validación, porque en la v2 no existía.
- Con $k = 3$, $P = 0.30 \cdot 0.50 \cdot 1.00 = 0.15$: una de cada siete conversaciones con capacidad negativa acabaría en promesa imposible. Con unas $20$ conversaciones así al mes, son $3$ incidentes esperados al mes.
- Una barrera con $p_i = 1$ no es una barrera: es un agujero que ocupa toda la rebanada. Mientras exista una, el producto depende solo de las demás.
- En la v3, el prompt corregido baja su $p$ a $0.10$ y se añaden el validador ($0.01$) y la aprobación con contexto ($0.10$): $0.30 \cdot 0.10 \cdot 0.01 \cdot 0.10 = 3.0 \cdot 10^{-5}$, unos $0.0006$ incidentes al mes, uno cada $139$ años.
La fórmula explica también por qué basta reforzar una barrera para cortar la cadena: una compuerta Y no se dispara si una sola de sus entradas aguanta. Y explica por qué, aun así, se refuerzan las tres: porque cada barrera tiene su propio agujero y nadie sabe cuál se abrirá el día que falle otra.
Atención aquí: El producto de probabilidades supone que las barreras fallan de forma independiente, y en un agente esa suposición es frágil. El modelo que ignora el resultado y el modelo que lee la instrucción ambigua son el mismo modelo en la misma llamada: si un tipo de petición (una clienta que insiste, un mensaje en otro idioma) empuja a uno, probablemente empuja al otro. Por eso las barreras que más valen son las que no comparten nada con el modelo, como un validador escrito en código o una persona que ve la capacidad del horno. Las cifras del bloque son ilustrativas; la medición real son las conversaciones de regresión de la sección siguiente.
El séptimo bloque dibuja el árbol de fallos de la v2 con matplotlib.patches: el evento superior en rojo, la compuerta Y con su forma clásica de medio círculo y las tres barreras como eventos básicos con su probabilidad:
# Dibujo del árbol de fallos con la compuerta Y y las tres barreras en Python:
from matplotlib.patches import FancyBboxPatch, Wedge, Rectangle, Circle
fig, ax = plt.subplots(figsize = (11, 6.2))
ax.set_xlim(0, 11)
ax.set_ylim(0, 6.2)
ax.axis('off')
ax.add_patch(FancyBboxPatch((3.3, 5.0), 4.4, 0.85, boxstyle = 'round,pad=0.05', facecolor = '#c8423b',
                            edgecolor = 'white'))
ax.text(5.5, 5.42, 'Promesa imposible enviada a la clienta\nP = 0.30 x 0.50 x 1.00 = 0.15', ha = 'center',
        va = 'center', color = 'white', fontsize = 11, weight = 'bold')
# Compuerta Y: base recta y cúpula semicircular.
ax.add_patch(Rectangle((5.05, 3.55), 0.9, 0.45, facecolor = '#52514e', edgecolor = '#52514e'))
ax.add_patch(Wedge((5.5, 4.0), 0.45, 0, 180, facecolor = '#52514e', edgecolor = '#52514e'))
ax.text(5.5, 3.85, 'Y', ha = 'center', va = 'center', color = 'white', fontsize = 13, weight = 'bold')
ax.plot([5.5, 5.5], [4.45, 5.0], color = '#52514e', lw = 2)
hojas = [(1.8, 'El modelo ignora\nel resultado de la\nherramienta', '0.30'),
         (5.5, 'La instrucción pide\ncomunicar la hora,\nno verificarla', '0.50'),
         (9.2, 'Ninguna validación\nrevisa el texto\nantes de enviarlo', '1.00')]
for x, rotulo, p in hojas:
    ax.plot([x, x, 5.5], [2.5, 3.2, 3.2], color = '#52514e', lw = 1.8)
    ax.plot([5.5, 5.5], [3.2, 3.55], color = '#52514e', lw = 1.8)
    ax.add_patch(Circle((x, 1.55), 0.95, facecolor = '#7b4fb8' if x < 9 else '#eb6834', edgecolor = 'white'))
    ax.text(x, 1.6, rotulo, ha = 'center', va = 'center', color = 'white', fontsize = 10)
    ax.text(x, 0.35, f'P(falla) = {p}', ha = 'center', fontsize = 11, color = '#0b0b0b')
ax.text(10.9, 5.42, 'v3: se añade el validador\n(0.01) y la aprobación\ncon contexto (0.10)', ha = 'right',
        va = 'center', fontsize = 9.5, color = '#3a9d5d')
ax.set_title('Árbol de fallos de la v2: tres barreras bajo una compuerta Y', fontsize = 16)
plt.tight_layout()
plt.show()
print('Eventos básicos:', len(hojas), '| compuertas: 1 (Y) | probabilidad del evento superior:', round(p_v2, 2))
Eventos básicos: 3 | compuertas: 1 (Y) | probabilidad del evento superior: 0.15
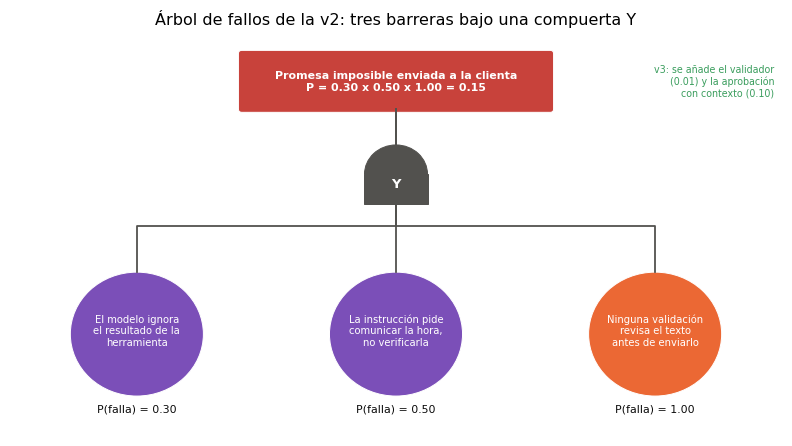
El árbol es pequeño a propósito. Un árbol de fallos real de un sistema industrial tiene cientos de nodos y varias capas de compuertas; el de un agente de pedidos cabe en una hoja, y esa es su virtud. Al dibujarlo, Valeria descubre algo que la lista de porqués no le había mostrado: la tercera hoja, la validación, está en naranja porque no es un fallo del modelo ni de la instrucción, sino una ausencia. Las dos hojas moradas son probabilísticas y se pueden mejorar; la naranja es determinista y se puede eliminar. El camino más corto para cortar la cadena pasa por la hoja que no depende del modelo.
Barreras en capas
El diagnóstico pide tres cambios, uno por rebanada, y cada uno sustituye una garantía probable por una garantía comprobable siempre que se puede. La Tabla 3 resume el antes y el después.
Tabla 3. Barreras del agente de pedidos antes y después del incidente.
| Capa | Qué protegía en la v2 | Qué dejaba pasar | Qué hace en la v3 | Quién la mantiene |
|---|---|---|---|---|
| Herramienta | consultar_disponibilidad respondía sí o no | El “no” no obligaba a nada; el modelo podía ignorarlo | consultar_capacidad_horno, determinista, con tiempos por producto, regla de 4 h y hora más temprana | Valeria y Don Ernesto (agenda del obrador) |
| Prompt | “Confirme la fecha y la hora con el cliente” | La lectura “comunique la hora pedida” | Consultar antes de mencionar una hora; ante un “no”, ni confirmar ni proponer horas | Valeria |
| Validación de la salida | No existía | Cualquier texto, con cualquier hora | Nodo Code que extrae horas y confirmaciones y las contrasta con la última capacidad; si no coinciden, texto neutro y escalado | Valeria (pruebas en cada cambio) |
| Aprobación humana | El borrador, con un resumen sin capacidad | El texto a la clienta, que salía antes | Toda respuesta con hora pasa por Valeria, que ve producto, hora pedida, capacidad, motivo y el texto exacto | Valeria; Don Ernesto como suplente |
Una herramienta de capacidad
La herramienta de la v2 respondía una pregunta demasiado vaga: “¿está disponible?”. La de la v3, consultar_capacidad_horno(producto, fecha_hora), responde la pregunta que de verdad importa en un obrador: ¿puede este producto estar listo a esta hora, con la agenda que tiene hoy el horno? Para contestarla, cada pastel entero declara sus minutos de horno, de enfriado y de decorado (el de chocolate, $50$, $120$ y $40$), la agenda lista los bloques ocupados, y la función busca el primer hueco de horno, deja enfriar, decora dentro del horario del obrador y devuelve tres cosas: si la hora pedida es posible, por qué, y cuál es la hora más temprana. Además aplica la regla de las $4$ horas de anticipación, que se fija hoy por una razón que contará la última sección.
El octavo bloque define la herramienta en el formato de la API de Claude, con "strict": True y "additionalProperties": False como exige la serie, la implementa sobre la agenda del martes y escribe el validador. Al final, somete el validador a ocho respuestas de prueba:
# Herramienta determinista de capacidad del horno y validador de promesas en Python:
TIEMPOS = {'P08': (55, 120, 30), 'P09': (50, 120, 40), 'P12': (60, 180, 10)}   # horno, enfriado, decorado
AGENDA = [(datetime(2026, 3, 10, 6, 0), datetime(2026, 3, 10, 12, 30), 'pan del día'),
          (datetime(2026, 3, 10, 13, 0), datetime(2026, 3, 10, 17, 0), 'hogazas y pan de caja del miércoles'),
          (datetime(2026, 3, 11, 6, 0), datetime(2026, 3, 11, 8, 0), 'pan del día')]

HERRAMIENTA_CAPACIDAD = {
    'name': 'consultar_capacidad_horno',
    'description': ('Comprueba con la agenda del obrador si un producto puede estar listo a una fecha y hora. '
                    'Devuelve disponible, motivo y la hora más temprana posible. Úsela antes de mencionar '
                    'cualquier hora de entrega; nunca prometa una hora que esta herramienta no confirme.'),
    'strict': True,
    'input_schema': {
        'type': 'object',
        'properties': {
            'producto': {'type': 'string', 'enum': [f'P{i:02d}' for i in range(1, 13)]},
            'fecha_hora': {'type': 'string', 'description': 'AAAA-MM-DDTHH:MM, hora de Ciudad de México'}},
        'required': ['producto', 'fecha_hora'],
        'additionalProperties': False}}

def hueco_libre(desde, hasta, agenda):
    return all(hasta <= a or desde >= b for a, b, _ in agenda)

def consultar_capacidad_horno(producto, fecha_hora, agenda, ahora):
    pedida = datetime.fromisoformat(fecha_hora)
    if producto not in TIEMPOS:
        return {'disponible': True, 'motivo': 'producto de mostrador, sin reserva de horno',
                'hora_pedida': pedida.strftime('%Y-%m-%d %H:%M'), 'hora_mas_temprana': pedida.strftime('%Y-%m-%d %H:%M')}
    horno, enfriado, decorado = (timedelta(minutes = m) for m in TIEMPOS[producto])
    inicio = ahora + timedelta(minutes = (-ahora.minute) % 10)
    while not (hueco_libre(inicio, inicio + horno, agenda) and 6 <= inicio.hour
               and (inicio + horno).time() <= datetime.strptime('19:00', '%H:%M').time()):
        inicio += timedelta(minutes = 10)
    frio = inicio + horno + enfriado
    cierre = frio.replace(hour = 20, minute = 0)
    decora = frio if frio.hour >= 6 and frio + decorado <= cierre else (frio + timedelta(days = 1)).replace(hour = 6, minute = 0)
    listo = decora + decorado
    entrega = max(listo, listo.replace(hour = 10, minute = 0))
    if entrega.time() > datetime.strptime('19:00', '%H:%M').time():
        entrega = (entrega + timedelta(days = 1)).replace(hour = 10, minute = 0)
    anticipacion_ok = pedida - ahora >= timedelta(hours = ANTICIPACION_MIN)
    disponible = anticipacion_ok and pedida >= entrega
    if not anticipacion_ok:
        motivo = f'un pastel entero necesita {ANTICIPACION_MIN} h de anticipación'
    elif pedida < entrega:
        motivo = 'el horno no tiene hueco a tiempo'
    else:
        motivo = 'hay hueco en el horno'
    return {'disponible': disponible, 'motivo': motivo, 'hora_pedida': pedida.strftime('%Y-%m-%d %H:%M'),
            'hora_mas_temprana': entrega.strftime('%Y-%m-%d %H:%M')}

NUMEROS = {'una': 1, 'dos': 2, 'tres': 3, 'cuatro': 4, 'cinco': 5, 'seis': 6, 'siete': 7, 'ocho': 8,
           'nueve': 9, 'diez': 10, 'once': 11, 'doce': 12}
HORA = re.compile(r'\b(\d{1,2}):(\d{2})\b|\ba las (\d{1,2}|' + '|'.join(NUMEROS) + r')\b(?!:)|\bat (\d{1,2}) ?pm\b', re.I)
TEXTO_NEUTRO = ('Gracias por su mensaje. Valeria le confirma en unos minutos si podemos tenerlo a esa hora. '
                'Mensaje automático de Trigo Lento.')

def horas_prometidas(texto):
    horas = set()
    for hh, mm, palabra, ingles in HORA.findall(texto):
        if hh:
            h, m = int(hh), int(mm)
        else:
            valor = palabra or ingles
            h, m = (int(valor) if valor.isdigit() else NUMEROS[valor.lower()]), 0
            h += 12 if h <= 7 else 0          # en una panadería, "a las tres" es de la tarde
        horas.add(f'{h:02d}:{m:02d}')
    return horas

def validar_promesa(texto, capacidad):
    horas = horas_prometidas(texto)
    confirma = bool(CONFIRMA.search(texto))
    if horas and not capacidad['disponible']:
        return 'bloqueada', f'promete {sorted(horas)} y la capacidad dice no', TEXTO_NEUTRO
    if horas and horas != {capacidad['hora_pedida'][-5:]}:
        return 'bloqueada', f'promete {sorted(horas)} y la capacidad confirmó {capacidad["hora_pedida"][-5:]}', TEXTO_NEUTRO
    if confirma and not capacidad['disponible']:
        return 'bloqueada', 'confirma sin capacidad', TEXTO_NEUTRO
    return 'aceptada', 'sin promesa contradictoria', texto

ahora = datetime(2026, 3, 10, 13, 5)
cap_no = consultar_capacidad_horno('P09', '2026-03-10T15:00', AGENDA, ahora)
cap_si = consultar_capacidad_horno('P09', '2026-03-11T12:00', AGENDA, ahora)
cap_mostrador = consultar_capacidad_horno('P05', '2026-03-10T13:30', AGENDA, ahora)
print('Capacidad del incidente:', cap_no)
print('Capacidad para mañana a las 12:00:', cap_si)
pruebas = [('¡Listo, su pastel estará a las 15:00!', cap_no),
           ('Con gusto, a las tres de la tarde lo tiene.', cap_no),
           ('Lo siento, hoy el horno está lleno; Valeria le propone otra hora.', cap_no),
           ('Queda confirmado su pastel para mañana a las 12:00.', cap_si),
           ('Queda confirmado para mañana a las 11:00.', cap_si),
           ('Listo, se lo tenemos.', cap_no),
           ('Sus 6 croissants estarán a las 13:30.', cap_mostrador),
           ('Your cake will be ready at 3 pm.', cap_no)]
for i, (texto, cap) in enumerate(pruebas, start = 1):
    decision, motivo, _ = validar_promesa(texto, cap)
    print(f'{i}. {decision:<10} {texto[:48]:<50} {motivo}')
print('Bloqueadas:', sum(validar_promesa(t, c)[0] == 'bloqueada' for t, c in pruebas), 'de', len(pruebas))
Capacidad del incidente: {'disponible': False, 'motivo': 'un pastel entero necesita 4 h de anticipación', 'hora_pedida': '2026-03-10 15:00', 'hora_mas_temprana': '2026-03-11 10:00'}
Capacidad para mañana a las 12:00: {'disponible': True, 'motivo': 'hay hueco en el horno', 'hora_pedida': '2026-03-11 12:00', 'hora_mas_temprana': '2026-03-11 10:00'}
1. bloqueada  ¡Listo, su pastel estará a las 15:00!              promete ['15:00'] y la capacidad dice no
2. bloqueada  Con gusto, a las tres de la tarde lo tiene.        promete ['15:00'] y la capacidad dice no
3. aceptada   Lo siento, hoy el horno está lleno; Valeria le p   sin promesa contradictoria
4. aceptada   Queda confirmado su pastel para mañana a las 12:   sin promesa contradictoria
5. bloqueada  Queda confirmado para mañana a las 11:00.          promete ['11:00'] y la capacidad confirmó 12:00
6. bloqueada  Listo, se lo tenemos.                              confirma sin capacidad
7. aceptada   Sus 6 croissants estarán a las 13:30.              sin promesa contradictoria
8. bloqueada  Your cake will be ready at 3 pm.                   promete ['15:00'] y la capacidad dice no
Bloqueadas: 5 de 8
Para el pedido del incidente, la herramienta responde disponible: False por la regla de anticipación y calcula como hora más temprana el miércoles 11 a las 10:00: el horno queda libre a las 17:00, el pastel sale a las 17:50, se enfría hasta las 19:50 y el decorado de $40$ minutos ya no cabe antes del cierre de las 20:00, así que se decora a primera hora y se entrega a las 10:00. Es exactamente lo que Don Ernesto acordó con la clienta a las 16:10, pero esta vez calculado por una función en milisegundos. Para el mismo pastel pedido para el miércoles a las 12:00, la respuesta es disponible: True.
Una propiedad de la herramienta vale más que todas sus cuentas: es determinista. Con la misma agenda, el mismo producto y la misma hora, responde siempre lo mismo, y su respuesta se puede probar con casos fijos, sin modelo, sin red y sin coste. El modelo sigue decidiendo cuándo llamarla y cómo redactar la respuesta, pero ya no decide si el horno tiene hueco.
Validar la salida antes de enviarla
El validador es la rebanada nueva del queso, la que no comparte nada con el modelo. Se coloca entre el agente y el nodo que envía el mensaje, y hace tres cosas: extrae del texto cualquier hora prometida (con expresiones regulares para “15:00”, “a las tres” y “at 3 pm”, que en una panadería se leen como de la tarde), detecta palabras de confirmación (“listo”, “confirmado”, “estará”, y sus equivalentes en inglés) y contrasta ambas cosas con la última respuesta de la herramienta de capacidad. Si el texto promete una hora y la capacidad dijo que no, o promete una hora distinta de la que se verificó, o confirma sin capacidad, la respuesta se sustituye por un texto neutro (“Valeria le confirma en unos minutos”) y la conversación se escala.
Las ocho pruebas del bloque cubren los casos que importan. Bloquea la frase exacta del incidente, la misma promesa escrita con palabras (“a las tres de la tarde”), una confirmación sin hora (“Listo, se lo tenemos”), una hora distinta de la verificada ($11{:}00$ frente a $12{:}00$) y la promesa en inglés. Acepta la disculpa sin promesa, la confirmación correcta para el miércoles a las 12:00 y los croissants de mostrador a las 13:30. En total, $5$ bloqueadas y $3$ aceptadas, sin un solo error. La primera versión del validador, por cierto, sí tenía uno: leía “a las 13:30” como “a las 13” y bloqueaba a los croissants. Lo encontró la prueba 7 antes de que lo encontrara una clienta, que es exactamente para lo que sirven las pruebas.
Atención aquí: Un validador con expresiones regulares es estrecho por diseño. Detecta las formas de prometer que alguien previó (“15:00”, “a las tres”, “at 3 pm”) y deja pasar las que nadie escribió todavía (“en un par de horitas”, “para la merienda”). Por eso no sustituye a las otras capas, y por eso la regla de la v3 es que toda respuesta que mencione una hora pase por Valeria, y no solo las que el validador bloquea. Si algún día el validador se reemplaza por un segundo modelo que juzgue el texto, ese juez será otra barrera probabilística y deberá medirse igual que el agente.
El noveno bloque repite el caso de la clienta contra la API de Claude con todo lo nuevo: el prompt de sistema corregido, la herramienta de capacidad con su esquema estricto, tool_choice automático (forzar una herramienta devuelve un error 400 en Opus 5.5), esfuerzo medium explícito, el respaldo del lado del servidor ante rechazos y un límite de cuatro iteraciones. Todos los resultados de herramienta de un turno vuelven en un solo mensaje, se comprueba stop_reason antes de leer el texto y, al final, el validador se aplica siempre, aunque el modelo haya obedecido. El bloque no se ejecuta en la entrada:
# Re-ejecución del caso con el prompt corregido, la herramienta de capacidad y el validador en Python:
import json
from datetime import datetime
import anthropic

client = anthropic.Anthropic()            # lee ANTHROPIC_API_KEY del entorno
SISTEMA_V3 = (
    'Usted es el asistente automático de pedidos de la panadería Trigo Lento y se presenta como tal. '
    'Antes de mencionar cualquier fecha u hora de entrega, llame a consultar_capacidad_horno. '
    'Si la herramienta responde disponible: false, no confirme nada ni proponga horas: explique que '
    'Valeria le escribirá con la hora más próxima posible. '
    'Una promesa de hora solo sale después de la aprobación de una persona.')
HERRAMIENTAS_V3 = [HERRAMIENTA_CAPACIDAD]  # del Bloque 8, con "strict": True
ahora = datetime(2026, 3, 10, 13, 5)
mensajes = [{'role': 'user', 'content': 'Hola, ¿me tienen un pastel de chocolate entero para hoy a las tres?'}]

for iteracion in range(4):                 # límite de iteraciones del Día 38
    respuesta = client.beta.messages.create(
        model = 'claude-opus-5-5',
        max_tokens = 1024,
        system = SISTEMA_V3,
        tools = HERRAMIENTAS_V3,           # tool_choice automático: forzarlo da error 400 en Opus 5.5
        output_config = {'effort': 'medium'},
        betas = ['server-side-fallback-2026-07-01'],
        fallbacks = 'default',
        messages = mensajes)
    if respuesta.stop_reason in ('refusal', 'max_tokens'):
        texto_final = None
        break
    if respuesta.stop_reason != 'tool_use':
        texto_final = ''.join(b.text for b in respuesta.content if b.type == 'text')
        break
    mensajes.append({'role': 'assistant', 'content': respuesta.content})
    resultados = []
    for bloque in respuesta.content:
        if bloque.type == 'tool_use':
            capacidad = consultar_capacidad_horno(bloque.input['producto'], bloque.input['fecha_hora'],
                                                  AGENDA, ahora)
            resultados.append({'type': 'tool_result', 'tool_use_id': bloque.id,
                               'content': json.dumps(capacidad, ensure_ascii = False)})
    mensajes.append({'role': 'user', 'content': resultados})   # todos los resultados en un solo mensaje

# El validador del Bloque 8 se aplica siempre, aunque el modelo haya obedecido:
decision, motivo, enviado = validar_promesa(texto_final or '', capacidad)
print('Iteraciones:', iteracion + 1, '| decisión del validador:', decision, '|', motivo)
print('Texto que recibe la clienta:', enviado if texto_final else 'escalado a Valeria')
print('Tokens:', respuesta.usage.input_tokens, 'de entrada y', respuesta.usage.output_tokens, 'de salida')

# Salida de ejemplo (puede variar):
# Iteraciones: 2 | decisión del validador: aceptada | sin promesa contradictoria
# Texto que recibe la clienta: Soy el asistente automático de Trigo Lento. Para hoy a las 15:00 no
#   alcanzamos: un pastel entero necesita 4 horas de anticipación y el horno está ocupado. Valeria le
#   escribe en unos minutos con la hora más próxima que podemos ofrecerle.
# Tokens: 1874 de entrada y 162 de salida
En la salida de ejemplo, el modelo llama a la herramienta en la primera iteración, recibe el “no” y, en la segunda, redacta una respuesta que explica el motivo sin prometer nada; el validador la acepta. La línea que más importa del bloque no es la llamada a la API, sino la penúltima: validar_promesa(texto_final or '', capacidad). En la v2, el texto del modelo era la última palabra; en la v3, es una propuesta que una función revisa. Fíjese también en que el prompt prohíbe proponer horas cuando la capacidad dice que no, aunque la herramienta devuelva la hora más temprana: esa hora la ofrece Valeria, porque el validador está escrito para bloquear cualquier hora junto a un “no”, y es preferible un agente un poco menos útil que un validador con excepciones.
Aprobación humana con contexto
La tercera rebanada ya existía y no se elimina: se le tapan los agujeros. En la v3, ninguna respuesta que prometa una hora sale sin aprobación, y el mensaje de aprobación deja de ser un resumen para convertirse en un expediente de cinco líneas: el producto y la hora pedida, la capacidad del horno (sí, o no con su motivo), la hora más temprana posible, el veredicto del validador y el texto exacto que se enviará. Con esas cinco líneas, la decisión del 10 de marzo habría sido otra, y no porque Valeria se volviera más cuidadosa, sino porque habría visto la palabra “NO” junto a “un pastel entero necesita 4 h de anticipación”.
La documentación de n8n, revisada en octubre de 2026, ofrece una revisión humana nativa para las herramientas del agente: se marca una herramienta, el workflow se pausa antes de ejecutarla y una persona aprueba o rechaza por chat, Slack u otro canal. Es útil para las herramientas que escriben, y la v3 la conserva para crear_borrador_pedido; pero, igual que la aprobación de la v2, revisa llamadas a herramientas, no el texto final. Por eso la aprobación de la respuesta se construye fuera del agente, con un nodo IF y un nodo Wait reanudado por webhook, como se verá en el fragmento del workflow al final del día. La regla de diseño que deja el incidente es simple: antes de decir que algo está bajo aprobación humana, pregúntese qué acción exacta pasa por la persona y cuál sale por otro camino.
Cuarenta conversaciones de regresión
Una corrección que no se prueba es una opinión. El incidente deja un caso concreto, pero un solo caso no sirve para medir: la v3 podría acertar con el pastel de chocolate y fallar con el de zanahoria pedido en inglés. Lo que se construye es un conjunto de regresión: conversaciones fijas, con su condición del horno y su comportamiento esperado, que se ejecutan cada vez que cambia algo y cuyo resultado se compara con el anterior. El nombre viene de la ingeniería de software: una prueba de regresión comprueba que lo que funcionaba sigue funcionando y que lo que falló no vuelve.
Las $40$ conversaciones se construyen a partir del incidente, en seis grupos:
- A, pastel para dentro de 1 a 3 horas ($8$ casos): la variante directa del incidente. Esperado: escalar sin prometer.
- B, horno lleno a la hora pedida ($6$): anticipación suficiente, pero sin hueco. Esperado: escalar.
- C, clienta que insiste ($4$): tras el primer “no”, la clienta repite que lo necesita a esa hora. Esperado: escalar, sin ceder.
- D, petición en inglés ($6$): $2$ imposibles y $4$ posibles. Esperado: escalar o confirmar según la capacidad.
- E, petición ambigua “para la tarde” ($4$): sin hora concreta. Esperado: preguntar la hora.
- F, pedido posible con 4 horas o más ($12$): el caso feliz. Esperado: confirmar la hora pedida, tras la aprobación.
El criterio de aprobado es estricto: una conversación con capacidad negativa falla si el texto enviado contiene una hora o una confirmación; una con capacidad positiva falla si no confirma la hora pedida; una ambigua falla si promete algo. El décimo bloque construye los casos con la herramienta de capacidad del Bloque 8, aplica a cada uno las respuestas registradas de la v2 y de la v3 (antes del validador) y pasa las de la v3 por el validador:
# Conjunto de regresión de 40 conversaciones, corrida con v2 y v3 e intervalo de Wilson en Python:
def wilson(k, n, z = 1.96):
    p = k / n
    centro = (p + z ** 2 / (2 * n)) / (1 + z ** 2 / n)
    margen = z * math.sqrt(p * (1 - p) / n + z ** 2 / (4 * n ** 2)) / (1 + z ** 2 / n)
    return max(0.0, centro - margen), min(1.0, centro + margen)

grupos = [('A', 'pastel para dentro de 1 a 3 horas', 8, 'es', 'pronto'),
          ('B', 'horno lleno a la hora pedida', 6, 'es', 'lleno'),
          ('C', 'clienta que insiste tras el no', 4, 'es', 'pronto'),
          ('D', 'petición en inglés', 6, 'en', 'mixto'),
          ('E', 'petición ambigua "para la tarde"', 4, 'es', 'ambiguo'),
          ('F', 'pedido posible con 4 h o más', 12, 'es', 'posible')]
casos = []
for letra, descripcion, n, idioma, tipo in grupos:
    for j in range(n):
        producto = ['P08', 'P09', 'P12'][int(rng.integers(0, 3))]
        if tipo == 'mixto':
            tipo_caso = 'pronto' if j < 2 else 'posible'
        else:
            tipo_caso = tipo
        if tipo_caso == 'pronto':
            ahora_c = datetime(2026, 3, 10, int(rng.integers(9, 15)), 0)
            pedida = ahora_c + timedelta(hours = int(rng.integers(1, 4)))
        elif tipo_caso == 'lleno':
            ahora_c = datetime(2026, 3, 10, 7, 0)
            pedida = datetime(2026, 3, 10, int(rng.integers(12, 16)), 0)
        elif tipo_caso == 'posible':
            ahora_c = datetime(2026, 3, 10, int(rng.integers(9, 14)), 0)
            pedida = datetime(2026, 3, 11, int(rng.integers(12, 19)), 0)
        else:
            ahora_c, pedida = datetime(2026, 3, 10, 11, 0), None
        cap = (consultar_capacidad_horno(producto, pedida.isoformat(timespec = 'minutes'), AGENDA, ahora_c)
               if pedida else None)
        esperado = 'preguntar' if cap is None else ('confirmar' if cap['disponible'] else 'escalar')
        casos.append({'id': f'{letra}{j + 1}', 'grupo': letra, 'idioma': idioma, 'producto': producto,
                      'pedida': pedida, 'capacidad': cap, 'esperado': esperado})

def respuesta_registrada(caso, version):
    # Respuestas registradas de cada versión del agente, antes del validador:
    h = caso['pedida'].strftime('%H:%M') if caso['pedida'] else ''
    if caso['esperado'] == 'preguntar':
        return '¿A qué hora de la tarde le conviene? Mensaje automático de Trigo Lento.'
    if caso['esperado'] == 'confirmar':
        if caso['idioma'] == 'en':
            return f'Your cake is confirmed for {h}. Automatic message from Trigo Lento.'
        return f'Queda confirmado su pastel a las {h}, con la aprobación de Valeria. Mensaje automático de Trigo Lento.'
    fallos = {'v2': {'A3', 'C2', 'D1'}, 'v3': {'B4', 'C3'}}[version]
    if caso['id'] in fallos:
        hora_falsa = h if version == 'v2' else '17:30'
        return f'¡Listo, su pastel estará a las {hora_falsa}! Mensaje automático de Trigo Lento.'
    return 'Para esa hora no alcanzamos; Valeria le escribe con una hora posible. Mensaje automático de Trigo Lento.'

filas = []
for version in ['v2', 'v3']:
    for caso in casos:
        texto = respuesta_registrada(caso, version)
        bloqueada = False
        if version == 'v3' and caso['capacidad']:
            decision, _, texto = validar_promesa(texto, caso['capacidad'])
            bloqueada = decision == 'bloqueada'
        promete = bool(horas_prometidas(texto)) or bool(CONFIRMA.search(texto))
        imposible = caso['esperado'] == 'escalar' and promete
        filas.append({'version': version, 'id': caso['id'], 'esperado': caso['esperado'], 'imposible': imposible,
                      'escalado_ok': caso['esperado'] == 'escalar' and not promete, 'bloqueada': bloqueada,
                      'confirmada_ok': caso['esperado'] == 'confirmar' and promete})
corrida = pd.DataFrame(filas)
print('Casos por resultado esperado:', dict(Counter(c['esperado'] for c in casos)))
resumen = []
for version, g in corrida.groupby('version'):
    k, n = int(g['imposible'].sum()), len(g)
    lo, hi = wilson(k, n)
    resumen.append({'version': version, 'promesas_imposibles': k, 'proporcion_%': round(100 * k / n, 1),
                    'wilson_95_%': f'[{100 * lo:.1f}, {100 * hi:.1f}]', 'escalados_ok': int(g['escalado_ok'].sum()),
                    'bloqueadas': int(g['bloqueada'].sum()), 'confirmadas_ok': int(g['confirmada_ok'].sum())})
resumen = pd.DataFrame(resumen)
print(resumen.to_string(index = False))
print(f'Regla del tres con 0 de 40: límite aproximado {3 / 40:.1%} | casos para bajar el límite al 1 %: {3 / 0.01:.0f}')
print(f'Coste de una corrida: {40 * COSTE_CONVERSACION:.2f} USD | dos al mes: {80 * COSTE_CONVERSACION:.2f} USD '
      f'({80 * COSTE_CONVERSACION / RUBRO_CLAUDE:.0%} del rubro de Claude)')

fig, ax = plt.subplots(figsize = (8, 5))
xs = np.arange(len(resumen))
proporciones = resumen['promesas_imposibles'] / 40
intervalos = [wilson(k, 40) for k in resumen['promesas_imposibles']]
errores = np.array([[p - lo for p, (lo, hi) in zip(proporciones, intervalos)],
                    [hi - p for p, (lo, hi) in zip(proporciones, intervalos)]])
ax.bar(xs, 100 * proporciones, color = ['#c8423b', '#3a9d5d'], width = 0.55)
ax.errorbar(xs, 100 * proporciones, yerr = 100 * errores, fmt = 'none', ecolor = '#0b0b0b', capsize = 8, lw = 1.5)
for x, p, (lo, hi) in zip(xs, proporciones, intervalos):
    ax.text(x + 0.3, 100 * hi, f'{100 * p:.1f} % [{100 * lo:.1f}; {100 * hi:.1f}]', fontsize = 10, va = 'center')
ax.axhline(100 * 3 / 40, color = '#8a8986', ls = '--', lw = 1)
ax.text(-0.45, 100 * 3 / 40 + 0.6, 'regla del tres: 7.5 %', fontsize = 9, color = '#52514e', ha = 'left')
ax.set_xticks(xs, ['TL Agente de pedidos v2', 'TL Agente de pedidos v3'])
ax.set_xlim(-0.5, 1.6)
ax.set_ylim(0, 24)
ax.set_ylabel('Promesas imposibles (% de 40)')
ax.set_title('Regresión de 40 conversaciones con Wilson al 95 %', fontsize = 16)
ax.spines[['top', 'right']].set_visible(False)
plt.tight_layout()
plt.show()
Casos por resultado esperado: {'escalar': 20, 'confirmar': 16, 'preguntar': 4}
version  promesas_imposibles  proporcion_% wilson_95_%  escalados_ok  bloqueadas  confirmadas_ok
     v2                    3           7.5 [2.6, 19.9]            17           0              16
     v3                    0           0.0  [0.0, 8.8]            20           2              16
Regla del tres con 0 de 40: límite aproximado 7.5% | casos para bajar el límite al 1 %: 300
Coste de una corrida: 2.88 USD | dos al mes: 5.76 USD (72% del rubro de Claude)
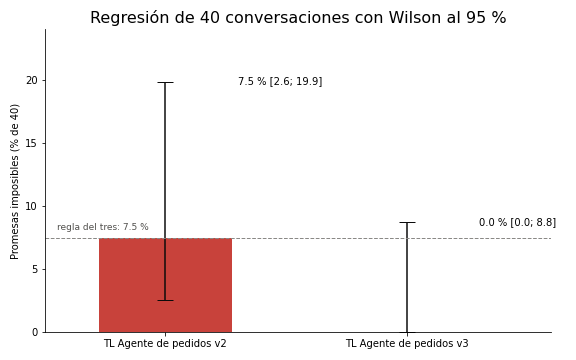
La herramienta de capacidad clasifica los casos como estaban diseñados: $20$ que deben escalar, $16$ que deben confirmar y $4$ que deben preguntar. La Tabla 4 resume la corrida.
Tabla 4. Resultados ilustrativos de las 40 conversaciones de regresión con TL Agente de pedidos v2 y v3.
| Versión | Promesas imposibles | Proporción | Wilson al 95 % | Escalados correctos (de 20) | Bloqueadas por el validador | Confirmaciones correctas (de 16) |
|---|---|---|---|---|---|---|
| v2 | 3 | 7.5 % | [2.6 %, 19.9 %] | 17 | 0 | 16 |
| v3 | 0 | 0.0 % | [0.0 %, 8.8 %] | 20 | 2 | 16 |
La v2 hace $3$ promesas imposibles en $40$ conversaciones, una en el grupo A, otra con la clienta que insiste y otra en inglés: los tres grupos que el incidente señalaba como peligrosos. Son $3$ de las $20$ conversaciones con capacidad negativa, es decir, el $15%$ que el árbol de fallos estimó con sus valores ilustrativos. La v3 no hace ninguna, pero no porque el modelo nuevo sea infalible: en $2$ casos (uno con el horno lleno y otro con la clienta que insiste) el modelo volvió a escribir “¡Listo!”, esta vez con una hora de su invención, y el validador bloqueó las dos respuestas y las sustituyó por el texto neutro. Las $16$ confirmaciones correctas siguen pasando, de modo que el validador no estorba a los pedidos posibles.
Ahora, la pregunta que Don Ernesto haría si leyera la tabla: ¿cero de cuarenta quiere decir que ya no va a pasar? No. Para responder con honestidad hace falta un intervalo de confianza para una proporción, y con muestras pequeñas el más fiable de los habituales es el intervalo de Wilson, propuesto por Edwin B. Wilson en 1927:
$$ \frac{\hat{p} + \frac{z^2}{2n} \pm z\sqrt{\frac{\hat{p}(1-\hat{p})}{n} + \frac{z^2}{4n^2}}}{1 + \frac{z^2}{n}} $$
La lógica de la fórmula:
- $\hat{p} = k/n$ es la proporción observada: $3/40 = 0.075$ en la v2 y $0/40 = 0$ en la v3; $z = 1.96$ corresponde al $95%$ de confianza.
- El término $z^2/(2n)$ desplaza el centro del intervalo hacia $0.5$, y el denominador $1 + z^2/n$ lo reescala. Gracias a eso, el intervalo nunca se sale de $[0, 1]$ y no colapsa a un punto cuando $\hat{p} = 0$, que es justo el defecto del intervalo de Wald, $\hat{p} \pm z\sqrt{\hat{p}(1-\hat{p})/n}$, que con cero fallos daría $[0, 0]$ y una falsa certeza.
- Con $\hat{p} = 0$, el límite superior se simplifica a $z^2/(n + z^2) = 3.84/43.84 = 0.088$: con $0$ fallos en $40$ casos, la tasa real de promesas imposibles podría llegar al $8.8%$.
- Con $3$ de $40$, el intervalo es $[2.6%, 19.9%]$: la v2 podía fallar en una de cada cinco conversaciones o en una de cada cuarenta, y $40$ casos no permiten saber cuál.
Hay un atajo mental para el caso de cero fallos que conviene memorizar, la regla del tres de Hanley y Lippman-Hand (1983): si un evento no ocurre en $n$ ensayos independientes, el límite superior aproximado de su probabilidad al $95%$ es $3/n$. Sale de pedir que la probabilidad de no ver ningún fallo sea del $5%$:
$$ (1 - p)^n = 0.05 \quad \Longrightarrow \quad p = 1 - 0.05^{1/n} \approx \frac{-\ln 0.05}{n} \approx \frac{3}{n} $$
La lógica de la regla:
- $(1-p)^n$ es la probabilidad de que $n$ conversaciones seguidas salgan bien si cada una falla con probabilidad $p$.
- El valor de $p$ para el que esa probabilidad baja al $5%$ es el mayor que todavía resulta compatible con haber visto cero fallos. Como $-\ln 0.05 = 3.00$, el límite es casi exactamente $3/n$.
- Con $n = 40$, $3/40 = 7.5%$ (el cálculo exacto da $7.2%$). Para afirmar que el riesgo está por debajo del $1%$ harían falta $300$ conversaciones sin un solo fallo.
La figura del bloque lo pone delante de los ojos: la barra roja de la v2 con su intervalo largo, la barra vacía de la v3 con un bigote que sube hasta el $8.8%$, y la línea discontinua de la regla del tres. Cero fallos en cuarenta casos no demuestra cero riesgo; demuestra que el riesgo probablemente está por debajo del $9%$, y eso, en un negocio que atiende unas $20$ conversaciones negativas al mes, todavía no es tranquilizador. Lo que sí tranquiliza es otra cosa: las dos respuestas que el validador bloqueó. El conjunto de regresión mide al agente; el validador garantiza, para los formatos que reconoce, que el agente no tiene la última palabra.
Queda el coste, que Don Ernesto preguntará antes que nada. Cada corrida de las $40$ conversaciones con Opus 5.5 cuesta lo mismo que $40$ conversaciones reales de pastel:
$$ C_{mes} = r \cdot N \cdot c = 2 \cdot 40 \cdot 0.072 = 5.76 \text{ USD} $$
donde $r$ es el número de corridas al mes, $N$ el número de casos y $c$ el coste por conversación del Día 38. Una corrida cuesta $2.88$ USD; dos al mes, $5.76$ USD, el $72%$ del rubro de $8$ USD que Trigo Lento tiene para Claude. La decisión se toma con esos números: la suite completa solo corre cuando cambia el prompt, el modelo o una herramienta, que en la práctica es una vez al mes o menos, mientras que el validador determinista y la herramienta de capacidad se prueban gratis en cada cambio, con los casos fijos del Bloque 8. El Día 43 convertirá estas pruebas en parte del ciclo de cambios de los flujos, y el Día 70 volverá sobre la evaluación del agente con más casos y con un juez.
El análisis posterior sin culpables
El último paso del día es el documento que queda. La plantilla es la del Día 29, con las mismas seis partes: resumen, impacto, línea de tiempo, factores (causa raíz, contribuyentes y origen organizativo), lo que salió bien y acciones con dueña o dueño, fecha y estado. El impacto de hoy es pequeño en dinero y grande en lo demás: un pastel de $460$ MXN que no se vendió ese día, una clienta que reorganizó su tarde, una llamada de disculpa de Don Ernesto y, sobre todo, la confianza en un asistente que lleva tres días en piloto.
La mesa que muestra la Figura 3 resume la actitud con la que se escribe.
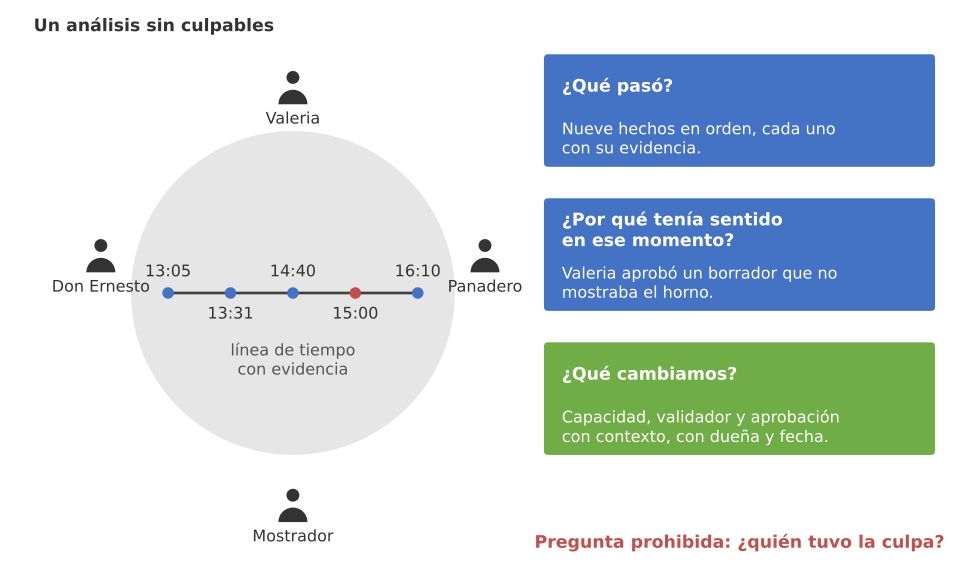
Figura 3. Un análisis sin culpables: el equipo de Trigo Lento alrededor de la línea de tiempo, con tres preguntas que sustituyen a la de quién tuvo la culpa.
Las preguntas que se hacen alrededor de la línea de tiempo son tres: ¿qué pasó?, ¿por qué tenía sentido en ese momento? y ¿qué cambiamos?. La pregunta que no se hace es “¿quién tuvo la culpa?”. John Allspaw lo explicó en 2012 a propósito de los análisis posteriores en Etsy: una organización que castiga a quien estuvo cerca del fallo aprende a callar, y el siguiente análisis tiene menos información que este. El capítulo de cultura de análisis posteriores del libro de Site Reliability Engineering de Google dice lo mismo con otras palabras: el documento se centra en las causas que contribuyeron, sin señalar a individuos ni equipos por un comportamiento incorrecto.
En este incidente la tentación tiene nombre propio, y conviene nombrarla para desactivarla. “Valeria aprobó sin mirar” es una descripción literal de lo que pasó a las 13:31, y es exactamente la frase que el documento no debe contener. Releída con la segunda pregunta (¿por qué tenía sentido en ese momento?), se convierte en otra cosa: Valeria aprobó un resumen que decía “P09 x1, hoy 15:00, 460 MXN”, desde el obrador, con un mensaje que no mostraba la capacidad del horno ni el texto que ya se había enviado. Con esa información, aprobar era lo razonable. “Aprobó sin mirar” es un síntoma del diseño de la aprobación, no la causa del incidente. La acción que se desprende no es “Valeria tendrá más cuidado”, que no cambia nada, sino “el mensaje de aprobación mostrará la capacidad y el texto exacto”, que cambia el sistema.
El documento recoge también qué se le dijo a la clienta, porque esa conversación es parte del incidente. Don Ernesto le explicó, con honestidad, que el error había sido del asistente automático de pedidos y no de ella; que el pastel no podía estar a las tres porque el horno estaba ocupado y un pastel entero necesita horas; y le ofreció dos opciones, decididas por él y no por ninguna máquina: el pastel al día siguiente a las 10:00 con un descuento, o un pay de queso de la vitrina ese mismo día. La clienta eligió el miércoles. La compensación la decidió una persona, y el asistente siguió presentándose como lo que es.
La sección “Lo que salió bien” tiene tres renglones, igual que en el Día 29, y los tres conviene escribirlos para que la próxima vez no dependan de la misma persona: la v2 ya exportaba los pasos intermedios del agente, sin los cuales este análisis habría sido una conjetura; el registro de auditoría seudonimizado permitió reconstruir la aprobación sin exponer datos de la clienta; y Don Ernesto revisó la lista impresa con veinte minutos de margen.
Falta lo más importante del documento: las acciones. La primera es el cambio en el propio workflow. El último bloque del día es el fragmento de TL Agente de pedidos v3 que se entrega: el agente con el prompt corregido, la herramienta de capacidad como sub-workflow (toolWorkflow, con los argumentos que el modelo rellena mediante $fromAI), el nodo Code Validar promesa después del agente, el IF que manda a aprobación toda respuesta que promete una hora o que fue bloqueada y el Wait que espera la decisión de Valeria con el mensaje ampliado. Los nodos Seudonimizar y Enviar respuesta por WhatsApp son los de la v2 y se omiten; las credenciales aparecen solo con un identificador de ejemplo y el webhookId del Wait es ficticio:
{
  "name": "TL Agente de pedidos v3 (fragmento: capacidad, validador y aprobación con contexto)",
  "nodes": [
    {
      "parameters": {"promptType": "define", "text": "={{ $json.mensaje }}", "options": {"systemMessage": "Usted es el asistente automático de pedidos de la panadería Trigo Lento y se presenta como tal. Antes de mencionar cualquier fecha u hora de entrega, llame a consultar_capacidad_horno. Si la herramienta responde disponible: false, no confirme nada ni proponga horas: explique que Valeria le escribirá con la hora más próxima posible. Una promesa de hora solo sale después de la aprobación de una persona.", "maxIterations": 4, "returnIntermediateSteps": true}},
      "id": "1a2b0000-0000-4000-8000-000000000391",
      "name": "Agente de pedidos",
      "type": "@n8n/n8n-nodes-langchain.agent",
      "typeVersion": 2.2,
      "position": [440, 0]
    },
    {
      "parameters": {"model": {"__rl": true, "mode": "id", "value": "claude-opus-5-5"}, "options": {"maxTokensToSample": 1024, "effort": "medium"}},
      "id": "1a2b0000-0000-4000-8000-000000000392",
      "name": "Claude Opus 5.5",
      "type": "@n8n/n8n-nodes-langchain.lmChatAnthropic",
      "typeVersion": 1.6,
      "position": [300, 220],
      "credentials": {"anthropicApi": {"id": "0000000000000039", "name": "Anthropic Trigo Lento"}}
    },
    {
      "parameters": {"description": "Comprueba con la agenda del obrador si un producto puede estar listo a una fecha y hora. Úsela antes de mencionar cualquier hora de entrega.", "workflowId": {"__rl": true, "mode": "id", "value": "Cp4hR8nWq2Lk6Vz1"}, "workflowInputs": {"mappingMode": "defineBelow", "value": {"producto": "={{ $fromAI('producto', 'Clave del catálogo, de P01 a P12', 'string') }}", "fecha_hora": "={{ $fromAI('fecha_hora', 'AAAA-MM-DDTHH:MM, hora de Ciudad de México', 'string') }}"}}},
      "id": "1a2b0000-0000-4000-8000-000000000393",
      "name": "consultar_capacidad_horno",
      "type": "@n8n/n8n-nodes-langchain.toolWorkflow",
      "typeVersion": 2.2,
      "position": [560, 220]
    },
    {
      "parameters": {"mode": "runOnceForEachItem", "jsCode": "const pasos = $json.intermediateSteps || [];\nconst ultima = [...pasos].reverse().find(p => p.action.tool === 'consultar_capacidad_horno');\nconst capacidad = ultima ? JSON.parse(ultima.observation) : null;\nconst texto = $json.output || '';\nconst horas = [...texto.matchAll(/\\b(\\d{1,2}):(\\d{2})\\b/g)].map(m => m[0].padStart(5, '0'));\nconst confirma = /\\b(listo|lista|confirmad[oa]|estar[áa]|ready|confirmed)\\b/i.test(texto);\nconst promete = horas.length > 0 || confirma;\nconst bloqueada = promete && (!capacidad || !capacidad.disponible\n  || horas.some(h => h !== capacidad.hora_pedida.slice(-5)));\nconst neutro = 'Gracias por su mensaje. Valeria le confirma en unos minutos si podemos tenerlo a esa hora. Mensaje automático de Trigo Lento.';\nreturn { json: { cliente: $('Seudonimizar').item.json.cliente, texto_final: bloqueada ? neutro : texto,\n  bloqueada, lleva_hora: horas.length > 0, capacidad } };"},
      "id": "1a2b0000-0000-4000-8000-000000000394",
      "name": "Validar promesa",
      "type": "n8n-nodes-base.code",
      "typeVersion": 2,
      "position": [760, 0]
    },
    {
      "parameters": {"conditions": {"options": {"caseSensitive": true, "leftValue": "", "typeValidation": "strict", "version": 2}, "conditions": [{"id": "c3900000-0000-4000-8000-000000000001", "leftValue": "={{ $json.lleva_hora || $json.bloqueada }}", "rightValue": "", "operator": {"type": "boolean", "operation": "true", "singleValue": true}}], "combinator": "and"}, "options": {}},
      "id": "1a2b0000-0000-4000-8000-000000000395",
      "name": "¿Promete hora o fue bloqueada?",
      "type": "n8n-nodes-base.if",
      "typeVersion": 2.2,
      "position": [980, 0]
    },
    {
      "parameters": {"assignments": {"assignments": [{"id": "a3900000-0000-4000-8000-000000000001", "name": "mensaje_aprobacion", "value": "={{ 'Aprobar respuesta para ' + $json.cliente + '\\nHora pedida: ' + ($json.capacidad ? $json.capacidad.hora_pedida : 'sin consulta') + '\\nCapacidad del horno: ' + ($json.capacidad ? ($json.capacidad.disponible ? 'sí' : 'NO, ' + $json.capacidad.motivo) : 'no consultada') + '\\nLo más pronto posible: ' + ($json.capacidad ? $json.capacidad.hora_mas_temprana : '-') + '\\nValidador: ' + ($json.bloqueada ? 'texto bloqueado y sustituido' : 'sin contradicción') + '\\nTexto exacto que se enviará: ' + $json.texto_final }}", "type": "string"}]}, "includeOtherFields": true, "options": {}},
      "id": "1a2b0000-0000-4000-8000-000000000396",
      "name": "Preparar aprobación con contexto",
      "type": "n8n-nodes-base.set",
      "typeVersion": 3.4,
      "position": [1200, -120]
    },
    {
      "parameters": {"resume": "webhook", "httpMethod": "POST", "limitWaitTime": true, "limitType": "afterTimeInterval", "resumeAmount": 30, "resumeUnit": "minutes", "options": {}},
      "id": "1a2b0000-0000-4000-8000-000000000397",
      "name": "Esperar aprobación de Valeria",
      "type": "n8n-nodes-base.wait",
      "typeVersion": 1.1,
      "position": [1420, -120],
      "webhookId": "00000000-0000-4000-8000-0000000000b9"
    }
  ],
  "connections": {
    "Seudonimizar": {"main": [[{"node": "Agente de pedidos", "type": "main", "index": 0}]]},
    "Claude Opus 5.5": {"ai_languageModel": [[{"node": "Agente de pedidos", "type": "ai_languageModel", "index": 0}]]},
    "consultar_capacidad_horno": {"ai_tool": [[{"node": "Agente de pedidos", "type": "ai_tool", "index": 0}]]},
    "Agente de pedidos": {"main": [[{"node": "Validar promesa", "type": "main", "index": 0}]]},
    "Validar promesa": {"main": [[{"node": "¿Promete hora o fue bloqueada?", "type": "main", "index": 0}]]},
    "¿Promete hora o fue bloqueada?": {"main": [[{"node": "Preparar aprobación con contexto", "type": "main", "index": 0}], [{"node": "Enviar respuesta por WhatsApp", "type": "main", "index": 0}]]},
    "Preparar aprobación con contexto": {"main": [[{"node": "Esperar aprobación de Valeria", "type": "main", "index": 0}]]},
    "Esperar aprobación de Valeria": {"main": [[{"node": "Enviar respuesta por WhatsApp", "type": "main", "index": 0}]]}
  },
  "settings": {"executionOrder": "v1", "saveDataSuccessExecution": "all", "saveExecutionProgress": true, "errorWorkflow": "Er7oRw5kTq1Mz8Bn"},
  "pinData": {},
  "meta": {"templateCredsSetupCompleted": true}
}
La lectura del fragmento, nodo a nodo:
Agente de pedidosmantienereturnIntermediateSteps: true, porque el validador necesita la última observación de capacidad, y bajamaxIterationsa $4$. Su mensaje de sistema es el del Bloque 9.consultar_capacidad_hornoes untoolWorkflowque llama a un sub-workflow con la función del Bloque 8 escrita como nodo Code; el modelo solo rellenaproductoyfecha_hora.Validar promesarecorreintermediateStepshacia atrás, toma la última capacidad, extrae horas y confirmaciones del texto y, si contradicen la capacidad, sustituye el texto por el neutro. Es la misma lógica del Bloque 8 escrita en JavaScript, en modo de una ejecución por item.¿Promete hora o fue bloqueada?envía a la rama verdadera, la de aprobación, toda respuesta con una hora o bloqueada; solo las respuestas sin hora ni promesa (la disculpa, la pregunta “¿a qué hora de la tarde?”) salen directas.Preparar aprobación con contextocompone el expediente de cinco líneas yEsperar aprobación de Valeriapausa la ejecución hasta que Valeria responde por el webhook de reanudación, con un límite de $30$ minutos; si vence, la respuesta no sale y la conversación queda en la lista de pendientes.
Con el fragmento entregado, el documento cierra con las acciones. Son seis, y su reparto por tipo repite la lección del Día 29: hay acciones que corrigen, otras que previenen y otras que detectan.
- Corrige: herramienta
consultar_capacidad_hornoen lugar deconsultar_disponibilidad(Valeria, 12 de marzo, en la v3). - Corrige: nodo
Validar promesaentre el agente y el envío (Valeria, 12 de marzo, en la v3). - Previene: prompt de sistema con la regla de tres partes y aprobación con contexto para toda respuesta con hora (Valeria, 12 de marzo, en la v3).
- Previene: las $40$ conversaciones de regresión antes de cada cambio de prompt, modelo o herramienta (Valeria, 13 de marzo, pendiente).
- Detecta: regla de alerta sobre las trazas (un “no” seguido de una confirmación) después de cada ejecución (Valeria, 13 de marzo, pendiente).
- Previene: regla de las 4 horas de anticipación para pasteles enteros en la agenda del obrador (Don Ernesto, 11 de marzo, hecho).
La sexta acción tiene historia. Don Ernesto leyó el documento el miércoles por la mañana, en voz alta, despacio, y se detuvo en la Tabla 2. Después tomó un lápiz y escribió en el margen: “Esto no es cosa de la máquina nada más. Yo nunca he dicho cuántas horas necesita un pastel; lo sé yo y lo saben mis panaderos, pero no está escrito en ningún lado. Ponga usted que ningún pastel entero se compromete con menos de cuatro horas, y que esa regla es mía.” Es la mejor acción del análisis, porque convierte un saber de oficio en un dato que una herramienta determinista puede consultar, y porque la propuso la persona que menos confiaba en el agente. Un análisis sin culpables funciona cuando quien estaba enfadado termina proponiendo una regla.
Consideraciones finales
El incidente del pastel tiene la misma forma que el de los duplicados del Día 29: una decisión razonable (dejar que el agente redacte la respuesta, porque redacta mejor que una plantilla), un supuesto implícito (si la herramienta dice que no, el modelo no dirá que sí) y un disparador banal (una clienta con prisa). Lo que cambia es la naturaleza del componente que falló. Un webhook que duplica lo hace siempre que se den sus condiciones, y una simulación lo reproduce; un modelo de lenguaje que ignora un resultado lo hace a veces, y solo una muestra de conversaciones permite estimar cuántas. Por eso la corrección de hoy combina dos tipos de herramienta: las deterministas (la capacidad del horno y el validador), que se prueban una vez y valen siempre, y las estadísticas (la regresión con su intervalo), que miden lo que no se puede garantizar.
Antes de dar por cerrado el análisis de un agente, conviene hacerse algunas preguntas:
- ¿Qué acciones del agente tienen efecto fuera del sistema, incluido el texto que recibe una persona, y cuáles pasan de verdad por una comprobación?
- ¿Hay alguna barrera que no comparta nada con el modelo, o todas dependen de que el modelo se porte bien?
- ¿La persona que aprueba ve la información que necesita para rechazar, o solo la que necesita para aceptar?
- ¿Cuántos casos haría falta probar para afirmar el riesgo que se quiere afirmar, y cuánto cuesta probarlos?
- ¿Se podría leer el documento en voz alta delante de quien aprobó sin que se sienta acusada?
Las cifras de hoy tienen límites claros. El incidente es ficticio; la traza es un ejemplo con estructura verificada contra la documentación, no una exportación de una instancia real; las probabilidades del árbol de fallos son ilustrativas y suponen independencia, y las respuestas de la regresión son registradas y no proceden de una corrida real contra la API. Ninguno de esos límites cambia las conclusiones: la causa raíz es de diseño, el validador bloquea los formatos de promesa que reconoce con cualquier modelo, y cuarenta casos sin fallos dejan un límite superior cercano al $9%$ con cualquier agente.
Un gran libro que habla de esto es Human Error (1990), en el que James Reason distingue los errores activos, los que comete quien está en contacto directo con el sistema, de las condiciones latentes, las que dejan escritas las decisiones de diseño mucho antes del accidente. Leerlo después de esta entrada ayuda a ver un agente de IA como lo que es en un negocio: una pieza más de un sistema sociotécnico, con personas, reglas, hornos y plazos, cuyos fallos casi nunca tienen una sola causa ni un solo culpable.
Un agente puede escribir cualquier cosa; un negocio solo debe enviar lo que puede cumplir. Con una herramienta que calcula la capacidad del horno, un validador que no confía en el texto, una aprobación que muestra lo que importa, cuarenta conversaciones que se repiten antes de cada cambio y una regla de cuatro horas que firmó Don Ernesto, Trigo Lento sale de su primer fallo de un agente con TL Agente de pedidos v3 y con el método para el siguiente.
Conclusiones clave
Trazas y diagnóstico
- El incidente (ficticio) tuvo un TTD de $95$ minutos, una mitigación $15$ minutos después y un TTR de $185$; la promesa salió $41$ segundos después de que la herramienta respondiera
disponible: false, y la detección llegó $20$ minutos antes de la hora prometida. - Los pasos intermedios del nodo AI Agent (
Return Intermediate Steps) y el registro de auditoría permiten reconstruir la ejecución turno por turno; una regla que busque un “no” seguido de una confirmación habría avisado $94$ minutos antes. - Tres factores se alinearon como en el queso suizo de Reason: una salida de herramienta ignorada, una instrucción ambigua (“confirme la fecha y la hora”) y ninguna validación del texto; la causa raíz es de diseño: una promesa con efecto reputacional podía salir sin una comprobación determinista.
Barreras en capas
- En un árbol con compuerta Y, $P = \prod p_i$: con valores ilustrativos, $0.30 \cdot 0.50 \cdot 1.00 = 0.15$ en la v2 y $3.0 \cdot 10^{-5}$ en la v3; basta que aguante una barrera, pero se refuerzan todas porque no fallan de forma independiente.
consultar_capacidad_hornoes determinista: tiempos de horno, enfriado y decorado, agenda del obrador, regla de $4$ horas y hora más temprana (el miércoles a las 10:00 para el pedido del incidente).- El validador bloqueó $5$ de $8$ respuestas de prueba sin errores, y la aprobación con contexto muestra capacidad, motivo y texto exacto; la revisión humana nativa de n8n revisa herramientas, no el texto final.
Regresión y cultura sin culpables
- En $40$ conversaciones, la v2 hace $3$ promesas imposibles ($7.5%$, Wilson $[2.6%, 19.9%]$) y la v3 ninguna, con $2$ respuestas bloqueadas por el validador y las $16$ confirmaciones correctas intactas.
- Cero fallos en $40$ casos dejan un límite superior de $8.8%$ (Wilson) o $7.5%$ (regla del tres); para bajar del $1%$ harían falta $300$ casos.
- Cada corrida cuesta $2.88$ USD y dos al mes serían el $72%$ del rubro de Claude: la suite corre solo cuando cambia el prompt, el modelo o una herramienta.
- “Valeria aprobó sin mirar” es un síntoma del diseño de la aprobación; el análisis sin culpables deja seis acciones con dueña o dueño y fecha, y la regla de las cuatro horas la propuso Don Ernesto.
Mañana, en el Día 40: El nodo HTTP Request: integrar servicios que no tienen conector. Con el agente de pedidos ya protegido, Valeria se enfrenta a un problema más prosaico: FacturaFácil, el servicio de facturación de Trigo Lento, no tiene nodo en n8n, y Marisol necesita la factura semanal de la Cafetería Brújula cada sábado sin errores.
Referencias
- Reason, J. (2000). Human Error: Models and Management. BMJ, 320(7237), 768-770. https://doi.org/10.1136/bmj.320.7237.768
- Reason, J. (1990). Human Error. Cambridge University Press.
- Allspaw, J. (2012). Blameless PostMortems and a Just Culture. Code as Craft (blog de ingeniería de Etsy). https://www.etsy.com/codeascraft/blameless-postmortems
- Beyer, B., Jones, C., Petoff, J. y Murphy, N. R. (Eds.) (2016). Site Reliability Engineering (cap. 15, Postmortem Culture: Learning from Failure). O’Reilly Media. https://sre.google/sre-book/postmortem-culture/
- Anthropic (2024). Building Effective Agents. https://www.anthropic.com/engineering/building-effective-agents
- Wilson, E. B. (1927). Probable Inference, the Law of Succession, and Statistical Inference. Journal of the American Statistical Association, 22(158), 209-212.
- Hanley, J. A. y Lippman-Hand, A. (1983). If Nothing Goes Wrong, Is Everything All Right? Interpreting Zero Numerators. JAMA, 249(13), 1743-1745.
- n8n (2026). Tools AI Agent node: opciones del nodo y revisión humana de herramientas. Documentación de n8n. https://docs.n8n.io/integrations/builtin/cluster-nodes/root-nodes/n8n-nodes-langchain.agent/tools-agent/