
Arquitecto de automatización con IA: Día 42
 Jeshua Romero Guadarrama
- 61 Min para leer
- 14 Mar, 2026
Índice de contenido
Resumen:
Un viernes por la tarde, una frase añadida al prompt del agente de pedidos hizo que el sábado escalara el doble de conversaciones, y nadie supo decir qué había cambiado ni cuál era la versión buena. En esta entrada, Valeria convierte los workflows de n8n y los blueprints de Make de Trigo Lento en archivos de un repositorio git privado: los exporta con la CLI y con las API, los normaliza para que el diff muestre solo los cambios reales, compara versiones nodo por nodo, etiqueta versiones semánticas con su registro de cambios y pone un gancho que impide que un secreto entre al historial. Al terminar, usted sabrá distinguir un respaldo de un historial, encontrar en minutos el cambio que rompió un flujo y volver a una versión etiquetada.
¿Cómo citar el presente artículo?
Romero, J. (14 de marzo de 2026). Arquitecto de automatización con IA: Día 42. python-data-engineer. https://www.python-data-engineer.com/post/aai/dia_42/.
Arquitecto de automatización con IA: Día 42 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/aai/dia_42/.
Precios, límites y políticas revisados en octubre de 2026: planes, precios y límites de Make, n8n, Zapier, WhatsApp (Meta, Twilio, Wati) y de la API de Claude. Las opciones de n8n export:workflow (--all, --separate, --pretty, --output y --backup, que equivale a las tres primeras), el comportamiento de import:workflow (sobrescribe los workflows con el mismo identificador), la paginación por cursor de la API pública de n8n (100 resultados por omisión, 250 como máximo, cabecera X-N8N-API-KEY), el endpoint GET /scenarios/{scenarioId}/blueprint de la API de Make (cabecera Authorization: Token ...) y la disponibilidad del control de versiones integrado de n8n se contrastaron con la documentación oficial, revisado en octubre de 2026. No se pudo levantar un contenedor de n8n al escribir la entrada: las exportaciones tienen la estructura verificada contra la documentación, revisado en octubre de 2026, con identificadores de ejemplo. Los comandos de git de los bloques 5 y 11 se ejecutaron de verdad en un repositorio local de prueba, con fechas fijadas para que los identificadores de commit sean reproducibles; los bloques 2, 3 y 12 se muestran sin ejecutar.
Día 42. Versionado de flujos: exportar el JSON a git, revisar diferencias y etiquetar versiones
Introducción
Ayer, en el Día 41 (Datos masivos: loops, lotes y sub-workflows), Valeria aprendió a partir un proceso grande en lotes con Loop Over Items, sub-workflows y puntos de control que permiten reanudar sin duplicar, y Trigo Lento ganó TL Importación histórica con su sub-workflow por lotes. Hoy el problema no es el volumen, sino la memoria: la de los propios flujos.
Es sábado 14 de marzo, a las nueve y media de la mañana. El obrador lleva tres horas trabajando y Valeria revisa, como cada mañana, el registro de auditoría del agente de pedidos. Algo no cuadra. Desde las siete, TL Agente de pedidos v3 ha pasado a Valeria nueve de las veintitrés conversaciones, cuando un sábado normal pasa cuatro o cinco. Las escaladas no son de alergias ni de quejas: son preguntas tan simples como “¿lo quiere con texto?” que el agente ya no hace y que ahora le llegan a ella. Valeria recuerda que el viernes por la tarde, después del incidente del pastel imposible del Día 39 (Anatomía de un fallo real II: el agente que prometió un pastel imposible), abrió el editor de n8n “solo para ajustar una frase” del prompt. No recuerda cuál. Tampoco recuerda si movió algo más. Y no tiene a mano la versión del jueves para compararla.
Sí tiene, en cambio, la copia nocturna del Día 35 (Seguridad II: credenciales cifradas, respaldo y restauración de n8n): cada madrugada, a las tres, la CLI de n8n exporta todos los workflows a una carpeta con fecha. El archivo del jueves 12 está ahí, intacto. Valeria descarga desde el editor la versión actual, abre los dos archivos lado a lado en un comparador y se le cae el ánimo: $222$ líneas marcadas como distintas. Claves en otro orden, nodos en otro orden, fechas, posiciones del lienzo, un identificador que no reconoce. En algún lugar de ese mar de rojo y verde está la frase del viernes.
Don Ernesto, que ha subido a la oficina a firmar la factura de la harina, mira la pantalla y pregunta lo que preguntaría de cualquier receta: “En el obrador cada receta tiene su fecha y quién la cambió. Cuando el pan de caja salió denso en enero, abrí la libreta y vi que el panadero nuevo le había bajado el agua. ¿Sus flujos no tienen libreta?” La respuesta honesta es que no. Tienen copias, que es otra cosa. Una copia dice cómo estaba todo a las tres de la mañana; una libreta dice qué cambió, quién lo cambió, por qué y cuál era la versión buena. Esa libreta, para un flujo, se llama control de versiones, y la herramienta estándar para llevarla es git.
En la presente entrada, descubrirá por qué un respaldo no sustituye a un historial y cómo exportar los workflows de n8n con la CLI y con la API pública, y los blueprints de Make con su API. Normalizará el JSON exportado para que el diff de dos exportaciones muestre solo los cambios reales, y medirá cuánto ruido quita cada regla. Montará un repositorio privado con su .gitignore y su registro de cambios, escribirá un diff semántico que compara nodo por nodo y encuentra la frase del viernes, propondrá la versión semántica de cada cambio, etiquetará la corrección como tl-agente-pedidos/v3.0.1 y pondrá en la puerta del repositorio un detector de secretos que detiene el commit que lleva una llave. Al final, verá cómo volver a una versión etiquetada y qué ofrece n8n de forma nativa.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Distinguir un respaldo (Día 35) de un historial de cambios y exportar los workflows de n8n con la CLI y la API pública, y los blueprints de Make con su API.
- Normalizar el JSON exportado (ordenar claves, quitar campos volátiles, ordenar nodos) para que git muestre solo los cambios reales.
- Calcular diferencias semánticas entre dos versiones de un workflow en Python (nodos añadidos, eliminados, parámetros y conexiones modificados).
- Etiquetar versiones semánticas, mantener un registro de cambios e impedir que un secreto llegue al historial de git.
Respaldo no es historial
El Día 35 protegió a Trigo Lento contra la pérdida: si el servidor no vuelve, la copia nocturna, la clave de cifrado del gestor y el manual de restauración levantan otra instancia en $43$ minutos. Hoy el riesgo es distinto: el servidor está perfecto, los workflows funcionan y, sin embargo, uno de ellos se comporta peor que ayer. El enemigo no es el disco que falla, sino el cambio no explicado. Contra la pérdida se hacen copias; contra el cambio no explicado se lleva un historial.
Un sistema de control de versiones responde cuatro preguntas que una copia no contesta:
- ¿Qué cambió? No “qué archivos son distintos”, sino qué nodo, qué parámetro, qué conexión.
- ¿Quién lo cambió? Cada cambio guardado (un commit, en la terminología de git) lleva autor y fecha.
- ¿Por qué? Cada commit lleva un mensaje escrito por una persona; el registro de cambios lo resume para quien no lee commits.
- ¿Cómo vuelvo? Las versiones buenas llevan una etiqueta (en inglés, tag) con nombre propio, y cualquier versión se recupera tal como era.
La Tabla 1 compara las dos protecciones campo por campo. No compiten: Trigo Lento necesita las dos, porque cada una cubre un agujero que la otra deja abierto.
Tabla 1. Respaldo frente a control de versiones de los flujos de Trigo Lento.
| Aspecto | Respaldo (Día 35) | Control de versiones (hoy) |
|---|---|---|
| Qué protege | La instancia completa: base, credenciales cifradas, ejecuciones | El diseño de cada flujo: nodos, parámetros, conexiones |
| Contra qué | Pérdida del servidor, borrado, corrupción | Cambio no explicado, regresión, cambio sin revisar |
| Frecuencia | Una copia cada noche, a las 03:00 | Un commit por cada cambio con sentido |
| Granularidad | Todo o nada, por fecha | Por archivo, por nodo, por línea |
| Quién lo consulta | Quien restaura tras un desastre | Quien revisa, depura o audita un cambio |
| Cómo se restaura | pg_restore o import:workflow de la carpeta del día | Importar el archivo de una etiqueta por la API |
| Qué no dice | Por qué cambió algo ni quién | Nada de las ejecuciones ni de los secretos |
La diferencia más importante está en la última fila. La copia del jueves tiene el workflow bueno, pero no dice que es el bueno: es una de siete copias diarias, todas con el mismo aspecto. Para saber cuál es la buena hay que recordarlo, y la memoria es exactamente lo que falló el viernes. Un historial convierte “creo que el jueves estaba bien” en “la etiqueta v3.0.0 es la última versión revisada”.
Comencemos, como cada día, por las importaciones base y la semilla de la serie. El primer bloque lee las cinco exportaciones con las que trabajará el día: el agente y el workflow de pedidos de n8n tal como los dejó la copia del jueves (CLI) y tal como los descargó Valeria el sábado desde el editor, y el escenario de Make tal como lo devuelve su API. Para cada archivo cuenta líneas y nodos y muestra sus tres primeras claves:
# Importaciones base, semilla de la serie y lectura de las exportaciones del jueves y del sábado en Python:
import warnings
warnings.filterwarnings('ignore')
import copy
import difflib
import hashlib
import json
import re
import textwrap
from datetime import date, timedelta
from pathlib import Path
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from matplotlib.patches import FancyBboxPatch, FancyArrowPatch, Polygon

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 120)
carpeta = Path('trigo_lento') / 'dia_42'
exportaciones = carpeta / 'exportaciones'

def leer(ruta):
    return json.loads(ruta.read_text(encoding = 'utf-8'))

archivos = {
    'agente, jueves (CLI)': exportaciones / '2026-03-12' / 'n8n' / 'Ag7kRt2mWq9pLs4V.json',
    'agente, sábado (editor)': exportaciones / '2026-03-14' / 'n8n' / 'TL_Agente_de_pedidos_v3.json',
    'pedidos n8n, jueves (CLI)': exportaciones / '2026-03-12' / 'n8n' / 'Pd4wQx8NcV1mTe6R.json',
    'pedidos n8n, sábado (editor)': exportaciones / '2026-03-14' / 'n8n' / 'TL_Pedidos_WhatsApp_n8n_v1.json',
    'escenario de Make (API)': exportaciones / '2026-03-14' / 'make' / 'escenario_4127.json',
}
filas = []
for etiqueta, ruta in archivos.items():
    datos = leer(ruta)
    filas.append({'exportacion': etiqueta, 'lineas': len(ruta.read_text(encoding = 'utf-8').splitlines()),
                  'nodos': len(datos.get('nodes', datos.get('response', {}).get('blueprint', {}).get('flow', []))),
                  'primeras_claves': ', '.join(list(datos)[:3])})
print(pd.DataFrame(filas).to_string(index = False))
jueves, sabado = leer(archivos['agente, jueves (CLI)']), leer(archivos['agente, sábado (editor)'])
print('Mismo workflow:', jueves['id'] == sabado['id'], '|', jueves['name'])
print('versionId:', jueves['versionId'][-4:], '->', sabado['versionId'][-4:],
      '| pinData del jueves:', list(jueves['pinData']) or 'vacío')
                 exportacion  lineas  nodos          primeras_claves
        agente, jueves (CLI)     919     20 createdAt, updatedAt, id
     agente, sábado (editor)     903     20     name, nodes, pinData
   pedidos n8n, jueves (CLI)     294      6 createdAt, updatedAt, id
pedidos n8n, sábado (editor)     291      6     name, nodes, pinData
     escenario de Make (API)    1417      6           code, response
Mismo workflow: True | TL Agente de pedidos v3
versionId: 0039 -> 0313 | pinData del jueves: ['Mensaje entrante']
La salida ya adelanta el problema. Los dos archivos del agente describen el mismo workflow (mismo identificador, Ag7kRt2mWq9pLs4V), con $20$ nodos cada uno, pero empiezan de forma distinta: la exportación de la CLI abre con createdAt, updatedAt e id, y la descarga del editor, con name, nodes y pinData. El versionId cambió de ...0039 a ...0313, como cambia cada vez que alguien guarda. Y la copia del jueves trae datos fijados en el nodo Mensaje entrante: un mensaje de prueba que Valeria fijó el miércoles para trabajar sin esperar a un cliente y que, por descuido, se quedó en el workflow. Ninguna de esas diferencias es un cambio de diseño, y todas aparecerán en el diff.
La libreta que pidió Don Ernesto tiene, en realidad, la forma de la Figura 1: cada versión del flujo es una página con fecha, autor y motivo, y las versiones buenas llevan una cinta de marcador.
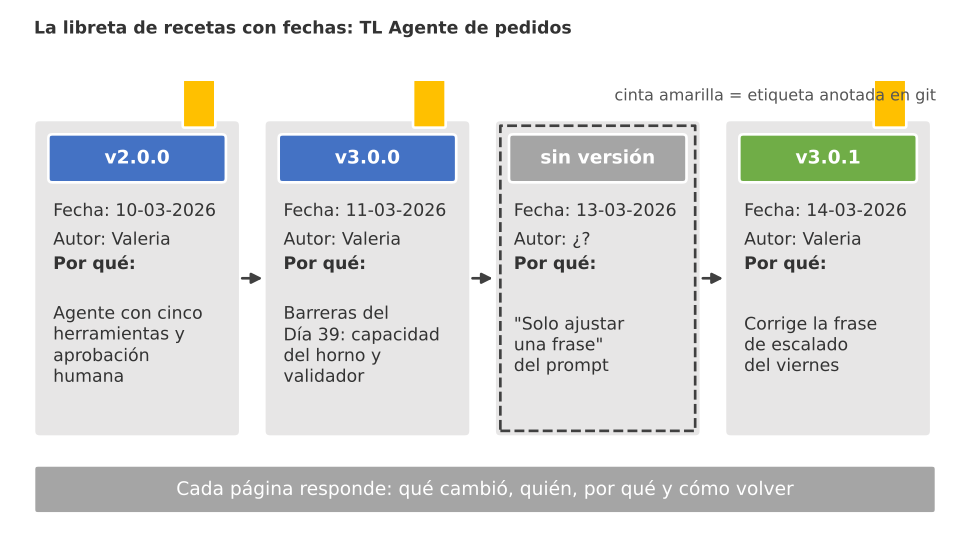
Figura 1. La libreta de recetas con fechas: cada versión de TL Agente de pedidos es una página con fecha, autor y motivo; las versiones revisadas llevan una cinta de etiqueta, y el cambio del viernes 13 quedó como una página sin versión.
Exportar los flujos
Antes de versionar hay que sacar los flujos de la plataforma como archivos. n8n y Make guardan sus flujos en su propia base de datos; git solo entiende archivos. La pregunta práctica es con qué herramienta exportarlos, y la respuesta depende de dónde vive la instancia y de quién hace la exportación.
La CLI de n8n
En una instalación propia, como la de Trigo Lento desde el Día 34, la forma más directa es la interfaz de línea de comandos (o CLI, por sus siglas en inglés: “Command Line Interface”) que trae la imagen de n8n. El comando n8n export:workflow tiene cuatro opciones que interesan hoy, según la documentación oficial revisada en octubre de 2026: --all exporta todos los workflows, --separate escribe un archivo por workflow (y exige que --output sea una carpeta), --pretty formatea el JSON con sangría para que sea legible y --output fija el destino. La opción --backup, que usa la copia nocturna del Día 35, equivale a las tres primeras juntas.
El comando se ejecuta dentro del contenedor, con el usuario node, y la carpeta resultante se copia fuera con docker compose cp. Cada archivo se llama como el identificador del workflow, que es estable mientras el workflow exista en esa instancia. Este bloque no se ejecutó al escribir la entrada, porque no había un contenedor disponible; la salida es un ejemplo comentado:
# Exportación de todos los workflows con la CLI de n8n, dentro del contenedor, en Bash:
cd /opt/trigo_lento                                  # carpeta del docker-compose.yml del Día 34
FECHA=$(date +%F)                                    # 2026-03-14
DESTINO=/home/node/.n8n/exportaciones/$FECHA

# Un archivo por workflow, con sangría legible (sin credenciales: esas van en el respaldo del Día 35):
docker compose exec -u node n8n n8n export:workflow --all --separate --pretty --output=$DESTINO/
docker compose cp n8n:$DESTINO ./exportaciones/
ls exportaciones/$FECHA

# Salida de ejemplo (puede variar):
# Successfully exported 9 workflows.
# Ag7kRt2mWq9pLs4V.json  Cq5hNz8vTb2kWr4G.json  Hc4pRt7wQz1mNb5A.json  Jd8sVk2xLp6qWc3B.json
# Mf3tYb9zRq4nXe7C.json  Pd4wQx8NcV1mTe6R.json  Pw6uZc1aTs8kHd2D.json  Rk9vBe5cWu3tJf6E.json
# Vn2qGh7dYm5sLa8F.json
Observe dos decisiones. La primera: el bloque exporta workflows, no credenciales. Las credenciales tienen su propia exportación, cifrada con N8N_ENCRYPTION_KEY, que vive en el respaldo del Día 35 y nunca en el repositorio. La segunda: las exportaciones de workflows no contienen los secretos de las credenciales, pero sí su nombre e identificador (por ejemplo, "anthropicApi": {"id": "Qm4TzV8nR2wLs6Hd", "name": "Anthropic TL nodo"}), y la documentación de n8n advierte que pueden ser sensibles. En un repositorio privado de Trigo Lento esos identificadores son aceptables; en una publicación, como los JSON de esta serie, se sustituyen por valores de ejemplo.
La API pública de n8n
La CLI necesita acceso al servidor. Si la instancia fuera n8n Cloud, o si la exportación la hiciera un programa desde la laptop de Valeria, la vía es la API pública de n8n: GET /api/v1/workflows devuelve los workflows por páginas, con la clave en la cabecera X-N8N-API-KEY. La paginación es por cursor: cada respuesta trae, si quedan resultados, un campo nextCursor, que se pasa como parámetro cursor en la siguiente petición. Por omisión llegan $100$ resultados por página, y el máximo permitido con limit es $250$.
Los blueprints de Make
El escenario TL Pedidos WhatsApp v3 del Día 33 vive en Make, no en n8n, y también entra al repositorio. Make lo exporta de dos maneras: a mano, desde el menú del escenario con “Export Blueprint”, o por su API, con GET /scenarios/{scenarioId}/blueprint. La respuesta de la API no es el blueprint a secas: llega envuelta en un objeto con code y response, y dentro de response vienen el blueprint, la programación (scheduling), la secuencia de identificadores y la versión del escenario. La autenticación es una cabecera Authorization con el valor Token seguido de la clave, y la dirección base depende de la zona de la organización (us2.make.com, eu1.make.com y otras). La opción blueprintId permite pedir una versión anterior del blueprint, lo que ya es una forma rudimentaria de historial dentro de Make.
El siguiente bloque exporta las dos cosas por API, con las claves leídas del entorno. Llama a servicios reales y no se ejecutó para escribir la entrada; la salida es un ejemplo comentado:
# Exportación por la API pública de n8n (con cursor) y del blueprint de Make por su API en Python:
import json
import os
from pathlib import Path

import requests

N8N_URL = 'https://n8n.trigolento.example/api/v1'           # dirección de ejemplo de la instancia
MAKE_URL = 'https://us2.make.com/api/v2'                     # la zona depende de la organización de Make
destino = Path('exportaciones') / '2026-03-14'

def exportar_n8n():
    cabeceras = {'X-N8N-API-KEY': os.environ['N8N_API_KEY']}  # la clave vive en el .env, nunca aquí
    params, total = {'limit': 100}, 0                         # 100 por omisión, 250 como máximo
    while True:
        r = requests.get(f'{N8N_URL}/workflows', headers = cabeceras, params = params, timeout = 30)
        r.raise_for_status()
        pagina = r.json()
        for wf in pagina['data']:
            (destino / 'n8n' / f"{wf['id']}.json").write_text(json.dumps(wf, indent = 2, ensure_ascii = False),
                                                               encoding = 'utf-8')
            total += 1
        if not pagina.get('nextCursor'):
            return total
        params['cursor'] = pagina['nextCursor']               # la siguiente página se pide con el cursor

def exportar_make(escenario_id):
    cabeceras = {'Authorization': f"Token {os.environ['MAKE_API_TOKEN']}"}
    r = requests.get(f'{MAKE_URL}/scenarios/{escenario_id}/blueprint', headers = cabeceras, timeout = 30)
    r.raise_for_status()
    respuesta = r.json()                                      # {"code": ..., "response": {"blueprint": ...}}
    (destino / 'make' / f'escenario_{escenario_id}.json').write_text(
        json.dumps(respuesta, indent = 2, ensure_ascii = False), encoding = 'utf-8')
    return respuesta['response']['blueprint']['name'], len(respuesta['response']['blueprint']['flow'])

(destino / 'n8n').mkdir(parents = True, exist_ok = True)
(destino / 'make').mkdir(parents = True, exist_ok = True)
print('Workflows de n8n exportados:', exportar_n8n())
print('Escenario de Make:', exportar_make(4127))

# Salida de ejemplo (puede variar):
# Workflows de n8n exportados: 9
# Escenario de Make: ('TL Pedidos WhatsApp v3', 6)
Con tres vías de exportación (CLI, API de n8n y descarga desde el editor), conviene fijar una como la oficial. Valeria elige la CLI para las copias nocturnas y la API para el repositorio, y deja la descarga desde el editor para emergencias como la de hoy. El motivo se verá enseguida: cada vía escribe el mismo workflow con un orden de claves distinto, y mezclar vías multiplica el ruido del diff.
Normalizar antes de guardar
Git compara archivos línea por línea. Para saber cuántas líneas marca como cambiadas entre dos versiones $A$ y $B$ de un archivo, cuenta las que salen y las que entran:
$$ L(A, B) = |A \setminus B| + |B \setminus A| $$
- $A \setminus B$ son las líneas de la versión anterior que no aparecen, en ese lugar, en la nueva (las que el diff pinta en rojo con un signo menos); $B \setminus A$, las nuevas que no estaban (en verde, con un signo más).
- El diff se calcula sobre secuencias, no sobre conjuntos: una línea idéntica que cambió de posición cuenta como una que sale y otra que entra.
- Por eso un archivo en el que solo cambió el orden de los elementos puede tener un $L$ enorme sin un solo cambio de contenido.
Dos exportaciones del mismo workflow difieren, aunque nadie haya tocado su diseño, por cinco causas. El orden de las claves depende de la herramienta que exporta. El orden de los nodos en el arreglo nodes no está garantizado: un nodo borrado y vuelto a crear pasa al final. Los campos volátiles cambian con cada guardado o ejecución: updatedAt, versionId, triggerCount, el estado active, los datos estáticos de los disparadores y el instanceId que añade la descarga desde el editor. Los datos fijados (pinData) de las pruebas viajan con el workflow si no se vacían. Y las posiciones en el lienzo (position) cambian cada vez que alguien reacomoda los nodos, como el identificador de nodo cambia cuando alguien borra un nodo y lo vuelve a crear. La Tabla 2 fija qué se hace con cada campo.
Tabla 2. Campos de la exportación por plataforma y su tratamiento antes de guardarlos en git.
| Plataforma | Campo | Por qué cambia | Tratamiento |
|---|---|---|---|
| n8n | updatedAt, createdAt | Cada guardado | Se quita |
| n8n | versionId | Cada guardado | Se quita (git lleva su propio identificador) |
| n8n | active, triggerCount, staticData | Estado de operación, no de diseño | Se quitan |
| n8n | meta.instanceId | Lo añade la descarga desde el editor | Se quita |
| n8n | pinData | Datos de prueba, a veces con datos personales | Se vacía ({}) |
| n8n | id de nodo | Cambia si el nodo se recrea | Se conserva en el archivo; se ignora al comparar |
| n8n | position | Cambia al reacomodar el lienzo | Se conserva en el archivo; se ignora al comparar |
| n8n | webhookId | Identifica la ruta de producción del webhook | Se conserva |
| n8n | Credenciales (id y name) | Solo cambian si se reasignan | Se conservan en el repositorio privado; nunca hay secretos |
| n8n | tags | Etiquetas del editor | Se conservan solo los nombres, ordenados |
| Make | Envoltorio de la API (code, scheduling, version…) | Metadatos del escenario | Se guarda solo response.blueprint |
| Make | __IMTCONN__ | Identificador de la conexión de esa cuenta | Se sustituye por 0 |
| Make | hook | Identificador del webhook de esa cuenta | Se sustituye por 0 |
| Make | metadata.designer (x, y) | Cambia al mover módulos | Se conserva; se ignora al comparar |
Las reglas de formato completan la tabla: claves ordenadas alfabéticamente, sangría de dos espacios, acentos sin escapar (ensure_ascii = False, para que “aprobación” se lea como “aprobación” y no como aprobación), un salto de línea al final y nodos ordenados por nombre. Hay una decisión sutil en las filas de id y position: se guardan, pero no se comparan. Se guardan porque, sin ellos, un workflow restaurado perdería su disposición en el lienzo y la relación con sus ejecuciones; no se comparan porque su cambio casi nunca altera el comportamiento.
El siguiente bloque escribe las dos funciones de normalización y mide el efecto de cada regla. La función etapas produce cinco versiones de cada exportación, cada una con una causa de ruido menos que la anterior (claves ordenadas, nodos ordenados, sin campos volátiles, sin posiciones ni identificadores de nodo), y el bloque cuenta las líneas que marca el diff en cada etapa. Al final guarda las versiones normalizadas que irán al repositorio y comprueba el escenario de Make contra el blueprint publicado el Día 33:
# Normalización de las exportaciones de n8n y de Make y diff de líneas antes y después en Python:
VOLATILES_N8N = ['createdAt', 'updatedAt', 'versionId', 'triggerCount', 'active', 'staticData']

def normalizar_n8n(wf, comparar = False):
    wf = copy.deepcopy(wf)
    for campo in VOLATILES_N8N:                          # cambian aunque nadie toque el diseño
        wf.pop(campo, None)
    wf.get('meta', {}).pop('instanceId', None)
    wf['pinData'] = {}                                   # datos fijados de prueba: fuera del repositorio
    wf['tags'] = sorted(t['name'] if isinstance(t, dict) else t for t in wf.get('tags', []))
    wf['nodes'] = sorted(wf['nodes'], key = lambda n: n['name'])
    if comparar:                                         # solo para comparar: el archivo guardado los conserva
        for n in wf['nodes']:
            n.pop('id', None)
            n.pop('position', None)
    return wf

def normalizar_make(respuesta):
    bp = copy.deepcopy(respuesta.get('response', {}).get('blueprint', respuesta))
    def limpiar(valor):
        if isinstance(valor, dict):
            return {k: (0 if k in ('__IMTCONN__', 'hook') else limpiar(v)) for k, v in valor.items()}
        return [limpiar(v) for v in valor] if isinstance(valor, list) else valor
    return limpiar(bp)

def como_texto(datos, ordenar = True):
    return json.dumps(datos, indent = 2, ensure_ascii = False, sort_keys = ordenar) + '\n'

def lineas_cambiadas(a, b):
    diff = difflib.unified_diff(a.splitlines(), b.splitlines(), lineterm = '', n = 0)
    return sum(1 for l in diff if l[:1] in '+-' and not l.startswith(('+++', '---')))

def etapas(wf):
    # Cada etapa quita una causa de ruido más que la anterior:
    ordenado = copy.deepcopy(wf)
    ordenado['nodes'] = sorted(ordenado['nodes'], key = lambda n: n['name'])
    sin_volatiles = normalizar_n8n(wf)
    return [como_texto(wf, ordenar = False), como_texto(wf), como_texto(ordenado),
            como_texto(sin_volatiles), como_texto(normalizar_n8n(wf, comparar = True))]

causas = ['orden de claves', 'orden de nodos', 'campos volátiles y pinData', 'posiciones e id de nodo', 'cambio real']
desglose = {}
for nombre, a, b in [('TL Agente de pedidos v3', jueves, sabado),
                     ('TL Pedidos WhatsApp n8n v1', leer(archivos['pedidos n8n, jueves (CLI)']),
                      leer(archivos['pedidos n8n, sábado (editor)']))]:
    marcadas = [lineas_cambiadas(x, y) for x, y in zip(etapas(a), etapas(b))]
    desglose[nombre] = [marcadas[i] - marcadas[i + 1] for i in range(4)] + [marcadas[4]]
    print(f'{nombre}: diff crudo {marcadas[0]} líneas | por etapa {marcadas[1:]} | cambio real {marcadas[4]}')
tabla_desglose = pd.DataFrame(desglose, index = causas)
print(tabla_desglose.to_string())

# Archivos normalizados que irán al repositorio (con id y posiciones, sin campos volátiles):
salida = carpeta / 'normalizados'
(salida / 'n8n').mkdir(parents = True, exist_ok = True)
(salida / 'make').mkdir(parents = True, exist_ok = True)
v2 = normalizar_n8n(leer(carpeta / 'historial' / 'agente_pedidos_v2.json'))
v3_0_0 = normalizar_n8n(jueves)
for archivo, datos in [('agente_pedidos_v2.json', v2), ('agente_pedidos_v3.json', v3_0_0),
                       ('pedidos_whatsapp_n8n_v1.json', normalizar_n8n(leer(archivos['pedidos n8n, jueves (CLI)'])))]:
    (salida / 'n8n' / archivo).write_text(como_texto(datos), encoding = 'utf-8', newline = '\n')
make = normalizar_make(leer(archivos['escenario de Make (API)']))
(salida / 'make' / 'pedidos_whatsapp_v3.blueprint.json').write_text(como_texto(make), encoding = 'utf-8', newline = '\n')
dia_33 = leer(Path('trigo_lento') / 'dia_33' / 'flujos' / 'make' / 'pedidos_whatsapp_v3.blueprint.json')
huella = lambda d: hashlib.sha256(como_texto(d).encode()).hexdigest()[:12]
print('Make: conexiones y webhook en 0 | igual al blueprint del Día 33:', huella(make) == huella(dia_33),
      '| huella', huella(make))
print('Líneas del agente normalizado:', len(como_texto(v3_0_0).splitlines()))

colores = ['#8a8a8a', '#b8b6b0', '#eb6834', '#2a78d6', '#1f9d55']
fig, ax = plt.subplots(figsize = (9, 4.2))
izquierda = np.zeros(2)
for causa, color in zip(causas, colores):
    valores = tabla_desglose.loc[causa].values
    ax.barh(['TL Agente de pedidos v3', 'TL Pedidos WhatsApp n8n v1'], valores, left = izquierda,
            color = color, label = causa)
    izquierda += valores
ax.annotate(f"cambio real: {desglose['TL Agente de pedidos v3'][4]} líneas", (izquierda[0], 0),
            (izquierda[0] * 0.62, -0.52), fontsize = 9, arrowprops = dict(arrowstyle = '->', color = '#52514e'))
ax.set_ylim(1.6, -0.75)
ax.set_xlabel('Líneas marcadas como cambiadas por el diff de líneas')
ax.set_title('Diff crudo desglosado por causa: casi todo es ruido', fontsize = 14)
ax.legend(fontsize = 9, loc = 'lower right')
ax.grid(alpha = 0.3, axis = 'x')
plt.tight_layout()
plt.show()
TL Agente de pedidos v3: diff crudo 222 líneas | por etapa [74, 48, 26, 2] | cambio real 2
TL Pedidos WhatsApp n8n v1: diff crudo 63 líneas | por etapa [5, 5, 0, 0] | cambio real 0
                            TL Agente de pedidos v3  TL Pedidos WhatsApp n8n v1
orden de claves                                 148                          58
orden de nodos                                   26                           0
campos volátiles y pinData                       22                           5
posiciones e id de nodo                          24                           0
cambio real                                       2                           0
Make: conexiones y webhook en 0 | igual al blueprint del Día 33: True | huella b4406df5f3ba
Líneas del agente normalizado: 900
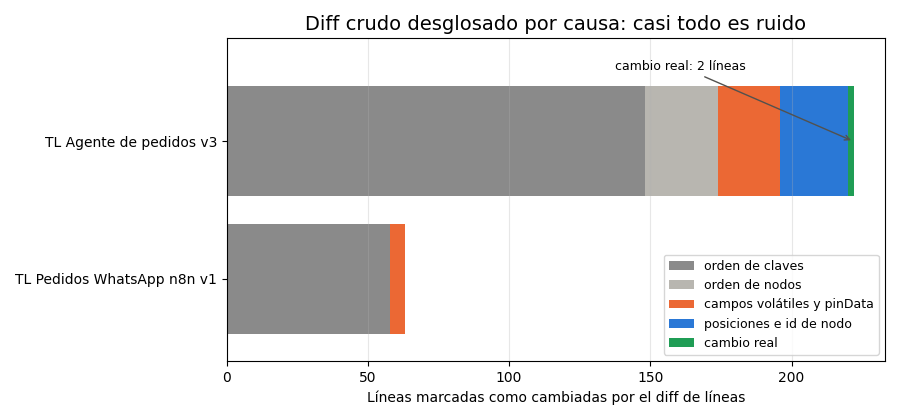
El resultado responde a la pregunta de la mañana con una cifra: de las $222$ líneas que marcaba el comparador, $220$ son ruido y $2$ son el cambio real: una línea que sale y otra que entra, las del systemMessage del agente. El desglose, que dibuja la gráfica, reparte el ruido así:
- En primer lugar, el orden de las claves aporta $148$ líneas, dos tercios del total. Es la diferencia entre la CLI y la descarga desde el editor, y desaparece con
sort_keys = True. - En segundo lugar, el orden de los nodos aporta $26$: la memoria, que Valeria borró por error el viernes y volvió a crear, pasó al final del arreglo.
- En tercer lugar, los campos volátiles y los datos fijados aportan $22$: fechas,
versionId,instanceIdy el mensaje de prueba olvidado enpinData. - En cuarto lugar, las posiciones y los identificadores de nodo aportan $24$: seis nodos movidos en el lienzo y el identificador nuevo de la memoria.
El workflow de pedidos de n8n confirma la regla por el lado contrario: nadie lo tocó entre el jueves y el sábado, y aun así el diff crudo marca $63$ líneas; normalizado, marca $0$. La proporción entre señal y ruido del agente se puede escribir en una línea:
$$ R = \frac{L_{\text{real}}}{L_{\text{crudo}}} = \frac{2}{222} \approx 0.009 $$
- $L_{\text{real}}$ son las líneas que cambian en la vista de comparación, ya sin ninguna causa de ruido; $L_{\text{crudo}}$, las que marca el diff entre los archivos tal como salieron de n8n.
- Con $R$ menor que el $1%$, una persona que revisa el diff crudo tiene que leer más de cien líneas de ruido por cada línea de cambio; en la práctica, deja de leer.
- Normalizar no hace el diff más inteligente: lo hace más pequeño, que es lo que permite que una persona lo revise.
La comprobación de Make termina en True: el blueprint exportado por la API, con el envoltorio fuera y las conexiones y el webhook en 0, es idéntico, con la misma huella SHA-256 (b4406df5f3ba), al que se publicó el Día 33. La normalización convierte dos archivos distintos en el mismo archivo cuando el flujo es el mismo, y esa es la propiedad que hace útil a git.
La Figura 2 resume la idea: a la izquierda, dos exportaciones superpuestas con cientos de líneas rojas y verdes; a la derecha, después de normalizar, una sola línea resaltada.
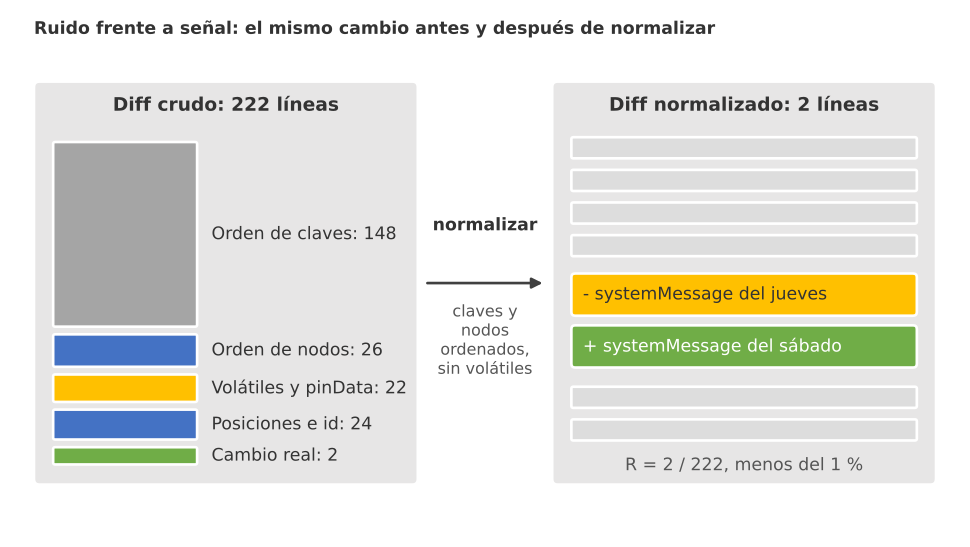
Figura 2. Ruido frente a señal: el diff crudo entre la copia del jueves y la descarga del sábado marca 222 líneas, casi todas por orden de claves, orden de nodos, campos volátiles y posiciones; tras normalizar quedan 2, las del cambio real.
Un repositorio para los flujos
Con los archivos normalizados, Valeria crea el repositorio flujos-trigo-lento. Su estructura es pequeña a propósito:
flujos/n8n/: un archivo por workflow, con el nombre del proceso y la versión mayor (agente_pedidos_v3.json), como fija la convención de la serie.flujos/make/: un blueprint por escenario (pedidos_whatsapp_v3.blueprint.json).CHANGELOG.md: el registro de cambios, con una sección por flujo..gitignore: lo que nunca entra (el.env, las exportaciones crudas, los respaldos, las credenciales y las bases de datos)..gitattributes: fija los finales de línea de los JSON en LF, para que una edición desde Windows no marque como cambiadas todas las líneas del archivo.
Tres reglas de trabajo acompañan a la estructura. El repositorio es privado: aunque no tenga secretos, describe la operación del negocio, sus proveedores y sus reglas de negocio. Un commit por cambio, con un mensaje que diga el porqué y no solo el qué (“sustituye la frase de escalado del viernes”, no “actualiza JSON”). Y cada cambio se hace en una rama propia y se revisa antes de unirse a la rama principal, main, que solo contiene versiones revisadas.
El siguiente bloque crea el repositorio, escribe el .gitignore, copia el CHANGELOG.md inicial con las versiones que ya estaban en servicio (y muestra su primera sección), hace el primer commit con los flujos normalizados y etiqueta lo que ya existía. Después reproduce el paso de la versión $2$ a la $3$ del agente con git mv, para que git sepa que agente_pedidos_v3.json es el mismo archivo que agente_pedidos_v2.json con otro nombre. Este bloque sí se ejecutó, en un repositorio local de prueba, y la salida es la real:
# Repositorio privado de los flujos: estructura, .gitignore, registro de cambios y primeros commits en Bash:
cd trigo_lento/dia_42
git init -q -b main flujos-trigo-lento
git init -q --bare remoto/flujos-trigo-lento.git     # en este ejemplo, el remoto privado es un repositorio local
cd flujos-trigo-lento
git config user.name "Valeria Ortiz"
git config user.email "valeria@ejemplo.com"
mkdir -p flujos/n8n flujos/make

# Lo que nunca entra al repositorio:
cat > .gitignore <<'FIN'
.env
.env.*
exportaciones/
respaldos/
credenciales/
*.sqlite
*.dump
FIN
echo '*.json text eol=lf' > .gitattributes

# Registro de cambios con las versiones que ya estaban en servicio (formato Keep a Changelog):
cp ../CHANGELOG_inicial.md CHANGELOG.md
sed -n '5,12p' CHANGELOG.md

# Primer commit: los flujos ya normalizados (bloque anterior) y las etiquetas de lo que ya estaba en servicio:
cp ../normalizados/n8n/agente_pedidos_v2.json ../normalizados/n8n/pedidos_whatsapp_n8n_v1.json flujos/n8n/
cp ../normalizados/make/pedidos_whatsapp_v3.blueprint.json flujos/make/
git add .gitignore .gitattributes CHANGELOG.md flujos/
git commit -q -m "Agrega los flujos normalizados de Trigo Lento y su registro de cambios"
git tag -a tl-agente-pedidos/v2.0.0 -m "TL Agente de pedidos 2.0.0 (Día 38)"
git tag -a tl-pedidos-whatsapp-n8n/v1.0.0 -m "TL Pedidos WhatsApp n8n 1.0.0 (Día 36)"
git tag -a tl-pedidos-whatsapp-make/v3.0.0 -m "TL Pedidos WhatsApp de Make 3.0.0 (Día 33)"

# Segundo commit: la versión mayor 3 sustituye a la 2 en el mismo archivo, renombrado:
git mv flujos/n8n/agente_pedidos_v2.json flujos/n8n/agente_pedidos_v3.json
cp ../normalizados/n8n/agente_pedidos_v3.json flujos/n8n/
git add flujos/n8n/agente_pedidos_v3.json
git commit -m "TL Agente de pedidos 3.0.0: capacidad del horno, validador de la promesa y aprobación con contexto"
git tag -a tl-agente-pedidos/v3.0.0 -m "TL Agente de pedidos 3.0.0 (Día 39)"

git remote add origin ../remoto/flujos-trigo-lento.git
git push -q --follow-tags origin main
git log --oneline --decorate
## TL Agente de pedidos

### [3.0.0] - 2026-03-11
#### Añadido
- Herramienta consultar_capacidad_horno, nodos "Validar promesa" y "¿Promesa válida?" y aprobación con contexto (Día 39).
#### Eliminado
- Herramienta consultar_disponibilidad (la sustituye consultar_capacidad_horno).

[main 7f6fd85] TL Agente de pedidos 3.0.0: capacidad del horno, validador de la promesa y aprobación con contexto
 1 file changed, 155 insertions(+), 55 deletions(-)
 rename flujos/n8n/{agente_pedidos_v2.json => agente_pedidos_v3.json} (81%)
7f6fd85 (HEAD -> main, tag: tl-agente-pedidos/v3.0.0, origin/main) TL Agente de pedidos 3.0.0: capacidad del horno, validador de la promesa y aprobación con contexto
e7d7e36 (tag: tl-pedidos-whatsapp-n8n/v1.0.0, tag: tl-pedidos-whatsapp-make/v3.0.0, tag: tl-agente-pedidos/v2.0.0) Agrega los flujos normalizados de Trigo Lento y su registro de cambios
La salida muestra el historial que Valeria acaba de crear, con dos commits y cuatro etiquetas:
- El commit
e7d7e36lleva tres etiquetas, una por flujo:tl-agente-pedidos/v2.0.0,tl-pedidos-whatsapp-n8n/v1.0.0ytl-pedidos-whatsapp-make/v3.0.0. Las etiquetas llevan el nombre del flujo como prefijo porque en un mismo repositorio conviven varios flujos con versiones independientes. - El commit
7f6fd85es la versión $3.0.0$ del agente. Git informarename ... (81%): detecta que el archivo nuevo es el viejo renombrado, con un $81%$ de similitud, y por eso conserva la historia del archivo a través del cambio de nombre. origin/mainaparece junto aHEAD -> main: el envío (push) con--follow-tagssubió la rama y las etiquetas anotadas al remoto privado.
Un detalle sobre las etiquetas: git tag -a crea una etiqueta anotada, que guarda autor, fecha y mensaje, como un commit. Las etiquetas ligeras (sin -a) son solo un nombre que apunta a un commit; sirven para marcas personales, pero no para versiones de un flujo en servicio, porque no dicen quién decidió que esa versión era buena.
Diferencias semánticas
La normalización reduce el diff de $222$ líneas a $2$, pero esas dos líneas son un problema en sí mismas: el systemMessage del agente ocupa una sola línea de JSON de casi mil caracteres, y git solo dice que cambió entera. Para un flujo, el diff de líneas es la herramienta equivocada en el nivel equivocado. Lo que Valeria quiere saber se dice en el idioma de n8n: qué nodos se añadieron o eliminaron, qué parámetros de qué nodo cambiaron, qué conexiones aparecieron o se rompieron.
Un diff semántico compara así:
- Por nombre de nodo, porque en n8n el nombre es la clave de las conexiones; pero detecta los renombrados por el identificador del nodo, que se conserva al renombrar. Sin esa regla, un renombrado aparecería como un nodo eliminado y otro añadido.
- Parámetro por parámetro, con su ruta, aplanando el árbol de parámetros:
nodes[Agente de pedidos].parameters.options.systemMessagedice exactamente dónde está el cambio, sin abrir el JSON. - Conexión por conexión, como cuartetos (origen, tipo, salida, destino), de modo que una rama falsa de un IF que pierde su destino aparece como una conexión rota.
- Sin
idniposition, por las razones de la Tabla 2.
El siguiente bloque escribe diff_semantico y la usa dos veces: para leer lo que hizo el Día 39 al pasar de la versión $2.0.0$ a la $3.0.0$, y para encontrar lo que cambió entre la copia del jueves y la descarga del sábado. Cuando el cambio está en un texto largo, lo parte en frases y muestra solo las que entran o salen:
# Diff semántico por nodo, conexiones y ajustes entre dos versiones de un workflow en Python:
def aplanar(valor, ruta):
    if isinstance(valor, dict):
        for k in sorted(valor):
            yield from aplanar(valor[k], f'{ruta}.{k}')
    elif isinstance(valor, list) and any(isinstance(v, (dict, list)) for v in valor):
        for i, v in enumerate(valor):
            yield from aplanar(v, f'{ruta}[{i}]')
    else:
        yield ruta, valor

def aristas(wf, renombre = None):
    renombre = renombre or {}
    return {(renombre.get(o, o), tipo, salida, renombre.get(d['node'], d['node']))
            for o, s in wf['connections'].items() for tipo, lista in s.items()
            for salida, destinos in enumerate(lista) for d in destinos}

def diff_semantico(antes, despues):
    A = {n['name']: n for n in antes['nodes']}
    B = {n['name']: n for n in despues['nodes']}
    nombre_por_id = {n['id']: n['name'] for n in antes['nodes']}
    renombrados = {nombre_por_id[n['id']]: n['name'] for n in despues['nodes']
                   if n['id'] in nombre_por_id and nombre_por_id[n['id']] != n['name'] and n['name'] not in A}
    anadidos = sorted(set(B) - set(A) - set(renombrados.values()))
    eliminados = sorted(set(A) - set(B) - set(renombrados))
    cambios = []
    for viejo in sorted(set(A) & set(B) | set(renombrados)):
        nuevo = renombrados.get(viejo, viejo)
        quitar = lambda n: {k: v for k, v in n.items() if k not in ('id', 'name', 'position')}
        va, vb = dict(aplanar(quitar(A[viejo]), f'nodes[{nuevo}]')), dict(aplanar(quitar(B[nuevo]), f'nodes[{nuevo}]'))
        cambios += [(r, va.get(r), vb.get(r)) for r in sorted(set(va) | set(vb)) if va.get(r) != vb.get(r)]
    ea, eb = aristas(antes, renombrados), aristas(despues)
    ajustes = [(r, a, b) for r, a, b in [(k, antes['settings'].get(k), despues['settings'].get(k))
               for k in sorted(set(antes['settings']) | set(despues['settings']))] if a != b]
    return {'anadidos': anadidos, 'eliminados': eliminados, 'renombrados': renombrados, 'cambios': cambios,
            'conexiones_nuevas': sorted(eb - ea), 'conexiones_rotas': sorted(ea - eb), 'ajustes': ajustes}

def imprimir(informe, titulo):
    print(f'== {titulo}')
    print(f"Nodos añadidos: {informe['anadidos'] or 'ninguno'}")
    print(f"Nodos eliminados: {informe['eliminados'] or 'ninguno'}")
    print(f"Renombrados (mismo id): {informe['renombrados'] or 'ninguno'}")
    print(f"Parámetros cambiados: {len(informe['cambios'])} | conexiones nuevas: "
          f"{len(informe['conexiones_nuevas'])} | rotas: {len(informe['conexiones_rotas'])} | ajustes: {len(informe['ajustes'])}")

sabado_norm = normalizar_n8n(sabado)
informe_v3 = diff_semantico(v2, v3_0_0)
imprimir(informe_v3, 'v2.0.0 -> v3.0.0 (Día 39)')
informe_viernes = diff_semantico(v3_0_0, sabado_norm)
imprimir(informe_viernes, 'v3.0.0 (jueves) -> exportación del sábado')
for ruta, a, b in informe_viernes['cambios']:
    print('Ruta:', ruta)
    pa, pb = re.split(r'(?<=[.:])\s+', a), re.split(r'(?<=[.:])\s+', b)
    for linea in difflib.ndiff(pa, pb):
        if linea[:1] in '+-':
            print(textwrap.fill(linea, 100, subsequent_indent = '  '))
== v2.0.0 -> v3.0.0 (Día 39)
Nodos añadidos: ['Preparar aprobación con contexto', 'Validar promesa', 'consultar_capacidad_horno', '¿Promesa válida?']
Nodos eliminados: ['consultar_disponibilidad']
Renombrados (mismo id): {'Esperar aprobación': 'Esperar aprobación de Valeria'}
Parámetros cambiados: 2 | conexiones nuevas: 7 | rotas: 3 | ajustes: 0
== v3.0.0 (jueves) -> exportación del sábado
Nodos añadidos: ninguno
Nodos eliminados: ninguno
Renombrados (mismo id): ninguno
Parámetros cambiados: 1 | conexiones nuevas: 0 | rotas: 0 | ajustes: 0
Ruta: nodes[Agente de pedidos].parameters.options.systemMessage
+ Si tiene cualquier duda sobre el pedido, no pregunte al cliente:
+ pase la conversación a Valeria.
Las dos comparaciones cuentan historias muy distintas, y las dos se leen en segundos:
- En primer lugar, del Día 38 al Día 39 el agente ganó $4$ nodos, perdió $1$ y renombró otro: la herramienta
consultar_capacidad_hornosustituyó aconsultar_disponibilidad, el validador de la promesa y su IF se intercalaron antes de responder, y el nodo Wait pasó a llamarse “Esperar aprobación de Valeria”. El diff lo detecta como renombrado porque conserva el identificador; un diff solo por nombre habría contado un nodo eliminado y otro añadido. Además cambiaron $2$ parámetros, $7$ conexiones son nuevas y $3$ se rompieron, todas explicadas por los nodos intercalados. - En segundo lugar, entre el jueves y el sábado no cambió ningún nodo, ninguna conexión y ningún ajuste, y cambió exactamente $1$ parámetro:
nodes[Agente de pedidos].parameters.options.systemMessage. - En tercer lugar, dentro de ese parámetro entró una sola frase: “Si tiene cualquier duda sobre el pedido, no pregunte al cliente: pase la conversación a Valeria.”
Ahí está el viernes. Valeria quiso reforzar la prudencia del agente después del pastel imposible y escribió una instrucción que el modelo cumplió al pie de la letra: ante cualquier duda, por pequeña que fuera, no preguntar y escalar. La pregunta “¿lo quiere con texto?” es una duda; el agente dejó de hacerla y la pasó a Valeria. Es el mismo tipo de fallo que el Día 39 encontró en “confirme la fecha y la hora”, ahora en sentido contrario: una instrucción demasiado amplia, escrita para corregir un problema, que crea otro.
El siguiente bloque dibuja la versión $3.0.0$ del agente con la función dibujar_flujo de la serie, adaptada para colorear cada nodo según el tipo de cambio respecto a la versión $2.0.0$, y lista aparte lo eliminado, que ya no tiene lugar en el dibujo:
# Dibujo de TL Agente de pedidos v3 con los nodos coloreados por tipo de cambio en Python:
FORMAS = {'webhook': 'disparador', 'code': 'accion', 'httpRequest': 'accion', 'executeWorkflow': 'accion',
          'if': 'decision', 'wait': 'humano', 'agent': 'ia', 'lmChatAnthropic': 'ia', 'memoryBufferWindow': 'ia',
          'toolWorkflow': 'ia'}
COLOR_CAMBIO = {'añadido': '#1f9d55', 'modificado': '#eb6834', 'renombrado': '#2a78d6', 'sin cambio': '#a9a7a1'}

def clasificar(wf, informe):
    modificados = {re.match(r'nodes\[(.+?)\]', r).group(1) for r, _, _ in informe['cambios']}
    tipo = {}
    for n in wf['nodes']:
        if n['name'] in informe['anadidos']:
            tipo[n['name']] = 'añadido'
        elif n['name'] in informe['renombrados'].values():
            tipo[n['name']] = 'renombrado'
        elif n['name'] in modificados:
            tipo[n['name']] = 'modificado'
        else:
            tipo[n['name']] = 'sin cambio'
    return tipo

def dibujar_cambios(wf, tipo, titulo, eliminados):
    fig, ax = plt.subplots(figsize = (15, 4.8))
    pos = {n['name']: (n['position'][0] / 100, -n['position'][1] / 100) for n in wf['nodes']}
    for n in wf['nodes']:
        x, y = pos[n['name']]
        forma, color = FORMAS[n['type'].split('.')[-1]], COLOR_CAMBIO[tipo[n['name']]]
        if forma == 'decision':
            ax.add_patch(Polygon([(x - 0.85, y), (x, y + 0.5), (x + 0.85, y), (x, y - 0.5)], facecolor = color,
                                 edgecolor = 'white', linewidth = 2))
        elif forma == 'humano':
            ax.add_patch(Polygon([(x - 0.8, y), (x - 0.55, y + 0.4), (x + 0.55, y + 0.4), (x + 0.8, y),
                                  (x + 0.55, y - 0.4), (x - 0.55, y - 0.4)], facecolor = color, edgecolor = 'white'))
        else:
            estilo = 'round,pad=0.05,rounding_size=0.35' if forma == 'disparador' else 'round,pad=0.05'
            ax.add_patch(FancyBboxPatch((x - 0.8, y - 0.38), 1.6, 0.76, boxstyle = estilo, facecolor = color,
                                        edgecolor = '#7b4fc9' if forma == 'ia' else 'white', linewidth = 2))
        ax.text(x, y, textwrap.fill(n['name'].replace('_', ' '), 14, break_long_words = False), ha = 'center',
                va = 'center', color = 'white', fontsize = 7.5)
    for o, tipo_c, salida_c, d in aristas(wf):
        (x1, y1), (x2, y2) = pos[o], pos[d]
        if tipo_c.startswith('ai_'):
            ax.add_patch(FancyArrowPatch((x1, y1 + 0.42), (x2 + (x1 - x2) * 0.15, y2 - 0.42), arrowstyle = '-|>',
                                         mutation_scale = 11, color = '#7b4fc9', linestyle = '--', linewidth = 1.1))
        else:
            curva = 'arc3,rad=0.1' if abs(x2 - x1) > 3 else 'arc3,rad=0'     # las ramas largas pasan por abajo
            ax.add_patch(FancyArrowPatch((x1 + 0.86, y1), (x2 - 0.86, y2), arrowstyle = '-|>', mutation_scale = 12,
                                         color = '#52514e', linewidth = 1.2, connectionstyle = curva))
    for i, (nombre, color) in enumerate(COLOR_CAMBIO.items()):
        ax.add_patch(FancyBboxPatch((14.2 + i * 2.6, -3.75), 0.5, 0.3, boxstyle = 'round,pad=0.02', facecolor = color))
        ax.text(14.85 + i * 2.6, -3.6, nombre, va = 'center', fontsize = 9)
    ax.text(14.2, -3.1, 'Eliminado: ' + ', '.join(eliminados), fontsize = 9, color = '#d6402a')
    ax.set_xlim(-1, 25.5)
    ax.set_ylim(-4.0, 1.6)
    ax.set_aspect('equal')
    ax.axis('off')
    ax.set_title(titulo, fontsize = 14)
    return ax

tipo_nodo = clasificar(v3_0_0, informe_v3)
print(pd.Series(tipo_nodo).value_counts().to_string())
print('Modificados:', sorted(k for k, v in tipo_nodo.items() if v == 'modificado'))
dibujar_cambios(v3_0_0, tipo_nodo, 'TL Agente de pedidos v3.0.0 frente a v2.0.0: qué cambió en cada nodo',
                informe_v3['eliminados'])
plt.tight_layout()
plt.show()
sin cambio    13
añadido        4
modificado     2
renombrado     1
Modificados: ['Agente de pedidos', 'Avisar a Valeria']
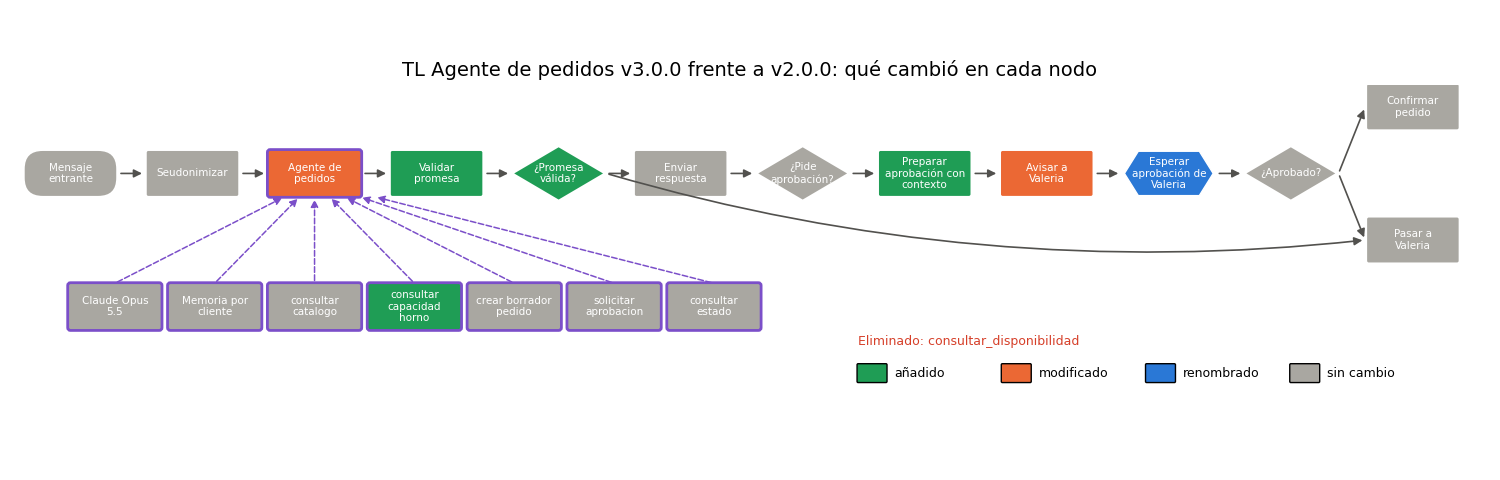
De los $20$ nodos de la versión $3.0.0$, $13$ no cambiaron, $4$ son nuevos, $2$ se modificaron y $1$ se renombró. El dibujo muestra algo que la lista no muestra: los cambios del Día 39 se concentran en dos zonas. Una está entre el agente y la respuesta a la clienta, donde ahora hay un validador y un IF cuya rama falsa salta, por debajo de todo el flujo, hasta “Pasar a Valeria”. La otra está en la rama de aprobación, donde el mensaje a Valeria lleva el resultado de capacidad del horno. Un dibujo coloreado por cambio es la forma más rápida de revisar un cambio ajeno: quien revisa sabe dónde mirar antes de leer una sola línea.
Versiones semánticas y registro de cambios
Valeria ya sabe qué cambió el viernes. Ahora tiene que corregirlo, y la corrección merece un número. El versionado semántico (o SemVer, por sus siglas en inglés: “Semantic Versioning”), en su especificación 2.0.0, escribe cada versión como tres enteros, MAYOR.MENOR.PARCHE, y fija cuál se incrementa según el tipo de cambio. La regla, aplicada a un flujo, se escribe como una función de la versión actual $(M, m, p)$:
$$ \text{siguiente}(M, m, p) = \begin{cases} (M + 1,\ 0,\ 0) & \text{si el cambio rompe el contrato del flujo} \ (M,\ m + 1,\ 0) & \text{si añade una capacidad compatible} \ (M,\ m,\ p + 1) & \text{si solo corrige o ajusta} \end{cases} $$
- Rompe el contrato cuando cambia lo que otros esperan del flujo: el formato de la entrada o de la salida, la ruta o el método del webhook, un nodo del que algo dependía o el efecto sobre los clientes. Quien llama al flujo tiene que adaptarse.
- Añade una capacidad compatible cuando aparece algo nuevo (una herramienta, una rama) y todo lo que funcionaba sigue funcionando igual.
- Corrige o ajusta cuando cambian parámetros sin cambiar el contrato, incluido un ajuste de prompt. Que un ajuste de prompt sea un parche no significa que sea inofensivo: el del viernes duplicó los escalados. Significa que no obliga a nadie a cambiar cómo usa el flujo.
La Tabla 3 traduce la regla a ejemplos de Trigo Lento. El sufijo del nombre del workflow (TL Agente de pedidos v3) sigue a la versión mayor y solo cambia cuando ella cambia.
Tabla 3. Reglas de versionado semántico aplicadas a los flujos de Trigo Lento.
| Tipo de cambio | Ejemplo en Trigo Lento | Versión | Etiqueta |
|---|---|---|---|
| Rompe el contrato | Barreras del Día 39: se elimina consultar_disponibilidad | $2.0.0 \to 3.0.0$ | tl-agente-pedidos/v3.0.0 |
| Rompe el contrato | Campo obligatorio nuevo en el sobre del pedido (Día 4) | $3.0.1 \to 4.0.0$ | tl-agente-pedidos/v4.0.0 |
| Rompe el contrato | Nueva ruta del webhook agente-pedidos-v4 | $3.0.1 \to 4.0.0$ | tl-agente-pedidos/v4.0.0 |
| Capacidad compatible | Nueva herramienta consultar_promociones | $3.0.1 \to 3.1.0$ | tl-agente-pedidos/v3.1.0 |
| Corrección o ajuste | Sustituir la frase de escalado del viernes | $3.0.0 \to 3.0.1$ | tl-agente-pedidos/v3.0.1 |
El siguiente bloque convierte la tabla en código. proponer_version lee el informe del diff semántico: si hay nodos eliminados, una ruta o un método de webhook cambiados, o si quien hace el cambio declara que cambió el contrato, propone una versión mayor; si hay nodos añadidos, una menor; en otro caso, un parche. Antes, el bloque escribe la corrección de Valeria, que sustituye la frase del viernes por una regla precisa, y la guarda normalizada. Después comprueba la función con los cinco casos de la Tabla 3 y escribe la entrada del registro de cambios, una sola vez, bajo la sección del agente:
# Versión semántica propuesta a partir del informe y entrada del registro de cambios en Python:
def proponer_version(actual, informe, contrato_cambiado = False):
    mayor, menor, parche = map(int, actual.split('.'))
    webhook = [r for r, _, _ in informe['cambios'] if r.endswith(('.parameters.path', '.parameters.httpMethod'))]
    if informe['eliminados'] or webhook or contrato_cambiado:
        return f'{mayor + 1}.0.0', 'mayor'
    if informe['anadidos']:
        return f'{mayor}.{menor + 1}.0', 'menor'
    return f'{mayor}.{menor}.{parche + 1}', 'parche'

# La corrección de Valeria: la frase del viernes se sustituye por una regla precisa:
FRASE_VIERNES = ('Si tiene cualquier duda sobre el pedido, no pregunte al cliente: pase la conversación a Valeria. ')
FRASE_NUEVA = ('Si falta un dato, pregúnteselo al cliente; pase la conversación a Valeria solo ante una línea roja '
               'o si consultar_capacidad_horno responde disponible: false. ')
v3_0_1 = copy.deepcopy(sabado_norm)
agente = next(n for n in v3_0_1['nodes'] if n['name'] == 'Agente de pedidos')
agente['parameters']['options']['systemMessage'] = agente['parameters']['options']['systemMessage'].replace(
    FRASE_VIERNES, FRASE_NUEVA)
(carpeta / 'normalizados' / 'n8n' / 'agente_pedidos_v3.json').write_text(como_texto(v3_0_1), encoding = 'utf-8', newline = '\n')

# Comprobación de las reglas con el cambio del Día 39, la corrección de hoy y tres cambios hipotéticos:
def con_cambio(wf, funcion):
    copia = copy.deepcopy(wf)
    funcion(copia)
    return copia

def nueva_herramienta(wf):
    wf['nodes'].append({**copy.deepcopy(wf['nodes'][-1]), 'name': 'consultar_promociones', 'id': 'nuevo'})

def nueva_ruta(wf):
    next(n for n in wf['nodes'] if n['name'] == 'Mensaje entrante')['parameters']['path'] = 'agente-pedidos-v4'

casos = [('Barreras del Día 39', '2.0.0', informe_v3, False),
         ('Corrección de la frase del viernes', '3.0.0', diff_semantico(v3_0_0, v3_0_1), False),
         ('Nueva herramienta consultar_promociones', '3.0.1', diff_semantico(v3_0_1, con_cambio(v3_0_1, nueva_herramienta)), False),
         ('Nueva ruta del webhook', '3.0.1', diff_semantico(v3_0_1, con_cambio(v3_0_1, nueva_ruta)), False),
         ('Campo obligatorio nuevo en el sobre del pedido', '3.0.1', diff_semantico(v3_0_1, v3_0_1), True)]
for nombre, actual, informe, contrato in casos:
    nueva, tipo = proponer_version(actual, informe, contrato)
    print(f'{nombre:<48} {actual} -> {nueva} ({tipo})')

# Entrada del registro de cambios (Keep a Changelog), insertada una sola vez bajo el flujo:
informe_hoy = diff_semantico(v3_0_0, v3_0_1)
entrada = '\n'.join([
    '### [3.0.1] - 2026-03-14',
    '#### Corregido',
    '- Prompt del agente: la frase "Si tiene cualquier duda sobre el pedido, no pregunte al cliente: pase la',
    '  conversación a Valeria", añadida el viernes 13 sin versión, duplicó los escalados del sábado; se sustituye',
    '  por una regla precisa (preguntar lo que falta; escalar solo ante una línea roja o sin capacidad de horno).',
    '#### Cambiado',
    '- Lienzo reacomodado y nodo "Memoria por cliente" recreado con los mismos parámetros (sin efecto).',
    f"- Rutas cambiadas: {', '.join(r for r, _, _ in informe_hoy['cambios'])}.",
    ''])
repo = carpeta / 'flujos-trigo-lento'
registro = (repo / 'CHANGELOG.md').read_text(encoding = 'utf-8')
if '### [3.0.1]' not in registro:
    registro = registro.replace('### [3.0.0]', entrada + '\n### [3.0.0]', 1)
    (repo / 'CHANGELOG.md').write_text(registro, encoding = 'utf-8', newline = '\n')
print(entrada)
Barreras del Día 39                              2.0.0 -> 3.0.0 (mayor)
Corrección de la frase del viernes               3.0.0 -> 3.0.1 (parche)
Nueva herramienta consultar_promociones          3.0.1 -> 3.1.0 (menor)
Nueva ruta del webhook                           3.0.1 -> 4.0.0 (mayor)
Campo obligatorio nuevo en el sobre del pedido   3.0.1 -> 4.0.0 (mayor)
### [3.0.1] - 2026-03-14
#### Corregido
- Prompt del agente: la frase "Si tiene cualquier duda sobre el pedido, no pregunte al cliente: pase la
  conversación a Valeria", añadida el viernes 13 sin versión, duplicó los escalados del sábado; se sustituye
  por una regla precisa (preguntar lo que falta; escalar solo ante una línea roja o sin capacidad de horno).
#### Cambiado
- Lienzo reacomodado y nodo "Memoria por cliente" recreado con los mismos parámetros (sin efecto).
- Rutas cambiadas: nodes[Agente de pedidos].parameters.options.systemMessage.
La función reproduce las cinco filas de la Tabla 3, y la de hoy da $3.0.0 \to 3.0.1$, un parche. Hay un matiz en la fila del campo obligatorio: un campo nuevo en el sobre del pedido no se ve en el JSON del workflow (vive en el contrato de datos del Día 4), así que el diff no puede detectarlo y la función depende de que la persona lo declare con contrato_cambiado = True. La versión la propone el código, pero la decide una persona, porque solo una persona sabe qué esperan los demás del flujo.
La entrada del registro sigue el formato de Keep a Changelog: la versión y la fecha en el encabezado, y los cambios agrupados por tipo (“Añadido”, “Cambiado”, “Corregido”, “Eliminado”). Dos detalles la hacen útil dentro de un mes. Dice el porqué con palabras de negocio (“duplicó los escalados del sábado”), no solo la ruta del parámetro. Y deja constancia de algo incómodo: que el viernes hubo un cambio sin versión, que nunca pasó por el repositorio. No es para señalar a nadie: el registro explica decisiones, no busca culpables, con el mismo espíritu del análisis sin culpables del Día 39.
¿Cuánto historial produce esta forma de trabajar? El siguiente bloque dibuja las etiquetas reales de los flujos de Trigo Lento en marzo, una por cada versión que ha entrado en servicio desde el escenario de Make del Día 33, junto con los commits de trabajo que habría entre una etiqueta y otra. Las etiquetas salen de la serie; los commits intermedios se simulan con una distribución de Poisson, como supuesto declarado:
# Historial de versiones de los flujos de Trigo Lento en marzo (etiquetas reales y commits simulados) en Python:
etiquetas = [('TL Pedidos WhatsApp (Make)', '2026-03-05', 'v3.0.0'),
             ('TL Pedidos WhatsApp n8n', '2026-03-08', 'v1.0.0'),
             ('TL Clasificador IA', '2026-03-09', 'v1.0.0'),
             ('TL Agente de pedidos', '2026-03-10', 'v2.0.0'),
             ('TL Agente de pedidos', '2026-03-11', 'v3.0.0'),
             ('TL Facturación', '2026-03-12', 'v1.0.0'),
             ('TL Importación histórica', '2026-03-13', 'v1.0.0'),
             ('TL Agente de pedidos', '2026-03-14', 'v3.0.1')]
flujos = list(dict.fromkeys(f for f, _, _ in etiquetas))
inicio = {f: min(date.fromisoformat(d) for g, d, _ in etiquetas if g == f) for f in flujos}
dias = [date(2026, 3, 1) + timedelta(days = i) for i in range(14)]
commits = []
for f in flujos:
    for d in dias:
        if d >= inicio[f]:
            # El día de creación, un commit más una cantidad Poisson de media 1; los demás días, media 0.3 (supuesto):
            for _ in range((1 + rng.poisson(1.0)) if d == inicio[f] else rng.poisson(0.3)):
                commits.append((f, d))
historial = pd.DataFrame(commits, columns = ['flujo', 'fecha'])
resumen = (historial.groupby('flujo').size().rename('commits').to_frame()
           .join(pd.Series([f for f, _, _ in etiquetas]).value_counts().rename('etiquetas'))
           .reindex(flujos).fillna(0).astype(int))
print(resumen.to_string())
print('Total:', len(historial), 'commits y', len(etiquetas), 'etiquetas entre el 1 y el 14 de marzo')

fig, ax = plt.subplots(figsize = (10, 4.6))
for i, f in enumerate(flujos):
    sub = historial[historial.flujo == f]
    desplazamiento = sub.groupby('fecha').cumcount() * 0.12
    ax.scatter(pd.to_datetime(sub.fecha), i + desplazamiento.values, color = '#2a78d6', s = 22, zorder = 3)
    ax.hlines(i, pd.to_datetime(inicio[f]), pd.Timestamp('2026-03-14'), color = '#b8b6b0', linewidth = 1)
for f, d, v in etiquetas:
    i = flujos.index(f)
    ax.scatter(pd.Timestamp(d), i - 0.28, marker = 'D', color = '#eb6834', s = 50, zorder = 4)
    ax.text(pd.Timestamp(d), i - 0.62, v, ha = 'center', fontsize = 8, color = '#52514e')
ax.scatter([], [], color = '#2a78d6', s = 22, label = 'commit (simulado)')
ax.scatter([], [], marker = 'D', color = '#eb6834', s = 50, label = 'etiqueta de versión')
ax.set_yticks(range(len(flujos)))
ax.set_yticklabels(flujos, fontsize = 9)
ax.set_ylim(len(flujos) - 0.4, -0.9)
ax.set_xlim(pd.Timestamp('2026-03-04'), pd.Timestamp('2026-03-15'))
ax.xaxis.set_major_formatter(matplotlib.dates.DateFormatter('%d-%m'))
ax.set_title('Historial de versiones de los flujos de Trigo Lento, marzo de 2026', fontsize = 14)
ax.legend(fontsize = 9, loc = 'lower left')
ax.grid(alpha = 0.3, axis = 'x')
plt.tight_layout()
plt.show()
                            commits  etiquetas
flujo
TL Pedidos WhatsApp (Make)        4          1
TL Pedidos WhatsApp n8n           3          1
TL Clasificador IA                2          1
TL Agente de pedidos              2          3
TL Facturación                    4          1
TL Importación histórica          1          1
Total: 16 commits y 8 etiquetas entre el 1 y el 14 de marzo
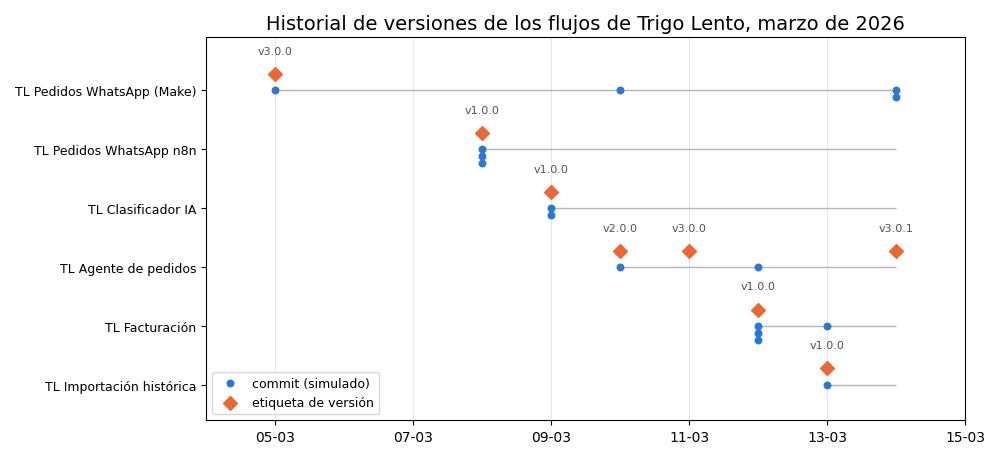
Entre el 1 y el 14 de marzo hay $8$ etiquetas y $16$ commits en seis flujos. El agente de pedidos es el único con tres etiquetas, y las tres están en cinco días: $2.0.0$ el martes 10, $3.0.0$ el miércoles 11 y $3.0.1$ hoy. Esa densidad no es casual: el flujo que más cambia es el que tiene un modelo de lenguaje dentro, porque su comportamiento depende de un texto que se ajusta a menudo. Es también el flujo donde un cambio sin versión hace más daño, porque un ajuste de prompt no rompe nada visible: solo cambia lo que el agente decide.
Ningún secreto en el historial
Git tiene una propiedad que es su mayor virtud y, para los secretos, su mayor peligro: lo que entra al historial se queda en el historial. Borrar una clave en el commit siguiente no la quita del commit anterior, y cualquiera que tenga una copia del repositorio la puede recuperar con un git log -p. Por eso la defensa no puede estar después del commit, sino antes: en un gancho (en inglés, hook), un programa que git ejecuta en un momento fijo. El gancho pre-commit se ejecuta antes de crear cada commit, y si termina con un código distinto de cero, el commit no se crea.
Los flujos de Trigo Lento no deberían llevar secretos: las claves viven en las credenciales de n8n y en las conexiones o el llavero de Make, y en los JSON solo aparecen sus nombres. Pero “no deberían” no es “no llevan”. Un nodo HTTP Request importado desde un comando cURL trae la cabecera de autenticación pegada en sus parámetros, un nodo Code de una prueba rápida puede llevar una clave escrita a mano y un nodo de aviso puede llevar la URL completa de un webhook de Slack, que funciona como una contraseña. La Tabla 4 lista lo que busca el detector de Trigo Lento.
Tabla 4. Patrones de secretos que busca el detector, con un ejemplo inventado y la acción que corresponde.
| Patrón | Expresión (resumen) | Ejemplo inventado | Acción si aparece |
|---|---|---|---|
| Clave de la API de Claude | sk-ant- y 20 o más caracteres | sk-ant-api03-EJEMPLO-NO-REAL-000... | Revocar en la consola de Claude y crear otra |
| Cabecera de autenticación con valor fijo | Authorization, x-api-key o X-N8N-API-KEY con un valor que no es expresión | Bearer EJEMPLO-NO-REAL-token-... | Mover el valor a una credencial de n8n y rotarlo |
| URL de webhook de Slack | https://hooks.slack.com/services/... | .../T00000000/B00000000/EJEMPLO-NO-REAL-0000 | Regenerar el webhook en Slack |
| Token de la API de Meta | EAA y 20 o más caracteres | EAAG-EJEMPLO-NO-REAL-... | Revocar el token del usuario del sistema |
| Teléfono con formato real | +52 y diez dígitos que no son de prueba | +52 55 1234 5678 | Sustituir por un número de prueba +52 55 0000 00XX |
La segunda fila tiene una excepción deliberada: un valor que empieza con = es una expresión de n8n (por ejemplo, ={{ $env.TL_CLAVE_FACTURACION }}), que lee el secreto del entorno en tiempo de ejecución y no lo contiene. La última fila no es un secreto, sino un dato personal; el detector la incluye porque el repositorio tampoco debe tener teléfonos de clientes, y los números de prueba de la serie (+52 55 0000 00XX) quedan fuera del patrón.
¿Vale la pena el esfuerzo para una panadería? Suponga que un commit de cada cien lleva un secreto por descuido ($q = 0.01$) y que el detector reconoce una fracción $d$ de esos secretos. La probabilidad de que al menos uno llegue al historial en $k$ commits es:
$$ P_{\text{fuga}}(k) = 1 - \left(1 - q,(1 - d)\right)^{k} $$
- $q,(1 - d)$ es la probabilidad de que un commit lleve un secreto y el detector no lo vea; su complemento, la de que ese commit sea seguro.
- Elevar al número de commits $k$ da la probabilidad de que todos sean seguros, y su complemento, la de al menos una fuga.
- Con un ritmo de unos $200$ commits al año (supuesto), la cifra muestra lo que hace un detector, incluso uno imperfecto.
El siguiente bloque escribe el detector con re, lo prueba sobre un archivo con tres secretos inventados sembrados (y con una expresión y un teléfono de prueba, que no debe marcar), lo pasa por los cuatro archivos normalizados del repositorio, escribe el gancho pre-commit y su script, y dibuja la probabilidad de fuga con y sin detector:
# Detector de secretos, gancho pre-commit y probabilidad de que un secreto llegue al historial en Python:
PATRONES = {
    'Clave de la API de Claude': r'sk-ant-[A-Za-z0-9_\-]{20,}',
    'Cabecera de autenticación con valor fijo':
        r'"name":\s*"(?:[Aa]uthorization|x-api-key|X-N8N-API-KEY)",\s*"value":\s*"(?!=)[^"]+"',
    'URL de webhook de Slack': r'https://hooks\.slack\.com/services/[A-Za-z0-9_/\-]+',
    'Token de la API de Meta': r'EAA[A-Za-z0-9\-]{20,}',
    'Teléfono con formato real': r'\+52\s?(?:1\s?)?(?!55\s?0000)\d{2}\s?\d{4}\s?\d{4}(?!\d)',
}

def detectar_secretos(rutas):
    hallazgos = []
    for ruta in rutas:
        texto = Path(ruta).read_text(encoding = 'utf-8')
        for nombre, patron in PATRONES.items():
            for m in re.finditer(patron, texto):
                linea = texto.count('\n', 0, m.start()) + 1
                hallazgos.append((Path(ruta).name, linea, nombre, ' '.join(m.group(0).split())[:30] + '...'))
    return sorted(hallazgos, key = lambda h: (h[0], h[1]))

# Archivo de prueba con tres secretos inventados sembrados, una expresión y un teléfono de prueba:
prueba = {'nodes': [
    {'name': 'Llamar a Claude', 'type': 'n8n-nodes-base.code',
     'parameters': {'jsCode': "const clave = 'sk-ant-api03-EJEMPLO-NO-REAL-000000000000000000';"}},
    {'name': 'Avisar por Slack', 'type': 'n8n-nodes-base.httpRequest',
     'parameters': {'url': 'https://hooks.slack.com/services/T00000000/B00000000/EJEMPLO-NO-REAL-0000'}},
    {'name': 'Facturación', 'type': 'n8n-nodes-base.httpRequest',
     'parameters': {'headerParameters': {'parameters': [
         {'name': 'Authorization', 'value': 'Bearer EJEMPLO-NO-REAL-token-facturacion-0000'},
         {'name': 'x-api-key', 'value': '={{ $env.TL_CLAVE_FACTURACION }}'}]},
                    'jsonBody': '{"cliente": "+52 55 0000 0042"}'}}]}
(carpeta / 'prueba_secretos.json').write_text(como_texto(prueba), encoding = 'utf-8', newline = '\n')
for h in detectar_secretos([carpeta / 'prueba_secretos.json']):
    print(h)
limpios = sorted((carpeta / 'normalizados').rglob('*.json'))
print('Hallazgos en los', len(limpios), 'flujos normalizados:', len(detectar_secretos(limpios)))

# El gancho: un script que el pre-commit llama con los archivos preparados para el commit:
ganchos = carpeta / 'flujos-trigo-lento' / 'ganchos'
ganchos.mkdir(exist_ok = True)
(ganchos / 'detectar_secretos.py').write_text(
    '# Detector de secretos de flujos-trigo-lento (generado en el Día 42): sale con 1 si encuentra algo.\n'
    'import re, sys\n'
    f'PATRONES = {json.dumps(PATRONES, ensure_ascii = False, indent = 4)}\n'
    'malos = 0\n'
    'for ruta in sys.argv[1:]:\n'
    '    texto = open(ruta, encoding = "utf-8").read()\n'
    '    for nombre, patron in PATRONES.items():\n'
    '        for m in re.finditer(patron, texto):\n'
    '            malos += 1\n'
    '            print(f"{ruta}:{texto.count(chr(10), 0, m.start()) + 1}: {nombre}")\n'
    'if malos:\n'
    '    print(f"Commit detenido: {malos} posibles secretos. Revoque la clave si ya salió del equipo.")\n'
    'sys.exit(1 if malos else 0)\n', encoding = 'utf-8', newline = '\n')
(ganchos / 'pre-commit').write_text(
    '#!/bin/sh\n'
    '# Revisa los archivos preparados para el commit antes de que entren al historial:\n'
    'archivos=$(git diff --cached --name-only --diff-filter=ACM)\n'
    '[ -z "$archivos" ] && exit 0\n'
    'exec python ganchos/detectar_secretos.py $archivos\n', encoding = 'utf-8', newline = '\n')

# Probabilidad de que al menos un secreto llegue al historial en k commits:
q = 0.01                                     # commits que llevan un secreto por descuido (supuesto)
k = np.arange(0, 301)
for d, nombre in [(0.0, 'sin detector'), (0.6, 'detector que cubre el 60 %'), (0.95, 'detector que cubre el 95 %')]:
    print(f'{nombre:<28} P(fuga en 200 commits) = {1 - (1 - q * (1 - d)) ** 200:.3f}')
fig, ax = plt.subplots(figsize = (8, 4.4))
for d, color, nombre in [(0.0, '#d6402a', 'Sin detector'), (0.6, '#eb6834', 'Detector que cubre el 60 %'),
                         (0.95, '#1f9d55', 'Detector que cubre el 95 %')]:
    ax.plot(k, 100 * (1 - (1 - q * (1 - d)) ** k), color = color, label = nombre)
ax.axvline(200, color = '#52514e', linestyle = ':', label = 'Un año de commits de Trigo Lento (supuesto)')
ax.set_xlabel('Commits')
ax.set_ylabel('Probabilidad de al menos una fuga (%)')
ax.set_title('Un secreto en el historial: probabilidad acumulada', fontsize = 14)
ax.legend(fontsize = 9)
ax.grid(alpha = 0.3)
plt.tight_layout()
plt.show()
('prueba_secretos.json', 6, 'Clave de la API de Claude', 'sk-ant-api03-EJEMPLO-NO-REAL-0...')
('prueba_secretos.json', 13, 'URL de webhook de Slack', 'https://hooks.slack.com/servic...')
('prueba_secretos.json', 23, 'Cabecera de autenticación con valor fijo', '"name": "Authorization", "valu...')
Hallazgos en los 4 flujos normalizados: 0
sin detector                 P(fuga en 200 commits) = 0.866
detector que cubre el 60 %   P(fuga en 200 commits) = 0.551
detector que cubre el 95 %   P(fuga en 200 commits) = 0.095
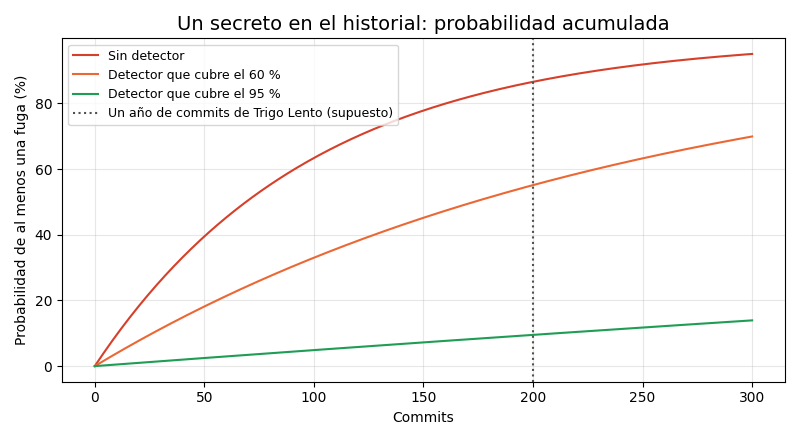
El detector encuentra los tres secretos sembrados, cada uno con su línea y su patrón, y ninguno en los cuatro archivos normalizados: ni la expresión ={{ $env.TL_CLAVE_FACTURACION }} ni el teléfono de prueba +52 55 0000 0042 dan falsos positivos. Las cifras de la fórmula ponen el resto en perspectiva:
- En primer lugar, sin detector, la probabilidad de que un secreto llegue al historial en un año es del $86.6%$: con $200$ commits, el descuido de uno de cada cien es casi seguro que ocurra alguna vez.
- En segundo lugar, un detector que cubre el $95%$ de los casos la baja al $9.5%$. No la lleva a cero, porque ningún conjunto de patrones reconoce todos los secretos posibles.
- En tercer lugar, un detector que solo cubre el $60%$ la deja en el $55.1%$: un detector con pocos patrones da una falsa sensación de seguridad. Por eso la Tabla 4 se revisa cada vez que Trigo Lento conecta un servicio nuevo.
Atención aquí: si un secreto ya entró al historial, el orden de las acciones importa. Primero, revóquelo y rótelo en el servicio de origen (la consola de Claude, Slack, Meta, el servicio de facturación), porque desde ese momento debe darlo por comprometido: cualquier copia del repositorio, cualquier clon en otra máquina y cualquier respaldo lo conserva. Después, si quiere, limpie el historial con una herramienta de reescritura como git filter-repo y un envío forzado; esa limpieza reduce la exposición futura, pero no deshace la pasada. Un git rm o un commit que borra la línea no sirve de nada: el secreto sigue en el commit anterior. Y no confíe en que el repositorio sea privado: privado no significa que nadie más lo vaya a clonar nunca.
El portero que imagina la Figura 3 está en la puerta de git y revisa cada archivo antes de dejarlo pasar: el que lleva una llave se queda fuera.
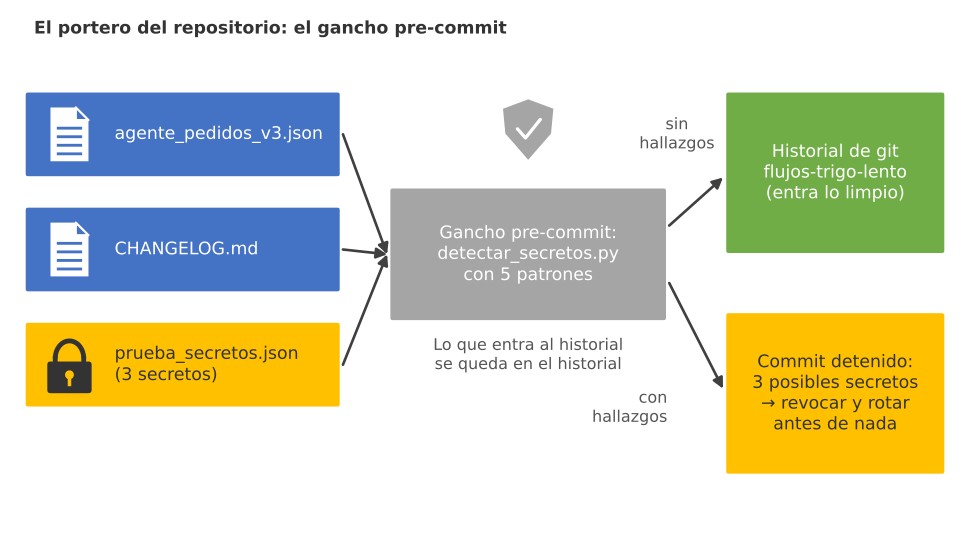
Figura 3. El portero del repositorio: el gancho pre-commit revisa cada archivo preparado con el detector de secretos; los flujos limpios entran al historial y el archivo con tres secretos sembrados se detiene en la puerta.
Falta ponerlo a trabajar. El último bloque de git del día hace el recorrido completo de la corrección: activa los ganchos versionados con core.hooksPath, crea la rama cambio/agente-pedidos-3.0.1, prepara el flujo corregido, el registro de cambios y los ganchos, y hace el commit. Después intenta, a propósito, colar el archivo con los secretos sembrados, para ver al gancho actuar. Por último une la rama a main con un commit de unión, etiqueta la versión y la envía al remoto. Se ejecutó en el mismo repositorio de prueba, y la salida es la real:
# Rama de cambio, gancho pre-commit, unión, etiqueta anotada y envío al remoto privado en Bash:
cd trigo_lento/dia_42/flujos-trigo-lento
git config core.hooksPath ganchos                    # los ganchos viven en el repositorio y se versionan
git switch -q -c cambio/agente-pedidos-3.0.1
cp ../normalizados/n8n/agente_pedidos_v3.json flujos/n8n/
git add flujos/n8n/agente_pedidos_v3.json CHANGELOG.md ganchos/
git diff --cached --stat
git commit -q -m "TL Agente de pedidos 3.0.1: sustituye la frase de escalado del viernes 13" \
              -m "La frase 'Si tiene cualquier duda...' duplicó los escalados del sábado; ver CHANGELOG."

# El portero en acción: un archivo con secretos sembrados no pasa:
cp ../prueba_secretos.json flujos/n8n/
git add flujos/n8n/prueba_secretos.json
git commit -q -m "Prueba: archivo con secretos sembrados" || echo ">> El gancho detuvo el commit"
git rm -q --cached flujos/n8n/prueba_secretos.json && rm flujos/n8n/prueba_secretos.json

# Revisión hecha: se une a main, se etiqueta y se envía con las etiquetas:
git switch -q main
git merge -q --no-ff cambio/agente-pedidos-3.0.1 -m "Une cambio/agente-pedidos-3.0.1"
git tag -a tl-agente-pedidos/v3.0.1 -m "TL Agente de pedidos 3.0.1: corrige la frase de escalado"
git push -q --follow-tags origin main
git log --oneline --decorate
git tag -n1 --list 'tl-agente-pedidos/*'
git diff --stat tl-agente-pedidos/v3.0.0 tl-agente-pedidos/v3.0.1 -- flujos/
 CHANGELOG.md                      |  9 +++++++++
 flujos/n8n/agente_pedidos_v3.json | 26 +++++++++++++-------------
 ganchos/detectar_secretos.py      | 19 +++++++++++++++++++
 ganchos/pre-commit                |  5 +++++
 4 files changed, 46 insertions(+), 13 deletions(-)
flujos/n8n/prueba_secretos.json:6: Clave de la API de Claude
flujos/n8n/prueba_secretos.json:23: Cabecera de autenticación con valor fijo
flujos/n8n/prueba_secretos.json:13: URL de webhook de Slack
Commit detenido: 3 posibles secretos. Revoque la clave si ya salió del equipo.
>> El gancho detuvo el commit
c69f757 (HEAD -> main, tag: tl-agente-pedidos/v3.0.1, origin/main) Une cambio/agente-pedidos-3.0.1
5f2520c (cambio/agente-pedidos-3.0.1) TL Agente de pedidos 3.0.1: sustituye la frase de escalado del viernes 13
7f6fd85 (tag: tl-agente-pedidos/v3.0.0) TL Agente de pedidos 3.0.0: capacidad del horno, validador de la promesa y aprobación con contexto
e7d7e36 (tag: tl-pedidos-whatsapp-n8n/v1.0.0, tag: tl-pedidos-whatsapp-make/v3.0.0, tag: tl-agente-pedidos/v2.0.0) Agrega los flujos normalizados de Trigo Lento y su registro de cambios
tl-agente-pedidos/v2.0.0 TL Agente de pedidos 2.0.0 (Día 38)
tl-agente-pedidos/v3.0.0 TL Agente de pedidos 3.0.0 (Día 39)
tl-agente-pedidos/v3.0.1 TL Agente de pedidos 3.0.1: corrige la frase de escalado
 flujos/n8n/agente_pedidos_v3.json | 26 +++++++++++++-------------
 1 file changed, 13 insertions(+), 13 deletions(-)
La salida se lee de arriba abajo como el sábado de Valeria:
- El commit de la corrección toca cuatro archivos: $9$ líneas nuevas en el registro de cambios, los dos archivos del gancho y $26$ líneas del agente ($13$ que salen y $13$ que entran). Que sean $13$ y no $1$ se explica con la Tabla 2: el archivo guardado conserva las posiciones y los identificadores de nodo, así que el diff de git muestra también los seis nodos movidos y la memoria recreada. Quien revise en git verá esas líneas; quien revise con el diff semántico, solo la frase.
- El gancho detuvo el commit con los secretos sembrados: imprimió los tres hallazgos con su línea, el mensaje “Commit detenido: 3 posibles secretos” y terminó con error, de modo que git no creó el commit. El archivo se retiró del área de preparación sin dejar rastro en el historial.
- El historial muestra la rama y su unión: el commit
5f2520cen la rama de cambio, el commit de uniónc69f757enmain, con la etiquetatl-agente-pedidos/v3.0.1, yorigin/mainen el mismo punto, es decir, ya en el remoto. - Las tres etiquetas del agente listan su historia en tres líneas, y el último diff entre
v3.0.0yv3.0.1confirma que, en los flujos, solo cambió el archivo del agente.
Ahora la frase del viernes tiene fecha, autor, motivo y una versión que la corrige. Si el lunes alguien pregunta por qué el agente vuelve a preguntar si el pastel lleva texto, la respuesta está en git log y en CHANGELOG.md.
Volver atrás y la función nativa de n8n
Un historial que no sirve para volver atrás es solo un diario. Para Trigo Lento, volver atrás significa llevar a la instancia de n8n el JSON de una etiqueta. Hay dos caminos. El de la CLI, n8n import:workflow, que el Día 35 usó en el simulacro de restauración, tiene una advertencia en la documentación oficial: si en la base ya existe un workflow con el mismo identificador, lo sobrescribe, y los workflows importados quedan desactivados por omisión. Para restaurar una versión del mismo workflow eso es justo lo que se quiere; para importar un flujo nuevo copiado de otro, es un riesgo, y conviene cambiar el identificador antes.
El segundo camino es la API pública, el mismo enlace con el Día 36 (Primer workflow en n8n: nodos, items y expresiones), que importó su primer workflow por API: PUT /api/v1/workflows/{id} actualiza el workflow existente con el contenido que se le envía. Hay una trampa conocida en el foro de la comunidad: el cuerpo no admite todos los campos de la exportación, y un JSON exportado reenviado tal cual suele devolver un error de propiedades adicionales. Por eso la función del siguiente bloque envía solo name, nodes, connections y los ajustes admitidos, y lee el archivo de la etiqueta con git show, no de la copia de trabajo, para restaurar exactamente lo que se revisó. Llama a la instancia real y no se ejecutó al escribir la entrada; la salida es un ejemplo comentado:
# Restaurar en n8n una versión etiquetada en git, por la API pública, en Python:
import json
import os
import subprocess

import requests

N8N_URL = 'https://n8n.trigolento.example/api/v1'
AJUSTES_ADMITIDOS = {'executionOrder', 'timezone', 'errorWorkflow', 'saveDataSuccessExecution',
                     'saveManualExecutions', 'executionTimeout'}   # contrástelos con la referencia de su versión

def restaurar(etiqueta, archivo):
    # El archivo se lee de la etiqueta, no de la copia de trabajo: es exactamente lo que se revisó:
    texto = subprocess.run(['git', 'show', f'{etiqueta}:{archivo}'], capture_output = True, text = True,
                           encoding = 'utf-8', check = True, cwd = 'flujos-trigo-lento').stdout
    wf = json.loads(texto)
    cuerpo = {'name': wf['name'], 'nodes': wf['nodes'], 'connections': wf['connections'],
              'settings': {k: v for k, v in wf['settings'].items() if k in AJUSTES_ADMITIDOS}}
    r = requests.put(f"{N8N_URL}/workflows/{wf['id']}", json = cuerpo, timeout = 30,
                     headers = {'X-N8N-API-KEY': os.environ['N8N_API_KEY']})
    r.raise_for_status()
    return r.json()['id'], r.json()['name'], len(r.json()['nodes'])

print(restaurar('tl-agente-pedidos/v3.0.0', 'flujos/n8n/agente_pedidos_v3.json'))

# Salida de ejemplo (puede variar):
# ('Ag7kRt2mWq9pLs4V', 'TL Agente de pedidos v3', 20)
Con esa función, volver a la versión del jueves es una línea. Valeria no la necesita hoy, porque la corrección ya está en main, pero la deja escrita en el manual de restauración del Día 35, en un paso nuevo: “si un cambio de un flujo empeora el servicio, restaure la última etiqueta y abra una rama para entender qué pasó”.
El control de versiones integrado de n8n
¿No hace n8n todo esto solo? En parte, y depende del plan. La documentación oficial, revisada en octubre de 2026, describe dos funciones:
- Historial de versiones del workflow: el editor guarda las versiones de cada workflow y permite verlas y restaurarlas. Las de las últimas $24$ horas están disponibles para todos los usuarios; el historial completo es de los planes Enterprise, y las versiones con nombre, que n8n no poda automáticamente, son de n8n Cloud Pro y Enterprise y de los planes autoalojados Business y Enterprise.
- Control de fuentes y entornos: vincula la instancia a un repositorio git y crea entornos (por ejemplo, desarrollo y producción) respaldados por ramas, con operaciones de enviar y traer cambios desde la interfaz. Está disponible en los planes Business y Enterprise.
Trigo Lento usa la edición Community autoalojada, la de $0$ euros más el servidor de la Tabla B de la serie. Con ella, el historial nativo cubre las últimas $24$ horas: habría bastado para ver el cambio del viernes el sábado por la mañana, pero no para saber, dentro de un mes, cuál fue la última versión buena antes de un cambio. El control de fuentes integrado queda fuera de su plan, y el plan Business está muy por encima de los $45$ USD al mes de todo el ecosistema. Por eso Trigo Lento lleva su propio repositorio: cuesta $0$ USD, funciona igual para n8n y para Make, y deja el historial fuera de la plataforma que versiona, de modo que sobrevive incluso a un cambio de plataforma. El precio es la disciplina: exportar, normalizar y hacer commit no ocurre solo, y la próxima mejora natural es que la copia nocturna del Día 35 termine con un commit automático cuando el JSON normalizado cambie.
Don Ernesto, que ha vuelto a subir para preguntar si ya se arregló “lo del robot”, escucha la explicación de las ramas, las etiquetas y el portero, mira el historial en la terminal y lo resume a su manera: “Entonces es como mi libreta de recetas, pero que no se moja.” Y, después de pensarlo un poco: “Y que no deja apuntar la combinación de la caja fuerte.”
Consideraciones finales
El día empezó con $222$ líneas rojas y verdes y una frase perdida, y termina con un repositorio privado de tres flujos, cinco etiquetas, un registro de cambios y un portero. Los números caben en un párrafo: la normalización redujo el diff del agente de $222$ líneas a $2$ y el del workflow sin cambios de $63$ a $0$; el diff semántico encontró, en un parámetro de $20$ nodos, la única frase añadida el viernes; la corrección se propuso y se etiquetó como el parche $3.0.1$; y el detector encontró los tres secretos sembrados sin un solo falso positivo, con una probabilidad de fuga anual que baja del $86.6%$ al $9.5%$ si cubre el $95%$ de los casos.
Las cifras tienen límites que conviene decir. Las exportaciones del día tienen la estructura documentada de n8n y de Make, pero no salieron de una instancia en marcha; el orden exacto de las claves de cada vía de exportación puede variar entre versiones, y la normalización existe precisamente para que eso no importe. Los commits intermedios del historial de marzo son simulados, y la probabilidad de fuga descansa en un $q$ y un $d$ supuestos. Y hay un límite que no es de las cifras: un diff semántico dice qué cambió en el JSON, no qué cambió en el comportamiento. La frase del viernes era una sola línea, y duplicó los escalados; solo una prueba con conversaciones, como las del Día 38, lo habría anticipado.
Antes de dar por versionado cualquier flujo, conviene hacerse algunas preguntas:
- Si hoy alguien cambia una frase del prompt de su agente, ¿cuánto tardaría usted en saber qué frase era, quién la cambió y por qué?
- ¿Sus exportaciones salen siempre por la misma vía, o mezclan la CLI, la API y el editor, con su ruido?
- ¿Qué secreto podría llegar hoy a su repositorio que ninguno de sus patrones reconoce?
- ¿Su versión “buena” tiene una etiqueta, o solo vive en la memoria de alguien?
Un gran libro que habla de esto es Pro Git, de Scott Chacon y Ben Straub, que se puede leer gratis y en varios idiomas en la página oficial de git. Sus primeros capítulos explican con calma la idea que hoy sostiene todo: git no guarda diferencias, sino fotografías completas de los archivos en cada commit, y por eso cualquier versión se recupera entera. Los capítulos de ramas y de etiquetas son, casi palabra por palabra, el flujo de trabajo que Valeria montó hoy.
Un flujo sin historial funciona hasta el día en que alguien lo mejora. Trigo Lento ya tiene la libreta que pedía Don Ernesto: cada versión de cada flujo con su fecha, su autor y su porqué, con las buenas marcadas y una puerta que no deja pasar llaves. El viernes no se puede deshacer, pero el próximo viernes dejará rastro.
Conclusiones clave
Exportar y normalizar
- Un respaldo protege contra la pérdida; un historial, contra el cambio no explicado: responde qué cambió, quién, por qué y cómo volver.
n8n export:workflow --all --separate --pretty --output=...(o--backup) exporta un archivo por workflow; la API pública pagina por cursor conX-N8N-API-KEY, y Make entrega el blueprint enresponse.blueprintdeGET /scenarios/{scenarioId}/blueprint.- Dos exportaciones del mismo workflow difieren por el orden de claves y de nodos, los campos volátiles,
pinData, las posiciones y los identificadores; normalizar redujo el diff del agente de $222$ líneas a $2$, y el de un workflow sin cambios de $63$ a $0$.
Diferencias y versiones
- Un diff semántico compara por nombre de nodo, detecta renombrados por el identificador y da la ruta de cada parámetro: encontró la única frase añadida el viernes en
nodes[Agente de pedidos].parameters.options.systemMessage. - SemVer aplicado a flujos: mayor si se rompe el contrato (nodo eliminado, ruta de webhook, sobre del pedido), menor si se añade una capacidad compatible, parche si solo se ajusta, incluido un prompt; la versión la propone el código y la decide una persona.
- El registro de cambios dice el porqué con palabras de negocio y deja constancia de los cambios sin versión, para explicar decisiones y no para buscar culpables.
Secretos y restauración
- Lo que entra al historial se queda en el historial: un gancho
pre-commitcon un detector de patrones detuvo el commit con tres secretos sembrados, sin falsos positivos en los flujos reales. - Con $P_{\text{fuga}}(k) = 1 - (1 - q(1-d))^k$, $q = 0.01$ y $200$ commits, la probabilidad de fuga anual baja del $86.6%$ al $9.5%$ con un detector que cubre el $95%$; si un secreto se sube, se revoca y se rota antes de limpiar nada.
- Restaurar es leer la etiqueta con
git showy enviarla por la API; el control de versiones integrado de n8n es de los planes Business y Enterprise, y en Community el historial nativo cubre $24$ horas.
Mañana, en el Día 43: Laboratorio guiado: pruebas de flujos con datos fijados y un entorno de ensayo. Con los flujos en un repositorio y sus versiones etiquetadas, Valeria quiere probar TL Agente de pedidos v3.0.1 y TL Pedidos WhatsApp n8n v1 sin escribir a ningún cliente real, con casos de prueba, contratos y una instancia de ensayo que solo recibe lo que sale de una etiqueta.
Referencias
- Chacon, S. y Straub, B. (2014). Pro Git (2.ª ed.). Apress. https://git-scm.com/book
- Preston-Werner, T. (2013). Semantic Versioning 2.0.0. https://semver.org
- Lacan, O. (2026). Keep a Changelog. https://keepachangelog.com
- n8n (2026). CLI commands y API pública (autenticación y paginación). n8n Docs. https://docs.n8n.io/hosting/cli-commands/ y https://docs.n8n.io/api/pagination/
- n8n (2026). Source control and environments y Workflow history. n8n Docs. https://docs.n8n.io/source-control-environments/ y https://docs.n8n.io/workflows/history/
- Make (2026). Scenarios: Get scenario blueprint. Make Developer Hub. https://developers.make.com/api-documentation/api-reference/scenarios/blueprints
- Git (2026). githooks: ganchos de git (
pre-commit,core.hooksPath). https://git-scm.com/docs/githooks