
Arquitecto de automatización con IA: Día 43
 Jeshua Romero Guadarrama
- 60 Min para leer
- 15 Mar, 2026
Índice de contenido
Resumen:
Un domingo sin clientes, Valeria prueba los flujos de Trigo Lento sin escribirle a nadie: fija mensajes inventados en el Webhook de n8n, escribe 30 casos con su archivo de referencia, valida 30 cuerpos de webhook con contratos de pydantic, levanta una instancia de ensayo con su propia base, su propia clave de cifrado y credenciales de prueba, y corre una suite de 12 comprobaciones estáticas sobre los JSON exportados del repositorio. Al terminar, usted sabrá comparar la salida de un flujo con una referencia sin que lo estropeen las marcas de tiempo, sembrar regresiones para comprobar que la suite las ve, leer un flujo de integración continua y calcular cuántos casos hacen falta para detectar un error que afecta a una fracción de los mensajes.
¿Cómo citar el presente artículo?
Romero, J. (15 de marzo de 2026). Arquitecto de automatización con IA: Día 43. python-data-engineer. https://www.python-data-engineer.com/post/aai/dia_43/.
Arquitecto de automatización con IA: Día 43 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/aai/dia_43/.
Precios, límites y políticas revisados en octubre de 2026: planes, precios y límites de Make, n8n, Zapier, WhatsApp (Meta, Twilio, Wati) y de la API de Claude. Los datos fijados de n8n (solo se usan en ejecuciones manuales y de prueba, no en las de producción; no admiten salidas con datos binarios ni nodos con más de una salida principal), los comandos n8n import:workflow y n8n execute --id de la CLI y las Evaluaciones de n8n (nodos Evaluation Trigger y Evaluation) se contrastaron con la documentación oficial, revisado en octubre de 2026. No se pudo levantar un contenedor de n8n al escribir la entrada (el servicio de Docker no respondía): el pinData del Bloque 2 y el archivo de Compose del Bloque 5 tienen la estructura verificada contra la documentación, revisado en octubre de 2026, con identificadores de ejemplo. El Bloque 8 llama a la instancia de ensayo y su salida es un ejemplo comentado; los demás bloques de Python se ejecutan sin red y sus salidas son las reales.
Día 43. Laboratorio guiado: pruebas de flujos con datos fijados y un entorno de ensayo
Introducción
Ayer, en el Día 42 (Versionado de flujos: exportar el JSON a git, revisar diferencias y etiquetar versiones), Valeria aprendió a exportar los workflows, normalizarlos para que git muestre solo los cambios reales, leer una diferencia por nodo y etiquetar versiones, y Trigo Lento ganó un repositorio con sus flujos normalizados, etiquetas y un detector de secretos. Hoy ese repositorio deja de ser un archivo y se convierte en un banco de pruebas.
Es domingo 15 de marzo. La panadería descansa, el horno está frío y el teléfono de pedidos no suena. Es el único día de la semana en que Valeria puede tocar los flujos sin miedo a romper un encargo a media mañana, y tiene una razón concreta para hacerlo: mañana, en la evaluación del módulo, tendrá que defender que TL Agente de pedidos v3.0.1 y TL Pedidos WhatsApp n8n v1 hacen lo que dicen. Hasta hoy, su forma de probarlos ha sido la del Día 36 (Primer workflow en n8n: nodos, items y expresiones): fijar un mensaje en el Webhook, pulsar “Probar workflow” y mirar el panel de datos nodo por nodo. Funciona para un cambio, pero no para diez, y no deja rastro de qué se comprobó.
El Día 39 (Anatomía de un fallo real II: el agente que prometió un pastel imposible) ya construyó cuarenta conversaciones de regresión para el agente. Faltaba lo mismo para todo lo demás: el flujo de entrada, las reglas que reparten los mensajes, los cuerpos que llegan del exterior y la forma de los propios archivos JSON. Y faltaba un lugar donde probarlo todo sin que una clienta reciba un “¡Listo!” de prueba en su teléfono.
Don Ernesto, que ha venido a revisar la masa madre del lunes, escucha el plan con los brazos cruzados y lo resume a su manera: “Las recetas nuevas se prueban en una charola, no en el aparador. Y en la charola no se ponen los pasteles de los clientes.” Es exactamente la regla del día, en dos frases. La charola es un entorno de ensayo con sus propios ingredientes; el aparador es producción, y solo pasa a él lo que salió bien en la charola. La segunda frase es la parte ética: en las pruebas no se usan datos reales de nadie.
En la presente entrada, descubrirá qué se prueba en un flujo y cuánto cuesta cada nivel de prueba. Fijará tres mensajes inventados en el Webhook de n8n, escribirá 30 casos de prueba con sus archivos de referencia y un comparador que ignora los campos que cambian en cada ejecución, y validará 30 cuerpos de webhook con contratos de pydantic. Levantará una instancia de ensayo separada de producción, con su base, su clave de cifrado, su número de prueba y su tope de gasto, a la que solo llegan versiones etiquetadas en git. Después correrá una suite de 12 comprobaciones estáticas sobre los seis workflows del repositorio, sembrará regresiones para comprobar que la suite las detecta, leerá un flujo de integración continua y calculará con una fórmula cuántos casos hacen falta para confiar en el resultado.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Fijar datos de prueba en n8n (
pinData) y construir casos de prueba con archivos de referencia que comparan la salida esperada sin depender de marcas de tiempo ni identificadores. - Escribir pruebas de contrato con pydantic para los cuerpos de webhook y el sobre del pedido.
- Montar una instancia de ensayo de n8n separada de producción (base, credenciales, clave de cifrado, número de prueba y tope de gasto propios) y promover cambios desde git.
- Ejecutar una suite de regresión en Python sobre los JSON exportados, leer un flujo de integración continua y decidir cuántos casos hacen falta.
Qué se prueba en un flujo
Un flujo de automatización parece una sola cosa en el lienzo de n8n, pero se puede romper por cinco sitios distintos, y cada uno se prueba de una manera. La pregunta que ordena el día es ¿qué puede cambiar sin que nadie se dé cuenta? Una expresión de un nodo Edit Fields que deja de producir un campo; una regla de un IF o de un Switch que manda un mensaje por la rama equivocada; un cuerpo que llega del exterior con una forma nueva; un camino completo que ya no termina en la respuesta correcta; y un agente que, con el mismo prompt, decide algo distinto. La Tabla 1 reúne los cinco niveles con lo que verifica cada uno, la herramienta, el coste y el momento en que se ejecuta.
Tabla 1. Niveles de prueba de un flujo de Trigo Lento: qué verifica, herramienta, coste y cuándo se ejecuta.
| Nivel | Qué verifica | Herramienta | Coste | Cuándo se ejecuta |
|---|---|---|---|---|
| 1. Transformaciones | Que los nodos Code y Edit Fields producen los campos esperados | Datos fijados y referencias | 0 USD, determinista | En cada cambio del nodo |
| 2. Reglas | Que IF y Switch mandan cada mensaje por la rama correcta | 30 casos con ruta esperada | 0 USD, determinista | En cada solicitud de cambios |
| 3. Contratos | Que los cuerpos de webhook y el sobre del pedido tienen la forma pactada | pydantic, 30 cuerpos | 0 USD, determinista | En cada solicitud de cambios |
| 4. Flujo completo | Que el camino de punta a punta termina en la respuesta correcta | Instancia de ensayo y comparador | 0 USD en instalación propia; una ejecución por caso en n8n Cloud | Antes de promover una etiqueta |
| 5. Agente | Que el agente escala, no promete y respeta sus herramientas | 40 conversaciones del Día 39 | 2.88 USD por corrida con Opus 5.5 | Solo cuando cambia el prompt, el modelo o una herramienta |
Tres ideas se leen en la tabla, y conviene fijarlas antes de escribir una línea de código:
- Los cuatro primeros niveles son deterministas y gratis. Con la misma entrada dan siempre la misma salida, de modo que una diferencia significa un cambio, no mala suerte. Se pueden correr cien veces al día sin gastar un centavo de la API de Claude.
- El quinto nivel es estadístico y cuesta tokens. El Día 39 calculó $2.88$ USD por cada corrida de las cuarenta conversaciones con Claude Opus 5.5, y dos corridas al mes serían el $72%$ del rubro de $8$ USD. Por eso el agente se prueba cuando cambia algo que lo afecta, no en cada solicitud de cambios.
- Cada nivel atrapa lo que los anteriores dejan pasar. Un contrato correcto no garantiza que el Switch reparta bien; un Switch correcto no garantiza que el nodo de respuesta use el campo que el Switch produjo. Las pruebas se apilan como las barreras del Día 39.
La pirámide de pruebas de la ingeniería de software dice lo mismo con otras palabras: muchas pruebas pequeñas, rápidas y baratas en la base, y pocas pruebas grandes, lentas y caras en la punta. En un flujo de automatización la base son las transformaciones y las reglas, y la punta es el agente. Lo que no conviene es invertir la pirámide, que es justo lo que pasa cuando la única prueba es pulsar “Probar workflow” y leer el resultado a ojo: una prueba de punta a punta, manual, sin referencia y sin registro. El Día 83 extenderá esta misma idea a todo el ecosistema, con pruebas de punta a punta y de caos; hoy se construye la base.
La idea completa del laboratorio cabe en la charola de Don Ernesto, como muestra la Figura 1.
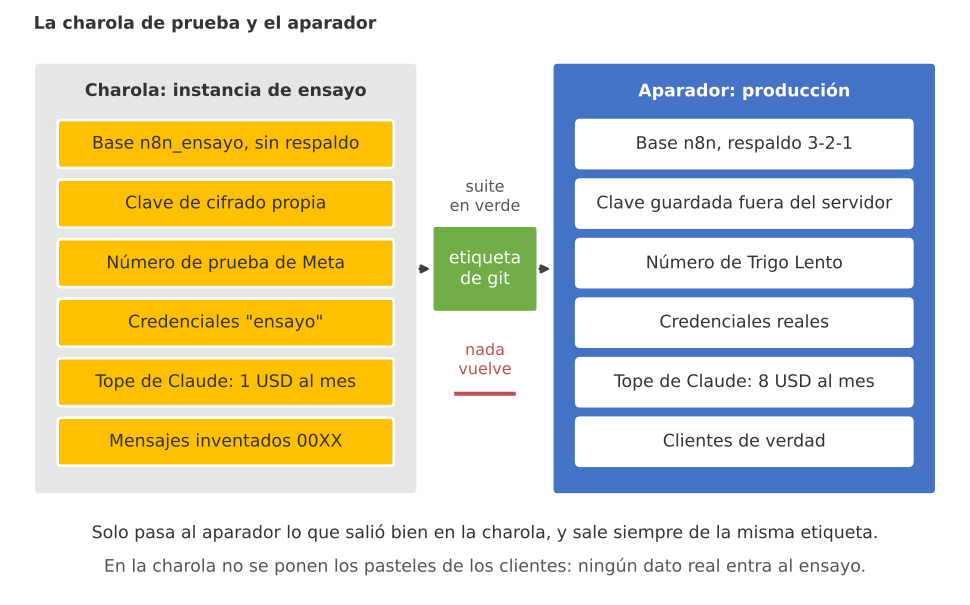
Figura 1. La charola de prueba y el aparador: la instancia de ensayo tiene su propia base, su clave de cifrado, un número de prueba, credenciales de ensayo y un tope de 1 USD; a producción solo pasa una etiqueta de git con la suite en verde, y nada vuelve del aparador a la charola.
Fíjese en lo que no está en la charola: ningún teléfono real, ninguna conversación copiada del historial de ejecuciones, ninguna credencial de producción. Todo lo que se prueba hoy es inventado, con los formatos de prueba de la serie (+52 55 0000 00XX), y todo lo que pasa al aparador llega desde una etiqueta de git.
El primer bloque fija las importaciones, la semilla y los supuestos del día. La carpeta trigo_lento/dia_43/repositorio/ es una copia del repositorio que el Día 42 dejó etiquetado, con los seis workflows que viven hoy en el servidor de Trigo Lento:
# Importaciones base, semilla de la serie, carpeta del día y supuestos del laboratorio en Python:
import warnings
warnings.filterwarnings('ignore')
import hashlib
import json
import math
import re
from collections import Counter
from pathlib import Path
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 120)
carpeta = Path('trigo_lento') / 'dia_43'
repositorio = carpeta / 'repositorio' / 'flujos' / 'n8n'   # copia del repositorio etiquetado el Día 42
carpeta.mkdir(parents = True, exist_ok = True)

# Supuestos fijos de la serie (A.4.5 y A.5):
EJECUCIONES_STARTER = 2_500   # ejecuciones al mes incluidas en n8n Cloud Starter
DIAS_MES = 30                 # una corrida diaria de la suite
TELEFONO_PRUEBA = re.compile(r'^\+?52550000\d{4}$')   # rango de prueba de la serie: +52 55 0000 00XX
print('numpy', np.__version__, '| pandas', pd.__version__)
print('Workflows en el repositorio:', sorted(p.name for p in repositorio.glob('*.json')))
numpy 2.4.6 | pandas 3.0.3
Workflows en el repositorio: ['agente_pedidos_v3.json', 'clasificador_ia_v1.json', 'facturacion_v1.json', 'importacion_historica_v1.json', 'lote_importacion_v1.json', 'pedidos_whatsapp_n8n_v1.json']
Los seis archivos son los que el módulo fue construyendo: el flujo de entrada del Día 36, el clasificador del Día 37, el agente de pedidos en su versión 3 (la del Día 38 con las barreras del Día 39), la facturación del Día 40 y los dos workflows de importación por lotes del Día 41. Sobre ellos correrá la suite estática del Paso 5.
Paso 1. Datos fijados en n8n
El Día 36 presentó los datos fijados (en el editor de n8n, pin data): guardar la salida de un nodo para que, en las ejecuciones manuales, n8n no lo vuelva a ejecutar y use lo guardado. Para un Webhook, eso significa que no hace falta que nadie escriba por WhatsApp cada vez que se cambia un nodo de más adelante. Hoy se usan con más método: en lugar de un solo mensaje, se fijan tres, uno por cada camino importante del flujo, de modo que una sola ejecución de prueba recorra el borrador de pedido, la respuesta de horario y la baja.
Los datos fijados viven en la clave pinData del workflow, indexados por el nombre del nodo, como una lista de items con la misma forma que produciría el nodo. Este es el pinData que Valeria fija en Mensaje de Twilio, el Webhook de TL Pedidos WhatsApp n8n v1, con tres clientes inventados del rango de prueba. Su estructura se verificó contra la documentación, revisado en octubre de 2026:
{
  "pinData": {
    "Mensaje de Twilio": [
      {
        "json": {
          "headers": {"host": "ensayo.n8n.trigolento.example", "content-type": "application/x-www-form-urlencoded"},
          "params": {},
          "query": {},
          "body": {
            "MessageSid": "SM0000000000000000000000000000a431",
            "AccountSid": "AC00000000000000000000000000000000",
            "From": "whatsapp:+525500000011",
            "To": "whatsapp:+525500000001",
            "WaId": "525500000011",
            "ProfileName": "Cliente de prueba 01",
            "Body": "Hola, quiero 2 conchas de vainilla y 1 hogaza para el martes a las 9:00",
            "NumMedia": "0"
          },
          "webhookUrl": "https://ensayo.n8n.trigolento.example/webhook-test/pedidos-whatsapp",
          "executionMode": "test"
        }
      },
      {
        "json": {
          "headers": {"host": "ensayo.n8n.trigolento.example", "content-type": "application/x-www-form-urlencoded"},
          "params": {},
          "query": {},
          "body": {
            "MessageSid": "SM0000000000000000000000000000a432",
            "AccountSid": "AC00000000000000000000000000000000",
            "From": "whatsapp:+525500000016",
            "To": "whatsapp:+525500000001",
            "WaId": "525500000016",
            "ProfileName": "Cliente de prueba 06",
            "Body": "¿A qué hora abren el domingo?",
            "NumMedia": "0"
          },
          "webhookUrl": "https://ensayo.n8n.trigolento.example/webhook-test/pedidos-whatsapp",
          "executionMode": "test"
        }
      },
      {
        "json": {
          "headers": {"host": "ensayo.n8n.trigolento.example", "content-type": "application/x-www-form-urlencoded"},
          "params": {},
          "query": {},
          "body": {
            "MessageSid": "SM0000000000000000000000000000a433",
            "AccountSid": "AC00000000000000000000000000000000",
            "From": "whatsapp:+525500000031",
            "To": "whatsapp:+525500000001",
            "WaId": "525500000031",
            "ProfileName": "Cliente de prueba 21",
            "Body": "BAJA",
            "NumMedia": "0"
          },
          "webhookUrl": "https://ensayo.n8n.trigolento.example/webhook-test/pedidos-whatsapp",
          "executionMode": "test"
        }
      }
    ]
  }
}
Cada item imita lo que el Webhook entregaría si Twilio hiciera la petición de verdad: las cabeceras, los parámetros, la consulta y, sobre todo, body, con los campos que Twilio manda en formulario (From, WaId, ProfileName, Body). Los identificadores de mensaje terminan en a431, a432 y a433 para que, si alguna vez aparecen en un registro, se reconozcan a primera vista como datos de prueba. La URL apunta a webhook-test, la ruta de pruebas del editor, y al dominio de ensayo.
Cuatro reglas convierten esta herramienta en una práctica segura:
- Solo se usan en ejecuciones manuales y de prueba. La documentación de n8n es explícita: los datos fijados no están disponibles en las ejecuciones de producción. Un mensaje real que llegue al Webhook activo nunca se confunde con uno fijado.
- No sirven para todo. n8n no permite fijar la salida de un nodo que produce datos binarios (una foto o un PDF adjuntos) ni la de un nodo con más de una salida principal, como un IF o un Switch. Se fija el disparador o el nodo anterior a la bifurcación, y las ramas se prueban dejándolas ejecutarse.
- Se inventan, nunca se copian de una ejecución real. El historial de ejecuciones guarda conversaciones de clientes; fijar una de ellas metería un nombre y un teléfono reales en el workflow, y con él en cada exportación, copia y repositorio.
- Se vacían antes de exportar a git. El Día 42 normaliza
pinDataa{}antes de guardar; el archivo con los tres mensajes vive aparte, enflujos/n8n/pin_data_webhook.json, donde se revisa una sola vez.
Atención aquí: un pinData olvidado no rompe nada en producción, y por eso es peligroso. El workflow funciona, el editor muestra los datos fijados con un aviso discreto y la exportación viaja con ellos a git, al respaldo del Día 35 y a cualquier persona que reciba el archivo. Si ese pinData salió de una ejecución real, el repositorio guarda desde ese momento el teléfono de una clienta, y borrarlo del historial de git es mucho más difícil que no haberlo subido. La suite del Paso 5 incluye dos comprobaciones para este caso: pinData vacío y teléfonos solo del rango de prueba.
Los datos fijados resuelven el primer nivel de la Tabla 1: con ellos Valeria comprueba que Preparar borrador produce los nueve campos y que la clave seudónima del cliente se calcula bien. Pero la comprobación sigue siendo visual. Para que sea repetible hace falta escribir, en un archivo, qué se esperaba.
Paso 2. Casos de prueba y archivos de referencia
Un caso de prueba es una entrada fija con nombre propio; un archivo de referencia (en la literatura de pruebas, golden file, el archivo dorado) es la salida que esa entrada debe producir, guardada en el repositorio y revisada por una persona. La prueba consiste en ejecutar el flujo con la entrada, comparar la salida con la referencia y fallar si difieren. Gerard Meszaros, en xUnit Test Patterns, llama a esto una verificación de estado con objeto esperado: no se comprueba cómo trabajó el flujo por dentro, sino que el resultado sea el pactado.
La estructura en disco es deliberadamente simple: una carpeta pruebas/casos/ con un JSON por caso y una carpeta pruebas/esperado/ con un JSON del mismo nombre por referencia. El mismo nombre de archivo es el contrato entre las dos carpetas.
Los 30 casos de TL Pedidos WhatsApp n8n v1 se reparten en seis categorías de cinco, las mismas que el Switch de palabras clave del flujo de entrada distingue, como recordó el Día 37: pedido, horario, precio, queja, baja y texto ambiguo. Cada caso lleva un mensaje inventado, la categoría que le pondría una persona, la ruta que debe tomar el Switch y la respuesta que debe salir. La Tabla 2 muestra dos casos de cada categoría.
Tabla 2. Casos de prueba de TL Pedidos WhatsApp n8n v1: mensaje inventado, categoría, ruta esperada del Switch y respuesta esperada (12 de 30).
| Caso | Mensaje inventado | Categoría | Ruta esperada | Respuesta esperada |
|---|---|---|---|---|
| 01 | Hola, quiero 2 conchas de vainilla y 1 hogaza para el martes a las 9:00 | Pedido | borrador_pedido | Recibimos su pedido; Valeria lo confirma en breve. |
| 04 | Quisiera encargar 3 baguettes para el jueves | Pedido | borrador_pedido | Recibimos su pedido; Valeria lo confirma en breve. |
| 06 | ¿A qué hora abren el domingo? | Horario | respuesta_horario | Abrimos de lunes a sábado de 7:00 a 20:00. |
| 08 | ¿Hasta qué hora cierran hoy? | Horario | respuesta_horario | Abrimos de lunes a sábado de 7:00 a 20:00. |
| 11 | ¿Cuánto cuesta el pay de queso? | Precio | respuesta_precio | Le enviamos la lista de precios del catálogo. |
| 15 | ¿Cuánto sale un rol de canela? | Precio | respuesta_precio | Le enviamos la lista de precios del catálogo. |
| 16 | El pan de ayer llegó frío y tarde | Queja | revision_humana | Gracias por avisarnos; una persona del equipo le escribe hoy. |
| 17 | Quiero poner una queja por el pedido del viernes | Queja | revision_humana | Gracias por avisarnos; una persona del equipo le escribe hoy. |
| 21 | BAJA | Baja | baja | Listo, ya no recibirá mensajes de Trigo Lento. Para volver, escriba ALTA. |
| 24 | Quiero darme de baja | Baja | baja | Listo, ya no recibirá mensajes de Trigo Lento. Para volver, escriba ALTA. |
| 26 | Hola | Ambiguo | revision_humana | ¿Nos cuenta un poco más para ayudarle? |
| 29 | Mañana paso | Ambiguo | revision_humana | ¿Nos cuenta un poco más para ayudarle? |
Los casos no se eligieron al azar. Varios están escritos para tropezar: el caso 17 dice “quiero” y “pedido”, dos palabras de la regla de pedidos, pero es una queja; el caso 24 dice “quiero”, pero es una baja; el caso 20, “Tengo un reclamo sobre mi encargo”, contiene “encarg”. Son exactamente los mensajes que un Switch por palabras clave puede clasificar mal si alguien cambia el orden de sus reglas, y por eso conviene tenerlos fijos. Las quejas y las bajas, además, tienen el requisito ético más fuerte del flujo: una queja la atiende una persona, y una baja se respeta de inmediato y sin preguntas.
El tercer bloque genera los 30 casos y sus referencias, y escribe el comparador. La función comparar recibe la salida obtenida y la esperada y devuelve la lista de campos que difieren, sin mirar los que cambian en cada ejecución por diseño: la hora de recepción (recibido_en) y el identificador del evento (id_evento):
# Generador de 30 casos de prueba y de sus archivos de referencia en Python:
MENSAJES = {
    'pedido': ['Hola, quiero 2 conchas de vainilla y 1 hogaza para el martes a las 9:00',
               '¿Me aparta 6 croissants para mañana?',
               'Pedido: 1 pastel de zanahoria para el sábado',
               'Quisiera encargar 3 baguettes para el jueves',
               'Necesito una caja de 12 panes dulces para el viernes temprano'],
    'horario': ['¿A qué hora abren el domingo?', '¿Cuál es su horario entre semana?',
                '¿Hasta qué hora cierran hoy?', '¿Abren en Semana Santa?',
                'Buen día, ¿qué horario tienen el sábado?'],
    'precio': ['¿Cuánto cuesta el pay de queso?', '¿Qué precio tiene la hogaza?',
               '¿Cuánto vale la caja de 12 panes dulces?', '¿Me pasa precios de pasteles enteros?',
               '¿Cuánto sale un rol de canela?'],
    'queja': ['El pan de ayer llegó frío y tarde', 'Quiero poner una queja por el pedido del viernes',
              'Me cobraron mal el pastel', 'La baguette venía quemada, qué molestia',
              'Tengo un reclamo sobre mi encargo'],
    'baja': ['BAJA', 'Ya no me manden mensajes, por favor', 'No me escriban más',
             'Quiero darme de baja', 'STOP'],
    'ambiguo': ['Hola', '¿Siguen ahí?', 'Gracias', 'Mañana paso', 'Ok, luego le digo'],
}
# Ruta del Switch de palabras clave y respuesta que espera cada categoría:
ESPERADO = {
    'pedido': ('borrador_pedido', 'Recibimos su pedido; Valeria lo confirma en breve.'),
    'horario': ('respuesta_horario', 'Abrimos de lunes a sábado de 7:00 a 20:00.'),
    'precio': ('respuesta_precio', 'Le enviamos la lista de precios del catálogo.'),
    'queja': ('revision_humana', 'Gracias por avisarnos; una persona del equipo le escribe hoy.'),
    'baja': ('baja', 'Listo, ya no recibirá mensajes de Trigo Lento. Para volver, escriba ALTA.'),
    'ambiguo': ('revision_humana', '¿Nos cuenta un poco más para ayudarle?'),
}
VARIABLES = {'recibido_en', 'id_evento'}          # cambian en cada ejecución: no se comparan

def clave_cliente(wa_id):
    return hashlib.sha256(wa_id.encode()).hexdigest()[:12]   # el seudónimo del Día 36

casos_dir, esperado_dir = carpeta / 'pruebas' / 'casos', carpeta / 'pruebas' / 'esperado'
for d in (casos_dir, esperado_dir):
    d.mkdir(parents = True, exist_ok = True)
    for viejo in d.glob('*.json'):
        viejo.unlink()
casos = []
for categoria, textos in MENSAJES.items():
    for texto in textos:
        n = len(casos) + 1
        wa_id = f'5255000000{n + 10:02d}'             # +52 55 0000 00XX, rango de prueba
        caso = {'id': f'caso_{n:02d}', 'categoria': categoria,
                'cuerpo': {'From': f'whatsapp:+{wa_id}', 'WaId': wa_id, 'ProfileName': f'Cliente de prueba {n:02d}',
                           'Body': texto, 'To': 'whatsapp:+525500000001',
                           'AccountSid': 'AC00000000000000000000000000000000'}}
        ruta, respuesta = ESPERADO[categoria]
        referencia = {'ruta': ruta, 'respuesta': respuesta + ' Mensaje automático de Trigo Lento.',
                      'estado': 'por revisar' if ruta == 'borrador_pedido' else 'atendido',
                      'canal': 'whatsapp', 'clave_cliente': clave_cliente(wa_id)}
        (casos_dir / f"{caso['id']}.json").write_text(json.dumps(caso, ensure_ascii = False, indent = 2), encoding = 'utf-8')
        (esperado_dir / f"{caso['id']}.json").write_text(json.dumps(referencia, ensure_ascii = False, indent = 2), encoding = 'utf-8')
        casos.append(caso)

def comparar(obtenido, esperado, ignorar = VARIABLES):
    # Devuelve los campos que difieren, sin mirar los que cambian en cada ejecución:
    campos = (set(obtenido) | set(esperado)) - set(ignorar)
    return sorted(c for c in campos if obtenido.get(c, '<falta>') != esperado.get(c, '<falta>'))

tabla2 = pd.DataFrame([{'id': c['id'], 'categoria': c['categoria'], 'mensaje': c['cuerpo']['Body'][:42],
                        'ruta_esperada': ESPERADO[c['categoria']][0]} for c in casos])
print(tabla2.iloc[::5].to_string(index = False))
print('Casos por categoría:', dict(Counter(tabla2['categoria'])))
print('Archivos escritos:', len(list(casos_dir.glob('*.json'))), 'casos y',
      len(list(esperado_dir.glob('*.json'))), 'referencias')
# Comparación de prueba: una salida idéntica salvo los campos variables no debe fallar:
ref = json.loads((esperado_dir / 'caso_01.json').read_text(encoding = 'utf-8'))
salida = dict(ref, recibido_en = '2026-03-15T11:02:09-06:00', id_evento = 'ev-ejemplo-01')
print('Diferencias ignorando variables:', comparar(salida, ref),
      '| sin ignorarlas:', comparar(salida, ref, ignorar = ()))
     id categoria                                    mensaje     ruta_esperada
caso_01    pedido Hola, quiero 2 conchas de vainilla y 1 hog   borrador_pedido
caso_06   horario              ¿A qué hora abren el domingo? respuesta_horario
caso_11    precio            ¿Cuánto cuesta el pay de queso?  respuesta_precio
caso_16     queja          El pan de ayer llegó frío y tarde   revision_humana
caso_21      baja                                       BAJA              baja
caso_26   ambiguo                                       Hola   revision_humana
Casos por categoría: {'pedido': 5, 'horario': 5, 'precio': 5, 'queja': 5, 'baja': 5, 'ambiguo': 5}
Archivos escritos: 30 casos y 30 referencias
Diferencias ignorando variables: [] | sin ignorarlas: ['id_evento', 'recibido_en']
El bloque escribe $30$ casos y $30$ referencias, cinco por categoría, y la última línea demuestra para qué sirve la lista de campos variables. La referencia del caso 01 y una salida idéntica salvo por la hora y el identificador del evento no difieren en nada cuando se ignoran esos dos campos ([]), y difieren en dos campos cuando no se ignoran (['id_evento', 'recibido_en']). Sin esa lista, todas las pruebas fallarían en todas las ejecuciones, y una suite que siempre falla se deja de mirar a la segunda semana.
La medida que usa la suite para cada caso es el número de campos distintos de su referencia:
$$ \Delta_i = \sum_{c ,\in, C_i \setminus V} \mathbf{1}\left[o_{i,c} \neq e_{i,c}\right] $$
La lógica detrás de esta medida es sencilla:
- $C_i$ es la unión de los campos de la salida obtenida $o_i$ y de la referencia $e_i$ del caso $i$; un campo que solo existe en una de las dos cuenta como diferencia, porque un campo renombrado aparece como uno que falta y otro que sobra.
- $V$ es el conjunto de campos variables, aquí
recibido_eneid_evento, que se excluyen antes de comparar. - La función indicadora $\mathbf{1}[\cdot]$ vale $1$ si el valor obtenido no coincide con el esperado y $0$ si coincide.
- En conclusión, $\Delta_i = 0$ significa que el caso pasa; cualquier valor positivo es un fallo, y su tamaño da una pista de cuánto cambió.
El comparador funciona como el molde de la Figura 2.
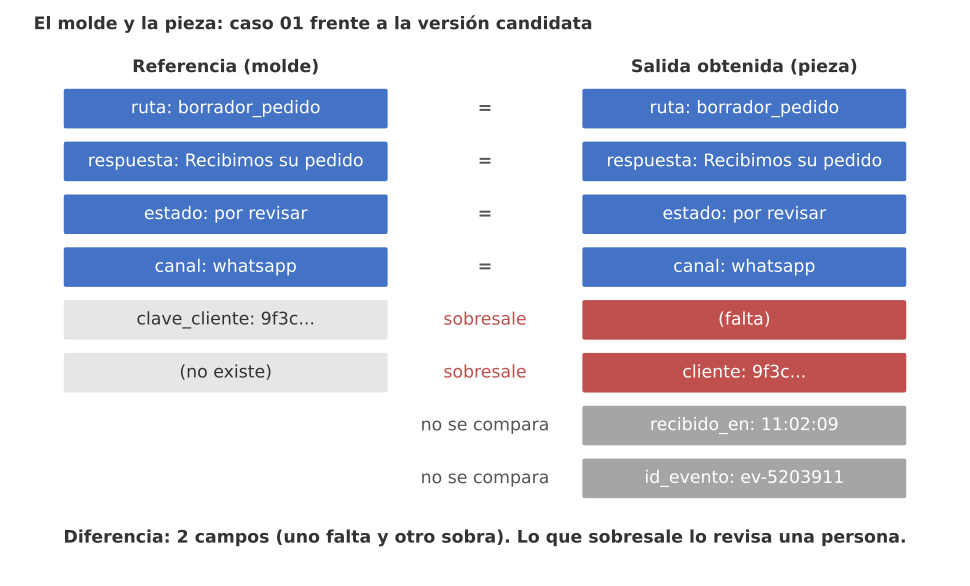
Figura 2. El molde y la pieza: la referencia del caso 01 frente a la salida de la versión candidata; coinciden ruta, respuesta, estado y canal, sobresalen clave_cliente y cliente (2 campos distintos) y la hora y el identificador del evento, en gris, no se comparan.
Lo que sobresale del molde es lo que alguien tiene que mirar. Y aquí aparece la pregunta más delicada del método: ¿cuándo se actualiza una referencia? La respuesta es que solo cuando el cambio es intencionado, y nunca en el mismo gesto que lo produce. Si Valeria decide cambiar el horario de apertura a las 6:30, la referencia de los cinco casos de horario debe cambiar, y ese cambio de referencia pasa por la misma revisión que el cambio del flujo: una solicitud de cambios en la que alguien lee la diferencia de la referencia y dice “sí, esto es lo que queremos”. Regenerar las referencias a partir de la salida actual cada vez que una prueba falla convierte la suite en un espejo, que siempre dice que todo está bien.
Paso 3. Pruebas de contrato
El Día 4 (Arquitectura de flujos II: entradas, salidas y contratos de datos) escribió el contrato del pedido de Trigo Lento como un esquema JSON: qué campos lleva el sobre del pedido, de qué tipo y con qué valores permitidos. Una prueba de contrato comprueba que lo que cruza una frontera (un cuerpo que llega por webhook, un sobre que un flujo le entrega a otro) cumple lo pactado, antes de que ningún nodo lo use. Si el contrato falla, el flujo lo rechaza con un motivo; si no existiera, el error aparecería tres nodos más adelante, con un mensaje que nadie entiende.
Hoy se escriben dos contratos con pydantic, la biblioteca de validación de datos de Python, que convierte una clase con anotaciones de tipo en un validador:
CuerpoWebhookMeta, la forma del cuerpo que envía la Cloud API de WhatsApp de Meta cuando llega un mensaje:objectigual awhatsapp_business_account, una listaentryconchanges, y dentro devalue.messagescada mensaje con su remitente (from, el número sin el signo+), su identificador, su marca de tiempo como texto de diez dígitos, su tipo y su texto. El módulo 5 evaluará esa conexión directa; escribir hoy su contrato permite que la suite ya la cubra el día que llegue el primer cuerpo real.SobrePedido, el contrato del Día 4 traducido a pydantic: identificadorTL-AAAAMMDD-NNNN, canal, cliente con teléfono+52y diez dígitos, entre uno y doce renglones con clave del catálogoP01aP12y cantidad de $1$ a $200$, fecha de entrega y total en centavos.
Los dos modelos heredan de Estricto, que activa dos opciones de pydantic: strict=True, que impide que la biblioteca convierta tipos por su cuenta (una cantidad "2" escrita como texto no se convierte en el número $2$, se rechaza), y extra="forbid", que rechaza cualquier campo que no esté declarado. Las dos responden a la misma idea: un contrato que tolera variaciones no es un contrato, es una sugerencia.
Los 30 cuerpos de prueba son 20 válidos y 10 rotos a propósito, con los cuatro tipos de defecto que la serie ya ha visto llegar por los canales de Trigo Lento: campo faltante, tipo incorrecto, teléfono sin formato y producto fuera de catálogo. El cuarto bloque los construye, los valida contra los dos contratos y muestra el primer error de cada cuerpo roto:
# Contratos con pydantic para el cuerpo de webhook de Meta y el sobre del pedido en Python:
from datetime import date
from typing import Literal
from pydantic import BaseModel, ConfigDict, Field, ValidationError

class Estricto(BaseModel):
    model_config = ConfigDict(strict = True, extra = 'forbid', populate_by_name = True)

class Texto(Estricto):
    body: str = Field(min_length = 1, max_length = 4096)

class MensajeMeta(Estricto):
    de: str = Field(alias = 'from', pattern = r'^52\d{10}$')   # Meta envía el número sin el signo +
    id: str = Field(min_length = 8)
    timestamp: str = Field(pattern = r'^\d{10}$')
    type: Literal['text']
    text: Texto

class Valor(Estricto):
    messaging_product: Literal['whatsapp']
    metadata: dict
    messages: list[MensajeMeta] = Field(min_length = 1)

class Cambio(Estricto):
    field: Literal['messages']
    value: Valor

class Entrada(Estricto):
    id: str
    changes: list[Cambio] = Field(min_length = 1)

class CuerpoWebhookMeta(Estricto):
    object: Literal['whatsapp_business_account']
    entry: list[Entrada] = Field(min_length = 1)

CLAVES = Literal['P01', 'P02', 'P03', 'P04', 'P05', 'P06', 'P07', 'P08', 'P09', 'P10', 'P11', 'P12']
class Cliente(Estricto):
    nombre: str = Field(min_length = 2, max_length = 80)
    telefono: str = Field(pattern = r'^\+52\d{10}$')

class Renglon(Estricto):
    clave: CLAVES
    cantidad: int = Field(ge = 1, le = 200)

class SobrePedido(Estricto):              # el contrato del pedido del Día 4
    id_pedido: str = Field(pattern = r'^TL-\d{8}-\d{4}$')
    canal: Literal['whatsapp', 'instagram', 'formulario', 'telefono']
    cliente: Cliente
    renglones: list[Renglon] = Field(min_length = 1, max_length = 12)
    fecha_entrega: date = Field(strict = False)        # llega como texto ISO desde JSON
    total_centavos: int = Field(ge = 0)

PRECIOS = {'P01': 95, 'P02': 38, 'P04': 22, 'P05': 34, 'P06': 38, 'P07': 60, 'P10': 240}
def par_valido(n):
    tel = f'5255000000{n + 40:02d}'
    claves = rng.choice(list(PRECIOS), size = int(rng.integers(1, 4)), replace = False)
    renglones = [{'clave': str(k), 'cantidad': int(rng.integers(1, 7))} for k in claves]
    cuerpo = {'object': 'whatsapp_business_account', 'entry': [{'id': 'WABA_EJEMPLO', 'changes': [{
        'field': 'messages', 'value': {'messaging_product': 'whatsapp', 'metadata': {'phone_number_id': 'ID_EJEMPLO'},
        'messages': [{'from': tel, 'id': f'wamid.EJEMPLO{n:04d}', 'timestamp': str(1773590400 + 60 * n),
                      'type': 'text', 'text': {'body': f'Pedido de prueba {n:02d}'}}]}}]}]}
    sobre = {'id_pedido': f'TL-20260317-{n:04d}', 'canal': 'whatsapp',
             'cliente': {'nombre': f'Cliente de prueba {n:02d}', 'telefono': '+' + tel},
             'renglones': renglones, 'fecha_entrega': '2026-03-17',
             'total_centavos': 100 * sum(PRECIOS[r['clave']] * r['cantidad'] for r in renglones)}
    return cuerpo, sobre

def mensaje(cuerpo):
    return cuerpo['entry'][0]['changes'][0]['value']['messages'][0]
roturas = [   # (motivo, función que rompe el par): 10 cuerpos rotos
    ('campo faltante', lambda c, s: mensaje(c).pop('timestamp')),
    ('campo faltante', lambda c, s: s.pop('total_centavos')),
    ('campo faltante', lambda c, s: s['cliente'].pop('telefono')),
    ('tipo incorrecto', lambda c, s: mensaje(c).update(timestamp = 1773590400)),
    ('tipo incorrecto', lambda c, s: s['renglones'][0].update(cantidad = '2')),
    ('teléfono sin formato', lambda c, s: s['cliente'].update(telefono = '55 0000 0031')),
    ('teléfono sin formato', lambda c, s: mensaje(c).update({'from': '+525500000032'})),
    ('teléfono sin formato', lambda c, s: s['cliente'].update(telefono = '+52 55 0000 0033')),
    ('producto fuera de catálogo', lambda c, s: s['renglones'][0].update(clave = 'P13')),
    ('producto fuera de catálogo', lambda c, s: s['renglones'][0].update(clave = 'pastel tres leches')),
]
contratos = []
for n in range(1, 31):
    cuerpo, sobre = par_valido(n)
    motivo = 'válido'
    if n > 20:
        motivo, romper = roturas[n - 21]
        romper(cuerpo, sobre)
    errores = []
    for modelo, datos in ((CuerpoWebhookMeta, cuerpo), (SobrePedido, sobre)):
        try:
            modelo.model_validate(datos)
        except ValidationError as error:
            primero = error.errors()[0]
            errores.append(f"{modelo.__name__}.{'.'.join(map(str, primero['loc']))}: {primero['type']}")
    contratos.append({'n': n, 'sembrado': motivo, 'aceptado': not errores, 'error': errores[0] if errores else ''})
resultado = pd.DataFrame(contratos)
print('Aceptados:', int(resultado['aceptado'].sum()), '| rechazados:', int((~resultado['aceptado']).sum()))
print(resultado[resultado['n'] > 20][['n', 'sembrado', 'error']].to_string(index = False))
print('Válidos rechazados por error:', int(((resultado['n'] <= 20) & ~resultado['aceptado']).sum()),
      '| rotos aceptados por error:', int(((resultado['n'] > 20) & resultado['aceptado']).sum()))
Aceptados: 20 | rechazados: 10
 n                   sembrado                                                                              error
21             campo faltante            CuerpoWebhookMeta.entry.0.changes.0.value.messages.0.timestamp: missing
22             campo faltante                                                SobrePedido.total_centavos: missing
23             campo faltante                                              SobrePedido.cliente.telefono: missing
24            tipo incorrecto        CuerpoWebhookMeta.entry.0.changes.0.value.messages.0.timestamp: string_type
25            tipo incorrecto                                         SobrePedido.renglones.0.cantidad: int_type
26       teléfono sin formato                              SobrePedido.cliente.telefono: string_pattern_mismatch
27       teléfono sin formato CuerpoWebhookMeta.entry.0.changes.0.value.messages.0.from: string_pattern_mismatch
28       teléfono sin formato                              SobrePedido.cliente.telefono: string_pattern_mismatch
29 producto fuera de catálogo                                       SobrePedido.renglones.0.clave: literal_error
30 producto fuera de catálogo                                       SobrePedido.renglones.0.clave: literal_error
Válidos rechazados por error: 0 | rotos aceptados por error: 0
El resultado es el que debe ser: $20$ cuerpos aceptados y $10$ rechazados, con $0$ válidos rechazados por error y $0$ rotos aceptados por error. Las dos cifras de la última línea son las que importan, porque son los dos fallos posibles de un contrato: rechazar lo que estaba bien (un falso positivo que hace perder pedidos) y dejar pasar lo que estaba mal (un falso negativo que rompe un nodo más adelante).
Lea la columna de errores, porque cada tipo de rechazo enseña algo:
- En primer lugar, los campos faltantes se rechazan con el tipo
missingy la ruta exacta del campo:entry.0.changes.0.value.messages.0.timestampdice en qué mensaje, de qué cambio, de qué entrada faltaba la marca de tiempo. Esa ruta es la que el flujo debe registrar al rechazar. - En segundo lugar, los tipos incorrectos (
string_type,int_type) son los que el modo estricto atrapa. Sin él, la marca de tiempo numérica y la cantidad"2"habrían pasado convertidas en silencio. En el caso de la cantidad, esa conversión sería inofensiva; en el de un total, una cadena con coma decimal podría convertirse en otro número. - En tercer lugar, los teléfonos sin formato fallan por patrón (
string_pattern_mismatch), tanto en el sobre (55 0000 0031, sin prefijo de país;+52 55 0000 0033, con espacios) como en el cuerpo de Meta (+525500000032, con el signo+que Meta no envía). El mismo número se escribe distinto en cada lado de la frontera, y el contrato de cada lado debe saberlo. - En cuarto lugar, los productos fuera de catálogo (
P13,pastel tres leches) fallan conliteral_error: la clave no está entre las doce permitidas. El mismoenumque el Día 38 puso en las herramientas del agente vive ahora en el contrato del sobre.
La relación entre los contratos y los casos del Paso 2 es de reparto de trabajo: los contratos prueban la forma de lo que entra y sale, y los casos prueban el comportamiento del flujo con entradas de forma correcta. Juntos suman los $60$ casos deterministas de la suite de Trigo Lento: $30$ mensajes y $30$ cuerpos de contrato.
Paso 4. Una instancia de ensayo
Los pasos anteriores prueban piezas sin necesidad de un servidor. El cuarto nivel de la Tabla 1, el flujo completo, sí necesita uno: hay que enviar el caso al Webhook, dejar que n8n ejecute todos los nodos y leer la respuesta. Hacerlo contra la instancia de producción tiene tres problemas que Don Ernesto resumiría en uno solo (“no se prueba en el aparador”): las ejecuciones de prueba se mezclan en el historial con las de los clientes, las credenciales son las reales (un error de prueba puede escribir a una clienta de verdad o gastar el rubro de Claude) y cualquier cambio a medio probar está a un clic de quedarse activo.
La solución es una instancia de ensayo (en inglés, staging): una segunda instalación de n8n, con la misma versión que producción, pero con todo lo demás propio. La Tabla 3 compara las dos, rubro por rubro.
Tabla 3. Producción frente a ensayo en la instalación propia de Trigo Lento.
| Rubro | Producción (aparador) | Ensayo (charola) |
|---|---|---|
| URL del webhook | https://n8n.trigolento.example/webhook/... | https://ensayo.n8n.trigolento.example/webhook/... |
| Base de datos | Postgres n8n, con respaldo 3-2-1 (Día 35) | Postgres n8n_ensayo, sin respaldo: se recrea desde git |
| Clave de cifrado | N8N_ENCRYPTION_KEY de producción, guardada fuera del servidor | N8N_ENCRYPTION_KEY_ENSAYO, distinta |
| Credenciales | Las reales, con mínimo privilegio | De prueba, con “ensayo” en el nombre |
| Número de WhatsApp | El de Trigo Lento | Número de prueba de Meta, que solo escribe a destinatarios autorizados |
| Canal de Slack | #operaciones | #pruebas-automatizacion |
| Tope de gasto de Claude | $8$ USD al mes (rubro de A.4.6) | $1$ USD al mes, en una clave aparte |
| Historial de ejecuciones | $14$ días (Día 35) | $3$ días |
| Quién activa flujos | Valeria, solo desde una etiqueta revisada | Valeria, libremente |
Cada fila responde a una forma concreta de que una prueba se escape al mundo real:
- La clave de cifrado distinta es la fila más importante. n8n cifra las credenciales en la base con esa clave; si el ensayo usara la misma, cualquier copia de la base de producción restaurada en ensayo dejaría las credenciales reales disponibles para cualquier workflow de prueba. Con claves distintas, una base copiada por error es inservible: sus credenciales no se pueden descifrar.
- El número de prueba de Meta solo puede escribir a una lista corta de destinatarios autorizados, de modo que un flujo de ensayo mal configurado no puede llegar a una clienta aunque lo intente.
- El tope de gasto de la clave de ensayo convierte un bucle atascado de prueba en un error de presupuesto de un dólar, no en un susto a fin de mes.
- La promoción solo desde una etiqueta cierra el último hueco: lo que llega a producción es exactamente lo que se probó en ensayo, porque los dos salen del mismo
git tag.
La idea es la de Continuous Delivery, el libro de Jez Humble y David Farley: un solo artefacto que pasa por entornos sucesivos, cada uno más parecido a producción, y que nunca se reconstruye a mano en el camino. En Trigo Lento el artefacto es la carpeta flujos/n8n/ en una etiqueta concreta, y los entornos son dos.
El quinto bloque es el archivo de Compose de la instancia de ensayo. Vive en el mismo servidor que la de producción (un segundo n8n con poco tráfico cabe en el VPS pequeño del Día 34, un supuesto que se comprueba con el consumo de memoria real antes de dejarlo fijo), pero declara un nombre de proyecto propio, de modo que sus contenedores, su red y sus volúmenes no se tocan con los de producción. Su estructura se verificó contra la documentación, revisado en octubre de 2026:
# Instancia de ensayo de n8n para Trigo Lento, archivo docker-compose.ensayo.yml:
# Vive junto al docker-compose.yml de producción (Día 34), pero no comparte con él ni la base,
# ni los volúmenes, ni la clave de cifrado, ni el puerto. Las variables ${...} salen de .env.ensayo.
name: trigo-lento-ensayo                         # proyecto de Compose distinto: contenedores y volúmenes propios

services:
  postgres-ensayo:
    image: postgres:16
    restart: unless-stopped
    environment:
      POSTGRES_DB: n8n_ensayo
      POSTGRES_USER: n8n_ensayo
      POSTGRES_PASSWORD: ${POSTGRES_PASSWORD_ENSAYO}
    volumes:
      - postgres_ensayo:/var/lib/postgresql/data
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U n8n_ensayo -d n8n_ensayo"]
      interval: 10s
      timeout: 5s
      retries: 5

  n8n-ensayo:
    image: docker.n8n.io/n8nio/n8n:2.43.7        # la MISMA versión que producción: se prueba lo que se va a usar
    restart: unless-stopped
    depends_on:
      postgres-ensayo:
        condition: service_healthy
    ports:
      - "127.0.0.1:5679:5678"                     # otro puerto local; Caddy publica ensayo.n8n.trigolento.example
    environment:
      DB_TYPE: postgresdb
      DB_POSTGRESDB_HOST: postgres-ensayo
      DB_POSTGRESDB_PORT: 5432
      DB_POSTGRESDB_DATABASE: n8n_ensayo
      DB_POSTGRESDB_USER: n8n_ensayo
      DB_POSTGRESDB_PASSWORD: ${POSTGRES_PASSWORD_ENSAYO}
      N8N_ENCRYPTION_KEY: ${N8N_ENCRYPTION_KEY_ENSAYO}   # distinta de la de producción, a propósito
      N8N_HOST: ensayo.n8n.trigolento.example
      N8N_PORT: 5678
      N8N_PROTOCOL: https
      N8N_WEBHOOK_URL: https://ensayo.n8n.trigolento.example/   # desde n8n 2.30.0; antes, WEBHOOK_URL
      GENERIC_TIMEZONE: America/Mexico_City
      TZ: America/Mexico_City
      EXECUTIONS_DATA_PRUNE: "true"
      EXECUTIONS_DATA_MAX_AGE: 72                # en ensayo, 3 días de historial bastan
      N8N_ENFORCE_SETTINGS_FILE_PERMISSIONS: "true"
    volumes:
      - n8n_ensayo:/home/node/.n8n
      - ./flujos:/flujos:ro                      # la exportación de la etiqueta, solo lectura

volumes:
  postgres_ensayo:
  n8n_ensayo:
Tres líneas del archivo merecen una segunda lectura. La imagen es n8nio/n8n:2.43.7, la misma versión fijada que producción: probar con una versión distinta sería probar otro programa. El puerto local es el 5679, de modo que las dos instancias conviven sin choque detrás del mismo Caddy. Y el volumen ./flujos:/flujos:ro monta en solo lectura la carpeta con la exportación de la etiqueta, que es lo único que entra al ensayo desde fuera.
El sexto bloque crea el archivo .env.ensayo con valores de ejemplo, levanta la instancia e importa los workflows de una etiqueta. Las contraseñas y claves que aparecen son marcadores evidentes (EJEMPLO-NO-REAL), no valores reales: en el servidor se generan con openssl rand -hex 32 y nunca se escriben en un archivo que entre al repositorio. Los comandos import:workflow y execute --id de la CLI se contrastaron con la documentación oficial, revisado en octubre de 2026:
# Crear .env.ensayo, levantar la instancia de ensayo e importar una etiqueta de git en Bash:
cd ~/trigo_lento
umask 077                                        # .env.ensayo solo legible por el usuario
cat > .env.ensayo <<'FIN'
POSTGRES_PASSWORD_ENSAYO=EJEMPLO-NO-REAL-cambie-esta-contrasena
N8N_ENCRYPTION_KEY_ENSAYO=EJEMPLO-NO-REAL-genere-con-openssl-rand-hex-32
N8N_URL_ENSAYO=https://ensayo.n8n.trigolento.example
N8N_API_KEY_ENSAYO=EJEMPLO-NO-REAL-clave-de-la-api-de-ensayo
WEBHOOK_ENSAYO_USUARIO=prueba
WEBHOOK_ENSAYO_CONTRASENA=EJEMPLO-NO-REAL-contrasena-basic-auth
FIN
docker compose -f docker-compose.ensayo.yml --env-file .env.ensayo up -d
docker compose -f docker-compose.ensayo.yml ps   # postgres-ensayo (healthy) y n8n-ensayo (running)

# La promoción empieza siempre en una etiqueta, nunca en la copia de trabajo:
git fetch --tags
git worktree add /tmp/tl-v3.0.1 tl-agente-pedidos/v3.0.1
rm -rf flujos && cp -r /tmp/tl-v3.0.1/flujos/n8n flujos
docker compose -f docker-compose.ensayo.yml exec n8n-ensayo \
  n8n import:workflow --separate --input=/flujos   # entran inactivos (--activeState=false por defecto)

# Prueba de humo: ejecutar un workflow guardado por su identificador desde la CLI:
docker compose -f docker-compose.ensayo.yml exec n8n-ensayo n8n list:workflow
docker compose -f docker-compose.ensayo.yml exec n8n-ensayo n8n execute --id Hm7EnsayoImpHist1
git worktree remove /tmp/tl-v3.0.1
El orden de los comandos es el procedimiento de promoción entero:
- Se parte de una etiqueta, no de la copia de trabajo.
git worktree addsaca una copia limpia detl-agente-pedidos/v3.0.1en una carpeta temporal, sin tocar la rama en la que Valeria está trabajando. - Se importa con la CLI.
n8n import:workflow --separate --input=/flujoslee un JSON por workflow; desde n8n 2.0 los workflows importados quedan inactivos por omisión (--activeState=false), de modo que importar y publicar siguen siendo dos decisiones separadas, como en el Día 36. - Se hace una prueba de humo.
n8n list:workflowmuestra los identificadores que la instancia asignó, yn8n execute --idejecuta un workflow guardado por su identificador desde la terminal. Sirve para workflows con disparador manual, comoTL Importación histórica v1; los de Webhook se prueban enviándoles los casos, que es lo que hace el Paso 5. - Se limpia. La copia temporal se borra, y lo que queda en ensayo es exactamente lo que dice la etiqueta.
La promoción a producción repite los mismos pasos con el archivo de Compose de producción, pero solo cuando la etiqueta pasó por ensayo con la suite en verde. Si Trigo Lento usara n8n Cloud o un plan con la función de entornos, la documentación de n8n describe un mecanismo nativo (entornos ligados a ramas de un repositorio git) cuya disponibilidad depende del plan y la versión; en la instalación Community propia, el procedimiento de arriba hace el mismo trabajo con herramientas que Valeria ya conoce.
Paso 5. La suite de regresión en Python
Con los casos, los contratos y la instancia de ensayo listos, falta la pieza que convierte todo en una sola orden: la suite de regresión. Tiene dos partes. La primera es estática: lee los JSON exportados del repositorio, sin ejecutar nada, y comprueba propiedades que todo workflow de Trigo Lento debe cumplir. La segunda es dinámica: envía los casos al Webhook de ensayo y compara las respuestas con las referencias.
Las doce comprobaciones estáticas salen de errores que la serie ya ha visto o que ha estado a punto de ver:
- Estructura: el archivo tiene
nodesyconnections. - Nombres únicos: dos nodos con el mismo nombre confunden las conexiones, que se indexan por nombre.
- Conexiones válidas: todo origen y todo destino de
connectionsexiste como nodo. - IF con sus dos salidas: la rama falsa de un IF que no lleva a ningún sitio deja items sin destino, salvo que el nodo diga en sus notas que es un “fin intencional”.
- HTTP con manejo de error: cada HTTP Request tiene reintentos, una salida de error o la opción de no fallar y revisar el código de estado después, como la facturación del Día 40.
pinDatavacío, por la advertencia del Paso 1.- Sin secretos: ninguna clave de Anthropic, token de Slack o de Meta ni cabecera
Authorizationox-api-keycon un valor escrito, con los patrones del detector del Día 42. - Teléfonos de prueba: todo número con formato mexicano que aparezca pertenece al rango
+52 55 0000 00XX. - Rutas de webhook únicas en todo el repositorio, porque dos workflows activos con la misma ruta compiten por los mismos mensajes.
typeVersionfijado en cada nodo, para que una actualización de n8n no cambie el comportamiento de un nodo sin que el JSON lo diga.- Orden de ejecución
v1en los ajustes, el que la serie usa desde el Día 36. - Credenciales de un solo entorno: un workflow de producción no referencia credenciales “de ensayo” o “de prueba”, ni al revés.
Para comprobar que la suite ve lo que dice ver, Valeria siembra dos fallos en una rama de práctica, una técnica que la literatura de pruebas llama inyección de defectos: deja en TL Pedidos WhatsApp n8n v1 un pinData copiado de una ejecución, con un teléfono que no es del rango de prueba, y pega en una cabecera de la facturación una clave de Claude inventada, marcada como de ejemplo. Si la suite no encuentra esos dos fallos, la suite está rota. El séptimo bloque escribe revisar_workflow, siembra los fallos y dibuja la matriz de resultados:
# Suite estática: revisar_workflow con 12 comprobaciones sobre los JSON exportados en Python:
from matplotlib.colors import ListedColormap

SECRETO = re.compile(r'(sk-ant-[A-Za-z0-9_-]{8,}|xox[bp]-[A-Za-z0-9-]{8,}|hooks\.slack\.com/services/|'
                     r'EAA[A-Za-z0-9]{20,}|"(authorization|x-api-key)"\s*:\s*"[^"={]{8,})', re.I)
TELEFONO = re.compile(r'\+?52\d{10}')
COMPROBACIONES = ['estructura', 'nombres_unicos', 'conexiones_validas', 'if_dos_salidas', 'http_con_error',
                  'pindata_vacio', 'sin_secretos', 'telefonos_de_prueba', 'webhook_unico', 'typeversion_fijo',
                  'orden_v1', 'credenciales_un_entorno']

def revisar_workflow(wf, rutas_vistas, entorno = 'produccion'):
    nodos = wf.get('nodes', [])
    nombres = [n['name'] for n in nodos]
    conexiones = wf.get('connections', {})
    texto = json.dumps(wf, ensure_ascii = False)
    r = {'estructura': isinstance(nodos, list) and isinstance(conexiones, dict) and len(nodos) > 0,
         'nombres_unicos': len(nombres) == len(set(nombres))}
    destinos = [d['node'] for salidas in conexiones.values() for tipo in salidas.values()
                for salida in tipo for d in salida]
    r['conexiones_validas'] = set(conexiones) | set(destinos) <= set(nombres)
    def ramas(n):
        return [bool(s) for s in conexiones.get(n['name'], {}).get('main', [])] + [False, False]
    r['if_dos_salidas'] = all(all(ramas(n)[:2]) or 'fin intencional' in n.get('notes', '')
                              for n in nodos if n['type'] == 'n8n-nodes-base.if')
    r['http_con_error'] = all(n.get('retryOnFail') or n.get('onError') or
                              n['parameters'].get('options', {}).get('response', {}).get('response', {}).get('neverError')
                              for n in nodos if n['type'] == 'n8n-nodes-base.httpRequest')
    r['pindata_vacio'] = not wf.get('pinData')
    r['sin_secretos'] = not SECRETO.search(texto)
    r['telefonos_de_prueba'] = all(TELEFONO_PRUEBA.match(t) for t in TELEFONO.findall(texto))
    rutas = [n['parameters'].get('path') for n in nodos if n['type'] == 'n8n-nodes-base.webhook']
    r['webhook_unico'] = not any(p in rutas_vistas for p in rutas)
    rutas_vistas.update(rutas)
    r['typeversion_fijo'] = all(isinstance(n.get('typeVersion'), (int, float)) for n in nodos)
    r['orden_v1'] = wf.get('settings', {}).get('executionOrder') == 'v1'
    credenciales = [c['name'] for n in nodos for c in n.get('credentials', {}).values()]
    de_ensayo = [('ensayo' in c.lower() or 'prueba' in c.lower()) for c in credenciales]
    r['credenciales_un_entorno'] = all(de_ensayo) if entorno == 'ensayo' else not any(de_ensayo)
    return r

# Rama de práctica: Valeria siembra dos fallos en copias de dos workflows:
flujos = {p.stem: json.loads(p.read_text(encoding = 'utf-8')) for p in sorted(repositorio.glob('*.json'))}
flujos['pedidos_whatsapp_n8n_v1']['pinData'] = {'Mensaje de Twilio': [{'json': {'body': {
    'From': 'whatsapp:+525512345678', 'Body': 'Quiero 2 conchas'}}}]}           # fallo sembrado 1
for nodo in flujos['facturacion_v1']['nodes']:
    if nodo['name'] == 'Redactar nota con Claude':
        nodo['parameters']['headerParameters']['parameters'].append(
            {'name': 'x-api-key', 'value': 'sk-ant-api03-EJEMPLO-NO-REAL-0000'})   # fallo sembrado 2

rutas_vistas = set()
matriz = pd.DataFrame({nombre: revisar_workflow(wf, rutas_vistas) for nombre, wf in flujos.items()}).T
matriz = matriz[COMPROBACIONES]
tabla4 = pd.DataFrame({'nodos': [len(flujos[n]['nodes']) for n in matriz.index],
                       'aprobadas': matriz.sum(axis = 1), 'fallidas': (~matriz).sum(axis = 1)})
print(tabla4.to_string())
print('Comprobaciones fallidas:', {f: [c for c in COMPROBACIONES if not matriz.loc[f, c]]
                                   for f in matriz.index if not matriz.loc[f].all()})
print(f'Total: {int(matriz.values.sum())} de {matriz.size} aprobadas')

fig, ax = plt.subplots(figsize = (11, 4.8))
ax.imshow(matriz.values.astype(int), cmap = ListedColormap(['#c8423b', '#3a9d5d']),
          aspect = 'auto', vmin = 0, vmax = 1)
ax.set_xticks(range(len(COMPROBACIONES)))
ax.set_xticklabels([c.replace('_', ' ') for c in COMPROBACIONES], rotation = 35, ha = 'right', fontsize = 9)
ax.set_yticks(range(len(matriz)))
ax.set_yticklabels(matriz.index, fontsize = 9)
for i in range(len(matriz)):
    for j in range(len(COMPROBACIONES)):
        ax.text(j, i, 'ok' if matriz.iat[i, j] else 'falla', ha = 'center', va = 'center', fontsize = 8, color = 'white')
ax.set_xticks(np.arange(-0.5, len(COMPROBACIONES)), minor = True)
ax.set_yticks(np.arange(-0.5, len(matriz)), minor = True)
ax.grid(which = 'minor', color = 'white', linewidth = 2)
ax.tick_params(which = 'minor', length = 0)
ax.set_title('Suite estática: 6 workflows por 12 comprobaciones', fontsize = 16)
plt.tight_layout()
plt.show()
                          nodos  aprobadas  fallidas
agente_pedidos_v3            22         10         2
clasificador_ia_v1            8         12         0
facturacion_v1               13         11         1
importacion_historica_v1      6         12         0
lote_importacion_v1           4         12         0
pedidos_whatsapp_n8n_v1       6         10         2
Comprobaciones fallidas: {'agente_pedidos_v3': ['if_dos_salidas', 'http_con_error'], 'facturacion_v1': ['sin_secretos'], 'pedidos_whatsapp_n8n_v1': ['pindata_vacio', 'telefonos_de_prueba']}
Total: 67 de 72 aprobadas
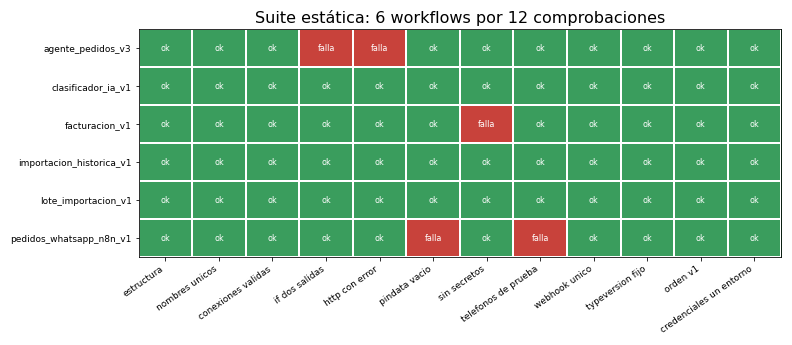
La suite aprueba $67$ de las $72$ comprobaciones ($6$ workflows por $12$ comprobaciones) y encuentra fallos en tres workflows. Los dos fallos sembrados aparecen donde debían: el pinData de pedidos_whatsapp_n8n_v1 hace fallar dos comprobaciones a la vez (pinData vacío y teléfonos de prueba), y la clave pegada en la facturación hace fallar sin_secretos. Que un solo descuido active dos comprobaciones no es redundancia: es la confirmación de que el pinData olvidado era, además, un dato personal.
Lo interesante es la tercera fila roja, la del agente, porque nadie la sembró. La suite encontró dos problemas reales en agente_pedidos_v3, heredados de la versión 2 del Día 38:
if_dos_salidas: el IF¿Pide aprobación?tiene la rama falsa vacía. Es intencional (si el agente no pidió aprobación, la conversación termina ahí), pero el JSON no lo dice. La corrección no es conectar la rama a algo inútil, sino escribir en las notas del nodo “fin intencional: sin aprobación pendiente”, de modo que la próxima persona que lea el workflow, o la próxima corrida de la suite, sepa que el hueco es una decisión.http_con_error: los tres nodos HTTP Request que hablan con Twilio (Enviar respuesta por WhatsApp,Avisar a ValeriayPasar a Valeria) no tienen reintentos ni salida de error. Si Twilio devuelve un 503 pasajero, la ejecución falla y el aviso a Valeria no sale. El workflow tiene unerrorWorkflowconfigurado, de modo que el fallo no es silencioso, pero el Día 28 enseñó que un error pasajero se reintenta antes de despertar a nadie.
La Tabla 4 resume la suite completa por workflow, con las dos partes estáticas y las dos dinámicas.
Tabla 4. Resultado de la suite por workflow: comprobaciones estáticas, contratos y casos aprobados y fallidos (rama de práctica con dos fallos sembrados).
| Workflow | Nodos | Estáticas aprobadas | Estáticas fallidas | Contratos | Casos con referencia |
|---|---|---|---|---|---|
TL Agente de pedidos v3 | 22 | 10 | 2 (reales) | No aplica | 40 conversaciones del Día 39, aparte |
TL Clasificador IA v1 | 8 | 12 | 0 | No aplica | No aplica |
TL Facturación | 13 | 11 | 1 (sembrado) | No aplica | No aplica |
TL Importación histórica v1 | 6 | 12 | 0 | No aplica | No aplica |
TL Lote de importación v1 | 4 | 12 | 0 | No aplica | No aplica |
TL Pedidos WhatsApp n8n v1 | 6 | 10 | 2 (sembrado) | 20 aceptados y 10 rechazados, como se esperaba | 30 de 30 en la versión etiquetada |
En la matriz de la figura, cada fila es un workflow y cada columna una comprobación; las celdas rojas son los cinco fallos. La lectura por columnas también dice algo: ninguna comprobación falla en más de un workflow, y siete columnas están completamente en verde. Eso no significa que esas siete comprobaciones sobren, sino que hoy protegen contra errores que todavía no han ocurrido, como el día en que alguien duplique un workflow y olvide cambiar la ruta de su Webhook.
La parte dinámica envía los 30 casos al Webhook de ensayo. El octavo bloque lee la URL y la contraseña de .env.ensayo, se niega a ejecutarse si la URL no contiene “ensayo” (una línea que evita el error más caro posible, que es correr la suite contra producción) y compara cada respuesta con su referencia usando el mismo comparar del Bloque 3. Este bloque llama al servidor de ensayo y no se ejecutó para escribir la entrada; su salida es un ejemplo comentado:
# Envío de los 30 casos al webhook de ensayo y comparación con las referencias en Python:
import json
import os
from pathlib import Path
import requests

from suite_flujos import comparar          # el comparador del Bloque 3, guardado en pruebas/suite_flujos.py

def leer_env(ruta = '.env.ensayo'):
    # Lee CLAVE=valor sin exportarlo al entorno del sistema:
    pares = (l.split('=', 1) for l in Path(ruta).read_text(encoding = 'utf-8').splitlines() if '=' in l)
    return {k.strip(): v.strip() for k, v in pares}

env = leer_env()
URL = env['N8N_URL_ENSAYO'] + '/webhook/pedidos-whatsapp'       # ensayo, nunca producción
assert 'ensayo' in URL, 'La suite solo se ejecuta contra la instancia de ensayo.'
AUTENTICACION = (env['WEBHOOK_ENSAYO_USUARIO'], env['WEBHOOK_ENSAYO_CONTRASENA'])

carpeta = Path('trigo_lento') / 'dia_43' / 'pruebas'
fallidos = []
for ruta_caso in sorted((carpeta / 'casos').glob('caso_*.json')):
    caso = json.loads(ruta_caso.read_text(encoding = 'utf-8'))
    esperado = json.loads((carpeta / 'esperado' / ruta_caso.name).read_text(encoding = 'utf-8'))
    r = requests.post(URL, data = caso['cuerpo'], auth = AUTENTICACION, timeout = 30)
    if r.status_code != 200:
        fallidos.append((caso['id'], f'HTTP {r.status_code}'))
        continue
    diferencias = comparar(r.json(), esperado)
    if diferencias:
        fallidos.append((caso['id'], diferencias))
print(f'Casos: 30 | fallidos: {len(fallidos)}')
for id_caso, motivo in fallidos:
    print(f'  {id_caso}: {motivo}')

# Salida de ejemplo (puede variar):
# Casos: 30 | fallidos: 0
Con la versión etiquetada, los 30 casos pasan. Pero una suite que solo se ha visto en verde no ha demostrado nada: falta comprobar que se pone en rojo cuando debe. El noveno bloque repite la corrida sin red, con simular_post, una función que imita la respuesta del Webhook con la misma interfaz que requests.post (status_code, headers y json()) y que añade en cada llamada una hora y un identificador de evento aleatorios, como haría el flujo real. Simula dos versiones del flujo: la etiquetada y una candidata con dos regresiones sembradas, de las que pasan una revisión a ojo sin que nadie las note:
- Regresión 1, una ruta del Switch cambiada: alguien movió la regla de quejas al final de la lista para “ordenar” el Switch. Parece inofensivo, porque las reglas siguen siendo las mismas.
- Regresión 2, un campo renombrado: en el nodo que prepara el borrador de pedido,
clave_clientepasó a llamarsecliente, un cambio de nombre que el nodo siguiente todavía no conoce.
# El mismo comparador sobre respuestas simuladas con simular_post y dos regresiones sembradas en Python:
from types import SimpleNamespace

REGLAS_V1 = [('baja', r'\b(baja|stop)\b|ya no|no me escriban'),
             ('revision_humana', r'queja|reclamo|\bmal\b|fr[ií]o|tarde|molest'),
             ('respuesta_horario', r'horario|abren|cierran|a qu[eé] hora'),
             ('respuesta_precio', r'precio|cu[aá]nto|cuesta|vale'),
             ('borrador_pedido', r'quiero|aparta|pedido|encarg|necesito|quisiera')]
# Versión candidata: alguien movió la regla de quejas al final y renombró un campo del borrador:
REGLAS_V2 = [REGLAS_V1[0]] + REGLAS_V1[2:] + [REGLAS_V1[1]]

def flujo_simulado(cuerpo, reglas, campo_cliente = 'clave_cliente'):
    texto = cuerpo['Body'].lower()
    ruta = next((r for r, patron in reglas if re.search(patron, texto)), 'revision_humana')
    categoria = {v[0]: k for k, v in ESPERADO.items() if k != 'ambiguo'}[ruta]
    salida = {'ruta': ruta, 'respuesta': ESPERADO[categoria][1] + ' Mensaje automático de Trigo Lento.',
              'estado': 'por revisar' if ruta == 'borrador_pedido' else 'atendido', 'canal': 'whatsapp'}
    salida['clave_cliente' if ruta != 'borrador_pedido' else campo_cliente] = clave_cliente(cuerpo['WaId'])
    if ruta == 'revision_humana' and not re.search(REGLAS_V1[1][1], texto):
        salida['respuesta'] = ESPERADO['ambiguo'][1] + ' Mensaje automático de Trigo Lento.'
    return salida

def simular_post(url, cuerpo, rng, version = 'v1'):
    # Imita requests.post contra el webhook de ensayo: misma interfaz, sin red:
    reglas, campo = (REGLAS_V1, 'clave_cliente') if version == 'v1' else (REGLAS_V2, 'cliente')
    datos = flujo_simulado(cuerpo, reglas, campo)
    datos['recibido_en'] = f'2026-03-15T11:{int(rng.integers(0, 60)):02d}:{int(rng.integers(0, 60)):02d}-06:00'
    datos['id_evento'] = f'ev-{int(rng.integers(10**6, 10**7))}'
    return SimpleNamespace(status_code = 200, headers = {'content-type': 'application/json'}, json = lambda: datos)

def correr_suite(version):
    filas = []
    for caso in casos:
        ref = json.loads((esperado_dir / f"{caso['id']}.json").read_text(encoding = 'utf-8'))
        r = simular_post('https://ensayo.n8n.trigolento.example/webhook/pedidos-whatsapp', caso['cuerpo'], rng, version)
        filas.append({'id': caso['id'], 'categoria': caso['categoria'], 'diferencias': comparar(r.json(), ref),
                      'sin_ignorar': len(comparar(r.json(), ref, ignorar = ()))})
    return pd.DataFrame(filas)

base, candidata = correr_suite('v1'), correr_suite('v2')
for nombre, corrida in (('v1 (etiquetada)', base), ('candidata', candidata)):
    fallidos = corrida[corrida['diferencias'].map(len) > 0]
    print(f'{nombre}: {len(fallidos)} de {len(corrida)} casos fallan | sin ignorar variables fallarían '
          f'{int((corrida["sin_ignorar"] > 0).sum())}')
print(candidata[candidata['diferencias'].map(len) > 0].to_string(index = False, columns = ['id', 'categoria', 'diferencias']))

fig, ax = plt.subplots(figsize = (11, 4.6))
delta = candidata['diferencias'].map(len)
colores = ['#c8423b' if 'ruta' in d else ('#eb6834' if d else '#3a9d5d') for d in candidata['diferencias']]
ax.bar(range(len(candidata)), delta, color = colores, edgecolor = 'white', linewidth = 1.5)
ax.set_xticks(range(len(candidata)))
ax.set_xticklabels([f"{c[-2:]}\n{g[:4]}" for c, g in zip(candidata['id'], candidata['categoria'])], fontsize = 7)
for x, d in enumerate(delta):
    if d:
        ax.text(x, d + 0.08, str(d), ha = 'center', fontsize = 9)
ax.bar([0], [0], color = '#c8423b', label = 'Regresión 1: ruta del Switch cambiada')
ax.bar([0], [0], color = '#eb6834', label = 'Regresión 2: campo renombrado')
ax.bar([0], [0], color = '#3a9d5d', label = 'Igual a la referencia')
ax.set_ylim(0, delta.max() + 1)
ax.set_ylabel('Campos distintos de la referencia')
ax.set_title('Candidata frente a referencias: 30 casos, sin campos variables', fontsize = 16)
ax.legend(loc = 'upper right', frameon = False, fontsize = 9)
ax.spines[['top', 'right']].set_visible(False)
plt.tight_layout()
plt.show()
v1 (etiquetada): 0 de 30 casos fallan | sin ignorar variables fallarían 30
candidata: 7 de 30 casos fallan | sin ignorar variables fallarían 30
     id categoria                                       diferencias
caso_01    pedido                          [clave_cliente, cliente]
caso_02    pedido                          [clave_cliente, cliente]
caso_03    pedido                          [clave_cliente, cliente]
caso_04    pedido                          [clave_cliente, cliente]
caso_05    pedido                          [clave_cliente, cliente]
caso_17     queja [clave_cliente, cliente, estado, respuesta, ruta]
caso_20     queja [clave_cliente, cliente, estado, respuesta, ruta]
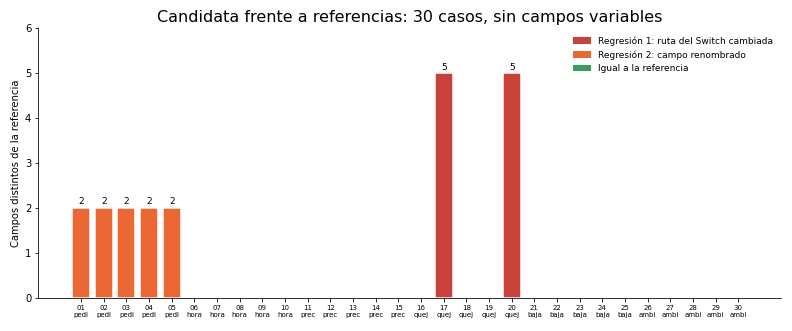
La versión etiquetada pasa $30$ de $30$ y la candidata falla $7$ de $30$. La segunda cifra de cada línea es la advertencia del Paso 2 hecha número: sin ignorar los campos variables, las dos versiones fallarían los $30$ casos, y la suite no distinguiría la buena de la mala.
La gráfica separa las dos regresiones por su firma:
- Las barras naranjas de altura $2$ son los cinco pedidos (casos 01 a 05). Cada uno tiene dos campos distintos: falta
clave_clientey sobracliente. Es la firma clásica de un campo renombrado, y por eso la definición de $\Delta_i$ cuenta los campos de las dos salidas. - Las barras rojas de altura $5$ son dos quejas, los casos 17 y 20. “Quiero poner una queja por el pedido del viernes” y “Tengo un reclamo sobre mi encargo” contienen palabras de la regla de pedidos, y al mover la regla de quejas al final las atrapa la de pedidos: cambian la ruta, la respuesta y el estado, y además heredan el campo renombrado del borrador. Una clienta molesta recibiría “Recibimos su pedido; Valeria lo confirma en breve”.
- Las otras tres quejas no cambian, porque no contienen ninguna palabra de las reglas anteriores. La regresión 1 afecta solo a las quejas que mencionan un pedido, y eso es lo que la hace peligrosa: en producción sería rara, y por eso nadie la vería durante semanas.
Esa última observación es la pregunta de la sección siguiente, en su forma más concreta: si la regresión 1 hubiera afectado al $1%$ de los mensajes reales en lugar de a $2$ de $30$ casos, ¿cuántos casos habría hecho falta tener para verla?
Paso 6. Integración continua, mostrada y no ejecutada
La suite sirve de poco si depende de que Valeria se acuerde de correrla. La integración continua (o CI, por sus siglas en inglés: “Continuous Integration”) es la práctica de ejecutar las pruebas automáticamente cada vez que alguien propone un cambio, antes de que el cambio se una a la rama principal. En el repositorio de Trigo Lento, que el Día 42 dejó en GitHub como privado, eso se hace con GitHub Actions: un archivo YAML en .github/workflows/ que describe qué ejecutar y cuándo.
El décimo bloque es ese archivo. Se muestra para leerlo, no se ejecuta en la entrada:
# Integración continua de los flujos de Trigo Lento, archivo .github/workflows/pruebas-flujos.yml:
# Se ejecuta en cada solicitud de cambios hacia main y no necesita secretos: solo lee archivos.
name: Pruebas de flujos

on:
  pull_request:
    branches: [main]
    paths:
      - "flujos/**"
      - "pruebas/**"

permissions:
  contents: read                              # mínimo privilegio: la suite no escribe en el repositorio

jobs:
  suite-determinista:
    runs-on: ubuntu-latest
    timeout-minutes: 10
    steps:
      - name: Descargar el repositorio
        uses: actions/checkout@v4

      - name: Preparar Python 3.12
        uses: actions/setup-python@v5
        with:
          python-version: "3.12"

      - name: Instalar dependencias fijadas
        run: pip install -r pruebas/requisitos.txt   # numpy, pandas y pydantic con versión exacta

      - name: Detector de secretos (Día 42)
        run: python pruebas/detectar_secretos.py flujos/

      - name: Suite estática sobre los JSON exportados
        run: python pruebas/revisar_workflows.py flujos/n8n/ --entorno produccion

      - name: Contratos de webhook y del sobre del pedido
        run: python pruebas/contratos.py pruebas/contratos/

      - name: Casos con referencias, contra el flujo simulado
        run: python pruebas/correr_casos.py --modo simulado

# Fuera de este ciclo, a propósito: las pruebas del agente con Claude (cuestan tokens) y el
# envío de casos al webhook de ensayo (necesita la VPN del servidor); Valeria las corre a mano.
El archivo se lee de arriba abajo como una receta:
on.pull_requestconpaths: la suite corre en cada solicitud de cambios haciamainque toqueflujos/opruebas/. Un cambio en el registro de cambios no la dispara.permissions: contents: read: el trabajo solo puede leer el repositorio. Es el mínimo privilegio del Día 17 aplicado a la propia integración continua.- Cuatro pasos de prueba, en orden de coste: el detector de secretos del Día 42 primero (si hay un secreto, lo demás da igual), la suite estática del Bloque 7, los contratos del Bloque 4 y los casos con referencias contra el flujo simulado del Bloque 9.
- Ningún secreto en el archivo: la suite determinista no los necesita, y por eso puede correr en una máquina de GitHub sin acceso al servidor de Trigo Lento.
Lo que se deja fuera del ciclo automático es tan importante como lo que entra, y el comentario final del archivo lo dice: las pruebas del agente con Claude cuestan $2.88$ USD por corrida y no pueden correr en cada solicitud de cambios sin agotar el rubro, y el envío de casos al Webhook de ensayo necesita acceso a un servidor que no está expuesto a internet. Valeria las corre a mano, antes de promover una etiqueta, con el Bloque 8 y la regresión del Día 39.
La cadena completa, de la solicitud de cambios al semáforo, aparece en la Figura 3.
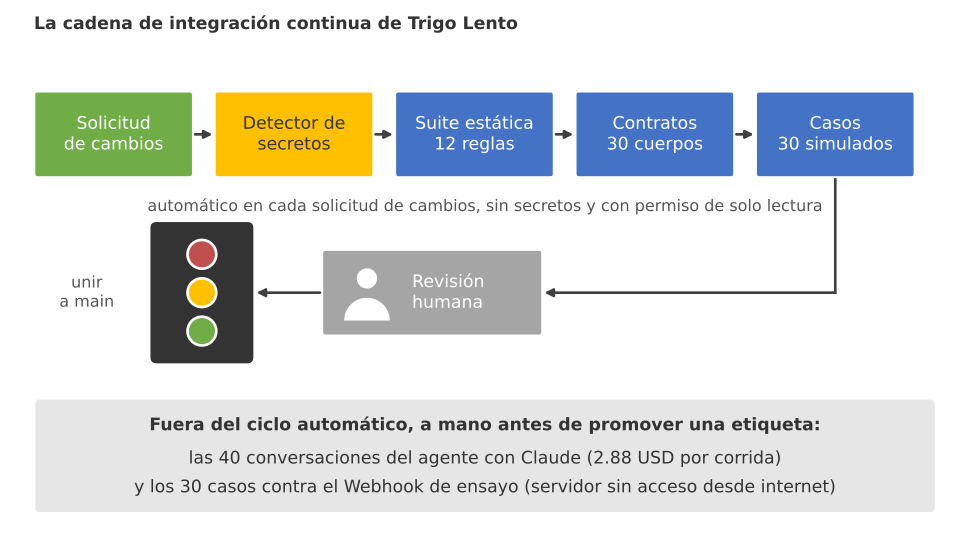
Figura 3. La cadena de integración continua: cada solicitud de cambios pasa por el detector de secretos, 12 comprobaciones estáticas, 30 contratos y 30 casos simulados antes de la revisión humana; el agente con Claude y los casos contra ensayo se corren a mano antes de promover.
El último eslabón de la cadena no es un programa: es una persona que lee la diferencia y aprueba. La integración continua no sustituye la revisión humana del Día 42; le quita a la persona el trabajo mecánico (¿quedó un pinData?, ¿hay una clave?, ¿cambió alguna referencia?) para que pueda dedicar su atención a la pregunta que ningún programa responde: ¿este cambio es lo que Trigo Lento quiere?
n8n ofrece, además, una función propia para el nivel 5 de la Tabla 1: las Evaluaciones (en la interfaz, Evaluations). Con un nodo Evaluation Trigger que lee un conjunto de casos de una tabla de datos o de una hoja de Google, el workflow se ejecuta una vez por fila, y el nodo Evaluation escribe las salidas y, en las evaluaciones con métricas, una puntuación numérica por caso. La documentación distingue las evaluaciones ligeras, durante la construcción, de las evaluaciones con métricas, que según la misma documentación están disponibles en los planes Pro y Enterprise y, para un solo workflow, en Starter y en la edición comunitaria registrada (revisado en octubre de 2026). Para el agente de Trigo Lento es una alternativa razonable a ejecutar las cuarenta conversaciones desde Python; para las pruebas deterministas de hoy, la suite en Python sigue siendo más barata y vive en el repositorio junto a los flujos.
Cuántos casos bastan
La suite de Trigo Lento tiene $60$ casos deterministas. ¿Son muchos o pocos? La pregunta tiene una respuesta cuantitativa si se plantea bien. Suponga que un cambio introduce una regresión que afecta a una fracción $p$ de los mensajes reales, y que los casos de la suite son una muestra al azar de esos mensajes. La probabilidad de que al menos un caso caiga en la parte rota, y la suite falle, es:
$$ P = 1 - (1 - p)^n $$
La lógica detrás de esta fórmula es múltiple:
- Cada caso, por separado, cae fuera de la regresión con probabilidad $1 - p$.
- Si los $n$ casos son independientes, la probabilidad de que todos caigan fuera es el producto, $(1 - p)^n$: es la probabilidad de que la suite pase en verde aunque la regresión exista.
- La detección es el suceso contrario: basta un caso en rojo.
- En conclusión, $P$ crece rápido al principio y despacio después: los primeros casos aportan mucho y los últimos, poco.
Despejando $n$ se obtiene cuántos casos hacen falta para una probabilidad de detección objetivo $P^{*}$:
$$ n \geq \frac{\ln(1 - P^{*})}{\ln(1 - p)} $$
La lógica de este despeje:
- Se pide $1 - (1 - p)^n \geq P^{}$, que equivale a $(1 - p)^n \leq 1 - P^{}$.
- Al tomar logaritmos, los dos lados son negativos y la desigualdad se invierte al dividir entre $\ln(1 - p)$.
- En conclusión, el número de casos crece como $1/p$: si la regresión es cinco veces más rara, hacen falta unas cinco veces más casos.
El undécimo bloque calcula las dos fórmulas para tres tamaños de regresión, las aplica a la regresión 1 del Bloque 9 y dibuja la curva:
# Probabilidad de detectar una regresión frente al número de casos y coste en n8n Cloud en Python:
def deteccion(n, p):
    return 1 - (1 - p) ** n

def casos_necesarios(objetivo, p):
    return math.ceil(math.log(1 - objetivo) / math.log(1 - p))

for p in (0.01, 0.02, 0.05):
    print(f'p = {p:.2f}: 20 casos {deteccion(20, p):.3f} | 60 casos {deteccion(60, p):.3f} | '
          f'200 casos {deteccion(200, p):.3f} | para 95 %: {casos_necesarios(0.95, p)} casos')
# Las dos regresiones del Bloque 9, vistas como fracción de la suite:
p_ruta = 2 / 30
print(f'Regresión de ruta: p = {p_ruta:.3f} en la suite | 10 casos al azar la verían con {deteccion(10, p_ruta):.3f}')
corridas_mes = 60 * DIAS_MES
print(f'n8n Cloud Starter: {corridas_mes} ejecuciones al mes = {corridas_mes / EJECUCIONES_STARTER:.0%} '
      f'de las {EJECUCIONES_STARTER} incluidas | self-hosted: 0 ejecuciones de cuota')

n = np.arange(1, 201)
fig, ax = plt.subplots(figsize = (10, 4.8))
for p, color in ((0.01, '#7b4fb8'), (0.02, '#2a78d6'), (0.05, '#eb6834')):
    ax.plot(n, deteccion(n, p), color = color, linewidth = 2.2, label = f'p = {p:.2f}')
    ax.scatter([60], [deteccion(60, p)], color = color, s = 50, zorder = 3)
    ax.annotate(f'{deteccion(60, p):.3f}', (60, deteccion(60, p)), textcoords = 'offset points',
                xytext = (8, -12), fontsize = 9)
ax.axvline(60, color = '#52514e', linestyle = '--', linewidth = 1)
ax.text(62, 0.06, 'suite de Trigo Lento: 60 casos', fontsize = 9, color = '#52514e')
ax.axhline(0.95, color = '#8a8986', linestyle = ':', linewidth = 1)
ax.set_xlim(0, 200)
ax.set_ylim(0, 1.02)
ax.set_xlabel('Número de casos elegidos al azar (n)')
ax.set_ylabel('Probabilidad de detectar la regresión')
ax.set_title('P = 1 - (1 - p)^n para tres tamaños de regresión', fontsize = 16)
ax.legend(loc = 'lower right', frameon = False)
ax.grid(color = '#e6e5e1')
ax.set_axisbelow(True)
plt.tight_layout()
plt.show()
p = 0.01: 20 casos 0.182 | 60 casos 0.453 | 200 casos 0.866 | para 95 %: 299 casos
p = 0.02: 20 casos 0.332 | 60 casos 0.702 | 200 casos 0.982 | para 95 %: 149 casos
p = 0.05: 20 casos 0.642 | 60 casos 0.954 | 200 casos 1.000 | para 95 %: 59 casos
Regresión de ruta: p = 0.067 en la suite | 10 casos al azar la verían con 0.498
n8n Cloud Starter: 1800 ejecuciones al mes = 72% de las 2500 incluidas | self-hosted: 0 ejecuciones de cuota
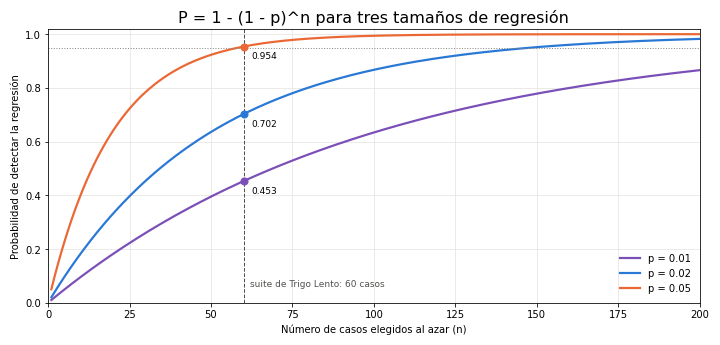
Las cifras ponen la suite en su sitio. Si un cambio rompe el $5%$ de los mensajes, $60$ casos lo detectan con probabilidad $0.954$, y $20$ casos solo con $0.642$. Si rompe el $1%$, los mismos $60$ casos lo detectan con probabilidad $0.453$: menos que una moneda al aire. Para llegar al $95%$ con $p = 0.01$ harían falta $299$ casos, y con $p = 0.02$, $149$. La curva naranja de la gráfica se aplana enseguida; la morada sigue subiendo despacio hasta los $200$ casos sin llegar al $0.95$.
La conclusión práctica no es “escriba 300 casos”, sino no elija los casos al azar. La fórmula supone una muestra aleatoria, y la suite de Trigo Lento no lo es: los casos 17, 20 y 24 se escribieron a propósito para tropezar con las reglas del Switch, y por eso la regresión 1, que en producción podría afectar a muy pocos mensajes, la detectaron $2$ casos de $30$. La línea del bloque lo muestra al revés: con $p = 0.067$, la fracción de la suite que la regresión rompía, $10$ casos tomados al azar la habrían visto solo con probabilidad $0.498$. Los casos dirigidos (uno por cada categoría, uno por cada fallo conocido del Día 39, uno por cada frontera de una regla) valen mucho más que los casos al azar, y la fórmula da el piso de lo que se puede esperar de los segundos.
Queda el coste. En la instalación propia de Trigo Lento, la suite determinista cuesta $0$ USD y $0$ ejecuciones de cuota: corre en Python y, cuando toca el Webhook de ensayo, en un servidor que ya se paga. Si la instancia fuera n8n Cloud, cada caso enviado al Webhook sería una ejecución, y la fracción de la cuota mensual que consumiría una corrida diaria es:
$$ f = \frac{n \cdot d}{Q} $$
La lógica de este cociente:
- $n$ son los casos por corrida ($60$), $d$ las corridas al mes ($30$, una diaria) y $Q$ las ejecuciones incluidas en el plan ($2,500$ en Starter, según la Tabla B de la serie).
- Con esos valores, $f = 60 \cdot 30 / 2,500 = 0.72$: el $72%$ de la cuota se iría en pruebas, y quedarían $700$ ejecuciones para los $1,560$ mensajes reales del mes.
- En conclusión, en n8n Cloud la suite dinámica se correría solo antes de promover una etiqueta, no a diario, y la parte estática, que no toca n8n, seguiría siendo gratis.
Mañana Valeria se examina, y la suite le da la lista de preparación más honesta posible, porque es la lista de lo que ya comprobó:
- Datos fijados en el Webhook, inventados y fuera del JSON exportado.
- Treinta casos con referencia y un comparador que ignora
recibido_eneid_evento. - Contratos de Meta y del sobre del pedido: $20$ aceptados, $10$ rechazados, $0$ errores del contrato.
- Instancia de ensayo con clave de cifrado, credenciales, número y tope de gasto propios.
- Doce comprobaciones estáticas: dos fallos sembrados detectados y dos hallazgos reales en el agente, con su corrección.
- Dos regresiones sembradas detectadas por $7$ casos de $30$, y la fórmula para decidir cuántos casos bastan.
Consideraciones finales
El laboratorio de hoy no añadió ningún nodo a los flujos de Trigo Lento, y sin embargo cambió lo que Valeria puede afirmar de ellos. Antes podía decir “lo probé y funcionó”; ahora puede decir “pasa $67$ de $72$ comprobaciones estáticas, sé cuáles son las cinco que fallan y por qué, sus $30$ casos coinciden con las referencias y sus contratos rechazan los $10$ cuerpos rotos sin rechazar ninguno bueno”. La primera frase es una opinión; la segunda es una medición que cualquiera puede repetir.
Antes de dar por buena una suite de pruebas, conviene hacerse algunas preguntas:
- ¿La he visto fallar? Una suite que nunca se ha puesto en rojo con un fallo sembrado no ha demostrado que sepa hacerlo.
- ¿Qué campos de mis salidas cambian en cada ejecución, y están todos en la lista de variables?
- ¿Quién revisa un cambio de referencia, y lo revisa con la misma atención que un cambio de flujo?
- ¿Mis casos están elegidos por categoría y por los fallos conocidos, o son los primeros que se me ocurrieron?
- ¿Hay algún camino por el que una prueba pueda escribirle a un cliente real o gastar con una credencial de producción?
Las cifras de hoy tienen límites claros. Los mensajes, los teléfonos y las respuestas son inventados; el flujo dinámico se simuló con simular_post y la corrida contra el Webhook de ensayo se muestra como ejemplo; el archivo de Compose y el pinData tienen la estructura verificada contra la documentación, no una exportación de una instancia levantada para la entrada; y la fórmula de detección supone casos independientes y elegidos al azar, que es justo lo que una buena suite evita. Ninguno de esos límites cambia las conclusiones: las pruebas deterministas son gratis y se corren siempre, las del agente cuestan y se corren cuando hace falta, los campos variables se excluyen antes de comparar y los casos dirigidos detectan lo que el azar deja pasar.
Un gran libro que habla de esto es xUnit Test Patterns: Refactoring Test Code (2007), en el que Gerard Meszaros cataloga los patrones de las pruebas automatizadas y, sobre todo, sus defectos: las pruebas frágiles que fallan por motivos que no importan (como una marca de tiempo), las pruebas que nunca fallan y las que se reescriben para que pasen. Leerlo después de esta entrada ayuda a reconocer esos defectos en una suite de flujos, que tiene los mismos que una de software aunque se escriba sobre archivos JSON.
Las recetas nuevas se prueban en la charola; lo que pasa al aparador sale de una etiqueta. Con tres mensajes fijados, treinta casos con su referencia, dos contratos estrictos, una instancia de ensayo que no comparte nada con producción, doce comprobaciones que ya encontraron dos fallos reales y una fórmula que dice cuánto se puede confiar en sesenta casos, Trigo Lento llega a la evaluación del módulo con flujos que se pueden cambiar sin miedo.
Conclusiones clave
Datos fijados y referencias
- Los datos fijados (
pinData) solo se usan en ejecuciones manuales y de prueba, no admiten datos binarios ni nodos con varias salidas principales, se inventan con formatos de prueba y se vacían antes de exportar. - Treinta casos en
pruebas/casos/con su referencia enpruebas/esperado/comparan la salida campo a campo; sin excluirrecibido_eneid_evento, los $30$ casos fallarían siempre. - Una referencia se actualiza solo por un cambio intencionado y pasa por la misma revisión que el flujo.
Contratos y ensayo
CuerpoWebhookMetaySobrePedido, constrict=Trueyextra="forbid", aceptaron $20$ cuerpos y rechazaron $10$ (campo faltante, tipo incorrecto, teléfono sin formato y producto fuera de catálogo) sin ningún error del contrato.- La instancia de ensayo usa la misma versión de n8n, pero base, clave de cifrado, credenciales, número de prueba, canal de Slack y tope de gasto de $1$ USD propios.
- Solo se promueve desde una etiqueta de git:
git worktree,n8n import:workflow(los workflows entran inactivos) y una prueba de humo conn8n execute --id.
Regresión e integración continua
- Doce comprobaciones estáticas aprobaron $67$ de $72$: detectaron los dos fallos sembrados y dos problemas reales del agente (un IF sin rama falsa declarada y tres nodos HTTP sin reintentos).
- Con respuestas simuladas, la versión etiquetada pasa $30$ de $30$ y la candidata con dos regresiones falla $7$; la ruta cambiada solo afectaba a las quejas que mencionan un pedido.
- $P = 1 - (1 - p)^n$: $60$ casos detectan con $0.954$ una regresión del $5%$ y con $0.453$ una del $1%$; por eso los casos se eligen por categoría y por fallos conocidos.
- La integración continua corre en cada solicitud de cambios el detector de secretos, la suite estática, los contratos y los casos simulados; el agente con Claude y el ensayo quedan fuera por coste y acceso, y en n8n Cloud una corrida diaria de $60$ casos consumiría el $72%$ de Starter.
Mañana, en el Día 44: Evaluación final: del fundamento al agente. Valeria pondrá a prueba lo aprendido en los módulos 1 a 4 con veinte preguntas autocorregibles y un caso nuevo que tendrá que diseñar de punta a punta, y esta vez podrá apoyar cada respuesta en una suite que ya sabe ponerse en rojo.
Referencias
- Humble, J. y Farley, D. (2010). Continuous Delivery: Reliable Software Releases through Build, Test, and Deployment Automation. Addison-Wesley.
- Meszaros, G. (2007). xUnit Test Patterns: Refactoring Test Code. Addison-Wesley.
- n8n (2026). Data pinning. Documentación de n8n. https://docs.n8n.io/data/data-pinning/
- n8n (2026). CLI commands: import, execute y publicación de workflows. Documentación de n8n. https://docs.n8n.io/hosting/cli-commands/
- n8n (2026). Evaluations: light evaluations y metric-based evaluations. Documentación de n8n. https://docs.n8n.io/advanced-ai/evaluations/overview/
- Pydantic (2026). Models, strict mode y validation errors. Documentación de pydantic. https://docs.pydantic.dev
- GitHub (2026). Documentación de GitHub Actions: workflow syntax y permisos. https://docs.github.com/actions
- Meta (2026). WhatsApp Cloud API: webhooks y estructura de las notificaciones de mensajes. https://developers.facebook.com/docs/whatsapp/cloud-api/webhooks