
Arquitecto de automatización con IA: Día 49
 Jeshua Romero Guadarrama
- 63 Min para leer
- 21 Mar, 2026
Índice de contenido
Resumen:
Un recordatorio que una clienta de 78 años oye como “pastel de cumpleaños, croissant, destellos” antes de saber cuándo recoger su pedido no es un mensaje automatizado, es ruido con buena intención. En esta entrada, Valeria mide la legibilidad de cinco plantillas de Trigo Lento con el índice de Szigriszt-Pazos y la escala INFLESZ, las reescribe en lectura fácil, comprueba cómo suenan en un lector de pantalla, escribe fechas, horas y moneda sin ambigüedad para clientes mexicanos y extranjeros, y opera la plantilla de recogida en es_MX y en en_US con un detector de idioma por reglas y traducciones de Claude que una persona revisa. Al terminar, usted sabrá revisar cualquier mensaje automático con criterios medibles de accesibilidad, con WCAG 2.2 como referencia y con su coste calculado.
¿Cómo citar el presente artículo?
Romero, J. (21 de marzo de 2026). Arquitecto de automatización con IA: Día 49. python-data-engineer. https://www.python-data-engineer.com/post/aai/dia_49/.
Arquitecto de automatización con IA: Día 49 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/aai/dia_49/.
Precios, límites y políticas revisados en octubre de 2026: planes, precios y límites de Make, n8n, Zapier, WhatsApp (Meta, Twilio, Wati) y de la API de Claude. El límite de 1 024 caracteres del cuerpo de una plantilla, los 60 del pie y el formato de parámetros con nombre (parameter_format y body_text_named_params) se contrastaron en la página de componentes de plantillas de Meta; un proveedor menciona un tope de 550 caracteres para plantillas de marketing y de utilidad, así que las fuentes no coinciden y la serie usa el valor de Meta. Los códigos es_MX y en_US figuran en la lista de idiomas admitidos de Meta. Que cada traducción de una plantilla se revise por separado lo dicen la documentación de varios proveedores, no una página de Meta. Los niveles de los criterios de WCAG 2.2 se tomaron de la recomendación del W3C (versión del 12 de diciembre de 2024). El JSON del Bloque 7 tiene la estructura verificada contra la documentación, revisado en octubre de 2026.
Día 49. Accesibilidad y multilingüismo de los mensajes
Introducción
Ayer, en el Día 48 (WhatsApp Business API: plantillas, ventana de 24 horas, secuencias y chatbots), Valeria registró las plantillas de Trigo Lento en su categoría correcta, diseñó secuencias que respetan el consentimiento por finalidad, el horario y la baja inmediata, y Trigo Lento ganó TL WhatsApp secuencias v1 y un chatbot de preguntas frecuentes que sabe cuándo pasar la conversación a una persona. Hoy toca una pregunta que ninguna de esas piezas se hizo: quién lee de verdad esos mensajes, y en qué condiciones.
Es sábado 21 de marzo, a las once de la mañana, la hora pico del mostrador. Entra Julián, el nieto de Doña Carmen, la clienta que compra pan en Trigo Lento desde hace veinte años. Doña Carmen tiene 78 años y casi no ve; usa el lector de pantalla de su teléfono, que le lee en voz alta todo lo que aparece. Julián trae el teléfono de su abuela y le pide a Valeria que escuche el recordatorio de recogida que llegó la víspera. El teléfono dice, con voz pausada: “Pastel de cumpleaños, croissant, destellos, erre negrita matemática, e negrita matemática, ce negrita matemática…”, y así doce letras, antes de llegar a la palabra “pedido”. “Mi abuela colgó a la tercera letra”, dice Julián. “Pensó que era publicidad.” Doña Carmen no recogió su hogaza el viernes.
Ese mismo sábado, dos turistas escriben al WhatsApp de la panadería en inglés. Preguntan si el pan de caja que aparece a $72 cuesta setenta y dos dólares, y si “4:00 p. m.” es la hora de la Ciudad de México o la de su teléfono, que sigue en la hora de Chicago. El chatbot del Día 48 les contestó en español, con el precio en pesos y sin decir que eran pesos.
Don Ernesto escucha las dos historias con los brazos cruzados y pone el dedo en la llaga: "¿Y si la máquina le dice a un turista que la concha es una shell? Aquí el pan tiene nombre propio. Y a Doña Carmen no le mande dibujitos: mándele la hora." Tiene razón dos veces. Un mensaje automático que no se entiende no ahorra tiempo, lo traslada al mostrador; y una traducción automática que convierte el nombre de un pan en una palabra genérica le quita al negocio parte de su identidad. Ninguna de las dos objeciones se responde con buena voluntad: se responden con reglas que se pueden medir y con una persona que revisa.
En la presente entrada, descubrirá cómo diseñar mensajes automáticos que entienden todos los lectores de un negocio pequeño. Medirá la legibilidad en español con el índice de Szigriszt-Pazos y la escala INFLESZ, reescribirá cinco plantillas en lectura fácil y comprobará que su índice sube de $45.5$ a $82.1$ puntos de media. Simulará cómo suena cada mensaje en un lector de pantalla, aprenderá a describir imágenes con texto alternativo y escribirá fechas, horas y moneda con zoneinfo para clientes mexicanos y extranjeros. Después operará la plantilla recordatorio_recogida en es_MX y en en_US, detectará el idioma del cliente con reglas y solo usará Claude para lo ambiguo y para traducir con un glosario, calculará cuánto cuesta todo eso al mes y terminará con un revisor de accesibilidad que se ejecuta antes de enviar cualquier plantilla a Meta, con WCAG 2.2 como referencia.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Redactar mensajes automáticos en lectura fácil (frases cortas, lo importante primero, longitud contenida) y medir su legibilidad en español con el índice de Szigriszt-Pazos y la escala INFLESZ.
- Anticipar cómo suenan los mensajes en un lector de pantalla (emojis, mayúsculas, letras decorativas) y acompañar las imágenes con texto alternativo.
- Formatear fechas, horas y moneda según el idioma y la zona horaria sin ambigüedades para clientes mexicanos y extranjeros.
- Operar plantillas de WhatsApp en
es_MXyen_US, detectar el idioma del cliente y traducir con Claude bajo revisión humana, con WCAG 2.2 como referencia.
Quién lee los mensajes de Trigo Lento
Hasta hoy, cada mensaje de Trigo Lento se diseñó pensando en un lector implícito: alguien de mediana edad, que lee español con soltura, que mira la pantalla con calma y que vive en la Ciudad de México. Ese lector existe, pero no es el único, y diseñar solo para él tiene un coste que no aparece en ninguna factura de Meta: la clienta que no recoge su pedido, el turista que no compra porque cree que el pan cuesta setenta y dos dólares, la persona que llama por teléfono para preguntar lo que el mensaje ya decía. Cada una de esas llamadas consume los minutos de Valeria que el módulo 1 se propuso liberar.
La accesibilidad de un mensaje es la propiedad de poder ser percibido, entendido y usado por el mayor número posible de personas, incluidas las que tienen una discapacidad visual, cognitiva o de lectura, sin adaptaciones especiales. No es un extra que se añade al final, como un adorno; es un requisito de diseño, igual que el consentimiento o el coste. Un mensaje inaccesible falla aunque se entregue, del mismo modo que un pedido falla aunque el obrador lo hornee si nadie sabe cuándo recogerlo.
El primer bloque fija las importaciones, la semilla de la serie y los supuestos del día: los $1,560$ mensajes entrantes de WhatsApp al mes, un $8%$ en inglés (supuesto didáctico) y el tope de gasto de la API de Claude de $8$ USD al mes que mantiene el presupuesto revisado del Día 46:
# Importaciones base, semilla de la serie, carpeta del día y supuestos fijos en Python:
import warnings
warnings.filterwarnings('ignore')
import json
import re
from pathlib import Path
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 130)
carpeta = Path('trigo_lento') / 'dia_49'
carpeta.mkdir(parents = True, exist_ok = True)

# Supuestos de la serie (A.4.4, A.4.6 y A.5) y del día:
MENSAJES_MES = 1_560          # mensajes entrantes de WhatsApp al mes
PROP_INGLES = 0.08            # proporción de mensajes en inglés (supuesto didáctico)
RUBRO_CLAUDE = 8.00           # tope de gasto de la API de Claude, USD al mes
MXN_POR_USD = 18.50           # tipo de cambio didáctico fijo
PRECIOS = {'claude-opus-5-5': (4.00, 20.00), 'claude-sonnet-5-5': (2.00, 10.00),
           'claude-haiku-5-5': (0.10, 0.50)}   # USD por millón de tokens (entrada, salida)
print('numpy', np.__version__, '| pandas', pd.__version__)
print(f'Mensajes al mes: {MENSAJES_MES} | en inglés (8 %): {MENSAJES_MES * PROP_INGLES:.1f} | '
      f'rubro de Claude: {RUBRO_CLAUDE:.2f} USD')
numpy 2.4.6 | pandas 3.0.3
Mensajes al mes: 1560 | en inglés (8 %): 124.8 | rubro de Claude: 8.00 USD
Con un $8%$ en inglés, Trigo Lento recibiría unos $125$ mensajes al mes de turistas o clientes extranjeros. No es una cifra medida, sino un supuesto que se puede ajustar en una línea; más adelante, el Bloque 10 estudia qué pasa si la proporción sube.
Valeria hace una lista de las personas que leen los mensajes de la panadería, con lo que cada una necesita, lo que pasa si se ignora y la regla de diseño que la protege. El siguiente código la guarda como DataFrame para que las reglas se puedan reutilizar en el revisor del final:
# Personas lectoras de Trigo Lento y sus necesidades como DataFrame en Python:
lectores = pd.DataFrame([
    ('Persona mayor', 'Lee despacio, letra grande', 'Lo importante primero',
     'No entiende cuándo recoger', 'Qué, cuándo y dónde en la primera frase'),
    ('Baja visión con lector de pantalla', 'Oye el mensaje con TalkBack o VoiceOver', 'Texto que suene bien',
     'Oye nombres de emojis antes del aviso', 'Un emoji como máximo, al final'),
    ('Poca familiaridad con la lectura', 'Evita textos largos', 'Frases cortas y verbos activos',
     'Llama por teléfono o no viene', 'Índice de Szigriszt de 65 o más'),
    ('Prisa en el mostrador', 'Mira la pantalla de bloqueo', 'Dato clave en 2 líneas',
     'Pregunta otra vez en mostrador', 'Menos de 200 caracteres'),
    ('Turista o cliente extranjero', 'Escribe en inglés, otra moneda', 'Idioma, zona y moneda claros',
     'Cree que 95 pesos son dólares', 'MXN escrito y hora de la Ciudad de México'),
], columns = ['lector', 'situacion', 'necesidad', 'riesgo_si_se_ignora', 'regla_de_diseno'])
for fila in lectores.itertuples(index = False):
    print(f'- {fila.lector}: {fila.situacion} | necesita: {fila.necesidad}')
    print(f'    riesgo: {fila.riesgo_si_se_ignora} | regla: {fila.regla_de_diseno}')
print('Lectores:', len(lectores), '| reglas de diseño distintas:', lectores.regla_de_diseno.nunique())
- Persona mayor: Lee despacio, letra grande | necesita: Lo importante primero
    riesgo: No entiende cuándo recoger | regla: Qué, cuándo y dónde en la primera frase
- Baja visión con lector de pantalla: Oye el mensaje con TalkBack o VoiceOver | necesita: Texto que suene bien
    riesgo: Oye nombres de emojis antes del aviso | regla: Un emoji como máximo, al final
- Poca familiaridad con la lectura: Evita textos largos | necesita: Frases cortas y verbos activos
    riesgo: Llama por teléfono o no viene | regla: Índice de Szigriszt de 65 o más
- Prisa en el mostrador: Mira la pantalla de bloqueo | necesita: Dato clave en 2 líneas
    riesgo: Pregunta otra vez en mostrador | regla: Menos de 200 caracteres
- Turista o cliente extranjero: Escribe en inglés, otra moneda | necesita: Idioma, zona y moneda claros
    riesgo: Cree que 95 pesos son dólares | regla: MXN escrito y hora de la Ciudad de México
Lectores: 5 | reglas de diseño distintas: 5
La lista se resume en la Tabla 1. Cinco lectores producen $5$ reglas de diseño distintas, y ninguna de ellas es cara: todas se cumplen escribiendo de otra manera, no comprando otra herramienta.
Tabla 1. Personas lectoras de Trigo Lento: situación, necesidad, riesgo si se ignora y regla de diseño.
| Lector | Situación | Necesidad | Riesgo si se ignora | Regla de diseño |
|---|---|---|---|---|
| Persona mayor | Lee despacio, letra grande | Lo importante primero | No entiende cuándo recoger | Qué, cuándo y dónde en la primera frase |
| Baja visión con lector de pantalla | Oye el mensaje con TalkBack o VoiceOver | Texto que suene bien | Oye nombres de emojis antes del aviso | Un emoji como máximo, al final |
| Poca familiaridad con la lectura | Evita textos largos | Frases cortas y verbos activos | Llama por teléfono o no viene | Índice de Szigriszt de 65 o más |
| Prisa en el mostrador | Mira la pantalla de bloqueo | Dato clave en 2 líneas | Pregunta otra vez en mostrador | Menos de 200 caracteres |
| Turista o cliente extranjero | Escribe en inglés, otra moneda | Idioma, zona y moneda claros | Cree que 95 pesos son dólares | MXN escrito y hora de la Ciudad de México |
Fíjese en que las cinco personas no son categorías excluyentes. Doña Carmen es a la vez persona mayor y usuaria de lector de pantalla; un turista con prisa en el mostrador suma dos situaciones. Por eso las reglas se aplican a todos los mensajes y no a un segmento: no se trata de mandar una versión “especial” a quien la necesita, porque eso exigiría saber quién la necesita, y ese es un dato que Trigo Lento ni tiene ni debe inferir. Un mensaje claro para Doña Carmen es también un mensaje más rápido de leer para Marisol a las 7:40 de la mañana.
TalkBack (en Android) y VoiceOver (en iPhone) son los lectores de pantalla que traen los teléfonos de fábrica. Leen en voz alta el texto, los botones y las descripciones de las imágenes, y permiten navegar por gestos. Para quien no ve, el mensaje no es lo que aparece en la pantalla: el mensaje es lo que el lector de pantalla dice, en el orden en que lo dice.
Lectura fácil y longitud
La lectura fácil es un método de redacción y de adaptación de textos pensado para personas con dificultades de comprensión lectora, que en la práctica beneficia a casi todos los lectores. En España tiene una norma experimental, la UNE 153101:2018 EX, y en el mundo hispanohablante una tradición de guías que coinciden en lo esencial. Para mensajes de WhatsApp o de correo, Valeria lo resume en seis reglas:
- Una idea por frase. Si una frase tiene un “y que”, probablemente son dos frases.
- Lo importante primero: qué pasa, cuándo y dónde. “Su pedido está listo” va antes que cualquier saludo largo o fórmula de cortesía.
- Verbos en voz activa. “Puede recogerlo mañana” en lugar de “se encuentra disponible para ser recogido”.
- Números en cifras cuando son datos: “a las 4 de la tarde”, “45 minutos”. Las cifras se encuentran con la vista más rápido que las palabras.
- Sin siglas ni tecnicismos: “hrs.” o “conforme a disponibilidad del obrador” obligan a traducir mentalmente.
- Longitud contenida: un aviso que no cabe en la pantalla de bloqueo obliga a abrir la conversación para saber de qué trata.
La sexta regla tiene dos límites distintos que conviene no confundir. El primero es técnico: según la página de componentes de plantillas de Meta (revisado en octubre de 2026), el cuerpo de una plantilla admite como máximo $1,024$ caracteres, el encabezado y el pie $60$ cada uno y el texto de un botón $25$. Un proveedor menciona un tope de $550$ caracteres para plantillas de marketing y de utilidad; las fuentes no coinciden y conviene verificarlo antes de registrar una plantilla larga. El segundo límite es de diseño y lo pone Trigo Lento: menos de $200$ caracteres para cualquier notificación, porque esa es, aproximadamente, la longitud que se lee sin abrir el mensaje en una pantalla de bloqueo de tamaño medio. El primer límite dice lo que Meta acepta; el segundo, lo que un cliente lee.
Veamos un ejemplo con el mensaje que el sistema de pedidos enviaba cuando un encargo quedaba registrado:
Le informamos que su pedido ha sido registrado satisfactoriamente en nuestro sistema y que la entrega se efectuará conforme a la disponibilidad del obrador.
Son $24$ palabras en una sola frase, con dos verbos en voz pasiva (“ha sido registrado”, “se efectuará”), un adverbio de nueve sílabas y ningún dato útil: no dice qué pedido, ni cuándo, ni dónde. Su versión en lectura fácil es esta:
Su pedido está listo. Puede recogerlo hoy desde las cuatro de la tarde. Gracias.
Tres frases, catorce palabras y la información que el cliente necesita para actuar. ¿Cómo se demuestra que la segunda es más fácil, más allá de la intuición? Midiendo.
Medir la legibilidad en español
Los índices de legibilidad estiman la dificultad de un texto a partir de rasgos que se pueden contar: cuántas sílabas tienen sus palabras y cuántas palabras tienen sus frases. No miden si el texto es correcto, amable o útil; miden su carga de lectura. Para el inglés, el más conocido es el de Flesch (1948). Para el español, Francisco Szigriszt Pazos adaptó esa fórmula en su tesis doctoral de 1993 con el nombre de índice de perspicuidad:
$$ P = 206.835 - 62.3 \cdot \frac{S}{W} - \frac{W}{F} $$
La lógica detrás de esta fórmula es múltiple:
- $S$ es el número total de sílabas, $W$ el de palabras y $F$ el de frases del texto. Los tres se cuentan, no se estiman.
- $\frac{S}{W}$ son las sílabas por palabra: cuanto más largas las palabras, más difícil el texto. Cada sílaba media de más por palabra resta $62.3$ puntos, así que este término domina la fórmula.
- $\frac{W}{F}$ son las palabras por frase: cada palabra media de más por frase resta un punto. Una frase de $24$ palabras pierde $24$ puntos solo por su longitud.
- La constante $206.835$ es la de Flesch, conservada para que la escala ocupe aproximadamente el intervalo de $0$ a $100$; los textos muy difíciles pueden dar valores negativos.
- En conclusión, cuanto mayor es $P$, más fácil es el texto, y las dos palancas para subirlo son las mismas que pide la lectura fácil: palabras más cortas y frases más cortas.
Inés M. Barrio-Cantalejo y sus coautores validaron en 2008 una escala para interpretar ese índice en textos dirigidos a pacientes, la escala INFLESZ, con cinco niveles: menos de $40$ es “muy difícil”, de $40$ a $55$ “algo difícil”, de $55$ a $65$ “normal”, de $65$ a $80$ “bastante fácil” y más de $80$ “muy fácil”. Algunas fuentes llaman “bastante difícil” al segundo tramo; los límites coinciden. Trigo Lento fija su umbral en $65$: ningún mensaje a clientes por debajo de “bastante fácil”.
Contar sílabas a mano es lento y propenso a errores, así que el siguiente código las aproxima con las reglas del español. La idea es contar núcleos vocálicos: dos vocales seguidas forman una sola sílaba (un diptongo, como en “cua-tro” o “gra-cias”) salvo que ambas sean fuertes ($a$, $e$, $o$) o que una débil lleve tilde (“dí-a”, “re-ú-ne”), en cuyo caso hay hiato. Después calcula $P$ y su nivel INFLESZ para los dos mensajes del ejemplo:
# Sílabas aproximadas del español e índice de Szigriszt-Pazos con la escala INFLESZ en Python:
FUERTES = set('aeoáéóíú')     # í y ú con tilde rompen el diptongo (hiato)
VOCALES = FUERTES | set('iuü')

def contar_silabas(palabra):
    # Cuenta núcleos vocálicos: dos vocales seguidas forman una sílaba salvo que ambas sean fuertes:
    p = palabra.lower()
    if p.isdigit() or ':' in p:
        return 2                                   # cifras: aproximación fija de 2 sílabas
    if p == 'y':
        return 1
    p = re.sub(r'y$', 'i', p)                      # "hoy", "muy": la y final suena como i
    silabas, previa = 0, ''
    for letra in p:
        if letra in VOCALES:
            if previa not in VOCALES or (previa in FUERTES and letra in FUERTES):
                silabas += 1
        previa = letra
    return max(silabas, 1)

def palabras_de(texto):
    sin_enlaces = re.sub(r'https?://\S+', ' ', texto.lower())
    return re.findall(r'\d+(?::\d+)?|[a-záéíóúüñ]+', sin_enlaces)

def frases_de(texto):
    return [f for f in re.split(r'[.!?]+(?:\s|$)', re.sub(r'https?://\S+', 'enlace', texto)) if palabras_de(f)]

def nivel_inflesz(p):
    for limite, nivel in [(40, 'muy difícil'), (55, 'algo difícil'), (65, 'normal'), (80, 'bastante fácil')]:
        if p < limite:
            return nivel
    return 'muy fácil'

def szigriszt(texto):
    palabras = palabras_de(texto)
    S, W, F = sum(contar_silabas(w) for w in palabras), len(palabras), len(frases_de(texto))
    P = 206.835 - 62.3 * S / W - W / F
    return {'silabas': S, 'palabras': W, 'frases': F, 'P': round(P, 2), 'nivel': nivel_inflesz(P)}

largo = ('Le informamos que su pedido ha sido registrado satisfactoriamente en nuestro sistema y que la '
         'entrega se efectuará conforme a la disponibilidad del obrador.')
corto = 'Su pedido está listo. Puede recogerlo hoy desde las cuatro de la tarde. Gracias.'
for nombre, texto in [('largo', largo), ('corto', corto)]:
    print(nombre, szigriszt(texto))
print('Prueba de sílabas:', {w: contar_silabas(w) for w in ['satisfactoriamente', 'efectuará', 'día',
                                                              'gracias', 'hoy', 'disponibilidad', 'cuatro']})
largo {'silabas': 56, 'palabras': 24, 'frases': 1, 'P': 37.47, 'nivel': 'muy difícil'}
corto {'silabas': 26, 'palabras': 14, 'frases': 3, 'P': 86.47, 'nivel': 'muy fácil'}
Prueba de sílabas: {'satisfactoriamente': 7, 'efectuará': 4, 'día': 2, 'gracias': 2, 'hoy': 1, 'disponibilidad': 6, 'cuatro': 2}
El mensaje largo obtiene $P = 37.47$, “muy difícil”, y el corto $P = 86.47$, “muy fácil”. Las cuentas coinciden con las hechas a mano: $206.835 - 62.3 \cdot 56/24 - 24/1 = 37.47$ y $206.835 - 62.3 \cdot 26/14 - 14/3 = 86.47$. Observe de dónde sale la diferencia. Las sílabas por palabra bajan de $2.33$ a $1.86$, lo que suma unos $29$ puntos; las palabras por frase bajan de $24$ a $4.7$, lo que suma otros $19$. La mitad de la mejora viene de partir la frase y la otra mitad de elegir palabras cortas.
La prueba de sílabas de la última línea confirma los casos difíciles del contador: “satisfactoriamente” tiene $7$ sílabas, “efectuará” $4$ (el diptongo “ua” no se rompe), “día” $2$ (la tilde en la í crea el hiato) y “hoy” $1$ (la y final suena como vocal). Tenga en cuenta que el contador es una aproximación: no distingue algunos hiatos sin tilde (“ri-o” frente a “rí-o” en ciertos dialectos), cuenta cada cifra como dos sílabas y no conoce los prefijos. Para mensajes de veinte palabras, el error de una o dos sílabas mueve el índice dos o tres puntos, lo bastante poco para comparar versiones de un mismo mensaje, que es su uso aquí.
Una alternativa histórica: Fernández Huerta
Antes de Szigriszt, José Fernández Huerta publicó en 1959 otra adaptación de Flesch al español, todavía muy citada:
$$ L = 206.84 - 0.60 \cdot P_{100} - 1.02 \cdot F_{100} $$
La lógica detrás de esta fórmula es múltiple:
- $P_{100}$ son las sílabas por cada cien palabras y $F_{100}$ las frases por cada cien palabras; es la misma información que en Szigriszt, expresada por cien palabras.
- El signo del segundo término sorprende: más frases por cada cien palabras restan en lugar de sumar, cuando frases más cortas deberían facilitar la lectura. Varios autores han señalado esa errata en la transcripción de la fórmula, y las versiones que circulan en artículos y páginas web no coinciden entre sí en los coeficientes ni en el signo.
- Con la versión de arriba, el mensaje largo obtiene $L = 206.84 - 0.60 \cdot 233.33 - 1.02 \cdot 4.17 = 62.59$ y el corto $L = 73.55$: la diferencia entre ambos se reduce de $49$ puntos a $11$ y el mensaje largo parece “normal”.
- En conclusión, las escalas de dos índices no son intercambiables. Trigo Lento usa Szigriszt con INFLESZ porque es la combinación validada para textos dirigidos a no especialistas en español, y nunca mezcla cifras de índices distintos.
Cinco plantillas antes y después
Con el índice listo, Valeria reúne las cinco plantillas que más se envían en Trigo Lento: la confirmación de pedido, el recordatorio de recogida, el aviso de pedido listo, el aviso de retraso y la respuesta automática de horario. De cada una tiene la versión que se usaba hasta ayer y la reescrita en lectura fácil. El siguiente código mide las diez versiones y dibuja la escala INFLESZ con una flecha por plantilla:
# Cinco plantillas de Trigo Lento antes y después de reescribirlas, con sus métricas, en Python:
EMOJI = re.compile('[\U0001F300-\U0001FAFF\u2600-\u27BF]')
DECORATIVAS = re.compile('[\U0001D400-\U0001D7FF]')

plantillas = {
    'confirmacion_pedido': (
        '🎂🥐✨ ¡¡HOLA!! Le confirmamos que su pedido ha quedado debidamente registrado en nuestro sistema de '
        'encargos y que será elaborado por nuestro equipo de panaderos conforme a la disponibilidad del obrador, '
        'por un importe total de $460. 😊',
        'Hola, Ana. Recibimos su pedido: un pastel de chocolate. Cuesta 460 pesos. Puede recogerlo el sábado '
        'a las 4 de la tarde. Gracias 🙂'),
    'recordatorio_recogida': (
        '🎂🥐✨ 𝗥𝗘𝗖𝗢𝗥𝗗𝗔𝗧𝗢𝗥𝗜𝗢: Estimada clienta, por medio del presente le recordamos que su pedido se '
        'encuentra disponible para ser recogido en nuestra sucursal a partir de las 16:00 horas del día de mañana.',
        'Hola, Carmen. Su pedido está listo. Puede recogerlo mañana desde las 4 de la tarde. Gracias.'),
    'pedido_listo': (largo, corto),
    'aviso_retraso': (
        '⚠️⚠️ ATENCIÓN: Debido a circunstancias ajenas a nuestra voluntad relacionadas con el proceso de '
        'fermentación de la masa madre, la entrega de su pedido experimentará un retraso aproximado de cuarenta '
        'y cinco minutos respecto del horario originalmente comprometido. 🙏',
        'Su pedido se retrasa 45 minutos. La masa necesitó más tiempo. Estará listo a las 5 de la tarde. '
        'Disculpe la espera.'),
    'respuesta_horario': (
        '¡Hola! 👋😊 Nuestro horario de atención al público es de lunes a sábado de 7:00 a 20:00 hrs., y los '
        'domingos de 8:00 a 14:00 hrs., exceptuando días festivos oficiales, en los cuales el horario podrá '
        'variar sin previo aviso. Para más información haga clic aquí: https://ejemplo.com/h',
        'Abrimos de lunes a sábado, de 7 de la mañana a 8 de la noche. El domingo abrimos de 8 de la mañana '
        'a 2 de la tarde. Vea el horario de días festivos en https://ejemplo.com/horario'),
}

filas = []
for nombre, versiones in plantillas.items():
    for version, texto in zip(['antes', 'después'], versiones):
        m = szigriszt(texto)
        filas.append({'plantilla': nombre, 'version': version, 'caracteres': len(texto),
                      'palabras_por_frase': round(m['palabras'] / m['frases'], 1),
                      'emojis': len(EMOJI.findall(texto)), 'P': m['P'], 'nivel': m['nivel']})
tabla2 = pd.DataFrame(filas)
print(tabla2.to_string(index = False))
medias = tabla2.groupby('version', sort = False)[['caracteres', 'palabras_por_frase', 'emojis', 'P']].mean().round(1)
print(medias.to_string())

# Gráfica de la escala INFLESZ con las plantillas antes y después:
bandas = [(0, 40, 'Muy difícil', '#f4d6d2'), (40, 55, 'Algo difícil', '#f9e5cc'), (55, 65, 'Normal', '#f3f2ee'),
          (65, 80, 'Bastante fácil', '#dcefe3'), (80, 100, 'Muy fácil', '#c3e6cf')]
fig, ax = plt.subplots(figsize = (11, 5.2))
for ini, fin, etiqueta, color in bandas:
    ax.axvspan(ini, fin, color = color, zorder = 0)
    ax.text((ini + fin) / 2, 4.75, etiqueta, ha = 'center', fontsize = 10, color = '#52514e')
antes = tabla2[tabla2.version == 'antes'].reset_index(drop = True)
despues = tabla2[tabla2.version == 'después'].reset_index(drop = True)
for i in range(len(antes)):
    ax.annotate('', xy = (despues.P[i], i), xytext = (antes.P[i], i),
                arrowprops = dict(arrowstyle = '-|>', color = '#8a8986', lw = 1.5))
ax.scatter(antes.P, range(len(antes)), color = '#c8423b', s = 70, zorder = 3, label = 'Antes')
ax.scatter(despues.P, range(len(despues)), color = '#2a78d6', s = 70, zorder = 3, label = 'Después')
for i in range(len(antes)):
    ax.text(antes.P[i] - 1.5, i + 0.18, f'{antes.P[i]:.1f}', ha = 'right', fontsize = 9, color = '#c8423b')
    ax.text(despues.P[i] + 1.5, i + 0.18, f'{despues.P[i]:.1f}', ha = 'left', fontsize = 9, color = '#2a78d6')
ax.axvline(65, color = '#3a9d5d', linestyle = '--', linewidth = 1.5)
ax.set_yticks(range(len(antes)), antes.plantilla)
ax.set_xlim(0, 100)
ax.set_ylim(-0.6, 5.1)
ax.set_xlabel('Índice de perspicuidad de Szigriszt-Pazos (P)')
ax.set_title('Cinco plantillas de Trigo Lento sobre la escala INFLESZ', fontsize = 16)
ax.legend(loc = 'lower left', frameon = True)
plt.tight_layout()
plt.show()
            plantilla version  caracteres  palabras_por_frase  emojis     P          nivel
  confirmacion_pedido   antes         233                18.0       4 50.39   algo difícil
  confirmacion_pedido después         130                 4.6       1 77.64 bastante fácil
recordatorio_recogida   antes         195                30.0       3 52.24   algo difícil
recordatorio_recogida después          92                 4.0       0 78.24 bastante fácil
         pedido_listo   antes         156                24.0       0 37.47    muy difícil
         pedido_listo después          80                 4.7       0 86.47      muy fácil
        aviso_retraso   antes         265                37.0       3 13.24    muy difícil
        aviso_retraso después         115                 5.5       0 79.57 bastante fácil
    respuesta_horario   antes         280                15.0       2 74.16 bastante fácil
    respuesta_horario después         178                11.7       0 88.37      muy fácil
         caracteres  palabras_por_frase  emojis     P
version
antes         225.8                24.8     2.4  45.5
después       119.0                 6.1     0.2  82.1
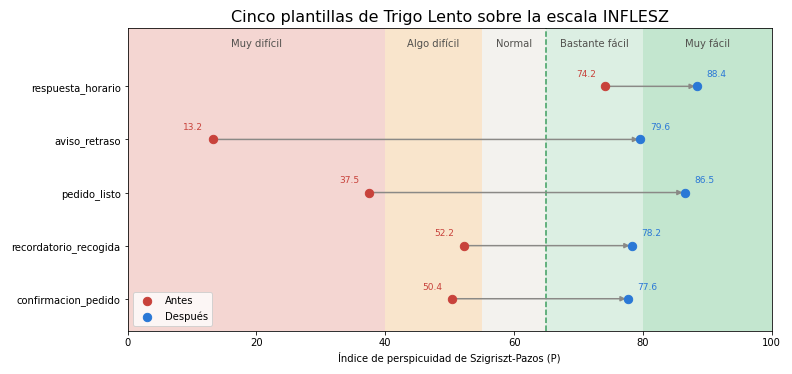
La Tabla 2 recoge las cifras. De media, las plantillas reescritas tienen $119.0$ caracteres frente a $225.8$, $6.1$ palabras por frase frente a $24.8$, $0.2$ emojis frente a $2.4$ y un índice de $82.1$ frente a $45.5$: pasan, de media, del nivel “algo difícil” al nivel “muy fácil”.
Tabla 2. Cinco plantillas antes y después: caracteres, palabras por frase, emojis e índice de Szigriszt-Pazos con su nivel INFLESZ.
| Plantilla | Versión | Caracteres | Palabras por frase | Emojis | Índice P | Nivel INFLESZ |
|---|---|---|---|---|---|---|
confirmacion_pedido | antes | 233 | 18.0 | 4 | 50.39 | algo difícil |
confirmacion_pedido | después | 130 | 4.6 | 1 | 77.64 | bastante fácil |
recordatorio_recogida | antes | 195 | 30.0 | 3 | 52.24 | algo difícil |
recordatorio_recogida | después | 92 | 4.0 | 0 | 78.24 | bastante fácil |
pedido_listo | antes | 156 | 24.0 | 0 | 37.47 | muy difícil |
pedido_listo | después | 80 | 4.7 | 0 | 86.47 | muy fácil |
aviso_retraso | antes | 265 | 37.0 | 3 | 13.24 | muy difícil |
aviso_retraso | después | 115 | 5.5 | 0 | 79.57 | bastante fácil |
respuesta_horario | antes | 280 | 15.0 | 2 | 74.16 | bastante fácil |
respuesta_horario | después | 178 | 11.7 | 0 | 88.37 | muy fácil |
La gráfica muestra el mismo resultado sobre las bandas de color de la escala. Cuatro de las cinco plantillas antiguas estaban por debajo del umbral de $65$ (la línea verde discontinua), y el aviso de retraso, con $P = 13.24$, era prácticamente ilegible: una sola frase de $37$ palabras que explicaba la fermentación de la masa madre antes de decir cuánto tardaría el pedido. Su versión nueva dice primero lo que el cliente necesita (“Su pedido se retrasa 45 minutos”) y después la causa en cinco palabras.
La quinta plantilla merece una advertencia. La respuesta de horario antigua obtiene $74.16$, “bastante fácil”, y sin embargo es mala: abre con dos emojis, usa “hrs.” y termina en “haga clic aquí”. El índice la salva porque su “¡Hola!” inicial cuenta como una frase de una palabra y baja la media de palabras por frase a $15$, cuando la frase real tiene $38$. Un índice es una media, y una media esconde la frase más larga. Por eso el revisor del final de la entrada no se conforma con $P$: también mira la frase más larga, los emojis y los enlaces. Y por eso, sobre todo, un índice no sustituye leer el mensaje con una persona real; solo ayuda a decidir cuál de dos versiones probar primero.
La escalera de los cinco peldaños de INFLESZ, con cada mensaje de Trigo Lento en el peldaño que ocupaba antes y en el que ocupa después, se ve completa en la Figura 1.
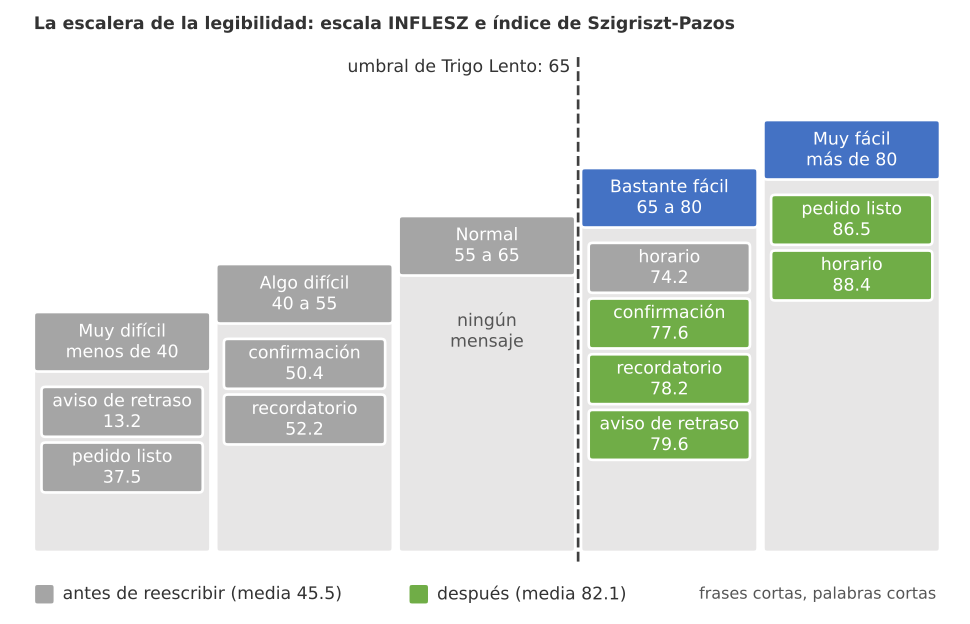
Figura 1. La escalera de la legibilidad: los cinco peldaños de la escala INFLESZ con las cinco plantillas de Trigo Lento antes de reescribirlas (gris) y después (verde); el índice medio sube de 45.5 a 82.1 y todas las versiones nuevas superan el umbral de 65.
Emojis y lectores de pantalla
Un emoji es un carácter de texto como cualquier otro, con un nombre oficial en el estándar Unicode. Los lectores de pantalla no lo dibujan: pronuncian su nombre. “🎂” se oye “pastel de cumpleaños”, “✨” se oye “destellos” y “😊” algo como “cara feliz con ojos sonrientes”, según el lector, el idioma y la versión del sistema. Tres emojis decorativos al principio de un mensaje son, para Doña Carmen, tres frases sin sentido antes de la primera palabra.
Peor todavía son las letras decorativas. Algunas aplicaciones permiten escribir “𝗥𝗘𝗖𝗢𝗥𝗗𝗔𝗧𝗢𝗥𝗜𝗢” con letras que parecen negritas. No son negritas: son caracteres del bloque de símbolos alfanuméricos matemáticos de Unicode, pensados para fórmulas. El lector de pantalla no las reconoce como palabra y, según el lector, las deletrea una a una con su nombre matemático o se las salta. Las mayúsculas sostenidas (“ATENCIÓN”, “¡¡HOLA!!”) tienen otro problema: algunos lectores las leen como siglas, letra por letra, y para quien ve se perciben como un grito.
El signo de pesos es el tercer tropiezo. $460 se escribe igual en pesos mexicanos que en dólares, y muchos lectores de pantalla configurados en español lo pronuncian “460 dólares”. Para Doña Carmen es una curiosidad; para un turista, es una duda real sobre el precio.
El siguiente código simula cómo suena un mensaje: sustituye cada emoji por su nombre leído (con un diccionario ilustrativo, porque cada lector usa sus propios nombres), deletrea las letras decorativas, convierte $ seguido de cifras en “dólares” y señala los problemas. Después cuenta los caracteres escritos y los que se pronuncian en las diez versiones de la Tabla 2:
# Cómo suena un mensaje en un lector de pantalla: emojis, letras decorativas y signo de pesos en Python:
NOMBRES_EMOJI = {'🎂': 'pastel de cumpleaños', '🥐': 'croissant', '✨': 'destellos', '😊': 'cara feliz con ojos sonrientes',
                 '🙂': 'cara sonriendo ligeramente', '⚠': 'advertencia', '🙏': 'manos en oración',
                 '👋': 'mano saludando'}   # nombres ilustrativos; cada lector y versión los dice a su manera

def letra_normal(c):
    # Convierte letras negritas matemáticas (sans y serif) en su letra base:
    for base_may, base_min in [(0x1D5D4, 0x1D5EE), (0x1D400, 0x1D41A)]:
        if base_may <= ord(c) < base_may + 26:
            return chr(ord('A') + ord(c) - base_may)
        if base_min <= ord(c) < base_min + 26:
            return chr(ord('a') + ord(c) - base_min)
    return c

def leer_en_voz(texto):
    # Devuelve (texto tal como se oye, alertas) con una lectura ilustrativa:
    alertas, partes = [], []
    if DECORATIVAS.search(texto):
        alertas.append('letras decorativas: se deletrean una a una')
    if re.search(r'\b[A-ZÁÉÍÓÚÑ]{4,}\b', texto):
        alertas.append('mayúsculas sostenidas')
    if re.search(r'\$\s?\d', texto) and 'MXN' not in texto:
        alertas.append('signo $ sin MXN: se oye "dólares"')
    for c in texto:
        if c == '\ufe0f':
            continue
        if c in NOMBRES_EMOJI:
            partes.append(f' {NOMBRES_EMOJI[c]}, ')
        elif DECORATIVAS.match(c):
            partes.append(f' {letra_normal(c)} negrita matemática, ')
        else:
            partes.append(c)
    voz = re.sub(r'\$\s?(\d+)', r'\1 dólares', ''.join(partes))
    return re.sub(r'\s+', ' ', voz).strip(), alertas

voz = leer_en_voz(plantillas['recordatorio_recogida'][0])
print('Se oye:', voz[0][:160], '...')
print('Alertas:', voz[1])
print('Se oye:', leer_en_voz(plantillas['confirmacion_pedido'][0])[0])
conteo = []
for nombre, (texto_antes, texto_despues) in plantillas.items():
    for version, texto in [('antes', texto_antes), ('después', texto_despues)]:
        oido, alertas = leer_en_voz(texto)
        conteo.append({'plantilla': nombre, 'version': version, 'escritos': len(texto), 'oidos': len(oido),
                       'extra': len(oido) - len(texto), 'alertas': len(alertas)})
conteo = pd.DataFrame(conteo)
print(conteo.to_string(index = False))
antes_voz = conteo[conteo.version == 'antes']
print(f'Antes: {antes_voz.extra.sum()} caracteres de más al oído | '
      f'después: {conteo[conteo.version == "después"].extra.sum()}')

fig, ax = plt.subplots(figsize = (11, 5.2))
x = np.arange(len(plantillas))
for k, (version, color_e, color_o) in enumerate([('antes', '#f0b3ab', '#c8423b'), ('después', '#a9c8ef', '#2a78d6')]):
    datos = conteo[conteo.version == version]
    ax.bar(x + (k - 0.5) * 0.38 - 0.095, datos.escritos, width = 0.19, color = color_e, label = f'{version}: escritos')
    ax.bar(x + (k - 0.5) * 0.38 + 0.095, datos.oidos, width = 0.19, color = color_o, label = f'{version}: oídos')
ax.set_xticks(x, list(plantillas), fontsize = 9)
ax.set_ylabel('Caracteres')
ax.set_title('Lo que se escribe y lo que pronuncia el lector de pantalla', fontsize = 16)
ax.legend(ncol = 4, loc = 'upper center', bbox_to_anchor = (0.5, -0.1), frameon = False)
ax.grid(axis = 'y', color = '#e6e5e1')
ax.set_axisbelow(True)
plt.tight_layout()
plt.show()
Se oye: pastel de cumpleaños, croissant, destellos, R negrita matemática, E negrita matemática, C negrita matemática, O negrita matemática, R negrita matemática, D negr ...
Alertas: ['letras decorativas: se deletrean una a una']
Se oye: pastel de cumpleaños, croissant, destellos, ¡¡HOLA!! Le confirmamos que su pedido ha quedado debidamente registrado en nuestro sistema de encargos y que será elaborado por nuestro equipo de panaderos conforme a la disponibilidad del obrador, por un importe total de 460 dólares. cara feliz con ojos sonrientes,
            plantilla version  escritos  oidos  extra  alertas
  confirmacion_pedido   antes       233    310     77        2
  confirmacion_pedido después       130    156     26        0
recordatorio_recogida   antes       195    487    292        1
recordatorio_recogida después        92     92      0        0
         pedido_listo   antes       156    156      0        0
         pedido_listo después        80     80      0        0
        aviso_retraso   antes       265    302     37        1
        aviso_retraso después       115    115      0        0
    respuesta_horario   antes       280    325     45        0
    respuesta_horario después       178    178      0        0
Antes: 451 caracteres de más al oído | después: 26
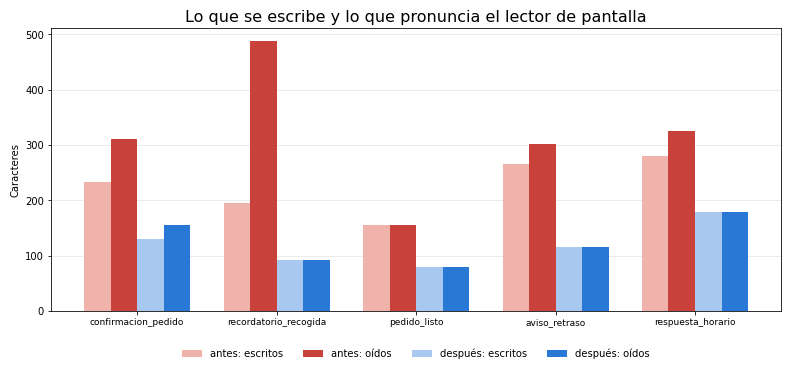
La primera línea reproduce lo que oyó Julián: “pastel de cumpleaños, croissant, destellos, R negrita matemática, E negrita matemática…”. El recordatorio antiguo tiene $195$ caracteres escritos y $487$ pronunciados: el lector dice $292$ caracteres de más, y casi todos van antes de la palabra “pedido”. La confirmación de pedido antigua termina en “460 dólares” y en el nombre del emoji sonriente, con una coma colgando.
Sumadas las cinco plantillas antiguas, el lector pronuncia $451$ caracteres que nadie escribió con intención de informar. En las nuevas quedan $26$, todos del único emoji que sobrevivió, “🙂”, al final de la confirmación. Ese es el criterio de Trigo Lento, y la gráfica lo hace visible: en las barras rojas, la oscura (lo que se oye) supera mucho a la clara (lo que se escribe); en las azules, son casi iguales.
Lo que se ve y lo que se oye no coinciden, y la diferencia está toda al principio del mensaje, como muestra la Figura 2.
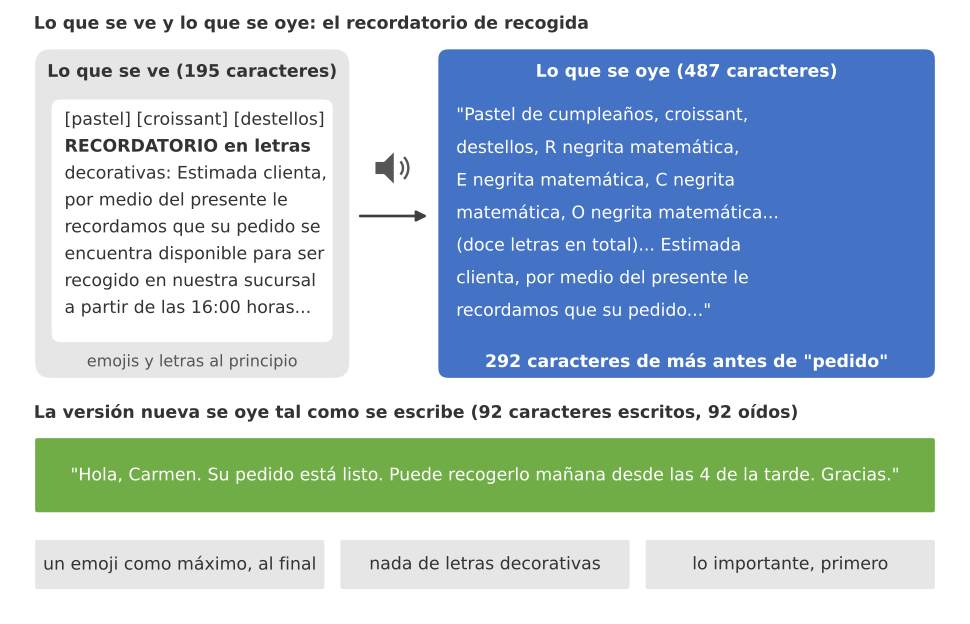
Figura 2. Lo que se ve y lo que se oye: el recordatorio antiguo tiene 195 caracteres escritos y el lector de pantalla pronuncia 487, con los nombres de tres emojis y doce letras decorativas antes de la palabra pedido; la versión nueva se oye exactamente como se escribe.
Valeria convierte el resultado en cuatro reglas que se añaden al código de honor del Día 6:
- Como máximo un emoji, y al final. Nunca antes de la información, nunca repetido y nunca como único portador de un dato: “✅” no sustituye a “Su pago se recibió”.
- Nada de letras decorativas. Si algo merece resaltarse, se dice primero.
- Mayúsculas solo para palabras que el cliente debe escribir tal cual, como “BAJA” o “STOP”, y siempre como palabra suelta.
- Enlaces con texto que diga adónde llevan. “Haga clic aquí” no dice nada a quien navega por los enlaces de un mensaje; “Vea el horario de días festivos en…” sí.
Atención aquí: Las reglas de accesibilidad se aplican a todos los mensajes, no a un grupo de clientes marcado como “con discapacidad”. Trigo Lento no infiere ni registra ninguna condición de salud o discapacidad a partir de cómo escribe o de qué pide un cliente: sería un dato personal sensible según la Ley Federal de Protección de Datos Personales en Posesión de los Particulares, tratado sin consentimiento y sin finalidad declarada. Si un cliente pide un formato concreto (por ejemplo, que le llamen en lugar de escribirle), se apunta su preferencia de contacto, no su motivo.
Imágenes con texto alternativo
Cuando un pastel está terminado, el obrador le hace una foto y Valeria la envía al cliente por WhatsApp antes de la recogida, para que confirme la leyenda. Para quien ve, la foto lo dice todo. Para Doña Carmen, el lector de pantalla anuncia “imagen” y nada más, porque una foto no trae texto propio. La solución en WhatsApp es sencilla: el pie de la imagen describe lo que muestra. Un buen pie para la foto de un pastel dice qué es, qué tiene escrito y cualquier detalle que el cliente deba confirmar:
Pastel de chocolate con la leyenda “Feliz cumpleaños, Ana” en letras blancas y doce velas.
Ese pie cumple tres funciones a la vez. Le dice a Doña Carmen qué hay en la foto; le permite a cualquier cliente buscar el mensaje después escribiendo “pastel” o “Ana”; y deja constancia escrita de lo que se entregó, que es justo lo que se necesita si la leyenda tenía una errata. Un pie como “¡Mire qué bonito quedó! 🎂✨” no cumple ninguna de las tres.
En la web y en las redes sociales, la misma idea tiene nombre técnico: el atributo alt de las imágenes, que los lectores de pantalla leen en lugar de la imagen. WCAG lo exige en su primer criterio, el 1.1.1, contenido no textual, de nivel A: todo contenido no textual que se presente al usuario tiene una alternativa de texto que cumple el mismo propósito. El Día 72 (Publicación multired: Instagram, Facebook y LinkedIn por API o con Make y n8n) aplicará la regla a cada publicación de Trigo Lento, y el Día 73 (Caso de otro negocio VI: descripciones de producto accesibles para la tienda en línea) la llevará a las fichas de producto de una tienda en línea.
Escribir un buen texto alternativo tiene tres reglas que caben en una línea cada una:
- Describa el propósito, no los píxeles. “Pastel de chocolate con la leyenda Feliz cumpleaños, Ana” sirve; “imagen de un objeto marrón sobre fondo blanco” no.
- Sea breve: una o dos frases. Si la imagen tiene mucho texto (un menú, un cartel con precios), ese texto va en el cuerpo del mensaje, no solo en la foto.
- No repita lo que ya dice el texto que la acompaña. Si el mensaje dice “Su pastel ya está listo”, el pie describe el pastel, no vuelve a anunciar que está listo.
¿Podría Claude escribir el pie de cada foto? Técnicamente sí, porque los modelos actuales describen imágenes con bastante precisión. Pero una leyenda de cumpleaños es exactamente el tipo de dato en el que un error (un nombre mal transcrito) tiene efecto reputacional, así que en Trigo Lento el pie lo escribe la persona que envía la foto, que además acaba de verla. El modelo puede proponer un borrador, nunca enviarlo.
Fechas, horas y moneda
“El sábado a las 4” parece inequívoco hasta que lo lee alguien que no está en la Ciudad de México. Las fechas, las horas y los importes son los datos que más se malinterpretan entre idiomas y países, y son también los que un cliente usa para actuar: llegar a una hora, pagar una cantidad. Hay cuatro ambigüedades típicas:
- La zona horaria. Un servidor guarda las horas en UTC, el teléfono de un turista puede seguir en la hora de su país y la Ciudad de México está en UTC $-6$ todo el año (México eliminó el horario de verano en la mayor parte del país en 2022). El mensaje debe decir la hora de la panadería y, en inglés, decir explícitamente que lo es.
- El formato de la hora. En México se escribe “4:00 p. m.” y en Estados Unidos “4:00 PM”. Las dos son de doce horas; el formato de veinticuatro horas (“16:00”) es inequívoco, pero a muchas personas mayores les cuesta más leerlo.
- El orden de la fecha. “03/04” es 3 de abril en México y 4 de marzo en Estados Unidos. Escribir el nombre del mes elimina el problema.
- La moneda. El signo
$es el del peso mexicano y el del dólar. Escribir “MXN” y, para un extranjero, la palabra “pesos” con un equivalente aproximado, elimina la duda de los turistas del sábado.
El siguiente código escribe la misma recogida, el sábado 21 de marzo a las 16:00 de la Ciudad de México, y dos importes, $95$ y $1,250$ pesos, en los dos idiomas. Usa zoneinfo de la biblioteca estándar con la zona America/Mexico_City y diccionarios propios con los nombres de días y meses, para no depender de la configuración regional del servidor de n8n, que suele estar en inglés:
# Fechas, horas y moneda según el idioma con zoneinfo en Python:
from datetime import datetime
from zoneinfo import ZoneInfo

CDMX = ZoneInfo('America/Mexico_City')
DIAS = {'es_MX': ['lunes', 'martes', 'miércoles', 'jueves', 'viernes', 'sábado', 'domingo'],
        'en_US': ['Monday', 'Tuesday', 'Wednesday', 'Thursday', 'Friday', 'Saturday', 'Sunday']}
MESES = {'es_MX': ['enero', 'febrero', 'marzo', 'abril', 'mayo', 'junio', 'julio', 'agosto', 'septiembre',
                   'octubre', 'noviembre', 'diciembre'],
         'en_US': ['January', 'February', 'March', 'April', 'May', 'June', 'July', 'August', 'September',
                   'October', 'November', 'December']}

def formatear(fecha, importe, idioma):
    # fecha con zona horaria; se convierte a la hora de la Ciudad de México antes de escribirla:
    f = fecha.astimezone(CDMX)
    dia, mes = DIAS[idioma][f.weekday()], MESES[idioma][f.month - 1]
    h12 = f.hour % 12 or 12
    if idioma == 'es_MX':
        sufijo = 'a. m.' if f.hour < 12 else 'p. m.'
        return {'fecha': f'{dia} {f.day} de {mes}', 'hora': f'{h12}:{f.minute:02d} {sufijo}',
                'importe': f'{importe:,.2f} MXN', 'para_extranjero': None}
    sufijo = 'AM' if f.hour < 12 else 'PM'
    return {'fecha': f'{dia}, {mes} {f.day}', 'hora': f'{h12}:{f.minute:02d} {sufijo} (Mexico City time)',
            'importe': f'MXN {importe:,.2f}',
            'para_extranjero': f'MXN {importe:,.2f} (Mexican pesos, about USD {importe / MXN_POR_USD:,.2f})'}

recogida = datetime(2026, 3, 21, 16, 0, tzinfo = CDMX)
for idioma in ['es_MX', 'en_US']:
    for importe in [95, 1_250]:
        print(idioma, formatear(recogida, importe, idioma))

# La misma recogida guardada en UTC por el servidor y escrita para el cliente:
en_utc = recogida.astimezone(ZoneInfo('UTC'))
print('Guardada en UTC:', en_utc.isoformat(), '| para el cliente:', formatear(en_utc, 95, 'es_MX')['hora'])
es_MX {'fecha': 'sábado 21 de marzo', 'hora': '4:00 p. m.', 'importe': '95.00 MXN', 'para_extranjero': None}
es_MX {'fecha': 'sábado 21 de marzo', 'hora': '4:00 p. m.', 'importe': '1,250.00 MXN', 'para_extranjero': None}
en_US {'fecha': 'Saturday, March 21', 'hora': '4:00 PM (Mexico City time)', 'importe': 'MXN 95.00', 'para_extranjero': 'MXN 95.00 (Mexican pesos, about USD 5.14)'}
en_US {'fecha': 'Saturday, March 21', 'hora': '4:00 PM (Mexico City time)', 'importe': 'MXN 1,250.00', 'para_extranjero': 'MXN 1,250.00 (Mexican pesos, about USD 67.57)'}
Guardada en UTC: 2026-03-21T22:00:00+00:00 | para el cliente: 4:00 p. m.
La salida da los formatos de la Tabla 3. Dos detalles importan más que el resto. El primero está en la última línea: la recogida guardada en UTC es 2026-03-21T22:00:00+00:00, las diez de la noche, y la función la devuelve como “4:00 p. m.” porque convierte a la hora de la Ciudad de México antes de escribir. Si el flujo escribiera la hora tal como la guarda el servidor, Doña Carmen leería “10:00 p. m.” y encontraría la panadería cerrada. El segundo es el equivalente para extranjeros: $95$ pesos son unos $5.14$ USD al tipo de cambio didáctico de la serie, $18.50$ MXN por dólar, y $1,250$ pesos unos $67.57$. La palabra “unos” no es retórica: el tipo de cambio es un supuesto fijo y el mensaje no debe prometer una conversión exacta que no controla.
Tabla 3. Formatos por idioma: fecha, hora, moneda, separador de miles y ejemplo para es_MX y en_US.
| Elemento | es_MX | en_US | Regla de Trigo Lento |
|---|---|---|---|
| Fecha | sábado 21 de marzo | Saturday, March 21 | Nombre del día y del mes, nunca 21/03 |
| Hora | 4:00 p. m. | 4:00 PM (Mexico City time) | Siempre la hora de la panadería; en inglés, dicho explícitamente |
| Moneda | 95.00 MXN | MXN 95.00 | Nunca $ solo |
| Separador de miles y decimales | 1,250.00 | 1,250.00 | Coma para miles y punto decimal en ambos |
| Para extranjeros | No aplica | MXN 95.00 (Mexican pesos, about USD 5.14) | Equivalente aproximado con la palabra pesos |
Observe la fila del separador: en México, como en Estados Unidos, la coma separa los miles y el punto los decimales, al contrario que en España y en buena parte de Europa. Un turista español leería “1,250” como “uno con veinticinco”. Trigo Lento no puede resolver todas las convenciones del mundo en un mensaje, pero sí evitar la cifra suelta: “1,250.00 MXN” con decimales explícitos deja poco margen a la confusión.
Español e inglés
Dos turistas en un sábado no justifican traducir la panadería entera. Sí justifican tener en inglés las pocas plantillas que se envían fuera de la ventana de atención (la confirmación y el recordatorio de recogida) y saber responder en inglés a quien escribe en inglés. Esta sección resuelve las tres piezas: plantillas por idioma, detección del idioma y traducción con revisión.
Plantillas por idioma
En WhatsApp Business Platform, una plantilla tiene un nombre y una o varias traducciones, cada una con su código de idioma. Los códigos es_MX (español de México) y en_US (inglés de Estados Unidos) figuran en la lista de idiomas admitidos de Meta (revisado en octubre de 2026). Cada traducción se registra con su propio texto y, según la documentación de varios proveedores, Meta la revisa y la aprueba por separado: puede estar aprobada en español y pendiente o rechazada en inglés. Al enviar, el mensaje indica el nombre y el código de idioma, y si esa traducción no existe o no está aprobada, el envío falla.
El siguiente JSON es el cuerpo de las dos peticiones de creación de recordatorio_recogida, una por idioma, en la categoría de utilidad y con parámetros con nombre (parameter_format en NAMED), los mismos nombre, pedido y hora que el Día 26 usó al enviar la plantilla. Cada elemento de la lista es el cuerpo de una petición POST al punto de acceso de plantillas de la cuenta de WhatsApp Business; los ejemplos de cada variable son inventados y se guarda como trigo_lento/dia_49/recordatorio_recogida_plantillas.json:
[
  {
    "name": "recordatorio_recogida",
    "language": "es_MX",
    "category": "UTILITY",
    "parameter_format": "NAMED",
    "components": [
      {
        "type": "BODY",
        "text": "Hola, {{nombre}}. Su pedido {{pedido}} está listo. Puede recogerlo mañana a las {{hora}} en Trigo Lento. Si ya no desea estos avisos, responda BAJA.",
        "example": {
          "body_text_named_params": [
            {"param_name": "nombre", "example": "Carmen"},
            {"param_name": "pedido", "example": "TL-260321-07"},
            {"param_name": "hora", "example": "4:00 p. m."}
          ]
        }
      },
      {
        "type": "FOOTER",
        "text": "Mensaje automático de Trigo Lento"
      }
    ]
  },
  {
    "name": "recordatorio_recogida",
    "language": "en_US",
    "category": "UTILITY",
    "parameter_format": "NAMED",
    "components": [
      {
        "type": "BODY",
        "text": "Hello, {{nombre}}. Your order {{pedido}} is ready. You can pick it up tomorrow at {{hora}} (Mexico City time) at Trigo Lento. To stop these messages, reply STOP.",
        "example": {
          "body_text_named_params": [
            {"param_name": "nombre", "example": "Emma"},
            {"param_name": "pedido", "example": "TL-260321-11"},
            {"param_name": "hora", "example": "4:00 PM"}
          ]
        }
      },
      {
        "type": "FOOTER",
        "text": "Automated message from Trigo Lento"
      }
    ]
  }
]
Cada campo responde a una regla de la entrada. El texto en español sigue la lectura fácil: lo importante primero, frases cortas, la hora como variable que formatear llenará con “4:00 p. m.”. El texto en inglés no es una traducción palabra por palabra: añade (Mexico City time) después de la hora, porque esa ambigüedad solo la tiene el lector extranjero, y cambia “responda BAJA” por reply STOP, porque un cliente que escribe en inglés escribirá la palabra de baja en inglés. El flujo de bajas del Día 48 debe reconocer las dos. El pie, en ambos idiomas, dice que el mensaje es automático, una obligación de la serie desde el Día 6.
La plantilla, su traducción, el glosario que se usó para traducirla y la firma de la persona que la revisó forman un solo paquete, como muestra la Figura 3.
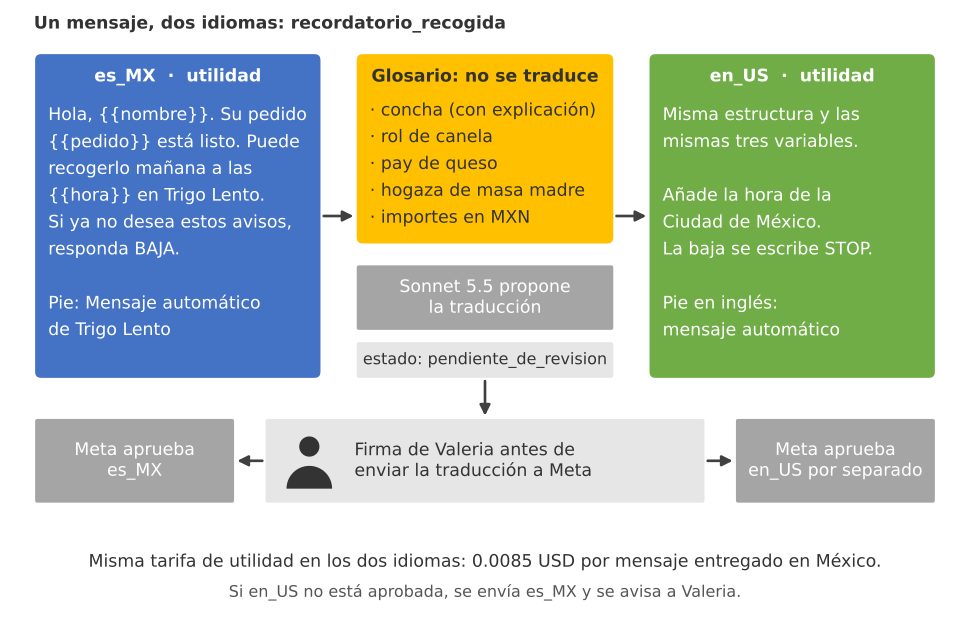
Figura 3. Un mensaje, dos idiomas: la plantilla recordatorio_recogida en es_MX y en en_US, con el glosario de panes que no se traducen en medio, la propuesta de Sonnet 5.5 y la firma de Valeria antes de que cada traducción se envíe a Meta para su aprobación por separado.
Dos reglas cierran la operación. La primera: el idioma preferido del cliente se guarda junto a su consentimiento, en consentimientos.json, con la misma finalidad, y solo si el cliente lo eligió o escribió en ese idioma; Trigo Lento no deduce nacionalidad ni idioma de un nombre o de un prefijo telefónico. La segunda es la regla de respaldo: si un cliente prefiere inglés y la traducción en_US de una plantilla no está aprobada, se envía la de es_MX y Valeria recibe un aviso para registrar la que falta. Un recordatorio en español es mejor que un recordatorio que no llega.
En cuanto al coste, no hay sorpresa: las plantillas en en_US se cobran a la misma tarifa por categoría que las de es_MX, porque Meta cobra por la categoría y por el país del destinatario, no por el idioma (Tabla C de la serie: $0.0085$ USD por plantilla de utilidad entregada en México). El idioma no cambia el precio; solo exige una aprobación más por plantilla.
Detectar el idioma
Antes de responder en inglés hay que saber que el cliente escribió en inglés. La tentación es pasar cada mensaje por un modelo de lenguaje, pero el orden correcto es el contrario: primero lo que el cliente eligió, después reglas y solo al final el modelo. Si el cliente pulsó el botón English del menú del chatbot del Día 48, la cuestión está resuelta y nada la contradice. Si no, basta contar cuántas palabras frecuentes de cada idioma tiene el mensaje: “hola”, “quiero”, “mañana” frente a hi, want, tomorrow. Solo cuando las reglas no deciden, un modelo barato como Haiku 5.5 clasifica el mensaje.
El siguiente código define detectar_idioma(texto, preferencia) con dos listas de palabras frecuentes, genera $200$ mensajes simulados con la semilla de la serie (un $84%$ en español, un $8%$ en inglés, un $4%$ que mezcla los dos idiomas y un $4%$ sin idioma, como “ok”, “👍” o “P05 x6”) y compara lo detectado con lo real en una matriz de confusión:
# Detector de idioma por reglas sobre 200 mensajes simulados y matriz de confusión en Python:
ES = {'hola', 'quiero', 'para', 'el', 'la', 'los', 'las', 'de', 'que', 'por', 'con', 'una', 'pedido', 'gracias',
      'mañana', 'hoy', 'tiene', 'tienen', 'cuánto', 'cuesta', 'me', 'mi', 'su', 'y', 'en', 'es', 'está', 'hay',
      'puedo', 'buenas', 'buenos', 'días', 'tardes', 'precio', 'pastel', 'dos', 'recoger', 'aparta', 'horario'}
EN = {'hi', 'hello', 'i', 'want', 'to', 'the', 'for', 'is', 'are', 'do', 'you', 'have', 'how', 'much', 'order',
      'thanks', 'thank', 'please', 'tomorrow', 'today', 'can', 'pick', 'up', 'cake', 'my', 'what', 'time',
      'open', 'two', 'would', 'like', 'of', 'it', 'and'}

def detectar_idioma(texto, preferencia = None):
    # La elección explícita del cliente siempre manda; si no hay, se cuentan palabras frecuentes:
    if preferencia in ('es_MX', 'en_US'):
        return preferencia
    palabras = re.findall(r'[a-záéíóúüñ]+', texto.lower())
    es, en = sum(p in ES for p in palabras), sum(p in EN for p in palabras)
    if es + en == 0:
        return 'ambiguo'
    margen = (es - en) / (es + en)
    return 'es_MX' if margen >= 0.5 else 'en_US' if margen <= -0.5 else 'ambiguo'

FRASES = {
    'español': ['Hola, quiero {n} conchas para mañana', '¿Cuánto cuesta el pastel de chocolate?',
                'Buenas tardes, ¿tienen pan de caja integral hoy?', 'Me aparta {n} hogazas para el sábado por favor',
                '¿A qué hora puedo recoger mi pedido?', 'Gracias, paso por el pedido en la tarde',
                'Quiero cambiar mi pedido de {n} baguettes', 'Buenos días, ¿cuál es su horario el domingo?',
                'Sí, gracias', 'Ok, gracias', 'Perfecto', '¿Hay rol de canela?'],
    'inglés': ['Hi, do you have conchas today?', 'How much is the chocolate cake?',
               'Hello, I would like to order {n} croissants for tomorrow', 'What time do you open on Sunday?',
               'Can I pick up my order at 5?', 'Thanks! Is the $95 in dollars or pesos?'],
    'mezclado': ['Hi, quiero {n} conchas para mañana', 'Hola, can I pick up my pedido at 5?',
                 'Thanks, paso por el pedido mañana', 'Hello, ¿tienen pay de queso today?'],
    'neutro': ['ok', '👍', 'P05 x{n}', '11:30', '🙏🙏'],
}
etiquetas_reales = rng.choice(list(FRASES), size = 200, p = [0.84, 0.08, 0.04, 0.04])
mensajes = [str(rng.choice(FRASES[e])).format(n = int(rng.integers(2, 7))) for e in etiquetas_reales]
predichas = [detectar_idioma(m) for m in mensajes]
matriz = pd.crosstab(pd.Series(etiquetas_reales, name = 'real'), pd.Series(predichas, name = 'detectado'))
matriz = matriz.reindex(index = list(FRASES), columns = ['es_MX', 'en_US', 'ambiguo'], fill_value = 0)
print(matriz.to_string())

correcto = {'español': 'es_MX', 'inglés': 'en_US'}
decididos = [(r, p) for r, p in zip(etiquetas_reales, predichas) if p != 'ambiguo']
aciertos = sum(correcto.get(r) == p for r, p in decididos)
errores_graves = sum(r in correcto and correcto[r] != p for r, p in decididos)
ambiguos = predichas.count('ambiguo')
print(f'Decididos por reglas: {len(decididos)} | aciertos: {aciertos} ({aciertos / len(decididos):.1%})')
print(f'Errores entre español e inglés: {errores_graves} | ambiguos que pasan a Haiku 5.5: {ambiguos} '
      f'({ambiguos / len(mensajes):.1%})')
print('Ejemplos ambiguos:', sorted(set(m for m, p in zip(mensajes, predichas) if p == 'ambiguo'))[:6])
print('Con preferencia explícita:', detectar_idioma('ok', preferencia = 'en_US'))

fig, ax = plt.subplots(figsize = (9, 5.4))
im = ax.imshow(matriz.values, cmap = 'Blues', aspect = 'auto')
for i in range(matriz.shape[0]):
    for j in range(matriz.shape[1]):
        v = matriz.values[i, j]
        ax.text(j, i, str(v), ha = 'center', va = 'center', fontsize = 13,
                color = 'white' if v > matriz.values.max() / 2 else '#0b0b0b')
ax.set_xticks(range(3), ['español\n(es_MX)', 'inglés\n(en_US)', 'ambiguo:\nHaiku 5.5'])
ax.set_yticks(range(4), ['español', 'inglés', 'mezclado', 'sin idioma'])
ax.set_xlabel('Idioma detectado por reglas')
ax.set_ylabel('Idioma real del mensaje')
ax.set_title('Detector de idioma por reglas: 200 mensajes simulados', fontsize = 15)
fig.colorbar(im, ax = ax, label = 'Mensajes')
plt.tight_layout()
plt.show()
detectado  es_MX  en_US  ambiguo
real
español      152      0       19
inglés         0     17        0
mezclado       2      0        5
neutro         0      0        5
Decididos por reglas: 171 | aciertos: 169 (98.8%)
Errores entre español e inglés: 0 | ambiguos que pasan a Haiku 5.5: 29 (14.5%)
Ejemplos ambiguos: ['Hello, ¿tienen pay de queso today?', 'Hola, can I pick up my pedido at 5?', 'P05 x6', 'Perfecto', 'ok', '👍']
Con preferencia explícita: en_US
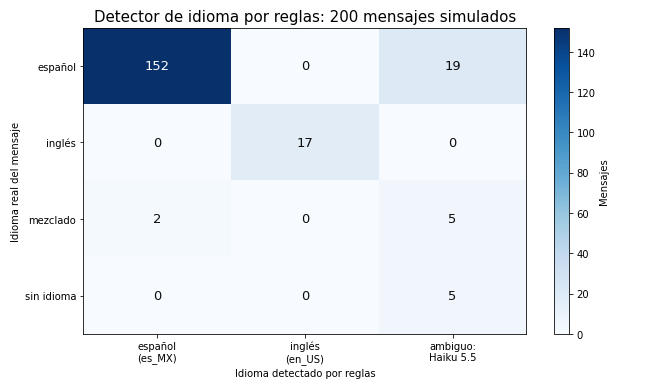
La matriz cuenta una historia tranquilizadora. De los $200$ mensajes, las reglas deciden $171$ y aciertan $169$, el $98.8%$; los dos fallos son mensajes mezclados que el detector asigna al español, lo que es razonable porque la mayoría de sus palabras lo son. Lo más importante es la cifra de en medio: $0$ errores entre español e inglés. Ningún cliente que escribió en español recibirá una respuesta en inglés, y ningún turista una en español, por culpa del detector.
Los otros $29$ mensajes, el $14.5%$, quedan como ambiguos. Son de dos tipos. Unos son mensajes mezclados (Hola, can I pick up my pedido at 5?), donde de verdad hace falta criterio. Otros son mensajes sin palabras reconocibles: “Perfecto”, “ok”, “👍”, “P05 x6”. Para estos, enviar el mensaje a Haiku 5.5 sería pagar por una pregunta sin respuesta, porque “ok” no está en ningún idioma. La regla práctica de Trigo Lento es heredar el idioma de la conversación: si el cliente escribió Hi, do you have conchas today? hace diez minutos, su “ok” se responde en inglés. Solo un mensaje ambiguo sin conversación previa pasa a Haiku 5.5, y el Bloque 10 calcula el coste en el peor caso, como si todos los ambiguos pasaran.
Traducir con Claude y revisar
La traducción de una plantilla se hace una vez y se revisa con calma; la de una respuesta libre se hace en segundos y nadie la revisa antes de enviarla. Por eso son dos procesos distintos con controles distintos.
Para las plantillas, Valeria usa Sonnet 5.5, el modelo que la serie reserva para la redacción cuidada a coste medio, con un glosario en el prompt de sistema. El glosario resuelve la objeción de Don Ernesto: “concha” no se traduce por shell; se escribe “concha” y se explica entre paréntesis la primera vez. Lo mismo vale para el rol de canela, el pay de queso y la hogaza de masa madre. El resultado no va a Meta: entra en una cola de revisión y solo sale con la firma de una persona.
El siguiente bloque llama a la API y no se ejecutó para escribir esta entrada; la salida es un ejemplo comentado. Activa el respaldo del lado del servidor (fallbacks = "default" con su cabecera beta) para que un rechazo del modelo no deje la petición sin respuesta, controla el gasto con effort en lugar de temperature y pide una salida estructurada con output_config.format:
# Traducción de una plantilla con glosario de Trigo Lento con Sonnet 5.5 y cola de revisión humana en Python:
import json
import anthropic

GLOSARIO = {   # nombres propios del pan: no se traducen, se explican entre paréntesis
    'concha': 'concha (Mexican sweet bread with a sugar shell topping)',
    'rol de canela': 'rol de canela (cinnamon roll)',
    'pay de queso': 'pay de queso (Mexican-style cheesecake)',
    'hogaza de masa madre': 'hogaza de masa madre (sourdough loaf)',
}
SISTEMA = ('Usted traduce mensajes de la panadería Trigo Lento (Ciudad de México) del español de México al inglés '
           'de Estados Unidos. Reglas: conserve las variables {{nombre}}, {{pedido}} y {{hora}} sin cambios; '
           'escriba los importes como MXN; no traduzca los nombres del glosario, úselos tal como aparecen; '
           'no añada promociones ni datos que no estén en el original; no traduzca alergias ni ingredientes: '
           'si aparecen, escriba REVISAR en la nota.\nGlosario:\n' + json.dumps(GLOSARIO, ensure_ascii = False, sort_keys = True))
original = ('Hola, {{nombre}}. Su pedido {{pedido}} está listo: 6 conchas y un rol de canela. '
            'Puede recogerlo mañana a las {{hora}} en Trigo Lento. Si ya no desea estos avisos, responda BAJA.')

ESQUEMA = {'type': 'object', 'additionalProperties': False, 'required': ['texto_en', 'nota'],
           'properties': {'texto_en': {'type': 'string'}, 'nota': {'type': 'string'}}}

cliente = anthropic.Anthropic()   # lee ANTHROPIC_API_KEY del entorno
respuesta = cliente.beta.messages.create(
    model = 'claude-sonnet-5-5',
    max_tokens = 1024,
    betas = ['server-side-fallback-2026-07-01'],
    fallbacks = 'default',                     # respaldo del lado del servidor ante un rechazo
    output_config = {'effort': 'low',           # sin temperature ni top_p
                     'format': {'type': 'json_schema', 'schema': ESQUEMA}},
    system = SISTEMA,
    messages = [{'role': 'user', 'content': f'<original>{original}</original>'}],
)
if respuesta.stop_reason != 'end_turn':
    raise SystemExit(f'Revisión humana: stop_reason = {respuesta.stop_reason}')
propuesta = json.loads(next(b.text for b in respuesta.content if b.type == 'text'))

# Nada se envía a Meta sin la firma de una persona: la propuesta entra en la cola de revisión:
cola = {'plantilla': 'recordatorio_recogida', 'idioma': 'en_US', 'propuesta': propuesta['texto_en'],
        'nota_del_modelo': propuesta['nota'], 'estado': 'pendiente_de_revision', 'revisa': 'Valeria'}
print(json.dumps(cola, ensure_ascii = False, indent = 2))
print('Tokens:', respuesta.usage.input_tokens, 'de entrada y', respuesta.usage.output_tokens, 'de salida')

# Salida de ejemplo (puede variar):
# {
#   "plantilla": "recordatorio_recogida",
#   "idioma": "en_US",
#   "propuesta": "Hello, {{nombre}}. Your order {{pedido}} is ready: 6 conchas (Mexican sweet bread with a
#                 sugar shell topping) and one rol de canela (cinnamon roll). You can pick it up tomorrow at
#                 {{hora}} at Trigo Lento. To stop these messages, reply STOP.",
#   "nota_del_modelo": "Se cambió BAJA por STOP en la versión en inglés; confirmar que el flujo reconoce las dos.",
#   "estado": "pendiente_de_revision",
#   "revisa": "Valeria"
# }
# Tokens: 412 de entrada y 139 de salida
Recorra el bloque con calma, porque cada línea responde a una regla:
- El glosario va en el
systemy se serializa consort_keys = True, para que el prefijo sea idéntico en cada llamada y, si algún día crece, se pueda cachear. - Las variables se conservan entre llaves dobles. Una traducción que convirtiera
{{nombre}}en{{name}}rompería la plantilla, y el validador de variables del Día 48 la rechazaría antes de llegar a Meta. - Las alergias y los ingredientes no se traducen sin revisión. Si el original los menciona, el modelo escribe “REVISAR” en la nota. Una traducción errónea de “contiene nuez” es un riesgo para la salud, no una errata.
- La salida estructurada garantiza dos campos,
texto_enynota, sin tener que limpiar el texto de la respuesta. - El estado
pendiente_de_revisiones la regla del módulo aplicada a la traducción: el modelo propone y una persona dispone.
En la salida de ejemplo, el modelo conserva “conchas” y “rol de canela” con su explicación, deja las tres variables intactas y, en la nota, avisa de que cambió “BAJA” por “STOP”. Esa nota es la parte más útil: le dice a Valeria exactamente qué decisión tomó la máquina por su cuenta, para que la confirme o la corrija.
Para las respuestas libres en inglés, el agente de pedidos del Día 38 redacta con Sonnet 5.5 en el idioma detectado y aplica el mismo glosario. No hay revisión previa, porque la respuesta debe salir en segundos, pero sí dos salvaguardas: la respuesta se identifica como automática (Automated reply from Trigo Lento) y cualquier pregunta sobre alergias o ingredientes se deriva a una persona, en cualquier idioma.
¿Cuánto cuesta todo esto al mes? Si $N$ mensajes al mes se responden con un modelo de precios $p$ (entrada) y $q$ (salida) por millón de tokens, con $t_e$ tokens de entrada y $t_s$ de salida por respuesta:
$$ C = \frac{N \cdot (t_e \cdot p + t_s \cdot q)}{10^6} $$
La lógica detrás de esta fórmula es múltiple:
- $N = 1,560 \cdot 0.08 \approx 125$ respuestas en inglés al mes con el supuesto del día.
- Con Sonnet 5.5 ($p = 2$, $q = 10$ USD por millón), $400$ tokens de entrada y $150$ de salida, cada respuesta cuesta $(400 \cdot 2 + 150 \cdot 10)/10^6 = 0.0023$ USD: la salida pesa más que la entrada aunque sea casi tres veces más corta, porque cada token de salida cuesta cinco veces más.
- El coste es lineal en $N$: si la proporción de turistas se duplica, el coste se duplica, sin escalones ni cuotas fijas.
- En conclusión, $C = 125 \cdot 2,300 / 10^6 \approx 0.29$ USD al mes, una cifra que solo importa comparada con el rubro de Claude.
El siguiente código calcula las tres partidas del día (las respuestas en inglés con Sonnet 5.5, la clasificación de los ambiguos con Haiku 5.5 y la traducción, una sola vez, de seis plantillas) y dibuja la sensibilidad a la proporción de mensajes en inglés:
# Coste mensual de responder en inglés con Sonnet 5.5 y de clasificar los ambiguos con Haiku 5.5 en Python:
def coste(modelo, n, tokens_entrada, tokens_salida):
    p_ent, p_sal = PRECIOS[modelo]
    return n * (tokens_entrada * p_ent + tokens_salida * p_sal) / 1e6

n_ingles = MENSAJES_MES * PROP_INGLES
n_ambiguos = MENSAJES_MES * ambiguos / len(mensajes)
partidas = pd.Series({
    'Respuestas en inglés (Sonnet 5.5)': coste('claude-sonnet-5-5', n_ingles, 400, 150),
    'Clasificar ambiguos (Haiku 5.5)': coste('claude-haiku-5-5', n_ambiguos, 250, 10),
    'Traducir 6 plantillas, una vez (Sonnet 5.5)': coste('claude-sonnet-5-5', 6, 1_200, 300),
})
print(partidas.round(4).to_string())
total = partidas.sum()
print(f'Mensajes en inglés: {n_ingles:.0f} | ambiguos: {n_ambiguos:.0f} | total: {total:.4f} USD '
      f'({total / RUBRO_CLAUDE:.1%} del rubro de Claude, {total * MXN_POR_USD:.2f} MXN)')
print(f'Las mismas respuestas con Opus 5.5: {coste("claude-opus-5-5", n_ingles, 400, 150):.4f} USD')
print(f'Plantillas en en_US: misma tarifa que en es_MX (utilidad, 0.0085 USD); '
      f'solo cambia el número de aprobaciones')

# Sensibilidad a la proporción de mensajes en inglés:
proporciones = np.linspace(0, 0.40, 41)
curva_sonnet = [coste('claude-sonnet-5-5', MENSAJES_MES * q, 400, 150) for q in proporciones]
curva_opus = [coste('claude-opus-5-5', MENSAJES_MES * q, 400, 150) for q in proporciones]
fig, ax = plt.subplots(figsize = (11, 5.2))
ax.plot(100 * proporciones, curva_sonnet, color = '#2a78d6', linewidth = 2.5, label = 'Sonnet 5.5')
ax.plot(100 * proporciones, curva_opus, color = '#eb6834', linewidth = 2.5, label = 'Opus 5.5 (comparación)')
ax.axvline(100 * PROP_INGLES, color = '#52514e', linestyle = ':', linewidth = 1.5)
ax.text(100 * PROP_INGLES + 0.5, 2.6, 'Supuesto del día: 8 %\n(125 mensajes al mes)', fontsize = 10, color = '#52514e')
ax.scatter([100 * PROP_INGLES], [partidas.iloc[0]], color = '#2a78d6', zorder = 3, s = 60)
ax.text(100 * PROP_INGLES + 0.5, partidas.iloc[0] - 0.22, f'{partidas.iloc[0]:.2f} USD', fontsize = 10, color = '#2a78d6')
ax.set_xlabel('Mensajes en inglés (% de 1 560 al mes)')
ax.set_ylabel('USD al mes')
ax.set_ylim(0, 3.2)
ax.set_title('Coste de responder en inglés frente a la proporción de turistas', fontsize = 16)
ax.legend(loc = 'upper left', frameon = False)
ax.grid(color = '#e6e5e1')
ax.set_axisbelow(True)
plt.tight_layout()
plt.show()
Respuestas en inglés (Sonnet 5.5)              0.2870
Clasificar ambiguos (Haiku 5.5)                0.0068
Traducir 6 plantillas, una vez (Sonnet 5.5)    0.0324
Mensajes en inglés: 125 | ambiguos: 226 | total: 0.3262 USD (4.1% del rubro de Claude, 6.04 MXN)
Las mismas respuestas con Opus 5.5: 0.5741 USD
Plantillas en en_US: misma tarifa que en es_MX (utilidad, 0.0085 USD); solo cambia el número de aprobaciones
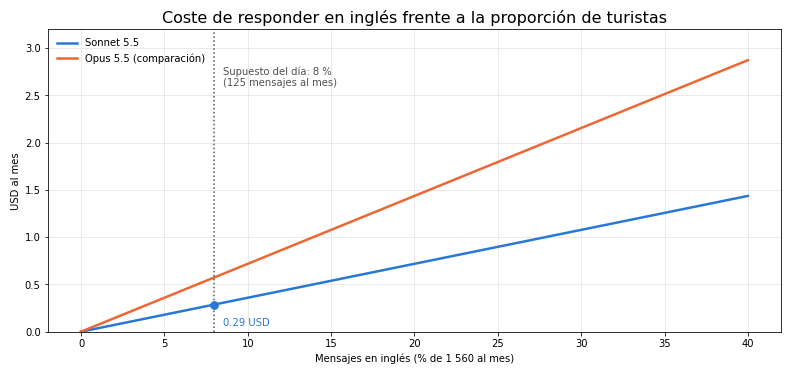
Las respuestas en inglés cuestan $0.287$ USD al mes; clasificar con Haiku 5.5 los $226$ mensajes ambiguos del peor caso, $0.0068$ USD; y traducir seis plantillas, $0.0324$ USD una sola vez. En total, $0.33$ USD, el $4.1%$ del rubro de $8$ USD de Claude (unos $6.04$ MXN). La gráfica muestra que, aun si un tercio de los mensajes llegara en inglés, el coste con Sonnet 5.5 no pasaría de $1.5$ USD. Con Opus 5.5, el modelo por defecto de la serie, las mismas respuestas costarían $0.57$ USD; la diferencia es pequeña en dinero, pero responder a How much is the chocolate cake? no necesita el modelo más capaz, y la serie baja de modelo solo cuando lo justifica con números, como aquí.
La conclusión de coste es clara: la accesibilidad y el segundo idioma no son un problema de presupuesto. Lo caro de esta entrada no son los tokens; es el tiempo de Valeria revisando traducciones, que por eso se limita a unas pocas plantillas.
WCAG 2.2 como referencia
Las Pautas de Accesibilidad para el Contenido Web (WCAG, por sus siglas en inglés: “Web Content Accessibility Guidelines”) son la recomendación del W3C que define cómo hacer accesible el contenido web. La versión 2.2 se publicó en octubre de 2023 y se actualizó el 12 de diciembre de 2024. Organizan sus criterios de conformidad en tres niveles: A (lo mínimo), AA (el nivel que exigen la mayoría de las leyes) y AAA (el más exigente).
WCAG está pensada para páginas web, no para mensajes de WhatsApp ni para correos, y conviene decirlo con honestidad: un mensaje de WhatsApp no “cumple WCAG” porque WCAG no se le aplica. Pero varios de sus criterios describen problemas que un mensaje automático tiene igual que una página, y sirven como guía de diseño. La Tabla 4 traslada seis de ellos a los mensajes de Trigo Lento:
Tabla 4. Criterios de WCAG 2.2 trasladados a mensajes automáticos: criterio, nivel, qué significa en un mensaje de WhatsApp o correo y regla de Trigo Lento.
| Criterio | Nivel | Qué significa en un mensaje | Regla de Trigo Lento |
|---|---|---|---|
| 1.1.1 Contenido no textual | A | Toda imagen, emoji o archivo con información tiene una alternativa en texto | Pie descriptivo en cada foto; ningún dato solo en un emoji |
| 1.4.1 Uso del color | A | El color no es el único medio de transmitir información | Nada de “lo marcado en rojo”; el estado se dice con palabras |
| 2.4.4 Propósito de los enlaces (en contexto) | A | El texto del enlace o su contexto dice adónde lleva | Nunca “haga clic aquí” |
| 3.1.1 Idioma de la página | A | El idioma principal se puede determinar | Cada plantilla declara es_MX o en_US |
| 3.1.2 Idioma de las partes | AA | Los fragmentos en otro idioma se pueden identificar | Nombres de pan en español dentro del texto en inglés, explicados entre paréntesis |
| 3.1.5 Nivel de lectura | AAA | Si el texto exige más que la educación secundaria inferior, hay una versión más sencilla | Índice de Szigriszt de 65 o más |
Lo que no se puede trasladar también conviene tenerlo claro. En un mensaje de WhatsApp, Trigo Lento no controla el contraste de colores, el tamaño de letra ni el orden de foco, porque los decide la aplicación del cliente; no puede marcar el idioma de una palabra suelta para que el lector de pantalla cambie de voz, como haría el atributo lang en una página; y no puede añadir un alt a la imagen, solo un pie. Por eso la tabla habla de reglas de Trigo Lento inspiradas en WCAG y no de conformidad. En la web y en el correo en HTML, en cambio, los mismos criterios sí se aplican tal cual, y el Día 72 los usará.
Con todas las reglas del día, Valeria amplía el validador de plantillas del Día 48, que ya revisaba variables, longitud, botones y palabras promocionales, con una función revisar_accesibilidad(nombre, idioma, texto) que comprueba la longitud (el límite de Meta y el de notificación), la frase más larga, los emojis, las letras decorativas, las mayúsculas sostenidas, el formato de moneda, el idioma declarado frente al detectado y el índice mínimo de $65$ para el español. La aplica a las dos traducciones del Bloque 7, con sus valores de ejemplo en lugar de las variables, y a las diez versiones de la Tabla 2:
# Revisión de accesibilidad de plantillas, ampliación del validador del Día 48, en Python:
EXCEPCIONES_MAYUSCULAS = {'BAJA', 'STOP', 'MXN', 'USD'}

def revisar_accesibilidad(nombre, idioma, texto):
    alertas = []
    if len(texto) > 1024:
        alertas.append('supera 1 024 caracteres (límite de Meta)')
    elif len(texto) > 200:
        alertas.append(f'{len(texto)} caracteres: más de 200 para una notificación')
    frases = frases_de(texto)
    larga = max(len(palabras_de(f)) for f in frases)
    if larga > 20:
        alertas.append(f'frase de {larga} palabras (máximo 20)')
    emojis = [m for m in EMOJI.finditer(texto) if m.group() != '\u2122']
    if len(emojis) > 1:
        alertas.append(f'{len(emojis)} emojis (máximo 1)')
    elif emojis and texto.rstrip()[-1] != emojis[0].group():
        alertas.append('emoji fuera del final')
    if DECORATIVAS.search(texto):
        alertas.append('letras decorativas')
    gritos = [w for w in re.findall(r'\b[A-ZÁÉÍÓÚÑ]{4,}\b', texto) if w not in EXCEPCIONES_MAYUSCULAS]
    if gritos:
        alertas.append(f'mayúsculas sostenidas: {gritos}')
    if re.search(r'\$\s?\d', texto) and 'MXN' not in texto:
        alertas.append('importe con $ sin MXN')
    detectado = detectar_idioma(texto)
    if detectado not in (idioma, 'ambiguo'):
        alertas.append(f'idioma declarado {idioma}, detectado {detectado}')
    if idioma == 'es_MX':
        P = szigriszt(texto)['P']
        if P < 65:
            alertas.append(f'índice de Szigriszt {P} (mínimo 65)')
    return alertas

# Plantillas del Bloque 7 con sus valores de ejemplo en lugar de las variables:
with open(carpeta / 'recordatorio_recogida_plantillas.json', encoding = 'utf-8') as f:
    aprobables = json.load(f)
revision = {}
for p in aprobables:
    cuerpo = next(c for c in p['components'] if c['type'] == 'BODY')
    texto = cuerpo['text']
    for v in cuerpo['example']['body_text_named_params']:
        texto = texto.replace('{{' + v['param_name'] + '}}', v['example'])
    revision[f"{p['name']} ({p['language']})"] = revisar_accesibilidad(p['name'], p['language'], texto)
for nombre, (texto_antes, texto_despues) in plantillas.items():
    revision[f'{nombre} (antes)'] = revisar_accesibilidad(nombre, 'es_MX', texto_antes)
    revision[f'{nombre} (después)'] = revisar_accesibilidad(nombre, 'es_MX', texto_despues)
for nombre, alertas in revision.items():
    print(f'{nombre:<38} {len(alertas)} alertas' + (f': {"; ".join(alertas)}' if alertas else ''))
limpias = sum(not a for a in revision.values())
print(f'Plantillas sin alertas: {limpias} de {len(revision)}')
recordatorio_recogida (es_MX)          0 alertas
recordatorio_recogida (en_US)          0 alertas
confirmacion_pedido (antes)            6 alertas: 233 caracteres: más de 200 para una notificación; frase de 35 palabras (máximo 20); 4 emojis (máximo 1); mayúsculas sostenidas: ['HOLA']; importe con $ sin MXN; índice de Szigriszt 50.39 (mínimo 65)
confirmacion_pedido (después)          0 alertas
recordatorio_recogida (antes)          4 alertas: frase de 30 palabras (máximo 20); 3 emojis (máximo 1); letras decorativas; índice de Szigriszt 52.24 (mínimo 65)
recordatorio_recogida (después)        0 alertas
pedido_listo (antes)                   2 alertas: frase de 24 palabras (máximo 20); índice de Szigriszt 37.47 (mínimo 65)
pedido_listo (después)                 0 alertas
aviso_retraso (antes)                  5 alertas: 265 caracteres: más de 200 para una notificación; frase de 37 palabras (máximo 20); 3 emojis (máximo 1); mayúsculas sostenidas: ['ATENCIÓN']; índice de Szigriszt 13.24 (mínimo 65)
aviso_retraso (después)                0 alertas
respuesta_horario (antes)              3 alertas: 280 caracteres: más de 200 para una notificación; frase de 38 palabras (máximo 20); 2 emojis (máximo 1)
respuesta_horario (después)            0 alertas
Plantillas sin alertas: 7 de 12
El revisor deja pasar $7$ de las $12$ plantillas sin una sola alerta: las dos traducciones de recordatorio_recogida y las cinco versiones reescritas. Las cinco antiguas acumulan entre $2$ y $6$ alertas cada una, y la confirmación de pedido antigua las reúne casi todas: $233$ caracteres, una frase de $35$ palabras, $4$ emojis, “HOLA” en mayúsculas, un importe con $ sin “MXN” y un índice de $50.39$. Fíjese también en la respuesta de horario antigua: con $P = 74.16$ habría pasado un control basado solo en el índice, pero el revisor la detiene por su frase de $38$ palabras y sus dos emojis.
En TL WhatsApp secuencias v1, el revisor se ejecuta como un nodo Code antes de enviar cualquier plantilla nueva a revisión de Meta: si devuelve alertas, el flujo se detiene y avisa a Valeria. Es la misma lógica que la de las pruebas de flujos del Día 43: una regla que no se comprueba de forma automática acaba por no cumplirse.
Hay, sin embargo, una prueba que ningún código sustituye. Don Ernesto, que empezó el día pidiendo que a Doña Carmen le mandaran la hora y no dibujitos, propone la última regla: antes de activar un mensaje nuevo, él mismo activa el lector de pantalla de su teléfono, cierra los ojos y lo escucha. Si al terminar no sabe qué tiene que hacer, cuándo y dónde, el mensaje no sale. Valeria lo apunta en el código de honor con su nombre: la prueba de Don Ernesto.
Consideraciones finales
El día empezó con una clienta que colgó a la tercera letra decorativa y dos turistas que no sabían si el pan costaba pesos o dólares, y termina con cinco plantillas que suben de $45.5$ a $82.1$ puntos en la escala de legibilidad, un lector de pantalla que ya no pronuncia $451$ caracteres de adorno, una plantilla en dos idiomas con su glosario y un revisor que detiene lo que no cumple. Nada de eso exigió una herramienta nueva ni un aumento de presupuesto: el segundo idioma cuesta $0.33$ USD al mes y la accesibilidad, nada en tokens.
Las cifras de hoy tienen límites que conviene decir. El contador de sílabas es una aproximación; el índice de Szigriszt mide la carga de lectura, no la claridad ni el tono, y su media esconde la frase más larga; los nombres que pronuncian los lectores de pantalla cambian con el lector, el idioma y la versión; la proporción de mensajes en inglés es un supuesto; y la revisión separada de cada traducción se apoya en documentación de proveedores, no en una página de Meta. Ninguno de esos límites cambia las reglas, pero todos justifican lo que ninguna fórmula hace: leer el mensaje con una persona real.
Antes de activar cualquier mensaje automático en un negocio, conviene hacerse algunas preguntas:
- ¿Dice lo importante (qué, cuándo, dónde) en la primera frase?
- ¿Cómo suena en un lector de pantalla, y qué oye el cliente antes del primer dato?
- ¿Se entiende la hora, la fecha y el importe sin saber en qué país está el negocio?
- ¿Quién revisó la traducción, y qué palabras del negocio no se traducen?
- ¿Lo ha escuchado alguien con los ojos cerrados?
Un gran libro que habla de esto es Lectura Fácil: métodos de redacción y evaluación, de Óscar García Muñoz, publicado por el Real Patronato sobre Discapacidad, en el que se explican, con ejemplos, las pautas de la lectura fácil, cómo se validan los textos con lectores reales y por qué los índices automáticos son solo una ayuda. Leerlo desde la automatización es útil por una razón concreta: cada pauta del libro se puede convertir en una comprobación de código, y cada comprobación de código necesita, como el libro insiste, un lector de verdad que la confirme.
Un mensaje automático no está terminado cuando se envía, sino cuando lo entiende quien lo recibe, con los ojos, con los oídos o en otro idioma. Escribir para Doña Carmen y para los turistas del sábado no fue una concesión: fue la forma de que los mensajes de Trigo Lento hagan, para todos, el trabajo que se diseñaron para hacer.
Conclusiones clave
Lectura fácil y legibilidad
- El índice de Szigriszt-Pazos, $P = 206.835 - 62.3 \cdot S/W - W/F$, mide la carga de lectura en español; con la escala INFLESZ, el mensaje largo del ejemplo da $37.47$ (“muy difícil”) y su versión en lectura fácil $86.47$ (“muy fácil”).
- Reescribir cinco plantillas con frases cortas, lo importante primero y verbos activos sube el índice medio de $45.5$ a $82.1$ y baja la longitud media de $225.8$ a $119.0$ caracteres.
- Un índice es una media: la respuesta de horario antigua daba $74.16$ con una frase de $38$ palabras, y por eso el revisor también mira la frase más larga; ningún índice sustituye leer el mensaje con una persona.
Lectores de pantalla y formatos
- Los lectores de pantalla pronuncian el nombre de cada emoji y deletrean las letras decorativas: el recordatorio antiguo pasaba de $195$ caracteres escritos a $487$ oídos, casi todos antes de la palabra “pedido”.
- Regla de Trigo Lento: como máximo un emoji, al final; nada de letras decorativas; mayúsculas solo para “BAJA” o “STOP”; enlaces que digan adónde llevan; un pie descriptivo en cada foto.
- Las horas se guardan en UTC y se escriben en la hora de la Ciudad de México; los importes llevan “MXN” y, para extranjeros, la palabra pesos y un equivalente aproximado ($95$ MXN, unos $5.14$ USD).
Dos idiomas con control humano
- La plantilla
recordatorio_recogidavive enes_MXy enen_US, cada traducción con su aprobación; el idioma no cambia la tarifa de Meta, que cobra por categoría y país. - La elección del cliente manda; después, reglas con palabras frecuentes, que deciden $171$ de $200$ mensajes con un $98.8%$ de aciertos y ningún error entre español e inglés; Haiku 5.5 solo para lo ambiguo sin conversación previa.
- Sonnet 5.5 traduce con un glosario que no traduce el pan, toda plantilla traducida pasa por una persona y el segundo idioma cuesta $0.33$ USD al mes, el $4.1%$ del rubro de Claude.
Mañana, en el Día 50: Slack como centro de operaciones: webhooks, Block Kit y aprobaciones. Las alertas de los flujos siguen llegando al teléfono personal de Valeria y los panaderos no se enteran de los cambios de pedido; mañana Trigo Lento tendrá canales de Slack por función, mensajes con botones de aprobación y una firma verificada antes de reanudar cualquier flujo en n8n.
Referencias
- W3C (2024). Web Content Accessibility Guidelines (WCAG) 2.2. W3C Recommendation, 12 de diciembre de 2024. https://www.w3.org/TR/WCAG22/ (revisado en octubre de 2026).
- Szigriszt Pazos, F. (1993). Sistemas predictivos de legibilidad del mensaje escrito: fórmula de perspicuidad (tesis doctoral). Universidad Complutense de Madrid.
- Barrio-Cantalejo, I. M., Simón-Lorda, P., Melguizo, M., Escalona, I., Marijuán, M. I. y Hernando, P. (2008). Validación de la Escala INFLESZ para evaluar la legibilidad de los textos dirigidos a pacientes. Anales del Sistema Sanitario de Navarra, 31(2), 135-152.
- Fernández Huerta, J. (1959). Medidas sencillas de lecturabilidad. Consigna, 214, 29-32.
- Meta (2026). Template components y Supported languages. WhatsApp Business Platform. https://developers.facebook.com/documentation/business-messaging/whatsapp/templates/components (revisado en octubre de 2026).
- García Muñoz, Ó. (2012). Lectura Fácil: métodos de redacción y evaluación. Real Patronato sobre Discapacidad.
- AENOR (2018). UNE 153101:2018 EX. Lectura Fácil. Pautas y recomendaciones para la elaboración de documentos. Asociación Española de Normalización.
- Flesch, R. (1948). A new readability yardstick. Journal of Applied Psychology, 32(3), 221-233.