
Arquitecto de automatización con IA: Día 5
 Jeshua Romero Guadarrama
- 65 Min para leer
- 05 Feb, 2026
Índice de contenido
Resumen:
Un contrato de datos solo demuestra su valor cuando se enfrenta a mensajes con la forma de los de verdad. En este laboratorio guiado, Valeria convierte el contrato del pedido en un modelo de pydantic con validadores de campo y de modelo, lo pone a prueba con 100 mensajes sintéticos de WhatsApp, Instagram, el formulario web y el teléfono, traduce los errores a un catálogo propio y mide el rechazo por canal y por campo. Al terminar, usted sabrá leer los errores de validación de forma estructurada, guardar lo rechazado en una cola de cuarentena seudonimizada y redactar una sola repregunta que pide al cliente únicamente el dato que falta.
¿Cómo citar el presente artículo?
Romero, J. (5 de febrero de 2026). Arquitecto de automatización con IA: Día 5. python-data-engineer. https://www.python-data-engineer.com/post/aai/dia_5/.
Arquitecto de automatización con IA: Día 5 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/aai/dia_5/.
Precios, límites y políticas revisados en octubre de 2026: planes, precios y límites de Make, n8n, Zapier, WhatsApp (Meta, Twilio, Wati) y de la API de Claude. Este día no llama a ningún servicio: los once bloques se ejecutan sin red y sus salidas son las reales. Los validadores de campo y de modelo, el contexto de validación, ValidationError.errors() y model_json_schema() se contrastaron con la documentación de Pydantic v2 (versión 2.13) vigente en octubre de 2026.
Día 5. Laboratorio guiado: validar cien mensajes contra el contrato de datos
Introducción
Ayer, en el Día 4 (Arquitectura de flujos II: entradas, salidas y contratos de datos), vio por qué cada flujo necesita una frontera con reglas escritas, normalizó teléfonos, fechas y dinero, y Trigo Lento ganó el contrato del pedido en JSON Schema, un validador escrito a mano y la base trigo_lento.sqlite. Hoy no hay concepto nuevo que aprender, sino un contrato que poner a prueba: es un día de laboratorio, con las manos en el código de principio a fin.
Es jueves 5 de febrero y Valeria tiene el contrato impreso junto al teclado, con sus campos, sus tipos y sus reglas subrayadas en amarillo. Funciona con los ejemplos que ella misma escribió ayer, pero esos ejemplos los escribió alguien que conocía el contrato. Los clientes de Trigo Lento no lo conocen. Escriben “2 hogazas pal 5” por WhatsApp, piden por Instagram “el pastel de siempre” sin decir para cuándo, llenan el formulario con el teléfono de la oficina a medias, y por teléfono dictan una hora de recogida a la que la panadería ya cerró. La pregunta de Valeria es concreta: ¿qué pasará cuando lleguen cien mensajes con la forma de los de verdad, desde los cuatro canales a la vez?
Don Ernesto, que ha visto el contrato impreso y no termina de fiarse de tanta regla, plantea la suya mientras enharina la mesa: “Si su sistema rechaza a uno de cada cinco clientes, me quedo sin clientes. Aquí nadie se va sin su pan porque escribió mal la fecha.” Es una objeción seria, y la cifra que menciona no es caprichosa: veremos que se parece mucho a la que sale del laboratorio. La respuesta, como siempre en esta serie, se dará con números, y tendrá un matiz que a Don Ernesto le va a gustar.
En la presente entrada, descubrirá cómo convertir el contrato del Día 4 en un modelo de pydantic que no solo describe los datos, sino que los comprueba con validadores de campo y de modelo. Generará un lote de $100$ mensajes sintéticos con errores sembrados según un plan declarado, lo validará entero, leerá los errores que devuelve pydantic con su ubicación, su tipo y su mensaje, y los traducirá a un catálogo propio de siete códigos. Medirá la tasa de rechazo por canal y por campo, con un intervalo de confianza que le dirá cuánto se puede concluir con tan pocos mensajes. Después diseñará la cola de cuarentena, donde nada se borra en silencio, y la repregunta al cliente, que agrupa en una sola pregunta los datos que faltan. Al final, el embudo del lote completo responderá a Don Ernesto.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Convertir el contrato de datos del pedido del Día 4 en un modelo de pydantic con validadores de campo y de modelo.
- Validar un lote de 100 mensajes sintéticos de los cuatro canales y leer los errores de forma estructurada (
ValidationError.errors()). - Construir un catálogo de errores con códigos propios y medir la tasa de rechazo por canal y por campo.
- Diseñar una cola de cuarentena y mensajes de repregunta al cliente que piden solo el dato que falta.
Preparar el laboratorio
Un laboratorio de validación tiene una regla que lo distingue de un flujo en producción: no envía nada a nadie. Todo lo que se haga hoy ocurre en la computadora de Valeria, con mensajes inventados, una copia de la base de datos y un registro de cada decisión. Si algo sale mal, se borra la carpeta y se empieza de nuevo; ningún cliente recibe una pregunta equivocada, ningún pedido llega al obrador y ningún dato real sale de la panadería.
La carpeta del laboratorio es trigo_lento/laboratorio_validacion/. Dentro vivirá una copia de laboratorio de trigo_lento.sqlite con una tabla nueva, cuarentena, y nada más. El laboratorio lee dos archivos de días anteriores sin modificarlos: catalogo.json, con los $12$ productos del Día 1, y contrato_pedido.schema.json, el contrato del Día 4. Al terminar, Valeria tendrá cuatro piezas que se reutilizarán en el resto de la serie:
- El modelo
PedidoContrato, el contrato ejecutable: una clase de Python que acepta un diccionario y devuelve un pedido válido o una lista de errores. - El catálogo de errores, siete códigos propios (E01 a E07) con su campo, su severidad y la persona que debe corregir cada uno.
- La cola de cuarentena, una tabla con los mensajes rechazados, su estado, sus intentos y su fecha de caducidad.
- Las plantillas de repregunta, frases en tono de mostrador que se combinan en una sola pregunta por mensaje.
La herramienta central del día es pydantic, la biblioteca de validación de datos más usada en Python. La serie la conoce desde el Día 2, cuando sirvió para definir la salida estructurada del clasificador, y el Día 4 la usó para extraer un pedido de texto libre con Claude. Hoy cambia de papel: ya no describe lo que debe devolver un modelo de lenguaje, sino lo que debe cumplir un pedido para entrar en el sistema. Se usa la versión 2, cuyo motor de validación está escrito en Rust y valida miles de objetos por segundo, de modo que validar los $468$ encargos del mes es instantáneo.
El primer bloque fija las importaciones, la semilla global de la serie, $2026$, y la carpeta del laboratorio. Además de las bibliotecas de siempre, importa de pydantic las piezas que usará el modelo: BaseModel para declarar la estructura, Field para las restricciones de cada campo, field_validator y model_validator para las reglas propias, ValidationError para capturar los fallos y PydanticCustomError para que esos fallos lleven un tipo con nombre propio:
# Importaciones base, semilla de la serie y carpeta del laboratorio en Python:
import warnings
warnings.filterwarnings('ignore')
import json
import hashlib
import hmac
import sqlite3
from collections import Counter
from datetime import date, datetime, time, timedelta
from pathlib import Path
from typing import Literal, Optional
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import pydantic
from pydantic import BaseModel, ConfigDict, Field, ValidationError, ValidationInfo
from pydantic import field_validator, model_validator
from pydantic_core import PydanticCustomError

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 120)
LAB = Path('trigo_lento') / 'laboratorio_validacion'
LAB.mkdir(parents = True, exist_ok = True)
print('numpy', np.__version__, '| pandas', pd.__version__, '| pydantic', pydantic.VERSION)
numpy 2.4.6 | pandas 3.0.3 | pydantic 2.13.4
El entorno queda con numpy $2.4.6$, pandas $3.0.3$ y pydantic $2.13.4$. La versión de pydantic importa: la versión 1 tenía otra sintaxis para los validadores (@validator y @root_validator) y otro formato de errores, y buena parte de los ejemplos que circulan en internet todavía la usan. Si copia un fragmento antiguo, el síntoma suele ser un aviso de obsolescencia o un validador que nunca se ejecuta.
La Figura 1 resume el banco de pruebas que se montará a lo largo del día: cien sobres de cuatro colores, uno por canal, pasan por un torniquete con siete sensores, uno por cada código del catálogo, y se reparten entre la bandeja de los válidos y la de cuarentena.
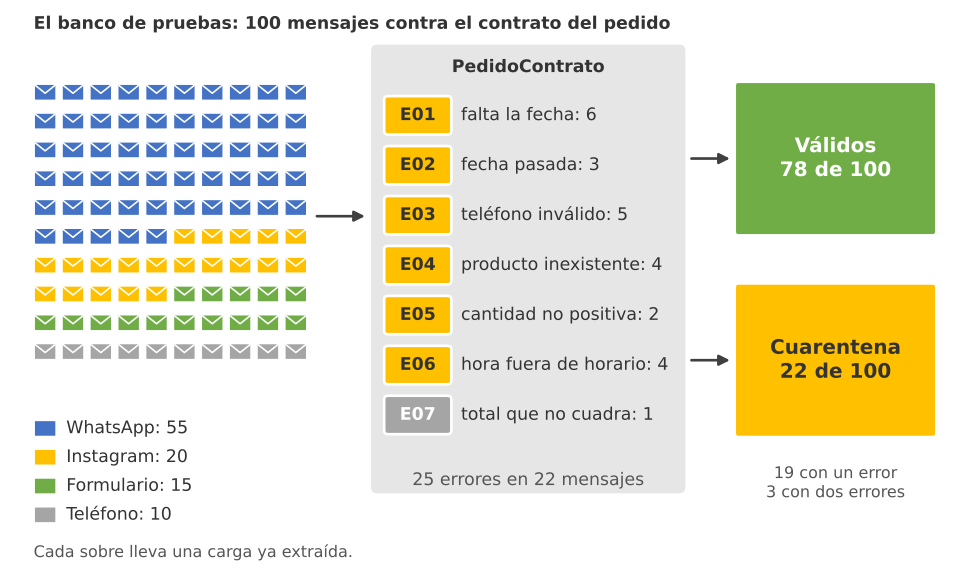
Figura 1. El banco de pruebas: cien sobres de cuatro canales (55 de WhatsApp, 20 de Instagram, 15 del formulario y 10 del teléfono) pasan por el contrato, cuyos siete sensores E01 a E07 reparten 78 mensajes a la bandeja de válidos y 22 a la de cuarentena, con 25 errores en total.
Paso 1: el contrato como modelo de pydantic
El contrato del Día 4 es un documento JSON Schema: dice qué campos lleva un pedido, de qué tipo es cada uno y cuáles son obligatorios. Es una descripción excelente para compartir con Make o con n8n, que entienden ese formato, pero tiene un límite: un esquema describe, no actúa. Para que un programa de Python lo haga cumplir hace falta un validador, y ayer Valeria escribió uno a mano, con un if por regla. Funciona, pero cada regla nueva obliga a tocar el validador y a escribir de nuevo el mensaje de error.
Pydantic resuelve eso con una idea sencilla: el contrato se escribe como una clase, cada campo con su tipo, y la propia clase sabe validarse. Al llamar a PedidoContrato.model_validate(datos), pydantic recorre el diccionario, convierte lo que se puede convertir (la cadena "2026-02-07" en una fecha, "10:30" en una hora), comprueba cada restricción y, si algo falla, lanza un ValidationError con todos los fallos encontrados, no solo el primero.
El modelo Pedido del Día 4 y el PedidoContrato de hoy no son el mismo objeto, y conviene entender por qué. El Pedido de ayer era un formato de extracción: el molde que se le pasaba a Claude con client.messages.parse para convertir “2 hogazas pal 5” en un diccionario. Ese molde debe ser permisivo, porque si el cliente no dijo la fecha, el modelo de lenguaje tiene que poder devolver “sin fecha”. Un molde de extracción con la fecha obligatoria obligaría al modelo a inventarse una, y las salidas estructuradas garantizan el formato, no la verdad. El PedidoContrato, en cambio, es la aduana: decide qué entra en el sistema, y ahí la fecha sí es obligatoria. Extraer y aprobar son dos papeles distintos, y mezclarlos en un solo modelo produce datos inventados con apariencia de válidos.
Validadores de campo y de modelo
El modelo se compone de tres clases anidadas, igual que el contrato: Cliente (nombre y teléfono), Renglon (clave del producto y cantidad) y PedidoContrato, que contiene un cliente, una lista de renglones y el resto de los campos. Cada regla del contrato se expresa con la herramienta más sencilla que la resuelve:
Literalpara los valores cerrados. El canal solo puede ser uno de cuatro y la clave del producto uno de doce (P01 a P12). Cualquier otro valor produce un error de tipoliteral_error.Fieldpara los rangos y las longitudes.Field(gt = 0, le = 200)exige una cantidad mayor que cero y no mayor que $200$;Field(min_length = 1, max_length = 12)exige entre uno y doce renglones;Field(pattern = ...)exige el formato del identificadorTL-AAAAMMDD-NNNN.field_validatorpara las reglas de un solo campo que no caben en un tipo. El teléfono se normaliza a E.164 antes de validarse (modobefore), la fecha de entrega no puede estar en el pasado y la hora de recogida debe caer entre las 7:00 y las 20:00, el horario de la panadería.model_validatorpara las reglas entre campos. El total en centavos debe ser igual a la suma de precio por cantidad de cada renglón. Esa regla no pertenece a ningún campo en particular, sino al pedido completo, y por eso se valida después de todos los campos (modoafter).
Dos detalles de implementación merecen atención. El primero es ConfigDict(extra = 'forbid'), el equivalente de "additionalProperties": false del Día 4: un campo que no está en el contrato, como un "sabor_favorito" que a alguien se le ocurrió añadir, se rechaza en lugar de pasar en silencio. El segundo es PydanticCustomError: cuando un validador propio falla, lanza un error con un tipo que se elige (fecha_pasada, telefono_invalido, hora_fuera_de_horario, total_no_cuadra) y un mensaje con huecos que se rellenan con los datos del caso. Así, más adelante, el catálogo podrá reconocer cada fallo por su tipo sin tener que interpretar el texto del mensaje.
Queda una pregunta delicada: ¿qué significa “fecha pasada”? Depende del día en que se valida. Si el validador usara siempre date.today(), el mismo mensaje sería válido el jueves e inválido el viernes, y el laboratorio no se podría repetir. Por eso la fecha de referencia llega en el contexto de validación, un diccionario que se pasa a model_validate(datos, context = {'hoy': ...}) y que el validador lee en info.context. En el laboratorio, “hoy” es siempre el jueves 5 de febrero de 2026.
El siguiente bloque escribe los tres modelos, valida el pedido de juguete del Día 4 (dos hogazas y un pay de queso) y compara, campo a campo, el esquema que genera pydantic con el contrato JSON Schema del Día 4:
# Contrato del pedido como modelo de pydantic con validadores de campo y de modelo en Python:
catalogo = json.loads(Path('trigo_lento/catalogo.json').read_text(encoding = 'utf-8'))
PRECIOS = {p['clave']: p['precio_mxn'] * 100 for p in catalogo}     # en centavos (Día 4)
Clave = Literal['P01', 'P02', 'P03', 'P04', 'P05', 'P06', 'P07', 'P08', 'P09', 'P10', 'P11', 'P12']

class Cliente(BaseModel):
    model_config = ConfigDict(extra = 'forbid')
    nombre: str = Field(min_length = 2, max_length = 80)
    telefono: str

    @field_validator('telefono', mode = 'before')
    @classmethod
    def telefono_e164(cls, valor):
        # Normaliza a E.164 (+52 y 10 dígitos) o rechaza:
        digitos = ''.join(c for c in str(valor) if c.isdigit())
        if len(digitos) == 10:
            digitos = '52' + digitos
        if len(digitos) != 12 or not digitos.startswith('52'):
            raise PydanticCustomError('telefono_invalido',
                                      'Teléfono no convertible a E.164: {valor}', {'valor': valor})
        return '+' + digitos

class Renglon(BaseModel):
    model_config = ConfigDict(extra = 'forbid')
    clave: Clave
    cantidad: int = Field(gt = 0, le = 200)

class PedidoContrato(BaseModel):
    model_config = ConfigDict(extra = 'forbid')
    id_pedido: str = Field(pattern = r'^TL-[0-9]{8}-[0-9]{4}$')
    canal: Literal['whatsapp', 'instagram', 'formulario', 'telefono']
    cliente: Cliente
    renglones: list[Renglon] = Field(min_length = 1, max_length = 12)
    fecha_entrega: date
    hora_recogida: Optional[time] = None
    notas: Optional[str] = Field(default = None, max_length = 280)
    total_centavos: int = Field(ge = 0)

    @field_validator('fecha_entrega')
    @classmethod
    def fecha_no_pasada(cls, valor, info: ValidationInfo):
        # La fecha de referencia llega por el contexto para que el laboratorio sea reproducible:
        hoy = (info.context or {}).get('hoy', date.today())
        if valor < hoy:
            raise PydanticCustomError('fecha_pasada', 'La fecha {fecha} ya pasó (hoy es {hoy})',
                                      {'fecha': valor.isoformat(), 'hoy': hoy.isoformat()})
        return valor

    @field_validator('hora_recogida')
    @classmethod
    def dentro_del_horario(cls, valor):
        if valor is not None and not time(7, 0) <= valor <= time(20, 0):
            raise PydanticCustomError('hora_fuera_de_horario',
                                      'La hora {hora} está fuera del horario de 7:00 a 20:00',
                                      {'hora': valor.strftime('%H:%M')})
        return valor

    @model_validator(mode = 'after')
    def total_cuadra(self):
        # Regla entre campos: el total debe salir del catálogo y de los renglones:
        esperado = sum(PRECIOS[r.clave] * r.cantidad for r in self.renglones)
        if self.total_centavos != esperado:
            raise PydanticCustomError('total_no_cuadra', 'El total {total} no cuadra con los renglones ({esperado})',
                                      {'total': self.total_centavos, 'esperado': esperado})
        return self

# El pedido de juguete del Día 4: 2 hogazas y 1 pay de queso:
ejemplo = {'id_pedido': 'TL-20260205-0000', 'canal': 'whatsapp',
           'cliente': {'nombre': 'Clienta de prueba', 'telefono': '+52 55 0000 0000'},
           'renglones': [{'clave': 'P01', 'cantidad': 2}, {'clave': 'P12', 'cantidad': 1}],
           'fecha_entrega': '2026-02-07', 'hora_recogida': '10:30', 'total_centavos': 57000}
pedido = PedidoContrato.model_validate(ejemplo, context = {'hoy': date(2026, 2, 5)})
print('Ejemplo del Día 4:', pedido.cliente.telefono, pedido.fecha_entrega, pedido.hora_recogida,
      pedido.total_centavos, 'centavos')

# Comparación campo a campo con el contrato JSON Schema del Día 4:
def aplanar(esquema, defs = None, prefijo = ''):
    defs = esquema.get('$defs', {}) if defs is None else defs
    filas = {}
    requeridos = set(esquema.get('required', []))
    for campo, regla in esquema.get('properties', {}).items():
        opciones = regla.get('anyOf', [regla])
        regla = next(o for o in opciones if o.get('type') != 'null')
        regla = defs[regla['$ref'].split('/')[-1]] if '$ref' in regla else regla
        nombre = prefijo + campo
        if 'enum' in regla:
            tipo = f"enum({len(regla['enum'])})"
        else:
            reglas = [k for k in ('format', 'pattern', 'minimum', 'exclusiveMinimum', 'maximum',
                                  'minLength', 'maxLength', 'minItems', 'maxItems') if k in regla]
            tipo = regla.get('type', '?') + (' ' + ','.join(reglas) if reglas else '')
        filas[nombre] = (tipo, campo in requeridos)
        if regla.get('type') == 'object':
            filas.update(aplanar(regla, defs, nombre + '.'))
        if regla.get('type') == 'array':
            items = regla['items']
            items = defs[items['$ref'].split('/')[-1]] if '$ref' in items else items
            filas.update(aplanar(items, defs, nombre + '[].'))
    return filas

dia4 = aplanar(json.loads(Path('trigo_lento/contrato_pedido.schema.json').read_text(encoding = 'utf-8')))
pyd = aplanar(PedidoContrato.model_json_schema())
comparacion = pd.DataFrame([{'campo': c, 'Día 4': dia4[c][0], 'pydantic': pyd.get(c, ('falta', None))[0],
                             'obligatorio': 'sí' if dia4[c][1] else 'no',
                             'igual': dia4[c] == pyd.get(c)} for c in dia4])
print(comparacion.to_string(index = False))
print('Campos idénticos:', int(comparacion.igual.sum()), 'de', len(comparacion),
      '| campos de pydantic que no están en el Día 4:', sorted(set(pyd) - set(dia4)))
Ejemplo del Día 4: +525500000000 2026-02-07 10:30:00 57000 centavos
               campo                      Día 4                         pydantic obligatorio  igual
           id_pedido             string pattern                   string pattern          sí   True
               canal                    enum(4)                          enum(4)          sí   True
             cliente                     object                           object          sí   True
      cliente.nombre string minLength,maxLength       string minLength,maxLength          sí   True
    cliente.telefono             string pattern                           string          sí  False
           renglones    array minItems,maxItems          array minItems,maxItems          sí   True
   renglones[].clave                   enum(12)                         enum(12)          sí   True
renglones[].cantidad    integer minimum,maximum integer exclusiveMinimum,maximum          sí  False
       fecha_entrega              string format                    string format          sí   True
       hora_recogida             string pattern                    string format          no  False
               notas           string maxLength                 string maxLength          no   True
      total_centavos            integer minimum                  integer minimum          sí   True
Campos idénticos: 9 de 12 | campos de pydantic que no están en el Día 4: []
El pedido de juguete pasa la validación: el teléfono +52 55 0000 0000, escrito con espacios, sale normalizado como +525500000000, la fecha y la hora salen convertidas a sus tipos, y el total de $57,000$ centavos cuadra con $2 \cdot 9,500 + 38,000$. Es la misma cifra que calculó ayer, ahora comprobada por el propio modelo.
Atención aquí: un validador que consulta el reloj (date.today() o datetime.now()) hace que el resultado dependa del momento en que se ejecuta, y además usa la zona horaria de la máquina, no la de la panadería. Un servidor en otra región que valide a las 23:30 de Ciudad de México ya vive en el día siguiente y rechazaría como “pasada” una entrega para hoy. Pase siempre la fecha de referencia en el contexto, calculada en la zona America/Mexico_City, y deje date.today() solo como último recurso.
El esquema que genera pydantic
Cada modelo de pydantic sabe describirse a sí mismo: PedidoContrato.model_json_schema() devuelve un JSON Schema generado a partir de los tipos y de los Field. Eso abre una comprobación muy útil, que el bloque anterior ya hizo: comparar el esquema generado con el contrato publicado el Día 4. Si alguien cambia el modelo y olvida el contrato, o al revés, la comparación lo detecta. Se le suele llamar prueba de deriva, porque mide cuánto se han separado dos descripciones que deberían decir lo mismo.
La función aplanar recorre los dos esquemas, resuelve las referencias internas (pydantic guarda Cliente y Renglon en una sección $defs y los enlaza con $ref; el contrato del Día 4 los escribe en línea) y resume cada campo con su tipo y sus restricciones. El resultado: $9$ de los $12$ campos son idénticos y no hay ningún campo de más ni de menos. Las tres diferencias son instructivas:
cliente.telefono: el contrato del Día 4 declara unpattern(^\+52[0-9]{10}$) y pydantic solo dicestring. La regla existe en el modelo, pero vive dentro de unfield_validator, y lo que se escribe como código no aparece en el esquema generado. Es la diferencia más importante del día: el esquema que pydantic publica es más débil que el modelo que lo genera.renglones[].cantidad: el Día 4 diceminimum: 1y pydantic diceexclusiveMinimum: 0. Para números enteros son equivalentes (mayor que cero es lo mismo que al menos uno), pero un comparador literal no lo sabe. Es una diferencia de forma, no de fondo.hora_recogida: el Día 4 la describe con un patrónHH:MMy pydantic con el formatotime. El tipotimede Python acepta además segundos (“10:30:00”), así que el modelo es un poco más permisivo en la forma y bastante más estricto en el fondo, porque el validador exige el horario de 7:00 a 20:00, que ningún esquema expresa.
De ahí sale una regla de diseño que Valeria anota en su cuaderno: el contrato JSON Schema del Día 4 sigue siendo el contrato público, el que se comparte con Make y con n8n; el modelo de pydantic es el contrato ejecutable, con más reglas de las que caben en un esquema (fecha no pasada, horario, total que cuadra, normalización del teléfono). La prueba de deriva se ejecuta cada vez que cambia cualquiera de los dos, y las diferencias que quedan se documentan, como estas tres, en lugar de descubrirse en producción. Kleppmann dedica buena parte de su capítulo sobre codificación y evolución de datos a este problema: los esquemas cambian, y lo que protege a un sistema no es que no cambien, sino saber en cada momento qué versión del contrato habla con cuál.
Paso 2: cien mensajes sintéticos de cuatro canales
Para poner a prueba el contrato hacen falta mensajes con la forma de los reales, pero sin datos reales. Valeria no va a copiar cien conversaciones de WhatsApp de sus clientes a un laboratorio: eso sería tratar datos personales para una finalidad que nadie autorizó. En su lugar, genera mensajes sintéticos: inventados, con nombres ficticios abreviados (“Lucía H.”, “Tomás R.”), teléfonos con el formato de prueba de la serie (+52 55 0000 00XX) y productos, cantidades, fechas y horas elegidos al azar dentro de lo razonable.
Los mensajes llegan ya extraídos a diccionarios, como si hubieran pasado por la extracción con Claude del Día 4. Eso aísla el experimento: hoy se mide el contrato, no la extracción. Cada mensaje viaja en un sobre con su identificador, su canal y la hora de recepción, y dentro del sobre va la carga, el diccionario que se valida. El reparto sigue los datos fijos de la serie: $55$ mensajes de WhatsApp, $20$ de Instagram, $15$ del formulario web y $10$ del teléfono, es decir, el $55%$, el $20%$, el $15%$ y el $10%$ de los encargos de Trigo Lento.
Un generador de datos de prueba que mete errores al azar tiene un problema: después no se sabe si el validador encontró todo lo que había. Por eso los errores se siembran según un plan declarado antes de generar nada, recogido en la Tabla 1. El plan no es arbitrario; refleja lo que Valeria ha visto en su libreta durante años: la fecha es el dato que más falta en WhatsApp e Instagram, el teléfono falla en los canales donde se teclea o se dicta, y las claves de producto inexistentes aparecen cuando alguien pide algo de temporada que ya no se hace.
Tabla 1. Plan de errores sembrados por canal y campo (25 errores en 22 mensajes; tres mensajes traen dos errores).
| Campo | Formulario | Teléfono | Total | ||
|---|---|---|---|---|---|
| Fecha de entrega (falta o ya pasó) | 6 | 2 | 0 | 1 | 9 |
| Teléfono | 0 | 3 | 1 | 1 | 5 |
| Clave de producto | 3 | 1 | 0 | 0 | 4 |
| Cantidad | 1 | 0 | 1 | 0 | 2 |
| Hora de recogida | 2 | 1 | 0 | 1 | 4 |
| Total | 1 | 0 | 0 | 0 | 1 |
| Errores | 13 | 7 | 2 | 3 | 25 |
| Mensajes con error | 11 de 55 | 6 de 20 | 2 de 15 | 3 de 10 | 22 de 100 |
La tabla esconde una decisión de diseño. WhatsApp tiene $13$ errores repartidos en $11$ mensajes, e Instagram $7$ en $6$: hay tres mensajes con dos errores cada uno, dos de WhatsApp y uno de Instagram. Están ahí a propósito, para comprobar que el validador informa de los dos a la vez y que la repregunta los agrupa en una sola pregunta. Los nueve errores de fecha se reparten, además, entre dos códigos distintos: seis mensajes sin fecha y tres con una fecha que ya pasó.
El siguiente bloque genera los cien mensajes. La función sembrar traduce cada código del plan en un defecto concreto: quitar la fecha (E01), poner una fecha de los tres días anteriores (E02), escribir un teléfono con nueve o trece dígitos o con texto (E03), usar una clave que no existe como P13 o PAN-MUERTO (E04), poner una cantidad de cero o negativa (E05), una hora antes de las 7:00 o después de las 20:00 (E06) o sumar $10$ pesos al total (E07). Las posiciones de los mensajes defectuosos dentro de cada canal se eligen con el generador de la semilla $2026$, y cada mensaje guarda en sembrados la lista de códigos que se le metieron, para comparar después:
# Cien mensajes sintéticos de cuatro canales con un plan de errores declarado en Python:
HOY = date(2026, 2, 5)                                   # jueves 5 de febrero de 2026
REPARTO = {'whatsapp': 55, 'instagram': 20, 'formulario': 15, 'telefono': 10}
PLAN = {   # cada lista es un mensaje defectuoso con los códigos que se le siembran (Tabla 1)
    'whatsapp': [['E01', 'E06'], ['E04', 'E01'], ['E01'], ['E01'], ['E02'], ['E02'],
                 ['E04'], ['E04'], ['E05'], ['E06'], ['E07']],
    'instagram': [['E03', 'E01'], ['E01'], ['E03'], ['E03'], ['E04'], ['E06']],
    'formulario': [['E03'], ['E05']],
    'telefono': [['E02'], ['E03'], ['E06']],
}
NOMBRES = ['Lucía H.', 'Tomás R.', 'Carmen V.', 'Andrés P.', 'Sofía M.', 'Jorge L.',
           'Elena G.', 'Raúl C.', 'Inés D.', 'Pablo S.', 'Marta N.', 'Óscar F.']
FORMATO_TEL = {'whatsapp': '+52 55 0000 {:04d}', 'instagram': '55 0000 {:04d}',
               'formulario': '550000{:04d}', 'telefono': '55-0000-{:04d}'}
DIAS = [HOY + timedelta(days = d) for d in range(1, 15) if (HOY + timedelta(days = d)).weekday() != 6]
HORAS = [f'{h:02d}:{m:02d}' for h in range(8, 20) for m in (0, 30)]
usados = Counter()

def sembrar(datos, codigo):
    # Introduce en el mensaje el defecto que corresponde a cada código del catálogo:
    i = usados[codigo]
    usados[codigo] += 1
    if codigo == 'E01':
        datos.pop('fecha_entrega')
    elif codigo == 'E02':
        datos['fecha_entrega'] = (HOY - timedelta(days = 1 + i % 3)).isoformat()
    elif codigo == 'E03':
        datos['cliente']['telefono'] = ['55 0000 001', '+52 55 0000 00123', 'sin dato'][i % 3]
    elif codigo == 'E04':
        datos['renglones'][0]['clave'] = ['P13', 'P00', 'PAN-MUERTO'][i % 3]
    elif codigo == 'E05':
        datos['renglones'][0]['cantidad'] = [0, -2][i % 2]
    elif codigo == 'E06':
        datos['hora_recogida'] = ['06:30', '21:00', '22:15', '05:45'][i % 4]
    elif codigo == 'E07':
        datos['total_centavos'] += 1000

mensajes, n = [], 0
for canal, total in REPARTO.items():
    posiciones = rng.choice(total, size = len(PLAN[canal]), replace = False)
    defectuosos = {int(p): codigos for p, codigos in zip(posiciones, PLAN[canal])}
    for j in range(total):
        n += 1
        claves = rng.choice(list(PRECIOS), size = int(rng.integers(1, 4)), replace = False)
        renglones = [{'clave': str(c), 'cantidad': int(rng.integers(1, 7))} for c in claves]
        datos = {'id_pedido': f'TL-20260205-{n:04d}', 'canal': canal,
                 'cliente': {'nombre': NOMBRES[int(rng.integers(len(NOMBRES)))],
                             'telefono': FORMATO_TEL[canal].format(n)},
                 'renglones': renglones,
                 'fecha_entrega': DIAS[int(rng.integers(len(DIAS)))].isoformat(),
                 'hora_recogida': HORAS[int(rng.integers(len(HORAS)))],
                 'total_centavos': sum(PRECIOS[r['clave']] * r['cantidad'] for r in renglones)}
        for codigo in defectuosos.get(j, []):
            sembrar(datos, codigo)
        recibido = datetime(2026, 2, 5, 7) + timedelta(minutes = int(rng.integers(0, 13 * 60)))
        mensajes.append({'id_mensaje': f'M{n:03d}', 'canal': canal,
                         'recibido_en': recibido.isoformat(timespec = 'minutes'),
                         'sembrados': sorted(defectuosos.get(j, [])), 'datos': datos})

lote = pd.DataFrame([{'canal': m['canal'], 'con_error': bool(m['sembrados']),
                      'errores': len(m['sembrados'])} for m in mensajes])
resumen = lote.groupby('canal', sort = False).agg(mensajes = ('canal', 'size'),
                                                  con_errores = ('con_error', 'sum'),
                                                  errores_sembrados = ('errores', 'sum'))
print(resumen.to_string())
print('Total:', len(mensajes), 'mensajes |', int(lote.con_error.sum()), 'con errores |',
      int(lote.errores.sum()), 'errores sembrados')
for m in (mensajes[0], mensajes[56], mensajes[95]):
    print(m['id_mensaje'], m['canal'], json.dumps(m['datos'], ensure_ascii = False))
            mensajes  con_errores  errores_sembrados
canal
whatsapp          55           11                 13
instagram         20            6                  7
formulario        15            2                  2
telefono          10            3                  3
Total: 100 mensajes | 22 con errores | 25 errores sembrados
M001 whatsapp {"id_pedido": "TL-20260205-0001", "canal": "whatsapp", "cliente": {"nombre": "Raúl C.", "telefono": "+52 55 0000 0001"}, "renglones": [{"clave": "P08", "cantidad": 5}, {"clave": "P04", "cantidad": 1}, {"clave": "P11", "cantidad": 4}], "fecha_entrega": "2026-02-17", "hora_recogida": "15:30", "total_centavos": 238600}
M057 instagram {"id_pedido": "TL-20260205-0057", "canal": "instagram", "cliente": {"nombre": "Óscar F.", "telefono": "55 0000 0057"}, "renglones": [{"clave": "P07", "cantidad": 1}, {"clave": "P02", "cantidad": 4}, {"clave": "P05", "cantidad": 1}], "fecha_entrega": "2026-02-10", "hora_recogida": "19:00", "total_centavos": 24600}
M096 telefono {"id_pedido": "TL-20260205-0096", "canal": "telefono", "cliente": {"nombre": "Sofía M.", "telefono": "55-0000-0096"}, "renglones": [{"clave": "P03", "cantidad": 1}, {"clave": "P09", "cantidad": 1}], "fecha_entrega": "2026-02-18", "hora_recogida": "12:30", "total_centavos": 53200}
El lote tiene exactamente lo que dice el plan: $100$ mensajes, $22$ con errores y $25$ errores sembrados, repartidos por canal como en la Tabla 1. Los tres mensajes de muestra son válidos y enseñan algo que el contrato tiene que tolerar: el mismo dato llega con formas distintas según el canal. El teléfono de WhatsApp viene con prefijo y espacios (+52 55 0000 0001), el de Instagram sin prefijo (55 0000 0057) y el del teléfono con guiones (55-0000-0096), tal como lo apunta quien contesta la llamada. Los tres son el mismo tipo de dato y los tres deben salir del validador como +52 seguido de diez dígitos.
Observe también el primer pedido: cinco pasteles de zanahoria, una concha y cuatro paquetes de bollos, por $2,386$ pesos ($238,600$ centavos). Es un pedido grande, posible en un generador al azar, y un buen recordatorio de que los datos sintéticos sirven para probar el contrato, no para estimar el ticket medio de la panadería, que la serie fija en $380$ pesos.
Paso 3: validar y leer los errores
Con el modelo y el lote listos, la validación es un bucle de pocas líneas. Cada carga pasa por PedidoContrato.model_validate dentro de un try: si sale bien, el pedido validado se guarda con su sobre; si falla, se captura el ValidationError y se guarda la lista que devuelve su método errors(). Esa lista es la pieza central del día, porque convierte un fallo en datos: cada elemento es un diccionario con cuatro campos que conviene aprender de memoria.
loc: la ubicación del error, como una tupla de nombres e índices.('cliente', 'telefono')es el teléfono del cliente;('renglones', 0, 'clave')es la clave del primer renglón; una tupla vacía()señala un error del pedido completo, el que lanza el validador de modelo.type: el tipo de error, una etiqueta estable que no depende del idioma. Los tipos que trae pydantic (missing,literal_error,greater_than) se combinan con los propios del modelo (fecha_pasada,telefono_invalido,hora_fuera_de_horario,total_no_cuadra).msg: el mensaje legible, pensado para una persona. Sirve para depurar, no para decidir: puede cambiar entre versiones.input: el valor que provocó el error, tal como llegó. Cuando falta un campo,inputes el objeto completo que lo debía contener.
El bloque pasa include_url = False a errors() para no incluir en cada error el enlace a la documentación de pydantic, que alarga la salida sin aportar nada al laboratorio. Al final muestra la anatomía completa de un mensaje de Instagram con dos errores:
# Validación del lote con PedidoContrato.model_validate y captura de ValidationError en Python:
validos, rechazados = [], []
for m in mensajes:
    try:
        validos.append((m, PedidoContrato.model_validate(m['datos'], context = {'hoy': HOY})))
    except ValidationError as error:
        rechazados.append((m, error.errors(include_url = False)))

n_errores = sum(len(errores) for _, errores in rechazados)
print(f'Válidos: {len(validos)} | rechazados: {len(rechazados)} | errores: {n_errores}')
print('Mensajes por número de errores:', dict(sorted(Counter(len(e) for _, e in rechazados).items())))

# Anatomía de los errores de un mensaje con dos defectos:
m, errores = next((m, e) for m, e in rechazados if m['canal'] == 'instagram' and len(e) == 2)
print(f"\n{m['id_mensaje']} ({m['canal']}): {len(errores)} errores devueltos a la vez")
for e in errores:
    entrada = e['input'] if not isinstance(e['input'], dict) else '{...pedido completo...}'
    print(f"  loc={e['loc']} | type={e['type']}\n    msg={e['msg']}\n    input={entrada!r}")
Válidos: 78 | rechazados: 22 | errores: 25
Mensajes por número de errores: {1: 19, 2: 3}

M059 (instagram): 2 errores devueltos a la vez
  loc=('cliente', 'telefono') | type=telefono_invalido
    msg=Teléfono no convertible a E.164: 55 0000 001
    input='55 0000 001'
  loc=('fecha_entrega',) | type=missing
    msg=Field required
    input='{...pedido completo...}'
El resultado coincide con el plan: $78$ mensajes válidos y $22$ rechazados, con $25$ errores en total. De los rechazados, $19$ tienen un solo error y $3$ tienen dos. La anatomía del mensaje M059 muestra la propiedad más útil de pydantic para un flujo: los dos errores llegan a la vez. El teléfono 55 0000 001, con nueve dígitos, no se puede convertir a E.164 (tipo telefono_invalido, el error propio del validador), y la fecha de entrega falta (tipo missing, con el mensaje "Field required" y el pedido completo como input).
Que lleguen juntos no es un detalle menor. Un validador que se detiene en el primer error obligaría a preguntar al cliente por el teléfono, esperar su respuesta, volver a validar, descubrir que también falta la fecha y preguntar otra vez. Dos idas y vueltas donde bastaba una. Con la lista completa, la repregunta del Paso 6 podrá pedir los dos datos en el mismo mensaje.
Hay una excepción que conviene conocer. El validador de modelo, el que comprueba que el total cuadra, solo se ejecuta si todos los campos son válidos: no tiene sentido sumar precios de renglones con una clave inexistente. Por eso, en el plan, el error de total (E07) se sembró solo en un mensaje sin otros defectos. Si un mensaje trae una clave inválida y además un total mal sumado, pydantic informará de la clave y callará el total hasta que la clave se corrija. No es un fallo, es el orden lógico de las comprobaciones, pero obliga a revalidar siempre después de cada corrección.
La Figura 2 despliega uno de estos errores en sus cuatro partes y sigue su recorrido: del type y el loc a un código del catálogo, y del código a la frase de la repregunta.
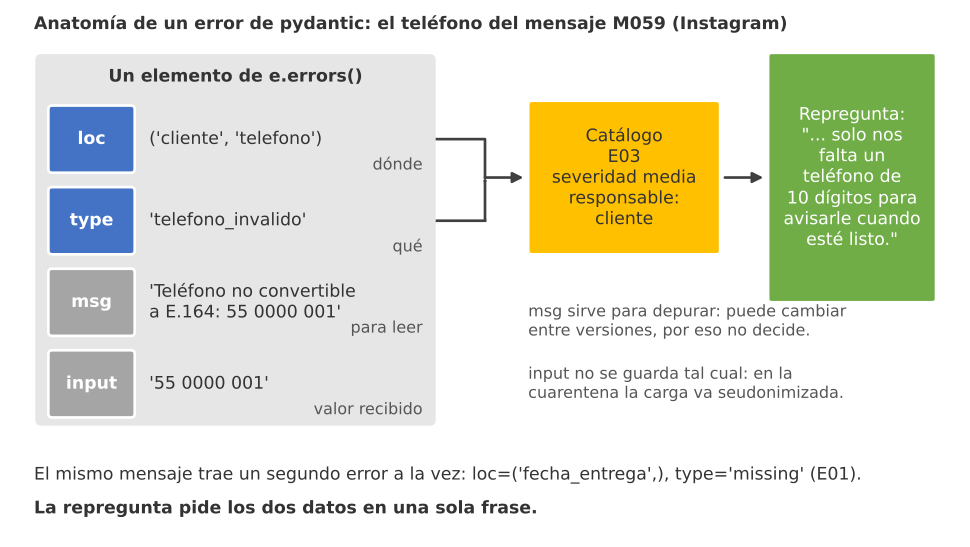
Figura 2. Anatomía de un error de pydantic: el teléfono del mensaje M059 desplegado en loc, type, msg e input; loc y type lo traducen al código E03 del catálogo, y E03 a la frase de la repregunta.
El catálogo de errores
Los tipos de pydantic son estables, pero no son del negocio. missing en la fecha y missing en el teléfono piden acciones distintas, y literal_error no le dice nada a Don Ernesto. El último paso de la lectura es traducir cada error a un catálogo propio: una lista corta de códigos con nombre, en el idioma de la panadería, que diga para cada uno qué campo falla, con qué tipo de pydantic se reconoce, qué tan grave es y quién debe corregirlo.
La Tabla 2 recoge los siete códigos del catálogo de Trigo Lento. La columna de severidad usa tres niveles con un significado operativo, no emocional: baja si el pedido se puede preparar mientras llega la respuesta (la hora de recogida solo afecta al mostrador), media si el pedido queda detenido hasta que el cliente conteste, y alta si no se debe preguntar al cliente porque el problema es del propio sistema o tiene efecto económico.
Tabla 2. Catálogo de errores del contrato del pedido: código, campo, tipo de pydantic, severidad, repregunta y responsable.
| Código | Campo | Tipo de pydantic | Severidad | Texto de repregunta | Responsable |
|---|---|---|---|---|---|
| E01 | fecha_entrega | missing | Media | El día en que quiere su pedido | Cliente |
| E02 | fecha_entrega | fecha_pasada | Media | Otra fecha de entrega, porque la indicada ya pasó | Cliente |
| E03 | cliente.telefono | telefono_invalido | Media | Un teléfono de 10 dígitos para avisarle | Cliente |
| E04 | renglones.clave | literal_error | Media | Qué producto del catálogo desea | Cliente (Don Ernesto si es un pedido especial) |
| E05 | renglones.cantidad | greater_than | Media | Cuántas piezas quiere | Cliente |
| E06 | hora_recogida | hora_fuera_de_horario | Baja | Una hora entre las 7:00 y las 20:00 | Cliente |
| E07 | total_centavos | total_no_cuadra | Alta | Sin repregunta: no se discute un precio por mensaje automático | Valeria |
El caso de E07 merece una explicación. Si el total no cuadra con el catálogo, el error no es del cliente: o alguien le prometió un precio distinto, o el precio cambió y una lista quedó vieja, o la extracción entendió mal una cantidad. En los tres casos, preguntarle al cliente “¿cuánto le dijimos que costaba?” es mala atención y, además, una decisión con dinero de por medio, que la serie reserva siempre a una persona. E04 tiene un matiz parecido: si el cliente pide algo que no está en el catálogo, la repregunta le ofrece la lista; si insiste en un pan especial, la decisión es de Don Ernesto, que es quien sabe si puede hornearlo.
El siguiente bloque escribe el catálogo como un diccionario y la función a_codigo, que traduce cada error de pydantic a su código. La traducción usa el campo (la parte de loc sin los índices de la lista, porque un error en el renglón $0$ o en el $2$ es el mismo código) y el type. Cualquier combinación que no esté en el catálogo recibe el código E99, que significa “error no catalogado” y va siempre a una persona: un catálogo cerrado debe tener una salida para lo imprevisto. El bloque termina con dos comprobaciones de calidad del propio laboratorio:
# Traducción de e.errors() al catálogo propio de códigos E01 a E07 en Python:
CATALOGO_ERRORES = {   # código: (campo, type de pydantic, severidad, responsable)
    'E01': ('fecha_entrega', 'missing', 'media', 'cliente'),
    'E02': ('fecha_entrega', 'fecha_pasada', 'media', 'cliente'),
    'E03': ('cliente.telefono', 'telefono_invalido', 'media', 'cliente'),
    'E04': ('renglones.clave', 'literal_error', 'media', 'cliente'),
    'E05': ('renglones.cantidad', 'greater_than', 'media', 'cliente'),
    'E06': ('hora_recogida', 'hora_fuera_de_horario', 'baja', 'cliente'),
    'E07': ('total_centavos', 'total_no_cuadra', 'alta', 'Valeria'),
}

def a_codigo(error):
    # Los índices de lista (renglón 0, 1...) no cambian el código; el validador de modelo llega con loc vacío:
    campo = '.'.join(str(p) for p in error['loc'] if not isinstance(p, int)) or 'total_centavos'
    for codigo, (c, tipo, _, _) in CATALOGO_ERRORES.items():
        if (c, tipo) == (campo, error['type']):
            return codigo
    return 'E99'   # error no catalogado: va a una persona

filas = []
for m, errores in rechazados:
    codigos = sorted(a_codigo(e) for e in errores)
    m['codigos'] = codigos
    for c in codigos:
        filas.append({'id_mensaje': m['id_mensaje'], 'canal': m['canal'], 'codigo': c,
                      'campo': CATALOGO_ERRORES.get(c, ('desconocido',))[0]})
errores_df = pd.DataFrame(filas)
tabla2 = pd.DataFrame(CATALOGO_ERRORES, index = ['campo', 'type', 'severidad', 'responsable']).T
tabla2['casos'] = errores_df.codigo.value_counts().reindex(tabla2.index, fill_value = 0)
print(tabla2.to_string())
coinciden = sum(m['codigos'] == m['sembrados'] for m, _ in rechazados)
falsos = sum(1 for m, _ in validos if m['sembrados'])
print(f'Errores sin catalogar (E99): {(errores_df.codigo == "E99").sum()} | '
      f'mensajes cuyo diagnóstico coincide con el plan: {coinciden} de {len(rechazados)} | '
      f'errores sembrados que pasaron sin detectar: {falsos}')
                  campo                   type severidad responsable  casos
E01       fecha_entrega                missing     media     cliente      6
E02       fecha_entrega           fecha_pasada     media     cliente      3
E03    cliente.telefono      telefono_invalido     media     cliente      5
E04     renglones.clave          literal_error     media     cliente      4
E05  renglones.cantidad           greater_than     media     cliente      2
E06       hora_recogida  hora_fuera_de_horario      baja     cliente      4
E07      total_centavos        total_no_cuadra      alta     Valeria      1
Errores sin catalogar (E99): 0 | mensajes cuyo diagnóstico coincide con el plan: 22 de 22 | errores sembrados que pasaron sin detectar: 0
La tabla de la salida es la Tabla 2 con su columna de casos: $6$ mensajes sin fecha (E01), $3$ con fecha pasada (E02), $5$ teléfonos inválidos (E03), $4$ productos inexistentes (E04), $2$ cantidades no positivas (E05), $4$ horas fuera del horario (E06) y $1$ total que no cuadra (E07). Suman $25$, los mismos del plan.
Las dos comprobaciones finales son las que dan validez al laboratorio:
- Ningún error quedó sin catalogar (cero E99). Si apareciera alguno, sería la señal de que el contrato tiene una regla que el catálogo no conoce, o de que pydantic cambió el tipo de un error al actualizarse.
- Los $22$ diagnósticos coinciden con el plan y ningún error sembrado pasó sin detectar. Es decir, el validador no tiene falsos negativos (errores que no ve) ni falsos positivos (mensajes buenos que rechaza) en este lote.
La segunda comprobación es la razón de haber sembrado los errores con un plan. Con errores al azar, un validador que dejara pasar una fecha pasada daría igualmente una tasa de rechazo razonable, y nadie lo notaría. Con el plan declarado, cada error tiene un dueño y su ausencia salta a la vista. Breck y sus colaboradores, que diseñaron la validación de datos de los sistemas de aprendizaje automático de Google, insisten en la misma idea: el esquema se prueba con datos de los que se conoce la respuesta antes de confiarle datos de los que no se conoce.
Paso 4: medir el rechazo por canal y por campo
Con cada error traducido a un código, Valeria puede responder a la pregunta que de verdad le interesa: ¿dónde se rompen los pedidos? La respuesta tiene dos ejes, el canal por el que llega el mensaje y el campo que falla, y una medida para cada combinación.
La tasa de rechazo de un canal $c$ es la fracción de sus mensajes que no cumplen el contrato, y la tasa global se puede escribir de dos formas equivalentes:
$$ r = \frac{\sum_c R_c}{\sum_c N_c} = \sum_c w_c , r_c, \qquad r_c = \frac{R_c}{N_c}, \qquad w_c = \frac{N_c}{N} $$
La lógica detrás de esta fórmula es múltiple:
- $R_c$ es el número de mensajes rechazados del canal $c$ y $N_c$ el número de mensajes que llegaron por él; su cociente $r_c$ es la tasa del canal.
- $w_c$ es el peso del canal en el total de mensajes: $0.55$ para WhatsApp, $0.20$ para Instagram, $0.15$ para el formulario y $0.10$ para el teléfono.
- La tasa global es el promedio de las tasas de los canales ponderado por su peso, no el promedio simple. Con las cifras del lote, $0.55 \cdot 0.200 + 0.20 \cdot 0.300 + 0.15 \cdot 0.133 + 0.10 \cdot 0.300 = 0.22$.
- En conclusión, un canal con mucho volumen y una tasa moderada, como WhatsApp, pesa más en el total que un canal pequeño con una tasa alta, como el teléfono: mejorar WhatsApp un punto vale más que mejorar el teléfono tres.
El siguiente bloque calcula las tasas por canal, cuenta los errores por campo y dibuja un mapa de calor con los conteos de cada combinación y su porcentaje sobre los mensajes del canal:
# Tasas de rechazo por canal y por campo, y mapa de calor de errores en Python:
canales = list(REPARTO)
campos = ['fecha_entrega', 'cliente.telefono', 'renglones.clave', 'renglones.cantidad',
          'hora_recogida', 'total_centavos']
nombres_campo = ['Fecha', 'Teléfono', 'Producto', 'Cantidad', 'Hora', 'Total']
tasas = pd.DataFrame({'mensajes': pd.Series(REPARTO),
                      'rechazados': pd.Series(Counter(m['canal'] for m, _ in rechazados))})
tasas['tasa_%'] = (100 * tasas.rechazados / tasas.mensajes).round(1)
tasas.loc['global'] = [tasas.mensajes.sum(), tasas.rechazados.sum(),
                       round(100 * tasas.rechazados.sum() / tasas.mensajes.sum(), 1)]
tasas = tasas.astype({'mensajes': int, 'rechazados': int})
print(tasas.to_string())
cruce = pd.crosstab(errores_df.canal, errores_df.campo).reindex(index = canales, columns = campos, fill_value = 0)
por_campo = cruce.sum().rename(dict(zip(campos, nombres_campo)))
print('Errores por campo:', por_campo.to_dict())

porcentaje = 100 * cruce.div(pd.Series(REPARTO), axis = 0)
fig, ax = plt.subplots(figsize = (9, 4.6))
imagen = ax.imshow(porcentaje.values, cmap = 'Oranges', vmin = 0, vmax = 20)
for i in range(len(canales)):
    for j in range(len(campos)):
        valor = cruce.values[i, j]
        color = 'white' if porcentaje.values[i, j] > 11 else '#0b0b0b'
        ax.text(j, i, f'{valor}\n{porcentaje.values[i, j]:.1f} %', ha = 'center', va = 'center',
                fontsize = 10, color = color)
ax.set_xticks(range(len(campos)))
ax.set_xticklabels(nombres_campo)
ax.set_yticks(range(len(canales)))
ax.set_yticklabels([f'{c} ({REPARTO[c]})' for c in canales])
fig.colorbar(imagen, ax = ax, label = '% de los mensajes del canal')
ax.set_title('Errores por canal y campo en 100 mensajes', fontsize = 16)
plt.tight_layout()
plt.show()
            mensajes  rechazados  tasa_%
whatsapp          55          11    20.0
instagram         20           6    30.0
formulario        15           2    13.3
telefono          10           3    30.0
global           100          22    22.0
Errores por campo: {'Fecha': 9, 'Teléfono': 5, 'Producto': 4, 'Cantidad': 2, 'Hora': 4, 'Total': 1}
La Tabla 3 resume la primera parte de la salida.
Tabla 3. Tasa de rechazo por canal en el lote de 100 mensajes, con su intervalo de Wilson al 95 %.
| Canal | Mensajes | Rechazados | Tasa | Intervalo de Wilson al 95 % |
|---|---|---|---|---|
| 55 | 11 | 20.0 % | 11.6 % a 32.4 % | |
| 20 | 6 | 30.0 % | 14.5 % a 51.9 % | |
| Formulario | 15 | 2 | 13.3 % | 3.7 % a 37.9 % |
| Teléfono | 10 | 3 | 30.0 % | 10.8 % a 60.3 % |
| Global | 100 | 22 | 22.0 % |
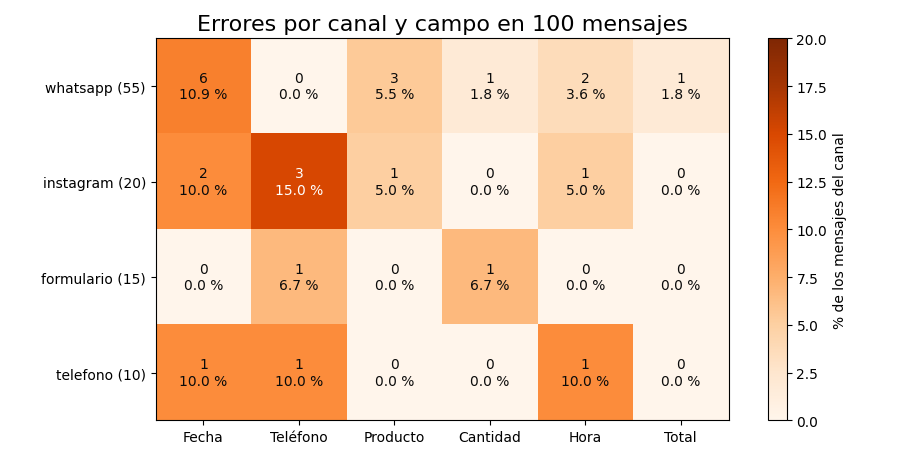
La tasa global es $22%$: algo más de uno de cada cinco mensajes no cumple el contrato. Es casi exactamente la cifra que temía Don Ernesto. Por canal, Instagram y el teléfono rechazan el $30%$, WhatsApp el $20%$ y el formulario el $13.3%$. Por campo, la fecha es el problema dominante con $9$ de los $25$ errores, seguida del teléfono con $5$ y del producto y la hora con $4$ cada uno.
El mapa de calor añade la combinación de los dos ejes, y ahí aparecen los patrones que explican las tasas:
- En WhatsApp e Instagram falla sobre todo la fecha ($10.9%$ y $10.0%$ de sus mensajes). Es el canal de la conversación informal: “me aparta un pastel” se escribe sin pensar en el cuándo, porque en una charla el cuándo se pregunta después.
- En Instagram falla además el teléfono ($15%$ de sus mensajes, la celda más oscura del mapa). Es lógico: en un mensaje directo de Instagram el número no viene con la conversación, como en WhatsApp, sino que el cliente lo escribe a mano, a veces incompleto.
- El formulario solo tiene dos errores, un teléfono y una cantidad. Sus campos son obligatorios en origen: no se puede enviar sin fecha, y la fecha se elige en un calendario que no ofrece días pasados. Lo que falla es lo que el formulario no comprueba.
- El teléfono reparte sus tres errores entre fecha, teléfono y hora: son los datos que se dictan, se escuchan mal y se apuntan deprisa.
La lección para el diseño es directa: la mejor validación es la que ocurre en el origen. El formulario rechaza menos no porque sus clientes sean más cuidadosos, sino porque no les deja equivocarse en lo que más falla en los otros canales. Cada regla que el formulario pueda comprobar al escribir (el teléfono con diez dígitos, la cantidad mayor que cero) es una repregunta menos.
Cuánto se puede concluir con cien mensajes
Antes de convertir esas diferencias en decisiones, conviene preguntarse si son reales. Diez mensajes de teléfono con tres rechazos dan un $30%$, pero con tres rechazos más o menos la tasa sería del $0%$ o del $60%$. Con muestras tan pequeñas, una tasa sin su incertidumbre engaña. Como en el Día 2, la herramienta es el intervalo de Wilson, que funciona bien con pocos datos y con proporciones cercanas a cero o a uno:
$$ \frac{\hat{p} + \frac{z^2}{2n} \pm z\sqrt{\frac{\hat{p}(1-\hat{p})}{n} + \frac{z^2}{4n^2}}}{1 + \frac{z^2}{n}} $$
La lógica detrás de esta fórmula es múltiple:
- $\hat{p} = R_c / N_c$ es la tasa observada del canal, $n = N_c$ su número de mensajes y $z = 1.96$ el valor que corresponde a un nivel de confianza del $95%$.
- El término $z^2/2n$ desplaza el centro del intervalo hacia $0.5$, y el denominador $1 + z^2/n$ lo encoge: con pocos datos, el intervalo no se fía de una tasa extrema.
- La raíz es el radio del intervalo; crece cuando $n$ es pequeño, y por eso el teléfono, con $n = 10$, tiene el intervalo más ancho.
- En conclusión, dos canales cuyos intervalos se solapan mucho no se pueden declarar distintos con estos datos, aunque sus tasas lo parezcan.
El siguiente bloque calcula los intervalos, comprueba que la suma ponderada da la tasa global y dibuja las barras de rechazo por canal con sus intervalos y la línea del $22%$:
# Tasa de rechazo por canal con intervalos de Wilson y la tasa global en Python:
def wilson(k, n, z = 1.96):
    p = k / n
    centro = (p + z ** 2 / (2 * n)) / (1 + z ** 2 / n)
    radio = z * np.sqrt(p * (1 - p) / n + z ** 2 / (4 * n ** 2)) / (1 + z ** 2 / n)
    return centro - radio, centro + radio

filas = tasas.loc[canales]
intervalos = [wilson(r, n) for r, n in zip(filas.rechazados, filas.mensajes)]
for canal, (r, n), (bajo, alto) in zip(canales, zip(filas.rechazados, filas.mensajes), intervalos):
    print(f'{canal:<11} {r:>2} de {n:>2} = {r / n:6.1%}  Wilson 95 %: [{bajo:.3f}, {alto:.3f}]')
global_ = tasas.loc['global', 'rechazados'] / tasas.loc['global', 'mensajes']
pesos = pd.Series(REPARTO) / sum(REPARTO.values())
print(f'Global: {global_:.2f} | suma ponderada por canal: {(pesos * filas.rechazados / filas.mensajes).sum():.4f}')

fig, ax = plt.subplots(figsize = (8, 4.4))
x = np.arange(len(canales))
alturas = 100 * filas.rechazados / filas.mensajes
errores_barra = 100 * np.array([[h / 100 - b, a - h / 100] for h, (b, a) in zip(alturas, intervalos)]).T
ax.bar(x, alturas, color = ['#2a78d6', '#7b5ea7', '#3a9d5d', '#eb6834'], edgecolor = 'white', linewidth = 2,
       yerr = errores_barra, capsize = 6, ecolor = '#52514e')
for xi, h, (r, n) in zip(x, alturas, zip(filas.rechazados, filas.mensajes)):
    ax.text(xi + 0.2, h / 2, f'{h:.1f} %\n{r} de {n}', ha = 'center', va = 'center', fontsize = 9,
            color = 'white')
ax.axhline(100 * global_, color = '#52514e', linestyle = '--', linewidth = 1.5)
ax.text(-0.45, 100 * global_ + 1.2, 'global 22 %', ha = 'left', fontsize = 9, color = '#52514e')
ax.set_xticks(x)
ax.set_xticklabels(canales)
ax.set_ylabel('Mensajes rechazados (%)')
ax.set_ylim(0, 65)
ax.set_title('Tasa de rechazo por canal (barras: Wilson 95 %)', fontsize = 16)
ax.grid(axis = 'y', color = '#e6e5e1')
ax.set_axisbelow(True)
plt.tight_layout()
plt.show()
whatsapp    11 de 55 =  20.0%  Wilson 95 %: [0.116, 0.324]
instagram    6 de 20 =  30.0%  Wilson 95 %: [0.145, 0.519]
formulario   2 de 15 =  13.3%  Wilson 95 %: [0.037, 0.379]
telefono     3 de 10 =  30.0%  Wilson 95 %: [0.108, 0.603]
Global: 0.22 | suma ponderada por canal: 0.2200
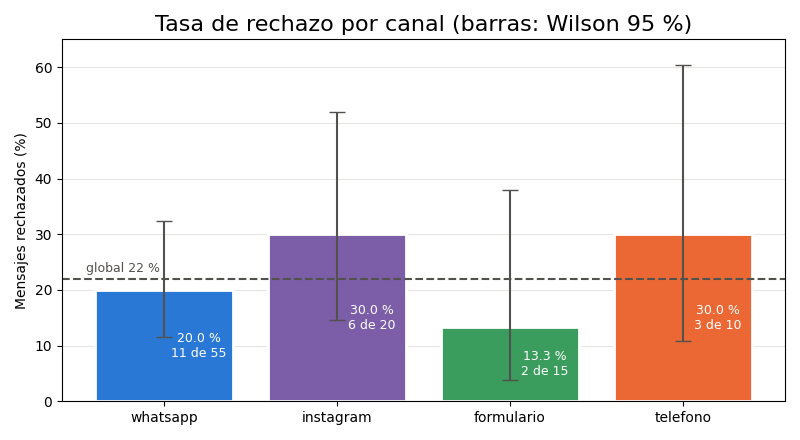
La suma ponderada da $0.2200$, exactamente la tasa global: la fórmula se cumple. Los intervalos cuentan la otra mitad de la historia. El de WhatsApp va del $11.6%$ al $32.4%$, el del teléfono del $10.8%$ al $60.3%$ y el del formulario del $3.7%$ al $37.9%$. Todos se solapan entre sí y todos contienen la tasa global del $22%$. Dicho sin rodeos: con cien mensajes, el laboratorio no puede afirmar que un canal rechace más que otro.
Eso no invalida las explicaciones del mapa de calor, que tienen un mecanismo claro detrás (el formulario obliga, la conversación olvida, el dictado se oye mal), pero sí obliga a ser prudente con las decisiones de inversión. Si Valeria quisiera justificar con datos un cambio caro en un canal, necesitaría varios cientos de mensajes por canal. Con el volumen de Trigo Lento, $468$ encargos al mes, un mes de registros reales bastará para estrechar el intervalo de WhatsApp a unos $\pm 5$ puntos, mientras que el del teléfono, con unos $47$ encargos al mes, seguirá siendo ancho.
Paso 5: la cola de cuarentena
Un mensaje rechazado no es basura. Es un cliente que quiere comprar pan y que no dio todos los datos. La tentación de un flujo mal diseñado es descartarlo, o dejarlo en un registro de errores que nadie lee, que en la práctica es lo mismo. La regla de Trigo Lento, que Valeria escribe en grande en la primera página de su cuaderno, es otra: nada se borra en silencio.
El patrón tiene nombre desde hace más de veinte años. Hohpe y Woolf, en su catálogo de patrones de integración empresarial, describen el canal de mensajes inválidos (en inglés, Invalid Message Channel): cuando un receptor recibe un mensaje que no puede procesar, no lo descarta ni lo procesa a medias, sino que lo aparta a un canal especial donde alguien lo revisa. Lo distinguen del canal de mensajes muertos (Dead Letter Channel), que recoge los mensajes que el sistema de mensajería no pudo entregar. La cuarentena de Trigo Lento es un canal de mensajes inválidos: los mensajes llegaron bien, pero su contenido no cumple el contrato.
En el laboratorio, la cuarentena es una tabla de la copia de trigo_lento.sqlite, con estas columnas:
id_mensaje,canalyrecibido_en: el sobre del mensaje, para saber de dónde vino y cuándo.codigosyseveridad: el diagnóstico del catálogo, con la severidad más alta de sus códigos.estado:pendiente_repregunta,con_valeria,corregidoocaducado. Una restricciónCHECKimpide cualquier otro valor, de modo que un error de programación no puede inventar un estado que ningún proceso atiende.intentos: cuántas veces se ha pedido el dato al cliente.caduca_en: la fecha y hora a partir de la cual el mensaje deja de esperar. Se fija en $48$ horas después de la recepción.carga: el pedido rechazado, seudonimizado. El nombre y el teléfono del cliente se sustituyen por un identificador calculado con HMAC (código de autenticación de mensajes basado en una función de dispersión; o HMAC, por sus siglas en inglés: “Hash-based Message Authentication Code”), una huella que permite reconocer al mismo cliente sin guardar quién es.
¿Por qué seudonimizar algo que ya está en la conversación de WhatsApp? Porque la cuarentena es una copia, y cada copia de un dato personal es un lugar más donde se puede filtrar. La repregunta no necesita el teléfono guardado en la tabla: viaja por la conversación que el cliente abrió, que ya sabe a quién responder. Lo que la cuarentena necesita es el pedido incompleto, para revalidarlo cuando llegue la respuesta, y eso se puede guardar sin nombre ni teléfono.
Atención aquí: un mensaje rechazado sigue siendo un dato personal, y la ley de protección de datos no hace excepciones para los datos “en espera”. La cuarentena debe tener acceso limitado (solo Valeria y el proceso de repregunta), una fecha de caducidad que se cumpla de verdad y una clave HMAC guardada fuera del código. En el bloque siguiente la clave está escrita en el programa porque es un laboratorio con datos inventados; en producción viviría en el gestor de secretos que la serie configurará en el Día 17, y un seudónimo calculado con una clave publicada deja de proteger a nadie.
El siguiente bloque crea la tabla en la copia de laboratorio, inserta los $22$ mensajes rechazados con su carga seudonimizada y consulta cuántos hay en cada estado. Los mensajes de severidad alta entran directamente con el estado con_valeria; el resto, con pendiente_repregunta. El bloque termina con una aplicación de la ley de Little al volumen real de la panadería:
# Tabla cuarentena en la copia de laboratorio de trigo_lento.sqlite con la carga seudonimizada en Python:
CLAVE_LAB = b'clave-de-laboratorio-no-usar-en-produccion'   # en producción, fuera del código (Día 17)

def seudonimizar(datos):
    # El nombre y el teléfono se sustituyen por un seudónimo HMAC; el resto del pedido se conserva:
    carga = json.loads(json.dumps(datos))
    cliente = carga.pop('cliente', {})
    huella = f"{cliente.get('nombre', '')}|{cliente.get('telefono', '')}".encode('utf-8')
    carga['cliente_ref'] = 'c_' + hmac.new(CLAVE_LAB, huella, hashlib.sha256).hexdigest()[:10]
    return carga

ruta_bd = LAB / 'trigo_lento.sqlite'
ruta_bd.unlink(missing_ok = True)                        # copia de laboratorio desde cero
conexion = sqlite3.connect(ruta_bd)
conexion.execute("""CREATE TABLE cuarentena (
    id_mensaje TEXT PRIMARY KEY, canal TEXT NOT NULL, recibido_en TEXT NOT NULL,
    codigos TEXT NOT NULL, severidad TEXT NOT NULL,
    estado TEXT NOT NULL CHECK (estado IN ('pendiente_repregunta', 'con_valeria', 'corregido', 'caducado')),
    intentos INTEGER NOT NULL DEFAULT 0, caduca_en TEXT NOT NULL, carga TEXT NOT NULL)""")
ORDEN_SEVERIDAD = {'baja': 0, 'media': 1, 'alta': 2}
for m, _ in rechazados:
    severidad = max((CATALOGO_ERRORES.get(c, ('', '', 'alta'))[2] for c in m['codigos']),
                    key = ORDEN_SEVERIDAD.get)
    estado = 'con_valeria' if severidad == 'alta' else 'pendiente_repregunta'
    caduca = datetime.fromisoformat(m['recibido_en']) + timedelta(hours = 48)
    conexion.execute('INSERT INTO cuarentena VALUES (?, ?, ?, ?, ?, ?, 0, ?, ?)',
                     (m['id_mensaje'], m['canal'], m['recibido_en'], ','.join(m['codigos']), severidad,
                      estado, caduca.isoformat(timespec = 'minutes'),
                      json.dumps(seudonimizar(m['datos']), ensure_ascii = False)))
conexion.commit()
print(pd.read_sql('SELECT estado, severidad, COUNT(*) AS mensajes FROM cuarentena '
                  'GROUP BY estado, severidad ORDER BY mensajes DESC', conexion).to_string(index = False))
fila = conexion.execute("SELECT id_mensaje, codigos, caduca_en, carga FROM cuarentena "
                        "WHERE codigos LIKE '%,%' ORDER BY id_mensaje LIMIT 1").fetchone()
print('Ejemplo:', fila[0], fila[1], 'caduca', fila[2])
print('  carga:', fila[3])

# Ley de Little con el volumen real de Trigo Lento:
llegadas = 18 * 0.22                                     # encargos rechazados por día
for horas in (12, 24, 48):
    print(f'Estancia media de {horas:>2} h -> en cuarentena a la vez: {llegadas * horas / 24:.2f} mensajes')
              estado severidad  mensajes
pendiente_repregunta     media        18
pendiente_repregunta      baja         3
         con_valeria      alta         1
Ejemplo: M002 E01,E04 caduca 2026-02-07T12:36
  carga: {"id_pedido": "TL-20260205-0002", "canal": "whatsapp", "renglones": [{"clave": "P13", "cantidad": 1}, {"clave": "P04", "cantidad": 2}], "hora_recogida": "09:00", "total_centavos": 8200, "cliente_ref": "c_de31c18062"}
Estancia media de 12 h -> en cuarentena a la vez: 1.98 mensajes
Estancia media de 24 h -> en cuarentena a la vez: 3.96 mensajes
Estancia media de 48 h -> en cuarentena a la vez: 7.92 mensajes
De los $22$ mensajes, $21$ quedan pendientes de repregunta ($18$ de severidad media y $3$ de severidad baja, las horas fuera del horario) y $1$ pasa directamente a Valeria: el mensaje M035, con el total que no cuadra. El ejemplo de la salida, M002, es uno de los mensajes de WhatsApp con dos errores (E01 y E04): su carga ya no tiene nombre ni teléfono, sino el seudónimo c_de31c18062; conserva la clave inexistente P13 y no tiene fecha de entrega, que es justo lo que se le preguntará al cliente. Caduca el sábado 7 de febrero a las 12:36, $48$ horas después de haber llegado.
¿Cuántos mensajes habrá en cuarentena a la vez cuando el sistema funcione con el volumen real? La ley de Little, que la serie usó el Día 1 para la cola de la hora pico, responde sin necesidad de simular:
$$ L = \lambda W $$
La lógica detrás de esta fórmula es múltiple:
- $\lambda$ es el ritmo de llegada a la cuarentena: $18$ encargos al día por la tasa de rechazo de $0.22$, es decir, $3.96$ mensajes al día.
- $W$ es el tiempo medio que un mensaje pasa en cuarentena, desde que llega hasta que se corrige, pasa a Valeria o caduca.
- $L$ es el número medio de mensajes que hay en la cola en cualquier momento. La ley se cumple para cualquier sistema estable, sin suponer nada sobre cómo se reparten las llegadas ni las esperas.
- En conclusión, el tamaño de la cuarentena lo decide la rapidez de la respuesta: con una estancia media de $12$ horas habrá unos $2$ mensajes esperando; con $24$ horas, unos $4$; y si todos agotaran las $48$ horas de caducidad, unos $8$, que es el techo.
Es una cifra tranquilizadora para Valeria: la cuarentena de Trigo Lento es una bandeja con un puñado de mensajes, no un almacén. Y es una cifra útil para vigilar el sistema: si un día la tabla tiene $30$ mensajes pendientes, algo se ha roto (la repregunta no sale, o un cambio en la extracción hace fallar un campo en todos los pedidos), y la ley de Little lo delata antes de que un cliente se queje.
La Figura 3 dibuja esa bandeja como una sala de espera: los mensajes aguardan con su reloj de caducidad, una flecha vuelve al cliente con la repregunta y una puerta lleva a Valeria.
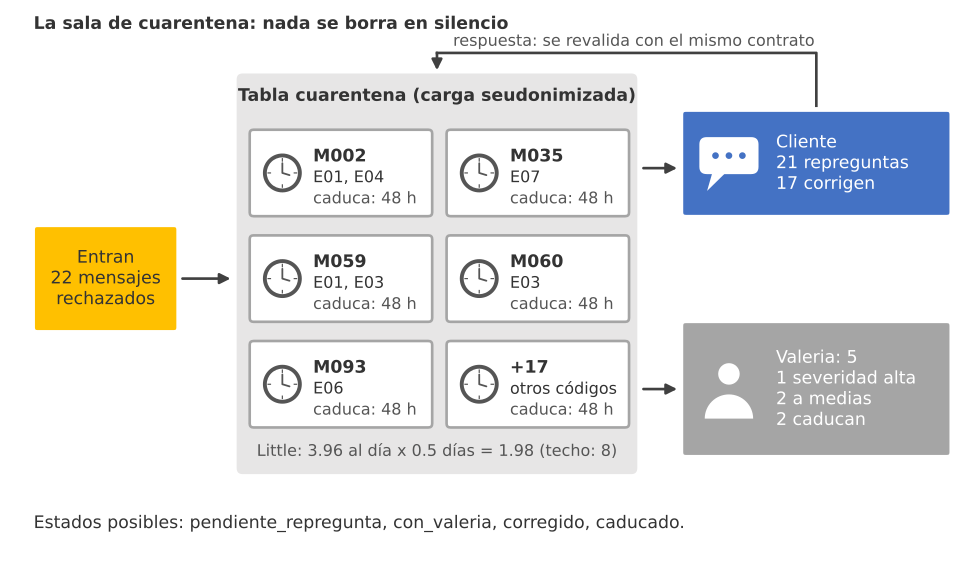
Figura 3. La sala de cuarentena: 22 mensajes esperan con un reloj de caducidad de 48 horas; 21 vuelven al cliente con una sola repregunta y 17 se corrigen, mientras 5 cruzan la puerta hacia Valeria.
Paso 6: repreguntar al cliente
La cuarentena aparta el mensaje; la repregunta lo rescata. Es la pieza que convierte el $22%$ de rechazo en algo muy distinto de lo que temía Don Ernesto, y por eso Valeria la diseña con cuatro reglas, todas tomadas de lo que ya hace en el mostrador:
- Una sola pregunta por mensaje. Si faltan la fecha y el producto, se piden los dos en la misma frase. Dos mensajes seguidos de la panadería se leen como un interrogatorio.
- Solo lo que falta. La repregunta no vuelve a pedir el pedido completo ni datos que el contrato no usa. Es la minimización de datos aplicada a la conversación: si el cliente ya dijo qué quería, no se le pregunta de nuevo.
- Dentro de la conversación que abrió el cliente. Por WhatsApp o Instagram, como respuesta en el mismo hilo; en el formulario, en su pantalla de confirmación; por teléfono, como guion para quien devuelve la llamada. Nunca como un mensaje nuevo a quien no escribió, que en WhatsApp, además, exigiría una plantilla aprobada y un consentimiento que el Día 6 tratará con detalle.
- En tono de mostrador. De usted, con un agradecimiento al principio y sin tecnicismos: el cliente no necesita saber qué es un
literal_error.
El siguiente bloque escribe las plantillas, una por código salvo E07, y la función redactar_repregunta(codigos, canal), que las une con comas y una “y” final, añade el cierre propio del canal y devuelve None si algún código no tiene plantilla, que es la forma de decir “esto no se le pregunta al cliente”. Después actualiza la cuarentena para registrar el primer intento:
# Repregunta al cliente que agrupa en una sola pregunta los datos que faltan en Python:
PLANTILLAS = {
    'E01': 'el día en que quiere su pedido',
    'E02': 'otra fecha de entrega, porque la que nos indicó ya pasó',
    'E03': 'un teléfono de 10 dígitos para avisarle cuando esté listo',
    'E04': 'qué producto de nuestro catálogo desea, porque no encontramos el que nos indicó',
    'E05': 'cuántas piezas quiere, porque la cantidad no nos llegó bien',
    'E06': 'una hora de recogida entre las 7:00 y las 20:00',
}
CIERRES = {'whatsapp': 'Puede contestarnos aquí mismo.',
           'instagram': 'Puede contestarnos en este mismo mensaje directo.',
           'formulario': 'Puede corregirlo en la pantalla de confirmación del formulario.',
           'telefono': '(Guion para quien devuelve la llamada al cliente.)'}

def redactar_repregunta(codigos, canal):
    # Si algún código no tiene plantilla (severidad alta), no se pregunta al cliente:
    if any(c not in PLANTILLAS for c in codigos):
        return None
    faltan = [PLANTILLAS[c] for c in codigos]
    lista = faltan[0] if len(faltan) == 1 else ', '.join(faltan[:-1]) + ' y ' + faltan[-1]
    return f'¡Gracias por su pedido en Trigo Lento! Para dejarlo listo solo nos falta {lista}. {CIERRES[canal]}'

repreguntas = {m['id_mensaje']: redactar_repregunta(m['codigos'], m['canal']) for m, _ in rechazados}
enviadas = {k: v for k, v in repreguntas.items() if v}
print(f'Repreguntas redactadas: {len(enviadas)} | sin repregunta (a Valeria): '
      f'{[k for k, v in repreguntas.items() if v is None]}')
print('Palabras por repregunta: mínimo', min(len(v.split()) for v in enviadas.values()),
      '| máximo', max(len(v.split()) for v in enviadas.values()))
# Tres ejemplos: un WhatsApp con dos errores, un Instagram con uno y una llamada telefónica:
muestras = [next(m for m, _ in rechazados if m['canal'] == 'whatsapp' and len(m['codigos']) == 2),
            next(m for m, _ in rechazados if m['canal'] == 'instagram' and len(m['codigos']) == 1),
            next(m for m, _ in rechazados if m['canal'] == 'telefono')]
for m in muestras:
    print(f"\n{m['id_mensaje']} {m['canal']} {m['codigos']}:\n  {repreguntas[m['id_mensaje']]}")
conexion.execute("UPDATE cuarentena SET intentos = 1 WHERE estado = 'pendiente_repregunta'")
conexion.commit()
Repreguntas redactadas: 21 | sin repregunta (a Valeria): ['M035']
Palabras por repregunta: mínimo 24 | máximo 38

M002 whatsapp ['E01', 'E04']:
  ¡Gracias por su pedido en Trigo Lento! Para dejarlo listo solo nos falta el día en que quiere su pedido y qué producto de nuestro catálogo desea, porque no encontramos el que nos indicó. Puede contestarnos aquí mismo.

M060 instagram ['E03']:
  ¡Gracias por su pedido en Trigo Lento! Para dejarlo listo solo nos falta un teléfono de 10 dígitos para avisarle cuando esté listo. Puede contestarnos en este mismo mensaje directo.

M093 telefono ['E06']:
  ¡Gracias por su pedido en Trigo Lento! Para dejarlo listo solo nos falta una hora de recogida entre las 7:00 y las 20:00. (Guion para quien devuelve la llamada al cliente.)
Se redactan $21$ repreguntas, una por cada mensaje pendiente, y el mensaje M035 queda sin repregunta, como debía. Las repreguntas tienen entre $24$ y $38$ palabras: lo bastante cortas para leerse en la pantalla de un teléfono sin desplazarse. Los tres ejemplos muestran las tres situaciones típicas: el mensaje de WhatsApp con dos errores recibe una sola pregunta que pide el día y el producto; el de Instagram con el teléfono mal escrito recibe una pregunta con el cierre del mensaje directo; y el del teléfono se convierte en un guion para quien devuelve la llamada.
La Tabla 4 reúne las plantillas y el ejemplo combinado.
Tabla 4. Plantillas de repregunta por código y ejemplo combinado para un mensaje con dos errores.
| Código | Fragmento de la plantilla |
|---|---|
| E01 | el día en que quiere su pedido |
| E02 | otra fecha de entrega, porque la que nos indicó ya pasó |
| E03 | un teléfono de 10 dígitos para avisarle cuando esté listo |
| E04 | qué producto de nuestro catálogo desea, porque no encontramos el que nos indicó |
| E05 | cuántas piezas quiere, porque la cantidad no nos llegó bien |
| E06 | una hora de recogida entre las 7:00 y las 20:00 |
| E07 | Sin plantilla: el mensaje pasa a Valeria |
| E01 y E04 (M002, WhatsApp) | ¡Gracias por su pedido en Trigo Lento! Para dejarlo listo solo nos falta el día en que quiere su pedido y qué producto de nuestro catálogo desea, porque no encontramos el que nos indicó. Puede contestarnos aquí mismo. |
Las plantillas dan una razón cuando la razón ayuda a contestar bien (“porque la que nos indicó ya pasó”) y la callan cuando sería un reproche. Nadie recibe un “su teléfono es inválido”; recibe una petición de “un teléfono de 10 dígitos para avisarle cuando esté listo”, que explica para qué se quiere el dato. Es un detalle pequeño, pero la finalidad declarada es también una exigencia de la ley de datos personales, y aquí se cumple en una sola frase.
Fíjese en lo que no hace la repregunta: no la escribe un modelo de lenguaje. Son plantillas fijas, revisadas por Valeria y por Don Ernesto, combinadas por una función determinista. Un modelo podría redactar frases más variadas, pero también podría prometer una hora que el obrador no puede cumplir o un precio que no existe. Para seis tipos de dato que falta, seis frases escritas por una persona son más seguras, más baratas y suficientes.
El embudo del lote completo
Queda la pregunta de Don Ernesto: de los $22$ clientes cuyo mensaje se rechazó, ¿cuántos se pierden? Para responderla sin clientes reales, el laboratorio simula las respuestas con un plan declarado, igual que sembró los errores. Valeria toma como supuesto que $17$ de los $22$ mensajes se corrigen al primer intento, y fija cómo se reparten los $5$ restantes:
- El mensaje con el total que no cuadra (E07) no recibe repregunta y va directamente a Valeria.
- Dos clientes no contestan en las $48$ horas: su mensaje caduca y pasa a Valeria, que decide si llamar o dejarlo.
- Dos clientes con dos errores contestan a medias: responden solo a la primera parte de la pregunta. Su respuesta se revalida, vuelve a fallar, y ese segundo intento fallido manda el mensaje a Valeria.
- Los otros $17$ contestan lo que se les pidió. Su respuesta se aplica al pedido, el sistema recalcula el total con el catálogo (el cliente nunca dicta el total) y el pedido se revalida con el mismo modelo. No hay atajos: un pedido corregido pasa por la misma aduana que uno que llegó bien.
El siguiente bloque ejecuta ese plan, actualiza la cuarentena, dibuja el embudo del lote y proyecta el resultado al volumen mensual de Trigo Lento:
# Simulación de las respuestas a la repregunta, revalidación y embudo del lote en Python:
RESPUESTA = {'E01': ('fecha_entrega', '2026-02-07'), 'E02': ('fecha_entrega', '2026-02-07'),
             'E03': ('telefono', '+52 55 0000 0099'), 'E04': ('clave', 'P01'),
             'E05': ('cantidad', 2), 'E06': ('hora_recogida', '09:00')}

def aplicar_respuesta(datos, codigos):
    # El cliente aporta lo que se le pidió y el sistema recalcula el total con el catálogo:
    d = json.loads(json.dumps(datos))
    for c in codigos:
        campo, valor = RESPUESTA[c]
        if campo == 'telefono':
            d['cliente']['telefono'] = valor
        elif campo in ('clave', 'cantidad'):
            d['renglones'][0][campo] = valor
        else:
            d[campo] = valor
    d['total_centavos'] = sum(PRECIOS.get(r['clave'], 0) * r['cantidad'] for r in d['renglones'])
    return d

# Plan declarado: 2 clientes no contestan en 48 h y 2 de los mensajes con dos errores contestan a medias:
pendientes = [m for m, _ in rechazados if repreguntas[m['id_mensaje']]]
dobles = [m['id_mensaje'] for m in pendientes if len(m['codigos']) == 2]
a_medias = set(rng.choice(dobles, size = 2, replace = False))
sin_respuesta = set(rng.choice([m['id_mensaje'] for m in pendientes if m['id_mensaje'] not in a_medias],
                               size = 2, replace = False))
destino = Counter()
for m in pendientes:
    if m['id_mensaje'] in sin_respuesta:
        estado = 'caducado'
    else:
        respondidos = m['codigos'][:1] if m['id_mensaje'] in a_medias else m['codigos']
        try:
            PedidoContrato.model_validate(aplicar_respuesta(m['datos'], respondidos), context = {'hoy': HOY})
            estado = 'corregido'
        except ValidationError:
            estado = 'con_valeria'                       # segundo intento fallido
    destino[estado] += 1
    intentos = 2 if estado == 'con_valeria' else 1
    conexion.execute('UPDATE cuarentena SET estado = ?, intentos = ? WHERE id_mensaje = ?',
                     (estado, intentos, m['id_mensaje']))
conexion.execute("UPDATE cuarentena SET estado = 'con_valeria' WHERE estado = 'caducado'")
conexion.commit()
print('Tras la repregunta:', dict(destino))
print(pd.read_sql('SELECT estado, COUNT(*) AS mensajes, SUM(intentos) AS intentos FROM cuarentena '
                  'GROUP BY estado', conexion).to_string(index = False))
corregidos = destino['corregido']
a_valeria = len(rechazados) - corregidos
embudo = {'Recibidos': len(mensajes), 'Válidos al primer intento': len(validos),
          'En cuarentena': len(rechazados), 'Corregidos tras una repregunta': corregidos,
          'A Valeria': a_valeria}
print(embudo, '| válidos al final:', len(validos) + corregidos)

# Proyección al mes: 468 encargos, 2 minutos por pregunta manual (Tabla 3 del Día 1):
incompletos = 468 * len(rechazados) / len(mensajes)
llegan_a_valeria = incompletos * a_valeria / len(rechazados)
minutos = (incompletos - llegan_a_valeria) * 2
print(f'Incompletos al mes: {incompletos:.2f} | llegan a Valeria: {llegan_a_valeria:.1f} | '
      f'minutos ahorrados: {minutos:.2f} = {minutos / 60:.2f} h = {minutos / 60 * 75:.2f} MXN')

fig, ax = plt.subplots(figsize = (8, 4.4))
colores = ['#8a8986', '#3a9d5d', '#c8423b', '#2a78d6', '#7b5ea7']
for fila, ((etapa, valor), color) in enumerate(zip(embudo.items(), colores)):
    ax.barh(fila, valor, left = (100 - valor) / 2, height = 0.7, color = color, edgecolor = 'white')
    ax.text(50, fila, str(valor), ha = 'center', va = 'center', fontsize = 11, color = 'white')
ax.set_yticks(range(len(embudo)))
ax.set_yticklabels(list(embudo), fontsize = 10)
ax.invert_yaxis()
ax.set_xlim(0, 100)
ax.set_xlabel('Mensajes del lote')
ax.set_title('Embudo: 100 mensajes, 95 pedidos válidos', fontsize = 16)
plt.tight_layout()
plt.show()
Tras la repregunta: {'corregido': 17, 'con_valeria': 2, 'caducado': 2}
     estado  mensajes  intentos
con_valeria         5         6
  corregido        17        17
{'Recibidos': 100, 'Válidos al primer intento': 78, 'En cuarentena': 22, 'Corregidos tras una repregunta': 17, 'A Valeria': 5} | válidos al final: 95
Incompletos al mes: 102.96 | llegan a Valeria: 23.4 | minutos ahorrados: 159.12 = 2.65 h = 198.90 MXN
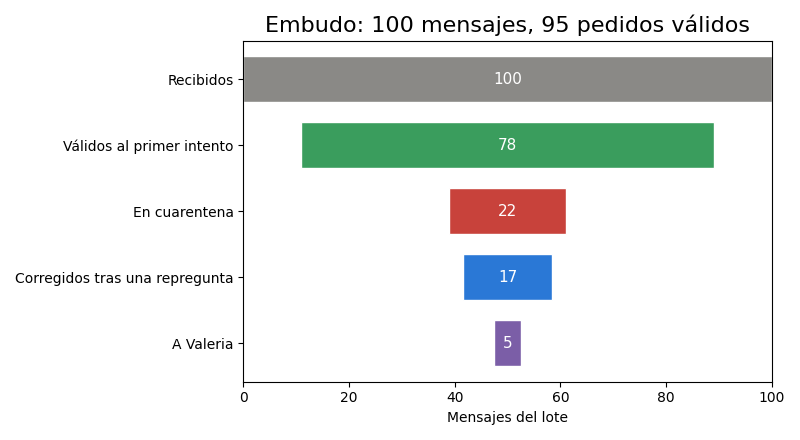
El embudo responde a Don Ernesto con cinco números: $100$ mensajes recibidos, $78$ válidos al primer intento, $22$ en cuarentena, $17$ corregidos tras una repregunta y $5$ que llegan a Valeria. Al final del proceso hay $95$ pedidos válidos de $100$, y los $5$ restantes no se han perdido: están en manos de una persona, con el diagnóstico hecho. La consulta a la cuarentena lo confirma desde la base de datos: $17$ mensajes en estado corregido con un intento cada uno, y $5$ con Valeria que suman $6$ intentos (dos de los que contestaron a medias, uno por cada mensaje caducado y ninguno para el total que no cuadra).
¿Cuánto tiempo le ahorra esto a Valeria? Sea $N$ el número de encargos del mes, $r$ la tasa de rechazo, $V$ los mensajes que acaban con Valeria de cada $Q$ en cuarentena y $t$ los minutos que ella dedica a preguntar un dato que falta:
$$ M = N \cdot r \cdot \left(1 - \frac{V}{Q}\right) \cdot t $$
La lógica detrás de esta fórmula es múltiple:
- $N \cdot r = 468 \cdot 0.22 = 102.96$ son los encargos incompletos que se esperan al mes, los que hoy obligan a Valeria a escribir o llamar al cliente.
- La fracción $V/Q = 5/22$ son los que seguirán llegando a ella; $1 - V/Q = 17/22 = 0.773$ son los que resuelve la repregunta automática. De los $102.96$, solo $23.4$ llegan a Valeria.
- $t = 2$ minutos es el tiempo del paso “preguntar los datos faltantes” de la Tabla 3 del Día 1.
- En conclusión, $M = (102.96 - 23.4) \cdot 2 = 159.12$ minutos al mes, unas $2.65$ horas, que a $75$ pesos la hora valen $198.90$ MXN al mes.
No es una cifra espectacular, y conviene decirlo: son dos horas y media al mes, no un empleado. Pero tiene dos virtudes que no se ven en el número. La primera es que esas preguntas ya no interrumpen a Valeria en la hora pico, cuando atiende sola nueve mensajes por hora. La segunda es que las $23.4$ que sí le llegan vienen con el diagnóstico hecho: Valeria no tiene que leer el mensaje para descubrir qué falta, porque el código se lo dice.
La respuesta a Don Ernesto cabe en una frase, y Valeria se la da con el embudo impreso: el sistema no rechaza clientes; rechaza mensajes incompletos y pregunta por ellos. De cada cien mensajes, noventa y cinco acaban en un pedido válido sin que nadie de la panadería intervenga, y los otros cinco llegan a una persona. Don Ernesto mira el papel un buen rato y concede a medias: “Mientras la pregunta la escriba usted y no la máquina, me parece bien.” Es exactamente lo que dice la Tabla 4.
El flujo completo del laboratorio
Para cerrar el laboratorio, Valeria dibuja el flujo que ha construido con la función dibujar_flujo del Día 2, copiada aquí para que la entrada se entienda sola. Usa la paleta de formas de la serie: el disparador en óvalo verde, la decisión en rombo naranja, las acciones en rectángulo azul, el manejador de error en rectángulo rojo y la puerta humana en hexágono gris. Las etiquetas de las flechas llevan las cifras del lote:
# Función dibujar_flujo (Día 2) y flujo del laboratorio de validación en Python:
from matplotlib.patches import Ellipse, FancyBboxPatch, Polygon, RegularPolygon, FancyArrowPatch

FORMAS = {   # paleta de formas de la serie: tipo -> (forma, relleno)
    'disparador': ('ovalo', '#3a9d5d'), 'accion': ('rectangulo', '#2a78d6'),
    'decision': ('rombo', '#eb6834'), 'ia': ('rectangulo', '#7b5ea7'),
    'error': ('rectangulo', '#c8423b'), 'humano': ('hexagono', '#8a8986'),
}

def dibujar_flujo(nodos, aristas, titulo, ancho = 1.9, alto = 0.9):
    fig, ax = plt.subplots(figsize = (12, 5.6))
    for n in nodos:
        forma, color = FORMAS[n['tipo']]
        x, y = n['x'], n['y']
        if forma == 'ovalo':
            figura = Ellipse((x, y), ancho, alto)
        elif forma == 'rombo':
            figura = Polygon([(x - ancho / 2, y), (x, y + alto / 1.4), (x + ancho / 2, y), (x, y - alto / 1.4)])
        elif forma == 'hexagono':
            figura = RegularPolygon((x, y), 6, radius = ancho / 2, orientation = np.pi / 6)
        else:
            figura = FancyBboxPatch((x - ancho / 2, y - alto / 2), ancho, alto, boxstyle = 'round,pad=0.03')
        figura.set_facecolor(color)
        figura.set_edgecolor('white')
        figura.set_linewidth(2)
        ax.add_patch(figura)
        ax.text(x, y, n['texto'], ha = 'center', va = 'center', fontsize = 9.5, color = 'white')
    posicion = {n['id']: (n['x'], n['y']) for n in nodos}
    for origen, destino, etiqueta in aristas:
        (x1, y1), (x2, y2) = posicion[origen], posicion[destino]
        ax.add_patch(FancyArrowPatch((x1, y1), (x2, y2), arrowstyle = '-|>', mutation_scale = 14,
                                     shrinkA = 42, shrinkB = 44, color = '#52514e', linewidth = 1.4))
        if etiqueta:
            ax.text((x1 + x2) / 2, (y1 + y2) / 2 + 0.18, etiqueta, ha = 'center', fontsize = 8.5,
                    color = '#52514e', bbox = dict(facecolor = 'white', edgecolor = 'none', pad = 1))
    xs, ys = [n['x'] for n in nodos], [n['y'] for n in nodos]
    ax.set_xlim(min(xs) - 1.3, max(xs) + 1.3)
    ax.set_ylim(min(ys) - 1.1, max(ys) + 1.1)
    ax.set_aspect('equal')
    ax.axis('off')
    ax.set_title(titulo, fontsize = 16)
    return fig, ax

nodos = [
    {'id': 'n1', 'tipo': 'disparador', 'texto': 'Mensaje\nextraído', 'x': 0, 'y': 0},
    {'id': 'n2', 'tipo': 'decision', 'texto': '¿Cumple el\ncontrato?', 'x': 2.8, 'y': 0},
    {'id': 'n3', 'tipo': 'accion', 'texto': 'Guardar\npedido', 'x': 5.8, 'y': 1.7},
    {'id': 'n4', 'tipo': 'accion', 'texto': 'Confirmar\nal cliente', 'x': 8.8, 'y': 1.7},
    {'id': 'n5', 'tipo': 'error', 'texto': 'Cuarentena\n(códigos E01-E07)', 'x': 5.8, 'y': -1.7},
    {'id': 'n6', 'tipo': 'accion', 'texto': 'Repregunta\nal cliente', 'x': 8.8, 'y': -0.3},
    {'id': 'n7', 'tipo': 'humano', 'texto': 'Valeria\nrevisa', 'x': 8.8, 'y': -3.0},
]
aristas = [('n1', 'n2', ''), ('n2', 'n3', 'sí (78)'), ('n3', 'n4', ''), ('n2', 'n5', 'no (22)'),
           ('n5', 'n6', 'media o baja (21)'), ('n6', 'n2', 'respuesta (17 corrigen)'),
           ('n5', 'n7', 'alta (1)'), ('n6', 'n7', 'falla o caduca (4)')]
fig, ax = dibujar_flujo(nodos, aristas, 'Laboratorio de validación: contrato, cuarentena y repregunta')
print('Nodos por tipo:', pd.Series([n['tipo'] for n in nodos]).value_counts().to_dict())
print('Aristas:', len(aristas), '| pasos de IA:', sum(n['tipo'] == 'ia' for n in nodos),
      '| puertas humanas:', sum(n['tipo'] == 'humano' for n in nodos))
conexion.close()
plt.tight_layout()
plt.show()
Nodos por tipo: {'accion': 3, 'disparador': 1, 'decision': 1, 'error': 1, 'humano': 1}
Aristas: 8 | pasos de IA: 0 | puertas humanas: 1
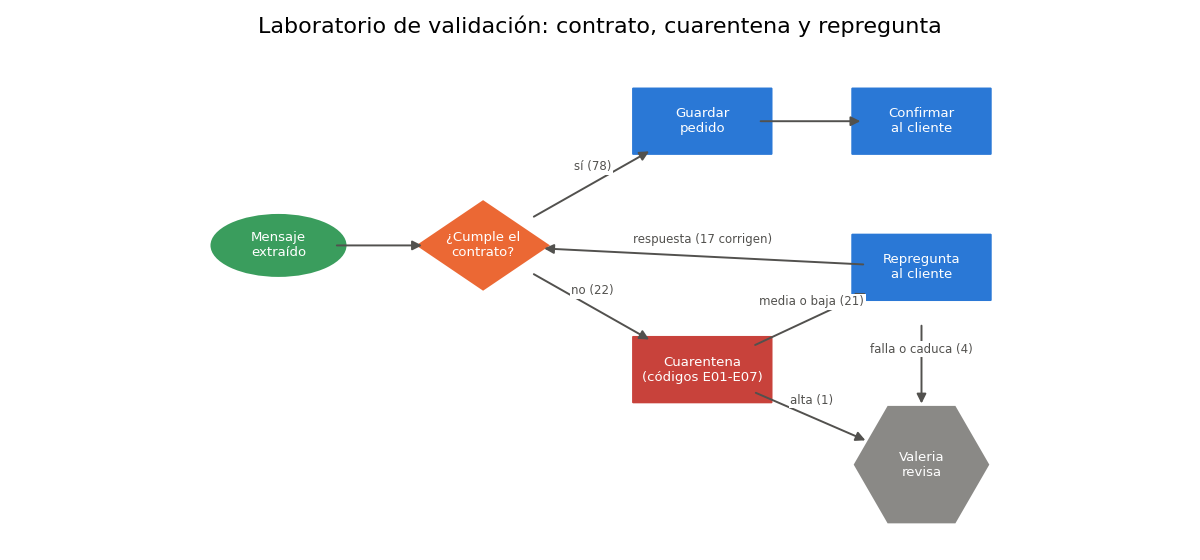
El diagrama tiene $7$ nodos, $8$ aristas, una puerta humana y ningún paso de IA. Esa última cifra no es un descuido: la validación, la cuarentena y la repregunta son código determinista de principio a fin. La IA trabajó antes, en la extracción del Día 4, y volverá a trabajar en días posteriores; aquí, donde se decide qué entra en el sistema, mandan las reglas escritas.
Dos flechas merecen una mirada atenta. La que vuelve de la repregunta al rombo de validación es la que hace que un pedido corregido pase otra vez por el mismo contrato: el flujo tiene un ciclo, pero un ciclo con salida, porque el segundo fallo o la caducidad lo sacan hacia Valeria. Y la flecha que va directamente de la cuarentena a Valeria, con un solo mensaje, es la de la severidad alta: el único camino del flujo en el que el sistema decide no hablar con el cliente.
Consideraciones finales
El día empezó con un contrato impreso que funcionaba con los ejemplos de quien lo escribió, y termina con un contrato ejecutable que ha pasado por cien mensajes con la forma de los reales. El laboratorio ha dejado cuatro cifras que resumen el estado de la frontera de Trigo Lento: el $22%$ de los mensajes no cumple el contrato; la fecha es el dato que más falta; con cien mensajes no se puede afirmar que un canal sea peor que otro; y una repregunta bien hecha convierte ese $22%$ en un $5%$ que llega a una persona. Validar no es rechazar: es saber exactamente qué falta y a quién preguntárselo.
Antes de llevar un contrato a producción, conviene hacerse algunas preguntas:
- ¿Ha probado su validador con errores sembrados según un plan, y sabe cuántos falsos negativos tiene?
- ¿Las reglas de su contrato público y las de su contrato ejecutable dicen lo mismo, y qué prueba se lo avisa cuando dejan de decirlo?
- ¿Qué pasa con un mensaje rechazado una semana después: dónde está, quién lo ve y cuándo se borra?
- ¿Su repregunta pide solo lo que falta, en una sola frase y dentro de la conversación que abrió el cliente?
Las cifras de hoy tienen límites claros. Los mensajes son sintéticos y los errores se sembraron con un plan que refleja la experiencia de Valeria, no una medición: la tasa real de rechazo de Trigo Lento se conocerá con el primer mes de registros. Las respuestas de los clientes a la repregunta también son un supuesto declarado ($17$ de $22$ al primer intento), y en la realidad dependerán de la hora, del canal y de la paciencia de cada cliente. Ninguno de esos límites cambia las decisiones de diseño: el contrato se hace cumplir en la frontera, los errores se leen como datos, nada se borra en silencio y la pregunta al cliente es una sola.
Un gran libro que habla de esto es Enterprise Integration Patterns (o Patrones de integración empresarial), en el que Gregor Hohpe y Bobby Woolf recogen, con diagramas y ejemplos, los patrones con los que los sistemas se pasan mensajes sin perderlos: el canal de mensajes inválidos de hoy, el canal de mensajes muertos, el traductor de mensajes, el filtro y el enrutador. Aunque se escribió para grandes empresas, casi todos los flujos que Valeria construirá en Make y en n8n son combinaciones de esos patrones, y leerlo le dará nombres precisos para cosas que ya intuye.
Con un modelo de pydantic que hace cumplir el contrato del Día 4 y la prueba de deriva que lo vigila, un catálogo de siete códigos en el idioma de la panadería, una cuarentena seudonimizada que caduca a las $48$ horas y una repregunta que cabe en una pantalla de teléfono, Trigo Lento tiene su frontera de datos probada. Don Ernesto no se ha convertido en entusiasta de la automatización, pero ya no teme quedarse sin clientes: ha visto, en un papel, que de cada cien mensajes incompletos no se pierde ninguno.
Conclusiones clave
Modelo y validadores
- El contrato ejecutable es un modelo de pydantic:
Literalpara valores cerrados,Fieldpara rangos y longitudes,field_validatorpara reglas de un campo ymodel_validatorpara reglas entre campos, conextra = 'forbid'para rechazar campos desconocidos. - El formato de extracción debe ser permisivo y el contrato estricto: un molde de extracción con la fecha obligatoria obliga al modelo de lenguaje a inventarla.
model_json_schema()solo publica las reglas declarativas: $9$ de $12$ campos coinciden con el contrato del Día 4, y lo escrito en validadores (teléfono, horario, total) no aparece en el esquema.
Medición del rechazo
- En el lote de $100$ mensajes, $22$ no cumplen el contrato con $25$ errores; pydantic devuelve todos los errores de un mensaje a la vez, con
loc,type,msgeinput. - La tasa global es la suma ponderada de las tasas por canal: WhatsApp $20%$, Instagram $30%$, formulario $13.3%$ y teléfono $30%$; la fecha es el campo que más falla ($9$ de $25$).
- Los intervalos de Wilson (del $10.8%$ al $60.3%$ en el teléfono) se solapan todos: con cien mensajes no se puede afirmar que un canal rechace más que otro.
Cuarentena y repregunta
- La cuarentena es un canal de mensajes inválidos con estado, intentos, caducidad de $48$ horas y carga seudonimizada; por la ley de Little guardará entre $2$ y $8$ mensajes a la vez.
- La repregunta pide solo lo que falta, en una sola frase de $24$ a $38$ palabras, dentro de la conversación del cliente y con plantillas escritas por personas; el total que no cuadra va siempre a Valeria.
- El embudo deja $95$ pedidos válidos de $100$ y $5$ en manos de Valeria; al mes son unos $159$ minutos ahorrados ($198.90$ MXN): el sistema no rechaza clientes, rechaza mensajes incompletos y pregunta por ellos.
Mañana, en el Día 6: Ética y seguridad: el código de honor del arquitecto de automatización. Hoy la cuarentena ya guarda datos seudonimizados y la repregunta solo habla con quien escribió primero; mañana esas decisiones se convierten en reglas escritas, porque un error automatizado se repite cientos de veces sin que nadie lo vea, y Don Ernesto tiene algo que decir sobre sus recetas y los teléfonos de sus clientes.
Referencias
- Pydantic (2026). Documentación de Pydantic v2: modelos, validadores y errores de validación. https://docs.pydantic.dev
- Breck, E., Polyzotis, N., Roy, S., Whang, S. E. y Zinkevich, M. (2019). Data Validation for Machine Learning. Proceedings of Machine Learning and Systems (SysML 2019).
- Hohpe, G. y Woolf, B. (2003). Enterprise Integration Patterns: Designing, Building, and Deploying Messaging Solutions. Addison-Wesley. (Patrones Invalid Message Channel y Dead Letter Channel.) https://www.enterpriseintegrationpatterns.com
- Kleppmann, M. (2017). Designing Data-Intensive Applications. O’Reilly Media.
- Wilson, E. B. (1927). Probable Inference, the Law of Succession, and Statistical Inference. Journal of the American Statistical Association, 22(158), 209-212.
- Little, J. D. C. (1961). A Proof for the Queuing Formula: L = λW. Operations Research, 9(3), 383-387. https://doi.org/10.1287/opre.9.3.383