
Arquitecto de automatización con IA: Día 52
 Jeshua Romero Guadarrama
- 73 Min para leer
- 24 Mar, 2026
Índice de contenido
Resumen:
Una clienta pidió el mismo pastel por WhatsApp y por Instagram y recibió dos confirmaciones; Marisol escribió el mismo cambio por correo y por WhatsApp y nadie supo cuál contestar primero. En esta entrada, Valeria une los cinco canales de Trigo Lento en un sobre común con identidad seudonimizada, enruta cada evento con reglas explícitas y prioridades, detecta duplicados entre canales con una huella y una ventana de 30 minutos, pone horarios y una cola fuera de horario que respeta la ventana de 24 horas, y mide los niveles de servicio con percentiles, una simulación de la cola humana y la fórmula de Erlang C. Al terminar, usted sabrá diseñar un orquestador multicanal en n8n que responde una sola vez, a tiempo y por la persona correcta.
¿Cómo citar el presente artículo?
Romero, J. (24 de marzo de 2026). Arquitecto de automatización con IA: Día 52. python-data-engineer. https://www.python-data-engineer.com/post/aai/dia_52/.
Arquitecto de automatización con IA: Día 52 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/aai/dia_52/.
Precios, límites y políticas revisados en octubre de 2026: planes, precios y límites de Make, n8n, Zapier, WhatsApp (Meta, Twilio, Wati) y de la API de Claude. Los nodos Execute Sub-workflow (executeWorkflow) y Execute Sub-workflow Trigger (executeWorkflowTrigger, en el lienzo “When Executed by Another Workflow”) se contrastaron con la documentación de n8n; el JSON del Bloque 9 tiene la estructura verificada contra la documentación, revisado en octubre de 2026, porque no había Docker disponible para exportarlo de una instancia real. La ventana de atención de 24 horas de WhatsApp y la de Instagram (24 horas para mensajes automáticos y hasta 7 días para respuestas de una persona con la etiqueta de agente humano) se tomaron de la documentación de proveedores; Meta las describe en su plataforma de mensajería y conviene contrastarlas antes de publicar un flujo.
Día 52. Orquestación multicanal sin volverse loco: enrutamiento, deduplicación, horarios y SLA
Introducción
Ayer, en el Día 51 (Caso de otro negocio IV: recordatorios de citas por WhatsApp en la clínica dental), Valeria llevó a la Clínica Dental Sonrisa Norte las plantillas de utilidad, el consentimiento por finalidad y la Cloud API desde n8n que había construido en este módulo, y Trigo Lento ganó la prueba de que sus piezas viajan a otro negocio: SN Recordatorios de citas v1, un flujo que recuerda sin revelar datos de salud y que deja a una persona todo lo que no es un botón. Hoy la pregunta vuelve a casa, y es menos elegante: qué pasa cuando los canales que se automatizaron uno por uno empiezan a pisarse.
Es martes 24 de marzo, a las diez de la mañana. Valeria abre la hoja de pedidos y encuentra dos renglones idénticos: Ana Ruiz, un pastel de chocolate y seis conchas para el sábado 28. Uno llegó por WhatsApp a las 9:41; el otro, por Instagram a las 9:52. El agente de pedidos del Día 38 hizo bien su trabajo dos veces: preparó dos borradores, Valeria aprobó los dos sin darse cuenta y Ana recibió dos confirmaciones, una por cada aplicación. A media mañana escribe, divertida y un poco alarmada: "¿Me van a hacer dos pasteles? Solo quiero uno, lo pedí por los dos lados porque no sabía cuál veían ustedes." En el buzón de mayoristas espera otro caso: Marisol Peña, de la Cafetería Brújula, mandó a las 7:38 un correo para subir las baguettes del miércoles de $40$ a $55$ y, como nadie le contestó en diez minutos, repitió el cambio por WhatsApp a las 7:49. El borrador de Gmail del Día 47 y el chatbot del Día 48 se pusieron a trabajar en paralelo sin saber uno del otro.
Don Ernesto lo resume desde la mesa de amasado, sin levantar la vista: “Una cosa es tener muchos canales y otra tener muchos problemas. Si la señora pidió un pastel, se hace un pastel. Y a Marisol se le contesta una vez, bien y rápido, no dos veces a medias.” Tiene razón, y lo que dice cabe en tres reglas de diseño: cada petición se responde una sola vez, cada cliente es una sola persona aunque escriba por cinco puertas y cada tipo de cliente tiene un tiempo de respuesta comprometido y medido. Ninguna de las tres se cumple añadiendo un canal más; se cumplen poniendo un orquestador delante de todos.
En la presente entrada, descubrirá cómo se ordena la atención de un negocio que recibe mensajes por WhatsApp, Instagram, Gmail, un formulario web y teléfono. Definirá un sobre común que convierte cualquier evento en la misma estructura, con un cliente seudonimizado; resolverá la identidad del cliente con coincidencias exactas y sugerencias que confirma una persona; enrutará cada evento con un motor de reglas y prioridades; detectará los duplicados entre canales con una huella y elegirá con datos el ancho de la ventana; pondrá horarios, un acuse automático y una cola nocturna que no rompe la ventana de 24 horas de WhatsApp; y medirá los niveles de servicio con percentiles, una simulación de la cola humana y la fórmula de Erlang C. Al final, tendrá el workflow TL Orquestador v1 en n8n, leído y dibujado desde su JSON.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Unificar los eventos de WhatsApp, Instagram, formulario, Gmail y teléfono en un sobre común con identidad de cliente.
- Enrutar cada evento al flujo y a la persona correctos con reglas explícitas y prioridades.
- Deduplicar a un cliente que escribe por dos canales y evitar respuestas dobles.
- Fijar horarios, colas fuera de horario y niveles de servicio por tipo de cliente, y medirlos.
El sobre común
Hasta hoy, cada canal de Trigo Lento tenía su propio flujo y su propio formato. La Cloud API de Meta entrega los mensajes de WhatsApp dentro de una estructura anidada (entry, changes, value, messages) con el teléfono en from y la hora como marca de tiempo en segundos; Instagram entrega sus mensajes en entry y messaging, con un identificador de remitente que no es un teléfono y la hora en milisegundos; el flujo de Gmail del Día 47 entrega un correo ya leído, con remitente, asunto y cuerpo; el formulario web manda un folio y un teléfono; y las llamadas no entregan nada, porque las apunta una persona del mostrador. Cinco formatos, cinco maneras de escribir la hora y tres maneras de identificar a la misma clienta.
Un orquestador no puede razonar sobre cinco formatos. Necesita que todo evento, venga de donde venga, tenga la misma forma. En los patrones de integración empresarial de Hohpe y Woolf, esa idea se llama modelo de datos canónico (en inglés, Canonical Data Model): cada canal traduce su mensaje a un formato común en la frontera, y de ahí hacia dentro nadie vuelve a preocuparse por el origen. En Trigo Lento se llama, más modestamente, el sobre: un contenedor con siete campos fijos, que amplía el contrato del pedido del Día 4 (Arquitectura de flujos II: entradas, salidas y contratos de datos) a todo lo que entra, no solo a los pedidos.
La Tabla 1 describe los siete campos, de dónde sale cada uno y qué regla cumple.
Tabla 1. Campos del sobre común de Trigo Lento: tipo, origen y regla.
| Campo | Tipo | De dónde sale | Regla |
|---|---|---|---|
id_evento | texto | Prefijo del canal y SHA-256 del identificador nativo | Estable: el mismo mensaje reenviado da el mismo id |
canal | lista cerrada | El normalizador que lo recibió | whatsapp, instagram, gmail, formulario o telefono |
cliente_id | texto | HMAC-SHA256 de la credencial (Día 6) | Nunca el teléfono ni el correo en claro |
recibido_en | fecha y hora | Marca de tiempo del canal, convertida a UTC | ISO 8601 con zona; se muestra en hora de la Ciudad de México |
tipo | lista cerrada | Reglas de palabras clave; Claude solo para lo ambiguo | pedido, cambio, informacion, queja, factura o baja |
cuerpo | texto | El texto del mensaje, cortado a 500 caracteres | Se borra con la política de conservación del Día 6 |
prioridad | entero | La fija el enrutador, no el normalizador | De 1 (baja inmediata) a 6 (información) |
Tres decisiones de diseño se leen en la tabla. La primera es que el id_evento no es un número consecutivo, sino un resumen criptográfico del identificador que trae el propio canal: si Meta reintenta la entrega del mismo mensaje (lo hace cuando el webhook tarda en contestar, como se vio en el Día 45), el sobre resultante tiene el mismo id y la base de datos lo rechaza. La segunda es que el cliente_id es un seudónimo desde el primer momento, con la misma función HMAC del Día 6: el orquestador no necesita saber el teléfono de Ana para saber que es Ana. La tercera es que la prioridad llega vacía: decidir qué es urgente es trabajo del enrutador, no del normalizador, y mezclar las dos responsabilidades es la forma más rápida de que una regla de negocio acabe escondida en el código de un canal.
El primer bloque fija las importaciones, la semilla de la serie y los supuestos del día. Los volúmenes mensuales son los del plan del módulo (WhatsApp $1,560$, Instagram $400$, Gmail $300$ y formulario $70$, un total de $2,330$ eventos digitales) más las $47$ llamadas que el mostrador captura cada mes (el $10%$ de los $468$ encargos), y la tasa de duplicados entre canales, un $6%$, es un supuesto didáctico:
# Importaciones base, semilla de la serie, carpeta del día y supuestos fijos en Python:
import warnings
warnings.filterwarnings('ignore')
import json
import math
import re
import hmac
import hashlib
from datetime import datetime, timedelta, timezone
from zoneinfo import ZoneInfo
from pathlib import Path
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 130)
carpeta = Path('trigo_lento') / 'dia_52'
carpeta.mkdir(parents = True, exist_ok = True)

# Supuestos de la serie (A.5) y del día: eventos al mes por canal:
CDMX = ZoneInfo('America/Mexico_City')
VOLUMEN_MES = {'whatsapp': 1_560, 'instagram': 400, 'gmail': 300, 'formulario': 70, 'telefono': 47}
TASA_DUPLICADOS = 0.06        # eventos que repiten en otro canal algo ya dicho (supuesto didáctico)
HORARIO = (7, 20)             # atención de mensajes: de 7:00 a 20:00, de lunes a sábado
SLA_MIN = {'brujula': 15, 'encargo': 30, 'informacion': 120}   # minutos hábiles hasta la primera respuesta humana
print('numpy', np.__version__, '| pandas', pd.__version__)
print(f'Eventos al mes: {sum(VOLUMEN_MES.values())} | sin teléfono: {sum(VOLUMEN_MES.values()) - 47} | '
      f'duplicados esperados (6 %): {sum(VOLUMEN_MES.values()) * TASA_DUPLICADOS:.0f}')
numpy 2.4.6 | pandas 3.0.3
Eventos al mes: 2377 | sin teléfono: 2330 | duplicados esperados (6 %): 143
Trigo Lento recibe $2,377$ eventos al mes por sus cinco puertas, y con un $6%$ de duplicados, unos $143$ serían peticiones repetidas por otro canal: casi cinco al día que, sin orquestador, producirían una respuesta doble, un pedido duplicado o, en el peor caso, dos pasteles.
Ahora los cinco normalizadores. Cada uno recibe la carga tal como la entrega su canal (con identificadores y teléfonos de prueba) y devuelve un sobre con los mismos siete campos. El tipo se asigna con reglas de palabras clave, en el orden en que importan: una baja va antes que cualquier otra cosa, una queja antes que un pedido. El siguiente código define el sobre y los normalizadores, y convierte un evento de cada canal:
# Sobre común de Trigo Lento y normalizadores por canal en Python:
CLAVE = os.environ.get('TL_CLAVE_SEUDONIMOS', 'EJEMPLO-NO-REAL-clave-de-seudonimos').encode('utf-8')
CAMPOS_SOBRE = ['id_evento', 'canal', 'cliente_id', 'recibido_en', 'tipo', 'cuerpo', 'prioridad']

def seudonimo(valor, prefijo = 'c_'):
    # HMAC-SHA256 con clave, como en el Día 6: mismo valor, mismo seudónimo; sin la clave no se revierte:
    return prefijo + hmac.new(CLAVE, valor.encode('utf-8'), hashlib.sha256).hexdigest()[:10]

def tipo_por_reglas(texto):
    t = texto.lower()
    reglas = [('baja', r'^\W*(baja|ya no)\W*$'), ('queja', r'queja|lleg[oó] tarde|crud|quemad|reclam'),
              ('factura', r'factur|\bcfdi\b|\brfc\b'), ('cambio', r'cambi|en lugar de|ahora son|agregar|añadir'),
              ('pedido', r'quiero|quisiera|encarg|apart|pedido|me manda|necesito \d')]
    for tipo, patron in reglas:
        if re.search(patron, t):
            return tipo
    return 'informacion'

def sobre(canal, id_nativo, identificador, recibido_utc, texto):
    return {'id_evento': canal[:2] + '_' + hashlib.sha256(f'{canal}:{id_nativo}'.encode()).hexdigest()[:10],
            'canal': canal, 'cliente_id': seudonimo(identificador), 'recibido_en': recibido_utc.isoformat(),
            'tipo': tipo_por_reglas(texto), 'cuerpo': texto[:500], 'prioridad': None}   # la fija el enrutador

def normalizar_whatsapp(p):    # carga de la Cloud API de Meta (entry > changes > value > messages)
    m = p['entry'][0]['changes'][0]['value']['messages'][0]
    return sobre('whatsapp', m['id'], '+' + m['from'], datetime.fromtimestamp(int(m['timestamp']), timezone.utc),
                 m['text']['body'])
def normalizar_instagram(p):   # evento de mensajería de Instagram (entry > messaging)
    m = p['entry'][0]['messaging'][0]
    return sobre('instagram', m['message']['mid'], 'ig:' + m['sender']['id'],
                 datetime.fromtimestamp(m['timestamp'] / 1000, timezone.utc), m['message']['text'])
def normalizar_gmail(p):       # correo ya leído por TL Gmail mayoristas v1 (Día 47)
    correo = re.search(r'<([^>]+)>', p['de']).group(1).lower()
    return sobre('gmail', p['id'], correo, datetime.fromtimestamp(int(p['internalDate']) / 1000, timezone.utc),
                 p['asunto'] + '. ' + p['texto'])
def normalizar_formulario(p):  # formulario web de encargos
    return sobre('formulario', p['folio'], p['telefono'].replace(' ', ''),
                 datetime.fromisoformat(p['enviado']).astimezone(timezone.utc), 'Pedido: ' + p['detalle'])
def normalizar_telefono(p):    # llamada capturada por el mostrador en el formulario interno
    return sobre('telefono', p['folio'], p['telefono'].replace(' ', ''),
                 datetime.fromisoformat(p['hora']).astimezone(timezone.utc), p['nota'])

hora = datetime(2026, 3, 24, 10, 5, tzinfo = CDMX)
ejemplos = [
    normalizar_whatsapp({'entry': [{'changes': [{'value': {'messages': [{'id': 'wamid.EJEMPLO01',
        'from': '525500000042', 'timestamp': str(int(hora.timestamp())),
        'text': {'body': 'Quiero un pastel de chocolate para el sábado'}}]}}]}]}),
    normalizar_instagram({'entry': [{'messaging': [{'sender': {'id': '1790000000000042'},
        'timestamp': int((hora + timedelta(minutes = 4)).timestamp() * 1000),
        'message': {'mid': 'm_EJEMPLO02', 'text': 'Hola, ¿a qué hora abren el domingo?'}}]}]}),
    normalizar_gmail({'id': '18e0000000000052', 'de': 'Marisol Peña <compras@brujula.ejemplo>',
        'internalDate': str(int((hora + timedelta(minutes = 9)).timestamp() * 1000)),
        'asunto': 'Cambio para el miércoles', 'texto': 'Ahora son 55 baguettes en lugar de 40.'}),
    normalizar_formulario({'folio': 'F-0352', 'telefono': '+52 55 0000 0017',
        'enviado': '2026-03-24T10:20:00-06:00', 'detalle': '2 x P05, 1 x P10 para el 26 de marzo'}),
    normalizar_telefono({'folio': 'T-0118', 'telefono': '+52 55 0000 0031',
        'hora': '2026-03-24T10:31:00-06:00', 'nota': 'Llamó para encargar 6 conchas para mañana'}),
]
for ev in ejemplos:
    print({k: ev[k] for k in CAMPOS_SOBRE if k != 'cuerpo'} | {'cuerpo': ev['cuerpo'][:38]})
print('Campos idénticos en los 5 canales:', all(list(ev) == CAMPOS_SOBRE for ev in ejemplos))
{'id_evento': 'wh_912b996067', 'canal': 'whatsapp', 'cliente_id': 'c_afa830c2cd', 'recibido_en': '2026-03-24T16:05:00+00:00', 'tipo': 'pedido', 'prioridad': None, 'cuerpo': 'Quiero un pastel de chocolate para el '}
{'id_evento': 'in_4d1aad83f6', 'canal': 'instagram', 'cliente_id': 'c_68e08ee1b0', 'recibido_en': '2026-03-24T16:09:00+00:00', 'tipo': 'informacion', 'prioridad': None, 'cuerpo': 'Hola, ¿a qué hora abren el domingo?'}
{'id_evento': 'gm_e14a30fe00', 'canal': 'gmail', 'cliente_id': 'c_290ae55030', 'recibido_en': '2026-03-24T16:14:00+00:00', 'tipo': 'cambio', 'prioridad': None, 'cuerpo': 'Cambio para el miércoles. Ahora son 55'}
{'id_evento': 'fo_4f02d11062', 'canal': 'formulario', 'cliente_id': 'c_e40b94930f', 'recibido_en': '2026-03-24T16:20:00+00:00', 'tipo': 'pedido', 'prioridad': None, 'cuerpo': 'Pedido: 2 x P05, 1 x P10 para el 26 de'}
{'id_evento': 'te_044b1815ac', 'canal': 'telefono', 'cliente_id': 'c_d24bd12870', 'recibido_en': '2026-03-24T16:31:00+00:00', 'tipo': 'pedido', 'prioridad': None, 'cuerpo': 'Llamó para encargar 6 conchas para mañ'}
Campos idénticos en los 5 canales: True
Los cinco sobres tienen exactamente los mismos campos en el mismo orden (True en la última línea), y en ninguno aparece un teléfono o un correo: el cliente_id es un seudónimo de diez caracteres hexadecimales. La hora de los cinco está en UTC (+00:00): las 10:05 de la Ciudad de México son las 16:05 UTC, porque la ciudad está en UTC $-6$ todo el año. El tipo salió bien en los cinco casos: el pastel de WhatsApp es un pedido, la pregunta de Instagram por el horario del domingo es informacion, el correo de Marisol (“Ahora son 55 baguettes en lugar de 40”) es un cambio, y el formulario y la llamada son pedidos.
Fíjese en un detalle del normalizador de Gmail: la credencial es la dirección de correo en minúsculas, extraída de entre los signos < y >. “Marisol Peña” es lo que el remitente escribe como nombre visible, y cualquiera puede escribir lo que quiera ahí; la dirección, en cambio, es lo que Gmail verificó. Esa diferencia entre lo que el cliente dice ser y lo que el canal garantiza es el centro de la siguiente sección.
Una semana de eventos
Antes de enrutar nada conviene ver cómo llegan los eventos. El siguiente código genera un mes de juguete, marzo de 2026, con los volúmenes del Bloque 1 y un perfil horario distinto por canal: WhatsApp tiene su pico de 10:00 a 12:00 (los nueve mensajes por hora de la serie) y un segundo pico por la tarde; Instagram crece por la noche; Gmail se concentra entre las 7:00 y las 9:00, cuando las cafeterías hacen sus pedidos; el formulario se reparte; y el teléfono solo suena cuando la panadería está abierta. El domingo llegan mensajes con un $40%$ del peso de un día normal, y ninguna llamada. Encima, el generador añade dos fenómenos que la deduplicación tendrá que distinguir: los duplicados reales, una petición repetida por otro canal minutos después, y las repeticiones legítimas, un cliente que, horas después, vuelve a pedir lo mismo porque de verdad quiere otro. Después dibuja una semana, del lunes 16 al domingo 22, con el horario de atención sombreado:
# Generación de un mes de eventos multicanal y una semana por hora en Python:
PERFIL = {   # peso relativo por hora local (0 a 23) de cada canal, supuesto didáctico
    'whatsapp':   [1, 1, 0, 0, 0, 1, 3, 6, 8, 10, 14, 14, 11, 8, 7, 7, 8, 10, 11, 10, 8, 6, 4, 2],
    'instagram':  [2, 1, 0, 0, 0, 0, 1, 2, 3, 4, 5, 5, 5, 5, 5, 5, 6, 7, 9, 11, 12, 11, 8, 4],
    'gmail':      [1, 0, 0, 0, 1, 2, 5, 12, 12, 9, 7, 6, 5, 5, 5, 5, 4, 3, 2, 2, 1, 1, 1, 1],
    'formulario': [1, 1, 0, 0, 0, 0, 1, 2, 3, 4, 5, 5, 4, 4, 4, 4, 5, 6, 7, 8, 7, 5, 3, 2],
    'telefono':   [0, 0, 0, 0, 0, 0, 0, 4, 6, 8, 10, 10, 8, 6, 6, 6, 6, 6, 5, 4, 0, 0, 0, 0]}
TIPOS = {'whatsapp':  {'pedido': .165, 'cambio': .08, 'informacion': .70, 'queja': .03, 'factura': .015, 'baja': .01},
         'instagram': {'pedido': .235, 'cambio': .03, 'informacion': .70, 'queja': .03, 'baja': .005},
         'gmail':     {'pedido': .10, 'cambio': .35, 'informacion': .25, 'queja': .05, 'factura': .25},
         'formulario': {'pedido': 1.0}, 'telefono': {'pedido': 1.0}}
INICIO = datetime(2026, 3, 1, tzinfo = CDMX)            # marzo de 2026 empieza en domingo

def momentos(canal, n, rng):
    # Reparte n eventos en los 31 días con peso 0.4 el domingo (0 para el teléfono) y el perfil horario:
    pesos = np.array([[(0.0 if canal == 'telefono' else 0.4) if (INICIO + timedelta(days = d)).weekday() == 6
                       else 1.0] * 24 for d in range(31)]) * np.array(PERFIL[canal])
    celdas = rng.choice(pesos.size, size = n, p = (pesos / pesos.sum()).ravel())
    minutos = celdas * 60 + rng.uniform(0, 60, n)
    return np.sort(minutos)                               # minutos desde el 1 de marzo a las 0:00

def generar_mes(rng):
    total = sum(VOLUMEN_MES.values())
    n_dup = round(total * TASA_DUPLICADOS)
    dup_canal = {c: round(n_dup * v / total) for c, v in VOLUMEN_MES.items()}
    filas = []
    for canal, n in VOLUMEN_MES.items():
        tipos = list(TIPOS[canal])
        for m in momentos(canal, n - dup_canal[canal], rng):
            filas.append({'canal': canal, 'minuto': m, 'tipo': rng.choice(tipos, p = list(TIPOS[canal].values())),
                          'cliente': f'k{rng.integers(1, 701):03d}', 'origen': None})
    eventos = pd.DataFrame(filas)
    eventos['mayorista'] = (eventos.canal == 'gmail') & (rng.random(len(eventos)) < 0.6)
    eventos.loc[(eventos.canal == 'whatsapp') & (rng.random(len(eventos)) < 0.013), 'mayorista'] = True
    eventos.loc[eventos.mayorista, 'cliente'] = 'k000'                       # Cafetería Brújula
    eventos['contenido'] = [f'{t}-{rng.integers(1, 40)}' for t in eventos.tipo]   # productos y fecha, o tema
    # Repeticiones legítimas (un segundo pedido igual, la misma pregunta horas después): no son duplicados:
    eventos = eventos.sort_values('minuto').reset_index(drop = True)
    for i in rng.choice(len(eventos), size = round(0.03 * len(eventos)), replace = False):
        objetivo = eventos.at[i, 'minuto'] + rng.exponential(240)
        siguientes = eventos.index[(eventos.minuto >= objetivo) & (eventos.tipo == eventos.at[i, 'tipo'])
                                   & ~eventos.mayorista]
        if len(siguientes) and not eventos.at[i, 'mayorista']:
            j = siguientes[0]
            eventos.loc[j, ['cliente', 'contenido']] = eventos.loc[i, ['cliente', 'contenido']].to_numpy()
    # Duplicados entre canales: la misma petición repetida por otro canal, con retraso lognormal:
    originales = eventos.index[eventos.tipo.isin(['pedido', 'cambio', 'informacion', 'queja'])].to_numpy()
    for canal, n in dup_canal.items():
        candidatos = [i for i in originales if eventos.at[i, 'canal'] != canal]
        for i in rng.choice(candidatos, size = n, replace = False):
            d = eventos.loc[i].copy()
            d['canal'], d['origen'] = canal, int(i)
            d['minuto'] = eventos.at[i, 'minuto'] + rng.lognormal(math.log(10), 1.0)
            eventos = pd.concat([eventos, d.to_frame().T], ignore_index = True)
    eventos['minuto'] = eventos.minuto.astype(float)
    eventos['recibido'] = [INICIO + timedelta(minutes = m) for m in eventos.minuto]
    return eventos.sort_values('minuto').reset_index(names = 'id_original')

mes = generar_mes(rng)
mes = mes[mes.minuto < 31 * 1440].reset_index(drop = True)
print('Eventos generados en marzo:', len(mes), '| duplicados reales:', int(mes.origen.notna().sum()))
print(mes.groupby('canal').size().reindex(list(VOLUMEN_MES)).to_dict())

semana = mes[(mes.minuto >= 15 * 1440) & (mes.minuto < 22 * 1440)].copy()   # lunes 16 a domingo 22
semana['hora'] = ((semana.minuto - 15 * 1440) // 60).astype(int)
por_hora = semana.groupby(['hora', 'canal']).size().unstack(fill_value = 0).reindex(
    index = range(7 * 24), columns = list(VOLUMEN_MES), fill_value = 0)
habil = np.array([(h // 24) < 6 and HORARIO[0] <= h % 24 < HORARIO[1] for h in range(7 * 24)])
print(f'Semana del 16 al 22 de marzo: {len(semana)} eventos | fuera de horario: '
      f'{por_hora[~habil].to_numpy().sum()} ({por_hora[~habil].to_numpy().sum() / len(semana):.1%})')

fig, ax = plt.subplots(figsize = (12, 4.8))
colores = ['#1f9d55', '#c2410c', '#2a78d6', '#7b4bb7', '#8a8986']
ax.stackplot(range(7 * 24), por_hora.T.to_numpy(), labels = list(VOLUMEN_MES), colors = colores, alpha = 0.9)
for d in range(6):
    ax.axvspan(d * 24 + HORARIO[0], d * 24 + HORARIO[1], color = '#e8f1fb', zorder = 0)
ax.set_xticks([d * 24 + 12 for d in range(7)], ['lun 16', 'mar 17', 'mié 18', 'jue 19', 'vie 20', 'sáb 21', 'dom 22'])
ax.set_xlim(0, 7 * 24)
ax.set_ylabel('Eventos por hora')
ax.set_title('Una semana de eventos por canal (sombreado: horario de atención)', fontsize = 16)
ax.legend(loc = 'upper right', ncol = 5, frameon = False)
plt.tight_layout()
plt.show()
Eventos generados en marzo: 2377 | duplicados reales: 143
{'whatsapp': 1560, 'instagram': 400, 'gmail': 300, 'formulario': 70, 'telefono': 47}
Semana del 16 al 22 de marzo: 534 eventos | fuera de horario: 136 (25.5%)
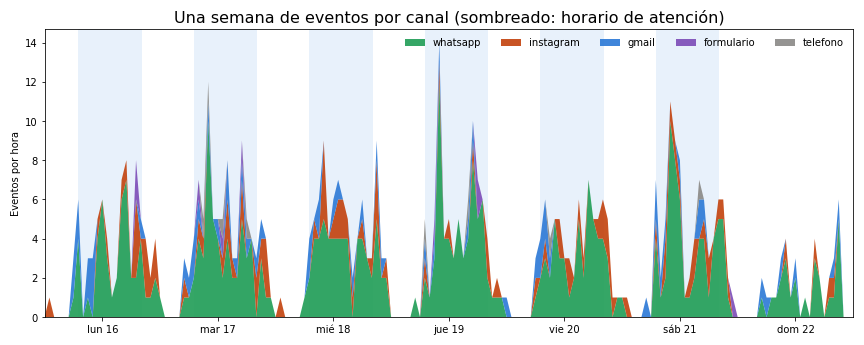
El mes tiene $2,377$ eventos, exactamente los del supuesto canal por canal, de los que $143$ son duplicados reales. La semana dibujada tiene $534$ eventos, y $136$ ($25.5%$) llegan fuera del horario de atención: de noche, de madrugada o en domingo. Es la primera cifra incómoda del día. Uno de cada cuatro mensajes llega cuando nadie lo puede atender, y la sección de horarios tendrá que decidir qué se le contesta mientras tanto.
La gráfica también enseña la forma del problema. El verde de WhatsApp domina las mañanas, con picos de más de diez eventos por hora; el naranja de Instagram asoma al final de cada sombreado y sigue después de las 20:00; y el domingo, sin sombra, tiene actividad aunque nadie trabaje. El mostrador de Trigo Lento abre el domingo por la mañana, pero la atención de mensajes y encargos es de lunes a sábado: el domingo, Valeria descansa.
La imagen que Valeria dibuja en su cuaderno es la de una central de autobuses: cinco andenes, uno por canal, que desembocan en una sola sala de espera, y un tablero que dice a cada pasajero a qué autobús subir.
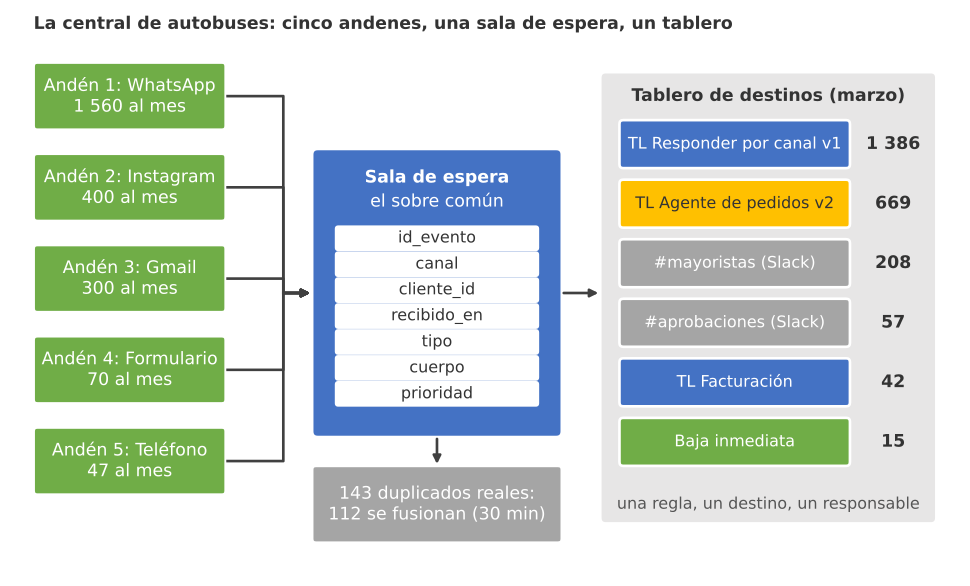
Figura 1. La central de autobuses: cinco andenes (WhatsApp, Instagram, Gmail, formulario y teléfono, con 2 377 eventos al mes) llegan a una sola sala de espera, el sobre común, y un tablero reparte cada evento a su flujo; 112 duplicados se fusionan antes de llegar al tablero.
Identidad del cliente
Para saber que el pastel de WhatsApp y el de Instagram son el mismo, primero hay que saber que Ana es la misma persona en los dos canales. Parece trivial y no lo es. En WhatsApp, Ana es un teléfono; en Instagram, un identificador numérico que Meta asigna a cada cuenta y que no se puede convertir en un teléfono; en Gmail, una dirección de correo. Ningún canal sabe nada de los otros.
Hay dos maneras de unir esas credenciales, y solo una es aceptable:
- Coincidencia exacta. El cliente dio sus credenciales a Trigo Lento: el teléfono al hacer su primer pedido, el correo para la factura, el usuario de Instagram cuando aceptó el aviso de privacidad. El directorio guarda las tres bajo un mismo
cliente_id, y una credencial que llega se busca tal cual, normalizada (sin espacios, sin guiones, en minúsculas, con el prefijo de país). - Coincidencia sugerida. La credencial no está en el directorio, pero algo se parece: el nombre visible, los últimos dígitos, el dominio del correo. El orquestador no une a esos clientes; propone la unión y una persona la confirma o la rechaza. Un parecido no es una prueba, y unir por error a dos personas significa mandarle a una el pedido, la dirección o la factura de la otra.
Lo que nunca se hace es la tercera manera: buscar al cliente en sus redes, cruzar su foto de perfil con otra cuenta o adivinar su teléfono por el nombre. Trigo Lento solo une lo que el cliente le dio, y la sugerencia por parecido no es una búsqueda externa, sino una comparación con el propio directorio.
El siguiente código normaliza diez credenciales que llegan por distintos canales, las busca en un directorio de cuatro clientes con datos de prueba y, cuando no hay coincidencia exacta, compara el nombre visible con difflib.SequenceMatcher, que mide la similitud entre dos cadenas de $0$ a $1$. Por encima de $0.80$ propone la unión; por debajo, crea un cliente nuevo con su propio seudónimo:
# Resolución de identidad: coincidencia exacta y coincidencia sugerida en Python:
import difflib

def normalizar_id(valor):
    v = valor.strip().lower()
    if '@' in v and not v.startswith('@'):
        return 'correo:' + v
    if v.startswith('@') or v.startswith('ig:'):
        return 'ig:' + v.lstrip('@').removeprefix('ig:')
    digitos = re.sub(r'\D', '', v)
    return 'tel:+52' + digitos[-10:] if len(digitos) >= 10 else 'desconocido:' + v

DIRECTORIO = {   # credenciales que cada cliente dio en el aviso de privacidad (datos de prueba)
    'c_ana':     {'nombre': 'Ana Ruiz', 'ids': ['+52 55 0000 0042', 'ana@ejemplo.com', '@ana.hornea']},
    'c_brujula': {'nombre': 'Marisol Peña', 'ids': ['+52 55 0000 0007', 'compras@brujula.ejemplo']},
    'c_luis':    {'nombre': 'Luis Mora', 'ids': ['+52 55 0000 0017']},
    'c_carmen':  {'nombre': 'Carmen Díaz', 'ids': ['+52 55 0000 0031']},
}
INDICE = {normalizar_id(i): c for c, d in DIRECTORIO.items() for i in d['ids']}

def resolver(identificador, nombre_visible = ''):
    clave = normalizar_id(identificador)
    if clave in INDICE:
        return 'exacta', INDICE[clave], 1.0
    # Sin coincidencia exacta: se sugiere por nombre visible, nunca se une sola:
    mejor = max(DIRECTORIO, key = lambda c: difflib.SequenceMatcher(None, nombre_visible.lower(),
                                                                     DIRECTORIO[c]['nombre'].lower()).ratio())
    r = difflib.SequenceMatcher(None, nombre_visible.lower(), DIRECTORIO[mejor]['nombre'].lower()).ratio()
    return ('sugerida', mejor, round(r, 2)) if r >= 0.80 else ('nuevo', seudonimo(clave), round(r, 2))

llegadas = [('5255 0000 0042', ''), ('ANA@ejemplo.com', ''), ('@ana.hornea', ''), ('+52 (55) 0000-0007', ''),
            ('compras@brujula.ejemplo', ''), ('marisol.p@correo.ejemplo', 'Marisol Pena'),
            ('@lmora_cdmx', 'Luis Mora'), ('+52 55 0000 0099', 'Ana Ruíz'), ('@pan_y_cafe', 'Café Altura'),
            ('55 0000 0031', '')]
resultado = pd.DataFrame([(i, n) + resolver(i, n) for i, n in llegadas],
                         columns = ['identificador', 'nombre_visible', 'coincidencia', 'cliente', 'similitud'])
print(resultado.to_string(index = False))
print(resultado.coincidencia.value_counts().to_dict())
           identificador nombre_visible coincidencia      cliente  similitud
          5255 0000 0042                      exacta        c_ana       1.00
         ANA@ejemplo.com                      exacta        c_ana       1.00
             @ana.hornea                      exacta        c_ana       1.00
      +52 (55) 0000-0007                      exacta    c_brujula       1.00
 compras@brujula.ejemplo                      exacta    c_brujula       1.00
marisol.p@correo.ejemplo   Marisol Pena     sugerida    c_brujula       0.92
             @lmora_cdmx      Luis Mora     sugerida       c_luis       1.00
        +52 55 0000 0099       Ana Ruíz     sugerida        c_ana       0.88
             @pan_y_cafe    Café Altura        nuevo c_b52457714d       0.36
            55 0000 0031                      exacta     c_carmen       1.00
{'exacta': 6, 'sugerida': 3, 'nuevo': 1}
De las diez credenciales, $6$ coinciden de forma exacta, $3$ quedan como sugerencias y $1$ crea un cliente nuevo. Las exactas muestran por qué la normalización es la mitad del trabajo: “5255 0000 0042” (sin el signo de más), “ANA@ejemplo.com” (en mayúsculas) y “+52 (55) 0000-0007” (con paréntesis y guiones) se encuentran porque antes de buscar se reducen a la misma forma. Sin esa reducción, la misma Ana serían tres clientes.
Las tres sugerencias son los casos interesantes:
- “marisol.p@correo.ejemplo” con el nombre “Marisol Pena” apunta a Brújula con una similitud de $0.92$. Probablemente sea Marisol escribiendo desde su correo personal, pero también podría ser otra Marisol. Si el orquestador la uniera sola, un correo de una desconocida recibiría el trato, los precios y la prioridad de un cliente mayorista.
- "@lmora_cdmx" con el nombre “Luis Mora” tiene similitud $1.00$ con Luis, y aun así es una sugerencia: dos personas pueden llamarse igual. El nombre visible lo escribe el usuario; Instagram no lo verifica.
- "+52 55 0000 0099" con el nombre “Ana Ruíz” se parece a Ana con $0.88$, pero el teléfono no es el suyo. Puede ser su número nuevo o el de otra Ana.
La credencial “@pan_y_cafe” de “Café Altura” tiene una similitud de $0.36$ con el cliente más parecido y crea un cliente nuevo. Las sugerencias se publican en #aprobaciones de Slack (Día 50) con dos botones, “Es la misma persona” y “Son personas distintas”, y mientras nadie decide, el evento se atiende con el cliente_id provisional: se contesta, pero no se mezcla con el historial de nadie.
Las tres credenciales de una misma clienta y lo que pasa con las que no coinciden se ven juntas en la Figura 2.
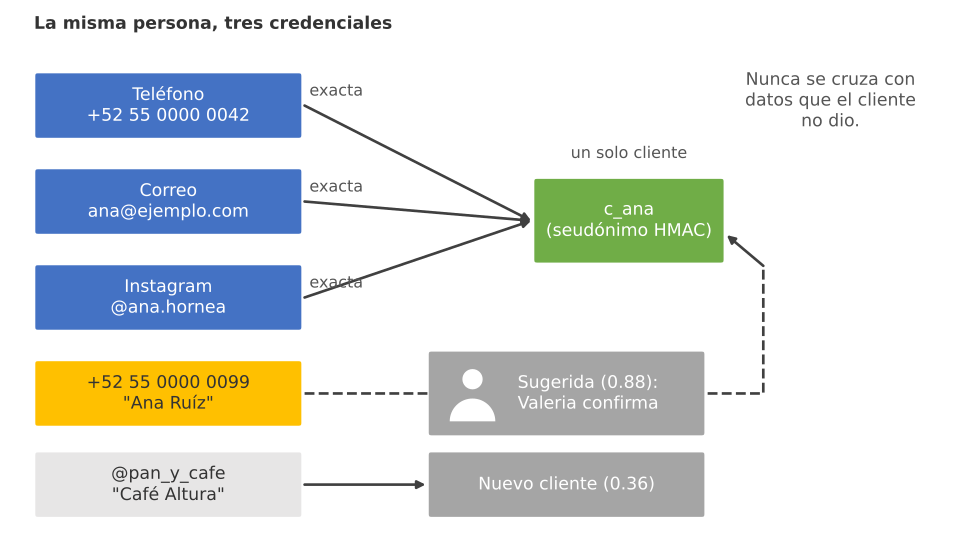
Figura 2. La misma persona, tres credenciales: el teléfono, el correo y el usuario de Instagram de Ana apuntan al mismo cliente seudonimizado; una coincidencia sugerida (similitud de 0.88) espera la confirmación de una persona y una credencial sin parecido crea un cliente nuevo.
Atención aquí: Unir identidades entre canales es tratamiento de datos personales. Según la Ley Federal de Protección de Datos Personales en Posesión de los Particulares, Trigo Lento debe informar esa finalidad en su aviso de privacidad (“relacionar los medios de contacto que usted nos proporcione para atender sus pedidos sin duplicarlos”), usarla solo para atender pedidos y permitir que el cliente pida que se separen sus credenciales o que se borren. Las coincidencias dudosas las confirma una persona, y nunca se cruzan con datos de redes sociales, directorios públicos o listas compradas que el cliente no dio. Un umbral de similitud no es una base legal.
Enrutamiento
Con el sobre y la identidad resueltos, falta decidir a dónde va cada evento. En la serie ya hubo routers: el de Make del Día 24 repartía por tipo de mensaje y el switch de n8n del Día 45 separaba bajas, quejas, facturas y preguntas. Lo nuevo de hoy es que el enrutador recibe los cinco canales a la vez y que su salida no es solo un flujo, sino también una persona responsable y una clase de nivel de servicio.
El patrón tiene nombre en Hohpe y Woolf: enrutador basado en contenido (Content-Based Router). Un componente sin estado examina cada mensaje y lo envía a un único destino según su contenido, sin modificarlo. Sus dos virtudes son las que pedía Don Ernesto: cada mensaje va a un solo sitio, y la lógica de reparto está en un único lugar, legible, en lugar de repartida entre cinco flujos. Su defecto también es conocido: el enrutador debe conocer todos los destinos, y cada destino nuevo obliga a tocarlo.
Valeria escribe las reglas como una lista ordenada. Cada regla tiene una prioridad, una condición, un flujo destino, una persona responsable y una clase de SLA; el enrutador recorre la lista y se queda con la primera regla que se cumple. El orden importa: si un mayorista se queja, la regla de mayorista (prioridad $2$) gana a la regla de queja (prioridad $3$), porque a Brújula se le atiende con su propio canal y su propio plazo. El siguiente código implementa el motor, lo aplica a una muestra de veinte eventos de marzo con todos los tipos representados y cuenta el reparto del mes completo:
# Motor de reglas de enrutamiento con prioridades en Python:
REGLAS = [   # (prioridad, condición, flujo destino, responsable, clase de SLA)
    (1, lambda e: e['tipo'] == 'baja', 'Baja inmediata (consentimientos)', 'Automático', None),
    (2, lambda e: e['mayorista'], 'TL Slack operaciones v1 (#mayoristas)', 'Valeria', 'brujula'),
    (3, lambda e: e['tipo'] == 'queja', 'TL Slack operaciones v1 (#aprobaciones)', 'Valeria o Don Ernesto', 'encargo'),
    (4, lambda e: e['tipo'] in ('pedido', 'cambio'), 'TL Agente de pedidos v2', 'Valeria (aprueba)', 'encargo'),
    (5, lambda e: e['tipo'] == 'factura', 'TL Facturación', 'Valeria', 'informacion'),
    (6, lambda e: e['tipo'] == 'informacion', 'TL Responder por canal v1', 'Automático; mostrador si no sabe', 'informacion'),
]
def enrutar(evento):
    # Enrutador basado en contenido: la primera regla que se cumple, en orden de prioridad:
    for prioridad, condicion, destino, responsable, clase in REGLAS:
        if condicion(evento):
            return {'prioridad': prioridad, 'destino': destino, 'responsable': responsable, 'clase_sla': clase}
    return {'prioridad': 9, 'destino': 'Revisión humana', 'responsable': 'Valeria', 'clase_sla': 'informacion'}

cuantos = {'pedido': 5, 'informacion': 5, 'cambio': 3, 'queja': 3, 'factura': 2, 'baja': 2}
muestra = pd.concat([mes[mes.tipo == t].sample(n, random_state = 52) for t, n in cuantos.items()]).sort_values('minuto')
filas = []
for _, e in muestra.iterrows():
    r = enrutar(e)
    filas.append({'hora': e.recibido.strftime('%d %H:%M'), 'canal': e.canal, 'tipo': e.tipo,
                  'mayorista': bool(e.mayorista)} | r)
tabla_rutas = pd.DataFrame(filas)
print(tabla_rutas.drop(columns = 'responsable').to_string(index = False))
todas = pd.DataFrame([enrutar(e) for _, e in mes.iterrows()])
print('Mes completo por destino:', todas.destino.value_counts().to_dict())
    hora     canal        tipo  mayorista  prioridad                                 destino   clase_sla
02 09:11  whatsapp       queja      False          3 TL Slack operaciones v1 (#aprobaciones)     encargo
02 14:44     gmail     factura       True          2   TL Slack operaciones v1 (#mayoristas)     brujula
03 10:23  whatsapp      pedido      False          4                 TL Agente de pedidos v2     encargo
03 13:48  whatsapp      cambio      False          4                 TL Agente de pedidos v2     encargo
03 20:00     gmail     factura       True          2   TL Slack operaciones v1 (#mayoristas)     brujula
05 12:00  whatsapp        baja      False          1        Baja inmediata (consentimientos)         NaN
10 10:02  whatsapp      pedido       True          2   TL Slack operaciones v1 (#mayoristas)     brujula
12 18:35 instagram      pedido      False          4                 TL Agente de pedidos v2     encargo
12 19:25 instagram informacion      False          6               TL Responder por canal v1 informacion
16 17:07  whatsapp informacion      False          6               TL Responder por canal v1 informacion
16 21:08 instagram      pedido      False          4                 TL Agente de pedidos v2     encargo
16 21:30 instagram      cambio      False          4                 TL Agente de pedidos v2     encargo
17 12:05     gmail      cambio       True          2   TL Slack operaciones v1 (#mayoristas)     brujula
17 14:00  whatsapp        baja      False          1        Baja inmediata (consentimientos)         NaN
18 08:56 instagram informacion      False          6               TL Responder por canal v1 informacion
21 21:20 instagram       queja      False          3 TL Slack operaciones v1 (#aprobaciones)     encargo
24 22:56 instagram informacion      False          6               TL Responder por canal v1 informacion
26 08:10  whatsapp informacion      False          6               TL Responder por canal v1 informacion
27 12:01     gmail       queja       True          2   TL Slack operaciones v1 (#mayoristas)     brujula
31 20:54 instagram      pedido      False          4                 TL Agente de pedidos v2     encargo
Mes completo por destino: {'TL Responder por canal v1': 1386, 'TL Agente de pedidos v2': 669, 'TL Slack operaciones v1 (#mayoristas)': 208, 'TL Slack operaciones v1 (#aprobaciones)': 57, 'TL Facturación': 42, 'Baja inmediata (consentimientos)': 15}
La muestra recorre las seis reglas. Las dos bajas van a la regla $1$ y no tienen clase de SLA (NaN): una baja no espera a nadie, se aplica en el acto y se confirma con un mensaje automático. Los eventos de Brújula, sea un pedido por WhatsApp, una factura o una queja por correo, van todos a #mayoristas con la clase brujula. Las quejas de clientes particulares van a #aprobaciones, donde Valeria o Don Ernesto responden en persona. Pedidos y cambios van al agente de pedidos, y la información, a las respuestas automáticas.
En el mes completo, $1,386$ eventos van a TL Responder por canal v1, el $58.3%$: más de la mitad de lo que entra son preguntas que se responden solas (horarios, precios, dirección). El agente de pedidos recibe $669$, #mayoristas $208$, #aprobaciones $57$, facturación $42$ y bajas $15$. La Tabla 2 resume las reglas con sus cifras.
Tabla 2. Reglas de enrutamiento de Trigo Lento: canal, tipo, prioridad, flujo destino, persona responsable, SLA y eventos de marzo.
| Prioridad | Canal y tipo | Flujo destino | Responsable | SLA | Eventos en marzo |
|---|---|---|---|---|---|
| 1 | Cualquier canal, baja | Baja inmediata en consentimientos | Automático | Inmediato | 15 |
| 2 | Cualquier canal, cliente mayorista | TL Slack operaciones v1 (#mayoristas) | Valeria | 15 minutos | 208 |
| 3 | Cualquier canal, queja | TL Slack operaciones v1 (#aprobaciones) | Valeria o Don Ernesto | 30 minutos | 57 |
| 4 | Cualquier canal, pedido o cambio | TL Agente de pedidos v2 | Valeria aprueba | 30 minutos | 669 |
| 5 | Cualquier canal, factura | TL Facturación | Valeria | 2 horas | 42 |
| 6 | Cualquier canal, informacion | TL Responder por canal v1 | Automático; mostrador si no sabe | 2 horas | 1 386 |
Dos observaciones sobre la tabla. La columna de canal dice “cualquier canal” en todas las filas, y no es descuido: el canal decide cómo se responde, no a dónde va el evento. Un pedido de Instagram y uno de WhatsApp van al mismo agente; lo que cambia es que la respuesta vuelve por Instagram o por WhatsApp. Y los totales suman $2,377$, los eventos antes de deduplicar: el enrutador de hoy todavía cuenta dos veces el pastel de Ana. Eso se arregla en la siguiente sección, que va antes del enrutador en el flujo.
La imagen completa, con los andenes, la sala de espera y el tablero de destinos, es la de la Figura 1.
Deduplicación entre canales
El pastel de Ana no fue un error del agente, sino del sistema: dos eventos distintos, por dos canales distintos, con dos id_evento distintos, que significaban lo mismo. Ningún control por identificador lo detecta, porque los identificadores son, con razón, diferentes. Lo que tienen en común es su contenido: la misma clienta, los mismos productos, la misma fecha de entrega.
Hohpe y Woolf llaman receptor idempotente (Idempotent Receiver) al componente que puede recibir el mismo mensaje varias veces con el mismo efecto que si lo recibiera una sola: o elimina los duplicados explícitamente o define operaciones que se pueden repetir sin daño. El Día 45 aplicó la primera forma a los reintentos de un mismo canal con la tabla mensajes_vistos. Hoy se aplica a varios canales, y la clave ya no es el identificador del mensaje, sino una huella (fingerprint) de lo que pide:
$$ h = \mathrm{SHA256}\big(,\texttt{cliente_id} ;\Vert; \mathrm{canon}(\text{renglones}) ;\Vert; \text{fecha de entrega},\big) $$
La lógica detrás de esta fórmula es múltiple:
- $\Vert$ significa concatenar con un separador. La huella depende de quién pide, de qué pide y de para cuándo; no depende del canal ni de la hora, porque esas son justo las dos cosas que cambian entre un duplicado y su original.
- $\mathrm{canon}$ es la forma canónica de los renglones: claves del catálogo ordenadas con sus cantidades. “Un pastel de chocolate y seis conchas” y “seis conchas y un pastel de chocolate” deben dar la misma huella.
- SHA-256 convierte la cadena en un resumen de longitud fija del que no se puede reconstruir el pedido; se guardan doce caracteres hexadecimales, suficientes para que dos pedidos distintos de un mes no choquen.
- En conclusión, dos eventos con la misma huella dicen lo mismo; si además llegan cerca en el tiempo, probablemente son la misma petición.
Ese “cerca en el tiempo” es la ventana de deduplicación. Si la ventana es corta, los duplicados que llegan tarde (el cliente que esperó una hora antes de repetir por otro canal) pasan como nuevos. Si es larga, las repeticiones legítimas (el cliente que, por la tarde, de verdad quiere otro pastel igual para otra persona) se fusionan por error. Con un retraso del duplicado que sigue una distribución lognormal de mediana $m$ y dispersión $\sigma$, y repeticiones legítimas separadas por un tiempo exponencial de media $\tau$, la ventana $W$ tiene dos efectos medibles:
$$ P(\text{detectar}) = q \cdot \Phi!\left(\frac{\ln W - \ln m}{\sigma}\right), \qquad P(\text{falso positivo}) \approx 1 - e^{-W/\tau} $$
La lógica detrás de estas dos fórmulas es múltiple:
- $\Phi$ es la función de distribución normal estándar: el logaritmo de un retraso lognormal es normal, así que la probabilidad de que el duplicado llegue dentro de la ventana es la de que $\ln \delta \le \ln W$.
- $q$ es la fracción de duplicados cuyo cliente tiene sus canales unidos en el directorio; si la identidad no está unida, la huella del duplicado lleva otro
cliente_idy ninguna ventana lo detecta. - La segunda fórmula es la probabilidad de que una repetición legítima caiga dentro de la ventana; crece casi en línea recta con $W$ mientras $W$ es pequeña frente a $\tau$.
- Con los supuestos del generador ($m = 10$ minutos, $\sigma = 1$, $q = 0.88$, $\tau = 240$ minutos) y $W = 30$: $P(\text{detectar}) = 0.88 \cdot \Phi(1.099) = 0.88 \cdot 0.864 = 0.760$ y $P(\text{falso positivo}) \approx 1 - e^{-0.125} = 0.118$.
- En conclusión, la ventana tiene un techo que no depende de ella, el de la identidad, y un coste que sí crece con ella, el de los falsos positivos.
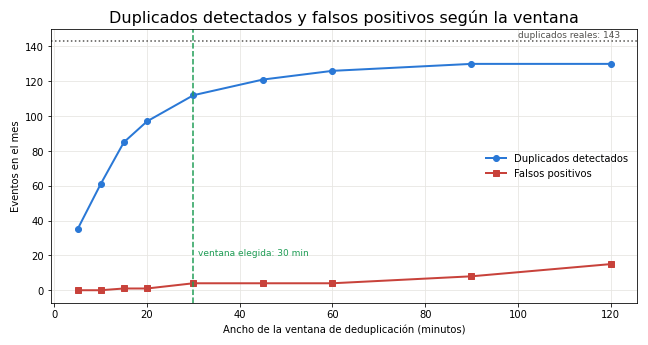
El siguiente código define la huella del pedido, comprueba que el orden de los renglones no la cambia y después recorre el mes de marzo con nueve ventanas, de $5$ a $120$ minutos. En cada una cuenta los duplicados reales detectados, los falsos positivos (eventos marcados como duplicados que eran peticiones nuevas) y los duplicados que se escapan. La función deduplicar guarda, para cada huella, la última vez que se vio, y marca un evento si su huella apareció dentro de la ventana:
# Deduplicación por huella con ventana variable en Python:
identidad_unida = rng.random(len(mes)) < 0.88         # el 88 % de los clientes tiene sus canales unidos
mes['cliente_visto'] = np.where(identidad_unida | mes.origen.isna(), mes.cliente,
                                [f'nuevo{i}' for i in range(len(mes))])

def huella(cliente, contenido):
    return hashlib.sha256(f'{cliente}|{contenido}'.encode()).hexdigest()[:12]

def huella_pedido(cliente_id, renglones, fecha_entrega):
    # Forma canónica: claves del catálogo ordenadas, cantidades y fecha; el canal y la hora no entran:
    canon = ';'.join(f'{clave}x{n}' for clave, n in sorted(renglones.items()))
    return huella(cliente_id, f'{canon}|{fecha_entrega}')

print('WhatsApp :', huella_pedido('c_ana', {'P09': 1, 'P04': 6}, '2026-03-28'))
print('Instagram:', huella_pedido('c_ana', {'P04': 6, 'P09': 1}, '2026-03-28'))
print('Cambio   :', huella_pedido('c_ana', {'P08': 1, 'P04': 6}, '2026-03-28'))

def deduplicar(eventos, ventana_min):
    # Idempotent Receiver: un evento cuya huella se vio hace menos de la ventana se fusiona:
    ultima, marcados = {}, []
    for e in eventos.itertuples():
        h = huella(e.cliente_visto, e.contenido)
        marcados.append(h in ultima and e.minuto - ultima[h] <= ventana_min)
        ultima[h] = e.minuto
    return np.array(marcados)

real = mes.origen.notna().to_numpy()
ventanas = [5, 10, 15, 20, 30, 45, 60, 90, 120]
curva = []
for w in ventanas:
    m = deduplicar(mes, w)
    curva.append({'ventana': w, 'detectados': int((m & real).sum()), 'falsos_positivos': int((m & ~real).sum()),
                  'sin_detectar': int((~m & real).sum())})
curva = pd.DataFrame(curva)
print(curva.to_string(index = False))
sin_identidad = int((real & (mes.cliente_visto != mes.cliente).to_numpy()).sum())
print(f'Duplicados reales: {real.sum()} | con la identidad sin unir (ninguna ventana los ve): {sin_identidad}')

m30 = deduplicar(mes, 30)
tabla2 = mes.assign(dup_real = real, detectado = m30 & real, falso = m30 & ~real).groupby('canal').agg(
    eventos = ('canal', 'size'), duplicados_reales = ('dup_real', 'sum'), detectados_30 = ('detectado', 'sum'),
    falsos_positivos = ('falso', 'sum')).reindex(list(VOLUMEN_MES))
tabla2.loc['total'] = tabla2.sum()
print(tabla2.to_string())

fig, ax = plt.subplots(figsize = (9, 4.8))
ax.plot(curva.ventana, curva.detectados, marker = 'o', color = '#2a78d6', linewidth = 2, label = 'Duplicados detectados')
ax.plot(curva.ventana, curva.falsos_positivos, marker = 's', color = '#c8423b', linewidth = 2, label = 'Falsos positivos')
ax.axhline(real.sum(), color = '#52514e', linestyle = ':', linewidth = 1.5)
ax.text(122, real.sum() + 2, f'duplicados reales: {real.sum()}', ha = 'right', fontsize = 9, color = '#52514e')
ax.axvline(30, color = '#1f9d55', linestyle = '--', linewidth = 1.5)
ax.text(31, 20, 'ventana elegida: 30 min', fontsize = 9, color = '#1f9d55')
ax.set_xlabel('Ancho de la ventana de deduplicación (minutos)')
ax.set_ylabel('Eventos en el mes')
ax.set_title('Duplicados detectados y falsos positivos según la ventana', fontsize = 16)
ax.legend(loc = 'center right', frameon = False)
ax.grid(color = '#e6e5e1')
ax.set_axisbelow(True)
plt.tight_layout()
plt.show()
WhatsApp : caf398e54ce5
Instagram: caf398e54ce5
Cambio   : 71e5bf303bc0
 ventana  detectados  falsos_positivos  sin_detectar
       5          35                 0           108
      10          61                 0            82
      15          85                 1            58
      20          97                 1            46
      30         112                 4            31
      45         121                 4            22
      60         126                 4            17
      90         130                 8            13
     120         130                15            13
Duplicados reales: 143 | con la identidad sin unir (ninguna ventana los ve): 11
            eventos  duplicados_reales  detectados_30  falsos_positivos
canal
whatsapp       1560                 94             75                 3
instagram       400                 24             16                 1
gmail           300                 18             16                 0
formulario       70                  4              2                 0
telefono         47                  3              3                 0
total          2377                143            112                 4
Las dos primeras huellas son idénticas (caf398e54ce5) aunque el pedido de Instagram escribe los renglones en otro orden; la tercera, con un pastel de zanahoria en lugar del de chocolate, es distinta. Es exactamente lo que se quería: el canal y el orden no cuentan, el contenido sí.
La tabla de ventanas cuenta la historia completa:
- Con $5$ minutos, solo se detectan $35$ de los $143$ duplicados: la mayoría de la gente tarda más de cinco minutos en impacientarse y repetir.
- Con $30$ minutos, se detectan $112$ ($78.3%$) con solo $4$ falsos positivos. La fórmula predecía un $76.0%$; la simulación queda a dos puntos.
- Con $120$ minutos, se detectan $130$, apenas $18$ más que con $30$, y los falsos positivos se multiplican por casi cuatro, hasta $15$.
- Ninguna ventana pasa de $130$: los $13$ duplicados restantes son, sobre todo, los $11$ cuya identidad no estaba unida, más un par cuyo retraso supera las dos horas. El techo de la deduplicación lo pone el directorio de identidades, no la ventana.
La fórmula de falsos positivos sobreestima: predice unos ocho y la simulación cuenta cuatro, porque el generador asigna cada repetición legítima al siguiente evento del mismo tipo que llega después del instante sorteado, y eso alarga las separaciones reales. La dirección del efecto es la misma; el número exacto lo da la simulación. La gráfica muestra las dos curvas: la azul sube deprisa hasta los $30$ minutos y después se aplana; la roja apenas se mueve hasta los $60$ y luego crece. Treinta minutos es el codo: donde ampliar la ventana empieza a costar más de lo que rinde.
La Tabla 3 reparte el resultado de la ventana de $30$ minutos por canal.
Tabla 3. Volumen mensual por canal, duplicados reales, duplicados detectados con la ventana de 30 minutos y falsos positivos en el mes simulado.
| Canal | Eventos al mes | Duplicados reales | Detectados (30 min) | Falsos positivos |
|---|---|---|---|---|
| 1 560 | 94 | 75 | 3 | |
| 400 | 24 | 16 | 1 | |
| Gmail | 300 | 18 | 16 | 0 |
| Formulario | 70 | 4 | 2 | 0 |
| Teléfono | 47 | 3 | 3 | 0 |
| Total | 2 377 | 143 | 112 | 4 |
Sin deduplicar, los $143$ duplicados habrían producido $143$ respuestas dobles al mes; con la ventana de $30$ minutos quedan $31$, y $4$ peticiones legítimas se fusionan por error. Esas cuatro son el riesgo que hay que gestionar, y por eso la deduplicación no se limita a borrar:
- Huella idéntica dentro de la ventana: se fusiona. El evento nuevo se marca como
fusionado_enel original, no se genera un segundo borrador y la respuesta se envía por el canal del original con una línea más: “Recibimos su mensaje también por Instagram; es el mismo pedido”. - Mismo cliente y misma fecha, pero renglones distintos: se pregunta. Puede ser un cambio o un segundo pedido. El agente no decide; responde “¿Quiere cambiar su pedido del sábado o añadir uno nuevo?” y espera.
- Fusión deshecha por el cliente: se registra. Si el cliente contesta “no, son dos”, el evento fusionado se reactiva, y la reactivación se cuenta: si las reactivaciones crecen, la ventana es demasiado ancha.
Esa línea de “Recibimos su mensaje también por Instagram” es la que convierte un falso positivo en una molestia menor en lugar de en un pastel que no se hornea: el cliente ve que su segundo mensaje se entendió como repetición y puede corregirlo.
Horarios y colas
La atención de mensajes de Trigo Lento es de 7:00 a 20:00, de lunes a sábado. Fuera de ese horario los eventos siguen llegando, un $25.5%$ en la semana dibujada, y el orquestador tiene que decidir tres cosas: qué contesta en el momento, dónde guarda el evento y cuándo lo vuelve a sacar.
La respuesta de Trigo Lento es un acuse automático y una cola. El acuse dice lo que pasa sin prometer lo que no se puede cumplir (“Recibimos su mensaje. Le respondemos mañana a partir de las 7:00. Si es para darse de baja, ya quedó registrada”) y la cola guarda el sobre hasta la apertura. Las bajas no esperan: se aplican de noche igual que de día, porque así lo exige la regla del módulo. El acuse por WhatsApp es una respuesta dentro de la ventana de atención, que abrió el propio cliente al escribir, así que no necesita plantilla.
La ventana trae, sin embargo, un problema que solo aparece al hacer las cuentas. WhatsApp permite responder con texto libre durante las 24 horas siguientes al último mensaje del cliente; pasado ese plazo, solo se puede escribir con una plantilla aprobada por Meta. Un mensaje que llega el martes a las 22:00 se atiende el miércoles a las 7:00, nueve horas después: la ventana sigue abierta. Uno que llega el sábado a las 20:40 se atiende el lunes a las 7:00, $34.3$ horas después: la ventana ya se cerró. El siguiente código calcula, para cada evento único del mes, el siguiente instante hábil, la espera hasta él y cuántos mensajes de WhatsApp encuentran la ventana cerrada al abrir:
# Horario de atención, acuse fuera de horario, cola y ventana de 24 horas en Python:
def apertura(t):
    # Siguiente instante hábil: de lunes a sábado, de 7:00 a 20:00 (hora de la Ciudad de México):
    if t.weekday() < 6 and HORARIO[0] <= t.hour < HORARIO[1]:
        return t
    dia = t if t.hour < HORARIO[0] and t.weekday() < 6 else t + timedelta(days = 1)
    while dia.weekday() == 6:
        dia += timedelta(days = 1)
    return dia.replace(hour = HORARIO[0], minute = 0, second = 0, microsecond = 0)

unicos = mes[~m30].copy()                                # tras deduplicar con la ventana de 30 minutos
unicos['abre'] = [apertura(t) for t in unicos.recibido]
unicos['espera_h'] = [(a - t).total_seconds() / 3600 for a, t in zip(unicos.abre, unicos.recibido)]
fuera = unicos[unicos.espera_h > 0]
print(f'Eventos únicos: {len(unicos)} | fuera de horario: {len(fuera)} ({len(fuera) / len(unicos):.1%}) '
      f'| acuses automáticos: {len(fuera)}')
print(f'Espera media hasta la apertura: {fuera.espera_h.mean():.1f} h | mediana: {fuera.espera_h.median():.1f} h '
      f'| máxima: {fuera.espera_h.max():.1f} h')
print('Fuera de horario por canal:', fuera.canal.value_counts().to_dict())
wa = fuera[fuera.canal == 'whatsapp']
cerrada = wa[wa.espera_h >= 24]
DIAS_ES = ['lunes', 'martes', 'miércoles', 'jueves', 'viernes', 'sábado', 'domingo']
dias_cerrada = sorted({t.date() for t in cerrada.recibido})
print(f'WhatsApp fuera de horario: {len(wa)} | ventana de 24 h ya cerrada al abrir: {len(cerrada)}')
print('Días en que llegaron:', ', '.join(f'{DIAS_ES[d.weekday()]} {d.day}' for d in dias_cerrada))
ejemplo = datetime(2026, 3, 21, 20, 40, tzinfo = CDMX)
abre = apertura(ejemplo)
print(f'Sábado 21, 20:40 -> {DIAS_ES[abre.weekday()]} {abre.day}, {abre:%H:%M} | horas de espera: '
      f'{(abre - ejemplo).total_seconds() / 3600:.1f}')
Eventos únicos: 2261 | fuera de horario: 605 (26.8%) | acuses automáticos: 605
Espera media hasta la apertura: 12.6 h | mediana: 10.2 h | máxima: 35.0 h
Fuera de horario por canal: {'whatsapp': 356, 'instagram': 166, 'gmail': 66, 'formulario': 17}
WhatsApp fuera de horario: 356 | ventana de 24 h ya cerrada al abrir: 39
Días en que llegaron: sábado 7, domingo 8, sábado 14, domingo 15, sábado 21, domingo 22, sábado 28, domingo 29
Sábado 21, 20:40 -> lunes 23, 07:00 | horas de espera: 34.3
Después de deduplicar quedan $2,261$ eventos únicos, de los que $605$ ($26.8%$) llegan fuera de horario y reciben un acuse automático. La espera media hasta la apertura es de $12.6$ horas, con una mediana de $10.2$ y un máximo de $35.0$: la mediana es una noche, el máximo es un fin de semana completo.
El reparto por canal confirma la gráfica de la semana: $356$ de WhatsApp, $166$ de Instagram (el canal más nocturno, con más del $40%$ de sus mensajes fuera de horario), $66$ de Gmail y $17$ del formulario. La línea importante es la de la ventana: $39$ mensajes de WhatsApp encuentran la ventana de 24 horas cerrada cuando Valeria llega el lunes, y todos llegaron un sábado por la noche o un domingo. Para responderles, Trigo Lento tiene tres opciones, y elige con números:
- Usar una plantilla de utilidad (“Le escribimos sobre el mensaje que nos envió el fin de semana; responda a este mensaje para continuar”). Cuesta $0.0085$ USD por mensaje en México según la Tabla C de la serie: $39 \cdot 0.0085 = 0.33$ USD al mes. La respuesta del cliente reabre la ventana.
- Atender el domingo una hora, de 18:00 a 19:00, solo para responder lo que caducaría. Cuesta una hora de Valeria cada domingo, unos $75$ MXN a la semana, y Valeria no quiere.
- Hacer que el acuse del sábado pida una respuesta corta (“Responda SÍ si quiere que le escribamos el lunes”). Una respuesta del cliente el domingo reabre la ventana hasta el lunes, pero depende de que conteste.
Trigo Lento combina la primera y la tercera: el acuse del fin de semana invita a responder, y si el cliente no lo hace, el lunes sale la plantilla. Para Instagram la regla es parecida y más estricta con la automatización: los mensajes automáticos solo caben en las 24 horas siguientes al último mensaje del cliente, y una persona puede responder hasta siete días después con la etiqueta de agente humano, que no admite contenido promocional ni secuencias automáticas. El lunes, la cola de Instagram la responde Valeria en persona.
Una última regla, que parece de cortesía y es de diseño: el acuse nunca dice “en breve”. Dice la hora a la que habrá respuesta, porque esa hora es un compromiso que se puede medir, y la siguiente sección lo mide.
Niveles de servicio
Un acuerdo de nivel de servicio (o SLA, por sus siglas en inglés: “Service Level Agreement”) es un compromiso medible sobre la calidad de un servicio; el Día 8 (Métricas de proceso y primeros acuerdos de nivel de servicio) los presentó para el proceso de encargos. Hoy se fijan por tipo de cliente, y la medida es el tiempo, en minutos de horario hábil, desde que llega el evento hasta la primera respuesta de una persona. Las respuestas automáticas no cuentan: un acuse no atiende, solo avisa.
Valeria fija tres objetivos, cada uno con su razón:
- Cafetería Brújula: 15 minutos. Marisol hace su pedido antes de abrir la cafetería; si el cambio de baguettes del miércoles no se confirma antes de que el obrador cierre la masa, ya no hay cambio. Es el cliente que más factura y el que menos margen tiene.
- Encargos (pedidos, cambios y quejas): 30 minutos. Un cliente que pidió un pastel quiere saber que alguien lo leyó; un cliente que se quejó, todavía más.
- Información y facturas: 2 horas. La mayoría se responde sola; lo que queda para una persona (una pregunta que el bot no sabe contestar, una factura) puede esperar sin daño.
El compromiso no se mide con el promedio, sino con percentiles. El percentil $50$ (p50, la mediana) dice cómo le va al cliente típico; el percentil $95$ (p95) dice cómo le va al cliente que peor lo pasa, sin contar los casos más extremos. Un promedio de cinco minutos puede esconder a veinte clientes que esperaron una hora, y esos veinte son los que se van. El objetivo de cumplimiento es que el $95%$ de los eventos de cada clase reciba respuesta humana dentro de su plazo.
La cola humana
Las escalaciones que quedan para personas forman una cola con dos servidores, Valeria y la persona de mostrador que cubre los mensajes, y en teoría de colas (el libro clásico es el primer volumen de Queueing Systems, de Leonard Kleinrock) se modelan como un sistema M/M/c con $c = 2$: llegadas de Poisson (la primera M), tiempos de atención exponenciales (la segunda M) y $c$ servidores. Las dos personas atienden también el mostrador, así que el tiempo efectivo de cada atención incluye interrupciones: el código usa medias de $10$ minutos por pedido, $8$ por cambio, $15$ por queja, $10$ por factura y $6$ por pregunta de información (solo el $15%$ de las preguntas, las que el bot no resuelve, llegan a una persona).
Para una cola M/M/c en régimen estable, Agner Krarup Erlang dedujo en 1917 la probabilidad de que un cliente que llega tenga que esperar porque los $c$ servidores están ocupados, la fórmula de Erlang C:
$$ C(c, A) = \frac{\dfrac{A^{c}}{c!},\dfrac{1}{1-\rho}}{\displaystyle\sum_{k=0}^{c-1}\frac{A^{k}}{k!} + \dfrac{A^{c}}{c!},\dfrac{1}{1-\rho}}, \qquad A = \frac{\lambda}{\mu}, \quad \rho = \frac{A}{c} $$
La lógica detrás de esta fórmula es múltiple:
- $\lambda$ es la tasa de llegadas (eventos por minuto) y $\mu$ la tasa de atención de una persona ($1/\mu$ es el tiempo medio de atención). $A = \lambda/\mu$ es la carga ofrecida, en erlangs: cuántas personas harían falta, en promedio, para atender todo sin pausa.
- $\rho = A/c$ es la ocupación de cada servidor. La fórmula solo vale si $\rho < 1$; con $\rho \ge 1$ la cola crece sin límite.
- El numerador es el peso de los estados en los que todos los servidores están ocupados (con la cola de cualquier longitud, que suma una serie geométrica de razón $\rho$, de ahí el factor $1/(1-\rho)$); el denominador suma además los estados con algún servidor libre.
- En conclusión, $C(c, A)$ es la fracción de clientes que no encuentran a nadie libre al llegar.
De ahí salen las dos cifras que sirven para un SLA: el tiempo medio de espera en cola y la probabilidad de esperar más de $t$ minutos:
$$ W_q = \frac{C(c, A)}{c\mu - \lambda}, \qquad P(W > t) = C(c, A), e^{-(c\mu - \lambda),t} $$
La lógica detrás de estas fórmulas es múltiple:
- Quien espera, espera a que se libere el primero de $c$ servidores, que se liberan a ritmo $c\mu$ mientras llegan clientes a ritmo $\lambda$; el exceso $c\mu - \lambda$ es la velocidad a la que se vacía la cola.
- La espera de quien espera es exponencial con esa tasa; multiplicada por la probabilidad de esperar, $C$, da la cola completa de la distribución.
- Con la ley de Little, $L_q = \lambda W_q$, se obtiene cuántas personas hay en cola en promedio.
- En conclusión, el SLA de $15$ minutos se cumple para el $95%$ si $C \cdot e^{-(c\mu - \lambda) \cdot 15} \le 0.05$.
El siguiente código simula el mes completo con una cola no expropiativa de dos personas que solo atienden en horario hábil y que sacan primero a Brújula, después los encargos y por último la información; mide la espera de cada evento en minutos hábiles y calcula el cumplimiento por clase. Después toma la hora pico real del mes (de 10:00 a 12:00), calcula Erlang C con sus llegadas y su tiempo medio de atención y lo compara con una simulación estacionaria de $200,000$ clientes en orden de llegada:
# Simulación de SLA con la cola humana M/M/2 por prioridades y comparación con Erlang C en Python:
import heapq

ATENCION_MIN = {'pedido': 10, 'cambio': 8, 'queja': 15, 'factura': 10, 'informacion': 6}   # media, con interrupciones
humanos = unicos[(unicos.tipo != 'baja') & ((unicos.tipo != 'informacion') | (rng.random(len(unicos)) < 0.15))].copy()
humanos['clase'] = [enrutar(e)['clase_sla'] for _, e in humanos.iterrows()]
humanos['servicio'] = [rng.exponential(ATENCION_MIN[t]) for t in humanos.tipo]
ORDEN = {'brujula': 0, 'encargo': 1, 'informacion': 2}

def minutos_habiles(t0, t1):
    # Minutos de horario hábil entre dos instantes (el reloj del SLA se detiene fuera de horario):
    total, t = 0.0, apertura(t0)
    while t < t1:
        cierre = t.replace(hour = HORARIO[1], minute = 0, second = 0, microsecond = 0)
        total += (min(cierre, t1) - t).total_seconds() / 60
        t = apertura(cierre)
    return total

def simular_cola(eventos, c = 2):
    # Cola no expropiativa con c personas; solo atienden en horario hábil; prioridad por clase:
    pendientes = sorted(eventos.itertuples(), key = lambda e: e.abre)
    libres, cola, esperas, i = [apertura(pendientes[0].abre)] * c, [], {}, 0
    while i < len(pendientes) or cola:
        persona = min(range(c), key = lambda k: libres[k])
        ahora = apertura(libres[persona])
        while i < len(pendientes) and pendientes[i].abre <= ahora:
            e = pendientes[i]
            heapq.heappush(cola, (ORDEN[e.clase], e.abre, e.Index, e))
            i += 1
        if not cola:
            libres[persona] = max(libres[persona], pendientes[i].abre)
            continue
        _, _, _, e = heapq.heappop(cola)
        esperas[e.Index] = minutos_habiles(e.recibido, ahora)
        fin = ahora + timedelta(minutes = e.servicio)
        cierre = ahora.replace(hour = HORARIO[1], minute = 0, second = 0, microsecond = 0)
        libres[persona] = fin if fin <= cierre else apertura(cierre) + (fin - cierre)   # se termina al día siguiente
    return pd.Series(esperas)

humanos['espera'] = simular_cola(humanos)
tabla3 = humanos.groupby('clase').agg(eventos = ('espera', 'size'), p50 = ('espera', 'median'),
                                      p95 = ('espera', lambda x: x.quantile(0.95))).reindex(list(SLA_MIN))
tabla3['objetivo'] = [SLA_MIN[k] for k in tabla3.index]
tabla3['cumplimiento'] = [(humanos.espera[humanos.clase == k] <= SLA_MIN[k]).mean() for k in tabla3.index]
print(tabla3.round(3).to_string())
humanos['franja'] = np.where(humanos.espera_h > 0, 'llegó fuera de horario', 'llegó en horario')
for (clase, franja), g in humanos.groupby(['clase', 'franja']):
    print(f'{clase:<12} {franja:<23} n = {len(g):>3} | p95 = {g.espera.quantile(0.95):6.1f} min | '
          f'cumple = {(g.espera <= SLA_MIN[clase]).mean():.1%}')

# Erlang C en la hora pico (10:00 a 12:00 de lunes a sábado) frente a una simulación FIFO estacionaria:
pico = humanos[(humanos.recibido.dt.hour.isin([10, 11])) & (humanos.recibido.dt.weekday < 6)]
lam = len(pico) / (26 * 2) / 60                      # llegadas por minuto en la hora pico
mu, c = 1 / humanos.servicio.mean(), 2
A, rho = lam / mu, lam / (c * mu)
suma = sum(A ** k / math.factorial(k) for k in range(c))
ultimo = A ** c / math.factorial(c) / (1 - rho)
erlang_c = ultimo / (suma + ultimo)
wq = erlang_c / (c * mu - lam)
print(f'Pico: lambda = {lam * 60:.2f} por hora | servicio medio = {1 / mu:.2f} min | A = {A:.3f} | rho = {rho:.3f}')
print(f'Erlang C: P(esperar) = {erlang_c:.3f} | Wq = {wq:.2f} min | P(W > 15) = {erlang_c * math.exp(-(c * mu - lam) * 15):.3f}'
      f' | Lq = {lam * wq:.2f}')
llegada = np.cumsum(rng.exponential(1 / lam, 200_000))
servicio = rng.exponential(1 / mu, 200_000)
libre, espera_sim = [0.0, 0.0], np.empty(200_000)
for k in range(200_000):
    j = 0 if libre[0] <= libre[1] else 1
    inicio = max(llegada[k], libre[j])
    espera_sim[k] = inicio - llegada[k]
    libre[j] = inicio + servicio[k]
print(f'Simulación FIFO: P(esperar) = {(espera_sim > 0).mean():.3f} | Wq = {espera_sim.mean():.2f} min '
      f'| P(W > 15) = {(espera_sim > 15).mean():.3f}')

fig, ax = plt.subplots(figsize = (8, 4.8))
nombres = ['Brújula (15 min)', 'Encargos (30 min)', 'Información (2 h)']
barras = ax.bar(nombres, tabla3.cumplimiento * 100, color = ['#7b4bb7', '#2a78d6', '#1f9d55'], width = 0.55)
ax.axhline(95, color = '#c8423b', linestyle = '--', linewidth = 1.5)
ax.text(-0.4, 96.5, 'objetivo: 95 %', ha = 'left', fontsize = 9, color = '#c8423b')
for b, v, p95 in zip(barras, tabla3.cumplimiento * 100, tabla3.p95):
    ax.text(b.get_x() + b.get_width() / 2, v - 6, f'{v:.1f} %\np95 = {p95:.1f} min', ha = 'center',
            va = 'top', color = 'white', fontsize = 10)
ax.set_ylim(0, 105)
ax.set_ylabel('Eventos atendidos dentro del SLA (%)')
ax.set_title('Cumplimiento del SLA en el mes simulado', fontsize = 16)
plt.tight_layout()
plt.show()
             eventos  p50     p95  objetivo  cumplimiento
clase
brujula          148  0.0  12.583        15         0.959
encargo          682  0.0  53.121        30         0.897
informacion      241  0.0  80.600       120         1.000
brujula      llegó en horario        n = 113 | p95 =    4.5 min | cumple = 99.1%
brujula      llegó fuera de horario  n =  35 | p95 =   25.3 min | cumple = 85.7%
encargo      llegó en horario        n = 515 | p95 =    3.5 min | cumple = 99.0%
encargo      llegó fuera de horario  n = 167 | p95 =   75.2 min | cumple = 61.1%
informacion  llegó en horario        n = 190 | p95 =   14.7 min | cumple = 100.0%
informacion  llegó fuera de horario  n =  51 | p95 =  107.4 min | cumple = 100.0%
Pico: lambda = 3.35 por hora | servicio medio = 8.87 min | A = 0.495 | rho = 0.247
Erlang C: P(esperar) = 0.098 | Wq = 0.58 min | P(W > 15) = 0.008 | Lq = 0.03
Simulación FIFO: P(esperar) = 0.100 | Wq = 0.58 min | P(W > 15) = 0.008
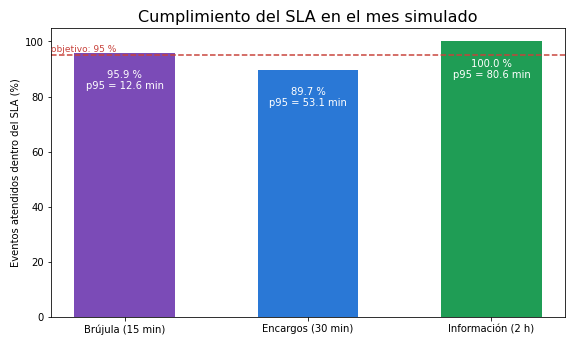
Primero, la comprobación del modelo. En la hora pico llegan $3.35$ escalaciones por hora con una atención media de $8.87$ minutos: la carga es $A = 0.495$ y cada persona está ocupada un $24.7%$ del tiempo. Erlang C da una probabilidad de esperar de $0.098$, una espera media de $0.58$ minutos y una probabilidad de esperar más de $15$ minutos de $0.008$; la simulación de $200,000$ clientes da $0.100$, $0.58$ y $0.008$. La fórmula y la simulación coinciden en las tres cifras, y la ley de Little dice que en la hora pico hay, en promedio, $L_q = 0.03$ personas esperando. En la hora pico, la cola humana de Trigo Lento sobra.
Y sin embargo, el mes no cumple. La Tabla 4 recoge el resultado por clase.
Tabla 4. SLA por tipo de cliente en el mes simulado: objetivo, eventos, p50, p95 y cumplimiento, en total y según la hora de llegada.
| Clase | Objetivo | Eventos | p50 (min) | p95 (min) | Cumplimiento | Llegó en horario | Llegó fuera de horario |
|---|---|---|---|---|---|---|---|
| Brújula | 15 minutos | 148 | 0.0 | 12.6 | 95.9 % | 99.1 % | 85.7 % |
| Encargos | 30 minutos | 682 | 0.0 | 53.1 | 89.7 % | 99.0 % | 61.1 % |
| Información | 2 horas | 241 | 0.0 | 80.6 | 100 % | 100 % | 100 % |
Brújula cumple con un $95.9%$ y la información con un $100%$, pero los encargos se quedan en $89.7%$, por debajo del $95%$, con un p95 de $53.1$ minutos frente a un objetivo de $30$. La mediana de las tres clases es $0.0$: la mayoría de los eventos se atienden en cuanto llegan. El problema está entero en la cola, y las dos últimas columnas dicen dónde: los encargos que llegan en horario cumplen un $99.0%$, y los que llegaron de noche, solo un $61.1%$, con un p95 de $75.2$ minutos.
Es la cola de las 7:00. Cada mañana, las escalaciones que se acumularon durante la noche se vuelven atendibles en el mismo instante, y la cola M/M/2 estable de la hora pico se convierte durante un rato en una cola que se vacía a la velocidad de dos personas. El tiempo que tarda en vaciarse se estima con una cuenta sencilla:
$$ T_{\text{vaciado}} \approx \frac{N \cdot \bar{s}}{c} $$
La lógica detrás de esta fórmula es múltiple:
- $N$ es el número de escalaciones que esperan a la apertura: $35 + 167 + 51 = 253$ en el mes, unas $9.7$ por día hábil.
- $\bar{s}$ es el tiempo medio de atención, $8.87$ minutos, y $c = 2$ las personas que atienden.
- Con esos valores, $T_{\text{vaciado}} \approx 9.7 \cdot 8.87 / 2 = 43$ minutos: el último encargo de la noche espera más que su SLA de $30$ aun con la cola por prioridades, y los lunes, con la cola del sábado por la noche y del domingo, la espera es mayor.
- En conclusión, Erlang C describe bien el régimen estable, pero no ve los picos que crea el propio horario; para eso hace falta simular el día completo.
La gráfica pone las tres barras contra la línea del $95%$: la morada de Brújula queda apenas por encima, la azul de los encargos, claramente por debajo. Valeria tiene tres palancas, y las prueba en el cuaderno antes de elegir:
- Abrir la atención a las 6:30 con una persona para vaciar la cola nocturna antes de las 7:00, cuando empiezan a llegar los mensajes del día. Es la palanca más directa y la que más cuesta: media hora diaria.
- Contar el SLA de lo nocturno desde la apertura con otro objetivo: el acuse ya dijo “a partir de las 7:00”, y el compromiso razonable es “antes de las 8:00”. Es honesto si el acuse lo dice así, y tramposo si se cambia la medida para que el número salga bien.
- Ordenar la cola de la mañana por antigüedad dentro de cada clase, que ya se hace, y dejar que el agente de pedidos prepare los borradores de noche para que la atención de la mañana sea aprobar, no redactar. Eso baja el tiempo medio de atención de los encargos nocturnos y, con él, el vaciado.
Trigo Lento elige la tercera de inmediato, porque no cuesta nada, y la segunda con su acuse reescrito (“Le respondemos mañana antes de las 8:00”). El Día 53 medirá si basta.
Las tres esferas del reloj del servicio resumen la sección: tres plazos, tres cumplimientos y una cola que se forma cuando nadie mira.
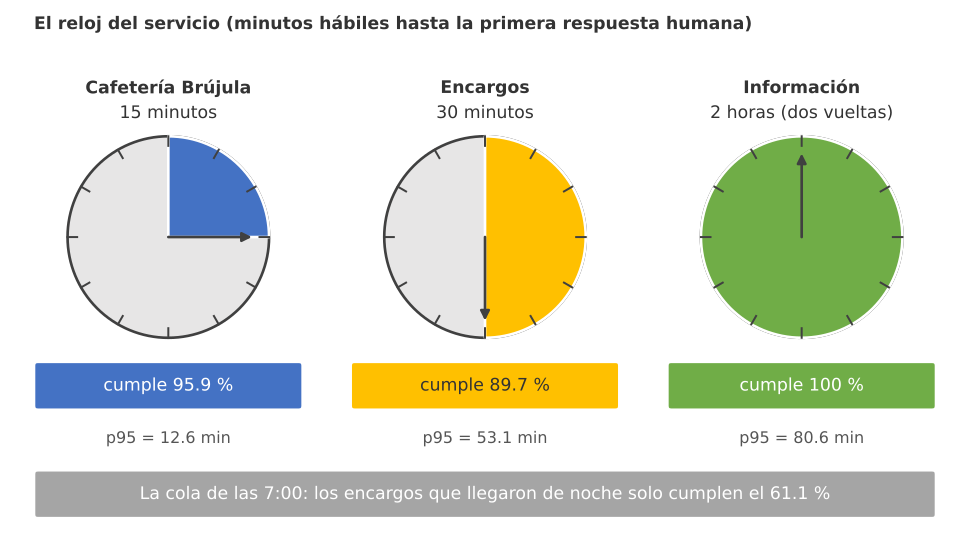
Figura 3. El reloj del servicio: el SLA de Brújula (15 minutos), de los encargos (30 minutos) y de la información (2 horas), con su cumplimiento en el mes simulado (95.9 %, 89.7 % y 100 %) y la cola de las 7:00, donde los encargos que llegaron de noche solo cumplen el 61.1 %.
Atención aquí: Un SLA medido sobre la primera respuesta automática siempre se cumple, y por eso no sirve. Si el orquestador contara el acuse nocturno como “respuesta”, el cumplimiento de los encargos subiría al $100%$ sin que ningún cliente recibiera antes su confirmación. Mida siempre hasta la primera respuesta de una persona (o hasta la resolución, si eso es lo que el cliente espera), declare en qué horas corre el reloj y no cambie la definición después de ver el número: cambiar la medida para cumplir el objetivo es la forma más común de engañarse con un indicador.
TL Orquestador v1
Todo lo anterior se monta en un workflow de n8n, TL Orquestador v1, en el servidor propio de Trigo Lento. Es un sub-workflow de entrada única: los flujos de cada canal (TL WhatsApp secuencias v1 del Día 48, el lector de TL Gmail mayoristas v1 del Día 47 y el de mensajes de Instagram) dejan de decidir qué hacer con lo que reciben y se limitan a pasarlo al orquestador con el nodo Execute Sub-workflow. El formulario web y la captura de llamadas del mostrador, que no tienen flujo propio, entran por un webhook protegido con una clave en la cabecera.
El orquestador tiene dos disparadores y diecinueve nodos en total. Recorrido de izquierda a derecha:
- Dos entradas: “Desde flujos de canal” (el disparador de sub-workflow, que en el lienzo se llama “When Executed by Another Workflow”) y “Formulario y mostrador” (un webhook con autenticación por cabecera).
- Normalizar al sobre: un nodo Code con la misma lógica que el Bloque 2, que produce el sobre con su
id_eventoy su tipo. - Resolver identidad: una consulta a la tabla
identidadesde Postgres que devuelve elcliente_idy si es mayorista; si no hay coincidencia, el sobre sigue con un cliente pendiente de revisión. - Registrar huella y ¿Duplicado?: la deduplicación como una única sentencia SQL atómica, con
INSERT ... ON CONFLICT, que guarda la huella y devuelve si ya se había visto en los últimos 30 minutos. Si se había visto, “Fusionar con el original” marca el evento y el flujo termina. - Horario y prioridad y ¿En horario?: un nodo Code calcula la hora de la Ciudad de México y la clase de SLA; fuera de horario, el sobre va a la cola y sale el acuse automático, salvo las bajas, que pasan siempre.
- Enrutar: un nodo Switch con cinco reglas (baja, mayorista, pedido o cambio, factura, información) y una salida de respaldo, “Persona”, para las quejas y todo lo que no encaje.
- Seis destinos: la baja inmediata en Postgres y cinco llamadas a sub-workflows:
TL Slack operaciones v1(dos veces, a#mayoristasy a#aprobaciones),TL Agente de pedidos v2,TL FacturaciónyTL Responder por canal v1. - Registrar ejecución: una fila en
ejecucionescon el id del evento, el canal y el destino, nunca el texto del mensaje.
La deduplicación merece un comentario aparte. Hacerla en un nodo Code con una variable en memoria sería más corto y estaría mal: si dos mensajes del mismo cliente llegan con un segundo de diferencia, n8n puede procesarlos en paralelo, y los dos verían la memoria vacía. La sentencia INSERT ... ON CONFLICT la resuelve la base de datos de forma atómica: el primero que llega inserta la huella, y el segundo encuentra el conflicto. Es el mismo principio de “decide el primero” que el Día 50 aplicó a las aprobaciones de Slack. Así queda la exportación, con identificadores de ejemplo y las credenciales referidas solo por nombre:
{
  "name": "TL Orquestador v1",
  "nodes": [
    {"id": "0b1c5200-0000-4000-8000-000000000001", "name": "Desde flujos de canal", "type": "n8n-nodes-base.executeWorkflowTrigger", "typeVersion": 1.1, "position": [0, -120],
      "parameters": {"inputSource": "jsonExample", "jsonExample": "{\n  \"canal\": \"whatsapp\",\n  \"carga\": {}\n}"}
    },
    {"id": "0b1c5200-0000-4000-8000-000000000002", "name": "Formulario y mostrador", "type": "n8n-nodes-base.webhook", "typeVersion": 2, "position": [0, 120], "webhookId": "00000000-0000-4000-8000-0000000052aa", "credentials": {"httpHeaderAuth": {"id": "EJEMPLO-NO-REAL-HA", "name": "Clave del formulario TL"}},
      "parameters": {"httpMethod": "POST", "path": "tl-entrada-mostrador", "authentication": "headerAuth", "responseMode": "onReceived", "options": {}}
    },
    {"id": "0b1c5200-0000-4000-8000-000000000003", "name": "Normalizar al sobre", "type": "n8n-nodes-base.code", "typeVersion": 2, "position": [220, 0],
      "parameters": {"jsCode": "const e = $json.body ?? $json;\nconst canal = e.canal ?? (e.folio?.startsWith('T-') ? 'telefono' : 'formulario');\nconst c = {whatsapp: () => e.carga.entry[0].changes[0].value.messages[0], instagram: () => e.carga.entry[0].messaging[0], gmail: () => e.carga, formulario: () => e, telefono: () => e}[canal]();\nconst id = {whatsapp: c.id, instagram: c.message?.mid, gmail: c.id, formulario: c.folio, telefono: c.folio}[canal];\nconst identificador = {whatsapp: '+' + c.from, instagram: 'ig:' + c.sender?.id, gmail: (c.de ?? '').match(/<([^>]+)>/)?.[1]?.toLowerCase(), formulario: c.telefono, telefono: c.telefono}[canal];\nconst texto = ({whatsapp: c.text?.body, instagram: c.message?.text, gmail: c.asunto + '. ' + c.texto, formulario: 'Pedido: ' + c.detalle, telefono: c.nota}[canal] ?? '').slice(0, 500);\nconst sha = (s) => require('crypto').createHash('sha256').update(s).digest('hex');\nconst reglas = [['baja', /^\\W*(baja|ya no)\\W*$/i], ['queja', /queja|lleg[oó] tarde|crud|quemad|reclam/i], ['factura', /factur|\\bcfdi\\b|\\brfc\\b/i], ['cambio', /cambi|en lugar de|ahora son|agregar|añadir/i], ['pedido', /quiero|quisiera|encarg|apart|pedido|me manda|necesito \\d/i]];\nconst tipo = (reglas.find(([, r]) => r.test(texto)) ?? ['informacion'])[0];\nreturn [{json: {id_evento: canal.slice(0, 2) + '_' + sha(canal + ':' + id).slice(0, 10), canal, identificador, recibido_en: new Date().toISOString(), tipo, cuerpo: texto, prioridad: null, contenido: texto.toLowerCase().replace(/\\W+/g, ' ').trim()}}];"}
    },
    {"id": "0b1c5200-0000-4000-8000-000000000004", "name": "Resolver identidad", "type": "n8n-nodes-base.postgres", "typeVersion": 2.6, "position": [440, 0], "credentials": {"postgres": {"id": "EJEMPLO-NO-REAL-PG", "name": "Postgres Trigo Lento"}},
      "parameters": {"operation": "executeQuery", "query": "SELECT cliente_id, mayorista FROM identidades WHERE credencial = $1 UNION ALL SELECT NULL, false LIMIT 1;", "options": {"queryReplacement": "={{ $json.identificador }}"}}
    },
    {"id": "0b1c5200-0000-4000-8000-000000000005", "name": "Registrar huella", "type": "n8n-nodes-base.postgres", "typeVersion": 2.6, "position": [660, 0], "credentials": {"postgres": {"id": "EJEMPLO-NO-REAL-PG", "name": "Postgres Trigo Lento"}},
      "parameters": {"operation": "executeQuery", "query": "WITH previa AS (SELECT visto_en FROM huellas WHERE huella = encode(sha256(convert_to($1 || '|' || $2, 'UTF8')), 'hex')) INSERT INTO huellas (huella, id_evento, visto_en) VALUES (encode(sha256(convert_to($1 || '|' || $2, 'UTF8')), 'hex'), $3, now()) ON CONFLICT (huella) DO UPDATE SET id_evento = CASE WHEN now() - huellas.visto_en <= interval '30 minutes' THEN huellas.id_evento ELSE EXCLUDED.id_evento END, visto_en = now() RETURNING huellas.id_evento AS original, COALESCE((SELECT now() - visto_en <= interval '30 minutes' FROM previa), false) AS duplicado;", "options": {"queryReplacement": "={{ $json.cliente_id ?? $('Normalizar al sobre').item.json.identificador }},{{ $('Normalizar al sobre').item.json.contenido }},{{ $('Normalizar al sobre').item.json.id_evento }}"}}
    },
    {"id": "0b1c5200-0000-4000-8000-000000000006", "name": "¿Duplicado?", "type": "n8n-nodes-base.if", "typeVersion": 2.2, "position": [880, 0],
      "parameters": {"conditions": {"options": {"caseSensitive": true, "leftValue": "", "typeValidation": "strict", "version": 2}, "conditions": [{"id": "c5200001", "leftValue": "={{ $json.duplicado }}", "rightValue": "", "operator": {"type": "boolean", "operation": "true", "singleValue": true}}], "combinator": "and"}, "options": {}}
    },
    {"id": "0b1c5200-0000-4000-8000-000000000007", "name": "Fusionar con el original", "type": "n8n-nodes-base.postgres", "typeVersion": 2.6, "position": [1100, -240], "credentials": {"postgres": {"id": "EJEMPLO-NO-REAL-PG", "name": "Postgres Trigo Lento"}},
      "parameters": {"operation": "executeQuery", "query": "UPDATE eventos SET fusionado_en = $1 WHERE id_evento = $2;", "options": {"queryReplacement": "={{ $json.original }},{{ $('Normalizar al sobre').item.json.id_evento }}"}}
    },
    {"id": "0b1c5200-0000-4000-8000-000000000008", "name": "Horario y prioridad", "type": "n8n-nodes-base.code", "typeVersion": 2, "position": [1100, 0],
      "parameters": {"jsCode": "const id = $('Resolver identidad').item.json;\nconst s = {...$('Normalizar al sobre').item.json, cliente_id: id.cliente_id ?? 'pendiente_revision', mayorista: id.mayorista === true};\nconst ahora = new Date(new Date().toLocaleString('en-US', {timeZone: 'America/Mexico_City'}));\nconst en_horario = ahora.getDay() !== 0 && ahora.getHours() >= 7 && ahora.getHours() < 20;\nconst sla_min = s.mayorista ? 15 : (['pedido', 'cambio', 'queja'].includes(s.tipo) ? 30 : 120);\nreturn [{json: {...s, en_horario, sla_min}}];"}
    },
    {"id": "0b1c5200-0000-4000-8000-000000000009", "name": "¿En horario?", "type": "n8n-nodes-base.if", "typeVersion": 2.2, "position": [1320, 0],
      "parameters": {"conditions": {"options": {"caseSensitive": true, "leftValue": "", "typeValidation": "strict", "version": 2}, "conditions": [{"id": "c5200002", "leftValue": "={{ $json.en_horario || $json.tipo === 'baja' }}", "rightValue": "", "operator": {"type": "boolean", "operation": "true", "singleValue": true}}], "combinator": "and"}, "options": {}}
    },
    {"id": "0b1c5200-0000-4000-8000-000000000010", "name": "Encolar fuera de horario", "type": "n8n-nodes-base.postgres", "typeVersion": 2.6, "position": [1540, 400], "credentials": {"postgres": {"id": "EJEMPLO-NO-REAL-PG", "name": "Postgres Trigo Lento"}},
      "parameters": {"operation": "executeQuery", "query": "INSERT INTO cola_fuera_de_horario (id_evento, canal, cliente_id, recibido_en, sla_min) VALUES ($1, $2, $3, $4, $5) ON CONFLICT (id_evento) DO NOTHING;", "options": {"queryReplacement": "={{ $json.id_evento }},{{ $json.canal }},{{ $json.cliente_id }},{{ $json.recibido_en }},{{ $json.sla_min }}"}}
    },
    {"id": "0b1c5200-0000-4000-8000-000000000011", "name": "Acuse automático", "type": "n8n-nodes-base.executeWorkflow", "typeVersion": 1.2, "position": [1760, 400],
      "parameters": {"source": "database", "workflowId": {"__rl": true, "value": "EJEMPLO-NO-REAL-52R", "mode": "list", "cachedResultName": "TL Responder por canal v1"}, "workflowInputs": {"mappingMode": "defineBelow", "value": {"sobre": "={{ JSON.stringify($('Horario y prioridad').item.json) }}", "modo": "acuse_fuera_de_horario"}, "matchingColumns": [], "schema": [], "attemptToConvertTypes": false, "convertFieldsToString": true}, "mode": "once", "options": {"waitForSubWorkflow": false}}
    },
    {"id": "0b1c5200-0000-4000-8000-000000000012", "name": "Enrutar", "type": "n8n-nodes-base.switch", "typeVersion": 3.2, "position": [1540, -100],
      "parameters": {"rules": {"values": [{"conditions": {"options": {"caseSensitive": true, "leftValue": "", "typeValidation": "strict", "version": 2}, "conditions": [{"id": "c5200003", "leftValue": "={{ $json.tipo === 'baja' }}", "rightValue": "", "operator": {"type": "boolean", "operation": "true", "singleValue": true}}], "combinator": "and"}, "renameOutput": true, "outputKey": "Baja"}, {"conditions": {"options": {"caseSensitive": true, "leftValue": "", "typeValidation": "strict", "version": 2}, "conditions": [{"id": "c5200004", "leftValue": "={{ $json.mayorista === true }}", "rightValue": "", "operator": {"type": "boolean", "operation": "true", "singleValue": true}}], "combinator": "and"}, "renameOutput": true, "outputKey": "Mayorista"}, {"conditions": {"options": {"caseSensitive": true, "leftValue": "", "typeValidation": "strict", "version": 2}, "conditions": [{"id": "c5200005", "leftValue": "={{ ['pedido', 'cambio'].includes($json.tipo) }}", "rightValue": "", "operator": {"type": "boolean", "operation": "true", "singleValue": true}}], "combinator": "and"}, "renameOutput": true, "outputKey": "Pedido o cambio"}, {"conditions": {"options": {"caseSensitive": true, "leftValue": "", "typeValidation": "strict", "version": 2}, "conditions": [{"id": "c5200006", "leftValue": "={{ $json.tipo === 'factura' }}", "rightValue": "", "operator": {"type": "boolean", "operation": "true", "singleValue": true}}], "combinator": "and"}, "renameOutput": true, "outputKey": "Factura"}, {"conditions": {"options": {"caseSensitive": true, "leftValue": "", "typeValidation": "strict", "version": 2}, "conditions": [{"id": "c5200007", "leftValue": "={{ $json.tipo === 'informacion' }}", "rightValue": "", "operator": {"type": "boolean", "operation": "true", "singleValue": true}}], "combinator": "and"}, "renameOutput": true, "outputKey": "Información"}]}, "options": {"fallbackOutput": "extra", "renameFallbackOutput": "Persona"}}
    },
    {"id": "0b1c5200-0000-4000-8000-000000000013", "name": "Baja inmediata", "type": "n8n-nodes-base.postgres", "typeVersion": 2.6, "position": [1980, -700], "credentials": {"postgres": {"id": "EJEMPLO-NO-REAL-PG", "name": "Postgres Trigo Lento"}},
      "parameters": {"operation": "executeQuery", "query": "UPDATE consentimientos SET consentimiento = 'baja', baja_en = now() WHERE cliente_id = $1;", "options": {"queryReplacement": "={{ $json.cliente_id }}"}}
    },
    {"id": "0b1c5200-0000-4000-8000-000000000014", "name": "Avisar en #mayoristas", "type": "n8n-nodes-base.executeWorkflow", "typeVersion": 1.2, "position": [1980, -480],
      "parameters": {"source": "database", "workflowId": {"__rl": true, "value": "EJEMPLO-NO-REAL-50S", "mode": "list", "cachedResultName": "TL Slack operaciones v1"}, "workflowInputs": {"mappingMode": "defineBelow", "value": {"sobre": "={{ JSON.stringify($('Horario y prioridad').item.json) }}", "canal_slack": "mayoristas"}, "matchingColumns": [], "schema": [], "attemptToConvertTypes": false, "convertFieldsToString": true}, "mode": "once", "options": {"waitForSubWorkflow": false}}
    },
    {"id": "0b1c5200-0000-4000-8000-000000000015", "name": "Agente de pedidos", "type": "n8n-nodes-base.executeWorkflow", "typeVersion": 1.2, "position": [1980, -260],
      "parameters": {"source": "database", "workflowId": {"__rl": true, "value": "EJEMPLO-NO-REAL-38A", "mode": "list", "cachedResultName": "TL Agente de pedidos v2"}, "workflowInputs": {"mappingMode": "defineBelow", "value": {"sobre": "={{ JSON.stringify($('Horario y prioridad').item.json) }}"}, "matchingColumns": [], "schema": [], "attemptToConvertTypes": false, "convertFieldsToString": true}, "mode": "once", "options": {"waitForSubWorkflow": false}}
    },
    {"id": "0b1c5200-0000-4000-8000-000000000016", "name": "Facturación", "type": "n8n-nodes-base.executeWorkflow", "typeVersion": 1.2, "position": [1980, -40],
      "parameters": {"source": "database", "workflowId": {"__rl": true, "value": "EJEMPLO-NO-REAL-40F", "mode": "list", "cachedResultName": "TL Facturación"}, "workflowInputs": {"mappingMode": "defineBelow", "value": {"sobre": "={{ JSON.stringify($('Horario y prioridad').item.json) }}"}, "matchingColumns": [], "schema": [], "attemptToConvertTypes": false, "convertFieldsToString": true}, "mode": "once", "options": {"waitForSubWorkflow": false}}
    },
    {"id": "0b1c5200-0000-4000-8000-000000000017", "name": "Respuestas frecuentes", "type": "n8n-nodes-base.executeWorkflow", "typeVersion": 1.2, "position": [1980, 180],
      "parameters": {"source": "database", "workflowId": {"__rl": true, "value": "EJEMPLO-NO-REAL-52R", "mode": "list", "cachedResultName": "TL Responder por canal v1"}, "workflowInputs": {"mappingMode": "defineBelow", "value": {"sobre": "={{ JSON.stringify($('Horario y prioridad').item.json) }}", "modo": "respuesta_frecuente"}, "matchingColumns": [], "schema": [], "attemptToConvertTypes": false, "convertFieldsToString": true}, "mode": "once", "options": {"waitForSubWorkflow": false}}
    },
    {"id": "0b1c5200-0000-4000-8000-000000000018", "name": "Escalar en #aprobaciones", "type": "n8n-nodes-base.executeWorkflow", "typeVersion": 1.2, "position": [1980, 620],
      "parameters": {"source": "database", "workflowId": {"__rl": true, "value": "EJEMPLO-NO-REAL-50S", "mode": "list", "cachedResultName": "TL Slack operaciones v1"}, "workflowInputs": {"mappingMode": "defineBelow", "value": {"sobre": "={{ JSON.stringify($('Horario y prioridad').item.json) }}", "canal_slack": "aprobaciones"}, "matchingColumns": [], "schema": [], "attemptToConvertTypes": false, "convertFieldsToString": true}, "mode": "once", "options": {"waitForSubWorkflow": false}}
    },
    {"id": "0b1c5200-0000-4000-8000-000000000019", "name": "Registrar ejecución", "type": "n8n-nodes-base.postgres", "typeVersion": 2.6, "position": [2420, 0], "credentials": {"postgres": {"id": "EJEMPLO-NO-REAL-PG", "name": "Postgres Trigo Lento"}}, "onError": "continueRegularOutput",
      "parameters": {"operation": "executeQuery", "query": "INSERT INTO ejecuciones (flujo, id_evento, canal, destino, registrado_en) VALUES ('TL Orquestador v1', $1, $2, $3, now());", "options": {"queryReplacement": "={{ $('Normalizar al sobre').item.json.id_evento }},{{ $('Normalizar al sobre').item.json.canal }},{{ $prevNode.name }}"}}
    }
  ],
  "connections": {
    "Desde flujos de canal": {"main": [[{"node": "Normalizar al sobre", "type": "main", "index": 0}]]},
    "Formulario y mostrador": {"main": [[{"node": "Normalizar al sobre", "type": "main", "index": 0}]]},
    "Normalizar al sobre": {"main": [[{"node": "Resolver identidad", "type": "main", "index": 0}]]},
    "Resolver identidad": {"main": [[{"node": "Registrar huella", "type": "main", "index": 0}]]},
    "Registrar huella": {"main": [[{"node": "¿Duplicado?", "type": "main", "index": 0}]]},
    "¿Duplicado?": {"main": [[{"node": "Fusionar con el original", "type": "main", "index": 0}], [{"node": "Horario y prioridad", "type": "main", "index": 0}]]},
    "Fusionar con el original": {"main": [[{"node": "Registrar ejecución", "type": "main", "index": 0}]]},
    "Horario y prioridad": {"main": [[{"node": "¿En horario?", "type": "main", "index": 0}]]},
    "¿En horario?": {"main": [[{"node": "Enrutar", "type": "main", "index": 0}], [{"node": "Encolar fuera de horario", "type": "main", "index": 0}]]},
    "Encolar fuera de horario": {"main": [[{"node": "Acuse automático", "type": "main", "index": 0}]]},
    "Acuse automático": {"main": [[{"node": "Registrar ejecución", "type": "main", "index": 0}]]},
    "Enrutar": {"main": [[{"node": "Baja inmediata", "type": "main", "index": 0}], [{"node": "Avisar en #mayoristas", "type": "main", "index": 0}], [{"node": "Agente de pedidos", "type": "main", "index": 0}], [{"node": "Facturación", "type": "main", "index": 0}], [{"node": "Respuestas frecuentes", "type": "main", "index": 0}], [{"node": "Escalar en #aprobaciones", "type": "main", "index": 0}]]},
    "Baja inmediata": {"main": [[{"node": "Registrar ejecución", "type": "main", "index": 0}]]},
    "Avisar en #mayoristas": {"main": [[{"node": "Registrar ejecución", "type": "main", "index": 0}]]},
    "Agente de pedidos": {"main": [[{"node": "Registrar ejecución", "type": "main", "index": 0}]]},
    "Facturación": {"main": [[{"node": "Registrar ejecución", "type": "main", "index": 0}]]},
    "Respuestas frecuentes": {"main": [[{"node": "Registrar ejecución", "type": "main", "index": 0}]]},
    "Escalar en #aprobaciones": {"main": [[{"node": "Registrar ejecución", "type": "main", "index": 0}]]}
  },
  "settings": {"executionOrder": "v1", "saveDataSuccessExecution": "none", "callerPolicy": "workflowsFromSameOwner"},
  "pinData": {},
  "meta": {"templateCredsSetupCompleted": true}
}
Tres detalles del JSON conviene mirarlos con calma. Ningún nodo lleva una clave: Postgres usa la credencial “Postgres Trigo Lento” y el webhook, “Clave del formulario TL”, que n8n guarda cifradas; los identificadores de credenciales y de workflows son de ejemplo. Los nodos Execute Sub-workflow llaman a sus destinos con waitForSubWorkflow: false, de modo que el orquestador no espera a que el agente de pedidos termine para registrar la ejecución: el agente puede tardar minutos esperando la aprobación de Valeria, y el orquestador debe quedar libre para el siguiente evento. Y la configuración del workflow no guarda los datos de las ejecuciones correctas (saveDataSuccessExecution: none) y solo admite llamadas de workflows del mismo propietario (callerPolicy), para que ningún otro flujo de la instancia pueda inyectar eventos.
El último bloque lee el JSON, lo revisa con las reglas de hoy (todos los sub-workflows llamados existen en la lista de flujos conocidos, ninguna salida del enrutador queda sin conectar, la deduplicación es atómica, no hay secretos pegados y no hay conexiones rotas), prueba la revisión con una copia a la que se le desconecta la salida “Información” y dibuja el flujo con las formas de la serie: disparadores en óvalo verde, acciones en azul, decisiones en rombo naranja, el agente con IA en morado y las escalaciones a personas en hexágono gris:
# Lectura, revisión y dibujo del workflow TL Orquestador v1 en Python:
import textwrap
from matplotlib.patches import FancyBboxPatch, FancyArrowPatch, Polygon, RegularPolygon

wf = json.loads((carpeta / 'flujos' / 'n8n' / 'orquestador_v1.json').read_text(encoding = 'utf-8'))

def nodos_desde_n8n(wf):
    nodos = [{'id': n['name'], 'tipo': n['type'].split('.')[-1],
              'destino': n['parameters'].get('workflowId', {}).get('cachedResultName', ''),
              'x': n['position'][0] / 75, 'y': -n['position'][1] / 100} for n in wf['nodes']]
    aristas = [(o, d['node'], k) for o, s in wf['connections'].items()
               for lista in s.values() for k, destinos in enumerate(lista) for d in destinos]
    return nodos, aristas

CONOCIDOS = {'TL Agente de pedidos v2', 'TL Facturación', 'TL Slack operaciones v1', 'TL Responder por canal v1'}
def revisar_orquestador(wf):
    hallazgos, nombres = [], {n['name'] for n in wf['nodes']}
    nodos, aristas = nodos_desde_n8n(wf)
    for n in wf['nodes']:
        texto = json.dumps(n['parameters'], ensure_ascii = False)
        if n['type'].endswith('executeWorkflow'):
            destino = n['parameters']['workflowId'].get('cachedResultName')
            if destino not in CONOCIDOS:
                hallazgos.append(f"{n['name']}: llama a un flujo desconocido ({destino})")
        if re.search(r'Bearer\s+[A-Za-z0-9]|sk-ant-|EAA[A-Za-z0-9]{10}', texto):
            hallazgos.append(f"{n['name']}: secreto pegado en los parámetros")
        if n['type'].endswith('switch'):
            extra = n['parameters']['options'].get('fallbackOutput') == 'extra'
            salidas = len(n['parameters']['rules']['values']) + extra
            usadas = {k for o, d, k in aristas if o == n['name']}
            if usadas != set(range(salidas)):
                hallazgos.append(f"{n['name']}: salidas sin conectar {sorted(set(range(salidas)) - usadas)}")
    if not any('ON CONFLICT' in json.dumps(n['parameters']) for n in wf['nodes']):
        hallazgos.append('falta el registro idempotente de la huella')
    for o, d, _ in aristas:
        if o not in nombres or d not in nombres:
            hallazgos.append(f'conexión rota: {o} -> {d}')
    return hallazgos

nodos, aristas = nodos_desde_n8n(wf)
tipos = {k: int(v) for k, v in pd.Series([n['tipo'] for n in nodos]).value_counts().items()}
print(f"{wf['name']}: {len(nodos)} nodos | {len(aristas)} conexiones | tipos: {tipos}")
print('Hallazgos:', revisar_orquestador(wf) or 'ninguno')
alterado = json.loads(json.dumps(wf))
alterado['connections']['Enrutar']['main'][4] = []
print('Hallazgos en una copia sin la salida "Información":', revisar_orquestador(alterado))

COLORES = {'disparador': '#1f9d55', 'accion': '#2a78d6', 'decision': '#eb6834', 'ia': '#7b4bb7', 'humano': '#8a8986'}
def forma_de(n):
    if n['tipo'] in ('webhook', 'executeWorkflowTrigger'):
        return 'disparador'
    if n['tipo'] in ('if', 'switch'):
        return 'decision'
    if 'Slack' in n['destino']:
        return 'humano'
    return 'ia' if 'Agente' in n['destino'] else 'accion'

fig, ax = plt.subplots(figsize = (16, 8.4))
pos = {n['id']: (n['x'], n['y']) for n in nodos}
for n in nodos:
    forma, (x, y) = forma_de(n), pos[n['id']]
    color = COLORES[forma]
    if forma == 'decision':
        ax.add_patch(Polygon([(x - 1.3, y), (x, y + 0.75), (x + 1.3, y), (x, y - 0.75)], facecolor = color, edgecolor = 'white'))
    elif forma == 'humano':
        ax.add_patch(RegularPolygon((x, y), 6, radius = 1.2, orientation = math.pi / 6, facecolor = color, edgecolor = 'white'))
    else:
        estilo = 'round,pad=0.05,rounding_size=0.4' if forma == 'disparador' else 'round,pad=0.05'
        ax.add_patch(FancyBboxPatch((x - 1.2, y - 0.5), 2.4, 1.0, boxstyle = estilo, facecolor = color,
                                    edgecolor = 'white', linewidth = 2))
    nombre = textwrap.fill(n['id'], 13, break_long_words = False, break_on_hyphens = False)
    ax.text(x, y + 0.1, nombre, ha = 'center', va = 'center', color = 'white', fontsize = 7.5)
    ax.text(x, y - 0.36, n['tipo'], ha = 'center', va = 'center', color = 'white', fontsize = 6)
for o, d, k in aristas:
    (x1, y1), (x2, y2) = pos[o], pos[d]
    ax.add_patch(FancyArrowPatch((x1, y1), (x2, y2), arrowstyle = '-|>', mutation_scale = 12, shrinkA = 30,
                                 shrinkB = 32, color = '#52514e', linewidth = 1.2))
    if o in ('¿Duplicado?', '¿En horario?'):
        ax.text((x1 + x2) / 2 + 0.1, (y1 + y2) / 2 + 0.2, 'sí' if k == 0 else 'no', fontsize = 9, color = '#eb6834')
ax.set_xlim(-1.5, max(p[0] for p in pos.values()) + 1.5)
ax.set_ylim(min(p[1] for p in pos.values()) - 1.0, max(p[1] for p in pos.values()) + 1.0)
ax.set_aspect('equal')
ax.axis('off')
ax.set_title(f"{wf['name']}: una sola entrada, una huella por petición y un destino por regla", fontsize = 14)
plt.tight_layout()
plt.show()
TL Orquestador v1: 19 nodos | 25 conexiones | tipos: {'postgres': 6, 'executeWorkflow': 6, 'code': 2, 'if': 2, 'executeWorkflowTrigger': 1, 'webhook': 1, 'switch': 1}
Hallazgos: ninguno
Hallazgos en una copia sin la salida "Información": ['Enrutar: salidas sin conectar [4]']
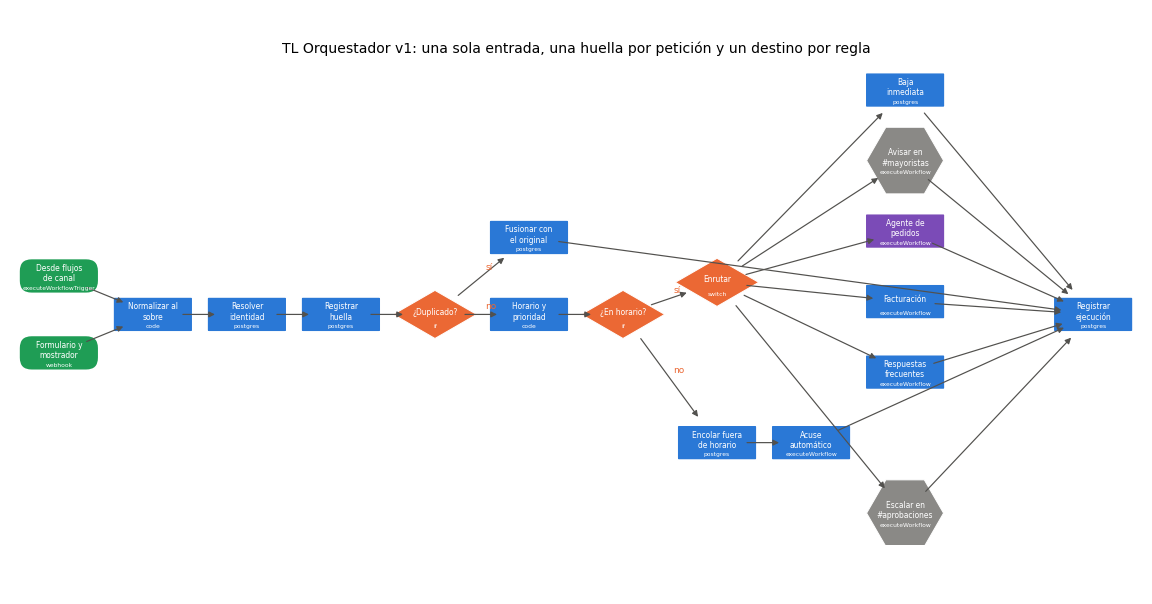
El workflow tiene $19$ nodos y $25$ conexiones, y la revisión no encuentra ningún hallazgo. La copia alterada demuestra para qué sirve: al desconectar la salida $4$ del enrutador, la de “Información”, la revisión responde “salidas sin conectar [4]”. En n8n, una salida de Switch sin conectar no es un error: los eventos que caen en ella simplemente se pierden, sin aviso. Para un orquestador, perder en silencio el $58.3%$ de los eventos (las preguntas de información) sería el peor fallo posible, y es exactamente el que un cambio apresurado en el lienzo puede provocar.
El dibujo enseña la arquitectura: una línea recta de normalización, identidad y huella; la salida temprana de los duplicados hacia arriba; la bifurcación del horario hacia la cola de abajo; y el abanico del enrutador hacia los seis destinos, con los dos hexágonos grises donde el evento llega a una persona. Todas las ramas terminan en el mismo registro, y eso permite al Día 53 calcular los percentiles de cada destino con una sola consulta.
Consideraciones finales
El día empezó con dos confirmaciones para un solo pastel y un cambio de Marisol que llegó por dos puertas, y termina con un orquestador que convierte $2,377$ eventos al mes en un mismo sobre, une las credenciales que los clientes dieron sin adivinar las que no dieron, detecta $112$ de $143$ duplicados con $4$ falsos positivos, responde de noche con un acuse que dice una hora y no “en breve”, y mide su servicio con percentiles: Brújula cumple su plazo en el $95.9%$ de los casos, los encargos en el $89.7%$ y la información siempre. Nada de eso necesitó un modelo de lenguaje; necesitó reglas, una huella, una base de datos que decide quién llegó primero y una simulación honesta.
Las cifras tienen límites que conviene decir. Los volúmenes por canal son los del plan, pero los perfiles horarios, la tasa de duplicados, los tiempos de atención con interrupciones y la fracción de identidades unidas son supuestos didácticos; el modelo de cola trata a Valeria y al mostrador como dos servidores idénticos, cuando en la realidad no lo son; y la deduplicación por huella depende de que el agente extraiga bien los renglones, porque “un pastel de chocolate” y “un pastel de cacao” deben acabar en la misma clave del catálogo. Ninguno de esos límites cambia las conclusiones: el techo de la deduplicación lo pone la identidad, la ventana tiene un codo, y los SLA se rompen en los bordes del horario, no en la hora pico.
Antes de poner un orquestador delante de varios canales, conviene hacerse algunas preguntas:
- ¿Tiene cada evento un identificador estable, de modo que un reintento del canal no lo duplique?
- ¿Une usted las identidades solo con lo que el cliente le dio, y quién confirma las coincidencias dudosas?
- ¿Qué ventana de deduplicación usa, y cuántas fusiones le deshacen los clientes al mes?
- ¿Qué pasa con un mensaje del sábado a las 21:00, y sigue abierta su ventana cuando alguien lo lee?
- ¿Mide usted el SLA hasta la primera respuesta de una persona, con percentiles y por tipo de cliente?
Un gran libro que habla de esto es Enterprise Integration Patterns (o Patrones de integración empresarial), en el que Gregor Hohpe y Bobby Woolf catalogan las soluciones que se repiten cada vez que varios sistemas tienen que intercambiar mensajes: el modelo de datos canónico, el enrutador basado en contenido, el receptor idempotente, la cola de mensajes muertos. Fue escrito para grandes empresas, pero cada patrón tiene una versión del tamaño de una panadería, y leerlo después de esta entrada ayuda a reconocer qué patrón está implementando cada nodo de un workflow y cuál le falta.
Un negocio con cinco canales no necesita cinco veces más atención; necesita que los cinco desemboquen en un solo lugar donde cada petición se cuenta una vez. Don Ernesto, que empezó el día con el pastel doble de Ana, lo dice a su manera al ver la Tabla 4: “Entonces el problema no es el mediodía, es la mañana. Eso lo sé desde hace cuarenta años: el pan de la noche se saca primero.”
Conclusiones clave
Sobre e identidad
- Un sobre común de siete campos (
id_evento,canal,cliente_id,recibido_en,tipo,cuerpoyprioridad) convierte los cinco formatos de entrada en uno; elid_eventoes un resumen del identificador nativo, para que un reintento del canal no duplique nada. - El
cliente_ides un seudónimo HMAC desde la frontera; la identidad se une solo con las credenciales que el cliente dio, y de diez credenciales de prueba, $6$ coinciden de forma exacta, $3$ quedan como sugerencias que confirma una persona y $1$ crea un cliente nuevo. - Normalizar antes de buscar es la mitad del trabajo: sin quitar espacios, guiones y mayúsculas, la misma clienta serían tres.
Enrutamiento y duplicados
- Un enrutador basado en contenido con seis reglas ordenadas manda cada evento a un solo destino, con su responsable y su clase de SLA; el canal decide cómo se responde, no a dónde va el evento, y el $58.3%$ del mes es información que se responde sola.
- La huella SHA-256 de cliente, renglones en forma canónica y fecha de entrega detecta los duplicados entre canales; con una ventana de $30$ minutos se detectan $112$ de $143$ ($78.3%$, frente al $76.0%$ que predice la fórmula) con $4$ falsos positivos.
- Ninguna ventana pasa de $130$ detecciones: el techo lo pone el directorio de identidades; lo idéntico se fusiona avisando al cliente, lo parecido se pregunta y la deduplicación se hace con una sentencia SQL atómica.
Horarios y SLA
- Un $26.8%$ de los eventos llega fuera de horario; reciben un acuse con una hora concreta y esperan una mediana de $10.2$ horas, y $39$ mensajes de WhatsApp del fin de semana encuentran cerrada la ventana de 24 horas, lo que cuesta $0.33$ USD al mes en plantillas de utilidad.
- Erlang C y la simulación coinciden en la hora pico ($P(\text{esperar}) = 0.098$ frente a $0.100$, $W_q = 0.58$ minutos): la cola humana sobra al mediodía.
- Aun así, los encargos cumplen su SLA de $30$ minutos solo en el $89.7%$ de los casos, porque la cola de las 7:00 tarda unos $43$ minutos en vaciarse; los que llegaron de noche cumplen el $61.1%$, y el SLA se mide siempre hasta la primera respuesta humana.
Mañana, en el Día 53: Métricas y SLA de la atención: percentiles, presupuesto de error y alertas. El orquestador ya registra cada evento con su destino y su espera; mañana Valeria convertirá esos registros en indicadores semanales con percentiles, decidirá cuánto incumplimiento se puede permitir antes de cambiar algo y configurará alertas que avisen cuando la cola de las 7:00 vuelva a crecer, sin despertar a nadie por un solo mensaje lento.
Referencias
- Hohpe, G. y Woolf, B. (2003). Enterprise Integration Patterns: Designing, Building, and Deploying Messaging Solutions. Addison-Wesley. (Canonical Data Model, Content-Based Router e Idempotent Receiver; catálogo en línea: https://www.enterpriseintegrationpatterns.com/, revisado en octubre de 2026.)
- Kleinrock, L. (1975). Queueing Systems, Volume 1: Theory. Wiley.
- Erlang, A. K. (1917). Solution of some problems in the theory of probabilities of significance in automatic telephone exchanges. Elektroteknikeren, 13.
- Beyer, B., Jones, C., Petoff, J. y Murphy, N. R. (Eds.) (2016). Site Reliability Engineering: How Google Runs Production Systems. O’Reilly Media. (Capítulo 4, “Service Level Objectives”.)
- Little, J. D. C. (1961). A Proof for the Queuing Formula: L = λW. Operations Research, 9(3), 383-387.
- n8n (2026). Execute Sub-workflow y Execute Sub-workflow Trigger. Documentación de n8n. https://docs.n8n.io/integrations/builtin/core-nodes/n8n-nodes-base.executeworkflow/ (revisado en octubre de 2026).
- Meta (2026). WhatsApp Business Platform: mensajes de plantilla y ventana de atención al cliente. https://developers.facebook.com/documentation/business-messaging/whatsapp (revisado en octubre de 2026).
- Cámara de Diputados del H. Congreso de la Unión (2025). Ley Federal de Protección de Datos Personales en Posesión de los Particulares. Diario Oficial de la Federación, 20 de marzo de 2025.