
Arquitecto de automatización con IA: Día 53
 Jeshua Romero Guadarrama
- 67 Min para leer
- 25 Mar, 2026
Índice de contenido
Resumen:
Marisol Peña quiere saber cómo se comprueba que Trigo Lento le contesta en 15 minutos, y Don Ernesto no quiere promedios, sino cuántos clientes esperaron demasiado. En esta entrada, Valeria convierte los registros del orquestador del Día 52 en indicadores de servicio: define un SLI por canal con eventos válidos, eventos buenos y minutos hábiles, calcula los percentiles p50, p90 y p95 con su intervalo bootstrap, mide el presupuesto de error y su tasa de consumo, diseña alertas multiventana que no suenan por ruido y le propone a la Cafetería Brújula un 95 % en 15 minutos hábiles con una probabilidad de romperlo de 0.050. Al terminar, usted sabrá medir la atención de un negocio por canal, decidir cuándo una alerta merece interrumpir a alguien y firmar un compromiso con los números que lo respaldan.
¿Cómo citar el presente artículo?
Romero, J. (25 de marzo de 2026). Arquitecto de automatización con IA: Día 53. python-data-engineer. https://www.python-data-engineer.com/post/aai/dia_53/.
Arquitecto de automatización con IA: Día 53 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/aai/dia_53/.
Precios, límites y políticas revisados en octubre de 2026: planes, precios y límites de Make, n8n, Zapier, WhatsApp (Meta, Twilio, Wati) y de la API de Claude. La tabla de alertas multiventana (tasa 14.4 en 1 hora con ventana corta de 5 minutos, tasa 6 en 6 horas con ventana corta de 30 minutos y tasa 1 en 3 días, para un SLO del 99.9 % en 30 días) y la fórmula que relaciona la tasa con la fracción del presupuesto gastada se contrastaron en el capítulo “Alerting on SLOs” de The Site Reliability Workbook, en su edición en línea; ese capítulo no fija un número mínimo de eventos por ventana, y el mínimo que usa esta entrada es una decisión de diseño. El límite de un mensaje por segundo de los webhooks entrantes de Slack y la respuesta 429 con la cabecera Retry-After salen de la documentación oficial de Slack sobre límites de tasa. El JSON del Bloque 12 tiene la estructura verificada contra la documentación, revisado en octubre de 2026, con identificadores de ejemplo; no se exportó desde una instancia de n8n. Este día no llama a la API de Claude.
Día 53. Métricas y SLA de la atención: percentiles, presupuesto de error y alertas
Introducción
Ayer, en el Día 52 (Orquestación multicanal sin volverse loco: enrutamiento, deduplicación, horarios y SLA), Valeria juntó WhatsApp, Instagram, el formulario, Gmail y el teléfono en un sobre común con identidad de cliente, enrutó cada evento al flujo y a la persona correctos, eliminó las respuestas dobles y fijó horarios y colas, y Trigo Lento ganó TL Orquestador v1, una puerta de entrada única que deja una marca de tiempo por cada mensaje. Hoy esas marcas se convierten en lo que el Día 8 (Métricas de proceso y primeros acuerdos de nivel de servicio) solo pudo simular: indicadores medidos evento a evento.
Es miércoles 25 de marzo, a las ocho y media de la mañana. Valeria todavía no termina el café cuando entra un mensaje de Marisol Peña, de la Cafetería Brújula: “Valeria, me dijo usted en febrero que los 15 minutos me los prometía cuando funcionara el flujo nuevo. Ya veo que me contestan rapidísimo, pero ¿y cómo sé que de verdad me contestan en 15 minutos? No quiero una impresión, quiero un número.” Tiene razón en pedirlo. Hace siete semanas, con la línea base del Día 8, Valeria solo pudo firmarle un $95%$ en 30 minutos, porque un compromiso de 15 minutos se habría roto en el $91.3%$ de los meses. El orquestador cambió el proceso; falta demostrarlo.
Don Ernesto, que está acomodando las conchas en la vitrina, escucha a su hija leer el mensaje en voz alta y deja la charola para decir lo suyo: “Con promedios cualquiera queda bien, Valeria. Usted me dice ‘contestamos en cuatro minutos’ y yo le creo, pero yo quiero saber cuántos clientes esperaron demasiado. Y otra cosa: si mañana algo se descompone, ¿quién me avisa? ¿Me va a sonar el teléfono cada vez que alguien tarde un minuto de más?” Son dos objeciones distintas y las dos son buenas. La primera pide medir la cola, no el centro. La segunda pide alertas que suenen cuando hay un problema de verdad y que se callen cuando no lo hay. Ninguna se responde con entusiasmo; las dos se responden con un registro y unas cuantas fórmulas.
En la presente entrada, descubrirá cómo convertir los registros de un orquestador de mensajería en indicadores de servicio que se pueden auditar. Simulará un mes de eventos de los cuatro canales con los supuestos declarados del orquestador y escribirá la función que cuenta minutos hábiles, porque el reloj de un negocio se detiene de noche y en domingo. Definirá un indicador por canal con su evento válido y su evento bueno, lo comparará con la línea base del Día 8, calculará los percentiles p50, p90 y p95 con su intervalo de confianza bootstrap y comprobará por qué los percentiles de varios canales no se promedian. Después medirá el presupuesto de error de cada canal, descubrirá que el formulario lo rebasa aunque el indicador global se vea excelente, calculará la tasa de consumo y diseñará alertas multiventana con un mínimo de eventos, que en el mes simulado bajan de $20$ avisos a $1$ sin perder el incidente. Terminará con el compromiso de 15 minutos para Brújula, calculado con la distribución binomial, con el panel de atención que se publica en Slack cada lunes y con el workflow TL Métricas de atención v1, que hace todo esto cada hora hábil sin que nadie lo pida.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Definir un indicador de servicio (SLI) por canal a partir de los registros del orquestador del Día 52, con eventos válidos, eventos buenos y minutos hábiles.
- Calcular e interpretar los percentiles p50, p90 y p95 del tiempo de primera respuesta por canal, con su incertidumbre cuando hay pocos eventos, y compararlos con la línea base del Día 8.
- Calcular el presupuesto de error y la tasa de consumo de cada canal, y diseñar alertas multiventana a Slack que no se disparen por ruido.
- Proponer a la Cafetería Brújula un compromiso de 95 % en 15 minutos con su probabilidad de incumplimiento, y presentar todo en un panel de atención.
De la línea base del Día 8 a hoy
El Día 8 midió un proceso que todavía no tenía flujos. Valeria tomó a mano, durante dos semanas de enero, la hora de llegada y la hora de respuesta de los encargos que pudo apuntar, estimó con esa muestra una distribución lognormal de mediana 12 minutos y $\sigma = 0.9$, y con ella simuló un mes de 468 encargos. El resultado fue claro y poco agradable: la mediana teórica era de $12$ minutos, pero el p95 llegaba a $52.7$ y solo el $84.6%$ de los encargos recibía respuesta en 30 minutos o menos. El presupuesto de error del objetivo interno del $90%$ se gastaba al $143%$ y ninguna semana lo cumplía. Por eso el compromiso con Brújula quedó en 30 minutos y no en 15.
Desde entonces cambiaron tres cosas. El enrutamiento del Día 52 manda cada mensaje al flujo y a la persona correctos sin que Valeria tenga que leerlos todos; las colas fuera de horario dejan los mensajes nocturnos ordenados para la mañana con un acuse automático; y el agente de pedidos del Día 38 (Agentes autónomos con supervisión humana: el asistente de pedidos) contesta lo que puede contestar y prepara borradores de lo que necesita aprobación. Y cambió algo más importante para hoy: ahora cada mensaje deja un registro. La tabla ejecuciones del orquestador guarda, para cada evento del sobre común, la marca recibido_en y la marca primera_respuesta_en, con el canal, el tipo y el cliente seudonimizado. Ya no hace falta una muestra tomada a mano, que, como advirtió el Día 8, suele olvidar justo los peores casos.
Hay que decir con la misma claridad lo que todavía no ha cambiado. TL Orquestador v1 lleva un día en marcha, y un día no es un mes. Para escribir esta entrada, Valeria simula un mes completo con el calendario de marzo de 2026, los volúmenes por canal del Día 52 y unos tiempos de respuesta lognormales por canal que declara como supuestos de la simulación, no como mediciones. El código que sigue es el mismo que leerá la tabla real a fin de abril; lo que cambiará entonces es el origen de los datos, no el método.
El primer bloque fija las importaciones, la semilla de la serie, la carpeta del día y el horario de atención del Día 52, de 7:00 a 20:00 de lunes a sábado. En marzo de 2026 hay $26$ días hábiles (el mes empieza en domingo y tiene cinco domingos), y $26 \cdot 13 = 338$ horas hábiles, la cifra que fijará las alertas más adelante:
# Importaciones base, zona horaria, semilla de la serie y supuestos del día en Python:
import warnings
warnings.filterwarnings('ignore')
import hashlib
import json
import sqlite3
from datetime import datetime, timedelta
from pathlib import Path
from zoneinfo import ZoneInfo
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import scipy
from scipy import stats

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 130)
pd.set_option('display.max_columns', 12)
carpeta = Path('trigo_lento') / 'dia_53'
carpeta.mkdir(parents = True, exist_ok = True)
CDMX = ZoneInfo('America/Mexico_City')

# Horario del Día 52: de 7:00 a 20:00, de lunes a sábado (26 días hábiles en marzo de 2026):
APERTURA, CIERRE = 7, 20
DIAS_HABILES = [d for d in pd.date_range('2026-03-01', '2026-03-31') if d.dayofweek < 6]
HORAS_HABILES = len(DIAS_HABILES) * (CIERRE - APERTURA)
print('numpy', np.__version__, '| pandas', pd.__version__, '| scipy', scipy.__version__)
print(f'Días hábiles: {len(DIAS_HABILES)} | horas hábiles al mes: {HORAS_HABILES}')
numpy 2.4.6 | pandas 3.0.3 | scipy 1.17.1
Días hábiles: 26 | horas hábiles al mes: 338
Las versiones son las mismas del Día 8, de modo que las cifras de las dos entradas son comparables. Las $338$ horas hábiles son el denominador del mes: de ellas se habla cuando se dice “el ritmo sostenible” de gasto del presupuesto.
Un mes de eventos del orquestador
El siguiente bloque simula los $2,330$ eventos del mes con el reparto de la Tabla 2 del Día 52: $1,560$ mensajes de WhatsApp, $400$ de Instagram, $300$ correos de Gmail y $70$ formularios. Dentro de los de WhatsApp van los $26$ mensajes de Brújula, uno por día hábil entre las 17:00 y las 19:00, como en el Día 8. Los supuestos, escritos en el diccionario CANALES, son estos: WhatsApp contesta con una mediana de $3$ minutos hábiles y $\sigma = 0.8$, porque el agente responde casi todo al instante; Instagram, con $6$ minutos y $\sigma = 0.9$, porque sus mensajes directos pasan más por el mostrador; Gmail, con $35$ minutos y $\sigma = 0.7$, porque el buzón de mayoristas del Día 47 deja borradores que Valeria revisa en bloques; y el formulario, con $10$ minutos y $\sigma = 0.8$, porque llega a una bandeja que nadie mira con la misma frecuencia que el teléfono. Brújula tiene sus propios parámetros, mediana de $4$ minutos y $\sigma = 0.6$.
Las llegadas siguen el patrón de la serie: el $12%$ de los eventos entra fuera de horario (de noche o en domingo) y, de los que llegan en horario, el $35%$ cae en la hora pico de 10:00 a 12:00, como en el Día 8. El bloque siembra además un incidente: el martes 17 de marzo, de 10:00 a 12:00, el $60%$ de los mensajes de WhatsApp se contesta tarde. No es un capricho: es la forma de comprobar, más adelante, que las alertas detectan lo que deben detectar. Cada evento recibe un identificador EV-AAAAMMDD-NNNN y un cliente seudonimizado con los primeros diez caracteres de un hash SHA-256, como manda el Día 6:
# Un mes de eventos del orquestador con tiempos de primera respuesta lognormales por canal en Python:
# Supuestos de la simulación (mediana y sigma en minutos hábiles, umbral del SLI en minutos):
CANALES = {
    'whatsapp':   {'eventos': 1560, 'mediana': 3,  'sigma': 0.8, 'umbral': 30},
    'instagram':  {'eventos': 400,  'mediana': 6,  'sigma': 0.9, 'umbral': 30},
    'gmail':      {'eventos': 300,  'mediana': 35, 'sigma': 0.7, 'umbral': 120},
    'formulario': {'eventos': 70,   'mediana': 10, 'sigma': 0.8, 'umbral': 30},
}
BRUJULA = {'eventos': 26, 'mediana': 4, 'sigma': 0.6, 'umbral': 15}   # dentro de los 1 560 de WhatsApp
FUERA_DE_HORARIO = 0.12                                                # llegan de noche o en domingo
PICO = 0.35                                    # de lo que llega en horario, 35 % entre 10:00 y 12:00 (Día 8)
INCIDENTE = (pd.Timestamp('2026-03-17 10:00', tz = CDMX), pd.Timestamp('2026-03-17 12:00', tz = CDMX), 0.60)

def llegadas(n):
    # 88 % dentro del horario (35 % de ellos en la hora pico) y 12 % fuera, de noche o en domingo:
    dentro = rng.random(n) >= FUERA_DE_HORARIO
    dias = rng.integers(0, len(DIAS_HABILES), n)
    hora = np.where(rng.random(n) < PICO, rng.uniform(10, 12, n), rng.uniform(APERTURA, CIERRE, n))
    t = [DIAS_HABILES[d] + pd.Timedelta(hours = h) for d, h in zip(dias, hora)]
    for i in np.flatnonzero(~dentro):
        while True:              # un minuto no hábil al azar, del domingo 1 al martes 31 antes de las 7:00
            c = pd.Timestamp('2026-03-01') + pd.Timedelta(minutes = int(rng.integers(0, 30 * 1440 + 420)))
            if c.dayofweek == 6 or not APERTURA <= c.hour < CIERRE:
                t[i] = c
                break
    return pd.DatetimeIndex(t).tz_localize(CDMX).round('s')

partes = []
for canal, p in CANALES.items():
    n = p['eventos'] - (BRUJULA['eventos'] if canal == 'whatsapp' else 0)
    partes.append(pd.DataFrame({'canal': canal, 'tipo': 'general', 'recibido_en': llegadas(n),
                                'tpr_habil': rng.lognormal(np.log(p['mediana']), p['sigma'], n)}))
# Brújula: un mensaje por día hábil, entre las 17:00 y las 19:00, por WhatsApp:
hora_b = [d + pd.Timedelta(hours = h) for d, h in zip(DIAS_HABILES, rng.uniform(17, 19, len(DIAS_HABILES)))]
partes.append(pd.DataFrame({'canal': 'whatsapp', 'tipo': 'brujula',
                            'recibido_en': pd.DatetimeIndex(hora_b).tz_localize(CDMX).round('s'),
                            'tpr_habil': rng.lognormal(np.log(BRUJULA['mediana']), BRUJULA['sigma'], 26)}))
eventos = pd.concat(partes).sort_values('recibido_en').reset_index(drop = True)

# Incidente sembrado: martes 17 de marzo, de 10:00 a 12:00, el 60 % de WhatsApp sale tarde:
inicio_i, fin_i, p_tarde_i = INCIDENTE
en_incidente = (eventos['canal'] == 'whatsapp') & eventos['recibido_en'].between(inicio_i, fin_i, inclusive = 'left')
tarde = en_incidente & (rng.random(len(eventos)) < p_tarde_i)
eventos.loc[tarde, 'tpr_habil'] = rng.uniform(35, 95, tarde.sum())
eventos['id_evento'] = [f'EV-{t:%Y%m%d}-{i + 1:04d}' for i, t in enumerate(eventos['recibido_en'])]
eventos['cliente_id'] = [hashlib.sha256(f'cliente-{i % 640}'.encode()).hexdigest()[:10] for i in range(len(eventos))]
print(eventos.groupby('canal').size().reindex(list(CANALES)).rename('eventos').to_string())
print('Total:', len(eventos), '| Brújula:', (eventos['tipo'] == 'brujula').sum(),
      '| fuera de horario:', f"{100 * (~eventos['recibido_en'].apply(lambda t: t.dayofweek < 6 and APERTURA <= t.hour < CIERRE)).mean():.1f} %")
print(f'WhatsApp durante el incidente: {en_incidente.sum()} mensajes, {tarde.sum()} fuera de umbral')
canal
whatsapp      1560
instagram      400
gmail          300
formulario      70
Total: 2330 | Brújula: 26 | fuera de horario: 12.0 %
WhatsApp durante el incidente: 17 mensajes, 9 fuera de umbral
El mes tiene los $2,330$ eventos previstos, $26$ de ellos de Brújula, y el $12.0%$ llegó fuera de horario. Durante las dos horas del incidente entraron $17$ mensajes de WhatsApp, más del doble de la media de $4.6$ por hora hábil, porque el incidente cae justo en la hora pico; $9$ de ellos quedaron fuera de umbral por la siembra. Retenga esas dos cifras, porque las alertas tendrán que distinguir este martes de cualquier otro.
El reloj de los minutos hábiles
Un mensaje que llega el sábado a las 19:40 y se contesta el lunes a las 7:20 tardó, en el reloj de pared, más de un día y medio. ¿Es justo contar esa espera contra Trigo Lento? El Día 52 decidió que no: la panadería atiende de 7:00 a 20:00 de lunes a sábado, fuera de ese horario envía un acuse automático (“recibimos su mensaje; le contestamos mañana a partir de las 7:00”) y el reloj del servicio se detiene. Esa decisión tiene dos consecuencias que conviene escribir antes de medir nada:
- El tiempo se cuenta en minutos hábiles, los que caen dentro del horario de atención. La espera del sábado a las 19:40 al lunes a las 7:20 son $20$ minutos del sábado más $20$ del lunes: $40$ minutos hábiles.
- El acuse automático no cuenta como respuesta. Decir “le contestamos mañana” no resuelve nada; si contara, todo mensaje nocturno tendría una “respuesta” en cero segundos y el indicador mediría la velocidad de un robot, no la de la atención.
La función minutos_habiles(inicio, fin) suma, día por día, el tramo de cada jornada hábil que queda entre los dos instantes; sumar_minutos_habiles(inicio, minutos) hace lo contrario, avanza un número de minutos hábiles desde un instante. Las dos usan la zona America/Mexico_City de zoneinfo, que desde 2022 no tiene horario de verano. El bloque las prueba con seis casos, convierte el tiempo de cada evento en la marca primera_respuesta_en, comprueba que el viaje de ida y vuelta devuelve el mismo número y escribe la tabla ejecuciones en una base SQLite propia del día:
# Minutos hábiles entre dos instantes con el horario de 7:00 a 20:00 de lunes a sábado en Python:
def es_habil(t):
    return t.weekday() < 6 and APERTURA <= t.hour < CIERRE

def siguiente_apertura(t):
    # Primer instante hábil igual o posterior a t:
    if es_habil(t):
        return t
    dia = t.replace(hour = APERTURA, minute = 0, second = 0, microsecond = 0)
    if t.hour >= CIERRE or t.weekday() == 6:
        dia += timedelta(days = 1)
    while dia.weekday() == 6:
        dia += timedelta(days = 1)
    return dia if dia >= t else siguiente_apertura(dia + timedelta(days = 1))

def minutos_habiles(inicio, fin):
    total, t = 0.0, siguiente_apertura(inicio)
    while t < fin:
        cierre = t.replace(hour = CIERRE, minute = 0, second = 0, microsecond = 0)
        total += (min(fin, cierre) - t).total_seconds() / 60
        t = siguiente_apertura(cierre)
    return total

def sumar_minutos_habiles(inicio, minutos):
    t = siguiente_apertura(inicio)
    while True:
        cierre = t.replace(hour = CIERRE, minute = 0, second = 0, microsecond = 0)
        disponible = (cierre - t).total_seconds() / 60
        if minutos <= disponible:
            return t + timedelta(minutes = minutos)
        minutos -= disponible
        t = siguiente_apertura(cierre)

casos = [('Martes 10:00 a 10:25', '2026-03-17 10:00', '2026-03-17 10:25'),
         ('Martes 19:50 a miércoles 7:10', '2026-03-17 19:50', '2026-03-18 07:10'),
         ('Martes 23:00 a miércoles 7:30', '2026-03-17 23:00', '2026-03-18 07:30'),
         ('Sábado 19:40 a lunes 7:20', '2026-03-21 19:40', '2026-03-23 07:20'),
         ('Domingo 12:00 a lunes 8:00', '2026-03-22 12:00', '2026-03-23 08:00'),
         ('Viernes 18:00 a sábado 9:00', '2026-03-20 18:00', '2026-03-21 09:00')]
for nombre, a, b in casos:
    ia, ib = datetime.fromisoformat(a).replace(tzinfo = CDMX), datetime.fromisoformat(b).replace(tzinfo = CDMX)
    print(f'{nombre:<32} reloj: {(ib - ia).total_seconds() / 60:>6.0f} min | hábiles: {minutos_habiles(ia, ib):>5.0f} min')

# Marca de primera respuesta y registro en la tabla ejecuciones (sin texto de clientes):
eventos['primera_respuesta_en'] = [sumar_minutos_habiles(t.to_pydatetime(), m) for t, m in
                                   zip(eventos['recibido_en'], eventos['tpr_habil'])]
eventos['tpr_min'] = [minutos_habiles(a.to_pydatetime(), b) for a, b in
                      zip(eventos['recibido_en'], eventos['primera_respuesta_en'])]
eventos['acuse_automatico'] = ~eventos['recibido_en'].apply(lambda t: es_habil(t.to_pydatetime()))
print(f"Ida y vuelta: diferencia máxima {np.abs(eventos['tpr_min'] - eventos['tpr_habil']).max():.2e} min")
con = sqlite3.connect(carpeta / 'trigo_lento_dia53.sqlite')
tabla = eventos[['id_evento', 'canal', 'tipo', 'cliente_id', 'recibido_en', 'primera_respuesta_en', 'acuse_automatico']].copy()
tabla['recibido_en'] = tabla['recibido_en'].map(lambda t: t.isoformat())
tabla['primera_respuesta_en'] = tabla['primera_respuesta_en'].map(lambda t: t.isoformat())
tabla.to_sql('ejecuciones', con, if_exists = 'replace', index = False)
print('Filas en ejecuciones:', con.execute('SELECT COUNT(*) FROM ejecuciones').fetchone()[0],
      '| con acuse automático:', int(eventos['acuse_automatico'].sum()))
Martes 10:00 a 10:25             reloj:     25 min | hábiles:    25 min
Martes 19:50 a miércoles 7:10    reloj:    680 min | hábiles:    20 min
Martes 23:00 a miércoles 7:30    reloj:    510 min | hábiles:    30 min
Sábado 19:40 a lunes 7:20        reloj:   2140 min | hábiles:    40 min
Domingo 12:00 a lunes 8:00       reloj:   1200 min | hábiles:    60 min
Viernes 18:00 a sábado 9:00      reloj:    900 min | hábiles:   240 min
Ida y vuelta: diferencia máxima 8.33e-09 min
Filas en ejecuciones: 2330 | con acuse automático: 279
Los seis casos se leen de arriba abajo. Dentro de horario, el reloj de pared y el hábil coinciden ($25$ minutos). Un mensaje que llega el martes a las 19:50 y se contesta el miércoles a las 7:10 lleva $680$ minutos de reloj, pero solo $20$ hábiles: los diez últimos del martes y los diez primeros del miércoles. El mensaje del domingo a las 12:00 empieza a contar el lunes a las 7:00, de modo que contestarlo a las 8:00 cuesta $60$ minutos hábiles. Y el viernes a las 18:00 contestado el sábado a las 9:00 suma $120$ minutos del viernes y $120$ del sábado: $240$.
La diferencia máxima del viaje de ida y vuelta es de $8.3 \times 10^{-9}$ minutos, un error de redondeo de coma flotante: las dos funciones son inversas una de la otra. La tabla ejecuciones tiene $2,330$ filas y $279$ eventos con acuse automático, los que llegaron fuera de horario. Observe lo que la tabla no guarda: ni el texto del mensaje, ni el teléfono, ni el nombre. Para medir la atención bastan un identificador, un canal, un tipo, un cliente seudonimizado y dos instantes.
El orquestador frente a la línea base
Con las marcas de tiempo, el indicador de cada canal es un conteo. El siguiente bloque marca cada evento como bueno o malo según el umbral de su canal, calcula el SLI de cada uno y el de Brújula con su umbral de 15 minutos, y pone lado a lado la línea base del Día 8 y el mes con el orquestador:
# SLI por canal desde la tabla ejecuciones y comparación con la línea base del Día 8 en Python:
UMBRAL = {c: p['umbral'] for c, p in CANALES.items()}
eventos['umbral'] = eventos['canal'].map(UMBRAL)
eventos['bueno'] = eventos['tpr_min'] <= eventos['umbral']
sli = eventos.groupby('canal').agg(validos = ('bueno', 'size'), buenos = ('bueno', 'sum'),
                                  umbral = ('umbral', 'first')).reindex(list(CANALES))
sli['sli'] = sli['buenos'] / sli['validos']
brujula = eventos[eventos['tipo'] == 'brujula']
sli.loc['brujula (15 min)'] = [len(brujula), int((brujula['tpr_min'] <= 15).sum()), 15,
                               (brujula['tpr_min'] <= 15).mean()]
print(sli.round(4).to_string())

# Línea base del Día 8 (lognormal de mediana 12 y sigma 0.9) frente al mes con el orquestador:
base = stats.lognorm(s = 0.9, scale = 12)
treinta = eventos[eventos['umbral'] == 30]['tpr_min']
filas = [('Día 8, teórico', base.median(), base.ppf(0.90), base.ppf(0.95), 100 * base.cdf(30)),
         ('Día 8, mes simulado', 11.2, 37.1, 50.1, 84.8),
         ('Con orquestador (umbral 30)', *np.percentile(treinta, [50, 90, 95]), 100 * (treinta <= 30).mean()),
         ('Brújula, Día 8 teórico', 8.0, *stats.lognorm(s = 0.6, scale = 8).ppf([0.90, 0.95]),
          100 * stats.lognorm(s = 0.6, scale = 8).cdf(15)),
         ('Brújula con orquestador', *np.percentile(brujula['tpr_min'], [50, 90, 95]),
          100 * (brujula['tpr_min'] <= 15).mean())]
tabla_1 = pd.DataFrame(filas, columns = ['origen', 'p50', 'p90', 'p95', '% en umbral'])
print(tabla_1.round(1).to_string(index = False))
                  validos  buenos  umbral     sli
canal
whatsapp           1560.0  1549.0    30.0  0.9929
instagram           400.0   387.0    30.0  0.9675
gmail               300.0   292.0   120.0  0.9733
formulario           70.0    66.0    30.0  0.9429
brujula (15 min)     26.0    26.0    15.0  1.0000
                     origen  p50  p90  p95  % en umbral
             Día 8, teórico 12.0 38.0 52.7         84.6
        Día 8, mes simulado 11.2 37.1 50.1         84.8
Con orquestador (umbral 30)  3.6 11.9 15.9         98.6
     Brújula, Día 8 teórico  8.0 17.3 21.5         85.3
    Brújula con orquestador  4.2  7.5  9.5        100.0
La segunda tabla de la salida es la Tabla 1, que responde la primera pregunta de Marisol con los mismos percentiles que usó el Día 8.
Tabla 1. Línea base del Día 8 frente al mes simulado con el orquestador: tiempo de primera respuesta en minutos y proporción dentro del umbral.
| Origen | p50 | p90 | p95 | Dentro del umbral |
|---|---|---|---|---|
| Día 8, encargos generales (teórico) | 12.0 | 38.0 | 52.7 | 84.6 % en 30 min |
| Día 8, encargos generales (mes simulado) | 11.2 | 37.1 | 50.1 | 84.8 % en 30 min |
| Marzo con orquestador (WhatsApp, Instagram y formulario) | 3.6 | 11.9 | 15.9 | 98.6 % en 30 min |
| Día 8, Brújula (teórico) | 8.0 | 17.3 | 21.5 | 85.3 % en 15 min |
| Marzo con orquestador, Brújula | 4.2 | 7.5 | 9.5 | 100.0 % en 15 min |
El cambio es grande y conviene leerlo con cuidado. En los canales con umbral de 30 minutos, el p95 baja de $50.1$ a $15.9$ minutos y la proporción dentro del umbral sube del $84.8%$ al $98.6%$. Para Brújula, el p95 pasa de $21.5$ a $9.5$ minutos, por debajo de los 15 que pide Marisol, y los $26$ mensajes del mes simulado reciben respuesta dentro de ese plazo. La comparación tiene una diferencia de método que hay que declarar: el Día 8 medía en minutos de reloj con todas las llegadas dentro del horario, y hoy se mide en minutos hábiles con el $12%$ de llegadas fuera de horario. Para un mensaje que llega en horario y se contesta en horario, las dos medidas coinciden; para uno nocturno, la de hoy es la única justa.
Un SLI por canal
El Día 8 definió el indicador de servicio como una proporción de eventos buenos entre eventos válidos, y advirtió que definir qué cuenta como válido y qué como bueno es una decisión de diseño que se escribe, porque cambia la cifra:
$$ \text{SLI}_c = \frac{\left|{, i \in V_c : t_i \le u_c ,}\right|}{\left|V_c\right|} $$
La lógica detrás de esta fórmula, aplicada a cada canal $c$, es múltiple:
- $V_c$ es el conjunto de eventos válidos del canal: los mensajes entrantes del sobre común que requieren respuesta. Un “gracias” o un emoji suelto no la requieren; el enrutador del Día 52 ya los marca con el tipo
cortesiay quedan fuera. - $t_i$ es el tiempo de primera respuesta del evento $i$ en minutos hábiles, de
recibido_enaprimera_respuesta_en, y una respuesta solo cuenta si es útil: una confirmación, un precio o una pregunta concreta por un dato que falta; el acuse automático no lo es. - $u_c$ es el umbral del canal: 30 minutos para WhatsApp, Instagram y el formulario; 2 horas para Gmail, porque el correo de mayoristas no es una conversación en vivo; y 15 minutos para los mensajes de Brújula, que tienen su propio indicador.
- En conclusión, un canal no se mide con la vara de otro: cada uno tiene su umbral, y el número que sale es comparable entre canales porque todos están en la misma escala de $0$ a $1$.
La Tabla 2 deja por escrito las cinco definiciones, con la fuente de las marcas de tiempo y lo que se excluye. Es el equivalente, para la atención multicanal, del archivo metricas.json del Día 8.
Tabla 2. Definición del SLI de cada canal: evento válido, evento bueno, umbral, fuente de las marcas y exclusiones.
| Canal | Evento válido | Evento bueno | Umbral | Fuente de las marcas | Exclusiones |
|---|---|---|---|---|---|
| Mensaje entrante que requiere respuesta | Primera respuesta útil dentro del umbral | 30 min hábiles | Webhook de la Cloud API y nodo de envío del orquestador | Cortesías, bajas (“BAJA”) y acuses automáticos | |
| Mensaje directo que requiere respuesta | Primera respuesta útil dentro del umbral | 30 min hábiles | Evento de mensajería y registro del orquestador | Reacciones y menciones en historias | |
| Gmail | Correo de mayorista que pide algo | Borrador aprobado y enviado por una persona | 120 min hábiles | Etiqueta del Día 47 y hora de envío en el hilo | Boletines, avisos de proveedores y correo no deseado |
| Formulario | Envío completo del formulario web | Primera respuesta útil dentro del umbral | 30 min hábiles | Webhook del formulario y registro del orquestador | Envíos de prueba y duplicados fusionados el Día 52 |
| Brújula | Mensaje de Marisol por WhatsApp que requiere respuesta | Primera respuesta útil dentro del umbral | 15 min hábiles | Las mismas de WhatsApp, filtradas por cliente | Las mismas de WhatsApp |
Con esas definiciones, la primera tabla de la salida del Bloque 4 da los indicadores del mes: WhatsApp $0.9929$, Instagram $0.9675$, Gmail $0.9733$, el formulario $0.9429$ y Brújula $1.0000$. Tres detalles merecen atención:
- Gmail se mide desde que llega hasta que una persona envía. El Día 47 decidió que ningún correo sale solo; por eso el evento bueno no es “Claude dejó un borrador”, sino “Valeria lo aprobó y lo envió”. Medir el borrador sería medir la máquina; medir el envío es medir lo que vive Marisol.
- Las bajas no son eventos válidos. Un “BAJA” se procesa al instante y de forma automática (Día 48); contarlo como mensaje que requiere respuesta inflaría el indicador con eventos que nadie tiene que atender.
- Los duplicados fusionados el Día 52 cuentan una sola vez. Una clienta que pide el mismo pastel por WhatsApp y por Instagram genera un evento válido, no dos; si contara dos, el canal que respondió segundo cargaría con un “incumplimiento” que ya estaba resuelto.
Percentiles por canal
El SLI responde “¿qué proporción llegó a tiempo?”. Don Ernesto pregunta otra cosa: ¿cuánto esperaron los que más esperaron? Para eso están los percentiles, que el Día 8 calculó con la interpolación lineal de Hyndman y Fan (el “tipo 7”, el que numpy usa por omisión). Hoy se calculan por canal, y aparecen dos problemas que el Día 8 solo vio de pasada: qué hacer cuando un canal tiene pocos eventos y por qué no se pueden juntar los percentiles de varios canales en uno.
La incertidumbre de un percentil
El p95 del formulario se calcula con $70$ eventos: $66.5$ de ellos quedan por debajo y $3.5$ por encima. Es decir, el percentil depende casi por completo de los tres o cuatro formularios que más esperaron. Si en otro mes idéntico uno de ellos hubiera llegado diez minutos antes, el p95 sería otro. ¿Cuánto podría moverse? La respuesta clásica para estadísticos sin fórmula cerrada, como un percentil alto, es el bootstrap de Efron: remuestrear los datos observados con reemplazo, calcular el estadístico en cada remuestra y mirar cómo se reparte.
$$ \hat{q}^{}{b} = Q{95}!\left(x^{}{b,1}, \dots, x^{*}{b,n}\right), \qquad \text{IC}{95%} = \left[, \hat{q}^{*}{(2.5%)},; \hat{q}^{*}_{(97.5%)} ,\right] $$
La lógica detrás de esta fórmula es múltiple:
- Cada remuestra $b$ toma $n$ valores al azar con reemplazo de los $n$ observados: algunos tiempos salen dos veces y otros ninguna, como si se hubiera vivido otro mes con la misma distribución.
- En cada remuestra se calcula el p95, $\hat{q}^{*}_{b}$, con el mismo método de siempre; con $B = 5,000$ remuestras se obtienen $5,000$ valores del p95.
- El intervalo de confianza del $95%$ por percentiles toma el $2.5%$ y el $97.5%$ de esos valores: el rango donde cayó el p95 en el $95%$ de los meses imaginados.
- En conclusión, el ancho del intervalo dice cuánto creerle a un p95: estrecho con miles de eventos, ancho con decenas. El bootstrap no inventa datos, solo hace visible la incertidumbre que ya tenían.
El siguiente bloque calcula los tres percentiles de cada canal, el intervalo bootstrap del p95 con $5,000$ remuestras y, al final, compara tres formas de obtener un “p95 de toda la atención”: el promedio simple de los cuatro p95, el promedio ponderado por eventos y el p95 calculado sobre los $2,330$ eventos juntos:
# Percentiles por canal, intervalo bootstrap del p95 y por qué no se promedian percentiles en Python:
def bootstrap_p95(x, repeticiones = 5000, nivel = 0.95):
    x = np.asarray(x)
    muestras = rng.choice(x, size = (repeticiones, len(x)), replace = True)
    p95 = np.percentile(muestras, 95, axis = 1)
    return np.percentile(p95, [100 * (1 - nivel) / 2, 100 * (1 + nivel) / 2])

filas = []
for canal in CANALES:
    x = eventos.loc[eventos['canal'] == canal, 'tpr_min']
    bajo, alto = bootstrap_p95(x)
    filas.append([canal, len(x), *np.percentile(x, [50, 90, 95]), bajo, alto, UMBRAL[canal]])
percentiles = pd.DataFrame(filas, columns = ['canal', 'n', 'p50', 'p90', 'p95', 'ic95_bajo', 'ic95_alto', 'umbral'])
percentiles['ancho_ic'] = percentiles['ic95_alto'] - percentiles['ic95_bajo']
print(percentiles.round(1).to_string(index = False))
promedio_p95 = percentiles['p95'].mean()
ponderado_p95 = np.average(percentiles['p95'], weights = percentiles['n'])
global_p95 = np.percentile(eventos['tpr_min'], 95)
print(f'Promedio simple de los p95: {promedio_p95:.1f} | ponderado por eventos: {ponderado_p95:.1f} '
      f'| p95 global real: {global_p95:.1f} min')

# Puntos con el intervalo del p95 y el umbral de cada canal:
fig, ax = plt.subplots(figsize = (10.5, 4.8))
y = np.arange(len(percentiles))
ax.hlines(y, percentiles['ic95_bajo'], percentiles['ic95_alto'], color = '#eb6834', linewidth = 6, alpha = 0.35,
          label = 'Intervalo bootstrap del p95 (95 %)')
for col, marca, color in [('p50', 'o', '#2a78d6'), ('p90', 's', '#52514e'), ('p95', 'D', '#eb6834')]:
    ax.scatter(percentiles[col], y, marker = marca, s = 60, color = color, zorder = 3, label = col)
ax.scatter(percentiles['umbral'], y, marker = '|', s = 400, color = '#b8361a', zorder = 3, label = 'Umbral del SLI')
ax.set_yticks(y)
ax.set_yticklabels([f"{c} (n = {n})" for c, n in zip(percentiles['canal'], percentiles['n'])])
ax.set_xscale('log')
ax.set_xticks([1, 3, 10, 30, 120])
ax.set_xticklabels(['1', '3', '10', '30', '120'])
ax.invert_yaxis()
ax.set_xlabel('Minutos hábiles hasta la primera respuesta (escala logarítmica)')
ax.set_title('Percentiles del tiempo de primera respuesta por canal', fontsize = 16)
ax.legend(loc = 'upper left', bbox_to_anchor = (1.0, 1.0), fontsize = 9, frameon = False)
ax.spines[['top', 'right']].set_visible(False)
plt.tight_layout()
plt.show()
     canal    n  p50  p90   p95  ic95_bajo  ic95_alto  umbral  ancho_ic
  whatsapp 1560  3.1  8.4  11.9       11.0       12.7      30       1.7
 instagram  400  5.7 18.7  24.3       20.8       30.2      30       9.4
     gmail  300 35.8 89.5 106.1       96.2      115.1     120      18.9
formulario   70  9.3 24.0  35.3       22.5       51.2      30      28.6
Promedio simple de los p95: 44.4 | ponderado por eventos: 26.9 | p95 global real: 46.1 min
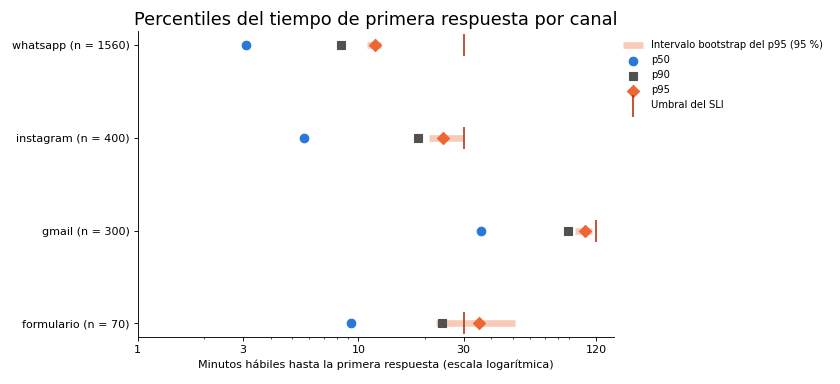
La salida tiene dos lecturas. La primera es la de los anchos. El p95 de WhatsApp es de $11.9$ minutos y su intervalo va de $11.0$ a $12.7$: con $1,560$ eventos, el p95 se conoce casi al minuto. El de Instagram, con $400$, va de $20.8$ a $30.2$. El del formulario es de $35.3$ minutos, por encima de su umbral de 30, pero su intervalo va de $22.5$ a $51.2$: un ancho de $28.6$ minutos. Con $70$ eventos, el p95 del formulario podría estar en realidad por debajo del umbral o casi en una hora. Un percentil sin su intervalo es una cifra; con su intervalo, es una afirmación que se puede discutir.
La gráfica pone los tres percentiles de cada canal en una escala logarítmica, para que quepan los $3$ minutos de la mediana de WhatsApp y los $106$ del p95 de Gmail, con la franja del intervalo del p95 y la raya roja del umbral. La distancia entre el rombo del p95 y la raya del umbral es el margen de cada canal. WhatsApp tiene un margen enorme; Instagram y Gmail, uno pequeño; el formulario está del otro lado.
Los percentiles no se promedian
La segunda lectura está en la última línea de la salida. El promedio simple de los cuatro p95 da $44.4$ minutos; el ponderado por eventos, $26.9$; el p95 real de los $2,330$ eventos juntos, $46.1$. Tres cifras distintas para la misma pregunta, y solo la última es un percentil. La razón es que un percentil es una posición en una lista ordenada, no una cantidad que se reparta: el p95 de la unión depende de cómo se mezclan las colas de los canales, y la cola de Gmail, con sus tiempos de hasta dos horas, ocupa $100$ de los $117$ lugares del $5%$ superior de la lista conjunta aunque Gmail sea solo el $13%$ de los eventos. El promedio ponderado, en cambio, lo diluye con los p95 bajos de WhatsApp.
Hay además una objeción de fondo: un “p95 global” que mezcla canales con umbrales de 30 y de 120 minutos no responde ninguna pregunta útil. A Marisol no le sirve saber que el p95 de toda la panadería es de $46$ minutos, porque sus mensajes van por WhatsApp; a Valeria no le sirve tampoco, porque no dice qué canal mejorar. Los percentiles se calculan por canal y se informan por canal; si alguien necesita una sola cifra, se le da la proporción de eventos buenos, que sí se puede sumar. La Figura 1 pone las cuatro filas una al lado de la otra, cada una medida contra su propia línea.
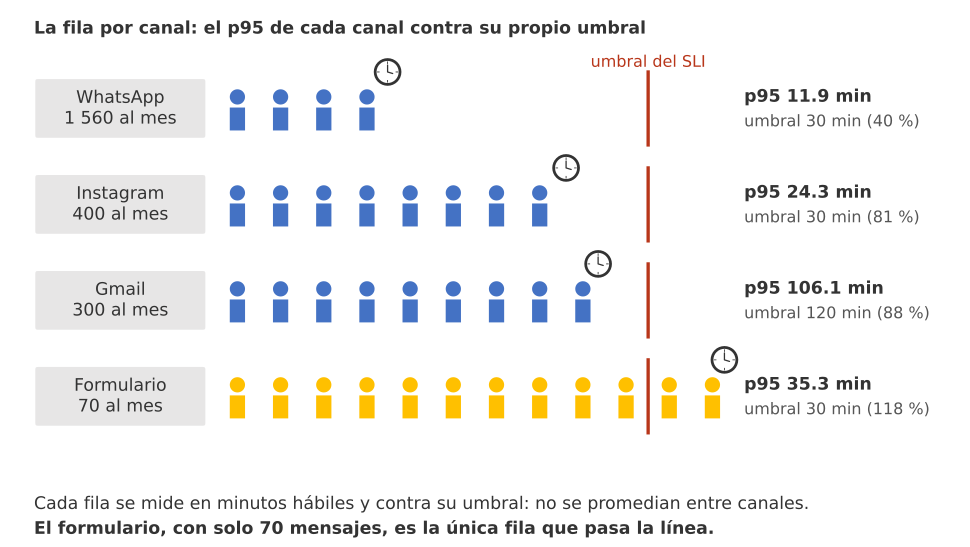
Figura 1. La fila por canal: cada canal es una fila medida contra su propio umbral; el cronómetro marca el p95 (WhatsApp 11.9 de 30 minutos, Instagram 24.3 de 30, Gmail 106.1 de 120 y formulario 35.3 de 30), y la fila del formulario es la única que rebasa su línea.
La comparación con el Día 8 es inmediata. Aquel día, la media de $16.6$ minutos escondía a los $30$ clientes que esperaron más de 45; hoy, el indicador global de $0.9845$ (el $98.45%$ de los eventos a tiempo) esconde al formulario. Es la misma lección en otra escala: el cliente vive en la cola, y la cola de un canal pequeño desaparece dentro del promedio de uno grande.
SLO y presupuesto de error
Un SLI dice dónde está la atención; un objetivo de nivel de servicio (SLO) dice dónde debería estar. Valeria fija un SLO del $95%$ para los cuatro canales: más exigente que el $90%$ del Día 8, porque el proceso ya lo permite, y no tan alto como para que un solo mensaje lento lo rompa. El presupuesto de error es la misma fórmula del Día 8, ahora por canal:
$$ B_c = (1 - \text{SLO}_c) \cdot N_c $$
La lógica detrás de esta fórmula es múltiple:
- $N_c$ es el número de eventos válidos del canal en el mes y $1 - \text{SLO}_c$ la fracción tolerada: con WhatsApp, $B = 0.05 \cdot 1,560 = 78$ respuestas tardías al mes.
- Cada canal tiene su propio presupuesto porque tiene su propio volumen: Instagram puede gastar $20$, Gmail $15$ y el formulario solo $3.5$, es decir, tres respuestas tardías enteras.
- El presupuesto no se traspasa: que WhatsApp gaste poco no autoriza al formulario a gastar más, por la misma razón que los percentiles no se promedian.
- En conclusión, un presupuesto por canal convierte el SLO en una cifra que se gasta día a día y permite ver qué canal se está quedando sin margen, aunque el total vaya bien.
El siguiente bloque calcula el presupuesto de cada canal, cuenta los incumplimientos del mes, encuentra el día hábil en que se agota (si se agota) y dibuja el consumo acumulado en porcentaje del presupuesto:
# Presupuesto de error del mes y su consumo diario por canal en Python:
SLO = {'whatsapp': 0.95, 'instagram': 0.95, 'gmail': 0.95, 'formulario': 0.95}
eventos['dia'] = eventos['recibido_en'].map(lambda t: siguiente_apertura(t.to_pydatetime()).date())
filas, consumo = [], {}
for canal, objetivo in SLO.items():
    x = eventos[eventos['canal'] == canal]
    presupuesto = (1 - objetivo) * len(x)              # B = (1 - SLO) N
    malos = int((~x['bueno']).sum())
    diario = (~x['bueno']).groupby(x['dia']).sum().reindex([d.date() for d in DIAS_HABILES], fill_value = 0)
    consumo[canal] = 100 * diario.cumsum() / presupuesto
    agotado = next((i + 1 for i, v in enumerate(consumo[canal]) if v > 100), None)
    filas.append([canal, objetivo, len(x), presupuesto, malos, presupuesto - malos,
                  100 * malos / presupuesto, agotado])
tabla_3 = pd.DataFrame(filas, columns = ['canal', 'slo', 'eventos', 'presupuesto', 'incumplimientos',
                                         'restante', '% gastado', 'dia_agotado'])
print(tabla_3.round({'presupuesto': 1, 'restante': 1, '% gastado': 1}).to_string(index = False))
global_sli = eventos['bueno'].mean()
print(f'SLI global de los cuatro canales: {global_sli:.4f} (el formulario pesa {70 / len(eventos):.1%} del total)')

# Consumo acumulado del presupuesto en porcentaje, por día hábil:
fig, ax = plt.subplots(figsize = (10, 4.8))
colores = {'whatsapp': '#2a78d6', 'instagram': '#52514e', 'gmail': '#1f9d55', 'formulario': '#eb6834'}
for canal, serie in consumo.items():
    ax.plot(range(1, len(serie) + 1), serie.values, marker = 'o', markersize = 3, linewidth = 2,
            color = colores[canal], label = canal)
ax.axhline(100, color = '#0b0b0b', linestyle = '--', linewidth = 1.5)
ax.text(17, 104, 'Presupuesto agotado (100 %)', fontsize = 10)
ax.set_title('Consumo acumulado del presupuesto de error por canal', fontsize = 16)
ax.set_xlabel('Día hábil de marzo')
ax.set_ylabel('% del presupuesto mensual')
ax.legend(loc = 'upper left', bbox_to_anchor = (1.0, 1.0), frameon = False)
ax.spines[['top', 'right']].set_visible(False)
plt.tight_layout()
plt.show()
     canal  slo  eventos  presupuesto  incumplimientos  restante  % gastado  dia_agotado
  whatsapp 0.95     1560         78.0               11      67.0       14.1          NaN
 instagram 0.95      400         20.0               13       7.0       65.0          NaN
     gmail 0.95      300         15.0                8       7.0       53.3          NaN
formulario 0.95       70          3.5                4      -0.5      114.3         15.0
SLI global de los cuatro canales: 0.9845 (el formulario pesa 3.0% del total)
La salida es la Tabla 3, que ya responde la segunda pregunta de Don Ernesto: cuántos clientes esperaron demasiado, canal por canal.
Tabla 3. SLO, eventos, presupuesto de error, incumplimientos y presupuesto restante por canal en el mes simulado.
| Canal | SLO | Eventos al mes | Presupuesto de error | Incumplimientos | Restante | Gastado |
|---|---|---|---|---|---|---|
| 95 % en 30 min | 1 560 | 78.0 | 11 | 67.0 | 14.1 % | |
| 95 % en 30 min | 400 | 20.0 | 13 | 7.0 | 65.0 % | |
| Gmail | 95 % en 120 min | 300 | 15.0 | 8 | 7.0 | 53.3 % |
| Formulario | 95 % en 30 min | 70 | 3.5 | 4 | -0.5 | 114.3 % |
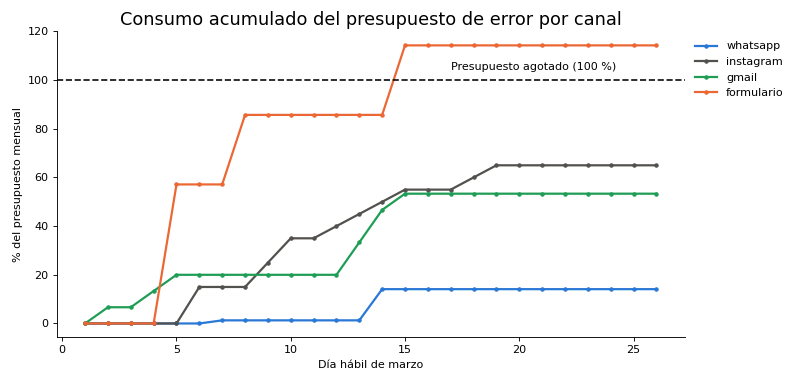
Tres canales cumplen y uno no. WhatsApp gastó $11$ de $78$, el $14.1%$, y $10$ de esos $11$ fueron del incidente del martes 17. Instagram y Gmail gastaron más de la mitad de su presupuesto, pero sin rebasarlo. El formulario gastó $4$ de $3.5$, el $114.3%$, y agotó su presupuesto el día hábil 15, el miércoles 18 de marzo. La gráfica lo muestra con escalones: el formulario sube de golpe el día $5$ (dos formularios tardíos el viernes 6), el día $8$ y el día $15$; cada formulario lento es casi un tercio de su presupuesto.
Y ahora la frase que justifica todo el día: el SLI global de los cuatro canales es de $0.9845$, más de tres puntos por encima del SLO del $95%$. Quien mirara solo esa cifra diría que todo va bien. El formulario pesa el $3.0%$ de los eventos, así que su incumplimiento no mueve el total; pero para las $70$ personas que escribieron por el formulario, la panadería incumplió su propio objetivo.
Atención aquí: con $70$ eventos al mes, el presupuesto del formulario es de $3.5$ respuestas tardías y la diferencia entre cumplir y no cumplir es un solo formulario. Antes de cambiar nada, compruebe que el incumplimiento no es azar: con el supuesto de la simulación (mediana de 10 minutos y $\sigma = 0.8$), la probabilidad de que un formulario tarde más de 30 minutos es de $0.085$, y se esperan $5.9$ formularios tardíos al mes frente a $3.5$ tolerados. El problema es estructural, no de mala suerte. Lo contrario también ocurre: un canal pequeño puede cumplir un mes por azar con un proceso que, en promedio, no cumple. Con pocos eventos, juzgue el canal con la distribución que lo genera, no con la cifra de un solo mes.
Valeria decide la acción con Don Ernesto esa misma tarde. El formulario no tiene un agente que conteste al instante ni el aviso sonoro de WhatsApp: entra a una bandeja que se revisa cuando hay un rato. La corrección es barata: cada formulario nuevo publica un aviso en el canal #pedidos-del-dia de Slack (Día 50) con el identificador del evento y el plazo de respuesta, sin datos del cliente. No es una alerta por consumo del presupuesto, porque con $70$ eventos al mes esas alertas no funcionan, como se verá en la sección siguiente; es un aviso por evento, que en un canal con $2.7$ formularios al día no cansa a nadie.
Tasa de consumo y alertas
El presupuesto dice cuánto se ha gastado; no dice si se está gastando demasiado rápido ahora mismo. El martes 17, a las 12:00, el presupuesto de WhatsApp seguía al $86%$ y, mirado a fin de mes, nadie habría notado nada raro. Pero durante dos horas, más de la mitad de los mensajes se contestó tarde, y eso es justo lo que Don Ernesto quiere saber a tiempo. La herramienta para verlo es la tasa de consumo (en el libro de trabajo de SRE, burn rate):
$$ r = \frac{e}{1 - \text{SLO}} $$
La lógica detrás de esta fórmula es múltiple:
- $e$ es la tasa de error observada en una ventana de tiempo: los eventos malos de la ventana entre los válidos de la ventana. En las dos horas del incidente, $e = 10 / 17 = 0.588$.
- $1 - \text{SLO}$ es la tasa de error que el objetivo tolera ($0.05$). Dividir entre ella mide cuántas veces más rápido de lo sostenible se está gastando el presupuesto: $r = 0.588 / 0.05 = 11.8$.
- $r = 1$ es el ritmo exacto que agota el presupuesto el último minuto del mes; $r = 2$ lo agota a la mitad; $r = 11.8$, sostenido, lo agotaría en $338 / 11.8 = 29$ horas hábiles, menos de tres días.
- En conclusión, la tasa de consumo convierte un porcentaje de errores, que depende del SLO, en una velocidad que se puede comparar con un umbral fijo, sea cual sea el canal.
Alertas multiventana
¿Desde qué tasa conviene avisar? El capítulo “Alerting on SLOs” de The Site Reliability Workbook razona al revés: primero se decide qué fracción del presupuesto justifica interrumpir a alguien y en qué ventana, y de ahí sale el umbral. Si la ventana dura $w$ horas y el periodo del SLO tiene $H$ horas, una tasa $r$ sostenida durante toda la ventana gasta la fracción $r \cdot w / H$ del presupuesto. Despejando:
$$ r^{*} = \frac{f \cdot H}{w} $$
La lógica detrás de esta fórmula es múltiple:
- $f$ es la fracción del presupuesto mensual que, gastada en una sola ventana, merece un aviso; $w$, la duración de la ventana; $H$, las horas del periodo. El libro usa $H = 720$ horas (30 días seguidos) y recomienda, para un SLO del $99.9%$, avisar con $f = 2%$ en 1 hora ($r^{} = 0.02 \cdot 720 / 1 = 14.4$) y con $f = 5%$ en 6 horas ($r^{} = 6$).
- Trigo Lento no atiende 720 horas al mes, sino $338$: el reloj de su presupuesto solo corre en horas hábiles. Con $H = 338$, la regla del libro de $2%$ en una hora da $r^{*} = 6.76$, y una hora con tasa $14.4$ gastaría el $14.4 / 338 = 4.3%$ del presupuesto, no el $2%$.
- La adaptación de Valeria usa dos ventanas: la rápida, $f = 5%$ en $w = 2$ horas ($r^{} = 8.45$), para incidentes agudos; y la lenta, $f = 10%$ en $w = 6$ horas ($r^{} = 5.63$), para degradaciones que duran media jornada.
- En conclusión, el umbral no se elige a ojo: se deriva de cuánto presupuesto se está dispuesto a perder antes de enterarse.
Pocos eventos, alertas ruidosas
El libro de trabajo de SRE está escrito para servicios con miles de peticiones por minuto. En Trigo Lento, WhatsApp recibe $1,560 / 338 = 4.6$ mensajes por hora hábil; Instagram, $1.2$; el formulario, $0.2$. Con esos volúmenes, una ventana de una hora decide con tres o cuatro eventos, y un solo mensaje tardío dispara la tasa: uno de dos es $e = 0.5$ y $r = 10$; uno de uno es $r = 20$. Una regla que funciona con miles de eventos se vuelve, con cuatro, un generador de falsas alarmas.
Las dos defensas son las que ya se anunciaron: ventanas más largas (2 y 6 horas en lugar de 1) y un mínimo de eventos por ventana ($8$ en la rápida y $20$ en la lenta), por debajo del cual la regla no decide. El libro no fija ese mínimo; es una decisión de diseño de Trigo Lento que se escribe junto a la regla. El siguiente bloque compara, canal por canal, una regla ingenua (1 hora, $r^{*} = 6.76$, sin mínimo) con la regla multiventana, cuenta las alertas de cada una (una racha de horas consecutivas con la regla activa cuenta como un solo aviso), separa las del incidente de las falsas y dibuja la tasa de consumo de WhatsApp en las dos ventanas a lo largo del mes:
# Tasa de consumo y alertas multiventana con mínimo de eventos sobre el mes simulado en Python:
eventos['hora_habil'] = [DIAS_HABILES.index(pd.Timestamp(siguiente_apertura(t.to_pydatetime()).date())) * 13
                         + siguiente_apertura(t.to_pydatetime()).hour - APERTURA for t in eventos['recibido_en']]

def umbral_tasa(fraccion, ventana_h, horas = HORAS_HABILES):
    # Tasa que gasta una fracción del presupuesto mensual en una ventana: r = f H / w:
    return fraccion * horas / ventana_h

REGLAS = {'ingenua (1 h, sin mínimo)': [(1, umbral_tasa(0.02, 1), 0)],
          'multiventana (2 h y 6 h, con mínimo)': [(2, umbral_tasa(0.05, 2), 8), (6, umbral_tasa(0.10, 6), 20)]}
incidente_horas = set(eventos.loc[en_incidente, 'hora_habil'])

def evaluar(canal, reglas):
    x = eventos[eventos['canal'] == canal]
    malos = (~x['bueno']).groupby(x['hora_habil']).sum().reindex(range(HORAS_HABILES), fill_value = 0).to_numpy()
    validos = x.groupby('hora_habil').size().reindex(range(HORAS_HABILES), fill_value = 0).to_numpy()
    disparos, tasas = set(), {}
    for ventana, limite, minimo in reglas:
        m = np.convolve(malos, np.ones(ventana))[:HORAS_HABILES]
        v = np.convolve(validos, np.ones(ventana))[:HORAS_HABILES]
        r = np.where(v > 0, m / np.maximum(v, 1), 0) / (1 - SLO[canal])
        tasas[ventana] = r
        disparos |= set(np.flatnonzero((r >= limite) & (v >= minimo)))
    # Un aviso por racha: horas consecutivas con la regla activa cuentan como una sola alerta:
    rachas = [h for h in sorted(disparos) if h - 1 not in disparos]
    verdaderas = [h for h in rachas if canal == 'whatsapp' and any(h <= i + 6 and h >= i for i in incidente_horas)]
    return len(rachas), len(verdaderas), tasas

print('Umbrales: ingenua r >=', round(umbral_tasa(0.02, 1), 2), '| rápida r >=', round(umbral_tasa(0.05, 2), 2),
      '| lenta r >=', round(umbral_tasa(0.10, 6), 2))
for nombre, reglas in REGLAS.items():
    for canal in SLO:
        n, ok, _ = evaluar(canal, reglas)
        print(f'{nombre:<38} {canal:<11} alertas: {n:>3} | del incidente: {ok} | falsas: {n - ok}')
_, _, tasas_wa = evaluar('whatsapp', REGLAS['multiventana (2 h y 6 h, con mínimo)'])
h0 = min(incidente_horas)
print(f'Incidente: hora hábil {h0} | tasa a 2 h: {tasas_wa[2][h0 + 1]:.1f} | a 6 h: {tasas_wa[6][h0 + 1]:.1f}')
gastados = (~eventos.loc[en_incidente, 'bueno']).sum()
print(f'Incumplimientos del incidente: {gastados} = {100 * gastados / (0.05 * 1560):.1f} % del presupuesto de WhatsApp')
wa = eventos[eventos['canal'] == 'whatsapp']
for nombre, (ventana, limite, minimo) in [('ingenua', REGLAS['ingenua (1 h, sin mínimo)'][0]),
                                          ('rápida', REGLAS['multiventana (2 h y 6 h, con mínimo)'][0])]:
    v = np.convolve(wa.groupby('hora_habil').size().reindex(range(HORAS_HABILES), fill_value = 0), np.ones(ventana))
    r = evaluar('whatsapp', [(ventana, limite, minimo)])[2][ventana]
    h = next(i for i in range(h0, HORAS_HABILES) if r[i] >= limite and v[i] >= minimo)
    restante = 78 - (~wa.loc[wa['hora_habil'] <= h, 'bueno']).sum()
    print(f'Aviso {nombre}: al cerrar la hora de {APERTURA + h % 13}:00 a {APERTURA + h % 13 + 1}:00 del día hábil '
          f'{h // 13 + 1} | eventos en ventana: {int(v[h])} | r = {r[h]:.1f} | presupuesto restante: {restante}')

# Tasa de consumo de WhatsApp en ventanas de 2 y 6 horas hábiles:
fig, ax = plt.subplots(figsize = (10, 4.8))
ax.plot(tasas_wa[2], color = '#2a78d6', linewidth = 1.2, label = 'Ventana de 2 h')
ax.plot(tasas_wa[6], color = '#1f9d55', linewidth = 1.6, label = 'Ventana de 6 h')
ax.axhline(umbral_tasa(0.05, 2), color = '#eb6834', linestyle = '--', linewidth = 1.5)
ax.axhline(umbral_tasa(0.10, 6), color = '#b8361a', linestyle = ':', linewidth = 1.5)
ax.text(5, umbral_tasa(0.05, 2) + 0.4, f'Aviso rápido: r >= {umbral_tasa(0.05, 2):.2f}', fontsize = 10, color = '#eb6834')
ax.text(5, umbral_tasa(0.10, 6) - 1.1, f'Aviso lento: r >= {umbral_tasa(0.10, 6):.2f}', fontsize = 10, color = '#b8361a')
ax.axvspan(h0 - 0.5, h0 + 1.5, color = '#eb6834', alpha = 0.15)
ax.text(h0 + 4, 12.6, 'Incidente sembrado:\nmartes 17, 10:00 a 12:00', fontsize = 10)
ax.set_ylim(-0.5, 15)
for d in range(0, HORAS_HABILES, 13 * 6):
    ax.axvline(d, color = '#e6e5e1', linewidth = 0.8, zorder = 0)
ax.set_xlim(0, HORAS_HABILES)
ax.set_title('Tasa de consumo de WhatsApp en marzo (338 horas hábiles)', fontsize = 16)
ax.set_xlabel('Hora hábil del mes (líneas grises: cada lunes)')
ax.set_ylabel('Tasa de consumo r')
ax.legend(loc = 'upper right', frameon = False)
ax.spines[['top', 'right']].set_visible(False)
plt.tight_layout()
plt.show()
Umbrales: ingenua r >= 6.76 | rápida r >= 8.45 | lenta r >= 5.63
ingenua (1 h, sin mínimo)              whatsapp    alertas:   1 | del incidente: 1 | falsas: 0
ingenua (1 h, sin mínimo)              instagram   alertas:   9 | del incidente: 0 | falsas: 9
ingenua (1 h, sin mínimo)              gmail       alertas:   7 | del incidente: 0 | falsas: 7
ingenua (1 h, sin mínimo)              formulario  alertas:   3 | del incidente: 0 | falsas: 3
multiventana (2 h y 6 h, con mínimo)   whatsapp    alertas:   1 | del incidente: 1 | falsas: 0
multiventana (2 h y 6 h, con mínimo)   instagram   alertas:   0 | del incidente: 0 | falsas: 0
multiventana (2 h y 6 h, con mínimo)   gmail       alertas:   0 | del incidente: 0 | falsas: 0
multiventana (2 h y 6 h, con mínimo)   formulario  alertas:   0 | del incidente: 0 | falsas: 0
Incidente: hora hábil 172 | tasa a 2 h: 11.8 | a 6 h: 7.1
Incumplimientos del incidente: 10 = 12.8 % del presupuesto de WhatsApp
Aviso ingenua: al cerrar la hora de 10:00 a 11:00 del día hábil 14 | eventos en ventana: 4 | r = 15.0 | presupuesto restante: 74
Aviso rápida: al cerrar la hora de 11:00 a 12:00 del día hábil 14 | eventos en ventana: 17 | r = 11.8 | presupuesto restante: 67
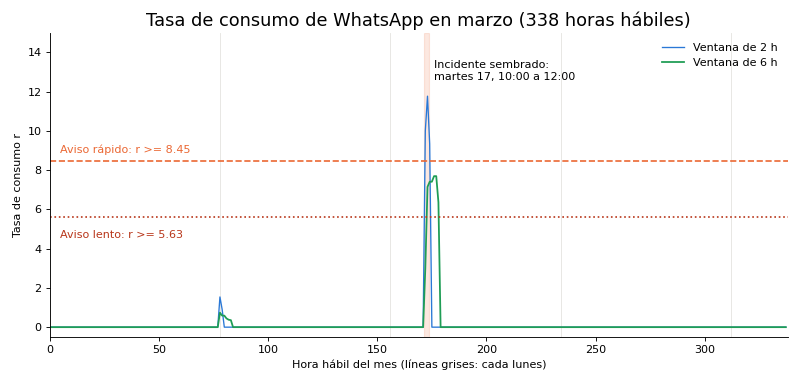
Las cifras son contundentes. La regla ingenua da $20$ avisos en el mes: $1$ del incidente y $19$ falsos, $9$ de Instagram, $7$ de Gmail y $3$ del formulario. Cada uno de esos $19$ avisos es una hora en la que un solo mensaje lento, entre muy pocos, hizo saltar la tasa. La regla multiventana da $1$ aviso, el del incidente, y ninguno falso. Es la diferencia entre un canal de #alertas que Valeria aprende a ignorar en una semana, la fatiga de alertas del Día 50 (Slack como centro de operaciones: webhooks, Block Kit y aprobaciones), y uno que cuando suena merece atención.
El precio de esa limpieza es una hora de retraso. La regla ingenua avisa al cerrar la hora de 10:00 a 11:00, con $4$ eventos en la ventana y $r = 15.0$; la multiventana avisa al cerrar la de 11:00 a 12:00, con $17$ eventos y $r = 11.8$, cuando el presupuesto restante es de $67$. En esa hora de espera se gastaron unos siete incumplimientos más. Es un intercambio deliberado: avisar con cuatro eventos habría significado avisar también las otras $19$ veces. En este incidente, las dos reglas se cumplen en la misma hora: la azul, de 2 horas, llega a $11.8$ con $17$ eventos, y la verde, de 6 horas, a $7.1$ con $28$, por encima de su umbral de $5.63$ (después sube hasta $7.7$). La regla lenta no está para los incidentes agudos, sino para las degradaciones suaves y largas: una mañana entera con el $35%$ de los mensajes tarde daría $r = 7$, que nunca alcanza el umbral rápido de $8.45$ y sí el lento. El pequeño pico de la hora 78 es un mensaje tardío aislado: no llega a ningún umbral.
Hay una consecuencia incómoda que la tabla también dice: las reglas por tasa de consumo nunca avisarán del formulario. Con $0.2$ eventos por hora hábil, en 6 horas hay uno o dos formularios, lejos del mínimo de $20$. Para el canal pequeño, la alerta por tasa no sirve; sirve el aviso por evento que se decidió en la sección anterior, y el informe semanal del presupuesto en el panel. Cada canal se vigila con la herramienta que su volumen permite.
La Figura 2 junta las dos ideas en un tablero: la tasa de consumo como la aguja de un velocímetro y el presupuesto como el depósito que esa aguja vacía.
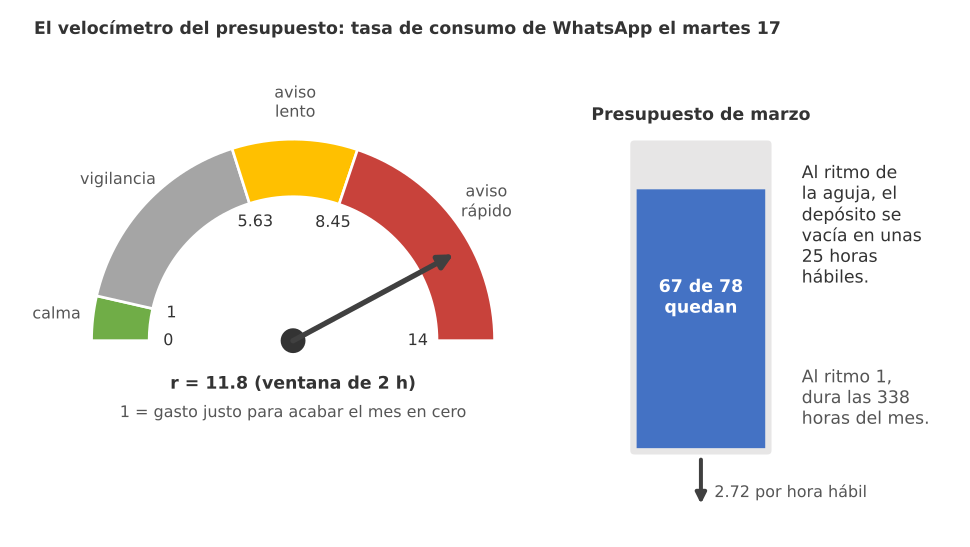
Figura 2. El velocímetro del presupuesto: la tasa de consumo de WhatsApp es la aguja, en 11.8 durante el incidente del martes 17, por encima del aviso lento (5.63) y del rápido (8.45); a ese ritmo el depósito de 78 incumplimientos del mes, con 67 todavía dentro, se vaciaría en unas 25 horas hábiles.
El aviso en Slack
Cuando una regla se cumple, el aviso va al canal #alertas de Slack que el Día 50 reservó para los fallos de los flujos. El mensaje sigue las reglas de Block Kit de aquel día: un texto de notificación de una línea que se entiende desde la pantalla bloqueada del teléfono, una sección con el qué, seis campos con los datos para decidir, una línea de contexto que recuerda que el aviso no lleva datos de clientes y dos botones, uno para abrir el panel y otro para que alguien diga “lo atiendo yo”. Las cifras son las del incidente del martes 17:
{
  "text": "Aviso rápido de WhatsApp: tasa de consumo 11.8 en 2 h; quedan 67 de 78 incumplimientos del mes",
  "blocks": [
    {
      "type": "section",
      "text": {
        "type": "mrkdwn",
        "text": "*WhatsApp está gastando su presupuesto de error 11.8 veces más rápido de lo sostenible*\nRegla rápida: ventana de 2 horas hábiles, umbral 8.45, mínimo 8 eventos."
      }
    },
    {
      "type": "section",
      "fields": [
        {"type": "mrkdwn", "text": "*Canal*\nWhatsApp (SLO 95 % en 30 min)"},
        {"type": "mrkdwn", "text": "*Ventana*\nMartes 17, 10:00 a 12:00"},
        {"type": "mrkdwn", "text": "*Tasa a 2 h / a 6 h*\n11.8 / 7.1"},
        {"type": "mrkdwn", "text": "*Fuera de umbral*\n10 de 17 mensajes"},
        {"type": "mrkdwn", "text": "*Presupuesto restante*\n67 de 78 (85.9 %)"},
        {"type": "mrkdwn", "text": "*Si sigue así*\nSe agota en unas 25 horas hábiles"}
      ]
    },
    {
      "type": "context",
      "elements": [
        {"type": "mrkdwn", "text": "TL Métricas de atención v1 · sin datos de clientes · próximo aviso de este canal no antes de 2 h"}
      ]
    },
    {"type": "divider"},
    {
      "type": "actions",
      "block_id": "alerta_whatsapp_20260317_12",
      "elements": [
        {
          "type": "button",
          "action_id": "abrir_panel",
          "text": {"type": "plain_text", "text": "Abrir el panel"},
          "url": "https://panel.trigo-lento.example/atencion?canal=whatsapp"
        },
        {
          "type": "button",
          "action_id": "reconocer",
          "text": {"type": "plain_text", "text": "Lo atiendo yo"},
          "style": "primary",
          "value": "alerta_whatsapp_20260317_12"
        }
      ]
    }
  ]
}
El campo “Si sigue así” es el que convierte la tasa en una decisión. Con $r = 11.8$, el presupuesto de WhatsApp se gasta a $11.8 \cdot 78 / 338 = 2.72$ incumplimientos por hora hábil, y los $67$ que quedan durarían unas $25$ horas hábiles, menos de dos jornadas. No es “hay errores”, es “a este ritmo, el jueves ya no le podemos cumplir a nadie”. El botón “Lo atiendo yo” responde a la otra mitad de la objeción de Don Ernesto: el aviso no suena en su bolsa, llega a quien atiende el canal, y en cuanto alguien lo reconoce los demás saben que ya hay una persona en ello.
El envío usa el webhook entrante de #alertas con la misma función publicar del Día 50, que respeta el Retry-After de una respuesta 429, más una regla de agrupación: si el mismo canal ya avisó en las últimas dos horas, el aviso nuevo no se envía. Sin ella, una regla que sigue activa a las 13:00 (la tasa de 2 horas sigue en $9.3$) mandaría un segundo aviso igual al primero. Este bloque llama a un servicio real y no se ejecutó para escribir la entrada; su salida es un ejemplo comentado:
# Envío de la alerta de consumo a #alertas con el webhook entrante, agrupación y manejo de 429 en Python:
import json
import os
import time
from pathlib import Path

import requests

# La URL del webhook es un secreto: se lee del entorno, nunca se escribe en el código ni en el flujo.
# Tiene la forma https://hooks.slack.com/services/T.../B.../EJEMPLO-NO-REAL:
URL_ALERTAS = os.environ['TL_SLACK_WEBHOOK_ALERTAS']
alerta = json.loads((Path('trigo_lento') / 'dia_53' / 'alerta_consumo.json').read_text(encoding = 'utf-8'))
ultimo_aviso = {}                                 # canal -> instante del último aviso enviado
SILENCIO = 2 * 3600                               # un aviso por canal cada 2 horas como máximo

def publicar(url, cuerpo, max_intentos = 4):
    # Publica un mensaje y respeta Retry-After cuando Slack responde 429:
    for intento in range(1, max_intentos + 1):
        respuesta = requests.post(url, json = cuerpo, timeout = 10)
        if respuesta.status_code == 200 and respuesta.text == 'ok':
            return intento, 'ok'
        if respuesta.status_code == 429:
            espera = int(respuesta.headers.get('Retry-After', '1'))
            print(f'Intento {intento}: 429, Slack pide esperar {espera} s')
            time.sleep(espera)
            continue
        return intento, f'{respuesta.status_code} {respuesta.text}'   # 400, 403, 404: se corrige, no se reintenta
    return max_intentos, 'agotado'

def avisar(canal, cuerpo, ahora):
    # Agrupación del Día 50: si el canal ya avisó hace menos de 2 h, no se repite el aviso:
    if ahora - ultimo_aviso.get(canal, -SILENCIO) < SILENCIO:
        return 'agrupado (ya hay un aviso abierto)'
    intentos, resultado = publicar(URL_ALERTAS, cuerpo)
    if resultado == 'ok':
        ultimo_aviso[canal] = ahora
    return f'{resultado} en {intentos} intento(s)'

# La regla rápida se evalúa cada hora; a las 12:00 y a las 13:00 del martes 17 sigue activa:
for hora, ahora in [('12:00', 0), ('13:00', 3600)]:
    print(f'Martes 17, {hora}: whatsapp ->', avisar('whatsapp', alerta, ahora))

# Salida de ejemplo (puede variar):
# Martes 17, 12:00: whatsapp -> ok en 1 intento(s)
# Martes 17, 13:00: whatsapp -> agrupado (ya hay un aviso abierto)
La salida de ejemplo muestra las dos ramas: a las 12:00 el aviso se publica; a las 13:00 la regla sigue activa, pero el canal ya tiene un aviso abierto y el segundo se agrupa. La dirección del webhook se lee de la variable de entorno TL_SLACK_WEBHOOK_ALERTAS, como en el Día 50, y nunca aparece en el código, en el JSON del mensaje ni en el workflow.
El compromiso con Brújula
Con los indicadores medidos, la pregunta de Marisol tiene respuesta. El Día 8 evaluó los candidatos de compromiso con la distribución binomial: si cada mensaje de Brújula tiene una probabilidad $p$ de recibir respuesta tarde y los mensajes son independientes, el número de mensajes tardíos en un mes de $n = 26$ sigue una binomial, y un acuerdo que tolera $k$ incumplimientos se rompe cuando hay más de $k$:
$$ P(\text{romper}) = P(X > k) = 1 - \sum_{j=0}^{k} \binom{n}{j}, p^{j} (1 - p)^{n - j}, \qquad k = \lfloor (1 - \text{objetivo}) \cdot n \rfloor $$
La lógica detrás de esta fórmula es múltiple:
- Con el objetivo del $95%$ y $26$ mensajes al mes, $k = \lfloor 1.3 \rfloor = 1$: el acuerdo tolera un solo mensaje tardío. El SLI mensual de Brújula solo puede valer $1.0$, $0.9615$, $0.9231$ y así hacia abajo; no existe un $0.95$ exacto.
- $p$ sale ahora del orquestador, no de la muestra de enero: con la lognormal de mediana 4 minutos y $\sigma = 0.6$, la probabilidad de pasar de 15 minutos hábiles es $p = 0.0138$.
- El número esperado de mensajes tardíos, $n,p = 0.36$, queda muy por debajo del único tolerado, y por eso la probabilidad de romper el acuerdo es pequeña.
- En conclusión, la misma fórmula que el Día 8 usó para decir “todavía no” sirve hoy para decir “ahora sí”, y la diferencia la pone el proceso, no la fórmula.
El siguiente bloque compara tres compromisos: los dos del Día 8 (95 % en 30 minutos y 95 % en 15, con la línea base de Brújula) y el que Valeria propone hoy (95 % en 15 minutos hábiles, con el orquestador):
# Compromiso con Brújula: probabilidad de romper el 95 % en 15 minutos hábiles en un mes con la binomial en Python:
n_mes = 26
tolerados = int(np.floor((1 - 0.95) * n_mes + 1e-9))
candidatos = [('Día 8: 95 % en 30 min (línea base)', stats.lognorm(s = 0.6, scale = 8).sf(30)),
              ('Día 8: 95 % en 15 min (línea base)', stats.lognorm(s = 0.6, scale = 8).sf(15)),
              ('Hoy: 95 % en 15 min (orquestador)', stats.lognorm(s = BRUJULA['sigma'], scale = BRUJULA['mediana']).sf(15))]
filas = [[nombre, p, tolerados, n_mes * p, stats.binom.sf(tolerados, n_mes, p)] for nombre, p in candidatos]
tabla_4 = pd.DataFrame(filas, columns = ['compromiso', 'p_tarde', 'tolerados', 'esperados', 'p_romper_mes'])
print(tabla_4.round(4).to_string(index = False))
tarde_b = int((brujula['tpr_min'] > 15).sum())
print(f'Marzo simulado: {tarde_b} de {n_mes} mensajes de Brújula después de 15 min hábiles '
      f'-> {"cumple" if tarde_b <= tolerados else "incumple"}')
print(f'Meses rotos esperados en un año: {12 * tabla_4.loc[2, "p_romper_mes"]:.2f}')
# Con 26 eventos, el SLI mensual solo puede tomar estos valores:
print('SLI posibles con 0, 1, 2 y 3 fallos:', [round(1 - k / n_mes, 4) for k in range(4)])
                        compromiso  p_tarde  tolerados  esperados  p_romper_mes
Día 8: 95 % en 30 min (línea base)   0.0138          1     0.3588        0.0497
Día 8: 95 % en 15 min (línea base)   0.1474          1     3.8322        0.9130
 Hoy: 95 % en 15 min (orquestador)   0.0138          1     0.3588        0.0497
Marzo simulado: 0 de 26 mensajes de Brújula después de 15 min hábiles -> cumple
Meses rotos esperados en un año: 0.60
SLI posibles con 0, 1, 2 y 3 fallos: [1.0, 0.9615, 0.9231, 0.8846]
La Tabla 4 resume la salida.
Tabla 4. Compromiso con Brújula: probabilidad de tardar por mensaje, incumplimientos tolerados y esperados al mes y probabilidad de romper el acuerdo en un mes.
| Compromiso | Origen de p | Probabilidad de tardar por mensaje | Incumplimientos tolerados | Incumplimientos esperados al mes | Probabilidad de romper el acuerdo en un mes |
|---|---|---|---|---|---|
| 95 % en 30 min (firmado el Día 8) | Línea base: mediana 8, sigma 0.6 | 0.0138 | 1 | 0.36 | 0.0497 |
| 95 % en 15 min (rechazado el Día 8) | Línea base: mediana 8, sigma 0.6 | 0.1474 | 1 | 3.83 | 0.9130 |
| 95 % en 15 min hábiles (propuesto hoy) | Orquestador: mediana 4, sigma 0.6 | 0.0138 | 1 | 0.36 | 0.0497 |
La coincidencia de la primera y la tercera fila no es casualidad, y es la forma más clara de explicárselo a Marisol. El orquestador redujo a la mitad la mediana de Brújula (de 8 a 4 minutos) sin cambiar su dispersión; como la lognormal escala, tardar más de 15 minutos con mediana 4 es exactamente igual de probable que tardar más de 30 con mediana 8. El compromiso de 15 minutos de hoy tiene el mismo riesgo que el de 30 minutos que se firmó en febrero: una probabilidad de romperlo de $0.0497$, unos $0.6$ meses de cada $12$. El de 15 minutos con el proceso de febrero se habría roto el $91.3%$ de los meses. En el mes simulado, los $26$ mensajes de Brújula llegaron a tiempo.
Valeria redacta el compromiso para Marisol con las cuatro piezas que lo hacen honesto:
- El umbral y el objetivo: el $95%$ de sus mensajes por WhatsApp con una respuesta útil en 15 minutos hábiles. Con $26$ mensajes al mes, eso significa que se tolera un mensaje tardío; con dos, el acuerdo se rompe.
- La ventana de medición: el mes natural, sin redondeos a favor de la panadería. Los minutos hábiles van de 7:00 a 20:00 de lunes a sábado, y se escriben en el compromiso para que Marisol sepa que el reloj se detiene de noche y en domingo.
- El informe: el primer día de cada mes, Marisol recibe por correo el SLI de sus mensajes, el p95 y la lista de mensajes tardíos con su identificador, aunque el mes se haya cumplido.
- La consecuencia: la misma del Día 8, un $10%$ de descuento en la factura de la semana siguiente si se rompe, y una revisión conjunta del proceso.
La Figura 3 resume la arquitectura del compromiso: el papel que firma Marisol arriba y, abajo, las dos piezas que lo sostienen.
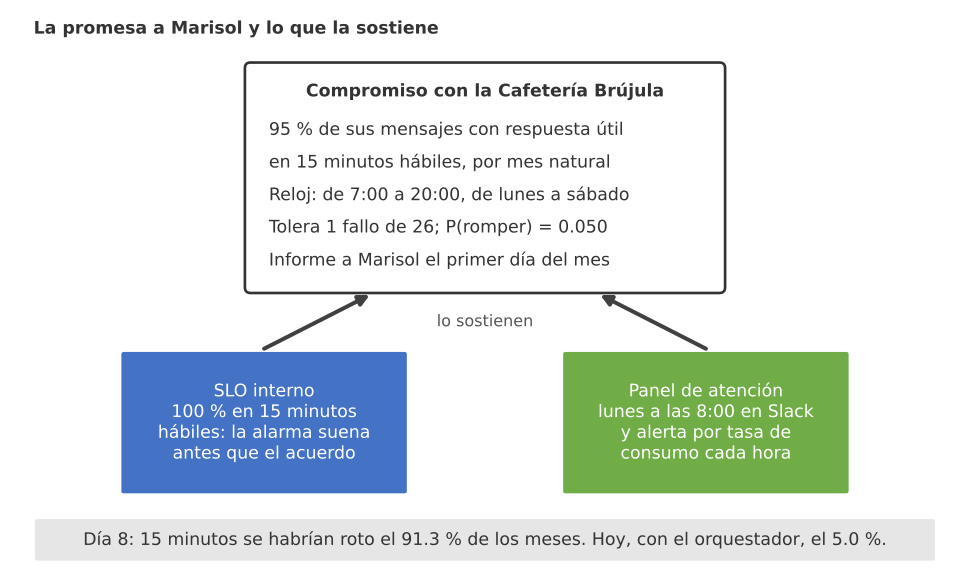
Figura 3. La promesa a Marisol: el compromiso del 95 % en 15 minutos hábiles, con un fallo tolerado al mes y una probabilidad de romperlo de 0.050, se apoya en el SLO interno del 100 % y en el panel que lo mide cada lunes a las 8:00.
El SLO interno de Brújula es más estricto que el compromiso, el $100%$ en 15 minutos hábiles, como el Día 8 enseñó que debe ser: un solo mensaje tardío dispara la revisión interna, antes de que un segundo rompa el acuerdo. La formalización completa de este SLA, con los SLO internos de todos los procesos y su revisión trimestral, queda para el Día 82. La respuesta de Marisol llega en diez minutos: “Así sí. Y si un mes fallan, prefiero enterarme por usted que por mi reloj.”
El panel de atención
Las tablas sirven para decidir; para mirar cada semana hace falta algo más rápido. El panel de atención junta en una sola imagen las cuatro preguntas que Valeria se hace cada lunes: ¿cómo fue cada día?, ¿cómo está la cola?, ¿cuánto margen queda? y ¿le estamos cumpliendo a Brújula? El siguiente bloque dibuja las cuatro gráficas, el SLI diario por canal, el p95 semanal, el presupuesto restante y el cumplimiento semanal de Brújula, en un PNG que el workflow publica en #pedidos-del-dia cada lunes a las 8:00:
# Panel de atención de cuatro gráficas para publicar en Slack cada lunes a las 8:00 en Python:
eventos['semana'] = pd.to_datetime(eventos['dia']).dt.isocalendar().week.astype(int) - 9
fig, ejes = plt.subplots(2, 2, figsize = (12, 7.6))
ax = ejes[0, 0]
for canal in SLO:
    x = eventos[eventos['canal'] == canal].groupby('dia')['bueno'].mean()
    ax.plot(range(1, len(x) + 1), 100 * x.values, marker = 'o', markersize = 3, color = colores[canal], label = canal)
ax.axhline(95, color = '#0b0b0b', linestyle = '--', linewidth = 1)
ax.set_ylim(40, 103)
ax.set_title('SLI diario por canal (%)', fontsize = 13)
ax.set_xlabel('Día hábil')
ax.legend(fontsize = 8, loc = 'lower left', frameon = False, ncol = 2)
ax = ejes[0, 1]
p95_sem = eventos.groupby(['semana', 'canal'])['tpr_min'].quantile(0.95).unstack()
for canal in SLO:
    ax.plot(p95_sem.index, p95_sem[canal], marker = 'o', color = colores[canal], label = canal)
ax.set_yscale('log')
ax.set_xticks(p95_sem.index)
ax.set_title('p95 semanal (minutos hábiles, escala log)', fontsize = 13)
ax.set_xlabel('Semana de marzo')
ax = ejes[1, 0]
restante = 100 - tabla_3['% gastado']
barras = ax.barh(tabla_3['canal'], restante, color = ['#2a78d6' if r >= 0 else '#b8361a' for r in restante])
for b, r in zip(barras, restante):
    ax.text(r + (2 if r >= 0 else -2), b.get_y() + b.get_height() / 2, f'{r:.0f} %', va = 'center',
            ha = 'left' if r >= 0 else 'right', fontsize = 10)
ax.axvline(0, color = '#0b0b0b', linewidth = 1)
ax.set_xlim(-130, 115)
ax.invert_yaxis()
ax.set_title('Presupuesto de error restante del mes', fontsize = 13)
ax = ejes[1, 1]
b_sem = eventos[eventos['tipo'] == 'brujula']
cumple = b_sem.groupby('semana')['tpr_min'].apply(lambda s: 100 * (s <= 15).mean())
ax.bar(cumple.index, cumple.values, color = '#1f9d55', width = 0.6)
for s, v in cumple.items():
    ax.text(s, v - 8, f'{v:.0f} %', ha = 'center', color = 'white', fontsize = 10)
ax.axhline(95, color = '#0b0b0b', linestyle = '--', linewidth = 1)
ax.set_ylim(0, 105)
ax.set_xticks(cumple.index)
ax.set_title(f'Brújula en 15 min hábiles ({26 - tarde_b} de 26)', fontsize = 13)
ax.set_xlabel('Semana de marzo')
for a in ejes.flat:
    a.spines[['top', 'right']].set_visible(False)
fig.suptitle('Panel de atención de Trigo Lento: marzo de 2026 (mes simulado)', fontsize = 16)
plt.tight_layout()
plt.show()
print('Eventos por semana:', eventos.groupby('semana').size().to_dict())
print('p95 semanal de WhatsApp:', p95_sem['whatsapp'].round(1).to_dict())
print('p95 semanal del formulario:', p95_sem['formulario'].round(1).to_dict())
Eventos por semana: {1: 553, 2: 554, 3: 519, 4: 510, 5: 194}
p95 semanal de WhatsApp: {1: 12.1, 2: 11.2, 3: 12.9, 4: 10.1, 5: 12.0}
p95 semanal del formulario: {1: 43.7, 2: 28.0, 3: 31.6, 4: 17.4, 5: 11.3}
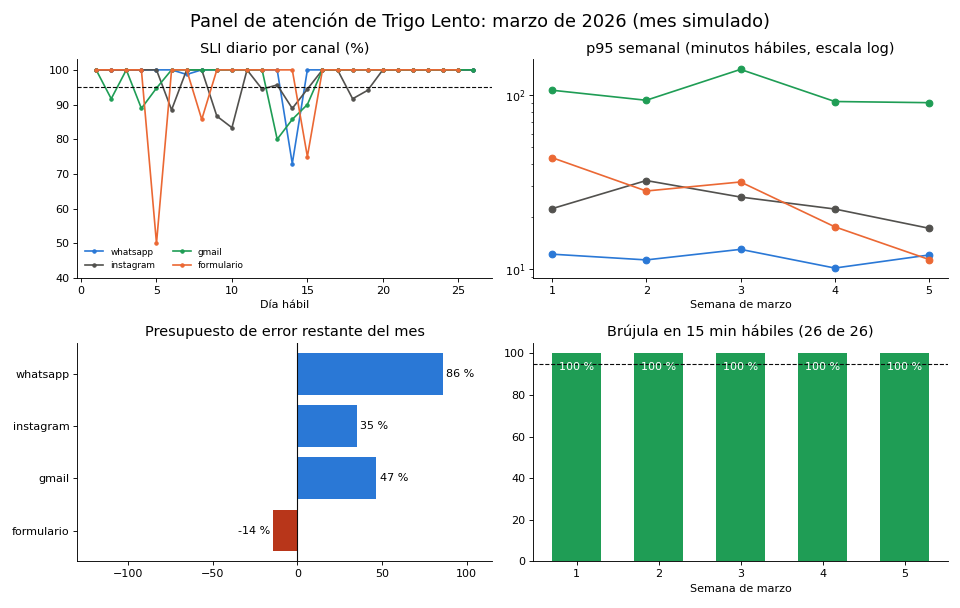
El panel se lee en el sentido de las agujas del reloj. Arriba a la izquierda, el SLI diario muestra que la mayoría de los días todos los canales están en el $100%$, con caídas puntuales: la de WhatsApp el día 14 es el incidente, y las del formulario llegan al $50%$ porque un día con dos formularios y uno tardío es medio día perdido. Arriba a la derecha, el p95 semanal de WhatsApp se mantiene entre $10.1$ y $12.9$ minutos las cinco semanas, mientras el del formulario baja de $43.7$ minutos en la primera semana a $11.3$ en la quinta, que solo tiene dos días y pocos eventos. Abajo a la izquierda, el presupuesto restante, la barra que Don Ernesto entiende sin explicación: azul hacia la derecha si queda margen, roja hacia la izquierda si se gastó de más. Y abajo a la derecha, Brújula con sus cinco semanas en el $100%$.
Don Ernesto mira el panel el lunes siguiente, con la libreta del obrador bajo el brazo, y va directo a la barra roja: "¿Y el formulario? WhatsApp va de maravilla, pero esa barrita roja es gente que se quedó esperando. ¿Quién mira esa bandeja?" Valeria le explica el aviso por evento en #pedidos-del-dia y él asiente, pero añade lo que nadie había pensado: “Póngale también al formulario la frase de que le contestamos en media hora. Si la gente sabe cuánto va a esperar, espera tranquila.” Es una mejora de comunicación, no de proceso, y entra en la lista de cambios para la sesión práctica del Día 56.
El panel agrega por canal y por semana a propósito. No dice quién contestó cada mensaje ni cuánto tardó cada persona, y no lo dirá: el Día 8 lo dejó escrito en metricas.json (uso prohibido: evaluar el desempeño de personas). El Día 75 llevará este panel a un cuadro de mando de todas las automatizaciones de Trigo Lento, con la misma regla.
TL Métricas de atención v1
Todo lo anterior se calculó con un cuaderno; en producción lo hace un workflow de n8n que nadie tiene que lanzar. TL Métricas de atención v1 tiene seis nodos:
- Cada hora hábil (
scheduleTrigger): se ejecuta a los cinco minutos de cada hora, de 8:05 a 20:05, de lunes a sábado, con la expresión cron5 8-20 * * 1-6en la zonaAmerica/Mexico_City. - Contar eventos por ventana (
postgres): una consulta que cuenta, por canal y para las ventanas de 2 y 6 horas, los eventos válidos y los malos, y trae la hora del último aviso enviado. - Calcular tasas de consumo (
code): aplica las dos reglas del Bloque 7, con sus umbrales $r^{*} = f H / w$, sus mínimos de eventos y la agrupación de dos horas, y devuelve un elemento por aviso. - ¿Hay avisos? (
if): si el nodo anterior no encontró nada, el workflow termina en silencio. - Avisar en #alertas (
httpRequest): publica el aviso en el webhook leído de$env.TL_SLACK_WEBHOOK_ALERTAS, uno por segundo como pide Slack y con tres intentos. - Registrar aviso (
postgres): apunta el canal, la regla, la tasa y la hora en la tablaalertas_slo, que es lo que el paso 3 consulta para agrupar.
El detalle más fino está en la consulta del paso 2. El orquestador, al registrar un evento, calcula con sumar_minutos_habiles el instante en que vence su umbral y lo guarda en la columna vence_en. Así, un evento es evaluable cuando ya respondió o cuando su plazo ya venció, y es malo si no tiene respuesta o si la respuesta llegó después de vence_en. Contar por la hora de vencimiento, y no por la de llegada, tiene dos ventajas: un mensaje que todavía está dentro de su plazo no cuenta ni como bueno ni como malo, y un mensaje que nadie ha contestado cuenta como malo en cuanto vence, sin esperar a que alguien lo conteste. Como el workflow solo se ejecuta en horario y los mensajes nocturnos vencen a partir de las 7:00, una ventana de reloj de dos horas coincide con dos horas hábiles. El JSON, con identificadores de ejemplo y sin secretos, es el siguiente:
{
  "name": "TL Métricas de atención v1",
  "nodes": [
    {
      "parameters": {"rule": {"interval": [{"field": "cronExpression", "expression": "5 8-20 * * 1-6"}]}},
      "id": "5a530000-0000-4000-8000-000000000001",
      "name": "Cada hora hábil",
      "type": "n8n-nodes-base.scheduleTrigger",
      "typeVersion": 1.2,
      "position": [0, 0]
    },
    {
      "parameters": {"operation": "executeQuery", "query": "SELECT canal, w.horas, COUNT(*) AS validos, COUNT(*) FILTER (WHERE primera_respuesta_en IS NULL OR primera_respuesta_en > vence_en) AS malos, (SELECT MAX(enviada_en) FROM alertas_slo a WHERE a.canal = e.canal) AS ultima_alerta FROM ejecuciones e CROSS JOIN (VALUES (2), (6)) AS w(horas) WHERE e.requiere_respuesta AND e.vence_en <= now() AND e.vence_en > now() - make_interval(hours => w.horas) GROUP BY canal, w.horas;", "options": {}},
      "id": "5a530000-0000-4000-8000-000000000002",
      "name": "Contar eventos por ventana",
      "type": "n8n-nodes-base.postgres",
      "typeVersion": 2.6,
      "position": [220, 0],
      "credentials": {"postgres": {"id": "0000000000000042", "name": "Postgres TL"}}
    },
    {
      "parameters": {"jsCode": "const SLO = 0.95, HORAS = 338;\nconst reglas = [{ horas: 2, fraccion: 0.05, minimo: 8, nombre: 'rápida' }, { horas: 6, fraccion: 0.10, minimo: 20, nombre: 'lenta' }];\nconst filas = $input.all().map(i => i.json);\nconst avisos = [];\nfor (const canal of [...new Set(filas.map(f => f.canal))]) {\n  const silencio = filas.find(f => f.canal === canal).ultima_alerta;\n  if (silencio && Date.now() - new Date(silencio).getTime() < 2 * 3600 * 1000) continue;\n  for (const r of reglas) {\n    const f = filas.find(x => x.canal === canal && Number(x.horas) === r.horas);\n    if (!f || Number(f.validos) < r.minimo) continue;\n    const tasa = (Number(f.malos) / Number(f.validos)) / (1 - SLO);\n    const umbral = r.fraccion * HORAS / r.horas;\n    if (tasa >= umbral) {\n      avisos.push({ json: { canal, regla: r.nombre, tasa: Math.round(tasa * 10) / 10, umbral: Math.round(umbral * 100) / 100, validos: Number(f.validos), malos: Number(f.malos), text: `Aviso ${r.nombre} de ${canal}: tasa de consumo ${tasa.toFixed(1)} en ${r.horas} h (umbral ${umbral.toFixed(2)})` } });\n      break;\n    }\n  }\n}\nreturn avisos.length ? avisos : [{ json: { sin_avisos: true } }];"},
      "id": "5a530000-0000-4000-8000-000000000003",
      "name": "Calcular tasas de consumo",
      "type": "n8n-nodes-base.code",
      "typeVersion": 2,
      "position": [440, 0]
    },
    {
      "parameters": {"conditions": {"options": {"caseSensitive": true, "leftValue": "", "typeValidation": "loose", "version": 2}, "conditions": [{"id": "c5300001", "leftValue": "={{ $json.canal }}", "rightValue": "", "operator": {"type": "string", "operation": "exists", "singleValue": true}}], "combinator": "and"}, "options": {}},
      "id": "5a530000-0000-4000-8000-000000000004",
      "name": "¿Hay avisos?",
      "type": "n8n-nodes-base.if",
      "typeVersion": 2.2,
      "position": [660, 0]
    },
    {
      "parameters": {"method": "POST", "url": "={{ $env.TL_SLACK_WEBHOOK_ALERTAS }}", "sendBody": true, "specifyBody": "json", "jsonBody": "={{ JSON.stringify({ text: $json.text, blocks: [{ type: 'section', text: { type: 'mrkdwn', text: '*' + $json.text + '*\\n' + $json.malos + ' de ' + $json.validos + ' mensajes fuera de umbral en la ventana.' } }, { type: 'context', elements: [{ type: 'mrkdwn', text: 'TL Métricas de atención v1 · panel: https://panel.trigo-lento.example/atencion' }] }] }) }}", "options": {"timeout": 10000, "batching": {"batch": {"batchSize": 1, "batchInterval": 1100}}}},
      "id": "5a530000-0000-4000-8000-000000000005",
      "name": "Avisar en #alertas",
      "type": "n8n-nodes-base.httpRequest",
      "typeVersion": 4.2,
      "position": [880, -100],
      "retryOnFail": true,
      "maxTries": 3,
      "waitBetweenTries": 2000
    },
    {
      "parameters": {"operation": "executeQuery", "query": "INSERT INTO alertas_slo (canal, regla, tasa, enviada_en) VALUES ($1, $2, $3, now());", "options": {"queryReplacement": "={{ [$('Calcular tasas de consumo').item.json.canal, $('Calcular tasas de consumo').item.json.regla, $('Calcular tasas de consumo').item.json.tasa] }}"}},
      "id": "5a530000-0000-4000-8000-000000000006",
      "name": "Registrar aviso",
      "type": "n8n-nodes-base.postgres",
      "typeVersion": 2.6,
      "position": [1100, -100],
      "credentials": {"postgres": {"id": "0000000000000042", "name": "Postgres TL"}}
    }
  ],
  "connections": {
    "Cada hora hábil": {"main": [[{"node": "Contar eventos por ventana", "type": "main", "index": 0}]]},
    "Contar eventos por ventana": {"main": [[{"node": "Calcular tasas de consumo", "type": "main", "index": 0}]]},
    "Calcular tasas de consumo": {"main": [[{"node": "¿Hay avisos?", "type": "main", "index": 0}]]},
    "¿Hay avisos?": {"main": [[{"node": "Avisar en #alertas", "type": "main", "index": 0}], []]},
    "Avisar en #alertas": {"main": [[{"node": "Registrar aviso", "type": "main", "index": 0}]]}
  },
  "settings": {"executionOrder": "v1", "timezone": "America/Mexico_City", "executionTimeout": 60, "saveDataSuccessExecution": "none", "errorWorkflow": "Xe7rTb4mKq9wPz2G"},
  "pinData": {},
  "meta": {"templateCredsSetupCompleted": true}
}
Tres detalles del JSON merecen una nota:
- La salida falsa del IF no lleva a ningún nodo (
[]enconnections). Una hora sin avisos es el caso normal y no debe dejar rastro en Slack; la ejecución termina y, consaveDataSuccessExecutionennone, tampoco deja datos guardados en n8n. - El nodo HTTP agrupa los envíos de uno en uno con una pausa de $1.1$ segundos (
batching), para no rebasar el mensaje por segundo de los webhooks entrantes si dos canales avisan en la misma hora, y reintenta tres veces con dos segundos de espera ante un fallo de red. Si Slack responde 429, la espera la dictaRetry-After, como en el Bloque 9. - El cuerpo del aviso no lleva datos de clientes: canal, regla, tasa y conteos. El panel enlazado en el contexto tampoco los muestra. Un aviso que se reenvía por error a otro canal no expone a nadie.
Antes de importar el workflow, Valeria lo pasa por el detector de secretos del Día 17 (Seguridad I: OAuth, secretos y mínimo privilegio en las conexiones) y por la comprobación de conexiones del Día 50: seis nodos, cinco conexiones, ninguna rota, ninguna dirección de webhook escrita en el archivo.
Consideraciones finales
El día empezó con dos preguntas y termina con dos respuestas medidas. A Marisol: el p95 de sus mensajes es de $9.5$ minutos hábiles, los $26$ del mes llegaron en menos de 15, y un compromiso del $95%$ en 15 minutos hábiles tiene una probabilidad de romperse de $0.0497$, la misma que el de 30 minutos que firmó en febrero. A Don Ernesto: en el mes simulado esperaron demasiado $11$ clientes de WhatsApp, $13$ de Instagram, $8$ de Gmail y $4$ del formulario, y el formulario es el único canal que rebasó su presupuesto, aunque el $98.45%$ de todos los eventos llegara a tiempo. Y su teléfono no sonará cada vez que alguien tarde un minuto de más: en un mes, la regla multiventana avisó una vez, cuando había que avisar.
Atención aquí: se mide el servicio, no a las personas. El panel agrega por canal y por semana y no muestra quién respondió cada mensaje; los registros guardan marcas de tiempo e identificadores seudonimizados, nunca el texto de los clientes; y ningún indicador de este día se usa para evaluar a Valeria ni al personal de mostrador. Un indicador que se convierte en evaluación individual deja de medir el proceso: las personas aprenden a contestar “en un momento le confirmo” para detener el reloj. Por la misma razón, a Brújula se le informa con honestidad cuando el compromiso se incumple, sin cambiar la ventana de medición después de los hechos, y los minutos hábiles se declaran en el compromiso para que Marisol sepa cuándo corre el reloj y cuándo no.
Las cifras tienen límites que conviene decir. El mes es una simulación con tiempos lognormales por canal declarados como supuestos; el incidente está sembrado a propósito; y la binomial supone mensajes independientes, cuando en la realidad los incumplimientos llegan en grupos (el incidente del martes lo demuestra). El mínimo de eventos por ventana no viene del libro de trabajo de SRE, que no lo fija, sino de una decisión de diseño que habrá que revisar con los datos reales de abril. Y el intervalo bootstrap del formulario recuerda que, con $70$ eventos, ninguna cifra mensual es definitiva. Ninguno de esos límites cambia el método; todos son razones para que el workflow lea la tabla real cuanto antes.
Antes de poner indicadores a la atención de su propio negocio, conviene hacerse algunas preguntas:
- ¿Qué cuenta como respuesta útil en cada canal, y qué respuesta automática podría hacerse pasar por una?
- ¿Su reloj corre en horas de pared o en horas de atención, y lo saben sus clientes?
- ¿Qué canal pequeño queda escondido dentro del indicador global, y quién mira su cola?
- ¿Cuántos avisos recibió su canal de alertas el mes pasado, y cuántos correspondían a un problema real?
- ¿Con qué probabilidad se rompe en un mes lo que usted le promete a su mejor cliente?
Un gran libro que habla de esto es The Site Reliability Workbook: Practical Ways to Implement SRE (o El libro de trabajo de la ingeniería de fiabilidad de sitios), editado por Betsy Beyer, Niall Richard Murphy, David K. Rensin, Kent Kawahara y Stephen Thorne, compañero práctico del libro que el Día 8 recomendó. Su capítulo sobre alertas basadas en SLO recorre, una por una, seis formas de alertar, desde la más ingenua hasta la multiventana con varias tasas de consumo, y muestra para cada una cuánto tarda en detectar, cuántas falsas alarmas da y cuánto presupuesto se gasta antes del aviso. Está escrito para servicios con mucho tráfico, y precisamente por eso su sección sobre servicios con poco tráfico es la que más le servirá a un negocio pequeño.
Una métrica de servicio no es un promedio que tranquiliza: es la cola de cada canal, el presupuesto que le queda y una alerta que solo suena cuando ese presupuesto corre peligro. Trigo Lento ya puede prometerle 15 minutos a su cliente más exigente, sabe cuál de sus canales está fallando aunque el total se vea bien y tiene un aviso que, en un mes, sonó una sola vez.
Conclusiones clave
SLI y percentiles
- Un SLI por canal es la proporción de eventos válidos con primera respuesta útil dentro del umbral del canal, medida en minutos hábiles; el acuse automático fuera de horario no es una respuesta.
- Con el orquestador, el p95 de los canales de 30 minutos baja de $50.1$ a $15.9$ minutos y la proporción a tiempo sube del $84.8%$ al $98.6%$; el p95 de Brújula pasa de $21.5$ a $9.5$ minutos.
- Los percentiles se informan por canal y con su intervalo bootstrap (WhatsApp de $11.0$ a $12.7$; formulario de $22.5$ a $51.2$); promediarlos da $44.4$ o $26.9$ minutos frente a un p95 conjunto de $46.1$.
Presupuesto y alertas
- Con un SLO del $95%$, el presupuesto es $B = 0.05 \cdot N$ por canal ($78$ en WhatsApp, $3.5$ en el formulario); el formulario gasta el $114.3%$ aunque el SLI global sea de $0.9845$.
- La tasa de consumo $r = e / (1 - \text{SLO})$ mide la velocidad del gasto; el umbral se deriva con $r^{*} = f H / w$ sobre las $338$ horas hábiles del mes ($8.45$ en 2 horas y $5.63$ en 6 horas).
- Con pocos eventos por hora, una regla de una hora sin mínimo da $20$ avisos y $19$ falsos; la multiventana con mínimo de eventos da $1$, el del incidente, una hora más tarde y con el presupuesto al $86%$.
Compromiso y panel
- El compromiso con Brújula, $95%$ en 15 minutos hábiles por mes natural, tolera un mensaje tardío de $26$ y se rompe con probabilidad $0.0497$, la misma que el de 30 minutos del Día 8.
- El panel de cuatro gráficas se publica en Slack cada lunes a las 8:00, agrega por canal y semana y no muestra personas; el formulario recibe un aviso por evento porque su volumen no admite alertas por tasa.
TL Métricas de atención v1evalúa cada hora hábil los eventos ya vencidos, aplica las dos reglas con agrupación de dos horas y solo escribe en#alertascuando hay algo que atender.
Mañana, en el Día 54: Anatomía de un fallo real III: la plantilla pausada y los recordatorios que no salieron. Al encender estos indicadores, Valeria descubrirá que un flujo que llevaba doce días “en verde” no había entregado un solo recordatorio de recogida, y reconstruirá con los registros, sin buscar culpables, cómo una plantilla de WhatsApp pasó de pausada a desactivada sin que nadie se enterara.
Referencias
- Beyer, B., Jones, C., Petoff, J. y Murphy, N. R. (Eds.) (2016). Site Reliability Engineering: How Google Runs Production Systems. O’Reilly Media. (Capítulo 4, “Service Level Objectives”.) https://sre.google/sre-book/service-level-objectives/
- Beyer, B., Murphy, N. R., Rensin, D. K., Kawahara, K. y Thorne, S. (Eds.) (2018). The Site Reliability Workbook: Practical Ways to Implement SRE. O’Reilly Media. (Capítulo 5, “Alerting on SLOs”.) https://sre.google/workbook/alerting-on-slos/ (revisado en octubre de 2026).
- Hyndman, R. J. y Fan, Y. (1996). Sample Quantiles in Statistical Packages. The American Statistician, 50(4), 361-365. https://doi.org/10.1080/00031305.1996.10473566
- Efron, B. y Tibshirani, R. J. (1993). An Introduction to the Bootstrap. Chapman & Hall/CRC.
- Slack (2026). Sending messages using incoming webhooks. Slack Developer Docs. https://docs.slack.dev/messaging/sending-messages-using-incoming-webhooks (revisado en octubre de 2026).
- Slack (2026). Block Kit. Slack Developer Docs. https://docs.slack.dev/block-kit (revisado en octubre de 2026).
- Slack (2026). Rate limits. Slack Developer Docs. https://docs.slack.dev/apis/web-api/rate-limits (revisado en octubre de 2026).