
Arquitecto de automatización con IA: Día 54
 Jeshua Romero Guadarrama
- 66 Min para leer
- 26 Mar, 2026
Índice de contenido
Resumen:
Durante trece días, el flujo de recordatorios de recogida de Trigo Lento se ejecutó “en verde” mientras la plantilla de WhatsApp que usaba estaba pausada y, después, desactivada por Meta: 212 recordatorios no llegaron y nadie se enteró hasta que el panel del Día 53 marcó un 0 % y una clienta preguntó. En esta entrada, Valeria reconstruye la línea de tiempo desde el registro, entiende la calificación de calidad y la pausa escalonada de las plantillas, aplica cinco porqués, un diagrama de Ishikawa y un árbol de fallos, y cierra el hueco con webhooks de estado de plantillas, una plantilla de respaldo y alertas por consumo del presupuesto de error. Al terminar, usted sabrá diagnosticar un incidente de mensajería con método, leer los errores que delatan una plantilla caída, medir el impacto contra un objetivo de servicio y escribir un análisis posterior sin culpables.
¿Cómo citar el presente artículo?
Romero, J. (26 de marzo de 2026). Arquitecto de automatización con IA: Día 54. python-data-engineer. https://www.python-data-engineer.com/post/aai/dia_54/.
Arquitecto de automatización con IA: Día 54 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/aai/dia_54/.
Precios, límites y políticas revisados en octubre de 2026: planes, precios y límites de Make, n8n, Zapier, WhatsApp (Meta, Twilio, Wati) y de la API de Claude. Lo específico de hoy se revisó en octubre de 2026 en la documentación oficial de WhatsApp Business Platform: la pausa de 3 horas, la de 6 horas y la desactivación a la tercera caída de calidad, que la API rechace los envíos de una plantilla pausada sin cobrarlos, los campos de los webhooks message_template_status_update (event, other_info.title con FIRST_PAUSE, SECOND_PAUSE y DISABLED, disable_info) y message_template_quality_update (previous_quality_score y new_quality_score con GREEN, YELLOW, RED o UNKNOWN), y la descripción de los errores 132015 y 132016. La tabla de errores de Meta no publica el estado HTTP de cada código; la simulación usa 400, como lo describen guías de proveedores. La firma X-Hub-Signature-256 se contrastó con guías y bibliotecas que coinciden entre sí. El JSON del Bloque 9 tiene la estructura verificada contra la documentación, revisado en octubre de 2026, con identificadores de ejemplo; no se exportó desde una instancia de n8n.
Día 54. Anatomía de un fallo real III: la plantilla pausada y los recordatorios que no salieron
Introducción
Ayer, en el Día 53 (Métricas y SLA de la atención: percentiles, presupuesto de error y alertas), Valeria definió un indicador de servicio por canal, midió percentiles en lugar de promedios, calculó el presupuesto de error y la tasa de consumo de cada canal, diseñó alertas multiventana hacia Slack y Trigo Lento ganó un panel de atención y un compromiso de $15$ minutos con la Cafetería Brújula. Ese panel, el mismo día en que se encendió, destapó algo que nadie buscaba.
Una aclaración antes de seguir, la misma que abrió el Día 29 (Anatomía de un fallo real I: el webhook que duplicó 37 pedidos) y el Día 39 (Anatomía de un fallo real II: el agente que prometió un pastel imposible): el incidente de hoy es ficticio e ilustrativo. Los clientes, los mensajes y las cifras son inventados, y los registros se reconstruyen con datos de juguete, sin teléfonos ni textos de clientes. Para contarlo con la calma que exige el método, el relato se toma una licencia: supone que el recordatorio de recogida ya corría por la Cloud API de Meta desde febrero, en un piloto del workflow TL WhatsApp secuencias, y que el Día 48 (WhatsApp Business API: plantillas, ventana de 24 horas, secuencias y chatbots) lo presentó ya pulido. Lo que no es inventado es el mecanismo: una plantilla que se pausa por baja calidad, un flujo que no lee la respuesta de la API y un tablero que mide lo que no importa.
Es miércoles 25 de marzo, a las 10:30. Valeria enciende el panel de atención del Día 53 y añade, casi por curiosidad, un indicador que no estaba en el plan: la proporción de recordatorios de recogida entregados por día. La gráfica tarda en dibujarse y, cuando aparece, parece rota: una línea plana en $0%$ desde el viernes 13 de marzo. Al mismo tiempo, en el mostrador, una clienta que recoge un pastel de zanahoria pregunta, con amabilidad pero con extrañeza, por qué ya no le avisan un día antes, como antes. Valeria abre el historial de ejecuciones de n8n: todas en verde. Abre el registro de envíos: todos dicen “enviado”. Abre WhatsApp Manager: la plantilla recordatorio_recogida aparece desactivada desde el 12 de marzo. En trece días, $212$ recordatorios no salieron y el sistema no dijo nada.
Don Ernesto se entera a mediodía, entre una hornada y otra, y su reacción es breve: "¿Doce días mandando nada y la computadora tan tranquila? Usted me dijo que si algo fallaba nos iba a avisar, Valeria. Yo prefiero una libreta que se moja a una máquina que miente." Tiene razón en lo esencial y conviene decirlo sin rodeos: la máquina no mintió, pero tampoco se le preguntó lo correcto. Medía si el flujo corría, no si el recordatorio llegaba. Esa diferencia es el tema de hoy.
En la presente entrada, descubrirá cómo se diagnostica un incidente de mensajería sin adivinar y sin buscar a quién señalar. Reconstruirá la línea de tiempo desde el registro de envíos, las respuestas de la API y los eventos de webhook, y medirá el impacto en recordatorios y en pesos. Aprenderá cómo califica Meta la calidad de cada plantilla, por qué la pausa es escalonada (3 horas, 6 horas y desactivación) y qué códigos de error la delatan. Aplicará cinco porqués, un diagrama de Ishikawa y un árbol de fallos para separar el disparador de la causa raíz. Después cerrará el hueco: un manejador de los eventos de plantillas que verifica la firma de Meta, cambia a una plantilla de respaldo y avisa a Slack; un objetivo de servicio nuevo, medido sobre recordatorios entregados, con alertas por tasa de consumo; el workflow TL Monitor de plantillas v1; y un análisis posterior sin culpables con acciones, dueños y fechas.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Reconstruir la línea de tiempo de un incidente de mensajería a partir de registros, respuestas de la API y eventos de webhook, y medir su impacto en recordatorios perdidos y en pesos.
- Explicar la calificación de calidad de las plantillas de WhatsApp, su pausa escalonada y su desactivación, y reconocer los códigos de error que las delatan.
- Diagnosticar la causa raíz con 5 porqués, un diagrama de Ishikawa y un árbol de fallos, distinguiendo el disparador, la causa y el hueco de monitoreo.
- Cerrar el hueco con webhooks de estado de plantillas, una plantilla de respaldo, alertas por consumo del presupuesto de error del Día 53 y un análisis posterior sin culpables.
Qué pasó: la línea de tiempo
Un incidente se cuenta primero en orden y con evidencias, antes de cualquier hipótesis. Valeria tiene cuatro fuentes: el registro de envíos de TL WhatsApp secuencias (una fila por recordatorio), el historial de versiones del workflow en n8n (el Día 42, Versionado de flujos: exportar el JSON a git, revisar diferencias y etiquetar versiones, dejó las exportaciones en Git), los eventos de plantillas que Meta envió y que nadie recibía, y que hoy se piden en WhatsApp Manager, y las personas: la clienta del mostrador y el propio panel del Día 53.
La historia empieza tres semanas antes. El lunes 2 de marzo, Valeria publicó la versión 1.3 del workflow para añadir un segundo idioma a los recordatorios. Al reescribir la consulta que elige a quién recordar, se perdió la condición estado = 'pendiente': desde ese día, el flujo recordaba también encargos ya recogidos o cancelados. Nadie lo notó, porque los clientes de verdad seguían recibiendo su aviso. Los que lo recibieron por error, en cambio, hicieron lo que hace cualquiera con un mensaje que no entiende: algunos lo ignoraron, algunos bloquearon el número y alguno lo reportó.
El primer bloque fija las importaciones, la semilla global y los supuestos del día:
# Importaciones base, semilla de la serie, carpeta del día y supuestos fijos en Python:
import warnings
warnings.filterwarnings('ignore')
import hashlib
import hmac
import json
import os
import re
import textwrap
from datetime import datetime, timedelta
from pathlib import Path
from zoneinfo import ZoneInfo
import numpy as np
import pandas as pd
import matplotlib.dates as mdates
import matplotlib.pyplot as plt
from matplotlib.patches import FancyBboxPatch, FancyArrowPatch, Polygon

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 120)
carpeta = Path('trigo_lento') / 'dia_54'
carpeta.mkdir(parents = True, exist_ok = True)
CDMX = ZoneInfo('America/Mexico_City')

# Supuestos del día (ficha) y datos fijos de la serie:
SLO = 0.97                  # recordatorios de recogida entregados en 28 días
VENTANA_DIAS = 28
TICKET_MXN = 380            # ticket medio de encargo
UTILIDAD_USD = 0.0085       # plantilla de utilidad en México (Día 46)
print('numpy', np.__version__, '| pandas', pd.__version__)
print(f'SLO: {SLO:.0%} en {VENTANA_DIAS} días | margen de fallos: {1 - SLO:.0%}')
numpy 2.4.6 | pandas 3.0.3
SLO: 97% en 28 días | margen de fallos: 3%
El objetivo de servicio que se usará en toda la entrada es el $97%$ de recordatorios entregados en una ventana móvil de $28$ días, lo que deja un margen del $3%$ para fallos. Se justificará en la sección de monitoreo; por ahora basta saber que es la vara con la que se medirá el daño.
El segundo bloque reconstruye la agenda: $16$ recordatorios por día de lunes a viernes, $28$ los sábados (el día de más encargos) y ninguno en domingo, del lunes 2 al miércoles 25 de marzo. Cada envío pasa por simular_post, la función de la serie que imita una respuesta HTTP sin red ni cuentas. Aquí imita a la Cloud API: devuelve $200$ con un identificador de mensaje (wamid) cuando la plantilla está activa y un error con el código $132015$ (plantilla pausada) o $132016$ (plantilla desactivada) según la hora del envío. Observe la línea que escribe el registro: la versión 1.3 anotaba “enviado” antes de mirar la respuesta, exactamente como estaba en producción:
# Agenda de recordatorios del 2 al 25 de marzo y registro de envíos con simular_post en Python:
HORAS_ENTRE_SEMANA = ['09:00', '09:10', '09:20', '09:40', '10:00', '10:20', '11:15', '12:15',
                      '12:45', '13:20', '14:00', '14:40', '15:10', '16:30', '18:00', '19:30']
HORAS_SABADO = [f'{9 + (20 * i) // 60:02d}:{(20 * i) % 60:02d}' for i in range(28)]   # cada 20 min

def agenda(inicio, fin):
    # 16 recordatorios de lunes a viernes, 28 los sábados y ninguno en domingo:
    filas, dia = [], inicio
    while dia <= fin:
        if dia.weekday() < 6:
            horas = HORAS_SABADO if dia.weekday() == 5 else HORAS_ENTRE_SEMANA
            for i, h in enumerate(horas):
                hh, mm = map(int, h.split(':'))
                filas.append({'recordatorio': f'r_{dia:%m%d}_{i + 1:02d}',
                              'programado': dia.replace(hour = hh, minute = mm)})
        dia += timedelta(days = 1)
    return pd.DataFrame(filas)

# Estado real de la plantilla recordatorio_recogida (lo que Meta sabía y nadie leyó):
PAUSAS = [(datetime(2026, 3, 10, 12, 0), datetime(2026, 3, 10, 15, 0)),
          (datetime(2026, 3, 11, 9, 30), datetime(2026, 3, 11, 15, 30))]
DESACTIVADA = datetime(2026, 3, 12, 12, 50)
DETECCION = datetime(2026, 3, 25, 10, 30)
RELOJ = {'ahora': None}     # reloj simulado: la hora a la que corre cada envío

class Respuesta:
    def __init__(self, status_code, cuerpo):
        self.status_code, self._cuerpo = status_code, cuerpo
        self.headers = {'content-type': 'application/json'}
    def json(self):
        return self._cuerpo

def simular_post(url, cuerpo, rng):
    # Cloud API simulada: 200 con wamid, o 400 si la plantilla está pausada o desactivada:
    t = RELOJ['ahora']
    if t >= DESACTIVADA:
        codigo, texto = 132016, 'Template has been paused too many times due to low quality and is now permanently disabled.'
    elif any(a <= t < b for a, b in PAUSAS):
        codigo, texto = 132015, 'Template is paused due to low quality so it cannot be sent in a template message.'
    else:
        return Respuesta(200, {'messaging_product': 'whatsapp',
                               'messages': [{'id': f'wamid.EJEMPLO{rng.integers(10**8, 10**9)}',
                                             'message_status': 'accepted'}]})
    return Respuesta(400, {'error': {'message': texto, 'type': 'OAuthException', 'code': codigo,
                                     'error_data': {'messaging_product': 'whatsapp', 'details': texto}}})

URL = 'https://graph.facebook.com/v26.0/EJEMPLO-NO-REAL/messages'
programa = agenda(datetime(2026, 3, 2), datetime(2026, 3, 25))
registro = []
for fila in programa[programa['programado'] < DETECCION].itertuples():
    RELOJ['ahora'] = fila.programado
    cuerpo = {'messaging_product': 'whatsapp', 'to': 'EJEMPLO', 'type': 'template',
              'template': {'name': 'recordatorio_recogida', 'language': {'code': 'es_MX'}}}
    r = simular_post(URL, cuerpo, rng)
    # Así registraba la versión 1.3: "enviado" antes de mirar la respuesta.
    registro.append({'recordatorio': fila.recordatorio, 'programado': fila.programado, 'http': r.status_code,
                     'codigo': r.json().get('error', {}).get('code'), 'estado_registrado': 'enviado'})
registro = pd.DataFrame(registro)
registro.to_csv(carpeta / 'registro_recordatorios.csv', index = False)

def tramo(t):
    # Tramo de la línea de tiempo al que pertenece cada recordatorio perdido:
    if t.date() == datetime(2026, 3, 10).date(): return '1. Pausa 1: mar 10, 12:00 a 15:00'
    if t.date() == datetime(2026, 3, 11).date(): return '2. Pausa 2: mié 11, 9:30 a 15:30'
    if t.date() == datetime(2026, 3, 12).date(): return '3. Desactivada: jue 12, desde 12:50'
    if t < datetime(2026, 3, 25): return '4. Vie 13 a mar 24 (16 o 28 al día)'
    return '5. Mié 25 hasta las 10:30'

perdidos = registro[registro['http'] != 200].copy()
perdidos['tramo'] = perdidos['programado'].map(tramo)
print('Envíos intentados:', len(registro), '| con 200:', (registro['http'] == 200).sum(),
      '| con 400:', (registro['http'] == 400).sum())
print('Códigos de error:', perdidos['codigo'].astype(int).value_counts().sort_index().to_dict())
print('Estado que escribió el registro:', registro['estado_registrado'].value_counts().to_dict())
print(perdidos.groupby('tramo').size().rename('perdidos').to_string())
print('Total de recordatorios perdidos:', len(perdidos))
Envíos intentados: 362 | con 200: 150 | con 400: 212
Códigos de error: {132015: 15, 132016: 197}
Estado que escribió el registro: {'enviado': 362}
tramo
1. Pausa 1: mar 10, 12:00 a 15:00        5
2. Pausa 2: mié 11, 9:30 a 15:30        10
3. Desactivada: jue 12, desde 12:50      7
4. Vie 13 a mar 24 (16 o 28 al día)    184
5. Mié 25 hasta las 10:30                6
Total de recordatorios perdidos: 212
De $362$ envíos intentados antes de la detección, $150$ recibieron un $200$ y $212$ recibieron un error: $15$ con el código $132015$ durante las dos pausas y $197$ con el $132016$ después de la desactivación. El registro, sin embargo, dice “enviado” en las $362$ filas. Esa sola columna explica la mitad del incidente: el sistema tenía la información correcta en la mano, en la respuesta de la API, y escribió la incorrecta.
El reparto por tramos coincide con lo que Valeria reconstruye a mano: $5$ recordatorios perdidos en la primera pausa, $10$ en la segunda, $7$ el jueves 12 desde las 12:50, $184$ entre el viernes 13 y el martes 24 y $6$ el miércoles 25 antes de las 10:30. La Tabla 1 junta esas cifras con las señales que estaban disponibles en cada momento y con quién las vio.
Tabla 1. Línea de tiempo del incidente de la plantilla pausada (incidente ficticio; horas de Ciudad de México).
| Fecha y hora | Evento | Señal disponible | Quién la vio | Recordatorios perdidos |
|---|---|---|---|---|
| Lun 2 de marzo, 9:00 | Se publica la versión 1.3 sin el filtro de pendientes | Historial de versiones en n8n y en Git | Valeria, que hizo el cambio | 0 |
| Jue 5 de marzo, 16:40 | La calidad de la plantilla pasa de verde a amarilla | Webhook de calidad y WhatsApp Manager | Nadie | 0 |
| Mar 10 de marzo, 11:52 | La calidad baja a roja | Webhook de calidad | Nadie | 0 |
| Mar 10 de marzo, 12:00 a 15:00 | Primera pausa, de 3 horas | Webhook PAUSED con FIRST_PAUSE, correo de Meta y error 132015 | Nadie: el correo llegó a la bandeja general | 5 |
| Mié 11 de marzo, 9:30 a 15:30 | Segunda pausa, de 6 horas | Webhook PAUSED con SECOND_PAUSE y error 132015 | Nadie | 10 |
| Jue 12 de marzo, 12:50 | La plantilla queda desactivada | Webhook DISABLED y error 132016 | Nadie | 7 |
| Vie 13 a mar 24 de marzo | Todos los envíos fallan; las ejecuciones siguen en verde | Error 132016 en cada respuesta | Nadie | 184 |
| Mié 25 de marzo, 10:30 | Detección: el panel marca 0 % y una clienta pregunta | Panel del Día 53 y la clienta | Valeria y el mostrador | 6 |
| Total | 212 |
La tabla tiene una columna que duele más que las cifras: “Quién la vio” dice “Nadie” en seis de las ocho filas. Hubo al menos siete avisos (dos de calidad, tres de estado, el correo de Meta y $212$ respuestas con error) y ninguno llegó a una persona. Con esa evidencia ya se puede reconstruir la tasa de entrega diaria y medir los tiempos del incidente, como se hace en el siguiente código:
# Reconstrucción de la línea de tiempo desde el registro y tasa de entrega diaria en Python:
completo = agenda(datetime(2026, 3, 2), datetime(2026, 3, 25))
completo['dia'] = completo['programado'].dt.normalize()
diario = completo.groupby('dia').size().rename('programados').to_frame()
perdidos['dia'] = perdidos['programado'].dt.normalize()
diario['perdidos'] = perdidos.groupby('dia').size().reindex(diario.index, fill_value = 0)
diario['entregados'] = diario['programados'] - diario['perdidos']
diario['tasa'] = diario['entregados'] / diario['programados']
primera_falla = perdidos['programado'].min()
ultima_entrega = registro.loc[registro['http'] == 200, 'programado'].max()

def duracion(td):
    h, m = divmod(int(td.total_seconds() // 60), 60)
    return f'{h // 24} d {h % 24} h {m} min'

print('Primera falla:', primera_falla, '| último 200 antes de la detección:', ultima_entrega)
print('Detección (una clienta y el panel del Día 53):', DETECCION)
print('Tiempo hasta detectar desde la primera falla:', duracion(DETECCION - primera_falla))
print('Tiempo hasta detectar desde la desactivación:', duracion(DETECCION - DESACTIVADA))
print('Días con recordatorios y entrega del 0 %:', int(((diario['tasa'] == 0) & (diario['programados'] > 0)).sum()))
print('Ejecuciones del flujo marcadas como correctas:', f"{len(registro)} de {len(registro)} (100 %)")
print(diario.loc['2026-03-09':'2026-03-14'].assign(tasa = lambda d: (100 * d['tasa']).round(1)).to_string())

# Recordatorios programados y entregados por día, con las pausas, la desactivación y la detección:
fig, ax = plt.subplots(figsize = (11, 4.8))
x = np.arange(len(diario))
etiquetas = [d.strftime('%d') for d in diario.index]
ax.bar(x, diario['programados'], color = '#d9d9d9', label = 'Programados')
ax.bar(x, diario['entregados'], color = '#2a78d6', label = 'Entregados')
i10, i11, i12, i25 = [list(diario.index).index(pd.Timestamp(f'2026-03-{d}')) for d in (10, 11, 12, 25)]
ax.axvspan(i10 - 0.45, i10 + 0.45, color = '#eb6834', alpha = 0.25, label = 'Pausa de 3 h y de 6 h')
ax.axvspan(i11 - 0.45, i11 + 0.45, color = '#eb6834', alpha = 0.25)
ax.axvspan(i12 - 0.1, i25 + 0.45, color = '#d62728', alpha = 0.10, label = 'Plantilla desactivada')
ax.axvline(i25, color = '#1f9d55', linestyle = '--', linewidth = 2, label = 'Detección: 25 de marzo, 10:30')
ax.set_xticks(x)
ax.set_xticklabels(etiquetas)
ax.set_xlabel('Día de marzo de 2026 (los domingos no hay recordatorios)')
ax.set_ylabel('Recordatorios')
ax.set_title('Recordatorios de recogida programados y entregados', fontsize = 16)
ax.legend(loc = 'upper left', fontsize = 9, ncol = 2)
ax.set_ylim(0, 38)
plt.tight_layout()
plt.show()
Primera falla: 2026-03-10 12:15:00 | último 200 antes de la detección: 2026-03-12 12:45:00
Detección (una clienta y el panel del Día 53): 2026-03-25 10:30:00
Tiempo hasta detectar desde la primera falla: 14 d 22 h 15 min
Tiempo hasta detectar desde la desactivación: 12 d 21 h 40 min
Días con recordatorios y entrega del 0 %: 10
Ejecuciones del flujo marcadas como correctas: 362 de 362 (100 %)
            programados  perdidos  entregados   tasa
dia
2026-03-09           16         0          16  100.0
2026-03-10           16         5          11   68.8
2026-03-11           16        10           6   37.5
2026-03-12           16         7           9   56.2
2026-03-13           16        16           0    0.0
2026-03-14           28        28           0    0.0
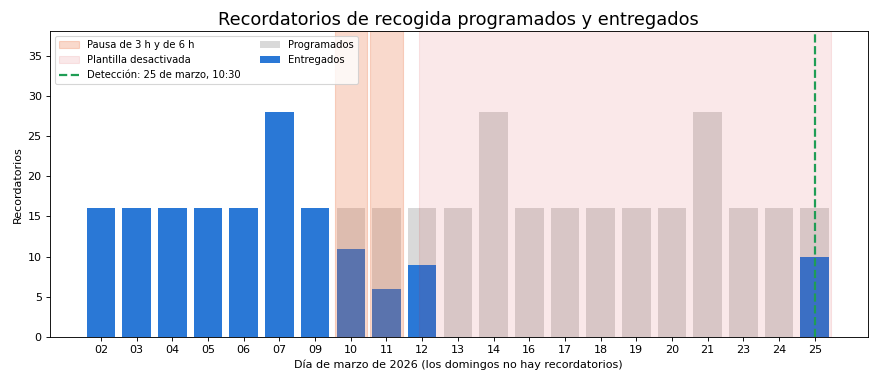
La primera falla ocurrió el martes 10 a las 12:15 y la detección, el miércoles 25 a las 10:30: un tiempo hasta detectar (TTD, por sus siglas en inglés: “Time To Detect”) de $14$ días, $22$ horas y $15$ minutos. Desde la desactivación, el TTD fue de $12$ días y $21$ horas. Hubo $10$ días con recordatorios programados y una entrega del $0%$, mientras el historial de n8n mostraba $362$ de $362$ ejecuciones correctas. La gráfica lo dice sin palabras: las dos pausas son muescas pequeñas (la entrega del martes 10 cae al $68.8%$ y la del miércoles 11 al $37.5%$) que nadie habría notado en un promedio semanal; a partir del jueves 12, las barras azules desaparecen.
Las barras del miércoles 25 muestran $10$ recordatorios entregados: son los que quedaban del día después de las 10:30, y salieron por llamada telefónica del mostrador mientras se resolvía lo demás, como verá en la sección de corrección.
Antes de diagnosticar, conviene ponerle precio. Meta no cobra una plantilla que no se entrega, así que el incidente “ahorró” $212 \cdot 0.0085 = 1.80$ USD. El coste real está en otro lado. Si se supone que sin recordatorio la tasa de encargos no recogidos sube $7$ puntos porcentuales, el riesgo esperado es:
$$ \text{riesgo} = n \cdot \Delta p \cdot \text{ticket} $$
donde:
- $n = 212$ son los recordatorios que no llegaron.
- $\Delta p = 0.07$ es el aumento supuesto de la probabilidad de no recoger el encargo cuando falta el recordatorio; es un supuesto didáctico, no una medición.
- $\text{ticket} = 380$ MXN es el ticket medio de encargo de la serie.
El resultado es $212 \cdot 0.07 = 14.8$, unos $15$ encargos en riesgo, alrededor de $5,700$ MXN, frente a $1.80$ USD que Meta no cobró. El incidente fue barato en mensajería y caro en pan. Por eso la métrica que importa es la entrega, no el gasto.
Calidad y pausa de plantillas
El Día 48 presentó de pasada la calidad de las plantillas; hoy hace falta entenderla bien, porque es el mecanismo que convirtió un filtro perdido en $212$ recordatorios perdidos.
Cada plantilla de WhatsApp Business Platform tiene una calificación de calidad propia, distinta de la calidad del número de teléfono. Según la documentación de Meta (revisado en octubre de 2026), la calificación se expresa en la API como GREEN, YELLOW, RED o UNKNOWN (en WhatsApp Manager, alta, media, baja o sin datos) y se calcula con las señales que dejan los propios usuarios al recibirla: bloqueos, reportes y los motivos que eligen al bloquear, junto con las tasas de lectura. Meta no publica los umbrales, y la entrada no los inventa.
Cuando una plantilla llega a la calificación más baja, Meta la pausa de forma automática para proteger la calidad del número que la usa. La pausa es escalonada:
- Primera vez: la plantilla queda pausada $3$ horas y luego vuelve sola a estar activa.
- Segunda vez: la pausa dura $6$ horas.
- Tercera vez: la plantilla queda desactivada, y no vuelve sola.
Durante la pausa, la API rechaza los envíos de esa plantilla; esos intentos no se cobran ni cuentan para el límite de mensajería. Meta avisa por tres vías: WhatsApp Manager, un correo al administrador de la cuenta y el webhook message_template_status_update. En Trigo Lento, la primera vía nadie la miraba, la segunda llegó a una bandeja general y la tercera no estaba suscrita. El ciclo completo de la plantilla recordatorio_recogida, con sus tres “tarjetas”, se ve en la Figura 1.
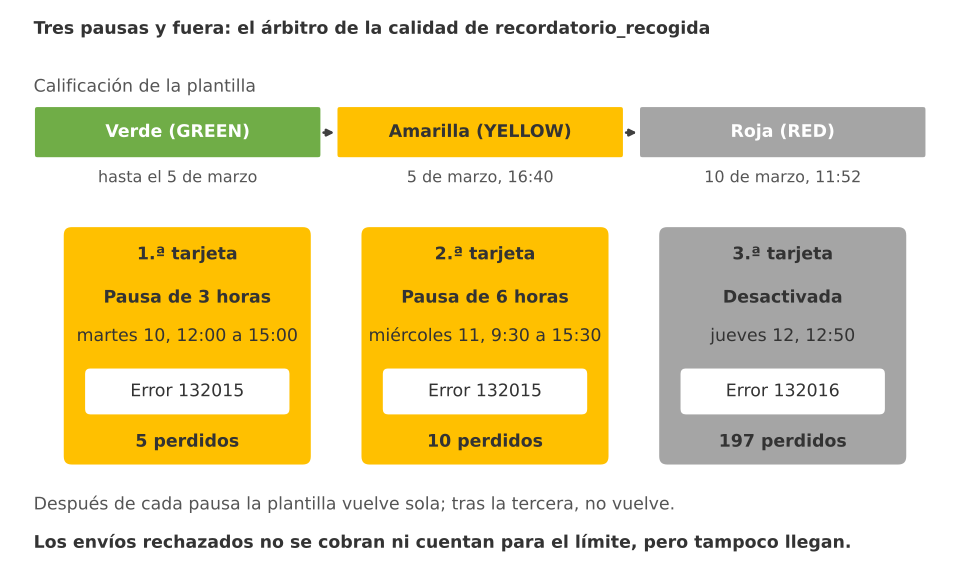
Figura 1. Tres pausas y fuera: la calificación de recordatorio_recogida pasa de verde a amarilla y a roja, y Meta saca tres tarjetas: una pausa de 3 horas el martes 10, una de 6 horas el miércoles 11 y la desactivación del jueves 12, con el error que devuelve la API y los recordatorios perdidos en cada tramo.
La diferencia con la calidad del número del Día 48 conviene tenerla clara. La calidad del número resume los últimos siete días de todo lo que envía el negocio y, si baja, limita a cuántas personas puede escribir al día o impide subir de nivel. La calidad de la plantilla es local: castiga a una plantilla concreta, con pausas, y deja a las demás funcionando. Por eso el incidente fue silencioso: la confirmación de pedido y el chatbot siguieron trabajando con normalidad, y solo el recordatorio se apagó.
¿Qué señales dejaron los recordatorios indebidos? El siguiente bloque las simula con tasas declaradas como supuestos: un recordatorio que el cliente esperaba se bloquea con probabilidad $0.4%$ y se reporta con $0.1%$; uno indebido, a un encargo ya recogido o cancelado, se bloquea con $6%$ y se reporta con $2%$. Los indebidos por día siguen una distribución de Poisson de media $11$ entre semana y $18$ los sábados, y se cuentan solo las horas en que la plantilla no estaba en pausa:
# Señales de calidad simuladas antes y después del cambio del 2 de marzo en Python:
dias = pd.date_range('2026-02-02', '2026-03-12')
CAMBIO = pd.Timestamp('2026-03-02')
P_BLOQUEO = {'debido': 0.004, 'indebido': 0.06}    # supuestos de la simulación
P_REPORTE = {'debido': 0.001, 'indebido': 0.02}
senales = []
for d in dias:
    if d.weekday() == 6:
        continue
    debidos = 28 if d.weekday() == 5 else 16
    activa = {pd.Timestamp('2026-03-10'): 13 / 16, pd.Timestamp('2026-03-11'): 6 / 16,
              pd.Timestamp('2026-03-12'): 9 / 16}.get(d, 1.0)            # fracción del día sin pausa
    indebidos = rng.poisson(18 if d.weekday() == 5 else 11) if d >= CAMBIO else 0
    debidos, indebidos = round(debidos * activa), round(indebidos * activa)
    bloqueos = rng.binomial(debidos, P_BLOQUEO['debido']) + rng.binomial(indebidos, P_BLOQUEO['indebido'])
    reportes = rng.binomial(debidos, P_REPORTE['debido']) + rng.binomial(indebidos, P_REPORTE['indebido'])
    senales.append({'dia': d, 'debidos': debidos, 'indebidos': indebidos, 'bloqueos': bloqueos, 'reportes': reportes})
senales = pd.DataFrame(senales).set_index('dia')
antes, despues = senales[senales.index < CAMBIO], senales[senales.index >= CAMBIO]
for nombre, s in [('Antes del cambio (2 feb a 1 mar)', antes), ('Después del cambio (2 a 12 mar)', despues)]:
    enviados = s['debidos'].sum() + s['indebidos'].sum()
    negativos = s['bloqueos'].sum() + s['reportes'].sum()
    print(f'{nombre}: enviados {enviados}, indebidos {s["indebidos"].sum()}, bloqueos {s["bloqueos"].sum()}, '
          f'reportes {s["reportes"].sum()}, señales negativas por cada 100: {100 * negativos / enviados:.2f}')
tasa_a = (antes['bloqueos'].sum() + antes['reportes'].sum()) / (antes['debidos'].sum() + antes['indebidos'].sum())
tasa_d = (despues['bloqueos'].sum() + despues['reportes'].sum()) / (despues['debidos'].sum() + despues['indebidos'].sum())
print(f'La tasa de señales negativas se multiplicó por {tasa_d / tasa_a:.1f}')
print('Clientes que recibieron un recordatorio indebido (cota superior):', despues['indebidos'].sum())

# Señales negativas por día y recordatorios indebidos, con los cambios de calificación:
fig, ax = plt.subplots(figsize = (11, 4.8))
xs = np.arange(len(senales))
ax.bar(xs, senales['bloqueos'], color = '#d62728', label = 'Bloqueos')
ax.bar(xs, senales['reportes'], bottom = senales['bloqueos'], color = '#eb6834', label = 'Reportes')
ax2 = ax.twinx()
ax2.plot(xs, senales['indebidos'], color = '#52514e', marker = 'o', label = 'Recordatorios indebidos')
ax2.set_ylabel('Recordatorios indebidos al día')
marcas = [('2026-03-02', 'Versión 1.3'), ('2026-03-05', 'Amarilla'), ('2026-03-10', 'Roja y pausa'),
          ('2026-03-12', 'Desactivada')]
for fecha, texto in marcas:
    i = list(senales.index).index(pd.Timestamp(fecha))
    ax.axvline(i, color = '#1f9d55', linestyle = '--', linewidth = 1.5)
    ax.text(i + 0.1, 7.3, texto, fontsize = 9, color = '#1f9d55', rotation = 90, va = 'top')
ax.set_xticks(xs)
ax.set_xticklabels([d.strftime('%d/%m') if i % 2 == 0 else '' for i, d in enumerate(senales.index)], rotation = 60, fontsize = 8)
ax.set_ylim(0, 7.5)
ax2.set_ylim(0, 30)
ax.set_ylabel('Bloqueos y reportes')
ax.set_title('Señales de calidad de recordatorio_recogida (simuladas)', fontsize = 16)
h1, l1 = ax.get_legend_handles_labels()
h2, l2 = ax2.get_legend_handles_labels()
ax.legend(h1 + h2, l1 + l2, loc = 'upper left', fontsize = 9)
plt.tight_layout()
plt.show()
Antes del cambio (2 feb a 1 mar): enviados 432, indebidos 0, bloqueos 2, reportes 0, señales negativas por cada 100: 0.46
Después del cambio (2 a 12 mar): enviados 270, indebidos 118, bloqueos 5, reportes 1, señales negativas por cada 100: 2.22
La tasa de señales negativas se multiplicó por 4.8
Clientes que recibieron un recordatorio indebido (cota superior): 118
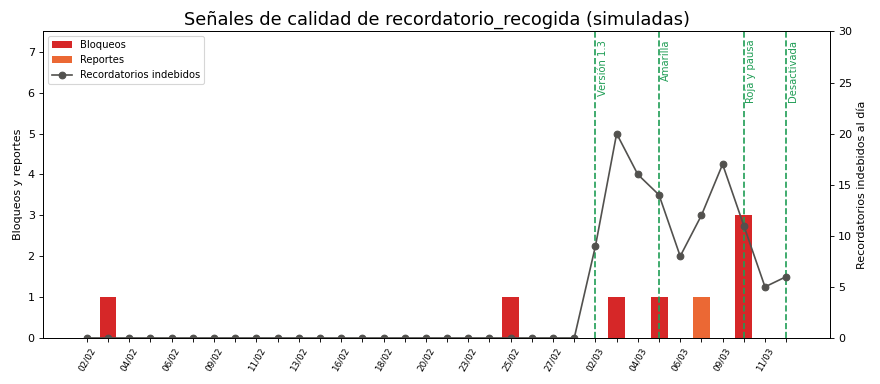
Antes del cambio del 2 de marzo, la plantilla recibía $0.46$ señales negativas por cada $100$ envíos; después, $2.22$, unas $4.8$ veces más. Ninguna cifra es dramática por sí sola: cinco bloqueos y un reporte en once días. Pero la calificación no mira el número absoluto, mira la proporción, y $118$ recordatorios indebidos en un volumen de $270$ envíos son el $44%$ de lo enviado. La gráfica muestra además el orden de los hechos que Meta sí registró: la versión 1.3, la calificación amarilla del jueves 5, la roja y la primera pausa del martes 10 y la desactivación del jueves 12. Entre la causa y la consecuencia pasaron ocho días, tiempo de sobra para corregir si alguien hubiera estado escuchando.
Hay una cifra en la salida que es la más incómoda del día: $118$ clientes, como máximo, recibieron un mensaje que no debían recibir. Es una cota superior, porque algunos pudieron recibir más de uno, pero basta para ordenar las prioridades. La calidad de la plantilla no es el problema; es el termómetro del problema. El problema es haber molestado a clientes que ya habían recogido su pan.
Los códigos de error que el flujo ignoró
Cada envío durante la pausa y después de la desactivación recibió una respuesta de error con un código preciso. La tabla de errores de la Cloud API (revisado en octubre de 2026) describe así los dos que importan hoy:
- $132015$: la plantilla está pausada por baja calidad y no se puede enviar como mensaje de plantilla.
- $132016$: la plantilla se pausó demasiadas veces por baja calidad y ahora está desactivada de forma permanente.
La misma documentación advierte que los errores de la Cloud API pueden llegar en la respuesta síncrona, en el webhook de mensajes o en los dos, y recomienda vigilar ambos canales. La versión 1.3 no vigilaba ninguno: el nodo HTTP tenía activada la opción de continuar ante error y el nodo siguiente escribía “enviado” sin leer el cuerpo de la respuesta.
Conviene detenerse en la naturaleza de estos errores, porque decide qué hacer con ellos. El Día 28 (Flujos profesionales: manejo de errores, reintentos y ejecuciones incompletas) separó los errores reintentables (un $429$ por exceso de ritmo, un $5$xx del servidor, un corte de red) de los no reintentables (una petición mal formada, un permiso que falta, un recurso que no existe). Un $132015$ o un $132016$ pertenecen al segundo grupo. Un error 400 no es “un error de red”: es la API diciéndole que su petición, tal como está, no va a funcionar. Reintentar una plantilla pausada tres veces seguidas solo produce tres rechazos; reintentar una desactivada produce rechazos para siempre. Lo correcto es tratar el código como un dato de negocio: cambiar a otra plantilla, avisar a una persona y registrar el fallo como fallo.
Hay una sutileza más. El $200$ de la Cloud API significa “aceptado por Meta”, no “entregado al cliente”, como recordó el Día 48: la entrega llega después por el webhook de estados (sent, delivered, read o failed). En este incidente la distinción no cambió nada, porque los envíos fallaron antes de ser aceptados, pero el indicador de servicio que se construirá más adelante sí la respeta.
Por qué nadie se enteró
El Día 29 terminó con una pregunta de Don Ernesto que hoy vuelve con más fuerza: ¿por qué nos enteramos por una persona y no por la propia máquina? En el incidente del webhook duplicado pasaron $38$ minutos; hoy pasaron casi quince días. Cuatro decisiones, cada una razonable por separado, se alinearon:
- El nodo HTTP tenía “continuar ante error”. Valeria la activó en febrero para que un fallo de un recordatorio no detuviera los demás, una buena intención. Pero sin una rama de error que hiciera algo, la opción convirtió cada rechazo en una ejecución exitosa.
- El registro escribía “enviado” antes de leer la respuesta. El estado que quedó en la base de datos describía la intención del flujo, no el resultado.
- Nadie estaba suscrito a los eventos de plantillas. El webhook de la Cloud API de Trigo Lento recibía mensajes y estados de entrega, pero no los campos
message_template_status_updatenimessage_template_quality_update, que se suscriben aparte. - El tablero medía ejecuciones del flujo, no recordatorios entregados. Un tablero de ejecuciones responde a la pregunta ¿corrió la máquina? La pregunta del negocio es otra: ¿le llegó el aviso a la clienta?
La cuarta es la que conviene grabarse. Hay dos maneras de vigilar un sistema. Monitorear la máquina mide la salud de los componentes: el servidor responde, el workflow se ejecuta, la base de datos acepta escrituras. Monitorear el resultado mide lo que el cliente recibe: recordatorios entregados, pedidos confirmados, respuestas en plazo. Las dos son necesarias, pero solo la segunda detecta un fallo cuyo efecto está fuera de la máquina. En este incidente, toda la máquina de Trigo Lento estaba sana; lo que estaba enfermo era una plantilla en los servidores de Meta. El semáforo de la plantilla pasó de verde a rojo mientras el del tablero seguía en verde, como muestra la Figura 2.
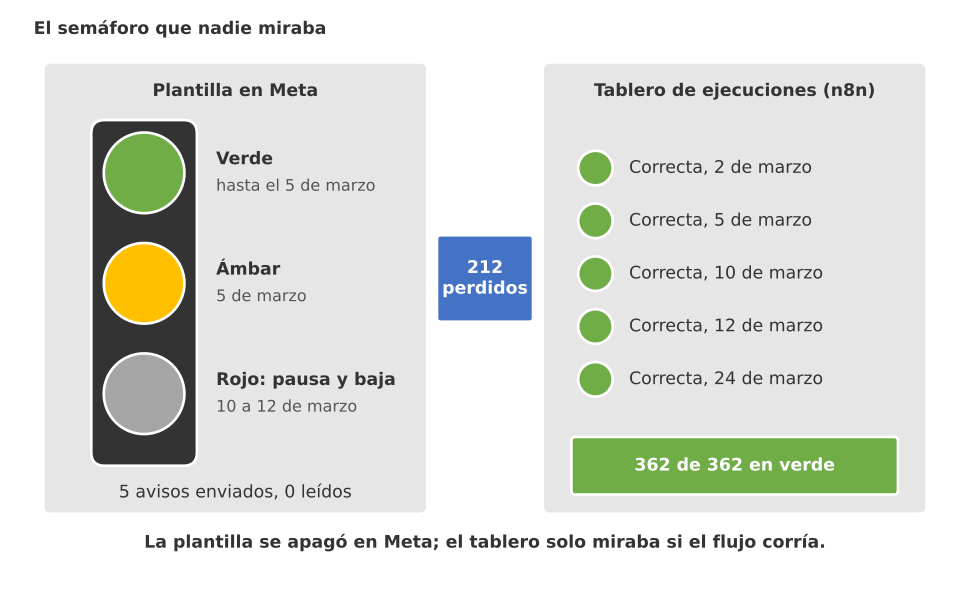
Figura 2. El semáforo que nadie miraba: a la izquierda, el semáforo de la plantilla en Meta cambia de verde a ámbar y a rojo entre el 2 y el 12 de marzo; a la derecha, el tablero de ejecuciones de n8n sigue en verde con 362 de 362 ejecuciones correctas mientras se pierden 212 recordatorios.
El patrón tiene nombre en la ingeniería de confiabilidad: es una falla silenciosa, un componente que deja de hacer su trabajo sin dejar de responder. Son las más caras, porque su coste crece con cada hora que pasan sin verse, y las más comunes en integraciones con terceros, donde el estado real vive en un sistema que usted no controla. La defensa no es tener más alertas, sino tener al menos una alerta sobre el resultado, y suscribirse a las notificaciones que el proveedor ya ofrece.
Diagnóstico
Con la línea de tiempo y el mecanismo claros, toca preguntar por qué, con método. La serie usa tres herramientas complementarias: los cinco porqués, que siguen una cadena causal hasta algo que se puede cambiar; el diagrama de Ishikawa (o diagrama de espina de pescado), que obliga a mirar por familias de causas para no quedarse con la primera; y el árbol de fallos, que dice qué combinación de condiciones fue necesaria para que el incidente ocurriera.
El árbol de fallos usa dos compuertas lógicas. Una compuerta O se dispara si ocurre cualquiera de sus entradas; una compuerta Y, solo si ocurren todas. Si las entradas son independientes, sus probabilidades se combinan así:
$$ P_{\text{O}} = 1 - \prod_{i} (1 - p_i), \qquad P_{\text{Y}} = \prod_{i} p_i $$
La lógica de cada compuerta:
- La compuerta O se acerca a la suma de sus entradas cuando son pequeñas: cuantas más maneras hay de que una plantilla deje de enviarse (pausa por calidad, reclasificación de categoría, rechazo tras una edición, número restringido), más probable es que alguna ocurra.
- La compuerta Y se hunde con cada barrera: si para que el incidente pase hace falta que fallen tres detecciones a la vez, basta con que una funcione para cortarlo.
- El evento superior del incidente es una Y: “recordatorios perdidos sin que nadie lo sepa” exige que la plantilla caiga y que la falla no se vea. Ninguna de las dos basta sola.
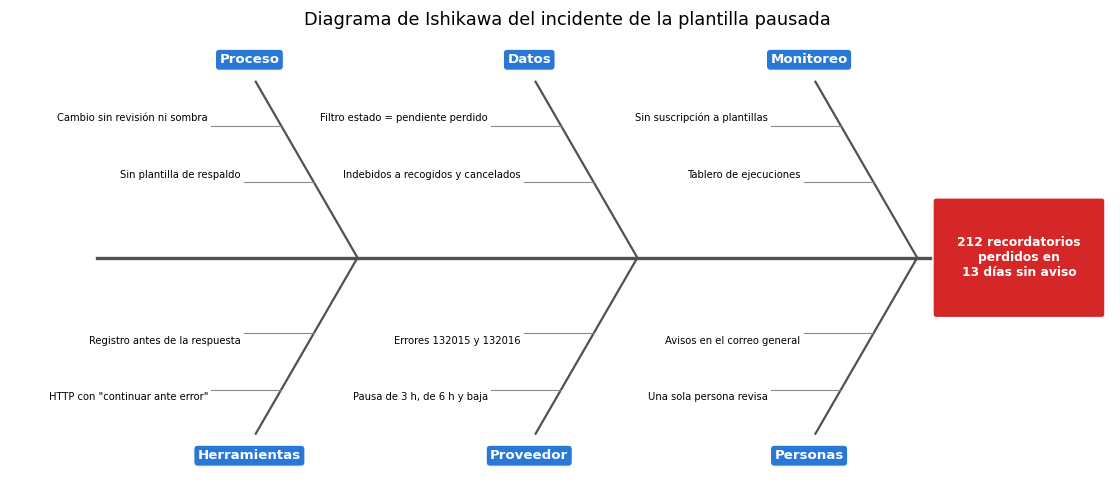
El siguiente bloque escribe los cinco porqués y el árbol como estructuras de datos, calcula las compuertas con probabilidades ilustrativas por trimestre (no son mediciones) y dibuja el diagrama de Ishikawa con seis espinas:
# Cinco porqués, árbol de fallos con compuertas Y y O, y diagrama de Ishikawa en Python:
porques = [
    ('¿Por qué no salieron 212 recordatorios?', 'La plantilla se pausó dos veces y el 12 de marzo quedó desactivada.'),
    ('¿Por qué se pausó?', 'Su calidad bajó a roja por bloqueos y reportes de los clientes.'),
    ('¿Por qué la bloquearon?', 'Desde el 2 de marzo recordaba encargos ya recogidos o cancelados.'),
    ('¿Por qué la versión 1.3 salió sin el filtro?', 'No había prueba de regresión ni periodo en sombra para el cambio.'),
    ('¿Por qué nadie lo vio en 13 días?', 'Se medía que el flujo corriera, no que el recordatorio llegara.'),
]
for i, (p, r) in enumerate(porques, 1):
    print(f'{i}. {p}\n   {r}')

def compuerta_o(ps):
    return float(1 - np.prod([1 - p for p in ps]))

def compuerta_y(ps):
    return float(np.prod(list(ps)))

# Probabilidades ilustrativas por trimestre (no son mediciones):
cae = {'pausa por calidad': 0.08, 'reclasificación de categoría': 0.03, 'rechazo tras una edición': 0.02,
       'número restringido': 0.01}
no_se_ve = {'v1.3': {'sin eventos de plantillas': 1.0, 'registro antes de la respuesta': 1.0, 'tablero de ejecuciones': 1.0},
            'v2': {'sin eventos de plantillas': 0.05, 'registro antes de la respuesta': 0.10, 'tablero de ejecuciones': 0.20}}
p_cae = compuerta_o(cae.values())
print(f'P(la plantilla cae en un trimestre) = {p_cae:.4f}')
for version, capas in no_se_ve.items():
    p_oculta = compuerta_y(capas.values())
    print(f'{version}: P(la falla no se ve) = {p_oculta:.4f} | P(evento superior) = {compuerta_y([p_cae, p_oculta]):.6f}')

# Diagrama de Ishikawa con seis espinas:
espinas = {
    'Proceso': ['Cambio sin revisión ni sombra', 'Sin plantilla de respaldo'],
    'Herramientas': ['HTTP con "continuar ante error"', 'Registro antes de la respuesta'],
    'Datos': ['Filtro estado = pendiente perdido', 'Indebidos a recogidos y cancelados'],
    'Proveedor': ['Pausa de 3 h, de 6 h y baja', 'Errores 132015 y 132016'],
    'Monitoreo': ['Sin suscripción a plantillas', 'Tablero de ejecuciones'],
    'Personas': ['Una sola persona revisa', 'Avisos en el correo general'],
}
fig, ax = plt.subplots(figsize = (14, 6.2))
ax.plot([0.5, 13.6], [0, 0], color = '#52514e', linewidth = 3)
ax.add_patch(FancyBboxPatch((13.7, -0.9), 2.6, 1.8, boxstyle = 'round,pad=0.05', facecolor = '#d62728',
                            edgecolor = 'white'))
ax.text(15.0, 0, '212 recordatorios\nperdidos en\n13 días sin aviso', ha = 'center', va = 'center',
        color = 'white', fontsize = 11, fontweight = 'bold')
for k, (nombre, causas) in enumerate(espinas.items()):
    arriba = k % 2 == 0
    xb = 3.0 + (k // 2) * 4.4
    signo = 1 if arriba else -1
    ax.plot([xb, xb + 1.6], [signo * 2.8, 0], color = '#52514e', linewidth = 2)
    ax.text(xb - 0.1, signo * 3.15, nombre, ha = 'center', va = 'center', fontsize = 12, fontweight = 'bold',
            bbox = dict(boxstyle = 'round', facecolor = '#2a78d6', edgecolor = 'white'), color = 'white')
    for j, causa in enumerate(causas):
        yc = signo * (2.1 - 0.9 * j)
        xc = xb + 1.6 * (1 - abs(yc) / 2.8)
        ax.plot([xc - 1.1, xc], [yc, yc], color = '#8a8a8a', linewidth = 1)
        ax.text(xc - 1.15, yc + 0.12 * signo, causa, ha = 'right', va = 'center', fontsize = 9)
ax.set_xlim(-0.6, 16.4)
ax.set_ylim(-3.6, 3.6)
ax.axis('off')
ax.set_title('Diagrama de Ishikawa del incidente de la plantilla pausada', fontsize = 16)
plt.tight_layout()
plt.show()
1. ¿Por qué no salieron 212 recordatorios?
   La plantilla se pausó dos veces y el 12 de marzo quedó desactivada.
2. ¿Por qué se pausó?
   Su calidad bajó a roja por bloqueos y reportes de los clientes.
3. ¿Por qué la bloquearon?
   Desde el 2 de marzo recordaba encargos ya recogidos o cancelados.
4. ¿Por qué la versión 1.3 salió sin el filtro?
   No había prueba de regresión ni periodo en sombra para el cambio.
5. ¿Por qué nadie lo vio en 13 días?
   Se medía que el flujo corriera, no que el recordatorio llegara.
P(la plantilla cae en un trimestre) = 0.1342
v1.3: P(la falla no se ve) = 1.0000 | P(evento superior) = 0.134194
v2: P(la falla no se ve) = 0.0010 | P(evento superior) = 0.000134
Los cinco porqués llevan del síntoma ($212$ recordatorios) a dos decisiones de diseño que se pueden cambiar: un cambio salió a producción sin una prueba que protegiera el filtro, y el sistema medía que el flujo corriera, no que el recordatorio llegara. Observe que la cadena se bifurca en el cuarto porqué: uno explica por qué la plantilla cayó y otro por qué nadie lo vio. Es lo normal; un incidente rara vez tiene una sola cadena.
El árbol pone números a esa bifurcación. Con las probabilidades ilustrativas, la plantilla cae en un trimestre con probabilidad $0.1342$, y en la versión 1.3, donde ninguna capa de detección existía, la falla pasaba inadvertida con probabilidad $1$: el evento superior valía lo mismo que la caída, $0.1342$. Con las tres capas de la versión 2 (eventos de plantillas, registro según la respuesta, tablero de entregas), la probabilidad de no ver la falla baja a $0.05 \cdot 0.10 \cdot 0.20 = 0.001$ y el evento superior a $0.000134$, mil veces menos. La caída de la plantilla seguirá pasando; lo que se puede volver casi imposible es que pase en silencio. Como en el Día 39, las capas no son del todo independientes (las tres dependen de que n8n esté en pie), y por eso se refuerzan todas en lugar de confiar en el producto.
El diagrama de Ishikawa completa la mirada con seis familias de causas: proceso (cambio sin revisión ni periodo en sombra, ninguna plantilla de respaldo), herramientas (el nodo HTTP que continuaba ante error, el registro escrito antes de la respuesta), datos (el filtro perdido y los recordatorios a encargos recogidos o cancelados), proveedor (la pausa escalonada y los errores $132015$ y $132016$), monitoreo (ninguna suscripción a eventos de plantillas, un tablero de ejecuciones) y personas (una sola persona revisa los cambios, los avisos de Meta llegan a un correo general). La espina de “personas” no dice “Valeria se equivocó”; dice que el sistema dependía de que una sola persona no se equivocara nunca.
Causa raíz y corrección
El diagnóstico separa tres cosas que en la conversación del miércoles estaban mezcladas:
- El disparador fue el filtro
estado = 'pendiente'perdido en la versión 1.3. Sin él, la plantilla no habría caído en marzo. - La causa del daño fue la pausa escalonada de Meta, que actuó como estaba diseñada para actuar: protegió la calidad del número castigando a la plantilla que molestaba.
- La causa raíz es el hueco de monitoreo: un sistema que no medía el resultado ni escuchaba al proveedor. Con monitoreo, el mismo disparador habría costado unas horas y unos pocos recordatorios; sin él, costó trece días.
La distinción importa porque cada una pide una corrección distinta. Corregir solo el disparador deja el sistema igual de ciego ante el próximo filtro perdido, la próxima reclasificación de categoría o la próxima regla nueva de Meta. Corregir solo el monitoreo deja a los clientes recibiendo mensajes indebidos. Hacen falta las dos.
La corrección del miércoles 25 tuvo tres pasos, en este orden:
- Dejar de molestar. Lo primero fue desactivar el envío automático hasta restaurar el filtro, aunque la plantilla ya estuviera desactivada: si Meta la hubiera reactivado, la versión 1.3 habría vuelto a escribir a encargos cancelados.
- Cubrir el día. Los $10$ recordatorios que quedaban del miércoles, y los pasteles del jueves, se avisaron por teléfono desde el mostrador, con la lista impresa y sin guardar notas de las llamadas. Una plantilla de respaldo habría resuelto esto en segundos; no existía, y esa ausencia entra en el análisis.
- Restaurar el filtro con una prueba.
TL WhatsApp secuencias v2recupera la condiciónestado = 'pendiente'y, por primera vez, lleva una prueba de regresión que falla si alguien la vuelve a quitar; la verá en el Bloque 11. La plantilla desactivada no se reutiliza: Valeria envió a revisión una plantilla nueva,aviso_recogida, con otra redacción y la misma categoría de utilidad.
Atención aquí: La tentación, tras un incidente así, es “recuperar la calificación” escribiendo a todos los clientes afectados para compensar. No lo haga. El incidente nació de mensajes que los clientes no debían recibir; la primera corrección es dejar de molestar, no escribir más. Una disculpa, si se envía, va solo a quien tiene una base vigente (un encargo en curso o el consentimiento de confirmaciones), por el canal que ya usaba, sin promociones dentro, y el registro del incidente no guarda teléfonos ni textos de clientes.
Monitorear lo que importa
El Día 53 enseñó a convertir una promesa en un objetivo medible. Hoy se aplica el mismo método a una cosa nueva: no a mensajes respondidos, sino a recordatorios entregados. El indicador de servicio (o SLI, por sus siglas en inglés: “Service Level Indicator”) es la proporción de recordatorios programados que llegan entregados antes de la hora de recogida, y el objetivo de servicio (o SLO, por sus siglas en inglés: “Service Level Objective”) es el $97%$ en una ventana móvil de $28$ días. ¿Por qué $97$ y no $99$? Porque con $432$ recordatorios en $28$ días, un $99%$ dejaría un margen de $4$ fallos, y cualquier corte de red de una tarde lo agotaría; el $97%$ deja unos $13$, suficientes para absorber lo cotidiano y lo bastante pocos para que un incidente de verdad se note.
La primera defensa, sin embargo, no es un número: es escuchar al proveedor. Meta ya avisa cuando una plantilla cambia de estado o de calidad; basta con suscribirse a esos campos del webhook de la cuenta de WhatsApp Business. La pregunta de qué se mide, la máquina o al cliente, se resume en dos termómetros, como en la Figura 3.
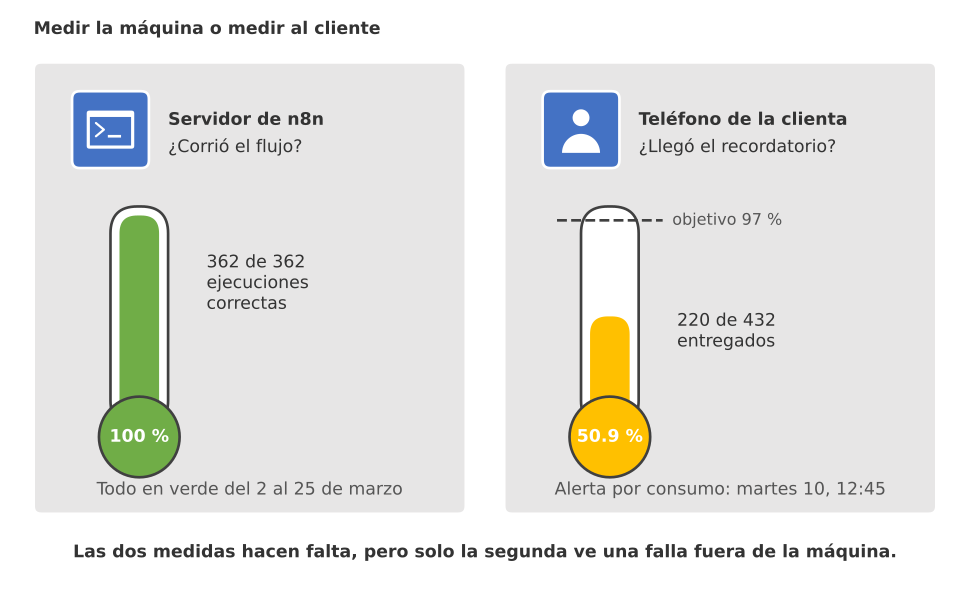
Figura 3. Medir la máquina o medir al cliente: el termómetro del servidor marca 100 % de ejecuciones correctas y el del teléfono de la clienta, 50.9 % de recordatorios entregados frente a un objetivo del 97 %; solo el segundo habría avisado el martes 10 a las 12:45.
El siguiente bloque muestra los cinco eventos que Meta habría enviado durante el incidente, con la estructura de la documentación vigente (revisado en octubre de 2026) e identificadores de ejemplo. Los dos primeros son de calidad (message_template_quality_update): de verde a amarilla el jueves 5 y de amarilla a roja el martes 10. Los tres siguientes son de estado (message_template_status_update): la primera pausa, la segunda y la desactivación, cada una con su other_info.title:
[
  {
    "object": "whatsapp_business_account",
    "entry": [{"id": "105400000000000", "time": 1772750400, "changes": [{"field": "message_template_quality_update",
      "value": {"previous_quality_score": "GREEN", "new_quality_score": "YELLOW",
                "message_template_id": 1054000000000001, "message_template_name": "recordatorio_recogida",
                "message_template_language": "es_MX"}}]}]
  },
  {
    "object": "whatsapp_business_account",
    "entry": [{"id": "105400000000000", "time": 1773165120, "changes": [{"field": "message_template_quality_update",
      "value": {"previous_quality_score": "YELLOW", "new_quality_score": "RED",
                "message_template_id": 1054000000000001, "message_template_name": "recordatorio_recogida",
                "message_template_language": "es_MX"}}]}]
  },
  {
    "object": "whatsapp_business_account",
    "entry": [{"id": "105400000000000", "time": 1773165600, "changes": [{"field": "message_template_status_update",
      "value": {"event": "PAUSED", "message_template_id": 1054000000000001,
                "message_template_name": "recordatorio_recogida", "message_template_language": "es_MX",
                "message_template_category": "UTILITY", "reason": "NONE",
                "other_info": {"title": "FIRST_PAUSE", "description": "Texto de ejemplo: la plantilla se pausó 3 horas por baja calidad."}}}]}]
  },
  {
    "object": "whatsapp_business_account",
    "entry": [{"id": "105400000000000", "time": 1773243000, "changes": [{"field": "message_template_status_update",
      "value": {"event": "PAUSED", "message_template_id": 1054000000000001,
                "message_template_name": "recordatorio_recogida", "message_template_language": "es_MX",
                "message_template_category": "UTILITY", "reason": "NONE",
                "other_info": {"title": "SECOND_PAUSE", "description": "Texto de ejemplo: la plantilla se pausó 6 horas por baja calidad."}}}]}]
  },
  {
    "object": "whatsapp_business_account",
    "entry": [{"id": "105400000000000", "time": 1773341400, "changes": [{"field": "message_template_status_update",
      "value": {"event": "DISABLED", "message_template_id": 1054000000000001,
                "message_template_name": "recordatorio_recogida", "message_template_language": "es_MX",
                "message_template_category": "UTILITY", "reason": "NONE",
                "disable_info": {"disable_date": 1773341400},
                "other_info": {"title": "DISABLED", "description": "Texto de ejemplo: la plantilla se desactivó tras una tercera caída de calidad."}}}]}]
  }
]
Fíjese en tres detalles del formato. El campo field de cada cambio dice qué tipo de evento es, y es lo primero que mira el manejador. El campo time está en segundos Unix y en UTC: 1773165600 es el martes 10 de marzo a las 18:00 UTC, las 12:00 en Ciudad de México. Y el evento de desactivación añade disable_info.disable_date, la marca de tiempo de la baja, que es la que se copia al análisis posterior.
El manejador de eventos de plantillas
Un webhook es una puerta abierta a internet, y el Día 50 (Slack como centro de operaciones: webhooks, Block Kit y aprobaciones) ya explicó por qué cada petición que llega se verifica antes de creerla. Meta firma cada evento con la cabecera X-Hub-Signature-256, cuyo valor es sha256= seguido de un código de autenticación de mensajes basado en hash (o HMAC, por sus siglas en inglés: “Hash-based Message Authentication Code”) con SHA-256, calculado sobre los bytes crudos del cuerpo con el secreto de la aplicación de Meta. Dos errores son frecuentes: calcular la firma sobre el JSON ya interpretado y vuelto a serializar (los bytes cambian y la firma nunca coincide) y compararla con ==, que filtra información por el tiempo que tarda; se usa hmac.compare_digest.
El manejador del siguiente bloque hace cuatro cosas: verifica la firma, ignora los eventos repetidos (Meta reintenta las entregas que no recibieron un $200$ a tiempo), clasifica cada evento y, si la plantilla se pausó o se desactivó, cambia el recordatorio a la plantilla de respaldo y prepara la alerta para #alertas. Se prueban siete entregas: los cinco eventos, un reintento del tercero y una copia del último con el cuerpo alterado para que diga APPROVED:
# Manejador del webhook de plantillas: firma, clasificación, respaldo y alerta para Slack en Python:
SECRETO_APP = os.environ.get('TL_META_APP_SECRET', 'EJEMPLO-NO-REAL-secreto-de-app').encode()
eventos = json.loads((carpeta / 'eventos_plantillas.json').read_text(encoding = 'utf-8'))

def firmar(crudo):
    return 'sha256=' + hmac.new(SECRETO_APP, crudo, hashlib.sha256).hexdigest()

ESTADO = {'recordatorio_recogida': 'APPROVED'}
RESPALDO = {'recordatorio_recogida': 'aviso_recogida'}
vistos, alertas = set(), []

def manejar(crudo, firma):
    # 1) Firma sobre los bytes crudos, con comparación de tiempo constante:
    if not hmac.compare_digest(firma, firmar(crudo)):
        return '401 firma inválida'
    salidas = []
    for entrada in json.loads(crudo)['entry']:
        for cambio in entrada['changes']:
            v, campo = cambio['value'], cambio['field']
            clave = (campo, v['message_template_name'], entrada['time'])
            if clave in vistos:                       # Meta puede reintentar la entrega
                salidas.append('duplicado, ignorado')
                continue
            vistos.add(clave)
            plantilla = v['message_template_name']
            hora = datetime.fromtimestamp(entrada['time'], CDMX).strftime('%d/%m %H:%M')
            # 2) Clasificación del evento:
            if campo == 'message_template_status_update' and v['event'] in ('PAUSED', 'DISABLED'):
                ESTADO[plantilla] = v['event']
                titulo = v.get('other_info', {}).get('title', '')
                alertas.append(f'[{hora}] {plantilla} {v["event"]} ({titulo}). '
                               f'Recordatorios desviados a {RESPALDO[plantilla]}. Dueña: Valeria.')
                salidas.append(f'{hora} {v["event"]} ({titulo}): crítica, respaldo {RESPALDO[plantilla]}')
            elif campo == 'message_template_quality_update':
                nivel = 'crítica' if v['new_quality_score'] == 'RED' else 'aviso'
                salidas.append(f'{hora} calidad {v["previous_quality_score"]} -> {v["new_quality_score"]}: {nivel}')
            else:
                salidas.append(f'{hora} {campo}: solo registro')
    return '200 ' + ' | '.join(salidas)

def plantilla_a_usar(nombre):
    # 3) Lo que consulta TL WhatsApp secuencias v2 antes de cada envío:
    return RESPALDO[nombre] if ESTADO.get(nombre) in ('PAUSED', 'DISABLED') else nombre

entregas = [json.dumps(e, separators = (',', ':')).encode() for e in eventos]
entregas.insert(3, entregas[2])                                       # reintento de Meta
falsa = entregas[-1].replace(b'"DISABLED"', b'"APPROVED"', 1)          # cuerpo alterado
for i, crudo in enumerate(entregas, 1):
    print(f'Entrega {i}:', manejar(crudo, firmar(crudo)))
print('Entrega 7 (alterada):', manejar(falsa, firmar(entregas[-1])))
print('Plantilla que usará el próximo recordatorio:', plantilla_a_usar('recordatorio_recogida'))
print('Alertas para #alertas:', len(alertas))
print(textwrap.fill(alertas[0], 100))
Entrega 1: 200 05/03 16:40 calidad GREEN -> YELLOW: aviso
Entrega 2: 200 10/03 11:52 calidad YELLOW -> RED: crítica
Entrega 3: 200 10/03 12:00 PAUSED (FIRST_PAUSE): crítica, respaldo aviso_recogida
Entrega 4: 200 duplicado, ignorado
Entrega 5: 200 11/03 09:30 PAUSED (SECOND_PAUSE): crítica, respaldo aviso_recogida
Entrega 6: 200 12/03 12:50 DISABLED (DISABLED): crítica, respaldo aviso_recogida
Entrega 7 (alterada): 401 firma inválida
Plantilla que usará el próximo recordatorio: aviso_recogida
Alertas para #alertas: 3
[10/03 12:00] recordatorio_recogida PAUSED (FIRST_PAUSE). Recordatorios desviados a aviso_recogida.
Dueña: Valeria.
Las siete entregas se resuelven como deben. Los dos eventos de calidad se registran como aviso (amarilla) y como crítica (roja); los tres de estado cambian la plantilla a aviso_recogida y generan $3$ alertas para Slack; el reintento se ignora sin duplicar la alerta; y la entrega alterada se rechaza con $401$, porque su firma ya no corresponde a sus bytes. La última línea es la importante: el próximo recordatorio saldrá con la plantilla de respaldo sin que nadie tenga que intervenir, y Valeria tiene en #alertas un mensaje con la hora, el evento, la plantilla y qué hizo el sistema.
Observe también lo que el manejador no hace: no reintenta la plantilla pausada, no cambia el texto de nada que vaya a un cliente y no guarda teléfonos. El cambio a respaldo es una decisión que la persona puede revertir; la corrección de fondo sigue siendo humana.
Alertar por consumo del presupuesto
El webhook de plantillas cubre una causa concreta. El objetivo de servicio cubre todas: si mañana falla el token de acceso, el servidor de n8n o una regla nueva de Meta que nadie conoce, los recordatorios entregados bajarán igual. Por eso la segunda defensa es el método del Día 53 aplicado al nuevo SLO. El presupuesto de error es el número de fallos que el objetivo tolera en la ventana:
$$ B = (1 - \text{SLO}) \cdot N $$
donde:
- $N$ son los recordatorios programados en la ventana de $28$ días: del jueves 26 de febrero al miércoles 25 de marzo, $432$.
- $1 - \text{SLO}$ es la fracción que se permite fallar: $0.03$.
- $B$ es el presupuesto, en fallos: $432 \cdot 0.03 = 12.96$. Gastarlo no es un fracaso; gastarlo de golpe sí es una señal.
La tasa de consumo del Día 53 mide a qué velocidad se gasta ese presupuesto, y de ella sale cuánto tarda en agotarse:
$$ r = \frac{e}{1 - \text{SLO}}, \qquad T_{\text{agotar}} = \frac{T}{r} $$
Su lógica:
- $e$ es la tasa de error observada en una ventana corta (fallos entre recordatorios de esa ventana).
- $r = 1$ significa que el presupuesto se gasta exactamente al ritmo que lo agotaría al final de los $28$ días; $r > 1$, más rápido.
- Con todo fallando, $e = 1$ y $r = 1 / 0.03 = 33.3$: el presupuesto de $T = 28$ días se agota en $28 / 33.3 = 0.84$ días, unas $20$ horas.
Para que la alerta no suene por un solo recordatorio fallido, se usan las reglas multiventana del Día 53, con el umbral que gasta una fracción $f$ del presupuesto en una ventana de $w$ horas dentro de una ventana de servicio de $H$ horas:
$$ r^{*} = \frac{f \cdot H}{w} $$
Con $H = 28 \cdot 24 = 672$ horas, la regla rápida gasta el $2%$ en $1$ hora ($r^{} = 13.44$, con al menos $2$ recordatorios en la ventana) y la regla lenta gasta el $5%$ en $6$ horas ($r^{} = 5.6$, con al menos $5$). Los mínimos de eventos son necesarios porque, con unos $1.5$ recordatorios por hora entre semana, una ventana de una hora decide con uno o dos datos, el problema que el Día 53 llamó “pocos eventos, alertas ruidosas”. El siguiente bloque calcula el presupuesto, recorre el registro real con las dos reglas y compara tres historias: la real, una con el webhook de plantillas y otra con la alerta por consumo y un cambio manual a la plantilla de respaldo $30$ minutos después del aviso:
# Presupuesto de error y tasa de consumo con el método del Día 53 en Python:
ventana = agenda(datetime(2026, 2, 26), datetime(2026, 3, 25))
N = len(ventana)
B = (1 - SLO) * N
fallos = len(perdidos)
r_todo = 1 / (1 - SLO)
horas_agotar = VENTANA_DIAS * 24 / r_todo
print(f'Programados en la ventana (26 feb a 25 mar): {N} | presupuesto B = {B:.2f} fallos')
print(f'Perdidos: {fallos} = {fallos / B:.1f} veces el presupuesto | entrega de la ventana: {(N - fallos) / N:.1%}')
print(f'Tasa de consumo con todo fallando: r = {r_todo:.1f} | presupuesto agotado en {horas_agotar:.1f} h')

# Alertas multiventana sobre el flujo de resultados (umbral r = f * horas de la ventana SLO / horas de la regla):
H = VENTANA_DIAS * 24
REGLAS = [('rápida', 1, 0.02 * H / 1, 2), ('lenta', 6, 0.05 * H / 6, 5)]
res = registro.assign(malo = registro['http'] != 200).sort_values('programado')
disparo = None
for t in res['programado']:
    for nombre, horas, umbral, minimo in REGLAS:
        w = res[(res['programado'] > t - timedelta(hours = horas)) & (res['programado'] <= t)]
        r = w['malo'].mean() / (1 - SLO)
        if len(w) >= minimo and r >= umbral and disparo is None:
            disparo = (t, nombre, len(w), r)
print('Umbrales: rápida r >= {:.2f} en 1 h | lenta r >= {:.2f} en 6 h'.format(REGLAS[0][2], REGLAS[1][2]))
print(f'Primera alerta por consumo: {disparo[0]} (regla {disparo[1]}, {disparo[2]} eventos, r = {disparo[3]:.1f})')

# Tres historias: la real, con alerta por webhook y con alerta por consumo (respaldo manual 30 min después):
corte = {'real': DETECCION, 'webhook': PAUSAS[0][0] + timedelta(minutes = 1),
         'consumo': disparo[0] + timedelta(minutes = 30)}
perdidos_por = {k: int((perdidos['programado'] < v).sum()) for k, v in corte.items()}
tabla2 = pd.DataFrame({'historia': list(corte), 'detección': [DETECCION, PAUSAS[0][0], disparo[0]],
                       'perdidos': list(perdidos_por.values())})
tabla2['presupuesto_usado_%'] = (100 * tabla2['perdidos'] / B).round(1)
print(tabla2.to_string(index = False))

# Presupuesto consumido acumulado en marzo en las tres historias:
fig, ax = plt.subplots(figsize = (11, 4.8))
dias_v = pd.date_range('2026-02-26', '2026-03-25')
colores = {'real': '#d62728', 'webhook': '#1f9d55', 'consumo': '#2a78d6'}
nombres = {'real': 'Real: detección el 25 de marzo', 'webhook': 'Con webhook de plantillas',
           'consumo': 'Con alerta por tasa de consumo'}
for k, fin in corte.items():
    serie = [100 * ((perdidos['programado'] < min(d + timedelta(days = 1), fin))).sum() / B for d in dias_v]
    ax.step(dias_v, serie, where = 'post', color = colores[k], linewidth = 4 if k == 'webhook' else 2.5,
            linestyle = ':' if k == 'webhook' else '-', zorder = 3 if k == 'webhook' else 2, label = nombres[k])
ax.axhline(100, color = '#52514e', linestyle = '--', label = 'Presupuesto de 28 días (12.96 fallos)')
ax.set_yscale('symlog', linthresh = 10)
ax.set_ylim(0, 4000)
ax.set_ylabel('Presupuesto consumido (%)')
ax.set_title('Presupuesto de error del recordatorio de recogida', fontsize = 16)
ax.legend(loc = 'upper left', fontsize = 9)
ax.xaxis.set_major_formatter(mdates.DateFormatter('%d/%m'))
plt.tight_layout()
plt.show()
Programados en la ventana (26 feb a 25 mar): 432 | presupuesto B = 12.96 fallos
Perdidos: 212 = 16.4 veces el presupuesto | entrega de la ventana: 50.9%
Tasa de consumo con todo fallando: r = 33.3 | presupuesto agotado en 20.2 h
Umbrales: rápida r >= 13.44 en 1 h | lenta r >= 5.60 en 6 h
Primera alerta por consumo: 2026-03-10 12:45:00 (regla rápida, 2 eventos, r = 33.3)
historia           detección  perdidos  presupuesto_usado_%
    real 2026-03-25 10:30:00       212               1635.8
 webhook 2026-03-10 12:00:00         0                  0.0
 consumo 2026-03-10 12:45:00         2                 15.4
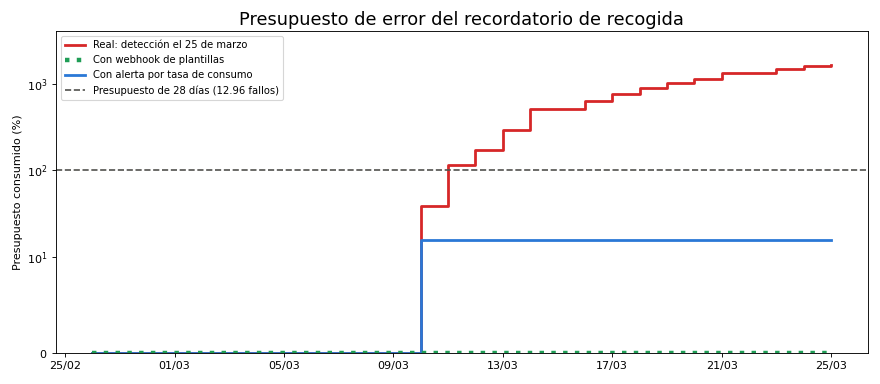
Las cifras resumen el incidente mejor que cualquier frase. El presupuesto era de $12.96$ fallos y se perdieron $212$: $16.4$ veces el presupuesto; la entrega de la ventana quedó en el $50.9%$ frente a un objetivo del $97%$. Con todo fallando, la tasa de consumo es $33.3$ y el presupuesto de un mes se agota en $20.2$ horas. La regla rápida habría sonado el martes 10 a las 12:45, con dos recordatorios fallidos en la hora y $r = 33.3$, cuarenta y cinco minutos después de la primera pausa. La Tabla 2 junta los números.
Tabla 2. Presupuesto de error del recordatorio de recogida (ventana del 26 de febrero al 25 de marzo de 2026).
| Concepto | Valor | Cómo se obtiene |
|---|---|---|
| SLO | 97 % de recordatorios entregados | Ventana móvil de 28 días |
| Recordatorios programados | 432 | 16 por día entre semana y 28 los sábados |
| Presupuesto de error | 12.96 fallos | (1 - 0.97) por 432 |
| Recordatorios perdidos | 212 | 5 + 10 + 7 + 184 + 6 |
| Veces el presupuesto | 16.4 | 212 entre 12.96 |
| Entrega de la ventana | 50.9 % | 220 entre 432 |
| Tasa de consumo con todo fallando | 33.3 | 1 entre 0.03 |
| Tiempo hasta agotar el presupuesto | 20.2 horas (0.84 días) | 28 días entre 33.3 |
| Detección real | 25 de marzo, 10:30 | 212 perdidos, 1 635.8 % del presupuesto |
| Con webhook de plantillas | 10 de marzo, 12:00 | 0 perdidos: respaldo automático |
| Con alerta por tasa de consumo | 10 de marzo, 12:45 | 2 perdidos, 15.4 % del presupuesto |
La gráfica, en escala logarítmica, enseña lo mismo con forma: la línea roja cruza el presupuesto completo el miércoles 11 y sigue subiendo hasta el $1,636%$; la azul se queda en el $15.4%$; la verde no se despega del cero. Una alerta sobre el resultado habría convertido trece días en cuarenta y cinco minutos. Las dos defensas no compiten: el webhook es más rápido pero solo ve lo que Meta decide contar, y la alerta por consumo es más lenta pero ve cualquier causa. Juntas cubren lo conocido y lo desconocido.
TL Monitor de plantillas v1
El manejador del Bloque 7 se lleva a n8n como un workflow propio, separado del que envía, por una razón de diseño: quien vigila no debe depender de quien es vigilado. Si TL WhatsApp secuencias v2 se rompe, el monitor sigue escuchando. El workflow tiene diez nodos:
- Eventos de Meta (
webhook): recibe los eventos conrawBodyactivo, para conservar los bytes que se firman. - Verificar firma (
code): calculasha256=más el HMAC con el secreto de la aplicación, leído de la variable de entornoTL_META_APP_SECRET, y separa cada cambio del lote en un elemento. - ¿Firma válida? (
if): con firma correcta responde $200$ de inmediato; si no, $401$. - Registrar evento (
postgres): guarda campo, evento, plantilla, idioma, calidad y momento, con una restricción única que hace idempotente el registro ante los reintentos de Meta. - Tipo de evento (
switch): una salida para pausas y desactivaciones y otra para cambios de calidad que no sean a verde. - Activar respaldo (
executeWorkflow): llama aTL WhatsApp secuencias v2con la acciónusar_respaldo. - Alerta crítica y Alerta de calidad (
httpRequest): publican en#alertaspor el webhook entrante del Día 50, cuya dirección se lee deTL_SLACK_WEBHOOK_ALERTAS.
La verificación del punto de conexión (la petición GET con hub.challenge que Meta hace al suscribirse) se resuelve con un segundo nodo webhook que no se muestra. El JSON, con la estructura de exportación de n8n e identificadores de ejemplo, es el siguiente:
{
  "name": "TL Monitor de plantillas v1",
  "nodes": [
    {
      "parameters": {"httpMethod": "POST", "path": "meta-plantillas", "responseMode": "responseNode", "options": {"rawBody": true}},
      "id": "54a00000-0000-4000-8000-000000000001",
      "name": "Eventos de Meta",
      "type": "n8n-nodes-base.webhook",
      "typeVersion": 2,
      "position": [0, 0],
      "webhookId": "00000000-0000-4000-8000-0000000000c4"
    },
    {
      "parameters": {"jsCode": "const crypto = require('crypto');\nconst secreto = $env.TL_META_APP_SECRET;\nconst firma = String($input.first().json.headers['x-hub-signature-256'] || '');\nconst crudo = await this.helpers.getBinaryDataBuffer(0, 'data');\nconst esperada = 'sha256=' + crypto.createHmac('sha256', secreto).update(crudo).digest('hex');\nconst igual = firma.length === esperada.length && crypto.timingSafeEqual(Buffer.from(firma), Buffer.from(esperada));\nif (!igual) return [{ json: { valida: false } }];\nconst cuerpo = JSON.parse(crudo.toString('utf8'));\nconst salida = [];\nfor (const entrada of cuerpo.entry || []) {\n  for (const cambio of entrada.changes || []) {\n    const v = cambio.value || {};\n    salida.push({ json: { valida: true, campo: cambio.field, evento: v.event || null, plantilla: v.message_template_name, idioma: v.message_template_language, calidad: v.new_quality_score || null, titulo: (v.other_info || {}).title || null, momento: entrada.time } });\n  }\n}\nreturn salida.length ? salida : [{ json: { valida: true, campo: 'vacio' } }];"},
      "id": "54a00000-0000-4000-8000-000000000002",
      "name": "Verificar firma",
      "type": "n8n-nodes-base.code",
      "typeVersion": 2,
      "position": [220, 0]
    },
    {
      "parameters": {"conditions": {"options": {"caseSensitive": true, "leftValue": "", "typeValidation": "strict", "version": 2}, "conditions": [{"id": "c5400001", "leftValue": "={{ $json.valida }}", "rightValue": "", "operator": {"type": "boolean", "operation": "true", "singleValue": true}}], "combinator": "and"}, "options": {}},
      "id": "54a00000-0000-4000-8000-000000000003",
      "name": "¿Firma válida?",
      "type": "n8n-nodes-base.if",
      "typeVersion": 2.2,
      "position": [440, 0]
    },
    {
      "parameters": {"respondWith": "noData", "options": {}},
      "id": "54a00000-0000-4000-8000-000000000004",
      "name": "Responder 200",
      "type": "n8n-nodes-base.respondToWebhook",
      "typeVersion": 1.1,
      "position": [660, -100]
    },
    {
      "parameters": {"respondWith": "noData", "options": {"responseCode": 401}},
      "id": "54a00000-0000-4000-8000-000000000005",
      "name": "Responder 401",
      "type": "n8n-nodes-base.respondToWebhook",
      "typeVersion": 1.1,
      "position": [660, 140]
    },
    {
      "parameters": {"operation": "executeQuery", "query": "INSERT INTO eventos_plantillas (campo, evento, plantilla, idioma, calidad, titulo, momento) VALUES ($1, $2, $3, $4, $5, $6, to_timestamp($7)) ON CONFLICT (plantilla, campo, momento) DO NOTHING RETURNING id;", "options": {"queryReplacement": "={{ [$json.campo, $json.evento, $json.plantilla, $json.idioma, $json.calidad, $json.titulo, $json.momento] }}"}},
      "id": "54a00000-0000-4000-8000-000000000006",
      "name": "Registrar evento",
      "type": "n8n-nodes-base.postgres",
      "typeVersion": 2.6,
      "position": [880, -100],
      "alwaysOutputData": true,
      "credentials": {"postgres": {"id": "0000000000000054", "name": "Postgres TL"}}
    },
    {
      "parameters": {"rules": {"values": [
        {"conditions": {"options": {"caseSensitive": true, "leftValue": "", "typeValidation": "strict", "version": 2}, "conditions": [{"id": "c5400002", "leftValue": "={{ ['PAUSED', 'DISABLED'].includes($('Verificar firma').item.json.evento) }}", "rightValue": "", "operator": {"type": "boolean", "operation": "true", "singleValue": true}}], "combinator": "and"}, "renameOutput": true, "outputKey": "Pausa o baja"},
        {"conditions": {"options": {"caseSensitive": true, "leftValue": "", "typeValidation": "strict", "version": 2}, "conditions": [{"id": "c5400003", "leftValue": "={{ $('Verificar firma').item.json.campo === 'message_template_quality_update' && $('Verificar firma').item.json.calidad !== 'GREEN' }}", "rightValue": "", "operator": {"type": "boolean", "operation": "true", "singleValue": true}}], "combinator": "and"}, "renameOutput": true, "outputKey": "Calidad"}
      ]}, "options": {"fallbackOutput": "none"}},
      "id": "54a00000-0000-4000-8000-000000000007",
      "name": "Tipo de evento",
      "type": "n8n-nodes-base.switch",
      "typeVersion": 3.2,
      "position": [1100, -100]
    },
    {
      "parameters": {"source": "database", "workflowId": {"__rl": true, "value": "EJEMPLO-NO-REAL-54W", "mode": "list", "cachedResultName": "TL WhatsApp secuencias v2"}, "workflowInputs": {"mappingMode": "defineBelow", "value": {"accion": "usar_respaldo", "plantilla_caida": "={{ $('Verificar firma').item.json.plantilla }}", "respaldo": "aviso_recogida"}}, "mode": "once", "options": {"waitForSubWorkflow": true}},
      "id": "54a00000-0000-4000-8000-000000000008",
      "name": "Activar respaldo",
      "type": "n8n-nodes-base.executeWorkflow",
      "typeVersion": 1.2,
      "position": [1320, -220]
    },
    {
      "parameters": {"method": "POST", "url": "={{ $env.TL_SLACK_WEBHOOK_ALERTAS }}", "sendBody": true, "specifyBody": "json", "jsonBody": "={{ JSON.stringify({ text: 'Plantilla ' + $('Verificar firma').item.json.plantilla + ': ' + $('Verificar firma').item.json.evento + ' (' + ($('Verificar firma').item.json.titulo || '') + '). Respaldo activado. Revise TL WhatsApp secuencias v2.' }) }}", "options": {"timeout": 10000}},
      "id": "54a00000-0000-4000-8000-000000000009",
      "name": "Alerta crítica",
      "type": "n8n-nodes-base.httpRequest",
      "typeVersion": 4.2,
      "position": [1540, -220],
      "retryOnFail": true,
      "maxTries": 3,
      "waitBetweenTries": 2000
    },
    {
      "parameters": {"method": "POST", "url": "={{ $env.TL_SLACK_WEBHOOK_ALERTAS }}", "sendBody": true, "specifyBody": "json", "jsonBody": "={{ JSON.stringify({ text: 'Calidad de la plantilla ' + $('Verificar firma').item.json.plantilla + ': ' + $('Verificar firma').item.json.calidad + '. Revise bloqueos y a quién se escribe.' }) }}", "options": {"timeout": 10000}},
      "id": "54a00000-0000-4000-8000-000000000010",
      "name": "Alerta de calidad",
      "type": "n8n-nodes-base.httpRequest",
      "typeVersion": 4.2,
      "position": [1320, 20],
      "retryOnFail": true,
      "maxTries": 3,
      "waitBetweenTries": 2000
    }
  ],
  "connections": {
    "Eventos de Meta": {"main": [[{"node": "Verificar firma", "type": "main", "index": 0}]]},
    "Verificar firma": {"main": [[{"node": "¿Firma válida?", "type": "main", "index": 0}]]},
    "¿Firma válida?": {"main": [[{"node": "Responder 200", "type": "main", "index": 0}], [{"node": "Responder 401", "type": "main", "index": 0}]]},
    "Responder 200": {"main": [[{"node": "Registrar evento", "type": "main", "index": 0}]]},
    "Registrar evento": {"main": [[{"node": "Tipo de evento", "type": "main", "index": 0}]]},
    "Tipo de evento": {"main": [[{"node": "Activar respaldo", "type": "main", "index": 0}], [{"node": "Alerta de calidad", "type": "main", "index": 0}]]},
    "Activar respaldo": {"main": [[{"node": "Alerta crítica", "type": "main", "index": 0}]]}
  },
  "settings": {"executionOrder": "v1", "errorWorkflow": "EJEMPLO-NO-REAL-ERR"},
  "pinData": {},
  "meta": {"templateCredsSetupCompleted": true}
}
Como en cada día de la serie, el JSON no se da por bueno a simple vista: se lee con Python, se comprueba que cada conexión apunte a un nodo existente, que no haya secretos ni direcciones de webhook escritas y que el disparador conserve el cuerpo crudo, y se dibuja con la paleta de formas de la serie:
# Lectura del workflow TL Monitor de plantillas v1, comprobaciones de seguridad y dibujo en Python:
texto_wf = (carpeta / 'flujos' / 'n8n' / 'monitor_plantillas_v1.json').read_text(encoding = 'utf-8')
workflow = json.loads(texto_wf)

FORMAS = {'webhook': ('disparador', '#1f9d55'), 'code': ('accion', '#2a78d6'), 'httpRequest': ('accion', '#2a78d6'),
          'postgres': ('accion', '#2a78d6'), 'respondToWebhook': ('accion', '#2a78d6'),
          'executeWorkflow': ('accion', '#2a78d6'), 'if': ('decision', '#eb6834'), 'switch': ('decision', '#eb6834')}

def nodos_desde_n8n(wf):
    nodos = [{'id': n['name'], 'tipo': n['type'].split('.')[-1],
              'x': n['position'][0] / 100, 'y': -n['position'][1] / 100} for n in wf['nodes']]
    aristas = [(o, d['node'], tipo, i) for o, s in wf['connections'].items()
               for tipo, lista in s.items() for i, destinos in enumerate(lista) for d in destinos]
    return nodos, aristas

def dibujar_flujo(nodos, aristas, titulo):
    fig, ax = plt.subplots(figsize = (15, 5.0))
    pos = {n['id']: (n['x'], n['y']) for n in nodos}
    tipo_de = {n['id']: n['tipo'] for n in nodos}
    for n in nodos:
        forma, color = FORMAS[n['tipo']]
        x, y = n['x'], n['y']
        if forma == 'decision':
            ax.add_patch(Polygon([(x - 0.95, y), (x, y + 0.55), (x + 0.95, y), (x, y - 0.55)], facecolor = color,
                                 edgecolor = 'white', linewidth = 2))
        else:
            estilo = 'round,pad=0.05,rounding_size=0.35' if forma == 'disparador' else 'round,pad=0.05'
            ax.add_patch(FancyBboxPatch((x - 0.85, y - 0.4), 1.7, 0.8, boxstyle = estilo,
                                        facecolor = color, edgecolor = 'white', linewidth = 2))
        ax.text(x, y + 0.1, textwrap.fill(n['id'], 13), ha = 'center', va = 'center', color = 'white', fontsize = 9)
        ax.text(x, y - 0.27, n['tipo'], ha = 'center', va = 'center', color = 'white', fontsize = 7)
    for o, d, tipo, salida in aristas:
        (x1, y1), (x2, y2) = pos[o], pos[d]
        ax.add_patch(FancyArrowPatch((x1 + 0.9, y1), (x2 - 0.9, y2), arrowstyle = '-|>', mutation_scale = 13,
                                     color = '#52514e', linewidth = 1.4))
        if tipo_de[o] in ('if', 'switch'):
            rotulo = ('sí' if salida == 0 else 'no') if tipo_de[o] == 'if' else ['pausa o baja', 'calidad'][salida]
            ax.text((x1 + x2) / 2 - 0.2, (y1 + y2) / 2, rotulo, fontsize = 9, color = '#52514e', ha = 'right')
    ax.set_xlim(-1, max(p[0] for p in pos.values()) + 1)
    ax.set_ylim(-2.0, 2.9)
    ax.set_aspect('equal')
    ax.axis('off')
    ax.set_title(titulo, fontsize = 14)
    return ax

nodos, aristas = nodos_desde_n8n(workflow)
nombres_n = {n['id'] for n in nodos}
print('Nodos:', len(nodos), '| conexiones:', len(aristas))
print('Tipos:', pd.Series([n['tipo'] for n in nodos]).value_counts().to_dict())
print('Destinos inexistentes:', [d for _, d, _, _ in aristas if d not in nombres_n] or 'ninguno')
print('rawBody en el disparador:', workflow['nodes'][0]['parameters']['options']['rawBody'])
sospechosos = [p for p in ['EAAG', 'hooks.slack.com/services/', 'Bearer ', 'x-api-key'] if p in texto_wf]
print('Secretos o URL de webhook en el JSON:', sospechosos or 'ninguno')
print('Variables de entorno usadas:', sorted(set(re.findall(r'\$env\.(\w+)', texto_wf))))
dibujar_flujo(nodos, aristas, f"{workflow['name']}, leído del JSON exportado")
plt.tight_layout()
plt.show()
Nodos: 10 | conexiones: 9
Tipos: {'respondToWebhook': 2, 'httpRequest': 2, 'webhook': 1, 'code': 1, 'if': 1, 'postgres': 1, 'switch': 1, 'executeWorkflow': 1}
Destinos inexistentes: ninguno
rawBody en el disparador: True
Secretos o URL de webhook en el JSON: ninguno
Variables de entorno usadas: ['TL_META_APP_SECRET', 'TL_SLACK_WEBHOOK_ALERTAS']
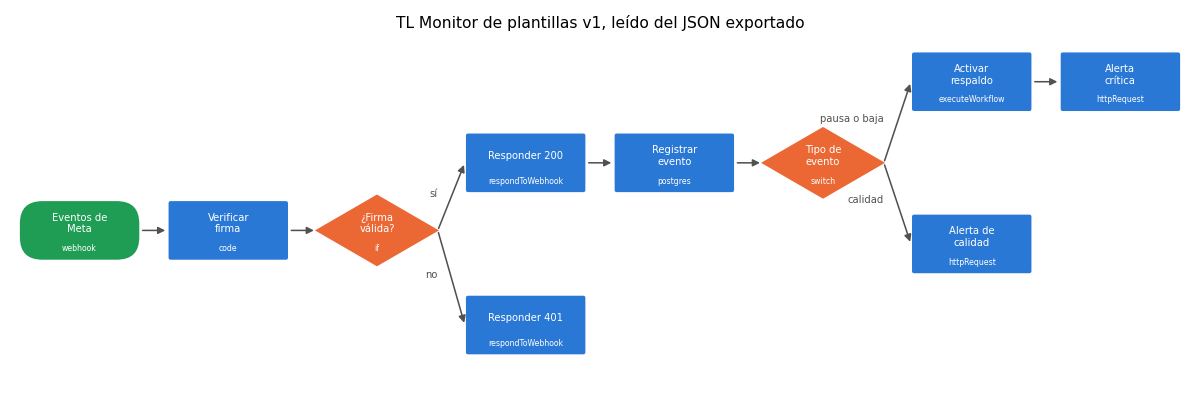
El workflow tiene $10$ nodos y $9$ conexiones, ningún destino inexistente, rawBody activo y ningún secreto escrito: las dos únicas variables de entorno son el secreto de la aplicación de Meta y la dirección del webhook de Slack. En el dibujo se lee el recorrido completo: el disparador verde, las dos decisiones naranjas y, a la derecha, las dos salidas del switch, una que activa el respaldo y avisa y otra que solo avisa. Observe que la respuesta $200$ sale antes de registrar y de avisar: Meta espera una confirmación rápida, y si no la recibe, reintenta.
Respaldo sin engaños
Una plantilla de respaldo es una segunda plantilla de utilidad, aprobada de antemano, con la misma finalidad y otra redacción, que el flujo usa cuando la principal no está disponible. En Trigo Lento, la principal será aviso_recogida (la que se envió a revisión el miércoles) y la de respaldo, recordatorio_entrega, con frases distintas y las mismas cuatro variables. Las dos se escriben, se validan con el validador del Día 48 y con el revisor de accesibilidad del Día 49, y se envían a revisión el mismo día, para que la de respaldo no se estrene en medio de un incidente.
El cambio es automático, pero tiene reglas que no se negocian:
- El respaldo es de utilidad y solo de utilidad. No se aprovecha el cambio para colar una promoción: eso reclasificaría la plantilla como marketing, la haría más cara y la dejaría fuera del alcance de los clientes que solo aceptaron confirmaciones.
- El respaldo hereda las mismas reglas de envío. Pasa por la función
puede_enviardel Día 48: consentimiento por finalidad, horario y baja. Que la principal se haya caído no da permiso para nada que la principal no tuviera. - El respaldo no sustituye la corrección. Si la principal se pausó por bloqueos, la de respaldo recibirá los mismos bloqueos si el flujo sigue escribiendo a quien no debe, y en tres días estará igual. Por eso la alerta crítica lleva a una persona a buscar la causa, y por eso el respaldo se apaga solo si su propia calidad baja a amarilla.
- Cuando fallan las dos, hay una persona. Para los encargos de pastel, el producto más caro y el que más se olvida, el mostrador recibe una cola de llamadas con la lista del día siguiente si ninguna plantilla está activa a las 17:00. Son pocas llamadas, un promedio de dos pasteles por día, y es exactamente donde un recordatorio perdido cuesta más.
Don Ernesto, que escuchó la explicación con los brazos cruzados, pone la objeción que faltaba: “Entonces, si la primera falla usted manda la segunda. ¿Y quién le dice a la segunda que no haga lo mismo que la primera?” La respuesta es la tercera regla, y es la razón por la que el respaldo se llama “sin engaños”: cambiar de plantilla compra tiempo, no arregla nada. Un respaldo que oculta la causa es otra falla silenciosa, solo que más elegante.
El análisis posterior sin culpables
El último paso es el documento que queda. Un análisis posterior sin culpables (en inglés, “blameless postmortem”) es el informe de un incidente escrito para aprender, no para señalar. La idea, que John Allspaw popularizó en 2012 desde Etsy y que el libro de trabajo de ingeniería de confiabilidad de Google convirtió en práctica estándar, parte de una observación sencilla: si las personas temen ser castigadas por lo que cuentan, dejan de contar, y la organización pierde justo la información que necesita para no repetir el fallo.
El análisis de Trigo Lento tiene seis partes, las mismas de los días 29 y 39:
- Resumen: qué pasó, en tres frases y sin adjetivos.
- Impacto: $212$ recordatorios perdidos, $118$ clientes como máximo con un mensaje indebido, unos $15$ encargos y $5,700$ MXN en riesgo, $1.80$ USD no cobrados, TTD de casi quince días.
- Línea de tiempo: la Tabla 1, con sus evidencias.
- Causas: el disparador, la causa del daño y la causa raíz, con los cinco porqués, el Ishikawa y el árbol.
- Lo que salió bien: la clienta que preguntó con amabilidad, el panel del Día 53 que hizo visible lo invisible el mismo día en que se encendió, y el mostrador que cubrió el día por teléfono.
- Acciones: cada una con tipo, dueño, fecha y una forma de verificar que se hizo.
Hay un dato que el documento no esconde: fue Valeria quien hizo el cambio del 2 de marzo. El análisis lo registra en la línea de tiempo, como un hecho, y no vuelve sobre él. La pregunta que sí hace es otra: ¿qué permitió que el sistema dejara pasar ese cambio? La respuesta tiene tres partes, y ninguna es “Valeria se equivocó”: no había una prueba que protegiera el filtro, no había una segunda persona que revisara cambios en flujos que escriben a clientes y no había un periodo en sombra que comparara la versión nueva con la anterior antes de activarla. Cualquiera que hubiera hecho el cambio habría producido el mismo incidente.
La primera acción es la prueba de regresión del filtro, la pieza que faltó el 2 de marzo. El siguiente bloque la escribe con ocho encargos de prueba (pendientes, recogidos, cancelados, sin consentimiento y de otro día), la ejecuta contra la versión 1.3 y contra la versión 2, y genera la lista de acciones del análisis:
# Prueba de regresión del filtro de pendientes y acciones del análisis posterior en Python:
manana = datetime(2026, 3, 27).date()
casos = pd.DataFrame([
    ('E-101', 'pendiente', manana, True, True), ('E-102', 'pendiente', manana, True, True),
    ('E-103', 'recogido', manana, True, False), ('E-104', 'cancelado', manana, True, False),
    ('E-105', 'pendiente', manana, False, False), ('E-106', 'pendiente', manana + timedelta(days = 1), True, False),
    ('E-107', 'recogido', manana - timedelta(days = 1), True, False), ('E-108', 'pendiente', manana, True, True),
], columns = ['encargo', 'estado', 'recogida', 'optin', 'esperado'])

def a_recordar_v13(p, dia):
    # Versión 1.3: la reescritura perdió la condición sobre el estado.
    return p[(p['recogida'] == dia) & p['optin']]

def a_recordar_v2(p, dia):
    return p[(p['recogida'] == dia) & p['optin'] & (p['estado'] == 'pendiente')]

def prueba_regresion(funcion):
    elegidos = set(funcion(casos, manana)['encargo'])
    esperados = set(casos.loc[casos['esperado'], 'encargo'])
    return elegidos == esperados, sorted(elegidos - esperados), sorted(esperados - elegidos)

for nombre, f in [('v1.3', a_recordar_v13), ('v2', a_recordar_v2)]:
    ok, sobran, faltan = prueba_regresion(f)
    print(f'{nombre}: {"APROBADA" if ok else "FALLA"} | sobran: {sobran or "ninguno"} | faltan: {faltan or "ninguno"}')

acciones = pd.DataFrame([
    ('Restaurar estado = pendiente con prueba de regresión', 'prevenir', 'Valeria', '26 mar', 'Prueba v2 aprobada en cada cambio'),
    ('Mensaje de disculpa por el canal y la base existentes', 'mitigar', 'Mostrador', '26 mar', 'Registro sin teléfonos'),
    ('Suscribir eventos de estado y calidad de plantillas', 'detectar', 'Valeria', '27 mar', 'Evento de prueba en #alertas'),
    ('Registrar el resultado según la respuesta de la API', 'detectar', 'Valeria', '27 mar', 'Un 400 de prueba queda como fallido'),
    ('Alerta por tasa de consumo del SLO de entrega', 'detectar', 'Valeria', '31 mar', 'Caída simulada avisa en menos de 1 h'),
    ('Plantilla de respaldo aprobada y cambio automático', 'mitigar', 'Valeria', '31 mar', 'Envío de prueba con la principal pausada'),
    ('Cola de llamadas para pasteles si fallan las dos', 'mitigar', 'Don Ernesto', '28 mar', 'Simulacro con 3 encargos'),
    ('Revisión de otra persona y 24 h en sombra', 'prevenir', 'Don Ernesto', '3 abr', 'Lista firmada en el cambio siguiente'),
], columns = ['accion', 'tipo', 'dueno', 'fecha', 'verificacion'])
print(acciones.to_string(index = False))
print('Acciones por tipo:', acciones['tipo'].value_counts().to_dict())
v1.3: FALLA | sobran: ['E-103', 'E-104'] | faltan: ninguno
v2: APROBADA | sobran: ninguno | faltan: ninguno
                                               accion     tipo       dueno  fecha                             verificacion
 Restaurar estado = pendiente con prueba de regresión prevenir     Valeria 26 mar        Prueba v2 aprobada en cada cambio
Mensaje de disculpa por el canal y la base existentes  mitigar   Mostrador 26 mar                   Registro sin teléfonos
  Suscribir eventos de estado y calidad de plantillas detectar     Valeria 27 mar             Evento de prueba en #alertas
  Registrar el resultado según la respuesta de la API detectar     Valeria 27 mar      Un 400 de prueba queda como fallido
        Alerta por tasa de consumo del SLO de entrega detectar     Valeria 31 mar     Caída simulada avisa en menos de 1 h
   Plantilla de respaldo aprobada y cambio automático  mitigar     Valeria 31 mar Envío de prueba con la principal pausada
     Cola de llamadas para pasteles si fallan las dos  mitigar Don Ernesto 28 mar                 Simulacro con 3 encargos
            Revisión de otra persona y 24 h en sombra prevenir Don Ernesto  3 abr     Lista firmada en el cambio siguiente
Acciones por tipo: {'mitigar': 3, 'detectar': 3, 'prevenir': 2}
La prueba hace lo que se espera de ella: la versión 1.3 falla porque elige a E-103 (recogido) y a E-104 (cancelado), y la versión 2 queda aprobada, sin sobrantes ni faltantes. Desde hoy, la prueba corre con las demás pruebas de flujos del Día 43 (Laboratorio guiado: pruebas de flujos con datos fijados y un entorno de ensayo) cada vez que alguien toca la consulta, y un cambio que vuelva a quitar el filtro no podrá publicarse sin que alguien lea un “FALLA” en rojo.
Las ocho acciones se reparten en $3$ que detectan, $3$ que mitigan y $2$ que previenen, como resume la Tabla 3.
Tabla 3. Acciones del análisis posterior del incidente de la plantilla pausada.
| Acción | Tipo | Dueño | Fecha compromiso | Verificación |
|---|---|---|---|---|
Restaurar estado = 'pendiente' con prueba de regresión | Prevenir | Valeria | 26 de marzo | La prueba de la versión 2 aprobada en cada cambio |
| Mensaje de disculpa por el canal y con la base existentes | Mitigar | Mostrador | 26 de marzo | Registro del envío sin teléfonos |
| Suscribir los eventos de estado y de calidad de plantillas | Detectar | Valeria | 27 de marzo | Un evento de prueba llega a #alertas |
| Registrar el resultado según la respuesta de la API | Detectar | Valeria | 27 de marzo | Un 400 de prueba queda registrado como fallido |
| Alerta por tasa de consumo del SLO de entrega | Detectar | Valeria | 31 de marzo | Una caída simulada avisa en menos de 1 hora |
| Plantilla de respaldo aprobada y cambio automático | Mitigar | Valeria | 31 de marzo | Envío de prueba con la principal pausada |
| Cola de llamadas para pasteles si fallan las dos plantillas | Mitigar | Don Ernesto | 28 de marzo | Simulacro con 3 encargos |
| Revisión de otra persona y 24 horas en sombra para cambios | Prevenir | Don Ernesto | 3 de abril | Lista firmada en el cambio siguiente |
Dos de las acciones tienen como dueño a Don Ernesto, y no es un detalle. La cola de llamadas la propuso él (“Si el teléfono de la clienta no suena, que suene el del mostrador”), y la revisión de otra persona lo convierte en el segundo par de ojos de cualquier cambio en un flujo que escribe a clientes. No necesita saber leer JSON: la lista de comprobación pregunta en castellano llano a quién le escribe el flujo, qué cambió y qué pasaría si el cambio estuviera mal. El análisis sin culpables no reparte la culpa entre todos: reparte el trabajo de que no vuelva a pasar.
Consideraciones finales
El día empezó con una línea plana en el $0%$ y una clienta extrañada, y termina con una línea de tiempo de ocho hitos, $212$ recordatorios perdidos explicados uno por uno, un disparador, una causa del daño y una causa raíz separadas, un manejador que verifica la firma de Meta y cambia de plantilla sin intervención, un objetivo de servicio que habría avisado en $45$ minutos y ocho acciones con dueño y fecha. Ninguna de esas piezas es sofisticada; todas juntas son la diferencia entre un incidente de trece días y uno de una tarde.
Las cifras tienen límites que conviene decir. El incidente es ficticio, las tasas de bloqueo y de reporte son supuestos de la simulación, las probabilidades del árbol de fallos son ilustrativas, el aumento de $7$ puntos en los encargos no recogidos es un supuesto didáctico y el estado HTTP de los errores de la simulación sale de guías de proveedores, porque Meta no lo publica por código. Ninguno de esos límites cambia las conclusiones, que se apoyan en lo verificado en la documentación oficial: la pausa escalonada, los eventos de plantillas y los códigos $132015$ y $132016$.
Antes de dar por buena cualquier automatización que escriba a sus clientes, conviene hacerse algunas preguntas:
- ¿Mide usted que el flujo corre, o que el mensaje llega?
- ¿Qué hace su flujo con un error 400 de la API: lo registra como fallo, lo reintenta o lo esconde?
- ¿Está suscrito a las notificaciones que su proveedor ya envía sobre el estado de sus plantillas, sus números y sus límites?
- ¿Tiene un objetivo de servicio sobre el resultado, con un presupuesto de error y una alerta por consumo?
- Si mañana su plantilla principal se desactiva, ¿qué sale en su lugar y quién se entera?
Un gran libro que habla de esto es The Site Reliability Workbook (o El libro de trabajo de la ingeniería de confiabilidad), editado por Betsy Beyer, Niall Richard Murphy, David K. Rensin, Kent Kawahara y Stephen Thorne, cuyos capítulos sobre alertas basadas en objetivos de servicio y sobre la cultura de los análisis posteriores son la fuente directa de las reglas multiventana y del documento de hoy. Está escrito para servicios con millones de usuarios, pero su consejo central se aplica sin cambios a una panadería: alerte sobre lo que siente el usuario, no sobre lo que hace la máquina.
Un sistema que no mide lo que el cliente recibe puede fallar trece días seguidos con todas sus luces en verde. Trigo Lento ya no tiene ese punto ciego: escucha a Meta, mide la entrega, cambia de plantilla sola cuando hace falta y, sobre todo, pregunta qué permitió el error antes de preguntar quién lo cometió.
Conclusiones clave
Detección
- El incidente (ficticio) perdió $212$ recordatorios entre el 10 y el 25 de marzo, con un TTD de $14$ días y $22$ horas; el registro decía “enviado” en las $362$ filas y n8n mostraba $362$ de $362$ ejecuciones correctas.
- Monitorear la máquina responde si el flujo corre; monitorear el resultado responde si el recordatorio llega. Solo lo segundo detecta una falla silenciosa en un proveedor.
- Con un SLO del $97%$ sobre $432$ recordatorios, el presupuesto es de $12.96$ fallos; el incidente lo consumió $16.4$ veces y dejó la entrega en el $50.9%$. Con todo fallando, $r = 33.3$ y el presupuesto se agota en $20.2$ horas; la regla rápida habría avisado el martes 10 a las 12:45.
Plantillas y proveedor
- Cada plantilla tiene su calificación (
GREEN,YELLOW,REDoUNKNOWN) calculada con las señales de los usuarios; en rojo se pausa $3$ horas, luego $6$, y a la tercera se desactiva. - Los errores $132015$ (pausada) y $132016$ (desactivada) no son reintentables: se tratan como datos de negocio, con cambio de plantilla, alerta y registro como fallo.
- Los eventos
message_template_status_updateymessage_template_quality_updateavisan de todo eso; con la firmaX-Hub-Signature-256verificada sobre los bytes crudos,TL Monitor de plantillas v1cambia al respaldo sin perder ningún recordatorio.
Aprender sin culpables
- El filtro perdido fue el disparador, la pausa de Meta la causa del daño y el hueco de monitoreo la causa raíz; en el árbol de fallos, las tres capas de detección bajan el evento superior de $0.1342$ a $0.000134$ por trimestre.
- La primera corrección es dejar de molestar: $118$ clientes, como máximo, recibieron un mensaje indebido, y ninguna compensación justifica escribirles más.
- El análisis registra que Valeria hizo el cambio y pregunta qué lo dejó pasar; sus ocho acciones ($3$ detectan, $3$ mitigan, $2$ previenen) tienen dueño, fecha y verificación, y dos son de Don Ernesto.
Mañana, en el Día 55: Repaso del ecosistema de comunicación. Con Gmail, Slack, WhatsApp, la orquestación multicanal, las métricas de atención y ahora el monitoreo de plantillas en su sitio, Valeria hará un repaso de todo el módulo 5 antes del cierre: qué pieza resuelve cada problema de Trigo Lento, cuánto cuesta cada una dentro de los $45$ USD y qué falla cuando una de ellas se cae.
Referencias
- Meta (2026). Template pausing. WhatsApp Business Platform. https://developers.facebook.com/documentation/business-messaging/whatsapp/templates/template-pausing (revisado en octubre de 2026).
- Meta (2026). message_template_status_update y message_template_quality_update webhook reference. WhatsApp Business Platform. https://developers.facebook.com/documentation/business-messaging/whatsapp/webhooks/reference/message_template_status_update (revisado en octubre de 2026).
- Meta (2026). Error codes de la Cloud API de WhatsApp. https://developers.facebook.com/documentation/business-messaging/whatsapp/support/error-codes (revisado en octubre de 2026).
- Meta (2026). Calificación de calidad de plantillas y del número de teléfono. WhatsApp Business Platform. https://developers.facebook.com/documentation/business-messaging/whatsapp (revisado en octubre de 2026).
- Beyer, B., Murphy, N. R., Rensin, D. K., Kawahara, K. y Thorne, S. (Eds.) (2018). The Site Reliability Workbook: Practical Ways to Implement SRE. O’Reilly Media. (Capítulo 5, “Alerting on SLOs”, y capítulo 10, “Postmortem Culture: Learning from Failure”.)
- Allspaw, J. (2012). Blameless PostMortems and a Just Culture. Code as Craft (Etsy). https://www.etsy.com/codeascraft/blameless-postmortems
- Ishikawa, K. (1986). Guide to Quality Control (2.ª ed.). Asian Productivity Organization.
- Vesely, W. E., Goldberg, F. F., Roberts, N. H. y Haasl, D. F. (1981). Fault Tree Handbook (NUREG-0492). U.S. Nuclear Regulatory Commission.
- Krawczyk, H., Bellare, M. y Canetti, R. (1997). HMAC: Keyed-Hashing for Message Authentication. RFC 2104. IETF. https://www.rfc-editor.org/rfc/rfc2104