
Arquitecto de automatización con IA: Día 55
 Jeshua Romero Guadarrama
- 65 Min para leer
- 27 Mar, 2026
Índice de contenido
Resumen:
Antes de la semana de pruebas, Valeria se detiene a revisar con calma todo lo que Trigo Lento construyó en el módulo 5: WhatsApp por la Cloud API de Meta, borradores de Gmail que solo salen con su firma, Slack como centro de operaciones, un orquestador que evita respuestas dobles e indicadores que avisan cuando algo se rompe. En esta entrada reunirá esas piezas en un solo mapa, comprobará su comprensión con doce preguntas de decisión que se corrigen solas, auditará con código cuatro workflows exportados contra los diez artículos del código de honor, medirá cuánto bajan los riesgos con los controles y consolidará el coste de la comunicación: $32.19$ USD de $45$, con $12.81$ libres para el módulo 6. Al terminar sabrá decir, mensaje por mensaje, quién contesta qué.
¿Cómo citar el presente artículo?
Romero, J. (27 de marzo de 2026). Arquitecto de automatización con IA: Día 55. python-data-engineer. https://www.python-data-engineer.com/post/aai/dia_55/.
Arquitecto de automatización con IA: Día 55 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/aai/dia_55/.
Precios, límites y políticas revisados en octubre de 2026: planes, precios y límites de Make, n8n, Zapier, WhatsApp (Meta, Twilio, Wati) y de la API de Claude. Se contrastaron en octubre de 2026 la regla de la ventana de atención de 24 horas (fuera de ella solo se admiten plantillas aprobadas), el cobro de los mensajes de servicio a partir del número $1,001$ de cada mes desde el 1 de octubre de 2026 (fuentes de proveedores; la página de Meta se revisa cada trimestre) y la política de mensajería de WhatsApp Business. Las cifras de coste proceden de los días 30, 38 y 46 a 49; las preguntas, los riesgos y los consentimientos son casos inventados y no se recoge ningún dato del lector.
Día 55. Repaso del ecosistema de comunicación
Introducción
Ayer, en el Día 54 (Anatomía de un fallo real III: la plantilla pausada y los recordatorios que no salieron), Valeria reconstruyó con los registros, sin buscar culpables, cómo una plantilla de WhatsApp pasó de pausada a desactivada mientras el flujo seguía “en verde”, y Trigo Lento ganó TL Monitor de plantillas v1, una plantilla de respaldo y alertas que miran los recordatorios entregados y no las ejecuciones. Con ese incidente cerrado, el módulo 5 tiene todas sus piezas en su sitio, y hoy toca algo que ningún flujo hace por sí mismo: mirarlas juntas.
Es viernes 27 de marzo, por la tarde. El domingo es de Ramos y la semana que viene es de pruebas: el Día 56 pondrá a funcionar una semana entera de comunicación automatizada, con todos los canales a la vez. Valeria no quiere llegar a esa semana con una colección de flujos que solo ella entiende. Abre el cuaderno en una página en blanco y escribe tres preguntas: ¿qué tenemos?, ¿lo entiendo de verdad? y ¿qué puede salir mal? La cuarta se la hace Don Ernesto, que entra a la oficina con el delantal todavía puesto y mira la pantalla llena de cajas de colores: “Valeria, en estas dos semanas usted me ha enseñado el WhatsApp nuevo, el correo, el Slack ese y el orquestador. Yo ya no sé quién le contesta a quién. Si mañana una clienta se queja de lo que le dijeron, ¿a quién le pregunto? ¿Al aparato?”
La pregunta es justa y no se responde con otra explicación técnica. Se responde con un inventario, con un mapa y con una regla escrita para cada tipo de mensaje. Un repaso, además, no es releer: la investigación sobre memoria de Henry Roediger y Jeffrey Karpicke mostró que intentar recordar y decidir, con una prueba, fija lo aprendido mucho mejor que volver a leer los apuntes. Por eso el repaso de hoy no es un resumen, sino un examen que el propio lector corrige, seguido de una auditoría que se ejecuta sobre los flujos reales.
En la presente entrada, descubrirá cómo cerrar un módulo de automatización con criterio de arquitecto. Hará el inventario de los flujos de comunicación con su canal, su base de envío y la persona al mando, y dibujará el mapa del ecosistema. Responderá doce preguntas de decisión, como qué puede enviarle a una clienta que escribió hace $26$ horas, y las corregirá con un banco en Python que da retroalimentación por opción y dice qué días conviene repasar. Después auditará con código cuatro workflows exportados contra el código de honor del Día 6, construirá una matriz de riesgos antes y después de los controles, consolidará el coste mensual frente a los $45$ USD, revisará las bajas y los consentimientos que se quedaron atrás y terminará con la matriz que responde a Don Ernesto: quién contesta qué.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Integrar en un solo mapa lo construido en los días 46 a 54: canales, bases de envío, proveedores, aprobaciones y orquestación.
- Comprobar la comprensión con 12 preguntas autocorregibles centradas en decisiones, no en definiciones.
- Auditar el ecosistema con el código de honor y con una matriz de riesgos de comunicación.
- Consolidar el coste mensual de comunicación y de Claude frente al presupuesto.
El mapa del ecosistema de comunicación
Nueve días de trabajo dejan muchas piezas, y la primera tarea de un repaso es contarlas. Valeria empieza por el principio del módulo. El Día 46 (El reto de la mensajería: el mapa de canales y el coste real de WhatsApp) eligió la Cloud API de Meta directa desde n8n porque Twilio cobraba $0.005$ USD por cada mensaje recibido y enviado. El Día 47 (Gmail con criterio: OAuth, etiquetas y borradores contextuales con Claude) conectó el buzón de mayoristas con un solo alcance y sin ningún nodo de envío. El Día 48 (WhatsApp Business API: plantillas, ventana de 24 horas, secuencias y chatbots) registró las plantillas, escribió la regla puede_enviar y montó la secuencia de bienvenida. El Día 49 (Accesibilidad y multilingüismo de los mensajes) hizo legibles las plantillas y abrió el inglés con revisión humana. El Día 50 (Slack como centro de operaciones: webhooks, Block Kit y aprobaciones) sacó los avisos del teléfono personal de Valeria. El Día 51 llevó el método a una clínica dental. El Día 52 (Orquestación multicanal sin volverse loco: enrutamiento, deduplicación, horarios y SLA) puso una sola puerta de entrada; el Día 53 (Métricas y SLA de la atención: percentiles, presupuesto de error y alertas) la midió, y el Día 54 cerró el hueco de monitoreo que dejó pasar doce días sin recordatorios.
Un inventario útil no es una lista de nombres. Para cada flujo hay que poder responder cinco preguntas: en qué día nació, por qué canal habla, en qué dirección (entra, sale, conversa o se queda dentro del equipo), con qué base de envío escribe a un cliente y qué persona está al mando de lo que hace. La base de envío es la regla del módulo convertida en columna: un mensaje solo sale si el cliente escribió primero y la ventana de atención sigue abierta, o si hay consentimiento expreso para esa finalidad y se usa una plantilla aprobada por Meta en la categoría correcta. Ninguna fila puede quedar en blanco.
Comencemos por importar las bibliotecas, fijar la semilla de la serie y declarar los supuestos del módulo:
# Importaciones base, semilla de la serie, carpeta del día y supuestos fijos en Python:
import warnings
warnings.filterwarnings('ignore')
import json
import re
import sqlite3
import textwrap
from collections import Counter
from datetime import datetime, timedelta
from pathlib import Path
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from matplotlib.patches import FancyBboxPatch, FancyArrowPatch, Polygon, RegularPolygon, Ellipse
from scipy import stats

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 120)
pd.set_option('display.max_colwidth', 48)
proyecto = Path('trigo_lento')
carpeta = proyecto / 'dia_55'
carpeta.mkdir(parents = True, exist_ok = True)

# Supuestos de la serie (A.4.6 y A.5) y del módulo 5:
PRESUPUESTO = 45.00          # USD al mes para todo el ecosistema
MXN_POR_USD = 18.50          # tipo de cambio didáctico fijo
EVENTOS_MES = {'WhatsApp': 1560, 'Instagram': 400, 'Gmail': 300, 'Formulario': 70}   # Día 52
print('numpy', np.__version__, '| pandas', pd.__version__, '| carpeta:', carpeta.as_posix())
print(f'Eventos de comunicación al mes: {sum(EVENTOS_MES.values()):,}'.replace(',', ' '),
      '| presupuesto:', f'{PRESUPUESTO:.2f} USD ({PRESUPUESTO * MXN_POR_USD:.2f} MXN)')
numpy 2.4.6 | pandas 3.0.3 | carpeta: trigo_lento/dia_55
Eventos de comunicación al mes: 2 330 | presupuesto: 45.00 USD (832.50 MXN)
El volumen de referencia es el del Día 52: $2,330$ eventos al mes entre WhatsApp, Instagram, Gmail y el formulario, que se reparten en $1,560$, $400$, $300$ y $70$. Con ese volumen y con el presupuesto de $45$ USD ($832.50$ MXN al tipo didáctico) se comprobará todo lo demás. El siguiente código escribe el inventario como un DataFrame y lo guarda en inventario_modulo_5.csv, para que el Día 56 y el módulo 8 lo lean sin volver a teclearlo:
# Inventario de los flujos del módulo 5 con canal, base de envío, dueño y persona al mando en Python:
inventario = pd.DataFrame([
    ('TL Orquestador v1', 52, 'Todos', 'Entrada', 'No escribe: enruta', 'Valeria', 'Escala a #aprobaciones'),
    ('TL Responder por canal v1', 52, 'WhatsApp, Instagram', 'Salida', 'Ventana abierta', 'Valeria',
     'Acuse y respuestas fijas'),
    ('TL Agente de pedidos v2', 38, 'WhatsApp', 'Conversación', 'Ventana abierta', 'Valeria',
     'Aprueba pasteles y cambios'),
    ('TL Gmail mayoristas v1', 47, 'Gmail', 'Borrador', 'Relación mayorista', 'Valeria', 'Valeria envía'),
    ('TL WhatsApp secuencias v2', 54, 'WhatsApp', 'Salida', 'Opt-in o pedido en curso', 'Valeria',
     'Plantillas que aprobó Valeria'),
    ('TL Slack operaciones v1', 50, 'Slack', 'Interno', 'Equipo', 'Valeria', 'Valeria o Don Ernesto'),
    ('TL Métricas de atención v1', 53, 'Slack', 'Interno', 'Equipo', 'Valeria', 'Lee #alertas'),
    ('TL Monitor de plantillas v1', 54, 'Slack', 'Interno', 'Equipo', 'Valeria', 'Lee #alertas'),
], columns = ['flujo', 'dia', 'canal', 'direccion', 'base_de_envio', 'dueno', 'persona_al_mando'])
inventario.to_csv(carpeta / 'inventario_modulo_5.csv', index = False, encoding = 'utf-8')
print(inventario.drop(columns = 'dueno').to_string(index = False))
print('Flujos:', len(inventario), '| escriben a clientes:',
      int(inventario.direccion.isin(['Salida', 'Conversación']).sum()),
      '| sin base de envío declarada:', int(inventario.base_de_envio.eq('').sum()),
      '| dueños distintos:', inventario.dueno.nunique())
                      flujo  dia               canal    direccion            base_de_envio              persona_al_mando
          TL Orquestador v1   52               Todos      Entrada       No escribe: enruta        Escala a #aprobaciones
  TL Responder por canal v1   52 WhatsApp, Instagram       Salida          Ventana abierta      Acuse y respuestas fijas
    TL Agente de pedidos v2   38            WhatsApp Conversación          Ventana abierta    Aprueba pasteles y cambios
     TL Gmail mayoristas v1   47               Gmail     Borrador       Relación mayorista                 Valeria envía
  TL WhatsApp secuencias v2   54            WhatsApp       Salida Opt-in o pedido en curso Plantillas que aprobó Valeria
    TL Slack operaciones v1   50               Slack      Interno                   Equipo         Valeria o Don Ernesto
 TL Métricas de atención v1   53               Slack      Interno                   Equipo                  Lee #alertas
TL Monitor de plantillas v1   54               Slack      Interno                   Equipo                  Lee #alertas
Flujos: 8 | escriben a clientes: 3 | sin base de envío declarada: 0 | dueños distintos: 1
El inventario tiene $8$ flujos, de los cuales $3$ escriben a clientes (TL Responder por canal v1, TL Agente de pedidos v2 y TL WhatsApp secuencias v2), y ninguno sin base de envío declarada. El correo de mayoristas no cuenta como “escribe a clientes” porque deja borradores: quien envía es Valeria. La Tabla 1 resume el inventario con la base de cada flujo.
Tabla 1. Inventario de los flujos de comunicación de Trigo Lento al cierre del módulo 5.
| Flujo | Día | Canal | Dirección | Base de envío | Persona al mando |
|---|---|---|---|---|---|
TL Orquestador v1 | 52 | Todos | Entrada | No escribe: enruta | Escala a #aprobaciones |
TL Responder por canal v1 | 52 | WhatsApp, Instagram | Salida | Ventana abierta | Acuse y respuestas fijas |
TL Agente de pedidos v2 | 38 | Conversación | Ventana abierta | Valeria aprueba pasteles y cambios | |
TL Gmail mayoristas v1 | 47 | Gmail | Borrador | Relación mayorista | Valeria revisa y envía |
TL WhatsApp secuencias v2 | 54 | Salida | Opt-in o pedido en curso | Plantillas que aprobó Valeria | |
TL Slack operaciones v1 | 50 | Slack | Interno | Equipo | Valeria o Don Ernesto |
TL Métricas de atención v1 | 53 | Slack | Interno | Equipo | Quien lee #alertas |
TL Monitor de plantillas v1 | 54 | Slack | Interno | Equipo | Quien lee #alertas |
Hay una cifra del inventario que pasa desapercibida y que conviene subrayar: un solo dueño. Los ocho flujos tienen a Valeria como responsable. En una panadería de seis personas es lo natural, pero es también un riesgo de operación: si Valeria se enferma la semana de Pascua, nadie sabe qué hacer con una alerta de plantilla pausada. El inventario no lo arregla, pero lo hace visible, y el módulo 8 dedicará un día entero a los manuales de operación que permiten que otra persona tome el relevo.
La tabla dice qué hay; el mapa dice cómo se conecta. El siguiente código dibuja el ecosistema con las formas fijas de la serie: los canales como óvalos verdes, el orquestador como rombo naranja porque decide, los flujos con Claude en morado, el monitor de plantillas en rojo porque maneja errores y las personas como hexágonos grises:
# Mapa del ecosistema de comunicación dibujado con las formas de la serie en Python:
FORMAS = {'canal': ('disparador', '#1f9d55'), 'flujo': ('accion', '#2a78d6'), 'decision': ('decision', '#eb6834'),
          'ia': ('ia', '#7a5cc9'), 'persona': ('humano', '#8a8a8a'), 'error': ('error', '#c8423b')}

def dibujar_flujo(nodos, aristas, titulo, ancho = 1.9, alto = 0.8, tamano = (15, 8.4)):
    fig, ax = plt.subplots(figsize = tamano)
    pos = {n['id']: (n['x'], n['y']) for n in nodos}
    medio = {n['id']: {'decision': (1.15, 0.62), 'humano': (0.6, 0.6)}.get(FORMAS[n['tipo']][0],
                                                                            (ancho / 2, alto / 2)) for n in nodos}
    for o, d, rotulo in aristas:
        (x1, y1), (x2, y2) = pos[o], pos[d]
        if x1 == x2:      # vertical: de borde inferior o superior al opuesto
            s = 1 if y2 > y1 else -1
            a, b = (x1, y1 + s * medio[o][1]), (x2, y2 - s * medio[d][1])
        else:             # de izquierda a derecha: del borde derecho al borde izquierdo
            a, b = (x1 + medio[o][0], y1), (x2 - medio[d][0], y2)
        ax.add_patch(FancyArrowPatch(a, b, arrowstyle = '-|>', mutation_scale = 14, color = '#7d7b76',
                                     linewidth = 1.3, shrinkA = 2, shrinkB = 3, zorder = 1))
        if rotulo:
            ax.text((x1 + x2) / 2, (y1 + y2) / 2 + 0.12, rotulo, fontsize = 9, color = '#52514e', ha = 'center')
    for n in nodos:
        forma, color = FORMAS[n['tipo']]
        x, y = n['x'], n['y']
        if forma == 'decision':
            ax.add_patch(Polygon([(x - 1.15, y), (x, y + 0.62), (x + 1.15, y), (x, y - 0.62)],
                                 facecolor = color, edgecolor = 'white', linewidth = 2, zorder = 2))
        elif forma == 'disparador':
            ax.add_patch(Ellipse((x, y), ancho, alto, facecolor = color, edgecolor = 'white', linewidth = 2, zorder = 2))
        elif forma == 'humano':
            ax.add_patch(RegularPolygon((x, y), 6, radius = 0.62, orientation = np.pi / 6, facecolor = color,
                                        edgecolor = 'white', linewidth = 2, zorder = 2))
        else:
            ax.add_patch(FancyBboxPatch((x - ancho / 2, y - alto / 2), ancho, alto, boxstyle = 'round,pad=0.04',
                                        facecolor = color, edgecolor = 'white', linewidth = 2, zorder = 2))
        ax.text(x, y, textwrap.fill(n['id'], 15), ha = 'center', va = 'center', color = 'white',
                fontsize = 9, zorder = 3)
    xs = [p[0] for p in pos.values()]
    ys = [p[1] for p in pos.values()]
    ax.set_xlim(min(xs) - 1.3, max(xs) + 1.3)
    ax.set_ylim(min(ys) - 0.9, max(ys) + 0.9)
    ax.set_aspect('equal')
    ax.axis('off')
    ax.set_title(titulo, fontsize = 15)
    return fig, ax

nodos = ([{'id': c, 'tipo': 'canal', 'x': 0, 'y': y} for c, y in
          [('WhatsApp', 4), ('Instagram', 2.6), ('Gmail', 1.2), ('Formulario', -0.2), ('Teléfono', -1.6)]] +
         [{'id': 'TL Orquestador v1', 'tipo': 'decision', 'x': 3.3, 'y': 1.2},
          {'id': 'TL Responder por canal v1', 'tipo': 'flujo', 'x': 6.6, 'y': 4.3},
          {'id': 'TL Agente de pedidos v2', 'tipo': 'ia', 'x': 6.6, 'y': 2.9},
          {'id': 'TL Gmail mayoristas v1', 'tipo': 'ia', 'x': 6.6, 'y': 1.5},
          {'id': 'TL WhatsApp secuencias v2', 'tipo': 'flujo', 'x': 6.6, 'y': 0.1},
          {'id': 'TL Monitor de plantillas v1', 'tipo': 'error', 'x': 6.6, 'y': -1.3},
          {'id': 'TL Slack operaciones v1', 'tipo': 'flujo', 'x': 9.9, 'y': 1.5},
          {'id': 'TL Métricas de atención v1', 'tipo': 'flujo', 'x': 9.9, 'y': -0.3},
          {'id': 'Valeria', 'tipo': 'persona', 'x': 12.9, 'y': 4.0},
          {'id': 'Don Ernesto', 'tipo': 'persona', 'x': 12.9, 'y': 1.5},
          {'id': 'Mostrador', 'tipo': 'persona', 'x': 12.9, 'y': -1.0}])
aristas = ([(c, 'TL Orquestador v1', '') for c in ['WhatsApp', 'Instagram', 'Gmail', 'Formulario', 'Teléfono']] +
           [('TL Orquestador v1', f, '') for f in ['TL Responder por canal v1', 'TL Agente de pedidos v2',
                                                   'TL Gmail mayoristas v1']] +
           [('TL Agente de pedidos v2', 'TL Slack operaciones v1', 'aprobación'),
            ('TL Gmail mayoristas v1', 'Valeria', 'borrador'),
            ('TL WhatsApp secuencias v2', 'TL Monitor de plantillas v1', ''),
            ('TL Monitor de plantillas v1', 'TL Métricas de atención v1', ''),
            ('TL Métricas de atención v1', 'TL Slack operaciones v1', '#alertas'),
            ('TL Slack operaciones v1', 'Valeria', ''), ('TL Slack operaciones v1', 'Don Ernesto', 'relevo'),
            ('TL Slack operaciones v1', 'Mostrador', '')])
nombres = {n['id'] for n in nodos}
assert all(o in nombres and d in nombres for o, d, _ in aristas), 'Arista hacia un nodo inexistente'
print('Nodos:', len(nodos), '| aristas:', len(aristas), '|', dict(Counter(n['tipo'] for n in nodos)))
grado = Counter([o for o, _, _ in aristas] + [d for _, d, _ in aristas])
print('Nodo con más conexiones:', grado.most_common(1)[0])
dibujar_flujo(nodos, aristas, 'Ecosistema de comunicación de Trigo Lento al cierre del módulo 5')
plt.tight_layout()
plt.show()
Nodos: 16 | aristas: 16 | {'canal': 5, 'decision': 1, 'flujo': 4, 'ia': 2, 'error': 1, 'persona': 3}
Nodo con más conexiones: ('TL Orquestador v1', 8)
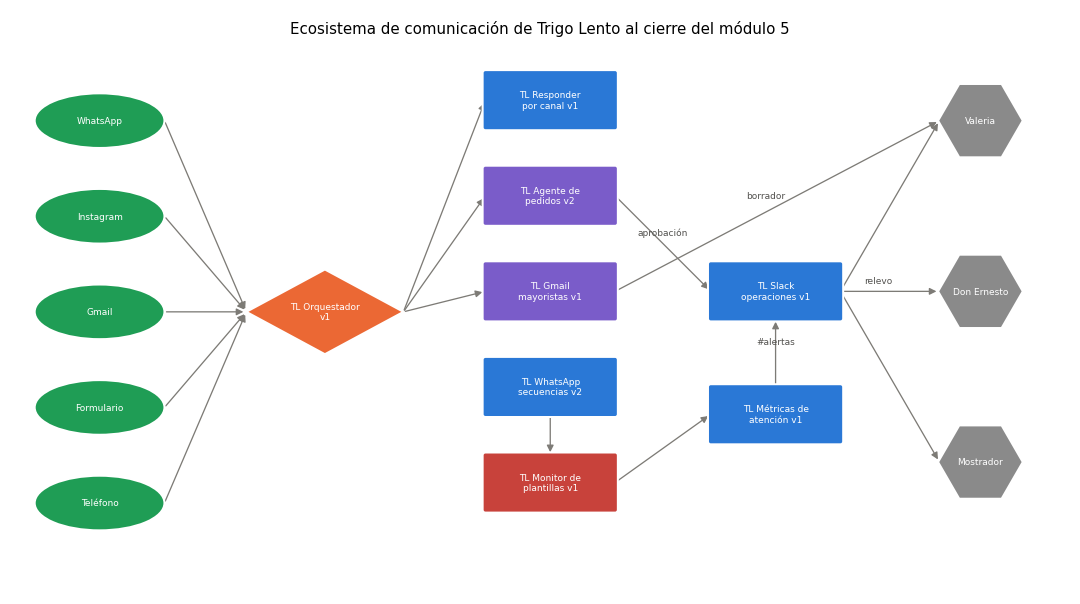
El mapa tiene $16$ nodos y $16$ conexiones, y el nodo con más conexiones es el orquestador, con $8$: cinco entradas y tres salidas. Se lee de izquierda a derecha. Los cinco canales entran por una sola puerta, TL Orquestador v1, que reconoce al cliente, descarta los duplicados y manda cada evento al flujo que le toca. Los flujos con Claude, en morado, nunca terminan en un cliente sin pasar por una persona: el agente pide aprobación en Slack y el de Gmail deja un borrador en la bandeja de Valeria. La secuencia de WhatsApp tiene ahora debajo al monitor de plantillas del Día 54, que alimenta las métricas del Día 53, que a su vez escriben en #alertas. Y a la derecha, las tres personas que cierran cada camino.
La Figura 1 reúne en un mapa conceptual las ideas que sostienen ese dibujo: cada mensaje recorre canal, base de envío, ventana o plantilla, proveedor, aprobación y orquestador, y termina medido contra su SLA.
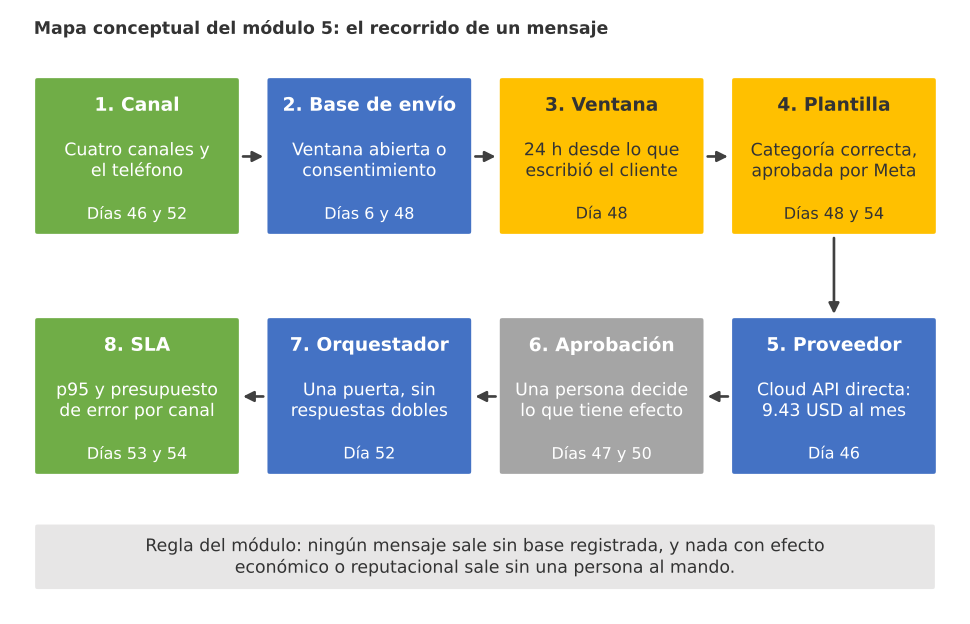
Figura 1. Mapa conceptual del módulo 5: cada mensaje recorre canal, base de envío, ventana, plantilla, proveedor, aprobación y orquestador, y termina medido contra su SLA; cada concepto lleva su regla y el día que la construyó.
Conviene notar lo que el mapa no muestra: el teléfono no tiene flujo propio, porque las llamadas las atiende el mostrador y solo se registran en el formulario interno; e Instagram entra al orquestador, pero no tiene secuencias ni plantillas, porque el Día 48 decidió que el pan de temporada se anuncia en la red social y no por WhatsApp. Un mapa honesto también enseña lo que se decidió no automatizar.
Doce preguntas de decisión
Un repaso que pregunta definiciones ("¿qué es una plantilla de utilidad?") mide memoria, no criterio. Las preguntas de hoy plantean situaciones que Valeria encontrará la semana que viene y piden una decisión. Están agrupadas en cuatro temas de tres preguntas cada uno: ventana y plantillas, consentimiento y orquestación, control humano, y medición y costes. Cada pregunta indica el día en el que se trató el asunto, para que quien falle sepa adónde volver.
La primera pregunta es la que Valeria se hizo esta misma mañana. Una clienta encargó un pastel el miércoles a las 15:00 y el jueves a las 17:00, $26$ horas después de su último mensaje, nadie le ha confirmado la hora de recogida. ¿Qué se le puede enviar? La regla de la ventana se escribe así:
$$ \text{texto libre permitido} \iff t_{\text{envío}} - t_{\text{último mensaje del cliente}} < 24\ \text{h} $$
La lógica detrás de esta regla es la siguiente:
- $t_{\text{último mensaje del cliente}}$ es la marca de tiempo del último mensaje que el cliente envió; los mensajes del negocio no abren ni renuevan la ventana.
- Si la diferencia es menor de $24$ horas, el negocio puede responder con texto libre, botones o listas; desde el 1 de octubre de 2026, cada respuesta por encima de las $1,000$ del mes se cobra a la tarifa de utilidad.
- Si la diferencia es de $24$ horas o más, solo cabe una plantilla aprobada, y su categoría tiene que corresponder a la base: utilidad para el pedido en curso, marketing solo con consentimiento de marketing.
A las $26$ horas la ventana está cerrada, pero la clienta tiene un pedido en curso: cabe una plantilla de utilidad aprobada sobre ese pedido, como el recordatorio de recogida. No cabe un texto libre ni, menos aún, aprovechar para ofrecerle conchas. La Tabla 2 reúne las doce preguntas con sus cuatro opciones.
Tabla 2. Doce preguntas de decisión del módulo 5, con cuatro opciones y el día que trata cada caso.
| # | Pregunta | A | B | C | D | Día |
|---|---|---|---|---|---|---|
| 1 | Una clienta escribió hace 26 horas y pregunta si su pastel ya está listo. ¿Qué se le puede enviar? | Un texto libre con la respuesta | Una plantilla de marketing con el pastel | Una plantilla de utilidad aprobada sobre su pedido en curso | Nada hasta que vuelva a escribir | 48 |
| 2 | Valeria registra como utilidad una plantilla que dice “Su pedido está listo. ¡Y llévese 10 % en conchas!”. ¿Qué ocurre? | Nada: la categoría la elige el negocio | Meta la trata como marketing | Se cobra igual que antes | Solo cambia el pie del mensaje | 48 |
| 3 | Al enviar un recordatorio, la Cloud API responde 400 porque la plantilla está pausada. ¿Qué debe hacer el flujo? | Reintentar cada 5 segundos | Marcarlo como enviado | Cambiar la plantilla por un texto libre | Registrar el fallo, avisar en #alertas y usar la plantilla de respaldo | 54 |
| 4 | Un cliente dio su consentimiento solo para confirmaciones de pedido. ¿Se le puede enviar la bienvenida de novedades? | No: falta el consentimiento de marketing | Sí, si se envía en horario | Sí, una sola vez | Sí, como plantilla de utilidad | 48 |
| 5 | Una clienta responde “ya no” a un recordatorio de recogida. ¿Qué ocurre? | Se le pregunta el motivo primero | Se le da de baja solo de los recordatorios | Baja inmediata en todas las finalidades | Valeria decide al final del día | 48 |
| 6 | Una clienta pide el mismo pastel por WhatsApp y por Instagram con 10 minutos de diferencia. ¿Qué hace el orquestador? | Responde en los dos canales | Fusiona los eventos por su huella y responde una sola vez | Borra el segundo mensaje | Le pregunta por cuál canal seguir | 52 |
| 7 | Marisol escribe un correo con un cambio de pedido y una queja por una entrega tardía. ¿Qué deja TL Gmail mayoristas v1? | Un borrador con un hueco para que Valeria conteste la queja | La respuesta completa, ya enviada | Nada: las quejas se ignoran | Una disculpa redactada por Claude | 47 |
| 8 | Llega a n8n la pulsación de un botón de Slack con firma válida y una marca de tiempo de hace 10 minutos. ¿Qué hace el flujo? | La acepta, porque la firma es válida | La acepta si viene de Valeria | La guarda para el día siguiente | La rechaza: la tolerancia es de 5 minutos | 50 |
| 9 | Un cliente encarga un pastel y avisa que su hija es alérgica a la nuez. ¿Quién le confirma el pedido? | El agente, si la receta lo permite | El chatbot, con un mensaje fijo | Valeria, después de consultar a Don Ernesto | Nadie: se rechaza el pedido | 38 |
| 10 | El p95 de WhatsApp es de 11.9 minutos y el del formulario de 35.3. ¿Cuál es el p95 de los dos canales juntos? | 23.6 minutos, la media de los dos | 35.3 minutos, el peor de los dos | 11.9 minutos, el del canal con más eventos | El que resulte de calcularlo sobre todos los eventos juntos | 53 |
| 11 | Con un SLO del 95 % y 1 560 mensajes de WhatsApp al mes, ¿cuál es el presupuesto de error? | 1 482 incumplimientos | 78 incumplimientos | 95 incumplimientos | 7.8 incumplimientos | 53 |
| 12 | ¿Por qué la mensajería de WhatsApp por Twilio costaba 19.13 USD al mes? | Por el recargo de 0.005 USD por cada mensaje recibido y enviado | Por las tarifas de marketing | Por la cuota fija de Twilio | Por los mensajes de servicio | 46 |
Antes de seguir, conviene que usted conteste las doce preguntas en un papel, sin mirar los días anteriores. El valor de la prueba está justo en el esfuerzo de recordar y decidir. Las respuestas, con la razón de cada una, están plegadas al final de la siguiente sección.
Las preguntas no se escribieron solo en una tabla: viven también en un banco de datos que se puede corregir, ampliar y reutilizar. El siguiente código guarda cada pregunta con su tema, su día, su respuesta correcta y una retroalimentación por opción, es decir, una frase que explica por qué cada respuesta incorrecta es incorrecta, que es lo que de verdad enseña:
# Banco de 12 preguntas de decisión con retroalimentación por opción en Python:
def pregunta(n, tema, dia, enunciado, correcta, opciones):
    # opciones: cuatro pares (texto, retroalimentación) en el orden A, B, C, D:
    return {'n': n, 'tema': tema, 'dia': dia, 'enunciado': enunciado, 'correcta': correcta,
            'opciones': {l: t for l, (t, _) in zip('ABCD', opciones)},
            'retro': {l: r for l, (_, r) in zip('ABCD', opciones)}}

BANCO = [
    pregunta(1, 'Ventana y plantillas', 48, 'Escribió hace 26 h y pregunta por su pastel: ¿qué se le envía?', 'C', [
        ('Un texto libre con la respuesta', 'A las 24 horas la ventana se cerró: ya no cabe texto libre.'),
        ('Una plantilla de marketing con el pastel', 'Sin opt-in de marketing, y además no es promoción.'),
        ('Una plantilla de utilidad aprobada sobre su pedido', 'Correcto: el pedido en curso es la base.'),
        ('Nada hasta que vuelva a escribir', 'Sí hay base: su pedido en curso admite una plantilla de utilidad.')]),
    pregunta(2, 'Ventana y plantillas', 48, 'Utilidad con "llévese 10 % en conchas": ¿qué pasa?', 'B', [
        ('Nada: la categoría la elige el negocio', 'La categoría la decide el contenido, no quien la registra.'),
        ('Meta la trata como marketing', 'Correcto: más cara y exige consentimiento de marketing.'),
        ('Se cobra igual que antes', 'Pasa de 0.0085 a 0.0397 USD por mensaje.'),
        ('Solo cambia el pie del mensaje', 'Cambian categoría, tarifa y consentimiento exigido.')]),
    pregunta(3, 'Ventana y plantillas', 54, 'La Cloud API responde 400: plantilla pausada. ¿Qué hace el flujo?', 'D', [
        ('Reintenta cada 5 segundos', 'Un 400 no es un error de red: reintentar no cambia nada.'),
        ('Lo marca como enviado', 'Es justo lo que ocultó el incidente del Día 54.'),
        ('Cambia la plantilla por texto libre', 'Fuera de la ventana el texto libre no está permitido.'),
        ('Registra, avisa en #alertas y usa el respaldo', 'Correcto: se ve el fallo y el recordatorio sale.')]),
    pregunta(4, 'Consentimiento y orquestación', 48, 'Opt-in solo de confirmaciones: ¿bienvenida de novedades?', 'A', [
        ('No: falta el consentimiento de marketing', 'Correcto: el consentimiento es por finalidad.'),
        ('Sí, si se envía en horario', 'El horario no sustituye al consentimiento.'),
        ('Sí, una sola vez', 'Ni una vez: la finalidad no coincide.'),
        ('Sí, como plantilla de utilidad', 'Una bienvenida comercial no es utilidad.')]),
    pregunta(5, 'Consentimiento y orquestación', 48, 'Responde "ya no" a un recordatorio: ¿qué ocurre?', 'C', [
        ('Se le pregunta el motivo primero', 'La baja no se condiciona a nada.'),
        ('Baja solo de recordatorios', 'La baja se aplica a todas las finalidades.'),
        ('Baja inmediata en todas las finalidades', 'Correcto: en el mismo minuto, sin borrar el registro.'),
        ('Valeria decide al final del día', 'No hay nada que decidir.')]),
    pregunta(6, 'Consentimiento y orquestación', 52, 'Mismo pastel por WhatsApp e Instagram en 10 min: ¿qué hace?', 'B', [
        ('Responde en los dos canales', 'Es la respuesta doble que el orquestador evita.'),
        ('Fusiona por huella y responde una vez', 'Correcto: ventana de 30 min con huella del pedido.'),
        ('Borra el segundo mensaje', 'No se borra nada: se fusiona y queda registrado.'),
        ('Pregunta a la clienta por cuál siguen', 'Solo se pregunta si la coincidencia es dudosa.')]),
    pregunta(7, 'Control humano', 47, 'Correo de Marisol con queja y cambio de pedido: ¿qué deja el flujo?', 'A', [
        ('Un borrador con hueco para la queja', 'Correcto: la queja la escribe y firma Valeria.'),
        ('La respuesta enviada sola', 'TL Gmail mayoristas v1 no tiene ningún nodo de envío.'),
        ('Nada: las quejas se ignoran', 'Se etiqueta y se deja lista para Valeria.'),
        ('Una disculpa redactada por Claude', 'Las quejas no las redacta el modelo.')]),
    pregunta(8, 'Control humano', 50, 'Botón de Slack con firma válida y marca de hace 10 min: ¿qué hace?', 'D', [
        ('La acepta: la firma es válida', 'Una firma vieja puede ser una repetición.'),
        ('La acepta si viene de Valeria', 'La identidad no corrige una marca vencida.'),
        ('La guarda para mañana', 'No hay nada que guardar: se rechaza.'),
        ('La rechaza: tolerancia de 5 minutos', 'Correcto: firma, marca y que nadie haya decidido antes.')]),
    pregunta(9, 'Control humano', 38, 'Pastel con alergia a la nuez: ¿quién confirma al cliente?', 'C', [
        ('El agente, si la receta lo permite', 'Las recetas no entran en ningún modelo.'),
        ('El chatbot con un mensaje fijo', 'Una alergia no tiene respuesta fija segura.'),
        ('Valeria, tras consultar a Don Ernesto', 'Correcto: es una puerta humana desde el Día 6.'),
        ('Nadie: se rechaza el pedido', 'Se atiende, pero lo decide una persona.')]),
    pregunta(10, 'Medición y costes', 53, 'p95 de WhatsApp 11.9 y del formulario 35.3: ¿p95 conjunto?', 'D', [
        ('23.6 minutos, la media', 'Los percentiles no se promedian.'),
        ('35.3, el peor de los dos', 'El conjunto mezcla volúmenes muy distintos.'),
        ('11.9, el canal con más eventos', 'Hay que mirar todos los eventos juntos.'),
        ('Se calcula sobre todos los eventos juntos', 'Correcto: percentil de la muestra conjunta.')]),
    pregunta(11, 'Medición y costes', 53, 'SLO del 95 % y 1 560 mensajes al mes: ¿presupuesto de error?', 'B', [
        ('1 482 incumplimientos', 'Es el número de mensajes buenos, no el presupuesto.'),
        ('78 incumplimientos', 'Correcto: B = (1 - 0.95) * 1 560 = 78.'),
        ('95 incumplimientos', 'Confundió el SLO con un número de eventos.'),
        ('7.8 incumplimientos', 'Usó un SLO del 99.5 %.')]),
    pregunta(12, 'Medición y costes', 46, '¿Por qué WhatsApp por Twilio costaba 19.13 USD?', 'A', [
        ('Recargo de 0.005 por mensaje recibido y enviado', 'Correcto: 85 % de la factura era recargo.'),
        ('Por las tarifas de marketing', 'Trigo Lento casi no enviaba marketing.'),
        ('Por la cuota fija de Twilio', 'Twilio no tiene cuota fija en ese uso.'),
        ('Por los mensajes de servicio', 'Antes de octubre de 2026 Meta no los cobraba.')]),
]
TEMAS = ['Ventana y plantillas', 'Consentimiento y orquestación', 'Control humano', 'Medición y costes']
(carpeta / 'banco_preguntas_dia_55.json').write_text(json.dumps(BANCO, ensure_ascii = False, indent = 2),
                                                    encoding = 'utf-8')
banco = pd.DataFrame(BANCO)
print('Preguntas por tema:', banco.groupby('tema', sort = False).size().to_dict())
print('Respuestas correctas por letra:', banco['correcta'].value_counts().sort_index().to_dict())
print('Días que cubre el banco:', sorted(banco['dia'].unique().tolist()))
Preguntas por tema: {'Ventana y plantillas': 3, 'Consentimiento y orquestación': 3, 'Control humano': 3, 'Medición y costes': 3}
Respuestas correctas por letra: {'A': 3, 'B': 3, 'C': 3, 'D': 3}
Días que cubre el banco: [38, 46, 47, 48, 50, 52, 53, 54]
El banco tiene tres preguntas por tema y las respuestas correctas están repartidas por igual entre las cuatro letras, $3$ cada una, para que nadie acierte por adivinar un patrón (“casi siempre es la C”). Cubre ocho días del módulo y de los anteriores: $38$, $46$, $47$, $48$, $50$, $52$, $53$ y $54$. El Día 49 no tiene pregunta propia, porque su revisor de accesibilidad se pondrá a prueba en la práctica el Día 56, y el Día 51 trató otro negocio.
Autocorrección en Python
Con el banco listo, corregir es comparar. La función corregir recibe las respuestas de un lector como un diccionario y devuelve una fila por pregunta con el acierto y la retroalimentación de la opción elegida. Después se agrupa por tema y se compara con un umbral del $80%$, el mismo que usaron las evaluaciones de los días 9, 32 y 44. La puntuación de un tema $t$ es:
$$ p_t = \frac{1}{n_t}\sum_{i \in t} \mathbb{1}[,r_i = c_i,], \qquad P(X \geq 10) = \sum_{k=10}^{12}\binom{12}{k},0.25^{k},0.75^{12-k} $$
La lógica detrás de estas dos fórmulas es la siguiente:
- $r_i$ es la respuesta elegida en la pregunta $i$ y $c_i$ la correcta; la función indicadora $\mathbb{1}[\cdot]$ vale $1$ si coinciden y $0$ si no, de modo que $p_t$ es la proporción de aciertos del tema.
- Con $n_t = 3$ preguntas por tema, un solo fallo deja el tema en $66.7%$, por debajo del umbral: el diagnóstico es exigente a propósito, porque cada tema es una regla que se aplica cada día.
- $P(X \geq 10)$ es la probabilidad de acertar $10$ o más de $12$ preguntas contestando al azar, con $X$ binomial de parámetros $n = 12$ y $p = 0.25$; si es pequeñísima, un buen resultado no es suerte.
El lector de ejemplo es inventado y sirve para ver cómo responde el banco a un repaso casi bueno:
# Corrección, diagnóstico por tema con umbral del 80 % y días a repasar en Python:
def corregir(respuestas, banco = BANCO):
    # Una fila por pregunta con el acierto y la retroalimentación de la opción elegida:
    return pd.DataFrame([{'n': p['n'], 'tema': p['tema'], 'dia': p['dia'],
                          'elegida': respuestas.get(p['n'], '-'), 'correcta': p['correcta'],
                          'acierto': respuestas.get(p['n']) == p['correcta'],
                          'retro': p['retro'].get(respuestas.get(p['n']), 'Sin respuesta.')} for p in banco])

# Respuestas de un lector de ejemplo (inventadas para la demostración):
lector = {1: 'C', 2: 'B', 3: 'D', 4: 'A', 5: 'C', 6: 'B', 7: 'A', 8: 'D', 9: 'C', 10: 'A', 11: 'B', 12: 'B'}
resultado = corregir(lector)
aciertos = int(resultado['acierto'].sum())
print(f'Aciertos: {aciertos} de {len(resultado)} ({aciertos / len(resultado):.1%})')
for _, f in resultado[~resultado['acierto']].iterrows():
    print(f'Pregunta {f.n} (Día {f.dia}): eligió {f.elegida}, era {f.correcta}. {f.retro}')
por_tema = resultado.groupby('tema', sort = False)['acierto'].agg(['sum', 'count'])
por_tema['porcentaje'] = 100 * por_tema['sum'] / por_tema['count']
print(por_tema.to_string())
print('Temas bajo el umbral del 80 %:', por_tema.index[por_tema.porcentaje < 80].tolist(),
      '| días a repasar:', sorted(resultado.loc[~resultado.acierto, 'dia'].unique().tolist()))
print(f'P(10 o más aciertos al azar) = {stats.binom.sf(9, 12, 0.25):.2e} | media al azar: '
      f'{stats.binom.mean(12, 0.25):.0f} aciertos')

fig, ax = plt.subplots(figsize = (9, 4.2))
colores = ['#3a9d5d' if v >= 80 else '#eb6834' for v in por_tema['porcentaje']]
ax.barh(por_tema.index[::-1], por_tema['porcentaje'][::-1], color = colores[::-1], height = 0.55)
for i, (v, s, c) in enumerate(zip(por_tema['porcentaje'][::-1], por_tema['sum'][::-1], por_tema['count'][::-1])):
    ax.text(v - 2, i, f'{v:.0f} % ({s} de {c})', ha = 'right', va = 'center', color = 'white', fontsize = 11)
ax.axvline(80, color = '#52514e', linestyle = '--', linewidth = 1.5)
ax.text(81, 3.45, 'umbral 80 %', fontsize = 10, color = '#52514e')
ax.set_xlim(0, 108)
ax.set_ylim(-0.5, 3.75)
ax.set_xlabel('Aciertos (%)')
ax.set_title('Lector de ejemplo: puntuación por tema del módulo 5', fontsize = 15)
ax.grid(axis = 'x', color = '#e6e5e1')
ax.set_axisbelow(True)
plt.tight_layout()
plt.show()
Aciertos: 10 de 12 (83.3%)
Pregunta 10 (Día 53): eligió A, era D. Los percentiles no se promedian.
Pregunta 12 (Día 46): eligió B, era A. Trigo Lento casi no enviaba marketing.
                               sum  count  porcentaje
tema
Ventana y plantillas             3      3  100.000000
Consentimiento y orquestación    3      3  100.000000
Control humano                   3      3  100.000000
Medición y costes                1      3   33.333333
Temas bajo el umbral del 80 %: ['Medición y costes'] | días a repasar: [46, 53]
P(10 o más aciertos al azar) = 3.76e-05 | media al azar: 3 aciertos
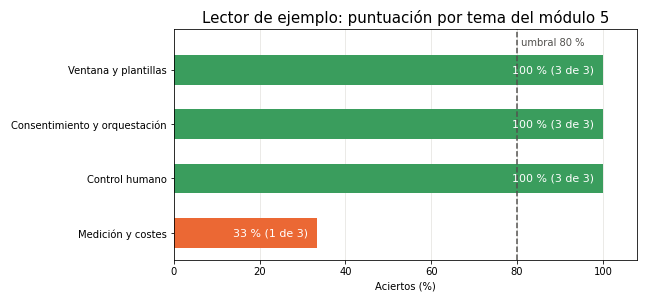
El lector acierta $10$ de $12$ preguntas, un $83.3%$, y supera el umbral global, pero el diagnóstico por tema es más fino que el total: tres temas están al $100%$ y “Medición y costes” se queda en el $33%$, con dos fallos. En la pregunta 10 promedió los percentiles de dos canales, justo el error que el Día 53 desmontó, y en la pregunta 12 atribuyó la factura de Twilio a las tarifas de marketing, cuando el $85%$ era recargo por mensaje. La retroalimentación no dice solo “incorrecto”: dice por qué, y la salida termina con los días que conviene releer, el $46$ y el $53$.
La probabilidad de lograr $10$ aciertos o más al azar es de $3.76 \times 10^{-5}$, unas cuatro veces entre cien mil, y la media al azar es de $3$ aciertos: el resultado del lector refleja lo que sabe, y sus dos fallos también. La gráfica deja ver de un vistazo lo que el total esconde: tres barras verdes por encima de la línea del $80%$ y una barra naranja muy por debajo.
Un buen resultado global no autoriza a pasar de largo un tema débil. En la semana de pruebas, quien confunda percentiles promediará los tiempos de respuesta de los canales y le prometerá a Marisol un servicio que no existe; quien no sepa de dónde salían los $19.13$ USD de Twilio no reconocerá el siguiente recargo escondido. Por eso el diagnóstico se lee por tema y la recomendación se da por día.
Ver solución
Tabla 3. Respuestas correctas de las doce preguntas y el error típico de cada una.
| # | Correcta | Por qué | Error típico que conviene revisar |
|---|---|---|---|
| 1 | C | La ventana se cerró a las 24 horas, pero el pedido en curso es base suficiente para una plantilla de utilidad aprobada. | Pensar que con la ventana cerrada ya no se puede escribir nada, o lo contrario, que un texto libre “corto” no cuenta. |
| 2 | B | La categoría la decide el contenido: un descuento convierte la plantilla en marketing, que cuesta 0.0397 USD en lugar de 0.0085 y exige consentimiento de marketing. | Creer que la etiqueta que se elige al registrar la plantilla manda sobre lo que dice. |
| 3 | D | Un 400 por plantilla pausada no se arregla reintentando: se registra, se avisa en #alertas y el recordatorio sale con la plantilla de respaldo. | Marcarlo como enviado, que es exactamente lo que escondió el incidente del Día 54. |
| 4 | A | El consentimiento es por finalidad: quien aceptó confirmaciones no aceptó novedades. | Pensar que el horario o “una sola vez” sustituyen al consentimiento. |
| 5 | C | La baja se aplica en el mismo minuto a todas las finalidades, se confirma una vez y el registro se conserva. | Pedir explicaciones o aplazar la baja. |
| 6 | B | El orquestador calcula la huella del pedido y fusiona los eventos dentro de una ventana de 30 minutos; responde una sola vez. | Responder en los dos canales, la respuesta doble que el Día 52 eliminó. |
| 7 | A | El flujo no tiene nodo de envío: deja un borrador en el hilo y un hueco para que Valeria conteste la queja con sus palabras. | Pensar que el modelo puede disculparse por la panadería. |
| 8 | D | La firma se verifica sobre una marca de tiempo con tolerancia de 5 minutos; una petición vieja puede ser una repetición. | Confiar en la firma sin mirar la marca de tiempo. |
| 9 | C | Una alergia es un dato de salud y una puerta humana desde el Día 6; las recetas no entran en ningún modelo. | Dejar que el agente “consulte la receta”. |
| 10 | D | Los percentiles no se promedian: el p95 conjunto se calcula sobre todos los eventos juntos. | Promediar 11.9 y 35.3. |
| 11 | B | B = (1 - 0.95) · 1 560 = 78 incumplimientos al mes. | Confundir los eventos buenos (1 482) con el presupuesto. |
| 12 | A | Twilio cobraba 0.005 USD por cada mensaje recibido y enviado: 16.35 de los 19.13 USD, el 85.4 %. | Culpar a las tarifas de Meta, que eran la parte pequeña. |
Auditoría con el código de honor
El examen dice lo que sabe Valeria; la auditoría dice lo que hacen sus flujos. Desde el Día 6 (Ética y seguridad: el código de honor del arquitecto de automatización), ningún flujo de Trigo Lento entra en producción si no cumple los diez artículos del código de honor: humano al mando, consentimiento, minimización, transparencia, secretos, entradas verificadas, dato y no orden, registro sin datos sensibles, coste y caída, y lo que no sale (las recetas de Don Ernesto). Aquel día se comprobaron sobre una descripción del flujo escrita a mano. Hoy se comprueban sobre lo que de verdad se importaría en n8n: el JSON exportado de cuatro workflows del módulo.
La diferencia importa. Una descripción dice lo que su autor cree que hace el flujo; el JSON dice lo que hace. El siguiente código lee TL Gmail mayoristas v1 (Día 47), TL WhatsApp secuencias v1 (Día 48), TL Slack operaciones v1 (Día 50) y TL Orquestador v1 (Día 52) y aplica a cada uno una regla por artículo. Las reglas son deliberadamente sencillas y se pueden leer en una línea: si el flujo llama a la API de Claude, debe tener un nodo Seudonimizar y su instrucción de sistema debe decir que el texto del cliente es un dato; si escribe a clientes por la Cloud API, su consulta debe cruzar los consentimientos y sus plantillas deben identificarse como automáticas; si recibe un webhook, debe verificar una firma o una cabecera; ninguna ejecución correcta debe guardar sus datos; ningún error debe silenciarse sin un workflow de errores que avise. Un artículo que no se aplica (un flujo interno no escribe a clientes) se marca “no aplica”, no “cumple”:
# Auditoría automática del código de honor sobre los cuatro workflows exportados del módulo en Python:
RUTAS = {'TL Gmail mayoristas v1': 'dia_47/flujos/n8n/gmail_mayoristas_v1.json',
         'TL WhatsApp secuencias v1': 'dia_48/flujos/n8n/whatsapp_secuencias_v1.json',
         'TL Slack operaciones v1': 'dia_50/flujos/n8n/slack_operaciones_v1.json',
         'TL Orquestador v1': 'dia_52/flujos/n8n/orquestador_v1.json'}
PLANTILLAS = {p['name']: p for p in json.loads((proyecto / 'dia_48' / 'plantillas_trigo_lento.json')
                                              .read_text(encoding = 'utf-8'))}
# Plantillas que envía cada flujo según su máquina de estados (Día 48):
ENVIA = {'TL WhatsApp secuencias v1': ['bienvenida_novedades', 'bienvenida_favoritos']}
SECRETO = re.compile(r'(?i)(sk-ant-[\w-]{8,}|xox[bp]-[\w-]+|hooks\.slack\.com/services/T\w+|'
                     r'"bearer [\w.-]{12,}|"x-api-key"\s*:\s*"[^"=]{8,}")')

def auditar(nombre, wf, texto):
    nodos = wf['nodes']
    urls = [n['parameters'].get('url', '') for n in nodos]
    tipos = [n['type'].split('.')[-1] for n in nodos]
    a_clientes = any('graph.facebook.com' in u and u.endswith('/messages') for u in urls)
    usa_claude = any('api.anthropic.com' in u for u in urls)
    con_webhook = 'webhook' in tipos
    plantillas = ENVIA.get(nombre, [])
    silenciados = [n['name'] for n in nodos if n.get('onError') == 'continueRegularOutput' or
                   '"neverError": true' in json.dumps(n.get('parameters', {}))]
    r = {}
    r[1] = ('cumple' if not any('/send' in u for u in urls) and (not a_clientes or 'template' in texto)
            else 'pendiente')
    r[2] = ('no aplica' if not a_clientes and 'consentimientos' not in texto else
            'cumple' if 'consentimientos' in texto and ('baja' in texto) else 'pendiente')
    r[3] = ('no aplica' if not usa_claude else 'cumple' if 'Seudonimizar' in [n['name'] for n in nodos]
            else 'pendiente')
    pies = [c.get('text', '') for p in plantillas for c in PLANTILLAS.get(p, {}).get('components', [])
            if c['type'] == 'FOOTER']
    r[4] = ('no aplica' if not a_clientes else 'cumple' if pies and all('automático' in t for t in pies)
            else 'pendiente')
    r[5] = 'pendiente' if SECRETO.search(texto) else 'cumple'
    r[6] = ('no aplica' if not con_webhook else 'cumple' if ('headerAuth' in texto or 'createHmac' in texto)
            else 'pendiente')
    r[7] = ('no aplica' if not usa_claude else 'cumple' if 'dato, no una instrucción' in texto else 'pendiente')
    r[8] = 'cumple' if wf['settings'].get('saveDataSuccessExecution') == 'none' else 'pendiente'
    r[9] = 'cumple' if wf['settings'].get('errorWorkflow') and not silenciados else 'pendiente'
    r[10] = 'pendiente' if re.search(r'(?i)receta', texto) else 'cumple'
    return r, silenciados

ARTICULOS = ['Humano al mando', 'Consentimiento', 'Minimización', 'Transparencia', 'Secretos',
             'Entradas verificadas', 'Dato, no orden', 'Registro sin datos sensibles', 'Coste y caída',
             'Lo que no sale']
auditoria, notas = {}, {}
for nombre, ruta in RUTAS.items():
    texto = (proyecto / ruta).read_text(encoding = 'utf-8')
    wf = json.loads(texto)
    assert wf['name'] == nombre, f'El archivo {ruta} no es {nombre}'
    auditoria[nombre], notas[nombre] = auditar(nombre, wf, texto)
tabla_honor = pd.DataFrame(auditoria)
tabla_honor.index = [f'{i}. {a}' for i, a in zip(tabla_honor.index, ARTICULOS)]
print(tabla_honor.rename(columns = lambda c: c.replace('TL ', '').replace(' v1', '')).to_string())
for nombre in RUTAS:
    col = tabla_honor[nombre]
    print(f'{nombre}: cumple {int((col == "cumple").sum())} de {int((col != "no aplica").sum())} aplicables;'
          f' pendientes: {[a.split(". ")[1] for a in col.index[col == "pendiente"]] or "ninguno"}')
print('Nodos con errores silenciados:', {k: v for k, v in notas.items() if v} or 'ninguno')
print('Aceptados para producción sin cambios:', [n for n in RUTAS if (tabla_honor[n] != 'pendiente').all()])
                                Gmail mayoristas WhatsApp secuencias Slack operaciones Orquestador
1. Humano al mando                        cumple              cumple            cumple      cumple
2. Consentimiento                      no aplica              cumple         no aplica      cumple
3. Minimización                           cumple           no aplica         no aplica   no aplica
4. Transparencia                       no aplica           pendiente         no aplica   no aplica
5. Secretos                               cumple              cumple            cumple      cumple
6. Entradas verificadas                no aplica           no aplica            cumple      cumple
7. Dato, no orden                         cumple           no aplica         no aplica   no aplica
8. Registro sin datos sensibles           cumple           pendiente            cumple      cumple
9. Coste y caída                       pendiente           pendiente            cumple   pendiente
10. Lo que no sale                        cumple              cumple            cumple      cumple
TL Gmail mayoristas v1: cumple 6 de 7 aplicables; pendientes: ['Coste y caída']
TL WhatsApp secuencias v1: cumple 4 de 7 aplicables; pendientes: ['Transparencia', 'Registro sin datos sensibles', 'Coste y caída']
TL Slack operaciones v1: cumple 6 de 6 aplicables; pendientes: ninguno
TL Orquestador v1: cumple 6 de 7 aplicables; pendientes: ['Coste y caída']
Nodos con errores silenciados: {'TL WhatsApp secuencias v1': ['Enviar plantilla'], 'TL Orquestador v1': ['Registrar ejecución']}
Aceptados para producción sin cambios: ['TL Slack operaciones v1']
El resultado es mejor de lo que Valeria temía y peor de lo que le gustaría. Solo TL Slack operaciones v1 se acepta sin cambios, con $6$ de $6$ artículos aplicables. El correo de mayoristas y el orquestador cumplen $6$ de $7$; la secuencia de WhatsApp, $4$ de $7$. La Tabla 4 recoge los hallazgos con su corrección.
Tabla 4. Artículos pendientes del código de honor en los cuatro workflows auditados y su corrección.
| Flujo | Artículo pendiente | Qué encontró el código | Corrección |
|---|---|---|---|
TL WhatsApp secuencias v1 | 4. Transparencia | Las plantillas bienvenida_novedades y bienvenida_favoritos dicen cómo darse de baja, pero no que son mensajes automáticos | Pie “Mensaje automático de Trigo Lento. Para no recibir novedades, escriba BAJA”, con nueva aprobación de Meta |
TL WhatsApp secuencias v1 | 8. Registro sin datos sensibles | Sin saveDataSuccessExecution: none: n8n guarda cada ejecución correcta con el teléfono y el nombre del cliente | Fijar none como en los otros tres flujos |
TL WhatsApp secuencias v1 | 9. Coste y caída | El nodo Enviar plantilla usa neverError y el flujo no tiene workflow de errores | Rama de error hacia #alertas y workflow de errores del Día 54 |
TL Gmail mayoristas v1 | 9. Coste y caída | Sin workflow de errores: si Gmail o Claude fallan tres veces, nadie se entera | Asignar el workflow de errores |
TL Orquestador v1 | 9. Coste y caída | Registrar ejecución continúa ante error y no hay workflow de errores; sin registro, los indicadores del Día 53 se quedan ciegos | Workflow de errores y alerta si el registro falla |
Los tres hallazgos de la secuencia cuentan una historia coherente con el Día 54 (Anatomía de un fallo real III: la plantilla pausada y los recordatorios que no salieron). El nodo que envía la plantilla nunca da error, por diseño, para que el flujo pueda leer el código HTTP y avanzar la secuencia; el problema es que nadie mira ese código fuera del propio flujo. Es el mismo patrón del incidente: un error convertido en dato y un dato que nadie lee. La versión 2 de la secuencia, construida ayer, corrigió el filtro de pedidos pendientes y el tratamiento de las plantillas pausadas; los tres artículos de hoy se revisan también sobre ella antes del lunes, porque una corrección puntual no garantiza que el resto del flujo cumpla.
El hallazgo de transparencia es el más fácil de pasar por alto. Las plantillas de utilidad del Día 48 llevan el pie “Mensaje automático de Trigo Lento”; las de marketing llevan “Para no recibir novedades, escriba BAJA”, que es obligatorio, pero no dicen que nadie las escribió en ese momento. El artículo 4 nació el Día 6 con una frase de Valeria a su padre: “Usted siempre dice que al cliente no se le engaña ni con el peso del pan.” Una línea más en el pie lo resuelve, a cambio de volver a enviar dos plantillas a revisión.
El artículo 9 aparece en tres de los cuatro flujos, y no es casualidad. Los flujos se construyeron en días distintos, cada uno con su propio manejo de errores, y solo el de Slack, que el Día 50 diseñó con la fatiga de alertas en mente, apunta a un workflow de errores. La corrección es la misma para los tres y cabe en una tarde: asignar en la configuración de cada workflow el manejador de errores que el Día 54 ya creó.
Atención aquí: Una auditoría automática solo encuentra lo que sus reglas saben buscar. Las de este bloque leen textos y configuraciones del JSON: no prueban que la firma se verifique bien, que la consulta de consentimientos sea correcta ni que la plantilla de respaldo esté aprobada. Un “cumple” significa “no se encontró el problema”, no “el flujo es seguro”. Las pruebas de punta a punta del módulo 8 y la revisión humana de cada cambio siguen siendo necesarias, y el código de honor se vuelve a pasar cada vez que un flujo cambia de versión.
Riesgos de la comunicación automatizada
El código de honor revisa flujo por flujo. Una matriz de riesgos mira el ecosistema entero y pregunta otra cosa: ¿qué puede salir mal entre los flujos, con los proveedores o con las personas, y cuánto daño haría? Valeria reúne nueve riesgos que el módulo ya encontró, uno por día, y les pone dos números del $1$ al $5$: la probabilidad de que ocurra en un mes y su impacto si ocurre (un $5$ es perder a la Cafetería Brújula o una sanción; un $1$, una molestia que se arregla con una disculpa). El riesgo de cada uno y la exposición del ecosistema son:
$$ R_j = P_j \cdot I_j, \qquad E = \sum_{j=1}^{9} R_j, \qquad \Delta E = 1 - \frac{E_{\text{después}}}{E_{\text{antes}}} $$
La lógica detrás de estas fórmulas es la siguiente:
- $P_j$ e $I_j$ son la probabilidad y el impacto del riesgo $j$ en una escala ordinal de $1$ a $5$; su producto $R_j$ va de $1$ a $25$ y ordena los riesgos, pero no es una probabilidad ni un importe.
- Un control casi siempre baja la probabilidad (la regla
puede_enviarhace muy raro un mensaje fuera de ventana) y a veces el impacto (la plantilla de respaldo hace que una pausa cueste horas y no días); el riesgo residual es $R_j’ = P_j’ \cdot I_j’$. - $E$ suma los riesgos para comparar el antes y el después del módulo, y $\Delta E$ es la fracción de exposición que eliminaron los controles.
El siguiente código construye la matriz, calcula el riesgo antes y después de los controles y dibuja los dos mapas de calor, uno junto al otro:
# Matriz de riesgos de la comunicación antes y después de los controles, con mapa de calor, en Python:
riesgos = pd.DataFrame([
    ('R1', 'Mensaje libre fuera de ventana', 4, 3, 'puede_enviar antes de cada envío', 48, 1, 3),
    ('R2', 'Plantilla mal categorizada', 3, 3, 'Validador de plantillas', 48, 1, 3),
    ('R3', 'Borrador enviado sin revisar', 2, 5, 'Sin nodo de envío en Gmail', 47, 1, 5),
    ('R4', 'Alerta perdida o ignorada', 4, 4, 'Severidades y agrupación en #alertas', 50, 2, 3),
    ('R5', 'Respuesta doble entre canales', 4, 2, 'Huella y ventana de 30 min', 52, 2, 2),
    ('R6', 'Datos de clientes en Slack', 3, 4, 'Lista blanca de campos', 50, 1, 4),
    ('R7', 'Cambio de tarifas de Meta', 3, 2, 'Taxímetro y revisión trimestral', 46, 3, 1),
    ('R8', 'Plantilla pausada sin aviso', 3, 4, 'Webhook de estado y respaldo', 54, 2, 2),
    ('R9', 'Traducción que cambia el sentido', 2, 3, 'Glosario y revisión humana', 49, 1, 3),
], columns = ['id', 'riesgo', 'p', 'i', 'control', 'dia', 'p_res', 'i_res'])
riesgos['antes'] = riesgos.p * riesgos.i
riesgos['despues'] = riesgos.p_res * riesgos.i_res
riesgos['reduccion'] = 1 - riesgos.despues / riesgos.antes
print(riesgos[['id', 'riesgo', 'p', 'i', 'antes', 'p_res', 'i_res', 'despues', 'dia']].to_string(index = False))
print(f'Exposición total: {riesgos.antes.sum()} antes y {riesgos.despues.sum()} después '
      f'({1 - riesgos.despues.sum() / riesgos.antes.sum():.1%} menos)')
print('Riesgos que siguen en 6 o más:', riesgos.loc[riesgos.despues >= 6, 'id'].tolist(),
      '| el de mayor riesgo residual:', riesgos.loc[riesgos.despues.idxmax(), 'riesgo'])

fig, ejes = plt.subplots(1, 2, figsize = (13, 5.6), sharey = True)
fondo = np.add.outer(np.arange(1, 6), np.arange(1, 6))
for ax, (titulo, pc, ic) in zip(ejes, [('Antes de los controles', 'p', 'i'),
                                        ('Después de los controles', 'p_res', 'i_res')]):
    malla = np.outer(np.arange(1, 6), np.arange(1, 6))
    ax.imshow(malla, origin = 'lower', cmap = 'YlOrRd', vmin = 1, vmax = 25, extent = (0.5, 5.5, 0.5, 5.5))
    celdas = riesgos.groupby([pc, ic])['id'].apply(list)
    for (p, i), ids in celdas.items():
        ax.text(i, p, '\n'.join([' '.join(ids[k:k + 2]) for k in range(0, len(ids), 2)]), ha = 'center',
                va = 'center', fontsize = 11, fontweight = 'bold', color = '#1f1f1f')
    ax.set_xticks(range(1, 6))
    ax.set_yticks(range(1, 6))
    ax.set_xlabel('Impacto (1 a 5)')
    ax.set_title(f'{titulo}: exposición {riesgos[pc].mul(riesgos[ic]).sum()}', fontsize = 13)
ejes[0].set_ylabel('Probabilidad (1 a 5)')
fig.suptitle('Riesgos de la comunicación automatizada de Trigo Lento', fontsize = 15)
plt.tight_layout()
plt.show()
id                           riesgo  p  i  antes  p_res  i_res  despues  dia
R1   Mensaje libre fuera de ventana  4  3     12      1      3        3   48
R2       Plantilla mal categorizada  3  3      9      1      3        3   48
R3     Borrador enviado sin revisar  2  5     10      1      5        5   47
R4        Alerta perdida o ignorada  4  4     16      2      3        6   50
R5    Respuesta doble entre canales  4  2      8      2      2        4   52
R6       Datos de clientes en Slack  3  4     12      1      4        4   50
R7        Cambio de tarifas de Meta  3  2      6      3      1        3   46
R8      Plantilla pausada sin aviso  3  4     12      2      2        4   54
R9 Traducción que cambia el sentido  2  3      6      1      3        3   49
Exposición total: 91 antes y 35 después (61.5% menos)
Riesgos que siguen en 6 o más: ['R4'] | el de mayor riesgo residual: Alerta perdida o ignorada
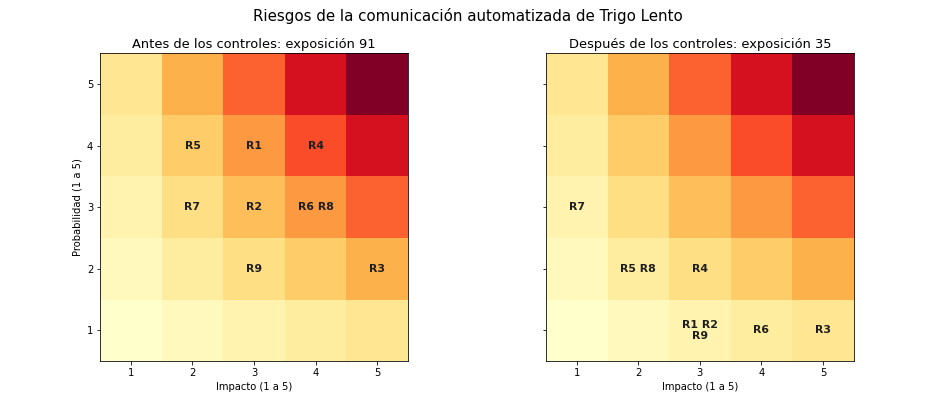
La exposición baja de $91$ a $35$ puntos, un $61.5%$ menos, y la Tabla 5 muestra cada riesgo con su control y el día que lo construyó.
Tabla 5. Matriz de riesgos de la comunicación de Trigo Lento: probabilidad, impacto, control y día que lo resuelve.
| Id. | Riesgo | P × I antes | Control | P × I después | Día |
|---|---|---|---|---|---|
| R1 | Mensaje libre fuera de la ventana de 24 horas | 4 × 3 = 12 | puede_enviar antes de cada envío | 1 × 3 = 3 | 48 |
| R2 | Plantilla mal categorizada | 3 × 3 = 9 | Validador de plantillas antes de enviarlas a Meta | 1 × 3 = 3 | 48 |
| R3 | Borrador de correo enviado sin revisar | 2 × 5 = 10 | Ningún nodo de envío en TL Gmail mayoristas v1 | 1 × 5 = 5 | 47 |
| R4 | Alerta perdida o ignorada | 4 × 4 = 16 | Severidades, agrupación por sesiones y #alertas | 2 × 3 = 6 | 50 |
| R5 | Respuesta doble entre canales | 4 × 2 = 8 | Huella del pedido y ventana de 30 minutos | 2 × 2 = 4 | 52 |
| R6 | Datos de clientes en Slack | 3 × 4 = 12 | Lista blanca de campos antes de publicar | 1 × 4 = 4 | 50 |
| R7 | Cambio de tarifas de Meta | 3 × 2 = 6 | Taxímetro de los webhooks y revisión trimestral | 3 × 1 = 3 | 46 |
| R8 | Plantilla pausada sin aviso | 3 × 4 = 12 | Webhook de estado, alerta y plantilla de respaldo | 2 × 2 = 4 | 54 |
| R9 | Traducción que cambia el sentido | 2 × 3 = 6 | Glosario del pan y revisión humana | 1 × 3 = 3 | 49 |
Tres lecturas salen de la tabla y de la gráfica. La primera: los controles bajan casi siempre la probabilidad y casi nunca el impacto. Un borrador enviado sin revisar a Marisol seguiría siendo un $5$; lo que cambió es que el flujo no puede enviarlo. Por eso en el mapa de la derecha los riesgos se apilan en la fila de abajo, pero siguen repartidos en horizontal.
La segunda: el cambio de tarifas de Meta, R7, es el único que no baja de probabilidad. Meta revisa sus tarifas cada trimestre y Trigo Lento no lo controla; lo único que puede hacer es enterarse el mismo día, con el taxímetro del Día 46, y tener reserva para absorberlo. Es el ejemplo de un riesgo que se acepta y se vigila, no que se elimina.
La tercera: el riesgo residual más alto es R4, la alerta perdida o ignorada, con $6$ puntos. No es casualidad que coincida con el artículo 9 de la auditoría: tres flujos no tienen todavía un workflow de errores, y el incidente del Día 54 fue, en el fondo, una alerta que nadie podía ver. Ese es el primer punto de la lista del lunes.
El coste consolidado
El módulo empezó con una cifra subrayada en rojo, los $19.13$ USD de WhatsApp por Twilio frente a un rubro de $12$, y cada día añadió una línea al gasto. Hoy se suman todas. El coste mensual del ecosistema y el margen que queda son:
$$ C = C_{\text{WA}} + \sum_{f} C_{\text{Claude},f} + C_{\text{Make}} + C_{\text{servidor}} + C_{\text{Slack}}, \qquad M = 45 - C $$
La lógica detrás de esta suma es la siguiente:
- $C_{\text{WA}}$ es lo que Meta cobra por la Cloud API directa: las respuestas y los recordatorios del Día 46 en el régimen de octubre de 2026 ($6.25$ USD) más la secuencia de bienvenida del Día 48 ($3.18$).
- $\sum_f C_{\text{Claude},f}$ suma el gasto de Claude de cada flujo $f$ que lo usa en la comunicación: la cascada de clasificación del Día 30, el agente de pedidos del Día 38, la clasificación y los borradores de Gmail del Día 47, el chatbot del Día 48 y la traducción al inglés del Día 49.
- $C_{\text{Make}}$ y $C_{\text{servidor}}$ son fijos ($10.59$ y $6.00$ USD), y $C_{\text{Slack}} = 0$ porque Trigo Lento vive en el plan gratuito; $M$ es lo que queda libre de los $45$ USD.
El siguiente código hace la suma con las cifras de cada día, la compara con los rubros del presupuesto revisado el Día 46 y dibuja el reparto:
# Coste mensual consolidado de la comunicación frente a los 45 USD en Python:
claude = pd.Series({'Cascada de clasificación (Día 30)': 1.47, 'Agente de pedidos (Día 38)': 2.88,
                    'Gmail: Haiku y Sonnet (Día 47)': 0.039 + 1.43, 'Chatbot: Haiku (Día 48)': 0.0254,
                    'Traducción al inglés (Día 49)': 0.33})
whatsapp = pd.Series({'Respuestas y recordatorios (Día 46)': 6.25, 'Secuencia de bienvenida (Día 48)': 3.18})
coste = pd.Series({'WhatsApp (Cloud API)': whatsapp.sum(), 'API de Claude': claude.sum(), 'Make Core': 10.59,
                   'Servidor n8n': 6.00, 'Slack (plan gratuito)': 0.00})
rubro = pd.Series({'WhatsApp (Cloud API)': 12.00, 'API de Claude': 8.00, 'Make Core': 10.59,
                   'Servidor n8n': 6.00, 'Slack (plan gratuito)': 0.00})
tabla3 = pd.DataFrame({'gasto': coste.round(2), 'rubro': rubro})
tabla3['uso_del_rubro'] = (tabla3.gasto / tabla3.rubro).map(lambda v: f'{v:.0%}' if np.isfinite(v) else '-')
print(claude.round(4).to_string())
print(tabla3.to_string())
total = coste.sum()
print(f'Total: {total:.2f} USD ({total * MXN_POR_USD:.2f} MXN) | libre: {PRESUPUESTO - total:.2f} USD '
      f'({(PRESUPUESTO - total) / PRESUPUESTO:.1%} del presupuesto)')
# Escenario de volumen de diseño del Día 46 (todo cliente responde y todo encargo lleva recordatorio):
diseno = total - whatsapp.iloc[0] + 8.74
print(f'Con el volumen de diseño: WhatsApp {8.74 + whatsapp.iloc[1]:.2f} USD de 12 y total {diseno:.2f} USD '
      f'(libre {PRESUPUESTO - diseno:.2f})')

fig, ax = plt.subplots(figsize = (11, 3.6))
colores = ['#3a9d5d', '#7a5cc9', '#2a78d6', '#52514e']
izquierda = 0
for (nombre, v), color in zip(coste[coste > 0].items(), colores):
    ax.barh(0, v, left = izquierda, color = color, edgecolor = 'white', label = nombre)
    ax.text(izquierda + v / 2, 0, f'{v:.2f}', ha = 'center', va = 'center', color = 'white', fontsize = 11)
    izquierda += v
ax.barh(0, PRESUPUESTO - total, left = total, color = '#e6e5e1', edgecolor = 'white', label = 'Libre')
ax.text(total + (PRESUPUESTO - total) / 2, 0, f'libre {PRESUPUESTO - total:.2f}', ha = 'center', va = 'center',
        fontsize = 11, color = '#1f1f1f')
ax.axvline(PRESUPUESTO, color = '#c8423b', linestyle = '--', linewidth = 1.5)
ax.axvline(diseno, color = '#52514e', linestyle = ':', linewidth = 1.5)
ax.text(diseno, 0.56, f'volumen de diseño: {diseno:.2f}', ha = 'center', fontsize = 10, color = '#52514e')
ax.set_yticks([])
ax.set_xlim(0, 47)
ax.set_ylim(-0.5, 0.8)
ax.set_xlabel('USD al mes')
ax.set_title(f'Gasto mensual por rubro: {total:.2f} de {PRESUPUESTO:.0f} USD', fontsize = 15)
ax.legend(loc = 'upper center', bbox_to_anchor = (0.5, -0.32), ncol = 5, frameon = False)
plt.tight_layout()
plt.show()
Cascada de clasificación (Día 30)    1.4700
Agente de pedidos (Día 38)           2.8800
Gmail: Haiku y Sonnet (Día 47)       1.4690
Chatbot: Haiku (Día 48)              0.0254
Traducción al inglés (Día 49)        0.3300
                       gasto  rubro uso_del_rubro
WhatsApp (Cloud API)    9.43  12.00           79%
API de Claude           6.17   8.00           77%
Make Core              10.59  10.59          100%
Servidor n8n            6.00   6.00          100%
Slack (plan gratuito)   0.00   0.00             -
Total: 32.19 USD (595.60 MXN) | libre: 12.81 USD (28.5% del presupuesto)
Con el volumen de diseño: WhatsApp 11.92 USD de 12 y total 34.68 USD (libre 10.32)
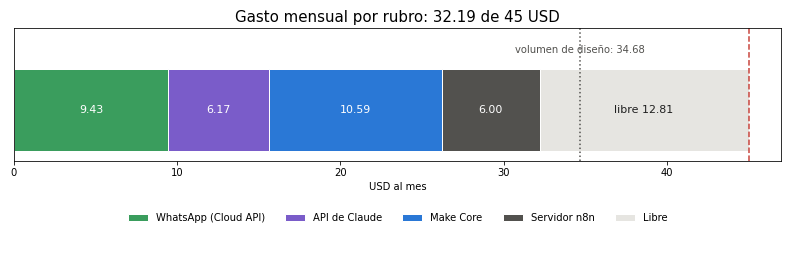
El ecosistema de comunicación cuesta $32.19$ USD al mes ($595.60$ MXN al tipo didáctico) y deja $12.81$ USD libres, el $28.5%$ del presupuesto. La Tabla 6 lo detalla.
Tabla 6. Coste mensual consolidado de la comunicación de Trigo Lento frente a su rubro (USD, revisado en octubre de 2026).
| Rubro | Desglose | Gasto | Rubro asignado | Uso |
|---|---|---|---|---|
| WhatsApp (Cloud API) | Respuestas y recordatorios 6.25 (Día 46) + secuencia de bienvenida 3.18 (Día 48) | 9.43 | 12.00 | 79 % |
| API de Claude | Cascada 1.47 (Día 30) + agente 2.88 (Día 38) + Gmail 1.47 (Día 47) + chatbot 0.03 (Día 48) + traducción 0.33 (Día 49) | 6.17 | 8.00 | 77 % |
| Make Core | Plan mensual | 10.59 | 10.59 | 100 % |
| Servidor n8n | VPS pequeño (supuesto de la serie) | 6.00 | 6.00 | 100 % |
| Slack | Plan gratuito | 0.00 | 0.00 | - |
| Total | 32.19 | 36.59 | Libre: 12.81 de 45 |
Ningún rubro variable se rompe. WhatsApp usa el $79%$ del suyo y Claude el $77%$, y en Claude manda el agente de pedidos: sus $2.88$ USD son casi la mitad de todo el gasto en el modelo, porque cada conversación arrastra su historial. Los dos rubros fijos, Make y el servidor, suman $16.59$ USD y son ya más de la mitad del gasto, una proporción que el Día 84 tendrá que revisar, porque Make se mantiene para los escenarios que no se migraron el Día 45.
La Figura 2 pone el mismo reparto en una balanza, con los cuatro rubros en un platillo y los $45$ USD en el otro.
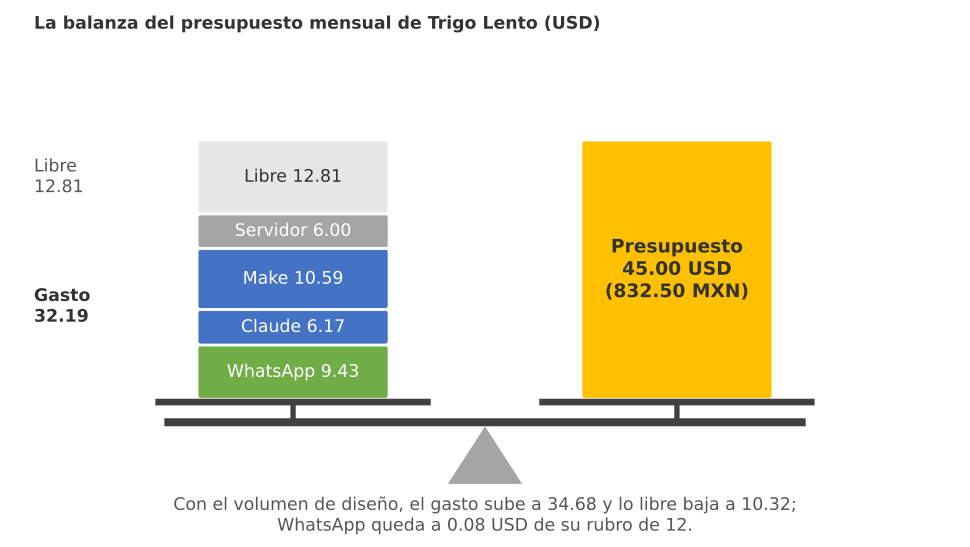
Figura 2. La balanza del presupuesto: WhatsApp 9.43, Claude 6.17, Make 10.59 y servidor 6.00 USD suman 32.19; con 12.81 libres equilibran los 45 USD del otro platillo. Con el volumen de diseño el gasto sube a 34.68.
La línea punteada de la gráfica responde a una pregunta prudente: ¿y si todo crece? Con el volumen de diseño del Día 46, en el que todo cliente responde y todo encargo lleva recordatorio, WhatsApp sube a $11.92$ USD, a ocho centavos de su rubro, y el total a $34.68$, con $10.32$ libres. El presupuesto aguanta, pero WhatsApp queda sin holgura: cualquier difusión de marketing, como ya advirtió el Día 48, rompería el rubro. Por eso la regla se mantiene: el pan de temporada se anuncia por Instagram.
Don Ernesto lee la cifra y hace la cuenta a su manera: “Treinta y dos dólares son unos seiscientos pesos. Lo que vendemos en dos pasteles de chocolate.” No es una mala manera de verlo. El Día 1 calculó en $46.8$ horas al mes el tiempo que Valeria dedicaba a los encargos; a $75$ MXN la hora, son $3,510$ MXN, casi seis veces el gasto mensual de toda la comunicación automatizada.
Bajas y consentimientos antes del fin de semana
Un repaso del módulo de comunicación no está completo si solo mira flujos y dinero. La regla del módulo dice que ningún mensaje sale sin base registrada, y esa base cambia todos los días: hay clientes que piden la baja, consentimientos que envejecen y personas que ya no recuerdan haberse suscrito. Antes de una semana en la que todos los flujos funcionarán a la vez, Valeria hace dos comprobaciones en la base de datos.
La primera busca bajas pendientes: clientes que escribieron “BAJA” o “ya no” esta semana y que, sin embargo, siguen con un consentimiento activo. Debería ser cero, porque el orquestador del Día 52 aplica la baja en el mismo minuto, pero un mensaje que entró por un canal mal normalizado o un registro que falló en silencio (el artículo 9 de la auditoría) basta para que alguien siga recibiendo lo que pidió no recibir. La segunda busca consentimientos de marketing con más de doce meses sin renovar. Ninguna ley mexicana fija ese plazo; es una regla interna de Trigo Lento, que prefiere preguntar otra vez a seguir escribiendo a quien quizá ya cambió de opinión.
El siguiente código reproduce la revisión en una base SQLite en memoria con $320$ consentimientos inventados y siete palabras de baja recibidas esta semana, de las cuales el orquestador aplicó cinco:
# Revisión de bajas pendientes y consentimientos caducados en SQLite antes del fin de semana en Python:
con = sqlite3.connect(':memory:')
con.executescript('''
CREATE TABLE consentimientos (cliente_id TEXT, finalidad TEXT, canal TEXT, otorgado_en TEXT, baja_en TEXT);
CREATE TABLE mensajes_entrantes (cliente_id TEXT, recibido_en TEXT, texto_normalizado TEXT);''')
hoy = datetime(2026, 3, 27, 9, 0)
filas = []
for k in range(1, 321):
    cid = f'C{k:04d}'
    otorgado = hoy - timedelta(days = int(rng.integers(3, 520)))
    finalidad = 'marketing' if k % 3 == 0 else 'confirmaciones'
    baja = (otorgado + timedelta(days = int(rng.integers(1, 60)))).isoformat() if rng.random() < 0.06 else None
    filas.append((cid, finalidad, 'whatsapp', otorgado.isoformat(), baja))
con.executemany('INSERT INTO consentimientos VALUES (?, ?, ?, ?, ?)', filas)
# Palabras de baja recibidas esta semana (seudonimizadas; el texto ya llega normalizado a la palabra clave):
activos = [f[0] for f in filas if f[4] is None]
bajas_recibidas = [(c, (hoy - timedelta(hours = int(h))).isoformat(), 'BAJA')
                   for c, h in zip(rng.choice(activos, 7, replace = False), rng.integers(2, 120, 7))]
con.executemany('INSERT INTO mensajes_entrantes VALUES (?, ?, ?)', bajas_recibidas)
con.executemany('UPDATE consentimientos SET baja_en = ? WHERE cliente_id = ?',
                [(t, c) for c, t, _ in bajas_recibidas[:5]])     # cinco ya aplicadas por el orquestador
pendientes = con.execute('''
SELECT m.cliente_id, m.recibido_en FROM mensajes_entrantes m JOIN consentimientos c USING (cliente_id)
WHERE m.texto_normalizado = 'BAJA' AND c.baja_en IS NULL ORDER BY m.recibido_en''').fetchall()
caducados = con.execute('''
SELECT COUNT(*) FROM consentimientos WHERE finalidad = 'marketing' AND baja_en IS NULL
AND julianday(?) - julianday(otorgado_en) > 365''', (hoy.isoformat(),)).fetchone()[0]
vigentes = con.execute('''SELECT finalidad, COUNT(*) FROM consentimientos WHERE baja_en IS NULL
GROUP BY finalidad''').fetchall()
print('Consentimientos vigentes por finalidad:', dict(vigentes))
print('Bajas recibidas esta semana:', len(bajas_recibidas), '| sin aplicar:', len(pendientes))
for c, t in pendientes:
    print(f'  {c} pidió la baja el {t[:16].replace("T", " ")} y sigue activo')
print('Consentimientos de marketing con más de 12 meses sin renovar:', caducados)
con.close()
Consentimientos vigentes por finalidad: {'confirmaciones': 196, 'marketing': 101}
Bajas recibidas esta semana: 7 | sin aplicar: 2
  C0064 pidió la baja el 2026-03-25 13:00 y sigue activo
  C0167 pidió la baja el 2026-03-26 19:00 y sigue activo
Consentimientos de marketing con más de 12 meses sin renovar: 32
Hay $297$ consentimientos vigentes: $196$ de confirmaciones y $101$ de marketing. De las $7$ bajas recibidas esta semana, $2$ siguen sin aplicar: la del cliente C0064, del miércoles 25 a las 13:00, y la de C0167, del jueves 26 a las 19:00. La simulación no dice por qué fallaron; en la realidad, el primer sospechoso es el nodo Registrar ejecución del orquestador, que continúa ante error sin avisar a nadie. Valeria las aplica a mano en ese momento, antes de cerrar el cuaderno, y anota la causa en la lista del lunes junto al artículo 9.
La segunda comprobación encuentra $32$ consentimientos de marketing con más de doce meses. No se les escribe más novedades hasta renovar el permiso, y la renovación tampoco puede hacerse con una plantilla de marketing a quien ya no tiene un consentimiento vigente para ella: se les preguntará en el mostrador o la próxima vez que escriban ellos, cuando la ventana esté abierta. Es más lento, pero es la única forma de no convertir una renovación en spam.
Lo que dijo Don Ernesto
Queda la pregunta con la que empezó el día: quién le contesta a quién. La respuesta no es una frase, es una matriz. Valeria clasifica los $2,330$ eventos del mes por tipo de mensaje y asigna a cada tipo una de cinco maneras de contestar: la máquina sola (respuestas fijas, acuses, bajas), la máquina con aviso al equipo (el encargo sencillo que se confirma y aparece en #pedidos-del-dia), la máquina con aprobación previa de una persona (pasteles y cambios de pedido), el borrador y persona (el modelo propone y una persona revisa y firma) y solo persona (quejas, alergias y lo que no encaja en nada). Los volúmenes por tipo son supuestos didácticos que suman los eventos del Día 52:
# Matriz "quién contesta qué" por tipo de mensaje y volumen mensual en Python:
quien = pd.DataFrame([
    ('Horario, precios y ubicación', 620, 'Máquina sola', 'Chatbot con reglas y botones'),
    ('Fuera de horario', 380, 'Máquina sola', 'Acuse automático y cola'),
    ('Baja ("BAJA", "ya no")', 30, 'Máquina sola', 'Baja inmediata'),
    ('Correo informativo (molino, boletín)', 170, 'Máquina sola', 'Etiqueta en Gmail, sin respuesta'),
    ('Encargo sencillo', 420, 'Máquina con aviso', 'Agente de pedidos y #pedidos-del-dia'),
    ('Pastel por encargo', 40, 'Máquina con aprobación', 'Agente y #aprobaciones'),
    ('Cambio de pedido', 120, 'Máquina con aprobación', 'Agente y Valeria o Don Ernesto'),
    ('Correo que pide respuesta', 130, 'Borrador y persona', 'Gmail: Valeria revisa y envía'),
    ('Mensaje libre en inglés', 90, 'Borrador y persona', 'Sonnet propone y una persona revisa'),
    ('Queja', 60, 'Solo persona', 'Valeria contesta y firma'),
    ('Alergia o ingrediente', 40, 'Solo persona', 'Valeria consulta a Don Ernesto'),
    ('Otros o ambiguos', 230, 'Solo persona', 'Mostrador o Valeria'),
], columns = ['tipo', 'al_mes', 'quien_contesta', 'como'])
assert quien.al_mes.sum() == sum(EVENTOS_MES.values()), 'La matriz no suma los 2 330 eventos'
resumen = quien.groupby('quien_contesta', sort = False)['al_mes'].sum().to_frame()
resumen['porcentaje'] = (100 * resumen.al_mes / resumen.al_mes.sum()).round(1)
print(quien[['tipo', 'al_mes', 'quien_contesta']].to_string(index = False))
print(resumen.to_string())
persona = resumen.loc[['Borrador y persona', 'Solo persona'], 'al_mes'].sum()
print(f'Mensajes que firma o decide una persona: {persona} de {quien.al_mes.sum()} '
      f'({persona / quien.al_mes.sum():.1%}); con aprobación previa: '
      f'{resumen.loc["Máquina con aprobación", "al_mes"]}; sin ninguna persona: '
      f'{resumen.loc["Máquina sola", "al_mes"]}')
                                tipo  al_mes         quien_contesta
        Horario, precios y ubicación     620           Máquina sola
                    Fuera de horario     380           Máquina sola
              Baja ("BAJA", "ya no")      30           Máquina sola
Correo informativo (molino, boletín)     170           Máquina sola
                    Encargo sencillo     420      Máquina con aviso
                  Pastel por encargo      40 Máquina con aprobación
                    Cambio de pedido     120 Máquina con aprobación
           Correo que pide respuesta     130     Borrador y persona
             Mensaje libre en inglés      90     Borrador y persona
                               Queja      60           Solo persona
               Alergia o ingrediente      40           Solo persona
                    Otros o ambiguos     230           Solo persona
                        al_mes  porcentaje
quien_contesta
Máquina sola              1200        51.5
Máquina con aviso          420        18.0
Máquina con aprobación     160         6.9
Borrador y persona         220         9.4
Solo persona               330        14.2
Mensajes que firma o decide una persona: 550 de 2330 (23.6%); con aprobación previa: 160; sin ninguna persona: 1200
La matriz responde a Don Ernesto con cifras. De $2,330$ mensajes al mes, $1,200$ los contesta la máquina sola ($51.5%$), y todos son mensajes sin decisión: el horario, los precios, el acuse fuera de horario, las bajas y los correos informativos del molino. Otros $420$, los encargos sencillos, los confirma el agente y avisa al equipo. En $550$ mensajes ($23.6%$) una persona firma o decide, y en otros $160$ aprueba antes de que el cliente reciba nada. La Tabla 7 resume la matriz.
Tabla 7. Quién contesta qué en Trigo Lento: tipos de mensaje, volumen mensual y forma de respuesta.
| Tipo de mensaje | Al mes | Quién contesta | Cómo |
|---|---|---|---|
| Horario, precios y ubicación | 620 | Máquina sola | Chatbot con reglas y botones |
| Fuera de horario | 380 | Máquina sola | Acuse automático y cola |
| Baja (“BAJA”, “ya no”) | 30 | Máquina sola | Baja inmediata en todas las finalidades |
| Correo informativo (molino, boletín) | 170 | Máquina sola | Etiqueta en Gmail, sin respuesta |
| Encargo sencillo | 420 | Máquina con aviso | Agente de pedidos y #pedidos-del-dia |
| Pastel por encargo | 40 | Máquina con aprobación | Agente y #aprobaciones |
| Cambio de pedido | 120 | Máquina con aprobación | Agente y Valeria, o Don Ernesto a los 20 minutos |
| Correo que pide respuesta | 130 | Borrador y persona | Gmail: Valeria revisa y envía |
| Mensaje libre en inglés | 90 | Borrador y persona | Sonnet propone y una persona revisa |
| Queja | 60 | Solo persona | Valeria contesta y firma |
| Alergia o ingrediente | 40 | Solo persona | Valeria consulta a Don Ernesto |
| Otros o ambiguos | 230 | Solo persona | Mostrador o Valeria |
Valeria le imprime la tabla y se la deja junto a la báscula. Don Ernesto la lee de arriba abajo, despacio, como lee las facturas del molino. Se detiene en la fila de las alergias y asiente; se detiene en la de las quejas y levanta la vista: “O sea que si una clienta se queja, le contesta usted, no el aparato.” Valeria le dice que sí, y que si la queja es de un pastel, el agente ni siquiera lo intenta. Don Ernesto dobla la hoja en cuatro y se la guarda en la bolsa del delantal: “Ahora sí sé quién contesta qué. Y si un día la máquina contesta algo que no está en esta hoja, me avisa, que la hoja se cambia antes que el pan.”
Esa última frase es, en el fondo, el artículo 1 del código de honor dicho por un panadero: la regla escrita va primero y la automatización la obedece. Para que Don Ernesto la reciba cada lunes sin abrir Slack, el resumen de la semana se puede redactar con Claude a partir de las cifras agregadas de esta entrada, nunca de los mensajes de los clientes. El siguiente bloque llama a Claude Opus 5.5, el modelo predeterminado de la serie, con un esfuerzo bajo, porque la tarea es de redacción breve sobre datos ya calculados, y pide la respuesta con un esquema JSON fijo. Después comprueba que cada cifra del resumen existe en la entrada; si el modelo inventa un número, se ve:
# Resumen de una página para Don Ernesto con Claude Opus 5.5 a partir de cifras agregadas en Python (bloque API, no se ejecuta aquí):
import json
import re
import anthropic

# Solo cifras agregadas de los bloques 6, 7, 8, 9 y 10: ni nombres, ni teléfonos, ni textos de clientes:
cifras = {
    'flujos_auditados': 4, 'aceptados_sin_cambios': ['TL Slack operaciones v1'],
    'pendientes': {'TL WhatsApp secuencias v1': ['Transparencia', 'Registro sin datos sensibles', 'Coste y caída'],
                   'TL Gmail mayoristas v1': ['Coste y caída'], 'TL Orquestador v1': ['Coste y caída']},
    'exposicion_riesgo': {'antes': 91, 'despues': 35, 'mayor_residual': 'Alerta perdida o ignorada'},
    'coste_usd': {'whatsapp': 9.43, 'claude': 6.17, 'make': 10.59, 'servidor': 6.00, 'total': 32.19, 'libre': 12.81},
    'bajas_sin_aplicar': 2, 'consentimientos_marketing_vencidos': 32,
    'quien_contesta': {'maquina_sola': 1200, 'maquina_con_aviso': 420, 'con_aprobacion': 160,
                       'borrador_y_persona': 220, 'solo_persona': 330},
}
ESQUEMA = {'type': 'object', 'additionalProperties': False,
           'required': ['titular', 'lo_que_ya_funciona', 'lo_que_falta', 'decision_para_el_lunes'],
           'properties': {'titular': {'type': 'string'},
                          'lo_que_ya_funciona': {'type': 'array', 'items': {'type': 'string'}},
                          'lo_que_falta': {'type': 'array', 'items': {'type': 'string'}},
                          'decision_para_el_lunes': {'type': 'string'}}}
SISTEMA = ('Usted escribe para Don Ernesto, dueño de la panadería Trigo Lento, un resumen semanal de una página. '
           'Escriba en español, de usted, con frases cortas y sin palabras técnicas en inglés. Use solo las cifras '
           'del bloque <cifras>; no invente ninguna y no redondee los importes. Diga primero quién contesta qué, '
           'después lo que falta y termine con una sola decisión que él pueda tomar el lunes.')

cliente = anthropic.Anthropic()   # lee ANTHROPIC_API_KEY del entorno
respuesta = cliente.beta.messages.create(
    model = 'claude-opus-5-5',
    max_tokens = 1500,
    betas = ['server-side-fallback-2026-07-01'],
    fallbacks = 'default',                      # respaldo del lado del servidor ante un rechazo
    output_config = {'effort': 'low',            # sin temperature ni top_p
                     'format': {'type': 'json_schema', 'schema': ESQUEMA}},
    system = SISTEMA,
    messages = [{'role': 'user', 'content': f'<cifras>{json.dumps(cifras, ensure_ascii = False)}</cifras>'}],
)
if respuesta.stop_reason != 'end_turn':
    raise SystemExit(f'Sin resumen ({respuesta.stop_reason}): Valeria lo escribe a mano')
resumen = json.loads(next(b.text for b in respuesta.content if b.type == 'text'))
# Comprobación barata: cada cifra del resumen debe existir en las cifras de entrada:
permitidas = set(re.findall(r'\d+(?:\.\d+)?', json.dumps(cifras)))
inventadas = set(re.findall(r'\d+(?:\.\d+)?', json.dumps(resumen, ensure_ascii = False))) - permitidas
print(json.dumps(resumen, ensure_ascii = False, indent = 2))
print('Cifras que no estaban en la entrada:', sorted(inventadas) or 'ninguna')
print('Tokens:', respuesta.usage.input_tokens, 'de entrada y', respuesta.usage.output_tokens, 'de salida')

# Salida de ejemplo (puede variar):
# {
#   "titular": "La máquina contesta sola 1200 mensajes al mes; 330 los atiende solo una persona.",
#   "lo_que_ya_funciona": ["Slack de operaciones cumple todo el código de honor.",
#                          "El riesgo baja de 91 a 35 puntos con los controles.",
#                          "La comunicación cuesta 32.19 USD y quedan 12.81 libres."],
#   "lo_que_falta": ["Aplicar 2 bajas que siguen sin aplicar.",
#                    "Pedir de nuevo el permiso a 32 clientes de novedades.",
#                    "Que los errores de tres flujos avisen en Slack."],
#   "decision_para_el_lunes": "Autorizar que las novedades digan que son mensajes automáticos."
# }
# Cifras que no estaban en la entrada: ninguna
# Tokens: 518 de entrada y 214 de salida
El bloque no se ejecutó en esta entrada, y la salida es un ejemplo de lo que puede devolver. Su diseño, sin embargo, es lo importante: el modelo recibe solo cifras agregadas, ningún nombre ni teléfono; responde con un esquema que obliga a separar lo que funciona de lo que falta; y la comprobación final rechaza cualquier número que no estuviera en la entrada. Con unos $520$ tokens de entrada y $210$ de salida, a $4$ y $20$ USD por millón, cada resumen cuesta unos $0.006$ USD y los de un mes, menos de tres centavos: no cambia la Tabla 6. Valeria lee el resumen antes de imprimirlo, como lee cada borrador de Gmail.
La Figura 3 lleva la matriz a un dibujo que cabe en la pared del obrador: cada columna es una manera de contestar, con sus tipos de mensaje debajo, y la altura de cada barra es su volumen.
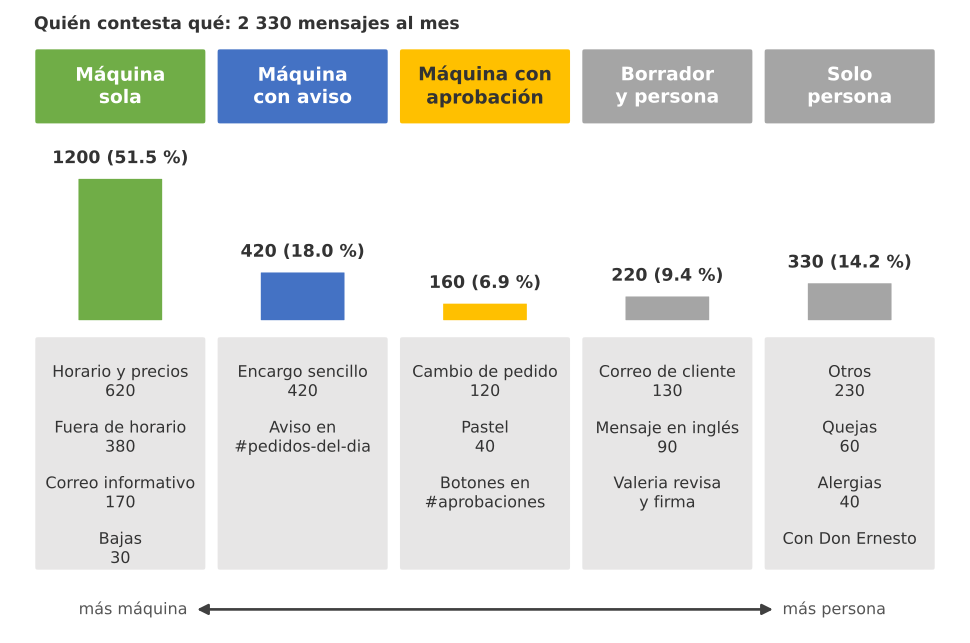
Figura 3. Quién contesta qué: de 2 330 mensajes al mes, la máquina contesta sola 1 200, avisa al equipo en 420, pide aprobación en 160, deja un borrador a una persona en 220 y 330 los atiende solo una persona.
Consideraciones finales
El día empezó con la pregunta de un panadero que ya no sabía quién le contestaba a sus clientes y termina con una hoja doblada en la bolsa de su delantal. Entre una y otra, el repaso hizo cuatro cosas que ningún flujo hace solo: contar las piezas (ocho flujos, un solo dueño), comprobar el criterio con doce decisiones (el lector de ejemplo aprueba con $83.3%$ y se lleva dos días para repasar), auditar el código real (un flujo aceptado sin cambios, cinco correcciones pendientes y un patrón repetido de errores que nadie ve) y poner números al riesgo y al dinero ($91$ puntos de exposición que bajan a $35$, y $32.19$ USD de $45$).
Las cifras de hoy tienen límites que conviene decir. Las probabilidades y los impactos de la matriz son juicios de Valeria en una escala ordinal, no mediciones; el producto ordena los riesgos, pero un $12$ no es “el doble de malo” que un $6$. Las reglas de la auditoría leen texto y configuración, no comportamiento. Los costes vienen de meses simulados en días distintos y suponen que las tarifas de Meta revisadas en octubre de 2026 no cambian; los volúmenes de la matriz “quién contesta qué” son supuestos que el orquestador confirmará con sus registros. Y el lector de ejemplo es inventado: la única puntuación que importa es la suya.
Antes de dar por cerrado cualquier módulo de automatización de la comunicación, conviene hacerse algunas preguntas:
- ¿Cada flujo que escribe a un cliente tiene una base de envío declarada, y se puede demostrar para cada mensaje?
- ¿Quién más, además de su autor, sabe qué hacer cuando un flujo falla un sábado?
- ¿Qué errores se convierten en datos que nadie lee, y quién se entera de ellos?
- ¿Las bajas de esta semana están aplicadas, y cuántos consentimientos envejecieron sin renovarse?
- ¿Podría explicar en una hoja, a alguien que no usa ninguna de las herramientas, quién contesta qué?
Un gran libro que habla de esto es Patrones de integración empresarial (o Enterprise Integration Patterns), de Gregor Hohpe y Bobby Woolf, que dio nombre a casi todas las piezas del módulo: el enrutador basado en contenido que es el orquestador, el receptor idempotente que evita las respuestas dobles, el canal de mensajes inválidos y el bus de control que vigila a los demás. Leerlo después de construir un ecosistema pequeño tiene una ventaja: cada patrón deja de ser un diagrama abstracto y se convierte en el nombre de un problema que ya tuvo la panadería, y en la solución que otras empresas encontraron antes.
Un ecosistema de comunicación está listo cuando cualquiera en el negocio puede decir quién contesta qué, con qué permiso y cuánto cuesta. Trigo Lento llega a la semana de pruebas con ese mapa, con cinco correcciones anotadas, dos bajas aplicadas a mano y $12.81$ USD libres para lo que viene.
Conclusiones clave
Canales y bases de envío
- El módulo 5 deja $8$ flujos de comunicación con un solo dueño; $3$ escriben a clientes y todos declaran su base de envío: ventana abierta, consentimiento por finalidad o pedido en curso.
- Fuera de la ventana de $24$ horas solo cabe una plantilla aprobada de la categoría correcta: a las $26$ horas, una plantilla de utilidad sobre el pedido en curso, nunca un texto libre ni una promoción.
- Antes de la semana de pruebas, $2$ de $7$ bajas seguían sin aplicar y $32$ consentimientos de marketing tenían más de doce meses: la revisión de la base se hace cada semana, no solo cuando algo falla.
Control humano
- De $2,330$ mensajes al mes, la máquina contesta sola $1,200$ ($51.5%$), todos sin decisión; en $550$ ($23.6%$) una persona firma o decide, y en $160$ aprueba antes de que el cliente reciba nada.
- La auditoría automática del código de honor acepta sin cambios solo
TL Slack operaciones v1; la secuencia de WhatsApp tiene tres pendientes (transparencia, registro y errores) y Gmail y el orquestador uno cada uno. - El banco de doce preguntas corrige por tema con un umbral del $80%$: el lector de ejemplo acierta $10$ de $12$, pero “Medición y costes” se queda en el $33%$ y el diagnóstico lo envía a los días $46$ y $53$.
Costes y riesgos
- La comunicación cuesta $32.19$ USD al mes: WhatsApp $9.43$, Claude $6.17$, Make $10.59$ y servidor $6.00$; quedan $12.81$ libres, y con el volumen de diseño el total sube a $34.68$ y WhatsApp queda a ocho centavos de su rubro.
- Los controles del módulo bajan la exposición al riesgo de $91$ a $35$ puntos ($61.5%$), casi siempre por probabilidad y no por impacto; el riesgo residual más alto es la alerta perdida, con $6$.
- El cambio de tarifas de Meta es el único riesgo que no se puede reducir: se vigila con el taxímetro de los webhooks y se absorbe con la reserva.
Mañana, en el Día 56: Sesión práctica: la semana de comunicación automatizada de Trigo Lento. Con el mapa, las correcciones y el presupuesto de hoy, Valeria pondrá a funcionar todos los canales a la vez durante una semana de Pascua, en modo sombra primero, y comprobará con los registros del orquestador que ninguna respuesta sale doble, fuera de su base o sin la persona que le corresponde.
Referencias
- Roediger, H. L. y Karpicke, J. D. (2006). Test-Enhanced Learning: Taking Memory Tests Improves Long-Term Retention. Psychological Science, 17(3), 249-255. https://doi.org/10.1111/j.1467-9280.2006.01693.x
- Meta (2026). WhatsApp Business Messaging Policy. https://business.whatsapp.com/policy (revisado en octubre de 2026).
- Hohpe, G. y Woolf, B. (2003). Enterprise Integration Patterns: Designing, Building, and Deploying Messaging Solutions. Addison-Wesley.
- Meta (2026). Precios de WhatsApp Business Platform y ventana de atención al cliente. https://developers.facebook.com/docs/whatsapp/pricing (revisado en octubre de 2026).
- Floridi, L. y Cowls, J. (2019). A Unified Framework of Five Principles for AI in Society. Harvard Data Science Review, 1(1). https://doi.org/10.1162/99608f92.8cd550d1