
Arquitecto de automatización con IA: Día 58
 Jeshua Romero Guadarrama
- 62 Min para leer
- 30 Mar, 2026
Índice de contenido
Resumen:
Valeria captura a mano 60 PDF al mes, entre facturas de proveedores y remisiones firmadas, y una factura de harina cobró 12 sacos cuando al obrador llegaron 10. En esta entrada, usted genera una factura de dos páginas y una remisión escaneada en PDF reales, mide qué capas trae cada archivo, arma el bloque document en base64 y lo compara con la API de archivos dentro de los límites de 32 MB y 600 páginas, extrae los dos documentos a un esquema de pydantic con client.beta.messages.parse, valida la aritmética en centavos, coteja pedido, remisión y factura en un mes de juguete con nueve discrepancias sembradas y pide citas de página en una segunda llamada, porque las citas no se combinan con la salida estructurada. Al terminar, sabrá leer documentos de negocio con Claude, decidir qué modelo paga la lectura con números y dejar cada reclamo en manos de una persona.
¿Cómo citar el presente artículo?
Romero, J. (30 de marzo de 2026). Arquitecto de automatización con IA: Día 58. python-data-engineer. https://www.python-data-engineer.com/post/aai/dia_58/.
Arquitecto de automatización con IA: Día 58 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/aai/dia_58/.
Precios, límites y políticas revisados en octubre de 2026: planes, precios y límites de Make, n8n, Zapier, WhatsApp (Meta, Twilio, Wati) y de la API de Claude. Los límites del soporte de PDF (32 MB por petición, que varía según la plataforma, y 600 páginas por petición, o 100 cuando la ventana de contexto de la petición es menor de un millón de tokens), el procesamiento de cada página como texto más imagen, el coste aproximado de 1 500 a 3 000 tokens de texto por página, la fórmula de tokens visuales por bloques de 28 x 28 píxeles, la incompatibilidad entre citations y output_config.format y el formato page_location de las citas se contrastaron en la documentación oficial de Claude (páginas “PDF support”, “Vision” y “Citations”), revisado en octubre de 2026. La API de archivos salió de beta: ya no necesita la cabecera files-api-2025-04-14 y el SDK de Python usa client.files; algunos ejemplos anteriores todavía usan client.beta.files con esa cabecera, que sigue funcionando con las formas de respuesta antiguas. Los bloques 6, 8 y 11 llaman a la API y no se ejecutaron para escribir esta entrada: sus salidas son ejemplos comentados. Las tasas de acierto por modelo de la Tabla 3 son ilustrativas.
Día 58. Visión de documentos: facturas y remisiones en PDF
Introducción
Ayer, en el Día 57 (Por qué Claude para razonar: esfuerzo, decisiones con restricciones y salidas verificables), Valeria pidió a Claude el plan de horneado del sábado con una salida estructurada, lo comprobó con un verificador en Python antes de enseñárselo a su padre y midió cuánto cuesta cada nivel de esfuerzo, y Trigo Lento ganó un plan que el modelo propone, el código comprueba y Don Ernesto aprueba. Hoy el mismo principio sale del horno y entra a la oficina: el modelo lee, el código cuadra y una persona decide, pero lo que se lee ya no es un mensaje de texto, sino un PDF.
Es lunes 30 de marzo, a las cuatro de la tarde, y Valeria tiene sobre el escritorio la carpeta de marzo. En la computadora, una bandeja de correo con los mismos papeles en PDF: $18$ facturas de proveedores (harina, mantequilla y empaques), $18$ remisiones de esos proveedores que se escanean en el obrador después de firmarlas y $24$ remisiones que firma cada mañana la persona de la Cafetería Brújula al recibir sus baguettes. Son $60$ documentos al mes, y Valeria los captura uno por uno en la hoja de compras: proveedor, folio, fecha, renglones, subtotal, impuestos, total. Le toma entre cuatro y seis minutos cada uno, y lo hace por la noche, cuando el mostrador ya cerró.
Esta tarde la captura se detuvo en la factura A-1187 de Molino La Espiga. Cobra $12$ sacos de harina de trigo para pan a $520.00$ pesos. La remisión del mismo día también dice $12$, impreso por el proveedor, pero alguien tachó el número y escribió a un lado, con pluma azul, “Recibí 10. E. O.”. Valeria le enseña la hoja a su padre. Don Ernesto no necesita mirarla dos veces: “Eso lo vi yo, no la computadora. Llegaron diez sacos, los conté en la puerta y lo anoté. Si usted pone una máquina a leer estas hojas, ¿quién va a ver lo que yo vi?”
La pregunta es mejor de lo que parece. La diferencia es de $12 - 10 = 2$ sacos, $1,040$ pesos cobrados de más, y no se ve dentro de la factura: la factura es perfectamente coherente, $12$ por $520$ da $6,240$ y los renglones suman el subtotal. El error solo aparece cuando se pone la factura al lado de la remisión y del pedido. Y la prueba no está en el texto impreso, sino en una corrección hecha a mano sobre un papel escaneado. Don Ernesto tiene razón en algo importante: lo que él vio es la fuente de verdad. Lo que no sabe todavía es que un modelo que lee la página como imagen puede leer también su pluma azul, y que el trabajo de la computadora no es sustituir lo que él vio, sino ponerlo al lado de lo que el proveedor cobró, cada vez y sin cansarse.
En la presente entrada, descubrirá cómo lee Claude un PDF y qué diferencia hay entre un PDF nativo y uno escaneado. Generará un mes de documentos de juguete con errores sembrados y, con matplotlib, una factura de dos páginas y una remisión escaneada que existen de verdad como archivos PDF. Medirá sus capas leyendo los bytes del archivo, armará el bloque document en base64 sin saltos de línea y lo comparará con la API de archivos, siempre dentro de los límites de $32$ MB y $600$ páginas por petición. Escribirá el esquema de extracción con pydantic, pedirá la extracción con client.beta.messages.parse y el respaldo del lado del servidor, validará lo extraído en centavos enteros y cotejará pedido, remisión y factura con tolerancias declaradas. Terminará con las citas de página para auditar cada discrepancia y con el coste mensual por modelo, medido con count_tokens y con el tiempo que cuesta revisar lo que el modelo lee mal.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Enviar un PDF a Claude como bloque
documenten base64 (antes del texto) o como archivo de la API de archivos, y conocer sus límites (32 MB por petición y 600 páginas). - Extraer facturas de proveedores y remisiones de Brújula a un esquema validado.
- Conciliar pedido, remisión y factura (cotejo de tres vías) y mandar a revisión humana lo que no cuadra.
- Elegir modelo por coste medido con
count_tokensy decidir cuándo pedir citas de página (incompatibles conoutput_config.format).
El mes de papeles de Trigo Lento
Antes de hablar de modelos conviene ver con claridad qué papeles circulan y para qué sirve cada uno, porque la automatización de hoy no consiste en “leer PDF”, sino en responder una pregunta contable concreta: ¿lo que pagamos coincide con lo que pedimos y con lo que recibimos? Para responderla hacen falta tres documentos por cada compra:
- La orden de compra (o pedido al proveedor): lo que Trigo Lento pidió, con la cantidad y el precio pactado. Valeria la registra en la hoja de compras al hacer el pedido por teléfono o por WhatsApp; es un dato propio y no hace falta leerla de un PDF.
- La remisión (o nota de entrega): el papel que acompaña a la mercancía. La imprime el proveedor con lo que dice haber enviado, y en el obrador alguien cuenta, firma y, si algo no cuadra, corrige a mano. Después se escanea. Es la prueba de lo recibido.
- La factura: lo que el proveedor cobra. Llega por correo como un CFDI (el XML que tiene valor fiscal) acompañado de su representación impresa en PDF. Muchos proveedores pequeños solo mandan el PDF al correo de compras y el XML se descarga después del portal del SAT, así que el PDF es lo que Valeria tiene a la mano cuando captura.
Con la Cafetería Brújula los papeles se invierten. Trigo Lento es el proveedor: entrega $40$ baguettes cada día hábil, la persona de Brújula firma la remisión al recibirlas y cada sábado Trigo Lento emite la factura semanal que construye el sub-workflow TL Facturación del Día 40 (El nodo HTTP Request: integrar servicios que no tienen conector). Marisol Peña lo dijo desde el primer día: quiere confirmaciones a tiempo y facturas sin errores. El mismo cotejo que protege a Trigo Lento de un proveedor que cobra de más protege a Marisol de una factura de Trigo Lento que cobra pan que no llegó.
El primer bloque fija las importaciones, la semilla de la serie y la carpeta del día, y escribe el catálogo de insumos de juguete con su precio pactado en centavos y una tasa de IVA. Las tasas son un supuesto didáctico: $0%$ para los insumos alimenticios y $16%$ para los empaques; la tasa correcta de cada concepto la decide el contador, no el código. Los RFC tienen formato válido y no corresponden a nadie. La línea pdf.fonttype = 42 importa más de lo que parece: hace que matplotlib incruste las fuentes TrueType en los PDF que generará más adelante, de modo que el archivo conserve una capa de texto real, como la de una factura emitida por un sistema de facturación:
# Importaciones base, semilla de la serie, carpeta del día y catálogo de insumos en Python:
import warnings
warnings.filterwarnings('ignore')
import base64
import json
import math
import re
from decimal import Decimal
from pathlib import Path
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from matplotlib.backends.backend_pdf import PdfPages
import pydantic

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 130)
pd.set_option('display.max_columns', 12)
plt.rcParams['pdf.fonttype'] = 42          # fuentes TrueType incrustadas: el PDF conserva su capa de texto
carpeta = Path('trigo_lento') / 'dia_58'
(carpeta / 'pdf').mkdir(parents = True, exist_ok = True)

# Proveedores e insumos de juguete (RFC con formato válido que no corresponden a nadie):
RFC_TRIGO_LENTO = 'TLE170308PN5'
PROVEEDORES = {
    'Molino La Espiga':    {'rfc': 'MES190415AB3', 'serie': 'A'},
    'Lácteos Santa Clara': {'rfc': 'LSC170822K91', 'serie': 'LS'},
    'Empaques del Valle':  {'rfc': 'EVA200301QW7', 'serie': 'F'},
}
# clave: (proveedor, descripción, unidad, precio pactado en centavos, tasa de IVA supuesta)
INSUMOS = {
    'H25':   ('Molino La Espiga',    'Harina de trigo para pan, saco de 25 kg', 'saco',    52000, 0.00),
    'HI25':  ('Molino La Espiga',    'Harina integral, saco de 25 kg',          'saco',    61000, 0.00),
    'M10':   ('Lácteos Santa Clara', 'Mantequilla sin sal, caja de 10 kg',      'caja',   185000, 0.00),
    'BK100': ('Empaques del Valle',  'Bolsa kraft, paquete de 100',             'paquete', 14500, 0.16),
    'CP25':  ('Empaques del Valle',  'Caja para pastel, paquete de 25',         'paquete', 31000, 0.16),
    'ET500': ('Empaques del Valle',  'Etiqueta adhesiva, rollo de 500',         'rollo',   18000, 0.16),
}
CLAVE_POR_DESCRIPCION = {v[1]: k for k, v in INSUMOS.items()}
print('numpy', np.__version__, '| pandas', pd.__version__, '| matplotlib', matplotlib.__version__,
      '| pydantic', pydantic.__version__)
print(f'Proveedores: {len(PROVEEDORES)} | insumos en catálogo: {len(INSUMOS)} | carpeta: {carpeta.as_posix()}')
numpy 2.4.6 | pandas 3.0.3 | matplotlib 3.10.9 | pydantic 2.13.4
Proveedores: 3 | insumos en catálogo: 6 | carpeta: trigo_lento/dia_58
Las versiones quedan escritas para que las cifras de esta entrada se puedan reproducir. El catálogo tiene $6$ insumos de $3$ proveedores; el sexto, la etiqueta adhesiva, no se pide nunca en el mes de juguete, y por eso servirá para sembrar el caso de un producto que aparece en una factura sin haberse pedido.
Un mes con errores sembrados
El siguiente bloque genera las órdenes de compra de marzo con el calendario de cada proveedor (Molino La Espiga los lunes y jueves, Lácteos Santa Clara los martes y Empaques del Valle los miércoles), sus remisiones y sus facturas. Al principio, todo coincide: la remisión dice lo que se pidió y la factura cobra lo que se pidió al precio pactado. Después se siembran, a la vista, los errores que el cotejo tendrá que encontrar:
- Cantidad: la factura A-1187 de la introducción (se pidieron y llegaron $10$ sacos, se cobran $12$) y otras dos facturas que cobran una pieza más de lo recibido.
- Precio unitario: una caja de mantequilla a $1,920.00$ en lugar de $1,850.00$ y un paquete de cajas para pastel a $325.00$ en lugar de $310.00$.
- Redondeo tolerado: un saco de harina a $521.50$ en lugar de $520.00$, una diferencia del $0.29%$ que el cotejo no debe marcar.
- Producto no pedido: un rollo de etiquetas que aparece en una factura de empaques.
- Documento duplicado: una factura de Molino La Espiga que llegó dos veces al correo con el mismo folio.
- Factura pendiente: una orden de Lácteos Santa Clara cuya factura todavía no llega.
Para Brújula, el bloque genera las remisiones firmadas de los $24$ días hábiles del 2 al 28 de marzo: $40$ baguettes cada día, salvo dos días en los que la cafetería devolvió dos piezas quemadas y la remisión dice $38$. Y siembra un error propio: la factura semanal de la semana 12 (del 16 al 21 de marzo) cobra $240$ baguettes aunque las remisiones firmadas suman $238$. Así se comprueba que el cotejo funciona en las dos direcciones:
# Un mes de órdenes, remisiones y facturas de juguete con errores sembrados en Python:
CALENDARIO = {'Molino La Espiga': [2, 5, 9, 12, 16, 19, 23, 26],
              'Lácteos Santa Clara': [3, 10, 17, 24, 27],
              'Empaques del Valle': [4, 11, 18, 25, 28]}
pedidos_base = {'Molino La Espiga': lambda: {'H25': int(rng.integers(8, 13)), 'HI25': int(rng.integers(1, 4))},
                'Lácteos Santa Clara': lambda: {'M10': int(rng.integers(2, 5))},
                'Empaques del Valle': lambda: {'BK100': int(rng.integers(3, 7)), 'CP25': int(rng.integers(1, 4))}}
compras = sorted((dia, prov) for prov, dias in CALENDARIO.items() for dia in dias)
ordenes, remisiones, facturas = {}, {}, []
for i, (dia, prov) in enumerate(compras, start = 1):
    oc = f'OC-2603-{i:02d}'
    ordenes[oc] = {'orden': oc, 'proveedor': prov, 'fecha': f'2026-03-{dia:02d}', 'renglones': pedidos_base[prov]()}
ordenes['OC-2603-13']['renglones'] = {'H25': 10, 'HI25': 2}      # el pedido de harina de la introducción

# Remisión: lo que llegó al obrador; factura: lo que se cobra (al principio, idéntico al pedido):
for oc, o in ordenes.items():
    remisiones[oc] = {'orden': oc, 'impreso': dict(o['renglones']), 'recibido': dict(o['renglones'])}
    renglones = {k: {'cantidad': q, 'precio': INSUMOS[k][3]} for k, q in o['renglones'].items()}
    facturas.append({'orden': oc, 'proveedor': o['proveedor'], 'fecha': o['fecha'], 'renglones': renglones})
f_por_oc = {f['orden']: f for f in facturas}

# Errores sembrados (y un redondeo que debe quedar dentro de la tolerancia):
remisiones['OC-2603-13']['impreso']['H25'] = 12                  # el proveedor imprimió 12 sacos...
f_por_oc['OC-2603-13']['renglones']['H25']['cantidad'] = 12      # ...cobró 12 y en el obrador se contaron 10
f_por_oc['OC-2603-05']['renglones']['HI25']['cantidad'] += 1     # cantidad: un saco de más
f_por_oc['OC-2603-10']['renglones']['M10']['cantidad'] += 1      # cantidad: una caja de más
f_por_oc['OC-2603-06']['renglones']['M10']['precio'] = 192000    # precio: 1 920.00 en lugar de 1 850.00
f_por_oc['OC-2603-15']['renglones']['CP25']['precio'] = 32500    # precio: 325.00 en lugar de 310.00
f_por_oc['OC-2603-08']['renglones']['H25']['precio'] = 52150     # redondeo de 0.29 %: dentro de tolerancia
f_por_oc['OC-2603-11']['renglones']['ET500'] = {'cantidad': 1, 'precio': 18000}   # producto no pedido
# Folio consecutivo por proveedor (la factura de harina del 23 de marzo es la A-1187):
for prov, datos in PROVEEDORES.items():
    for n, f in enumerate([f for f in facturas if f['proveedor'] == prov], start = 1181):
        f['folio'] = f"{datos['serie']}-{n}"
facturas = [f for f in facturas if f['orden'] != 'OC-2603-17']  # factura que todavía no llega
facturas.append(json.loads(json.dumps(f_por_oc['OC-2603-04'])))  # la misma factura, reenviada por correo

# Brújula: 40 baguettes por día hábil; 2 días recibió 38 y una factura semanal cobra 240 en vez de 238:
dias_brujula = [d for d in pd.date_range('2026-03-02', '2026-03-28') if d.dayofweek < 6]
remisiones_brujula = {d.strftime('%Y-%m-%d'): (38 if d.day in (11, 18) else 40) for d in dias_brujula}
semanas = {s: [k for k in remisiones_brujula if pd.Timestamp(k).isocalendar().week == s] for s in (10, 11, 12, 13)}
facturas_brujula = {s: sum(remisiones_brujula[k] for k in ds) for s, ds in semanas.items()}
facturas_brujula[12] = 240

resumen = pd.DataFrame([
    ('Factura de proveedor', 'nativo', 2, len(facturas)),
    ('Remisión de proveedor', 'escaneo', 1, len(remisiones)),
    ('Remisión firmada por Brújula', 'escaneo', 1, len(remisiones_brujula)),
], columns = ['documento', 'origen', 'paginas', 'pdf_al_mes'])
print(resumen.to_string(index = False))
print('Total de PDF:', resumen['pdf_al_mes'].sum(), '| páginas:', (resumen['paginas'] * resumen['pdf_al_mes']).sum(),
      '| órdenes de compra:', len(ordenes), '| facturas semanales a Brújula:', len(facturas_brujula))
(carpeta / 'mes_de_juguete.json').write_text(json.dumps(
    {'ordenes': ordenes, 'remisiones': remisiones, 'facturas': facturas,
     'remisiones_brujula': remisiones_brujula, 'facturas_brujula': facturas_brujula},
    ensure_ascii = False, indent = 1), encoding = 'utf-8')
                   documento  origen  paginas  pdf_al_mes
        Factura de proveedor  nativo        2          18
       Remisión de proveedor escaneo        1          18
Remisión firmada por Brújula escaneo        1          24
Total de PDF: 60 | páginas: 78 | órdenes de compra: 18 | facturas semanales a Brújula: 4
El mes tiene exactamente los $60$ PDF de la introducción: $18$ facturas nativas de dos páginas, $18$ remisiones de proveedor escaneadas y $24$ remisiones de Brújula escaneadas, en total $78$ páginas. Las $18$ facturas no corresponden a $18$ órdenes distintas: una orden no tiene factura todavía y otra la tiene dos veces. Ese detalle, que a mano se pierde con facilidad, es el primero que el cotejo debe atrapar. Todo el mes se guarda en mes_de_juguete.json dentro de la carpeta del día, para que los bloques siguientes lo lean.
Qué ve Claude en un PDF
Un PDF no es una sola cosa. Hay dos familias que, para un modelo, se comportan de forma muy distinta:
- El PDF nativo lo genera un programa: un sistema de facturación, un procesador de textos, matplotlib. Además de dibujar la página, guarda el texto como texto, con sus fuentes incrustadas. Se puede seleccionar, copiar y buscar con Ctrl+F.
- El PDF escaneado lo genera un escáner o la cámara de un teléfono. Cada página es una fotografía: una matriz de píxeles sin una sola letra adentro. Lo que parece texto son manchas de tinta sobre un fondo gris.
Según la documentación de Claude, cuando se envía un PDF el sistema convierte cada página en una imagen y, además, extrae el texto de cada página y lo entrega junto a su imagen. El modelo recibe las dos capas y razona con ambas. En un PDF nativo, la capa de texto da precisión (los dígitos de un importe llegan como caracteres, sin ambigüedad) y la imagen da estructura (qué número va en qué columna, qué está tachado, dónde está el sello). En un escaneo la capa de texto llega vacía y todo depende de la visión: el modelo lee la página como la leería una persona, con las mismas dificultades ante una fotografía borrosa, torcida o con letra pequeña. La Figura 1 dibuja esta idea.
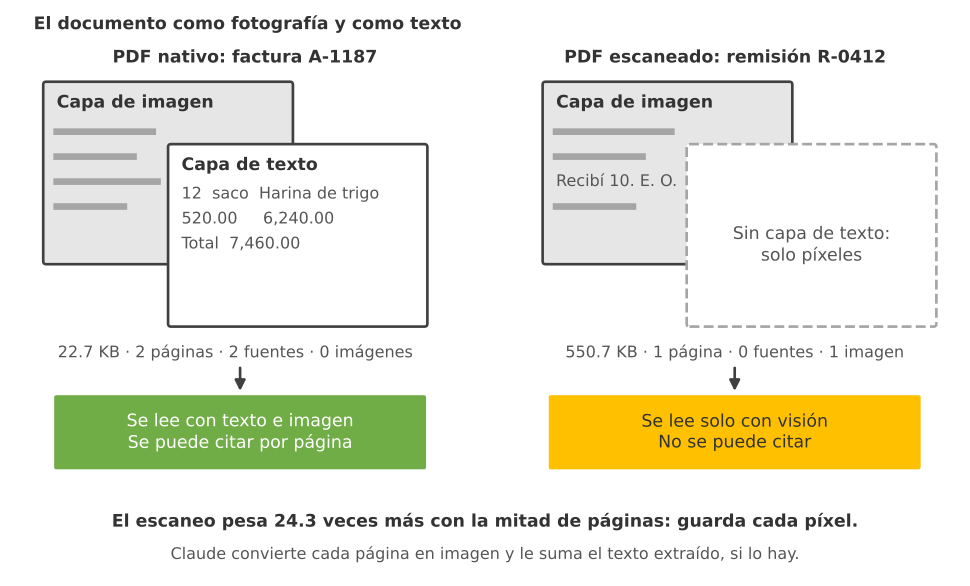
Figura 1. El documento como fotografía y como texto: la factura nativa A-1187 llega con capa de imagen y capa de texto (22.7 KB, 2 fuentes) y se puede leer y citar; la remisión escaneada R-0412 solo trae la imagen (550.7 KB, 24.3 veces más) y se puede leer, pero no citar.
Esa doble lectura tiene un coste. La documentación estima entre $1,500$ y $3,000$ tokens de texto por página según su densidad, y a eso suma el coste de la imagen, que se calcula como el de cualquier imagen enviada a Claude. Las imágenes se miden en bloques de $28 \times 28$ píxeles llamados tokens visuales:
$$ T_{\text{visual}} = \left\lceil \frac{w}{28} \right\rceil \cdot \left\lceil \frac{h}{28} \right\rceil $$
donde:
- $w$ y $h$ son el ancho y el alto de la imagen en píxeles, después de cualquier reducción.
- $\lceil \cdot \rceil$ redondea hacia arriba: un bloque incompleto en el borde cuenta como bloque entero.
- Los modelos de alta resolución (Claude 4.7 y posteriores, entre ellos los tres de esta serie) reducen la imagen si su lado mayor pasa de $2,576$ píxeles o si pasaría de $4,784$ tokens visuales, lo que pone un techo al coste por página.
Una página vista a $850 \times 1,100$ píxeles, como la remisión escaneada de hoy, costaría $\lceil 850/28 \rceil \cdot \lceil 1,100/28 \rceil = 31 \cdot 40 = 1,240$ tokens visuales. La documentación no publica la resolución exacta a la que se convierte cada página de un PDF, así que esta cifra es una ilustración del orden de magnitud y no una predicción; la medición la hará count_tokens en el Bloque 6.
Una factura y una remisión que existen de verdad
Para que los bloques siguientes trabajen con archivos reales, el siguiente bloque dibuja con matplotlib la factura A-1187 en dos páginas (encabezado y renglones en la primera; totales, forma de pago y folio fiscal en la segunda) y la guarda como PDF con PdfPages. Después dibuja la remisión R-0412 con el $12$ impreso, el tachón y la nota “Recibí 10. E. O.” y la rasteriza: la convierte en una matriz de píxeles en gris con un poco de ruido y una ligera inclinación, que es lo que hace un escáner, y guarda esa imagen como un PDF de una página. El folio fiscal es inventado y los sellos digitales, que en un comprobante real ocupan cientos de caracteres, no aparecen:
# Factura de dos páginas y remisión escaneada dibujadas con matplotlib y guardadas como PDF en Python:
def pesos(c):
    return f'{c / 100:,.2f}'

def pagina(lineas, titulo):
    # Una página carta (8.5 x 11 pulgadas) con texto real en coordenadas de la figura:
    fig = plt.figure(figsize = (8.5, 11))
    fig.text(0.08, 0.94, titulo, fontsize = 18, weight = 'bold')
    for x, y, s, kw in lineas:
        fig.text(x, y, s, fontsize = kw.get('tam', 11), weight = kw.get('peso', 'normal'),
                 ha = kw.get('ha', 'left'), family = 'DejaVu Sans')
    return fig

f = f_por_oc['OC-2603-13']
prov = PROVEEDORES[f['proveedor']]
subtotal = sum(r['cantidad'] * r['precio'] for r in f['renglones'].values())
iva = round(sum(r['cantidad'] * r['precio'] * INSUMOS[k][4] for k, r in f['renglones'].items()))
p1 = [(0.08, 0.90, f"{f['proveedor']}, S.A. de C.V.   RFC {prov['rfc']}", {}),
      (0.08, 0.87, f'Receptor: Trigo Lento   RFC {RFC_TRIGO_LENTO}   Uso CFDI G01', {}),
      (0.08, 0.84, f"Folio {f['folio']}   Fecha 2026-03-23   Orden de compra {f['orden']}", {}),
      (0.08, 0.78, 'Cantidad   Unidad   Descripción', {'peso': 'bold'}),
      (0.70, 0.78, 'P. unitario', {'peso': 'bold', 'ha': 'right'}),
      (0.92, 0.78, 'Importe', {'peso': 'bold', 'ha': 'right'})]
for j, (k, r) in enumerate(f['renglones'].items()):
    y = 0.74 - 0.04 * j
    p1 += [(0.08, y, f"{r['cantidad']:>4}       {INSUMOS[k][2]:<8} {INSUMOS[k][1]}", {'tam': 10}),
           (0.70, y, pesos(r['precio']), {'tam': 10, 'ha': 'right'}),
           (0.92, y, pesos(r['cantidad'] * r['precio']), {'tam': 10, 'ha': 'right'})]
p1 += [(0.08, 0.10, 'Página 1 de 2', {'tam': 9})]
p2 = [(0.60, 0.86, 'Subtotal', {}), (0.92, 0.86, pesos(subtotal), {'ha': 'right'}),
      (0.60, 0.83, 'IVA trasladado', {}), (0.92, 0.83, pesos(iva), {'ha': 'right'}),
      (0.60, 0.80, 'Total', {'peso': 'bold'}), (0.92, 0.80, pesos(subtotal + iva), {'ha': 'right', 'peso': 'bold'}),
      (0.08, 0.72, 'Forma de pago: transferencia, a 15 días.', {}),
      (0.08, 0.69, 'Este documento es una representación impresa de un CFDI.', {}),
      (0.08, 0.66, 'Folio fiscal: 7C1E4B2A-9D3F-4E8A-B6C5-2F1A0D9E8B73', {'tam': 10}),
      (0.08, 0.10, 'Página 2 de 2', {'tam': 9})]
ruta_factura = carpeta / 'pdf' / 'factura_A-1187.pdf'
paginas_factura = [pagina(p1, 'FACTURA'), pagina(p2, 'FACTURA (continuación)')]
with PdfPages(ruta_factura) as pdf:
    for fig in paginas_factura:
        pdf.savefig(fig)

# La remisión impresa por el proveedor, firmada y corregida a mano en el obrador:
r_lineas = [(0.08, 0.90, f"{f['proveedor']}   Remisión R-0412   2026-03-23", {}),
            (0.08, 0.86, f"Orden de compra {f['orden']}   Entregar en: Trigo Lento, Narvarte", {}),
            (0.08, 0.80, 'Cantidad   Descripción', {'peso': 'bold'})]
for j, (k, q) in enumerate(remisiones['OC-2603-13']['impreso'].items()):
    r_lineas.append((0.08, 0.76 - 0.04 * j, f'{q:>4}       {INSUMOS[k][1]}', {}))
r_lineas.append((0.08, 0.30, 'Recibí de conformidad: ____________________', {}))
fig_r = pagina(r_lineas, 'REMISIÓN')
fig_r.text(0.58, 0.765, 'Recibí 10. E. O.', fontsize = 15, style = 'italic', color = '#1f3a93')
fig_r.add_artist(plt.Line2D([0.085, 0.13], [0.768, 0.768], color = '#1f3a93', lw = 2))
fig_r.text(0.45, 0.31, 'E. Ortiz', fontsize = 20, style = 'italic', color = '#1f3a93')

def rasterizar(fig, dpi = 100):
    # Lo que hace un escáner: la página se vuelve una matriz de píxeles en gris, con ruido y algo torcida:
    fig.set_dpi(dpi)
    fig.canvas.draw()
    gris = np.asarray(fig.canvas.buffer_rgba())[:, :, :3].mean(axis = 2) / 255
    gris = np.clip(gris * 0.92 + 0.05 + rng.normal(0, 0.04, gris.shape), 0, 1)
    return np.stack([np.roll(fila, int(i * 0.012)) for i, fila in enumerate(gris)])

escaneo = rasterizar(fig_r)
ruta_remision = carpeta / 'pdf' / 'remision_R-0412.pdf'
fig_s = plt.figure(figsize = (8.5, 11))
fig_s.figimage(escaneo, cmap = 'gray', vmin = 0, vmax = 1, resize = True)
fig_s.savefig(ruta_remision, dpi = 100)

# Vista de la mitad superior de las tres páginas, lado a lado:
vistas = [np.asarray((p.canvas.draw(), p.canvas.buffer_rgba())[1]) for p in paginas_factura]
vistas = [img[: img.shape[0] // 2] for img in vistas + [escaneo]]
fig, ejes = plt.subplots(1, 3, figsize = (13, 4.2))
for ax, img, titulo in zip(ejes, vistas,
                           ['Factura A-1187, página 1\n(PDF nativo)', 'Factura A-1187, página 2\n(PDF nativo)',
                            'Remisión R-0412 firmada\n(PDF escaneado)']):
    ax.imshow(img, cmap = 'gray' if img.ndim == 2 else None)
    ax.set_title(titulo, fontsize = 12)
    ax.axis('off')
fig.suptitle('Los dos documentos del pedido de harina del 23 de marzo', fontsize = 16)
plt.tight_layout(rect = (0, 0, 1, 0.95))
plt.show()
plt.close('all')
print(f'Factura: {len(f["renglones"])} renglones, subtotal {pesos(subtotal)}, IVA {pesos(iva)}, '
      f'total {pesos(subtotal + iva)} MXN')
print(f'Escaneo: {escaneo.shape[1]} x {escaneo.shape[0]} píxeles en escala de grises')
Factura: 2 renglones, subtotal 7,460.00, IVA 0.00, total 7,460.00 MXN
Escaneo: 850 x 1100 píxeles en escala de grises
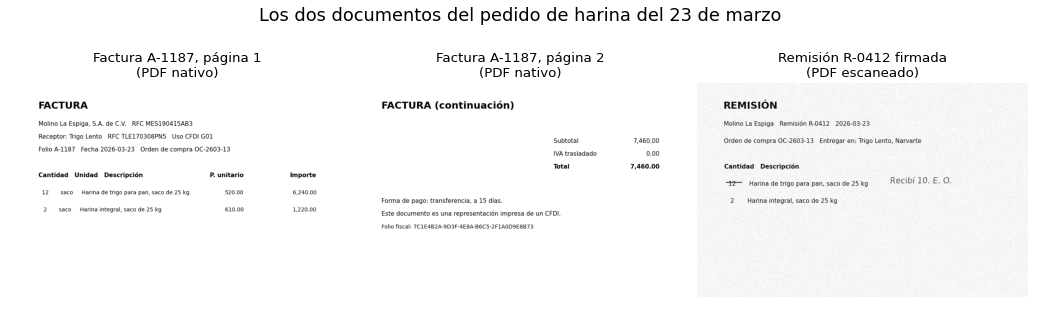
La factura cobra $7,460.00$ MXN: $12$ sacos de harina de trigo a $520.00$ ($6,240.00$) y $2$ de harina integral a $610.00$ ($1,220.00$), sin IVA por el supuesto de tasa cero. La gráfica muestra la mitad superior de las tres páginas. A simple vista, la página escaneada se parece mucho a las nativas; la diferencia está por dentro, y el siguiente bloque la hace visible.
Las capas de un PDF, leídas en sus bytes
Un PDF es un archivo de texto con partes binarias. Sus objetos se declaran con diccionarios legibles: una página es un objeto /Type /Page, una fuente se nombra con /BaseFont y una imagen incrustada lleva /Subtype /Image. Si el archivo está cifrado aparece un diccionario /Encrypt, y la documentación de Claude es clara en ese punto: solo se admiten PDF estándar, sin contraseña ni cifrado. La función capas_pdf(ruta) cuenta esas marcas con expresiones regulares sobre los bytes, sin ninguna biblioteca de PDF. Es una inspección rápida, suficiente para clasificar los archivos de una bandeja antes de enviarlos, no un analizador completo:
# Capas de un PDF nativo y de uno escaneado leídas en los bytes del archivo en Python:
def capas_pdf(ruta):
    datos = Path(ruta).read_bytes()
    return {'archivo': Path(ruta).name,
            'kb': round(len(datos) / 1024, 1),
            'paginas': len(re.findall(rb'/Type\s*/Page\b(?!s)', datos)),
            'fuentes': len(set(re.findall(rb'/BaseFont\s*/([\w+-]+)', datos))),
            'imagenes': len(re.findall(rb'/Subtype\s*/Image', datos)),
            'cifrado': b'/Encrypt' in datos}

capas = pd.DataFrame([capas_pdf(ruta_factura), capas_pdf(ruta_remision)])
capas['capa_de_texto'] = np.where(capas['fuentes'] > 0, 'sí', 'no')
print(capas.to_string(index = False))
print('Relación de tamaño escaneo / nativo:', round(capas['kb'][1] / capas['kb'][0], 1))
            archivo    kb  paginas  fuentes  imagenes  cifrado capa_de_texto
 factura_A-1187.pdf  22.7        2        2         0    False            sí
remision_R-0412.pdf 550.7        1        0         1    False            no
Relación de tamaño escaneo / nativo: 24.3
La tabla de salida separa las dos familias sin ambigüedad. La factura tiene $2$ páginas, $2$ fuentes y ninguna imagen: es texto con forma. La remisión tiene $1$ página, ninguna fuente y $1$ imagen: es una fotografía con forma de documento. Ninguno está cifrado. Al preparar esta entrada se abrió la factura con un lector de PDF y su texto se pudo copiar y pegar; en la remisión no hay nada que copiar.
La última línea dice algo que tendrá consecuencias en la sección de límites: el escaneo pesa $24.3$ veces lo que la factura nativa ($550.7$ KB frente a $22.7$ KB), aunque tenga la mitad de páginas. Un escaneo guarda cada píxel; un PDF nativo guarda instrucciones de dibujo y caracteres. Y hay una tercera consecuencia, que aparecerá al hablar de citas: como la remisión no tiene capa de texto, Claude puede leerla, pero no puede citarla.
El bloque document
En la API de Mensajes, un PDF viaja como un bloque de contenido de tipo document dentro del mensaje del usuario. Su source admite tres formas: base64 (los bytes del archivo codificados como texto dentro de la petición), url (una dirección pública desde la que la API descarga el archivo) y file (un identificador file_id de la API de archivos). Las facturas de Trigo Lento no deben estar en una dirección pública, así que la forma url queda descartada desde el principio. Quedan dos.
Base64: el archivo dentro de la petición
La codificación base64 convierte cada grupo de $3$ bytes en $4$ caracteres de un alfabeto de $64$ símbolos, para que un archivo binario pueda viajar dentro de un JSON. Por eso crece:
$$ B_{64} = 4 \cdot \left\lceil \frac{n}{3} \right\rceil $$
donde:
- $n$ es el tamaño del PDF en bytes y $B_{64}$ el de su versión en base64, en caracteres (un byte cada uno).
- El cociente se redondea hacia arriba porque el último grupo incompleto se rellena con el símbolo
=. - En la práctica, $B_{64} \approx 1.33 , n$: un PDF de $24$ MB ya no cabe en una petición de $32$ MB, aunque el archivo “pese menos” que el límite.
Tres detalles del bloque se cumplen siempre. El media_type es application/pdf. La cadena base64 va en una sola línea: base64.standard_b64encode no inserta saltos, a diferencia de otras herramientas que cortan cada $76$ caracteres, y una cadena con saltos de línea no es base64 válido para la API. Y el documento va antes que el texto de las instrucciones, que es la primera recomendación de la documentación para mejorar los resultados. El siguiente bloque construye la petición con la factura y la remisión, mide su tamaño en bytes y en páginas y dibuja cuántos documentos como estos caben en una sola petición:
# Bloque document en base64, comprobación de límites y documentos que caben en una petición en Python:
LIMITE_BYTES = 32_000_000       # 32 MB por petición (se toma el millón decimal, el más estricto)
LIMITE_PAGINAS = 600            # 600 páginas por petición en modelos con contexto de 1M (100 si es menor)

def bloque_documento(ruta, titulo = None):
    datos = base64.standard_b64encode(Path(ruta).read_bytes()).decode('ascii')   # una sola línea
    bloque = {'type': 'document', 'source': {'type': 'base64', 'media_type': 'application/pdf', 'data': datos}}
    if titulo:
        bloque['title'] = titulo
    return bloque

INSTRUCCIONES = ('Extraiga la factura y la remisión adjuntas al esquema indicado. Copie importes y fechas tal '
                 'como aparecen impresos; si una cantidad está corregida a mano, anote la corregida.')
contenido = [bloque_documento(ruta_factura, 'Factura del proveedor'),
             bloque_documento(ruta_remision, 'Remisión firmada en el obrador'),
             {'type': 'text', 'text': INSTRUCCIONES}]          # el PDF va antes que el texto
cuerpo = {'model': 'claude-sonnet-5-5', 'max_tokens': 4000, 'messages': [{'role': 'user', 'content': contenido}]}
bytes_peticion = len(json.dumps(cuerpo).encode('utf-8'))
paginas = int(capas['paginas'].sum())
for b, ruta in zip(contenido[:2], [ruta_factura, ruta_remision]):
    n = ruta.stat().st_size
    print(f"{ruta.name}: {n:,} bytes -> base64 {len(b['source']['data']):,} "
          f"(4 * ceil(n / 3) = {4 * math.ceil(n / 3):,}), saltos de línea: {b['source']['data'].count(chr(10))}")
print(f'Petición: {bytes_peticion:,} bytes ({100 * bytes_peticion / LIMITE_BYTES:.2f} % de 32 MB), '
      f'{paginas} páginas de {LIMITE_PAGINAS}')

# ¿Cuántos documentos como estos caben en una sola petición?
tipos = {'Factura nativa (2 páginas)': (4 * math.ceil(ruta_factura.stat().st_size / 3), 2),
         'Remisión escaneada (1 página)': (4 * math.ceil(ruta_remision.stat().st_size / 3), 1)}
n_docs = np.arange(1, 701)
fig, ax = plt.subplots(figsize = (8, 4.8))
for (nombre, (b64, pags)), color in zip(tipos.items(), ['#4472C4', '#ED7D31']):
    maximo = min(LIMITE_BYTES // b64, LIMITE_PAGINAS // pags)
    print(f'{nombre}: caben {maximo} por petición (por tamaño {LIMITE_BYTES // b64}, '
          f'por páginas {LIMITE_PAGINAS // pags})')
    validos = n_docs * pags <= LIMITE_PAGINAS
    ax.plot(n_docs[validos], n_docs[validos] * b64 / 1e6, color = color, label = f'{nombre}: {maximo} por petición')
    ax.plot(n_docs[~validos], n_docs[~validos] * b64 / 1e6, color = color, ls = ':')
ax.axhline(32, color = 'red', lw = 1.5, ls = '--', label = 'Límite de 32 MB por petición')
ax.set_title('Documentos por petición frente a los límites', fontsize = 16)
ax.set_xlabel('Documentos en la misma petición')
ax.set_ylabel('Tamaño en base64 (MB)')
ax.set_ylim(0, 60)
ax.legend(fontsize = 9, loc = 'upper left')
plt.tight_layout()
plt.show()
factura_A-1187.pdf: 23,210 bytes -> base64 30,948 (4 * ceil(n / 3) = 30,948), saltos de línea: 0
remision_R-0412.pdf: 563,952 bytes -> base64 751,936 (4 * ceil(n / 3) = 751,936), saltos de línea: 0
Petición: 783,469 bytes (2.45 % de 32 MB), 3 páginas de 600
Factura nativa (2 páginas): caben 300 por petición (por tamaño 1033, por páginas 300)
Remisión escaneada (1 página): caben 42 por petición (por tamaño 42, por páginas 600)
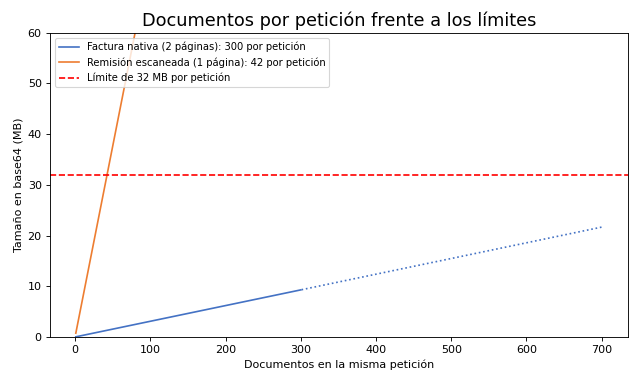
La fórmula se cumple al carácter: la factura de $23,210$ bytes se convierte en $30,948$ caracteres, exactamente $4 \cdot \lceil 23,210 / 3 \rceil$, y ninguna de las dos cadenas tiene saltos de línea. La petición completa ocupa $783,469$ bytes, el $2.45%$ del límite, con $3$ páginas de $600$. Ese es el caso de Trigo Lento: una compra por petición, muy lejos de cualquier límite.
Los dos límites, sin embargo, no se alcanzan igual. Con facturas nativas manda el límite de páginas: caben $300$ facturas de dos páginas por petición, y harían falta $1,033$ para llenar los $32$ MB. Con escaneos manda el límite de tamaño: caben solo $42$ remisiones, y el tope de páginas ni se asoma. La gráfica lo muestra con dos rectas de pendientes muy distintas, y la línea punteada de la factura indica la zona que el tope de páginas prohíbe aunque el tamaño lo permitiría. Dos precisiones de la documentación completan el cuadro: los dos límites cuentan la petición entera, con todo lo que viaje junto a los PDF, y el tope de $600$ páginas baja a $100$ cuando la ventana de contexto de la petición es menor de un millón de tokens. Opus 5.5, Sonnet 5.5 y Haiku 5.5 tienen ventana de un millón, de modo que en esta serie rige el de $600$.
Atención aquí: que un PDF quepa en los límites no garantiza que la petición funcione. La documentación advierte que los PDF densos (muchas páginas con letra pequeña, tablas complejas o gráficos pesados) pueden llenar la ventana de contexto antes de llegar al límite de páginas, y que una petición con PDF grandes puede fallar antes de alcanzarlo incluso con la API de archivos. Para Trigo Lento la regla práctica es sencilla: un documento de compra por petición, y si algún día llega un estado de cuenta de cien páginas, se divide por secciones y se reduce la resolución de las imágenes incrustadas antes de enviarlo.
La API de archivos: subir una vez, citar muchas
La segunda forma evita reenviar el archivo. Con la API de archivos, el PDF se sube una sola vez con client.files.upload y la respuesta trae un file_id; desde entonces, el bloque document lleva {"type": "file", "file_id": ...} en lugar de los bytes. Desde octubre de 2026 la API de archivos está fuera de beta y no necesita cabecera. La Tabla 4 compara las dos formas en lo que le importa a Trigo Lento.
Tabla 4. Base64 frente a la API de archivos para los PDF de Trigo Lento (revisado en octubre de 2026).
| Aspecto | Base64 en la petición | API de archivos (file_id) |
|---|---|---|
| Dónde viaja el PDF | Dentro de cada petición | Se sube una vez; la petición lleva un identificador |
| Tamaño de la petición | Crece $1.33$ veces el PDF en cada llamada | Pequeño, aunque el documento se use muchas veces |
| Límite por archivo | El de la petición: 32 MB en total | 500 MB por archivo, 1 TB por organización |
| Coste de subir, listar o borrar | No aplica | Gratis; el contenido usado en un mensaje se cobra como tokens de entrada |
| Vida del archivo | Solo dura la petición | Persiste hasta que se borra o hasta su expires_at (de 1 hora a 90 días si se fija al subir) |
| Quién puede usarlo | Quien hace la petición | Cualquier clave con acceso al mismo espacio de trabajo |
| Uso en Trigo Lento | Pruebas y una sola lectura | Extracción más segunda llamada con citas sobre el mismo PDF |
La fila decisiva es la penúltima. La documentación advierte que los archivos subidos son accesibles para todo el espacio de trabajo, no para un usuario ni para una conversación, y que nunca se debe aceptar un file_id que venga de fuera: Trigo Lento guarda la relación entre cada documento y su identificador en su propia base y borra el archivo de la API en cuanto termina el cotejo. Hay otra razón para borrarlo pronto: según la documentación, la API de archivos no es elegible para la retención cero de datos, algo que conviene saber cuando el archivo es una factura con datos fiscales de un tercero.
Cuántos tokens pesa una factura
Antes de decidir qué modelo lee las facturas, hay que medir cuánto pesan. client.messages.count_tokens recibe la misma petición que se enviaría a messages.create y devuelve los tokens de entrada sin generar nada ni cobrar la inferencia; la documentación de la API pide pasar el mismo modelo que se usará, porque cada familia cuenta con su propio tokenizador. El siguiente bloque cuenta la factura de dos páginas con las instrucciones para los tres modelos de la serie. Llama a la API y no se ejecutó para escribir la entrada; su salida es un ejemplo comentado:
# Conteo de tokens del PDF de la factura con count_tokens antes de elegir modelo en Python:
import anthropic

client = anthropic.Anthropic()          # lee ANTHROPIC_API_KEY del entorno; nunca se escribe en el código
peticion = [{'role': 'user', 'content': [bloque_documento(ruta_factura, 'Factura del proveedor'),
                                         {'type': 'text', 'text': INSTRUCCIONES}]}]
for modelo in ('claude-opus-5-5', 'claude-sonnet-5-5', 'claude-haiku-5-5'):
    conteo = client.messages.count_tokens(model = modelo, messages = peticion)
    print(f'{modelo:<18} {conteo.input_tokens:>6,} tokens de entrada '
          f'({conteo.input_tokens / 2:,.0f} por página)')

# Salida de ejemplo (puede variar):
# claude-opus-5-5     4,862 tokens de entrada (2,431 por página)
# claude-sonnet-5-5   4,906 tokens de entrada (2,453 por página)
# claude-haiku-5-5    5,318 tokens de entrada (2,659 por página)
La salida de ejemplo queda alrededor de $2,400$ a $2,700$ tokens por página, dentro del rango que anuncia la documentación y muy cerca del supuesto de $2,500$ que usa la ficha de este día. La diferencia entre Haiku 5.5 y los otros dos modelos ilustra lo que dice la documentación sobre los tokenizadores: el mismo PDF no pesa lo mismo en todas las familias, y por eso la cuenta se hace con el modelo que se usará. Cuando Valeria ejecute el bloque con su clave, las cifras reales sustituirán al supuesto en la Tabla 3.
Esquema de extracción
Leer un PDF y “contar lo que dice” no sirve de nada a una hoja de compras. Lo que se necesita es una fila con columnas fijas, y para obtenerla de forma fiable la API ofrece las salidas estructuradas: se describe el esquema con un modelo de pydantic, se pasa como output_format a messages.parse y la respuesta llega ya validada en parsed_output. La Figura 2 mostrará ese viaje de la página a la fila; antes hay que decidir qué columnas tiene la fila.
Tres decisiones de diseño definen el esquema de hoy. La primera: el modelo copia, el código calcula. Los importes se piden como texto, tal como aparecen impresos (“6,240.00”), y es Python quien los convierte a centavos y los suma. Si el modelo convirtiera y sumara, un error de lectura y un error de aritmética serían indistinguibles; separados, el validador encuentra cada uno. La segunda: nada de campos de más. Cada clase lleva extra = 'forbid', que en el esquema JSON se traduce en additionalProperties: false, la condición que exigen las salidas estructuradas para todos los objetos. La tercera: un dato ilegible es null, no un invento. Los campos que pueden faltar (la orden de compra que no todos los proveedores imprimen, la cantidad corregida a mano que casi nunca existe, la nota manuscrita) son Optional, obligatorios pero con permiso para ser nulos:
# Esquema de extracción de factura y remisión con pydantic (sin campos de más) en Python:
from typing import Literal, Optional
from pydantic import BaseModel, ConfigDict, Field

class Renglon(BaseModel):
    model_config = ConfigDict(extra = 'forbid')
    descripcion: str
    cantidad: float
    unidad: str
    precio_unitario: str = Field(description = 'Tal como aparece impreso, por ejemplo "520.00"')
    importe: str = Field(description = 'Tal como aparece impreso, por ejemplo "6,240.00"')

class Factura(BaseModel):
    model_config = ConfigDict(extra = 'forbid')
    tipo: Literal['factura']
    proveedor: str
    rfc_emisor: str
    rfc_receptor: str
    folio: str
    fecha: str = Field(description = 'AAAA-MM-DD')
    orden_compra: Optional[str]
    renglones: list[Renglon]
    subtotal: str
    iva: str
    total: str

class RenglonRemision(BaseModel):
    model_config = ConfigDict(extra = 'forbid')
    descripcion: str
    cantidad_impresa: float
    cantidad_recibida: Optional[float] = Field(description = 'La anotada a mano, si alguien la corrigió')

class Remision(BaseModel):
    model_config = ConfigDict(extra = 'forbid')
    tipo: Literal['remision']
    emisor: str
    folio: str
    fecha: str = Field(description = 'AAAA-MM-DD')
    orden_compra: Optional[str]
    renglones: list[RenglonRemision]
    firma_presente: bool
    nota_manuscrita: Optional[str]

class Documentos(BaseModel):
    model_config = ConfigDict(extra = 'forbid')
    factura: Factura
    remision: Remision

esquema = Documentos.model_json_schema()
for nombre, definicion in esquema['$defs'].items():
    print(f"{nombre:<16} campos: {len(definicion['properties']):>2} | obligatorios: {len(definicion['required']):>2} "
          f"| additionalProperties: {definicion['additionalProperties']}")
print('Nivel superior:', list(esquema['properties']), '| obligatorios:', esquema['required'])
Factura          campos: 11 | obligatorios: 11 | additionalProperties: False
Remision         campos:  8 | obligatorios:  8 | additionalProperties: False
Renglon          campos:  5 | obligatorios:  5 | additionalProperties: False
RenglonRemision  campos:  3 | obligatorios:  3 | additionalProperties: False
Nivel superior: ['factura', 'remision'] | obligatorios: ['factura', 'remision']
La salida confirma lo que se pidió: $11$ campos en la factura, $8$ en la remisión, $5$ en cada renglón de factura y $3$ en cada renglón de remisión, todos obligatorios y todos con additionalProperties en False. Que un campo Optional sea obligatorio parece una contradicción y no lo es: obliga al modelo a decir algo sobre ese campo, aunque sea “no lo vi”, en lugar de omitirlo en silencio. La Tabla 1 resume el esquema con la regla de validación que el Bloque 9 aplicará a cada campo.
Tabla 1. Esquema de factura y de remisión con tipo y regla de validación.
| Documento | Campo | Tipo | Regla de validación |
|---|---|---|---|
| Factura | proveedor | texto | Debe existir en la lista de proveedores |
| Factura | rfc_emisor, rfc_receptor | texto | Formato ^[A-ZÑ&]{3,4}\d{6}[A-Z0-9]{3}$; el receptor es Trigo Lento |
| Factura | folio | texto | No vacío; con el RFC del emisor forma la llave contra duplicados |
| Factura | fecha | texto AAAA-MM-DD | Fecha válida dentro del periodo y no posterior a hoy |
| Factura | orden_compra | texto o nulo | Si existe, debe corresponder a una orden registrada |
| Factura | renglones[] | lista de 5 campos | Importe igual a cantidad por precio, en centavos; concepto dentro del catálogo |
| Factura | subtotal, iva, total | texto impreso | Suma de importes igual al subtotal; IVA por renglón con 1 centavo de holgura; subtotal más IVA igual al total |
| Remisión | emisor, folio, fecha | texto | Mismo proveedor y misma orden que la factura |
| Remisión | renglones[] | lista de 3 campos | Si hay cantidad recibida anotada a mano, manda sobre la impresa |
| Remisión | firma_presente | booleano | Sin firma, la remisión no prueba la recepción: va a revisión |
| Remisión | nota_manuscrita | texto o nulo | Se guarda para la auditoría; nunca se interpreta sin una persona |
La extracción con messages.parse
Con el esquema listo, la llamada es corta. El siguiente bloque sube la factura y la remisión con la API de archivos y pide la extracción a Claude Sonnet 5.5 con client.beta.messages.parse. Tres parámetros merecen una explicación:
output_format = Documentosentrega el esquema del Bloque 7; la respuesta llega validada enrespuesta.parsed_output, como un objeto de pydantic.output_config = {'effort': 'low'}baja el esfuerzo. En Sonnet 5.5 el esfuerzo predeterminado eshighy el pensamiento adaptativo viene activado; copiar campos de una factura no es un problema de razonamiento como el plan de horneado del Día 57, y el esfuerzo bajo ahorra tokens de salida. Es una hipótesis, no un dogma: se mide con los $20$ documentos etiquetados de la sección de coste y, si la tasa de acierto baja, se sube amedium.betas = ['server-side-fallback-2026-07-01']yfallbacks = 'default'activan el respaldo del lado del servidor, la regla de la serie para Opus 5.5 y Sonnet 5.5. Conviene saber su alcance real: según la documentación, en Sonnet 5.5 el respaldo vuelve a intentar en Sonnet 5 los rechazos de las categoríascyberyfrontier_llm, y no los demás. Una factura de harina difícilmente activa un rechazo; el parámetro está ahí porque el código de la serie se escribe igual para todos los flujos y porque el caso raro también debe tener salida.
El orden de las comprobaciones repite el del Día 57: primero stop_reason y después el contenido. Si la respuesta no terminó con end_turn (por ejemplo, max_tokens o refusal), el documento no se adivina: va a la bandeja de revisión humana. Este bloque llama a la API y no se ejecutó; su salida es un ejemplo comentado, y el archivo extraccion_A-1187.json que guardaría se escribió a mano con esa misma salida para que el Bloque 9 pueda trabajar:
# Subida con la API de archivos y extracción validada con messages.parse y respaldo del servidor en Python:
import anthropic

client = anthropic.Anthropic()

# 1. Cada PDF se sube una sola vez; después se cita por su file_id (la API de archivos ya no pide cabecera beta):
with open(ruta_factura, 'rb') as archivo:
    subida_f = client.files.upload(file = (ruta_factura.name, archivo, 'application/pdf'))
with open(ruta_remision, 'rb') as archivo:
    subida_r = client.files.upload(file = (ruta_remision.name, archivo, 'application/pdf'))

SISTEMA = ('Usted captura documentos de compra de una panadería. Copie lo que ve, no lo corrija: '
           'importes y fechas tal como están impresos. Si un dato no se lee, déjelo vacío o en null.')

# 2. Extracción: los documentos van antes que el texto; el esquema es el modelo Documentos del Bloque 7:
respuesta = client.beta.messages.parse(
    model = 'claude-sonnet-5-5',
    max_tokens = 4000,
    betas = ['server-side-fallback-2026-07-01'],
    fallbacks = 'default',                       # respaldo del lado del servidor ante un rechazo
    output_config = {'effort': 'low'},           # copiar campos no pide pensar mucho; se mide con 20 documentos
    output_format = Documentos,
    system = SISTEMA,
    messages = [{'role': 'user', 'content': [
        {'type': 'document', 'source': {'type': 'file', 'file_id': subida_f.id}, 'title': 'Factura del proveedor'},
        {'type': 'document', 'source': {'type': 'file', 'file_id': subida_r.id},
         'title': 'Remisión firmada en el obrador'},
        {'type': 'text', 'text': INSTRUCCIONES}]}],
)

# 3. Primero el motivo de parada; solo después se lee el contenido:
if respuesta.stop_reason != 'end_turn' or respuesta.parsed_output is None:
    print('A revisión humana:', respuesta.stop_reason)
else:
    documentos = respuesta.parsed_output
    (carpeta / 'extraccion_A-1187.json').write_text(documentos.model_dump_json(indent = 2), encoding = 'utf-8')
    print(documentos.factura.folio, documentos.factura.total, documentos.remision.nota_manuscrita)
    print('Modelo:', respuesta.model, '| entrada:', respuesta.usage.input_tokens,
          '| salida:', respuesta.usage.output_tokens)

# Salida de ejemplo (puede variar):
# A-1187 7,460.00 Recibí 10. E. O.
# Modelo: claude-sonnet-5-5 | entrada: 5641 | salida: 702
La salida de ejemplo trae los tres datos que importan para la historia de hoy: el folio A-1187, el total $7,460.00$ tal como está impreso y, lo más interesante, la nota manuscrita “Recibí 10. E. O.” leída sobre el escaneo. En el archivo de ejemplo, el renglón de harina de la remisión tiene cantidad_impresa $12$ y cantidad_recibida $10$: el modelo distinguió el número del proveedor del número de Don Ernesto. Esa distinción es exactamente la que pedía el esquema con la descripción del campo, y es la que un sistema de reconocimiento de caracteres tradicional, que solo transcribe, no hace por sí mismo. La Figura 2 resume el recorrido: cada campo del papel termina en una columna de la fila, y los cálculos se quedan del lado del código.
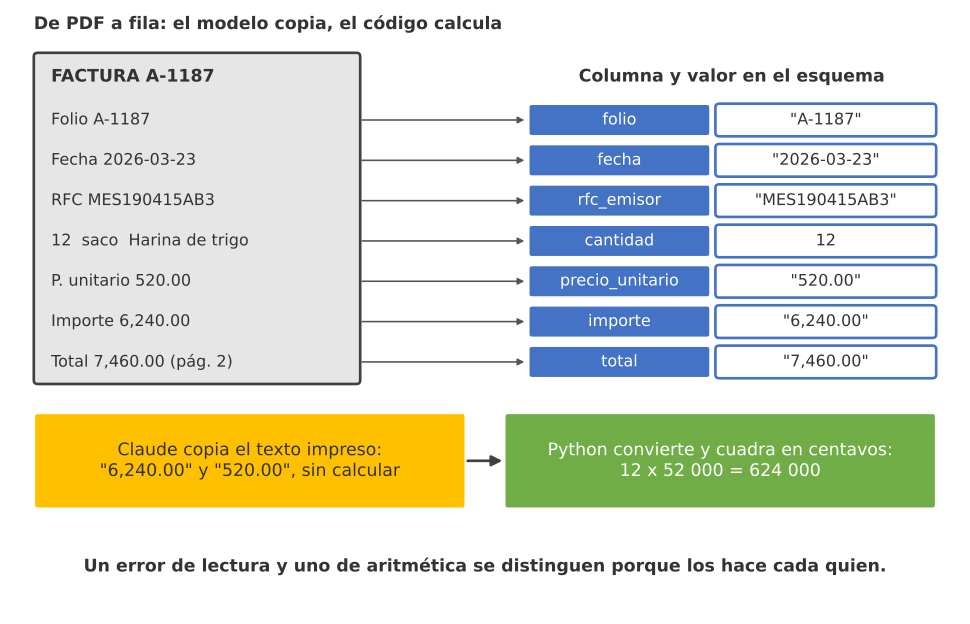
Figura 2. De PDF a fila: cada campo impreso de la factura A-1187 pasa como texto a una columna del esquema; el modelo copia y el código convierte a centavos y comprueba que 12 por 52 000 da 624 000.
Validar lo extraído
Que la respuesta cumpla el esquema solo garantiza la forma: hay un folio, una fecha con forma de fecha y un total con forma de importe. No garantiza que el total sea el que está impreso, ni que los renglones sumen el subtotal. Una salida estructurada puede ser perfectamente válida y estar equivocada, y por eso la serie nunca actúa sobre lo que dice un modelo sin pasarlo antes por un validador, como el Día 4 (Arquitectura de flujos II: entradas, salidas y contratos de datos) hizo con los pedidos y el Día 31 (Caso de otro negocio III: el despacho contable recibe y clasifica comprobantes con Make) con los CFDI.
La regla central de una factura es aritmética y se comprueba en centavos enteros, nunca en coma flotante:
$$ \sum_{i=1}^{m} q_i , p_i = S, \qquad \sum_{i=1}^{m} t_i , q_i , p_i = I, \qquad S + I = T $$
donde:
- $q_i$ es la cantidad del renglón $i$, $p_i$ su precio unitario en centavos y $q_i , p_i$ su importe, que debe coincidir con el impreso.
- $S$ es el subtotal, $t_i$ la tasa de IVA del concepto (del catálogo, no de la factura), $I$ el IVA trasladado y $T$ el total.
- La comparación del IVA admite $1$ centavo de diferencia, porque el redondeo por renglón y el redondeo del total pueden diferir en el último dígito; las demás son exactas.
El siguiente bloque escribe validar_factura(fac), que aplica las reglas de la Tabla 1: formato de los dos RFC, receptor igual a Trigo Lento, fecha legible y dentro del periodo, importe de cada renglón igual a cantidad por precio, concepto dentro del catálogo, suma de renglones, IVA y total. La función centavos(texto) usa Decimal para convertir “6,240.00” en $624,000$ sin pasar por un número de coma flotante. El bloque la prueba con la extracción de ejemplo, con una copia en la que el total se leyó mal (un $4$ y un $6$ intercambiados, el error de lectura más común en una página borrosa) y muestra lo que el modelo leyó en la remisión:
# Validación de lo extraído: RFC, fechas, aritmética en centavos e IVA por renglón en Python:
RFC = re.compile(r'^[A-ZÑ&]{3,4}\d{6}[A-Z0-9]{3}$')

def centavos(texto):
    return int(Decimal(texto.replace(',', '')) * 100)        # "6,240.00" -> 624000, sin coma flotante

def validar_factura(fac, hoy = '2026-03-30'):
    hallazgos = []
    for campo in ('rfc_emisor', 'rfc_receptor'):
        if not RFC.match(getattr(fac, campo)):
            hallazgos.append(f'{campo} con formato inválido')
    if fac.rfc_receptor != RFC_TRIGO_LENTO:
        hallazgos.append('La factura no está a nombre de Trigo Lento')
    if not re.fullmatch(r'\d{4}-\d{2}-\d{2}', fac.fecha):
        hallazgos.append(f'Fecha ilegible: {fac.fecha}')
    elif not '2026-03-01' <= fac.fecha <= hoy:
        hallazgos.append(f'Fecha fuera del periodo: {fac.fecha}')
    suma, iva = 0, 0
    for r in fac.renglones:
        importe = centavos(r.importe)
        if round(Decimal(str(r.cantidad)) * centavos(r.precio_unitario)) != importe:
            hallazgos.append(f'Importe que no es cantidad por precio: {r.descripcion}')
        clave = CLAVE_POR_DESCRIPCION.get(r.descripcion)
        if clave is None:
            hallazgos.append(f'Concepto fuera del catálogo: {r.descripcion}')
        else:
            iva += round(importe * INSUMOS[clave][4])
        suma += importe
    if suma != centavos(fac.subtotal):
        hallazgos.append(f'Renglones suman {pesos(suma)} y el subtotal dice {fac.subtotal}')
    if abs(iva - centavos(fac.iva)) > 1:
        hallazgos.append(f'IVA esperado {pesos(iva)} y el impreso dice {fac.iva}')
    if centavos(fac.subtotal) + centavos(fac.iva) != centavos(fac.total):
        hallazgos.append('Subtotal más IVA no da el total')
    return hallazgos

extraido = Documentos.model_validate_json((carpeta / 'extraccion_A-1187.json').read_text(encoding = 'utf-8'))
print('Factura A-1187 tal como se extrajo:', validar_factura(extraido.factura) or 'sin hallazgos')
mal_leida = extraido.factura.model_copy(update = {'total': '7,640.00'})        # un 4 y un 6 intercambiados
print('La misma, con el total mal leído:  ', validar_factura(mal_leida))
r = extraido.remision.renglones[0]
print(f'Remisión: {r.descripcion} | impresa {r.cantidad_impresa:g} | recibida {r.cantidad_recibida:g} '
      f'| firma: {extraido.remision.firma_presente} | nota: {extraido.remision.nota_manuscrita}')
Factura A-1187 tal como se extrajo: sin hallazgos
La misma, con el total mal leído:   ['Subtotal más IVA no da el total']
Remisión: Harina de trigo para pan, saco de 25 kg | impresa 12 | recibida 10 | firma: True | nota: Recibí 10. E. O.
La factura A-1187 sale sin hallazgos, y ese es el punto más importante de la sección. La factura del cobro de más es internamente perfecta: $12 \cdot 520.00 = 6,240.00$, los renglones suman $7,460.00$ y el total cuadra. Ningún validador de un documento aislado puede encontrar un error que solo existe entre documentos. La copia mal leída, en cambio, se detiene de inmediato con el hallazgo “Subtotal más IVA no da el total”: un error de lectura de dos dígitos que, capturado a mano a las once de la noche, habría llegado intacto a la hoja de compras.
La última línea confirma lo que el cotejo necesita de la remisión: impresa $12$, recibida $10$, firma presente y la nota de Don Ernesto. Con eso se puede, por fin, poner los papeles uno al lado del otro.
Cotejo de tres vías
El cotejo de tres vías (o three-way match, como se le conoce en los textos de sistemas de información contable) es un control clásico de cuentas por pagar: antes de autorizar un pago se comparan tres documentos que vienen de tres fuentes distintas. La orden de compra dice lo que se pidió y a qué precio, la remisión dice lo que se recibió y la factura dice lo que se cobra. Cada documento lo produce alguien diferente (Trigo Lento, el obrador y el proveedor), y esa independencia es la que da fuerza al control: para que un cobro de más pase, tendrían que equivocarse los tres en el mismo sentido. La Figura 3 lo dibuja como tres llaves que deben coincidir para abrir el pago.
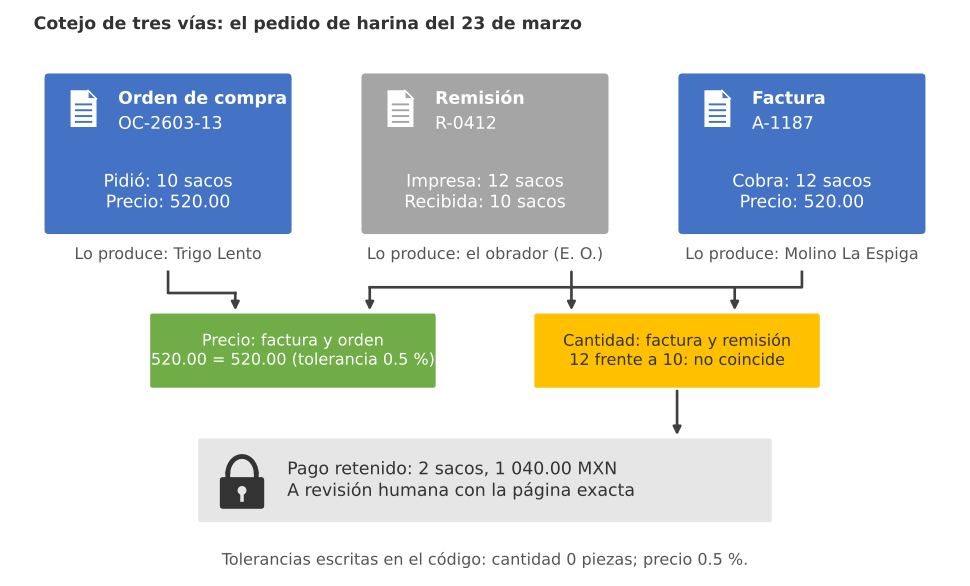
Figura 3. Cotejo de tres vías: la orden OC-2603-13 (10 sacos a 520.00), la remisión R-0412 (impresa 12, recibida 10) y la factura A-1187 (12 sacos a 520.00) son tres llaves; el precio coincide, la cantidad no, y el pago de 1 040.00 MXN queda en revisión humana.
Las reglas comparan pares concretos de documentos, cada uno con su tolerancia:
$$ q_f - q_r \le \tau_q, \qquad \frac{\lvert p_f - p_o \rvert}{p_o} \le \tau_p $$
donde:
- $q_f$ es la cantidad facturada y $q_r$ la recibida según la remisión (la corregida a mano si existe, la impresa si no); con $\tau_q = 0$, se paga lo recibido y ni una pieza más.
- $p_f$ es el precio unitario facturado y $p_o$ el pactado en la orden; con $\tau_p = 0.005$, se toleran diferencias de hasta el $0.5%$, que cubren redondeos del proveedor sin tener que discutir centavos.
- Fuera de estas dos fórmulas quedan tres reglas de existencia: un concepto facturado que no está en la orden es un producto no pedido; el mismo par (RFC del emisor, folio) visto dos veces es un documento duplicado; y una orden sin factura al cierre del periodo es una factura pendiente, que no es un error del proveedor pero sí un pago que hay que prever.
Las tolerancias son decisiones de negocio y se escriben en el código, a la vista, como constantes con nombre. Si algún día Molino La Espiga empieza a vender por kilo y a granel, $\tau_q$ dejará de ser cero y la decisión quedará registrada en un solo lugar. El siguiente bloque aplica las reglas al mes de juguete, añade el cotejo de las facturas semanales de Brújula contra sus remisiones firmadas y dibuja las discrepancias por tipo y por proveedor:
# Cotejo de tres vías del mes: pedido, remisión y factura con tolerancias en Python:
TOLERANCIA_PRECIO = 0.005       # 0.5 % del precio pactado (redondeos del proveedor)
TOLERANCIA_CANTIDAD = 0         # se cobra lo recibido, ni una pieza más

def cotejar(ordenes, remisiones, facturas):
    discrepancias, vistas = [], set()
    for f in facturas:
        llave = (PROVEEDORES[f['proveedor']]['rfc'], f['folio'])
        if llave in vistas:
            total = sum(r['cantidad'] * r['precio'] * (1 + INSUMOS[k][4]) for k, r in f['renglones'].items())
            discrepancias.append((f['proveedor'], 'Documento duplicado', f['folio'], round(total)))
            continue
        vistas.add(llave)
        pedido, recibido = ordenes[f['orden']]['renglones'], remisiones[f['orden']]['recibido']
        for k, r in f['renglones'].items():
            tasa = 1 + INSUMOS[k][4]
            if k not in pedido:
                discrepancias.append((f['proveedor'], 'Producto no pedido', f['folio'], round(r['cantidad'] * r['precio'] * tasa)))
                continue
            if r['cantidad'] - recibido.get(k, 0) > TOLERANCIA_CANTIDAD:
                exceso = (r['cantidad'] - recibido.get(k, 0)) * r['precio'] * tasa
                discrepancias.append((f['proveedor'], 'Cantidad', f['folio'], round(exceso)))
            if abs(r['precio'] - INSUMOS[k][3]) / INSUMOS[k][3] > TOLERANCIA_PRECIO:
                diferencia = (r['precio'] - INSUMOS[k][3]) * r['cantidad'] * tasa
                discrepancias.append((f['proveedor'], 'Precio unitario', f['folio'], round(diferencia)))
    facturadas = {f['orden'] for f in facturas}
    for oc, o in ordenes.items():
        if oc not in facturadas:
            discrepancias.append((o['proveedor'], 'Factura pendiente', oc, 0))
    return pd.DataFrame(discrepancias, columns = ['proveedor', 'tipo', 'documento', 'centavos'])

tabla = cotejar(ordenes, remisiones, facturas)
# Brújula: la factura semanal que emite Trigo Lento contra la suma de las remisiones firmadas:
for s, cobradas in facturas_brujula.items():
    recibidas = sum(remisiones_brujula[k] for k in semanas[s])
    if cobradas != recibidas:
        tabla.loc[len(tabla)] = ['Brújula (factura propia)', 'Cantidad', f'Semana {s}', (cobradas - recibidas) * 3800]
tabla['MXN'] = tabla['centavos'] / 100
print(tabla[['proveedor', 'tipo', 'documento', 'MXN']].to_string(index = False))
por_tipo = tabla.groupby('tipo').agg(casos = ('tipo', 'size'), MXN = ('MXN', 'sum'))
print(por_tipo.to_string())
dentro = f_por_oc['OC-2603-08']['renglones']['H25']['precio']
print(f'Discrepancias: {len(tabla)} | en juego: {tabla["MXN"].sum():,.2f} MXN | '
      f'redondeo tolerado en OC-2603-08: {100 * (dentro - 52000) / 52000:.2f} %')

conteo = tabla.pivot_table(index = 'proveedor', columns = 'tipo', values = 'MXN', aggfunc = 'size', fill_value = 0)
conteo = conteo.reindex(['Molino La Espiga', 'Lácteos Santa Clara', 'Empaques del Valle', 'Brújula (factura propia)'])
ax = conteo.plot.bar(stacked = True, figsize = (8, 4.8), rot = 0,
                     color = ['#4472C4', '#ED7D31', '#A5A5A5', '#FFC000', '#70AD47'])
ax.set_title('Discrepancias del cotejo de tres vías por tipo', fontsize = 16)
ax.set_xlabel('')
ax.set_ylabel('Casos en el mes')
ax.set_yticks(range(0, 5))
ax.set_xticklabels(['Molino\nLa Espiga', 'Lácteos\nSanta Clara', 'Empaques\ndel Valle', 'Brújula\n(factura propia)'])
ax.legend(title = '', fontsize = 9)
plt.tight_layout()
plt.show()
               proveedor                tipo  documento    MXN
        Molino La Espiga            Cantidad     A-1183  610.0
     Lácteos Santa Clara     Precio unitario    LS-1182  210.0
     Lácteos Santa Clara            Cantidad    LS-1183 1850.0
      Empaques del Valle  Producto no pedido     F-1183  208.8
        Molino La Espiga            Cantidad     A-1187 1040.0
      Empaques del Valle     Precio unitario     F-1184   34.8
        Molino La Espiga Documento duplicado     A-1182 5810.0
     Lácteos Santa Clara   Factura pendiente OC-2603-17    0.0
Brújula (factura propia)            Cantidad  Semana 12   76.0
                     casos     MXN
tipo
Cantidad                 4  3576.0
Documento duplicado      1  5810.0
Factura pendiente        1     0.0
Precio unitario          2   244.8
Producto no pedido       1   208.8
Discrepancias: 9 | en juego: 9,839.60 MXN | redondeo tolerado en OC-2603-08: 0.29 %
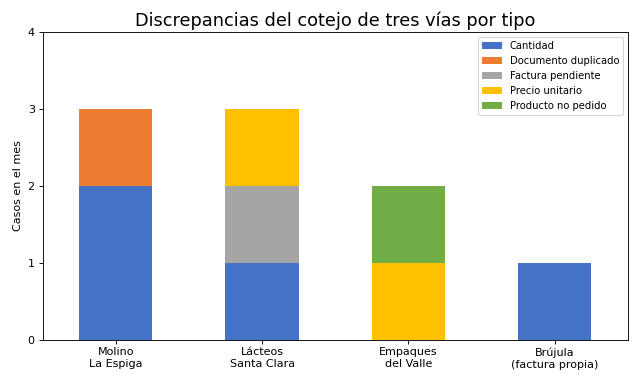
El cotejo encuentra las $9$ discrepancias sembradas y ninguna más, con $9,839.60$ MXN en juego. La Tabla 2 las ordena por tipo, con la regla, el dinero y la acción que corresponde a cada una.
Tabla 2. Discrepancias del cotejo de tres vías en los 60 documentos de juguete de marzo, con su tolerancia y su acción.
| Tipo | Regla y tolerancia | Casos | MXN en juego | Acción |
|---|---|---|---|---|
| Cantidad | Facturado menos recibido mayor que $0$ | 4 | 3 576.00 | Valeria revisa la remisión firmada y pide nota de crédito; en Brújula, se corrige la factura propia antes de enviarla |
| Precio unitario | Diferencia mayor que $0.5%$ del precio pactado | 2 | 244.80 | Se confirma el precio vigente con el proveedor antes de pagar |
| Producto no pedido | Concepto facturado que no está en la orden | 1 | 208.80 | Se pregunta en el obrador si llegó; si no, nota de crédito |
| Documento duplicado | Mismo RFC y mismo folio dos veces | 1 | 5 810.00 | Se archiva la copia y se marca para no pagarla dos veces |
| Factura pendiente | Orden sin factura al cierre | 1 | 0.00 | Se le pide al proveedor; el pago se reserva |
| Redondeo tolerado | $0.29%$ en un precio | 0 | 0.00 | Ninguna: queda dentro de la tolerancia |
Tres lecturas salen de la tabla. La primera es de dinero: el documento duplicado es el caso de mayor importe, $5,810.00$ pesos, el de una factura completa que se habría pagado dos veces; no es el error más frecuente, pero es el más caro, y es el que una captura nocturna deja pasar con más facilidad porque el segundo PDF “se ve igual que el que ya capturé”. La segunda es de método: las $4$ discrepancias de cantidad suman $3,576.00$ pesos e incluyen los $1,040.00$ de la harina de la introducción, y todas necesitan la remisión para verse. La tercera es de reputación: la única discrepancia de Brújula es de Trigo Lento. La factura de la semana 12 cobraba $2$ baguettes que la cafetería no recibió, $76.00$ pesos que Marisol habría encontrado por su cuenta. Detectarlo antes de enviar la factura vale mucho más que los $76$ pesos.
La gráfica muestra que cada proveedor falla de forma distinta. Molino La Espiga concentra cantidades y el duplicado; Lácteos Santa Clara reparte precio, cantidad y la factura pendiente; Empaques del Valle tiene el precio y el producto no pedido. Con un solo mes de juguete no se puede decir que un proveedor sea peor que otro, pero con seis meses de cotejo real esa gráfica se convierte en un argumento para la próxima negociación de Don Ernesto con sus proveedores, con fechas y folios en la mano.
Atención aquí: una discrepancia es una sospecha, no una acusación. El flujo nunca le escribe al proveedor por su cuenta: deja cada caso en la bandeja de revisión de Valeria con los tres documentos y la página exacta, y es ella, o Don Ernesto, quien llama a Molino La Espiga. La remisión pudo firmarse con prisa, el proveedor pudo haber mandado los dos sacos en una segunda entrega o el modelo pudo leer mal un número escrito a mano. Reclamar sin revisar daña una relación de años con un proveedor por un error de lectura de una máquina.
Citas de página para auditar
Cuando Valeria llame al proveedor, le dirán lo que dice cualquier proveedor: "¿Dónde dice eso?". Para auditar una discrepancia no basta con el número; hace falta señalar el lugar del documento donde aparece. Para eso existen las citas (citations) de la API: se activan en el bloque document con "citations": {"enabled": True} y la respuesta llega en varios bloques de texto, cada uno con la lista de pasajes que lo respaldan. Para un PDF, cada cita es de tipo page_location y trae el índice del documento, el texto citado (cited_text) y el rango de páginas con start_page_number y end_page_number. Dos detalles del formato evitan errores al leerlo: las páginas se cuentan desde $1$ y el final es exclusivo, de modo que una cita de la página 1 llega como start_page_number = 1 y end_page_number = 2.
Hay una restricción que obliga a cambiar el diseño, y la documentación la marca como advertencia: las citas y las salidas estructuradas son incompatibles. Si un documento tiene las citas activadas y la petición incluye output_config.format (o el antiguo output_format), la API devuelve un error 400, y messages.parse siempre envía un formato de salida construido con el modelo de pydantic. La razón es mecánica: las citas intercalan bloques de cita con el texto de la respuesta, y eso no cabe dentro de un JSON con esquema estricto.
La salida es hacerlo en dos pasos. El primero ya está hecho: la extracción estructurada del Bloque 8 dio los campos y el cotejo encontró las discrepancias. El segundo solo se da para las discrepancias que lo necesitan: una llamada sin esquema, con las citas activadas, que pregunta por los datos en disputa y devuelve dónde están. En el mes de juguete son $6$ llamadas (las $3$ de cantidad de proveedores, las $2$ de precio y la del producto no pedido); el duplicado y la factura pendiente no necesitan cita, y la factura de Brújula la emite Trigo Lento. Como el PDF ya está en la API de archivos, la segunda llamada reutiliza el mismo file_id sin volver a subir nada.
Dos reglas de la documentación deciden qué documento se envía. Las citas se activan en todos los documentos de la petición o en ninguno, y en un PDF solo se cita texto: un escaneo sin texto extraíble no se puede citar. Así que la remisión escaneada no viaja en esta llamada; su prueba es la imagen que Valeria abrirá junto a la cita de la factura. El siguiente bloque llama a la API y no se ejecutó; su salida es un ejemplo comentado:
# Segunda llamada con citas de página para auditar una discrepancia de cantidad en Python:
import anthropic

client = anthropic.Anthropic()

# Sin output_config.format: las citas y la salida estructurada juntas devuelven un error 400.
# Solo va la factura: las citas se activan en todos los documentos de la petición o en ninguno,
# y la remisión escaneada no tiene capa de texto que citar.
documento = {'type': 'document', 'source': {'type': 'file', 'file_id': subida_f.id},
             'title': 'Factura A-1187', 'citations': {'enabled': True}}
pregunta = ('¿Cuántos sacos de "Harina de trigo para pan, saco de 25 kg" cobra esta factura, a qué precio '
            'unitario y cuál es el total? Responda en una frase por dato.')
respuesta = client.messages.create(
    model = 'claude-sonnet-5-5',
    max_tokens = 1500,
    output_config = {'effort': 'low'},
    messages = [{'role': 'user', 'content': [documento, {'type': 'text', 'text': pregunta}]}],
)

if respuesta.stop_reason == 'end_turn':
    for bloque in respuesta.content:
        if bloque.type != 'text' or not bloque.citations:
            continue
        for cita in bloque.citations:
            if cita.type == 'page_location':       # páginas desde 1, con fin exclusivo
                paginas = range(cita.start_page_number, cita.end_page_number)
                print(f'{bloque.text.strip()!r} -> página(s) {list(paginas)}: "{cita.cited_text.strip()}"')

# Salida de ejemplo (puede variar):
# 'La factura cobra 12 sacos de harina de trigo para pan' -> página(s) [1]: "12 saco Harina de trigo para pan, saco de 25 kg 520.00 6,240.00"
# 'a 520.00 pesos cada uno' -> página(s) [1]: "12 saco Harina de trigo para pan, saco de 25 kg 520.00 6,240.00"
# 'y su total es de 7,460.00 pesos' -> página(s) [2]: "Total 7,460.00"
La salida de ejemplo trae tres afirmaciones y tres pasajes: los $12$ sacos y el precio de $520.00$ están en la página 1, en el renglón de la harina, y el total de $7,460.00$ en la página 2. Es exactamente lo que Valeria necesita poner en el mensaje para el proveedor: “factura A-1187, página 1, renglón de harina de trigo: $12$ sacos; remisión R-0412 firmada en el obrador: recibidos $10$”. La documentación añade dos ventajas que hacen barata esta segunda llamada: el cited_text no cuenta como tokens de salida, y tampoco cuenta como entrada si se reenvía en un turno posterior. Las citas sí suben un poco los tokens de entrada, por las instrucciones que la API añade y por la división del documento en frases.
Queda por decir lo que las citas no hacen. No prueban que la remisión diga $10$: eso lo prueba la imagen del escaneo y, en última instancia, la firma de Don Ernesto. Y no sustituyen la revisión: una cita demuestra que el texto existe en esa página, no que la conclusión que se saca de él sea correcta.
Coste por documento y modelo
Falta la pregunta de Don Ernesto que nunca falla: ¿cuánto cuesta? El coste mensual de leer los documentos con la API se calcula con los precios de la Tabla A de la serie:
$$ C_{\text{API}} = \frac{P , t_p , \pi_e + D , t_s , \pi_s + L , (t_{ce} , \pi_e + t_{cs} , \pi_s)}{10^6} $$
donde:
- $P$ son las páginas del mes ($78$), $t_p$ los tokens por página (supuesto de $2,500$, a sustituir por la medición del Bloque 6) y $\pi_e$ el precio de entrada en USD por millón de tokens.
- $D$ son los documentos ($60$), $t_s$ los tokens de salida por documento (supuesto de $600$, JSON más pensamiento a esfuerzo bajo) y $\pi_s$ el precio de salida.
- $L$ son las llamadas con citas ($6$), con $t_{ce} = 5,000$ tokens de entrada y $t_{cs} = 400$ de salida cada una.
Pero el precio de la API no es todo el coste. Un modelo que lee mal un campo obliga a alguien a revisarlo, y el tiempo de Valeria tiene precio. La comparación honesta suma los dos términos:
$$ C_{\text{total}} = C_{\text{API}} + (1 - a) \cdot D \cdot k \cdot \frac{m}{60} \cdot \frac{v}{18.50} $$
donde:
- $a$ es la tasa de campos correctos del modelo y $k = 12$ los campos que se revisan por documento.
- $m = 1.5$ son los minutos que cuesta detectar y corregir un campo mal leído y $v = 75$ MXN el valor de la hora de Valeria; $18.50$ es el tipo de cambio didáctico de la serie.
- Las tasas de acierto que usa el bloque ($0.985$, $0.980$ y $0.935$) son ilustrativas: el plan del día manda medirlas en $20$ documentos etiquetados a mano antes de decidir, y el código está escrito para recibir esa medición.
El siguiente bloque calcula las dos partes para los tres modelos, compara con el supuesto de la ficha del día ($60$ PDF de dos páginas, $120$ páginas) y dibuja el resultado frente al rubro de Claude de $8$ USD:
# Coste mensual por modelo con la Tabla A y coste de revisar los campos mal leídos en Python:
PRECIOS = {'claude-opus-5-5': (4.00, 20.00), 'claude-sonnet-5-5': (2.00, 10.00), 'claude-haiku-5-5': (0.10, 0.50)}
TOKENS_POR_PAGINA = 2_500       # supuesto de la ficha: sustitúyalo por la medición de count_tokens
SALIDA_POR_DOCUMENTO = 600      # JSON de un documento más el pensamiento a esfuerzo bajo (supuesto)
CITAS = {'llamadas': int((tabla['tipo'].isin(['Cantidad', 'Precio unitario', 'Producto no pedido'])
                          & ~tabla['proveedor'].str.startswith('Brújula')).sum()),
         'entrada': 5_000, 'salida': 400}
ACIERTO = {'claude-opus-5-5': 0.985, 'claude-sonnet-5-5': 0.980, 'claude-haiku-5-5': 0.935}   # ilustrativo
CAMPOS_POR_DOCUMENTO, MINUTOS_POR_CAMPO, MXN_HORA, MXN_USD = 12, 1.5, 75, 18.50

documentos = int(resumen['pdf_al_mes'].sum())
paginas_mes = int((resumen['paginas'] * resumen['pdf_al_mes']).sum())
filas = []
for modelo, (p_ent, p_sal) in PRECIOS.items():
    entrada = paginas_mes * TOKENS_POR_PAGINA + CITAS['llamadas'] * CITAS['entrada']
    salida = documentos * SALIDA_POR_DOCUMENTO + CITAS['llamadas'] * CITAS['salida']
    api = (entrada * p_ent + salida * p_sal) / 1e6
    ficha = (60 * 2 * TOKENS_POR_PAGINA * p_ent + 60 * SALIDA_POR_DOCUMENTO * p_sal) / 1e6
    errores = (1 - ACIERTO[modelo]) * documentos * CAMPOS_POR_DOCUMENTO
    revision = errores * MINUTOS_POR_CAMPO / 60 * MXN_HORA / MXN_USD
    filas.append((modelo, entrada, salida, round(api, 3), round(ficha, 3), ACIERTO[modelo],
                  round(errores, 1), round(revision, 2), round(api + revision, 2)))
coste = pd.DataFrame(filas, columns = ['modelo', 'tokens_entrada', 'tokens_salida', 'api_usd', 'ficha_120_pag_usd',
                                       'acierto', 'campos_mal', 'revision_usd', 'total_usd'])
print(f'Mes: {documentos} PDF, {paginas_mes} páginas, {CITAS["llamadas"]} llamadas con citas')
print(coste.to_string(index = False))
mejor = coste.loc[coste['total_usd'].idxmin(), 'modelo']
print('Modelo con menor coste total:', mejor, '| rubro de Claude: 8.00 USD al mes')

fig, ax = plt.subplots(figsize = (8, 4.8))
x = np.arange(len(coste))
ax.bar(x, coste['api_usd'], color = '#4472C4', label = 'API de Claude')
ax.bar(x, coste['revision_usd'], bottom = coste['api_usd'], color = '#A5A5A5', label = 'Revisar campos mal leídos')
for i, fila in coste.iterrows():
    ax.text(i, fila['total_usd'] + 0.12, f"{fila['total_usd']:.2f} USD\nacierto {100 * fila['acierto']:.1f} %",
            ha = 'center', fontsize = 10)
ax.axhline(8, color = 'red', ls = '--', lw = 1.5, label = 'Rubro de Claude: 8 USD')
ax.set_xticks(x)
ax.set_xticklabels(['Opus 5.5', 'Sonnet 5.5', 'Haiku 5.5'])
ax.set_title('Coste mensual de leer 60 PDF por modelo', fontsize = 16)
ax.set_ylabel('USD al mes')
ax.set_ylim(0, 9)
ax.legend(fontsize = 9, loc = 'upper right')
plt.tight_layout()
plt.show()
Mes: 60 PDF, 78 páginas, 6 llamadas con citas
           modelo  tokens_entrada  tokens_salida  api_usd  ficha_120_pag_usd  acierto  campos_mal  revision_usd  total_usd
  claude-opus-5-5          225000          38400    1.668              1.920    0.985        10.8          1.09       2.76
claude-sonnet-5-5          225000          38400    0.834              0.960    0.980        14.4          1.46       2.29
 claude-haiku-5-5          225000          38400    0.042              0.048    0.935        46.8          4.74       4.78
Modelo con menor coste total: claude-sonnet-5-5 | rubro de Claude: 8.00 USD al mes
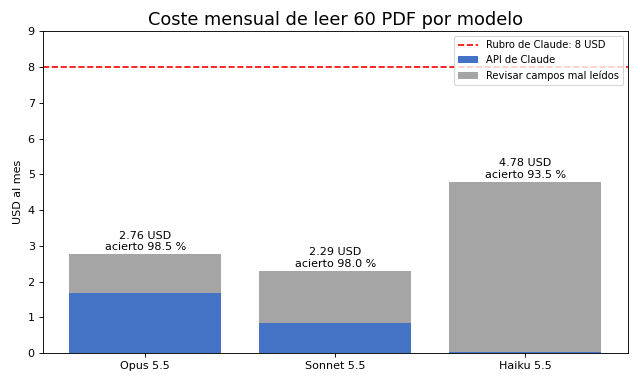
La Tabla 3 resume la salida.
Tabla 3. Coste mensual por modelo para los 60 PDF de marzo (78 páginas, 2 500 tokens por página como supuesto y 6 llamadas con citas); tasas de acierto ilustrativas.
| Modelo | Tokens de entrada | Tokens de salida | API (USD) | Supuesto de la ficha, 120 páginas (USD) | Acierto | Campos mal leídos | Revisión (USD) | Total (USD) |
|---|---|---|---|---|---|---|---|---|
| Opus 5.5 | 225 000 | 38 400 | 1.668 | 1.920 | 98.5 % | 10.8 | 1.09 | 2.76 |
| Sonnet 5.5 | 225 000 | 38 400 | 0.834 | 0.960 | 98.0 % | 14.4 | 1.46 | 2.29 |
| Haiku 5.5 | 225 000 | 38 400 | 0.042 | 0.048 | 93.5 % | 46.8 | 4.74 | 4.78 |
Si solo se mirara la columna de la API, Haiku 5.5 ganaría por goleada: $0.042$ USD al mes, cuarenta veces menos que Opus 5.5. Pero con un acierto ilustrativo del $93.5%$, lee mal unos $47$ campos al mes, y revisarlos cuesta $4.74$ USD del tiempo de Valeria. Sonnet 5.5 cuesta $0.834$ USD de API, lee mal unos $14$ campos y queda en $2.29$ USD de coste total, el menor de los tres. Opus 5.5 lee un poco mejor, pero el medio punto de acierto no paga el doble de precio. Con los supuestos de la ficha, $120$ páginas en lugar de $78$, las cifras de API serían $1.92$, $0.96$ y $0.048$ USD, las mismas que se calcularon al planear el día. Cualquiera de los tres cabe con holgura en el rubro de $8$ USD: el límite aquí no lo pone la API, lo pone el tiempo de quien revisa.
La regla de decisión queda escrita para cuando lleguen los datos reales: se elige Sonnet 5.5 si su tasa de campos correctos en los $20$ documentos etiquetados no baja respecto de la de Opus 5.5; si baja, se paga la diferencia. Y Haiku 5.5 tiene una limitación más, que no aparece en la tabla: no cuenta con respaldo del lado del servidor, así que un rechazo se queda en rechazo y hay que atenderlo desde el cliente.
Consideraciones finales
El día empezó con una frase de Don Ernesto, “Eso lo vi yo, no la computadora”, y termina dándole la razón de una manera que él no esperaba. Lo que vio sigue siendo la fuente de verdad: la remisión firmada en la puerta del obrador, con su $10$ escrito a mano. Lo que cambió es quién pone esa verdad al lado de la factura. Antes lo hacía Valeria de noche, cuando se acordaba y con los ojos cansados; ahora lo hace un flujo que lee los dos papeles, cuadra los centavos, encuentra los $2$ sacos de diferencia y le deja el caso a Valeria con la página exacta. En el mes de juguete fueron $9$ discrepancias y $9,839.60$ pesos en juego, por unos $0.83$ USD de API al mes con Sonnet 5.5.
Atención aquí: las facturas y las remisiones contienen datos fiscales de terceros: RFC, razones sociales, domicilios y montos de los proveedores y de la Cafetería Brújula. Se procesan solo para la contabilidad de Trigo Lento, se conservan el plazo que exige la ley (el artículo 30 del Código Fiscal de la Federación fija, por regla general, cinco años para la contabilidad y su documentación, revisado en octubre de 2026) y no se usan para entrenar nada. Los archivos subidos a la API de archivos se borran en cuanto termina el cotejo, porque son accesibles para todo el espacio de trabajo y no son elegibles para la retención cero de datos. Y una discrepancia nunca se reclama al proveedor ni se le comunica a Marisol sin revisión humana: el flujo propone, una persona verifica y decide.
Las cifras tienen límites que conviene decir. El mes es de juguete y sus errores se sembraron a mano, así que el cotejo los encontró todos porque sabía que existían; en los documentos reales habrá errores que nadie sembró, como una remisión sin firma o un folio ilegible, y el flujo debe mandarlos a revisión en lugar de forzarlos a una regla. Las salidas de las llamadas a la API son ejemplos comentados, no mediciones; los tokens por página son un supuesto hasta que count_tokens dé el número; y las tasas de acierto de la Tabla 3 son ilustrativas hasta que Valeria etiquete sus $20$ documentos. Ninguno de esos límites cambia el método: todos dicen qué medir primero.
Antes de poner a leer documentos a un modelo en su propio negocio, conviene hacerse algunas preguntas:
- ¿Qué pregunta contable responde la lectura, y qué documentos hacen falta para responderla?
- ¿Cuáles de sus documentos son nativos y cuáles escaneados, y qué pierde cuando un escaneo no se puede citar?
- ¿Qué calcula su código y qué copia el modelo, y está esa frontera escrita en el esquema?
- ¿Qué tolerancias aplica su cotejo, quién las decidió y dónde están escritas?
- ¿Cuánto cuesta revisar un campo mal leído, y lo incluyó al comparar modelos?
Un gran libro que habla de esto es Accounting Information Systems (o Sistemas de información contable), de Marshall B. Romney y Paul J. Steinbart, cuya decimocuarta edición explica los ciclos de compras y pagos y los controles que los protegen, entre ellos el cotejo de la orden de compra, el informe de recepción y la factura antes de autorizar un pago. Leerlo antes de automatizar cuentas por pagar evita un error frecuente: automatizar la captura y olvidar el control. La captura ahorra minutos; el control es lo que ahorra dinero.
Un modelo que lee documentos no es un capturista más rápido: es un par de ojos que copia, mientras el código cuadra los números y una persona decide qué se reclama. Trigo Lento ya no captura de noche los $60$ papeles del mes, sabe qué compra no cuadra antes de pagarla y puede señalar a cada proveedor la página exacta del error.
Conclusiones clave
PDF en la API
- Claude recibe cada página de un PDF como imagen y, si existe, como texto extraído; un PDF nativo trae las dos capas, un escaneo solo la imagen, y en el ejemplo pesa $24.3$ veces más ($550.7$ KB frente a $22.7$ KB).
- El bloque
documentllevamedia_typeapplication/pdf, la cadena base64 en una sola línea ($B_{64} = 4 \lceil n/3 \rceil$) y va antes del texto; la petición de hoy usa el $2.45%$ de los $32$ MB y $3$ de las $600$ páginas. - Con facturas nativas manda el límite de páginas ($300$ por petición) y con escaneos el de tamaño ($42$); la API de archivos sube cada PDF una vez y lo reutiliza por
file_id, pero sus archivos son visibles para todo el espacio de trabajo.
Extracción y validación
- El esquema de pydantic tiene $11$ campos de factura y $8$ de remisión, todos obligatorios y con
additionalProperties: false; el modelo copia los importes como texto y el código los convierte a centavos conDecimal. client.beta.messages.parsecon Sonnet 5.5, esfuerzo bajo yfallbacks = 'default'extrae la factura y la nota manuscrita del escaneo; primero se mirastop_reasony lo que no termina enend_turnva a revisión.- La factura A-1187 pasa la validación sin hallazgos porque es internamente coherente; un total mal leído se detiene de inmediato con “Subtotal más IVA no da el total”.
Cotejo y coste
- El cotejo de tres vías con $\tau_q = 0$ y $\tau_p = 0.5%$ encuentra las $9$ discrepancias sembradas, con $9,839.60$ MXN en juego, y deja pasar el redondeo del $0.29%$; el duplicado es el caso más caro ($5,810.00$) y la factura propia a Brújula, el más delicado.
- Las citas devuelven
page_locationcon páginas desde $1$ y fin exclusivo, no se combinan conoutput_config.format(error 400) y no funcionan sobre escaneos sin texto: se piden en una segunda llamada solo para las $6$ discrepancias que lo necesitan. - Con $78$ páginas al mes, la API cuesta $1.668$, $0.834$ y $0.042$ USD con Opus 5.5, Sonnet 5.5 y Haiku 5.5; sumando la revisión de campos mal leídos, Sonnet 5.5 queda en $2.29$ USD, el menor coste total, siempre que la medición en $20$ documentos lo confirme.
Mañana, en el Día 59: Caso de otro negocio V: el despacho contable concilia comprobantes con Claude. Valeria volverá al despacho de Ricardo Ledesma, que conoció el Día 31, donde lo que hoy se hizo con $60$ PDF de una panadería se hace con miles de registros: conciliar los comprobantes de $120$ clientes contra sus estados de cuenta antes del cierre de marzo, leer con visión los que llegan solo en PDF y dejar a Claude únicamente los emparejamientos ambiguos, con un contador que firma cada conciliación.
Referencias
- Anthropic (2026). PDF support. Documentación de Claude. https://platform.claude.com/docs/en/build-with-claude/pdf-support (revisado en octubre de 2026).
- Anthropic (2026). Files API. Documentación de Claude. https://platform.claude.com/docs/en/build-with-claude/files (revisado en octubre de 2026).
- Anthropic (2026). Citations. Documentación de Claude. https://platform.claude.com/docs/en/build-with-claude/citations (revisado en octubre de 2026).
- Anthropic (2026). Vision. Documentación de Claude. https://platform.claude.com/docs/en/build-with-claude/vision (revisado en octubre de 2026).
- Anthropic (2026). Token counting. Documentación de Claude. https://platform.claude.com/docs/en/build-with-claude/token-counting (revisado en octubre de 2026).
- Anthropic (2026). Structured outputs. Documentación de Claude. https://platform.claude.com/docs/en/build-with-claude/structured-outputs (revisado en octubre de 2026).
- Romney, M. B. y Steinbart, P. J. (2018). Accounting Information Systems (14.ª ed., edición global). Pearson. (Ciclo de compras y pagos; cotejo de orden de compra, recepción y factura.)
- Cámara de Diputados del H. Congreso de la Unión (2026). Código Fiscal de la Federación, artículo 30. https://www.diputados.gob.mx/LeyesBiblio/pdf/CFF.pdf (revisado en octubre de 2026).