
Arquitecto de automatización con IA: Día 62
 Jeshua Romero Guadarrama
- 60 Min para leer
- 03 Apr, 2026
Índice de contenido
Resumen:
El inventario de harina, mantequilla, azúcar y cajas de Trigo Lento vive en una hoja que nadie actualiza, y cada viernes Don Ernesto pregunta si alcanza la harina para el sábado sin que nadie sepa responder. En esta entrada, usted conoce el Model Context Protocol (MCP) y sus piezas (cliente, servidor, herramientas, recursos y prompts), guarda ocho semanas de movimientos en SQLite, calcula el punto de reorden de cada insumo y comprueba con simulaciones cuándo protege y cuándo no, diseña cinco herramientas con esquemas cerrados que separan la lectura de las propuestas, escribe el servidor con el SDK oficial de MCP para Python, lo prueba de verdad por stdio y por HTTP con token, y deja cada llamada en un registro seudonimizado. Al terminar, sabrá exponer los datos de un negocio a cualquier cliente MCP con el mínimo privilegio y sin dejar que un modelo compre nada.
¿Cómo citar el presente artículo?
Romero, J. (3 de abril de 2026). Arquitecto de automatización con IA: Día 62. python-data-engineer. https://www.python-data-engineer.com/post/aai/dia_62/.
Arquitecto de automatización con IA: Día 62 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/aai/dia_62/.
Precios, límites y políticas revisados en octubre de 2026: planes, precios y límites de Make, n8n, Zapier, WhatsApp (Meta, Twilio, Wati) y de la API de Claude. El servidor de esta entrada usa el SDK oficial de MCP para Python en su versión 2.3.0 (publicada el 2 de octubre de 2026). En la rama 2 del SDK la clase que la documentación antigua llama FastMCP se renombró MCPServer y vive en mcp.server; importar mcp.server.fastmcp en la versión 2 falla con un mensaje que remite a la guía de migración. El servidor y el cliente de prueba (bloques 7, 8 y 11) se ejecutaron de verdad al preparar la entrada, en un entorno virtual con esa versión, y sus salidas son las obtenidas. Los requisitos del conector MCP de la API de Claude (cabecera beta mcp-client-2025-11-20, servidor público por HTTP con transporte Streamable HTTP o SSE, solo herramientas, sin retención cero de datos) se contrastaron con la documentación oficial de Claude, revisado en octubre de 2026. El Bloque 9 llama a la API de Claude y no se ejecutó: su salida es un ejemplo comentado.
Día 62. Model Context Protocol I: un servidor MCP para el inventario de Trigo Lento
Introducción
Ayer, en el Día 61 (Caché de prompts para flujos recurrentes), Valeria aprendió que la caché es una coincidencia de prefijo, colocó puntos de caché en el agente de pedidos y en los borradores de correo, calculó el ahorro con los precios reales de cada modelo y comprobó los aciertos con usage.cache_read_input_tokens, y Trigo Lento ganó TL Agente de pedidos v3, un agente que deja de pagar cuatro veces por las mismas instrucciones. Hoy el módulo cambia de pregunta: ya no se trata de cuánto cuesta lo que el modelo lee, sino de qué datos del negocio puede leer y quién decide cuáles.
Es viernes 3 de abril, Viernes Santo, a las cinco de la tarde. Mañana es Sábado de Gloria, el día con más encargos del año, y en el obrador hay una sola pregunta que importa. Don Ernesto se limpia las manos en el mandil, mira los sacos apilados junto a la amasadora y le pregunta a Valeria lo mismo que pregunta todos los viernes: “Valeria, ¿alcanza la harina para el sábado?”. Valeria abre la hoja de cálculo del inventario. La última fila tiene fecha del 12 de marzo. Desde entonces llegaron pedidos de Molino La Espiga, se rompió un saco, se compraron dos de emergencia en la tienda de la esquina, y nadie apuntó nada. La hoja dice $87$ kilos; el conteo que hace Don Ernesto a ojo, saco por saco, dice que hay unos $140$.
No es la primera vez. En las últimas ocho semanas, la harina no alcanzó para todo lo que se quería hornear en $10$ de $47$ días hábiles, y en cada uno alguien tuvo que cambiar el plan de la hornada o salir corriendo por un saco. La práctica de la casa es razonable en apariencia: Don Ernesto pide seis sacos cuando ve que quedan “los dos días que tarda el molino”. Hoy se verá con números por qué esa regla falla una de cada dos veces.
Valeria ya sabe lo que quiere: que la pregunta del viernes se pueda hacer en Slack, en el agente de n8n o directamente a Claude, y que la respuesta salga de los datos y no de la memoria de nadie. Su padre, sin embargo, tiene dos condiciones, y las dice antes de que ella termine de explicar. “Mire, Valeria, que la máquina cuente sacos me parece bien. Pero mis recetas no salen de este obrador, y la máquina no compra nada. Si un día me llega un camión de harina que yo no pedí, apago todo.” Las dos condiciones son, sin que él lo sepa, los dos principios de diseño de un buen servidor MCP: exponer solo lo necesario y separar lo que se lee de lo que cambia algo.
En la presente entrada, descubrirá qué es el Model Context Protocol, qué papel tienen el cliente y el servidor y qué diferencia hay entre una herramienta, un recurso y un prompt. Guardará el inventario de Trigo Lento en dos tablas de SQLite con ocho semanas de movimientos simulados, calculará el punto de reorden de cada insumo con su fórmula y comprobará con simulaciones qué lo hace funcionar y qué lo rompe. Diseñará cinco herramientas con esquemas cerrados, tres de lectura y dos que solo crean propuestas, y escribirá el servidor con el SDK oficial de MCP para Python. Lo probará de verdad, primero por stdio con un cliente mínimo y después por HTTP con un token, verá cómo lo usaría Claude en local y dejará cada llamada en un registro que no guarda datos personales. Mañana, en el Día 63, Claude se conectará a este mismo servidor desde la API.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Explicar el Model Context Protocol (MCP): cliente, servidor, herramientas, recursos y prompts, y los transportes local y remoto.
- Diseñar las herramientas del inventario con esquemas estrictos, separando lectura de escritura.
- Implementar un servidor MCP en Python sobre
trigo_lento.sqlitecon el SDK oficial de MCP y probarlo localmente. - Calcular el punto de reorden de la harina y exponerlo como herramienta, con la escritura sujeta a aprobación.
Qué es MCP
El Model Context Protocol (MCP, por sus siglas en inglés: “Model Context Protocol”) es un protocolo abierto que estandariza cómo una aplicación con un modelo de lenguaje descubre y usa datos y herramientas externos. Lo presentó Anthropic en noviembre de 2024 y hoy lo implementan muchos clientes y proveedores. La idea cabe en una frase: en lugar de escribir una integración distinta para cada combinación de modelo y sistema, cada sistema publica un servidor MCP y cada aplicación incluye un cliente MCP, y cualquier cliente puede hablar con cualquier servidor.
El protocolo define tres papeles:
- El anfitrión (host): la aplicación con la que trabaja una persona o un flujo, como Claude Desktop, un editor de código, un agente de n8n o un programa en Python que llama a la API.
- El cliente: la pieza dentro del anfitrión que mantiene una conexión con un servidor concreto. Un anfitrión puede tener varios clientes, uno por servidor.
- El servidor: el programa que expone las capacidades de un sistema. Hoy, el inventario de Trigo Lento.
Y el servidor ofrece tres tipos de capacidades, que conviene no confundir porque cada una tiene un dueño distinto:
- Herramientas (tools): funciones que el modelo decide llamar, con un nombre, una descripción y un esquema JSON de sus argumentos.
consultar_existenciases una herramienta. - Recursos (resources): datos que la aplicación decide leer, identificados por una URI. El catálogo de insumos, en
inventario://insumos, es un recurso. - Prompts: plantillas de instrucciones que la persona elige, como un atajo. “La pregunta del viernes” es un prompt.
Por debajo, los mensajes son JSON-RPC 2.0: el cliente envía initialize, después tools/list para descubrir las herramientas y tools/call para usarlas, y lo mismo con resources/list, resources/read, prompts/list y prompts/get. Esos mensajes viajan por un transporte. La especificación define dos estándar: stdio, en el que el cliente arranca el servidor como un proceso hijo y le habla por la entrada y la salida estándar (ideal para pruebas y para herramientas en la misma computadora), y Streamable HTTP, en el que el servidor escucha en una URL y puede atender a clientes remotos. Muchos servidores todavía ofrecen también el transporte SSE, anterior, que la especificación conserva por compatibilidad.
La pregunta práctica es por qué no basta con lo que Valeria ya hace desde el Día 38: definir las herramientas dentro de cada petición a la API, con su input_schema, y ejecutarlas en su propio código. La Tabla 1 compara las dos formas.
Tabla 1. Herramienta definida en la petición frente a servidor MCP.
| Aspecto | Herramienta en la petición | Servidor MCP |
|---|---|---|
| Dónde vive el código | Dentro de cada programa o flujo que llama al modelo | En un solo proceso, junto a los datos |
| Reutilización entre clientes | Se copia en cada agente (Claude, n8n, un script) | Cualquier cliente MCP la descubre con tools/list |
| Descubrimiento | La lista se escribe a mano en cada petición | El cliente la pide al servidor al conectarse |
| Autenticación | La del programa que ejecuta la herramienta | Token u OAuth del propio servidor, uno por cliente |
| Versionado | Un cambio obliga a tocar cada flujo | Se cambia el servidor y todos los clientes lo ven |
| Registro de llamadas | Disperso en cada flujo | Centralizado en el servidor |
| Coste en tokens | Las definiciones viajan en cada petición | Igual: el cliente las pasa al modelo en cada petición |
La última fila es la que más se olvida. MCP no hace gratis las herramientas: la definición de cada una sigue llegando al modelo en cada petición, igual que la $D$ de la fórmula del agente del Día 37. Lo que cambia es dónde vive la verdad. Con herramientas en la petición, el agente de pedidos de n8n, el informe del lunes y el canal de Slack tendrían tres copias de “cuánta harina queda”, y tarde o temprano dirían tres cosas distintas, igual que la hoja de cálculo de hoy. Con un servidor, hay una sola copia. Esa es la imagen de la Figura 1.
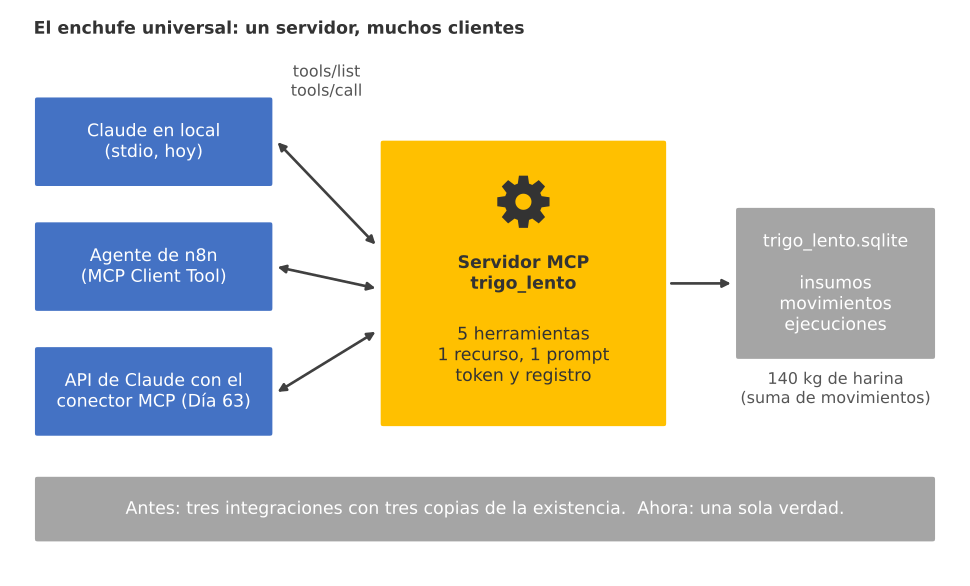
Figura 1. El enchufe universal: un solo servidor MCP, trigo_lento, con 5 herramientas, 1 recurso y 1 prompt sobre trigo_lento.sqlite, atiende a Claude en local por stdio, al agente de n8n y, desde el Día 63, a la API de Claude con el conector MCP; antes harían falta tres integraciones distintas.
Para Trigo Lento, la decisión es clara por el número de clientes. Hoy la pregunta del viernes la hará Claude en local; mañana, la API de Claude desde un flujo de n8n con el conector MCP; y el agente de pedidos de n8n puede usar las mismas herramientas con su nodo MCP Client Tool, que el Día 37 (Nodos de IA de n8n: modelos, cadenas, memoria y agentes con LangChain) dejó presentado. Tres clientes, un solo servidor.
El inventario de Trigo Lento
Antes de escribir una línea del servidor hay que tener datos que servir. El inventario de la panadería cabe en dos tablas. insumos es el catálogo: la clave, el nombre, la unidad en la que se cuenta, la presentación en la que se compra, el proveedor, los días que tarda en llegar un pedido, el nivel de servicio que se quiere y el pedido habitual. movimientos es el diario: cada fila es una entrada (llegó un pedido), un consumo (se usó en el obrador), una merma (se dañó) o un ajuste (el conteo físico no coincidió con lo apuntado). La existencia de un insumo no se guarda en ninguna parte: se calcula sumando sus movimientos, y por eso nunca puede quedar desactualizada respecto del diario.
El primer bloque fija las importaciones, la semilla de la serie y la carpeta del día:
# Importaciones base, semilla de la serie y carpeta del día en Python:
import warnings
warnings.filterwarnings('ignore')
import hashlib
import hmac
import json
import math
import sqlite3
from pathlib import Path
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from matplotlib.patches import FancyBboxPatch, FancyArrowPatch
from scipy import stats

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 130)
pd.set_option('display.max_columns', 12)
carpeta = Path('trigo_lento') / 'dia_62'
carpeta.mkdir(parents = True, exist_ok = True)
import scipy
print('numpy', np.__version__, '| pandas', pd.__version__, '| matplotlib', matplotlib.__version__,
      '| scipy', scipy.__version__)
print('Carpeta del día:', carpeta.as_posix())
numpy 2.4.6 | pandas 3.0.3 | matplotlib 3.10.9 | scipy 1.17.1
Carpeta del día: trigo_lento/dia_62
Las versiones quedan escritas para que las cifras de esta entrada se puedan reproducir. scipy aparece hoy por primera vez en el módulo, solo por scipy.stats, para la distribución normal del punto de reorden.
El siguiente bloque crea las dos tablas en trigo_lento.sqlite y simula ocho semanas de operación, del lunes 9 de febrero al viernes 3 de abril, con la práctica actual de la casa. Los cuatro insumos son la harina de trigo para pan (sacos de $25$ kg, Molino La Espiga), la mantequilla sin sal (cajas de $10$ kg, Lácteos Santa Clara), el azúcar estándar (bultos de $50$ kg) y las cajas para pastel (paquetes de $25$, Empaques del Valle). El consumo de cada día se genera como la suma de cuatro hornadas, porque así trabaja el obrador; para la harina, cada hornada usa en promedio $9.5$ kg con una desviación de $3$ kg, de modo que el día suma $38$ kg con una desviación de $6$ kg. La práctica actual se modela tal como la describe Don Ernesto: al cerrar, si la existencia quedó en los kilos que se gastan mientras llega el pedido ($38 \cdot 2 = 76$ kg en la harina), se pide el pedido habitual. Al final se apuntan tres mermas, la compra urgente de dos sacos del viernes y el conteo físico de la tarde:
# Tablas insumos y movimientos en SQLite con ocho semanas de consumo simulado en Python:
# clave, nombre, unidad, presentación, contenido, proveedor, días de entrega, nivel de servicio,
# pedido habitual (en presentaciones), consumo medio y desviación diarios (solo para simular):
INSUMOS = [
    ('H25',  'Harina de trigo para pan', 'kg',    'saco de 25 kg',  25, 'Molino La Espiga',    2, 0.95, 6, 38.0, 6.0),
    ('M10',  'Mantequilla sin sal',      'kg',    'caja de 10 kg',  10, 'Lácteos Santa Clara', 3, 0.95, 3, 4.5, 1.2),
    ('AZ50', 'Azúcar estándar',          'kg',    'bulto de 50 kg', 50, 'Abastos del Centro',  2, 0.90, 1, 9.0, 2.0),
    ('CP25', 'Caja para pastel',         'pieza', 'paquete de 25',  25, 'Empaques del Valle',  5, 0.90, 2, 6.0, 2.5),
]
INICIAL = {'H25': 200.0, 'M10': 22.0, 'AZ50': 40.0, 'CP25': 45.0}
dias = [d for d in pd.date_range('2026-02-09', '2026-04-03') if d.dayofweek < 6]   # lunes a sábado

def simular_politica(demanda, inicial, umbral, pedido, entrega):
    # Por periodo (un día o una hornada): llegan los pedidos, se consume y, si la existencia cae al umbral, se pide:
    existencia, llegadas, filas = inicial, {}, []
    for t, d in enumerate(demanda):
        entrada = llegadas.pop(t, 0.0)
        existencia += entrada
        servido = min(existencia, d)
        existencia -= servido
        if existencia <= umbral and not llegadas:
            llegadas[t + entrega + 1] = pedido          # pedido al cierre: llega tras 'entrega' días de consumo
        filas.append({'t': t, 'entrada': entrada, 'demanda': d, 'servido': servido,
                      'faltante': d - servido, 'existencia': existencia})
    return pd.DataFrame(filas)

ruta_bd = carpeta / 'trigo_lento.sqlite'
ruta_bd.unlink(missing_ok = True)
con = sqlite3.connect(ruta_bd)
con.executescript('''
CREATE TABLE insumos (clave TEXT PRIMARY KEY, nombre TEXT NOT NULL, unidad TEXT NOT NULL,
    presentacion TEXT NOT NULL, contenido REAL NOT NULL, proveedor TEXT NOT NULL,
    entrega_dias INTEGER NOT NULL, nivel_servicio REAL NOT NULL, pedido_habitual INTEGER NOT NULL);
CREATE TABLE movimientos (id INTEGER PRIMARY KEY, fecha TEXT NOT NULL, clave TEXT NOT NULL REFERENCES insumos,
    tipo TEXT NOT NULL CHECK (tipo IN ('entrada', 'consumo', 'merma', 'ajuste')),
    cantidad REAL NOT NULL, nota TEXT);
''')
con.executemany('INSERT INTO insumos VALUES (?, ?, ?, ?, ?, ?, ?, ?, ?)', [i[:9] for i in INSUMOS])

# La práctica actual: se pide "cuando quedan los días que tarda en llegar" (umbral = consumo medio x entrega):
demanda, historia = {}, {}
for clave, _, _, _, contenido, _, entrega, _, habitual, media, desv in INSUMOS:
    # Cuatro hornadas por día; la suma de cuatro hornadas tiene la media y la desviación diarias:
    hornadas = np.clip(rng.normal(media / 4, desv / 2, (len(dias), 4)), 0, None)
    demanda[clave] = np.round(hornadas.sum(axis = 1), 1)
    if clave == 'H25':
        demanda_hornadas = np.round(hornadas.ravel(), 2)
    historia[clave] = simular_politica(demanda[clave], INICIAL[clave], media * entrega, habitual * contenido, entrega)
    con.execute('INSERT INTO movimientos (fecha, clave, tipo, cantidad, nota) VALUES (?, ?, ?, ?, ?)',
                (dias[0].strftime('%Y-%m-%d'), clave, 'ajuste', INICIAL[clave], 'inventario inicial'))
    for t, fila in historia[clave].iterrows():
        fecha = dias[t].strftime('%Y-%m-%d')
        if fila['entrada'] > 0:
            con.execute('INSERT INTO movimientos (fecha, clave, tipo, cantidad, nota) VALUES (?, ?, ?, ?, ?)',
                        (fecha, clave, 'entrada', fila['entrada'], 'pedido habitual'))
        nota = f"faltaron {fila['faltante']:.1f}" if fila['faltante'] > 0 else None
        con.execute('INSERT INTO movimientos (fecha, clave, tipo, cantidad, nota) VALUES (?, ?, ?, ?, ?)',
                    (fecha, clave, 'consumo', -fila['servido'], nota))

# Mermas apuntadas a mano, compra urgente del viernes y conteo físico del 3 de abril (harina: 140 kg en sacos):
con.executemany('INSERT INTO movimientos (fecha, clave, tipo, cantidad, nota) VALUES (?, ?, ?, ?, ?)',
                [('2026-04-03', 'H25', 'entrada', 50.0, 'compra urgente: 2 sacos'),
                 ('2026-02-24', 'H25', 'merma', -3.5, 'saco roto'), ('2026-03-17', 'M10', 'merma', -1.0, 'caja golpeada'),
                 ('2026-03-26', 'H25', 'merma', -2.0, 'humedad')])
teorica = dict(con.execute('SELECT clave, ROUND(SUM(cantidad), 1) FROM movimientos GROUP BY clave'))
conteo = {'H25': 140.0, 'M10': round(teorica['M10']), 'AZ50': round(teorica['AZ50']), 'CP25': round(teorica['CP25'])}
for clave, contado in conteo.items():
    if abs(contado - teorica[clave]) > 0.01:
        con.execute('INSERT INTO movimientos (fecha, clave, tipo, cantidad, nota) VALUES (?, ?, ?, ?, ?)',
                    ('2026-04-03', clave, 'ajuste', round(contado - teorica[clave], 1), 'conteo físico'))
con.commit()

existencias = pd.read_sql('''SELECT i.clave, i.nombre, i.unidad, ROUND(SUM(m.cantidad), 1) AS existencia,
       SUM(m.tipo = 'consumo') AS dias_con_consumo, SUM(m.nota LIKE 'faltaron%') AS dias_con_faltante
FROM insumos i JOIN movimientos m USING (clave) GROUP BY i.clave ORDER BY i.rowid''', con)
print(f'Días hábiles simulados: {len(dias)} (del {dias[0]:%d/%m} al {dias[-1]:%d/%m/%Y}) | '
      f'movimientos: {con.execute("SELECT COUNT(*) FROM movimientos").fetchone()[0]}')
print(existencias.to_string(index = False))
print('Ajuste de la harina por conteo físico:', round(140.0 - teorica['H25'], 1), 'kg')
Días hábiles simulados: 47 (del 09/02 al 03/04/2026) | movimientos: 227
clave                   nombre unidad  existencia  dias_con_consumo  dias_con_faltante
  H25 Harina de trigo para pan     kg       140.0                47                 10
  M10      Mantequilla sin sal     kg        11.0                47                  7
 AZ50          Azúcar estándar     kg         2.0                47                  6
 CP25         Caja para pastel  pieza        16.0                47                  5
Ajuste de la harina por conteo físico: -9.3 kg
La base tiene $227$ movimientos en $47$ días hábiles, y la consulta que calcula las existencias responde la pregunta que la hoja no pudo: hay $140.0$ kg de harina, $11$ kg de mantequilla, $2$ kg de azúcar y $16$ cajas para pastel. La columna de faltantes cuenta los días en los que lo que había no alcanzó para lo que se quería usar: $10$ en la harina, $7$ en la mantequilla, $6$ en el azúcar y $5$ en las cajas. Son días en que el obrador improvisó.
El ajuste del conteo físico merece una línea propia: la suma de los movimientos daba $149.3$ kg y Don Ernesto contó $140$, así que se apunta un ajuste de $-9.3$ kg. Es harina que se usó, se tiró o se derramó sin que nadie lo apuntara. Un sistema de inventario sin ajustes es un sistema que miente: el conteo físico periódico no es desconfianza, es el control que mantiene honesto al diario. Y la decisión de diseño tiene una consecuencia para el servidor de hoy: las herramientas leerán siempre la suma de movimientos, ajustes incluidos, nunca un número tecleado en una celda.
Punto de reorden
La pregunta del viernes tiene dos partes. La primera, ¿alcanza para mañana?, se responde con la existencia y el consumo esperado. La segunda, ¿cuándo hay que pedir?, es la que de verdad evita los $10$ días de faltante, y tiene una respuesta clásica en la gestión de inventarios: el punto de reorden, la existencia a la que se debe hacer el pedido para que llegue antes de que se acabe el insumo, con una probabilidad elegida de antemano. Se calcula así:
$$ R = \bar{d} \cdot L + z \cdot \sigma_d \cdot \sqrt{L} $$
donde:
- $\bar{d}$ es el consumo medio diario y $L$ el tiempo de entrega en días: el primer término, $\bar{d} \cdot L$, es lo que se espera gastar mientras el pedido viene en camino. Es exactamente la regla de Don Ernesto.
- $\sigma_d$ es la desviación estándar del consumo diario. Si los días son independientes, la desviación del consumo en $L$ días es $\sigma_d \sqrt{L}$, no $\sigma_d \cdot L$: las variaciones de días distintos se compensan en parte.
- $z$ es el factor de servicio: el número de desviaciones que se añaden como colchón. Con $z = 1.645$, el consumo durante la entrega supera a $R$ solo en el $5%$ de los ciclos de pedido, es decir, se fija un nivel de servicio por ciclo del $95%$.
- El segundo término, $SS = z \cdot \sigma_d \cdot \sqrt{L}$, es la existencia de seguridad: lo que la regla de la casa no tiene. Sin él, $z = 0$ y el faltante ocurre en la mitad de los ciclos.
Con los valores del plan del día ($\bar{d} = 38$ kg, $\sigma_d = 6$ kg, $L = 2$ días y $z = 1.645$), el punto de reorden de la harina es $R = 38 \cdot 2 + 1.645 \cdot 6 \cdot \sqrt{2} = 89.96$ kg: hay que pedir cuando queden unos $90$ kg, es decir, $3.6$ sacos, que en la práctica son $4$. La Figura 2 lo pinta sobre un costal.
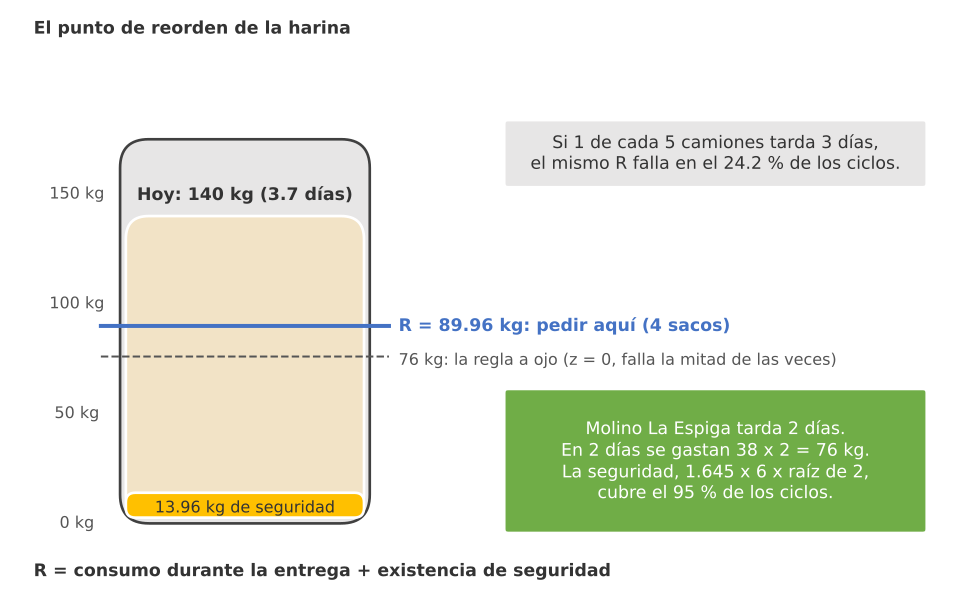
Figura 2. El punto de reorden: en el costal de harina se pinta una línea en 89.96 kg, que son los 76 kg que se gastan en los 2 días que tarda el camión del molino más 13.96 kg de existencia de seguridad; hoy hay 140 kg y el pedido se hace al cruzar la línea, cuando quedan unos 4 sacos.
El siguiente bloque calcula el punto de reorden de los cuatro insumos con los consumos medidos en la base, no con los del plan. Hay un detalle que separa un cálculo de libro de uno honesto: los días con faltante no se usan para estimar el consumo. En esos días, el movimiento de consumo registra lo que se pudo usar, no lo que se quería usar, y meterlos en la media la sesgaría hacia abajo justo en los días de más demanda. El bloque descarta esas filas, estima la media y la desviación con el resto y aplica la fórmula con el tiempo de entrega y el nivel de servicio de cada insumo:
# Punto de reorden por insumo con el consumo medido, el tiempo de entrega y el nivel de servicio en Python:
consumos = pd.read_sql('''SELECT clave, fecha, -cantidad AS consumo, nota FROM movimientos
                          WHERE tipo = 'consumo' ''', con)
limpios = consumos[consumos['nota'].isna()]          # los días con faltante subestiman la demanda: fuera
param = pd.read_sql('SELECT clave, contenido, entrega_dias, nivel_servicio FROM insumos', con).set_index('clave')
reorden = limpios.groupby('clave')['consumo'].agg(media = 'mean', desv = lambda s: s.std(ddof = 1)).join(param)
reorden['z'] = stats.norm.ppf(reorden['nivel_servicio'])
reorden['seguridad'] = reorden['z'] * reorden['desv'] * np.sqrt(reorden['entrega_dias'])
reorden['R'] = reorden['media'] * reorden['entrega_dias'] + reorden['seguridad']
reorden['R_present'] = np.ceil(reorden['R'] / reorden['contenido']).astype(int)
reorden['existencia'] = existencias.set_index('clave')['existencia']
reorden['pedir_ya'] = np.where(reorden['existencia'] <= reorden['R'], 'sí', 'no')
reorden = reorden.loc[[i[0] for i in INSUMOS]]
print(reorden[['media', 'desv', 'entrega_dias', 'nivel_servicio', 'z', 'seguridad', 'R', 'R_present',
               'existencia', 'pedir_ya']].round(2).to_string())
R_ficha = 38 * 2 + 1.645 * 6 * math.sqrt(2)
print(f'Harina con los valores del plan (38 kg, 6 kg, 2 días, z = 1.645): R = {R_ficha:.2f} kg '
      f'= {R_ficha / 25:.2f} sacos')
       media  desv  entrega_dias  nivel_servicio     z  seguridad      R  R_present  existencia pedir_ya
clave
H25    38.15  6.97             2            0.95  1.64      16.22  92.51          4       140.0       no
M10     4.28  1.15             3            0.95  1.64       3.27  16.11          2        11.0       sí
AZ50    9.01  2.48             2            0.90  1.28       4.49  22.52          1         2.0       sí
CP25    6.42  2.45             5            0.90  1.28       7.03  39.12          2        16.0       sí
Harina con los valores del plan (38 kg, 6 kg, 2 días, z = 1.645): R = 89.96 kg = 3.60 sacos
La Tabla 3 resume la salida.
Tabla 3. Punto de reorden por insumo con el consumo medido en las ocho semanas (días sin faltante).
| Insumo | Consumo medio diario | Desviación | Entrega (días) | Nivel de servicio | $z$ | Existencia de seguridad | Punto de reorden | En presentaciones | Existencia hoy | ¿Pedir ya? |
|---|---|---|---|---|---|---|---|---|---|---|
| Harina (kg) | 38.15 | 6.97 | 2 | 95 % | 1.645 | 16.22 | 92.51 | 4 sacos | 140.0 | No |
| Mantequilla (kg) | 4.28 | 1.15 | 3 | 95 % | 1.645 | 3.27 | 16.11 | 2 cajas | 11.0 | Sí |
| Azúcar (kg) | 9.01 | 2.48 | 2 | 90 % | 1.282 | 4.49 | 22.52 | 1 bulto | 2.0 | Sí |
| Cajas para pastel (piezas) | 6.42 | 2.45 | 5 | 90 % | 1.282 | 7.03 | 39.12 | 2 paquetes | 16 | Sí |
La harina medida se parece mucho a la del plan: $38.15$ kg de media y una desviación algo mayor, $6.97$ kg, que sube el punto de reorden a $92.51$ kg, todavía $4$ sacos. Con $140$ kg en existencia, la respuesta a la segunda parte de la pregunta del viernes es que todavía no hay que pedir harina. La sorpresa está en las otras filas: la mantequilla, el azúcar y las cajas ya están por debajo de su punto de reorden, y el azúcar, con $2$ kg, está prácticamente agotado. Nadie había preguntado por ellos. Un servidor que responde sobre cualquier insumo cambia la conversación del viernes: ya no es “¿alcanza la harina?”, sino “¿qué hay que pedir?”.
Los niveles de servicio son una decisión de negocio, no de estadística. La harina y la mantequilla llevan $95%$ porque sin ellas no hay pan; el azúcar y las cajas llevan $90%$ porque, si faltan, hay sustitutos o se compran en la tienda de la esquina. Subir el nivel cuesta existencia inmovilizada: con $98%$, el factor $z$ sería $2.054$ y la existencia de seguridad de la harina pasaría de $16.22$ a $20.25$ kg.
Lo que la fórmula supone
Una fórmula vale lo que valen sus supuestos, y esta tiene dos que en el obrador no se cumplen solos. El primero: supone que alguien mira la existencia todo el tiempo y pide en el instante en que cruza $R$. La práctica de la casa mira una vez al día, al cerrar; para entonces la existencia puede haber cruzado la línea por la mañana y haber bajado otros $30$ kilos. El siguiente bloque repite las mismas ocho semanas de consumo, con la misma demanda hornada por hornada, bajo tres reglas: la práctica a ojo ($76$ kg, revisada al cierre), el punto de reorden revisado al cierre y el punto de reorden revisado después de cada hornada, que es lo que hará posible el servidor, porque el obrador podrá consultar la existencia en cualquier momento:
# Existencias de harina con la práctica a ojo y con el punto de reorden revisado al cierre y por hornada en Python:
R_harina = float(reorden.loc['H25', 'R'])
umbral_ojo = 38.0 * 2
practica = simular_politica(demanda['H25'], INICIAL['H25'], umbral_ojo, 150.0, 2)
al_cierre = simular_politica(demanda['H25'], INICIAL['H25'], R_harina, 150.0, 2)
por_hornada = simular_politica(demanda_hornadas, INICIAL['H25'], R_harina, 150.0, 2 * 4)
# La simulación por hornada se resume por día: lo servido y lo que faltó se suman; la existencia es la del cierre:
politica = por_hornada.groupby(por_hornada['t'] // 4).agg(
    entrada = ('entrada', 'sum'), servido = ('servido', 'sum'), faltante = ('faltante', 'sum'),
    existencia = ('existencia', 'last'))
casos = [('Práctica a ojo, al cierre', practica), ('Punto de reorden, al cierre', al_cierre),
         ('Punto de reorden, por hornada', politica)]
for nombre, h in casos:
    print(f'{nombre:<30} días con faltante: {int((h["faltante"] > 0.05).sum()):>2} | kg no servidos: '
          f'{h["faltante"].sum():6.1f} | existencia media: {h["existencia"].mean():6.1f} kg | '
          f'pedidos: {int((h["entrada"] > 0).sum())}')

fig, ax = plt.subplots(figsize = (9, 4.8))
ax.step(range(len(dias)), practica['existencia'], where = 'post', color = '#ED7D31', lw = 1.6,
        label = 'Práctica a ojo')
ax.step(range(len(dias)), politica['existencia'], where = 'post', color = '#4472C4', lw = 1.8,
        label = 'Punto de reorden por hornada')
ax.axhline(R_harina, color = '#4472C4', ls = '--', lw = 1, label = f'Punto de reorden: {R_harina:.1f} kg')
ax.axhline(umbral_ojo, color = '#ED7D31', ls = ':', lw = 1, label = 'Umbral a ojo: 76 kg')
llegan = politica.index[politica['entrada'] > 0]
ax.scatter(llegan, politica.loc[llegan, 'existencia'] + politica.loc[llegan, 'servido'], marker = 'v',
           s = 30, color = '#4472C4', zorder = 3, label = 'Llega un pedido (6 sacos)')
faltas = practica.index[practica['faltante'] > 0.05]
ax.scatter(faltas, np.zeros(len(faltas)), marker = 'x', s = 45, color = 'red', zorder = 3,
           label = 'Día con faltante (práctica)')
semanas = list(range(0, len(dias), 6))
ax.set_xticks(semanas)
ax.set_xticklabels([dias[i].strftime('%d/%m') for i in semanas])
ax.set_title('Existencias de harina en ocho semanas', fontsize = 16)
ax.set_xlabel('Día hábil (lunes de cada semana)')
ax.set_ylabel('Harina al cierre del día (kg)')
ax.set_ylim(-10, 300)
ax.legend(fontsize = 8, loc = 'upper right', ncol = 2)
plt.tight_layout()
plt.show()
Práctica a ojo, al cierre      días con faltante: 10 | kg no servidos:  248.3 | existencia media:   55.2 kg | pedidos: 10
Punto de reorden, al cierre    días con faltante:  4 | kg no servidos:   54.0 | existencia media:   66.3 kg | pedidos: 11
Punto de reorden, por hornada  días con faltante:  1 | kg no servidos:   21.9 | existencia media:   84.6 kg | pedidos: 11
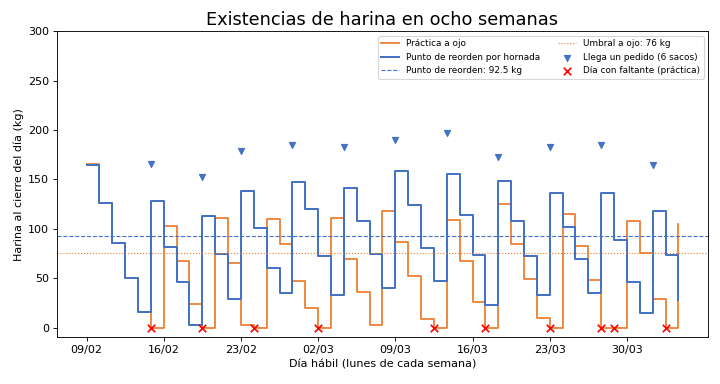
Las tres líneas de la salida cuentan la historia completa. La práctica a ojo deja $10$ días con faltante y $248.3$ kg sin servir en ocho semanas. El punto de reorden revisado una vez al día los baja a $4$ días y $54.0$ kg: la existencia de seguridad ayuda, pero la revisión tardía se come parte del colchón. Revisado por hornada, queda $1$ día con faltante y $21.9$ kg sin servir, con una existencia media de $84.6$ kg frente a $55.2$. La gráfica muestra por qué: la línea naranja de la práctica toca el cero una y otra vez, marcado con cruces rojas, mientras la azul rebota sobre la línea discontinua del punto de reorden. El precio de la tranquilidad son unos $29$ kg más de harina en el almacén en promedio, poco más de un saco, y un pedido más en ocho semanas ($11$ frente a $10$).
El segundo supuesto es más traicionero: la fórmula supone que el pedido tarda siempre lo mismo. Molino La Espiga entrega en dos días, casi siempre. Pero el plan de hoy no se juega en el “casi”. El siguiente bloque simula $10,000$ ciclos de pedido para cada valor de $z$ entre $0$ y $2.5$ y compara tres cosas: la probabilidad teórica de faltante, que con consumo normal es
$$ P(\text{faltante}) = P\left(D_L > R\right) = 1 - \Phi(z) $$
donde $D_L$ es el consumo durante la entrega y $\Phi$ la función de distribución normal estándar; la simulación con entrega fija de $2$ días; y la simulación en la que uno de cada cinco camiones tarda $3$ días. Para el segundo caso, la teoría ofrece una corrección que combina las dos fuentes de variación:
$$ \sigma_{D_L} = \sqrt{\bar{L} \cdot \sigma_d^{2} + \bar{d}^{2} \cdot \sigma_L^{2}} $$
donde:
- $\bar{L}$ y $\sigma_L$ son la media y la desviación del tiempo de entrega: con $2$ días el $80%$ de las veces y $3$ el $20%$, $\bar{L} = 2.2$ días y $\sigma_L = 0.4$ días.
- El primer sumando es la variación del consumo diario acumulada en la entrega; el segundo, la del tiempo de entrega multiplicada por el consumo de cada día que se alarga.
- El punto de reorden corregido es $R = \bar{d} \cdot \bar{L} + z \cdot \sigma_{D_L}$; el segundo sumando pesa mucho más que el primero porque un día de retraso equivale a $38$ kg, más de seis desviaciones diarias.
# Probabilidad de quedarse sin harina frente al nivel de servicio z con 10 000 ciclos en Python:
media, desv, ciclos = 38.0, 6.0, 10_000
zs = np.round(np.arange(0, 2.51, 0.05), 2)
diario = rng.normal(media, desv, (ciclos, 3))
d_fijo = diario[:, :2].sum(axis = 1)                                   # entrega en 2 días, siempre
tarda_tres = rng.random(ciclos) < 0.20                                 # 1 de cada 5 camiones tarda 3 días
d_variable = np.where(tarda_tres, diario.sum(axis = 1), d_fijo)
R_z = media * 2 + zs[:, None] * desv * np.sqrt(2)
p_fijo = (d_fijo[None, :] > R_z).mean(axis = 1)
p_variable = (d_variable[None, :] > R_z).mean(axis = 1)
p_teoria = 1 - stats.norm.cdf(zs)
i95 = int(np.where(zs == 1.65)[0][0])
z95 = stats.norm.ppf(0.95)
print(f'z = {z95:.3f}: teoría {1 - stats.norm.cdf(z95):.3f} | simulado con entrega fija '
      f'{(d_fijo > media * 2 + z95 * desv * math.sqrt(2)).mean():.3f} | con entrega variable '
      f'{(d_variable > media * 2 + z95 * desv * math.sqrt(2)).mean():.3f}')
L_media, L_desv = 2.2, math.sqrt(0.2 * 0.8)
sigma_DL = math.sqrt(L_media * desv ** 2 + media ** 2 * L_desv ** 2)
R_variable = media * L_media + z95 * sigma_DL
print(f'Entrega variable: L media {L_media}, desviación {L_desv:.2f} días, sigma de la demanda en la entrega '
      f'{sigma_DL:.2f} kg -> R = {R_variable:.2f} kg ({math.ceil(R_variable / 25)} sacos); '
      f'faltante simulado con ese R: {(d_variable > R_variable).mean():.3f}')

fig, ax = plt.subplots(figsize = (8, 4.8))
ax.plot(zs, p_teoria, color = 'black', lw = 1.2, ls = '--', label = 'Teoría: 1 - Φ(z)')
ax.plot(zs, p_fijo, color = '#4472C4', lw = 2, label = 'Simulación: entrega siempre en 2 días')
ax.plot(zs, p_variable, color = '#ED7D31', lw = 2, label = 'Simulación: 1 de cada 5 entregas tarda 3 días')
ax.axvline(z95, color = 'gray', lw = 1, ls = ':')
ax.annotate(f'z = 1.645\n{p_fijo[i95]:.1%} frente a {p_variable[i95]:.1%}', xy = (z95, p_variable[i95]),
            xytext = (1.85, 0.32), fontsize = 9, arrowprops = dict(arrowstyle = '->', color = 'gray'))
ax.set_title('Probabilidad de quedarse sin harina por ciclo', fontsize = 16)
ax.set_xlabel('Factor de servicio z')
ax.set_ylabel('Ciclos con faltante (proporción)')
ax.set_ylim(0, 0.55)
ax.legend(fontsize = 9)
plt.tight_layout()
plt.show()
z = 1.645: teoría 0.050 | simulado con entrega fija 0.053 | con entrega variable 0.242
Entrega variable: L media 2.2, desviación 0.40 días, sigma de la demanda en la entrega 17.61 kg -> R = 112.57 kg (5 sacos); faltante simulado con ese R: 0.109
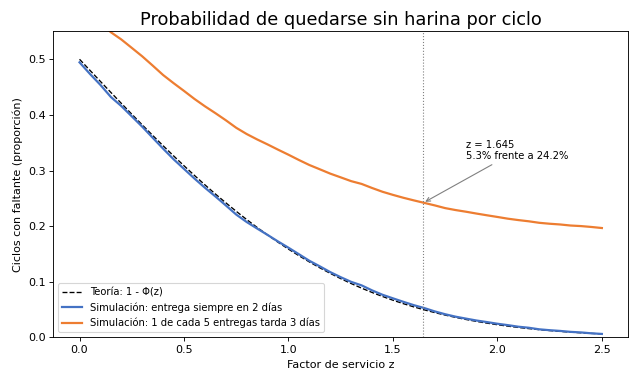
Con entrega fija, la simulación reproduce la teoría casi al decimal: $5.3%$ de ciclos con faltante frente a $5.0%$. Con un camión de cada cinco que tarda un día más, el mismo $R$ falla en el $24.2%$ de los ciclos, casi cinco veces lo prometido, y la curva naranja de la gráfica apenas baja del $20%$ por mucho que se suba $z$: cuando el camión tarda tres días, faltan $38$ kg que ningún colchón razonable cubre. La corrección de la fórmula lleva el punto de reorden a $112.57$ kg, $5$ sacos, y baja el faltante al $10.9%$, todavía lejos del $5%$, porque la demanda durante la entrega ya no es normal, sino una mezcla de dos campanas. La lección para el diseño del servidor es concreta: calcular_reorden debe leer el tiempo de entrega de la tabla insumos, y ese tiempo debe medirse con las fechas reales de pedido y llegada, no con lo que promete el proveedor por teléfono.
Atención aquí: el punto de reorden que devuelve una herramienta es tan bueno como los datos que la alimentan. Si el obrador no registra los consumos de cada hornada, si las mermas no se apuntan o si el tiempo de entrega del proveedor cambia y nadie actualiza la tabla insumos, el modelo que llame a calcular_reorden recibirá un número preciso y equivocado, y lo dirá con la misma seguridad que uno correcto. Por eso el conteo físico de cada viernes sigue siendo obligatorio, por eso el ajuste se guarda como movimiento y no se borra, y por eso ninguna herramienta de hoy pide nada por su cuenta: proponer un pedido no es lo mismo que hacerlo.
Herramientas, recursos y prompts del servidor
Con los datos y el cálculo listos, toca decidir qué expone el servidor. La regla de diseño viene de la condición de Don Ernesto y es la misma que el Día 17 aplicó a las credenciales: mínimo privilegio. El servidor ofrece lo que hace falta para responder preguntas de inventario y nada más. No hay una herramienta genérica de “consulta SQL” (un modelo con SQL libre puede leer cualquier tabla, incluidas las que algún día tengan recetas o clientes), no hay borrado y no hay compras. La Tabla 2 lista las cinco herramientas.
Tabla 2. Herramientas del servidor trigo_lento.
| Herramienta | Entrada | Salida | Efecto | Aprobación |
|---|---|---|---|---|
consultar_existencias | insumo (una de 4 claves) | Existencia, unidad y días de cobertura | Lectura | No hace falta |
consultar_consumo | insumo, dias (7, 14, 28 o 56) | Media, desviación y días válidos | Lectura | No hace falta |
calcular_reorden | insumo, nivel_servicio (0.90, 0.95 o 0.98) | Punto de reorden, existencia de seguridad y presentaciones | Lectura | No hace falta |
registrar_merma | insumo, cantidad, motivo (lista cerrada), nota | Número de propuesta | Propuesta pendiente | Valeria o Don Ernesto |
proponer_pedido_proveedor | insumo, presentaciones (1 a 8) | Número de propuesta | Propuesta pendiente | Don Ernesto |
Las dos últimas son las únicas que escriben, y lo que escriben no es un movimiento ni un pedido: es una fila en una tabla propuestas con estado “pendiente”. La merma no descuenta existencias hasta que una persona la aprueba; el pedido no llega al molino hasta que Don Ernesto lo confirma por su canal de siempre. Esa es la Figura 3: una ventanilla, no una bodega abierta. Y hay una segunda barrera: las dos herramientas de propuesta ni siquiera se registran si el servidor no arranca con la variable TL_MCP_ESCRITURA=1. El modo predeterminado es solo lectura.
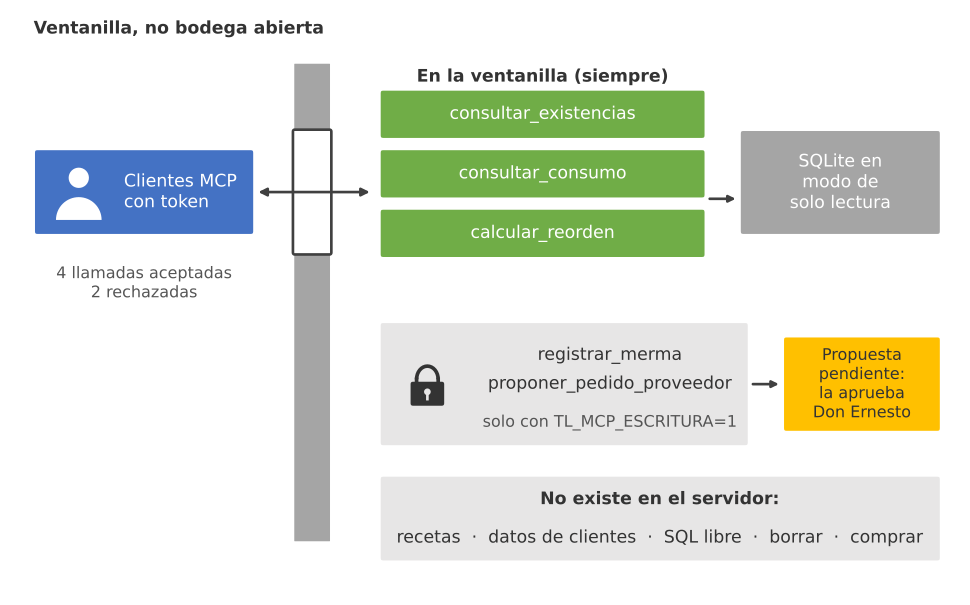
Figura 3. Ventanilla, no bodega abierta: por la ventanilla se atienden 3 herramientas de lectura; 2 herramientas de propuesta quedan bajo llave y solo dejan filas pendientes que aprueba Don Ernesto; recetas, datos de clientes, SQL libre y compras no existen en el servidor.
Además de las herramientas, el servidor publica un recurso, inventario://insumos, con el catálogo (clave, nombre, unidad, presentación, proveedor y días de entrega), y un prompt, pregunta_del_viernes, que convierte la pregunta de Don Ernesto en una instrucción lista para usar con las herramientas. Una diferencia importante entre ellos se verá al final de la entrada: el conector MCP de la API de Claude solo usa herramientas, de modo que todo lo que el modelo deba poder consultar por sí mismo tiene que ser una herramienta.
El contrato del servidor se escribe primero como JSON, en el mismo formato que devuelve tools/list en la especificación de MCP: nombre, título, descripción, inputSchema y anotaciones. Tres decisiones se repiten en cada herramienta. Primera, esquemas cerrados: additionalProperties: false y todos los campos en required, para que un argumento inventado se rechace en lugar de ignorarse. Segunda, listas cerradas donde se pueda: las claves de insumo, las ventanas de días, los niveles de servicio y los motivos de merma son enumeraciones, porque una enumeración no admite “harina de la buena” ni $0.999$. Tercera, descripciones que dicen cuándo usar la herramienta, no solo qué hace, que es lo que la documentación de Claude recomienda para que el modelo elija bien:
{
  "server": "trigo_lento",
  "version": "1.0.0",
  "tools": [
    {
      "name": "consultar_existencias",
      "title": "Existencias de un insumo",
      "description": "Úsela cuando pregunten cuánto queda de un insumo o si alcanza para un día. Devuelve la existencia, la unidad y los días de cobertura.",
      "inputSchema": {
        "type": "object",
        "properties": {
          "insumo": {"type": "string", "enum": ["H25", "M10", "AZ50", "CP25"], "description": "Clave del insumo"}
        },
        "required": ["insumo"],
        "additionalProperties": false
      },
      "annotations": {"readOnlyHint": true, "destructiveHint": false, "idempotentHint": true, "openWorldHint": false}
    },
    {
      "name": "consultar_consumo",
      "title": "Consumo reciente de un insumo",
      "description": "Úsela para conocer el consumo medio y su variación en los últimos días hábiles.",
      "inputSchema": {
        "type": "object",
        "properties": {
          "insumo": {"type": "string", "enum": ["H25", "M10", "AZ50", "CP25"]},
          "dias": {"type": "integer", "enum": [7, 14, 28, 56], "description": "Ventana en días hábiles"}
        },
        "required": ["insumo", "dias"],
        "additionalProperties": false
      },
      "annotations": {"readOnlyHint": true, "destructiveHint": false, "idempotentHint": true, "openWorldHint": false}
    },
    {
      "name": "calcular_reorden",
      "title": "Punto de reorden",
      "description": "Úsela cuando pregunten cuándo pedir. Calcula el punto de reorden con el consumo de 28 días, el tiempo de entrega del proveedor y el nivel de servicio.",
      "inputSchema": {
        "type": "object",
        "properties": {
          "insumo": {"type": "string", "enum": ["H25", "M10", "AZ50", "CP25"]},
          "nivel_servicio": {"type": "number", "enum": [0.9, 0.95, 0.98]}
        },
        "required": ["insumo", "nivel_servicio"],
        "additionalProperties": false
      },
      "annotations": {"readOnlyHint": true, "destructiveHint": false, "idempotentHint": true, "openWorldHint": false}
    },
    {
      "name": "registrar_merma",
      "title": "Proponer una merma",
      "description": "Úsela solo si alguien informa de producto dañado. No descuenta existencias: crea una propuesta pendiente que una persona aprueba.",
      "inputSchema": {
        "type": "object",
        "properties": {
          "insumo": {"type": "string", "enum": ["H25", "M10", "AZ50", "CP25"]},
          "cantidad": {"type": "number", "description": "En la unidad del insumo"},
          "motivo": {"type": "string", "enum": ["humedad", "saco roto", "caducidad", "plaga", "otro"]},
          "nota": {"type": "string", "description": "Texto breve, sin nombres de clientes"}
        },
        "required": ["insumo", "cantidad", "motivo", "nota"],
        "additionalProperties": false
      },
      "annotations": {"readOnlyHint": false, "destructiveHint": false, "idempotentHint": false, "openWorldHint": false}
    },
    {
      "name": "proponer_pedido_proveedor",
      "title": "Proponer un pedido al proveedor",
      "description": "Úsela cuando la existencia esté en el punto de reorden o por debajo. No compra ni envía nada: deja una propuesta pendiente de aprobación.",
      "inputSchema": {
        "type": "object",
        "properties": {
          "insumo": {"type": "string", "enum": ["H25", "M10", "AZ50", "CP25"]},
          "presentaciones": {"type": "integer", "enum": [1, 2, 3, 4, 5, 6, 7, 8]}
        },
        "required": ["insumo", "presentaciones"],
        "additionalProperties": false
      },
      "annotations": {"readOnlyHint": false, "destructiveHint": false, "idempotentHint": false, "openWorldHint": false}
    }
  ],
  "resources": [
    {"uri": "inventario://insumos", "name": "catalogo_insumos", "mimeType": "application/json"}
  ],
  "prompts": [
    {"name": "pregunta_del_viernes", "arguments": [{"name": "insumo", "required": true}]}
  ]
}
Las anotaciones (readOnlyHint, destructiveHint, idempotentHint, openWorldHint) le dicen al cliente qué esperar: las tres de lectura no modifican nada, se pueden repetir sin efecto y no tocan el mundo exterior; las dos de propuesta sí modifican algo, aunque no destruyen nada. La especificación advierte que son pistas, no garantías: un cliente no debe fiarse de las anotaciones de un servidor que no controla. La garantía real está en el código, que hoy registra o no registra las herramientas de escritura según una variable de entorno. Fíjese también en que cantidad es el único número libre de todo el contrato; los demás números son enumeraciones. Es una decisión deliberada: las herramientas estrictas de Claude no admiten restricciones numéricas como minimum o maximum, y una enumeración logra lo mismo de una forma que cualquier cliente entiende.
El servidor en Python
El servidor se escribe con el SDK oficial de MCP para Python, el paquete mcp, que el plan de la serie admite como dependencia nueva solo en los días 62 y 63. En su versión 2.3.0, la clase de alto nivel se llama MCPServer (la documentación de la rama 1 la llamaba FastMCP) y funciona con decoradores: @mcp.tool() convierte una función en herramienta, @mcp.resource(uri) en recurso y @mcp.prompt() en prompt. El SDK deduce el esquema de los argumentos a partir de las anotaciones de tipo de la función, y por eso las enumeraciones del contrato se escriben con Literal: Literal['H25', 'M10', 'AZ50', 'CP25'] se publica como un enum de cuatro valores.
Hay cuatro detalles que conviene leer en el archivo antes de ejecutarlo:
- Conexión de solo lectura: la función
consultaabre SQLite conmode=ro. Aunque alguien añadiera por error una herramienta que intentara escribir con ella, la base lo rechazaría. - Escritura detrás de una variable: las dos herramientas de propuesta se definen dentro de
if ESCRITURA:; sinTL_MCP_ESCRITURA=1no existen para ningún cliente. - Esquemas cerrados a mano: al preparar la entrada se comprobó que la versión 2.3.0 del SDK publica los esquemas sin
additionalProperties: falsey acepta en silencio argumentos de más. El bucle final del archivo cierra cada esquema y obliga al modelo de validación a rechazar lo que sobra. Ese bucle usa un atributo interno del SDK (_tool_manager), así que se revisa en cada actualización del paquete. - Token en HTTP: con
--http, el servidor exige un token en el encabezadoAuthorizationy lo compara en tiempo constante conhmac.compare_digest, el mismo cuidado que el Día 17 tuvo con las firmas de los webhooks.
El archivo servidor_inventario.py se muestra completo; no se ejecuta dentro de la entrada, sino como proceso aparte, que es como lo arrancan los clientes:
# Servidor MCP del inventario de Trigo Lento con el SDK oficial de MCP para Python (mcp 2.3.0):
# Uso local:  python servidor_inventario.py               (transporte stdio, para pruebas)
# Uso remoto: python servidor_inventario.py --http        (Streamable HTTP en 127.0.0.1:8765/mcp, detrás de HTTPS)
import hmac
import json
import math
import os
import sqlite3
import sys
from datetime import datetime
from pathlib import Path
from typing import Literal

from mcp.server import MCPServer
from mcp.server.auth.provider import AccessToken
from mcp.server.auth.settings import AuthSettings
from mcp.types import ToolAnnotations

BD = Path(os.environ.get('TL_BD', Path(__file__).with_name('trigo_lento.sqlite')))
ESCRITURA = os.environ.get('TL_MCP_ESCRITURA') == '1'          # solo lectura salvo que se active a propósito
Insumo = Literal['H25', 'M10', 'AZ50', 'CP25']
LECTURA = ToolAnnotations(read_only_hint=True, destructive_hint=False, idempotent_hint=True, open_world_hint=False)
PROPUESTA = ToolAnnotations(read_only_hint=False, destructive_hint=False, idempotent_hint=False, open_world_hint=False)
Z = {0.9: 1.2816, 0.95: 1.6449, 0.98: 2.0537}


class VerificadorDeToken:
    # Compara el token del encabezado Authorization con el del entorno, en tiempo constante:
    async def verify_token(self, token: str) -> AccessToken | None:
        esperado = os.environ.get('TRIGO_LENTO_MCP_TOKEN', '')
        if esperado and hmac.compare_digest(token.encode(), esperado.encode()):
            return AccessToken(token=token, client_id='trigo_lento', scopes=['inventario:leer'])
        return None


http = '--http' in sys.argv
mcp = MCPServer(
    'trigo_lento',
    instructions='Inventario de insumos de la panadería Trigo Lento. Solo insumos: sin recetas ni clientes.',
    version='1.0.0',
    token_verifier=VerificadorDeToken() if http else None,
    auth=AuthSettings(issuer_url='https://auth.trigolento.example', required_scopes=['inventario:leer'],
                      resource_server_url='https://mcp.trigolento.example/mcp') if http else None,
)


def consulta(sql, parametros=()):
    with sqlite3.connect(f'file:{BD}?mode=ro', uri=True) as con:    # conexión de solo lectura
        return con.execute(sql, parametros).fetchall()


def consumo_diario(insumo, dias):
    filas = consulta('''SELECT -cantidad FROM movimientos WHERE clave = ? AND tipo = 'consumo' AND nota IS NULL
                        ORDER BY fecha DESC LIMIT ?''', (insumo, dias))
    valores = [f[0] for f in filas]
    media = sum(valores) / len(valores)
    desv = math.sqrt(sum((v - media) ** 2 for v in valores) / (len(valores) - 1))
    return media, desv, len(valores)


@mcp.tool(annotations=LECTURA)
def consultar_existencias(insumo: Insumo) -> dict:
    """Úsela cuando pregunten cuánto queda de un insumo o si alcanza para un día."""
    (existencia,), = consulta('SELECT ROUND(SUM(cantidad), 1) FROM movimientos WHERE clave = ?', (insumo,))
    (unidad,), = consulta('SELECT unidad FROM insumos WHERE clave = ?', (insumo,))
    media, _, _ = consumo_diario(insumo, 28)
    return {'insumo': insumo, 'existencia': existencia, 'unidad': unidad,
            'dias_de_cobertura': round(existencia / media, 1)}


@mcp.tool(annotations=LECTURA)
def consultar_consumo(insumo: Insumo, dias: Literal[7, 14, 28, 56]) -> dict:
    """Úsela para conocer el consumo medio y su variación en los últimos días hábiles."""
    media, desv, n = consumo_diario(insumo, dias)
    return {'insumo': insumo, 'dias_validos': n, 'media_diaria': round(media, 2), 'desviacion': round(desv, 2)}


@mcp.tool(annotations=LECTURA)
def calcular_reorden(insumo: Insumo, nivel_servicio: Literal[0.9, 0.95, 0.98]) -> dict:
    """Úsela cuando pregunten cuándo pedir: punto de reorden con 28 días de consumo y la entrega del proveedor."""
    media, desv, _ = consumo_diario(insumo, 28)
    (entrega, contenido, presentacion), = consulta(
        'SELECT entrega_dias, contenido, presentacion FROM insumos WHERE clave = ?', (insumo,))
    seguridad = Z[nivel_servicio] * desv * math.sqrt(entrega)
    reorden = media * entrega + seguridad
    return {'insumo': insumo, 'punto_de_reorden': round(reorden, 1), 'existencia_de_seguridad': round(seguridad, 1),
            'en_presentaciones': math.ceil(reorden / contenido), 'presentacion': presentacion}


@mcp.resource('inventario://insumos', mime_type='application/json')
def catalogo_insumos() -> str:
    """Catálogo de insumos: clave, nombre, unidad, presentación, proveedor y días de entrega."""
    filas = consulta('SELECT clave, nombre, unidad, presentacion, proveedor, entrega_dias FROM insumos')
    campos = ['clave', 'nombre', 'unidad', 'presentacion', 'proveedor', 'entrega_dias']
    return json.dumps([dict(zip(campos, f)) for f in filas], ensure_ascii=False)


@mcp.prompt()
def pregunta_del_viernes(insumo: str) -> str:
    """La pregunta de Don Ernesto, lista para usar con las herramientas del servidor."""
    return (f'Con las herramientas del inventario, diga si la existencia de {insumo} alcanza para mañana, '
            'cuántos días de cobertura quedan y si ya se llegó al punto de reorden con nivel de servicio 0.95.')


if ESCRITURA:
    def proponer(tipo, datos):
        # Las "escrituras" solo crean propuestas pendientes; una persona las aprueba fuera del servidor:
        with sqlite3.connect(BD) as con:
            con.execute('CREATE TABLE IF NOT EXISTS propuestas (id INTEGER PRIMARY KEY, creada TEXT, tipo TEXT, '
                        "datos TEXT, estado TEXT DEFAULT 'pendiente')")
            cursor = con.execute('INSERT INTO propuestas (creada, tipo, datos) VALUES (?, ?, ?)',
                                 (datetime.now().isoformat(timespec='seconds'), tipo, json.dumps(datos)))
            return {'propuesta': cursor.lastrowid, 'estado': 'pendiente de aprobación'}

    @mcp.tool(annotations=PROPUESTA)
    def registrar_merma(insumo: Insumo, cantidad: float,
                        motivo: Literal['humedad', 'saco roto', 'caducidad', 'plaga', 'otro'], nota: str) -> dict:
        """Úsela solo si alguien informa de producto dañado. Crea una propuesta; no descuenta existencias."""
        return proponer('merma', {'insumo': insumo, 'cantidad': cantidad, 'motivo': motivo, 'nota': nota[:120]})

    @mcp.tool(annotations=PROPUESTA)
    def proponer_pedido_proveedor(insumo: Insumo, presentaciones: Literal[1, 2, 3, 4, 5, 6, 7, 8]) -> dict:
        """Úsela cuando la existencia esté en el punto de reorden. No compra: deja una propuesta pendiente."""
        return proponer('pedido', {'insumo': insumo, 'presentaciones': presentaciones})

# La versión 2.3.0 no cierra los esquemas por sí sola: se añade additionalProperties: false a cada herramienta.
for herramienta in mcp._tool_manager.list_tools():
    herramienta.fn_metadata.arg_model.model_config['extra'] = 'forbid'
    herramienta.fn_metadata.arg_model.model_rebuild(force=True)
    herramienta.parameters['additionalProperties'] = False

if __name__ == '__main__':
    if http:
        mcp.run('streamable-http', host='127.0.0.1', port=8765, streamable_http_path='/mcp')
    else:
        mcp.run()
El servidor tiene unas $140$ líneas y ninguna de ellas habla de Claude. Ese es el punto: el servidor no sabe qué modelo lo usa. Expone funciones con contratos claros sobre una base de datos, y cualquier cliente que hable MCP puede usarlas. La función calcular_reorden es la fórmula de la sección anterior con una diferencia deliberada: usa los últimos $28$ días hábiles sin faltante, no las ocho semanas completas, para que el punto de reorden siga los cambios de temporada. La tabla Z guarda los factores de servicio de los tres niveles permitidos, de modo que el servidor no necesita scipy para responder.
Probar el servidor
Un servidor que no se ha probado no existe. La prueba más sencilla no necesita ningún modelo: un cliente MCP mínimo que arranca el servidor por stdio, pide la lista de herramientas y llama a cada una con argumentos conocidos, incluido uno que debe fallar. El archivo probar_servidor.py hace exactamente eso con la clase Client del SDK, y comprueba de paso que todos los esquemas publicados están cerrados. El siguiente bloque instala el paquete y ejecuta la prueba dos veces, en modo de solo lectura y con las propuestas activadas. La salida es la que se obtuvo al preparar la entrada:
# Instalación del SDK de MCP y prueba del servidor por stdio, sin y con propuestas, en Bash:
python -m pip install "mcp==2.3.0"
python probar_servidor.py
echo "--- Con TL_MCP_ESCRITURA=1:"
TL_MCP_ESCRITURA=1 python probar_servidor.py
tools/list: ['consultar_existencias', 'consultar_consumo', 'calcular_reorden']
Esquema cerrado en todas: True
resources/list: ['inventario://insumos']
tools/call consultar_existencias: ok -> {"insumo": "H25", "existencia": 140.0, "unidad": "kg", "dias_de_cobertura": 3.7}
tools/call consultar_consumo: ok -> {"insumo": "H25", "dias_validos": 28, "media_diaria": 37.95, "desviacion": 7.68}
tools/call calcular_reorden: ok -> {"insumo": "H25", "punto_de_reorden": 93.8, "existencia_de_seguridad": 17.9, "en_presentaciones": 4, "presentacion": "saco de 25 kg"}
tools/call consultar_existencias: ERROR -> Extra inputs are not permitted
tools/call registrar_merma: ERROR -> Unknown tool: registrar_merma
--- Con TL_MCP_ESCRITURA=1:
tools/list: ['consultar_existencias', 'consultar_consumo', 'calcular_reorden', 'registrar_merma', 'proponer_pedido_proveedor']
Esquema cerrado en todas: True
resources/list: ['inventario://insumos']
tools/call consultar_existencias: ok -> {"insumo": "H25", "existencia": 140.0, "unidad": "kg", "dias_de_cobertura": 3.7}
tools/call consultar_consumo: ok -> {"insumo": "H25", "dias_validos": 28, "media_diaria": 37.95, "desviacion": 7.68}
tools/call calcular_reorden: ok -> {"insumo": "H25", "punto_de_reorden": 93.8, "existencia_de_seguridad": 17.9, "en_presentaciones": 4, "presentacion": "saco de 25 kg"}
tools/call consultar_existencias: ERROR -> Extra inputs are not permitted
tools/call registrar_merma: ok -> {"propuesta": 1, "estado": "pendiente de aprobación"}
La primera ejecución es la del modo predeterminado y confirma tres cosas. tools/list devuelve solo las $3$ herramientas de lectura, con los esquemas cerrados. consultar_existencias responde $140.0$ kg y $3.7$ días de cobertura, y calcular_reorden da $93.8$ kg, $4$ sacos, un poco más que los $92.51$ de la Tabla 3 porque usa la ventana de $28$ días, en la que la desviación del consumo fue de $7.68$ kg. Y las dos pruebas negativas fallan como deben: el argumento inventado receta se rechaza con “Extra inputs are not permitted”, y registrar_merma ni siquiera existe (“Unknown tool”). La segunda ejecución, con la variable activada, publica las $5$ herramientas y la merma se convierte en la propuesta número $1$, pendiente de aprobación; las existencias no se movieron.
La cobertura merece su fórmula, porque es la cifra que responde la primera mitad de la pregunta del viernes:
$$ c = \frac{E}{\bar{d}} $$
donde $E$ es la existencia actual y $\bar{d}$ el consumo medio diario. Con $E = 140$ kg y $\bar{d} = 37.95$ kg, $c = 3.7$ días: alcanza para el sábado aunque se gaste el doble de lo normal. Es un indicador sencillo y engañoso si se usa solo, porque no dice nada de la variación; por eso la respuesta completa combina la cobertura con el punto de reorden.
Claude como cliente en local
La prueba anterior demuestra que el servidor cumple su contrato. Falta ver a un modelo usándolo. Para un servidor local hay un camino que no necesita exponer nada a internet: el SDK de Anthropic incluye ayudantes de MCP (anthropic.lib.tools.mcp, con el extra anthropic[mcp]) que convierten las herramientas de una sesión MCP en herramientas del tool runner del SDK. El programa arranca el servidor por stdio, abre la sesión, convierte las herramientas con async_mcp_tool y deja que el tool runner haga el bucle: el modelo pide una herramienta, el ayudante la llama en el servidor y devuelve el resultado.
El bloque sigue las reglas de la serie: claude-opus-5-5 con output_config={"effort": "low"}, porque la pregunta es sencilla; el respaldo del lado del servidor con fallbacks="default"; sin tool_choice forzado, que Opus 5.5 rechaza con un error 400, sino una instrucción explícita en el system para que use las herramientas en cada cifra; y la comprobación de stop_reason antes de leer la respuesta. Llama a la API y no se ejecutó para escribir la entrada; la salida es un ejemplo comentado:
# Prueba local del servidor con Claude y los ayudantes MCP del SDK de Anthropic (pip install "anthropic[mcp]") en Python:
import asyncio
import sys
import anthropic
from anthropic.lib.tools.mcp import async_mcp_tool
from mcp import ClientSession
from mcp.client.stdio import StdioServerParameters, stdio_client

client = anthropic.AsyncAnthropic()          # lee ANTHROPIC_API_KEY del entorno; nunca se escribe en el código
SISTEMA = ('Usted responde preguntas sobre los insumos de la panadería Trigo Lento. Use las herramientas del '
           'inventario para cada cifra, no invente existencias y responda en dos frases.')
PREGUNTA = '¿Alcanza la harina para mañana sábado? ¿Ya hay que pedir?'

async def main():
    servidor = StdioServerParameters(command = sys.executable, args = ['servidor_inventario.py'])
    async with stdio_client(servidor) as (lectura, escritura):
        async with ClientSession(lectura, escritura) as sesion:
            await sesion.initialize()
            herramientas = (await sesion.list_tools()).tools            # solo las tres de lectura
            runner = client.beta.messages.tool_runner(
                model = 'claude-opus-5-5', max_tokens = 2000,
                betas = ['server-side-fallback-2026-07-01'], fallbacks = 'default',
                output_config = {'effort': 'low'}, system = SISTEMA,
                tools = [async_mcp_tool(h, sesion) for h in herramientas],
                messages = [{'role': 'user', 'content': PREGUNTA}])
            final = None
            async for mensaje in runner:                                # cada vuelta del bucle de herramientas
                final = mensaje
                for bloque in mensaje.content:
                    if bloque.type == 'tool_use':
                        print('Herramienta:', bloque.name, bloque.input)
            if final.stop_reason != 'end_turn':
                print('Revisar a mano, stop_reason =', final.stop_reason)
            else:
                print(next(b.text for b in final.content if b.type == 'text'))
            print('Tokens de la última vuelta:', final.usage.input_tokens, 'de entrada y',
                  final.usage.output_tokens, 'de salida')

asyncio.run(main())

# Salida de ejemplo (puede variar):
# Herramienta: consultar_existencias {'insumo': 'H25'}
# Herramienta: calcular_reorden {'insumo': 'H25', 'nivel_servicio': 0.95}
# Sí alcanza: hay 140 kg de harina y el consumo medio es de unos 38 kg al día (3.7 días de cobertura).
# Todavía no hay que pedir: el punto de reorden es de 93.8 kg (4 sacos), así que el pedido toca el lunes.
# Tokens de la última vuelta: 1874 de entrada y 96 de salida
En el ejemplo, el modelo llama primero a consultar_existencias y después a calcular_reorden, y responde con las cifras de las herramientas: alcanza, quedan $3.7$ días, y el pedido toca cuando la harina baje de $93.8$ kg. Lo importante no está en la respuesta, sino en lo que no pudo hacer: el servidor arrancó en modo de solo lectura, así que, aunque la pregunta hubiera sido “pide harina”, el modelo no tenía ninguna herramienta para hacerlo. Los $1,874$ tokens de entrada de la última vuelta del ejemplo incluyen las definiciones de las tres herramientas y sus resultados, que es lo que la Tabla 1 anunciaba: MCP centraliza el código, no abarata las definiciones.
Seguridad del servidor
Mientras el servidor vive en la computadora de Valeria y habla por stdio, su superficie de ataque es pequeña: solo un proceso hijo puede hablarle. En cuanto escucha por HTTP, cualquier programa que llegue a su puerto puede intentarlo. El plan de seguridad de hoy tiene cinco piezas, y todas aparecen en el dibujo de arquitectura que genera el siguiente bloque: los tres clientes previstos fuera del límite de confianza, el servidor con su token y su registro dentro, la base de datos a la que solo se llega a través de las herramientas, y Don Ernesto como único camino para que una propuesta se convierta en un hecho:
# Arquitectura de clientes, servidor MCP y base de datos con el límite de confianza en Python:
def caja(ax, x, y, w, h, texto, color, tam = 9):
    ax.add_patch(FancyBboxPatch((x, y), w, h, boxstyle = 'round,pad=0.02', fc = color, ec = '#333333', lw = 1))
    ax.text(x + w / 2, y + h / 2, texto, ha = 'center', va = 'center', fontsize = tam)

def flecha(ax, x1, y1, x2, y2, texto = '', doble = False):
    ax.add_patch(FancyArrowPatch((x1, y1), (x2, y2), arrowstyle = '<|-|>' if doble else '-|>',
                                 mutation_scale = 12, color = '#555555', lw = 1.2))
    if texto:
        ax.text((x1 + x2) / 2, (y1 + y2) / 2 + 0.18, texto, ha = 'center', fontsize = 7.5, color = '#333333')

fig, ax = plt.subplots(figsize = (10, 5.6))
ax.set_xlim(0, 10.4)
ax.set_ylim(0, 6)
ax.axis('off')
clientes = [('Claude en local\n(stdio, hoy)', 4.6), ('Agente de n8n\n(MCP Client Tool)', 3.0),
            ('API de Claude con el\nconector MCP (Día 63)', 1.4)]
for texto, y in clientes:
    caja(ax, 0.2, y, 2.2, 0.95, texto, '#DDEBF7')
ax.add_patch(FancyBboxPatch((3.3, 0.5), 6.95, 5.2, boxstyle = 'round,pad=0.02', fc = 'none', ec = 'red',
                            lw = 1.4, ls = '--'))
ax.text(6.8, 5.45, 'Límite de confianza: obrador de Trigo Lento', ha = 'center', fontsize = 9, color = 'red')
caja(ax, 3.7, 2.3, 2.5, 2.4, 'Servidor MCP\ntrigo_lento\n\ntoken + registro\n5 herramientas\n1 recurso, 1 prompt',
     '#E4DFEC')
caja(ax, 7.1, 3.9, 2.4, 0.95, 'Lectura:\nexistencias, consumo,\nreorden', '#E2EFDA', tam = 8.5)
caja(ax, 7.1, 2.5, 2.4, 0.95, 'Propuestas:\nmerma, pedido\n(estado pendiente)', '#FFF2CC', tam = 8.5)
caja(ax, 7.1, 1.0, 2.4, 0.95, 'trigo_lento.sqlite\ninsumos, movimientos,\nejecuciones', '#EDEDED', tam = 8.5)
for _, y in clientes:
    flecha(ax, 2.45, y + 0.47, 3.65, 3.5, doble = True)
flecha(ax, 6.25, 3.9, 7.05, 4.35)
flecha(ax, 6.25, 3.2, 7.05, 2.95)
ax.annotate('', xy = (9.5, 1.6), xytext = (9.5, 4.2), arrowprops = dict(arrowstyle = '-|>', color = '#555555',
            connectionstyle = 'bar,fraction=-0.08'))
ax.text(9.72, 2.95, 'SELECT\n(solo\nlectura)', fontsize = 7.5, color = '#333333', va = 'center')
flecha(ax, 8.3, 2.45, 8.3, 2.0)
ax.text(8.4, 2.12, 'INSERT', fontsize = 7.5, color = '#333333')
caja(ax, 3.7, 0.75, 2.5, 0.9, 'Don Ernesto aprueba\nlas propuestas', '#F2F2F2')
flecha(ax, 6.25, 1.3, 7.05, 2.6)
ax.text(1.3, 0.75, 'Fuera del límite: nadie\nve recetas ni clientes', ha = 'center', fontsize = 8, color = '#555555')
ax.set_title('Arquitectura del servidor MCP del inventario', fontsize = 16)
plt.tight_layout()
plt.show()
print('Clientes:', len(clientes), '| herramientas: 5 (3 de lectura y 2 de propuesta) | recurso: 1 | prompt: 1')
Clientes: 3 | herramientas: 5 (3 de lectura y 2 de propuesta) | recurso: 1 | prompt: 1
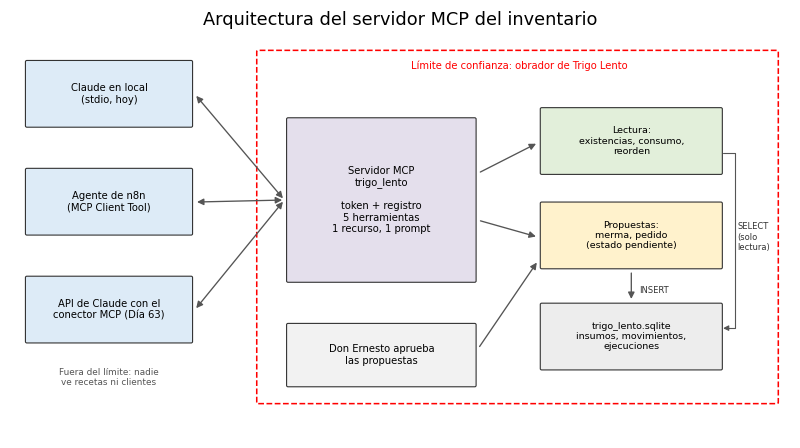
Las cinco piezas, de afuera hacia adentro:
- Autenticación con token: sin el encabezado
Authorization: Bearer <token>, el servidor responde 401. El token vive en una variable de entorno o en el gestor de secretos, nunca en el código ni en un flujo exportado; se rota cada trimestre y se revoca de inmediato si se filtra, con el procedimiento del Día 17. - HTTPS delante: el servidor escucha solo en
127.0.0.1; el mundo exterior llega por el mismo proxy con HTTPS que ya protege a n8n desde el Día 34. Un token que viaja sin cifrar es un token publicado. - Mínimo privilegio: tres herramientas de lectura en el modo predeterminado, conexión de solo lectura a SQLite, sin SQL libre y sin recetas ni datos de clientes en ninguna tabla que el servidor lea, como decidió el Día 6.
- Escritura como propuesta: lo único que el servidor puede escribir es una fila pendiente en
propuestas, y solo si se arrancó a propósito con las propuestas activadas. - Registro de llamadas: cada llamada queda en la tabla
ejecuciones, sin datos personales.
Las dos primeras se pueden comprobar con tres peticiones de curl contra el servidor arrancado en modo HTTP: una sin token, una con un token equivocado y una con el correcto. El token del ejemplo es un valor de prueba que lleva EJEMPLO-NO-REAL dentro, como todos los secretos de ejemplo de la serie. La salida es la que se obtuvo al preparar la entrada:
# Servidor por HTTP con token y tres peticiones de prueba con curl en Bash:
export TRIGO_LENTO_MCP_TOKEN="EJEMPLO-NO-REAL-token-del-servidor"   # en producción sale del gestor de secretos
python servidor_inventario.py --http > servidor_http.log 2>&1 &
sleep 8
CABECERAS=(-H "Content-Type: application/json" -H "Accept: application/json, text/event-stream")
LISTA='{"jsonrpc":"2.0","id":1,"method":"tools/list"}'
INICIO='{"jsonrpc":"2.0","id":1,"method":"initialize","params":{"protocolVersion":"2025-11-25","capabilities":{},"clientInfo":{"name":"curl","version":"1"}}}'
curl -s -o /dev/null -w "Sin token: %{http_code}\n" -X POST http://127.0.0.1:8765/mcp "${CABECERAS[@]}" -d "$LISTA"
curl -s -o /dev/null -w "Token equivocado: %{http_code}\n" -X POST http://127.0.0.1:8765/mcp "${CABECERAS[@]}" \
     -H "Authorization: Bearer otro-token" -d "$LISTA"
curl -s -D - -X POST http://127.0.0.1:8765/mcp "${CABECERAS[@]}" -H "Authorization: Bearer $TRIGO_LENTO_MCP_TOKEN" \
     -d "$INICIO" | grep -o -E '^HTTP/1.1 [0-9]+|"protocolVersion":"[^"]*"|"serverInfo":\{[^}]*\}'
kill %1
Sin token: 401
Token equivocado: 401
HTTP/1.1 200
"protocolVersion":"2025-11-25"
"serverInfo":{"name":"trigo_lento","version":"1.0.0"}
Las dos primeras peticiones reciben 401 antes de que el servidor lea una sola línea del JSON-RPC: la autenticación ocurre en la puerta, no en cada herramienta. La tercera completa el saludo initialize con la versión del protocolo 2025-11-25 y el nombre trigo_lento. La respuesta 401 trae además un encabezado WWW-Authenticate que apunta a los metadatos del recurso protegido, que es como la especificación de autorización de MCP le dice a un cliente dónde conseguir un token cuando el servidor usa OAuth. Para Trigo Lento, con tres clientes conocidos, un token por cliente basta; si algún día hubiera usuarios externos, el paso siguiente sería un servidor de autorización OAuth real.
La quinta pieza, el registro, tiene su propio problema. Registrar quién llamó y con qué argumentos es indispensable para auditar, pero el registro no puede convertirse en una base de datos personal paralela. La solución es la seudonimización del Día 6: los identificadores de cliente y los textos libres se sustituyen por una huella con clave,
$$ h = \operatorname{prefijo}_{48}\left(\text{HMAC-SHA256}_k(x)\right) $$
donde $x$ es el texto original (el nombre del cliente o la nota de una merma), $k$ una clave secreta que vive fuera de la base y $\operatorname{prefijo}_{48}$ conserva los primeros $48$ bits de la huella, es decir, sus primeros $12$ caracteres hexadecimales. Con la clave, el mismo cliente siempre produce la misma huella, de modo que se pueden contar sus llamadas; sin la clave, la huella no se puede revertir ni adivinar probando nombres, que es la diferencia con un simple SHA-256. Los valores cerrados, como las claves de insumo o los motivos de merma, se guardan tal cual, porque no identifican a nadie.
El siguiente bloque lee el contrato JSON del Bloque 5, valida contra él seis llamadas de la tarde del viernes (cuatro correctas y dos que no deben pasar) y guarda cada una en ejecuciones con el cliente y la nota seudonimizados. La clave del registro se lee del entorno; el valor de respaldo del ejemplo lleva EJEMPLO-NO-REAL y no debe usarse nunca fuera de esta entrada:
# Validación de argumentos con los esquemas y registro seudonimizado de llamadas en la tabla ejecuciones en Python:
esquemas = {h['name']: h['inputSchema']
            for h in json.loads((carpeta / 'herramientas_inventario.json').read_text(encoding = 'utf-8'))['tools']}
CLAVE_REGISTRO = os.environ.get('TL_CLAVE_REGISTRO', 'EJEMPLO-NO-REAL-clave-de-registro').encode()

def seudonimo(texto):
    return hmac.new(CLAVE_REGISTRO, texto.encode('utf-8'), hashlib.sha256).hexdigest()[:12]

def validar(herramienta, argumentos):
    esquema = esquemas.get(herramienta)
    if esquema is None:
        return 'herramienta desconocida'
    sobran = set(argumentos) - set(esquema['properties'])
    faltan = set(esquema['required']) - set(argumentos)
    if sobran or faltan:
        return f'sobran {sorted(sobran)}, faltan {sorted(faltan)}'
    for campo, valor in argumentos.items():
        regla = esquema['properties'][campo]
        if 'enum' in regla and valor not in regla['enum']:
            return f'{campo} fuera de la lista'
        if regla.get('type') == 'number' and not isinstance(valor, (int, float)):
            return f'{campo} no es número'
    return None

con.execute('''CREATE TABLE IF NOT EXISTS ejecuciones (id INTEGER PRIMARY KEY, momento TEXT, flujo TEXT,
    herramienta TEXT, cliente TEXT, argumentos TEXT, resultado TEXT, duracion_ms INTEGER)''')
llamadas = [
    ('2026-04-03 17:02:11', 'valeria', 'consultar_existencias', {'insumo': 'H25'}),
    ('2026-04-03 17:02:12', 'valeria', 'calcular_reorden', {'insumo': 'H25', 'nivel_servicio': 0.95}),
    ('2026-04-03 17:02:14', 'n8n-obrador', 'consultar_consumo', {'insumo': 'H25', 'dias': 28}),
    ('2026-04-03 17:03:40', 'valeria', 'registrar_merma',
     {'insumo': 'H25', 'cantidad': 2.0, 'motivo': 'humedad', 'nota': 'Lo vio Ernesto al abrir el saco'}),
    ('2026-04-03 17:04:05', 'n8n-obrador', 'consultar_existencias', {'insumo': 'H25', 'receta': 'baguette'}),
    ('2026-04-03 17:04:30', 'valeria', 'borrar_movimientos', {'desde': '2026-01-01'}),
]
for momento, cliente, herramienta, argumentos in llamadas:
    error = validar(herramienta, argumentos)
    # Los textos libres no se guardan: solo su huella; los valores cerrados (claves, enumeraciones) sí:
    guardados = {k: (f'hmac:{seudonimo(v)}' if k == 'nota' else v) for k, v in argumentos.items()}
    con.execute('INSERT INTO ejecuciones (momento, flujo, herramienta, cliente, argumentos, resultado, duracion_ms) '
                'VALUES (?, ?, ?, ?, ?, ?, ?)',
                (momento, 'TL Servidor MCP inventario v1', herramienta, seudonimo(cliente),
                 json.dumps(guardados, ensure_ascii = False, sort_keys = True),
                 'rechazada: ' + error if error else 'ok', int(rng.integers(8, 40))))
con.commit()
registro = pd.read_sql('SELECT momento, herramienta, cliente, argumentos, resultado FROM ejecuciones', con)
registro['momento'] = registro['momento'].str[11:]
with pd.option_context('display.max_colwidth', 58):
    print(registro.to_string(index = False))
print('Aceptadas:', int((registro['resultado'] == 'ok').sum()), '| rechazadas:',
      int(registro['resultado'].str.startswith('rechazada').sum()))
con.close()
 momento           herramienta      cliente                                                                           argumentos                               resultado
17:02:11 consultar_existencias 83c41502c27e                                                                    {"insumo": "H25"}                                      ok
17:02:12      calcular_reorden 83c41502c27e                                            {"insumo": "H25", "nivel_servicio": 0.95}                                      ok
17:02:14     consultar_consumo b15ca2029561                                                        {"dias": 28, "insumo": "H25"}                                      ok
17:03:40       registrar_merma 83c41502c27e {"cantidad": 2.0, "insumo": "H25", "motivo": "humedad", "nota": "hmac:d1c47dffe304"}                                      ok
17:04:05 consultar_existencias b15ca2029561                                              {"insumo": "H25", "receta": "baguette"} rechazada: sobran ['receta'], faltan []
17:04:30    borrar_movimientos 83c41502c27e                                                              {"desde": "2026-01-01"}      rechazada: herramienta desconocida
Aceptadas: 4 | rechazadas: 2
El registro tiene $4$ llamadas aceptadas y $2$ rechazadas, y cada rechazo dice por qué. La quinta llamada intentó pasar una receta a consultar_existencias, el tipo de argumento que un modelo podría inventar si alguien le pregunta por una receta: el esquema cerrado la detiene. La sexta pidió borrar_movimientos, una herramienta que no existe: el servidor no puede hacer lo que no tiene. Los clientes aparecen como 83c41502c27e (Valeria) y b15ca2029561 (el flujo de n8n del obrador), y la nota de la merma, “Lo vio Ernesto al abrir el saco”, quedó como hmac:d1c47dffe304: se sabe que hubo una nota, no lo que decía ni a quién nombraba. Fíjese en que los argumentos se guardan con sort_keys = True: el mismo truco que el Día 61 usó contra los invalidadores de caché sirve aquí para que dos llamadas iguales produzcan exactamente el mismo texto en el registro.
Lo que pedirá el conector MCP
El servidor de hoy se diseñó pensando en el cliente de mañana. El Día 63 conectará Claude a este servidor desde la API con el conector MCP, una función en beta con la que la propia API de Claude se conecta al servidor, descubre sus herramientas y las llama dentro de la misma petición, sin que el programa de Valeria ejecute nada. Según la documentación oficial, revisada en octubre de 2026, la petición necesita dos mitades que van siempre juntas: la lista mcp_servers, con {"type": "url", "url": ..., "name": "trigo_lento"} y un authorization_token opcional, y una entrada {"type": "mcp_toolset", "mcp_server_name": "trigo_lento"} en tools, todo con la cabecera beta mcp-client-2025-11-20. Mañana se escribirá esa petición; hoy importa lo que el conector le exige al servidor, que resume la Tabla 4.
Tabla 4. Requisitos del conector MCP de la API de Claude y su consecuencia en el servidor de Trigo Lento (revisado en octubre de 2026).
| Requisito de la documentación | Consecuencia en el diseño de hoy |
|---|---|
| El servidor debe estar expuesto públicamente por HTTP (Streamable HTTP o SSE); stdio no se puede conectar | El modo --http con Streamable HTTP en /mcp, detrás del proxy con HTTPS |
La URL debe empezar con https:// | El servidor escucha en 127.0.0.1; el proxy pone el certificado |
authorization_token se envía como token OAuth de portador | El verificador acepta un token de portador y responde 401 sin él |
| De la especificación MCP solo se usan las llamadas a herramientas | Todo lo que el modelo deba consultar es herramienta; el recurso y el prompt sirven a clientes locales |
default_config y configs habilitan o deshabilitan herramientas por nombre | Nombres estables y separados: lectura y propuesta se distinguen por nombre |
| El conector no está cubierto por la retención cero de datos | Las herramientas no devuelven datos personales ni recetas; solo insumos |
| Disponible en beta en la API de Claude, Claude Platform on AWS y Microsoft Foundry | Trigo Lento usa la API de Claude directamente; no depende de otra plataforma |
La cuarta fila es la que más cambia el diseño. Un recurso como inventario://insumos es útil para un cliente local que lo adjunta a la conversación, pero el conector no lo verá; si Claude necesita saber qué insumos existen, la enumeración de cada herramienta ya se lo dice. La sexta fila es la razón de fondo de la condición de Don Ernesto, dicha en el idioma de la documentación: lo que pasa por el conector, incluidas las definiciones y los resultados de las herramientas, se conserva según la política estándar de retención de datos, así que el servidor no debe devolver nada que no se quiera conservar fuera del obrador. Hay además una novedad que conviene anotar para mañana: la documentación describe una cabecera más reciente, mcp-client-2026-09-15, que guarda la lista de herramientas que devolvió el servidor y permite fijarla, de modo que un servidor que cambia sus herramientas a mitad de una conversación no cambia lo que el modelo ve.
Atención aquí: exponer un servidor MCP a internet convierte al inventario en una puerta de entrada al obrador. Antes de publicar la URL, compruebe que el modo de solo lectura es el predeterminado, que el token es largo, aleatorio y distinto para cada cliente, que el proxy limita el número de peticiones por minuto, que el registro funciona y que ninguna tabla que el servidor lea contiene recetas, nombres de clientes ni teléfonos. Las anotaciones de una herramienta son pistas para el cliente, no controles de seguridad, y la descripción de una herramienta es texto que el modelo lee: un servidor de terceros con descripciones maliciosas puede intentar dar órdenes al modelo, el tema del Día 64. Un servidor propio, pequeño y revisado reduce ese riesgo; no lo elimina.
Consideraciones finales
El viernes empezó con una hoja de cálculo que decía $87$ kilos y un maestro panadero que contaba $140$, y termina con un servidor que responde $140.0$ kg, $3.7$ días de cobertura y un punto de reorden de $93.8$ kg a cualquier cliente que tenga el token. Pero el servidor es la parte visible. Lo que de verdad cambió es que el inventario dejó de ser un número tecleado y pasó a ser la suma de un diario de movimientos con ajustes por conteo físico, y que la regla de pedir “cuando quedan los dos días que tarda el molino” se convirtió en una fórmula con existencia de seguridad. En las ocho semanas simuladas, esa diferencia, revisada por hornada, pasa de $10$ días con faltante a $1$.
Don Ernesto puso dos condiciones y las dos se cumplen por construcción, no por buena voluntad. Las recetas no salen del obrador porque no están en ninguna tabla que el servidor lea. La máquina no compra nada porque no hay ninguna herramienta que compre: en el modo predeterminado ni siquiera hay herramientas que escriban, y en el modo de propuestas lo único que se escribe es una fila pendiente que él aprueba. Cuando el control está en el diseño, no hace falta confiar en que el modelo se porte bien.
Las cifras tienen límites que conviene decir. Las ocho semanas de consumo son simuladas con una distribución normal por hornada, y el consumo real de una panadería tiene picos de calendario, como el Sábado de Gloria de mañana, que una media de $28$ días no ve. El tiempo de entrega de $2$ días es un supuesto hasta que se mida con las fechas reales de pedido y llegada, y la simulación del Bloque 6 mostró cuánto cambia todo cuando falla. Y la salida de la prueba con Claude es un ejemplo comentado, no una medición.
Antes de construir un servidor MCP para su propio negocio, conviene hacerse algunas preguntas:
- ¿Qué preguntas concretas debe poder responder un cliente, y qué herramienta mínima responde cada una?
- ¿Qué datos del sistema no debe ver ningún modelo, y está garantizado por diseño que el servidor no los lee?
- ¿Qué herramientas cambian algo, y por qué esas no pueden ser propuestas que una persona aprueba?
- ¿Los esquemas están cerrados, con listas cerradas donde se pueda, y lo comprobó con un argumento inventado?
- ¿Quién guarda el token, cada cuánto se rota y qué pasa en los primeros treinta minutos si se filtra?
Un gran libro que habla de esto es Inventory and Production Management in Supply Chains (o Gestión de inventarios y producción en cadenas de suministro), de Edward A. Silver, David F. Pyke y Douglas J. Thomas, cuya cuarta edición explica con detalle el punto de reorden, la existencia de seguridad, la diferencia entre revisión continua y periódica y el efecto de un tiempo de entrega variable, que son exactamente los dos supuestos que hoy se rompieron en la simulación. Leerlo antes de automatizar compras evita confundir una fórmula con una política: la fórmula da un número; la política decide cada cuánto se mira y quién firma.
Un servidor MCP no le da poder al modelo: le da una ventanilla, y el arquitecto decide qué se atiende en ella. Trigo Lento ya sabe cuánta harina tiene sin contar sacos, cuándo pedirla con un nivel de servicio elegido y qué propuestas esperan la firma de Don Ernesto.
Conclusiones clave
Protocolo
- MCP separa anfitrión, cliente y servidor; el servidor ofrece herramientas (las elige el modelo), recursos (los elige la aplicación) y prompts (los elige la persona), por stdio en local o por Streamable HTTP en remoto.
- Frente a las herramientas definidas en cada petición, un servidor MCP concentra el código, el acceso y el registro en un solo lugar para varios clientes, pero las definiciones siguen costando tokens en cada petición.
- El SDK oficial de Python, versión 2.3.0, usa
MCPServer(antesFastMCP) con decoradores; las pruebas reales por stdio confirmarontools/listcon $3$ herramientas en modo de lectura y $5$ con propuestas.
Diseño de herramientas e inventario
- El inventario es la suma de un diario de movimientos con ajustes por conteo físico: $140.0$ kg de harina tras un ajuste de $-9.3$ kg; los días con faltante se excluyen al estimar el consumo.
- El punto de reorden $R = \bar{d}L + z\sigma_d\sqrt{L}$ da $89.96$ kg con los datos del plan y $92.51$ kg con los medidos; revisado por hornada, baja los faltantes de $10$ días a $1$ y los kilos sin servir de $248.3$ a $21.9$.
- Con un camión de cada cinco que tarda un día más, el mismo $R$ falla en el $24.2%$ de los ciclos en lugar del $5%$; la corrección con $\sigma_{D_L}$ lo sube a $112.57$ kg.
- Cinco herramientas con esquemas cerrados y listas cerradas: tres de lectura y dos que solo crean propuestas pendientes; la versión 2.3.0 del SDK no cierra los esquemas por sí sola y hubo que hacerlo en el servidor.
Seguridad
- Solo lectura por defecto, conexión de SQLite con
mode=ro, sin SQL libre, sin recetas y sin datos de clientes; las propuestas existen solo conTL_MCP_ESCRITURA=1. - Por HTTP, el servidor responde 401 sin token o con un token equivocado y completa
initializecon el correcto; detrás va HTTPS y un límite de peticiones. - El registro en
ejecucionesguarda clientes y textos libres como huellas HMAC de $12$ caracteres: de $6$ llamadas de prueba, $4$ se aceptaron y $2$ se rechazaron con su motivo.
Mañana, en el Día 63: Model Context Protocol II: el conector MCP desde la API de Claude. El viernes a las cinco de la tarde, Don Ernesto hará su pregunta en Slack, y un flujo de n8n la llevará a la API de Claude, que se conectará a este mismo servidor con el conector MCP, con una lista blanca que solo deja ver las herramientas de lectura, para devolverle una respuesta con números en lugar de un “creo que sí”.
Referencias
- Model Context Protocol (2025). Specification (versión 2025-11-25): arquitectura, herramientas, recursos, prompts, transportes y autorización. https://modelcontextprotocol.io/specification/2025-11-25 (revisado en octubre de 2026).
- Model Context Protocol (2026). MCP Python SDK, versión 2.3.0, y guía de migración a la versión 2. https://github.com/modelcontextprotocol/python-sdk (revisado en octubre de 2026).
- Anthropic (2024). Introducing the Model Context Protocol. https://www.anthropic.com/news/model-context-protocol
- Anthropic (2026). MCP connector. Documentación de Claude. https://platform.claude.com/docs/en/agents-and-tools/mcp-connector (revisado en octubre de 2026).
- Anthropic (2026). Tool use with Claude. Documentación de Claude. https://platform.claude.com/docs/en/agents-and-tools/tool-use/overview (revisado en octubre de 2026).
- Silver, E. A., Pyke, D. F. y Thomas, D. J. (2017). Inventory and Production Management in Supply Chains (4.ª ed.). CRC Press.
- OWASP Foundation (2025). OWASP Top 10 for LLM Applications 2025 (LLM06: Excessive Agency). https://genai.owasp.org/llm-top-10/