
Arquitecto de automatización con IA: Día 68
 Jeshua Romero Guadarrama
- 66 Min para leer
- 09 Apr, 2026
Índice de contenido
Resumen:
La política de cancelaciones, los alérgenos declarados y el horario del puente del 1 de mayo de Trigo Lento viven en Notion, pero el agente de pedidos no los conoce: o los repite de memoria, desactualizados, o tiene que pasarle la pregunta a Valeria. En esta entrada, Valeria convierte las $40$ páginas publicables en una base de conocimiento que un agente puede consultar. Lee las páginas con la API de Notion respetando su límite de $180$ peticiones por minuto ($67$ peticiones y $24.7$ segundos en la simulación), aplana los bloques en texto con sus encabezados, los corta en $219$ fragmentos de hasta $300$ tokens con un solapamiento de $50$, calcula vectores con TF-IDF en numpy y con Voyage AI, los guarda en SQLite y mantiene el índice al día con una marca de agua sobre last_edited_time, que en la primera sincronización relee $5$ páginas, retira $2$ y vuelve a embeber solo $815$ tokens. Al terminar, usted sabrá construir y mantener el índice de una base de conocimiento por menos de un centavo de dólar al mes.
¿Cómo citar el presente artículo?
Romero, J. (9 de abril de 2026). Arquitecto de automatización con IA: Día 68. python-data-engineer. https://www.python-data-engineer.com/post/aai/dia_68/.
Arquitecto de automatización con IA: Día 68 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/aai/dia_68/.
Precios, límites y políticas revisados en octubre de 2026: planes, precios y límites de Make, n8n, Zapier, WhatsApp (Meta, Twilio, Wati) y de la API de Claude. Los límites de la API de Notion (página oficial de límites de peticiones y registro de cambios) y su versión vigente, 2026-03-11, se consultaron en la documentación oficial, revisado en octubre de 2026; la ficha del plan pedía verificar la versión 2025-09-03, que introdujo las fuentes de datos y sigue vigente como base, y la 2026-03-11 añadió tres cambios incompatibles que se explican en la entrada. Los modelos y precios de Voyage AI se consultaron en su documentación de precios y en la página de embeddings de la documentación de Claude, revisado en octubre de 2026: la generación vigente es voyage-4 (el plan citaba voyage-3.5, hoy de la generación anterior, al mismo precio de $0.06$ USD por millón de tokens). Los bloques 7 y 9 llaman a servicios reales y no se ejecutaron para escribir la entrada; sus salidas son ejemplos comentados. El JSON del Bloque 3 lo produce el simulador con la estructura documentada de los objetos de bloque, revisado en octubre de 2026; no es una respuesta capturada de una cuenta real. El texto de las páginas de Trigo Lento es ficticio y se generó con plantillas a partir de los datos fijos de la serie.
Día 68. Una base de conocimiento en Notion: API, fragmentos y embeddings
Introducción
Ayer, en el Día 67 (Sesión práctica de consolidación: el informe de negocio del lunes), Valeria juntó en un solo flujo los lotes nocturnos, las facturas en PDF, la caché, el inventario por MCP y el razonamiento con verificación, con las cifras calculadas en Python y la redacción a cargo de Claude sin un solo número inventado, y Trigo Lento ganó TL Informe del lunes v1 y un gasto de Claude de $7.99$ USD al mes, a un centavo de su rubro de $8$. Hoy comienza el módulo 7/8, Diseño de agentes y automatización de la creatividad: los agentes de Trigo Lento van a tener memoria propia, el contenido de redes va a pasar de la idea a la publicación con una persona que aprueba cada pieza y, al final, Don Ernesto verá en un solo panel si todo funciona.
Es jueves 9 de abril, a las nueve de la mañana. Valeria revisa las conversaciones de la tarde anterior y encuentra dos que le quitan la tranquilidad de la Semana Santa. En la primera, una clienta preguntó por WhatsApp si podía cancelar el pastel que encargó para el viernes 1 de mayo, y el agente de pedidos le contestó que sí, “hasta 24 horas antes”. La respuesta salió de las instrucciones de sistema que Valeria escribió en marzo, cuando la regla era esa; desde el 20 de marzo, la política de cancelaciones de Notion dice 48 horas. En la segunda, otra clienta preguntó si el rol de canela llevaba nuez, porque su hijo es alérgico. El agente hizo lo correcto según sus líneas rojas del Día 38 (Agentes autónomos con supervisión humana: el asistente de pedidos): no contestó y pasó la conversación a una persona. Valeria estaba en la hora pico y tardó veinticinco minutos en abrir la ficha del producto en Notion para copiar la respuesta, que estaba ahí desde febrero.
Los dos casos tienen la misma causa. Lo que Trigo Lento sabe de sí mismo (sus políticas, sus horarios de temporada, sus fichas de producto y los alérgenos que declara) está escrito en Notion, en las páginas que el Día 15 (Comparativa de herramientas II: Airtable, Notion y Google Sheets con Apps Script como base operativa) dejó como base de conocimiento, pero el agente no puede leerlas. Lo que sabe el agente es lo que alguien le copió en el prompt, y eso envejece en silencio.
Don Ernesto, que escucha el relato mientras saca la segunda hornada, no discute la idea: la acota. “Que lea lo que usted quiera, Valeria, pero le digo una cosa: si el robot dice que el pan no tiene nuez y sí tiene, cerramos. Y mis recetas no entran en esa computadora.” Las dos condiciones son exactas y se cumplen por diseño. La primera pide que el agente responda con el texto que Don Ernesto aprobó, y no con lo que “suele” llevar un rol de canela en cualquier panadería; la segunda, que la integración solo vea las páginas que Valeria marcó como publicables, como se decidió en el Día 6 (Ética y seguridad: el código de honor del arquitecto de automatización). Las preguntas de alergia seguirán pasando a una persona; lo que cambia es que esa persona, y más adelante el agente, tendrán la respuesta declarada en segundos.
En la presente entrada, descubrirá qué es una base de conocimiento para un agente y por qué el patrón de buscar antes de contestar resuelve los dos casos de ayer. Leerá páginas y fuentes de datos de Notion con su API, con una integración interna, la versión fijada en la cabecera Notion-Version y un cliente que pagina por cursor y respeta los límites de tasa, primero contra un simulador y después contra la API real. Convertirá los bloques en texto limpio con sus encabezados, lo dividirá en fragmentos con metadatos, calculará vectores con TF-IDF en numpy y con Voyage AI, los guardará en SQLite y terminará con una sincronización incremental que solo vuelve a leer y a embeber lo que cambió.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Leer páginas y bases de datos de Notion con su API (integración interna, permisos por página, versión de la API en la cabecera
Notion-Version) respetando su límite de tasa. - Convertir bloques de Notion en texto limpio y dividirlo en fragmentos con metadatos (página, sección, fecha de edición).
- Calcular embeddings con Voyage AI (API) y con TF-IDF en numpy (offline), y guardarlos en SQLite.
- Mantener el índice actualizado con sincronización incremental por fecha de última edición.
Qué es una base de conocimiento para un agente
Piense en la persona nueva del mostrador. Nadie espera que se sepa de memoria la política de cancelaciones, el horario del puente ni qué piezas llevan nuez; se espera que, ante una pregunta que no sabe, abra la carpeta de políticas, busque la página correcta, lea el párrafo y conteste con lo que dice. Si no lo encuentra, pregunta a Valeria. Esa costumbre, buscar primero y responder después, es exactamente lo que necesita el agente de pedidos.
En el vocabulario de los modelos de lenguaje, ese patrón se llama generación aumentada por recuperación (RAG, por sus siglas en inglés: “Retrieval-Augmented Generation”). Lewis y sus colegas lo propusieron en 2020 con una observación sencilla: un modelo guarda en sus parámetros mucho conocimiento general, pero no puede actualizarlo sin volver a entrenarse, no puede decir de dónde sacó un dato y no sabe nada de lo que no vio. Si antes de generar la respuesta se recuperan unos pocos pasajes de una colección propia y se le entregan al modelo junto con la pregunta, la respuesta se apoya en esos pasajes, que se pueden citar y que se actualizan editando un documento. En Trigo Lento, la colección propia son las páginas de Notion, y el pasaje que habría evitado el error de ayer es un párrafo de la política de cancelaciones.
Una base de conocimiento para un agente tiene dos mitades que trabajan en momentos distintos:
- Indexar ocurre antes de que llegue ninguna pregunta: se leen las páginas, se cortan en fragmentos manejables, se calcula para cada fragmento un vector que represente su contenido y se guarda todo en un índice. Es el tema de hoy.
- Recuperar y responder ocurre con cada pregunta: se calcula el vector de la pregunta, se buscan los fragmentos más parecidos y se le entregan al modelo con la instrucción de citar la página y de abstenerse si no hay evidencia. Es el tema del Día 69.
La separación importa por una razón práctica: indexar es lento, pide muchas peticiones a Notion y cuesta tokens de embeddings, pero se hace pocas veces; recuperar tiene que ser rápido y barato porque ocurre en cada conversación. Por eso el índice vive en SQLite, en el mismo servidor que n8n, y no se consulta Notion en cada mensaje.
La Figura 1 dibuja esa idea con el mostrador de Trigo Lento.
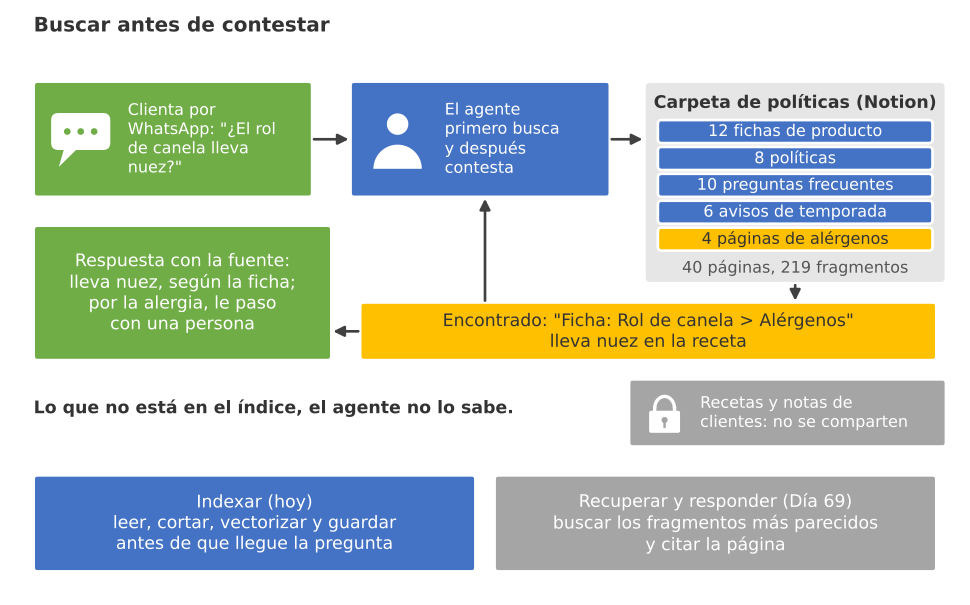
Figura 1. Buscar antes de contestar: ante la pregunta del rol de canela, el agente consulta primero la carpeta de políticas (las 40 páginas publicables de Notion) y responde con la sección que encontró; las recetas quedan fuera del índice.
La base de conocimiento no sustituye a las líneas rojas del agente, las ordena. Una pregunta de alergia seguirá pasando a una persona, pero con los fragmentos de la ficha y de la página de alérgenos ya encontrados; una pregunta de cancelación se responderá con la política vigente y no con la que alguien copió en marzo. Y hay una regla que no se negocia: lo que no está en el índice, el agente no lo sabe. Las recetas de Don Ernesto no están, ni lo estarán.
Como en cada entrada, el primer bloque fija las importaciones, la semilla de la serie y la carpeta del día. Además, copia trigo_lento.sqlite a la carpeta del día: el índice se construye y se prueba en esa copia de ensayo, y solo cuando pase las pruebas se crea la misma tabla en la base de producción. El bloque carga también paginas_conocimiento.json, el texto de las páginas del espacio de trabajo simulado:
# Importaciones base, semilla de la serie y carpeta del día en Python:
import warnings
warnings.filterwarnings('ignore')
import hashlib
import json
import math
import re
import shutil
import sqlite3
import uuid
from collections import Counter, defaultdict
from datetime import datetime, timedelta, timezone
from pathlib import Path
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 130)
carpeta = Path('trigo_lento') / 'dia_68'
carpeta.mkdir(parents = True, exist_ok = True)
# Copia de ensayo de la base: el índice se prueba aquí antes de tocar la base de producción:
BASE = carpeta / 'trigo_lento.sqlite'
shutil.copy(Path('trigo_lento') / 'trigo_lento.sqlite', BASE)
paginas_fuente = json.loads((carpeta / 'paginas_conocimiento.json').read_text(encoding = 'utf-8'))
print('numpy', np.__version__, '| pandas', pd.__version__, '| páginas del espacio de trabajo:', len(paginas_fuente))
numpy 2.4.6 | pandas 3.0.3 | páginas del espacio de trabajo: 50
El espacio de trabajo simulado tiene $50$ páginas. No todas se van a indexar, y la diferencia entre “existe en Notion” y “entra en el índice” es la primera decisión de diseño del día.
La API de Notion
Notion ofrece una API REST en https://api.notion.com/v1 con objetos que reflejan lo que se ve en pantalla: páginas, bloques (cada párrafo, encabezado, elemento de lista o desplegable de una página es un bloque) y bases de datos. Para leerlas desde un programa hacen falta tres cosas.
Integración interna y permisos por página
La primera es una integración interna: una conexión que crea quien administra el espacio de trabajo y que recibe un token secreto. A diferencia de una integración pública, no usa OAuth ni la instala nadie más; vive en el espacio de trabajo de Trigo Lento y actúa con los permisos que se le den. Al crearla, Valeria marca solo la capacidad de leer contenido: ni insertar ni actualizar ni leer información de usuarios. Es el mínimo privilegio del Día 17 (Seguridad I: OAuth, secretos y mínimo privilegio en las conexiones) aplicado a Notion.
La segunda es compartir con la integración las páginas que debe ver. Una integración recién creada no ve nada: el acceso se concede página por página (o a una página padre, con todo lo que cuelga de ella) desde el menú de conexiones. Valeria comparte una sola cosa, la base de datos “Base de conocimiento”, y deja fuera la página “Recetas del obrador” y las notas de clientes. Esta es la garantía más fuerte que tiene Don Ernesto, porque no depende de ningún filtro que alguien pueda olvidar: lo que no se comparte, la API no lo devuelve, ni en una búsqueda ni pidiéndolo por su identificador.
La tercera es la versión de la API, que viaja en la cabecera Notion-Version de cada petición. Notion publica versiones con fecha y mantiene las anteriores; la versión decide la forma de las respuestas, así que se fija en el código y se cambia a propósito, nunca por accidente.
Bases de datos, fuentes de datos y bloques
La versión 2025-09-03 cambió el modelo de las bases de datos: una base de datos puede contener varias fuentes de datos (data sources), cada una con sus propiedades y sus filas, y casi todas las operaciones que antes usaban database_id ahora piden un data_source_id. Para Trigo Lento, con una sola fuente, el cambio se reduce a consultar POST /v1/data_sources/{data_source_id}/query en lugar del antiguo endpoint de bases de datos. La versión 2026-03-11, la vigente al revisar en octubre de 2026, añadió tres cambios incompatibles: el campo archived pasó a llamarse in_trash en páginas, bases de datos, bloques y fuentes de datos; el parámetro after para insertar bloques se sustituyó por un objeto position; y el tipo de bloque transcription pasó a llamarse meeting_notes. El indexador solo lee, así que el único cambio que le afecta es in_trash.
El indexador usa tres endpoints:
POST /v1/searchcon el filtro{"property": "object", "value": "data_source"}para encontrar la fuente de datos “Base de conocimiento” entre lo que la integración puede ver.POST /v1/data_sources/{data_source_id}/querycon un filtro sobre la casillaPublicablepara listar las páginas que se indexan, con sus propiedades y sulast_edited_time.GET /v1/blocks/{block_id}/childrenpara leer los bloques de cada página. El identificador de una página también es el de su bloque raíz, y un bloque conhas_childrenen verdadero (un desplegable de preguntas frecuentes, una lista anidada) obliga a otra petición para leer sus hijos.
Las tres respuestas son listas paginadas: devuelven como máximo $100$ elementos, un has_more que dice si hay más y un next_cursor que se envía como start_cursor en la siguiente petición. Como pide el plan de la serie, el bloque siguiente simula la API sin red, con funciones simular_get y simular_post que tienen la misma interfaz que requests (devuelven status_code, headers y json()). El simulador guarda las $50$ páginas en memoria, distingue las compartidas de las privadas, aplica el límite por conexión de $180$ peticiones por ventana de $60$ segundos con un reloj simulado y puede devolver, con probabilidades declaradas, errores 429 del límite por espacio de trabajo y 529 de sobrecarga. Al final guarda una respuesta real del simulador, los dos primeros bloques de la política de cancelaciones:
# Simulador de la API de Notion: búsqueda, fuente de datos, bloques hijos y límites de tasa en Python:
UTC = timezone.utc
URL_NOTION = 'https://api.notion.com/v1'
VERSION_NOTION = '2026-03-11'

def nuevo_id(nombre):
    # Identificadores con forma de UUID, deterministas y de ejemplo:
    return str(uuid.uuid5(uuid.NAMESPACE_URL, 'trigo-lento-ejemplo/' + nombre))

def rich(texto):
    # Texto enriquecido como lo devuelve Notion (un solo tramo, sin formato):
    return [{'type': 'text', 'text': {'content': texto, 'link': None},
             'annotations': {'bold': False, 'italic': False, 'strikethrough': False, 'underline': False,
                             'code': False, 'color': 'default'}, 'plain_text': texto, 'href': None}]

class RespuestaSimulada:
    def __init__(self, status_code, cuerpo, headers = None):
        self.status_code, self._cuerpo, self.headers = status_code, cuerpo, headers or {}
    def json(self):
        return self._cuerpo

class EspacioNotion:
    # Un espacio de trabajo de Notion en memoria, con un reloj simulado y los límites documentados:
    LIMITE_VENTANA, VENTANA = 180, 60.0        # 180 peticiones por ventana de 60 s por conexión
    def __init__(self, paginas, rng, inicio, p_espacio = 0.0, p_sobrecarga = 0.0):
        self.rng, self.reloj, self.inicio = rng, 0.0, inicio
        self.p_espacio, self.p_sobrecarga = p_espacio, p_sobrecarga
        self.ventanas = Counter()
        self.ds = nuevo_id('fuente-de-datos/base-de-conocimiento')
        self.paginas, self.bloques, self.hijos = {}, {}, defaultdict(list)
        for p in paginas:
            editado = inicio - timedelta(days = int(rng.integers(1, 38)), minutes = int(rng.integers(0, 600)))
            self.crear_pagina(p, editado)
    def crear_pagina(self, p, editado):
        pid = nuevo_id(p['titulo'])
        marca = editado.strftime('%Y-%m-%dT%H:%M:00.000Z')
        self.paginas[pid] = {'id': pid, 'titulo': p['titulo'], 'tipo': p['tipo'], 'publicable': p['publicable'],
                             'compartida': p['compartida'], 'in_trash': False, 'editado': marca}
        self.hijos[pid] = []
        for i, b in enumerate(p['bloques']):
            self._agregar_bloque(pid, f"{p['titulo']}/{i}", b, marca, 'page_id')
        return pid
    def _agregar_bloque(self, padre, nombre, b, marca, tipo_padre):
        bid = nuevo_id(nombre)
        t = b['tipo']
        contenido = {'rich_text': rich(b['texto']), 'color': 'default'}
        if t.startswith('heading'):
            contenido['is_toggleable'] = False
        if t == 'callout':
            contenido.update({'icon': None, 'color': 'gray_background'})
        self.bloques[bid] = {'object': 'block', 'id': bid, 'parent': {'type': tipo_padre, tipo_padre: padre},
                             'created_time': marca, 'last_edited_time': marca,
                             'created_by': {'object': 'user', 'id': nuevo_id('usuario/valeria')},
                             'last_edited_by': {'object': 'user', 'id': nuevo_id('usuario/valeria')},
                             'has_children': bool(b.get('hijos')), 'in_trash': False, 'type': t, t: contenido}
        self.hijos[padre].append(bid)
        for j, h in enumerate(b.get('hijos', [])):
            self._agregar_bloque(bid, f'{nombre}/{j}', h, marca, 'block_id')
    def objeto_pagina(self, p):
        return {'object': 'page', 'id': p['id'], 'created_time': p['editado'], 'last_edited_time': p['editado'],
                'in_trash': p['in_trash'], 'parent': {'type': 'data_source_id', 'data_source_id': self.ds},
                'properties': {'Nombre': {'id': 'title', 'type': 'title', 'title': rich(p['titulo'])},
                               'Tipo': {'type': 'select', 'select': {'name': p['tipo']}},
                               'Publicable': {'type': 'checkbox', 'checkbox': p['publicable']}},
                'url': 'https://www.notion.so/' + p['id'].replace('-', '')}
    def _limites(self):
        # Latencia de la petición y comprobación de los límites antes de responder:
        self.reloj += float(self.rng.lognormal(np.log(0.15), 0.3))
        ventana = int(self.reloj // self.VENTANA)
        if self.ventanas[ventana] >= self.LIMITE_VENTANA:
            espera = math.ceil((ventana + 1) * self.VENTANA - self.reloj)
            return RespuestaSimulada(429, {'object': 'error', 'status': 429, 'code': 'rate_limited',
                                           'additional_data': {'retry_after': str(espera)}},
                                     {'Retry-After': str(espera), 'motivo': 'conexion'})
        self.ventanas[ventana] += 1
        if self.rng.random() < self.p_espacio:          # límite del espacio de trabajo, sin cifra publicada
            espera = int(self.rng.integers(1, 4))
            return RespuestaSimulada(429, {'object': 'error', 'status': 429, 'code': 'rate_limited',
                                           'additional_data': {'retry_after': str(espera)}},
                                     {'Retry-After': str(espera), 'motivo': 'espacio'})
        if self.rng.random() < self.p_sobrecarga:
            return RespuestaSimulada(529, {'object': 'error', 'status': 529, 'code': 'service_overload'},
                                     {'Retry-After': '2', 'motivo': 'sobrecarga'})
        return None
    def _lista(self, elementos, params, tipo):
        tam = min(int(params.get('page_size', 100)), 100)
        inicio = 0
        if params.get('start_cursor'):
            inicio = [e['id'] for e in elementos].index(params['start_cursor'])
        tramo = elementos[inicio:inicio + tam]
        hay_mas = inicio + tam < len(elementos)
        return RespuestaSimulada(200, {'object': 'list', 'results': tramo,
                                       'next_cursor': elementos[inicio + tam]['id'] if hay_mas else None,
                                       'has_more': hay_mas, 'type': tipo, tipo: {},
                                       'request_id': nuevo_id(f'peticion/{self.reloj:.3f}')})
    def _cumple(self, p, filtro):
        if not filtro:
            return True
        if 'and' in filtro:
            return all(self._cumple(p, f) for f in filtro['and'])
        if filtro.get('property') == 'Publicable':
            return p['publicable'] == filtro['checkbox']['equals']
        if filtro.get('timestamp') == 'last_edited_time':
            return p['editado'] >= filtro['last_edited_time']['on_or_after']
        raise ValueError('filtro no simulado')
    def get(self, url, params):
        error = self._limites()
        if error:
            return error
        ruta = url.replace(URL_NOTION, '')
        m = re.fullmatch(r'/blocks/([0-9a-f-]+)/children', ruta)
        if m and m.group(1) in self.hijos:
            visibles = [self.bloques[b] for b in self.hijos[m.group(1)] if not self.bloques[b]['in_trash']]
            return self._lista(visibles, params, 'block')
        return RespuestaSimulada(404, {'object': 'error', 'status': 404, 'code': 'object_not_found'})
    def post(self, url, cuerpo):
        error = self._limites()
        if error:
            return error
        ruta = url.replace(URL_NOTION, '')
        compartidas = [p for p in self.paginas.values() if p['compartida'] and not p['in_trash']]
        if ruta == '/search':
            if cuerpo.get('filter', {}).get('value') == 'data_source':
                ds = {'object': 'data_source', 'id': self.ds, 'title': rich('Base de conocimiento')}
                return self._lista([ds], cuerpo, 'page_or_data_source')
            texto = cuerpo.get('query', '').lower()
            hallados = [self.objeto_pagina(p) for p in compartidas if texto in p['titulo'].lower()]
            return self._lista(hallados, cuerpo, 'page_or_data_source')
        if ruta == f'/data_sources/{self.ds}/query':
            filas = sorted((p for p in compartidas if self._cumple(p, cuerpo.get('filter'))),
                           key = lambda p: (p['editado'], p['id']))
            return self._lista([self.objeto_pagina(p) for p in filas], cuerpo, 'page_or_data_source')
        return RespuestaSimulada(404, {'object': 'error', 'status': 404, 'code': 'object_not_found'})

INICIO = datetime(2026, 4, 9, 16, 0, tzinfo = UTC)       # jueves 9 de abril, 10:00 en la Ciudad de México
NOTION = EspacioNotion(paginas_fuente, rng, INICIO)

def simular_get(url, params, rng):
    # Misma interfaz que requests.get: devuelve status_code, headers y json():
    return NOTION.get(url, params)

def simular_post(url, cuerpo, rng):
    return NOTION.post(url, cuerpo)

politica = next(p for p in NOTION.paginas.values() if p['titulo'] == 'Política de cancelaciones')
muestra = simular_get(f"{URL_NOTION}/blocks/{politica['id']}/children", {'page_size': 2}, rng).json()
(carpeta / 'respuesta_bloques_politica.json').write_text(json.dumps(muestra, ensure_ascii = False, indent = 2),
                                                         encoding = 'utf-8')
resumen = Counter((p['compartida'], p['publicable']) for p in NOTION.paginas.values())
print('Páginas en el espacio de trabajo:', len(NOTION.paginas), '| bloques:', len(NOTION.bloques))
print('Compartidas y publicables:', resumen[(True, True)], '| compartidas en borrador:', resumen[(True, False)],
      '| privadas (la integración no las ve):', resumen[(False, False)])
print('Muestra de bloques hijos:', len(muestra['results']), 'bloques, has_more =', muestra['has_more'])
Páginas en el espacio de trabajo: 50 | bloques: 1290
Compartidas y publicables: 40 | compartidas en borrador: 3 | privadas (la integración no las ve): 7
Muestra de bloques hijos: 2 bloques, has_more = True
De las $50$ páginas, $40$ están compartidas y marcadas como publicables, $3$ están compartidas pero en borrador (la casilla Publicable está apagada) y $7$ son privadas: las seis recetas y las notas de clientes. Las $40$ páginas suman $1,290$ bloques, que es lo que el indexador tendrá que recorrer. La muestra trae dos bloques y has_more en verdadero, porque se pidió con page_size de $2$.
Así se ve esa respuesta. Es la forma que tiene cualquier lista de bloques hijos en la versión 2026-03-11: un objeto list con results, next_cursor, has_more y un request_id, y en cada bloque su type, un objeto con el nombre de ese tipo y, dentro, el texto enriquecido:
{
  "object": "list",
  "results": [
    {
      "object": "block",
      "id": "bea9ce05-fc78-52b0-93bd-8e19005b88de",
      "parent": {
        "type": "page_id",
        "page_id": "7fcba2ce-1192-5b6f-942f-c86735e40283"
      },
      "created_time": "2026-03-29T09:39:00.000Z",
      "last_edited_time": "2026-03-29T09:39:00.000Z",
      "created_by": {
        "object": "user",
        "id": "9ddcabc6-3bcf-587c-9cde-389126ce6354"
      },
      "last_edited_by": {
        "object": "user",
        "id": "9ddcabc6-3bcf-587c-9cde-389126ce6354"
      },
      "has_children": false,
      "in_trash": false,
      "type": "heading_2",
      "heading_2": {
        "rich_text": [
          {
            "type": "text",
            "text": {
              "content": "Plazos para cancelar",
              "link": null
            },
            "annotations": {
              "bold": false,
              "italic": false,
              "strikethrough": false,
              "underline": false,
              "code": false,
              "color": "default"
            },
            "plain_text": "Plazos para cancelar",
            "href": null
          }
        ],
        "color": "default",
        "is_toggleable": false
      }
    },
    {
      "object": "block",
      "id": "39065a07-21ec-54ad-a7df-9951a6a07307",
      "parent": {
        "type": "page_id",
        "page_id": "7fcba2ce-1192-5b6f-942f-c86735e40283"
      },
      "created_time": "2026-03-29T09:39:00.000Z",
      "last_edited_time": "2026-03-29T09:39:00.000Z",
      "created_by": {
        "object": "user",
        "id": "9ddcabc6-3bcf-587c-9cde-389126ce6354"
      },
      "last_edited_by": {
        "object": "user",
        "id": "9ddcabc6-3bcf-587c-9cde-389126ce6354"
      },
      "has_children": false,
      "in_trash": false,
      "type": "paragraph",
      "paragraph": {
        "rich_text": [
          {
            "type": "text",
            "text": {
              "content": "Un encargo de pastel o de caja de pan dulce se puede cancelar sin costo hasta 48 horas antes de la hora de recogida. Entre 48 y 24 horas antes se retiene el 50 % del anticipo; con menos de 24 horas el anticipo no se devuelve.",
              "link": null
            },
            "annotations": {
              "bold": false,
              "italic": false,
              "strikethrough": false,
              "underline": false,
              "code": false,
              "color": "default"
            },
            "plain_text": "Un encargo de pastel o de caja de pan dulce se puede cancelar sin costo hasta 48 horas antes de la hora de recogida. Entre 48 y 24 horas antes se retiene el 50 % del anticipo; con menos de 24 horas el anticipo no se devuelve.",
            "href": null
          }
        ],
        "color": "default"
      }
    }
  ],
  "next_cursor": "a990420b-fee2-5bc9-93fa-f92e98ef5191",
  "has_more": true,
  "type": "block",
  "block": {},
  "request_id": "8ae86a89-9726-599b-862b-e15d061a3a33"
}
Tres detalles de este JSON deciden cómo se escribe el indexador. El texto no está en un campo text plano, sino en una lista rich_text de tramos, cada uno con su plain_text y sus anotaciones de formato; un párrafo con una palabra en negrita llega partido en tres tramos, y cada tramo admite como máximo $2,000$ caracteres, así que el texto de un bloque se obtiene concatenando los plain_text. El campo in_trash sustituye al antiguo archived, como manda la versión 2026-03-11. Y next_cursor es el identificador del siguiente bloque: el cursor es opaco y no se fabrica, solo se copia de la respuesta anterior.
Límites de la API
El límite de tasa de Notion cambió en 2026 y conviene leerlo con cuidado. Desde el 9 de septiembre de 2026, el límite por conexión es una ventana fija de $60$ segundos: $180$ peticiones por minuto en los planes gratuito y Plus (un promedio de $3$ por segundo) y $600$ en Business y Enterprise. Dentro de la ventana, el presupuesto se puede gastar al ritmo que se quiera, incluso de golpe. Desde junio existe además un límite por espacio de trabajo, compartido por todas las conexiones y proporcional al plan, cuya cifra no se publica; una integración puede recibir un 429 aunque ella sola esté dentro de su límite, porque otra conexión del mismo espacio gastó la cuota. La Tabla 1 reúne los límites que afectan al indexador.
Tabla 1. Límites de la API de Notion con su fuente y cómo los respeta el indexador de Trigo Lento (revisado en octubre de 2026).
| Límite | Valor | Fuente | Cómo lo respeta el indexador |
|---|---|---|---|
| Peticiones por conexión, planes gratuito y Plus | 180 por ventana de 60 s (promedio de 3 por segundo) | Oficial: límites de peticiones y registro de cambios del 9 de septiembre de 2026 | Ritmo propio de 3 por segundo; 67 peticiones en 24.7 s |
| Peticiones por conexión, Business y Enterprise | 600 por ventana de 60 s | Oficial | No aplica: Trigo Lento usa el plan Plus |
| Límite por espacio de trabajo | Compartido por todas las conexiones; sin cifra publicada | Oficial, desde junio de 2026 | Se trata como cualquier 429 |
| Respuesta al exceder un límite | 429 rate_limited con Retry-After en segundos enteros (como máximo 60 en el límite por conexión), repetido en additional_data.retry_after | Oficial | Espera exactamente lo que pide el servidor y reintenta |
| Sobrecarga del servicio | 529 service_overload, que se reintenta como un 429 | Oficial | El mismo manejo que el 429 |
| Paginación | page_size máximo de 100, con has_more y next_cursor | Oficial | Pide 100 y sigue el cursor hasta el final |
| Texto enriquecido | 2 000 caracteres por tramo de text.content | Oficial | Solo lee: concatena los plain_text de todos los tramos |
| Arreglos y carga útil | 100 elementos por arreglo; 1 000 bloques y 500 KB por petición | Oficial | Solo afectan a las escrituras, que el indexador no hace |
Con un ritmo fijo, el tiempo mínimo de una corrida se calcula antes de ejecutarla:
$$ t_{min} = \frac{R}{r} $$
La lógica detrás de esta fórmula:
- $R$ es el número de peticiones de la corrida: una búsqueda, una consulta por cada $100$ páginas, una lectura de bloques por página y una más por cada bloque con hijos.
- $r$ es el ritmo que se impone el cliente, $3$ peticiones por segundo, el promedio del límite por conexión.
- Con $R = 80$ peticiones, la cifra que estimó el plan, $t_{min} = 80/3 \approx 27$ segundos; los 429 y los 529 añaden encima lo que pida cada
Retry-After. - En conclusión, la primera indexación es lenta por diseño y no por la red: el cuello de botella es el límite de tasa, y por eso las siguientes corridas deben pedir lo menos posible.
¿Para qué imponerse un ritmo si la ventana admite ráfagas? Por tres razones. El límite por espacio de trabajo no tiene cifra y lo comparten otras conexiones, de modo que gastarse el minuto en ocho segundos puede dejar sin cuota a otra integración del mismo espacio. Un ritmo constante hace predecible la duración, que es lo que necesita un flujo programado. Y si el indexador se ejecuta varias veces seguidas, como pasa mientras se desarrolla, la ráfaga sí choca contra el límite por conexión.
El cliente del bloque siguiente reúne las tres prácticas: un ritmo propio de $3$ peticiones por segundo, la espera exacta que pide Retry-After ante un 429 o un 529 y la paginación por cursor, incluida la bajada a los bloques con hijos. Recibe como parámetros las funciones de transporte y de reloj, de modo que pasar del simulador a la API real consiste en cambiar esos parámetros, como se hará en el Bloque 7. Para probarlo, busca la fuente de datos, consulta las páginas publicables y lee los bloques de la política de cancelaciones:
# Cliente de Notion con paginación por cursor, ritmo propio y respeto de Retry-After en Python:
class ClienteNotion:
    def __init__(self, obtener, enviar, ahora, dormir, ritmo = 3.0, reintentos = 6):
        self.obtener, self.enviar, self.ahora, self.dormir = obtener, enviar, ahora, dormir
        self.ritmo, self.reintentos, self.ultima = ritmo, reintentos, -1e9
        self.registro = []                     # una fila por petición: instante, ruta, estado y espera

    def pedir(self, metodo, ruta, datos):
        for intento in range(self.reintentos):
            if self.ritmo:                      # nunca más de `ritmo` peticiones por segundo
                hueco = self.ultima + 1 / self.ritmo - self.ahora()
                if hueco > 0:
                    self.dormir(hueco)
            self.ultima = self.ahora()
            url = URL_NOTION + ruta
            r = self.obtener(url, datos) if metodo == 'GET' else self.enviar(url, datos)
            fila = {'t': self.ahora(), 'ruta': ruta.split('/')[1], 'estado': r.status_code, 'espera': 0.0,
                    'motivo': r.headers.get('motivo', '')}
            self.registro.append(fila)
            if r.status_code in (429, 529):     # se espera lo que pide el servidor, ni un segundo menos
                fila['espera'] = float(r.headers.get('Retry-After', 2 ** intento))
                self.dormir(fila['espera'])
                continue
            if r.status_code >= 400:
                raise RuntimeError(f'{r.status_code} en {ruta}: {r.json()}')
            return r.json()
        raise RuntimeError(f'Sin respuesta tras {self.reintentos} intentos: {ruta}')

    def paginar(self, metodo, ruta, datos = None):
        datos = dict(datos or {}, page_size = 100)
        while True:
            cuerpo = self.pedir(metodo, ruta, datos)
            yield from cuerpo['results']
            if not cuerpo['has_more']:
                break
            datos['start_cursor'] = cuerpo['next_cursor']

    def bloques(self, bloque_id, profundidad = 0):
        # Recorre los bloques hijos y baja a los que tienen hijos (desplegables, listas anidadas):
        for b in self.paginar('GET', f'/blocks/{bloque_id}/children'):
            yield profundidad, b
            if b['has_children'] and b['type'] not in ('child_page', 'child_database'):
                yield from self.bloques(b['id'], profundidad + 1)

def avanzar(segundos):
    NOTION.reloj += segundos

cliente = ClienteNotion(obtener = lambda url, p: simular_get(url, p, rng),
                        enviar = lambda url, c: simular_post(url, c, rng),
                        ahora = lambda: NOTION.reloj, dormir = avanzar, ritmo = 3.0)
fuente = next(cliente.paginar('POST', '/search', {'query': 'Base de conocimiento',
                                                  'filter': {'property': 'object', 'value': 'data_source'}}))
publicables = list(cliente.paginar('POST', f"/data_sources/{fuente['id']}/query",
                                   {'filter': {'property': 'Publicable', 'checkbox': {'equals': True}}}))
bloques_politica = list(cliente.bloques(politica['id']))
print('Fuente de datos:', fuente['title'][0]['plain_text'], '| páginas publicables:', len(publicables))
print('Política de cancelaciones:', len(bloques_politica), 'bloques, profundidad máxima',
      max(p for p, _ in bloques_politica))
print('Peticiones:', len(cliente.registro), '| estados:', dict(Counter(f['estado'] for f in cliente.registro)),
      f'| tiempo simulado: {NOTION.reloj:.2f} s')
Fuente de datos: Base de conocimiento | páginas publicables: 40
Política de cancelaciones: 40 bloques, profundidad máxima 0
Peticiones: 3 | estados: {200: 3} | tiempo simulado: 1.13 s
El cliente encontró la fuente de datos, listó las $40$ páginas publicables en una sola consulta (caben en una página de $100$) y leyó los $40$ bloques de la política de cancelaciones, todos de primer nivel. Fueron $3$ peticiones, todas con estado 200, en $1.13$ segundos simulados. Los tres borradores no aparecen en la consulta porque el filtro pide Publicable en verdadero, y las recetas no aparecen en ningún lado porque no están compartidas.
El indexador completo contra los límites
El siguiente bloque recorre las $40$ páginas con dos clientes y compara su comportamiento. El primero es el cliente con ritmo propio, que hace una pasada. El segundo no tiene ritmo y lanza las peticiones tan rápido como responde el servidor, y hace cuatro pasadas seguidas, como haría Valeria si ejecutara el indexador una y otra vez mientras lo prueba. En los dos, el simulador devuelve un 429 del espacio de trabajo con probabilidad $0.03$ y un 529 con probabilidad $0.01$; son supuestos declarados para ver el manejo de errores, no tasas medidas de Notion. La salida es la Tabla 1 comprobada con números:
# Indexador simulado de las 40 páginas con límites, errores 429 y 529 y ventanas de 60 s en Python:
def titulo_de(pagina):
    return ''.join(t['plain_text'] for t in pagina['properties']['Nombre']['title'])

def indexar(cliente):
    fuente = next(cliente.paginar('POST', '/search', {'query': 'Base de conocimiento',
                                                      'filter': {'property': 'object', 'value': 'data_source'}}))
    filtro = {'filter': {'property': 'Publicable', 'checkbox': {'equals': True}}}
    leidas = {}
    for p in cliente.paginar('POST', f"/data_sources/{fuente['id']}/query", filtro):
        leidas[p['id']] = {'titulo': titulo_de(p), 'tipo': p['properties']['Tipo']['select']['name'],
                           'editado': p['last_edited_time'], 'bloques': list(cliente.bloques(p['id']))}
    return fuente['id'], leidas

def corrida(ritmo, pasadas, p_espacio, p_sobrecarga, semilla):
    global NOTION
    NOTION = EspacioNotion(paginas_fuente, np.random.default_rng(semilla), INICIO, p_espacio, p_sobrecarga)
    c = ClienteNotion(lambda url, p: simular_get(url, p, rng), lambda url, b: simular_post(url, b, rng),
                      lambda: NOTION.reloj, avanzar, ritmo = ritmo)
    for _ in range(pasadas):
        ds, leidas = indexar(c)
    reg = pd.DataFrame(c.registro)
    por_ventana = reg[reg['motivo'] != 'conexion'].groupby(reg['t'] // 60).size()   # lo que cuenta el servidor
    return {'peticiones': len(reg), 'duracion_s': round(NOTION.reloj, 1),
            '429_conexion': int((reg['motivo'] == 'conexion').sum()),
            '429_espacio': int((reg['motivo'] == 'espacio').sum()), '529': int((reg['estado'] == 529).sum()),
            'espera_s': round(reg['espera'].sum(), 1), 'max_en_60s': int(por_ventana.max()),
            'paginas': len(leidas)}, reg, ds, leidas

res_rafaga, reg_rafaga, _, _ = corrida(None, 4, 0.03, 0.01, 69)
res_ritmo, reg_ritmo, DS, leidas = corrida(3.0, 1, 0.03, 0.01, 68)
tabla_1 = pd.DataFrame([res_ritmo, res_rafaga], index = ['a ritmo, 1 pasada', 'en ráfaga, 4 pasadas'])
print(tabla_1.T.to_string())
reintentos = reg_ritmo[reg_ritmo['estado'] != 200]
print('Comprobaciones: máximo en una ventana <= 180:', bool(tabla_1['max_en_60s'].max() <= 180),
      '| cada 429 y 529 esperó su Retry-After:', bool((reintentos['espera'] > 0).all()),
      '| ritmo medio:', round(res_ritmo['peticiones'] / res_ritmo['duracion_s'], 2), 'peticiones/s')

fig, ejes = plt.subplots(1, 2, figsize = (11, 4.2))
seg = reg_ritmo['t'].astype(int)
ejes[0].bar(*np.unique(seg, return_counts = True), width = 0.9, color = '#4f81bd', label = 'peticiones en cada segundo')
ejes[0].axhline(3, color = '#c0504d', ls = '--', label = 'promedio permitido: 3 por segundo')
for _, f in reintentos.iterrows():
    ejes[0].axvspan(f['t'], f['t'] + f['espera'], color = '#f2c14e', alpha = 0.35)
    ejes[0].plot(f['t'], 4.3, 'x', color = '#c0504d', ms = 8)
ejes[0].set_title('Cliente con ritmo propio: una pasada', fontsize = 12)
ejes[0].set_xlabel('Segundos simulados (x = 429 o 529; franja = espera)')
ejes[0].set_ylabel('Peticiones')
ejes[0].set_ylim(0, 5.6)
ejes[0].legend(frameon = False, fontsize = 8, loc = 'upper right')
acum = reg_rafaga[reg_rafaga['motivo'] != 'conexion'].groupby(reg_rafaga['t'] // 60).cumcount() + 1
ejes[1].plot(reg_rafaga.loc[acum.index, 't'], acum, '.', ms = 3, color = '#4f81bd',
             label = 'peticiones aceptadas en la ventana')
ejes[1].axhline(180, color = '#c0504d', ls = '--', label = 'límite: 180 por ventana de 60 s')
for _, f in reg_rafaga[reg_rafaga['motivo'] == 'conexion'].iterrows():
    ejes[1].axvspan(f['t'], f['t'] + f['espera'], color = '#f2c14e', alpha = 0.35)
ejes[1].set_title('Cliente en ráfaga: cuatro pasadas seguidas', fontsize = 12)
ejes[1].set_xlabel('Segundos simulados (franja = espera por Retry-After)')
ejes[1].set_ylabel('Peticiones acumuladas en la ventana')
ejes[1].legend(frameon = False, fontsize = 8, loc = 'lower right')
plt.tight_layout()
plt.show()
              a ritmo, 1 pasada  en ráfaga, 4 pasadas
peticiones                 67.0                 276.0
duracion_s                 24.7                  90.6
429_conexion                0.0                   1.0
429_espacio                 1.0                  15.0
529                         1.0                   0.0
espera_s                    3.0                  48.0
max_en_60s                 67.0                 180.0
paginas                    40.0                  40.0
Comprobaciones: máximo en una ventana <= 180: True | cada 429 y 529 esperó su Retry-After: True | ritmo medio: 2.71 peticiones/s
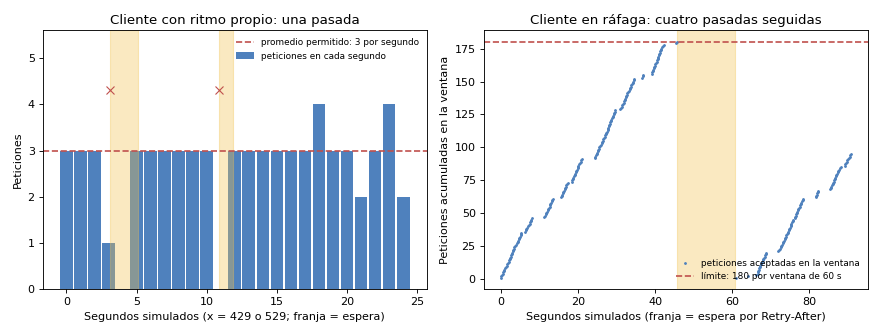
La primera indexación cuesta $67$ peticiones: $65$ útiles (una búsqueda, una consulta, $40$ lecturas de bloques y $23$ lecturas de los desplegables de las preguntas frecuentes) y $2$ reintentos. Con el ritmo propio dura $24.7$ segundos simulados, muy cerca de los $67/3 = 22.3$ de la fórmula; la diferencia son los $3$ segundos que esperó por un 429 del espacio de trabajo y un 529, cada uno con su reintento. El ritmo medio queda en $2.71$ peticiones por segundo y la ventana más cargada tuvo $67$ peticiones, lejos de las $180$. El cliente en ráfaga hizo $276$ peticiones ($4 \cdot 65 = 260$ útiles y $16$ reintentos) en $90.6$ segundos, llenó la primera ventana hasta $180$, recibió el 429 del límite por conexión y tuvo que esperar a que empezara la ventana siguiente, más $15$ esperas por el límite del espacio de trabajo: $48$ segundos parado en total.
La gráfica de la izquierda muestra el cliente con ritmo: tres peticiones por segundo como un metrónomo, con dos franjas amarillas donde esperó lo que pidió el servidor. La de la derecha muestra la ráfaga: la línea de peticiones acumuladas sube hasta tocar el límite de $180$ y se queda plana durante la espera. Las dos terminan el trabajo; la diferencia es que la ráfaga se gasta en menos de un minuto la cuota entera de la ventana, y con ella buena parte de lo que comparten las conexiones del espacio de trabajo, y si TL Lote nocturno v1 o cualquier otra integración leyera Notion en ese momento, el 429 le llegaría a ella.
De bloques a fragmentos
Una página completa es una mala unidad de búsqueda. La política de cancelaciones tiene $1,600$ tokens y habla de plazos, de anticipos, de excepciones y de mayoristas; si se le entrega al agente entera cada vez que alguien pregunta por un plazo, paga tokens de más y le da al modelo cuatro temas donde solo importa uno. Una frase suelta es el error contrario: “48 horas antes de la recogida” no dice de qué. El punto medio es el fragmento: un trozo de unos cientos de tokens, cortado por secciones, que lleva consigo la página y la sección de donde salió.
Aplanar los bloques sin perder los encabezados
Aplanar es convertir la lista de bloques en texto. La regla que más importa es conservar los encabezados: cada heading_2 abre una sección nueva y su texto viaja como etiqueta de todos los fragmentos que salgan de ella. Los demás bloques se convierten en líneas con un prefijo que conserva su papel: un elemento de lista empieza con un guion, una pregunta de un desplegable con “Pregunta:”, un aviso destacado (callout) con “Aviso:”, y los hijos de un desplegable, que son la respuesta, llevan sangría. Los separadores y los bloques sin texto se descartan.
Fragmentos con solapamiento
Dentro de cada sección, el texto se corta en ventanas de $L = 300$ tokens que avanzan $L - s = 250$, de modo que dos fragmentos consecutivos comparten $s = 50$ tokens. El solapamiento evita que una idea quede partida justo en el corte sin estar completa en ninguno de los dos lados. El número de fragmentos de una sección se calcula antes de cortar:
$$ n = \begin{cases} 1 & \text{si } T \le L \ \left\lceil \dfrac{T - s}{L - s} \right\rceil & \text{si } T > L \end{cases} $$
La lógica detrás de esta fórmula:
- $T$ es el número de tokens de la sección, $L$ el tamaño máximo del fragmento ($300$) y $s$ el solapamiento ($50$).
- El primer fragmento cubre $L$ tokens y cada uno de los siguientes añade $L - s$ tokens nuevos; hacen falta tantos como para cubrir los $T - s$ tokens que quedan después del primer solapamiento.
- La sección “Plazos para cancelar” de la política, con $325$ tokens, da $\lceil 275/250 \rceil = 2$ fragmentos, de $300$ y de $75$ tokens, que comparten $50$; la sección “Alérgenos” de la ficha del rol de canela, con $198$, da uno solo, más corto que $L$.
- En conclusión, el solapamiento cuesta tokens: los tokens embebidos son $\sum_i n_i L$ como máximo, algo más que el texto original, y ese sobrecoste se mide en el bloque siguiente.
Para contar tokens sin depender de ningún servicio, el bloque usa una aproximación de laboratorio: cada palabra y cada signo de puntuación cuentan como un token. Los tokenizadores reales cortan las palabras largas en varias piezas y en español suelen dar más tokens que esta cuenta; para una estimación de tamaños y costes basta, y la API de Voyage AI devuelve en cada respuesta el número exacto que factura. Cada fragmento se guarda con su identificador (página:orden), la página, el tipo, la sección, el orden, el texto con una cabecera “Página > Sección”, el número de tokens, una huella SHA-256 del texto y la fecha de edición de la página:
# Aplanado de bloques en texto y división en fragmentos de 300 tokens con solapamiento de 50 en Python:
PATRON_TOKEN = re.compile(r'\w+|[^\w\s]')

def contar_tokens(texto):
    # Aproximación de laboratorio: una palabra o un signo cuenta como un token:
    return len(PATRON_TOKEN.findall(texto))

PREFIJO = {'bulleted_list_item': '- ', 'numbered_list_item': '1. ', 'toggle': 'Pregunta: ',
           'callout': 'Aviso: ', 'quote': '> ', 'paragraph': '', 'to_do': '[ ] '}

def texto_de(b):
    return ''.join(t['plain_text'] for t in b[b['type']].get('rich_text', []))

def aplanar(bloques):
    # Convierte la lista de bloques en secciones de texto, conservando los encabezados:
    secciones, actual = [], {'seccion': 'Inicio', 'lineas': []}
    for profundidad, b in bloques:
        t = b['type']
        if t in ('heading_1', 'heading_2', 'heading_3'):
            if actual['lineas']:
                secciones.append(actual)
            actual = {'seccion': texto_de(b), 'lineas': []}
        elif t in PREFIJO:
            actual['lineas'].append('  ' * profundidad + PREFIJO[t] + texto_de(b))
    if actual['lineas']:
        secciones.append(actual)
    return secciones

def fragmentar(pagina_id, pagina, L = 300, s = 50):
    fragmentos, orden = [], 0
    for sec in aplanar(pagina['bloques']):
        cuerpo = '\n'.join(sec['lineas'])
        tramos = [m.span() for m in PATRON_TOKEN.finditer(cuerpo)]
        inicio = 0
        while True:
            fin = min(inicio + L, len(tramos))
            texto = f"{pagina['titulo']} > {sec['seccion']}\n" + cuerpo[tramos[inicio][0]:tramos[fin - 1][1]]
            fragmentos.append({'id': f'{pagina_id}:{orden:03d}', 'pagina_id': pagina_id,
                               'titulo': pagina['titulo'], 'tipo': pagina['tipo'], 'seccion': sec['seccion'],
                               'orden': orden, 'texto': texto, 'tokens': fin - inicio,
                               'huella': hashlib.sha256(texto.encode('utf-8')).hexdigest()[:16],
                               'editado': pagina['editado']})
            orden += 1
            if fin == len(tramos):
                break
            inicio = fin - s
    return fragmentos

fragmentos = [f for pid, pag in leidas.items() for f in fragmentar(pid, pag)]
tam_paginas = {pid: sum(contar_tokens(l) for sec in aplanar(p['bloques']) for l in sec['lineas'])
               for pid, p in leidas.items()}
tabla_2 = (pd.DataFrame([{'tipo': p['tipo'], 'tokens': tam_paginas[pid],
                          'fragmentos': sum(f['pagina_id'] == pid for f in fragmentos)} for pid, p in leidas.items()])
           .groupby('tipo').agg(paginas = ('tokens', 'size'), tokens = ('tokens', 'sum'),
                                tokens_medios = ('tokens', 'mean'), fragmentos = ('fragmentos', 'sum')))
tabla_2.loc['total'] = [tabla_2['paginas'].sum(), tabla_2['tokens'].sum(),
                        tabla_2['tokens'].sum() / tabla_2['paginas'].sum(), tabla_2['fragmentos'].sum()]
print(tabla_2.round(0).astype(int).to_string())
tam_frag = np.array([f['tokens'] for f in fragmentos])
n_secciones = sum(len(aplanar(p['bloques'])) for p in leidas.values())
print(f'Fragmentos: {len(fragmentos)} | tokens embebidos: {tam_frag.sum()} | media {tam_frag.mean():.1f} '
      f'| mediana {np.median(tam_frag):.0f} | máximo {tam_frag.max()} | secciones: {n_secciones}')
print('Un fragmento de ejemplo:')
print(next(f['texto'] for f in fragmentos if f['titulo'] == 'Ficha: Rol de canela' and f['seccion'] == 'Alérgenos'))

fig, ejes = plt.subplots(1, 2, figsize = (11, 4))
ejes[0].hist(list(tam_paginas.values()), bins = 12, color = '#8064a2', edgecolor = 'white')
ejes[0].axvline(300, color = '#c0504d', ls = '--', label = 'tamaño objetivo del fragmento: 300')
ejes[0].set_title('Antes: 40 páginas completas', fontsize = 12)
ejes[0].set_xlabel('Tokens por página')
ejes[0].set_ylabel('Páginas')
ejes[0].legend(frameon = False, fontsize = 9)
ejes[1].hist(tam_frag, bins = np.arange(0, 325, 25), color = '#4f81bd', edgecolor = 'white')
ejes[1].axvline(300, color = '#c0504d', ls = '--')
ejes[1].set_title(f'Después: {len(fragmentos)} fragmentos', fontsize = 12)
ejes[1].set_xlabel('Tokens por fragmento (sin la cabecera)')
ejes[1].set_ylabel('Fragmentos')
plt.tight_layout()
plt.show()
           paginas  tokens  tokens_medios  fragmentos
tipo
alergenos        4    5881           1470          26
aviso            6    4302            717          23
faq             10   11282           1128          52
ficha           12   12405           1034          60
politica         8   12864           1608          58
total           40   46734           1168         219
Fragmentos: 219 | tokens embebidos: 51034 | media 233.0 | mediana 238 | máximo 300 | secciones: 133
Un fragmento de ejemplo:
Ficha: Rol de canela > Alérgenos
Aviso: Rol de canela: lleva nuez en la receta.
Rol de canela contiene: gluten, leche, huevo, nuez. Puede contener trazas de almendra, porque se elabora en el mismo obrador.
Las fotografías de la pieza son del obrador y muestran el tamaño real. Si la receta cambia, esta ficha se actualiza antes de que la pieza nueva llegue al mostrador. El peso y la forma pueden variar ligeramente porque cada pieza se forma a mano.
Los ingredientes se compran a proveedores locales y se revisan cada vez que cambia un lote. Si necesita más de 4 piezas, conviene encargarlas con al menos 72 horas de anticipación. El precio publicado incluye el empaque de papel; las cajas para regalo se cotizan aparte.
Se hornea de jueves a sábado en el obrador de la colonia Narvarte. Para encargos por WhatsApp, indique la clave del producto, la cantidad, el día y la hora de recogida.
La pieza se prepara en tandas pequeñas, de modo que la disponibilidad en mostrador cambia a lo largo de la mañana.
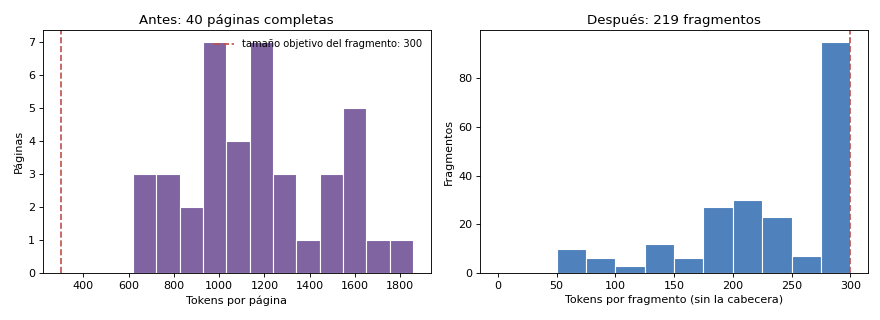
Las $40$ páginas suman $46,734$ tokens, con una media de $1,168$ por página, y se convierten en $219$ fragmentos a partir de $133$ secciones. La Tabla 2 resume el reparto por tipo de página.
Tabla 2. Páginas publicables de Trigo Lento por tipo, con su tamaño en tokens y los fragmentos que producen (fragmentos de hasta 300 tokens con solapamiento de 50).
| Tipo de página | Páginas | Tokens | Tokens medios por página | Fragmentos |
|---|---|---|---|---|
| Fichas de producto | 12 | 12 405 | 1 034 | 60 |
| Políticas | 8 | 12 864 | 1 608 | 58 |
| Preguntas frecuentes | 10 | 11 282 | 1 128 | 52 |
| Avisos de temporada | 6 | 4 302 | 717 | 23 |
| Alérgenos declarados | 4 | 5 881 | 1 470 | 26 |
| Total | 40 | 46 734 | 1 168 | 219 |
El plan estimaba unos $160$ fragmentos, la cuenta de $48,000 / 300$. Salen $219$ porque el corte respeta las secciones: una sección de $180$ tokens produce un fragmento de $180$, no se completa con el principio de la siguiente. La gráfica lo muestra: las páginas, a la izquierda, están todas entre $600$ y $1,900$ tokens, muy por encima del objetivo; los fragmentos, a la derecha, se acumulan cerca de $300$ (las secciones largas cortadas en ventanas completas) y forman una segunda joroba entre $175$ y $250$ (las secciones que caben enteras). La media es de $233$ tokens y ninguno pasa de $300$. Los tokens que se embeben son $51,034$, un $9.2%$ más que el texto original: ese es el precio del solapamiento.
El fragmento de ejemplo enseña por qué la cabecera importa. Empieza con “Ficha: Rol de canela > Alérgenos” y su segunda línea es el aviso destacado que Valeria puso en la ficha: lleva nuez en la receta. Si el fragmento no llevara la cabecera, el texto “contiene: gluten, leche, huevo, nuez” seguiría siendo cierto, pero ni un buscador ni una persona sabrían de qué producto habla. La Figura 2 muestra el corte de una página en fragmentos con su etiqueta.
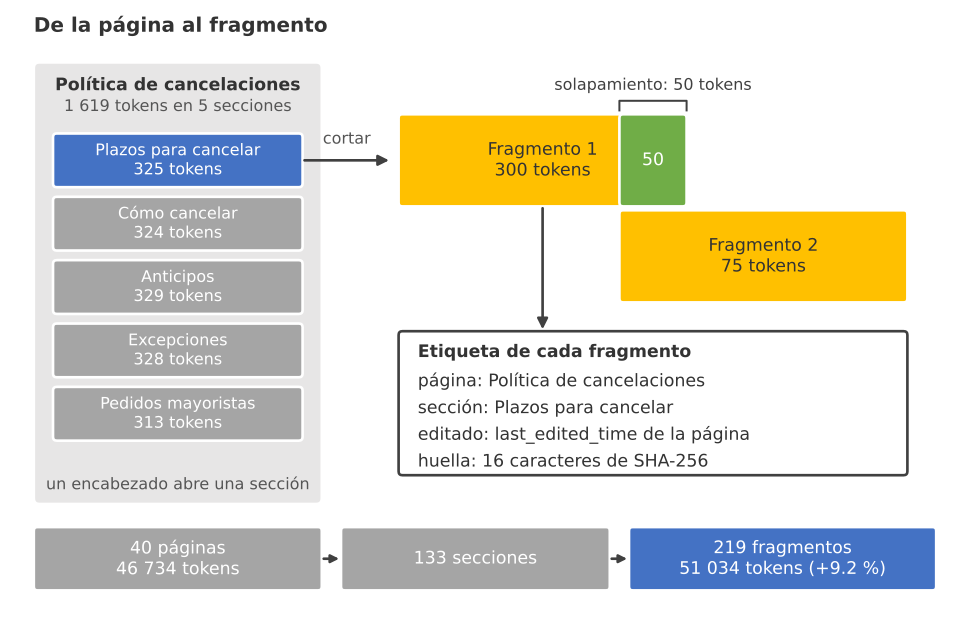
Figura 2. De la página al fragmento: la política de cancelaciones se corta por secciones en fragmentos de hasta 300 tokens que comparten 50, cada uno con su etiqueta de página, sección, fecha y huella; 40 páginas, 133 secciones y 219 fragmentos.
Del simulador a la API real
El bloque siguiente es el mismo indexador contra la API real de Notion. Cambian solo los parámetros del cliente: las funciones de transporte pasan a ser requests.get y requests.post con las cabeceras de autenticación y de versión, y el reloj y la espera pasan a ser time.monotonic y time.sleep. El token de la integración se lee de la variable de entorno NOTION_TOKEN, que en el servidor de n8n viene de la credencial cifrada del Día 35 (Seguridad II: credenciales cifradas, respaldo y restauración de n8n); nunca se escribe en el código. Este bloque llama a la API y no se ejecutó para escribir la entrada; la salida es un ejemplo comentado:
# Lectura real de la base de conocimiento con la API de Notion y el mismo cliente en Python:
import os
import time
import requests

CABECERAS = {
    'Authorization': f"Bearer {os.environ['NOTION_TOKEN']}",   # token de la integración interna, fuera del código
    'Notion-Version': '2026-03-11',                             # versión fijada; cambiarla es una decisión
    'Content-Type': 'application/json',
}
cliente_real = ClienteNotion(
    obtener = lambda url, p: requests.get(url, params = p, headers = CABECERAS, timeout = 30),
    enviar = lambda url, c: requests.post(url, json = c, headers = CABECERAS, timeout = 30),
    ahora = time.monotonic, dormir = time.sleep, ritmo = 3.0)
ds_real, leidas_reales = indexar(cliente_real)
registro = cliente_real.registro
print('Fuente de datos:', ds_real, '| páginas publicables leídas:', len(leidas_reales))
print('Peticiones:', len(registro), '| estados:', dict(Counter(f['estado'] for f in registro)),
      '| espera por Retry-After:', sum(f['espera'] for f in registro), 's')
fragmentos_reales = [f for pid, pag in leidas_reales.items() for f in fragmentar(pid, pag)]
print('Fragmentos:', len(fragmentos_reales), '| tokens:', sum(f['tokens'] for f in fragmentos_reales))

# Salida de ejemplo (puede variar):
# Fuente de datos: 2f4c0a1e-0000-4000-8000-00000000d5a1 | páginas publicables leídas: 40
# Peticiones: 68 | estados: {200: 67, 429: 1} | espera por Retry-After: 1.0 s
# Fragmentos: 221 | tokens: 51388
En el ejemplo, la lectura real hizo $68$ peticiones, una de ellas rechazada con un 429 que pidió un segundo de espera, y salen $221$ fragmentos porque el espacio de trabajo real no es idéntico al simulado. Lo que sí es idéntico es el código que corta y etiqueta, de modo que todo lo que se pruebe sobre el simulador vale para la lectura real.
Embeddings
Un embedding (en español, vector de representación; la serie usa el término original porque es el que aparece en toda la documentación) es una lista de números que representa el contenido de un texto de modo que textos parecidos queden cerca. “¿El rol de canela lleva nuez?” y el fragmento de alérgenos de la ficha del rol de canela deben quedar más cerca entre sí que cualquiera de los dos y el horario del puente. Una vez que cada fragmento tiene su vector, buscar es medir distancias. Hay dos maneras de obtener esos vectores, y la serie usa las dos.
TF-IDF: un vector de palabras que se calcula sin cuenta
La primera es clásica y se calcula con numpy en milisegundos: TF-IDF (por sus siglas en inglés: “Term Frequency-Inverse Document Frequency”, frecuencia del término por frecuencia inversa en los documentos). Cada dimensión del vector es una palabra del vocabulario, y su peso crece con las veces que la palabra aparece en el fragmento y decrece con el número de fragmentos que la contienen:
$$ w_{t,d} = \left(1 + \ln f_{t,d}\right) \cdot \left(\ln \frac{1 + N}{1 + n_t} + 1\right) $$
La lógica detrás de esta fórmula:
- $f_{t,d}$ es el número de veces que la palabra $t$ aparece en el fragmento $d$; el logaritmo evita que una palabra repetida diez veces pese diez veces más.
- $N$ es el número de fragmentos ($219$) y $n_t$ el número de fragmentos que contienen $t$; una palabra que aparece en todos (“obrador”, “pedido”) recibe un peso bajo, y una que aparece en pocos (“nuez”, “cancelar”) uno alto. Los unos del numerador y del denominador evitan dividir entre cero.
- Después, cada vector se divide entre su norma para que todos midan $1$, de modo que un fragmento largo no gane solo por tener más palabras.
- En conclusión, TF-IDF representa qué palabras distinguen a un fragmento de los demás; no sabe que “anular” y “cancelar” significan lo mismo, porque son palabras distintas.
Para comparar dos vectores se usa la similitud de coseno, el coseno del ángulo que forman:
$$ \cos(\mathbf{q}, \mathbf{d}) = \frac{\mathbf{q} \cdot \mathbf{d}}{\lVert \mathbf{q} \rVert , \lVert \mathbf{d} \rVert} $$
La lógica detrás de esta fórmula:
- $\mathbf{q}$ es el vector de la pregunta y $\mathbf{d}$ el de un fragmento; el numerador suma los productos de sus componentes, dimensión por dimensión.
- Si los dos vectores ya tienen norma $1$, el denominador vale $1$ y el coseno es el producto punto, que numpy calcula para todos los fragmentos con una multiplicación de matriz por vector.
- El valor va de $0$ (nada en común) a $1$ (la misma dirección) con pesos positivos como los de TF-IDF; con embeddings de un modelo puede ser negativo.
- En conclusión, buscar los fragmentos más parecidos a una pregunta es ordenar por coseno y quedarse con los primeros; el Día 69 añadirá un umbral por debajo del cual el agente se abstiene.
El bloque siguiente escribe el vectorizador con numpy, crea la tabla fragmentos en la copia de ensayo de trigo_lento.sqlite con cada vector serializado como bytes, prueba tres preguntas de mostrador y proyecta los $219$ vectores a dos dimensiones con la descomposición en valores singulares (SVD) de numpy, para poder dibujarlos:
# Vectorizador TF-IDF con numpy, tabla de fragmentos en SQLite y mapa 2D con SVD en Python:
VACIAS = set('de la el en y a los las del se un una por con para es no al lo su sus o que le como más '
             'pero si este esta hasta sin ya cada todos todas muy son'.split())

def palabras(texto):
    return [w for w in re.findall(r'\w+', texto.lower()) if w not in VACIAS and not w.isdigit()]

class TfIdf:
    def ajustar(self, textos):
        docs = [Counter(palabras(t)) for t in textos]
        df = Counter(w for d in docs for w in d)
        self.vocab = {w: i for i, w in enumerate(sorted(df))}
        n = len(textos)
        self.idf = np.array([math.log((1 + n) / (1 + df[w])) + 1 for w in sorted(df)])
        return self
    def transformar(self, textos):
        M = np.zeros((len(textos), len(self.vocab)), dtype = np.float32)
        for i, t in enumerate(textos):
            for w, f in Counter(palabras(t)).items():
                if w in self.vocab:
                    M[i, self.vocab[w]] = (1 + math.log(f)) * self.idf[self.vocab[w]]
        normas = np.linalg.norm(M, axis = 1, keepdims = True)
        return M / np.where(normas == 0, 1, normas)

def guardar_indice(con, fragmentos, matriz, modelo):
    con.execute('''CREATE TABLE IF NOT EXISTS fragmentos (
        id TEXT PRIMARY KEY, pagina_id TEXT NOT NULL, titulo TEXT, tipo TEXT, seccion TEXT, orden INTEGER,
        texto TEXT NOT NULL, tokens INTEGER, huella TEXT NOT NULL, editado TEXT NOT NULL,
        modelo TEXT NOT NULL, dimension INTEGER NOT NULL, vector BLOB NOT NULL)''')
    con.execute('CREATE INDEX IF NOT EXISTS fragmentos_pagina ON fragmentos (pagina_id)')
    con.execute('DELETE FROM fragmentos WHERE modelo = ?', (modelo,))
    con.executemany('INSERT INTO fragmentos VALUES (?,?,?,?,?,?,?,?,?,?,?,?,?)',
                    [(f['id'], f['pagina_id'], f['titulo'], f['tipo'], f['seccion'], f['orden'], f['texto'],
                      f['tokens'], f['huella'], f['editado'], modelo, matriz.shape[1],
                      matriz[i].astype(np.float32).tobytes()) for i, f in enumerate(fragmentos)])
    con.commit()

def buscar(con, vectorizador, pregunta, k = 3, modelo = 'tfidf-numpy'):
    filas = con.execute('SELECT titulo, seccion, vector FROM fragmentos WHERE modelo = ?', (modelo,)).fetchall()
    V = np.stack([np.frombuffer(f[2], dtype = np.float32) for f in filas])
    q = vectorizador.transformar([pregunta])[0]
    sims = V @ q                                 # vectores normalizados: el producto punto es el coseno
    return [(round(float(sims[i]), 3), filas[i][0], filas[i][1]) for i in np.argsort(-sims)[:k]]

textos = [f['texto'] for f in fragmentos]
tfidf = TfIdf().ajustar(textos)
X = tfidf.transformar(textos)
con = sqlite3.connect(BASE)
guardar_indice(con, fragmentos, X, 'tfidf-numpy')
n_filas, n_bytes = con.execute("SELECT COUNT(*), SUM(LENGTH(vector)) FROM fragmentos").fetchone()
print(f'Matriz TF-IDF: {X.shape[0]} x {X.shape[1]} | no nulos: {100 * (X > 0).mean():.1f} % '
      f'| filas en SQLite: {n_filas} | bytes de vectores: {n_bytes}')
for pregunta in ['¿El rol de canela lleva nuez?', '¿Hasta cuándo puedo cancelar un pastel?',
                 '¿Abren el 1 de mayo?']:
    print(pregunta)
    for sim, titulo, seccion in buscar(con, tfidf, pregunta):
        print(f'   {sim:.3f}  {titulo} > {seccion}')

# Proyección 2D con SVD de la matriz centrada:
tipos = np.array([f['tipo'] for f in fragmentos])
media = X.mean(axis = 0)
U, S, Vt = np.linalg.svd(X - media, full_matrices = False)
P = (X - media) @ Vt[:2].T
varianza = (S[:2] ** 2).sum() / (S ** 2).sum()
sim_frag = X @ X.T
np.fill_diagonal(sim_frag, -1)
vecino = sim_frag.argmax(axis = 1)
pureza = (tipos[vecino] == tipos).mean()
print(f'Varianza explicada por 2 componentes: {100 * varianza:.1f} % | el vecino más cercano es del mismo tipo '
      f'en el {100 * pureza:.1f} % de los fragmentos')

COLORES = {'ficha': '#4f81bd', 'politica': '#c0504d', 'faq': '#9bbb59', 'aviso': '#f2c14e', 'alergenos': '#8064a2'}
NOMBRES = {'ficha': 'Fichas de producto', 'politica': 'Políticas', 'faq': 'Preguntas frecuentes',
           'aviso': 'Avisos de temporada', 'alergenos': 'Alérgenos'}
fig, ax = plt.subplots(figsize = (8, 5.6))
for t, color in COLORES.items():
    ax.scatter(P[tipos == t, 0], P[tipos == t, 1], s = 22, color = color, alpha = 0.8,
               label = f'{NOMBRES[t]} ({(tipos == t).sum()})')
q2 = (tfidf.transformar(['¿El rol de canela lleva nuez?'])[0] - media) @ Vt[:2].T
ax.scatter(*q2, marker = '*', s = 260, color = 'black', label = 'pregunta: ¿el rol de canela lleva nuez?')
ax.set_title('Mapa de los fragmentos: TF-IDF proyectado con SVD', fontsize = 13)
ax.set_xlabel('Componente 1')
ax.set_ylabel('Componente 2')
ax.legend(frameon = False, fontsize = 8)
plt.tight_layout()
plt.show()
Matriz TF-IDF: 219 x 549 | no nulos: 11.9 % | filas en SQLite: 219 | bytes de vectores: 480924
¿El rol de canela lleva nuez?
   0.452  Ficha: Rol de canela > Alérgenos
   0.342  Ficha: Rol de canela > Ingredientes declarados
   0.317  Ficha: Rol de canela > Precio y encargos
¿Hasta cuándo puedo cancelar un pastel?
   0.321  Preguntas frecuentes: cambios y cancelaciones > Respuestas rápidas
   0.183  Política de cancelaciones > Cómo cancelar
   0.183  Política de cancelaciones > Plazos para cancelar
¿Abren el 1 de mayo?
   0.146  Aviso: puente del 1 de mayo > Fechas
   0.145  Aviso: puente del 1 de mayo > Encargos
   0.143  Aviso: puente del 1 de mayo > Horario
Varianza explicada por 2 componentes: 44.0 % | el vecino más cercano es del mismo tipo en el 100.0 % de los fragmentos
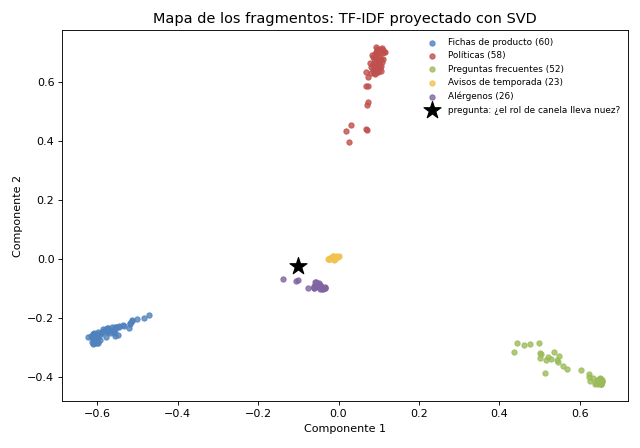
El vocabulario tiene $549$ palabras, así que cada vector tiene $549$ dimensiones, de las que solo el $11.9%$ no son cero. Las tres preguntas enseñan lo que TF-IDF hace bien y lo que no. “¿El rol de canela lleva nuez?” encuentra en primer lugar, con un coseno de $0.452$, el fragmento “Ficha: Rol de canela > Alérgenos”, el que habría resuelto la pregunta de ayer en segundos. “¿Hasta cuándo puedo cancelar un pastel?” encuentra la pregunta frecuente sobre cancelaciones y las dos secciones de la política. “¿Abren el 1 de mayo?” encuentra el aviso del puente, pero con cosenos de apenas $0.146$: el vectorizador descarta los números como palabras vacías, de modo que el “1” de la pregunta no cuenta y la coincidencia descansa en “mayo”. Es un recordatorio de que cada decisión de preprocesamiento cambia lo que se puede encontrar, y volverá a aparecer al sincronizar.
La gráfica es el mapa de los fragmentos. Los dos ejes son las dos direcciones de mayor variación de la matriz, que juntas explican el $44.0%$ de la varianza; el resto se pierde en el dibujo, pero no en la búsqueda, que usa las $549$ dimensiones. Los cinco tipos de página forman cinco grupos separados, y en el $100%$ de los fragmentos el vecino más cercano es del mismo tipo. Esa pureza perfecta se debe en parte a que el texto de las páginas simuladas sale de plantillas por tipo; en las páginas reales de Valeria los grupos se tocan, porque una pregunta frecuente sobre alergias usa las mismas palabras que la página de alérgenos. La estrella de la pregunta cae junto al grupo de alérgenos, a medio camino de las fichas, que es donde están sus respuestas. La Figura 3 traduce la gráfica a la metáfora del obrador.
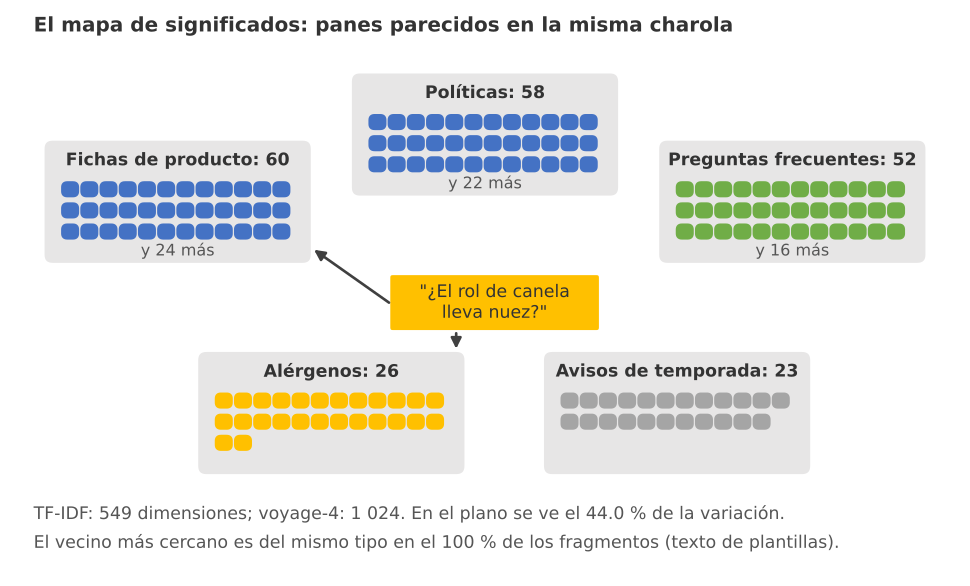
Figura 3. El mapa de significados: los fragmentos parecidos quedan juntos como panes en la misma charola, y la pregunta del rol de canela cae junto a los alérgenos y las fichas, donde está su respuesta.
Voyage AI: vectores de significado
La segunda manera es un modelo de embeddings: una red neuronal entrenada para que textos con el mismo significado queden cerca aunque no compartan palabras. Anthropic no ofrece un modelo de embeddings propio; la documentación de Claude, revisada en octubre de 2026, remite a Voyage AI, hoy parte de MongoDB, y explica su uso. La generación vigente es la familia voyage-4: voyage-4-large para la mejor calidad, voyage-4 como equilibrio y voyage-4-lite para el menor coste y la menor latencia, las tres con un contexto de $32,000$ tokens y vectores de $1,024$ dimensiones por omisión (también $256$, $512$ o $2,048$ con el parámetro output_dimension). Según la página de precios, revisada en octubre de 2026, voyage-4 cuesta $0.06$ USD por millón de tokens, voyage-4-lite $0.02$ y voyage-4-large $0.12$, con $200$ millones de tokens gratuitos por cuenta en la familia voyage-4; la API de lotes descuenta un $33%$. Valeria elige voyage-4: la calidad de voyage-4-large no hace falta para $219$ fragmentos de una panadería, y la diferencia de precio con voyage-4-lite se mide en milésimas de centavo.
Dos parámetros importan. input_type vale "document" al indexar y "query" al preguntar: el modelo antepone a cada texto una instrucción distinta según el caso, y la documentación pide no omitirlo en tareas de recuperación. Y los vectores vuelven con norma $1$, así que el producto punto es el coseno, como en TF-IDF. Las peticiones admiten hasta $1,000$ textos y $320,000$ tokens en voyage-4; el bloque manda lotes de $128$ fragmentos para no acercarse a ninguno de los dos límites. Este bloque llama a la API y no se ejecutó para escribir la entrada; la salida es un ejemplo comentado:
# Embeddings de los fragmentos con la API de Voyage AI y guardado en SQLite en Python:
import os
import time
import requests

URL_VOYAGE = 'https://ai.mongodb.com/v1/embeddings'          # API de Atlas para los modelos de Voyage AI
CABECERAS_VOYAGE = {'Authorization': f"Bearer {os.environ['VOYAGE_API_KEY']}",   # clave fuera del código
                    'Content-Type': 'application/json'}

def embeber(textos, tipo_entrada, modelo = 'voyage-4', dimension = 1024, lote = 128):
    # tipo_entrada: 'document' al indexar y 'query' al preguntar (cambia el prefijo que añade el modelo):
    vectores, tokens = [], 0
    for i in range(0, len(textos), lote):
        cuerpo = {'input': textos[i:i + lote], 'model': modelo, 'input_type': tipo_entrada,
                  'output_dimension': dimension}
        for intento in range(5):
            r = requests.post(URL_VOYAGE, json = cuerpo, headers = CABECERAS_VOYAGE, timeout = 60)
            if r.status_code != 429:
                break
            time.sleep(float(r.headers.get('Retry-After', 2 ** intento)))
        r.raise_for_status()
        datos = r.json()
        vectores += [d['embedding'] for d in sorted(datos['data'], key = lambda d: d['index'])]
        tokens += datos['usage']['total_tokens']
    return np.array(vectores, dtype = np.float32), tokens

V, tokens_doc = embeber([f['texto'] for f in fragmentos], 'document')
con = sqlite3.connect(BASE)
guardar_indice(con, fragmentos, V, 'voyage-4')               # misma tabla, otra columna de modelo
print('Vectores:', V.shape, '| normas:', np.round(np.linalg.norm(V, axis = 1)[:3], 3),
      '| tokens facturados:', tokens_doc, f'| coste: {tokens_doc * 0.06 / 1e6:.5f} USD')

q, _ = embeber(['¿El rol de canela lleva nuez?'], 'query')
sims = V @ q[0]                                              # vectores de norma 1: producto punto = coseno
for i in np.argsort(-sims)[:3]:
    print(f"   {sims[i]:.3f}  {fragmentos[i]['titulo']} > {fragmentos[i]['seccion']}")
con.close()

# Salida de ejemplo (puede variar):
# Vectores: (219, 1024) | normas: [1. 1. 1.] | tokens facturados: 68912 | coste: 0.00413 USD
#    0.712  Ficha: Rol de canela > Alérgenos
#    0.655  Alérgenos: nuez y frutos secos > Productos con nuez
#    0.641  Preguntas frecuentes: alergias > Respuestas rápidas
En el ejemplo, los $219$ vectores tienen $1,024$ dimensiones y norma $1$, y la API factura $68,912$ tokens, un $35%$ más que los $51,034$ de la cuenta aproximada del Bloque 6: es la diferencia entre contar palabras y contar los tokens reales del modelo en español. Aun así, la indexación completa cuesta $0.00413$ USD, menos de medio centavo, y entra en los tokens gratuitos de la cuenta. La pregunta del rol de canela encuentra el mismo primer fragmento que TF-IDF, con coseno $0.712$, pero los siguientes ya no son otras secciones de la misma ficha, sino la página de alérgenos de nuez y la pregunta frecuente sobre alergias: el modelo entiende que la pregunta trata de alergias aunque esas páginas no repitan “rol de canela”. Esa es la ventaja de un modelo de embeddings sobre TF-IDF, y la razón de que el índice guarde los dos.
Atención aquí: enviar un texto a un servicio de embeddings es enviarlo a un tercero. Los fragmentos de Trigo Lento son públicos por diseño (políticas, horarios, fichas y alérgenos que ya están en el mostrador y en las redes), y aun así Valeria leyó los términos de uso de datos de Voyage AI y de MongoDB Atlas antes de crear la clave, revisado en octubre de 2026. La regla que protege el índice no está en el proveedor sino antes: la integración de Notion solo ve la base de datos compartida, el indexador solo lee páginas con Publicable en verdadero, y ninguna receta, nombre de cliente ni teléfono entra en un fragmento. Si algún día una página publicable incluyera datos personales, el fragmento se seudonimiza o se excluye antes de embeberlo, como pide el Día 6.
Guardar el índice
El índice vive en una tabla de SQLite, fragmentos, dentro de trigo_lento.sqlite. No hace falta una base de datos vectorial: con $219$ fragmentos, comparar la pregunta con todos es una multiplicación de una matriz de $219 \times 1,024$ por un vector, que numpy resuelve en microsegundos. Una base vectorial empieza a compensar con cientos de miles de fragmentos, cuando la búsqueda exhaustiva se vuelve lenta y conviene un índice aproximado; Trigo Lento está tres órdenes de magnitud por debajo. La Tabla 4 describe las columnas que creó el Bloque 8.
Tabla 4. Columnas de la tabla fragmentos en trigo_lento.sqlite y para qué sirve cada una.
| Columna | Tipo | Ejemplo | Para qué sirve |
|---|---|---|---|
id | Texto, clave primaria | <id de página>:003 | Identifica el fragmento por página y orden; permite reemplazarlo sin duplicar |
pagina_id | Texto, con índice | Identificador de Notion | Borrar o releer todos los fragmentos de una página |
titulo, tipo, seccion | Texto | “Ficha: Rol de canela”, “ficha”, “Alérgenos” | Metadatos que el agente cita y que permiten filtrar por tipo |
orden | Entero | 3 | Reconstruir el orden de lectura dentro de la página |
texto | Texto | Cabecera y cuerpo del fragmento | Lo que se entrega al modelo como contexto |
tokens | Entero | 198 | Presupuesto de contexto y coste de embeber |
huella | Texto | 16 caracteres de SHA-256 | Saber si el fragmento cambió sin compararlo letra por letra |
editado | Texto ISO 8601 | 2026-03-20T15:02:00.000Z | Marca de agua y antigüedad de la información |
modelo, dimension | Texto y entero | tfidf-numpy, 549; voyage-4, 1024 | Separar los vectores de cada modelo; nunca se mezclan |
vector | BLOB | Bytes de float32 | El vector serializado con tobytes() y leído con np.frombuffer |
Tres decisiones de esta tabla merecen explicación:
- El vector como BLOB de
float32. Cada número ocupa $4$ bytes; los $219$ vectores de TF-IDF ocupan $480,924$ bytes y los devoyage-4ocuparían $219 \cdot 1,024 \cdot 4 = 897,024$, menos de un megabyte. Guardarlos como texto JSON triplicaría el tamaño y obligaría a convertirlos en cada búsqueda. - La columna
modelo. Un vector de TF-IDF y uno de Voyage AI no se pueden comparar entre sí: tienen dimensiones distintas y, aunque coincidieran, sus espacios no tienen relación. Incluso dentro de Voyage AI solo los modelos de la familiavoyage-4comparten espacio; cambiar de familia obliga a reindexar todo. La columna hace imposible mezclar por accidente. - La huella. Es la pieza que hace barata la sincronización: si la huella de un fragmento recién cortado coincide con la guardada, el texto es idéntico y no hace falta volver a embeberlo.
El índice tiene además una tabla pequeña, sincronizaciones, con una fila por corrida: la marca de agua, la hora, las páginas releídas, los fragmentos nuevos, los borrados y los tokens enviados al proveedor. Es el registro que el cuadro de mando del Día 75 leerá para saber si el índice está al día.
Sincronización incremental
Volver a indexar todo cada noche funcionaría: $67$ peticiones, $25$ segundos y menos de medio centavo. Pero es un hábito caro a medida que crece la base y, sobre todo, ciego: no dice qué cambió. La alternativa es la sincronización incremental del Día 16 (Conexiones y sincronizaciones: claves, OAuth, webhooks y fuentes de verdad) aplicada a Notion, con last_edited_time como marca de agua: se guarda el mayor last_edited_time visto en la última corrida y, en la siguiente, solo se piden las páginas editadas desde entonces.
La consulta a la fuente de datos admite un filtro por marca de tiempo, {"timestamp": "last_edited_time", "last_edited_time": {"on_or_after": marca}}. El Día 16 enseñó la trampa de las marcas de agua: si se usa “después de” estricto, una página editada en el mismo instante que la marca se pierde; con “en o después de”, la página de la frontera se vuelve a leer cada vez. Valeria elige lo segundo y deja que la huella absorba el coste: la página de la frontera se relee, pero sus fragmentos no se vuelven a embeber. Además, “en o después de” no depende de la precisión con que Notion registre la hora de cada edición: si dos ediciones comparten instante, las dos se leen.
Hay dos cambios que la marca de agua no ve, y los dos importan:
- Una página despublicada. Si Valeria apaga la casilla
Publicable, la página sí aparece en la consulta por fecha (apagar la casilla es una edición), pero ya no debe estar en el índice. - Una página en la papelera. Las páginas con
in_trashno aparecen en las consultas, así que la marca de agua nunca las verá cambiar.
La solución es una reconciliación en cada corrida: una consulta más, filtrada por Publicable, que devuelve los identificadores vigentes; todo lo que está en el índice y no está en esa lista se borra, sea porque se despublicó o porque está en la papelera. Cuesta una petición por cada $100$ páginas.
Para probarlo, el bloque siguiente reproduce lo que Valeria hizo en Notion la tarde del jueves, entre las 16:20 y las 17:40: corrige el plazo de cancelación con la regla del puente, deja explícito en la ficha del rol de canela que todas las piezas llevan nuez, cambia el horario del 1 de mayo a las 15:00, crea una página de preguntas frecuentes para el Día de las Madres, despublica el aviso de la Rosca de Reyes y manda a la papelera el de Semana Santa, que ya pasó. Después ejecuta la sincronización, vuelve a calcular los vectores y prepara la Tabla 3 de coste y tiempo:
# Sincronización incremental por last_edited_time con borrado de páginas despublicadas en Python:
def sincronizar(cliente, con, ds, marca, vectorizador_nuevo, ejecutada):
    con.execute('''CREATE TABLE IF NOT EXISTS sincronizaciones (fuente TEXT, marca_de_agua TEXT,
                   ejecutada TEXT, cambiadas INTEGER, nuevos INTEGER, borrados INTEGER, tokens INTEGER)''')
    antes = len(cliente.registro)
    cambios = list(cliente.paginar('POST', f'/data_sources/{ds}/query', {
        'filter': {'timestamp': 'last_edited_time', 'last_edited_time': {'on_or_after': marca}}}))
    vigentes = {p['id'] for p in cliente.paginar('POST', f'/data_sources/{ds}/query', {
        'filter': {'property': 'Publicable', 'checkbox': {'equals': True}}})}
    indexadas = {r[0] for r in con.execute('SELECT DISTINCT pagina_id FROM fragmentos')}
    actuales = {r[0]: r[1] for r in con.execute('SELECT id, huella FROM fragmentos')}
    cuenta, releidas = Counter(), []
    nuevos_frag = []
    for p in cambios:
        if not p['properties']['Publicable']['checkbox']:
            continue                                  # despublicada: la borra la reconciliación de abajo
        pagina = {'titulo': titulo_de(p), 'tipo': p['properties']['Tipo']['select']['name'],
                  'editado': p['last_edited_time'], 'bloques': list(cliente.bloques(p['id']))}
        frescos = fragmentar(p['id'], pagina)
        viejos = {k: h for k, h in actuales.items() if k.startswith(p['id'] + ':')}
        for f in frescos:
            if f['id'] not in viejos:
                cuenta['nuevos'] += 1
                nuevos_frag.append(f)
            elif viejos[f['id']] != f['huella']:
                cuenta['actualizados'] += 1
                nuevos_frag.append(f)
            else:
                cuenta['sin_cambios'] += 1
        sobrantes = set(viejos) - {f['id'] for f in frescos}
        cuenta['borrados'] += len(sobrantes)
        con.executemany('DELETE FROM fragmentos WHERE id = ?', [(k,) for k in sobrantes])
        con.executemany('DELETE FROM fragmentos WHERE id = ?', [(f['id'],) for f in frescos])
        cuenta['paginas'] += 1
        releidas.append(pagina['titulo'])
        for f in frescos:
            fragmentos_vivos[f['id']] = f
    # Reconciliación: lo indexado que ya no es publicable (despublicado o en la papelera) se borra:
    for pid in indexadas - vigentes:
        n = con.execute('DELETE FROM fragmentos WHERE pagina_id = ?', (pid,)).rowcount
        cuenta['borrados'] += n
        cuenta['paginas_retiradas'] += 1
        for k in [k for k in fragmentos_vivos if k.startswith(pid + ':')]:
            del fragmentos_vivos[k]
    # Con TF-IDF el idf depende del corpus: se recalculan todos los vectores (es barato y local):
    todos = sorted(fragmentos_vivos.values(), key = lambda f: f['id'])
    matriz = vectorizador_nuevo.ajustar([f['texto'] for f in todos]).transformar([f['texto'] for f in todos])
    guardar_indice(con, todos, matriz, 'tfidf-numpy')
    nueva_marca = max([marca] + [p['last_edited_time'] for p in cambios])
    tokens_api = sum(f['tokens'] for f in nuevos_frag)
    con.execute('INSERT INTO sincronizaciones VALUES (?,?,?,?,?,?,?)',
                ('notion', nueva_marca, ejecutada, cuenta['paginas'],
                 cuenta['nuevos'] + cuenta['actualizados'], cuenta['borrados'], tokens_api))
    con.commit()
    return cuenta, len(cliente.registro) - antes, nueva_marca, tokens_api, len(todos), releidas

fragmentos_vivos = {f['id']: f for f in fragmentos}
marca_inicial = max(p['editado'] for p in leidas.values())
cliente_sync = ClienteNotion(lambda url, p: simular_get(url, p, rng), lambda url, b: simular_post(url, b, rng),
                             lambda: NOTION.reloj, avanzar, ritmo = 3.0)
# Lo que hizo Valeria en Notion la tarde del jueves 9 de abril (16:20 a 17:40):
def ahora_iso(minutos):
    return (INICIO + timedelta(minutes = minutos)).strftime('%Y-%m-%dT%H:%M:00.000Z')
def editar(titulo, contiene, texto_nuevo, minutos):
    # Cambia el bloque que contiene un texto y actualiza last_edited_time, como lo haría Notion:
    pid = nuevo_id(titulo)
    bid = next(b for b in NOTION.hijos[pid] if contiene in texto_de(NOTION.bloques[b]))
    NOTION.bloques[bid][NOTION.bloques[bid]['type']]['rich_text'] = rich(texto_nuevo)
    NOTION.paginas[pid]['editado'] = ahora_iso(minutos)
editar('Política de cancelaciones', 'sin costo hasta 48 horas', 'Un encargo de pastel o de caja de pan dulce se puede cancelar sin costo '
       'hasta 48 horas antes de la hora de recogida. Para el puente del 1 de mayo, el plazo vence el martes 28 '
       'de abril a las 19:00.', 380)
editar('Ficha: Rol de canela', 'lleva nuez en la receta', 'Rol de canela lleva nuez picada sobre el glaseado en todas sus piezas; '
       'no se prepara una versión sin nuez.', 395)
editar('Aviso: puente del 1 de mayo', 'de 8:00 a 14:00', 'El viernes 1 de mayo el mostrador abre de 8:00 a 15:00 y no hay '
       'entregas a domicilio.', 410)
NOTION.crear_pagina({'titulo': 'Preguntas frecuentes: Día de las Madres', 'tipo': 'faq', 'publicable': True,
                     'compartida': True, 'bloques': [
    {'tipo': 'heading_2', 'texto': 'Respuestas rápidas'},
    {'tipo': 'toggle', 'texto': '¿Hasta cuándo encargo un pastel para el 10 de mayo?',
     'hijos': [{'tipo': 'paragraph', 'texto': 'Hasta el jueves 7 de mayo a las 19:00, o antes si se llena el horno.'}]},
    {'tipo': 'toggle', 'texto': '¿Abren el domingo 10 de mayo?',
     'hijos': [{'tipo': 'paragraph', 'texto': 'Sí, de manera excepcional, de 8:00 a 14:00 y solo para recoger encargos.'}]}]},
    INICIO + timedelta(minutes = 425))
pid_rosca = nuevo_id('Aviso: Rosca de Reyes')
NOTION.paginas[pid_rosca].update({'publicable': False, 'editado': ahora_iso(440)})
NOTION.paginas[nuevo_id('Aviso: Semana Santa 2026')].update({'in_trash': True, 'editado': ahora_iso(460)})

tfidf_v2 = TfIdf()
cuenta, peticiones, nueva_marca, tokens_api, total, releidas = sincronizar(cliente_sync, con, DS, marca_inicial,
                                                                 tfidf_v2, ahora_iso(480))
print('Marca de agua anterior:', marca_inicial, '| nueva:', nueva_marca)
print('Peticiones a Notion:', peticiones, '| páginas releídas:', cuenta['paginas'],
      '| páginas retiradas del índice:', cuenta['paginas_retiradas'])
print('Releídas:', releidas)
print('Fragmentos nuevos:', cuenta['nuevos'], '| actualizados:', cuenta['actualizados'],
      '| sin cambios:', cuenta['sin_cambios'], '| borrados:', cuenta['borrados'], '| en el índice:', total)
print('Tokens que irían a Voyage AI en esta sincronización:', tokens_api)
print('¿Abren el 1 de mayo?', buscar(con, tfidf_v2, '¿Abren el 1 de mayo?', k = 1)[0])

# Coste y tiempo de indexar con voyage-4 (0.06 USD por millón de tokens, revisado en octubre de 2026):
PRECIO_VOYAGE = 0.06
filas = [('Primera indexación', res_ritmo['peticiones'], int(tam_frag.sum())),
         ('Sincronización de hoy', peticiones, tokens_api),
         ('Sincronización sin cambios', 2, 0)]
tabla_3 = pd.DataFrame(filas, columns = ['corrida', 'peticiones_notion', 'tokens_embebidos'])
tabla_3['segundos_minimos'] = (tabla_3['peticiones_notion'] / 3).round(1)
tabla_3['usd_voyage'] = (tabla_3['tokens_embebidos'] * PRECIO_VOYAGE / 1e6).round(5)
mes = {'corrida': 'Mes típico (30 diarias, 4 con cambios)',
       'peticiones_notion': 4 * peticiones + 26 * 2, 'tokens_embebidos': 4 * tokens_api}
mes['segundos_minimos'] = round(mes['peticiones_notion'] / 3, 1)
mes['usd_voyage'] = round(mes['tokens_embebidos'] * PRECIO_VOYAGE / 1e6, 5)
tabla_3.loc[len(tabla_3)] = mes
print(tabla_3.to_string(index = False))
con.close()
Marca de agua anterior: 2026-04-08T13:55:00.000Z | nueva: 2026-04-09T23:20:00.000Z
Peticiones a Notion: 12 | páginas releídas: 5 | páginas retiradas del índice: 2
Releídas: ['Preguntas frecuentes: conservación', 'Política de cancelaciones', 'Ficha: Rol de canela', 'Aviso: puente del 1 de mayo', 'Preguntas frecuentes: Día de las Madres']
Fragmentos nuevos: 1 | actualizados: 4 | sin cambios: 18 | borrados: 8 | en el índice: 212
Tokens que irían a Voyage AI en esta sincronización: 815
¿Abren el 1 de mayo? (0.472, 'Preguntas frecuentes: Día de las Madres', 'Respuestas rápidas')
                               corrida  peticiones_notion  tokens_embebidos  segundos_minimos  usd_voyage
                    Primera indexación                 67             51034              22.3     0.00306
                 Sincronización de hoy                 12               815               4.0     0.00005
            Sincronización sin cambios                  2                 0               0.7     0.00000
Mes típico (30 diarias, 4 con cambios)                100              3260              33.3     0.00020
La sincronización hizo $12$ peticiones a Notion en lugar de $67$. Releyó $5$ páginas: las tres editadas, la nueva y “Preguntas frecuentes: conservación”, que era la página de la frontera (su last_edited_time coincidía con la marca anterior) y que se releyó por usar “en o después de”. De sus fragmentos, $1$ es nuevo, $4$ cambiaron y $18$ siguen idénticos, entre ellos todos los de la página de la frontera, que no se vuelven a embeber. La reconciliación retiró del índice las $2$ páginas despublicadas, con sus $8$ fragmentos, y el índice queda en $212$. A Voyage AI solo irían $815$ tokens, el $1.6%$ de la primera indexación.
La última pregunta de la salida es un aviso, no un éxito: “¿Abren el 1 de mayo?” ahora devuelve primero la página nueva del Día de las Madres, porque su pregunta “¿Abren el domingo 10 de mayo?” comparte con la consulta “abren” y “mayo”, y el número que las distinguiría se descarta. El índice está al día y aun así da una respuesta peor que antes: sincronizar bien no garantiza recuperar bien. Por eso el Día 69 medirá la recuperación con un conjunto de preguntas etiquetadas y comparará TF-IDF con los vectores de Voyage AI, que no dependen de una palabra exacta.
Hay una diferencia entre los dos índices que el bloque deja escrita en un comentario. Con TF-IDF, el peso de cada palabra depende de todo el corpus, de modo que al cambiar fragmentos hay que recalcular todos los vectores; es barato porque ocurre en numpy, sin red. Con Voyage AI, el vector de un fragmento solo depende de su texto, y por eso basta con embeber los fragmentos nuevos o cambiados. La Tabla 3 resume coste y tiempo.
Tabla 3. Coste y tiempo de indexar la base de conocimiento: peticiones a Notion, tokens embebidos y coste con voyage-4 a 0.06 USD por millón de tokens (revisado en octubre de 2026).
| Corrida | Peticiones a Notion | Tiempo mínimo a 3 por segundo | Tokens embebidos (cuenta aproximada) | Coste con voyage-4 |
|---|---|---|---|---|
| Primera indexación | 67 | 22.3 s (24.7 s en la simulación) | 51 034 | 0.00306 USD |
| Sincronización del jueves | 12 | 4.0 s | 815 | 0.00005 USD |
| Sincronización sin cambios | 2 | 0.7 s | 0 | 0 USD |
| Mes típico: 30 sincronizaciones diarias, 4 con cambios | 100 | 33.3 s | 3 260 | 0.00020 USD |
La cuenta confirma el ejemplo del plan y lo afina. Indexar las $40$ páginas una vez cuesta $51,034 \cdot 0.06 / 10^6 \approx 0.003$ USD con la cuenta aproximada, y unos $0.004$ con los tokens reales del ejemplo del Bloque 9; un mes de sincronizaciones diarias, $0.0002$ USD. Son cifras que caben en los tokens gratuitos de Voyage AI y que, aun pagadas, no mueven el presupuesto de $45$ USD: salen de la reserva de $8.41$ USD y entran en el redondeo, lo que importa porque el rubro de Claude quedó ayer a un centavo de su tope. La primera indexación es barata y lenta; las siguientes son baratas y rápidas porque solo tocan lo editado.
El flujo de producción es TL Indexador Notion v1 en n8n: un disparador programado cada día a las 6:00, antes de que abra el mostrador, que ejecuta la sincronización, escribe la fila de sincronizaciones y avisa en el Slack del obrador solo si algo falla o si se retiraron páginas. Valeria puede lanzarlo a mano después de editar una política, y desde hoy esa es la regla: una política se cambia en Notion, no en el prompt.
Consideraciones finales
El día empezó con dos respuestas que el agente no tenía: una que había aprendido mal en marzo y otra que nunca le habían enseñado. Termina con un índice de $219$ fragmentos que salen de las mismas páginas que Valeria edita y que Don Ernesto revisa, que se pone al día cada mañana con una docena de peticiones y que cuesta menos de un centavo al mes. Todavía no responde nada: hoy se construyó la carpeta de políticas que la persona del mostrador consulta antes de contestar, y mañana se le enseñará a consultarla.
Las cifras tienen límites que conviene decir. El espacio de trabajo es simulado y su texto sale de plantillas, lo que explica la pureza perfecta del mapa de fragmentos; los 429 del espacio de trabajo y los 529 tienen probabilidades supuestas, no medidas; y la cuenta de tokens es una aproximación que se quedó un $35%$ corta frente a los tokens reales del ejemplo. Lo que sí es transferible es la arquitectura: una integración que solo ve lo compartido, un filtro de publicables, un cliente que respeta Retry-After, fragmentos con su página y su sección, una huella por fragmento y una marca de agua con reconciliación.
Antes de conectar una base de conocimiento a un agente, conviene hacerse algunas preguntas:
- ¿Qué páginas ve la integración y quién decide que una página es publicable?
- ¿Qué sabe hoy su agente porque alguien lo copió en el prompt, y cuándo se revisó por última vez?
- Si una política cambia a las 17:00, ¿cuánto tarda el índice en saberlo y quién puede forzar la sincronización?
- ¿Cómo se entera el índice de que una página se despublicó o se mandó a la papelera?
- ¿Qué vectores de qué modelo hay en su índice, y qué pasará el día que cambie de modelo?
Atención aquí: una base de conocimiento no convierte al agente en una fuente de verdad sobre alergias. La página de alérgenos dice lo que Trigo Lento declara y advierte que ningún producto se puede garantizar libre de trazas; por la regla del Día 6, toda pregunta de alergia sigue pasando a una persona, que ahora tendrá delante los fragmentos de la ficha y de la página de alérgenos. Las páginas de alérgenos las aprueba Don Ernesto antes de marcarlas como publicables, y cualquier cambio de receta o de proveedor obliga a revisar la ficha antes de que la pieza llegue al mostrador.
Un gran libro que habla de esto es Introduction to Information Retrieval (o Introducción a la recuperación de información), de Christopher Manning, Prabhakar Raghavan y Hinrich Schütze. Explica con paciencia el modelo vectorial, TF-IDF, la similitud de coseno, los índices invertidos y la evaluación de la recuperación, mucho antes de que existieran los modelos de embeddings. Leerlo hoy tiene una ventaja inesperada: casi todos los problemas de un sistema RAG (qué unidad indexar, cómo normalizar el texto, qué hacer con los números, cómo saber si se recupera bien) ya están planteados ahí, con la diferencia de que el lector final ya no es una persona con una lista de resultados, sino un modelo con una ventana de contexto.
Un agente no sabe lo que su negocio sabe: sabe lo que su índice le deja encontrar, y el índice solo es tan bueno como la última sincronización. Trigo Lento termina el jueves con sus políticas, fichas y alérgenos fragmentados, etiquetados y guardados en SQLite, con dos tipos de vectores, con una marca de agua y con una regla nueva para Valeria: lo que cambia, cambia en Notion.
Conclusiones clave
API de Notion
- Una integración interna con permiso de solo lectura ve únicamente lo que se comparte con ella: de $50$ páginas del espacio de trabajo, la integración ve $43$ y el indexador lee las $40$ marcadas como publicables; las recetas no existen para la API.
- La versión se fija en la cabecera
Notion-Version; la vigente en octubre de 2026 es2026-03-11, que renombraarchivedcomoin_trash, sobre el modelo de fuentes de datos de2025-09-03, que consulta/v1/data_sources/{data_source_id}/query. - El límite por conexión es de $180$ peticiones por ventana de $60$ segundos más un límite por espacio de trabajo sin cifra: con ritmo propio, la primera indexación hizo $67$ peticiones en $24.7$ segundos; en ráfaga, cuatro pasadas tocaron el tope de $180$ y esperaron $48$ segundos.
Fragmentos
- Los bloques se aplanan conservando los encabezados y el papel de cada bloque, y el texto se obtiene concatenando los
plain_textde todos los tramos derich_text. - Con $L = 300$ y $s = 50$, una sección produce $n = \lceil (T - s)/(L - s) \rceil$ fragmentos; las $40$ páginas ($46,734$ tokens) dieron $219$ fragmentos de $233$ tokens de media, y el solapamiento añadió un $9.2%$ de tokens.
- Cada fragmento lleva página, tipo, sección, orden, fecha de edición y una huella SHA-256 que dice si cambió sin compararlo letra por letra.
Embeddings e índice
- TF-IDF con numpy da vectores de $549$ dimensiones sin cuenta ni red y encontró la ficha del rol de canela con coseno $0.452$, pero no entiende sinónimos y depende del preprocesamiento: al descartar los números, “¿Abren el 1 de mayo?” acabó en la página del Día de las Madres.
- Anthropic no ofrece embeddings propios y remite a Voyage AI:
voyage-4cuesta $0.06$ USD por millón de tokens, con vectores de $1,024$ dimensiones y norma $1$;input_typedistingue documentos de preguntas, y los vectores de modelos distintos nunca se mezclan. - La sincronización por
last_edited_timecon “en o después de”, huellas y una reconciliación de publicables hizo $12$ peticiones, reembebió $815$ tokens y retiró $2$ páginas; un mes cuesta unos $0.0002$ USD.
Mañana, en el Día 69: Agentes con memoria: recuperación, contexto y olvido. Una clienta preguntará si el pay de queso lleva gluten y Don Ernesto exigirá que el agente diga de dónde lo saca; Valeria convertirá este índice en una herramienta del agente de pedidos, medirá con preguntas etiquetadas qué tan bien recupera, le enseñará a citar la página y a decir “no lo sé, le pregunto a una persona”, y decidirá qué recuerda el agente de cada cliente y cuándo lo olvida.
Referencias
- Notion (2026). Request limits; Changelog; Upgrading to version 2025-09-03; Upgrading to version 2026-03-11. Notion Developers. https://developers.notion.com/reference/request-limits (revisado en octubre de 2026).
- Anthropic (2026). Embeddings. Documentación de Claude. https://platform.claude.com/docs/en/build-with-claude/embeddings (revisado en octubre de 2026).
- Voyage AI (2026). Text embeddings; Pricing. Documentación de Voyage AI y MongoDB. https://docs.voyageai.com/docs/pricing (revisado en octubre de 2026).
- Lewis, P., Perez, E., Piktus, A., Petroni, F., Karpukhin, V., Goyal, N., Küttler, H., Lewis, M., Yih, W., Rocktäschel, T., Riedel, S. y Kiela, D. (2020). Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. Advances in Neural Information Processing Systems 33 (NeurIPS 2020). https://arxiv.org/abs/2005.11401
- Manning, C. D., Raghavan, P. y Schütze, H. (2008). Introduction to Information Retrieval. Cambridge University Press. https://nlp.stanford.edu/IR-book/