
Arquitecto de automatización con IA: Día 7
 Jeshua Romero Guadarrama
- 56 Min para leer
- 07 Feb, 2026
Índice de contenido
Resumen:
Un método solo es un método si funciona fuera del negocio donde nació. En esta entrada, Valeria aplica a la Clínica Dental Sonrisa Norte, una clínica ficticia de Lindavista, la plantilla que usó en Trigo Lento el Día 1: mapa del proceso, minutos por paso, coste a mano, cola de la hora pico y matriz de priorización. Descubrirá que las 42 horas al mes de la recepción cuestan 2 940 MXN, pero que las inasistencias cuestan 45 900 MXN, más de quince veces más; que la cola de la recepción baja de 20 a 6.7 minutos si la mitad de las solicitudes se agenda sola; y que los datos de salud, por ser datos personales sensibles, cambian el diseño del flujo antes de escribir una sola regla. Al terminar sabrá transferir el método a cualquier negocio de citas y separar lo que puede salir de la clínica de lo que no.
¿Cómo citar el presente artículo?
Romero, J. (7 de febrero de 2026). Arquitecto de automatización con IA: Día 7. python-data-engineer. https://www.python-data-engineer.com/post/aai/dia_7/.
Arquitecto de automatización con IA: Día 7 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/aai/dia_7/.
Precios, límites y políticas de Make, n8n, Zapier, WhatsApp (Meta, Twilio, Wati) y de la API de Claude revisados en octubre de 2026. El texto de la Ley Federal de Protección de Datos Personales en Posesión de los Particulares que se cita es el publicado en el Diario Oficial de la Federación el 20 de marzo de 2025, consultado en octubre de 2026. En este día no se llama a ningún servicio: todos los bloques de código se ejecutan sin red y sus salidas son las reales.
Día 7. Caso de otro negocio I: la clínica dental mide y prioriza sus citas
Introducción
Ayer, en el Día 6 (Ética y seguridad: el código de honor del arquitecto de automatización), vio por qué un error automatizado se multiplica en silencio, cómo se registra el consentimiento de un cliente y cómo se seudonimiza un mensaje antes de que llegue a un modelo, y Trigo Lento ganó su código de honor de diez artículos en codigo_de_honor.md. Hoy ese código sale por primera vez de la panadería, porque la pregunta que toca responder es incómoda y necesaria: ¿el método de esta serie sirve para otro negocio, o solo funciona con pan?
Es sábado 7 de febrero y Trigo Lento cierra temprano. La Dra. Lucía Fernández, amiga de Valeria desde la preparatoria y socia de la Clínica Dental Sonrisa Norte, pasa a recoger una hogaza y se queda a tomar un café en la mesa del fondo. Le cuenta su semana sin que nadie le pregunte: Irma Salgado, la recepcionista, pasa la mañana entera al teléfono; las tardes, llamando uno por uno a los pacientes del día siguiente para recordarles su cita; y aun así, “uno de cada siete pacientes no llega, Valeria. Ni avisa. El sillón se queda vacío, el Dr. Ríos se queda mirando la pared y yo sigo pagando la renta”. Valeria saca el cuaderno donde, hace una semana, cronometró los encargos de la panadería. "¿Me deja medir su recepción igual que medí la mía?"
Don Ernesto, que ha escuchado todo desde el mostrador mientras acomoda las últimas conchas, se acerca con el trapo al hombro: “Valeria, tenga cuidado. Una muela no es una concha: allá un error no se arregla con otro pan.” Tiene razón, y por eso este día existe. En Trigo Lento, un encargo mal apuntado se compensa con un pastel de regalo; en una clínica, un mensaje que revela un tratamiento a quien no debía leerlo no se compensa con nada. El método debería servir igual, pero las unidades, los costes invisibles y el riesgo de los datos son otros, y un buen arquitecto lo nota antes de construir.
En la presente entrada, descubrirá cómo transferir la plantilla del Día 1 (mapa del proceso, tiempos, coste a mano, cola y matriz de priorización) a un negocio que no vende productos sino tiempo de sillón. Levantará la ficha de la clínica y el mapa de su proceso de citas con los minutos de cada paso; calculará las horas y los pesos que cuesta la recepción y, sobre todo, el ingreso que se pierde por inasistencias, un coste que no aparece en ninguna hoja de horas; modelará la cola de la recepción en la hora pico con la teoría de colas y con una simulación, y la comparará con la de Trigo Lento; ampliará la matriz de priorización con una columna de datos sensibles y una regla de exclusión; y verá por qué los datos de salud, según la ley mexicana, cambian el diseño de un flujo desde el primer paso. Al final pondrá los dos negocios lado a lado y dibujará el proceso de citas propuesto, con una persona en cada puerta que toca lo clínico.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Transferir el método del Día 1 (mapa del proceso, tiempos, coste a mano, cola y matriz de priorización) a un negocio distinto de Trigo Lento.
- Cuantificar el coste de las inasistencias y distinguir el valor en horas del valor en ingresos no percibidos.
- Modelar la cola de la recepción en la hora pico y compararla con la de Trigo Lento.
- Explicar por qué los datos de salud son datos personales sensibles según la LFPDPPP y cómo cambian el diseño de un flujo.
La Clínica Dental Sonrisa Norte
Antes de medir nada conviene fijar el negocio, igual que el Día 1 se fijó Trigo Lento, porque las cifras de hoy se reutilizarán el Día 51, cuando la clínica ponga en marcha sus recordatorios por WhatsApp, y el Día 85, cuando la serie reúna los tres negocios de otros sectores. Sonrisa Norte es una clínica dental ficticia en la colonia Lindavista, en el norte de la Ciudad de México. La llevan dos dentistas, la Dra. Lucía Fernández y el Dr. Andrés Ríos, con una sola recepcionista, Irma Salgado. Atiende de lunes a viernes de 9:00 a 19:00, con una media de 18 citas al día; con los 20 días hábiles de un mes como febrero de 2026, son $18 \cdot 20 = 360$ citas al mes.
Las solicitudes de cita llegan por tres canales: la mitad por teléfono, el $40%$ por WhatsApp y el $10%$ en persona, en el mostrador. El reparto es casi el inverso del de Trigo Lento, donde el teléfono era el canal más pequeño ($10%$) y WhatsApp el más grande ($55%$). No es casualidad: los pacientes de una clínica suelen ser de más edad que los clientes que encargan un pastel por mensaje, y muchas solicitudes traen una pregunta ("¿me duele si…?", "¿cuánto cuesta una limpieza?") que la gente prefiere hacer de viva voz. Este primer dato ya avisa de algo que la matriz confirmará más adelante: automatizar solo WhatsApp dejaría fuera a la mitad de los pacientes.
Dos cifras de la clínica no son de tiempo, sino de dinero. El ingreso medio por cita es de 850 MXN y la inasistencia, la fracción de citas a las que el paciente no llega ni avisa, es del $15%$, la cifra que Lucía resume como “uno de cada siete”. Ambas son supuestos didácticos, igual que el valor de la hora de Irma, 70 MXN, que se usa para pasar horas a pesos. La Tabla 1 reúne la ficha completa.
Tabla 1. Ficha de la Clínica Dental Sonrisa Norte (negocio ficticio; todas las cifras son inventadas y se declaran como supuestos).
| Concepto | Valor | Nota |
|---|---|---|
| Ubicación | Lindavista, Ciudad de México | Negocio ficticio |
| Dentistas | Dra. Lucía Fernández y Dr. Andrés Ríos | Socios de la clínica |
| Recepción | Irma Salgado | Una sola persona para teléfono, WhatsApp y mostrador |
| Horario | Lunes a viernes, 9:00 a 19:00 | 20 días hábiles al mes |
| Citas | 18 al día, 360 al mes | Supuesto didáctico |
| Canales de solicitud | Teléfono 50 %, WhatsApp 40 %, presencial 10 % | 180, 144 y 36 citas al mes |
| Ingreso medio por cita | 850 MXN | Supuesto didáctico |
| Inasistencia | 15 % de las citas | Supuesto didáctico (“uno de cada siete”) |
| Valor de la hora de recepción | 70 MXN | Supuesto didáctico |
El método de esta serie no es un conjunto de fórmulas sueltas, sino una plantilla de cinco piezas que se aplican en orden. La Figura 1 la pone en paralelo para los dos negocios: la misma secuencia de mapa, tiempos, coste, cola y matriz, con la unidad de valor de cada uno, el encargo en la panadería y el sillón en la clínica.
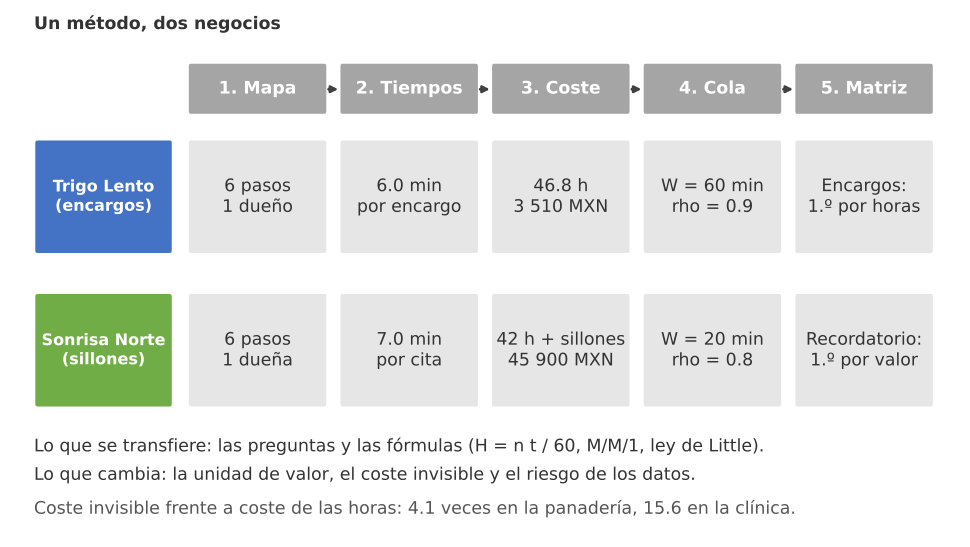
Figura 1. Un método, dos negocios: las cinco piezas del Día 1 (mapa, tiempos, coste, cola y matriz) aplicadas a Trigo Lento, que cuenta encargos, y a Sonrisa Norte, que cuenta sillones.
Como en Trigo Lento, el primer bloque prepara el entorno con las importaciones base y la semilla de la serie, $2026$. La diferencia es la carpeta: los archivos de este caso viven en sonrisa_norte/, separados de los de la panadería, porque los datos de dos negocios distintos no se mezclan nunca en un mismo proyecto, aunque los lleve la misma persona:
# Importaciones base, semilla de la serie y carpeta del caso de la clínica en Python:
import warnings
warnings.filterwarnings('ignore')
import json
import re
from pathlib import Path
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 120)
pd.set_option('display.max_columns', 12)
clinica = Path('sonrisa_norte')
clinica.mkdir(exist_ok = True)
print('numpy', np.__version__, '| pandas', pd.__version__)
print('Carpeta del caso:', clinica.resolve().name)
numpy 2.4.6 | pandas 3.0.3
Carpeta del caso: sonrisa_norte
La salida confirma las versiones con las que se calcularon todas las cifras de hoy y la carpeta del caso. Ningún bloque de esta entrada toca trigo_lento/ ni la base trigo_lento.sqlite del Día 4: lo que se compara con la panadería se toma de las cifras publicadas del Día 1, no de sus archivos.
El siguiente código guarda la ficha de la Tabla 1 en sonrisa_norte/ficha_clinica.json y reparte las 360 citas del mes por canal:
# Ficha de la Clínica Dental Sonrisa Norte (datos inventados) en Python:
citas_dia, dias_habiles = 18, 20                  # lunes a viernes de 9:00 a 19:00
ficha_clinica = {
    'negocio': 'Clínica Dental Sonrisa Norte (Lindavista, CDMX)',
    'dentistas': 'Dra. Lucía Fernández y Dr. Andrés Ríos',
    'recepcion': 'Irma Salgado',
    'horario': 'Lunes a viernes, 9:00 a 19:00',
    'citas_dia': citas_dia,
    'citas_mes': citas_dia * dias_habiles,
    'canales': {'Teléfono': 0.50, 'WhatsApp': 0.40, 'Presencial': 0.10},
    'ingreso_medio_cita_mxn': 850,                # supuesto didáctico
    'inasistencia': 0.15,                         # supuesto didáctico
    'valor_hora_recepcion_mxn': 70,               # supuesto didáctico
}
(clinica / 'ficha_clinica.json').write_text(json.dumps(ficha_clinica, ensure_ascii = False, indent = 2),
                                            encoding = 'utf-8')
for clave, valor in ficha_clinica.items():
    print(f'{clave:>24}: {valor}')
citas_mes = ficha_clinica['citas_mes']
por_canal = {c: round(p * citas_mes) for c, p in ficha_clinica['canales'].items()}
print('Citas al mes por canal:', por_canal)
                 negocio: Clínica Dental Sonrisa Norte (Lindavista, CDMX)
               dentistas: Dra. Lucía Fernández y Dr. Andrés Ríos
               recepcion: Irma Salgado
                 horario: Lunes a viernes, 9:00 a 19:00
               citas_dia: 18
               citas_mes: 360
                 canales: {'Teléfono': 0.5, 'WhatsApp': 0.4, 'Presencial': 0.1}
  ingreso_medio_cita_mxn: 850
            inasistencia: 0.15
valor_hora_recepcion_mxn: 70
Citas al mes por canal: {'Teléfono': 180, 'WhatsApp': 144, 'Presencial': 36}
La ficha queda guardada con sus diez campos y el reparto por canal da $180$ citas por teléfono, $144$ por WhatsApp y $36$ en persona. Cada cifra de los bloques siguientes sale de este diccionario y no de un número escrito a mano, el mismo hábito que el Día 1 aplicó a la ficha de encargos: si Lucía corrige la inasistencia o el ingreso medio, todo lo demás se recalcula solo.
El mapa del proceso de citas
Valeria pasó la mañana del sábado sentada junto a Irma con el cronómetro del teléfono, igual que había hecho con sus propios encargos. Anotó cada paso de una cita, desde que alguien la pide hasta que se registra si llegó o no, con su duración, su dueño y lo que puede fallar en él. El resultado, redondeado a medios minutos, se recoge en la Tabla 2.
Tabla 2. Pasos del proceso de citas de Sonrisa Norte con minutos, dueño, momento y punto de error.
| Orden | Paso | Minutos | Dueño | Momento | Qué puede fallar |
|---|---|---|---|---|---|
| 1 | Recibir la solicitud | 1.0 | Irma | Al pedir la cita | Llamada perdida mientras atiende el mostrador |
| 2 | Buscar hueco en la agenda | 1.5 | Irma | Al pedir la cita | Hueco con el dentista equivocado o empalmado |
| 3 | Apuntar los datos | 1.0 | Irma | Al pedir la cita | Teléfono mal anotado, nombre con otra grafía |
| 4 | Confirmar la cita | 0.5 | Irma | Al pedir la cita | Paciente que entiende otro día u otra hora |
| 5 | Llamar el día anterior para recordar | 2.0 | Irma | La víspera | Nadie contesta; se deja recado con un familiar |
| 6 | Registrar asistencia | 1.0 | Irma | El día de la cita | Inasistencia sin registrar; nadie reagenda |
| Total | 7.0 |
Los seis pasos suman 7 minutos por cita, uno más que el encargo de Trigo Lento. La tabla tiene una columna que la del Día 1 no necesitaba, la del momento: los cuatro primeros pasos ocurren cuando el paciente pide la cita, pero el recordatorio se hace la víspera y el registro, el mismo día. En la panadería todo el encargo se resolvía de una sentada; en la clínica, el proceso se estira a lo largo de días o semanas, y eso cambia qué pasos compiten por el tiempo de Irma en la hora pico. Observe también la columna de dueños: los seis pasos dependen de la misma persona, como en Trigo Lento dependían de Valeria. Cuando Irma sale a comer, la clínica deja de agendar.
El paso 5 merece una nota aparte. En la clínica, recordar una cita es una llamada, y una llamada que nadie contesta deja un recado. Si el recado lo toma la suegra del paciente y Irma dice “le recuerdo su cita de endodoncia de mañana”, la clínica acaba de revelar un dato de salud a una persona que no tenía por qué conocerlo. Ese riesgo, que en la panadería no existe, volverá en la sección de datos sensibles.
El siguiente código construye la tabla de pasos con pandas, calcula los porcentajes y dibuja el diagrama de Pareto con la línea del porcentaje acumulado, como el Día 1. El paso del recordatorio se pinta en naranja para distinguirlo:
# Pasos del proceso de citas con minutos y diagrama de Pareto en Python:
pasos_cita = pd.DataFrame({
    'paso': ['Recibir la solicitud', 'Buscar hueco en la agenda', 'Apuntar los datos',
             'Confirmar la cita', 'Recordar el día anterior', 'Registrar asistencia'],
    'minutos': [1.0, 1.5, 1.0, 0.5, 2.0, 1.0],
    'momento': ['al pedir', 'al pedir', 'al pedir', 'al pedir', 'la víspera', 'el día'],
})
pareto = pasos_cita.sort_values('minutos', ascending = False, kind = 'stable').reset_index(drop = True)
pareto['pct'] = 100 * pareto['minutos'] / pareto['minutos'].sum()
pareto['pct_acumulado'] = pareto['pct'].cumsum()
print(pareto.round(1).to_string(index = False))
print('Total por cita:', pasos_cita['minutos'].sum(), 'minutos | al pedir la cita:',
      pasos_cita.loc[pasos_cita['momento'] == 'al pedir', 'minutos'].sum(), 'minutos')

# Barras de minutos por paso y línea del porcentaje acumulado:
fig, ax = plt.subplots(figsize = (9, 4.8))
colores_paso = ['#eb6834' if p == 'Recordar el día anterior' else '#2a78d6' for p in pareto['paso']]
ax.bar(pareto['paso'], pareto['minutos'], color = colores_paso, width = 0.65)
ax.set_ylabel('Minutos por cita')
ax.set_ylim(0, 2.6)
ax2 = ax.twinx()
ax2.plot(pareto['paso'], pareto['pct_acumulado'], color = '#52514e', marker = 'o', linewidth = 2)
ax2.axhline(80, color = '#9a9994', linestyle = '--', linewidth = 1)
ax2.set_ylim(0, 115)
ax2.set_ylabel('Porcentaje acumulado del tiempo')
for x, y in zip(range(len(pareto)), pareto['pct_acumulado']):
    ax2.text(x, y + 5, f'{y:.1f} %', ha = 'center', fontsize = 9, color = '#52514e',
             bbox = dict(facecolor = 'white', edgecolor = 'none', pad = 1))
ax.set_title('Pareto de los 7 minutos de una cita en Sonrisa Norte', fontsize = 16)
ax.set_xticks(range(len(pareto)))
ax.set_xticklabels(pareto['paso'], rotation = 20, ha = 'right')
ax.spines[['top']].set_visible(False)
ax2.spines[['top']].set_visible(False)
plt.tight_layout()
plt.show()
                     paso  minutos    momento  pct  pct_acumulado
 Recordar el día anterior      2.0 la víspera 28.6           28.6
Buscar hueco en la agenda      1.5   al pedir 21.4           50.0
     Recibir la solicitud      1.0   al pedir 14.3           64.3
        Apuntar los datos      1.0   al pedir 14.3           78.6
     Registrar asistencia      1.0     el día 14.3           92.9
        Confirmar la cita      0.5   al pedir  7.1          100.0
Total por cita: 7.0 minutos | al pedir la cita: 4.0 minutos
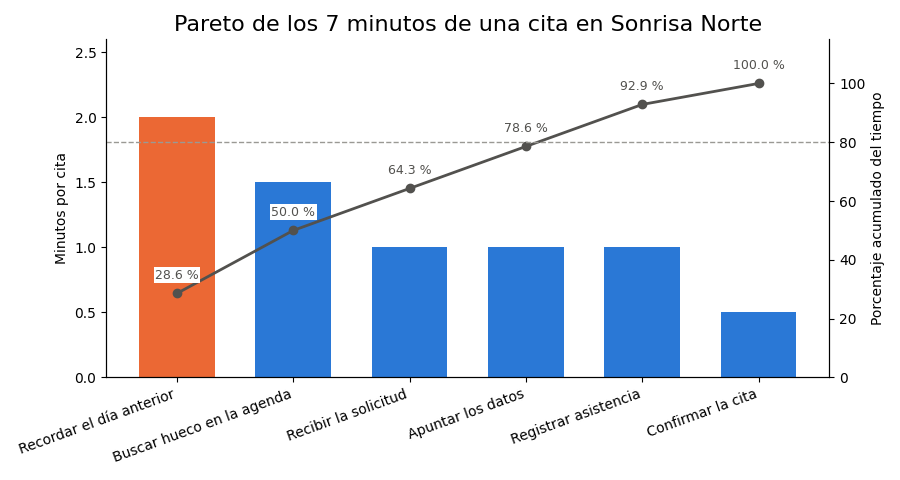
El paso más largo es recordar la cita la víspera, con $2.0$ minutos y el $28.6%$ del tiempo de cada cita, seguido de buscar un hueco en la agenda ($21.4%$). Los cuatro primeros pasos del gráfico acumulan el $78.6%$, justo por debajo de la línea del $80%$; hace falta el quinto para cruzarla. El reparto es más plano que en Trigo Lento, donde un solo paso, preguntar los datos que faltan, se llevaba el $33.3%$. La lectura por causas, que es la útil, queda así:
- Recordar la víspera ($2.0$ minutos) es comunicación repetible: el mismo mensaje, con otro nombre y otra hora, 360 veces al mes. Es el candidato natural a un flujo, con la condición de que el mensaje no revele nada clínico.
- Buscar un hueco ($1.5$ minutos) es consulta de agenda: si la agenda está en un sistema que el paciente puede ver, el paciente busca su propio hueco. Ese es el autoagendado que se modela en la sección de la cola.
- Recibir, apuntar y confirmar ($1.0 + 1.0 + 0.5$ minutos) son, como en Trigo Lento, trabajo de entrada: un formulario o un mensaje guiado los convierte en un solo registro.
- En conclusión, los cuatro pasos que ocurren al pedir la cita suman $4.0$ minutos, y ese dato será el que conecte el mapa con la cola: Irma atiende, como mucho, $60 / 4 = 15$ solicitudes por hora.
Cuánto cuesta hacerlo a mano
La fórmula del Día 1 no cambia al cambiar de negocio. Si $n$ es el número de unidades al mes (aquí, citas) y $t$ el tiempo de atención por unidad en minutos, las horas de trabajo al mes son:
$$ H = \frac{n \cdot t}{60} $$
La lógica detrás de esta fórmula es múltiple:
- Es la misma del Día 1, y esa es la primera lección del día: una fórmula de proceso no sabe de qué negocio se trata; solo pide una unidad que se repita y un tiempo por unidad.
- Con $n = 360$ citas y $t = 7$ minutos, $H = 360 \cdot 7 / 60 = 42$ horas al mes, casi las mismas que las $46.8$ de Trigo Lento con $468$ encargos de $6$ minutos.
- El valor de esas horas es $H$ por el valor de la hora de quien hace el trabajo: 70 MXN para Irma, un supuesto didáctico.
- En conclusión, la fórmula mide lo que cuesta hacer el proceso, pero no lo que cuesta que el proceso falle. En la clínica, esa segunda cifra es mucho mayor.
El sillón vacío
Cuando un paciente no llega, la clínica no ahorra nada: la renta, el sueldo de Irma, el material esterilizado y la hora del dentista se pagan igual. Lo que se pierde es el ingreso de esa cita, que ya no se puede recuperar porque la hora pasó. Si $p$ es la tasa de inasistencia y $v$ el ingreso medio por cita, el ingreso no percibido al mes es:
$$ I = n \cdot p \cdot v $$
La lógica detrás de esta fórmula es múltiple:
- $n \cdot p$ es el número esperado de citas perdidas: con $n = 360$ y $p = 0.15$, son $54$ citas al mes, casi tres por día hábil.
- Multiplicar por $v = 850$ MXN da el dinero que no entra, $54 \cdot 850 = 45,900$ MXN. Es un coste de oportunidad: no sale de la caja, pero tampoco entra, y por eso no aparece en ninguna hoja de horas ni en ninguna factura.
- La fórmula es lineal en $p$: cada punto porcentual de inasistencia cuesta $360 \cdot 0.01 \cdot 850 = 3,060$ MXN al mes. Bajar la inasistencia del $15%$ al $9%$ recupera seis puntos, $18,360$ MXN.
- En conclusión, el arquitecto que solo mide horas ve la mitad pequeña del problema. El coste invisible de un proceso puede ser mayor que su coste visible, y hay que buscarlo a propósito.
La Figura 2 pone esa idea en la agenda de un día: dieciocho citas, tres huecos por inasistencia y el ingreso que se va con cada uno.
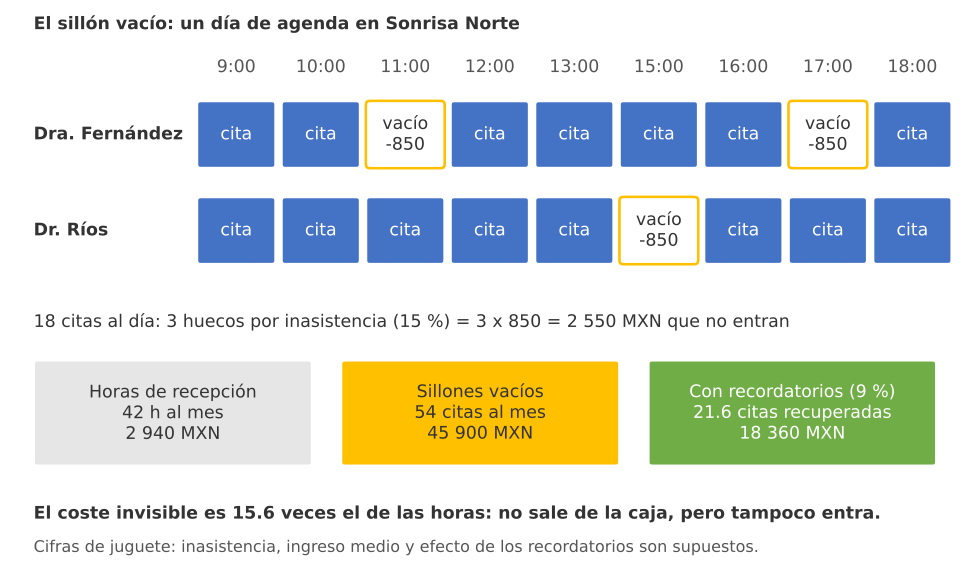
Figura 2. El sillón vacío: un día de agenda con 18 citas y tres inasistencias; cada hueco son 850 MXN que no entran, y al mes suman 54 citas y 45 900 MXN.
El siguiente código aplica las dos fórmulas a la recepción, separa las horas que se van en llamadas de recordatorio y compara el ingreso no percibido hoy con el que habría si los recordatorios bajaran la inasistencia al $9%$. La última línea traduce a la clínica el resultado de un metaanálisis real sobre recordatorios por mensaje de texto:
# Horas y pesos de la recepción e ingreso no percibido por inasistencias en Python:
def horas_al_mes(n, t):
    # H = n * t / 60, con t en minutos por unidad (la fórmula del Día 1):
    return n * t / 60

minutos_cita = pasos_cita['minutos'].sum()
valor_hora = ficha_clinica['valor_hora_recepcion_mxn']
ingreso_cita = ficha_clinica['ingreso_medio_cita_mxn']
h_recepcion = horas_al_mes(citas_mes, minutos_cita)
h_recordatorio = horas_al_mes(citas_mes, 2.0)
print(f'Horas de recepción al mes: {h_recepcion:.1f} h = {h_recepcion * valor_hora:,.0f} MXN')
print(f'  de ellas, llamadas de recordatorio: {h_recordatorio:.1f} h = {h_recordatorio * valor_hora:,.0f} MXN')

def no_percibido(n, p, v):
    # I = n * p * v: citas perdidas por su ingreso medio:
    return n * p, n * p * v

for nombre, p in [('Hoy (15 %)', 0.15), ('Con recordatorios (9 %)', 0.09)]:
    perdidas, mxn = no_percibido(citas_mes, p, ingreso_cita)
    print(f'{nombre:>24}: {perdidas:5.1f} citas perdidas = {mxn:,.0f} MXN al mes')
recuperadas = citas_mes * (0.15 - 0.09)
print(f'Citas recuperadas: {recuperadas:.1f} = {recuperadas * ingreso_cita:,.0f} MXN al mes')
print(f'Ingreso no percibido / coste de las horas: '
      f'{no_percibido(citas_mes, 0.15, ingreso_cita)[1] / (h_recepcion * valor_hora):.1f} veces')

# Qué inasistencia implica el efecto resumido de Guy et al. (2012) si se lee como razón de momios:
asistencia = 1 - 0.15
momios = asistencia / (1 - asistencia) * 1.48
print(f'Asistencia con un efecto de 1.48 sobre los momios: {momios / (1 + momios):.4f} '
      f'(inasistencia del {100 * (1 - momios / (1 + momios)):.1f} %)')
Horas de recepción al mes: 42.0 h = 2,940 MXN
  de ellas, llamadas de recordatorio: 12.0 h = 840 MXN
              Hoy (15 %):  54.0 citas perdidas = 45,900 MXN al mes
 Con recordatorios (9 %):  32.4 citas perdidas = 27,540 MXN al mes
Citas recuperadas: 21.6 = 18,360 MXN al mes
Ingreso no percibido / coste de las horas: 15.6 veces
Asistencia con un efecto de 1.48 sobre los momios: 0.8935 (inasistencia del 10.7 %)
La recepción consume $42$ horas al mes, que al valor de la hora de Irma cuestan $2,940$ MXN; de ellas, $12$ horas y $840$ MXN se van solo en las llamadas de recordatorio. Las inasistencias, en cambio, cuestan $45,900$ MXN al mes, $15.6$ veces el coste de todas las horas de la recepción. Si los recordatorios bajaran la inasistencia al $9%$, se perderían $32.4$ citas en lugar de $54$ y se recuperarían $21.6$ citas, unos $18,360$ MXN al mes. Dicho de otro modo: automatizar el recordatorio libera $840$ MXN de horas de Irma, pero su verdadero valor está en los sillones que dejan de quedarse vacíos, que valen más de veinte veces eso.
El $9%$ es un supuesto didáctico y conviene saber de dónde podría salir y de dónde no. Guy y sus coautores (2012) reunieron 18 estudios sobre recordatorios por mensaje de texto en servicios de salud; en los ocho ensayos aleatorizados, el efecto resumido sobre la asistencia fue de $1.48$ (intervalo de confianza del $95%$: $1.23$ a $1.72$). La literatura, por tanto, respalda la dirección de la mejora. La última línea del bloque hace un ejercicio de lectura: si ese $1.48$ se aplicara a los momios de asistir de Sonrisa Norte, la asistencia pasaría del $85%$ al $89.35%$ y la inasistencia bajaría al $10.7%$, no al $9%$. El supuesto de la serie es, pues, algo optimista frente a ese promedio, y el Día 51 lo tratará como un escenario y no como una promesa. Una cifra de la literatura sirve para acotar un supuesto, no para garantizar un resultado en un negocio concreto.
Atención aquí: Los recordatorios no eliminan las inasistencias; las reducen, y la reducción depende de la población, del momento del aviso, del canal y de si el paciente puede reprogramar con facilidad. No presente nunca a un cliente un ahorro calculado con una tasa supuesta como si fuera una medición. Diga el supuesto, diga de dónde sale y mida la tasa real durante las primeras semanas: con 360 citas al mes, la inasistencia mensual varía varios puntos por puro azar, como muestra la simulación del Bloque 6. Y recuerde que el recordatorio es un mensaje sobre la salud de una persona: su redacción importa tanto como su envío.
La cola de la recepción
El coste en horas y el ingreso no percibido son las cifras de Lucía. El paciente vive otra: cuánto tarda en que alguien lo atienda cuando llama o escribe. En Sonrisa Norte, la hora pico es de 9:00 a 11:00: los pacientes llaman antes de entrar a trabajar, el mostrador recibe a los primeros de la mañana y el WhatsApp acumula los mensajes de la noche. En esas dos horas llegan, en promedio, 12 solicitudes por hora (citas nuevas, cambios, cancelaciones y preguntas; no todas terminan en una cita), y la atención de cada una ocupa a Irma los $4$ minutos de los pasos que ocurren al pedir la cita, de modo que su ritmo máximo es de $\mu = 15$ solicitudes por hora.
Se usa el mismo modelo M/M/1 del Día 1: llegadas de Poisson con tasa $\lambda$, atención exponencial con tasa $\mu$ y un solo servidor, que aquí es Irma. Las medidas clave son el tiempo medio en el sistema $W$, el tiempo medio de espera antes de ser atendido $W_q$ y, por la ley de Little, el número medio de solicitudes en el sistema $L$:
$$ W = \frac{1}{\mu - \lambda}, \qquad W_q = \frac{\lambda}{\mu,(\mu - \lambda)}, \qquad L = \lambda, W $$
La lógica detrás de estas fórmulas es múltiple:
- La utilización es $\rho = \lambda / \mu = 12 / 15 = 0.8$: Irma está ocupada el $80%$ del tiempo de la hora pico, menos que el $90%$ de Valeria en Trigo Lento, pero ya en la zona donde la espera crece deprisa.
- La holgura $\mu - \lambda = 3$ solicitudes por hora da $W = 1/3$ de hora, 20 minutos en el sistema, de los que $W_q = 12 / (15 \cdot 3) = 0.267$ horas, 16 minutos, son de espera antes de que Irma conteste.
- Por la ley de Little, $L = 12 \cdot 1/3 = 4$: en un momento cualquiera de la hora pico hay, en promedio, cuatro solicitudes sin resolver, entre la llamada que se atiende, la que espera en línea y los mensajes sin leer.
- Si la mitad de las solicitudes se agenda sola, Irma solo recibe $\lambda = 6$ por hora: la holgura sube a $9$, $W = 1/9$ de hora, unos 6.7 minutos, y la utilización baja a $0.4$.
El siguiente código implementa las fórmulas en la función mm1(lam, mu), la misma del Día 1 con la tasa de llegadas y la de atención como columnas, y compara los dos escenarios de la clínica con el de Trigo Lento:
# Cola M/M/1 de la recepción frente a la de Trigo Lento en Python:
def mm1(lam, mu):
    # Medidas de una cola M/M/1 estable (lam < mu), tiempos en horas:
    if lam >= mu:
        raise ValueError('La cola no es estable: lam debe ser menor que mu.')
    W = 1 / (mu - lam)
    Wq = lam / (mu * (mu - lam))
    return {'lam': lam, 'mu': mu, 'rho': lam / mu, 'W_min': 60 * W, 'Wq_min': 60 * Wq, 'L': lam * W}

colas = pd.DataFrame({
    'Sonrisa Norte hoy': mm1(12, 15),
    'Sonrisa Norte, mitad sola': mm1(6, 15),
    'Trigo Lento hoy (Día 1)': mm1(9, 10),
}).T
print(colas.round(2))
print('Minutos por solicitud en la recepción:', 60 / 15, '| al pedir la cita (Tabla 2):',
      pasos_cita.loc[pasos_cita['momento'] == 'al pedir', 'minutos'].sum())
                            lam    mu  rho  W_min  Wq_min     L
Sonrisa Norte hoy          12.0  15.0  0.8  20.00   16.00  4.00
Sonrisa Norte, mitad sola   6.0  15.0  0.4   6.67    2.67  0.67
Trigo Lento hoy (Día 1)     9.0  10.0  0.9  60.00   54.00  9.00
Minutos por solicitud en la recepción: 4.0 | al pedir la cita (Tabla 2): 4.0
La salida confirma las cuentas a mano. Hoy, una solicitud pasa $20$ minutos en la recepción de Sonrisa Norte, espera $16$ antes de ser atendida y hay $4$ en el sistema. Con la mitad agendada sola, el tiempo en el sistema baja a $6.67$ minutos y la espera a $2.67$. En Trigo Lento, con $\lambda = 9$ y $\mu = 10$, el tiempo en el sistema era de $60$ minutos: la recepción de la clínica, aun con más solicitudes por hora, espera tres veces menos que la panadería, porque su holgura es de tres solicitudes por hora y la de Trigo Lento de una sola. La última línea comprueba la coherencia entre el mapa y la cola: los $4.0$ minutos por solicitud que implica $\mu = 15$ son exactamente los cuatro pasos de la Tabla 2 que ocurren al pedir la cita. Una cola bien modelada usa los mismos minutos que el mapa del proceso; si no coinciden, uno de los dos está mal medido.
Del promedio a la simulación
Las dos secciones anteriores terminaron en promedios: $54$ citas perdidas al mes y $16$ minutos de espera en la hora pico. Los promedios son útiles para decidir, pero ningún mes ni ninguna mañana son el promedio, y un arquitecto necesita saber cuánto se separa la realidad de la cifra que presentó. Dos simulaciones con la semilla de la serie responden a esa pregunta: la primera para las inasistencias de un mes, la segunda para la espera de mil horas pico.
Un mes con sillones vacíos
Las $54$ citas perdidas son un promedio. Un mes concreto puede tener más o menos, y un día concreto puede tener cero o cinco. Para verlo, el siguiente código simula un mes de 20 días hábiles con 18 citas cada uno, en el que cada paciente falta con probabilidad $0.15$ de forma independiente (una variable de Bernoulli por cita). Con el mismo azar, cada paciente falta también en el escenario con recordatorios si su número aleatorio cae por debajo de $0.09$, de modo que la diferencia entre los escenarios se debe solo a la tasa:
# Un mes de citas simuladas con inasistencias (Bernoulli) en Python:
u = rng.uniform(size = (dias_habiles, citas_dia))          # mismo azar para los dos escenarios
falta_hoy = (u < 0.15).sum(axis = 1)
falta_rec = (u < 0.09).sum(axis = 1)
dias = np.arange(1, dias_habiles + 1)
print('Inasistencias del mes, hoy:', falta_hoy.sum(), '| media diaria:', round(falta_hoy.mean(), 2),
      '| día con más:', falta_hoy.max())
print('Inasistencias del mes con recordatorios:', falta_rec.sum())
print(f'Ingreso no percibido del mes simulado: {falta_hoy.sum() * ingreso_cita:,} MXN hoy, '
      f'{falta_rec.sum() * ingreso_cita:,} MXN con recordatorios')
print('Días sin ninguna inasistencia:', (falta_hoy == 0).sum(), '| días con 5 o más:', (falta_hoy >= 5).sum())

# Barras de inasistencias por día y el ingreso no percibido acumulado en un segundo eje:
fig, ax = plt.subplots(figsize = (9.5, 4.8))
ax.bar(dias, falta_hoy, color = '#2a78d6', width = 0.7, label = 'Inasistencias del día (15 %)')
ax.axhline(falta_hoy.mean(), color = '#0b0b0b', linestyle = '--', linewidth = 1.2)
ax.text(0.6, falta_hoy.mean() + 0.15, f'media {falta_hoy.mean():.2f} por día', fontsize = 9)
ax.set_xlabel('Día hábil del mes')
ax.set_ylabel('Citas a las que nadie llegó')
ax.set_ylim(0, falta_hoy.max() + 3)
ax.set_xticks(dias)
ax2 = ax.twinx()
ax2.plot(dias, np.cumsum(falta_hoy) * ingreso_cita / 1000, color = '#eb6834', linewidth = 2.2,
         marker = 'o', markersize = 4, label = 'Acumulado hoy')
ax2.plot(dias, np.cumsum(falta_rec) * ingreso_cita / 1000, color = '#eb6834', linewidth = 1.6,
         linestyle = ':', label = 'Acumulado con recordatorios (9 %)')
ax2.set_ylabel('Ingreso no percibido acumulado (miles de MXN)')
ax2.set_ylim(0, 60)
lineas = ax.get_legend_handles_labels()[0] + ax2.get_legend_handles_labels()[0]
ax.legend(lineas, [l.get_label() for l in lineas], loc = 'upper left', fontsize = 9, frameon = False)
ax.set_title('El sillón vacío: un mes simulado en Sonrisa Norte', fontsize = 16)
ax.spines[['top']].set_visible(False)
ax2.spines[['top']].set_visible(False)
plt.tight_layout()
plt.show()
Inasistencias del mes, hoy: 45 | media diaria: 2.25 | día con más: 4
Inasistencias del mes con recordatorios: 25
Ingreso no percibido del mes simulado: 38,250 MXN hoy, 21,250 MXN con recordatorios
Días sin ninguna inasistencia: 3 | días con 5 o más: 0
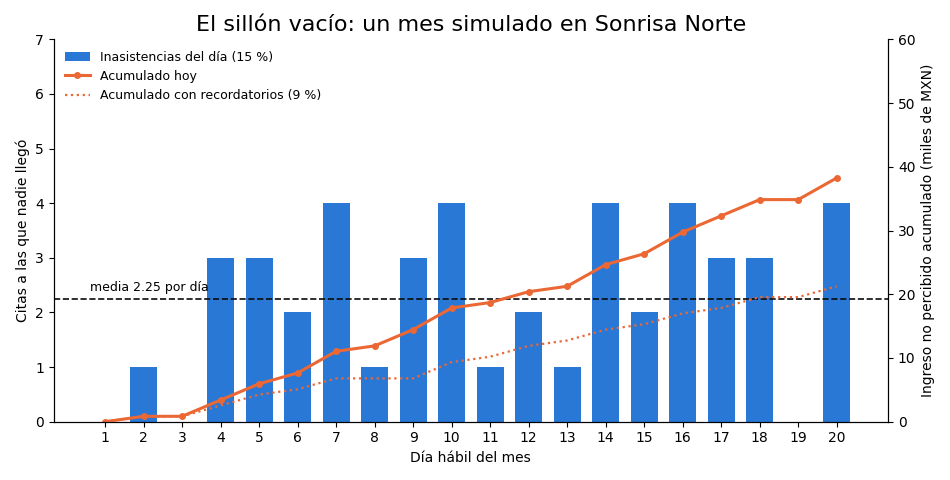
El mes simulado tuvo $45$ inasistencias, nueve menos que las $54$ del promedio, con una media de $2.25$ por día, un máximo de $4$ y tres días sin ninguna. El ingreso no percibido fue de $38,250$ MXN y, con recordatorios, de $21,250$ MXN. La diferencia entre $45$ y $54$ es la lección del bloque: con 360 citas, la desviación típica del número de inasistencias es $\sqrt{360 \cdot 0.15 \cdot 0.85} \approx 6.8$, así que un mes con $45$ está dentro de lo normal. Si Lucía mide la inasistencia de un solo mes antes y después de automatizar, el azar puede esconder o inventar la mejora. Para afirmar que los recordatorios funcionan hacen falta varios meses o un grupo de comparación, una idea que el Día 8 retomará al hablar de métricas.
La gráfica cuenta lo mismo con la forma: las barras azules saltan de un día a otro sin patrón, mientras la línea naranja del acumulado sube con una pendiente casi constante, unos $1,900$ MXN por día hábil. La línea punteada, la del escenario con recordatorios, se separa poco a poco. Ninguna barra individual impresiona; el mes completo, sí. Así se comportan los costes invisibles: se notan al sumarlos, no al vivirlos.
Simulación de la hora pico
Las fórmulas describen un régimen estable que dura para siempre. Como el Día 1, una simulación de eventos discretos con la recursión de Lindley permite ver la distribución completa de las esperas y corregir el modelo con la realidad de una mañana que empieza con la recepción vacía. El siguiente código simula 1 000 horas pico seguidas con $\lambda = 12$, repite la simulación quitando al azar la mitad de las solicitudes (las que se agendarían solas, con los mismos tiempos de atención para las que quedan) y, por último, simula 500 ventanas reales de 9:00 a 11:00:
# Simulación de eventos discretos de 1 000 horas pico en la recepción en Python:
def simular_cola(llegadas, servicios):
    # Recursión de Lindley: cada solicitud espera a que Irma termine la anterior:
    espera = np.zeros(len(llegadas))
    fin_anterior = 0.0
    for i, (a, s) in enumerate(zip(llegadas, servicios)):
        inicio = max(a, fin_anterior)
        espera[i] = inicio - a
        fin_anterior = inicio + s
    return espera

horas_sim = 1000
llegadas = np.cumsum(rng.exponential(1 / 12, size = int(12 * horas_sim * 1.1)))
llegadas = llegadas[llegadas < horas_sim]
base = rng.exponential(1.0, size = len(llegadas))
espera_hoy = 60 * simular_cola(llegadas, base / 15)
quedan = rng.uniform(size = len(llegadas)) < 0.5           # la otra mitad se agenda sola
espera_mitad = 60 * simular_cola(llegadas[quedan], base[quedan] / 15)
print('Solicitudes simuladas:', len(llegadas), '| atendidas por Irma con autoagendado:', quedan.sum())
for nombre, w in [('Hoy', espera_hoy), ('Mitad sola', espera_mitad)]:
    print(f'{nombre:>10}: espera media {w.mean():5.1f} min | mediana {np.median(w):5.1f} | '
          f'p90 {np.percentile(w, 90):5.1f} | sin espera {100 * (w == 0).mean():4.1f} %')

# Ventanas reales de 9:00 a 11:00 que empiezan con la recepción vacía:
medias_ventana = []
for _ in range(500):
    lleg = np.cumsum(rng.exponential(1 / 12, size = 60))
    lleg = lleg[lleg < 2]
    medias_ventana.append(60 * simular_cola(lleg, rng.exponential(1 / 15, size = len(lleg))).mean())
print(f'Ventanas de 2 h que empiezan vacías (hoy): espera media {np.mean(medias_ventana):.1f} min')

# Histogramas superpuestos de la espera: hoy frente a la mitad agendada sola:
fig, ax = plt.subplots(figsize = (9, 4.8))
cortes = np.linspace(0, 90, 46)
ax.hist(np.clip(espera_hoy, 0, 89.9), bins = cortes, color = '#eb6834', alpha = 0.75, label = 'Hoy (12 por hora)')
ax.hist(np.clip(espera_mitad, 0, 89.9), bins = cortes, color = '#2a78d6', alpha = 0.75,
        label = 'Mitad agendada sola (6 por hora)')
ax.axvline(espera_hoy.mean(), color = '#eb6834', linestyle = '--', linewidth = 1.5)
ax.axvline(espera_mitad.mean(), color = '#2a78d6', linestyle = '--', linewidth = 1.5)
ax.set_yscale('log')
ax.set_xlabel('Minutos de espera antes de que Irma atienda (90 o más en la última barra)')
ax.set_ylabel('Solicitudes (escala logarítmica)')
ax.set_title('Espera en la recepción de 9:00 a 11:00: 1 000 horas simuladas', fontsize = 16)
ax.legend(frameon = False)
ax.spines[['top', 'right']].set_visible(False)
plt.tight_layout()
plt.show()
Solicitudes simuladas: 11874 | atendidas por Irma con autoagendado: 6008
       Hoy: espera media  15.2 min | mediana   7.6 | p90  40.6 | sin espera 22.5 %
Mitad sola: espera media   2.5 min | mediana   0.0 | p90   8.7 | sin espera 62.0 %
Ventanas de 2 h que empiezan vacías (hoy): espera media 8.0 min
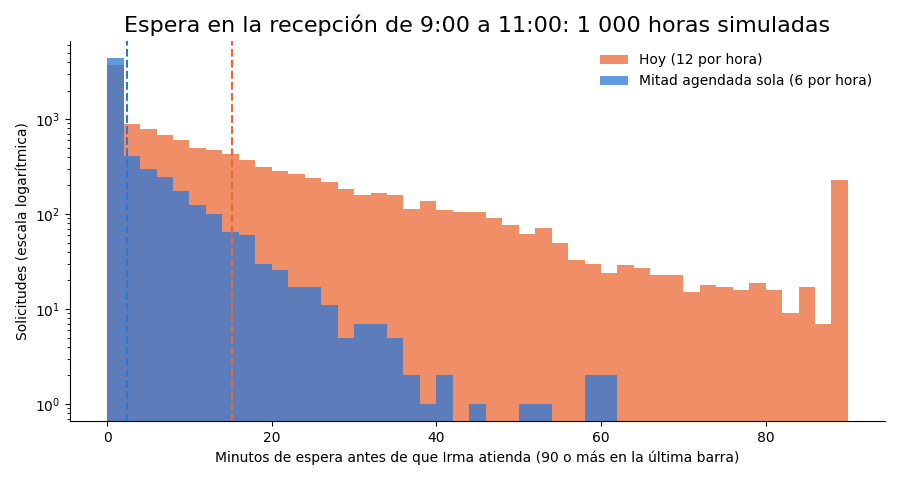
Se simularon $11,874$ solicitudes, de las que $6,008$ seguirían llegando a Irma con autoagendado. Hoy, la espera media es de $15.2$ minutos, cerca de los $16$ de la fórmula; la mediana es de $7.6$ y el percentil 90 de $40.6$ minutos: uno de cada diez pacientes espera más de cuarenta minutos a que alguien le conteste. El $22.5%$ se atiende sin esperar, muy cerca del $1 - \rho = 20%$ teórico. Con la mitad agendada sola, la espera media baja a $2.5$ minutos, el percentil 90 a $8.7$ y el $62%$ de las solicitudes no espera nada (la teoría da $1 - 0.4 = 60%$).
El histograma, en escala logarítmica para que se vea la cola larga, muestra la forma de las dos distribuciones. Las barras naranjas se extienden hasta los 90 minutos, y la última barra acumula todas las esperas de 90 o más; las azules se desvanecen antes de los 40. Las líneas discontinuas marcan las medias. Lo que cambia con el autoagendado no es solo la espera típica, sino sobre todo la cola: los pacientes que esperan media hora o más casi desaparecen, y son ellos los que cuelgan y llaman a otra clínica.
La última línea de la salida trae, como el Día 1, la corrección del negocio real. La hora pico dura dos horas y empieza cada mañana con la recepción vacía, así que la espera media en una mañana normal es de $8.0$ minutos, la mitad que en el régimen estable. Las dos cifras son ciertas y responden preguntas distintas. Y hay un detalle que la cola de la clínica comparte con la de Trigo Lento y que ningún modelo M/M/1 recoge: Irma no solo atiende el teléfono, también recibe a los pacientes que llegan a su cita. Cada persona en el mostrador es una interrupción de prioridad alta que alarga la espera de quien está en línea.
Qué automatizar primero en la clínica
Con el mapa, el coste y la cola medidos, toca ordenar. Lucía tiene más procesos que el de citas, y Valeria hace con ella la misma lista de candidatos que hizo el Día 1 en Trigo Lento: recordatorio de cita, agendar cita, confirmar cita, reagendar cancelaciones, recordatorio de revisión semestral, notas del expediente clínico, y cobro y factura. Para cada uno anota la frecuencia mensual, los minutos por vez, la tasa de error, el riesgo de 1 a 5 y, en una columna que la panadería no necesitaba, si el proceso toca datos sensibles. Además estima cuántas citas recuperaría cada proceso al mes (sus “sillones”), con supuestos que se declaran: $21.6$ para el recordatorio (Bloque 4), $7.2$ para reagendar cancelaciones más deprisa y $9$ para el recordatorio semestral.
La matriz del Día 1 combinaba cuatro criterios normalizados. Hoy se usan dos puntajes más directos, porque la pregunta es justamente si el orden cambia al cambiar la unidad de valor:
$$ P^{\text{horas}}_i = H_i\left(1 - \frac{r_i - 1}{8}\right), \qquad P^{\text{valor}}_i = \frac{70,H_i + 850,S_i}{1000}\left(1 - \frac{r_i - 1}{8}\right) $$
donde $H_i$ son las horas al mes del proceso $i$, $S_i$ los sillones recuperados al mes y $r_i$ su riesgo de 1 a 5. La lógica detrás de estas fórmulas es múltiple:
- $P^{\text{horas}}$ es el criterio del Día 1 reducido a lo esencial: horas liberadas, descontadas por el riesgo. Se mide en horas al mes.
- $P^{\text{valor}}$ suma a las horas (a 70 MXN) los sillones recuperados (a 850 MXN) y lo expresa en miles de pesos al mes. Es la versión que ve el coste invisible.
- El factor de riesgo $1 - (r_i - 1)/8$ vale $1$ con riesgo 1 y $0.5$ con riesgo 5: penaliza el riesgo, pero, a diferencia del Día 1, no lo lleva a cero, porque el riesgo extremo se trata con una regla, no con un descuento.
- Esa regla es la exclusión: un proceso con riesgo 5 o que toca datos clínicos (diagnóstico, tratamiento, notas del expediente) no recibe puntaje y queda fuera de la automatización, por alto que sea su número de horas.
El siguiente código construye la matriz, calcula los dos puntajes, aplica la regla de exclusión y dibuja las burbujas: horas al mes en el eje horizontal, riesgo en el vertical, tamaño según el valor mensual y borde rojo para los procesos con datos sensibles:
# Matriz de priorización con datos sensibles, dos puntajes y regla de exclusión en Python:
candidatos = pd.DataFrame({
    'proceso': ['Recordatorio de cita', 'Agendar cita', 'Confirmar cita', 'Reagendar cancelaciones',
                'Recordatorio semestral', 'Notas del expediente', 'Cobro y factura'],
    'frecuencia_mes': [360, 360, 360, 36, 60, 360, 360],
    'minutos': [2.0, 3.5, 0.5, 4.0, 2.5, 3.0, 2.5],
    'tasa_error': [0.06, 0.04, 0.03, 0.08, 0.05, 0.02, 0.03],
    'riesgo': [2, 3, 1, 2, 2, 5, 4],                          # de 1 (bajo) a 5 (alto)
    'datos_clinicos': [False, False, False, False, False, True, False],
    'datos_sensibles': [True, True, False, False, True, True, False],
    'sillones_mes': [21.6, 0.0, 0.0, 7.2, 9.0, 0.0, 0.0],     # citas recuperadas (supuestos)
}).set_index('proceso')
candidatos['horas_mes'] = horas_al_mes(candidatos['frecuencia_mes'], candidatos['minutos'])
candidatos['factor_riesgo'] = 1 - (candidatos['riesgo'] - 1) / 8
candidatos['valor_mxn'] = candidatos['horas_mes'] * valor_hora + candidatos['sillones_mes'] * ingreso_cita
excluido = (candidatos['riesgo'] == 5) | candidatos['datos_clinicos']
candidatos['p_horas'] = (candidatos['horas_mes'] * candidatos['factor_riesgo']).where(~excluido)
candidatos['p_valor'] = (candidatos['valor_mxn'] / 1000 * candidatos['factor_riesgo']).where(~excluido)
print(candidatos[['horas_mes', 'riesgo', 'datos_sensibles', 'valor_mxn', 'p_horas', 'p_valor']]
      .sort_values('p_horas', ascending = False).round(2))
print('Primero por horas:', candidatos['p_horas'].idxmax(), '| primero por valor:', candidatos['p_valor'].idxmax())
print('Excluidos por regla:', ', '.join(candidatos.index[excluido]))

# Burbujas: horas al mes frente a riesgo, tamaño por valor mensual, borde rojo si hay datos sensibles:
fig, ax = plt.subplots(figsize = (9.5, 5.4))
desplazamientos = {'Recordatorio de cita': (14, 12), 'Agendar cita': (-60, 24), 'Confirmar cita': (12, -26),
                   'Reagendar cancelaciones': (16, 14), 'Recordatorio semestral': (14, -30),
                   'Notas del expediente': (-160, -2), 'Cobro y factura': (14, 10)}
for nombre, fila in candidatos.iterrows():
    ax.scatter(fila['horas_mes'], fila['riesgo'], s = 40 + fila['valor_mxn'] / 18,
               color = '#c3c2b7' if excluido[nombre] else '#2a78d6', alpha = 0.8,
               edgecolor = '#c8423b' if fila['datos_sensibles'] else '#52514e',
               linewidth = 2.5 if fila['datos_sensibles'] else 1)
    etiqueta = 'excluido' if excluido[nombre] else f"{fila['p_horas']:.2f} h | {fila['p_valor']:.2f} mil"
    ax.annotate(f'{nombre}\n{etiqueta}', (fila['horas_mes'], fila['riesgo']),
                xytext = desplazamientos[nombre], textcoords = 'offset points', fontsize = 8.5)
ax.axhline(4.5, color = '#c8423b', linestyle = '--', linewidth = 1)
ax.text(0.5, 4.62, 'Riesgo 5 o datos clínicos: fuera de la automatización', fontsize = 9, color = '#c8423b')
ax.set_xlim(0, 26)
ax.set_ylim(0.3, 5.6)
ax.set_xlabel('Horas de trabajo al mes')
ax.set_ylabel('Riesgo (1 bajo, 5 alto)')
ax.set_title('Qué automatizar primero en Sonrisa Norte', fontsize = 16)
ax.text(25.5, 0.45, 'Tamaño: valor mensual | borde rojo: datos sensibles', fontsize = 8.5,
        color = '#52514e', ha = 'right')
ax.spines[['top', 'right']].set_visible(False)
plt.tight_layout()
plt.show()
                         horas_mes  riesgo  datos_sensibles  valor_mxn  p_horas  p_valor
proceso
Agendar cita                  21.0       3             True     1470.0    15.75     1.10
Recordatorio de cita          12.0       2             True    19200.0    10.50    16.80
Cobro y factura               15.0       4            False     1050.0     9.38     0.66
Confirmar cita                 3.0       1            False      210.0     3.00     0.21
Recordatorio semestral         2.5       2             True     7825.0     2.19     6.85
Reagendar cancelaciones        2.4       2            False     6288.0     2.10     5.50
Notas del expediente          18.0       5             True     1260.0      NaN      NaN
Primero por horas: Agendar cita | primero por valor: Recordatorio de cita
Excluidos por regla: Notas del expediente
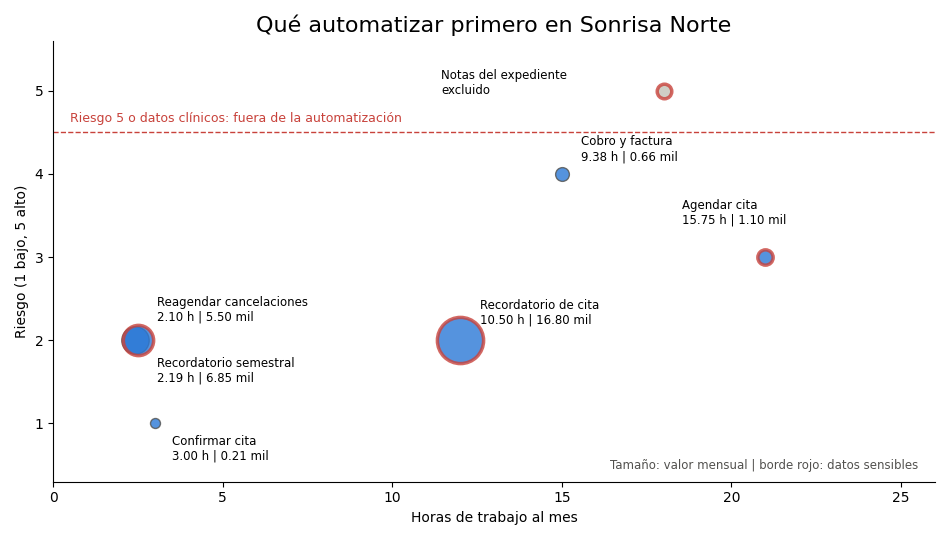
El resultado se recoge en la Tabla 3, ordenada por el puntaje en horas.
Tabla 3. Matriz de priorización de Sonrisa Norte con la columna de datos sensibles y los dos puntajes (tasas de error, riesgos y sillones recuperados son supuestos didácticos).
| Proceso | Veces al mes | Minutos | Tasa de error | Riesgo (1 a 5) | Datos sensibles | Horas al mes | Puntaje por horas | Puntaje por valor (miles de MXN) |
|---|---|---|---|---|---|---|---|---|
| Agendar cita | 360 | 3.5 | 0.04 | 3 | Sí | 21.0 | 15.75 | 1.10 |
| Recordatorio de cita | 360 | 2.0 | 0.06 | 2 | Sí | 12.0 | 10.50 | 16.80 |
| Cobro y factura | 360 | 2.5 | 0.03 | 4 | No | 15.0 | 9.38 | 0.66 |
| Confirmar cita | 360 | 0.5 | 0.03 | 1 | No | 3.0 | 3.00 | 0.21 |
| Recordatorio de revisión semestral | 60 | 2.5 | 0.05 | 2 | Sí | 2.5 | 2.19 | 6.85 |
| Reagendar cancelaciones | 36 | 4.0 | 0.08 | 2 | No | 2.4 | 2.10 | 5.50 |
| Notas del expediente clínico | 360 | 3.0 | 0.02 | 5 | Sí | 18.0 | Excluido | Excluido |
Por horas gana agendar cita, con $21$ horas al mes y un puntaje de $15.75$, por delante del recordatorio de cita ($10.50$) y del cobro ($9.38$). Es el resultado que obtendría cualquiera que mirara solo la hoja de horas de Irma: agendar es el bloque más grande de su día. Por valor, el orden se invierte: el recordatorio de cita sube al primer lugar con $16.80$ miles de MXN ponderados al mes, porque sus $21.6$ sillones recuperados pesan mucho más que sus 12 horas; detrás quedan el recordatorio semestral ($6.85$) y reagendar cancelaciones ($5.50$), dos procesos que por horas eran casi irrelevantes y que por valor pasan delante de agendar. Las notas del expediente, con 18 horas al mes, habrían quedado segundas por horas, pero la regla las excluye.
La gráfica hace visible la tensión. A la derecha están los procesos con muchas horas (agendar, expediente, cobro), con burbujas pequeñas; abajo en el centro, la burbuja enorme del recordatorio de cita, con borde rojo porque toca la agenda de salud de una persona; arriba, por encima de la línea discontinua, el expediente en gris. El mismo método da dos respuestas según la unidad de valor que se elija, y elegir la unidad es una decisión del negocio, no del método. En Trigo Lento, horas y valor apuntaban al mismo proceso; en la clínica, no. Lucía elige empezar por el recordatorio, y la decisión es defendible con números: es el proceso que más dinero mueve, tiene riesgo bajo si se diseña bien y su fallo típico (un recordatorio que no llega) deja las cosas como están hoy.
El borde rojo del recordatorio no es decorativo. Es la señal de que ese flujo solo se construye después de responder la pregunta de la sección siguiente: ¿qué datos puede llevar un mensaje que sale de la clínica?
Datos de salud: datos personales sensibles
En Trigo Lento, el Día 6 trató nombres, teléfonos y direcciones: datos personales que exigen aviso de privacidad, finalidad y minimización, pero cuya fuga, aunque grave, no expone la intimidad de nadie. En una clínica dental, la misma agenda contiene otra clase de información. Que una persona tenga una endodoncia el martes, que tome anticoagulantes o que sea alérgica a la penicilina son datos de salud, y la ley mexicana los trata aparte.
La Ley Federal de Protección de Datos Personales en Posesión de los Particulares (LFPDPPP) vigente es la publicada en el Diario Oficial de la Federación el 20 de marzo de 2025. Según el texto consultado en octubre de 2026, su artículo 2, fracción VI, define los datos personales sensibles como aquellos que afectan a la esfera más íntima de la persona titular, o cuya utilización indebida puede dar origen a discriminación o conllevar un riesgo grave, y menciona expresamente entre ellos el estado de salud presente o futuro. Su artículo 8 establece que, para tratar datos sensibles, el responsable debe obtener el consentimiento expreso y por escrito de la persona titular, mediante firma autógrafa, firma electrónica o cualquier otro mecanismo de autenticación. Y la fracción XV del artículo 2 identifica como autoridad a la Secretaría Anticorrupción y Buen Gobierno, que asumió las funciones de supervisión en materia de datos personales en posesión de particulares.
A la ley se suma la norma propia del sector. La Norma Oficial Mexicana NOM-004-SSA3-2012, Del expediente clínico, obliga a los establecimientos de salud a integrar un expediente por paciente, a tratar su información con confidencialidad y a conservarlo por un periodo mínimo de cinco años contados desde el último acto médico. El expediente es el documento donde viven el diagnóstico, el tratamiento y la evolución; es, por definición, el cajón más protegido de la clínica.
La Figura 3 resume cómo se traducen ley y norma en el diseño: tres cajones de datos con candados de distinto grosor y una flecha que dice qué cajón puede salir de la clínica y hacia dónde.
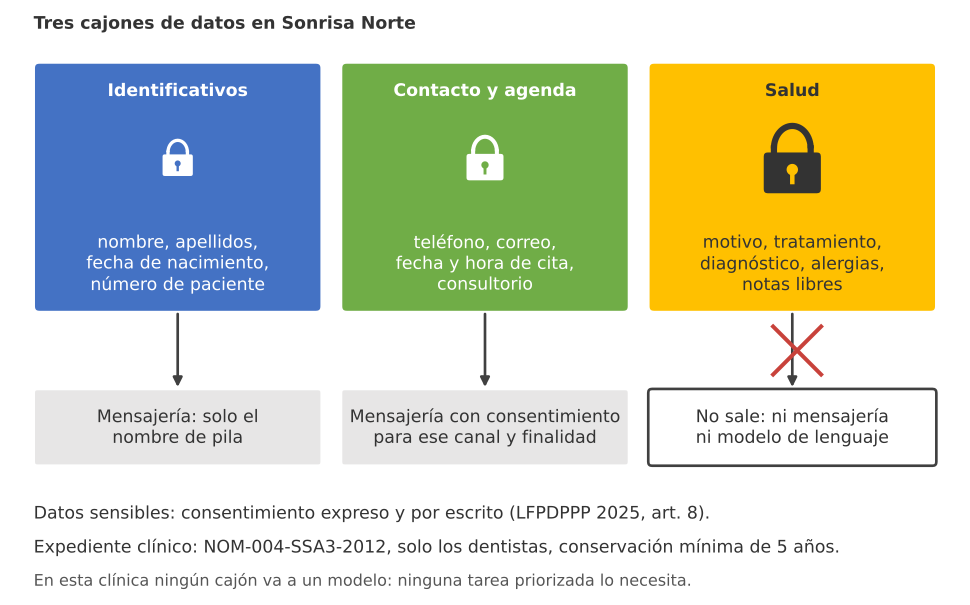
Figura 3. Tres cajones de datos: identificativos, de contacto y agenda, y de salud, con candados de distinto grosor; solo los dos primeros pueden salir de la clínica, y ninguno hacia un modelo de lenguaje.
En la práctica, los datos de la clínica se reparten en esos tres cajones, y cada uno tiene su base de tratamiento, sus personas autorizadas y sus salidas permitidas. La Tabla 4 los ordena.
Tabla 4. Datos de Sonrisa Norte por cajón: base de tratamiento, quién los ve y si pueden salir hacia un proveedor de mensajería o hacia un modelo de lenguaje.
| Cajón | Campos de ejemplo | Base de tratamiento | Quién los ve | ¿Puede ir a un proveedor de mensajería? | ¿Puede ir a un modelo de lenguaje? |
|---|---|---|---|---|---|
| Identificativo | Nombre, apellidos, fecha de nacimiento, número de paciente | Relación de servicio y aviso de privacidad | Recepción y dentistas | Solo el nombre de pila, si hace falta en el saludo | No en este caso |
| Contacto y agenda | Teléfono, correo, fecha y hora de la cita, consultorio | Relación de servicio; consentimiento para cada canal | Recepción y dentistas | Sí, con consentimiento para ese canal y la finalidad declarada | No en este caso |
| Salud | Motivo de consulta, tratamiento, diagnóstico, alergias, medicamentos, radiografías, notas libres | Consentimiento expreso y por escrito (LFPDPPP, art. 8) y NOM-004-SSA3-2012 | Solo los dentistas; la recepción, lo indispensable para agendar | No | No |
La última columna dice “no” en las tres filas y merece una explicación. Los identificativos y los de contacto no son sensibles, y en otro negocio podrían enviarse seudonimizados a un modelo, como hizo el Día 6 con los mensajes de Trigo Lento. En la clínica, sin embargo, ninguna de las tareas que la matriz priorizó necesita un modelo de lenguaje: el recordatorio es una plantilla fija, el autoagendado es una consulta a la agenda y la confirmación es una respuesta “1” o “2”. Si una tarea no necesita un modelo, el dato no viaja a un modelo, aunque la ley lo permitiera. Es el principio de minimización aplicado a la arquitectura, no solo a los formularios.
Atención aquí: Esta entrada explica principios de diseño, no da asesoría legal. El texto de la LFPDPPP de 2025 se cita según la versión publicada en el DOF y consultada en octubre de 2026; antes de poner en marcha un flujo con datos de pacientes, una clínica real debe revisar su aviso de privacidad, sus formatos de consentimiento y las obligaciones de la NOM-004-SSA3-2012 con un especialista, y comprobar si hay reformas posteriores. Además, ningún flujo de esta serie toma decisiones clínicas: diagnosticar, indicar un tratamiento o decidir si un paciente puede esperar es siempre trabajo de los dentistas.
Lo que cambia en el flujo
Ley y norma se convierten en cinco reglas concretas de diseño para cualquier flujo de la clínica:
- El recordatorio no nombra el tratamiento. Dice día, hora y clínica; nunca “endodoncia”, “extracción” ni “implante”. El teléfono puede estar en la mesa de la cena.
- Ningún dato clínico va a un modelo de lenguaje. Ni para redactar, ni para resumir, ni para “mejorar el tono”. El cajón de salud no tiene flecha hacia fuera.
- Acceso por rol. La recepción ve la agenda; el expediente, solo los dentistas. Un flujo que necesite el motivo de consulta para elegir la duración de la cita usa una categoría neutra (“cita larga”, “cita corta”), no el motivo.
- Registros sin motivo de consulta. El registro de ejecuciones del flujo (qué se envió, a quién, cuándo, con qué resultado) guarda identificadores y estados, nunca el contenido clínico.
- Conservación con plazo. Los mensajes enviados y las respuestas de los pacientes se borran del proveedor de mensajería cuando dejan de hacer falta; lo que deba conservarse va al expediente, con los plazos de la norma.
Las reglas 1 y 2 se pueden comprobar con código antes de que una plantilla salga de la clínica. El siguiente bloque define clasificar_campo(nombre), que asigna cada campo a su cajón y trata como salud cualquier campo que no reconoce, por prudencia, y revisar_mensaje(plantilla), que rechaza un recordatorio si usa un campo de salud, si nombra un tratamiento o si no ofrece una forma de darse de baja. Después lo prueba con dos plantillas, una como la que Irma diría hoy por teléfono y otra rediseñada:
# Cajones de datos y revisión de plantillas de recordatorio en Python:
CAJONES = {
    'identificativo': {'nombre', 'apellidos', 'fecha_nacimiento', 'id_paciente'},
    'contacto': {'telefono', 'correo', 'fecha_cita', 'hora_cita', 'consultorio'},
    'salud': {'motivo_consulta', 'tratamiento', 'diagnostico', 'alergias', 'medicamentos', 'radiografias'},
}
PALABRAS_SALUD = r'\b(endodoncia|extracci[oó]n|implante|ortodoncia|caries|dolor|resina|corona|diagn[oó]stico)\b'

def clasificar_campo(nombre):
    # Devuelve el cajón del campo; lo que no se reconoce se trata como salud, por prudencia:
    for cajon, campos in CAJONES.items():
        if nombre in campos:
            return cajon
    return 'salud'

def revisar_mensaje(plantilla):
    # Rechaza un recordatorio que use campos de salud, nombre un tratamiento o no permita la baja:
    motivos = [f'campo de salud: {c}' for c in re.findall(r'\{(\w+)\}', plantilla)
               if clasificar_campo(c) == 'salud']
    motivos += [f'palabra clínica: {p}' for p in re.findall(PALABRAS_SALUD, plantilla, flags = re.I)]
    if 'BAJA' not in plantilla:
        motivos.append('sin forma de darse de baja')
    return (len(motivos) == 0), motivos

campos = ['nombre', 'telefono', 'fecha_cita', 'hora_cita', 'motivo_consulta', 'tratamiento',
          'alergias', 'correo', 'notas_libres']
tabla_campos = pd.DataFrame({'campo': campos, 'cajon': [clasificar_campo(c) for c in campos]})
tabla_campos['puede_ir_a_mensajeria'] = tabla_campos['cajon'] != 'salud'
tabla_campos['puede_ir_a_un_modelo'] = False
print(tabla_campos.to_string(index = False))
(clinica / 'campos_clinica.json').write_text(json.dumps(tabla_campos.to_dict(orient = 'records'),
                                             ensure_ascii = False, indent = 2), encoding = 'utf-8')

plantillas = {
    'A': 'Hola {nombre}, le recordamos su cita de endodoncia ({tratamiento}) el {fecha_cita} a las {hora_cita}.',
    'B': 'Hola {nombre}, le recordamos su cita en Sonrisa Norte el {fecha_cita} a las {hora_cita}. '
         'Responda 1 para confirmar o 2 para cambiarla. Si no desea avisos, responda BAJA.',
}
for clave, texto in plantillas.items():
    aceptada, motivos = revisar_mensaje(texto)
    print(f'Plantilla {clave}:', 'ACEPTADA' if aceptada else 'RECHAZADA', '|', '; '.join(motivos) or 'sin observaciones')
          campo          cajon  puede_ir_a_mensajeria  puede_ir_a_un_modelo
         nombre identificativo                   True                 False
       telefono       contacto                   True                 False
     fecha_cita       contacto                   True                 False
      hora_cita       contacto                   True                 False
motivo_consulta          salud                  False                 False
    tratamiento          salud                  False                 False
       alergias          salud                  False                 False
         correo       contacto                   True                 False
   notas_libres          salud                  False                 False
Plantilla A: RECHAZADA | campo de salud: tratamiento; palabra clínica: endodoncia; sin forma de darse de baja
Plantilla B: ACEPTADA | sin observaciones
La tabla de campos es la versión en código de la Tabla 4: el nombre es identificativo; el teléfono, el correo, la fecha y la hora son de contacto y agenda; el motivo de consulta, el tratamiento y las alergias son de salud. Fíjese en notas_libres, que no aparece en ningún cajón y por eso cae en salud: un campo de texto libre en una clínica puede contener cualquier cosa, y el error seguro es tratarlo como sensible. La columna puede_ir_a_un_modelo es False en todas las filas por la decisión de diseño explicada arriba.
Las dos plantillas muestran la diferencia entre lo habitual y lo correcto. La plantilla A, “su cita de endodoncia”, queda rechazada por tres motivos: usa el campo tratamiento, nombra una palabra clínica y no permite darse de baja. La plantilla B queda aceptada: dice clínica, día y hora, ofrece confirmar con “1” o cambiar con “2” y termina con la palabra BAJA. Es menos informativa, y esa es precisamente su virtud. El revisor tiene límites evidentes: una lista de palabras no detecta “su tratamiento de conducto” ni una sigla médica, y por eso se complementa con la revisión humana de cada plantilla nueva antes de aprobarla, el mismo principio de humano al mando del código de honor. Un revisor automático no sustituye a la persona que aprueba la plantilla; evita que se le escape lo obvio.
El recordatorio semestral, además, plantea un problema de base que ningún revisor resuelve. El recordatorio de cita responde a una cita que el paciente pidió; el semestral (“hace seis meses de su última limpieza”) no responde a nada en curso. Necesita su propio consentimiento, pedido aparte y por escrito, con la finalidad declarada y una baja inmediata. Sin ese consentimiento, un mensaje bienintencionado se parece demasiado a la publicidad no solicitada que la serie prohíbe desde el primer día.
Trigo Lento y Sonrisa Norte, lado a lado
Con los dos negocios medidos, se puede comprobar qué del método se transfirió intacto y qué tuvo que adaptarse. El siguiente código reúne en una sola tabla las cifras del Día 1 (los $468$ encargos de $6$ minutos, los $60$ minutos en el sistema de la hora pico y el $8%$ de encargos con error) y las de hoy, y calcula para cada negocio la proporción entre su coste invisible y el coste de sus horas:
# El método del Día 1 en los dos negocios, lado a lado, en Python:
comparativa = pd.DataFrame({
    'Trigo Lento': {'proceso': 'Encargos', 'unidad': 'encargo', 'volumen_mes': 468, 'min_por_unidad': 6.0,
                    'horas_mes': horas_al_mes(468, 6.0), 'valor_hora_mxn': 75,
                    'W_pico_min': colas.loc['Trigo Lento hoy (Día 1)', 'W_min'],
                    'coste_invisible_mxn': 0.08 * 468 * 380, 'datos': 'personales'},
    'Sonrisa Norte': {'proceso': 'Citas', 'unidad': 'sillón (cita)', 'volumen_mes': citas_mes,
                      'min_por_unidad': minutos_cita, 'horas_mes': h_recepcion, 'valor_hora_mxn': valor_hora,
                      'W_pico_min': colas.loc['Sonrisa Norte hoy', 'W_min'],
                      'coste_invisible_mxn': no_percibido(citas_mes, 0.15, ingreso_cita)[1],
                      'datos': 'sensibles (salud)'},
})
print(comparativa.to_string())
for negocio in comparativa.columns:
    c = comparativa[negocio]
    coste_horas = c['horas_mes'] * c['valor_hora_mxn']
    print(f'{negocio}: horas {coste_horas:,.0f} MXN | invisible {c["coste_invisible_mxn"]:,.0f} MXN | '
          f'proporción {c["coste_invisible_mxn"] / coste_horas:.1f}')
                    Trigo Lento      Sonrisa Norte
proceso                Encargos              Citas
unidad                  encargo      sillón (cita)
volumen_mes                 468                360
min_por_unidad              6.0                7.0
horas_mes                  46.8               42.0
valor_hora_mxn               75                 70
W_pico_min                 60.0               20.0
coste_invisible_mxn     14227.2            45900.0
datos                personales  sensibles (salud)
Trigo Lento: horas 3,510 MXN | invisible 14,227 MXN | proporción 4.1
Sonrisa Norte: horas 2,940 MXN | invisible 45,900 MXN | proporción 15.6
La salida se recoge en la Tabla 5.
Tabla 5. El método en los dos negocios: unidad, volumen, minutos, horas, cola en el pico, coste invisible y riesgo de datos.
| Concepto | Trigo Lento (Día 1) | Sonrisa Norte (Día 7) |
|---|---|---|
| Proceso | Encargos | Citas |
| Unidad de valor | Encargo | Sillón (cita) |
| Volumen al mes | 468 | 360 |
| Minutos por unidad | 6.0 | 7.0 |
| Horas al mes | 46.8 | 42.0 |
| Coste de las horas | 3 510 MXN (75 MXN la hora) | 2 940 MXN (70 MXN la hora) |
| Tiempo en el sistema en el pico (M/M/1) | 60 minutos ($\lambda = 9$, $\mu = 10$) | 20 minutos ($\lambda = 12$, $\mu = 15$) |
| Coste invisible | 14 227 MXN de encargos con algún error (8 %), en riesgo | 45 900 MXN de citas perdidas (15 %), no percibidos |
| Coste invisible frente a coste de las horas | 4.1 veces | 15.6 veces |
| Riesgo de los datos | Personales | Sensibles (salud) |
Leída por filas, la tabla separa lo que el método conserva de lo que el negocio cambia:
- Se transfiere intacto el esqueleto: un proceso con unidad, volumen, minutos por paso y dueño; la fórmula $H = n \cdot t / 60$; la cola M/M/1 con la ley de Little y su contraste con una simulación; y una matriz que ordena candidatos. Ninguna de esas piezas sabe si se trata de pan o de muelas.
- Cambia la unidad de valor. En la panadería, un encargo perdido es un ticket de 380 MXN; en la clínica, un sillón vacío es una hora del dentista que no vuelve. Por eso el coste invisible de la clínica es $15.6$ veces el de sus horas y el de Trigo Lento, $4.1$ veces. Además, el de Trigo Lento es un valor en riesgo (encargos con algún error, que muchas veces se corrigen), mientras que el de la clínica es dinero que ya no entró.
- Cambia la cola. La clínica recibe más solicitudes por hora que la panadería, pero tiene más holgura, y espera tres veces menos. La cola de Trigo Lento era su problema principal; la de Sonrisa Norte es secundaria frente a las inasistencias.
- Cambia el riesgo de los datos, y con él la regla de exclusión de la matriz, el consentimiento y la arquitectura: en Trigo Lento, los mensajes seudonimizados pueden ir a un modelo; en la clínica, el cajón de salud no sale.
Lo que se reutiliza más adelante también queda claro. El Día 51 tomará la ficha, el revisor de plantillas y el escenario del $9%$ para poner en marcha los recordatorios por WhatsApp con plantillas de utilidad y consentimiento; el Día 85 reunirá a Sonrisa Norte con Café Altura y el Despacho Contable Ledesma y Asociados para comprobar que el método se transfiere a tres sectores. Y Trigo Lento gana algo para sí: la columna de datos sensibles y la regla de exclusión, que su propia matriz no tenía y que el Día 6 ya anticipaba con las recetas de Don Ernesto.
El proceso de citas propuesto
Falta dibujar el sistema, como se hizo con Trigo Lento. El siguiente código copia la función dibujar_flujo del Día 2, con la paleta de formas de la serie, y dibuja el proceso de citas propuesto: la solicitud entra por WhatsApp o por la página web; si menciona síntomas, pasa a Irma; si no, el sistema ofrece huecos de la agenda, confirma sin nombrar el tratamiento y envía el recordatorio la víspera; si el paciente responde “2” o no responde, Irma reagenda. El expediente queda en un hexágono aparte, con los dentistas, y solo se toca en la consulta:
# Proceso de citas propuesto con puertas humanas, dibujado con dibujar_flujo en Python:
from matplotlib.patches import Ellipse, FancyBboxPatch, Polygon, RegularPolygon, FancyArrowPatch

FORMAS = {   # paleta de formas de la serie: tipo -> (forma, relleno)
    'disparador': ('ovalo', '#3a9d5d'), 'accion': ('rectangulo', '#2a78d6'),
    'decision': ('rombo', '#eb6834'), 'ia': ('rectangulo', '#7b5ea7'),
    'error': ('rectangulo', '#c8423b'), 'humano': ('hexagono', '#8a8986'),
}

def dibujar_flujo(nodos, aristas, titulo, ancho = 1.9, alto = 0.9):
    fig, ax = plt.subplots(figsize = (12, 5.6))
    for n in nodos:
        forma, color = FORMAS[n['tipo']]
        x, y = n['x'], n['y']
        if forma == 'ovalo':
            figura = Ellipse((x, y), ancho, alto)
        elif forma == 'rombo':
            figura = Polygon([(x - ancho / 2, y), (x, y + alto / 1.4), (x + ancho / 2, y), (x, y - alto / 1.4)])
        elif forma == 'hexagono':
            figura = RegularPolygon((x, y), 6, radius = ancho / 2, orientation = np.pi / 6)
        else:
            figura = FancyBboxPatch((x - ancho / 2, y - alto / 2), ancho, alto, boxstyle = 'round,pad=0.03')
        figura.set_facecolor(color)
        figura.set_edgecolor('white')
        figura.set_linewidth(2)
        ax.add_patch(figura)
        ax.text(x, y, n['texto'], ha = 'center', va = 'center', fontsize = 9.5, color = 'white')
    posicion = {n['id']: (n['x'], n['y']) for n in nodos}
    for origen, destino, etiqueta in aristas:
        (x1, y1), (x2, y2) = posicion[origen], posicion[destino]
        ax.add_patch(FancyArrowPatch((x1, y1), (x2, y2), arrowstyle = '-|>', mutation_scale = 14,
                                     shrinkA = 42, shrinkB = 44, color = '#52514e', linewidth = 1.4))
        if etiqueta:
            ax.text((x1 + x2) / 2, (y1 + y2) / 2 + 0.18, etiqueta, ha = 'center', fontsize = 8.5,
                    color = '#52514e', bbox = dict(facecolor = 'white', edgecolor = 'none', pad = 1))
    xs, ys = [n['x'] for n in nodos], [n['y'] for n in nodos]
    ax.set_xlim(min(xs) - 1.3, max(xs) + 1.3)
    ax.set_ylim(min(ys) - 1.1, max(ys) + 1.1)
    ax.set_aspect('equal')
    ax.axis('off')
    ax.set_title(titulo, fontsize = 16)
    return fig, ax

nodos = [
    {'id': 'n1', 'tipo': 'disparador', 'texto': 'Solicitud\n(WhatsApp o web)', 'x': 0, 'y': 0},
    {'id': 'n2', 'tipo': 'decision', 'texto': '¿Menciona\nsíntomas?', 'x': 2.5, 'y': 0},
    {'id': 'n3', 'tipo': 'accion', 'texto': 'Ofrecer huecos\nde la agenda', 'x': 5.0, 'y': 0},
    {'id': 'n4', 'tipo': 'accion', 'texto': 'Confirmar\nsin tratamiento', 'x': 7.5, 'y': 0},
    {'id': 'n5', 'tipo': 'accion', 'texto': 'Recordatorio\nla víspera', 'x': 10.0, 'y': 0},
    {'id': 'n6', 'tipo': 'decision', 'texto': '¿Responde\n1 o 2?', 'x': 10.0, 'y': -1.8},
    {'id': 'n7', 'tipo': 'humano', 'texto': 'Irma\natiende', 'x': 2.5, 'y': -1.8},
    {'id': 'n8', 'tipo': 'humano', 'texto': 'Irma\nreagenda', 'x': 7.5, 'y': -1.8},
    {'id': 'n9', 'tipo': 'humano', 'texto': 'Dentista:\nexpediente', 'x': 5.0, 'y': 2.2},
]
aristas = [('n1', 'n2', ''), ('n2', 'n3', 'no'), ('n2', 'n7', 'sí'), ('n3', 'n4', ''), ('n4', 'n5', ''),
           ('n5', 'n6', ''), ('n6', 'n8', '2 o sin respuesta'), ('n3', 'n9', 'solo en consulta')]
fig, ax = dibujar_flujo(nodos, aristas, 'Sonrisa Norte: citas automatizadas con puertas humanas')
tipos = pd.Series([n['tipo'] for n in nodos]).value_counts().to_dict()
print('Nodos por tipo:', tipos)
print('Pasos con IA:', tipos.get('ia', 0), '| puertas humanas:', tipos.get('humano', 0))
plt.tight_layout()
plt.show()
Nodos por tipo: {'accion': 3, 'humano': 3, 'decision': 2, 'disparador': 1}
Pasos con IA: 0 | puertas humanas: 3
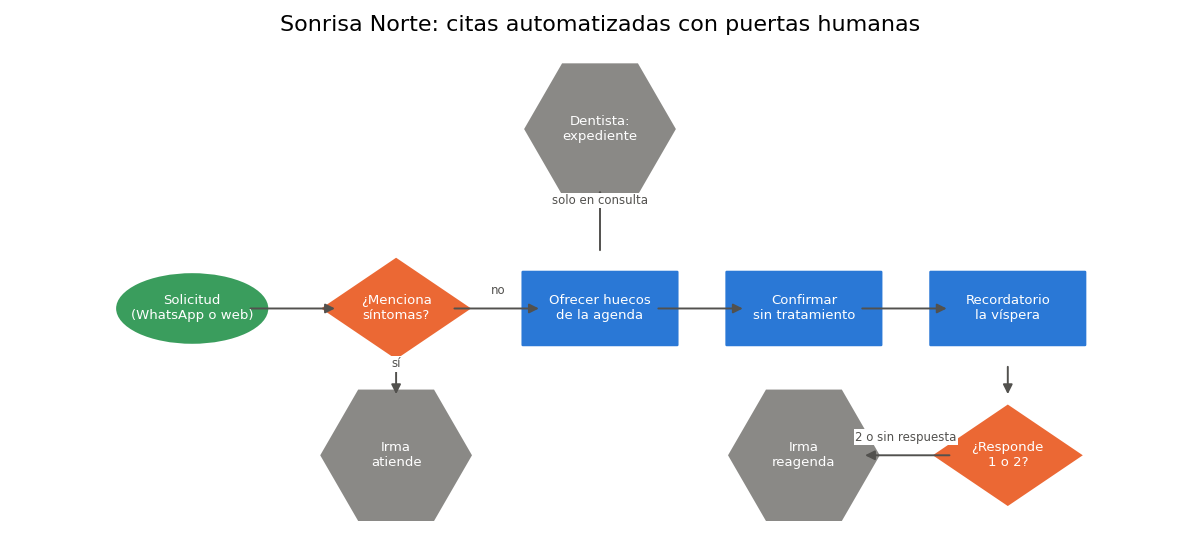
El diagrama tiene tres puertas humanas (hexágonos grises) y ningún paso de IA: es la primera vez en la serie que un flujo propuesto no usa un modelo de lenguaje, y no es un olvido. La decisión del rombo “¿Menciona síntomas?” es una regla sencilla de palabras clave que, ante la duda, deriva a Irma; un paciente que escribe “me duele mucho” no debe recibir una lista de huecos, sino una persona que decida si es una urgencia. El teléfono, con la mitad de las solicitudes, sigue llegando a Irma como hoy; lo que cambia es que ya no compite con los mensajes que se agendan solos ni con las llamadas de la tarde para recordar.
Don Ernesto, que ha seguido la explicación con más interés del que reconoce, mira el diagrama y señala los hexágonos: “Eso sí me gusta. Donde hay muelas, hay una persona.” Es, casi palabra por palabra, la regla que el código de honor de ayer escribió para Trigo Lento con otras palabras.
Consideraciones finales
La tarde de hoy deja una conclusión que no era evidente por la mañana: el método del Día 1 se transfiere a la clínica sin cambiar una sola fórmula, pero sus respuestas cambian por completo. En Trigo Lento, el problema era la cola y la prioridad eran los encargos; en Sonrisa Norte, la cola es tolerable, el coste grande no está en las horas sino en los sillones vacíos, y la prioridad depende de qué unidad de valor se elija. Si Valeria hubiera copiado las conclusiones de la panadería en lugar de copiar el método, habría automatizado el agendado, habría ahorrado unas horas a Irma y habría dejado intactos los $45,900$ MXN al mes que se pierden por inasistencias.
Las limitaciones también conviene decirlas. Todas las cifras de la clínica son inventadas: la inasistencia del $15%$, el ingreso medio de 850 MXN, la tasa de $9%$ con recordatorios y los sillones recuperados de cada proceso son supuestos didácticos, y el metaanálisis de Guy y colaboradores sugiere que el $9%$ es optimista. La cola M/M/1 ignora las interrupciones del mostrador; el puntaje de la matriz depende de un factor de riesgo que es una decisión, no una ley natural; y el revisor de plantillas solo detecta lo que está en su lista. Ninguna de esas limitaciones invalida el método, pero todas obligan a medir en cuanto el flujo esté en marcha.
Antes de pasar al Día 8, conviene que usted se haga algunas preguntas sobre un negocio que conozca:
- ¿Cuál es su unidad de valor: un pedido, una cita, una hora facturable, una mesa? ¿Qué cuesta que una de ellas se pierda?
- ¿Hay un coste invisible mayor que el coste de las horas, como el sillón vacío de la clínica? ¿Lo ha buscado a propósito?
- ¿Qué datos de su proceso son sensibles, y cuáles de sus flujos los necesitan de verdad?
- Si ordena sus procesos por horas y después por valor, ¿cambia el primero de la lista?
Un gran libro que habla de esto es Fundamentals of Business Process Management (o Fundamentos de la gestión de procesos de negocio), de Marlon Dumas, Marcello La Rosa, Jan Mendling y Hajo Reijers, el mismo que acompañó al Día 1. Sus capítulos de análisis cuantitativo de procesos enseñan a medir tiempos de ciclo, costes y colas en cualquier organización, de un hospital a una aseguradora, y su insistencia en separar el método de sus resultados es justo la lección de hoy: el método se transfiere; las conclusiones, no.
Transferir un método no es copiar sus conclusiones: es volver a medir con las mismas preguntas en un negocio que tiene otras unidades, otros costes invisibles y otros riesgos. Hoy Sonrisa Norte tiene lo que Trigo Lento tuvo hace una semana: su proceso medido, su coste visible y su coste invisible calculados, su cola explicada, una lista ordenada de qué hacer primero y, además, una frontera clara entre lo que puede salir de la clínica y lo que no.
Conclusiones clave
Transferir el método
- La plantilla del Día 1 (mapa, tiempos, coste, cola y matriz) se aplica sin cambiar una fórmula: en Sonrisa Norte, $360$ citas de $7$ minutos suman $42$ horas al mes y $2,940$ MXN de recepción.
- El mapa y la cola deben usar los mismos minutos: los $4$ minutos de los pasos que ocurren al pedir la cita dan $\mu = 15$ solicitudes por hora.
- Con $\lambda = 12$, la recepción tiene $20$ minutos en el sistema y $L = 4$; con la mitad de las solicitudes agendadas solas, $6.67$ minutos, frente a los $60$ de Trigo Lento con $\lambda = 9$ y $\mu = 10$.
El coste invisible
- Las inasistencias del $15%$ cuestan $I = n \cdot p \cdot v = 45,900$ MXN al mes, $15.6$ veces el coste de las horas; bajar al $9%$ recuperaría $21.6$ citas y $18,360$ MXN.
- Un mes simulado tuvo $45$ inasistencias y no $54$: con 360 citas, el azar mueve la cifra varios puntos, y un solo mes no basta para demostrar una mejora.
- Por horas gana agendar cita ($15.75$); por valor, el recordatorio de cita ($16.80$ miles de MXN): elegir la unidad de valor es una decisión del negocio.
Datos sensibles
- Según la LFPDPPP de 2025, los datos de salud son datos personales sensibles (art. 2, fr. VI) y exigen consentimiento expreso y por escrito (art. 8); la NOM-004-SSA3-2012 protege el expediente clínico.
- El recordatorio no nombra el tratamiento, ningún dato clínico va a un modelo, el acceso es por rol, los registros no guardan el motivo de consulta y todo se conserva con plazo.
- La matriz gana una columna de datos sensibles y una regla de exclusión: el expediente clínico queda fuera de la automatización por regla, no por puntaje, y las decisiones clínicas son siempre de los dentistas.
Mañana, en el Día 8: Métricas de proceso y primeros acuerdos de nivel de servicio. Marisol Peña quiere saber en 15 minutos si su pedido quedó, siempre, y Valeria aprenderá a medir tiempos de ciclo y percentiles antes de prometerle nada, porque, como diría Don Ernesto, no se promete lo que no se ha medido.
Referencias
- Guy, R., Hocking, J., Wand, H., Stott, S., Ali, H. y Kaldor, J. (2012). How Effective Are Short Message Service Reminders at Increasing Clinic Attendance? A Meta-Analysis and Systematic Review. Health Services Research, 47(2), 614-632. https://doi.org/10.1111/j.1475-6773.2011.01342.x
- Cámara de Diputados del H. Congreso de la Unión (2025). Ley Federal de Protección de Datos Personales en Posesión de los Particulares. Diario Oficial de la Federación, 20 de marzo de 2025. https://www.ordenjuridico.gob.mx/Documentos/Federal/html/wo125102.html
- Secretaría de Salud (2012). Norma Oficial Mexicana NOM-004-SSA3-2012, Del expediente clínico. Diario Oficial de la Federación, 15 de octubre de 2012. https://www.dof.gob.mx/nota_detalle_popup.php?codigo=5272787
- Dumas, M., La Rosa, M., Mendling, J. y Reijers, H. A. (2018). Fundamentals of Business Process Management (2.ª ed.). Springer. https://doi.org/10.1007/978-3-662-56509-4
- Little, J. D. C. (1961). A Proof for the Queuing Formula: L = λW. Operations Research, 9(3), 383-387. https://doi.org/10.1287/opre.9.3.383