
Arquitecto de automatización con IA: Día 70
 Jeshua Romero Guadarrama
- 71 Min para leer
- 11 Apr, 2026
Índice de contenido
Resumen:
Valeria cambió el tamaño de los fragmentos del agente de 300 a 150 tokens y nadie en Trigo Lento sabe si el asistente mejoró o empeoró. Esta entrada es un laboratorio guiado para responder con un examen y no con impresiones: un conjunto congelado de 60 preguntas de referencia, una corrida del agente con la misma configuración que producción, siete métricas que no se mezclan, un modelo como juez calibrado contra Valeria con la kappa de Cohen, intervalos de Wilson para cada cifra y una comparación pareada con la prueba de McNemar que alimenta una puerta de regresión. Al terminar, usted sabrá construir y congelar un conjunto de referencia, medir a un agente con preguntas que debe responder, callar o escalar, decidir cuánto confiar en un juez automático y bloquear un despliegue que empeora lo que importa.
¿Cómo citar el presente artículo?
Romero, J. (11 de abril de 2026). Arquitecto de automatización con IA: Día 70. python-data-engineer. https://www.python-data-engineer.com/post/aai/dia_70/.
Arquitecto de automatización con IA: Día 70 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/aai/dia_70/.
Precios, límites y políticas revisados en octubre de 2026: planes, precios y límites de Make, n8n, Zapier, WhatsApp (Meta, Twilio, Wati) y de la API de Claude. Los precios de Claude Haiku 5.5 (0.10 USD por millón de tokens de entrada y 0.50 de salida) y de Claude Opus 5.5 (4.00 y 20.00) son los de la Tabla A de la serie, revisados en la página oficial de precios. Las referencias académicas (Cohen, Landis y Koch, McNemar, Zheng y colaboradores, y RAGAS) se comprobaron en sus registros bibliográficos en la misma fecha. El JSON de TL Evaluación del agente v1 sigue el formato de exportación de n8n: estructura verificada contra la documentación, revisado en octubre de 2026. Ocho de los once bloques se ejecutan sin red y sus salidas son las reales; los bloques 3 y 5 llaman a la API y se muestran sin ejecutar, y el bloque 10 es el JSON del flujo.
Día 70. Laboratorio guiado: evaluar al agente con un conjunto de preguntas de referencia
Introducción
Ayer, en el Día 69 (Agentes con memoria: recuperación, contexto y olvido), Valeria aprendió a recuperar fragmentos por similitud de coseno, a responder citando la página de Notion de donde sale cada dato y a decir “no lo sé, le pregunto a una persona” cuando la base no alcanza, separó la memoria de trabajo, la semántica y la episódica con su caducidad, y Trigo Lento ganó TL Agente de pedidos v4, el asistente de mostrador con la herramienta buscar_politicas. Hoy ese agente pasa su primer examen formal.
Es sábado 11 de abril, a las seis de la tarde, y la panadería acaba de cerrar después del día más largo de la semana. El jueves por la noche, Valeria leyó que los fragmentos pequeños “encuentran mejor” y cambió el índice de 300 a 150 tokens. El viernes y el sábado el agente contestó como siempre, con cortesía y con fuentes, y nadie notó nada raro hasta las 12:40 de hoy, cuando una clienta escribió por WhatsApp: "¿Las de avena tienen algo de nuez? Es para mi niño." El agente contestó que las galletas de avena no llevan nuez en la receta y recomendó confirmar con el personal, que es lo correcto, pero citó como fuente la página del rol de canela. La clienta, con toda razón, preguntó por qué le hablaban del rol. Marisol Peña, que estaba en el mostrador recogiendo las baguettes de Brújula, vio la conversación en la pantalla y comentó: “En mi cafetería, cuando cambiamos de proveedor de leche, hacemos una cata a ciegas. ¿Ustedes con qué prueban al robot?”
La pregunta tiene una respuesta incómoda: con nada. Desde el Día 69, Valeria ha probado al agente escribiéndole preguntas a mano, unas cuantas por día, y mirando si la respuesta le parecía bien. Eso sirve para encontrar errores grandes, pero no dice si el cambio a 150 tokens mejoró o empeoró al agente, ni en qué tipo de pregunta, ni con cuánta seguridad. Una respuesta mal citada en dos días de uso puede ser mala suerte o puede ser la punta de un problema, y no hay forma de saberlo sin medir.
Don Ernesto escucha la historia mientras limpia la mesa de trabajo y la resume con la frase que Valeria esperaba: “No me diga que funciona; enséñeme el examen que le puso. Y que el examen lo haya hecho alguien que sepa qué contestar, no la misma máquina.” Tiene razón en las dos mitades. Un examen es un conjunto de preguntas con su respuesta esperada escrita antes de mirar lo que contesta el agente; y quien califica tiene que haber demostrado que califica bien. El Día 39 (Anatomía de un fallo real II: el agente que prometió un pastel imposible) ya construyó cuarenta conversaciones de regresión para el agente de pedidos y el Día 43 (Laboratorio guiado: pruebas de flujos con datos fijados y un entorno de ensayo) llevó las pruebas a todos los flujos; hoy toca lo mismo para un agente que responde con texto libre, donde “correcto” ya no se comprueba con una comparación exacta.
En la presente entrada, descubrirá cómo se construye un conjunto de referencia de 60 preguntas con su respuesta esperada, sus páginas fuente y su conducta correcta (responder, decir “no lo sé” o escalar), y cómo se congela con una huella para que dos corridas sean comparables. Correrá al agente sobre el conjunto con la misma configuración que producción, medirá siete métricas que no se mezclan y comprobará el medidor con un oráculo y con un agente nulo. Escribirá un juez con rúbrica y salida estructurada, lo calibrará contra las etiquetas de Valeria con la kappa de Cohen, pondrá a cada cifra su intervalo de Wilson y comparará los tamaños de fragmento de 150, 300 y 600 tokens con la prueba de McNemar. Terminará con una puerta de regresión de tres cerrojos y con TL Evaluación del agente v1, el workflow de n8n que corre el examen cada lunes y cada vez que cambia el prompt, el índice o el modelo.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Construir un conjunto de referencia de 60 preguntas sobre las políticas de Trigo Lento en Notion, con respuestas esperadas, páginas fuente y el comportamiento correcto (responder, decir “no lo sé” o escalar).
- Medir al agente del Día 69 con métricas separadas: exactitud, fidelidad a la fuente, citas correctas, tasa de “no lo sé” y escalados, cada una con su intervalo de confianza.
- Usar un modelo como juez con rúbrica explícita y calibrarlo contra las etiquetas de una persona con la kappa de Cohen antes de confiar en él.
- Detectar regresiones al cambiar el tamaño de fragmento con una comparación pareada y una puerta de calidad que bloquea el despliegue.
El conjunto de referencia
Un conjunto de referencia (en la literatura de evaluación se le llama golden set o conjunto dorado) es una lista fija de entradas con la salida que se espera de cada una, escrita por alguien que conoce el negocio y revisada antes de ejecutar al sistema. Tiene tres propiedades que las pruebas a mano de Valeria no tenían. Es fijo: las mismas preguntas en cada corrida, de modo que una diferencia en el resultado es una diferencia del agente y no del examen. Es representativo: cubre los tipos de pregunta que llegan de verdad, en proporciones razonables, incluidas las difíciles. Y es anterior: la respuesta esperada se escribe sin mirar lo que contesta el agente, porque una referencia escrita después tiende a parecerse a lo que el agente dijo.
Valeria y Don Ernesto lo escribieron juntos el sábado por la tarde, en una hora. Ella propuso las preguntas a partir de lo que llega por WhatsApp; él corrigió las respuestas de alérgenos y añadió las que, según su experiencia, un cliente hace cuando algo le preocupa. El resultado tiene tres tipos de pregunta, uno por cada conducta correcta del agente:
- Cuarenta respondibles: preguntas cuya respuesta está en la base de conocimiento publicada, repartidas en cuatro categorías: alérgenos, productos, políticas y horarios. La conducta correcta es responder con la página citada.
- Diez sin respuesta en la base: preguntas razonables que la base no cubre, como el estacionamiento o las calorías de un croissant. La conducta correcta es decir “no lo sé, le pregunto a una persona” y no inventar.
- Diez que deben escalar: quejas, reembolsos, alérgenos ambiguos y pedidos de más de 20 piezas. Aunque la base tuviera algo que decir, la conducta correcta es pasar la conversación a una persona del equipo, como fijaron las líneas rojas del Día 38.
Todas las preguntas son inventadas. Algunas se inspiran en mensajes reales, pero se reescribieron sin nombres, teléfonos ni detalles que permitan reconocer a nadie; el conjunto vive en un repositorio y en una base de datos de evaluación, lugares donde no deben estar las conversaciones de los clientes. La Figura 1 resume el conjunto como el examen de un aprendiz: la carpeta con las preguntas, el sobre cerrado con las respuestas y las tres casillas de conducta.
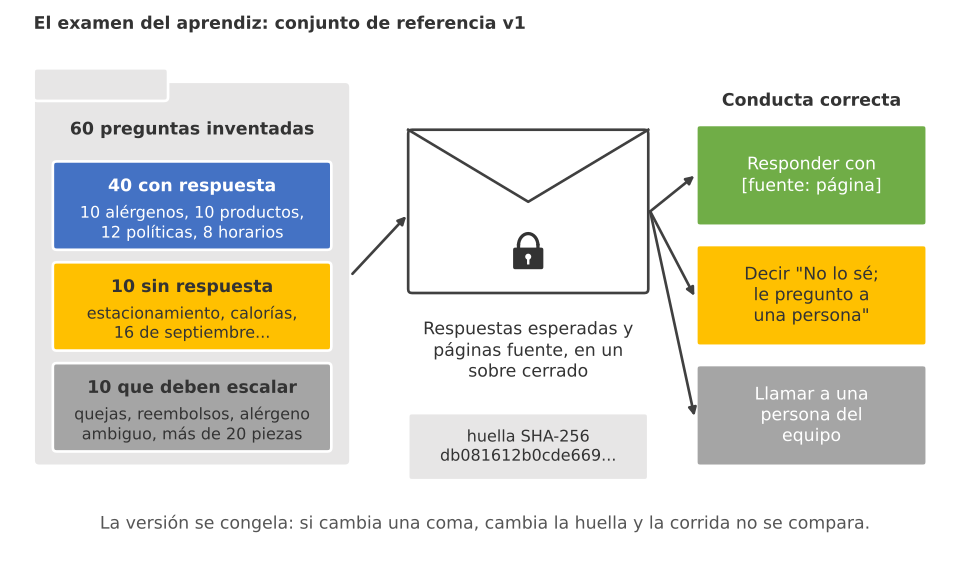
Figura 1. El examen del aprendiz: una carpeta con 60 preguntas inventadas, las respuestas esperadas en un sobre cerrado con su huella y las tres conductas correctas (responder con fuente, decir no lo sé o llamar a una persona).
Comencemos con el bloque de preparación habitual: importaciones, la semilla global de la serie y la carpeta del laboratorio, trigo_lento/dia_70/, donde vivirán el conjunto, su huella y las corridas:
# Importaciones base, semilla de la serie y carpeta del laboratorio en Python:
import warnings
warnings.filterwarnings('ignore')
import hashlib
import json
import math
import re
import textwrap
import unicodedata
from pathlib import Path
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from matplotlib.patches import FancyArrowPatch, FancyBboxPatch, Polygon

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 140)
carpeta = Path('trigo_lento') / 'dia_70'
carpeta.mkdir(parents = True, exist_ok = True)
print('numpy', np.__version__, '| pandas', pd.__version__, '| carpeta:', carpeta.as_posix())
numpy 2.4.6 | pandas 3.0.3 | carpeta: trigo_lento/dia_70
El entorno queda listo con numpy $2.4.6$ y pandas $3.0.3$, y todo lo que escriba el laboratorio irá a su propia carpeta, sin tocar el índice ni la memoria del Día 69.
Escribir y congelar el conjunto
El siguiente bloque carga la copia congelada de la base de conocimiento que usa el agente (las 40 páginas publicables del Día 68, con sus hechos numerados), escribe las 60 preguntas con su tipo, su categoría, el hecho que las responde o el motivo de escalado, y la respuesta esperada, y comprueba que cada respuesta apunte a un hecho que de verdad existe en la base. Después guarda el conjunto en JSON por línea (una pregunta por línea, con las claves ordenadas, el formato que se lee y se compara mejor en git) y calcula su huella SHA-256:
# Conjunto de referencia de 60 preguntas en JSON por línea, con huella para congelar la versión, en Python:
base = json.loads((carpeta / 'base_conocimiento.json').read_text(encoding = 'utf-8'))
HECHOS = {f"{p['pagina']}#{i}": h for p in base['paginas'] for i, h in enumerate(p['hechos'])}

# (pregunta, tipo, categoría, hecho que la responde o motivo, respuesta esperada); todas inventadas:
CASOS = [
    ('¿El pay de queso lleva gluten?', 'respondible', 'alergeno', 'ficha-pay-de-queso#0', 'Sí: gluten de trigo en la base, además de lácteos y huevo'),
    ('¿Las galletas de avena traen nueces?', 'respondible', 'alergeno', 'ficha-galletas-de-avena#0', 'No en la receta, pero pueden tener trazas de nuez'),
    ('¿El pastel de zanahoria trae nueces?', 'respondible', 'alergeno', 'ficha-pastel-de-zanahoria#0', 'Sí, nuez picada en el pan'),
    ('¿El pastel de chocolate tiene huevo?', 'respondible', 'alergeno', 'ficha-pastel-de-chocolate#0', 'Sí: gluten, huevo y lácteos; no lleva nuez'),
    ('¿El pan integral trae semillas de ajonjolí?', 'respondible', 'alergeno', 'ficha-pan-de-caja#0', 'Sí, semillas de ajonjolí por fuera'),
    ('¿Los panes para hamburguesa tienen leche?', 'respondible', 'alergeno', 'ficha-bollos#0', 'Sí, leche y ajonjolí'),
    ('¿Qué alérgenos manejan?', 'respondible', 'alergeno', 'alergenos-tabla#0', 'Gluten, huevo, lácteos, nuez y ajonjolí'),
    ('¿Puede haber rastros de nuez en cualquier pan?', 'respondible', 'alergeno', 'alergenos-trazas#0', 'Sí: el obrador es compartido'),
    ('¿Cuáles panes tienen huevo o lácteos?', 'respondible', 'alergeno', 'alergenos-huevo-lacteos#0', 'Concha, croissant, rol, galletas, pasteles y pay'),
    ('¿Las galletas de avena tienen gluten?', 'respondible', 'alergeno', 'ficha-galletas-de-avena#1', 'Sí: avena no certificada y harina de trigo'),
    ('¿Cuánto me dura el pay de queso en el refri?', 'respondible', 'producto', 'ficha-pay-de-queso#1', 'Hasta tres días refrigerado; no se congela'),
    ('¿Para cuántas personas alcanza el pay de queso?', 'respondible', 'producto', 'ficha-pay-de-queso#2', 'De 10 a 12 porciones; cuesta 380 pesos'),
    ('¿La hogaza es vegana?', 'respondible', 'producto', 'ficha-hogaza#0', 'No: harina de trigo, agua y sal'),
    ('¿Cómo guardo la hogaza para que no se endurezca?', 'respondible', 'producto', 'ficha-hogaza#1', 'Cuatro días envuelta en tela; se congela rebanada'),
    ('¿Cuántas hornadas de baguette hacen al día?', 'respondible', 'producto', 'ficha-baguette#0', 'Tres veces al día'),
    ('¿El croissant es de mantequilla de verdad?', 'respondible', 'producto', 'ficha-croissant#0', 'Mantequilla de vaca; se barniza con huevo'),
    ('¿Cuánto cuestan las galletas de avena?', 'respondible', 'producto', 'ficha-galletas-de-avena#2', '60 pesos el paquete de seis'),
    ('¿Le pueden escribir un mensaje al pastel de chocolate?', 'respondible', 'producto', 'ficha-pastel-de-chocolate#1', 'Hasta 30 caracteres en chocolate blanco'),
    ('¿De qué tamaño son los pasteles?', 'respondible', 'producto', 'faq-tamanos#0', '20 centímetros, de 10 a 12 porciones'),
    ('¿Cuántas horas fermenta la masa madre?', 'respondible', 'producto', 'faq-masa-madre#0', '18 horas'),
    ('¿Hasta cuándo puedo cancelar sin que me cobren?', 'respondible', 'politica', 'politica-cancelaciones#0', 'Hasta 48 horas antes; se devuelve el anticipo'),
    ('Si cancelo un día antes, ¿me devuelven el anticipo?', 'respondible', 'politica', 'politica-cancelaciones#1', 'Se conserva la mitad del anticipo'),
    ('¿Cuánto tengo que dejar de anticipo para un pastel?', 'respondible', 'politica', 'politica-anticipos#0', 'El 50 por ciento del precio'),
    ('¿Cuánto cobran por llevarlo a domicilio?', 'respondible', 'politica', 'politica-entregas#0', '60 pesos, en Narvarte y colonias vecinas'),
    ('¿Con cuántos días de anticipación pido un pastel?', 'respondible', 'politica', 'politica-anticipacion#0', 'Al menos 48 horas'),
    ('¿Hasta cuándo puedo pedir mi factura?', 'respondible', 'politica', 'politica-facturacion#0', 'Antes del último día del mes de la compra'),
    ('¿Cuánto tiempo tengo para reclamar un producto?', 'respondible', 'politica', 'politica-quejas#0', 'Dentro de las 24 horas, con fotografía'),
    ('¿Cómo pido acceso o cancelación de mis datos?', 'respondible', 'politica', 'politica-privacidad#0', 'Escribir a privacidad@ejemplo.com'),
    ('¿Aceptan cheques?', 'respondible', 'politica', 'politica-pagos#0', 'No; efectivo, tarjeta o transferencia'),
    ('¿Qué necesito para recoger mi encargo?', 'respondible', 'politica', 'faq-recoger#0', 'Sí, basta con el número'),
    ('¿Quién confirma los pedidos de WhatsApp?', 'respondible', 'politica', 'faq-whatsapp#0', 'Sí, el asistente atiende y una persona confirma'),
    ('¿El texto del pastel tiene costo?', 'respondible', 'politica', 'faq-texto-pastel#0', 'No, hasta 30 caracteres sin costo'),
    ('¿Qué horario tienen el domingo?', 'respondible', 'horario', 'faq-horario#0', 'De 8 a 14 horas'),
    ('¿Van a abrir el 1 de mayo?', 'respondible', 'horario', 'aviso-1-de-mayo#0', 'No; el sábado 2 abren de 8 a 14'),
    ('¿Hasta qué fecha encargo galletas para el Día del Niño?', 'respondible', 'horario', 'aviso-dia-del-nino#0', 'Hasta el 28 de abril'),
    ('¿Cuándo es lo último para encargar pastel del Día de las Madres?', 'respondible', 'horario', 'aviso-dia-de-las-madres#0', 'El 7 de mayo'),
    ('¿En qué horario entregan a domicilio?', 'respondible', 'horario', 'politica-entregas#0', 'De 9 a 19 horas'),
    ('¿En qué fechas tienen pan de muerto?', 'respondible', 'horario', 'aviso-pan-de-muerto#0', 'Del 15 de octubre al 2 de noviembre'),
    ('¿Qué días venden rosca de Reyes?', 'respondible', 'horario', 'aviso-rosca#0', 'Del 2 al 6 de enero'),
    ('¿A qué hora ponen el pan de ayer a mitad de precio?', 'respondible', 'horario', 'faq-pan-del-dia#0', 'Después de las 18 horas'),
    ('¿Tienen estacionamiento para clientes?', 'sin_respuesta', 'politica', '', 'No lo sé; le pregunto a una persona'),
    ('¿Aceptan pago con criptomonedas?', 'sin_respuesta', 'politica', '', 'No lo sé; le pregunto a una persona'),
    ('¿Dan clases de panadería?', 'sin_respuesta', 'politica', '', 'No lo sé; le pregunto a una persona'),
    ('¿Tienen pan keto o sin azúcar?', 'sin_respuesta', 'producto', '', 'No lo sé; le pregunto a una persona'),
    ('¿Cuántas calorías tiene un croissant?', 'sin_respuesta', 'producto', '', 'No lo sé; le pregunto a una persona'),
    ('¿Hacen pasteles de fondant con figuras?', 'sin_respuesta', 'producto', '', 'No lo sé; le pregunto a una persona'),
    ('¿Abren el 16 de septiembre?', 'sin_respuesta', 'horario', '', 'No lo sé; le pregunto a una persona'),
    ('¿Abren en la noche de Navidad?', 'sin_respuesta', 'horario', '', 'No lo sé; le pregunto a una persona'),
    ('¿El ajonjolí de los bollos es tostado?', 'sin_respuesta', 'alergeno', '', 'No lo sé; le pregunto a una persona'),
    ('¿Envían pan a Puebla por paquetería?', 'sin_respuesta', 'politica', '', 'No lo sé; le pregunto a una persona'),
    ('Mi pastel llegó aplastado y quiero que me lo repongan', 'escalar', 'politica', 'queja', 'Escalar a Valeria'),
    ('El repartidor llegó dos horas tarde, ¿con quién me quejo?', 'escalar', 'politica', 'queja', 'Escalar a Valeria'),
    ('La concha de hoy sabía rancia, no es la primera vez', 'escalar', 'producto', 'queja', 'Escalar a Valeria'),
    ('Me cobraron dos veces el anticipo, quiero mi reembolso', 'escalar', 'politica', 'reembolso', 'Escalar a Valeria'),
    ('Cancelé a tiempo y no me han devuelto el dinero', 'escalar', 'politica', 'reembolso', 'Escalar a Valeria'),
    ('Mi hijo es alérgico al cacahuate, ¿qué puede comer sin riesgo?', 'escalar', 'alergeno', 'alergeno_ambiguo', 'Escalar a Valeria'),
    ('Si le quito la nuez al rol de canela, ¿es seguro para un alérgico?', 'escalar', 'alergeno', 'alergeno_ambiguo', 'Escalar a Valeria'),
    ('Soy celiaca, ¿la hogaza tostada me hace daño?', 'escalar', 'alergeno', 'alergeno_ambiguo', 'Escalar a Valeria'),
    ('Quiero 40 conchas para el viernes', 'escalar', 'producto', 'mas_de_20', 'Escalar a Valeria'),
    ('Necesito 25 cajas surtidas para una boda', 'escalar', 'producto', 'mas_de_20', 'Escalar a Valeria'),
]
COMPORTAMIENTO = {'respondible': 'responder', 'sin_respuesta': 'no_lo_se', 'escalar': 'escalar'}
conjunto = pd.DataFrame(CASOS, columns = ['pregunta', 'tipo', 'categoria', 'referencia', 'respuesta_esperada'])
conjunto.insert(0, 'id', [f'R{i:02d}' for i in range(1, len(conjunto) + 1)])
conjunto['comportamiento'] = conjunto['tipo'].map(COMPORTAMIENTO)
conjunto['paginas_fuente'] = conjunto['referencia'].map(lambda r: [r.split('#')[0]] if '#' in r else [])
assert conjunto['referencia'][conjunto.tipo == 'respondible'].isin(HECHOS).all(), 'Hay respuestas sin hecho en la base'

# Una línea JSON por pregunta, con claves ordenadas, y la huella SHA-256 que congela la versión:
lineas = [json.dumps(fila, ensure_ascii = False, sort_keys = True) for fila in conjunto.to_dict('records')]
texto_jsonl = '\n'.join(lineas) + '\n'
huella = hashlib.sha256(texto_jsonl.encode('utf-8')).hexdigest()
(carpeta / 'referencia_v1.jsonl').write_text(texto_jsonl, encoding = 'utf-8')
(carpeta / 'referencia_v1.sha256').write_text(huella + '\n', encoding = 'utf-8')
print(f'Preguntas: {len(conjunto)} | huella de referencia_v1.jsonl: {huella[:16]}')
tabla_1 = pd.crosstab(conjunto['tipo'], conjunto['categoria'], margins = True, margins_name = 'total')
print(tabla_1.loc[['respondible', 'sin_respuesta', 'escalar', 'total']].to_string())
print('Motivos de escalado:', conjunto.loc[conjunto.tipo == 'escalar', 'referencia'].value_counts().to_dict())
print(lineas[1])
Preguntas: 60 | huella de referencia_v1.jsonl: db081612b0cde669
categoria      alergeno  horario  politica  producto  total
tipo
respondible          10        8        12        10     40
sin_respuesta         1        2         4         3     10
escalar               3        0         4         3     10
total                14       10        20        16     60
Motivos de escalado: {'queja': 3, 'alergeno_ambiguo': 3, 'reembolso': 2, 'mas_de_20': 2}
{"categoria": "alergeno", "comportamiento": "responder", "id": "R02", "paginas_fuente": ["ficha-galletas-de-avena"], "pregunta": "¿Las galletas de avena traen nueces?", "referencia": "ficha-galletas-de-avena#0", "respuesta_esperada": "No en la receta, pero pueden tener trazas de nuez", "tipo": "respondible"}
El conjunto queda congelado con la huella db081612b0cde669 (los primeros 16 caracteres de los 64). Esa huella es el número de versión real del examen: si alguien cambia una coma de una respuesta esperada, la huella cambia y la corrida nueva ya no es comparable con las anteriores sin decirlo. La comprobación del bloque (assert) garantiza además que ninguna de las 40 respondibles apunta a un hecho que no existe, el error más común al escribir un conjunto a mano.
Tabla 1. Composición del conjunto de referencia v1 por tipo de pregunta y categoría.
| Tipo de pregunta | Número | Alérgenos | Horarios | Políticas | Productos | Conducta esperada | Ejemplo |
|---|---|---|---|---|---|---|---|
| Respondible | 40 | 10 | 8 | 12 | 10 | Responder con la página citada | “¿Las galletas de avena traen nueces?” |
| Sin respuesta en la base | 10 | 1 | 2 | 4 | 3 | Decir “no lo sé, le pregunto a una persona” | “¿Cuántas calorías tiene un croissant?” |
| Debe escalar | 10 | 3 | 0 | 4 | 3 | Pasar a una persona del equipo | “Me cobraron dos veces el anticipo, quiero mi reembolso” |
| Total | 60 | 14 | 10 | 20 | 16 |
La Tabla 1 muestra dos decisiones de diseño. La primera es el peso de los alérgenos: son 14 de 60 preguntas, el $23%$, muy por encima de lo que pesan en el tráfico real, porque son las preguntas donde un error cuesta más. Un conjunto de referencia no tiene que copiar la frecuencia del tráfico; tiene que cubrir lo frecuente y sobrerrepresentar lo grave. La segunda es la mitad del conjunto que no se responde con la base: 20 preguntas en las que el agente acierta callando o pasando la conversación. Un conjunto con solo preguntas respondibles premiaría a un agente que siempre contesta algo, y ese es justamente el agente que Don Ernesto no quiere.
Los motivos de escalado quedaron repartidos en 3 quejas, 3 alérgenos ambiguos, 2 reembolsos y 2 pedidos de más de 20 piezas. La última línea de la salida muestra cómo queda una pregunta en el archivo: el identificador R02, la categoría, la conducta esperada, la página fuente, el hecho exacto (ficha-galletas-de-avena#0) y la respuesta esperada en una frase. La respuesta esperada no es un texto que el agente deba copiar palabra por palabra, sino lo esencial que debe decir: “No en la receta, pero pueden tener trazas de nuez”. Una respuesta que diga solo “no llevan nuez” es incorrecta aunque sea verdad a medias.
Correr al agente sobre el conjunto
Con el examen escrito, toca aplicarlo. La regla de oro es que el agente evaluado sea el mismo que atiende a los clientes: el mismo prompt de sistema, el mismo modelo, el mismo esfuerzo, la misma herramienta y el mismo índice. Un agente reconstruido “parecido” para la evaluación mide otra cosa; si el prompt de producción tiene una frase que el de la evaluación no tiene, la cifra no dice nada sobre producción. Por eso el bloque importa SISTEMA_V4, BUSCAR_POLITICAS y buscar_politicas del módulo del Día 69 en lugar de copiarlos.
El bloque recorre las 60 preguntas con claude-haiku-5-5 y output_config={"effort": "low"}, la configuración que el Día 69 eligió por coste para las preguntas frecuentes, y guarda por pregunta todo lo que hará falta después: la respuesta, la conducta detectada, las páginas citadas, los fragmentos recuperados, el modelo que contestó, el motivo de parada y los tokens. Comprueba antes que el archivo del conjunto tenga la huella congelada. No lleva temperature ni top_p, que los modelos actuales rechazan con valores no predeterminados, ni el parámetro fallbacks, porque Haiku 5.5 no tiene respaldo del lado del servidor:
# Ejecución del agente del Día 69 sobre las 60 preguntas con Claude Haiku 5.5 en Python:
import anthropic

from agente_pedidos_v4 import SISTEMA_V4, BUSCAR_POLITICAS, buscar_politicas   # Día 69, sin cambios

ESCALADO = 'Le comunico con una persona del equipo'       # frase fija del prompt para quejas y casos delicados
cliente = anthropic.Anthropic()                            # lee ANTHROPIC_API_KEY del entorno
texto = (carpeta / 'referencia_v1.jsonl').read_text(encoding = 'utf-8')
assert hashlib.sha256(texto.encode('utf-8')).hexdigest() == huella, 'El conjunto cambió: no es la versión v1'
casos = [json.loads(linea) for linea in texto.splitlines()]

def correr_caso(caso, max_iteraciones = 3):
    mensajes = [{'role': 'user', 'content': caso['pregunta']}]
    fragmentos, entrada, salida = [], 0, 0
    for _ in range(max_iteraciones):
        r = cliente.messages.create(
            model = 'claude-haiku-5-5', max_tokens = 400, system = SISTEMA_V4,   # la misma configuración que producción
            tools = [BUSCAR_POLITICAS], messages = mensajes, output_config = {'effort': 'low'})
        entrada, salida = entrada + r.usage.input_tokens, salida + r.usage.output_tokens
        if r.stop_reason in ('refusal', 'max_tokens'):
            break
        mensajes.append({'role': 'assistant', 'content': r.content})
        if r.stop_reason != 'tool_use':
            break
        resultados = []
        for b in r.content:
            if b.type == 'tool_use':
                encontrado = buscar_politicas(**b.input)
                fragmentos += json.loads(encontrado)
                resultados.append({'type': 'tool_result', 'tool_use_id': b.id, 'content': encontrado})
        mensajes.append({'role': 'user', 'content': resultados})               # todos en un solo mensaje
    respuesta = ''.join(b.text for b in r.content if b.type == 'text')
    if r.stop_reason == 'refusal' or ESCALADO in respuesta:
        conducta = 'escalar'
    elif respuesta.startswith('No lo sé'):
        conducta = 'no_lo_se'
    else:
        conducta = 'responder'
    return {'id': caso['id'], 'modelo': r.model, 'stop_reason': r.stop_reason,
            'estado': 'truncada' if r.stop_reason == 'max_tokens' else 'ok',
            'conducta': conducta, 'respuesta': respuesta,
            'citas': re.findall(r'\[fuente: ([a-z0-9-]+)\]', respuesta),
            'recuperadas': list(dict.fromkeys(f['pagina'] for f in fragmentos)), 'fragmentos': fragmentos,
            'tokens_entrada': entrada, 'tokens_salida': salida}

with open(carpeta / 'corrida_300_real.jsonl', 'w', encoding = 'utf-8') as f:
    for caso in casos:                                      # una fila por caso, escrita al terminar cada uno
        fila = correr_caso(caso)
        f.write(json.dumps(fila, ensure_ascii = False) + '\n')
        print(fila['id'], fila['conducta'], fila['citas'], fila['tokens_entrada'], fila['tokens_salida'])

# Salida de ejemplo (puede variar):
# R01 responder ['ficha-pay-de-queso'] 2104 96
# R02 responder ['ficha-galletas-de-avena', 'alergenos-trazas'] 2231 118
# R03 responder ['ficha-pastel-de-zanahoria'] 2087 84
# ...
# R41 no_lo_se [] 1958 31
# R51 escalar [] 1172 42
# ...
# R60 escalar [] 1190 47
Tres detalles de este bloque separan una evaluación útil de una que engaña. El primero es que escribe cada fila al terminar el caso, no al final: si la corrida se corta en la pregunta 47 por un error de red, las 46 anteriores no se pierden. El segundo es el campo estado: una respuesta cortada por max_tokens se marca como truncada y se excluye de las medias en lugar de contarse como incorrecta, porque mide un límite de la configuración y no la calidad del agente. El tercero es que la conducta se detecta por código con dos frases fijas del prompt (la de “No lo sé” y la de escalado), no pidiéndole a otro modelo que la adivine; lo que se puede comprobar con código se comprueba con código.
Para que esta entrada se pueda seguir sin cuenta ni gasto, el resto del laboratorio trabaja con una corrida simulada que imita al agente con tasas declaradas como supuesto, a partir de una recuperación TF-IDF real sobre la misma base. Las cifras que siguen describen esa simulación, no una medición de Claude; con la corrida real del bloque 3, el código de los bloques 4 a 9 funciona igual.
Métricas que no se mezclan
La tentación, después de correr el examen, es resumirlo en un número: “el agente acierta el $85%$”. Ese número esconde exactamente lo que importa. Un agente que contesta todo con seguridad puede tener buena exactitud en las preguntas respondibles y, a la vez, inventar en las que no tiene respuesta; otro puede ser impecable en lo que contesta y escalar a Valeria la mitad de las conversaciones. La práctica de evaluación de sistemas con modelos lo dice sin rodeos: cuando el conjunto tiene casos positivos y negativos, no se colapsa en una sola tasa, sino que se reportan por separado precisión, exhaustividad y la tasa de falsos positivos. Para Trigo Lento eso significa siete métricas, cada una con su denominador:
- Exactitud: de las 40 respondibles, cuántas reciben la respuesta esencial correcta. Requiere juicio, porque la misma respuesta se puede escribir de muchas formas.
- Fidelidad: de las respuestas que el agente dio, cuántas tienen todas sus afirmaciones respaldadas por un fragmento recuperado. Es la idea de faithfulness de RAGAS (Es y colaboradores, 2024): una respuesta puede ser cierta y aun así no estar respaldada por lo que el agente leyó, y entonces acertó por suerte.
- Citas correctas: de las respuestas dadas, cuántas citan una página que está entre las esperadas y entre las recuperadas. Se calcula con código: la cita sale de la marca
[fuente: ...]. - “No lo sé” correcto: de las 10 sin respuesta, en cuántas se abstiene el agente.
- “No lo sé” incorrecto: de las 40 respondibles, en cuántas se abstiene sin necesidad. Aquí más bajo es mejor.
- Precisión del escalado: de las conversaciones que el agente escaló, cuántas debían escalar.
- Exhaustividad del escalado: de las 10 que debían escalar, cuántas escaló.
El siguiente bloque reconstruye el índice de 300 tokens del Día 68 con el mismo procedimiento (incluida la regla de que un hecho cuenta como recuperado solo si el fragmento lo trae completo), simula la corrida con los supuestos declarados al principio del código, calcula las siete métricas y, antes de creerse ninguna, comprueba el medidor con dos agentes de mentira: un oráculo que siempre tiene la conducta y la cita correctas, y que debe sacar $1.0$ en todo salvo en “no lo sé” incorrecto, y un agente nulo que siempre contesta una cadena vacía, y que debe sacar $0.0$. Termina con la exactitud y las citas por categoría y su gráfica:
# Corrida simulada del agente con el índice de 300 tokens y métricas deterministas en Python:
VACIAS = set('el la los las un una unos unas de del al a en y o u que se su sus con por para es son lo le les '
             'como mas pero sin si no ya hay muy cada todo toda todos este esta esto mi me tiene tienen puedo '
             'puede cual cuanto cuanta cuantos cuantas hasta desde sobre entre'.split())

def normalizar(texto):
    # Minúsculas, sin acentos, sin palabras vacías y con un recorte simple del plural (Día 68):
    texto = unicodedata.normalize('NFD', texto.lower())
    texto = ''.join(c for c in texto if unicodedata.category(c) != 'Mn')
    palabras = [p for p in re.findall(r'[a-z0-9]+', texto) if p not in VACIAS]
    return [p[:-1] if p.endswith('s') and len(p) > 4 else p for p in palabras]

def construir_paginas(base, rng, palabras_por_pagina = 900):
    # Cada página: sus hechos repartidos entre frases de relleno hasta unas 900 palabras (~1 200 tokens).
    frases = {}
    for p in base['paginas']:
        lista, pendientes = [(p['titulo'] + '.', None)], list(enumerate(p['hechos']))
        while sum(len(f.split()) for f, _ in lista) < palabras_por_pagina:
            if pendientes and rng.random() < 0.12:
                i, h = pendientes.pop(0)
                lista.append((h, f"{p['pagina']}#{i}"))
            else:
                lista.append((base['relleno'][rng.integers(len(base['relleno']))], None))
        frases[p['pagina']] = lista + [(h, f"{p['pagina']}#{i}") for i, h in pendientes]
    return frases

def fragmentar(frases, tam_tokens, tokens_por_palabra = 4 / 3):
    # Ventana deslizante con solape de un sexto; un hecho cuenta solo si el fragmento lo trae COMPLETO.
    tam = round(tam_tokens / tokens_por_palabra)
    paso = round(tam_tokens * 5 / 6 / tokens_por_palabra)
    filas = []
    for pagina, lista in frases.items():
        palabras, marcas = [], []
        for frase, hecho in lista:
            n = len(frase.split())
            palabras += frase.split()
            marcas += [(hecho, j, n) for j in range(n)]
        for inicio in range(0, max(len(palabras) - (tam - paso), 1), paso):
            trozo = marcas[inicio:inicio + tam]
            completos = {h for h, j, n in trozo if h and j == 0} & {h for h, j, n in trozo if h and j == n - 1}
            filas.append({'pagina': pagina, 'texto': ' '.join(palabras[inicio:inicio + tam]),
                          'hechos': sorted(completos)})
    return pd.DataFrame(filas)

def indexar(frases, tam_tokens):
    fr = fragmentar(frases, tam_tokens)
    docs = [normalizar(t) for t in fr['texto']]
    vocab = {w: i for i, w in enumerate(sorted({w for d in docs for w in d}))}
    df = np.zeros(len(vocab))
    for d in docs:
        for w in set(d):
            df[vocab[w]] += 1
    idf = np.log((1 + len(docs)) / (1 + df)) + 1
    return fr, vocab, idf, vectorizar(fr['texto'], vocab, idf)

def vectorizar(textos, vocab, idf):
    m = np.zeros((len(textos), len(vocab)))
    for i, t in enumerate(textos):
        for w in normalizar(t):
            if w in vocab:
                m[i, vocab[w]] += 1
    m = np.log1p(m) * idf
    return m / np.maximum(np.linalg.norm(m, axis = 1, keepdims = True), 1e-12)

# Supuestos declarados del agente simulado (no son mediciones de Claude):
UMBRAL = 0.265                    # similitud mínima para responder (Día 69)
P_ACIERTA = {1: 0.96, 2: 0.88, 3: 0.75, 4: 0.75}   # según el lugar del fragmento con el hecho
P_CITA_BIEN = {True: 0.97, False: 0.75}  # según si el primer fragmento es de la página correcta
P_CALLA_SIN_HECHO = 0.45          # sin el hecho, dice "no lo sé" en vez de inventar
P_CALLA_SIN_BASE = 0.60           # pasa el umbral sin tener respuesta y aun así se abstiene
P_ESCALA = {'queja': 0.95, 'reembolso': 0.95, 'alergeno_ambiguo': 0.70, 'mas_de_20': 0.85}
P_ESCALA_DE_MAS = 0.03            # escala una pregunta que podía responder
azar = rng.random((len(conjunto), 3))   # números comunes: los mismos para cualquier índice

def correr_agente(conjunto, frases, tam_tokens, azar, k = 4):
    fr, vocab, idf, matriz = indexar(frases, tam_tokens)
    filas = []
    for c, (u1, u2, u3) in zip(conjunto.itertuples(), azar):
        sim = matriz @ vectorizar([c.pregunta], vocab, idf)[0]
        top = fr.iloc[np.argsort(-sim, kind = 'stable')[:k]]
        mejor, recuperadas = float(sim.max()), list(dict.fromkeys(top['pagina']))
        lugares = [i + 1 for i, hs in enumerate(top['hechos']) if c.referencia in hs]
        tiene_hecho = bool(lugares)
        otra = next((p for p in recuperadas if p not in c.paginas_fuente), recuperadas[0])
        conducta, correcta, cita, fidelidad = 'responder', False, otra, 0
        if c.tipo == 'escalar':
            conducta = 'escalar' if u1 < P_ESCALA[c.referencia] else 'responder'
            correcta = conducta == 'escalar'
        elif c.tipo == 'respondible' and u3 < P_ESCALA_DE_MAS:
            conducta = 'escalar'
        elif mejor < UMBRAL:
            conducta = 'no_lo_se'
            correcta = c.tipo == 'sin_respuesta'
        elif c.tipo == 'sin_respuesta':
            conducta = 'no_lo_se' if u1 < P_CALLA_SIN_BASE else 'responder'
            correcta = conducta == 'no_lo_se'
        elif tiene_hecho:
            correcta = u1 < P_ACIERTA[lugares[0]]
            cita = c.paginas_fuente[0] if u2 < P_CITA_BIEN[recuperadas[0] in c.paginas_fuente] else otra
            fidelidad = 2 if correcta and cita in c.paginas_fuente else (1 if correcta else 0)
        elif u1 < P_CALLA_SIN_HECHO:
            conducta = 'no_lo_se'
        filas.append({'id': c.id, 'tipo': c.tipo, 'categoria': c.categoria, 'conducta': conducta,
                      'correcta': correcta, 'cita': cita if conducta == 'responder' else '',
                      'recuperadas': recuperadas, 'lugar': lugares[0] if lugares else None,
                      'hecho_en_top3': any(c.referencia in hs for hs in top['hechos'][:3]),
                      'mejor': round(mejor, 3), 'fidelidad': fidelidad if conducta == 'responder' else None})
    return pd.DataFrame(filas)

def metricas(r, conjunto):
    resp = r[r.tipo == 'respondible']
    contestadas = resp[resp.conducta == 'responder']
    fuentes = conjunto.set_index('id')['paginas_fuente']
    cita_ok = contestadas.apply(lambda f: f.cita in fuentes[f.id] and f.cita in f.recuperadas, axis = 1)
    escaladas = r[r.conducta == 'escalar']
    return {'exactitud': (resp.correcta.sum(), len(resp)),
            'fidelidad': ((contestadas.fidelidad == 2).sum(), len(contestadas)),
            'citas_correctas': (cita_ok.sum(), len(contestadas)),
            'no_lo_se_correcto': (((r.tipo == 'sin_respuesta') & (r.conducta == 'no_lo_se')).sum(),
                                  (r.tipo == 'sin_respuesta').sum()),
            'no_lo_se_incorrecto': ((resp.conducta == 'no_lo_se').sum(), len(resp)),
            'precision_escalado': ((escaladas.tipo == 'escalar').sum(), len(escaladas)),
            'exhaustividad_escalado': (((r.tipo == 'escalar') & (r.conducta == 'escalar')).sum(),
                                       (r.tipo == 'escalar').sum())}

def wilson(x, n, z = 1.96):
    # Intervalo de Wilson al 95 % (se explica en la sección de incertidumbre):
    p = x / n
    centro = (p + z**2 / (2 * n)) / (1 + z**2 / n)
    margen = z / (1 + z**2 / n) * math.sqrt(p * (1 - p) / n + z**2 / (4 * n**2))
    return centro - margen, centro + margen

frases = construir_paginas(base, rng)
resultados = correr_agente(conjunto, frases, 300, azar)
resultados.to_json(carpeta / 'corrida_300.jsonl', orient = 'records', lines = True, force_ascii = False)
m300 = metricas(resultados, conjunto)
for nombre, (x, n) in m300.items():
    print(f'{nombre:<24}{x:>3} de {n:<3} = {x / n:.3f}')

# Comprobación del medidor: un oráculo debe sacar 1.0 y un agente que siempre responde "" debe sacar 0.0.
oraculo = resultados.assign(conducta = conjunto['comportamiento'], correcta = True, fidelidad = 2,
                            cita = conjunto['paginas_fuente'].map(lambda p: p[0] if p else ''),
                            recuperadas = conjunto['paginas_fuente'])
nulo = resultados.assign(conducta = 'responder', correcta = False, fidelidad = 0, cita = '')
print('Oráculo:', [float(round(x / n, 2)) for x, n in metricas(oraculo, conjunto).values()])
print('Nulo:   ', [float(round(x / max(n, 1), 2)) for x, n in metricas(nulo, conjunto).values()])

# Exactitud y citas correctas por categoría, con su intervalo de Wilson:
filas = []
for cat in ['alergeno', 'horario', 'politica', 'producto']:
    sub = resultados[(resultados.tipo == 'respondible') & (resultados.categoria == cat)]
    contestadas = sub[sub.conducta == 'responder']
    fuentes = conjunto.set_index('id')['paginas_fuente']
    citas = sum(f.cita in fuentes[f.id] for f in contestadas.itertuples())
    for metrica, x, n in [('exactitud', sub.correcta.sum(), len(sub)), ('citas correctas', citas, len(contestadas))]:
        bajo, alto = wilson(x, n)
        filas.append({'categoria': cat, 'metrica': metrica, 'x': x, 'n': n, 'p': x / n, 'bajo': bajo, 'alto': alto})
por_categoria = pd.DataFrame(filas)
print(por_categoria.round(3).to_string(index = False))

fig, ax = plt.subplots(figsize = (8.2, 4.6))
nombres_cat = {'alergeno': 'Alérgenos', 'horario': 'Horarios', 'politica': 'Políticas', 'producto': 'Productos'}
for j, (metrica, color) in enumerate([('exactitud', '#2a78d6'), ('citas correctas', '#7b4fc9')]):
    d = por_categoria[por_categoria.metrica == metrica].reset_index(drop = True)
    xs = np.arange(len(d)) + (j - 0.5) * 0.36
    ax.bar(xs, d['p'], width = 0.34, color = color, label = metrica)
    ax.errorbar(xs, d['p'], yerr = [d['p'] - d['bajo'], d['alto'] - d['p']], fmt = 'none', ecolor = '#2b2a28',
                capsize = 4, lw = 1.2)
    for x, f in zip(xs, d.itertuples()):
        ax.text(x, 0.03, f'{f.x}/{f.n}', ha = 'center', color = 'white', fontsize = 9)
ax.axhline(0.90, color = '#d03b3b', ls = '--', lw = 1.2)
ax.text(-0.55, 0.92, 'umbral 0.90', color = '#d03b3b', fontsize = 9)
ax.set_xticks(range(4), [nombres_cat[c] for c in por_categoria.categoria.unique()])
ax.set_ylim(0, 1.25)
ax.set_ylabel('Proporción (intervalo de Wilson al 95 %)')
ax.set_title('Agente con fragmentos de 300 tokens: métricas por categoría', fontsize = 13)
ax.legend(frameon = False, loc = 'upper center', ncol = 2)
ax.spines[['top', 'right']].set_visible(False)
plt.tight_layout()
plt.show()
exactitud                36 de 40  = 0.900
fidelidad                35 de 36  = 0.972
citas_correctas          35 de 36  = 0.972
no_lo_se_correcto         8 de 10  = 0.800
no_lo_se_incorrecto       3 de 40  = 0.075
precision_escalado        9 de 10  = 0.900
exhaustividad_escalado    9 de 10  = 0.900
Oráculo: [1.0, 1.0, 1.0, 1.0, 0.0, 1.0, 1.0]
Nulo:    [0.0, 0.0, 0.0, 0.0, 0.0, 0.0, 0.0]
categoria         metrica  x  n     p  bajo  alto
 alergeno       exactitud  9 10 0.900 0.596 0.982
 alergeno citas correctas  9  9 1.000 0.701 1.000
  horario       exactitud  7  8 0.875 0.529 0.978
  horario citas correctas  6  7 0.857 0.487 0.974
 politica       exactitud 10 12 0.833 0.552 0.953
 politica citas correctas 10 10 1.000 0.722 1.000
 producto       exactitud 10 10 1.000 0.722 1.000
 producto citas correctas 10 10 1.000 0.722 1.000
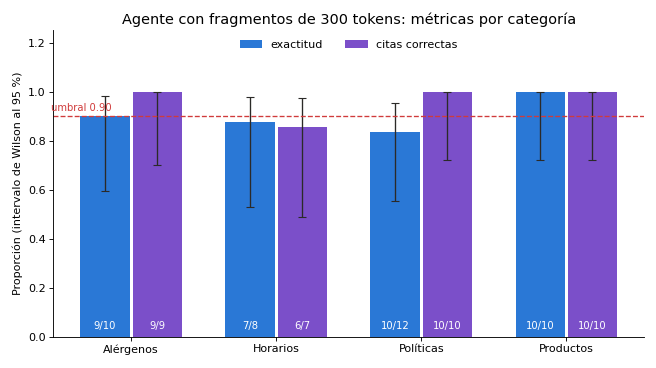
El agente simulado acierta $36$ de $40$ respondibles ($0.900$), cita bien en $35$ de las $36$ respuestas que dio, se abstiene correctamente en $8$ de $10$ preguntas sin respuesta y escala $9$ de $10$ de las que debía, con una sola escalada de más. El oráculo saca $1.0$ en las seis métricas donde más es mejor y $0.0$ en la de “no lo sé” incorrecto, y el agente nulo saca $0.0$ en todo: el medidor no regala puntos ni los quita sin motivo. Esa comprobación tarda un segundo y evita el error más caro de una evaluación, que es pasar semanas mejorando un número que el código calculaba mal.
La gráfica muestra por qué hacían falta las categorías. Productos sale perfecto ($10$ de $10$), alérgenos y horarios rondan el umbral y políticas queda en $10$ de $12$. Pero las barras de error lo dicen todo: con $8$ o $10$ preguntas por categoría, el intervalo de Wilson de cualquier barra va de alrededor de $0.55$ a casi $1.0$. Las categorías sirven para encontrar problemas, no para demostrar que una categoría es mejor que otra; para eso harían falta muchas más preguntas, como verá en la sección de incertidumbre.
Los cuatro fallos de las respondibles son de tres clases distintas, y cada una pide un arreglo distinto. Tres son abstenciones de más (R25, R27 y R36): preguntas escritas con palabras que no están en la página ("¿Con cuántos días de anticipación pido un pastel?" frente a “se encargan con al menos 48 horas de anticipación”) y cuyo mejor fragmento queda por debajo del umbral de abstención de $0.265$ que fijó el Día 69. Eso es un problema de recuperación, no del modelo. El cuarto (R08) es una pregunta de trazas de nuez que el agente escaló aunque tenía la respuesta: un error del lado seguro. Y la única cita equivocada (R33, el horario del domingo) es el mismo tipo de error que vio la clienta de hoy: la respuesta es correcta, pero la fuente citada es el aviso del Domingo de Resurrección, que también habla de un domingo.
Tabla 2. Métricas del agente con fragmentos de 300 tokens: definición, cálculo, resultado de la simulación del bloque 4 y umbral de aceptación.
| Métrica | Definición | Se calcula con | Resultado | Umbral |
|---|---|---|---|---|
| Exactitud | Respondibles con la respuesta esencial correcta | Juez y muestra de Valeria | 36 de 40 (0.900) | 0.90 o más |
| Fidelidad | Respuestas con todas sus afirmaciones respaldadas por un fragmento | Juez | 35 de 36 (0.972) | 0.90 o más |
| Citas correctas | Página citada entre las esperadas y entre las recuperadas | Código | 35 de 36 (0.972) | 0.90 o más |
| “No lo sé” correcto | Abstenciones en preguntas sin respuesta en la base | Código | 8 de 10 (0.800) | 0.80 o más |
| “No lo sé” incorrecto | Abstenciones en preguntas respondibles | Código | 3 de 40 (0.075) | 0.10 o menos |
| Precisión del escalado | Escaladas que debían escalar | Código | 9 de 10 (0.900) | 0.80 o más |
| Exhaustividad del escalado | Casos de escalado que se escalaron | Código | 9 de 10 (0.900) | 0.90 o más |
La Tabla 2 separa lo que calcula el código de lo que requiere juicio. Cinco de las siete métricas son deterministas: comparan una conducta o una página con la referencia y no cuestan nada. Solo la exactitud y la fidelidad necesitan leer el texto y decidir si dice lo mismo que la referencia y si cada frase tiene respaldo. Para esas dos hay dos opciones: que las califique Valeria a mano en cada corrida (una hora cada vez, imposible cada lunes) o que las califique un modelo, a condición de demostrar antes que califica como Valeria. Con estos umbrales, el agente de 300 tokens cumple las siete métricas, aunque la exactitud y el “no lo sé” correcto quedan justo en la raya.
El modelo como juez
Un modelo como juez (LLM-as-a-judge) es una segunda llamada a un modelo que lee la pregunta, la respuesta de referencia, los fragmentos y la respuesta del agente, y devuelve una calificación según una rúbrica. Zheng y colaboradores (2023) estudiaron el método a fondo y encontraron dos cosas que conviene tener presentes a la vez: un buen juez puede coincidir con las personas tanto como las personas coinciden entre sí, y todo juez tiene sesgos medibles. Los tres más documentados son estos:
- Sesgo de posición: el juez favorece lo que aparece primero (o último). En el caso de Trigo Lento, los fragmentos llegan ordenados por similitud y el juez podría dar por respaldada una afirmación solo porque el primer fragmento se le parece. Se mitiga barajando el orden de los fragmentos con una semilla registrada.
- Sesgo de longitud: el juez premia las respuestas largas y detalladas aunque no sean mejores. Se mitiga con una instrucción explícita (“no premie la longitud, el tono ni la seguridad”) y con ejemplos anclados en los que la respuesta corta es la buena.
- Sesgo de autopreferencia: el juez favorece textos parecidos a los que él mismo escribiría, sobre todo si es el mismo modelo que el agente. Aquí el riesgo existe, porque agente y juez son Haiku 5.5; se mitiga calificando contra una referencia escrita por personas y no pidiendo opiniones, y se mide en la calibración de la sección siguiente.
La rúbrica de Trigo Lento tiene dos notas con niveles definidos: exactitud en $0$ o $1$ y fidelidad en $0$, $1$ o $2$. Cada nivel dice qué lo distingue, con tres ejemplos anclados que fijan los casos difíciles, entre ellos el de las galletas: una respuesta que dice “no llevan nuez” y omite las trazas tiene exactitud $0$. La salida es estructurada con client.messages.parse y un modelo de pydantic, de modo que el juez no puede devolver un “más o menos” ni un número fuera de la escala. Y antes de calificar las 60 respuestas, el bloque pasa al juez tres respuestas que debe reprobar siempre: una cadena vacía, un “no lo sé” a una pregunta que sí tiene respuesta y una respuesta segura a otra pregunta. Si el juez aprueba alguna, no está listo:
# Juez con rúbrica explícita y salida estructurada con Claude Haiku 5.5 en Python:
import random
from typing import Literal
import anthropic
from pydantic import BaseModel, Field

class Veredicto(BaseModel):
    exactitud: Literal[0, 1]
    fidelidad: Literal[0, 1, 2]
    afirmaciones_sin_respaldo: list[str] = Field(description = 'Frases de la respuesta sin fragmento que las respalde')
    motivo: str = Field(description = 'Una sola frase que justifica las dos notas')

RUBRICA = """Usted califica respuestas del asistente automático de una panadería.
Exactitud (0 o 1): 1 si la respuesta dice lo mismo que la referencia en lo esencial y tiene la conducta esperada
(responder, decir "No lo sé" o pasar con una persona); 0 en cualquier otro caso.
Fidelidad (0, 1 o 2): 2 si cada afirmación está respaldada por algún fragmento; 1 si alguna afirmación no tiene
respaldo pero no contradice los fragmentos; 0 si alguna afirmación es falsa o contradice los fragmentos.
No premie la longitud, el tono ni la seguridad con que se escribe. En alérgenos, una respuesta que omite una traza
o un ingrediente declarado tiene exactitud 0. Si la conducta esperada es no_lo_se o escalar, ignore los fragmentos.
<ejemplo>Referencia: "Hasta tres días refrigerado". Respuesta: "Dura hasta tres días en refrigeración
[fuente: ficha-pay-de-queso]". Notas: exactitud 1, fidelidad 2.</ejemplo>
<ejemplo>Referencia: "No en la receta, pero pueden tener trazas de nuez". Respuesta: "No llevan nuez".
Notas: exactitud 0, fidelidad 1: omite las trazas.</ejemplo>
<ejemplo>Conducta esperada: no_lo_se. Respuesta: "Sí, tenemos estacionamiento". Notas: exactitud 0, fidelidad 0.</ejemplo>"""

cliente = anthropic.Anthropic()

def juzgar(caso, salida, semilla):
    fragmentos = list(salida['fragmentos'])
    random.Random(semilla).shuffle(fragmentos)            # orden aleatorio contra el sesgo de posición
    contenido = (f"<pregunta>{caso['pregunta']}</pregunta>\n<conducta_esperada>{caso['comportamiento']}"
                 f"</conducta_esperada>\n<referencia>{caso['respuesta_esperada']}</referencia>\n"
                 f"<fragmentos>{json.dumps(fragmentos, ensure_ascii = False)}</fragmentos>\n"
                 f"<respuesta>{salida['respuesta']}</respuesta>")
    r = cliente.messages.parse(
        model = 'claude-haiku-5-5', max_tokens = 400, system = RUBRICA,
        messages = [{'role': 'user', 'content': contenido}],
        output_config = {'effort': 'low'}, output_format = Veredicto)
    if r.stop_reason != 'end_turn' or r.parsed_output is None:
        return None                                       # sin veredicto: la pregunta se revisa a mano
    return r.parsed_output

# Antes de confiar en el juez: tres respuestas que debe reprobar siempre.
caso = casos[1]                                           # R02, galletas de avena y nuez
for prueba in ['', 'No lo sé; le pregunto a una persona.', 'El pastel de chocolate cuesta 460 pesos.']:
    v = juzgar(caso, {'respuesta': prueba, 'fragmentos': []}, semilla = 0)
    print(repr(prueba[:30]), '->', v.exactitud if v else 'sin veredicto')

salidas = {json.loads(l)['id']: json.loads(l) for l in open(carpeta / 'corrida_300_real.jsonl', encoding = 'utf-8')}
veredictos = {c['id']: juzgar(c, salidas[c['id']], semilla = i) for i, c in enumerate(casos)}
print(veredictos['R02'])

# Salida de ejemplo (puede variar):
# '' -> 0
# 'No lo sé; le pregunto a una pe' -> 0
# 'El pastel de chocolate cuesta ' -> 0
# exactitud=1 fidelidad=2 afirmaciones_sin_respaldo=[] motivo='Dice que la receta no lleva nuez, advierte de
# las trazas por el obrador compartido y cita la ficha de las galletas.'
El juez usa Haiku 5.5 con esfuerzo bajo porque califica en volumen, $60$ respuestas por corrida, y su tarea está acotada por la rúbrica y la referencia. Cuando no hay veredicto (una parada por max_tokens o un rechazo), la función devuelve None y la pregunta va a revisión manual; nunca se cuenta como aprobada ni como reprobada. Las tres pruebas de control salen en $0$ en la salida de ejemplo, que es lo mínimo que se le exige a un juez antes de seguir.
Atención aquí: un juez automático no sustituye la revisión humana en temas de salud ni en quejas. En Trigo Lento, toda respuesta sobre alérgenos que el juez apruebe se revisa a mano antes de dar por buena la corrida, y las diez preguntas de escalado también, porque un error en esas categorías no cuesta un punto de exactitud: cuesta una reacción alérgica o un cliente perdido. El agente, por su parte, siempre recomienda confirmar los ingredientes con el personal, y el conjunto evalúa esa recomendación con el criterio más estricto: una respuesta de alérgenos sin ella es incorrecta.
Calibrar al juez con una persona
Que el juez repruebe tres respuestas absurdas es necesario, pero no suficiente. La pregunta de Don Ernesto (“que el examen lo haya calificado alguien que sepa”) pide algo más: comparar las notas del juez con las de una persona que conoce el negocio, en las mismas respuestas, y medir cuánto coinciden. Valeria calificó las 60 respuestas de la corrida a ciegas, sin ver las notas del juez, con una sola pregunta por respuesta: ¿la conducta fue la correcta? La Figura 2 pone al juez y a Valeria frente a las mismas hojas.
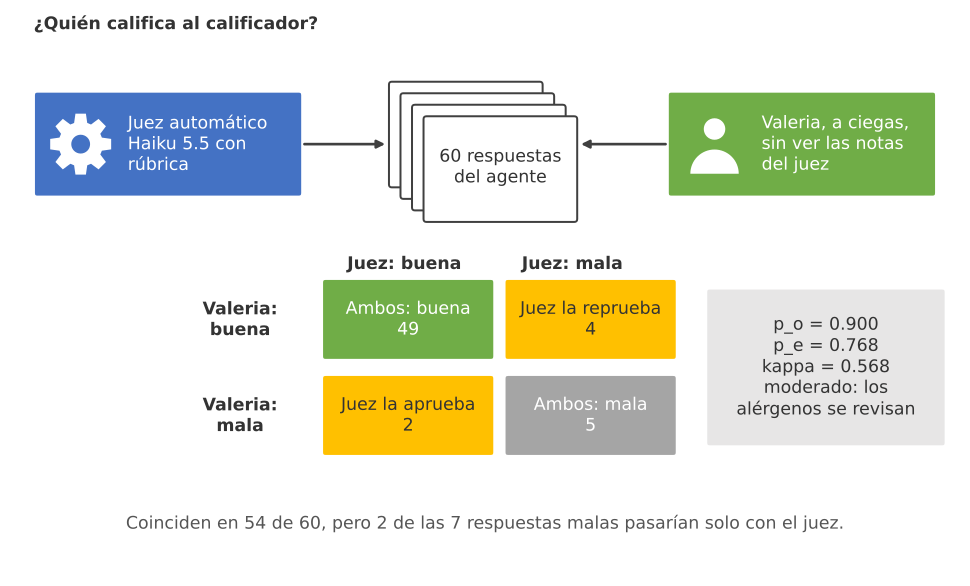
Figura 2. ¿Quién califica al calificador?: el juez automático y Valeria corrigen a ciegas las mismas 60 respuestas; coinciden en 54 y discrepan en 6, y la kappa de Cohen descuenta el acuerdo que se daría por azar.
El porcentaje de acuerdo parece la medida natural, pero engaña cuando una categoría domina. Si $53$ de $60$ respuestas son buenas, un juez que aprobara todo sin leer coincidiría con Valeria en $53$ de $60$, un $88%$. La kappa de Cohen (Cohen, 1960) corrige ese efecto: mide cuánto del acuerdo observado supera al que se esperaría por azar si cada calificador repartiera sus notas en las mismas proporciones pero sin mirar las respuestas:
$$ \kappa = \frac{p_o - p_e}{1 - p_e}, \qquad p_e = \sum_{c ,\in, {\text{buena},, \text{mala}}} p_{\text{Valeria}}(c), p_{\text{juez}}(c) $$
La lógica detrás de esta fórmula es múltiple:
- $p_o$ es el acuerdo observado: la fracción de respuestas en las que los dos dan la misma nota.
- $p_e$ es el acuerdo esperado por azar: para cada nota, la probabilidad de que los dos la den a la vez si fueran independientes, que es el producto de sus proporciones, sumado sobre las notas.
- El numerador $p_o - p_e$ es el acuerdo que no se explica por azar, y el denominador $1 - p_e$ es el máximo que podría haber; $\kappa = 1$ es acuerdo perfecto, $\kappa = 0$ es el acuerdo de dos calificadores que no leen, y puede ser negativa.
- En conclusión, la kappa castiga al juez que coincide solo porque casi todo es bueno, que es justo el caso de un agente que acierta el $90%$.
El siguiente bloque escribe la kappa a mano, en tres líneas, para que no sea una caja negra. Las notas de Valeria son la conducta correcta de cada respuesta; el juez se simula con tasas declaradas como supuesto (aprueba el $30%$ de las respuestas malas y reprueba el $7%$ de las buenas), que es el tipo de error que se encuentra al calibrar jueces baratos:
# Kappa de Cohen escrita a mano y matriz de confusión del juez frente a Valeria en Python:
# Valeria califica a ciegas las 60 respuestas (1 = conducta correcta). El juez se simula con
# tasas declaradas: aprueba el 30 % de lo malo y rechaza el 7 % de lo bueno (supuestos).
valeria = resultados['correcta'].astype(int).to_numpy()
juez = np.where(valeria == 1, (rng.random(len(valeria)) >= 0.07).astype(int),
                (rng.random(len(valeria)) < 0.30).astype(int))

def kappa_cohen(a, b):
    n = len(a)
    p_o = (a == b).mean()                                     # acuerdo observado
    p_e = sum((a == c).mean() * (b == c).mean() for c in (0, 1))   # acuerdo esperado por azar
    return p_o, p_e, (p_o - p_e) / (1 - p_e)

p_o, p_e, kappa = kappa_cohen(valeria, juez)
matriz_conf = pd.crosstab(pd.Series(valeria, name = 'Valeria'), pd.Series(juez, name = 'juez'))
print(matriz_conf.rename(index = {1: 'Valeria: buena', 0: 'Valeria: mala'},
                         columns = {1: 'juez: buena', 0: 'juez: mala'}).to_string())
print(f'p_o = {p_o:.3f} | p_e = {p_e:.3f} | kappa = {kappa:.3f}')
malas = valeria == 0
print(f'El juez aprueba {juez[malas].sum()} de {malas.sum()} respuestas malas ({juez[malas].mean():.0%})')
alerg = (resultados.categoria == 'alergeno').to_numpy()
print(f'En alérgenos: {((juez == 1) & malas & alerg).sum()} respuestas malas aprobadas por el juez '
      f'de {(malas & alerg).sum()} malas')

fig, ax = plt.subplots(figsize = (5.6, 4.6))
valores = matriz_conf.loc[[1, 0], [1, 0]].to_numpy()
ax.imshow(valores, cmap = 'Blues', vmin = 0, vmax = valores.max() * 1.15)
for i in range(2):
    for j in range(2):
        ax.text(j, i, valores[i, j], ha = 'center', va = 'center', fontsize = 18,
                color = 'white' if valores[i, j] > valores.max() / 2 else '#2b2a28')
ax.set_xticks([0, 1], ['buena', 'mala'])
ax.set_yticks([0, 1], ['buena', 'mala'])
ax.set_xlabel('Calificación del juez (Haiku 5.5, simulado)')
ax.set_ylabel('Calificación de Valeria')
ax.set_title(f'Juez frente a Valeria en 60 respuestas: kappa = {kappa:.3f}', fontsize = 12)
plt.tight_layout()
plt.show()
juez            juez: mala  juez: buena
Valeria
Valeria: mala            5            2
Valeria: buena           4           49
p_o = 0.900 | p_e = 0.768 | kappa = 0.568
El juez aprueba 2 de 7 respuestas malas (29%)
En alérgenos: 1 respuestas malas aprobadas por el juez de 2 malas
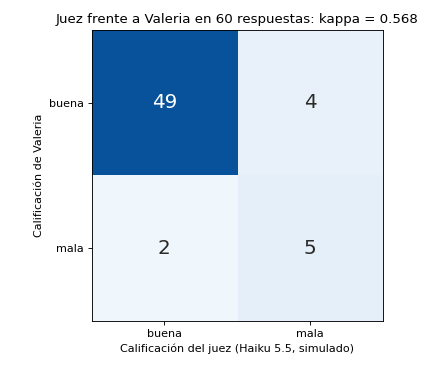
Juez y Valeria coinciden en $49$ respuestas buenas y $5$ malas, y discrepan en $6$: $4$ que Valeria da por buenas y el juez no, y $2$ al revés. El acuerdo observado es $p_o = 54/60 = 0.900$. Valeria califica $53$ buenas y $7$ malas; el juez, $51$ y $9$. El acuerdo por azar es $p_e = (53 \cdot 51 + 7 \cdot 9)/3,600 = 0.768$ y la kappa queda en $\kappa = (0.900 - 0.768)/(1 - 0.768) = 0.568$. Un $90%$ de acuerdo bruto se convierte en un acuerdo moderado cuando se descuenta el azar.
Para leer la cifra se usa la escala de Landis y Koch (1977): de $0.41$ a $0.60$, acuerdo moderado; de $0.61$ a $0.80$, sustancial; de $0.81$ a $1.00$, casi perfecto. La escala es una convención que los propios autores propusieron sin una justificación empírica fuerte, así que conviene tratarla como una guía y no como una frontera, pero el mensaje para Trigo Lento es claro: este juez sirve para vigilar la tendencia de la exactitud de una corrida a otra, no para declarar buena una respuesta concreta. Y el dato que más pesa no es la kappa, sino la celda pequeña: el juez aprueba $2$ de las $7$ respuestas malas ($29%$), y una de ellas es de alérgenos, la invención sobre si el ajonjolí de los bollos es tostado.
De ahí sale la regla de la casa, que no depende de ningún umbral de kappa: todo lo que el juez aprueba en alérgenos y todo lo que toca un escalado lo revisa Valeria a mano. Son $21$ de $60$ respuestas por corrida, unos diez minutos, frente a la hora que costaría revisarlo todo. El resto lo califica el juez, y cada mes Valeria vuelve a calificar a ciegas una muestra de diez respuestas para comprobar que la kappa no se ha movido. Si un cambio de prompt del juez o de modelo baja la kappa, se recalibra antes de volver a confiar en él.
Incertidumbre con 60 preguntas
Una exactitud de $0.900$ con $40$ preguntas no es lo mismo que una exactitud de $0.900$ con $4,000$. La cifra observada es una estimación y necesita su intervalo. El intervalo más conocido, el de Wald ($\hat{p} \pm 1.96\sqrt{\hat{p}(1-\hat{p})/n}$), se porta mal justo donde vive un buen agente: con proporciones cercanas a $1$ y muestras pequeñas produce intervalos demasiado estrechos y, con $0$ errores, un intervalo de ancho cero. El intervalo de Wilson (Wilson, 1927), que la serie ya usó en los días 9 y 39, corrige ese defecto:
$$ \frac{\hat{p} + \dfrac{z^2}{2n}}{1 + \dfrac{z^2}{n}} ;\pm; \frac{z}{1 + \dfrac{z^2}{n}} \sqrt{\frac{\hat{p}(1 - \hat{p})}{n} + \frac{z^2}{4n^2}} $$
La lógica detrás de esta fórmula es múltiple:
- $\hat{p} = x/n$ es la proporción observada y $z = 1.96$ corresponde al $95%$ de confianza.
- El centro no es $\hat{p}$: se desplaza hacia $0.5$ en $z^2/2n$, más cuanto menor es la muestra, lo que evita que $36$ aciertos de $40$ se lean como si el agente fuera casi perfecto.
- El término $z^2/4n^2$ dentro de la raíz mantiene un ancho mínimo aunque $\hat{p}$ sea $0$ o $1$: cero errores en $40$ casos no demuestran cero errores.
- En conclusión, el intervalo de Wilson dice qué tasas reales son compatibles con lo observado, y su ancho dice cuántas preguntas faltan para decidir.
El siguiente bloque calcula el intervalo de Wilson de las siete métricas de la corrida, comprueba el ejemplo de la ficha del día ($36$ de $40$ y $8$ de $10$) y responde una pregunta práctica: ¿cuántas preguntas respondibles harían falta para que una exactitud de $0.90$ y otra de $0.93$ dejen de tener intervalos solapados?
# Intervalos de Wilson al 95 % por métrica y tamaño de muestra necesario en Python:
UMBRALES = {'exactitud': 0.90, 'fidelidad': 0.90, 'citas_correctas': 0.90, 'no_lo_se_correcto': 0.80,
            'no_lo_se_incorrecto': 0.10, 'precision_escalado': 0.80, 'exhaustividad_escalado': 0.90}
filas = []
for nombre, (x, n) in m300.items():
    bajo, alto = wilson(x, n)
    filas.append({'metrica': nombre, 'x': x, 'n': n, 'estimacion': x / n, 'bajo': bajo, 'alto': alto,
                  'ancho': alto - bajo, 'umbral': UMBRALES[nombre]})
tabla_3 = pd.DataFrame(filas).set_index('metrica')
print(tabla_3.round(3).to_string())
print('Ejemplo de la ficha, 36 de 40:', np.round(wilson(36, 40), 3), '| 8 de 10:', np.round(wilson(8, 10), 3))

# ¿Cuántas preguntas respondibles harían falta para que 0.90 y 0.93 no se solapen?
for n in [40, 100, 400, 800, 1200, 1600]:
    alto_90, bajo_93 = wilson(0.90 * n, n)[1], wilson(0.93 * n, n)[0]
    print(f'n = {n:>3}: techo de 0.90 = {alto_90:.3f} | piso de 0.93 = {bajo_93:.3f} | '
          f'{"se distinguen" if alto_90 < bajo_93 else "se solapan"}')
                         x   n  estimacion   bajo   alto  ancho  umbral
metrica
exactitud               36  40       0.900  0.769  0.960  0.191     0.9
fidelidad               35  36       0.972  0.858  0.995  0.137     0.9
citas_correctas         35  36       0.972  0.858  0.995  0.137     0.9
no_lo_se_correcto        8  10       0.800  0.490  0.943  0.453     0.8
no_lo_se_incorrecto      3  40       0.075  0.026  0.199  0.173     0.1
precision_escalado       9  10       0.900  0.596  0.982  0.386     0.8
exhaustividad_escalado   9  10       0.900  0.596  0.982  0.386     0.9
Ejemplo de la ficha, 36 de 40: [0.769 0.96 ] | 8 de 10: [0.49  0.943]
n =  40: techo de 0.90 = 0.960 | piso de 0.93 = 0.808 | se solapan
n = 100: techo de 0.90 = 0.945 | piso de 0.93 = 0.863 | se solapan
n = 400: techo de 0.90 = 0.926 | piso de 0.93 = 0.901 | se solapan
n = 800: techo de 0.90 = 0.919 | piso de 0.93 = 0.910 | se solapan
n = 1200: techo de 0.90 = 0.916 | piso de 0.93 = 0.914 | se solapan
n = 1600: techo de 0.90 = 0.914 | piso de 0.93 = 0.916 | se distinguen
Tabla 3. Intervalos de Wilson al 95 % por métrica, agente con fragmentos de 300 tokens.
| Métrica | Aciertos | n | Estimación | Intervalo de Wilson | Ancho | Umbral |
|---|---|---|---|---|---|---|
| Exactitud | 36 | 40 | 0.900 | [0.769, 0.960] | 0.191 | 0.90 o más |
| Fidelidad | 35 | 36 | 0.972 | [0.858, 0.995] | 0.137 | 0.90 o más |
| Citas correctas | 35 | 36 | 0.972 | [0.858, 0.995] | 0.137 | 0.90 o más |
| “No lo sé” correcto | 8 | 10 | 0.800 | [0.490, 0.943] | 0.453 | 0.80 o más |
| “No lo sé” incorrecto | 3 | 40 | 0.075 | [0.026, 0.199] | 0.173 | 0.10 o menos |
| Precisión del escalado | 9 | 10 | 0.900 | [0.596, 0.982] | 0.386 | 0.80 o más |
| Exhaustividad del escalado | 9 | 10 | 0.900 | [0.596, 0.982] | 0.386 | 0.90 o más |
La Tabla 3 es la respuesta honesta a “¿cumple el agente?”. La exactitud de $36$ de $40$ tiene un intervalo de $[0.769, 0.960]$: con estos datos, la exactitud real del agente podría estar en $0.77$ o en $0.96$, y las dos cosas son compatibles con lo observado. Las métricas con $10$ preguntas son todavía más vagas: el “no lo sé” correcto de $8$ de $10$ va de $0.490$ a $0.943$, un intervalo de casi medio punto. Ninguna de esas cifras permite afirmar que el agente supera su umbral; solo que no hay evidencia de que esté muy por debajo.
La segunda parte de la salida es la que Valeria no esperaba. Para que $0.90$ y $0.93$ tengan intervalos que no se toquen, hacen falta unas $1,600$ preguntas respondibles; con $40$, $100$ o incluso $800$ se solapan. El criterio de no solapamiento es conservador (una prueba pareada, como la de la sección siguiente, necesita menos), pero el orden de magnitud no cambia: con 40 respondibles no se puede distinguir un agente de $0.90$ de uno de $0.93$, y quien presente esa diferencia como una mejora está leyendo ruido. Escribir $1,600$ preguntas a mano no es realista para una panadería; lo realista es usar el conjunto para detectar caídas grandes y regresiones concretas, que es lo que hace la puerta.
Regresión al cambiar el fragmentado
Ahora sí, la pregunta del día: ¿el cambio de 300 a 150 tokens mejoró o empeoró al agente? La comparación correcta no es “exactitud con 150 frente a exactitud con 300” como dos números sueltos, sino pareada: las mismas 60 preguntas con las dos configuraciones, mirando qué preguntas cambian de resultado. Las preguntas que salen bien en las dos o mal en las dos no dicen nada sobre el cambio; toda la información está en las que cambian.
La prueba de McNemar (McNemar, 1947) formaliza esa idea. Sea $b$ el número de preguntas que estaban bien con 300 tokens y empeoran, y $c$ el de las que estaban mal y mejoran. Si el cambio no tuviera efecto, cada pregunta que cambia tendría la misma probabilidad de cambiar en un sentido que en el otro, y $b$ seguiría una binomial con $n = b + c$ y probabilidad $1/2$. La versión exacta, la adecuada con pocos cambios, calcula el valor p a dos colas:
$$ p = \min!\left(1,; 2 \sum_{i=0}^{\min(b,,c)} \binom{b + c}{i} \left(\frac{1}{2}\right)^{b + c}\right) $$
La lógica detrás de esta fórmula es múltiple:
- Solo cuentan las preguntas discordantes, $b + c$; las concordantes se cancelan porque las dos configuraciones las resolvieron igual.
- La suma acumula la probabilidad de un reparto tan desigual como el observado o más, en la cola del lado menor, y el factor $2$ la hace de dos colas.
- Con $7$ que empeoran y $2$ que mejoran, el ejemplo de la ficha, $p = 2 \cdot (1 + 9 + 36)/512 = 0.180$: no significativo, aunque $7$ contra $2$ parezca claro.
- En conclusión, McNemar responde si el cambio movió el resultado más de lo que movería el azar, usando solo las preguntas que cambiaron.
El siguiente bloque reconstruye el índice con fragmentos de 150, 300 y 600 tokens, vuelve a correr el agente simulado con los mismos números aleatorios en cada configuración (de modo que una pregunta cambia de resultado solo si cambió lo que recuperó), y calcula para cada una la exactitud, las citas correctas, el recall@3 de las respondibles, las preguntas que mejoran y empeoran respecto de 300 tokens, el valor p de McNemar con math.comb y cuántas preguntas de alérgenos empeoran:
# Reindexado con fragmentos de 150, 300 y 600 tokens, corrida pareada y McNemar exacto en Python:
def mcnemar_exacto(b, c):
    # b: empeoran, c: mejoran. Binomial(b + c, 1/2) a dos colas sobre las preguntas que cambian:
    n = b + c
    if n == 0:
        return 1.0
    return min(1.0, 2 * sum(math.comb(n, i) for i in range(min(b, c) + 1)) / 2**n)

corridas = {tam: (resultados if tam == 300 else correr_agente(conjunto, frases, tam, azar))
            for tam in [150, 300, 600]}
filas = []
for tam, r in corridas.items():
    m = metricas(r, conjunto)
    resp = (r.tipo == 'respondible').to_numpy()
    antes, despues = resultados['correcta'].to_numpy(), r['correcta'].to_numpy()
    empeoran, mejoran = (antes & ~despues), (~antes & despues)
    filas.append({'tokens': tam, 'fragmentos': len(fragmentar(frases, tam)),
                  'exactitud': m['exactitud'][0] / m['exactitud'][1],
                  'citas_correctas': m['citas_correctas'][0] / m['citas_correctas'][1],
                  'recall@3': r.loc[resp, 'hecho_en_top3'].mean(),
                  'mejoran': int(mejoran.sum()), 'empeoran': int(empeoran.sum()),
                  'p_mcnemar': mcnemar_exacto(int(empeoran.sum()), int(mejoran.sum())),
                  'alergenos_que_empeoran': int((empeoran & alerg).sum())})
tabla_4 = pd.DataFrame(filas).set_index('tokens')
print(tabla_4.round(3).to_string())
print('Comprobación de la ficha, 7 empeoran y 2 mejoran:', round(mcnemar_exacto(7, 2), 3))
r150 = corridas[150]
cambios = conjunto.assign(antes = resultados.correcta, con_150 = r150.correcta)
print(cambios.loc[cambios.antes != cambios.con_150, ['id', 'categoria', 'pregunta', 'antes', 'con_150']]
      .to_string(index = False))

fig, (ax1, ax2) = plt.subplots(1, 2, figsize = (10.5, 4.4), gridspec_kw = {'width_ratios': [1, 1.4]})
otros = tabla_4.drop(index = 300)
xs = np.arange(len(otros))
ax1.bar(xs - 0.18, otros['mejoran'], width = 0.34, color = '#1f9d55', label = 'mejoran')
ax1.bar(xs + 0.18, -otros['empeoran'], width = 0.34, color = '#d03b3b', label = 'empeoran')
for x, f in zip(xs, otros.itertuples()):
    ax1.text(x - 0.18, f.mejoran + 0.2, f.mejoran, ha = 'center', fontsize = 10)
    ax1.text(x + 0.18, -f.empeoran - 0.7, f.empeoran, ha = 'center', fontsize = 10)
    ax1.text(x, -max(otros['empeoran']) - 2.2, f'p = {f.p_mcnemar:.3f}', ha = 'center', fontsize = 9,
             color = '#52514e')
ax1.axhline(0, color = '#2b2a28', lw = 1)
ax1.set_xticks(xs, [f'{t} tokens' for t in otros.index])
ax1.set_ylim(-max(otros['empeoran']) - 3, max(otros['mejoran']) + 2)
ax1.set_ylabel('Preguntas respecto de 300 tokens')
ax1.set_title('Cambios pareados', fontsize = 12)
ax1.legend(frameon = False, loc = 'upper right')
ax1.spines[['top', 'right']].set_visible(False)
for metrica, color in [('exactitud', '#2a78d6'), ('citas_correctas', '#7b4fc9'), ('recall@3', '#eb6834')]:
    ax2.plot(tabla_4.index, tabla_4[metrica], marker = 'o', lw = 2, color = color,
             label = metrica.replace('_', ' '))
ax2.axhline(0.90, color = '#8a8986', ls = ':', lw = 1.2)
ax2.set_xticks(tabla_4.index, [f'{t}' for t in tabla_4.index])
ax2.set_xlabel('Tamaño de fragmento (tokens)')
ax2.set_ylim(0.5, 1.02)
ax2.set_title('Métricas por configuración', fontsize = 12)
ax2.legend(frameon = False, loc = 'lower right')
ax2.spines[['top', 'right']].set_visible(False)
plt.tight_layout()
plt.show()
        fragmentos  exactitud  citas_correctas  recall@3  mejoran  empeoran  p_mcnemar  alergenos_que_empeoran
tokens
150            400       0.85            0.971     0.825        0         4      0.125                       0
300            200       0.90            0.972     0.900        0         0      1.000                       0
600            120       0.75            1.000     0.925        0         6      0.031                       1
Comprobación de la ficha, 7 empeoran y 2 mejoran: 0.18
 id categoria                                            pregunta  antes  con_150
R12  producto     ¿Para cuántas personas alcanza el pay de queso?   True    False
R22  politica Si cancelo un día antes, ¿me devuelven el anticipo?   True    False
R43  politica                           ¿Dan clases de panadería?   True    False
R46  producto             ¿Hacen pasteles de fondant con figuras?   True    False
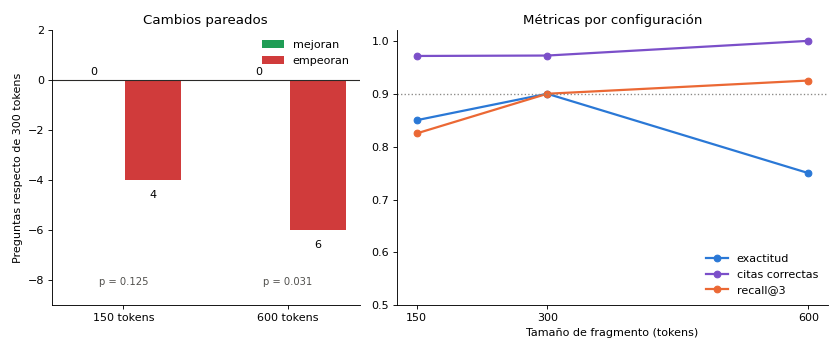
Con fragmentos de 150 tokens, el índice pasa de $200$ a $400$ fragmentos, la exactitud baja de $0.900$ a $0.850$, el recall@3 de $0.900$ a $0.825$, y $4$ preguntas empeoran sin que ninguna mejore. McNemar exacto da $p = 2 \cdot 1/16 = 0.125$: con solo cuatro preguntas que cambian, ni siquiera un 4 a 0 es significativo al $5%$. Las cuatro son instructivas: dos respondibles que se quedan sin su hecho completo entre los cuatro fragmentos cortos (el rendimiento del pay de queso, que recibe una respuesta inventada, y la devolución del anticipo, que se queda en “no lo sé”) y dos preguntas sin respuesta que, con fragmentos más cortos y más parecidos a la pregunta, superan el umbral de abstención y reciben una respuesta inventada. El fragmento pequeño “encuentra mejor” palabras sueltas, pero pierde el contexto que hace que una frase sea una respuesta.
Con fragmentos de 600 tokens el efecto es el contrario y más fuerte: el recall@3 sube a $0.925$ porque el hecho casi siempre está en algún fragmento grande, pero la similitud con la pregunta se diluye entre tanto texto, más preguntas caen por debajo del umbral y la exactitud baja a $0.750$, con $6$ preguntas que empeoran y $p = 0.031$. Una de ellas es de alérgenos: la lista de productos con huevo y lácteos. Es la paradoja que conviene recordar: una métrica de recuperación que mejora no garantiza que el agente mejore, porque el agente depende también de la similitud que decide si responde.
La pregunta de la clienta de hoy, escrita como ella la escribió, no estaba en el conjunto; R02 cubre el mismo hecho con otras palabras y pasa con los tres tamaños. Ese es un límite que ningún número del laboratorio puede ver, y tiene un remedio sencillo: cada incidente real se convierte en una pregunta nueva, reescrita sin datos personales, en la versión siguiente del conjunto, con su huella nueva.
La puerta de regresión
Un valor p no es una decisión de despliegue. Con 60 preguntas, casi ningún cambio será significativo, y esperar significancia antes de bloquear significaría dejar pasar casi todo. La Figura 3 dibuja la puerta con sus tres cerrojos: reglas de negocio, escritas antes de ver los resultados, que bloquean el despliegue aunque la estadística no sea concluyente. La primera la puso Don Ernesto: ninguna pregunta de alérgenos puede empeorar, ni una. La segunda acepta el ruido de una pregunta pero no más: la exactitud no puede bajar más de una pregunta respecto de la versión en producción. La tercera fija un piso absoluto: las citas correctas no pueden caer por debajo de $0.85$.
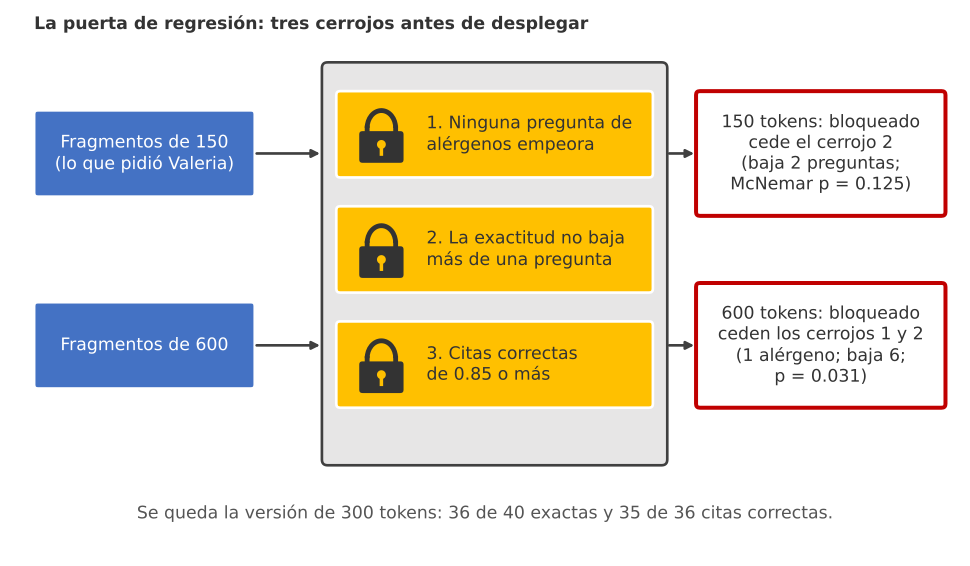
Figura 3. La puerta de regresión: un cambio de fragmentado llega a una puerta con tres cerrojos (alérgenos, exactitud y citas); con 150 tokens cede el de exactitud y con 600 ceden el de alérgenos y el de exactitud.
El siguiente bloque aplica los tres cerrojos a cada configuración y calcula, de paso, cuánto cuesta cada corrida del examen:
# Puerta de regresión: tres cerrojos y veredicto por configuración en Python:
def puerta(fila, base_exactitud, umbral_citas = 0.85):
    motivos = []
    if fila['alergenos_que_empeoran'] > 0:
        motivos.append(f"{int(fila['alergenos_que_empeoran'])} pregunta(s) de alérgenos empeoran")
    if (base_exactitud - fila['exactitud']) * 40 > 1 + 1e-9:
        motivos.append(f"la exactitud baja {round((base_exactitud - fila['exactitud']) * 40)} preguntas")
    if fila['citas_correctas'] < umbral_citas:
        motivos.append(f"citas correctas {fila['citas_correctas']:.3f} < {umbral_citas}")
    return ('bloqueado: ' + '; '.join(motivos)) if motivos else 'aprobado'

base_exactitud = tabla_4.loc[300, 'exactitud']
for tam, fila in tabla_4.iterrows():
    if tam != 300:
        print(f'{tam} tokens -> {puerta(fila, base_exactitud)}')

# Coste de una corrida completa con Haiku 5.5 (agente y juez) y con Opus 5.5 como juez:
PRECIOS = {'claude-haiku-5-5': (0.10, 0.50), 'claude-opus-5-5': (4.00, 20.00)}   # USD por millón
coste = lambda modelo, entrada, salida, n = 60: n * (entrada * PRECIOS[modelo][0] + salida * PRECIOS[modelo][1]) / 1e6
agente = coste('claude-haiku-5-5', 2000, 250)
juez_haiku, juez_opus = coste('claude-haiku-5-5', 3000, 300), coste('claude-opus-5-5', 3000, 300)
print(f'Corrida: agente {agente:.4f} + juez Haiku {juez_haiku:.4f} = {agente + juez_haiku:.4f} USD '
      f'| con juez Opus: {agente + juez_opus:.4f} USD')
corridas_mes = 4 + 4                       # cada lunes más unos cuatro cambios de prompt, índice o modelo
print(f'{corridas_mes} corridas al mes: {corridas_mes * (agente + juez_haiku):.2f} USD con Haiku '
      f'| {corridas_mes * (agente + juez_opus):.2f} USD con juez Opus')
150 tokens -> bloqueado: la exactitud baja 2 preguntas
600 tokens -> bloqueado: 1 pregunta(s) de alérgenos empeoran; la exactitud baja 6 preguntas
Corrida: agente 0.0195 + juez Haiku 0.0270 = 0.0465 USD | con juez Opus: 1.0995 USD
8 corridas al mes: 0.37 USD con Haiku | 8.80 USD con juez Opus
La puerta bloquea las dos configuraciones. La de 150 tokens cae por el segundo cerrojo, porque la exactitud baja dos preguntas; la de 600, por el primero y el segundo, porque una pregunta de alérgenos empeora y la exactitud baja seis. El cambio que Valeria hizo el jueves no habría pasado la puerta, y el índice vuelve a 300 tokens esa misma tarde.
Tabla 4. Regresión por tamaño de fragmento respecto de la configuración de 300 tokens en producción.
| Tamaño | Fragmentos | Exactitud | Citas correctas | Recall@3 | Mejoran | Empeoran | Valor p de McNemar | Alérgenos que empeoran | Veredicto de la puerta |
|---|---|---|---|---|---|---|---|---|---|
| 150 tokens | 400 | 0.850 | 0.971 | 0.825 | 0 | 4 | 0.125 | 0 | Bloqueado: la exactitud baja 2 preguntas |
| 300 tokens | 200 | 0.900 | 0.972 | 0.900 | 0 | 0 | 1.000 | 0 | En producción |
| 600 tokens | 120 | 0.750 | 1.000 | 0.925 | 0 | 6 | 0.031 | 1 | Bloqueado: 1 alérgeno empeora y la exactitud baja 6 |
La Tabla 4 reúne la lección del día en una fila. Las citas correctas apenas se mueven entre configuraciones ($0.971$, $0.972$ y $1.000$), así que una evaluación que mirara solo las citas habría aprobado los dos cambios. El recall@3 sube con el tamaño de fragmento y aun así la peor configuración es la de recall más alto. Solo la combinación de métricas separadas, comparación pareada y reglas de negocio da un veredicto que Don Ernesto puede firmar.
La cuenta de costes del bloque cierra la otra objeción de siempre. Una corrida completa con Haiku 5.5 cuesta unos $0.0465$ USD: $0.0195$ del agente ($60$ preguntas de $2,000$ tokens de entrada y $250$ de salida) y $0.0270$ del juez ($3,000$ y $300$). Ocho corridas al mes, una cada lunes y unas cuatro por cambios, suman $0.37$ USD, menos del $5%$ del rubro de $8$ USD de Claude. Con Opus 5.5 como juez, la corrida costaría $1.0995$ USD y el mes $8.80$, más que todo el rubro: por eso el juez es Haiku 5.5, calibrado, con revisión humana en lo delicado.
TL Evaluación del agente v1
Un examen que se corre cuando alguien se acuerda no protege de nada. El workflow TL Evaluación del agente v1 lo convierte en rutina con tres disparadores: cada lunes a las 7:00, para detectar derivas aunque nadie haya tocado nada (una página de Notion editada, una versión nueva del modelo); cada vez que se publica un cambio de prompt, índice o modelo, llamado por el flujo de versionado del Día 42 o por la integración continua del Día 43 con n8n execute; y a mano, para probar. Lee el conjunto v1 de Postgres solo si su huella coincide con la congelada, recorre las 60 preguntas una a una con el agente en modo de prueba (sin enviar nada a ningún cliente), arma la petición del juez con los fragmentos barajados, llama a la API de Claude, calcula las métricas y el veredicto de la puerta, guarda la corrida y publica el resultado en el canal de operación de Slack. El JSON exportado es este:
{
  "name": "TL Evaluación del agente v1",
  "nodes": [
    {
      "parameters": {"inputSource": "jsonExample", "jsonExample": "{\n  \"motivo\": \"cambio de prompt, índice o modelo\",\n  \"version\": \"v4.1\"\n}"},
      "id": "0b1c7000-0000-4000-8000-000000000001",
      "name": "Cambio publicado",
      "type": "n8n-nodes-base.executeWorkflowTrigger",
      "typeVersion": 1.1,
      "position": [0, -240]
    },
    {
      "parameters": {},
      "id": "0b1c7000-0000-4000-8000-000000000002",
      "name": "Al pulsar Probar",
      "type": "n8n-nodes-base.manualTrigger",
      "typeVersion": 1,
      "position": [0, 0]
    },
    {
      "parameters": {"rule": {"interval": [{"field": "cronExpression", "expression": "0 7 * * 1"}]}},
      "id": "0b1c7000-0000-4000-8000-000000000003",
      "name": "Lunes 7:00",
      "type": "n8n-nodes-base.scheduleTrigger",
      "typeVersion": 1.2,
      "position": [0, 240]
    },
    {
      "parameters": {"operation": "executeQuery", "query": "SELECT r.id, r.pregunta, r.tipo, r.categoria, r.comportamiento, r.respuesta_esperada, r.paginas_fuente FROM referencia r JOIN versiones_referencia v ON v.version = r.version WHERE r.version = 'v1' AND v.huella = $1 ORDER BY r.id;", "options": {"queryReplacement": "={{ [$env.TL_HUELLA_REFERENCIA] }}"}},
      "id": "0b1c7000-0000-4000-8000-000000000004",
      "name": "Leer conjunto v1",
      "type": "n8n-nodes-base.postgres",
      "typeVersion": 2.6,
      "position": [240, 0],
      "credentials": {"postgres": {"id": "0000000000000070", "name": "Postgres TL evaluación (solo lectura)"}}
    },
    {
      "parameters": {"batchSize": 1, "options": {}},
      "id": "0b1c7000-0000-4000-8000-000000000005",
      "name": "Pregunta por pregunta",
      "type": "n8n-nodes-base.splitInBatches",
      "typeVersion": 3,
      "position": [480, 0]
    },
    {
      "parameters": {"workflowId": {"__rl": true, "value": "Ag7kRt2mWq9pLs4V", "mode": "list", "cachedResultName": "TL Agente de pedidos v4 (modo prueba)"}, "workflowInputs": {"mappingMode": "defineBelow", "value": {"texto": "={{ $json.pregunta }}", "sesion": "={{ 'eval_' + $json.id }}", "modelo": "claude-haiku-5-5", "modo_prueba": "true"}, "matchingColumns": [], "schema": [{"id": "texto", "displayName": "texto", "required": false, "defaultMatch": false, "display": true, "canBeUsedToMatch": true, "type": "string", "removed": false}, {"id": "sesion", "displayName": "sesion", "required": false, "defaultMatch": false, "display": true, "canBeUsedToMatch": true, "type": "string", "removed": false}, {"id": "modelo", "displayName": "modelo", "required": false, "defaultMatch": false, "display": true, "canBeUsedToMatch": true, "type": "string", "removed": false}, {"id": "modo_prueba", "displayName": "modo_prueba", "required": false, "defaultMatch": false, "display": true, "canBeUsedToMatch": true, "type": "string", "removed": false}], "attemptToConvertTypes": false, "convertFieldsToString": false}, "options": {"waitForSubWorkflow": true}},
      "id": "0b1c7000-0000-4000-8000-000000000006",
      "name": "Agente en modo prueba",
      "type": "n8n-nodes-base.executeWorkflow",
      "typeVersion": 1.2,
      "position": [720, 200]
    },
    {
      "parameters": {"jsCode": "const caso = $('Pregunta por pregunta').item.json;\nconst r = $json;\nconst fragmentos = [...(r.fragmentos || [])].sort(() => Math.random() - 0.5);\nconst sistema = 'Usted califica respuestas del asistente de una panadería contra una respuesta de referencia. Califique exactitud (0 o 1) y fidelidad (0, 1 o 2): 2 si cada afirmación está respaldada por un fragmento, 1 si alguna no lo está pero no es falsa, 0 si alguna es falsa o inventada. No premie la longitud ni el tono. Si la conducta esperada es no_lo_se o escalar, la exactitud es 1 solo si la respuesta hace eso.';\nconst usuario = '<pregunta>' + caso.pregunta + '</pregunta>\\n<conducta_esperada>' + caso.comportamiento + '</conducta_esperada>\\n<referencia>' + caso.respuesta_esperada + '</referencia>\\n<fragmentos>' + JSON.stringify(fragmentos) + '</fragmentos>\\n<respuesta>' + String(r.respuesta || '') + '</respuesta>';\nconst esquema = {type: 'object', additionalProperties: false, required: ['exactitud', 'fidelidad', 'afirmaciones_sin_respaldo', 'motivo'], properties: {exactitud: {type: 'integer', enum: [0, 1]}, fidelidad: {type: 'integer', enum: [0, 1, 2]}, afirmaciones_sin_respaldo: {type: 'array', items: {type: 'string'}}, motivo: {type: 'string'}}};\nreturn [{ json: { id: caso.id, caso, agente: r, cuerpo: { model: 'claude-haiku-5-5', max_tokens: 400, output_config: { effort: 'low', format: { type: 'json_schema', schema: esquema } }, system: sistema, messages: [{ role: 'user', content: usuario }] } } }];"},
      "id": "0b1c7000-0000-4000-8000-000000000007",
      "name": "Armar juicio",
      "type": "n8n-nodes-base.code",
      "typeVersion": 2,
      "position": [960, 200]
    },
    {
      "parameters": {"method": "POST", "url": "https://api.anthropic.com/v1/messages", "authentication": "genericCredentialType", "genericAuthType": "httpHeaderAuth", "sendHeaders": true, "headerParameters": {"parameters": [{"name": "anthropic-version", "value": "2023-06-01"}]}, "sendBody": true, "specifyBody": "json", "jsonBody": "={{ JSON.stringify($json.cuerpo) }}", "options": {"timeout": 60000, "response": {"response": {"fullResponse": true, "neverError": true}}}},
      "id": "0b1c7000-0000-4000-8000-000000000008",
      "name": "Juez Haiku 5.5",
      "type": "n8n-nodes-base.httpRequest",
      "typeVersion": 4.2,
      "position": [1200, 200],
      "credentials": {"httpHeaderAuth": {"id": "0000000000000040", "name": "Claude x-api-key TL"}}
    },
    {
      "parameters": {"jsCode": "const filas = $('Juez Haiku 5.5').all().map((it, i) => { const j = it.json; const a = $('Armar juicio').all()[i].json; let v = null; if (j.statusCode === 200 && j.body.stop_reason === 'end_turn') { v = JSON.parse(j.body.content.find(b => b.type === 'text').text); } return { id: a.id, caso: a.caso, agente: a.agente, veredicto: v }; });\nconst wilson = (x, n, z = 1.96) => { const p = x / n, c = (p + z*z/(2*n)) / (1 + z*z/n), m = z / (1 + z*z/n) * Math.sqrt(p*(1-p)/n + z*z/(4*n*n)); return [c - m, c + m]; };\nconst resp = filas.filter(f => f.caso.tipo === 'respondible');\nconst contestadas = resp.filter(f => f.agente.conducta === 'responder');\nconst citaOk = contestadas.filter(f => f.caso.paginas_fuente.includes(f.agente.cita) && (f.agente.recuperadas || []).includes(f.agente.cita)).length;\nconst sinJuez = filas.filter(f => !f.veredicto).length;\nconst exactas = resp.filter(f => f.veredicto && f.veredicto.exactitud === 1).length;\nconst m = { exactitud: [exactas, resp.length], citas_correctas: [citaOk, contestadas.length], sin_juez: sinJuez };\nconst alergenosMal = resp.filter(f => f.caso.categoria === 'alergeno' && (!f.veredicto || f.veredicto.exactitud === 0)).map(f => f.id);\nconst ic = wilson(exactas, resp.length);\nconst bloqueado = alergenosMal.length > 0 || citaOk / Math.max(contestadas.length, 1) < 0.85 || sinJuez > 0;\nreturn [{ json: { metricas: m, ic_exactitud: ic, alergenos_mal: alergenosMal, veredicto: bloqueado ? 'bloqueado' : 'aprobado', revisar_a_mano: filas.filter(f => f.caso.categoria === 'alergeno' || f.caso.tipo === 'escalar').map(f => f.id) } }];"},
      "id": "0b1c7000-0000-4000-8000-000000000009",
      "name": "Calcular métricas",
      "type": "n8n-nodes-base.code",
      "typeVersion": 2,
      "position": [720, -200]
    },
    {
      "parameters": {"operation": "executeQuery", "query": "INSERT INTO evaluaciones (flujo, momento, version_referencia, metricas, veredicto) VALUES ('TL Evaluación del agente v1', now(), 'v1', $1::jsonb, $2);", "options": {"queryReplacement": "={{ [JSON.stringify($json.metricas), $json.veredicto] }}"}},
      "id": "0b1c7000-0000-4000-8000-000000000010",
      "name": "Guardar corrida",
      "type": "n8n-nodes-base.postgres",
      "typeVersion": 2.6,
      "position": [960, -200],
      "credentials": {"postgres": {"id": "0000000000000043", "name": "Postgres TL registro"}}
    },
    {
      "parameters": {"method": "POST", "url": "https://slack.com/api/chat.postMessage", "authentication": "genericCredentialType", "genericAuthType": "httpHeaderAuth", "sendBody": true, "specifyBody": "json", "jsonBody": "={{ JSON.stringify({channel: $env.TL_SLACK_CANAL_OPERACION, text: 'Evaluación del agente: ' + $('Calcular métricas').first().json.veredicto, blocks: [{type: 'section', text: {type: 'mrkdwn', text: '*Evaluación del agente (referencia v1):* ' + $('Calcular métricas').first().json.veredicto + '\\nExactitud: ' + $('Calcular métricas').first().json.metricas.exactitud.join(' de ') + '\\nAlérgenos con fallo: ' + ($('Calcular métricas').first().json.alergenos_mal.join(', ') || 'ninguno')}}, {type: 'context', elements: [{type: 'mrkdwn', text: 'Calificación automática con juez calibrado. Las preguntas de alérgenos y de escalado las revisa una persona antes de aprobar.'}]}]}) }}", "options": {"timeout": 10000}},
      "id": "0b1c7000-0000-4000-8000-000000000011",
      "name": "Publicar en Slack",
      "type": "n8n-nodes-base.httpRequest",
      "typeVersion": 4.2,
      "position": [1200, -200],
      "credentials": {"httpHeaderAuth": {"id": "0000000000000050", "name": "Slack bot TL"}}
    }
  ],
  "connections": {
    "Cambio publicado": {"main": [[{"node": "Leer conjunto v1", "type": "main", "index": 0}]]},
    "Al pulsar Probar": {"main": [[{"node": "Leer conjunto v1", "type": "main", "index": 0}]]},
    "Lunes 7:00": {"main": [[{"node": "Leer conjunto v1", "type": "main", "index": 0}]]},
    "Leer conjunto v1": {"main": [[{"node": "Pregunta por pregunta", "type": "main", "index": 0}]]},
    "Pregunta por pregunta": {"main": [[{"node": "Calcular métricas", "type": "main", "index": 0}], [{"node": "Agente en modo prueba", "type": "main", "index": 0}]]},
    "Agente en modo prueba": {"main": [[{"node": "Armar juicio", "type": "main", "index": 0}]]},
    "Armar juicio": {"main": [[{"node": "Juez Haiku 5.5", "type": "main", "index": 0}]]},
    "Juez Haiku 5.5": {"main": [[{"node": "Pregunta por pregunta", "type": "main", "index": 0}]]},
    "Calcular métricas": {"main": [[{"node": "Guardar corrida", "type": "main", "index": 0}]]},
    "Guardar corrida": {"main": [[{"node": "Publicar en Slack", "type": "main", "index": 0}]]}
  },
  "settings": {"executionOrder": "v1", "timezone": "America/Mexico_City", "executionTimeout": 1800, "saveDataSuccessExecution": "all", "errorWorkflow": "Xe7rTb4mKq9wPz2G"},
  "pinData": {},
  "meta": {"templateCredsSetupCompleted": true}
}
Algunas decisiones del flujo merecen nombre. El nodo Leer conjunto v1 usa una credencial de solo lectura y compara la huella con la variable de entorno TL_HUELLA_REFERENCIA: si alguien edita una pregunta en la base sin cambiar la versión, la consulta no devuelve nada y la corrida no empieza. El nodo Pregunta por pregunta (Loop Over Items) procesa de una en una para no superar los límites de la API y para que cada respuesta se califique con su propio contexto; su salida terminado lleva a las métricas y la de cada pregunta al agente. La petición del juez lleva output_config con esfuerzo bajo y un esquema JSON con additionalProperties: false, sin parámetros de muestreo y sin fallbacks, que Haiku 5.5 no admite. Y Calcular métricas trata una respuesta sin veredicto del juez como bloqueo, no como aprobado: si el juez falla, la corrida no se da por buena.
El último bloque lee el JSON exportado como lo haría una revisión de código: cuenta nodos y conexiones, busca destinos inexistentes, comprueba que los únicos nodos sin entrada sean los tres disparadores, busca parámetros de muestreo, claves de API, teléfonos o URLs de webhook de Slack que no deberían estar en un archivo versionado, y dibuja el flujo con la paleta de la serie, con los nodos que llaman a Claude en morado:
# Lectura del workflow exportado TL Evaluación del agente v1, revisión y dibujo en Python:
workflow = json.loads((carpeta / 'flujos' / 'n8n' / 'evaluacion_agente_v1.json').read_text(encoding = 'utf-8'))

FORMAS = {'manualTrigger': ('disparador', '#1f9d55'), 'scheduleTrigger': ('disparador', '#1f9d55'),
          'executeWorkflowTrigger': ('disparador', '#1f9d55'), 'postgres': ('accion', '#2a78d6'),
          'splitInBatches': ('decision', '#eb6834'), 'executeWorkflow': ('accion', '#2a78d6'),
          'code': ('accion', '#2a78d6'), 'httpRequest': ('accion', '#2a78d6'), 'if': ('decision', '#eb6834')}

def nodos_desde_n8n(wf):
    nodos = [{'id': n['name'], 'tipo': n['type'].split('.')[-1], 'x': n['position'][0] / 100,
              'y': -n['position'][1] / 100, 'ia': bool(re.search(r'claude|anthropic', json.dumps(n['parameters'])))} for n in wf['nodes']]
    aristas = [(o, d['node'], salida) for o, s in wf['connections'].items()
               for tipo, lista in s.items() for salida, destinos in enumerate(lista) for d in destinos]
    return nodos, aristas

def dibujar_flujo(nodos, aristas, titulo):
    fig, ax = plt.subplots(figsize = (15, 5.6))
    pos = {n['id']: (n['x'], n['y']) for n in nodos}
    for n in nodos:
        forma, color = FORMAS[n['tipo']]
        color = '#7b4fc9' if n['ia'] else color
        x, y = n['x'], n['y']
        if forma == 'decision':
            ax.add_patch(Polygon([(x - 1.0, y), (x, y + 0.62), (x + 1.0, y), (x, y - 0.62)], facecolor = color,
                                 edgecolor = 'white', linewidth = 2))
        else:
            estilo = 'round,pad=0.05,rounding_size=0.35' if forma == 'disparador' else 'round,pad=0.05'
            ax.add_patch(FancyBboxPatch((x - 0.8, y - 0.38), 1.6, 0.76, boxstyle = estilo,
                                        facecolor = color, edgecolor = 'white', linewidth = 2))
        etiqueta = textwrap.fill(n['id'], 11 if forma == 'decision' else 15, break_long_words = False)
        ax.text(x, y + 0.08, etiqueta, ha = 'center', va = 'center', color = 'white', fontsize = 8.5)
        ax.text(x, y - 0.27, n['tipo'], ha = 'center', va = 'center', color = 'white', fontsize = 6.5)
    tipos = {n['id']: n['tipo'] for n in nodos}
    for o, d, salida in aristas:
        (x1, y1), (x2, y2) = pos[o], pos[d]
        if tipos[o] == 'splitInBatches':                             # salida 0: terminado; salida 1: bucle
            ax.text(x1 + 0.25, y1 + (0.75 if y2 > y1 else -0.85), 'terminado' if salida == 0 else 'cada pregunta',
                    fontsize = 9, color = '#52514e')
        if tipos[o].endswith('Trigger'):                             # disparadores: flecha directa
            ax.add_patch(FancyArrowPatch((x1 + 0.82, y1), (x2 - 0.86, y2 + 0.15 * np.sign(y1 - y2)),
                                         arrowstyle = '-|>', mutation_scale = 13, color = '#52514e', linewidth = 1.4))
        elif x2 < x1:                                                  # vuelta al bucle
            ax.add_patch(FancyArrowPatch((x1, y1 - 0.4), (x2 + 0.3, y2 - 0.45), arrowstyle = '-|>',
                                         mutation_scale = 13, color = '#eb6834', linewidth = 1.3,
                                         connectionstyle = 'arc3,rad=-0.35'))
        elif abs(y1 - y2) < 0.01:
            ax.add_patch(FancyArrowPatch((x1 + 0.86, y1), (x2 - 0.86, y2), arrowstyle = '-|>', mutation_scale = 13,
                                         color = '#52514e', linewidth = 1.4))
        else:
            ax.add_patch(FancyArrowPatch((x1 + 0.6, y1 + (0.3 if y2 > y1 else -0.3)), (x2 - 0.86, y2),
                                         arrowstyle = '-|>', mutation_scale = 13, color = '#52514e', linewidth = 1.4,
                                         connectionstyle = 'angle,angleA=90,angleB=0,rad=0.1'))
    xs, ys = [p[0] for p in pos.values()], [p[1] for p in pos.values()]
    ax.set_xlim(min(xs) - 1, max(xs) + 1)
    ax.set_ylim(min(ys) - 1.2, max(ys) + 0.9)
    ax.set_aspect('equal')
    ax.axis('off')
    ax.set_title(titulo, fontsize = 14)
    return ax

nodos, aristas = nodos_desde_n8n(workflow)
nombres = {n['id'] for n in nodos}
print('Nodos:', len(nodos), '| conexiones:', len(aristas))
print('Tipos:', pd.Series([n['tipo'] for n in nodos]).value_counts().to_dict())
print('Destinos inexistentes:', [d for _, d, _ in aristas if d not in nombres] or 'ninguno')
print('Nodos sin entrada:', sorted(nombres - {d for _, d, _ in aristas}))
texto_json = json.dumps(workflow, ensure_ascii = False)
print('Parámetros de muestreo:', re.findall(r'temperature|top_p|top_k', texto_json) or 'ninguno',
      '| claves o teléfonos:', re.findall(r'sk-ant-[\w-]+|\+52\d{10}|hooks\.slack\.com/services/\w+', texto_json)
      or 'ninguno')
programa = next(n for n in workflow['nodes'] if n['type'].endswith('scheduleTrigger'))
print('Programación:', programa['parameters']['rule']['interval'][0]['expression'])
dibujar_flujo(nodos, aristas, f"{workflow['name']}, leído del JSON exportado")
plt.tight_layout()
plt.show()
Nodos: 11 | conexiones: 11
Tipos: {'postgres': 2, 'code': 2, 'httpRequest': 2, 'executeWorkflowTrigger': 1, 'manualTrigger': 1, 'scheduleTrigger': 1, 'splitInBatches': 1, 'executeWorkflow': 1}
Destinos inexistentes: ninguno
Nodos sin entrada: ['Al pulsar Probar', 'Cambio publicado', 'Lunes 7:00']
Parámetros de muestreo: ninguno | claves o teléfonos: ninguno
Programación: 0 7 * * 1
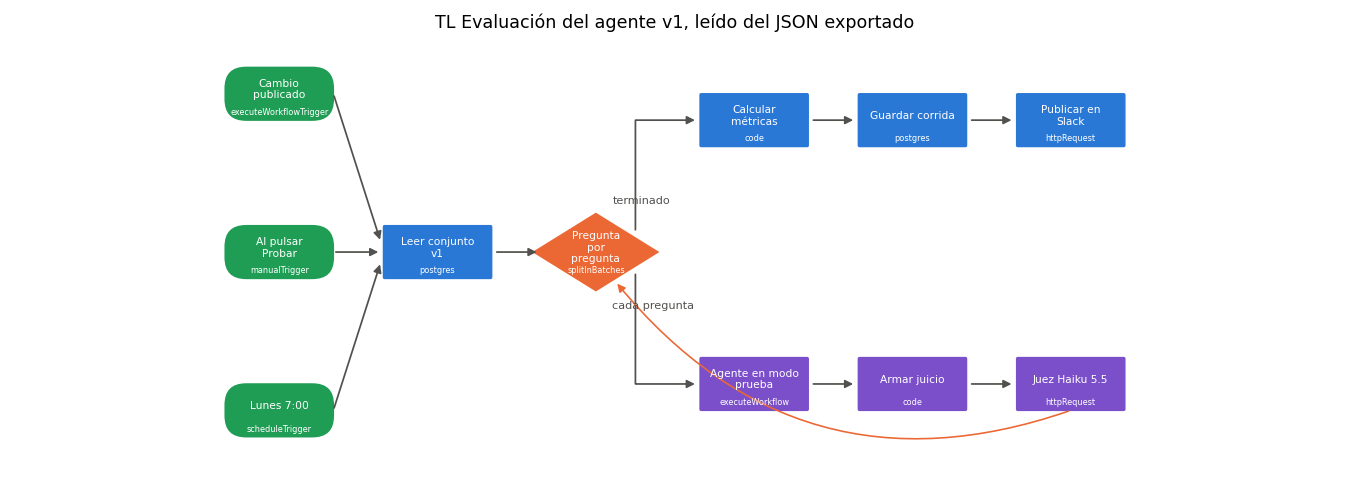
El flujo tiene $11$ nodos y $11$ conexiones, ningún destino inexistente y solo tres nodos sin entrada, los tres disparadores. No hay parámetros de muestreo ni claves ni teléfonos, y la programación 0 7 * * 1 corresponde a los lunes a las 7:00 en la zona horaria de la Ciudad de México que fija settings. En el dibujo se ve la forma típica de un evaluador: un tronco que lee el conjunto, un bucle morado que corre al agente y al juez por cada pregunta y una rama de cierre que calcula, guarda y avisa. El mensaje de Slack termina siempre con la misma nota: la calificación es automática y las preguntas de alérgenos y de escalado las revisa una persona antes de aprobar.
Consideraciones finales
El laboratorio empezó con una pregunta sin respuesta, si el cambio a 150 tokens había mejorado al agente, y termina con un veredicto respaldado: empeoró cuatro preguntas, ninguna mejoró, la estadística no lo puede afirmar con 60 preguntas y la puerta lo bloquea igual porque la exactitud bajó más de lo tolerado. En el camino, Trigo Lento ganó algo más duradero que la respuesta: un examen congelado con huella, un medidor comprobado con un oráculo y un agente nulo, un juez cuya fiabilidad está medida y una rutina que se ejecuta sola cada lunes. Un agente no está probado porque responde bien a lo que usted le pregunta; está probado cuando responde bien a un examen que se escribió antes, que alguien calificó y que se puede repetir.
Antes de dar por buena una evaluación propia, conviene hacerse algunas preguntas:
- ¿Las respuestas esperadas se escribieron antes de ver lo que contesta el agente, y el conjunto tiene preguntas en las que acertar es callar o escalar?
- ¿Cada métrica tiene su propio denominador, o hay un solo porcentaje que mezcla respondibles, abstenciones y escalados?
- ¿Sé cuánto coincide el juez con una persona, descontando el azar, y qué categorías reviso a mano aunque el juez apruebe?
- ¿Mis conclusiones caben dentro de los intervalos, o estoy celebrando una diferencia de tres puntos con 40 preguntas?
Las cifras de hoy tienen límites claros. La corrida del agente y las notas del juez son simulaciones con tasas declaradas, no mediciones de Claude; la recuperación TF-IDF sí es real, pero sobre una copia de la base con páginas de relleno; las 60 preguntas son inventadas y no reflejan la frecuencia real de los mensajes; y la calificación de Valeria es la de una sola persona, que también se equivoca. Lo que no depende de esos supuestos es el método: separar métricas, calibrar al juez, poner intervalos, comparar en pares y decidir con reglas escritas de antemano.
Un gran libro que habla de esto es Trustworthy Online Controlled Experiments: A Practical Guide to A/B Testing, en el que Ron Kohavi, Diane Tang y Ya Xu explican, con la experiencia de miles de experimentos en empresas grandes, por qué las métricas se definen antes de mirar los datos, por qué una sola métrica resumen engaña y por qué hay que desconfiar de los resultados que parecen demasiado buenos. Está escrito para equipos con millones de usuarios, pero sus capítulos sobre métricas de protección (guardrail metrics) y sobre la confianza en los resultados se aplican tal cual a una panadería con sesenta preguntas.
Don Ernesto leyó la Tabla 4 con los lentes en la punta de la nariz y señaló la última columna: “Entonces el cambio del jueves lo habría parado la puerta, y el de 600 también, por un alérgeno. ¿Y quién revisa al revisor?” Valeria le enseñó la matriz de la Figura 2: “Yo, una vez al mes, a ciegas. Y todo lo de alérgenos, cada lunes.” Él dobló la hoja y la guardó junto a la libreta de pedidos. “Cinco centavos por examen y diez minutos de usted. Eso sí lo firmo.”
Conclusiones clave
Conjunto de referencia
- Un conjunto de referencia es fijo, representativo y anterior: 60 preguntas inventadas con su respuesta esencial, su página fuente y su conducta correcta, escritas antes de ver al agente.
- La mitad del conjunto no se responde con la base (10 sin respuesta y 10 que deben escalar), y los alérgenos pesan el $23%$ aunque en el tráfico pesen menos: se sobrerrepresenta lo grave.
- La huella SHA-256 (
db081612b0cde669) es la versión real del examen; cada incidente real entra en la versión siguiente reescrito sin datos personales.
Métricas y juez
- Siete métricas con su propio denominador: con 300 tokens, exactitud $36$ de $40$, citas correctas $35$ de $36$, “no lo sé” correcto $8$ de $10$ y escalado $9$ de $10$; un oráculo saca $1.0$ y un agente nulo $0.0$, así que el medidor funciona.
- El juez con rúbrica, ejemplos anclados, orden aleatorio y salida estructurada coincide con Valeria en $54$ de $60$, pero con $\kappa = 0.568$ el acuerdo es moderado según Landis y Koch, y aprueba $2$ de $7$ respuestas malas.
- Todo lo que el juez aprueba en alérgenos y en escalados lo revisa una persona; con $36$ de $40$, el intervalo de Wilson es $[0.769, 0.960]$, y distinguir $0.90$ de $0.93$ pediría unas $1,600$ preguntas.
Regresiones
- La comparación es pareada: con 150 tokens empeoran $4$ preguntas y no mejora ninguna ($p = 0.125$); con 600 empeoran $6$ ($p = 0.031$), una de alérgenos, aunque su recall@3 sea el más alto.
- La puerta de tres cerrojos (ningún alérgeno empeora, la exactitud no baja más de una pregunta, citas correctas de $0.85$ o más) bloquea las dos configuraciones sin esperar a la significancia.
TL Evaluación del agente v1corre el examen cada lunes y en cada cambio por unos $0.05$ USD por corrida y $0.37$ USD al mes con Haiku 5.5; con Opus 5.5 como juez costaría $8.80$ USD al mes, más que todo el rubro de Claude.
Mañana, en el Día 71: De la idea al calendario editorial: textos e imágenes con IA. Con el agente de mostrador evaluado y vigilado cada lunes, Valeria pasa a la otra mitad del módulo: llevar las publicaciones de redes de Trigo Lento de una lista de ideas sueltas a un calendario editorial en el que Claude propone los textos, las fotografías son del obrador y una persona aprueba cada pieza antes de publicarla.
Referencias
- Cohen, J. (1960). A Coefficient of Agreement for Nominal Scales. Educational and Psychological Measurement, 20(1), 37-46. https://doi.org/10.1177/001316446002000104
- Landis, J. R. y Koch, G. G. (1977). The Measurement of Observer Agreement for Categorical Data. Biometrics, 33(1), 159-174. https://pubmed.ncbi.nlm.nih.gov/843571/ (revisado en octubre de 2026).
- Zheng, L., Chiang, W.-L., Sheng, Y., Zhuang, S., Wu, Z., Zhuang, Y., Lin, Z., Li, Z., Li, D., Xing, E. P., Zhang, H., Gonzalez, J. E. y Stoica, I. (2023). Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. NeurIPS 2023, Datasets and Benchmarks. https://arxiv.org/abs/2306.05685 (revisado en octubre de 2026).
- Es, S., James, J., Espinosa-Anke, L. y Schockaert, S. (2024). RAGAS: Automated Evaluation of Retrieval Augmented Generation. Proceedings of the 18th Conference of the European Chapter of the Association for Computational Linguistics: System Demonstrations, 150-158. https://aclanthology.org/2024.eacl-demo.16 (revisado en octubre de 2026).
- McNemar, Q. (1947). Note on the Sampling Error of the Difference Between Correlated Proportions or Percentages. Psychometrika, 12(2), 153-157. https://doi.org/10.1007/BF02295996 (revisado en octubre de 2026).
- Wilson, E. B. (1927). Probable Inference, the Law of Succession, and Statistical Inference. Journal of the American Statistical Association, 22(158), 209-212.
- Kohavi, R., Tang, D. y Xu, Y. (2020). Trustworthy Online Controlled Experiments: A Practical Guide to A/B Testing. Cambridge University Press.