
Arquitecto de automatización con IA: Día 71
 Jeshua Romero Guadarrama
- 63 Min para leer
- 12 Apr, 2026
Índice de contenido
Resumen:
Trigo Lento publica en redes cuando alguien se acuerda, y la última publicación de Instagram tiene diecinueve días. En esta entrada, Valeria planea mayo de 2026 con un generador de calendario que respeta temporadas y la capacidad del obrador ($12$ publicaciones y $36$ piezas en tres redes), escribe el manual de voz como datos, pide borradores con salidas estructuradas y el manual en un system cacheado, usa la visión de Claude solo para describir y recortar fotografías reales, revisa cada borrador con una lista automática antes de que lo lea una persona y lleva el calendario a una base de Notion. Al terminar, usted sabrá montar un flujo editorial en el que la IA redacta, el código comprueba y una persona aprueba, por unos $0.30$ USD al mes y $9.5$ horas menos de trabajo.
¿Cómo citar el presente artículo?
Romero, J. (12 de abril de 2026). Arquitecto de automatización con IA: Día 71. python-data-engineer. https://www.python-data-engineer.com/post/aai/dia_71/.
Arquitecto de automatización con IA: Día 71 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/aai/dia_71/.
Precios, límites y políticas revisados en octubre de 2026: planes, precios y límites de Make, n8n, Zapier, WhatsApp (Meta, Twilio, Wati) y de la API de Claude. Los precios de Sonnet 5.5 (2.00 y 10.00 USD por millón de tokens de entrada y de salida; lectura de caché a 0.05 veces la entrada) son los de la Tabla A del plan y del Día 67. Los límites de formato de Instagram, Facebook y LinkedIn de la Tabla 3 se contrastaron en octubre de 2026 con la documentación de Meta para desarrolladores y con fuentes secundarias, que no siempre coinciden; donde discrepan se dice. La API de Notion se usa con la versión 2026-03-11, la misma del Día 68. Los bloques 4, 5 y 8 llaman a servicios reales y no se ejecutaron para escribir la entrada; sus salidas son ejemplos comentados.
Día 71. De la idea al calendario editorial: textos e imágenes con IA
Introducción
Ayer, en el Día 70 (Laboratorio guiado: evaluar al agente con un conjunto de preguntas de referencia), Valeria le puso al agente de pedidos un examen de sesenta preguntas con sus respuestas esperadas, separó la exactitud de la fidelidad y de las citas, calibró al juez automático contra su propio criterio con la kappa de Cohen y comprobó que bajar los fragmentos a $150$ tokens no pasaba la puerta de regresión, y Trigo Lento ganó TL Evaluación del agente v1, que vuelve a examinar al agente con cada cambio. El agente que contesta ya tiene examen. Hoy el módulo cambia de mostrador: del cliente que pregunta al cliente que todavía no sabe que Trigo Lento existe.
Es domingo 12 de abril. Abril va a la mitad, la primavera ya llegó a la Narvarte y la tienda cierra a las dos de la tarde. Mientras cuadra la caja, Valeria abre la cuenta de Instagram de la panadería y hace una cuenta incómoda: la última publicación tiene diecinueve días, es una foto de conchas con un texto de tres palabras, y la anterior es de febrero. En Facebook la página no se mueve desde enero, y la de LinkedIn, que abrió en marzo para hablar con cafeterías y oficinas como la Cafetería Brújula de Marisol, tiene una sola publicación. Trigo Lento publica cuando alguien se acuerda, y casi nunca se acuerda nadie: entre semana el mostrador no da tregua, y los domingos por la tarde nadie quiere escribir.
Valeria sabe que el problema no es de talento sino de proceso. Las ideas existen (el pan de muerto, la masa madre de dieciocho horas, los pasteles del 10 de mayo), pero no están en ningún lado, nadie decide qué se publica cuándo, y cada pieza se escribe desde cero, tres veces, porque Instagram, Facebook y LinkedIn piden cosas distintas. Le propone a su padre usar a Claude para los borradores. Don Ernesto, que tiene opiniones firmes sobre cómo se habla de su pan, no se opone; pone una condición: “Que no digan que mi pan es artesanal de origen ancestral; es pan bien hecho. Y que nadie diga que algo es sin gluten, porque aquí todo lleva trigo. Si la máquina escribe una mentira bonita, la firmamos nosotros.”
La objeción tiene tres capas, y las tres son de arquitectura. La primera es de voz: un modelo de lenguaje, sin instrucciones, escribe como escribe la publicidad promedio, con adjetivos grandes y promesas vagas. La segunda es legal: en México, la Ley Federal de Protección al Consumidor exige que la publicidad sea veraz y comprobable, y una afirmación de salud o de “sin gluten” sin respaldo es exactamente lo que no se puede publicar. La tercera es de responsabilidad: lo que sale en la cuenta de Trigo Lento lo dice Trigo Lento, lo haya redactado quien lo haya redactado. Las tres se resuelven igual que en los días anteriores: con reglas escritas como datos, con código que las comprueba y con una persona que aprueba antes de publicar.
En la presente entrada, descubrirá cómo convertir un puñado de ideas sueltas en un calendario editorial mensual que respeta las temporadas y la capacidad del obrador, cómo escribir un manual de voz que sirve a la vez de instrucción para el modelo y de regla para el código, y cómo pedir borradores para tres redes con salidas estructuradas y el manual en un system que se cachea. Verá qué hace la visión de Claude con una fotografía real del obrador (describirla, proponer su texto alternativo y sugerir recortes) y por qué no se le piden fotos de pan que no existe; construirá una plantilla de rótulos con matplotlib que comprueba el precio y el contraste; pondrá una lista de comprobación automática delante de la revisión humana, llevará el calendario a una base de datos de Notion con un estado por pieza y terminará midiendo tiempo y coste frente al trabajo manual.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Construir un calendario editorial mensual en Notion a partir de temporadas, productos y capacidad del obrador.
- Generar borradores de texto por red (Instagram, Facebook, LinkedIn) con un manual de voz de la marca y salida estructurada.
- Preparar imágenes a partir de fotografías reales: textos alternativos y recortes sugeridos con la visión de Claude, y plantillas de rótulos con matplotlib.
- Medir tiempo y coste del flujo editorial frente al trabajo manual, con revisión humana de cada pieza.
El calendario editorial
Un calendario editorial es la lista de lo que se va a publicar, cuándo, dónde y sobre qué, decidida antes de escribir una sola línea. Parece burocracia y es lo contrario: separa la decisión de qué contar (que exige criterio de negocio y la toma Valeria con su padre una vez al mes) de la tarea de redactar (que se repite treinta y seis veces y es la que conviene delegar). Sin calendario, cada publicación es una decisión urgente tomada el día que toca; con calendario, el día que toca solo hay que revisar un borrador.
El calendario de Trigo Lento descansa en cuatro pilares de contenido, las cuatro cosas de las que la panadería tiene algo verdadero que decir:
- Producto: una pieza del catálogo con su precio, sus alérgenos declarados y cómo se encarga.
- Oficio: cómo se hace el pan (la fermentación de dieciocho horas, el laminado del croissant, las tres horneadas de baguette), contado con datos que se pueden comprobar en el obrador.
- Temporada: fechas con demanda propia (el 10 de mayo, el Día del Maestro, el pan de muerto), publicadas antes de la fecha límite de encargo, no el mismo día.
- Comunidad: la colonia, el equipo, el pan del día anterior a mitad de precio; nunca reseñas inventadas ni sorteos para ganar seguidores, que la serie prohíbe desde el Día 6.
Valeria fija la frecuencia con la capacidad real del equipo, no con lo que recomiendan los blogs de mercadotecnia: tres publicaciones por semana (martes, jueves y sábado), cada una en las tres redes. La capacidad pone además dos reglas que un calendario genérico no conoce. La primera, de cierre: el viernes 1 de mayo la tienda está cerrada, como dice el aviso de temporada que el agente del Día 69 ya cita. La segunda, de obrador lleno: el sábado 9 de mayo, víspera del Día de las Madres, nadie tiene tiempo de revisar una publicación, y además no tiene sentido anunciar pasteles enteros la semana en que el horno ya no admite más encargos. El primer bloque prepara las importaciones, la semilla y el catálogo de la serie:
# Importaciones base, semilla de la serie, carpeta del día y catálogo en Python:
import warnings
warnings.filterwarnings('ignore')
import hashlib
import json
import re
from datetime import date, timedelta
from pathlib import Path
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from matplotlib.patches import Rectangle

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 140)
pd.set_option('display.max_colwidth', 60)
carpeta = Path('trigo_lento') / 'dia_71'
carpeta.mkdir(parents = True, exist_ok = True)
catalogo = {p['clave']: p for p in json.loads((Path('trigo_lento') / 'catalogo.json').read_text(encoding = 'utf-8'))}
print('numpy', np.__version__, '| pandas', pd.__version__, '| productos en el catálogo:', len(catalogo))
numpy 2.4.6 | pandas 3.0.3 | productos en el catálogo: 12
El catálogo es el catalogo.json del Día 1, con los $12$ productos y sus precios en pesos. Todo lo que hoy diga un precio, sea un borrador, un rótulo o una página de Notion, se comprobará contra este archivo y contra ningún otro.
Generar el mes con reglas
El calendario se genera con código porque sus reglas son pocas y precisas, y porque el mes que viene se generará igual cambiando solo las fechas. El orden de las reglas importa: primero se descartan los días sin publicación (cerrado y obrador lleno), después se reservan los huecos de temporada, contando hacia atrás desde la fecha límite de encargo, y al final se reparten los demás pilares con una cuota y la condición de no repetir el mismo pilar dos veces seguidas. Para los productos hay dos restricciones más: ninguno se repite en catorce días y los pasteles enteros no se anuncian en la semana del 10 de mayo. El siguiente bloque genera el calendario y lo dibuja como una cuadrícula mensual:
# Generador del calendario editorial de mayo de 2026 con reglas de frecuencia, temporada y capacidad en Python:
DIAS = ['lunes', 'martes', 'miércoles', 'jueves', 'viernes', 'sábado', 'domingo']
REDES = ['instagram', 'facebook', 'linkedin']
PUBLICA = {1, 3, 5}                                  # martes, jueves y sábado (weekday de Python)
CERRADO = {date(2026, 5, 1)}                         # aviso del puente del 1 de mayo
SATURADO = {date(2026, 5, 9)}                        # víspera del 10 de mayo: nadie revisa publicaciones
TEMPORADA = [  # (fecha límite de encargo, motivo, producto, publicaciones antes del límite)
    (date(2026, 5, 7), 'Día de las Madres: encargos hasta el 7 de mayo', 'P09', 2),
    (date(2026, 5, 13), 'Día del Maestro: cajas para la escuela', 'P10', 1),
]
CUOTA = {'producto': 4, 'oficio': 3, 'comunidad': 2}  # más 3 de temporada = 12 publicaciones
OFICIO = [('La masa madre fermenta 18 horas', 'P01'), ('Así se lamina un croissant', 'P05'),
          ('La baguette sale del horno tres veces al día', 'P02')]
COMUNIDAD = [('Pan del día anterior a mitad de precio después de las 18 h', 'P04'),
             ('Detrás del mostrador: el equipo de seis personas', None)]
PASTELES = {'P08', 'P09', 'P12'}                     # capacidad: no se anuncian en la semana del 10 de mayo
SEMANA_MADRES = (date(2026, 5, 4), date(2026, 5, 10))

huecos = [d for d in (date(2026, 5, 1) + timedelta(i) for i in range(31))
          if d.weekday() in PUBLICA and d not in CERRADO | SATURADO]
plan = {}
for limite, motivo, clave, n in TEMPORADA:          # temporada primero: los últimos huecos antes del límite
    previos = [d for d in huecos if d < limite and d not in plan][-n:]
    for d in previos:
        plan[d] = ('temporada', motivo, clave)

restante, anterior = dict(CUOTA), None
oficio, comunidad = iter(OFICIO), iter(COMUNIDAD)
candidatos = [c for c in rng.permutation(sorted(catalogo)) if c not in {'P09', 'P10'}]
usados = {}
for d in huecos:
    if d in plan:
        anterior = plan[d][0]
        continue
    pilar = max((p for p in restante if restante[p] > 0 and p != anterior), key = lambda p: restante[p],
                default = anterior)
    restante[pilar] -= 1
    if pilar == 'producto':
        clave = next(c for c in candidatos
                     if (d - usados.get(c, date(2000, 1, 1))).days > 14
                     and not (c in PASTELES and SEMANA_MADRES[0] <= d <= SEMANA_MADRES[1]))
        candidatos.remove(clave)
        tema = catalogo[clave]['producto']
    else:
        tema, clave = next(oficio) if pilar == 'oficio' else next(comunidad)
    usados[clave] = d
    plan[d] = (pilar, tema, clave)
    anterior = pilar

calendario = pd.DataFrame([{'fecha': d, 'dia': DIAS[d.weekday()], 'pilar': p, 'tema': t, 'producto': c or '-',
                            'redes': len(REDES), 'estado': 'idea'} for d, (p, t, c) in sorted(plan.items())])
print(calendario.to_string(index = False))
print('Publicaciones:', len(calendario), '| piezas (por red):', calendario['redes'].sum(),
      '| por pilar:', calendario['pilar'].value_counts().to_dict())
calendario.to_csv(carpeta / 'calendario_mayo_2026.csv', index = False)

COLORES = {'producto': '#2a78d6', 'oficio': '#eb6834', 'temporada': '#7b4fc9', 'comunidad': '#2e9e5b'}
fig, ax = plt.subplots(figsize = (9.0, 5.6))
primero = date(2026, 5, 1).weekday()
for i in range(31):
    d = date(2026, 5, 1) + timedelta(i)
    fila, col = (i + primero) // 7, d.weekday()
    x, y = col, -fila
    color, borde = 'white', '#c9c8c4'
    if d in plan:
        color = COLORES[plan[d][0]]
    ax.add_patch(Rectangle((x, y), 0.96, 0.92, facecolor = color, edgecolor = borde, lw = 1,
                           hatch = '///' if d in CERRADO | SATURADO else None))
    ax.text(x + 0.06, y + 0.78, str(d.day), fontsize = 9, color = 'white' if d in plan else '#52514e',
            fontweight = 'bold')
    if d in plan:
        ax.text(x + 0.48, y + 0.36, plan[d][0], fontsize = 8, color = 'white', ha = 'center')
    elif d in CERRADO:
        ax.text(x + 0.48, y + 0.36, 'cerrado', fontsize = 8, color = '#52514e', ha = 'center')
    elif d in SATURADO:
        ax.text(x + 0.48, y + 0.36, 'obrador lleno', fontsize = 7.5, color = '#52514e', ha = 'center')
for col, nombre in enumerate(DIAS):
    ax.text(col + 0.48, 1.12, nombre, ha = 'center', fontsize = 9, color = '#52514e')
for pilar, color in COLORES.items():
    ax.bar(0, 0, color = color, label = f'{pilar} ({(calendario.pilar == pilar).sum()})')
ax.legend(loc = 'upper center', bbox_to_anchor = (0.5, -0.02), ncol = 4, frameon = False, fontsize = 9)
ax.set_xlim(-0.1, 7.05)
ax.set_ylim(-4.15, 1.35)
ax.axis('off')
ax.set_title('Calendario editorial de mayo de 2026: 12 publicaciones, 36 piezas', fontsize = 13)
plt.tight_layout()
plt.show()
     fecha    dia     pilar                                                       tema producto  redes estado
2026-05-02 sábado temporada             Día de las Madres: encargos hasta el 7 de mayo      P09      3   idea
2026-05-05 martes temporada             Día de las Madres: encargos hasta el 7 de mayo      P09      3   idea
2026-05-07 jueves  producto                           Galletas de avena (paquete de 6)      P07      3   idea
2026-05-12 martes temporada                     Día del Maestro: cajas para la escuela      P10      3   idea
2026-05-14 jueves  producto                                       Baguette tradicional      P02      3   idea
2026-05-16 sábado    oficio                            La masa madre fermenta 18 horas      P01      3   idea
2026-05-19 martes  producto                                        Pay de queso entero      P12      3   idea
2026-05-21 jueves    oficio                                 Así se lamina un croissant      P05      3   idea
2026-05-23 sábado comunidad Pan del día anterior a mitad de precio después de las 18 h      P04      3   idea
2026-05-26 martes  producto                                       Pan de caja integral      P03      3   idea
2026-05-28 jueves    oficio               La baguette sale del horno tres veces al día      P02      3   idea
2026-05-30 sábado comunidad           Detrás del mostrador: el equipo de seis personas        -      3   idea
Publicaciones: 12 | piezas (por red): 36 | por pilar: {'producto': 4, 'temporada': 3, 'oficio': 3, 'comunidad': 2}
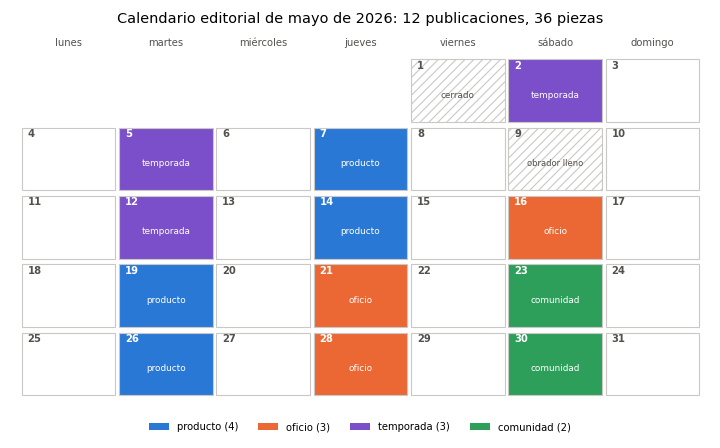
El generador produce $12$ publicaciones y $36$ piezas (una por red), con $4$ de producto, $3$ de temporada, $3$ de oficio y $2$ de comunidad, como se muestra en la Tabla 1.
Tabla 1. Calendario editorial de mayo de 2026 generado con reglas de frecuencia, temporada y capacidad (cada publicación sale en Instagram, Facebook y LinkedIn).
| Fecha | Día | Pilar | Tema | Producto | Estado |
|---|---|---|---|---|---|
| 2 de mayo | sábado | temporada | Día de las Madres: encargos hasta el 7 de mayo | P09 | idea |
| 5 de mayo | martes | temporada | Día de las Madres: encargos hasta el 7 de mayo | P09 | idea |
| 7 de mayo | jueves | producto | Galletas de avena (paquete de 6) | P07 | idea |
| 12 de mayo | martes | temporada | Día del Maestro: cajas para la escuela | P10 | idea |
| 14 de mayo | jueves | producto | Baguette tradicional | P02 | idea |
| 16 de mayo | sábado | oficio | La masa madre fermenta 18 horas | P01 | idea |
| 19 de mayo | martes | producto | Pay de queso entero | P12 | idea |
| 21 de mayo | jueves | oficio | Así se lamina un croissant | P05 | idea |
| 23 de mayo | sábado | comunidad | Pan del día anterior a mitad de precio después de las 18 h | P04 | idea |
| 26 de mayo | martes | producto | Pan de caja integral | P03 | idea |
| 28 de mayo | jueves | oficio | La baguette sale del horno tres veces al día | P02 | idea |
| 30 de mayo | sábado | comunidad | Detrás del mostrador: el equipo de seis personas | - | idea |
La cuadrícula enseña lo que la tabla esconde. Las dos publicaciones del Día de las Madres caen el sábado 2 y el martes 5, antes del jueves 7, que es el último día para encargar; publicarlas el 9 o el 10 habría sido anunciar algo que ya no se puede comprar. La del Día del Maestro sale el martes 12, la víspera del límite del 13. El jueves 7, que en el hueco de producto podía haber sido un pastel, queda para las galletas de avena porque la regla de capacidad aparta los pasteles enteros de la semana del 4 al 10. Y el sábado 9, rayado en la figura, no tiene publicación: no porque falte una idea, sino porque falta una persona libre para revisarla.
Hay dos decisiones que el código no tomó y conviene decirlas. El reparto de $4$, $3$, $3$ y $2$ lo fijaron Valeria y Don Ernesto: producto pesa más porque es lo que se vende, y comunidad pesa menos porque es lo que más fácilmente cae en el relleno. Y la publicación del 30 de mayo, sobre el equipo, tiene una condición previa que ningún algoritmo puede cumplir: que las seis personas acepten salir en la foto, por escrito.
Ideas, borradores y piezas aprobadas
Antes de seguir conviene ver el flujo entero, porque cada sección de esta entrada es una de sus etapas. La Figura 1 dibuja el flujo completo como una cocina, con la metáfora que Don Ernesto entiende sin explicación: las ideas del calendario entran como harina, se amasan en borradores con el manual de voz, reposan en una revisión automática que devuelve a la artesa lo que no está bien, y solo entra al horno lo que aprueba una persona.
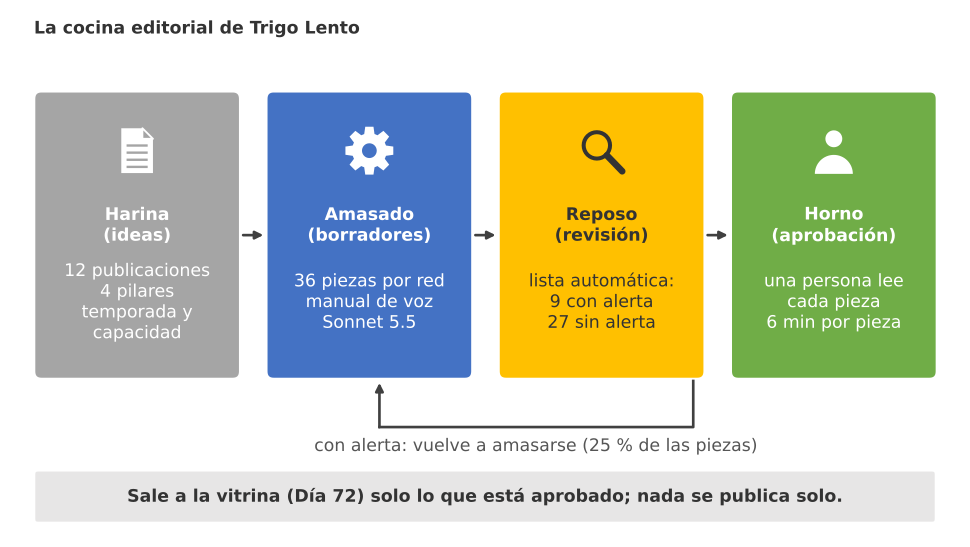
Figura 1. La cocina editorial: 12 ideas del calendario entran como harina, se amasan en 36 borradores con el manual de voz y la lista de comprobación, y solo las piezas que aprueba una persona salen del horno.
Lo importante del dibujo es la flecha que regresa. En una cocina, una masa que no levantó no se hornea “a ver qué pasa”: se vuelve a trabajar. En el flujo editorial, un borrador con una alerta no llega a la persona que aprueba como si estuviera bien; vuelve a redactarse, y esa vuelta tiene un coste que la última sección pondrá en números.
El manual de voz
Un manual de voz (o guía de estilo de marca) dice cómo habla una marca: qué tono usa, qué palabras prefiere, cuáles evita y qué afirmaciones no hace nunca. En una empresa grande es un documento de cuarenta páginas que nadie lee. En Trigo Lento tiene que ser corto, porque lo van a leer dos lectores muy distintos: el modelo, que lo recibirá como instrucción en cada petición, y el código de la lista de comprobación, que lo usará como regla. Por eso Valeria no lo escribe en un documento de texto, sino como una estructura de datos: las mismas listas que el modelo lee como ejemplos son las que el código recorre con expresiones regulares.
El manual tiene cinco partes. El tono recoge lo que Don Ernesto dijo con otras palabras durante semanas: de usted, concreto, orgulloso sin exagerar. Las listas de hacer y no hacer van con ejemplos, porque un modelo aprende mucho más de un par “así no, así sí” que de un adjetivo. Las palabras prohibidas se agrupan por motivo (exageración, salud, “sin gluten”, comparación, urgencia falsa), y el motivo importa: no es lo mismo una frase cursi que una afirmación que la Procuraduría Federal del Consumidor podría considerar engañosa. Y el formato fija por red los objetivos de la casa, más estrictos que los límites de cada plataforma. Al final se añaden el catálogo y tres publicaciones de abril que Don Ernesto aprobó, como ejemplos anclados del estilo. El siguiente bloque escribe el manual, arma el system congelado y calcula su huella:
# Manual de voz de Trigo Lento como estructura de datos y system congelado con su huella en Python:
MANUAL_VOZ = {
    'marca': 'Trigo Lento, panadería de masa madre en la colonia Narvarte, Ciudad de México',
    'tono': ['de usted, cercano y sin prisa', 'concreto: ingredientes, horas, fechas y precios reales',
             'orgulloso del oficio sin adjetivos grandilocuentes', 'una idea por publicación'],
    'hacer': [
        ('Nombrar el pan como se llama en el mostrador', 'Concha de vainilla, no "pan dulce tradicional"'),
        ('Contar el oficio con datos verificables', 'La masa madre fermenta 18 horas'),
        ('Dar el precio del catálogo con su moneda', 'Pastel de chocolate entero: 460 MXN'),
        ('Terminar con una sola llamada a la acción', 'Encárguelo por WhatsApp hasta el jueves 7'),
        ('Avisar los alérgenos declarados cuando se habla de un producto', 'Contiene gluten, huevo y lácteos'),
    ],
    'no_hacer': [
        ('Exagerar el origen', 'artesanal de origen ancestral', 'pan bien hecho, con 18 horas de fermentación'),
        ('Prometer efectos en la salud', 'saludable y nutritivo', 'hecho con harina integral de trigo'),
        ('Decir "sin gluten" sin certificación', 'apto para celiacos', 'todo el obrador trabaja con trigo'),
        ('Compararse con otros negocios', 'mejor que el pan de cadena', 'lo horneamos en la madrugada'),
        ('Inventar urgencia o escasez', 'últimas piezas, solo hoy', 'se encarga con 48 horas de anticipación'),
    ],
    'prohibidas': {
        'exageracion': [r'ancestral', r'\bel mejor\b', r'\bmilenari', r'\búnic[oa] en\b', r'100 ?% natural'],
        'salud': [r'saludable', r'nutritiv', r'\blight\b', r'sin culpa', r'\bcura\b', r'adelgaz'],
        'sin_gluten': [r'sin gluten', r'libre de gluten', r'apto para celiac', r'gluten free'],
        'comparacion': [r'mejor que', r'a diferencia de otras', r'de cadena'],
        'urgencia_falsa': [r'[úu]ltimas piezas', r'solo hoy', r'corra'],
    },
    'formato': {  # objetivos de la casa, por debajo de los límites de cada red (Tabla 3)
        'instagram': {'max_caracteres': 600, 'max_etiquetas': 5},
        'facebook': {'max_caracteres': 500, 'max_etiquetas': 3},
        'linkedin': {'max_caracteres': 1300, 'max_etiquetas': 3},
    },
    'llamadas_accion': ['Encárguelo por WhatsApp', 'Pase por la tienda de 7 a 20 h',
                        'Escríbanos para pedidos de mayoreo'],
    'etiquetado_ia': 'Los textos se redactan con ayuda de IA y los revisa y aprueba una persona del equipo.',
}
APROBADAS = [  # tres publicaciones de abril que Don Ernesto aprobó: ejemplos anclados del estilo
    'La hogaza de masa madre fermenta 18 horas antes de entrar al horno. Solo lleva harina de trigo, agua '
    'y sal. 95 MXN la pieza de 800 g. Pase por ella a la tienda de 7 a 20 h.',
    'Los martes horneamos pan de caja integral con ajonjolí por fuera. Contiene gluten y ajonjolí. '
    '72 MXN. Encárguelo por WhatsApp con un día de anticipación.',
    'Cafeterías de la Narvarte: horneamos baguettes tres veces al día y las entregamos antes de las 8. '
    'Escríbanos para pedidos de mayoreo con factura semanal.',
]
system_manual = ('Usted redacta borradores de publicaciones para redes sociales de Trigo Lento. '
                 'Siga el manual de voz, use solo los productos y precios del catálogo y devuelva un borrador '
                 'por red. Una persona revisa y aprueba cada pieza antes de publicarla.\n\n'
                 'MANUAL DE VOZ:\n' + json.dumps(MANUAL_VOZ, ensure_ascii = False, sort_keys = True, indent = 1)
                 + '\n\nCATÁLOGO:\n' + json.dumps(list(catalogo.values()), ensure_ascii = False, sort_keys = True)
                 + '\n\nPUBLICACIONES APROBADAS (ejemplos de estilo):\n' + '\n'.join(f'- {t}' for t in APROBADAS))
huella = hashlib.sha256(system_manual.encode('utf-8')).hexdigest()[:16]
tokens_system = round(len(system_manual) / 3.5)        # aproximación; count_tokens da la cifra exacta
(carpeta / 'manual_de_voz.json').write_text(json.dumps(MANUAL_VOZ, ensure_ascii = False, indent = 1),
                                            encoding = 'utf-8')
print(f'System: {len(system_manual):,} caracteres | unos {tokens_system:,} tokens | huella {huella}')
print('¿Supera el prefijo mínimo cacheable de 512 tokens?', tokens_system >= 512)
print('Reglas: hacer', len(MANUAL_VOZ['hacer']), '| no hacer', len(MANUAL_VOZ['no_hacer']),
      '| patrones prohibidos', sum(len(v) for v in MANUAL_VOZ['prohibidas'].values()))
for regla, mal, bien in MANUAL_VOZ['no_hacer']:
    print(f'  No: {regla:<38} "{mal}"  ->  "{bien}"')
System: 4,136 caracteres | unos 1,182 tokens | huella 2900795eba584a30
¿Supera el prefijo mínimo cacheable de 512 tokens? True
Reglas: hacer 5 | no hacer 5 | patrones prohibidos 21
  No: Exagerar el origen                     "artesanal de origen ancestral"  ->  "pan bien hecho, con 18 horas de fermentación"
  No: Prometer efectos en la salud           "saludable y nutritivo"  ->  "hecho con harina integral de trigo"
  No: Decir "sin gluten" sin certificación   "apto para celiacos"  ->  "todo el obrador trabaja con trigo"
  No: Compararse con otros negocios          "mejor que el pan de cadena"  ->  "lo horneamos en la madrugada"
  No: Inventar urgencia o escasez            "últimas piezas, solo hoy"  ->  "se encarga con 48 horas de anticipación"
El system mide $4,136$ caracteres, unos $1,182$ tokens, y su huella es 2900795eba584a30. Las dos cifras tienen una función. La de tokens dice que el prefijo supera con holgura el mínimo de $512$ tokens que la documentación indica para cachear en los modelos 5.5, así que la caché del Día 61 (Caché de prompts para flujos recurrentes) va a funcionar; la estimación divide caracteres entre $3.5$ y es solo una aproximación, que client.messages.count_tokens convierte en la cifra exacta. La huella detecta cualquier cambio: el manual se serializa con sort_keys=True precisamente para que dos ensamblados del mismo manual den la misma huella, y si un día alguien añade una palabra prohibida, la huella cambia, la caché se escribe de nuevo una sola vez y el registro deja constancia de qué versión del manual redactó cada pieza.
Tabla 2. Manual de voz de Trigo Lento: hacer y no hacer, con ejemplos (versión con huella 2900795eba584a30).
| Regla | Así no | Así sí | Motivo |
|---|---|---|---|
| Exagerar el origen | “artesanal de origen ancestral” | “pan bien hecho, con 18 horas de fermentación” | Voz de la casa |
| Prometer efectos en la salud | “saludable y nutritivo” | “hecho con harina integral de trigo” | Publicidad veraz |
| Decir “sin gluten” sin certificación | “apto para celiacos” | “todo el obrador trabaja con trigo” | Salud de los clientes |
| Compararse con otros negocios | “mejor que el pan de cadena” | “lo horneamos en la madrugada” | Publicidad comparativa |
| Inventar urgencia o escasez | “últimas piezas, solo hoy” | “se encarga con 48 horas de anticipación” | Publicidad veraz |
| Nombrar el pan como en el mostrador | “pan dulce tradicional” | “concha de vainilla” | Voz de la casa |
| Dar el precio del catálogo con su moneda | “a un precio increíble” | “pastel de chocolate entero: 460 MXN” | Exactitud |
| Avisar los alérgenos declarados | (no decir nada) | “contiene gluten, huevo y lácteos” | Salud de los clientes |
La Tabla 2 junta las dos mitades del manual. Las cinco primeras filas son las que el código vigila con $21$ patrones; las tres últimas son las que el modelo debe cumplir y la persona que revisa debe comprobar, porque no hay expresión regular que sepa si una foto es de una concha o de un cuerno. Esa frontera entre lo que se comprueba con código y lo que se comprueba con ojos es la misma del Día 67 (Sesión práctica de consolidación: el informe de negocio del lunes): cada capa atrapa lo que la anterior deja pasar.
Atención aquí: el manual de voz no sustituye a la ley ni a la etiqueta del producto. La Ley Federal de Protección al Consumidor exige que la información y la publicidad sean veraces y comprobables, y una frase como “sin gluten”, “apto para celiacos” o “saludable” necesita un respaldo que Trigo Lento no tiene: su obrador trabaja con harina de trigo y no certifica nada. Si un borrador la incluye, no se corrige “suavizándola”; se elimina. Ante cualquier duda sobre alérgenos, la publicación remite al personal, igual que el agente del Día 69.
Borradores por red
Con el calendario y el manual, Valeria puede pedir borradores. La pregunta de diseño es qué pedir exactamente, y la respuesta tiene tres partes: un borrador por red, porque las tres redes no son la misma vitrina; en una salida estructurada, porque el código tiene que leer cada borrador sin adivinar dónde empieza el texto y dónde las etiquetas; y con el manual en un system cacheado, porque las doce peticiones del mes comparten ese prefijo palabra por palabra.
Tres redes, tres formatos
Las tres redes difieren en lo que se ve, en cuánto se lee y en quién lo lee. Instagram es una red de imágenes: la gente ve la foto y, si le interesa, lee las primeras palabras antes de que la aplicación corte el texto con un “más”. Facebook es, para la clientela de Trigo Lento, la red de las familias de la colonia, donde una publicación se comparte en un grupo de vecinos. LinkedIn es la red de las oficinas, las cafeterías y los restaurantes que compran pan al mayoreo, el público de Marisol. La Tabla 3 recoge los límites que publican o que se observan en cada red, revisados en octubre de 2026, y los objetivos de la casa que el manual fija por debajo de ellos.
Tabla 3. Formatos por red: límites de cada plataforma (revisado en octubre de 2026) y objetivos de la casa del manual de voz.
| Concepto | |||
|---|---|---|---|
| Límite del texto de la publicación | 2 200 caracteres (fuentes secundarias) | 63 206 caracteres (fuentes secundarias) | 3 000 caracteres |
| Texto visible antes de “más” | unos 125 caracteres | unas pocas líneas | unos 210 en escritorio y 140 en móvil |
| Etiquetas (hashtags) | 30 como máximo por publicación | sin límite práctico | sin límite documentado |
| Imagen de la serie | JPEG, 4:5 (1080 x 1350 px) | 1.91:1 (1200 x 628 px) | 1.91:1 (1200 x 628 px) |
| Objetivo de la casa: longitud | 600 caracteres | 500 caracteres | 1 300 caracteres |
| Objetivo de la casa: etiquetas | 5 | 3 | 3 |
| Publicación por API (Día 72) | 50 o 100 publicaciones cada 24 horas, según la página de Meta que se lea | programación entre 10 minutos y 30 días (otra página de Meta dice 75) | Community Management API, con revisión de acceso |
Dos lecturas de la tabla merecen una frase. La primera: los límites de las plataformas no son el problema, porque nadie lee $2,200$ caracteres en una foto de pan; los objetivos de la casa son los que mandan, y son los que el código comprueba. La segunda: la documentación de Meta se contradice a sí misma en dos cifras de su API de publicación (el tope de publicaciones por día de Instagram y la ventana de programación de Facebook), y la serie no elige la que más le conviene, sino que lo dice y lo deja para el Día 72, que es el que publica de verdad. La Figura 2 pone las tres versiones del mismo mensaje lado a lado.
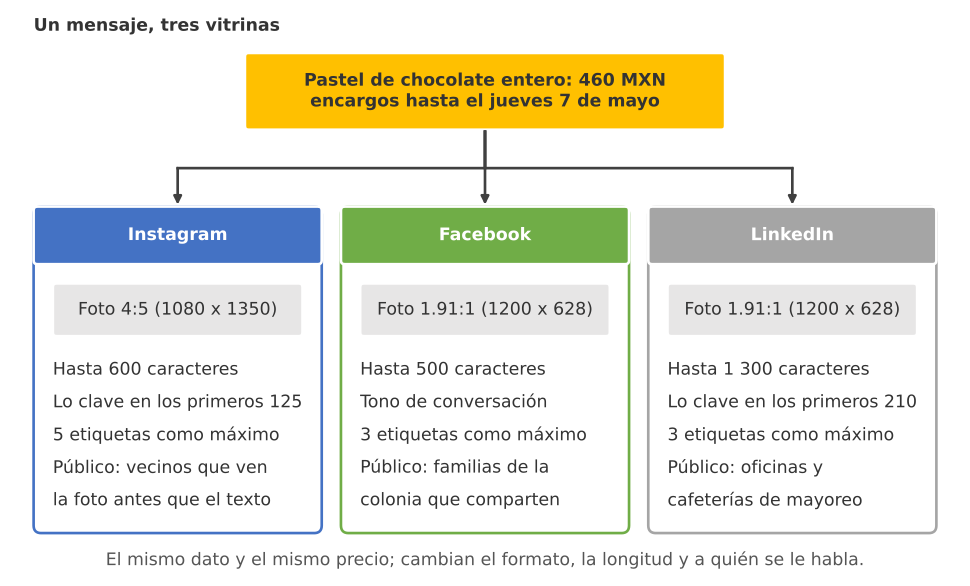
Figura 2. Un mensaje, tres vitrinas: el pastel de chocolate del 10 de mayo, a 460 MXN, contado para Instagram, Facebook y LinkedIn con el formato, la longitud y el público de cada red.
Lo que cambia entre vitrinas es el formato, la longitud y a quién se le habla. Lo que no cambia es el dato: el mismo pastel, el mismo precio, la misma fecha límite. Si el precio de Instagram y el de LinkedIn no coinciden, uno de los dos está mal, y la lista de comprobación lo encontrará.
Salida estructurada y caché del manual
Para que el modelo devuelva tres borradores que el código pueda leer, Valeria define dos modelos de pydantic: Publicacion, con la red, el texto, las etiquetas, la llamada a la acción y una lista de afirmaciones que una persona debe verificar; y LotePublicaciones, que agrupa las tres piezas de una fecha. La llamada usa client.beta.messages.parse con output_format=LotePublicaciones: la API garantiza que la respuesta sigue el esquema y el SDK la valida y la entrega como objeto. La versión beta hace falta por el respaldo del lado del servidor (fallbacks="default"), que la serie activa siempre con Sonnet 5.5 y Opus 5.5: si el modelo rechazara la petición, la API la reintentaría con el modelo de respaldo en la misma llamada.
El modelo es claude-sonnet-5-5, no Opus 5.5 ni Haiku 5.5, y la elección tiene números detrás. Redactar textos cortos para clientes con matices de tono es la tarea para la que la Tabla A del plan reserva a Sonnet 5.5; Haiku 5.5 escribiría más barato, pero el Día 49 (Accesibilidad y multilingüismo de los mensajes) ya usó Sonnet 5.5 para traducir con glosario por la misma razón, y Opus 5.5 costaría el doble por token sin que una publicación de cuatro líneas lo justifique. El esfuerzo va en medium, explícito, y el system lleva cache_control para que la primera petición del mes escriba el manual en la caché y las once siguientes lo lean. Este bloque llama a la API y no se ejecutó para escribir la entrada; la salida es un ejemplo comentado:
# Borradores por red con salidas estructuradas y el manual de voz en un system cacheado en Python:
from typing import List, Literal
import anthropic
from pydantic import BaseModel

class Publicacion(BaseModel):
    red: Literal['instagram', 'facebook', 'linkedin']
    texto: str
    etiquetas: List[str]
    llamada_accion: str
    afirmaciones_a_verificar: List[str]      # lo que una persona debe confirmar antes de aprobar

class LotePublicaciones(BaseModel):
    fecha: str
    publicaciones: List[Publicacion]

client = anthropic.Anthropic()               # lee ANTHROPIC_API_KEY del entorno; nunca en el código
SYSTEM = [{'type': 'text', 'text': system_manual,          # el system congelado del Bloque 3
           'cache_control': {'type': 'ephemeral'}}]         # se escribe una vez y se lee 5 minutos
lotes, uso = [], []
for fila in calendario.itertuples():
    pedido = json.dumps({'fecha': str(fila.fecha), 'pilar': fila.pilar, 'tema': fila.tema,
                         'producto': fila.producto, 'redes': REDES}, ensure_ascii = False, sort_keys = True)
    respuesta = client.beta.messages.parse(
        model = 'claude-sonnet-5-5',
        max_tokens = 4000,
        betas = ['server-side-fallback-2026-07-01'],
        fallbacks = 'default',                              # respaldo del lado del servidor ante un rechazo
        output_config = {'effort': 'medium'},
        system = SYSTEM,
        messages = [{'role': 'user', 'content': 'Redacte un borrador para cada red de esta entrada del '
                                                'calendario. Use solo precios del catálogo. ' + pedido}],
        output_format = LotePublicaciones,
    )
    if respuesta.stop_reason != 'end_turn' or respuesta.parsed_output is None:
        print(fila.fecha, 'sin borrador:', respuesta.stop_reason, '-> lo redacta una persona')
        continue
    lotes.append(respuesta.parsed_output)
    u = respuesta.usage
    uso.append((u.input_tokens, u.cache_creation_input_tokens, u.cache_read_input_tokens, u.output_tokens))

print('Lotes:', len(lotes), '| piezas:', sum(len(l.publicaciones) for l in lotes))
print('Primera petición (entrada, escrita, leída, salida):', uso[0])
print('Segunda petición (entrada, escrita, leída, salida):', uso[1])
for p in lotes[0].publicaciones:
    print(f'[{p.red}] {p.texto}\n  etiquetas: {p.etiquetas} | verificar: {p.afirmaciones_a_verificar}')

# Salida de ejemplo (puede variar):
# Lotes: 12 | piezas: 36
# Primera petición (entrada, escrita, leída, salida): (112, 1174, 0, 1146)
# Segunda petición (entrada, escrita, leída, salida): (109, 0, 1174, 1093)
# [instagram] Para el 10 de mayo, un pastel de chocolate entero de 20 cm, para 10 a 12 personas.
#   Lleva texto de hasta 30 caracteres sin costo. 460 MXN. Encárguelo por WhatsApp hasta el jueves 7.
#   Contiene gluten, huevo y lácteos.
#   etiquetas: ['#TrigoLento', '#DiaDeLasMadres', '#Narvarte'] | verificar: ['fecha límite: 7 de mayo']
# [facebook] Mamá merece un pastel bien hecho. Pastel de chocolate entero, 460 MXN, con su nombre escrito
#   en chocolate blanco. Encárguelo por WhatsApp hasta el jueves 7 de mayo.
#   etiquetas: ['#TrigoLento', '#DiaDeLasMadres'] | verificar: ['texto en chocolate blanco']
# [linkedin] Si su empresa celebra el 10 de mayo con el equipo, horneamos pasteles de chocolate enteros
#   para 10 a 12 personas (460 MXN cada uno). Escríbanos para pedidos de mayoreo antes del jueves 7.
#   etiquetas: ['#TrigoLento', '#DiaDeLasMadres'] | verificar: ['pedidos de empresa con factura']
La salida de ejemplo enseña lo que se quería comprobar. La primera petición escribe en la caché $1,174$ tokens del manual y la segunda los lee: es la señal de que el prefijo es idéntico entre peticiones, la misma comprobación que el Día 61 convirtió en prueba automática. Los tres borradores del 2 de mayo dicen el mismo precio, $460$ MXN, y la misma fecha límite, pero hablan a públicos distintos: Instagram empieza por el producto, Facebook por la ocasión y LinkedIn por las empresas que celebran con su equipo. Y cada borrador trae su lista de afirmaciones a verificar: el modelo no puede saber si este año el chocolate blanco alcanza para escribir nombres, pero sí puede señalar que lo afirmó, para que una persona lo confirme.
Fíjese también en lo que el código hace con una respuesta que no llega completa. Si stop_reason no es end_turn (por un rechazo de toda la cadena o por agotar max_tokens) o si el objeto no se puede leer, esa fecha no recibe borrador y la redacta una persona. No hay prefill, no hay reintentos ciegos y no hay texto a medias que pase como si fuera bueno.
Sobre el etiquetado del contenido generado con IA (revisado en octubre de 2026): Meta muestra la etiqueta “Información de IA” en imágenes y videos fotorrealistas creados o editados de forma notable con IA, detectados por metadatos del sector o declarados por quien publica; LinkedIn muestra las credenciales de contenido (C2PA) cuando una imagen las trae. Trigo Lento no publica imágenes generadas, y sus textos los redacta la IA y los aprueba una persona: lo declara en la biografía de cada cuenta (“Algunos textos se redactan con ayuda de IA y los revisa una persona del equipo”), y cada pieza lleva en Notion la casilla “Asistido por IA”. Si algún día se publicara una imagen generada, se activaría la etiqueta de cada red al publicarla.
Imágenes reales, ayudadas por IA
La regla del módulo sobre imágenes es corta y no admite excepciones: las fotos de producto son fotografías reales del obrador. Claude no genera imágenes, y aunque otra herramienta pudiera hacerlo, una foto de un pan que Trigo Lento no hornea, o de un pan “mejorado” que se ve distinto del que se entrega, es publicidad engañosa con apariencia de foto. Lo que la IA sí puede hacer con una foto real es útil y aburrido, que es la mejor combinación: describirla, proponer su texto alternativo, sugerir dónde recortarla para cada red y avisar si aparece una persona.
Texto alternativo y recorte con la visión de Claude
El texto alternativo es la descripción que leen los lectores de pantalla en lugar de la imagen. El Día 49 lo presentó con Doña Carmen, que usa el lector de su teléfono, y lo convirtió en regla de la casa: cada foto lleva un pie descriptivo. Las tres redes permiten escribirlo al publicar desde su aplicación, y el Día 72 revisará cómo se envía por la API de cada una junto con la foto. El texto alternativo bueno dice qué producto se ve y cómo, no empieza con “imagen de” y no repite el texto de la publicación.
Una foto entra en la petición como un bloque image en base64, antes del texto, y cuesta tokens según su tamaño. La documentación de Claude da una aproximación por área:
$$ T_{\text{imagen}} \approx \frac{w \cdot h}{784} $$
La lógica detrás de esta aproximación es la siguiente:
- $w$ y $h$ son el ancho y el alto de la imagen en píxeles; $784 = 28 \times 28$ es el área del parche que cuenta como un token, según la guía de costes de la documentación, que pide confirmar la fórmula vigente en la página de visión.
- Una foto de $1280 \times 960$ píxeles cuesta unos $1,567$ tokens; la misma foto a $4000 \times 3000$, tal como sale del teléfono, costaría unos $15,306$ y, por encima del tamaño máximo, la API la reduciría de todos modos.
- El coste crece con el área y no con la información: una foto de pan no tiene más detalles útiles a $12$ megapíxeles que a $1.2$.
- En conclusión, la foto se reduce antes de enviarla, a lo que la tarea necesita; para describir un pastel bastan $1280$ píxeles de lado.
El siguiente bloque envía una foto real del obrador, reducida a $1280 \times 960$, y pide con salida estructurada la descripción, el texto alternativo de $125$ caracteres como máximo, si aparecen personas y un recorte por red. El esfuerzo va en low, porque describir una foto no exige razonar. Este bloque llama a la API y no se ejecutó para escribir la entrada; la salida es un ejemplo comentado:
# Texto alternativo y recorte sugerido de una foto real del obrador con la visión de Claude en Python:
import base64

class Recorte(BaseModel):
    red: Literal['instagram', 'facebook', 'linkedin']
    proporcion: str                          # '4:5' o '1.91:1'
    x: float                                 # esquina inferior izquierda y tamaño, en fracciones de la foto
    y: float
    ancho: float
    alto: float

class DescripcionFoto(BaseModel):
    descripcion: str
    texto_alternativo: str                   # 125 caracteres como máximo, sin "imagen de"
    personas_visibles: bool                  # si es True, se exige el consentimiento escrito
    texto_visible: List[str]
    recortes: List[Recorte]
    advertencias: List[str]

INSTRUCCION_FOTO = ('Describa esta fotografía real del obrador de Trigo Lento. Proponga un texto alternativo '
                    'de hasta 125 caracteres que diga qué producto se ve y cómo, sin empezar con "imagen de"; '
                    'indique si aparecen personas o rostros; y sugiera un recorte 4:5 para Instagram y uno '
                    '1.91:1 para Facebook y LinkedIn que deje el producto dentro del margen seguro. '
                    'No invente ingredientes que no se vean.')
ruta_foto = carpeta / 'fotos' / '2026-05-02_pastel_chocolate.jpg'   # foto real reducida a 1280 x 960 px
datos = base64.standard_b64encode(ruta_foto.read_bytes()).decode('utf-8')
respuesta = client.beta.messages.parse(
    model = 'claude-sonnet-5-5',
    max_tokens = 3000,
    betas = ['server-side-fallback-2026-07-01'],
    fallbacks = 'default',
    output_config = {'effort': 'low'},
    messages = [{'role': 'user', 'content': [
        {'type': 'image', 'source': {'type': 'base64', 'media_type': 'image/jpeg', 'data': datos}},
        {'type': 'text', 'text': INSTRUCCION_FOTO}]}],
    output_format = DescripcionFoto,
)
foto = respuesta.parsed_output
assert len(foto.texto_alternativo) <= 125, 'Texto alternativo demasiado largo'
print('Alt:', foto.texto_alternativo, f'({len(foto.texto_alternativo)} caracteres)')
print('Personas visibles:', foto.personas_visibles, '| texto en la foto:', foto.texto_visible)
for r in foto.recortes:
    print(f'  {r.red:<9} {r.proporcion:<7} x={r.x:.2f} y={r.y:.2f} ancho={r.ancho:.2f} alto={r.alto:.2f}')
print('Advertencias:', foto.advertencias)
print('Tokens:', respuesta.usage.input_tokens, 'de entrada,', respuesta.usage.output_tokens, 'de salida')

# Salida de ejemplo (puede variar):
# Alt: Pastel de chocolate entero con betún oscuro y la palabra Mamá en chocolate blanco, sobre una mesa de madera (107 caracteres)
# Personas visibles: True | texto en la foto: ['Mamá']
#   instagram 4:5     x=0.22 y=0.05 ancho=0.56 alto=0.90
#   facebook  1.91:1  x=0.00 y=0.18 ancho=1.00 alto=0.70
#   linkedin  1.91:1  x=0.00 y=0.18 ancho=1.00 alto=0.70
# Advertencias: ['Se ven las manos y parte del rostro de una persona en el borde izquierdo']
# Tokens: 1802 de entrada, 341 de salida
El texto alternativo de ejemplo mide $107$ caracteres y dice lo que importa: el producto, cómo se ve y la palabra escrita en el pastel. Los recortes vienen en fracciones de la foto, así que sirven para cualquier resolución: el de Instagram toma el $56%$ central del ancho para llegar a $4{:}5$, y el de Facebook y LinkedIn conserva el ancho completo y recorta arriba y abajo. La entrada cuesta $1,802$ tokens, casi todos de la imagen, muy cerca de los $1,567$ que predijo la fórmula más las instrucciones.
La línea más importante de la salida es la de las personas: en la foto se ven las manos y parte del rostro de alguien del obrador. El modelo no decide si la foto se puede publicar; lo avisa, y la regla de la casa decide: una persona reconocible en una foto de Trigo Lento necesita su consentimiento por escrito, que se guarda y que se puede retirar. Hasta que exista, la foto se recorta para que no se reconozca a nadie o se cambia por otra. Es la misma lógica del consentimiento de WhatsApp de los días 6 y 48, aplicada a la imagen de una persona.
Rótulos con una plantilla
Algunas publicaciones llevan un rótulo: una banda con el nombre del producto, el precio y la fecha límite, puesta encima de la foto. Hacerlo a mano en una aplicación de diseño lleva diez minutos por pieza y produce, tarde o temprano, un precio desactualizado. Valeria lo convierte en una plantilla de matplotlib con tres garantías: el precio se lee del catálogo y la plantilla se niega a dibujar uno distinto; el texto queda dentro de un margen seguro, la franja interior que ninguna red recorta al mostrar la miniatura; y el color del texto contra el fondo tiene contraste suficiente para leerse en un teléfono al sol.
El contraste se mide con la fórmula de las Pautas de Accesibilidad para el Contenido Web (o WCAG, por sus siglas en inglés: “Web Content Accessibility Guidelines”), las mismas que el Día 49 tomó como referencia:
$$ C = \frac{L_1 + 0.05}{L_2 + 0.05}, \qquad L = 0.2126,R + 0.7152,G + 0.0722,B $$
La lógica detrás de esta razón es múltiple:
- $L_1$ es la luminancia relativa del color más claro y $L_2$ la del más oscuro; cada una combina los canales rojo, verde y azul, ya linealizados (sin la corrección gamma de la pantalla), con pesos que reflejan cuánto aporta cada canal a la claridad que percibe el ojo.
- El $0.05$ evita dividir entre cero con el negro puro y modela el reflejo de la luz ambiente sobre la pantalla.
- La razón va de $1{:}1$ (el mismo color) a $21{:}1$ (negro sobre blanco); WCAG pide al menos $4.5{:}1$ para texto normal y $3{:}1$ para texto grande en el nivel AA.
- En conclusión, el contraste no se juzga a ojo en la pantalla del escritorio, donde casi todo se lee bien; se calcula, y el rótulo que no llega a $4.5{:}1$ no se usa.
El siguiente bloque escribe la plantilla, mide tres combinaciones de color y dibuja el mismo rótulo en el formato de Instagram y en el de Facebook y LinkedIn, con un rectángulo de color en el lugar de la foto real:
# Plantilla de rótulo con matplotlib: foto de juguete, margen seguro, logotipo textual y contraste WCAG en Python:
def luminancia(hex_color):
    c = np.array([int(hex_color[i:i + 2], 16) / 255 for i in (1, 3, 5)])
    c = np.where(c <= 0.04045, c / 12.92, ((c + 0.055) / 1.055) ** 2.4)
    return float(c @ [0.2126, 0.7152, 0.0722])

def contraste(texto, fondo):
    l1, l2 = sorted([luminancia(texto), luminancia(fondo)], reverse = True)
    return (l1 + 0.05) / (l2 + 0.05)

FORMATOS = {'instagram 4:5': (1080, 1350), 'facebook y linkedin 1.91:1': (1200, 628)}
MARGEN = 0.08                                        # margen seguro: 8 % del lado menor
BANDA, LETRA = '#4a2f1a', '#fff8ec'                  # café de la marca y crema

def rotulo(ax, ancho, alto, titulo, detalle, clave):
    precio = catalogo[clave]['precio_mxn']
    assert f'{precio} MXN' in detalle, 'El precio del rótulo no coincide con el catálogo'
    ax.add_patch(Rectangle((0, 0), ancho, alto, color = '#c9a27a'))           # la foto real va aquí
    ax.text(ancho / 2, alto * 0.62, 'FOTO REAL DEL OBRADOR', ha = 'center', color = '#7a5a3c', fontsize = 8)
    m = MARGEN * min(ancho, alto)
    ax.add_patch(Rectangle((m, m), ancho - 2 * m, alto - 2 * m, fill = False, ls = '--', ec = 'white', lw = 1))
    h = alto * (0.24 if alto > ancho else 0.34)
    ax.add_patch(Rectangle((m, m), ancho - 2 * m, h, color = BANDA))
    ax.text(m + 0.04 * ancho, m + h * 0.66, titulo, color = LETRA, fontsize = 10, fontweight = 'bold', va = 'center')
    ax.text(m + 0.04 * ancho, m + h * 0.28, detalle, color = LETRA, fontsize = 8, va = 'center')
    ax.text(ancho - m - 0.02 * ancho, alto - m - 0.05 * alto, 'TRIGO LENTO', color = 'white', ha = 'right',
            fontsize = 9, fontweight = 'bold')
    ax.set_xlim(0, ancho)
    ax.set_ylim(0, alto)
    ax.set_aspect('equal')
    ax.axis('off')

for nombre, (texto_c, fondo_c) in {'crema sobre café (rótulo)': (LETRA, BANDA),
                                    'blanco sobre foto clara': ('#ffffff', '#c9a27a'),
                                    'amarillo sobre blanco': ('#ffc000', '#ffffff')}.items():
    r = contraste(texto_c, fondo_c)
    print(f'{nombre:<28} contraste {r:5.2f}:1 | AA texto normal (4.5): {"sí" if r >= 4.5 else "no"}'
          f' | AA texto grande (3.0): {"sí" if r >= 3 else "no"}')

fig, ejes = plt.subplots(1, 2, figsize = (9.0, 5.0), gridspec_kw = {'width_ratios': [1, 1.5]})
for ax, (nombre, (ancho, alto)) in zip(ejes, FORMATOS.items()):
    rotulo(ax, ancho, alto, 'Pastel de chocolate entero', 'Encárguelo hasta el jueves 7 · 460 MXN', 'P09')
    ax.set_title(f'{nombre} ({ancho} x {alto} px)', fontsize = 10)
fig.suptitle('Plantilla de rótulo: la foto es real, el texto lo pone la plantilla', fontsize = 12)
plt.tight_layout()
plt.show()
print('Margen seguro:', {k: round(MARGEN * min(v)) for k, v in FORMATOS.items()}, 'px')
crema sobre café (rótulo)    contraste 11.61:1 | AA texto normal (4.5): sí | AA texto grande (3.0): sí
blanco sobre foto clara      contraste  2.35:1 | AA texto normal (4.5): no | AA texto grande (3.0): no
amarillo sobre blanco        contraste  1.64:1 | AA texto normal (4.5): no | AA texto grande (3.0): no
Margen seguro: {'instagram 4:5': 86, 'facebook y linkedin 1.91:1': 50} px
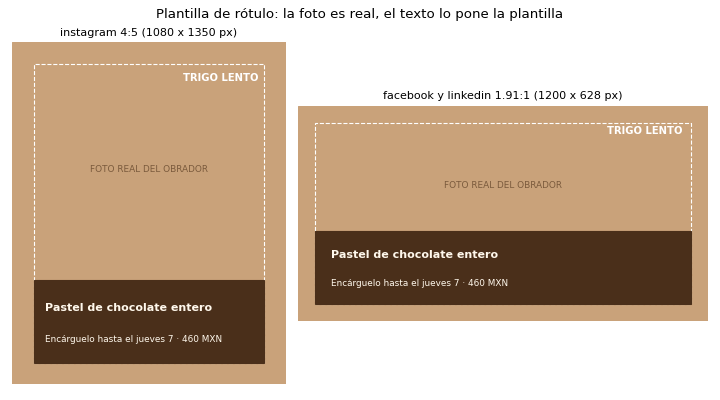
El crema sobre café de la banda da un contraste de $11.61{:}1$, muy por encima del mínimo. Las otras dos combinaciones explican por qué existe la banda: el texto blanco directamente sobre una foto clara de pan da $2.35{:}1$ y el amarillo sobre blanco, que a muchos les parece “alegre”, $1.64{:}1$; ninguno pasa ni siquiera el umbral de texto grande. El margen seguro es de $86$ píxeles en el formato de Instagram y de $50$ en el horizontal, el $8%$ del lado menor, y la línea discontinua de la figura lo hace visible para quien revisa. La plantilla, además, falla con un error si el precio del rótulo no es el del catálogo: un rótulo con $450$ MXN para el pastel de chocolate no se dibuja.
La Figura 3 resume la regla de las imágenes en una sola línea de trabajo: la cámara del obrador pone la foto, la IA propone y avisa, la plantilla rotula con datos del catálogo, y la foto inventada queda fuera.
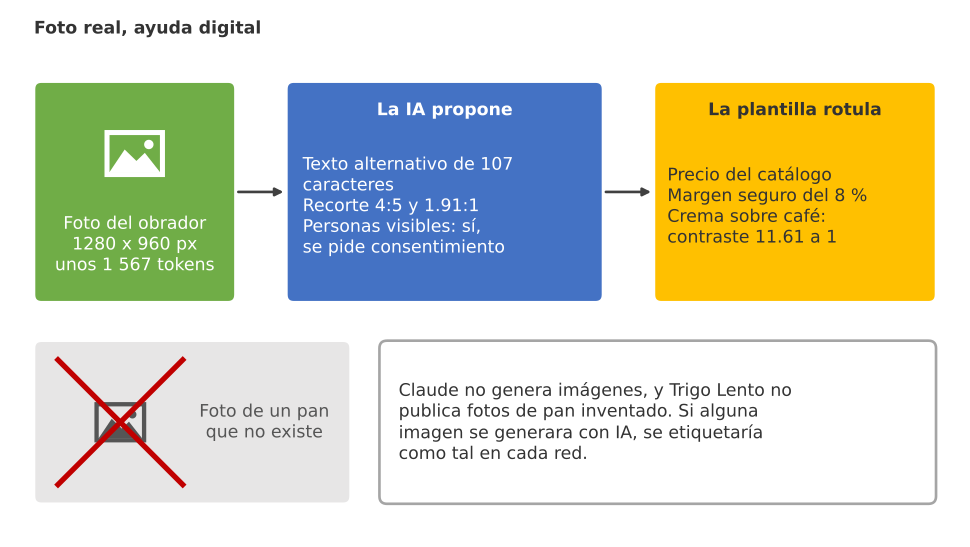
Figura 3. Foto real, ayuda digital: la cámara del obrador toma la foto, la IA propone texto alternativo y recortes, la plantilla pone el rótulo con contraste de 11.61 a 1, y la foto inventada queda tachada.
Revisar con criterios
Un borrador que llega a la persona que aprueba debería estar casi bien. Si la persona tiene que encontrar el precio equivocado, contar las etiquetas y buscar la palabra “saludable” en cada una de las treinta y seis piezas, la revisión se vuelve una tarea mecánica, y las tareas mecánicas repetidas son justo las que una persona cansada hace mal. Por eso, entre el modelo y la persona, Valeria pone una lista de comprobación automática: cinco reglas que el código evalúa en cada borrador y que salen directamente del manual de voz y del catálogo.
- Precio igual al del catálogo: cada cifra seguida de “MXN” se compara con el precio del producto de la pieza.
- Palabras prohibidas: los $21$ patrones del manual, sin distinguir mayúsculas.
- Longitud por red: el texto no supera el objetivo de la casa de la Tabla 3.
- Llamada a la acción: el texto incluye una de las llamadas del manual.
- Etiquetas por red: no más de las que fija el manual.
Para medir la lista sin depender de la API, el siguiente bloque simula los $36$ borradores del mes con errores sembrados a tasas declaradas como supuesto (un $10%$ de palabras prohibidas, un $8%$ de precios distintos y de textos largos, un $6%$ de piezas sin llamada a la acción o con etiquetas de más) y un sexto tipo de error que la lista no está diseñada para ver: el precio escrito con letra. Después compara lo que se sembró con lo que la lista encontró:
# Lista de comprobación automática sobre 36 borradores simulados con errores sembrados en Python:
TASAS = {'precio_distinto': 0.08, 'palabra_prohibida': 0.10, 'demasiado_largo': 0.08,
         'sin_llamada': 0.06, 'exceso_etiquetas': 0.06, 'precio_en_letra': 0.08}   # supuestos declarados
LETRAS = {22: 'treinta y dos', 34: 'cuarenta y cuatro', 38: 'cuarenta y ocho', 60: 'setenta',  # precio + 10
          66: 'setenta y seis', 72: 'ochenta y dos', 95: 'ciento cinco', 240: 'doscientos cincuenta',
          380: 'trescientos noventa', 420: 'cuatrocientos treinta', 460: 'cuatrocientos setenta'}
RELLENO_LARGO = (' En el obrador trabajamos desde la madrugada para que cada pieza salga a tiempo, y el '
                 'equipo del mostrador le ayuda a elegir el tamaño adecuado para su mesa.')

def borrador(fila, red, rng):
    clave = fila.producto if fila.producto != '-' else 'P02'
    p = catalogo[clave]
    precio = p['precio_mxn']
    sembrados = {k for k, t in TASAS.items() if rng.random() < t}
    if 'precio_distinto' in sembrados:
        precio = precio + int(rng.choice([-10, 10, 20]))
    texto = f'{fila.tema}. {p["producto"]}: {precio} MXN.'
    if 'precio_en_letra' in sembrados:
        texto = f'{fila.tema}. {p["producto"]}: {LETRAS[p["precio_mxn"]]} pesos.'
    if 'palabra_prohibida' in sembrados:
        texto += ' ' + str(rng.choice(['Un pan artesanal de origen ancestral.', 'Saludable y nutritivo.',
                                       'Apto para celiacos.', 'Mejor que el de cadena.']))
    largo = MANUAL_VOZ['formato'][red]['max_caracteres']
    if 'demasiado_largo' in sembrados:
        while len(texto) <= largo:
            texto += RELLENO_LARGO
    if 'sin_llamada' not in sembrados:
        texto += ' ' + MANUAL_VOZ['llamadas_accion'][0 if red != 'linkedin' else 2] + '.'
    n_etiquetas = MANUAL_VOZ['formato'][red]['max_etiquetas'] + (4 if 'exceso_etiquetas' in sembrados else -1)
    etiquetas = ['#TrigoLento', '#Narvarte', '#MasaMadre', '#PanDeCDMX', '#Panaderia', '#Hornear',
                 '#PanFresco', '#CDMX', '#Encargos'][:n_etiquetas]
    return {'fecha': fila.fecha, 'red': red, 'clave': clave, 'texto': texto, 'etiquetas': etiquetas,
            'sembrados': sorted(sembrados)}

def revisar(b):
    # Reglas de la lista: cada una devuelve el nombre de la alerta o nada.
    alertas, formato = [], MANUAL_VOZ['formato'][b['red']]
    for m in re.finditer(r'(\d+) MXN', b['texto']):
        if int(m.group(1)) != catalogo[b['clave']]['precio_mxn']:
            alertas.append('precio_distinto')
    texto = b['texto'].lower()
    if any(re.search(p, texto) for ps in MANUAL_VOZ['prohibidas'].values() for p in ps):
        alertas.append('palabra_prohibida')
    if len(b['texto']) > formato['max_caracteres']:
        alertas.append('demasiado_largo')
    if not any(c.lower() in texto for c in MANUAL_VOZ['llamadas_accion']):
        alertas.append('sin_llamada')
    if len(b['etiquetas']) > formato['max_etiquetas']:
        alertas.append('exceso_etiquetas')
    return alertas

borradores = [borrador(f, red, rng) for f in calendario.itertuples() for red in REDES]
for b in borradores:
    b['alertas'] = revisar(b)
revision = pd.DataFrame(borradores)
sembrado = revision['sembrados'].explode().value_counts()
detectado = revision['alertas'].explode().value_counts()
resumen = pd.DataFrame({'sembrados': sembrado, 'detectados': detectado}).fillna(0).astype(int)
print(resumen.sort_values('sembrados', ascending = False).to_string())
limpios = (revision['alertas'].str.len() == 0).sum()
print(f'Borradores sin alerta: {limpios} de {len(revision)} | con al menos una alerta: {len(revision) - limpios}')
no_vistos = revision[revision['sembrados'].map(lambda s: 'precio_en_letra' in s)]
print('Errores que la lista no ve (precio escrito con letra):', len(no_vistos))
if len(no_vistos):
    print('  Ejemplo:', no_vistos.iloc[0]['texto'][:110])

fig, ax = plt.subplots(figsize = (8.0, 4.4))
orden = resumen.sort_values('sembrados').index
y = np.arange(len(orden))
ax.barh(y - 0.2, resumen.loc[orden, 'sembrados'], height = 0.4, color = '#c9c8c4', label = 'errores sembrados')
ax.barh(y + 0.2, resumen.loc[orden, 'detectados'], height = 0.4, color = '#eb6834', label = 'alertas de la lista')
ax.set_yticks(y)
ax.set_yticklabels([o.replace('_', ' ') for o in orden])
for yi, v in zip(y, resumen.loc[orden, 'detectados']):
    ax.text(v + 0.08, yi + 0.2, str(v), va = 'center', fontsize = 9)
ax.set_xlabel('Borradores (de 36)')
ax.set_title(f'Lista de comprobación sobre 36 borradores: {limpios} sin alerta', fontsize = 13)
ax.legend(frameon = False, loc = 'lower right')
ax.spines[['top', 'right']].set_visible(False)
plt.tight_layout()
plt.show()
                   sembrados  detectados
exceso_etiquetas           4           4
palabra_prohibida          3           3
demasiado_largo            2           2
precio_distinto            1           1
precio_en_letra            1           0
sin_llamada                1           1
Borradores sin alerta: 27 de 36 | con al menos una alerta: 9
Errores que la lista no ve (precio escrito con letra): 1
  Ejemplo: La baguette sale del horno tres veces al día. Baguette tradicional: cuarenta y ocho pesos. Escríbanos para ped
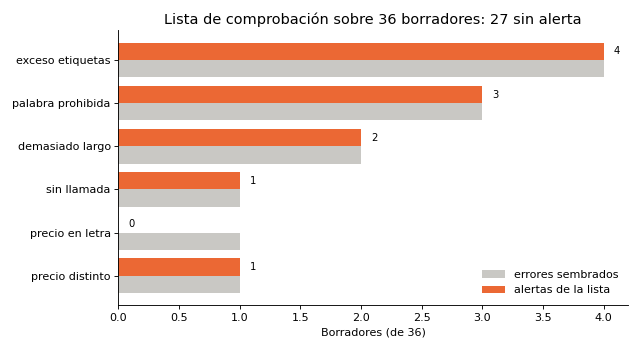
La lista marcó $9$ de los $36$ borradores ($25%$) y encontró todos los errores de los cinco tipos que vigila: $4$ con etiquetas de más, $3$ con palabras prohibidas, $2$ demasiado largos, $1$ sin llamada a la acción y $1$ con un precio distinto. Pero de los $27$ borradores sin alerta, uno tiene un error: dice que la baguette cuesta “cuarenta y ocho pesos”, diez más que en el catálogo, escrito con letra. La regla del precio busca cifras seguidas de “MXN”, y esa frase no tiene ninguna.
El hallazgo tiene dos respuestas, y las dos son correctas. La primera es mejorar el código: añadir al manual la regla “los precios se escriben con número y con MXN” y una alerta para cualquier precio escrito con letra, que es fácil de detectar aunque no sea fácil de convertir. La segunda es más importante: una lista de comprobación encuentra los errores que alguien imaginó antes; los demás los encuentra una persona. Por eso la lista no aprueba nada. Lo que hace es mandar de vuelta los nueve borradores con alerta, para que vuelvan a redactarse antes de que alguien pierda tiempo con ellos, y entregar los otros veintisiete a la persona que revisa con una lista corta de lo que todavía tiene que mirar con sus ojos: los precios con letra, las afirmaciones a verificar que señaló el modelo, la foto y su texto alternativo.
La tasa del $25%$ no es una medición del modelo, sino de la simulación, y conviene no confundirlas. Cuando el flujo corra con borradores reales, la lista registrará sus alertas en cada pieza y, al cabo de un mes, Valeria tendrá la tasa verdadera, que alimentará el coste de rehacer borradores de la última sección.
El calendario en Notion
El calendario vive en una base de datos de Notion, por la misma razón por la que la base de conocimiento del Día 68 (Una base de conocimiento en Notion: API, fragmentos y embeddings) vive ahí: es donde Valeria y Don Ernesto ya trabajan, y una base de Notion se lee y se edita igual de bien desde el teléfono que desde la API. Cada pieza (una fecha y una red) es una página de la base, con sus propiedades: fecha, pilar, red, producto, la casilla “Asistido por IA”, quién revisó y un estado que recorre seis valores.
- Idea: la fila existe en el calendario, sin texto.
- Borrador: el modelo redactó y la lista no encontró alertas.
- Revisado: una persona leyó el texto, la foto y el texto alternativo y anotó cambios.
- Aprobado: Don Ernesto o Valeria dieron el visto bueno.
- Programado: el flujo del Día 72 dejó la pieza en la cola de la red.
- Publicado: la red confirmó la publicación y devolvió su identificador.
El estado es la pieza central del gobierno del flujo, porque ninguna automatización puede saltarse un estado: el flujo de publicación del Día 72 solo leerá páginas en aprobado, y solo una persona puede poner ese valor. El siguiente bloque crea la base con su esquema y las $36$ páginas del mes, con la versión 2026-03-11 de la API fijada en la cabecera, el token de la integración leído del entorno y una pausa de $0.35$ segundos entre peticiones para quedar por debajo del límite medio de tres por segundo; ante un 429, espera lo que indique la cabecera Retry-After. Las piezas con alerta entran en estado idea, no borrador, para que nadie las confunda con algo listo para revisar. Este bloque llama a la API y no se ejecutó para escribir la entrada; la salida es un ejemplo comentado:
# Creación de la base del calendario y de sus 36 páginas en Notion con requests en Python:
import os
import time
import requests

URL_NOTION = 'https://api.notion.com/v1'
CABECERAS = {'Authorization': 'Bearer ' + os.environ['NOTION_TOKEN'],   # token de la integración interna
             'Notion-Version': '2026-03-11', 'Content-Type': 'application/json'}
ESTADOS = ['idea', 'borrador', 'revisado', 'aprobado', 'programado', 'publicado']

def enviar(ruta, cuerpo, intentos = 4):
    # POST con espera ante 429 (límite medio de 3 peticiones por segundo por integración):
    for _ in range(intentos):
        r = requests.post(URL_NOTION + ruta, headers = CABECERAS, json = cuerpo, timeout = 30)
        if r.status_code != 429:
            r.raise_for_status()
            return r.json()
        time.sleep(float(r.headers.get('Retry-After', 1)))
    raise RuntimeError('Notion sigue respondiendo 429')

opciones = lambda nombres: {'options': [{'name': n} for n in nombres]}
base = enviar('/databases', {
    'parent': {'type': 'page_id', 'page_id': os.environ['NOTION_PAGINA_REDES']},
    'title': [{'type': 'text', 'text': {'content': 'Calendario editorial'}}],
    'initial_data_source': {'properties': {
        'Pieza': {'title': {}},
        'Fecha': {'date': {}},
        'Pilar': {'select': opciones(COLORES)},
        'Red': {'select': opciones(REDES)},
        'Producto': {'rich_text': {}},
        'Estado': {'select': opciones(ESTADOS)},       # selección: sus opciones se definen por la API
        'Asistido por IA': {'checkbox': {}},
        'Revisó': {'people': {}},
    }},
})
fuente = base['data_sources'][0]['id']
inicio, creadas = time.monotonic(), 0
for b in borradores:                                     # 36 piezas: una página por red y fecha
    enviar('/pages', {
        'parent': {'type': 'data_source_id', 'data_source_id': fuente},
        'properties': {
            'Pieza': {'title': [{'text': {'content': f"{b['fecha']} {b['red']}"}}]},
            'Fecha': {'date': {'start': str(b['fecha'])}},
            'Pilar': {'select': {'name': calendario.set_index('fecha').loc[b['fecha'], 'pilar']}},
            'Red': {'select': {'name': b['red']}},
            'Producto': {'rich_text': [{'text': {'content': b['clave']}}]},
            'Estado': {'select': {'name': 'borrador' if not b['alertas'] else 'idea'}},
            'Asistido por IA': {'checkbox': True},
        },
        'children': [{'object': 'block', 'type': 'paragraph',
                      'paragraph': {'rich_text': [{'text': {'content': b['texto'][:2000]}}]}}],
    })
    creadas += 1
    time.sleep(0.35)                                     # por debajo de 3 peticiones por segundo
print(f'Fuente de datos: {fuente[:8]}... | páginas creadas: {creadas} en {time.monotonic() - inicio:.1f} s')

# Salida de ejemplo (puede variar):
# Fuente de datos: 1f4c2a9e... | páginas creadas: 36 en 27.8 s
Dos decisiones del bloque merecen explicación. La primera: desde la versión 2025-09-03 de la API, una base de datos de Notion contiene fuentes de datos, y las páginas se crean con un padre de tipo data_source_id, no con el identificador de la base; por eso el bloque crea la base con initial_data_source y toma la fuente de la respuesta, como el Día 68 hacía al leer. La segunda: el estado se crea como propiedad de selección y no como propiedad de tipo estado, porque, según la documentación revisada, las opciones de una propiedad de estado no se pueden definir por la API; una selección con los seis valores hace el mismo trabajo y la crea el mismo bloque. Las $36$ páginas tardan unos $28$ segundos con la pausa, una espera que no importa en un proceso que corre una vez al mes.
Quién puede mover cada pieza
Un estado en Notion es solo una etiqueta, y cualquiera con acceso a la base, persona o flujo, puede cambiarla. La regla “solo una persona aprueba” no se cumple por escribirla en un documento: se cumple si el código que mueve las piezas la comprueba. Valeria la escribe como una máquina de estados, una tabla con las transiciones permitidas y el actor que puede hacer cada una. El flujo puede pasar una idea a borrador, una pieza aprobada a programada y una programada a publicada; una persona puede revisar, aprobar y devolver. Todo lo demás se rechaza y queda en una bitácora. El siguiente bloque la pone a prueba con un mes simulado: Valeria revisa los $27$ borradores sin alerta, Don Ernesto aprueba o devuelve, y el flujo intenta tres atajos que no debería poder tomar:
# Máquina de estados del calendario: transiciones válidas y quién puede hacer cada una en Python:
TRANSICIONES = {('idea', 'borrador'): 'flujo', ('borrador', 'idea'): 'flujo',
                ('borrador', 'revisado'): 'persona', ('revisado', 'borrador'): 'persona',
                ('revisado', 'aprobado'): 'persona', ('aprobado', 'revisado'): 'persona',
                ('aprobado', 'programado'): 'flujo', ('programado', 'aprobado'): 'persona',
                ('programado', 'publicado'): 'flujo'}

def mover(pieza, nuevo, actor, registro):
    # Solo se permiten las transiciones de la tabla y solo al actor que la tabla indica:
    permitido = TRANSICIONES.get((pieza['estado'], nuevo))
    ok = permitido == actor
    registro.append({'pieza': pieza['id'], 'de': pieza['estado'], 'a': nuevo, 'actor': actor, 'ok': ok})
    if ok:
        pieza['estado'] = nuevo
    return ok

piezas = [{'id': f"{b['fecha']}-{b['red']}", 'estado': 'idea' if b['alertas'] else 'borrador'} for b in borradores]
registro = []
pendientes = [p for p in piezas if p['estado'] == 'borrador']
for p in pendientes:                                   # Valeria revisa los 27 borradores sin alerta
    mover(p, 'revisado', 'persona', registro)
for i, p in enumerate(pendientes):                     # Don Ernesto aprueba o devuelve
    mover(p, 'borrador' if i in (1, 4) else 'aprobado', 'persona', registro)
mover(pendientes[2], 'revisado', 'flujo', registro)    # el flujo intenta devolver una pieza aprobada
mover(pendientes[1], 'aprobado', 'flujo', registro)    # el flujo intenta aprobar por su cuenta
mover(pendientes[1], 'publicado', 'flujo', registro)   # el flujo intenta publicar un borrador
for p in piezas:
    if p['estado'] == 'aprobado':
        mover(p, 'programado', 'flujo', registro)
bitacora = pd.DataFrame(registro)
print('Movimientos:', len(bitacora), '| permitidos:', bitacora['ok'].sum(), '| rechazados:', (~bitacora['ok']).sum())
print(bitacora[~bitacora['ok']].to_string(index = False))
print('Piezas por estado:', pd.Series([p['estado'] for p in piezas]).value_counts().to_dict())
bitacora.to_csv(carpeta / 'bitacora_estados.csv', index = False)
Movimientos: 82 | permitidos: 79 | rechazados: 3
               pieza       de         a actor    ok
2026-05-05-instagram aprobado  revisado flujo False
 2026-05-02-facebook borrador  aprobado flujo False
 2026-05-02-facebook borrador publicado flujo False
Piezas por estado: {'programado': 25, 'idea': 9, 'borrador': 2}
De $82$ movimientos, $79$ se permitieron y $3$ se rechazaron, y los tres rechazados son justo los que la regla existe para impedir: el flujo intentó devolver a revisión una pieza aprobada, aprobar un borrador por su cuenta y publicarlo, precisamente el de Facebook del 2 de mayo que Don Ernesto acababa de devolver. Al final del mes simulado quedan $25$ piezas programadas, las que Don Ernesto aprobó; $2$ borradores que devolvió (uno de ellos, ese de Facebook, con su “Mamá merece” tachado) y las $9$ ideas cuyos borradores tuvieron alerta y esperan una nueva redacción. La bitácora se guarda en un CSV y, en producción, cada movimiento llevará además la hora y el nombre de quien lo hizo, que es lo que permite responder la pregunta que Don Ernesto hará el día que algo salga mal: quién aprobó esto.
Atención aquí: el token de la integración de Notion da acceso a todo lo que se haya compartido con ella. Comparta con la integración del calendario solo la página que contiene la base, no el espacio de trabajo entero, y use una integración distinta de la que lee la base de conocimiento del Día 68: si una se compromete, la otra sigue a salvo. El token va en la variable de entorno NOTION_TOKEN o en la credencial cifrada de n8n, nunca en el código ni en un flujo exportado.
Tiempo y coste
Queda la pregunta que Don Ernesto hace siempre, y que hoy tiene dos mitades: cuánto tiempo ahorra el flujo y cuánto cuesta. El tiempo se calcula con la fórmula que el Día 20 (Caso de otro negocio II: el mapa de automatización de una tienda en línea) usó para Café Altura:
$$ H = \frac{n , (t_a - t_d)}{60} $$
La lógica detrás de esta fórmula es la siguiente:
- $n = 36$ es el número de piezas al mes, $t_a = 20$ los minutos que Valeria tarda en redactar y adaptar una pieza a mano y $t_d = 6$ los minutos de revisión de un borrador; $H$ son las horas ahorradas al mes.
- Con esos valores, $H = 36 \cdot (20 - 6)/60 = 8.4$ horas solo en redacción; la planeación del mes y los textos alternativos ajustan el total.
- Los $6$ minutos de revisión no son un ahorro que se pueda recortar: son la condición para publicar.
- En conclusión, el flujo no elimina el trabajo editorial, lo cambia de redactar a revisar, y la revisión es justo la parte que no se delega.
El coste de Claude se calcula con la fórmula de coste con caché del Día 67, adaptada a esta carga:
$$ C = \frac{n,(e - c),p_e + c,p_e,\left[w,(n - k) + r,k\right] + n,s,p_s}{10^{6}} $$
La lógica detrás de esta fórmula es múltiple:
- $n$ es el número de peticiones, $e$ los tokens de entrada de cada una, $c$ los tokens cacheados (el
systemdel manual), $s$ los tokens de salida y $p_e = 2.00$ y $p_s = 10.00$ los precios de Sonnet 5.5 en USD por millón. - El primer término paga la parte no cacheada de la entrada; el segundo paga la caché, que se escribe en $n - k$ peticiones a $w = 1.25$ veces la entrada y se lee en $k$ peticiones a $r = 0.05$ veces; el tercero paga la salida.
- Con un lote por publicación, $n = 12$ peticiones de $e = 1,582$ tokens y $s = 1,200$; si las doce se hacen seguidas, dentro de los $5$ minutos de vida de la caché, $k = 11$.
- En conclusión, la salida domina: $144,000$ de los $157,913$ millonésimos de dólar del lote con caché son de salida, y la caché solo puede abaratar lo demás.
El último bloque compara cuatro maneras de pedir los borradores, suma la visión de las $12$ fotos y el coste de rehacer las piezas con alerta, y pone el tiempo de Valeria al lado:
# Tiempo y coste mensual del flujo editorial frente al trabajo manual en Python:
PRECIO = {'claude-sonnet-5-5': (2.00, 10.00)}       # USD por millón de tokens, revisado en octubre de 2026
LECTURA, ESCRITURA = 0.05, 1.25                      # caché: veces el precio de entrada (5 minutos)
pe, ps = PRECIO['claude-sonnet-5-5']
PIEZAS, PUBLICACIONES, FOTOS = len(revision), len(calendario), len(calendario)
HORA_VALERIA, TIPO = 75, 18.50                       # MXN por hora y MXN por USD (supuestos de la serie)
USUARIO, SALIDA_PIEZA = 400, 400                     # tokens por petición y por pieza

def coste(n, entrada, salida, cacheado = 0, lecturas = 0):
    # n peticiones; de la entrada, 'cacheado' tokens se escriben una vez y se leen en 'lecturas' peticiones:
    normal = n * (entrada - cacheado) * pe
    cache = cacheado * pe * (ESCRITURA * (n - lecturas) + LECTURA * lecturas)
    return (normal + cache + n * salida * ps) / 1e6

escenarios = {
    'por pieza (supuesto del plan)': coste(PIEZAS, 2500, SALIDA_PIEZA),
    'por pieza (system medido)': coste(PIEZAS, tokens_system + USUARIO, SALIDA_PIEZA),
    'lote por publicación': coste(PUBLICACIONES, tokens_system + USUARIO, 3 * SALIDA_PIEZA),
    'lote + caché del manual': coste(PUBLICACIONES, tokens_system + USUARIO, 3 * SALIDA_PIEZA,
                                     cacheado = tokens_system, lecturas = PUBLICACIONES - 1),
}
tokens_foto = round(1280 * 960 / 784)               # una foto reducida a 1280 x 960 px
vision = coste(FOTOS, tokens_foto + 300, 350)
tasa_rehacer = (revision['alertas'].str.len() > 0).mean()
rehacer = coste(round(PIEZAS * tasa_rehacer), tokens_system + USUARIO + SALIDA_PIEZA, SALIDA_PIEZA,
                cacheado = tokens_system, lecturas = round(PIEZAS * tasa_rehacer) - 1)
for nombre, usd in escenarios.items():
    print(f'Borradores, {nombre:<30} {usd:.4f} USD al mes')
print(f'Visión: {tokens_foto} tokens por foto | {FOTOS} fotos: {vision:.4f} USD')
print(f'Rehacer las piezas con alerta ({tasa_rehacer:.1%}): {rehacer:.4f} USD')
claude_mes = escenarios['lote + caché del manual'] + vision + rehacer
margen_rubro = 10.50 - 10.12
print(f'Claude en el flujo editorial: {claude_mes:.3f} USD al mes | margen del rubro: {margen_rubro:.2f} USD '
      f'| usa el {claude_mes / margen_rubro:.0%} del margen')

horas = pd.DataFrame({
    'manual': {'planear el mes': 2.0, 'redactar y adaptar': PIEZAS * 20 / 60, 'textos alternativos': 0.0},
    'flujo': {'planear el mes': 0.5, 'redactar y adaptar': PIEZAS * 6 / 60, 'textos alternativos': FOTOS * 2 / 60},
})
tabla_3 = pd.DataFrame({'horas_mes': horas.sum().round(2)})
tabla_3['MXN_tiempo'] = (tabla_3['horas_mes'] * HORA_VALERIA).round(0)
tabla_3['USD_Claude'] = [0.0, round(claude_mes, 3)]
tabla_3['MXN_total'] = (tabla_3['MXN_tiempo'] + tabla_3['USD_Claude'] * TIPO).round(1)
print(horas.round(2).to_string())
print(tabla_3.to_string())
ahorro_h = tabla_3.loc['manual', 'horas_mes'] - tabla_3.loc['flujo', 'horas_mes']
ahorro = tabla_3.loc['manual', 'MXN_total'] - tabla_3.loc['flujo', 'MXN_total']
print(f'Solo redacción: manual {PIEZAS * 20 / 60:.1f} h frente a flujo {PIEZAS * 6 / 60:.1f} h')
print(f'Ahorro: {ahorro_h:.2f} horas y {ahorro:,.1f} MXN al mes ({ahorro / TIPO:.2f} USD)')

fig, (ax1, ax2) = plt.subplots(1, 2, figsize = (9.6, 4.4), gridspec_kw = {'width_ratios': [1.1, 1]})
abajo = np.zeros(2)
for tarea, color in zip(horas.index, ['#c9c8c4', '#2a78d6', '#7b4fc9']):
    ax1.bar(['manual', 'flujo'], horas.loc[tarea], bottom = abajo, color = color, label = tarea, width = 0.55)
    abajo += horas.loc[tarea].to_numpy()
for i, total in enumerate(abajo):
    ax1.text(i, total + 0.2, f'{total:.1f} h', ha = 'center', fontsize = 10)
ax1.set_ylabel('Horas de Valeria al mes')
ax1.set_ylim(0, 16.5)
ax1.set_title('Tiempo: 36 piezas al mes', fontsize = 12)
ax1.legend(frameon = False, fontsize = 8, loc = 'upper right')
ax1.spines[['top', 'right']].set_visible(False)
nombres = list(escenarios) + ['flujo completo']
valores = list(escenarios.values()) + [claude_mes]
ax2.barh(nombres, valores, color = ['#c9c8c4', '#c9c8c4', '#c9c8c4', '#2a78d6', '#eb6834'])
ax2.axvline(margen_rubro, color = '#52514e', ls = ':', lw = 1.2)
ax2.text(margen_rubro - 0.005, -0.75, f'margen del rubro: {margen_rubro:.2f} USD', fontsize = 8,
         ha = 'right', color = '#52514e')
for yi, v in enumerate(valores):
    ax2.text(v + 0.005, yi, f'{v:.3f}', va = 'center', fontsize = 9)
ax2.set_xlabel('USD al mes (Sonnet 5.5)')
ax2.set_title('Coste de Claude', fontsize = 12)
ax2.set_ylim(len(nombres) - 0.5, -1.0)
ax2.set_xlim(0, 0.45)
ax2.spines[['top', 'right']].set_visible(False)
plt.tight_layout()
plt.show()
Borradores, por pieza (supuesto del plan)  0.3240 USD al mes
Borradores, por pieza (system medido)      0.2579 USD al mes
Borradores, lote por publicación           0.1820 USD al mes
Borradores, lote + caché del manual        0.1579 USD al mes
Visión: 1567 tokens por foto | 12 fotos: 0.0868 USD
Rehacer las piezas con alerta (25.0%): 0.0543 USD
Claude en el flujo editorial: 0.299 USD al mes | margen del rubro: 0.38 USD | usa el 79% del margen
                     manual  flujo
planear el mes          2.0    0.5
redactar y adaptar     12.0    3.6
textos alternativos     0.0    0.4
        horas_mes  MXN_tiempo  USD_Claude  MXN_total
manual       14.0      1050.0       0.000     1050.0
flujo         4.5       338.0       0.299      343.5
Solo redacción: manual 12.0 h frente a flujo 3.6 h
Ahorro: 9.50 horas y 706.5 MXN al mes (38.19 USD)
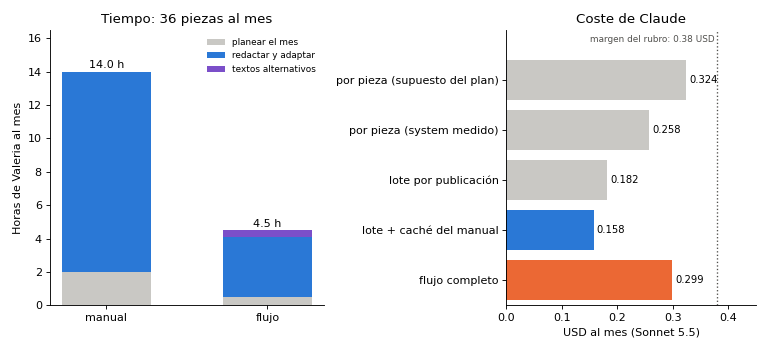
Tabla 4. Tiempo y coste mensual del flujo editorial de 36 piezas: trabajo manual frente a borradores con Claude y revisión humana (precios de Sonnet 5.5 revisados en octubre de 2026; hora de Valeria a 75 MXN y 18.50 MXN por USD).
| Concepto | Manual | Flujo con revisión |
|---|---|---|
| Planear el mes | 2.0 h | 0.5 h |
| Redactar y adaptar (20 min por pieza a mano, 6 min de revisión con el flujo) | 12.0 h | 3.6 h |
| Textos alternativos (2 min por foto con el flujo) | 0.0 h | 0.4 h |
| Horas al mes | 14.0 | 4.5 |
| Tiempo de Valeria | 1 050 MXN | 338 MXN |
| Borradores con Claude (lote por publicación y caché) | 0 | 0.158 USD |
| Visión de 12 fotos | 0 | 0.087 USD |
| Rehacer las piezas con alerta (25 %) | 0 | 0.054 USD |
| Claude al mes | 0 | 0.299 USD |
| Total al mes | 1 050 MXN | 343.5 MXN |
Las cifras del plan se confirman y se afinan. Pedir una pieza por petición con los supuestos del plan ($2,500$ tokens de entrada y $400$ de salida) cuesta $0.324$ USD al mes, la cifra calculada al planear; con el system medido en el Bloque 3 baja a $0.258$. Pedir las tres piezas de una fecha en un solo lote la deja en $0.182$, porque el manual se envía doce veces y no treinta y seis, y la caché la baja a $0.158$: un ahorro de solo $0.024$ USD, porque la salida es el $91%$ del coste y la caché no la toca, la misma lección del informe del lunes. Con la visión de las fotos y el coste de rehacer los nueve borradores con alerta, el flujo completo cuesta $0.299$ USD al mes, unos $5.53$ pesos.
En tiempo, el resultado coincide con el ejemplo del plan: redactar a mano las $36$ piezas lleva $12$ horas y revisarlas, $3.6$. Con la planeación y los textos alternativos, Valeria pasa de $14$ a $4.5$ horas al mes, un ahorro de $9.5$ horas, $706.5$ pesos al valor didáctico de su hora, unos $38$ USD. La comparación con lo que cuesta Claude no admite discusión, y por eso la discusión útil es otra: qué hace Valeria con esas horas. La respuesta que ella anota es la que le da sentido al flujo: la mitad se va a tomar mejores fotos en el obrador, que es lo único de esta cadena que ningún modelo puede hacer.
Queda el presupuesto. El Día 67 dejó el rubro de Claude en $10.50$ USD con un gasto de $10.12$, un margen de $0.38$, y puso una condición: cualquier pieza nueva del módulo 7 sale de la reserva o de un ahorro medido. El flujo editorial usaría el $79%$ de ese margen, y Valeria no lo usa: lo anota contra la reserva, que el Día 69 dejó en $4.80$ USD, y la deja en $4.50$. El margen del rubro se queda donde estaba, para lo imprevisto, que en la experiencia de Don Ernesto siempre llega.
Consideraciones finales
El flujo de hoy no automatiza la publicación; automatiza lo que la rodea. El calendario decide qué se cuenta y cuándo, con reglas que conocen el cierre del 1 de mayo y la víspera del 10; el manual de voz convierte las opiniones de Don Ernesto en datos que leen el modelo y el código; los borradores llegan estructurados, con sus afirmaciones a verificar; las fotos son del obrador y la IA solo las describe y recorta; y la lista de comprobación filtra lo que se puede filtrar con código. Ninguna de esas piezas publica nada, y esa es la decisión de diseño más importante del día.
Las cifras tienen límites que conviene decir. Los $36$ borradores del Bloque 7 son simulados, y la tasa de alertas del $25%$ es un supuesto, no una medición; con borradores reales será otra. Los tokens del manual son una estimación por caracteres, y la salida de los bloques que llaman a la API es un ejemplo, no una medición. Los $20$ minutos por pieza a mano y los $6$ de revisión son supuestos del plan que Valeria debe cronometrar en mayo. Y la lista de comprobación tiene un punto ciego demostrado: dejó pasar un precio escrito con letra.
Antes de montar un flujo editorial con IA en su negocio, conviene hacerse algunas preguntas:
- ¿Quién decide qué se publica, y en qué momento esa decisión deja de ser urgente?
- ¿Su manual de voz está escrito de forma que lo pueda comprobar un programa, o solo de forma que lo pueda leer una persona?
- ¿Qué afirmaciones no puede hacer su negocio por ley, y qué código las busca antes de publicar?
- ¿Las fotos que publica son de su producto real, y las personas que aparecen en ellas dieron su consentimiento por escrito?
- ¿Qué parte del coste viene de la salida del modelo, y qué gana de verdad con la caché?
Un gran libro que habla de esto es Everybody Writes (o Todo el mundo escribe), de Ann Handley. Su tesis es que, en un negocio, todo el que publica algo escribe en nombre de la marca, y que escribir bien no es un don, sino un proceso con borradores, reglas y revisiones; sus capítulos sobre la voz de marca y sobre la edición son, en el fondo, el manual de voz y la lista de comprobación de esta entrada escritos para personas. Leerlo después de montar el flujo ayuda a ver que la IA no cambió el proceso editorial: lo hizo más barato de seguir.
Un calendario editorial con IA no es una máquina de publicar, sino una cocina en la que la IA amasa, el código revisa y una persona decide qué sale del horno. Don Ernesto lee los tres borradores del 2 de mayo, tacha “Mamá merece” en el de Facebook porque le parece cursi y aprueba los otros dos. Es exactamente el trabajo que tenía que quedarle.
Conclusiones clave
Calendario
- El calendario separa la decisión de qué contar de la tarea de redactar: $12$ publicaciones de mayo en cuatro pilares ($4$ de producto, $3$ de temporada, $3$ de oficio y $2$ de comunidad) se convierten en $36$ piezas para tres redes.
- Las reglas de capacidad importan tanto como las de frecuencia: el 1 de mayo está cerrado, el 9 no hay quien revise, y la temporada se publica antes del límite de encargo, no el día de la fiesta.
- En Notion, cada pieza es una página con un estado de seis valores; la máquina de estados permitió $79$ de $82$ movimientos y rechazó los $3$ atajos del flujo (aprobar, publicar un borrador y devolver una pieza aprobada), así que solo una persona pasa una pieza a aprobado.
Textos
- El manual de voz se escribe como datos: el modelo lo lee como instrucción y el código como regla; serializado con
sort_keys=Truemide unos $1,182$ tokens, supera el mínimo cacheable de $512$ y su huella delata cualquier cambio. - Los borradores se piden por lote de fecha con
client.beta.messages.parse,output_format=LotePublicaciones, Sonnet 5.5, esfuerzomediumy respaldo del lado del servidor; una respuesta incompleta no pasa, la redacta una persona. - La lista de comprobación encontró los $11$ errores de los cinco tipos que vigila en $9$ de $36$ borradores, pero dejó pasar un precio escrito con letra: encuentra lo que alguien imaginó antes, y lo demás lo encuentra una persona.
Imágenes y coste
- Las fotos de producto son reales; la visión de Claude propone el texto alternativo ($107$ caracteres en el ejemplo), los recortes y avisa de personas visibles, que exigen consentimiento escrito.
- La plantilla de rótulos toma el precio del catálogo, respeta un margen seguro del $8%$ y exige contraste WCAG de $4.5{:}1$: el crema sobre café da $11.61{:}1$ y el blanco sobre una foto clara, $2.35{:}1$.
- El flujo completo cuesta $0.299$ USD al mes frente a $9.5$ horas ahorradas ($706.5$ MXN); la salida es el $91%$ del coste de los borradores, y la pieza se anota contra la reserva sin tocar el margen del rubro de Claude.
Mañana, en el Día 72: Publicación multired: Instagram, Facebook y LinkedIn por API o con Make y n8n. Las $36$ piezas aprobadas de mayo esperan en Notion y nadie quiere copiarlas a mano en tres aplicaciones; Valeria conocerá los permisos, las revisiones de aplicación y los límites de cada red, elegirá entre la API directa, Make y n8n, y programará cada pieza con su etiqueta de contenido asistido por IA sin que nada salga sin aprobación.
Referencias
- Notion (2026). Create a page; Create a database; Versioning. Notion Developers. https://developers.notion.com/reference (revisado en octubre de 2026).
- Anthropic (2026). Vision; Structured outputs; Prompt caching. Documentación de Claude. https://platform.claude.com/docs (revisado en octubre de 2026).
- Handley, A. (2014). Everybody Writes: Your Go-To Guide to Creating Ridiculously Good Content. Wiley.
- Procuraduría Federal del Consumidor (2026). Publicidad y Ley Federal de Protección al Consumidor. https://www.gob.mx/profeco (revisado en octubre de 2026).
- Meta (2026). Content Publishing; IG User Content Publishing Limit. Instagram Platform, Meta for Developers. https://developers.facebook.com/docs/instagram-platform/content-publishing (revisado en octubre de 2026).
- World Wide Web Consortium (2023). Web Content Accessibility Guidelines (WCAG) 2.2. W3C Recommendation. https://www.w3.org/TR/WCAG22/