
Arquitecto de automatización con IA: Día 72
 Jeshua Romero Guadarrama
- 67 Min para leer
- 13 Apr, 2026
Índice de contenido
Resumen:
El calendario de mayo de Trigo Lento tiene $36$ piezas aprobadas para Instagram, Facebook y LinkedIn, y publicarlas a mano el día y la hora correctos es un trabajo aparte. En esta entrada, Valeria reúne los requisitos de cada red con su fuente y su nivel de confianza ($10$ oficiales, $2$ secundarios y $3$ en los que las fuentes no coinciden), construye una cola en la hora de la Ciudad de México, comprueba que Trigo Lento publica como máximo $2$ piezas por cuenta en 24 horas frente a un límite de $50$, compara la API directa, Make y n8n con su coste y su mantenimiento, y bloquea $6$ piezas que no tenían una aprobación válida, una vigencia o el precio del catálogo. Al terminar, usted sabrá publicar por API en las tres redes, elegir la herramienta con números, etiquetar el contenido hecho con ayuda de IA y montar TL Publicación multired v1 en n8n con registro e idempotencia.
¿Cómo citar el presente artículo?
Romero, J. (13 de abril de 2026). Arquitecto de automatización con IA: Día 72. python-data-engineer. https://www.python-data-engineer.com/post/aai/dia_72/.
Arquitecto de automatización con IA: Día 72 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/aai/dia_72/.
Precios, límites y políticas revisados en octubre de 2026: planes, precios y límites de Make, n8n, Zapier, WhatsApp (Meta, Twilio, Wati) y de la API de Claude. Las cifras de las redes salen de la documentación para desarrolladores de Meta (Instagram Platform y Pages API, con ejemplos en la versión v25.0 de la Graph API) y de la documentación de LinkedIn en Microsoft Learn, contrastadas con fuentes secundarias; donde no coinciden, la entrada lo dice y usa la cifra más conservadora. La versión 202609 de la cabecera LinkedIn-Version es un ejemplo: consulte la lista de versiones activas antes de fijarla. Los bloques 5, 6 y 8 llaman a las API de Meta y de LinkedIn y no se ejecutaron para escribir la entrada; sus salidas son ejemplos comentados. El JSON del Bloque 10 tiene la estructura verificada contra la documentación de n8n, revisado en octubre de 2026.
Día 72. Publicación multired: Instagram, Facebook y LinkedIn por API o con Make y n8n
Introducción
Ayer, en el Día 71 (De la idea al calendario editorial: textos e imágenes con IA), Valeria convirtió temporadas, productos y capacidad del obrador en un calendario editorial de mayo con doce publicaciones en tres redes, redactó los borradores con un manual de voz y salida estructurada, preparó textos alternativos y rótulos sobre fotografías reales, y Trigo Lento ganó un calendario de $36$ piezas revisadas por una persona en una base de Notion. Ese calendario, aprobado, todavía no ha llegado a nadie. Hoy toca la última milla: que cada pieza salga en su red, a su hora, una sola vez y con la etiqueta que le corresponde.
Es lunes 13 de abril, a las diez de la mañana. Don Ernesto aprobó el domingo en la noche las piezas de mayo, sentado en la mesa de la cocina, con el lápiz rojo que usa para las listas de la harina. Valeria abre la base de Notion y hace la cuenta que nadie había hecho: Instagram funciona mejor a la una de la tarde, cuando ella atiende la hora de comida del mostrador; Facebook, a las siete de la noche, cuando cierra caja; LinkedIn, donde la Cafetería Brújula y otros clientes de mayoreo siguen a la panadería, a las nueve de la mañana y solo entre semana. Son $36$ momentos exactos repartidos en un mes, y en cada uno tendría que dejar lo que esté haciendo para copiar un texto, subir una foto y pulsar un botón. El año pasado, la promoción del Día de las Madres salió el 9 de mayo a las 23:40, desde su teléfono, con el precio del pastel de chocolate del año anterior.
Don Ernesto escucha el plan con la misma cara con la que escucha a los vendedores de hornos. “Facebook ya trae un botón para programar, y es gratis. ¿Para qué quiere otro robot? Y le digo otra cosa: si una máquina publica sola la promoción con el precio viejo, aquí no da la cara la máquina, la doy yo.” Las dos objeciones son buenas, y la primera tiene más razón de la que parece: la herramienta gratuita de Meta programa publicaciones de Facebook y de Instagram sin escribir una línea de código. Lo que no hace es comprobar que la pieza que sale es la que él aprobó, con el precio del catálogo y con la leyenda de IA, ni dejar un registro de quién aprobó qué. Esa diferencia se puede medir, y también lo que cuesta.
En la presente entrada, descubrirá qué pide cada red para publicar por API: cuentas profesionales, permisos, revisión de la aplicación y versiones, con la fuente y el nivel de confianza de cada dato. Construirá un programador propio en la zona horaria de la Ciudad de México, comprobará la ventana móvil de 24 horas del límite de Instagram y verá por qué un flujo sin idempotencia lo rompe en doce horas. Publicará en Instagram en dos pasos, programará en Facebook con su ventana de diez minutos a treinta días y publicará en LinkedIn como organización. Comparará la publicación a mano, la API directa, Make y n8n con su coste y su mantenimiento, insertará la leyenda de IA y bloqueará las piezas sin aprobación válida, repasará los límites legales de la publicidad en México y terminará con TL Publicación multired v1 en n8n.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Conocer los requisitos de publicación por API de cada red: cuentas profesionales, permisos, revisión de la aplicación y versiones.
- Publicar y programar respetando los límites documentados (Instagram por cuenta y 24 horas, ventana de programación de Facebook, acceso a la Community Management API de LinkedIn).
- Elegir entre API directa, módulos de Make o nodos de n8n con criterios de coste, mantenimiento y riesgo.
- Etiquetar el contenido generado o asistido por IA y cumplir los límites legales de publicidad.
Requisitos por red
Publicar por API no es pulsar un botón desde otro sitio: es pedirle a cada red que confíe en una aplicación que actúa en nombre de la panadería. Cada red lo resuelve con tres piezas parecidas y nombres distintos. La primera es una cuenta del tipo correcto: una persona no puede publicar por API en su perfil personal de Instagram, sino en una cuenta profesional; en LinkedIn, la panadería publica desde su página de empresa, no desde el perfil de Valeria. La segunda es un permiso concreto, que la persona dueña de la cuenta concede a la aplicación al iniciar sesión y que queda dentro de un token. La tercera es la revisión de la plataforma: Meta y LinkedIn revisan las aplicaciones que publican en cuentas ajenas, y LinkedIn, además, revisa a quién deja usar su API de gestión de páginas.
El primer bloque fija las importaciones, la semilla de la serie, la zona horaria de la panadería y la carpeta del día:
# Importaciones base, semilla de la serie, zona horaria y carpeta del día en Python:
import warnings
warnings.filterwarnings('ignore')
import hashlib
import json
import re
import textwrap
from datetime import datetime, timedelta, timezone
from pathlib import Path
from zoneinfo import ZoneInfo
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from matplotlib.patches import FancyArrowPatch, FancyBboxPatch, Polygon

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 140)
pd.set_option('display.max_colwidth', 60)
CDMX = ZoneInfo('America/Mexico_City')
carpeta = Path('trigo_lento') / 'dia_72'
carpeta.mkdir(parents = True, exist_ok = True)
print('numpy', np.__version__, '| pandas', pd.__version__)
print('Desfase de la Ciudad de México en enero y en mayo de 2026:',
      datetime(2026, 1, 15, 12, tzinfo = CDMX).strftime('%z'), datetime(2026, 5, 15, 12, tzinfo = CDMX).strftime('%z'))
numpy 2.4.6 | pandas 3.0.3
Desfase de la Ciudad de México en enero y en mayo de 2026: -0600 -0600
La salida confirma un detalle que importará en todo el día: la Ciudad de México está en $-06{:}00$ en enero y en mayo. Desde que México eliminó el horario de verano en 2022, la zona America/Mexico_City ya no cambia en abril; un servidor que todavía tenga una base de zonas horarias anterior a esa ley adelantaría una hora todas las publicaciones de mayo. Por eso el programador trabaja con zoneinfo y con instantes en UTC, y nunca con horas “a secas”.
Valeria no escribe los requisitos de memoria. Los apunta en una tabla con una columna que casi nunca aparece en los tutoriales: de dónde salió el dato y cuánto confía en él. Distingue tres niveles: “oficial” cuando lo dice la documentación de la red, “secundaria” cuando solo lo dicen guías de terceros o lo confirma a medias la documentación, y “no coincidente” cuando las fuentes dan cifras distintas. El siguiente bloque guarda esa tabla y cuenta los niveles por red:
# Requisitos y límites de publicación por red, con fuente y nivel de confianza, en Python:
REQUISITOS = [
    ('Instagram', 'Cuenta', 'Profesional (empresa o creador); con inicio de sesión de Facebook, vinculada a una página', 'oficial'),
    ('Instagram', 'Permisos', 'instagram_basic e instagram_content_publish (o sus equivalentes instagram_business_*)', 'oficial'),
    ('Instagram', 'Revisión de Meta', 'Acceso avanzado y verificación del negocio solo si la usan cuentas sin rol en la app', 'oficial'),
    ('Instagram', 'Límite de publicación', '50 por cuenta en 24 h móviles (referencia); otra página dice 100 y blogs dicen 25', 'no coincidente'),
    ('Instagram', 'Programación', 'La API no programa: publica al llamar a media_publish', 'oficial'),
    ('Instagram', 'Imagen y pie', 'JPEG en una URL pública; pie de hasta 2 200 caracteres y 30 etiquetas', 'oficial'),
    ('Facebook', 'Página y permisos', 'Token de página con la tarea CREATE_CONTENT; pages_manage_posts y pages_read_engagement', 'oficial'),
    ('Facebook', 'Revisión de Meta', 'La misma regla de acceso avanzado que Instagram', 'oficial'),
    ('Facebook', 'Programación', 'published=false y scheduled_publish_time de 10 minutos a 30 días (guía de la Pages API)', 'oficial'),
    ('Facebook', 'Máximo de programación', 'Otras páginas dicen 75 días (feed), 6 meses (videos) o 29 días (reels)', 'no coincidente'),
    ('LinkedIn', 'Página y rol', 'Página de empresa; rol ADMINISTRATOR, CONTENT_ADMIN o DIRECT_SPONSORED_CONTENT_POSTER', 'oficial'),
    ('LinkedIn', 'Permiso y acceso', 'w_organization_social, que solo llega con la Community Management API tras revisión', 'secundaria'),
    ('LinkedIn', 'Cabeceras', 'LinkedIn-Version en formato AAAAMM y X-Restli-Protocol-Version 2.0.0', 'oficial'),
    ('LinkedIn', 'Token', 'Unos 60 días; la renovación automática solo para socios aprobados', 'no coincidente'),
    ('LinkedIn', 'Programación y texto', 'La Posts API publica al momento; texto de hasta 3 000 caracteres', 'secundaria'),
]
requisitos = pd.DataFrame(REQUISITOS, columns = ['red', 'requisito', 'valor', 'confianza'])
requisitos.to_csv(carpeta / 'requisitos_por_red.csv', index = False, encoding = 'utf-8')
print(requisitos[['red', 'requisito', 'confianza']].to_string(index = False))
print()
print(pd.crosstab(requisitos['red'], requisitos['confianza'], margins = True, margins_name = 'total').to_string())
      red              requisito      confianza
Instagram                 Cuenta        oficial
Instagram               Permisos        oficial
Instagram       Revisión de Meta        oficial
Instagram  Límite de publicación no coincidente
Instagram           Programación        oficial
Instagram           Imagen y pie        oficial
 Facebook      Página y permisos        oficial
 Facebook       Revisión de Meta        oficial
 Facebook           Programación        oficial
 Facebook Máximo de programación no coincidente
 LinkedIn           Página y rol        oficial
 LinkedIn       Permiso y acceso     secundaria
 LinkedIn              Cabeceras        oficial
 LinkedIn                  Token no coincidente
 LinkedIn   Programación y texto     secundaria

confianza  no coincidente  oficial  secundaria  total
red
Facebook                1        3           0      4
Instagram               1        5           0      6
LinkedIn                1        2           2      5
total                   3       10           2     15
De los $15$ requisitos, $10$ son oficiales, $2$ secundarios y $3$ no coincidentes, uno por red. La Tabla 1 los reúne con su valor y su fuente:
Tabla 1. Requisitos y límites de publicación por red, con fuente y nivel de confianza (revisado en octubre de 2026).
| Red | Requisito | Valor | Fuente | Confianza |
|---|---|---|---|---|
| Cuenta | Profesional (empresa o creador); con inicio de sesión de Facebook, vinculada a una página | Meta, Instagram Platform | Oficial | |
| Permisos | instagram_basic e instagram_content_publish (o instagram_business_* con el inicio de sesión de Instagram) | Meta, Content Publishing | Oficial | |
| Revisión de Meta | Acceso avanzado y verificación del negocio solo si la aplicación la usan cuentas sin rol en ella | Meta, Instagram Platform | Oficial | |
| Límite de publicación | 50 por cuenta en 24 horas móviles; otra página de Meta dice 100 y blogs de terceros dicen 25 | Referencia content_publishing_limit frente a otras páginas | No coincidente | |
| Programación | La API no programa: publica al llamar a media_publish | Meta, Content Publishing | Oficial | |
| Imagen y pie | JPEG en una URL pública al publicar; pie de hasta 2 200 caracteres y 30 etiquetas | Meta, Content Publishing | Oficial | |
| Página y permisos | Token de página con la tarea CREATE_CONTENT; pages_manage_posts y pages_read_engagement | Meta, Pages API | Oficial | |
| Revisión de Meta | La misma regla de acceso avanzado que Instagram | Meta, revisión de aplicaciones | Oficial | |
| Programación | published=false y scheduled_publish_time de 10 minutos a 30 días | Meta, guía de publicaciones de la Pages API | Oficial | |
| Máximo de programación | Otras páginas dicen 75 días (feed), 6 meses (videos) o 29 días (reels) | Referencias de Meta citadas por terceros | No coincidente | |
| Página y rol | Página de empresa; rol ADMINISTRATOR, CONTENT_ADMIN o DIRECT_SPONSORED_CONTENT_POSTER | LinkedIn, Microsoft Learn | Oficial | |
| Permiso y acceso | w_organization_social, que solo llega con la Community Management API tras una revisión | Microsoft Learn y guías de terceros | Secundaria | |
| Cabeceras | LinkedIn-Version en formato AAAAMM y X-Restli-Protocol-Version: 2.0.0 | LinkedIn, Microsoft Learn | Oficial | |
| Token | Unos 60 días; la renovación automática solo para socios aprobados | Guías de terceros, en desacuerdo | No coincidente | |
| Programación y texto | La Posts API publica al momento; texto de hasta 3 000 caracteres | Guías de terceros | Secundaria |
Tres filas de la tabla cambian el diseño. La primera es el límite de Instagram: la referencia del punto de consulta content_publishing_limit devuelve un cupo de $50$ publicaciones en $86,400$ segundos, una página más reciente de la misma documentación habla de $100$ y varios blogs repiten $25$. Cuando las fuentes no coinciden, el arquitecto no elige la que le conviene: diseña con la más baja que tenga respaldo oficial y comprueba que el negocio queda lejos de todas. La segunda es la ventana de Facebook, con el mismo problema en el máximo. La tercera es el token de LinkedIn, cuya duración de unos sesenta días repiten muchas fuentes, pero cuya renovación automática no está al alcance de cualquier aplicación: en la práctica, alguien tendrá que volver a autorizar la aplicación antes de que caduque, y el flujo tiene que avisarle a tiempo.
La Figura 1 dibuja los requisitos como lo que son para un negocio pequeño: tres ventanillas, cada una con su lista de papeles.
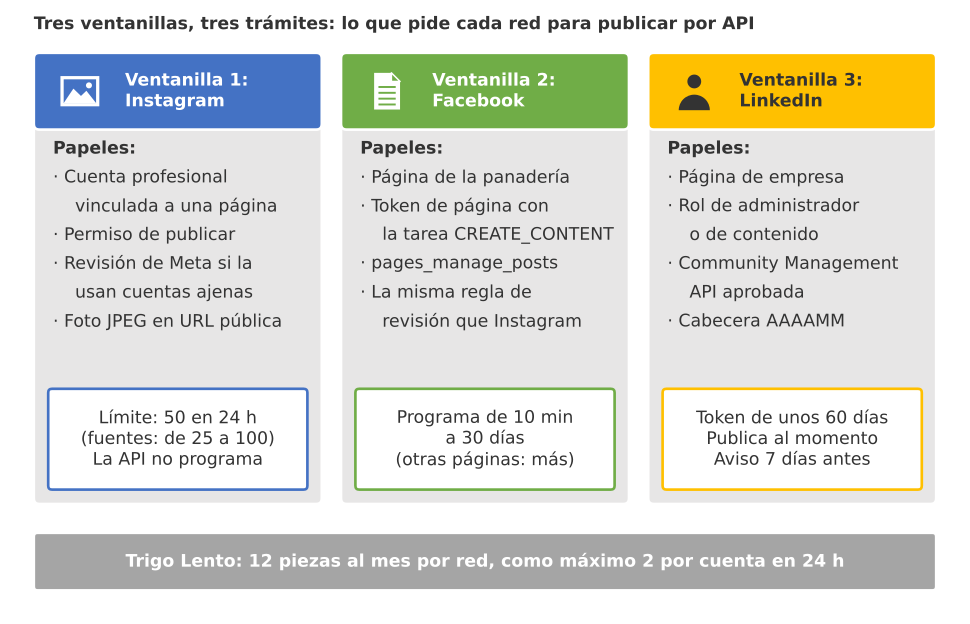
Figura 1. Tres ventanillas, tres trámites: Instagram pide cuenta profesional, permiso de publicación y revisión de Meta si hay terceros; Facebook pide página, token de página y permiso de publicar; LinkedIn pide página de empresa, rol de administrador y la Community Management API aprobada, y cada ventanilla marca su límite.
Para Trigo Lento, la revisión de Meta es más ligera de lo que parece. La aplicación de Valeria publica solo en las cuentas de la propia panadería, con personas que tienen un rol en la aplicación, y la documentación de Meta reserva el acceso avanzado y la verificación del negocio para aplicaciones que usan cuentas sin rol. En LinkedIn ocurre lo contrario: el permiso w_organization_social llega con la Community Management API, que exige solicitar el acceso y esperar su aprobación, y que los propios desarrolladores describen como cerrada a particulares. El plan de publicación tiene que funcionar sin LinkedIn mientras llega esa aprobación, y por eso el flujo trata cada red como un camino independiente.
Atención aquí: un token de página de Meta o un token de LinkedIn publica en nombre de la panadería sin pedir contraseña a nadie. Se guardan en las credenciales de n8n o en variables de entorno del servidor, nunca en el código, en un blueprint, en un JSON exportado ni en la URL que escribe un registro (los ejemplos de Meta pasan access_token como parámetro: no registre las URL completas). Use el permiso mínimo que necesita cada flujo: publicar no requiere leer mensajes directos ni gestionar anuncios. Si un token se filtra, se revoca desde la red y se emite otro, como estableció el Día 17 (Seguridad I: OAuth, secretos y mínimo privilegio en las conexiones).
La API de Instagram publica en dos pasos. El primero crea un contenedor: la aplicación envía la URL pública de la foto y el texto, y Meta descarga la imagen y la procesa. El segundo publica el contenedor con media_publish. El límite de $50$ publicaciones se comprueba en el segundo paso, no en el primero, y la documentación recomienda que la propia aplicación vigile su cupo. Hay un detalle que cambia el diseño de todo el día: la API de Instagram no programa. Publica en el instante en que se llama a media_publish. Si Trigo Lento quiere que la pieza salga el jueves 7 de mayo a la una de la tarde, alguien tiene que llamar a la API el jueves 7 de mayo a la una de la tarde, y ese alguien es el flujo.
Un programador propio
La Figura 2 resume la idea antes del código: programar es poner piezas aprobadas en una cola con su hora; publicar es lo que hace, a esa hora, un único proceso que lee la cola.
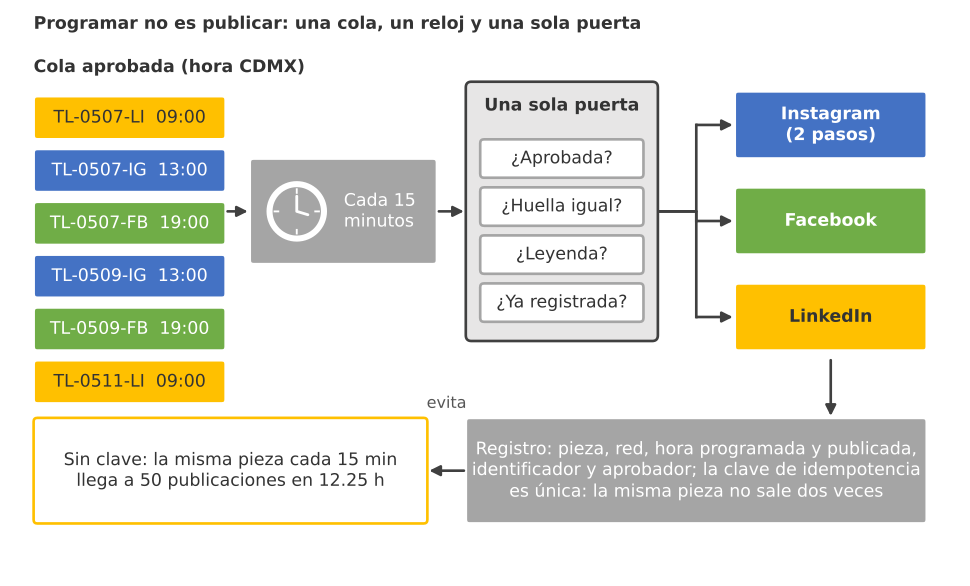
Figura 2. Programar no es publicar: las piezas aprobadas esperan en una cola con su hora en la Ciudad de México, un reloj que revisa cada 15 minutos las deja salir por una sola puerta hacia Instagram, Facebook o LinkedIn, y el registro con su clave de idempotencia impide que la misma pieza salga dos veces.
La cola sale de la base de Notion del Día 71: cada publicación del calendario se convierte en tres piezas, una por red, con la hora de esa red. LinkedIn tiene una regla más, porque su público son cafeterías y oficinas: las piezas que caen en sábado se mueven al lunes siguiente a las nueve. El siguiente bloque reconstruye la cola con las mismas reglas (para que la entrada se pueda ejecutar sin la cuenta de Notion de Trigo Lento), calcula para cada pieza su hora local, su hora UTC y su marca de tiempo Unix, y muestra las próximas diez a partir del 1 de mayo:
# Programador propio: cola de piezas aprobadas con hora local de la Ciudad de México y hora UTC en Python:
CATALOGO = {p['clave']: p for p in json.loads(Path('trigo_lento/catalogo.json').read_text(encoding = 'utf-8'))}
# Calendario de mayo aprobado el Día 71 (12 publicaciones): fecha, pilar y producto.
CALENDARIO = [('2026-05-02', 'producto', 'P01'), ('2026-05-05', 'oficio', 'P01'), ('2026-05-07', 'temporada', 'P09'),
              ('2026-05-09', 'temporada', 'P09'), ('2026-05-12', 'comunidad', 'P02'), ('2026-05-14', 'producto', 'P12'),
              ('2026-05-16', 'oficio', 'P05'), ('2026-05-19', 'producto', 'P06'), ('2026-05-21', 'comunidad', 'P10'),
              ('2026-05-23', 'temporada', 'P08'), ('2026-05-26', 'oficio', 'P03'), ('2026-05-28', 'producto', 'P07')]
HORA_POR_RED = {'instagram': (13, 0), 'facebook': (19, 0), 'linkedin': (9, 0)}   # horas con más alcance medido
SIGLA = {'instagram': 'IG', 'facebook': 'FB', 'linkedin': 'LI'}

def hora_programada(fecha, red):
    h, m = HORA_POR_RED[red]
    local = datetime.fromisoformat(fecha).replace(hour = h, minute = m, tzinfo = CDMX)
    if red == 'linkedin' and local.weekday() >= 5:             # LinkedIn solo de lunes a viernes
        local += timedelta(days = 7 - local.weekday())
    return local

filas = []
for fecha, pilar, clave in CALENDARIO:
    for red in HORA_POR_RED:
        local = hora_programada(fecha, red)
        filas.append({'pieza': f'TL-{fecha[5:7]}{fecha[8:]}-{SIGLA[red]}', 'red': red, 'pilar': pilar,
                      'producto': CATALOGO[clave]['producto'], 'local': local,
                      'utc': local.astimezone(timezone.utc), 'epoch': int(local.timestamp())})
cola = pd.DataFrame(filas).sort_values('utc', kind = 'stable').reset_index(drop = True)
print(f'Piezas en la cola: {len(cola)} | por red: {cola.red.value_counts().sort_index().to_dict()}')
print('Piezas de LinkedIn movidas a lunes:', int((cola.red.eq('linkedin') &
      (cola.local.map(lambda t: t.date().isoformat()) != cola.pieza.map(lambda p: f'2026-{p[3:5]}-{p[5:7]}'))).sum()))
ahora = datetime(2026, 5, 1, 0, 0, tzinfo = CDMX)
proximas = cola[cola['local'] >= ahora].head(10)
print(proximas.assign(hora_local = proximas['local'].map(lambda t: t.strftime('%a %d %H:%M')),
                      hora_utc = proximas['utc'].map(lambda t: t.strftime('%d %H:%MZ')))
      [['pieza', 'red', 'producto', 'hora_local', 'hora_utc', 'epoch']].to_string(index = False))
cola.assign(local = cola['local'].map(lambda t: t.isoformat()), utc = cola['utc'].map(lambda t: t.isoformat())
            ).to_csv(carpeta / 'cola_mayo.csv', index = False, encoding = 'utf-8')
Piezas en la cola: 36 | por red: {'facebook': 12, 'instagram': 12, 'linkedin': 12}
Piezas de LinkedIn movidas a lunes: 4
     pieza       red                     producto   hora_local  hora_utc      epoch
TL-0502-IG instagram Hogaza de masa madre (800 g) Sat 02 13:00 02 19:00Z 1777748400
TL-0502-FB  facebook Hogaza de masa madre (800 g) Sat 02 19:00 03 01:00Z 1777770000
TL-0502-LI  linkedin Hogaza de masa madre (800 g) Mon 04 09:00 04 15:00Z 1777906800
TL-0505-LI  linkedin Hogaza de masa madre (800 g) Tue 05 09:00 05 15:00Z 1777993200
TL-0505-IG instagram Hogaza de masa madre (800 g) Tue 05 13:00 05 19:00Z 1778007600
TL-0505-FB  facebook Hogaza de masa madre (800 g) Tue 05 19:00 06 01:00Z 1778029200
TL-0507-LI  linkedin   Pastel de chocolate entero Thu 07 09:00 07 15:00Z 1778166000
TL-0507-IG instagram   Pastel de chocolate entero Thu 07 13:00 07 19:00Z 1778180400
TL-0507-FB  facebook   Pastel de chocolate entero Thu 07 19:00 08 01:00Z 1778202000
TL-0509-IG instagram   Pastel de chocolate entero Sat 09 13:00 09 19:00Z 1778353200
La cola tiene $36$ piezas, $12$ por red, y $4$ piezas de LinkedIn se movieron de sábado a lunes (las del 2, 9, 16 y 23 de mayo). Las tres columnas de tiempo dicen lo mismo de tres maneras: la hora local es la que entiende Don Ernesto, la hora UTC es la que guarda la base de datos y la marca Unix es la que pide Facebook en scheduled_publish_time. La publicación de Facebook del sábado 2 a las $19{:}00$ en la Ciudad de México ocurre el domingo 3 a la $01{:}00$ en UTC: un programador que compare fechas sin zona horaria la publicaría un día antes o un día después, según el reloj del servidor.
El orden de la cola tampoco es casual. Las piezas se ordenan por su instante UTC y, a igualdad, por el orden en que se escribieron; así, dos ejecuciones del programador con la misma cola producen el mismo orden, y una prueba del Día 43 (Laboratorio guiado: pruebas de flujos con datos fijados y un entorno de ensayo) puede fijar la salida y compararla.
La ventana móvil de 24 horas
El límite de Instagram no se cuenta por días del calendario, sino en una ventana móvil: a cualquier hora, la cuenta no puede llevar más de $Q$ publicaciones en las últimas 24 horas. Para la serie de instantes de publicación $t_1, t_2, \ldots$ de una cuenta, el número de publicaciones en la ventana que termina en $t$ es:
$$ N(t) = \sum_{i} \mathbb{1}\left[, t - 86,400 < t_i \le t ,\right], \qquad \max_t N(t) \le Q - m $$
La lógica detrás de esta comprobación es la siguiente:
- $t_i$ son los instantes de publicación en segundos (marcas Unix) y $86,400$ los segundos de 24 horas; $\mathbb{1}[\cdot]$ vale $1$ si la publicación cae dentro de la ventana y $0$ si no.
- $N(t)$ solo cambia cuando entra o sale una publicación, así que basta evaluarla en cada $t_i$: con las marcas ordenadas, una búsqueda binaria cuenta cuántas quedan dentro.
- $Q = 50$ es el cupo de la referencia y $m$ un margen propio (el Bloque 5 usa $m = 5$): el flujo se detiene antes que Meta, porque un error de cupo a mitad de una promoción es peor que una pieza aplazada.
- En conclusión, la ventana móvil convierte la pregunta “¿cuántas publicamos al día?” en la pregunta correcta, “¿cuántas llevamos en las últimas 24 horas en cualquier momento?”.
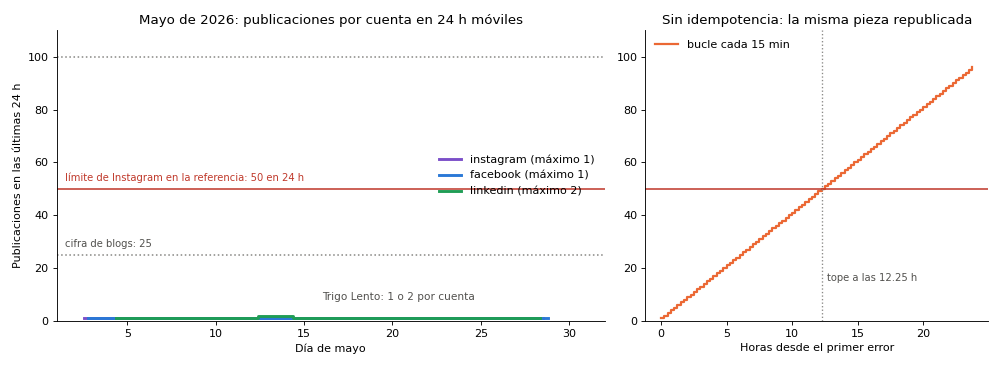
El siguiente bloque publica el mes con simular_post, la función de la serie que imita una respuesta HTTP sin red ni cuentas: falla con un $2%$ de errores 429 (límite de tasa) y un $4%$ de errores 5xx declarados, y la función publicar reintenta hasta tres veces con espera exponencial y respeta la cabecera retry-after. Después mide la ventana móvil por cuenta y dibuja, a la derecha, lo que pasaría con un flujo que pierde el registro y vuelve a publicar la misma pieza en cada vuelta del disparador:
# Publicación simulada con reintentos, registro y ventana móvil de 24 horas por cuenta en Python:
class Respuesta:
    def __init__(self, status_code, cuerpo, headers = None):
        self.status_code, self._cuerpo, self.headers = status_code, cuerpo, headers or {}
    def json(self):
        return self._cuerpo

def simular_post(url, cuerpo, rng, p_429 = 0.02, p_5xx = 0.04):
    # Falla con probabilidades declaradas: 2 % de límite de tasa y 4 % de error del servidor.
    u = rng.random()
    if u < p_429:
        return Respuesta(429, {'error': {'message': 'rate limit'}}, {'retry-after': '60'})
    if u < p_429 + p_5xx:
        return Respuesta(500, {'error': {'message': 'temporarily unavailable'}})
    return Respuesta(200 if 'linkedin' not in url else 201, {'id': str(int(rng.integers(10**15, 10**16)))})

def publicar(pieza, red, rng, max_intentos = 3, espera_base = 60):
    # Reintentos con espera exponencial (60, 120 s) y respeto de retry-after:
    retraso = float(rng.uniform(2, 20))                 # el disparador lee la cola y prepara la petición
    for intento in range(1, max_intentos + 1):
        r = simular_post(f'https://{red}.ejemplo/publicar', {'pieza': pieza}, rng)
        if r.status_code in (200, 201):
            return intento, retraso, r.json()['id']
        retraso += float(r.headers.get('retry-after', espera_base * 2 ** (intento - 1)))
    return max_intentos, retraso, None

APROBADORES = ['Valeria', 'Valeria', 'Valeria', 'Don Ernesto']
registro = []
for p in cola.itertuples():
    intentos, retraso, id_pub = publicar(p.pieza, p.red, rng)
    registro.append({'pieza': p.pieza, 'red': p.red, 'programada': p.local,
                     'publicada': p.local + timedelta(seconds = retraso) if id_pub else pd.NaT,
                     'intentos': intentos, 'id_publicacion': id_pub,
                     'aprobador': APROBADORES[int(rng.integers(len(APROBADORES)))]})
registro = pd.DataFrame(registro)
publicadas = registro.dropna(subset = ['id_publicacion'])
print(f'Publicadas: {len(publicadas)} de {len(registro)} | con reintento: {(registro.intentos > 1).sum()} '
      f'| fallidas tras 3 intentos: {registro.id_publicacion.isna().sum()}')
retrasos = (publicadas['publicada'] - publicadas['programada']).dt.total_seconds()
print(f'Retraso sobre la hora programada: mediana {retrasos.median():.0f} s, máximo {retrasos.max():.0f} s')
print(registro.head(6).assign(programada = registro['programada'].map(lambda t: t.strftime('%d/%m %H:%M')),
                              publicada = registro['publicada'].map(lambda t: t.strftime('%H:%M:%S')))
      .to_string(index = False))
registro.to_csv(carpeta / 'registro_publicaciones.csv', index = False, encoding = 'utf-8')

def ventana_movil(instantes, segundos = 86400):
    # N(t): publicaciones de la misma cuenta en (t - 24 h, t], evaluado en cada publicación.
    t = np.sort(np.asarray(instantes, dtype = float))
    return t, np.arange(1, len(t) + 1) - np.searchsorted(t, t - segundos, side = 'right')

LIMITE = 50
maximos = {}
fig, (ax1, ax2) = plt.subplots(1, 2, figsize = (12.5, 4.6), gridspec_kw = {'width_ratios': [1.6, 1]})
for red, color in zip(['instagram', 'facebook', 'linkedin'], ['#7b4fc9', '#2a78d6', '#1f9d55']):
    seg = publicadas.loc[publicadas.red == red, 'publicada'].map(lambda t: t.timestamp())
    t, n = ventana_movil(seg)
    maximos[red] = int(n.max())
    dias = (t - ahora.timestamp()) / 86400 + 1
    ax1.step(dias, n, where = 'post', color = color, lw = 2.6, label = f'{red} (máximo {n.max()})')
for q, estilo in [(25, ':'), (LIMITE, '-'), (100, ':')]:
    ax1.axhline(q, color = '#c0392b' if q == LIMITE else '#8a8986', ls = estilo, lw = 1.4)
ax1.text(1.5, LIMITE + 3, 'límite de Instagram en la referencia: 50 en 24 h', color = '#c0392b', fontsize = 9)
ax1.text(1.5, 28, 'cifra de blogs: 25', color = '#52514e', fontsize = 9)
ax1.text(16, 8, 'Trigo Lento: 1 o 2 por cuenta', color = '#52514e', fontsize = 9.5)
ax1.set_ylim(0, 110)
ax1.set_xlim(1, 32)
ax1.set_title('Mayo de 2026: publicaciones por cuenta en 24 h móviles', fontsize = 12)
ax1.set_xlabel('Día de mayo')
ax1.set_ylabel('Publicaciones en las últimas 24 h')
ax1.legend(frameon = False, loc = 'center right')
# Escenario de fallo: un flujo sin clave de idempotencia republica la misma pieza cada 15 minutos.
t_bucle = np.arange(0, 24 * 3600, 15 * 60)
_, n_bucle = ventana_movil(t_bucle)
horas_al_limite = t_bucle[np.argmax(n_bucle >= LIMITE)] / 3600
ax2.step(t_bucle / 3600, n_bucle, where = 'post', color = '#eb6834', lw = 2, label = 'bucle cada 15 min')
ax2.axhline(LIMITE, color = '#c0392b', lw = 1.4)
ax2.axvline(horas_al_limite, color = '#8a8986', ls = ':', lw = 1.2)
ax2.text(horas_al_limite + 0.4, 15, f'tope a las {horas_al_limite:.2f} h', color = '#52514e', fontsize = 9)
ax2.set_title('Sin idempotencia: la misma pieza republicada', fontsize = 12)
ax2.set_xlabel('Horas desde el primer error')
ax2.set_ylim(0, 110)
ax2.legend(frameon = False, loc = 'upper left')
for ax in (ax1, ax2):
    ax.spines[['top', 'right']].set_visible(False)
plt.tight_layout()
plt.show()
print('Máximo en 24 h por cuenta:', maximos, '| holgura frente a 50:', {r: LIMITE // m for r, m in maximos.items()})
print(f'Bucle sin idempotencia: {LIMITE} publicaciones a las {horas_al_limite:.2f} horas')
Publicadas: 36 de 36 | con reintento: 1 | fallidas tras 3 intentos: 0
Retraso sobre la hora programada: mediana 12 s, máximo 79 s
     pieza       red  programada publicada  intentos   id_publicacion   aprobador
TL-0502-IG instagram 02/05 13:00  13:00:05         1 5205415610291366     Valeria
TL-0502-FB  facebook 02/05 19:00  19:00:08         1 9146294530094565     Valeria
TL-0502-LI  linkedin 04/05 09:00  09:00:05         1 3684724906200124     Valeria
TL-0505-LI  linkedin 05/05 09:00  09:00:18         1 7774588873711779 Don Ernesto
TL-0505-IG instagram 05/05 13:00  13:00:11         1 5035424908600928     Valeria
TL-0505-FB  facebook 05/05 19:00  19:00:07         1 5732351590107236     Valeria
Máximo en 24 h por cuenta: {'instagram': 1, 'facebook': 1, 'linkedin': 2} | holgura frente a 50: {'instagram': 50, 'facebook': 50, 'linkedin': 25}
Bucle sin idempotencia: 50 publicaciones a las 12.25 horas
Las $36$ piezas se publicaron, $1$ necesitó un reintento y ninguna falló tras tres intentos. La mediana del retraso sobre la hora programada es de $12$ segundos y el máximo, de $79$, que es el reintento con su espera de $60$ segundos. La probabilidad de que una pieza agote sus intentos explica por qué tres bastan:
$$ P_{\text{falla}} = p^{,r}, \qquad E[\text{fallidas}] = n , p^{,r} $$
La lógica detrás de esta cuenta es la siguiente:
- $p = 0.06$ es la probabilidad declarada de que un intento falle ($0.02$ de errores 429 más $0.04$ de errores 5xx) y $r = 3$ el número de intentos.
- Con fallos independientes, $P_{\text{falla}} = 0.06^3 = 0.000216$, y con $n = 36$ piezas al mes se esperan $0.0078$ piezas fallidas: una cada diez años.
- Los reintentos esperados son unos $36 \cdot 0.06 = 2.16$ al mes; la simulación tuvo $1$, dentro de lo razonable para un solo mes.
- En conclusión, el riesgo no está en los fallos independientes, que tres intentos resuelven, sino en los fallos que no son independientes: un token caducado o una versión retirada fallan siempre, y ahí reintentar solo hace ruido. Por eso los bloques 5 y 8 distinguen esos errores y avisan a una persona.
La gráfica de la izquierda es la que Don Ernesto necesitaba ver. Trigo Lento publica como máximo $1$ pieza por cuenta en 24 horas en Instagram y en Facebook, y $2$ en LinkedIn, donde la pieza del sábado 9 se movió al lunes 11 a las nueve y la del martes 12 sale 23 horas, 59 minutos y 59 segundos después, por los segundos de retraso de cada una. Frente a $50$, la holgura es de $50$ veces en Instagram; frente a la cifra más baja que circula, $25$, sigue siendo de $25$ veces. Las tres líneas apenas se despegan del suelo. Con un calendario de doce publicaciones al mes, el límite de Instagram no es una restricción de Trigo Lento; es una alarma para cuando algo se rompe.
La gráfica de la derecha muestra cuándo suena esa alarma. Si el nodo que registra la publicación falla y el flujo no tiene una clave que identifique cada pieza, la consulta de la cola vuelve a ver la misma pieza “pendiente” cada quince minutos y la publica otra vez. Con una publicación cada $15$ minutos, la $n$-ésima ocurre en el minuto $15(n - 1)$, y la publicación número $50$ llega a los $15 \cdot 49 = 735$ minutos: $12.25$ horas después del primer error, de noche, mientras nadie mira. Para entonces, los seguidores de la panadería habrán visto la misma hogaza cuarenta y nueve veces. La defensa no es vigilar el cupo, sino la idempotencia: cada pieza lleva una clave única (clave_idempotencia), el registro la guarda con una restricción de unicidad y la consulta de la cola excluye todo lo que ya está registrado, como se verá en el workflow.
Publicar en dos pasos
El bloque que publica de verdad sigue el orden de la documentación de Meta: consulta el cupo con content_publishing_limit, se detiene si queda a menos de $5$ del tope, crea el contenedor con la URL pública de la foto real y el texto final (con su leyenda), espera a que el contenedor pase a FINISHED y publica. El token de página viene del entorno y la versión de la Graph API está fijada en una constante que se revisa cada trimestre. El bloque llama a la API de Meta y no se ejecutó para escribir la entrada; la salida es un ejemplo comentado:
# Publicación en Instagram en dos pasos (crear contenedor y publicar) con la Graph API en Python:
import os
import time
import requests

GRAPH = 'https://graph.facebook.com/v25.0'          # versión fijada a mano; se revisa cada trimestre
IG_USER_ID = os.environ['TL_IG_USER_ID']            # cuenta profesional de Instagram de Trigo Lento
TOKEN = os.environ['TL_META_TOKEN_PAGINA']          # token de página: nunca en el código ni en el registro
MARGEN_CUPO = 5                                     # el flujo se detiene antes que Meta

def cupo_instagram():
    # Uso del cupo en las últimas 24 horas según la referencia content_publishing_limit:
    r = requests.get(f'{GRAPH}/{IG_USER_ID}/content_publishing_limit', timeout = 30,
                     params = {'fields': 'config,quota_usage', 'access_token': TOKEN})
    r.raise_for_status()
    dato = r.json()['data'][0]
    return dato['quota_usage'], dato['config']['quota_total'], dato['config']['quota_duration']

def publicar_instagram(pieza, max_consultas = 10):
    usados, total, duracion = cupo_instagram()
    print(f'cupo usado: {usados} de {total} en {duracion // 3600} h')
    if usados >= total - MARGEN_CUPO:
        return {'estado': 'aplazada', 'motivo': f'cupo {usados}/{total}'}
    # Paso 1: el contenedor con la foto real (JPEG en una URL pública) y el texto final con su leyenda.
    r = requests.post(f'{GRAPH}/{IG_USER_ID}/media', timeout = 30, data = {
        'image_url': pieza['url_imagen'], 'caption': pieza['texto_final'], 'access_token': TOKEN})
    r.raise_for_status()
    contenedor = r.json()['id']
    for consulta in range(1, max_consultas + 1):        # esperar a que Meta procese la imagen
        estado = requests.get(f'{GRAPH}/{contenedor}', timeout = 30,
                              params = {'fields': 'status_code', 'access_token': TOKEN}).json()['status_code']
        if estado == 'FINISHED':
            break
        if estado in ('ERROR', 'EXPIRED'):
            return {'estado': 'fallida', 'motivo': f'contenedor {estado}'}
        time.sleep(6)
    print(f'contenedor {contenedor}: {estado} en {consulta} consultas')
    # Paso 2: publicar. Aquí es donde cuenta el límite de 24 horas.
    r = requests.post(f'{GRAPH}/{IG_USER_ID}/media_publish', timeout = 30,
                      data = {'creation_id': contenedor, 'access_token': TOKEN})
    r.raise_for_status()
    return {'estado': 'publicada', 'contenedor': contenedor, 'id_publicacion': r.json()['id']}

pieza = {'pieza': 'TL-0507-IG', 'url_imagen': 'https://www.ejemplo.com/fotos/pastel-chocolate-obrador.jpg',
         'texto_final': 'Pastel de chocolate entero: 460 MXN, precio total. ... Promoción válida del 7 al 10 de '
                        'mayo de 2026.\n\nTexto preparado con ayuda de IA y revisado por el equipo de Trigo Lento.'}
print(publicar_instagram(pieza))

# Salida de ejemplo (puede variar):
# cupo usado: 0 de 50 en 24 h
# contenedor 17912345678901234: FINISHED en 2 consultas
# {'estado': 'publicada', 'contenedor': '17912345678901234', 'id_publicacion': '17987654321098765'}
El ejemplo publica la pieza del jueves 7 de mayo, la primera de la promoción del Día de las Madres. Antes de publicar, el cupo usado es $0$ de $50$, porque la cuenta no ha publicado nada en las últimas 24 horas; el contenedor tarda dos consultas en quedar listo y la publicación devuelve su identificador, que el registro guardará. Cuatro decisiones del bloque merecen subrayarse:
- La foto vive en una URL pública cuando se llama a la API. Meta la descarga en ese momento; si el enlace caduca o pide contraseña, el contenedor termina en
ERROR. Trigo Lento sirve las fotos del obrador desde una carpeta pública de su sitio, sin datos personales en el nombre del archivo. - El texto final ya lleva la leyenda de IA, porque Instagram no permite editar después lo que la API publicó con la misma comodidad que en la aplicación, y porque el texto que se publica tiene que ser exactamente el que se aprobó (Bloque 9).
- El cupo se consulta antes de cada publicación, aunque Trigo Lento esté lejos del tope: es una petición barata que convierte un error de Meta en una decisión del flujo.
- El estado
EXPIREDno se reintenta: un contenedor que no se publica en el plazo que fija Meta caduca, y la pieza vuelve a la cola para crear uno nuevo.
Facebook sí programa. La guía de publicaciones de la Pages API permite crear una publicación en el feed de la página con published=false y una marca scheduled_publish_time, siempre que esa hora caiga entre $10$ minutos y $30$ días después de la petición. Otras páginas de la misma documentación, según las fuentes secundarias consultadas, dan otros máximos para el feed, los videos y los reels; la serie usa los $30$ días de la guía, que son los más restrictivos para publicaciones con texto y enlace.
Programar en Facebook tiene una ventaja que Instagram no ofrece: la publicación ya está en los servidores de Meta. Si el servidor de n8n de Trigo Lento se cae el sábado a las seis de la tarde, la pieza de las siete sale igual. Tiene también un coste: una vez programada, la pieza vive en dos sitios (la base de Notion y la página de Facebook), y un cambio de último minuto hay que hacerlo en los dos. Valeria decide usar la programación nativa como segundo seguro para las piezas de temporada, las que no pueden fallar, y dejar el resto al flujo. El siguiente bloque intenta programar las $12$ piezas de Facebook de la cola el lunes 13 de abril y comprueba la ventana antes de llamar a la API, para no gastar peticiones en errores conocidos. El bloque llama a la API de Meta y no se ejecutó para escribir la entrada; la salida es un ejemplo comentado:
# Publicación programada en la página de Facebook con published=false y scheduled_publish_time en Python:
import os
import requests

GRAPH = 'https://graph.facebook.com/v25.0'
PAGE_ID = os.environ['TL_PAGE_ID']
TOKEN = os.environ['TL_META_TOKEN_PAGINA']          # token de página con la tarea CREATE_CONTENT
MINIMO, MAXIMO = timedelta(minutes = 10), timedelta(days = 30)   # guía de la Pages API, revisado en octubre de 2026

def programar_facebook(pieza, cuando, ahora = None):
    ahora = ahora or datetime.now(timezone.utc)
    if not MINIMO <= cuando - ahora <= MAXIMO:      # se comprueba antes de llamar: Meta respondería con error
        return {'pieza': pieza['pieza'], 'estado': 'fuera de ventana', 'dias': (cuando - ahora).days}
    r = requests.post(f'{GRAPH}/{PAGE_ID}/feed', timeout = 30, data = {
        'message': pieza['texto_final'], 'link': pieza['enlace'],
        'published': 'false', 'scheduled_publish_time': int(cuando.timestamp()), 'access_token': TOKEN})
    r.raise_for_status()
    return {'pieza': pieza['pieza'], 'estado': 'programada', 'id_publicacion': r.json()['id']}

# Las 12 piezas de Facebook de la cola del Bloque 3, programadas el lunes 13 de abril a las 10:00 (16:00 UTC):
ahora = datetime(2026, 4, 13, 16, 0, tzinfo = timezone.utc)
resultados = [programar_facebook({'pieza': p.pieza, 'texto_final': '...', 'enlace': 'https://www.ejemplo.com/catalogo'},
                                 p.utc, ahora) for p in cola[cola.red == 'facebook'].itertuples()]
print(pd.DataFrame(resultados)['estado'].value_counts().to_dict())
r = requests.get(f'{GRAPH}/{PAGE_ID}/scheduled_posts', timeout = 30,
                 params = {'fields': 'id,scheduled_publish_time', 'access_token': TOKEN})
print('Programadas en la página:', len(r.json()['data']))

# Salida de ejemplo (puede variar):
# {'fuera de ventana': 7, 'programada': 5}
# Programadas en la página: 5
La ventana de $30$ días deja entrar $5$ de las $12$ piezas: las del 2, 5, 7, 9 y 12 de mayo, cuya hora UTC cae antes del 13 de mayo a las $16{:}00$. Las otras $7$ quedan “fuera de ventana” y el bloque ni siquiera las envía. El resultado enseña la regla de diseño: con la programación nativa, el calendario de un mes entero no cabe en una sola sentada. Hace falta una corrida semanal que programe lo que entra en la ventana, o un flujo que publique a la hora, que es lo que hará TL Publicación multired v1. Para la promoción del Día de las Madres, Valeria usa las dos cosas: la pieza del 7 de mayo queda programada en Facebook desde hoy, y el flujo la reconoce como ya publicada gracias a su clave.
La comprobación de la ventana usa la diferencia entre dos instantes con zona horaria, cuando - ahora, y no entre dos fechas. Es la misma lección del Bloque 3 desde el otro lado: las ventanas de las API se miden en segundos desde la petición, no en días del calendario de la Ciudad de México.
API directa, Make o n8n
Con los requisitos y los límites a la vista, queda la pregunta de Don Ernesto: ¿para qué otro robot, si Meta programa gratis? La respuesta honesta empieza por reconocer que la opción gratuita existe y que, en dinero, es la más barata. Valeria compara cuatro caminos con dos números para cada uno: lo que se paga a una plataforma y las horas de una persona, que en Trigo Lento valen $75$ MXN (el supuesto didáctico de la serie). El coste mensual de cada herramienta es:
$$ C_h = U_h , p_h + \left( \frac{n , a_h}{60} + M_h \right) \frac{w}{\tau} $$
La lógica detrás de esta fórmula es múltiple:
- $U_h$ son las unidades que consume la herramienta al mes (créditos de Make, ejecuciones de n8n) y $p_h$ su precio prorrateado: en Make Core, $10.59$ USD por $10,000$ créditos.
- $n = 36$ piezas, $a_h$ los minutos de atención por pieza (cuatro para copiar, pegar y programar a mano; medio minuto para revisar el registro cuando la publicación es automática) y $M_h$ las horas de mantenimiento al mes: tokens que caducan, versiones de API que se retiran, módulos que cambian.
- $w = 75$ MXN es el valor de la hora de Valeria y $\tau = 18.50$ MXN por USD el tipo de cambio didáctico.
- En conclusión, el coste de publicar no está en la plataforma, que casi no cobra por $36$ piezas, sino en las horas: las de publicar a mano o las de mantener el código. Las $M_h$ son supuestos de Valeria a partir de lo que le costó mantener los flujos del módulo 5, y se declaran como tales.
El siguiente bloque calcula la Tabla 2 y la gráfica. Para Make cuenta los créditos por red: el disparador, la lectura de la cola, los pasos de publicación (dos en Instagram; la subida de imagen y la publicación en LinkedIn), el registro y el aviso; para n8n cuenta las ejecuciones de un disparador que revisa la cola cada $15$ minutos:
# Coste mensual y mantenimiento por herramienta de publicación para 36 piezas en Python:
PIEZAS, HORA_VALERIA_MXN, MXN_POR_USD = 36, 75, 18.50
CREDITOS_POR_PIEZA = {'instagram': 6, 'facebook': 5, 'linkedin': 6}     # disparador, lectura, pasos, registro, aviso
creditos_make = sum(CREDITOS_POR_PIEZA[r] * n for r, n in cola.red.value_counts().items())
CREDITOS_CORE, PRECIO_CORE, USO_PREVIO_MAKE = 10000, 10.59, 7644      # uso previo: flujo de mensajes (Día 12)
EJECUCIONES_DISPARADOR = 30 * 24 * 4                                  # n8n consulta la cola cada 15 minutos

opciones = pd.DataFrame({
    'herramienta': ['A mano (Meta Business Suite y LinkedIn)', 'API directa (Python en el servidor)',
                    'Make (módulos de cada red)', 'n8n self-hosted (HTTP Request)'],
    'unidades_mes': ['36 piezas a mano', '36 llamadas por cron', f'{creditos_make} créditos',
                     f'{EJECUCIONES_DISPARADOR} ejecuciones'],
    'usd_incremental': [0.0, 0.0, 0.0, 0.0],
    'usd_prorrateado': [0.0, 0.0, round(PRECIO_CORE * creditos_make / CREDITOS_CORE, 3), 0.0],
    'min_por_pieza': [4.0, 0.5, 0.5, 0.5],          # copiar, pegar, programar; o solo revisar el registro
    'h_mantenimiento': [0.0, 1.5, 0.5, 1.0],        # tokens, versiones de API, módulos que cambian
    'riesgo_version': ['bajo', 'alto', 'medio', 'alto'],
})
opciones['h_mes'] = (PIEZAS * opciones['min_por_pieza'] / 60 + opciones['h_mantenimiento']).round(2)
opciones['coste_total_usd'] = (opciones['usd_prorrateado'] +
                               opciones['h_mes'] * HORA_VALERIA_MXN / MXN_POR_USD).round(2)
print(opciones.drop(columns = ['min_por_pieza']).to_string(index = False))
print(f'Créditos de Make: {creditos_make} ({creditos_make / CREDITOS_CORE:.1%} de Core); con el flujo de mensajes, '
      f'{(USO_PREVIO_MAKE + creditos_make) / CREDITOS_CORE:.1%}')
print(f'n8n Cloud Starter (2 500 ejecuciones) con el disparador cada 15 min: {EJECUCIONES_DISPARADOR / 2500:.0%} '
      f'de la cuota; cada hora: {30 * 24} ejecuciones')

fig, ax = plt.subplots(figsize = (8.6, 4.4))
y = np.arange(len(opciones))[::-1]
ax.barh(y, opciones['usd_prorrateado'], color = '#2a78d6', label = 'plataforma (USD prorrateados)')
ax.barh(y, opciones['coste_total_usd'] - opciones['usd_prorrateado'], left = opciones['usd_prorrateado'],
        color = '#f2b33d', label = 'horas de Valeria a 75 MXN')
for yi, v, h in zip(y, opciones['coste_total_usd'], opciones['h_mes']):
    ax.text(v + 0.1, yi, f'{v:.2f} USD ({h:.2f} h)', va = 'center', fontsize = 9.5)
ax.set_yticks(y)
ax.set_yticklabels([textwrap.fill(t, 26) for t in opciones['herramienta']], fontsize = 9.5)
ax.set_xlabel('USD al mes por publicar 36 piezas')
ax.set_xlim(0, 15)
ax.set_title('Coste mensual de publicar: plataforma más horas de mantenimiento', fontsize = 12)
ax.legend(frameon = False, loc = 'lower right')
ax.spines[['top', 'right']].set_visible(False)
plt.tight_layout()
plt.show()
                            herramienta         unidades_mes  usd_incremental  usd_prorrateado  h_mantenimiento riesgo_version  h_mes  coste_total_usd
A mano (Meta Business Suite y LinkedIn)     36 piezas a mano              0.0            0.000              0.0           bajo    2.4             9.73
    API directa (Python en el servidor) 36 llamadas por cron              0.0            0.000              1.5           alto    1.8             7.30
             Make (módulos de cada red)         204 créditos              0.0            0.216              0.5          medio    0.8             3.46
         n8n self-hosted (HTTP Request)     2880 ejecuciones              0.0            0.000              1.0           alto    1.3             5.27
Créditos de Make: 204 (2.0% de Core); con el flujo de mensajes, 78.5%
n8n Cloud Starter (2 500 ejecuciones) con el disparador cada 15 min: 115% de la cuota; cada hora: 720 ejecuciones
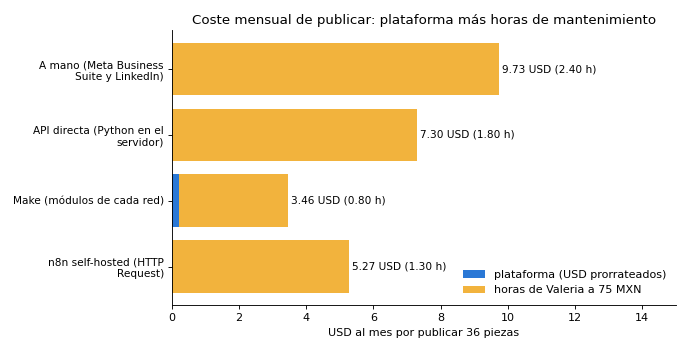
Tabla 2. API directa, Make y n8n frente a la publicación a mano: coste mensual para 36 piezas, esfuerzo de mantenimiento y riesgo de cambio de versión (horas a 75 MXN y 18.50 MXN por USD).
| Herramienta | Unidades al mes | USD de plataforma (prorrateados) | Horas de mantenimiento | Horas totales | Coste total en USD | Riesgo de cambio de versión |
|---|---|---|---|---|---|---|
| A mano (Meta Business Suite y LinkedIn) | 36 piezas a mano | 0.000 | 0.0 | 2.40 | 9.73 | Bajo |
| API directa (Python en el servidor) | 36 llamadas por cron | 0.000 | 1.5 | 1.80 | 7.30 | Alto |
| Make (módulos de cada red) | 204 créditos | 0.216 | 0.5 | 0.80 | 3.46 | Medio |
| n8n self-hosted (HTTP Request) | 2 880 ejecuciones | 0.000 | 1.0 | 1.30 | 5.27 | Alto |
La primera lectura sorprende: el camino más barato en total es Make, con $3.46$ USD al mes, y el más caro es publicar a mano, con $9.73$, aunque no pague nada a ninguna plataforma. Las $36$ piezas consumen $204$ créditos de Make, el $2.0%$ de Core, que son $0.216$ USD prorrateados; el ejemplo de juguete del plan estimaba unos $180$ con cinco créditos por pieza, y la cifra sube a $204$ al contar el segundo paso de Instagram y la subida de imagen de LinkedIn. Los módulos de Make para Instagram, Facebook y LinkedIn los mantiene Make: cuando una red cambia de versión, el módulo se actualiza sin que Valeria toque nada, y por eso su mantenimiento es el más bajo.
La segunda lectura es la que decide. Con los $7,644$ créditos del flujo de mensajes que midió el Día 12 (Costes y límites: créditos, tareas, ejecuciones y cuotas), sumar la publicación deja Make Core al $78.5%$, a un paso de la alerta del $80%$ que el mismo día dejó configurada, y aquel cálculo ya anunciaba que la cuota se rompería en el sexto mes con un crecimiento del $5%$. En n8n, en cambio, las ejecuciones no cuestan nada en el servidor propio, la cola y las aprobaciones ya viven en el Postgres del servidor desde el módulo 4, y el registro de publicaciones queda junto al de pedidos, donde lo leerá el cuadro de mando del Día 75. El precio es más mantenimiento: los nodos HTTP Request hablan directamente con las API y, cuando Meta o LinkedIn retiran una versión, la cambia Valeria.
Hay un tercer dato escondido en la columna de unidades que vale para cualquier lector que use n8n Cloud: un disparador que revisa la cola cada $15$ minutos son $2,880$ ejecuciones al mes, el $115%$ del plan Starter de $2,500$, aunque solo $36$ de ellas publiquen algo. Revisar cada hora serían $720$. En un servidor propio da igual; en la nube, la frecuencia del disparador es una decisión de presupuesto, y la alternativa correcta sería un disparador por evento (la aprobación en Notion programa una espera hasta la hora de la pieza) en lugar de un sondeo.
La gráfica pone las dos componentes del coste una sobre otra: el azul de la plataforma apenas se ve, y todo el coste es amarillo, horas de Valeria. Valeria elige n8n por $1.81$ USD al mes más que Make y lo escribe así en el registro de decisiones, con sus razones (cuota de Make cerca del límite, cola y aprobaciones en el mismo Postgres, registro único para el cuadro de mando) y con la condición de revisar la decisión si el mantenimiento real supera $1.5$ horas al mes. Don Ernesto acepta el argumento con una corrección: “Entonces el botón gratis de Facebook me sale a diez dólares, porque me cuesta a mi hija.” Es exactamente eso.
LinkedIn es la red más exigente de las tres y la de menor volumen para Trigo Lento: doce piezas al mes, pensadas para cafeterías, oficinas y clientes de mayoreo como la Cafetería Brújula de Marisol Peña. Marisol lo dijo sin rodeos cuando Valeria le preguntó qué le interesaba: “No necesito ver pan bonito todos los días. Necesito saber con una semana de anticipación cuándo cambian los horarios de reparto y los precios del mayoreo.” Esa frase redefine el pilar de LinkedIn: menos producto, más avisos de servicio.
Para publicar como organización, la aplicación necesita tres cosas que no se consiguen el mismo día. La persona que autoriza debe tener en la página de empresa uno de los roles que admite el permiso w_organization_social (administrador, administrador de contenido o publicador de contenido patrocinado); si no lo tiene, la API responde con un error de acceso aunque el permiso esté concedido. La aplicación debe tener aprobado el acceso a la Community Management API, que LinkedIn revisa. Y cada petición lleva dos cabeceras: LinkedIn-Version, con la versión de la API en formato AAAAMM, y X-Restli-Protocol-Version: 2.0.0. Las versiones de LinkedIn se retiran con el tiempo; una aplicación que fije una versión y la olvide dejará de publicar el día que esa versión se retire.
El token es la otra pieza frágil. Las fuentes coinciden en que dura unos sesenta días y discrepan en la renovación: algunas dicen que hay tokens de renovación de un año y otras que solo los reciben socios aprobados. Valeria diseña para el caso pesimista: anota la fecha de caducidad al autorizar, y el flujo se niega a publicar cuando quedan $7$ días o menos y le avisa para que vuelva a autorizar. Con tokens de $60$ días, son unas seis reautorizaciones al año, y cada una le lleva cinco minutos si la ve venir y una mañana entera si la descubre por un error.
El siguiente bloque publica una pieza con imagen en tres llamadas: inicializa la subida de la imagen, sube los bytes a la URL que devuelve LinkedIn y crea la publicación con la imagen y su texto alternativo, el mismo que preparó el Día 71 con la regla de accesibilidad del Día 49 (Accesibilidad y multilingüismo de los mensajes). También escapa los caracteres reservados del formato de texto de LinkedIn, que sin escape pueden cortar o deformar la publicación (verifique la lista en la documentación del formato de texto de la API). El bloque llama a la API de LinkedIn y no se ejecutó para escribir la entrada; la salida es un ejemplo comentado:
# Publicación en LinkedIn como organización, con imagen, encabezado de versión y caducidad del token en Python:
import os
from datetime import date
import requests

LI = 'https://api.linkedin.com/rest'
ORG = f"urn:li:organization:{os.environ['TL_LI_ORG_ID']}"
CABECERAS = {'Authorization': f"Bearer {os.environ['TL_LI_TOKEN']}",    # token de unos 60 días
             'LinkedIn-Version': '202609',                               # AAAAMM: se fija y se revisa
             'X-Restli-Protocol-Version': '2.0.0'}
CADUCA = date.fromisoformat(os.environ['TL_LI_TOKEN_CADUCA'])            # se anota al autorizar
RESERVADOS = re.compile(r'([\\|{}@\[\]()<>#*_~])')                       # formato de texto de LinkedIn

def escapar(texto):
    # Sin escape, un paréntesis o una almohadilla pueden cortar o deformar el texto publicado:
    return RESERVADOS.sub(r'\\\1', texto)

def subir_imagen(ruta):
    r = requests.post(f'{LI}/images?action=initializeUpload', headers = CABECERAS, timeout = 30,
                      json = {'initializeUploadRequest': {'owner': ORG}})
    r.raise_for_status()
    valor = r.json()['value']
    with open(ruta, 'rb') as f:
        requests.put(valor['uploadUrl'], data = f, timeout = 60,
                     headers = {'Authorization': CABECERAS['Authorization']}).raise_for_status()
    return valor['image']                                               # urn:li:image:...

def publicar_linkedin(pieza):
    dias = (CADUCA - date.today()).days
    if dias <= 7:
        return {'estado': 'aplazada', 'motivo': f'el token caduca en {dias} días: Valeria debe reautorizar'}
    cuerpo = {'author': ORG, 'commentary': escapar(pieza['texto_final']), 'visibility': 'PUBLIC',
              'distribution': {'feedDistribution': 'MAIN_FEED', 'targetEntities': [],
                               'thirdPartyDistributionChannels': []},
              'content': {'media': {'id': subir_imagen(pieza['ruta_imagen']), 'altText': pieza['texto_alternativo']}},
              'lifecycleState': 'PUBLISHED', 'isReshareDisabledByAuthor': False}
    r = requests.post(f'{LI}/posts', headers = CABECERAS, json = cuerpo, timeout = 30)
    if r.status_code == 403:
        return {'estado': 'fallida', 'motivo': 'sin rol en la página o sin acceso aprobado a la API'}
    if r.status_code in (400, 426) and 'VERSION' in r.text.upper():
        return {'estado': 'fallida', 'motivo': 'versión de la API retirada: actualizar LinkedIn-Version'}
    r.raise_for_status()
    return {'estado': 'publicada', 'id_publicacion': r.headers['x-restli-id'], 'dias_token': dias}

pieza = {'pieza': 'TL-0505-LI', 'ruta_imagen': 'fotos/hogaza_corte.jpg',
         'texto_alternativo': 'Hogaza de masa madre cortada por la mitad sobre la mesa del obrador.',
         'texto_final': 'Nuestro oficio (y el de Don Ernesto): 18 horas de fermentación #masamadre ...'}
print(escapar('Nuestro oficio (y el de Don Ernesto) #masamadre'))
print(publicar_linkedin(pieza))

# Salida de ejemplo (puede variar):
# Nuestro oficio \(y el de Don Ernesto\) \#masamadre
# {'estado': 'publicada', 'id_publicacion': 'urn:li:share:7318000000000000001', 'dias_token': 41}
La primera línea de la salida muestra el escape: los paréntesis y la almohadilla de “#masamadre” llevan una barra invertida delante, y LinkedIn los mostrará como texto normal. La publicación devuelve su identificador en la cabecera x-restli-id, no en el cuerpo de la respuesta; el workflow de n8n pide la respuesta completa por esa razón. El token tenía $41$ días por delante, lejos del aviso.
Los dos errores que el bloque distingue son los que no se arreglan reintentando. Un 403 casi siempre significa que la persona que autorizó perdió su rol en la página o que la aplicación todavía no tiene el acceso aprobado; un error que menciona la versión significa que hay que actualizar la cabecera. En los dos casos, el flujo marca la pieza como fallida, no la reintenta y avisa a Valeria por Slack. Mientras LinkedIn no apruebe el acceso, las doce piezas de LinkedIn salen a mano, con la misma cola y el mismo registro: Valeria las publica desde la página de empresa cuando el flujo le avisa, y anota el identificador. Es la publicación manual con el control del flujo, que es mejor que la publicación automática sin él.
Etiquetar lo hecho con IA
Las piezas de Trigo Lento no son imágenes inventadas: las fotos son del obrador y los textos los redactó un modelo a partir del manual de voz y los revisó una persona. Aun así, la serie adopta una política propia de transparencia: todo texto preparado con ayuda de IA lleva al final la leyenda “Texto preparado con ayuda de IA y revisado por el equipo de Trigo Lento.”, y los textos que escribió Valeria sin ayuda (el pilar de comunidad, con los nombres y las historias de los vecinos que dieron su permiso) no la llevan. La regla tiene tres razones, de más a menos importante.
La primera es la confianza de los clientes, que es lo que vende una panadería de barrio. La segunda es el artículo 50 del Reglamento de Inteligencia Artificial de la Unión Europea (Reglamento (UE) 2024/1689), cuyas obligaciones de transparencia se aplican desde el 2 de agosto de 2026: quien despliega un sistema de IA que genera texto publicado para informar al público sobre asuntos de interés público debe revelar que fue generado o manipulado artificialmente, salvo que haya pasado por revisión humana o control editorial y alguien asuma la responsabilidad editorial; y los proveedores de sistemas generativos deben marcar sus salidas de forma legible por máquina, con una transición hasta el 2 de diciembre de 2026 para los sistemas que ya estaban en el mercado, según la modificación acordada en 2026 (fuentes secundarias consultadas en octubre de 2026). Trigo Lento no tiene público en la Unión Europea y sus textos de pan no son asuntos de interés público, de modo que la obligación no le alcanza; pero la excepción del propio reglamento describe lo que Trigo Lento ya hace (revisión humana y responsabilidad editorial), y la leyenda lo declara. La tercera son las etiquetas de IA de Meta: según las fuentes consultadas, Meta muestra la etiqueta “Información de IA” en imágenes, videos y audios generados o muy alterados con IA, detectados por señales del sector o declarados por quien publica. La política se refiere a contenido visual y sonoro, no a textos; como Trigo Lento no genera fotos, la etiqueta de Meta no debería aplicarse a sus piezas. Es una política que no se confirmó en las fuentes oficiales consultadas y conviene verificarla antes de publicar contenido visual retocado.
La Figura 3 usa la imagen que Don Ernesto entiende mejor: la leyenda de IA es la etiqueta de ingredientes del empaque.
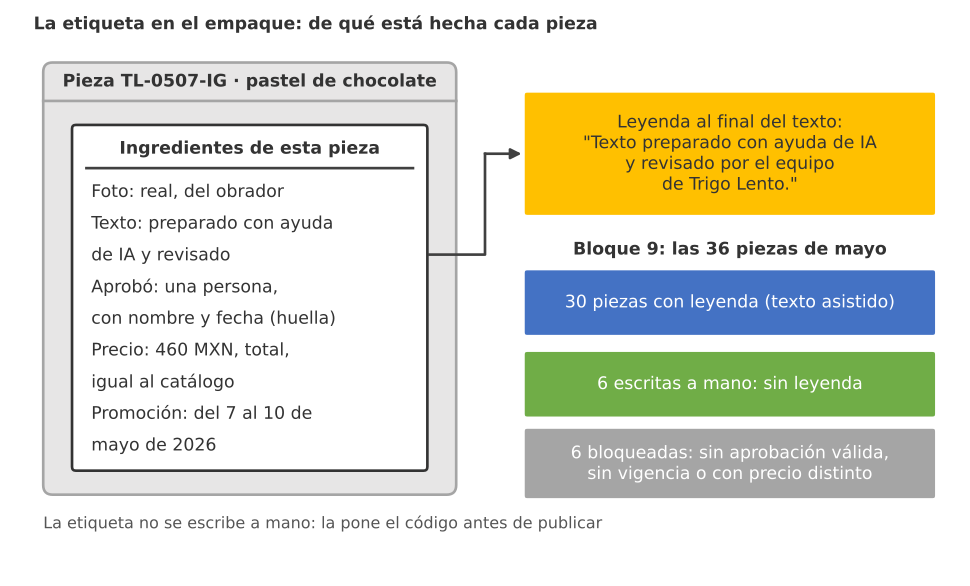
Figura 3. La etiqueta en el empaque: como la etiqueta de ingredientes de un pan, la leyenda de una pieza declara de qué está hecha: foto real del obrador, texto preparado con ayuda de IA, revisado y aprobado por una persona con su nombre y la fecha, precio igual al catálogo y vigencia de la promoción.
La leyenda y la aprobación, en código
Una leyenda que depende de que alguien se acuerde de escribirla falla la primera semana de prisas. Valeria la inserta el código, justo antes de publicar, y aprovecha el mismo paso para la comprobación que su padre pidió con otras palabras (“si sale con el precio viejo, doy la cara yo”): ninguna pieza sale sin una aprobación registrada que coincida con el texto que va a salir. La aprobación guarda una huella SHA-256 del texto aprobado, como las huellas de fragmentos del Día 68; si alguien corrige una coma después de aprobar, la huella deja de coincidir y la pieza vuelve a revisión. Además, una promoción sin vigencia no sale, y un precio que no coincide con catalogo.json tampoco.
Al exportar mayo de la base del Día 71, Valeria encuentra cosas que el estado “aprobado” de Notion no mostraba: dos piezas corregidas después de la aprobación, una promoción del sábado 9 sin fechas, un pay de queso a $360$ MXN cuando el catálogo dice $380$ y dos piezas del 28 de mayo que siguen en “revisado”. El siguiente bloque inserta la leyenda, revisa cada pieza y lista las bloqueadas con su motivo:
# Leyenda de IA automática y bloqueo de piezas sin aprobación válida, promoción incompleta o precio distinto en Python:
LEYENDA = 'Texto preparado con ayuda de IA y revisado por el equipo de Trigo Lento.'
LIMITE_TEXTO = {'instagram': 2200, 'facebook': 63206, 'linkedin': 3000}
huella = lambda texto: hashlib.sha256(texto.encode('utf-8')).hexdigest()[:12]

def texto_base(p):
    precio = CATALOGO[next(k for k, v in CATALOGO.items() if v['producto'] == p.producto)]['precio_mxn']
    largo = {'instagram': 6, 'facebook': 3, 'linkedin': 9}[p.red]
    cuerpo = ' '.join(['Hecho cada madrugada con masa madre en Narvarte.'] * largo)
    return f'{p.producto}: {precio} MXN, precio total. {cuerpo}'

piezas = cola[['pieza', 'red', 'pilar', 'producto']].copy()
piezas['texto'] = [texto_base(p) for p in piezas.itertuples()]
piezas['asistida_ia'] = True
piezas.loc[piezas.pilar.eq('comunidad'), 'asistida_ia'] = False          # las escribe Valeria a mano
piezas['huella_aprobada'] = piezas['texto'].map(huella)
piezas['aprobador'] = registro['aprobador'].values
piezas['promocion'], piezas['vigencia'] = False, ''
# Lo que encontró Valeria al exportar mayo de la base del Día 71:
piezas.loc[piezas.pieza.str.startswith('TL-0507'), ['promocion', 'vigencia']] = [True, 'del 7 al 10 de mayo de 2026']
piezas.loc[piezas.pieza.eq('TL-0509-IG'), 'promocion'] = True                         # promoción sin vigencia
piezas.loc[piezas.pieza.isin(['TL-0514-FB', 'TL-0526-IG']), 'texto'] += ' Corrección de última hora.'   # editadas tras aprobar
piezas.loc[piezas.pieza.eq('TL-0514-IG'), 'texto'] = piezas.loc[piezas.pieza.eq('TL-0514-IG'), 'texto'].str.replace('380', '360')
piezas.loc[piezas.pieza.eq('TL-0514-IG'), 'huella_aprobada'] = huella(piezas.loc[piezas.pieza.eq('TL-0514-IG'), 'texto'].iloc[0])
piezas.loc[piezas.pieza.isin(['TL-0528-LI', 'TL-0528-FB']), 'aprobador'] = None          # siguen en "revisado"

def revisar(p):
    motivos = []
    if pd.isna(p.aprobador):
        motivos.append('sin aprobación registrada')
    elif huella(p.texto) != p.huella_aprobada:
        motivos.append('editada después de aprobar')
    if p.promocion and not p.vigencia:
        motivos.append('promoción sin vigencia ni condiciones')
    for producto, precio in re.findall(r'^(.+?): (\d+) MXN', p.texto):
        oficial = next(v['precio_mxn'] for v in CATALOGO.values() if v['producto'] == producto)
        if int(precio) != oficial:
            motivos.append(f'precio {precio} distinto del catálogo ({oficial})')
    final = p.texto + (f' Promoción válida {p.vigencia}.' if p.promocion and p.vigencia else '')
    final += ('\n\n' + LEYENDA) if p.asistida_ia else ''
    if len(final) > LIMITE_TEXTO[p.red]:
        motivos.append('texto más largo que el límite de la red')
    return pd.Series({'texto_final': final, 'motivos': '; '.join(motivos)})

piezas = piezas.join(piezas.apply(revisar, axis = 1))
bloqueadas = piezas[piezas.motivos != '']
print(f'Piezas: {len(piezas)} | con leyenda de IA: {piezas.texto_final.str.endswith(LEYENDA).sum()} '
      f'| sin leyenda (escritas a mano): {(~piezas.asistida_ia).sum()} | bloqueadas: {len(bloqueadas)}')
print(bloqueadas[['pieza', 'red', 'aprobador', 'motivos']].to_string(index = False))
print('Longitud máxima del texto final por red:', piezas.groupby('red')['texto_final'].apply(lambda s: s.str.len().max()).to_dict())
print('Ejemplo con leyenda:\n' + textwrap.indent(piezas.loc[piezas.pieza.eq('TL-0507-IG'), 'texto_final'].iloc[0][-180:], '  '))
piezas.to_json(carpeta / 'piezas_revisadas.json', orient = 'records', force_ascii = False, indent = 1)
Piezas: 36 | con leyenda de IA: 30 | sin leyenda (escritas a mano): 6 | bloqueadas: 6
     pieza       red   aprobador                                motivos
TL-0509-IG instagram Don Ernesto  promoción sin vigencia ni condiciones
TL-0514-IG instagram     Valeria precio 360 distinto del catálogo (380)
TL-0514-FB  facebook Don Ernesto             editada después de aprobar
TL-0526-IG instagram     Valeria             editada después de aprobar
TL-0528-LI  linkedin         NaN              sin aprobación registrada
TL-0528-FB  facebook         NaN              sin aprobación registrada
Longitud máxima del texto final por red: {'facebook': 317, 'instagram': 464, 'linkedin': 611}
Ejemplo con leyenda:
  n Narvarte. Hecho cada madrugada con masa madre en Narvarte. Promoción válida del 7 al 10 de mayo de 2026.

  Texto preparado con ayuda de IA y revisado por el equipo de Trigo Lento.
De las $36$ piezas, $30$ llevan la leyenda de IA, $6$ no la llevan porque las escribió Valeria (el pilar de comunidad) y $6$ quedan bloqueadas. Los motivos son los cuatro que Valeria encontró: una promoción sin vigencia ni condiciones (TL-0509-IG), un precio de $360$ distinto del catálogo ($380$) en TL-0514-IG, dos piezas editadas después de aprobar (TL-0514-FB y TL-0526-IG) y dos sin aprobación registrada (TL-0528-LI y TL-0528-FB). La pieza del pay a $360$ es la más instructiva: estaba aprobada y su huella coincidía, porque Don Ernesto aprobó el error. La aprobación humana no sustituye las comprobaciones automáticas; las dos se necesitan, y en orden: primero la máquina descarta lo que se puede comprobar, después la persona juzga lo que no.
Las longitudes finales, con la leyenda y la vigencia incluidas, quedan muy lejos de los límites de cada red: $464$ caracteres en Instagram frente a $2,200$, $611$ en LinkedIn frente a $3,000$ y $317$ en Facebook. La comprobación de longitud está ahí para el día en que el modelo se alargue, no para hoy. Al final de la salida se ve la pieza del 7 de mayo tal como saldrá: el texto, la vigencia de la promoción y, separada por una línea en blanco, la leyenda.
Atención aquí: la automatización de redes de Trigo Lento publica solo en las cuentas propias de la panadería. No publica en grupos ajenos, no compra seguidores ni alcance engañoso, no automatiza comentarios, reacciones ni mensajes directos a desconocidos y no genera reseñas, como fija el código de honor del Día 6 (Ética y seguridad: el código de honor del arquitecto de automatización). Las personas que aparecen en una foto dieron su consentimiento por escrito y pueden retirarlo; cuando lo retiran, la pieza se borra de la cola y, si ya salió, se elimina de la red. Toda pieza lleva una aprobación registrada y, si es una promoción, sus condiciones y su vigencia.
Límites legales de la publicidad en México
Una publicación de una panadería con un precio es publicidad, y en México la publicidad dirigida a consumidores la regula la Ley Federal de Protección al Consumidor, con la Procuraduría Federal del Consumidor (PROFECO) como autoridad. Valeria no es abogada y la serie tampoco da asesoría legal; lo que sí puede hacer un arquitecto es convertir tres reglas generales de la ley en comprobaciones automáticas, y dejar las dudas para una persona que sepa.
La primera regla es la información veraz y comprobable. El artículo 32 de la ley pide que la información y la publicidad de bienes y servicios sean veraces, comprobables y exentas de textos, diálogos, sonidos, imágenes u otras descripciones que induzcan o puedan inducir a error o confusión por engañosas o abusivas. En Trigo Lento, eso significa que el manual de voz del Día 71 prohíbe “sin gluten” sin certificación, afirmaciones de salud y comparaciones con competidores, y que la foto de una pieza es la del pan que se vende, no la de uno más grande o más bonito. El Bloque 9 no puede juzgar si una frase engaña; puede, en cambio, comprobar que la afirmación más fácil de verificar, el precio, coincide con el catálogo.
La segunda regla es el precio total. La ley pide que los proveedores informen el monto total a pagar, con impuestos incluidos, y que respeten el precio anunciado. El manual de voz ya lo resolvía con la fórmula “precio total” junto a cada importe en pesos, y el Bloque 9 comprueba el importe. Si mañana el obrador vendiera un producto con IVA, la regla no cambiaría: el número que ve el cliente es el que paga.
La tercera regla son las promociones. La ley dedica un capítulo a las promociones y ofertas, y exige que las condiciones, el plazo de duración o el volumen de los bienes ofrecidos se informen al consumidor. Por eso el Bloque 9 bloquea cualquier pieza marcada como promoción que no tenga vigencia, y la leyenda de la promoción del Día de las Madres dice “Promoción válida del 7 al 10 de mayo de 2026” en el propio texto, no en un comentario aparte. Si la promoción tuviera un límite de piezas (“los primeros 30 pasteles”), ese límite también iría en el texto.
Hay dos reglas más que no salen de la ley de protección al consumidor, sino de la serie. Los textos para menores, como las cajas de galletas del Día del Niño, no apelan a que los niños convenzan a sus padres. Y las piezas que mencionan a una persona (una vecina con su pastel, un panadero en el obrador) se publican solo con su permiso por escrito, que vive junto a la pieza en Notion y se revisa en la aprobación.
TL Publicación multired v1
Con las piezas probadas por separado, Valeria arma el flujo en n8n. Su forma sigue la Figura 2: un disparador que revisa la cola cada $15$ minutos con la zona horaria de la Ciudad de México; una consulta de Postgres que trae hasta diez piezas con estado programado cuya hora ya llegó, junto con su aprobación, y que excluye las que ya tienen su clave de idempotencia en el registro; un IF que solo deja pasar las piezas con aprobador, con la huella aprobada igual a la actual y con la leyenda resuelta (leyenda_ok, que es verdadera si la pieza lleva leyenda o no la necesita); un Switch que separa las tres redes; las peticiones HTTP de cada una (dos para Instagram, una para Facebook y una para LinkedIn, con la respuesta completa para leer x-restli-id); un nodo Edit Fields que normaliza el identificador y la hora; y un Postgres que escribe el registro con ON CONFLICT DO NOTHING. La rama falsa del IF marca la pieza como bloqueada. El JSON exportado, con identificadores de ejemplo y sin secretos, es este:
{
  "name": "TL Publicación multired v1",
  "nodes": [
    {
      "parameters": {"rule": {"interval": [{"field": "minutes", "minutesInterval": 15}]}},
      "id": "0b1c7200-0000-4000-8000-000000000001",
      "name": "Cada 15 minutos",
      "type": "n8n-nodes-base.scheduleTrigger",
      "typeVersion": 1.2,
      "position": [0, 0]
    },
    {
      "parameters": {"operation": "executeQuery", "query": "SELECT p.id, p.pieza, p.red, p.texto_final, p.url_imagen, p.enlace, p.hora_programada, p.clave_idempotencia, p.huella AS huella_actual, p.leyenda_ok, a.aprobador, a.huella AS huella_aprobada FROM publicaciones p LEFT JOIN aprobaciones a ON a.pieza = p.pieza AND a.red = p.red WHERE p.estado = 'programado' AND p.hora_programada <= now() AND NOT EXISTS (SELECT 1 FROM registro_publicaciones r WHERE r.clave_idempotencia = p.clave_idempotencia) ORDER BY p.hora_programada LIMIT 10;", "options": {}},
      "id": "0b1c7200-0000-4000-8000-000000000002",
      "name": "Piezas por publicar",
      "type": "n8n-nodes-base.postgres",
      "typeVersion": 2.5,
      "position": [220, 0],
      "credentials": {"postgres": {"id": "Pg7rTq2mWx5LnB8c", "name": "Postgres TL solo publicaciones"}}
    },
    {
      "parameters": {"conditions": {"options": {"caseSensitive": true, "leftValue": "", "typeValidation": "loose", "version": 2}, "conditions": [{"id": "c7200001", "leftValue": "={{ $json.aprobador }}", "rightValue": "", "operator": {"type": "string", "operation": "notEmpty", "singleValue": true}}, {"id": "c7200002", "leftValue": "={{ $json.huella_actual }}", "rightValue": "={{ $json.huella_aprobada }}", "operator": {"type": "string", "operation": "equals"}}, {"id": "c7200003", "leftValue": "={{ $json.leyenda_ok }}", "rightValue": "", "operator": {"type": "boolean", "operation": "true", "singleValue": true}}], "combinator": "and"}, "options": {}},
      "id": "0b1c7200-0000-4000-8000-000000000003",
      "name": "¿Aprobada y con leyenda?",
      "type": "n8n-nodes-base.if",
      "typeVersion": 2.2,
      "position": [440, 0]
    },
    {
      "parameters": {"operation": "executeQuery", "query": "UPDATE publicaciones SET estado = 'bloqueado', motivo = 'sin aprobación vigente o sin leyenda' WHERE id = $1;", "options": {"queryReplacement": "={{ [$json.id] }}"}},
      "id": "0b1c7200-0000-4000-8000-000000000004",
      "name": "Marcar bloqueada",
      "type": "n8n-nodes-base.postgres",
      "typeVersion": 2.5,
      "position": [660, 300],
      "credentials": {"postgres": {"id": "Pg7rTq2mWx5LnB8c", "name": "Postgres TL solo publicaciones"}}
    },
    {
      "parameters": {"rules": {"values": [{"conditions": {"options": {"caseSensitive": true, "leftValue": "", "typeValidation": "strict", "version": 2}, "conditions": [{"id": "s7200001", "leftValue": "={{ $json.red }}", "rightValue": "instagram", "operator": {"type": "string", "operation": "equals"}}], "combinator": "and"}, "renameOutput": true, "outputKey": "instagram"}, {"conditions": {"options": {"caseSensitive": true, "leftValue": "", "typeValidation": "strict", "version": 2}, "conditions": [{"id": "s7200002", "leftValue": "={{ $json.red }}", "rightValue": "facebook", "operator": {"type": "string", "operation": "equals"}}], "combinator": "and"}, "renameOutput": true, "outputKey": "facebook"}, {"conditions": {"options": {"caseSensitive": true, "leftValue": "", "typeValidation": "strict", "version": 2}, "conditions": [{"id": "s7200003", "leftValue": "={{ $json.red }}", "rightValue": "linkedin", "operator": {"type": "string", "operation": "equals"}}], "combinator": "and"}, "renameOutput": true, "outputKey": "linkedin"}]}, "options": {}},
      "id": "0b1c7200-0000-4000-8000-000000000005",
      "name": "¿Qué red?",
      "type": "n8n-nodes-base.switch",
      "typeVersion": 3.2,
      "position": [660, 0]
    },
    {
      "parameters": {"method": "POST", "url": "={{ 'https://graph.facebook.com/v25.0/' + $env.TL_IG_USER_ID + '/media' }}", "authentication": "genericCredentialType", "genericAuthType": "httpQueryAuth", "sendBody": true, "contentType": "form-urlencoded", "bodyParameters": {"parameters": [{"name": "image_url", "value": "={{ $json.url_imagen }}"}, {"name": "caption", "value": "={{ $json.texto_final }}"}]}, "options": {"timeout": 30000}},
      "id": "0b1c7200-0000-4000-8000-000000000006",
      "name": "Instagram: crear contenedor",
      "type": "n8n-nodes-base.httpRequest",
      "typeVersion": 4.2,
      "position": [880, -240],
      "credentials": {"httpQueryAuth": {"id": "Mt3kVb9sQe1HwZ6p", "name": "Meta TL token de página"}}
    },
    {
      "parameters": {"method": "POST", "url": "={{ 'https://graph.facebook.com/v25.0/' + $env.TL_IG_USER_ID + '/media_publish' }}", "authentication": "genericCredentialType", "genericAuthType": "httpQueryAuth", "sendBody": true, "contentType": "form-urlencoded", "bodyParameters": {"parameters": [{"name": "creation_id", "value": "={{ $json.id }}"}]}, "options": {"timeout": 30000}},
      "id": "0b1c7200-0000-4000-8000-000000000007",
      "name": "Instagram: publicar",
      "type": "n8n-nodes-base.httpRequest",
      "typeVersion": 4.2,
      "position": [1100, -240],
      "credentials": {"httpQueryAuth": {"id": "Mt3kVb9sQe1HwZ6p", "name": "Meta TL token de página"}}
    },
    {
      "parameters": {"method": "POST", "url": "={{ 'https://graph.facebook.com/v25.0/' + $env.TL_PAGE_ID + '/feed' }}", "authentication": "genericCredentialType", "genericAuthType": "httpQueryAuth", "sendBody": true, "contentType": "form-urlencoded", "bodyParameters": {"parameters": [{"name": "message", "value": "={{ $json.texto_final }}"}, {"name": "link", "value": "={{ $json.enlace }}"}]}, "options": {"timeout": 30000}},
      "id": "0b1c7200-0000-4000-8000-000000000008",
      "name": "Facebook: publicar en la página",
      "type": "n8n-nodes-base.httpRequest",
      "typeVersion": 4.2,
      "position": [990, 0],
      "credentials": {"httpQueryAuth": {"id": "Mt3kVb9sQe1HwZ6p", "name": "Meta TL token de página"}}
    },
    {
      "parameters": {"method": "POST", "url": "https://api.linkedin.com/rest/posts", "authentication": "genericCredentialType", "genericAuthType": "httpHeaderAuth", "sendHeaders": true, "headerParameters": {"parameters": [{"name": "LinkedIn-Version", "value": "202609"}, {"name": "X-Restli-Protocol-Version", "value": "2.0.0"}]}, "sendBody": true, "specifyBody": "json", "jsonBody": "={{ JSON.stringify({ author: 'urn:li:organization:' + $env.TL_LI_ORG_ID, commentary: $json.texto_final.replace(/([\\\\|{}@\\[\\]()<>#*_~])/g, '\\\\$1'), visibility: 'PUBLIC', distribution: { feedDistribution: 'MAIN_FEED', targetEntities: [], thirdPartyDistributionChannels: [] }, lifecycleState: 'PUBLISHED', isReshareDisabledByAuthor: false }) }}", "options": {"response": {"response": {"fullResponse": true}}, "timeout": 30000}},
      "id": "0b1c7200-0000-4000-8000-000000000009",
      "name": "LinkedIn: publicar como organización",
      "type": "n8n-nodes-base.httpRequest",
      "typeVersion": 4.2,
      "position": [990, 240],
      "credentials": {"httpHeaderAuth": {"id": "Li5nRw8tYc2KdM4x", "name": "LinkedIn TL página"}}
    },
    {
      "parameters": {"assignments": {"assignments": [{"id": "a7200001", "name": "id_publicacion", "value": "={{ $json.id || $json.headers?.['x-restli-id'] }}", "type": "string"}, {"id": "a7200002", "name": "hora_publicada", "value": "={{ $now.toISO() }}", "type": "string"}, {"id": "a7200003", "name": "pieza", "value": "={{ $('¿Qué red?').item.json.pieza }}", "type": "string"}, {"id": "a7200004", "name": "red", "value": "={{ $('¿Qué red?').item.json.red }}", "type": "string"}, {"id": "a7200005", "name": "clave_idempotencia", "value": "={{ $('¿Qué red?').item.json.clave_idempotencia }}", "type": "string"}, {"id": "a7200006", "name": "aprobador", "value": "={{ $('¿Qué red?').item.json.aprobador }}", "type": "string"}, {"id": "a7200007", "name": "hora_programada", "value": "={{ $('¿Qué red?').item.json.hora_programada }}", "type": "string"}]}, "options": {}},
      "id": "0b1c7200-0000-4000-8000-000000000010",
      "name": "Normalizar resultado",
      "type": "n8n-nodes-base.set",
      "typeVersion": 3.4,
      "position": [1320, 0]
    },
    {
      "parameters": {"operation": "executeQuery", "query": "INSERT INTO registro_publicaciones (clave_idempotencia, pieza, red, hora_programada, hora_publicada, id_publicacion, aprobador) VALUES ($1, $2, $3, $4, $5, $6, $7) ON CONFLICT (clave_idempotencia) DO NOTHING; UPDATE publicaciones SET estado = 'publicado' WHERE clave_idempotencia = $1;", "options": {"queryReplacement": "={{ [$json.clave_idempotencia, $json.pieza, $json.red, $json.hora_programada, $json.hora_publicada, $json.id_publicacion, $json.aprobador] }}"}},
      "id": "0b1c7200-0000-4000-8000-000000000011",
      "name": "Registrar publicación",
      "type": "n8n-nodes-base.postgres",
      "typeVersion": 2.5,
      "position": [1540, 0],
      "credentials": {"postgres": {"id": "Pg7rTq2mWx5LnB8c", "name": "Postgres TL solo publicaciones"}}
    }
  ],
  "connections": {
    "Cada 15 minutos": {"main": [[{"node": "Piezas por publicar", "type": "main", "index": 0}]]},
    "Piezas por publicar": {"main": [[{"node": "¿Aprobada y con leyenda?", "type": "main", "index": 0}]]},
    "¿Aprobada y con leyenda?": {"main": [[{"node": "¿Qué red?", "type": "main", "index": 0}], [{"node": "Marcar bloqueada", "type": "main", "index": 0}]]},
    "¿Qué red?": {"main": [[{"node": "Instagram: crear contenedor", "type": "main", "index": 0}], [{"node": "Facebook: publicar en la página", "type": "main", "index": 0}], [{"node": "LinkedIn: publicar como organización", "type": "main", "index": 0}]]},
    "Instagram: crear contenedor": {"main": [[{"node": "Instagram: publicar", "type": "main", "index": 0}]]},
    "Instagram: publicar": {"main": [[{"node": "Normalizar resultado", "type": "main", "index": 0}]]},
    "Facebook: publicar en la página": {"main": [[{"node": "Normalizar resultado", "type": "main", "index": 0}]]},
    "LinkedIn: publicar como organización": {"main": [[{"node": "Normalizar resultado", "type": "main", "index": 0}]]},
    "Normalizar resultado": {"main": [[{"node": "Registrar publicación", "type": "main", "index": 0}]]}
  },
  "settings": {"executionOrder": "v1", "timezone": "America/Mexico_City", "executionTimeout": 120, "saveDataSuccessExecution": "all", "errorWorkflow": "Xe7rTb4mKq9wPz2G"},
  "pinData": {},
  "meta": {"templateCredsSetupCompleted": true}
}
Cuatro detalles del JSON son decisiones, no configuración por defecto. Las credenciales aparecen solo por su nombre (Meta TL token de página, LinkedIn TL página, Postgres TL solo publicaciones), y la de Postgres pertenece a un usuario que solo puede leer y escribir las tablas de publicaciones, no las de pedidos. Los identificadores de cuenta (TL_IG_USER_ID, TL_PAGE_ID, TL_LI_ORG_ID) vienen de variables de entorno del servidor, de modo que el mismo JSON sirve para el entorno de ensayo del Día 43 con cuentas de prueba. La versión de la Graph API y la de LinkedIn están escritas en el JSON, a la vista, para que el control de versiones del Día 42 (Versionado de flujos: exportar el JSON a git, revisar diferencias y etiquetar versiones) registre cada cambio de versión como un cambio del flujo. Y el registro hace dos cosas en una sola consulta: inserta la publicación (sin duplicar si la clave ya existe) y cambia el estado de la pieza a publicado.
El siguiente bloque lee el JSON exportado, comprueba las conexiones, el disparador, los destinos de las peticiones, las credenciales y que no haya tokens, verifica que la consulta excluye lo ya registrado y dibuja el flujo con las formas de la serie:
# Lectura del workflow exportado TL Publicación multired v1, comprobaciones y dibujo en Python:
workflow = json.loads((carpeta / 'flujos' / 'n8n' / 'publicacion_multired_v1.json').read_text(encoding = 'utf-8'))

FORMAS = {'scheduleTrigger': ('disparador', '#1f9d55'), 'postgres': ('accion', '#2a78d6'),
          'httpRequest': ('accion', '#2a78d6'), 'set': ('accion', '#2a78d6'), 'if': ('decision', '#eb6834'),
          'switch': ('decision', '#eb6834')}

def nodos_desde_n8n(wf):
    nodos = [{'id': n['name'], 'tipo': n['type'].split('.')[-1],
              'x': n['position'][0] / 100, 'y': -n['position'][1] / 100} for n in wf['nodes']]
    aristas = [(o, d['node'], tipo, salida) for o, s in wf['connections'].items()
               for tipo, lista in s.items() for salida, destinos in enumerate(lista) for d in destinos]
    return nodos, aristas

def dibujar_flujo(nodos, aristas, titulo, rotulos):
    fig, ax = plt.subplots(figsize = (15, 6.2))
    pos = {n['id']: (n['x'], n['y']) for n in nodos}
    for n in nodos:
        forma, color = FORMAS[n['tipo']]
        x, y = n['x'], n['y']
        if forma == 'decision':
            ax.add_patch(Polygon([(x - 0.9, y), (x, y + 0.55), (x + 0.9, y), (x, y - 0.55)], facecolor = color,
                                 edgecolor = 'white', linewidth = 2))
        else:
            estilo = 'round,pad=0.05,rounding_size=0.35' if forma == 'disparador' else 'round,pad=0.05'
            ax.add_patch(FancyBboxPatch((x - 0.85, y - 0.4), 1.7, 0.8, boxstyle = estilo,
                                        facecolor = color, edgecolor = 'white', linewidth = 2))
        etiqueta = textwrap.fill(n['id'], 12 if forma == 'decision' else 20, break_long_words = False)
        ax.text(x, y + 0.08, etiqueta, ha = 'center', va = 'center', color = 'white', fontsize = 8.3)
        ax.text(x, y - 0.29, n['tipo'], ha = 'center', va = 'center', color = 'white', fontsize = 6.5)
    for o, d, _, salida in aristas:
        (x1, y1), (x2, y2) = pos[o], pos[d]
        if abs(y1 - y2) < 0.01:
            ax.add_patch(FancyArrowPatch((x1 + 0.92, y1), (x2 - 0.92, y2), arrowstyle = '-|>', mutation_scale = 13,
                                         color = '#52514e', linewidth = 1.4))
        elif abs(y1) < 0.01:                                         # sale de la línea principal
            ax.add_patch(FancyArrowPatch((x1, y1 + (0.56 if y2 > y1 else -0.56)), (x2 - 0.92, y2),
                                         arrowstyle = '-|>', mutation_scale = 13, color = '#52514e', linewidth = 1.4,
                                         connectionstyle = 'angle,angleA=90,angleB=0,rad=0.1'))
        else:                                                        # vuelve a la línea principal
            ax.add_patch(FancyArrowPatch((x1 + 0.92, y1), (x2, y2 + (0.42 if y1 > y2 else -0.42)),
                                         arrowstyle = '-|>', mutation_scale = 13, color = '#52514e', linewidth = 1.4,
                                         connectionstyle = 'angle,angleA=0,angleB=90,rad=0.1'))
    for nodo, dx, dy, texto in rotulos:
        ax.text(pos[nodo][0] + dx, pos[nodo][1] + dy, texto, fontsize = 9, color = '#52514e')
    xs = [p[0] for p in pos.values()]
    ys = [p[1] for p in pos.values()]
    ax.set_xlim(min(xs) - 1, max(xs) + 1)
    ax.set_ylim(min(ys) - 0.9, max(ys) + 0.9)
    ax.set_aspect('equal')
    ax.axis('off')
    ax.set_title(titulo, fontsize = 14)
    return ax

nodos, aristas = nodos_desde_n8n(workflow)
nombres = {n['id'] for n in nodos}
print('Nodos:', len(nodos), '| conexiones:', len(aristas))
print('Tipos:', pd.Series([n['tipo'] for n in nodos]).value_counts().to_dict())
print('Destinos inexistentes:', [d for _, d, _, _ in aristas if d not in nombres] or 'ninguno')
sin_salida = sorted(nombres - {o for o, _, _, _ in aristas})
print('Nodos terminales:', sin_salida)
disparador = next(n for n in workflow['nodes'] if n['type'].endswith('scheduleTrigger'))
intervalo = disparador['parameters']['rule']['interval'][0]
print('Disparador: cada', intervalo['minutesInterval'], 'minutos | zona horaria:', workflow['settings']['timezone'])
http = [n for n in workflow['nodes'] if n['type'].endswith('httpRequest')]
print('Peticiones HTTP:', [(n['name'], n['parameters']['url'].split('/')[2]) for n in http])
print('Credenciales (solo nombres):', sorted({c['name'] for n in workflow['nodes'] for c in n.get('credentials', {}).values()}))
texto_json = json.dumps(workflow, ensure_ascii = False)
print('Tokens o claves en el JSON:', re.findall(r'EAA[A-Za-z0-9]{20,}|AQ[A-Za-z0-9_-]{30,}|access_token=\w+', texto_json) or 'ninguno')
consulta = next(n for n in workflow['nodes'] if n['name'] == 'Piezas por publicar')['parameters']['query']
print('La consulta excluye lo ya registrado (idempotencia):', 'clave_idempotencia' in consulta and 'NOT EXISTS' in consulta)
dibujar_flujo(nodos, aristas, f"{workflow['name']}, leído del JSON exportado",
              [('¿Aprobada y con leyenda?', 0.55, 0.45, 'sí'), ('¿Aprobada y con leyenda?', 0.25, -0.85, 'no'),
               ('¿Qué red?', 0.12, 1.3, 'instagram'), ('¿Qué red?', 1.0, 0.15, 'facebook'),
               ('¿Qué red?', 0.12, -1.4, 'linkedin')])
plt.tight_layout()
plt.show()
Nodos: 11 | conexiones: 12
Tipos: {'httpRequest': 4, 'postgres': 3, 'scheduleTrigger': 1, 'if': 1, 'switch': 1, 'set': 1}
Destinos inexistentes: ninguno
Nodos terminales: ['Marcar bloqueada', 'Registrar publicación']
Disparador: cada 15 minutos | zona horaria: America/Mexico_City
Peticiones HTTP: [('Instagram: crear contenedor', 'graph.facebook.com'), ('Instagram: publicar', 'graph.facebook.com'), ('Facebook: publicar en la página', 'graph.facebook.com'), ('LinkedIn: publicar como organización', 'api.linkedin.com')]
Credenciales (solo nombres): ['LinkedIn TL página', 'Meta TL token de página', 'Postgres TL solo publicaciones']
Tokens o claves en el JSON: ninguno
La consulta excluye lo ya registrado (idempotencia): True
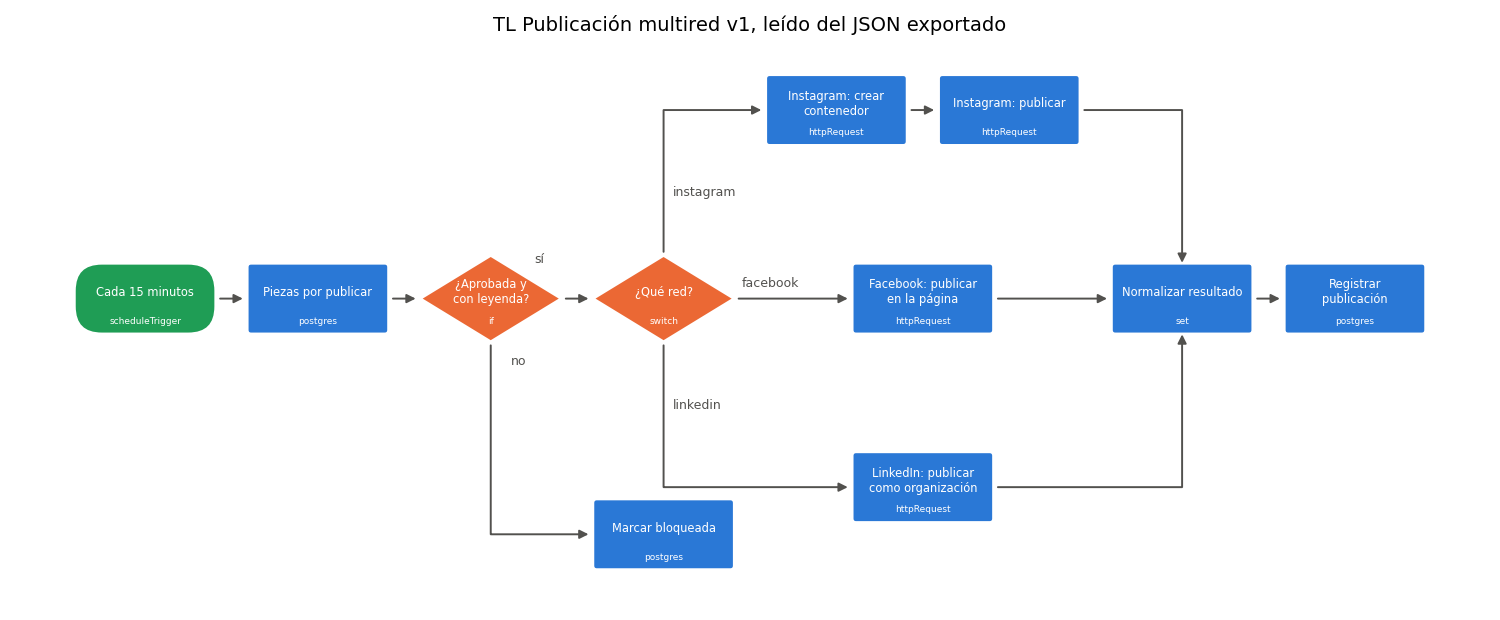
El workflow tiene $11$ nodos y $12$ conexiones, sin destinos inexistentes, y termina en dos nodos: Registrar publicación para las piezas que salieron y Marcar bloqueada para las que no pasaron el IF. El disparador corre cada $15$ minutos con la zona horaria de la Ciudad de México, las cuatro peticiones HTTP van solo a graph.facebook.com y a api.linkedin.com, el JSON no contiene tokens y la consulta de la cola excluye las claves ya registradas. En el dibujo se ve la forma del diseño: una sola entrada, una sola puerta de aprobación, tres caminos que se vuelven a juntar en un único registro.
Ese registro es la pieza que Don Ernesto pidió sin saberlo cuando dijo “doy la cara yo”. La Tabla 3 muestra sus primeras filas, tal como las escribió la simulación del Bloque 4:
Tabla 3. Registro de publicaciones de mayo (primeras seis filas de la simulación del Bloque 4; identificadores de juguete).
| Pieza | Red | Hora programada | Hora publicada | Identificador de la publicación | Aprobador |
|---|---|---|---|---|---|
| TL-0502-IG | 02/05 13:00 | 13:00:05 | 5205415610291366 | Valeria | |
| TL-0502-FB | 02/05 19:00 | 19:00:08 | 9146294530094565 | Valeria | |
| TL-0502-LI | 04/05 09:00 | 09:00:05 | 3684724906200124 | Valeria | |
| TL-0505-LI | 05/05 09:00 | 09:00:18 | 7774588873711779 | Don Ernesto | |
| TL-0505-IG | 05/05 13:00 | 13:00:11 | 5035424908600928 | Valeria | |
| TL-0505-FB | 05/05 19:00 | 19:00:07 | 5732351590107236 | Valeria |
Cada fila responde a las cuatro preguntas que alguien hará algún día: qué salió, dónde, cuándo y quién lo aprobó. Con el identificador de la publicación, Valeria puede abrirla en la red o borrarla por API si hace falta; con el aprobador, Don Ernesto sabe a quién preguntar; con la diferencia entre la hora programada y la publicada, el cuadro de mando del Día 75 medirá la puntualidad del flujo. La pieza TL-0502-LI muestra la regla del sábado: programada para el lunes 4, publicada el lunes 4.
Lo que el flujo no hace también es una decisión. No responde comentarios, no da “me gusta”, no sigue cuentas y no envía mensajes directos: publicar es la única acción que tiene permiso de hacer. Y no aprueba nada: la aprobación ocurre antes, en Notion, y el flujo solo comprueba que existe y que coincide. El Día 74 llevará esa aprobación a Slack y a WhatsApp con botones, y el Día 76 estudiará qué pasa cuando una pieza sale sin ella.
Consideraciones finales
El día empezó con $36$ momentos exactos que Valeria tendría que atender a mano y termina con un flujo que publica a la hora, una sola vez, con la leyenda que corresponde y con una aprobación que coincide con el texto. Las cifras tienen límites que conviene decir. Los requisitos y los límites de las redes cambian sin aviso, y en tres de quince las propias fuentes no coinciden: la Tabla 1 tiene fecha de revisión y caduca. La simulación del Bloque 4 usa probabilidades de fallo declaradas, no medidas en las API reales. Las horas de mantenimiento de la Tabla 2 son supuestos, y la diferencia entre Make y n8n ($1.81$ USD al mes) es menor que el error de esos supuestos: la decisión se tomó por la cuota de Make y por tener todo el registro en un sitio, y se revisará con las horas reales. Y las comprobaciones del Bloque 9 detectan lo que se puede comprobar (huellas, fechas, precios), no si una frase engaña.
Antes de automatizar las publicaciones de un negocio, conviene hacerse algunas preguntas:
- ¿Qué requisitos de cada red están respaldados por la documentación oficial y cuáles solo por terceros, y cuál es la cifra más baja que circula para cada límite?
- ¿Qué pasa si el registro falla y la misma pieza vuelve a la cola, y qué impide que se publique dos veces?
- ¿Cuántas horas al mes cuesta mantener la herramienta elegida, y cuándo caducan sus tokens y sus versiones?
- ¿Qué comprobaciones hace el código antes de la aprobación humana, y qué juzga solo la persona?
- ¿Quién puede retirar una pieza publicada, cómo y en cuánto tiempo?
Un gran libro que habla de esto es Everybody Writes (o Todo el mundo escribe), de Ann Handley. Su tesis es que en un negocio todos escriben y que el contenido útil se gana con proceso: planear, redactar, revisar, publicar con constancia. El Día 71 tomó de él el manual de voz; hoy se le podría añadir un capítulo que el libro da por supuesto: el proceso de publicar también se diseña, se prueba y se registra.
Programar no es publicar: es dejar escrito qué sale, cuándo y con la aprobación de quién, y que una sola puerta lo compruebe cada vez. Trigo Lento tiene hoy una cola de mayo que sale sola a su hora, seis piezas detenidas antes de que nadie las viera y un registro que dice quién aprobó cada una. Don Ernesto, al leer la pieza del pay a $360$, solo dice que la próxima vez revisará el precio con el catálogo en la mano. El código ya lo hace por él, pero la intención es la correcta.
Conclusiones clave
Requisitos y límites
- Cada red pide una cuenta del tipo correcto, un permiso dentro de un token y, a veces, una revisión: de $15$ requisitos, $10$ tienen fuente oficial, $2$ solo secundaria y en $3$ las fuentes no coinciden.
- El límite de Instagram es de $50$ publicaciones en 24 horas móviles según la referencia (otras fuentes dicen $100$ o $25$); Trigo Lento publica como máximo $1$ por cuenta en Instagram y Facebook y $2$ en LinkedIn, pero un flujo sin idempotencia lo rompe en $12.25$ horas.
- La API de Instagram no programa, Facebook programa de $10$ minutos a $30$ días ($5$ de $12$ piezas cupieron el 13 de abril) y LinkedIn exige rol, acceso aprobado, cabecera
LinkedIn-Versiony un token de unos $60$ días.
Herramientas
- La cola trabaja en
America/Mexico_City(siempre $-06{:}00$ desde 2022) e instantes UTC; tres intentos con espera exponencial dejan una probabilidad de fallo de $0.06^3 = 0.000216$ por pieza. - Publicar $36$ piezas cuesta $9.73$ USD al mes a mano, $7.30$ con la API directa, $3.46$ con Make y $5.27$ con n8n, casi todo en horas de Valeria; Make consume $204$ créditos y dejaría Core al $78.5%$.
- Valeria elige n8n por la cuota de Make, por tener cola, aprobaciones y registro en el mismo Postgres, y porque un disparador cada $15$ minutos ($2,880$ ejecuciones) no cuesta nada en el servidor propio, aunque sería el $115%$ de n8n Cloud Starter.
Etiquetado y ley
- La leyenda “Texto preparado con ayuda de IA y revisado por el equipo de Trigo Lento.” la inserta el código: $30$ piezas la llevan y $6$, escritas a mano, no.
- Ninguna pieza sale sin aprobación cuya huella coincida con el texto, sin vigencia si es promoción o con un precio distinto del catálogo: $6$ de $36$ quedaron bloqueadas, una de ellas aprobada con el error.
- El artículo 50 del Reglamento de IA de la UE (desde el 2 de agosto de 2026) y la Ley Federal de Protección al Consumidor (información veraz, precio total y promociones con condiciones y vigencia) se traducen en comprobaciones, no en buenas intenciones.
Mañana, en el Día 73: Caso de otro negocio VI: descripciones de producto accesibles para la tienda en línea. Café Altura, el tostador que surte a Trigo Lento, relanza su tienda con $120$ fichas copiadas de los productores, fotos sin texto alternativo y un café anunciado como “orgánico” con el certificado vencido; Valeria llevará el manual de voz, la salida estructurada y la comprobación de afirmaciones de esta semana a otro negocio, con textos accesibles en dos idiomas y una persona que aprueba cada ficha.
Referencias
- Meta (2026). Instagram Platform: Content Publishing; IG User Content Publishing Limit (
content_publishing_limit). Meta for Developers. https://developers.facebook.com/documentation/instagram-platform/content-publishing (revisado en octubre de 2026). - Meta (2026). Pages API: Posts (publicar y programar con
scheduled_publish_time). Meta for Developers. https://developers.facebook.com/documentation/pages-api/posts (revisado en octubre de 2026). - LinkedIn (2026). Community Management API: Posts API; Images API; Versioning. Microsoft Learn. https://learn.microsoft.com/linkedin/ (revisado en octubre de 2026).
- Parlamento Europeo y Consejo de la Unión Europea (2024). Reglamento (UE) 2024/1689 por el que se establecen normas armonizadas en materia de inteligencia artificial (Reglamento de Inteligencia Artificial), artículo 50. Diario Oficial de la Unión Europea, L, 12 de julio de 2024. https://eur-lex.europa.eu/eli/reg/2024/1689/oj
- Cámara de Diputados del H. Congreso de la Unión (2026). Ley Federal de Protección al Consumidor (texto vigente). https://www.diputados.gob.mx/LeyesBiblio/
- Procuraduría Federal del Consumidor (2026). Publicidad y derechos del consumidor. https://www.gob.mx/profeco
- Meta (2024). Our Approach to Labeling AI-Generated Content and Manipulated Media. Meta Newsroom. https://about.fb.com/news/ (revisado en octubre de 2026).
- Handley, A. (2014). Everybody Writes: Your Go-To Guide to Creating Ridiculously Good Content. Wiley.