
Arquitecto de automatización con IA: Día 75
 Jeshua Romero Guadarrama
- 66 Min para leer
- 16 Apr, 2026
Índice de contenido
Resumen:
Trigo Lento ya tiene seis flujos en marcha y nadie puede decir en un minuto si funcionan, cuánto cuestan y dónde fallan: la respuesta está repartida en cinco pestañas. En esta entrada, Valeria define indicadores y objetivos por flujo (éxito, latencia p95, coste por ejecución e intervención humana), une los registros de Make, n8n, Claude y WhatsApp en una tabla común sin datos de clientes, calcula el coste de cada ejecución con las tablas de precios, construye un panel de seis gráficas con Python y matplotlib, mide el presupuesto de errores con alertas por tasa de consumo y lo compara con Looker Studio. Al terminar, usted sabrá montar un cuadro de mando que contesta tres preguntas con números: $3$ de $6$ flujos cumplen sus objetivos, el mes cuesta $26.57$ USD y el sábado 18 se llevó $22$ de los $23$ fallos de pedidos.
¿Cómo citar el presente artículo?
Romero, J. (16 de abril de 2026). Arquitecto de automatización con IA: Día 75. python-data-engineer. https://www.python-data-engineer.com/post/aai/dia_75/.
Arquitecto de automatización con IA: Día 75 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/aai/dia_75/.
Precios, límites y políticas revisados en octubre de 2026: planes, precios y límites de Make, n8n, Zapier, WhatsApp (Meta, Twilio, Wati) y de la API de Claude. Los precios por millón de tokens son los de la Tabla A del plan (Opus 5.5: 4.00 y 20.00 USD; Sonnet 5.5: 2.00 y 10.00; Haiku 5.5: 0.10 y 0.50; lectura de caché a 0.20 USD en Opus 5.5 y en Sonnet 5.5). El informe de costes de la API de administración de Claude (/v1/organizations/cost_report) se contrastó con su referencia: devuelve importes en centavos de dólar como cadenas decimales, por día y con un máximo de 31 cubetas por página, y solo está disponible para cuentas de organización con una clave de administración. En las notas de versión de Google Cloud, Looker Studio aparece rebautizado como Data Studio desde el 16 de abril de 2026; la página de producto de Google indica 9 USD por usuario y por proyecto al mes para la edición Pro, con variaciones según la duración de la suscripción. El método files.upload de Slack se retiró y la subida de archivos se hace con files.getUploadURLExternal y files.completeUploadExternal. El Bloque 9 llama a servicios reales y no se ejecutó para escribir la entrada; su salida es un ejemplo comentado. El workflow del Bloque 10 sigue la estructura de exportación de n8n, verificada contra la documentación y revisada en octubre de 2026.
Día 75. Cuadros de mando de las automatizaciones: métricas, costes y errores
Introducción
Ayer, en el Día 74 (Humano en el bucle: aprobaciones con Slack y WhatsApp), Valeria decidió con una matriz de riesgo e impacto qué acciones necesitan una persona, convirtió cada aprobación en un estado persistente con caducidad y escalado, llevó los botones a Slack y al WhatsApp de Don Ernesto y midió la carga de la supervisión, y Trigo Lento ganó TL Aprobaciones v1, el sub-workflow que todos los flujos llaman antes de actuar. Con eso, el módulo ya tiene agentes que responden, contenido que se publica y personas que aprueban. Lo que no tiene es una forma de mirarlo todo junto.
Es jueves 16 de abril, a las seis de la tarde. El obrador está limpio, la última charola de conchas salió hace una hora y Don Ernesto se sienta frente a la computadora de la oficina con una pregunta que lleva semanas guardando: “Valeria, ya tenemos el robot de los pedidos, el de los correos, el de las publicaciones, el que contesta y el del informe del lunes. Dígame una cosa sencilla: ¿esto está funcionando?” Valeria abre el historial de escenarios de Make, la lista de ejecuciones de n8n, la consola de Claude con el gasto del mes, el administrador de WhatsApp de Meta y el canal #alertas de Slack. Cinco pestañas. A los veinte minutos ha encontrado tres fallos en Make que nadie había visto, un gasto de Claude que no sabe a qué flujo cargar y ninguna respuesta corta.
Don Ernesto la mira pasar de una pestaña a otra y pone sus condiciones, que son tres y son buenas. “Yo no quiero cinco pantallas, quiero una hoja que se lea con el café. Quiero saber si funciona, cuánto me cuesta y dónde falla, en ese orden. Y otra cosa: no quiero que esa hoja me diga cuánto trabaja cada quien. Aquí se mide el pan, no a la gente.” La primera condición pide un cuadro de mando: una sola vista con pocas cifras elegidas antes de mirar los datos. La segunda pide que cada cifra tenga un objetivo con el que compararla, porque “funciona” sin objetivo es una opinión. La tercera es una regla de diseño que esta entrada respeta de principio a fin: el panel mide flujos, no personas.
Hay un problema práctico que conviene decir desde el principio. Valeria todavía no tiene un mes completo con los seis flujos encendidos: la publicación multired del Día 72 arrancó el lunes 13 y el informe del lunes solo ha corrido dos veces. Por eso construye el panel con un mes simulado de 30 días, con el calendario de abril de 2026 y los volúmenes que ya conoce, y lo conectará a los registros reales en cuanto el registro común esté en producción. Todas las cifras de fallos, latencias y tokens de esta entrada salen de esa simulación y se declaran como tales; los precios, en cambio, son los reales, revisados en octubre de 2026.
En la presente entrada, descubrirá qué medir de cada flujo (éxito, latencia p95, coste por ejecución e intervención humana) y de todo el negocio (encargos atendidos y horas ahorradas), y por qué cada indicador necesita un objetivo propio. Unirá los registros de Make, n8n, Claude y WhatsApp en una tabla ejecuciones sin contenido de clientes, calculará el coste de cada ejecución con los precios de los tokens, las plantillas y los créditos, y comprobará qué flujos cumplen sus objetivos. Dibujará un panel de seis gráficas en una sola imagen, medirá el presupuesto de errores de cada flujo con la tasa de consumo y verá cuánto tarda en sonar una alerta un sábado por la mañana. Después leerá el panel con Don Ernesto en un minuto, lo comparará con Looker Studio y terminará con TL Alertas de flujos v1, el workflow de n8n que vigila los flujos cada diez minutos.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Definir indicadores de servicio (SLI) y objetivos (SLO) por flujo: tasa de éxito, latencia p95, coste por ejecución, intervención humana.
- Unificar los registros de Make, n8n, Claude (campo
usage) y mensajería enregistro_ejecuciones.csvy en la tablaejecuciones. - Construir un panel propio con Python y matplotlib y compararlo con Looker Studio (gratuito; Pro a 9 USD por usuario y proyecto al mes).
- Calcular el presupuesto de errores y disparar alertas cuando se consume demasiado rápido.
Qué medir
Un cuadro de mando (en inglés, dashboard) es una vista única que muestra, de un vistazo, el estado de un sistema frente a sus objetivos. La definición tiene tres partes y las tres importan. Única, porque cinco pestañas obligan a quien mira a hacer de integrador, que es justo el trabajo que había que automatizar. De un vistazo, porque Stephen Few, el autor que más ha escrito sobre el diseño de estos paneles, insiste en que un cuadro de mando cabe en una pantalla y se lee sin desplazarse; si hay que buscar, ya es un informe. Y frente a sus objetivos, porque una cifra sola no dice nada: un $98.57%$ de éxito puede ser una buena noticia o una mala, según lo que se haya prometido.
Antes de dibujar nada, Valeria escribe qué va a medir. Lo hace en dos niveles. En el nivel de flujo mide cuatro cosas, las mismas para los seis flujos, para que se puedan comparar:
- Éxito: la proporción de ejecuciones que terminaron por la ruta normal y no por el manejador de errores del Día 28 (Flujos profesionales: manejo de errores, reintentos y ejecuciones incompletas).
- Latencia p95: el tiempo, en segundos, por debajo del cual termina el $95%$ de las ejecuciones exitosas. Se usa el percentil y no la media por la razón que el Día 8 (Métricas de proceso y primeros acuerdos de nivel de servicio) demostró con la línea base: los tiempos tienen cola larga, y la media la esconde.
- Coste por ejecución: lo que cuesta, en dólares, una corrida completa del flujo, sumando tokens de Claude, mensajes de WhatsApp y la parte que le toca de la plataforma.
- Intervención humana: la proporción de ejecuciones en las que una persona tuvo que hacer algo que el flujo no hizo, como completar un pedido, editar un borrador o corregir un informe.
En el nivel de negocio mide dos cosas, las que Don Ernesto entiende sin explicación: los encargos atendidos por los flujos y las horas ahorradas, calculadas con los 6 minutos de trabajo manual por encargo del Día 1 frente al objetivo de 1.5 minutos de atención humana.
La intervención humana merece una aclaración, porque es la que más fácilmente se convierte en lo que Don Ernesto prohibió. Se mide por flujo: cuántas ejecuciones del flujo de Gmail necesitaron una edición, no cuántas editó Valeria ni cuánto tardó en hacerlo. Un panel que mostrara “aprobaciones por persona” o “tiempo de respuesta de cada empleado” sería una herramienta de vigilancia del personal, y en Trigo Lento no se construye. La pregunta que contesta la intervención humana es otra: ¿qué tan bien hace el flujo su parte? Un flujo de pedidos en el que una persona tiene que completar el $40%$ de los encargos no está automatizando gran cosa, y eso es un problema del flujo, no de quien lo completa.
Cada indicador lleva su objetivo. Un indicador de nivel de servicio (o SLI, por sus siglas en inglés: “Service Level Indicator”) es una medida cuantitativa de un aspecto del servicio, casi siempre una proporción de eventos buenos entre eventos válidos; un objetivo de nivel de servicio (o SLO, por sus siglas en inglés: “Service Level Objective”) es el valor que ese indicador debe alcanzar en un periodo. Son los mismos conceptos que el Día 53 (Métricas y SLA de la atención: percentiles, presupuesto de error y alertas) aplicó a la atención de clientes, ahora llevados a todas las automatizaciones. La Tabla 1 fija los seis flujos que vigila el panel, su plataforma, su volumen esperado y sus objetivos.
Tabla 1. SLI y SLO por flujo: volumen esperado al mes y objetivos de éxito, latencia, coste e intervención humana.
| Flujo | Plataforma y versión | Ejecuciones al mes | Éxito | Latencia p95 | Coste medio | Intervención humana |
|---|---|---|---|---|---|---|
| Pedidos | Make, TL Pedidos WhatsApp v3 | 1 560 | 99 % | 30 s | 0.010 USD | 25 % como máximo |
| Agente | n8n, TL Agente de pedidos v4 | 600 | 98 % | 45 s | 0.015 USD | 15 % como máximo |
| Gmail | n8n, TL Gmail mayoristas v1 | 120 | 99 % | 90 s | 0.030 USD | 35 % como máximo |
| Secuencias | n8n, TL WhatsApp secuencias v2 | 680 | 99.5 % | 10 s | 0.010 USD | 5 % como máximo |
| Informe | n8n, TL Informe del lunes v1 | 4 | 100 % | 300 s | 0.300 USD | 50 % como máximo |
| Publicación | n8n, TL Publicación multired v1 | 36 | 97 % | 60 s | 0.010 USD | 20 % como máximo; aprobación válida en el 100 % |
Tres decisiones de la tabla tienen un porqué. La primera: los objetivos son distintos porque los flujos son distintos. Las secuencias de WhatsApp envían confirmaciones que el cliente espera al instante, así que su latencia se mide en pocos segundos y su éxito exige un $99.5%$; el informe del lunes tarda minutos porque Opus 5.5 redacta y el comprobador del Día 67 (Sesión práctica de consolidación: el informe de negocio del lunes) revisa, y nadie lo espera de pie. La segunda: el flujo de publicación lleva un indicador más, la aprobación válida, que no es una proporción que se negocia, sino una condición: toda pieza publicada tiene que tener una aprobación con estado “aprobada” en TL Aprobaciones v1. Su objetivo es el $100%$ y cualquier excepción es un incidente. La tercera: la intervención humana del informe y de Gmail es alta por diseño, porque en los dos una persona aprueba siempre; lo que se vigila ahí no es la aprobación, que es obligatoria, sino las correcciones, que indican que el borrador llegó mal.
Antes de seguir, Valeria pone a punto el cuaderno. El primer bloque prepara las importaciones, la semilla de la serie y los precios que se usarán en todo el día:
# Importaciones base, semilla de la serie, carpeta del día y precios revisados en octubre de 2026 en Python:
import warnings
warnings.filterwarnings('ignore')
import json
import sqlite3
from datetime import date, datetime, timedelta
from pathlib import Path
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 140)
carpeta = Path('trigo_lento') / 'dia_75'
carpeta.mkdir(parents = True, exist_ok = True)
# Tabla A del plan (USD por millón de tokens): entrada, salida, lectura y escritura de caché de 5 minutos:
PRECIOS = {'claude-opus-5-5': (4.00, 20.00, 0.20, 5.00),
           'claude-sonnet-5-5': (2.00, 10.00, 0.20, 2.50),
           'claude-haiku-5-5': (0.10, 0.50, 0.01, 0.125)}
PLANTILLA_UTILIDAD = 0.0085             # USD por plantilla de utilidad entregada en México (Tabla C)
CREDITO_MAKE = 10.59 / 10_000           # Make Core: 10.59 USD al mes por 10 000 créditos
SERVIDOR_N8N = 6.00                     # VPS de n8n self-hosted, USD al mes (Tabla E)
print('numpy', np.__version__, '| pandas', pd.__version__)
print(f'Crédito de Make: {CREDITO_MAKE:.6f} USD | plantilla de utilidad: {PLANTILLA_UTILIDAD} USD')
numpy 2.4.6 | pandas 3.0.3
Crédito de Make: 0.001059 USD | plantilla de utilidad: 0.0085 USD
El crédito de Make cuesta $0.001059$ USD: los 10.59 USD del plan Core divididos entre sus 10 000 créditos. La cifra es un precio de lista, no un gasto: Trigo Lento paga los 10.59 USD use los créditos que use, y la diferencia entre lo pagado y lo usado es capacidad ociosa que el panel también tiene que enseñar.
Las cuatro medidas de flujo se parecen a los instrumentos de un horno, y la Figura 1 lo dibuja con la metáfora que Don Ernesto usa para su propio oficio: nadie hornea mirando solo el termómetro.
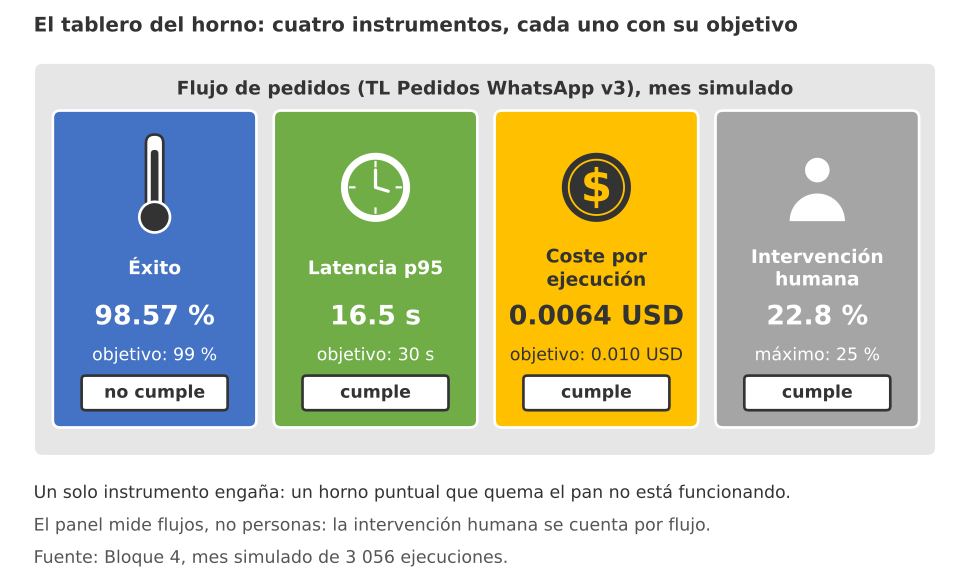
Figura 1. El tablero del horno: el termómetro es el éxito, el reloj la latencia p95, el contador el coste por ejecución y la persona la intervención humana, cada uno con su objetivo; cifras del flujo de pedidos.
Un registro común
El problema de las cinco pestañas no es que haya cinco herramientas, sino que cada una cuenta su propia historia con su propio idioma. Make guarda en el historial de cada escenario la duración de la ejecución en milisegundos, los créditos que consumió y un estado numérico (éxito, advertencia o error), y los expone por su API en el recurso de registros del escenario. n8n guarda cada ejecución con su hora de inicio y de fin, su estado y el identificador del workflow, y los devuelve por su API pública en GET /api/v1/executions, como ya hizo el Día 56. La API de Claude devuelve en cada respuesta el campo usage, con input_tokens, output_tokens, cache_read_input_tokens y cache_creation_input_tokens. Y la Cloud API de WhatsApp informa por el webhook de estados cuándo se entregó cada plantilla. Ninguna de las cuatro sabe que las otras existen.
La solución es un registro común: una tabla en la que cada flujo, al terminar, escribe una fila con los mismos campos, se ejecute donde se ejecute. No se trata de copiar los historiales de Make y de n8n, que siguen existiendo para depurar, sino de escribir lo mínimo que el panel necesita, con nombres que no cambian de una plataforma a otra. En Make, la fila se escribe con un módulo HTTP al final de la ruta normal y con otro en el manejador de errores; en n8n, con un nodo de Postgres al final y con el workflow de errores del Día 28 cuando algo falla. Así, una ejecución que falla también deja su fila, que es justo la que más importa.
Hay dos tablas y no una. La tabla ejecuciones tiene una fila por corrida de un flujo. La tabla llamadas_claude tiene una fila por cada petición a la API de Claude, porque una sola ejecución puede hacer varias: el flujo de pedidos clasifica con Haiku 5.5 y, si duda, escala a Opus 5.5, como en la cascada del Día 30 (IA dentro de Make: llamar a la API de Claude con el módulo HTTP). Guardar los tokens por petición, con su modelo, permite aplicar el precio correcto a cada una; sumarlos antes en la ejecución mezclaría tokens que cuestan $0.10$ USD por millón con tokens que cuestan $4.00$.
El siguiente bloque simula el mes completo de los seis flujos: unas 3 000 ejecuciones con llegadas de Poisson, una hora pico de 10 a 12, fallos con la probabilidad base de cada flujo, latencias lognormales, tokens por modelo y un incidente el sábado 18, cuando la conexión de Make con la hoja de pedidos caduca a las 8:30 y nadie la renueva hasta las 12:30. Después crea las dos tablas en SQLite con sus restricciones y escribe registro_ejecuciones.csv:
# Un mes simulado de ejecuciones de seis flujos con fallos, latencias y tokens en Python:
FLUJOS = {  # flujo: (plataforma, nombre y versión, ejecuciones por día de operación, prob. de fallo)
    'pedidos': ('make', 'TL Pedidos WhatsApp v3', 60.0, 0.004),
    'agente': ('n8n', 'TL Agente de pedidos v4', 600 / 26, 0.008),
    'gmail': ('n8n', 'TL Gmail mayoristas v1', 120 / 22, 0.005),
    'secuencias': ('n8n', 'TL WhatsApp secuencias v2', 680 / 26, 0.003),
    'informe': ('n8n', 'TL Informe del lunes v1', 1.0, 0.0),
    'publicacion': ('n8n', 'TL Publicación multired v1', 3.0, 0.02),
}
DIAS = [date(2026, 4, 1) + timedelta(i) for i in range(30)]   # 30 días con el calendario de abril de 2026
PESO_HORA = np.array([1, 2, 3, 6, 9, 9, 6, 5, 5, 4, 4, 3, 2], float)  # 7:00 a 19:59, pico de 10 a 12
INCIDENTE = (datetime(2026, 4, 18, 8, 30), datetime(2026, 4, 18, 12, 30))  # conexión de Make caducada

def opera(flujo, d):
    # Días en que corre cada flujo: domingo cerrado; Gmail de lunes a viernes; informe los lunes;
    # publicaciones martes, jueves y sábado salvo el Jueves Santo (2 de abril):
    if flujo == 'informe':
        return d.weekday() == 0
    if flujo == 'publicacion':
        return d.weekday() in (1, 3, 5) and d != date(2026, 4, 2)
    if flujo == 'gmail':
        return d.weekday() < 5
    return d.weekday() < 6

def horas_del_dia(flujo, d, n):
    if flujo == 'informe':
        return [datetime(d.year, d.month, d.day, 6, 30)]
    if flujo == 'publicacion':
        return [datetime(d.year, d.month, d.day, h) for h in (9, 13, 19)]   # LinkedIn, Instagram, Facebook
    pesos = PESO_HORA / PESO_HORA.sum() if flujo in ('pedidos', 'agente') else np.ones(13) / 13
    horas = 7 + rng.choice(13, size = n, p = pesos)
    segundos = rng.integers(0, 3600, size = n)
    return sorted(datetime(d.year, d.month, d.day, int(h)) + timedelta(seconds = int(s))
                  for h, s in zip(horas, segundos))

ejecuciones, llamadas = [], []
def llamada(id_ejec, modelo, entrada, salida, lectura = 0, escritura = 0):
    llamadas.append({'id_ejecucion': id_ejec, 'modelo': modelo, 'entrada': int(entrada),
                     'salida': int(salida), 'cache_lectura': int(lectura), 'cache_escritura': int(escritura)})

for d in DIAS:
    for flujo, (plataforma, nombre, por_dia, p_fallo) in FLUJOS.items():
        if not opera(flujo, d):
            continue
        n = rng.poisson(por_dia) if flujo not in ('informe', 'publicacion') else 0
        for inicio in horas_del_dia(flujo, d, n):
            i = f'E{len(ejecuciones) + 1:05d}'
            en_incidente = flujo == 'pedidos' and INCIDENTE[0] <= inicio < INCIDENTE[1]
            fallo = rng.random() < (0.95 if en_incidente else p_fallo)
            fila = {'id_ejecucion': i, 'flujo': flujo, 'plataforma': plataforma, 'version': nombre,
                    'inicio': inicio, 'estado': 'fallo' if fallo else 'exito', 'creditos_make': 0,
                    'plantillas': 0, 'intervencion_humana': bool(fallo), 'aprobador': None,
                    'aprobacion': None, 'es_encargo': False}
            latencia = rng.lognormal(np.log(1.5), 0.4) if fallo else 0.0
            if flujo == 'pedidos':
                llamada(i, 'claude-haiku-5-5', rng.normal(1100, 150), rng.normal(50, 10))
                escala = rng.random() < 0.15
                if escala:
                    llamada(i, 'claude-opus-5-5', rng.normal(1100, 150), rng.normal(120, 25))
                fila['creditos_make'] = 3 if fallo else int(rng.choice([3, 4, 5, 6], p = [.2, .35, .3, .15])) + 4 * escala
                if not fallo:
                    latencia = rng.lognormal(np.log(6), 0.5) + escala * rng.lognormal(np.log(6), 0.5)
                    fila['es_encargo'] = rng.random() < 0.30
                    fila['intervencion_humana'] = rng.random() < 0.22
            elif flujo == 'agente':
                llamada(i, 'claude-haiku-5-5', rng.normal(700, 120), rng.normal(150, 30), lectura = 1800)
                escala = rng.random() < 0.19
                if escala:
                    llamada(i, 'claude-opus-5-5', rng.normal(3000, 300), rng.normal(700, 150))
                if not fallo:
                    latencia = rng.lognormal(np.log(8), 0.5) + escala * rng.lognormal(np.log(12), 0.4)
                    fila['intervencion_humana'] = rng.random() < 0.10
            elif flujo == 'gmail':
                llamada(i, 'claude-haiku-5-5', rng.normal(600, 80), rng.normal(30, 5))
                llamada(i, 'claude-sonnet-5-5', rng.normal(2500, 300), rng.normal(600, 120))
                fila['aprobador'], fila['aprobacion'] = 'valeria', 'aprobada'
                if not fallo:
                    latencia = rng.lognormal(np.log(14), 0.4)
                    fila['intervencion_humana'] = rng.random() < 0.25
            elif flujo == 'secuencias':
                fila['plantillas'] = int(rng.random() < 0.55)     # fuera de la ventana de 24 horas
                if not fallo:
                    latencia = rng.lognormal(np.log(2.5), 0.4)
                    fila['intervencion_humana'] = rng.random() < 0.02
            elif flujo == 'informe':
                llamada(i, 'claude-opus-5-5', rng.normal(6000, 300), rng.normal(2700, 300))
                corregido = rng.random() < 0.25
                if corregido:
                    llamada(i, 'claude-opus-5-5', rng.normal(6500, 300), rng.normal(1200, 200), lectura = 6000)
                fila['aprobador'], fila['aprobacion'] = 'don_ernesto', 'aprobada'
                latencia = rng.lognormal(np.log(95), 0.3) + corregido * 60
                fila['intervencion_humana'] = corregido
            elif flujo == 'publicacion':
                fila['aprobador'] = 'don_ernesto' if rng.random() < 0.6 else 'valeria'
                fila['aprobacion'] = 'aprobada'
                if not fallo:
                    latencia = rng.lognormal(np.log(4), 0.5)
                    fila['intervencion_humana'] = rng.random() < 0.05
            fila['latencia_s'] = round(float(latencia), 2)
            fila['fin'] = inicio + timedelta(seconds = float(latencia))
            ejecuciones.append(fila)

registro = pd.DataFrame(ejecuciones)
usos = pd.DataFrame(llamadas)
# Registro común: la tabla ejecuciones (una fila por corrida) y llamadas_claude (una por petición):
con = sqlite3.connect(carpeta / 'trigo_lento_panel.sqlite')
con.executescript('''
DROP TABLE IF EXISTS llamadas_claude;
DROP TABLE IF EXISTS ejecuciones;
CREATE TABLE ejecuciones (
    id_ejecucion  TEXT PRIMARY KEY,
    flujo         TEXT NOT NULL,
    plataforma    TEXT NOT NULL CHECK (plataforma IN ('make', 'n8n')),
    version       TEXT NOT NULL,
    inicio        TEXT NOT NULL,
    fin           TEXT NOT NULL,
    estado        TEXT NOT NULL CHECK (estado IN ('exito', 'fallo')),
    latencia_s    REAL NOT NULL CHECK (latencia_s >= 0),
    creditos_make INTEGER NOT NULL DEFAULT 0,
    plantillas    INTEGER NOT NULL DEFAULT 0,
    intervencion_humana INTEGER NOT NULL CHECK (intervencion_humana IN (0, 1)),
    aprobador     TEXT CHECK (aprobador IN ('valeria', 'don_ernesto')),
    aprobacion    TEXT,
    es_encargo    INTEGER NOT NULL DEFAULT 0);
CREATE TABLE llamadas_claude (
    id_ejecucion  TEXT NOT NULL REFERENCES ejecuciones (id_ejecucion),
    modelo        TEXT NOT NULL,
    entrada       INTEGER NOT NULL, salida INTEGER NOT NULL,
    cache_lectura INTEGER NOT NULL, cache_escritura INTEGER NOT NULL);
''')
columnas = ['id_ejecucion', 'flujo', 'plataforma', 'version', 'inicio', 'fin', 'estado', 'latencia_s',
            'creditos_make', 'plantillas', 'intervencion_humana', 'aprobador', 'aprobacion', 'es_encargo']
filas = registro[columnas].assign(inicio = registro['inicio'].map(lambda t: t.isoformat() + '-06:00'),
                                  fin = registro['fin'].map(lambda t: t.isoformat(timespec = 'seconds') + '-06:00'))
with con:
    con.executemany(f'INSERT INTO ejecuciones VALUES ({",".join("?" * len(columnas))})',
                    filas.astype(object).where(filas.notna(), None).values.tolist())
    con.executemany('INSERT INTO llamadas_claude VALUES (?, ?, ?, ?, ?, ?)', usos.values.tolist())
filas.to_csv(carpeta / 'registro_ejecuciones.csv', index = False)
resumen = registro.groupby('flujo', sort = False).agg(plataforma = ('plataforma', 'first'),
                                                      ejecuciones = ('id_ejecucion', 'size'),
                                                      fallos = ('estado', lambda s: (s == 'fallo').sum()),
                                                      con_claude = ('id_ejecucion', lambda s: s.isin(usos.id_ejecucion).sum()))
print(resumen.to_string())
print('Total de ejecuciones:', len(registro), '| llamadas a Claude:', len(usos),
      '| encargos atendidos por el flujo:', int(registro['es_encargo'].sum()))
            plataforma  ejecuciones  fallos  con_claude
flujo
pedidos           make         1603      23        1603
agente             n8n          630       1         630
gmail              n8n          114       2         114
secuencias         n8n          669       2           0
publicacion        n8n           36       0           0
informe            n8n            4       0           4
Total de ejecuciones: 3056 | llamadas a Claude: 2829 | encargos atendidos por el flujo: 475
El mes simulado tiene $3,056$ ejecuciones, $1,603$ de ellas del flujo de pedidos, y $2,829$ llamadas a Claude. Los fallos están muy concentrados: el flujo de pedidos tiene $23$, el agente $1$, Gmail $2$, las secuencias $2$, y la publicación y el informe ninguno. Los flujos atendieron $475$ encargos, cerca de los $468$ del plan; la diferencia es el azar de las llegadas de Poisson.
La Tabla 2 documenta el esquema del registro común: qué tipo tiene cada campo y de dónde sale en cada plataforma.
Tabla 2. Esquema del registro común: tipo y origen de cada campo de las tablas ejecuciones y llamadas_claude.
| Campo | Tipo | Origen |
|---|---|---|
id_ejecucion | texto, clave primaria | Identificador de la ejecución en el historial de Make o de n8n |
flujo y version | texto | Nombre del inventario (TL <proceso> v<n>), fijado en el propio flujo |
plataforma | texto: make o n8n | Fijado en el propio flujo |
inicio y fin | fecha ISO 8601 con -06:00 | Reloj de la plataforma al disparar y al escribir la fila |
estado | texto: exito o fallo | Ruta normal o manejador de errores (Día 28) |
latencia_s | real, segundos | fin menos inicio |
creditos_make | entero | Historial del escenario de Make |
plantillas | entero | Plantillas de WhatsApp enviadas en la ejecución (Cloud API de Meta) |
intervencion_humana | 0 o 1 | El flujo marca si derivó el caso a una persona o si su borrador se editó |
aprobador y aprobacion | rol y estado | TL Aprobaciones v1 (Día 74): quién aprobó y con qué resultado |
es_encargo | 0 o 1 | Clasificación del mensaje: era un encargo |
modelo, entrada, salida | texto y enteros | respuesta.model y respuesta.usage de cada llamada a Claude |
cache_lectura, cache_escritura | enteros | usage.cache_read_input_tokens y usage.cache_creation_input_tokens |
Lo más importante de la tabla es lo que no tiene. No hay teléfono, ni nombre, ni texto del mensaje, ni dirección de entrega. El Día 64 (Seguridad II: inyección de instrucciones y fuga de datos en flujos con IA) ya advirtió que un registro con datos personales es una segunda base de clientes sin aviso de privacidad ni control de acceso; este registro no lo es, porque para medir si un flujo funciona no hace falta saber a quién atendió. El campo aprobador sí guarda un rol (valeria o don_ernesto), porque la responsabilidad de una aprobación tiene que poder auditarse, como pide el Día 74; pero el panel nunca lo agrega ni lo dibuja.
Fíjese también en las restricciones CHECK del esquema. El estado solo puede ser exito o fallo, la latencia no puede ser negativa y el aprobador solo puede ser uno de los dos roles. Una fila mal formada no entra, y un flujo que intenta escribir un estado inventado falla de forma visible en lugar de ensuciar el panel en silencio.
Coste por ejecución
Don Ernesto preguntó cuánto cuesta “todo esto”, y la respuesta honesta tiene tres capas que se suman en cada ejecución. La primera son los tokens de Claude, que se pagan por millón y por modelo, con precios distintos para la entrada, la salida, la lectura de caché y la escritura de caché. La segunda son los mensajes de WhatsApp: con la Cloud API directa que eligió el Día 46, Trigo Lento no paga recargo por mensaje, pero cada plantilla de utilidad entregada fuera de la ventana de 24 horas cuesta $0.0085$ USD en México, según la Tabla C del plan. La tercera es la plataforma: los créditos de Make que consume cada ejecución y la parte que le toca del servidor de n8n, que cuesta 6 USD al mes corra lo que corra.
El coste de una ejecución $i$ queda así:
$$ c_i = \sum_{k \in K_i} \frac{p^{\text{ent}}{m_k} x^{\text{ent}}k + p^{\text{sal}}{m_k} x^{\text{sal}}k + p^{\text{lec}}{m_k} x^{\text{lec}}k + p^{\text{esc}}{m_k} x^{\text{esc}}k}{10^6} + q_i , p_q + \kappa_i , p\kappa + \frac{F}{N{\text{n8n}}} $$
La lógica detrás de esta fórmula es múltiple:
- $K_i$ es el conjunto de llamadas a Claude de la ejecución; cada llamada $k$ usa un modelo $m_k$ y consume $x^{\text{ent}}_k$ tokens de entrada sin caché, $x^{\text{sal}}_k$ de salida, $x^{\text{lec}}_k$ leídos de la caché y $x^{\text{esc}}_k$ escritos en ella. Los precios $p$ son los de la Tabla A, en USD por millón, y por eso se divide entre $10^6$.
- $q_i$ es el número de plantillas de WhatsApp de la ejecución y $p_q = 0.0085$ USD; las respuestas dentro de la ventana de atención no suman nada.
- $\kappa_i$ son los créditos de Make y $p_\kappa = 0.001059$ USD, el precio de lista del crédito; solo se aplica a las ejecuciones de Make.
- $F / N_{\text{n8n}}$ reparte el coste fijo del servidor, $F = 6$ USD, entre las $N_{\text{n8n}}$ ejecuciones de n8n del mes; es un reparto, no un gasto que dependa de la ejecución, y conviene no confundir las dos cosas.
- En conclusión, el coste por ejecución suma lo que se paga por uso y una parte de lo que se paga aunque no se use; la primera parte baja si el flujo mejora, la segunda solo baja si corren más ejecuciones.
El siguiente bloque aplica la fórmula a cada llamada y a cada ejecución, agrega por flujo y separa el gasto de Claude por modelo:
# Coste por ejecución con la Tabla A (tokens), la Tabla C (plantillas) y los créditos de Make en Python:
def coste_llamada(f):
    entrada, salida, lectura, escritura = PRECIOS[f.modelo]
    return (entrada * f.entrada + salida * f.salida + lectura * f.cache_lectura
            + escritura * f.cache_escritura) / 1e6
usos['coste'] = usos.apply(coste_llamada, axis = 1)
registro['coste_claude'] = registro['id_ejecucion'].map(usos.groupby('id_ejecucion')['coste'].sum()).fillna(0)
registro['coste_mensajes'] = registro['plantillas'] * PLANTILLA_UTILIDAD
n_n8n = (registro['plataforma'] == 'n8n').sum()
registro['coste_plataforma'] = np.where(registro['plataforma'] == 'make',
                                        registro['creditos_make'] * CREDITO_MAKE,   # créditos usados
                                        SERVIDOR_N8N / n_n8n)                       # reparto del servidor fijo
registro['coste_usd'] = registro[['coste_claude', 'coste_mensajes', 'coste_plataforma']].sum(axis = 1)
costes = registro.groupby('flujo', sort = False).agg(
    ejecuciones = ('id_ejecucion', 'size'), claude = ('coste_claude', 'sum'), mensajes = ('coste_mensajes', 'sum'),
    plataforma = ('coste_plataforma', 'sum'), total = ('coste_usd', 'sum'), media = ('coste_usd', 'mean'),
    mediana = ('coste_usd', 'median'))
print(costes.round({'claude': 2, 'mensajes': 2, 'plataforma': 2, 'total': 2, 'media': 4, 'mediana': 4}).to_string())
creditos = int(registro['creditos_make'].sum())
print(f'Claude: {registro.coste_claude.sum():.2f} USD | WhatsApp: {registro.coste_mensajes.sum():.2f} USD | '
      f'créditos de Make usados: {creditos:,} de 10,000 ({creditos / 100:.1f} %)')
print(f'Por modelo (USD): {usos.groupby("modelo")["coste"].sum().round(2).to_dict()}')
print(f'Coste medio por ejecución de todo el registro: {registro.coste_usd.mean():.4f} USD')
             ejecuciones  claude  mensajes  plataforma  total   media  mediana
flujo
pedidos             1603    1.89      0.00        8.45  10.34  0.0064   0.0054
agente               630    3.07      0.00        2.60   5.67  0.0090   0.0043
gmail                114    1.28      0.00        0.47   1.75  0.0154   0.0153
secuencias           669    0.00      3.28        2.76   6.04  0.0090   0.0126
publicacion           36    0.00      0.00        0.15   0.15  0.0041   0.0041
informe                4    0.45      0.00        0.02   0.47  0.1176   0.1287
Claude: 6.70 USD | WhatsApp: 3.28 USD | créditos de Make usados: 7,981 de 10,000 (79.8 %)
Por modelo (USD): {'claude-haiku-5-5': 0.33, 'claude-opus-5-5': 5.09, 'claude-sonnet-5-5': 1.28}
Coste medio por ejecución de todo el registro: 0.0080 USD
La salida dice mucho más que el total. Claude cuesta $6.70$ USD en el mes para los seis flujos, y $5.09$ de ellos son de Opus 5.5, aunque Haiku 5.5 hace muchas más llamadas: el $76%$ del gasto de Claude viene de los escalados del flujo de pedidos y del agente, y del informe. WhatsApp cuesta $3.28$ USD, todo en plantillas de las secuencias. El flujo de pedidos consumió $7,981$ créditos, el $79.8%$ de los $10,000$ de Make Core, una cifra coherente con la que el Día 72 (Publicación multired: Instagram, Facebook y LinkedIn por API o con Make y n8n) usó para descartar Make como plataforma de publicación. La Tabla 3 lo resume por flujo.
Tabla 3. Coste del mes simulado por flujo y por capa, en USD (precios revisados en octubre de 2026).
| Flujo | Ejecuciones | Claude | Plataforma | Total | Media por ejecución | Mediana por ejecución | |
|---|---|---|---|---|---|---|---|
| Pedidos | 1 603 | 1.89 | 0.00 | 8.45 | 10.34 | 0.0064 | 0.0054 |
| Agente | 630 | 3.07 | 0.00 | 2.60 | 5.67 | 0.0090 | 0.0043 |
| Gmail | 114 | 1.28 | 0.00 | 0.47 | 1.75 | 0.0154 | 0.0153 |
| Secuencias | 669 | 0.00 | 3.28 | 2.76 | 6.04 | 0.0090 | 0.0126 |
| Publicación | 36 | 0.00 | 0.00 | 0.15 | 0.15 | 0.0041 | 0.0041 |
| Informe | 4 | 0.45 | 0.00 | 0.02 | 0.47 | 0.1176 | 0.1287 |
| Total | 3 056 | 6.70 | 3.28 | 14.45 | 24.43 | 0.0080 | - |
Dos lecturas de la tabla cambian decisiones. La primera es la distancia entre media y mediana en el agente: la ejecución típica cuesta $0.0043$ USD, pero la media es $0.0090$, más del doble, porque el $19%$ de las conversaciones escala a Opus 5.5 y una conversación escalada cuesta unas siete veces más que la típica. Si un día alguien propone “bajar el coste del agente”, la palanca no es el modelo de la conversación típica, sino la tasa de escalado. La segunda es el peso de la plataforma: de los $24.43$ USD, $14.45$ son de Make y del servidor, y esa parte apenas se mueve con el número de ejecuciones. El coste de Claude, que tanto preocupaba en el módulo 6, es la parte pequeña de la cuenta de estos seis flujos.
Atención aquí: el registro común mide el coste de los seis flujos, no el rubro completo de Claude ni el de WhatsApp. El lote nocturno del Día 60, la evaluación del Día 70, el calendario editorial del Día 71 y la lectura de facturas en PDF también gastan tokens, y hay cargos de WhatsApp que no pasan por ninguna ejecución. Por eso el panel no sustituye a la factura: se concilia con ella. El Bloque 9 lee el informe de costes de la API de administración de Claude y calcula la diferencia entre lo que la consola cobró y lo que el registro explica. Una diferencia grande y que crece es una pieza que gasta sin escribir su fila. Y la clave de administración (sk-ant-admin...) puede gestionar toda la organización: se guarda aparte, la usa un solo flujo y nunca se pega en un workflow.
SLI y SLO por flujo
Con el registro y los costes, cada indicador de la Tabla 1 se puede calcular. El de éxito es una proporción, y la latencia se resume con un percentil:
$$ \text{SLI}_f = \frac{\left|{, i \in E_f : \text{estado}_i = \text{éxito} ,}\right|}{|E_f|}, \qquad \text{p95}f = \text{percentil}{95}{, \ell_i : i \in E_f,\ \text{estado}_i = \text{éxito} ,} $$
La lógica detrás de estas dos definiciones es la siguiente:
- $E_f$ es el conjunto de ejecuciones del flujo $f$ en el periodo y $|E_f|$ su número; el SLI de éxito cuenta las que terminaron bien y divide entre todas, de modo que va de $0$ a $1$.
- La latencia $\ell_i$ se mide solo en las ejecuciones exitosas, porque una ejecución que falla en el primer módulo tarda un segundo y bajaría el percentil precisamente cuando el flujo está peor.
- El percentil se calcula con la interpolación lineal de numpy, la misma que el Día 8 comprobó a mano.
- En conclusión, cada flujo tiene dos números que se leen distinto: el éxito dice si el flujo hace su trabajo y el p95 dice cuánto tarda cuando lo hace; ninguno de los dos sustituye al otro.
El siguiente bloque calcula los cuatro indicadores de cada flujo, los compara con sus objetivos y comprueba el indicador especial de la publicación:
# SLI del mes y cumplimiento de los SLO por flujo en Python:
SLO = {  # flujo: (éxito mínimo, p95 máximo en segundos, coste medio máximo en USD, intervención humana máxima)
    'pedidos': (0.99, 30, 0.010, 0.25), 'agente': (0.98, 45, 0.015, 0.15),
    'gmail': (0.99, 90, 0.030, 0.35), 'secuencias': (0.995, 10, 0.010, 0.05),
    'informe': (1.00, 300, 0.300, 0.50), 'publicacion': (0.97, 60, 0.010, 0.20),
}
def sli(x):
    exitos = x[x['estado'] == 'exito']
    return pd.Series({'n': len(x), 'exito': (x['estado'] == 'exito').mean(),
                      'p95_s': np.percentile(exitos['latencia_s'], 95) if len(exitos) else np.nan,
                      'coste_medio': x['coste_usd'].mean(), 'intervencion': x['intervencion_humana'].mean()})
tabla_1 = registro.groupby('flujo', sort = False).apply(sli)
for flujo, (exito, p95, coste, humano) in SLO.items():
    f = tabla_1.loc[flujo]
    fallan = [nombre for nombre, ok in (('éxito', f.exito >= exito), ('p95', f.p95_s <= p95),
                                        ('coste', f.coste_medio <= coste), ('humano', f.intervencion <= humano))
              if not ok]
    tabla_1.loc[flujo, 'incumple'] = ', '.join(fallan) or '-'
tabla_1['n'] = tabla_1['n'].astype(int)
print(tabla_1.round({'exito': 4, 'p95_s': 1, 'coste_medio': 4, 'intervencion': 3}).to_string())
pub = registro[registro['flujo'] == 'publicacion']
validas = (pub['aprobacion'] == 'aprobada') & pub['aprobador'].notna()
print(f'Publicaciones con aprobación válida: {validas.sum()} de {len(pub)} (SLO: 100 %)')
                n   exito  p95_s  coste_medio  intervencion incumple
flujo
pedidos      1603  0.9857   16.5       0.0064         0.228    éxito
agente        630  0.9984   27.8       0.0090         0.100        -
gmail         114  0.9825   27.3       0.0154         0.263    éxito
secuencias    669  0.9970    5.0       0.0090         0.024        -
publicacion    36  1.0000    8.7       0.0041         0.028        -
informe         4  1.0000  136.7       0.1176         0.750   humano
Publicaciones con aprobación válida: 36 de 36 (SLO: 100 %)
Tres de los seis flujos cumplen todos sus objetivos y tres incumplen uno. El agente, las secuencias y la publicación están en verde: el agente con un éxito de $0.9984$ y un p95 de $27.8$ segundos frente a $45$; las secuencias con $5.0$ segundos frente a $10$; y la publicación con sus $36$ piezas aprobadas de $36$. Los incumplimientos merecen cada uno su propia lectura, porque no significan lo mismo.
El flujo de pedidos tiene un éxito de $0.9857$ frente al $0.99$ del objetivo, y la causa es una sola mañana. Sin las $22$ ejecuciones que fallaron el sábado 18, el flujo habría tenido $1$ fallo en $1,581$ ejecuciones, un éxito de $0.9994$. Esa es la diferencia entre un flujo que funciona mal y un flujo que funciona bien y tuvo un incidente, y el panel tiene que dejar ver las dos cosas, como se verá en el presupuesto de errores.
El flujo de Gmail tiene un éxito de $0.9825$: $2$ fallos en $114$ ejecuciones. Aquí la pregunta correcta no es “¿qué falló?”, sino “¿es posible cumplir este objetivo con tan pocas ejecuciones?”. Si la probabilidad real de fallo del flujo fuera exactamente la de su diseño, $0.005$, la probabilidad de ver $2$ fallos o más en $114$ ejecuciones sería de $0.112$, según la distribución binomial. Es decir, un flujo de Gmail sano rompería un objetivo del $99%$ uno de cada nueve meses por puro azar. Con $114$ ejecuciones, el presupuesto del mes es de $1.14$ fallos, y el segundo fallo ya lo rebasa. La lección del Día 53 sobre el formulario se repite: con poco volumen, el objetivo mensual en porcentaje es demasiado frágil, y conviene evaluarlo por trimestre o alertar por evento.
El informe del lunes incumple la intervención humana: $3$ de sus $4$ ejecuciones necesitaron una corrección, el $75%$ frente a un máximo del $50%$. Con cuatro ejecuciones, eso no es una estadística; es una lista de cuatro casos que Valeria puede leer uno por uno. Si la probabilidad de corrección fuera de $0.25$, ver $3$ o más correcciones en $4$ informes tendría una probabilidad de $0.051$, baja pero no imposible. El panel lo muestra, pero la decisión se toma leyendo los cuatro informes, no mirando la barra.
El panel propio
Con los indicadores calculados, el panel es la parte fácil, siempre que se diseñe con una regla: una pregunta por gráfica. Stephen Few lo dice de otra forma en Information Dashboard Design: cada elemento del panel tiene que ganarse su lugar, y los que solo decoran se quitan. Valeria elige seis gráficas, en una página PNG que el flujo enviará a Slack cada lunes a las 8:00, junto al informe del Día 67:
- Éxito diario por flujo: líneas con el SLO del $99%$ como referencia. Contesta ¿hubo un día malo?
- Latencia p95 frente a su SLO: una barra por flujo y una raya con su objetivo. Contesta ¿algún flujo va lento?
- Coste diario por rubro: barras apiladas con el servidor, Make, Claude y WhatsApp. Contesta ¿cuánto cuesta y en qué?
- Intervención humana por flujo frente a su máximo. Contesta ¿qué flujo necesita más ayuda?
- Presupuesto de errores restante. Contesta ¿cuánto margen queda antes de romper una promesa?
- Encargos atendidos por día y horas ahorradas. Contesta ¿para qué sirve todo esto?
Los colores siguen al flujo y no a su posición: pedidos es siempre azul, el agente siempre naranja, y así en las seis gráficas, para que nadie tenga que volver a la leyenda. El coste por rubro usa tonos de un solo azul y un gris, porque los rubros no son flujos y no deben confundirse con ellos. El siguiente bloque dibuja el panel completo:
# Panel de seis gráficas del mes en una sola página PNG en Python:
COLOR = {'pedidos': '#2a78d6', 'agente': '#eb6834', 'gmail': '#1baf7a', 'secuencias': '#eda100',
         'informe': '#e87ba4', 'publicacion': '#008300'}
ORDEN = list(COLOR)
ETIQUETA = {f: f.replace('publicacion', 'publicación').replace('gmail', 'Gmail') for f in ORDEN}
registro['dia'] = registro['inicio'].dt.day
fig, ejes = plt.subplots(3, 2, figsize = (12, 12.5))
# 1. Éxito diario de los flujos con volumen diario:
ax = ejes[0, 0]
for flujo in ['pedidos', 'agente', 'gmail', 'secuencias']:
    serie = registro[registro.flujo == flujo].groupby('dia')['estado'].apply(lambda s: (s == 'exito').mean())
    ax.plot(serie.index, serie.values, marker = 'o', markersize = 3, lw = 2, color = COLOR[flujo], label = ETIQUETA[flujo])
ax.axhline(0.99, color = '#52514e', ls = '--', lw = 1)
ax.text(30.5, 0.99, 'SLO 99 %', fontsize = 9, va = 'center', color = '#52514e')
ax.set_ylim(0.55, 1.02)
ax.set_title('1. Tasa de éxito diaria por flujo', fontsize = 12)
ax.set_xlabel('Día del mes')
ax.legend(frameon = False, fontsize = 9, loc = 'lower left')
# 2. p95 de latencia frente a su SLO:
ax = ejes[0, 1]
y = np.arange(len(ORDEN))
ax.barh(y, [tabla_1.loc[f, 'p95_s'] for f in ORDEN], color = [COLOR[f] for f in ORDEN], height = 0.6)
ax.scatter([SLO[f][1] for f in ORDEN], y, marker = '|', s = 400, color = '#0b0b0b', label = 'SLO', zorder = 3)
for yi, f in zip(y, ORDEN):
    ax.text(max(tabla_1.loc[f, 'p95_s'], SLO[f][1]) * 1.15, yi, f'{tabla_1.loc[f, "p95_s"]:.1f} s', va = 'center',
            fontsize = 9)
ax.set_yticks(y)
ax.set_yticklabels([ETIQUETA[f] for f in ORDEN])
ax.set_xscale('symlog', linthresh = 10)
ax.set_xlim(0, 900)
ax.set_title('2. Latencia p95 (barra) y su SLO (raya)', fontsize = 12)
ax.set_xlabel('Segundos (escala logarítmica por encima de 10)')
# 3. Coste diario por rubro (barras apiladas):
ax = ejes[1, 0]
diario = registro.groupby('dia')[['coste_claude', 'coste_mensajes']].sum()
diario['make'] = registro[registro.plataforma == 'make'].groupby('dia')['coste_plataforma'].sum()
diario = diario.reindex(range(1, 31), fill_value = 0).fillna(0)
diario['servidor'] = SERVIDOR_N8N / 30
abajo = np.zeros(30)
for col, nombre, color in [('servidor', 'servidor de n8n', '#0d366b'), ('make', 'Make (créditos)', '#2a78d6'),
                           ('coste_claude', 'Claude', '#86b6ef'), ('coste_mensajes', 'WhatsApp', '#c3c2b7')]:
    ax.bar(diario.index, diario[col], bottom = abajo, color = color, label = nombre, edgecolor = 'white', lw = 0.5)
    abajo += diario[col].values
ax.set_title(f'3. Coste diario por rubro: {abajo.sum():.2f} USD en el mes', fontsize = 12)
ax.set_xlabel('Día del mes')
ax.set_ylabel('USD')
ax.legend(frameon = False, fontsize = 9, ncol = 2, loc = 'upper left')
ax.set_ylim(0, abajo.max() * 1.35)
# 4. Intervención humana por flujo frente a su máximo:
ax = ejes[1, 1]
ax.barh(y, [100 * tabla_1.loc[f, 'intervencion'] for f in ORDEN], color = [COLOR[f] for f in ORDEN], height = 0.6)
ax.scatter([100 * SLO[f][3] for f in ORDEN], y, marker = '|', s = 400, color = '#0b0b0b', zorder = 3)
for yi, f in zip(y, ORDEN):
    ax.text(100 * max(tabla_1.loc[f, 'intervencion'], SLO[f][3]) + 2, yi, f'{100 * tabla_1.loc[f, "intervencion"]:.1f} %',
            va = 'center', fontsize = 9)
ax.set_yticks(y)
ax.set_yticklabels([ETIQUETA[f] for f in ORDEN])
ax.set_xlim(0, 100)
ax.set_title('4. Ejecuciones con intervención humana (raya: máximo)', fontsize = 12)
ax.set_xlabel('% de las ejecuciones del flujo')
# 5. Presupuesto de errores restante:
ax = ejes[2, 0]
restante = {}
for f in ORDEN:
    b = (1 - SLO[f][0]) * tabla_1.loc[f, 'n']
    malos = (registro[registro.flujo == f]['estado'] == 'fallo').sum()
    restante[f] = 100 * (b - malos) / b if b > 0 else np.nan
valores = [restante[f] for f in ORDEN]
ax.barh(y, np.nan_to_num(valores), color = [COLOR[f] for f in ORDEN], height = 0.6)
ax.axvline(0, color = '#0b0b0b', lw = 1)
for yi, v in zip(y, valores):
    texto = 'SLO de 100 %: sin margen' if np.isnan(v) else f'{v:.0f} %'
    ax.text((v if v > 0 else 0) + 3 if not np.isnan(v) else 3, yi, texto, va = 'center', fontsize = 9)
ax.set_yticks(y)
ax.set_yticklabels([ETIQUETA[f] for f in ORDEN])
ax.set_xlim(min(-60, np.nanmin(valores) - 10), 130)
ax.set_title('5. Presupuesto de errores restante al día 30', fontsize = 12)
ax.set_xlabel('% del presupuesto del mes (negativo: rebasado)')
# 6. Encargos atendidos por el flujo y horas ahorradas:
ax = ejes[2, 1]
encargos = registro[registro.es_encargo].groupby('dia').size().reindex(range(1, 31), fill_value = 0)
horas = encargos.sum() * (6 - 1.5) / 60
ax.bar(encargos.index, encargos.values, color = '#2a78d6', edgecolor = 'white', lw = 0.5)
ax.set_title(f'6. Encargos atendidos: {encargos.sum()} en el mes, {horas:.1f} h ahorradas', fontsize = 12)
ax.set_xlabel('Día del mes (domingos cerrado)')
ax.set_ylabel('Encargos')
for ax in ejes.flat:
    ax.spines[['top', 'right']].set_visible(False)
fig.suptitle('Cuadro de mando de las automatizaciones de Trigo Lento (mes simulado de 30 días)', fontsize = 15)
plt.tight_layout()
plt.show()
print('Presupuesto restante (%):', {f: (None if np.isnan(v) else round(float(v), 1)) for f, v in restante.items()})
Presupuesto restante (%): {'pedidos': -43.5, 'agente': 92.1, 'gmail': -75.4, 'secuencias': 40.2, 'informe': None, 'publicacion': 100.0}
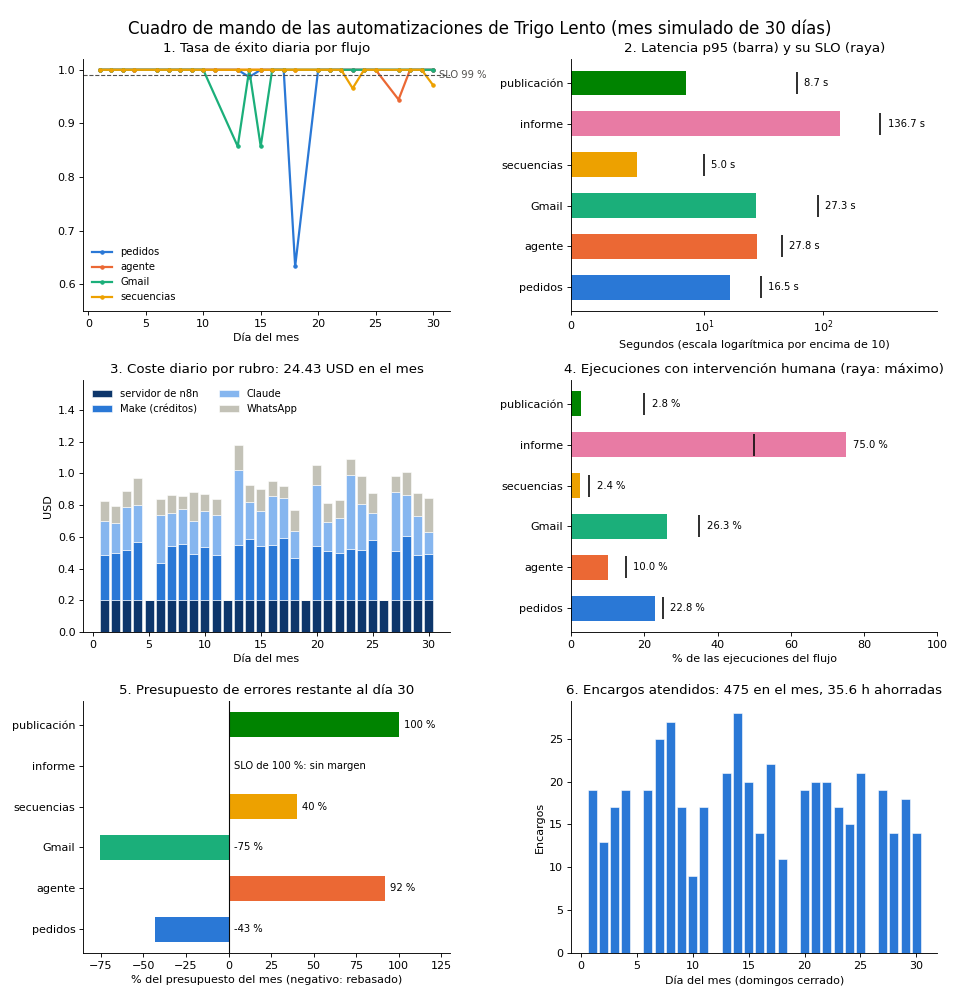
El panel enseña de un vistazo lo que las tablas tardaron tres bloques en decir. En la gráfica 1, la línea azul de pedidos se desploma el día 18 hasta $0.63$ y vuelve a la normalidad al día siguiente; la verde de Gmail baja dos veces a $0.86$, los días 13 y 15, con un fallo cada vez en días de pocos correos. En la gráfica 2 todas las barras quedan a la izquierda de su raya: ningún flujo va lento. En la gráfica 3, el mes cuesta $24.43$ USD en el registro, con una franja fija de servidor de $0.20$ USD diarios y los domingos reducidos a esa franja, porque solo el servidor cobra cuando la panadería cierra. En la gráfica 4, la barra rosa del informe pasa de su raya, con las salvedades de la sección anterior. En la gráfica 5, pedidos y Gmail aparecen a la izquierda del cero: rebasaron su presupuesto en un $43%$ y un $75%$. Y en la gráfica 6, los flujos atendieron $475$ encargos y ahorraron $35.6$ horas, unos $2,672$ MXN al valor didáctico de la hora de Valeria.
Hay una cifra que el panel deja fuera a propósito: el coste de Make Core completo. La gráfica 3 suma los créditos usados, $8.45$ USD, porque eso es lo que cuesta el flujo de pedidos al precio de lista; pero Trigo Lento paga los $10.59$ USD del plan, y los $2.14$ de diferencia son capacidad comprada que nadie usó. Para la pregunta de Don Ernesto, “¿cuánto me cuesta?”, la cifra correcta es la que incluye el plan completo, y así se dará más adelante.
Presupuesto de errores y tasa de consumo
Un SLO del $99%$ dice, al revés, que se tolera un $1%$ de fallos. Esa tolerancia se puede contar en ejecuciones, y entonces se convierte en un presupuesto de errores, como lo llama el libro de ingeniería de confiabilidad de Google:
$$ B = (1 - \text{SLO}) \cdot N $$
La lógica detrás de esta fórmula es múltiple:
- $N$ es el número de ejecuciones del periodo y $1 - \text{SLO}$ la fracción que se tolera que falle; con unas $3,000$ ejecuciones al mes y un SLO del $99%$, el presupuesto es de $0.01 \cdot 3,000 = 30$ ejecuciones fallidas.
- El presupuesto se gasta: cada fallo resta uno, y lo que importa no es solo cuánto queda, sino a qué ritmo baja.
- Cuando el presupuesto se agota, el SLO del mes ya está roto, y la regla del libro de Google es dejar de añadir cambios arriesgados y dedicar el tiempo a la confiabilidad hasta recuperarlo.
- En conclusión, el presupuesto convierte un porcentaje abstracto en un número de fallos que Don Ernesto puede contar, y hace explícito que algunos fallos son aceptables: un objetivo del $100%$ no tiene presupuesto y convierte cada fallo en un incidente.
El presupuesto dice cuánto se ha gastado; la tasa de consumo (en inglés, burn rate) dice a qué velocidad. Es la misma del Día 53, con su umbral:
$$ r = \frac{e}{1 - \text{SLO}}, \qquad r^{*} = \frac{f \cdot H}{w} $$
La lógica detrás de estas dos fórmulas es la siguiente:
- $e$ es la proporción de ejecuciones fallidas dentro de una ventana de $w$ horas; dividirla entre la fracción tolerada da cuántas veces más rápido de lo sostenible se gasta el presupuesto. Con $r = 1$, el presupuesto se agota justo al final del mes.
- $r^{*}$ es el umbral de alerta: si se tolera gastar una fracción $f$ del presupuesto en una ventana de $w$ horas, y el mes tiene $H$ horas de operación, la tasa que gasta esa fracción es $f H / w$. Trigo Lento opera de 7:00 a 20:00 de lunes a sábado: $H = 13 \cdot 26 = 338$ horas.
- La regla rápida usa una ventana de $1$ hora y $f = 0.02$, con umbral $r^{*} = 6.76$; la lenta, una ventana de $6$ horas y $f = 0.10$, con umbral $5.63$.
- En conclusión, la alerta no suena por un fallo, sino por un ritmo de fallos que, sostenido, rompería el objetivo del mes; y suena antes cuanto más rápido es el ritmo.
Con pocas ejecuciones por hora, la fórmula sola no basta, como demostró el Día 53 con veinte avisos falsos. Valeria añade tres condiciones: un mínimo de ejecuciones en la ventana ($4$ en la rápida y $12$ en la lenta), un mínimo de $3$ fallos, porque un fallo aislado no es una tendencia, y una ventana corta de $30$ minutos que confirme que el flujo sigue fallando ahora, para que la alerta se calle cuando el problema ya se resolvió. Además, un flujo que ya avisó guarda dos horas de silencio. Los flujos de poco volumen (Gmail, el informe y la publicación) no usan la tasa: avisan por cada fallo, porque con $36$ ejecuciones al mes cada una cuenta. El siguiente bloque calcula el presupuesto de cada flujo y busca las alertas, evaluando las reglas cada diez minutos a lo largo del mes:
# Presupuesto de errores por flujo y alertas por tasa de consumo con dos ventanas en Python:
H = 13 * 26                                   # horas de operación del mes: 7:00 a 20:00, lunes a sábado
REGLAS = [('rápida', 1, 0.02, 4), ('lenta', 6, 0.10, 12)]   # (nombre, ventana w en h, fracción f, mínimo)
MIN_FALLOS = 3                                 # un fallo aislado no es una tendencia
CORTA = timedelta(minutes = 30)                # ventana corta: ¿sigue fallando ahora?
N = len(registro)
fallos = registro['estado'] == 'fallo'
print(f'Global: N = {N}, SLO 99 % -> B = {0.01 * N:.1f} fallos; gastados {fallos.sum()} '
      f'({100 * fallos.sum() / (0.01 * N):.1f} %); el incidente del día 18 se lleva {int((fallos & (registro.dia == 18)).sum())}')
filas = []
for f in ORDEN:
    x = registro[registro.flujo == f]
    b = (1 - SLO[f][0]) * len(x)
    acumulado = (x['estado'] == 'fallo').groupby(x['dia']).sum().reindex(range(1, 31), fill_value = 0).cumsum()
    agotado = next((d for d, v in acumulado.items() if b > 0 and v > b), None)
    filas.append([f, SLO[f][0], len(x), round(b, 2), int(acumulado.iloc[-1]), agotado])
print(pd.DataFrame(filas, columns = ['flujo', 'slo', 'n', 'presupuesto', 'fallos', 'dia_agotado'])
      .astype({'dia_agotado': 'Int64'}).to_string(index = False))

def alertas_por_tasa(flujo, paso = timedelta(minutes = 10), silencio = timedelta(hours = 2)):
    x = registro[registro.flujo == flujo]
    t_ini, malos = x['inicio'].values, (x['estado'] == 'fallo').values
    objetivo, avisos, ultimo = SLO[flujo][0], [], None
    for d in DIAS:
        t = datetime(d.year, d.month, d.day, 7, 0)
        while t <= datetime(d.year, d.month, d.day, 20, 0):
            for nombre, w, fraccion, minimo in REGLAS:
                dentro = (t_ini >= np.datetime64(t - timedelta(hours = w))) & (t_ini < np.datetime64(t))
                n, m = int(dentro.sum()), int(malos[dentro].sum())
                if n < minimo or m < MIN_FALLOS:
                    continue
                tasa, umbral = (m / n) / (1 - objetivo), fraccion * H / w
                corta = (t_ini >= np.datetime64(t - CORTA)) & (t_ini < np.datetime64(t))
                sigue = corta.sum() > 0 and (malos[corta].mean() / (1 - objetivo)) >= umbral
                if tasa >= umbral and sigue and (ultimo is None or t - ultimo >= silencio):
                    avisos.append((flujo, nombre, t, n, m, round(tasa, 1), round(umbral, 2)))
                    ultimo = t
            t += paso
    return avisos
avisos = [a for f in ['pedidos', 'agente', 'secuencias'] for a in alertas_por_tasa(f)]
for flujo, regla, t, n, m, tasa, umbral in avisos:
    print(f'Aviso {regla} de {flujo}: {t:%d/%m %H:%M} | {m} fallos de {n} | tasa {tasa} >= umbral {umbral}')
por_evento = registro[fallos & registro.flujo.isin(['gmail', 'informe', 'publicacion'])]
print('Avisos por evento en flujos de poco volumen:', [(r.flujo, r.inicio.strftime('%d/%m %H:%M')) for r in por_evento.itertuples()])
print('Días con aviso por tasa de consumo:', sorted({t.day for _, _, t, *_ in avisos}))
inc = registro[(registro.flujo == 'pedidos') & (registro.dia == 18) & fallos]
primero = min(t for f, _, t, *_ in avisos if f == 'pedidos' and t.day == 18)
evitables = (inc['inicio'] >= primero + timedelta(minutes = 20)).sum()
print(f'Incidente: primer fallo {inc.inicio.min():%H:%M}, aviso {primero:%H:%M}; con 20 minutos de reacción '
      f'se evitaban {evitables} de {len(inc)} fallos')
Global: N = 3056, SLO 99 % -> B = 30.6 fallos; gastados 28 (91.6 %); el incidente del día 18 se lleva 22
      flujo   slo    n  presupuesto  fallos  dia_agotado
    pedidos 0.990 1603        16.03      23           18
     agente 0.980  630        12.60       1         <NA>
      gmail 0.990  114         1.14       2           15
 secuencias 0.995  669         3.35       2         <NA>
    informe 1.000    4         0.00       0         <NA>
publicacion 0.970   36         1.08       0         <NA>
Aviso rápida de pedidos: 18/04 10:30 | 4 fallos de 4 | tasa 100.0 >= umbral 6.76
Aviso rápida de pedidos: 18/04 12:30 | 7 fallos de 7 | tasa 100.0 >= umbral 6.76
Avisos por evento en flujos de poco volumen: [('gmail', '13/04 10:07'), ('gmail', '15/04 17:51')]
Días con aviso por tasa de consumo: [18]
Incidente: primer fallo 08:33, aviso 10:30; con 20 minutos de reacción se evitaban 13 de 22 fallos
En la suma de todos los flujos, el presupuesto es de $30.6$ fallos y se gastaron $28$, el $91.6%$; el incidente del sábado 18 se llevó $22$, el $72%$ del presupuesto global en una sola mañana. Pero el presupuesto global esconde lo importante, igual que el SLI global escondía el formulario en el Día 53: por flujo, pedidos agotó su presupuesto de $16.0$ fallos el día 18 y Gmail agotó el suyo el día 15, con su segundo fallo.
La parte incómoda está en las horas. El primer fallo del sábado 18 fue a las 08:33 y la alerta rápida sonó a las 10:30, casi dos horas después. No fue un defecto de la fórmula, sino del sábado por la mañana: entre las 8:00 y las 10:00 llegan pocos mensajes, y en ninguna ventana de una hora antes de las 10:30 hubo las $4$ ejecuciones que exige el mínimo. A esa hora, la tasa de consumo era de $100$, casi quince veces el umbral. El segundo aviso, a las 12:30, es el recordatorio que se dispara al terminar las dos horas de silencio, porque el flujo había seguido fallando hasta las 12:22. Si Valeria hubiera renovado la conexión veinte minutos después del primer aviso, se habrían evitado $13$ de los $22$ fallos. La Figura 2 cuenta la mañana del sábado con el costal de harina de Don Ernesto.
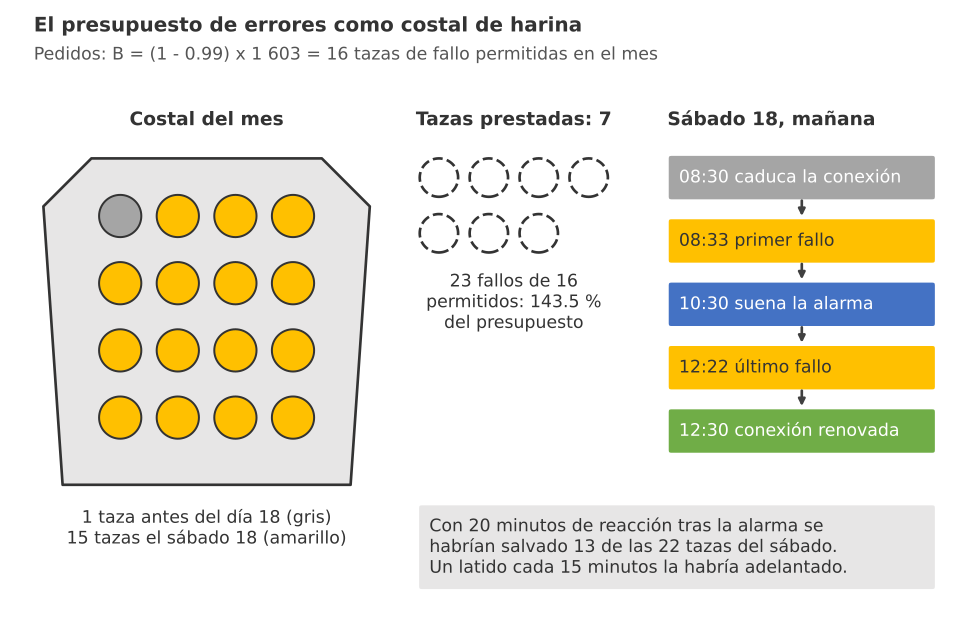
Figura 2. El presupuesto de errores como costal de harina: el flujo de pedidos tiene 16 tazas al mes, gastó una antes del sábado 18 y esa mañana vació el costal y pidió 7 prestadas; la alarma sonó a las 10:30.
El siguiente bloque dibuja el consumo acumulado del presupuesto de pedidos y del global a lo largo del mes, con la franja del incidente y el momento del aviso:
# Consumo del presupuesto de errores en el mes con el incidente del día 18 y su aviso en Python:
fig, ax = plt.subplots(figsize = (10, 5))
series = {'pedidos (B = 16.0)': (registro.flujo == 'pedidos', 0.01 * (registro.flujo == 'pedidos').sum(), '#2a78d6'),
          'todos los flujos (B = 30.6)': (registro.flujo.notna(), 0.01 * N, '#52514e')}
for nombre, (mascara, b, color) in series.items():
    x = registro[mascara]
    consumo = 100 * (x['estado'] == 'fallo').groupby(x['dia']).sum().reindex(range(1, 31), fill_value = 0).cumsum() / b
    ax.step(consumo.index, consumo.values, where = 'post', lw = 2.2, color = color, label = nombre)
    print(f'{nombre}: día 17 {consumo[17]:.1f} %, día 18 {consumo[18]:.1f} %, día 30 {consumo[30]:.1f} %')
ax.axhline(100, color = '#0b0b0b', ls = '--', lw = 1.2)
ax.text(1, 104, 'presupuesto agotado (100 %)', fontsize = 10)
ax.axvspan(18, 19, color = '#d03b3b', alpha = 0.12)
aviso = min(t for f, _, t, *_ in avisos if f == 'pedidos')
ax.annotate(f'aviso por tasa de consumo\nsábado 18, {aviso:%H:%M} (primer fallo 08:33)', xy = (18, 60),
            xytext = (3, 122), fontsize = 10, arrowprops = {'arrowstyle': '->', 'color': '#d03b3b'})
ax.set_xlim(1, 31)
ax.set_ylim(0, 170)
ax.set_xlabel('Día del mes')
ax.set_ylabel('% del presupuesto de errores gastado')
ax.set_title('Consumo del presupuesto de errores: SLO de éxito del 99 %', fontsize = 15)
ax.legend(frameon = False, loc = 'lower right')
ax.spines[['top', 'right']].set_visible(False)
plt.tight_layout()
plt.show()
pedidos (B = 16.0): día 17 6.2 %, día 18 143.5 %, día 30 143.5 %
todos los flujos (B = 30.6): día 17 9.8 %, día 18 81.8 %, día 30 91.6 %
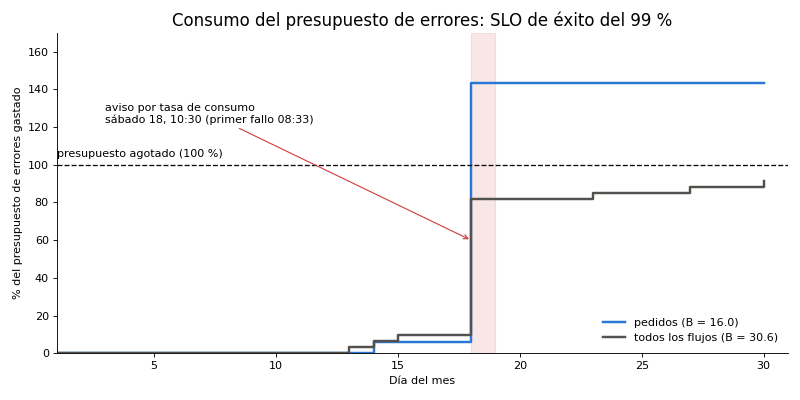
La gráfica tiene la forma típica de un incidente: una escalera casi plana durante diecisiete días, con fallos sueltos que gastan el $6.2%$ del presupuesto de pedidos, y un escalón que el día 18 lo lleva al $143.5%$. La línea gris del total sube del $9.8%$ al $81.8%$ el mismo día y termina el mes en el $91.6%$, todavía por debajo del $100%$: quien mirara solo el total diría que el mes se salvó. La azul dice la verdad: una mañana rompió la promesa de pedidos de todo el mes.
¿Qué se hace con un presupuesto agotado el día 18 de un mes de 30? La respuesta de la ingeniería de confiabilidad es congelar los cambios del flujo afectado hasta entender la causa, y Valeria la adapta a Trigo Lento: el escenario de pedidos no recibe cambios nuevos hasta que la renovación de la conexión tenga su propio aviso. La causa del incidente no es Make ni la hoja de cálculo, sino que nadie sabía que la conexión iba a caducar. Y queda una mejora que el bloque deja a la vista: con poco volumen, la forma de detectar antes no es bajar los mínimos, que volvería a llenar Slack de avisos falsos, sino enviar cada quince minutos un mensaje de prueba que el flujo reconoce, un latido que, si no llega a la hoja, avisa sin esperar a que escriban los clientes.
Atención aquí: el panel mide flujos, no personas, y esa regla se cumple en el diseño, no en la buena voluntad. No hay gráficas por aprobador, ni tiempos de respuesta por empleado, ni clasificaciones; el campo aprobador existe para auditar una decisión concreta, no para evaluar a quien la tomó. El registro no guarda texto, teléfono ni nombre de ningún cliente, y lo que sale hacia Looker Studio son agregados diarios por flujo. Si algún día alguien pide “ver quién tarda más en aprobar”, la respuesta correcta es revisar el flujo de aprobación (plazos, escalado y carga), no a la persona; y cualquier tratamiento de datos del personal tendría que estar, además, en el aviso de privacidad para empleados que exige la ley mexicana de protección de datos.
Leer el panel con Don Ernesto
Un panel que nadie lee es un adorno caro. El criterio de Valeria para darlo por terminado es el que puso su padre: tres preguntas, en ese orden, contestadas en un minuto. La Figura 3 las dibuja como las verá él cada lunes.
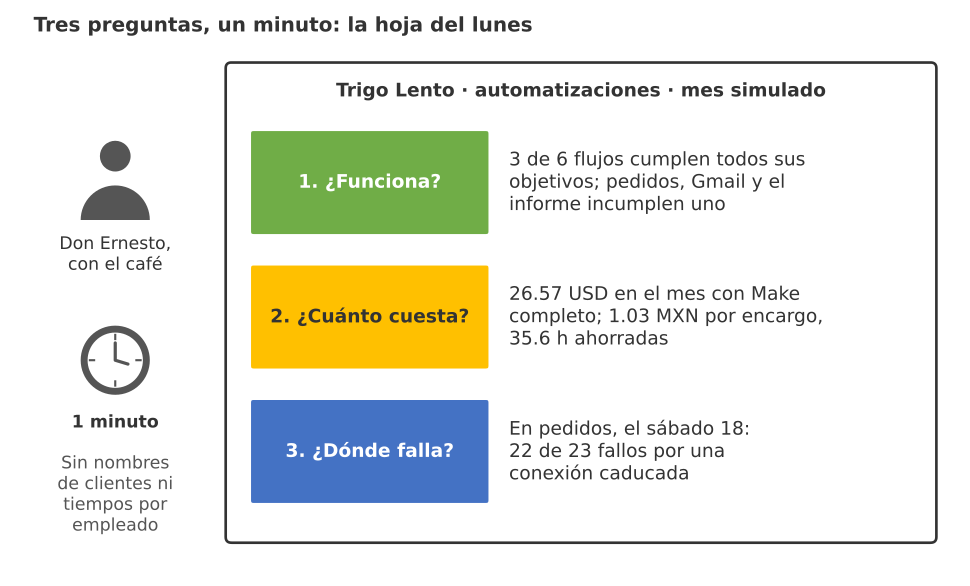
Figura 3. Tres preguntas, un minuto: la hoja del lunes que lee Don Ernesto contesta si funciona (3 de 6 flujos), cuánto cuesta (26.57 USD, 1.03 MXN por encargo) y dónde falla (pedidos, el sábado 18).
Antes de las tres respuestas, conviene mirar de cerca la segunda, la del coste, porque una media sola engaña. El siguiente bloque dibuja el coste por ejecución de cada flujo en un diagrama de cajas, con su mediana y su media, y después escribe las tres respuestas con las cifras del mes:
# Coste por ejecución por flujo en cajas con la mediana, y las tres respuestas para Don Ernesto en Python:
fig, ax = plt.subplots(figsize = (10, 5))
datos = [registro.loc[registro.flujo == f, 'coste_usd'].values for f in ORDEN]
cajas = ax.boxplot(datos, vert = False, patch_artist = True, widths = 0.55, showfliers = True,
                   medianprops = {'color': '#0b0b0b', 'lw': 2}, flierprops = {'marker': 'o', 'markersize': 3})
for caja, f in zip(cajas['boxes'], ORDEN):
    caja.set_facecolor(COLOR[f])
    caja.set_alpha(0.75)
for i, (f, x) in enumerate(zip(ORDEN, datos), start = 1):
    ax.text(x.max() * 1.25, i, f'mediana {np.median(x):.4f} | media {x.mean():.4f}', va = 'center', fontsize = 9)
ax.set_yticks(range(1, len(ORDEN) + 1))
ax.set_yticklabels([ETIQUETA[f] for f in ORDEN])
ax.set_xscale('log')
ax.set_xlim(0.002, 2)
ax.set_xlabel('USD por ejecución (escala logarítmica)')
ax.set_title('Coste por ejecución por flujo: Claude, mensajes y plataforma', fontsize = 15)
ax.spines[['top', 'right']].set_visible(False)
plt.tight_layout()
plt.show()

# Las tres preguntas que el panel debe contestar en un minuto:
cumplen = [f for f in ORDEN if tabla_1.loc[f, 'incumple'] == '-']
gastado = {f: 100 - restante[f] for f in ORDEN if not np.isnan(restante[f])}
peor = max(gastado, key = gastado.get)
encargos_mes = int(registro['es_encargo'].sum())
total_mes = registro['coste_usd'].sum() + (10.59 - registro.loc[registro.plataforma == 'make', 'coste_plataforma'].sum())
print(f'1. ¿Funciona? {len(cumplen)} de {len(ORDEN)} flujos cumplen todos sus SLO; '
      f'incumplen: {", ".join(f + " (" + tabla_1.loc[f, "incumple"] + ")" for f in ORDEN if f not in cumplen)}.')
print(f'2. ¿Cuánto cuesta? {total_mes:.2f} USD en el mes con Make Core completo; '
      f'{total_mes / encargos_mes:.3f} USD por encargo atendido ({total_mes * 18.5 / encargos_mes:.2f} MXN).')
conteo = registro[registro.estado == 'fallo'].groupby('flujo').size().sort_values(ascending = False)
print('3. ¿Dónde falla? ' + '; '.join(f'{f}: {n} fallo{"s" if n != 1 else ""}, {gastado[f]:.0f} % de su presupuesto' for f, n in conteo.items())
      + f' | el sábado 18 se llevó {len(inc)} de los {conteo["pedidos"]} de pedidos.')
1. ¿Funciona? 3 de 6 flujos cumplen todos sus SLO; incumplen: pedidos (éxito), gmail (éxito), informe (humano).
2. ¿Cuánto cuesta? 26.57 USD en el mes con Make Core completo; 0.056 USD por encargo atendido (1.03 MXN).
3. ¿Dónde falla? pedidos: 23 fallos, 143 % de su presupuesto; gmail: 2 fallos, 175 % de su presupuesto; secuencias: 2 fallos, 60 % de su presupuesto; agente: 1 fallo, 8 % de su presupuesto | el sábado 18 se llevó 22 de los 23 de pedidos.
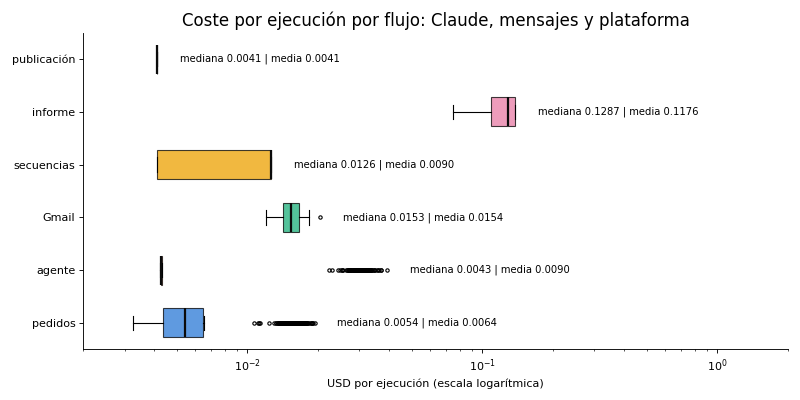
Las cajas confirman lo que la Tabla 3 insinuaba. El agente tiene una caja aplastada en $0.0043$ USD, que es el reparto del servidor más una conversación con Haiku 5.5, y una nube de puntos sueltos entre $0.02$ y $0.04$ USD: los escalados a Opus 5.5. Las secuencias tienen dos valores, con plantilla y sin ella, y la publicación uno solo, porque solo paga su parte del servidor. El informe es el más caro por ejecución, unos $0.12$ USD, y uno de los más baratos del mes en total, porque corre cuatro veces.
Las tres respuestas, en la forma en que Don Ernesto las va a leer:
- ¿Funciona? $3$ de $6$ flujos cumplen todos sus objetivos. Pedidos incumple el éxito por una sola mañana; Gmail lo incumple con $2$ fallos en $114$ ejecuciones, lo que puede ser azar; el informe incumple la intervención humana con $3$ correcciones en $4$ lunes.
- ¿Cuánto cuesta? $26.57$ USD en el mes, con el plan completo de Make, es decir, $0.056$ USD por encargo atendido, $1.03$ MXN. Los encargos ahorraron $35.6$ horas.
- ¿Dónde falla? En pedidos, el sábado 18: $22$ de sus $23$ fallos fueron esa mañana, por una conexión caducada; el resto del mes, los fallos de todos los flujos se cuentan con los dedos de las dos manos.
Valeria le enseña la hoja a su padre a las siete y cuarto. Don Ernesto la lee en silencio y pregunta lo único que le importa: "¿Y lo del sábado ya no pasa?" Valeria le explica el latido y el aviso de caducidad de la conexión. Él asiente, dobla la hoja y la deja junto a la libreta de la harina. Es la primera vez en tres meses que un papel de la computadora termina en ese lugar.
Looker Studio y el envío del lunes
El panel propio no es la única opción, y conviene compararlo con la más obvia. Looker Studio es la herramienta gratuita de Google para crear paneles interactivos en el navegador, conectados a fuentes como una hoja de cálculo de Google o una tabla de BigQuery. Se llamó Data Studio hasta 2022, Looker Studio después y, según las notas de versión de Google Cloud, el 16 de abril de 2026 volvió a llamarse Data Studio; la edición de pago pasó a llamarse Data Studio Pro. Las fuentes secundarias que anunciaban el cambio tenían razón esta vez, y la serie lo confirma con la nota oficial, revisada en octubre de 2026. En esta entrada se usa el nombre que tenía cuando Valeria lo evaluó: Looker Studio.
Panel propio frente a Looker Studio
La edición gratuita no cobra a quien crea los informes ni a quien los ve. La edición Pro añade gestión de equipos, administración en Google Cloud y soporte, por 9 USD por usuario y por proyecto al mes, según la página de producto de Google consultada en octubre de 2026, que advierte que el precio varía con la duración de la suscripción. Para Trigo Lento, la Pro no tiene sentido: dos personas miran el panel y ninguna necesita administrarlo. La comparación de verdad es entre el panel propio y la edición gratuita, y la resume la Tabla 4.
Tabla 4. Panel propio frente a Looker Studio: coste, interactividad, ubicación de los datos y mantenimiento (revisado en octubre de 2026).
| Criterio | Panel propio (Python y matplotlib) | Looker Studio gratuito | Looker Studio Pro (Data Studio Pro) |
|---|---|---|---|
| Coste | 0 USD; corre en el servidor de n8n que ya se paga | 0 USD | 9 USD por usuario y proyecto al mes |
| Interactividad | Ninguna: una imagen fija por semana | Filtros por fecha y por flujo, detalle al pasar el cursor | La misma, más gestión de equipos |
| Ubicación de los datos | En el servidor de Trigo Lento | En Google: la hoja o la tabla de origen | En Google, con administración en Google Cloud |
| Qué datos salen | Ninguno; solo la imagen hacia Slack | Agregados diarios por flujo, sin datos de clientes | Los mismos agregados |
| Mantenimiento | Código propio: cada gráfica nueva es Python | Arrastrar y soltar; el conector puede requerir ajustes | Como el gratuito |
| Dónde se ve | En #operaciones de Slack, sin cuentas nuevas | En el navegador, con cuenta de Google | En el navegador, con cuenta de Google |
| Alertas | Las da TL Alertas de flujos v1 | No son su función | No son su función |
La tabla no tiene un ganador absoluto, y por eso Valeria no elige uno. El panel propio es el que llega a Don Ernesto: una imagen en Slack, cada lunes, con las tres respuestas. Looker Studio es el que usa ella cuando necesita investigar: filtrar el sábado 18, comparar dos semanas, ver solo el agente. Para alimentarlo, el flujo escribe cada lunes en una hoja de Google la tabla diaria agregada por flujo, sin teléfonos, sin textos y sin aprobadores. Los datos que salen hacia Google no identifican a nadie, y por eso no necesitan una finalidad nueva en el aviso de privacidad.
Exportar y enviar
El siguiente bloque hace las tres tareas de los lunes que necesitan servicios reales. Primero concilia el gasto de Claude: lee el informe de costes de la API de administración, que devuelve los importes en centavos de dólar como cadenas decimales, agrupados por descripción y con el modelo de cada partida, y calcula cuánto del gasto de la consola explica el registro. Después escribe la tabla diaria agregada, con la API de Google Sheets, en la hoja que lee Looker Studio. Y por último sube el PNG del panel a Slack con el método de tres pasos, porque files.upload ya no se acepta: pedir una URL de subida, enviar el archivo a esa URL y completar la subida en el canal. Las claves salen del entorno, y la de administración de Claude vive separada de la clave con la que los flujos llaman a la API. Este bloque llama a servicios reales y no se ejecutó para escribir la entrada; la salida es un ejemplo comentado:
# Conciliación con el informe de costes de Claude, exportación agregada para Looker Studio y envío del panel a Slack en Python:
import os
import requests

# 1. Lo que la consola de Claude cobró en el mes (API de administración, informe de costes, en centavos):
ADMIN = {'x-api-key': os.environ['ANTHROPIC_ADMIN_KEY'], 'anthropic-version': '2023-06-01'}  # clave sk-ant-admin
r = requests.get('https://api.anthropic.com/v1/organizations/cost_report', headers = ADMIN, timeout = 30,
                 params = {'starting_at': '2026-04-01T06:00:00Z', 'ending_at': '2026-05-01T06:00:00Z',
                           'group_by[]': 'description', 'limit': 31})
r.raise_for_status()
informe = r.json()
consola = sum(float(x['amount']) for cubeta in informe['data'] for x in cubeta['results']) / 100
por_modelo = {}
for cubeta in informe['data']:
    for x in cubeta['results']:
        if x['model']:
            por_modelo[x['model']] = por_modelo.get(x['model'], 0) + float(x['amount']) / 100
print(f'Consola: {consola:.2f} USD | registro de los seis flujos: {registro.coste_claude.sum():.2f} USD | '
      f'otras piezas: {consola - registro.coste_claude.sum():.2f} USD | ¿más páginas?: {informe["has_more"]}')

# 2. Tabla diaria agregada para Looker Studio: sin teléfonos, sin textos, sin aprobadores:
agregado = registro.groupby([registro['inicio'].dt.date.astype(str), 'flujo']).agg(
    ejecuciones = ('id_ejecucion', 'size'), fallos = ('estado', lambda s: int((s == 'fallo').sum())),
    p95_s = ('latencia_s', lambda s: round(float(np.percentile(s, 95)), 1)),
    coste_usd = ('coste_usd', lambda s: round(float(s.sum()), 4)),
    intervencion = ('intervencion_humana', lambda s: int(s.sum()))).reset_index()
agregado.columns = ['fecha', 'flujo', 'ejecuciones', 'fallos', 'p95_s', 'coste_usd', 'intervencion']
agregado.to_csv(carpeta / 'panel_diario.csv', index = False)
HOJA = os.environ['TL_HOJA_PANEL']                   # identificador de la hoja de cálculo de Google
cuerpo = {'majorDimension': 'ROWS', 'values': [list(agregado.columns)] + agregado.astype(str).values.tolist()}
r = requests.put(f'https://sheets.googleapis.com/v4/spreadsheets/{HOJA}/values/diario!A1',
                 params = {'valueInputOption': 'RAW'}, json = cuerpo, timeout = 30,
                 headers = {'Authorization': 'Bearer ' + os.environ['GOOGLE_ACCESS_TOKEN']})
r.raise_for_status()
print('Hoja actualizada:', r.json()['updatedRows'], 'filas y', r.json()['updatedColumns'], 'columnas')

# 3. El PNG del panel en Slack, con la subida en tres pasos (files.upload ya no se acepta):
SLACK = {'Authorization': 'Bearer ' + os.environ['SLACK_BOT_TOKEN']}   # alcance files:write
png = (carpeta / 'panel_semana.png').read_bytes()         # el PNG del Bloque 5, guardado con savefig
paso1 = requests.post('https://slack.com/api/files.getUploadURLExternal', headers = SLACK, timeout = 30,
                      data = {'filename': 'panel_semana.png', 'length': len(png)}).json()
assert paso1['ok'], paso1
requests.post(paso1['upload_url'], files = {'file': ('panel_semana.png', png, 'image/png')},
              timeout = 60).raise_for_status()
paso3 = requests.post('https://slack.com/api/files.completeUploadExternal', headers = SLACK, timeout = 30,
                      json = {'files': [{'id': paso1['file_id'], 'title': 'Panel de automatizaciones'}],
                              'channel_id': os.environ['TL_SLACK_CANAL_OPERACIONES'],
                              'initial_comment': 'Panel del lunes: funciona, cuánto cuesta y dónde falla.'}).json()
print('Slack:', paso3['ok'], '| archivo', paso3['files'][0]['id'][:4] + '...')
# Salida de ejemplo (puede variar):
# Consola: 10.34 USD | registro de los seis flujos: 6.70 USD | otras piezas: 3.64 USD | ¿más páginas?: False
# Hoja actualizada: 117 filas y 7 columnas
# Slack: True | archivo F07E...
La línea que más importa de la salida de ejemplo es la primera: la consola cobró $10.34$ USD en el mes, el registro explica $6.70$ y quedan $3.64$ USD de “otras piezas”. Esa diferencia no es un error; es el lote nocturno, la evaluación del agente, el calendario editorial y las facturas en PDF, que todavía no escriben su fila en el registro común. El Día 79 hará el inventario de todos los flujos con su dueño, y cada pieza del inventario tendrá que escribir su fila; mientras tanto, la diferencia se vigila: si crece de un mes a otro sin que se haya encendido nada nuevo, hay una pieza que gasta sin avisar.
TL Alertas de flujos v1
El panel de los lunes cuenta lo que pasó; las alertas avisan de lo que está pasando. En producción, las reglas del Bloque 6 las ejecuta un workflow de n8n, TL Alertas de flujos v1, que extiende a todos los flujos el que el Día 53 escribió para la atención de clientes. Tiene seis nodos:
- Cada 10 minutos en horario (
scheduleTrigger): la expresión*/10 7-20 * * 1-6en la zonaAmerica/Mexico_City, de lunes a sábado. - Contar ejecuciones por ventana (
postgres): cuenta, por flujo y para las ventanas de 1 y 6 horas, las ejecuciones, los fallos, los de la ventana corta de 30 minutos y la hora del último aviso. - Calcular tasas de consumo (
code): aplica las dos reglas con sus umbrales $r^{*} = f H / w$, sus mínimos y el silencio de dos horas. - ¿Hay avisos? (
if): si no hay nada, la ejecución termina sin dejar rastro. - Avisar en #alertas (
httpRequest): publica el aviso en el webhook leído de$env.TL_SLACK_WEBHOOK_ALERTAS, uno por segundo y con tres intentos. - Registrar aviso (
postgres): apunta el flujo, la regla y la tasa enalertas_flujos, la tabla que el paso 2 consulta para el silencio.
Los flujos de poco volumen no pasan por este workflow: Gmail, el informe y la publicación tienen configurado un workflow de errores que avisa por evento, así que cada fallo llega a Slack en el momento. El JSON, con identificadores de ejemplo y sin secretos, es el siguiente:
{
  "name": "TL Alertas de flujos v1",
  "nodes": [
    {
      "parameters": {"rule": {"interval": [{"field": "cronExpression", "expression": "*/10 7-20 * * 1-6"}]}},
      "id": "7a750000-0000-4000-8000-000000000001",
      "name": "Cada 10 minutos en horario",
      "type": "n8n-nodes-base.scheduleTrigger",
      "typeVersion": 1.2,
      "position": [0, 0]
    },
    {
      "parameters": {"operation": "executeQuery", "query": "SELECT e.flujo, w.horas, COUNT(*) AS n, COUNT(*) FILTER (WHERE e.estado = 'fallo') AS fallos, COUNT(*) FILTER (WHERE e.inicio > now() - interval '30 minutes') AS n_corta, COUNT(*) FILTER (WHERE e.estado = 'fallo' AND e.inicio > now() - interval '30 minutes') AS fallos_corta, (SELECT MAX(a.enviada_en) FROM alertas_flujos a WHERE a.flujo = e.flujo) AS ultima_alerta FROM ejecuciones e CROSS JOIN (VALUES (1), (6)) AS w(horas) WHERE e.inicio > now() - make_interval(hours => w.horas) AND e.flujo IN ('pedidos', 'agente', 'secuencias') GROUP BY e.flujo, w.horas;", "options": {}},
      "id": "7a750000-0000-4000-8000-000000000002",
      "name": "Contar ejecuciones por ventana",
      "type": "n8n-nodes-base.postgres",
      "typeVersion": 2.6,
      "position": [220, 0],
      "credentials": {"postgres": {"id": "0000000000000042", "name": "Postgres TL"}}
    },
    {
      "parameters": {"jsCode": "const SLO = { pedidos: 0.99, agente: 0.98, secuencias: 0.995 }, H = 338, MIN_FALLOS = 3;\nconst reglas = [{ horas: 1, fraccion: 0.02, minimo: 4, nombre: 'rápida' }, { horas: 6, fraccion: 0.10, minimo: 12, nombre: 'lenta' }];\nconst filas = $input.all().map(i => i.json);\nconst avisos = [];\nfor (const flujo of [...new Set(filas.map(f => f.flujo))]) {\n  const silencio = filas.find(f => f.flujo === flujo).ultima_alerta;\n  if (silencio && Date.now() - new Date(silencio).getTime() < 2 * 3600 * 1000) continue;\n  const tolerado = 1 - SLO[flujo];\n  for (const r of reglas) {\n    const f = filas.find(x => x.flujo === flujo && Number(x.horas) === r.horas);\n    if (!f || Number(f.n) < r.minimo || Number(f.fallos) < MIN_FALLOS) continue;\n    const tasa = (Number(f.fallos) / Number(f.n)) / tolerado;\n    const umbral = r.fraccion * H / r.horas;\n    const sigue = Number(f.n_corta) > 0 && (Number(f.fallos_corta) / Number(f.n_corta)) / tolerado >= umbral;\n    if (tasa >= umbral && sigue) {\n      avisos.push({ json: { flujo, regla: r.nombre, tasa: Math.round(tasa * 10) / 10, umbral: Math.round(umbral * 100) / 100, n: Number(f.n), fallos: Number(f.fallos), text: `Aviso ${r.nombre} de ${flujo}: ${f.fallos} fallos de ${f.n} en ${r.horas} h, tasa de consumo ${tasa.toFixed(1)} (umbral ${umbral.toFixed(2)})` } });\n      break;\n    }\n  }\n}\nreturn avisos.length ? avisos : [{ json: { sin_avisos: true } }];"},
      "id": "7a750000-0000-4000-8000-000000000003",
      "name": "Calcular tasas de consumo",
      "type": "n8n-nodes-base.code",
      "typeVersion": 2,
      "position": [440, 0]
    },
    {
      "parameters": {"conditions": {"options": {"caseSensitive": true, "leftValue": "", "typeValidation": "loose", "version": 2}, "conditions": [{"id": "c7500001", "leftValue": "={{ $json.flujo }}", "rightValue": "", "operator": {"type": "string", "operation": "exists", "singleValue": true}}], "combinator": "and"}, "options": {}},
      "id": "7a750000-0000-4000-8000-000000000004",
      "name": "¿Hay avisos?",
      "type": "n8n-nodes-base.if",
      "typeVersion": 2.2,
      "position": [660, 0]
    },
    {
      "parameters": {"method": "POST", "url": "={{ $env.TL_SLACK_WEBHOOK_ALERTAS }}", "sendBody": true, "specifyBody": "json", "jsonBody": "={{ JSON.stringify({ text: $json.text, blocks: [{ type: 'section', text: { type: 'mrkdwn', text: '*' + $json.text + '*' } }, { type: 'context', elements: [{ type: 'mrkdwn', text: 'TL Alertas de flujos v1 · registro común, sin datos de clientes' }] }] }) }}", "options": {"timeout": 10000, "batching": {"batch": {"batchSize": 1, "batchInterval": 1100}}}},
      "id": "7a750000-0000-4000-8000-000000000005",
      "name": "Avisar en #alertas",
      "type": "n8n-nodes-base.httpRequest",
      "typeVersion": 4.2,
      "position": [880, -100],
      "retryOnFail": true,
      "maxTries": 3,
      "waitBetweenTries": 2000
    },
    {
      "parameters": {"operation": "executeQuery", "query": "INSERT INTO alertas_flujos (flujo, regla, tasa, enviada_en) VALUES ($1, $2, $3, now());", "options": {"queryReplacement": "={{ [$('Calcular tasas de consumo').item.json.flujo, $('Calcular tasas de consumo').item.json.regla, $('Calcular tasas de consumo').item.json.tasa] }}"}},
      "id": "7a750000-0000-4000-8000-000000000006",
      "name": "Registrar aviso",
      "type": "n8n-nodes-base.postgres",
      "typeVersion": 2.6,
      "position": [1100, -100],
      "credentials": {"postgres": {"id": "0000000000000042", "name": "Postgres TL"}}
    }
  ],
  "connections": {
    "Cada 10 minutos en horario": {"main": [[{"node": "Contar ejecuciones por ventana", "type": "main", "index": 0}]]},
    "Contar ejecuciones por ventana": {"main": [[{"node": "Calcular tasas de consumo", "type": "main", "index": 0}]]},
    "Calcular tasas de consumo": {"main": [[{"node": "¿Hay avisos?", "type": "main", "index": 0}]]},
    "¿Hay avisos?": {"main": [[{"node": "Avisar en #alertas", "type": "main", "index": 0}], []]},
    "Avisar en #alertas": {"main": [[{"node": "Registrar aviso", "type": "main", "index": 0}]]}
  },
  "settings": {"executionOrder": "v1", "timezone": "America/Mexico_City", "executionTimeout": 60, "saveDataSuccessExecution": "none", "errorWorkflow": "Xe7rTb4mKq9wPz2G"},
  "pinData": {},
  "meta": {"templateCredsSetupCompleted": true}
}
Tres detalles del JSON merecen una nota. La consulta del paso 2 filtra solo los tres flujos con volumen, para que las reglas de tasa no se apliquen donde no tienen sentido. El código del paso 3 lleva los SLO de cada flujo escritos dentro, y eso es una deuda declarada: si un SLO cambia en la Tabla 1, hay que cambiarlo también aquí, y por eso el bloque siguiente comprueba que las reglas coinciden con las del cuaderno. Y el cuerpo del aviso no lleva datos de clientes, solo el flujo, la regla, los conteos y la tasa. Antes de importarlo, Valeria lo revisa con código:
# Revisión del workflow TL Alertas de flujos v1 antes de importarlo en Python:
import re
flujo_n8n = json.loads((carpeta / 'flujos' / 'n8n' / 'alertas_de_flujos_v1.json').read_text(encoding = 'utf-8'))
nombres = {n['name'] for n in flujo_n8n['nodes']}
destinos = [d['node'] for salidas in flujo_n8n['connections'].values() for s in salidas['main'] for d in s]
rotas = [d for d in destinos + list(flujo_n8n['connections']) if d not in nombres]
texto = json.dumps(flujo_n8n, ensure_ascii = False)
secretos = re.findall(r'sk-ant-[\w-]+|xox[bp]-[\w-]+|hooks\.slack\.com/services/\w+|Bearer [A-Za-z0-9._-]{20,}', texto)
codigo = next(n for n in flujo_n8n['nodes'] if n['type'] == 'n8n-nodes-base.code')['parameters']['jsCode']
reglas_js = [(int(h), float(f), int(m)) for h, f, m in re.findall(r'horas: (\d+), fraccion: ([\d.]+), minimo: (\d+)', codigo)]
reglas_py = [(w, f, m) for _, w, f, m in REGLAS]
cron = flujo_n8n['nodes'][0]['parameters']['rule']['interval'][0]['expression']
print(f'Nodos: {len(nombres)} | conexiones: {len(destinos)} | destinos inexistentes: {rotas or "ninguno"}')
print('Tipos:', sorted({n["type"].split(".")[-1] + " v" + str(n["typeVersion"]) for n in flujo_n8n['nodes']}))
print('Secretos escritos en el JSON:', secretos or 'ninguno', '| URL de Slack desde', re.findall(r'\$env\.\w+', texto))
print('Reglas iguales a las del Bloque 6:', reglas_js == reglas_py, reglas_js)
print('Disparador:', cron, '| zona:', flujo_n8n['settings']['timezone'],
      '| guarda ejecuciones exitosas:', flujo_n8n['settings']['saveDataSuccessExecution'])
Nodos: 6 | conexiones: 5 | destinos inexistentes: ninguno
Tipos: ['code v2', 'httpRequest v4.2', 'if v2.2', 'postgres v2.6', 'scheduleTrigger v1.2']
Secretos escritos en el JSON: ninguno | URL de Slack desde ['$env.TL_SLACK_WEBHOOK_ALERTAS']
Reglas iguales a las del Bloque 6: True [(1, 0.02, 4), (6, 0.1, 12)]
Disparador: */10 7-20 * * 1-6 | zona: America/Mexico_City | guarda ejecuciones exitosas: none
La revisión pasa sin hallazgos: $6$ nodos, $5$ conexiones, ningún destino inexistente, ninguna clave ni dirección de webhook escrita en el archivo, la dirección de Slack leída del entorno y las reglas idénticas a las del Bloque 6. El ajuste saveDataSuccessExecution en none hace que las ejecuciones sin novedad no guarden datos en n8n: con seis ejecuciones por hora, de las 7:00 a las 20:50 y de lunes a sábado, son unas $2,200$ ejecuciones al mes que, sin ese ajuste, llenarían el historial de ruido.
Consideraciones finales
El cuadro de mando de hoy no añade ninguna automatización nueva al negocio; añade la capacidad de saber si las que ya existen hacen su trabajo. Eso exigió cuatro piezas que no se ven en la imagen final: una lista de indicadores con objetivos escrita antes de mirar los datos, un registro común que cada flujo escribe al terminar, una fórmula de coste que separa lo que se paga por uso de lo que se reparte, y unas reglas de alerta que no suenan por cada fallo ni se callan ante un incidente.
Las cifras tienen límites que conviene decir. El mes es simulado: las probabilidades de fallo, las latencias, los tokens y el incidente del sábado 18 son supuestos declarados, y las cifras reales llegarán cuando el registro común lleve un mes en producción. El reparto del servidor de n8n entre ejecuciones es una convención contable, no un gasto que dependa de cada una. Los objetivos de Gmail y del informe se evalúan con muy pocas ejecuciones, y su incumplimiento puede ser azar. Y la alerta del sábado llegó tarde por falta de tráfico, un límite que solo resuelve una prueba sintética.
Antes de montar un cuadro de mando para sus automatizaciones, conviene hacerse algunas preguntas:
- ¿Cada flujo escribe su fila también cuando falla, o solo cuando termina bien?
- ¿Sus objetivos se escribieron antes de mirar los datos, o se ajustaron para que todo saliera en verde?
- ¿Qué parte del coste depende del uso y qué parte se paga aunque nada corra?
- ¿Cuántas ejecuciones al mes tiene cada flujo, y con ese volumen un porcentaje significa algo?
- ¿Su panel mide procesos o, sin quererlo, mide personas?
Un gran libro que habla de esto es Information Dashboard Design (o Diseño de cuadros de mando de información), de Stephen Few. Su tesis es que un cuadro de mando no es un lugar para lucir gráficas, sino un instrumento para notar algo en segundos, y que casi todos los paneles fallan por exceso: demasiados colores, demasiadas cifras sin objetivo, demasiada decoración. Leído junto con los capítulos sobre objetivos de servicio de Site Reliability Engineering, de Google, explica las dos mitades de esta entrada: qué mostrar y contra qué compararlo.
Un cuadro de mando no es la suma de las pantallas de cada herramienta, sino tres preguntas con objetivo, contestadas con un registro común que no sabe nada de los clientes. El viernes por la mañana, Valeria conectará el panel a los registros reales. Don Ernesto ya pidió que el lunes la hoja llegue también impresa.
Conclusiones clave
Indicadores
- Cada flujo se mide con los mismos cuatro indicadores (éxito, latencia p95, coste por ejecución e intervención humana) y su propio objetivo; la publicación lleva además la aprobación válida, con un objetivo del $100%$ que en el mes se cumplió con $36$ de $36$.
- $3$ de $6$ flujos cumplen todos sus SLO: pedidos incumple el éxito ($0.9857$) por una sola mañana, Gmail lo incumple con $2$ fallos en $114$ (probabilidad de $0.112$ por azar) y el informe incumple la intervención humana con $3$ de $4$.
- La intervención humana se mide por flujo y nunca por persona: el panel no tiene gráficas por aprobador ni tiempos por empleado.
Registro y coste
- El registro común tiene una fila por ejecución y otra por llamada a Claude, con el modelo y los tokens de
usage; no guarda teléfonos, nombres ni textos, y sus restriccionesCHECKrechazan filas mal formadas. - El coste por ejecución suma tokens con la Tabla A, plantillas a $0.0085$ USD, créditos de Make a $0.001059$ y el reparto del servidor; el mes cuesta $24.43$ USD en el registro y $26.57$ con Make Core completo, $1.03$ MXN por encargo atendido.
- Opus 5.5 es el $76%$ del gasto de Claude por los escalados: la ejecución típica del agente cuesta $0.0043$ USD y la media $0.0090$, así que la palanca es la tasa de escalado, no el modelo base.
Paneles y alertas
- Con $3,056$ ejecuciones y un SLO del $99%$, el presupuesto global es de $30.6$ fallos y el incidente del sábado 18 gastó $22$; el de pedidos, de $16.0$, quedó en el $143.5%$ ese mismo día.
- La tasa de consumo $r = e / (1 - \text{SLO})$, con umbrales $r^{*} = f H / w$ ($6.76$ en 1 hora y $5.63$ en 6 horas), mínimos y ventana corta, avisó a las 10:30 de un fallo que empezó a las 08:33; con poco tráfico, el remedio es un latido sintético.
- El panel propio llega a Slack cada lunes, y Looker Studio (Data Studio desde abril de 2026; gratuito, y Pro a 9 USD por usuario y proyecto al mes) sirve para investigar con agregados que no identifican a nadie.
Mañana, en el Día 76: Anatomía de un fallo real IV: la publicación que salió sin aprobación. El viernes 17 a las 8:00, el cuadro de mando de hoy marcará en rojo un indicador que debía estar siempre en verde, el de publicaciones con aprobación válida, y Valeria reconstruirá con los registros, sin buscar culpables, cómo una pieza que Don Ernesto había rechazado llegó a Instagram y a Facebook.
Referencias
- Beyer, B., Jones, C., Petoff, J. y Murphy, N. R. (Eds.) (2016). Site Reliability Engineering: How Google Runs Production Systems. O’Reilly Media. https://sre.google/sre-book/table-of-contents/
- Beyer, B., Murphy, N. R., Rensin, D. K., Kawahara, K. y Thorne, S. (Eds.) (2018). The Site Reliability Workbook. O’Reilly Media. Capítulo “Alerting on SLOs”. https://sre.google/workbook/alerting-on-slos/
- Few, S. (2013). Information Dashboard Design: Displaying Data for At-a-Glance Monitoring (2.ª ed.). Analytics Press.
- Google (2026). Data Studio (antes Looker Studio) y Data Studio Pro; notas de versión. Google Cloud. https://cloud.google.com/looker-studio y https://docs.cloud.google.com/data-studio/release-notes (revisado en octubre de 2026).
- Anthropic (2026). Usage and Cost API; Pricing; Prompt caching. Documentación de Claude. https://platform.claude.com/docs/en/manage-claude/usage-cost-api (revisado en octubre de 2026).
- Slack (2026). files.getUploadURLExternal y files.completeUploadExternal; retiro de files.upload. Slack Developer Docs. https://docs.slack.dev/reference/methods/files.getUploadURLExternal (revisado en octubre de 2026).
- Make (2026). API reference: Scenarios, Logs. Make Developer Hub. https://developers.make.com/api-documentation (revisado en octubre de 2026).