Arquitecto de automatización con IA: Día 78
 Jeshua Romero Guadarrama
- 62 Min para leer
- 19 Apr, 2026
Índice de contenido
Resumen:
Valeria se va una semana de vacaciones en mayo y alguien tiene que entender el ecosistema de Trigo Lento sin ella. Hoy comienza el Proyecto integrador documentando la arquitectura en tres niveles, contexto, contenedores y flujos, con $5$ personas, $9$ servicios externos, $7$ contenedores, $15$ relaciones y $25$ flujos en $5$ dominios, escritos como datos y dibujados desde ellos. Después identifica los $6$ puntos únicos de falla, calcula la disponibilidad compuesta del camino crítico de WhatsApp ($0.9930$, unas $5.03$ horas de caída al mes, de las que el $71%$ pone el servidor propio), muestra qué cambia con una respuesta de plantilla cuando Claude no responde, levanta la tabla de fronteras de datos por proveedor y deja escritas cinco decisiones de arquitectura (ADR). Al terminar, usted sabrá documentar un ecosistema de automatización con IA de modo que otra persona pueda entenderlo, calcular qué tan disponible es y comprobar que respeta los límites de datos y el código de honor.
¿Cómo citar el presente artículo?
Romero, J. (19 de abril de 2026). Arquitecto de automatización con IA: Día 78. python-data-engineer. https://www.python-data-engineer.com/post/aai/dia_78/.
Arquitecto de automatización con IA: Día 78 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/aai/dia_78/.
Precios, límites y políticas revisados en octubre de 2026: planes, precios y límites de Make, n8n, Zapier, WhatsApp (Meta, Twilio, Wati) y de la API de Claude. Los tres niveles de hoy siguen el modelo C4 de Simon Brown (contexto, contenedores, componentes y código; la serie usa los dos primeros y llama “flujos” al tercero) y el formato de registro de decisiones de Michael Nygard (2011), ambos revisados en octubre de 2026. Todos los bloques de esta entrada son offline y se ejecutaron con la semilla de la serie; ninguno llama a una API. Las disponibilidades por componente son supuestos declarados de Trigo Lento, no acuerdos de nivel de servicio medidos ni publicados por los proveedores. El presupuesto que se cita es el que dejó el Día 77: $40.53$ USD de $45$, con una reserva de $4.02$ y el rubro de Claude en $10.50$.
Día 78. Proyecto integrador I: la arquitectura final del ecosistema
Introducción
Ayer, en el Día 77 (Sesión práctica: la campaña de primavera, de la idea a la publicación), Valeria llevó la campaña del 10 de mayo desde un brief con huella hasta ocho piezas publicadas con aprobación válida, con $30$ de $30$ casos de prueba superados y la cuenta honesta del módulo 7 ($3.95$ USD al mes, no los $0.59$ del plan), y Trigo Lento ganó TL Campaña primavera v1 y un presupuesto que cierra en $40.53$ USD de $45$, con $4.02$ de reserva. Hoy comienza el módulo 8/8, el Proyecto integrador: en doce días, las piezas de setenta y siete entradas se convierten en un sistema que otra persona pueda entender, operar, probar y pagar, con la arquitectura documentada, el inventario de flujos con dueños, los manuales de operación, las pruebas de punta a punta y de caos, el coste final frente a los $45$ USD y la entrega.
Es domingo 19 de abril. El obrador está cerrado y Valeria aprovecha la mesa grande para extender, por primera vez, todo lo que construyó desde febrero: dos plataformas, un servidor, tres bases de datos, nueve servicios externos y veinticinco flujos que se llaman unos a otros. Tiene un motivo concreto para hacerlo hoy. Del 11 al 16 de mayo, justo después del Día de las Madres, se va una semana de vacaciones, la primera desde que empezó la serie, y en ese momento alguien tendrá que entender el sistema sin ella. Faltan $22$ días. Las piezas funcionan, el cuadro de mando del Día 75 (Cuadros de mando de las automatizaciones: métricas, costes y errores) lo demuestra cada lunes, pero el mapa de cómo encajan está en un solo sitio: su cabeza.
Don Ernesto se sienta enfrente con un café y mira los papeles sueltos. “Valeria, yo no voy a aprender a mover esos flujos en una semana, y la persona del mostrador tampoco. Lo que necesito es otra cosa. Cuando compramos el horno grande, el instalador me dejó un plano: dónde está cada cosa, qué pasa si se corta el gas, a quién llamar. Explíquemelo como si fuera el plano del obrador. Qué entra, qué sale, qué se puede romper y qué hacemos ese día.” La petición es, palabra por palabra, la definición de un documento de arquitectura, y tiene una condición que Don Ernesto no dice porque la da por sentada: el plano debe decir también qué no sale nunca del obrador. Sus recetas, como se decidió el Día 6 (Ética y seguridad: el código de honor del arquitecto de automatización), siguen fuera de todo sistema.
En la presente entrada, descubrirá cómo se documenta un ecosistema de automatización en tres niveles que hacen zoom uno sobre otro: el contexto (quién usa el sistema y de quién depende), los contenedores (dónde vive cada pieza y qué datos se mueven entre ellas) y los flujos (qué hace cada proceso, agrupado por dominio). Escribirá el inventario como estructuras de datos y dibujará los diagramas desde ellas, para que el plano no envejezca por separado del sistema. Identificará los puntos únicos de falla, calculará la disponibilidad compuesta del camino crítico con las fórmulas de serie y paralelo, la contrastará con una simulación de cinco mil meses y verá qué cambia con una degradación controlada. Levantará la tabla de fronteras de datos por proveedor, dejará escritas cinco decisiones de arquitectura con su contexto y sus consecuencias, comprobará el código de honor contra la arquitectura y los quince flujos exportados, y terminará con el documento que Valeria dejará sobre la mesa del obrador el 10 de mayo.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Documentar la arquitectura del ecosistema en tres niveles (contexto, contenedores y flujos) con decisiones registradas.
- Identificar puntos únicos de falla y calcular la disponibilidad compuesta del camino crítico, con y sin degradación controlada.
- Escribir registros de decisiones de arquitectura (ADR) para las decisiones clave de la serie.
- Comprobar que la arquitectura respeta los límites de datos (qué sale a cada proveedor) y el código de honor.
Nivel 1: el contexto
Un plano de arquitectura no es un dibujo bonito del sistema: es un conjunto de vistas, cada una para una pregunta distinta y para una persona distinta. El modelo C4 de Simon Brown propone cuatro niveles de zoom (contexto, contenedores, componentes y código) y una regla que vale más que la notación: cada nivel responde a una pregunta y no intenta responder las demás. Trigo Lento necesita dos niveles y medio. El contexto responde a la pregunta de Don Ernesto: ¿quién usa esto y de quién dependemos? Los contenedores responden a la de la persona que tendrá que reiniciar algo un sábado: ¿dónde vive cada pieza y qué datos se mueven entre ellas? Y los flujos, que en C4 serían los componentes, responden a la de Valeria cuando vuelva de vacaciones: ¿qué hace cada proceso y de cuál depende? El nivel del código no se dibuja: son los JSON exportados de Make y n8n que el Día 42 (Versionado de flujos: exportar el JSON a git, revisar diferencias y etiquetar versiones) guardó en el repositorio.
La Figura 1 muestra la idea con la que Valeria convence a Don Ernesto: tres hojas de plano superpuestas, como el plano del local, el de los hornos y la receta de cada pan, que hacen zoom una sobre la otra sin repetirse.
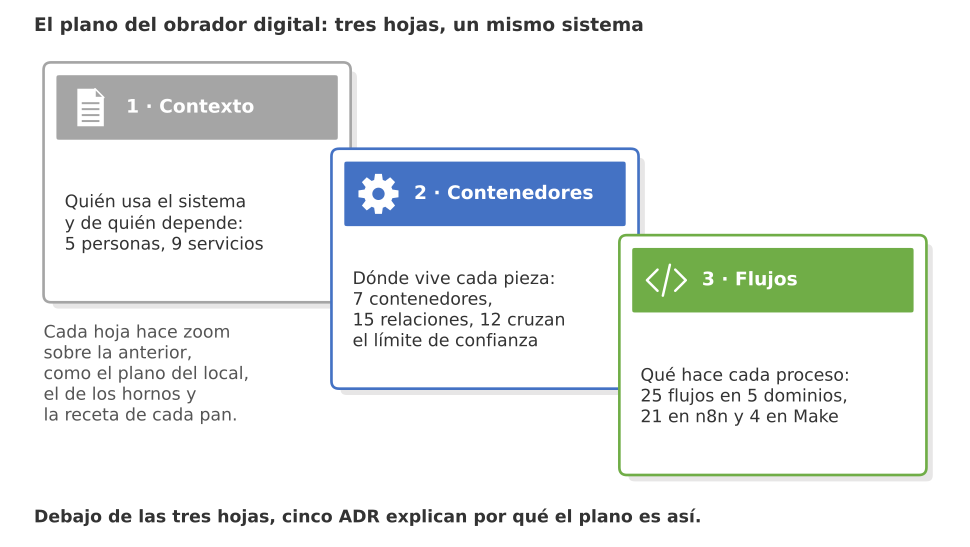
Figura 1. El plano del obrador digital: tres hojas superpuestas, el contexto con 5 personas y 9 servicios, los contenedores con 7 piezas y 15 relaciones, y los flujos con 25 procesos en 5 dominios.
La decisión metodológica más importante del día se toma antes de dibujar nada: el inventario se escribe como datos y los diagramas se generan desde él. Un diagrama dibujado a mano en una herramienta de pizarra envejece el día en que se añade un flujo; un diagrama generado desde las mismas estructuras que después alimentan el documento, las comprobaciones y el inventario del Día 79 cambia cuando cambian los datos. Es la misma idea que el Día 2 aplicó a los flujos con dibujar_flujo y que el Día 67 (Sesión práctica de consolidación: el informe de negocio del lunes) aplicó al informe: Python calcula y dibuja, y nadie copia cifras a mano.
El primer bloque fija las importaciones, la semilla de la serie, la zona horaria y la carpeta del día, y calcula cuántos días quedan para preparar el relevo:
# Importaciones base, semilla de la serie, zona horaria y carpeta del día en Python:
import warnings
warnings.filterwarnings('ignore')
import hashlib
import json
import re
import textwrap
from datetime import datetime, timedelta
from pathlib import Path
from zoneinfo import ZoneInfo
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from matplotlib.patches import FancyArrowPatch, FancyBboxPatch, Rectangle

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 150)
pd.set_option('display.max_colwidth', 60)
CDMX = ZoneInfo('America/Mexico_City')
carpeta = Path('trigo_lento') / 'dia_78'
carpeta.mkdir(parents = True, exist_ok = True)
huella = lambda texto: hashlib.sha256(texto.encode('utf-8')).hexdigest()[:12]
fecha_dia = lambda n: datetime(2026, 2, 1, tzinfo = CDMX) + timedelta(days = n - 1)   # Día N de la serie
hoy = datetime(2026, 4, 19, 10, 0, tzinfo = CDMX)
vacaciones = (datetime(2026, 5, 11, tzinfo = CDMX), datetime(2026, 5, 16, tzinfo = CDMX))
DIAS = ['lunes', 'martes', 'miércoles', 'jueves', 'viernes', 'sábado', 'domingo']
print('numpy', np.__version__, '| pandas', pd.__version__)
print(f'Hoy: {DIAS[hoy.weekday()]} {hoy:%d/%m/%Y} (Día 78 = {fecha_dia(78):%d/%m}) | '
      f'vacaciones de Valeria: {vacaciones[0]:%d/%m} a {vacaciones[1]:%d/%m} | '
      f'días para preparar el relevo: {(vacaciones[0] - hoy.replace(hour = 0)).days}')
numpy 2.4.6 | pandas 3.0.3
Hoy: domingo 19/04/2026 (Día 78 = 19/04) | vacaciones de Valeria: 11/05 a 16/05 | días para preparar el relevo: 22
Es domingo 19 de abril y quedan $22$ días para el 11 de mayo. El generador aleatorio con la semilla $2026$ se usará solo en la simulación de caídas del Bloque 7; todo lo demás es determinista, porque un documento de arquitectura no se sortea.
El segundo bloque es el inventario propiamente dicho: los siete contenedores con su tecnología, su responsable, los datos que guardan, su dependencia externa y su respaldo; las quince relaciones entre ellos con lo que viaja por cada una y si cruza o no el límite de confianza del servidor propio; y los veinticinco flujos con su dominio, su plataforma y el día en que nacieron. Las tres estructuras se guardan en la carpeta del día, porque el Día 79 las leerá de nuevo:
# Inventario de contenedores, relaciones y flujos del ecosistema como estructuras de datos en Python:
CONTENEDORES = pd.DataFrame([
    ('n8n 2.43.7', 'Docker en el servidor propio', 'Valeria', 'Workflows, credenciales cifradas, historial de ejecuciones',
     'Proveedor del servidor', 'Copias diarias y semanales (Día 35); JSON en Git (Día 42)'),
    ('Postgres', 'Docker en el servidor propio', 'Valeria', 'Clientes, pedidos, renglones, consentimientos, ejecuciones, aprobaciones',
     'Proveedor del servidor', '7 copias diarias y 4 semanales cifradas fuera del servidor'),
    ('Servidor MCP de inventario', 'Python con el SDK mcp, detrás de HTTPS', 'Valeria', 'Nada propio: lee el inventario en modo de solo lectura',
     'Proveedor del servidor', 'Código en Git; se reconstruye en minutos'),
    ('trigo_lento.sqlite', 'SQLite en el servidor propio', 'Valeria', 'Catálogo, inventario, movimientos, índice de conocimiento',
     'Proveedor del servidor', 'Copia diaria con la de Postgres'),
    ('Make Core', 'Nube de Make', 'Valeria', '4 escenarios cortos y su historial',
     'Make', 'Blueprints exportados en Git'),
    ('Slack', 'Nube de Slack', 'Valeria', 'Canal de operaciones: alertas y botones de aprobación',
     'Slack', 'Las decisiones también quedan en Postgres'),
    ('Notion', 'Nube de Notion', 'Don Ernesto aprueba, Valeria edita', '40 páginas publicables: fichas, políticas, avisos',
     'Notion', 'Exportación semanal en Markdown'),
], columns = ['contenedor', 'tecnologia', 'responsable', 'datos', 'dependencia', 'respaldo'])
RELACIONES = [  # origen, destino, qué viaja, ¿cruza el límite de confianza?
    ('Cloud API de Meta', 'n8n 2.43.7', 'mensajes y estados (webhook firmado)', True),
    ('n8n 2.43.7', 'Cloud API de Meta', 'respuestas y plantillas', True),
    ('n8n 2.43.7', 'Postgres', 'pedidos, ejecuciones y aprobaciones', False),
    ('n8n 2.43.7', 'trigo_lento.sqlite', 'consulta del índice de conocimiento', False),
    ('n8n 2.43.7', 'API de Claude', 'texto seudonimizado y fragmentos', True),
    ('API de Claude', 'Servidor MCP de inventario', 'llamadas del conector (token)', True),
    ('Servidor MCP de inventario', 'trigo_lento.sqlite', 'lectura con mode=ro', False),
    ('n8n 2.43.7', 'Slack', 'alertas y solicitudes de aprobación', True),
    ('Slack', 'n8n 2.43.7', 'decisiones de aprobación (firma)', True),
    ('Notion', 'n8n 2.43.7', 'páginas publicadas para el índice', True),
    ('n8n 2.43.7', 'Voyage AI', 'fragmentos públicos para embeddings', True),
    ('Make Core', 'Postgres', 'formulario, recogidas y pedido de Brújula', True),
    ('n8n 2.43.7', 'Gmail', 'borradores para mayoristas', True),
    ('n8n 2.43.7', 'Redes sociales', 'publicaciones aprobadas', True),
    ('n8n 2.43.7', 'FacturaFácil', 'datos de factura', True),
]
FLUJOS = pd.DataFrame([
    ('pedidos', 'TL Orquestador v1', 'n8n', 52), ('pedidos', 'TL Agente de pedidos v4', 'n8n', 69),
    ('pedidos', 'TL Facturación', 'n8n', 40), ('pedidos', 'TL Formulario v2', 'Make', 22),
    ('pedidos', 'TL Recordatorio de recogida v1', 'Make', 26), ('pedidos', 'TL Brújula diario v1', 'Make', 32),
    ('pedidos', 'Sincronización de clientes', 'Make', 16),
    ('comunicación', 'TL WhatsApp Cloud API v1', 'n8n', 56), ('comunicación', 'TL Responder por canal v1', 'n8n', 52),
    ('comunicación', 'TL WhatsApp secuencias v2', 'n8n', 49), ('comunicación', 'TL Gmail mayoristas v1', 'n8n', 47),
    ('comunicación', 'TL Slack operaciones v1', 'n8n', 50), ('comunicación', 'TL Monitor de plantillas v1', 'n8n', 54),
    ('inteligencia de negocio', 'TL Lote nocturno v1', 'n8n', 60), ('inteligencia de negocio', 'TL Remisiones v1', 'n8n', 66),
    ('inteligencia de negocio', 'TL Consulta de inventario v1', 'n8n', 63),
    ('inteligencia de negocio', 'TL Informe del lunes v1', 'n8n', 67),
    ('contenido', 'TL Indexador Notion v1', 'n8n', 68), ('contenido', 'TL Aprobaciones v2', 'n8n', 76),
    ('contenido', 'TL Publicación multired v2', 'n8n', 76), ('contenido', 'TL Campaña primavera v1', 'n8n', 77),
    ('operación', 'TL Errores v1', 'n8n', 43), ('operación', 'TL Métricas de atención v1', 'n8n', 53),
    ('operación', 'TL Evaluación del agente v1', 'n8n', 70), ('operación', 'TL Alertas de flujos v1', 'n8n', 75),
], columns = ['dominio', 'flujo', 'plataforma', 'dia'])
print(CONTENEDORES[['contenedor', 'tecnologia', 'responsable', 'dependencia']].to_string(index = False))
cruzan = sum(r[3] for r in RELACIONES)
print(f'Contenedores: {len(CONTENEDORES)} | relaciones: {len(RELACIONES)} | cruzan el límite de confianza: {cruzan}')
print('Contenedores con Valeria como única responsable:', int((CONTENEDORES.responsable == 'Valeria').sum()),
      'de', len(CONTENEDORES))
print(pd.crosstab(FLUJOS.dominio, FLUJOS.plataforma, margins = True, margins_name = 'total').to_string())
print('Flujos sin el prefijo "TL":', FLUJOS.loc[~FLUJOS.flujo.str.startswith('TL '), 'flujo'].tolist())
CONTENEDORES.to_csv(carpeta / 'contenedores.csv', index = False, encoding = 'utf-8')
FLUJOS.to_csv(carpeta / 'flujos_por_dominio.csv', index = False, encoding = 'utf-8')
                contenedor                             tecnologia                        responsable            dependencia
                n8n 2.43.7           Docker en el servidor propio                            Valeria Proveedor del servidor
                  Postgres           Docker en el servidor propio                            Valeria Proveedor del servidor
Servidor MCP de inventario Python con el SDK mcp, detrás de HTTPS                            Valeria Proveedor del servidor
        trigo_lento.sqlite           SQLite en el servidor propio                            Valeria Proveedor del servidor
                 Make Core                           Nube de Make                            Valeria                   Make
                     Slack                          Nube de Slack                            Valeria                  Slack
                    Notion                         Nube de Notion Don Ernesto aprueba, Valeria edita                 Notion
Contenedores: 7 | relaciones: 15 | cruzan el límite de confianza: 12
Contenedores con Valeria como única responsable: 6 de 7
plataforma               Make  n8n  total
dominio
comunicación                0    6      6
contenido                   0    4      4
inteligencia de negocio     0    4      4
operación                   0    4      4
pedidos                     4    3      7
total                       4   21     25
Flujos sin el prefijo "TL": ['Sincronización de clientes']
El inventario deja a la vista tres cifras que el resto del día va a perseguir. Hay $7$ contenedores y $15$ relaciones, de las que $12$ cruzan el límite de confianza: solo tres movimientos de datos se quedan dentro del servidor propio (de n8n a Postgres, de n8n a trigo_lento.sqlite y del servidor MCP a la misma base); todo lo demás entra o sale por una frontera. Valeria es la única responsable de $6$ de los $7$ contenedores, que es la forma numérica del problema de las vacaciones. Y de los $25$ flujos, $21$ viven en n8n y $4$ en Make, repartidos en cinco dominios: $7$ de pedidos, $6$ de comunicación, $4$ de inteligencia de negocio, $4$ de contenido y $4$ de operación. Un hallazgo menor, pero real: el escenario de sincronización de clientes del Día 16 es el único que no sigue la convención TL <proceso> v<n>; queda anotado para el inventario del Día 79.
El tercer bloque dibuja el nivel 1 desde esas estructuras. A la izquierda, las cinco personas o grupos que usan el sistema; en el centro, el ecosistema como una sola caja, que es la regla del contexto (desde fuera, el sistema es una cosa); a la derecha, los nueve servicios externos de los que depende, con los dos proveedores de modelos de IA en otro color:
# Diagrama de contexto del ecosistema dibujado con patches en Python:
PERSONAS = ['Clientes de mostrador\ny por encargo', 'Cafetería Brújula\n(Marisol)', 'Valeria\n(administración)',
            'Don Ernesto\n(dueño, aprueba)', 'Equipo de obrador\ny mostrador']
SERVICIOS = ['Meta: WhatsApp,\nInstagram, Facebook', 'Google: Gmail', 'Slack', 'Notion', 'Anthropic:\nAPI de Claude',
             'Voyage AI:\nembeddings', 'Make', 'LinkedIn', 'FacturaFácil']
QUE_PASA = {0: 'encargos y dudas', 1: 'pedido diario y facturas', 2: 'opera y mantiene', 3: 'aprueba por WhatsApp',
            4: 'avisos del obrador'}

def caja(ax, x, y, w, h, texto, color, tam = 9.5, estilo = 'round,pad=0.02,rounding_size=0.08'):
    ax.add_patch(FancyBboxPatch((x - w / 2, y - h / 2), w, h, boxstyle = estilo, facecolor = color,
                                edgecolor = 'white', linewidth = 2))
    ax.text(x, y, texto, ha = 'center', va = 'center', color = 'white', fontsize = tam)

def flecha(ax, a, b, color = '#52514e', estilo = '-|>', lw = 1.3):
    ax.add_patch(FancyArrowPatch(a, b, arrowstyle = estilo, mutation_scale = 12, color = color, linewidth = lw))

fig, ax = plt.subplots(figsize = (13, 7.2))
caja(ax, 0, 0, 3.6, 1.8, f'Ecosistema de IA\nde Trigo Lento\n({len(FLUJOS)} flujos, {len(CONTENEDORES)} contenedores)', '#1f9d55', tam = 12)
for i, p in enumerate(PERSONAS):
    y = 3.2 - i * 1.6
    caja(ax, -5.6, y, 2.6, 1.05, p, '#8a8a8a', tam = 10.5)
    flecha(ax, (-4.28, y), (-1.85, y * 0.22), estilo = '<|-|>')
    ax.text(-3.1, y * 0.61 + 0.24, QUE_PASA[i], fontsize = 9, color = '#52514e', ha = 'center')
for i, s in enumerate(SERVICIOS):
    y = 3.6 - i * 0.9
    caja(ax, 5.6, y, 2.6, 0.75, s, '#7b4fc9' if 'Anthropic' in s or 'Voyage' in s else '#2a78d6', tam = 9.8)
    flecha(ax, (1.85, y * 0.22), (4.28, y), estilo = '<|-|>', color = '#8a8986', lw = 1.0)
ax.text(-5.6, 4.35, 'Personas', fontsize = 12, ha = 'center', weight = 'bold')
ax.text(5.6, 4.35, 'Servicios externos', fontsize = 12, ha = 'center', weight = 'bold')
ax.set_xlim(-7.1, 7.1)
ax.set_ylim(-4.4, 4.7)
ax.set_aspect('equal')
ax.axis('off')
ax.set_title('Nivel 1, contexto: quién usa el sistema y de quién depende', fontsize = 14)
plt.tight_layout()
plt.show()
print(f'Personas: {len(PERSONAS)} | servicios externos: {len(SERVICIOS)} | '
      f'de ellos con modelos de IA: {sum(("Anthropic" in s) or ("Voyage" in s) for s in SERVICIOS)}')
Personas: 5 | servicios externos: 9 | de ellos con modelos de IA: 2
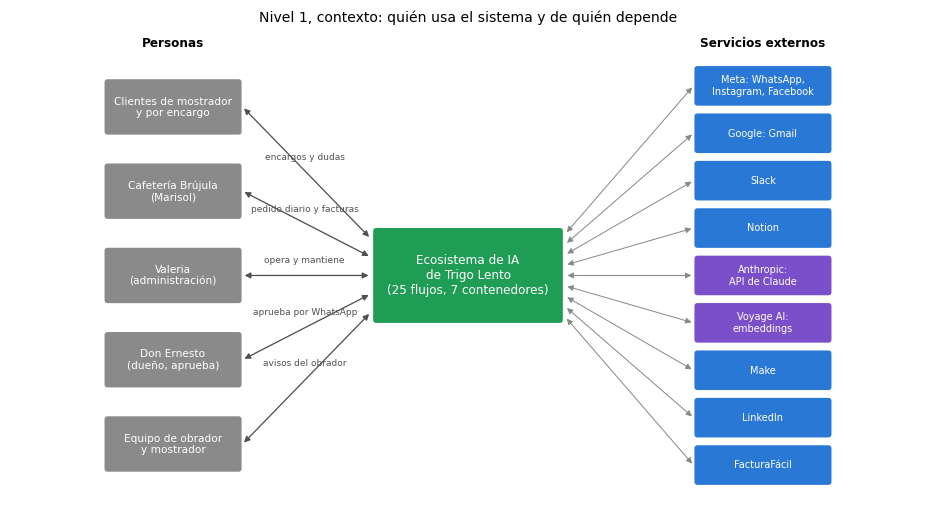
El diagrama de contexto es el único que Don Ernesto necesita leer entero, y por eso no tiene ni un nombre de tecnología. Dice que cinco personas o grupos tocan el sistema (los clientes de mostrador y por encargo, la Cafetería Brújula de Marisol, Valeria, el propio Don Ernesto y el equipo de obrador y mostrador), que el sistema depende de nueve servicios externos y que dos de ellos son proveedores de modelos de IA: Anthropic, con la API de Claude, y Voyage AI, con los embeddings del Día 68 (Una base de conocimiento en Notion: API, fragmentos y embeddings). Lo que cada persona hace con el sistema cabe en tres palabras sobre cada flecha, y esa brevedad es deliberada: si para explicar el contexto hace falta un párrafo, el contexto está mal dibujado.
Hay una lectura menos amable del mismo dibujo. Nueve dependencias externas para una panadería de seis personas son nueve cuentas, nueve políticas de precios que pueden cambiar y nueve sitios donde pueden estar datos de clientes. Ninguna de las nueve está de más (cada una entró en la serie con un cálculo que la justificaba), pero el diagrama es la primera vez que se ven juntas, y la pregunta de Don Ernesto sobre “de quién dependemos” tiene una respuesta más larga de lo que parecía desde dentro.
Nivel 2: los contenedores
En el vocabulario de C4, un contenedor es cualquier cosa que se ejecuta o guarda datos por separado: una aplicación, una base de datos, un servicio en la nube. No tiene que ver con Docker, aunque en Trigo Lento tres de los siete contenedores sean, además, contenedores de Docker en el servidor propio. La pregunta de este nivel es la que hará la persona de guardia cuando algo falle: ¿dónde vive cada pieza, qué guarda y qué datos se mueven entre ellas? La Tabla 1 recoge los siete contenedores tal como salieron del Bloque 2, con la columna que más importa el 11 de mayo: cómo se respalda cada uno.
Tabla 1. Contenedores del ecosistema: tecnología, responsable, datos que guarda, dependencia externa y respaldo.
| Contenedor | Tecnología | Responsable | Datos que guarda | Dependencia externa | Respaldo |
|---|---|---|---|---|---|
| n8n 2.43.7 | Docker en el servidor propio | Valeria | Workflows, credenciales cifradas, historial de ejecuciones | Proveedor del servidor | Copias diarias y semanales (Día 35); JSON en Git (Día 42) |
| Postgres | Docker en el servidor propio | Valeria | Clientes, pedidos, renglones, consentimientos, ejecuciones, aprobaciones | Proveedor del servidor | 7 copias diarias y 4 semanales cifradas fuera del servidor |
| Servidor MCP de inventario | Python con el SDK mcp, detrás de HTTPS | Valeria | Nada propio: lee el inventario en modo de solo lectura | Proveedor del servidor | Código en Git; se reconstruye en minutos |
trigo_lento.sqlite | SQLite en el servidor propio | Valeria | Catálogo, inventario, movimientos, índice de conocimiento | Proveedor del servidor | Copia diaria con la de Postgres |
| Make Core | Nube de Make | Valeria | 4 escenarios cortos y su historial | Make | Blueprints exportados en Git |
| Slack | Nube de Slack | Valeria | Canal de operaciones: alertas y botones de aprobación | Slack | Las decisiones también quedan en Postgres |
| Notion | Nube de Notion | Don Ernesto aprueba, Valeria edita | 40 páginas publicables: fichas, políticas, avisos | Notion | Exportación semanal en Markdown |
El cuarto bloque dibuja el nivel 2 con las quince relaciones como flechas. Las cuatro piezas que viven en el servidor propio quedan dentro de un rectángulo discontinuo, el límite de confianza: todo lo que cruza esa línea entra o sale del control de Trigo Lento y se pinta en naranja; lo que se queda dentro, en gris. El color no es decorativo, es la lista de puertas que el Día 80 va a auditar:
# Diagrama de contenedores con flechas de datos y el límite de confianza en Python:
POS = {'n8n 2.43.7': (0, 0), 'Postgres': (-2.6, -2.3), 'trigo_lento.sqlite': (0, -2.3),
       'Servidor MCP de inventario': (2.6, -2.3), 'Make Core': (-6.4, -1.2), 'Slack': (-6.4, 1.4),
       'Notion': (-6.4, 3.4), 'Cloud API de Meta': (6.4, 3.4), 'API de Claude': (6.4, 1.2),
       'Voyage AI': (6.4, -0.6), 'Gmail': (6.4, -2.3), 'Redes sociales': (2.6, 3.4), 'FacturaFácil': (-2.6, 3.4)}
PROPIOS = {'n8n 2.43.7', 'Postgres', 'trigo_lento.sqlite', 'Servidor MCP de inventario'}
fig, ax = plt.subplots(figsize = (13.5, 7.0))
ax.add_patch(Rectangle((-4.1, -3.3), 8.2, 4.35, fill = False, ls = '--', lw = 1.6, edgecolor = '#c0392b'))
ax.text(-4.0, -3.18, 'límite de confianza: servidor propio', fontsize = 10.5, color = '#c0392b')
for nombre, (x, y) in POS.items():
    color = '#2a78d6' if nombre in PROPIOS else ('#7b4fc9' if nombre in ('API de Claude', 'Voyage AI') else '#8a8a8a')
    caja(ax, x, y, 2.5, 0.9, textwrap.fill(nombre, 18), color, tam = 10.5)
for origen, destino, dato, cruza in RELACIONES:
    (x1, y1), (x2, y2) = POS[origen], POS[destino]
    ax.add_patch(FancyArrowPatch((x1, y1), (x2, y2), arrowstyle = '-|>', mutation_scale = 11, shrinkA = 34,
                                 shrinkB = 34, color = '#eb6834' if cruza else '#52514e', lw = 1.2,
                                 connectionstyle = 'arc3,rad=0.08'))
ax.text(0, -3.75, 'naranja: el dato sale o entra por el límite de confianza; gris: se queda dentro', fontsize = 9.5,
        ha = 'center', color = '#52514e')
ax.set_xlim(-7.8, 7.8)
ax.set_ylim(-4.1, 4.1)
ax.set_aspect('equal')
ax.axis('off')
ax.set_title('Nivel 2, contenedores: dónde vive cada pieza y qué datos se mueven', fontsize = 14)
plt.tight_layout()
plt.show()
grado = pd.Series([o for o, *_ in RELACIONES] + [d for _, d, *_ in RELACIONES]).value_counts()
print('Relaciones por contenedor (entrada + salida):', grado.head(4).to_dict())
print(f'Relaciones que tocan n8n: {grado["n8n 2.43.7"]} de {len(RELACIONES)} '
      f'({grado["n8n 2.43.7"] / len(RELACIONES):.0%}) | dentro del límite: {len(RELACIONES) - cruzan}')
Relaciones por contenedor (entrada + salida): {'n8n 2.43.7': 12, 'Cloud API de Meta': 2, 'API de Claude': 2, 'Servidor MCP de inventario': 2}
Relaciones que tocan n8n: 12 de 15 (80%) | dentro del límite: 3
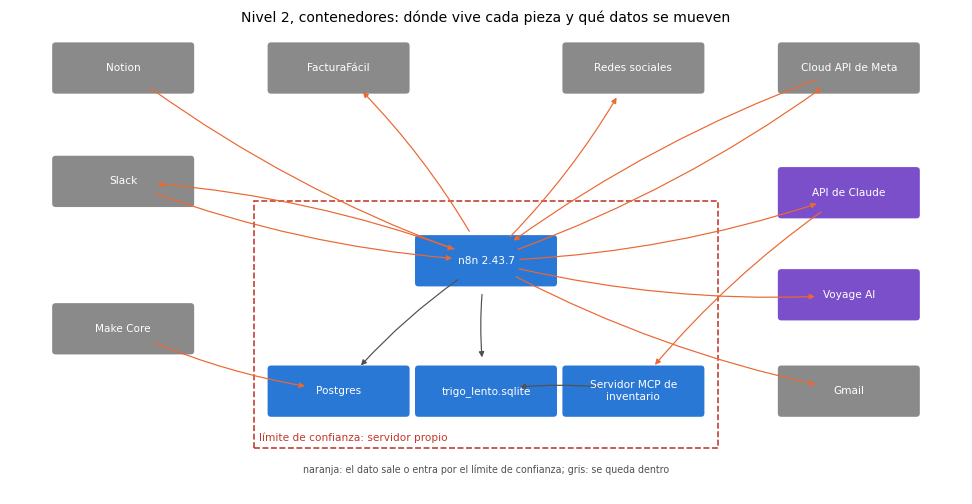
La cifra que resume el diagrama es que n8n participa en $12$ de las $15$ relaciones, el $80%$, y las tres restantes también acaban en el servidor propio (Make escribe en Postgres, el conector MCP de Claude entra al servidor MCP y este lee la base SQLite). Eso tiene dos lecturas, y las dos son ciertas. La primera es buena: hay un solo lugar al que mirar cuando algo falla, y es el historial de ejecuciones de n8n, la tabla ejecuciones del Día 75 y las alertas de TL Alertas de flujos v1. La segunda es la que ocupa la sección de puntos únicos de falla: si el servidor propio se cae, no se cae un flujo, se cae el obrador digital entero, con la excepción de los cuatro escenarios de Make, que siguen recibiendo formularios y mandando recordatorios, pero sin poder escribir en Postgres.
El dibujo deja ver también por qué el servidor MCP del Día 62 (Model Context Protocol I: un servidor MCP para el inventario de Trigo Lento) es un contenedor aparte y no una función dentro de n8n: es la única pieza del servidor propio a la que entra una llamada desde fuera que no es un webhook firmado de Meta o de Slack, sino el conector MCP de la API de Claude con su token. Tenerlo separado, en modo de solo lectura y con tres herramientas en lista blanca, es lo que permite que esa puerta exista sin que abra el resto de la casa. La decisión está escrita en el ADR-004 de la sección de decisiones.
Nivel 3: los flujos
El tercer nivel ya no se dibuja como un diagrama único, porque veinticinco cajas con sus flechas no se leen; se agrupa por dominio, que es la unidad con la que el negocio piensa. Un dominio responde a una pregunta del negocio (¿llegó el pedido?, ¿se contestó al cliente?, ¿qué vendimos?, ¿qué publicamos?, ¿funciona todo?) y reúne los flujos que la atienden, vengan de la plataforma que vengan. La Tabla 2 resume el cruce del Bloque 2, con el día en que nació cada flujo y la puerta humana que lo supervisa, porque “autónomo” en este módulo significa que opera solo dentro de los límites que fijaron las personas, no que actúa sin ellas.
Tabla 2. Flujos en producción agrupados por dominio, con su plataforma, el día en que nacieron y la puerta humana.
| Dominio | Flujos en n8n | Flujos en Make | Total | Puerta humana |
|---|---|---|---|---|
| Pedidos | TL Orquestador v1 (52), TL Agente de pedidos v4 (69), TL Facturación (40) | TL Formulario v2 (22), TL Recordatorio de recogida v1 (26), TL Brújula diario v1 (32), Sincronización de clientes (16) | 7 | Valeria revisa facturas; el agente escala lo ambiguo |
| Comunicación | TL WhatsApp Cloud API v1 (56), TL Responder por canal v1 (52), TL WhatsApp secuencias v2 (49), TL Gmail mayoristas v1 (47), TL Slack operaciones v1 (50), TL Monitor de plantillas v1 (54) | ninguno | 6 | Borradores de Gmail que Valeria envía; consentimiento y plantilla aprobada |
| Inteligencia de negocio | TL Lote nocturno v1 (60), TL Remisiones v1 (66), TL Consulta de inventario v1 (63), TL Informe del lunes v1 (67) | ninguno | 4 | Aprobación en Slack de remisiones e informe |
| Contenido | TL Indexador Notion v1 (68), TL Aprobaciones v2 (76), TL Publicación multired v2 (76), TL Campaña primavera v1 (77) | ninguno | 4 | TL Aprobaciones v2 antes de publicar |
| Operación | TL Errores v1 (43), TL Métricas de atención v1 (53), TL Evaluación del agente v1 (70), TL Alertas de flujos v1 (75) | ninguno | 4 | Las alertas las lee una persona |
Dos cosas se ven en la tabla que no se veían desde dentro de cada módulo. La primera es que el dominio de pedidos es el único repartido entre dos plataformas, y es así por una decisión, no por un accidente: el Día 45 (Sesión práctica de consolidación: migrar el escenario de Make a n8n) dejó en Make los cuatro escenarios cortos con conector y movió a n8n el agente, la mensajería y los lotes. La frontera entre plataformas pasa por la mitad de un dominio, y la persona que releve a Valeria tiene que conocer las dos. La segunda es que cuatro de los cinco dominios tienen una puerta humana nombrada, y el quinto, operación, consiste precisamente en avisar a una persona. Ningún flujo de la tabla cobra, cancela, publica ni escribe a un cliente fuera de la ventana sin que alguien lo haya decidido antes; es el artículo 1 del código de honor, y el Bloque 10 lo comprobará contra los JSON exportados.
Lo que la tabla no muestra, y el Día 79 (Proyecto integrador II: inventario de flujos y gobierno) construirá, es el grafo de quién llama a quién: TL Orquestador v1 invoca al agente, el agente a la facturación, la campaña a las aprobaciones y estas a la publicación. Hoy basta con saber que esas llamadas existen y que todas pasan por n8n, porque es lo que convierte al servidor propio en el primer punto único de falla.
Puntos únicos de falla
Un punto único de falla (o SPOF, por sus siglas en inglés: “Single Point of Failure”) es un componente cuya caída detiene un servicio del negocio y para el que no hay alternativa preparada. La definición tiene dos mitades y las dos cuentan: que muchas cosas dependan de un componente lo hace importante, pero solo lo convierte en punto único si no hay un camino alternativo. Un componente del que dependen seis servicios pero que tiene respaldo documentado es un riesgo gestionado; uno del que depende un solo servicio sin alternativa es un punto único.
El quinto bloque toma seis servicios del negocio tal como los nombraría Don Ernesto (responder un encargo, confirmar el pedido de Brújula, publicar una pieza, consultar el inventario desde el obrador, el informe del lunes y emitir una factura), lista los componentes que sostienen cada uno, incluidas las personas y las credenciales, y cruza esa lista con las alternativas que la serie dejó preparadas:
# Puntos únicos de falla: qué componente sostiene cada servicio del negocio y si tiene alternativa en Python:
SERVICIOS_NEGOCIO = {
    'Responder un encargo por WhatsApp': ['Cloud API de Meta', 'Token de la Cloud API', 'Servidor propio', 'API de Claude',
                                          'Clave de Claude'],
    'Confirmar el pedido de Brújula': ['Make Core', 'Servidor propio', 'Gmail', 'Valeria'],
    'Publicar una pieza aprobada': ['Servidor propio', 'Slack', 'Persona que aprueba', 'Redes sociales'],
    'Consultar el inventario desde el obrador': ['Slack', 'API de Claude', 'Clave de Claude', 'Servidor propio'],
    'Informe del lunes': ['Servidor propio', 'API de Claude', 'Clave de Claude', 'Persona que aprueba'],
    'Emitir una factura': ['Servidor propio', 'FacturaFácil', 'Valeria'],
}
ALTERNATIVA = {'API de Claude': 'respuesta de plantilla o respaldo sin IA', 'Cloud API de Meta': 'Twilio documentado (ADR-001)',
               'Persona que aprueba': 'escalado al siguiente aprobador a los 60 minutos', 'Gmail': 'enviar desde el teléfono',
               'Redes sociales': 'publicar a mano desde la aplicación', 'Slack': 'aprobación por WhatsApp (Día 74)'}
dependencias = pd.Series([c for comps in SERVICIOS_NEGOCIO.values() for c in comps]).value_counts()
puntos = pd.DataFrame({'servicios': dependencias,
                       'alternativa': [ALTERNATIVA.get(c, 'ninguna') for c in dependencias.index]})
puntos['punto_unico'] = puntos.alternativa.eq('ninguna')
print(puntos.to_string())
spof = puntos.index[puntos.punto_unico].tolist()
print('Puntos únicos de falla:', spof)
sin_valeria = [s for s, comps in SERVICIOS_NEGOCIO.items() if 'Valeria' in comps]
print(f'Servicios que dependen del servidor propio: {dependencias["Servidor propio"]} de {len(SERVICIOS_NEGOCIO)} | '
      f'que se detienen sin Valeria: {sin_valeria}')
                       servicios                                       alternativa  punto_unico
Servidor propio                6                                           ninguna         True
API de Claude                  3          respuesta de plantilla o respaldo sin IA        False
Clave de Claude                3                                           ninguna         True
Valeria                        2                                           ninguna         True
Slack                          2                  aprobación por WhatsApp (Día 74)        False
Persona que aprueba            2  escalado al siguiente aprobador a los 60 minutos        False
Cloud API de Meta              1                      Twilio documentado (ADR-001)        False
Token de la Cloud API          1                                           ninguna         True
Make Core                      1                                           ninguna         True
Gmail                          1                          enviar desde el teléfono        False
Redes sociales                 1               publicar a mano desde la aplicación        False
FacturaFácil                   1                                           ninguna         True
Puntos únicos de falla: ['Servidor propio', 'Clave de Claude', 'Valeria', 'Token de la Cloud API', 'Make Core', 'FacturaFácil']
Servicios que dependen del servidor propio: 6 de 6 | que se detienen sin Valeria: ['Confirmar el pedido de Brújula', 'Emitir una factura']
El resultado tiene dos partes. Los componentes con alternativa no son puntos únicos aunque sostengan varios servicios: la API de Claude sostiene $3$ de los $6$ servicios, pero el Día 38 (Agentes autónomos con supervisión humana: el asistente de pedidos) dejó la respuesta de plantilla y el Día 63 el respaldo sin IA de la consulta de inventario; Slack sostiene dos, y el Día 74 (Humano en el bucle: aprobaciones con Slack y WhatsApp) dejó la aprobación por WhatsApp; la persona que aprueba escala al siguiente aprobador a los sesenta minutos. Los $6$ puntos únicos son los que no tienen alternativa escrita: el servidor propio, del que dependen los $6$ servicios; la clave de Claude, de la que dependen tres; Valeria, de la que dependen dos (el pedido de Brújula, porque ella envía los borradores de Gmail, y la factura, porque ella la revisa); el token de la Cloud API; Make Core; y FacturaFácil.
Conviene separar dos tipos de punto único que la lista mezcla a propósito. El servidor, Make y FacturaFácil son componentes: fallan por sí mismos, con una probabilidad que se puede suponer y medir. La clave de Claude y el token de la Cloud API son credenciales: no fallan, caducan o se revocan, y cuando lo hacen el componente al que dan acceso está perfectamente sano. El Día 81 (Proyecto integrador III: manuales de operación (runbooks) y continuidad) abre precisamente con un viernes a las seis de la tarde en que el token de la Cloud API caducó y nadie sabía qué hacer. Y Valeria es un tercer tipo, una persona, cuya “caída” ya tiene fecha: del 11 al 16 de mayo. De los tres tipos, el último es el único que se resuelve sin tecnología, nombrando un suplente; es lo que hará el inventario del Día 79.
La decisión de incluir a las personas y a las credenciales en la lista de componentes no es un adorno. Si la lista solo tuviera servidores y servicios, el diagrama diría que el ecosistema resiste la ausencia de Valeria, y sería falso: dos servicios del negocio se detienen sin ella. Un plano que omite a las personas no es un plano más limpio, es un plano equivocado.
Disponibilidad compuesta
Saber qué es un punto único no dice cuánto cuesta. Para eso hace falta la disponibilidad, la fracción del tiempo en que un componente funciona, y una regla para combinarla. Si un servicio necesita que varios componentes funcionen a la vez, es decir, si están en serie, su disponibilidad es el producto de las disponibilidades de cada uno:
$$ A_{\text{serie}} = \prod_{i=1}^{n} A_i $$
- $A_i$ es la disponibilidad del componente $i$, una fracción entre $0$ y $1$; $0.999$ significa que funciona el $99.9%$ del tiempo.
- El producto es siempre menor o igual que la menor de las $A_i$: una cadena no es más fuerte que su eslabón más débil, y cada eslabón que se añade la debilita un poco más.
- La fórmula supone que los componentes fallan de forma independiente; si el servidor y Postgres caen juntos porque comparten la máquina, se cuentan como un solo componente, que es lo que hace la Tabla 3.
Si, en cambio, basta con que uno de varios componentes funcione, están en paralelo, y lo que se multiplica es la probabilidad de que fallen todos a la vez:
$$ A_{\text{paralelo}} = 1 - \prod_{i=1}^{n} (1 - A_i) $$
- $1 - A_i$ es la fracción del tiempo en que el componente $i$ está caído; el producto es la fracción en que están caídos todos.
- El resultado es siempre mayor o igual que la mayor de las $A_i$: un respaldo mediocre mejora a un componente excelente, aunque poco.
- Una degradación controlada es un paralelo con un componente de disponibilidad $1$: la respuesta de plantilla “no necesita” nada para funcionar, así que $1 - (1 - A_{\text{Claude}})(1 - 1) = 1$ y Claude desaparece del camino crítico.
Las fracciones se vuelven tangibles cuando se convierten en horas. Con un mes de $30$ días, cada componente deja de funcionar durante:
$$ H_{\text{caída}} = (1 - A) \cdot 720 $$
- $720$ son las horas de un mes de $30$ días ($30 \cdot 24$); el Día 82 recortará la cuenta al horario de servicio, que es lo que de verdad importa a los clientes.
- Con $A = 0.999$, la caída es de $0.72$ horas al mes, unos $43$ minutos; con $A = 0.995$, de $3.6$ horas.
- La relación es lineal: pasar de $99.5%$ a $99.9%$ no gana “cuatro décimas”, gana cinco veces menos caída.
El sexto bloque aplica las tres fórmulas al camino crítico de un mensaje de WhatsApp, que atraviesa la Cloud API de Meta, el servidor de n8n con Postgres y la API de Claude, con las disponibilidades supuestas de Trigo Lento, y calcula tres escenarios: la cadena en serie, la cadena con respuesta de plantilla cuando Claude no responde, y esa misma con un servidor más disponible. Además, aplica el paralelo a un componente que no es una máquina, la persona que aprueba:
# Disponibilidad compuesta analítica del camino crítico, con y sin degradación, en Python:
HORAS_MES = 30 * 24
DISPONIBILIDAD = {'Cloud API de Meta': 0.999, 'Servidor de n8n (con Postgres)': 0.995, 'API de Claude': 0.999,
                  'Make Core': 0.999, 'Slack': 0.999, 'Notion': 0.999}   # supuestos declarados, no SLA medidos
serie = lambda *a: float(np.prod(a))
paralelo = lambda *a: 1 - float(np.prod([1 - x for x in a]))
caida = lambda a: (1 - a) * HORAS_MES
d = DISPONIBILIDAD
escenarios = {
    'Camino crítico sin degradación': serie(d['Cloud API de Meta'], d['Servidor de n8n (con Postgres)'], d['API de Claude']),
    'Con respuesta de plantilla si Claude cae': serie(d['Cloud API de Meta'], d['Servidor de n8n (con Postgres)'],
                                                      paralelo(d['API de Claude'], 1.0)),
    'Con plantilla y servidor al 99.9 %': serie(d['Cloud API de Meta'], 0.999, paralelo(d['API de Claude'], 1.0)),
}
tabla3 = pd.DataFrame({'disponibilidad': list(DISPONIBILIDAD.values()) + list(escenarios.values())},
                      index = list(DISPONIBILIDAD) + list(escenarios))
tabla3['horas_de_caida_al_mes'] = caida(tabla3.disponibilidad)
print(tabla3.round({'disponibilidad': 5, 'horas_de_caida_al_mes': 2}).to_string())
peso = {k: caida(v) for k, v in list(DISPONIBILIDAD.items())[:3]}
print('Parte de la caída del camino crítico por componente:',
      {k.split(' (')[0]: f'{v / sum(peso.values()):.0%}' for k, v in peso.items()})
# La persona que aprueba como punto único de falla: probabilidad de que alguien decida en menos de 60 minutos.
aprobar = {'Valeria': 0.90, 'Don Ernesto': 0.80, 'Persona de mostrador': 0.70}
print(f"Aprobación con Valeria y Don Ernesto: {paralelo(aprobar['Valeria'], aprobar['Don Ernesto']):.2f} | "
      f"solo Don Ernesto (vacaciones): {aprobar['Don Ernesto']:.2f} | "
      f"Don Ernesto y suplente de mostrador: {paralelo(aprobar['Don Ernesto'], aprobar['Persona de mostrador']):.2f}")
                                          disponibilidad  horas_de_caida_al_mes
Cloud API de Meta                                0.99900                   0.72
Servidor de n8n (con Postgres)                   0.99500                   3.60
API de Claude                                    0.99900                   0.72
Make Core                                        0.99900                   0.72
Slack                                            0.99900                   0.72
Notion                                           0.99900                   0.72
Camino crítico sin degradación                   0.99301                   5.03
Con respuesta de plantilla si Claude cae         0.99400                   4.32
Con plantilla y servidor al 99.9 %               0.99800                   1.44
Parte de la caída del camino crítico por componente: {'Cloud API de Meta': '14%', 'Servidor de n8n': '71%', 'API de Claude': '14%'}
Aprobación con Valeria y Don Ernesto: 0.98 | solo Don Ernesto (vacaciones): 0.80 | Don Ernesto y suplente de mostrador: 0.94
La Tabla 3 recoge los resultados. Los supuestos son los que la serie viene usando desde el Día 45: $99.9%$ para los servicios en la nube y $99.5%$ para el servidor propio, que no tiene equipo de guardia.
Tabla 3. Disponibilidad supuesta por componente (declarada como supuesto, no como SLA medido) y compuesta del camino crítico de WhatsApp.
| Componente o escenario | Disponibilidad | Horas de caída al mes |
|---|---|---|
| Cloud API de Meta | 0.99900 | 0.72 |
| Servidor de n8n (con Postgres) | 0.99500 | 3.60 |
| API de Claude | 0.99900 | 0.72 |
| Make Core | 0.99900 | 0.72 |
| Slack | 0.99900 | 0.72 |
| Notion | 0.99900 | 0.72 |
| Camino crítico sin degradación | 0.99301 | 5.03 |
| Con respuesta de plantilla si Claude cae | 0.99400 | 4.32 |
| Con plantilla y servidor al 99.9 % | 0.99800 | 1.44 |
El camino crítico sin degradación está disponible el $0.9930$ del tiempo: $0.999 \cdot 0.995 \cdot 0.999$, unas $5.03$ horas de caída al mes. Cuando Claude no responde y el flujo contesta con una plantilla (“Recibimos su mensaje, en unos minutos le confirmamos”), la disponibilidad sube a $0.9940$, $4.32$ horas: la IA deja de estar en el camino crítico, pero el camino mejora poco, porque la IA nunca fue el problema. El reparto lo dice con claridad: el servidor propio aporta el $71%$ de la caída, y Meta y Claude el $14%$ cada uno. Si el servidor estuviera al $99.9%$, el camino quedaría en $0.9980$, $1.44$ horas, tres veces y media menos. El eslabón débil de un ecosistema de automatización con IA no es la IA; es la máquina de seis dólares al mes de la que depende todo.
La última línea del bloque aplica la fórmula del paralelo a las personas, y el resultado explica mejor que cualquier argumento por qué hace falta un suplente. Si Valeria aprueba a tiempo el $90%$ de las veces y Don Ernesto el $80%$, entre los dos llegan al $0.98$; en vacaciones, con solo Don Ernesto, la cifra cae al $0.80$; con la persona de mostrador como suplente, aunque solo acierte el $70%$ de las veces, sube a $0.94$. Un suplente mediocre mejora mucho a un aprobador bueno que está solo.
La Figura 2 dibuja la cadena tal como la verá Don Ernesto: tres eslabones, el del medio en rojo, y el desvío de la plantilla que saca a Claude del camino cuando no responde.
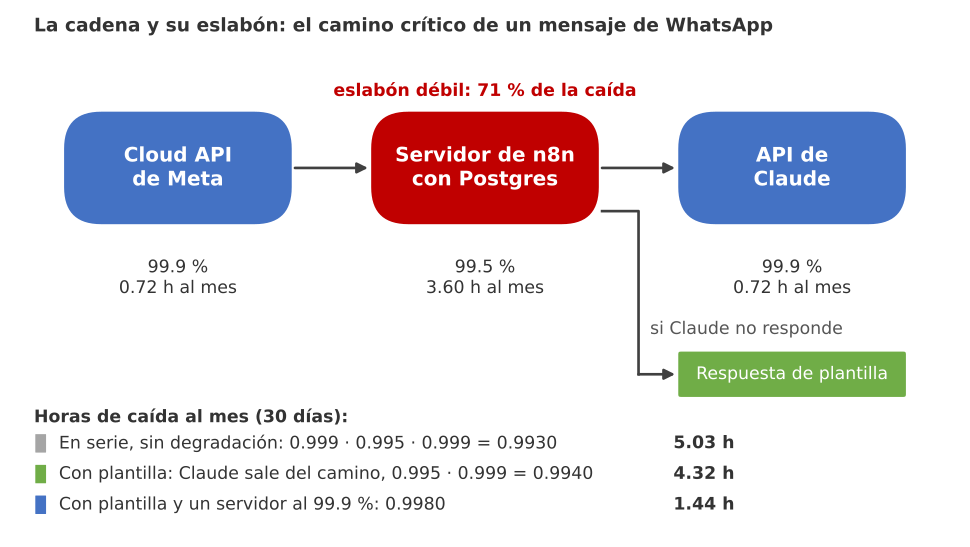
Figura 2. La cadena y su eslabón: la Cloud API de Meta, el servidor de n8n y la API de Claude en serie; el servidor, con un 99.5 por ciento supuesto, aporta el 71 por ciento de la caída, y la respuesta de plantilla saca a Claude del camino crítico.
Las fórmulas dan promedios, y un promedio de $5$ horas al mes puede ser un mes limpio y otro con un día entero caído. Para ver la dispersión, el séptimo bloque simula cinco mil meses: cada componente sufre un número de incidentes de Poisson, con una duración media distinta (media hora para Meta, algo más de una hora para el servidor, que hay que reiniciar a mano, y veinticuatro minutos para Claude), y se mide cuántas horas del mes está caído el camino, uniendo los tramos que se solapan para no contarlos dos veces:
$$ \lambda = \frac{(1 - A) \cdot 720}{d} $$
- $\lambda$ es el número esperado de incidentes al mes de un componente con disponibilidad $A$ y duración media $d$ horas por incidente; el servidor, con $3.6$ horas de caída y $1.2$ horas por incidente, sufre unos $3$ incidentes al mes.
- El número real de incidentes se sortea de una Poisson con media $\lambda$ y cada duración de una exponencial con media $d$, el mismo modelo de llegadas y servicios que las colas del Día 8.
- Dos componentes caídos a la vez cuentan una sola vez: por eso la media simulada puede quedar ligeramente por debajo de la analítica, que suma caídas como si nunca coincidieran.
# Simulación de caídas de un mes por componente y efecto de la degradación controlada en Python:
DURACION_MEDIA = {'meta': 0.5, 'n8n': 1.2, 'claude': 0.4}          # horas por incidente (supuestos)
def incidentes(disponibilidad, duracion_media):
    lam = caida(disponibilidad) / duracion_media                     # incidentes esperados al mes
    n = rng.poisson(lam)
    inicio = rng.uniform(0, HORAS_MES, n)
    return np.column_stack([inicio, np.minimum(inicio + rng.exponential(duracion_media, n), HORAS_MES)])

def horas_union(*listas):
    tramos = sorted(map(tuple, np.vstack([l for l in listas if len(l)] or [np.empty((0, 2))])))
    total, fin = 0.0, -1.0
    for a, b in tramos:
        if b > fin:
            total += b - max(a, fin)
            fin = b
    return total

MESES = 5000
resultados = {k: [] for k in ('sin degradación', 'con plantilla', 'plantilla y servidor 99.9 %')}
culpa_n8n = []
for _ in range(MESES):
    meta, n8n, claude = (incidentes(0.999, DURACION_MEDIA['meta']), incidentes(0.995, DURACION_MEDIA['n8n']),
                         incidentes(0.999, DURACION_MEDIA['claude']))
    n8n_mejor = incidentes(0.999, DURACION_MEDIA['n8n'])
    resultados['sin degradación'].append(horas_union(meta, n8n, claude))
    resultados['con plantilla'].append(horas_union(meta, n8n))
    resultados['plantilla y servidor 99.9 %'].append(horas_union(meta, n8n_mejor))
    culpa_n8n.append(horas_union(n8n))
sim = pd.DataFrame(resultados)
resumen = sim.describe(percentiles = [0.5, 0.95]).loc[['mean', '50%', '95%', 'max']].T
resumen['meses_sobre_5_h'] = (sim > 5).mean()
print(resumen.round(2).to_string())
print(f"Parte de la caída sin degradación que viene de n8n: {np.mean(culpa_n8n) / sim['sin degradación'].mean():.0%}")

fig, ax = plt.subplots(figsize = (11, 4.6))
bins = np.arange(0, 21, 0.5)
for col, color in zip(sim.columns, ['#c0392b', '#eb6834', '#1f9d55']):
    ax.hist(sim[col], bins = bins, histtype = 'step', lw = 2.2, color = color,
            label = f'{col}: media {sim[col].mean():.2f} h, p95 {sim[col].quantile(0.95):.2f} h')
ax.axvline(5, color = '#8a8986', ls = '--', lw = 1.2)
ax.text(5.15, ax.get_ylim()[1] * 0.92, '5 horas', color = '#52514e', fontsize = 9.5)
ax.set_xlabel('Horas de caída del camino crítico en un mes')
ax.set_ylabel(f'Meses (de {MESES} simulados)')
ax.set_title('Caídas del camino crítico de WhatsApp: el eslabón débil es el servidor propio', fontsize = 12)
ax.legend(frameon = False, fontsize = 9.5)
ax.spines[['top', 'right']].set_visible(False)
plt.tight_layout()
plt.show()
                             mean   50%    95%    max  meses_sobre_5_h
sin degradación              4.98  4.42  10.97  23.50             0.42
con plantilla                4.27  3.74  10.19  23.03             0.34
plantilla y servidor 99.9 %  1.43  0.95   4.56  12.67             0.04
Parte de la caída sin degradación que viene de n8n: 72%
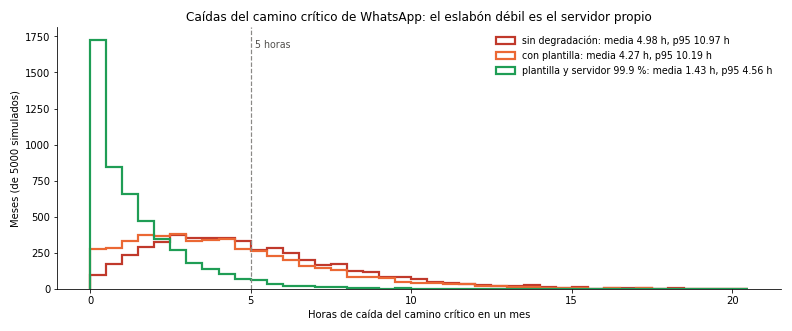
La simulación confirma las fórmulas y añade lo que las fórmulas no dicen. Sin degradación, la media es de $4.98$ horas, a cinco centésimas de las $5.03$ analíticas, pero la mediana es de $4.42$, el percentil $95$ de $10.97$ horas y el peor de los cinco mil meses llega a $23.5$: el $42%$ de los meses supera las $5$ horas. Con la plantilla, la media baja a $4.27$ y los meses malos al $34%$. Con la plantilla y un servidor al $99.9%$, la media cae a $1.43$ horas, el percentil $95$ a $4.56$ y solo el $4%$ de los meses pasa de $5$ horas. La parte de la caída que viene del servidor, medida en la simulación, es del $72%$, la misma que la analítica. La figura lo muestra con tres histogramas: los dos primeros casi se superponen, y el tercero se aprieta contra el cero. Si Don Ernesto pregunta en qué conviene gastar la reserva, la respuesta es la curva verde, no un modelo más caro.
Atención aquí: las disponibilidades de la Tabla 3 son supuestos declarados por Trigo Lento, no acuerdos de nivel de servicio publicados por Meta, Anthropic, Make, Slack o Notion ni mediciones propias. Se eligieron redondas y conservadoras para que el cálculo sea reproducible, y el $99.5%$ del servidor es una estimación de un VPS pequeño sin guardia, no una promesa del proveedor. Usar estas cifras para firmar un compromiso con un cliente sería presentar una simulación como una medición, que es lo que el código de honor prohíbe; el Día 82 derivará el acuerdo con Brújula de los indicadores medidos del cuadro de mando y dejará un margen explícito frente a estos supuestos.
Fronteras de datos
El diagrama de contenedores pinta en naranja doce relaciones que cruzan el límite de confianza, pero no dice qué cruza. Para el aviso de privacidad, para la Ley Federal de Protección de Datos Personales en Posesión de los Particulares y para la promesa de Don Ernesto sobre sus recetas, la pregunta exacta es otra: ¿qué dato sale a qué proveedor, en qué forma y con qué base? La forma importa tanto como el destino. Un nombre que sale identificable convierte al proveedor en encargado del tratamiento y obliga a nombrarlo en el aviso; el mismo nombre seudonimizado, sustituido por un código antes de salir, como se hace con Claude desde el Día 6, no identifica a nadie fuera de Trigo Lento; un dato público o agregado, como una ficha de producto o las ventas de la semana sumadas, no es un dato personal.
El octavo bloque escribe la matriz de diez tipos de dato por nueve proveedores, con la forma en que sale cada uno ($0$ no sale, $1$ público o agregado, $2$ seudonimizado, $3$ identificable), la finalidad y la base de cada proveedor, y la dibuja como un mapa de calor:
# Fronteras de datos: qué dato sale a qué proveedor, en qué forma y con qué base, en Python:
FORMA = {0: 'no sale', 1: 'público o agregado', 2: 'seudonimizado', 3: 'identificable (necesario)'}
TIPOS = ['nombre', 'teléfono', 'dirección', 'texto del mensaje', 'pedido', 'datos fiscales', 'ventas', 'fichas y políticas',
         'fotos de producto', 'recetas']
FRONTERAS = pd.DataFrame({  # 0 no sale, 1 público o agregado, 2 seudonimizado, 3 identificable
    'Meta (WhatsApp y redes)': [3, 3, 3, 3, 3, 0, 0, 1, 1, 0],
    'Google (Gmail)':          [3, 0, 3, 3, 3, 3, 0, 0, 0, 0],
    'Slack':                   [2, 0, 0, 2, 2, 0, 1, 1, 1, 0],
    'Notion':                  [0, 0, 0, 0, 0, 0, 0, 1, 1, 0],
    'Anthropic (Claude)':      [2, 0, 2, 2, 2, 3, 1, 1, 1, 0],
    'Voyage AI':               [0, 0, 0, 0, 0, 0, 0, 1, 0, 0],
    'Make':                    [3, 3, 3, 3, 3, 0, 0, 0, 0, 0],
    'FacturaFácil':            [3, 0, 3, 0, 3, 3, 0, 0, 0, 0],
    'LinkedIn':                [0, 0, 0, 0, 0, 0, 0, 1, 1, 0],
}, index = TIPOS).T
FINALIDAD = {'Meta (WhatsApp y redes)': ('atender encargos y publicar', 'pedido en curso o consentimiento'),
             'Google (Gmail)': ('pedidos y facturas de mayoristas', 'contrato con Brújula'),
             'Slack': ('alertas y aprobaciones internas', 'interés del servicio, sin identidad'),
             'Notion': ('base de conocimiento publicada', 'sin datos personales'),
             'Anthropic (Claude)': ('clasificar, redactar y leer facturas de proveedores', 'seudonimizado (Día 6)'),
             'Voyage AI': ('embeddings de páginas públicas', 'sin datos personales'),
             'Make': ('formulario, recogidas y Brújula', 'pedido en curso'),
             'FacturaFácil': ('emitir CFDI', 'obligación fiscal'),
             'LinkedIn': ('publicar piezas aprobadas', 'sin datos personales')}
tabla2 = pd.DataFrame({
    'identificable': (FRONTERAS == 3).sum(axis = 1), 'seudonimizado': (FRONTERAS == 2).sum(axis = 1),
    'publico_o_agregado': (FRONTERAS == 1).sum(axis = 1),
    'finalidad': [FINALIDAD[p][0] for p in FRONTERAS.index], 'base': [FINALIDAD[p][1] for p in FRONTERAS.index]})
print(tabla2.to_string())
print('Proveedores que reciben recetas:', FRONTERAS.index[FRONTERAS['recetas'] > 0].tolist() or 'ninguno')
print('Encargados con datos personales identificables (aviso de privacidad):',
      FRONTERAS.index[(FRONTERAS[TIPOS[:6]] == 3).any(axis = 1)].tolist())
print('Lo identificable que recibe Claude:', FRONTERAS.columns[FRONTERAS.loc['Anthropic (Claude)'] == 3].tolist())

fig, ax = plt.subplots(figsize = (12, 5.2))
from matplotlib.colors import ListedColormap
mapa = ListedColormap(['#f2f1ee', '#9cc7ef', '#f2c14e', '#c0392b'])
ax.imshow(FRONTERAS.to_numpy(), cmap = mapa, vmin = -0.5, vmax = 3.5, aspect = 'auto')
for i in range(FRONTERAS.shape[0]):
    for j in range(FRONTERAS.shape[1]):
        v = FRONTERAS.iat[i, j]
        ax.text(j, i, ['', 'P', 'S', 'I'][v], ha = 'center', va = 'center', fontsize = 10,
                color = 'white' if v == 3 else '#333333')
ax.set_xticks(range(len(TIPOS)), TIPOS, rotation = 30, ha = 'right')
ax.set_yticks(range(len(FRONTERAS)), FRONTERAS.index)
ax.set_title('Fronteras de datos: P público o agregado, S seudonimizado, I identificable', fontsize = 12)
plt.tight_layout()
plt.show()
                         identificable  seudonimizado  publico_o_agregado                                            finalidad                                 base
Meta (WhatsApp y redes)              5              0                   2                          atender encargos y publicar     pedido en curso o consentimiento
Google (Gmail)                       5              0                   0                     pedidos y facturas de mayoristas                 contrato con Brújula
Slack                                0              3                   3                      alertas y aprobaciones internas  interés del servicio, sin identidad
Notion                               0              0                   2                       base de conocimiento publicada                 sin datos personales
Anthropic (Claude)                   1              4                   3  clasificar, redactar y leer facturas de proveedores                seudonimizado (Día 6)
Voyage AI                            0              0                   1                       embeddings de páginas públicas                 sin datos personales
Make                                 5              0                   0                      formulario, recogidas y Brújula                      pedido en curso
FacturaFácil                         4              0                   0                                          emitir CFDI                    obligación fiscal
LinkedIn                             0              0                   2                            publicar piezas aprobadas                 sin datos personales
Proveedores que reciben recetas: ninguno
Encargados con datos personales identificables (aviso de privacidad): ['Meta (WhatsApp y redes)', 'Google (Gmail)', 'Anthropic (Claude)', 'Make', 'FacturaFácil']
Lo identificable que recibe Claude: ['datos fiscales']
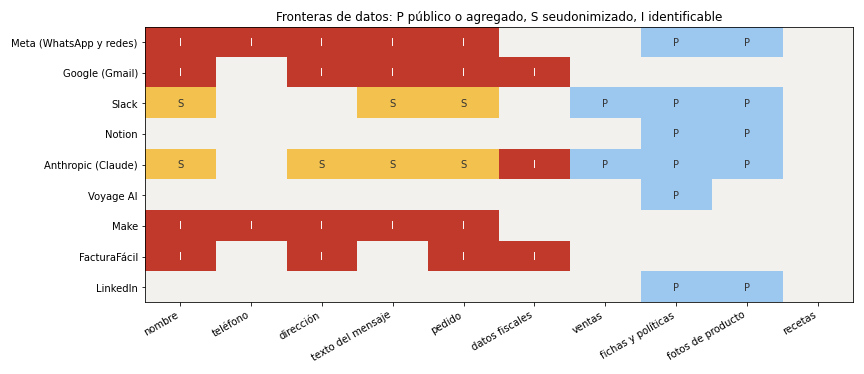
La Tabla 4 resume la matriz por proveedor. Cada fila es, en la práctica, una línea del aviso de privacidad.
Tabla 4. Fronteras de datos por proveedor: cuántos tipos de dato recibe en cada forma, con qué finalidad y con qué base.
| Proveedor | Identificable | Seudonimizado | Público o agregado | Finalidad | Base |
|---|---|---|---|---|---|
| Meta (WhatsApp y redes) | 5 | 0 | 2 | Atender encargos y publicar | Pedido en curso o consentimiento |
| Google (Gmail) | 5 | 0 | 0 | Pedidos y facturas de mayoristas | Contrato con Brújula |
| Slack | 0 | 3 | 3 | Alertas y aprobaciones internas | Interés del servicio, sin identidad |
| Notion | 0 | 0 | 2 | Base de conocimiento publicada | Sin datos personales |
| Anthropic (Claude) | 1 | 4 | 3 | Clasificar, redactar y leer facturas de proveedores | Seudonimizado (Día 6) |
| Voyage AI | 0 | 0 | 1 | Embeddings de páginas públicas | Sin datos personales |
| Make | 5 | 0 | 0 | Formulario, recogidas y Brújula | Pedido en curso |
| FacturaFácil | 4 | 0 | 0 | Emitir CFDI | Obligación fiscal |
| 0 | 0 | 2 | Publicar piezas aprobadas | Sin datos personales |
Tres resultados del bloque merecen cada uno su frase. Primero, ningún proveedor recibe recetas: la columna está vacía de arriba abajo, y esa columna vacía es la promesa de Don Ernesto convertida en una comprobación que se ejecuta. Segundo, cinco encargados reciben datos personales identificables (Meta, Google, Anthropic, Make y FacturaFácil) y los cinco tienen que aparecer con nombre en el aviso de privacidad, con su finalidad; Slack, Notion, Voyage AI y LinkedIn no reciben datos personales en forma identificable y no son encargados. Tercero, lo único identificable que recibe Claude son los datos fiscales, y solo en un flujo: la lectura de facturas y remisiones de proveedores en PDF del Día 58 (Visión de documentos: facturas y remisiones en PDF), donde el RFC y la razón social del proveedor son el dato que hay que extraer y no se pueden seudonimizar antes de leerlos. Nombre, teléfono, dirección y texto del mensaje llegan a Claude seudonimizados, como fija el artículo 3 del código de honor, y el Bloque 10 lo comprobará leyendo esta misma matriz.
La Figura 3 lo dibuja como una aduana: a la izquierda, lo que vive dentro de Trigo Lento; a la derecha, cada proveedor con lo que recibe y en qué forma; y abajo a la izquierda, en rojo, lo que no cruza.
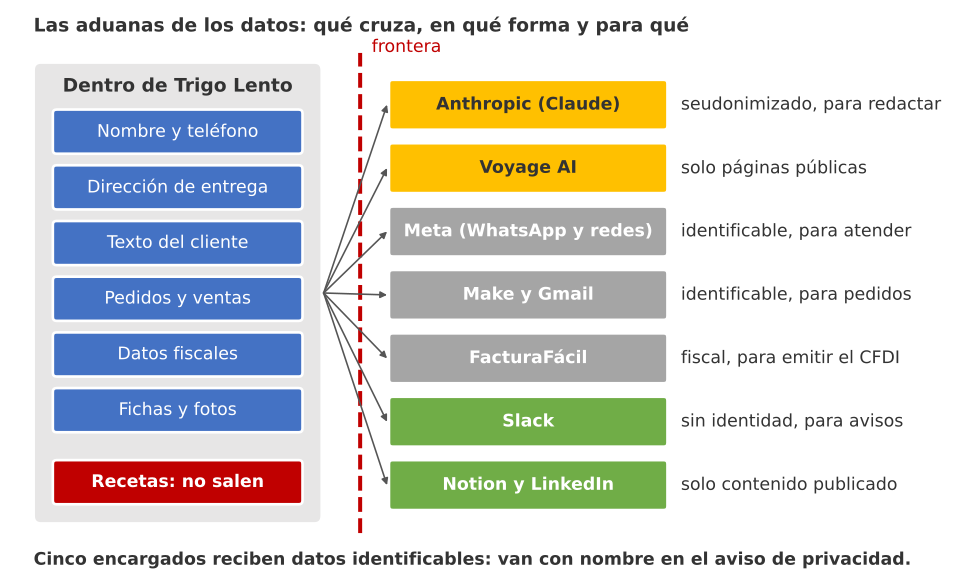
Figura 3. Las aduanas de los datos: cada proveedor recibe solo lo que su finalidad necesita, Claude recibe texto seudonimizado, Voyage AI solo páginas públicas y las recetas no cruzan ninguna frontera.
La matriz tiene un uso que va más allá de hoy. Cuando el Día 80 (Auditoría de seguridad del ecosistema: secretos, permisos y simulacro de restauración) revise los alcances de cada credencial, la pregunta por credencial será la misma que por proveedor: ¿necesita este acceso para la finalidad declarada? Y cuando un flujo nuevo quiera mandar un dato a un proveedor, la regla es añadir primero la celda a la matriz, con su forma y su base, y solo después escribir el nodo. Un dato que no está en la matriz no sale.
Decisiones de arquitectura
Un plano dice cómo es el sistema; no dice por qué. Y el porqué es lo primero que se pierde: dentro de seis meses, alguien mirará el diagrama de contenedores, verá que WhatsApp entra por la Cloud API de Meta directa y no por Twilio, y no sabrá si fue una decisión o una casualidad, ni cuándo conviene cambiarla. Michael Nygard propuso en 2011 una solución de una página por decisión, el registro de decisiones de arquitectura (o ADR, por sus siglas en inglés: “Architecture Decision Record”), con cinco apartados: título, estado, contexto, decisión y consecuencias. La serie añade un sexto, cuándo revisarla, porque una decisión sin condición de revisión se convierte en dogma.
El noveno bloque escribe la plantilla de ADR y las cinco decisiones que más pesan en la arquitectura de Trigo Lento, cada una con el día en que se tomó, quién la tomó y las cifras que la justificaron, generadas desde un diccionario para que el formato sea idéntico en las cinco; imprime la primera completa y la huella de todas:
# Plantilla de ADR y las cinco decisiones de arquitectura generadas desde un diccionario en Python:
PLANTILLA_ADR = textwrap.dedent("""\
    # {id}. {titulo}

    - Estado: {estado} ({fecha:%d/%m/%Y}, Día {dia})
    - Decidieron: {quien}

    ## Contexto
    {contexto}

    ## Decisión
    {decision}

    ## Consecuencias
    {consecuencias}

    ## Cuándo revisarla
    {revisar}
    """)
ADR = [
    dict(id = 'ADR-001', titulo = 'Cloud API de Meta directa para WhatsApp', dia = 46, quien = 'Valeria y Don Ernesto',
         contexto = 'Con Twilio, WhatsApp costaba 19.13 USD al mes frente a un rubro de 12; el 85.4 % era el recargo '
                    'de 0.005 USD por mensaje recibido o enviado.',
         decision = 'Atender WhatsApp con la Cloud API de Meta desde n8n propio; Twilio queda documentado como respaldo.',
         consecuencias = ['WhatsApp baja a unos 6.25 USD al mes con el régimen de octubre de 2026.',
                          'El webhook vive en el servidor propio: n8n pasa a estar en el camino de cada mensaje.',
                          'Hay que mantener la verificación del negocio, el token de sistema y la firma de la app.'],
         revisar = 'Si Meta cambia las tarifas de utilidad o si la disponibilidad del servidor baja del 99.5 %.'),
    dict(id = 'ADR-002', titulo = 'n8n propio para el agente, los lotes y lo masivo', dia = 45, quien = 'Valeria',
         contexto = 'El escenario de pedidos consumía el 80.9 % de los créditos de Make; a 12 meses, Make costaba '
                    '486.04 USD, n8n Cloud 593.64 y el servidor propio 302.04.',
         decision = 'Make conserva los cuatro escenarios cortos con conector; el agente, la mensajería y los lotes viven en n8n propio.',
         consecuencias = ['Ahorro de 184 USD al año con el servidor ya pagado.',
                          'Unas 2 horas de mantenimiento al mes y un punto único de falla con un 99.5 % supuesto.',
                          'Dos plataformas que conocer: el relevo de Valeria necesita las dos.'],
         revisar = 'Si el mantenimiento supera 4.30 horas al mes o si Make cambia su precio por crédito.'),
    dict(id = 'ADR-003', titulo = 'Modelo de Claude asignado por tarea', dia = 67, quien = 'Valeria',
         contexto = 'Con un solo modelo, la carga costaba de 0.47 USD (Haiku 5.5) a 18.72 (Opus 5.5); con asignación '
                    'por tarea, caché y lotes, 4.99 USD.',
         decision = 'Haiku 5.5 clasifica, Sonnet 5.5 redacta y Opus 5.5 razona y escala lo ambiguo; cada cambio se mide antes.',
         consecuencias = ['El rubro de Claude, ampliado a 10.50 USD, se sostiene con la reserva (quedan 4.02 USD).',
                          'Hay tres modelos que evaluar en cada migración con el conjunto de referencia del Día 70.'],
         revisar = 'Con cada modelo nuevo o cuando el gasto mensual supere el rubro dos meses seguidos.'),
    dict(id = 'ADR-004', titulo = 'Servidor MCP de solo lectura para el inventario', dia = 63, quien = 'Valeria',
         contexto = 'El obrador pregunta por existencias y puntos de reorden; el conector ganó 2.25 a 1.75 al cliente propio.',
         decision = 'Un servidor MCP con tres herramientas de lectura en lista blanca, token propio y SQLite en mode=ro.',
         consecuencias = ['El servidor debe ser público con HTTPS: es una puerta más que vigilar.',
                          'Si cae, la consulta del obrador responde con un respaldo sin IA.'],
         revisar = 'Si se habilitan las herramientas que proponen pedidos a proveedores.'),
    dict(id = 'ADR-005', titulo = 'Fotos reales en todo el contenido de producto', dia = 71, quien = 'Don Ernesto',
         contexto = 'Una imagen generada de un pan que no existe promete algo que el obrador no hace.',
         decision = 'Las piezas usan fotos reales del obrador; la IA solo propone el texto alternativo y los recortes.',
         consecuencias = ['Cada foto con personas exige consentimiento escrito.',
                          'Más tiempo de Valeria por pieza; a cambio, ninguna reclamación por "no se parece".'],
         revisar = 'No se revisa por coste: solo si cambia la política de Don Ernesto.'),
]
(carpeta / 'adr').mkdir(exist_ok = True)
for a in ADR:
    a['estado'], a['fecha'] = 'Aceptada', fecha_dia(a['dia'])
    texto = PLANTILLA_ADR.format(**{**a, 'consecuencias': '\n'.join(f'- {c}' for c in a['consecuencias'])})
    (carpeta / 'adr' / f"{a['id'].lower()}.md").write_text(texto, encoding = 'utf-8')
    a['palabras'], a['huella'] = len(texto.split()), huella(texto)
print((carpeta / 'adr' / 'adr-001.md').read_text(encoding = 'utf-8'))
for a in ADR:
    print(f"{a['id']}  Día {a['dia']:>2}  {a['palabras']:>3} palabras  {a['huella']}  {a['titulo']}")
# ADR-001. Cloud API de Meta directa para WhatsApp

- Estado: Aceptada (18/03/2026, Día 46)
- Decidieron: Valeria y Don Ernesto

## Contexto
Con Twilio, WhatsApp costaba 19.13 USD al mes frente a un rubro de 12; el 85.4 % era el recargo de 0.005 USD por mensaje recibido o enviado.

## Decisión
Atender WhatsApp con la Cloud API de Meta desde n8n propio; Twilio queda documentado como respaldo.

## Consecuencias
- WhatsApp baja a unos 6.25 USD al mes con el régimen de octubre de 2026.
- El webhook vive en el servidor propio: n8n pasa a estar en el camino de cada mensaje.
- Hay que mantener la verificación del negocio, el token de sistema y la firma de la app.

## Cuándo revisarla
Si Meta cambia las tarifas de utilidad o si la disponibilidad del servidor baja del 99.5 %.

ADR-001  Día 46  143 palabras  fa863a46a4ed  Cloud API de Meta directa para WhatsApp
ADR-002  Día 45  136 palabras  7d1a462bfd00  n8n propio para el agente, los lotes y lo masivo
ADR-003  Día 67  119 palabras  659375d405c2  Modelo de Claude asignado por tarea
ADR-004  Día 63  100 palabras  a8b41cd371f8  Servidor MCP de solo lectura para el inventario
ADR-005  Día 71   98 palabras  c3a11b283a04  Fotos reales en todo el contenido de producto
Las cinco decisiones, leídas en orden, son la historia de la serie contada por sus bifurcaciones. El ADR-001 (Día 46, El reto de la mensajería: el mapa de canales y el coste real de WhatsApp) eligió la Cloud API de Meta directa porque con Twilio WhatsApp costaba $19.13$ USD al mes frente a un rubro de $12$, y el $85.4%$ de esa cifra era un recargo de medio centavo por mensaje; su consecuencia más importante no es el ahorro, sino que el webhook pasó a vivir en el servidor propio, que desde entonces está en el camino de cada mensaje. El ADR-002 (Día 45) dejó en Make los cuatro escenarios cortos y mudó a n8n propio el agente y lo masivo, con $302.04$ USD a doce meses frente a $486.04$ de Make y $593.64$ de n8n Cloud; su consecuencia es el punto único de falla que esta entrada acaba de medir, y por eso su condición de revisión es el mantenimiento mensual. El ADR-003 (Día 67) asignó un modelo de Claude por tarea, Haiku 5.5 para clasificar, Sonnet 5.5 para redactar y Opus 5.5 para razonar y escalar, con un rubro ampliado a $10.50$ USD que la reserva sostiene con $4.02$ de holgura. El ADR-004 (Día 63, Model Context Protocol II: el conector MCP desde la API de Claude) separó el inventario en un servidor MCP de solo lectura con tres herramientas en lista blanca, a cambio de una puerta pública más que vigilar. Y el ADR-005 (Día 71, De la idea al calendario editorial: textos e imágenes con IA) es la única decisión que no se revisa por coste, porque la tomó Don Ernesto por una razón de oficio: las fotos de producto son reales, y la IA solo propone el texto alternativo.
Cada ADR tiene entre $98$ y $143$ palabras y una huella propia; la huella no es un adorno, es lo que permitirá al Día 88 comprobar que el documento de entrega contiene las decisiones tal como se aprobaron. Y la sección de consecuencias lista también las malas, como pedía Nygard: “dos plataformas que conocer” en el ADR-002 y “una puerta más que vigilar” en el ADR-004 son las frases que el relevo de Valeria más necesita leer.
Aceptación y documento para el relevo
La regla del módulo 8 es que el código de honor del Día 6 es el criterio de aceptación de cada entrega y que cada día termina con su comprobación automática. Hoy la comprobación tiene algo que ningún día anterior tenía: la arquitectura entera como datos. El décimo bloque revisa los artículos que se pueden comprobar con lo construido hoy: humano al mando (todo flujo con efecto económico o reputacional tiene una puerta humana declarada), minimización (lo que recibe Claude de nombre, teléfono, dirección y texto está, como máximo, seudonimizado, leído de la matriz de fronteras), secretos (ningún patrón de clave en los quince JSON exportados de Make y n8n), coste y caída (el presupuesto cabe en los $45$ USD y cada punto único de falla tiene un modo manual escrito) y lo que no sale (la columna de recetas vacía). Los artículos que dependen de conducta o de pruebas de otros días quedan señalados para revisión humana con su referencia:
# Comprobación automática del código de honor sobre la arquitectura y los flujos exportados en Python:
EXPORTADOS = ['dia_22/flujos/make/formulario_v2.blueprint.json', 'dia_26/flujos/make/recordatorio_recogida_v1.blueprint.json',
              'dia_32/flujos/make/brujula_diario_v1.blueprint.json', 'dia_40/flujos/n8n/facturacion_v1.json',
              'dia_47/flujos/n8n/gmail_mayoristas_v1.json', 'dia_50/flujos/n8n/slack_operaciones_v1.json',
              'dia_52/flujos/n8n/orquestador_v1.json', 'dia_53/flujos/n8n/metricas_atencion_v1.json',
              'dia_54/flujos/n8n/monitor_plantillas_v1.json', 'dia_60/flujos/n8n/lote_nocturno_v1.json',
              'dia_63/flujos/n8n/consulta_inventario_v1.json', 'dia_67/flujos/n8n/informe_lunes_v1.json',
              'dia_69/flujos/n8n/agente_pedidos_v4.json', 'dia_70/flujos/n8n/evaluacion_agente_v1.json',
              'dia_77/flujos/n8n/campana_primavera_v1.json']
textos = {r: Path('trigo_lento', r).read_text(encoding = 'utf-8') for r in EXPORTADOS}
SECRETO = re.compile(r'sk-ant-[\w-]{10,}|EAA[A-Za-z0-9]{20,}|xox[bp]-[\w-]{10,}|Bearer [A-Za-z0-9._-]{20,}')
con_secreto = [r for r, t in textos.items() if SECRETO.search(t)]
PUERTAS = {'TL Publicación multired v2': 'TL Aprobaciones v2', 'TL Campaña primavera v1': 'TL Aprobaciones v2',
           'TL Gmail mayoristas v1': 'borrador que Valeria envía', 'TL Facturación': 'revisión de Valeria',
           'TL Remisiones v1': 'aprobación en Slack', 'TL WhatsApp secuencias v2': 'consentimiento y plantilla aprobada'}
EFECTO = FLUJOS.flujo[FLUJOS.flujo.str.contains('Publicación|Campaña|Gmail|Facturación|Remisiones|secuencias')]
MODO_MANUAL = {'Servidor propio': 'libreta y teléfono; Meta reintenta los webhooks pendientes; restaurar copia (Día 35)',
               'Token de la Cloud API': 'segundo token de usuario del sistema guardado en el llavero',
               'Clave de Claude': 'clave de respaldo en otro espacio de trabajo, con tope de gasto propio',
               'Make Core': 'los cuatro escenarios tienen versión manual en la libreta del mostrador',
               'FacturaFácil': 'facturar desde el portal web del proveedor',
               'Valeria': 'suplente nombrado en el inventario del Día 79'}
claude = FRONTERAS.loc['Anthropic (Claude)']
comprobaciones = [
    (1, 'Humano al mando', all(f in PUERTAS for f in EFECTO)),
    (3, 'Minimización', claude[['nombre', 'teléfono', 'dirección', 'texto del mensaje']].max() <= 2),
    (5, 'Secretos', not con_secreto),
    (9, 'Coste y caída', 40.53 <= 45 and set(spof) <= set(MODO_MANUAL)),
    (10, 'Lo que no sale', FRONTERAS['recetas'].sum() == 0),
]
MANUALES = {2: 'Consentimiento: se revisa en consentimientos.json, no en la arquitectura',
            4: 'Transparencia: leyendas de IA y "Mensaje automático" se prueban en cada flujo',
            6: 'Entradas verificadas: firmas de Meta y Slack; el Día 80 audita las credenciales',
            7: 'Dato, no orden: batería de ataques del Día 64, mensual',
            8: 'Registro sin datos sensibles: columnas de ejecuciones revisadas el Día 75'}
for articulo, nombre, cumple in comprobaciones:
    print(f'Artículo {articulo:>2}. {nombre:<17} {"cumple" if cumple else "NO CUMPLE"}')
for articulo, nota in MANUALES.items():
    print(f'Artículo {articulo:>2}. revisión humana: {nota}')
print(f'Flujos exportados revisados: {len(textos)} ({sum(len(t) for t in textos.values())} caracteres) | '
      f'con secretos: {con_secreto or "ninguno"}')
print(f'Flujos con efecto económico o reputacional: {len(EFECTO)}, todos con puerta humana declarada | '
      f'puntos únicos con modo manual: {sum(p in MODO_MANUAL for p in spof)} de {len(spof)}')
print(f'Automáticos: {sum(c for *_, c in comprobaciones)} de {len(comprobaciones)} | revisión humana: {len(MANUALES)}')
Artículo  1. Humano al mando   cumple
Artículo  3. Minimización      cumple
Artículo  5. Secretos          cumple
Artículo  9. Coste y caída     cumple
Artículo 10. Lo que no sale    cumple
Artículo  2. revisión humana: Consentimiento: se revisa en consentimientos.json, no en la arquitectura
Artículo  4. revisión humana: Transparencia: leyendas de IA y "Mensaje automático" se prueban en cada flujo
Artículo  6. revisión humana: Entradas verificadas: firmas de Meta y Slack; el Día 80 audita las credenciales
Artículo  7. revisión humana: Dato, no orden: batería de ataques del Día 64, mensual
Artículo  8. revisión humana: Registro sin datos sensibles: columnas de ejecuciones revisadas el Día 75
Flujos exportados revisados: 15 (138175 caracteres) | con secretos: ninguno
Flujos con efecto económico o reputacional: 6, todos con puerta humana declarada | puntos únicos con modo manual: 6 de 6
Automáticos: 5 de 5 | revisión humana: 5
Los $5$ artículos comprobables se cumplen y $5$ quedan en revisión humana. Los $15$ flujos exportados, $138,175$ caracteres de JSON entre tres blueprints de Make y doce workflows de n8n, no contienen ningún patrón de clave de Anthropic, token de Meta, token de bot de Slack ni cabecera de autorización. Los $6$ flujos con efecto económico o reputacional (las dos publicaciones, la campaña, los borradores de Gmail, la facturación, las remisiones y las secuencias de WhatsApp) tienen su puerta humana declarada. Y los $6$ puntos únicos de falla tienen modo manual, de la libreta y el teléfono para el servidor caído al segundo token de usuario del sistema guardado en el llavero. La revisión humana de los otros cinco artículos no es una debilidad del comprobador, sino honestidad sobre lo que mide: el consentimiento se verifica en consentimientos.json, la transparencia en las leyendas de cada flujo, las entradas verificadas en las firmas de Meta y Slack que el Día 80 auditará, “dato, no orden” con la batería de ataques del Día 64 (Seguridad III: inyección de instrucciones, herramientas con mínimo privilegio y registros limpios) y el registro limpio con las columnas que revisó el Día 75.
Hay que decir también lo que esta comprobación no ve. Busca que exista una puerta humana para cada flujo de la lista EFECTO, pero la lista la escribió Valeria; un flujo nuevo que publique y que nadie añada a la lista pasaría la prueba. El Día 79 cerrará ese hueco leyendo los nodos de publicación directamente de los JSON, como hizo el Día 77 con antes_de_publicar_hay_puerta. Y “cada punto único tiene modo manual” comprueba que el modo esté escrito, no que funcione: eso es lo que el ensayo de mesa del Día 81 y las pruebas de caos del Día 83 van a medir con reloj.
El último bloque genera el documento que Valeria dejará sobre la mesa del obrador: siete secciones (contexto, contenedores, flujos por dominio, disponibilidad, fronteras de datos, decisiones y “si algo falla”), todas escritas desde las estructuras de esta entrada, sin una sola cifra tecleada a mano, con su huella al final:
# Documento de arquitectura para el relevo de Valeria generado desde las estructuras del día en Python:
SI_FALLA = [(k, MODO_MANUAL.get(k) or ALTERNATIVA[k]) for k in puntos.index]
secciones = {
    '1. Contexto': [f'{p.replace(chr(10), " ")}' for p in PERSONAS] + [s.replace('\n', ' ') for s in SERVICIOS],
    '2. Contenedores': [f'{r.contenedor}: {r.tecnologia}; guarda {r.datos.lower()}; respaldo: {r.respaldo}'
                        for r in CONTENEDORES.itertuples()],
    '3. Flujos por dominio': [f'{dom}: ' + ', '.join(g.flujo) for dom, g in FLUJOS.groupby('dominio', sort = False)],
    '4. Disponibilidad': [f'{k}: {v:.4f} ({caida(v):.2f} h de caída al mes)' for k, v in escenarios.items()],
    '5. Fronteras de datos': [f'{p}: {f}; base: {b}' for p, (f, b) in FINALIDAD.items()],
    '6. Decisiones': [f"{a['id']} {a['titulo']} ({a['estado'].lower()}, Día {a['dia']})" for a in ADR],
    '7. Si algo falla': [f'{k}: {v}' for k, v in SI_FALLA],
}
documento = '# Arquitectura del ecosistema de Trigo Lento, versión 1 (19 de abril de 2026)\n\n' + '\n\n'.join(
    f'## {titulo}\n' + '\n'.join(f'- {linea}' for linea in lineas) for titulo, lineas in secciones.items())
(carpeta / 'arquitectura_v1.md').write_text(documento, encoding = 'utf-8')
for titulo, lineas in secciones.items():
    print(f'{titulo:<24} {len(lineas):>2} entradas')
print(f'Palabras: {len(documento.split())} | huella: {huella(documento)}')
print(documento.split('## 7. Si algo falla\n')[1])
1. Contexto              14 entradas
2. Contenedores           7 entradas
3. Flujos por dominio     5 entradas
4. Disponibilidad         3 entradas
5. Fronteras de datos     9 entradas
6. Decisiones             5 entradas
7. Si algo falla         12 entradas
Palabras: 708 | huella: 09bf025704b3
- Servidor propio: libreta y teléfono; Meta reintenta los webhooks pendientes; restaurar copia (Día 35)
- API de Claude: respuesta de plantilla o respaldo sin IA
- Clave de Claude: clave de respaldo en otro espacio de trabajo, con tope de gasto propio
- Valeria: suplente nombrado en el inventario del Día 79
- Slack: aprobación por WhatsApp (Día 74)
- Persona que aprueba: escalado al siguiente aprobador a los 60 minutos
- Cloud API de Meta: Twilio documentado (ADR-001)
- Token de la Cloud API: segundo token de usuario del sistema guardado en el llavero
- Make Core: los cuatro escenarios tienen versión manual en la libreta del mostrador
- Gmail: enviar desde el teléfono
- Redes sociales: publicar a mano desde la aplicación
- FacturaFácil: facturar desde el portal web del proveedor
El documento arquitectura_v1.md tiene $708$ palabras y la huella 09bf025704b3. Es corto a propósito: un plano que no se lee en diez minutos no se lee. La sección que Don Ernesto pidió, “si algo falla”, tiene doce entradas, una por componente de la lista de puntos únicos y de alternativas, y cada una cabe en una línea: qué hacer si el servidor propio se cae (libreta y teléfono; Meta reintenta los webhooks pendientes; restaurar la copia del Día 35), si Claude no responde (plantilla), si Slack no está (aprobar por WhatsApp), si FacturaFácil falla (el portal del proveedor). La línea de Valeria dice “suplente nombrado en el inventario del Día 79”, que es una promesa con fecha, no una solución. Como cada día del módulo, la huella del documento es la que el Día 88 comprobará en la entrega.
Antes de guardar el archivo, Don Ernesto lo lee entero en el teléfono de Valeria. Se detiene en la sección de disponibilidad y pregunta qué significa “$0.9930$”. Valeria le dice que son cinco horas al mes sin contestar WhatsApp, repartidas como salgan, y que tres horas y media de esas cinco son del servidor de seis dólares. “Entonces el plano dice que lo que más se rompe es lo más barato que tenemos. Eso ya lo sabía del horno chico.” Después lee “si algo falla” hasta el final y dice que ese papel sí lo entiende, y que lo quiere pegado junto al del gas.
Consideraciones finales
El Proyecto integrador empieza por la arquitectura y no por las pruebas ni por los manuales por una razón de orden: no se puede probar ni operar lo que no se ha descrito. Las tres hojas del plano (contexto, contenedores y flujos) no añaden ninguna pieza al ecosistema; lo que añaden es la capacidad de que alguien que no es Valeria lo entienda, y de que las cifras de los días siguientes (el factor autobús del Día 79, el tiempo de recuperación del Día 80, la disponibilidad en horario de servicio del Día 82, el coste final del Día 84) se calculen sobre el mismo inventario y no sobre recuerdos.
Las cifras de hoy tienen límites que conviene decir. Las disponibilidades son supuestos redondos, no mediciones; la simulación de caídas usa duraciones medias inventadas y supone incidentes independientes, cuando en la vida real una caída del proveedor del servidor y una de Postgres suelen ser la misma; la matriz de fronteras la escribió Valeria leyendo sus propios flujos, y una celda olvidada es exactamente el tipo de error que una matriz no detecta; y los cinco ADR son los que hoy parecen más importantes, lo que no significa que las decisiones pequeñas (el LIMIT 1 del Día 45, la salida por defecto del switch del Día 76) no hayan costado más caras. Un plano honesto dice lo que no sabe.
Para quien quiera profundizar, el sitio del modelo C4 de Simon Brown explica en una tarde por qué cada nivel responde a una pregunta y a un público, y por qué conviene empezar por los dos primeros; el texto de Michael Nygard sobre documentar decisiones de arquitectura sigue siendo la referencia más breve y más útil sobre ADR, y Software Architecture in Practice (Bass, Clements y Kazman, 2021) dedica un capítulo entero a las tácticas de disponibilidad que hoy se usaron de forma intuitiva: detectar, recuperar y prevenir. Y para la aritmética de los “nueves”, el apéndice de Site Reliability Engineering (Beyer et al., 2016) trae la tabla de minutos permitidos por nivel de disponibilidad que la Tabla 3 reproduce en horas.
Un ecosistema de automatización no está terminado cuando funciona, sino cuando otra persona puede leer en diez minutos qué entra, qué sale, qué se rompe y qué hacer ese día.
Conclusiones clave
Niveles
- El plano se escribe como datos y se dibuja desde ellos: $5$ personas y $9$ servicios externos en el contexto, $7$ contenedores y $15$ relaciones en el nivel 2 ($12$ cruzan el límite de confianza) y $25$ flujos en $5$ dominios en el nivel 3, $21$ en n8n y $4$ en Make.
- Cada nivel responde a una pregunta de una persona: el contexto a Don Ernesto, los contenedores a quien esté de guardia, los flujos a Valeria cuando vuelva; el código son los JSON exportados en Git.
- n8n participa en $12$ de las $15$ relaciones y Valeria es la única responsable de $6$ de los $7$ contenedores: el ecosistema se entiende desde un solo lugar y depende de una sola persona.
Fallas y disponibilidad
- Hay $6$ puntos únicos de falla sin alternativa escrita, de tres tipos: componentes (servidor propio, Make Core, FacturaFácil), credenciales (clave de Claude, token de la Cloud API) y una persona (Valeria, de la que dependen dos servicios).
- El camino crítico de WhatsApp está disponible el $0.9930$ del tiempo, unas $5.03$ horas de caída al mes; con respuesta de plantilla, $0.9940$ y $4.32$ horas; el servidor propio aporta el $71%$ de la caída, y con él al $99.9%$ la cifra baja a $1.44$ horas.
- En $5,000$ meses simulados, el $42%$ supera las $5$ horas sin degradación y el $4%$ con plantilla y servidor mejorado; un suplente que acierte el $70%$ sube la aprobación a tiempo de $0.80$ a $0.94$.
Decisiones
- Cinco encargados reciben datos identificables (Meta, Google, Anthropic, Make y FacturaFácil) y van con nombre en el aviso de privacidad; Claude solo recibe identificables los datos fiscales de proveedores; ningún proveedor recibe recetas.
- Cinco ADR con contexto, decisión, consecuencias y condición de revisión explican por qué el plano es así: Cloud API directa, n8n propio, modelo por tarea, MCP de solo lectura y fotos reales.
- El código de honor se cumple en sus $5$ artículos comprobables sobre $15$ flujos exportados sin secretos, $6$ flujos con puerta humana y $6$ puntos únicos con modo manual;
arquitectura_v1.mdtiene $708$ palabras y la huella09bf025704b3.
Mañana, en el Día 79: Proyecto integrador II: inventario de flujos y gobierno. En el Día 19 había ocho flujos y hoy hay veinticinco que se llaman unos a otros; Valeria generará el inventario leyendo los JSON exportados, asignará dueño y suplente a cada flujo, dibujará el grafo de dependencias y medirá cuántos flujos críticos se detienen si una sola persona falta una semana.
Referencias
- Brown, S. (2018). The C4 model for visualising software architecture. Sitio oficial del modelo, revisado en octubre de 2026. https://c4model.com
- Nygard, M. (2011). Documenting Architecture Decisions. Cognitect, entrada del 15 de noviembre de 2011, revisada en octubre de 2026. https://cognitect.com/blog/2011/11/15/documenting-architecture-decisions
- Bass, L., Clements, P. y Kazman, R. (2021). Software Architecture in Practice (4.ª ed.). Addison-Wesley Professional. Capítulo 4, “Availability”.
- Beyer, B., Jones, C., Petoff, J. y Murphy, N. R. (Eds.) (2016). Site Reliability Engineering: How Google Runs Production Systems. O’Reilly Media. Apéndice A, “Availability Table”.
- Fowler, M. (2024). Architecture Decision Record. Bliki, revisado en octubre de 2026. https://www.martinfowler.com/bliki/ArchitectureDecisionRecord.html