
Arquitecto de automatización con IA: Día 8
 Jeshua Romero Guadarrama
- 52 Min para leer
- 08 Feb, 2026
Índice de contenido
Resumen:
Antes de prometerle un plazo a un cliente hay que medir el proceso que lo va a cumplir. En esta entrada levantará la línea base de Trigo Lento con un mes simulado de 468 encargos: tiempo de primera respuesta, tiempo de ciclo, rendimiento y tasa de error; verá por qué la media de 16.6 minutos esconde a los clientes que esperan casi una hora y por qué el p95 dice más que ella; distinguirá indicador, objetivo y acuerdo de nivel de servicio (SLI, SLO y SLA), calculará un presupuesto de error de 46.8 incumplimientos que la línea base gasta al 143 % y elegirá, con la distribución binomial, el compromiso que Valeria puede firmar hoy con la Cafetería Brújula: 95 % en 30 minutos, no en 15.
¿Cómo citar el presente artículo?
Romero, J. (8 de febrero de 2026). Arquitecto de automatización con IA: Día 8. python-data-engineer. https://www.python-data-engineer.com/post/aai/dia_8/.
Arquitecto de automatización con IA: Día 8 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/aai/dia_8/.
Precios, límites y políticas de Make, n8n, Zapier, WhatsApp (Meta, Twilio, Wati) y de la API de Claude revisados en octubre de 2026. Este día no compara planes ni llama a ningún servicio: los once bloques de código se ejecutan sin red, sus salidas son las reales y la línea base es una simulación declarada, no una medición de un negocio real.
Día 8. Métricas de proceso y primeros acuerdos de nivel de servicio
Introducción
Ayer, en el Día 7 (Caso de otro negocio I: la clínica dental mide y prioriza sus citas), llevó el método del Día 1 a la Clínica Dental Sonrisa Norte, con sus 42 horas de recepción al mes y sus sillones vacíos por inasistencia, y Trigo Lento ganó la prueba de que su forma de medir y priorizar no depende del pan: sirve en cualquier negocio que atienda a personas con un proceso repetible. Hoy esa forma de medir se vuelve más fina, porque ya no basta con saber cuántas horas cuesta un proceso: hace falta saber cuánto espera cada cliente y qué se le puede prometer.
Es domingo 8 de febrero y la panadería está cerrada. Valeria tiene la mesa de la cocina cubierta de apuntes: el Pareto del Día 1, el contrato del pedido del Día 4, el embudo del laboratorio del Día 5, el código de honor del Día 6. Pero hay un mensaje que no la deja tranquila. El viernes por la tarde, Marisol Peña, de la Cafetería Brújula, le escribió por WhatsApp después de una semana con dos confirmaciones tardías: “Valeria, se lo digo con cariño: necesito saber en 15 minutos si mi pedido quedó, siempre. Si no me contesta, a las siete de la noche no sé si mañana tengo pan para mis desayunos.” Valeria estuvo a punto de responder “claro que sí, cuente con ello”. No lo hizo.
No lo hizo porque Don Ernesto, que leyó el mensaje por encima de su hombro mientras cerraba la caja, le dijo una sola frase: “No prometa lo que no ha medido. Si usted le dice que sí y luego falla, el problema ya no es el pan, es su palabra.” Es la objeción más sensata de la semana. Una promesa de servicio es un número, y un número que nadie ha medido es un deseo. El trabajo de hoy es convertir el deseo de Marisol en una pregunta que se puede responder: ¿con qué frecuencia contesta hoy Trigo Lento en 15 minutos, y con qué probabilidad fallaría la promesa en un mes cualquiera?
En la presente entrada, descubrirá las cuatro métricas básicas de un proceso (tiempo de ciclo, tiempo de primera respuesta, rendimiento y tasa de error) y cómo se calculan a partir de tres marcas de tiempo. Levantará la línea base de Trigo Lento con un mes simulado de 468 encargos, escrito en un archivo CSV como si fuera el registro de un mes real. Verá por qué la media engaña cuando los tiempos tienen cola larga, calculará percentiles a mano con interpolación lineal y los comparará con numpy. Después distinguirá tres palabras que suelen usarse como sinónimos y no lo son, indicador, objetivo y acuerdo de nivel de servicio, calculará el presupuesto de error del mes y evaluará con la distribución binomial cuatro candidatos de compromiso con Brújula. Terminará comprobando la ley de Little con la línea base y escribiendo las métricas en un archivo que los flujos de los módulos siguientes leerán.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Definir y medir el tiempo de ciclo, el tiempo de primera respuesta y la tasa de error de un proceso.
- Calcular e interpretar los percentiles p50, p90 y p95, y explicar por qué la media engaña en distribuciones con cola larga.
- Distinguir indicador (SLI), objetivo (SLO) y acuerdo (SLA), y calcular un presupuesto de error.
- Levantar la línea base de Trigo Lento antes de automatizar y proponer un compromiso de confirmación a un cliente con su probabilidad de incumplimiento.
Qué se mide en un proceso
El Día 1 midió el proceso de encargos con un cronómetro y una pregunta: cuántos minutos de trabajo cuesta cada pedido. Esa medida, el tiempo de atención, es la que ve el dueño, porque se convierte en horas y en pesos. El cliente ve otra cosa. Para Marisol no importa que Valeria tarde 6 minutos en atender su pedido; importa que entre el momento en que escribe y el momento en que recibe la confirmación pasen 8 minutos o pasen 50. Esa diferencia, entre el trabajo que se hace y el tiempo que se espera, es la primera lección de las métricas de proceso.
Un proceso se observa con marcas de tiempo: instantes registrados en que algo le pasa a un caso. Para un encargo de Trigo Lento bastan tres. La llegada es el instante en que el mensaje del cliente entra por cualquier canal. La primera respuesta es el instante en que alguien de la panadería, o más adelante un flujo, le contesta por primera vez algo útil (no un “ahorita le escribo”, sino una confirmación o una pregunta concreta por un dato que falta). El registro es el instante en que el pedido queda apuntado, completo y confirmado. Con esas tres marcas y una columna que diga si el pedido salió bien o mal se calculan las cuatro métricas de la Tabla 1.
Tabla 1. Métricas de proceso: definición, fórmula, unidad, marcas de tiempo y ejemplo de Trigo Lento.
| Métrica | Definición | Fórmula | Unidad | Dónde se mide | Ejemplo de Trigo Lento |
|---|---|---|---|---|---|
| Tiempo de primera respuesta | Cuánto espera el cliente hasta que alguien le contesta algo útil | primera respuesta menos llegada | minutos | Marca de llegada y marca de primera respuesta | Marisol escribe a las 18:04 y recibe la confirmación a las 18:12: 8 minutos |
| Tiempo de ciclo | Cuánto tarda un caso de principio a fin | registro menos llegada | minutos | Marca de llegada y marca de registro | Un pastel pedido a las 10:05 que queda apuntado y confirmado a las 10:44: 39 minutos |
| Rendimiento | Cuántos casos termina el proceso por unidad de tiempo | casos registrados entre tiempo | encargos por día | Marca de registro | 18 encargos registrados por día hábil |
| Tasa de error | Qué proporción de casos sale mal | casos con error entre casos totales | % de encargos | Columna de error al revisar el pedido | Un pedido de 2 hogazas apuntado como 12: uno de cada cincuenta |
Las cuatro métricas responden a preguntas distintas y ninguna sustituye a las otras. El tiempo de primera respuesta mide la sensación del cliente: es lo que Marisol pide en 15 minutos. El tiempo de ciclo mide el proceso completo, incluido el ir y venir de preguntas por los datos que faltan, que el Día 1 identificó como el paso más caro. El rendimiento mide la capacidad: si llegan 18 encargos al día y se terminan 18, el sistema está en equilibrio; si se terminan 15, la bandeja crece. Y la tasa de error mide la calidad: un proceso rapidísimo que apunta mal uno de cada diez pedidos no sirve.
Hay una relación entre tres de estas magnitudes que ya conoce. La ley de Little, que el Día 1 usó para la cola de la hora pico, dice que en cualquier sistema estable el número medio de casos dentro del sistema es igual a la tasa de llegada por el tiempo medio que cada caso pasa dentro:
$$ L = \lambda, W $$
La lógica detrás de esta fórmula, aplicada a las métricas de hoy, es múltiple:
- $\lambda$ es la tasa de llegada, que en equilibrio coincide con el rendimiento: los encargos que entran por hora son los que salen por hora.
- $W$ es el tiempo medio en el sistema; si el sistema empieza en la llegada y termina en el registro, $W$ es el tiempo de ciclo medio.
- $L$ es el número medio de encargos abiertos, es decir, los que llegaron y todavía no están registrados: lo que Valeria tiene “pendiente” en un momento cualquiera.
- En conclusión, conocidas dos de las tres magnitudes, la tercera queda determinada. Si un día la bandeja de pendientes crece sin que lleguen más pedidos, el tiempo de ciclo se ha alargado, aunque nadie lo haya cronometrado.
Comencemos por preparar el entorno con las importaciones de siempre, a las que hoy se suma scipy.stats para trabajar con distribuciones de probabilidad. Todo lo que escriba este día irá a una carpeta propia, trigo_lento/dia_8, para no tocar los archivos de días anteriores:
# Importaciones base, semilla de la serie y carpeta del día en Python:
import warnings
warnings.filterwarnings('ignore')
import json
from pathlib import Path
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import scipy
from scipy import stats

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 120)
pd.set_option('display.max_columns', 12)
carpeta = Path('trigo_lento') / 'dia_8'
carpeta.mkdir(parents = True, exist_ok = True)
print('numpy', np.__version__, '| pandas', pd.__version__, '| scipy', scipy.__version__)
numpy 2.4.6 | pandas 3.0.3 | scipy 1.17.1
La salida confirma las versiones con las que se calcularon todas las cifras de la entrada: numpy 2.4.6, pandas 3.0.3 y scipy 1.17.1. La semilla $2026$ es la misma de toda la serie, de modo que cualquier lector que ejecute los bloques en orden obtendrá exactamente los mismos números.
La línea base de Trigo Lento
Una línea base es la medición del proceso tal como funciona hoy, antes de cambiar nada. Sin ella, cualquier mejora es una opinión: si dentro de dos meses el flujo de Make contesta en 2 minutos, nadie sabrá cuánto mejoró si no sabe cuánto tardaba antes. La línea base es también lo que permite responder a Marisol con honestidad, porque dice qué puede cumplir el proceso actual sin heroicidades.
Lo ideal sería tomar un mes de registros reales. Trigo Lento no los tiene: la libreta apunta los pedidos, pero no la hora exacta de la primera respuesta. Lo que sí tiene Valeria es una muestra que tomó a mano durante dos semanas de enero, apuntando la hora de llegada y la de respuesta de cada encargo que pudo. Con esa muestra estimó dos distribuciones y, con ellas, simulará un mes completo. Se declara desde ahora y se repetirá cuando haga falta: lo que sigue es una simulación con parámetros estimados, no una medición. Se sustituirá por datos reales cuando los flujos registren sus ejecuciones.
La lognormal: tiempos que no pueden ser negativos
Los tiempos de espera tienen una forma característica. Nunca son negativos, la mayoría son cortos y unos pocos son muy largos: el cliente que escribió justo cuando Valeria atendía el mostrador, el que llegó a las 10:30 con otros doce mensajes delante, el que escribió el sábado a las 19:55. Una distribución que reproduce bien esa forma es la lognormal: una variable cuyo logaritmo sigue una distribución normal. Se describe con dos números, la mediana $m$ (el tiempo que deja a la mitad de los casos por debajo) y el parámetro de dispersión $\sigma$ (cuánto se abre la cola). Su media y sus percentiles tienen fórmula cerrada:
$$ \text{media} = m, e^{\sigma^2/2}, \qquad q_p = m, e^{\sigma, z_p} $$
La lógica detrás de estas fórmulas es múltiple:
- La media es la mediana multiplicada por $e^{\sigma^2/2}$, un factor siempre mayor que 1: en una lognormal la media siempre queda por encima de la mediana, y tanto más cuanto más larga es la cola.
- Con la mediana de 12 minutos y $\sigma = 0.9$ que Valeria estimó para los encargos generales, el factor es $e^{0.405} = 1.50$ y la media es de $18.0$ minutos: la mitad de los clientes espera menos de 12, pero el promedio dice 18.
- $z_p$ es el cuantil de la normal estándar ($z_{0.90} = 1.2816$ y $z_{0.95} = 1.6449$), de modo que el p90 es $12, e^{0.9 \cdot 1.2816} = 38.0$ minutos y el p95 es $12, e^{0.9 \cdot 1.6449} = 52.7$ minutos.
- En conclusión, con dos números se describe toda la distribución, y los percentiles altos crecen de forma exponencial con $\sigma$: reducir la dispersión mejora la cola mucho más que reducir la mediana.
Para la Cafetería Brújula la muestra da otra cosa. Su pedido llega siempre a la misma hora, por la tarde, cuando el mostrador está tranquilo, y Valeria lo reconoce de inmediato. Su mediana es de 8 minutos y su dispersión, $\sigma = 0.6$, mucho menor. El tiempo entre la primera respuesta y el registro también se modela con lognormales: mediana de 20 minutos y $\sigma = 0.6$ para los encargos generales, que a menudo exigen preguntar sabor, tamaño o fecha, y de 5 minutos con $\sigma = 0.4$ para Brújula, cuyo pedido es siempre el mismo. La tasa de error humana es la del Día 6: un $2%$ de pedidos apuntados mal.
Un mes simulado de 468 encargos
El mes de línea base es enero de 2026, de lunes a sábado: el viernes 2 y el sábado 3 (el jueves 1 la panadería cerró por Año Nuevo) y las cuatro semanas completas que siguen, en total 26 días hábiles. Llegan 442 encargos generales repartidos al azar entre esos días, el $35%$ de ellos en la hora pico de 10:00 a 12:00 y el resto entre las 8:00 y las 20:00, por los cuatro canales con el reparto del Día 1; y 26 pedidos de Brújula, uno por día, entre las 17:00 y las 19:00. El siguiente código simula las tres marcas de tiempo de cada encargo, numera los pedidos con el formato de identificador del Día 4 y escribe el resultado en trigo_lento/dia_8/linea_base.csv:
# Un mes simulado de 468 encargos con marcas de tiempo de llegada, primera respuesta y registro en Python:
dias = [d for d in pd.date_range('2026-01-02', '2026-01-31') if d.dayofweek < 6]   # 26 días, lunes a sábado
n_general, n_brujula = 442, 26

# Parámetros de las lognormales (mediana en minutos y sigma), estimados con la muestra de Valeria:
TPR = {'general': (12, 0.9), 'brujula': (8, 0.6)}        # tiempo de primera respuesta
RESTO = {'general': (20, 0.6), 'brujula': (5, 0.4)}      # de la primera respuesta al registro
TASA_ERROR = 0.02                                        # errores humanos del Día 6

def simular(cliente, n, dia_idx, hora):
    mediana, sigma = TPR[cliente]
    tpr = rng.lognormal(np.log(mediana), sigma, n)
    mediana_r, sigma_r = RESTO[cliente]
    ciclo = tpr + rng.lognormal(np.log(mediana_r), sigma_r, n)
    llegada = (pd.to_datetime([dias[i] for i in dia_idx]) + pd.to_timedelta(hora, unit = 'h')).round('s')
    return pd.DataFrame({'cliente': cliente, 'llegada': llegada,
                         'primera_respuesta': (llegada + pd.to_timedelta(tpr, unit = 'm')).round('s'),
                         'registro': (llegada + pd.to_timedelta(ciclo, unit = 'm')).round('s'),
                         'error': (rng.random(n) < TASA_ERROR).astype(int)})

# Encargos generales: 35 % en la hora pico de 10:00 a 12:00 y el resto de 8:00 a 20:00:
pico = rng.random(n_general) < 0.35
hora = np.where(pico, rng.uniform(10, 12, n_general), rng.uniform(8, 20, n_general))
general = simular('general', n_general, rng.integers(0, 26, n_general), hora)
general['canal'] = rng.choice(['whatsapp', 'instagram', 'formulario', 'telefono'], n_general,
                              p = [0.55, 0.20, 0.15, 0.10])
# Brújula: un pedido al día, entre las 17:00 y las 19:00, siempre por WhatsApp:
brujula = simular('brujula', n_brujula, np.arange(26), rng.uniform(17, 19, n_brujula))
brujula['canal'] = 'whatsapp'

linea_base = pd.concat([general, brujula]).sort_values('llegada').reset_index(drop = True)
linea_base['id_pedido'] = [f'TL-{t:%Y%m%d}-{i + 1:04d}' for i, t in enumerate(linea_base['llegada'])]
linea_base = linea_base[['id_pedido', 'cliente', 'canal', 'llegada', 'primera_respuesta', 'registro', 'error']]
linea_base.to_csv(carpeta / 'linea_base.csv', index = False)
print(linea_base.head(4).to_string(index = False))
print('Encargos:', len(linea_base), '| días:', linea_base['llegada'].dt.date.nunique(),
      '| Brújula:', (linea_base['cliente'] == 'brujula').sum(), '| con error:', linea_base['error'].sum())
print(linea_base['canal'].value_counts().to_string())
       id_pedido cliente      canal             llegada   primera_respuesta            registro  error
TL-20260102-0001 general   whatsapp 2026-01-02 08:42:33 2026-01-02 08:47:00 2026-01-02 08:55:13      0
TL-20260102-0002 general   whatsapp 2026-01-02 10:01:43 2026-01-02 10:22:48 2026-01-02 10:46:30      0
TL-20260102-0003 general   whatsapp 2026-01-02 10:07:21 2026-01-02 10:11:01 2026-01-02 10:33:49      0
TL-20260102-0004 general formulario 2026-01-02 10:09:47 2026-01-02 10:12:15 2026-01-02 10:23:53      0
Encargos: 468 | días: 26 | Brújula: 26 | con error: 7
canal
whatsapp      274
instagram      85
formulario     63
telefono       46
El archivo tiene $468$ encargos repartidos en $26$ días, $26$ de ellos de Brújula, con las tres marcas de tiempo redondeadas al segundo. Por canales, WhatsApp concentra $274$ encargos (incluidos los de Brújula), Instagram $85$, el formulario $63$ y el teléfono $46$: el mismo orden que en el Día 1. Hubo $7$ encargos con error, un $1.5%$, algo por debajo del $2%$ esperado; con 468 casos, una diferencia así es puro azar (la desviación típica del conteo es de unos $3$ pedidos).
Observe las primeras filas, porque enseñan a leer el registro. El primer encargo llegó a las 08:42:33 del viernes 2 de enero, recibió respuesta a las 08:47:00 y quedó registrado a las 08:55:13: cuatro minutos y medio de primera respuesta y trece de ciclo. El segundo llegó en la hora pico, a las 10:01:43, y esperó 21 minutos su primera respuesta. No hay nombres ni teléfonos: el registro de métricas solo necesita un identificador, un canal y tres instantes. Medir un proceso no exige guardar datos personales, y el archivo se diseñó así a propósito.
Las cuatro métricas del mes
Con las marcas de tiempo, las métricas de la Tabla 1 son restas y promedios. El siguiente código calcula el tiempo de primera respuesta y el tiempo de ciclo de cada encargo, el rendimiento diario y la tasa de error del mes, y después compara la distribución simulada con la teórica de las lognormales:
# Tiempo de primera respuesta, tiempo de ciclo, rendimiento y tasa de error con pandas en Python:
linea_base['tpr_min'] = (linea_base['primera_respuesta'] - linea_base['llegada']).dt.total_seconds() / 60
linea_base['ciclo_min'] = (linea_base['registro'] - linea_base['llegada']).dt.total_seconds() / 60
por_dia = linea_base.groupby(linea_base['registro'].dt.date).size()
tabla_1 = pd.DataFrame({
    'media': [linea_base['tpr_min'].mean(), linea_base['ciclo_min'].mean(), por_dia.mean(),
              100 * linea_base['error'].mean()],
    'mediana': [linea_base['tpr_min'].median(), linea_base['ciclo_min'].median(), por_dia.median(), np.nan],
    'unidad': ['minutos', 'minutos', 'encargos por día', '% de encargos']},
    index = ['Tiempo de primera respuesta', 'Tiempo de ciclo', 'Rendimiento', 'Tasa de error'])
print(tabla_1.round(1).to_string())

# Línea base simulada frente a los valores teóricos de la lognormal:
filas = []
for cliente, (mediana, sigma) in TPR.items():
    x = linea_base.loc[linea_base['cliente'] == cliente, 'tpr_min']
    teorica = stats.lognorm(s = sigma, scale = mediana)
    filas.append([cliente, 'teórica', teorica.mean(), *teorica.ppf([0.5, 0.9, 0.95])])
    filas.append([cliente, 'simulada', x.mean(), *np.percentile(x, [50, 90, 95])])
tabla_2 = pd.DataFrame(filas, columns = ['cliente', 'origen', 'media', 'p50', 'p90', 'p95'])
print(tabla_2.round(1).to_string(index = False))
                             media  mediana            unidad
Tiempo de primera respuesta   16.6     11.0           minutos
Tiempo de ciclo               39.1     33.4           minutos
Rendimiento                   18.0     19.0  encargos por día
Tasa de error                  1.5      NaN     % de encargos
cliente   origen  media  p50  p90  p95
general  teórica   18.0 12.0 38.0 52.7
general simulada   17.0 11.2 37.1 50.1
brujula  teórica    9.6  8.0 17.3 21.5
brujula simulada    9.8  7.3 18.4 22.2
Las cifras del mes son estas. El tiempo de primera respuesta tiene una media de $16.6$ minutos y una mediana de $11.0$. El tiempo de ciclo tiene una media de $39.1$ minutos y una mediana de $33.4$: un encargo tarda, de principio a fin, unos 40 minutos, aunque el trabajo de Valeria en él sea de 6. El rendimiento es de $18.0$ encargos registrados por día hábil, justo los que llegan, de modo que el sistema está en equilibrio. Y la tasa de error es del $1.5%$.
La segunda tabla de la salida es la Tabla 2, que pone lado a lado los valores teóricos de las lognormales y los que produjo la simulación:
Tabla 2. Línea base del tiempo de primera respuesta en minutos: valores teóricos de la lognormal y valores del mes simulado.
| Cliente | Origen | Media | p50 | p90 | p95 |
|---|---|---|---|---|---|
| Encargos generales | Teórico | 18.0 | 12.0 | 38.0 | 52.7 |
| Encargos generales | Mes simulado | 17.0 | 11.2 | 37.1 | 50.1 |
| Brújula | Teórico | 9.6 | 8.0 | 17.3 | 21.5 |
| Brújula | Mes simulado | 9.8 | 7.3 | 18.4 | 22.2 |
En los encargos generales, con 442 casos, la simulación queda a menos de un minuto de la teoría en la media y en el p90, y a $2.6$ minutos en el p95. En Brújula, con solo 26 pedidos, las diferencias son del mismo orden, pero se deben a menos datos: con 26 observaciones, el p95 se estima con el pedido 24 y el 25 de la lista ordenada, y uno solo de ellos puede mover la cifra un par de minutos. Cuantos menos casos, más ruido tiene un percentil alto, una idea que volverá con fuerza cuando se hable del acuerdo con Brújula.
Hay una lectura de negocio que conviene subrayar. La mediana de los encargos generales es de unos 11 minutos, por debajo de los 15 que pide Marisol. Si Valeria mirara solo la mediana, pensaría que el proceso ya cumple. El p95, de $50.1$ minutos, dice otra cosa: uno de cada veinte clientes espera más de cincuenta minutos su primera respuesta.
Percentiles: el cliente vive en la cola
Un percentil $p$ es el valor que deja por debajo al $p%$ de los casos. El p50 es la mediana; el p90 deja por debajo al $90%$ y por encima al $10%$; el p95 deja por encima a uno de cada veinte. En operaciones se usan los percentiles altos porque describen la experiencia de los clientes peor atendidos, que son los que se quejan, los que cancelan y los que escriben reseñas. Un dicho de los equipos de servicio lo resume: el cliente no vive en la media, vive en la cola.
Calcular un percentil con muchos datos es intuitivo; con pocos datos aparece un problema: la posición exacta casi nunca cae sobre una observación. Si hay 10 tiempos ordenados, ¿cuál es el p95? No hay un “noveno y medio” cliente. Hyndman y Fan revisaron en 1996 las definiciones que usaban los paquetes estadísticos y encontraron nueve distintas; la más común, que es la que numpy usa por omisión (su “tipo 7”), interpola linealmente entre los dos vecinos. Con los valores ordenados $x_{(1)} \le x_{(2)} \le \dots \le x_{(n)}$:
$$ h = (n - 1), \frac{p}{100}, \qquad Q(p) = x_{(\lfloor h \rfloor + 1)} + \left(h - \lfloor h \rfloor\right) \left(x_{(\lfloor h \rfloor + 2)} - x_{(\lfloor h \rfloor + 1)}\right) $$
La lógica detrás de esta fórmula es múltiple:
- $h$ es la posición del percentil contando desde cero: el p0 cae en la primera observación ($h = 0$) y el p100 en la última ($h = n - 1$).
- La parte entera $\lfloor h \rfloor$ dice entre qué dos vecinos cae el percentil, y la parte decimal $h - \lfloor h \rfloor$ dice cuánto se avanza desde el menor hacia el mayor.
- Con 10 valores, el p95 está en $h = 9 \cdot 0.95 = 8.55$: entre la novena y la décima observación, a un $55%$ del camino.
- En conclusión, la interpolación da percentiles continuos aunque los datos sean pocos, pero no inventa información: con 10 datos, el p95 depende casi por completo de los dos clientes que más esperaron.
La fila del mostrador de la Figura 1 muestra la idea con diez clientes de un sábado por la mañana. Sus esperas, ordenadas, son 2, 4, 6, 8, 11, 13, 17, 24, 41 y 58 minutos.
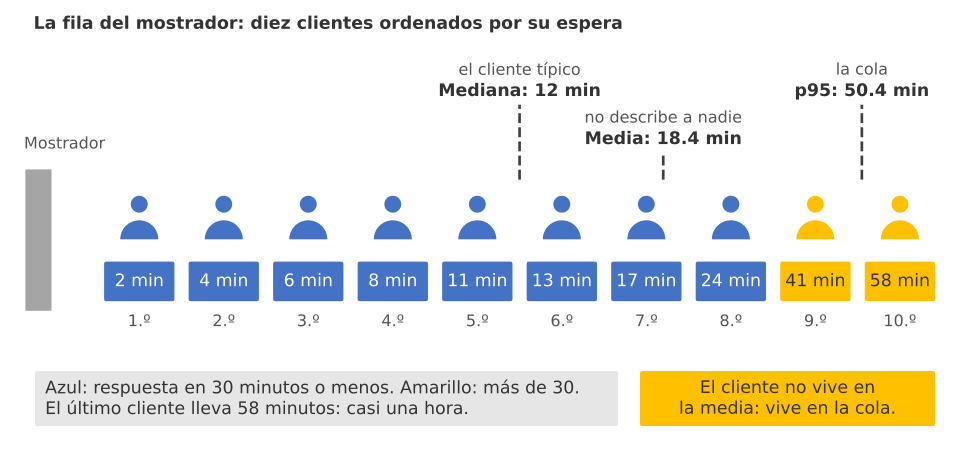
Figura 1. La fila del mostrador: diez clientes ordenados por su espera; la media de 18.4 minutos no describe a nadie, la mediana de 12 describe al cliente típico y el p95 de 50.4 señala al final de la fila, donde alguien lleva casi una hora.
Los diez clientes de la figura tienen una media de $18.4$ minutos, y esa cifra no describe a nadie: queda entre el séptimo cliente, que esperó 17, y el octavo, que esperó 24. La mediana, de $12$ minutos, describe bien al cliente típico. El p95, de $50.4$ minutos, cae entre el penúltimo, con 41, y el último, que lleva 58 minutos, casi una hora, esperando a que alguien le diga si su pastel quedó apuntado. Ese último cliente es el que Marisol teme ser.
El siguiente código escribe el percentil a mano con la fórmula anterior, lo aplica a la fila del mostrador, lo compara con np.percentile sobre los 442 encargos generales y dibuja el histograma del tiempo de primera respuesta de todo el mes con la media y los tres percentiles marcados:
# Percentil con interpolación lineal escrito a mano, comparado con numpy, e histograma en Python:
def percentil(valores, q):
    # Tipo 7 de Hyndman y Fan: posición h = (n - 1) q / 100 e interpolación entre vecinos:
    x = np.sort(np.asarray(valores, dtype = float))
    h = (len(x) - 1) * q / 100
    i = int(np.floor(h))
    if i + 1 >= len(x):
        return x[-1]
    return x[i] + (h - i) * (x[i + 1] - x[i])

fila = [2, 4, 6, 8, 11, 13, 17, 24, 41, 58]         # la fila del mostrador, en minutos
print('Fila de 10: media', np.mean(fila), '| p50', percentil(fila, 50), '| p90', round(percentil(fila, 90), 1),
      '| p95', round(percentil(fila, 95), 1))
tpr_general = linea_base.loc[linea_base['cliente'] == 'general', 'tpr_min']
for q in [50, 90, 95]:
    print(f'p{q}: a mano {percentil(tpr_general, q):.3f} | numpy {np.percentile(tpr_general, q):.3f}')
print(f'Encargos generales por encima de la media: {100 * (tpr_general > tpr_general.mean()).mean():.1f} %')
print(f'Encargos generales con más de 45 minutos: {(tpr_general > 45).sum()}')

# Histograma con la media y los percentiles marcados:
fig, ax = plt.subplots(figsize = (9, 4.8))
ax.hist(linea_base['tpr_min'], bins = np.arange(0, 125, 5), color = '#9ec5f4', edgecolor = 'white')
marcas = [('media', linea_base['tpr_min'].mean(), '#0b0b0b', '--'),
          ('p50', percentil(linea_base['tpr_min'], 50), '#2a78d6', '-'),
          ('p90', percentil(linea_base['tpr_min'], 90), '#eb6834', '-'),
          ('p95', percentil(linea_base['tpr_min'], 95), '#b8361a', '-')]
for i, (nombre, valor, color, estilo) in enumerate(marcas):
    ax.axvline(valor, color = color, linestyle = estilo, linewidth = 1.8)
    ax.text(valor + 1, ax.get_ylim()[1] * (0.92 - 0.09 * i), f'{nombre} {valor:.1f} min', fontsize = 10,
            color = color, bbox = dict(facecolor = 'white', edgecolor = 'none', pad = 1))
ax.set_title('Tiempo de primera respuesta: 468 encargos de la línea base', fontsize = 16)
ax.set_xlabel('Minutos desde la llegada del mensaje')
ax.set_ylabel('Encargos')
ax.spines[['top', 'right']].set_visible(False)
plt.tight_layout()
plt.show()
Fila de 10: media 18.4 | p50 12.0 | p90 42.7 | p95 50.4
p50: a mano 11.192 | numpy 11.192
p90: a mano 37.122 | numpy 37.122
p95: a mano 50.052 | numpy 50.052
Encargos generales por encima de la media: 32.4 %
Encargos generales con más de 45 minutos: 30
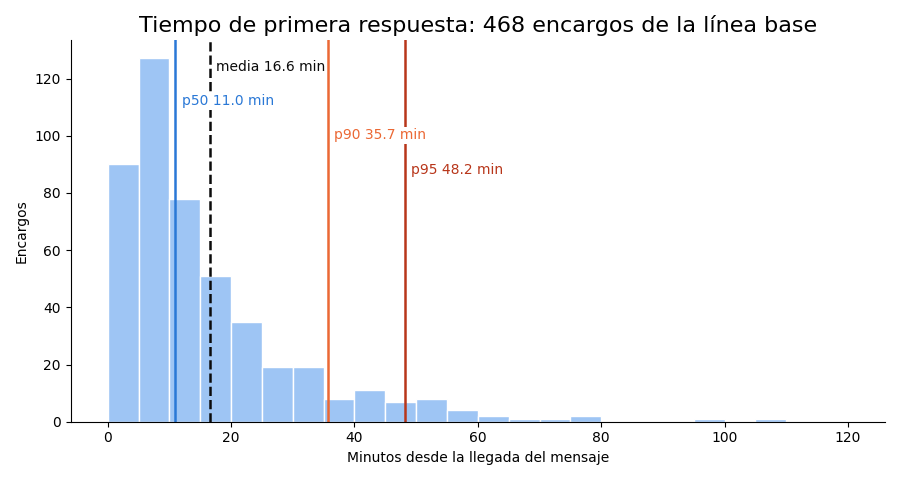
La función escrita a mano y numpy coinciden hasta el tercer decimal: p50 de $11.192$, p90 de $37.122$ y p95 de $50.052$ minutos en los encargos generales. No es una casualidad: las dos aplican el tipo 7 de Hyndman y Fan. Conviene saberlo porque otras herramientas usan definiciones distintas (algunas hojas de cálculo ofrecen dos funciones de percentil con resultados diferentes) y, con pocos datos, la elección cambia la cifra. Cuando publique un percentil, diga cómo lo calculó.
El histograma de los 468 encargos muestra la forma típica de un tiempo de espera: una montaña pegada a la izquierda, con la mayoría de las respuestas entre 0 y 20 minutos, y una cola larga que se estira hasta más de cien. La media, de $16.6$ minutos, queda a la derecha de la mediana, de $11.0$, empujada por esa cola. El p90 está en $35.7$ minutos y el p95 en $48.2$.
Por qué la media engaña
Hay tres razones por las que la media es una mala promesa para un cliente, y las tres se ven en la salida anterior:
- La media no la vive casi nadie. Solo el $32.4%$ de los encargos generales espera más que la media; dos de cada tres esperan menos. La media no es “lo normal”, es un punto de equilibrio arrastrado por los extremos.
- La media esconde la cola. Un promedio de 16.6 minutos suena aceptable, incluso bueno. Pero en el mismo mes $30$ encargos generales esperaron más de 45 minutos su primera respuesta, más de uno por día hábil. Con la teoría de la lognormal, la media de 18 minutos convive con un p95 de casi 53.
- La media mejora sin que mejore la experiencia. Si Valeria contestara al instante los mensajes fáciles (los “gracias”, los saludos) y dejara igual los encargos difíciles, la media bajaría y los clientes de la cola seguirían esperando lo mismo. Un indicador que se puede mejorar sin mejorar el servicio es un indicador peligroso.
Por eso los equipos de operaciones expresan sus objetivos con percentiles o, de forma equivalente, con proporciones: “el $90%$ de los encargos con respuesta en 30 minutos o menos” es lo mismo que decir “el p90 debe ser de 30 minutos o menos”. La proporción tiene una ventaja práctica: se puede contar evento a evento, sin ordenar todo el mes.
La distribución acumulada: leer cualquier umbral
El histograma responde “¿cuántos encargos esperaron entre 20 y 25 minutos?”. Para fijar promesas interesa otra pregunta: ¿qué proporción recibe respuesta antes de $x$ minutos? La responde la función de distribución acumulada empírica, que para cada tiempo $x$ da la proporción de casos con un tiempo menor o igual. Se dibuja ordenando los tiempos y subiendo un escalón de altura $1/n$ en cada uno. El siguiente código la dibuja para los encargos generales y para Brújula, con los umbrales de 15 y 30 minutos y una línea en el $95%$, y compara cada proporción con la teórica:
# Distribución acumulada empírica, general y de Brújula, con los umbrales de 15 y 30 minutos en Python:
fig, ax = plt.subplots(figsize = (9, 4.8))
for cliente, color, nombre in [('general', '#2a78d6', 'Encargos generales'), ('brujula', '#eb6834', 'Brújula')]:
    x = np.sort(linea_base.loc[linea_base['cliente'] == cliente, 'tpr_min'].to_numpy())
    ax.step(x, np.arange(1, len(x) + 1) / len(x), where = 'post', color = color, linewidth = 2,
            label = f'{nombre} (n = {len(x)})')
    for umbral in [15, 30]:
        print(f'{nombre:>18}: con {umbral} min o menos, {100 * (x <= umbral).mean():5.1f} % '
              f'(teórico {100 * stats.lognorm(s = TPR[cliente][1], scale = TPR[cliente][0]).cdf(umbral):5.1f} %)')
for umbral in [15, 30]:
    ax.axvline(umbral, color = '#9a9994', linestyle = '--', linewidth = 1)
    ax.text(umbral + 1, 0.05, f'{umbral} min', fontsize = 10, color = '#52514e')
ax.axhline(0.95, color = '#b8361a', linestyle = ':', linewidth = 1)
ax.text(1, 0.965, '95 %', fontsize = 10, color = '#b8361a')
ax.set_xlim(0, 100)
ax.set_ylim(0, 1.02)
ax.set_title('¿Qué proporción recibe respuesta antes de x minutos?', fontsize = 16)
ax.set_xlabel('Minutos hasta la primera respuesta')
ax.set_ylabel('Proporción acumulada')
ax.legend(loc = 'center right', frameon = False)
ax.spines[['top', 'right']].set_visible(False)
plt.tight_layout()
plt.show()
Encargos generales: con 15 min o menos,  62.4 % (teórico  59.8 %)
Encargos generales: con 30 min o menos,  84.8 % (teórico  84.6 %)
           Brújula: con 15 min o menos,  76.9 % (teórico  85.3 %)
           Brújula: con 30 min o menos, 100.0 % (teórico  98.6 %)
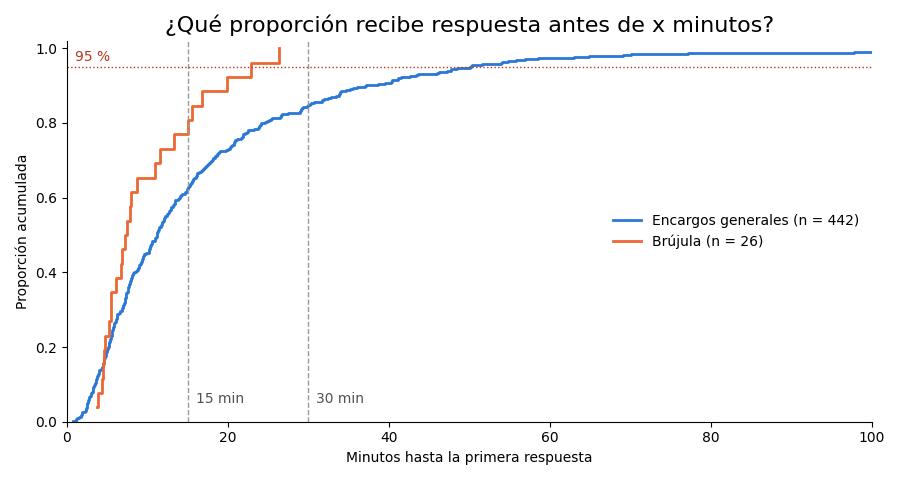
La gráfica se lee de abajo arriba: sobre cada umbral, la altura de la curva es la proporción de encargos atendidos a tiempo. Para los encargos generales, el $62.4%$ recibe respuesta en 15 minutos o menos y el $84.8%$ en 30 minutos o menos (la teoría da $59.8%$ y $84.6%$). Para Brújula, el $76.9%$ en 15 minutos o menos y el $100%$ en 30 (la teoría da $85.3%$ y $98.6%$). La curva de Brújula está siempre a la izquierda de la general: su pedido se atiende antes porque llega en una hora tranquila y es siempre el mismo.
La línea punteada del $95%$ da la respuesta a Marisol antes de hacer ninguna cuenta más. La curva de Brújula cruza esa línea mucho después de los 15 minutos: hoy, uno de cada cuatro o cinco de sus pedidos tarda más de 15 minutos en recibir respuesta. En cambio, en 30 minutos la curva ya llegó al techo. Prometer 15 minutos “siempre” sería prometer algo que el proceso actual incumple varias veces al mes.
SLI, SLO y SLA
La palabra “nivel de servicio” se usa para tres cosas distintas, y confundirlas es la forma más común de firmar un compromiso imposible. Los ingenieros de fiabilidad de Google popularizaron en su libro Site Reliability Engineering una distinción en tres niveles que sirve igual para un servicio web que para una panadería:
- Un indicador de nivel de servicio (o SLI, por sus siglas en inglés: “Service Level Indicator”) es una medida cuantitativa de algún aspecto del servicio. Se expresa casi siempre como una proporción de eventos buenos entre eventos válidos: “proporción de encargos con primera respuesta en 30 minutos o menos”.
- Un objetivo de nivel de servicio (o SLO, por sus siglas en inglés: “Service Level Objective”) es el valor que el propio equipo se fija para un indicador en una ventana de tiempo: “el $90%$ de los encargos del mes”. Es interno; no lo firma nadie de fuera.
- Un acuerdo de nivel de servicio (o SLA, por sus siglas en inglés: “Service Level Agreement”) es un compromiso con un cliente que incluye consecuencias si se incumple: un descuento, una devolución, la posibilidad de rescindir.
El indicador se define con una fórmula sencilla, que es la que se usará en todo el día:
$$ \text{SLI} = \frac{\text{eventos buenos}}{\text{eventos válidos}} $$
La lógica detrás de esta fórmula es múltiple:
- Los eventos válidos son los que el indicador debe contar: todos los encargos del mes, o solo los de Brújula, o solo los que llegaron en horario de atención. Definirlos es una decisión de diseño que se escribe, porque cambia la cifra.
- Los eventos buenos son los válidos que cumplieron la condición: primera respuesta de 30 minutos o menos, pedido sin error, ciclo de una hora o menos.
- El cociente está entre $0$ y $1$ y “más es mejor”, lo que permite comparar indicadores muy distintos con la misma escala y fijar objetivos como “al menos $0.90$”.
- En conclusión, un SLI bien definido no admite discusión: dos personas que cuentan los mismos eventos obtienen la misma cifra.
La Tabla 3 resume los tres niveles con un ejemplo de Trigo Lento.
Tabla 3. SLI, SLO y SLA: qué es, quién lo fija, qué pasa si se incumple y ejemplo de Trigo Lento.
| Nivel | Qué es | Quién lo fija | Si se incumple | Ejemplo de Trigo Lento |
|---|---|---|---|---|
| SLI | Medida: eventos buenos entre eventos válidos | Lo define quien diseña el proceso; lo calcula el registro | Nada: es solo una medida | Proporción de encargos con primera respuesta en 30 minutos o menos |
| SLO | Objetivo interno para el SLI en una ventana | El equipo (Valeria, con el visto bueno de Don Ernesto) | Se detienen los cambios y se mejora el proceso | El 90 % de los encargos del mes con respuesta en 30 minutos o menos |
| SLA | Compromiso firmado con un cliente, con consecuencias | El negocio y el cliente, por escrito | Descuento, devolución o pérdida del cliente | Con Brújula: 95 % de sus pedidos del mes confirmados en 30 minutos o menos |
Los tres niveles forman una escalera, que la Figura 2 dibuja como un termómetro, una marca y un papel firmado.
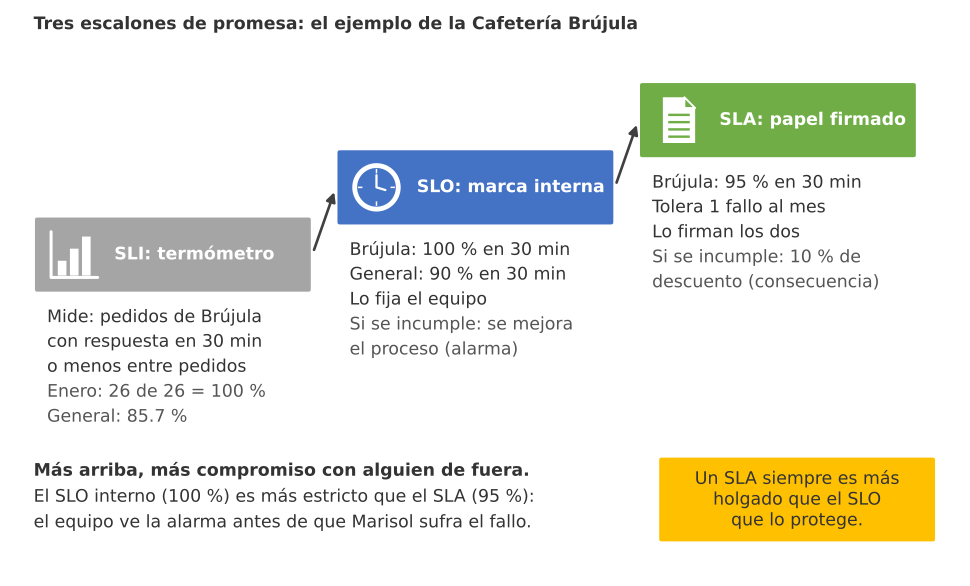
Figura 2. Tres escalones de promesa: el SLI mide, el SLO es la marca interna que da la alarma y el SLA es el papel firmado con Brújula, más holgado que el objetivo que lo protege.
La regla que se lee en la figura es la más importante de la sección: un SLA siempre es más holgado que el SLO que lo protege. Si el compromiso con el cliente fuera igual de exigente que el objetivo interno, la primera semana mala rompería el acuerdo sin aviso previo. Con un objetivo interno más estricto, el equipo se entera de que algo va mal (incumple su SLO) antes de que el cliente lo sufra (antes de que se incumpla el SLA). El SLO es la alarma; el SLA, la consecuencia. En Trigo Lento, el SLO interno de Brújula será el $100%$ de sus pedidos confirmados en 30 minutos, y lo firmado, el $95%$.
El SLI semanal de Trigo Lento
El SLO del $90%$ en 30 minutos se aplica a todos los encargos del mes. Valeria lo calcula por semanas para ver la tendencia. La semana 1 incluye el viernes 2 y el sábado 3 de enero, así que tiene ocho días hábiles en lugar de seis. El siguiente código marca cada encargo como bueno o malo, agrupa por semana y dibuja el SLI de cada una frente a la línea del SLO:
# SLI semanal (primera respuesta de 30 minutos o menos) frente al SLO del 90 % en Python:
SLO, UMBRAL = 0.90, 30
linea_base['bueno'] = linea_base['tpr_min'] <= UMBRAL
linea_base['semana'] = (linea_base['llegada'].dt.isocalendar().week.astype(int) - 1).clip(lower = 1)
sli_semanal = linea_base.groupby('semana').agg(encargos = ('bueno', 'size'), buenos = ('bueno', 'sum'))
sli_semanal['sli'] = sli_semanal['buenos'] / sli_semanal['encargos']
sli_semanal['del'] = linea_base.groupby('semana')['llegada'].min().dt.strftime('%d/%m')
sli_semanal['al'] = linea_base.groupby('semana')['llegada'].max().dt.strftime('%d/%m')
print(sli_semanal.round(3).to_string())
print(f'SLI del mes: {linea_base["bueno"].mean():.3f} | SLO: {SLO} | semanas que cumplen: '
      f'{(sli_semanal["sli"] >= SLO).sum()} de {len(sli_semanal)}')

# Barras del SLI de cada semana con la línea del SLO:
fig, ax = plt.subplots(figsize = (9, 4.8))
colores = ['#2a78d6' if s >= SLO else '#eb6834' for s in sli_semanal['sli']]
barras = ax.bar([f'Semana {s}\n{a} a {b}' for s, a, b in zip(sli_semanal.index, sli_semanal['del'], sli_semanal['al'])],
                sli_semanal['sli'], color = colores, width = 0.6)
for b, s in zip(barras, sli_semanal['sli']):
    ax.text(b.get_x() + b.get_width() / 2, s - 0.03, f'{100 * s:.1f} %', ha = 'center', fontsize = 11, color = 'white')
ax.axhline(SLO, color = '#0b0b0b', linestyle = '--', linewidth = 1.5)
ax.text(3.35, SLO + 0.01, 'SLO 90 %', fontsize = 10, ha = 'right')
ax.set_ylim(0.6, 1.0)
ax.set_title('SLI semanal: respuesta en 30 minutos o menos', fontsize = 16)
ax.set_ylabel('Proporción de encargos')
ax.spines[['top', 'right']].set_visible(False)
plt.tight_layout()
plt.show()
        encargos  buenos    sli    del     al
semana
1            160     141  0.881  02/01  10/01
2            108      95  0.880  12/01  17/01
3             99      78  0.788  19/01  24/01
4            101      87  0.861  26/01  31/01
SLI del mes: 0.857 | SLO: 0.9 | semanas que cumplen: 0 de 4
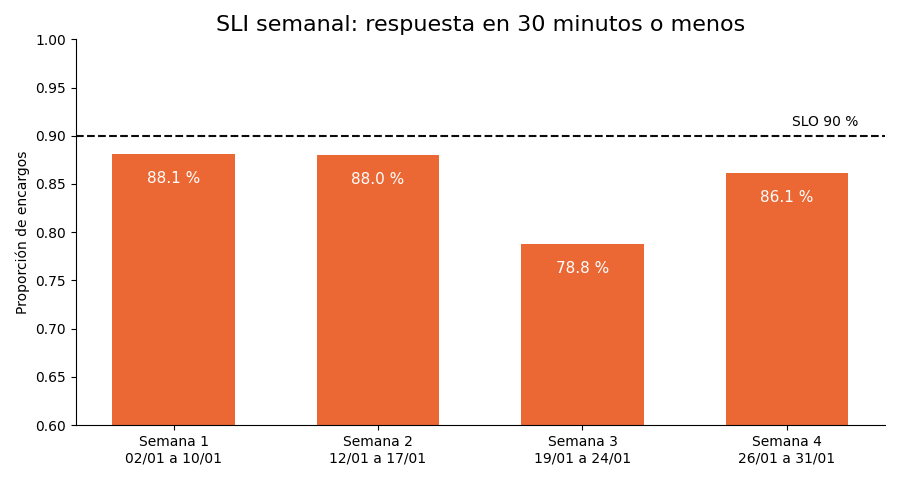
Ninguna de las $4$ semanas cumple el objetivo. La semana 1 se queda en el $88.1%$, la 2 en el $88.0%$, la 3 cae al $78.8%$ y la 4 sube al $86.1%$; el mes completo da un SLI de $0.857$, cinco puntos por debajo del $0.90$. Es la conclusión que Don Ernesto intuía: el proceso actual no sostiene ni siquiera el objetivo interno más modesto. La semana 3 merece atención propia. No tuvo más encargos que las demás (99, frente a 108 y 101), así que su caída no se explica por volumen: en la simulación es azar, pero en un registro real sería la semana de investigar qué pasó, si Valeria estuvo enferma, si se fue el internet o si hubo un pedido grande que absorbió las mañanas.
El presupuesto de error
Un SLO del $90%$ dice, leído al revés, que el $10%$ de los encargos puede incumplir sin que el objetivo se rompa. Esa tolerancia tiene nombre: el presupuesto de error. Es la cantidad de eventos malos que el proceso se puede permitir en la ventana:
$$ B = (1 - \text{SLO}) \cdot N $$
La lógica detrás de esta fórmula es múltiple:
- $N$ es el número de eventos válidos de la ventana (468 encargos al mes) y $1 - \text{SLO}$ la fracción tolerada ($0.10$): $B = 0.10 \cdot 468 = 46.8$ respuestas tardías al mes.
- El presupuesto convierte un porcentaje abstracto en un número que se puede gastar: cada respuesta de más de 30 minutos consume una unidad, y cuando el contador pasa de $46.8$ el objetivo del mes está roto.
- Sirve para decidir. Mientras quede presupuesto, se pueden hacer cambios con cierto riesgo (probar un flujo nuevo, cambiar un horario); cuando se agota, se congelan los cambios y el esfuerzo va a mejorar el proceso. Es la regla que el libro de fiabilidad de Google propone para equilibrar novedad y estabilidad.
- En conclusión, el presupuesto de error transforma el SLO en una herramienta de gestión diaria y no en un número que se revisa a fin de mes, cuando ya no se puede hacer nada.
La metáfora de la Figura 3 es la de un costal de harina: el mes empieza con 46.8 tazas, y cada respuesta tardía saca una.
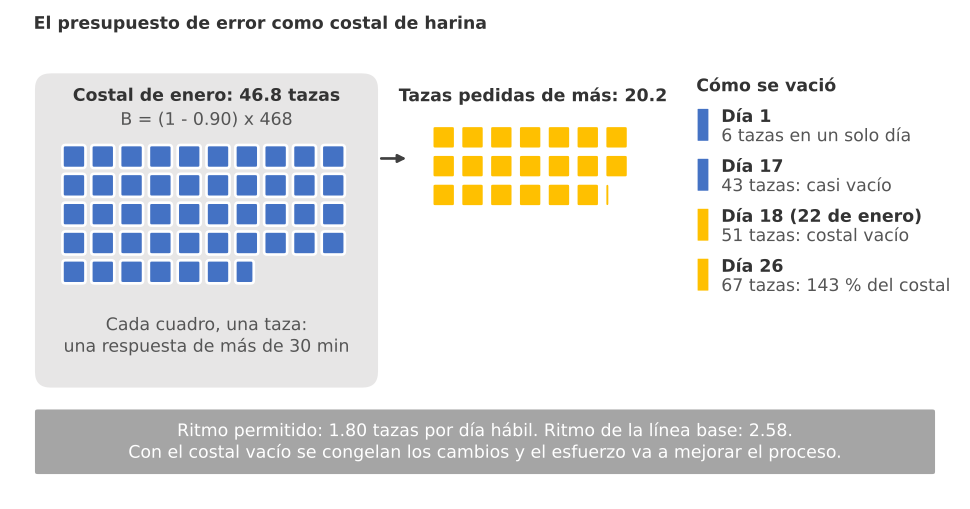
Figura 3. El presupuesto de error como costal de harina: el mes trae 46.8 tazas, la línea base saca 67 y el costal queda vacío el día hábil 18, el 22 de enero.
El siguiente código calcula el presupuesto del mes, cuenta las respuestas tardías día a día, encuentra el día en que se agota y dibuja el consumo acumulado junto con el ritmo que lo agotaría justo al final del mes:
# Presupuesto de error del mes y su consumo día a día en Python:
N = len(linea_base)
presupuesto = (1 - SLO) * N                          # B = (1 - SLO) N
malos_por_dia = (~linea_base['bueno']).groupby(linea_base['llegada'].dt.date).sum()
consumo = malos_por_dia.cumsum()
dia_agotado = consumo[consumo > presupuesto].index[0]
print(f'Presupuesto: {presupuesto:.1f} incumplimientos | gastados: {consumo.iloc[-1]} '
      f'({100 * consumo.iloc[-1] / presupuesto:.0f} % del presupuesto)')
print(f'Teórico con la lognormal: {N * stats.lognorm(s = 0.9, scale = 12).sf(UMBRAL):.1f} incumplimientos')
print('Presupuesto agotado el', dia_agotado, '| día hábil', list(consumo.index).index(dia_agotado) + 1, 'de 26')
print(f'Ritmo de consumo: {consumo.iloc[-1] / 26:.2f} al día frente a {presupuesto / 26:.2f} permitidos')

# Consumo acumulado frente a la línea del presupuesto:
fig, ax = plt.subplots(figsize = (9, 4.8))
x = np.arange(1, len(consumo) + 1)
ax.plot(x, consumo.values, color = '#eb6834', marker = 'o', markersize = 4, linewidth = 2,
        label = 'Incumplimientos acumulados')
ax.plot(x, presupuesto * x / len(x), color = '#9a9994', linestyle = ':', linewidth = 1.5,
        label = 'Ritmo que agota el presupuesto el día 26')
ax.axhline(presupuesto, color = '#0b0b0b', linestyle = '--', linewidth = 1.5)
ax.text(1, presupuesto + 2, f'Presupuesto del mes: {presupuesto:.1f}', fontsize = 10)
ax.set_title('Consumo del presupuesto de error en la línea base', fontsize = 16)
ax.set_xlabel('Día hábil del mes')
ax.set_ylabel('Respuestas de más de 30 minutos')
ax.legend(loc = 'lower right', frameon = False)
ax.spines[['top', 'right']].set_visible(False)
plt.tight_layout()
plt.show()
Presupuesto: 46.8 incumplimientos | gastados: 67 (143 % del presupuesto)
Teórico con la lognormal: 72.2 incumplimientos
Presupuesto agotado el 2026-01-22 | día hábil 18 de 26
Ritmo de consumo: 2.58 al día frente a 1.80 permitidos
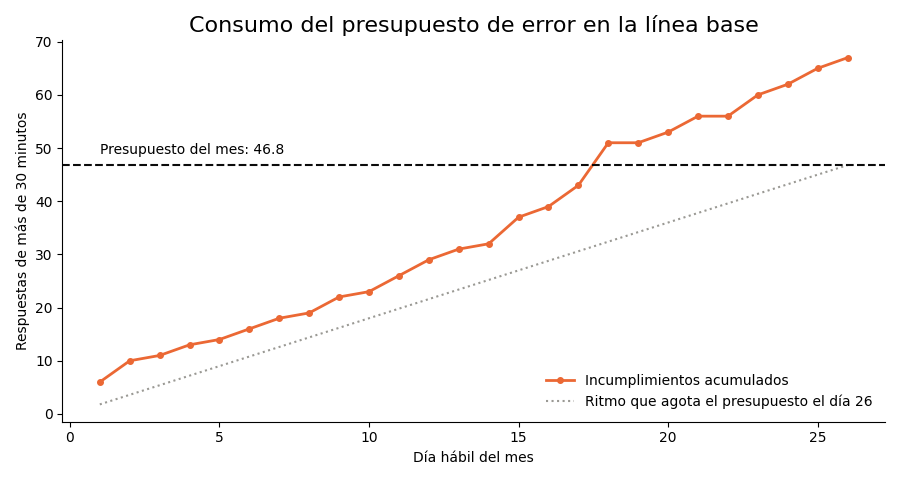
La línea base gasta $67$ respuestas tardías en un mes que solo tenía $46.8$ de presupuesto: el $143%$. La teoría de la lognormal predecía todavía más, $72.2$ incumplimientos, porque la simulación tuvo un mes algo mejor que el promedio teórico. El presupuesto se agotó el jueves 22 de enero, el día hábil $18$ de 26, y desde entonces todo el mes estuvo en números rojos. La curva naranja va siempre por encima de la línea punteada: el proceso gasta $2.58$ respuestas tardías por día cuando solo podría gastar $1.80$.
La conclusión es inmediata y no es agradable: hay que mejorar antes de prometer. Si Valeria firmara hoy con todos sus clientes un $90%$ en 30 minutos, lo incumpliría cada mes. Esto no significa que no pueda prometerle nada a Brújula; significa que la promesa tiene que apoyarse en el desempeño de los pedidos de Brújula, que es otro, y que el objetivo general queda como meta de mejora para cuando funcionen los flujos.
Atención aquí: Con pocos eventos, un SLO no se puede afinar al décimo de punto. Brújula hace 26 pedidos al mes: un SLA del 95 % tolera $0.05 \cdot 26 = 1.3$ incumplimientos, es decir, uno solo, porque no existen los pedidos fraccionarios. Un SLA del 96 % tolera $1.04$, también uno, y uno del 97 %, $0.78$, ninguno. Entre el 95 % y el 96 % no hay ninguna diferencia real, y entre el 96 % y el 97 % la diferencia es enorme. Antes de firmar un porcentaje con un cliente pequeño, tradúzcalo a “cuántos fallos al mes” y firme ese número.
El compromiso con Brújula
Marisol pidió una promesa: “15 minutos, siempre”. Ningún proceso cumple “siempre”, ni siquiera uno automatizado (un flujo también se cae, el internet también se va), así que la pregunta útil es qué porcentaje y qué plazo se pueden firmar con una probabilidad razonable de cumplir todos los meses. Esa probabilidad no es la misma que la de cumplir con un pedido: un acuerdo se rompe por acumulación.
Si cada pedido de Brújula tiene una probabilidad $p$ de recibir respuesta tarde, y los pedidos son independientes, el número de pedidos tardíos en un mes de $n = 26$ sigue una distribución binomial. Un SLA que tolera $k$ incumplimientos se rompe cuando hay más de $k$:
$$ P(\text{romper}) = P(X > k) = 1 - \sum_{j=0}^{k} \binom{n}{j}, p^{j} (1 - p)^{n - j} $$
La lógica detrás de esta fórmula es múltiple:
- $k = \lfloor (1 - \text{objetivo}) \cdot n \rfloor$ es el presupuesto de error del acuerdo redondeado hacia abajo: con el $95%$ y 26 pedidos, $k = 1$; con el $90%$, $k = 2$.
- $p$ sale de la línea base de Brújula: con su lognormal de mediana 8 minutos y $\sigma = 0.6$, la probabilidad de tardar más de 30 minutos es $p = 0.014$, y la de tardar más de 15, $p = 0.147$.
- La suma es la probabilidad de que el mes tenga $k$ incumplimientos o menos; su complemento es la probabilidad de romper el acuerdo. El número esperado de incumplimientos, $n,p$, ayuda a intuirla: si se esperan más incumplimientos de los tolerados, el acuerdo se romperá casi siempre.
- En conclusión, la binomial traduce “qué tan rápido somos” en “cuántos meses al año fallaremos a Marisol”, que es la pregunta de negocio.
El siguiente código evalúa los cuatro candidatos que combinan dos plazos (15 y 30 minutos) con dos objetivos ($90%$ y $95%$), con scipy.stats.binom, y añade la proporción de pedidos tardíos que se observó en el mes simulado:
# Candidatos de SLA para Brújula con la distribución binomial en Python:
n_mes = 26
tpr_brujula = linea_base.loc[linea_base['cliente'] == 'brujula', 'tpr_min']
candidatos = []
for umbral in [15, 30]:
    p_tarde = stats.lognorm(s = 0.6, scale = 8).sf(umbral)          # según la línea base de Brújula
    for objetivo in [0.90, 0.95]:
        tolerados = int(np.floor((1 - objetivo) * n_mes + 1e-9))
        candidatos.append({'umbral_min': umbral, 'objetivo': objetivo, 'p_tarde': p_tarde,
                           'p_tarde_mes_simulado': (tpr_brujula > umbral).mean(),
                           'tolerados': tolerados, 'esperados': n_mes * p_tarde,
                           'p_romper_mes': stats.binom.sf(tolerados, n_mes, p_tarde)})
tabla_4 = pd.DataFrame(candidatos)
print(tabla_4.round(3).to_string(index = False))
print(f'Meses rotos en un año con 95 % en 30 min: {12 * tabla_4.loc[3, "p_romper_mes"]:.1f}'
      f' | con 95 % en 15 min: {12 * tabla_4.loc[1, "p_romper_mes"]:.1f}')
 umbral_min  objetivo  p_tarde  p_tarde_mes_simulado  tolerados  esperados  p_romper_mes
         15      0.90    0.147                 0.231          2      3.832         0.759
         15      0.95    0.147                 0.231          1      3.832         0.913
         30      0.90    0.014                 0.000          2      0.359         0.005
         30      0.95    0.014                 0.000          1      0.359         0.050
Meses rotos en un año con 95 % en 30 min: 0.6 | con 95 % en 15 min: 11.0
La salida se resume en la Tabla 4.
Tabla 4. Candidatos de SLA para Brújula evaluados contra la línea base (26 pedidos al mes).
| Plazo | Objetivo | Probabilidad de tardar por pedido | Tardíos en el mes simulado | Incumplimientos tolerados | Incumplimientos esperados al mes | Probabilidad de romper el acuerdo en un mes |
|---|---|---|---|---|---|---|
| 15 minutos | 90 % | 0.147 | 23.1 % | 2 | 3.83 | 0.759 |
| 15 minutos | 95 % | 0.147 | 23.1 % | 1 | 3.83 | 0.913 |
| 30 minutos | 90 % | 0.014 | 0.0 % | 2 | 0.36 | 0.005 |
| 30 minutos | 95 % | 0.014 | 0.0 % | 1 | 0.36 | 0.050 |
Los dos candidatos de 15 minutos son inviables. Con el proceso actual se esperan $3.83$ pedidos tardíos al mes, cuando el acuerdo tolera uno o dos. Firmar el $95%$ en 15 minutos que pide Marisol rompería el acuerdo en el $91.3%$ de los meses, unos $11$ meses de cada 12; rebajarlo al $90%$ apenas ayuda ($75.9%$). El mes simulado lo confirma: el $23.1%$ de los pedidos de Brújula tardó más de 15 minutos.
Los candidatos de 30 minutos cuentan otra historia. Con $p = 0.014$ se esperan $0.36$ pedidos tardíos al mes. El $95%$ en 30 minutos tolera uno y se rompería con probabilidad $0.050$: uno de cada veinte meses, unos $0.6$ meses al año. El $90%$ en 30 minutos es todavía más seguro ($0.005$), pero no vale la pena firmar algo tan holgado: a Marisol le importa que el compromiso le diga algo, y “nueve de cada diez” le sonaría a poco.
Valeria escribe la respuesta el mismo domingo, con calma y con los números delante: “Marisol, hoy le puedo firmar que el 95 % de sus pedidos del mes quedarán confirmados en 30 minutos o menos, y que si fallamos más de una vez en un mes le descontamos un 10 % de la factura de la semana siguiente. Los 15 minutos se los prometo cuando funcione el flujo automático que estamos construyendo; antes no, porque hoy no los puedo cumplir.” La respuesta de Marisol llega en diez minutos: “Prefiero eso a una promesa bonita. Trato hecho.” Don Ernesto, al leerla, solo asiente. Tenía razón: con el proceso actual, prometer 15 minutos era prometer fallar casi todos los meses. El compromiso de 15 minutos tiene fecha: el Día 52, cuando el orquestador multicanal confirme los pedidos de Brújula sin esperar a que Valeria esté libre.
Una advertencia sobre el modelo antes de cerrar la sección. La binomial supone que los pedidos son independientes, y en la realidad no siempre lo son: si Valeria se enferma una semana, todos los pedidos de esa semana tardan a la vez. Esa dependencia hace que los incumplimientos lleguen en grupos y que la probabilidad real de romper el acuerdo sea algo mayor que la calculada. Por eso el SLO interno de Brújula se fija en el $100%$: deja margen para la mala semana que el modelo no ve.
La línea base por escrito: Little y el archivo de métricas
Quedan dos tareas para cerrar la línea base. La primera es comprobar que sus cifras son coherentes entre sí, con la ley de Little como prueba. La segunda es escribir las métricas en un archivo, para que no vivan en la cabeza de Valeria ni en un cuaderno, sino en un formato que los flujos de los módulos siguientes puedan leer.
La ley de Little cuadra
La ley de Little ofrece una comprobación gratuita de cualquier registro de proceso: si la tasa de llegada por el tiempo medio en el sistema no se parece al número medio de casos abiertos, algo está mal medido. Trigo Lento atiende de 8:00 a 20:00, 12 horas durante 26 días: 312 horas en las que llegan 468 encargos, es decir, $\lambda = 1.5$ encargos por hora. El tiempo medio en el sistema es el tiempo de ciclo medio. El lado izquierdo, $L$, se mide contando, minuto a minuto durante el horario de atención, cuántos encargos han llegado y todavía no están registrados. El siguiente código calcula los dos lados:
# Comprobación de la ley de Little con la línea base en Python:
horas_abierto = 26 * 12                                 # de 8:00 a 20:00, 26 días
lam = N / horas_abierto                                 # encargos por hora
W = linea_base['ciclo_min'].mean() / 60                 # horas en el sistema
# L medido: encargos sin registrar, contados minuto a minuto durante el horario de atención:
minutos = pd.DatetimeIndex(np.concatenate([pd.date_range(d + pd.Timedelta(hours = 8), periods = 720, freq = 'min')
                                           for d in dias]))
llegadas = np.sort(linea_base['llegada'].to_numpy())
registros = np.sort(linea_base['registro'].to_numpy())
en_sistema = (np.searchsorted(llegadas, minutos.to_numpy(), side = 'right')
              - np.searchsorted(registros, minutos.to_numpy(), side = 'right'))
print(f'lambda = {lam:.3f} encargos por hora | W = {60 * W:.1f} min = {W:.3f} h')
print(f'Lado derecho, lambda * W: {lam * W:.3f} encargos')
print(f'Lado izquierdo, L medido: {en_sistema.mean():.3f} encargos | máximo: {en_sistema.max()}')
print(f'Minutos con 3 o más encargos abiertos: {100 * (en_sistema >= 3).mean():.1f} %')
lambda = 1.500 encargos por hora | W = 39.1 min = 0.651 h
Lado derecho, lambda * W: 0.976 encargos
Lado izquierdo, L medido: 0.950 encargos | máximo: 8
Minutos con 3 o más encargos abiertos: 10.3 %
Con $\lambda = 1.5$ encargos por hora y $W = 39.1$ minutos ($0.651$ horas), el lado derecho da $0.976$ encargos; el conteo minuto a minuto da $0.950$. La diferencia, de menos del $3%$, se explica por los bordes: los encargos que llegan a las 19:50 se registran después de las 20:00, fuera de los minutos que se cuentan. La ley cuadra, y eso dice que las tres marcas de tiempo del registro son coherentes.
Un encargo abierto en promedio parece poco, y lo es: el problema de Trigo Lento no es el volumen medio, sino la concentración. El máximo fue de $8$ encargos abiertos a la vez, y en el $10.3%$ de los minutos de atención había 3 o más. Esos son los momentos en que nacen las respuestas tardías: no faltan horas al día, faltan manos en la hora pico, la misma conclusión que dio la cola M/M/1 del Día 1 por otro camino.
El archivo de métricas
Una métrica que solo existe en un cuaderno se pierde. Valeria escribe la definición de sus indicadores en un archivo, trigo_lento/dia_8/metricas.json, con todo lo que hace falta para calcularlos sin ambigüedad: el nombre del indicador, qué eventos son válidos, cuál es un evento bueno, la ventana, el objetivo, el tipo (SLO interno o SLA con un cliente) y el dueño. Las condiciones se escriben como expresiones que pandas sabe evaluar, de modo que el mismo archivo sirve de documentación para una persona y de configuración para un programa:
{
  "version": "1.0",
  "proceso": "Encargos de Trigo Lento",
  "fuente": "trigo_lento/dia_8/linea_base.csv",
  "ventana": {"tipo": "mes", "dias_habiles": 26, "agregacion_publicada": "semanal"},
  "indicadores": [
    {
      "nombre": "primera_respuesta_30",
      "descripcion": "Proporción de encargos con primera respuesta en 30 minutos o menos",
      "evento_valido": "todos",
      "evento_bueno": "tpr_min <= 30",
      "objetivo": 0.90,
      "tipo": "SLO",
      "dueno": "Valeria Ortiz"
    },
    {
      "nombre": "brujula_respuesta_30",
      "descripcion": "Proporción de pedidos de Brújula confirmados en 30 minutos o menos",
      "evento_valido": "cliente == 'brujula'",
      "evento_bueno": "tpr_min <= 30",
      "objetivo": 0.95,
      "tipo": "SLA",
      "dueno": "Valeria Ortiz",
      "contraparte": "Cafetería Brújula",
      "consecuencia": "Más de 1 incumplimiento al mes: 10 % de descuento en la factura semanal siguiente"
    },
    {
      "nombre": "registro_sin_error",
      "descripcion": "Proporción de encargos registrados sin error de producto, cantidad o fecha",
      "evento_valido": "todos",
      "evento_bueno": "error == 0",
      "objetivo": 0.98,
      "tipo": "SLO",
      "dueno": "Valeria Ortiz"
    },
    {
      "nombre": "ciclo_60",
      "descripcion": "Proporción de encargos registrados y confirmados en 60 minutos o menos",
      "evento_valido": "todos",
      "evento_bueno": "ciclo_min <= 60",
      "objetivo": 0.80,
      "tipo": "SLO",
      "dueno": "Valeria Ortiz"
    }
  ],
  "privacidad": {
    "datos_personales": "ninguno: solo identificador del pedido, canal y marcas de tiempo",
    "uso_prohibido": "evaluar el desempeño de personas"
  }
}
El archivo declara cuatro indicadores. Dos ya se conocen: primera_respuesta_30, el SLO general del $90%$, y brujula_respuesta_30, el SLA del $95%$ con su contraparte y su consecuencia escrita. Los otros dos completan el cuadro con la calidad y el proceso completo: registro_sin_error, con un objetivo del $98%$ que corresponde al $2%$ de errores del Día 6, y ciclo_60, que pide que el $80%$ de los encargos quede registrado y confirmado en una hora o menos. El bloque final de privacidad deja escrito, para quien herede el archivo, que el registro no lleva datos personales y que no se usa para evaluar a las personas.
El siguiente código lee el archivo, evalúa cada indicador contra la línea base con query y eval de pandas y dice si cumple su objetivo, con el presupuesto y lo gastado de cada uno:
# Lectura de metricas.json y evaluación de cada indicador contra la línea base en Python:
definicion = json.loads((carpeta / 'metricas.json').read_text(encoding = 'utf-8'))
filas = []
for m in definicion['indicadores']:
    validos = linea_base if m['evento_valido'] == 'todos' else linea_base.query(m['evento_valido'])
    buenos = validos.eval(m['evento_bueno']).sum()
    sli = buenos / len(validos)
    presupuesto_m = (1 - m['objetivo']) * len(validos)
    filas.append({'indicador': m['nombre'], 'tipo': m['tipo'], 'validos': len(validos), 'buenos': int(buenos),
                  'sli': round(sli, 3), 'objetivo': m['objetivo'], 'presupuesto': round(presupuesto_m, 1),
                  'gastado': len(validos) - int(buenos), 'cumple': 'sí' if sli >= m['objetivo'] else 'no'})
print(pd.DataFrame(filas).to_string(index = False))
print('Uso prohibido:', definicion['privacidad']['uso_prohibido'])
           indicador tipo  validos  buenos   sli  objetivo  presupuesto  gastado cumple
primera_respuesta_30  SLO      468     401 0.857      0.90         46.8       67     no
brujula_respuesta_30  SLA       26      26 1.000      0.95          1.3        0     sí
  registro_sin_error  SLO      468     461 0.985      0.98          9.4        7     sí
            ciclo_60  SLO      468     405 0.865      0.80         93.6       63     sí
Uso prohibido: evaluar el desempeño de personas
El tablero cabe en cuatro filas. El SLO general de primera respuesta no se cumple ($0.857$ frente a $0.90$, con $67$ incumplimientos sobre un presupuesto de $46.8$). El SLA de Brújula se cumple con holgura: sus 26 pedidos del mes simulado respondieron en 30 minutos o menos, sin gastar nada de su presupuesto de $1.3$. El registro sin error cumple por poco ($0.985$ frente a $0.98$: 7 errores de 9.4 permitidos), y el ciclo de una hora cumple ($0.865$ frente a $0.80$). La lectura de conjunto es la del día: Trigo Lento cumple con su cliente más exigente, pero no con el resto, y el objetivo general de 30 minutos es la primera meta que los flujos tendrán que alcanzar.
Este archivo es una pieza de arquitectura, no un apunte. Cuando el módulo 3 construya el escenario de pedidos en Make y el módulo 4 el agente de n8n, sus registros de ejecución tendrán las mismas tres marcas de tiempo, y este mismo código calculará los mismos indicadores con datos reales. La línea base simulada quedará entonces como lo que es: el punto de partida contra el que se medirá la mejora.
Antes de la evaluación
Con este día se cierra la parte conceptual del módulo 1. Los ocho primeros días construyeron, pieza a pieza, la forma de pensar de un arquitecto de automatización: medir antes de construir, entender qué hace un modelo de lenguaje, decidir cuándo arranca un flujo, fijar contratos de datos, validarlos, escribir reglas éticas, llevar el método a otro negocio y, hoy, convertir mediciones en compromisos. Mañana, el Día 9 pondrá a prueba todo eso con una evaluación. La Tabla 5 resume qué entra de cada día y dónde se profundiza más adelante.
Tabla 5. Lo que entra en la evaluación del Día 9 y dónde se profundiza en la serie.
| Día | Tema | Idea que entra en la evaluación | Cifra de referencia | Dónde se profundiza |
|---|---|---|---|---|
| 1 | Automatización de procesos | Rediseñar antes de automatizar; cola M/M/1 y ley de Little | 46.8 h al mes; 54 min de espera en el pico | Días 21 y 84 |
| 2 | Modelos de lenguaje en flujos | Un modelo es una función probabilística de texto a texto que cobra por token | Reglas: 70 % de acierto en 60 mensajes | Módulos 3 y 6 |
| 3 | Disparadores | Sondeo frente a webhook; entregas repetidas y firma HMAC | Sondeo cada 15 min: 7.45 min de espera media | Días 23 y 40 |
| 4 | Contratos de datos | Formato canónico, validación en la frontera, normalización | 176 válidos y 24 rechazados de 200 | Días 14 y 27 |
| 5 | Validación de entradas | Validadores de pydantic, cuarentena y repregunta | 95 de 100 mensajes salvados | Días 28 y 43 |
| 6 | Ética de la automatización | Un error automatizado se repite en silencio; código de honor | 2 % de error humano frente a fallos sistemáticos | Días 64 y 80 |
| 7 | Caso de otro negocio | El método se transfiere; los datos de salud son sensibles | 42 h de recepción al mes en la clínica | Días 51 y 85 |
| 8 | Métricas y niveles de servicio | Percentiles, SLI, SLO, SLA y presupuesto de error | p95 de 50.1 min; presupuesto gastado al 143 % | Días 53, 75 y 82 |
Las métricas de hoy reaparecerán tres veces con más profundidad. El Día 53 construirá los indicadores de servicio de la atención multicanal con datos reales de los flujos de mensajería; el Día 75 los llevará a un cuadro de mando que Valeria y Don Ernesto podrán consultar sin abrir Python; y el Día 82 cerrará el ciclo con la gestión formal de los niveles de servicio del ecosistema completo, incluidas las revisiones periódicas del acuerdo con Brújula. Las fórmulas de hoy, $B = (1 - \text{SLO}) \cdot N$ y la binomial del compromiso, son las mismas en los tres días; lo que cambia es que los datos dejarán de ser simulados.
Consideraciones finales
El número más importante del día no es un tiempo, es una probabilidad: $0.913$, la de romper en un mes cualquiera el acuerdo que Marisol pedía. Si Valeria hubiera contestado “claro que sí” el viernes, habría firmado un compromiso que el proceso actual incumpliría unos once meses al año. El cálculo no le dijo que no a Marisol; le dijo qué sí podía darle hoy (95 % en 30 minutos, con una probabilidad de romperlo de $0.050$) y qué tiene que cambiar para darle lo que pide.
Atención aquí: Medir procesos no es vigilar personas. Las marcas de tiempo de Trigo Lento se agregan por semana y por mes, no se guardan con el nombre de quien atendió y no se usan para evaluar a Valeria ni al personal de mostrador: un indicador que se convierte en evaluación individual deja de medir el proceso y empieza a medir el miedo, porque las personas aprenden a mejorar el número en lugar del servicio. Además, un SLA solo se firma con números que lo respalden: prometer de más a un cliente, sabiendo que no se podrá cumplir, es una forma de engaño. La línea base de este día es una simulación declarada y se sustituirá por mediciones reales en cuanto los flujos registren sus ejecuciones.
Las limitaciones también conviene decirlas. Las lognormales se estimaron con una muestra tomada a mano en dos semanas, y una muestra así suele olvidar justo los casos peores (los mensajes que nadie vio a tiempo tampoco se apuntaron). Los pedidos de la simulación son independientes, y en la realidad no lo son. El tiempo de primera respuesta no distingue entre una respuesta que resuelve y un “ahorita le confirmo”, y la definición de “respuesta útil” tendrá que escribirse con más cuidado cuando un flujo la produzca. Ninguna de estas limitaciones invalida el método; todas son razones para reemplazar la simulación por registros reales lo antes posible.
Antes de pasar al Día 9, conviene que usted se haga algunas preguntas sobre un proceso que conozca:
- ¿Qué tres marcas de tiempo necesitaría registrar para medirlo, y cuáles registra hoy?
- ¿Cuál es su p95, y cuánto se aleja de la media? ¿Quién es el cliente que vive en esa cola?
- ¿Qué promesa de plazo ha hecho, o le han pedido, y con qué probabilidad se rompería en un mes?
- ¿Su objetivo interno es más estricto que lo que promete al cliente, o son el mismo número?
Un gran libro que habla de esto es Site Reliability Engineering (o Ingeniería de fiabilidad de sitios), editado por Betsy Beyer, Chris Jones, Jennifer Petoff y Niall Richard Murphy, en el que los ingenieros de Google explican cómo convirtieron la fiabilidad en un problema de números: indicadores, objetivos, presupuestos de error y la regla de congelar los cambios cuando el presupuesto se agota. Aunque sus ejemplos son de servicios con millones de usuarios, el capítulo sobre objetivos de nivel de servicio se lee igual de bien pensando en una panadería con 26 pedidos de un cliente mayorista, y su compañero práctico, The Site Reliability Workbook, trae ejemplos de cómo elegir indicadores y calcular presupuestos.
Una promesa de servicio es una probabilidad con consecuencias: antes de firmarla, mida el proceso, cuente los fallos que tolera y calcule cuántos meses la va a romper. Trigo Lento no tiene todavía ningún flujo en producción, pero tiene algo que muchos negocios con flujos no tienen: sabe cuánto espera hoy cada cliente, qué puede prometer y qué tiene que mejorar.
Conclusiones clave
Métricas de proceso
- Tres marcas de tiempo (llegada, primera respuesta y registro) y una columna de error bastan para medir el tiempo de primera respuesta, el tiempo de ciclo, el rendimiento y la tasa de error.
- En la línea base simulada de 468 encargos, la primera respuesta tiene una media de 16.6 minutos y una mediana de 11.0; el ciclo, una media de 39.1 minutos; se registran 18 encargos por día y el 1.5 % sale con error.
- La ley de Little cuadra con el registro: $\lambda W = 0.976$ encargos frente a $0.950$ medidos minuto a minuto; el problema no es el volumen medio, sino los picos de hasta 8 encargos abiertos.
Percentiles
- El percentil de tipo 7 de Hyndman y Fan interpola entre los dos vecinos de la posición $h = (n - 1),p/100$; escrito a mano coincide con
np.percentile(p95 de 50.052 minutos en los encargos generales). - En una lognormal la media supera siempre a la mediana: con mediana de 12 minutos y $\sigma = 0.9$, la media es 18.0 y el p95 52.7; solo el 32.4 % de los encargos espera más que la media.
- Los objetivos se expresan con percentiles o proporciones, no con medias: un promedio de 16.6 minutos convivió con 30 encargos que esperaron más de 45.
SLI, SLO y SLA
- El SLI es una proporción de eventos buenos entre válidos; el SLO, el objetivo interno; el SLA, el compromiso con consecuencias, siempre más holgado que el SLO que lo protege.
- Con un SLO del 90 % en 30 minutos, el presupuesto es $B = 0.10 \cdot 468 = 46.8$ incumplimientos; la línea base gasta 67 (143 %), lo agota el día hábil 18 y ninguna semana cumple.
- Para Brújula, la binomial descarta los 15 minutos (romper el 95 % en un mes: 0.913) y respalda el 95 % en 30 minutos (0.050); con 26 pedidos al mes, un SLA tolera fallos enteros, no décimos de punto.
Mañana, en el Día 9: Evaluación de fundamentos: IA, prompts y flujos. Valeria pondrá a prueba lo aprendido en los ocho primeros días con quince preguntas autocorregibles y un caso de Trigo Lento con rúbrica, y usted podrá comprobar si sabría decidir qué medir, qué prometer y qué no automatizar.
Referencias
- Beyer, B., Jones, C., Petoff, J. y Murphy, N. R. (Eds.) (2016). Site Reliability Engineering: How Google Runs Production Systems. O’Reilly Media. https://sre.google/sre-book/table-of-contents/
- Beyer, B., Murphy, N. R., Rensin, D. K., Kawahara, K. y Thorne, S. (Eds.) (2018). The Site Reliability Workbook: Practical Ways to Implement SRE. O’Reilly Media. https://sre.google/workbook/table-of-contents/
- Hyndman, R. J. y Fan, Y. (1996). Sample Quantiles in Statistical Packages. The American Statistician, 50(4), 361-365. https://doi.org/10.1080/00031305.1996.10473566
- Little, J. D. C. (1961). A Proof for the Queuing Formula: L = λW. Operations Research, 9(3), 383-387. https://doi.org/10.1287/opre.9.3.383