Arquitecto de automatización con IA: Día 81
 Jeshua Romero Guadarrama
- 74 Min para leer
- 22 Apr, 2026
Índice de contenido
Resumen:
Un viernes a las seis de la tarde caducó el token de WhatsApp de Trigo Lento y nadie supo qué hacer durante $142$ minutos. En esta entrada, Valeria convierte esa tarde en ocho manuales de operación (runbooks) con la misma estructura de seis secciones, clasifica los incidentes en tres severidades con tiempos de respuesta, escribe el modo manual que devuelve la libreta al mostrador sin perder ni duplicar pedidos, prueba de verdad una copia de la base operativa, inventaría $17$ secretos con su fecha de rotación y construye un detector de gasto anómalo de Claude que avisa a los cuatro minutos de empezar un bucle. Un año simulado de incidentes pasa de $79.4$ a $19.5$ horas de afectación con manuales, y el ensayo de mesa del token caducado baja de $142$ a $24$ minutos. Al terminar, usted sabrá escribir manuales que otra persona pueda seguir, fijar objetivos de recuperación, diseñar un plan de continuidad con copias, restauración y secretos, y ensayar un incidente antes de que ocurra.
¿Cómo citar el presente artículo?
Romero, J. (22 de abril de 2026). Arquitecto de automatización con IA: Día 81. python-data-engineer. https://www.python-data-engineer.com/post/aai/dia_81/.
Arquitecto de automatización con IA: Día 81 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/aai/dia_81/.
Precios, límites y políticas revisados en octubre de 2026: planes, precios y límites de Make, n8n, Zapier, WhatsApp (Meta, Twilio, Wati) y de la API de Claude. Los comandos de copia y restauración del Bloque 6 se contrastaron con la documentación de la CLI de n8n (export:workflow --backup, export:credentials --backup, import:workflow --separate) y con la referencia de pg_dump y pg_restore de PostgreSQL, revisadas en octubre de 2026; el Bloque 6 se muestra y no se ejecuta. Los códigos de error de la API de Claude (rate_limit_error 429 y overloaded_error 529) y las opciones de caducidad del token de usuario del sistema de Meta (60 días o sin caducidad) se revisaron en la misma fecha. Los demás bloques se ejecutaron con la semilla de la serie y sus salidas son reales; las frecuencias de incidentes y los tiempos de recuperación son supuestos declarados, no mediciones de un producto, y el incidente del viernes 10 de abril es ficticio, como todo lo de Trigo Lento.
Día 81. Proyecto integrador III: manuales de operación (runbooks) y continuidad
Introducción
Ayer, en el Día 80 (Auditoría de seguridad del ecosistema: secretos, permisos y simulacro de restauración), Valeria contó las llaves de la casa como Don Ernesto cuenta las del obrador cada noche, encontró credenciales compartidas, cuentas personales donde debía haber cuentas del negocio y tokens que caducan solos, y levantó el ecosistema entero en un servidor nuevo con lo que había en las copias, y Trigo Lento ganó un inventario de credenciales con hallazgos fechados y un tiempo de recuperación medido. Hoy toca lo que la auditoría dejó señalado con el dedo: qué hace una persona, a las seis de la tarde de un viernes, cuando algo de todo eso falla y Valeria no está.
Porque ya pasó. El viernes 10 de abril, a las 18:00, el token del usuario del sistema de la Cloud API de WhatsApp caducó. Se había creado el 9 de febrero, durante las primeras pruebas de la Cloud API, con la opción de sesenta días que el Business Manager ofrece por defecto, y nadie lo volvió a mirar cuando el corte del 6 de abril lo puso en producción. Los mensajes de los clientes seguían entrando por el webhook; las respuestas, ninguna, porque cada envío devolvía el código $190$ de Meta. Una clienta llamó al mostrador a las 18:41: “les escribí hace rato y no me contestan”. Itzel, en el mostrador, no sabía si era el teléfono, el sistema o la clienta. Valeria, desde su casa, revisó flujos uno por uno hasta encontrar la frase “Error validating access token” en el nodo de envío, y después tardó tres cuartos de hora en reunir la contraseña del Business Manager, el segundo factor que vive en el teléfono de Don Ernesto y el lugar exacto de n8n donde se pega un token. A las 20:22 todo volvió a funcionar. Catorce mensajes esperaron en la cola; uno era un pedido de dos pasteles para el sábado.
Don Ernesto escuchó el relato el lunes sin levantar la voz. “En el obrador hay un papel pegado en la pared que dice qué hacer si se va la luz: cerrar hornos, apagar motores, llamar al 071 y en qué orden encender cuando vuelve. Lo escribí en 2019 y cualquiera de los muchachos lo sigue sin llamarme. ¿Y aquí? ¿Dónde está el papel de esta casa?” No lo había. Había una arquitectura documentada (Día 78), un inventario de flujos con dueños (Día 79) y una auditoría de llaves (Día 80), y ninguna hoja que dijera, para el viernes a las seis, cuál es el primer paso.
En la presente entrada, descubrirá qué es un manual de operación y por qué tiene seis secciones fijas (síntoma, impacto, diagnóstico, acción, verificación y comunicación), cómo se clasifican los incidentes en tres severidades con tiempos de respuesta y canales de aviso, y cómo se escriben los ocho manuales que cubren los fallos más probables del ecosistema de Trigo Lento, del servidor caído al gasto anómalo de Claude. Simulará un año de incidentes para medir cuántas horas de afectación ahorra tener el papel en la pared, escribirá el modo manual que devuelve la libreta al mostrador sin perder ni duplicar pedidos, verá los comandos de copia y restauración de Postgres, SQLite y n8n, probará de verdad una restauración, inventariará los secretos con su fecha de rotación y construirá el detector de gasto que dispara uno de los manuales. Al final, el viernes del token se vuelve a jugar sobre la mesa, con el manual delante y el cronómetro en marcha.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Escribir manuales de operación (runbooks) para los incidentes más probables, con síntomas, diagnóstico, acción y verificación.
- Clasificar incidentes por severidad y fijar tiempos objetivo de respuesta y recuperación.
- Diseñar el plan de continuidad: copias de seguridad, restauración probada, rotación de secretos y modo manual.
- Ensayar un incidente de mesa y medir el tiempo de recuperación.
Qué es un manual de operación
Un manual de operación (en la literatura de fiabilidad, runbook) es el documento que una persona abre cuando algo falla y que le dice, en ese orden, qué está pasando, a quién afecta, cómo confirmarlo, qué hacer, cómo saber que ya pasó y a quién avisar. No es la documentación del sistema: la arquitectura del Día 78 explica cómo está hecho el ecosistema; el manual explica qué hacer a las seis de la tarde cuando una pieza se rompe. Se escribe para el peor momento, cuando la persona que lo lee está nerviosa, no es la que construyó el flujo y no tiene tiempo de entender nada. Por eso cabe en una hoja, no supone conocimientos y empieza por el síntoma, que es lo único que esa persona ve.
El papel de Don Ernesto contra los cortes de luz es un manual de operación perfecto, y lleva siete años en la pared. Tiene un síntoma (“se apagan hornos, luz y amasadora”), un impacto (“la hornada en curso y el frío de la cámara”), un diagnóstico ("¿solo nosotros? mirar la calle y el interruptor"), una acción en orden (“cerrar hornos, apagar motores, llamar al 071”), una verificación (“vuelve la luz: encender por orden, el horno al final”) y una regla de comunicación (“avisar a Valeria y a Brújula si pasa de una hora”). Lo escribió alguien que sabía qué hacer, para que lo siguiera alguien que no. La Figura 1 pone los dos papeles uno junto al otro: el del obrador y el que hoy escribe Valeria para el token de WhatsApp.
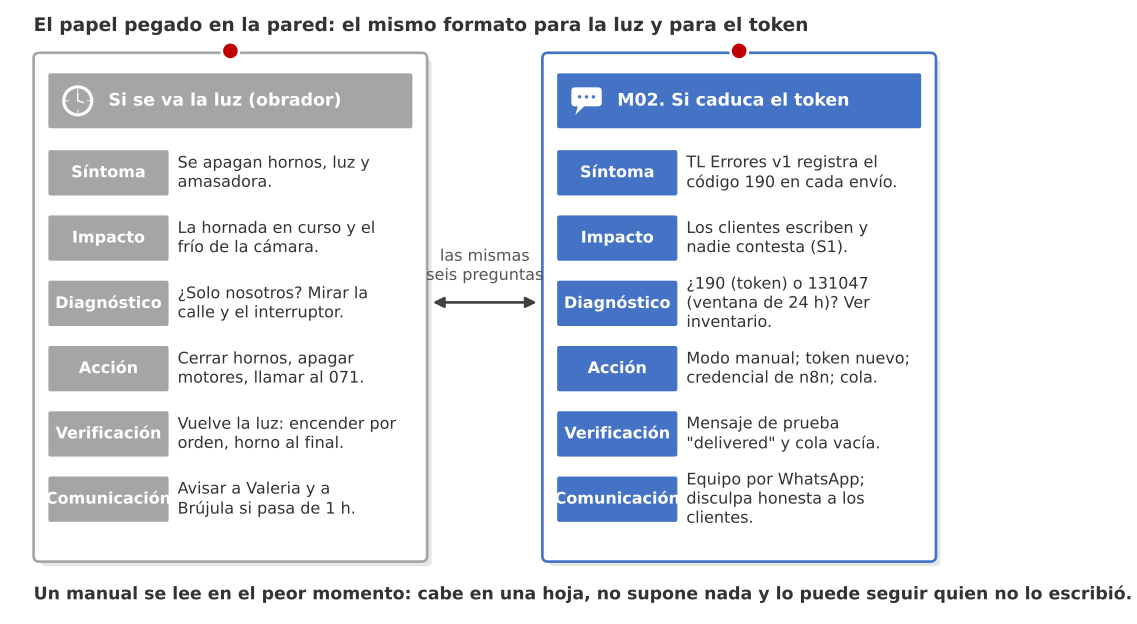
Figura 1. El papel pegado en la pared: el aviso del obrador para los cortes de luz y el manual M02 del token de WhatsApp tienen las mismas seis secciones (síntoma, impacto, diagnóstico, acción, verificación y comunicación), caben en una hoja y se leen en el peor momento.
Las seis secciones no son una preferencia de formato, son un orden de trabajo:
- Síntoma: lo que ve la persona, escrito con las palabras del registro o de la pantalla (“TL Errores v1 registra el código 190”), para que se pueda reconocer sin interpretar.
- Impacto: quién está esperando y qué deja de pasar; de aquí sale la severidad y la urgencia.
- Diagnóstico: dos o tres comprobaciones que distinguen este incidente de otro parecido (el código 190 es el token; el 131047 es la ventana de 24 horas cerrada, y se arregla distinto).
- Acción: los pasos en orden, con el primero siempre dirigido a los clientes (activar el modo manual) y nunca con un secreto escrito dentro.
- Verificación: la prueba que dice que el incidente terminó, no la sensación de que terminó.
- Comunicación: a quién se avisa, por dónde y con qué honestidad; a los clientes se les dice que hubo una demora, no que “el sistema” tuvo un problema.
Los manuales de hoy son estructuras de datos antes que documentos: cada uno es un diccionario de Python con esas seis claves, y el archivo Markdown se genera desde ahí. La razón es la misma que la del brief del Día 77: si el manual vive como datos, el código puede comprobar que ninguno carece de una sección, que todos tienen responsable y suplente, que los tiempos objetivo son coherentes con la severidad y que el detector del Bloque 5 puede citar la primera acción del manual que dispara. El primer bloque fija las importaciones, la semilla de la serie, la zona horaria, la carpeta del día y las dos fechas que hoy importan, la del incidente y la de creación del token:
# Importaciones base, semilla de la serie, zona horaria y carpeta del día en Python:
import warnings
warnings.filterwarnings('ignore')
import glob
import json
import re
import sqlite3
import tempfile
import textwrap
import time
from datetime import datetime, timedelta
from pathlib import Path
from zoneinfo import ZoneInfo
import numpy as np
import pandas as pd
import matplotlib.dates as mdates
import matplotlib.pyplot as plt
from matplotlib.patches import Patch

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 150)
pd.set_option('display.max_colwidth', 70)
CDMX = ZoneInfo('America/Mexico_City')
carpeta = Path('trigo_lento') / 'dia_81'
(carpeta / 'manuales').mkdir(parents = True, exist_ok = True)
DIAS = ['lunes', 'martes', 'miércoles', 'jueves', 'viernes', 'sábado', 'domingo']
hoy = datetime(2026, 4, 22, 9, 0, tzinfo = CDMX)
incidente = datetime(2026, 4, 10, 18, 0, tzinfo = CDMX)          # el viernes del token caducado
creado = datetime(2026, 2, 9, 11, 30, tzinfo = CDMX)             # token del usuario del sistema, 60 días
print('numpy', np.__version__, '| pandas', pd.__version__)
print(f'Hoy: {DIAS[hoy.weekday()]} {hoy:%d/%m/%Y %H:%M} | incidente: {DIAS[incidente.weekday()]} {incidente:%d/%m %H:%M} | '
      f'token creado el {creado:%d/%m} con 60 días: caducó el {creado + timedelta(days = 60):%d/%m}')
numpy 2.4.6 | pandas 3.0.3
Hoy: miércoles 22/04/2026 09:00 | incidente: viernes 10/04 18:00 | token creado el 09/02 con 60 días: caducó el 10/04
El token se creó el 9 de febrero con la opción de sesenta días y caducó exactamente el viernes 10 de abril; Valeria tardó un minuto en comprobarlo con timedelta y dos meses en no comprobarlo. Esa es, en una línea, la diferencia entre tener un inventario de secretos con fechas (Bloque 8) y no tenerlo. Hoy es miércoles 22 de abril; quedan diecinueve días para que Valeria se vaya de vacaciones el 11 de mayo, y la meta del módulo es que, para entonces, Itzel y Joaquín puedan seguir estos manuales sin llamarla.
Severidades
No todos los incidentes merecen la misma prisa, y decirlo por escrito evita dos errores simétricos: tratar como urgente lo que puede esperar al lunes (y gastar las noches de Valeria) y tratar como interno lo que tiene a una clienta esperando (el viernes 10). Trigo Lento usa tres severidades, con el criterio de quién está esperando:
- S1, clientes sin atención: el canal de pedidos no responde o responde mal a clientes. Responde quien esté en el local, con Valeria o su suplente por teléfono, en menos de $15$ minutos, y el aviso va por llamada y por el WhatsApp del equipo, porque Slack puede ser precisamente lo que falla.
- S2, degradación: una pieza falla y otra la cubre; el agente responde con plantilla porque Claude devuelve 429, o las aprobaciones pasan por WhatsApp porque Slack está caído. Responde Valeria o su suplente en horario de servicio, en menos de $60$ minutos, por Slack y WhatsApp.
- S3, interno: nada que vea un cliente; informes, indexación de Notion, contenido programado. Responde Valeria en el siguiente día hábil (ocho horas de servicio), por Slack.
El tiempo de respuesta es el que pasa entre la detección y el momento en que alguien empieza a trabajar en el incidente; el tiempo de recuperación, que cada manual fija por separado, es el que pasa hasta la verificación. Son dos relojes distintos, y conviene no confundirlos: el viernes 10 la respuesta fue rápida una vez detectado el problema (Valeria empezó a mirar en cuanto Itzel la llamó), y aun así la recuperación tardó $142$ minutos, porque nadie sabía qué mirar.
El siguiente bloque escribe las tres severidades y los ocho manuales como datos, genera un archivo Markdown por manual en trigo_lento/dia_81/manuales/ e imprime las dos tablas que resumen la sección y la siguiente, más el manual del token completo, que es el que se ensayará al final:
# Severidades, los ocho manuales de operación como estructuras de datos y generación de manuales/*.md en Python:
SEVERIDADES = pd.DataFrame([
    ('S1', 'Clientes sin atención', 'El canal de pedidos no responde o responde mal a clientes',
     'Quien esté en el local; Valeria o su suplente por teléfono', 15, 'Llamada y WhatsApp del equipo'),
    ('S2', 'Degradación', 'Una pieza falla y otra la cubre: plantilla en vez de Claude, aprobación por WhatsApp',
     'Valeria o su suplente en horario de servicio', 60, 'Slack #operaciones y WhatsApp'),
    ('S3', 'Interno', 'Nada que vea un cliente: informes, indexación, contenido programado',
     'Valeria en el siguiente día hábil', 480, 'Slack #operaciones'),
], columns = ['severidad', 'nombre', 'ejemplo', 'responde', 'respuesta_min', 'canal'])

def manual(id_, nombre, sev, sintoma, impacto, diagnostico, accion, verificacion, comunicacion, objetivo_min,
           responsable = 'Valeria', suplente = 'Itzel (mostrador)'):
    return dict(id = id_, nombre = nombre, severidad = sev, sintoma = sintoma, impacto = impacto,
                diagnostico = diagnostico, accion = accion, verificacion = verificacion, comunicacion = comunicacion,
                objetivo_min = objetivo_min, responsable = responsable, suplente = suplente)

MANUALES = [
    manual('M01', 'Servidor de n8n caído', 'S1',
           'El latido sintético del Día 75 no responde dos veces seguidas; n8n no abre; WhatsApp no contesta.',
           'Ningún flujo de n8n corre: pedidos, agente, aprobaciones, Gmail y Slack. Los escenarios de Make siguen.',
           ['Abrir el panel del proveedor del servidor: ¿la máquina está encendida y responde a ping?',
            'Entrar por SSH y ejecutar "docker compose ps": ¿están arriba n8n y postgres?',
            'Si están arriba, mirar "docker compose logs --tail=100 n8n" buscando el último error.'],
           ['Activar el modo manual (M00) en el mostrador: la libreta y la plantilla de respuesta.',
            'Si un contenedor cayó: "docker compose restart n8n" (o postgres primero y después n8n).',
            'Si el disco está lleno: borrar ejecuciones antiguas con "n8n executionData:prune" y reiniciar.',
            'Si la máquina no vuelve en 30 minutos: levantar el servidor nuevo con el Bloque 5 (restauración).'],
           'El latido responde en menos de 60 s y un mensaje de prueba al número de pruebas recibe respuesta.',
           'S1: aviso al equipo por WhatsApp al detectar; a Brújula si pasa de 1 hora en horario de pedidos.', 30),
    manual('M02', 'Token de WhatsApp caducado', 'S1',
           'TL Errores v1 registra el código 190 de Meta ("Error validating access token") en cada envío; '
           'los mensajes entran por el webhook, pero ninguna respuesta sale.',
           'Los clientes escriben y nadie les contesta: el peor síntoma, porque parece que la panadería ignora.',
           ['Confirmar en TL Errores v1 que el error es 190 (token) y no 131047 (ventana de 24 h cerrada).',
            'Revisar en el inventario de secretos (Bloque 8) la fecha de caducidad del token del usuario del sistema.'],
           ['Activar el modo manual (M00) mientras dura la acción.',
            'Generar un token nuevo del usuario del sistema en el Business Manager, con caducidad "nunca" y solo los '
            'permisos whatsapp_business_messaging y whatsapp_business_management.',
            'Pegarlo en la credencial de n8n "Meta Cloud API" (nunca en el flujo ni en este manual).',
            'Reprocesar los mensajes en cola desde TL Errores v1 ("reintentar desde el nodo de envío").',
            'Anotar la rotación en el inventario de secretos con fecha y persona.'],
           'Un mensaje de prueba sale y vuelve con estado "delivered"; la cola de TL Errores v1 queda vacía.',
           'S1: aviso al equipo por WhatsApp; a los clientes en cola, una disculpa honesta por la demora.', 30),
    manual('M03', 'API de Claude con 429 o 529', 'S2',
           'TL Errores v1 registra rate_limit_error (429) u overloaded_error (529) en el agente de pedidos.',
           'El agente responde con la plantilla del Día 78 (degradación controlada); los pedidos ambiguos esperan a una persona.',
           ['Leer el cuerpo del error: 429 por límite de velocidad trae retry-after; 429 por tope de gasto no lo trae y no '
            'sirve reintentar; 529 es sobrecarga del servicio.',
            'Comprobar la consola de Claude (tope de gasto del espacio de trabajo) y status.claude.com.'],
           ['Si es velocidad o 529: dejar que el SDK reintente (espera exponencial) y mantener la plantilla activa.',
            'Si es tope de gasto: comparar con el detector del Bloque 5; si el gasto es legítimo, subir el tope con la '
            'aprobación de Don Ernesto; si no, ir al M05.',
            'Si dura más de 2 horas: pasar el triaje a Haiku 5.5 (sin respaldo del lado del servidor) y avisar.'],
           'Una llamada de prueba con effort low devuelve end_turn; las plantillas dejan de activarse.',
           'S2: Slack #operaciones al detectar y al cerrar.', 20),
    manual('M04', 'Plantilla rechazada por Meta', 'S3',
           'TL Monitor de plantillas v1 informa de una plantilla en estado REJECTED o PAUSED.',
           'Las confirmaciones fuera de la ventana de 24 h no salen con esa plantilla; dentro de la ventana todo sigue.',
           ['Leer la razón del rechazo en el Administrador de WhatsApp (categoría equivocada, texto promocional, variables).',
            'Comprobar qué flujos usan la plantilla (inventario del Día 79).'],
           ['Cambiar los flujos a la plantilla de reserva de la misma categoría (siempre hay dos aprobadas).',
            'Corregir el texto y reenviar a revisión; si la categoría era el problema, registrarla como utilidad y '
            'quitar todo lo que suene a promoción.'],
           'La plantilla nueva aparece APPROVED y un envío de prueba fuera de ventana llega.',
           'S3: Slack #operaciones; nada a clientes.', 90),
    manual('M05', 'Gasto anómalo de Claude', 'S2',
           'El detector del Bloque 5 marca un día (o una hora) por encima del umbral; la consola muestra el gasto.',
           'Si sigue, el rubro de 10.50 USD se agota y el tope de gasto bloquea a todos los flujos (M03).',
           ['Agrupar las llamadas de las últimas 2 horas por flujo y modelo en el registro común (Día 75).',
            'Buscar un bucle: el mismo id_ejecucion con muchas llamadas, o reentregas del webhook sin deduplicar.'],
           ['Desactivar el workflow que gasta (el interruptor de n8n), no el servidor.',
            'Si es un bucle de reentregas: comprobar la clave de idempotencia del Día 52.',
            'Reactivar solo con la causa corregida y una prueba que la reproduzca.'],
           'El gasto por hora vuelve a la banda normal durante 2 horas seguidas.',
           'S2: Slack #operaciones con el flujo y el gasto; a Don Ernesto si pasa de 2 USD.', 30),
    manual('M06', 'Webhook con firmas inválidas', 'S2',
           'El nodo de verificación de firma rechaza peticiones (X-Hub-Signature-256 o la firma de Slack) de forma sostenida.',
           'Mensajes legítimos pueden estar rebotando, o alguien está probando el webhook; nada se procesa sin firma.',
           ['Contar rechazos por origen (IP y cabeceras) en el registro: ¿todo el tráfico o solo una parte?',
            'Comprobar si alguien rotó el secreto de la aplicación de Meta o de Slack sin actualizar la credencial.'],
           ['Si todo el tráfico falla: actualizar el secreto en la credencial de n8n (M02 para el procedimiento).',
            'Si solo una parte: dejar que se rechace, bloquear el origen en el cortafuegos y conservar el registro.',
            'Nunca desactivar la verificación "para que pase".'],
           'Un mensaje de prueba firmado se procesa y los rechazos vuelven a cero.',
           'S2: Slack #operaciones; si hubo intento de intrusión, registrar en la auditoría del Día 80.', 40),
    manual('M07', 'Notion inaccesible', 'S3',
           'TL Indexador Notion v1 falla con 5xx o tiempo de espera; el agente responde con el índice de ayer.',
           'La base de conocimiento no se actualiza; las respuestas usan la última copia de trigo_lento.sqlite.',
           ['Revisar status.notion.so y el registro del indexador.', 'Comprobar que la integración sigue autorizada.'],
           ['No hacer nada durante la caída: el índice local sirve.', 'Si pasa de 24 horas, correr el indexador a mano al volver.'],
           'El indexador termina con páginas leídas igual a las publicadas.', 'S3: Slack #operaciones.', 60),
    manual('M08', 'Slack caído', 'S2',
           'Las alertas y los botones de aprobación no llegan; status.slack.com informa de un incidente.',
           'Las aprobaciones se detienen (falla cerrada): nada se publica ni se cobra hasta que alguien apruebe.',
           ['Confirmar en status.slack.com.', 'Listar aprobaciones pendientes en Postgres (estado = pendiente).'],
           ['Aprobar por el canal de respaldo: WhatsApp de Don Ernesto con el mismo registro en Postgres (Día 77).',
            'Las alertas S1 van por llamada mientras dure.'],
           'Un mensaje de prueba llega al canal y la cola de pendientes baja a cero.',
           'S2: WhatsApp del equipo.', 30),
]
SECCIONES = ['sintoma', 'impacto', 'diagnostico', 'accion', 'verificacion', 'comunicacion']
TITULOS = {'sintoma': 'Síntoma', 'impacto': 'Impacto', 'diagnostico': 'Diagnóstico', 'accion': 'Acción',
           'verificacion': 'Verificación', 'comunicacion': 'Comunicación'}

def escribir_manual(m):
    lineas = [f"# {m['id']}. {m['nombre']}", '',
              f"Severidad {m['severidad']} | objetivo de recuperación: {m['objetivo_min']} min | "
              f"responsable: {m['responsable']} | suplente: {m['suplente']}", '']
    for s in SECCIONES:
        lineas.append(f'## {TITULOS[s]}')
        contenido = m[s] if isinstance(m[s], list) else [m[s]]
        lineas += [f'{i}. {paso}' if isinstance(m[s], list) else paso for i, paso in enumerate(contenido, 1)]
        lineas.append('')
    texto = '\n'.join(lineas)
    (carpeta / 'manuales' / f"{m['id']}_{m['nombre'].lower().replace(' ', '_')}.md").write_text(texto, encoding = 'utf-8')
    return texto

print(SEVERIDADES[['severidad', 'nombre', 'responde', 'respuesta_min', 'canal']].to_string(index = False))
print()
tabla2 = pd.DataFrame([{'manual': m['id'], 'nombre': m['nombre'], 'sev': m['severidad'],
                        'primera_accion': m['accion'][0][:58], 'objetivo_min': m['objetivo_min']} for m in MANUALES])
print(tabla2.to_string(index = False))
textos = [escribir_manual(m) for m in MANUALES]
print(f'\nManuales escritos: {len(textos)} en {carpeta / "manuales"} | secciones por manual: {len(SECCIONES)} | '
      f'palabras en total: {sum(len(t.split()) for t in textos)}')
print('\n' + '\n'.join(textos[1].split('\n')[:14]))
severidad                nombre                                                   responde  respuesta_min                         canal
       S1 Clientes sin atención Quien esté en el local; Valeria o su suplente por teléfono             15 Llamada y WhatsApp del equipo
       S2           Degradación               Valeria o su suplente en horario de servicio             60 Slack #operaciones y WhatsApp
       S3               Interno                          Valeria en el siguiente día hábil            480            Slack #operaciones

manual                       nombre sev                                             primera_accion  objetivo_min
   M01        Servidor de n8n caído  S1 Activar el modo manual (M00) en el mostrador: la libreta y            30
   M02   Token de WhatsApp caducado  S1      Activar el modo manual (M00) mientras dura la acción.            30
   M03  API de Claude con 429 o 529  S2 Si es velocidad o 529: dejar que el SDK reintente (espera             20
   M04 Plantilla rechazada por Meta  S3 Cambiar los flujos a la plantilla de reserva de la misma c            90
   M05      Gasto anómalo de Claude  S2 Desactivar el workflow que gasta (el interruptor de n8n),             30
   M06 Webhook con firmas inválidas  S2 Si todo el tráfico falla: actualizar el secreto en la cred            40
   M07           Notion inaccesible  S3     No hacer nada durante la caída: el índice local sirve.            60
   M08                  Slack caído  S2 Aprobar por el canal de respaldo: WhatsApp de Don Ernesto             30

Manuales escritos: 8 en trigo_lento\dia_81\manuales | secciones por manual: 6 | palabras en total: 1395

# M02. Token de WhatsApp caducado

Severidad S1 | objetivo de recuperación: 30 min | responsable: Valeria | suplente: Itzel (mostrador)

## Síntoma
TL Errores v1 registra el código 190 de Meta ("Error validating access token") en cada envío; los mensajes entran por el webhook, pero ninguna respuesta sale.

## Impacto
Los clientes escriben y nadie les contesta: el peor síntoma, porque parece que la panadería ignora.

## Diagnóstico
1. Confirmar en TL Errores v1 que el error es 190 (token) y no 131047 (ventana de 24 h cerrada).
2. Revisar en el inventario de secretos (Bloque 8) la fecha de caducidad del token del usuario del sistema.
Ocho manuales de seis secciones, $1,395$ palabras en total: unas $175$ por manual, la extensión de una hoja. La Tabla 1 recoge las severidades con el ejemplo, quién responde, el tiempo de respuesta y el canal de aviso.
Tabla 1. Severidades de los incidentes de Trigo Lento: ejemplo, quién responde, tiempo de respuesta y canal de aviso.
| Severidad | Nombre | Ejemplo | Quién responde | Respuesta | Canal de aviso |
|---|---|---|---|---|---|
| S1 | Clientes sin atención | El canal de pedidos no responde o responde mal; el token caducado del viernes 10 | Quien esté en el local; Valeria o su suplente por teléfono | $15$ min | Llamada y WhatsApp del equipo |
| S2 | Degradación | Claude con 429 y el agente en plantilla; Slack caído y las aprobaciones por WhatsApp | Valeria o su suplente en horario de servicio | $60$ min | Slack #operaciones y WhatsApp |
| S3 | Interno | Notion inaccesible, una plantilla rechazada, el informe del lunes que no salió | Valeria en el siguiente día hábil | $480$ min | Slack #operaciones |
Tres detalles de la tabla son decisiones, no convenciones. El canal de S1 no es Slack, porque Slack es un proveedor más que puede caer, y el manual M08 existe por eso. El responsable de S1 es “quien esté en el local”, y no Valeria, porque a las seis de la tarde de un viernes la persona que está es Itzel; la primera acción de todo manual S1 es algo que Itzel puede hacer sin entrar a n8n: activar el modo manual. Y los $480$ minutos de S3 son ocho horas de servicio, no de reloj: un fallo del indexador de Notion un sábado por la tarde se atiende el lunes, y está bien que así sea.
Los ocho manuales de Trigo Lento
Los ocho manuales salen de las fallas que el ecosistema ya tuvo o que la arquitectura del Día 78 señaló como puntos únicos: el servidor propio, el token de la Cloud API, la clave de Claude y la persona que aprueba. La Tabla 2 los resume por síntoma, primera acción, verificación y responsable.
Tabla 2. Los ocho manuales de operación de Trigo Lento: síntoma, primera acción, verificación y responsable.
| Manual | Severidad | Síntoma | Primera acción | Verificación | Responsable y suplente |
|---|---|---|---|---|---|
| M01 Servidor de n8n caído | S1 | El latido sintético no responde dos veces seguidas; n8n no abre | Activar el modo manual en el mostrador | El latido responde en menos de $60$ s y un mensaje de prueba recibe respuesta | Valeria; Itzel |
| M02 Token de WhatsApp caducado | S1 | TL Errores v1 registra el código $190$ en cada envío | Activar el modo manual mientras dura la acción | Mensaje de prueba con estado “delivered” y cola vacía | Valeria; Itzel |
| M03 API de Claude con 429 o 529 | S2 | rate_limit_error u overloaded_error en el agente | Dejar que el SDK reintente y mantener la plantilla activa | Una llamada de prueba devuelve end_turn | Valeria; Itzel |
| M04 Plantilla rechazada por Meta | S3 | TL Monitor de plantillas v1 informa de REJECTED o PAUSED | Cambiar los flujos a la plantilla de reserva | La plantilla nueva aparece APPROVED y un envío de prueba llega | Valeria; Itzel |
| M05 Gasto anómalo de Claude | S2 | El detector del Bloque 5 marca un día o una hora | Desactivar el workflow que gasta, no el servidor | El gasto por hora vuelve a la banda normal durante $2$ horas | Valeria; Itzel |
| M06 Webhook con firmas inválidas | S2 | El nodo de verificación rechaza peticiones de forma sostenida | Actualizar el secreto si falla todo el tráfico; bloquear el origen si es una parte | Un mensaje firmado se procesa y los rechazos vuelven a cero | Valeria; Itzel |
| M07 Notion inaccesible | S3 | El indexador falla con 5xx; el agente usa el índice de ayer | No hacer nada durante la caída: el índice local sirve | El indexador termina con páginas leídas igual a las publicadas | Valeria; Itzel |
| M08 Slack caído | S2 | Las alertas y los botones de aprobación no llegan | Aprobar por WhatsApp con el mismo registro en Postgres | Un mensaje llega al canal y la cola de pendientes baja a cero | Valeria; Itzel |
Vale la pena leer tres de ellos despacio, porque enseñan tres ideas distintas.
El M02 es el del viernes 10 y es el más largo porque es el que más se equivocó. Su diagnóstico empieza por distinguir el código $190$ del $131047$: los dos impiden enviar, pero el segundo significa que la ventana de atención de $24$ horas se cerró y se arregla con una plantilla aprobada, no con un token. Su acción tiene cinco pasos y el primero no toca n8n: activar el modo manual para que los clientes dejen de esperar mientras alguien arregla la causa. El segundo genera el token nuevo con caducidad “nunca”, que es la otra opción que ofrece Meta junto a los sesenta días, con solo los dos permisos que WhatsApp necesita, y el tercero dice dónde se pega (la credencial “Meta Cloud API” de n8n) y dónde no (el flujo, el manual, un chat). El quinto anota la rotación en el inventario de secretos con fecha y persona, para que el Bloque 8 lo sepa. Elegir “nunca” no significa olvidarse del token: la política de rotación de $90$ días del inventario sigue aplicando, solo que ahora la fecha la pone Trigo Lento y no Meta.
El M03 enseña a leer un error antes de reaccionar. La API de Claude devuelve $429$ con rate_limit_error en dos situaciones que se parecen y se tratan al revés: si es un límite de velocidad, la respuesta trae la cabecera retry-after y el SDK de anthropic reintenta solo con espera exponencial, así que la acción es esperar con la plantilla activa; si es el tope de gasto del espacio de trabajo, no hay retry-after, reintentar no sirve y la decisión es económica, no técnica (subir el tope con la aprobación de Don Ernesto o esperar al mes siguiente). El $529$ con overloaded_error es sobrecarga del servicio, afecta a todos los clientes y se consulta en la página de estado. El manual no pide heroísmo: la degradación controlada del Día 78 ya hace que el agente responda con plantilla cuando Claude no contesta, y el manual solo añade cuándo bajar el triaje a Haiku 5.5 (si pasa de dos horas) y recordar que ese modelo no tiene respaldo del lado del servidor.
El M07 enseña a no hacer nada. Si Notion no responde, el indexador falla, el agente sigue contestando con el índice de ayer guardado en trigo_lento.sqlite y lo correcto es esperar; correr el indexador a mano cada diez minutos contra un servicio caído solo añade errores al registro. Un manual que dice “no haga nada hasta que pase esto” es tan valioso como uno de cinco pasos, porque la persona nerviosa necesita permiso para no actuar.
Cuánto vale tener el papel en la pared
Don Ernesto hizo la pregunta de siempre: "¿Y cuánto nos ahorra todo este papeleo?". La respuesta se puede estimar con supuestos declarados, no medir todavía, y conviene hacerlo antes de escribir el noveno manual. Para cada tipo de incidente $i$ se supone una frecuencia mensual $\lambda_i$ y un tiempo de recuperación lognormal con mediana $m_i$ y dispersión $\sigma_i$; con el manual, la mediana baja a $m_i’$ y la dispersión no cambia, porque un manual quita tiempo de búsqueda, no variabilidad del mundo. La esperanza anual de horas de afectación es:
$$ H = \sum_{i=1}^{8} 12,\lambda_i \cdot m_i \cdot e^{\sigma_i^2 / 2} \cdot \frac{1}{60} $$
La lógica detrás de esta fórmula es la siguiente:
- $12,\lambda_i$ es el número esperado de incidentes del tipo $i$ en un año; el servidor cae una vez al mes ($\lambda = 1$), el token caduca dos veces al año ($\lambda = 1/6$), Claude devuelve $429$ o $529$ un par de veces al mes.
- $m_i e^{\sigma_i^2/2}$ es la media de una lognormal con mediana $m_i$: la media siempre es mayor que la mediana, porque la cola derecha (el incidente que se complica) pesa más que la izquierda. Con $\sigma = 0.5$, la media es $1.133$ veces la mediana.
- Se divide entre $60$ para pasar de minutos a horas; el resultado son horas de afectación, no horas de trabajo de Valeria: en un incidente S3 nadie trabaja a las tres de la mañana, pero el informe no sale.
- En conclusión, el ahorro de un manual es $12,\lambda_i (m_i - m_i’) e^{\sigma_i^2/2}/60$ horas al año, y es mayor donde la frecuencia y la diferencia de medianas son grandes: el servidor y Claude, no Notion.
El siguiente bloque fija los supuestos, calcula la esperanza analítica y simula un año concreto con llegadas de Poisson y tiempos lognormales, con y sin manual:
# Simulación de un año de incidentes con frecuencias supuestas y tiempos de recuperación lognormales en Python:
PARAMETROS = pd.DataFrame([   # manual, incidentes por mes, mediana sin manual (min), mediana con manual (min), sigma
    ('M01', 1.0, 50, 15, 0.5), ('M02', 1 / 6, 140, 25, 0.4), ('M03', 2.0, 20, 5, 0.6), ('M04', 0.5, 180, 60, 0.5),
    ('M05', 0.25, 240, 30, 0.6), ('M06', 0.5, 90, 20, 0.5), ('M07', 0.5, 45, 10, 0.5), ('M08', 0.25, 60, 15, 0.5),
], columns = ['manual', 'por_mes', 'mediana_sin', 'mediana_con', 'sigma']).set_index('manual')
PARAMETROS['severidad'] = [m['severidad'] for m in MANUALES]
factor = np.exp(PARAMETROS.sigma ** 2 / 2)                       # media = mediana * exp(sigma^2 / 2)
PARAMETROS['esperado_sin_h'] = 12 * PARAMETROS.por_mes * PARAMETROS.mediana_sin * factor / 60
PARAMETROS['esperado_con_h'] = 12 * PARAMETROS.por_mes * PARAMETROS.mediana_con * factor / 60

def simular_anio(con_manual, rng):
    horas = {}
    for m, p in PARAMETROS.iterrows():
        n = rng.poisson(12 * p.por_mes)
        mediana = p.mediana_con if con_manual else p.mediana_sin
        horas[m] = rng.lognormal(np.log(mediana), p.sigma, n).sum() / 60
    return pd.Series(horas)

anio = pd.DataFrame({'sin_manual_h': simular_anio(False, rng), 'con_manual_h': simular_anio(True, rng)})
resumen = PARAMETROS[['severidad', 'por_mes', 'mediana_sin', 'mediana_con', 'esperado_sin_h', 'esperado_con_h']].join(anio)
print(resumen.round(2).to_string())
print(f'\nEsperanza anual: {PARAMETROS.esperado_sin_h.sum():.1f} h sin manual, {PARAMETROS.esperado_con_h.sum():.1f} h con manual '
      f'(ahorro de {PARAMETROS.esperado_sin_h.sum() - PARAMETROS.esperado_con_h.sum():.1f} h)')
s1 = PARAMETROS.severidad == 'S1'
print(f'Solo S1 (clientes sin atención): {PARAMETROS.esperado_sin_h[s1].sum():.1f} h sin manual, '
      f'{PARAMETROS.esperado_con_h[s1].sum():.1f} h con manual')
print(f'Año simulado: {anio.sin_manual_h.sum():.1f} h sin manual, {anio.con_manual_h.sum():.1f} h con manual')
print(f'Incidentes esperados al año: {12 * PARAMETROS.por_mes.sum():.0f}; un sábado de 10:00 a 12:00 sin servidor deja hasta '
      f'{9 * 2} clientes esperando')
       severidad  por_mes  mediana_sin  mediana_con  esperado_sin_h  esperado_con_h  sin_manual_h  con_manual_h
manual
M01           S1     1.00           50           15           11.33            3.40          7.02          3.64
M02           S1     0.17          140           25            5.06            0.90         13.56          0.44
M03           S2     2.00           20            5            9.58            2.39         11.19          3.10
M04           S3     0.50          180           60           20.40            6.80         19.54          4.87
M05           S2     0.25          240           30           14.37            1.80         10.39          1.18
M06           S2     0.50           90           20           10.20            2.27          5.33          1.68
M07           S3     0.50           45           10            5.10            1.13          2.27          1.14
M08           S2     0.25           60           15            3.40            0.85          3.71          0.60

Esperanza anual: 79.4 h sin manual, 19.5 h con manual (ahorro de 59.9 h)
Solo S1 (clientes sin atención): 16.4 h sin manual, 4.3 h con manual
Año simulado: 73.0 h sin manual, 16.6 h con manual
Incidentes esperados al año: 62; un sábado de 10:00 a 12:00 sin servidor deja hasta 18 clientes esperando
Con los supuestos declarados, un año de Trigo Lento tiene unos $62$ incidentes y $79.4$ horas esperadas de afectación sin manuales, que bajan a $19.5$ con ellos: $59.9$ horas de ahorro. El año simulado dio $73.0$ y $16.6$, cerca de la esperanza, pero con una sorpresa instructiva: el M02 aparece con $13.56$ horas sin manual frente a $5.06$ esperadas, porque el azar sortó más caducidades de token de las que tocaban y cada una, sin manual, cuesta más de dos horas. Es exactamente el tipo de incidente para el que el papel en la pared cambia más las cosas: poco frecuente, largo y resoluble en minutos cuando se sabe qué hacer. Las horas S1, las de clientes sin atención, bajan de $16.4$ a $4.3$; en el pico del sábado, con $9$ mensajes por hora, cada hora sin servidor deja hasta $18$ clientes esperando en dos horas, y esa es la cifra que Don Ernesto apunta.
Una esperanza es un promedio y un año concreto puede ser peor. El siguiente bloque simula $500$ años para ver la cola y dibuja los tiempos de recuperación por tipo con y sin manual:
# Tiempos de recuperación con y sin manual por tipo de incidente, en 500 años simulados y como cajas, en Python:
anios = pd.DataFrame([{'sin': simular_anio(False, rng).sum(), 'con': simular_anio(True, rng).sum()} for _ in range(500)])
print('Horas de afectación al año en 500 años simulados:')
print(anios.describe(percentiles = [.5, .95]).loc[['mean', '50%', '95%', 'max']].round(1).to_string())
servidor = 12 * 1.0 * (50 - 15) * np.exp(0.5 ** 2 / 2) / 60
print(f'Solo el servidor (una caída al mes, mediana de 50 a 15 min): ahorro esperado de {servidor:.2f} h al año')

muestras = {m: (rng.lognormal(np.log(p.mediana_sin), p.sigma, 1000), rng.lognormal(np.log(p.mediana_con), p.sigma, 1000))
            for m, p in PARAMETROS.iterrows()}
fig, ax = plt.subplots(figsize = (12.5, 5.2))
pos = np.arange(len(muestras))
cajas_sin = ax.boxplot([v[0] for v in muestras.values()], positions = pos - 0.19, widths = 0.32, patch_artist = True,
                       showfliers = False, medianprops = {'color': '#52514e'})
cajas_con = ax.boxplot([v[1] for v in muestras.values()], positions = pos + 0.19, widths = 0.32, patch_artist = True,
                       showfliers = False, medianprops = {'color': '#52514e'})
for caja in cajas_sin['boxes']:
    caja.set(facecolor = '#c9c7c1', edgecolor = '#8a8986')
for caja in cajas_con['boxes']:
    caja.set(facecolor = '#4472C4', edgecolor = '#2f4f8f')
ax.set_xticks(pos, [f'{m}\n{PARAMETROS.severidad[m]}' for m in muestras])
ax.set_yscale('log')
ax.set_yticks([5, 15, 30, 60, 120, 240, 480], ['5', '15', '30', '60', '120', '240', '480'])
ax.set_ylabel('minutos hasta recuperar (escala logarítmica)')
ax.set_title('Tiempo de recuperación por tipo de incidente: sin manual (gris) y con manual (azul), 1 000 incidentes simulados cada uno',
             fontsize = 11)
ax.axhline(30, color = '#c0392b', lw = 1, ls = '--')
ax.text(len(pos) - 0.6, 32, 'objetivo S1: 30 min', color = '#c0392b', fontsize = 9, ha = 'right')
ax.grid(axis = 'y', color = '#e6e4df', lw = 0.8)
ax.spines[['top', 'right']].set_visible(False)
plt.tight_layout()
plt.show()
Horas de afectación al año en 500 años simulados:
        sin   con
mean   78.7  19.3
50%    77.3  19.0
95%   104.3  26.5
max   127.2  31.5
Solo el servidor (una caída al mes, mediana de 50 a 15 min): ahorro esperado de 7.93 h al año
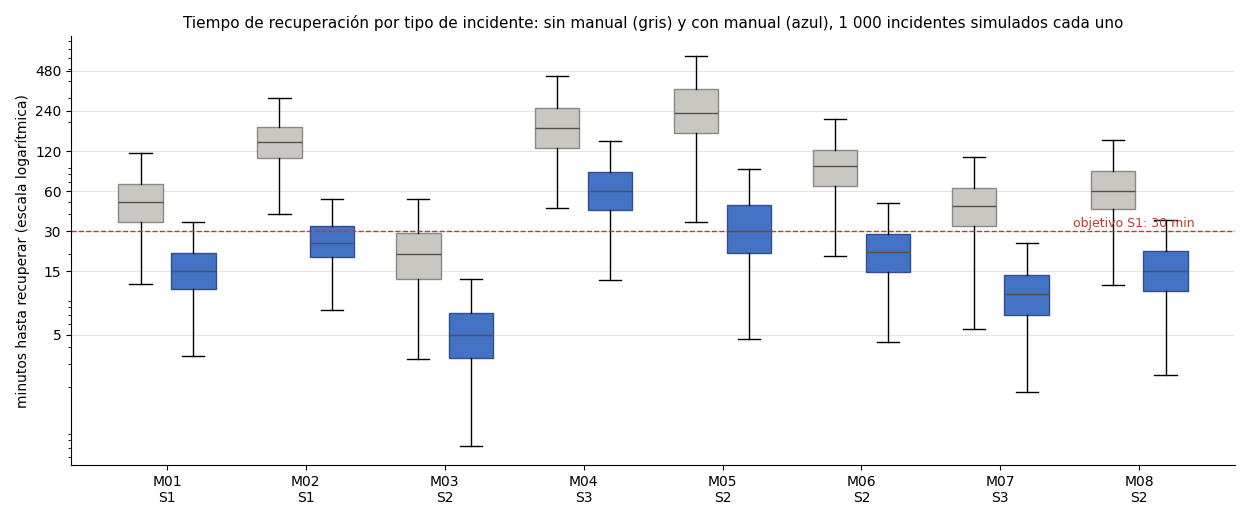
En $500$ años simulados, la mediana es de $77.3$ horas sin manual y $19.0$ con manual, y el año malo del percentil $95$ pasa de $104.3$ a $26.5$ horas. La gráfica, en escala logarítmica, enseña dos cosas. La primera es que el manual mueve las cajas hacia abajo sin estrecharlas: la dispersión es la del mundo, y un servidor que cae un sábado por la mañana con el disco lleno tarda más que uno que cae un martes con un contenedor reiniciable. La segunda es la línea roja de los $30$ minutos, el objetivo de recuperación de los manuales S1: sin manual, el servidor (M01) y el token (M02) la superan casi siempre; con manual, la mediana queda debajo, pero el cuarto superior de la caja del M01 todavía la roza. El objetivo no es una promesa, es el número que dice cuándo el manual necesita mejorar. Y el ejemplo de juguete de Don Ernesto queda resuelto: una caída mensual del servidor con mediana de $50$ minutos sin manual y de $15$ con manual ahorra $7.93$ horas de afectación al año, poco más de la mitad del ahorro de un cliente mayorista perdido, y por mucho menos trabajo.
El detector que dispara el M05
El M05, gasto anómalo de Claude, tiene una particularidad: su síntoma no lo ve nadie. Un bucle que reintenta una llamada a Opus 5.5 cada trece segundos no deja a ningún cliente sin respuesta, no rompe ningún flujo y solo se nota cuando llega la factura, o cuando el tope de gasto del espacio de trabajo bloquea a todos los flujos a la vez (y entonces el síntoma es el del M03). Por eso el manual necesita un detector que lo dispare: un cálculo que corra cada pocos minutos sobre el registro común de llamadas del Día 75, donde cada llamada a Claude deja su modelo y sus tokens de usage.
El detector compara el gasto del día con una línea base de los catorce días anteriores que no tuvieron alerta, y marca el día cuando supera el mayor de dos umbrales:
$$ u_t = \max\left( \mu_{14} + 3,\sigma_{14},; 2,\mu_{14} \right) $$
La lógica detrás de este umbral es la siguiente:
- $\mu_{14}$ y $\sigma_{14}$ son la media y la desviación típica del gasto diario en los catorce días previos sin alerta; el día evaluado no entra en su propia línea base, y los días marcados tampoco, para que un bucle de hoy no suba el umbral de mañana.
- $\mu_{14} + 3\sigma_{14}$ es la regla clásica de control: un día normal cae fuera de tres desviaciones muy pocas veces si el gasto fuera estable; pero el gasto de Trigo Lento no lo es (los lunes sale el informe con Opus 5.5), y por eso hay un segundo término.
- $2\mu_{14}$ exige además que el día duplique la media: con una desviación pequeña, tres sigmas podrían marcar un lunes cualquiera; con el doble de la media, hace falta un gasto real.
- En conclusión, el umbral es deliberadamente tosco y barato: un falso positivo cuesta cinco minutos de mirar el registro, y un falso negativo cuesta lo que el bucle gaste hasta la factura.
El siguiente bloque lee el registro de abril, inyecta un bucle de $180$ llamadas a Opus 5.5 el viernes 24 entre las 11:10 y las 11:50 (un reintento sin deduplicar que la clave de idempotencia del Día 52 debería haber parado), calcula el umbral día a día, encuentra la hora exacta en que el gasto acumulado lo cruza y cita la primera acción del M05:
# Detector de gasto anómalo de Claude sobre el registro de llamadas del Día 75: umbral móvil, hora de alerta y disparo del M05 en Python:
PRECIOS = {'claude-opus-5-5': (4.00, 20.00, 0.20, 5.00), 'claude-sonnet-5-5': (2.00, 10.00, 0.20, 2.50),
           'claude-haiku-5-5': (0.10, 0.50, 0.01, 0.125)}      # USD por millón: entrada, salida, lectura y escritura de caché
con = sqlite3.connect('trigo_lento/dia_75/trigo_lento_panel.sqlite')
llamadas = pd.read_sql('SELECT l.*, e.flujo, e.inicio FROM llamadas_claude l JOIN ejecuciones e USING (id_ejecucion)', con)
con.close()
coste = lambda r: (r.entrada * PRECIOS[r.modelo][0] + r.salida * PRECIOS[r.modelo][1]
                   + r.cache_lectura * PRECIOS[r.modelo][2] + r.cache_escritura * PRECIOS[r.modelo][3]) / 1e6
llamadas['usd'] = llamadas.apply(coste, axis = 1)
llamadas['inicio'] = pd.to_datetime(llamadas.inicio, utc = True).dt.tz_convert(CDMX)
# Bucle inyectado: un viernes el agente reintenta 180 veces el mismo pedido con Opus 5.5 entre las 11:10 y las 11:50:
bucle = pd.DataFrame({'id_ejecucion': 'E_BUCLE', 'modelo': 'claude-opus-5-5', 'entrada': 2500, 'salida': 600,
                      'cache_lectura': 0, 'cache_escritura': 0, 'flujo': 'agente',
                      'inicio': pd.date_range('2026-04-24 11:10', periods = 180, freq = '13s', tz = CDMX)})
bucle['usd'] = bucle.apply(coste, axis = 1)
registro = pd.concat([llamadas, bucle], ignore_index = True)
diario = registro.groupby(registro.inicio.dt.date).usd.sum()
diario.index = pd.to_datetime(diario.index)
umbral, alertas, base = {}, {}, []
for dia, gasto in diario.items():                                  # línea base: los 14 días previos sin alerta
    ventana = pd.Series(base[-14:])
    if len(ventana) >= 7:
        umbral[dia] = max(ventana.mean() + 3 * ventana.std(), 2 * ventana.mean())
        if gasto > umbral[dia]:
            alertas[dia] = gasto                                   # un día con alerta no contamina la línea base
            continue
    base.append(gasto)
umbral, alertas = pd.Series(umbral), pd.Series(alertas)
print(f'Gasto del mes sin el bucle: {llamadas.usd.sum():.2f} USD | con el bucle: {registro.usd.sum():.2f} USD '
      f'(el bucle costó {bucle.usd.sum():.2f} USD en {len(bucle)} llamadas y 40 minutos)')
print(f'Día típico: {diario.drop(alertas.index).median():.3f} USD; umbral del 24/04: {umbral.loc["2026-04-24"]:.3f} USD; '
      f'umbral del 30/04, con el bucle fuera de la línea base: {umbral.loc["2026-04-30"]:.3f} USD')
print('Días con alerta:', ', '.join(f'{d:%d/%m} ({v:.2f} USD, umbral {umbral[d]:.2f})' for d, v in alertas.items()))
dia_bucle = registro[registro.inicio.dt.date == pd.Timestamp('2026-04-24').date()].sort_values('inicio')
acumulado = dia_bucle.set_index('inicio').usd.cumsum()
cruce = acumulado[acumulado > umbral.loc['2026-04-24']].index.min()
print(f'El gasto acumulado del 24/04 cruza el umbral a las {cruce:%H:%M}, {(cruce - bucle.inicio.min()).total_seconds() / 60:.0f} min '
      f'después de empezar el bucle; un detector que corra cada 5 minutos avisa a las {cruce.ceil("5min"):%H:%M}')
sospechoso = dia_bucle.groupby(['flujo', 'id_ejecucion']).agg(llamadas = ('usd', 'size'), usd = ('usd', 'sum')).sort_values('usd').tail(1)
print('Diagnóstico del M05 (llamadas por ejecución):\n' + sospechoso.round(2).to_string())
m05 = next(m for m in MANUALES if m['id'] == 'M05')
print(f'Acción 1 del {m05["id"]}: {m05["accion"][0]}')

fig, ax = plt.subplots(figsize = (12.5, 4.6))
colores = ['#c0392b' if d in alertas.index else '#4472C4' for d in diario.index]
ax.bar(diario.index, diario.values, color = colores, width = 0.7)
ax.plot(umbral.index, umbral.values, color = '#52514e', lw = 1.5, ls = '--', label = 'umbral: máx(media + 3 desviaciones, 2 medias) de los 14 días previos')
ax.axhline(10.50 / 26, color = '#70AD47', lw = 1.2, label = 'ritmo del rubro: 10.50 USD entre 26 días')
for d, v in alertas.items():
    if d == pd.Timestamp('2026-04-24'):
        ax.annotate(f'bucle de 180 llamadas: {v:.2f} USD\nalerta a las {cruce:%H:%M}', (d, v * 0.6), xytext = (-16, 0),
                    textcoords = 'offset points', ha = 'right', va = 'center', fontsize = 9, color = '#c0392b',
                    arrowprops = {'arrowstyle': '-', 'color': '#c0392b', 'lw': 0.8})
    else:
        ax.annotate(f'falso positivo\n{v:.2f} USD', (d, v), xytext = (0, 8), textcoords = 'offset points', ha = 'center',
                    fontsize = 9, color = '#c0392b')
ax.set_ylim(0, diario.max() * 1.12)
ax.set_ylabel('USD al día')
ax.set_title('Gasto diario de Claude en abril con un bucle inyectado el viernes 24: el detector lo marca y dispara el M05', fontsize = 11)
ax.legend(loc = 'upper left', fontsize = 9, frameon = False)
ax.xaxis.set_major_formatter(mdates.DateFormatter('%d/%m'))
ax.spines[['top', 'right']].set_visible(False)
plt.tight_layout()
plt.show()
Gasto del mes sin el bucle: 6.70 USD | con el bucle: 10.66 USD (el bucle costó 3.96 USD en 180 llamadas y 40 minutos)
Día típico: 0.230 USD; umbral del 24/04: 0.508 USD; umbral del 30/04, con el bucle fuera de la línea base: 0.531 USD
Días con alerta: 13/04 (0.48 USD, umbral 0.47), 24/04 (4.25 USD, umbral 0.51)
El gasto acumulado del 24/04 cruza el umbral a las 11:13, 4 min después de empezar el bucle; un detector que corra cada 5 minutos avisa a las 11:15
Diagnóstico del M05 (llamadas por ejecución):
                     llamadas   usd
flujo  id_ejecucion
agente E_BUCLE            180  3.96
Acción 1 del M05: Desactivar el workflow que gasta (el interruptor de n8n), no el servidor.
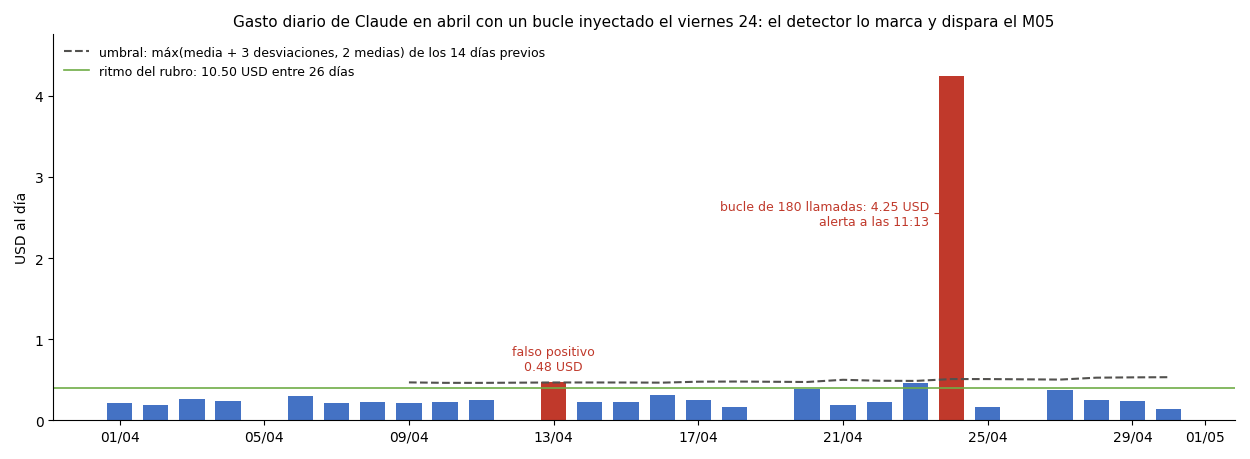
El bucle costó $3.96$ USD en $40$ minutos, más de la mitad de lo que Claude gasta en un mes normal ($6.70$ USD), y el detector lo marca a las 11:13, cuatro minutos después de empezar; un detector que corra cada cinco minutos avisa a las 11:15. La gráfica tiene dos barras rojas y conviene explicar las dos. La del viernes 24 es el bucle: $4.25$ USD contra un umbral de $0.51$. La del lunes 13 es un falso positivo: $0.48$ USD contra un umbral de $0.47$, porque la línea base de los primeros días no incluía todavía ningún lunes con informe, y el primer informe del mes la superó por un centavo. Valeria lo mira, ve que son las cuatro llamadas del informe del lunes y cierra en dos minutos; a partir de ahí, los lunes entran en la base y no vuelven a marcar. Y como el día del bucle no entra en la línea base, el umbral del día 30 queda en $0.53$ USD, no en los casi $4$ que saldrían si el bucle contaminara la media.
El diagnóstico del M05 es una agrupación por flujo y ejecución: $180$ llamadas con el mismo id_ejecucion no son un cliente conversador, son un bucle. La primera acción del manual es la que imprime el bloque: desactivar el workflow que gasta con el interruptor de n8n, no el servidor, porque apagar el servidor convierte un S2 en un S1. Con el rubro de Claude en $10.50$ USD al mes desde el Día 67, el ritmo normal son $0.40$ USD al día (la línea verde de la gráfica), y un bucle como el del ejemplo, sin detector, habría agotado el rubro en una mañana.
Atención aquí: un flujo que envió mensajes indebidos, publicó sin aprobación o gastó en bucle no se reactiva “para ver si ya pasó”. Se reactiva cuando la causa está corregida y existe una prueba que la reproduce, como exige la tercera acción del M05. Reactivar sin corregir repite el incidente con la ventaja de que ahora nadie se sorprende, y los clientes que recibieron un mensaje equivocado lo reciben dos veces.
El modo manual
Todos los manuales S1 empiezan igual: activar el modo manual. Es el manual cero, el M00, y no es una derrota. El código de honor del Día 5 lo pedía desde el primer módulo y el Día 56 lo dejó pendiente con dueño; hoy se escribe. Su idea es simple: la parte del sistema que no depende del sistema. Cuando el servidor, el token o Claude fallan, los clientes siguen escribiendo, y la panadería sigue teniendo una persona en el mostrador, un teléfono y una libreta. El modo manual dice cómo esa persona atiende con dignidad y cómo lo que apunte vuelve después al sistema sin perderse ni duplicarse. La Figura 3 dibuja el modo manual como lo que es: un plan B que se ensaya como cualquier otro flujo.
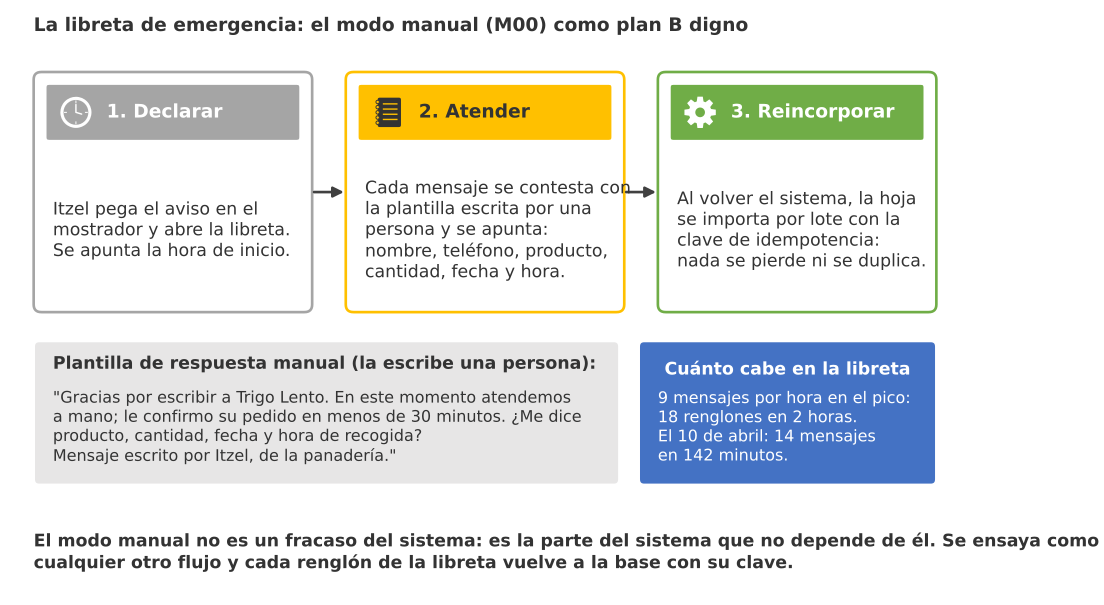
Figura 3. La libreta de emergencia: el modo manual como plan B digno; Itzel pega el aviso, responde con la plantilla escrita por una persona, apunta cada pedido con sus seis datos y, al volver el sistema, la libreta se reincorpora por lote con clave de idempotencia, sin perder ni duplicar nada.
Tiene tres pasos. El primero es declarar: Itzel pega el aviso en el mostrador, abre la libreta y apunta la hora de inicio, que es la que después servirá para saber qué mensajes atendió a mano. El segundo es atender: cada mensaje de WhatsApp que entra (el webhook sigue recibiendo aunque las respuestas no salgan, y si tampoco entra, está el teléfono del negocio) se contesta desde el teléfono con una plantilla escrita por una persona que dice que lo es:
“Gracias por escribir a Trigo Lento. En este momento atendemos a mano; le confirmo su pedido en menos de 30 minutos. ¿Me dice producto, cantidad, fecha y hora de recogida? Mensaje escrito por Itzel, de la panadería.”
Y cada pedido se apunta con los seis datos del contrato del Día 4: nombre, teléfono, producto, cantidad, fecha y hora. Ni uno más (no hace falta la dirección si recoge en tienda) ni uno menos (sin hora no hay hornada). El tercer paso es reincorporar: cuando el sistema vuelve, la hoja de la libreta se pasa a la hoja de captura del formulario web, que TL Formulario v2 importa por lote con la clave de idempotencia de siempre, sha256 del teléfono, la fecha de entrega y el producto. Si un cliente escribió a las 18:30, Itzel lo apuntó, y a las 20:25 el sistema reprocesó la cola y creó el mismo pedido, la clave coincide y el segundo se descarta. Nada se pierde, porque está en la libreta; nada se duplica, porque la clave lo impide.
¿Cuánto cabe en la libreta? La cola del Día 1 da la respuesta: en el pico del sábado llegan $9$ mensajes por hora, así que dos horas de modo manual son $18$ renglones, lo que una persona apunta sin dejar de atender el mostrador. El número de clientes que esperan durante un incidente es:
$$ N_{\text{espera}} = \lambda \cdot T_{\text{rec}} $$
La lógica detrás de esta cuenta es la siguiente:
- $\lambda$ es la tasa de llegada de mensajes en el horario del incidente: $9$ por hora en el pico de la mañana del sábado y unos $4$ por hora un viernes entre las seis y las ocho.
- $T_{\text{rec}}$ es el tiempo de recuperación en horas; es la ley de Little del Día 1 aplicada a una cola que nadie atiende: todo el que llega, espera.
- El viernes 10, con $\lambda = 4$ y $T_{\text{rec}} = 142$ minutos, se esperaban $9.5$ clientes y el registro contó $14$; con el manual y $24$ minutos, $1.6$.
- En conclusión, el modo manual no reduce $T_{\text{rec}}$, reduce lo que $T_{\text{rec}}$ cuesta: los $14$ clientes del viernes habrían recibido una respuesta humana en minutos y sus pedidos habrían estado en la libreta.
El aviso del mostrador y la plantilla tienen una regla ética que viene del Día 6 y del Día 49: se dice la verdad (“atendemos a mano”, “le confirmo en menos de 30 minutos”) y se dice quién escribe. No se promete lo que la libreta no puede cumplir, como una factura al momento para Brújula; para eso, el aviso tiene una línea aparte: “facturas al reanudar el sistema, hoy mismo”.
Copias y restauración
Un manual que dice “levantar el servidor nuevo con las copias” vale lo que valgan las copias. El Día 35 dejó la política de copias del n8n propio y el Día 80 la puso a prueba en un simulacro; hoy se escribe como parte del plan de continuidad, con tres piezas y dos números por pieza. Las piezas son la base de Postgres de n8n (workflows, credenciales cifradas e historial de ejecuciones), la base operativa trigo_lento.sqlite (catálogo, inventario, índice de conocimiento) y las exportaciones de flujos (JSON de n8n y blueprints de Make, que viven en Git desde el Día 42). Los dos números son el objetivo de punto de recuperación (RPO, por sus siglas en inglés: “Recovery Point Objective”), cuántos datos se aceptan perder, medido en tiempo desde la última copia, y el objetivo de tiempo de recuperación (RTO: “Recovery Time Objective”), cuánto se acepta tardar en volver. La norma ISO 22301:2019, la de la continuidad del negocio, los define dentro de un tercer plazo, el periodo máximo tolerable de interrupción, que para el canal de pedidos de Trigo Lento es una mañana de sábado.
El siguiente bloque muestra los comandos de la copia nocturna y de la restauración en un servidor nuevo; se muestra y no se ejecuta en la entrada, porque necesita el servidor:
# Copias y restauración del ecosistema de Trigo Lento (se muestran, no se ejecutan en la entrada):
# --- Copia nocturna a las 2:00 (cron en el servidor) ---
# 1. Postgres de n8n: copia lógica en formato custom (comprimida y restaurable por partes), sin TTY (-T) para no corromperla:
docker compose exec -T postgres pg_dump -U n8n -Fc n8n > copias/postgres_$(date +%F_%H%M).dump
# 2. Base operativa SQLite con la API de copia en caliente (consistente aunque un flujo esté escribiendo):
sqlite3 trigo_lento.sqlite ".backup 'copias/trigo_lento_$(date +%F_%H%M).sqlite'"
# 3. Flujos y credenciales de n8n, un archivo por elemento; las credenciales salen cifradas con N8N_ENCRYPTION_KEY:
docker compose exec -T n8n n8n export:workflow --backup --output=/backups/workflows/
docker compose exec -T n8n n8n export:credentials --backup --output=/backups/credentials/
# 4. Cifrado y envío fuera del servidor; la clave de cifrado de n8n vive en el gestor de secretos, nunca en la copia:
tar -czf - copias/ /backups/ | gpg --symmetric --cipher-algo AES256 --batch \
    --passphrase-file /run/secrets/frase_copias > copias_$(date +%F).tar.gz.gpg
rclone copy copias_$(date +%F).tar.gz.gpg remoto:trigo-lento-copias/
# 5. Retención: 7 diarias, 4 semanales y 3 mensuales (el Bloque 7 calcula cuáles se conservan):
rclone delete remoto:trigo-lento-copias/ --min-age 8d --exclude "*_domingo*" --exclude "*_dia01*"

# --- Restauración en un servidor nuevo (manual M01, paso 4) ---
rclone copy remoto:trigo-lento-copias/copias_2026-04-21.tar.gz.gpg . && gpg --decrypt copias_2026-04-21.tar.gz.gpg | tar -xzf -
docker compose up -d postgres
docker compose exec -T postgres pg_restore -U n8n -d n8n --clean --if-exists < copias/postgres_2026-04-21_0200.dump
export N8N_ENCRYPTION_KEY="$(cat /run/secrets/n8n_encryption_key)"   # la misma clave: sin ella las credenciales no se descifran
docker compose up -d n8n
docker compose exec -T n8n n8n import:credentials --separate --input=/backups/credentials/
docker compose exec -T n8n n8n import:workflow --separate --input=/backups/workflows/
# Prueba de humo: el latido sintético del Día 75 debe responder en menos de 60 s:
curl -s -X POST https://n8n.ejemplo.com/webhook/latido -H 'Content-Type: application/json' -d '{"origen": "prueba de humo"}'
Cuatro decisiones del bloque merecen explicación. La copia de Postgres usa el formato custom de pg_dump (-Fc), que va comprimido y permite restaurar por partes con pg_restore; y se ejecuta con docker compose exec -T, sin terminal, porque con una terminal asignada el volcado binario se corrompe con saltos de línea (un error conocido y fácil de evitar). La copia de SQLite usa .backup, la API de copia en caliente, en lugar de copiar el archivo: así la copia es consistente aunque un flujo esté escribiendo en ese instante. Las exportaciones de n8n usan --backup, que equivale a --all --pretty --separate y deja un archivo legible por workflow y por credencial; las credenciales salen cifradas con la clave de cifrado de n8n, que por eso no viaja en la copia, sino en el gestor de secretos, y que al restaurar se pone como N8N_ENCRYPTION_KEY antes de arrancar n8n. Y la copia completa se cifra con gpg y se manda fuera del servidor con rclone, porque una copia que vive en el disco que se rompe no es una copia.
Atención aquí: la CLI de n8n permite exportar las credenciales descifradas con --decrypted para moverlas a una instalación con otra clave. Ese archivo contiene todos los secretos en texto plano: no se guarda en la copia, no se sube a Git y se borra al terminar la migración. Y lo contrario también importa: si N8N_ENCRYPTION_KEY se pierde, las credenciales de la copia son irrecuperables y hay que volver a emitir los $17$ secretos del Bloque 8. Por eso la clave vive fuera del servidor y en dos sitios.
La política de retención dice cuántas copias se conservan y cuáles: siete diarias, cuatro semanales (la del domingo) y tres mensuales (la del día 1). Con ella se puede volver a cualquier día de la última semana, a cualquier semana del último mes y a cualquier mes del último trimestre, con trece archivos en lugar de noventa. El siguiente bloque calcula qué copias de los últimos $90$ días se conservan, prueba de verdad una restauración de trigo_lento.sqlite en un archivo temporal (copia en caliente, comprobación de integridad y comparación de conteos tabla por tabla) y revisa que las exportaciones de flujos guardadas en Git se puedan volver a importar:
# Política de retención de copias en 90 días y prueba real de restauración de trigo_lento.sqlite en Python:
RETENCION = {'diaria': 7, 'semanal': 4, 'mensual': 3}              # copias que se conservan de cada tipo
dias = pd.date_range(hoy.date() - timedelta(days = 89), hoy.date(), freq = 'D')
copias = pd.DataFrame({'fecha': dias})
edad = (pd.Timestamp(hoy.date()) - copias.fecha).dt.days                 # días desde que se hizo cada copia
copias['diaria'] = edad < RETENCION['diaria']
copias['semanal'] = (copias.fecha.dt.weekday == 6) & (edad < 7 * RETENCION['semanal'])
copias['mensual'] = (copias.fecha.dt.day == 1) & (edad < 31 * RETENCION['mensual'])
copias['retenida'] = copias[['diaria', 'semanal', 'mensual']].any(axis = 1)
print(f'Copias hechas en 90 días: {len(copias)} | retenidas: {int(copias.retenida.sum())} '
      f'(diarias {int(copias.diaria.sum())}, semanales {int(copias.semanal.sum())}, mensuales {int(copias.mensual.sum())})')
print('Fechas retenidas:', ', '.join(f'{f:%d/%m}' for f in copias.loc[copias.retenida, 'fecha']))
print(f'Copia más antigua conservada: {copias.loc[copias.retenida, "fecha"].min():%d/%m} (mensual); entre semana se puede volver '
      f'a cualquiera de los últimos 7 días; RPO de la copia diaria de las 2:00: hasta 24 h')

# Prueba de restauración: copia en caliente con la API de SQLite, apertura de la copia y comparación de conteos:
origen = sqlite3.connect('trigo_lento/trigo_lento.sqlite')
tablas = [r[0] for r in origen.execute("SELECT name FROM sqlite_master WHERE type = 'table' ORDER BY name")]
with tempfile.TemporaryDirectory() as tmp:
    destino_ruta = Path(tmp) / 'trigo_lento_restaurada.sqlite'
    t0 = time.perf_counter()
    destino = sqlite3.connect(destino_ruta)
    origen.backup(destino)                                        # copia consistente aunque haya escrituras
    duracion = time.perf_counter() - t0
    integridad = destino.execute('PRAGMA integrity_check').fetchone()[0]
    conteos = pd.DataFrame({'tabla': tablas,
                            'origen': [origen.execute(f'SELECT COUNT(*) FROM {t}').fetchone()[0] for t in tablas],
                            'restaurada': [destino.execute(f'SELECT COUNT(*) FROM {t}').fetchone()[0] for t in tablas]})
    conteos['coincide'] = conteos.origen == conteos.restaurada
    tamano_kb = destino_ruta.stat().st_size / 1024
    destino.close()
origen.close()
print(f'\nRestauración de trigo_lento.sqlite en un archivo temporal: {tamano_kb:.0f} KB, integridad "{integridad}", '
      f'en {"menos de 1 s" if duracion < 1 else f"{duracion:.1f} s"}')
print(conteos.to_string(index = False))
print('Restauración probada:', 'sí, todos los conteos coinciden' if conteos.coincide.all() else 'NO: revisar la copia')

# Exportaciones de flujos: ¿se pueden volver a importar? Cada JSON de n8n necesita nodes y connections; cada blueprint, flow y metadata:
n8n_json = sorted(glob.glob('trigo_lento/dia_*/flujos/n8n/*.json'))
make_json = sorted(glob.glob('trigo_lento/dia_*/flujos/make/*.json'))
completo = lambda ruta, claves: isinstance(d := json.loads(Path(ruta).read_text(encoding = 'utf-8')), dict) and claves <= d.keys()
n8n_ok = sum(completo(f, {'nodes', 'connections'}) for f in n8n_json)
make_ok = sum(completo(f, {'flow', 'metadata'}) for f in make_json)
print(f'Exportaciones en Git: n8n {n8n_ok} workflows completos de {len(n8n_json)} archivos; Make {make_ok} blueprints de '
      f'{len(make_json)} (el resto son fragmentos didácticos de días anteriores)')

fig, ax = plt.subplots(figsize = (12.5, 3.6))
filas = [('mensual', 2, '#70AD47', 's'), ('semanal', 1, '#4472C4', 'o'), ('diaria', 0, '#A5A5A5', 'o')]
ax.scatter(copias.fecha, [-0.9] * len(copias), s = 12, color = '#e6e4df', marker = '|', label = 'copia hecha y ya borrada')
for tipo, y, color, marcador in filas:
    sel = copias[copias[tipo]]
    ax.scatter(sel.fecha, [y] * len(sel), s = 90, color = color, marker = marcador, zorder = 3, label = f'{tipo} ({len(sel)})')
probada = pd.Timestamp(hoy.date() - timedelta(days = 1))
ax.scatter([probada], [0], s = 260, facecolors = 'none', edgecolors = '#c0392b', lw = 2, zorder = 4, label = 'restauración probada hoy')
ax.set_yticks([-0.9, 0, 1, 2], ['hechas', 'diaria', 'semanal', 'mensual'])
ax.set_ylim(-1.4, 2.6)
ax.set_title('Copias retenidas en 90 días: 7 diarias, 4 semanales (domingo) y 3 mensuales (día 1), y la restauración probada',
             fontsize = 11)
ax.legend(loc = 'upper left', ncol = 5, fontsize = 9, frameon = False)
ax.xaxis.set_major_formatter(mdates.DateFormatter('%d/%m'))
ax.spines[['top', 'right']].set_visible(False)
plt.tight_layout()
plt.show()
Copias hechas en 90 días: 90 | retenidas: 13 (diarias 7, semanales 4, mensuales 3)
Fechas retenidas: 01/02, 01/03, 29/03, 01/04, 05/04, 12/04, 16/04, 17/04, 18/04, 19/04, 20/04, 21/04, 22/04
Copia más antigua conservada: 01/02 (mensual); entre semana se puede volver a cualquiera de los últimos 7 días; RPO de la copia diaria de las 2:00: hasta 24 h

Restauración de trigo_lento.sqlite en un archivo temporal: 88 KB, integridad "ok", en menos de 1 s
          tabla  origen  restaurada  coincide
       clientes      72          72      True
consentimientos       0           0      True
    ejecuciones       2           2      True
        pedidos     176         176      True
      renglones     308         308      True
Restauración probada: sí, todos los conteos coinciden
Exportaciones en Git: n8n 30 workflows completos de 35 archivos; Make 21 blueprints de 25 (el resto son fragmentos didácticos de días anteriores)
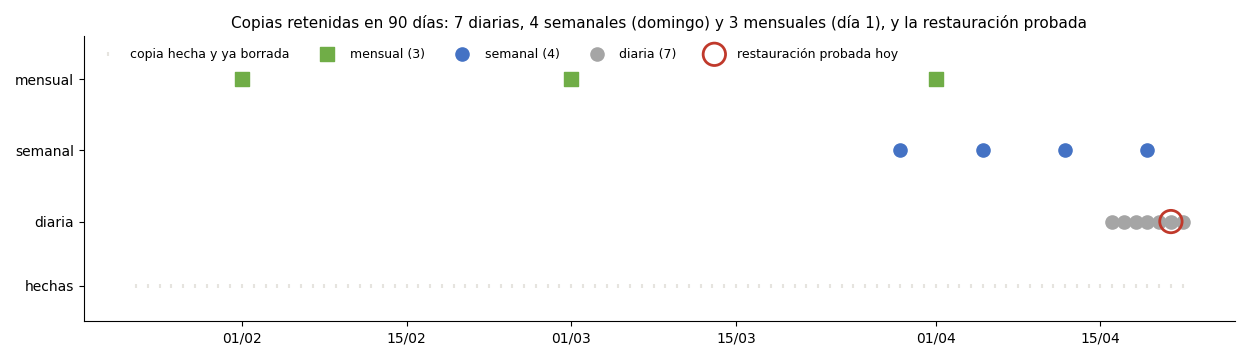
De $90$ copias, se conservan $13$, y la restauración de trigo_lento.sqlite ($88$ KB) termina en menos de un segundo con integridad ok y los conteos iguales en las cinco tablas: $72$ clientes, $176$ pedidos y $308$ renglones. Es una base pequeña y la prueba es barata; justo por eso se puede hacer cada semana y no una vez al año. Las exportaciones también pasan: $30$ workflows completos de n8n y $21$ blueprints de Make tienen las claves que su importador necesita (nodes y connections; flow y metadata); los archivos restantes son fragmentos didácticos de días anteriores, no flujos, y el bloque los distingue en lugar de contarlos. La gráfica muestra las trece copias retenidas sobre los noventa días y, con el círculo rojo, la copia de ayer que hoy se restauró: una copia que nunca se restauró es una hipótesis.
El RPO de la copia diaria de las 2:00 es de hasta $24$ horas. Para una caída en un momento al azar del día, los encargos perdidos desde la última copia son, en promedio:
$$ E[\text{pérdida}] = \lambda_e \cdot \frac{\Delta}{2} $$
La lógica detrás de esta estimación es la siguiente:
- $\lambda_e$ es la tasa de encargos, $18$ al día, y $\Delta$ el intervalo entre copias, $1$ día; la caída ocurre en un instante uniforme dentro del intervalo, así que en promedio se pierde la mitad.
- Con copia diaria, $E = 18 \cdot 0.5 = 9$ encargos, que habría que recapturar desde WhatsApp y desde la libreta del modo manual (el Día 80 afinó la cuenta con el perfil horario de las llegadas y obtuvo una cifra muy parecida).
- Con una copia cada hora en horario de atención, $\Delta = 1/13$ del día de servicio y la pérdida esperada baja a menos de un encargo.
- En conclusión, el RPO no se elige por gusto: se elige comparando lo que cuesta copiar más a menudo con lo que cuesta recapturar nueve encargos, y para Postgres, donde viven los pedidos, Trigo Lento pasa a una copia cada hora de 7:00 a 20:00 desde hoy.
La Tabla 3 recoge los objetivos de recuperación por componente y el resultado de los ensayos.
Tabla 3. Objetivos de recuperación por componente y resultado del ensayo de restauración.
| Componente | Copia | RPO objetivo | RTO objetivo | Ensayo |
|---|---|---|---|---|
| Postgres de n8n (pedidos, ejecuciones, aprobaciones, credenciales cifradas) | pg_dump -Fc cada hora de 7:00 a 20:00 y completa a las 2:00 | $1$ h en horario; $24$ h de noche | $2$ h | Simulacro de servidor nuevo del Día 80, dentro de las $4$ h de su objetivo; el objetivo baja hoy a $2$ h con los comandos ya escritos |
trigo_lento.sqlite (catálogo, inventario, índice de conocimiento) | .backup diario junto a Postgres | $24$ h | $15$ min | Restaurada hoy en menos de $1$ s, integridad ok, $5$ tablas con conteos iguales |
| Exportaciones de n8n (30 workflows) | export:workflow --backup diario y Git en cada cambio (Día 42) | Último commit | $30$ min | Los $30$ archivos tienen nodes y connections; importación probada el Día 42 |
| Credenciales de n8n ($17$ secretos) | export:credentials --backup diario, cifradas | $24$ h | $30$ min con la clave; $4$ h sin ella (reemisión) | Depende de N8N_ENCRYPTION_KEY, guardada en dos sitios fuera del servidor |
| Blueprints de Make (21 escenarios) | Git en cada cambio | Último commit | $20$ min (importar y reconectar) | Los $21$ archivos tienen flow y metadata |
| Notion, Slack, Gmail (proveedores) | Exportación semanal de Notion en Markdown; las decisiones de Slack viven también en Postgres | $7$ días | Sin RTO propio: lo fija el proveedor | M07 y M08 cubren la espera |
Secretos
El viernes 10 no falló el servidor ni el código: falló una fecha que nadie tenía apuntada. La auditoría del Día 80 construyó el inventario de credenciales con su alcance y su dueño; el plan de continuidad le añade lo que faltaba para que ningún token vuelva a caducar sin aviso: la fecha de la última rotación, la política de rotación por tipo, la caducidad propia cuando el proveedor la impone y una alerta a treinta días que entra en el calendario de gobierno del Día 79. La política es simple: $90$ días para claves de API y tokens de bot, $180$ para secretos de firma, contraseñas y tokens de actualización de OAuth, $365$ para la llave SSH, la caducidad del proveedor cuando es más corta (los tokens de página de Meta y de LinkedIn duran $60$ días) y rotación inmediata cuando alguien deja el equipo o un secreto se filtra. La clave de cifrado de n8n es la excepción: no se rota, porque rotarla significa volver a emitir todas las credenciales, y se guarda en dos sitios fuera del servidor.
El siguiente bloque escribe el inventario con esas fechas, aplica los dos plazos que dejó la auditoría de ayer (separar la clave de Claude de producción de la de evaluación en siete días y pasar la integración de Notion a una cuenta del negocio en treinta), calcula los días que quedan a cada secreto, marca los que vencen antes de treinta días y de las vacaciones de Valeria, y muestra el procedimiento de revocación de emergencia:
# Inventario de secretos con última rotación, política, caducidad propia y alerta de vencimiento en Python:
f = lambda d, m: datetime(2026, m, d, tzinfo = CDMX)
SECRETOS = pd.DataFrame([   # identificador, sistema, tipo, última rotación, política (días), caducidad propia, dónde vive
    ('token_cloud_api', 'Meta: Cloud API', 'token de usuario del sistema', f(10, 4), 90, None, 'credencial de n8n'),
    ('secreto_app_meta', 'Meta: firma del webhook', 'secreto de aplicación', f(18, 3), 180, None, 'credencial de n8n'),
    ('clave_claude_produccion', 'Anthropic', 'clave de API', f(4, 2), 90, None, 'credencial de n8n'),
    ('clave_claude_evaluacion', 'Anthropic', 'clave de API', f(11, 4), 90, None, 'variable del cuaderno'),
    ('clave_voyage', 'Voyage AI', 'clave de API', f(9, 4), 90, None, 'credencial de n8n'),
    ('token_bot_slack', 'Slack', 'token de bot', f(22, 3), 90, None, 'credencial de n8n'),
    ('secreto_firma_slack', 'Slack', 'secreto de firma', f(22, 3), 180, None, 'credencial de n8n'),
    ('integracion_notion', 'Notion', 'token de integración', f(9, 4), 90, None, 'credencial de n8n'),
    ('oauth_gmail', 'Google: Gmail', 'token de actualización OAuth', f(19, 3), 180, None, 'credencial de n8n'),
    ('token_paginas_meta', 'Meta: Instagram y Facebook', 'token de página de larga duración', f(13, 4), 60, f(12, 6), 'credencial de n8n'),
    ('token_linkedin', 'LinkedIn', 'token OAuth', f(13, 4), 60, f(12, 6), 'credencial de n8n'),
    ('clave_facturafacil', 'FacturaFácil', 'clave de API', f(12, 3), 90, None, 'credencial de n8n'),
    ('token_mcp', 'Servidor MCP propio', 'token portador', f(3, 4), 90, None, 'gestor de secretos'),
    ('clave_api_n8n', 'n8n', 'clave de API', f(6, 3), 90, None, 'gestor de secretos'),
    ('n8n_encryption_key', 'n8n', 'clave de cifrado de credenciales', f(6, 3), 0, None, 'gestor de secretos, fuera del servidor'),
    ('contrasena_postgres', 'Postgres', 'contraseña', f(6, 3), 180, None, 'archivo .env del servidor'),
    ('llave_ssh', 'Servidor', 'llave SSH', f(6, 3), 365, None, 'equipo de Valeria y gestor de secretos'),
], columns = ['secreto', 'sistema', 'tipo', 'rotado', 'politica_dias', 'caducidad_propia', 'guardado_en'])
PLAZOS_AUDITORIA = {'clave_claude_produccion': f(28, 4), 'integracion_notion': f(21, 5)}   # hallazgos del Día 80

def vence(fila):
    fechas = [fila.rotado + timedelta(days = int(fila.politica_dias))] if fila.politica_dias else []
    fechas += [fila.caducidad_propia] if fila.caducidad_propia is not None else []
    fechas += [PLAZOS_AUDITORIA[fila.secreto]] if fila.secreto in PLAZOS_AUDITORIA else []
    return min(fechas) if fechas else pd.NaT

SECRETOS['vence'] = SECRETOS.apply(vence, axis = 1)
SECRETOS['dias'] = SECRETOS.vence.apply(lambda v: (v - hoy).days if pd.notna(v) else np.nan)
SECRETOS['estado'] = pd.cut(SECRETOS.dias, [-10_000, -1, 30, 10_000], labels = ['vencido', 'por vencer', 'vigente']).astype(str)
SECRETOS.loc[SECRETOS.dias.isna(), 'estado'] = 'sin rotación: reemisión total'
vista = SECRETOS.sort_values('dias')[['secreto', 'tipo', 'rotado', 'politica_dias', 'vence', 'dias', 'estado']].copy()
vista['rotado'] = vista.rotado.dt.strftime('%d/%m/%y')
vista['vence'] = vista.vence.apply(lambda v: f'{v:%d/%m/%y}' if pd.notna(v) else 'nunca')
print(vista.to_string(index = False))
alerta = SECRETOS[SECRETOS.estado.isin(['vencido', 'por vencer'])]
print(f'\nSecretos: {len(SECRETOS)} | con alerta a 30 días: {len(alerta)} -> {", ".join(alerta.secreto)}')
print('Caducan solos antes de las vacaciones de Valeria (11/05):',
      ', '.join(SECRETOS[SECRETOS.vence < datetime(2026, 5, 11, tzinfo = CDMX)].secreto) or 'ninguno')
SECRETOS.to_csv(carpeta / 'inventario_secretos.csv', index = False, encoding = 'utf-8')

def revocar(secreto):
    # Revocación de emergencia: primero se cierra la puerta, después se investiga.
    s = SECRETOS.set_index('secreto').loc[secreto]
    pasos = [f'Revocar el secreto en la consola de {s.sistema} (no esperar a saber cómo se filtró).',
             'Emitir el secreto nuevo con el mismo alcance mínimo y guardarlo en el gestor, nunca en un chat.',
             f'Actualizarlo en {s.guardado_en} y reiniciar los flujos que lo usan (inventario del Día 79).',
             'Verificar con el latido sintético y una llamada de prueba.',
             'Investigar en registros y exportaciones cómo salió; anotar el hallazgo en la auditoría del Día 80.']
    return pasos

print('\nRevocación de emergencia de clave_claude_produccion:')
for i, paso in enumerate(revocar('clave_claude_produccion'), 1):
    print(f'  {i}. {paso}')
                secreto                              tipo   rotado  politica_dias    vence  dias                        estado
clave_claude_produccion                      clave de API 04/02/26             90 28/04/26   5.0                    por vencer
     integracion_notion              token de integración 09/04/26             90 21/05/26  28.0                    por vencer
          clave_api_n8n                      clave de API 06/03/26             90 04/06/26  42.0                       vigente
     clave_facturafacil                      clave de API 12/03/26             90 10/06/26  48.0                       vigente
     token_paginas_meta token de página de larga duración 13/04/26             60 12/06/26  50.0                       vigente
         token_linkedin                       token OAuth 13/04/26             60 12/06/26  50.0                       vigente
        token_bot_slack                      token de bot 22/03/26             90 20/06/26  58.0                       vigente
              token_mcp                    token portador 03/04/26             90 02/07/26  70.0                       vigente
           clave_voyage                      clave de API 09/04/26             90 08/07/26  76.0                       vigente
        token_cloud_api      token de usuario del sistema 10/04/26             90 09/07/26  77.0                       vigente
clave_claude_evaluacion                      clave de API 11/04/26             90 10/07/26  78.0                       vigente
    contrasena_postgres                        contraseña 06/03/26            180 02/09/26 132.0                       vigente
       secreto_app_meta             secreto de aplicación 18/03/26            180 14/09/26 144.0                       vigente
            oauth_gmail      token de actualización OAuth 19/03/26            180 15/09/26 145.0                       vigente
    secreto_firma_slack                  secreto de firma 22/03/26            180 18/09/26 148.0                       vigente
              llave_ssh                         llave SSH 06/03/26            365 06/03/27 317.0                       vigente
     n8n_encryption_key  clave de cifrado de credenciales 06/03/26              0    nunca   NaN sin rotación: reemisión total

Secretos: 17 | con alerta a 30 días: 2 -> clave_claude_produccion, integracion_notion
Caducan solos antes de las vacaciones de Valeria (11/05): clave_claude_produccion

Revocación de emergencia de clave_claude_produccion:
  1. Revocar el secreto en la consola de Anthropic (no esperar a saber cómo se filtró).
  2. Emitir el secreto nuevo con el mismo alcance mínimo y guardarlo en el gestor, nunca en un chat.
  3. Actualizarlo en credencial de n8n y reiniciar los flujos que lo usan (inventario del Día 79).
  4. Verificar con el latido sintético y una llamada de prueba.
  5. Investigar en registros y exportaciones cómo salió; anotar el hallazgo en la auditoría del Día 80.
De $17$ secretos, $2$ tienen alerta a treinta días: la clave de Claude de producción, que la auditoría obliga a separar antes del 28 de abril, y la integración de Notion, con plazo el 21 de mayo. El inventario también contesta la pregunta de las vacaciones: el único secreto que caduca solo antes del 11 de mayo es esa clave de Claude, y se rota esta semana, así que Itzel no tendrá que rotar nada en ausencia de Valeria. El token de WhatsApp, rotado el 10 de abril con caducidad “nunca”, vence por política el 9 de julio; la fecha ya está en el calendario y, esta vez, la pone la panadería. La Tabla 4 recoge los secretos que vencen antes de la revisión trimestral de julio.
Tabla 4. Secretos que vencen antes de la revisión trimestral de julio, por fecha.
| Secreto | Sistema | Última rotación | Vence | Días | Por qué vence |
|---|---|---|---|---|---|
clave_claude_produccion | Anthropic | 04/02 | 28/04 | $5$ | Plazo de la auditoría del Día 80: separar producción de evaluación |
integracion_notion | Notion | 09/04 | 21/05 | $28$ | Plazo de la auditoría: pasar a una cuenta del negocio |
clave_api_n8n | n8n | 06/03 | 04/06 | $42$ | Política de $90$ días |
clave_facturafacil | FacturaFácil | 12/03 | 10/06 | $48$ | Política de $90$ días |
token_paginas_meta | Meta: Instagram y Facebook | 13/04 | 12/06 | $50$ | Caducidad propia de $60$ días |
token_linkedin | 13/04 | 12/06 | $50$ | Caducidad propia de $60$ días | |
token_bot_slack | Slack | 22/03 | 20/06 | $58$ | Política de $90$ días |
La función revocar del bloque es el procedimiento de emergencia, y su orden es la regla ética de hoy: primero se cierra la puerta y después se investiga. Un secreto que aparece en un chat, en un registro o en una exportación se revoca en la consola del proveedor en el minuto uno, aunque no se sepa todavía cómo salió, porque el tiempo que se tarda en entenderlo es tiempo en que la llave sigue abriendo. Después se emite el nuevo con el mismo alcance mínimo, se actualiza en la credencial de n8n, se verifica con el latido y una llamada de prueba, y solo entonces se investiga y se anota el hallazgo en la auditoría. La búsqueda de secretos filtrados del Día 80 es la que detecta; la revocación de hoy es la que responde.
Ensayo de mesa
Un manual que nadie ha seguido nunca es una suposición. El ensayo de mesa (en los equipos de fiabilidad, tabletop exercise) consiste en sentar a las personas que responderían a un incidente, plantearles el síntoma y hacerles recorrer el manual en voz alta, paso a paso, con un cronómetro, sin tocar el sistema real. No prueba que el sistema aguante; prueba que las personas saben qué hacer, que el manual no tiene huecos y que el objetivo de recuperación es alcanzable. El que Valeria hace hoy, con Itzel y Joaquín en la mesa del obrador, es el viernes 10 de abril vuelto a jugar con el M02 delante.
La Figura 2 dibuja las cuatro fases como un reloj, porque todo incidente, con o sin manual, pasa por las mismas cuatro: detectar, diagnosticar, actuar y verificar. El tiempo de recuperación es la suma:
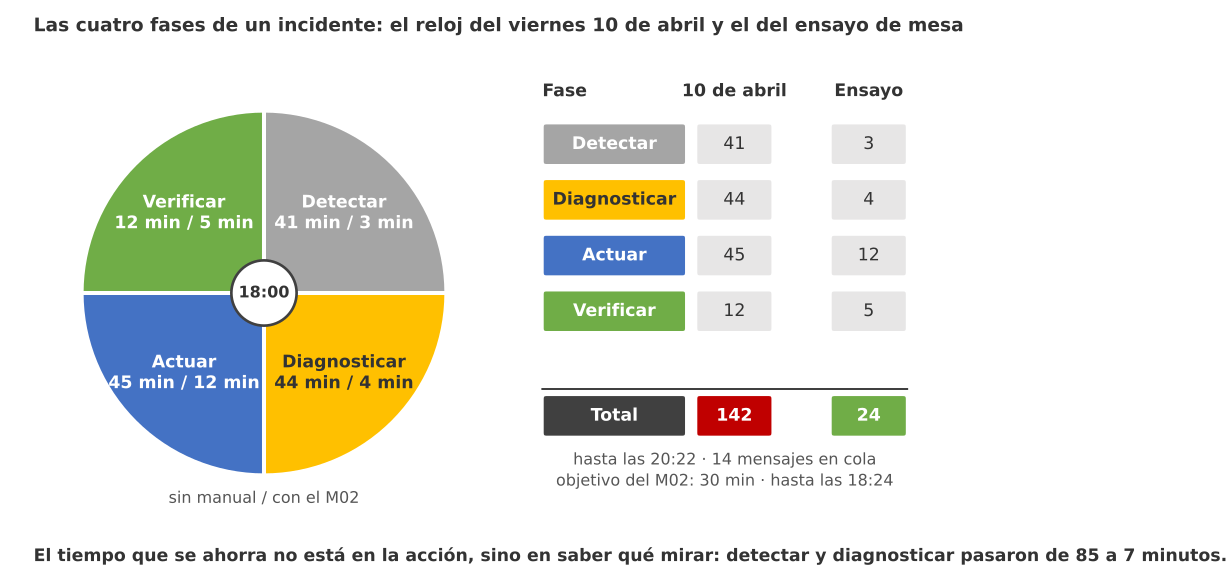
Figura 2. Las cuatro fases de un incidente como un reloj: detectar, diagnosticar, actuar y verificar; el viernes 10 de abril las cuatro sumaron 142 minutos sin manual y el ensayo de mesa con el M02 las hizo en 24.
$$ T_{\text{rec}} = T_{\text{det}} + T_{\text{diag}} + T_{\text{act}} + T_{\text{ver}} $$
La lógica detrás de esta descomposición es la siguiente:
- $T_{\text{det}}$ es el tiempo hasta que alguien sabe que algo falla; el viernes 10 fueron $41$ minutos, porque lo detectó una clienta, y en el ensayo son $3$, porque
TL Alertas de flujos v1avisa con tres errores $190$ seguidos. - $T_{\text{diag}}$ es el tiempo hasta saber qué falla; $44$ minutos de revisar flujos uno por uno frente a $4$ de abrir el M02 y leer que el código $190$ es el token.
- $T_{\text{act}}$ es lo que tarda la corrección; $45$ minutos de buscar contraseñas y segundos factores frente a $12$ con el procedimiento escrito y los accesos documentados por la auditoría de ayer.
- $T_{\text{ver}}$ es la prueba de que terminó; $12$ minutos de mandar un mensaje y esperar frente a $5$ con una verificación definida: estado “delivered” y cola vacía.
- En conclusión, un manual recorta sobre todo las dos primeras fases: la acción tardó $12$ minutos porque generar un token tarda lo que tarda, pero detectar y diagnosticar pasaron de $85$ minutos a $7$.
El siguiente bloque escribe las dos líneas de tiempo, la del viernes 10 según la libreta de Valeria y el registro de n8n, y la del ensayo de hoy, cronometrada sobre la mesa; calcula los clientes en espera en cada caso, sortea $500$ ensayos con una variación del $30%$ para ver si el objetivo de $30$ minutos del M02 es realista, y dibuja las fases:
# Ensayo de mesa del viernes del token caducado: lo que pasó el 10 de abril y el ensayo de hoy con el M02, en Python:
FASES = ['detección', 'diagnóstico', 'acción', 'verificación']
real = pd.Series([41, 44, 45, 12], index = FASES)      # minutos, según la libreta de Valeria y el registro de n8n
ensayo = pd.Series([3, 4, 12, 5], index = FASES)       # minutos, cronometrados hoy sobre la mesa con el M02 delante
QUIEN = {'detección': ('una clienta llama al mostrador: "les escribí hace rato y no me contestan"',
                       'TL Alertas de flujos v1: tres errores 190 seguidos en TL Errores v1'),
         'diagnóstico': ('Valeria revisa flujos uno por uno hasta leer "Error validating access token" en el nodo de envío',
                         'Itzel abre el M02: el código 190 es el token; el inventario dice que caducaba hoy'),
         'acción': ('buscar la contraseña del Business Manager, el segundo factor en el teléfono de Don Ernesto, generar '
                    'el token y adivinar dónde se pega en n8n',
                    'activar modo manual, generar el token con caducidad "nunca", pegarlo en la credencial, reprocesar la cola'),
         'verificación': ('mandar un mensaje desde el teléfono de Valeria y esperar; reprocesar 14 mensajes a mano',
                          'mensaje de prueba con estado "delivered" y cola de TL Errores v1 vacía')}
mensajes_en_cola = 14                                   # mensajes de clientes sin respuesta aquella tarde, según el registro
lam_tarde = 4.0                                         # mensajes por hora entre las 18:00 y las 20:00 (viernes)
for fase in FASES:
    print(f'{fase:>13}: {real[fase]:>3} min el 10/04 ({QUIEN[fase][0][:70]}...)')
    print(f'{"":>13}  {ensayo[fase]:>3} min hoy   ({QUIEN[fase][1][:70]}...)')
print(f'\nTotal: {real.sum()} min el 10 de abril (de {incidente:%H:%M} a {incidente + timedelta(minutes = int(real.sum())):%H:%M}) '
      f'frente a {ensayo.sum()} min en el ensayo; objetivo del M02: 30 min')
print(f'Clientes en espera a 4 mensajes por hora: {lam_tarde * real.sum() / 60:.1f} esperados el 10/04 ({mensajes_en_cola} en el registro) '
      f'frente a {lam_tarde * ensayo.sum() / 60:.1f} con manual')
ensayos = rng.lognormal(np.log(ensayo.values), 0.3, (500, 4)).sum(axis = 1)
print(f'500 ensayos con variación del 30 %: mediana {np.median(ensayos):.0f} min, p95 {np.percentile(ensayos, 95):.0f} min, '
      f'cumplen el objetivo de 30 min: {np.mean(ensayos <= 30) * 100:.0f} %')

COLORES = ['#A5A5A5', '#FFC000', '#4472C4', '#70AD47']
fig, ax = plt.subplots(figsize = (12.5, 4.2))
for y, (serie, rotulo) in enumerate([(real, 'Viernes 10 de abril, sin manual'), (ensayo, 'Ensayo de mesa, 22 de abril, con el M02')]):
    izquierda = 0
    for fase, color in zip(FASES, COLORES):
        ax.barh(y, serie[fase], left = izquierda, height = 0.5, color = color, edgecolor = 'white')
        if serie[fase] >= 8:
            ax.text(izquierda + serie[fase] / 2, y, f'{fase}\n{serie[fase]} min', ha = 'center', va = 'center', fontsize = 9,
                    color = 'white' if color != '#FFC000' else '#333333')
        izquierda += serie[fase]
    ax.text(izquierda + 2, y, f'{serie.sum()} min, hasta las {(incidente + timedelta(minutes = int(serie.sum()))):%H:%M}',
            va = 'center', fontsize = 10, fontweight = 'bold')
    ax.text(0, y + 0.42, rotulo, fontsize = 10, color = '#52514e')
ax.plot([30, 30], [-0.4, 1.3], color = '#c0392b', lw = 1, ls = '--')
ax.text(31, 1.2, 'objetivo del M02: 30 min', color = '#c0392b', fontsize = 9)
ax.legend(handles = [Patch(color = c, label = f) for f, c in zip(FASES, COLORES)], loc = 'lower right', ncol = 4,
          fontsize = 9, frameon = False)
ax.set_yticks([])
ax.set_ylim(-0.5, 1.9)
ax.set_xlim(0, 175)
ax.set_xlabel('minutos desde que caducó el token (18:00)')
ax.set_title('Las cuatro fases del incidente del token: detección, diagnóstico, acción y verificación', fontsize = 11)
ax.spines[['top', 'right', 'left']].set_visible(False)
plt.tight_layout()
plt.show()
    detección:  41 min el 10/04 (una clienta llama al mostrador: "les escribí hace rato y no me contest...)
                 3 min hoy   (TL Alertas de flujos v1: tres errores 190 seguidos en TL Errores v1...)
  diagnóstico:  44 min el 10/04 (Valeria revisa flujos uno por uno hasta leer "Error validating access ...)
                 4 min hoy   (Itzel abre el M02: el código 190 es el token; el inventario dice que c...)
       acción:  45 min el 10/04 (buscar la contraseña del Business Manager, el segundo factor en el tel...)
                12 min hoy   (activar modo manual, generar el token con caducidad "nunca", pegarlo e...)
 verificación:  12 min el 10/04 (mandar un mensaje desde el teléfono de Valeria y esperar; reprocesar 1...)
                 5 min hoy   (mensaje de prueba con estado "delivered" y cola de TL Errores v1 vacía...)

Total: 142 min el 10 de abril (de 18:00 a 20:22) frente a 24 min en el ensayo; objetivo del M02: 30 min
Clientes en espera a 4 mensajes por hora: 9.5 esperados el 10/04 (14 en el registro) frente a 1.6 con manual
500 ensayos con variación del 30 %: mediana 25 min, p95 33 min, cumplen el objetivo de 30 min: 87 %
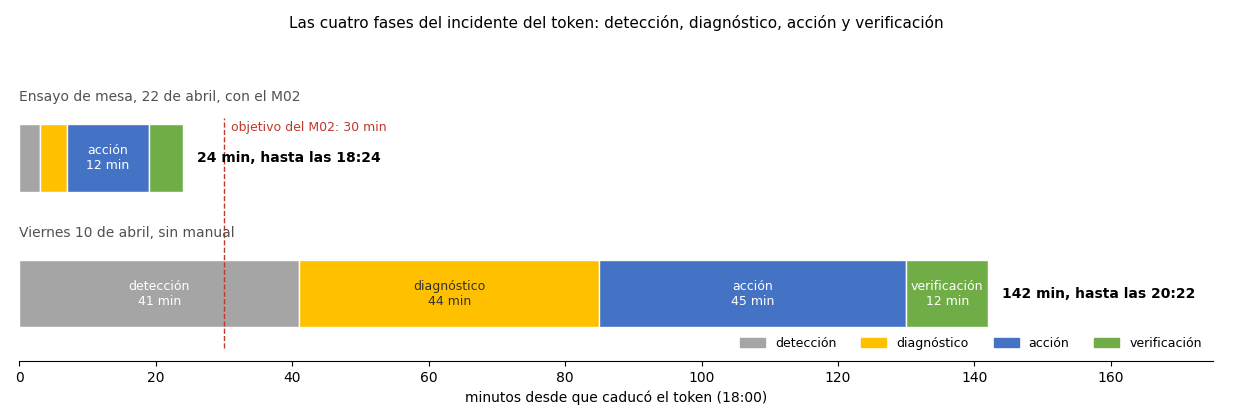
El viernes 10 duró $142$ minutos, de 18:00 a 20:22; el ensayo con el M02 dura $24$, hasta las 18:24, y el objetivo del manual, $30$ minutos, se cumple en el $87%$ de los $500$ ensayos sorteados, con una mediana de $25$ y un percentil $95$ de $33$ minutos. El dato del percentil es el que importa para el manual: uno de cada ocho ensayos se pasa del objetivo, casi siempre por la acción, y la mejora que sale del ensayo no es “ir más rápido”, sino quitar un paso: Valeria deja preparado en el gestor de secretos un token de reserva ya generado, con caducidad “nunca”, para que la acción del M02 sea pegar y reprocesar, no generar. El próximo ensayo medirá si con eso la acción baja de $12$ minutos a $5$.
Los clientes en espera cuentan la misma historia desde el mostrador: $9.5$ esperados y $14$ contados el viernes 10, frente a $1.6$ con el manual y, con el modo manual activado en el minuto tres, ninguno sin respuesta humana. Y el ensayo dejó, además, tres huecos que el manual no tenía escritos y que se añadieron antes de guardarlo: el M02 no decía que el segundo factor del Business Manager vive en el teléfono de Don Ernesto (ahora dice dónde está el segundo administrador que creó la auditoría), no decía cómo reprocesar la cola de TL Errores v1 (ahora lo dice con el nombre del botón) y no decía qué escribirle a los catorce clientes que esperaron (ahora remite a la plantilla del modo manual con una disculpa honesta). Un ensayo de mesa es la prueba unitaria de un manual: barata, repetible y más útil cuando falla.
La comprobación del día
La regla del módulo 8 es que cada entrega termina con su comprobación automática contra el código de honor del Día 5, y la de hoy no es la excepción. El siguiente bloque revisa que los ocho manuales tengan las seis secciones, responsable y suplente distintos y ningún secreto dentro (buscando los prefijos de claves conocidos, como hizo el Día 80 sobre las exportaciones); que la primera acción de todo S1 sea el modo manual y que los objetivos de recuperación quepan en el límite de su severidad; que la restauración se haya probado hoy; que ningún secreto esté vencido ni caduque solo en las vacaciones; que el detector dispare un manual que existe; y que el ensayo cumpla el objetivo del M02. Después escribe el índice del plan de continuidad en plan_continuidad.md:
# Comprobación automática del día: manuales, modo manual, restauración, secretos y ensayo contra el código de honor en Python:
PATRON_SECRETO = re.compile(r'(sk-ant-[A-Za-z0-9_-]{8,}|xox[bp]-[A-Za-z0-9-]{8,}|EAA[A-Za-z0-9]{20,}|AKIA[0-9A-Z]{16})')
LIMITE = {'S1': 30, 'S2': 60, 'S3': 480}
vacaciones = (datetime(2026, 5, 11, tzinfo = CDMX), datetime(2026, 5, 16, tzinfo = CDMX))
comprobaciones = {
    'ocho manuales con las seis secciones completas': len(MANUALES) == 8 and all(all(m[s] for s in SECCIONES) for m in MANUALES),
    'todo manual tiene responsable y suplente distintos': all(m['responsable'] != m['suplente'] for m in MANUALES),
    'ningún manual contiene un secreto (patrones de claves conocidas)': not any(PATRON_SECRETO.search(t) for t in textos),
    'la primera acción de todo S1 activa el modo manual': all('modo manual' in m['accion'][0] for m in MANUALES if m['severidad'] == 'S1'),
    'objetivo de recuperación dentro del límite de su severidad': all(m['objetivo_min'] <= LIMITE[m['severidad']] for m in MANUALES),
    'toda comunicación de S1 incluye a los clientes o al equipo': all(('cliente' in m['comunicacion'] or 'equipo' in m['comunicacion'])
                                                                     for m in MANUALES if m['severidad'] == 'S1'),
    'la restauración se probó hoy y los conteos coinciden': bool(conteos.coincide.all()) and integridad == 'ok',
    'ningún secreto vencido': not (SECRETOS.estado == 'vencido').any(),
    'ningún secreto caduca solo durante las vacaciones': not SECRETOS.vence.between(*vacaciones).any(),
    'el detector de gasto dispara un manual que existe': m05['id'] in {m['id'] for m in MANUALES},
    'el ensayo de mesa cumple el objetivo del M02': int(ensayo.sum()) <= next(m['objetivo_min'] for m in MANUALES if m['id'] == 'M02'),
}
for nombre, cumple in comprobaciones.items():
    print(f'{"cumple" if cumple else "FALLA ":>7}  {nombre}')
plan = ['# Plan de continuidad de Trigo Lento (Día 81)', '',
        f'Generado el {hoy:%d/%m/%Y}. Manuales en manuales/; secretos en inventario_secretos.csv; copias según copias_y_restauracion.sh.', '',
        '| Manual | Severidad | Objetivo (min) | Responsable | Suplente |', '|---|---|---|---|---|']
plan += [f"| {m['id']} {m['nombre']} | {m['severidad']} | {m['objetivo_min']} | {m['responsable']} | {m['suplente']} |" for m in MANUALES]
plan += ['', f'Retención: {RETENCION} | restauración probada: {hoy:%d/%m} | secretos con alerta: {len(alerta)} | '
         f'comprobaciones: {sum(comprobaciones.values())} de {len(comprobaciones)}']
(carpeta / 'plan_continuidad.md').write_text(chr(10).join(plan), encoding = 'utf-8')
print(f'{sum(comprobaciones.values())} de {len(comprobaciones)} comprobaciones cumplidas; plan_continuidad.md con {len(plan)} líneas, '
      f'{len(MANUALES)} manuales, {len(SECRETOS)} secretos y 1 restauración probada')
 cumple  ocho manuales con las seis secciones completas
 cumple  todo manual tiene responsable y suplente distintos
 cumple  ningún manual contiene un secreto (patrones de claves conocidas)
 cumple  la primera acción de todo S1 activa el modo manual
 cumple  objetivo de recuperación dentro del límite de su severidad
 cumple  toda comunicación de S1 incluye a los clientes o al equipo
 cumple  la restauración se probó hoy y los conteos coinciden
 cumple  ningún secreto vencido
 cumple  ningún secreto caduca solo durante las vacaciones
 cumple  el detector de gasto dispara un manual que existe
 cumple  el ensayo de mesa cumple el objetivo del M02
11 de 11 comprobaciones cumplidas; plan_continuidad.md con 16 líneas, 8 manuales, 17 secretos y 1 restauración probada
Las $11$ comprobaciones se cumplen, y el archivo plan_continuidad.md es la hoja que Itzel y Joaquín tendrán en la pared del obrador junto al papel de los cortes de luz: ocho manuales con su severidad, su objetivo y sus dos nombres, la política de copias, la fecha de la última restauración probada y los secretos con alerta. Las comprobaciones no demuestran que los manuales sean buenos (eso lo dice el ensayo), pero sí que nadie puede guardar un manual sin verificación, con un secreto pegado o con un objetivo imposible para su severidad, y que la próxima persona que añada el noveno manual tendrá que pasar por la misma puerta.
Don Ernesto cerró el ensayo con una pregunta que no era objeción: "¿Y esto lo hacemos cada cuánto?". Cada mes, uno de los ocho manuales, en orden de severidad, veinte minutos en la mesa del obrador después del pan de la mañana; en ocho meses se habrán ensayado todos y el primero, el del servidor, dos veces. Entra en el calendario de gobierno del Día 79 junto a la revisión de costes y la de secretos.
Consideraciones finales
Los manuales de hoy nacen de un incidente de $142$ minutos y de una frase de Don Ernesto sobre un papel pegado en la pared. Esa es su genealogía y conviene no olvidarla: un manual escrito antes de ningún incidente suele describir el sistema, no el síntoma, y un manual escrito después describe lo que pasó, que es lo que la siguiente persona verá. Los ocho de Trigo Lento cubren los fallos que ya ocurrieron o que la arquitectura señaló; el noveno se escribirá la tarde en que algo falle de otra manera, y el calendario de ensayos dirá qué le falta a cada uno.
Las cifras tienen límites que hay que decir. Las frecuencias de incidentes y las medianas de recuperación son supuestos declarados; las $79.4$ horas sin manual y las $19.5$ con manual son la consecuencia aritmética de esos supuestos, no una medición, y lo único que se puede afirmar con ellas es la forma del ahorro: grande donde el incidente es frecuente o largo y pequeño donde no. El ensayo de mesa mide a personas que sabían que iban a ser medidas, con el manual recién escrito y sin clientes de verdad esperando; el $87%$ de cumplimiento del objetivo es optimista y el ensayo del mes que viene lo corregirá. El detector de gasto tiene un umbral tosco a propósito y ya dio un falso positivo en catorce días; es barato porque lo mira una persona, y dejaría de serlo si marcara tres veces por semana. Y la restauración probada hoy es la de una base de $88$ KB; la de Postgres se ensayó ayer en un servidor nuevo y se volverá a ensayar cuando la copia pase a ser horaria.
Para quien quiera profundizar, The Site Reliability Workbook (Beyer, Murphy, Rensin, Kawahara y Thorne, 2018), disponible en línea, dedica sus capítulos 8, 9 y 10 a la guardia, la respuesta a incidentes y la cultura de análisis sin culpables, y es la fuente de la idea de que un manual se escribe para quien está de guardia y no para quien construyó el sistema. La norma ISO 22301:2019 da el vocabulario formal de la continuidad (periodo máximo tolerable de interrupción, RTO y RPO) con el que una panadería puede hablar con su cliente mayorista y, el Día 82, firmar un acuerdo. Y The Practice of Cloud System Administration (Limoncelli, Chalup y Hogan, 2014) tiene el capítulo más claro sobre por qué las copias que no se restauran no existen.
Un sistema autónomo supervisado no es el que nunca falla, sino el que falla con un papel pegado en la pared que cualquiera puede seguir. El viernes 10 de abril, Trigo Lento tenía veinticuatro flujos, un agente y una arquitectura documentada, y tardó $142$ minutos en pegar un token. Hoy tiene además ocho hojas, una libreta y un cronómetro, y la próxima vez tardará $24$.
Conclusiones clave
Manuales
- Un manual de operación tiene seis secciones en orden de trabajo (síntoma, impacto, diagnóstico, acción, verificación y comunicación), cabe en una hoja, empieza por lo que la persona ve y nunca contiene un secreto; los ocho de Trigo Lento suman $1,395$ palabras y se generan desde datos que el código puede comprobar.
- Las tres severidades se definen por quién espera: S1 (clientes sin atención) se responde en $15$ minutos por llamada y WhatsApp, S2 (degradación) en $60$ por Slack, S3 (interno) en el siguiente día hábil; la primera acción de todo S1 es activar el modo manual, algo que Itzel puede hacer sin abrir n8n.
- Con frecuencias y medianas supuestas, un año de $62$ incidentes pasa de $79.4$ a $19.5$ horas esperadas de afectación con manuales ($59.9$ de ahorro; $7.93$ solo por el servidor), y en $500$ años simulados el percentil $95$ baja de $104.3$ a $26.5$ horas; el ahorro está en detectar y diagnosticar, no en actuar.
Continuidad
- El modo manual es la parte del sistema que no depende del sistema: declarar, atender con una plantilla escrita por una persona que dice serlo y apuntar los seis datos del contrato, y reincorporar por lote con la clave de idempotencia; en el pico de $9$ mensajes por hora, dos horas son $18$ renglones de libreta.
- Las copias se hacen con
pg_dump -Fcsin terminal,.backupde SQLite yexport:workflow --backupde n8n, se cifran y salen del servidor; con $7$ diarias, $4$ semanales y $3$ mensuales se conservan $13$ de $90$, y la restauración detrigo_lento.sqlitese probó hoy en menos de un segundo con conteos iguales; con copia diaria se pierden en promedio $9$ encargos, por eso Postgres pasa a copia horaria. - De $17$ secretos, $2$ tienen alerta a treinta días (la clave de Claude de producción, por el plazo de la auditoría, y la integración de Notion) y ninguno caduca solo durante las vacaciones de Valeria; un secreto filtrado se revoca antes de investigarse, y la clave de cifrado de n8n vive fuera del servidor porque sin ella las credenciales de la copia no existen.
Ensayo
- El viernes 10 de abril duró $142$ minutos ($41$ de detección, $44$ de diagnóstico, $45$ de acción y $12$ de verificación) y dejó $14$ mensajes en cola; el ensayo de mesa con el M02 dura $24$ y cumple el objetivo de $30$ minutos en el $87%$ de $500$ ensayos sorteados, con un percentil $95$ de $33$.
- El detector de gasto marca un bucle de $180$ llamadas a Opus 5.5 ($3.96$ USD en $40$ minutos) a los cuatro minutos de empezar, con un umbral de $\max(\mu + 3\sigma, 2\mu)$ sobre los catorce días previos sin alerta; dio un falso positivo barato el primer lunes y dispara la primera acción del M05: desactivar el workflow, no el servidor.
- Un ensayo de mesa es la prueba unitaria de un manual: el de hoy encontró tres huecos (dónde está el segundo factor, cómo reprocesar la cola y qué decirles a los clientes), y a partir de ahora se ensaya un manual al mes en la mesa del obrador.
Mañana, en el Día 82: Acuerdos de servicio del ecosistema: SLA con Brújula, SLO internos y tablero de cumplimiento. Marisol Peña abrió dos cafeterías más y su socio quiere por escrito lo que hasta hoy era un compromiso de palabra, el $95%$ de confirmaciones en quince minutos; Valeria convertirá los objetivos internos de cada flujo, la disponibilidad compuesta del Día 78 y los manuales de hoy en un acuerdo que Trigo Lento pueda firmar, con exclusiones honestas, créditos con tope y un informe mensual que diga la verdad también cuando se incumple.
Referencias
- Beyer, B., Murphy, N. R., Rensin, D. K., Kawahara, K. y Thorne, S. (Eds.) (2018). The Site Reliability Workbook: Practical Ways to Implement SRE. O’Reilly Media. Capítulos 8 (On-Call), 9 (Incident Response) y 10 (Postmortem Culture). https://sre.google/workbook/table-of-contents/
- ISO (2019). ISO 22301:2019 Security and resilience: Business continuity management systems. Requirements. International Organization for Standardization. https://www.iso.org/standard/75106.html
- n8n (2026). CLI commands for n8n y Backup and restore. Documentación de n8n, revisada en octubre de 2026. https://docs.n8n.io/hosting/cli-commands/ y https://docs.n8n.io/deploy/host-n8n/keep-n8n-running/backup-and-restore
- PostgreSQL Global Development Group (2026). pg_dump y pg_restore. Documentación de PostgreSQL, revisada en octubre de 2026. https://www.postgresql.org/docs/current/app-pgdump.html
- Anthropic (2026). Errors. Documentación de la API de Claude, revisada en octubre de 2026. https://platform.claude.com/docs/en/api/errors
- Meta (2026). WhatsApp Cloud API: Get Started (tokens de usuario del sistema y su caducidad). Documentación para desarrolladores, revisada en octubre de 2026. https://developers.facebook.com/docs/whatsapp/cloud-api/get-started
- Limoncelli, T. A., Chalup, S. R. y Hogan, C. J. (2014). The Practice of Cloud System Administration: Designing and Operating Large Distributed Systems (vol. 2). Addison-Wesley.