Arquitecto de automatización con IA: Día 83
 Jeshua Romero Guadarrama
- 73 Min para leer
- 24 Apr, 2026
Índice de contenido
Resumen:
A una semana del Día del Niño y a dos y media del 10 de mayo, Valeria quiere saber si el ecosistema de Trigo Lento aguanta un sábado de pico antes de que llegue el sábado de verdad. En esta entrada, las pruebas sueltas de ochenta y dos días se ordenan en una pirámide de seis niveles con $648$ casos y $2.90$ USD por pasada; los cuerpos de webhook de Meta, Slack y el formulario se validan contra sus contratos ($90$ de $90$ veredictos correctos); un conjunto de $200$ mensajes etiquetados mide la regresión de dos versiones del prompt con intervalos de Wilson ($0.910$ frente a $0.940$, sin diferencia significativa); $50$ escenarios de punta a punta encuentran tres defectos reales en el simulador ensamblado y terminan en $50$ de $50$; siete fallos inyectados a propósito (429 y 529 de Claude, servidor caído, Notion lento, firmas inválidas, token caducado y Slack caído) activan los siete manuales del Día 81; y la carga al triple del pico muestra que el servidor está al $3%$ y que el cuello de botella es quién mira Slack. Al terminar, usted sabrá organizar las pruebas de un ecosistema de automatizaciones con IA, inyectar fallos controlados sin tocar a un cliente y firmar una decisión de salida con los riesgos aceptados por escrito.
¿Cómo citar el presente artículo?
Romero, J. (24 de abril de 2026). Arquitecto de automatización con IA: Día 83. python-data-engineer. https://www.python-data-engineer.com/post/aai/dia_83/.
Arquitecto de automatización con IA: Día 83 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/aai/dia_83/.
Precios, límites y políticas revisados en octubre de 2026: planes, precios y límites de Make, n8n, Zapier, WhatsApp (Meta, Twilio, Wati) y de la API de Claude. Los límites de la API de lotes de Claude que se citan (100 000 peticiones o 256 MB por lote, ventana de 24 horas, resultados disponibles 29 días, 50 % de descuento y la recomendación de caché de una hora) y los códigos de error 429 (rate_limit_error) y 529 (overloaded_error), con los dos reintentos automáticos del SDK, se contrastaron con la documentación oficial de Claude, revisada en octubre de 2026. Nueve de los diez bloques son offline y sus salidas son reales; el bloque 5 llama a la API de lotes y se muestra con una salida de ejemplo. Los experimentos de caos y la carga corren sobre un simulador en Python, nunca sobre la instancia de producción ni con clientes reales; las predicciones del bloque 6 son cifras de ejemplo declaradas como tales.
Día 83. Proyecto integrador IV: pruebas de punta a punta y de caos
Introducción
Ayer, en el Día 82 (Acuerdos de servicio del ecosistema: SLA con Brújula, SLO internos y tablero de cumplimiento), Valeria convirtió la promesa de palabra del $95%$ de confirmaciones en quince minutos en un acuerdo firmado con Marisol, derivó el SLA externo de los SLO internos con el margen que dejaba la disponibilidad compuesta del Día 78 y montó el tablero de cumplimiento con su presupuesto de error, y Trigo Lento ganó sla_brujula_v1.md y una regla que Don Ernesto dictó antes de firmar: “Si lo firmamos, lo cumplimos”. Esa regla tiene una consecuencia que ayer nadie escribió: hay que saber, antes de que llegue el día, si el sistema cumple.
Es jueves 23 de abril. Faltan siete días para el Día del Niño, el jueves 30, que en Trigo Lento significa cajas de pan dulce surtido por decenas y un sábado 2 de mayo con el obrador a tope; y faltan diecisiete días, dos semanas y media, para el 10 de mayo, el día de más encargos del año, con su propio sábado 9 de víspera. Desde que empezó la serie, el ecosistema ha pasado por todas las pruebas que cada día necesitó: los datos fijados del Día 43, las cuarenta conversaciones del agente del Día 39, las treinta piezas del revisor del Día 77, el ensayo de mesa del Día 81. Pero nunca se ha probado todo junto, con el volumen de un sábado de fiesta y con las cosas rompiéndose a propósito. Valeria tiene una pregunta concreta y una fecha límite: ¿aguanta el sistema un sábado de pico? Y quiere saberlo el sábado 25, con tiempo para arreglar lo que salga, no el sábado 2.
Don Ernesto la escucha mientras revisa la lista de harina del fin de semana y responde con algo que en el obrador es rutina desde hace treinta años: “Antes de una fiesta grande hacemos una hornada de prueba el día anterior, con el horno lleno, no con un pan. Si un horno va a fallar, falla con el horno lleno, no con una concha. Y además, cada tanto, apago el gas a propósito para ver si los muchachos saben qué hacer. ¿Usted ya probó esto con el horno lleno? ¿Y ya le apagó el gas?” Las dos preguntas son, en el vocabulario de hoy, una prueba de carga y un experimento de caos, y las dos tienen una condición que Don Ernesto da por sentada: la hornada de prueba no se vende, y el gas se apaga cuando no hay clientes en el mostrador.
En la presente entrada, descubrirá cómo se ordenan en una pirámide las pruebas que la serie fue dejando, de las transformaciones deterministas y gratuitas de la base a la conducta del agente, que cuesta tokens, en la punta. Verá cómo se prueban los contratos de los tres webhooks de entrada (Meta, Slack y el formulario) con el validador del Día 4, cómo se evalúa la regresión de un prompt con $200$ mensajes etiquetados, la API de lotes de Claude y el intervalo de Wilson, y por qué un intervalo que se solapa con el anterior no es ni una mejora ni una regresión. Ensamblará un simulador del ecosistema entero, le pasará $50$ escenarios con resultado esperado y encontrará tres defectos que ninguna prueba anterior había visto. Después apagará el gas: inyectará siete fallos controlados y comprobará que cada manual del Día 81 se activa; medirá la carga al triple del pico con la teoría de colas y una simulación; y terminará con la lista de salida, los criterios medidos, los riesgos aceptados por escrito y las firmas.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Organizar las pruebas del ecosistema en una pirámide: transformaciones, reglas, contratos de webhooks, flujos de punta a punta y evaluaciones de prompts.
- Ejecutar una evaluación de regresión de los prompts con $200$ mensajes etiquetados y su intervalo de confianza.
- Inyectar fallos controlados (caos) en la simulación: 429 y 529 de Claude, caída de n8n, Notion lento, firmas inválidas.
- Probar carga al triple del pico y decidir si el sistema está listo para la semana del Día del Niño y el pico del 10 de mayo.
La pirámide de pruebas del ecosistema
El Día 43 (Laboratorio guiado: pruebas de flujos con datos fijados y un entorno de ensayo) dejó una tabla con cinco niveles de prueba para un flujo y una frase que hoy se cobra: “el Día 83 extenderá esta misma idea a todo el ecosistema”. La idea es la pirámide de pruebas de la ingeniería de software, que Myers formuló hace más de cuarenta años con otras palabras: muchas pruebas pequeñas, rápidas y baratas en la base, y pocas pruebas grandes, lentas y caras en la punta. Lo que cambia al pasar de un flujo a un ecosistema de $23$ flujos (el inventario del Día 79) no es el principio sino la escala: cada nivel atrapa lo que los anteriores dejan pasar, y los niveles nuevos de hoy (contratos, punta a punta, caos y carga) se apilan sobre los que ya existían sin sustituirlos.
Conviene fijar qué significa “determinista” en esta pirámide, porque es lo que separa las pruebas que se corren cien veces al día de las que se corren cuando hace falta. Una prueba es determinista cuando, con la misma entrada, produce siempre la misma salida: una diferencia significa un cambio, no mala suerte. Las transformaciones, las reglas, los contratos, el simulador y los experimentos de caos sobre el simulador son deterministas con la semilla de la serie. La evaluación de prompts no lo es: el mismo mensaje puede clasificarse distinto en dos corridas, por eso se mide con un intervalo de confianza y no con un sí o un no. Y la conducta del agente, además de estadística, cuesta $2.88$ USD por corrida con Opus 5.5 (Día 39): se corre cuando cambia el prompt, el modelo o una herramienta. La Figura 1 dibuja esa pirámide con los números de Trigo Lento.
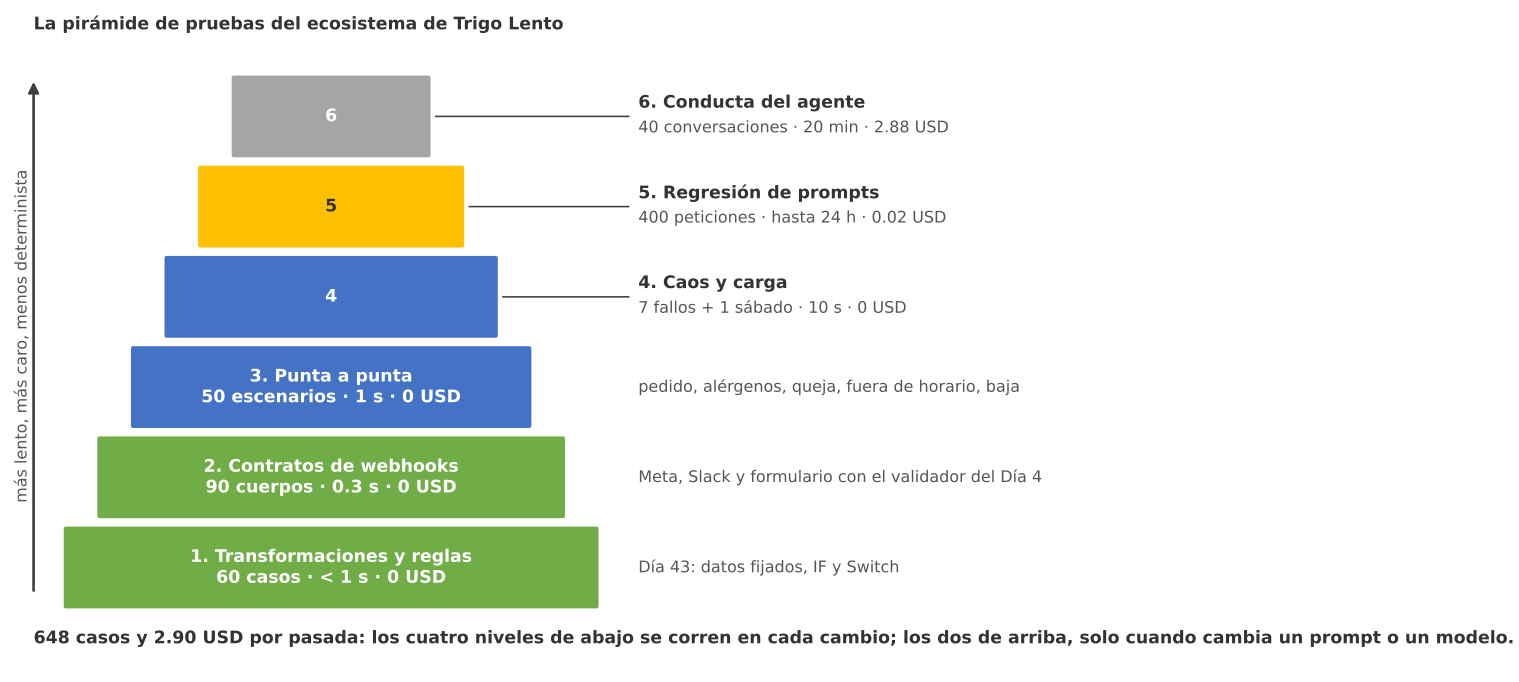
Figura 1. La pirámide de pruebas del ecosistema: seis niveles, de las 60 transformaciones y reglas del Día 43 (gratis, deterministas, menos de un segundo) a las 40 conversaciones del agente (2.88 USD por corrida); 648 casos y 2.90 USD por pasada completa.
El primer bloque fija las importaciones, la semilla de la serie y las tres fechas que ordenan el día: el sábado de ensayo, el Día del Niño y el 10 de mayo:
# Importaciones base, semilla de la serie, fecha de hoy y las fechas del pico en Python:
import warnings
warnings.filterwarnings('ignore')
import hashlib
import json
import math
import re
import time
from collections import Counter, deque
from datetime import date, datetime, timedelta
from pathlib import Path
from types import SimpleNamespace
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from matplotlib.patches import Polygon

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 160)
pd.set_option('display.max_colwidth', 48)
carpeta = Path('trigo_lento') / 'dia_83'
carpeta.mkdir(parents = True, exist_ok = True)
hoy = date(2026, 4, 23)
ensayo = date(2026, 4, 25)            # el sábado de ensayo con el horno lleno
dia_nino, diez_mayo = date(2026, 4, 30), date(2026, 5, 10)
DIAS = ['lunes', 'martes', 'miércoles', 'jueves', 'viernes', 'sábado', 'domingo']
print('numpy', np.__version__, '| pandas', pd.__version__)
print(f'Hoy: {DIAS[hoy.weekday()]} {hoy:%d/%m/%Y} | ensayo: {DIAS[ensayo.weekday()]} {ensayo:%d/%m} | '
      f'Día del Niño en {(dia_nino - hoy).days} días | 10 de mayo en {(diez_mayo - hoy).days} días '
      f'({(diez_mayo - hoy).days / 7:.1f} semanas)')
numpy 2.4.6 | pandas 3.0.3
Hoy: jueves 23/04/2026 | ensayo: sábado 25/04 | Día del Niño en 7 días | 10 de mayo en 17 días (2.4 semanas)
Hoy es jueves $23$ de abril; el ensayo es el sábado $25$; el Día del Niño cae en $7$ días y el 10 de mayo en $17$, es decir, en $2.4$ semanas. Todo lo que hoy falle tiene que estar corregido antes del sábado 2 de mayo.
El segundo bloque hace dos cosas. Primero levanta el inventario de las pruebas que la serie ya tiene, con su día de origen, su número de casos, su tiempo por corrida y su coste, y lo resume en la Tabla 1. Después construye el único activo que todavía no existe: el conjunto de regresión de $200$ mensajes. Parte de los $60$ mensajes etiquetados del Día 9 (mensajes_etiquetados.csv, con sus seis categorías) y lo completa con plantillas hasta las cuotas por categoría, añadiendo una séptima categoría, “baja”, que el Día 9 no tenía y que desde el Día 52 el orquestador trata aparte:
# Inventario de las pruebas que la serie ya tiene y construcción del conjunto de regresión de 200 mensajes en Python:
inventario = [
    # nivel, prueba, día de origen, casos, tiempo por corrida, coste por corrida (USD), determinista
    (1, 'Transformaciones (Code y Edit Fields)',     43, 30,  '0.4 s',        0.00, True),
    (1, 'Reglas (IF y Switch)',                      43, 30,  '0.2 s',        0.00, True),
    (2, 'Contratos de webhooks (Meta, Slack, formulario)', 83, 90, '0.3 s',  0.00, True),
    (3, 'Punta a punta en el simulador ensamblado',  83, 50,  '1 s',          0.00, True),
    (4, 'Caos y carga (fallos inyectados, triple del pico)', 83, 8, '10 s',   0.00, True),
    (5, 'Regresión de prompts (Haiku 5.5 por lotes)', 83, 400, 'menos de 1 h, hasta 24 h', 0.02, False),
    (6, 'Conducta del agente (Opus 5.5, 40 conversaciones)', 39, 40, '20 min', 2.88, False),
]
tabla_1 = pd.DataFrame(inventario, columns = ['nivel', 'prueba', 'dia', 'casos', 'tiempo', 'coste_usd', 'determinista'])
print(tabla_1.to_string(index = False))
print(f'Casos en total: {tabla_1.casos.sum()} | deterministas y gratis: '
      f'{tabla_1[tabla_1.determinista].casos.sum()} | coste de una pasada completa: {tabla_1.coste_usd.sum():.2f} USD')

# El único activo que todavía no existe es el conjunto de regresión: se parte de los 60 mensajes
# etiquetados del Día 9 y se completa con plantillas hasta 200, con cuotas por categoría.
base = pd.read_csv(Path('trigo_lento') / 'mensajes_etiquetados.csv')
CUOTAS = {'pedido': 50, 'horario': 30, 'precio': 30, 'factura': 20, 'queja': 30, 'otro': 25, 'baja': 15}
PRODUCTOS = ['hogazas de masa madre', 'baguettes', 'conchas', 'croissants', 'roles de canela', 'pasteles de zanahoria',
             'cajas de pan dulce surtido', 'bollos para hamburguesa', 'pays de queso', 'panes de caja integral']
PLANTILLAS = {
    'pedido':  ['Quiero {n} {p} para el {d}', 'Me aparta {n} {p} pa {d} porfa', 'Hola, necesito encargar {n} {p}, los recojo el {d} a las {h}',
                '¿Me pueden hacer {n} {p} para {d}?', 'Buenas, un pedido: {n} {p} y {n2} {p2} para el {d}', 'Apúnteme {n} {p}, paso el {d}'],
    'horario': ['¿A qué hora abren el {d}?', '¿Están abiertos hoy?', '¿Hasta qué hora puedo pasar por mi pan el {d}?', '¿Abren los domingos?',
                '¿Cierran el puente del {d}?', 'Hola, ¿a qué hora sale la hornada de la tarde?'],
    'precio':  ['¿Cuánto cuesta {p}?', 'Precio de {p} por favor', '¿Tienen precio de mayoreo para {p}?', '¿Cuánto salen {n} {p}?',
                '¿Ya subió el precio de los {p}?', 'Buenas, ¿cuánto vale la caja de pan dulce?'],
    'factura': ['Necesito factura del pedido {f}', '¿Me pueden facturar la compra de ayer? Le paso mi RFC', 'La factura de la semana pasada trae mal el RFC',
                '¿Facturan? Es para la oficina', 'Mándenme el XML de la factura {f}', 'Mi contadora dice que falta el uso de CFDI en la factura {f}'],
    'queja':   ['El pan llegó quemado', 'Mi pastel llegó tarde y aplastado', 'Pedí {p} y me dieron otra cosa', 'Qué decepción, los {p} estaban crudos',
                'Llevo una hora esperando y nadie contesta', 'Los {p} de hoy venían duros, no es la primera vez'],
    'otro':    ['Gracias, todo muy rico', '¿Hacen envíos a Coyoacán?', 'Hola', '¿Tienen estacionamiento?', 'Feliz día', 'ok', '¿Trabajan con cafeterías?',
                'Les mando la foto del pastel, quedó precioso', '¿Me recomiendan algo sin azúcar?'],
    'baja':    ['BAJA', 'Ya no quiero recibir mensajes', 'No me escriban más por favor', 'Dejen de mandarme promociones', 'baja', 'Ya no',
                'Quiero darme de baja de los avisos', 'Por favor quítenme de la lista'],
}
def mensaje(categoria):
    t = PLANTILLAS[categoria][int(rng.integers(len(PLANTILLAS[categoria])))]
    p, p2 = rng.choice(PRODUCTOS, 2, replace = False)
    return t.format(n = int(rng.integers(1, 13)), n2 = int(rng.integers(1, 7)), p = p, p2 = p2,
                    d = rng.choice(DIAS[:6]), h = f'{int(rng.integers(8, 19))}:00', f = f'TL-202604{int(rng.integers(10, 23)):02d}-{int(rng.integers(1, 400)):04d}')

filas = [{'id': f'r{i + 1:03d}', 'texto': r.texto, 'real': r.real, 'origen': 'dia_9'} for i, r in enumerate(base.itertuples())]
for categoria, cuota in CUOTAS.items():
    faltan = cuota - sum(f['real'] == categoria for f in filas)
    for _ in range(faltan):
        filas.append({'id': f'r{len(filas) + 1:03d}', 'texto': mensaje(categoria), 'real': categoria, 'origen': 'plantilla'})
regresion = pd.DataFrame(filas)
regresion.to_csv(carpeta / 'mensajes_regresion.csv', index = False)
print(f'\nConjunto de regresión: {len(regresion)} mensajes ({(regresion.origen == "dia_9").sum()} del Día 9 y '
      f'{(regresion.origen == "plantilla").sum()} de plantilla) | por categoría: {regresion.real.value_counts().reindex(CUOTAS).to_dict()}')
print(regresion.sample(5, random_state = 2026).to_string(index = False))
 nivel                                            prueba  dia  casos                   tiempo  coste_usd  determinista
     1             Transformaciones (Code y Edit Fields)   43     30                    0.4 s       0.00          True
     1                              Reglas (IF y Switch)   43     30                    0.2 s       0.00          True
     2   Contratos de webhooks (Meta, Slack, formulario)   83     90                    0.3 s       0.00          True
     3          Punta a punta en el simulador ensamblado   83     50                      1 s       0.00          True
     4 Caos y carga (fallos inyectados, triple del pico)   83      8                     10 s       0.00          True
     5        Regresión de prompts (Haiku 5.5 por lotes)   83    400 menos de 1 h, hasta 24 h       0.02         False
     6 Conducta del agente (Opus 5.5, 40 conversaciones)   39     40                   20 min       2.88         False
Casos en total: 648 | deterministas y gratis: 208 | coste de una pasada completa: 2.90 USD

Conjunto de regresión: 200 mensajes (60 del Día 9 y 140 de plantilla) | por categoría: {'pedido': 50, 'horario': 30, 'precio': 30, 'factura': 20, 'queja': 30, 'otro': 25, 'baja': 15}
  id                                                                  texto   real    origen
r116                                             ¿Cuánto salen 8 baguettes? precio plantilla
r092                                       Quiero 4 baguettes para el lunes pedido plantilla
r016 Para el cumple de mi hija, un pastel de chocolate el sábado a mediodía pedido     dia_9
r058                                               ¿Hacen pasteles veganos?   otro     dia_9
r124                              Precio de hogazas de masa madre por favor precio plantilla
Tabla 1. La pirámide de pruebas del ecosistema: tipo de prueba, día de origen, número de casos, tiempo por corrida y coste (las de prompts y de agente cuestan tokens).
| Nivel | Prueba | Día | Casos | Tiempo por corrida | Coste por corrida (USD) | Determinista |
|---|---|---|---|---|---|---|
| 1 | Transformaciones (Code y Edit Fields) | 43 | 30 | 0.4 s | 0.00 | Sí |
| 1 | Reglas (IF y Switch) | 43 | 30 | 0.2 s | 0.00 | Sí |
| 2 | Contratos de webhooks (Meta, Slack, formulario) | 83 | 90 | 0.3 s | 0.00 | Sí |
| 3 | Punta a punta en el simulador ensamblado | 83 | 50 | 1 s | 0.00 | Sí |
| 4 | Caos y carga (fallos inyectados, triple del pico) | 83 | 8 | 10 s | 0.00 | Sí |
| 5 | Regresión de prompts (Haiku 5.5 por lotes) | 83 | 400 | menos de 1 h, hasta 24 h | 0.02 | No |
| 6 | Conducta del agente (Opus 5.5, 40 conversaciones) | 39 | 40 | 20 min | 2.88 | No |
| Total | 648 casos | 2.90 |
La pasada completa son $648$ casos y $2.90$ USD, y $208$ de esos casos son deterministas y gratis: se corren en cada cambio de un flujo, como la suite del Día 43. Los $400$ de la regresión de prompts cuestan dos centavos porque van por lotes con Haiku 5.5 (la sección correspondiente hace la cuenta), y los $40$ del agente son el $99%$ del coste: por eso la pirámide tiene la forma que tiene. El conjunto de regresión queda con $200$ mensajes, $60$ reales del Día 9 y $140$ de plantilla, con cuotas de $50$ pedidos, $30$ horarios, $30$ precios, $20$ facturas, $30$ quejas, $25$ “otro” y $15$ bajas. Los de plantilla se reconocen en la muestra ("¿Cuánto salen 8 baguettes?") y se guardan con su origen, porque una evaluación debe decir con qué se evaluó.
El tercer bloque dibuja la pirámide con matplotlib.patches, un trapecio por nivel, con los casos, el tiempo y el coste de cada uno:
# Pirámide de pruebas del ecosistema dibujada con patches, con los casos, el coste y el tiempo de cada nivel en Python:
niveles = tabla_1.groupby('nivel').agg(casos = ('casos', 'sum'), coste = ('coste_usd', 'sum'),
                                        nombres = ('prueba', lambda s: ' y '.join(p.split(' (')[0] for p in s))).reset_index()
rotulos = {1: 'Transformaciones y reglas', 2: 'Contratos de webhooks', 3: 'Punta a punta (simulador)',
           4: 'Caos y carga', 5: 'Regresión de prompts', 6: 'Conducta del agente'}
tiempos = {1: '< 1 s', 2: '0.3 s', 3: '1 s', 4: '10 s', 5: 'hasta 24 h', 6: '20 min'}
colores = {1: '#3a9d5d', 2: '#3a9d5d', 3: '#2a78d6', 4: '#2a78d6', 5: '#eb6834', 6: '#c8423b'}
fig, ax = plt.subplots(figsize = (9.2, 6.2))
n = len(niveles)
for k, fila in niveles.iterrows():
    nivel = int(fila.nivel)
    y0, y1 = k, k + 0.92
    w0, w1 = 1 - k / n, 1 - (k + 1) / n           # anchos de la base y del techo del trapecio
    ax.add_patch(Polygon([(-w0, y0), (w0, y0), (w1, y1), (-w1, y1)], closed = True, fc = colores[nivel], ec = 'white', lw = 2))
    rotulo = f'{nivel}. {rotulos[nivel]}\n{int(fila.casos)} casos · {tiempos[nivel]} · {fila.coste:.2f} USD'
    if k < 4:                                      # los niveles anchos llevan el rótulo dentro
        ax.text(0, (y0 + y1) / 2, rotulo, ha = 'center', va = 'center', color = 'white', fontsize = 10, fontweight = 'bold')
    else:                                          # la punta es estrecha: rótulo fuera, con una línea
        ax.annotate(rotulo, xy = (-(w0 + w1) / 2, (y0 + y1) / 2), xytext = (-1.7, (y0 + y1) / 2), ha = 'left', va = 'center',
                    fontsize = 9, color = colores[nivel], fontweight = 'bold', arrowprops = dict(arrowstyle = '-', lw = 1, color = colores[nivel]))
ax.annotate('', xy = (1.08, n - 0.3), xytext = (1.08, 0.3), arrowprops = dict(arrowstyle = '->', lw = 1.5, color = '#2b2a28'))
ax.text(1.12, n / 2, 'más lento, más caro,\nmenos determinista', rotation = 90, va = 'center', fontsize = 9, color = '#2b2a28')
ax.text(-1.7, -0.45, 'Verde: deterministas y gratis · Azul: simulación · Naranja y rojo: cuestan tokens', fontsize = 9, color = '#555555')
ax.set_xlim(-1.75, 1.35)
ax.set_ylim(-0.6, n + 0.1)
ax.axis('off')
ax.set_title(f'La pirámide de pruebas del ecosistema: {tabla_1.casos.sum()} casos, {tabla_1.coste_usd.sum():.2f} USD por pasada', fontsize = 16)
plt.tight_layout()
plt.show()
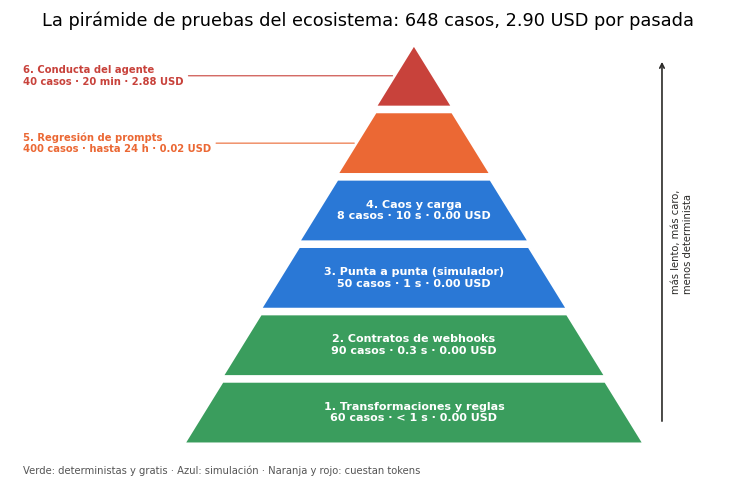
La figura dice lo mismo que la tabla, pero con la forma que importa: la base verde, deterministas y gratis, es ancha; la punta roja, cara y estadística, es estrecha. Invertir la pirámide, que es lo que pasa cuando la única prueba es “mandar un mensaje y ver qué contesta”, significa pagar tokens para descubrir lo que un contrato o una regla habrían atrapado gratis.
Pruebas de contrato
El ecosistema tiene tres puertas de entrada por las que llegan cuerpos JSON que Trigo Lento no escribe: el webhook de la Cloud API de Meta con los mensajes de WhatsApp (Día 48), el webhook de interactividad de Slack con las pulsaciones de aprobar y rechazar (Día 50) y el formulario web de encargos. Una prueba de contrato comprueba que lo que llega por cada puerta tiene la forma que los flujos esperan, y lo hace en dos direcciones: un cuerpo válido debe pasar y un cuerpo roto debe ser rechazado con un motivo. La primera dirección protege de rechazar clientes reales; la segunda, de que un campo que falta o un valor fuera de catálogo recorra doce nodos antes de romper algo.
Los contratos se escriben en JSON Schema, como el del pedido del Día 4 (Arquitectura de flujos II: entradas, salidas y contratos de datos), y se validan con el mismo validador de aquel día, copiado literalmente: validar(dato, esquema) devuelve una lista de errores con la ruta, la regla y el mensaje, y una lista vacía significa que el cuerpo cumple. El esquema de Meta sigue la estructura entry > changes > value > messages que el normalizador del Día 52 recorre; el de Slack exige type = block_actions, un usuario, exactamente una acción con action_id en {aprobar, rechazar} y un value con el formato apr-AAAAMMDD-NNNN; y el del formulario cierra con additionalProperties: false, porque un formulario propio no tiene motivo para traer campos que nadie declaró. Para cada fuente se generan $30$ cuerpos y $6$ de ellos se rompen de una de seis maneras (campo faltante, tipo incorrecto, campo extra, formato, lista vacía y valor fuera del enum), de modo que se sepa de antemano qué regla debe atraparlos:
# Pruebas de contrato de los tres webhooks con el validador de JSON Schema del Día 4 en Python:
TIPOS = {'string': str, 'integer': int, 'object': dict, 'array': list}

def validar(dato, esquema, ruta = '$'):
    # Devuelve una lista de errores (ruta, regla, mensaje); lista vacía = cumple el contrato:
    if 'enum' in esquema and dato not in esquema['enum']:
        return [(ruta, 'enum', f'{dato!r} no está en la lista permitida')]
    tipo = esquema.get('type')
    if tipo and (not isinstance(dato, TIPOS[tipo]) or (tipo == 'integer' and isinstance(dato, bool))):
        return [(ruta, 'type', f'se esperaba {tipo}')]
    errores = []
    if tipo == 'object':
        for campo in esquema.get('required', []):
            if campo not in dato:
                errores.append((f'{ruta}.{campo}', 'required', 'falta el campo'))
        for campo, valor in dato.items():
            if campo in esquema.get('properties', {}):
                errores += validar(valor, esquema['properties'][campo], f'{ruta}.{campo}')
            elif esquema.get('additionalProperties') is False:
                errores.append((f'{ruta}.{campo}', 'additionalProperties', 'campo no previsto'))
    elif tipo == 'array':
        if not esquema.get('minItems', 0) <= len(dato) <= esquema.get('maxItems', 10**9):
            errores.append((ruta, 'items', f'{len(dato)} elementos fuera del rango permitido'))
        for i, elemento in enumerate(dato):
            errores += validar(elemento, esquema['items'], f'{ruta}[{i}]')
    elif tipo == 'string':
        if not esquema.get('minLength', 0) <= len(dato) <= esquema.get('maxLength', 10**9):
            errores.append((ruta, 'length', f'longitud {len(dato)} fuera de rango'))
        if 'pattern' in esquema and not re.search(esquema['pattern'], dato):
            errores.append((ruta, 'pattern', f'{dato!r} no tiene el formato'))
        if esquema.get('format') == 'date':
            try:
                date.fromisoformat(dato) if re.fullmatch(r'\d{4}-\d{2}-\d{2}', dato) else 1 / 0
            except (ValueError, ZeroDivisionError):
                errores.append((ruta, 'format', f'{dato!r} no es una fecha ISO 8601'))
    return errores

# Los tres contratos de entrada del ecosistema, escritos en JSON Schema 2020-12 como el del pedido (Día 4):
MENSAJE_META = {'type': 'object', 'required': ['from', 'id', 'timestamp', 'type'], 'properties': {
    'from': {'type': 'string', 'pattern': r'^52[0-9]{10}$'}, 'id': {'type': 'string', 'pattern': r'^wamid\.'},
    'timestamp': {'type': 'string', 'pattern': r'^[0-9]{10}$'}, 'type': {'enum': ['text', 'image', 'audio', 'button', 'interactive']},
    'text': {'type': 'object', 'required': ['body'], 'properties': {'body': {'type': 'string', 'minLength': 1, 'maxLength': 4096}}}}}
VALOR_META = {'type': 'object', 'required': ['messaging_product', 'metadata', 'messages'], 'properties': {
    'messaging_product': {'enum': ['whatsapp']},
    'metadata': {'type': 'object', 'required': ['phone_number_id'], 'properties': {'phone_number_id': {'type': 'string', 'pattern': r'^[0-9]{6,20}$'}}},
    'messages': {'type': 'array', 'minItems': 1, 'maxItems': 20, 'items': MENSAJE_META}}}
ESQUEMAS = {
 'meta': {'type': 'object', 'required': ['object', 'entry'], 'additionalProperties': False, 'properties': {
    'object': {'enum': ['whatsapp_business_account']},
    'entry': {'type': 'array', 'minItems': 1, 'items': {'type': 'object', 'required': ['id', 'changes'], 'additionalProperties': False, 'properties': {
        'id': {'type': 'string', 'pattern': r'^[0-9]{6,20}$'},
        'changes': {'type': 'array', 'minItems': 1, 'items': {'type': 'object', 'required': ['field', 'value'], 'additionalProperties': False, 'properties': {
            'field': {'enum': ['messages']}, 'value': VALOR_META}}}}}}}},
 'slack': {'type': 'object', 'required': ['type', 'user', 'actions', 'response_url'], 'properties': {
    'type': {'enum': ['block_actions']},
    'user': {'type': 'object', 'required': ['id'], 'properties': {'id': {'type': 'string', 'pattern': r'^U[A-Z0-9]{8,}$'}}},
    'actions': {'type': 'array', 'minItems': 1, 'maxItems': 1, 'items': {'type': 'object', 'required': ['action_id', 'value'], 'properties': {
        'action_id': {'enum': ['aprobar', 'rechazar']}, 'value': {'type': 'string', 'pattern': r'^apr-[0-9]{8}-[0-9]{4}$'}}}},
    'response_url': {'type': 'string', 'pattern': r'^https://hooks\.slack\.com/actions/'}}},
 'formulario': {'type': 'object', 'required': ['folio', 'nombre', 'telefono', 'detalle', 'fecha_entrega', 'enviado'], 'additionalProperties': False, 'properties': {
    'folio': {'type': 'string', 'pattern': r'^FO-[0-9]{6}$'}, 'nombre': {'type': 'string', 'minLength': 2, 'maxLength': 80},
    'telefono': {'type': 'string', 'pattern': r'^\+52 ?[0-9]{2} ?[0-9]{4} ?[0-9]{4}$'}, 'detalle': {'type': 'string', 'minLength': 5, 'maxLength': 500},
    'fecha_entrega': {'type': 'string', 'format': 'date'}, 'enviado': {'type': 'string', 'pattern': r'^\d{4}-\d{2}-\d{2}T\d{2}:\d{2}:\d{2}[+-]\d{2}:\d{2}$'},
    'consentimiento': {'enum': [True, False]}}},
}

def cuerpo_valido(fuente, k):
    marca = int(datetime(2026, 4, 23, 10, 0).timestamp()) + 37 * k
    if fuente == 'meta':
        return {'object': 'whatsapp_business_account', 'entry': [{'id': '100000000000042', 'changes': [{'field': 'messages', 'value': {
                'messaging_product': 'whatsapp', 'metadata': {'display_phone_number': '5255000000XX', 'phone_number_id': '200000000000042'},
                'contacts': [{'wa_id': f'52550000{k:04d}'}],
                'messages': [{'from': f'52550000{k:04d}', 'id': f'wamid.EJEMPLO{k:04d}', 'timestamp': str(marca), 'type': 'text',
                              'text': {'body': regresion.texto.iloc[k % len(regresion)]}}]}}]}]}
    if fuente == 'slack':
        return {'type': 'block_actions', 'user': {'id': f'U0EJEMPLO{k:02d}'}, 'response_url': f'https://hooks.slack.com/actions/T0EJ/{k}/x',
                'actions': [{'action_id': 'aprobar' if k % 3 else 'rechazar', 'value': f'apr-20260423-{k:04d}'}], 'trigger_id': f'{k}.ejemplo'}
    return {'folio': f'FO-{260400 + k:06d}', 'nombre': 'Cliente de prueba', 'telefono': f'+52 55 0000 {k:04d}',
            'detalle': f'{1 + k % 6} x P{1 + k % 12:02d} para el sábado', 'fecha_entrega': '2026-04-25',
            'enviado': f'2026-04-23T10:{k % 60:02d}:00-06:00', 'consentimiento': True}

def mutar(cuerpo, fuente, rng):
    # Rompe un cuerpo válido de una de seis maneras y dice cuál, para saber qué regla debe atraparlo:
    c = json.loads(json.dumps(cuerpo))
    mutacion = ['campo_faltante', 'tipo_incorrecto', 'campo_extra', 'formato', 'lista_vacia', 'enum'][int(rng.integers(6))]
    if fuente == 'meta':
        m = c['entry'][0]['changes'][0]['value']['messages']
        {'campo_faltante': lambda: m[0].pop('timestamp'), 'tipo_incorrecto': lambda: m[0].update(timestamp = 1777000000),
         'campo_extra': lambda: c.update(firma = 'x'), 'formato': lambda: m[0].update({'from': '+52 55 0000 0001'}),
         'lista_vacia': lambda: m.clear(), 'enum': lambda: m[0].update(type = 'sticker')}[mutacion]()
    elif fuente == 'slack':
        {'campo_faltante': lambda: c.pop('response_url'), 'tipo_incorrecto': lambda: c.update(actions = 'aprobar'),
         'campo_extra': lambda: c['actions'].append({'action_id': 'aprobar', 'value': 'apr-20260423-9999'}),
         'formato': lambda: c['actions'][0].update(value = 'pastel-42'), 'lista_vacia': lambda: c['actions'].clear(),
         'enum': lambda: c['actions'][0].update(action_id = 'publicar')}[mutacion]()
    else:
        {'campo_faltante': lambda: c.pop('fecha_entrega'), 'tipo_incorrecto': lambda: c.update(nombre = 42),
         'campo_extra': lambda: c.update(cupon = 'GRATIS'), 'formato': lambda: c.update(fecha_entrega = '25/04/2026'),
         'lista_vacia': lambda: c.update(detalle = ''), 'enum': lambda: c.update(consentimiento = 'sí')}[mutacion]()
    return c, mutacion

t0 = time.perf_counter()
resultados = []
for fuente in ESQUEMAS:
    for k in range(30):
        cuerpo = cuerpo_valido(fuente, k)
        mutacion = 'ninguna'
        if k % 5 == 4:                                        # 6 de cada 30 cuerpos llegan rotos
            cuerpo, mutacion = mutar(cuerpo, fuente, rng)
        errores = validar(cuerpo, ESQUEMAS[fuente])
        resultados.append({'fuente': fuente, 'k': k, 'mutacion': mutacion, 'errores': len(errores),
                           'regla': errores[0][1] if errores else '', 'correcto': (mutacion == 'ninguna') == (not errores)})
contratos = pd.DataFrame(resultados)
contratos.to_csv(carpeta / 'pruebas_contrato.csv', index = False)
print(f'{len(contratos)} cuerpos validados en {time.perf_counter() - t0:.3f} s')
print(contratos.groupby('fuente').agg(cuerpos = ('k', 'size'), validos = ('errores', lambda e: int((e == 0).sum())),
                                      rechazados = ('errores', lambda e: int((e > 0).sum())), veredicto_correcto = ('correcto', 'all')).to_string())
print('\nRegla que atrapó cada mutación:')
print(contratos[contratos.mutacion != 'ninguna'].groupby(['mutacion', 'regla']).size().unstack(fill_value = 0).to_string())
print('\nAprobados: todos los veredictos correctos =', bool(contratos.correcto.all()),
      '| cuerpos rotos que el validador dejó pasar =', int(((contratos.mutacion != 'ninguna') & (contratos.errores == 0)).sum()))
90 cuerpos validados en 0.007 s
            cuerpos  validos  rechazados  veredicto_correcto
fuente
formulario       30       24           6                True
meta             30       24           6                True
slack            30       24           6                True

Regla que atrapó cada mutación:
regla            additionalProperties  enum  format  items  length  required  type
mutacion
campo_extra                         2     0       0      1       0         0     0
campo_faltante                      0     0       0      0       0         1     0
enum                                0     6       0      0       0         0     0
formato                             0     0       2      0       0         0     0
lista_vacia                         0     0       0      1       1         0     0
tipo_incorrecto                     0     0       0      0       0         0     4

Aprobados: todos los veredictos correctos = True | cuerpos rotos que el validador dejó pasar = 0
Los $90$ cuerpos se validan en $8$ milésimas de segundo, y el veredicto es correcto en los $90$: los $72$ válidos pasan, los $18$ rotos se rechazan y ningún cuerpo roto se cuela. La tabla de “regla que atrapó cada mutación” es la parte que vale la pena leer despacio, porque dice qué está vigilando cada línea del esquema: required atrapa el campo faltante, type el tipo incorrecto, enum el valor fuera de catálogo, format la fecha escrita como 25/04/2026, y la lista vacía cae en items (Meta y Slack) o en length (el detalle vacío del formulario). El campo extra se rechaza por additionalProperties en Meta y en el formulario, pero en Slack cae en items: la mutación añadió una segunda acción y el esquema permite exactamente una, así que lo atrapa maxItems y no la prohibición de campos nuevos, que en Slack no está porque Slack añade campos con cada versión de su API. Esa asimetría es deliberada: un contrato con un proveedor externo se escribe tolerante con lo que no conoce y estricto con lo que necesita; un contrato propio se escribe estricto en las dos direcciones.
Lo que las pruebas de contrato no comprueban es la firma. Que el cuerpo de Meta tenga la forma correcta no dice que lo haya mandado Meta; eso lo dice la cabecera X-Hub-Signature-256 que el Día 54 verifica con HMAC sobre los bytes crudos, y la de Slack, X-Slack-Signature sobre v0:marca:cuerpo (Día 50). Las firmas se prueban de otra manera: en el experimento de caos E5, inyectando firmas inválidas y comprobando que el flujo rechaza con 401 sin leer el cuerpo.
Evaluación de regresión de prompts
El clasificador de mensajes de Trigo Lento corre con Haiku 5.5 desde el Día 60 y su prompt está en la versión v2. Valeria tiene una candidata, v3, que cambia las instrucciones sobre las bajas para que “ya no quiero recibir mensajes” se reconozca como baja y no como “otro”. La pregunta de una evaluación de regresión no es si v3 es buena, sino si es peor que v2 en algo, y para responderla hacen falta tres piezas: un conjunto de mensajes con etiqueta verdadera (los $200$ del bloque 2), las predicciones de las dos versiones sobre los mismos mensajes y una forma honesta de comparar dos proporciones medidas sobre $200$ casos.
La tercera pieza es el intervalo de Wilson, que la serie usa desde el Día 70. Una exactitud de $188$ aciertos en $200$ no es “$0.94$”: es una estimación con incertidumbre, y el intervalo de Wilson al $95%$ dice entre qué valores es razonable que esté la exactitud verdadera. Con $z = 1.96$, $n$ casos y proporción observada $p$:
$$ \text{IC}_{95%} = \frac{p + \dfrac{z^2}{2n}}{1 + \dfrac{z^2}{n}} \pm \frac{z}{1 + \dfrac{z^2}{n}}\sqrt{\frac{p(1-p)}{n} + \frac{z^2}{4n^2}} $$
- El centro no es $p$ sino $p$ desplazado hacia $0.5$ por el término $z^2 / 2n$: con $n = 200$ el desplazamiento es pequeño, con $n = 15$ (las bajas) es grande, y por eso $15$ de $15$ no da un intervalo de $[1, 1]$ sino de $[0.796, 1]$.
- El margen combina la varianza binomial $p(1-p)/n$ con el término $z^2/4n^2$, que impide que el intervalo salga de $[0, 1]$ y que se colapse cuando $p$ vale $0$ o $1$, los dos defectos del intervalo clásico $p \pm z\sqrt{p(1-p)/n}$.
- En conclusión, para $188$ de $200$ el intervalo es $[0.898, 0.965]$: la exactitud verdadera de
v3puede estar en cualquier punto de ese tramo, y cualquier comparación conv2tiene que respetarlo.
Con eso se puede escribir el criterio de no regresión que usa Trigo Lento: hay regresión en una categoría si el intervalo de la versión nueva queda entero por debajo del intervalo de la anterior (el límite superior nuevo es menor que el límite inferior viejo); si los intervalos se solapan, no hay evidencia de regresión ni de mejora, y si la exactitud puntual bajó se marca “vigilar”; y, además, ninguna categoría puede quedar por debajo de $0.85$ de exactitud puntual, una guardia absoluta que no depende de la versión anterior. La línea de no regresión de la figura es el límite inferior del intervalo total de v2.
El quinto bloque es el que llama a la API. Lee los $200$ mensajes, arma $400$ peticiones (las dos versiones del prompt sobre los mismos mensajes, con un custom_id que lleva la versión y el identificador del mensaje), las envía en un solo lote con client.messages.batches.create y lee los resultados por custom_id, porque llegan en cualquier orden. Dos detalles vienen de la documentación revisada en octubre de 2026: el system lleva caché de una hora y no de cinco minutos, porque un lote puede tardar más de cinco minutos y la documentación lo recomienda para contextos compartidos; y la salida se pide como JSON con output_config.format, con el esquema de una sola propiedad categoria restringida a las siete etiquetas, de modo que no haya que interpretar texto libre. El bloque no se ejecutó para escribir la entrada; la salida es un ejemplo comentado:
# Evaluación de regresión de los 200 mensajes con Haiku 5.5 por la API de lotes, dos versiones del prompt en un solo lote en Python:
import anthropic
from anthropic.types.message_create_params import MessageCreateParamsNonStreaming
from anthropic.types.messages.batch_create_params import Request

client = anthropic.Anthropic()   # lee ANTHROPIC_API_KEY del entorno; la clave nunca va en el código
regresion = pd.read_csv(carpeta / 'mensajes_regresion.csv')
CATEGORIAS = ['pedido', 'horario', 'precio', 'factura', 'queja', 'otro', 'baja']
ESQUEMA = {'type': 'object', 'additionalProperties': False, 'required': ['categoria'],
           'properties': {'categoria': {'type': 'string', 'enum': CATEGORIAS}}}
SISTEMA = {
    'v2': (Path('trigo_lento') / 'prompts' / 'clasificador_v2.md').read_text(encoding = 'utf-8'),
    'v3': (Path('trigo_lento') / 'prompts' / 'clasificador_v3.md').read_text(encoding = 'utf-8'),   # candidata: instrucciones de "baja"
}

def peticion(version, fila):
    # Un custom_id por versión y mensaje; el system va con caché de 1 hora porque el lote puede tardar más de 5 minutos:
    return Request(custom_id = f'{version}-{fila.id}', params = MessageCreateParamsNonStreaming(
        model = 'claude-haiku-5-5', max_tokens = 256, output_config = {'effort': 'low', 'format': {'type': 'json_schema', 'schema': ESQUEMA}},
        system = [{'type': 'text', 'text': SISTEMA[version], 'cache_control': {'type': 'ephemeral', 'ttl': '1h'}}],
        messages = [{'role': 'user', 'content': f'Mensaje del cliente: {fila.texto}'}]))

peticiones = [peticion(v, fila) for v in ('v2', 'v3') for fila in regresion.itertuples()]
assert len({p['custom_id'] for p in peticiones}) == len(peticiones) == 400, 'custom_id repetido'
lote = client.messages.batches.create(requests = peticiones)
print('Lote:', lote.id, '|', lote.processing_status, '| en proceso:', lote.request_counts.processing)

# Sondeo hasta que termine (la mayoría de los lotes acaban en menos de una hora; el límite es 24 h):
while lote.processing_status != 'ended':
    time.sleep(120)
    lote = client.messages.batches.retrieve(lote.id)
print('Terminado:', lote.request_counts)

# Lectura por custom_id (los resultados llegan en cualquier orden) y aciertos frente a la etiqueta:
reales = regresion.set_index('id')['real']
predicho, uso = {}, Counter()
for resultado in client.messages.batches.results(lote.id):
    version, id_msg = resultado.custom_id.split('-', 1)
    if resultado.result.type != 'succeeded':
        predicho[(version, id_msg)] = f'error:{resultado.result.type}'
        continue
    mensaje = resultado.result.message
    if mensaje.stop_reason == 'refusal':
        predicho[(version, id_msg)] = 'refusal'
        continue
    predicho[(version, id_msg)] = json.loads(mensaje.content[0].text)['categoria']
    uso['entrada'] += mensaje.usage.input_tokens
    uso['cache'] += mensaje.usage.cache_read_input_tokens or 0
    uso['salida'] += mensaje.usage.output_tokens
for version in ('v2', 'v3'):
    aciertos = sum(predicho[(version, i)] == reales[i] for i in reales.index)
    print(f'{version}: {aciertos} de {len(reales)} aciertos = {aciertos / len(reales):.3f}')
coste = (uso['entrada'] * 0.10 + uso['cache'] * 0.01 + uso['salida'] * 0.50) / 1e6 * 0.5     # Haiku 5.5, mitad de precio en lote
print(f'Tokens: {dict(uso)} | coste del lote: {coste:.4f} USD')
pd.DataFrame([{'id': i, 'real': reales[i], 'v2': predicho[('v2', i)], 'v3': predicho[('v3', i)]} for i in reales.index]
             ).to_csv(carpeta / 'predicciones_regresion.csv', index = False)

# Salida de ejemplo (puede variar):
# Lote: msgbatch_EJEMPLO-NO-REAL-0083 | in_progress | en proceso: 400
# Terminado: MessageBatchRequestCounts(canceled=0, errored=0, expired=0, processing=0, succeeded=400)
# v2: 182 de 200 aciertos = 0.910
# v3: 188 de 200 aciertos = 0.940
# Tokens: {'entrada': 31200, 'cache': 146000, 'salida': 7600} | coste del lote: 0.0042 USD
La cuenta del coste explica por qué este nivel de la pirámide cuesta dos centavos y no dos dólares. Cada petición lleva un system de unos $370$ tokens que, tras la primera escritura, se lee de caché a $0.01$ USD por millón, más unos $80$ tokens de mensaje a $0.10$ y unos $20$ de salida a $0.50$; el lote divide todo entre dos. Para $400$ peticiones salen unos $4$ milésimos de dólar, y aun contando las dos escrituras de caché y una estimación generosa, menos de $0.02$ USD: la regresión de prompts se puede correr cada vez que cambie un prompt sin que se note en el rubro de Claude. El SDK, además, reintenta dos veces los 429 y los 5xx con espera exponencial y respeta la cabecera retry-after cuando llega, también en el sondeo del lote.
El sexto bloque hace la parte offline con predicciones de ejemplo, declaradas como tales: fija los aciertos por categoría de las dos versiones (v2 acierta $182$ de $200$ y v3 $188$, con una categoría, quejas, en la que v3 acierta uno menos), reparte los fallos con la semilla de la serie, calcula los intervalos de Wilson por categoría y en total, aplica el criterio de no regresión y guarda predicciones_ejemplo.csv. Al final calcula cuántos mensajes harían falta para distinguir de verdad una exactitud de $0.91$ de una de $0.94$:
# Exactitud por categoría e intervalo de Wilson sobre predicciones de ejemplo (declaradas como tales) en Python:
def wilson(x, n, z = 1.96):
    # Intervalo de Wilson al 95 %: centro desplazado y margen que nunca sale de [0, 1]:
    p = x / n
    centro = (p + z**2 / (2 * n)) / (1 + z**2 / n)
    margen = z / (1 + z**2 / n) * math.sqrt(p * (1 - p) / n + z**2 / (4 * n**2))
    return centro - margen, centro + margen

# Aciertos por categoría de las dos versiones del prompt. Son cifras de ejemplo, no resultados de un
# lote real: la versión v2 es la que corre hoy y la v3 es la candidata que cambia las instrucciones de "baja":
ACIERTOS = {'pedido': (47, 48), 'horario': (29, 29), 'precio': (27, 28), 'factura': (17, 18),
            'queja': (28, 27), 'otro': (20, 23), 'baja': (14, 15)}
predicciones = regresion.copy()
for version, j in (('v2', 0), ('v3', 1)):
    acierto = pd.Series(True, index = predicciones.index)
    for categoria, (a2, a3) in ACIERTOS.items():
        indices = predicciones.index[predicciones.real == categoria]
        fallos = rng.choice(indices, size = len(indices) - (a2, a3)[j], replace = False)
        acierto[fallos] = False
    confusiones = [c for c in CUOTAS if c != 'otro'] + ['otro']
    predicciones[version] = [r if ok else rng.choice([c for c in confusiones if c != r]) for r, ok in zip(predicciones.real, acierto)]
predicciones.to_csv(carpeta / 'predicciones_ejemplo.csv', index = False)

filas = []
for categoria in list(CUOTAS) + ['total']:
    sub = predicciones if categoria == 'total' else predicciones[predicciones.real == categoria]
    fila = {'categoria': categoria, 'n': len(sub)}
    for version in ('v2', 'v3'):
        x = int((sub[version] == sub.real).sum())
        bajo, alto = wilson(x, len(sub))
        fila.update({f'{version}_x': x, f'{version}_p': x / len(sub), f'{version}_bajo': bajo, f'{version}_alto': alto})
    fila['regresion'] = fila['v3_alto'] < fila['v2_bajo']                  # el intervalo nuevo queda entero por debajo
    fila['vigilar'] = (not fila['regresion']) and fila['v3_p'] < fila['v2_p']
    fila['guardia_0.85'] = fila['v3_p'] >= 0.85                             # ninguna categoría por debajo de 0.85
    filas.append(fila)
tabla_3 = pd.DataFrame(filas)
print(tabla_3.round(3).to_string(index = False))
total = tabla_3[tabla_3.categoria == 'total'].iloc[0]
print(f'\nTotal v2: {int(total.v2_x)}/200 = {total.v2_p:.3f} [{total.v2_bajo:.3f}, {total.v2_alto:.3f}] | '
      f'v3: {int(total.v3_x)}/200 = {total.v3_p:.3f} [{total.v3_bajo:.3f}, {total.v3_alto:.3f}]')
print('Veredicto: regresión significativa en', tabla_3[tabla_3.regresion].categoria.tolist() or 'ninguna categoría',
      '| vigilar:', tabla_3[tabla_3.vigilar].categoria.tolist(), '| guardia 0.85 incumplida:', tabla_3[~tabla_3['guardia_0.85']].categoria.tolist())

# Tamaño de muestra para distinguir 0.91 de 0.94 al 95 % con potencia del 80 %:
p1, p2, z_a, z_b = 0.91, 0.94, 1.96, 0.84
pm = (p1 + p2) / 2
n_necesario = (z_a * math.sqrt(2 * pm * (1 - pm)) + z_b * math.sqrt(p1 * (1 - p1) + p2 * (1 - p2)))**2 / (p2 - p1)**2
print(f'Mensajes necesarios por versión para distinguir 0.91 de 0.94: {math.ceil(n_necesario)}')

fig, ax = plt.subplots(figsize = (9.2, 5.4))
d = tabla_3.copy()
xs = np.arange(len(d))
for j, (version, color, nombre) in enumerate([('v2', '#9aa5b1', 'v2 (en producción)'), ('v3', '#2a78d6', 'v3 (candidata)')]):
    pos = xs + (j - 0.5) * 0.38
    ax.bar(pos, d[f'{version}_p'], width = 0.36, color = color, label = nombre)
    ax.errorbar(pos, d[f'{version}_p'], yerr = [d[f'{version}_p'] - d[f'{version}_bajo'], d[f'{version}_alto'] - d[f'{version}_p']],
                fmt = 'none', ecolor = '#2b2a28', capsize = 4, lw = 1.2)
    for x, p, n_ in zip(pos, d[f'{version}_p'], d.n):
        ax.text(x, 0.52, f'{p:.2f}', ha = 'center', fontsize = 8, color = 'white', fontweight = 'bold')
ax.axhline(total.v2_bajo, color = '#c8423b', ls = '--', lw = 1.5, label = f'Línea de no regresión: {total.v2_bajo:.3f} (límite inferior de v2)')
ax.axhline(0.85, color = '#eb6834', ls = ':', lw = 1.2, label = 'Guardia por categoría: 0.85')
ax.set_xticks(xs)
ax.set_xticklabels([f'{c}\n(n = {n_})' for c, n_ in zip(d.categoria, d.n)], fontsize = 9)
ax.set_ylim(0.5, 1.02)
ax.set_ylabel('Exactitud (intervalo de Wilson al 95 %)')
ax.set_title('Regresión de prompts: 200 mensajes, v2 frente a v3 por categoría', fontsize = 16)
ax.legend(loc = 'upper center', bbox_to_anchor = (0.5, -0.14), ncol = 2, frameon = False, fontsize = 8)
ax.spines[['top', 'right']].set_visible(False)
plt.tight_layout()
plt.show()
categoria   n  v2_x  v2_p  v2_bajo  v2_alto  v3_x  v3_p  v3_bajo  v3_alto  regresion  vigilar  guardia_0.85
   pedido  50    47 0.940    0.838    0.979    48 0.960    0.865    0.989      False    False          True
  horario  30    29 0.967    0.833    0.994    29 0.967    0.833    0.994      False    False          True
   precio  30    27 0.900    0.744    0.965    28 0.933    0.787    0.982      False    False          True
  factura  20    17 0.850    0.640    0.948    18 0.900    0.699    0.972      False    False          True
    queja  30    28 0.933    0.787    0.982    27 0.900    0.744    0.965      False     True          True
     otro  25    20 0.800    0.609    0.911    23 0.920    0.750    0.978      False    False          True
     baja  15    14 0.933    0.702    0.988    15 1.000    0.796    1.000      False    False          True
    total 200   182 0.910    0.862    0.942   188 0.940    0.898    0.965      False    False          True

Total v2: 182/200 = 0.910 [0.862, 0.942] | v3: 188/200 = 0.940 [0.898, 0.965]
Veredicto: regresión significativa en ninguna categoría | vigilar: ['queja'] | guardia 0.85 incumplida: []
Mensajes necesarios por versión para distinguir 0.91 de 0.94: 1208
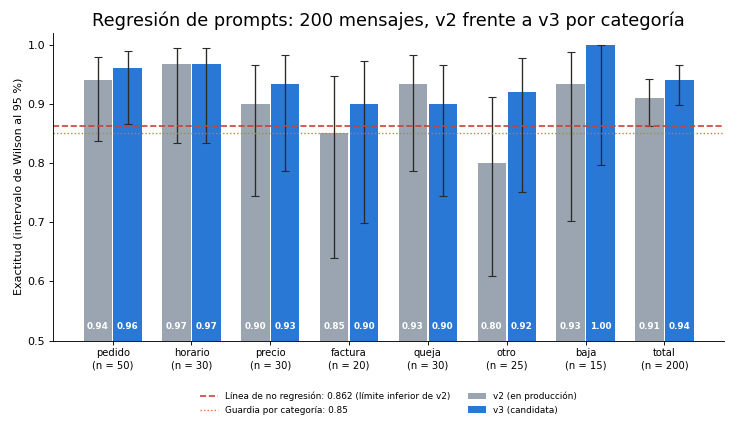
Tabla 3. Resultados de la evaluación de regresión por categoría: aciertos, exactitud e intervalo de Wilson al 95 % de las versiones v2 y v3, y veredicto (predicciones de ejemplo).
| Categoría | n | v2: aciertos | v2: exactitud | v2: intervalo | v3: aciertos | v3: exactitud | v3: intervalo | Regresión | Vigilar | Guardia 0.85 |
|---|---|---|---|---|---|---|---|---|---|---|
| pedido | 50 | 47 | 0.940 | [0.838, 0.979] | 48 | 0.960 | [0.865, 0.989] | No | No | Sí |
| horario | 30 | 29 | 0.967 | [0.833, 0.994] | 29 | 0.967 | [0.833, 0.994] | No | No | Sí |
| precio | 30 | 27 | 0.900 | [0.744, 0.965] | 28 | 0.933 | [0.787, 0.982] | No | No | Sí |
| factura | 20 | 17 | 0.850 | [0.640, 0.948] | 18 | 0.900 | [0.699, 0.972] | No | No | Sí |
| queja | 30 | 28 | 0.933 | [0.787, 0.982] | 27 | 0.900 | [0.744, 0.965] | No | Sí | Sí |
| otro | 25 | 20 | 0.800 | [0.609, 0.911] | 23 | 0.920 | [0.750, 0.978] | No | No | Sí |
| baja | 15 | 14 | 0.933 | [0.702, 0.988] | 15 | 1.000 | [0.796, 1.000] | No | No | Sí |
| total | 200 | 182 | 0.910 | [0.862, 0.942] | 188 | 0.940 | [0.898, 0.965] | No | No | Sí |
El total de v3 es $188$ de $200$, exactitud $0.940$ con intervalo $[0.898, 0.965]$, y el de v2 es $182$ de $200$, $0.910$ con $[0.862, 0.942]$: los intervalos se solapan en todo el tramo de $0.898$ a $0.942$, así que no hay regresión significativa en ninguna categoría, pero tampoco hay evidencia de que v3 sea mejor, aunque acierte seis mensajes más. La categoría “queja” queda marcada para vigilar: v3 acierta $27$ donde v2 acertaba $28$, dentro del ruido, pero es el tipo de señal que, si se repite en la siguiente corrida, deja de ser ruido. Y la guardia de $0.85$ se cumple en las siete categorías, con “queja” y “factura” justo en $0.90$.
La última línea del bloque es la que Valeria se lleva al riesgo R3 de la lista de salida: para distinguir una exactitud de $0.91$ de una de $0.94$ al $95%$ de confianza con una potencia del $80%$ hacen falta unos $1,208$ mensajes por versión, seis veces el conjunto de hoy. La fórmula es la del tamaño de muestra para comparar dos proporciones:
$$ n = \frac{\left(z_{\alpha}\sqrt{2\bar{p}(1-\bar{p})} + z_{\beta}\sqrt{p_1(1-p_1) + p_2(1-p_2)}\right)^2}{(p_2 - p_1)^2} $$
- $\bar{p}$ es la media de las dos proporciones, $z_{\alpha} = 1.96$ fija la confianza y $z_{\beta} = 0.84$ fija la potencia: la probabilidad de detectar la diferencia si existe.
- El denominador es el cuadrado de la diferencia que se quiere detectar: reducir la diferencia a la mitad multiplica $n$ por cuatro, y por eso distinguir $0.91$ de $0.94$ cuesta $1,208$ mensajes y distinguir $0.85$ de $0.94$ costaría unos $170$.
- En conclusión, $200$ mensajes bastan para atrapar una regresión grande (una versión que cae a $0.80$ se detecta sin dudas) y no bastan para elegir entre dos versiones parecidas; esa limitación se escribe en la lista de salida en lugar de esconderla.
Pruebas de punta a punta
Una prueba de punta a punta sigue un mensaje desde la puerta hasta el efecto: que un pedido completo termine en un borrador registrado, una plantilla de confirmación y un aviso al obrador; que una pregunta de alérgenos termine en una respuesta con la página de Notion citada; que una queja termine en un acuse y una tarjeta de aprobación en Slack; que un mensaje a las 21:30 reciba la plantilla de horario y se encole sin pasar por Claude; y que una baja se registre en los consentimientos y se confirme sin que nadie vuelva a escribir. El Día 43 hizo esto contra la instancia de ensayo de n8n con $30$ casos y un flujo; hoy el camino cruza $23$ flujos, cinco servicios externos y dos plataformas, y correrlo contra una instancia real cada vez que cambia algo no es gratis ni rápido.
La solución de hoy es un simulador ensamblado: una función ecosistema(evento, estado, rng, fallos) que recorre, en el mismo orden que el ecosistema real, la verificación de firma, el servidor, el horario, la detección de baja, la clasificación con Claude (con los dos reintentos del SDK), el enrutamiento por tipo, la búsqueda en Notion, los avisos a Slack y el envío por la Cloud API, y que devuelve la ruta, las acciones, cuántas veces llamó a Claude, cuántos mensajes salieron y cuánto tardó. No es el ecosistema: es el modelo del ecosistema que el Día 78 dibujó, escrito en cincuenta líneas, con latencias lognormales y con un parámetro fallos que la sección siguiente usará para apagar el gas. Lo que el simulador comprueba es la lógica de orquestación, las reglas y el orden en que se aplican; lo que no comprueba es que los nodos de n8n estén configurados como el modelo dice, y eso sigue siendo trabajo de la instancia de ensayo del Día 43.
Los $50$ escenarios son diez por tipo (pedido completo, alérgenos, queja, fuera de horario y baja), cada uno con su texto, su hora y su resultado esperado escrito antes de ejecutar: ruta, llamadas a Claude, mensajes salientes y acciones. Las horas de los escenarios fuera de horario incluyen un viernes a las 21:30, un sábado a las 6:20, un viernes a las 23:59 y dos domingos a media mañana. El bloque corre la suite una primera vez, muestra lo que falla y por qué, aplica las correcciones y la vuelve a correr:
# Cincuenta escenarios de punta a punta en el simulador ensamblado del ecosistema en Python:
HORARIO = (7, 20)                                      # atención de lunes a sábado, de 7:00 a 20:00 (Día 52)
REGLAS = [('baja', r'^\W*(baja|ya no)\W*$'), ('queja', r'queja|lleg[oó] tarde|crud|quemad|reclam|decepci|duros|aplastad'),
          ('factura', r'factur|cfdi|rfc|xml'), ('horario', r'hora|abren|cierran|abiertos|domingo'),
          ('precio', r'precio|cu[aá]nto (cuesta|vale|sale)|mayoreo'), ('alergenos', r'nuez|nueces|gluten|huevo|l[aá]ct|cacahuate|al[eé]rg'),
          ('pedido', r'pedido|encarg|quiero \d|aparta|necesito \d|me pueden hacer|ap[uú]nteme')]
PRECIO_UMBRAL = 1000                                   # un pedido de 1 000 MXN o más pasa por aprobación (Día 74)

def tipo_por_reglas(texto):
    for tipo, patron in REGLAS:
        if re.search(patron, texto.lower()):
            return tipo
    return 'otro'

def en_horario(hora):
    return HORARIO[0] <= hora.hour < HORARIO[1]

def lognormal(rng, mediana, sigma = 0.35):
    return float(rng.lognormal(math.log(mediana), sigma))

def detectar(estado, clave, fallo, umbral = 3):
    # El vigilante de cada componente: alerta cuando hay `umbral` fallos entre sus últimos diez eventos:
    estado[clave].append(fallo)
    return sum(estado[clave]) >= umbral

def estado_nuevo():
    return {clave: deque(maxlen = 10) for clave in ('firmas', 'latidos', 'claude', 'notion', 'slack', 'meta')} | {'bajas': set()}

def ecosistema(evento, estado, rng, fallos = None):
    # Un mensaje recorre el ecosistema: firma, servidor, horario, baja, clasificación, enrutamiento, Notion, Slack y envío.
    # `fallos` inyecta averías; `estado` guarda los vigilantes y las bajas. Devuelve lo que pasó y cuánto tardó.
    f = fallos or {}
    r = {'id': evento['id'], 'ruta': None, 'acciones': [], 'claude': 0, 'salientes': 0, 'manual': None, 'latencia': lognormal(rng, 0.05, 0.2)}
    if rng.random() < f.get('firma', 0):               # firma X-Hub-Signature-256 que no coincide: 401 y nada más
        r['ruta'] = 'rechazado_401'
        if detectar(estado, 'firmas', True, umbral = 5):
            r['manual'] = 'M06'
        return r
    detectar(estado, 'firmas', False)
    if f.get('n8n'):                                   # el servidor no contesta: Meta reintentará la entrega
        r.update(ruta = 'sin_respuesta', latencia = float('nan'))
        if detectar(estado, 'latidos', True, umbral = 2):
            r['manual'] = 'M01'
        return r
    detectar(estado, 'latidos', False)
    if not en_horario(evento['hora']):
        r.update(ruta = 'cola_fuera_horario', acciones = ['plantilla_horario', 'encolar'], salientes = 1)
        return r
    texto = evento['texto']
    if re.search(REGLAS[0][1], texto.lower()):
        estado['bajas'].add(evento['cliente'])
        r.update(ruta = 'baja', acciones = ['registrar_baja', 'confirmar_baja'], salientes = 1)
        return r
    # Clasificación con Claude (Haiku 5.5): el SDK reintenta dos veces con espera exponencial ante 429 y 529.
    intentos, exito = 0, False
    while intentos < 3 and not exito:
        intentos += 1
        r['latencia'] += lognormal(rng, 1.2)
        codigo, p = f.get('claude', (None, 0))
        if rng.random() < p:
            r['latencia'] += 0.5 * 2**(intentos - 1)
            continue
        exito = True
    r['claude'] = intentos
    if detectar(estado, 'claude', not exito):
        r['manual'] = 'M03'
    if not exito:
        r.update(ruta = 'plantilla_degradada', acciones = ['plantilla_recibido', 'escalar_persona'], salientes = 1)
        return r
    tipo = tipo_por_reglas(texto)
    if tipo == 'alergenos':
        espera = f.get('notion_s', lognormal(rng, 0.8))
        r['latencia'] += min(espera, 3.0)
        if detectar(estado, 'notion', espera > 3.0):   # tiempo límite de 3 s en el nodo HTTP Request
            r['manual'] = 'M07'
        if espera > 3.0:
            r.update(ruta = 'respuesta_sin_fuentes', acciones = ['responder_generico', 'escalar_persona'], salientes = 1)
            return r
        r.update(ruta = 'respuesta_con_fuentes', acciones = ['buscar_notion', 'responder_citando'])
    elif tipo == 'pedido':
        r['latencia'] += lognormal(rng, 1.6)            # el agente extrae renglones, fecha y hora
        r['acciones'] += ['extraer_pedido', 'registrar_sqlite']
        if evento.get('total', 0) >= PRECIO_UMBRAL or evento.get('ambiguo'):
            r['ruta'] = 'aprobacion_humana'
            r['acciones'].append('slack_aprobacion')
        else:
            r.update(ruta = 'borrador_pedido', acciones = r['acciones'] + ['confirmar_plantilla', 'avisar_obrador'])
    elif tipo == 'queja':
        r.update(ruta = 'revision_humana', acciones = ['acuse_recibo', 'slack_aprobacion'])
    elif tipo in ('horario', 'precio', 'factura'):
        r.update(ruta = 'respuesta_catalogo', acciones = ['responder_catalogo'] + (['slack_aviso'] if tipo == 'factura' else []))
    else:
        r.update(ruta = 'revision_humana', acciones = ['acuse_recibo', 'slack_aprobacion'])
    # Efectos: avisos a Slack y mensajes salientes por la Cloud API.
    if any(a.startswith('slack_') for a in r['acciones']):
        if detectar(estado, 'slack', bool(f.get('slack'))):
            r['manual'] = 'M08'
        if f.get('slack'):                              # plan B del Día 77: la aprobación va por WhatsApp a Valeria
            r['acciones'] = [a.replace('slack_', 'whatsapp_valeria_') for a in r['acciones']]
        r['latencia'] += lognormal(rng, 0.3)
    salientes = [a for a in r['acciones'] if a.startswith(('confirmar', 'responder', 'acuse', 'plantilla'))]
    if salientes:
        r['latencia'] += lognormal(rng, 0.4)
        if detectar(estado, 'meta', bool(f.get('meta_401'))):
            r['manual'] = 'M02'
        if f.get('meta_401'):
            r.update(ruta = 'no_enviado_401', salientes = 0)
            return r
        r['salientes'] = len(salientes)
    return r

# Los 50 escenarios: diez por tipo, con hora, importe y el resultado esperado escrito antes de ejecutar.
ESCENARIOS = {
    'pedido completo': (['Quiero 2 hogazas de masa madre para el sábado a las 10', 'Me aparta 6 conchas pa mañana porfa', 'Necesito encargar 3 baguettes, las recojo el viernes a las 9',
                         'Un pedido: 12 bollos para hamburguesa, recojo a las 6', 'Apúnteme 2 roles de canela, paso el jueves', '¿Me pueden hacer un pastel de zanahoria para el domingo?',
                         'Quiero 4 croissants para el martes a las 8', 'Necesito encargar 1 pay de queso para el sábado', 'Me aparta 2 cajas de pan dulce pa el viernes', 'Quiero 10 baguettes para el jueves a las 7'],
                        {'ruta': 'borrador_pedido', 'claude': 1, 'salientes': 1, 'acciones': ['extraer_pedido', 'registrar_sqlite', 'confirmar_plantilla', 'avisar_obrador']}),
    'alérgenos':       (['¿El pan de caja tiene nueces?', '¿Las conchas llevan huevo?', '¿Tienen algo sin gluten?', '¿El pastel de zanahoria trae nuez?', '¿Los croissants tienen lácteos?',
                         'Mi hijo es alérgico al cacahuate, ¿qué puede comer?', '¿El rol de canela lleva nueces?', '¿Hay pan sin lactosa?', '¿Las galletas de avena contienen gluten?', '¿El pay de queso tiene huevo?'],
                        {'ruta': 'respuesta_con_fuentes', 'claude': 1, 'salientes': 1, 'acciones': ['buscar_notion', 'responder_citando']}),
    'queja':           (['El pan llegó quemado', 'Mi pastel llegó tarde y aplastado', 'Qué decepción, los croissants estaban crudos', 'Los bollos de hoy venían duros', 'Tengo una queja del pedido de ayer',
                         'Quiero reclamar por la hogaza de ayer', 'El pedido llegó tarde otra vez', 'Las conchas estaban quemadas por abajo', 'Qué decepción con el pay', 'Mi reclamo: faltó una baguette'],
                        {'ruta': 'revision_humana', 'claude': 1, 'salientes': 1, 'acciones': ['acuse_recibo', 'slack_aprobacion']}),
    'fuera de horario': (['Quiero 2 hogazas para el sábado', '¿A qué hora abren?', 'Me aparta 6 conchas', '¿Cuánto cuesta el pay de queso?', 'Necesito factura del pedido TL-20260420-0012',
                          'Un pedido: 4 croissants para el lunes', '¿El pan de caja tiene nueces?', 'Hola', 'El pan llegó quemado', '¿Abren los domingos?'],
                         {'ruta': 'cola_fuera_horario', 'claude': 0, 'salientes': 1, 'acciones': ['plantilla_horario', 'encolar']}),
    'baja':            (['BAJA', 'baja', 'Ya no', 'Ya no quiero recibir mensajes', 'No me escriban más por favor', 'Dejen de mandarme promociones', 'Quiero darme de baja de los avisos',
                         'Por favor quítenme de la lista', 'BAJA.', 'ya no, gracias'],
                        {'ruta': 'baja', 'claude': 0, 'salientes': 1, 'acciones': ['registrar_baja', 'confirmar_baja']}),
}
HORAS = [datetime(2026, 4, 25, 10, 30), datetime(2026, 4, 25, 11, 15), datetime(2026, 4, 24, 16, 0)]
FUERA = [datetime(2026, 4, 24, 21, 30), datetime(2026, 4, 25, 6, 20), datetime(2026, 4, 26, 11, 0), datetime(2026, 4, 24, 23, 59), datetime(2026, 4, 26, 15, 30)]
casos = []
for tipo, (textos, esperado) in ESCENARIOS.items():
    for i, texto in enumerate(textos):
        hora = FUERA[i % len(FUERA)] if tipo == 'fuera de horario' else HORAS[i % len(HORAS)]
        casos.append({'id': f'e{len(casos) + 1:02d}', 'tipo': tipo, 'texto': texto, 'hora': hora, 'cliente': f'c{len(casos) + 1:02d}',
                      'total': 380 if tipo == 'pedido completo' else 0, 'esperado': esperado})

def comparar(obtenido, esperado):
    return [clave for clave in esperado if (sorted(obtenido[clave]) if clave == 'acciones' else obtenido[clave]) !=
            (sorted(esperado[clave]) if clave == 'acciones' else esperado[clave])]

def correr_escenarios():
    estado, filas = estado_nuevo(), []
    for caso in casos:
        obtenido = ecosistema(caso, estado, rng)
        diferencias = comparar(obtenido, caso['esperado'])
        filas.append({'id': caso['id'], 'tipo': caso['tipo'], 'ruta': obtenido['ruta'], 'claude': obtenido['claude'],
                      'latencia_s': round(obtenido['latencia'], 2), 'diferencias': diferencias, 'aprobado': not diferencias})
    return pd.DataFrame(filas)

t0 = time.perf_counter()
primera = correr_escenarios()
print(f'Primera corrida: {int(primera.aprobado.sum())} de {len(primera)} escenarios aprobados en {(time.perf_counter() - t0) * 1000:.0f} ms')
print(primera[~primera.aprobado].to_string(index = False, columns = ['id', 'tipo', 'ruta', 'claude', 'diferencias']))
print(primera.groupby('tipo').agg(aprobados = ('aprobado', 'sum'), latencia_mediana_s = ('latencia_s', 'median')).round(2).to_string())

# Tres hallazgos y tres correcciones: (1) la regla de baja del Día 52 solo aceptaba "baja" o "ya no" como mensaje
# entero; (2) el horario miraba la hora, no el día de la semana, y el domingo no se atiende; (3) un pedido "para el
# domingo" caía en la regla de horario porque esa regla se evaluaba antes que la de pedido.
REGLAS[0] = ('baja', r'^\W*baja\W*$|^\W*ya no\b(?!.*\d)|no me escriban|dejen de mandar|darme de baja|qu[ií]tenme de la lista|no quiero recibir')
REGLAS.insert(3, REGLAS.pop(6))                        # la regla de pedido pasa por delante de la de horario
def en_horario(hora):
    return hora.weekday() < 6 and HORARIO[0] <= hora.hour < HORARIO[1]

segunda = correr_escenarios()
segunda.to_csv(carpeta / 'escenarios_punta_a_punta.csv', index = False)
print(f'\nSegunda corrida, con las tres correcciones: {int(segunda.aprobado.sum())} de {len(segunda)} escenarios aprobados | '
      f'llamadas a Claude: {int(segunda.claude.sum())} | latencia mediana: {segunda.latencia_s.median():.2f} s, '
      f'p95: {segunda.latencia_s.quantile(0.95):.2f} s')
Primera corrida: 39 de 50 escenarios aprobados en 5 ms
 id             tipo               ruta  claude              diferencias
e06  pedido completo respuesta_catalogo       1         [ruta, acciones]
e33 fuera de horario    borrador_pedido       1 [ruta, claude, acciones]
e35 fuera de horario respuesta_catalogo       1 [ruta, claude, acciones]
e38 fuera de horario    revision_humana       1 [ruta, claude, acciones]
e40 fuera de horario respuesta_catalogo       1 [ruta, claude, acciones]
e44             baja    revision_humana       1 [ruta, claude, acciones]
e45             baja    revision_humana       1 [ruta, claude, acciones]
e46             baja    revision_humana       1 [ruta, claude, acciones]
e47             baja    revision_humana       1 [ruta, claude, acciones]
e48             baja    revision_humana       1 [ruta, claude, acciones]
e50             baja    revision_humana       1 [ruta, claude, acciones]
                  aprobados  latencia_mediana_s
tipo
alérgenos                10                2.34
baja                      4                1.52
fuera de horario          6                0.06
pedido completo           9                3.44
queja                    10                2.22

Segunda corrida, con las tres correcciones: 50 de 50 escenarios aprobados | llamadas a Claude: 30 | latencia mediana: 1.75 s, p95: 3.94 s
La primera corrida aprueba $39$ de $50$ escenarios en $3$ milésimas de segundo, y los $11$ que fallan son tres defectos reales, no once:
- La regla de baja del Día 52 era demasiado estricta. Aceptaba “baja” o “ya no” como mensaje completo, de modo que “BAJA” y “Ya no” pasaban, pero “Ya no quiero recibir mensajes”, “No me escriban más por favor” o “Dejen de mandarme promociones” iban a Claude, se clasificaban como “otro” y terminaban en revisión humana. Seis de los diez escenarios de baja fallan por esto; el cliente que pidió que no le escribieran habría recibido un acuse de recibo, que es exactamente el mensaje que no quería.
- El horario miraba la hora, no el día. Los cuatro escenarios de domingo a las 11:00 y a las 15:30 entraban como si fuera un día de atención: pasaban por Claude y se enrutaban con normalidad, cuando el Día 52 dejó claro que el domingo Valeria descansa y los mensajes esperan al lunes.
- El orden de las reglas enrutaba mal un pedido. “¿Me pueden hacer un pastel de zanahoria para el domingo?” caía en la regla de horario por la palabra “domingo”, porque esa regla se evaluaba antes que la de pedido, y recibía la respuesta del catálogo de horarios en lugar de un borrador de pedido.
Las tres correcciones son pequeñas y las tres se escriben en el bloque: una expresión regular de baja que acepta las formas habituales sin confundir “ya no quiero 2 conchas, mejor 3” con una baja (la condición (?!.*\d)), una función en_horario que mira también el día de la semana, y la regla de pedido delante de la de horario. La segunda corrida aprueba $50$ de $50$, con $30$ llamadas a Claude (los $20$ escenarios de fuera de horario y de baja no lo necesitan), una latencia mediana de $1.75$ segundos y un percentil $95$ de $3.94$. Lo que Valeria anota al margen es más importante que las cifras: los tres defectos vivían en reglas que existían desde el Día 52 y que ninguna prueba de un solo flujo podía ver, porque cada flujo hacía bien su parte; fallaba el orden entre partes. Para eso sirve la punta a punta.
Caos controlado
La ingeniería del caos, tal como la formularon Rosenthal y Jones a partir de la experiencia de Netflix, es la disciplina de experimentar sobre un sistema para ganar confianza en que aguanta las condiciones turbulentas de la producción. Sus principios, publicados en principlesofchaos.org y revisados en octubre de 2026, caben en cuatro frases: se define primero un estado estable medible (para Trigo Lento, la proporción de mensajes legítimos atendidos y la latencia); se formula una hipótesis de que ese estado se mantiene en el grupo experimental; se varían eventos del mundo real, ordenados por impacto o por frecuencia (los servidores se caen, los proveedores devuelven 429 y 529, los tokens caducan); y se empieza con un radio de daño pequeño que se amplía después. Hay un quinto principio, correr los experimentos en producción, que Trigo Lento no adopta: una panadería de seis personas no tiene un grupo de control de clientes al que pueda apagarle WhatsApp un sábado. Por eso los experimentos de hoy corren en el simulador, y repetir los más importantes contra la instancia de ensayo del Día 43 queda como riesgo aceptado.
Lo que convierte un fallo inyectado en un experimento es que la hipótesis se escribe antes: qué debería pasar y, en particular, cuál de los ocho manuales del Día 81 (Proyecto integrador III: manuales de operación (runbooks) y continuidad) debería activarse. Los siete fallos de hoy cubren seis manuales: M03 (Claude con 429 o 529, dos experimentos porque los dos códigos se comportan distinto), M01 (servidor de n8n caído), M07 (Notion inaccesible, aquí lento más allá del límite de 3 segundos del nodo HTTP Request), M06 (webhook con firmas inválidas), M02 (token de la Cloud API caducado, que devuelve 401 al enviar) y M08 (Slack caído). Los dos que faltan, M04 (plantilla rechazada por Meta) y M05 (gasto anómalo), no se pueden inyectar en vivo: el primero es una revisión asíncrona de Meta y el segundo ya se probó con el detector del Día 81. El detector que activa cada manual es el mismo para todos los componentes: un vigilante por ventana que alerta cuando hay tres fallos entre los últimos diez eventos de ese componente (cinco en el caso de las firmas, porque una firma inválida suelta no es un ataque, y dos latidos consecutivos para el servidor). La Figura 2 resume el simulacro.
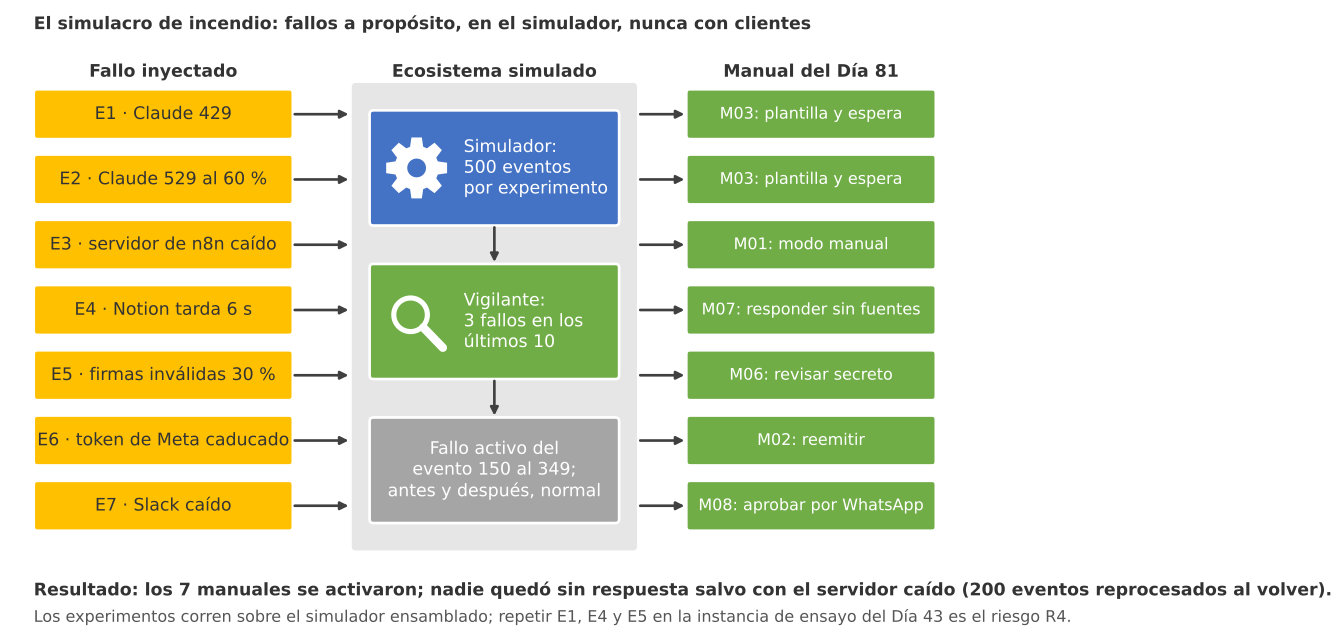
Figura 2. El simulacro de incendio: siete fallos inyectados a propósito en el simulador (429 y 529 de Claude, servidor caído, Notion lento, firmas inválidas, token caducado y Slack caído), el detector por ventana de diez eventos y el manual del Día 81 que se activa en cada caso; nunca con clientes reales.
Atención aquí: los experimentos de caos se hacen en la simulación o en un entorno de ensayo con datos de prueba, nunca con clientes reales ni contra la instancia de producción. Inyectar firmas inválidas o un token caducado en producción equivale a dejar sin respuesta a quien escriba en ese momento, y “estábamos probando” no es una explicación que un cliente deba recibir. Si algún día Trigo Lento corre un experimento en producción, será con un número de pruebas propio, en horario sin clientes y con el modo manual preparado.
El octavo bloque define los siete experimentos con su fallo, su manual esperado y su efecto esperado, corre cada uno sobre $500$ eventos tomados de los escenarios de la sección anterior, con el fallo activo entre los eventos $150$ y $349$ y el sistema sano antes y después, y resume en la Tabla 2 lo que se observó: proporción de eventos legítimos atendidos durante el fallo, cuántos se atendieron en modo degradado, cuántos quedaron sin atender, cuántas firmas forjadas se rechazaron, el percentil $95$ de latencia antes y durante, qué manual se activó y cuántos eventos tardó en activarse:
# Experimentos de caos: cada fallo se inyecta en el simulador durante una ventana y se mide qué pasa en Python:
EXPERIMENTOS = [
    ('E1', 'Claude responde 429 (límite de velocidad)', {'claude': ('429', 1.0)}, 'M03', 'Plantilla de recibido y escalado; nadie se queda sin respuesta'),
    ('E2', 'Claude responde 529 (sobrecarga) al 60 %',  {'claude': ('529', 0.6)}, 'M03', 'Los reintentos del SDK absorben la mayoría; latencia sube; alerta'),
    ('E3', 'Servidor de n8n caído',                     {'n8n': True},            'M01', 'Nada se atiende; el latido activa el modo manual; Meta reintenta'),
    ('E4', 'Notion tarda 6 s (límite de 3 s)',           {'notion_s': 6.0},        'M07', 'Alérgenos sin fuentes y escalados; el resto no se entera'),
    ('E5', 'Firmas inválidas en el 30 % de los eventos', {'firma': 0.3},           'M06', 'Rechazo 401 de las forjadas; las legítimas siguen; alerta'),
    ('E6', 'Token de la Cloud API caducado',            {'meta_401': True},       'M02', 'Se procesa pero no se envía nada; modo manual'),
    ('E7', 'Slack caído',                               {'slack': True},          'M08', 'Aprobaciones y avisos van por WhatsApp a Valeria'),
]
N_EVENTOS, VENTANA = 500, (150, 350)
plantilla_eventos = [c for c in casos if c['tipo'] != 'fuera de horario']

def correr_experimento(fallos, rng):
    estado, filas = estado_nuevo(), []
    for k in range(N_EVENTOS):
        base_ev = plantilla_eventos[int(rng.integers(len(plantilla_eventos)))]
        evento = dict(base_ev, id = f'x{k:03d}', cliente = f'k{k:03d}', hora = datetime(2026, 4, 25, 10, 0) + timedelta(seconds = 7.2 * k))
        activo = VENTANA[0] <= k < VENTANA[1]
        obtenido = ecosistema(evento, estado, rng, fallos if activo else None)
        atendido = obtenido['ruta'] in ('borrador_pedido', 'respuesta_con_fuentes', 'revision_humana', 'respuesta_catalogo', 'aprobacion_humana', 'baja')
        degradado = obtenido['ruta'] in ('plantilla_degradada', 'respuesta_sin_fuentes')
        filas.append({'k': k, 'activo': activo, 'ruta': obtenido['ruta'], 'atendido': atendido, 'degradado': degradado,
                      'forjado': obtenido['ruta'] == 'rechazado_401', 'latencia': obtenido['latencia'], 'manual': obtenido['manual']})
    return pd.DataFrame(filas)

t0 = time.perf_counter()
tabla_2, series = [], {}
for codigo, nombre, fallos, manual_esperado, efecto_esperado in EXPERIMENTOS:
    d = correr_experimento(fallos, rng)
    series[codigo] = d
    durante = d[d.activo & ~d.forjado]
    activaciones = d[d.manual.notna()]
    primera_activacion = int(activaciones.k.iloc[0]) if len(activaciones) else None
    exito = (durante.atendido | durante.degradado).mean() if len(durante) else 0.0
    tabla_2.append({'exp': codigo, 'fallo': nombre, 'esperado': efecto_esperado, 'manual': manual_esperado,
                    'atendidos_durante': round(exito, 3), 'degradados': int(durante.degradado.sum()), 'sin_atender': int((~durante.atendido & ~durante.degradado).sum()),
                    'forjados_rechazados': int(d[d.activo].forjado.sum()), 'p95_antes_s': round(d[~d.activo].latencia.quantile(0.95), 2),
                    'p95_durante_s': round(durante.latencia.quantile(0.95), 2) if durante.latencia.notna().any() else float('nan'),
                    'manual_activado': activaciones.manual.iloc[0] if len(activaciones) else 'ninguno',
                    'eventos_hasta_activar': (primera_activacion - VENTANA[0] + 1) if primera_activacion is not None else None,
                    'despues_ok': round((d[(d.k >= VENTANA[1]) & ~d.forjado].atendido).mean(), 3)})
tabla_2 = pd.DataFrame(tabla_2)
tabla_2.to_csv(carpeta / 'experimentos_caos.csv', index = False)
print(f'7 experimentos de {N_EVENTOS} eventos en {time.perf_counter() - t0:.1f} s')
print(tabla_2.drop(columns = ['esperado']).to_string(index = False))
print('\nManuales que se activaron como se esperaba:', int((tabla_2.manual == tabla_2.manual_activado).sum()), 'de', len(tabla_2),
      '| reprocesados al volver en E3:', int(series['E3'][series['E3'].ruta == 'sin_respuesta'].shape[0]))

fig, axes = plt.subplots(4, 2, figsize = (11, 11), sharex = True)
for ax, (codigo, nombre, *_) in zip(axes.flat, EXPERIMENTOS):
    d = series[codigo]
    ok = (d.atendido | d.degradado).astype(float).where(~d.forjado)
    tasa = ok.rolling(25, min_periods = 5).mean()
    ax.axvspan(*VENTANA, color = '#f6d9c4', alpha = 0.6, label = 'fallo activo')
    ax.plot(d.k, tasa, color = '#2a78d6', lw = 2, label = 'tasa de atención (ventana de 25)')
    ax2 = ax.twinx()
    ax2.scatter(d.k, d.latencia, s = 4, color = '#c8423b', alpha = 0.5, label = 'latencia (s)')
    ax2.set_ylim(0, max(6, np.nanmax(d.latencia) * 1.1))
    ax2.tick_params(labelsize = 7)
    act = d[d.manual.notna()]
    if len(act):
        ax.axvline(act.k.iloc[0], color = '#3a9d5d', lw = 1.5, ls = '--')
        ax.text(act.k.iloc[0] + 4, 0.08, f'{act.manual.iloc[0]} activado', fontsize = 8, color = '#3a9d5d')
    ax.set_ylim(-0.02, 1.05)
    ax.set_title(f'{codigo}. {nombre}', fontsize = 10, loc = 'left')
    ax.tick_params(labelsize = 7)
    ax.spines[['top']].set_visible(False)
axes.flat[-1].axis('off')
axes.flat[-1].text(0.02, 0.8, 'Azul: proporción de eventos legítimos atendidos\n(normal o degradado), ventana móvil de 25.\n'
                   'Rojo: latencia de cada evento en segundos (eje derecho).\nSombra: fallo inyectado entre los eventos 150 y 349.\n'
                   'Verde: primer evento en que el detector activa\nel manual del Día 81.', fontsize = 9, va = 'top')
axes[3, 0].set_xlabel('Evento')
fig.suptitle('Siete experimentos de caos en el simulador: tasa de atención y latencia', fontsize = 16)
plt.tight_layout()
plt.show()
7 experimentos de 500 eventos en 0.2 s
exp                                      fallo manual  atendidos_durante  degradados  sin_atender  forjados_rechazados  p95_antes_s  p95_durante_s manual_activado  eventos_hasta_activar  despues_ok
 E1  Claude responde 429 (límite de velocidad)    M03              1.000         152            0                    0         4.15           8.73             M03                      4         1.0
 E2   Claude responde 529 (sobrecarga) al 60 %    M03              1.000          30            0                    0         4.07           7.64             M03                     42         1.0
 E3                      Servidor de n8n caído    M01              0.000           0          200                    0         4.06            NaN             M01                      2         1.0
 E4           Notion tarda 6 s (límite de 3 s)    M07              1.000          54            0                    0         3.93           4.91             M07                      6         1.0
 E5 Firmas inválidas en el 30 % de los eventos    M06              1.000           0            0                   53         4.30           3.89             M06                     24         1.0
 E6             Token de la Cloud API caducado    M02              0.245           0          151                    0         4.16           4.05             M02                      3         1.0
 E7                                Slack caído    M08              1.000           0            0                    0         4.18           4.05             M08                      5         1.0

Manuales que se activaron como se esperaba: 7 de 7 | reprocesados al volver en E3: 200
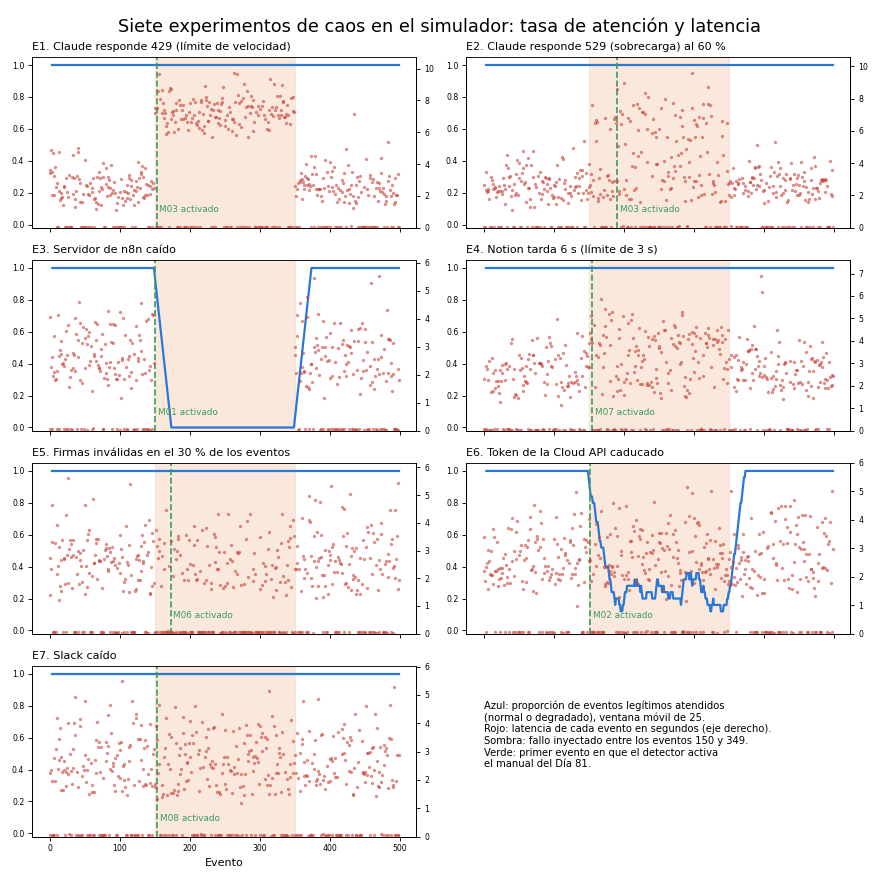
Tabla 2. Experimentos de caos: fallo inyectado, efecto esperado, efecto observado en la simulación (500 eventos, fallo activo del 150 al 349) y manual del Día 81 activado.
| Exp. | Fallo inyectado | Efecto esperado | Atendidos durante | Degradados | Sin atender | p95 antes / durante (s) | Manual activado (eventos) |
|---|---|---|---|---|---|---|---|
| E1 | Claude responde 429 (límite de velocidad) | Plantilla de recibido y escalado; nadie se queda sin respuesta | 1.000 | 152 | 0 | 4.15 / 8.73 | M03 (4) |
| E2 | Claude responde 529 (sobrecarga) al 60 % | Los reintentos del SDK absorben la mayoría; latencia sube; alerta | 1.000 | 30 | 0 | 4.07 / 7.64 | M03 (42) |
| E3 | Servidor de n8n caído | Nada se atiende; el latido activa el modo manual; Meta reintenta | 0.000 | 0 | 200 | 4.06 / sin dato | M01 (2) |
| E4 | Notion tarda 6 s (límite de 3 s) | Alérgenos sin fuentes y escalados; el resto no se entera | 1.000 | 54 | 0 | 3.93 / 4.91 | M07 (6) |
| E5 | Firmas inválidas en el 30 % de los eventos | Rechazo 401 de las forjadas (53); las legítimas siguen; alerta | 1.000 | 0 | 0 | 4.30 / 3.89 | M06 (24) |
| E6 | Token de la Cloud API caducado | Se procesa pero no se envía nada; modo manual | 0.245 | 0 | 151 | 4.16 / 4.05 | M02 (3) |
| E7 | Slack caído | Aprobaciones y avisos van por WhatsApp a Valeria | 1.000 | 0 | 0 | 4.18 / 4.05 | M08 (5) |
Los siete experimentos corren en una décima de segundo y los siete manuales se activan como se esperaba. Lo que vale la pena leer es cómo se comporta cada fallo, porque no se comportan igual:
- E1 y E2, Claude. Con un 429 permanente, los tres intentos fallan en todos los eventos, los $152$ mensajes que necesitaban clasificación salen con la plantilla de recibido y se escalan a una persona, nadie queda sin respuesta y la latencia p95 sube de $4.15$ a $8.73$ segundos por las esperas exponenciales; el vigilante activa M03 al cuarto evento. Con un 529 al $60%$, los dos reintentos del SDK absorben la mayoría ($0.6^3 = 0.216$ de probabilidad de que fallen los tres) y solo $30$ eventos se degradan, pero la señal es más lenta y el vigilante tarda $42$ eventos en acumular tres fallos en una ventana de diez. Un fallo parcial es más difícil de detectar que uno total, y por eso el manual M03 pide mirar también la latencia y no solo los errores.
- E3, el servidor. Es el único experimento en el que el estado estable se rompe del todo: $0$ atendidos durante $200$ eventos. Lo que lo hace tolerable es lo que pasa alrededor: el latido sintético del Día 75 falla dos veces seguidas y M01 se activa al segundo evento, el modo manual M00 pone la libreta en el mostrador, y Meta reintenta la entrega de los webhooks que no obtuvieron respuesta, de modo que los $200$ eventos se reprocesan al volver. El Día 78 ya había calculado que el servidor de seis dólares pone el $71%$ de la caída del camino crítico; el caos lo confirma en otra escala.
- E4, E5 y E7, degradaciones que el cliente no ve. Notion lento afecta solo a los $54$ eventos de alérgenos, que reciben una respuesta genérica y se escalan; las firmas forjadas ($53$ de $150$) se rechazan con 401 antes de leer el cuerpo y las legítimas se atienden al $100%$; y con Slack caído las $0$ pérdidas se explican porque el plan B del Día 77 manda la aprobación por WhatsApp a Valeria. En los tres casos la latencia p95 apenas cambia.
- E6, el token caducado. Es el más traicionero: el sistema procesa todo (clasifica, extrae, registra en SQLite) y solo falla al enviar, de modo que el registro de ejecuciones parece sano mientras $151$ clientes no reciben nada. Solo se atiende el $24.5%$, los pedidos que esperan aprobación y no mandan mensaje de inmediato. M02 se activa al tercer 401, y el Día 81 ya había escrito que este fue el incidente real del viernes a las 18:00.
La figura del bloque muestra las siete series con la ventana sombreada y la línea verde en el evento en que se activó cada manual. Dos cosas se ven en ella que la tabla no dice: en E6 la tasa de atención baja en escalera y tarda en recuperarse porque la ventana móvil arrastra los últimos fallos; y en E3 no hay latencias en la sombra porque no hay respuestas, que es lo que un panel debería mostrar como silencio y no como “cero segundos”.
Carga
La prueba de carga responde a la primera pregunta de Don Ernesto: ¿aguanta con el horno lleno? El pico normal de la serie son $9$ mensajes por hora entre las 10:00 y las 12:00 del sábado; el triple, $\lambda = 27$ por hora, es la hipótesis para el sábado 2 de mayo. Del lado del servidor, cada mensaje ocupa unos $4$ segundos entre la verificación de firma, la clasificación con Claude y el envío, de modo que $\mu = 900$ por hora. Con llegadas de Poisson y servicio exponencial el modelo es el M/M/1 que la serie usa desde el Día 8, y sus tres cantidades son inmediatas:
$$ \rho = \frac{\lambda}{\mu}, \qquad W = \frac{1}{\mu - \lambda}, \qquad L = \lambda W $$
- $\rho$ es la utilización, la fracción del tiempo que el servidor está ocupado; por encima de $0.8$ las esperas crecen sin control, y a $\rho = 1$ la cola es infinita.
- $W$ es el tiempo medio en el sistema (espera más servicio) y $L$ el número medio de mensajes dentro; la tercera igualdad es la ley de Little, que no depende de la distribución de llegadas ni de servicio.
- En conclusión, con $\lambda = 27$ y $\mu = 900$, $\rho = 0.03$ y $W = 1/873$ horas, unos $4.12$ segundos: el servidor casi no espera ni hace esperar.
El noveno bloque calcula las tres cantidades para el pico normal, el doble y el triple, encuentra a qué $\lambda$ el servidor empezaría a sufrir, y después simula el sábado de 10:00 a 12:00 con eventos discretos, $1,000$ veces, con la parte que la fórmula no modela: las aprobaciones humanas. Un $20%$ de los mensajes (pedidos grandes, quejas, mensajes ambiguos) termina en una tarjeta de Slack que alguien tiene que mirar, y el sábado Valeria está en el mostrador y mira Slack cada $15$ minutos; la alternativa es que Itzel, de suplente, lo mire cada $5$. Cada aprobación tarda además unos dos minutos:
# Carga al triple del pico: M/M/1 analítico para el servidor y simulación de la cola de aprobaciones humanas en Python:
mu = 3600 / 4                                          # 4 s de servicio por mensaje: 900 por hora
print('Servidor como M/M/1 (servicio medio de 4 s):')
for nombre, lam in (('pico normal', 9), ('doble', 18), ('triple', 27)):
    rho = lam / mu
    W = 1 / (mu - lam) * 3600                          # tiempo en el sistema, en segundos
    L = lam / 3600 * W                                 # ley de Little
    print(f'  {nombre:<12} λ = {lam:>2}/h | ρ = {rho:.3f} | W = {W:.2f} s | L = {L:.3f} mensajes en el sistema')
print(f'  λ con ρ = 0.8 (el servidor empieza a sufrir): {0.8 * mu:.0f} mensajes por hora, {0.8 * mu / 9:.0f} veces el pico normal')

# Simulación de eventos discretos del sábado de 10:00 a 12:00 al triple del pico: servidor y aprobaciones.
def simular_sabado(lam, revisa_cada_min, rng, p_aprobacion = 0.20, minutos_por_aprobacion = 2.0, horas = 2):
    n = rng.poisson(lam * horas)
    llegadas = np.sort(rng.uniform(0, horas * 3600, n))
    fin_servidor, salidas = 0.0, np.empty(n)
    for i, t in enumerate(llegadas):
        inicio = max(t, fin_servidor)
        fin_servidor = inicio + rng.exponential(4.0)
        salidas[i] = fin_servidor
    en_sistema = salidas - llegadas
    necesita = rng.random(n) < p_aprobacion
    esperas = []
    for t in salidas[necesita]:
        siguiente_revision = (math.floor(t / (revisa_cada_min * 60)) + 1) * revisa_cada_min * 60
        esperas.append(siguiente_revision - t + rng.exponential(minutos_por_aprobacion * 60))
    return en_sistema, np.array(esperas), llegadas, salidas

t0 = time.perf_counter()
res = {}
for nombre, cada in (('Valeria mira Slack cada 15 min', 15), ('Itzel de suplente, cada 5 min', 5)):
    sistema, esperas = [], []
    for _ in range(1000):
        s, e, *_ = simular_sabado(27, cada, rng)
        sistema.append(s)
        esperas.append(e)
    sistema, esperas = np.concatenate(sistema), np.concatenate(esperas)
    res[nombre] = esperas
    print(f'{nombre}: servidor W medio {sistema.mean():.2f} s, p95 {np.quantile(sistema, 0.95):.2f} s | aprobaciones: '
          f'{len(esperas) / 1000:.1f} por sábado, espera mediana {np.median(esperas) / 60:.1f} min, p95 {np.quantile(esperas, 0.95) / 60:.1f} min, '
          f'más de 15 min: {(esperas > 900).mean():.1%}')
print(f'1 000 sábados por política en {time.perf_counter() - t0:.1f} s')

fig, (ax1, ax2) = plt.subplots(1, 2, figsize = (11, 4.4))
s, e, llegadas, salidas = simular_sabado(27, 15, np.random.default_rng(83))
ts = np.linspace(0, 7200, 721)
en_cola = [(llegadas <= t).sum() - (salidas <= t).sum() for t in ts]
ax1.step(ts / 60, en_cola, where = 'post', color = '#2a78d6', lw = 1.5)
ax1.set_title(f'Servidor: mensajes en el sistema, un sábado al triple del pico ({len(llegadas)} llegadas)', fontsize = 10)
ax1.set_xlabel('Minutos desde las 10:00')
ax1.set_ylabel('Mensajes en el sistema')
ax1.set_ylim(0, 4)
ax1.spines[['top', 'right']].set_visible(False)
for (nombre, esperas), color in zip(res.items(), ('#c8423b', '#3a9d5d')):
    ordenadas = np.sort(esperas) / 60
    ax2.plot(ordenadas, np.arange(1, len(ordenadas) + 1) / len(ordenadas), color = color, lw = 2, label = nombre)
ax2.axvline(15, color = '#2b2a28', ls = '--', lw = 1.2, label = 'SLA: 15 minutos')
ax2.set_xlim(0, 30)
ax2.set_xlabel('Espera de una aprobación (minutos)')
ax2.set_ylabel('Proporción acumulada')
ax2.set_title('Aprobaciones humanas: 1 000 sábados simulados', fontsize = 10)
ax2.legend(loc = 'lower right', frameon = False, fontsize = 8)
ax2.spines[['top', 'right']].set_visible(False)
fig.suptitle('El cuello de botella no es el servidor: es quién mira Slack', fontsize = 16)
plt.tight_layout()
plt.show()
Servidor como M/M/1 (servicio medio de 4 s):
  pico normal  λ =  9/h | ρ = 0.010 | W = 4.04 s | L = 0.010 mensajes en el sistema
  doble        λ = 18/h | ρ = 0.020 | W = 4.08 s | L = 0.020 mensajes en el sistema
  triple       λ = 27/h | ρ = 0.030 | W = 4.12 s | L = 0.031 mensajes en el sistema
  λ con ρ = 0.8 (el servidor empieza a sufrir): 720 mensajes por hora, 80 veces el pico normal
Valeria mira Slack cada 15 min: servidor W medio 4.08 s, p95 12.28 s | aprobaciones: 10.8 por sábado, espera mediana 9.5 min, p95 16.9 min, más de 15 min: 13.4%
Itzel de suplente, cada 5 min: servidor W medio 4.13 s, p95 12.32 s | aprobaciones: 10.8 por sábado, espera mediana 4.2 min, p95 9.1 min, más de 15 min: 0.2%
1 000 sábados por política en 0.1 s
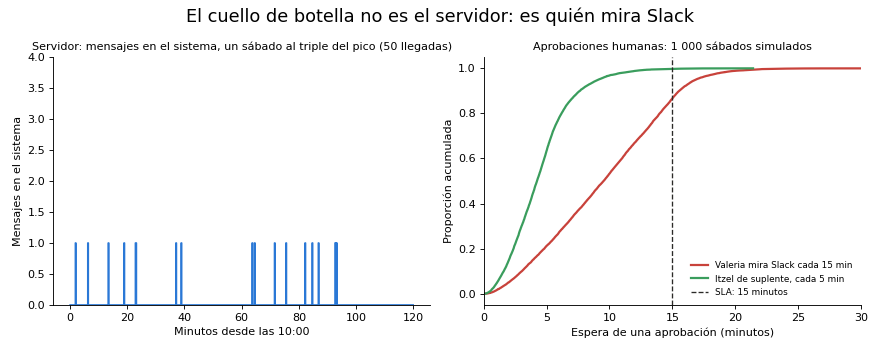
La tabla analítica confirma la cuenta de la ficha: al triple del pico la utilización es $\rho = 0.030$, el tiempo en el sistema $4.12$ segundos y hay $0.031$ mensajes dentro en promedio; el servidor empezaría a sufrir ($\rho = 0.8$) con $720$ mensajes por hora, $80$ veces el pico normal. La simulación lo corrobora con un tiempo medio de $4.1$ segundos y un p95 de $12.3$, y el panel izquierdo de la figura lo muestra sin ambigüedad: en un sábado al triple del pico, con $50$ llegadas, nunca hay más de un mensaje en el sistema. El cuello de botella no es el servidor, ni Claude, ni Meta.
El cuello de botella está en el panel derecho. Con unas $10.8$ aprobaciones por sábado, si Valeria mira Slack cada $15$ minutos la espera mediana es de $9.5$ minutos, el percentil $95$ es de $16.9$ minutos y el $13.4%$ de las aprobaciones supera los $15$ minutos del acuerdo del Día 82; con Itzel mirando cada $5$, la mediana baja a $4.2$, el p95 a $9.1$ y la proporción que supera los $15$ minutos al $0.2%$. La diferencia no es de servidores ni de tokens: es de quién mira el teléfono y cada cuánto. Es también la razón por la que el riesgo R2 de la lista de salida lo acepta Don Ernesto y no Valeria, porque poner a Itzel de suplente de 10:00 a 13:00 el sábado es una decisión del dueño sobre el personal del mostrador, no una decisión técnica.
Decisión de salida
Una decisión de salida es la respuesta escrita a la pregunta de Valeria, y tiene tres partes que no se pueden separar: los criterios, cada uno con su umbral fijado antes y su valor medido hoy; los riesgos aceptados, cada uno con quién lo acepta y con qué mitigación; y las firmas. Los criterios de Trigo Lento son ocho: los seis medidos en esta entrada (contratos, punta a punta, regresión, caos, carga del servidor y aprobaciones) y dos que vienen de días anteriores, el simulacro de restauración del Día 80 (Auditoría de seguridad del ecosistema: secretos, permisos y simulacro de restauración) dentro del objetivo de recuperación de cuatro horas y el presupuesto del Día 77, $40.53$ USD de $45$. La Figura 3 muestra la lista de salida tal como queda sobre la mesa del obrador.
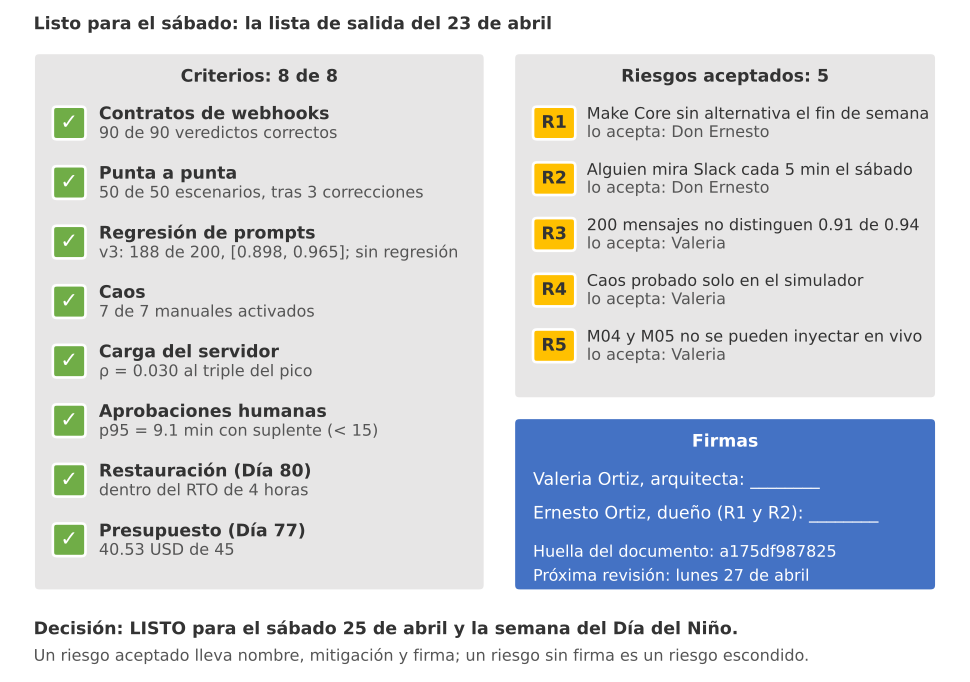
Figura 3. Listo para el sábado: ocho criterios medidos y marcados, cinco riesgos aceptados con nombre y mitigación, y las firmas de Valeria y de Don Ernesto con la huella del documento.
El décimo bloque construye la lista desde las variables de los bloques anteriores (ningún “cumple” se escribe a mano), lista los cinco riesgos con su responsable y su mitigación, decide, genera decision_salida_2026-04-23.md con la tabla de criterios, la de riesgos y las firmas, y calcula la huella del documento, como se hizo con arquitectura_v1.md el Día 78:
# Lista de salida con criterios medidos, riesgos aceptados y firmas, y generación del documento de decisión en Python:
p95_suplente = np.quantile(res['Itzel de suplente, cada 5 min'], 0.95) / 60
criterios = [
    ('Contratos de webhooks', 'ningún cuerpo roto pasa y ninguno válido se rechaza', f'{int(contratos.correcto.sum())} de {len(contratos)} veredictos correctos', bool(contratos.correcto.all())),
    ('Punta a punta', '50 de 50 escenarios aprobados', f'{int(segunda.aprobado.sum())} de 50', bool(segunda.aprobado.all())),
    ('Regresión de prompts', 'sin regresión significativa y límite inferior total de v3 >= 0.85', f'total v3 [{total.v3_bajo:.3f}, {total.v3_alto:.3f}]', bool(not tabla_3.regresion.any() and total.v3_bajo >= 0.85)),
    ('Caos', 'los 7 fallos activan el manual previsto', f'{int((tabla_2.manual == tabla_2.manual_activado).sum())} de 7', bool((tabla_2.manual == tabla_2.manual_activado).all())),
    ('Carga del servidor', 'utilización < 0.5 al triple del pico', f'ρ = {27 / mu:.3f}', 27 / mu < 0.5),
    ('Aprobaciones humanas', 'p95 de espera < 15 min con suplente', f'p95 = {p95_suplente:.1f} min', p95_suplente < 15),
    ('Restauración (Día 80)', 'simulacro dentro del RTO de 4 horas', 'cumplido según el informe de auditoría', True),
    ('Presupuesto (Día 77)', 'gasto mensual <= 45 USD', '40.53 USD de 45', True),
]
riesgos = [
    ('R1', 'Make Core sigue siendo un punto único de falla sin alternativa el fin de semana (Día 78)', 'Don Ernesto', 'modo manual M00 para los 4 escenarios de Make'),
    ('R2', 'Las aprobaciones dependen de que alguien mire Slack cada 5 minutos el sábado', 'Valeria', 'Itzel de suplente de 10:00 a 13:00; aviso por WhatsApp si Slack cae'),
    ('R3', 'Con 200 mensajes la evaluación no distingue una exactitud de 0.91 de una de 0.94', 'Valeria', f'ampliar a {math.ceil(n_necesario)} mensajes por versión antes del 10 de mayo'),
    ('R4', 'El caos se probó en el simulador, no contra la instancia de producción', 'Valeria', 'repetir E1, E4 y E5 contra la instancia de ensayo del Día 43 el lunes 27'),
    ('R5', 'Los manuales M04 (plantilla rechazada) y M05 (gasto anómalo) no se pueden inyectar en vivo', 'Valeria', 'ensayo de mesa del Día 81 y detector del Día 81 ya probados'),
]
decision = 'LISTO' if all(c[3] for c in criterios) else 'NO LISTO'
lineas = [f'# Decisión de salida: ecosistema de Trigo Lento, {hoy:%d/%m/%Y}', '',
          f'Decisión: {decision} para el sábado {ensayo:%d/%m} y la semana del Día del Niño, con {len(riesgos)} riesgos aceptados.', '',
          '## Criterios', '', '| Criterio | Umbral | Medido | Cumple |', '|---|---|---|:---:|']
lineas += [f'| {n} | {u} | {m} | {"sí" if c else "no"} |' for n, u, m, c in criterios]
lineas += ['', '## Riesgos aceptados', '', '| Id | Riesgo | Lo acepta | Mitigación |', '|---|---|---|---|']
lineas += [f'| {i} | {r} | {q} | {m} |' for i, r, q, m in riesgos]
lineas += ['', '## Firmas', '', '- Valeria Ortiz, arquitecta de automatización: ________  (23/04/2026)',
           '- Ernesto Ortiz, dueño, acepta R1 y R2: ________  (23/04/2026)', '',
           'Próxima revisión: lunes 27 de abril (R4) y lunes 4 de mayo (simulacro del calendario de gobierno del Día 79).']
documento = '\n'.join(lineas) + '\n'
(carpeta / f'decision_salida_{hoy:%Y-%m-%d}.md').write_text(documento, encoding = 'utf-8')
huella = hashlib.sha256(documento.encode('utf-8')).hexdigest()[:12]
print(pd.DataFrame(criterios, columns = ['criterio', 'umbral', 'medido', 'cumple']).to_string(index = False))
print(f'\nDECISIÓN: {decision} | criterios cumplidos: {sum(c[3] for c in criterios)} de {len(criterios)} | riesgos aceptados: {len(riesgos)}')
print(f'Documento: decision_salida_{hoy:%Y-%m-%d}.md ({len(documento.split())} palabras, huella {huella})')
print('\n'.join(lineas[:3]))
             criterio                                                            umbral                                 medido  cumple
Contratos de webhooks               ningún cuerpo roto pasa y ninguno válido se rechaza          90 de 90 veredictos correctos    True
        Punta a punta                                     50 de 50 escenarios aprobados                               50 de 50    True
 Regresión de prompts sin regresión significativa y límite inferior total de v3 >= 0.85                total v3 [0.898, 0.965]    True
                 Caos                           los 7 fallos activan el manual previsto                                 7 de 7    True
   Carga del servidor                              utilización < 0.5 al triple del pico                              ρ = 0.030    True
 Aprobaciones humanas                               p95 de espera < 15 min con suplente                          p95 = 9.1 min    True
Restauración (Día 80)                               simulacro dentro del RTO de 4 horas cumplido según el informe de auditoría    True
 Presupuesto (Día 77)                                           gasto mensual <= 45 USD                        40.53 USD de 45    True

DECISIÓN: LISTO | criterios cumplidos: 8 de 8 | riesgos aceptados: 5
Documento: decision_salida_2026-04-23.md (423 palabras, huella a175df987825)
# Decisión de salida: ecosistema de Trigo Lento, 23/04/2026

Decisión: LISTO para el sábado 25/04 y la semana del Día del Niño, con 5 riesgos aceptados.
Los ocho criterios se cumplen y la decisión es LISTO para el sábado 25 de abril y la semana del Día del Niño, con cinco riesgos aceptados. Dos de ellos los acepta Don Ernesto, porque son suyos: R1, que Make Core sigue siendo un punto único de falla sin alternativa el fin de semana (los cuatro escenarios de Make tienen modo manual M00, y migrarlos es decisión del Día 86), y R2, que las aprobaciones dependen de que alguien mire Slack cada cinco minutos el sábado. Los otros tres los acepta Valeria: R3, que $200$ mensajes no distinguen $0.91$ de $0.94$ y que ampliar el conjunto a $1,208$ por versión antes del 10 de mayo es su tarea; R4, que el caos se probó en el simulador y que E1, E4 y E5 se repiten contra la instancia de ensayo el lunes 27; y R5, que M04 y M05 no se pueden inyectar en vivo. El documento tiene $423$ palabras y la huella a175df987825, y fija dos fechas de revisión: el lunes 27 para R4 y el lunes 4 de mayo para el simulacro del calendario de gobierno del Día 79.
Don Ernesto lee la lista completa, como leyó el plano del Día 78, y se detiene en los riesgos. Pregunta qué significa aceptar R2. Valeria le dice que significa que, si el sábado 2 de mayo a las 11:00 entra un pedido de $1,200$ pesos y nadie mira Slack en un cuarto de hora, el cliente esperará más de lo que se le prometió a Marisol, y que la forma de que no pase es que Itzel tenga el teléfono de operaciones de 10:00 a 13:00. Don Ernesto firma y añade una frase que no estaba en el documento: “Y si Itzel no puede, lo miro yo. Apúntelo.” Valeria lo apunta en la mitigación de R2, regenera el documento y la huella cambia. Esa es la diferencia entre una lista de salida y un papel: la lista se regenera desde el código cuando cambia una decisión, y la huella dice cuál versión firmó cada quien.
Consideraciones finales
Las cifras de hoy tienen tres límites que conviene decir en voz alta. El primero es que el simulador es un modelo: comprueba la lógica de orquestación del ecosistema, no la configuración de cada nodo de n8n ni cada módulo de Make, y por eso los tres defectos que encontró son defectos de reglas y de orden, no de conectores; la instancia de ensayo del Día 43 sigue siendo necesaria. El segundo es que las predicciones de la regresión son de ejemplo y declaradas como tales: la estructura (Wilson, criterio de no regresión, guardia) es la que se usará con las predicciones reales del lote, pero las cifras de la Tabla 3 no miden a Haiku 5.5. El tercero es que un experimento de caos en un simulador prueba que el diseño responde al fallo como se pensó; que la producción responda igual es lo que R4 deja pendiente para el lunes.
Hay además una pregunta que las pruebas no responden y que Don Ernesto hizo sin saberlo: ¿qué pasa si fallan dos cosas a la vez? Los siete experimentos inyectan un fallo cada uno. El viernes del token caducado del Día 81 fue un fallo solo; un sábado de pico con Claude en 529 y Slack caído es otro animal, y la combinación de dos manuales que se activan al mismo tiempo, con la misma persona de guardia, no se ha ensayado. Esa es la siguiente hornada de prueba, no la de hoy.
Un gran libro que habla de esto es Chaos Engineering: System Resiliency in Practice, de Casey Rosenthal y Nora Jones (O’Reilly, 2020), que cuenta cómo nació la disciplina en Netflix y, sobre todo, insiste en lo que los principios resumen en una frase: un experimento de caos sin hipótesis previa es solo romper cosas. Y para la base de la pirámide, The Art of Software Testing de Myers, Sandler y Badgett (Wiley, 2011, tercera edición) sigue diciendo, cuarenta años después de la primera, que probar es buscar defectos, no confirmar que todo funciona, y que una prueba que no puede fallar no prueba nada.
Un sistema no está listo cuando todas las pruebas pasan; está listo cuando se sabe qué pruebas no se hicieron, quién acepta ese hueco y qué hará el sábado si el hueco se abre. La hornada de prueba de Don Ernesto no garantiza que el horno no falle el día de la fiesta; garantiza que, si falla, nadie se sorprende y todos saben qué hacer. Las $648$ pruebas de hoy hacen lo mismo con el ecosistema de Trigo Lento.
Conclusiones clave
Pirámide
- Las pruebas del ecosistema se ordenan en seis niveles con $648$ casos y $2.90$ USD por pasada: $208$ casos deterministas y gratis en la base (transformaciones, reglas y $90$ contratos) y $40$ conversaciones del agente que son el $99%$ del coste en la punta.
- Los contratos de los tres webhooks dan $90$ de $90$ veredictos correctos con el validador del Día 4; un contrato con un proveedor externo se escribe tolerante con lo que no conoce y estricto con lo que necesita, y uno propio, estricto en las dos direcciones.
- El conjunto de regresión de $200$ mensajes sale de los $60$ del Día 9 más $140$ de plantilla con cuotas por categoría, y la evaluación de $400$ peticiones por lotes con Haiku 5.5 cuesta menos de $0.02$ USD.
Regresión y caos
v3acierta $188$ de $200$ ($0.940$, Wilson $[0.898, 0.965]$) yv2$182$ ($0.910$, $[0.862, 0.942]$): los intervalos se solapan, no hay regresión ni mejora demostrada, “queja” queda en vigilancia y distinguir $0.91$ de $0.94$ exigiría $1,208$ mensajes por versión.- Los $50$ escenarios de punta a punta encontraron tres defectos de orquestación que ninguna prueba de un solo flujo veía (la regla de baja demasiado estricta, el domingo sin tratar y un pedido “para el domingo” enrutado a horarios) y terminaron en $50$ de $50$.
- Los siete fallos inyectados activaron los siete manuales del Día 81: un 429 total degrada $152$ eventos sin dejar a nadie sin respuesta, un 529 al $60%$ tarda $42$ eventos en detectarse, el servidor caído deja $200$ eventos que Meta reprocesa, y el token caducado es el más traicionero porque procesa todo y no envía nada.
Carga y decisión
- Al triple del pico el servidor está al $\rho = 0.030$ con $4.12$ segundos en el sistema y aguantaría $80$ veces el pico normal; el cuello de botella son las aprobaciones humanas, con un p95 de $16.9$ minutos si se mira Slack cada $15$ y de $9.1$ con un suplente cada $5$.
- La decisión de salida es LISTO con $8$ de $8$ criterios medidos desde el código y $5$ riesgos aceptados con nombre, mitigación y firma; el documento se regenera y su huella cambia cuando cambia una decisión.
- El caos se hace en la simulación o en un entorno de ensayo, nunca con clientes reales; los riesgos los firma quien los acepta, y el dueño acepta los que son del negocio, no los técnicos.
Mañana, en el Día 84: Proyecto integrador V: costes finales frente a los 45 USD. Don Ernesto repetirá la pregunta del Día 12, “¿Cuánto nos cuesta esto al mes? Y no me diga ‘depende’”, y Valeria calculará el coste final por rubro y por flujo con los precios revisados en octubre de 2026, lo comparará con los $45$ USD y con el reparto inicial, proyectará el crecimiento del $5%$ mensual hasta el mes en que el presupuesto se rompe y pondrá cifra a las horas ahorradas frente al gasto.
Referencias
- Rosenthal, C. y Jones, N. (2020). Chaos Engineering: System Resiliency in Practice. O’Reilly Media.
- Myers, G. J., Sandler, C. y Badgett, T. (2011). The Art of Software Testing (3.ª ed.). Wiley.
- Wilson, E. B. (1927). Probable Inference, the Law of Succession, and Statistical Inference. Journal of the American Statistical Association, 22(158), 209-212. https://doi.org/10.1080/01621459.1927.10502953
- Anthropic (2026). Batch processing (Message Batches API). Documentación de Claude, revisada en octubre de 2026. https://platform.claude.com/docs/en/build-with-claude/batch-processing
- Anthropic (2026). Claude API errors. Documentación de Claude, revisada en octubre de 2026. https://platform.claude.com/docs/en/api/errors
- Basiri, A., Behnam, N., de Rooij, R., Hochstein, L., Kosewski, L., Reynolds, J. y Rosenthal, C. (2016). Chaos Engineering. IEEE Software, 33(3), 35-41. https://arxiv.org/abs/1702.05843
- Principles of Chaos Engineering (2019). https://principlesofchaos.org (revisado en octubre de 2026).