
IA generativa en proyectos personales: Día 15
 Jeshua Romero Guadarrama
- 55 Min para leer
- 15 Jan, 2026
Índice de contenido
Resumen:
Un modelo de voz moderno puede imitar un timbre con unos segundos de audio, y por eso la clonación vocal es a la vez la función más atractiva y la más delicada del Cuaderno Vivo. En esta entrada Sofía clona únicamente su propia voz, después de firmar un consentimiento que el código valida antes de cargar cualquier modelo, y comprueba con un verificador automático que su muestra tiene buena calidad. Al terminar, usted sabrá cómo funciona la clonación zero-shot, qué ofrecen y qué exigen XTTS-v2 en local y ElevenLabs en la nube, por qué una huella MFCC de juguete no demuestra identidad y qué papel tienen la detección, la marca de agua y la ley.
¿Cómo citar el presente artículo?
Romero, J. (15 de enero de 2026). IA generativa en proyectos personales: Día 15. python-data-engineer. https://www.python-data-engineer.com/post/iag/dia_15/.
IA generativa en proyectos personales: Día 15 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/iag/dia_15/.
Modelos, precios, licencias, políticas de uso y regulación revisados en octubre de 2026.
Día 15. Clonación vocal con consentimiento: su propia voz
Introducción
Ayer, en el Día 14, recorrió el camino del texto al habla (normalización, modelo acústico y vocoder), sintetizó vocales con un modelo fuente-filtro y midió una voz sintética con MOS y WER, y el Cuaderno Vivo ganó una voz genérica capaz de leer en voz alta el resumen de la semana. Esa voz funciona, pero no es la de nadie: suena correcta, neutra y ajena.
Sofía quiere otra cosa. Escucha sus resúmenes mientras camina a la universidad y le gustaría que el cuaderno le hablara con su propia voz, como una nota de audio que se deja a sí misma. La idea tiene sentido: una voz conocida se atiende mejor y convierte el resumen en algo personal. Diego, que la escucha explicar el plan, le hace la pregunta que define todo el día: ¿Y si alguien usa su voz? Y añade otra, más incómoda todavía: ¿Cómo sabrá su familia que un audio con su voz lo grabó usted?
Atención aquí: Esta entrada trata solo de clonar la voz propia del lector, con su consentimiento escrito y documentado. No clone la voz de otra persona, aunque se lo permita, ni la de figuras públicas, y no use una voz clonada para hacer creer a nadie que habla una persona real. En los ejemplos ejecutables, “la voz de Sofía” es una señal sintetizada con numpy; el archivo mi_voz.wav de los bloques de clonación lo graba usted, con su propia voz.
La clonación vocal es la parte del módulo 4/6 en la que la técnica y la ética dejan de poder separarse. Técnicamente, un modelo zero-shot como XTTS-v2 necesita pocos segundos de audio para imitar un timbre. Éticamente, eso significa que la voz, uno de los rasgos más personales que existen, se ha vuelto un dato fácil de copiar. Por eso el orden del día está invertido respecto de lo habitual: primero el permiso, después la calidad de la muestra, después el modelo y, al final, cómo medir, detectar y marcar.
En la presente entrada, descubrirá qué es un embedding de hablante y por qué basta tan poco audio para clonar una voz. Verá un protocolo de consentimiento convertido en código (consentimiento_voz.json, firmado con una huella SHA-256 y validado antes de cualquier síntesis), un verificador automático de la muestra con pico, RMS, relación señal-ruido, recorte y silencios, y el uso de XTTS-v2 en local y de ElevenLabs como servicio, con sus licencias y salvaguardas. Construirá una huella vocal de juguete con MFCC calculados solo con numpy y scipy, medirá cuánto se parecen cuatro voces sintéticas y cuánto audio hace falta para que la medida se estabilice, y terminará con una marca de agua de audio de juguete y un repaso del marco legal vigente.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Entender cómo funciona la clonación de voz zero-shot: embeddings de hablante y condicionamiento del modelo.
- Comparar herramientas (XTTS-v2 local, ElevenLabs como servicio) por calidad, licencia, privacidad y salvaguardas.
- Aplicar un protocolo de consentimiento y grabar una muestra de la voz propia con buena calidad.
- Medir de forma aproximada la similitud entre hablantes con MFCC y reconocer los límites de esa medida.
Qué es clonar una voz
Un sistema de texto a voz (o TTS, por sus siglas en inglés: “Text-to-Speech”) como el del Día 14 aprende una sola voz: la de las grabaciones con las que se entrenó. Un sistema multihablante aprende muchas a la vez, y para saber cuál producir recibe, además del texto, un identificador del hablante. La clonación zero-shot da un paso más: en lugar de un identificador fijo de una lista cerrada, el modelo recibe un embedding de hablante (un vector de unos cientos de números que resume el timbre) calculado a partir de unos segundos de audio de una persona que el modelo nunca vio durante el entrenamiento.
El esquema tiene dos piezas. Un codificador de hablante $g_\phi$ convierte la muestra de referencia en el vector $\mathbf{e}$, y el sintetizador $f_\theta$ produce el audio a partir del texto, condicionado por ese vector:
$$ \mathbf{e} = g_\phi(\text{muestra}), \qquad \hat{y} = f_\theta(\text{texto}, \mathbf{e}) $$
La lógica detrás de esta descomposición es múltiple:
- La primera parte, $g_\phi$, separa quién habla de qué se dice. Jia et al. (2018) lo hicieron con un codificador entrenado para verificación de hablantes: una red que aprende a distinguir miles de voces produce, como efecto secundario, vectores en los que voces parecidas quedan cerca.
- La segunda parte, $f_\theta$, aprende a hablar con cualquier vector $\mathbf{e}$ de ese espacio, porque durante el entrenamiento vio miles de hablantes, cada uno con su vector.
- En conclusión, clonar no es “copiar una grabación”: es localizar un punto en un espacio de voces aprendido y pedirle al sintetizador que hable desde ese punto.
XTTS (Casanova et al., 2024) sigue esta idea con un modelo autorregresivo multilingüe: la muestra de referencia se convierte en unos vectores de condicionamiento que acompañan al texto, y un decodificador produce la onda a 24 kHz. Su ficha en Hugging Face anuncia clonación con un fragmento de 6 segundos y 17 idiomas, entre ellos el español (revisado en octubre de 2026).
Por qué basta tan poco audio
La pregunta natural es cómo puede bastar un fragmento de 6 segundos cuando el Día 14 necesitaba horas de grabación para entrenar una voz. La respuesta es que el trabajo pesado ya está hecho: el modelo aprendió el espacio de voces con miles de hablantes, y la muestra solo indica un punto en ese espacio. Seis segundos de habla contienen cientos de periodos glotales y varias vocales, suficiente para estimar la altura media de la voz, la posición aproximada de los formantes y la textura del timbre.
Lo que no contienen es todo lo demás: cómo ríe esa persona, cómo cambia su voz cuando está cansada, su forma de enfatizar o sus muletillas. Por eso un clon zero-shot suele sonar “parecido, pero plano”, y los servicios que buscan fidelidad alta piden mucho más audio (ElevenLabs recomienda alrededor de 30 minutos para su clonación profesional, revisado en octubre de 2026). Al final de la entrada medirá un efecto análogo con una huella de juguete: con 1 segundo la medida es casi aleatoria; con 8 segundos empieza a separar voces.
Que baste tan poco audio tiene una consecuencia de seguridad evidente: cualquier persona que haya publicado un video con su voz ha dejado material suficiente para un clon de baja calidad. Esa es la razón por la que el resto del día gira alrededor del consentimiento y de la defensa, no de la imitación.
Comencemos por preparar el entorno con las importaciones base, la semilla global de la serie, $2026$, la frecuencia de muestreo de $16,000$ Hz que se usó todo el módulo y la carpeta cuaderno_vivo/audio/, donde se guardarán los archivos del día con el prefijo dia15_. Todo el código ejecutable usa solo numpy, scipy y matplotlib:
# Importaciones base, semilla del día y carpetas del Cuaderno Vivo en Python:
import warnings
warnings.filterwarnings('ignore')
import json
import hashlib
from datetime import date
from pathlib import Path
import numpy as np
import scipy
import matplotlib.pyplot as plt
from scipy.io import wavfile
from scipy.signal import lfilter, stft
from scipy.fft import dct

# Generador aleatorio con la semilla global de la serie y frecuencia de muestreo:
rng = np.random.default_rng(2026)
FS = 16000
carpeta = Path('cuaderno_vivo')
carpeta_audio = carpeta / 'audio'
carpeta_audio.mkdir(parents = True, exist_ok = True)
print('numpy', np.__version__, '| scipy', scipy.__version__, '| frecuencia de muestreo:', FS, 'Hz')
numpy 2.4.6 | scipy 1.17.1 | frecuencia de muestreo: 16000 Hz
El entorno queda listo con numpy $2.4.6$ y scipy $1.17.1$. Los WAV se leen y se escriben con scipy.io.wavfile, los filtros de formantes con scipy.signal.lfilter, los espectrogramas con scipy.signal.stft y la transformada del coseno de los MFCC con scipy.fft.dct: no hace falta ninguna biblioteca de audio especializada para entender lo que hacen.
El protocolo de consentimiento
Puede parecer exagerado pedir un consentimiento escrito para clonar la propia voz. No lo es, por tres razones. La primera es que obliga a decidir para qué se clona antes de clonar: un resumen privado no es lo mismo que un pódcast público ni que un asistente que llama por teléfono. La segunda es que deja constancia de dónde vive la muestra y cuándo se borra, dos preguntas que nadie se hace hasta que un respaldo en la nube se filtra. La tercera es que convierte el permiso en una condición del programa: si el archivo falta, está incompleto, se editó o caducó, el pipeline de clonación se niega a ejecutarse.
El protocolo de Sofía tiene ocho campos obligatorios, como se muestra en la Tabla 1.
Tabla 1. Campos de consentimiento_voz.json.
| Campo | Pregunta que responde | Valor de Sofía |
|---|---|---|
titular | ¿De quién es la voz y quién la clona? | Sofía, titular de la voz y de las cuentas usadas |
finalidad | ¿Para qué se usará el clon? | Narrar en privado el resumen semanal |
alcance | ¿Qué se permite y qué no? | Uso personal, sin publicar, sin uso comercial, solo en español |
almacenamiento | ¿Dónde viven la muestra y los clones? | Disco cifrado de la laptop, sin copias en la nube |
caducidad | ¿Hasta cuándo vale el permiso? | 15 de enero de 2027 |
revocacion | ¿Cómo se retira el permiso? | Borrar muestra, clones y archivo; anotar la fecha de baja |
firma | ¿Se modificó el texto aceptado? | Huella SHA-256 del contenido |
fecha | ¿Cuándo se firmó? | 15 de enero de 2026 |
Dos campos merecen un comentario. La caducidad obliga a renovar el permiso cada año: lo que hoy parece razonable puede no serlo dentro de doce meses, y una decisión que se revisa es una decisión viva. La firma no es una firma electrónica con valor legal: es la huella SHA-256 del texto aceptado, que permite detectar si alguien (incluida la propia Sofía con prisa) amplió el alcance después de firmar. Quien tenga acceso al archivo puede recalcular la huella, de modo que protege contra errores y cambios descuidados, no contra un atacante; una firma con clave privada se verá el Día 20.
El siguiente código crea el archivo, lo firma y define validar_consentimiento(), la función que los bloques de clonación llamarán antes de cargar cualquier modelo. Termina con tres pruebas negativas para comprobar que el validador rechaza lo que debe rechazar:
# Protocolo de consentimiento: crear, firmar y validar consentimiento_voz.json en Python:
CAMPOS_OBLIGATORIOS = ['titular', 'finalidad', 'alcance', 'almacenamiento',
                       'caducidad', 'revocacion', 'firma', 'fecha']

def huella(datos):
    # Huella SHA-256 del contenido aceptado, sin el propio campo de firma:
    sin_firma = {k: v for k, v in datos.items() if k != 'firma'}
    texto = json.dumps(sin_firma, ensure_ascii = False, sort_keys = True)
    return hashlib.sha256(texto.encode('utf-8')).hexdigest()

def validar_datos(datos, hoy):
    faltan = [c for c in CAMPOS_OBLIGATORIOS if not datos.get(c)]
    if faltan:
        raise PermissionError('Faltan campos: ' + ', '.join(faltan))
    if huella(datos) != datos['firma']:
        raise PermissionError('La firma no coincide: el texto cambió después de firmarse.')
    if date.fromisoformat(datos['caducidad']) <= hoy:
        raise PermissionError('Consentimiento caducado el ' + datos['caducidad'])
    return datos

def validar_consentimiento(ruta, hoy):
    # Sin archivo no hay clonación: el pipeline se detiene aquí.
    if not Path(ruta).exists():
        raise PermissionError('No existe ' + str(ruta) + ': no se clona ninguna voz.')
    return validar_datos(json.loads(Path(ruta).read_text(encoding = 'utf-8')), hoy)

consentimiento = {
    'titular': 'Sofía, titular de la voz y de las cuentas usadas',
    'finalidad': 'Narrar en privado el resumen semanal del Cuaderno Vivo',
    'alcance': ['uso personal', 'sin publicar', 'sin uso comercial', 'solo en español'],
    'almacenamiento': 'cuaderno_vivo/audio/ en el disco cifrado de la laptop; sin copias en la nube',
    'caducidad': '2027-01-15',
    'revocacion': 'Borrar mi_voz.wav, los clones y este archivo; anotar la fecha de baja',
    'fecha': '2026-01-15',
}
consentimiento['firma'] = huella(consentimiento)
ruta_consentimiento = carpeta / 'consentimiento_voz.json'
ruta_consentimiento.write_text(json.dumps(consentimiento, ensure_ascii = False, indent = 2),
                               encoding = 'utf-8')

HOY = date(2026, 1, 15)
datos_consentimiento = validar_consentimiento(ruta_consentimiento, HOY)
print('Consentimiento válido hasta', datos_consentimiento['caducidad'],
      '| firma', datos_consentimiento['firma'][:16], '|', ruta_consentimiento.stat().st_size, 'bytes')

# Tres pruebas negativas: sin revocación, editado sin volver a firmar y caducado:
sin_revocacion = dict(consentimiento, revocacion = '')
editado = dict(consentimiento, alcance = ['uso personal', 'publicar en redes'])
caducado = dict(consentimiento, caducidad = '2026-01-10')
caducado['firma'] = huella(caducado)
for nombre, prueba in [('sin_revocacion', sin_revocacion), ('editado', editado), ('caducado', caducado)]:
    try:
        validar_datos(prueba, HOY)
        print(f'{nombre:<15} aceptado (no debería)')
    except PermissionError as error:
        print(f'{nombre:<15} rechazado: {error}')
Consentimiento válido hasta 2027-01-15 | firma 3c51d796a866ffa2 | 585 bytes
sin_revocacion  rechazado: Faltan campos: revocacion
editado         rechazado: La firma no coincide: el texto cambió después de firmarse.
caducado        rechazado: Consentimiento caducado el 2026-01-10
El consentimiento queda válido hasta el 15 de enero de 2027, ocupa $585$ bytes y su huella empieza por 3c51d796a866ffa2. Las tres pruebas negativas se rechazan cada una por su motivo: el archivo sin revocación falla porque falta un campo obligatorio; el archivo al que se le añadió “publicar en redes” sin volver a firmar falla porque la huella ya no coincide; y el que caducó el 10 de enero falla aunque esté bien firmado.
La huella se calcula sobre el JSON con las claves ordenadas:
$$ \text{firma} = \text{SHA-256}\left(\text{json}(\text{campos} \setminus {\text{firma}},\ \text{claves ordenadas})\right) $$
La lógica detrás de esta fórmula es múltiple:
- Ordenar las claves hace que la huella dependa del contenido y no del orden en que se escribieron los campos.
- Excluir el propio campo
firmaevita una dependencia circular: la huella no puede contenerse a sí misma. - En conclusión, cualquier cambio en un solo carácter de cualquier campo produce una huella distinta, y el validador lo detecta.
El consentimiento no es un trámite previo al diseño: es la primera línea del diseño. Si el archivo no existe, validar_consentimiento() lanza PermissionError y ningún bloque posterior llega a cargar el modelo. Si Sofía decide retirar el permiso, basta con borrar el archivo y los audios: el sistema deja de clonar sin tocar una línea de código.
Lo que nunca debe hacerse
El protocolo de Sofía cubre su propia voz. Hay usos que ningún archivo de consentimiento convierte en aceptables dentro de esta serie, y conviene escribirlos con la misma claridad que los campos:
- Clonar la voz de otra persona sin su participación activa en todo el proceso. En esta serie no se clona a terceros ni siquiera con su permiso: si alguien quiere un clon de su voz, lo crea y lo controla esa persona, en su propia cuenta.
- Clonar voces de figuras públicas, artistas, políticos o personajes conocidos, aunque sea “como homenaje” o “como broma”.
- Producir llamadas, mensajes de voz o audios que hagan creer a alguien que habla una persona real. Existen estafas telefónicas que usan voces clonadas para pedir dinero urgente a familiares; esta entrada no explica cómo se hacen, solo cómo protegerse.
- Publicar un audio sintético sin decir que lo es. La etiqueta “Generado con IA” del Día 12 tiene su versión sonora: una frase al inicio del audio y un texto visible donde se publique.
- Guardar la muestra de voz en lugares compartidos o sin cifrar, o conservarla después de revocar el permiso.
Diego, que no se fía de las buenas intenciones, propone una medida que no necesita ningún modelo: una palabra clave familiar. Si alguna vez la familia de Sofía recibe un audio urgente con su voz, preguntará la palabra clave o colgará y devolverá la llamada al número de siempre. Es una defensa antigua, barata y eficaz contra la suplantación, y conviene acordarla antes de clonar la propia voz, no después.
Grabar una buena muestra
Un clon hereda los defectos de su muestra. Si la referencia tiene eco, el clon suena en una habitación con eco; si tiene música de fondo, el clon arrastra un murmullo; si el nivel estaba tan alto que la onda se recortó, el clon reproduce la distorsión. Las recomendaciones prácticas son pocas y conviene cumplirlas todas:
- Entre 10 y 30 segundos de habla continua y natural, leyendo un texto con frases variadas que incluya todas las vocales.
- Una sala pequeña y silenciosa, con muebles blandos o cortinas que absorban el eco; sin música, ventiladores ni televisión.
- Micrófono a un palmo de la boca, siempre a la misma distancia, y nivel ajustado para que los picos queden por debajo de $-1$ dBFS.
- Formato WAV sin compresión, mono, de 16 bits; la frecuencia de muestreo la adapta después el modelo.
Las comprobaciones de esas recomendaciones se pueden automatizar con cuatro medidas clásicas. La primera es el pico en decibelios relativos a escala completa (o dBFS, por sus siglas en inglés: “Decibels relative to Full Scale”), donde $0$ dBFS es la amplitud máxima que puede guardar el archivo:
$$ \text{pico}{\text{dBFS}} = 20\log{10}\left(\max_n |x[n]|\right) $$
La segunda es el nivel medio, o valor eficaz (RMS, por sus siglas en inglés: “Root Mean Square”), expresado también en dBFS:
$$ \text{RMS}{\text{dBFS}} = 20\log{10}\sqrt{\frac{1}{N}\sum_{n=1}^{N} x[n]^2} $$
La tercera es la relación señal-ruido (o SNR, por sus siglas en inglés: “Signal-to-Noise Ratio”), estimada sin conocer el ruido por separado: se divide la señal en ventanas de 30 ms, se toma como energía de voz la media de la mitad más sonora y como energía de ruido la media del $10%$ más silencioso:
$$ \text{SNR}{\text{dB}} = 10\log{10}\frac{\bar{E}{\text{voz}}}{\bar{E}{\text{ruido}}} $$
La lógica detrás de estas tres medidas es múltiple:
- El pico usa $20\log_{10}$ porque mide amplitud; la SNR usa $10\log_{10}$ porque compara energías, que ya son amplitudes al cuadrado. Ambas expresan lo mismo en la misma escala de decibelios.
- El RMS resume el volumen percibido mejor que el pico: una sola palmada puede dar un pico alto con un RMS bajo.
- La SNR estimada aprovecha que el habla tiene pausas: en ellas solo queda el ruido de la sala, y su energía sirve de referencia.
- En conclusión, el pico vigila la distorsión, el RMS vigila que la voz no quede ni ahogada ni saturada y la SNR vigila el entorno.
La cuarta comprobación no tiene fórmula, sino dos conteos: el porcentaje de muestras recortadas (las que tocan el máximo, $|x| \geq 0.999$) y el silencio continuo más largo (ventanas cuya energía queda a menos de 6 dB del suelo de ruido). Los umbrales recomendados están en la Tabla 2, que más abajo se completa con los resultados reales de dos muestras.
Comprobaciones automáticas
El siguiente código implementa el verificador con scipy.io.wavfile. Devuelve, para cada medida, el valor y si cumple el umbral, e imprime los rangos aceptables:
# Verificador automático de una muestra de voz en Python:
UMBRALES = {'duracion_s': (10.0, 30.0), 'pico_dbfs': (-60.0, -1.0), 'rms_dbfs': (-30.0, -16.0),
            'snr_db': (30.0, 200.0), 'recorte_pct': (0.0, 0.0), 'silencio_max_s': (0.0, 1.0)}

def dbfs(valor):
    # Decibelios relativos a la escala completa (1.0 = 0 dBFS):
    return 20 * np.log10(max(float(valor), 1e-10))

def leer_wav(ruta):
    fs, x = wavfile.read(ruta)
    x = x.astype(np.float64) / 32768.0 if x.dtype == np.int16 else x.astype(np.float64)
    return fs, (x.mean(axis = 1) if x.ndim > 1 else x)

def verificar_muestra(ruta, umbrales = UMBRALES, ventana_s = 0.03):
    fs, x = leer_wav(ruta)
    n = int(ventana_s * fs)
    tramas = x[: len(x) // n * n].reshape(-1, n)
    energia = np.mean(tramas ** 2, axis = 1) + 1e-12
    orden = np.sort(energia)
    ruido = orden[: max(1, len(orden) // 10)].mean()   # el 10 % de ventanas más silenciosas
    voz = orden[- max(1, len(orden) // 2):].mean()      # la mitad más sonora
    # Silencio: ventanas a menos de 6 dB del suelo de ruido; se mide el tramo continuo más largo:
    silencio = energia < 4 * ruido
    racha, racha_max = 0, 0
    for es_silencio in silencio:
        racha = racha + 1 if es_silencio else 0
        racha_max = max(racha_max, racha)
    medidas = {'duracion_s': len(x) / fs,
               'pico_dbfs': dbfs(np.max(np.abs(x))),
               'rms_dbfs': dbfs(np.sqrt(np.mean(x ** 2))),
               'snr_db': 10 * np.log10(voz / ruido),
               'recorte_pct': 100 * np.mean(np.abs(x) >= 0.999),
               'silencio_max_s': racha_max * ventana_s}
    return {clave: (valor, umbrales[clave][0] <= valor <= umbrales[clave][1])
            for clave, valor in medidas.items()}

def imprimir_informe(nombre, informe):
    fallos = [clave for clave, (_, ok) in informe.items() if not ok]
    print(nombre, '->', 'APTA' if not fallos else 'NO APTA (' + ', '.join(fallos) + ')')
    for clave, (valor, ok) in informe.items():
        print(f'   {clave:<15} {valor:8.2f}   {"ok" if ok else "FALLA"}')

for clave, (minimo, maximo) in UMBRALES.items():
    print(f'{clave:<15} aceptable entre {minimo:7.1f} y {maximo:7.1f}')
duracion_s      aceptable entre    10.0 y    30.0
pico_dbfs       aceptable entre   -60.0 y    -1.0
rms_dbfs        aceptable entre   -30.0 y   -16.0
snr_db          aceptable entre    30.0 y   200.0
recorte_pct     aceptable entre     0.0 y     0.0
silencio_max_s  aceptable entre     0.0 y     1.0
Los rangos impresos son la política de calidad del Cuaderno Vivo. El pico debe quedar por debajo de $-1$ dBFS para dejar margen a los conversores; el RMS entre $-30$ y $-16$ dBFS, es decir, ni un susurro lejano ni una voz pegada al micrófono; la SNR por encima de $30$ dB, que corresponde a una sala doméstica tranquila; ninguna muestra recortada; y ningún silencio continuo de más de $1$ segundo, porque un silencio largo no aporta información sobre la voz y, en algunos modelos, se copia como pausa extraña en el clon.
Una muestra con defectos
Un verificador que nunca se ha visto fallar no merece confianza. Para ejercitarlo, el siguiente código construye una voz sintética con el modelo fuente-filtro del Día 14: un tren de pulsos a la frecuencia fundamental $F_0$, con un vibrato leve, filtrado por tres resonadores que colocan los formantes de cada vocal. Encadena sílabas de vocales al azar con pausas breves, como una frase sin palabras, y fabrica una muestra de 12 segundos de la voz A ($F_0 = 110$ Hz). Después crea una copia con dos defectos deliberados: $0.3$ segundos con la ganancia multiplicada por cuatro (recorte) y 2 segundos en los que nadie habla. Las dos versiones se guardan como WAV y pasan por el verificador:
# Voz sintética fuente-filtro y muestra de prueba con defectos en Python:
VOCALES = {'a': (800, 1200, 2500), 'e': (500, 1900, 2500), 'i': (300, 2300, 3000),
           'o': (500, 900, 2500), 'u': (300, 800, 2300)}
ANCHOS = (80, 100, 120)

def resonador(x, frecuencia, ancho, fs = FS):
    # Filtro resonante de segundo orden centrado en un formante:
    r = np.exp(-np.pi * ancho / fs)
    theta = 2 * np.pi * frecuencia / fs
    return lfilter([1 - r], [1, -2 * r * np.cos(theta), r ** 2], x)

def silaba(vocal, f0, factor, duracion, gen, fs = FS):
    t = np.arange(int(duracion * fs)) / fs
    # Fuente: tren de pulsos a F0 con vibrato de 5 Hz y una pendiente final de entonación:
    f0_t = f0 * (1 + 0.02 * np.sin(2 * np.pi * 5 * t) - 0.05 * t / duracion)
    fuente = np.diff(np.floor(np.cumsum(f0_t / fs)), prepend = 0.0)
    fuente = lfilter([1], [1, -0.9], fuente) + 0.02 * gen.standard_normal(len(t))
    # Filtro: tres formantes de la vocal, escalados por el tamaño del tracto vocal:
    y = fuente
    for frecuencia, ancho in zip(VOCALES[vocal], ANCHOS):
        y = resonador(y, frecuencia * factor, ancho)
    return y * np.sin(np.pi * np.linspace(0, 1, len(t))) ** 0.5

def sintetizar_voz(f0, factor, duracion, gen, fs = FS, ruido_dbfs = -55):
    partes, total = [], 0
    while total < duracion * fs:
        # Una frase de 4 a 7 sílabas separadas por pausas breves:
        for _ in range(int(gen.integers(4, 8))):
            vocal = str(gen.choice(list(VOCALES)))
            partes.append(silaba(vocal, f0 * gen.uniform(0.92, 1.08), factor, gen.uniform(0.12, 0.25), gen))
            partes.append(np.zeros(int(gen.uniform(0.02, 0.06) * fs)))
        partes.append(np.zeros(int(gen.uniform(0.25, 0.40) * fs)))
        total = sum(len(p) for p in partes)
    y = np.concatenate(partes)[: int(duracion * fs)]
    y = y / np.max(np.abs(y)) * 10 ** (-6 / 20)          # pico a -6 dBFS
    return y + 10 ** (ruido_dbfs / 20) * gen.standard_normal(len(y))

def guardar_wav(ruta, x, fs = FS):
    wavfile.write(ruta, fs, (np.clip(x, -1, 1) * 32767).astype(np.int16))

# Muestra de 12 s de la voz A y una copia con dos defectos deliberados:
muestra = sintetizar_voz(110, 1.00, 12, np.random.default_rng(2026))
defectuosa = muestra.copy()
i0, i1 = int(2.6 * FS), int(2.9 * FS)                        # 0.3 s con la ganancia demasiado alta
defectuosa[i0:i1] = np.clip(defectuosa[i0:i1] * 4, -1, 1)
s0, s1 = int(7.0 * FS), int(9.0 * FS)                        # 2 s en los que nadie habla
defectuosa[s0:s1] = 10 ** (-55 / 20) * rng.standard_normal(s1 - s0)
guardar_wav(carpeta_audio / 'dia15_muestra_defectos.wav', defectuosa)
guardar_wav(carpeta_audio / 'dia15_muestra_corregida.wav', muestra)

imprimir_informe('dia15_muestra_defectos.wav', verificar_muestra(carpeta_audio / 'dia15_muestra_defectos.wav'))
imprimir_informe('dia15_muestra_corregida.wav', verificar_muestra(carpeta_audio / 'dia15_muestra_corregida.wav'))
dia15_muestra_defectos.wav -> NO APTA (pico_dbfs, recorte_pct, silencio_max_s)
   duracion_s         12.00   ok
   pico_dbfs          -0.00   FALLA
   rms_dbfs          -22.61   ok
   snr_db             35.84   ok
   recorte_pct         0.10   FALLA
   silencio_max_s      2.01   FALLA
dia15_muestra_corregida.wav -> APTA
   duracion_s         12.00   ok
   pico_dbfs          -5.98   ok
   rms_dbfs          -25.04   ok
   snr_db             33.32   ok
   recorte_pct         0.00   ok
   silencio_max_s      0.39   ok
El verificador hace su trabajo. La muestra con defectos es NO APTA por tres motivos: el pico llega a $-0.00$ dBFS (la onda toca el techo del formato), el $0.10%$ de las muestras está recortado y hay un silencio continuo de $2.01$ segundos. La muestra corregida es APTA: pico de $-5.98$ dBFS, RMS de $-25.04$ dBFS, SNR de $33.32$ dB, ningún recorte y un silencio máximo de $0.39$ segundos, que es la pausa natural entre dos frases. Observe que el recorte sube el RMS de la muestra defectuosa a $-22.61$ dBFS y su SNR a $35.84$ dB: un fallo puede mejorar otras cifras, y por eso el verificador mira todas.
La Tabla 2 reúne los umbrales y los resultados de las dos muestras.
Tabla 2. Comprobaciones de la muestra: umbrales recomendados y resultados reales de las dos muestras sintéticas.
| Comprobación | Umbral recomendado | Muestra con defectos | Muestra corregida |
|---|---|---|---|
| Duración | 10 a 30 s | 12.00 s (ok) | 12.00 s (ok) |
| Pico máximo | < -1 dBFS | -0.00 dBFS (falla) | -5.98 dBFS (ok) |
| RMS | -30 a -16 dBFS | -22.61 dBFS (ok) | -25.04 dBFS (ok) |
| SNR estimada | > 30 dB | 35.84 dB (ok) | 33.32 dB (ok) |
| Muestras recortadas | 0 % | 0.10 % (falla) | 0.00 % (ok) |
| Silencio continuo máximo | < 1 s | 2.01 s (falla) | 0.39 s (ok) |
Un porcentaje de $0.10%$ parece pequeño, pero equivale a unas $190$ muestras concentradas en tres décimas de segundo, y el oído las percibe como un chasquido áspero. Ver dónde está cada defecto ayuda a entender por qué importa. El siguiente código dibuja la forma de onda de la muestra defectuosa con el recorte y el silencio marcados y las líneas del pico máximo recomendado:
# Forma de onda de la muestra con el recorte y el silencio marcados en Python:
t = np.arange(len(defectuosa)) / FS
umbral_pico = 10 ** (-1 / 20)
fig, ax = plt.subplots(figsize = (9, 4))
ax.plot(t, defectuosa, color = '#2a78d6', linewidth = 0.4)
ax.axvspan(2.6, 2.9, color = '#e34948', alpha = 0.25, label = 'Recorte (0.3 s)')
ax.axvspan(7.0, 9.0, color = '#52514e', alpha = 0.15, label = 'Silencio largo (2 s)')
for signo in (1, -1):
    ax.axhline(signo * umbral_pico, color = '#e34948', linewidth = 1, linestyle = '--')
ax.text(9.2, 1.03, 'Pico máximo: -1 dBFS (línea discontinua)', color = '#52514e', fontsize = 9)
ax.set_title('Muestra de 12 s con dos defectos', fontsize = 16)
ax.set_xlabel('Tiempo (s)')
ax.set_ylabel('Amplitud (escala completa = 1)')
ax.set_ylim(-1.15, 1.25)
ax.legend(loc = 'lower right', fontsize = 9, frameon = False, ncol = 2)
plt.tight_layout()
plt.show()
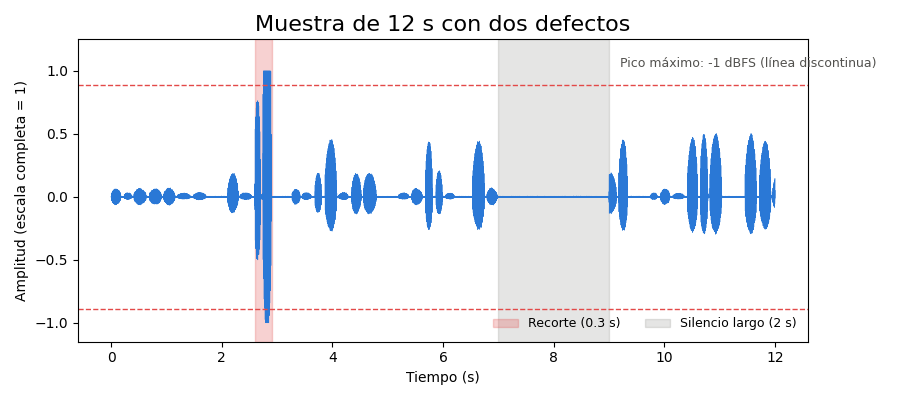
En la figura, el tramo rojo es el recorte: las crestas de la onda chocan contra el valor $\pm 1$ y se aplanan, muy por encima de las líneas discontinuas de $-1$ dBFS ($0.89$ en escala lineal). El tramo gris es el silencio de 2 segundos, que se ve como una línea plana entre dos grupos de sílabas. El resto de la muestra queda holgadamente dentro de los límites, con picos alrededor de $0.5$, que es lo que se espera de una grabación bien ajustada a $-6$ dBFS.
Si su propia grabación falla el verificador, no la “arregle” con un limitador o un reductor de ruido antes de clonarla: esos procesos dejan huellas que el modelo copiará. Es más rápido y da mejor resultado grabar de nuevo, con el nivel algo más bajo y en un momento más silencioso.
XTTS-v2 en local
Con el consentimiento validado y una muestra apta, Sofía puede clonar su voz en su propia laptop. XTTS-v2 es el modelo de clonación zero-shot de Coqui. Coqui cerró en diciembre de 2023, y el kit de herramientas que lo ejecuta se mantiene hoy en la bifurcación de Idiap, que se instala con pip install coqui-tts y se importa como from TTS.api import TTS. Según el README del repositorio idiap/coqui-ai-TTS, el kit está bajo la licencia MPL-2.0, se prueba con Python $\geq 3.10$ y $< 3.15$ y, desde la versión 0.27.4, no instala PyTorch por defecto (revisado en octubre de 2026).
La licencia del modelo es otra cosa: los pesos de XTTS-v2 se distribuyen bajo la Coqui Public Model License (CPML), que solo permite uso no comercial. Para el Cuaderno Vivo, un proyecto personal y privado, encaja; para un producto que se venda, no. La primera vez que se descarga el modelo, la biblioteca pide aceptar la licencia de forma interactiva; en un script se hace con la variable de entorno COQUI_TOS_AGREED=1, que solo debe definirse después de haber leído la licencia.
El siguiente bloque no se ejecuta en esta entrada (descarga cerca de 2 GB de pesos y es lento sin GPU). Antes de cargar el modelo comprueba el consentimiento con la fecha real del sistema y pasa mi_voz.wav por el verificador del Bloque 3:
# Clonación de la voz propia con XTTS-v2 en local, protegida por el consentimiento en Python:
# pip install coqui-tts   (bifurcación de Idiap; desde la 0.27.4 PyTorch se instala aparte)
import os
import torch
from TTS.api import TTS

# 1) Sin consentimiento válido y vigente no se carga ningún modelo:
datos_consentimiento = validar_consentimiento(carpeta / 'consentimiento_voz.json', date.today())

# 2) La muestra grabada por el propio titular debe pasar el verificador del Bloque 3:
informe = verificar_muestra('mi_voz.wav')
fallos = [clave for clave, (_, ok) in informe.items() if not ok]
if fallos:
    raise ValueError('Grabe de nuevo mi_voz.wav; fallan: ' + ', '.join(fallos))

# 3) Aceptación explícita de la licencia CPML (uso no comercial), solo después de leerla:
os.environ['COQUI_TOS_AGREED'] = '1'

# 4) Modelo multilingüe en la GPU si existe; en CPU funciona, pero mucho más despacio:
dispositivo = 'cuda' if torch.cuda.is_available() else 'cpu'
tts = TTS('tts_models/multilingual/multi-dataset/xtts_v2').to(dispositivo)
texto = ('Resumen de la semana. Esta narración usa una voz sintética. '
         'Repasé la media y la mediana, practiqué pandas y toqué la guitarra con metrónomo.')
tts.tts_to_file(text = texto, speaker_wav = 'mi_voz.wav', language = 'es',
                file_path = str(carpeta_audio / 'dia15_clon_propio.wav'))
print('Clon generado para:', datos_consentimiento['titular'])
print('Finalidad:', datos_consentimiento['finalidad'], '| dispositivo:', dispositivo)

# Salida de ejemplo (puede variar):
# Clon generado para: Sofía, titular de la voz y de las cuentas usadas
# Finalidad: Narrar en privado el resumen semanal del Cuaderno Vivo | dispositivo: cuda
Fíjese en el orden de las comprobaciones: consentimiento, calidad de la muestra, licencia y, solo entonces, modelo. Si cualquiera de las tres primeras falla, el programa se detiene antes de gastar tiempo de GPU. El texto narrado empieza con la frase “Esta narración usa una voz sintética”, que es la divulgación audible que el Día 16 hará obligatoria. El archivo resultante se guarda con el prefijo dia15_ junto a los demás audios del día, en la carpeta local y cifrada que declara el campo almacenamiento.
La ventaja decisiva de esta vía es la privacidad: la muestra de voz nunca sale de la laptop. Sus desventajas son la licencia no comercial, la necesidad de una GPU para trabajar con fluidez y la ausencia de salvaguardas propias: XTTS-v2 clonará cualquier voz que reciba, y la única barrera es el código que usted escriba alrededor. Por eso validar_consentimiento() no es un adorno, sino la salvaguarda que el modelo no trae.
ElevenLabs como servicio
ElevenLabs es un servicio comercial de voz sintética con dos modalidades de clonación, según su documentación (revisado en octubre de 2026). La clonación instantánea (Instant Voice Cloning) produce un clon utilizable con menos de dos minutos de audio. La clonación profesional (Professional Voice Cloning) entrena un modelo más fiel, recomienda alrededor de 30 minutos de audio de calidad y requiere el plan Creator o superior. Ambas modalidades pasan por una verificación por voz, la “Voice CAPTCHA”: el titular lee en voz alta un texto que aparece en pantalla, y el sistema comprueba que esa lectura coincide con la voz de las muestras.
El centro de ayuda de ElevenLabs es explícito sobre la clonación profesional: solo se puede crear un clon profesional de la propia voz, y ni siquiera el consentimiento de otra persona cambia esa regla. Si alguien quiere que usted use su voz, la vía prevista es que esa persona cree y verifique el clon en su propia cuenta y lo comparta. Su política de uso prohibido (actualizada el 9 de octubre de 2026) exige consentimiento explícito e informado para reproducir la voz de una persona, prohíbe expresamente eludir las salvaguardas, incluida la verificación por voz, prohíbe suplantar a candidatos políticos o cargos electos y obliga a revelar con claridad cuándo alguien está interactuando con IA.
El flujo de Sofía tiene, por tanto, dos partes. La primera ocurre en el panel web: sube sus muestras, supera la verificación leyendo el texto en voz alta y obtiene un voice_id. La segunda es el código, que solo usa ese identificador. El siguiente bloque llama al punto de acceso de texto a voz con requests; no se ejecuta en esta entrada porque necesita una cuenta y una clave:
# Síntesis con la voz profesional propia, ya verificada en ElevenLabs, en Python:
# La voz se crea y se verifica en el panel de ElevenLabs: el titular lee en voz alta un texto
# que aparece en pantalla (Voice CAPTCHA). El código solo usa el voice_id que resulta.
import os
import requests

datos_consentimiento = validar_consentimiento(carpeta / 'consentimiento_voz.json', date.today())
clave = os.environ['ELEVENLABS_API_KEY']        # nunca escriba la clave en el código
voice_id = os.environ['ELEVENLABS_VOICE_ID']    # la voz propia, creada y verificada por su titular

respuesta = requests.post(
    f'https://api.elevenlabs.io/v1/text-to-speech/{voice_id}',
    params = {'output_format': 'pcm_16000'},
    headers = {'xi-api-key': clave, 'Content-Type': 'application/json'},
    json = {'text': 'Resumen de la semana. Esta narración usa una voz sintética.',
            'model_id': 'eleven_multilingual_v2'},
    timeout = 60)
respuesta.raise_for_status()

# PCM de 16 bits a 16 kHz sin cabecera: se envuelve en un WAV con scipy:
pcm = np.frombuffer(respuesta.content, dtype = np.int16)
wavfile.write(carpeta_audio / 'dia15_clon_elevenlabs.wav', 16000, pcm)
print(f'{len(pcm) / 16000:.2f} s de audio | tipo: {respuesta.headers.get("Content-Type")}')

# Salida de ejemplo (puede variar):
# 3.86 s de audio | tipo: audio/pcm
La petición usa el modelo eleven_multilingual_v2, que es el valor por defecto del punto de acceso según su referencia de la API (revisado en octubre de 2026), y pide el audio en pcm_16000, PCM de 16 bits a 16 kHz, para guardarlo como WAV con la misma frecuencia de muestreo que el resto del módulo; sin ese parámetro, el servicio responde en MP3 a 44.1 kHz. La clave se lee de una variable de entorno, nunca del código, y la llamada también exige un consentimiento válido aunque ElevenLabs ya haya verificado la voz: la verificación prueba que la voz es de Sofía; el archivo de consentimiento recuerda para qué decidió usarla.
Atención aquí: Con un servicio en la nube, su muestra de voz y los textos que narre viajan a los servidores del proveedor. Según la referencia de la API de ElevenLabs, el modo sin retención de registros (enable_logging=false) solo está disponible para clientes empresariales (revisado en octubre de 2026). Lea la política de privacidad y de retención antes de subir su voz, no lea en voz alta datos personales al grabar las muestras y borre del panel la voz y las muestras si revoca su consentimiento. Revocar en consentimiento_voz.json no borra nada en la nube: hay que hacerlo también allí.
Comparativa de herramientas
¿Qué conviene más para el Cuaderno Vivo, el modelo local o el servicio? No hay una respuesta universal: depende de qué pesa más en cada proyecto. La Tabla 3 compara las dos vías con la voz genérica del Día 14 como base.
Tabla 3. TTS genérico, XTTS-v2 en local y ElevenLabs como servicio (revisado en octubre de 2026).
| Criterio | TTS genérico (Día 14) | XTTS-v2 en local | ElevenLabs (clon profesional) |
|---|---|---|---|
| Voz | De otra persona, anónima | La propia, zero-shot | La propia, entrenada |
| Audio de referencia | Ninguno | Desde 6 s | Alrededor de 30 min recomendados |
| Calidad esperada | Correcta y neutra | Parecida, algo plana | Alta y consistente |
| Coste | Gratuito | Gratuito; GPU recomendable | Suscripción (plan Creator o superior) |
| Privacidad | Todo local | Todo local | La voz y los textos viajan a la nube |
| Licencia | La del modelo elegido | CPML, solo uso no comercial | Términos del servicio y del plan |
| Salvaguardas propias | No aplica | Ninguna: las pone su código | Verificación por voz, solo voz propia, política de uso |
| Revocación | No aplica | Borrar archivos locales | Borrar voz y muestras en el panel |
La tabla muestra que las dos vías fallan en cosas distintas. XTTS-v2 gana en privacidad y coste, pero no protege a nadie por sí solo: la responsabilidad recae entera en quien escribe el código. ElevenLabs trae salvaguardas que un proyecto personal difícilmente podría construir (la verificación por voz es la más importante), pero a cambio de entregar la voz a un tercero y de pagar una suscripción.
Sofía elige una combinación razonable para su caso: XTTS-v2 en local para el resumen semanal privado, porque su voz no sale de su disco y el uso no es comercial, y la voz genérica del Día 14 como respaldo cuando el consentimiento falte o caduque. Si algún día quisiera publicar su pódcast o cobrar por él, la licencia CPML la obligaría a cambiar de herramienta, y la elección pasaría a ser un servicio con licencia comercial o un modelo abierto con una licencia que lo permita.
Diego plantea el caso contrario: ¿Y si usara ElevenLabs precisamente porque no confía en sí misma? No es una pregunta retórica. Para muchas personas, que un tercero verifique que la voz es suya y bloquee los usos prohibidos es una ventaja, no una molestia. La decisión correcta es la que deja por escrito qué se protege y quién lo protege.
¿Se parece? Similitud entre hablantes
Una vez generado un clon, la pregunta inmediata es ¿se parece a mí? La respuesta seria la dan oyentes humanos (con la escala MOS del Día 14) o un sistema de verificación de hablantes entrenado con miles de voces. Ninguna de las dos cosas cabe en una entrada sin modelos preentrenados, pero sí cabe construir una huella vocal de juguete que muestre cómo se mide la similitud y, sobre todo, por qué esa medida engaña con facilidad.
Para tener voces con diferencias conocidas, el siguiente código genera cuatro “voces” sintéticas de 8 segundos con el generador fuente-filtro del Bloque 4. A y A2 son la misma voz ($F_0 = 110$ Hz, formantes de referencia) diciendo frases distintas; B es más aguda ($180$ Hz) y con el tracto vocal más corto (formantes $\times 1.10$); C está en medio en altura ($140$ Hz), pero con los formantes más desplazados ($\times 1.18$). El código estima la $F_0$ real de cada una por autocorrelación para comprobar que el generador hace lo que dice, y guarda los cuatro WAV:
# Cuatro voces sintéticas que difieren en F0 y en formantes en Python:
VOCES = {'A':  {'f0': 110, 'factor': 1.00, 'semilla': 1, 'nota': 'voz de referencia'},
         'A2': {'f0': 110, 'factor': 1.00, 'semilla': 2, 'nota': 'misma voz, otra frase'},
         'B':  {'f0': 180, 'factor': 1.10, 'semilla': 3, 'nota': 'más aguda, tracto más corto'},
         'C':  {'f0': 140, 'factor': 1.18, 'semilla': 4, 'nota': 'formantes desplazados'}}

def estimar_f0(x, fs = FS, ventana_s = 0.04, fmin = 70, fmax = 400):
    # F0 por autocorrelación en las ventanas más sonoras; devuelve la mediana:
    n = int(ventana_s * fs)
    tramas = x[: len(x) // n * n].reshape(-1, n)
    sonoras = tramas[np.mean(tramas ** 2, axis = 1) > np.percentile(np.mean(tramas ** 2, axis = 1), 60)]
    estimaciones = []
    for trama in sonoras:
        trama = trama - trama.mean()
        ac = np.correlate(trama, trama, mode = 'full')[n - 1:]
        lo, hi = int(fs / fmax), int(fs / fmin)
        estimaciones.append(fs / (lo + np.argmax(ac[lo:hi])))
    return float(np.median(estimaciones))

voces = {}
for nombre, p in VOCES.items():
    voces[nombre] = sintetizar_voz(p['f0'], p['factor'], 8, np.random.default_rng(2026 + p['semilla']))
    guardar_wav(carpeta_audio / f'dia15_voz_{nombre}.wav', voces[nombre])
    print(f"Voz {nombre:<3} F0 nominal {p['f0']:>3} Hz | estimada {estimar_f0(voces[nombre]):6.1f} Hz | "
          f"formantes x{p['factor']:.2f} | RMS {dbfs(np.sqrt(np.mean(voces[nombre] ** 2))):6.1f} dBFS | {p['nota']}")
Voz A   F0 nominal 110 Hz | estimada  107.4 Hz | formantes x1.00 | RMS  -24.9 dBFS | voz de referencia
Voz A2  F0 nominal 110 Hz | estimada  105.3 Hz | formantes x1.00 | RMS  -25.5 dBFS | misma voz, otra frase
Voz B   F0 nominal 180 Hz | estimada  177.8 Hz | formantes x1.10 | RMS  -24.4 dBFS | más aguda, tracto más corto
Voz C   F0 nominal 140 Hz | estimada  135.6 Hz | formantes x1.18 | RMS  -25.0 dBFS | formantes desplazados
Las estimaciones por autocorrelación quedan cerca de los valores nominales: $107.4$ Hz para A, $105.3$ Hz para A2, $177.8$ Hz para B y $135.6$ Hz para C. Quedan ligeramente por debajo porque cada sílaba termina con una caída de entonación del $5%$, como una afirmación del Día 14. Los cuatro niveles RMS están entre $-25.5$ y $-24.4$ dBFS, así que ninguna diferencia posterior se deberá al volumen.
Antes de calcular números, conviene ver las voces. La escala mel imita la forma en que el oído distribuye su resolución: fina en los graves, gruesa en los agudos. Convierte una frecuencia $f$ en hercios a mels con:
$$ m = 2595,\log_{10}\left(1 + \frac{f}{700}\right) $$
La lógica detrás de esta escala es múltiple:
- Por debajo de unos 700 Hz, la relación es casi lineal: el oído distingue bien diferencias pequeñas en los graves, donde viven $F_0$ y el primer formante.
- Por encima, la relación se vuelve logarítmica: duplicar una frecuencia aguda se percibe como un salto parecido al de duplicar una grave.
- En conclusión, un banco de 40 filtros triangulares equiespaciados en mels dedica más filtros a las frecuencias donde la voz tiene más información.
El siguiente código construye ese banco de filtros con numpy, calcula la transformada de Fourier de tiempo corto con scipy.signal.stft (ventanas de 512 muestras, saltos de 10 ms) y dibuja los espectrogramas de mel de 3 segundos de las voces A y B:
# Espectrogramas de mel de las voces A y B en Python:
def hz_a_mel(f):
    return 2595 * np.log10(1 + f / 700)

def mel_a_hz(m):
    return 700 * (10 ** (m / 2595) - 1)

def banco_mel(n_bandas = 40, n_fft = 512, fs = FS, fmin = 50, fmax = 8000):
    # Filtros triangulares equiespaciados en la escala mel:
    bordes_hz = mel_a_hz(np.linspace(hz_a_mel(fmin), hz_a_mel(fmax), n_bandas + 2))
    frecuencias = np.linspace(0, fs / 2, n_fft // 2 + 1)
    banco = np.zeros((n_bandas, len(frecuencias)))
    for b in range(n_bandas):
        izq, centro, der = bordes_hz[b], bordes_hz[b + 1], bordes_hz[b + 2]
        subida = (frecuencias - izq) / (centro - izq)
        bajada = (der - frecuencias) / (der - centro)
        banco[b] = np.clip(np.minimum(subida, bajada), 0, None)
    return banco, bordes_hz[1:-1]

def espectrograma_mel(x, fs = FS, n_fft = 512, salto = 160):
    _, _, Z = stft(x, fs = fs, nperseg = n_fft, noverlap = n_fft - salto, boundary = None)
    banco, centros = banco_mel(n_fft = n_fft, fs = fs)
    return banco @ (np.abs(Z) ** 2), centros

fig, ejes = plt.subplots(1, 2, figsize = (10, 4.2), sharey = True, layout = 'constrained')
for ax, nombre in zip(ejes, ['A', 'B']):
    mel, centros = espectrograma_mel(voces[nombre][: 3 * FS])
    mel_db = 10 * np.log10(mel + 1e-10)
    imagen = ax.imshow(mel_db, origin = 'lower', aspect = 'auto', cmap = 'magma',
                       extent = [0, 3, 0, len(centros)], vmin = mel_db.max() - 70, vmax = mel_db.max())
    ax.set_title(f"Voz {nombre} (F0 = {VOCES[nombre]['f0']} Hz)", fontsize = 14)
    ax.set_xlabel('Tiempo (s)')
ejes[0].set_yticks([0, 10, 20, 30, 39])
ejes[0].set_yticklabels([f'{centros[k]:.0f}' for k in [0, 10, 20, 30, 39]])
ejes[0].set_ylabel('Frecuencia central de la banda mel (Hz)')
fig.colorbar(imagen, ax = ejes, label = 'Energía (dB)')
fig.suptitle('Espectrogramas de mel: 3 s de cada voz', fontsize = 16)
plt.show()
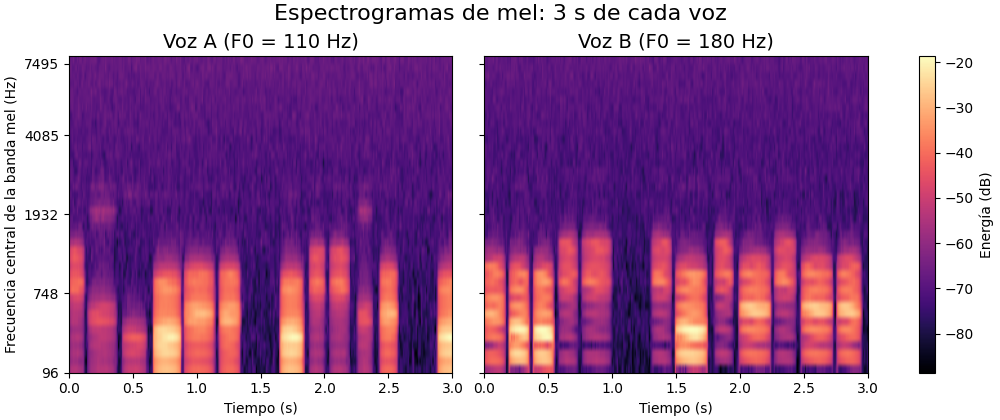
En los dos paneles, cada columna brillante es una sílaba y cada franja horizontal clara es una zona de energía. En la voz A, las franjas inferiores están más juntas porque los armónicos de una $F_0$ de 110 Hz están separados solo 110 Hz entre sí; en la voz B, con 180 Hz, las bandas de energía aparecen más espaciadas y desplazadas hacia arriba, porque sus formantes están un $10%$ más altos. Esa diferencia, que el ojo ve sin esfuerzo, es la que la huella vocal intentará resumir en un vector.
Una huella vocal con MFCC
Los coeficientes cepstrales en la escala mel (o MFCC, por sus siglas en inglés: “Mel-Frequency Cepstral Coefficients”) resumen la forma de la envolvente espectral de cada ventana en unos pocos números. Se obtienen aplicando una transformada discreta del coseno (DCT) al logaritmo de las energías de las $B$ bandas mel (salvo un factor de normalización, que scipy.fft.dct aplica con norm = 'ortho'):
$$ c_k = \sum_{b=0}^{B-1} \log E_b ,\cos\left[\frac{\pi k}{B}\left(b + \tfrac{1}{2}\right)\right], \qquad k = 0, 1, \dots, 12 $$
La lógica detrás de esta fórmula es múltiple:
- El logaritmo convierte en sumas los productos de la fuente y el filtro: el espectro de la voz es, aproximadamente, la fuente glotal multiplicada por la respuesta del tracto vocal, y el logaritmo los separa en dos términos que se suman.
- La DCT describe la forma de la curva de energías por bandas con pocos coeficientes: $c_1$ mide la inclinación general, $c_2$ la curvatura, y los siguientes detalles cada vez más finos.
- El coeficiente $c_0$ es proporcional a la energía total, es decir, al volumen; se descarta para que la huella no dependa de lo cerca que estaba el micrófono.
- En conclusión, los MFCC 1 a 12 resumen el timbre de cada ventana, y su media a lo largo del audio es una huella vocal elemental.
Para comparar dos huellas $\mathbf{u}$ y $\mathbf{v}$ se usa la similitud coseno, que mide el ángulo entre los vectores e ignora su longitud:
$$ \cos(\mathbf{u}, \mathbf{v}) = \frac{\mathbf{u} \cdot \mathbf{v}}{\lVert \mathbf{u} \rVert , \lVert \mathbf{v} \rVert} $$
Vale $1$ cuando los vectores apuntan en la misma dirección, $0$ cuando son perpendiculares y $-1$ cuando son opuestos. El siguiente código calcula los MFCC (solo en las ventanas con voz, para que las pausas no diluyan la huella), la huella media de cada voz, la matriz de similitud de las cuatro y su mapa de calor:
# Huella vocal de juguete con MFCC medios y similitud coseno en Python:
def mfcc(x, n_coef = 13):
    mel, _ = espectrograma_mel(x)
    log_mel = np.log(mel + 1e-10)
    coeficientes = dct(log_mel, type = 2, axis = 0, norm = 'ortho')[:n_coef]
    # Solo ventanas con voz (la energía total por encima de su mediana):
    sonoras = mel.sum(axis = 0) > np.median(mel.sum(axis = 0))
    return coeficientes[:, sonoras]

def huella_vocal(x):
    # Media de los MFCC 1 a 12; el coeficiente 0 (volumen global) se descarta:
    return mfcc(x)[1:].mean(axis = 1)

def similitud_coseno(u, v):
    return float(u @ v / (np.linalg.norm(u) * np.linalg.norm(v)))

nombres = list(voces)
huellas = {nombre: huella_vocal(voces[nombre]) for nombre in nombres}
matriz = np.array([[similitud_coseno(huellas[f], huellas[c]) for c in nombres] for f in nombres])
print('       ' + ''.join(f'{n:>8}' for n in nombres))
for nombre, fila in zip(nombres, matriz):
    print(f'{nombre:<7}' + ''.join(f'{valor:8.3f}' for valor in fila))

fig, ax = plt.subplots(figsize = (5.5, 4.6))
imagen = ax.imshow(matriz, cmap = 'Blues', vmin = matriz.min() - 0.02, vmax = 1)
ax.set_xticks(range(4))
ax.set_xticklabels(nombres)
ax.set_yticks(range(4))
ax.set_yticklabels(nombres)
for i in range(4):
    for j in range(4):
        ax.text(j, i, f'{matriz[i, j]:.3f}', ha = 'center', va = 'center', fontsize = 11,
                color = '#ffffff' if matriz[i, j] > matriz.min() + 0.6 * (1 - matriz.min()) else '#0b0b0b')
fig.colorbar(imagen, ax = ax, label = 'Similitud coseno')
ax.set_title('Similitud entre huellas MFCC', fontsize = 16)
plt.tight_layout()
plt.show()
              A      A2       B       C
A         1.000   0.998   0.925   0.980
A2        0.998   1.000   0.929   0.981
B         0.925   0.929   1.000   0.972
C         0.980   0.981   0.972   1.000
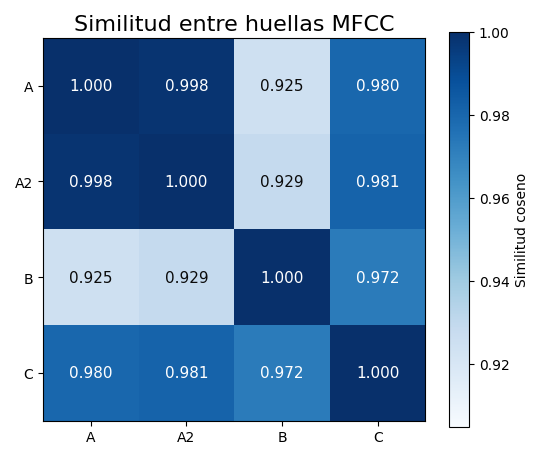
La Tabla 4 recoge la matriz que imprime el código.
Tabla 4. Matriz de similitud coseno entre las huellas MFCC de las cuatro voces sintéticas.
| Voz | A | A2 | B | C |
|---|---|---|---|---|
| A | 1.000 | 0.998 | 0.925 | 0.980 |
| A2 | 0.998 | 1.000 | 0.929 | 0.981 |
| B | 0.925 | 0.929 | 1.000 | 0.972 |
| C | 0.980 | 0.981 | 0.972 | 1.000 |
La primera lectura es alentadora: A y A2, la misma voz con frases distintas, obtienen $0.998$, la similitud más alta fuera de la diagonal. La huella reconoce que el texto cambió pero el timbre no. La voz B, la más distinta en altura, queda en $0.925$ respecto de A.
La segunda lectura es la que importa. Todas las similitudes están por encima de $0.92$, y la voz C, con los formantes desplazados un $18%$, obtiene $0.980$ respecto de A: más parecida a A que B, aunque sus formantes están más lejos de los de A que los de B. La huella media mezcla la altura de la voz con la forma del tracto, y el promedio comprime las diferencias. Con estas cifras, un umbral de “misma persona” en $0.95$ diría que C es A. Un oyente humano no se confundiría.
Cuánto audio hace falta
La matriz anterior usa 8 segundos limpios de cada voz. En la práctica, las muestras son más cortas y más ruidosas. El siguiente experimento responde dos preguntas a la vez: cuánto audio hace falta para que la huella sea estable y si, con suficiente audio, separa una voz de otra. Para ello genera 60 segundos de la voz A y 60 de la voz C con ruido de fondo a $-35$ dBFS, toma como referencia 30 segundos de A grabados en las mismas condiciones y, para cada duración entre 1 y 30 segundos, extrae 20 fragmentos al azar de cada voz y mide su similitud con la referencia. Al final repite la comparación con 30 segundos contra la referencia limpia A2 del bloque anterior:
# Similitud frente a la duración del fragmento de referencia en Python:
gen_curva = np.random.default_rng(2026)
voz_larga = sintetizar_voz(110, 1.00, 60, np.random.default_rng(2031), ruido_dbfs = -35)
impostor_largo = sintetizar_voz(140, 1.18, 60, np.random.default_rng(2032), ruido_dbfs = -35)
# Referencia: 30 s de la voz A grabados en las mismas condiciones de ruido:
referencia = sintetizar_voz(110, 1.00, 30, np.random.default_rng(2033), ruido_dbfs = -35)
huella_referencia = huella_vocal(referencia)
duraciones = [1, 2, 3, 5, 8, 12, 20, 30]
curvas = {'Misma voz (A)': voz_larga, 'Otra voz (C)': impostor_largo}
resultados = {}
for etiqueta, senal in curvas.items():
    medias, desviaciones = [], []
    for d in duraciones:
        valores = []
        for _ in range(20):
            inicio = int(gen_curva.integers(0, len(senal) - d * FS))
            valores.append(similitud_coseno(huella_vocal(senal[inicio: inicio + d * FS]), huella_referencia))
        medias.append(np.mean(valores))
        desviaciones.append(np.std(valores))
    resultados[etiqueta] = (np.array(medias), np.array(desviaciones))

print('Duración (s)  ' + '  '.join(f'{d:>5}' for d in duraciones))
for etiqueta, (medias, desviaciones) in resultados.items():
    print(f'{etiqueta:<14}' + '  '.join(f'{m:5.3f}' for m in medias))
    print(f'{"  desviación":<14}' + '  '.join(f'{s:5.3f}' for s in desviaciones))

# Cambio de condiciones: la referencia limpia A2 (ruido a -55 dBFS) frente a 30 s ruidosos:
for etiqueta, senal in curvas.items():
    print(f'{etiqueta:<14} contra A2 limpia: {similitud_coseno(huella_vocal(senal[:30 * FS]), huellas["A2"]):.3f}')

fig, ax = plt.subplots(figsize = (8, 4.5))
for (etiqueta, (medias, desviaciones)), color in zip(resultados.items(), ['#2a78d6', '#eb6834']):
    ax.plot(duraciones, medias, marker = 'o', color = color, linewidth = 2, label = etiqueta)
    ax.fill_between(duraciones, medias - desviaciones, np.minimum(medias + desviaciones, 1), color = color, alpha = 0.2)
ax.set_xscale('log')
ax.set_xticks(duraciones)
ax.set_xticklabels(duraciones)
ax.set_title('Similitud con la referencia según la duración', fontsize = 16)
ax.set_xlabel('Duración del fragmento (s, escala logarítmica)')
ax.set_ylabel('Similitud coseno (media ± 1 desv.)')
ax.grid(color = '#e1e0d9', linewidth = 0.8)
ax.legend(frameon = False)
plt.tight_layout()
plt.show()
Duración (s)      1      2      3      5      8     12     20     30
Misma voz (A) 0.698  0.833  0.939  0.958  0.977  0.982  0.986  0.987
  desviación  0.354  0.227  0.039  0.029  0.013  0.008  0.006  0.005
Otra voz (C)  0.611  0.829  0.850  0.864  0.910  0.927  0.906  0.912
  desviación  0.369  0.238  0.190  0.138  0.037  0.030  0.022  0.012
Misma voz (A)  contra A2 limpia: 0.865
Otra voz (C)   contra A2 limpia: 0.922
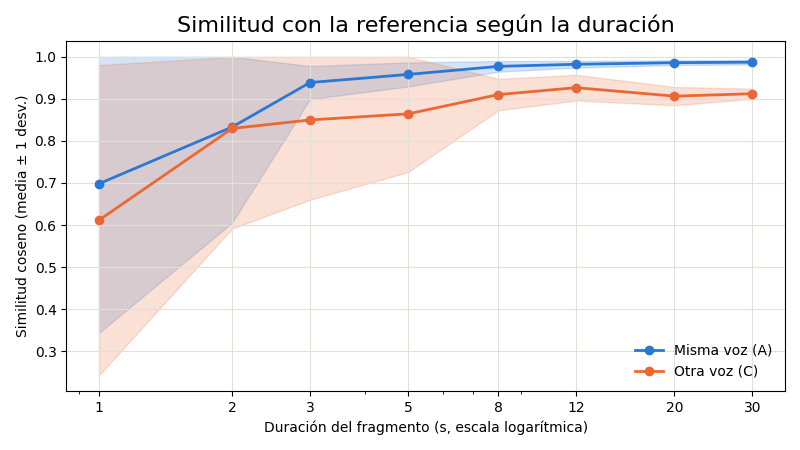
La Tabla 5 resume las medias y las desviaciones estándar que imprime el código.
Tabla 5. Similitud media con la referencia (desviación estándar entre paréntesis) según la duración del fragmento, 20 repeticiones por duración.
| Duración (s) | 1 | 2 | 3 | 5 | 8 | 12 | 20 | 30 |
|---|---|---|---|---|---|---|---|---|
| Misma voz (A) | 0.698 (0.354) | 0.833 (0.227) | 0.939 (0.039) | 0.958 (0.029) | 0.977 (0.013) | 0.982 (0.008) | 0.986 (0.006) | 0.987 (0.005) |
| Otra voz (C) | 0.611 (0.369) | 0.829 (0.238) | 0.850 (0.190) | 0.864 (0.138) | 0.910 (0.037) | 0.927 (0.030) | 0.906 (0.022) | 0.912 (0.012) |
La figura y la tabla cuentan la misma historia en tres tramos. Con 1 y 2 segundos, la medida es casi aleatoria: desviaciones de $0.35$ y $0.23$ y medias prácticamente iguales para la voz correcta y la incorrecta ($0.833$ frente a $0.829$ a los 2 segundos). Un fragmento tan corto puede contener una o dos sílabas, y la huella depende de qué vocales tocaron. Entre 3 y 5 segundos, la voz correcta se estabiliza, pero la incorrecta todavía oscila mucho. A partir de 8 segundos, las bandas se separan: $0.977 \pm 0.013$ frente a $0.910 \pm 0.037$, y a los 30 segundos $0.987 \pm 0.005$ frente a $0.912 \pm 0.012$.
Este resultado de juguete se parece, en su forma, a lo que ocurre con los modelos reales de clonación: unos segundos dan un clon reconocible pero inestable, y la fidelidad mejora con más audio hasta saturarse. Explica también por qué el verificador del Bloque 3 pide al menos 10 segundos.
Límites de la medida
Las dos últimas líneas de la salida del Bloque 11 contienen la lección más importante de la sección. Cuando la referencia es la grabación limpia A2 y los fragmentos son los ruidosos, la voz correcta obtiene $0.865$ y la incorrecta $0.922$: el orden se invierte. El ruido de fondo cambia la envolvente espectral de las pausas y de las colas de las sílabas más que la diferencia de timbre entre A y C, y la huella media no distingue una cosa de la otra. Una persona que se grabara en casa y luego en la calle podría “no parecerse a sí misma” mientras un desconocido en la misma calle “se parecería más”.
De ahí que, en la práctica, haya que tener presentes varios límites:
- Los MFCC medios no son un verificador de hablantes. No modelan la variabilidad de una voz, no compensan el canal (micrófono, sala, ruido) y no se entrenaron para separar personas.
- No use esta medida para “demostrar” identidad, ni para afirmar que un audio es de alguien ni para acusar a nadie de suplantación. Ni siquiera los sistemas profesionales dan certezas: dan puntuaciones con tasas de error que hay que conocer.
- Un clon que “se parece” no es una autorización. Que una métrica diga $0.98$ no cambia quién es el titular de la voz ni para qué dio permiso.
- Compare siempre en las mismas condiciones: misma sala, mismo micrófono, misma duración. La comparación justa del Bloque 11 (referencia ruidosa contra fragmentos ruidosos) es la que separa bien.
Detección, marca de agua y límites legales
La pregunta de Diego al inicio del día (¿cómo sabrá su familia que un audio con su voz lo grabó usted?) tiene tres respuestas parciales que se complementan: detectar el audio sintético después de producido, marcarlo en el momento de producirlo y apoyarse en las normas que obligan a etiquetarlo. Ninguna basta por sí sola.
Detectar voces sintéticas
Los detectores son clasificadores entrenados para distinguir habla real de habla sintética a partir de artefactos sutiles del vocoder, de la fase o de la distribución de energía en las altas frecuencias. Las campañas de evaluación ASVspoof, organizadas desde 2015 por la comunidad de verificación de hablantes, miden su rendimiento frente a sistemas de síntesis y de conversión de voz. Tienen dos límites conocidos: funcionan peor con generadores que no vieron durante el entrenamiento, y la compresión de una llamada telefónica o de una aplicación de mensajería borra parte de los artefactos que buscan. Un detector que dice “real” no prueba que el audio sea auténtico; solo que no encontró lo que sabe buscar.
Una marca de agua de juguete
La marca de agua invierte el problema: en lugar de buscar huellas involuntarias, el generador añade una señal deliberada, inaudible y detectable con una clave. La versión más sencilla es la de espectro ensanchado (Cox et al., 1997): se suma a la voz una secuencia pseudoaleatoria $\mathbf{w}$ de valores $\pm 1$, generada a partir de una clave, multiplicada por una amplitud pequeña $\alpha$. Para detectarla se calcula la correlación normalizada $\rho$ entre el audio y la secuencia de la clave, y se convierte en una puntuación:
$$ z = \rho,\sqrt{N}, \qquad \rho = \frac{\mathbf{x} \cdot \mathbf{w}}{\lVert \mathbf{x} \rVert , \lVert \mathbf{w} \rVert} $$
La lógica detrás de esta puntuación es múltiple:
- Si el audio no contiene la marca, $\mathbf{x}$ y $\mathbf{w}$ no tienen relación y $\rho$ se comporta como una variable aleatoria centrada en cero con desviación de aproximadamente $1/\sqrt{N}$; multiplicar por $\sqrt{N}$ la convierte en una puntuación $z$ estándar.
- Si la contiene, la parte $\alpha\mathbf{w}$ del audio se alinea con la secuencia y $\rho$ crece en proporción a $\alpha$ dividida por el nivel RMS de la voz.
- En conclusión, con $N = 128,000$ muestras (8 segundos), incluso una correlación de $0.03$ da una $z$ cercana a $11$, muy por encima del umbral habitual de $z > 4$.
El siguiente código marca el clon de juguete (la voz A) con la clave de Sofía, lo guarda como WAV de 16 bits, lo relee y prueba la detección en cinco casos:
# Marca de agua de juguete en el clon y detección por correlación en Python:
def secuencia_clave(clave, n):
    # Secuencia pseudoaleatoria de +1 y -1 que solo reproduce quien conoce la clave:
    return np.random.default_rng(clave).choice([-1.0, 1.0], size = n)

def insertar_marca(x, clave, alfa = 0.002):
    return x + alfa * secuencia_clave(clave, len(x))

def detectar_marca(x, clave):
    w = secuencia_clave(clave, len(x))
    rho = float(x @ w / (np.linalg.norm(x) * np.linalg.norm(w)))
    return rho, rho * np.sqrt(len(x))

CLAVE_SOFIA = 15012026
clon = voces['A']
clon_marcado = insertar_marca(clon, CLAVE_SOFIA)
guardar_wav(carpeta_audio / 'dia15_voz_A_marcada.wav', clon_marcado)
_, clon_releido = leer_wav(carpeta_audio / 'dia15_voz_A_marcada.wav')
ruido = 10 ** (-40 / 20) * rng.standard_normal(len(clon))
casos = {'Sin marca': clon,
         'Marcado (WAV releído)': clon_releido,
         'Marcado, clave incorrecta': None,
         'Marcado + ruido a -40 dBFS': clon_releido + ruido,
         'Marcado, volumen x0.5': 0.5 * clon_releido}
for caso, senal in casos.items():
    clave = 12345 if senal is None else CLAVE_SOFIA
    rho, z = detectar_marca(clon_releido if senal is None else senal, clave)
    print(f'{caso:<28} rho = {rho:7.4f} | z = {z:6.2f} | {"DETECTADA" if z > 4 else "no detectada"}')
print('Diferencia audible: marca a', round(dbfs(0.002), 1), 'dBFS frente a voz a',
      round(dbfs(np.sqrt(np.mean(clon ** 2))), 1), 'dBFS RMS')
Sin marca                    rho = -0.0035 | z =  -1.24 | no detectada
Marcado (WAV releído)        rho =  0.0317 | z =  11.34 | DETECTADA
Marcado, clave incorrecta    rho = -0.0002 | z =  -0.09 | no detectada
Marcado + ruido a -40 dBFS   rho =  0.0306 | z =  10.95 | DETECTADA
Marcado, volumen x0.5        rho =  0.0317 | z =  11.34 | DETECTADA
Diferencia audible: marca a -54.0 dBFS frente a voz a -24.9 dBFS RMS
Sin marca, la puntuación es $z = -1.24$, ruido puro. Con la marca, después de pasar por un WAV de 16 bits, sube a $z = 11.34$. Con una clave incorrecta cae a $-0.09$: solo quien conoce la clave puede detectarla. La marca sobrevive al ruido añadido a $-40$ dBFS ($z = 10.95$) y a una bajada de volumen a la mitad ($z = 11.34$, idéntica, porque la correlación normalizada no depende de la escala). Y es inaudible en la práctica: la marca está a $-54.0$ dBFS frente a una voz de $-24.9$ dBFS RMS, unos 29 dB por debajo.
Esta marca es un juguete y no debe presentarse como protección real. Cualquiera que sepa que existe puede degradarla con un filtro, un cambio de velocidad o una recompresión, y no resiste que se recorte o se mezcle el audio con habilidad. Las marcas de agua profesionales, como AudioSeal (San Roman et al., 2024), localizan la marca muestra a muestra y resisten mejor esas transformaciones, pero comparten un límite de fondo: la ausencia de marca no prueba que un audio sea auténtico, porque muchos generadores no marcan nada. El Día 16 medirá con más detalle la robustez de esta marca, y el Día 20 la combinará con metadatos de procedencia firmados.
El marco legal
El tercer apoyo son las normas. La Tabla 6 resume las que afectan directamente a un proyecto como el Cuaderno Vivo, con el estado verificado en las fuentes oficiales o en análisis jurídicos publicados. No es asesoría legal: las obligaciones dependen del país, del uso y de si el audio se publica.
Tabla 6. Normas y políticas que afectan a la clonación de la voz propia (revisado en octubre de 2026).
| Norma o política | Qué exige o prohíbe | Qué significa para Sofía |
|---|---|---|
| Reglamento (UE) 2024/1689, artículo 50 | Marcado legible por máquina de los contenidos sintéticos (proveedores) y etiquetado visible de las ultrasuplantaciones (quienes los publican) | Si publicara un audio con su voz clonada en la UE, debería declararlo como generado por IA |
| Código de Prácticas sobre marcado y etiquetado (Comisión Europea, junio de 2026) | Voluntario; propone al menos dos capas de marcado, como metadatos y marca de agua | Una guía práctica de cómo marcar: metadatos y marca de agua juntos |
| FCC, resolución declaratoria del 8 de febrero de 2024 (EE. UU.) | Las voces generadas con IA son voces “artificiales” bajo la ley TCPA; las llamadas automatizadas con ellas necesitan consentimiento previo | Nunca usar su clon para llamadas automatizadas |
| Licencia CPML de XTTS-v2 | Solo uso no comercial de los pesos del modelo | Válido para el resumen privado; no para un pódcast de pago |
| Política de uso prohibido de ElevenLabs (9 de octubre de 2026) | Consentimiento para reproducir voces; prohibido eludir la verificación por voz; obligación de revelar el uso de IA | La clonación profesional solo admite su propia voz verificada |
Sobre el calendario del artículo 50 conviene precisar dos fechas. Las obligaciones de transparencia se aplican desde el 2 de agosto de 2026. Para el marcado legible por máquina de los sistemas generativos que ya estaban en el mercado antes de esa fecha, el Reglamento (UE) 2026/1744 (Ómnibus Digital sobre IA), publicado en el Diario Oficial el 24 de julio de 2026, dio una prórroga hasta el 2 de diciembre de 2026 (revisado en octubre de 2026).
Además de estas normas específicas, la voz es un dato personal. Cuando se usa para identificar a una persona, el Reglamento General de Protección de Datos europeo la trata como dato biométrico, una categoría especial, y muchas leyes nacionales de protección de datos siguen un criterio parecido. La consecuencia práctica coincide con el protocolo de Sofía: finalidad declarada, almacenamiento mínimo y seguro, plazo de conservación y una forma real de borrar.
Consideraciones finales
El Cuaderno Vivo ya puede hablar con la voz de Sofía, y lo hace dentro de un perímetro que ella misma dibujó: un archivo de consentimiento firmado y con caducidad, una muestra que pasó un verificador con seis comprobaciones, un modelo que solo se carga si las dos cosas anteriores están en orden y una voz genérica de respaldo para cuando no lo estén. Nada de eso hace la clonación más difícil técnicamente; todo eso la hace más difícil de usar mal.
Las cifras del día tienen límites que conviene repetir. Las voces son sintéticas y sus diferencias se controlan con dos parámetros; las similitudes, la curva de duración y la marca de agua son resultados de juguete que ilustran métodos, no mediciones de un producto. La matriz de la Tabla 4 muestra que una huella media puede confundir voces que un oído distingue, y la inversión del Bloque 11 muestra que el ruido puede pesar más que el timbre. Las políticas y licencias citadas cambian con frecuencia y deben releerse antes de cada decisión.
Antes de clonar su propia voz, conviene hacerse algunas preguntas:
- ¿Para qué necesito exactamente un clon de mi voz, y lo escribí en el campo
finalidad? - ¿Dónde estará la muestra dentro de un año, y quién más puede acceder a esa carpeta o a ese respaldo?
- ¿Acordé con mi familia una palabra clave o una forma de confirmar que un audio urgente es mío?
- ¿Cómo sabrá quien escuche mis audios que la voz es sintética?
- ¿Qué haré si decido revocar el permiso: sé qué archivos y qué cuentas tengo que limpiar?
Un gran libro que habla de esto es The Voice Catchers (sin traducción al español), en el que Joseph Turow documenta cómo empresas de publicidad, centros de atención telefónica y asistentes de voz convierten la voz en datos para perfilar emociones, salud o personalidad. Escrito antes de la popularización de la clonación zero-shot, explica por qué la voz merece la misma protección que una huella dactilar y ayuda a leer con otros ojos cada “acepto” de una aplicación que pide su micrófono.
Su voz es parte de su identidad: el permiso para clonarla es la primera línea del diseño, no la última. Un proyecto personal no necesita un departamento legal para hacerlo bien; le bastan un archivo con ocho campos, una función que se niega a seguir sin él y la costumbre de decir siempre, en voz alta, que la voz que suena la generó una máquina.
Conclusiones clave
Cómo funciona
- La clonación zero-shot separa quién habla de qué se dice: un codificador convierte unos segundos de audio en un embedding de hablante y el sintetizador habla condicionado por ese vector.
- Basta poco audio porque el modelo ya aprendió un espacio de voces; la muestra solo indica un punto en él, y por eso cualquier audio publicado basta para un clon de baja calidad.
Consentimiento
- El consentimiento, incluso para la voz propia, se convierte en código: ocho campos obligatorios, una huella SHA-256 que detecta ediciones y una caducidad; sin un archivo válido, ningún modelo se carga.
- Nunca se clona a terceros (ni con su permiso), ni a figuras públicas, ni se usa un clon para hacer creer que habla una persona real; una palabra clave familiar es una defensa barata contra la suplantación.
Herramientas
- XTTS-v2 (licencia CPML, solo uso no comercial) mantiene la voz en la laptop, pero no trae salvaguardas: las pone su código.
- ElevenLabs verifica la voz con una Voice CAPTCHA y solo admite clones profesionales de la propia voz; a cambio, la muestra y los textos viajan a la nube.
- El verificador de la muestra rechazó la versión con defectos (pico de $-0.00$ dBFS, $0.10%$ de recorte y $2.01$ s de silencio) y aceptó la corregida.
Medición
- La huella MFCC de juguete reconoce la misma voz con otra frase ($0.998$), pero todas las similitudes superan $0.92$ y la voz C ($0.980$) parece más cercana a A que la voz B.
- Con 1 o 2 segundos la medida es casi aleatoria; desde 8 segundos separa la voz correcta ($0.977$) de la incorrecta ($0.910$) si las condiciones de grabación coinciden.
- Con condiciones distintas el orden se invierte ($0.865$ frente a $0.922$): los MFCC medios no son un verificador de hablantes y nunca deben usarse para demostrar identidad.
Detección y ley
- La marca de agua de juguete se detecta con $z = 11.34$ con la clave correcta y desaparece con una incorrecta, pero es fácil de eliminar y su ausencia no prueba autenticidad.
- El artículo 50 del Reglamento europeo de IA obliga a marcar y etiquetar contenidos sintéticos desde agosto de 2026, y en EE. UU. las llamadas automatizadas con voces de IA necesitan consentimiento previo desde 2024.
Mañana, en el Día 16: Mini proyecto: el Cuaderno Vivo habla y deja huella. Con la voz propia y su consentimiento en regla, Sofía producirá un episodio de 60 segundos con guion escrito por Claude, música de fondo sintetizada, mezcla con ducking y una marca de agua cuya robustez medirá frente al ruido, el volumen y el recorte, y cerrará el módulo 4/6 antes de que el módulo 5/6, Ética y Riesgos de la Inteligencia Artificial Generativa, convierta las preguntas de Diego en una matriz de riesgos.
Referencias
- Casanova, E. et al. (2024). XTTS: a Massively Multilingual Zero-Shot Text-to-Speech Model. Interspeech 2024. arXiv:2406.04904.
- Jia, Y. et al. (2018). Transfer Learning from Speaker Verification to Multispeaker Text-To-Speech Synthesis. Advances in Neural Information Processing Systems 31 (NeurIPS 2018).
- ElevenLabs (2026). Help center: “Can I create a Professional Voice Clone of someone else’s voice?”; Voice cloning; Text to Speech API reference; Prohibited Use Policy. https://elevenlabs.io/docs
- Coqui (2023). XTTS-v2, ficha del modelo y Coqui Public Model License. Hugging Face. https://huggingface.co/coqui/XTTS-v2
- Idiap Research Institute (2026). coqui-ai-TTS, README del repositorio. https://github.com/idiap/coqui-ai-TTS
- Davis, S. y Mermelstein, P. (1980). Comparison of Parametric Representations for Monosyllabic Word Recognition in Continuously Spoken Sentences. IEEE Transactions on Acoustics, Speech, and Signal Processing, 28(4), 357-366.
- Cox, I. J. et al. (1997). Secure Spread Spectrum Watermarking for Multimedia. IEEE Transactions on Image Processing, 6(12), 1673-1687.
- San Roman, R. et al. (2024). Proactive Detection of Voice Cloning with Localized Watermarking. ICML 2024. arXiv:2401.17264.
- Parlamento Europeo y Consejo de la Unión Europea (2024). Reglamento (UE) 2024/1689 por el que se establecen normas armonizadas en materia de inteligencia artificial, artículo 50. Diario Oficial de la Unión Europea.
- Comisión Europea (2026). Code of Practice on marking and labelling of AI-generated content. https://digital-strategy.ec.europa.eu/en/policies/code-practice-ai-generated-content
- Federal Communications Commission (2024). Declaratory Ruling on AI-generated voices in robocalls under the TCPA (CG Docket No. 23-362), 8 de febrero de 2024.
- Turow, J. (2021). The Voice Catchers: How Marketers Listen In to Exploit Your Feelings, Your Privacy, and Your Wallet. Yale University Press.