
IA generativa en proyectos personales: Día 20
 Jeshua Romero Guadarrama
- 61 Min para leer
- 20 Jan, 2026
Índice de contenido
Resumen:
Un contenido generado con IA plantea dos preguntas que ninguna métrica de calidad responde: de quién es y cómo se sabe que es sintético. En esta entrada se cierra el módulo 5/6 separando las tres preguntas legales que suelen mezclarse (datos de entrenamiento, autoría de la salida y licencia del modelo), repasando las obligaciones de transparencia del artículo 50 del Reglamento europeo de IA y comparando, con código que se ejecuta, tres huellas distintas: una marca de agua de texto de “lista verde” con su prueba $z$, una marca frágil y otra robusta en imagen, y un manifiesto firmado que se rompe con un solo píxel. Al terminar, usted sabrá medir cuántos tokens hacen falta para atribuir un texto, por qué los detectores pasivos de deepfakes no bastan y cómo redactar la política de divulgación del Cuaderno Vivo.
¿Cómo citar el presente artículo?
Romero, J. (20 de enero de 2026). IA generativa en proyectos personales: Día 20. python-data-engineer. https://www.python-data-engineer.com/post/iag/dia_20/.
IA generativa en proyectos personales: Día 20 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/iag/dia_20/.
Modelos, precios y regulación revisados en octubre de 2026. Las fechas del Reglamento europeo de IA, la versión de la especificación C2PA y el estado de SynthID que se citan hoy se contrastaron con fuentes oficiales y especializadas en octubre de 2026.
Día 20. Autoría, procedencia, marcas de agua y deepfakes
Introducción
Ayer, en el Día 19, aprendió a minimizar los datos que salen de su equipo, a redactar datos personales antes de enviarlos a la API y a defender un sistema por capas contra la inyección de prompts, y el Cuaderno Vivo ganó un filtro de datos personales y un banco de pruebas de inyección contra sí mismo. Con eso, el módulo 5/6 ya ha recorrido el mapa de riesgos (Día 17), la fiabilidad y los sesgos medidos con honestidad (Día 18) y la privacidad y la seguridad (Día 19). Hoy lo cierra con la pregunta que queda pendiente desde el módulo 3: ¿de quién es lo que genera el Cuaderno Vivo y cómo se sabe que es sintético?
La pregunta no es retórica. En cuatro módulos, el Cuaderno Vivo de Sofía ha aprendido a resumir notas con Claude, a generar portadas semanales con FLUX.1 schnell y a narrar un pódcast con la voz propia de Sofía. Cada una de esas salidas puede salir de su laptop: una portada compartida en una red social, un resumen pegado en un foro de estudiantes, un episodio enviado a una amiga. Una vez fuera, el archivo viaja solo, y con él viajan dos dudas. La primera es de autoría: si alguien copia la portada, ¿puede Sofía reclamarla como suya? La segunda es de procedencia: si alguien recibe el episodio sin contexto, ¿cómo puede saber que la voz es sintética?
Diego, que lleva cuatro días haciendo de abogado del diablo, lo plantea con su franqueza habitual: “Sus portadas llevan una etiqueta que dice Generado con IA, pero cualquiera la recorta en dos segundos. Y sus metadatos se borran al convertir a JPEG, usted misma lo demostró en el Día 12. ¿Qué queda entonces?” La respuesta de hoy es que queda un ecosistema: etiquetas visibles, metadatos, manifiestos firmados y marcas de agua invisibles, cada uno con un punto débil distinto, y ninguno suficiente por sí solo.
En la presente entrada, descubrirá cómo separar las tres preguntas legales que suelen confundirse en la IA generativa, qué exige el artículo 50 del Reglamento europeo de IA y desde cuándo, y cómo funcionan por dentro las marcas de agua. Implementará una marca de agua de texto de “lista verde”, como la propuesta por Kirchenbauer y sus colaboradores en $2023$, medirá su potencia estadística frente a la longitud del texto y frente a la edición, y la comparará con dos marcas en imagen (una frágil por bits menos significativos y otra robusta por espectro ensanchado) y con un manifiesto firmado. Verá por qué los detectores pasivos de deepfakes fallan justo cuando más se necesitan y terminará con el mini proyecto del módulo: la política de divulgación DIVULGACION.md del Cuaderno Vivo.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Distinguir tres preguntas legales distintas: datos de entrenamiento, autoría de la salida y licencia del modelo.
- Conocer las obligaciones de transparencia del artículo 50 del AI Act y su calendario, incluido el cambio introducido por el Reglamento (UE) 2026/1744.
- Comparar mecanismos de procedencia: metadatos, Content Credentials (C2PA) y marcas de agua (SynthID, AudioSeal, marcas en texto).
- Implementar y detectar una marca de agua de texto de “lista verde” de juguete y estudiar su potencia estadística.
- Explicar por qué la detección automática de deepfakes no basta y qué hacer como creador responsable.
- Redactar la política de divulgación del Cuaderno Vivo (mini proyecto del módulo).
Tres preguntas que suelen mezclarse
Cuando alguien pregunta "¿es legal usar IA generativa en mi proyecto?", suele mezclar tres preguntas que tienen respuestas, actores y riesgos distintos. Separarlas es el primer paso para responder alguna.
La primera es la pregunta de los datos de entrenamiento: ¿pudo el proveedor del modelo entrenarlo con las obras que usó? Es una pregunta sobre el proveedor, no sobre usted, y es la que se discute en los tribunales y en los reguladores. En la Unión Europea, el Reglamento de IA obliga a los proveedores de modelos de propósito general a tener una política de respeto de los derechos de autor y a publicar un resumen del contenido usado para entrenar; en Estados Unidos, la discusión gira en torno al uso legítimo (fair use) y la Oficina de Derechos de Autor le dedicó la tercera parte de su informe sobre IA. Para Sofía, la consecuencia práctica es modesta pero real: elegir modelos cuyos proveedores documenten su origen de datos y su licencia.
La segunda es la pregunta de la autoría de la salida: ¿es Sofía la autora de la portada que generó? Es una pregunta sobre ella y sobre lo que añadió de su mano. La tercera es la pregunta de la licencia del modelo: ¿qué le permite hacer el contrato de uso del modelo o del servicio con lo que genera? Es una pregunta contractual, y es la única de las tres que Sofía puede responder hoy mismo leyendo un documento: la ficha de FLUX.1 [schnell] en Hugging Face (Apache 2.0), la de XTTS-v2 (Coqui Public Model License, uso no comercial) o las condiciones comerciales de Anthropic para la API de Claude. La Tabla 1 las resume.
Tabla 1. Las tres preguntas legales, a quién afectan y qué hacer en un proyecto personal.
| Pregunta | A quién afecta sobre todo | Qué la decide | Qué hacer en el Cuaderno Vivo |
|---|---|---|---|
| Datos de entrenamiento | Al proveedor del modelo | Derechos de autor, excepciones de minería de textos y datos, litigios en curso | Preferir modelos con ficha, licencia y origen de datos documentados |
| Autoría de la salida | A quien genera y publica | Aportación humana perceptible en el resultado | Guardar prompt, semilla, guía de estilo y ediciones manuales |
| Licencia del modelo | A quien usa el modelo o el servicio | Contrato de uso (Apache 2.0, CPML, condiciones del servicio) | Leer la licencia antes de publicar; no usar XTTS-v2 con fines comerciales |
Observe que las tres preguntas pueden tener respuestas contrarias para el mismo archivo. Una portada de Sofía puede venir de un modelo cuya licencia permite el uso comercial (tercera pregunta resuelta), entrenado con datos cuya legalidad se discute en un tribunal (primera pregunta abierta) y ser, en su mayor parte, no protegible como obra suya (segunda pregunta). Que una licencia le permita usar una salida no la convierte en obra suya, y que no sea obra suya no le impide usarla.
Autoría de lo generado
El Día 12 ya presentó la postura de la Oficina de Derechos de Autor de Estados Unidos, publicada en enero de $2025$ en la segunda parte de su informe Copyright and Artificial Intelligence: una salida generada solo a partir de un prompt no se considera obra de autoría humana, porque el prompt, por detallado que sea, no controla los elementos expresivos del resultado. Lo que sí puede protegerse es la aportación humana perceptible: la selección y disposición creativa de elementos generados, las modificaciones hechas a mano y las obras propias que se usan como entrada y siguen siendo reconocibles en la salida.
Hoy interesa generalizar esa idea a las tres modalidades del Cuaderno Vivo:
- Texto. Un resumen que Claude escribe a partir de las notas de Sofía no es obra suya en ese marco; las notas originales, sí. Si Sofía reescribe el resumen, corrige el tono y decide qué incluir, la versión editada contiene aportación humana.
- Imagen. La acuarela de FLUX no sería suya; la composición de la portada (la banda, la tipografía, el título, la paleta de su guía de estilo) es trabajo humano de diseño.
- Audio. El guion editado por Sofía y la música compuesta a mano en el Día 16 son aportación humana; la voz sintetizada, aunque imite su timbre, es una salida del modelo. El timbre de una voz, además, se protege en muchos lugares por la vía de los derechos de la personalidad, no por la de los derechos de autor.
Otras jurisdicciones razonan de forma distinta. El Reino Unido conserva en su ley una figura específica para obras generadas por computadora sin autor humano, y algunos tribunales de China han reconocido protección a imágenes generadas cuando el usuario demostró un proceso creativo iterativo. La consecuencia práctica, sin embargo, coincide: documentar el proceso es documentar la parte del trabajo que es suya. El registro de prompts, semillas y ediciones del Cuaderno Vivo no es burocracia: es la prueba de su aportación.
Esta entrada no es asesoría jurídica. Resume documentos públicos para que usted sepa qué preguntas hacer; la respuesta a su caso concreto depende del país donde publique, del tipo de obra y de los contratos que haya aceptado. Si su proyecto tiene fines comerciales o involucra a terceros, consulte a un profesional del derecho de su jurisdicción.
Marcas de agua en texto: la lista verde
La autoría responde a de quién es; la procedencia responde a de dónde viene. Para el texto, la procedencia es especialmente difícil: un resumen no tiene metadatos ni píxeles donde esconder nada, y cualquiera puede copiarlo y pegarlo en otro lugar. La única huella posible es la propia elección de las palabras. Esa es la idea de las marcas de agua estadísticas en texto: sesgar ligeramente las elecciones del modelo, de una forma que solo reconoce quien conoce una clave.
El esquema más estudiado es el de Kirchenbauer y sus colaboradores, presentado en ICML $2023$. Funciona así en cada paso de la generación:
- Se toma el token anterior y una clave secreta, y con ambos se siembra un generador pseudoaleatorio.
- Ese generador reparte el vocabulario en dos listas: una verde, con una fracción $\gamma$ de los tokens, y una roja, con el resto.
- Se suma una constante $\delta$ a los logits de los tokens verdes, antes del softmax.
- Se muestrea el siguiente token como siempre (el muestreo del Día 3).
Como la lista cambia con el token anterior, ninguna palabra es verde siempre; un lector humano no ve nada raro. Pero un texto marcado tendrá muchos más tokens verdes de los que daría el azar, y quien tenga la clave puede contarlos. La probabilidad de que el siguiente token sea verde, si todos los tokens tuvieran el mismo logit, pasa de $\gamma$ a:
$$ p_V = \frac{\gamma , e^{\delta}}{1 - \gamma + \gamma , e^{\delta}} $$
La lógica detrás de esta fórmula es múltiple:
- Sumar $\delta$ a un logit multiplica su peso en el softmax por $e^{\delta}$. Los $\gamma V$ tokens verdes pasan a pesar $e^{\delta}$ cada uno, y los $(1-\gamma) V$ rojos siguen pesando $1$.
- La probabilidad de caer en la lista verde es el peso verde dividido entre el peso total; el tamaño $V$ del vocabulario se cancela.
- Con $\gamma = 0.5$ y $\delta = 2$, $p_V = 0.5 \cdot 7.389 / (0.5 + 0.5 \cdot 7.389) = 0.881$: en lugar de la mitad de los tokens, casi nueve de cada diez serían verdes.
- En conclusión, $\delta$ controla la fuerza de la marca: un $\delta$ grande la hace fácil de detectar, pero también fuerza al modelo a elegir palabras que no habría elegido, lo que empeora la calidad del texto.
Esa última viñeta tiene un matiz importante: la fórmula supone que el modelo duda entre muchas opciones. Cuando el modelo está muy seguro (por ejemplo, al completar “Ciudad de” con “México”), la diferencia de logits supera con mucho a $\delta$ y la marca no puede cambiar la elección. La marca de lista verde solo se imprime donde el modelo tiene libertad para elegir, y por eso los textos de baja entropía (código, listas, respuestas muy cortas) casi no se pueden marcar.
Un vocabulario y una clave
El modelo de juguete de hoy necesita un vocabulario, una clave y una función que reparta el vocabulario. Como en todos los días de la serie, el primer bloque fija las importaciones y la semilla global $2026$:
# Importaciones base y semilla del día en Python:
import warnings
warnings.filterwarnings('ignore')
import hashlib
import hmac
import io
import re
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import PIL
from PIL import Image
from PIL.PngImagePlugin import PngInfo
from scipy import stats

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
print('numpy', np.__version__, '| pandas', pd.__version__, '| Pillow', PIL.__version__)
numpy 2.4.6 | pandas 3.0.3 | Pillow 12.2.0
El vocabulario tiene $1,000$ tokens: las palabras únicas de las $12$ notas de Sofía (Tabla 1 del Día 1), completadas con tokens de relleno. La función lista_verde usa SHA-256 sobre la clave y el token anterior para sembrar un generador y permutar el vocabulario; los primeros $\gamma V$ tokens de la permutación son verdes. Como solo hay $1,000$ tokens previos posibles, conviene precalcular la tabla completa una vez:
# Vocabulario de juguete de 1 000 tokens y lista verde con clave en Python:
notas = [
    'La media resume un conjunto de datos en un solo número, pero es sensible a los valores extremos de la muestra.',
    'La desviación estándar mide cuánto se alejan los datos de la media y ayuda a comparar la dispersión de dos grupos.',
    'Un intervalo de confianza da un rango de valores plausibles para la media de la población a partir de una muestra.',
    'En Python una lista guarda elementos en orden y se puede recorrer con un ciclo for para sumar los datos.',
    'Pandas lee un archivo CSV y crea una tabla de datos que se puede filtrar, agrupar y resumir con pocas líneas.',
    'Una función en Python recibe argumentos y devuelve un resultado, lo que ayuda a no repetir el mismo código.',
    'El Renacimiento recuperó la perspectiva y la proporción del arte clásico para dar profundidad a la pintura.',
    'El impresionismo pintó la luz al aire libre con pinceladas sueltas y colores puros sin mezclar en la paleta.',
    'El cubismo rompió la perspectiva única y mostró un objeto desde varios puntos de vista en el mismo cuadro.',
    'Una escala mayor sigue el patrón tono, tono, semitono, tono, tono, tono, semitono y suena alegre en la guitarra.',
    'Un acorde se forma con tres notas de la escala y la guitarra puede tocar el mismo acorde en varias posiciones.',
    'Practicar la guitarra cada día con un metrónomo ayuda a medir el tiempo y a tocar con un ritmo estable.',
]
# Palabras únicas de las 12 notas de Sofía, completadas con tokens de relleno hasta 1 000:
palabras = sorted({p for nota in notas for p in re.findall(r'\w+', nota.lower())})
V = 1000
vocabulario = palabras + [f'tok{i:03d}' for i in range(V - len(palabras))]
GAMMA = 0.5                  # fracción del vocabulario que es verde en cada paso
CLAVE = 'cuaderno-vivo-2026' # clave secreta de Sofía

def lista_verde(token_previo, gamma = GAMMA, clave = CLAVE):
    # La clave y el token anterior siembran un generador que reparte el vocabulario:
    semilla = int.from_bytes(hashlib.sha256(f'{clave}|{token_previo}'.encode()).digest()[:8], 'big')
    orden = np.random.default_rng(semilla).permutation(V)
    verde = np.zeros(V, dtype = bool)
    verde[orden[:int(gamma * V)]] = True
    return verde

# Como solo hay 1 000 tokens previos posibles, se precalcula la tabla completa:
def tabla_verde(gamma = GAMMA, clave = CLAVE):
    return np.array([lista_verde(t, gamma, clave) for t in range(V)])

verdes = tabla_verde()
print(f'{len(palabras)} palabras de las notas + {V - len(palabras)} tokens de relleno = {len(vocabulario)} tokens')
previo = vocabulario.index('guitarra')
print(f'Después de "guitarra": {verdes[previo].sum()} tokens verdes de {V}')
print('Algunos verdes:', [vocabulario[i] for i in np.flatnonzero(verdes[previo])[:6]])
print('Coincidencia con la lista tras "media":', round((verdes[previo] == verdes[vocabulario.index('media')]).mean(), 3))
130 palabras de las notas + 870 tokens de relleno = 1000 tokens
Después de "guitarra": 500 tokens verdes de 1000
Algunos verdes: ['a', 'aire', 'al', 'archivo', 'arte', 'cada']
Coincidencia con la lista tras "media": 0.506
Las $12$ notas aportan $130$ palabras distintas, y los $870$ tokens restantes son de relleno. Tras la palabra “guitarra”, exactamente $500$ tokens son verdes, como corresponde a $\gamma = 0.5$, y entre ellos están “a”, “aire”, “al” y “archivo”. La última línea muestra que la lista depende del token previo: la lista que sigue a “media” coincide con la que sigue a “guitarra” en el $50.6%$ de los tokens, prácticamente lo que daría el azar. Sin la clave, nadie puede reconstruir qué palabras son verdes en cada paso.
Generar con la marca
El generador de juguete sustituye a la red neuronal por unas “preferencias” fijas (logits_base) más un ruido distinto en cada paso, que simula que el contexto cambia. Si marcar es verdadero, suma $\delta$ a los logits verdes según el token anterior, aplica el softmax del Día 3 y muestrea:
# Generador de texto de juguete con marca de lista verde en Python:
logits_base = rng.normal(0, 1.5, V)   # preferencias fijas de la "red" ficticia

def generar(T, delta = 2.0, marcar = True, tabla = verdes, rng = rng):
    tokens = [int(rng.integers(V))]   # primer token al azar, sin puntuar
    for _ in range(T):
        logits = logits_base + rng.normal(0, 1.0, V)   # cada paso, un contexto distinto
        if marcar:
            logits = logits + delta * tabla[tokens[-1]]  # empujón de delta a los verdes
        p = np.exp(logits - logits.max())
        p = p / p.sum()                                  # softmax del Día 3
        tokens.append(int(np.searchsorted(np.cumsum(p), rng.random())))
    return np.array(tokens)

texto_marcado = generar(100, delta = 2.0)
texto_libre = generar(100, marcar = False)
print('Primeros 20 ids marcados:', texto_marcado[1:21].tolist())
print('Como palabras:', ' '.join(vocabulario[i] for i in texto_marcado[1:9]))
Primeros 20 ids marcados: [172, 487, 412, 49, 378, 429, 613, 842, 360, 560, 511, 738, 48, 740, 46, 414, 710, 867, 95, 460]
Como palabras: tok042 tok357 tok282 guarda tok248 tok299 tok483 tok712
Los primeros $20$ identificadores del texto marcado no muestran ningún patrón visible, y traducidos a palabras dan una secuencia en la que se cuela “guarda”, una palabra de las notas de Python. El texto no tiene sentido porque el generador no es un modelo de lenguaje, pero eso no importa para la marca: lo único que se va a medir es cuántos tokens cayeron en la lista verde de su predecesor.
Detectar
Para detectar la marca no hace falta el modelo, ni los logits, ni el prompt: basta el texto y la clave. Se recorren los pares (token anterior, token actual), se cuenta cuántos tokens actuales están en la lista verde de su predecesor, $|s|_G$, y se compara con lo que daría el azar mediante una puntuación $z$:
$$ z = \frac{|s|_G - \gamma T}{\sqrt{T \gamma (1 - \gamma)}} $$
La lógica detrás de esta prueba es múltiple:
- Si el texto no tiene marca (lo escribió una persona, u otro modelo, o el mismo modelo sin la marca), cada token cae en la lista verde con probabilidad $\gamma$, de forma independiente de la clave. El conteo $|s|_G$ sigue una distribución binomial con media $\gamma T$.
- El denominador es la desviación estándar de esa binomial, $\sqrt{T\gamma(1-\gamma)}$. Dividir entre ella convierte el exceso de verdes en un número de desviaciones estándar, comparable entre textos de cualquier longitud.
- Para $T$ moderado, la binomial se parece a una normal, y $z$ se comporta como una normal estándar bajo la hipótesis de que no hay marca. El umbral de la serie, $z > 4$, deja una probabilidad de falsa alarma de unas $3$ en $100,000$.
- En conclusión, como en el audio del Día 16, detectar una marca es una prueba de hipótesis: $z$ dice cuánto se aleja el conteo observado de lo que daría el azar.
El ejemplo numérico de la ficha ayuda a fijar la escala: con $T = 100$ tokens y $75$ verdes, $z = (75 - 50) / \sqrt{100 \cdot 0.25} = 25 / 5 = 5$, suficiente para superar el umbral. El siguiente código implementa el detector y lo prueba con el texto marcado, con un texto sin marca y con el texto marcado pero una clave equivocada:
# Detector de la marca: tokens verdes y puntuación z en Python:
def detectar(tokens, gamma = GAMMA, tabla = verdes):
    previos, actuales = tokens[:-1], tokens[1:]
    T = len(actuales)
    n_verdes = int(tabla[previos, actuales].sum())   # |s|_G
    z = (n_verdes - gamma * T) / np.sqrt(T * gamma * (1 - gamma))
    return n_verdes, z

tabla_ajena = tabla_verde(clave = 'otra-clave')
for nombre, tokens, tabla in [('Marcado, clave correcta', texto_marcado, verdes),
                              ('Sin marca', texto_libre, verdes),
                              ('Marcado, clave incorrecta', texto_marcado, tabla_ajena)]:
    n_verdes, z = detectar(tokens, tabla = tabla)
    print(f'{nombre:<26} verdes = {n_verdes:>3} de 100 | z = {z:6.2f}')
print(f'Probabilidad de z > 4 por azar: {stats.norm.sf(4):.1e}')
Marcado, clave correcta    verdes =  91 de 100 | z =   8.20
Sin marca                  verdes =  48 de 100 | z =  -0.40
Marcado, clave incorrecta  verdes =  55 de 100 | z =   1.00
Probabilidad de z > 4 por azar: 3.2e-05
El texto marcado tiene $91$ tokens verdes de $100$ y una puntuación $z = 8.20$, muy por encima del umbral. El texto sin marca tiene $48$ verdes y $z = -0.40$, exactamente lo que se espera del azar. La tercera fila es la más instructiva: el mismo texto marcado, examinado con otra clave, da $z = 1.00$. Sin la clave correcta, la marca es invisible, lo que tiene dos caras: nadie ajeno puede detectarla, pero tampoco puede verificarla un tercero si el dueño de la clave no colabora. La última línea confirma la cifra del umbral: la probabilidad de que una normal estándar supere $4$ es $3.2 \times 10^{-5}$.
Mil textos
Un solo texto no basta para juzgar un detector. El siguiente bloque genera $500$ textos marcados y $500$ sin marcar, todos de $T = 100$ tokens con $\delta = 2$, y compara el resultado con la fracción verde teórica $p_V$ y con la puntuación esperada que de ella se deduce:
$$ \mathbb{E}[z] \approx \frac{(p_V - \gamma)\sqrt{T}}{\sqrt{\gamma(1-\gamma)}} $$
La lógica detrás de esta aproximación es múltiple:
- Si cada token es verde con probabilidad $p_V$, el conteo esperado es $p_V T$; restar $\gamma T$ y dividir entre la desviación estándar da la fórmula.
- El numerador crece con $T$ y el denominador de $z$ con $\sqrt{T}$, de modo que la puntuación esperada crece con $\sqrt{T}$: cuadruplicar la longitud duplica la evidencia.
- En conclusión, la fuerza de la marca ($\delta$, a través de $p_V$) y la longitud del texto ($T$) se compensan: un texto largo con una marca débil puede detectarse tan bien como uno corto con una marca fuerte.
# Simulación de 500 textos con marca y 500 sin marca (T = 100, delta = 2) en Python:
T, DELTA, N_TEXTOS = 100, 2.0, 500
z_libres = np.array([detectar(generar(T, marcar = False))[1] for _ in range(N_TEXTOS)])
z_marcados = np.array([detectar(generar(T, delta = DELTA))[1] for _ in range(N_TEXTOS)])

# Fracción verde esperada con el empujón delta y puntuación z esperada:
p_verde = GAMMA * np.exp(DELTA) / (1 - GAMMA + GAMMA * np.exp(DELTA))
z_teorica = (p_verde - GAMMA) * np.sqrt(T) / np.sqrt(GAMMA * (1 - GAMMA))
resumen = pd.DataFrame({
    'z medio': [z_libres.mean(), z_marcados.mean()],
    'desviación': [z_libres.std(), z_marcados.std()],
    'mínimo': [z_libres.min(), z_marcados.min()],
    'máximo': [z_libres.max(), z_marcados.max()],
    'z > 4 (%)': [100 * (z_libres > 4).mean(), 100 * (z_marcados > 4).mean()],
}, index = ['sin marca', 'con marca']).round(2)
print(resumen)
print(f'Fracción verde teórica: {p_verde:.3f} | z teórica: {z_teorica:.2f}')
           z medio  desviación  mínimo  máximo  z > 4 (%)
sin marca     0.00        1.04    -2.8     3.0        0.0
con marca     7.62        0.64     5.8     9.4      100.0
Fracción verde teórica: 0.881 | z teórica: 7.62
Los textos sin marca tienen una puntuación media de $0.00$ con desviación $1.04$, prácticamente una normal estándar, y ninguno supera el umbral: el máximo es $3.0$. Los textos marcados tienen una puntuación media de $7.62$, con un mínimo de $5.8$, y el $100%$ supera el umbral. La coincidencia con la teoría es exacta: la fracción verde teórica es $0.881$ y la puntuación esperada $7.62$. Esa coincidencia se debe a que el generador de juguete tiene mucha entropía (duda entre cientos de tokens en cada paso); en un modelo real, con pasos de baja entropía, la puntuación observada queda por debajo de la teórica.
El histograma del siguiente bloque muestra las dos distribuciones y el umbral:
# Histogramas de z con y sin marca y el umbral z = 4 en Python:
fig, ax = plt.subplots(figsize = (6.4, 4.8))
bordes = np.linspace(-4, 12, 65)
ax.hist(z_libres, bins = bordes, color = '#4C72B0', alpha = 0.75, label = 'Sin marca (500)')
ax.hist(z_marcados, bins = bordes, color = '#DD8452', alpha = 0.75, label = 'Con marca (500)')
ax.axvline(4, color = 'black', linestyle = '--', linewidth = 1.5, label = 'Umbral z = 4')
ax.set_title('Puntuación z del detector (T = 100)', fontsize = 16)
ax.set_xlabel('Puntuación z')
ax.set_ylabel('Número de textos')
ax.legend()
plt.tight_layout()

# Dos montañas separadas: la marca se distingue sin falsas alarmas:
plt.show()
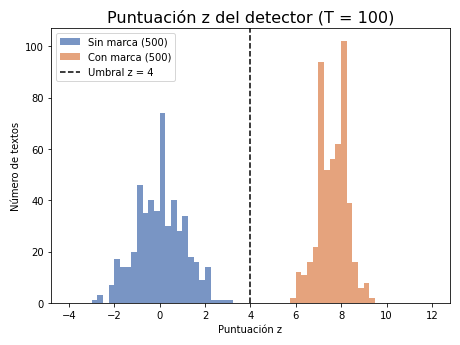
Las dos montañas no se tocan: la azul (sin marca) se concentra entre $-3$ y $3$, la naranja (con marca) entre $6$ y $9.5$, y la línea discontinua de $z = 4$ pasa por el valle vacío. Con $100$ tokens y $\delta = 2$, el detector de juguete no comete errores en $1,000$ textos.
Potencia frente a longitud
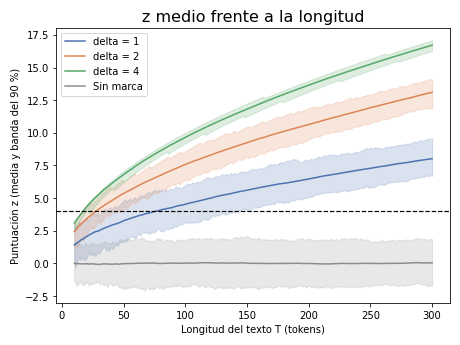
Cien tokens son unas $75$ palabras: un párrafo. ¿Qué pasa con un mensaje corto, como el título de una nota o una respuesta de dos líneas? La potencia de una prueba es la probabilidad de detectar la marca cuando está presente. El siguiente bloque genera $200$ textos de $300$ tokens para cada $\delta \in {1, 2, 4}$ y otros $200$ sin marca, calcula $z$ para cada prefijo de longitud $T$ entre $10$ y $300$ con una suma acumulada y dibuja la media con una banda que contiene al $90%$ de los textos:
# Puntuación z frente a la longitud del texto para delta = 1, 2 y 4 en Python:
T_MAX, N_LARGOS = 300, 200
longitudes = np.arange(10, T_MAX + 1)

def z_por_prefijo(tokens, gamma = GAMMA):
    # z de cada prefijo de longitud 1..T, con una suma acumulada de aciertos verdes:
    aciertos = np.cumsum(verdes[tokens[:-1], tokens[1:]])
    t = np.arange(1, len(aciertos) + 1)
    return (aciertos - gamma * t) / np.sqrt(t * gamma * (1 - gamma))

curvas = {d: np.array([z_por_prefijo(generar(T_MAX, delta = d)) for _ in range(N_LARGOS)])
          for d in [1.0, 2.0, 4.0]}
curvas[0.0] = np.array([z_por_prefijo(generar(T_MAX, marcar = False)) for _ in range(N_LARGOS)])

fig, ax = plt.subplots(figsize = (6.4, 4.8))
colores = {0.0: '#8C8C8C', 1.0: '#4C72B0', 2.0: '#DD8452', 4.0: '#55A868'}
for d, matriz in curvas.items():
    z = matriz[:, longitudes - 1]
    etiqueta = 'Sin marca' if d == 0 else f'delta = {d:.0f}'
    ax.plot(longitudes, z.mean(axis = 0), color = colores[d], label = etiqueta)
    ax.fill_between(longitudes, np.percentile(z, 5, axis = 0), np.percentile(z, 95, axis = 0),
                    color = colores[d], alpha = 0.2)
ax.axhline(4, color = 'black', linestyle = '--', linewidth = 1.2)
ax.set_title('z medio frente a la longitud', fontsize = 16)
ax.set_xlabel('Longitud del texto T (tokens)')
ax.set_ylabel('Puntuación z (media y banda del 90 %)')
ax.legend()
plt.tight_layout()

# La señal crece con la raíz de T; los textos cortos casi no se pueden atribuir:
plt.show()

# Tabla 2: z medio y tasa de detección con z > 4 por longitud:
filas = []
for T_i in [25, 50, 100, 200]:
    fila = {'T': T_i}
    for d in [1.0, 2.0, 4.0]:
        z = curvas[d][:, T_i - 1]
        fila[f'z medio d={d:.0f}'] = round(z.mean(), 2)
        fila[f'detección d={d:.0f} (%)'] = round(100 * (z > 4).mean(), 1)
    fila['falsas alarmas (%)'] = round(100 * (curvas[0.0][:, T_i - 1] > 4).mean(), 1)
    filas.append(fila)
print(pd.DataFrame(filas).to_string(index = False))
  T  z medio d=1  detección d=1 (%)  z medio d=2  detección d=2 (%)  z medio d=4  detección d=4 (%)  falsas alarmas (%)
 25         2.33                1.5         3.80               40.5         4.83               99.0                 0.0
 50         3.26               18.0         5.36               96.0         6.81              100.0                 0.0
100         4.53               70.0         7.58              100.0         9.66              100.0                 0.0
200         6.46               99.5        10.64              100.0        13.65              100.0                 0.0
La figura muestra la ley de la raíz cuadrada: todas las curvas crecen como $\sqrt{T}$, más deprisa cuanto mayor es $\delta$, y la banda gris de los textos sin marca se queda alrededor de cero sin importar la longitud. La Tabla 2 recoge las cifras de la salida para cuatro longitudes.
Tabla 2. Detección de la marca de texto de juguete: $z$ medio y tasa de detección con $z > 4$ ($200$ textos por celda, $\gamma = 0.5$).
| $T$ (tokens) | $z$ medio, $\delta = 1$ | Detección, $\delta = 1$ | $z$ medio, $\delta = 2$ | Detección, $\delta = 2$ | $z$ medio, $\delta = 4$ | Detección, $\delta = 4$ | Falsas alarmas |
|---|---|---|---|---|---|---|---|
| 25 | 2.33 | 1.5 % | 3.80 | 40.5 % | 4.83 | 99.0 % | 0.0 % |
| 50 | 3.26 | 18.0 % | 5.36 | 96.0 % | 6.81 | 100.0 % | 0.0 % |
| 100 | 4.53 | 70.0 % | 7.58 | 100.0 % | 9.66 | 100.0 % | 0.0 % |
| 200 | 6.46 | 99.5 % | 10.64 | 100.0 % | 13.65 | 100.0 % | 0.0 % |
La tabla se lee como una advertencia. Con $\delta = 2$, un texto de $25$ tokens (unas $18$ palabras, la longitud de una nota de Sofía) se detecta solo en el $40.5%$ de los casos; con $50$ tokens, en el $96%$. Con una marca suave, $\delta = 1$, que apenas altera el estilo, hacen falta unos $200$ tokens para detectar casi siempre. Solo $\delta = 4$ detecta textos de $25$ tokens, y a ese precio el modelo ya está eligiendo palabras forzadas. Las falsas alarmas son $0$ en todas las filas, como se espera de un umbral tan exigente. Los textos cortos casi no se pueden atribuir, y esa es una propiedad matemática del conteo, no un defecto de la implementación.
Atención aquí: La marca de agua de este día es un juguete didáctico y no es segura. La clave está escrita en el código, la lista verde depende solo del token anterior (con suficientes textos marcados, un atacante podría estimar qué pares son verdes por frecuencia) y no hay ninguna defensa contra la edición deliberada. Nunca la use para acusar a nadie de haber usado IA: una puntuación $z$ alta con su clave solo dice que el texto pasó por su generador marcado, y una baja no dice nada sobre quién lo escribió.
Editar el texto y la curva ROC
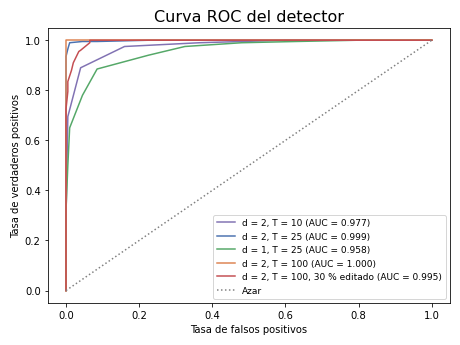
El umbral $z > 4$ es una elección. Bajarlo detecta más textos marcados, pero también produce más falsas alarmas. La curva ROC (por sus siglas en inglés: “Receiver Operating Characteristic”) resume todos los umbrales posibles a la vez: para cada umbral, dibuja la tasa de verdaderos positivos frente a la de falsos positivos, y el área bajo la curva (o AUC, por sus siglas en inglés: “Area Under the Curve”) vale $1$ para un detector perfecto y $0.5$ para uno que adivina.
El siguiente bloque calcula la curva con numpy, sin bibliotecas de aprendizaje automático, para cinco escenarios (en la leyenda, d es $\delta$). El último simula un ataque de edición: se sustituye al azar el $30%$ de los tokens de cada texto marcado, como haría un parafraseo torpe. Cada sustitución daña dos pares, porque el token nuevo cambia su propia pertenencia a la lista verde y también la lista del token siguiente:
# Curva ROC del detector y efecto de editar el 30 % de los tokens en Python:
def curva_roc(z_positivos, z_negativos):
    umbrales = np.sort(np.concatenate([z_positivos, z_negativos, [np.inf]]))[::-1]
    tvp = np.array([(z_positivos >= u).mean() for u in umbrales])
    tfp = np.array([(z_negativos >= u).mean() for u in umbrales])
    return tfp, tvp, np.trapezoid(tvp, tfp)

def editar(tokens, fraccion, rng = rng):
    # Sustituye al azar una fracción de los tokens, como un parafraseo torpe:
    editado = tokens.copy()
    posiciones = rng.choice(np.arange(1, len(tokens)), size = int(fraccion * (len(tokens) - 1)), replace = False)
    editado[posiciones] = rng.integers(V, size = len(posiciones))
    return editado

marcados_100 = [generar(100, delta = 2.0) for _ in range(N_LARGOS)]
z_editados = np.array([detectar(editar(t, 0.30))[1] for t in marcados_100])
escenarios = {
    'd = 2, T = 10': (curvas[2.0][:, 9], curvas[0.0][:, 9]),
    'd = 2, T = 25': (curvas[2.0][:, 24], curvas[0.0][:, 24]),
    'd = 1, T = 25': (curvas[1.0][:, 24], curvas[0.0][:, 24]),
    'd = 2, T = 100': (curvas[2.0][:, 99], curvas[0.0][:, 99]),
    'd = 2, T = 100, 30 % editado': (z_editados, curvas[0.0][:, 99]),
}
fig, ax = plt.subplots(figsize = (6.4, 4.8))
for (nombre, (positivos, negativos)), color in zip(escenarios.items(), ['#8172B3', '#4C72B0', '#55A868', '#DD8452', '#C44E52']):
    tfp, tvp, area = curva_roc(positivos, negativos)
    ax.plot(tfp, tvp, color = color, label = f'{nombre} (AUC = {area:.3f})')
    print(f'{nombre:<29} AUC = {area:.3f} | detección con z > 4: {100 * (positivos > 4).mean():5.1f} % '
          f'| z medio = {positivos.mean():.2f}')
ax.plot([0, 1], [0, 1], color = 'gray', linestyle = ':', label = 'Azar')
ax.set_title('Curva ROC del detector', fontsize = 16)
ax.set_xlabel('Tasa de falsos positivos')
ax.set_ylabel('Tasa de verdaderos positivos')
ax.legend(loc = 'lower right', fontsize = 9)
plt.tight_layout()

# Con 100 tokens la curva toca la esquina; con textos cortos, delta bajo o edición, se aleja:
plt.show()
d = 2, T = 10                 AUC = 0.977 | detección con z > 4:   0.0 % | z medio = 2.43
d = 2, T = 25                 AUC = 0.999 | detección con z > 4:  40.5 % | z medio = 3.80
d = 1, T = 25                 AUC = 0.958 | detección con z > 4:   1.5 % | z medio = 2.33
d = 2, T = 100                AUC = 1.000 | detección con z > 4: 100.0 % | z medio = 7.58
d = 2, T = 100, 30 % editado  AUC = 0.995 | detección con z > 4:  28.0 % | z medio = 3.63
La salida separa dos medidas que suelen confundirse. El AUC es altísimo en casi todos los escenarios: $0.999$ con $25$ tokens y $\delta = 2$, y $0.995$ incluso tras editar el $30%$ del texto. Eso significa que las puntuaciones de los textos marcados siguen estando casi siempre por encima de las de los textos sin marca. Pero la tasa de detección con el umbral $z > 4$ cuenta otra historia: $40.5%$ con $25$ tokens, $28%$ tras la edición y $0%$ con $10$ tokens. La explicación del último caso es aritmética: con $T = 10$ y $\gamma = 0.5$, el máximo posible es $z = (10 - 5)/\sqrt{2.5} = 3.16$, de modo que ningún texto de $10$ tokens puede superar el umbral, por marcado que esté.
La lección práctica es que un AUC alto no basta. En la vida real, un detector de procedencia debe trabajar con un umbral muy exigente, porque una falsa alarma (acusar de sintético un texto humano) tiene un coste alto, y con ese umbral lo que importa es la detección en el extremo izquierdo de la curva. La edición del $30%$ baja la puntuación media de $7.58$ a $3.63$, casi a la mitad. Un parafraseo con otro modelo, que cambia casi todos los tokens, la llevaría cerca de cero. Las marcas de texto reales, como SynthID-Text, usan esquemas más elaborados y detectores entrenados, pero comparten esta debilidad, como se verá más adelante.
Regulación: el artículo 50 del AI Act
Las marcas de agua dejaron de ser una curiosidad académica cuando la regulación empezó a exigirlas. La pieza central es el artículo 50 del Reglamento (UE) 2024/1689, conocido como Ley de IA o AI Act, titulado “Obligaciones de transparencia de los proveedores y responsables del despliegue de determinados sistemas de IA”. Sus apartados principales, revisados en octubre de 2026, son estos:
- Apartado 1 (sistemas que interactúan con personas). Los proveedores deben diseñar los sistemas destinados a interactuar con personas, como un chatbot, de forma que estas sepan que hablan con una IA, salvo que resulte evidente por el contexto.
- Apartado 2 (marcado legible por máquina). Los proveedores de sistemas que generan audio, imagen, video o texto sintéticos deben marcar las salidas en un formato legible por máquina y detectable como generado o manipulado artificialmente. Las soluciones deben ser eficaces, interoperables, sólidas y fiables en la medida en que sea técnicamente viable, teniendo en cuenta el coste y el estado de la técnica.
- Apartado 3 (reconocimiento de emociones y categorización biométrica). Quienes despliegan estos sistemas deben informar a las personas expuestas.
- Apartado 4 (ultrasuplantaciones y texto de interés público). Quienes despliegan un sistema que genera o manipula imagen, audio o video que constituye una ultrasuplantación (deepfake) deben hacer público que el contenido es artificial. Si la obra es evidentemente artística, creativa, satírica o de ficción, la obligación se limita a revelar la existencia del contenido generado de una manera que no estorbe su presentación o disfrute. Quien publica texto generado o manipulado para informar al público sobre asuntos de interés público también debe revelarlo, salvo que haya pasado por revisión humana o control editorial y alguien asuma la responsabilidad editorial.
Dos detalles importan para el Cuaderno Vivo. El primero es el reparto de papeles: el apartado 2 obliga al proveedor del sistema generativo (Anthropic, Black Forest Labs, Google), mientras que el apartado 4 obliga a quien despliega el sistema y difunde el contenido. El segundo es que el propio Reglamento excluye de la definición de responsable del despliegue a quien usa un sistema de IA en el curso de una actividad personal de carácter no profesional. Mientras el Cuaderno Vivo sea un proyecto privado de Sofía, el artículo 50 no le impone obligaciones directas; en cuanto publique contenidos, o si algún día lo ofrece a otros, sí. La serie aplica desde el principio la regla más exigente, porque el coste de cumplirla en un proyecto personal es casi nulo.
Calendario
El Reglamento entró en vigor el 1 de agosto de 2024, pero sus obligaciones se aplican de forma escalonada. En julio de 2026, el Reglamento (UE) 2026/1744, conocido como Ómnibus Digital sobre IA y publicado en el Diario Oficial el 24 de julio de 2026, modificó parte del calendario: retrasó las obligaciones de los sistemas de alto riesgo y dio a los proveedores de sistemas generativos ya comercializados antes del 2 de agosto de 2026 un plazo adicional, hasta el 2 de diciembre de 2026, para cumplir el marcado del apartado 2. Los apartados 1, 3 y 4 no se retrasaron. La Tabla 3 reúne los hitos relevantes para la IA generativa (revisado en octubre de 2026).
Tabla 3. Línea de tiempo del Reglamento (UE) 2024/1689 para la IA generativa (revisado en octubre de 2026).
| Fecha | Hito | Qué cambia para el contenido sintético |
|---|---|---|
| 1 de agosto de 2024 | Entrada en vigor del Reglamento | Comienza a correr el calendario; aún no hay obligaciones aplicables |
| 2 de febrero de 2025 | Prohibiciones y alfabetización en IA | Prácticas prohibidas del artículo 5, como la manipulación subliminal dañina |
| 2 de agosto de 2025 | Modelos de propósito general, gobernanza y sanciones | Política de derechos de autor y resumen de datos de entrenamiento para los proveedores de modelos |
| 10 de junio de 2026 | Código de prácticas sobre marcado y etiquetado | Guía voluntaria para proveedores y responsables del despliegue |
| 2 de agosto de 2026 | Artículo 50 aplicable | Chatbots que se identifican, etiquetado de deepfakes y de texto de interés público, marcado de sistemas nuevos |
| 2 de diciembre de 2026 | Fin del plazo adicional del apartado 2 | Marcado legible por máquina obligatorio también para sistemas comercializados antes del 2 de agosto de 2026 |
El incumplimiento de las obligaciones del artículo 50 puede sancionarse con multas de hasta $15$ millones de euros o el $3%$ del volumen de negocio mundial anual, la cantidad que sea mayor. El mismo Ómnibus añadió al artículo 5 una prohibición nueva, aplicable desde el 2 de diciembre de 2026, de los sistemas de IA destinados a generar material de abuso sexual infantil o contenido íntimo no consentido, el daño más grave asociado a los deepfakes.
La Comisión publicó el 10 de junio de 2026 la versión final del Código de prácticas sobre el marcado y el etiquetado de contenido generado por IA, abierto a la firma voluntaria de proveedores y responsables del despliegue. El código tiene una sección para cada uno de esos dos papeles, propone un icono común de la Unión Europea para las etiquetas visibles y reconoce un hecho técnico que esta entrada comprobará con código: con el estado actual de la técnica, ninguna técnica de marcado cumple por sí sola todos los requisitos de eficacia, interoperabilidad, solidez y fiabilidad, por lo que recomienda combinar varias capas. El siguiente bloque dibuja la línea de tiempo de la Tabla 3:
# Línea de tiempo del Reglamento europeo de IA dibujada con patches en Python:
hitos = [
    ('2024-08-01', 'Entrada en vigor\ndel Reglamento'),
    ('2025-02-02', 'Prohibiciones y\nalfabetización en IA'),
    ('2025-08-02', 'Modelos de propósito\ngeneral y sanciones'),
    ('2026-06-10', 'Código de prácticas\nde marcado y etiquetado'),
    ('2026-08-02', 'Artículo 50:\ntransparencia'),
    ('2026-12-02', 'Art. 50.2 para sistemas\nya comercializados'),
]
fechas = pd.to_datetime([h[0] for h in hitos])
fig, ax = plt.subplots(figsize = (12, 4.2))
ax.plot([fechas.min() - pd.Timedelta(days = 45), fechas.max() + pd.Timedelta(days = 45)], [0, 0],
        color = '#333333', linewidth = 2)
for i, (fecha, (_, texto)) in enumerate(zip(fechas, hitos)):
    arriba = 1 if i % 2 == 0 else -1
    color = '#DD8452' if fecha.year == 2026 else '#4C72B0'
    ax.plot([fecha, fecha], [0, 0.55 * arriba], color = color, linewidth = 1.5)
    ax.scatter([fecha], [0], color = color, s = 60, zorder = 3)
    ax.text(fecha, 0.55 * arriba + (0.21 if arriba > 0 else -0.21), f'{fecha:%d-%m-%Y}\n{texto}',
            ha = 'center', va = 'center', fontsize = 8.5,
            bbox = dict(boxstyle = 'round,pad=0.4', facecolor = 'white', edgecolor = color))
ax.set_ylim(-1.15, 1.15)
ax.set_yticks([])
for lado in ['left', 'right', 'top']:
    ax.spines[lado].set_visible(False)
ax.set_title('Calendario del Reglamento (UE) 2024/1689 relevante para la IA generativa', fontsize = 16)
plt.tight_layout()

# Los hitos de 2026 (naranja) son los que afectan al contenido sintético:
plt.show()
print('Días entre el Código de prácticas y el artículo 50:', (fechas[4] - fechas[3]).days)
Días entre el Código de prácticas y el artículo 50: 53
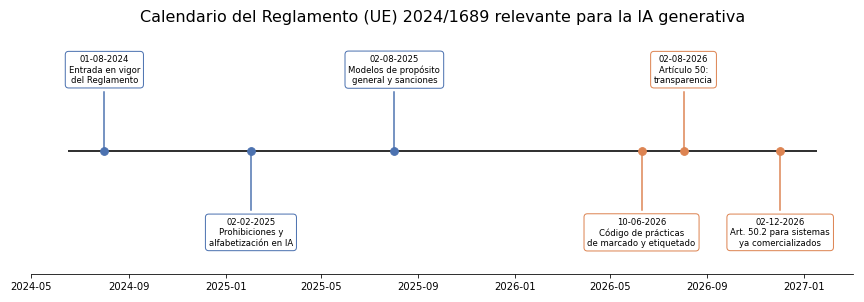
La figura separa en azul los hitos que ya estaban vigentes antes de 2026 y en naranja los tres que afectan directamente al contenido sintético. Entre la publicación del código de prácticas y la aplicación del artículo 50 pasaron solo $53$ días, un margen muy corto para que los proveedores adaptaran sus productos, y eso explica en parte el plazo adicional del Ómnibus. Fuera de Europa el panorama es fragmentario: en Estados Unidos, la ley federal TAKE IT DOWN, firmada en mayo de 2025, persigue la publicación de imágenes íntimas no consentidas, incluidas las falsificaciones generadas por IA, y obliga a las plataformas a retirarlas; varios estados tienen además leyes sobre deepfakes electorales.
Procedencia en imagen y audio
El apartado 2 del artículo 50 pide un marcado “legible por máquina y detectable”. ¿Con qué técnica? El Reglamento no lo dice, y hay varias candidatas que se diferencian en una propiedad clave: cómo se unen al contenido. La especificación de C2PA usa dos términos que conviene adoptar:
- Unión fuerte (hard binding). Una huella criptográfica (un hash SHA-256) de los bytes o los píxeles, guardada en un manifiesto firmado. Cambia un solo bit y la huella deja de coincidir. Es perfecta para detectar manipulaciones, pero no sobrevive a ninguna transformación, ni siquiera a una recompresión inocente.
- Unión débil (soft binding). Una marca de agua o una huella perceptual que sobrevive a ciertas transformaciones y permite encontrar el contenido aunque los bits hayan cambiado. Sirve para recuperar la procedencia de un archivo que ya perdió sus metadatos.
Para ver la diferencia con números, el siguiente bloque construye una portada de juguete de $256 \times 256$ píxeles y le aplica tres huellas a la vez. La primera es un manifiesto de juguete guardado en los metadatos del PNG con la clase PngInfo del Día 12, pero ahora con unión fuerte: la huella SHA-256 de los píxeles y una firma HMAC con una clave privada (una firma real usaría un certificado, como se verá después). La segunda es una marca frágil en el bit menos significativo (o LSB, por sus siglas en inglés: “Least Significant Bit”) del canal azul, que repite por toda la imagen los $256$ bits de un mensaje. La tercera es una marca robusta de espectro ensanchado, la misma técnica de Cox y sus colaboradores que el Día 16 aplicó al audio: un patrón de $+1$ y $-1$ generado con una clave, sumado con amplitud $\alpha = 3$ a los tres canales, y detectado con la puntuación $z = \rho\sqrt{N}$ sobre el detalle fino de la luminancia.
Después somete la portada a siete operaciones habituales en la vida de un archivo (volver a guardar, retocar un píxel, comprimir en JPEG, recortar, reducir y ampliar, cambiar el brillo) y mide qué sobrevive. Por último, barre la calidad JPEG de $100$ a $5$:
# Tres huellas en una portada de juguete: hash firmado, bits menos significativos y espectro ensanchado en Python:
alto = ancho = 256
yy, xx = np.mgrid[0:alto, 0:ancho] / alto
base = 120 + 60 * np.sin(6 * xx + 3 * yy) + 40 * np.cos(9 * yy) + rng.normal(0, 6, (alto, ancho))
portada = np.clip(np.stack([base, 0.8 * base + 30, 0.6 * base + 60], axis = -1), 0, 255).astype(np.uint8)

CLAVE_IMAGEN = 20260120
mensaje = np.unpackbits(np.frombuffer(hashlib.sha256(b'Cuaderno Vivo | Generado con IA').digest(), dtype = np.uint8))
patron = np.random.default_rng(CLAVE_IMAGEN).choice([-1.0, 1.0], size = (alto, ancho))

def marcar(imagen, alfa = 3.0):
    marcada = imagen.astype(float) + alfa * patron[..., None]       # espectro ensanchado en los tres canales
    marcada = np.clip(np.round(marcada), 0, 255).astype(np.uint8)
    azul = marcada[..., 2]
    bits = np.resize(mensaje, azul.size).reshape(azul.shape)        # 256 bits repetidos en todo el canal azul
    marcada[..., 2] = (azul & 0xFE) | bits                          # bit menos significativo
    return marcada

def sello(imagen, clave = b'clave-privada-de-sofia'):
    # Manifiesto de juguete: huella SHA-256 de los píxeles firmada con HMAC:
    huella = hashlib.sha256(imagen.tobytes()).hexdigest()
    firma = hmac.new(clave, huella.encode(), hashlib.sha256).hexdigest()
    info = PngInfo()
    for k, v in {'etiqueta': 'Generado con IA', 'sha256': huella, 'firma': firma}.items():
        info.add_text(k, v)
    return info

def leer_huellas(img, clave = b'clave-privada-de-sofia'):
    x = np.asarray(img.convert('RGB'))
    meta = getattr(img, 'text', {}) or {}
    if 'sha256' in meta:
        huella = hashlib.sha256(x.tobytes()).hexdigest()
        firma_ok = hmac.compare_digest(meta['firma'], hmac.new(clave, meta['sha256'].encode(), hashlib.sha256).hexdigest())
        manifiesto = 'válido' if (firma_ok and huella == meta['sha256']) else 'roto'
    else:
        manifiesto = 'ausente'
    h, w = x.shape[:2]
    # Bits menos significativos: voto por mayoría de cada uno de los 256 bits:
    lsb = (x[..., 2] & 1).ravel()
    posicion = np.arange(lsb.size) % len(mensaje)
    votos = np.bincount(posicion, weights = lsb, minlength = 256) / np.bincount(posicion, minlength = 256)
    bits_ok = 100 * ((votos > 0.5) == mensaje).mean()
    # Espectro ensanchado: correlación del detalle fino de la luminancia con el patrón:
    lum = x.astype(float).mean(axis = 2)
    suave = sum(np.roll(np.roll(lum, i, 0), j, 1) for i in (-1, 0, 1) for j in (-1, 0, 1)) / 9
    detalle = (lum - suave).ravel()
    w_ = patron[:h, :w].ravel()
    z = detalle @ w_ / (np.linalg.norm(detalle) * np.linalg.norm(w_)) * np.sqrt(detalle.size)
    return manifiesto, bits_ok, z

def transformar(marcada, operacion):
    buf = io.BytesIO()
    img = Image.fromarray(marcada)
    if operacion == 'Original (PNG con manifiesto)':
        img.save(buf, format = 'PNG', pnginfo = sello(marcada))
    elif operacion == 'Guardar sin metadatos':
        img.save(buf, format = 'PNG')
    elif operacion == 'Retocar 1 píxel':
        retocada = marcada.copy()
        retocada[128, 128] = 255 - retocada[128, 128]                # un solo píxel invertido
        Image.fromarray(retocada).save(buf, format = 'PNG', pnginfo = sello(marcada))
    elif operacion.startswith('JPEG'):
        img.save(buf, format = 'JPEG', quality = int(operacion.split()[-1]))
    elif operacion == 'Recorte de 16 px':
        img.crop((16, 16, ancho, alto)).save(buf, format = 'PNG')
    elif operacion == 'Reducir y ampliar':
        img.resize((128, 128), Image.BILINEAR).resize((ancho, alto), Image.BILINEAR).save(buf, format = 'PNG')
    elif operacion == 'Brillo +10 %':
        Image.fromarray(np.clip(marcada * 1.1, 0, 255).astype(np.uint8)).save(buf, format = 'PNG')
    buf.seek(0)
    return Image.open(buf)

marcada = marcar(portada)
diferencia = marcada.astype(float) - portada
print(f'PSNR de la portada marcada: {10 * np.log10(255 ** 2 / (diferencia ** 2).mean()):.1f} dB')
operaciones = ['Original (PNG con manifiesto)', 'Guardar sin metadatos', 'Retocar 1 píxel', 'JPEG calidad 90',
               'JPEG calidad 50', 'Recorte de 16 px', 'Reducir y ampliar', 'Brillo +10 %']
filas = [(op, *leer_huellas(transformar(marcada, op))) for op in operaciones]
filas.append(('Portada sin marcar', *leer_huellas(Image.fromarray(portada))))
huellas = pd.DataFrame(filas, columns = ['operación', 'manifiesto', 'bits LSB correctos (%)', 'z espectro'])
print(huellas.round(2).to_string(index = False))

# Supervivencia frente a la calidad JPEG:
calidades = np.arange(100, 4, -5)
supervivencia = np.array([leer_huellas(transformar(marcada, f'JPEG calidad {q}'))[1:] for q in calidades])
fig, (ax1, ax2) = plt.subplots(1, 2, figsize = (10, 4.2))
ax1.plot(calidades, supervivencia[:, 0], marker = 'o', color = '#4C72B0')
ax1.axhline(100, color = '#55A868', linestyle = '--', label = 'PNG sin pérdida')
ax1.axhline(50, color = 'gray', linestyle = ':', label = 'Azar (50 %)')
ax1.set_ylim(0, 105)
ax1.legend(loc = 'lower left')
ax1.set_title('Bits menos significativos', fontsize = 16)
ax1.set_xlabel('Calidad JPEG')
ax1.set_ylabel('Bits del mensaje recuperados (%)')
ax2.plot(calidades, supervivencia[:, 1], marker = 'o', color = '#DD8452')
ax2.axhline(4, color = 'black', linestyle = '--')
ax2.set_title('Espectro ensanchado', fontsize = 16)
ax2.set_xlabel('Calidad JPEG')
ax2.set_ylabel('Puntuación z')
for ax in (ax1, ax2):
    ax.invert_xaxis()
plt.tight_layout()

# La marca frágil muere con la primera compresión; la robusta aguanta más:
plt.show()
print('Calidad mínima con z > 4:', calidades[supervivencia[:, 1] > 4].min())
PSNR de la portada marcada: 38.5 dB
                    operación manifiesto  bits LSB correctos (%)  z espectro
Original (PNG con manifiesto)     válido                  100.00      112.51
        Guardar sin metadatos    ausente                  100.00      112.51
              Retocar 1 píxel       roto                  100.00      112.34
              JPEG calidad 90    ausente                   54.69       88.73
              JPEG calidad 50    ausente                   46.09       26.80
             Recorte de 16 px    ausente                   57.42       -1.13
            Reducir y ampliar    ausente                   52.73        7.16
                 Brillo +10 %    ausente                   53.52      112.49
           Portada sin marcar    ausente                   51.95       -1.61
Calidad mínima con z > 4: 25
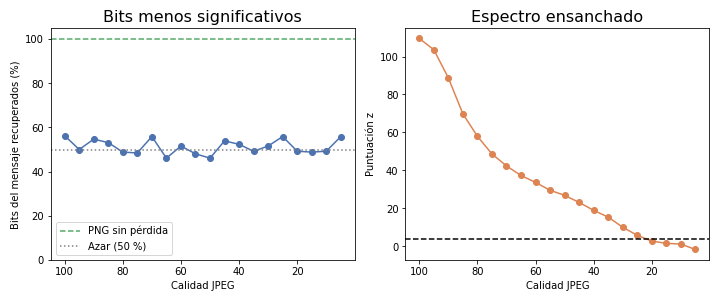
La relación señal a ruido de pico (PSNR) de la portada marcada es de $38.5$ dB, un valor al que las diferencias no se aprecian a simple vista. La Tabla 4 ordena el resto de la salida.
Tabla 4. Qué sobrevive de cada huella a operaciones habituales sobre la portada de juguete.
| Operación | Manifiesto (unión fuerte) | Bits LSB recuperados | $z$ del espectro ensanchado |
|---|---|---|---|
| Original (PNG con manifiesto) | Válido | 100.00 % | 112.51 |
| Guardar sin metadatos | Ausente | 100.00 % | 112.51 |
| Retocar 1 píxel | Roto | 100.00 % | 112.34 |
| JPEG calidad 90 | Ausente | 54.69 % | 88.73 |
| JPEG calidad 50 | Ausente | 46.09 % | 26.80 |
| Recorte de 16 px | Ausente | 57.42 % | -1.13 |
| Reducir y ampliar | Ausente | 52.73 % | 7.16 |
| Brillo +10 % | Ausente | 53.52 % | 112.49 |
| Portada sin marcar | Ausente | 51.95 % | -1.61 |
Cada huella falla de una forma distinta, y ahí está la lección:
- El manifiesto solo vale mientras viaja con el archivo y nadie toca los píxeles. Basta volver a guardar la imagen sin metadatos para que desaparezca, y basta invertir un solo píxel de $65,536$ para que la huella deje de coincidir y el detector lo declare “roto”. Esa fragilidad es su virtud: un manifiesto válido garantiza que el contenido no cambió desde que se firmó.
- La marca LSB sobrevive a todo lo que no altera los píxeles (volver a guardar en PNG, retocar un píxel) y muere con la primera compresión: con JPEG de calidad $90$ ya solo recupera el $54.69%$ de los bits, lo mismo que daría el azar ($51.95%$ en la portada sin marcar). El panel izquierdo de la figura lo confirma para todas las calidades: la línea azul oscila alrededor del $50%$ desde la calidad $100$.
- La marca de espectro ensanchado resiste la compresión, con $z = 26.80$ a calidad $50$ y por encima del umbral hasta calidad $25$, resiste el cambio de brillo y sobrevive a medias al reescalado ($z = 7.16$). Pero un recorte de $16$ píxeles la anula ($z = -1.13$): el detector compara cada píxel con el patrón en la misma posición, y al desplazar la imagen pierde la sincronía. Es el mismo fallo que el Día 16 encontró al recortar el inicio del audio.
La Tabla 5 generaliza la comparación a los mecanismos reales y a las tres modalidades del Cuaderno Vivo, incluidas las cifras de audio del Día 16 y las de texto de hoy.
Tabla 5. Comparativa de mecanismos de procedencia: robustez, verificabilidad y coste.
| Mecanismo | Modalidades | Robustez | Verificabilidad por terceros | Coste para Sofía |
|---|---|---|---|---|
| Etiqueta visible (“Generado con IA”) | Imagen, texto, audio (frase hablada) | Baja: se recorta o se borra | Inmediata para personas, nula para máquinas | Casi nulo |
| Metadatos (PNG, WAV INFO, IPTC) | Imagen, audio | Muy baja: se pierden al convertir o recomprimir | Cualquiera los lee, cualquiera los falsifica | Casi nulo |
| Manifiesto firmado C2PA (unión fuerte) | Imagen, video, audio, documentos | Baja ante transformaciones; alta ante falsificación | Alta si el certificado es de confianza | Certificado y biblioteca |
| Marca invisible frágil (LSB) | Imagen, audio | Muy baja: muere con JPEG de calidad 90 | Solo con la clave | Bajo |
| Marca invisible robusta (espectro ensanchado, SynthID, AudioSeal) | Imagen, audio, video | Media: resiste compresión; sensible a recortes y regeneración | Solo con la clave o el servicio del proveedor | Medio; en producción, del proveedor |
| Marca estadística de texto (lista verde, SynthID-Text) | Texto | Media en textos largos; baja en cortos o parafraseados | Solo con la clave o el servicio del proveedor | Solo posible para quien controla el muestreo |
La última columna merece una aclaración: Sofía no puede marcar los textos que genera Claude con la lista verde, porque la API no le da acceso al muestreo. La marca de texto solo la puede aplicar quien controla el modelo, y por eso el artículo 50 la exige al proveedor. Lo que Sofía sí controla es la etiqueta, los metadatos y, para sus imágenes, el manifiesto.
Content Credentials: firmar el manifiesto
El Día 12 leyó un manifiesto C2PA y prometió que hoy se vería cómo firmarlo. La Coalición para la Procedencia y Autenticidad del Contenido publica la especificación técnica de Content Credentials, cuya versión vigente es la 2.4 (revisado en octubre de 2026). Un manifiesto contiene afirmaciones (assertions): qué acciones se aplicaron al contenido (c2pa.created, c2pa.edited), con qué tipo de origen digital (el vocabulario IPTC trainedAlgorithmicMedia para contenido generado por un modelo) y qué ingredientes se usaron. Las afirmaciones se firman con un certificado X.509 y se unen al contenido con una huella fuerte, como el manifiesto de juguete del bloque anterior.
La biblioteca c2pa-python firma con las clases Builder y Signer; su versión más reciente es la $0.38.0$, del 29 de septiembre de 2026 (revisado en octubre de 2026), y su API ha cambiado varias veces, así que conviene fijar la versión exacta. El siguiente bloque sigue la referencia oficial de la API (Signer.from_info, Builder.sign_file y Reader). No se ejecuta en esta entrada porque necesita un certificado y una clave privada (de prueba, en el caso de Sofía), así que se muestra con una salida de ejemplo comentada:
# Firma de Content Credentials (C2PA) para una portada del Cuaderno Vivo en Python:
# pip install c2pa-python==0.38.0   (versión revisada en octubre de 2026; fije siempre la exacta)
import json
import c2pa

manifiesto = {
    'claim_generator_info': [{'name': 'cuaderno-vivo', 'version': '2.1'}],
    'title': 'Portada de la semana 3',
    'format': 'image/png',
    'assertions': [
        {'label': 'c2pa.actions',
         'data': {'actions': [
             {'action': 'c2pa.created',
              'digitalSourceType': 'http://cv.iptc.org/newscodes/digitalsourcetype/trainedAlgorithmicMedia'},
             {'action': 'c2pa.edited'},
         ]}},
    ],
}

# Certificado y clave de prueba, fuera del repositorio (nunca dentro del código):
with open('certificados/cv_es256_certs.pem', 'rb') as archivo:
    certificados = archivo.read()
with open('certificados/cv_es256_private.key', 'rb') as archivo:
    clave_privada = archivo.read()
info = c2pa.C2paSignerInfo(alg = b'es256', sign_cert = certificados,
                           private_key = clave_privada, ta_url = b'http://timestamp.digicert.com')

# Firma: el Builder escribe una copia de la portada con el manifiesto incrustado:
with c2pa.Signer.from_info(info) as firmante, c2pa.Builder(manifiesto) as constructor:
    constructor.sign_file('cuaderno_vivo/portadas/semana_03.png',
                          'cuaderno_vivo/portadas/semana_03_c2pa.png', firmante)

# Verificación: abrir la copia firmada y leer las acciones y el estado de validación:
with c2pa.Reader('cuaderno_vivo/portadas/semana_03_c2pa.png') as lector:
    almacen = json.loads(lector.json())
    activo = almacen['manifests'][almacen['active_manifest']]
    print('Acciones:', [a['action'] for a in activo['assertions'][0]['data']['actions']])
    print('Estado:', lector.get_validation_state())

# Salida de ejemplo (puede variar):
# Acciones: ['c2pa.created', 'c2pa.edited']
# Estado: Invalid
El estado Invalid sorprende la primera vez, pero es el esperado con un certificado de prueba: la documentación de la biblioteca advierte que, sin una configuración de confianza cargada, el estado de validación del manifiesto es inválido, porque el certificado no pertenece a ninguna lista de confianza. La firma prueba la integridad (nadie cambió el archivo desde que se firmó); la identidad del firmante solo la garantiza un certificado emitido por una autoridad reconocida. Para un proyecto personal, el manifiesto con certificado de prueba sigue siendo útil como registro interno de procedencia.
La especificación también resuelve el problema de la Tabla 4: si el manifiesto se pierde, ¿cómo se recupera? La propuesta se llama credenciales de contenido duraderas (Durable Content Credentials): se combina el manifiesto con una marca de agua invisible (unión débil) que lleva un identificador, y se guarda una copia del manifiesto en un repositorio. Si alguien borra los metadatos, la marca de agua sobrevive y su identificador permite buscar el manifiesto original. Es exactamente la combinación que la tabla sugería: la unión fuerte para garantizar la integridad y la débil para sobrevivir al viaje.
SynthID, AudioSeal y las marcas reales
Las marcas de agua de la industria son aprendidas, no escritas a mano. SynthID, de Google DeepMind, marca imágenes, audio, video y texto generados por los modelos de Google. Su versión de texto, SynthID-Text, se describió en un artículo de Nature en octubre de 2024 (Dathathri y otros) y se publicó como código abierto bajo licencia Apache 2.0, integrada en la biblioteca Transformers de Hugging Face; en lugar de una lista verde fija, usa un muestreo por torneo que modifica muy poco la distribución de probabilidad del texto. Las marcas de imagen, audio y video de SynthID no son abiertas, y su verificación se hace a través del portal SynthID Detector que Google presentó en mayo de 2025 (revisado en octubre de 2026). Tanto el propio artículo como la prensa especializada reconocen que la marca de texto se debilita cuando el texto se reescribe a fondo o se traduce, la misma debilidad que el ataque de edición del Bloque 8 mostró en miniatura.
En audio, el Día 16 presentó AudioSeal (San Roman y otros, $2024$), una marca aprendida y localizada que detecta muestra a muestra qué fragmentos de un audio son sintéticos, y comparó su marca de juguete: $z = 5.91$ en ocho segundos, resistente al ruido hasta SNR $0$ dB pero no a un recorte del inicio ni a un filtro pasa bajos. El patrón se repite en las tres modalidades: la robustez de una marca es siempre relativa a un conjunto de transformaciones, y siempre hay una transformación (recortar, regenerar, parafrasear) que la borra a cambio de degradar un poco el contenido.
Deepfakes
El Reglamento europeo define una ultrasuplantación (deepfake) como un contenido de imagen, audio o video generado o manipulado por una IA que se asemeja a personas, objetos, lugares, entidades o sucesos reales y que puede inducir a una persona a pensar erróneamente que es auténtico o verídico. La definición no exige mala intención: una parodia evidente también es una ultrasuplantación; lo que cambia es la obligación de divulgación, más ligera en las obras artísticas o satíricas.
Chesney y Citron, en un artículo de $2019$ que sigue siendo la referencia del tema, clasificaron los daños en dos niveles. Los daños individuales: el fraude (una voz clonada que pide una transferencia urgente), la extorsión y el acoso, en especial la creación de imágenes íntimas no consentidas, que es con mucho el uso más frecuente y más dañino de la técnica. Y los daños sociales: la desinformación electoral, la manipulación de mercados y la erosión de la confianza en cualquier prueba audiovisual. A este último fenómeno lo llamaron el dividendo del mentiroso: cuanto más sabe el público que existen los deepfakes, más fácil es para alguien negar una grabación auténtica diciendo que es falsa.
Por qué la detección automática no basta
Ante un daño así, la reacción natural es pedir un detector: un clasificador que reciba un video y diga si es real o sintético. Existen, y en sus artículos de presentación suelen reportar exactitudes altas. Pero un detector pasivo (que busca artefactos del generador, sin clave ni marca) tiene tres problemas estructurales:
- Generaliza mal. Aprende los artefactos de los generadores con que se entrenó, y los generadores nuevos no los tienen. La carrera es asimétrica: cada versión nueva del generador deja obsoleto al detector.
- Es atacable. Una compresión, un reescalado o una perturbación diseñada a propósito degradan sus puntuaciones, igual que el recorte borró la marca de espectro ensanchado.
- Sufre la tasa base. Este es el más contraintuitivo, y se entiende con el teorema de Bayes.
Suponga un detector hipotético con una sensibilidad del $95%$ (detecta $95$ de cada $100$ deepfakes) y una tasa de falsos positivos del $5%$ (marca como falsos $5$ de cada $100$ videos auténticos). Si en una plataforma solo el $1%$ de los videos son deepfakes, ¿qué probabilidad hay de que un video marcado como falso lo sea de verdad? El valor predictivo positivo (o VPP) responde a esa pregunta:
$$ VPP = \frac{s \cdot \pi}{s \cdot \pi + f \cdot (1 - \pi)} $$
La lógica detrás de esta fórmula es múltiple:
- El numerador, $s \cdot \pi$, es la fracción de todos los videos que son deepfakes y además se detectan, donde $s$ es la sensibilidad y $\pi$ la prevalencia.
- El segundo sumando del denominador, $f \cdot (1 - \pi)$, es la fracción de videos auténticos que se marcan por error, donde $f$ es la tasa de falsos positivos.
- El cociente dice qué parte de las alarmas son verdaderas. Cuando $\pi$ es pequeña, los falsos positivos sobre la enorme masa de videos auténticos ahogan a los verdaderos.
- En conclusión, la utilidad de un detector no depende solo de su calidad, sino de lo raro que sea aquello que busca.
Con las cifras del ejemplo, $VPP = 0.95 \cdot 0.01 / (0.95 \cdot 0.01 + 0.05 \cdot 0.99) = 0.0095 / 0.059 = 0.161$: solo el $16.1%$ de los videos marcados serían deepfakes; el resto serían videos auténticos acusados en falso. Con una prevalencia del $10%$, el VPP sube a $0.095 / 0.140 = 0.679$, y con una del $50%$, a $0.95$. Compare con la marca de agua de texto de hoy: con $T = 100$, $\delta = 2$, detección del $100%$ y falsos positivos de $3.2 \times 10^{-5}$, el VPP con prevalencia del $1%$ es $0.01 / (0.01 + 3.2 \times 10^{-5} \cdot 0.99) = 0.997$. La diferencia no es de calidad del algoritmo, sino de diseño: una marca de agua es una prueba con clave que el generador colabora en dejar; un detector pasivo es una conjetura sobre artefactos. Por eso la regulación apuesta por el marcado en origen y no por la detección a posteriori. Los detectores de texto generado tienen además un sesgo documentado: Liang y sus colaboradores mostraron en $2023$ que varios de ellos marcaban como sintéticos, con mucha más frecuencia, los textos de personas que escriben en una lengua que no es la suya.
Atención aquí: Esta entrada aborda los deepfakes solo desde la detección, la procedencia y el marco legal. El Cuaderno Vivo nunca representa a personas reales: las portadas no tienen rostros, la única voz clonada es la propia de Sofía con consentimiento escrito, y ninguna salida imita a una persona, marca o artista identificable. No use las técnicas de esta serie para suplantar a nadie, ni siquiera “en broma” con amigos: además del daño a la persona, en muchos países es un delito.
Qué hacer como creador responsable
Si la detección no basta, la responsabilidad recae en quien crea y en quien difunde. Para un proyecto personal como el de Sofía, eso se traduce en cinco reglas sencillas:
- Etiquetar todo lo sintético de forma visible o audible, en el propio contenido y no solo en el texto que lo acompaña.
- No representar a personas reales sin su consentimiento informado y por escrito, y nunca en contextos íntimos, políticos o financieros.
- Dejar huellas legibles por máquina cuando se pueda: metadatos con el tipo de origen IPTC, manifiestos C2PA y, si el proveedor la aplica, la marca de agua del modelo.
- Conservar el registro de generación (prompt, modelo, semilla, fecha) para poder demostrar el origen si alguien pregunta.
- Verificar antes de compartir contenido ajeno impactante: buscar la fuente original, comprobar si tiene Content Credentials y desconfiar de la urgencia emocional, el ingrediente común del fraude con voces clonadas.
Mini proyecto: la política de divulgación del Cuaderno Vivo
El mini proyecto del módulo 5 convierte todo lo anterior en un documento: DIVULGACION.md, la política que el Cuaderno Vivo aplica a cada salida antes de que salga de la laptop de Sofía. Una política así cumple dos funciones. Hacia dentro, es una especificación: dice qué debe hacer el código en cada caso. Hacia fuera, es una promesa pública: dice a quien vea el contenido qué puede esperar. La Tabla 6 fija las reglas por modalidad.
Tabla 6. Política de divulgación del Cuaderno Vivo por modalidad.
| Modalidad | Etiqueta visible o audible | Metadatos | Manifiesto o marca de agua |
|---|---|---|---|
| Resumen de texto (Claude) | Pie “Resumen generado con IA a partir de mis notas, revisado por mí” | Registro local de modelo, fecha y notas usadas | Ninguna propia (la API no da acceso al muestreo); la que aplique el proveedor |
| Portada (FLUX.1 schnell + Pillow) | Banda “Generado con IA” dentro de la imagen | PNG con digital_source_type IPTC, prompt, semilla y versión de la guía | Manifiesto C2PA con c2pa.created y c2pa.edited |
| Episodio de audio (XTTS-v2) | Frase “Este resumen se narra con una voz sintética” en el primer segundo y sello audible | WAV con bloque LIST/INFO | Marca de espectro ensanchado de juguete (Día 16), sin valor probatorio |
| Tarjetas de repaso del tutor | Icono “IA” junto a cada tarjeta generada | Campo origen en memoria.json | Ninguna |
Redactar una política a partir de una tabla es una buena tarea para un modelo potente: hay que convertir reglas escuetas en un texto claro, sin inventar obligaciones. El siguiente bloque pide el borrador a Claude Fable 5.1, el modelo más capaz de la serie, con el respaldo del lado del servidor activado (si el modelo rechazara la petición, la API la repite con el modelo de respaldo dentro de la misma llamada) y un esfuerzo medio. El borrador se guarda como tal; el archivo definitivo lo escribe Sofía tras revisarlo:
# Borrador de DIVULGACION.md con Claude Fable 5.1 a partir de la Tabla 6 en Python:
import anthropic
import pandas as pd
from pathlib import Path

client = anthropic.Anthropic()   # lee ANTHROPIC_API_KEY del entorno

# Las reglas de la Tabla 6, una fila por modalidad:
politica = pd.DataFrame({
    'modalidad': ['texto', 'portada', 'audio', 'tarjetas'],
    'etiqueta': ['Resumen generado con IA a partir de mis notas, revisado por mí',
                 'Banda "Generado con IA" dentro de la imagen',
                 'Frase "Este resumen se narra con una voz sintética" en el primer segundo',
                 'Icono "IA" junto a cada tarjeta'],
    'metadatos': ['registro local', 'PNG con tipo de origen IPTC', 'WAV LIST/INFO', 'campo origen'],
    'huella': ['la del proveedor', 'manifiesto C2PA', 'marca de juguete', 'ninguna'],
})

respuesta = client.beta.messages.create(
    model = 'claude-fable-5-1',
    max_tokens = 4000,
    betas = ['server-side-fallback-2026-07-01'],
    fallbacks = 'default',                     # respaldo del lado del servidor
    output_config = {'effort': 'medium'},
    system = ('Usted redacta políticas de transparencia para proyectos personales de software. '
              'Escriba en español, con tratamiento de usted, en Markdown. No invente obligaciones '
              'legales ni cite artículos de leyes que no aparezcan en la petición.'),
    messages = [{'role': 'user', 'content': (
        'Redacte DIVULGACION.md para el Cuaderno Vivo, un asistente personal de estudio. '
        'Incluya: propósito, una sección por modalidad con las reglas de la tabla, qué no se hará '
        '(representar a personas reales, clonar voces ajenas) y cómo contactar a la autora. '
        'Máximo 500 palabras.\n\n<tabla>\n' + politica.to_csv(index = False) + '</tabla>')}],
)

# Comprobar el motivo de parada antes de leer el contenido:
if respuesta.stop_reason == 'refusal':
    raise RuntimeError('El modelo y su respaldo rechazaron la petición.')
borrador = ''.join(bloque.text for bloque in respuesta.content if bloque.type == 'text')
Path('cuaderno_vivo/DIVULGACION_borrador.md').write_text(borrador, encoding = 'utf-8')
coste = respuesta.usage.input_tokens * 10 / 1e6 + respuesta.usage.output_tokens * 50 / 1e6
print(borrador[:420])
print(f'Tokens: {respuesta.usage.input_tokens} de entrada, {respuesta.usage.output_tokens} de salida | coste: {coste:.4f} USD')

# Salida de ejemplo (puede variar):
# # Política de divulgación del Cuaderno Vivo
#
# El Cuaderno Vivo es un asistente personal de estudio que usa modelos de IA generativa para
# resumir notas, ilustrar portadas y narrar resúmenes en audio. Esta política explica cómo se
# identifica cada contenido generado, para que usted sepa siempre qué parte es obra de la autora
# y qué parte salió de un modelo.
#
# ## Resúmenes de texto
# Cada resumen termina con el pie "Resumen generado con IA a partir de mis notas, revisado por mí".
# Tokens: 612 de entrada, 874 de salida | coste: 0.0498 USD
El ejemplo de salida muestra el tono buscado: claro, en usted y sin promesas legales. El coste de la salida de ejemplo, unos $0.05$ USD, se calcula con los precios de la serie para Fable 5.1 ($10$ USD por millón de tokens de entrada y $50$ por millón de salida) y entra holgadamente en el presupuesto de $10$ USD al mes, porque la política se redacta una vez. La revisión humana no es opcional: Sofía comprueba que cada regla de la Tabla 6 aparece tal cual, que el modelo no añadió compromisos que el código no cumple (por ejemplo, una marca de agua en el texto que la API no permite) y que la sección de lo que no se hará es explícita. Solo entonces renombra el borrador a cuaderno_vivo/DIVULGACION.md y enlaza el archivo desde cada página donde publique contenido.
Diego lee la versión final y hace la última pregunta del módulo: "¿Y si un día usted misma se salta la política?" Es la pregunta correcta, y su respuesta es de ingeniería: la política no debe depender de la memoria de Sofía, sino del código. Las funciones que exportan una portada, un episodio o un resumen deben aplicar la etiqueta y los metadatos por defecto, sin un parámetro para desactivarlos. Una política de divulgación que el código no aplica es solo una intención.
Consideraciones finales
El módulo 5/6 empezó con una matriz de riesgos y termina con una política de una página. Por el camino, el Cuaderno Vivo aprendió a medir sus alucinaciones y sesgos, a proteger los datos de Sofía y a defenderse de instrucciones incrustadas. Hoy aprendió algo distinto: que la procedencia es un ecosistema, no una tecnología. Ninguna de las huellas medidas hoy sobrevive a todo: el manifiesto muere al volver a guardar, la marca LSB con la primera compresión, la de espectro ensanchado con un recorte y la de texto con un parafraseo o con un texto demasiado corto. Juntas, en cambio, cubren casos distintos, y la última capa, la honestidad de quien publica, cubre el resto.
Antes de dar por cerrado el módulo, conviene hacerse algunas preguntas:
- ¿Qué pasaría si una persona tomara una portada del Cuaderno Vivo, recortara la banda y la publicara como propia? ¿Qué huella le quedaría a Sofía para demostrar el origen?
- ¿Cuántos tokens tienen los textos que Sofía publica? Si son mensajes de dos líneas, la Tabla 2 dice que ninguna marca estadística los atribuiría, y la divulgación tendrá que ser visible.
- ¿Quién controla las claves de las marcas que protegen sus contenidos? Si la verificación depende del portal de un proveedor, la procedencia depende de que ese portal siga existiendo.
- ¿Está preparada la política para el día en que el Cuaderno Vivo deje de ser personal? El artículo 50 se aplica en cuanto haya publicación con fines no personales.
Las cifras de hoy tienen límites claros. El generador de texto no es un modelo de lenguaje y tiene mucha más entropía que uno real, por lo que sus puntuaciones son un techo optimista; las marcas de imagen se probaron sobre una portada sintética de $256$ píxeles de lado; y el detector de deepfakes del ejemplo de Bayes es hipotético. Ninguno de esos límites cambia las conclusiones cualitativas, que coinciden con la literatura: la potencia crece con la raíz de la longitud, la robustez es relativa a las transformaciones y la tasa base domina cualquier detector pasivo.
Un gran libro que habla de esto es Deepfakes: The Coming Infocalypse, en el que Nina Schick describe cómo los medios sintéticos se suman a una crisis más amplia de la información y por qué la respuesta no puede ser solo técnica. Aunque se publicó en $2020$, antes de la explosión de los modelos de difusión, su análisis del dividendo del mentiroso y de la necesidad de infraestructura de procedencia se ha cumplido casi punto por punto; léalo junto con el artículo de Chesney y Citron para tener la visión jurídica y la periodística.
Una huella demuestra de dónde viene un archivo solo mientras sobrevive; una etiqueta honesta lo dice siempre. Con una marca de texto que da $z = 7.62$ en $100$ tokens y falla en $10$, una marca de imagen que resiste hasta JPEG de calidad $25$ y muere con un recorte de $16$ píxeles, y una política de divulgación que el código aplica por defecto, el Cuaderno Vivo cierra el módulo de ética sabiendo exactamente qué puede demostrar y qué solo puede declarar.
Conclusiones clave
Derechos
- Datos de entrenamiento, autoría de la salida y licencia del modelo son tres preguntas distintas, con actores distintos; la licencia es la única que usted puede resolver hoy leyendo un documento.
- En el marco de la Oficina de Derechos de Autor de Estados Unidos, una salida generada solo con un prompt no es obra protegible; sí lo es la aportación humana perceptible, y documentar el proceso es documentar esa aportación.
Regulación
- El artículo 50 del Reglamento (UE) 2024/1689 se aplica desde el 2 de agosto de 2026: chatbots que se identifican, marcado legible por máquina del contenido sintético y etiquetado de deepfakes y de texto de interés público.
- El Reglamento (UE) 2026/1744 dio hasta el 2 de diciembre de 2026 a los sistemas ya comercializados para el marcado del apartado 2; el código de prácticas del 10 de junio de 2026 recomienda combinar técnicas porque ninguna basta sola.
Procedencia y marcas
- La marca de lista verde se detecta con $z = (|s|_G - \gamma T)/\sqrt{T\gamma(1-\gamma)}$: con $T = 100$ y $\delta = 2$, $z$ medio de $7.62$ y detección del $100%$; con $25$ tokens, del $40.5%$; con $10$, imposible.
- Editar el $30%$ de los tokens baja $z$ de $7.58$ a $3.63$ y la detección al $28%$, aunque el AUC siga en $0.995$: con umbrales exigentes, el AUC engaña.
- En imagen, el manifiesto con unión fuerte se rompe con un píxel, la marca LSB muere con JPEG de calidad $90$ y la de espectro ensanchado resiste hasta calidad $25$ pero no un recorte de $16$ píxeles.
Deepfakes
- Un detector pasivo con $95%$ de sensibilidad y $5%$ de falsos positivos acierta solo en el $16.1%$ de sus alarmas si la prevalencia es del $1%$; una marca con clave, en el $99.7%$.
- La responsabilidad recae en quien crea y difunde: etiquetar, no representar a personas reales, dejar huellas legibles por máquina y conservar el registro de generación.
Mañana, en el Día 21: Arquitectura de soluciones IA: del requisito al diagrama. Comienza el módulo 6/6, Proyecto Integrador: Arquitecto de Soluciones IA, y el Cuaderno Vivo, que hoy aprendió a decir de dónde viene cada cosa que produce, se documentará como un sistema completo: de los requisitos de Sofía a un diagrama de componentes con sus costes, sus riesgos y su política de divulgación integrados desde el diseño.
Referencias
- Kirchenbauer, J., Geiping, J., Wen, Y., Katz, J., Miers, I. y Goldstein, T. (2023). A Watermark for Large Language Models. Proceedings of the 40th International Conference on Machine Learning (ICML 2023). arXiv:2301.10226.
- Parlamento Europeo y Consejo de la Unión Europea (2024). Reglamento (UE) 2024/1689, de 13 de junio de 2024, por el que se establecen normas armonizadas en materia de inteligencia artificial (Ley de Inteligencia Artificial), artículo 50. Diario Oficial de la Unión Europea.
- Chesney, R. y Citron, D. (2019). Deep Fakes: A Looming Challenge for Privacy, Democracy, and National Security. California Law Review, 107, 1753-1820.
- Parlamento Europeo y Consejo de la Unión Europea (2026). Reglamento (UE) 2026/1744, de 8 de julio de 2026 (Ómnibus Digital sobre IA), por el que se modifica el Reglamento (UE) 2024/1689. Diario Oficial de la Unión Europea, 24 de julio de 2026.
- Comisión Europea (2026). Code of Practice on Marking and Labelling of AI-Generated Content. Publicado el 10 de junio de 2026. https://digital-strategy.ec.europa.eu/
- Dathathri, S., See, A., Ghaisas, S. et al. (2024). Scalable watermarking for identifying large language model outputs. Nature, 634, 818-823.
- C2PA (2026). Content Credentials: C2PA Technical Specification, versión 2.4. Coalition for Content Provenance and Authenticity. https://spec.c2pa.org/
- U.S. Copyright Office (2025). Copyright and Artificial Intelligence, Part 2: Copyrightability. Library of Congress.
- Cox, I. J., Kilian, J., Leighton, F. T. y Shamoon, T. (1997). Secure Spread Spectrum Watermarking for Multimedia. IEEE Transactions on Image Processing, 6(12), 1673-1687.
- San Roman, R., Fernandez, P., Elsahar, H., Défossez, A., Furon, T. y Tran, T. (2024). Proactive Detection of Voice Cloning with Localized Watermarking. Proceedings of the 41st International Conference on Machine Learning (ICML 2024). arXiv:2401.17264.
- Liang, W., Yuksekgonul, M., Mao, Y., Wu, E. y Zou, J. (2023). GPT detectors are biased against non-native English writers. Patterns, 4(7), 100779.
- Schick, N. (2020). Deepfakes: The Coming Infocalypse. Twelve.