
IA generativa en proyectos personales: Día 24
 Jeshua Romero Guadarrama
- 68 Min para leer
- 24 Jan, 2026
Índice de contenido
Resumen:
Un proyecto que solo funciona en la laptop de quien lo escribió no es todavía una pieza de portafolio. En esta última entrada de la serie, el Cuaderno Vivo de Sofía se convierte en una entrega: un árbol de carpetas con dependencias fijadas y una configuración sin secretos, un programa final cuaderno_v4.py que extiende las cuatro versiones anteriores, un README que se genera a partir de datos, una prueba de humo que recorre la semana completa sin red ni GPU, una ficha del sistema en la línea de las model cards, una lista de verificación de ética, seguridad y coste, un tablero de métricas y una hoja de ruta. Al terminar, usted sabrá empaquetar, documentar y presentar un proyecto de IA generativa, y tendrá una plantilla de seis pasos para empezar el suyo.
¿Cómo citar el presente artículo?
Romero, J. (24 de enero de 2026). IA generativa en proyectos personales: Día 24. python-data-engineer. https://www.python-data-engineer.com/post/iag/dia_24/.
IA generativa en proyectos personales: Día 24 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/iag/dia_24/.
Modelos, precios y regulación revisados en octubre de 2026. Los precios por millón de tokens son los de la Tabla A de la serie (Haiku 5.5: $0.10$ y $0.50$ USD; Sonnet 5.5: $2$ y $10$ USD; Fable 5.1: $10$ y $50$ USD); compruébelos en la documentación oficial antes de presupuestar su propio proyecto.
Día 24. Entrega final: el Cuaderno Vivo como pieza de portafolio
Introducción
Ayer, en el Día 23 (Evaluación, costes y observabilidad del sistema), aprendió a decidir con evidencia si una versión del sistema es mejor que otra, a vigilar lo que cuesta cada llamada y a observar el funcionamiento del sistema sin guardar el contenido de las notas, y el Cuaderno Vivo ganó un conjunto de evaluación y un registro de uso con alertas de presupuesto. Hoy termina el módulo 6/6 y termina la serie. Hace veinticuatro días, la primera entrada hizo una promesa: aprenderá a aplicar herramientas de IA generativa en proyectos personales. Esta entrada es la prueba de que la promesa se cumplió, porque no presenta ninguna técnica nueva: junta las que ya tiene y las convierte en algo que otra persona puede instalar, ejecutar, auditar y entender.
Sofía tiene sobre la mesa un proyecto que funciona: un prototipo que resume notas con Claude Haiku 5.5 (Día 4), un tutor persistente con tarjetas y cajas de Leitner (Día 8), un generador de portadas con guía de estilo (Día 12), un narrador con su propia voz, consentimiento firmado y marca de agua (Día 16), un registro de riesgos, un filtro de datos personales y una política de divulgación (días 17 a 20), y la arquitectura, la orquestación y la evaluación del módulo 6. Lo que no tiene es una entrega. Si mañana un reclutador, un profesor o Diego le piden el proyecto, Sofía tendría que enviar una carpeta con cinco programas, una docena de archivos JSON, sus notas personales mezcladas con el código y ninguna explicación de por dónde empezar.
Diego, que en el Día 1 preguntó "¿Cuánto cuesta esto al mes?" y no ha dejado de preguntar desde entonces, lo resume con su franqueza de siempre: “Un proyecto que solo sabe ejecutar su autora es un pasatiempo. Uno que cualquiera puede instalar, que dice qué no hace y que demuestra lo que cuesta es un portafolio.” La entrada de hoy recorre esa distancia.
En la presente entrada, descubrirá cómo empaquetar un proyecto de IA generativa con una estructura de carpetas clara, dependencias fijadas y una configuración sin secretos; cómo escribir el programa final cuaderno_v4.py, que extiende sin romper las cuatro versiones anteriores; cómo generar el README a partir de datos y cómo comprobar con una prueba de humo que el flujo semanal completo produce los archivos esperados sin tocar la red. Verá también cómo redactar la ficha del sistema con ayuda de Claude Fable 5.1 y revisión humana obligatoria, cómo pasar una lista de verificación final de quince puntos, cómo presentar el proyecto en tres minutos y cómo trasladar el método de los veinticuatro días a un proyecto suyo.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Empaquetar el proyecto: estructura de carpetas, dependencias fijadas, configuración y README.
- Redactar la ficha del sistema (en la línea de las model cards) con usos previstos, límites, riesgos y métricas.
- Pasar una lista de verificación final de ética, seguridad y coste.
- Presentar el proyecto como portafolio y trazar una hoja de ruta.
- Transferir el método de los 24 días a un proyecto propio.
Lo que construyó Sofía
Antes de empaquetar conviene hacer inventario. Cada día de la serie dejó una pieza en el Cuaderno Vivo: a veces un programa, a veces un archivo de datos, a veces solo una decisión de diseño que cambió cómo se escribió todo lo demás. La Tabla 1 recorre las veinticuatro piezas, una línea por día, junto con el archivo de la entrega donde vive cada una.
Tabla 1. Las 24 piezas del Cuaderno Vivo y su lugar en la entrega.
| Día | Pieza | Archivo en la entrega |
|---|---|---|
| 1 | Modelo de bigramas y perplejidad sobre las 12 notas de Sofía | datos_ejemplo/notas.json (corpus) |
| 2 | Tokenizador BPE de juguete y vectores TF-IDF | recuperacion.py |
| 3 | Softmax, temperatura y muestreo con numpy; control con effort | Decisión de diseño en cada llamada |
| 4 | Prototipo v0 que resume una nota y registra el coste | cuaderno_v0.py, registro_uso.csv |
| 5 | Plantillas de prompt con rol, contexto, tarea y formato | tutor.py |
| 6 | Salidas estructuradas y cadena de prompts | tutor.py (Tarjeta, Mazo) |
| 7 | Memoria persistente y recuperación (RAG) | memoria.json, recuperacion.py |
| 8 | Tutor persistente con cajas de Leitner y caché de prompts | cuaderno_v1.py, progreso_tutor.json |
| 9 | Difusión explicada con numpy | Base conceptual de las portadas |
| 10 | Receta de prompt visual, paleta y contraste | estilo.json |
| 11 | Comparativa de herramientas y elección de FLUX.1 schnell | LICENCIAS.md |
| 12 | Portadas con guía de estilo, crítica y procedencia | cuaderno_v2.py, portadas.py, portadas/ |
| 13 | El sonido como datos: muestreo y espectrogramas | Base conceptual del audio |
| 14 | Síntesis de voz y guion escrito para el oído | narracion.py |
| 15 | Consentimiento de voz convertido en código | consentimiento_voz.json |
| 16 | Narrador con música, mezcla, sello y marca de agua | cuaderno_v3.py, audio/ |
| 17 | Matriz y registro de riesgos | riesgos.csv |
| 18 | Banco de alucinaciones con intervalos de Wilson | evaluacion/ |
| 19 | Filtro de datos personales y defensas contra inyección | guardianes.py |
| 20 | Política de divulgación por modalidad | DIVULGACION.md |
| 21 | Arquitectura de soluciones IA: del requisito al diagrama | docs/ |
| 22 | Orquestación: herramientas, agentes y flujos multimodales | cuaderno_v4.py (orden preparar) |
| 23 | Evaluación, costes y observabilidad del sistema | evaluacion/casos.jsonl, registro_uso.csv |
| 24 | Entrega final: README, ficha del sistema y prueba de humo | README.md, FICHA_SISTEMA.md, pruebas/ |
Observe dos cosas en la tabla. La primera es que no todas las piezas son código: los días 3, 9 y 13 dejaron sobre todo comprensión, y esa comprensión se nota en decisiones concretas (no enviar temperature a la API, elegir cuatro pasos para FLUX.1 schnell, muestrear a $16,000$ Hz). La segunda es que varias piezas comparten archivo: tutor.py reúne lo de los días 5, 6 y 8 porque son capas del mismo componente. Un inventario por días sirve para contar la historia; una entrega por componentes sirve para usarla.
El árbol de la entrega
Como en todos los días de la serie, el primer bloque fija las importaciones y la semilla global $2026$. Hoy solo hacen falta numpy, pandas, matplotlib y la biblioteca estándar de Python, de modo que todo lo que se ejecuta en esta entrada funciona en cualquier equipo con esas tres bibliotecas:
# Importaciones base y semilla del día en Python:
import warnings
warnings.filterwarnings('ignore')
import csv
import json
import re
import sys
import tempfile
import tomllib
import wave
from importlib import metadata
from pathlib import Path
import numpy as np
import pandas as pd
import matplotlib
import matplotlib.pyplot as plt
from matplotlib.patches import FancyBboxPatch, FancyArrowPatch

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
print('Python', sys.version.split()[0], '| numpy', np.__version__, '| pandas', pd.__version__,
      '| matplotlib', matplotlib.__version__)
Python 3.12.10 | numpy 2.4.6 | pandas 3.0.3 | matplotlib 3.10.9
La versión de Python es la $3.12$, suficiente para tomllib, el lector de archivos TOML que forma parte de la biblioteca estándar desde la $3.11$ y que se usará para leer la configuración.
El siguiente bloque crea la estructura de la entrega en un directorio temporal, para no ensuciar su disco: los archivos se crean vacíos, salvo notas.json, que recibe las 12 notas de Sofía de la Tabla 1 del Día 1 con el mismo formato del Día 4 (identificador, tema y texto). La función arbol imprime la estructura con las carpetas primero:
# Árbol de carpetas de la entrega en un directorio temporal en Python:
temporal = tempfile.TemporaryDirectory()        # se borra solo al cerrar Python
raiz = Path(temporal.name) / 'cuaderno-vivo'
ARCHIVOS = [
    'README.md', 'FICHA_SISTEMA.md', 'LICENCIAS.md', 'requirements.txt', 'config.toml',
    '.gitignore', '.env.ejemplo', 'preparar_semana.py',
    'cuaderno_v0.py', 'cuaderno_v1.py', 'cuaderno_v2.py', 'cuaderno_v3.py', 'cuaderno_v4.py',
    'tutor.py', 'portadas.py', 'narracion.py', 'recuperacion.py', 'guardianes.py',
    'cuaderno_vivo/notas.json', 'cuaderno_vivo/memoria.json', 'cuaderno_vivo/estilo.json',
    'cuaderno_vivo/consentimiento_voz.json', 'cuaderno_vivo/tarjetas.json',
    'cuaderno_vivo/progreso_tutor.json', 'cuaderno_vivo/prompt_tutor.txt',
    'cuaderno_vivo/riesgos.csv', 'cuaderno_vivo/registro_uso.csv', 'cuaderno_vivo/DIVULGACION.md',
    'cuaderno_vivo/portadas/semana_01.png', 'cuaderno_vivo/audio/semana_04.wav',
    'docs/arquitectura.png', 'docs/adr/ADR-001.md', 'evaluacion/casos.jsonl',
    'datos_ejemplo/notas.json', 'pruebas/prueba_humo.py',
]
for nombre in ARCHIVOS:
    ruta = raiz / nombre
    ruta.parent.mkdir(parents = True, exist_ok = True)
    ruta.touch()

# Las 12 notas de Sofía (Tabla 1 del Día 1), con el mismo formato de notas.json del Día 4:
textos = [
    ('estadística', 'La media resume un conjunto de datos en un solo número, pero es sensible a los valores extremos de la muestra.'),
    ('estadística', 'La desviación estándar mide cuánto se alejan los datos de la media y ayuda a comparar la dispersión de dos grupos.'),
    ('estadística', 'Un intervalo de confianza da un rango de valores plausibles para la media de la población a partir de una muestra.'),
    ('python', 'En Python una lista guarda elementos en orden y se puede recorrer con un ciclo for para sumar los datos.'),
    ('python', 'Pandas lee un archivo CSV y crea una tabla de datos que se puede filtrar, agrupar y resumir con pocas líneas.'),
    ('python', 'Una función en Python recibe argumentos y devuelve un resultado, lo que ayuda a no repetir el mismo código.'),
    ('historia del arte', 'El Renacimiento recuperó la perspectiva y la proporción del arte clásico para dar profundidad a la pintura.'),
    ('historia del arte', 'El impresionismo pintó la luz al aire libre con pinceladas sueltas y colores puros sin mezclar en la paleta.'),
    ('historia del arte', 'El cubismo rompió la perspectiva única y mostró un objeto desde varios puntos de vista en el mismo cuadro.'),
    ('música', 'Una escala mayor sigue el patrón tono, tono, semitono, tono, tono, tono, semitono y suena alegre en la guitarra.'),
    ('música', 'Un acorde se forma con tres notas de la escala y la guitarra puede tocar el mismo acorde en varias posiciones.'),
    ('música', 'Practicar la guitarra cada día con un metrónomo ayuda a medir el tiempo y a tocar con un ritmo estable.'),
]
notas = [{'id': i + 1, 'tema': tema, 'texto': texto} for i, (tema, texto) in enumerate(textos)]
(raiz / 'cuaderno_vivo/notas.json').write_text(json.dumps(notas, ensure_ascii = False, indent = 2), encoding = 'utf-8')

def arbol(carpeta, prefijo = ''):
    # Primero las carpetas, después los archivos, cada grupo en orden alfabético:
    hijos = sorted(carpeta.iterdir(), key = lambda p: (p.is_file(), p.name.lower()))
    for i, hijo in enumerate(hijos):
        ultimo = i == len(hijos) - 1
        print(prefijo + ('└── ' if ultimo else '├── ') + hijo.name + ('/' if hijo.is_dir() else ''))
        if hijo.is_dir():
            arbol(hijo, prefijo + ('    ' if ultimo else '│   '))

print(raiz.name + '/')
arbol(raiz)
print(f"{len(ARCHIVOS)} archivos | notas.json: {len(notas)} notas, {sum(len(n['texto'].split()) for n in notas)} palabras")
cuaderno-vivo/
├── cuaderno_vivo/
│   ├── audio/
│   │   └── semana_04.wav
│   ├── portadas/
│   │   └── semana_01.png
│   ├── consentimiento_voz.json
│   ├── DIVULGACION.md
│   ├── estilo.json
│   ├── memoria.json
│   ├── notas.json
│   ├── progreso_tutor.json
│   ├── prompt_tutor.txt
│   ├── registro_uso.csv
│   ├── riesgos.csv
│   └── tarjetas.json
├── datos_ejemplo/
│   └── notas.json
├── docs/
│   ├── adr/
│   │   └── ADR-001.md
│   └── arquitectura.png
├── evaluacion/
│   └── casos.jsonl
├── pruebas/
│   └── prueba_humo.py
├── .env.ejemplo
├── .gitignore
├── config.toml
├── cuaderno_v0.py
├── cuaderno_v1.py
├── cuaderno_v2.py
├── cuaderno_v3.py
├── cuaderno_v4.py
├── FICHA_SISTEMA.md
├── guardianes.py
├── LICENCIAS.md
├── narracion.py
├── portadas.py
├── preparar_semana.py
├── README.md
├── recuperacion.py
├── requirements.txt
└── tutor.py
35 archivos | notas.json: 12 notas, 238 palabras
La entrega tiene $35$ archivos organizados en seis carpetas, y notas.json recupera exactamente las $238$ palabras que contó el Día 4. La estructura sigue tres reglas que vale la pena hacer explícitas:
- Los programas viven en la raíz.
cuaderno_v0.pyacuaderno_v4.pyy los módulos auxiliares (tutor.py,portadas.py,narracion.py,recuperacion.py,guardianes.py) se importan entre sí sin configurar rutas. Es la misma disposición que han supuesto los programas desde el Día 8. - Los datos de Sofía viven en
cuaderno_vivo/, y esa carpeta no se publica: contiene sus notas, su progreso, su consentimiento de voz y su registro de uso. Para el portafolio existedatos_ejemplo/, con notas de muestra que cualquiera puede leer. - La documentación tiene nombre propio.
README.mddice cómo usar el proyecto,FICHA_SISTEMA.mddice qué es y qué no es,LICENCIAS.mddice con qué modelos se construyó ydocs/guarda la arquitectura.
El archivo preparar_semana.py merece una línea aparte: es un envoltorio de tres instrucciones que el programador de tareas de su sistema operativo (cron en Linux o el Programador de tareas en Windows) puede lanzar cada domingo. Calcula el número de semana e invoca la orden preparar de cuaderno_v4.py sin preguntar nada, de modo que, como verá más abajo, en ese modo nunca publica: solo prepara.
Un mapa de habilidades
La Tabla 1 dice qué se construyó; falta ver qué se aprendió. El siguiente bloque convierte los veinticuatro días en una matriz de ocho habilidades por veinticuatro días, con una intensidad de $0$ (no se trató) a $3$ (fue el tema central del día). Las intensidades son una valoración editorial, escrita como datos en el código para que usted pueda discutirlas y cambiarlas. El peso de cada habilidad en el recorrido se calcula como su parte del total:
$$ c_s = \frac{\sum_{d=1}^{24} I_{s,d}}{\sum_{s’} \sum_{d=1}^{24} I_{s’,d}} $$
La lógica detrás de esta proporción es múltiple:
- $I_{s,d}$ es la intensidad de la habilidad $s$ en el día $d$; sumarla sobre los días da los “puntos” de cada habilidad.
- El denominador suma los puntos de todas las habilidades, de modo que las $c_s$ suman $1$ y se pueden comparar entre sí.
- Una habilidad que aparece con intensidad baja en muchos días puede pesar tanto como otra que fue protagonista en pocos: la proporción mide presencia acumulada, no profundidad.
- En conclusión, $c_s$ responde a la pregunta "¿cuánto de la serie dediqué a esto?", que es justo la que un portafolio debe poder contestar.
# Mapa de calor de habilidades por día (intensidad de 0 a 3) en Python:
HABILIDADES = ['texto', 'prompts', 'memoria', 'imagen', 'audio', 'ética', 'arquitectura', 'evaluación']
# Intensidad de cada habilidad en cada día; lo que no aparece vale 0:
intensidad = {
    1: {'texto': 3, 'evaluación': 1, 'ética': 1},       2: {'texto': 3, 'memoria': 1, 'evaluación': 1},
    3: {'texto': 3, 'prompts': 1},                       4: {'texto': 2, 'arquitectura': 2, 'evaluación': 1, 'ética': 1},
    5: {'prompts': 3, 'evaluación': 2},                  6: {'prompts': 3, 'evaluación': 2, 'texto': 1},
    7: {'memoria': 3, 'prompts': 1, 'ética': 1},         8: {'memoria': 3, 'prompts': 2, 'arquitectura': 1, 'evaluación': 1},
    9: {'imagen': 3},                                    10: {'imagen': 3, 'prompts': 2},
    11: {'imagen': 3, 'evaluación': 2, 'ética': 1},      12: {'imagen': 3, 'prompts': 1, 'arquitectura': 1, 'ética': 1},
    13: {'audio': 3},                                    14: {'audio': 3, 'texto': 1, 'evaluación': 1},
    15: {'audio': 3, 'ética': 3},                        16: {'audio': 3, 'ética': 2, 'arquitectura': 1},
    17: {'ética': 3, 'arquitectura': 1},                 18: {'ética': 3, 'evaluación': 3, 'memoria': 1},
    19: {'ética': 3, 'memoria': 1, 'arquitectura': 1},   20: {'ética': 3, 'texto': 1, 'imagen': 1, 'audio': 1},
    21: {'arquitectura': 3, 'ética': 1, 'evaluación': 1}, 22: {'arquitectura': 3, 'prompts': 1},
    23: {'evaluación': 3, 'arquitectura': 2},
    24: {'arquitectura': 2, 'ética': 2, 'evaluación': 1, 'texto': 1, 'imagen': 1, 'audio': 1, 'memoria': 1, 'prompts': 1},
}
matriz = pd.DataFrame(0, index = HABILIDADES, columns = range(1, 25))
for dia, niveles in intensidad.items():
    for habilidad, nivel in niveles.items():
        matriz.loc[habilidad, dia] = nivel

fig, ax = plt.subplots(figsize = (11, 4.6))
imagen = ax.imshow(matriz.values, cmap = 'YlGnBu', vmin = 0, vmax = 3, aspect = 'auto')
ax.set_xticks(range(24), [str(d) for d in range(1, 25)])
ax.set_yticks(range(len(HABILIDADES)), HABILIDADES)
for frontera in [3.5, 7.5, 11.5, 15.5, 19.5]:   # separación entre módulos
    ax.axvline(frontera, color = 'white', linewidth = 3)
ax.set_title('Habilidades trabajadas en los 24 días del Cuaderno Vivo', fontsize = 16)
ax.set_xlabel('Día de la serie')
fig.colorbar(imagen, ax = ax, ticks = [0, 1, 2, 3], label = 'Intensidad')
plt.tight_layout()

# Peso de cada habilidad en el total y días en los que fue protagonista (nivel 3):
peso = (matriz.sum(axis = 1) / matriz.values.sum() * 100).round(1)
protagonista = matriz.apply(lambda fila: list(fila[fila == 3].index), axis = 1)
print(pd.DataFrame({'puntos': matriz.sum(axis = 1), 'peso (%)': peso, 'días con nivel 3': protagonista}))
print('Total de puntos:', int(matriz.values.sum()), '| días con al menos tres habilidades:', int(((matriz > 0).sum() >= 3).sum()))
# Una franja por módulo y la ética repartida por toda la serie:
plt.show()
              puntos  peso (%)      días con nivel 3
texto             15      11.6             [1, 2, 3]
prompts           15      11.6                [5, 6]
memoria           10       7.8                [7, 8]
imagen            14      10.9       [9, 10, 11, 12]
audio             14      10.9      [13, 14, 15, 16]
ética             25      19.4  [15, 17, 18, 19, 20]
arquitectura      17      13.2              [21, 22]
evaluación        19      14.7              [18, 23]
Total de puntos: 129 | días con al menos tres habilidades: 15
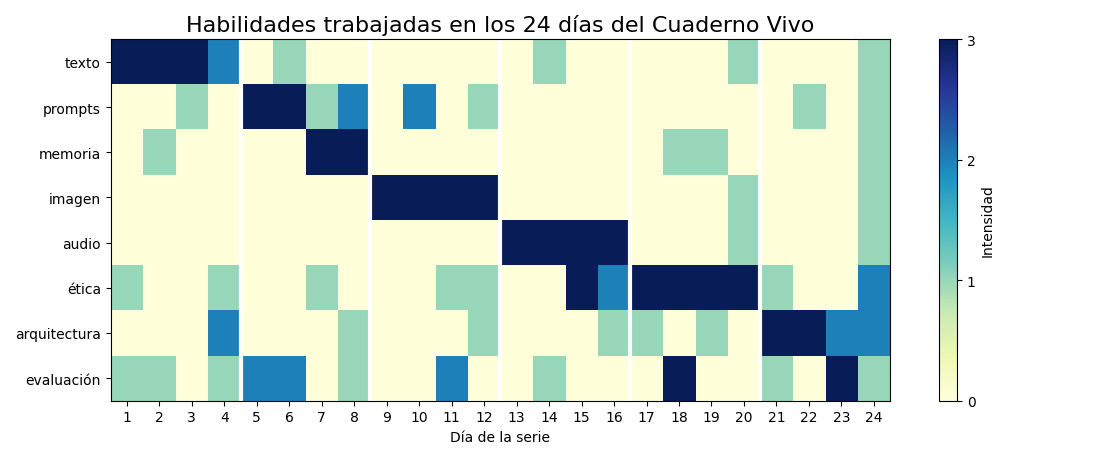
La habilidad con más peso es la ética, con $25$ de $129$ puntos ($19.4%$), y no por casualidad: fue el tema central de los días 15 y 17 a 20, pero además aparece con intensidad baja en el Día 1 (las frases generadas no son de Sofía), en el Día 7 (el perfil es un registro de datos personales), en los días 11 y 12 (licencias y procedencia) y en el Día 24. La evaluación es la segunda ($14.7%$), repartida desde la perplejidad del Día 1 hasta el juez del Día 23, y la arquitectura la tercera ($13.2%$). La memoria es la que menos pesa ($7.8%$), porque se concentró en dos días.
El mapa de calor lo muestra de un vistazo. Las franjas blancas separan los seis módulos, y en cada módulo hay un bloque oscuro (texto en el 1, prompts y memoria en el 2, imagen en el 3, audio en el 4, ética en el 5, arquitectura y evaluación en el 6). Lo interesante está fuera de los bloques: las celdas claras de ética y evaluación salpican toda la matriz, y $15$ de los $24$ días trabajaron al menos tres habilidades a la vez. La serie no fue una lista de herramientas, sino una misma forma de trabajar aplicada a modalidades distintas.
Empaquetar el proyecto
Empaquetar es responder por escrito a cuatro preguntas que, hasta hoy, solo Sofía sabía contestar: ¿qué hay que instalar?, ¿qué se configura y dónde?, ¿cómo se ejecuta? y ¿cómo sé que funciona? Cada una tiene un archivo: requirements.txt, config.toml, README.md y pruebas/prueba_humo.py.
Dependencias fijadas y configuración sin secretos
Una dependencia sin versión es una promesa que el tiempo rompe. pip install pandas instala hoy la versión $3.0.3$ y dentro de un año instalará otra, quizá con un cambio de comportamiento que nadie anotó. La práctica estándar es fijar cada dependencia directa con == a la versión con la que se probó el proyecto. El siguiente bloque no escribe las versiones a mano: las lee del entorno con importlib.metadata, igual que haría pip freeze pero solo para las dependencias directas de la serie, y después comprueba con una expresión regular que cada línea tenga la forma paquete==versión. En la segunda mitad escribe config.toml, .gitignore y .env.ejemplo, y los valida:
# requirements.txt fijado desde el entorno y config.toml validado en Python:
DIRECTAS = ['numpy', 'pandas', 'matplotlib', 'scipy', 'scikit-learn', 'Pillow',
            'requests', 'pydantic', 'anthropic', 'soundfile', 'librosa']
lineas = []
for paquete in DIRECTAS:
    try:
        lineas.append(f'{paquete}=={metadata.version(paquete)}')
    except metadata.PackageNotFoundError:
        lineas.append(f'{paquete}  # no instalado en este equipo: fíjelo con pip freeze')
(raiz / 'requirements.txt').write_text('\n'.join(lineas) + '\n', encoding = 'utf-8')

# Cada línea debe ser paquete==versión exacta; >=, ~= o un nombre suelto no cuentan:
FIJADA = re.compile(r'^[A-Za-z0-9_.-]+==\d+(\.\d+)*$')
sin_fijar = [linea.split()[0] for linea in lineas if not FIJADA.match(linea)]
print('\n'.join(lineas))
print(f'Fijadas: {len(lineas) - len(sin_fijar)} de {len(lineas)} | sin fijar: {sin_fijar}')

# Configuración sin secretos: modelos, presupuesto y reglas de privacidad:
CONFIG = '''
[proyecto]
nombre = "Cuaderno Vivo"
version = "4.0.0"

[presupuesto]
mensual_usd = 10.0
alerta = 0.8

[modelos]
resumir = "claude-haiku-5-5"
evaluar = "claude-haiku-5-5"
tarjetas = "claude-sonnet-5-5"
guion = "claude-sonnet-5-5"
revision = "claude-fable-5-1"
imagen_local = "black-forest-labs/FLUX.1-schnell"
voz_local = "tts_models/multilingual/multi-dataset/xtts_v2"

[privacidad]
redactar_datos_personales = true
audio_de_voz_a_la_nube = false

[divulgacion]
etiqueta = "Generado con IA"
'''
(raiz / 'config.toml').write_text(CONFIG, encoding = 'utf-8')
(raiz / '.gitignore').write_text('.env\nmi_voz.wav\ncuaderno_vivo/\n__pycache__/\n', encoding = 'utf-8')
(raiz / '.env.ejemplo').write_text('ANTHROPIC_API_KEY=\nCLAVE_MARCA_CUADERNO=\n', encoding = 'utf-8')

configuracion = tomllib.loads((raiz / 'config.toml').read_text(encoding = 'utf-8'))
PRECIOS = {'claude-haiku-5-5': (0.10, 0.50), 'claude-sonnet-5-5': (2.00, 10.00), 'claude-fable-5-1': (10.00, 50.00)}
modelos_claude = [m for m in configuracion['modelos'].values() if m.startswith('claude-')]
ignorados = (raiz / '.gitignore').read_text(encoding = 'utf-8').split()
texto_repo = ''.join(p.read_text(encoding = 'utf-8', errors = 'ignore') for p in raiz.rglob('*') if p.is_file())
comprobaciones = {
    'presupuesto de 10 USD con alerta al 80 %': configuracion['presupuesto'] == {'mensual_usd': 10.0, 'alerta': 0.8},
    'todos los modelos de Claude tienen precio': all(m in PRECIOS for m in modelos_claude),
    'la voz no viaja a la nube': configuracion['privacidad']['audio_de_voz_a_la_nube'] is False,
    '.env y mi_voz.wav en .gitignore': {'.env', 'mi_voz.wav'} <= set(ignorados),
    'ninguna clave escrita en el repositorio': re.search(r'sk-ant-[A-Za-z0-9]', texto_repo) is None,
}
for nombre, ok in comprobaciones.items():
    print(('OK   ' if ok else 'FALLA') + ' ' + nombre)
numpy==2.4.6
pandas==3.0.3
matplotlib==3.10.9
scipy==1.17.1
scikit-learn==1.9.0
Pillow==12.2.0
requests==2.34.2
pydantic==2.13.4
anthropic  # no instalado en este equipo: fíjelo con pip freeze
soundfile  # no instalado en este equipo: fíjelo con pip freeze
librosa  # no instalado en este equipo: fíjelo con pip freeze
Fijadas: 8 de 11 | sin fijar: ['anthropic', 'soundfile', 'librosa']
OK    presupuesto de 10 USD con alerta al 80 %
OK    todos los modelos de Claude tienen precio
OK    la voz no viaja a la nube
OK    .env y mi_voz.wav en .gitignore
OK    ninguna clave escrita en el repositorio
El resultado tiene una lectura honesta: $8$ de las $11$ dependencias quedaron fijadas y $3$ no, porque anthropic, soundfile y librosa no están instaladas en el equipo donde se escribió esta entrada (los bloques que llaman a la API o procesan audio real no se ejecutan aquí). La comprobación no las deja pasar: escribe un comentario en su lugar y las lista como pendientes. En la laptop de Sofía, donde esas bibliotecas sí están instaladas porque el Cuaderno Vivo las usa cada semana, el mismo bloque las fija y la lista queda completa. Ejecute siempre esta comprobación en el equipo donde el proyecto funciona, no en otro.
La configuración pasa sus cinco comprobaciones. Tres detalles de diseño:
config.tomlno contiene secretos. Guarda el presupuesto ($10$ USD con alerta al $80%$), el modelo de cada tarea y las reglas de privacidad. Las claves viven en variables de entorno, como fijó el Día 4, y.env.ejemplodocumenta qué variables hacen falta sin darles valor.- La tabla de modelos reproduce el enrutamiento de la serie. Haiku 5.5 para resumir y evaluar, Sonnet 5.5 para tarjetas y guiones, Fable 5.1 solo para revisiones puntuales, FLUX.1 schnell y XTTS-v2 en local. La comprobación verifica que todo modelo de Claude tiene precio, porque un modelo sin precio es un gasto que el registro no sabría calcular.
.gitignoreprotege lo que no debe salir. Además de.env, ignorami_voz.wav(la grabación de su voz del Día 15) y la carpetacuaderno_vivo/completa. La última comprobación busca en todos los archivos de la entrega algo con forma de clave de Anthropic (sk-ant-) y no encuentra nada.
El programa final: cuaderno_v4.py
Como los programas de los días 8, 12 y 16, cuaderno_v4.py no reemplaza a la versión anterior: la extiende. Importa de cuaderno_v0.py la carpeta del proyecto, de cuaderno_v1.py las órdenes tarjetas y repasar, de cuaderno_v2.py la orden portada y de cuaderno_v3.py la orden narrar, de modo que todo lo anterior sigue funcionando exactamente igual, y añade tres órdenes nuevas:
preparar --semana Nprepara la semana completa (tarjetas, portada, episodio e informe) después de pasar dos guardianes: el presupuesto y la revisión de la nota con las funcionesdetectaryfiltro_heuristicodel Día 19, que hoy se guardan enguardianes.py.estadomuestra el gasto acumulado frente al presupuesto y la vigencia del consentimiento de voz.cerrar-mes AAAA_MMarchiva el registro de uso del mes. El registro de seis columnas del Día 4 guarda la hora pero no la fecha, así que la forma más sencilla de llevar la cuenta mensual es cerrar un archivo por mes.
Este bloque llama a la API y no se ejecutó para escribir la entrada; la salida es un ejemplo comentado:
# Entrega final, archivo cuaderno_v4.py, en Python:
import argparse
import csv
import sys
import tomllib
from pathlib import Path

from cuaderno_v0 import CARPETA                     # el prototipo v0 sigue intacto
from cuaderno_v1 import crear_tarjetas, repasar     # el tutor v1
from cuaderno_v2 import crear_portada               # las portadas v2
from cuaderno_v3 import narrar                      # y el narrador v3
from portadas import semanas
from narracion import consentimiento_vigente
from guardianes import detectar, filtro_heuristico  # funciones del Día 19

CONFIG = tomllib.loads(Path('config.toml').read_text(encoding = 'utf-8'))
PRESUPUESTO = CONFIG['presupuesto']['mensual_usd']
ALERTA = CONFIG['presupuesto']['alerta']
ENCABEZADO = 'hora,id_nota,modelo,tokens_entrada,tokens_salida,coste_usd\n'

# Gasto acumulado del registro de seis columnas del Día 4 (un archivo por mes):
def gasto_acumulado():
    ruta = CARPETA / 'registro_uso.csv'
    if not ruta.exists():
        return 0.0
    with open(ruta, encoding = 'utf-8') as archivo:
        return sum(float(fila['coste_usd']) for fila in csv.DictReader(archivo))

# Guardianes de entrada: datos personales e instrucciones incrustadas:
def nota_segura(texto):
    if detectar(texto):
        return False, 'contiene datos personales sin redactar'
    if filtro_heuristico(texto):
        return False, 'posible instrucción incrustada; la nota va a cuarentena'
    return True, 'sin hallazgos'

# Orden preparar: la semana completa con presupuesto, guardianes y confirmación humana:
def preparar(semana, motor = 'xtts', maqueta = False, preguntar = True):
    s = semanas[semana]
    gasto = gasto_acumulado()
    if gasto >= PRESUPUESTO:
        sys.exit(f'Presupuesto agotado ({gasto:.2f} USD): la semana no se prepara.')
    if gasto >= ALERTA * PRESUPUESTO:
        print(f'Aviso: {gasto:.2f} USD, por encima del {ALERTA:.0%} del presupuesto.')
    segura, motivo = nota_segura(s['texto'])
    if not segura:
        sys.exit(f"Nota {s['nota_id']} detenida: {motivo}.")
    print(f"Guardianes: nota {s['nota_id']} {motivo} | gasto {gasto:.2f} de {PRESUPUESTO:.2f} USD")
    crear_tarjetas(s['nota_id'])     # v1
    crear_portada(semana, maqueta)   # v2
    narrar(semana, motor)            # v3
    informe = CARPETA / 'informes' / f'semana_{semana:02d}.md'
    informe.parent.mkdir(exist_ok = True)
    informe.write_text(f"# Semana {semana}: {s['tema']}\n\n{CONFIG['divulgacion']['etiqueta']}.\n\n"
                       f'- Portada: portadas/semana_{semana:02d}.png\n'
                       f'- Episodio: audio/semana_{semana:02d}.wav\n'
                       f'- Gasto acumulado: {gasto_acumulado():.2f} USD\n', encoding = 'utf-8')
    print(f'Informe: {informe}')
    # Publicar tiene efectos fuera del equipo: lo decide Sofía, nunca el programa solo:
    if preguntar and input('¿Copiar el informe a publicar/? [s/n] ').strip().lower() == 's':
        destino = Path('publicar') / informe.name
        destino.parent.mkdir(exist_ok = True)
        destino.write_text(informe.read_text(encoding = 'utf-8'), encoding = 'utf-8')
        print(f'Copiado a {destino}')

# Orden estado: gasto, alerta y consentimiento de voz:
def estado():
    gasto = gasto_acumulado()
    alerta = 'sí' if gasto >= ALERTA * PRESUPUESTO else 'no'
    print(f'Gasto acumulado: {gasto:.2f} USD de {PRESUPUESTO:.2f} ({gasto / PRESUPUESTO:.1%}) | '
          f'alerta al {ALERTA:.0%}: {alerta}')
    print('Consentimiento de voz:', consentimiento_vigente()[1])

# Orden cerrar-mes: archiva el registro y empieza uno nuevo con su encabezado:
def cerrar_mes(etiqueta):
    ruta = CARPETA / 'registro_uso.csv'
    ruta.rename(CARPETA / f'registro_uso_{etiqueta}.csv')
    ruta.write_text(ENCABEZADO, encoding = 'utf-8')
    print(f'Registro archivado como registro_uso_{etiqueta}.csv')

# Punto de entrada con siete órdenes:
def main(argumentos = None):
    lector = argparse.ArgumentParser(description = 'Cuaderno Vivo v4: la entrega final.')
    ordenes = lector.add_subparsers(dest = 'orden', required = True)
    ordenes.add_parser('tarjetas').add_argument('--id', type = int, required = True)
    ordenes.add_parser('repasar')
    for nombre in ['portada', 'narrar', 'preparar']:
        orden = ordenes.add_parser(nombre)
        orden.add_argument('--semana', type = int, required = True, choices = sorted(semanas))
        orden.add_argument('--maqueta', action = 'store_true', help = 'sin GPU: fondo de numpy')
        orden.add_argument('--motor', default = 'xtts', choices = ['xtts', 'juguete'])
    ordenes.add_parser('estado')
    ordenes.add_parser('cerrar-mes').add_argument('etiqueta', help = 'por ejemplo 2026_01')
    a = lector.parse_args(argumentos)
    if a.orden == 'tarjetas':
        crear_tarjetas(a.id)
    elif a.orden == 'repasar':
        repasar()
    elif a.orden == 'portada':
        crear_portada(a.semana, a.maqueta)
    elif a.orden == 'narrar':
        narrar(a.semana, a.motor)
    elif a.orden == 'preparar':
        preparar(a.semana, a.motor, a.maqueta)
    elif a.orden == 'estado':
        estado()
    else:
        cerrar_mes(a.etiqueta)

if __name__ == '__main__':
    main()

# Salida de ejemplo (puede variar):
# $ python cuaderno_v4.py estado
# Gasto acumulado: 1.26 USD de 10.00 (12.6%) | alerta al 80%: no
# Consentimiento de voz: válido hasta 2027-01-15
# $ python cuaderno_v4.py preparar --semana 4 --maqueta
# Guardianes: nota 12 sin hallazgos | gasto 1.26 de 10.00 USD
# 3 tarjetas nuevas; total en el mazo: 18
# Intento 1: semilla 2030 | puntuación 4 | Metrónomo y cuaderno en los dos tercios inferiores; paleta respetada.
# Color compartido con la semana 3: 0.861
# Guardada cuaderno_vivo/portadas/semana_04.png | coste de Claude: 0.01288 USD
# Consentimiento: válido hasta 2027-01-15 | voz propia (XTTS-v2) | cuaderno_vivo/audio/semana_04_voz.wav
# Guion: 114 palabras | notas [11, 12, 10] | divulgación al inicio: sí
# Episodio: cuaderno_vivo/audio/semana_04.wav | 52.4 s | marca z = 16.8 | coste de Claude: 0.00278 USD
# Informe: cuaderno_vivo/informes/semana_04.md
# ¿Copiar el informe a publicar/? [s/n] n
Recorra el programa por sus funciones:
gasto_acumuladoleeregistro_uso.csvconcsv.DictReadery suma la columnacoste_usd, la misma que escribenregistrar(Día 4) yapuntar(días 8, 12 y 16). Como todas las versiones escriben el mismo formato, una sola suma da el gasto real de todo el proyecto.nota_segurapone los guardianes del Día 19 a la entrada del flujo. Si la nota de la semana contiene un correo, un teléfono o una CURP, o una frase que parece una orden dirigida al asistente, la semana no se prepara. El programa no intenta arreglar la nota: la detiene y deja la decisión a Sofía, porque un guardián que corrige en silencio es un guardián que nadie revisa.prepararencadena las órdenes de las versiones anteriores en el orden de sus dependencias: tarjetas, portada y episodio, y por último el informe con la etiqueta “Generado con IA”. Lo hace en secuencia, por sencillez; el grafo de tareas del Día 22 muestra cómo ganar tiempo ejecutando en paralelo lo independiente.- La publicación pide confirmación. Copiar el informe a
publicar/es la única acción con efectos fuera del equipo, y solo ocurre si Sofía escribe “s”. Cuandopreparar_semana.pylanza la orden desde el programador de tareas, pasapreguntar = Falsey la copia nunca ocurre: el modo automático prepara, pero no publica. - La opción
--motoradmitexttsyjuguete. El motor en la nube del Día 16 sigue disponible encuaderno_v3.py narrar --motor elevenlabs, que pide además el identificador de la voz propia verificada; la orden semanal automática no lo usa para que el audio de voz no salga del equipo, como fijaconfig.toml. mainacepta una lista de argumentos, de modo quepreparar_semana.pyy las pruebas pueden llamar amain(['preparar', '--semana', '4'])sin pasar por la terminal.
En la salida de ejemplo, la semilla de la portada es $2030$, la que da la fórmula $s = 2026 + \text{semana} + 100,k$ del Día 12 con la semana $4$ y el primer intento ($k = 0$), y el episodio reproduce las cifras del Día 16 ($52.4$ s y $z = 16.8$). El programa también tiene límites conscientes: el diccionario semanas de portadas.py solo cubre cuatro semanas (ampliarlo es la primera tarea de cualquier mes nuevo), las órdenes se ejecutan una detrás de otra, y si la API falla a mitad de la semana, preparar se detiene sin deshacer lo que ya se generó. Volver a lanzarla repite las tarjetas, un caso que el Día 22 resolvió con claves de idempotencia.
Un README que se genera
Un README escrito a mano envejece en cuanto alguien añade una orden y olvida documentarla. La alternativa es generarlo a partir de los mismos datos que usa el programa: el nombre y la versión salen de config.toml, el presupuesto también, y la tabla de órdenes sale de una lista que se puede comprobar contra main. El siguiente bloque escribe README.md con instalación, órdenes y advertencias:
# README.md generado a partir de datos del proyecto en Python:
ORDENES = [  # (orden, versión que la introdujo, qué hace)
    ('python cuaderno_v0.py --id 5', 'v0, Día 4', 'Resume una nota con Haiku 5.5 y registra el coste'),
    ('python cuaderno_v4.py tarjetas --id 2', 'v1, Día 8', 'Crea tres tarjetas de repaso con Sonnet 5.5'),
    ('python cuaderno_v4.py repasar', 'v1, Día 8', 'Sesión de repaso con cajas de Leitner'),
    ('python cuaderno_v4.py portada --semana 2 --maqueta', 'v2, Día 12', 'Portada semanal con guía de estilo'),
    ('python cuaderno_v4.py narrar --semana 4 --motor juguete', 'v3, Día 16', 'Episodio de audio con divulgación y marca'),
    ('python cuaderno_v4.py preparar --semana 4', 'v4, Día 24', 'La semana completa, con guardianes y presupuesto'),
    ('python cuaderno_v4.py estado', 'v4, Día 24', 'Gasto del mes, consentimiento y lista de verificación'),
]

def generar_readme(config, ordenes):
    # Cada línea del README sale de config.toml o de la lista de órdenes:
    p, presupuesto = config['proyecto'], config['presupuesto']
    lineas = [
        f"# {p['nombre']} {p['version']}", '',
        'Asistente personal de estudio y diario creativo: resume notas, crea tarjetas de repaso,',
        'ilustra una portada por semana y narra un resumen con una voz sintética propia.',
        f"Presupuesto: {presupuesto['mensual_usd']:.0f} USD al mes, con alerta al {presupuesto['alerta']:.0%}.", '',
        '## Instalación', '',
        '    python -m venv .venv',
        '    pip install -r requirements.txt',
        '    copy .env.ejemplo .env      (y escriba allí su ANTHROPIC_API_KEY)', '',
        '## Órdenes', '',
        '| Orden | Desde | Qué hace |',
        '|---|---|---|',
    ]
    lineas += [f'| `{o}` | {v} | {d} |' for o, v, d in ordenes]
    lineas += ['', '## Antes de publicar nada', '',
               'Lea FICHA_SISTEMA.md (usos previstos y no previstos) y cuaderno_vivo/DIVULGACION.md.',
               f"Todo contenido generado lleva la etiqueta \"{config['divulgacion']['etiqueta']}\"."]
    return '\n'.join(lineas) + '\n'

readme = generar_readme(configuracion, ORDENES)
(raiz / 'README.md').write_text(readme, encoding = 'utf-8')
print(readme)
print(f"README.md: {len(readme.splitlines())} líneas, {len(readme.split())} palabras, {len(ORDENES)} órdenes")
# Cuaderno Vivo 4.0.0

Asistente personal de estudio y diario creativo: resume notas, crea tarjetas de repaso,
ilustra una portada por semana y narra un resumen con una voz sintética propia.
Presupuesto: 10 USD al mes, con alerta al 80%.

## Instalación

    python -m venv .venv
    pip install -r requirements.txt
    copy .env.ejemplo .env      (y escriba allí su ANTHROPIC_API_KEY)

## Órdenes

| Orden | Desde | Qué hace |
|---|---|---|
| `python cuaderno_v0.py --id 5` | v0, Día 4 | Resume una nota con Haiku 5.5 y registra el coste |
| `python cuaderno_v4.py tarjetas --id 2` | v1, Día 8 | Crea tres tarjetas de repaso con Sonnet 5.5 |
| `python cuaderno_v4.py repasar` | v1, Día 8 | Sesión de repaso con cajas de Leitner |
| `python cuaderno_v4.py portada --semana 2 --maqueta` | v2, Día 12 | Portada semanal con guía de estilo |
| `python cuaderno_v4.py narrar --semana 4 --motor juguete` | v3, Día 16 | Episodio de audio con divulgación y marca |
| `python cuaderno_v4.py preparar --semana 4` | v4, Día 24 | La semana completa, con guardianes y presupuesto |
| `python cuaderno_v4.py estado` | v4, Día 24 | Gasto del mes, consentimiento y lista de verificación |

## Antes de publicar nada

Lea FICHA_SISTEMA.md (usos previstos y no previstos) y cuaderno_vivo/DIVULGACION.md.
Todo contenido generado lleva la etiqueta "Generado con IA".

README.md: 28 líneas, 227 palabras, 7 órdenes
El README tiene $28$ líneas y $227$ palabras, y eso es una virtud: quien lo abre sabe en treinta segundos qué hace el proyecto, cuánto cuesta, cómo se instala y qué siete órdenes tiene. La columna “Desde” cuenta la historia del proyecto sin necesidad de explicarla: cada orden nació en una versión y sigue viva en la última. Y la sección final remite a los dos documentos que nadie debería saltarse antes de publicar nada, la ficha del sistema y la política de divulgación del Día 20.
Observe un detalle de diseño: el presupuesto aparece como “10 USD al mes, con alerta al 80%” porque así lo dice config.toml. Si Sofía sube el presupuesto a $15$ USD, el README cambia al regenerarlo, sin que nadie tenga que acordarse de editarlo.
Prueba de humo
Una prueba de humo (el nombre viene de la electrónica: se enciende el aparato y se mira si sale humo) no comprueba que cada pieza sea correcta; comprueba que el sistema completo arranca, recorre su camino principal y deja lo que tiene que dejar. Para un proyecto que depende de una API de pago, una GPU y un modelo de voz, la prueba de humo tiene una exigencia adicional: debe poder ejecutarse sin red, sin GPU y sin gastar un centavo, para que cualquiera que reciba la entrega pueda comprobar que la estructura funciona antes de configurar nada.
La técnica es sustituir cada servicio por un simulador: una función con la misma forma de entrada y salida que devuelve un resultado fijo. ClaudeSimulado devuelve textos fijos y un consumo de juguete con la forma de usage; flux_simulado devuelve ruido en lugar de una portada; tts_simulado devuelve un tono de $220$ Hz en lugar de una voz. Con ellos, el bloque recorre el grafo de siete tareas de “preparar la semana” del Día 22 (recuperar notas, crear tarjetas, escribir el guion, escribir el prompt de la portada, generar la portada, narrar y redactar el informe) con el algoritmo de Kahn, que ejecuta cada tarea en cuanto todas sus dependencias han terminado:
# Prueba de humo: la semana completa con simuladores, sin red ni GPU, en Python:
DIVULGACION = 'Este resumen se narra con una voz sintética.'
ETIQUETA = configuracion['divulgacion']['etiqueta']

class ClaudeSimulado:
    # Devuelve textos fijos y un consumo de juguete con la misma forma que usage:
    def __init__(self):
        self.llamadas = 0
    def responder(self, tarea, texto):
        self.llamadas += 1
        fijas = {
            'tarjetas': json.dumps([{'pregunta': '¿Qué patrón sigue una escala mayor?',
                                     'respuesta': 'Tono, tono, semitono, tono, tono, tono, semitono.'}] * 3,
                                   ensure_ascii = False),
            'guion': DIVULGACION + ' Esta semana Sofía repasó escalas, acordes y práctica con metrónomo.',
            'prompt': 'una guitarra de acuarela sobre un cuaderno abierto, paleta azul noche y mostaza',
        }
        return fijas[tarea], {'input_tokens': 2 * len(texto.split()), 'output_tokens': 60}

def flux_simulado(semilla, lado = 64):
    return np.random.default_rng(semilla).random((lado, lado, 3))   # una imagen de ruido, no una portada

def tts_simulado(texto, fs = 16000):
    t = np.arange(int(0.3 * len(texto.split()) * fs)) / fs          # 0.3 s por palabra
    return 0.1 * np.sin(2 * np.pi * 220 * t)

def escribir_wav(ruta, x, fs = 16000):
    with wave.open(str(ruta), 'wb') as archivo:
        archivo.setnchannels(1); archivo.setsampwidth(2); archivo.setframerate(fs)
        archivo.writeframes((x * 32767).astype('<i2').tobytes())

def preparar_semana(semana, tema, carpeta, claude):
    salida = carpeta / f'semana_{semana:02d}'
    salida.mkdir(parents = True, exist_ok = True)
    registro = carpeta / 'registro_uso.csv'
    estado = {}
    def apuntar(tarea, uso):   # mismas seis columnas del Día 4, coste cero por ser simulado
        with open(registro, 'a', newline = '', encoding = 'utf-8') as f:
            csv.writer(f).writerow(['00:00', tarea, 'simulador', uso['input_tokens'], uso['output_tokens'], '0.0000000'])
    def t1():
        estado['notas'] = [n for n in json.loads((raiz / 'cuaderno_vivo/notas.json').read_text(encoding = 'utf-8'))
                           if n['tema'] == tema]
        (salida / 'notas_recuperadas.json').write_text(json.dumps([n['id'] for n in estado['notas']]), encoding = 'utf-8')
    def t2():
        texto, uso = claude.responder('tarjetas', estado['notas'][0]['texto']); apuntar('T2', uso)
        (salida / 'tarjetas.json').write_text(texto, encoding = 'utf-8')
    def t3():
        estado['guion'], uso = claude.responder('guion', ' '.join(n['texto'] for n in estado['notas'])); apuntar('T3', uso)
        (salida / 'guion.txt').write_text(estado['guion'], encoding = 'utf-8')
    def t4():
        estado['prompt'], uso = claude.responder('prompt', estado['notas'][-1]['texto']); apuntar('T4', uso)
        (salida / 'prompt_portada.txt').write_text(estado['prompt'], encoding = 'utf-8')
    def t5():
        plt.imsave(salida / 'portada.png', flux_simulado(2026 + semana))
    def t6():
        escribir_wav(salida / 'episodio.wav', tts_simulado(estado['guion']))
    def t7():
        archivos = sorted(p.name for p in salida.iterdir())
        (salida / 'informe.md').write_text(f'# Semana {semana}: {tema}\n\n{ETIQUETA}.\n\n' +
                                           '\n'.join(f'- {a}' for a in archivos) + '\n', encoding = 'utf-8')
    # El grafo de siete tareas: (dependencias, función):
    grafo = {'T1': ([], t1), 'T2': (['T1'], t2), 'T3': (['T1'], t3), 'T4': (['T1'], t4),
             'T5': (['T4'], t5), 'T6': (['T3'], t6), 'T7': (['T2', 'T5', 'T6'], t7)}
    # Orden topológico de Kahn: se ejecuta una tarea cuando todas sus dependencias terminaron:
    pendientes, hechas, niveles = dict(grafo), set(), []
    while pendientes:
        listas = sorted(t for t, (deps, _) in pendientes.items() if set(deps) <= hechas)
        if not listas:
            raise RuntimeError('El grafo tiene un ciclo.')
        for t in listas:
            pendientes.pop(t)[1]()
        hechas.update(listas)
        niveles.append(listas)   # las tareas de un mismo nivel podrían ir en paralelo
    return salida, niveles

humo = raiz / 'pruebas' / 'humo'
claude = ClaudeSimulado()
salida, niveles = preparar_semana(4, 'música', humo, claude)

# Comprobaciones: archivos esperados, divulgación, etiqueta y registro:
ESPERADOS = ['notas_recuperadas.json', 'tarjetas.json', 'guion.txt', 'prompt_portada.txt',
             'portada.png', 'episodio.wav', 'informe.md']
tamanos = {a: (salida / a).stat().st_size if (salida / a).exists() else 0 for a in ESPERADOS}
filas = (humo / 'registro_uso.csv').read_text(encoding = 'utf-8').splitlines()
pruebas = {
    'archivos esperados y no vacíos': all(t > 0 for t in tamanos.values()),
    'el guion empieza por la divulgación': (salida / 'guion.txt').read_text(encoding = 'utf-8').startswith(DIVULGACION),
    'el informe lleva la etiqueta': ETIQUETA in (salida / 'informe.md').read_text(encoding = 'utf-8'),
    'una fila de registro por llamada': len(filas) == claude.llamadas,
}
print('Niveles de ejecución:', ' -> '.join('[' + ', '.join(n) + ']' for n in niveles))
for archivo, tamano in tamanos.items():
    print(f'  {archivo:<24} {tamano:>7} bytes')
for nombre, ok in pruebas.items():
    print(('OK   ' if ok else 'FALLA') + ' ' + nombre)
print(f'{sum(map(len, niveles))} de 7 tareas completadas | llamadas simuladas a Claude: {claude.llamadas}')
Niveles de ejecución: [T1] -> [T2, T3, T4] -> [T5, T6] -> [T7]
  notas_recuperadas.json        12 bytes
  tarjetas.json                366 bytes
  guion.txt                    117 bytes
  prompt_portada.txt            79 bytes
  portada.png                14563 bytes
  episodio.wav              172842 bytes
  informe.md                   152 bytes
OK    archivos esperados y no vacíos
OK    el guion empieza por la divulgación
OK    el informe lleva la etiqueta
OK    una fila de registro por llamada
7 de 7 tareas completadas | llamadas simuladas a Claude: 3
La prueba termina con $7$ de $7$ tareas completadas y sus cuatro comprobaciones en verde. La primera línea muestra los niveles del orden topológico: la tarea T1 sola, después T2, T3 y T4 (las tres dependen solo de las notas), después T5 y T6, y por último el informe. Las tareas de un mismo nivel son independientes entre sí, y por eso un orquestador puede ejecutarlas en paralelo. Los siete archivos existen y no están vacíos: el episodio simulado ocupa $172,842$ bytes y la portada de ruido $14,563$. El guion empieza por la frase de divulgación “Este resumen se narra con una voz sintética.”, el informe lleva la etiqueta “Generado con IA” y el registro tiene una fila por cada una de las $3$ llamadas simuladas a Claude, con coste cero.
Lo que la prueba no comprueba es igual de importante. No dice nada de la calidad: una portada de ruido la pasa igual que una buena. Para la calidad están el banco de alucinaciones del Día 18 y el conjunto de evaluación del Día 23. La prueba de humo responde a una pregunta más modesta y más frecuente: "¿rompí algo al cambiar el código?" Por eso se ejecuta antes de cada cambio que se publique, y por eso su sitio es pruebas/prueba_humo.py dentro de la entrega.
La ficha del sistema
En $2019$, Margaret Mitchell y sus colaboradores propusieron las fichas de modelo (o model cards, en inglés): documentos breves que acompañan a un modelo de aprendizaje automático y declaran para qué se entrenó, con qué datos, cómo se evaluó, en qué condiciones falla y para qué no debe usarse. Dos años después, Timnit Gebru y sus colaboradores hicieron lo mismo para los conjuntos de datos con las datasheets for datasets. La idea de fondo es la misma: quien usa un sistema tiene derecho a saber sus límites sin tener que descubrirlos por las malas.
El Cuaderno Vivo no es un modelo, sino un sistema que usa varios, así que hoy se escribe una ficha del sistema: la misma idea aplicada al conjunto. La Tabla 2 fija sus secciones y qué va en cada una.
Tabla 2. Secciones de la ficha del sistema del Cuaderno Vivo.
| Sección | Qué declara | Contenido en el Cuaderno Vivo |
|---|---|---|
| Descripción | Qué es el sistema y quién lo mantiene | Asistente personal de estudio y diario creativo de una sola usuaria, versión 4.0.0 |
| Usos previstos | Para qué está pensado | Resumir notas propias, repasar con tarjetas, ilustrar y narrar un resumen semanal |
| Usos no previstos | Para qué no debe usarse | Usar la voz clonada fuera del proyecto, evaluar formalmente a nadie con el tutor, procesar notas de terceros |
| Datos | Qué datos entran y cuáles salen del equipo | Notas propias; solo la nota necesaria viaja a la API, redactada; el audio de voz nunca sale |
| Modelos y licencias | Qué modelos usa y con qué licencia | Claude Haiku 5.5, Sonnet 5.5 y Fable 5.1 por API; FLUX.1 schnell (Apache 2.0) y XTTS-v2 (CPML, no comercial) en local |
| Métricas | Cómo se mide y con qué resultado | Tasa de alucinación con intervalo de Wilson, puntuación del juez, coste mensual frente a 10 USD |
| Riesgos y mitigaciones | Qué puede salir mal y qué se hizo | Registro de 10 riesgos del Día 17, filtro de datos personales, defensas contra inyección, divulgación |
| Contacto | A quién avisar de un problema | Correo de la autora del proyecto y fecha de la última revisión |
La sección más importante es la tercera. Los usos no previstos son la parte de la ficha que protege a terceros: dicen en voz alta lo que el sistema podría hacer técnicamente y no debe hacer. En el Cuaderno Vivo son tres. La voz clonada no se usa fuera del proyecto, ni siquiera por Sofía, porque el consentimiento del Día 15 la limita a narrar sus propios resúmenes. El tutor no sirve para evaluar formalmente a nadie, porque su juez tiene los sesgos que midió el Día 18 y su confianza no está calibrada. Y el sistema no procesa notas de terceros, porque todo su diseño de privacidad supone una sola titular de los datos.
Un borrador con Fable 5.1
Redactar la ficha a partir de los artefactos de los días 17 a 23 es una tarea de síntesis con muchas piezas y poca tolerancia al error: el modelo debe usar las cifras tal cual, sin redondearlas a su favor ni inventar mediciones. Es la clase de tarea para la que la serie reserva a Claude Fable 5.1, el modelo más capaz, con esfuerzo alto y con el respaldo del lado del servidor activado. Este bloque llama a la API y no se ejecutó para escribir la entrada; la salida es un ejemplo comentado:
# Borrador de FICHA_SISTEMA.md con Claude Fable 5.1 a partir de los artefactos, en Python:
import anthropic
from pathlib import Path

client = anthropic.Anthropic()   # lee ANTHROPIC_API_KEY del entorno

# Resúmenes de los artefactos de la serie, escritos por Sofía en una línea cada uno:
artefactos = {
    'riesgos': 'riesgos.csv: 10 riesgos; 85 puntos inherentes y 40 residuales tras 8 mitigaciones (Día 17).',
    'alucinaciones': 'Haiku 5.5 con notas: 4/25 respuestas incorrectas, Wilson 95 % [0.064, 0.347] (Día 18).',
    'privacidad': 'Redacción reversible de datos personales y filtro de inyección con cuarentena (Día 19).',
    'divulgacion': 'DIVULGACION.md: etiqueta visible, metadatos y huella por modalidad (Día 20).',
    'arquitectura': 'Arquitectura documentada del requisito al diagrama (Día 21).',
    'orquestacion': 'Flujo "preparar la semana" de siete tareas con confirmación humana (Día 22).',
    'evaluacion': 'Conjunto de evaluación, juez automático y registro de uso con alerta al 80 % (Día 23).',
    'coste': 'Coste mensual estimado: 1.68 USD de un presupuesto de 10 USD (Día 24).',
    'licencias': 'FLUX.1 schnell: Apache 2.0. XTTS-v2: Coqui Public Model License, uso no comercial.',
}
SECCIONES = ['Descripción', 'Usos previstos', 'Usos no previstos', 'Datos', 'Modelos y licencias',
             'Métricas', 'Riesgos y mitigaciones', 'Contacto']

respuesta = client.beta.messages.create(
    model = 'claude-fable-5-1',
    max_tokens = 8000,
    betas = ['server-side-fallback-2026-07-01'],
    fallbacks = 'default',                     # respaldo del lado del servidor
    output_config = {'effort': 'high'},
    system = ('Usted redacta fichas de sistema para proyectos personales de software con IA generativa. '
              'Escriba en español, con tratamiento de usted, en Markdown. Use solo las cifras de los '
              'artefactos, sin redondearlas ni añadir mediciones. Si falta un dato, escriba "pendiente".'),
    messages = [{'role': 'user', 'content': (
        'Redacte FICHA_SISTEMA.md para el Cuaderno Vivo con estas secciones, en este orden: '
        + ', '.join(SECCIONES) + '. En "Usos no previstos" incluya: usar la voz clonada fuera del '
        'proyecto, usar el tutor para evaluaciones formales y procesar notas de terceros. '
        'Máximo 700 palabras.\n\n<artefactos>\n'
        + '\n'.join(f'- {clave}: {valor}' for clave, valor in artefactos.items()) + '\n</artefactos>')}],
)

# Comprobar el motivo de parada antes de leer el contenido:
if respuesta.stop_reason == 'refusal':
    raise RuntimeError('El modelo y su respaldo rechazaron la petición.')
if respuesta.stop_reason == 'max_tokens':
    print('Aviso: el borrador se cortó; revise el final antes de usarlo.')
borrador = ''.join(bloque.text for bloque in respuesta.content if bloque.type == 'text')
Path('FICHA_SISTEMA_borrador.md').write_text(borrador, encoding = 'utf-8')
coste = respuesta.usage.input_tokens * 10 / 1e6 + respuesta.usage.output_tokens * 50 / 1e6
faltan = [s for s in SECCIONES if f'## {s}' not in borrador]
print(borrador[:520])
print(f'Secciones ausentes: {faltan} | tokens: {respuesta.usage.input_tokens} de entrada, '
      f'{respuesta.usage.output_tokens} de salida | coste: {coste:.4f} USD')

# Salida de ejemplo (puede variar):
# # Ficha del sistema: Cuaderno Vivo 4.0.0
#
# ## Descripción
# El Cuaderno Vivo es un asistente personal de estudio y diario creativo que usa una sola
# persona, su autora, en su propio equipo. Resume notas, genera tarjetas de repaso, ilustra
# una portada semanal y narra un resumen en audio con una voz sintética de la autora.
#
# ## Usos previstos
# - Resumir y repasar las notas de estudio propias.
# Secciones ausentes: [] | tokens: 1412 de entrada, 2236 de salida | coste: 0.1259 USD
Tres decisiones del bloque merecen comentario. La instrucción de sistema prohíbe redondear o añadir cifras y pide escribir “pendiente” cuando falte un dato: es más fácil revisar un hueco declarado que una cifra inventada con buena redacción. La comprobación faltan verifica de forma determinista que las ocho secciones de la Tabla 2 están presentes, sin pedirle al modelo que se evalúe a sí mismo. Y el borrador se guarda con el sufijo _borrador, igual que la política de divulgación del Día 20: el archivo definitivo lo escribe una persona.
El coste de la salida de ejemplo, unos $0.13$ USD con los precios de Fable 5.1 ($1,412 \cdot 10 / 10^6 + 2,236 \cdot 50 / 10^6 = 0.1259$), es el más alto de una sola llamada en toda la serie, y aun así es razonable: la ficha se redacta una vez y se revisa dos veces al año.
Atención aquí: La ficha del sistema es un compromiso público y la firma una persona, no un modelo. Antes de renombrar el borrador a FICHA_SISTEMA.md, compruebe cada cifra contra su artefacto de origen, confirme que los usos no previstos son explícitos (la voz clonada no se usa fuera del proyecto, el tutor no evalúa formalmente a nadie, no se procesan notas de terceros) y elimine cualquier promesa que el código no cumpla. Si el proyecto se publica, revise también las licencias de cada modelo y la obligación de etiquetado vigente en su jurisdicción, como el artículo 50 del Reglamento europeo de IA que estudió el Día 20.
Métricas finales
Una ficha del sistema sin cifras es un folleto. La sección “Métricas” necesita números, y el siguiente bloque los reúne en un tablero de cuatro paneles: el coste mensual por módulo, la puntuación del juez para dos versiones del sistema, la tasa de alucinación con su intervalo y el número de artefactos producidos.
El coste total es la suma de lo que gasta cada módulo, y la pregunta de Diego se responde comparándolo con el presupuesto $P = 10$ USD:
$$ C = \sum_{m=1}^{6} C_m, \qquad u = \frac{C}{P} $$
La lógica detrás de esta suma es múltiple:
- Cada $C_m$ sale de las cifras que el propio día publicó: $0.192$ USD de los resúmenes con Haiku 5.5 (Día 4), $0.904$ USD del tutor con caché y enrutamiento (Día 8), $0.099$ USD de la parte de Claude de las portadas (Día 12), cuatro guiones de $0.00278$ USD (Día 16) y la revisión de riesgos y el banco de alucinaciones (días 17 y 18).
- El módulo 6 se estima en el bloque con supuestos explícitos: cuatro ejecuciones semanales del orquestador con ocho iteraciones de Sonnet 5.5, quince casos del juez con Haiku 5.5 cada semana y una revisión de arquitectura con Fable 5.1 al mes.
- $u$ es la fracción del presupuesto que se usa; lo que queda, $P - C$, es el margen para crecer o para equivocarse.
- En conclusión, el coste se audita módulo a módulo: si $u$ sube, se sabe de inmediato qué componente lo empujó.
La tasa de alucinación se informa como enseñó el Día 18: con su denominador y con el intervalo de Wilson, que no da límites imposibles con muestras pequeñas:
$$ \frac{\hat{p} + \frac{z^2}{2n} \pm z\sqrt{\frac{\hat{p}(1-\hat{p})}{n} + \frac{z^2}{4n^2}}}{1 + \frac{z^2}{n}} $$
La lógica detrás de este intervalo es múltiple:
- $\hat{p} = k/n$ es la tasa observada, $n$ el número de preguntas y $z = 1.96$ el valor de la normal para el $95%$.
- El término $z^2/2n$ desplaza el centro hacia $0.5$ y el denominador $1 + z^2/n$ lo encoge: con pocas observaciones, el intervalo no se pega a $0$ ni a $1$.
- En conclusión, el intervalo dice cuánto podría equivocarse la tasa, que con $25$ preguntas es mucho.
# Tablero final 2x2 con las cifras de la serie en Python:
def coste(modelo, entrada, salida, llamadas = 1):
    p_ent, p_sal = PRECIOS[modelo]
    return llamadas * (entrada * p_ent + salida * p_sal) / 1e6

# Coste mensual por módulo con las cifras publicadas en cada día (USD):
modulo6 = (coste('claude-sonnet-5-5', 2500, 300, llamadas = 4 * 8)     # orquestador: 4 semanas x 8 iteraciones
           + coste('claude-haiku-5-5', 900, 120, llamadas = 4 * 15)    # juez: 15 casos cada semana
           + coste('claude-fable-5-1', 6000, 1500))                    # una revisión de arquitectura al mes
costes = pd.Series({
    'M1 resúmenes (Día 4)': coste('claude-haiku-5-5', 1200, 400, llamadas = 20 * 30),
    'M2 tutor (Día 8)': 0.904,
    'M3 portadas (Día 12)': 0.099,
    'M4 guiones (Día 16)': 4 * 0.00278,
    'M5 riesgos y banco (Días 17-18)': 0.049 + 0.002 + 0.02 + 0.0015,
    'M6 orquestación y juez (estimado)': modulo6,
})
# Juez de juguete: 15 casos puntuados de 1 a 5 en la versión 1 y en la versión 2:
v1 = np.clip(np.round(rng.normal(3.4, 0.8, 15)), 1, 5)
v2 = np.clip(v1 + rng.choice([0, 0, 1, 1, 1, 2, -1], 15), 1, 5)
# Tasas de alucinación del Día 18 con su intervalo de Wilson al 95 %:
def wilson(k, n, z = 1.96):
    p = k / n
    centro = (p + z**2 / (2 * n)) / (1 + z**2 / n)
    radio = z * np.sqrt(p * (1 - p) / n + z**2 / (4 * n**2)) / (1 + z**2 / n)
    return centro - radio, centro + radio
alucinaciones = {'Haiku sin notas': (8, 25), 'Haiku con notas': (4, 25), 'Con verificador': (1, 25)}
artefactos = pd.Series({'notas': 12, 'tarjetas': 15, 'portadas': 4, 'episodios': 1, 'riesgos': 10, 'documentos': 6})

fig, ejes = plt.subplots(2, 2, figsize = (11, 8))
ax = ejes[0, 0]
ax.barh(costes.index, costes.values, color = '#4C72B0')
ax.invert_yaxis()
ax.set_title(f'Coste mensual por módulo: {costes.sum():.2f} de 10 USD', fontsize = 13)
ax.set_xlabel('USD al mes')
ax = ejes[0, 1]
medias = [v1.mean(), v2.mean()]
errores = [1.96 * v.std(ddof = 1) / np.sqrt(len(v)) for v in (v1, v2)]
ax.bar(['Versión 1', 'Versión 2'], medias, yerr = errores, capsize = 8, color = ['#8C8C8C', '#55A868'])
ax.set_ylim(0, 5)
ax.set_title('Puntuación del juez (15 casos, de juguete)', fontsize = 13)
ax.set_ylabel('Puntuación media de 1 a 5')
ax = ejes[1, 0]
for i, (nombre, (k, n)) in enumerate(alucinaciones.items()):
    bajo, alto = wilson(k, n)
    ax.errorbar(i, k / n, yerr = [[k / n - bajo], [alto - k / n]], fmt = 'o', color = '#DD8452', capsize = 8, markersize = 9)
    ax.annotate(f'{k}/{n}', (i, k / n), textcoords = 'offset points', xytext = (12, -4))
ax.set_xticks(range(3), list(alucinaciones))
ax.set_xlim(-0.5, 2.5)
ax.set_title('Tasa de alucinación (Día 18) con Wilson 95 %', fontsize = 13)
ax.set_ylabel('Proporción de respuestas')
ax = ejes[1, 1]
ax.barh(artefactos.index, artefactos.values, color = '#8172B3')
ax.invert_yaxis()
ax.set_title('Artefactos producidos en la serie', fontsize = 13)
ax.set_xlabel('Cantidad')
plt.tight_layout()

print(costes.round(4).to_string())
print(f'Total: {costes.sum():.4f} USD al mes | uso del presupuesto: {costes.sum() / 10:.1%}')
print(f'Juez: v1 = {v1.mean():.2f}, v2 = {v2.mean():.2f}, diferencia = {v2.mean() - v1.mean():.2f}')
for nombre, (k, n) in alucinaciones.items():
    bajo, alto = wilson(k, n)
    print(f'{nombre:<16} {k:>2}/{n} = {k / n:.2f}  Wilson 95 %: [{bajo:.3f}, {alto:.3f}]')
# Cuatro paneles: coste, calidad, fiabilidad y producción:
plt.show()
M1 resúmenes (Día 4)                 0.1920
M2 tutor (Día 8)                     0.9040
M3 portadas (Día 12)                 0.0990
M4 guiones (Día 16)                  0.0111
M5 riesgos y banco (Días 17-18)      0.0725
M6 orquestación y juez (estimado)    0.4000
Total: 1.6786 USD al mes | uso del presupuesto: 16.8%
Juez: v1 = 3.47, v2 = 4.00, diferencia = 0.53
Haiku sin notas   8/25 = 0.32  Wilson 95 %: [0.172, 0.516]
Haiku con notas   4/25 = 0.16  Wilson 95 %: [0.064, 0.347]
Con verificador   1/25 = 0.04  Wilson 95 %: [0.007, 0.195]
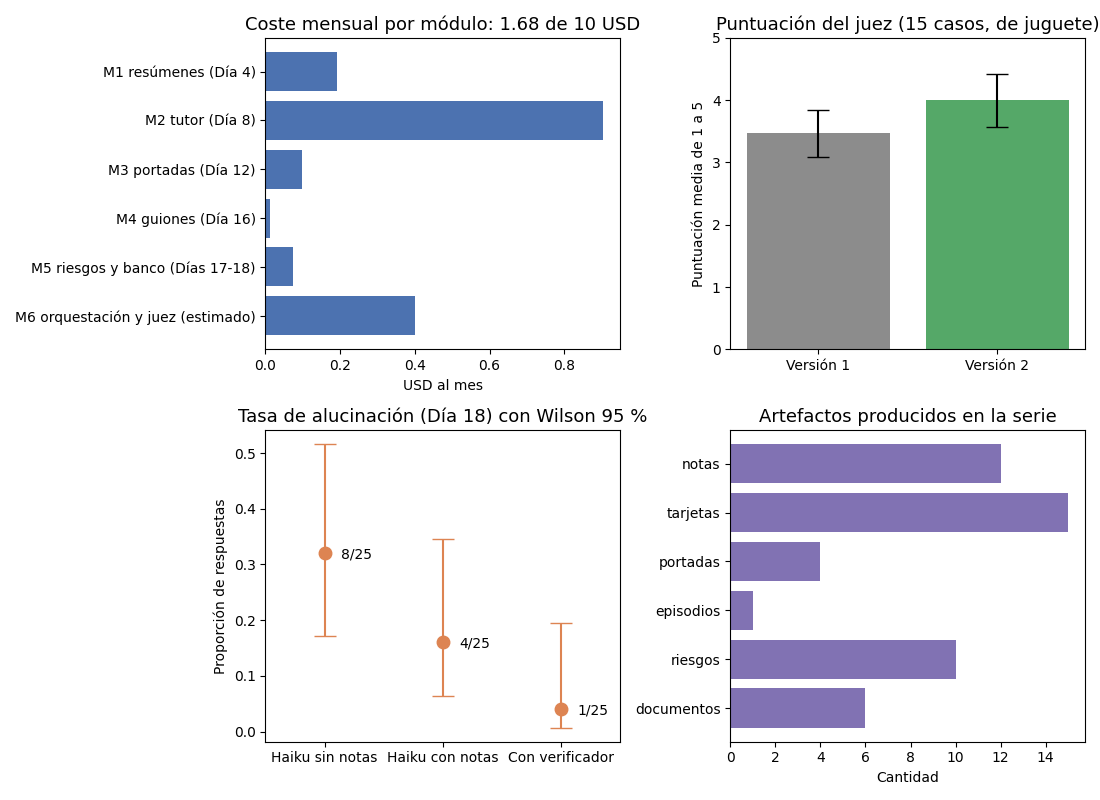
El panel superior izquierdo responde a Diego: el Cuaderno Vivo completo cuesta unos $1.68$ USD al mes, el $16.8%$ del presupuesto de $10$ USD, y deja un margen de $8.32$ USD. El tutor del Día 8 es el componente más caro ($0.904$ USD, más de la mitad del total), lo cual tiene sentido: es el que más se usa. El módulo 6 es el segundo ($0.40$ USD), casi todo por el orquestador con Sonnet 5.5. Los guiones del pódcast, en cambio, casi no se ven: $0.0111$ USD al mes. Recuerde de dónde viene cada cifra: cinco son las que publicaron los días de origen y la sexta es una estimación con supuestos escritos en el código. Ninguna es una factura real; la factura real la dará registro_uso.csv cuando Sofía use el sistema un mes completo.
El panel superior derecho compara dos versiones con un juez automático sobre $15$ casos. Las puntuaciones son de juguete, generadas en el bloque para que el tablero sea autocontenido (el Día 23 trató a fondo cómo obtenerlas y validarlas): la versión 2 obtiene $4.00$ de media frente a $3.47$ de la versión 1, una diferencia de $0.53$ puntos, con barras de error que casi se tocan. El panel inferior izquierdo reproduce las tres tasas del Día 18 con sus intervalos: $8/25 = 0.32$ sin notas, $[0.172, 0.516]$; $4/25 = 0.16$ con notas, $[0.064, 0.347]$, el mismo intervalo que publicó aquel día; y $1/25 = 0.04$ con el verificador, $[0.007, 0.195]$. Los tres intervalos se solapan, y esa es la lectura correcta: la tendencia es clara, pero $25$ preguntas no bastan para afirmar cuánto mejora cada paso. El panel inferior derecho cuenta lo producido: $12$ notas, $15$ tarjetas, $4$ portadas, $1$ episodio, $10$ riesgos registrados y $6$ documentos (README, ficha, divulgación, licencias, arquitectura y un primer ADR).
Lista de verificación final
Los pilotos de avión no despegan de memoria, aunque hayan despegado mil veces: recorren una lista. La razón no es que olviden cómo se vuela, sino que bajo presión cualquiera se salta un paso obvio. Una entrega tiene el mismo problema. El siguiente bloque convierte las comprobaciones finales en un DataFrame de $15$ filas con cinco columnas: el área, la comprobación, si es bloqueante (sin ella no se entrega), si está completa y la evidencia que lo demuestra. Tres filas no las declara nadie: se calculan con los resultados de los bloques 4 y 7. El porcentaje completado y la condición de entrega son:
$$ p = \frac{100}{N}\sum_{i=1}^{N} c_i, \qquad L = \prod_{i \in B} c_i $$
La lógica detrás de estas dos cifras es múltiple:
- $c_i$ vale $1$ si la comprobación $i$ está completa y $0$ si no; $p$ es el porcentaje de comprobaciones completas entre las $N = 15$.
- $B$ es el conjunto de comprobaciones bloqueantes. El producto $L$ vale $1$ solo si todas están completas: basta un cero para que la entrega no salga.
- $p$ informa del progreso, pero no decide. Un $93%$ con una bloqueante pendiente no se entrega; un $87%$ con todas las bloqueantes completas, sí.
- En conclusión, separar lo bloqueante de lo deseable convierte la lista en una regla de decisión y no en un adorno.
# Lista de verificación final como DataFrame en Python:
# Tres filas se calculan con los resultados de los bloques 4 y 7; el resto lo declara Sofía:
lista = pd.DataFrame([
    # (área, comprobación, bloqueante, completa, evidencia o justificación)
    ('ética', 'Consentimiento de voz vigente y firmado', True, True, 'consentimiento_voz.json, válido hasta 2027-01-15'),
    ('ética', 'Divulgación en texto, imagen y audio', True, True, 'DIVULGACION.md y prueba de humo'),
    ('ética', 'Ninguna persona real, marca ni artista vivo', True, True, 'revisión de prompts y portadas'),
    ('ética', 'Ficha del sistema revisada por una persona', True, True, 'FICHA_SISTEMA.md firmada por Sofía'),
    ('seguridad', 'Filtro de datos personales activo', True, True, 'guardianes.py antes de cada llamada'),
    ('seguridad', 'Defensas contra inyección de prompts', True, True, 'banco de pruebas del Día 19'),
    ('seguridad', 'Claves fuera del repositorio', True, comprobaciones['ninguna clave escrita en el repositorio'], 'Bloque 4'),
    ('seguridad', 'Datos reales fuera del repositorio', True, True, 'cuaderno_vivo/ ignorado, datos_ejemplo/'),
    ('coste', 'Presupuesto con alerta al 80 %', True, comprobaciones['presupuesto de 10 USD con alerta al 80 %'], 'Bloque 4'),
    ('coste', 'Registro de uso sin contenido personal', True, True, 'registro_uso.csv de seis columnas'),
    ('calidad', 'Dependencias fijadas con ==', True, True, 'pip freeze en la laptop de Sofía'),
    ('calidad', 'Prueba de humo sin red ni GPU', True, all(pruebas.values()), 'Bloque 7'),
    ('licencias', 'Licencias de modelos compatibles con el uso', True, True, 'LICENCIAS.md: Apache 2.0 y CPML no comercial'),
    ('procedencia', 'Portadas firmadas con un certificado de confianza', False, False, 'certificado de prueba; no se publica fuera'),
    ('calidad', 'Sonoridad medida en LUFS', False, False, 'RMS en dBFS basta para uso privado'),
], columns = ['área', 'comprobación', 'bloqueante', 'completa', 'evidencia'])
lista.index = range(1, len(lista) + 1)

porcentaje = 100 * lista['completa'].mean()
lista_para_entregar = lista.loc[lista['bloqueante'], 'completa'].all()
pd.set_option('display.width', 200)
print(lista[['área', 'comprobación', 'bloqueante', 'completa']].to_string())
print(f"Completas: {lista['completa'].sum()} de {len(lista)} ({porcentaje:.1f} %)")
print(f"Bloqueantes completas: {lista.loc[lista['bloqueante'], 'completa'].sum()} de {lista['bloqueante'].sum()} | lista para entregar: {'sí' if lista_para_entregar else 'no'}")
print('Pendientes:', lista.loc[~lista['completa'], 'comprobación'].tolist())
           área                                       comprobación  bloqueante  completa
1         ética            Consentimiento de voz vigente y firmado        True      True
2         ética               Divulgación en texto, imagen y audio        True      True
3         ética        Ninguna persona real, marca ni artista vivo        True      True
4         ética         Ficha del sistema revisada por una persona        True      True
5     seguridad                  Filtro de datos personales activo        True      True
6     seguridad               Defensas contra inyección de prompts        True      True
7     seguridad                       Claves fuera del repositorio        True      True
8     seguridad                 Datos reales fuera del repositorio        True      True
9         coste                     Presupuesto con alerta al 80 %        True      True
10        coste             Registro de uso sin contenido personal        True      True
11      calidad                        Dependencias fijadas con ==        True      True
12      calidad                      Prueba de humo sin red ni GPU        True      True
13    licencias        Licencias de modelos compatibles con el uso        True      True
14  procedencia  Portadas firmadas con un certificado de confianza       False     False
15      calidad                           Sonoridad medida en LUFS       False     False
Completas: 13 de 15 (86.7 %)
Bloqueantes completas: 13 de 13 | lista para entregar: sí
Pendientes: ['Portadas firmadas con un certificado de confianza', 'Sonoridad medida en LUFS']
La lista da $13$ de $15$ comprobaciones completas ($86.7%$) y las $13$ bloqueantes completas, de modo que $L = 1$: el Cuaderno Vivo se puede entregar. La Tabla 3 reproduce la lista con su evidencia.
Tabla 3. Lista de verificación final del Cuaderno Vivo.
| N.º | Área | Comprobación | Bloqueante | Estado | Evidencia o justificación |
|---|---|---|---|---|---|
| 1 | Ética | Consentimiento de voz vigente y firmado | Sí | Completa | consentimiento_voz.json, válido hasta 2027-01-15 |
| 2 | Ética | Divulgación en texto, imagen y audio | Sí | Completa | DIVULGACION.md y prueba de humo |
| 3 | Ética | Ninguna persona real, marca ni artista vivo | Sí | Completa | Revisión de prompts y portadas |
| 4 | Ética | Ficha del sistema revisada por una persona | Sí | Completa | FICHA_SISTEMA.md firmada por Sofía |
| 5 | Seguridad | Filtro de datos personales activo | Sí | Completa | guardianes.py antes de cada llamada |
| 6 | Seguridad | Defensas contra inyección de prompts | Sí | Completa | Banco de pruebas del Día 19 |
| 7 | Seguridad | Claves fuera del repositorio | Sí | Completa | Bloque 4 |
| 8 | Seguridad | Datos reales fuera del repositorio | Sí | Completa | cuaderno_vivo/ ignorado, datos_ejemplo/ |
| 9 | Coste | Presupuesto con alerta al 80 % | Sí | Completa | Bloque 4 |
| 10 | Coste | Registro de uso sin contenido personal | Sí | Completa | registro_uso.csv de seis columnas |
| 11 | Calidad | Dependencias fijadas con == | Sí | Completa | pip freeze en la laptop de Sofía |
| 12 | Calidad | Prueba de humo sin red ni GPU | Sí | Completa | Bloque 7 |
| 13 | Licencias | Licencias de modelos compatibles con el uso | Sí | Completa | LICENCIAS.md: Apache 2.0 y CPML no comercial |
| 14 | Procedencia | Portadas firmadas con un certificado de confianza | No | Pendiente | Certificado de prueba; no se publica fuera |
| 15 | Calidad | Sonoridad medida en LUFS | No | Pendiente | RMS en dBFS basta para uso privado |
Las dos pendientes están justificadas, no olvidadas. La firma C2PA de las portadas existe desde el Día 20, pero con un certificado de prueba que ninguna lista de confianza reconoce; mientras las portadas no se publiquen fuera del círculo de Sofía, la etiqueta visible y los metadatos bastan. La sonoridad se mide en RMS y no en LUFS, como advirtió el Día 16; para escuchar en casa es suficiente, y para publicar un pódcast no lo sería. Ambas pasan a la hoja de ruta con fecha. Una pendiente con justificación y fecha es una decisión; una pendiente sin ellas es una deuda que nadie ve.
Observe también la fila 11. La comprobación del Bloque 4 dejó tres dependencias sin fijar en el equipo de esta entrada, y la lista la marca como completa porque la evidencia es otra: el pip freeze de la laptop de Sofía, donde el proyecto se ejecuta. Es un buen ejemplo de por qué la columna de evidencia existe: una casilla marcada sin evidencia es una opinión.
Presentar el proyecto
Con la entrega lista, queda contarla. Sofía tiene una entrevista para unas prácticas de ingeniería de datos y le han pedido que presente “un proyecto personal” en tres minutos. Tres minutos son unas $400$ palabras habladas: no caben veinticuatro días. La Tabla 4 propone un guion que cabe.
Tabla 4. Guion de demostración de tres minutos.
| Tiempo | Qué se muestra | Qué se dice |
|---|---|---|
| 0:00 a 0:20 | Una nota de estudio y su portada semanal | El problema: estudiar cuatro materias con 10 USD al mes de IA |
| 0:20 a 0:50 | python cuaderno_v4.py estado y el tablero de métricas | El coste: 1.68 USD al mes, medido módulo a módulo |
| 0:50 a 1:40 | preparar --semana 4 en directo, con --maqueta | El flujo: tarjetas, portada y episodio con guardianes antes y confirmación al final |
| 1:40 a 2:20 | La ficha del sistema y la lista de verificación | Los límites: usos no previstos, alucinaciones con intervalo, dos pendientes con fecha |
| 2:20 a 3:00 | El mapa de habilidades y la hoja de ruta | Lo aprendido y lo siguiente: decisiones, no herramientas |
La demostración en directo usa --maqueta por una razón práctica: una sala de entrevistas no tiene GPU, y una demostración que depende de que todo salga bien es una apuesta. Si la red falla, Sofía tiene preparada la prueba de humo, que enseña el mismo flujo sin conexión.
Para la parte escrita del portafolio bastan cuatro capturas: el README en la página del repositorio, el mapa de calor de habilidades, una portada con su banda “Generado con IA” y el tablero de métricas. Cada una con una frase debajo que diga qué decisión ilustra.
Qué contar en una entrevista
La tentación es enumerar herramientas: Claude, FLUX, XTTS-v2, pandas, numpy. Pero las herramientas cambian cada pocos meses y quien entrevista lo sabe. Lo que se recuerda de una buena presentación son las decisiones, cada una con su cifra:
- Elegir el modelo por tarea, no por prestigio. Resumir con Fable 5.1 costaría $19.20$ USD al mes y con Haiku 5.5 cuesta $0.192$ (Día 4); Fable solo entra donde hace falta, como en la ficha de hoy.
- Pagar una vez lo que se repite. La caché de prompts ahorró el $59.6%$ del coste del tutor (Día 8).
- Llevar a local lo sensible. La voz de Sofía nunca sale de su laptop: XTTS-v2 corre en local, con un consentimiento que caduca (Día 15).
- Medir con intervalos. “$4$ de $25$, con un intervalo de $0.064$ a $0.347$” es una respuesta honesta; “un $16%$ de alucinaciones” no lo es (Día 18).
- Poner los guardianes en el código. La divulgación, el filtro de datos personales y la confirmación antes de publicar no dependen de la memoria de nadie (días 19, 20 y 24).
La última pregunta de Diego
Diego asiste al ensayo de la presentación sentado en el sofá, con los brazos cruzados, como lleva veinticuatro días. Escucha los tres minutos sin interrumpir y al final hace la pregunta que Sofía esperaba desde el Día 1: "¿Cuánto cuesta esto al mes?" Ella señala el tablero: un dólar con sesenta y ocho centavos, estimado módulo a módulo, con la factura real en camino. Diego asiente y, por primera vez en la serie, no tiene una segunda objeción.
Tiene, en cambio, una confesión. Su abuela guarda decenas de casetes con canciones que cantaba en las fiestas familiares, y lleva meses pensando en digitalizarlas. “Si yo quisiera hacer algo así, ¿por dónde empiezo?” Sofía no le habla de modelos. Le dice que empiece por pedirle permiso a su abuela, por escrito, como ella hizo con su propia voz; que decida qué saldrá de su equipo y qué no; que calcule cuánto puede gastar al mes; y que construya algo pequeño que funcione antes de añadir nada. Es decir, que empiece por el Día 1. La sección siguiente convierte esa respuesta en una plantilla.
Hoja de ruta
Un proyecto de portafolio que no tiene futuro escrito parece terminado, y un proyecto terminado parece abandonado. La hoja de ruta dice qué viene después, con horizontes de $1$, $3$ y $6$ meses. Las tareas salen de tres fuentes: las dos pendientes de la lista de verificación, los límites conscientes que cada versión del programa fue anotando y las preguntas que la serie dejó abiertas. El siguiente bloque las organiza en semanas a partir del lunes 2 de febrero de 2026 y dibuja un diagrama de Gantt:
# Hoja de ruta de seis meses como diagrama de Gantt en Python:
ruta = pd.DataFrame([
    # (horizonte, tarea, semana de inicio, semanas de duración)
    ('1 mes', 'Medir la sonoridad en LUFS', 0, 1),
    ('1 mes', 'Firmar portadas con un certificado propio', 1, 2),
    ('1 mes', 'Ampliar la evaluación de 15 a 50 casos', 0, 4),
    ('3 meses', 'Embeddings aprendidos en lugar de TF-IDF', 4, 4),
    ('3 meses', 'Interfaz web local mínima', 6, 5),
    ('3 meses', 'Tarjetas nocturnas por lotes', 9, 3),
    ('6 meses', 'Clasificar notas con un modelo local', 12, 5),
    ('6 meses', 'Marca de agua de audio aprendida', 15, 6),
    ('6 meses', 'Revisión semestral de riesgos y ficha', 23, 2),
], columns = ['horizonte', 'tarea', 'inicio', 'duracion'])
INICIO = pd.Timestamp('2026-02-02')   # primer lunes después del Día 24
ruta['desde'] = INICIO + pd.to_timedelta(7 * ruta['inicio'], unit = 'D')
ruta['hasta'] = ruta['desde'] + pd.to_timedelta(7 * ruta['duracion'], unit = 'D') - pd.Timedelta(days = 1)

colores = {'1 mes': '#55A868', '3 meses': '#4C72B0', '6 meses': '#8172B3'}
fig, ax = plt.subplots(figsize = (10, 5))
for i, fila in ruta.iterrows():
    ax.barh(i, fila['duracion'], left = fila['inicio'], color = colores[fila['horizonte']], height = 0.6)
for semana, etiqueta in [(4, '1 mes'), (13, '3 meses'), (26, '6 meses')]:
    ax.axvline(semana, color = 'gray', linestyle = '--', linewidth = 1)
    ax.text(semana - 0.2, -0.9, etiqueta, ha = 'right', color = 'gray')
ax.set_yticks(range(len(ruta)), ruta['tarea'])
ax.set_ylim(len(ruta) - 0.4, -1.4)   # eje invertido, con espacio arriba para los horizontes
ax.set_xlim(0, 26)
ax.set_xlabel('Semanas desde el 2 de febrero de 2026')
ax.set_title('Hoja de ruta del Cuaderno Vivo', fontsize = 16)
plt.tight_layout()

print(ruta[['horizonte', 'tarea', 'desde', 'hasta']].assign(
    desde = ruta['desde'].dt.strftime('%d/%m'), hasta = ruta['hasta'].dt.strftime('%d/%m')).to_string(index = False))
print('Semanas de trabajo:', int(ruta['duracion'].sum()), '| última entrega:', ruta['hasta'].max().date())
# Tres horizontes de color y las líneas de 1, 3 y 6 meses:
plt.show()
horizonte                                     tarea desde hasta
    1 mes                Medir la sonoridad en LUFS 02/02 08/02
    1 mes Firmar portadas con un certificado propio 09/02 22/02
    1 mes    Ampliar la evaluación de 15 a 50 casos 02/02 01/03
  3 meses  Embeddings aprendidos en lugar de TF-IDF 02/03 29/03
  3 meses                 Interfaz web local mínima 16/03 19/04
  3 meses              Tarjetas nocturnas por lotes 06/04 26/04
  6 meses      Clasificar notas con un modelo local 27/04 31/05
  6 meses          Marca de agua de audio aprendida 18/05 28/06
  6 meses     Revisión semestral de riesgos y ficha 13/07 26/07
Semanas de trabajo: 32 | última entrega: 2026-07-26
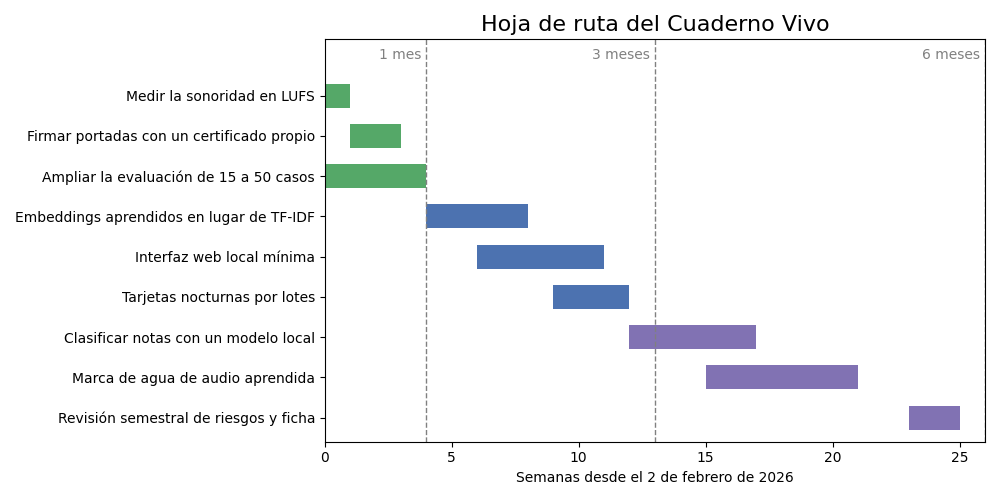
La hoja de ruta tiene $9$ tareas y $32$ semanas de trabajo repartidas en $26$ semanas de calendario (algunas se solapan), con la última entrega el 26 de julio de 2026. La Tabla 5 explica de dónde sale cada tarea.
Tabla 5. Hoja de ruta del Cuaderno Vivo a 1, 3 y 6 meses.
| Horizonte | Tarea | Origen | Criterio de terminado |
|---|---|---|---|
| 1 mes | Medir la sonoridad en LUFS | Pendiente 15 de la lista; límite del Día 16 | Episodio medido según ITU-R BS.1770 |
| 1 mes | Firmar portadas con un certificado propio | Pendiente 14 de la lista; Día 20 | Manifiesto C2PA válido con un certificado identificable |
| 1 mes | Ampliar la evaluación de 15 a 50 casos | Día 18: afinar exige bancos grandes | Intervalos de Wilson más estrechos que $0.15$ |
| 3 meses | Embeddings aprendidos en lugar de TF-IDF | Días 2 y 7: los conteos no ven sinónimos | Precisión@1 mayor que la del índice TF-IDF |
| 3 meses | Interfaz web local mínima | Comodidad de uso diario | Las siete órdenes accesibles sin terminal |
| 3 meses | Tarjetas nocturnas por lotes | API de lotes al $50%$ del precio estándar | Coste del tutor por debajo de su valor actual |
| 6 meses | Clasificar notas con un modelo local | Privacidad: menos texto hacia la nube | Exactitud igual o mejor con cero llamadas a la API |
| 6 meses | Marca de agua de audio aprendida | Día 16: la marca de juguete no resiste recortes | Detección tras recorte y filtro pasa bajos |
| 6 meses | Revisión semestral de riesgos y ficha | Día 17: el registro es un documento vivo | riesgos.csv y ficha con fecha de revisión nueva |
En el diagrama, las barras verdes del primer mes son cortas y concretas: son deudas pequeñas con fecha. Las azules del tercer mes mejoran la experiencia y el coste. Las moradas del sexto mes son las más ambiciosas y las más inciertas, y por eso están más lejos. La última, la revisión semestral, no añade nada nuevo: vuelve a mirar el registro de riesgos y la ficha con ojos frescos. Una hoja de ruta honesta reserva tiempo para revisar lo hecho, no solo para hacer cosas nuevas.
De Cuaderno Vivo a su proyecto
El Cuaderno Vivo era una excusa. Lo que la serie quería transmitir era un método, y un método se reconoce porque funciona con otro problema. El siguiente bloque dibuja ese método como una escalera de seis peldaños, uno por módulo, en la que cada paso se apoya en el anterior:
# Plantilla de seis pasos para un proyecto propio, dibujada como una escalera en Python:
PASOS = [
    ('Fundamentos', 'Una tarea, un coste y\nun prototipo v0', '1/6'),
    ('Prompts y memoria', 'Plantillas, salidas\nestructuradas y RAG', '2/6'),
    ('Imagen', 'Guía de estilo y\nprocedencia', '3/6'),
    ('Audio', 'Voz propia con\nconsentimiento', '4/6'),
    ('Riesgos', 'Matriz, filtros y\ndivulgación', '5/6'),
    ('Arquitectura', 'Diagrama, evaluación\ny entrega', '6/6'),
]
COLORES = ['#4C72B0', '#55A868', '#DD8452', '#C44E52', '#8172B3', '#937860']
fig, ax = plt.subplots(figsize = (11, 6))
for i, (nombre, detalle, modulo) in enumerate(PASOS):
    x, y = 0.3 + 1.75 * i, 0.3 + 0.85 * i
    ax.add_patch(FancyBboxPatch((x, y), 1.55, 1.35, boxstyle = 'round,pad=0.03,rounding_size=0.08',
                                facecolor = COLORES[i], edgecolor = 'white', alpha = 0.9))
    ax.text(x + 0.775, y + 1.08, f'Paso {i + 1}\n{nombre}', ha = 'center', va = 'center', color = 'white',
            fontsize = 9.5, weight = 'bold')
    ax.text(x + 0.775, y + 0.52, detalle, ha = 'center', va = 'center', color = 'white', fontsize = 8.5)
    ax.text(x + 0.775, y + 0.12, f'Módulo {modulo}', ha = 'center', color = 'white', fontsize = 8.5)
    if i < len(PASOS) - 1:
        ax.add_patch(FancyArrowPatch((x + 1.6, y + 0.65), (x + 1.72, y + 1.45), arrowstyle = '-|>',
                                     mutation_scale = 14, color = 'gray'))
ax.text(0.3, 5.6, 'De Cuaderno Vivo a su proyecto', fontsize = 16)
ax.text(0.3, 5.15, 'Cada peldaño se apoya en el anterior; el presupuesto y la ética viajan en todos.',
        fontsize = 10, color = 'dimgray')
ax.set_xlim(0, 11); ax.set_ylim(0, 6); ax.axis('off')
plt.tight_layout()

print(' -> '.join(f'{i + 1}. {nombre}' for i, (nombre, _, _) in enumerate(PASOS)))
# La escalera de seis peldaños, uno por módulo:
plt.show()
1. Fundamentos -> 2. Prompts y memoria -> 3. Imagen -> 4. Audio -> 5. Riesgos -> 6. Arquitectura
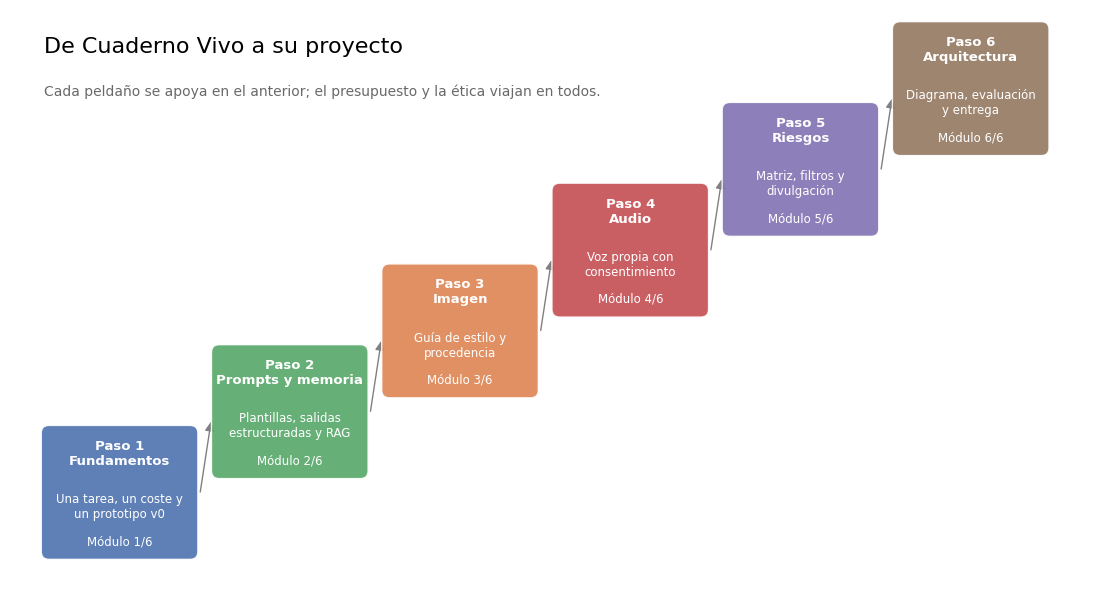
La escalera se lee de abajo arriba y cada peldaño tiene una pregunta que usted debe poder contestar antes de subir al siguiente:
- Fundamentos. ¿Qué tarea concreta resuelve, cuánto cuesta cada consulta y cuál es el prototipo v0 más pequeño que la cumple?
- Prompts y memoria. ¿Qué parte del prompt es fija, qué formato exige a la salida y qué debe recordar el sistema entre sesiones?
- Imagen. Si su proyecto genera imágenes, ¿qué guía de estilo las hace coherentes y cómo deja constancia de su procedencia?
- Audio. Si genera voz o música, ¿de quién es la voz, dónde está su consentimiento y cómo se avisa de que es sintética?
- Riesgos. ¿Qué puede salir mal, con qué probabilidad e impacto, y qué guardián en el código lo impide?
- Arquitectura y entrega. ¿Cómo se ven las piezas juntas, cómo se evalúa el conjunto y qué haría falta para que otra persona lo instale y lo entienda?
No todos los proyectos pasan por todos los peldaños: uno sin imágenes se salta el tercero. Pero ninguno debería saltarse el primero ni el quinto, y por eso el subtítulo de la figura dice que el presupuesto y la ética viajan en todos. La Tabla 6 aplica la plantilla a tres proyectos personales distintos.
Tabla 6. La plantilla de seis pasos aplicada a otros proyectos personales.
| Paso | Diario de viajes | Asistente de recetas | Archivo musical familiar |
|---|---|---|---|
| 1. Fundamentos | Resumir cada día de viaje en tres frases con un modelo barato | Proponer una receta con lo que hay en la despensa | Transcribir y fechar cada grabación |
| 2. Prompts y memoria | Perfil de viajero y recuperación de días anteriores | Salida estructurada con ingredientes y pasos; alergias en el perfil | Fichas estructuradas por canción y búsqueda por intérprete |
| 3. Imagen | Postal semanal con guía de estilo y etiqueta visible | Ilustración del plato, nunca presentada como foto real | Portada de cada álbum digital sin rostros de familiares |
| 4. Audio | Narración del diario con la voz propia | Lectura de pasos en voz alta con una voz genérica | Restaurar y separar voces; ninguna clonación sin consentimiento escrito de cada familiar |
| 5. Riesgos | Ubicaciones y fotos de terceros fuera de la nube | Alergias: el sistema nunca afirma que un plato es seguro | Consentimiento de cada intérprete o de sus herederos; datos de menores |
| 6. Arquitectura | Proceso nocturno local y presupuesto mensual | Reglas deterministas para alérgenos antes del modelo | Copia de seguridad 3-2-1 y ficha del sistema para la familia |
La tercera columna es el proyecto de Diego, y muestra por qué el quinto peldaño no es opcional. En un archivo musical familiar, las voces son de personas reales, algunas ya fallecidas, y la tentación de “hacer cantar a la abuela una canción nueva” es justo el uso no previsto que la ficha de ese sistema tendría que prohibir. La técnica sería la misma del Día 15; la diferencia la ponen el consentimiento y la honestidad. En el asistente de recetas, el riesgo principal no es técnico sino de salud: el modelo puede equivocarse con un alérgeno, y por eso la regla de los alérgenos va antes del modelo y en código determinista, igual que los guardianes del Cuaderno Vivo.
Si su proyecto sale de casa: en cuanto publique contenido generado fuera de su círculo personal, se aplican las reglas que la serie trató en el módulo 5: etiquetar lo sintético, conservar el registro de generación, revisar la licencia de cada modelo (XTTS-v2, por ejemplo, no admite uso comercial) y comprobar la obligación de etiquetado vigente en su jurisdicción. Nunca represente a personas reales sin su consentimiento informado y por escrito.
Consideraciones finales
Veinticuatro días después, el Cuaderno Vivo resume notas, pregunta tarjetas, ilustra semanas y las narra con la voz de su autora, y todo eso cuesta menos de dos dólares al mes. Pero lo más valioso que dejó la serie no está en ninguno de los $35$ archivos de la entrega. Está en una forma de trabajar: empezar pequeño, medir siempre, poner las reglas en el código y escribir lo que el sistema no hace. Las herramientas de esta serie cambiarán; algunas ya habrán cambiado cuando usted lea esto. El método no.
Antes de dar por cerrado su propio proyecto, hágase las preguntas que Sofía tuvo que contestar hoy:
- ¿Puede otra persona instalarlo y ejecutar la prueba de humo sin hablar con usted?
- ¿Sabe cuánto cuesta al mes y qué componente lo encarece?
- ¿Están escritos sus usos no previstos, y algún guardián del código los impide?
- ¿Qué cifra de su ficha del sistema no podría defender con su artefacto de origen?
- ¿Qué pendiente de su lista no tiene fecha?
Las cifras de hoy tienen límites claros. El coste de $1.68$ USD al mes suma cinco cifras publicadas en días anteriores y una estimación con supuestos escritos en el código; no es una factura. Las puntuaciones del juez son de juguete, y las tasas de alucinación, aunque son las del Día 18, salen de $25$ preguntas. El mapa de habilidades es una valoración editorial. Y la prueba de humo demuestra que la estructura funciona, no que el contenido sea bueno. Ninguno de esos límites invalida la entrega; todos están declarados en ella, que es exactamente lo que una ficha del sistema debe hacer.
Si quiere seguir aprendiendo, la serie deja varias puertas abiertas, y todas tienen buenas fuentes fuera de este blog. Para la evaluación, el artículo de Zheng y sus colaboradores sobre los modelos como jueces y el libro de Efron y Tibshirani sobre el bootstrap. Para la documentación responsable, los artículos de Mitchell sobre fichas de modelo y de Gebru sobre fichas de conjuntos de datos. Para la deuda técnica que acumulan los sistemas con aprendizaje automático, el artículo de Sculley y sus colaboradores, que en $2015$ ya describía los problemas que hoy tiene cualquier proyecto con modelos de terceros. Y para las novedades de modelos, precios y parámetros, la documentación oficial de cada proveedor y las fichas de los modelos en Hugging Face, que son la única fuente de verdad cuando una entrada como esta envejece.
Un gran libro que habla de esto es Designing Machine Learning Systems (o Diseño de sistemas de aprendizaje automático), en el que Chip Huyen recorre todo lo que rodea a un modelo: los datos, el despliegue, la monitorización, la deuda técnica y las personas. Complementa al AI Engineering que recomendó el Día 4: aquel enseña a construir con modelos fundacionales, este enseña a sostener cualquier sistema con aprendizaje automático cuando sale del cuaderno de quien lo escribió.
Un proyecto con IA generativa no se termina cuando funciona, se termina cuando otra persona puede entender qué hace, cuánto cuesta y qué no debe hacer. Sofía empezó con una restricción de $10$ USD al mes y un amigo que desconfiaba de todo. Termina con un sistema que gasta el $16.8%$ de ese presupuesto, que declara sus límites y que pasa trece de quince comprobaciones con las otras dos justificadas. Diego ya no desconfía: está pidiendo permiso a su abuela.
Conclusiones clave
Módulo 1: Fundamentos de la IA generativa
- Generar es muestrear de una distribución; los bigramas, la tokenización y el softmax con temperatura explican lo que hace un modelo grande con el mismo bucle de “predecir, muestrear, añadir”.
- El coste se calcula antes de construir: con el volumen de Sofía, resumir cuesta $0.192$ USD al mes con Haiku 5.5 y $19.20$ con Fable 5.1, y el prototipo v0 registra cada consulta desde el primer día.
Módulo 2: Prompt engineering y sistemas persistentes
- Un prompt se escribe por piezas (rol, contexto, tarea, restricciones y formato) y su salida se exige con un esquema, no con buenas intenciones.
- La memoria es un archivo que usted controla; con caché de prompts y enrutamiento, el tutor persistente cuesta $0.904$ USD al mes.
Módulo 3: IA visual
- La difusión convierte ruido en imagen paso a paso, y una guía de estilo en
estilo.jsones la memoria visual que el modelo no tiene. - Elegir herramienta es leer la licencia además de mirar la calidad, y toda portada lleva una etiqueta visible y su procedencia.
Módulo 4: IA sonora
- El sonido es una lista de números que se muestrea, se transforma y se sintetiza; la voz propia se clona solo con un consentimiento escrito que el código comprueba.
- Cada episodio lleva divulgación audible, metadatos y una marca de agua, y ninguna de esas capas basta sola.
Módulo 5: Ética y riesgos
- Los riesgos se mapean con probabilidad e impacto y se miden con intervalos: $4/25$ alucinaciones con notas, con un intervalo de Wilson de $[0.064, 0.347]$.
- La privacidad, las defensas contra la inyección y la política de divulgación funcionan porque están en el código, no en un documento.
Módulo 6: Proyecto integrador
- Una entrega es estructura, dependencias fijadas, configuración sin secretos, un README generado y una prueba de humo que pasa sin red: $7$ de $7$ tareas.
- La ficha del sistema declara usos no previstos, la lista de verificación separa lo bloqueante ($13$ de $13$) de lo deseable ($13$ de $15$, $86.7%$), y el coste estimado queda en $1.68$ USD de $10$.
Ahora, en su propio proyecto: la serie termina aquí, y lo que sigue es suyo. Elija una tarea pequeña que le importe, escriba su prototipo v0 con un presupuesto y un registro de uso, y suba la escalera de seis peldaños: fundamentos, prompts y memoria, imagen, audio, riesgos y arquitectura. Cuando otra persona pueda instalarlo, entender qué hace y saber qué no debe hacer, habrá cumplido la promesa del Día 1: habrá aplicado herramientas de IA generativa en un proyecto personal.
Referencias
- Mitchell, M., Wu, S., Zaldivar, A., Barnes, P., Vasserman, L., Hutchinson, B., Spitzer, E., Raji, I. D. y Gebru, T. (2019). Model Cards for Model Reporting. Proceedings of the Conference on Fairness, Accountability, and Transparency (FAT* ‘19), 220-229.
- Gebru, T., Morgenstern, J., Vecchione, B., Vaughan, J. W., Wallach, H., Daumé III, H. y Crawford, K. (2021). Datasheets for Datasets. Communications of the ACM, 64(12), 86-92.
- Sculley, D., Holt, G., Golovin, D., Davydov, E., Phillips, T., Ebner, D., Chaudhary, V., Young, M., Crespo, J.-F. y Dennison, D. (2015). Hidden Technical Debt in Machine Learning Systems. Advances in Neural Information Processing Systems 28 (NeurIPS 2015).
- Huyen, C. (2022). Designing Machine Learning Systems: An Iterative Process for Production-Ready Applications. O’Reilly Media.
- Kahn, A. B. (1962). Topological sorting of large networks. Communications of the ACM, 5(11), 558-562.
- Wilson, E. B. (1927). Probable Inference, the Law of Succession, and Statistical Inference. Journal of the American Statistical Association, 22(158), 209-212.
- National Institute of Standards and Technology (2024). Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile (NIST AI 600-1). https://doi.org/10.6028/NIST.AI.600-1
- Anthropic (2026). Documentación de Claude: modelos, precios y API de mensajes. https://platform.claude.com/docs