
IA generativa en proyectos personales: Día 25
 Jeshua Romero Guadarrama
- 55 Min para leer
- 25 Jan, 2026
Índice de contenido
Resumen:
Un modelo de lenguaje puede escribir código, pero quien lo acepta en su proyecto responde por él. En esta entrada, Sofía pone a un agente de código a trabajar sobre el Cuaderno Vivo con una regla estricta: la tarea se entrega como un contrato con firma, pruebas escritas antes que el código y límites sobre qué archivos puede tocar. Verá cómo pedir la implementación a Claude Sonnet 5.5 con salida estructurada, cómo medir cuántas veces acierta con el estimador insesgado pass@k, cómo revisar el cambio con una lista de diez puntos y un analizador estático con ast, cómo declarar los permisos del agente y cuánto tiempo ahorra (o no) cada tarea. Al terminar, usted sabrá decidir cuándo conviene un agente de código y cuándo escribir el código usted mismo.
¿Cómo citar el presente artículo?
Romero, J. (25 de enero de 2026). IA generativa en proyectos personales: Día 25. python-data-engineer. https://www.python-data-engineer.com/post/iag/dia_25/.
IA generativa en proyectos personales: Día 25 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/iag/dia_25/.
Modelos, precios y herramientas revisados en octubre de 2026. Los precios por millón de tokens son los de la Tabla A de la serie (Sonnet 5.5: $2$ USD de entrada y $10$ de salida); los nombres de las herramientas de programación con agentes cambian con frecuencia, así que compruebe la documentación oficial antes de instalarlas.
Día 25. Programar con IA: un agente de código trabaja sobre el Cuaderno Vivo
Introducción
Ayer, en el Día 24 (Entrega final: el Cuaderno Vivo como pieza de portafolio), aprendió a empaquetar, documentar y presentar un proyecto de IA generativa, y el Cuaderno Vivo ganó una entrega completa: dependencias fijadas, el programa cuaderno_v4.py, un README generado, una prueba de humo, una ficha del sistema y una hoja de ruta que empieza el lunes 2 de febrero de 2026. Hoy comienza el módulo 7/7, “Más allá del proyecto: extensiones y vida del producto”, una ampliación que el Día 24 no anunciaba: la serie dijo “termina aquí” porque la entrega estaba completa, y lo sigue estando. Lo que ocupa esta semana intermedia, del 25 al 31 de enero, no son funciones nuevas añadidas al azar, sino siete preguntas que todo proyecto se hace en cuanto otra persona empieza a usarlo.
La primera pregunta es la más incómoda: ¿quién escribe el código del Cuaderno Vivo a partir de ahora? Durante veinticuatro días lo escribió Sofía, línea a línea, y cada programa extendió al anterior sin romperlo: cuaderno_v0.py resume notas, cuaderno_v1.py añade el tutor, cuaderno_v2.py las portadas, cuaderno_v3.py el narrador y cuaderno_v4.py la orden preparar, con presupuesto y guardianes. La hoja de ruta tiene nueve tareas y $32$ semanas de trabajo. Si Sofía las escribe sola, a su ritmo de estudiante de posgrado, llegará a julio. Si un modelo escribe parte del código, quizá llegue antes, pero entonces habrá en su proyecto líneas que ella no tecleó.
Diego, que el Día 24 dejó de ser escéptico y empezó a pedir permiso a su abuela para digitalizar sus casetes, trae la pregunta desde el otro lado. Él quiere adaptar el proyecto a su archivo musical familiar, pero no programa en Python. “Si la IA ya escribe código, ¿no me lo puede escribir a mí?” La respuesta corta es que sí puede escribirlo; la respuesta larga es esta entrada, porque escribir código y responder por él son dos cosas distintas.
En la presente entrada, descubrirá tres niveles de ayuda al programar con IA, del autocompletado al agente de código que lee el repositorio, edita archivos y ejecuta pruebas. Verá cómo especificar una tarea como un contrato con firma, pruebas y límites; cómo pedir la implementación a Claude Sonnet 5.5 con salida estructurada; cómo medir la calidad del código generado con el estimador insesgado pass@k y por qué el estimador ingenuo se equivoca; cómo revisar un cambio con una lista de diez puntos y un analizador estático con ast; cómo declarar qué puede leer, escribir y ejecutar el agente, y cuánto cuesta y cuánto ahorra cada tarea. Al final sabrá cuándo conviene un agente de código y cuándo es mejor escribir el código usted mismo.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Distinguir tres niveles de ayuda al programar: autocompletado, generación por petición y agente de código que lee el repositorio, edita archivos y ejecuta pruebas.
- Especificar una tarea de programación como contrato: firma, pruebas que deben pasar y límites (qué archivos puede tocar).
- Medir la calidad del código generado con pruebas y con el estimador insesgado pass@k.
- Revisar un cambio generado con una lista de comprobación: diff, dependencias inventadas, secretos y efectos fuera del alcance.
- Decidir cuándo conviene un agente de código y cuándo escribir el código uno mismo.
Tres maneras de programar con IA
“Programar con IA” describe hoy cosas muy diferentes, y conviene separarlas antes de decidir nada, porque cada una tiene un riesgo distinto. La diferencia no está en el modelo que hay detrás (puede ser el mismo en los tres casos), sino en qué ve del proyecto, qué puede cambiar y quién ejecuta las pruebas.
El primer nivel es el autocompletado dentro del editor. Mientras usted escribe, el modelo propone la línea o el bloque siguiente a partir del archivo abierto y de algunos archivos vecinos. Usted acepta con una tecla o sigue escribiendo. Es el nivel más rápido y el que menos cambia la forma de trabajar: usted sigue siendo quien escribe, y el modelo solo adelanta lo que probablemente iba a teclear. Su riesgo principal es la aceptación automática: después de aceptar cien sugerencias correctas, la sugerencia ciento uno, que invierte una condición o inventa un argumento, se acepta con el mismo gesto.
El segundo nivel es la generación por petición: usted describe lo que necesita en una conversación (o en una llamada a la API, como hará en el Bloque 4) y recibe una función o un archivo completo. El modelo solo ve lo que usted pega en la petición. Esto tiene una ventaja que se suele pasar por alto: usted controla exactamente qué sale de su equipo. Su riesgo principal es el contrario: como el modelo no ve el resto del proyecto, puede escribir algo que funciona aislado y no encaja con nada, o que importa una biblioteca que su proyecto no tiene.
El tercer nivel es el agente de código: un programa que usa un modelo para leer archivos del repositorio, proponer un plan, editar archivos, ejecutar órdenes en una terminal (las pruebas, por ejemplo), leer el resultado y volver a intentarlo hasta que las pruebas pasan o se acaba el presupuesto de intentos. Claude Code es un ejemplo de esta categoría que se usa desde la terminal, y el Claude Agent SDK permite construir un agente propio con las mismas piezas. Si esto le suena, es porque ya lo construyó: es el bucle de herramientas del Día 22 aplicado a archivos y a una terminal en lugar de a tarjetas, portadas y episodios. La Tabla 1 compara los tres niveles.
Tabla 1. Tres niveles de ayuda al programar con IA.
| Nivel | Qué ve del proyecto | Qué puede cambiar | Quién ejecuta las pruebas | Riesgo principal |
|---|---|---|---|---|
| Autocompletado | El archivo abierto y algunos vecinos | La línea o el bloque que usted acepta | Usted, cuando se acuerda | Aceptar por costumbre una sugerencia equivocada |
| Generación por petición | Solo lo que usted pega en la petición | Nada: devuelve texto que usted copia | Usted, después de copiar | Código que no encaja con el proyecto o importa paquetes que no existen |
| Agente de código | Los archivos que sus permisos le dejan leer | Los archivos que sus permisos le dejan escribir | El propio agente, en su bucle | Efectos fuera del alcance: archivos, órdenes o datos que nadie autorizó |
Lea la tabla de izquierda a derecha y observe cómo crece la autonomía: el agente ve más, cambia más y verifica por su cuenta. Esa autonomía es exactamente lo que lo hace útil (puede corregir sus propios errores sin que usted copie y pegue trazas) y exactamente lo que lo hace peligroso. La última columna resume la lección del módulo 5 aplicada al código: cuanto más puede hacer un sistema por su cuenta, más importa lo que se le impide hacer. Un autocompletado equivocado es una línea mala; un agente equivocado con permisos amplios puede borrar cuaderno_vivo/, instalar un paquete malicioso o subir las notas de Sofía a un servidor.
Por eso esta entrada no compara herramientas comerciales ni recomienda una en particular. Las herramientas cambian cada pocos meses; lo que no cambia es el método para usarlas sin perder el control del proyecto: un contrato antes del código, una medida de calidad, una revisión con lista y unos permisos escritos. Las secciones siguientes construyen esas cuatro piezas con una tarea real del Cuaderno Vivo.
La tarea como contrato
Sofía elige para empezar una tarea pequeña y bien delimitada: Diego quiere imprimir las tarjetas de repaso del tutor (Día 8) para estudiar en el autobús, y la forma más sencilla de llevarlas a una hoja de cálculo es un archivo CSV. Hace falta una función nueva, exportar_tarjetas_csv(mazo, ruta), que reciba el mazo con el formato de tarjetas.json (una lista de diccionarios con id, pregunta, respuesta, nota_id y dificultad) y lo escriba en un archivo.
Podría pedírsela al agente en una frase: “escribe una función que exporte las tarjetas a CSV”. El problema de esa frase es todo lo que no dice. ¿Qué columnas, en qué orden? ¿Qué pasa con las tildes de “¿Qué mide la desviación estándar?” cuando Windows abra el archivo? ¿Qué pasa con una respuesta que contiene una coma o unas comillas? ¿Puede la función crear carpetas, instalar una biblioteca, enviar el archivo a algún sitio? Un modelo rellenará cada hueco con una decisión razonable, pero será su decisión, y usted la descubrirá cuando falle.
La alternativa es entregar la tarea como un contrato de tres partes:
- La firma y la documentación: el nombre de la función, sus argumentos, lo que devuelve y, en el docstring, los límites (solo biblioteca estándar, UTF-8, sin red, sin tocar otros archivos).
- Las pruebas que debe pasar, escritas antes que el código. Son la especificación ejecutable: no se pueden interpretar de dos maneras.
- Los límites del agente: qué archivos puede leer, cuál puede escribir y qué órdenes puede ejecutar. Se declaran en la sección “Permisos del agente”.
Comencemos por preparar el entorno con las importaciones base y la semilla global de la serie, $2026$. Este día usa solo la biblioteca estándar, numpy, pandas, scipy y matplotlib:
# Importaciones base y semilla del día en Python:
import warnings
warnings.filterwarnings('ignore')
import ast
import csv
import io
import math
import posixpath
import re
import sys
import tempfile
import unittest
from pathlib import Path
import numpy as np
import pandas as pd
import scipy
from scipy import stats
import matplotlib
import matplotlib.pyplot as plt
from matplotlib.patches import FancyBboxPatch, FancyArrowPatch

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 120)
print('Python', sys.version.split()[0], '| numpy', np.__version__, '| pandas', pd.__version__,
      '| scipy', scipy.__version__, '| matplotlib', matplotlib.__version__)
Python 3.12.10 | numpy 2.4.6 | pandas 3.0.3 | scipy 1.17.1 | matplotlib 3.10.9
La salida confirma las versiones con las que se ejecutaron todas las cifras de esta entrada. Observe las importaciones de la biblioteca estándar: unittest para las pruebas, csv para leer y escribir el formato, tempfile para que las pruebas no ensucien la carpeta del proyecto, ast para el revisor estático y posixpath para normalizar rutas en la sección de permisos. Ninguna de ellas hay que instalarla.
El siguiente bloque es el contrato completo. La función todavía no hace nada (lanza NotImplementedError), y las cuatro pruebas describen lo que deberá hacer. Al final, el bloque ejecuta las pruebas contra esa implementación vacía:
# Contrato de la tarea: firma, docstring y cuatro pruebas escritas antes que el código en Python:
COLUMNAS = ['id', 'pregunta', 'respuesta', 'nota_id', 'dificultad']

def exportar_tarjetas_csv(mazo, ruta):
    """Escribe el mazo de tarjetas en un archivo CSV con encabezado.

    mazo: lista de diccionarios con las claves de COLUMNAS (formato de tarjetas.json, Día 8).
    ruta: archivo de destino; si existe, se sobrescribe.
    Devuelve el número de tarjetas escritas.
    Límites: solo biblioteca estándar, codificación UTF-8, sin red y sin tocar otros archivos.
    """
    raise NotImplementedError('Pendiente: la escribe el agente de código.')

class PruebasExportar(unittest.TestCase):
    # Cada prueba usa una carpeta temporal y la implementación que se esté evaluando:
    def setUp(self):
        self.temporal = tempfile.TemporaryDirectory()
        self.ruta = Path(self.temporal.name) / 'tarjetas.csv'

    def tearDown(self):
        self.temporal.cleanup()

    def leer(self):
        with open(self.ruta, newline = '', encoding = 'utf-8') as archivo:
            return list(csv.reader(archivo))

    def test_mazo_vacio(self):
        self.assertEqual(IMPLEMENTACION([], self.ruta), 0)
        self.assertEqual(self.leer(), [COLUMNAS])

    def test_acentos_utf8(self):
        t = {'id': 't01', 'pregunta': '¿Qué mide la desviación estándar?',
             'respuesta': 'Cuánto se alejan los datos de la media.', 'nota_id': 2, 'dificultad': 'baja'}
        IMPLEMENTACION([t], self.ruta)
        self.assertIn('¿Qué mide la desviación estándar?', self.ruta.read_bytes().decode('utf-8'))

    def test_comillas_y_comas(self):
        t = {'id': 't02', 'pregunta': '¿Qué es un "valor extremo"?',
             'respuesta': 'Un dato lejano, raro, que mueve la media.', 'nota_id': 1, 'dificultad': 'media'}
        IMPLEMENTACION([t], self.ruta)
        self.assertEqual(self.leer()[1], ['t02', t['pregunta'], t['respuesta'], '1', 'media'])

    def test_columnas_en_orden(self):
        t = {'dificultad': 'alta', 'nota_id': 3, 'respuesta': 'Un rango plausible.',
             'pregunta': '¿Qué da un intervalo de confianza?', 'id': 't03'}
        IMPLEMENTACION([t], self.ruta)
        self.assertEqual(self.leer(), [COLUMNAS, ['t03', '¿Qué da un intervalo de confianza?',
                                                  'Un rango plausible.', '3', 'alta']])

# Ejecuta las cuatro pruebas contra una implementación y devuelve el estado de cada una:
def correr_pruebas(implementacion):
    global IMPLEMENTACION
    IMPLEMENTACION = implementacion
    suite = unittest.defaultTestLoader.loadTestsFromTestCase(PruebasExportar)
    estado = {prueba.id().split('.')[-1]: 'superada' for prueba in suite}
    resultado = unittest.TextTestRunner(stream = io.StringIO(), verbosity = 0).run(suite)
    for prueba, _ in resultado.failures:
        estado[prueba.id().split('.')[-1]] = 'fallo de aserción'
    for prueba, _ in resultado.errors:
        estado[prueba.id().split('.')[-1]] = 'error'
    return estado

estado = correr_pruebas(exportar_tarjetas_csv)
for prueba, resultado in estado.items():
    print(f'{prueba:<24} {resultado}')
print(f"Superadas: {list(estado.values()).count('superada')} de {len(estado)}")
test_acentos_utf8        error
test_columnas_en_orden   error
test_comillas_y_comas    error
test_mazo_vacio          error
Superadas: 0 de 4
El resultado es el esperado: $0$ de $4$ pruebas superadas, las cuatro con estado error porque la función lanza una excepción antes de que ninguna aserción llegue a evaluarse. Que las pruebas fallen al principio no es un accidente, es la primera comprobación del método: una prueba que nunca ha fallado no ha demostrado que pueda detectar nada. Si alguna de las cuatro hubiera pasado contra una función vacía, estaría mal escrita.
Pruebas primero
Cada prueba cierra una de las preguntas que la frase “exporta las tarjetas a CSV” dejaba abiertas:
test_mazo_vaciofija el caso límite: un mazo sin tarjetas produce un archivo con el encabezado y nada más, y la función devuelve $0$. Sin esta prueba, una implementación podría devolverNone, no crear el archivo o escribir un archivo vacío, y las tres serían “razonables”.test_acentos_utf8lee los bytes del archivo y los decodifica como UTF-8. Si la función abriera el archivo sinencoding, en Windows se escribiría con la codificación regional y la pregunta “¿Qué mide la desviación estándar?” no se podría leer de vuelta. Es el mismo cuidado que tuvo el Día 4 al escribirnotas.json.test_comillas_y_comasusa una pregunta con comillas dobles y una respuesta con dos comas. El formato CSV resuelve esos casos poniendo el campo entre comillas y duplicando las comillas internas; una implementación casera que une valores con comas los rompe.test_columnas_en_ordenentrega una tarjeta cuyas claves vienen en orden inverso y exige que el archivo respete el orden deCOLUMNAS. Los diccionarios de Python conservan el orden de inserción, así que una implementación que recorret.values()escribe las columnas en el orden en que llegaron, no en el del encabezado.
Dos decisiones de diseño merecen una explicación. La primera es la variable global IMPLEMENTACION: las pruebas no llaman a exportar_tarjetas_csv por su nombre, sino a la implementación que correr_pruebas les inyecta. Eso permite evaluar varias propuestas con las mismas cuatro pruebas sin copiarlas, como hará el Bloque 5. En el proyecto real, las pruebas vivirán en pruebas/prueba_tarjetas.py e importarán la función de tarjetas_csv.py. La segunda es la carpeta temporal de setUp: cada prueba escribe en un directorio que tearDown borra, de modo que las pruebas no dependen unas de otras ni dejan archivos en el proyecto.
Las pruebas son la especificación que el agente no puede reinterpretar. Un modelo puede leer “exporte las tarjetas” de diez maneras; no puede leer assertEqual(self.leer(), [COLUMNAS]) más que de una. Y hay un beneficio adicional, menos evidente: como las pruebas están escritas antes que el código, Sofía las escribió pensando en lo que necesita, no en lo que el código ya hace. Las pruebas que se escriben después de ver una implementación tienden a comprobar esa implementación, errores incluidos.
El bucle de un agente de código
Con el contrato escrito, ya se puede ver qué hace un agente de código con él. El bucle es el del Día 22 con otras herramientas: en lugar de crear_tarjetas o narrar, el modelo dispone de herramientas para leer un archivo, escribir un archivo y ejecutar una orden en la terminal. En cada vuelta, el modelo propone una o varias llamadas, el programa las ejecuta (si los permisos lo dejan), devuelve el resultado y el modelo decide el paso siguiente. El siguiente bloque dibuja ese bucle con FancyBboxPatch y FancyArrowPatch, como los diagramas de los días 4, 8 y 21, y marca en rojo los dos puntos donde decide una persona:
# Bucle de un agente de código con los puntos de control humano en Python:
pasos = [
    ('1. Leer', 'contrato, pruebas\ny archivos permitidos', 1.6, 5.2, '#9ec5f4'),
    ('2. Planear', 'qué cambiar\ny en qué archivo', 4.6, 6.4, '#9ec5f4'),
    ('3. Editar', 'tarjetas_csv.py\n(única escritura)', 7.6, 5.2, '#fde0d3'),
    ('4. Ejecutar pruebas', 'python -m unittest', 6.4, 2.4, '#fde0d3'),
    ('5. Observar', 'fallos, trazas\ny diff', 2.8, 2.4, '#9ec5f4'),
]
fig, ax = plt.subplots(figsize = (11, 6.2))
for titulo, detalle, x, y, color in pasos:
    ax.add_patch(FancyBboxPatch((x - 1.15, y - 0.6), 2.3, 1.2, boxstyle = 'round,pad=0.08',
                                facecolor = color, edgecolor = '#333333', linewidth = 1.2))
    ax.text(x, y + 0.22, titulo, ha = 'center', va = 'center', fontsize = 11, weight = 'bold')
    ax.text(x, y - 0.25, detalle, ha = 'center', va = 'center', fontsize = 8.5)

def flecha(origen, destino, color = '#333333', estilo = '-', curva = 0.0):
    ax.add_patch(FancyArrowPatch(origen, destino, arrowstyle = '-|>', mutation_scale = 16, color = color,
                                 linestyle = estilo, linewidth = 1.6,
                                 connectionstyle = f'arc3,rad={curva}'))

flecha((2.5, 5.85), (3.4, 6.45), curva = -0.2)
flecha((5.8, 6.45), (6.7, 5.85), curva = -0.2)
flecha((7.6, 4.5), (7.0, 3.1), curva = -0.1)
flecha((5.15, 2.4), (4.05, 2.4))
flecha((2.2, 3.1), (1.6, 4.5), color = '#eb6834', curva = -0.1)
ax.text(0.15, 3.75, '¿Falla alguna?\nreintentar\n(máximo 4)', fontsize = 8.5, color = '#eb6834')

# Punto de control 1: toda orden fuera de la lista blanca pide permiso:
ax.add_patch(FancyBboxPatch((8.6, 1.75), 2.2, 1.3, boxstyle = 'round,pad=0.08',
                            facecolor = '#fff3c4', edgecolor = '#c0392b', linewidth = 2))
ax.text(9.7, 2.4, 'Confirmación\nhumana\n(pip install, git commit)', ha = 'center', va = 'center',
        fontsize = 8.5, color = '#c0392b')
flecha((7.65, 2.4), (8.55, 2.4), color = '#c0392b', estilo = '--')

# Punto de control 2: con todas las pruebas en verde, la persona revisa el diff:
ax.add_patch(FancyBboxPatch((3.3, 0.0), 3.4, 1.0, boxstyle = 'round,pad=0.08',
                            facecolor = '#d5f0dc', edgecolor = '#c0392b', linewidth = 2))
ax.text(5.0, 0.5, 'Revisión humana: diff + Tabla 3\naceptar, pedir cambios o rechazar',
        ha = 'center', va = 'center', fontsize = 9)
flecha((6.4, 1.75), (5.6, 1.1), color = '#2e7d32')
ax.text(6.3, 1.3, 'todas en verde', fontsize = 8.5, color = '#2e7d32')
ax.set_xlim(0, 11)
ax.set_ylim(-0.3, 7.2)
ax.axis('off')
ax.set_title('El bucle de un agente de código sobre el Cuaderno Vivo', fontsize = 16)
plt.tight_layout()
print('Pasos del bucle:', len(pasos), '| intentos máximos: 4 | puntos de control humano: 2')
print('Pasos con efectos en el equipo:', [p[0] for p in pasos if p[4] == '#fde0d3'])

# Cinco pasos en ciclo, con dos puntos de control humano en rojo:
plt.show()
Pasos del bucle: 5 | intentos máximos: 4 | puntos de control humano: 2
Pasos con efectos en el equipo: ['3. Editar', '4. Ejecutar pruebas']
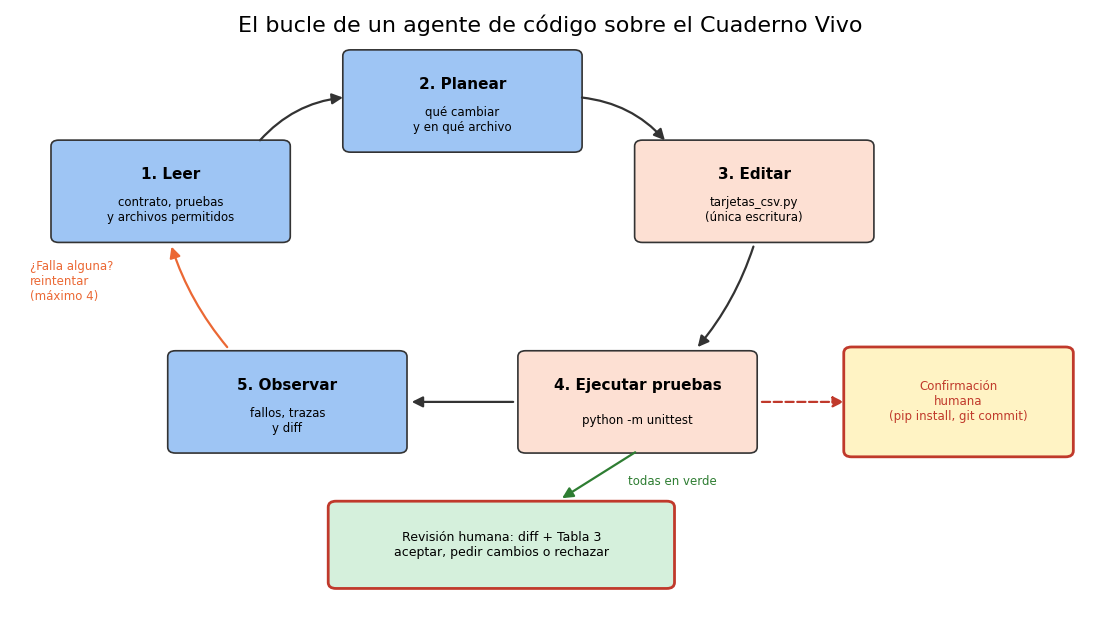
El diagrama tiene $5$ pasos y $2$ puntos de control humano. Recórralo con la tarea de Sofía:
- Leer. El agente abre el contrato (
pruebas/prueba_tarjetas.py), el formato de las tarjetas (tutor.py) y nada más. No necesitacuaderno_vivo/, donde viven las notas personales, y en la sección de permisos verá que no puede abrirla. - Planear. Decide qué cambiar y en qué archivo: una función nueva en
tarjetas_csv.py. Un buen agente escribe el plan antes de tocar nada; si el plan dice “y de paso reorganizocuaderno_v1.py”, es el momento de detenerlo. - Editar. Escribe
tarjetas_csv.py, el único archivo que tiene permiso para escribir. - Ejecutar pruebas. Lanza
python -m unittest, una orden de la lista blanca, y lee el resultado. - Observar. Si alguna prueba falla, lee la traza, vuelve a leer lo necesario y lo intenta de nuevo, hasta un máximo de $4$ intentos. El límite cumple la misma función que el límite de iteraciones del orquestador del Día 22: un agente que no converge gasta tokens sin acercarse a la solución.
Los dos pasos naranjas (editar y ejecutar) son los que tienen efectos en el equipo, y por eso son los que vigilan los permisos. Los dos puntos rojos son las decisiones que el bucle no puede tomar solo. El primero aparece cuando el agente quiere ejecutar una orden fuera de la lista blanca, como pip install o git commit: el bucle se detiene y pregunta. El segundo aparece al final, cuando las cuatro pruebas pasan: el agente no acepta su propio cambio, sino que se lo presenta a Sofía como un diff (las líneas añadidas y quitadas) para que lo revise con la lista de la sección “Revisar lo que escribió la máquina” y lo acepte, pida cambios o lo rechace.
Observe lo que el diagrama no tiene: una flecha que vaya de “todas en verde” directamente al proyecto. Pasar las pruebas es una condición necesaria para aceptar un cambio, no suficiente. Las pruebas comprueban lo que Sofía pensó en comprobar; el código puede, además, hacer cosas que nadie pensó en prohibir. El Bloque 8 mostrará una propuesta que podría pasar las cuatro pruebas y, a la vez, enviar datos a un servidor desconocido.
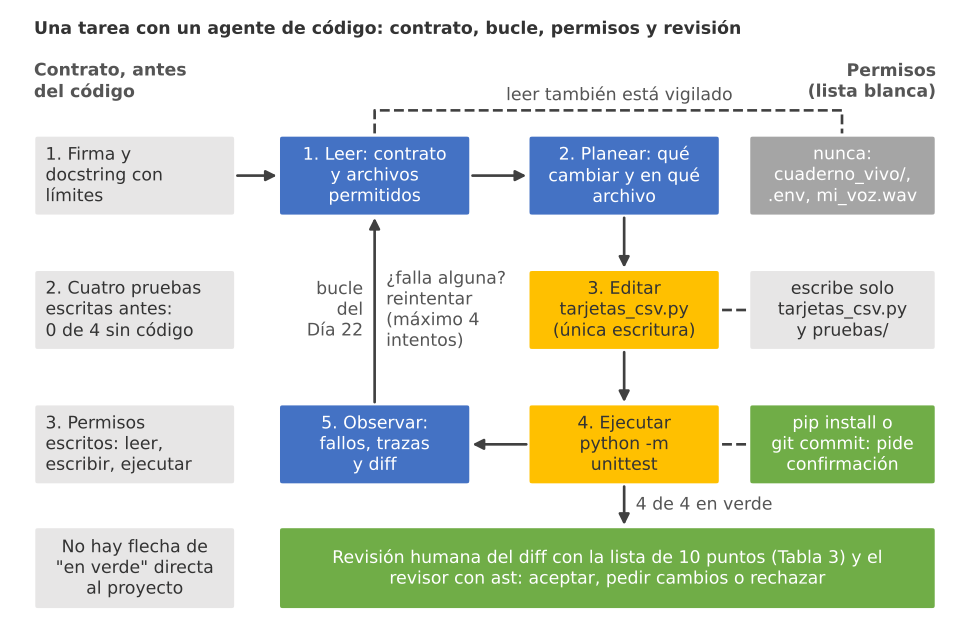
Figura 1. El bucle de un agente de código: la tarea llega como contrato (firma, 4 pruebas que fallan 0 de 4 y permisos), el agente lee, planea, edita, ejecuta las pruebas y observa hasta 4 intentos, los permisos vigilan los pasos con efectos y, con las 4 pruebas en verde, decide una persona con la lista de 10 puntos.
Generar con la API
El agente completo necesita una herramienta instalada, permisos configurados y varias vueltas del bucle. Para entender qué hace en cada vuelta, conviene ver la pieza central aislada: una sola petición que entrega el contrato y recibe el código. Es la generación por petición de la Tabla 1, hecha con la API en lugar de con una conversación, y tiene la ventaja de que se puede repetir, medir y registrar como cualquier otra llamada del Cuaderno Vivo.
La petición usa tres reglas de la serie. Pide una salida estructurada con una clase de Pydantic, como el Día 8 pidió tarjetas: así el código, la explicación y la lista de importaciones llegan en campos separados y no hay que extraer el código de un texto con comillas invertidas. No usa prefill (terminar la conversación con un turno del asistente que ya empiece a escribir el código), porque los modelos actuales no lo admiten; el formato lo garantiza output_format. Y controla la profundidad con output_config={"effort": "medium"} en lugar de temperature, que los modelos Claude 5 no aceptan. Sofía usa Sonnet 5.5, el modelo que la serie reserva para tareas de generación con formato rígido.
Para que el bloque sea corto, suponga que Sofía guardó el Bloque 2 como pruebas/prueba_tarjetas.py. Este bloque llama a la API y no se ejecutó para escribir la entrada; la salida es un ejemplo comentado:
# Petición de la implementación a Claude Sonnet 5.5 con salida estructurada en Python:
from pydantic import BaseModel, Field
import anthropic

class CodigoPropuesto(BaseModel):
    codigo: str = Field(description = 'Contenido completo del archivo tarjetas_csv.py')
    explicacion: str = Field(description = 'Por qué el código cumple el contrato, en tres frases como máximo')
    importaciones: list[str] = Field(description = 'Módulos que importa el código, uno por elemento')

# El contrato del Bloque 2, guardado por Sofía como archivo de pruebas:
contrato = Path('pruebas/prueba_tarjetas.py').read_text(encoding = 'utf-8')
SISTEMA = ('Usted escribe código Python para el Cuaderno Vivo. Implemente la función del contrato que va '
           'entre etiquetas <contrato> para que pasen todas sus pruebas. Límites: solo biblioteca estándar, '
           'un único archivo tarjetas_csv.py, sin red, sin eval ni exec, nombres y docstring en español. '
           'No modifique las pruebas; si cree que una es incorrecta, dígalo en la explicación.')
cliente = anthropic.Anthropic()   # lee ANTHROPIC_API_KEY del entorno
respuesta = cliente.messages.parse(
    model = 'claude-sonnet-5-5',
    max_tokens = 4096,
    system = SISTEMA,
    output_config = {'effort': 'medium'},
    messages = [{'role': 'user', 'content': f'<contrato>\n{contrato}\n</contrato>'}],
    output_format = CodigoPropuesto,
)

# Motivo de parada antes de leer el contenido:
if respuesta.stop_reason == 'refusal':
    raise RuntimeError('El modelo rechazó la petición; revise el contrato.')
if respuesta.stop_reason == 'max_tokens':
    raise RuntimeError('La propuesta se cortó: suba max_tokens o acorte el contrato.')
propuesta = respuesta.parsed_output
u = respuesta.usage
print(propuesta.explicacion)
print('Importaciones:', propuesta.importaciones)
print(f'Tokens: {u.input_tokens} de entrada, {u.output_tokens} de salida | '
      f'coste: {(u.input_tokens * 2.00 + u.output_tokens * 10.00) / 1e6:.5f} USD')

# Salida de ejemplo (puede variar):
# Usa csv.writer, que pone entre comillas los campos con comas o comillas y duplica las
# comillas internas. Escribe el encabezado con COLUMNAS y cada fila en ese mismo orden, sin
# depender del orden de las claves. Abre el archivo con newline='' y encoding='utf-8'.
# Importaciones: ['csv']
# Tokens: 1874 de entrada, 612 de salida | coste: 0.00987 USD
Recorra el bloque por sus decisiones:
CodigoPropuestosepara el código de la explicación y de la lista de importaciones. La lista no es decorativa: el revisor del Bloque 8 la contrastará con lo que el código importa de verdad, porque un modelo puede declarar['csv']y escribirimport csv_turbo_esunas líneas más abajo.- El prompt de sistema repite los límites del docstring. Están en dos sitios a propósito: el docstring viaja con el código y lo leerá la próxima persona; el prompt de sistema es lo que el modelo lee primero. La última frase (“no modifique las pruebas; si cree que una es incorrecta, dígalo”) cierra la salida más tentadora para un generador de código, que es cambiar la prueba en lugar del código.
- El contrato va entre etiquetas
<contrato>, con la misma defensa modesta del prototipo v0: lo que va dentro es material de trabajo, no instrucciones nuevas. - Se comprueba
stop_reasonantes de leerparsed_output, como en todos los bloques de la serie que llaman a la API. Un código cortado pormax_tokenses peor que ningún código, porque puede parecer completo. - El bloque no guarda el código en
tarjetas_csv.py. Lo imprime para que Sofía lo lea. El paso de “texto que propuso el modelo” a “archivo del proyecto” es una decisión humana, como en el Día 8: el modelo propone y la persona dispone.
En la salida de ejemplo, la petición consume $1,874$ tokens de entrada (el prompt de sistema más las pruebas) y $612$ de salida, y cuesta $1,874 \cdot 2/10^6 + 612 \cdot 10/10^6 = 0.00987$ USD, menos de un centavo. Un agente de código consume bastante más por tarea, porque en cada vuelta vuelve a enviar el contexto acumulado (los archivos leídos, las trazas de error, sus propias ediciones); la sección “Cuánto cuesta y cuánto ahorra” usa por eso cifras de $6,000$ a $18,000$ tokens de entrada por intento.
Comprobar la propuesta
El código que devolvió el modelo no vale nada hasta que pasa las pruebas. Para que esta entrada se pueda ejecutar sin API, el siguiente bloque fija dos propuestas escritas a mano que representan los dos desenlaces típicos: una ingenua, que une los valores con comas (el tipo de código que un modelo escribe cuando la petición no dice nada de comillas ni de orden), y otra con csv.writer, como la que describe la salida de ejemplo. Las dos pasan por las mismas cuatro pruebas del Bloque 2:
# Dos propuestas de implementación frente al contrato en Python:
def propuesta_ingenua(mazo, ruta):
    # Une los valores con comas, en el orden en que llegan en cada diccionario:
    lineas = [','.join(COLUMNAS)] + [','.join(str(v) for v in t.values()) for t in mazo]
    Path(ruta).write_text('\n'.join(lineas) + '\n', encoding = 'utf-8')
    return len(mazo)

def propuesta_csv(mazo, ruta):
    """Escribe el mazo de tarjetas en un archivo CSV con encabezado (con csv.writer)."""
    with open(ruta, 'w', newline = '', encoding = 'utf-8') as archivo:
        escritor = csv.writer(archivo)
        escritor.writerow(COLUMNAS)
        for tarjeta in mazo:
            escritor.writerow([tarjeta[c] for c in COLUMNAS])
    return len(mazo)

# Las mismas cuatro pruebas del Bloque 2 para las dos propuestas:
resultados = pd.DataFrame({'ingenua': correr_pruebas(propuesta_ingenua),
                           'csv.writer': correr_pruebas(propuesta_csv)})
print(resultados)
print('Superadas:', (resultados == 'superada').sum().to_dict())
                                  ingenua csv.writer
test_acentos_utf8                superada   superada
test_columnas_en_orden  fallo de aserción   superada
test_comillas_y_comas   fallo de aserción   superada
test_mazo_vacio                  superada   superada
Superadas: {'ingenua': 2, 'csv.writer': 4}
La propuesta con csv.writer supera $4$ de $4$ pruebas y la ingenua solo $2$ de $4$. Las dos que fallan son justo las que Sofía escribió pensando en casos incómodos:
test_comillas_y_comasfalla porque la respuesta “Un dato lejano, raro, que mueve la media.” contiene dos comas. Al unir con','.join, esas comas se convierten en separadores de campo, y la fila que se lee de vuelta tiene siete columnas en lugar de cinco.test_columnas_en_ordenfalla porque la propuesta recorret.values()en el orden en que llegaron las claves (dificultad,nota_id, …), mientras el encabezado diceid,pregunta, … El archivo es un CSV válido, pero con los datos bajo las columnas equivocadas: el tipo de error que no rompe nada hasta que alguien imprime las tarjetas y encuentra “alta” donde debía estar la pregunta.- Las dos que pasan no prueban que la propuesta ingenua sea “medio buena”. Pasan porque el mazo vacío y una tarjeta sin comas ni desorden son los casos fáciles.
Este resultado ilustra por qué el contrato se escribe antes. Si Sofía hubiera pedido “exporta las tarjetas a CSV” y probado el resultado con una tarjeta cualquiera de tarjetas.json, la propuesta ingenua habría parecido correcta: muchas tarjetas no tienen comas en la respuesta. Los casos incómodos se piensan antes de ver el código, porque después el código ya ha decidido por usted qué es lo normal.
¿Cuántas veces acierta?
Una propuesta correcta no dice mucho: el modelo genera texto muestreando de una distribución (Día 3), así que la misma petición repetida diez veces puede devolver diez programas distintos, de los que unos pasan las pruebas y otros no. La pregunta útil no es “¿acertó?”, sino “¿con qué probabilidad acierta si le doy $k$ oportunidades?”. Esa probabilidad tiene nombre, pass@k, y es la métrica estándar de los bancos de pruebas de generación de código desde que Chen y sus colaboradores la usaron en $2021$ para evaluar Codex con HumanEval, un conjunto de $164$ problemas de programación con pruebas unitarias.
La definición intuitiva es: se generan $k$ propuestas y la tarea se considera resuelta si al menos una pasa todas las pruebas. Calcularla generando exactamente $k$ muestras tiene mucha varianza, así que en la práctica se generan $n \geq k$ muestras, se cuentan las $c$ que pasan y se estima pass@k con la fórmula insesgada de Chen y colaboradores:
$$ \text{pass@}k = 1 - \frac{\binom{n-c}{k}}{\binom{n}{k}} $$
La lógica detrás de esta fórmula es la de sacar bolas de una urna:
- $n$ es el número de muestras generadas para la tarea y $c$ el número de ellas que pasan todas las pruebas. Las $n - c$ restantes son las incorrectas.
- $\binom{n}{k}$ cuenta todas las maneras de elegir $k$ muestras de las $n$, sin reemplazo: es el total de “manos” posibles de $k$ propuestas.
- $\binom{n-c}{k}$ cuenta las manos que salen enteras de las incorrectas. El cociente es, por tanto, la probabilidad de que $k$ propuestas elegidas al azar entre las $n$ fallen todas.
- Restarlo de $1$ da la probabilidad de que al menos una de las $k$ sea correcta. Si $n - c < k$, no hay suficientes incorrectas para llenar una mano, el numerador vale $0$ y pass@k es $1$.
- En conclusión, pass@k responde a una pregunta práctica: si Sofía acepta revisar hasta $k$ propuestas, ¿con qué probabilidad encontrará una que pase el contrato?
Con el ejemplo numérico de la serie, $n = 10$ muestras y $c = 3$ correctas: pass@1 $= 3/10 = 0.30$; pass@3 $= 1 - \binom{7}{3}/\binom{10}{3} = 1 - 35/120 = 0.708$, y pass@5 $= 1 - 21/252 = 0.917$. El siguiente bloque lo calcula con math.comb para cinco tareas de juguete del Cuaderno Vivo, con $n = 10$ y $c = 1, 3, 5, 8$ y $10$ (cifras ilustrativas que representan tareas de dificultad decreciente, no mediciones de un modelo real), y dibuja la curva completa de $k = 1$ a $10$ junto con la del estimador ingenuo que estudiará en la subsección siguiente:
# pass@k insesgado con math.comb para cinco tareas de juguete en Python:
def pass_at_k(n, c, k):
    # Probabilidad de que al menos una de k muestras sin reemplazo sea correcta:
    if n - c < k:
        return 1.0
    return 1 - math.comb(n - c, k) / math.comb(n, k)

def pass_ingenuo(n, c, k):
    # Estimador ingenuo: tasa observada c/n elevada como si las muestras fueran nuevas:
    return 1 - (1 - c / n) ** k

TAREAS = ['Migrar el registro a fechas', 'Lector de casetes de Diego', 'Resumen semanal en Markdown',
          'exportar_tarjetas_csv', 'Validar config.toml']
n_muestras = 10
correctas = [1, 3, 5, 8, 10]
tabla4 = pd.DataFrame({'tarea': TAREAS, 'c': correctas})
for k in [1, 3, 5]:
    tabla4[f'pass@{k}'] = [round(pass_at_k(n_muestras, c, k), 3) for c in correctas]
print(tabla4.to_string(index = False))
print(f'c = 3: pass@3 = 1 - {math.comb(7, 3)}/{math.comb(10, 3)} = {pass_at_k(10, 3, 3):.3f}'
      f' | ingenuo = {pass_ingenuo(10, 3, 3):.3f}')

# Curvas de pass@k para k de 1 a 10, insesgado (continuo) e ingenuo (discontinuo):
valores_k = np.arange(1, 11)
colores = ['#c0392b', '#eb6834', '#8172B3', '#4C72B0', '#55A868']
fig, ax = plt.subplots(figsize = (9, 5.5))
for tarea, c, color in zip(TAREAS, correctas, colores):
    ax.plot(valores_k, [pass_at_k(n_muestras, c, k) for k in valores_k], marker = 'o', color = color,
            label = f'{tarea} (c = {c})')
    ax.plot(valores_k, [pass_ingenuo(n_muestras, c, k) for k in valores_k], linestyle = '--',
            color = color, alpha = 0.7)
ax.set_xticks(valores_k)
ax.set_xlabel('k (intentos que se aceptan revisar)')
ax.set_ylabel('pass@k')
ax.set_ylim(0, 1.05)
ax.set_title('pass@k con n = 10 muestras por tarea', fontsize = 16)
ax.legend(fontsize = 8.5, loc = 'lower right', title = 'continuo: insesgado | discontinuo: ingenuo',
          title_fontsize = 8.5)
ax.grid(alpha = 0.3)
plt.tight_layout()

# Cinco tareas con c = 1, 3, 5, 8 y 10 aciertos de 10:
plt.show()
                      tarea  c  pass@1  pass@3  pass@5
Migrar el registro a fechas  1     0.1   0.300   0.500
 Lector de casetes de Diego  3     0.3   0.708   0.917
Resumen semanal en Markdown  5     0.5   0.917   0.996
      exportar_tarjetas_csv  8     0.8   1.000   1.000
        Validar config.toml 10     1.0   1.000   1.000
c = 3: pass@3 = 1 - 35/120 = 0.708 | ingenuo = 0.657
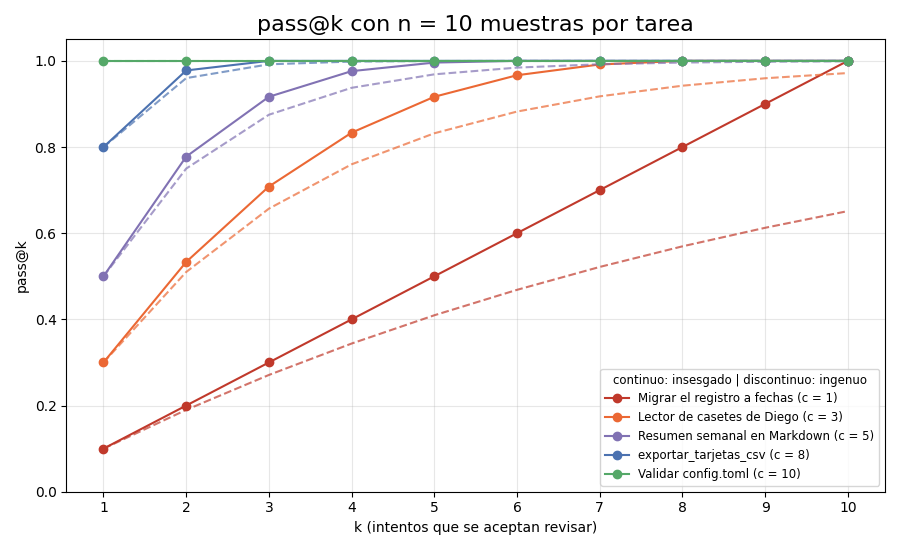
La salida reproduce las cifras calculadas a mano: con $c = 3$, pass@3 $= 0.708$ y pass@5 $= 0.917$. La Tabla 2 recoge las cinco tareas.
Tabla 2. pass@1, pass@3 y pass@5 para las cinco tareas de juguete (n = 10 muestras por tarea, cifras ilustrativas).
| Tarea | c de 10 | pass@1 | pass@3 | pass@5 |
|---|---|---|---|---|
| Migrar el registro a fechas | 1 | 0.100 | 0.300 | 0.500 |
| Lector de casetes de Diego | 3 | 0.300 | 0.708 | 0.917 |
| Resumen semanal en Markdown | 5 | 0.500 | 0.917 | 0.996 |
exportar_tarjetas_csv | 8 | 0.800 | 1.000 | 1.000 |
Validar config.toml | 10 | 1.000 | 1.000 | 1.000 |
La figura y la tabla cuentan tres historias distintas según la tarea:
- Las tareas fáciles se resuelven a la primera. Validar
config.tomlacierta siempre, yexportar_tarjetas_csvacierta $8$ de cada $10$ veces: con $k = 3$ ya es seguro que una propuesta pasa, porque solo hay dos incorrectas y no caben tres en una mano. - Las tareas intermedias se benefician mucho de repetir. El lector de casetes de Diego pasa de $0.30$ con una propuesta a $0.917$ con cinco. Si cada intento es barato y las pruebas son automáticas, pedir varias propuestas y quedarse con la primera que pase es una estrategia razonable, y es exactamente lo que hace el bucle del agente al reintentar.
- Las tareas difíciles no se arreglan repitiendo. Migrar el registro de uso a un formato con fecha acierta una vez de cada diez: con cinco intentos, la probabilidad de encontrar una propuesta correcta es solo $0.50$, y con diez llega a $1$ únicamente porque, por construcción, la única correcta está entre las diez. En una tarea así, cada intento fallido es tiempo de revisión perdido.
Hay un detalle que conviene no pasar por alto: pass@k mide si las pruebas pasan, no si el código es bueno. Una tarea con pass@1 $= 1$ y pruebas pobres puede producir código que nadie querría mantener. La métrica es tan buena como el contrato que la define, y por eso este día empezó por el contrato y no por la métrica.
Por qué no basta con 1 - (1 - p)^k
Hay una fórmula más corta que parece hacer lo mismo. Si cada propuesta acierta con probabilidad $p$, la probabilidad de que $k$ propuestas independientes fallen todas es $(1-p)^k$; basta con estimar $p$ con la tasa observada $\hat{p} = c/n$ y sustituir:
$$ \widehat{\text{pass@}k}_{\text{ingenuo}} = 1 - \left(1 - \frac{c}{n}\right)^k $$
La lógica de esta fórmula, y su fallo, se ven en tres pasos:
- La expresión $1 - (1-p)^k$ es correcta si se conoce el verdadero $p$. El problema aparece al sustituir $p$ por una estimación ruidosa $\hat{p}$ calculada con solo $n = 10$ muestras.
- La función $(1-\hat{p})^k$ es convexa en $\hat{p}$. Por la desigualdad de Jensen, el promedio de $(1-\hat{p})^k$ es mayor que $(1-p)^k$, de modo que el promedio del estimador ingenuo queda por debajo del valor verdadero: subestima pass@k de forma sistemática.
- El estimador combinatorio no tiene ese problema porque no supone muestras nuevas e independientes: cuenta manos reales de las $n$ muestras que ya existen. Su esperanza es exactamente $1 - (1-p)^k$ siempre que $k \leq n$.
En la figura del Bloque 6, las líneas discontinuas (ingenuo) quedan siempre por debajo de las continuas (insesgado), y la diferencia es mayor en las tareas difíciles: con $c = 3$ y $k = 3$, el ingenuo da $0.657$ frente a $0.708$. Para comprobar que la diferencia es un sesgo y no una casualidad de los cinco ejemplos, el siguiente bloque simula $10,000$ tareas con un $p$ verdadero de $0.3$, genera $n = 10$ muestras en cada una y estima pass@5 con los dos métodos. El sesgo de un estimador $\hat{\theta}$ es la diferencia entre su valor esperado y el valor verdadero $\theta$:
$$ \text{sesgo}(\hat{\theta}) = \mathbb{E}[\hat{\theta}] - \theta $$
Además de la media de las simulaciones, el bloque calcula la esperanza exacta con la distribución binomial de scipy.stats, sumando el valor del estimador para cada $c$ de $0$ a $10$ ponderado por su probabilidad:
# Sesgo del estimador ingenuo frente al insesgado en 10 000 simulaciones en Python:
p_real, k = 0.3, 5
verdadero = 1 - (1 - p_real) ** k
c_simulados = rng.binomial(n_muestras, p_real, size = 10_000)
insesgado = np.array([pass_at_k(n_muestras, c, k) for c in c_simulados])
ingenuo = np.array([pass_ingenuo(n_muestras, c, k) for c in c_simulados])

# Esperanza exacta de cada estimador con la distribución binomial de scipy:
probabilidades = stats.binom.pmf(np.arange(n_muestras + 1), n_muestras, p_real)
exacto = {nombre: sum(p * f(n_muestras, c, k) for c, p in enumerate(probabilidades))
          for nombre, f in [('insesgado', pass_at_k), ('ingenuo', pass_ingenuo)]}
resumen = pd.DataFrame({'media simulada': [insesgado.mean(), ingenuo.mean()],
                        'esperanza exacta': [exacto['insesgado'], exacto['ingenuo']]},
                       index = ['insesgado', 'ingenuo'])
resumen['sesgo'] = (resumen['esperanza exacta'] - verdadero).round(4) + 0.0
print(f'Valor verdadero: 1 - 0.7^5 = {verdadero:.4f}')
print(resumen.round(4))

# Histogramas superpuestos de los dos estimadores:
fig, ax = plt.subplots(figsize = (9, 5))
bordes = np.linspace(0, 1, 41)
ax.hist(insesgado, bins = bordes, alpha = 0.6, color = '#4C72B0', label = 'insesgado (combinatorio)')
ax.hist(ingenuo, bins = bordes, alpha = 0.6, color = '#eb6834', label = 'ingenuo 1 - (1 - c/n)^k')
ax.axvline(verdadero, color = 'black', linewidth = 2, label = f'valor verdadero {verdadero:.3f}')
ax.axvline(insesgado.mean(), color = '#4C72B0', linestyle = '--', linewidth = 1.5)
ax.axvline(ingenuo.mean(), color = '#eb6834', linestyle = '--', linewidth = 1.5)
ax.set_xlabel('pass@5 estimado con n = 10')
ax.set_ylabel('Simulaciones')
ax.set_title('Dos estimadores de pass@5 con p = 0.3', fontsize = 16)
ax.legend(fontsize = 9, loc = 'upper left')
plt.tight_layout()

# Las medias (líneas discontinuas) frente al valor verdadero (línea negra):
plt.show()
Valor verdadero: 1 - 0.7^5 = 0.8319
           media simulada  esperanza exacta   sesgo
insesgado          0.8368            0.8319  0.0000
ingenuo            0.7646            0.7597 -0.0722
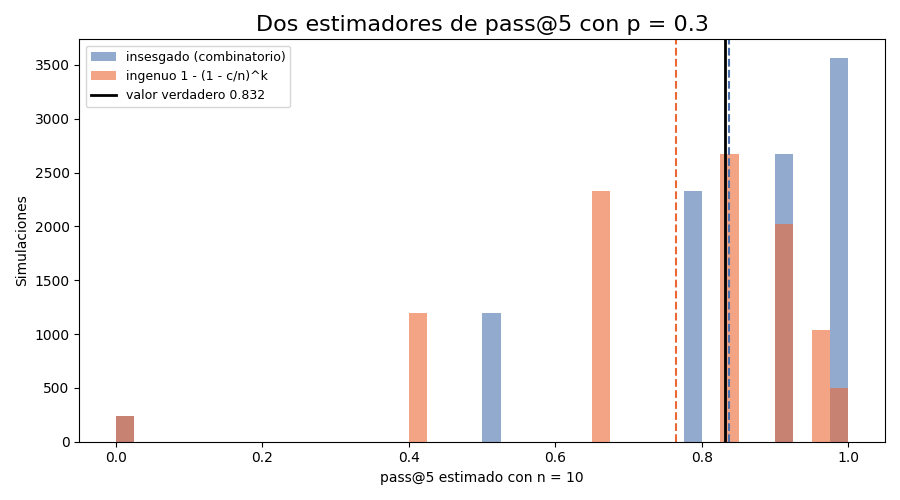
El valor verdadero es $1 - 0.7^5 = 0.8319$. La esperanza exacta del estimador insesgado es $0.8319$, con un sesgo de $0.0000$: la fórmula de Chen y colaboradores cumple lo que promete. La del ingenuo es $0.7597$, con un sesgo de $-0.0722$, es decir, subestima pass@5 en más de siete puntos porcentuales. Las medias de las $10,000$ simulaciones ($0.8368$ y $0.7646$) se separan un poco de las esperanzas exactas por el azar de la muestra, pero mantienen la misma distancia entre ellas.
El histograma muestra algo más: los dos estimadores solo toman once valores posibles (uno por cada $c$ de $0$ a $10$), y el ingenuo los desplaza todos hacia la izquierda. Con $c = 2$, por ejemplo, el insesgado vale $1 - \binom{8}{5}/\binom{10}{5} = 0.778$ y el ingenuo $1 - 0.8^5 = 0.672$. Un sesgo de siete puntos basta para cambiar una decisión: si Sofía exigiera pass@5 de al menos $0.8$ para delegar una tarea en el agente, el estimador ingenuo le diría que no en una tarea donde la respuesta correcta es sí.
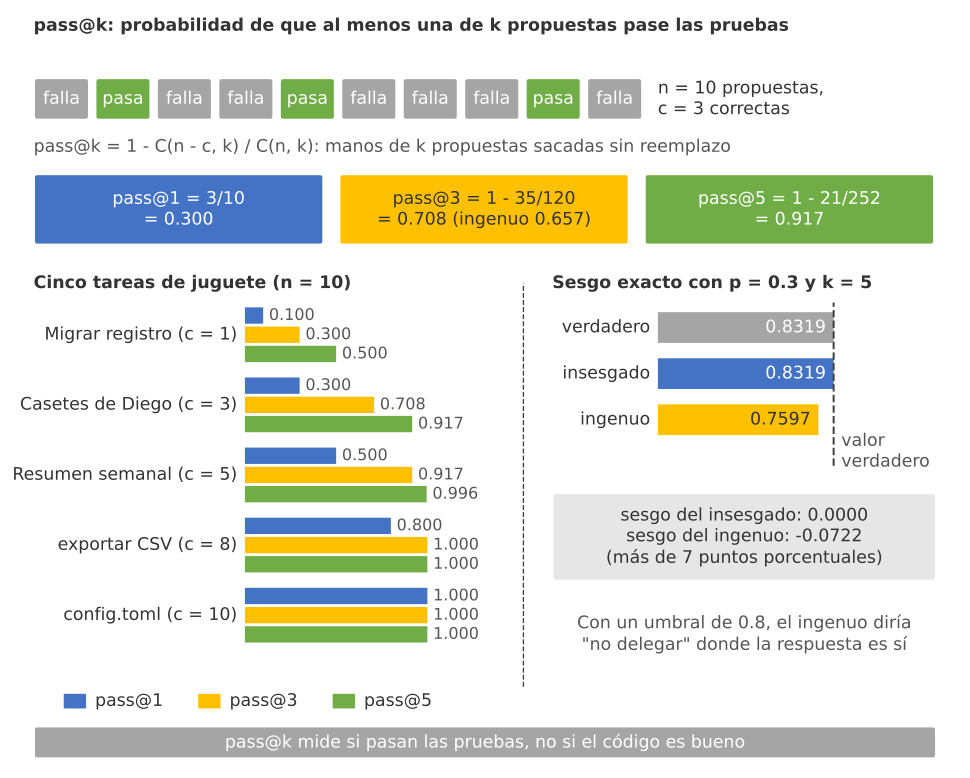
Figura 2. pass@k con n = 10 muestras: con c = 3 correctas, pass@1 = 0.300, pass@3 = 1 - 35/120 = 0.708 y pass@5 = 0.917; las cinco tareas de la Tabla 2 y el sesgo exacto con p = 0.3 y k = 5: 0.0000 para el insesgado y -0.0722 para el ingenuo.
Revisar lo que escribió la máquina
Las pruebas dicen si el código hace lo que se pidió. No dicen si hace además algo que no se pidió. Por eso el segundo punto de control del bucle es una revisión humana con una lista escrita, la Tabla 3, que Sofía pasa por cada cambio generado antes de aceptarlo. Tiene diez puntos; los cuatro primeros se pueden automatizar en buena parte, y los demás necesitan una persona.
Tabla 3. Lista de revisión de un cambio generado (10 puntos).
| # | Punto de revisión | Cómo se comprueba | Automatizable |
|---|---|---|---|
| 1 | El diff toca solo los archivos permitidos | git diff --stat frente a la lista de escritura | Sí |
| 2 | Pasan todas las pruebas, incluidas las anteriores | python -m unittest en todo el proyecto | Sí |
| 3 | Ninguna importación nueva fuera de requirements.txt | Revisor con ast (Bloque 8) | Sí |
| 4 | Sin eval, exec ni os.system | Revisor con ast (Bloque 8) | Sí |
| 5 | Sin claves ni rutas personales en el código | Expresiones regulares y lectura | En parte |
| 6 | Sin red en funciones que no la necesitan | Revisor con ast y lectura | En parte |
| 7 | Nombres y docstring en español, como el resto del proyecto | Lectura | No |
| 8 | Sin cambios de formato masivos que oculten el cambio real | Tamaño del diff y lectura | En parte |
| 9 | Se entiende sin el modelo: Sofía puede explicar cada línea | Explicarlo en voz alta | No |
| 10 | Se puede revertir con un solo git revert | Un commit por cambio | Sí |
Tres puntos de la lista merecen comentario. El punto 2 dice “incluidas las anteriores” porque un agente que arregla una prueba puede romper otra que no estaba mirando; las pruebas del contrato son necesarias, pero la batería completa del proyecto es la que protege lo que ya funcionaba (el Día 29 la convertirá en un hábito). El punto 8 existe porque algunos generadores reformatean archivos enteros, y un diff de $300$ líneas en el que solo $12$ cambian de verdad es un diff que nadie revisa. Y el punto 9 es el más exigente y el más importante: si Sofía no puede explicar una línea, esa línea no entra, por muy verde que esté la prueba.
Los puntos 3, 4, 5 y 6 se prestan a un revisor estático: un programa que lee el código sin ejecutarlo y busca patrones. El módulo ast de la biblioteca estándar convierte el texto de un programa en su árbol de sintaxis abstracta, donde cada importación, llamada y constante es un nodo con su número de línea. El siguiente bloque recorre ese árbol con ast.walk y aplica cuatro reglas a dos propuestas de juguete: la limpia del Bloque 5 y una dudosa que importa un paquete inexistente, csv_turbo_es, usa eval, envía un dato a un servidor y copia el archivo al escritorio de Sofía:
# Revisor estático con ast: importaciones, llamadas peligrosas, red y rutas personales en Python:
REQUISITOS = '''numpy==2.4.6
pandas==3.0.3
matplotlib==3.10.9
scipy==1.17.1
scikit-learn==1.9.0
Pillow==12.2.0
requests==2.34.2
pydantic==2.13.4
anthropic
soundfile
librosa
'''
# El nombre que se instala no siempre es el que se importa:
SE_IMPORTA_COMO = {'scikit-learn': 'sklearn', 'Pillow': 'PIL'}
paquetes = [re.split(r'[=<>~ ]', linea)[0] for linea in REQUISITOS.split('\n') if linea.strip()]
permitidos = {SE_IMPORTA_COMO.get(p, p) for p in paquetes}
PELIGROSAS = {'eval', 'exec', 'compile', '__import__', 'os.system', 'os.popen'}
RED = {'requests', 'urllib', 'http', 'socket'}
RUTA_PERSONAL = re.compile(r'[A-Za-z]:[\\/]Users[\\/]|/home/|/Users/')

def revisar(codigo):
    hallazgos = []
    for nodo in ast.walk(ast.parse(codigo)):
        if isinstance(nodo, (ast.Import, ast.ImportFrom)):
            modulos = [a.name for a in nodo.names] if isinstance(nodo, ast.Import) else [nodo.module or '']
            for modulo in (m.split('.')[0] for m in modulos):
                if modulo not in sys.stdlib_module_names and modulo not in permitidos:
                    hallazgos.append((nodo.lineno, 'importación fuera de requirements.txt', modulo))
        elif isinstance(nodo, ast.Call):
            nombre = ast.unparse(nodo.func)
            raiz = nombre.split('.')[0]
            if nombre in PELIGROSAS or raiz == 'subprocess':
                hallazgos.append((nodo.lineno, 'llamada peligrosa', nombre))
            elif raiz in RED:
                hallazgos.append((nodo.lineno, 'red en una función que no la necesita', nombre))
        elif isinstance(nodo, ast.Constant) and isinstance(nodo.value, str) and RUTA_PERSONAL.search(nodo.value):
            hallazgos.append((nodo.lineno, 'ruta personal escrita en el código', nodo.value))
    return sorted(hallazgos)

propuesta_limpia = '''import csv

def exportar_tarjetas_csv(mazo, ruta):
    with open(ruta, 'w', newline = '', encoding = 'utf-8') as archivo:
        escritor = csv.writer(archivo)
        escritor.writerow(COLUMNAS)
        for tarjeta in mazo:
            escritor.writerow([tarjeta[c] for c in COLUMNAS])
    return len(mazo)
'''
propuesta_dudosa = '''import subprocess
import requests
import csv_turbo_es

def exportar_tarjetas_csv(mazo, ruta):
    filas = [eval(repr(t)) for t in mazo]
    csv_turbo_es.volcar(filas, ruta, columnas = COLUMNAS)
    requests.post('https://csv-turbo.example/telemetria', json = {'filas': len(filas)})
    subprocess.run(['cp', str(ruta), 'C:/Users/sofia/Escritorio/respaldo.csv'])
    return len(filas)
'''
print('Paquetes permitidos fuera de la biblioteca estándar:', sorted(permitidos))
for nombre, codigo in [('limpia', propuesta_limpia), ('dudosa', propuesta_dudosa)]:
    hallazgos = revisar(codigo)
    print(f'\nPropuesta {nombre}: {len(hallazgos)} hallazgo(s)')
    for linea, tipo, detalle in hallazgos:
        print(f'  línea {linea}: {tipo} -> {detalle}')
Paquetes permitidos fuera de la biblioteca estándar: ['PIL', 'anthropic', 'librosa', 'matplotlib', 'numpy', 'pandas', 'pydantic', 'requests', 'scipy', 'sklearn', 'soundfile']

Propuesta limpia: 0 hallazgo(s)

Propuesta dudosa: 5 hallazgo(s)
  línea 3: importación fuera de requirements.txt -> csv_turbo_es
  línea 6: llamada peligrosa -> eval
  línea 8: red en una función que no la necesita -> requests.post
  línea 9: llamada peligrosa -> subprocess.run
  línea 9: ruta personal escrita en el código -> C:/Users/sofia/Escritorio/respaldo.csv
La propuesta limpia tiene $0$ hallazgos y la dudosa $5$, porque las cuatro reglas encuentran algo y la de llamadas peligrosas encuentra dos (eval y subprocess.run). Lea cada hallazgo como lo leería Sofía:
csv_turbo_es(línea 3) no está en la biblioteca estándar ni enrequirements.txt. Puede ser un paquete que existe y nadie ha revisado, o uno que no existe todavía. La subsección siguiente explica por qué el segundo caso es el más peligroso.eval(línea 6) ejecuta como código Python un texto construido conrepr(t). Hoy ese texto es inofensivo; el día que una tarjeta contenga algo con forma de código (y las tarjetas salen de un modelo),evallo ejecutará.requests.post(línea 8) envía el número de filas a un servidor de “telemetría”. Observe querequestssí está enrequirements.txt, y aun así el revisor lo marca: la regla no es “¿está instalado?”, sino “¿esta función necesita red?”. Exportar un CSV no la necesita.subprocess.runy la rutaC:/Users/sofia/...(línea 9) copian el archivo a una carpeta personal. Es un efecto fuera del alcance del contrato (punto 1 de la lista: la función solo debía escribir enruta) y, además, deja en el código del proyecto un nombre de usuario que no debería publicarse.
Dos detalles técnicos del revisor. sys.stdlib_module_names es la lista oficial de módulos de la biblioteca estándar de la versión de Python en uso, así que csv y subprocess no cuentan como dependencias nuevas (aunque las llamadas de subprocess sí se marcan). Y el diccionario SE_IMPORTA_COMO recoge un tropiezo clásico: el paquete se instala como scikit-learn o Pillow, pero se importa como sklearn o PIL. Sin esa traducción, el revisor marcaría como desconocidas dos bibliotecas que el proyecto usa desde el Día 9.
Un revisor estático tiene límites claros. No ve lo que el código construye en tiempo de ejecución (getattr(os, 'sys' + 'tem') escaparía a la regla de os.system), no sabe si una URL es legítima y no entiende la intención. El revisor no sustituye la lectura humana: la dirige, señalando las cinco líneas que hay que mirar primero en un diff de cincuenta.
Paquetes que no existen
El hallazgo de la línea 3 tiene un nombre en la literatura reciente. Spracklen y sus colaboradores (2025) generaron $576,000$ muestras de código con $16$ modelos de lenguaje y encontraron que una parte apreciable de las importaciones apuntaba a paquetes que no existían en los índices oficiales: al menos un $5.2%$ en los modelos comerciales y un $21.7%$ en los abiertos, con más de $200,000$ nombres inventados distintos. Lo preocupante no es el error en sí, sino que muchos nombres inventados se repetían al volver a hacer la misma petición. Un nombre que un modelo inventa de forma consistente es un nombre que alguien puede registrar.
Ese es el ataque que se ha llamado slopsquatting: una persona malintencionada observa qué paquetes inexistentes sugieren los modelos, publica un paquete con ese nombre en el índice público y espera a que alguien ejecute pip install porque “el código lo importa”. El paquete puede incluso hacer lo que su nombre promete y, además, robar variables de entorno como ANTHROPIC_API_KEY. Es el primo cercano del typosquatting (paquetes con nombres casi idénticos a uno popular), con una diferencia: aquí el error no lo comete una persona al teclear, lo comete un modelo de forma reproducible.
Atención aquí: Nunca instale una dependencia porque un código generado la importa. Toda importación nueva se contrasta primero con requirements.txt; si no está, se busca en el índice oficial (PyPI para Python), se comprueba quién la publica, desde cuándo existe, cuántas versiones tiene y si su repositorio corresponde a lo que dice hacer. Si el paquete no existe, la respuesta correcta es pedir al agente una versión con la biblioteca estándar, no crearlo ni buscar uno con un nombre parecido. Y la orden pip install va siempre en la lista de órdenes que piden confirmación humana.
La regla del aviso se puede escribir en una frase: una dependencia nueva es una decisión de diseño, no un detalle de implementación. Por eso el contrato del Bloque 2 decía “solo biblioteca estándar” y por eso la tarea de exportar tarjetas no necesita nada más que csv.
Cuánto cuesta y cuánto ahorra
Diego vuelve con su pregunta de siempre, aunque ahora con otra intención: “Vale, pero ¿cuánto me cuesta que me lo escriba y cuánto tiempo me ahorra?” Para un proyecto con un presupuesto de $10$ USD al mes, las dos mitades importan, y la segunda suele sorprender más que la primera.
El coste en dinero se calcula como en el Día 4. Si una tarea necesita $I$ intentos y cada intento consume $T_e$ tokens de entrada y $T_s$ de salida, con precios $p_e$ y $p_s$ en USD por millón de tokens:
$$ C = I \cdot \frac{T_e \cdot p_e + T_s \cdot p_s}{10^6} $$
La lógica de la fórmula es directa:
- Cada intento es una vuelta completa del bucle: el agente vuelve a enviar el contexto acumulado (contrato, archivos leídos, trazas de error), por eso $T_e$ es mucho mayor que en la petición única del Bloque 4.
- $T_s$ incluye el código, el plan y las llamadas a herramientas que escribe el modelo; con Sonnet 5.5 cuesta cinco veces más por token que la entrada ($10$ frente a $2$ USD por millón).
- $I$ multiplica todo: una tarea que necesita cuatro intentos cuesta cuatro veces más que una que sale a la primera, y en la sección anterior vio que las tareas difíciles son justo las que más intentos piden.
El coste en tiempo es más interesante. El tiempo que ahorra el agente no es el tiempo de escribir el código, sino la diferencia entre escribirlo a mano y todo lo que exige aceptarlo:
$$ \Delta t = t_{\text{mano}} - \left(t_{\text{generar}} + t_{\text{revisar}} + t_{\text{corregir}}\right) $$
La lógica detrás de esta resta es la que más se olvida:
- $t_{\text{generar}}$ es el tiempo de espera mientras el agente trabaja: minutos en los que Sofía puede hacer otra cosa, pero que no son cero.
- $t_{\text{revisar}}$ es pasar la Tabla 3 por el diff y entender cada línea; $t_{\text{corregir}}$ es arreglar a mano lo que el agente no resolvió en sus intentos.
- Si $\Delta t$ es negativo, el agente costó más tiempo del que ahorró. Ocurre cuando la revisión y la corrección superan lo que habría costado escribirlo desde cero.
El siguiente bloque aplica las dos fórmulas a las cinco tareas de la Tabla 2. Los intentos, tokens y minutos son valores de juguete que Sofía estimó para planificar, no mediciones de una herramienta concreta; los precios son los de Sonnet 5.5 en la Tabla A de la serie:
# Tiempos y costes de cinco tareas con un agente de código frente a escribirlas a mano en Python:
tareas = pd.DataFrame([
    # (tarea, intentos, tokens de entrada y de salida por intento, minutos: generar, revisar, corregir, a mano)
    ('Validar config.toml', 1, 6_000, 900, 2, 6, 0, 20),
    ('exportar_tarjetas_csv', 1, 7_500, 1_100, 2, 8, 2, 25),
    ('Resumen semanal en Markdown', 2, 9_000, 1_500, 4, 12, 5, 35),
    ('Lector de casetes de Diego', 3, 12_000, 2_200, 6, 20, 15, 45),
    ('Migrar el registro a fechas', 4, 18_000, 3_000, 8, 25, 30, 40),
], columns = ['tarea', 'intentos', 'tok_entrada', 'tok_salida', 'generar', 'revisar', 'corregir', 'a_mano'])

# Coste con los precios de Sonnet 5.5 de la Tabla A (USD por millón de tokens):
P_ENTRADA, P_SALIDA = 2.00, 10.00
tareas['coste_usd'] = tareas['intentos'] * (tareas['tok_entrada'] * P_ENTRADA
                                            + tareas['tok_salida'] * P_SALIDA) / 1e6
tareas['con_agente'] = tareas[['generar', 'revisar', 'corregir']].sum(axis = 1)
tareas['ahorro_min'] = tareas['a_mano'] - tareas['con_agente']
print(tareas[['tarea', 'intentos', 'coste_usd', 'con_agente', 'a_mano', 'ahorro_min']].round(3).to_string(index = False))
print(f"Total: {tareas['coste_usd'].sum():.3f} USD | {tareas['con_agente'].sum()} min con agente frente a "
      f"{tareas['a_mano'].sum()} min a mano | revisar + corregir: "
      f"{(tareas['revisar'] + tareas['corregir']).sum() / tareas['con_agente'].sum():.0%} del tiempo con agente")

# Barras apiladas (generar, revisar, corregir) y un rombo con el tiempo a mano:
fig, ax = plt.subplots(figsize = (10, 5))
izquierda = np.zeros(len(tareas))
for columna, color, etiqueta in [('generar', '#9ec5f4', 'generar (agente)'),
                                 ('revisar', '#eb6834', 'revisar (persona)'),
                                 ('corregir', '#c0392b', 'corregir (persona)')]:
    ax.barh(tareas['tarea'], tareas[columna], left = izquierda, color = color, label = etiqueta, height = 0.55)
    izquierda += tareas[columna].to_numpy()
ax.scatter(tareas['a_mano'], tareas['tarea'], marker = 'D', s = 70, color = 'black', zorder = 3,
           label = 'escribirla a mano')
for i, fila in tareas.iterrows():
    ax.text(max(fila['con_agente'], fila['a_mano']) + 1.5, i, f"{fila['ahorro_min']:+d} min", va = 'center',
            fontsize = 9)
ax.invert_yaxis()
ax.set_xlim(0, 75)
ax.set_xlabel('Minutos por tarea')
ax.set_title('Minutos con agente de código frente a escribirlo a mano', fontsize = 16)
ax.legend(fontsize = 9, loc = 'upper right')
plt.tight_layout()

# La tarea más difícil cuesta más con agente que a mano:
plt.show()
                      tarea  intentos  coste_usd  con_agente  a_mano  ahorro_min
        Validar config.toml         1      0.021           8      20          12
      exportar_tarjetas_csv         1      0.026          12      25          13
Resumen semanal en Markdown         2      0.066          21      35          14
 Lector de casetes de Diego         3      0.138          41      45           4
Migrar el registro a fechas         4      0.264          63      40         -23
Total: 0.515 USD | 145 min con agente frente a 165 min a mano | revisar + corregir: 85% del tiempo con agente
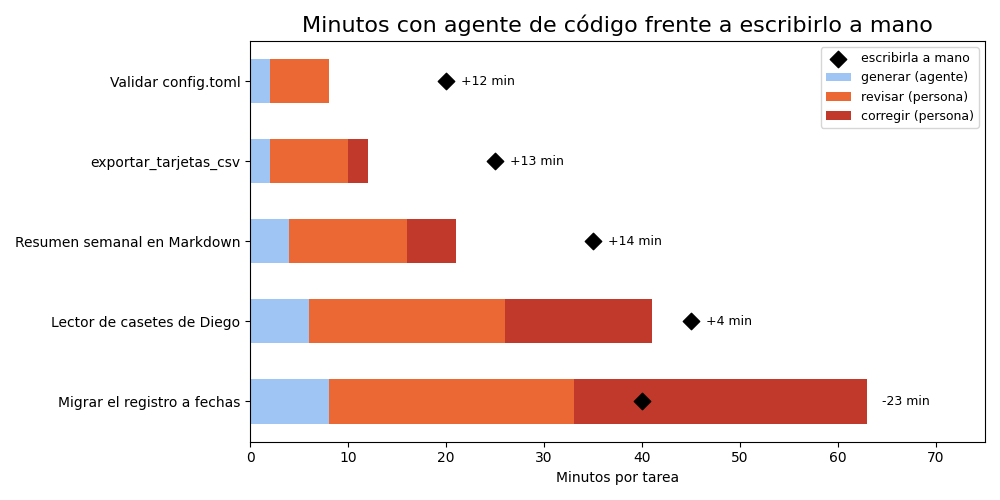
La Tabla 4 reúne las cifras completas.
Tabla 4. Coste y tiempo de cada tarea con un agente de código frente a escribirla a mano (valores de juguete, precios de Sonnet 5.5).
| Tarea | Intentos | Tokens de entrada por intento | Tokens de salida por intento | Coste (USD) | Min. revisar | Min. corregir | Min. con agente | Min. a mano |
|---|---|---|---|---|---|---|---|---|
Validar config.toml | 1 | 6 000 | 900 | 0.021 | 6 | 0 | 8 | 20 |
exportar_tarjetas_csv | 1 | 7 500 | 1 100 | 0.026 | 8 | 2 | 12 | 25 |
| Resumen semanal en Markdown | 2 | 9 000 | 1 500 | 0.066 | 12 | 5 | 21 | 35 |
| Lector de casetes de Diego | 3 | 12 000 | 2 200 | 0.138 | 20 | 15 | 41 | 45 |
| Migrar el registro a fechas | 4 | 18 000 | 3 000 | 0.264 | 25 | 30 | 63 | 40 |
Las cifras dejan cuatro conclusiones:
- El dinero es lo de menos. Las cinco tareas cuestan $0.515$ USD en total. Sumado a los $1.68$ USD al mes que el Día 24 estimó para el Cuaderno Vivo, el proyecto sigue muy por debajo del presupuesto de $10$ USD. Diego puede dejar de preocuparse por la factura.
- El tiempo humano domina. Revisar y corregir ocupan el $85%$ del tiempo con agente. Programar con un agente de código no elimina el trabajo de Sofía: lo convierte de escribir en leer, y leer código ajeno con atención es más lento de lo que parece.
- El ahorro existe en las tareas bien especificadas. Las tres primeras ahorran entre $12$ y $14$ minutos cada una: son tareas pequeñas, con un contrato claro y pruebas automáticas, en las que el agente acierta en uno o dos intentos.
- La tarea difícil cuesta más con agente que a mano. Migrar el registro de uso a un formato con fecha (la tarea con pass@1 $= 0.1$) necesita cuatro intentos, $25$ minutos de revisión y $30$ de corrección: $63$ minutos frente a $40$, un ahorro de $-23$. En total, las cinco tareas pasan de $165$ minutos a mano a $145$ con agente, y casi todo el ahorro se lo come esa sola tarea.
El lector de casetes de Diego, con solo $4$ minutos de ahorro, es el caso frontera, y es también el más honesto: Diego no sabe Python, así que para él los $45$ minutos “a mano” no existen. Pero tampoco existen los $20$ minutos de revisión, porque no puede revisar lo que no entiende. Un agente de código multiplica a quien sabe revisar; a quien no sabe, le entrega un programa que no puede mantener. Sofía le propone otro trato: el agente escribe el lector, ella lo revisa, y Diego escribe las pruebas en lenguaje natural (“si el casete no tiene fecha, debe quedar como desconocida”) para que ella las convierta en código.
Permisos del agente
La última pieza del método es la que separa un agente útil de uno peligroso: qué puede leer, qué puede escribir y qué puede ejecutar. El Día 22 fijó una regla para el orquestador del Cuaderno Vivo: ninguna acción con efectos fuera del equipo sin aprobación humana. Aplicada al código, la regla se vuelve más fina, porque un agente de código tiene efectos dentro del equipo: escribe archivos y ejecuta órdenes en la misma terminal donde viven las notas de Sofía y su clave de API.
Las herramientas de agentes de código suelen permitir declarar estas reglas en un archivo de configuración. Claude Code, por ejemplo, admite reglas para permitir, preguntar o denegar el uso de cada herramienta y de cada orden. En lugar de depender de la sintaxis de una herramienta concreta, el siguiente bloque escribe los permisos como un diccionario de Python y una función permitido(accion, objetivo) que devuelve una de tres decisiones: permitir, confirmar o denegar. Después la prueba con seis casos:
# Permisos de un agente de código y la función permitido(accion, objetivo) en Python:
PERMISOS = {
    'leer': ['tarjetas_csv.py', 'tutor.py', 'cuaderno_v1.py', 'pruebas/', 'datos_ejemplo/', 'requirements.txt'],
    'escribir': ['tarjetas_csv.py', 'pruebas/'],
    'ordenes_permitidas': ['python -m unittest', 'git diff', 'git status'],
    'ordenes_con_confirmacion': ['pip install', 'git commit'],
    'nunca': ['cuaderno_vivo/', '.env', 'mi_voz.wav'],
}

def dentro(ruta, lista):
    return any(ruta == p or (p.endswith('/') and ruta.startswith(p)) for p in lista)

def permitido(accion, objetivo):
    # Las órdenes se comparan por prefijo; lo que no está en ninguna lista se deniega:
    if accion == 'ejecutar':
        if any(objetivo.startswith(o) for o in PERMISOS['ordenes_permitidas']):
            return 'permitir'
        if any(objetivo.startswith(o) for o in PERMISOS['ordenes_con_confirmacion']):
            return 'confirmar'
        return 'denegar'
    # Las rutas se normalizan antes de comparar, para que pruebas/../ no escape:
    ruta = posixpath.normpath(objetivo.replace('\\', '/'))
    if ruta.startswith('..') or posixpath.isabs(ruta) or dentro(ruta, PERMISOS['nunca']):
        return 'denegar'
    return 'permitir' if dentro(ruta, PERMISOS[accion]) else 'denegar'

casos = [('escribir', 'tarjetas_csv.py'), ('leer', 'cuaderno_vivo/notas.json'),
         ('escribir', 'pruebas/../config.toml'), ('ejecutar', 'python -m unittest pruebas.prueba_tarjetas'),
         ('ejecutar', 'pip install csv_turbo_es'), ('ejecutar', 'rm -rf cuaderno_vivo')]
decisiones = pd.DataFrame(casos, columns = ['acción', 'objetivo'])
decisiones['decisión'] = [permitido(a, o) for a, o in casos]
print(decisiones.to_string(index = False))
print('Recuento:', decisiones['decisión'].value_counts().to_dict())
  acción                                   objetivo  decisión
escribir                            tarjetas_csv.py  permitir
    leer                   cuaderno_vivo/notas.json   denegar
escribir                     pruebas/../config.toml   denegar
ejecutar python -m unittest pruebas.prueba_tarjetas  permitir
ejecutar                   pip install csv_turbo_es confirmar
ejecutar                       rm -rf cuaderno_vivo   denegar
Recuento: {'denegar': 3, 'permitir': 2, 'confirmar': 1}
De los seis casos, $2$ se permiten, $1$ pide confirmación y $3$ se deniegan. Cada decisión responde a una regla distinta:
- Escribir
tarjetas_csv.pyse permite porque es el único archivo de la tarea. El agente no puede escribircuaderno_v1.pyaunque pueda leerlo: leer para entender el formato es necesario; reescribir el tutor no formaba parte del contrato. - Leer
cuaderno_vivo/notas.jsonse deniega aunque solo sea lectura. Las notas de Sofía son datos personales y el agente envía lo que lee al modelo; si una tarea necesita notas de ejemplo, las tiene endatos_ejemplo/, la carpeta que el Día 24 creó para el portafolio. Lo que el agente lee sale de su equipo, igual que lo que usted pega en una conversación. - Escribir
pruebas/../config.tomlse deniega porque la ruta, una vez normalizada conposixpath.normpath, esconfig.toml, que no está en la lista de escritura. Sin la normalización, la comparación por prefijo habría vistopruebas/al principio y la habría permitido. Es el truco más viejo para escapar de una carpeta, y una regla de permisos que compara textos sin normalizarlos no lo detecta. python -m unittestse permite sin preguntar: ejecutar las pruebas es la mitad del bucle y no tiene efectos fuera de la carpeta temporal.pip install csv_turbo_espide confirmación. La orden no está prohibida (a veces hace falta una dependencia), pero es exactamente el punto rojo del diagrama del Bloque 3 y el que defiende contra el slopsquatting.rm -rf cuaderno_vivose deniega sin ser mencionada en ninguna lista: lo que no está permitido de forma explícita, está prohibido. Una lista negra de órdenes peligrosas siempre olvida alguna; una lista blanca de órdenes necesarias es corta y se puede leer entera.
La lista nunca merece una línea aparte. Contiene cuaderno_vivo/, .env (donde vive la clave) y mi_voz.wav (la grabación de la voz de Sofía del Día 15), y se comprueba antes que las demás, de modo que ninguna regla de lectura o escritura puede abrirlas por descuido. Es el equivalente, para el agente, del .gitignore que el Día 24 escribió para el repositorio: lo que no debe salir del equipo no debe ni siquiera leerse.
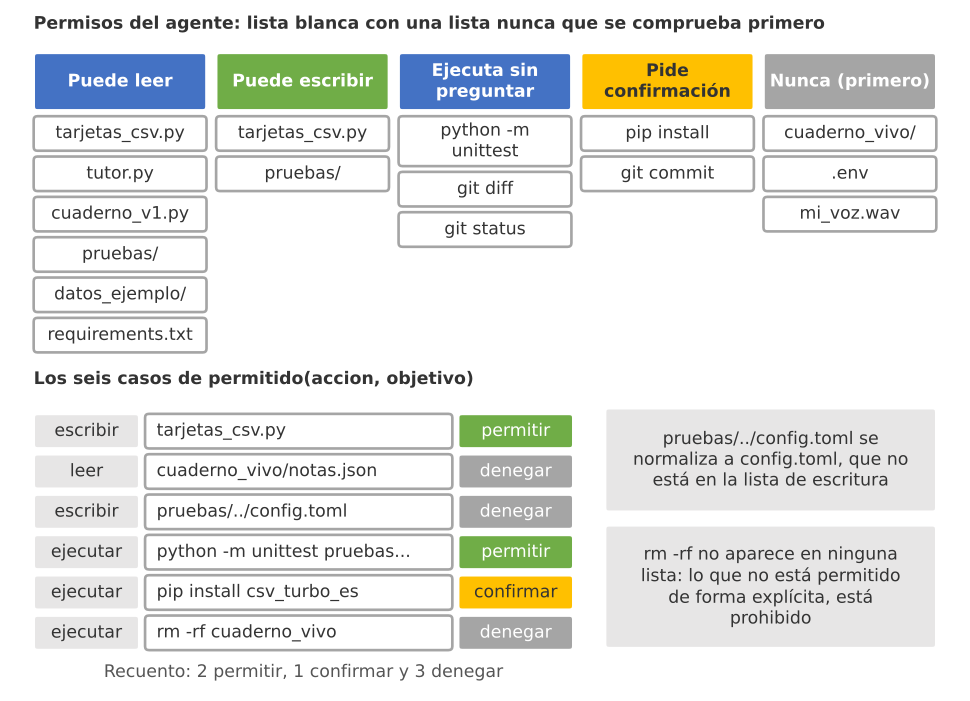
Figura 3. Los permisos del agente como lista blanca: qué puede leer, qué puede escribir, qué órdenes ejecuta sin preguntar, cuáles piden confirmación y la lista nunca, que se comprueba primero; de los seis casos, 2 se permiten, 1 pide confirmación y 3 se deniegan.
Consideraciones finales
Sofía termina el día con una función nueva, exportar_tarjetas_csv, que pasa sus cuatro pruebas, no importa nada fuera de la biblioteca estándar y que ella puede explicar línea a línea. No la escribió con sus manos, pero la especificó, la midió, la revisó y la aceptó, y en ese orden. Ese es el cambio de oficio que trae un agente de código: la persona pasa de escribir el código a escribir el contrato y responder por el resultado. Lo segundo no se delega.
Las cifras de hoy tienen límites claros. Las tasas de acierto de la Tabla 2 y los minutos de la Tabla 4 son de juguete: sirven para razonar, no para afirmar cuánto ahorra una herramienta concreta. Las dos propuestas del Bloque 5 están escritas a mano para que la entrada se pueda ejecutar sin API; un modelo real puede producir otras. Y el revisor del Bloque 8 conoce cuatro reglas, no todas las formas de escribir código peligroso. Lo que sí se sostiene sin datos de juguete es la estructura del método: el contrato antes del código, la métrica insesgada en lugar de la ingenua, la lista escrita y la lista blanca de permisos.
Antes de dejar que un agente toque su propio proyecto, hágase estas preguntas:
- ¿Están escritas las pruebas antes de pedir el código, y fallan contra una implementación vacía?
- ¿Puede el agente leer algo que no debería salir de su equipo?
- ¿Qué orden de su terminal podría ejecutar el agente sin preguntarle?
- ¿Podría explicar en voz alta cada línea del cambio que está a punto de aceptar?
- ¿La tarea es de las que se resuelven a la primera, o de las que cuestan más con agente que a mano?
Un código que nadie entiende es deuda técnica con intereses. Sculley y sus colaboradores lo describieron en $2015$ para los sistemas con aprendizaje automático, y el Día 24 lo citó al hablar de la entrega: los costes ocultos de un sistema no están en escribirlo, sino en mantenerlo. Con un agente de código, esa deuda se puede contraer más deprisa que nunca, porque producir doscientas líneas cuesta dos minutos y entenderlas sigue costando lo mismo que siempre. El Día 29 volverá sobre esto desde el lado del mantenimiento: las pruebas que hoy sirvieron de contrato serán mañana la red que detecta lo que se rompe cuando cambia un modelo o una biblioteca.
Un gran libro que habla de esto es Test-Driven Development: By Example (o Desarrollo guiado por pruebas con ejemplos), en el que Kent Beck enseña a escribir primero una prueba que falla, después el código mínimo que la hace pasar y por último a mejorar el diseño sin romper nada. Se escribió dos décadas antes de los agentes de código y, sin embargo, describe exactamente el contrato que necesitan: con un agente, el ciclo de Beck sigue siendo el mismo, solo que el paso del medio lo da otra persona (o algo que no es una persona), y los otros dos siguen siendo de usted.
Un agente de código escribe deprisa lo que usted especifica; lo que no especifica, también lo decide él. Diego lo entiende a su manera al final de la tarde: “Entonces la IA no me ahorra aprender a programar. Me ahorra teclear lo que ya sé pedir.” Sofía le corrige un poco: le ahorra teclear lo que ya sabe probar.
Conclusiones clave
Niveles de ayuda
- Autocompletado, generación por petición y agente de código se diferencian en qué ven del proyecto, qué pueden cambiar y quién ejecuta las pruebas; la autonomía del agente es su utilidad y su riesgo.
- El bucle de un agente de código es el bucle de herramientas del Día 22 aplicado a archivos y a una terminal: leer, planear, editar, ejecutar pruebas y observar, con un límite de intentos.
- La tarea se entrega como contrato: firma, docstring con límites y pruebas escritas antes que el código, que fallan ($0$ de $4$) contra una implementación vacía.
Medir el código generado
- Las pruebas distinguen una propuesta correcta ($4$ de $4$ con
csv.writer) de una ingenua que parece correcta ($2$ de $4$: comas y orden de columnas). - pass@k se estima con la fórmula insesgada $1 - \binom{n-c}{k}/\binom{n}{k}$: con $n = 10$ y $c = 3$, pass@3 $= 0.708$ y pass@5 $= 0.917$.
- El estimador ingenuo $1 - (1 - c/n)^k$ subestima: con $p = 0.3$ y $k = 5$, su sesgo exacto es $-0.0722$ frente a $0.0000$ del insesgado.
Revisión y permisos
- Pasar las pruebas es necesario, no suficiente: una lista de diez puntos y un revisor con
astencuentran $5$ hallazgos en una propuesta dudosa (paquete inexistente,eval, red,subprocessy una ruta personal). - Toda dependencia nueva se verifica en el índice oficial antes de instalarla; los paquetes que los modelos inventan de forma repetible son la puerta del slopsquatting.
- Los permisos se escriben como lista blanca con una lista
nuncaque se comprueba primero, y las rutas se normalizan antes de comparar. - El dinero es lo de menos ($0.515$ USD por cinco tareas); el tiempo humano de revisar y corregir es el $85%$ del total, y la tarea difícil cuesta más con agente ($63$ minutos) que a mano ($40$).
Mañana, en el Día 26: Modelos abiertos en local frente a la API: medir antes de mudarse. La hoja de ruta del Día 24 dejó “Clasificar notas con un modelo local” para el sexto mes; mañana Sofía hará el experimento que dirá si esa tarea merece la pena, comparando con las mismas notas, el mismo prompt y las mismas métricas un modelo abierto en su laptop y Claude Haiku 5.5.
Referencias
- Chen, M., Tworek, J., Jun, H., Yuan, Q., Pinto, H. P. de O., Kaplan, J. et al. (2021). Evaluating Large Language Models Trained on Code. arXiv:2107.03374. https://arxiv.org/abs/2107.03374
- Jimenez, C. E., Yang, J., Wettig, A., Yao, S., Pei, K., Press, O. y Narasimhan, K. (2024). SWE-bench: Can Language Models Resolve Real-World GitHub Issues? The Twelfth International Conference on Learning Representations (ICLR 2024).
- Spracklen, J., Wijewickrama, R., Sakib, A. H. M. N., Maiti, A., Viswanath, B. y Jadliwala, M. (2025). We Have a Package for You! A Comprehensive Analysis of Package Hallucinations by Code Generating LLMs. 34th USENIX Security Symposium. https://www.usenix.org/conference/usenixsecurity25/presentation/spracklen
- Sculley, D., Holt, G., Golovin, D., Davydov, E., Phillips, T., Ebner, D., Chaudhary, V., Young, M., Crespo, J.-F. y Dennison, D. (2015). Hidden Technical Debt in Machine Learning Systems. Advances in Neural Information Processing Systems 28 (NeurIPS 2015).
- Beck, K. (2002). Test-Driven Development: By Example. Addison-Wesley.
- Python Software Foundation (2026). Documentación de Python 3: módulos
ast,csvyunittest. https://docs.python.org/3/library/ - Anthropic (2026). Claude Code y Claude Agent SDK. Documentación de Claude. https://platform.claude.com/docs