
IA generativa en proyectos personales: Día 26
 Jeshua Romero Guadarrama
- 56 Min para leer
- 26 Jan, 2026
Índice de contenido
Resumen:
Ejecutar un modelo de lenguaje abierto en la propia laptop promete privacidad, independencia del proveedor y coste cero por token, pero esas promesas hay que medirlas antes de mudarse. En esta entrada, Sofía estima cuánta memoria necesita un modelo según sus parámetros y su cuantización, mide con numpy el error que introduce cuantizar a 8 y 4 bits, habla con un servidor local de Ollama y compara, con las mismas 60 notas y el mismo prompt, un modelo abierto de 4 000 millones de parámetros con Claude Haiku 5.5: exactitud con intervalos de Wilson, latencia p50 y p95, prueba de McNemar y punto de equilibrio económico. Al terminar, usted sabrá decidir con datos qué tareas de su proyecto conviene llevar a local, y por qué la razón casi nunca es el dinero.
¿Cómo citar el presente artículo?
Romero, J. (26 de enero de 2026). IA generativa en proyectos personales: Día 26. python-data-engineer. https://www.python-data-engineer.com/post/iag/dia_26/.
IA generativa en proyectos personales: Día 26 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/iag/dia_26/.
Modelos, licencias, precios y herramientas revisados en octubre de 2026. Los precios de Claude son los de la Tabla A de la serie (Haiku 5.5: $0.10$ USD por millón de tokens de entrada y $0.50$ de salida). Las licencias de los modelos abiertos de la Tabla 2 se comprobaron en sus fichas oficiales en octubre de 2026; cambian con cada versión, así que vuelva a leerlas antes de descargar un modelo.
Día 26. Modelos abiertos en local frente a la API: medir antes de mudarse
Introducción
Ayer, en el Día 25 (Programar con IA: un agente de código trabaja sobre el Cuaderno Vivo), aprendió a entregar una tarea de programación como un contrato con pruebas, a medir el código generado con pass@k y a revisar y acotar lo que hace un agente, y el Cuaderno Vivo ganó la función exportar_tarjetas_csv, aceptada solo después de pasar sus cuatro pruebas y una lista de diez puntos. Hoy toca la segunda pregunta de la semana de “vida del producto”: ¿qué parte del Cuaderno Vivo puede funcionar sin la nube?
La pregunta no sale de la nada. La hoja de ruta del Día 24 dejó para el sexto mes una tarea concreta, “Clasificar notas con un modelo local”, con un criterio de éxito igual de concreto: exactitud igual o mejor que la actual con cero llamadas a la API. Faltan meses para esa fecha, y Sofía no piensa adelantar la migración. Lo que sí puede hacer esta semana es el experimento que dirá si la tarea merece la pena tal como está escrita, o si hay que reescribirla. Medir ahora cuesta una tarde; migrar sin medir puede costar un mes de trabajo que luego se deshace.
Diego, que ya no pregunta cuánto cuesta sino si él también podrá usarlo, trae una preocupación práctica desde la casa de su abuela, donde la conexión falla a menudo: "¿Y si se cae internet o cambian los precios? Si todo depende de una API, el día que no hay red el cuaderno no clasifica nada." Tiene razón en la mitad del argumento. Un modelo en la laptop no depende de la red ni de la lista de precios de nadie. La otra mitad es la que hoy hay que medir: cuánta memoria pide, qué exactitud pierde, cuánto tarda y cuánto ahorra de verdad.
En la presente entrada, descubrirá qué piezas intervienen al ejecutar un modelo de lenguaje abierto en su equipo (pesos, formato GGUF y un servidor como Ollama) y por qué “abierto” no significa lo mismo en todas las licencias. Verá cómo estimar la memoria que necesita un modelo a partir de sus parámetros y de los bits por peso, más la caché del contexto; cómo funciona la cuantización simétrica y por qué un puñado de valores atípicos puede arruinarla; cómo hablar con el servidor local desde Python con salida JSON validada, y cómo diseñar una comparación justa con Claude Haiku 5.5: mismas notas, mismo prompt y las mismas métricas, con intervalos de Wilson, percentiles de latencia y una prueba de McNemar. Al final calculará el punto de equilibrio económico y escribirá la decisión como un ADR, el formato del Día 21.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Explicar qué significa ejecutar un modelo de lenguaje abierto en local y qué piezas intervienen (pesos, formato GGUF, servidor como Ollama o llama.cpp).
- Estimar la memoria que necesita un modelo según su número de parámetros y su cuantización, y medir el error que introduce cuantizar.
- Diseñar una comparación justa entre un modelo local y la API: misma tarea, mismos datos, mismas métricas (exactitud, latencia, coste, privacidad).
- Calcular el punto de equilibrio económico y reconocer cuándo la razón para ir a local es la privacidad y no el dinero.
- Leer la licencia de cada modelo abierto antes de elegirlo.
Qué hay dentro de un modelo local
El Día 4 presentó la diferencia entre un modelo de pesos abiertos y un modelo de API con una frase: el primero publica sus parámetros para que cualquiera los descargue, y el segundo se usa a través de un servicio que cobra por token. Aquel día la distinción servía para ordenar el mapa de herramientas; hoy hay que bajar al detalle, porque “descargar un modelo” esconde tres piezas distintas, cada una con su propio origen, su propia licencia y sus propios fallos.
La primera pieza son los pesos: los miles de millones de números que el entrenamiento ajustó. Un modelo de lenguaje no es solo eso, sin embargo. Lo acompañan su tokenizador, que convierte el texto en los números que el modelo entiende (el BPE de juguete del Día 2 hacía lo mismo a pequeña escala), y su plantilla de chat, que dice cómo se marcan los turnos de sistema, usuario y asistente. Si la plantilla no coincide con la que se usó al entrenar, el modelo responde peor sin que nada falle de forma visible.
Esas tres cosas viajan juntas en un único archivo con el formato GGUF, definido por el proyecto llama.cpp. Un archivo GGUF guarda los pesos (normalmente ya cuantizados, como verá más adelante), el vocabulario del tokenizador, la plantilla de chat y los metadatos de la arquitectura: número de capas, de cabezas de atención y longitud de contexto. Es un formato pensado para cargarse rápido desde disco y ejecutarse en una CPU corriente o en la GPU integrada de una laptop.
La segunda pieza es el motor de inferencia, el programa que hace las multiplicaciones de matrices. llama.cpp es el más conocido: está escrito en C y C++, no necesita Python y funciona en Windows, macOS y Linux. La tercera pieza es el servidor, que mantiene el modelo cargado en memoria y lo expone como un servicio. Ollama es un servidor y gestor de modelos que usa llama.cpp por dentro: descarga modelos con una orden (ollama pull qwen3:4b), los guarda en una carpeta local y atiende peticiones HTTP en http://localhost:11434. Para el código del Cuaderno Vivo, hablar con Ollama se parece mucho a hablar con una API en la nube, con una diferencia decisiva: la dirección empieza por localhost. La Tabla 1 resume las tres piezas.
Tabla 1. Piezas de una ejecución local de un modelo de lenguaje (revisado en octubre de 2026).
| Pieza | Ejemplo | Qué hace | Licencia |
|---|---|---|---|
| Motor de inferencia | llama.cpp | Ejecuta el modelo en CPU o GPU; define el formato GGUF | MIT |
| Servidor y gestor | Ollama | Descarga modelos, los mantiene cargados y ofrece una API HTTP en el puerto 11434 | MIT |
| Modelo | qwen3:4b (Qwen3-4B en GGUF) | Pesos, tokenizador y plantilla de chat | La del modelo (Apache 2.0 en este caso) |
Observe la última columna: el motor y el servidor tienen licencia MIT, que permite casi cualquier uso, pero eso no dice nada del modelo. La licencia del modelo es independiente y es la que decide qué puede hacer usted con él. Volveremos a esto en un momento.
Comencemos por preparar el entorno con las importaciones base y la semilla global de la serie, $2026$. Como en todo el módulo 7/7, los bloques que se ejecutan usan solo numpy, pandas, scipy, matplotlib y la biblioteca estándar:
# Importaciones base y semilla del día en Python:
import warnings
warnings.filterwarnings('ignore')
import re
import sys
import textwrap
import numpy as np
import pandas as pd
import scipy
from scipy import stats
import matplotlib
import matplotlib.pyplot as plt
from matplotlib.patches import FancyBboxPatch, FancyArrowPatch

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 120)
print('Python', sys.version.split()[0], '| numpy', np.__version__, '| pandas', pd.__version__,
      '| scipy', scipy.__version__, '| matplotlib', matplotlib.__version__)
Python 3.12.10 | numpy 2.4.6 | pandas 3.0.3 | scipy 1.17.1 | matplotlib 3.10.9
La salida confirma las versiones con las que se calcularon todas las cifras de esta entrada. Ni Ollama ni llama.cpp aparecen aquí, y no es un descuido: los bloques que necesitan el servidor local se marcan como tales y se muestran con una salida de ejemplo, exactamente como los que llaman a la API. Lo que sí se ejecuta de verdad es todo lo que se puede calcular sin servidor: memoria, cuantización, estadística y costes.
El primer paso con un servidor local siempre es comprobar que responde. El siguiente bloque pide a Ollama la lista de modelos instalados con GET /api/tags. Necesita el servidor en marcha, así que no se ejecutó para escribir la entrada y su salida es un ejemplo comentado:
# Comprobación de que el servidor local de Ollama responde en Python:
import requests

OLLAMA = 'http://localhost:11434'
try:
    respuesta = requests.get(f'{OLLAMA}/api/tags', timeout = 5)
    respuesta.raise_for_status()
except requests.exceptions.ConnectionError:
    raise SystemExit('Ollama no responde: ¿está abierto el servidor (ollama serve)?')

# Modelos instalados, con su tamaño en disco, sus parámetros y su cuantización:
for modelo in respuesta.json()['models']:
    detalles = modelo.get('details', {})
    print(f"{modelo['name']:<12} {modelo['size'] / 1e9:5.2f} GB  "
          f"{detalles.get('parameter_size', '?'):>6}  {detalles.get('quantization_level', '?')}")

# Salida de ejemplo (puede variar):
# qwen3:4b      2.50 GB    4.0B  Q4_K_M
El bloque es corto, pero tiene dos detalles que se repiten en todo el código local. El primero es el tiempo de espera (timeout = 5): un servidor local que no responde no debe colgar el Cuaderno Vivo, del mismo modo que una API caída no debía hacerlo en el Día 4. El segundo es el mensaje de error útil: la causa más frecuente de un ConnectionError contra localhost no es un fallo del modelo, sino que el servidor no está abierto.
La salida de ejemplo muestra un único modelo, qwen3:4b, que ocupa unos $2.5$ GB en disco con la cuantización Q4_K_M. Ese número va a reaparecer en la sección de memoria, porque se puede predecir con una multiplicación.
Licencias de los modelos abiertos
“Abierto” es una palabra cómoda que oculta diferencias importantes. Algunos modelos se publican con una licencia de software libre clásica, como Apache 2.0, que permite el uso comercial, la modificación y la redistribución con la única obligación de conservar los avisos. Otros se publican con licencias propias del fabricante, que permiten descargar y usar los pesos, pero añaden condiciones: una política de uso aceptable, un umbral de usuarios a partir del cual hay que pedir permiso o la obligación de mostrar una atribución concreta. Y la licencia puede cambiar de una generación a la siguiente de la misma familia. La Tabla 2 recoge cuatro familias que Sofía consideró.
Tabla 2. Licencias de modelos abiertos de ejemplo (revisado en octubre de 2026 en las fichas oficiales).
| Modelo | Tamaño | Licencia | Condiciones principales |
|---|---|---|---|
| Qwen3-4B (Qwen) | 4 000 millones | Apache 2.0 | Uso comercial permitido; conservar avisos de licencia |
| Mistral 7B Instruct v0.3 (Mistral AI) | 7 000 millones | Apache 2.0 | Uso comercial permitido; conservar avisos de licencia |
| Llama 3.2 (Meta) | 1 000 y 3 000 millones (texto) | Llama 3.2 Community License | Política de uso aceptable; atribución; licencia aparte por encima de 700 millones de usuarios activos al mes |
| Gemma 3 (Google) | De 1 000 a 27 000 millones | Gemma Terms of Use | Política de uso prohibido que se hereda en los derivados |
| Gemma 4 (Google) | Hasta 31 000 millones | Apache 2.0 | La familia cambió de licencia en 2026: compruebe la versión exacta que descarga |
La tabla enseña tres lecciones. La primera: la licencia sigue al modelo concreto, no a la marca. Gemma 3 y Gemma 4 son de la misma familia y tienen licencias distintas, de modo que “uso Gemma” no responde a la pregunta de qué puede hacer con él. La segunda: las licencias propias no son necesariamente restrictivas para un proyecto personal (el umbral de $700$ millones de usuarios de Llama no afectará al Cuaderno Vivo), pero sí añaden obligaciones que hay que cumplir aunque el proyecto sea pequeño, como la política de uso aceptable o la atribución si algún día se publica. La tercera: una versión cuantizada que descarga de un tercero hereda la licencia del original; quien la convirtió a GGUF no puede cambiarla.
Para el experimento, Sofía elige Qwen3-4B. Tiene licencia Apache 2.0, $4,000$ millones de parámetros (un tamaño que, como verá enseguida, cabe con holgura en su laptop) y una ficha técnica pública, el informe de Qwen Team (2025). La elección no es una recomendación universal: es la que mejor encaja con su equipo y con su tarea, y la sección final explica cómo repetir la comparación con otro modelo.
Antes de medir nada conviene dibujar qué cambia en el recorrido de una nota. En el Día 21, el diagrama de arquitectura del Cuaderno Vivo marcó en naranja la frontera de la red: la línea que separa lo que ocurre en la laptop de Sofía de lo que ocurre en servidores ajenos. El siguiente bloque dibuja las dos rutas posibles para clasificar una nota con FancyBboxPatch y FancyArrowPatch, como los diagramas de los días 4, 21 y 25:
# Las dos rutas de una nota: la API en la nube frente al servidor local en Python:
fig, ax = plt.subplots(figsize = (11, 6.2))

def caja(x, y, titulo, detalle, color, ancho = 2.3):
    ax.add_patch(FancyBboxPatch((x - ancho / 2, y - 0.55), ancho, 1.1, boxstyle = 'round,pad=0.08',
                                facecolor = color, edgecolor = '#333333', linewidth = 1.2))
    ax.text(x, y + 0.2, titulo, ha = 'center', va = 'center', fontsize = 10.5, weight = 'bold')
    ax.text(x, y - 0.22, detalle, ha = 'center', va = 'center', fontsize = 8.5)

def flecha(origen, destino, color = '#333333'):
    ax.add_patch(FancyArrowPatch(origen, destino, arrowstyle = '-|>', mutation_scale = 16,
                                 color = color, linewidth = 1.6))

# Ruta A (arriba): la nota sale del equipo hacia Claude Haiku 5.5:
caja(1.3, 5.0, 'Nota', 'cuaderno_vivo/\nnotas.json', '#9ec5f4')
caja(4.0, 5.0, 'Guardianes', 'detectar() y\nredactar() (Día 19)', '#fff3c4')
caja(9.6, 5.0, 'API de Claude', 'claude-haiku-5-5\n(en la nube)', '#fde0d3')
flecha((2.5, 5.0), (2.8, 5.0))
flecha((5.2, 5.0), (8.4, 5.0), color = '#eb6834')
ax.text(6.8, 5.25, 'texto redactado\n(HTTPS)', ha = 'center', fontsize = 8.5, color = '#eb6834')

# Ruta B (abajo): la nota no sale de la laptop:
caja(1.3, 2.0, 'Nota', 'cuaderno_vivo/\nnotas.json', '#9ec5f4')
caja(4.0, 2.0, 'Servidor local', 'Ollama en\nlocalhost:11434', '#d5f0dc')
caja(6.7, 2.0, 'Modelo abierto', 'qwen3:4b\nGGUF, 4 bits', '#d5f0dc')
flecha((2.5, 2.0), (2.8, 2.0))
flecha((5.2, 2.0), (5.5, 2.0))

# Frontera de la red del Día 21: solo la ruta A la cruza:
ax.plot([8.0, 8.0], [0.6, 6.3], color = '#eb6834', linestyle = '--', linewidth = 2)
ax.text(8.1, 0.75, 'frontera de la red', fontsize = 9.5, color = '#eb6834')
ax.text(0.2, 6.1, 'Laptop de Sofía (16 GB de RAM)', fontsize = 10, color = '#555555')
ax.text(8.6, 6.1, 'Nube', fontsize = 10, color = '#555555')
ax.text(0.2, 3.55, 'Ruta A: API', fontsize = 9.5, weight = 'bold')
ax.text(0.2, 0.75, 'Ruta B: local', fontsize = 9.5, weight = 'bold')
ax.set_xlim(0, 11)
ax.set_ylim(0.4, 6.5)
ax.axis('off')
ax.set_title('Dos rutas para clasificar una nota del Cuaderno Vivo', fontsize = 16)
plt.tight_layout()
rutas = {'A (API)': ['nota', 'guardianes', 'API de Claude'],
         'B (local)': ['nota', 'servidor local', 'modelo abierto']}
for ruta, piezas in rutas.items():
    print(f'Ruta {ruta}: {" -> ".join(piezas)} | cruza la frontera: {"API de Claude" in piezas}')

# Solo la ruta A cruza la frontera de la red:
plt.show()
Ruta A (API): nota -> guardianes -> API de Claude | cruza la frontera: True
Ruta B (local): nota -> servidor local -> modelo abierto | cruza la frontera: False
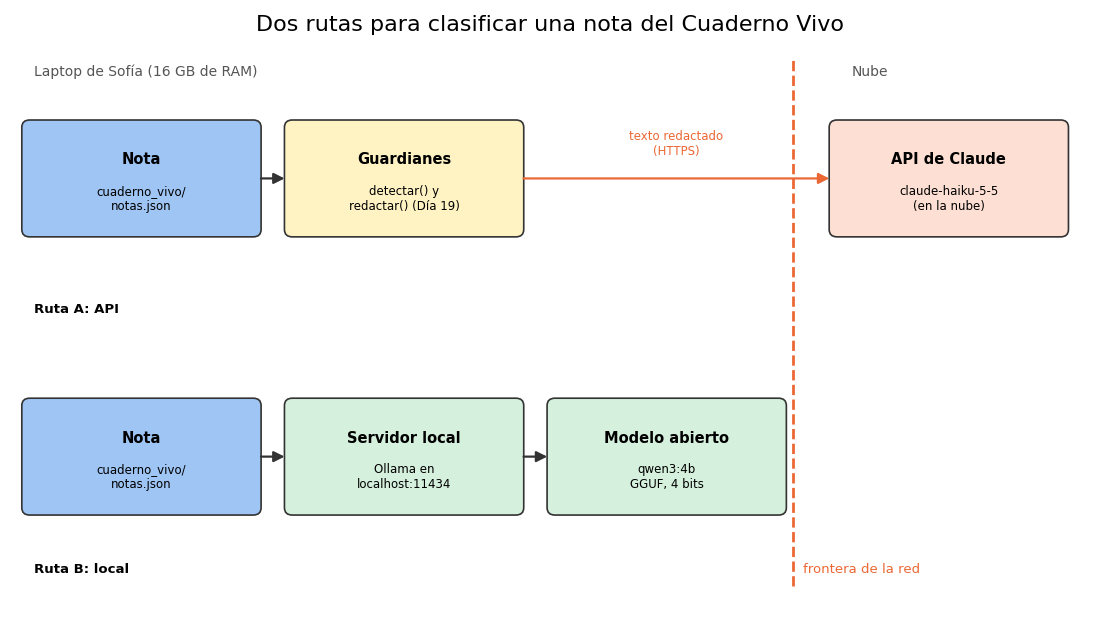
Las dos rutas empiezan igual, con una nota de cuaderno_vivo/notas.json, y se separan enseguida. En la ruta A, la nota pasa por los guardianes del Día 19 (detectar() y redactar(), que sustituyen correos y teléfonos por marcadores) y después cruza la frontera hacia la API de Claude por HTTPS. Lo que cruza no es la nota original, sino el texto redactado, y aun así cruza. En la ruta B, la nota va al servidor local en localhost:11434, que se la pasa al modelo cargado en memoria; las tres cajas quedan a la izquierda de la línea discontinua. La salida del bloque lo dice en una línea por ruta: solo la ruta A cruza la frontera.
Esa es la ventaja que ningún número de latencia o de coste puede igualar. El resto de la entrada mide lo que cuesta.
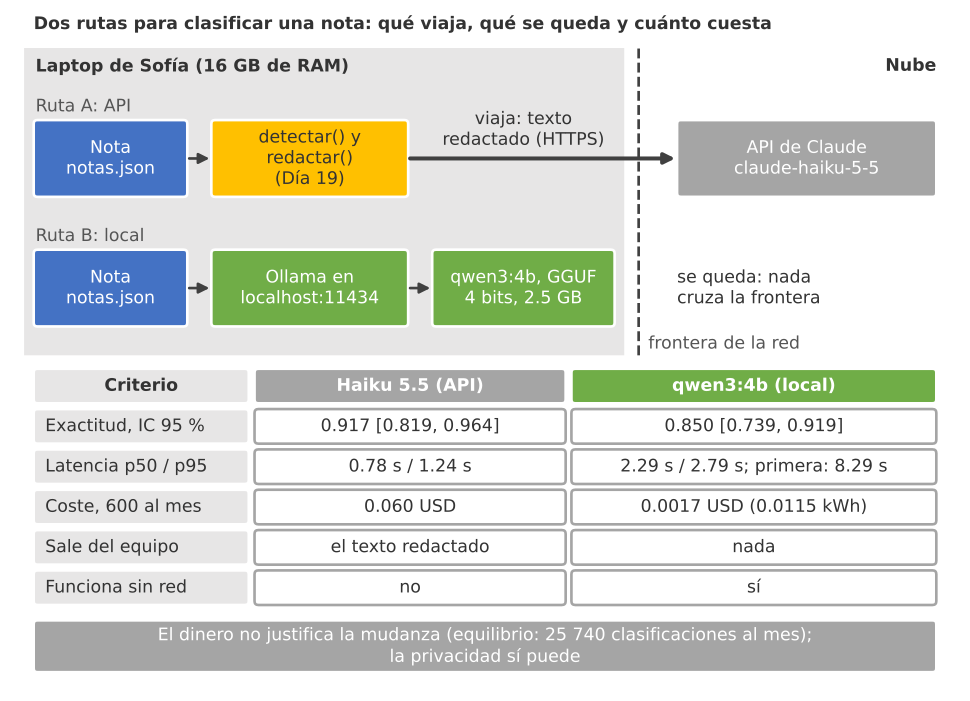
Figura 1. API frente a modelo local: por la API viaja el texto redactado de cada nota hacia Haiku 5.5; en local, la nota se queda en la laptop con qwen3:4b. La comparación de la Tabla 5: exactitud 0.917 frente a 0.850, latencia p50 de 0.78 s frente a 2.29 s y 0.060 USD frente a 0.0017 USD al mes con 600 clasificaciones.
Cuánta memoria hace falta
La primera pregunta práctica sobre un modelo local no es si es bueno, sino si cabe. Un modelo de lenguaje tiene que estar entero en memoria (en la RAM del sistema o en la memoria de la GPU) para generar cada token, porque cada token pasa por todas sus capas. La laptop de Sofía tiene $16$ GB de RAM compartidos con el sistema operativo, el navegador y el propio Cuaderno Vivo; en la práctica le quedan unos $10$ GB libres para un modelo.
La memoria de los pesos se estima con una multiplicación: cada parámetro ocupa tantos bits como la precisión con la que se guarda, y ocho bits son un byte.
$$ M_{\text{pesos}} \approx \frac{P \cdot b}{8} $$
La lógica detrás de esta fórmula es múltiple:
- $P$ es el número de parámetros. Un modelo “de 4B” tiene unos $4 \cdot 10^{9}$ parámetros, de modo que, si cada uno ocupara un byte, el modelo ocuparía $4$ GB.
- $b$ son los bits por peso. El entrenamiento suele hacerse con $16$ bits (formatos
float16obfloat16); la cuantización, que verá en la sección siguiente, reduce ese número a $8$ o a $4$ bits. - La división entre $8$ convierte bits en bytes. En conclusión, la memoria crece en proporción directa al tamaño del modelo y a los bits por peso, y por eso cuantizar a $4$ bits divide entre cuatro la memoria de un modelo de $16$ bits.
Los pesos no son lo único que ocupa memoria. Mientras genera, el modelo guarda para cada token del contexto las claves y valores de la atención en cada capa, para no recalcularlos en cada paso. Es la caché KV (por sus siglas en inglés: “Key-Value cache”), y crece con la longitud del contexto:
$$ M_{\text{KV}} = 2 \cdot L \cdot H_{\text{kv}} \cdot d \cdot T \cdot \text{bytes} $$
La lógica de esta segunda fórmula es la siguiente:
- El factor $2$ cuenta las claves y los valores, que se guardan por separado.
- $L$ es el número de capas, $H_{\text{kv}}$ el número de cabezas de clave y valor y $d$ la dimensión de cada cabeza; su producto es lo que se guarda por token y por capa.
- $T$ es el número de tokens del contexto y $\text{bytes}$ la precisión de la caché (dos bytes a $16$ bits). En conclusión, duplicar el contexto duplica la caché, aunque el modelo sea el mismo.
Para el cálculo se usa una arquitectura de juguete declarada: $36$ capas y $8$ cabezas de clave y valor de dimensión $128$, valores del orden de los de un modelo de $4,000$ millones de parámetros con atención agrupada, y un contexto de $4,096$ tokens, de sobra para clasificar una nota con tres ejemplos. El siguiente bloque calcula la memoria de los pesos para cuatro tamaños y tres precisiones, le suma la caché y dibuja un mapa de calor con el límite de la laptop:
# Memoria estimada por tamaño y cuantización, más la caché KV, en Python:
tamanos = [1, 4, 8, 14]          # miles de millones de parámetros
bits = [16, 8, 4]

def memoria_pesos_gb(parametros_mm, bits_por_peso):
    # Parámetros por bits por peso, entre 8 bits por byte, en GB (10^9 bytes):
    return parametros_mm * 1e9 * bits_por_peso / 8 / 1e9

# Caché KV de una arquitectura de juguete declarada (36 capas, 8 cabezas KV de 128):
capas, cabezas_kv, dim_cabeza, contexto, bytes_kv = 36, 8, 128, 4096, 2
kv_gb = 2 * capas * cabezas_kv * dim_cabeza * contexto * bytes_kv / 1e9
memoria = pd.DataFrame({f'{b} bits': [memoria_pesos_gb(p, b) for p in tamanos] for b in bits},
                       index = [f'{p} mil millones' for p in tamanos])
total = memoria + kv_gb
print('Memoria de los pesos (GB):')
print(memoria.round(1))
print(f'\nCaché KV para {contexto} tokens: {kv_gb:.2f} GB')
print(f'Modelo de 4 mil millones a 4 bits con caché: {total.loc["4 mil millones", "4 bits"]:.2f} GB')
print(f'Q4_K_M (unos 4.85 bits por peso de media): {memoria_pesos_gb(4, 4.85):.2f} GB')

# Mapa de calor con el límite de la laptop de Sofía (16 GB, unos 10 GB libres):
fig, ax = plt.subplots(figsize = (7.5, 5))
imagen = ax.imshow(total.values, cmap = 'YlOrRd', aspect = 'auto')
for i in range(len(tamanos)):
    for j in range(len(bits)):
        valor = total.values[i, j]
        marca = ' (X)' if valor > 16 else (' (!)' if valor > 10 else '')
        ax.text(j, i, f'{valor:.1f} GB{marca}', ha = 'center', va = 'center', fontsize = 11,
                color = 'white' if valor > 16 else 'black', weight = 'bold' if valor > 10 else 'normal')
ax.set_xticks(range(len(bits)))
ax.set_xticklabels(total.columns)
ax.set_yticks(range(len(tamanos)))
ax.set_yticklabels(total.index)
ax.set_xlabel('Bits por peso')
ax.set_ylabel('Parámetros')
fig.colorbar(imagen, ax = ax, label = 'GB (pesos + caché KV de 4 096 tokens)')
ax.set_title('Memoria estimada frente a 16 GB de RAM', fontsize = 16)
plt.tight_layout()

# (X) no cabe en 16 GB; (!) cabe, pero deja poco para el sistema y el navegador:
plt.show()
Memoria de los pesos (GB):
                 16 bits  8 bits  4 bits
1 mil millones       2.0     1.0     0.5
4 mil millones       8.0     4.0     2.0
8 mil millones      16.0     8.0     4.0
14 mil millones     28.0    14.0     7.0

Caché KV para 4096 tokens: 0.60 GB
Modelo de 4 mil millones a 4 bits con caché: 2.60 GB
Q4_K_M (unos 4.85 bits por peso de media): 2.42 GB
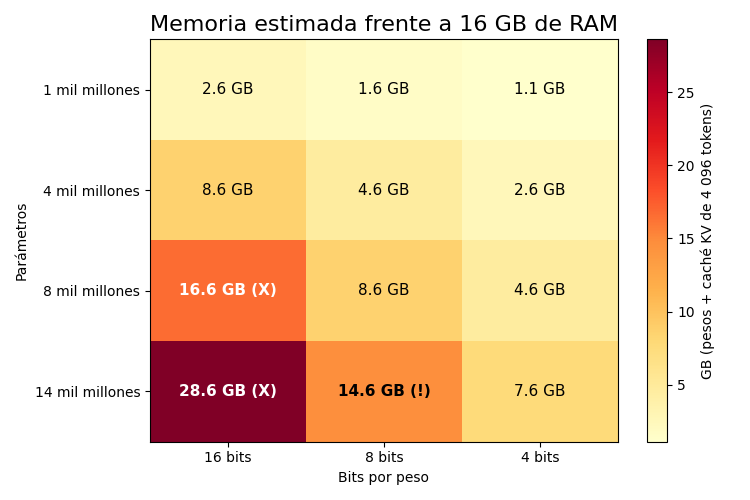
La salida da la Tabla 3 casi hecha. Un modelo de $4,000$ millones de parámetros ocupa $8.0$ GB a $16$ bits, $4.0$ a $8$ bits y $2.0$ GB a $4$ bits. La caché KV de $4,096$ tokens añade $0.60$ GB con la arquitectura de juguete, de modo que el total a $4$ bits es de $2.60$ GB: menos de la sexta parte de la RAM de Sofía.
Tabla 3. Memoria estimada de los pesos por tamaño y cuantización, en GB, sin la caché KV (que añade 0.60 GB con 4 096 tokens).
| Parámetros | 16 bits | 8 bits | 4 bits |
|---|---|---|---|
| 1 000 millones | 2.0 | 1.0 | 0.5 |
| 4 000 millones | 8.0 | 4.0 | 2.0 |
| 8 000 millones | 16.0 | 8.0 | 4.0 |
| 14 000 millones | 28.0 | 14.0 | 7.0 |
La fórmula también explica el tamaño de descarga del Bloque 2. La cuantización Q4_K_M de llama.cpp no usa exactamente $4$ bits por peso: guarda escalas por grupos y deja algunas capas sensibles con más precisión, y en promedio ronda los $4.85$ bits. Con ese valor, la fórmula predice $2.42$ GB, muy cerca de los $2.5$ GB que ocupa qwen3:4b en disco (la diferencia son el vocabulario y los metadatos del archivo GGUF). Una multiplicación basta para saber si un modelo cabe antes de descargarlo.
El mapa de calor lo resume con marcas. Dos combinaciones no caben en $16$ GB (X): $8,000$ millones a $16$ bits ($16.6$ GB con la caché) y $14,000$ millones a $16$ bits ($28.6$ GB). Una cabe sobre el papel pero deja al sistema sin aire (!): $14,000$ millones a $8$ bits, con $14.6$ GB. Todo lo demás cabe, y a $4$ bits cabe incluso un modelo de $14,000$ millones ($7.6$ GB).
Esas cifras son un límite inferior, no una predicción exacta. El servidor reserva memoria adicional para los cálculos intermedios, el sistema operativo no libera toda la RAM que parece libre y, si la laptop tiene GPU integrada, la memoria se reparte entre gráficos y modelo. Una regla prudente es dejar al menos un $30%$ de margen sobre la estimación. Con esa regla, Sofía podría probar modelos de hasta unos $8,000$ millones de parámetros a $4$ bits; el de $4,000$ millones le deja margen para seguir usando el navegador mientras clasifica.
Cuantizar: perder bits sin perder (casi) nada
La Tabla 3 muestra que la cuantización es lo que hace posible un modelo local en una laptop. Pero cuantizar es, literalmente, redondear: cada peso de $16$ bits se sustituye por un número entero pequeño multiplicado por una escala. ¿Cuánta información se pierde al redondear? La respuesta depende menos del número de bits que de cómo se elige la escala.
La forma más sencilla es la cuantización simétrica. Con $b$ bits se pueden representar los enteros de $-(2^{b-1}-1)$ a $2^{b-1}-1$: de $-127$ a $127$ con $8$ bits y de $-7$ a $7$ con $4$ bits. La escala $s$ se elige para que el peso más grande en valor absoluto caiga justo en el extremo, y cada peso se redondea al múltiplo de $s$ más cercano:
$$ \hat{w} = s \cdot \operatorname{round}!\left(\frac{w}{s}\right), \qquad s = \frac{\max |w|}{2^{b-1}-1} $$
La lógica detrás de esta fórmula es múltiple:
- $w/s$ lleva cada peso a la escala de los enteros disponibles, y $\operatorname{round}$ lo redondea al entero más cercano, que es lo único que se guarda (además de $s$).
- Multiplicar por $s$ devuelve el peso a su escala original; $\hat{w}$ es la aproximación que usará el modelo, y el error de cada peso es como mucho $s/2$.
- La escala depende de $\max |w|$. En conclusión, un solo peso muy grande agranda la escala de todos los demás, y con una escala grande los pesos pequeños se redondean a cero.
El último punto es el que importa. Si el máximo se toma sobre todo el tensor (cuantización por tensor), un único valor atípico fija la escala de un millón de pesos. Si se toma sobre grupos de pesos consecutivos (por ejemplo, de $32$ en $32$), cada grupo tiene su propia escala, y un atípico solo perjudica a sus $31$ vecinos. El precio es guardar una escala por grupo: con escalas de $16$ bits y grupos de $32$, se añaden $16/32 = 0.5$ bits por peso.
Valores atípicos
Los valores atípicos no son una rareza teórica. Dettmers y sus colaboradores (2022) mostraron, al presentar LLM.int8(), que los modelos de lenguaje grandes desarrollan unas pocas dimensiones con valores de magnitud muy superior al resto, y que tratar esas dimensiones aparte es lo que permite cuantizar a $8$ bits sin degradar el modelo. Métodos posteriores como GPTQ (Frantar y colaboradores, 2023) llegaron a $3$ y $4$ bits corrigiendo el error de redondeo de cada peso con los pesos que quedan por cuantizar. Las cuantizaciones K de llama.cpp, como Q4_K_M, combinan grupos con escalas propias y algunas capas en mayor precisión.
Para ver el efecto sin descargar ningún modelo, el siguiente bloque crea un millón de pesos de juguete con distribución normal de desviación $0.02$ (del orden de los pesos de una capa real) y sustituye un $0.1%$ de ellos, mil pesos, por valores atípicos de entre $0.3$ y $0.6$ en valor absoluto. Después los cuantiza a $8$ y $4$ bits, por tensor y por grupos de $32$, y mide el error cuadrático medio (ECM), el error máximo, el error relativo y el porcentaje de pesos que se redondean a cero:
# Cuantización simétrica a 8 y 4 bits, por tensor y por grupos de 32, en Python:
n_pesos = 1_000_000
pesos = rng.normal(0, 0.02, n_pesos)
atipicos = rng.choice(n_pesos, size = n_pesos // 1000, replace = False)
pesos[atipicos] = rng.choice([-1, 1], size = len(atipicos)) * rng.uniform(0.3, 0.6, len(atipicos))

def cuantizar(w, b, grupo = None):
    # Escala s = max|w| / (2^(b-1) - 1), por tensor o por cada grupo de pesos consecutivos:
    qmax = 2 ** (b - 1) - 1
    bloques = w.reshape(1, -1) if grupo is None else w.reshape(-1, grupo)
    s = np.abs(bloques).max(axis = 1, keepdims = True) / qmax
    return (s * np.clip(np.round(bloques / s), -qmax, qmax)).reshape(-1)

filas, errores = [], {}
for b in [8, 4]:
    for grupo in [None, 32]:
        nombre = f'{b} bits, ' + ('por tensor' if grupo is None else 'grupos de 32')
        cuantizados = cuantizar(pesos, b, grupo)
        error = cuantizados - pesos
        errores[nombre] = error
        filas.append({'variante': nombre, 'ECM': np.mean(error ** 2), 'error máximo': np.abs(error).max(),
                      'error relativo %': 100 * np.sqrt(np.mean(error ** 2)) / pesos.std(),
                      'pesos a cero %': 100 * np.mean(cuantizados == 0),
                      'bits por peso': b + (0 if grupo is None else 16 / grupo)})
tabla_cuant = pd.DataFrame(filas).set_index('variante')
print(f'Pesos: {n_pesos:,} | atípicos: {len(atipicos)} | max|w| = {np.abs(pesos).max():.3f}')
print(tabla_cuant.to_string(float_format = lambda v: f'{v:.3g}'))

# Histogramas del error (escala logarítmica en el eje vertical):
fig, ejes = plt.subplots(1, 2, figsize = (11, 4.4))
for ax, b in zip(ejes, [8, 4]):
    for nombre, color in [(f'{b} bits, por tensor', '#eb6834'), (f'{b} bits, grupos de 32', '#2a6fdb')]:
        ax.hist(errores[nombre], bins = 120, color = color, alpha = 0.55, label = nombre, log = True)
    ax.set_title(f'Error de cuantización a {b} bits', fontsize = 14)
    ax.set_xlabel('peso cuantizado - peso original')
    ax.set_ylabel('número de pesos (escala log)')
    ax.legend(fontsize = 9)
plt.tight_layout()

# Los grupos estrechan el error; a 4 bits por tensor casi todo se redondea a cero:
plt.show()
Pesos: 1,000,000 | atípicos: 1000 | max|w| = 0.600
                          ECM  error máximo  error relativo %  pesos a cero %  bits por peso
variante
8 bits, por tensor   1.86e-06       0.00236              5.53            9.42              8
8 bits, grupos de 32 4.38e-08       0.00236             0.849            0.94            8.5
4 bits, por tensor   0.000361        0.0429                77            96.7              4
4 bits, grupos de 32 1.19e-05        0.0425                14            15.5            4.5
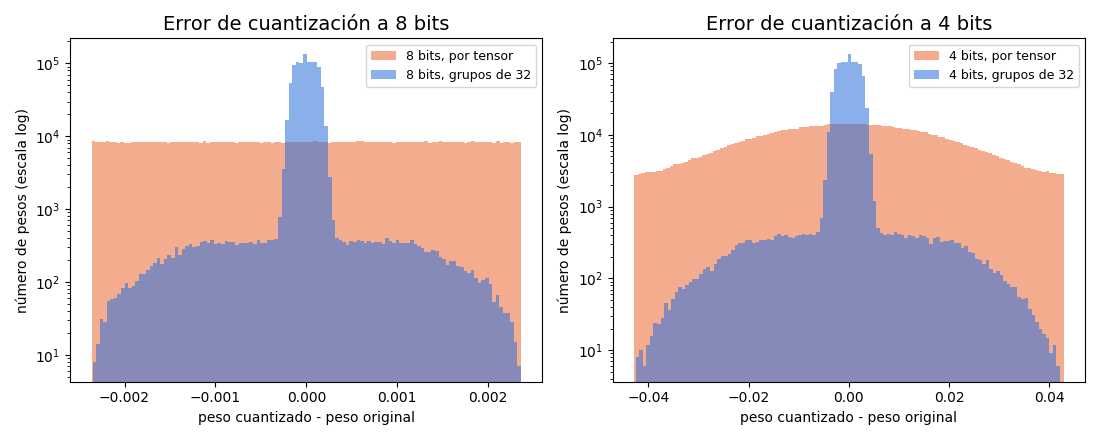
La Tabla 4 recoge la salida. Hay mucho que leer en ella, así que conviene ir fila a fila.
Tabla 4. Error de cuantización sobre un millón de pesos de juguete con un 0.1 % de valores atípicos.
| Variante | ECM | Error relativo | Pesos a cero | Bits por peso |
|---|---|---|---|---|
| 8 bits, por tensor | 1.86e-06 | 5.53 % | 9.42 % | 8 |
| 8 bits, grupos de 32 | 4.38e-08 | 0.849 % | 0.94 % | 8.5 |
| 4 bits, por tensor | 3.61e-04 | 77 % | 96.7 % | 4 |
| 4 bits, grupos de 32 | 1.19e-05 | 14 % | 15.5 % | 4.5 |
- A $8$ bits por tensor, el error relativo es del $5.53%$ y un $9.42%$ de los pesos se vuelve cero. La cifra tiene explicación exacta: la escala es $0.6/127 \approx 0.0047$, de modo que todo peso con $|w| < 0.0024$ se redondea a cero, y con desviación $0.02$ eso le ocurre a algo más del $9%$ de los pesos.
- A $8$ bits por grupos de $32$, el error relativo cae a $0.849%$, más de seis veces menor, a cambio de medio bit por peso. En un grupo sin atípicos, el mayor peso ronda $0.05$ y no $0.6$, de modo que su escala es más de diez veces más fina que la del tensor.
- A $4$ bits por tensor, el resultado es un desastre: la escala es $0.6/7 \approx 0.086$, todo peso con $|w| < 0.043$ se redondea a cero y eso afecta al $96.7%$ de los pesos. El error relativo es del $77%$: el tensor cuantizado conserva los mil atípicos y casi nada más.
- A $4$ bits por grupos de $32$, el error relativo es del $14%$ y solo un $15.5%$ de los pesos pasa a cero. Sigue siendo un error notable, pero el tensor conserva su estructura.
Observe un detalle de la salida que la tabla no muestra: el error máximo es casi el mismo con y sin grupos ($0.00236$ a $8$ bits en ambos casos). No es un error del código. El peor error está en los grupos que contienen un atípico, y dentro de esos grupos la escala es tan gruesa como la del tensor completo. Los grupos no eliminan el daño del atípico: lo confinan a sus $31$ vecinos en lugar de repartirlo entre un millón de pesos. Los histogramas lo muestran con claridad: en naranja, el error por tensor se reparte de forma casi uniforme por todo el intervalo; en azul, el error por grupos se concentra en un pico estrecho alrededor de cero, con unas colas bajas que corresponden a los grupos con atípicos.
La lección es que la escala importa tanto como los bits. Con el mismo número de bits, pasar de una escala por tensor a una por grupo divide el error relativo entre $6.5$ a $8$ bits y entre $5.5$ a $4$ bits, por solo medio bit más por peso. Por eso las cuantizaciones que se usan en la práctica son todas por grupos o por bloques.
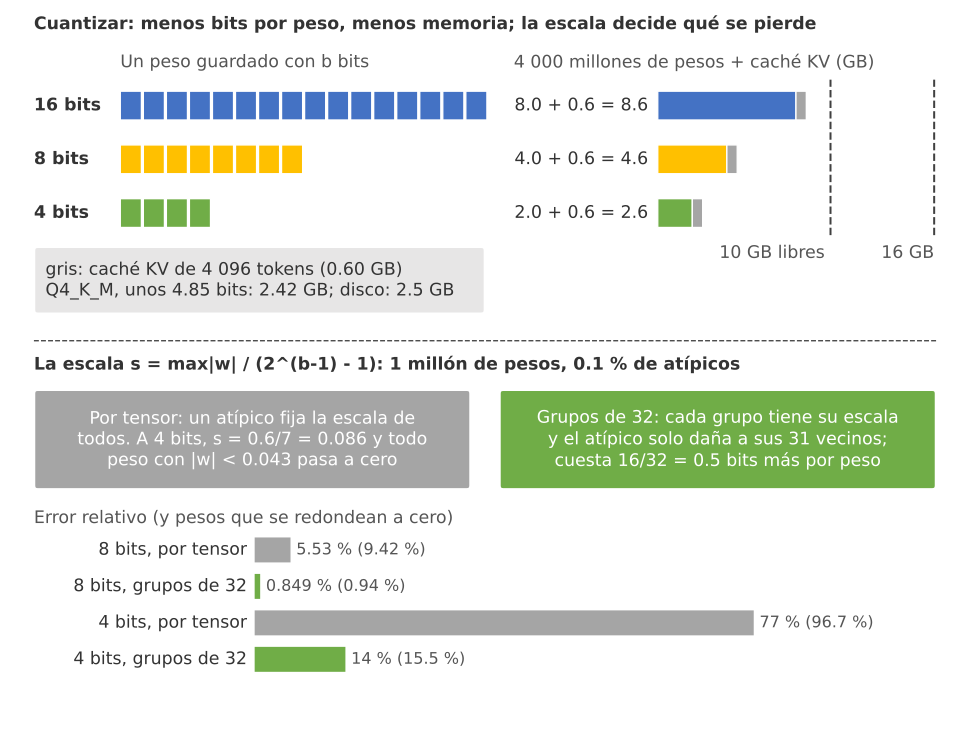
Figura 2. La cuantización como memoria por bits: 4 000 millones de pesos ocupan 8.0 GB a 16 bits, 4.0 a 8 bits y 2.0 a 4 bits, más 0.60 GB de caché KV, frente a los 16 GB de la laptop; con un 0.1 % de atípicos, la escala por grupos de 32 baja el error relativo a 4 bits del 77 % al 14 % por medio bit más por peso.
Este experimento tiene un límite que conviene decir en voz alta: mide el error en los pesos, no en las respuestas del modelo. Un error relativo del $14%$ en una capa puede notarse mucho o casi nada en la exactitud final, según la capa y la tarea. La única forma de saberlo es medir el modelo cuantizado en la tarea real, que es justo lo que hará el banco de pruebas.
Hablar con el servidor local
Con el modelo elegido y la memoria comprobada, falta la conexión con el código del Cuaderno Vivo. Ollama ofrece varias rutas HTTP; la que interesa aquí es POST /api/chat, que recibe una lista de mensajes con sus roles, como la API de Claude, y devuelve la respuesta del asistente. Para que la clasificación sea comparable con la de la API, Sofía reutiliza tres piezas del Día 6: la instrucción de sistema con los cuatro temas, la función prompt_few_shot() con tres ejemplos y el modelo Pydantic Etiqueta, que aquí se reduce al tema y la confianza.
La pieza nueva es el parámetro format. Según la documentación de la API de Ollama (revisada en octubre de 2026), format acepta la cadena "json" o un esquema JSON completo, y el servidor restringe la generación para que la salida cumpla ese esquema. Es el equivalente local de las salidas estructuradas de Claude. El esquema no hay que escribirlo a mano: Pydantic lo genera con Etiqueta.model_json_schema().
Este bloque necesita el servidor local con qwen3:4b descargado; no se ejecutó para escribir la entrada y la salida es un ejemplo comentado:
# Clasificación de una nota con el servidor local y validación con Pydantic en Python:
import time
from typing import Literal
from pydantic import BaseModel, Field, ValidationError

class Etiqueta(BaseModel):
    tema: Literal['estadística', 'python', 'historia del arte', 'música']
    confianza: float = Field(ge = 0, le = 1)

SISTEMA = ('Clasifique la nota de estudio de Sofía en uno de estos temas: '
           'estadística, python, historia del arte, música. '
           'Responda solo con el tema y su confianza, en el formato indicado.')
nota = 'Practicar la guitarra cada día con un metrónomo ayuda a medir el tiempo y a tocar con un ritmo estable.'
inicio = time.perf_counter()
respuesta = requests.post(f'{OLLAMA}/api/chat', timeout = 120, json = {
    'model': 'qwen3:4b',
    'messages': [{'role': 'system', 'content': SISTEMA},
                 {'role': 'user', 'content': prompt_few_shot(3, nota)}],   # el prompt del Día 6
    'stream': False,
    'think': False,                                # sin razonamiento visible: solo la etiqueta
    'format': Etiqueta.model_json_schema(),        # la salida debe cumplir este esquema
    'options': {'temperature': 0, 'num_ctx': 4096},
})
respuesta.raise_for_status()
datos_respuesta = respuesta.json()
segundos = time.perf_counter() - inicio

# El esquema restringe la generación, pero Pydantic comprueba el resultado:
try:
    etiqueta = Etiqueta.model_validate_json(datos_respuesta['message']['content'])
except ValidationError as error:
    raise RuntimeError(f'Salida local no válida: {error}')
velocidad = datos_respuesta['eval_count'] / (datos_respuesta['eval_duration'] / 1e9)
print(etiqueta)
print(f"Tokens: {datos_respuesta['prompt_eval_count']} de entrada, {datos_respuesta['eval_count']} de salida | "
      f'{velocidad:.1f} tokens/s | {segundos:.2f} s')

# Salida de ejemplo (puede variar):
# tema='música' confianza=0.95
# Tokens: 236 de entrada, 18 de salida | 21.7 tokens/s | 2.31 s
Recorra el bloque por sus decisiones:
'stream': Falsepide la respuesta completa en un solo JSON. Por defecto, Ollama la envía en trozos a medida que se genera, lo cual es útil en una interfaz de chat y molesto en un clasificador.'think': Falsedesactiva el razonamiento visible que la familia Qwen3 produce por defecto. Para elegir entre cuatro etiquetas no hace falta, y cada token de razonamiento en una laptop cuesta tiempo real.'format'recibe el esquema deEtiqueta. Aun así, el bloque valida la respuesta con Pydantic: el esquema reduce los errores de formato, pero un programa no debe dar por buena una salida que no ha comprobado, venga de donde venga.'options'fija la temperatura en cero y el contexto en $4,096$ tokens, el mismo de la estimación de memoria. Observe el contraste con la API: los modelos Claude 5 no aceptantemperature, mientras que en un servidor local usted controla el muestreo directamente, con lo que aprendió en el Día 3.- Los campos de tiempo vienen en la propia respuesta.
eval_countes el número de tokens generados yeval_durationel tiempo de generación en nanosegundos; su cociente da los tokens por segundo.prompt_eval_countcuenta los tokens del prompt, que en local no se pagan, pero sí se esperan.
Ahora, la misma nota por la otra ruta. El siguiente bloque usa client.messages.parse con el mismo modelo Etiqueta, el mismo prompt de sistema y los mismos tres ejemplos, y aplica antes redactar() del Día 19, porque esta vez la nota sí cruza la frontera. El control de profundidad es output_config={"effort": "low"}, el que el Día 21 asignó a la clasificación. Este bloque llama a la API y no se ejecutó para escribir la entrada:
# La misma clasificación con Claude Haiku 5.5 y salida estructurada en Python:
import anthropic

cliente = anthropic.Anthropic()          # lee ANTHROPIC_API_KEY del entorno
nota_segura, mapa = redactar(nota)       # guardián del Día 19: lo personal no cruza la frontera
inicio = time.perf_counter()
respuesta = cliente.messages.parse(
    model = 'claude-haiku-5-5',
    max_tokens = 512,
    system = SISTEMA,
    output_config = {'effort': 'low'},
    messages = [{'role': 'user', 'content': prompt_few_shot(3, nota_segura)}],
    output_format = Etiqueta,
)
segundos = time.perf_counter() - inicio

# Motivo de parada antes de leer el contenido:
if respuesta.stop_reason in ('refusal', 'max_tokens'):
    raise RuntimeError(f'Clasificación detenida: {respuesta.stop_reason}')
etiqueta = respuesta.parsed_output
u = respuesta.usage
print(etiqueta)
print(f'Tokens: {u.input_tokens} de entrada, {u.output_tokens} de salida | {segundos:.2f} s | '
      f'coste: {(u.input_tokens * 0.10 + u.output_tokens * 0.50) / 1e6:.6f} USD')

# Salida de ejemplo (puede variar):
# tema='música' confianza=0.97
# Tokens: 498 de entrada, 19 de salida | 0.81 s | coste: 0.000059 USD
Los dos bloques son casi simétricos, y esa simetría es deliberada: una comparación justa empieza por que lo único que cambie sea el motor. Mismo prompt de sistema, mismos ejemplos, mismo esquema de salida, misma nota. Las diferencias que quedan son las que se quieren medir: dónde se ejecuta, cuánto tarda y cuánto cuesta.
Hay, con todo, dos asimetrías que conviene declarar. Los tokens de entrada no coinciden ($236$ frente a $498$ en los ejemplos) porque cada modelo tiene su propio tokenizador y porque la salida estructurada de la API añade al contexto las instrucciones del esquema; por eso no se comparan tokens entre motores, sino tiempo, exactitud y dinero. Y la nota que recibe Claude es la redactada; si la nota tuviera un teléfono, el modelo local vería el teléfono y Claude vería [TELEFONO_1]. Para notas de estudio sin datos personales, como las del banco, ambas versiones son idénticas.
Atención aquí: Local no significa automáticamente privado. Un servidor local puede escribir registros con los prompts, algunas aplicaciones de escritorio envían telemetría y un modelo descargado de una fuente no oficial puede no ser el que dice ser. Antes de confiarle notas personales, compruebe tres cosas: que el servidor escucha solo en localhost (y no en todas las interfaces de la red de su casa), dónde guarda sus registros y que el archivo de pesos procede del repositorio oficial del modelo, con su hash verificado. La licencia y la política de uso aceptable del modelo se aplican igual en su laptop que en un servidor.
Un banco de pruebas justo
Una sola nota no dice nada. Para comparar dos clasificadores hace falta un banco: las $12$ notas del Día 1 (tres de cada tema) más $48$ notas de juguete adicionales escritas con el mismo estilo, $60$ en total, $15$ por tema. Cada nota se clasifica una vez con cada motor, con la configuración de tres ejemplos que el Día 6 eligió por su exactitud.
Los resultados del bloque siguiente son de juguete y están fijados en el código: no proceden de ejecutar Qwen3-4B ni Haiku 5.5, sino que reproducen un escenario plausible para que la entrada se pueda ejecutar sin servidor ni API. En el escenario, $49$ notas las aciertan ambos motores, $6$ solo la API, $2$ solo el modelo local y $3$ ninguno. Las latencias se simulan así: para la API, un tiempo hasta el primer token (o TTFT, por sus siglas en inglés: “Time To First Token”) lognormal con mediana de $0.6$ s, más $20$ tokens de salida a unos $120$ tokens por segundo; para el modelo local, un TTFT con mediana de $1.4$ s (el tiempo de procesar el prompt en la laptop), más $20$ tokens a unos $22$ tokens por segundo, y $6$ segundos extra en la primera llamada, cuando el servidor carga el modelo desde el disco.
Exactitud con intervalo
Con $60$ notas, una diferencia de exactitud de unos pocos puntos puede ser ruido. Por eso el Día 18 insistió en informar cada tasa con un intervalo de Wilson, que funciona bien con muestras pequeñas y proporciones cercanas a $1$:
$$ \frac{\hat{p}+\frac{z^{2}}{2n}\pm z\sqrt{\frac{\hat{p}(1-\hat{p})}{n}+\frac{z^{2}}{4n^{2}}}}{1+\frac{z^{2}}{n}} $$
donde $\hat{p} = k/n$ es la exactitud observada con $k$ aciertos en $n = 60$ notas y $z = 1.96$ para un $95%$ de confianza. La función wilson() del bloque es la misma del Día 18.
Latencia y velocidad
Para la latencia, el Día 23 enseñó a no mirar la media, que una sola llamada lenta desplaza, sino los percentiles: el p50 (la mediana, lo que tarda una clasificación típica) y el p95 (lo que tarda una de cada veinte en el peor caso habitual). El siguiente bloque calcula todo y dibuja dos paneles:
# Banco de 60 notas: aciertos y latencias de juguete de los dos clasificadores en Python:
n_notas = 60
# 49 aciertan ambos, 6 solo la API, 2 solo el modelo local y 3 fallan ambos:
patron = [(1, 1)] * 49 + [(1, 0)] * 6 + [(0, 1)] * 2 + [(0, 0)] * 3
patron = np.array(patron)[rng.permutation(n_notas)]
resultados = pd.DataFrame({'acierto_api': patron[:, 0], 'acierto_local': patron[:, 1]})

# Latencias: tiempo hasta el primer token (TTFT) más 20 tokens de salida:
ttft_api = rng.lognormal(np.log(0.6), 0.35, n_notas)
resultados['latencia_api'] = ttft_api + 20 / rng.normal(120, 15, n_notas)
ttft_local = rng.lognormal(np.log(1.4), 0.2, n_notas)
ttft_local[0] += 6.0                       # primera llamada: el servidor carga el modelo
tokens_por_s = rng.normal(22, 2, n_notas)
resultados['latencia_local'] = ttft_local + 20 / tokens_por_s

def wilson(k, n, z = 1.96):
    p = k / n
    centro = (p + z**2 / (2 * n)) / (1 + z**2 / n)
    margen = z * np.sqrt(p * (1 - p) / n + z**2 / (4 * n**2)) / (1 + z**2 / n)
    return centro - margen, centro + margen

resumen = {}
for motor in ['api', 'local']:
    k = resultados[f'acierto_{motor}'].sum()
    bajo, alto = wilson(k, n_notas)
    p50, p95 = np.percentile(resultados[f'latencia_{motor}'], [50, 95])
    resumen[motor] = {'aciertos': k, 'exactitud': k / n_notas, 'IC bajo': bajo, 'IC alto': alto,
                      'p50 s': p50, 'p95 s': p95}
resumen = pd.DataFrame(resumen).T
print(resumen.round(3))
print(f'Velocidad local de generación: {np.median(tokens_por_s):.1f} tokens/s (mediana)')
print(f'Primera llamada local (carga del modelo): {resultados.loc[0, "latencia_local"]:.2f} s')

# Dos paneles: exactitud con intervalo de Wilson y latencias p50 y p95:
fig, (ax1, ax2) = plt.subplots(1, 2, figsize = (11, 4.4))
colores = ['#2a6fdb', '#2e7d32']
etiquetas = ['Haiku 5.5 (API)', 'qwen3:4b (local)']
for i, motor in enumerate(['api', 'local']):
    fila = resumen.loc[motor]
    ax1.bar(i, fila['exactitud'], color = colores[i], width = 0.5,
            yerr = [[fila['exactitud'] - fila['IC bajo']], [fila['IC alto'] - fila['exactitud']]], capsize = 10)
    ax1.text(i + 0.27, fila['exactitud'], f"{fila['exactitud']:.3f}", va = 'center', fontsize = 11)
    ax2.bar(i - 0.17, fila['p50 s'], width = 0.34, color = colores[i], label = 'p50' if i == 0 else None)
    ax2.bar(i + 0.17, fila['p95 s'], width = 0.34, color = colores[i], alpha = 0.45,
            hatch = '//', label = 'p95' if i == 0 else None)
for ax in (ax1, ax2):
    ax.set_xticks([0, 1])
    ax.set_xticklabels(etiquetas)
ax1.set_ylim(0.6, 1.02)
ax1.set_xlim(-0.5, 1.7)
ax1.set_ylabel('exactitud (60 notas)')
ax1.set_title('Exactitud con intervalo de Wilson', fontsize = 14)
ax2.set_ylabel('segundos por clasificación')
ax2.set_title('Latencia p50 y p95', fontsize = 14)
ax2.legend()
plt.tight_layout()

# Los intervalos se solapan; la latencia local es varias veces la de la API:
plt.show()
       aciertos  exactitud  IC bajo  IC alto  p50 s  p95 s
api        55.0      0.917    0.819    0.964  0.784  1.240
local      51.0      0.850    0.739    0.919  2.289  2.789
Velocidad local de generación: 22.3 tokens/s (mediana)
Primera llamada local (carga del modelo): 8.29 s
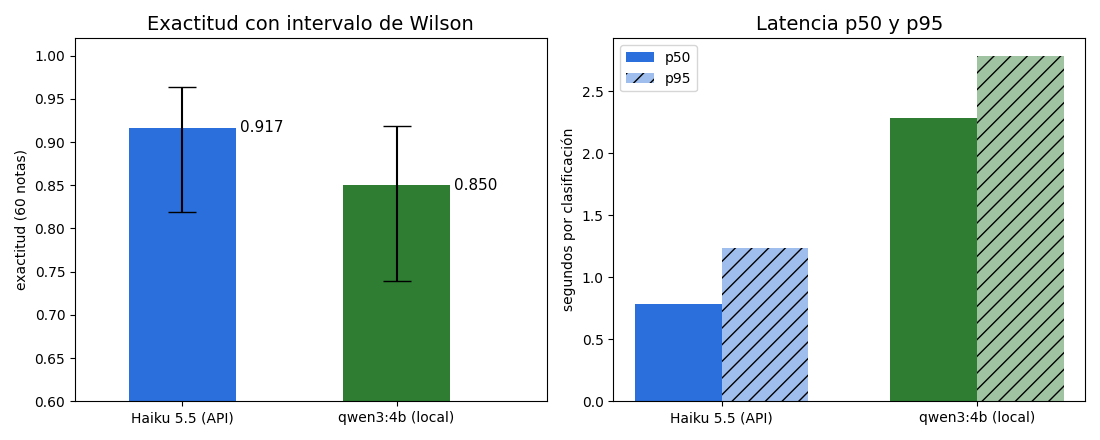
La salida resume el experimento en dos filas:
- Haiku 5.5 (API) acierta $55$ de $60$ notas, una exactitud de $0.917$ con un intervalo de Wilson de $[0.819, 0.964]$. Su latencia típica es de $0.78$ s y su p95 de $1.24$ s.
- qwen3:4b (local) acierta $51$ de $60$, una exactitud de $0.850$ con intervalo $[0.739, 0.919]$. Su latencia típica es de $2.29$ s, unas tres veces la de la API, con un p95 de $2.79$ s y una velocidad de generación de $22.3$ tokens por segundo.
El panel izquierdo muestra lo más importante: los dos intervalos se solapan ampliamente. El intervalo del modelo local llega hasta $0.919$, por encima de la exactitud observada de la API, y el de la API baja hasta $0.819$, por debajo de la del modelo local. Con $60$ notas no se puede afirmar que uno clasifique mejor que el otro; la sección de la decisión hará la prueba formal.
El panel derecho cuenta una historia más clara: la ruta local es más lenta en la llamada típica y en la cola. Y hay un dato que ni el p50 ni el p95 recogen: la primera llamada local tardó $8.29$ s, porque el servidor tuvo que cargar el modelo desde el disco. Una sola llamada de $60$ cae por encima del p95, así que los percentiles no la ven, pero el usuario sí. Ollama descarga el modelo de la memoria tras unos minutos sin uso (el parámetro keep_alive lo controla), de modo que, en un uso esporádico como el de Sofía, esa espera inicial será la experiencia frecuente y no la excepción.
¿Importan dos segundos en una clasificación? Depende de dónde ocurra. La clasificación del Cuaderno Vivo se ejecuta en lote, al importar notas, y nadie espera delante de la pantalla. En el tutor del Día 8, donde Sofía escribe una respuesta y espera la corrección, dos segundos más por turno sí se notarían. La latencia aceptable la fija la tarea, no el modelo.
El punto de equilibrio
El argumento económico a favor de lo local suena irrebatible: en local, cada token cuesta cero. Pero “cero por token” no es “cero”. La laptop consume más electricidad mientras genera, y si el modelo no cabe hay que mejorar el equipo. Para comparar con honestidad hay que poner ambos costes en la misma unidad: USD al mes.
El coste de la API es el del Día 4: tokens por precio. Con el supuesto conservador de $900$ tokens de entrada y $20$ de salida por clasificación (el prompt de tres ejemplos, el esquema y un margen), cada clasificación cuesta $(900 \cdot 0.10 + 20 \cdot 0.50)/10^6 = 0.0001$ USD. El coste eléctrico local es la potencia adicional por el tiempo de cada llamada, convertido a kWh y multiplicado por el precio de la electricidad. Si además hay que invertir $H$ USD en equipo y se quiere amortizar en $m$ meses, el volumen mensual a partir del cual compensa ir a local es:
$$ N^{*} = \frac{H/m}{c_{\text{API}} - c_{\text{local}}} $$
La lógica detrás de esta fórmula es múltiple:
- El numerador $H/m$ es la cuota mensual del equipo: lo que hay que ahorrar cada mes para recuperar la inversión en el plazo deseado.
- El denominador es el ahorro por clasificación: lo que cuesta en la API menos lo que cuesta en electricidad local.
- En conclusión, $N^{}$ es el número de clasificaciones al mes a partir del cual el ahorro paga el equipo. **Por debajo de $N^{}$, la API es más barata; por encima, lo es el modelo local.**
El siguiente bloque usa supuestos explícitos que usted puede cambiar: $30$ W adicionales durante la mediana de latencia local del bloque anterior, un precio de $0.15$ USD por kWh, una mejora de equipo de $60$ USD (por ejemplo, ampliar la RAM) amortizada en $24$ meses y el volumen de clasificaciones del Día 21, $600$ al mes:
# Punto de equilibrio entre la API y la electricidad del modelo local en Python:
tokens_entrada, tokens_salida = 900, 20
precio_entrada, precio_salida = 0.10, 0.50          # Haiku 5.5, USD por millón (Tabla A)
vatios_extra = 30                                    # consumo adicional de la laptop al inferir
segundos_por_llamada = round(resumen.loc['local', 'p50 s'], 1)
precio_kwh = 0.15                                    # USD por kWh: parámetro, cámbielo por el suyo
mejora_equipo = 60.0                                 # USD: por ejemplo, 16 GB más de RAM
meses_amortizacion = 24

coste_api_llamada = (tokens_entrada * precio_entrada + tokens_salida * precio_salida) / 1e6
kwh_llamada = vatios_extra * segundos_por_llamada / 3.6e6
coste_local_llamada = kwh_llamada * precio_kwh
volumen_sofia = 600
print(f'Segundos por llamada local (p50 del Bloque 8): {segundos_por_llamada}')
print(f'API por llamada: {coste_api_llamada:.6f} USD | local por llamada: {coste_local_llamada:.8f} USD')
print(f'Volumen de Sofía ({volumen_sofia}/mes): API {volumen_sofia * coste_api_llamada:.4f} USD | '
      f'local {volumen_sofia * kwh_llamada:.4f} kWh = {volumen_sofia * coste_local_llamada:.5f} USD')
ahorro_mensual = volumen_sofia * (coste_api_llamada - coste_local_llamada)
print(f'Meses para amortizar {mejora_equipo:.0f} USD de equipo: {mejora_equipo / ahorro_mensual:,.0f}')
equilibrio = mejora_equipo / meses_amortizacion / (coste_api_llamada - coste_local_llamada)
print(f'Volumen que amortiza el equipo en {meses_amortizacion} meses: {equilibrio:,.0f} clasificaciones al mes')

# Coste mensual según el volumen, en escala logarítmica:
volumenes = np.logspace(1, 6, 200)
fig, ax = plt.subplots(figsize = (8, 5))
ax.plot(volumenes, volumenes * coste_api_llamada, color = '#2a6fdb', label = 'API (Haiku 5.5)')
ax.plot(volumenes, volumenes * coste_local_llamada, color = '#2e7d32', label = 'Local: solo electricidad')
ax.plot(volumenes, volumenes * coste_local_llamada + mejora_equipo / meses_amortizacion, color = '#2e7d32',
        linestyle = '--', label = f'Local: electricidad + {mejora_equipo:.0f} USD en {meses_amortizacion} meses')
ax.axvline(volumen_sofia, color = '#eb6834', linestyle = ':')
ax.text(volumen_sofia * 1.15, 3e-4, f'Sofía:\n{volumen_sofia}/mes', color = '#eb6834')
ax.axvline(equilibrio, color = '#777777', linestyle = ':')
ax.text(equilibrio * 1.15, 3e-4, f'equilibrio:\n{equilibrio:.0f}/mes', color = '#555555')
ax.set_xscale('log')
ax.set_yscale('log')
ax.set_xlabel('clasificaciones al mes')
ax.set_ylabel('USD al mes')
ax.set_title('Coste mensual: API frente a modelo local', fontsize = 16)
ax.legend(fontsize = 9, loc = 'upper left')
plt.tight_layout()

# Con 600 clasificaciones al mes, la API cuesta menos que amortizar cualquier equipo:
plt.show()
Segundos por llamada local (p50 del Bloque 8): 2.3
API por llamada: 0.000100 USD | local por llamada: 0.00000288 USD
Volumen de Sofía (600/mes): API 0.0600 USD | local 0.0115 kWh = 0.00172 USD
Meses para amortizar 60 USD de equipo: 1,030
Volumen que amortiza el equipo en 24 meses: 25,740 clasificaciones al mes
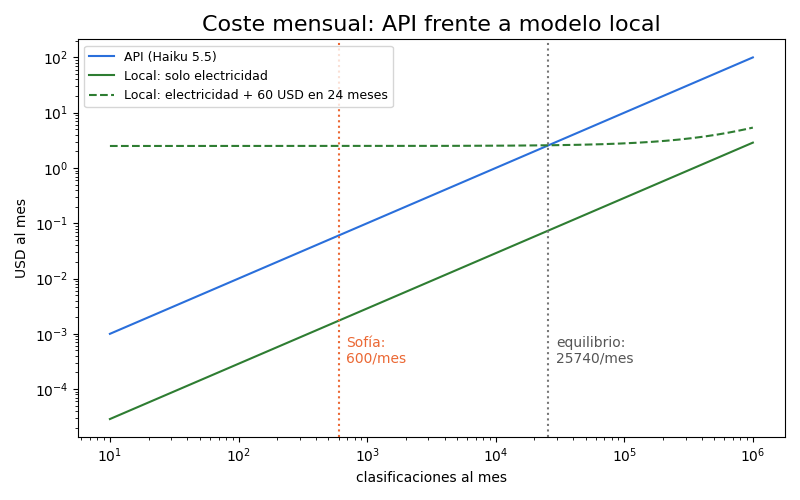
Las cifras hablan solas. Con el volumen de Sofía, la API cuesta $0.06$ USD al mes: seis centavos. La electricidad del modelo local, $0.0115$ kWh, cuesta $0.0017$ USD. El ahorro mensual de ir a local es de unos cinco centavos y medio, de modo que una mejora de equipo de $60$ USD tardaría $1,030$ meses en amortizarse: más de ochenta años. El punto de equilibrio con amortización en dos años está en $25,740$ clasificaciones al mes, unas cuarenta veces el volumen de Sofía. La figura, en escala logarítmica, lo muestra como el cruce entre la línea azul de la API y la línea verde discontinua del modelo local con equipo.
Las cifras de la API cuadran con las de días anteriores. El presupuesto del Día 21 asignaba a la clasificación $0.042$ USD al mes con $400$ tokens de entrada y $60$ de salida; hoy, con un supuesto más generoso, salen $0.06$. Cualquiera de las dos cifras es menos del $1%$ del presupuesto mensual de $10$ USD. La Tabla 5 reúne la comparación completa.
Tabla 5. Comparación final entre la API y el modelo local para clasificar 60 notas (resultados de juguete declarados).
| Criterio | Haiku 5.5 (API) | qwen3:4b (local) |
|---|---|---|
| Exactitud (IC de Wilson al 95 %) | 0.917 [0.819, 0.964] | 0.850 [0.739, 0.919] |
| Latencia p50 / p95 | 0.78 s / 1.24 s | 2.29 s / 2.79 s (primera llamada: 8.29 s) |
| Coste mensual con 600 clasificaciones | 0.060 USD | 0.0017 USD de electricidad (más el equipo, si hace falta) |
| Datos que salen del equipo | El texto redactado de cada nota | Ninguno |
| Mantenimiento | Lo hace el proveedor; puede retirar o cambiar el modelo | Actualizar Ollama y los pesos, verificar hashes, 2.5 GB de disco |
| Funciona sin red | No | Sí |
Leída en conjunto, la tabla desmonta el argumento económico y refuerza el otro. El dinero no justifica la mudanza; la privacidad sí puede. A $600$ clasificaciones al mes, la diferencia de coste es tan pequeña que ni siquiera merece la pena optimizarla, y el modelo local es más lento, algo menos exacto en este banco y exige mantenimiento. Lo que ofrece a cambio son las dos últimas filas: ninguna nota sale del equipo y el clasificador funciona sin red, la preocupación de Diego. Esas dos ventajas no tienen precio por token, y por eso no aparecen en la figura.
La decisión
Queda una pregunta antes de decidir: la diferencia de exactitud ($0.917$ frente a $0.850$), ¿es real o es ruido? Los intervalos de Wilson se solapan, pero comparar intervalos no es la forma correcta de contrastar dos clasificadores evaluados sobre las mismas notas. Las dos columnas de aciertos están emparejadas: la nota 17 es la misma para ambos motores, y si es difícil, lo es para los dos.
La prueba adecuada para datos emparejados de acierto o fallo es la prueba de McNemar. Su idea es que las notas en las que ambos motores aciertan o ambos fallan no dicen nada sobre cuál es mejor; solo informan los desacuerdos. Si $b$ es el número de notas que solo acierta la API y $c$ el número que solo acierta el modelo local, y ambos fueran igual de buenos, cada desacuerdo sería como lanzar una moneda. La versión exacta calcula la probabilidad de un reparto tan desigual o más con la distribución binomial:
$$ p = \min!\left(1,; 2 \sum_{i=0}^{\min(b,c)} \binom{b+c}{i} \left(\frac{1}{2}\right)^{b+c}\right) $$
La lógica detrás de esta fórmula es múltiple:
- Solo cuentan $b$ y $c$; las $49$ notas que aciertan ambos y las $3$ que fallan ambos se descartan, porque no distinguen a los motores.
- Bajo la hipótesis de igualdad, cada uno de los $b + c$ desacuerdos cae del lado de la API con probabilidad $1/2$, como una moneda.
- La suma da la probabilidad de un reparto tan extremo como el observado en una cola, y el factor $2$ la extiende a las dos. En conclusión, un valor $p$ pequeño indica que los desacuerdos están demasiado desequilibrados para ser azar.
En scipy, la prueba exacta de McNemar es una prueba binomial sobre los desacuerdos, stats.binomtest(b, b + c, 0.5). El siguiente bloque construye la tabla de $2 \times 2$, calcula el valor $p$ y explora qué repartos de los mismos desacuerdos habrían sido significativos:
# Prueba exacta de McNemar sobre los desacuerdos de los dos clasificadores en Python:
tabla_2x2 = pd.crosstab(resultados['acierto_api'].map({1: 'API acierta', 0: 'API falla'}),
                        resultados['acierto_local'].map({1: 'local acierta', 0: 'local falla'}))
print(tabla_2x2)
b = int(((resultados['acierto_api'] == 1) & (resultados['acierto_local'] == 0)).sum())
c = int(((resultados['acierto_api'] == 0) & (resultados['acierto_local'] == 1)).sum())
prueba = stats.binomtest(b, b + c, 0.5)
print(f'\nDesacuerdos: b = {b} (solo API), c = {c} (solo local) | valor p exacto = {prueba.pvalue:.4f}')

# ¿Qué reparto de los mismos 8 desacuerdos habría sido significativo?:
for solo_api in range(4, 9):
    p = stats.binomtest(solo_api, b + c, 0.5).pvalue
    print(f'  {solo_api} frente a {b + c - solo_api}: p = {p:.4f}' + ('  <- significativo al 5 %' if p < 0.05 else ''))
acierto_local  local acierta  local falla
acierto_api
API acierta               49            6
API falla                  2            3

Desacuerdos: b = 6 (solo API), c = 2 (solo local) | valor p exacto = 0.2891
  4 frente a 4: p = 1.0000
  5 frente a 3: p = 0.7266
  6 frente a 2: p = 0.2891
  7 frente a 1: p = 0.0703
  8 frente a 0: p = 0.0078  <- significativo al 5 %
La tabla de $2 \times 2$ reproduce el escenario: $49$ aciertos compartidos, $6$ de la API sola, $2$ del modelo local solo y $3$ fallos compartidos. Con $b = 6$ y $c = 2$, el valor $p$ exacto es $0.2891$: si los dos motores fueran igual de buenos, un reparto tan desigual de $8$ desacuerdos aparecería casi tres veces de cada diez. La diferencia no es significativa.
La exploración del final enseña algo más útil que el propio valor $p$: con solo $8$ desacuerdos, ni siquiera un reparto de $7$ frente a $1$ sería significativo ($p = 0.0703$); haría falta $8$ frente a $0$ ($p = 0.0078$). Dicho de otro modo, este banco es demasiado pequeño para detectar diferencias moderadas. No demuestra que los motores sean iguales; demuestra que $60$ notas no bastan para distinguirlos. Si la migración completa se plantea en serio en el sexto mes, el banco tendrá que crecer, y el Día 29 retomará esta prueba para vigilar si un cambio de modelo empeora la clasificación.
Con estas cifras, la decisión se puede escribir. El Día 21 introdujo los registros de decisión de arquitectura (o ADR, por sus siglas en inglés: “Architecture Decision Records”), con las cuatro secciones de Nygard: contexto, decisión, alternativas y consecuencias. El ADR-004 reutiliza la misma función adr_a_markdown() y añade la regla de enrutamiento que lo pone en práctica, elegir_motor(nota), apoyada en una versión abreviada del detector de datos personales del Día 19:
# ADR-004 con la plantilla del Día 21 y la regla de enrutamiento elegir_motor() en Python:
ADR_004 = {
    'id': 'ADR-004', 'titulo': 'Notas con datos personales al modelo local; el resto, a Haiku 5.5',
    'estado': 'aceptada', 'fecha': '2026-01-26',
    'contexto': ('Con 60 notas, Haiku 5.5 acierta 55 y qwen3:4b en local 51; la diferencia no es '
                 'significativa (McNemar exacto, p = 0.29). La API cuesta unos 0.06 USD al mes y responde '
                 'varias veces más rápido; el modelo local no envía nada fuera de la laptop.'),
    'decision': ('Las notas en las que detectar() encuentra datos personales se clasifican con qwen3:4b en '
                 'local y nunca salen del equipo. Las demás siguen en Haiku 5.5. Si el servidor local no '
                 'responde, esas notas esperan: no se envían a la nube.'),
    'alternativas': ['Migrar toda la clasificación al modelo local',
                     'Seguir solo con Haiku 5.5 y confiar en redactar()'],
    'consecuencias': ['La migración completa sigue en la hoja de ruta, ahora con datos',
                      'La exactitud local se vigila con el banco de 60 notas (Día 29)',
                      'Ollama y los pesos se actualizan a mano y con hash verificado']}

def adr_a_markdown(adr, ancho = 88):
    # Convierte un ADR en Markdown con las cuatro secciones de Nygard:
    lineas = [f"# {adr['id']}. {adr['titulo']}", f"Estado: {adr['estado']} | Fecha: {adr['fecha']}", '',
              '## Contexto', textwrap.fill(adr['contexto'], ancho), '',
              '## Decisión', textwrap.fill(adr['decision'], ancho), '', '## Alternativas consideradas']
    lineas += [f'- {alternativa}' for alternativa in adr['alternativas']]
    lineas += ['', '## Consecuencias'] + [f'- {consecuencia}' for consecuencia in adr['consecuencias']]
    return '\n'.join(lineas)

# Dos patrones del filtro de datos personales del Día 19 (versión abreviada):
PATRONES = {
    'correo': re.compile(r'\b[\w.+-]+@[\w-]+(?:\.[\w-]+)+\b'),
    'telefono': re.compile(r'(?<!\d)\d{2}[ -]?\d{4}[ -]?\d{4}(?!\d)'),
}

def detectar(texto):
    return [tipo for tipo, patron in PATRONES.items() if patron.search(texto)]

def elegir_motor(nota, local_disponible = True):
    # Regla del ADR-004: lo personal nunca cruza la frontera, ni siquiera como respaldo:
    if detectar(nota):
        return 'local: qwen3:4b' if local_disponible else 'en espera (no sale a la nube)'
    return 'nube: claude-haiku-5-5'

print(adr_a_markdown(ADR_004))
print()
casos = [('La media resume un conjunto de datos en un solo número.', True),
         ('Escribir a la profesora Ruiz (ruiz.estadistica@ejemplo.edu) sobre el intervalo.', True),
         ('Clase de guitarra con Tomás: llamarle al 55 1234 5678 para cambiar la hora.', True),
         ('Clase de guitarra con Tomás: llamarle al 55 1234 5678 para cambiar la hora.', False)]
for nota, disponible in casos:
    print(f'{elegir_motor(nota, disponible):<30} | local: {"sí" if disponible else "no"} | {nota[:40]}...')
# ADR-004. Notas con datos personales al modelo local; el resto, a Haiku 5.5
Estado: aceptada | Fecha: 2026-01-26

## Contexto
Con 60 notas, Haiku 5.5 acierta 55 y qwen3:4b en local 51; la diferencia no es
significativa (McNemar exacto, p = 0.29). La API cuesta unos 0.06 USD al mes y responde
varias veces más rápido; el modelo local no envía nada fuera de la laptop.

## Decisión
Las notas en las que detectar() encuentra datos personales se clasifican con qwen3:4b en
local y nunca salen del equipo. Las demás siguen en Haiku 5.5. Si el servidor local no
responde, esas notas esperan: no se envían a la nube.

## Alternativas consideradas
- Migrar toda la clasificación al modelo local
- Seguir solo con Haiku 5.5 y confiar en redactar()

## Consecuencias
- La migración completa sigue en la hoja de ruta, ahora con datos
- La exactitud local se vigila con el banco de 60 notas (Día 29)
- Ollama y los pesos se actualizan a mano y con hash verificado

nube: claude-haiku-5-5         | local: sí | La media resume un conjunto de datos en ...
local: qwen3:4b                | local: sí | Escribir a la profesora Ruiz (ruiz.estad...
local: qwen3:4b                | local: sí | Clase de guitarra con Tomás: llamarle al...
en espera (no sale a la nube)  | local: no | Clase de guitarra con Tomás: llamarle al...
El ADR-004 no migra la clasificación; la parte en dos. Las notas en las que detectar() encuentra datos personales, como el correo de una profesora o el teléfono de un profesor de guitarra, se clasifican con el modelo local y nunca cruzan la frontera, ni siquiera redactadas. Las demás, que son la gran mayoría, siguen en Haiku 5.5, que es más rápido y, en este banco, igual o algo más exacto. Los cuatro casos del final lo muestran: una nota de estadística va a la nube; la del correo y la del teléfono, a local.
El cuarto caso es el más importante del día. Cuando el servidor local no responde, la nota con teléfono no se envía a la nube como respaldo: queda en espera. Es una decisión de diseño deliberada, y la respuesta directa a Diego. Un respaldo automático hacia la API sería cómodo, pero convertiría la garantía “lo personal no sale de la laptop” en “lo personal no sale de la laptop, salvo cuando falla algo”, que es otra garantía mucho más débil. Una regla de privacidad que tiene excepciones automáticas no es una regla.
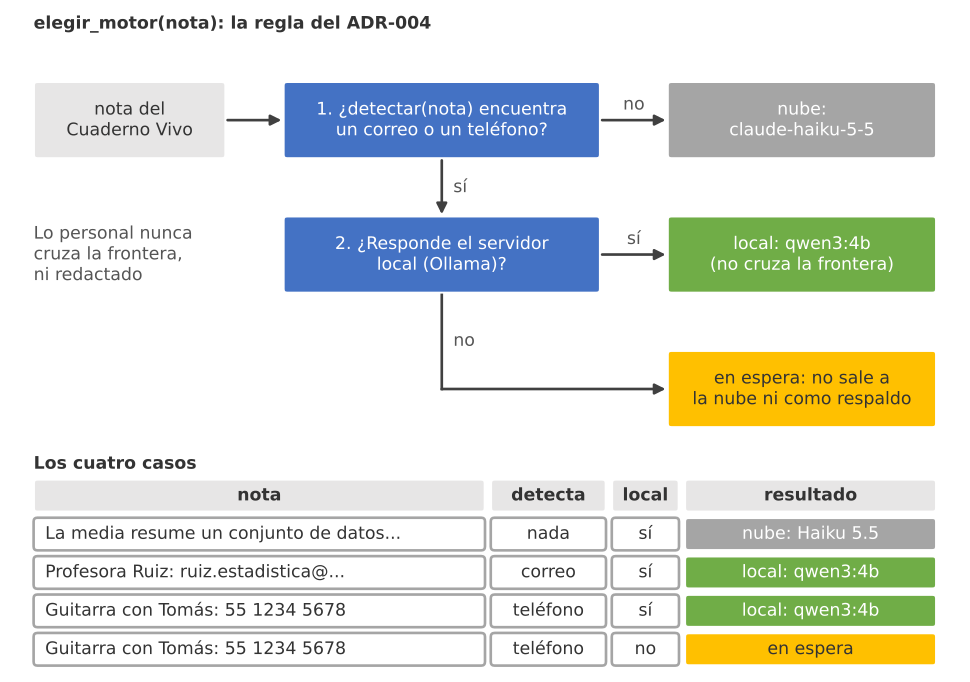
Figura 3. La regla elegir_motor(nota) del ADR-004 y sus cuatro casos: sin datos personales, a Haiku 5.5; con correo o teléfono, a qwen3:4b en local; y si el servidor local no responde, la nota queda en espera en lugar de salir a la nube.
La tarea de la hoja de ruta del Día 24 sigue en su sitio, pero con otra redacción. Su criterio de éxito era “exactitud igual o mejor con cero llamadas a la API”; el experimento dice que, con este modelo y este banco, la exactitud local es algo menor y la diferencia no es significativa. La tarea pasa a ser: ampliar el banco, repetir la comparación con uno o dos modelos más y decidir entonces si la ruta local se extiende al resto de notas. Ahora tiene datos, y no solo una intuición.
Consideraciones finales
Sofía termina el día sin haber migrado nada, y eso es exactamente lo que buscaba. Tiene un modelo abierto de licencia Apache 2.0 que cabe en su laptop con $2.6$ GB, un banco de $60$ notas, dos tablas de comparación y una regla de enrutamiento que mueve a local justo las notas que más lo necesitan. Medir antes de mudarse no consiste en desconfiar de los modelos locales, sino en saber qué se gana y qué se pierde antes de reescribir un sistema que funciona.
Las cifras de hoy tienen límites claros. Los aciertos y las latencias del banco son de juguete: están fijados en el código para que la entrada se ejecute sin servidor ni API, y un modelo real puede dar otras. El error de cuantización se midió sobre pesos sintéticos, no sobre un modelo. El consumo de $30$ W y el precio de $0.15$ USD por kWh son supuestos que usted debe sustituir por los de su equipo y su recibo de luz. Y la arquitectura de la caché KV es una aproximación declarada. Lo que se sostiene sin datos de juguete es el método: estimar la memoria con una multiplicación, medir con el mismo prompt y las mismas notas, informar intervalos, usar una prueba emparejada y poner todos los costes en la misma unidad.
Un modelo local tampoco es gratis aunque no cobre por token. Ocupa disco y memoria, hay que actualizar el servidor y los pesos, comprobar sus hashes, releer su licencia cuando cambia de versión y vigilar su exactitud, porque un modelo pequeño puede alucinar más que uno grande y los guardianes del módulo 5/6 deben seguir activos en ambas rutas. El proveedor de una API hace parte de ese trabajo por usted; en local, el trabajo es suyo.
Antes de llevar una tarea de su propio proyecto a un modelo local, hágase estas preguntas:
- ¿Cabe el modelo en su equipo con al menos un $30%$ de margen, según la fórmula de la memoria y la caché KV?
- ¿Ha leído la licencia del modelo concreto que va a descargar, y no la de su familia?
- ¿Ha comparado ambos motores con las mismas entradas, el mismo prompt y una prueba emparejada como la de McNemar?
- ¿Su volumen mensual está por encima o por debajo del punto de equilibrio?
- Si la razón es la privacidad, ¿qué ocurre cuando el servidor local no responde?
Un gran libro que habla de esto es AI Engineering: Building Applications with Foundation Models (o Ingeniería de IA: construir aplicaciones con modelos fundacionales), en el que Chip Huyen dedica capítulos enteros a elegir entre modelos abiertos y modelos de API, a la evaluación con conjuntos propios y a la optimización de la inferencia, incluida la cuantización. Su tesis encaja con la de hoy: la elección de modelo no es una cuestión de preferencia, sino de evaluación sobre su propia tarea con sus propias restricciones de coste, latencia y privacidad.
El mejor argumento para ejecutar un modelo en local casi nunca es el precio por token, sino la frontera que sus datos no cruzan. Diego lo resume a su manera al despedirse: “O sea que no te ahorra dinero, pero mis casetes no tendrían que salir de casa.” Sofía asiente: es exactamente la pregunta que harán sus clips del Día 27, y la que harán todos los datos de su abuela.
Conclusiones clave
Modelos locales
- Ejecutar un modelo en local requiere tres piezas: los pesos con su tokenizador y plantilla (en un archivo GGUF), un motor como llama.cpp y un servidor como Ollama, que atiende en
http://localhost:11434. - La licencia del motor no es la del modelo, y la licencia sigue al modelo concreto: Qwen3-4B y Mistral 7B usan Apache 2.0, Llama 3.2 y Gemma 3 licencias propias con condiciones, y Gemma 4 pasó a Apache 2.0 (revisado en octubre de 2026).
- La memoria se estima con $P \cdot b / 8$ más la caché KV: un modelo de $4,000$ millones ocupa $8$ GB a $16$ bits y $2.6$ GB a $4$ bits con $4,096$ tokens de contexto, y la fórmula predice los $2.5$ GB de descarga de
qwen3:4b.
Cuantización
- La cuantización simétrica guarda enteros y una escala $s = \max|w|/(2^{b-1}-1)$; el error por peso es como mucho $s/2$.
- Un $0.1%$ de valores atípicos arruina la escala por tensor: a $4$ bits, el $96.7%$ de los pesos de juguete se redondea a cero y el error relativo llega al $77%$.
- Los grupos de $32$ confinan el daño del atípico a sus vecinos por medio bit más por peso: a $4$ bits el error relativo baja al $14%$, y a $8$ bits, del $5.53%$ al $0.849%$.
Comparación y decisión
- Una comparación justa cambia solo el motor: mismas notas, mismo prompt, mismo esquema de salida y métricas con su incertidumbre.
- En el banco de juguete de $60$ notas, Haiku 5.5 acierta $0.917$ $[0.819, 0.964]$ y qwen3:4b $0.850$ $[0.739, 0.919]$; McNemar exacto da $p = 0.29$ y ni siquiera $7$ frente a $1$ desacuerdos sería significativo.
- La ruta local es unas tres veces más lenta en la mediana ($2.29$ s frente a $0.78$ s) y la primera llamada, con la carga del modelo, tarda $8.29$ s.
- Con $600$ clasificaciones al mes, la API cuesta $0.06$ USD; el equilibrio con $60$ USD de equipo en $24$ meses está en $25,740$ al mes, así que el dinero no justifica la mudanza y la privacidad sí puede.
- El ADR-004 manda a local solo las notas con datos personales y, si el servidor local no responde, las deja en espera en lugar de enviarlas a la nube.
Mañana, en el Día 27: Del fotograma al movimiento: animar las portadas del Cuaderno Vivo. La tercera pregunta de la semana es si el movimiento cabe en $10$ USD al mes; mañana Sofía convertirá sus portadas en clips animados, primero con técnicas procedurales que corren en cualquier laptop y después con los modelos de vídeo generativo, con su coste, su licencia y su etiqueta de contenido generado.
Referencias
- Dettmers, T., Lewis, M., Belkada, Y. y Zettlemoyer, L. (2022). LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale. Advances in Neural Information Processing Systems 35 (NeurIPS 2022). https://arxiv.org/abs/2208.07339
- Frantar, E., Ashkboos, S., Hoefler, T. y Alistarh, D. (2023). GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers. The Eleventh International Conference on Learning Representations (ICLR 2023). https://arxiv.org/abs/2210.17323
- Qwen Team (2025). Qwen3 Technical Report. arXiv:2505.09388. https://arxiv.org/abs/2505.09388
- Gerganov, G. y colaboradores (2023-2026). llama.cpp: inferencia de modelos de lenguaje en C/C++ (licencia MIT). https://github.com/ggml-org/llama.cpp
- Ollama (2026). Ollama (licencia MIT) y documentación de su API. https://github.com/ollama/ollama y https://docs.ollama.com/api/chat
- McNemar, Q. (1947). Note on the sampling error of the difference between correlated proportions or percentages. Psychometrika, 12(2), 153-157.
- Wilson, E. B. (1927). Probable inference, the law of succession, and statistical inference. Journal of the American Statistical Association, 22(158), 209-212.
- Huyen, C. (2025). AI Engineering: Building Applications with Foundation Models. O’Reilly Media.
- Meta (2024). Llama 3.2 Community License Agreement. https://www.llama.com/llama3_2/license/ ; Google (2026). Gemma Terms of Use y licencia de Gemma 4. https://ai.google.dev/gemma/terms