
IA generativa en proyectos personales: Día 27
 Jeshua Romero Guadarrama
- 56 Min para leer
- 27 Jan, 2026
Índice de contenido
Resumen:
Un vídeo es una pila de imágenes que deben parecerse entre sí, y esa exigencia de coherencia temporal es lo que hace que generarlo sea mucho más difícil y caro que generar una sola imagen. En esta entrada, Sofía anima las portadas del Cuaderno Vivo primero sin ningún modelo (efecto Ken Burns, paralaje por capas y fundidos con PIL y numpy), mide la estabilidad de cada animación con la diferencia entre fotogramas y un índice de parpadeo, y después estudia los modelos abiertos de imagen a vídeo, Wan2.2 TI2V-5B y Stable Video Diffusion, con su licencia, su memoria y su coste por clip. Al terminar, usted sabrá producir un clip animado y etiquetado con coste cero, medir si parpadea y decidir con números cuándo merece la pena pagar una GPU.
¿Cómo citar el presente artículo?
Romero, J. (27 de enero de 2026). IA generativa en proyectos personales: Día 27. python-data-engineer. https://www.python-data-engineer.com/post/iag/dia_27/.
IA generativa en proyectos personales: Día 27 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/iag/dia_27/.
Modelos, licencias y herramientas revisados en octubre de 2026. La ficha de Wan2.2 TI2V-5B en Hugging Face declara la licencia Apache 2.0, una resolución de 720p a 24 fotogramas por segundo y una GPU de al menos 24 GB para su guion de inferencia; la de Stable Video Diffusion declara la licencia comunitaria de Stability AI. Ambas cambian con cada versión: vuelva a leerlas antes de descargar un modelo o de publicar un clip.
Día 27. Del fotograma al movimiento: animar las portadas del Cuaderno Vivo
Introducción
Ayer, en el Día 26 (Modelos abiertos en local frente a la API: medir antes de mudarse), aprendió a estimar la memoria de un modelo según su cuantización y a comparar de forma justa un modelo local con la API, y el Cuaderno Vivo ganó el ADR-004, que manda a local solo las notas con datos personales. Hoy llega la tercera pregunta de la semana de “vida del producto”: ¿cabe el movimiento en $10$ USD al mes?
Sofía publica cada semana un episodio corto en audio con el resumen de sus notas, narrado con su propia voz (Día 16), y cada episodio ya tiene su portada cuadrada, generada con la guía de estilo del Día 12. Las plataformas de pódcast y las redes donde lo comparte, sin embargo, premian el movimiento: una imagen fija pasa desapercibida entre clips que se mueven. Sofía quiere un clip de $4$ segundos que acompañe a cada episodio, hecho a partir de su portada, con la misma paleta, la misma tipografía y la misma etiqueta “Generado con IA”.
Diego, que desde el Día 24 está digitalizando los casetes de su abuela con permiso y se ha convertido en el primer usuario externo del cuaderno, hace la pregunta de siempre con una cifra en la cabeza: “Si una imagen ya pedía una GPU, ¿cuánto pide un vídeo?” Recuerda que el Día 11 FLUX.1 schnell necesitaba una tarjeta con mucha memoria para una sola imagen de $1,024 \times 1,024$, y un vídeo de $4$ segundos son decenas de imágenes. La intuición de Diego es correcta, pero incompleta: no todo movimiento necesita un modelo generativo.
En la presente entrada, descubrirá cómo se representa un vídeo como datos (un tensor de fotogramas) y cuánto ocupa sin comprimir, por qué generar cada fotograma por separado produce parpadeo y cómo medirlo con dos métricas sencillas. Verá cómo animar una portada sin ningún modelo, con tres técnicas clásicas del cine y la animación (el efecto Ken Burns, el paralaje por capas y el fundido), todas con PIL y numpy, y cómo guardar el resultado como GIF con su comentario de procedencia. Después conocerá dos modelos abiertos de imagen a vídeo, Wan2.2 TI2V-5B y Stable Video Diffusion, con su licencia, su memoria y su coste real por clip, y verá por qué Sofía decide que el movimiento semanal no necesita un modelo. Terminará comprobando que la etiqueta “Generado con IA” sobrevive al movimiento, algo que no ocurre por sí solo.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Entender el vídeo como una secuencia de imágenes con coherencia temporal, y por qué generarlo es más difícil y más caro que generar una imagen.
- Animar una portada sin modelo generativo (paneo y zoom tipo Ken Burns, paralaje por capas, fundidos) con PIL y numpy.
- Medir la estabilidad de una animación con métricas sencillas de diferencia entre fotogramas y parpadeo.
- Conocer modelos abiertos de imagen a vídeo y su coste real en GPU, y decidir con el presupuesto de $10$ USD.
- Etiquetar y documentar la procedencia de un vídeo sintético.
El vídeo como datos
Desde el Día 9 usted trata una imagen en color como un arreglo de tres dimensiones: alto, ancho y tres canales (rojo, verde y azul), cada uno con un valor entero de $0$ a $255$ que ocupa un byte. Un vídeo añade una cuarta dimensión, el tiempo. Si el clip tiene $T$ fotogramas de $H \times W$ píxeles, el vídeo completo es un tensor de forma $T \times H \times W \times 3$. No hay nada más en él: el movimiento que percibe el ojo es la ilusión que producen imágenes fijas mostradas una tras otra a una tasa constante.
Esa tasa se mide en fotogramas por segundo (o fps, por sus siglas en inglés: “frames per second”). El cine tradicional usa $24$ fps; la animación limitada de televisión y muchos GIF se conforman con $12$, la mitad, y repiten cada dibujo dos veces cuando hace falta. El número de fotogramas de un clip es la duración por la tasa, y su tamaño sin comprimir sale de multiplicar todas las dimensiones del tensor:
$$ \text{bytes} = T \cdot H \cdot W \cdot 3, \qquad T = \text{duración} \cdot \text{fps} $$
La lógica detrás de esta fórmula es múltiple:
- Cada píxel de cada fotograma guarda tres bytes, uno por canal, igual que en una imagen fija; el vídeo no comprime nada por el hecho de ser vídeo.
- El tamaño crece de forma lineal con la duración y con la tasa, pero de forma cuadrática con el lado de la imagen: duplicar el ancho y el alto multiplica por cuatro el tamaño.
- Un modelo generativo de vídeo tiene que producir, de una vez o por trozos, todos esos números; por eso la memoria que necesita crece con $T$ igual que crece con el tamaño de lote en un modelo de imagen.
- En conclusión, antes de pensar en modelos conviene saber de qué tamaño es el objeto que se quiere fabricar.
Comencemos por preparar el entorno con las importaciones base y la semilla global de la serie, $2026$. Hoy se usa scipy.ndimage para suavizar ruido, PIL para dibujar y guardar los GIF, y ninguna biblioteca de vídeo: ni ffmpeg, ni moviepy, ni opencv son necesarios para lo que se ejecuta en esta entrada:
# Importaciones base y semilla del día en Python:
import warnings
warnings.filterwarnings('ignore')
import json
import sys
import tempfile
from pathlib import Path
import numpy as np
import pandas as pd
import scipy
from scipy import ndimage
import matplotlib
import matplotlib.pyplot as plt
from matplotlib.patches import Rectangle
import PIL
from PIL import Image, ImageDraw, ImageFont

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 120)
print('Python', sys.version.split()[0], '| numpy', np.__version__, '| scipy', scipy.__version__,
      '| matplotlib', matplotlib.__version__, '| Pillow', PIL.__version__)
Python 3.12.10 | numpy 2.4.6 | scipy 1.17.1 | matplotlib 3.10.9 | Pillow 12.2.0
La salida confirma las versiones con las que se calcularon todas las cifras y figuras de esta entrada. Pillow es la pieza central del día: además de dibujar, sabe escribir un GIF animado con todos sus fotogramas, su duración y un comentario de texto, sin ninguna dependencia adicional.
La portada de juguete en tres capas
Las portadas reales del Cuaderno Vivo son acuarelas generadas con FLUX.1 schnell, y para animarlas basta con la imagen final. Pero algunas técnicas de hoy, como el paralaje, necesitan la portada separada en capas: un fondo lejano, una figura cercana y el texto. Por eso el siguiente bloque construye una portada de juguete de $512 \times 512$ píxeles en tres capas, con la paleta de estilo.json del Día 12. El fondo es un degradado de azul noche a azul acero con unas vetas suaves, y es $64$ píxeles más ancho que la portada para que haya fondo de sobra al desplazarlo. La figura es un sol mostaza con círculos coral y cuatro líneas crema que recuerdan un pentagrama (la semana 4 está dedicada a la música). La capa de texto contiene la banda del título al $75%$ de opacidad y la etiqueta “Generado con IA”, exactamente con la geometría del Día 12:
# Portada de juguete en tres capas con la paleta de estilo.json (Día 12) en Python:
from matplotlib import font_manager

# Solo los campos de la guía que se usan hoy (el archivo completo es el del Día 12):
estilo = {'paleta': {'azul_noche': '#1B3A4B', 'azul_acero': '#3F7CAC', 'mostaza': '#F2C14E',
                     'coral': '#F78154', 'crema': '#F4F1DE'},
          'etiqueta': 'Generado con IA', 'semilla_base': 2026}
temas = {3: 'Historia del arte', 4: 'Música'}

def rgb(nombre):
    # '#1B3A4B' -> (27, 58, 75):
    h = estilo['paleta'][nombre].lstrip('#')
    return tuple(int(h[i:i + 2], 16) for i in (0, 2, 4))

def fuente(puntos, negrita = True):
    # DejaVu Sans viene con matplotlib, así el bloque funciona en cualquier sistema:
    prop = font_manager.FontProperties(family = 'DejaVu Sans', weight = 'bold' if negrita else 'normal')
    return ImageFont.truetype(font_manager.findfont(prop), puntos)

def capas_portada(semana, tam = 512, margen = 64):
    # Semilla derivada de la semana, como en la Etapa 2 del Día 12:
    g = np.random.default_rng(estilo['semilla_base'] + semana)
    # Capa 1, fondo: degradado vertical con vetas suaves, más ancho que la portada:
    y = np.linspace(0, 1, tam)[:, None, None]
    x = np.linspace(0, 1, tam + margen)[None, :, None]
    degradado = (1 - y) * np.array(rgb('azul_noche')) + y * np.array(rgb('azul_acero'))
    vetas = 9 * np.sin(2 * np.pi * (2.5 * x + 1.5 * y) + g.uniform(0, 2 * np.pi))
    fondo = Image.fromarray(np.clip(degradado + vetas, 0, 255).astype(np.uint8))
    # Capa 2, figura: un sol mostaza y círculos coral en los dos tercios inferiores:
    figura = Image.new('RGBA', (tam, tam), (0, 0, 0, 0))
    d = ImageDraw.Draw(figura)
    centro = (g.uniform(0.35, 0.65) * tam, g.uniform(0.58, 0.68) * tam)
    r = 0.15 * tam
    d.ellipse((centro[0] - r, centro[1] - r, centro[0] + r, centro[1] + r), fill = rgb('mostaza') + (255,))
    for _ in range(6):
        cx, cy, rc = g.uniform(0.1, 0.9) * tam, g.uniform(0.45, 0.88) * tam, g.uniform(0.02, 0.06) * tam
        d.ellipse((cx - rc, cy - rc, cx + rc, cy + rc), fill = rgb('coral') + (230,))
    for k in range(4):
        yk = (0.8 + 0.025 * k) * tam
        d.line((0.15 * tam, yk, 0.85 * tam, yk), fill = rgb('crema') + (160,), width = 2)
    # Capa 3, texto: banda al 75 %, título y etiqueta visible "Generado con IA":
    texto = Image.new('RGBA', (tam, tam), (0, 0, 0, 0))
    d = ImageDraw.Draw(texto)
    banda = (0, int(0.07 * tam), tam, int(0.27 * tam))
    d.rectangle(banda, fill = rgb('azul_noche') + (191,))
    d.text((tam / 2, (banda[1] + banda[3]) / 2), f'Semana {semana}: {temas[semana]}',
           font = fuente(int(0.065 * tam)), fill = rgb('crema') + (255,), anchor = 'mm')
    f_etq = fuente(int(0.034 * tam), negrita = False)
    caja = d.textbbox((0.04 * tam, 0.95 * tam), estilo['etiqueta'], font = f_etq, anchor = 'ld')
    caja = (int(caja[0]) - 6, int(caja[1]) - 5, int(caja[2]) + 6, int(caja[3]) + 5)
    d.rectangle(caja, fill = rgb('crema') + (255,))
    d.text((0.04 * tam, 0.95 * tam), estilo['etiqueta'], font = f_etq, fill = rgb('azul_noche') + (255,), anchor = 'ld')
    return {'fondo': fondo, 'figura': figura, 'texto': texto, 'centro': centro, 'caja_etiqueta': caja, 'tam': tam}

def componer(capas, con_texto = True):
    # Fondo recortado al tamaño de la portada, figura encima y, si se pide, el texto:
    tam = capas['tam']
    lienzo = capas['fondo'].crop((0, 0, tam, tam)).convert('RGBA')
    lienzo = Image.alpha_composite(lienzo, capas['figura'])
    if con_texto:
        lienzo = Image.alpha_composite(lienzo, capas['texto'])
    return lienzo.convert('RGB')

capas4 = capas_portada(4)
portada4 = componer(capas4)
ilustracion4 = componer(capas4, con_texto = False)
print(f"Portada {portada4.size[0]}x{portada4.size[1]} {portada4.mode} | fondo {capas4['fondo'].size[0]}x{capas4['fondo'].size[1]}"
      f" | semilla {estilo['semilla_base'] + 4}")
print('Centro del sol:', tuple(round(float(v), 1) for v in capas4['centro']), '| caja de la etiqueta:', capas4['caja_etiqueta'])
print('Paleta:', ', '.join(f'{k} {v}' for k, v in estilo['paleta'].items()))
print('Colores distintos en la portada:', len(portada4.getcolors(maxcolors = 1 << 20)))
Portada 512x512 RGB | fondo 576x512 | semilla 2030
Centro del sol: (303.0, 339.8) | caja de la etiqueta: (14, 463, 168, 486)
Paleta: azul_noche #1B3A4B, azul_acero #3F7CAC, mostaza #F2C14E, coral #F78154, crema #F4F1DE
Colores distintos en la portada: 2486
La portada de la semana 4 nace de la semilla $2030$ ($2026 + 4$, la misma regla de la Etapa 2 del Día 12), su fondo mide $576 \times 512$ píxeles y el sol queda centrado en el punto $(303.0, 339.8)$, dentro de los dos tercios inferiores que la guía reserva para el motivo. La caja de la etiqueta ocupa el rectángulo de $(14, 463)$ a $(168, 486)$: ese dato se usará al final de la entrada para comprobar si la etiqueta sobrevive al movimiento. La portada tiene $2,486$ colores distintos aunque la paleta solo tenga cinco, porque el degradado, las vetas y las mezclas semitransparentes producen tonos intermedios.
Cuánto ocupa un clip
Con la portada lista, la primera pregunta de Diego se puede responder sin ningún modelo: ¿de qué tamaño es un clip de $4$ segundos? El siguiente código aplica la fórmula a dos resoluciones, la de la portada de juguete ($512 \times 512$) y la de un vídeo de alta definición ($1,280 \times 720$), y a las dos tasas habituales, $12$ y $24$ fps:
# Tamaño sin comprimir de un clip de 4 segundos según resolución y tasa en Python:
duracion = 4
filas = []
for ancho, alto in [(512, 512), (1280, 720)]:
    for fps in (12, 24):
        T = duracion * fps
        n_bytes = T * alto * ancho * 3
        filas.append({'resolución': f'{ancho}x{alto}', 'fps': fps, 'fotogramas': T,
                      'bytes': n_bytes, 'MiB': round(n_bytes / 2 ** 20, 1)})
tabla_tamanos = pd.DataFrame(filas)
print(tabla_tamanos.to_string(index = False))

# Una imagen fija de 512x512 frente al clip más pequeño de la tabla:
imagen_fija = 512 * 512 * 3
print(f'Una portada fija: {imagen_fija} bytes ({imagen_fija / 2 ** 20:.2f} MiB);'
      f' el clip de 12 fps equivale a {filas[0]["bytes"] // imagen_fija} portadas')
resolución  fps  fotogramas     bytes   MiB
   512x512   12          48  37748736  36.0
   512x512   24          96  75497472  72.0
  1280x720   12          48 132710400 126.6
  1280x720   24          96 265420800 253.1
Una portada fija: 786432 bytes (0.75 MiB); el clip de 12 fps equivale a 48 portadas
Las cifras de la salida se recogen en la Tabla 1.
Tabla 1. Tamaño sin comprimir de un clip de 4 segundos según resolución y tasa de fotogramas.
| Resolución | fps | Fotogramas | Bytes | MiB |
|---|---|---|---|---|
| 512x512 | 12 | 48 | 37 748 736 | 36.0 |
| 512x512 | 24 | 96 | 75 497 472 | 72.0 |
| 1280x720 | 12 | 48 | 132 710 400 | 126.6 |
| 1280x720 | 24 | 96 | 265 420 800 | 253.1 |
El clip más modesto, $4$ segundos a $12$ fps en $512 \times 512$, ocupa $36$ MiB sin comprimir: lo mismo que $48$ portadas fijas. El de alta definición a $24$ fps sube a $253.1$ MiB, siete veces más. Estas cifras explican dos cosas. La primera, por qué nadie distribuye vídeo sin comprimir: los formatos de vídeo aprovechan que fotogramas consecutivos se parecen mucho y guardan sobre todo las diferencias. La segunda, por qué generar vídeo es caro: un modelo que produce un clip de $1,280 \times 720$ a $24$ fps tiene que fabricar el equivalente a $96$ imágenes coherentes entre sí, y lo hace en un espacio latente comprimido precisamente porque el tensor completo no cabría en memoria.
Más adelante, en el Bloque 6, medirá cuánto ocupa el mismo clip de $36$ MiB guardado como GIF. La comparación anticipa la idea central del día: la coherencia entre fotogramas es redundancia, y la redundancia se comprime.
Coherencia temporal
Suponga que dispone de un generador de imágenes perfecto y le pide $48$ portadas, una por fotograma, con el mismo prompt. Cada imagen será bonita por separado, pero la secuencia no será un vídeo: el sol cambiará de sitio, los círculos aparecerán y desaparecerán y los colores saltarán de un fotograma al siguiente. Ese defecto se llama parpadeo (en inglés, flicker), y es el primer problema que tuvieron que resolver los modelos de vídeo generativo. ¿Por qué ocurre, si cada fotograma es correcto?
Ocurre porque un modelo de difusión parte de ruido aleatorio (Día 9), y si cada fotograma parte de un ruido independiente, nada obliga a que dos fotogramas vecinos se parezcan. La solución conceptual es que el ruido, o la representación de la que se parte, esté correlacionado en el tiempo: que el fotograma $t$ se parezca al $t-1$ más de lo que se parece a uno cualquiera. El modelo de juguete más sencillo de esa idea es un proceso autorregresivo de orden 1 (o AR(1), por sus siglas en inglés: “autoregressive process of order 1”) aplicado a cada píxel:
$$ x_t = \rho, x_{t-1} + \sqrt{1-\rho^2};\varepsilon_t, \qquad \varepsilon_t \sim \mathcal{N}(0, 1) $$
La lógica detrás de esta fórmula es múltiple:
- El parámetro $\rho$, entre $0$ y $1$, dice cuánto del fotograma anterior se conserva: con $\rho = 0$ cada fotograma es ruido nuevo, y con $\rho$ cercano a $1$ el campo apenas cambia.
- El factor $\sqrt{1-\rho^2}$ que multiplica a la innovación $\varepsilon_t$ mantiene la varianza constante: si $x_{t-1}$ tiene varianza $1$, entonces $x_t$ también, porque $\rho^2 + (1 - \rho^2) = 1$. El contraste de la imagen no se apaga ni se dispara con el tiempo.
- La diferencia entre dos fotogramas consecutivos tiene varianza $\operatorname{Var}(x_t - x_{t-1}) = 2(1-\rho)$, frente a $2$ en el caso independiente. Su desviación típica, y con ella la diferencia absoluta media, se reduce en el factor $\sqrt{1-\rho}$.
- En conclusión, con $\rho = 0.9$ la teoría predice que los cambios entre fotogramas serán $\sqrt{0.1} \approx 0.316$ veces los del ruido independiente.
Los modelos de vídeo reales no usan exactamente un AR(1), pero la idea es la misma: compartir información entre fotogramas, ya sea con ruido correlacionado, con capas de atención que miran a lo largo del tiempo o generando todos los fotogramas a la vez en un mismo espacio latente.
Medir el parpadeo
Para comparar animaciones hace falta una medida. La más simple es la diferencia absoluta media entre fotogramas consecutivos, $D_t$, calculada sobre la intensidad de cada píxel en la escala de $0$ a $1$. A partir de la serie $D_1, \dots, D_{T-1}$ se obtienen tres números:
$$ D_t = \frac{1}{HW}\sum_{i,j}\left|F_t(i,j) - F_{t-1}(i,j)\right|, \qquad \bar{D} = \frac{1}{T-1}\sum_{t=1}^{T-1} D_t, \qquad P = \frac{1}{(T-2)HW}\sum_{t,i,j}\left|F_{t+1} - 2F_t + F_{t-1}\right| $$
La lógica detrás de estas medidas es múltiple:
- $\bar{D}$ mide cuánto cambia la imagen por fotograma. Un paneo rápido y un parpadeo violento dan valores altos los dos, así que $\bar{D}$ por sí sola no distingue el movimiento deseado del defecto.
- La desviación típica de la serie $D_t$, $\sigma_D$, mide si el cambio es regular: un movimiento a velocidad constante tiene $\sigma_D$ cercana a cero, y uno que acelera y frena la tiene mayor.
- $P$, la segunda diferencia media, mide la aceleración de cada píxel. Un movimiento suave cambia de forma gradual y su segunda diferencia es pequeña; un píxel que sube y baja de un fotograma a otro (el parpadeo genuino) tiene una segunda diferencia grande.
- En conclusión, $\bar{D}$ dice cuánto se mueve el clip y $P$ dice si se mueve con suavidad; el cociente $P / \bar{D}$ resume qué parte del cambio es irregular.
El siguiente código genera $48$ fotogramas de $64 \times 64$ píxeles de ruido espacialmente suave con dos recetas: ruido independiente en cada fotograma y ruido correlacionado con un AR(1) de $\rho = 0.9$. Después calcula $D_t$ para ambos y dibuja los seis primeros fotogramas de cada uno con la curva de diferencias debajo:
# Ruido independiente frente a ruido correlacionado AR(1) entre fotogramas en Python:
T, lado, rho = 48, 64, 0.9

def campo():
    # Ruido espacialmente suave (filtro gaussiano) con desviación típica 1:
    z = ndimage.gaussian_filter(rng.normal(size = (lado, lado)), sigma = 2, mode = 'wrap')
    return z / z.std()

def a_imagen(z):
    # Intensidad en [0, 1] centrada en gris medio:
    return np.clip(0.5 + 0.15 * z, 0, 1)

def diferencias(fotogramas):
    # D_t: diferencia absoluta media entre fotogramas consecutivos:
    f = np.asarray(fotogramas, dtype = float)
    return np.abs(np.diff(f, axis = 0)).mean(axis = tuple(range(1, f.ndim)))

independiente = np.array([a_imagen(campo()) for _ in range(T)])
x = campo()
correlacionado = [a_imagen(x)]
for t in range(1, T):
    x = rho * x + np.sqrt(1 - rho ** 2) * campo()
    correlacionado.append(a_imagen(x))
correlacionado = np.array(correlacionado)

d_ind, d_cor = diferencias(independiente), diferencias(correlacionado)
print(f'D medio: independiente {d_ind.mean():.4f} | correlacionado {d_cor.mean():.4f}'
      f' | cociente {d_cor.mean() / d_ind.mean():.3f} (teoría: raíz de 1 - rho = {np.sqrt(1 - rho):.3f})')

fig = plt.figure(figsize = (10, 6.4))
rejilla = fig.add_gridspec(3, 6, height_ratios = [1, 1, 1.1])
for fila, (nombre, serie) in enumerate([('Independiente', independiente), ('AR(1), rho = 0.9', correlacionado)]):
    for k in range(6):
        eje = fig.add_subplot(rejilla[fila, k])
        eje.imshow(serie[k], cmap = 'gray', vmin = 0, vmax = 1)
        eje.set_xticks([]); eje.set_yticks([])
        eje.set_title(f't = {k}', fontsize = 9)
        if k == 0:
            eje.set_ylabel(nombre, fontsize = 10)
eje = fig.add_subplot(rejilla[2, :])
eje.plot(range(1, T), d_ind, color = '#F78154', label = 'Ruido independiente')
eje.plot(range(1, T), d_cor, color = '#3F7CAC', label = 'Ruido correlacionado AR(1)')
eje.set_xlabel('Fotograma t'); eje.set_ylabel('$D_t$')
eje.set_ylim(0, None); eje.legend(fontsize = 9)
fig.suptitle('Coherencia temporal: ruido independiente frente a correlacionado', fontsize = 16)
plt.tight_layout()
plt.show()
D medio: independiente 0.1712 | correlacionado 0.0538 | cociente 0.314 (teoría: raíz de 1 - rho = 0.316)
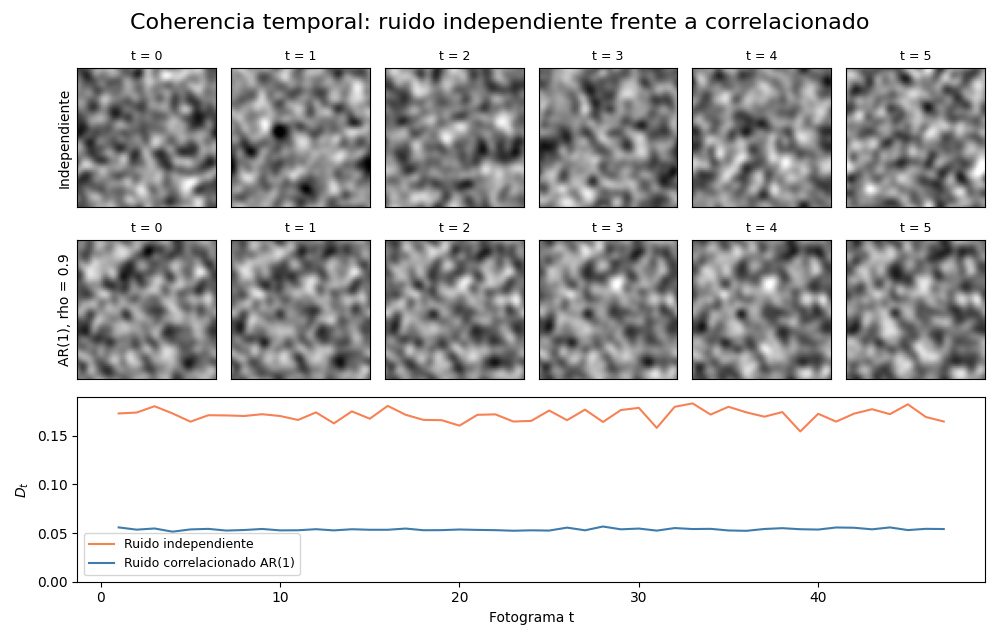
El cociente medido es $0.314$, prácticamente el $0.316$ que predice la teoría, y la diferencia media baja de $0.1712$ a $0.0538$. En la figura del bloque se ve lo que significan esos números. En la fila superior, cada fotograma es un dibujo de manchas distinto: si los mostrara a $12$ fps, vería un hervidero gris. En la fila inferior, las manchas se reconocen de un fotograma al siguiente y se deforman poco a poco, como nubes. La curva de abajo muestra que ambas series son estables en su propio nivel: el ruido independiente no parpadea “a veces”, parpadea siempre.
Este experimento es de juguete, pero reproduce el dilema de los primeros intentos de vídeo generativo: un modelo de imagen excelente aplicado fotograma a fotograma produce un vídeo malo. La calidad de un vídeo no es la calidad media de sus fotogramas, sino la coherencia entre ellos.
Movimiento sin modelo: el efecto Ken Burns
Antes de pagar por coherencia temporal, conviene recordar que existe una forma de obtenerla gratis: partir de una sola imagen y moverla. Si todos los fotogramas son vistas distintas de la misma portada, la coherencia está garantizada por construcción, porque no hay nada nuevo que inventar. Los documentalistas lo saben desde hace décadas: el efecto Ken Burns, llamado así por el documentalista estadounidense que lo popularizó con fotografías de archivo, consiste en recorrer una imagen fija con un paneo lento y un zoom suave. Da sensación de cámara y de tiempo sin un solo fotograma nuevo.
La implementación es un recorte que avanza y se amplía. Se elige una caja inicial (la portada completa) y una caja final (un cuadrado más pequeño centrado en el motivo, en este caso el sol), y en cada fotograma se toma una caja intermedia y se redimensiona al tamaño de salida. Para la caja intermedia se interpola cada coordenada entre la inicial y la final con un avance $s$ que va de $0$ a $1$. Si $s$ crece de forma lineal con el tiempo, la cámara arranca y se detiene en seco; para que arranque y frene con suavidad se usa una curva ease-in-out (entrada y salida suaves), el suavizado cúbico:
$$ s(t) = 3t^2 - 2t^3, \qquad s’(t) = 6t - 6t^2, \qquad t \in [0, 1] $$
La lógica detrás de esta curva es múltiple:
- Cumple $s(0) = 0$ y $s(1) = 1$, igual que la interpolación lineal: empieza en la caja inicial y termina en la final.
- Su derivada, la velocidad, vale $0$ en los dos extremos: la cámara sale del reposo y vuelve a él, sin tirones al empezar o terminar el bucle.
- La velocidad máxima, $1.5$, se alcanza en $t = 0.5$; para recorrer la misma distancia en el mismo tiempo, la curva compensa la lentitud de los extremos con un centro más rápido.
- En conclusión, es el polinomio de menor grado que une dos posiciones con velocidad nula en ambos extremos, y por eso es la opción por defecto en animación.
Hay un detalle técnico que importa para la estabilidad: las coordenadas de la caja intermedia casi nunca son enteras. El método Image.resize de PIL admite un argumento box con coordenadas decimales, de modo que el recorte se desplaza por fracciones de píxel y el filtro de Lanczos reparte el color entre los píxeles vecinos. Además, el título y la etiqueta no se recortan con la ilustración: se estampan después del movimiento, siempre en el mismo sitio, con la función estampar. El siguiente bloque genera los $48$ fotogramas del clip ($4$ segundos a $12$ fps) con un zoom final de $1.6$:
# Efecto Ken Burns: recorte que avanza y se amplía, 48 fotogramas a 12 fps, en Python:
def suave(t):
    # Interpolación ease-in-out (suavizado cúbico 3t^2 - 2t^3):
    return 3 * t ** 2 - 2 * t ** 3

def estampar(fotograma, capas):
    # Título y etiqueta se dibujan DESPUÉS del movimiento, siempre en el mismo sitio:
    return Image.alpha_composite(fotograma.convert('RGBA'), capas['texto']).convert('RGB')

def ken_burns(capas, zoom = 1.6, n = 48, curva = suave, entero = False):
    imagen, tam = componer(capas, con_texto = False), capas['tam']
    lado_fin = tam / zoom
    cx = np.clip(capas['centro'][0], lado_fin / 2, tam - lado_fin / 2)
    cy = np.clip(capas['centro'][1], lado_fin / 2, tam - lado_fin / 2)
    caja_ini = np.array([0, 0, tam, tam], dtype = float)
    caja_fin = np.array([cx - lado_fin / 2, cy - lado_fin / 2, cx + lado_fin / 2, cy + lado_fin / 2])
    fotogramas, cajas = [], []
    for i in range(n):
        s = curva(i / (n - 1))
        caja = (1 - s) * caja_ini + s * caja_fin
        if entero:
            caja = np.round(caja)
        # resize con box admite coordenadas con decimales: el recorte se mueve por subpíxeles:
        recorte = imagen.resize((tam, tam), Image.LANCZOS, box = tuple(caja))
        fotogramas.append(estampar(recorte, capas))
        cajas.append(caja)
    return fotogramas, np.array(cajas)

frames_kb, cajas_kb = ken_burns(capas4)
print(f'{len(frames_kb)} fotogramas de {frames_kb[0].size[0]}x{frames_kb[0].size[1]} | {len(frames_kb) / 12:.0f} s a 12 fps')
print('Caja inicial:', np.round(cajas_kb[0], 1), '| caja final:', np.round(cajas_kb[-1], 1))
paso = np.abs(np.diff(cajas_kb[:, 0]))
print(f'Avance de la esquina izquierda por fotograma: máximo {paso.max():.2f} px, primero {paso[0]:.3f} px')

fig = plt.figure(figsize = (11, 5.2))
rejilla = fig.add_gridspec(2, 4, width_ratios = [2.2, 1, 1, 1])
eje = fig.add_subplot(rejilla[:, 0])
eje.imshow(ilustracion4)
for i, color in zip([0, 12, 24, 36, 47], ['#F4F1DE', '#F2C14E', '#F78154', '#ffffff', '#F78154']):
    x0, y0, x1, y1 = cajas_kb[i]
    eje.add_patch(Rectangle((x0, y0), x1 - x0, y1 - y0, fill = False, edgecolor = color, linewidth = 1.6))
    eje.text(x0 + 4, y1 - 8, f'{i}', color = color, fontsize = 9, weight = 'bold')
eje.set_title('Recorte en los fotogramas 0, 12, 24, 36 y 47', fontsize = 11)
eje.axis('off')
for k, i in enumerate([0, 9, 19, 28, 38, 47]):
    eje = fig.add_subplot(rejilla[k // 3, 1 + k % 3])
    eje.imshow(frames_kb[i]); eje.axis('off')
    eje.set_title(f'Fotograma {i}', fontsize = 9)
fig.suptitle('Efecto Ken Burns sobre la portada de la semana 4', fontsize = 16)
plt.tight_layout()
plt.show()
48 fotogramas de 512x512 | 4 s a 12 fps
Caja inicial: [  0.   0. 512. 512.] | caja final: [143.  179.8 463.  499.8]
Avance de la esquina izquierda por fotograma: máximo 4.56 px, primero 0.191 px
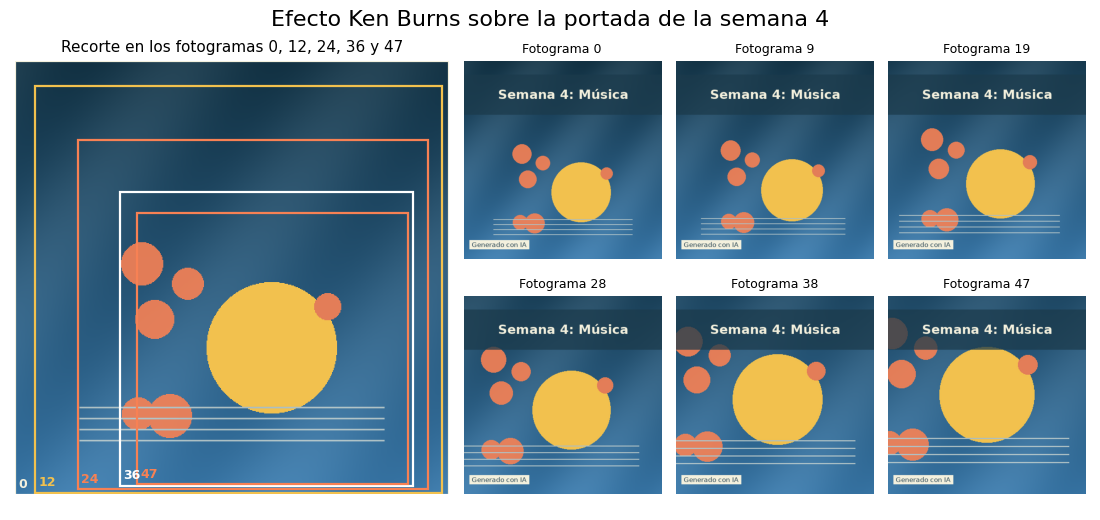
El recorte arranca en la portada completa, la caja $(0, 0, 512, 512)$, y termina en un cuadrado de $320$ píxeles de lado ($512 / 1.6$) que va de $(143.0, 179.8)$ a $(463.0, 499.8)$. El sol, centrado en $(303.0, 339.8)$, queda en el centro del encuadre final. La esquina izquierda del recorte avanza $0.191$ píxeles en el primer paso y un máximo de $4.56$ píxeles a mitad del clip: el efecto del ease-in-out, que se estudia en detalle en el Bloque 7.
En la figura, el panel izquierdo muestra la ilustración sin texto con cinco de las cajas de recorte superpuestas; se ve cómo se estrechan hacia el sol a la vez que bajan y se desplazan a la derecha. Los seis paneles de la derecha son fotogramas del clip ya terminado: el sol crece hasta llenar el encuadre, los círculos coral salen por la izquierda y las líneas del pentagrama por abajo, mientras la banda del título y la etiqueta “Generado con IA” permanecen quietas en su sitio.
Guardar el clip como GIF
El clip existe ahora como una lista de $48$ imágenes de PIL. Para compartirlo hace falta un archivo, y el formato más simple que Pillow sabe escribir sin dependencias es el GIF animado. El método save con save_all = True guarda el primer fotograma y añade los demás con append_images; duration fija los milisegundos de cada fotograma ($83$ ms equivalen a unos $12$ fps), loop = 0 hace que se repita sin fin y comment añade un texto al archivo. Sofía usa ese comentario para guardar la procedencia del clip en formato JSON. El siguiente código escribe el GIF en un directorio temporal y lo vuelve a abrir para comprobar qué se guardó de verdad:
# Guardado del clip como GIF animado con un comentario de procedencia en Python:
carpeta_tmp = Path(tempfile.mkdtemp(prefix = 'cuaderno_vivo_'))
procedencia = {'obra': 'Cuaderno Vivo, portada semana 4', 'etiqueta': estilo['etiqueta'],
               'movimiento': 'Ken Burns procedural (PIL)', 'modelo_video': None,
               'fps': 12, 'fotogramas': len(frames_kb)}
ruta_gif = carpeta_tmp / 'semana_04.gif'
frames_kb[0].save(ruta_gif, save_all = True, append_images = frames_kb[1:], duration = 83, loop = 0,
                  comment = json.dumps(procedencia, ensure_ascii = False))
bytes_gif = ruta_gif.stat().st_size
crudo = len(frames_kb) * 512 * 512 * 3

# Relectura del archivo: número de fotogramas, duración guardada y comentario:
with Image.open(ruta_gif) as gif:
    print(f'{ruta_gif.name}: {bytes_gif} bytes ({bytes_gif / 2 ** 20:.2f} MiB) | {gif.n_frames} fotogramas'
          f" | duración guardada {gif.info['duration']} ms | bucle {gif.info.get('loop')}")
    print('Comentario:', gif.info['comment'].decode('utf-8'))
print(f'Sin comprimir: {crudo} bytes | el GIF ocupa el {bytes_gif / crudo:.1%}')
semana_04.gif: 2447051 bytes (2.33 MiB) | 48 fotogramas | duración guardada 80 ms | bucle 0
Comentario: {"obra": "Cuaderno Vivo, portada semana 4", "etiqueta": "Generado con IA", "movimiento": "Ken Burns procedural (PIL)", "modelo_video": null, "fps": 12, "fotogramas": 48}
Sin comprimir: 37748736 bytes | el GIF ocupa el 6.5%
El GIF ocupa $2.33$ MiB, el $6.5%$ de los $36$ MiB del clip sin comprimir. El formato GIF no sabe nada de movimiento: reduce cada fotograma a una paleta de $256$ colores y lo comprime con el algoritmo LZW, que aprovecha las zonas repetidas dentro de cada imagen. Aun así, la reducción es de un factor de $15$. Un vídeo MP4 con el códec H.264, que sí aprovecha la semejanza entre fotogramas, ocuparía bastante menos, pero exigiría ffmpeg o una biblioteca equivalente, que el Cuaderno Vivo no necesita para clips de $4$ segundos.
El comentario se relee intacto, con la obra, la etiqueta, el método de movimiento y un campo modelo_video vacío (null) que deja constancia de que ningún modelo de vídeo intervino. Pero la relectura revela también una sorpresa en la duración.
Atención aquí: el formato GIF guarda la duración de cada fotograma en centésimas de segundo, no en milisegundos. Los $83$ ms pedidos se guardaron como $80$ ms, así que el clip se reproduce a $12.5$ fps y dura $3.84$ segundos en lugar de $4$. Para un clip decorativo la diferencia no importa, pero si el GIF debe sincronizarse con el audio de un episodio, elija una duración múltiplo de $10$ ms ($80$ o $90$) y calcule el número de fotogramas a partir de ella, o use un formato de vídeo con base de tiempo precisa.
Interpolación suave
La curva de avance decide cómo se siente el movimiento. El siguiente código compara la interpolación lineal con el ease-in-out: calcula la posición y la velocidad de ambas a lo largo del clip y mide, para el mismo recorrido del Bloque 5, cuántos píxeles avanza la esquina del recorte en cada fotograma:
# Interpolación lineal frente a ease-in-out: posición y velocidad del recorte en Python:
t = np.linspace(0, 1, 201)
pos_lineal, pos_suave = t, suave(t)
vel_lineal, vel_suave = np.ones_like(t), 6 * t - 6 * t ** 2
print(f'Velocidad relativa máxima: lineal {vel_lineal.max():.2f} | ease-in-out {vel_suave.max():.2f} (en t = {t[vel_suave.argmax()]:.2f})')
print(f'Velocidad en los extremos: lineal {vel_lineal[0]:.2f} | ease-in-out {vel_suave[0]:.2f}')

# Mismo recorrido en 48 fotogramas: paso de la esquina izquierda en píxeles:
_, cajas_lin = ken_burns(capas4, curva = lambda s: s)
paso_lin = np.abs(np.diff(cajas_lin[:, 0]))
print(f'Paso por fotograma: lineal {paso_lin.min():.2f} a {paso_lin.max():.2f} px | ease-in-out {paso.min():.3f} a {paso.max():.2f} px')

fig, ejes = plt.subplots(1, 2, figsize = (10, 4.2))
ejes[0].plot(t, pos_lineal, color = '#F78154', label = 'Lineal: $s = t$')
ejes[0].plot(t, pos_suave, color = '#1B3A4B', label = 'Ease-in-out: $s = 3t^2 - 2t^3$')
ejes[0].set_title('Posición del recorte'); ejes[0].set_xlabel('Tiempo normalizado $t$'); ejes[0].set_ylabel('Avance $s$')
ejes[1].plot(t, vel_lineal, color = '#F78154', label = 'Lineal')
ejes[1].plot(t, vel_suave, color = '#1B3A4B', label = 'Ease-in-out')
ejes[1].set_title('Velocidad del recorte'); ejes[1].set_xlabel('Tiempo normalizado $t$'); ejes[1].set_ylabel('$ds/dt$')
for eje in ejes:
    eje.grid(alpha = 0.3); eje.legend(fontsize = 9)
fig.suptitle('Interpolación lineal frente a ease-in-out', fontsize = 16)
plt.tight_layout()
plt.show()
Velocidad relativa máxima: lineal 1.00 | ease-in-out 1.50 (en t = 0.50)
Velocidad en los extremos: lineal 1.00 | ease-in-out 0.00
Paso por fotograma: lineal 3.04 a 3.04 px | ease-in-out 0.191 a 4.56 px
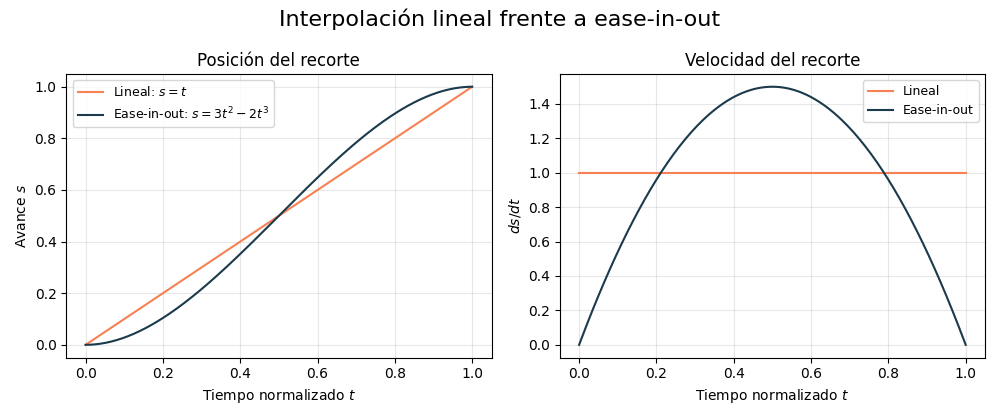
Con la interpolación lineal, la esquina avanza exactamente $3.04$ píxeles en cada uno de los $47$ pasos: velocidad constante desde el primer fotograma hasta el último. Con el ease-in-out, el paso va de $0.191$ a $4.56$ píxeles: la velocidad máxima es $1.5$ veces la lineal, en el centro, y la velocidad en los extremos es $0$.
En el panel izquierdo de la figura, la curva en forma de S del ease-in-out se separa de la recta al principio (va más despacio), la cruza en $t = 0.5$ y la vuelve a alcanzar al final. En el panel derecho, la velocidad lineal es una recta horizontal y la del ease-in-out una parábola que nace y muere en cero. La diferencia se nota sobre todo en un GIF que se repite en bucle: con interpolación lineal, al pasar del último fotograma al primero la cámara salta de “velocidad máxima hacia delante” a “velocidad máxima desde el inicio”, un tirón que el ojo detecta enseguida; con el ease-in-out, el bucle empieza y termina en reposo.
Los animadores llaman a este principio “entrada lenta y salida lenta” (slow in and slow out), y es uno de los doce principios de la animación que los estudios Disney formularon en los años treinta. No hay inteligencia artificial en él, y sin embargo es la diferencia entre un clip que parece hecho por una máquina y uno que parece hecho por una persona.
Paralaje por capas
El efecto Ken Burns mueve la imagen entera como una fotografía bajo una cámara. El paralaje da un paso más: simula profundidad moviendo cada capa a una velocidad distinta. Cuando usted mira por la ventanilla de un tren, los postes cercanos pasan deprisa y las montañas lejanas casi no se mueven; el cerebro interpreta esa diferencia de velocidades como distancia. En la portada de juguete, el fondo es lo lejano, la figura lo cercano y el texto se queda fijo, como si estuviera pegado al cristal de la cámara.
Cada capa $k$ se desplaza en horizontal una distancia máxima $\Delta_k$, modulada por el mismo avance suave del Ken Burns:
$$ x_k(t) = s(t),\Delta_k, \qquad \Delta_{\text{fondo}} = 16 \text{ px}, \quad \Delta_{\text{figura}} = 48 \text{ px}, \quad \Delta_{\text{texto}} = 0 $$
La lógica detrás de esta fórmula es múltiple:
- La razón entre desplazamientos, $48 / 16 = 3$, es la que el ojo traduce en profundidad: la figura parece tres veces más cerca que el fondo.
- El fondo se construyó $64$ píxeles más ancho que la portada, así que al desplazarlo $16$ píxeles nunca aparece un borde vacío.
- La figura es una capa con transparencia, de modo que al desplazarla no deja huecos: por donde sale, se ve el fondo.
- En conclusión, el paralaje necesita que la portada exista en capas; con una imagen plana, la única opción es el Ken Burns.
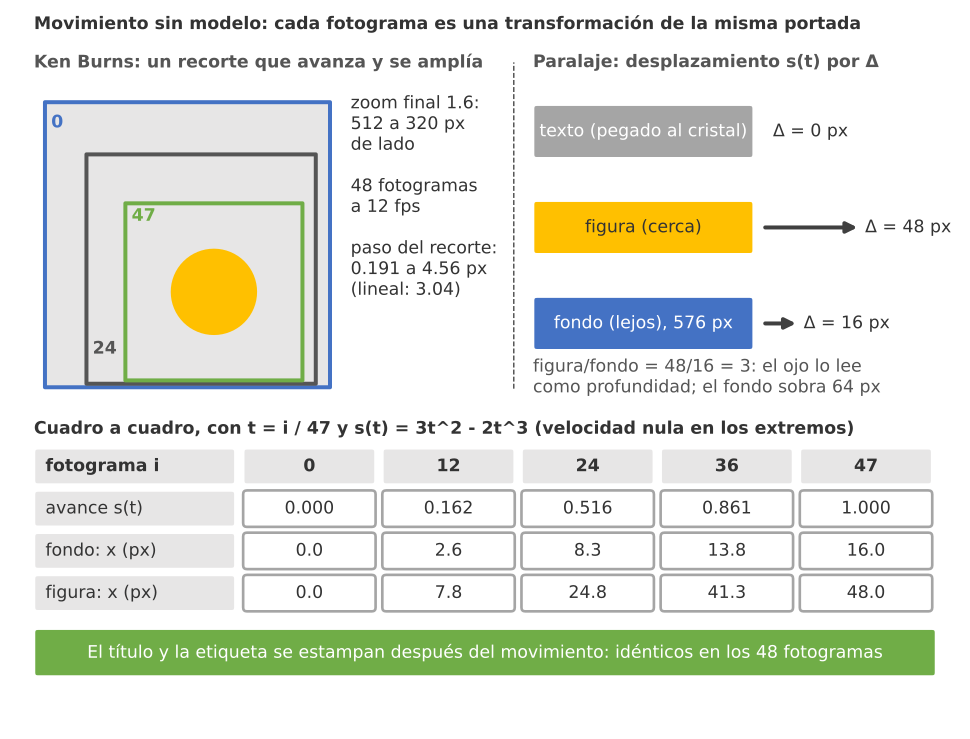
Figura 1. El Ken Burns y el paralaje como transformaciones cuadro a cuadro: el recorte pasa de 512 a 320 px de lado (zoom 1.6) con el avance s(t) = 3t^2 - 2t^3, y en el paralaje el fondo se desplaza 16 px, la figura 48 px y el texto nada; el título y la etiqueta se estampan después del movimiento.
En las portadas reales, generadas con FLUX como una sola imagen, separar capas exige recortar la figura a mano o con un modelo de segmentación, una tarea que Sofía deja para más adelante. Con la portada de juguete, las capas ya existen. El siguiente bloque genera $48$ fotogramas de paralaje con desplazamiento subpíxel (para el fondo, resize con box; para la figura, una transformación afín con interpolación bicúbica), y además el fundido entre las portadas de la semana 3 y la semana 4 que se describe en la sección siguiente:
# Paralaje por capas y fundido entre la portada de la semana 3 y la de la 4 en Python:
def paralaje(capas, n = 48, desp_fondo = 16, desp_figura = 48):
    tam, fotogramas = capas['tam'], []
    for i in range(n):
        s = suave(i / (n - 1))
        # El fondo, lejano, se desplaza poco; la figura, cercana, tres veces más:
        fondo = capas['fondo'].resize((tam, tam), Image.LANCZOS, box = (s * desp_fondo, 0, s * desp_fondo + tam, tam))
        figura = capas['figura'].transform((tam, tam), Image.AFFINE, (1, 0, s * desp_figura, 0, 1, 0),
                                           resample = Image.BICUBIC)
        lienzo = Image.alpha_composite(fondo.convert('RGBA'), figura)
        fotogramas.append(estampar(lienzo, capas))
    return fotogramas

def fundido(a, b, n = 24):
    # Mezcla lineal: F = (1 - a) A + a B, con a de 0 a 1:
    return [Image.blend(a, b, i / (n - 1)) for i in range(n)]

capas3 = capas_portada(3)
portada3 = componer(capas3)
frames_par = paralaje(capas4)
frames_fun = fundido(portada3, portada4)

def guardar_gif(fotogramas, nombre):
    ruta = carpeta_tmp / nombre
    fotogramas[0].save(ruta, save_all = True, append_images = fotogramas[1:], duration = 83, loop = 0,
                       comment = json.dumps(procedencia | {'movimiento': nombre}, ensure_ascii = False))
    return ruta.stat().st_size

for nombre, fotogramas in [('paralaje_04.gif', frames_par), ('fundido_03_04.gif', frames_fun)]:
    b = guardar_gif(fotogramas, nombre)
    print(f'{nombre:<18} {len(fotogramas):>2} fotogramas | {b} bytes ({b / 2 ** 20:.2f} MiB)')
mitad = np.asarray(frames_fun[12], dtype = float)
esperado = (1 - 12 / 23) * np.asarray(portada3, dtype = float) + 12 / 23 * np.asarray(portada4, dtype = float)
print(f'Fotograma 12 del fundido frente a la fórmula: diferencia máxima {np.abs(mitad - esperado).max():.1f} niveles')
paralaje_04.gif    48 fotogramas | 1578041 bytes (1.50 MiB)
fundido_03_04.gif  24 fotogramas | 1204132 bytes (1.15 MiB)
Fotograma 12 del fundido frente a la fórmula: diferencia máxima 1.0 niveles
El GIF del paralaje ocupa $1.50$ MiB para los mismos $48$ fotogramas, menos que el Ken Burns ($2.33$ MiB). La razón está en lo que cambia: en el paralaje, el fondo se mueve muy poco y el texto nada, de modo que cada fotograma tiene grandes zonas casi idénticas al anterior; en el Ken Burns, el zoom cambia la escala de toda la imagen en cada fotograma.
Fundidos entre semanas
La tercera técnica une dos portadas. Un fundido encadenado (en inglés, crossfade) mezcla la portada de la semana 3 con la de la semana 4 con un peso $\alpha$ que crece de $0$ a $1$:
$$ F_i = (1-\alpha_i),A + \alpha_i,B, \qquad \alpha_i = \frac{i}{n-1}, \quad i = 0, \dots, n-1 $$
Es la misma mezcla alfa con la que el Día 12 compuso la banda del título, pero aplicada a la imagen completa y variando en el tiempo. Con $n = 24$ fotogramas, el fundido dura $2$ segundos a $12$ fps; Sofía lo usará al principio del clip de cada semana para enlazar con la anterior. La función Image.blend de PIL implementa exactamente esa fórmula, y la última línea de la salida del Bloque 8 lo comprueba: el fotograma $12$ del fundido difiere del cálculo manual con numpy en como mucho $1$ nivel de $255$, que es el redondeo a entero de PIL.
El GIF del fundido ocupa $1.15$ MiB con solo $24$ fotogramas, más por fotograma que los otros dos clips. Tiene sentido: durante un fundido cada píxel cambia de color en cada fotograma, y la mezcla de dos paletas produce muchos tonos intermedios que la paleta de $256$ colores del GIF tiene que aproximar. Como las dos portadas llevan la etiqueta “Generado con IA” en la misma posición, la etiqueta se ve entera durante todo el fundido.
Medir la estabilidad de las animaciones
Con cinco animaciones en la mano (las dos de ruido del Bloque 4, el Ken Burns, una variante del Ken Burns que redondea el recorte a píxeles enteros y el paralaje), toca aplicarles las medidas de la sección de coherencia temporal. La variante con recorte entero responde a una pregunta práctica: ¿importa de verdad el desplazamiento subpíxel? Muchas implementaciones sencillas recortan con crop, que solo admite coordenadas enteras, y luego redimensionan. El siguiente código convierte los fotogramas en color a luminancia en la escala de $0$ a $1$ (con los pesos de la recomendación Rec. 601) y calcula $\bar{D}$, $\sigma_D$, $P$ y el cociente $P / \bar{D}$:
# Métricas de estabilidad de cinco animaciones en Python:
def gris(fotogramas):
    # Luminancia aproximada en [0, 1] (pesos de Rec. 601):
    f = np.asarray([np.asarray(im, dtype = float) for im in fotogramas]) / 255
    return f @ np.array([0.299, 0.587, 0.114])

def estabilidad(f):
    # D medio, desviación típica de D_t y parpadeo (segunda diferencia media):
    d = diferencias(f)
    parpadeo = np.abs(f[2:] - 2 * f[1:-1] + f[:-2]).mean()
    return d.mean(), d.std(), parpadeo

frames_kb_entero, _ = ken_burns(capas4, entero = True)
animaciones = {'Ruido independiente': independiente, 'Ruido correlacionado': correlacionado,
               'Ken Burns': gris(frames_kb), 'Ken Burns (recorte entero)': gris(frames_kb_entero),
               'Paralaje': gris(frames_par)}
tabla_estabilidad = pd.DataFrame([dict(zip(['animación', 'D_medio', 'sigma_D', 'parpadeo'], (k,) + estabilidad(np.asarray(v))))
                                  for k, v in animaciones.items()])
tabla_estabilidad['parpadeo/D'] = tabla_estabilidad['parpadeo'] / tabla_estabilidad['D_medio']
print(tabla_estabilidad.round(4).to_string(index = False))

fig, ejes = plt.subplots(1, 2, figsize = (11, 4.4))
colores = ['#F78154', '#3F7CAC', '#1B3A4B', '#F2C14E', '#7a9e7e']
for eje, columna, titulo in [(ejes[0], 'D_medio', 'Diferencia media entre fotogramas'),
                             (ejes[1], 'parpadeo', 'Parpadeo (segunda diferencia)')]:
    eje.barh(tabla_estabilidad['animación'], tabla_estabilidad[columna], color = colores)
    eje.set_xscale('log'); eje.invert_yaxis()
    eje.set_title(titulo); eje.grid(alpha = 0.3, axis = 'x')
    for y, v in enumerate(tabla_estabilidad[columna]):
        eje.text(v * 1.08, y, f'{v:.4f}', va = 'center', fontsize = 8.5)
ejes[1].set_yticklabels([])
fig.suptitle('Estabilidad de las animaciones (escala logarítmica)', fontsize = 16)
plt.tight_layout()
plt.show()
                 animación  D_medio  sigma_D  parpadeo  parpadeo/D
       Ruido independiente   0.1712   0.0063    0.2957      1.7273
      Ruido correlacionado   0.0538   0.0011    0.0790      1.4673
                 Ken Burns   0.0079   0.0038    0.0109      1.3860
Ken Burns (recorte entero)   0.0083   0.0042    0.0131      1.5876
                  Paralaje   0.0012   0.0006    0.0021      1.6547
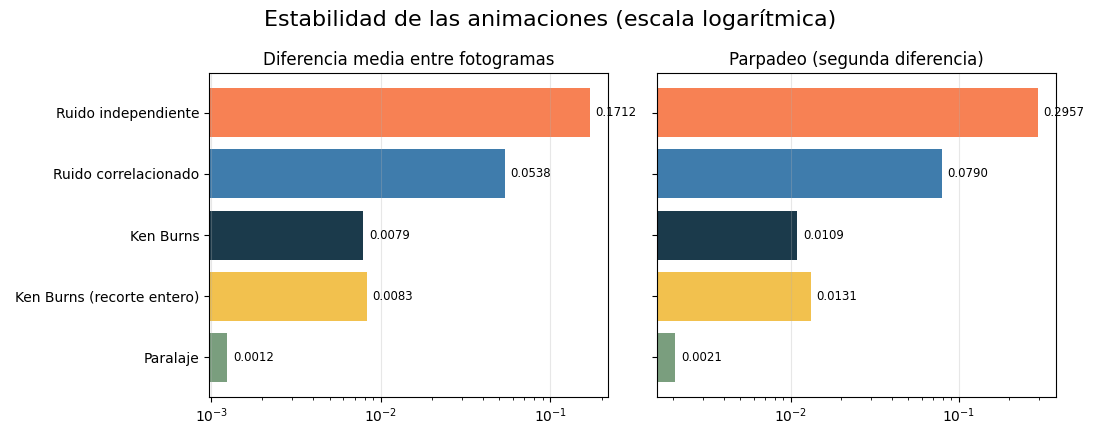
Los resultados se resumen en la Tabla 2.
Tabla 2. Métricas de estabilidad de cinco animaciones de 48 fotogramas (intensidad en la escala de 0 a 1).
| Animación | $\bar{D}$ | $\sigma_D$ | Parpadeo $P$ | $P / \bar{D}$ |
|---|---|---|---|---|
| Ruido independiente | 0.1712 | 0.0063 | 0.2957 | 1.73 |
| Ruido correlacionado AR(1) | 0.0538 | 0.0011 | 0.0790 | 1.47 |
| Ken Burns | 0.0079 | 0.0038 | 0.0109 | 1.39 |
| Ken Burns (recorte entero) | 0.0083 | 0.0042 | 0.0131 | 1.59 |
| Paralaje | 0.0012 | 0.0006 | 0.0021 | 1.65 |
La figura, en escala logarítmica, ordena las animaciones de forma clara. El ruido independiente parpadea $0.2957$, unas $27$ veces más que el Ken Burns ($0.0109$) y unas $140$ veces más que el paralaje ($0.0021$). El ruido correlacionado reduce el parpadeo a algo más de la cuarta parte ($0.0790$), pero sigue estando muy por encima de las animaciones procedurales, que parten de una sola imagen y por tanto heredan su coherencia.
La columna $\sigma_D$ cuenta otra historia. El Ken Burns tiene la $\sigma_D$ relativa más alta ($0.0038$ frente a un $\bar{D}$ de $0.0079$) porque su velocidad no es constante: el ease-in-out hace que los fotogramas centrales cambien mucho más que los de los extremos. No es un defecto, es el diseño. El ruido independiente, en cambio, tiene una $\sigma_D$ diminuta: cambia muchísimo, pero siempre lo mismo.
La comparación más útil es la de las dos versiones del Ken Burns. Con el recorte redondeado a píxeles enteros, el parpadeo sube de $0.0109$ a $0.0131$, un $20%$ más, y el cociente $P / \bar{D}$ pasa de $1.39$ a $1.59$, aunque el movimiento total ($\bar{D}$) es casi el mismo. Ese exceso es el temblor que produce un recorte que avanza a saltos de un píxel: unos fotogramas se mueven un píxel, otros cero y otros dos, en lugar de avanzar de forma continua. En un clip de $512$ píxeles apenas se nota; en una pantalla grande, con un zoom lento, se ve como una vibración del encuadre. El desplazamiento subpíxel es gratis y elimina un defecto que ningún espectador sabría nombrar, pero que todos notarían.
Conviene leer estas métricas con sus límites. Son medidas de juguete, pensadas para comparar animaciones entre sí dentro de un mismo proyecto; las publicaciones sobre vídeo generativo usan métricas más elaboradas, como la distancia de Fréchet de vídeo o medidas basadas en el flujo óptico, que tienen en cuenta el movimiento esperado. Además, $\bar{D}$ y $P$ dependen de la resolución y del contenido: un paralaje sobre una portada con mucho detalle tendría valores mayores. Lo que sí permiten es una regla práctica para el Cuaderno Vivo: si el parpadeo de un clip nuevo supera varias veces el del Ken Burns de referencia, algo se ha roto.
Modelos de imagen a vídeo
Las técnicas procedurales solo mueven lo que ya existe. Si Sofía quisiera que el sol de la portada saliera por el horizonte, que las notas del pentagrama flotaran o que la acuarela se fuera pintando sola, necesitaría inventar píxeles que no están en la imagen, y eso es lo que hacen los modelos generativos de vídeo.
La idea general prolonga lo que vio en el Día 9. Un modelo de difusión de imágenes aprende a quitar ruido a una imagen; un modelo de difusión de vídeo aprende a quitar ruido a un tensor de fotogramas completo, con una dimensión temporal añadida. Ho y colaboradores (2022) mostraron que bastaba con extender la red de eliminación de ruido con capas que mezclan información a lo largo del tiempo para obtener vídeos coherentes. Los modelos actuales trabajan, como Stable Diffusion, en un espacio latente: un autocodificador variacional (o VAE, por sus siglas en inglés: “Variational Autoencoder”) comprime el vídeo en el espacio y en el tiempo, la difusión ocurre en ese espacio comprimido y el decodificador devuelve los fotogramas. En la variante de imagen a vídeo, la portada entra como condición: el modelo genera un clip cuyo primer fotograma es la imagen dada.
La compresión latente es lo que hace posible el vídeo generativo en una GPU de consumo, y también lo que fija su coste. Generar $121$ fotogramas de $1,280 \times 704$ es, en términos de cálculo, parecido a generar un lote enorme de imágenes que además deben atenderse entre sí. La Tabla 3 resume dos modelos abiertos de ejemplo, con los datos de sus fichas oficiales.
Tabla 3. Modelos abiertos de imagen a vídeo de ejemplo (fichas revisadas en octubre de 2026).
| Modelo | Licencia | Resolución y fotogramas nativos | Memoria orientativa | Uso en el proyecto |
|---|---|---|---|---|
Wan2.2 TI2V-5B (Wan-AI/Wan2.2-TI2V-5B-Diffusers) | Apache 2.0 | 720p ($1,280 \times 704$), $24$ fps, $121$ fotogramas en el ejemplo oficial | $24$ GB o más con descarga a CPU, según su ficha | Experimento puntual en GPU alquilada |
Stable Video Diffusion XT (stabilityai/stable-video-diffusion-img2vid-xt) | Licencia comunitaria de Stability AI (uso comercial sujeto a sus condiciones) | $576 \times 1,024$, $25$ fotogramas | menos de $8$ GB con todas las optimizaciones de memoria de diffusers | Solo como referencia; no se usa |
Wan2.2 TI2V-5B es un modelo de $5,000$ millones de parámetros del equipo Wan que acepta texto, imagen o ambos (“TI2V” significa texto e imagen a vídeo). Su ficha afirma que genera un vídeo de $5$ segundos en 720p en menos de $9$ minutos en una sola GPU de consumo, y que su guion de inferencia funciona en una tarjeta con al menos $24$ GB de memoria, como una RTX 4090. Su licencia Apache 2.0 permite el uso comercial, aunque la ficha recuerda que el usuario es responsable de que el contenido generado no infrinja derechos ni normas.
Stable Video Diffusion, de Stability AI, fue uno de los primeros modelos abiertos de imagen a vídeo de calidad (Blattmann y colaboradores, 2023). Su variante XT genera $25$ fotogramas de $576 \times 1,024$, unos $2$ a $4$ segundos de vídeo, y la documentación de diffusers explica cómo bajar su consumo por debajo de $8$ GB descargando componentes a la CPU, decodificando por trozos y troceando las capas lineales. Su licencia es la licencia comunitaria de Stability AI: el uso de investigación y no comercial es libre, y el uso comercial está permitido a personas y organizaciones por debajo de un umbral de ingresos anuales (un millón de dólares en las condiciones vigentes), con registro previo; por encima, exige una licencia empresarial. Esas condiciones son de un proveedor concreto y pueden cambiar, así que la tabla remite a su página de licencias y no a una cifra.
Atención aquí: “abierto” no significa “sin condiciones”. Antes de publicar un clip generado con cualquiera de estos modelos, lea la licencia de la versión exacta que descargó, compruebe si su uso es comercial (un pódcast con patrocinio lo es) y conserve una copia de la licencia junto al registro de procedencia del clip. Además, ningún clip debe representar a personas reales: un vídeo realista de una persona es un deepfake aunque sea “solo una prueba”, como vio en el Día 20.
El siguiente bloque muestra cómo se animaría la portada de la semana 4 con Wan2.2 TI2V-5B usando diffusers. El model_index.json del repositorio declara la clase WanPipeline (texto a vídeo); para partir de una imagen, el mismo repositorio se carga con WanImageToVideoPipeline, cuyo codificador de imagen es opcional en la versión actual de diffusers y que admite el modo de pasos temporales expandidos que usa este modelo. Compruebe ambas cosas con su versión instalada antes de ejecutarlo. Necesita una GPU de al menos $24$ GB y las bibliotecas torch y diffusers, que no están instaladas en el equipo con el que se escribió esta entrada, así que no se ejecutó y su salida es un ejemplo comentado:
# Imagen a vídeo con Wan2.2 TI2V-5B en diffusers (GPU de 24 GB o más) en Python:
# pip install torch diffusers transformers accelerate  (diffusers con soporte de Wan2.2)
import time
import torch
from diffusers import WanImageToVideoPipeline, AutoencoderKLWan

modelo = 'Wan-AI/Wan2.2-TI2V-5B-Diffusers'
vae = AutoencoderKLWan.from_pretrained(modelo, subfolder = 'vae', torch_dtype = torch.float32)
tubo = WanImageToVideoPipeline.from_pretrained(modelo, vae = vae, torch_dtype = torch.bfloat16)
tubo.enable_model_cpu_offload()          # mueve a la CPU cada componente que no está en uso

# La ilustración SIN título ni etiqueta: el modelo deformaría las letras.
# El texto y la etiqueta se estampan después, fotograma a fotograma, con estampar():
entrada = ilustracion4.resize((704, 704), Image.LANCZOS)
generador = torch.Generator('cpu').manual_seed(estilo['semilla_base'] + 4)

inicio = time.perf_counter()
resultado = tubo(image = entrada,
                 prompt = 'acuarela digital, el sol mostaza asciende despacio, los círculos coral flotan, '
                          'cámara fija, luz suave y lateral, sin personas, sin texto',
                 negative_prompt = 'personas, rostros, letras, texto, logotipos, parpadeo, cortes de plano',
                 height = 704, width = 704, num_frames = 97,      # 4 s a 24 fps (4k + 1 fotogramas)
                 num_inference_steps = 50, guidance_scale = 5.0, generator = generador)
fotogramas_wan = [estampar(f.resize((512, 512), Image.LANCZOS), capas4) for f in resultado.frames[0]]
print(f'{len(fotogramas_wan)} fotogramas | {time.perf_counter() - inicio:.0f} s'
      f' | memoria máxima {torch.cuda.max_memory_allocated() / 2 ** 30:.1f} GB')

# Salida de ejemplo (puede variar):
# 97 fotogramas | 412 s | memoria máxima 21.6 GB
Hay tres decisiones en este bloque que conectan con lo visto antes. La primera: al modelo se le entrega la ilustración sin texto, y el título y la etiqueta se estampan después con la misma función estampar del Ken Burns. Un modelo de vídeo trata las letras como cualquier otra textura y las deforma de un fotograma a otro, y una etiqueta deformada deja de cumplir su función. La segunda: la semilla se deriva de la semana, como en el Día 12, y el generador se crea en la CPU para que el ruido inicial sea reproducible aunque el modelo se reparta entre CPU y GPU. La tercera: el número de fotogramas es $97$, de la forma $4k + 1$, porque el VAE de Wan comprime el tiempo en grupos de cuatro fotogramas más el primero. Las cifras del comentario son ilustrativas, no una medición.
Lo que cuesta de verdad
Diego quiere un número, y el número depende de supuestos que conviene escribir como parámetros. Sofía no tiene una GPU de $24$ GB: su laptop tiene $16$ GB de memoria compartida, y el Día 26 ya mostró lo justa que va con un modelo de lenguaje de $4,000$ millones de parámetros. Le quedan dos caminos para usar Wan2.2: comprar una tarjeta o alquilarla por horas. El coste mensual de cada opción se puede escribir con una sola fórmula:
$$ C_{\text{mes}} = N \left[\frac{m_{\text{clip}} + m_{\text{sesión}}}{60},\bigl(p_{\text{hora}} + \tfrac{W}{1,000},p_{\text{kWh}}\bigr)\right] + C_{\text{fijo}} $$
La lógica detrás de esta fórmula es múltiple:
- $N$ es el número de clips al mes ($4$, uno por episodio semanal), y $m_{\text{clip}}$ los minutos de cálculo por clip aceptado, que incluyen los intentos descartados: un modelo generativo no acierta a la primera, y el Día 12 ya vio que una portada podía necesitar dos intentos.
- $m_{\text{sesión}}$ son los minutos de preparación que se pagan sin generar nada: arrancar la máquina alquilada, descargar decenas de gigabytes de pesos y cargarlos en la GPU.
- El paréntesis suma el precio por hora del alquiler y la electricidad de una máquina propia, con su potencia $W$ en vatios y el precio del kWh.
- $C_{\text{fijo}}$ es la amortización mensual del equipo propio, que se paga se usen o no las horas. En conclusión, la fórmula pone todas las opciones en la misma unidad, dólares al mes, igual que el punto de equilibrio del Día 26.
El siguiente código aplica la fórmula a tres opciones con supuestos de juguete, declarados en el propio código: $9$ minutos por intento (la cifra de la ficha de Wan2.2 para un clip de $5$ segundos), tres intentos por clip aceptado, una GPU de $24$ GB comprada por $1,600$ USD y amortizada en $36$ meses con un consumo de $450$ W, un alquiler de $0.80$ USD por hora con $20$ minutos de preparación por sesión, y $0.15$ USD por kWh como en el Día 26. La opción procedural se modela con $20$ segundos de CPU a $30$ W:
# Coste por clip y por mes de tres opciones, con supuestos de juguete, en Python:
clips_mes = 4
precio_kwh = 0.15            # USD por kWh (supuesto del Día 26)
intentos_por_clip = 3        # descartes hasta aceptar un clip (supuesto de juguete)
minutos_gpu_intento = 9      # minutos por clip de 5 s en 720p según la ficha de Wan2.2 TI2V-5B
supuestos = {
    'Procedural local (PIL)': {'minutos': 20 / 60, 'vatios': 30, 'fijo_mes': 0.0, 'precio_hora': 0.0, 'sesion_min': 0},
    'Difusión en GPU propia': {'minutos': minutos_gpu_intento * intentos_por_clip, 'vatios': 450,
                               'fijo_mes': 1600 / 36, 'precio_hora': 0.0, 'sesion_min': 0},
    'Difusión en GPU alquilada': {'minutos': minutos_gpu_intento * intentos_por_clip, 'vatios': 0,
                                  'fijo_mes': 0.0, 'precio_hora': 0.80, 'sesion_min': 20},
}
filas = []
for opcion, s in supuestos.items():
    horas_clip = (s['minutos'] + s['sesion_min']) / 60
    energia = s['vatios'] / 1000 * horas_clip * precio_kwh
    alquiler = s['precio_hora'] * horas_clip
    por_clip = energia + alquiler + s['fijo_mes'] / clips_mes
    filas.append({'opción': opcion, 'min_por_clip': round(s['minutos'] + s['sesion_min'], 1),
                  'USD_por_clip': round(por_clip, 6), 'USD_al_mes': round(por_clip * clips_mes, 2)})
tabla_coste = pd.DataFrame(filas)
margen = 10 - 1.68          # presupuesto menos el gasto mensual del Día 24
tabla_coste['cabe_en_margen'] = tabla_coste['USD_al_mes'] <= margen
print(tabla_coste.to_string(index = False))
print(f'Margen del presupuesto: {margen:.2f} USD al mes')
                   opción  min_por_clip  USD_por_clip  USD_al_mes  cabe_en_margen
   Procedural local (PIL)           0.3      0.000025        0.00            True
   Difusión en GPU propia          27.0     11.141486       44.57           False
Difusión en GPU alquilada          47.0      0.626667        2.51            True
Margen del presupuesto: 8.32 USD al mes
Las cifras de la salida se recogen en la Tabla 4.
Tabla 4. Coste por clip y por mes de tres opciones para cuatro clips mensuales (supuestos de juguete).
| Opción | Minutos por clip | USD por clip | USD al mes | ¿Cabe en el margen de 8.32 USD? |
|---|---|---|---|---|
| Procedural local (PIL) | 0.3 | 0.000025 | 0.00 | Sí |
| Difusión en GPU propia | 27.0 | 11.14 | 44.57 | No |
| Difusión en GPU alquilada | 47.0 | 0.63 | 2.51 | Sí |
El margen del presupuesto es $8.32$ USD al mes: los $10$ USD del límite de Sofía menos los $1.68$ USD que el Cuaderno Vivo ya gasta en la API según el Día 24. La opción procedural cuesta $0.000025$ USD por clip, una cifra que solo existe para que la comparación sea honesta: es la electricidad de veinte segundos de CPU. La GPU propia queda descartada sin discusión: $44.57$ USD al mes, casi todo amortización, para fabricar cuatro clips.
La sorpresa es la GPU alquilada: $2.51$ USD al mes caben en el margen. El vídeo generativo no está fuera del presupuesto. Pero la cifra merece una lectura atenta. Se come el $30%$ del margen que queda; depende de que tres intentos basten, y con un modelo de vídeo, más sensible al prompt que uno de imagen, podrían ser cinco o seis; cada clip exige $47$ minutos de máquina y la atención de Sofía para revisar los descartes; y el precio por hora de juguete puede ser muy distinto del que encuentre el día que lo necesite. Si los intentos se duplican y el precio sube un poco, el coste se acerca a la mitad del margen. Que algo quepa en el presupuesto no significa que merezca el presupuesto.
La decisión de Sofía
Con las cuatro tablas delante, Sofía escribe la decisión en el formato de los ADR del Día 21, en tres frases. El clip semanal del pódcast se hará con Ken Burns y paralaje en local, con coste cero, parpadeo mínimo medido y la etiqueta estampada en todos los fotogramas. La difusión de vídeo queda como experimento puntual, no como componente: una sesión alquilada al trimestre, como mucho, para el episodio especial que de verdad necesite un movimiento que no se pueda fabricar moviendo la portada. Y cualquier clip generativo pasará por las mismas comprobaciones que los procedurales: parpadeo, etiqueta y procedencia.
Los motivos no son solo económicos. La opción procedural es determinista: el mismo código y la misma portada producen el mismo GIF, byte a byte, mientras que un modelo de vídeo depende de la versión de la biblioteca y de la GPU, como el Día 12 advirtió para FLUX. Es controlable: si el sol sale del encuadre, se corrige una coordenada, no un prompt. Y es coherente con la colección: el movimiento no introduce colores ni formas que la guía de estilo no autorizó, porque no inventa nada.
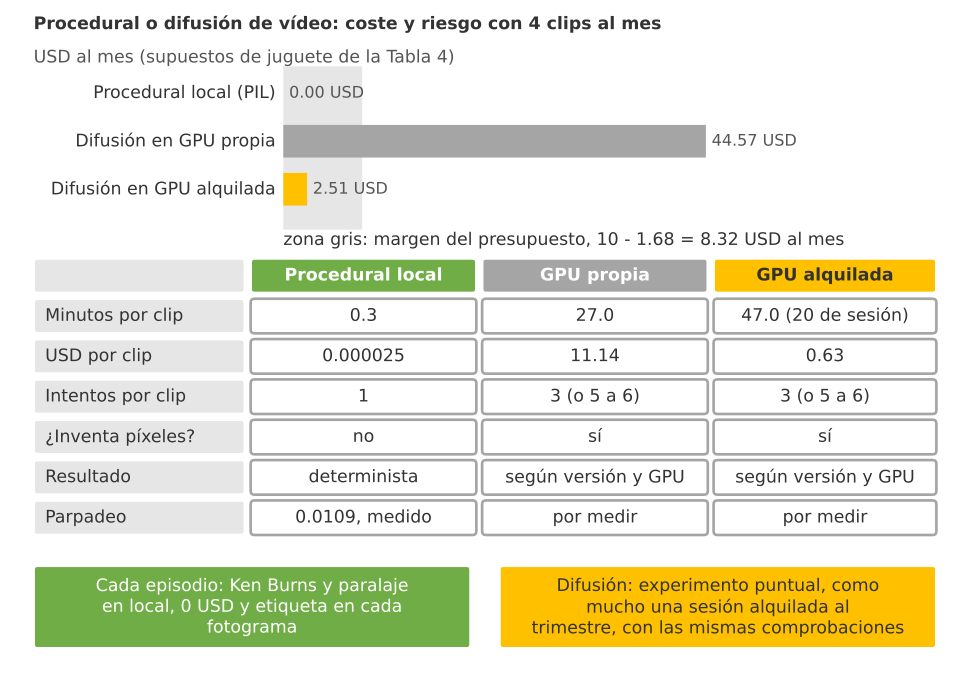
Figura 2. Procedural frente a difusión de vídeo con cuatro clips al mes: 0.00 USD en local, 44.57 USD con GPU propia y 2.51 USD con GPU alquilada, frente a un margen de 8.32 USD; la difusión cabe alquilada, pero inventa píxeles, no es determinista y pide varios intentos por clip.
Diego, que esperaba una cifra escandalosa, se queda con otra pregunta: "¿Y para los casetes de mi abuela? ¿Podrías animar las fotos viejas que vienen en las cajas?" Sofía le contesta con la regla de la serie: un Ken Burns sobre una fotografía familiar, con permiso de quien aparece en ella, es una técnica de documental; pedirle a un modelo que haga sonreír o hablar a una persona de una foto antigua es fabricar un vídeo realista de una persona real, y eso, aunque sea con cariño, entra en el terreno de los deepfakes del Día 20. La técnica procedural no solo es más barata: en ese caso es la única aceptable.
Etiquetar el movimiento
La ética de la serie exige que toda salida generada que se publique lleve la etiqueta visible “Generado con IA”, y el artículo 50 del Reglamento (UE) 2024/1689, el AI Act, obliga desde el 2 de agosto de 2026 a que los proveedores de sistemas que generan imagen, audio o vídeo sintéticos marquen sus salidas en un formato legible por máquina, y a que quien difunda un contenido que constituya un deepfake revele que es artificial. La portada de la semana 4 ya cumplía la parte visible. ¿La sigue cumpliendo cuando se mueve?
No necesariamente. Si el Ken Burns se aplica a la portada ya terminada, con la etiqueta dibujada en la esquina inferior izquierda, el zoom hacia el sol saca la esquina del encuadre en cuanto el recorte empieza a estrecharse. Un movimiento pensado para la estética elimina, sin que nadie lo decida, la marca de transparencia. El siguiente código lo mide con las cajas de recorte del Bloque 5 y la caja de la etiqueta del Bloque 2, comprueba píxel a píxel que en el clip real (con la etiqueta estampada después del movimiento) la etiqueta es idéntica a la de la portada en todos los fotogramas, y guarda junto al GIF un registro de procedencia en JSON:
# ¿Sobrevive la etiqueta al movimiento? Ken Burns ingenuo frente a etiqueta estampada en Python:
def etiqueta_visible(caja_recorte, caja_etiqueta):
    # La etiqueta se ve entera si su rectángulo cabe dentro del recorte:
    x0, y0, x1, y1 = caja_recorte
    e0, f0, e1, f1 = caja_etiqueta
    return x0 <= e0 and y0 <= f0 and e1 <= x1 and f1 <= y1

visibles = [etiqueta_visible(c, capas4['caja_etiqueta']) for c in cajas_kb]
ultimo = max(i for i, v in enumerate(visibles) if v)
print(f'Ken Burns sobre la portada ya etiquetada: etiqueta entera en {sum(visibles)} de {len(visibles)} fotogramas'
      f' (último con etiqueta: {ultimo}, a los {ultimo / 12:.2f} s)')

# Con la etiqueta estampada después del movimiento, se comprueba píxel a píxel:
e0, f0, e1, f1 = capas4['caja_etiqueta']
referencia = np.asarray(portada4, dtype = float)[f0:f1, e0:e1]
iguales = sum(np.abs(np.asarray(fr, dtype = float)[f0:f1, e0:e1] - referencia).max() < 1 for fr in frames_kb)
print(f'Ken Burns con etiqueta estampada: etiqueta idéntica a la portada en {iguales} de {len(frames_kb)} fotogramas')

# Registro de procedencia junto al GIF (archivo JSON hermano):
registro = procedencia | {'archivo': ruta_gif.name, 'bytes': bytes_gif, 'fuente': 'portadas/semana_04.png',
                          'ai_act_art50': 'contenido sintético marcado de forma visible'}
ruta_registro = ruta_gif.with_suffix('.json')
ruta_registro.write_text(json.dumps(registro, ensure_ascii = False, indent = 2), encoding = 'utf-8')
print(f'{ruta_registro.name}: {ruta_registro.stat().st_size} bytes | campos: {", ".join(registro)}')
Ken Burns sobre la portada ya etiquetada: etiqueta entera en 10 de 48 fotogramas (último con etiqueta: 9, a los 0.75 s)
Ken Burns con etiqueta estampada: etiqueta idéntica a la portada en 48 de 48 fotogramas
semana_04.json: 349 bytes | campos: obra, etiqueta, movimiento, modelo_video, fps, fotogramas, archivo, bytes, fuente, ai_act_art50
El resultado justifica el diseño del Bloque 5. Con el Ken Burns ingenuo, la etiqueta solo se ve entera en $10$ de los $48$ fotogramas, y desaparece después del fotograma $9$, a los $0.75$ segundos: durante más de tres segundos de los cuatro, el clip circularía sin marca visible. Con la etiqueta estampada después del movimiento, la etiqueta es idéntica a la de la portada en los $48$ fotogramas. Cualquier recorte temporal del clip, aunque alguien comparta solo un segundo, conserva la marca.
La etiqueta visible es la mitad del trabajo. La otra mitad es la procedencia legible por máquina, y ahí el GIF tiene un límite. El comentario JSON del Bloque 6 viaja dentro del archivo, pero muchas plataformas recomprimen los GIF al subirlos y descartan los comentarios, igual que el Día 12 vio que los bloques de texto de un PNG no sobreviven a la conversión a JPEG. Por eso Sofía guarda también un registro hermano, semana_04.json, con la obra de origen, el método, el modelo (ninguno), el tamaño del archivo y la referencia al artículo 50. Para un clip publicado en serio, el siguiente paso sería un manifiesto de Content Credentials (C2PA), como el del Día 20: la especificación C2PA cubre vídeo además de imagen, y su firma permite comprobar que el archivo no se modificó después de etiquetarlo. Para el GIF de $4$ segundos de un pódcast personal, la etiqueta visible en cada fotograma más el registro hermano es una solución proporcionada.
Tres reglas resumen la sección:
- La etiqueta se estampa después de cualquier transformación geométrica (recorte, zoom, paralaje o generación con un modelo), nunca antes.
- Se comprueba en todos los fotogramas, porque un clip se puede recortar en el tiempo igual que una imagen se recorta en el espacio.
- La procedencia se guarda dentro y fuera del archivo: dentro, para que viaje con él; fuera, porque dentro se pierde con facilidad.
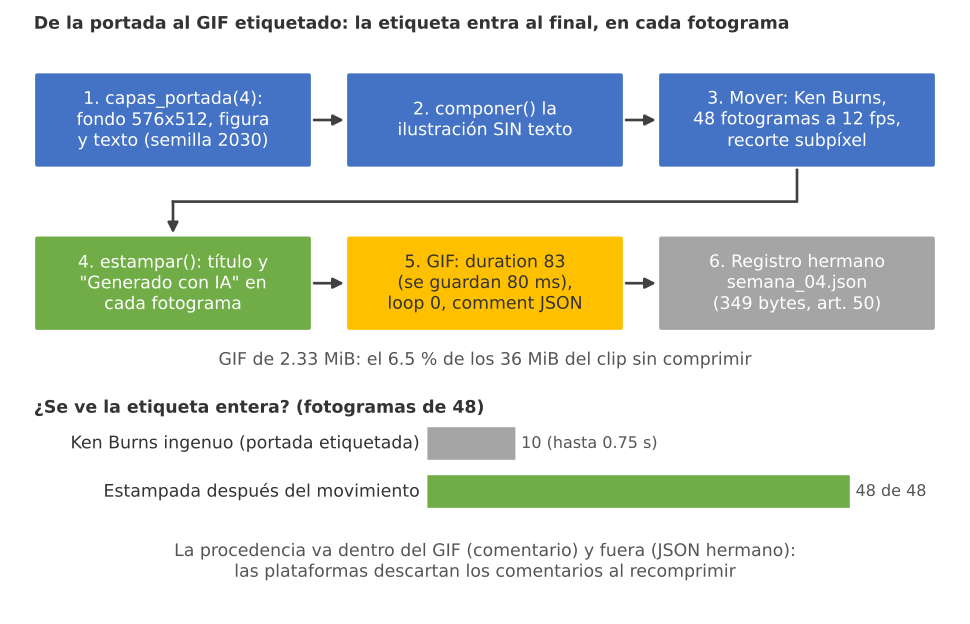
Figura 3. La tubería de la portada al GIF etiquetado: capas con semilla 2030, ilustración sin texto, 48 fotogramas de movimiento, estampar() en cada uno, GIF de 2.33 MiB con comentario JSON y registro hermano semana_04.json; la etiqueta queda entera en 48 de 48 fotogramas frente a 10 de 48 con el Ken Burns ingenuo.
Consideraciones finales
Sofía termina el día con tres GIF de su portada (Ken Burns, paralaje y fundido), un registro de procedencia y una decisión escrita, y no ha gastado un céntimo. Diego esperaba que el vídeo fuera la funcionalidad que rompiera el presupuesto, y resultó ser la que menos lo toca, porque casi todo el movimiento que necesita un pódcast personal se fabrica moviendo lo que ya existe.
Las cifras de hoy tienen límites que conviene declarar. La portada es de juguete, dibujada con formas geométricas; una acuarela real tiene más detalle y daría valores de $\bar{D}$ y de parpadeo más altos, aunque la ordenación entre técnicas se mantendría. Las métricas de estabilidad son sencillas y no saben distinguir un movimiento deseado de uno indeseado; sirven para comparar dentro del proyecto, no para juzgar un modelo. Los costes de la Tabla 4 dependen de supuestos de juguete (intentos por clip, precio por hora, minutos de preparación) que usted debe sustituir por los suyos. Y los datos de los modelos de la Tabla 3 salen de sus fichas, no de una medición propia: la única forma de saber cuánto tarda Wan2.2 en su caso es probarlo, con una sesión acotada y un presupuesto fijado de antemano.
Antes de añadir movimiento a su propio proyecto, hágase estas preguntas:
- ¿El movimiento que necesita se puede fabricar moviendo una imagen que ya tiene (zoom, paneo, capas, fundido), o de verdad hay que inventar píxeles?
- ¿Ha medido el parpadeo de su animación contra una referencia estable, y no solo la ha mirado una vez?
- ¿Cuántos intentos necesita un clip aceptable, y qué pasa con su coste si son el doble?
- ¿Ha leído la licencia de la versión exacta del modelo de vídeo y sabe si su uso es comercial?
- ¿La etiqueta “Generado con IA” está en todos los fotogramas, y la procedencia sobrevive a la plataforma donde lo publica?
Un gran libro que habla de esto es The Animator’s Survival Kit (que podría traducirse como El manual de supervivencia del animador), en el que Richard Williams, director de animación de ¿Quién engañó a Roger Rabbit?, explica con cientos de dibujos los principios del movimiento: el espaciado entre fotogramas, la entrada y salida lentas, el peso y el ritmo. No menciona la inteligencia artificial, y precisamente por eso conviene leerlo: enseña a ver por qué un movimiento parece vivo, y esa mirada es la que permite juzgar tanto un Ken Burns de diez líneas como un clip de un modelo de $5,000$ millones de parámetros.
El movimiento más barato es el que no necesita un modelo; la IA generativa se reserva para lo que no se puede hacer de otra forma. Diego lo traduce a su idioma al despedirse: “O sea que la cámara la pone el código, y el modelo solo hace falta si uno quiere que el sol salga de verdad.” Sofía asiente, y añade que el sol puede seguir saliendo en la imaginación de quien escucha el pódcast.
Conclusiones clave
Vídeo como datos
- Un vídeo es un tensor $T \times H \times W \times 3$; un clip de $4$ s a $12$ fps en $512 \times 512$ ocupa $36$ MiB sin comprimir, lo mismo que $48$ portadas, y uno de $1,280 \times 720$ a $24$ fps llega a $253.1$ MiB.
- Generar fotogramas con ruido independiente produce parpadeo; con ruido correlacionado AR(1) de $\rho = 0.9$, la diferencia media entre fotogramas baja en el factor $\sqrt{1-\rho}$: medido $0.314$, teoría $0.316$.
- La diferencia media $\bar{D}$ mide cuánto cambia un clip y la segunda diferencia $P$ si cambia con suavidad: el ruido independiente parpadea $0.2957$ y el Ken Burns $0.0109$.
Animación procedural
- El Ken Burns, el paralaje y el fundido animan una portada con PIL y numpy, sin modelo, con coherencia garantizada porque no inventan píxeles.
- El suavizado cúbico $3t^2 - 2t^3$ arranca y frena en reposo; el paso del recorte va de $0.191$ a $4.56$ píxeles, frente a $3.04$ constantes con interpolación lineal.
- El desplazamiento subpíxel con
resize(..., box = ...)evita un temblor medible: redondear el recorte a píxeles enteros sube el parpadeo un $20%$. - Un GIF de $48$ fotogramas ocupa $2.33$ MiB, el $6.5%$ del clip sin comprimir, y guarda la duración en centésimas: $83$ ms se convierten en $80$.
Modelos y coste
- Wan2.2 TI2V-5B (Apache 2.0) genera 720p a $24$ fps y pide una GPU de $24$ GB o más; Stable Video Diffusion XT usa la licencia comunitaria de Stability AI, con condiciones propias para el uso comercial (revisado en octubre de 2026).
- Con supuestos de juguete, cuatro clips al mes cuestan $0.00$ USD en local, $44.57$ USD con GPU propia y $2.51$ USD con GPU alquilada; la última cabe en el margen de $8.32$ USD, pero no lo merece como componente semanal.
- La decisión de Sofía: movimiento procedural para cada episodio y difusión de vídeo solo como experimento puntual.
Etiquetado y procedencia
- Un Ken Burns sobre la portada ya etiquetada deja la etiqueta entera solo en $10$ de $48$ fotogramas; estampada después del movimiento, aparece idéntica en los $48$.
- La procedencia se guarda dentro del GIF y en un registro JSON hermano, porque las plataformas descartan los comentarios al recomprimir.
Mañana, en el Día 28: Multilingüismo y accesibilidad: un Cuaderno Vivo para más personas. La cuarta pregunta de la semana es quién más puede usar el cuaderno; mañana Sofía traducirá los resúmenes, generará subtítulos y texto alternativo para las portadas, escribirá una versión de lectura fácil y comprobará que su paleta se distingue también con deficiencias en la visión del color.
Referencias
- Blattmann, A., Dockhorn, T., Kulal, S., Mendelevitch, D., Kilian, M., Lorenz, D. y colaboradores (2023). Stable Video Diffusion: Scaling Latent Video Diffusion Models to Large Datasets. arXiv:2311.15127. https://arxiv.org/abs/2311.15127
- Ho, J., Salimans, T., Gritsenko, A., Chan, W., Norouzi, M. y Fleet, D. J. (2022). Video Diffusion Models. Advances in Neural Information Processing Systems 35 (NeurIPS 2022). https://arxiv.org/abs/2204.03458
- Wan Team (2025). Wan: Open and Advanced Large-Scale Video Generative Models. arXiv:2503.20314. Ficha del modelo: https://huggingface.co/Wan-AI/Wan2.2-TI2V-5B-Diffusers
- Stability AI (2023-2026). Ficha de Stable Video Diffusion XT y licencia comunitaria. https://huggingface.co/stabilityai/stable-video-diffusion-img2vid-xt y https://stability.ai/license
- Hugging Face (2026). Documentación de
diffusers: Stable Video Diffusion y Wan. https://huggingface.co/docs/diffusers/main/en/using-diffusers/svd - Reglamento (UE) 2024/1689 del Parlamento Europeo y del Consejo, de 13 de junio de 2024, por el que se establecen normas armonizadas en materia de inteligencia artificial (AI Act), artículo 50. https://eur-lex.europa.eu/eli/reg/2024/1689/oj
- Williams, R. (2001). The Animator’s Survival Kit. Faber and Faber.