
IA generativa en proyectos personales: Día 30
 Jeshua Romero Guadarrama
- 61 Min para leer
- 30 Jan, 2026
Índice de contenido
Resumen:
Abrir un proyecto personal de IA generativa no consiste en subir una carpeta: hay que decidir qué sale del equipo, con qué licencia, cómo lo encuentra otra persona y qué reglas siguen quienes quieran mejorarlo. En esta entrada, Sofía clasifica la entrega del Cuaderno Vivo en público, privado y sintético, pasa el filtro de datos personales también por el historial del repositorio, elige licencias para el código y el contenido, comprueba su compatibilidad con las de los modelos mediante una matriz y un grafo de licencias SPDX, prepara un sitio estático con Hugo dentro de un presupuesto de peso y escribe el README, el registro de cambios y los archivos de comunidad. Al terminar, usted sabrá publicar un proyecto propio sin filtrar datos, sin incumplir licencias y con reglas claras para recibir contribuciones.
¿Cómo citar el presente artículo?
Romero, J. (30 de enero de 2026). IA generativa en proyectos personales: Día 30. python-data-engineer. https://www.python-data-engineer.com/post/iag/dia_30/.
IA generativa en proyectos personales: Día 30 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/iag/dia_30/.
Licencias, especificaciones y versiones revisadas en octubre de 2026: MIT, Apache 2.0, MPL 2.0, CC BY 4.0 y CC BY-SA 4.0 según la lista de licencias SPDX; FLUX.1 [schnell] con Apache 2.0 según su ficha en Hugging Face; XTTS-v2 con la Coqui Public Model License 1.0.0 (CPML), de uso no comercial, según el archivo de licencia de su ficha; Hugo con Apache 2.0 según su repositorio; Contributor Covenant 3.0, publicado el 28 de julio de 2025 por la Organization for Ethical Source y distribuido con CC BY-SA 4.0. Las licencias cambian de versión y las fichas de los modelos también: vuelva a comprobarlas antes de publicar su propio proyecto.
Día 30. Publicar y compartir: sitio estático, licencias, documentación y comunidad
Introducción
Ayer, en el Día 29 (Mantenimiento: pruebas, regresiones y migraciones de modelos y API), aprendió a convertir las comprobaciones dispersas de la serie en una batería de pruebas, a detectar regresiones cuando un modelo cambia de versión y a preparar la migración antes de que llegue una retirada, y el Cuaderno Vivo ganó esa batería y un registro de cambios con versionado semántico que ya llega a la versión $4.1.1$. Hoy llega la sexta pregunta de la semana de “vida del producto”: ¿cómo se comparte el proyecto sin perder el control?
La pregunta la trae Diego, otra vez con nombres propios. Lleva una semana digitalizando los casetes de su abuela, con permiso de ella, y quiere usar el Cuaderno Vivo para ordenar ese archivo musical: resúmenes por casete, una portada por colección y tarjetas para que sus primos aprendan las canciones. Su pregunta es directa: "¿Puedo copiarlo y cambiarlo?". Sofía iba a contestar que sí, por supuesto, y se detuvo. No sabe qué le está dando exactamente. ¿Le da el código? ¿Las portadas? ¿La voz? ¿Sus notas, que siguen en una carpeta del proyecto? ¿Puede Diego, si un día el archivo de la abuela se convierte en un pódcast con anuncios, cobrar por algo que nació de su código?
Esa pregunta, que parece de amistad, es una pregunta de licencias. Y detrás de ella hay otras tres que cualquier proyecto personal se encuentra el día que sale de casa. La primera es qué se publica: el Día 24 separó los datos de Sofía en cuaderno_vivo/, pero desde entonces el proyecto ha crecido y el historial del repositorio guarda cosas que nadie ha vuelto a mirar. La segunda es dónde se publica: un repositorio sirve a quien programa, pero la abuela de Diego no va a leer un archivo Markdown. La tercera es cómo se recibe ayuda: en cuanto Diego encuentre un error y quiera arreglarlo, el proyecto necesita reglas para aceptar código ajeno, sobre todo si ese código lo escribió un asistente.
En la presente entrada, descubrirá cómo hacer un inventario de publicación con reglas por patrón y cómo pasar el filtro de datos personales del Día 19 sobre todo lo que se publicará, incluido el historial. Verá cómo elegir licencias para el código y para el contenido, cómo comprobar su compatibilidad con las licencias de los modelos usados mediante una matriz de usos y un grafo de identificadores SPDX con su cierre transitivo, y cómo marcar cada archivo fuente con su cabecera. Construirá la estructura de un sitio estático con Hugo, con su configuración y el front matter de cada episodio, y lo mantendrá dentro de un presupuesto de peso por página. Terminará con el README, el registro de cambios, la guía de contribución, la política de seguridad, una revisión automática de contribuciones y el borrador del anuncio.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Separar lo que se publica (código, documentación, ejemplos sintéticos) de lo que nunca sale del equipo (notas, voz, registros).
- Elegir licencias para el código y para el contenido, y comprobar su compatibilidad con las licencias de los modelos usados.
- Publicar la documentación y una galería de ejemplos como sitio estático con Hugo, con un presupuesto de peso por página.
- Preparar el repositorio para otras personas: README, guía de contribución, código de conducta y política de seguridad.
- Recibir contribuciones sin perder el control de la calidad ni de la ética del proyecto.
Qué se publica y qué no
Publicar no es un verbo binario. Entre “todo” y “nada” hay tres categorías que conviene distinguir antes de tocar un solo archivo. Lo público es lo que otra persona necesita para entender, instalar y modificar el proyecto: el código, la documentación, la configuración sin secretos. Lo privado es lo que pertenece a Sofía y no tiene ningún valor para nadie más, salvo para quien quiera hacerle daño: sus notas, su progreso en el tutor, su consentimiento de voz, la grabación mi_voz.wav y la clave de la API. Y lo sintético es la tercera vía que hace posible publicar sin exponer: notas de demostración, portadas de ejemplo y casos de prueba que tienen la misma forma que los datos reales, pero no su contenido.
Comencemos, como siempre, por las importaciones y la semilla global $2026$. Hoy se usan fnmatch para comparar rutas con patrones, tomllib para validar la configuración de Hugo y Pillow para convertir las portadas; como en todo el módulo 7, ninguna biblioteca de audio ni de vídeo. Todos los archivos se escriben en un directorio temporal que se borra al cerrar Python:
# Importaciones base y semilla del día en Python:
import warnings
warnings.filterwarnings('ignore')
import io
import re
import sys
import json
import tempfile
import tomllib
from fnmatch import fnmatch
from pathlib import Path
import numpy as np
import pandas as pd
import matplotlib
import matplotlib.pyplot as plt
from matplotlib.patches import FancyBboxPatch, FancyArrowPatch
import PIL
from PIL import Image, ImageDraw

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 120)
temporal = tempfile.TemporaryDirectory()          # se borra solo al cerrar Python
raiz = Path(temporal.name) / 'cuaderno-vivo'
print('Python', sys.version.split()[0], '| numpy', np.__version__, '| pandas', pd.__version__,
      '| matplotlib', matplotlib.__version__, '| Pillow', PIL.__version__)
Python 3.12.10 | numpy 2.4.6 | pandas 3.0.3 | matplotlib 3.10.9 | Pillow 12.2.0
Las versiones quedan anotadas para que cualquiera pueda reproducir las cifras de esta entrada. Observe que la versión de Python es la $3.12$: tomllib forma parte de la biblioteca estándar desde la $3.11$, de modo que validar el TOML de Hugo no exige instalar nada.
El inventario parte del árbol de la entrega del Día 24, ampliado con lo que añadieron los días 25 a 29 (CHANGELOG.md, el registro de decisiones ADR-004.md del Día 26, dos archivos de pruebas del Día 29) y con tres archivos que suelen aparecer en cualquier carpeta de trabajo real: el archivo .env con la clave, la grabación mi_voz.wav del Día 15 y un notas_borrador.txt que Sofía dejó en la raíz una noche de prisa. El clasificador es una lista ordenada de reglas (patrón, clase, motivo); gana la primera que coincide, y lo que no coincide con ninguna no se publica por defecto, sino que queda marcado para revisión humana. Al final, el bloque sustituye las $12$ notas de Sofía por $12$ notas de demostración con el mismo formato de notas.json:
# Inventario de publicación con reglas por patrón sobre el árbol de la entrega en Python:
ARCHIVOS = [
    'README.md', 'FICHA_SISTEMA.md', 'LICENCIAS.md', 'CHANGELOG.md', 'requirements.txt',
    'config.toml', '.gitignore', '.env', '.env.ejemplo', 'mi_voz.wav', 'notas_borrador.txt',
    'preparar_semana.py', 'cuaderno_v0.py', 'cuaderno_v1.py', 'cuaderno_v2.py', 'cuaderno_v3.py',
    'cuaderno_v4.py', 'tutor.py', 'portadas.py', 'narracion.py', 'recuperacion.py', 'guardianes.py',
    'cuaderno_vivo/notas.json', 'cuaderno_vivo/memoria.json', 'cuaderno_vivo/estilo.json',
    'cuaderno_vivo/consentimiento_voz.json', 'cuaderno_vivo/progreso_tutor.json',
    'cuaderno_vivo/registro_uso.csv', 'cuaderno_vivo/riesgos.csv', 'cuaderno_vivo/DIVULGACION.md',
    'cuaderno_vivo/portadas/semana_01.png', 'cuaderno_vivo/audio/semana_04.wav',
    'docs/arquitectura.png', 'docs/adr/ADR-001.md', 'docs/adr/ADR-004.md',
    'evaluacion/casos.jsonl', 'datos_ejemplo/notas.json', 'datos_ejemplo/portadas/semana_01.png',
    'pruebas/prueba_humo.py', 'pruebas/test_guardianes.py', 'pruebas/test_idioma.py',
]
for nombre in ARCHIVOS:
    (raiz / nombre).parent.mkdir(parents = True, exist_ok = True)
    (raiz / nombre).touch()

# Reglas en orden: gana la primera que coincide; lo que no coincide con ninguna se revisa a mano:
REGLAS = [
    ('.env', 'privado', 'contiene la clave de la API'),
    ('mi_voz.wav', 'privado', 'muestra de la voz de Sofía (Día 15)'),
    ('cuaderno_vivo/DIVULGACION.md', 'público', 'política de divulgación (Día 20)'),
    ('cuaderno_vivo/*', 'privado', 'datos personales de Sofía'),
    ('evaluacion/*', 'privado', 'casos escritos a partir de notas reales'),
    ('datos_ejemplo/*', 'sintético', 'notas y portadas de demostración'),
    ('*.py', 'público', 'código fuente'),
    ('*.md', 'público', 'documentación'),
    ('docs/*', 'público', 'arquitectura y decisiones'),
    ('*.toml', 'público', 'configuración sin secretos'),
    ('requirements.txt', 'público', 'dependencias fijadas'),
    ('.gitignore', 'público', 'lista de lo que nunca se sube'),
    ('.env.ejemplo', 'público', 'plantilla de variables sin valores'),
]

def clasificar(ruta):
    # Devuelve (clase, motivo) de la primera regla que coincide con la ruta relativa:
    for patron, clase, motivo in REGLAS:
        if fnmatch(ruta, patron):
            return clase, motivo
    return 'revisar', 'ninguna regla lo cubre'

inventario = pd.DataFrame(
    [(p.relative_to(raiz).as_posix(), *clasificar(p.relative_to(raiz).as_posix()))
     for p in sorted(raiz.rglob('*')) if p.is_file()],
    columns = ['archivo', 'clase', 'motivo'])
print(inventario['clase'].value_counts().to_string())
print()
print(inventario[inventario['clase'] != 'público'].to_string(index = False))

# Las 12 notas de Sofía se sustituyen por 12 notas de demostración del mismo formato:
PLANTILLAS = {
    'estadística': ['La mediana de {a} es menos sensible a los extremos que la media.',
                    'La varianza de {a} mide la dispersión alrededor de su media.',
                    'Una muestra de {a} permite estimar un intervalo para la población.'],
    'python': ['Una lista con {a} se recorre con un ciclo for.',
               'Pandas agrupa {a} por columna con groupby.',
               'Una función que procesa {a} evita repetir código.'],
    'historia del arte': ['El barroco pinta {a} con contrastes fuertes de luz.',
                          'El art nouveau dibuja {a} con líneas curvas y orgánicas.',
                          'La Bauhaus reduce {a} a formas geométricas simples.'],
    'música': ['Una escala menor sobre {a} suena más oscura que la mayor.',
               'Un arpegio toca las notas de {a} una tras otra.',
               'El compás de tres tiempos organiza {a} como un vals.'],
}
OBJETOS = ['las temperaturas de una ciudad ficticia', 'los precios de una tienda de ejemplo',
           'los tiempos de una carrera simulada', 'unas frutas de juguete', 'unas ventas inventadas',
           'unos datos de prueba', 'un paisaje', 'un retrato imaginario', 'una silla',
           'la nota la', 'un acorde de do', 'una melodía de ejemplo']
demo = [{'id': i + 1, 'tema': tema, 'texto': frase.format(a = OBJETOS[i])}
        for i, (tema, frase) in enumerate((t, f) for t, fs in PLANTILLAS.items() for f in fs)]
(raiz / 'datos_ejemplo/notas.json').write_text(json.dumps(demo, ensure_ascii = False, indent = 2), encoding = 'utf-8')
print(f"\nNotas de demostración: {len(demo)} | primera: {demo[0]['texto']}")
clase
público      26
privado      12
sintético     2
revisar       1

                              archivo     clase                                  motivo
                                 .env   privado             contiene la clave de la API
    cuaderno_vivo/audio/semana_04.wav   privado               datos personales de Sofía
cuaderno_vivo/consentimiento_voz.json   privado               datos personales de Sofía
            cuaderno_vivo/estilo.json   privado               datos personales de Sofía
           cuaderno_vivo/memoria.json   privado               datos personales de Sofía
             cuaderno_vivo/notas.json   privado               datos personales de Sofía
 cuaderno_vivo/portadas/semana_01.png   privado               datos personales de Sofía
    cuaderno_vivo/progreso_tutor.json   privado               datos personales de Sofía
       cuaderno_vivo/registro_uso.csv   privado               datos personales de Sofía
            cuaderno_vivo/riesgos.csv   privado               datos personales de Sofía
             datos_ejemplo/notas.json sintético        notas y portadas de demostración
 datos_ejemplo/portadas/semana_01.png sintético        notas y portadas de demostración
               evaluacion/casos.jsonl   privado casos escritos a partir de notas reales
                           mi_voz.wav   privado     muestra de la voz de Sofía (Día 15)
                   notas_borrador.txt   revisar                  ninguna regla lo cubre

Notas de demostración: 12 | primera: La mediana de las temperaturas de una ciudad ficticia es menos sensible a los extremos que la media.
De los $41$ archivos del árbol, $26$ son públicos, $12$ privados, $2$ sintéticos y $1$ queda para revisión. La Tabla 1 resume el inventario por grupos, con el motivo de cada decisión.
Tabla 1. Inventario de publicación del Cuaderno Vivo.
| Archivo o carpeta | Clasificación | Motivo |
|---|---|---|
cuaderno_v0.py a cuaderno_v4.py, módulos y pruebas/ | Público | Código fuente |
README.md, FICHA_SISTEMA.md, LICENCIAS.md, CHANGELOG.md | Público | Documentación |
docs/ (arquitectura y ADR) | Público | Arquitectura y decisiones |
config.toml, requirements.txt, .gitignore, .env.ejemplo | Público | Configuración sin secretos |
cuaderno_vivo/DIVULGACION.md | Público | Política de divulgación (Día 20) |
cuaderno_vivo/ (resto: 9 archivos) | Privado | Datos personales de Sofía |
evaluacion/casos.jsonl | Privado | Casos escritos a partir de notas reales |
.env | Privado | Contiene la clave de la API |
mi_voz.wav | Privado | Muestra de la voz de Sofía (Día 15) |
datos_ejemplo/ | Sintético | Notas y portadas de demostración |
notas_borrador.txt | Revisar | Ninguna regla lo cubre |
Tres decisiones de la tabla merecen comentario:
- El orden de las reglas es parte de la política.
cuaderno_vivo/DIVULGACION.mdes público, aunque vive en una carpeta privada, porque su regla aparece antes quecuaderno_vivo/*. Si se invirtiera el orden, la política de divulgación, que es justamente lo que el público debe leer, quedaría oculta. Una lista de reglas ordenada es fácil de auditar: se lee de arriba abajo y la primera coincidencia explica la decisión. - Lo desconocido no se publica.
notas_borrador.txtno coincide con ninguna regla y el clasificador no adivina: lo marca comorevisar. Es el mismo principio de lista blanca que el Día 25 aplicó a los permisos del agente de código. Un clasificador que publicara por defecto habría subido las notas que Sofía escribió de madrugada. - Los casos de evaluación son privados, aunque parezcan técnicos. El Día 23 escribió
evaluacion/casos.jsonla partir de las notas reales, de modo que cada caso contiene fragmentos de ellas. Lo que se publica es la estructura de la evaluación, aplicada adatos_ejemplo/.
Las notas de demostración merecen una línea aparte. La primera dice “La mediana de las temperaturas de una ciudad ficticia es menos sensible a los extremos que la media.”: tiene el tema, la longitud y el tono de una nota de estudio, pero ningún dato de Sofía. Sirven para que la prueba de humo y el inicio rápido funcionen igual que con las notas reales, y declaran en cada frase que son ficticias.
Una última pasada del filtro
El inventario decide por nombre de archivo; no lee el contenido. Un documento público puede contener un dato privado, y el lugar donde eso ocurre con más frecuencia es el que nadie revisa: el historial del repositorio. Cuando se publica un repositorio de git, se publica cada versión de cada archivo y cada mensaje de cada commit, incluidas las pruebas apresuradas que se escribieron una noche y se borraron a la mañana siguiente. Borrar un archivo en el último commit no lo borra de la historia.
El siguiente bloque recupera literalmente el detector de datos personales del Día 19 (las mismas cuatro expresiones regulares: correo, teléfono, CURP y dirección) y lo pasa sobre dos documentos de juguete que se publicarán, sobre las notas de demostración y sobre los mensajes de los cuatro últimos commits:
# Última pasada del filtro de datos personales del Día 19 sobre lo que se publicará en Python:
PATRONES = {
    'correo': re.compile(r'\b[\w.+-]+@[\w-]+(?:\.[\w-]+)+\b'),
    'telefono': re.compile(r'(?<!\d)\d{2}[ -]?\d{4}[ -]?\d{4}(?!\d)'),
    'curp': re.compile(r'\b[A-Z]{4}\d{6}[HM][A-Z]{5}[A-Z0-9]\d\b'),
    'direccion': re.compile(r'\b(?:[Cc]alle|[Aa]v\.|[Aa]venida)\s+(?:[A-ZÁÉÍÓÚÑ][a-záéíóúñ]+\s+){1,3}\d{1,5}\b'),
}

def detectar(texto):
    # Lista de (tipo, inicio, fin, valor), sin solapes y en orden de aparición:
    hallazgos = []
    for tipo, patron in PATRONES.items():
        for m in patron.finditer(texto):
            if all(m.end() <= h[1] or m.start() >= h[2] for h in hallazgos):
                hallazgos.append((tipo, m.start(), m.end(), m.group(0)))
    return sorted(hallazgos, key = lambda h: h[1])

# Textos que se publicarán: dos documentos de juguete, las notas de demostración y el historial:
A_PUBLICAR = {
    'docs/adr/ADR-004.md': 'ADR-004. Las notas con datos personales se clasifican en local. '
                           'Lo decidimos con Diego en la Calle Olmo Azul 128 el 26 de enero.',
    'README.md (borrador)': 'Dudas y sugerencias: escriba a sofia.prueba@ejemplo.org o abra una incidencia.',
    'datos_ejemplo/notas.json': ' '.join(n['texto'] for n in demo),
}
HISTORIAL = [  # (identificador del commit, mensaje), del más reciente al más antiguo:
    ('a41c9e2', 'Corrige el idioma del resumen (4.1.1)'),
    ('7d03b18', 'Añade clips animados de las portadas'),
    ('c5e2f70', 'Prueba con la nota real: llamar a Diego al 55 0101 2026 antes del examen'),
    ('19b8d44', 'Entrega final 4.0.0'),
]
for nombre, texto in A_PUBLICAR.items():
    print(f'{nombre:26s}', [(t, v) for t, _, _, v in detectar(texto)] or 'limpio')
for commit, mensaje in HISTORIAL:
    if (hallazgos := detectar(mensaje)):
        print(f'historial {commit}         ', [(t, v) for t, _, _, v in hallazgos])
print(f'Commits revisados: {len(HISTORIAL)} | con datos personales: '
      f'{sum(bool(detectar(m)) for _, m in HISTORIAL)}')
docs/adr/ADR-004.md        [('direccion', 'Calle Olmo Azul 128')]
README.md (borrador)       [('correo', 'sofia.prueba@ejemplo.org')]
datos_ejemplo/notas.json   limpio
historial c5e2f70          [('telefono', '55 0101 2026')]
Commits revisados: 4 | con datos personales: 1
El filtro encuentra tres datos personales: una dirección en el registro de decisiones ADR-004.md, un correo en el borrador del README y un teléfono en el mensaje del commit c5e2f70. Las notas de demostración salen limpias, como debían. Cada hallazgo exige una acción distinta:
- La dirección del ADR se elimina del texto: el lugar de una conversación no aporta nada a una decisión de arquitectura.
- El correo del README se sustituye por un buzón del proyecto. Un correo personal en un repositorio público termina en listas de correo no deseado en cuestión de días, y la sección de comunidad ofrece mejores canales.
- El teléfono del historial es el caso difícil. Corregir el mensaje del commit exige reescribir la historia con una herramienta como
git filter-repo, y eso cambia el identificador de ese commit y de todos los posteriores. Antes de publicar por primera vez es barato; después de publicar es tarde, porque cualquier copia anterior conserva el dato.
Atención aquí: Revise el historial antes del primer git push a un repositorio público. Una vez publicado, reescribir la historia no borra las copias que otras personas ya hayan clonado ni las que guardan los servicios de archivo. Si el dato es una clave de API, no basta con borrarla del historial: revóquela en la consola del proveedor y genere otra. El filtro con expresiones regulares tampoco es exhaustivo; el Día 19 midió que falla con los formatos que su autor no imaginó, así que una lectura humana del historial completo sigue siendo obligatoria en un proyecto pequeño.
Licencias
Sin licencia, un repositorio público no es un proyecto abierto. Es un escaparate: cualquiera puede mirarlo, pero la ley de derechos de autor reserva a Sofía, por defecto, el derecho de copiarlo, modificarlo y distribuirlo. La respuesta honesta a la pregunta de Diego, sin licencia, sería “puede leerlo”. Una licencia es el documento con el que la autora concede a todo el mundo, por adelantado y sin negociar caso por caso, permisos que la ley no da por defecto, a cambio de unas condiciones.
El Cuaderno Vivo necesita al menos dos licencias, porque tiene dos tipos de obra. Para el código, las dos opciones más habituales en proyectos pequeños son la licencia MIT, de unas pocas líneas, que permite casi todo a cambio de conservar el aviso de copyright y el texto de la licencia, y la Apache 2.0, más larga, que añade una concesión expresa de patentes, la obligación de indicar los cambios y la de conservar el archivo NOTICE si existe. Para el contenido (documentación, entradas, ejemplos, imágenes propias), la opción natural es Creative Commons Atribución 4.0 (CC BY 4.0), la misma de este blog: permite copiar, adaptar y usar con fines comerciales a cambio de atribuir e indicar los cambios. Creative Commons desaconseja expresamente usar sus licencias para software, porque no tratan el código fuente ni las patentes, y por eso el proyecto usa dos.
Pero el Cuaderno Vivo no se construyó solo con obra de Sofía. Usa FLUX.1 [schnell], distribuido con Apache 2.0, para las portadas (Día 12); XTTS-v2, distribuido con la Coqui Public Model License 1.0.0 (CPML), para la voz clonada (Día 15); el kit coqui-tts, con MPL 2.0, para ejecutar XTTS-v2; y Hugo, con Apache 2.0, para el sitio de hoy. La Tabla 2 reúne las licencias del proyecto y de sus dependencias principales:
Tabla 2. Licencias del proyecto y de sus dependencias principales (revisado en octubre de 2026).
| Componente | Licencia | Identificador SPDX | Uso comercial | Obligación de atribución |
|---|---|---|---|---|
| Código del Cuaderno Vivo | MIT | MIT | Sí | Conservar el aviso y la licencia |
| Documentación y ejemplos | Creative Commons Atribución 4.0 | CC-BY-4.0 | Sí | Atribuir e indicar cambios |
| FLUX.1 [schnell] (portadas) | Apache 2.0 | Apache-2.0 | Sí | Licencia, NOTICE si existe, cambios |
| XTTS-v2 (voz clonada) | Coqui Public Model License 1.0.0 | LicenseRef-CPML-1.0.0 | No | Entregar los términos con el modelo o sus salidas |
coqui-tts (kit de voz) | Mozilla Public License 2.0 | MPL-2.0 | Sí | Código de los archivos modificados bajo MPL |
| Hugo (generador del sitio) | Apache 2.0 | Apache-2.0 | Sí | Solo si se redistribuye Hugo |
| Código de conducta | Contributor Covenant 3.0, con CC BY-SA 4.0 | CC-BY-SA-4.0 | Sí | Atribuir y compartir igual |
Sofía elige MIT para el código. La razón no es estética: como se verá en el grafo de compatibilidad, el código MIT puede integrarse en proyectos con más licencias que el código Apache 2.0, incluidos los que usan GPL 2.0 sin la cláusula “o posterior”, y la concesión de patentes de Apache aporta poco a un proyecto personal sin patentes. Si el Cuaderno Vivo creciera y recibiera contribuciones de empresas, Apache 2.0 sería la elección más prudente.
La fila de XTTS-v2 es la que cambia la respuesta a Diego. Según el archivo de licencia de su ficha en Hugging Face, la CPML 1.0.0 solo permite fines no comerciales, y define el uso no comercial con una condición estricta: no recibir ningún pago, directo ni indirecto, derivado del uso del modelo o de sus salidas. Un pódcast con anuncios, aunque sea pequeño, recibe un pago indirecto. Además, quien reciba el modelo, una modificación o sus salidas debe recibir también los términos de la licencia.
Compatibilidad
Una licencia aislada responde a “¿qué puedo hacer con esto?”. En un proyecto que combina piezas, la pregunta útil es otra: ¿qué puedo hacer con el conjunto? Y la respuesta la da la pieza más restrictiva. Si un componente $c$ está sujeto a un conjunto de restricciones $\mathcal{R}(c)$ (su licencia, pero también el consentimiento de voz del Día 15, la privacidad de los datos o la etiqueta de divulgación del Día 20), y cada restricción $r$ asigna a cada uso $u$ un nivel $n_r(u)$ (2 permitido, 1 con condiciones, 0 no permitido), el nivel del componente es:
$$ n(c, u) = \min_{r \in \mathcal{R}(c)} n_r(u) $$
La lógica detrás de esta regla es la siguiente:
- Cada restricción es independiente de las demás y todas se aplican a la vez: cumplir la licencia de un modelo no exime de cumplir el consentimiento firmado, y al revés.
- El mínimo representa el eslabón más débil. Basta una restricción que prohíba un uso para que el uso quede prohibido, aunque las demás lo permitan.
- Además del nivel, importa cuál restricción lo fija, porque es la que habría que cambiar para ampliar el uso: renegociar un consentimiento es posible, cambiar la licencia de un modelo ajeno no.
- En conclusión, la matriz no dice solo qué se puede publicar, sino por qué no se puede publicar lo demás.
El siguiente bloque escribe esas restricciones como un diccionario, calcula la matriz de $6$ componentes por $3$ usos y define puede_publicarse(componente, uso), que devuelve el nivel, la restricción que lo fija y todas las condiciones que hay que cumplir:
# Matriz de compatibilidad de licencias y función puede_publicarse en Python:
USOS = ['personal', 'publicar gratis', 'uso comercial']
NIVELES = {0: 'no permitido', 1: 'con condiciones', 2: 'permitido'}
# Cada restricción da un nivel por uso; el nivel final de un componente es el mínimo:
RESTRICCIONES = {
    'MIT': ([2, 1, 1], 'conservar el aviso de copyright y la licencia'),
    'CC-BY-4.0': ([2, 1, 1], 'atribuir e indicar cambios'),
    'Apache-2.0': ([2, 1, 1], 'incluir la licencia y el NOTICE si existe, indicar cambios'),
    'CPML-1.0.0': ([2, 1, 0], 'sin pago directo ni indirecto, entregar los términos'),
    'consentimiento': ([2, 0, 0], 'el alcance firmado dice "sin publicar"'),
    'privacidad': ([2, 0, 0], 'datos personales de Sofía'),
    'divulgación': ([2, 1, 1], 'etiqueta "Generado con IA" visible'),
    'herramienta': ([2, 2, 2], 'la licencia de Hugo no se extiende al sitio generado'),
}
COMPONENTES = {
    'Código del Cuaderno Vivo': ['MIT'],
    'Documentación y entradas': ['CC-BY-4.0'],
    'Portadas con FLUX.1 schnell': ['Apache-2.0', 'divulgación'],
    'Episodios con voz XTTS-v2': ['CPML-1.0.0', 'consentimiento', 'divulgación'],
    'Notas personales de Sofía': ['privacidad'],
    'Sitio generado con Hugo': ['herramienta'],
}

def puede_publicarse(componente, uso):
    # Nivel mínimo entre las restricciones del componente, la restricción que lo fija y las condiciones:
    j = USOS.index(uso)
    nivel, causa = min((RESTRICCIONES[r][0][j], r) for r in COMPONENTES[componente])
    condiciones = [RESTRICCIONES[r][1] for r in COMPONENTES[componente] if RESTRICCIONES[r][0][j] < 2]
    return NIVELES[nivel], causa, condiciones

matriz = np.array([[min(RESTRICCIONES[r][0][j] for r in rs) for j in range(len(USOS))]
                   for rs in COMPONENTES.values()])
print(pd.DataFrame(matriz, index = list(COMPONENTES), columns = USOS).to_string())
print()
for consulta in [('Episodios con voz XTTS-v2', 'publicar gratis'), ('Episodios con voz XTTS-v2', 'uso comercial'),
                 ('Portadas con FLUX.1 schnell', 'uso comercial')]:
    print(consulta[0], '|', consulta[1], '->', puede_publicarse(*consulta))

fig, ax = plt.subplots(figsize = (9, 4.8))
colores = matplotlib.colors.ListedColormap(['#C44E52', '#DD8452', '#55A868'])
ax.imshow(matriz, cmap = colores, vmin = 0, vmax = 2, aspect = 'auto')
for i in range(matriz.shape[0]):
    for j in range(matriz.shape[1]):
        ax.text(j, i, NIVELES[matriz[i, j]], ha = 'center', va = 'center', color = 'white', fontsize = 10)
ax.set_xticks(range(len(USOS)), USOS)
ax.set_yticks(range(len(COMPONENTES)), list(COMPONENTES))
ax.tick_params(top = True, bottom = False, labeltop = True, labelbottom = False)
ax.set_title('¿Qué se puede hacer con cada componente?', fontsize = 16, pad = 12)
plt.tight_layout()
# Verde: permitido; naranja: con condiciones; rojo: no permitido:
plt.show()
                             personal  publicar gratis  uso comercial
Código del Cuaderno Vivo            2                1              1
Documentación y entradas            2                1              1
Portadas con FLUX.1 schnell         2                1              1
Episodios con voz XTTS-v2           2                0              0
Notas personales de Sofía           2                0              0
Sitio generado con Hugo             2                2              2

Episodios con voz XTTS-v2 | publicar gratis -> ('no permitido', 'consentimiento', ['sin pago directo ni indirecto, entregar los términos', 'el alcance firmado dice "sin publicar"', 'etiqueta "Generado con IA" visible'])
Episodios con voz XTTS-v2 | uso comercial -> ('no permitido', 'CPML-1.0.0', ['sin pago directo ni indirecto, entregar los términos', 'el alcance firmado dice "sin publicar"', 'etiqueta "Generado con IA" visible'])
Portadas con FLUX.1 schnell | uso comercial -> ('con condiciones', 'Apache-2.0', ['incluir la licencia y el NOTICE si existe, indicar cambios', 'etiqueta "Generado con IA" visible'])
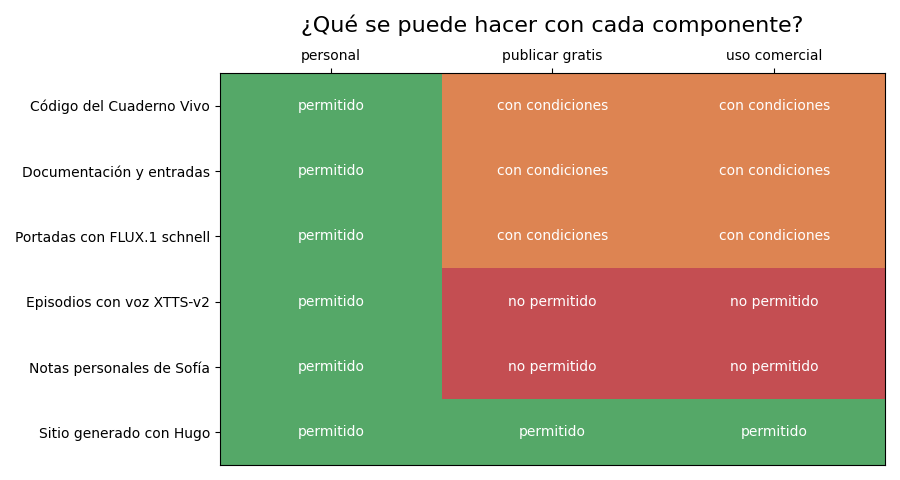
La Figura del bloque se lee por columnas. El uso personal está permitido para todo, como era de esperar: es lo que Sofía ha hecho durante treinta días. Publicar gratis separa el proyecto en tres grupos: el código, la documentación y las portadas se pueden publicar con condiciones (aviso de licencia, atribución, etiqueta “Generado con IA”); el sitio de Hugo no tiene ninguna, porque la licencia de una herramienta no se extiende a lo que se produce con ella; y los episodios con voz clonada y las notas personales no se pueden publicar.
El caso de los episodios es el más instructivo. La consulta puede_publicarse('Episodios con voz XTTS-v2', 'publicar gratis') devuelve “no permitido”, y la restricción que lo fija no es la licencia, sino el consentimiento: el alcance que Sofía firmó el Día 15 dice “uso personal, sin publicar, sin uso comercial, solo en español”. La CPML permitiría publicar gratis con condiciones; es la propia Sofía quien se lo prohibió por escrito. Para el uso comercial, en cambio, hay dos restricciones en cero, la CPML y el consentimiento, y aunque Sofía renovara su consentimiento, la licencia del modelo seguiría impidiéndolo. Por eso el sitio publicará la transcripción revisada de cada episodio, y no el audio.
Para la pregunta de Diego, la respuesta ya tiene forma. Puede copiar y cambiar el código y la documentación, también para un proyecto con anuncios, siempre que conserve el aviso MIT y atribuya la documentación. Puede usar FLUX.1 [schnell] para las portadas del archivo de su abuela. No puede usar XTTS-v2 si el proyecto genera ingresos, y en ningún caso puede usar la voz de Sofía. Y hay una pregunta que ninguna licencia del Cuaderno Vivo responde: los derechos de las grabaciones de los casetes. Si contienen música de otros autores, el permiso de la abuela cubre sus cintas, no las canciones.
Identificadores SPDX
Escribir “licencia MIT” en un README es útil para una persona y ambiguo para un programa. SPDX (por sus siglas en inglés: “Software Package Data Exchange”) es un estándar de la Linux Foundation que, entre otras cosas, mantiene una lista de licencias con un identificador corto para cada una: MIT, Apache-2.0, MPL-2.0, CC-BY-4.0, GPL-3.0-or-later. Las licencias que no figuran en la lista se nombran con el prefijo LicenseRef-; para la CPML no encontramos un identificador oficial al revisar la lista en octubre de 2026, y por eso se escribe LicenseRef-CPML-1.0.0, acompañado del texto completo de la licencia en el repositorio.
La práctica recomendada es que cada archivo fuente declare su licencia en una línea de comentario al principio, SPDX-License-Identifier: MIT, de modo que el archivo conserve su licencia aunque alguien lo copie suelto a otro proyecto. El siguiente bloque comprueba esa cabecera en seis archivos de ejemplo (aceptando un shebang en la primera línea) y, con los identificadores ya fijados, construye un grafo de compatibilidad: una arista $A \to B$ significa que la obra publicada bajo $A$ puede integrarse en una obra que se distribuye bajo $B$. Las seis aristas directas resumen relaciones conocidas: MIT es compatible con Apache 2.0 y con GPL 2.0; Apache 2.0 es compatible con GPL 3.0, pero no con GPL 2.0 sola; MPL 2.0 se combina con la GPL a través de sus “licencias secundarias”; y CC BY-SA 4.0 tiene una compatibilidad declarada en un solo sentido con GPL 3.0. Para deducir las relaciones indirectas, el bloque calcula el cierre transitivo de la matriz de adyacencia $R$ con el algoritmo de Warshall:
$$ R^{(k)}{ij} = R^{(k-1)}{ij} \lor \left( R^{(k-1)}{ik} \land R^{(k-1)}{kj} \right), \qquad k = 1, \dots, n $$
La lógica detrás del algoritmo es sencilla:
- $R^{(k)}_{ij}$ es verdadero si existe un camino de $i$ a $j$ que solo pasa por los $k$ primeros nodos como intermedios.
- En cada paso se permite un nodo intermedio más, $k$: hay camino si ya lo había, o si se puede ir de $i$ a $k$ y de $k$ a $j$.
- Tras $n$ pasos, $R^{(n)}$ contiene todos los caminos. Con matrices booleanas de numpy, cada paso es un producto exterior y un “o” lógico, y el coste total es del orden de $n^3$, irrelevante para ocho licencias.
# Cabeceras SPDX y grafo de compatibilidad con el cierre transitivo de Warshall en Python:
EJEMPLOS = {
    'cuaderno_v4.py': '# SPDX-License-Identifier: MIT\n# SPDX-FileCopyrightText: 2026 Sofía\nimport json\n',
    'tutor.py': '# SPDX-License-Identifier: MIT\nfrom pydantic import BaseModel\n',
    'portadas.py': '#!/usr/bin/env python3\n# SPDX-License-Identifier: MIT\nimport json\n',
    'guardianes.py': 'import re\n\n# SPDX-License-Identifier: MIT\n',
    'narracion.py': '"""Narrador semanal del Cuaderno Vivo."""\nimport numpy as np\n',
    'pruebas/test_idioma.py': '# SPDX-License-Identifier: MIT\nimport unittest\n',
}
SPDX = re.compile(r'^#\s*SPDX-License-Identifier:\s*([A-Za-z0-9.+-]+(?:\s+(?:AND|OR|WITH)\s+[A-Za-z0-9.+-]+)*)\s*$')

def licencia_declarada(texto):
    # La cabecera debe estar en las dos primeras líneas (la primera puede ser un shebang):
    for linea in texto.splitlines()[:2]:
        if (m := SPDX.match(linea)):
            return m.group(1)
    return None

for nombre, texto in EJEMPLOS.items():
    print(f'{nombre:24s}', licencia_declarada(texto) or 'SIN CABECERA')

# A -> B: lo publicado bajo A puede integrarse en una obra que se distribuye bajo B:
LICENCIAS = ['MIT', 'Apache-2.0', 'MPL-2.0', 'GPL-2.0-only', 'GPL-3.0-or-later',
             'CC-BY-4.0', 'CC-BY-SA-4.0', 'LicenseRef-CPML-1.0.0']
DIRECTAS = [('MIT', 'Apache-2.0'), ('MIT', 'GPL-2.0-only'), ('Apache-2.0', 'GPL-3.0-or-later'),
            ('MPL-2.0', 'GPL-3.0-or-later'), ('CC-BY-4.0', 'CC-BY-SA-4.0'), ('CC-BY-SA-4.0', 'GPL-3.0-or-later')]
n = len(LICENCIAS)
R = np.zeros((n, n), dtype = bool)
for a, b in DIRECTAS:
    R[LICENCIAS.index(a), LICENCIAS.index(b)] = True
cierre = R.copy()
for k in range(n):                                  # algoritmo de Warshall
    cierre |= np.outer(cierre[:, k], cierre[k, :])
derivadas = [(LICENCIAS[i], LICENCIAS[j]) for i, j in zip(*np.nonzero(cierre & ~R))]
print(f'\nAristas directas: {R.sum()} | tras el cierre: {cierre.sum()} | derivadas: {derivadas}')
print('Aisladas (ni entra ni sale ninguna arista):',
      [l for i, l in enumerate(LICENCIAS) if not cierre[i].any() and not cierre[:, i].any()])

posiciones = {'MIT': (0, 2), 'Apache-2.0': (2.1, 2.6), 'MPL-2.0': (2.1, 1.3), 'GPL-2.0-only': (2.1, 3.9),
              'GPL-3.0-or-later': (4.3, 2), 'CC-BY-4.0': (0, 0), 'CC-BY-SA-4.0': (2.1, 0),
              'LicenseRef-CPML-1.0.0': (4.3, 0)}
fig, ax = plt.subplots(figsize = (10, 5.4))
cajas = {}
for nombre, (x, y) in posiciones.items():
    color = '#C44E52' if nombre.startswith('LicenseRef') else ('#55A868' if nombre.startswith('CC') else '#4C72B0')
    cajas[nombre] = ax.add_patch(FancyBboxPatch((x - 0.66, y - 0.25), 1.32, 0.5, boxstyle = 'round,pad=0.05',
                                                facecolor = 'white', edgecolor = color, linewidth = 2))
    ax.text(x, y, nombre.replace('LicenseRef-', 'LicenseRef-\n'), ha = 'center', va = 'center', fontsize = 9)
for (a, b), estilo in [(par, '-') for par in DIRECTAS] + [(par, '--') for par in derivadas]:
    # Cada flecha nace y muere en el borde de su caja:
    ax.add_patch(FancyArrowPatch(posiciones[a], posiciones[b], patchA = cajas[a], patchB = cajas[b],
                                 arrowstyle = '-|>', mutation_scale = 18, linestyle = estilo,
                                 color = '#4C72B0' if estilo == '-' else '#8172B3',
                                 connectionstyle = 'arc3,rad=0.1' if estilo == '--' else 'arc3'))
ax.set_xlim(-0.9, 5.2); ax.set_ylim(-0.6, 4.5); ax.axis('off')
ax.set_title('Compatibilidad de licencias: directas (continuas) y derivadas (discontinuas)', fontsize = 14)
plt.tight_layout()
# Azul: código; verde: contenido; rojo: licencia propia sin aristas:
plt.show()
cuaderno_v4.py           MIT
tutor.py                 MIT
portadas.py              MIT
guardianes.py            SIN CABECERA
narracion.py             SIN CABECERA
pruebas/test_idioma.py   MIT

Aristas directas: 6 | tras el cierre: 8 | derivadas: [('MIT', 'GPL-3.0-or-later'), ('CC-BY-4.0', 'GPL-3.0-or-later')]
Aisladas (ni entra ni sale ninguna arista): ['LicenseRef-CPML-1.0.0']
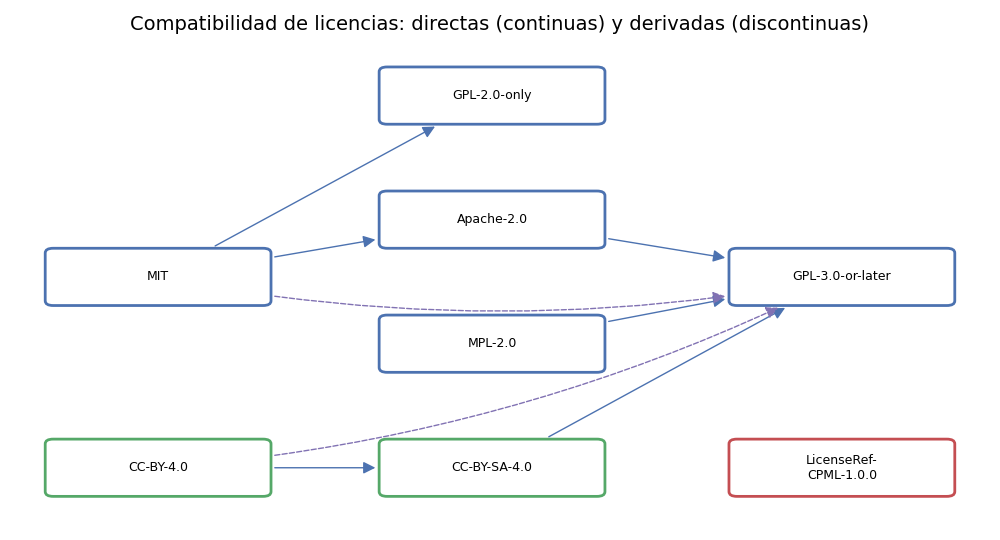
La comprobación de cabeceras encuentra dos archivos sin cabecera: narracion.py, que empieza con una cadena de documentación, y guardianes.py, que sí la tiene, pero en la tercera línea, detrás de una importación y una línea en blanco. La regla de las dos primeras líneas es deliberadamente estricta: una cabecera enterrada no la encuentran las herramientas que solo leen el principio del archivo. portadas.py pasa, porque su primera línea es un shebang y la cabecera está en la segunda.
El grafo pasa de $6$ aristas directas a $8$ tras el cierre. Las dos derivadas son MIT → GPL-3.0-or-later (a través de Apache 2.0) y CC-BY-4.0 → GPL-3.0-or-later (a través de CC BY-SA 4.0). Ambas son correctas, pero conviene leer el cierre con cautela: la compatibilidad de licencias no siempre es transitiva, porque cada paso puede añadir condiciones que el siguiente no admite. El cierre sirve para proponer relaciones que hay que comprobar, no para concluirlas.
La lectura más importante del grafo está en el rincón inferior derecho: LicenseRef-CPML-1.0.0 queda aislada, sin ninguna arista que entre ni salga. Ninguna licencia abierta de la lista permite integrar en su obra un modelo de uso no comercial, ni la CPML permite redistribuir el modelo bajo otra licencia. Por eso los pesos de XTTS-v2 nunca forman parte del repositorio del Cuaderno Vivo: el código los descarga de su ficha original, y quien lo ejecuta acepta la CPML por su cuenta con la variable COQUI_TOS_AGREED, como explicó el Día 15.
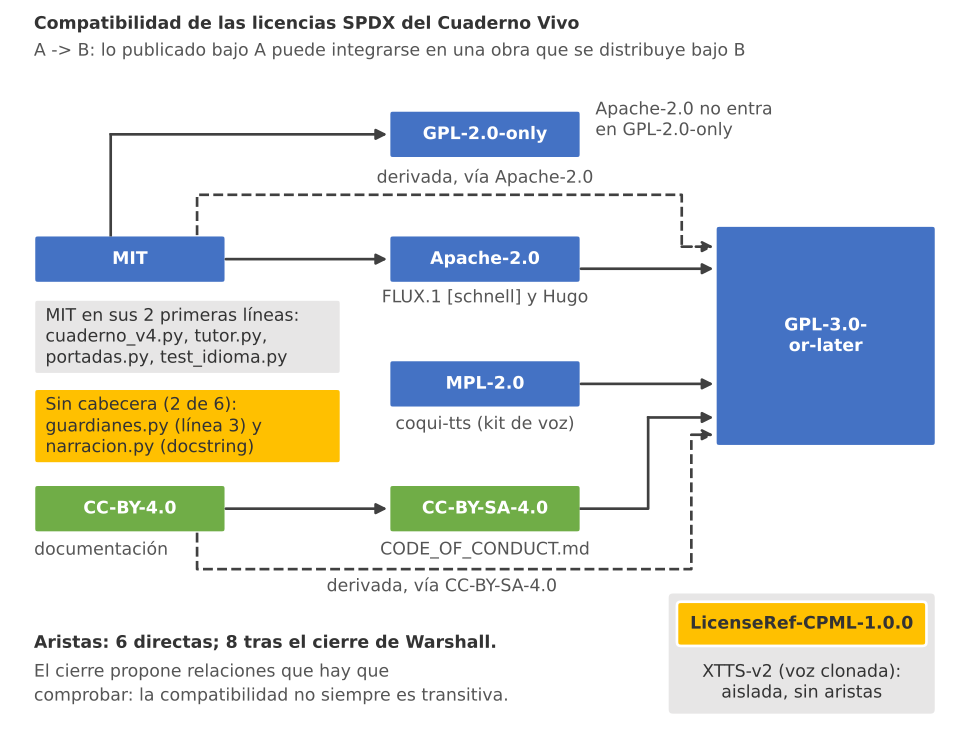
Figura 1. El grafo de compatibilidad de las licencias SPDX del Cuaderno Vivo: 6 aristas directas (continuas) y 2 derivadas por el cierre transitivo (discontinuas), con los archivos y componentes que usa cada licencia. LicenseRef-CPML-1.0.0, la de XTTS-v2, queda aislada, y 2 de los 6 archivos de ejemplo no tienen cabecera.
Un sitio estático con Hugo
El repositorio sirve a quien programa. Para la abuela de Diego, para un reclutador o para quien llega desde un buscador, el Cuaderno Vivo necesita un escaparate: una página con la documentación, la galería de portadas y las transcripciones de los episodios. Sofía elige un sitio estático, un conjunto de archivos HTML, CSS e imágenes generados una sola vez y servidos tal cual, por tres razones que se derivan de toda la serie:
- Sin servidor: no hay ningún programa en ejecución que mantener, actualizar ni proteger. La superficie de ataque de un sitio estático es mínima.
- Sin claves: el sitio no llama a ninguna API. Todo lo generado con modelos se generó antes, se revisó y se guardó como texto o imagen; la clave de Sofía nunca sale de su laptop.
- Sin coste de API: una visita no consume tokens. El presupuesto de $10$ USD al mes no depende de cuántas personas lean el sitio.
Conviene decirlo con claridad: este sitio no es la interfaz web local que la hoja de ruta del Día 24 programó para marzo. Aquella será una herramienta de trabajo para Sofía, con acciones; este es un escaparate de solo lectura. El generador elegido es Hugo, el mismo que publica este blog, distribuido con licencia Apache 2.0 según su repositorio. La Figura del siguiente bloque dibuja el mapa de contenidos del sitio con patches de matplotlib:
# Árbol de contenidos del sitio Hugo dibujado con patches en Python:
SITIO = {
    'Inicio': ['Documentación', 'Galería', 'Episodios', 'Ficha del sistema', 'Licencias'],
    'Documentación': ['Inicio en 5 minutos', 'Arquitectura', 'Contribuir'],
    'Galería': ['Portadas 1 a 4'],
    'Episodios': ['Semanas 1 a 4'],
    'Ficha del sistema': ['Usos y límites'],
    'Licencias': ['Código MIT', 'Contenido CC BY 4.0'],
}
fig, ax = plt.subplots(figsize = (12, 5))
ax.set_xlim(0, 12); ax.set_ylim(0, 5); ax.axis('off')

def caja(x, y, texto, color, ancho = 1.9):
    # Rectángulo redondeado con el texto centrado:
    ax.add_patch(FancyBboxPatch((x - ancho / 2, y - 0.28), ancho, 0.56, boxstyle = 'round,pad=0.04',
                                facecolor = color, edgecolor = 'none'))
    ax.text(x, y, texto, ha = 'center', va = 'center', color = 'white', fontsize = 9.5)

caja(6, 4.4, 'Inicio', '#333333', 1.6)
secciones = SITIO['Inicio']
nodos = 1 + len(secciones)
for x, seccion in zip(np.linspace(1.2, 10.8, len(secciones)), secciones):
    ax.add_patch(FancyArrowPatch((6, 4.1), (x, 3.3), arrowstyle = '-|>', mutation_scale = 12, color = 'gray'))
    caja(x, 3.0, seccion, '#4C72B0')
    for k, hijo in enumerate(SITIO[seccion]):
        y = 1.9 - 0.75 * k
        ax.add_patch(FancyArrowPatch((x, 2.7 if k == 0 else y + 0.45), (x, y + 0.3), arrowstyle = '-|>', mutation_scale = 10, color = '#BBBBBB'))
        caja(x, y, hijo, '#55A868' if seccion in ('Galería', 'Episodios') else '#8172B3')
    nodos += len(SITIO[seccion])
ax.set_title('Mapa del sitio estático del Cuaderno Vivo (solo lectura)', fontsize = 16)
plt.tight_layout()
print(f'Secciones: {len(secciones)} | nodos del mapa: {nodos}')
print('Páginas con las 4 semanas desplegadas:', nodos - 2 + 2 * 4)
# Verde: contenido que crece cada semana; morado: páginas fijas:
plt.show()
Secciones: 5 | nodos del mapa: 14
Páginas con las 4 semanas desplegadas: 20
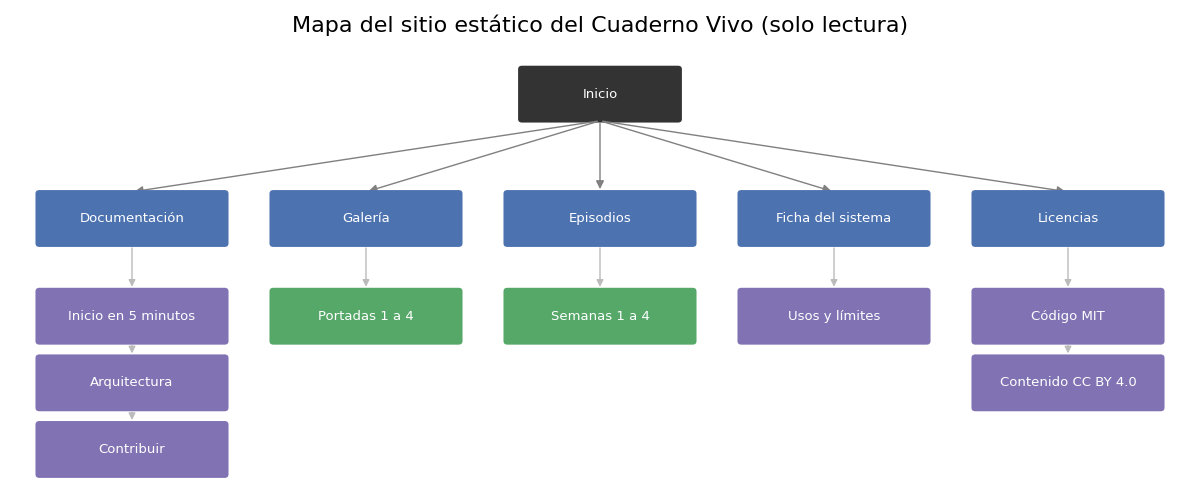
El mapa tiene $5$ secciones bajo la página de inicio y $14$ nodos; con las cuatro semanas desplegadas (una página por portada y otra por episodio), el sitio tiene $20$ páginas. Los colores separan dos tipos de contenido. En verde, la galería y los episodios, que crecen cada semana y, por eso, se generan desde datos. En morado, las páginas fijas: la guía de inicio en cinco minutos, la arquitectura del Día 21, la guía para contribuir, la ficha del sistema con sus usos y límites y las dos licencias. Que la licencia tenga su propia sección no es un detalle: quien llega al sitio debe poder saber, sin abrir el repositorio, qué puede hacer con lo que ve.
La configuración y los episodios
Hugo no está instalado en el equipo donde se escribió esta entrada, y no hace falta para entender su estructura: un sitio de Hugo es una carpeta con un archivo de configuración (hugo.toml) y una carpeta content/ con un archivo Markdown por página. Cada archivo empieza con un front matter, un bloque de metadatos que en formato TOML va entre dos líneas +++. El siguiente bloque escribe la configuración y los cuatro episodios en el directorio temporal y valida cada front matter con tomllib, la misma comprobación que haría Hugo al compilar. Cada episodio debe llevar título, fecha, etiquetas con “Generado con IA” y un texto alternativo de $125$ caracteres como máximo para su portada, el límite que fijó el Día 28:
# Configuración de Hugo y front matter de los episodios semanales en Python:
sitio = Path(temporal.name) / 'sitio'
HUGO_TOML = '''baseURL = "https://cuaderno-vivo.example.org/"
languageCode = "es-mx"
title = "Cuaderno Vivo"
enableRobotsTXT = true

[params]
  descripcion = "Asistente personal de estudio y diario creativo, de código abierto."
  etiqueta_ia = "Generado con IA"
  licencia_codigo = "MIT"
  licencia_contenido = "CC-BY-4.0"

[taxonomies]
  tag = "tags"

[markup.goldmark.renderer]
  unsafe = false

[imaging]
  quality = 80
'''
(sitio / 'content').mkdir(parents = True, exist_ok = True)
(sitio / 'hugo.toml').write_text(HUGO_TOML, encoding = 'utf-8')
SEMANAS = [(1, 'estadística', '2026-01-04'), (2, 'python', '2026-01-11'),
           (3, 'historia del arte', '2026-01-18'), (4, 'música', '2026-01-25')]

def episodio(numero, tema, fecha):
    # Front matter TOML (entre +++) y cuerpo del episodio de la semana:
    alt = f'Portada abstracta de la semana {numero} sobre {tema}. Generado con IA.'
    return (f'+++\ntitle = "Semana {numero}: {tema}"\ndate = {fecha}T10:00:00-06:00\n'
            f'tags = ["{tema}", "Generado con IA"]\n\n[params]\n  portada = "portada.webp"\n'
            f'  alt = "{alt}"\n  aviso_ia = "Generado con IA: resumen escrito por un modelo y revisado por Sofía."\n'
            f'  audio = "no se publica: la voz clonada solo tiene consentimiento de uso personal"\n+++\n\n'
            f'Transcripción revisada del episodio de la semana {numero}.\n')

for numero, tema, fecha in SEMANAS:
    carpeta = sitio / 'content' / 'episodios' / f'semana_{numero:02d}'
    carpeta.mkdir(parents = True, exist_ok = True)
    (carpeta / 'index.md').write_text(episodio(numero, tema, fecha), encoding = 'utf-8')

# Cada front matter debe ser TOML válido y llevar los campos obligatorios:
OBLIGATORIOS = {'title', 'date', 'tags'}
for archivo in sorted(sitio.rglob('index.md')):
    datos = tomllib.loads(archivo.read_text(encoding = 'utf-8').split('+++')[1])
    faltan = OBLIGATORIOS - datos.keys()
    ok = not faltan and 'Generado con IA' in datos['tags'] and len(datos['params']['alt']) <= 125
    print(archivo.relative_to(sitio).as_posix(), '| válido' if ok else f'| faltan {faltan}')
print('hugo.toml válido | licencia del contenido:', tomllib.loads(HUGO_TOML)['params']['licencia_contenido'])
print()
print((sitio / 'content/episodios/semana_04/index.md').read_text(encoding = 'utf-8'))
content/episodios/semana_01/index.md | válido
content/episodios/semana_02/index.md | válido
content/episodios/semana_03/index.md | válido
content/episodios/semana_04/index.md | válido
hugo.toml válido | licencia del contenido: CC-BY-4.0

+++
title = "Semana 4: música"
date = 2026-01-25T10:00:00-06:00
tags = ["música", "Generado con IA"]

[params]
  portada = "portada.webp"
  alt = "Portada abstracta de la semana 4 sobre música. Generado con IA."
  aviso_ia = "Generado con IA: resumen escrito por un modelo y revisado por Sofía."
  audio = "no se publica: la voz clonada solo tiene consentimiento de uso personal"
+++

Transcripción revisada del episodio de la semana 4.
Los cuatro episodios son válidos, y el de la semana $4$ muestra el resultado. Vale la pena leer la configuración línea a línea, porque cada opción responde a una decisión de la serie:
enableRobotsTXT = truegenera un archivorobots.txtpara que los buscadores sepan qué pueden indexar.[params]guarda los datos propios del proyecto: la etiqueta de divulgación y las dos licencias, que las plantillas pueden mostrar en el pie de cada página. Si la licencia cambia, cambia en un solo sitio.unsafe = falseimpide que el Markdown incluya HTML arbitrario. Es la opción por defecto de Hugo, pero escribirla deja constancia de la decisión: un texto generado por un modelo que llegue al sitio no puede insertar un<script>. Es la defensa del Día 19 aplicada a la publicación.[imaging] quality = 80fija la calidad de las imágenes que Hugo procese, la misma que se medirá en la siguiente sección.
El front matter del episodio también cuenta su historia. La etiqueta “Generado con IA” aparece en tres lugares: en las etiquetas, en el texto alternativo de la portada y en el aviso aviso_ia, que dice además quién revisó el texto. El campo audio explica por qué falta el audio, en lugar de omitirlo sin más: quien visite el sitio sabrá que existe un episodio narrado y que su voz no se publica por una decisión de consentimiento. Un último detalle práctico: en Hugo, los campos propios de cada página se agrupan bajo [params], de modo que la plantilla los lee como .Params.alt sin chocar con los campos que Hugo reserva.
Presupuesto de peso
Un escaparate lento es un escaparate vacío. La galería es la página más pesada del sitio, porque reúne las cuatro portadas a $1024 \times 1024$ píxeles, y Sofía le fija un presupuesto de peso de $1$ MB. El peso de la página $P$ es la suma de su HTML, su CSS y sus imágenes $b_i$, y debe quedar por debajo del presupuesto $B$:
$$ P = P_{\text{HTML}} + P_{\text{CSS}} + \sum_{i=1}^{4} b_i \le B, \qquad a = 1 - \frac{P_{\text{formato}}}{P_{\text{PNG}}} $$
La lógica detrás de estas dos cifras:
- En una galería, las imágenes dominan la suma; el HTML y el CSS de una plantilla mínima son del orden de decenas de kilobytes, y aquí se fijan como supuestos de $18$ y $24$ kB.
- El presupuesto se escribe antes de medir, como el de $10$ USD al mes de la serie: es una regla que obliga a decidir, no una descripción de lo que salió.
- El ahorro relativo $a$ compara cada formato con el PNG original y permite decidir si una conversión merece la pena.
El siguiente bloque crea cuatro portadas de juguete con Pillow (un degradado, círculos de la paleta y un grano fino que imita la textura de una imagen generada), las guarda en memoria como PNG, JPEG con calidad $80$ y WebP con calidad $80$, y mide el peso de la página en cada caso:
# Portadas de juguete en PNG, JPEG y WebP y peso de la página de la galería en Python:
PALETA = [(46, 64, 87), (232, 120, 96), (230, 180, 70), (85, 168, 104)]

def portada_juguete(semana, lado = 1024):
    # Degradado, círculos de la paleta y grano fino, como la textura de una imagen generada:
    y = np.mgrid[0:lado, 0:lado][0] / lado
    base = np.array(PALETA[0]) * (1 - y[..., None]) + np.array(PALETA[semana % 4]) * y[..., None]
    imagen = Image.fromarray(base.astype(np.uint8))
    dibujo = ImageDraw.Draw(imagen)
    for _ in range(6):
        cx, cy = rng.integers(100, lado - 100, 2)
        r = int(rng.integers(60, 220))
        dibujo.ellipse((cx - r, cy - r, cx + r, cy + r), fill = PALETA[int(rng.integers(1, 4))])
    grano = rng.normal(0, 6, (lado, lado, 3))
    return Image.fromarray(np.clip(np.asarray(imagen) + grano, 0, 255).astype(np.uint8))

def peso(imagen, formato, **opciones):
    # Bytes que ocupa la imagen guardada en memoria con ese formato:
    bufer = io.BytesIO()
    imagen.save(bufer, format = formato, **opciones)
    return bufer.tell()

portadas = [portada_juguete(s) for s in range(1, 5)]
pesos = pd.DataFrame({
    'PNG': [peso(p, 'PNG', optimize = True) for p in portadas],
    'JPEG': [peso(p, 'JPEG', quality = 80) for p in portadas],
    'WebP': [peso(p, 'WEBP', quality = 80) for p in portadas],
}, index = [f'semana_{s:02d}' for s in range(1, 5)])
HTML, CSS, PRESUPUESTO = 18_000, 24_000, 1_000_000     # bytes; HTML y CSS son supuestos
print('Peso de cada portada en kB:')
print((pesos / 1000).round(1).to_string())
pagina = HTML + CSS + pesos.sum()
for formato, total in pagina.items():
    print(f'{formato:5s} página: {total / 1e6:6.3f} MB | {total / PRESUPUESTO:6.1%} del presupuesto | '
          f'ahorro frente a PNG: {1 - total / pagina["PNG"]:.1%}')

fig, ax = plt.subplots(figsize = (8, 5))
abajo = np.zeros(3)
for etiqueta, valores, color in [('HTML', [HTML] * 3, '#8172B3'), ('CSS', [CSS] * 3, '#DD8452'),
                                 ('Portadas', pesos.sum().values, '#4C72B0')]:
    ax.bar(pesos.columns, np.array(valores) / 1e6, bottom = abajo, label = etiqueta, color = color)
    abajo += np.array(valores) / 1e6
for x, total in enumerate(abajo):
    ax.text(x, total + 0.1, f'{total:.2f} MB', ha = 'center')
ax.axhline(PRESUPUESTO / 1e6, color = '#C44E52', linestyle = '--', label = 'Presupuesto de 1 MB')
ax.set_ylabel('Peso de la página (MB)')
ax.set_title('Peso de la galería según el formato de las portadas', fontsize = 16)
ax.legend()
plt.tight_layout()
# Solo los formatos con pérdida caben bajo la línea roja:
plt.show()
Peso de cada portada en kB:
              PNG   JPEG  WebP
semana_01  1971.7  112.1  70.4
semana_02  1971.9  112.4  70.0
semana_03  1969.8  112.0  70.6
semana_04  1975.7  119.4  77.4
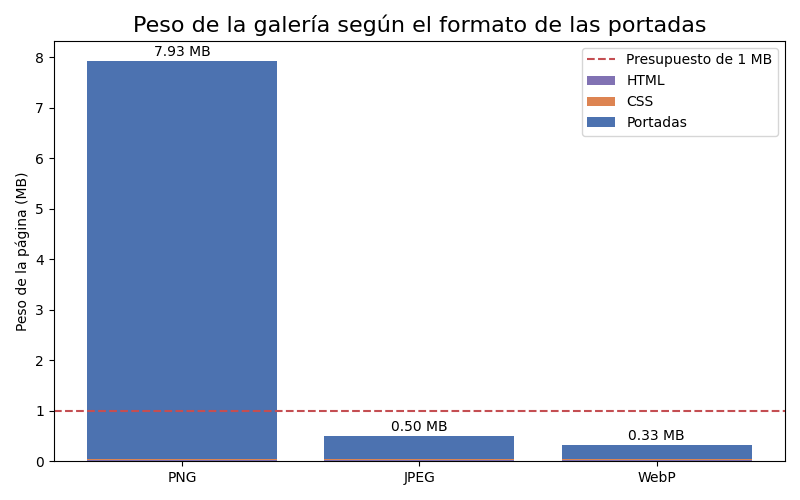
PNG   página:  7.931 MB | 793.1% del presupuesto | ahorro frente a PNG: 0.0%
JPEG  página:  0.498 MB |  49.8% del presupuesto | ahorro frente a PNG: 93.7%
WebP  página:  0.330 MB |  33.0% del presupuesto | ahorro frente a PNG: 95.8%
La Tabla 4 resume los pesos medidos:
Tabla 4. Peso de la página de la galería antes y después de convertir las portadas.
| Formato | Portada media | Cuatro portadas | Página completa | Del presupuesto de 1 MB | Ahorro frente a PNG |
|---|---|---|---|---|---|
| PNG | $1,972.3$ kB | $7,889.1$ kB | $7.931$ MB | $793.1%$ | $0%$ |
| JPEG, calidad 80 | $114.0$ kB | $455.9$ kB | $0.498$ MB | $49.8%$ | $93.7%$ |
| WebP, calidad 80 | $72.1$ kB | $288.4$ kB | $0.330$ MB | $33.0%$ | $95.8%$ |
Con las portadas en PNG, la galería pesa $7.931$ MB, casi ocho veces el presupuesto: en un teléfono con una conexión modesta, la página tardaría varios segundos en mostrarse completa. El PNG es un formato sin pérdida, y el grano fino de la imagen, que imita el de una imagen generada por difusión, es justo lo que peor comprime sin pérdida. Con JPEG de calidad $80$, la página baja a $0.498$ MB; con WebP de calidad $80$, a $0.330$ MB, un tercio del presupuesto y un ahorro del $95.8%$. Cada portada en WebP ocupa unas $27$ veces menos que en PNG y alrededor de un $37%$ menos que en JPEG.
Sofía elige WebP, con dos precauciones. La primera: mirar las portadas convertidas, no solo pesarlas; la calidad $80$ es un punto de partida razonable, pero los degradados suaves pueden mostrar bandas, y la decisión final es visual. La segunda: conservar los PNG originales en cuaderno_vivo/portadas/, que es privado, junto con su registro de procedencia del Día 12. La conversión reescribe el archivo y puede perder los metadatos de procedencia; por eso la etiqueta visible “Generado con IA” va en el texto alternativo y en la página, y no solo dentro de la imagen.
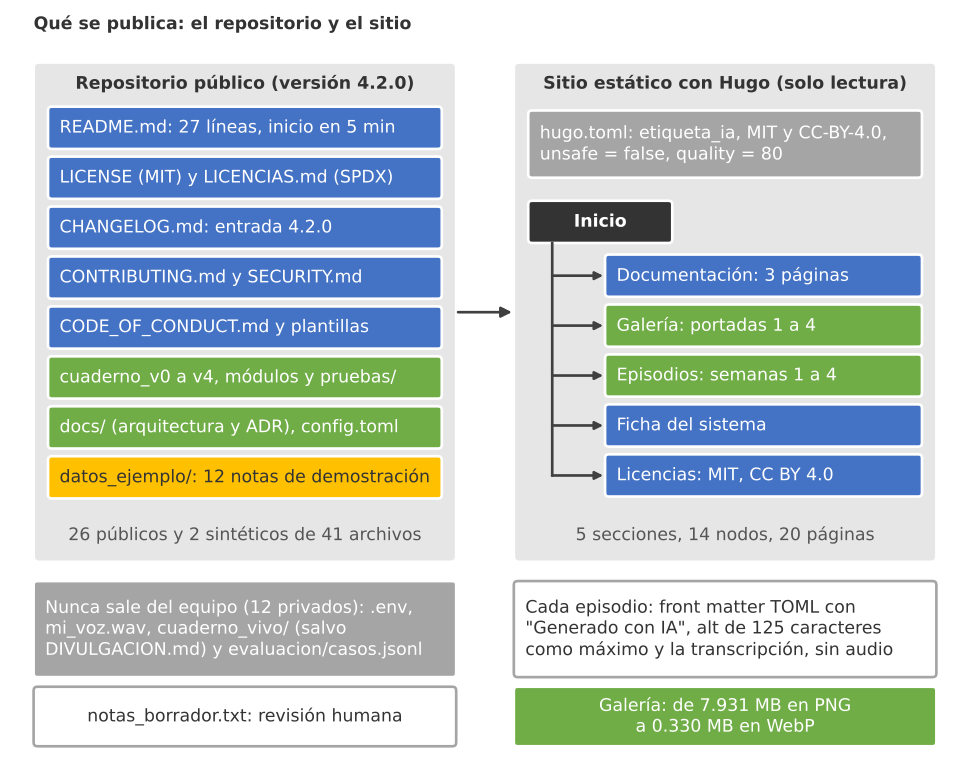
Figura 2. Lo que se publica: el repositorio con 26 archivos públicos y 2 sintéticos, mientras 12 privados no salen del equipo y 1 espera revisión, y el sitio Hugo de solo lectura, con 5 secciones, 20 páginas y una galería que baja de 7.931 MB en PNG a 0.330 MB en WebP.
Documentación que se lee
El README del Día 24 estaba escrito para Sofía y para quien evaluara su portafolio: explicaba las siete órdenes del programa y suponía que el lector tenía una clave de API. El README de un proyecto abierto tiene otro lector: alguien que llega sin contexto, con cinco minutos y ninguna intención de gastar dinero para probar. Por eso cambia de orden y de tono. Primero, qué es el proyecto en dos frases; después, un inicio en cinco minutos que funciona sin clave, sin red y sin GPU, con la prueba de humo del Día 24 y las notas de demostración; después, qué no hace; y al final, las licencias y la comunidad.
El siguiente bloque genera ese README a partir de datos, como el Día 24, y añade la entrada $4.2.0$ al registro de cambios que el Día 29 dejó en la versión $4.1.1$. Publicar no cambia el comportamiento del programa, pero añade archivos y una forma nueva de usarlo, de modo que, según el versionado semántico, corresponde una versión menor:
# README para otras personas y nueva entrada del CHANGELOG en Python:
PROYECTO = {'nombre': 'Cuaderno Vivo', 'version': '4.2.0', 'licencia_codigo': 'MIT',
            'licencia_contenido': 'CC BY 4.0', 'presupuesto_usd': 10}
INICIO_RAPIDO = [
    ('python -m venv .venv  y  pip install -r requirements.txt', 'un minuto'),
    ('python pruebas/prueba_humo.py', 'sin clave, sin red, sin GPU'),
    ('python cuaderno_v4.py preparar --semana 1 --datos datos_ejemplo --motor juguete', 'notas de demostración'),
    ('copy .env.ejemplo .env', 'y escriba allí su ANTHROPIC_API_KEY, solo si quiere usar la API'),
    ('python cuaderno_v4.py estado', 'gasto del mes y lista de verificación'),
]
NO_HACE = ['No clona voces: la voz propia exige su consentimiento escrito (consentimiento_voz.json).',
           'No evalúa formalmente a nadie: el tutor es una ayuda de repaso.',
           'No incluye notas reales: datos_ejemplo/ es sintético.']

def generar_readme(p):
    # Cada línea sale de los datos del proyecto o de las listas anteriores:
    lineas = [f"# {p['nombre']} {p['version']}", '',
              'Asistente personal de estudio y diario creativo de código abierto.',
              f"Pensado para un presupuesto de {p['presupuesto_usd']} USD al mes de API.", '',
              '## Inicio en cinco minutos', '']
    lineas += [f'{i}. `{orden}` ({nota})' for i, (orden, nota) in enumerate(INICIO_RAPIDO, start = 1)]
    lineas += ['', '## Qué no hace', ''] + [f'- {x}' for x in NO_HACE]
    lineas += ['', '## Licencias', '',
               f"Código: {p['licencia_codigo']} (LICENSE). Documentación y ejemplos: {p['licencia_contenido']}.",
               'Modelos de terceros: ver LICENCIAS.md (XTTS-v2 solo admite uso no comercial).', '',
               '## Comunidad', '', 'CONTRIBUTING.md, CODE_OF_CONDUCT.md y SECURITY.md.']
    return '\n'.join(lineas) + '\n'

readme = generar_readme(PROYECTO)
print(readme)
print(f'README.md: {len(readme.splitlines())} líneas, {len(readme.split())} palabras\n')
ENTRADA = {'version': '4.2.0', 'fecha': '2026-01-30', 'tipo': 'Añadido', 'cambios': [
    'LICENSE (MIT), LICENCIAS.md con identificadores SPDX y cabeceras en cada archivo .py.',
    'Sitio estático con Hugo: documentación, galería y transcripciones (sin audio con voz clonada).',
    'README para otras personas, CONTRIBUTING.md, CODE_OF_CONDUCT.md y SECURITY.md.']}
print(f"## [{ENTRADA['version']}] - {ENTRADA['fecha']}\n### {ENTRADA['tipo']}")
print('\n'.join(f'- {c}' for c in ENTRADA['cambios']))
anterior = (4, 1, 1)
nueva = tuple(int(x) for x in ENTRADA['version'].split('.'))
print('¿Es la versión MENOR siguiente a 4.1.1?', nueva == (anterior[0], anterior[1] + 1, 0))
# Cuaderno Vivo 4.2.0

Asistente personal de estudio y diario creativo de código abierto.
Pensado para un presupuesto de 10 USD al mes de API.

## Inicio en cinco minutos

1. `python -m venv .venv  y  pip install -r requirements.txt` (un minuto)
2. `python pruebas/prueba_humo.py` (sin clave, sin red, sin GPU)
3. `python cuaderno_v4.py preparar --semana 1 --datos datos_ejemplo --motor juguete` (notas de demostración)
4. `copy .env.ejemplo .env` (y escriba allí su ANTHROPIC_API_KEY, solo si quiere usar la API)
5. `python cuaderno_v4.py estado` (gasto del mes y lista de verificación)

## Qué no hace

- No clona voces: la voz propia exige su consentimiento escrito (consentimiento_voz.json).
- No evalúa formalmente a nadie: el tutor es una ayuda de repaso.
- No incluye notas reales: datos_ejemplo/ es sintético.

## Licencias

Código: MIT (LICENSE). Documentación y ejemplos: CC BY 4.0.
Modelos de terceros: ver LICENCIAS.md (XTTS-v2 solo admite uso no comercial).

## Comunidad

CONTRIBUTING.md, CODE_OF_CONDUCT.md y SECURITY.md.

README.md: 27 líneas, 155 palabras

## [4.2.0] - 2026-01-30
### Añadido
- LICENSE (MIT), LICENCIAS.md con identificadores SPDX y cabeceras en cada archivo .py.
- Sitio estático con Hugo: documentación, galería y transcripciones (sin audio con voz clonada).
- README para otras personas, CONTRIBUTING.md, CODE_OF_CONDUCT.md y SECURITY.md.
¿Es la versión MENOR siguiente a 4.1.1? True
El README nuevo tiene $27$ líneas y $155$ palabras, menos que el del Día 24 ($28$ líneas y $227$ palabras), y dice más cosas útiles para quien llega de fuera. Observe tres decisiones:
- El paso 2 es la prueba de humo. Antes de configurar nada, quien descarga el proyecto comprueba que funciona. Si falla ahí, el error es del proyecto, no de su configuración.
- La clave llega en el paso 4 y es opcional. Todo lo anterior funciona con el motor de juguete y las notas de demostración. Un proyecto que exige una tarjeta de crédito para probarlo pierde a la mayoría de sus visitantes en el primer minuto.
- “Qué no hace” va antes que las licencias. Es la versión corta de la ficha del sistema: los tres usos no previstos más importantes, escritos en negativo para que nadie los suponga.
La entrada del registro de cambios sigue el formato del Día 29 y pasa la comprobación: $4.2.0$ es exactamente la versión menor siguiente a $4.1.1$. La ficha del sistema también se actualiza, sin necesidad de un bloque propio: añade el módulo 7 en la sección de descripción (el agente de código con permisos, el experimento medido con un modelo local, los clips procedurales, la traducción y la accesibilidad, la batería de pruebas y la publicación), cambia “Datos” para indicar que el repositorio público solo contiene datos sintéticos y añade un uso no previsto nuevo: las salidas de XTTS-v2 no se publican ni se usan con fines comerciales.
Comunidad
Publicar el código con una licencia abierta invita a otras personas a mejorarlo. Para que esa invitación no se convierta en un problema, el repositorio necesita cuatro documentos que respondan, antes de que nadie pregunte, a las preguntas de cualquier persona que quiera participar. La Tabla 3 los resume:
Tabla 3. Archivos de comunidad del Cuaderno Vivo.
| Archivo | Propósito | Plantilla de origen |
|---|---|---|
CONTRIBUTING.md | Cómo proponer un cambio: incidencia previa, pruebas, cabecera SPDX y declaración de asistentes de IA | Propia, generada desde un diccionario |
CODE_OF_CONDUCT.md | Qué conductas se esperan, cuáles no y cómo se repara el daño | Contributor Covenant 3.0 (CC BY-SA 4.0) |
SECURITY.md | Cómo informar de una vulnerabilidad, incluidas las inyecciones de prompts | Propia, generada desde un diccionario |
| Plantillas de incidencias | Formularios para errores y propuestas, con la versión y los pasos para reproducir | Propias, en .github/ISSUE_TEMPLATE/ |
El código de conducta no se escribe desde cero. Sofía adopta el Contributor Covenant 3.0, que la Organization for Ethical Source publicó el 28 de julio de 2025 como una reescritura profunda de la versión anterior: un texto más claro, más fácil de traducir, pensado también para comunidades presenciales, y con una sección de aplicación llamada “Addressing and Repairing Harm” (abordar y reparar el daño), inspirada en la justicia restaurativa. Como se distribuye con CC BY-SA 4.0, el archivo conserva la atribución y, si Sofía lo adapta, la adaptación mantiene la misma licencia. Y un código de conducta es un compromiso: nombra a una persona y un canal para informar, y solo tiene sentido si esa persona va a responder.
El siguiente bloque genera CONTRIBUTING.md y SECURITY.md a partir de dos diccionarios, como el README:
# CONTRIBUTING.md, SECURITY.md y revisión automática de contribuciones en Python:
CONTRIBUIR = {
    'Antes de empezar': 'Abra una incidencia y espere a que alguien la confirme.',
    'Pruebas': 'Todo cambio pasa la batería completa: python -m unittest discover pruebas.',
    'Licencia': 'Cada archivo nuevo empieza con # SPDX-License-Identifier: MIT.',
    'Asistentes de IA': 'Declare en la solicitud si usó un asistente y para qué; usted responde por cada línea.',
    'Datos': 'Nunca incluya notas reales, voces ni claves; use datos_ejemplo/.',
}
SEGURIDAD = {
    'Qué informar': 'Fugas de datos, claves expuestas e inyecciones de prompts que alteren el resultado.',
    'Cómo': 'Por correo a seguridad@cuaderno-vivo.example.org, nunca en una incidencia pública.',
    'Plazo': 'Acuse de recibo en 7 días; es un proyecto de una persona, sin recompensas.',
}

def documento(titulo, secciones):
    # Markdown con un H1 y un H2 por clave del diccionario:
    return '\n'.join([f'# {titulo}', ''] + [f'## {k}\n\n{v}\n' for k, v in secciones.items()])

for titulo, secciones in [('Cómo contribuir', CONTRIBUIR), ('Política de seguridad', SEGURIDAD)]:
    texto = documento(titulo, secciones)
    print(texto)
    print(f'({len(texto.split())} palabras)\n')

SOLICITUDES = [  # contribuciones de juguete al repositorio publicado:
    {'id': 1, 'autor': 'Diego', 'pruebas': True, 'spdx': True, 'ia': 'no', 'privado': False, 'dependencia': False},
    {'id': 2, 'autor': 'Persona A', 'pruebas': True, 'spdx': True, 'ia': 'sí: generó las pruebas', 'privado': False, 'dependencia': False},
    {'id': 3, 'autor': 'Persona B', 'pruebas': False, 'spdx': True, 'ia': None, 'privado': False, 'dependencia': True},
    {'id': 4, 'autor': 'Persona C', 'pruebas': True, 'spdx': False, 'ia': 'no', 'privado': False, 'dependencia': False},
    {'id': 5, 'autor': 'Persona A', 'pruebas': True, 'spdx': True, 'ia': 'no', 'privado': True, 'dependencia': False},
]

def revisar_solicitud(s):
    # Rechazo si toca datos privados; cambios si falta algo; si no, pasa a revisión humana:
    if s['privado']:
        return 'rechazar', ['incluye un archivo privado']
    faltas = [m for c, m in [(not s['pruebas'], 'pruebas en rojo'), (not s['spdx'], 'sin cabecera SPDX'),
                             (s['ia'] is None, 'no declara uso de IA'),
                             (s['dependencia'], 'dependencia nueva sin incidencia')] if c]
    return ('pedir cambios', faltas) if faltas else ('revisión humana', [])

for s in SOLICITUDES:
    decision, motivos = revisar_solicitud(s)
    print(f"#{s['id']} {s['autor']:10s} -> {decision:15s} {'; '.join(motivos)}")
# Cómo contribuir

## Antes de empezar

Abra una incidencia y espere a que alguien la confirme.

## Pruebas

Todo cambio pasa la batería completa: python -m unittest discover pruebas.

## Licencia

Cada archivo nuevo empieza con # SPDX-License-Identifier: MIT.

## Asistentes de IA

Declare en la solicitud si usó un asistente y para qué; usted responde por cada línea.

## Datos

Nunca incluya notas reales, voces ni claves; use datos_ejemplo/.

(71 palabras)

# Política de seguridad

## Qué informar

Fugas de datos, claves expuestas e inyecciones de prompts que alteren el resultado.

## Cómo

Por correo a seguridad@cuaderno-vivo.example.org, nunca en una incidencia pública.

## Plazo

Acuse de recibo en 7 días; es un proyecto de una persona, sin recompensas.

(47 palabras)

#1 Diego      -> revisión humana
#2 Persona A  -> revisión humana
#3 Persona B  -> pedir cambios   pruebas en rojo; no declara uso de IA; dependencia nueva sin incidencia
#4 Persona C  -> pedir cambios   sin cabecera SPDX
#5 Persona A  -> rechazar        incluye un archivo privado
Los dos documentos son cortos a propósito: $71$ palabras la guía de contribución y $47$ palabras la política de seguridad. Un documento de comunidad que nadie lee no protege a nadie. La política de seguridad dice tres cosas que importan: qué informar (incluidas las inyecciones de prompts que alteren el resultado, el riesgo LLM01 que el Día 19 estudió con el OWASP Top 10 para aplicaciones con modelos de lenguaje), por dónde (un buzón privado, nunca una incidencia pública, para no anunciar la vulnerabilidad antes de corregirla) y en qué plazo, con una honestidad que vale más que una promesa: es un proyecto de una persona, sin recompensas.
Contribuciones generadas con IA
El Día 25 fijó una regla para el agente de código que trabajaba para Sofía: si no puede explicar una línea, esa línea no entra. Al abrir el proyecto, la regla se aplica a terceros, con un matiz: Sofía no puede saber cómo se escribió cada línea de una contribución, pero sí puede pedir que se declare. La guía de contribución lo hace en su sección “Asistentes de IA”, y la segunda mitad del bloque anterior convierte la guía en una revisión automática que se ejecuta sobre cada solicitud antes de que una persona la lea. La Tabla 5 recoge las cinco solicitudes de juguete y la decisión:
Tabla 5. Revisión automática de cinco contribuciones de juguete.
| Solicitud | Autor | Pruebas | Cabecera SPDX | Declara IA | Toca lo privado | Decisión |
|---|---|---|---|---|---|---|
| #1 | Diego | Sí | Sí | No usó | No | Revisión humana |
| #2 | Persona A | Sí | Sí | Sí, generó las pruebas | No | Revisión humana |
| #3 | Persona B | No | Sí | Sin declarar | No | Pedir cambios (3 motivos) |
| #4 | Persona C | Sí | No | No usó | No | Pedir cambios |
| #5 | Persona A | Sí | Sí | No usó | Sí | Rechazar |
Las decisiones siguen tres niveles, de más grave a menos grave:
- En primer lugar, lo privado se rechaza sin discusión: la solicitud #5 incluye un archivo que el inventario clasifica como privado, y ninguna calidad del resto la salva.
- En segundo lugar, lo incompleto se devuelve con motivos: la #3 tiene las pruebas en rojo, no declara si usó un asistente y añade una dependencia sin incidencia previa (la regla del Día 25: una dependencia nueva es una decisión de diseño); la #4 solo olvidó la cabecera SPDX.
- En tercer lugar, lo completo pasa a una persona: la revisión automática no aprueba nada. La #2 declaró que un asistente generó sus pruebas, y eso no la penaliza; le indica a Sofía dónde mirar con más atención.
Observe que declarar el uso de IA no es un motivo de rechazo. La regla no pretende prohibir los asistentes, sino que alguien responda por cada línea. Lo que sí es un motivo de devolución es no declarar, porque deja a Sofía sin saber qué revisar.
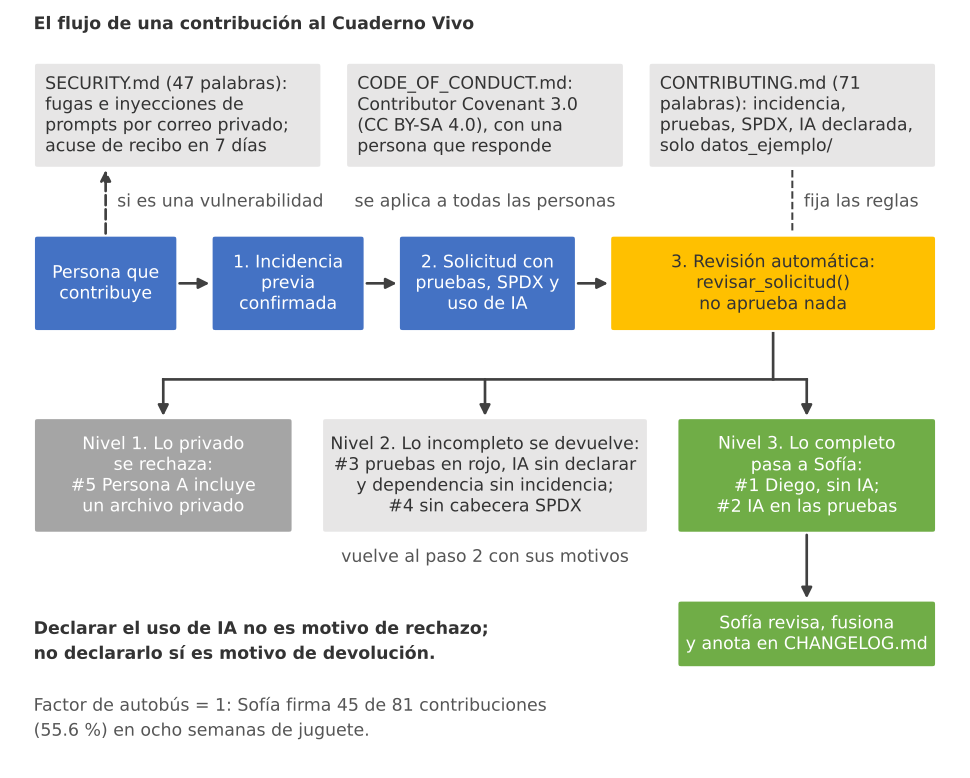
Figura 3. El flujo de una contribución: los archivos de comunidad fijan las reglas, la revisión automática no aprueba nada y reparte las cinco solicitudes de juguete en tres niveles (rechazar lo privado, devolver lo incompleto y pasar lo completo a Sofía); las vulnerabilidades van por correo privado.
Quién sostiene el proyecto
Una licencia abierta no garantiza una comunidad. En la mayoría de los proyectos pequeños, una persona hace casi todo el trabajo y unas pocas contribuyen de vez en cuando. Una forma sencilla de medirlo es el factor de autobús (en inglés, “bus factor”): el número mínimo de personas que tendrían que desaparecer del proyecto para que se detuviera. Una aproximación habitual es ordenar a las personas por su cuota de contribuciones $s_{(1)} \ge s_{(2)} \ge \dots$ y contar cuántas hacen falta para reunir la mitad:
$$ F = \min \left{ k : \sum_{i=1}^{k} s_{(i)} \ge 0.5 \right} $$
La lógica detrás de esta medida:
- Si una sola persona hace más de la mitad del trabajo, $F = 1$: el proyecto depende de ella.
- Un $F$ mayor indica que el conocimiento está repartido y que el proyecto sobreviviría a la ausencia de cualquiera.
- Es una aproximación gruesa: cuenta contribuciones, no su importancia, y una persona puede ser la única que entiende una parte crítica con muy pocas contribuciones.
El siguiente bloque simula, con datos de juguete generados con la semilla $2026$, las contribuciones de cinco personas durante las ocho semanas posteriores a la publicación, desde el lunes 2 de febrero de 2026, con un ritmo esperado que decae ligeramente con el tiempo, y calcula el factor de autobús:
# Mapa de contribuciones de las ocho semanas posteriores a la publicación en Python:
PERSONAS = ['Sofía', 'Diego', 'Persona A', 'Persona B', 'Persona C']
RITMO = np.array([6.0, 2.0, 1.0, 0.5, 0.3])          # contribuciones esperadas por semana (de juguete)
semanas = pd.date_range('2026-02-02', periods = 8, freq = '7D')
mapa = rng.poisson(RITMO[:, None] * np.linspace(1.3, 0.8, 8)[None, :])
contribuciones = pd.DataFrame(mapa, index = PERSONAS, columns = semanas.strftime('%d/%m'))
print(contribuciones.to_string())
totales = contribuciones.sum(axis = 1).sort_values(ascending = False)
cuota = totales / totales.sum()
factor_autobus = int((cuota.cumsum() < 0.5).sum() + 1)
print(f'\nTotal: {totales.sum()} | cuota de Sofía: {cuota["Sofía"]:.1%} | factor de autobús: {factor_autobus}')
print('Personas con al menos una contribución:', int((totales > 0).sum()), 'de', len(PERSONAS))

fig, ax = plt.subplots(figsize = (10, 4.2))
imagen = ax.imshow(contribuciones.values, cmap = 'Greens', aspect = 'auto')
for i in range(mapa.shape[0]):
    for j in range(mapa.shape[1]):
        ax.text(j, i, mapa[i, j], ha = 'center', va = 'center',
                color = 'white' if mapa[i, j] > mapa.max() / 2 else 'black')
ax.set_xticks(range(8), [f'Semana del {s}' for s in contribuciones.columns], rotation = 30, ha = 'right')
ax.set_yticks(range(len(PERSONAS)), PERSONAS)
fig.colorbar(imagen, ax = ax, label = 'Contribuciones')
ax.set_title('Contribuciones por persona y semana (datos de juguete)', fontsize = 16)
plt.tight_layout()
# Una fila oscura y cuatro claras: el proyecto depende de una persona:
plt.show()
           02/02  09/02  16/02  23/02  02/03  09/03  16/03  23/03
Sofía          7      7      4      5      6      7      6      3
Diego          2      4      6      3      2      3      0      0
Persona A      1      2      1      3      0      1      0      1
Persona B      0      1      0      1      0      0      0      1
Persona C      0      1      0      0      1      1      1      0

Total: 81 | cuota de Sofía: 55.6% | factor de autobús: 1
Personas con al menos una contribución: 5 de 5
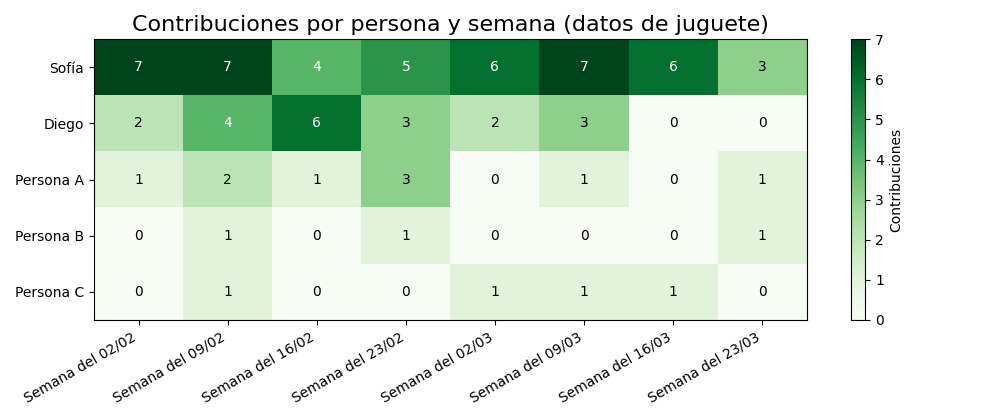
En las ocho semanas simuladas hay $81$ contribuciones, y Sofía firma $45$, el $55.6%$. El factor de autobús es $1$. Las cinco personas contribuyen al menos una vez, pero el mapa muestra una fila oscura y cuatro claras, y una tendencia que conviene vigilar: Diego, el segundo contribuyente, pasa de $6$ contribuciones en la semana del 16 de febrero a $0$ en las dos últimas. Es el patrón que Nadia Eghbal describe en los proyectos abiertos reales: el interés inicial de quienes llegan se apaga, y el mantenimiento vuelve a la autora.
Que el factor sea $1$ no es un fracaso en un proyecto personal; es su estado natural. Lo que sí es responsabilidad de Sofía es que ese $1$ no se convierta en $0$ sin aviso: el README debe decir con honestidad que el proyecto lo mantiene una persona, y la guía de contribución, qué partes acepta cambios y cuáles no.
El anuncio
Con todo preparado, falta contarlo. Sofía pide a Claude Sonnet 5.5 un borrador del anuncio a partir del README y de la ficha del sistema, con tres instrucciones explícitas en el mensaje de sistema: no exagerar cifras (toda cifra del anuncio debe estar en los documentos de entrada), no ocultar límites (nombrar lo que el proyecto no hace) y divulgar que el texto se redactó con ayuda de un modelo. Como en toda la serie, la clave se lee de la variable de entorno ANTHROPIC_API_KEY, la profundidad se controla con output_config={"effort": "low"} y no con temperature, que los modelos Claude 5 no aceptan, y se comprueba stop_reason antes de leer el texto. Al final, una comprobación automática busca cada número del borrador en los documentos de entrada. Este bloque llama a la API y no se ejecutó para escribir la entrada; su salida es un ejemplo:
# Borrador del anuncio con Claude Sonnet 5.5 y comprobación de cifras en Python:
import re
from pathlib import Path
import anthropic

client = anthropic.Anthropic()        # lee ANTHROPIC_API_KEY del entorno
entrada = Path('README.md').read_text(encoding = 'utf-8') + '\n' + Path('FICHA_SISTEMA.md').read_text(encoding = 'utf-8')
SISTEMA = ('Redacta en español el anuncio, de 120 palabras como máximo, de un proyecto personal de código abierto. '
           'Usa solo datos que aparezcan en los documentos: no añadas cifras, no exageres resultados y nombra '
           'al menos un límite del proyecto. Termina con esta frase literal: '
           '"Texto redactado con ayuda de un modelo de IA y revisado por Sofía."')
respuesta = client.messages.create(
    model = 'claude-sonnet-5-5',
    max_tokens = 1024,
    output_config = {'effort': 'low'},
    system = SISTEMA,
    messages = [{'role': 'user', 'content': f'<documentos>\n{entrada}\n</documentos>'}],
)

# Comprobación de stop_reason antes de leer el texto:
if respuesta.stop_reason != 'end_turn':
    raise RuntimeError(f'Respuesta incompleta o rechazada: {respuesta.stop_reason}')
anuncio = ''.join(b.text for b in respuesta.content if b.type == 'text')
print(anuncio)

# Cada número del anuncio debe aparecer en los documentos de entrada:
numeros = re.findall(r'\d+(?:\.\d+)?', anuncio)
sin_respaldo = [x for x in numeros if x not in entrada]
print(f'\nNúmeros en el anuncio: {numeros} | sin respaldo: {sin_respaldo}')
print(f'Tokens: {respuesta.usage.input_tokens} de entrada, {respuesta.usage.output_tokens} de salida')

# Salida de ejemplo (puede variar):
# El Cuaderno Vivo ya es público. Es un asistente personal de estudio y diario creativo que resume
# notas, crea tarjetas de repaso, ilustra una portada por semana y narra un resumen. Puede probarlo
# en 5 minutos sin clave ni GPU, con notas de demostración. Con la API, su coste estimado es de
# 1.68 USD al mes, dentro de un presupuesto de 10 USD. No clona voces ajenas ni evalúa formalmente
# a nadie, y el audio con voz clonada no se publica. El código es MIT y la documentación, CC BY 4.0;
# la galería muestra 4 portadas con la etiqueta "Generado con IA".
# Texto redactado con ayuda de un modelo de IA y revisado por Sofía.
#
# Números en el anuncio: ['5', '1.68', '10', '4', '4.0'] | sin respaldo: []
# Tokens: 1342 de entrada, 168 de salida
El borrador de ejemplo tiene las virtudes que pedía el mensaje de sistema. Dice qué es el proyecto, cómo probarlo sin clave, cuánto cuesta según la estimación del Día 24 ($1.68$ USD al mes), qué no hace y con qué licencias se publica, y termina con la divulgación. La comprobación de cifras encuentra $0$ números sin respaldo: los cinco que extrae ($5$, $1.68$, $10$, $4$ y el $4.0$ de “CC BY 4.0”) aparecen en el README o en la ficha del sistema.
La comprobación tiene un límite claro: verifica que los números existan en los documentos, no que se usen bien. Un anuncio que dijera “cuesta $10$ USD al mes” pasaría la prueba, aunque $10$ sea el presupuesto y no el coste. Y como busca cada número como texto dentro de los documentos, un $1$ inventado pasaría también, porque está dentro de “10”. Por eso Sofía lee el borrador entero antes de publicarlo, y lo firma ella, con la divulgación incluida: “Texto redactado con ayuda de un modelo de IA y revisado por Sofía.” Es la política del Día 20 aplicada a su propio anuncio.
Consideraciones finales
Sofía termina el día con un repositorio que puede hacerse público y un sitio que puede abrir cualquiera. El inventario separó $26$ archivos públicos de $12$ privados; el filtro encontró tres datos personales, uno de ellos en el historial; la matriz y el grafo de licencias explicaron por qué el audio con voz clonada no se publica; la galería bajó de $7.931$ a $0.330$ MB; y el proyecto tiene un README para desconocidos, una guía para contribuir, un código de conducta y una política de seguridad. Diego tiene su respuesta: puede copiar y cambiar el código y la documentación, con atribución, incluso si el archivo de su abuela algún día tiene anuncios, pero no la voz de Sofía, y no XTTS-v2 si cobra. Su comentario resume el día: “O sea que la licencia no era para protegerla de mí; era para que yo supiera qué puedo hacer sin preguntarle.”
Esa es la idea de fondo. Publicar es delegar confianza: quien publica confía en que otros respetarán las condiciones, y quien reutiliza confía en que lo publicado es lo que dice ser. Una licencia clara protege a ambos, y una política de seguridad, un código de conducta y una guía de contribución son la misma clase de promesa escrita. Por eso solo deben publicarse si se pueden cumplir: un código de conducta sin nadie que lo aplique, o una política de seguridad con un buzón que nadie lee, es peor que no tenerlos.
Las cifras de hoy tienen límites que conviene repetir. Las portadas son de juguete, y sus pesos dependen del grano que se les añadió; las contribuciones del mapa son simuladas; y la matriz y el grafo de licencias son simplificaciones didácticas: resumen las condiciones principales de cada licencia, no todas, y no sustituyen la lectura del texto completo ni, en caso de duda, el consejo de una persona experta en propiedad intelectual de su jurisdicción.
Antes de publicar su propio proyecto, hágase estas preguntas:
- ¿Tiene una lista ordenada de reglas que decida qué se publica, y lo que ninguna regla cubre queda para revisión en lugar de publicarse?
- ¿Ha pasado un filtro de datos personales por el historial completo del repositorio, y no solo por la última versión?
- ¿Sabe qué licencia tiene cada modelo y cada herramienta que usa, y cuál de ellas fija el límite de lo que puede hacer con el conjunto?
- ¿Cada archivo fuente declara su licencia con un identificador SPDX en sus primeras líneas?
- ¿Su sitio cabe en un presupuesto de peso, y cada imagen generada lleva su etiqueta visible?
- ¿Puede cumplir lo que promete su código de conducta y su política de seguridad?
Un gran libro que habla de esto es Working in Public: The Making and Maintenance of Open Source Software (que podría traducirse como Trabajar en público: cómo se crea y se mantiene el software de código abierto), en el que Nadia Eghbal estudia cómo funcionan de verdad los proyectos abiertos. Su tesis central contradice la imagen romántica de las grandes comunidades: la mayoría de los proyectos los sostiene una persona o unas pocas, y lo escaso no es el código, sino la atención de quien lo mantiene. Eghbal clasifica los proyectos según cuántas personas los usan y cuántas contribuyen; el Cuaderno Vivo es hoy lo que ella llama un juguete, un proyecto pequeño con pocos usuarios y una sola mantenedora, y el libro ayuda a decidir con calma si se quiere que deje de serlo.
Una licencia clara, un historial limpio y unas reglas que se pueden cumplir valen más que cualquier anuncio. Sofía lo deja escrito en su registro de decisiones con una frase más corta: “Hoy el cuaderno aprendió a decir qué es de todos y qué es solo mío.”
Conclusiones clave
Qué publicar
- Una lista ordenada de reglas clasifica la entrega en público, privado y sintético; de $41$ archivos, $26$ son públicos, $12$ privados, $2$ sintéticos y $1$ queda para revisión, porque lo desconocido no se publica por defecto.
- El filtro de datos personales del Día 19 encuentra $3$ datos en lo que se iba a publicar, uno de ellos en un mensaje de commit: el historial también se publica y se revisa antes del primer envío.
- Las notas de Sofía se sustituyen por $12$ notas de demostración con el mismo formato, que hacen funcionar la prueba de humo y el inicio rápido sin exponer nada.
Licencias
- El código se publica con MIT y el contenido con CC BY 4.0; Creative Commons desaconseja sus licencias para software.
- El nivel de uso de cada componente es el mínimo de sus restricciones: los episodios con voz XTTS-v2 no se publican por el consentimiento del Día 15, y no se usarían con fines comerciales aunque se renovara, por la CPML.
- El cierre transitivo de Warshall lleva el grafo de $6$ a $8$ aristas, pero la compatibilidad no siempre es transitiva;
LicenseRef-CPML-1.0.0queda aislada. - Cada archivo fuente declara
SPDX-License-Identifieren sus dos primeras líneas; $2$ de los $6$ archivos de ejemplo no lo cumplían.
Sitio y comunidad
- Un sitio estático con Hugo no tiene servidor, ni claves, ni coste de API; su configuración desactiva el HTML arbitrario y cada episodio lleva la etiqueta “Generado con IA” y publica la transcripción, no el audio.
- Convertir las portadas a WebP de calidad $80$ baja la galería de $7.931$ a $0.330$ MB, un ahorro del $95.8%$ que la deja en un tercio del presupuesto de $1$ MB.
- El README para desconocidos empieza por una prueba de humo sin clave y dice qué no hace; publicar es la versión $4.2.0$ del registro de cambios.
- Las contribuciones se revisan en tres niveles: lo privado se rechaza, lo incompleto se devuelve y lo completo pasa a una persona; declarar el uso de IA es obligatorio, no motivo de rechazo.
- En el mapa de juguete, Sofía firma el $55.6%$ de $81$ contribuciones y el factor de autobús es $1$: el estado natural de un proyecto personal, que conviene declarar.
Mañana, en el Día 31: Retrospectiva de 31 días: métricas finales y la vida del producto. Es la última pregunta de la semana y de la serie: qué aprendimos. Sofía y Diego reunirán las cifras de los 31 días en un tablero final, compararán lo estimado con lo medido y revisarán la hoja de ruta del Día 24 con la evidencia del módulo 7.
Referencias
- Creative Commons (2013). Attribution 4.0 International (CC BY 4.0). https://creativecommons.org/licenses/by/4.0/
- SPDX Workgroup, Linux Foundation (2026). SPDX License List. https://spdx.org/licenses/
- The Hugo Authors (2026). Hugo documentation (Hugo se distribuye con licencia Apache 2.0). https://gohugo.io/documentation/
- Organization for Ethical Source (2025). Contributor Covenant 3.0. https://www.contributor-covenant.org/
- Eghbal, N. (2020). Working in Public: The Making and Maintenance of Open Source Software. Stripe Press.
- Coqui (2023). XTTS-v2, ficha del modelo y Coqui Public Model License 1.0.0. Hugging Face. https://huggingface.co/coqui/XTTS-v2
- Black Forest Labs (2024). FLUX.1 [schnell], ficha del modelo. Hugging Face. https://huggingface.co/black-forest-labs/FLUX.1-schnell
- The Apache Software Foundation (2026). GPL Compatibility. https://www.apache.org/licenses/GPL-compatibility
- Warshall, S. (1962). A Theorem on Boolean Matrices. Journal of the ACM, 9(1), 11-12.
- Preston-Werner, T. (2013). Semantic Versioning 2.0.0. https://semver.org/