
IA generativa en proyectos personales: Día 31
 Jeshua Romero Guadarrama
- 62 Min para leer
- 31 Jan, 2026
Índice de contenido
Resumen:
Un proyecto personal con IA generativa no termina cuando funciona ni cuando se publica: termina bien cuando su autora puede decir, con cifras, qué funcionó, qué no, qué aprendió y qué cambiará. En esta última entrada de la serie, Sofía y Diego conducen la retrospectiva del Cuaderno Vivo con una regla: cada afirmación lleva una cifra y el día del que sale. Reúnen las fuentes de los treinta días anteriores, suman el coste mensual de los siete módulos, amplían el mapa de habilidades a $14 \times 31$, comparan cinco estimaciones con lo que después se midió, reparten el esfuerzo entre las fases de la vida del producto, revisan la hoja de ruta del Día 24 sin mover sus fechas y convierten la escalera de seis peldaños en un método de siete. Al terminar, usted sabrá cerrar su propio proyecto con una retrospectiva basada en datos y no en impresiones.
¿Cómo citar el presente artículo?
Romero, J. (31 de enero de 2026). IA generativa en proyectos personales: Día 31. python-data-engineer. https://www.python-data-engineer.com/post/iag/dia_31/.
IA generativa en proyectos personales: Día 31 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/iag/dia_31/.
Modelos, precios y fechas revisados en octubre de 2026. Todas las cifras de esta entrada proceden de las treinta entradas anteriores de la serie, y cada una se cita con su día de origen; las del módulo 7 que no se publicaron como coste mensual se convierten aquí con supuestos escritos en el código. Antes de usarlas en un proyecto propio, vuelva a consultar los precios en la documentación oficial del proveedor.
Día 31. Retrospectiva de 31 días: métricas finales y la vida del producto
Introducción
Ayer, en el Día 30 (Publicar y compartir: sitio estático, licencias, documentación y comunidad), aprendió a separar lo que se publica de lo que nunca sale del equipo, a elegir licencias compatibles con las de los modelos y a preparar un repositorio para recibir contribuciones, y el Cuaderno Vivo ganó un sitio estático de solo lectura, licencias claras y sus archivos de comunidad. Hoy llega la séptima y última pregunta de la semana de “vida del producto”, y con ella termina la serie: ¿qué aprendimos?
La promesa del Día 1 se cumplió el Día 24, cuando el Cuaderno Vivo quedó empaquetado como una pieza de portafolio que otra persona podía instalar, ejecutar y auditar. El módulo 7/7 no añadió esa promesa; añadió otra pregunta, más incómoda: cómo sobrevive un proyecto personal cuando su autora deja de mirarlo todos los días. Durante esta semana, Sofía puso a prueba a un agente de código, midió un modelo local antes de mudarse a él, animó sus portadas sin salirse del presupuesto, tradujo y subtituló los resúmenes, escribió una batería de pruebas que atrapó una regresión de idioma y abrió el proyecto con licencias y una política de seguridad.
Diego ya no es el escéptico del Día 1. Usa el cuaderno para catalogar los casetes de su abuela, migró su script heredado cuando supo que el modelo que usaba se retiraba y ayer envió su primera contribución, con sus pruebas, como pide la guía de contribución. Es él quien propone la retrospectiva, y la propone con una regla que habría firmado el Diego de hace un mes: “Cada afirmación lleva una cifra y el día de donde sale. Si no hay cifra, no es una conclusión, es una opinión.”
En la presente entrada, descubrirá cómo conducir una retrospectiva estructurada de un proyecto personal, sin culpas y con datos. Verá cómo reunir las fuentes de un proyecto largo en una tabla que se puede comprobar, cómo sumar el coste mensual de siete módulos sin mezclar cifras publicadas con estimaciones, cómo ampliar el mapa de habilidades del Día 24 a catorce filas y treinta y una columnas, cómo comparar lo que se estimó con lo que después se midió y explicar cada desviación, cómo repartir el esfuerzo entre las fases de la vida de un producto y cómo revisar una hoja de ruta sin reescribirla. Al final, la escalera de seis peldaños del Día 24 gana un séptimo, y usted tendrá un método completo para su propio proyecto.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Conducir una retrospectiva estructurada de un proyecto personal (qué funcionó, qué no, qué aprendimos, qué cambiaremos) apoyada en datos y no en impresiones.
- Reunir las métricas de los 31 días en un tablero final coherente con las cifras publicadas en cada día.
- Comparar lo estimado con lo medido y explicar las desviaciones.
- Revisar la hoja de ruta del Día 24 con lo aprendido en el módulo 7 sin perder sus horizontes ni sus fechas.
- Cerrar la serie con un método reutilizable de siete pasos para su propio proyecto.
Cómo hacer una retrospectiva
Una retrospectiva es una reunión, o un documento, en la que quienes trabajaron en un proyecto miran hacia atrás para decidir qué hacer distinto hacia adelante. La práctica viene de la ingeniería de software: Norman Kerth la sistematizó en 2001 en su manual Project Retrospectives, y Esther Derby y Diana Larsen la convirtieron en 2006 en una rutina de cinco fases (preparar el ambiente, reunir datos, generar ideas, decidir qué hacer y cerrar) que hoy usan miles de equipos al final de cada ciclo de trabajo. Que el proyecto sea personal no la vuelve innecesaria; la vuelve más fácil de saltarse, porque nadie la exige.
Kerth propuso además una regla que abre cada retrospectiva y que conviene leer en voz alta, aunque el equipo sea de dos personas: pase lo que pase, se parte de que cada quien hizo el mejor trabajo posible con lo que sabía en ese momento, con sus habilidades, con los recursos disponibles y en la situación en que estaba. No es ingenuidad, es método: una retrospectiva que busca culpables produce silencio, y el silencio esconde justo los errores que más enseñan. Sofía tiene dos incidentes en su historial (el bucle sin límite del Día 23 y el resumen en inglés del Día 29), y los dos los provocó ella. Si la retrospectiva fuera un juicio, tendría todos los motivos para no mencionarlos.
Las cuatro preguntas
El formato que usarán Sofía y Diego tiene cuatro columnas, una adaptación de las preguntas clave de Kerth:
- ¿Qué funcionó? Las decisiones que conviene repetir, porque si no se escriben se olvidan.
- ¿Qué no funcionó? Los errores, los incidentes y las estimaciones que se alejaron de la realidad.
- ¿Qué aprendimos? Lo que hoy se sabe y hace un mes no, formulado de modo que sirva a otro proyecto.
- ¿Qué cambiaremos? Acciones concretas, con dueño y fecha, que salen de las tres columnas anteriores.
Kerth tenía una cuarta pregunta que aquí no forma columna propia, "¿qué nos sigue desconcertando?", y conviene no perderla: en esta retrospectiva, sus respuestas aparecen como las cifras que todavía no se pueden afirmar, por ejemplo una latencia que solo se ha simulado. La regla de Diego añade una condición a cada fila: una cifra y un día de origen. La regla tiene una consecuencia práctica inmediata. Antes de discutir nada, hay que saber de dónde pueden salir las cifras, es decir, qué artefactos dejó cada día y qué métrica aporta cada uno. Por eso la primera tarea de la retrospectiva no es opinar, sino hacer inventario de las fuentes.
Las fuentes
Como en todos los días, el primer bloque carga las bibliotecas y fija la semilla global de la serie. Hoy todo lo ejecutable usa numpy, pandas, matplotlib y la biblioteca estándar; el único bloque que llama a la API, el último, se muestra con una salida de ejemplo comentada:
# Importaciones base y semilla global de la serie en Python:
import warnings
warnings.filterwarnings('ignore')
import re
import sys
import numpy as np
import pandas as pd
import matplotlib
import matplotlib.pyplot as plt
from matplotlib.patches import FancyBboxPatch, FancyArrowPatch

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 140)
pd.set_option('display.max_colwidth', 60)
print('Python', sys.version.split()[0], '| numpy', np.__version__, '| pandas', pd.__version__,
      '| matplotlib', matplotlib.__version__)
Python 3.12.10 | numpy 2.4.6 | pandas 3.0.3 | matplotlib 3.10.9
El siguiente bloque construye la tabla de fuentes como un DataFrame de tres columnas: el día, el artefacto que ese día dejó en la carpeta del proyecto y la métrica que aporta a la retrospectiva. Después aplica la regla de Diego como una comprobación automática: ninguna fila puede tener un día fuera de la serie, un artefacto vacío o una métrica vacía. Por último, cuenta cuántas fuentes aporta cada módulo:
# Fuentes de la retrospectiva: cada afirmación lleva un día y un artefacto, en Python:
fuentes = pd.DataFrame([
    # (día, artefacto, métrica que aporta)
    (4, 'registro_uso.csv del prototipo v0', 'coste por consulta y coste mensual de los resúmenes'),
    (8, 'progreso_tutor.json y caché de prompts', 'coste del tutor con caché y enrutamiento'),
    (12, 'estilo.json y portadas/', 'contraste del título y coste de la crítica'),
    (16, 'audio/ con marca de agua', 'z de detección y coste de los guiones'),
    (17, 'riesgos.csv', 'riesgo total inherente y residual'),
    (18, 'banco de alucinaciones', 'tasa de alucinación con intervalo de Wilson'),
    (19, 'guardianes.py', 'obediencia a inyecciones y F1 del filtro'),
    (21, 'docs/ y tabla RUTAS', 'presupuesto por componente y p95 simulado'),
    (22, 'orquestador de preparar la semana', 'ruta crítica y duración con una GPU'),
    (23, 'registro_uso.csv, versión 2', 'coste del mes, incidente y p95 por componente'),
    (24, 'lista de verificación y hoja de ruta', 'comprobaciones completas y fechas'),
    (25, 'tarjetas_csv.py y sus pruebas', 'pruebas superadas y tiempo humano'),
    (26, 'ADR-004 y banco de 60 notas', 'exactitud, McNemar y coste local'),
    (27, 'clips GIF con procedencia', 'parpadeo medido y coste por clip'),
    (28, 'subtítulos, texto alternativo y lectura fácil', 'coste de accesibilidad y legibilidad'),
    (29, 'pruebas/ y CHANGELOG.md', 'pruebas por capa y regresión por tema'),
    (30, 'LICENSE, CONTRIBUTING.md y SECURITY.md', 'licencias y archivos de comunidad'),
], columns = ['dia', 'artefacto', 'metrica'])

# Regla de Diego: ninguna fila sin un día de la serie, un artefacto y una métrica:
validas = (fuentes['dia'].between(1, 30) & fuentes['artefacto'].str.strip().str.len().gt(0)
           & fuentes['metrica'].str.strip().str.len().gt(0))
modulo = pd.cut(fuentes['dia'], bins = [0, 4, 8, 12, 16, 20, 24, 31], labels = [f'M{m}' for m in range(1, 8)])
print(fuentes.to_string(index = False))
print('Filas válidas:', int(validas.sum()), 'de', len(fuentes))
print('Fuentes por módulo:', modulo.value_counts().sort_index().to_dict())
 dia                                     artefacto                                             metrica
   4             registro_uso.csv del prototipo v0 coste por consulta y coste mensual de los resúmenes
   8        progreso_tutor.json y caché de prompts            coste del tutor con caché y enrutamiento
  12                       estilo.json y portadas/          contraste del título y coste de la crítica
  16                      audio/ con marca de agua               z de detección y coste de los guiones
  17                                   riesgos.csv                   riesgo total inherente y residual
  18                        banco de alucinaciones         tasa de alucinación con intervalo de Wilson
  19                                 guardianes.py            obediencia a inyecciones y F1 del filtro
  21                           docs/ y tabla RUTAS           presupuesto por componente y p95 simulado
  22             orquestador de preparar la semana                 ruta crítica y duración con una GPU
  23                   registro_uso.csv, versión 2       coste del mes, incidente y p95 por componente
  24          lista de verificación y hoja de ruta                   comprobaciones completas y fechas
  25                 tarjetas_csv.py y sus pruebas                   pruebas superadas y tiempo humano
  26                   ADR-004 y banco de 60 notas                    exactitud, McNemar y coste local
  27                     clips GIF con procedencia                    parpadeo medido y coste por clip
  28 subtítulos, texto alternativo y lectura fácil                coste de accesibilidad y legibilidad
  29                       pruebas/ y CHANGELOG.md               pruebas por capa y regresión por tema
  30        LICENSE, CONTRIBUTING.md y SECURITY.md                   licencias y archivos de comunidad
Filas válidas: 17 de 17
Fuentes por módulo: {'M1': 1, 'M2': 1, 'M3': 1, 'M4': 1, 'M5': 3, 'M6': 4, 'M7': 6}
Las $17$ filas son válidas, y la Tabla 1 las recoge tal como las usará el resto de la entrada. La cuenta por módulo dice algo que no es evidente a primera vista: los cuatro primeros módulos aportan una sola fuente cada uno, el día que cierra el módulo, mientras que el módulo 5 aporta $3$, el 6 aporta $4$ y el 7 aporta $6$. No es que los primeros días no produjeran cifras (el Día 3 calculó entropías, el Día 9 fracciones de señal), sino que sus cifras explicaban cómo funciona un modelo, y las de los últimos días miden cómo funciona el sistema de Sofía. Una retrospectiva de producto se alimenta sobre todo de estas últimas.
Tabla 1. Fuentes de la retrospectiva: día, artefacto y métrica que aporta.
| Día | Artefacto | Métrica que aporta |
|---|---|---|
| 4 | registro_uso.csv del prototipo v0 | Coste por consulta y coste mensual de los resúmenes |
| 8 | progreso_tutor.json y caché de prompts | Coste del tutor con caché y enrutamiento |
| 12 | estilo.json y portadas/ | Contraste del título y coste de la crítica |
| 16 | audio/ con marca de agua | $z$ de detección y coste de los guiones |
| 17 | riesgos.csv | Riesgo total inherente y residual |
| 18 | Banco de alucinaciones | Tasa de alucinación con intervalo de Wilson |
| 19 | guardianes.py | Obediencia a inyecciones y F1 del filtro |
| 21 | docs/ y tabla RUTAS | Presupuesto por componente y p95 simulado |
| 22 | Orquestador de “preparar la semana” | Ruta crítica y duración con una GPU |
| 23 | registro_uso.csv, versión 2 | Coste del mes, incidente y p95 por componente |
| 24 | Lista de verificación y hoja de ruta | Comprobaciones completas y fechas |
| 25 | tarjetas_csv.py y sus pruebas | Pruebas superadas y tiempo humano |
| 26 | ADR-004 y banco de 60 notas | Exactitud, McNemar y coste local |
| 27 | Clips GIF con procedencia | Parpadeo medido y coste por clip |
| 28 | Subtítulos, texto alternativo y lectura fácil | Coste de accesibilidad y legibilidad |
| 29 | pruebas/ y CHANGELOG.md | Pruebas por capa y regresión por tema |
| 30 | LICENSE, CONTRIBUTING.md y SECURITY.md | Licencias y archivos de comunidad |
Observe que la tabla no tiene ninguna fila del Día 31. Es deliberado: una retrospectiva no produce datos nuevos, los reúne. Si a mitad de la reunión alguien necesita una cifra que no está en ninguna fuente, la respuesta correcta no es estimarla en el momento, sino anotar que falta y decidir si merece medirse. Esa anotación ya es un resultado de la retrospectiva.
Las cifras de 31 días
Con las fuentes en la mano, lo primero es ver el recorrido completo. El siguiente bloque dibuja los $31$ días como una línea de tiempo hecha con FancyBboxPatch, una caja por día coloreada según su módulo, y marca sobre ella los hitos que cambiaron lo que el Cuaderno Vivo sabía hacer: el prototipo v0, el tutor, las portadas, la narración, los guardianes, la entrega, la batería de pruebas, la publicación y esta retrospectiva:
# Línea de tiempo de los 31 días, coloreada por módulo, en Python:
MODULOS = [
    ('1/7\nFundamentos', 1, 4, '#4C72B0'),
    ('2/7\nPrompts y memoria', 5, 8, '#55A868'),
    ('3/7\nIA visual', 9, 12, '#DD8452'),
    ('4/7\nIA sonora', 13, 16, '#C44E52'),
    ('5/7\nÉtica y riesgos', 17, 20, '#8172B3'),
    ('6/7\nProyecto integrador', 21, 24, '#937860'),
    ('7/7\nMás allá del proyecto', 25, 31, '#D1609E'),
]
HITOS = {4: 'Prototipo v0', 8: 'Tutor', 12: 'Portadas', 16: 'Narración', 19: 'Guardianes',
         24: 'Entrega', 29: 'Pruebas', 30: 'Publicación', 31: 'Retrospectiva'}

fig, ax = plt.subplots(figsize = (12, 4))
for nombre, inicio, fin, color in MODULOS:
    for dia in range(inicio, fin + 1):
        ax.add_patch(FancyBboxPatch((dia - 0.42, 0), 0.84, 1, boxstyle = 'round,pad=0.02,rounding_size=0.12',
                                    facecolor = color, edgecolor = 'white'))
        ax.text(dia, 0.5, str(dia), ha = 'center', va = 'center', color = 'white', fontsize = 9, weight = 'bold')
    ax.text((inicio + fin) / 2, -0.2, nombre, ha = 'center', va = 'top', fontsize = 8.5, color = color)
for i, (dia, hito) in enumerate(HITOS.items()):
    altura = 1.3 + 0.45 * (i % 3)
    ax.plot([dia, dia], [1.05, altura - 0.05], color = 'gray', linewidth = 1)
    ax.text(dia, altura, hito, ha = 'center', va = 'bottom', fontsize = 9)
ax.set_xlim(0.3, 31.9)
ax.set_ylim(-1.1, 2.7)
ax.axis('off')
ax.set_title('Los 31 días del Cuaderno Vivo', fontsize = 16)
plt.tight_layout()

dias_por_modulo = {nombre.split()[0]: fin - inicio + 1 for nombre, inicio, fin, _ in MODULOS}
print('Días por módulo:', dias_por_modulo, '| total:', sum(dias_por_modulo.values()))
print('Hitos:', ', '.join(f'{d} {h}' for d, h in HITOS.items()))
print('Días entre hitos:', np.diff(list(HITOS)).tolist())
# Siete franjas de color y nueve hitos sobre la línea:
plt.show()
Días por módulo: {'1/7': 4, '2/7': 4, '3/7': 4, '4/7': 4, '5/7': 4, '6/7': 4, '7/7': 7} | total: 31
Hitos: 4 Prototipo v0, 8 Tutor, 12 Portadas, 16 Narración, 19 Guardianes, 24 Entrega, 29 Pruebas, 30 Publicación, 31 Retrospectiva
Días entre hitos: [4, 4, 4, 3, 5, 5, 1, 1]
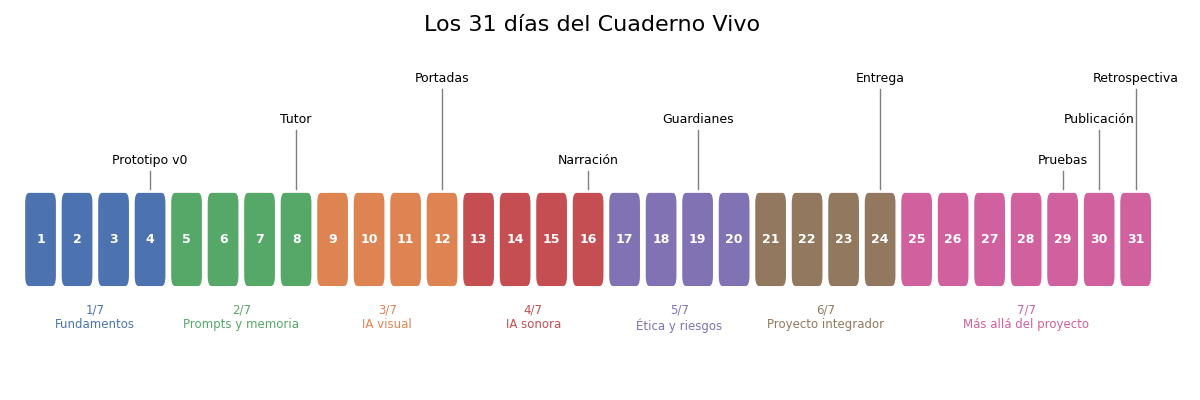
La línea de tiempo tiene una regularidad que solo se rompe al final. Los seis primeros módulos duran $4$ días cada uno y los hitos aparecen cada $3$ a $5$ días, casi siempre al cierre de un módulo o, en el caso de los guardianes, en el día que los puso en el código. El módulo 7 dura $7$ días y concentra tres hitos en los tres últimos, separados por un solo día. La razón está en la naturaleza de cada etapa: construir produce hitos espaciados, porque cada capacidad nueva necesita varios días de fundamentos; mantener y abrir producen hitos seguidos, porque cada uno se apoya en todo lo anterior y solo le añade una capa de cuidado. Las pruebas del Día 29 son lo que hizo posible publicar el Día 30, y publicar es lo que hace necesaria la retrospectiva de hoy.
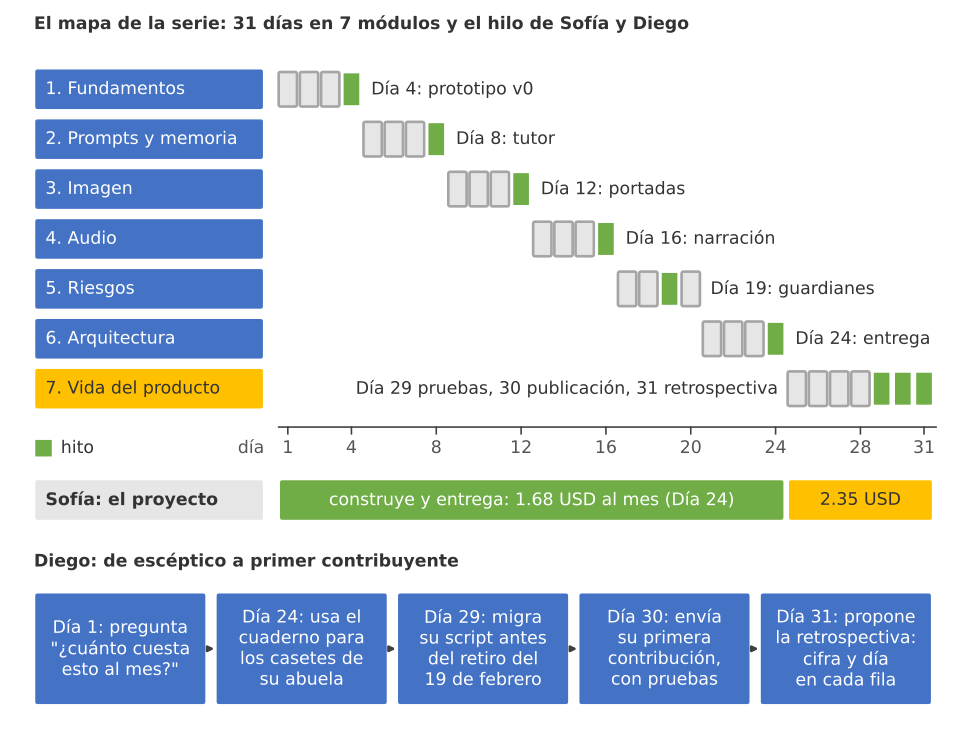
Figura 1. El mapa de la serie: seis módulos de 4 días y un séptimo de 7, con los nueve hitos del Cuaderno Vivo (del prototipo v0 del Día 4 a la retrospectiva del Día 31), el coste mensual de Sofía (1.68 USD en la entrega, 2.35 USD con el módulo 7) y el hilo de Diego, de la pregunta del Día 1 a su primera contribución.
El coste de los siete módulos
La primera pregunta de Diego, el Día 1, fue "¿Cuánto cuesta esto al mes?", y el Día 24 la contestó con $1.68$ USD. Aquella cifra sumaba lo que gastaba cada uno de los seis módulos. La retrospectiva la amplía al séptimo con la misma fórmula, ahora con siete sumandos:
$$ C = \sum_{m=1}^{7} C_m, \qquad u = \frac{C}{P}, \qquad \Delta_7 = \frac{C_7}{\sum_{m=1}^{6} C_m} $$
La lógica detrás de estas tres cifras es múltiple:
- $C_1$ a $C_6$ son exactamente las cifras del tablero final del Día 24, que a su vez salían de cada día de origen: $0.192$ USD de los resúmenes (Día 4), $0.904$ del tutor (Día 8), $0.099$ de las portadas (Día 12), cuatro guiones de $0.00278$ (Día 16), la revisión de riesgos y el banco (días 17 y 18) y la estimación del módulo 6.
- $C_7$ es nueva y es una estimación: suma el agente de código (Día 25), la clasificación con el ADR-004 (Día 26), los clips procedurales (Día 27), la accesibilidad (Día 28) y las pruebas de calidad (Día 29), con los supuestos escritos en el bloque.
- $u$ es la fracción del presupuesto $P = 10$ USD que se usa, y $\Delta_7$ dice cuánto encareció el módulo 7 lo que ya existía.
- En conclusión, la suma se audita sumando por sumando: si un día cambia un supuesto, se sabe qué fila tocar y cuánto se mueve el total.
El siguiente bloque reutiliza la función coste() del Día 24 y sus precios por millón de tokens, reconstruye los seis módulos publicados y añade el séptimo. Los supuestos que no publicó ningún día van como comentarios junto a la cifra que afectan: que el agente de código hace una tanda de cinco tareas al mes, que un $15%$ de las notas tiene datos personales y se clasifica en local, y que las pruebas de calidad se ejecutan una vez por semana:
# Coste mensual estimado por módulo: cifras publicadas más el módulo 7, en Python:
PRECIOS = {'claude-haiku-5-5': (0.10, 0.50), 'claude-sonnet-5-5': (2.00, 10.00),
           'claude-fable-5-1': (10.00, 50.00)}   # USD por millón de tokens: (entrada, salida)
PRESUPUESTO = 10.0

def coste(modelo, entrada, salida, llamadas = 1):
    p_ent, p_sal = PRECIOS[modelo]
    return llamadas * (entrada * p_ent + salida * p_sal) / 1e6

# Módulos 1 a 6: las mismas cifras del tablero final del Día 24 (USD al mes):
modulo6 = (coste('claude-sonnet-5-5', 2500, 300, llamadas = 4 * 8)     # orquestador: 4 semanas x 8 iteraciones
           + coste('claude-haiku-5-5', 900, 120, llamadas = 4 * 15)    # juez: 15 casos cada semana
           + coste('claude-fable-5-1', 6000, 1500))                    # una revisión de arquitectura al mes
costes = pd.Series({
    'M1 resúmenes (Día 4)': coste('claude-haiku-5-5', 1200, 400, llamadas = 20 * 30),
    'M2 tutor (Día 8)': 0.904,
    'M3 portadas (Día 12)': 0.099,
    'M4 guiones (Día 16)': 4 * 0.00278,
    'M5 riesgos y banco (Días 17-18)': 0.049 + 0.002 + 0.02 + 0.0015,
    'M6 orquestación y juez (Día 24)': modulo6,
})
# Módulo 7, con sus supuestos escritos aquí mismo:
FRACCION_LOCAL = 0.15   # supuesto: parte de las notas con datos personales que el ADR-004 manda a local
modulo7 = pd.Series({
    'agente de código (Día 25)': 0.515,                               # supuesto: cinco tareas al mes
    'clasificación (Día 26)': (600 * (1 - FRACCION_LOCAL) * coste('claude-haiku-5-5', 900, 20)
                               + FRACCION_LOCAL * 0.00172),          # más la electricidad de la parte local
    'clips procedurales (Día 27)': 4 * 0.000025,                      # cuatro clips en la CPU
    'accesibilidad y traducción (Día 28)': 0.02709,
    'pruebas de calidad (Día 29)': 4 * 0.0202,                        # supuesto: una pasada por semana
})
costes['M7 vida del producto (estimado)'] = modulo7.sum()
total = costes.sum()
print(costes.round(4).to_string())
print('Módulo 7 por componente:')
print(modulo7.round(5).to_string())
print(f'Total: {total:.4f} USD al mes | uso del presupuesto: {total / PRESUPUESTO:.1%} | margen: {PRESUPUESTO - total:.2f} USD')
print(f"Aumento por el módulo 7: {costes.iloc[-1]:.4f} USD ({costes.iloc[-1] / costes.iloc[:-1].sum():.1%} sobre el Día 24)")

fig, (ax1, ax2) = plt.subplots(1, 2, figsize = (12, 4.8), gridspec_kw = {'width_ratios': [1.6, 1]})
colores = ['#4C72B0', '#55A868', '#DD8452', '#C44E52', '#8172B3', '#937860', '#D1609E']
barras = ax1.barh(costes.index, costes.values, color = colores)
barras[-1].set_hatch('//')
barras[-1].set_edgecolor('white')
ax1.invert_yaxis()
for barra, valor in zip(barras, costes.values):
    ax1.text(valor + 0.01, barra.get_y() + barra.get_height() / 2, f'{valor:.3f}', va = 'center', fontsize = 9)
ax1.set_xlim(0, 1.15)
ax1.set_xlabel('USD al mes')
ax1.set_title('Coste mensual por módulo (con trama: estimación del módulo 7)', fontsize = 11)
acumulado = costes.cumsum()
ax2.plot(range(1, 8), acumulado.values, 'o-', color = '#2F4B7C', linewidth = 2, label = 'Acumulado')
ax2.axhline(PRESUPUESTO, color = '#C44E52', linewidth = 1.5, label = 'Presupuesto: 10 USD')
ax2.axhline(0.8 * PRESUPUESTO, color = '#DD8452', linestyle = '--', linewidth = 1.2, label = 'Alerta: 80 %')
ax2.set_xticks(range(1, 8), [f'M{m}' for m in range(1, 8)])
ax2.set_ylim(0, 11)
ax2.set_ylabel('USD al mes')
ax2.set_title(f'Total: {total:.2f} de 10 USD', fontsize = 11)
ax2.legend(fontsize = 8, loc = 'center right')
fig.suptitle('Coste mensual estimado del Cuaderno Vivo', fontsize = 16)
plt.tight_layout()
# Seis módulos publicados y uno estimado, frente al presupuesto:
plt.show()
M1 resúmenes (Día 4)               0.1920
M2 tutor (Día 8)                   0.9040
M3 portadas (Día 12)               0.0990
M4 guiones (Día 16)                0.0111
M5 riesgos y banco (Días 17-18)    0.0725
M6 orquestación y juez (Día 24)    0.4000
M7 vida del producto (estimado)    0.6742
Módulo 7 por componente:
agente de código (Día 25)              0.51500
clasificación (Día 26)                 0.05126
clips procedurales (Día 27)            0.00010
accesibilidad y traducción (Día 28)    0.02709
pruebas de calidad (Día 29)            0.08080
Total: 2.3529 USD al mes | uso del presupuesto: 23.5% | margen: 7.65 USD
Aumento por el módulo 7: 0.6742 USD (40.2% sobre el Día 24)
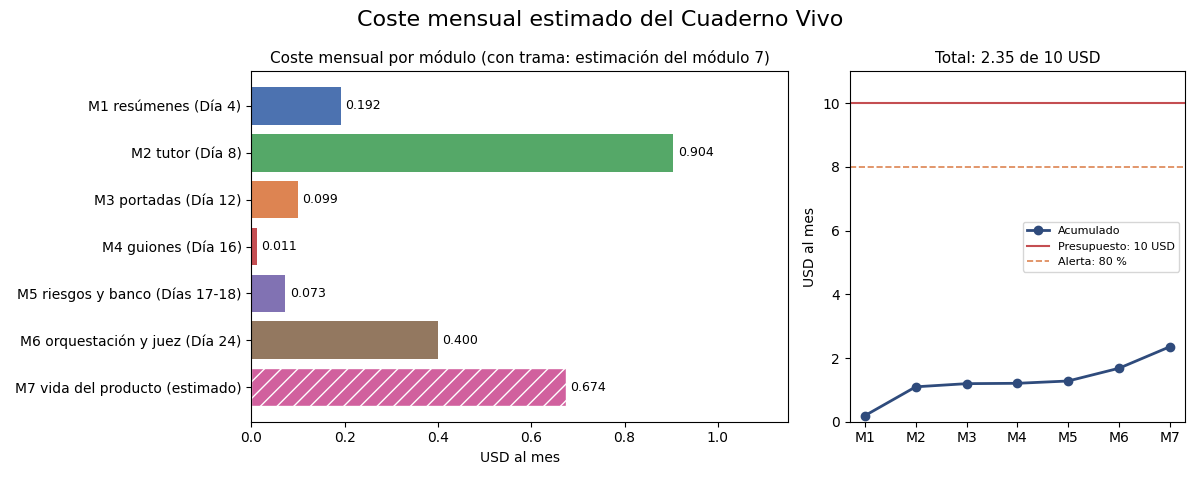
El Cuaderno Vivo completo, con los siete módulos, cuesta unos $2.35$ USD al mes, el $23.5%$ del presupuesto, y deja un margen de $7.65$ USD. El módulo 7 añade $0.674$ USD, un $40.2%$ sobre los $1.68$ USD del Día 24: una subida grande en proporción y pequeña en dinero. El panel izquierdo muestra de dónde sale. Casi todo el módulo 7 es el agente de código, $0.515$ de los $0.674$ USD, el $76%$; y aun así, como recordó el propio Día 25, el dinero era lo de menos, porque el $85%$ del coste de aquellas cinco tareas fue tiempo humano de revisión. Las pruebas de calidad, con una pasada semanal, suman $0.081$ USD; la clasificación con el ADR-004, $0.051$; la accesibilidad completa, con traducción, subtítulos, texto alternativo y lectura fácil, $0.027$; y los cuatro clips procedurales, una décima de centavo.
El panel derecho acumula los módulos uno tras otro frente a la línea roja de $10$ USD y la línea discontinua de alerta al $80%$ que el Día 23 convirtió en regla. La línea azul sube a saltos pequeños y queda muy lejos de las dos. El presupuesto de $10$ USD nunca fue el límite real del proyecto: lo fue la atención de Sofía. Esa conclusión no estaba clara el Día 1, cuando Fable 5.1 costaba $19.20$ USD al mes para resumir y parecía que el dinero iba a decidirlo todo; la decidió el enrutamiento, que mandó cada tarea al modelo más barato que la hacía bien.
Hay dos advertencias sobre esta cifra. La primera: ninguno de los siete sumandos es una factura. Seis son cifras publicadas en sus días de origen, calculadas con volúmenes supuestos, y el séptimo combina cifras publicadas con supuestos de este bloque. La segunda: el total omite costes puntuales que no se repiten cada mes, como el borrador del anuncio del Día 30 o las grabaciones de salidas del Día 29. Un mes con una migración de modelo costaría algo más; un mes sin tareas para el agente, bastante menos.
Lo que queda en la carpeta
El coste es la cifra que Diego pidió primero, pero no la única que una retrospectiva necesita. La entrega del Día 24 contaba $12$ notas, $15$ tarjetas, $4$ portadas, $1$ episodio, $10$ riesgos registrados y $6$ documentos. El módulo 7 añadió piezas de otra naturaleza: un ADR más (el 004, que parte la clasificación en dos rutas), clips animados con su registro de procedencia, subtítulos y textos alternativos, un registro de cambios con tres versiones ($4.0.0$, $4.1.0$ y $4.1.1$) y los archivos de comunidad. Y añadió, sobre todo, pruebas: las $30$ unitarias, $14$ de contrato y $15$ de calidad del Día 29, que se apoyan en los bancos que la serie fue construyendo (las $25$ preguntas de alucinación del Día 18, los $20$ intentos de inyección del Día 19, los $15$ casos de evaluación del Día 23 y las $60$ notas del banco de clasificación del Día 26).
Esa lista dice algo sobre la madurez del proyecto que el coste no dice. Un proyecto que empieza a tener más pruebas que funciones ha dejado de crecer y ha empezado a cuidarse. No es una señal de estancamiento, sino de que lo construido ya vale lo suficiente como para protegerlo.
El mapa de habilidades completo
El Día 24 resumió lo aprendido en una matriz de ocho habilidades por veinticuatro días, con una intensidad de $0$ (no se trató) a $3$ (fue el tema central del día). El módulo 7 no cabe en esas ocho filas: programar con un agente, ejecutar modelos en local, generar movimiento, hacer accesible el contenido, mantener el sistema y publicarlo son habilidades nuevas. La matriz crece en las dos direcciones, a $14$ filas y $31$ columnas, y el peso de cada habilidad se calcula con la misma proporción del Día 24, ahora sobre todos los días:
$$ c_s = \frac{\sum_{d=1}^{31} I_{s,d}}{\sum_{s’=1}^{14} \sum_{d=1}^{31} I_{s’,d}} $$
La lógica detrás de esta proporción es múltiple:
- $I_{s,d}$ es la intensidad de la habilidad $s$ en el día $d$; la suma sobre los días da los puntos de cada habilidad.
- El denominador suma los puntos de las catorce habilidades, de modo que las $c_s$ suman $1$ y se pueden comparar entre sí.
- Al añadir filas y columnas, el peso de las habilidades antiguas baja aunque sus puntos no cambien: $c_s$ mide la parte del recorrido, y el recorrido creció.
- En conclusión, comparar el $c_s$ de hoy con el del Día 24 dice cuánto cambió el foco de la serie, no cuánto se olvidó.
Las intensidades de los días 1 a 24 se copian sin cambios del Día 24, para que el bloque pueda comprobar que las ocho filas originales siguen sumando lo mismo. Las de los días 25 a 31 son una valoración editorial, escrita como datos para que usted pueda discutirlas. Hay además seis huellas previas, celdas de nivel $1$ en días anteriores al módulo 7 en las que una habilidad nueva ya apareció de paso: el contraste WCAG de los días 10 y 12 es accesibilidad; FLUX.1 schnell en la laptop (Día 11) y XTTS-v2 en local (Día 15) son modelos locales; las dependencias fijadas y el README del Día 24 son mantenimiento y publicación:
# Mapa de habilidades de 14 x 31 (intensidad de 0 a 3) en Python:
HABILIDADES = ['texto', 'prompts', 'memoria', 'imagen', 'audio', 'ética', 'arquitectura', 'evaluación',
               'código asistido', 'modelos locales', 'vídeo', 'accesibilidad', 'mantenimiento', 'publicación']
# Días 1 a 24: las intensidades del Día 24, sin cambios:
intensidad = {
    1: {'texto': 3, 'evaluación': 1, 'ética': 1},       2: {'texto': 3, 'memoria': 1, 'evaluación': 1},
    3: {'texto': 3, 'prompts': 1},                       4: {'texto': 2, 'arquitectura': 2, 'evaluación': 1, 'ética': 1},
    5: {'prompts': 3, 'evaluación': 2},                  6: {'prompts': 3, 'evaluación': 2, 'texto': 1},
    7: {'memoria': 3, 'prompts': 1, 'ética': 1},         8: {'memoria': 3, 'prompts': 2, 'arquitectura': 1, 'evaluación': 1},
    9: {'imagen': 3},                                    10: {'imagen': 3, 'prompts': 2},
    11: {'imagen': 3, 'evaluación': 2, 'ética': 1},      12: {'imagen': 3, 'prompts': 1, 'arquitectura': 1, 'ética': 1},
    13: {'audio': 3},                                    14: {'audio': 3, 'texto': 1, 'evaluación': 1},
    15: {'audio': 3, 'ética': 3},                        16: {'audio': 3, 'ética': 2, 'arquitectura': 1},
    17: {'ética': 3, 'arquitectura': 1},                 18: {'ética': 3, 'evaluación': 3, 'memoria': 1},
    19: {'ética': 3, 'memoria': 1, 'arquitectura': 1},   20: {'ética': 3, 'texto': 1, 'imagen': 1, 'audio': 1},
    21: {'arquitectura': 3, 'ética': 1, 'evaluación': 1}, 22: {'arquitectura': 3, 'prompts': 1},
    23: {'evaluación': 3, 'arquitectura': 2},
    24: {'arquitectura': 2, 'ética': 2, 'evaluación': 1, 'texto': 1, 'imagen': 1, 'audio': 1, 'memoria': 1, 'prompts': 1},
}
# Días 25 a 31 del módulo 7:
intensidad.update({
    25: {'código asistido': 3, 'evaluación': 2, 'ética': 1, 'arquitectura': 1},
    26: {'modelos locales': 3, 'evaluación': 2, 'ética': 1, 'arquitectura': 1},
    27: {'vídeo': 3, 'imagen': 2, 'evaluación': 1, 'ética': 1},
    28: {'accesibilidad': 3, 'texto': 2, 'imagen': 1, 'audio': 1, 'evaluación': 1, 'ética': 1},
    29: {'mantenimiento': 3, 'evaluación': 2, 'modelos locales': 1, 'arquitectura': 1},
    30: {'publicación': 3, 'ética': 2, 'mantenimiento': 1, 'accesibilidad': 1, 'imagen': 1},
    31: {'evaluación': 2, 'arquitectura': 1, 'ética': 1, 'mantenimiento': 1, 'publicación': 1},
})
# Huellas previas de las habilidades nuevas (el contraste WCAG, los modelos que corren en la laptop, la entrega):
HUELLAS_PREVIAS = {(10, 'accesibilidad'): 1, (12, 'accesibilidad'): 1, (11, 'modelos locales'): 1,
                   (15, 'modelos locales'): 1, (24, 'mantenimiento'): 1, (24, 'publicación'): 1}
matriz = pd.DataFrame(0, index = HABILIDADES, columns = range(1, 32))
for dia, niveles in intensidad.items():
    for habilidad, nivel in niveles.items():
        matriz.loc[habilidad, dia] = nivel
for (dia, habilidad), nivel in HUELLAS_PREVIAS.items():
    matriz.loc[habilidad, dia] = nivel

fig, ax = plt.subplots(figsize = (13, 6.2))
imagen = ax.imshow(matriz.values, cmap = 'YlGnBu', vmin = 0, vmax = 3, aspect = 'auto')
ax.set_xticks(range(31), [str(d) for d in range(1, 32)])
ax.set_yticks(range(len(HABILIDADES)), HABILIDADES)
for frontera in [3.5, 7.5, 11.5, 15.5, 19.5, 23.5]:   # separación entre módulos
    ax.axvline(frontera, color = 'white', linewidth = 3)
ax.axhline(7.5, color = 'white', linewidth = 3)       # las seis habilidades nuevas, debajo
ax.set_title('Habilidades trabajadas en los 31 días del Cuaderno Vivo', fontsize = 16)
ax.set_xlabel('Día de la serie')
fig.colorbar(imagen, ax = ax, ticks = [0, 1, 2, 3], label = 'Intensidad')
plt.tight_layout()

# Peso de cada habilidad en el total y días en los que fue protagonista (nivel 3):
peso = (matriz.sum(axis = 1) / matriz.values.sum() * 100).round(1)
protagonista = matriz.apply(lambda fila: list(fila[fila == 3].index), axis = 1)
print(pd.DataFrame({'puntos': matriz.sum(axis = 1), 'peso (%)': peso, 'días con nivel 3': protagonista}))
originales = int(matriz.loc[HABILIDADES[:8], 1:24].values.sum())
print('Total de puntos:', int(matriz.values.sum()), '| puntos del módulo 7:', int(matriz.loc[:, 25:31].values.sum()),
      '| 8 filas originales en los días 1 a 24:', originales)
print('Días con al menos tres habilidades:', int(((matriz > 0).sum() >= 3).sum()), 'de 31')
# Catorce filas, siete franjas y las habilidades nuevas debajo de la línea blanca:
plt.show()
                 puntos  peso (%)      días con nivel 3
texto                17       9.1             [1, 2, 3]
prompts              15       8.1                [5, 6]
memoria              10       5.4                [7, 8]
imagen               18       9.7       [9, 10, 11, 12]
audio                15       8.1      [13, 14, 15, 16]
ética                32      17.2  [15, 17, 18, 19, 20]
arquitectura         21      11.3              [21, 22]
evaluación           29      15.6              [18, 23]
código asistido       3       1.6                  [25]
modelos locales       6       3.2                  [26]
vídeo                 3       1.6                  [27]
accesibilidad         6       3.2                  [28]
mantenimiento         6       3.2                  [29]
publicación           5       2.7                  [30]
Total de puntos: 186 | puntos del módulo 7: 51 | 8 filas originales en los días 1 a 24: 129
Días con al menos tres habilidades: 24 de 31
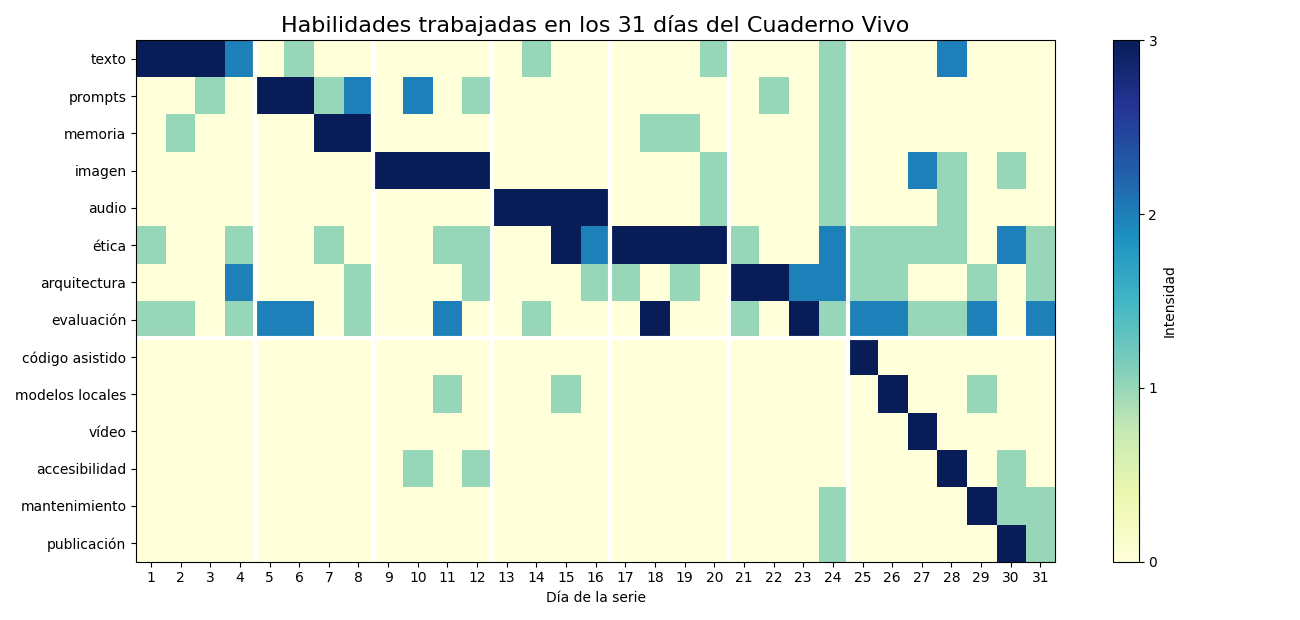
La comprobación de la penúltima línea sale bien: las ocho filas originales suman $129$ puntos en los días 1 a 24, los mismos del Día 24, así que la matriz ampliada es una extensión y no una reescritura. El total sube a $186$ puntos, de los que $51$ son del módulo 7.
La ética sigue siendo la habilidad con más peso, $32$ puntos y un $17.2%$, y la evaluación la segunda, con $29$ puntos y un $15.6%$. Ninguna de las dos fue el tema central del módulo 7, y sin embargo las dos crecieron: la ética, porque cada día del módulo tuvo su cuestión (permisos del agente, privacidad del modelo local, etiquetado de los clips, consentimiento para la voz en otros idiomas, licencias); la evaluación, porque cada decisión del módulo se tomó midiendo (pass@k, McNemar, el parpadeo de los clips, chrF, la regresión por tema). La memoria es la que menos pesa entre las antiguas ($5.4%$), y las seis nuevas pesan entre $1.6%$ y $3.2%$: son habilidades de un día, con alguna huella previa.
En el mapa de calor, las seis filas nuevas aparecen debajo de la línea blanca horizontal y forman una diagonal casi perfecta en los días 25 a 30: cada día del módulo 7 tuvo su propia habilidad protagonista. Por encima de la línea, en esos mismos días, las celdas claras de ética, evaluación y arquitectura siguen salpicando la matriz como lo hicieron desde el Día 1. Ahora son $24$ de los $31$ días los que trabajan al menos tres habilidades a la vez (el Día 24 contaba $15$ de $24$): los siete días del módulo 7 y dos días antiguos, el 10 y el 15, que con sus huellas previas suben a tres. La serie terminó como empezó: una misma forma de trabajar aplicada a problemas distintos.
Lo estimado frente a lo medido
Una retrospectiva que solo mira los resultados se pierde la mitad de la lección. La otra mitad está en las predicciones: cada vez que un día estimó una cifra antes de medirla, dejó una apuesta registrada, y la retrospectiva puede ahora comprobar quién ganó. No se trata de castigar las estimaciones fallidas, sino de entender por qué se desviaron, porque esa explicación es lo que mejora la siguiente estimación.
Para comparar cifras de magnitudes tan distintas (dólares, segundos, una medida adimensional de parpadeo) hacen falta dos medidas, una con signo y otra simétrica:
$$ e = \frac{M - E}{E}, \qquad q = \left|\log_2 \frac{M}{E}\right| $$
La lógica detrás de estas dos medidas es múltiple:
- $E$ es la cifra estimada y $M$ la medida; $e$ es el error relativo con signo: positivo si la realidad superó la estimación y negativo si quedó por debajo.
- El error relativo es asimétrico: quedarse en la mitad da $e = -0.5$, pero pasarse al doble da $e = +1$. Por eso se añade $q$, que vale $1$ en los dos casos, porque mide cuántas veces hay que duplicar o dividir entre dos la estimación para llegar a la medida.
- La lectura usa tres franjas: con $q < 0.1$ (menos de un $7%$ de diferencia) la estimación acierta; con $q < 1$ (menos del doble) se desvía; con $q \geq 1$, lo más probable es que cambiara un supuesto entre la estimación y la medida.
- En conclusión, $e$ dice hacia dónde se equivocó la estimación y $q$ cuánto, sin que importe el sentido.
El siguiente bloque compara cinco pares de cifras publicadas. Tres cruzan entradas distintas (una estimación de un día frente a la medición de otro); dos comparan, dentro de un mismo día, la cifra que predecía la teoría con la que dio el código:
# Lo estimado frente a lo medido: cinco pares de cifras publicadas, en Python:
pares = pd.DataFrame([
    # (cifra, día de la estimación, estimado, día de la medición, medido)
    ('Coste de los resúmenes (USD al mes)', 4, 0.192, 23, 1.3),
    ('Coste del mes sin incidente (USD)', 21, 1.842, 23, 2.467),
    ('p95 de la evaluación del tutor (s)', 21, 5.59, 23, 2.71),
    ('Semana con una GPU (s de juguete)', 22, 33.0, 22, 33.1),
    ('Parpadeo del ruido AR(1), rho = 0.9', 27, 0.316, 27, 0.314),
], columns = ['cifra', 'dia_est', 'estimado', 'dia_med', 'medido'])
pares['error_rel'] = (pares['medido'] - pares['estimado']) / pares['estimado']
pares['q'] = np.abs(np.log2(pares['medido'] / pares['estimado']))
# Lectura: q < 0.1 (menos de un 7 %) acierta; q < 1 (menos del doble) se desvía; q >= 1 cambió un supuesto:
pares['lectura'] = np.select([pares['q'] < 0.1, pares['q'] < 1], ['acierta', 'se desvía'], 'cambió un supuesto')
print(pares.round(3).to_string(index = False))
print(f"Mediana de |error relativo|: {pares['error_rel'].abs().median():.1%} | "
      f"aciertos: {(pares['lectura'] == 'acierta').sum()} de {len(pares)}")
print('Pares de una misma entrada:', int((pares['dia_est'] == pares['dia_med']).sum()),
      '| pares entre entradas distintas:', int((pares['dia_est'] != pares['dia_med']).sum()))
                              cifra  dia_est  estimado  dia_med  medido  error_rel     q            lectura
Coste de los resúmenes (USD al mes)        4     0.192       23   1.300      5.771 2.759 cambió un supuesto
  Coste del mes sin incidente (USD)       21     1.842       23   2.467      0.339 0.421          se desvía
 p95 de la evaluación del tutor (s)       21     5.590       23   2.710     -0.515 1.045 cambió un supuesto
  Semana con una GPU (s de juguete)       22    33.000       22  33.100      0.003 0.004            acierta
Parpadeo del ruido AR(1), rho = 0.9       27     0.316       27   0.314     -0.006 0.009            acierta
Mediana de |error relativo|: 33.9% | aciertos: 2 de 5
Pares de una misma entrada: 2 | pares entre entradas distintas: 3
Dos de los cinco pares aciertan, uno se desvía y dos cambiaron un supuesto por el camino. La mediana del error relativo absoluto es del $33.9%$, una cifra que no dice mucho por sí sola; lo que importa es la explicación de cada fila, que recoge la Tabla 2.
Tabla 2. Cinco estimaciones de la serie frente a lo que después se midió, con la causa de cada desviación.
| Cifra | Estimado (día) | Medido (día) | $e$ | Lectura | Causa de la diferencia |
|---|---|---|---|---|---|
| Coste de los resúmenes (USD al mes) | 0.192 (4) | 1.3 (23) | +5.771 | Cambió un supuesto | La estimación mandaba todo a Haiku 5.5; el registro manda un cuarto a Sonnet 5.5 |
| Coste del mes sin incidente (USD) | 1.842 (21) | 2.467 (23) | +0.339 | Se desvía | Los resúmenes con Sonnet suman más de lo que restan las revisiones con Fable que el mes simulado no incluye |
| p95 de la evaluación del tutor (s) | 5.59 (21) | 2.71 (23) | -0.515 | Cambió un supuesto | Dos simulaciones con supuestos de latencia distintos para la escalada |
| Semana con una GPU (s de juguete) | 33.0 (22) | 33.1 (22) | +0.003 | Acierta | El planificador predijo lo que los hilos reales midieron |
| Parpadeo del ruido AR(1), $\rho = 0.9$ | 0.316 (27) | 0.314 (27) | -0.006 | Acierta | La teoría $\sqrt{1-\rho}$ describe bien el ruido correlacionado |
La primera fila es la más instructiva. El Día 4 estimó el coste de resumir con Haiku 5.5 y, ese mismo día, su registro simulado ya mostraba que un $25%$ de las consultas iba a Sonnet 5.5 y se llevaba el $87%$ del gasto. El Día 23 simuló el mes con esa mezcla, y el resumen pasó a costar $1.3$ USD: casi siete veces la estimación. La estimación no estaba mal calculada; estaba calculada para otro sistema. Es el error más común al estimar costes de IA: la fórmula es correcta, pero el supuesto sobre qué modelo hace cada tarea deja de ser cierto en cuanto alguien añade una escalada “solo para los casos difíciles”.
La segunda fila muestra cómo dos errores se compensan en parte. Frente al presupuesto del Día 21, el mes simulado del Día 23 gasta más en resúmenes (por la misma razón de la primera fila) y menos en revisiones, porque no incluye las cuatro revisiones mensuales con Fable 5.1 que el Día 21 contaba como la mayor partida. El resultado neto es una desviación del $34%$, que habría sido mucho mayor si los dos supuestos no se hubieran movido en sentidos opuestos. Un total que acierta puede esconder dos componentes que fallan, la misma lección que el Día 29 aprendió con la exactitud por tema.
La tercera fila va en sentido contrario: el Día 21 estimó un p95 de $5.59$ s para la evaluación del tutor y el registro del Día 23 dio $2.71$ s. Aquí ninguna de las dos cifras es una medición real, sino dos simulaciones con distribuciones de latencia distintas para la escalada a Sonnet 5.5. La lectura honesta no es “el tutor es más rápido de lo que pensábamos”, sino “todavía no lo sabemos”: la latencia real solo la dará el registro de un mes de uso. Las dos últimas filas, en cambio, aciertan por menos de un $1%$, y no por casualidad: son estimaciones teóricas (el planificador de la ruta crítica, la fórmula del ruido correlacionado) contrastadas con el código que las implementa. Las estimaciones que fallan son las que dependen de cómo se usará el sistema; las que aciertan dependen solo de cómo está construido.
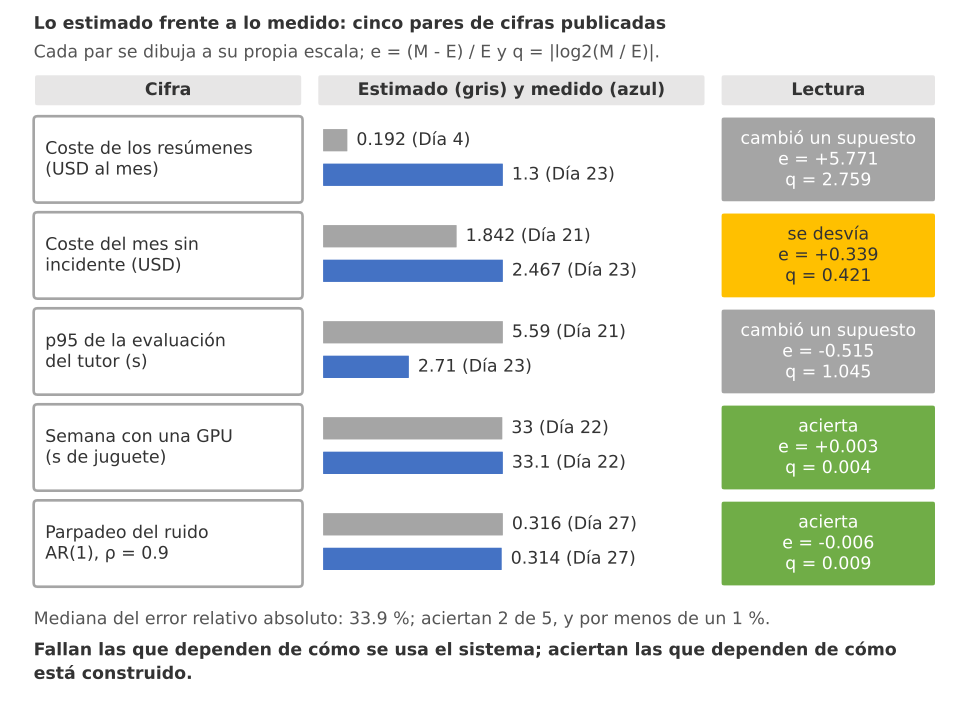
Figura 2. Lo estimado frente a lo medido, cada par a su propia escala: aciertan las dos estimaciones teóricas (33.0 frente a 33.1 s y 0.316 frente a 0.314), se desvía el coste del mes (1.842 frente a 2.467 USD) y cambió un supuesto en el coste de los resúmenes (0.192 frente a 1.3 USD) y en el p95 del tutor.
Atención aquí: en esta serie, “medido” casi nunca significa “facturado”. Tres de las cinco mediciones de la Tabla 2 salen del registro simulado del Día 23, y las otras dos de experimentos de juguete. Comparar una estimación con una simulación sirve para detectar supuestos incoherentes, pero no sustituye a un mes de uso real con registro_uso.csv. En su propio proyecto, no presente nunca una cifra simulada como una medición: escriba al lado de dónde sale, como hace la columna del día en cada tabla de esta entrada.
La vida del producto
El módulo 7 cambió la pregunta de la serie. Hasta el Día 24, cada día preguntaba "¿qué puede hacer el Cuaderno Vivo?"; desde el Día 25, cada día preguntó "¿qué le pasa al Cuaderno Vivo con el tiempo?". La ingeniería de software describe esa diferencia con el ciclo de vida de un producto, y para un proyecto personal bastan cuatro fases:
- Construir. Añadir capacidades: el prototipo, el tutor, las portadas, la narración, el orquestador.
- Endurecer. Hacer que lo construido falle menos y de forma más segura: riesgos, guardianes, evaluación, privacidad.
- Abrir. Hacer que otras personas puedan usarlo: la entrega, la accesibilidad, la publicación.
- Mantener. Hacer que siga funcionando cuando el mundo cambia: pruebas, migraciones, registro de cambios, retrospectiva.
Cada día de la serie se puede repartir entre esas fases. Algunos son puros (el Día 9 solo construye, el Día 29 solo mantiene) y otros se reparten (el Día 21 construye una arquitectura y, a la vez, la endurece con requisitos de privacidad). El esfuerzo de cada fase es la suma de esos repartos:
$$ E_f = \sum_{d=1}^{31} w_{d,f}, \qquad \sum_{f} w_{d,f} = 1 \quad \text{para cada día } d $$
La lógica detrás de esta suma es múltiple:
- $w_{d,f}$ es la fracción del día $d$ dedicada a la fase $f$; la condición de la derecha obliga a que cada día reparta exactamente un día de esfuerzo.
- Como cada día suma $1$, las cuatro $E_f$ suman $31$: el esfuerzo total no depende del reparto, solo cambia de fase.
- Los repartos son una valoración editorial, como las intensidades del mapa de habilidades; lo que se puede discutir no es la suma, sino cada $w_{d,f}$.
- En conclusión, $E_f$ convierte la impresión de “esta semana fue distinta” en una cifra que se puede comparar entre módulos.
El siguiente bloque escribe los repartos como datos, comprueba con un assert que ningún día se cuenta dos veces y dibuja el esfuerzo de cada fase como barras apiladas por módulo, con el séptimo módulo en trama:
# Esfuerzo por fase del ciclo de vida, en días, en Python:
FASES = ['construir', 'endurecer', 'abrir', 'mantener']
# Reparto de cada día entre las cuatro fases (cada día suma 1); es una valoración editorial:
reparto = {d: {'construir': 1.0} for d in range(1, 17)}
reparto[15] = {'construir': 0.5, 'endurecer': 0.5}             # el consentimiento convertido en código
reparto.update({d: {'endurecer': 1.0} for d in range(17, 21)})
reparto.update({
    21: {'construir': 0.5, 'endurecer': 0.5}, 22: {'construir': 0.75, 'endurecer': 0.25},
    23: {'endurecer': 0.75, 'mantener': 0.25}, 24: {'abrir': 0.75, 'endurecer': 0.25},
    25: {'construir': 0.5, 'mantener': 0.5}, 26: {'construir': 0.5, 'endurecer': 0.5},
    27: {'construir': 0.75, 'abrir': 0.25}, 28: {'abrir': 1.0},
    29: {'mantener': 1.0}, 30: {'abrir': 1.0}, 31: {'mantener': 1.0},
})
esfuerzo = pd.DataFrame(reparto).T.reindex(columns = FASES).fillna(0.0).sort_index()
esfuerzo['módulo'] = pd.cut(esfuerzo.index, bins = [0, 4, 8, 12, 16, 20, 24, 31],
                            labels = [f'M{m}' for m in range(1, 8)])
por_modulo = esfuerzo.groupby('módulo', observed = True)[FASES].sum()
assert np.allclose(esfuerzo[FASES].sum(axis = 1), 1.0)   # ningún día se cuenta dos veces

fig, ax = plt.subplots(figsize = (9, 5))
base = np.zeros(len(FASES))
for (nombre_modulo, fila), color in zip(por_modulo.iterrows(), colores):
    ax.bar(FASES, fila.values, bottom = base, color = color, edgecolor = 'white', label = nombre_modulo,
           hatch = '//' if nombre_modulo == 'M7' else None)
    base += fila.values
for x, valor in enumerate(base):
    ax.text(x, valor + 0.3, f'{valor:.2f} días', ha = 'center', fontsize = 10)
ax.set_ylim(0, 21)
ax.set_ylabel('Días de la serie')
ax.set_title('Esfuerzo por fase del ciclo de vida', fontsize = 16)
ax.legend(title = 'Módulo', ncol = 2, fontsize = 8)
plt.tight_layout()

print(por_modulo.round(2).to_string())
print('Total por fase:', esfuerzo[FASES].sum().round(2).to_dict(), '| suma:', esfuerzo[FASES].values.sum())
print('Módulo 7, parte de construir:', f"{por_modulo.loc['M7', 'construir'] / 7:.1%}",
      '| resto de la serie:', f"{por_modulo.loc['M1':'M6', 'construir'].sum() / 24:.1%}")
# Cuatro fases apiladas por módulo, el séptimo con trama:
plt.show()
        construir  endurecer  abrir  mantener
módulo
M1           4.00       0.00   0.00      0.00
M2           4.00       0.00   0.00      0.00
M3           4.00       0.00   0.00      0.00
M4           3.50       0.50   0.00      0.00
M5           0.00       4.00   0.00      0.00
M6           1.25       1.75   0.75      0.25
M7           1.75       0.50   2.25      2.50
Total por fase: {'construir': 18.5, 'endurecer': 6.75, 'abrir': 3.0, 'mantener': 2.75} | suma: 31.0
Módulo 7, parte de construir: 25.0% | resto de la serie: 69.8%
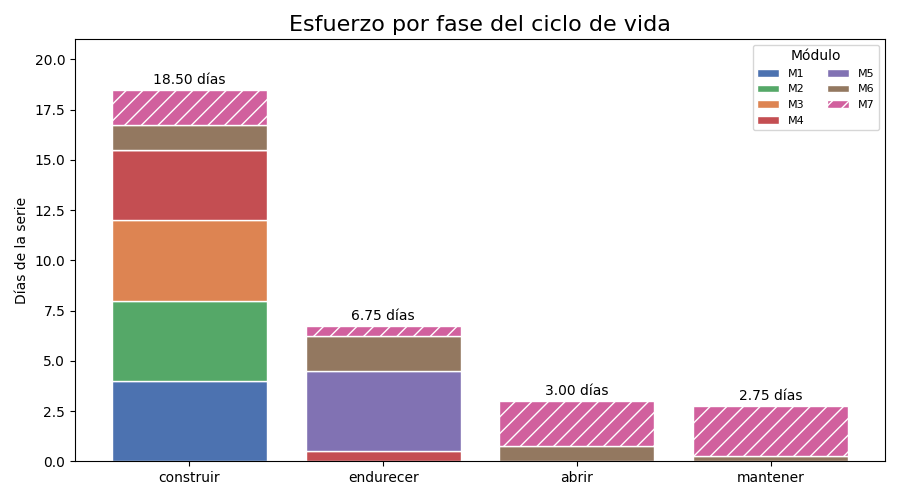
La serie dedicó $18.5$ de sus $31$ días a construir, $6.75$ a endurecer, $3$ a abrir y $2.75$ a mantener. La barra de construir es la más alta y casi toda viene de los cuatro primeros módulos, que construyeron sin interrupción salvo por el medio día del consentimiento de voz (Día 15). La de endurecer es casi entera del módulo 5 y del 6. Las de abrir y mantener, en cambio, son casi enteramente rayadas: sin el módulo 7, el Cuaderno Vivo habría tenido tres cuartos de día de apertura (la entrega) y un cuarto de día de mantenimiento (la observabilidad del Día 23).
La última línea de la salida lo resume en una proporción: el módulo 7 dedicó a construir solo un $25%$ de su tiempo, frente al $69.8%$ del resto de la serie. Esa inversión es la firma de un proyecto que pasa de la adolescencia a la madurez. En un producto profesional, el mantenimiento suele llevarse la mayor parte del esfuerzo total a lo largo de los años; en la serie, que mide solo un mes, apenas empieza a asomar. Si su proyecto personal dura más que la serie, la barra de mantener será la que más crezca, y conviene planificarla desde ahora en lugar de descubrirla cuando algo se rompa.
La hoja de ruta, revisada
El Día 24 dejó una hoja de ruta de seis meses con nueve tareas y fechas desde el lunes 2 de febrero de 2026. Una retrospectiva podría caer en la tentación de reescribirla con todo lo que se aprendió esta semana, pero eso tendría dos problemas: una hoja de ruta que cambia cada semana no sirve para planificar, y el módulo 7 no se diseñó para entregar ninguna de esas tareas, sino para informarlas. Por eso la revisión sigue tres reglas: no se mueve ninguna fecha, cada tarea recibe la evidencia nueva que exista (o ninguna) y el único cambio permitido es ajustar el alcance de una tarea cuando la evidencia lo justifica.
Dos tareas tienen evidencia nueva. La primera es “Clasificar notas con un modelo local”, prevista para el sexto mes: el Día 26 hizo el experimento y midió que qwen3:4b acertaba $0.850$ frente a $0.917$ de Haiku 5.5, sin diferencia significativa ($p = 0.29$ en la prueba de McNemar) y sin ahorro que justificara la mudanza; el ADR-004 decidió mandar a local solo las notas con datos personales. La tarea se mantiene, pero su alcance se ajusta: ya no es migrar toda la clasificación, sino consolidar esa ruta parcial. La segunda es “Interfaz web local mínima”: el sitio estático del Día 30 podría parecer que la resuelve, pero es un escaparate de solo lectura, sin órdenes ni datos personales, y la tarea sigue tal cual. El siguiente bloque reconstruye la hoja de ruta con las mismas filas del Día 24, añade la evidencia y comprueba que las fechas coinciden con las publicadas:
# Hoja de ruta del Día 24 revisada con la evidencia del módulo 7, sin mover sus fechas, en Python:
ruta = pd.DataFrame([
    # (horizonte, tarea, semana de inicio, semanas de duración): las mismas nueve filas del Día 24
    ('1 mes', 'Medir la sonoridad en LUFS', 0, 1),
    ('1 mes', 'Firmar portadas con un certificado propio', 1, 2),
    ('1 mes', 'Ampliar la evaluación de 15 a 50 casos', 0, 4),
    ('3 meses', 'Embeddings aprendidos en lugar de TF-IDF', 4, 4),
    ('3 meses', 'Interfaz web local mínima', 6, 5),
    ('3 meses', 'Tarjetas nocturnas por lotes', 9, 3),
    ('6 meses', 'Clasificar notas con un modelo local', 12, 5),
    ('6 meses', 'Marca de agua de audio aprendida', 15, 6),
    ('6 meses', 'Revisión semestral de riesgos y ficha', 23, 2),
], columns = ['horizonte', 'tarea', 'inicio', 'duracion'])
INICIO = pd.Timestamp('2026-02-02')   # primer lunes después del Día 24
ruta['desde'] = INICIO + pd.to_timedelta(7 * ruta['inicio'], unit = 'D')
ruta['hasta'] = ruta['desde'] + pd.to_timedelta(7 * ruta['duracion'], unit = 'D') - pd.Timedelta(days = 1)
# Evidencia nueva del módulo 7 y cambio que provoca en cada tarea:
EVIDENCIA = {
    'Clasificar notas con un modelo local': ('Día 26: 0.850 frente a 0.917, McNemar p = 0.29; ADR-004',
                                             'ajustar alcance'),
    'Interfaz web local mínima': ('Día 30: el sitio estático es un escaparate de solo lectura', 'ninguno'),
}
ruta['evidencia'] = ruta['tarea'].map(lambda t: EVIDENCIA.get(t, ('sin evidencia nueva', ''))[0])
ruta['cambio'] = ruta['tarea'].map(lambda t: EVIDENCIA.get(t, ('', 'ninguno'))[1])
# Tarea nueva del Día 29: una sesión de mantenimiento cada cuatro semanas, desde la semana 1:
sesiones = [INICIO + pd.Timedelta(weeks = s) for s in range(1, 26, 4)]
FECHAS_DIA24 = ['02/02', '09/02', '02/02', '02/03', '16/03', '06/04', '27/04', '18/05', '13/07']

tabla = ruta[['horizonte', 'tarea', 'desde', 'hasta', 'cambio']].assign(
    desde = ruta['desde'].dt.strftime('%d/%m'), hasta = ruta['hasta'].dt.strftime('%d/%m'))
print(tabla.to_string(index = False))
print('Fechas iguales a las del Día 24:', ruta['desde'].dt.strftime('%d/%m').tolist() == FECHAS_DIA24,
      '| última entrega:', ruta['hasta'].max().date())
print('Tareas con evidencia nueva:', int((ruta['evidencia'] != 'sin evidencia nueva').sum()),
      '| con alcance ajustado:', int((ruta['cambio'] == 'ajustar alcance').sum()))
print('Mantenimiento mensual:', ', '.join(s.strftime('%d/%m') for s in sesiones), f'({len(sesiones)} sesiones)')
horizonte                                     tarea desde hasta          cambio
    1 mes                Medir la sonoridad en LUFS 02/02 08/02         ninguno
    1 mes Firmar portadas con un certificado propio 09/02 22/02         ninguno
    1 mes    Ampliar la evaluación de 15 a 50 casos 02/02 01/03         ninguno
  3 meses  Embeddings aprendidos en lugar de TF-IDF 02/03 29/03         ninguno
  3 meses                 Interfaz web local mínima 16/03 19/04         ninguno
  3 meses              Tarjetas nocturnas por lotes 06/04 26/04         ninguno
  6 meses      Clasificar notas con un modelo local 27/04 31/05 ajustar alcance
  6 meses          Marca de agua de audio aprendida 18/05 28/06         ninguno
  6 meses     Revisión semestral de riesgos y ficha 13/07 26/07         ninguno
Fechas iguales a las del Día 24: True | última entrega: 2026-07-26
Tareas con evidencia nueva: 2 | con alcance ajustado: 1
Mantenimiento mensual: 09/02, 09/03, 06/04, 04/05, 01/06, 29/06, 27/07 (7 sesiones)
La comprobación da True: las nueve fechas de inicio son las mismas que publicó el Día 24, y la última entrega sigue siendo el 26 de julio de 2026. Dos tareas reciben evidencia nueva y solo una ajusta su alcance. La Tabla 3 reúne la hoja de ruta revisada.
Tabla 3. Hoja de ruta revisada: tareas del Día 24 con sus fechas, evidencia nueva del módulo 7 y cambio que provoca.
| Horizonte | Tarea del Día 24 | Desde | Hasta | Evidencia nueva del módulo 7 | Cambio |
|---|---|---|---|---|---|
| 1 mes | Medir la sonoridad en LUFS | 02/02 | 08/02 | Ninguna | Ninguno |
| 1 mes | Firmar portadas con un certificado propio | 09/02 | 22/02 | Ninguna | Ninguno |
| 1 mes | Ampliar la evaluación de 15 a 50 casos | 02/02 | 01/03 | Ninguna | Ninguno |
| 3 meses | Embeddings aprendidos en lugar de TF-IDF | 02/03 | 29/03 | Ninguna | Ninguno |
| 3 meses | Interfaz web local mínima | 16/03 | 19/04 | Día 30: el sitio estático es un escaparate de solo lectura | Ninguno |
| 3 meses | Tarjetas nocturnas por lotes | 06/04 | 26/04 | Ninguna | Ninguno |
| 6 meses | Clasificar notas con un modelo local | 27/04 | 31/05 | Día 26: 0.850 frente a 0.917, McNemar $p = 0.29$; ADR-004 | Ajustar alcance: consolidar la ruta local de las notas con datos personales |
| 6 meses | Marca de agua de audio aprendida | 18/05 | 28/06 | Ninguna | Ninguno |
| 6 meses | Revisión semestral de riesgos y ficha | 13/07 | 26/07 | Ninguna | Ninguno |
| Nueva | Mantenimiento mensual: batería de pruebas, identificadores de modelos y dependencias (Día 29) | 09/02 | 27/07 | Día 29: regresión de idioma y retiradas de modelos con aviso previo | Tarea nueva, 7 sesiones |
La fila nueva merece una explicación. El Día 29 mostró que un sistema con IA se rompe aunque nadie toque su código, y que el remedio no es una tarea que se hace una vez, sino una rutina: ejecutar la batería de pruebas, revisar la página de retiradas de modelos, comprobar las dependencias fijadas y anotar en el registro de cambios lo que se haya tocado. La rutina tiene siete sesiones, una cada cuatro semanas desde el 9 de febrero. La fecha de la primera no es arbitraria: llega diez días antes del 19 de febrero de 2026, el día en que se retira claude-3-5-haiku-20241022, el modelo del script heredado de Diego. Diego ya migró su script, pero la primera sesión es justo la que comprobaría que lo hizo bien.
Observe también lo que la revisión no hace. La sonoridad en LUFS y la firma de las portadas siguen siendo las dos primeras tareas, aunque el módulo 7 no las tocó; y ninguna de las funciones nuevas de esta semana (los clips, la traducción, el agente de código) entra en la hoja de ruta como tarea. Ya existen, y lo que necesitan no es una tarea nueva, sino estar dentro de la rutina de mantenimiento. Una hoja de ruta revisada con disciplina cambia poco, y lo que cambia queda justificado por escrito.
De 24 a 31: el método en siete pasos
El Día 24 dibujó el método de la serie como una escalera de seis peldaños, uno por módulo, con el presupuesto y la ética viajando en todos. Siete días después, la escalera necesita un peldaño más. El módulo 7 no enseñó ninguna modalidad nueva en el sentido de los módulos 3 y 4; enseñó lo que hay que hacer para que los seis peldaños anteriores sigan en pie. El siguiente bloque dibuja la escalera completa:
# El método en siete pasos, dibujado como una escalera, en Python:
PASOS = [
    ('Fundamentos', 'Una tarea, un coste y\nun prototipo v0', '1/7'),
    ('Prompts y memoria', 'Plantillas, salidas\nestructuradas y RAG', '2/7'),
    ('Imagen', 'Guía de estilo y\nprocedencia', '3/7'),
    ('Audio', 'Voz propia con\nconsentimiento', '4/7'),
    ('Riesgos', 'Matriz, filtros y\ndivulgación', '5/7'),
    ('Arquitectura', 'Diagrama, evaluación\ny entrega', '6/7'),
    ('Vida del producto', 'Pruebas, migraciones,\npublicación y\nretrospectiva', '7/7'),
]
fig, ax = plt.subplots(figsize = (12, 6.5))
for i, (nombre, detalle, modulo_paso) in enumerate(PASOS):
    x, y = 0.2 + 1.66 * i, 0.25 + 0.78 * i
    ax.add_patch(FancyBboxPatch((x, y), 1.52, 1.35, boxstyle = 'round,pad=0.03,rounding_size=0.08',
                                facecolor = colores[i], edgecolor = 'white', alpha = 0.92))
    ax.text(x + 0.76, y + 1.08, f'Paso {i + 1}\n{nombre}', ha = 'center', va = 'center', color = 'white',
            fontsize = 9, weight = 'bold')
    ax.text(x + 0.76, y + 0.55, detalle, ha = 'center', va = 'center', color = 'white', fontsize = 8)
    ax.text(x + 0.76, y + 0.12, f'Módulo {modulo_paso}', ha = 'center', color = 'white', fontsize = 8.5)
    if i < len(PASOS) - 1:
        ax.add_patch(FancyArrowPatch((x + 1.56, y + 0.65), (x + 1.64, y + 1.38), arrowstyle = '-|>',
                                     mutation_scale = 14, color = 'gray'))
ax.text(0.2, 6.55, 'De Cuaderno Vivo a su proyecto: siete peldaños', fontsize = 16)
ax.text(0.2, 6.15, 'El séptimo no añade funciones: mantiene vivas las seis anteriores.',
        fontsize = 10, color = 'dimgray')
ax.set_xlim(0, 12)
ax.set_ylim(0, 7)
ax.axis('off')
plt.tight_layout()

print(' -> '.join(f'{i + 1}. {nombre}' for i, (nombre, _, _) in enumerate(PASOS)))
print('Peldaños añadidos desde el Día 24:', len(PASOS) - 6, '| días por peldaño:',
      [fin - inicio + 1 for _, inicio, fin, _ in MODULOS])
# La escalera de siete peldaños, uno por módulo:
plt.show()
1. Fundamentos -> 2. Prompts y memoria -> 3. Imagen -> 4. Audio -> 5. Riesgos -> 6. Arquitectura -> 7. Vida del producto
Peldaños añadidos desde el Día 24: 1 | días por peldaño: [4, 4, 4, 4, 4, 4, 7]
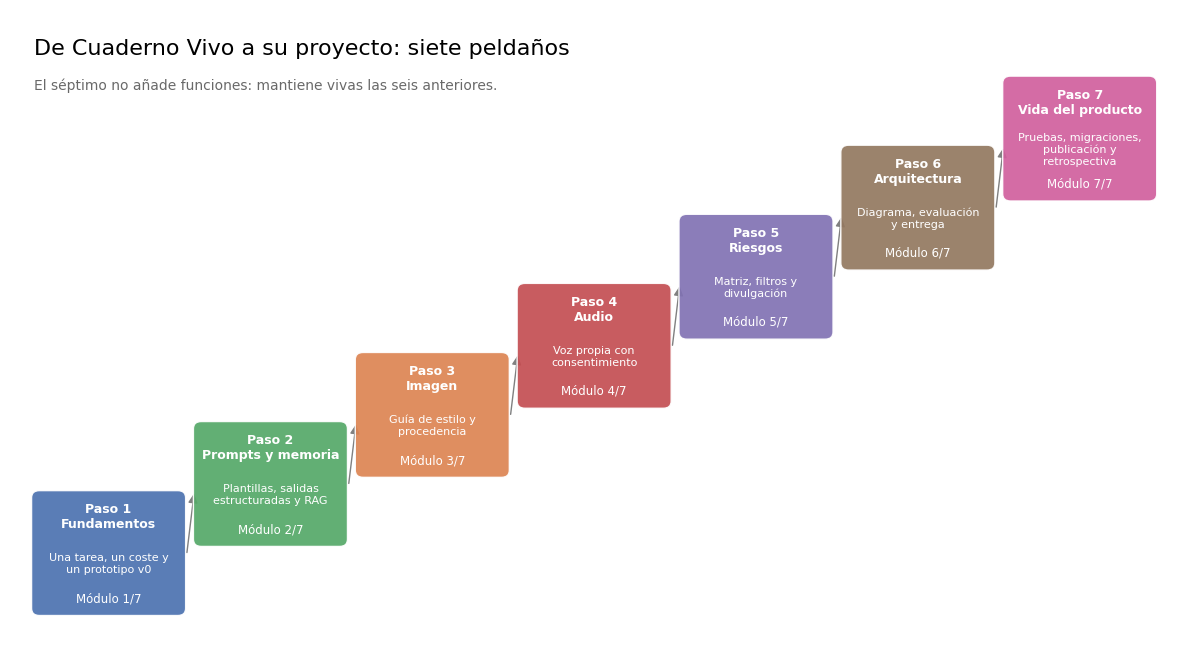
El séptimo peldaño, “vida del producto”, reúne las pruebas, las migraciones, la publicación y la retrospectiva, y es el único que ocupa siete días en lugar de cuatro. Como los anteriores, tiene una pregunta que usted debe poder contestar antes de dar el proyecto por vivo:
- Vida del producto. ¿Qué pruebas atraparían una rotura que no provocó usted, qué hará el día que se retire su modelo, qué parte del proyecto puede publicar sin exponer a nadie y cuándo volverá a mirar sus cifras para decidir qué cambiar?
Las seis preguntas anteriores siguen siendo las del Día 24: qué tarea resuelve y cuánto cuesta, qué es fijo en el prompt y qué se recuerda, qué guía hace coherentes las imágenes, de quién es la voz, qué guardián impide cada riesgo y cómo se ven las piezas juntas. El séptimo peldaño no las sustituye; las mantiene vivas. Por eso el subtítulo de la figura dice que el séptimo no añade funciones. Un proyecto que sube los seis primeros y se queda ahí funciona el día de la entrega; uno que sube el séptimo funciona también seis meses después.
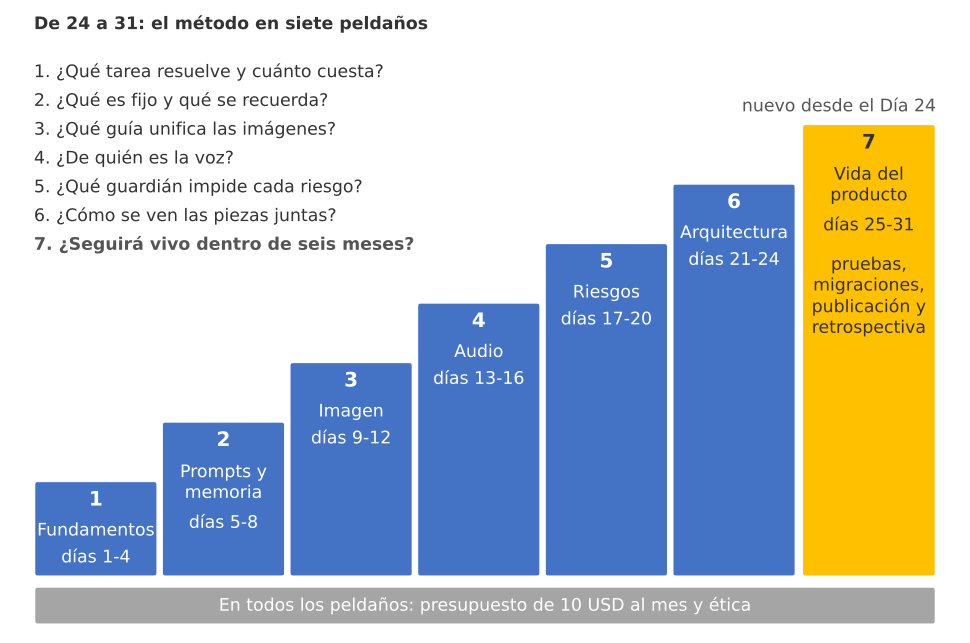
Figura 3. La escalera del método en siete peldaños, uno por módulo: el séptimo, vida del producto, ocupa siete días, no añade funciones y mantiene en pie los seis anteriores; el presupuesto y la ética viajan en todos.
La Tabla 4 continúa la Tabla 1 del Día 24, que recorría las veinticuatro piezas del Cuaderno Vivo, con las siete del módulo 7 y el archivo donde vive cada una.
Tabla 4. Las piezas 25 a 31 del Cuaderno Vivo (continuación de la Tabla 1 del Día 24).
| Día | Pieza | Archivo en la entrega |
|---|---|---|
| 25 | Agente de código con la tarea escrita como contrato, pruebas previas y permisos acotados | tarjetas_csv.py, pruebas/prueba_tarjetas.py |
| 26 | Experimento medido de modelo local frente a la API y regla de enrutamiento por privacidad | ADR-004 en docs/, config.toml |
| 27 | Clips procedurales con etiqueta estampada después del movimiento y registro de procedencia | portadas/ (GIF y registro JSON) |
| 28 | Traducción con glosario, subtítulos, texto alternativo y versión de lectura fácil | audio/ (subtítulos .vtt), estilo.json |
| 29 | Batería de pruebas en tres capas, detector de parámetros retirados y registro de cambios | pruebas/, CHANGELOG.md |
| 30 | Licencias, sitio estático de solo lectura y archivos de comunidad | LICENSE, CONTRIBUTING.md, SECURITY.md |
| 31 | Retrospectiva con cifras de origen y hoja de ruta revisada | docs/RETROSPECTIVA.md |
La tabla confirma lo que mostró la barra de fases: de las siete piezas, solo dos añaden algo que Sofía no podía hacer antes (los clips y la traducción); las otras cinco cambian cómo se hace lo que ya existía. La pieza 31 es un documento, y está bien que lo sea. Dentro de seis meses, cuando Sofía se pregunte por qué la clasificación no se mudó entera a local o por qué el presupuesto real se parece tan poco a la estimación del Día 4, la respuesta estará en docs/RETROSPECTIVA.md, junto a los ADR, y no en su memoria.
Qué funcionó y qué no
Con las fuentes reunidas, las cifras sumadas, las estimaciones contrastadas y la hoja de ruta revisada, la retrospectiva puede por fin contestar sus cuatro preguntas. Sofía y Diego llenan la tabla fila a fila, y la regla de Diego descarta varias candidatas antes de entrar: “el tutor es muy útil” no tiene cifra; “las portadas quedaron bonitas” no tiene ni cifra ni día. Las que pasan el filtro forman la Tabla 5.
Tabla 5. Retrospectiva del Cuaderno Vivo en cuatro columnas, con una cifra y un día de origen por celda.
| Funcionó | No funcionó | Aprendimos | Cambiaremos |
|---|---|---|---|
| Enrutar cada tarea a su modelo: 1.842 frente a 9.538 USD al mes (Día 21) | Un bucle sin límite: 100 llamadas y 3.539 USD en un día (Día 23) | Una mejora global esconde un tema que empeora: música de 0.933 a 0.667 (Día 29) | El límite de vueltas no se desactiva ni para depurar (Día 22) |
| La caché donde el token es caro: tutor de 3.487 a 0.904 USD (Día 8) | Un cambio propio rompió el idioma: similitud de 0.08 con la salida grabada (Día 29) | Las muestras pequeñas no deciden: 207 preguntas para un margen de 5 puntos (Día 18) | Ampliar los bancos antes de afinar los prompts (Día 24) |
| Los guardianes en el código: obediencia de 13/20 a 1/20 (Día 19) | El juez no alcanza el acuerdo exigido: kappa de 0.55 frente a 0.60 (Día 23) | El tiempo humano domina: 85 % del coste de las tareas con agente (Día 25) | Revisión humana de todo lo que proponga el agente (Día 25) |
| Lo procedural antes que lo generativo: 0.00 frente a 2.51 USD al mes por los clips (Día 27) | El resumen se estimó solo con Haiku 5.5: 0.192 frente a 1.3 USD (días 4 y 23) | Una métrica de parecido no mide corrección: chrF de 95.4 para la traducción que rompe el glosario (Día 28) | Prueba de idioma en cada commit y un mes de registro real (Día 29) |
La columna de lo que funcionó tiene un patrón: las cuatro decisiones pusieron una regla en el código antes de pedirle nada al modelo. El enrutamiento decide qué modelo usa cada tarea; la caché decide qué se reenvía; los guardianes deciden qué entra y qué sale; y lo procedural decide que ciertas cosas no necesitan un modelo. Ninguna de ellas mejoró la inteligencia del sistema; todas redujeron cuánto dependía de ella.
La columna de lo que no funcionó también tiene un patrón, y es menos cómodo: tres de los cuatro fallos los provocó la propia Sofía. El bucle sin límite fue una prueba de depuración con una protección desactivada; el resumen en inglés, un glosario añadido a una instrucción compartida; la estimación del resumen, un supuesto que dejó de ser cierto cuando ella misma añadió la escalada a Sonnet 5.5. Solo el juez falló por una razón ajena, su acuerdo moderado con el criterio humano. Este reparto es la razón de ser de la regla de Kerth: si la retrospectiva buscara culpables, Sofía tendría motivos para omitir tres filas, y la tabla perdería sus lecciones más útiles.
Las columnas de aprendizajes y cambios se leen juntas. Cada cambio sale de una fila anterior: el límite de vueltas, del bucle; ampliar los bancos, de las muestras pequeñas; la revisión humana, del tiempo que costó revisar al agente; la prueba de idioma, del resumen en inglés. Y cada cambio tiene ya un lugar en la hoja de ruta o en la rutina de mantenimiento, de modo que no queda como buena intención.
Un resumen que no inventa cifras
La retrospectiva termina en un documento, docs/RETROSPECTIVA.md, y su primer párrafo es un resumen para quien no va a leer la tabla entera. Es una tarea natural para un modelo, con un riesgo que la serie conoce bien desde el Día 18: un resumen fluido puede añadir una cifra que no está en ninguna fuente. El último bloque pide el resumen a Claude Sonnet 5.5 con output_config={"effort": "medium"}, la instrucción explícita de citar el día de cada cifra y de no añadir datos, y una comprobación automática al final: toda cifra que aparezca en el texto debe aparecer también en los datos de entrada. Como todos los bloques que llaman a la API, este no se ejecuta en la entrada; su salida es un ejemplo comentado:
# Resumen de la retrospectiva con Claude Sonnet 5.5 y comprobación de cifras en Python:
import anthropic

client = anthropic.Anthropic()   # lee ANTHROPIC_API_KEY del entorno; la clave nunca va en el código

# Datos de entrada: las filas de la Tabla 5 y los costes del Bloque 4, con su día de origen:
filas_retro = [
    'Funcionó: enrutar cada tarea a su modelo, 1.842 frente a 9.538 USD al mes (Día 21)',
    'Funcionó: la caché donde el token es caro, tutor de 3.487 a 0.904 USD (Día 8)',
    'Funcionó: los guardianes en el código, obediencia de 13/20 a 1/20 (Día 19)',
    'Funcionó: lo procedural antes que lo generativo, 0.00 frente a 2.51 USD al mes (Día 27)',
    'No funcionó: un bucle sin límite, 100 llamadas y 3.539 USD en un día (Día 23)',
    'No funcionó: un cambio propio rompió el idioma, similitud de 0.08 (Día 29)',
    'No funcionó: el juez no alcanza el acuerdo, kappa de 0.55 frente a 0.60 (Día 23)',
    'No funcionó: el resumen se estimó solo con Haiku 5.5, 0.192 frente a 1.3 USD (días 4 y 23)',
    'Aprendimos: una mejora global esconde un tema que empeora, música de 0.933 a 0.667 (Día 29)',
    'Aprendimos: hacen falta 207 preguntas para un margen de 5 puntos (Día 18)',
    'Cambiaremos: el límite de vueltas no se desactiva (Día 22); prueba de idioma en cada commit (Día 29)',
]
datos = '\n'.join(filas_retro) + '\n' + costes.round(3).to_string() + f'\nTotal: {costes.sum():.3f} USD al mes'
sistema = ('Eres el editor de la retrospectiva de un proyecto personal. Escribe en español un solo párrafo '
           'de 120 palabras como máximo con lo que funcionó, lo que no y lo que se cambiará. Cita entre '
           'paréntesis el día de origen de cada cifra, por ejemplo (Día 23). No añadas cifras, porcentajes '
           'ni conclusiones que no estén en los datos.')

respuesta = client.messages.create(
    model = 'claude-sonnet-5-5',
    max_tokens = 1024,
    system = sistema,
    output_config = {'effort': 'medium'},
    messages = [{'role': 'user', 'content': f'<datos>\n{datos}\n</datos>'}],
)
# Comprobar el motivo de parada antes de leer el contenido:
if respuesta.stop_reason != 'end_turn':
    raise RuntimeError(f'Respuesta incompleta o rechazada: {respuesta.stop_reason}')
texto = ''.join(bloque.text for bloque in respuesta.content if bloque.type == 'text')

# Toda cifra del texto debe aparecer en los datos de entrada, incluidos los números de día:
patron = r'\d+(?:\.\d+)?'
sin_origen = sorted(set(re.findall(patron, texto)) - set(re.findall(patron, datos)))
coste_llamada = coste('claude-sonnet-5-5', respuesta.usage.input_tokens, respuesta.usage.output_tokens)
print(texto)
print('Cifras sin origen en los datos:', sin_origen if sin_origen else 'ninguna')
print(f'tokens: {respuesta.usage.input_tokens} de entrada, {respuesta.usage.output_tokens} de salida | '
      f'coste: {coste_llamada:.4f} USD')

# Salida de ejemplo (puede variar):
# El Cuaderno Vivo funcionó mejor donde las reglas se escribieron en el código: enrutar cada tarea
# a su modelo dejó el coste en 1.842 USD al mes frente a 9.538 (Día 21), y los guardianes bajaron
# la obediencia a inyecciones de 13/20 a 1/20 (Día 19). No funcionaron un bucle sin límite, con 100
# llamadas y 3.539 USD en un día (Día 23), ni un cambio propio que rompió el idioma del resumen, con
# una similitud de 0.08 (Día 29). Con los siete módulos, el coste estimado es de 2.353 USD al mes.
# Se cambiará: el límite de vueltas no se desactiva (Día 22) y habrá una prueba de idioma en cada
# commit (Día 29).
# Cifras sin origen en los datos: ninguna
# tokens: 912 de entrada, 247 de salida | coste: 0.0043 USD
El resumen de ejemplo cumple las dos instrucciones: cita el día de cada cifra y la comprobación no encuentra ningún número sin origen. El párrafo cuesta menos de medio centavo con Sonnet 5.5. Observe, sin embargo, lo que la comprobación no puede ver. Comprueba que cada número exista en los datos, pero no que esté bien atribuido: si el modelo escribiera que el bucle costó $1.842$ USD, la comprobación pasaría, porque $1.842$ aparece en otra fila. Tampoco detecta una conclusión inventada que no lleve números, como “el proyecto fue un éxito rotundo”. Por eso la comprobación es una red, no una garantía, y el párrafo lo firma Sofía después de leerlo. La misma regla que la serie aplicó a la ficha del sistema del Día 24 se aplica a su retrospectiva: el modelo redacta, la persona responde.
Consideraciones finales
Treinta y un días después, el Cuaderno Vivo resume notas, prepara y corrige tarjetas, ilustra y anima cada semana, la narra con la voz de su autora, traduce, subtitula, clasifica en local lo que es privado, prepara la semana con una sola orden, se prueba a sí mismo antes de cada versión y se puede compartir sin exponer a nadie. Todo eso cuesta, según la mejor estimación disponible, unos $2.35$ USD al mes. Pero la cifra más importante de la retrospectiva no es esa, sino las tres de la columna central de la Tabla 5 que provocó la propia Sofía: son la prueba de que la retrospectiva se hizo con honestidad.
Las cifras de hoy tienen límites que conviene declarar una última vez. El coste total suma seis cifras publicadas y una estimación con supuestos escritos en el código; no es una factura. Tres de las cinco mediciones de la Tabla 2 salen de un registro simulado. El mapa de habilidades y el reparto del esfuerzo entre fases son valoraciones editoriales, escritas como datos para que se puedan discutir. Y la hoja de ruta revisada es un plan, no una promesa: la evidencia de dentro de un mes puede volver a ajustar alcances, aunque las fechas se mantengan.
Antes de cerrar su propio proyecto, hágase las preguntas que Sofía y Diego tuvieron que contestar hoy:
- ¿Puede citar el día, el archivo o el registro del que sale cada cifra de su retrospectiva?
- ¿Qué estimaciones de su proyecto se pueden comparar ya con una medición, y cuál de sus supuestos dejó de ser cierto por el camino?
- ¿Están en su tabla los errores que provocó usted, y no solo los que llegaron de fuera?
- ¿Qué parte de su tiempo dedica a construir y qué parte a mantener, y tiene la segunda una fecha en el calendario?
- ¿Cambió alguna fecha de su hoja de ruta sin una evidencia escrita que lo justifique?
Si quiere seguir aprendiendo, las puertas que abrió el Día 24 siguen abiertas, y el módulo 7 añadió tres. Para la evaluación, el artículo de Zheng y sus colaboradores sobre los modelos como jueces y el libro de Efron y Tibshirani sobre el bootstrap. Para la documentación responsable, los artículos de Mitchell sobre fichas de modelo y de Gebru sobre fichas de conjuntos de datos. Para la deuda técnica de los sistemas con aprendizaje automático, el artículo de Sculley y sus colaboradores, y para el ciclo de vida completo, el libro de Chip Huyen. Las tres puertas nuevas son el artículo de Chen y sus colaboradores que definió pass@k para el código generado (Día 25), la rúbrica de Breck y sus colaboradores para probar sistemas de aprendizaje automático en producción (Día 29) y el libro de Nadia Eghbal sobre cómo se mantiene el software abierto y quién lo mantiene (Día 30). Y para todo lo que tenga que ver con modelos, precios y parámetros, la documentación oficial de cada proveedor y las fichas de los modelos en Hugging Face siguen siendo la única fuente de verdad: esta serie habrá envejecido en algún detalle cuando usted la lea. Si prefiere seguir en este mismo blog, en febrero empieza la serie “Arquitecto de automatización con IA”, en la categoría “AI Automation”, que parte de donde termina esta: de un sistema que ya funciona y hay que poner a trabajar solo.
Un gran libro que habla de esto es Project Retrospectives: A Handbook for Team Reviews (que podría traducirse como Retrospectivas de proyecto: un manual para revisiones en equipo), en el que Norman Kerth explica por qué la mayoría de los equipos repite los mismos errores de un proyecto a otro y cómo una revisión bien conducida lo evita. Su aportación más citada es la regla que abrió esta entrada, la de presumir que cada quien hizo lo mejor que pudo con lo que sabía; la más útil para un proyecto personal es quizá su insistencia en que lo aprendido sirva al proyecto siguiente, y no solo al que termina. Complementa a Agile Retrospectives, de Derby y Larsen, que convierte esa idea en una rutina corta para repetir al final de cada ciclo.
Las reglas viajan con usted: el método de siete pasos sirve para cualquier proyecto, y las reglas de la serie también. Clone solo su propia voz, con un consentimiento escrito, incluso para uso privado. Etiquete como “Generado con IA” todo lo que publique y conserve su procedencia. No represente a personas reales, marcas ni el estilo de artistas vivos. Lea la licencia de cada modelo antes de usar sus salidas fuera de casa. En un archivo familiar como el de Diego, cada voz grabada es de una persona real, y algunas ya no pueden dar su permiso: la técnica del Día 15 no cambia, pero la respuesta a “¿podemos hacer cantar a la abuela una canción nueva?” sigue siendo no.
Un proyecto personal con IA generativa no se mide por lo que hizo el día de la entrega, sino por lo que su autora sabe de él un mes después. Sofía empezó con una restricción de $10$ USD al mes y un amigo que desconfiaba de todo. Termina con un sistema que gasta menos de la cuarta parte de ese presupuesto, una tabla que reconoce sus propios errores y una hoja de ruta que no se movió de su sitio. Diego, que en el Día 1 preguntaba cuánto costaba, cierra la retrospectiva con otra pregunta: "¿Cuándo hacemos la siguiente?" La respuesta ya está en la Tabla 3: el 9 de febrero, en la primera sesión de mantenimiento.
Conclusiones clave
Módulo 1: Fundamentos de la IA generativa
- Generar es muestrear de una distribución, y el mismo bucle de “predecir, muestrear, añadir” explica desde los bigramas del Día 1 hasta un modelo grande.
- El coste se calcula antes de construir: resumir cuesta $0.192$ USD al mes con Haiku 5.5, aunque la retrospectiva mostró que ese supuesto se rompe en cuanto una cuarta parte de las consultas sube a Sonnet 5.5 ($1.3$ USD, Día 23).
Módulo 2: Prompt engineering y sistemas persistentes
- Un prompt se escribe por piezas y su salida se exige con un esquema; la memoria es un archivo que usted controla.
- Caché y enrutamiento bajaron el tutor de $3.487$ a $0.904$ USD al mes, la partida más grande de los siete módulos.
Módulo 3: IA visual
- La difusión convierte ruido en imagen, y una guía de estilo en
estilo.jsones la memoria visual que el modelo no tiene. - Elegir herramienta es leer la licencia además de mirar la calidad, y toda portada lleva una etiqueta visible y su procedencia.
Módulo 4: IA sonora
- La voz propia se clona solo con un consentimiento escrito que el código comprueba, y el consentimiento se renueva si cambia su alcance, como al narrar en otros idiomas (Día 28).
- Cada episodio lleva divulgación audible, metadatos y una marca de agua, porque ninguna de esas capas basta sola.
Módulo 5: Ética y riesgos
- Los riesgos se mapean con probabilidad e impacto y se miden con intervalos: $4/25$ alucinaciones con notas, con un Wilson de $[0.064, 0.347]$.
- Los guardianes funcionan porque están en el código: la obediencia a inyecciones bajó de $13/20$ a $1/20$, y la ética es la habilidad con más peso de los 31 días ($17.2%$).
Módulo 6: Proyecto integrador
- El enrutamiento dejó el sistema en $1.842$ USD al mes frente a $9.538$ sin él, y la entrega pasó $13$ de $13$ comprobaciones bloqueantes.
- Un incidente de $100$ llamadas costó $3.539$ USD en un día: la alerta por proyección avisa, pero lo que detiene es el límite del bucle.
Módulo 7: Más allá del proyecto
- La vida del producto cuesta poco dinero y mucha atención: el módulo 7 añade $0.674$ USD al mes y deja el total en $2.35$ USD ($23.5%$), pero dedicó solo un $25%$ de su tiempo a construir.
- Las estimaciones teóricas aciertan por menos de un $1%$ y las que dependen del uso se desvían hasta siete veces: compare siempre lo estimado con lo medido, y escriba de dónde sale cada cifra.
Ahora, en su propio proyecto: aquí termina la serie, y lo que sigue es suyo. Elija una tarea pequeña que le importe, escriba su prototipo v0 con un presupuesto y un registro de uso, y suba la escalera de siete peldaños: fundamentos, prompts y memoria, imagen, audio, riesgos, arquitectura y vida del producto. Cuando otra persona pueda instalarlo y entender qué hace y qué no debe hacer, habrá cumplido la promesa del Día 1. Cuando un mes después pueda decir, con cifras y con sus propios errores en la tabla, qué funcionó y qué cambiará, habrá aprendido también lo que enseñó el Día 31: que un proyecto personal con IA generativa se termina de construir el día que se entrega, pero se sigue cuidando mientras alguien lo use.
Referencias
- Derby, E. y Larsen, D. (2006). Agile Retrospectives: Making Good Teams Great. Pragmatic Bookshelf.
- Kerth, N. L. (2001). Project Retrospectives: A Handbook for Team Reviews. Dorset House.
- Huyen, C. (2022). Designing Machine Learning Systems: An Iterative Process for Production-Ready Applications. O’Reilly Media.
- Sculley, D., Holt, G., Golovin, D., Davydov, E., Phillips, T., Ebner, D., Chaudhary, V., Young, M., Crespo, J.-F. y Dennison, D. (2015). Hidden Technical Debt in Machine Learning Systems. Advances in Neural Information Processing Systems 28 (NeurIPS 2015).
- Zheng, L., Chiang, W.-L., Sheng, Y., Zhuang, S., Wu, Z., Zhuang, Y. y colaboradores (2023). Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. Advances in Neural Information Processing Systems 36 (NeurIPS 2023).
- Efron, B. y Tibshirani, R. J. (1993). An Introduction to the Bootstrap. Chapman & Hall.
- Mitchell, M., Wu, S., Zaldivar, A., Barnes, P., Vasserman, L., Hutchinson, B., Spitzer, E., Raji, I. D. y Gebru, T. (2019). Model Cards for Model Reporting. Proceedings of the Conference on Fairness, Accountability, and Transparency (FAT* ‘19), 220-229.
- Gebru, T., Morgenstern, J., Vecchione, B., Vaughan, J. W., Wallach, H., Daumé III, H. y Crawford, K. (2021). Datasheets for Datasets. Communications of the ACM, 64(12), 86-92.
- Chen, M., Tworek, J., Jun, H., Yuan, Q., Pinto, H. P. de O., Kaplan, J. y colaboradores (2021). Evaluating Large Language Models Trained on Code. arXiv:2107.03374.
- Breck, E., Cai, S., Nielsen, E., Salib, M. y Sculley, D. (2017). The ML Test Score: A Rubric for ML Production Readiness and Technical Debt Reduction. Proceedings of the IEEE International Conference on Big Data 2017, 1123-1132.
- Eghbal, N. (2020). Working in Public: The Making and Maintenance of Open Source Software. Stripe Press.
- Anthropic (2026). Documentación de Claude: modelos, precios y API de mensajes. https://platform.claude.com/docs